

Společnost Supermicro je průkopníkem v technologii blade serverů a její systémy SuperBlade toho dokazují. Představení šasi a blade serverů Supermicro X13 SuperBlade otevírá novou kapitolu v této technologii s blade servery s podporou GPU a integrací nejnovějších procesorů Emerald Rapids a grafických karet NVIDIA H100. Tato vylepšení přinášejí výjimečný výpočetní výkon a efektivitu, díky čemuž je X13 ideálním kandidátem pro různé špičkové aplikace.
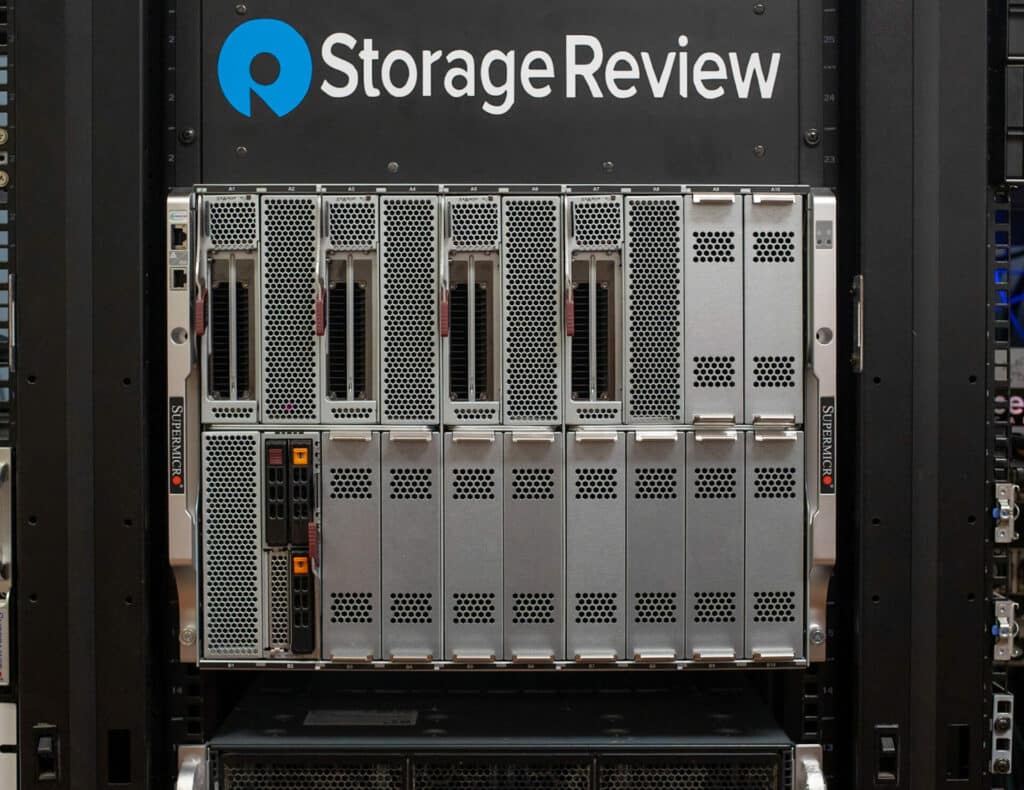
Návrh a specifikace
Šasi Supermicro X13 SuperBlade si zachovává známý design šasi 8U, známý pro svou vysokou hustotu a flexibilitu. Každé šasi podporuje až 20 blade serverů, přičemž nejnovější nabídka je výrazně vylepšena integrací procesorů Emerald Rapids a grafických karet NVIDIA H100. Tato výkonná kombinace slibuje bezprecedentní výpočetní kapacitu. Šasi navíc disponuje komunikací 200G InfiniBand a 25G Ethernet, což zajišťuje vysokorychlostní přenos dat a efektivitu sítě.
Oblíbené případy použití:
- Analýza datDíky pokročilému výpočetnímu výkonu procesorů Emerald Rapids a zrychleným výpočetním schopnostem grafických karet NVIDIA H100 jsou servery X13 SuperBlades mimořádně vhodné pro náročné úlohy datové analýzy. Mezi tyto úkoly patří zpracování dat v reálném čase a rozsáhlé operace dolování dat, které jsou v dnešním světě založeném na datech stále důležitější.
- Umělá inteligence a strojové učeníX13 SuperBlades nabízí potřebný výkon pro modely umělé inteligence a strojového učení, zejména algoritmy hlubokého učení vyžadující značné výpočetní zdroje.
- Vysoce výkonné výpočtyVědecké simulace, lékařský výzkum a pokročilé výpočetní úlohy v inženýrství budou mít výrazný prospěch ze zlepšeného výkonu X13, což z něj činí prvotřídní volbu pro vysoce výkonné výpočetní aplikace.
- Cloud ComputingZvýšená hustota a výkon blade serverů je činí ideálními pro poskytovatele cloudových služeb. Dokážou zvládnout mnoho cloudových aplikací a služeb, včetně těch, které vyžadují intenzivní virtualizaci a kontejnerizaci.
- Sítě a komunikaceDíky komunikaci 200G InfiniBand a 25G Ethernet vyniká X13 v aplikacích s vysokou šířkou pásma a nízkou latencí, což ho činí vhodným pro náročné síťové a komunikační úlohy. Díky externímu síťovému připojení může SuperBlade fungovat jako rozbočovač a poskytovat komunikaci InfiniBand a Ethernet s tradičními servery bez blade technologií ve stejném racku nebo datovém centru.
V našem testovacím zařízení od společnosti Supermicro jsme měli celkem pět blade serverů. Čtyři byly vybaveny jedním procesorem a možností připojení akcelerátoru PCIe, v našem případě čtyřmi grafickými kartami NVIDIA H100 a jedním blade serverem se dvěma procesory. Na tento výpočetní blade se budeme věnovat v další recenzi, délka této recenze ji trochu zbytečně rozšířila.
Datový list Supermicro X13 SuperBlade
| Složka | Popis |
|---|---|
| Příloha | 1x SBE-820H2-630 |
| PSW | 6x PWS-3K01A-BR |
| Fanoušek | 2x PWS-DF006-2F |
| BBP | 1x AOC-MB-BBP01-P |
| CMM | MBM-CMM-6 |
| IB přepínač | 1x SBM-IBS-H4020 |
| Přepínač EN | 2x SBM-25G-200 |
| Konfigurace čepele |
|
SuperBlades grafických procesorů Supermicro X13
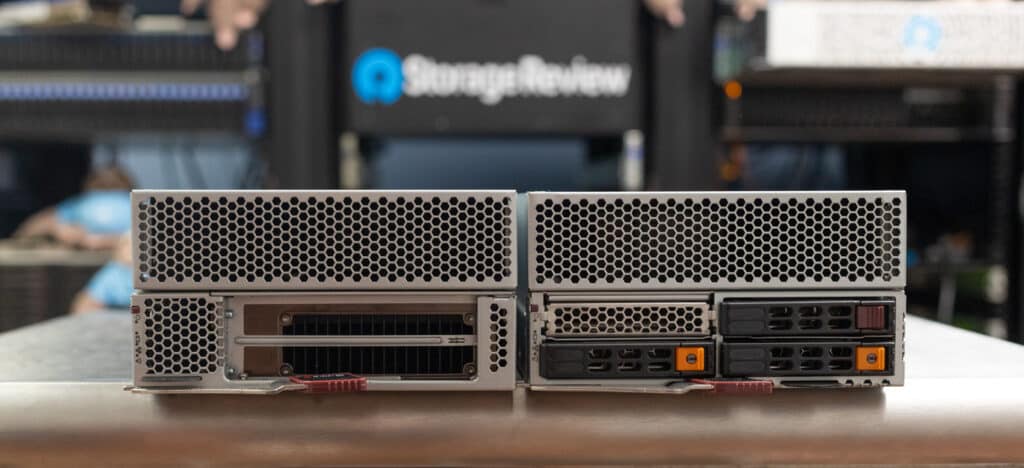
GPU blade na první pohled svědčí o svém výkonu, s předním sáním, přičemž náš duální procesor blade má místo GPU několik 2.5″ NVMe slotů.
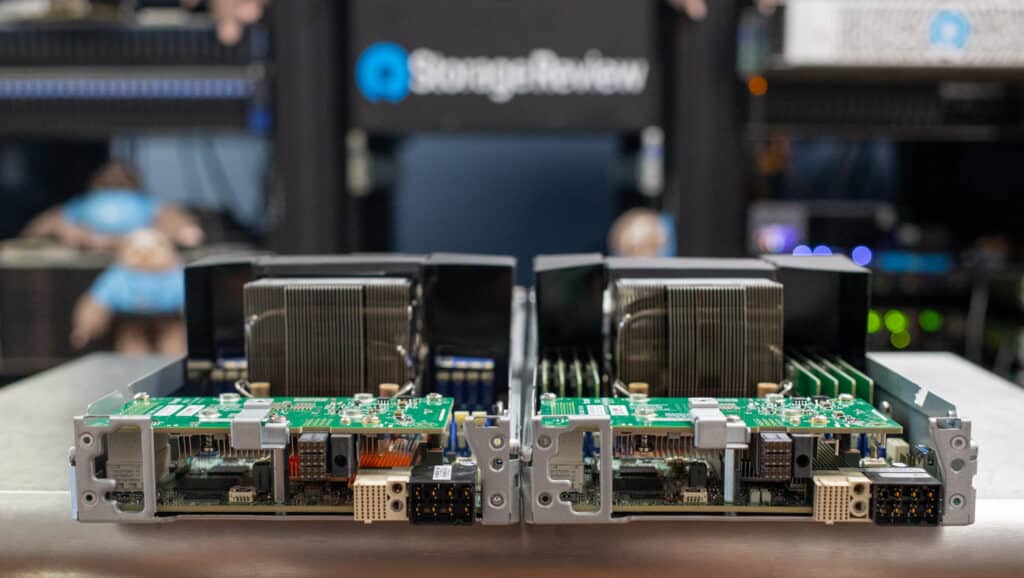
Kolem zadní strany se nachází oslnivé množství pinů pro připojení blade desky k šasi, které přenášejí veškeré napájení a data.
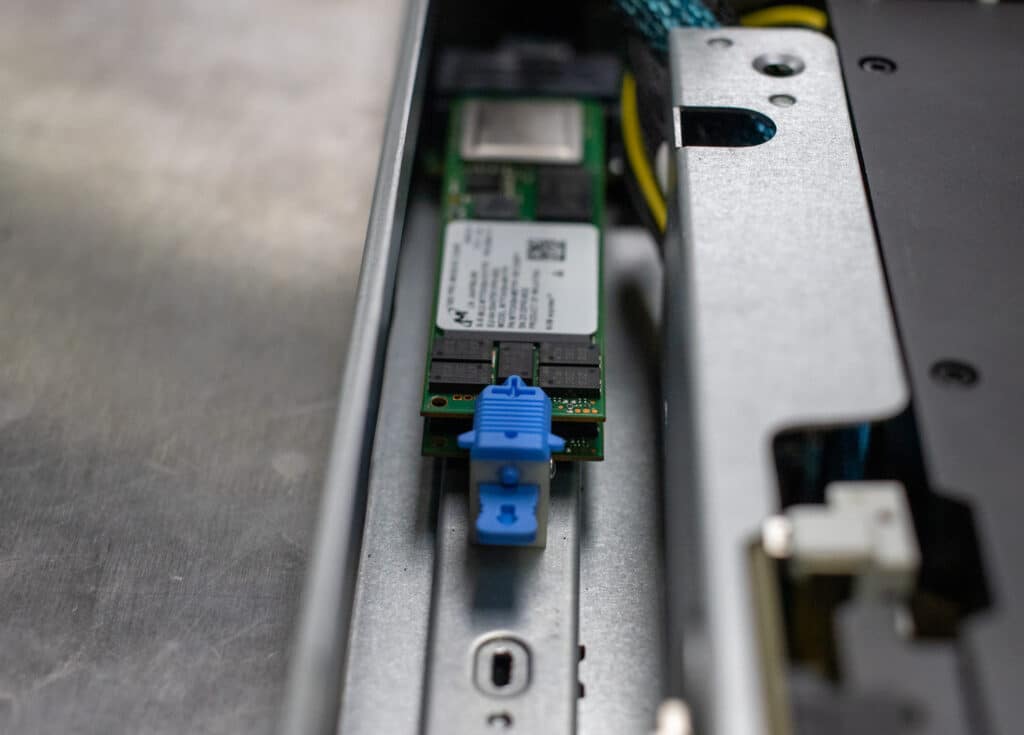
Při pohledu dovnitř vidíme bootovací SSD disky m.2 v grafické kartě.
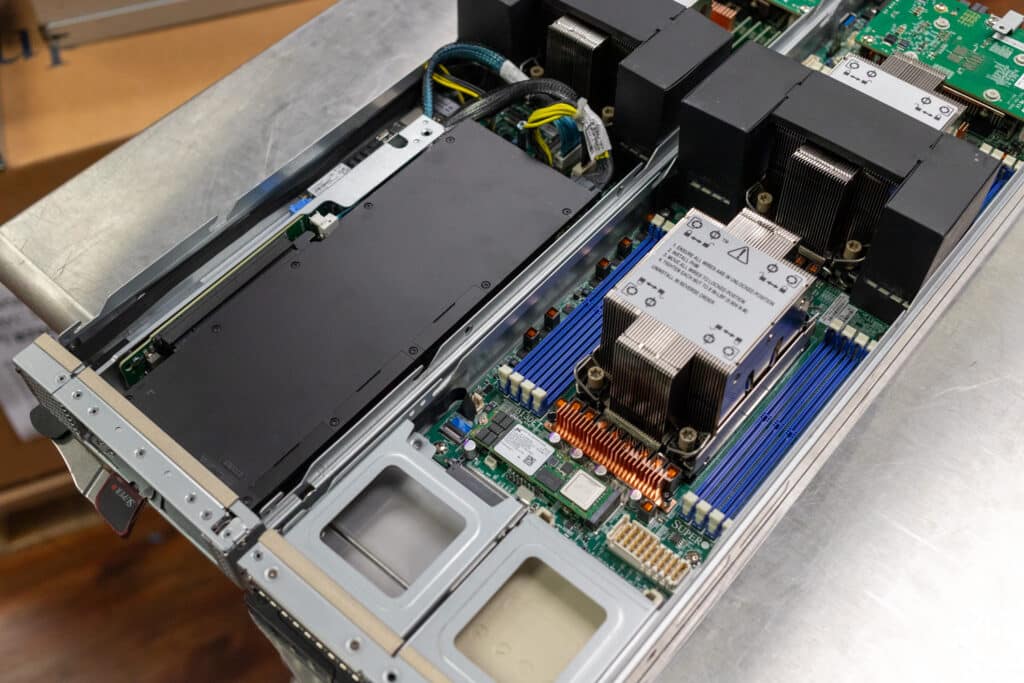
Shora vidíme vodítka pro odvod vzduchu. Všimněte si rozdílu mezi bladem GPU a bladem Dual CPU. Základní deska s bladem GPU je identická s duálním CPU, ale má pouze zadní I/O polovinu.
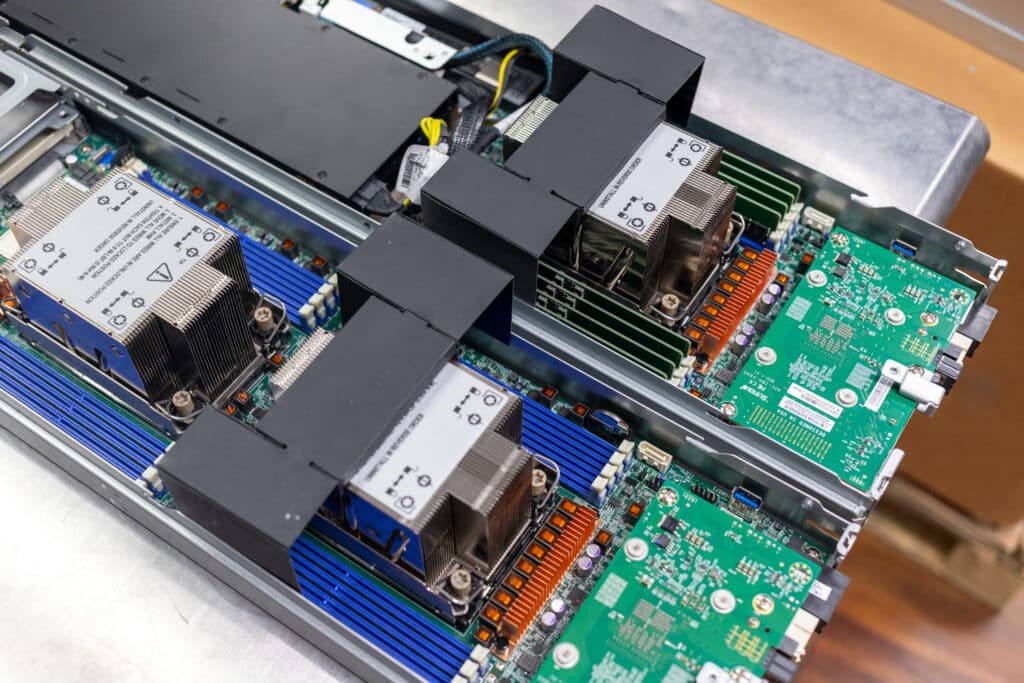
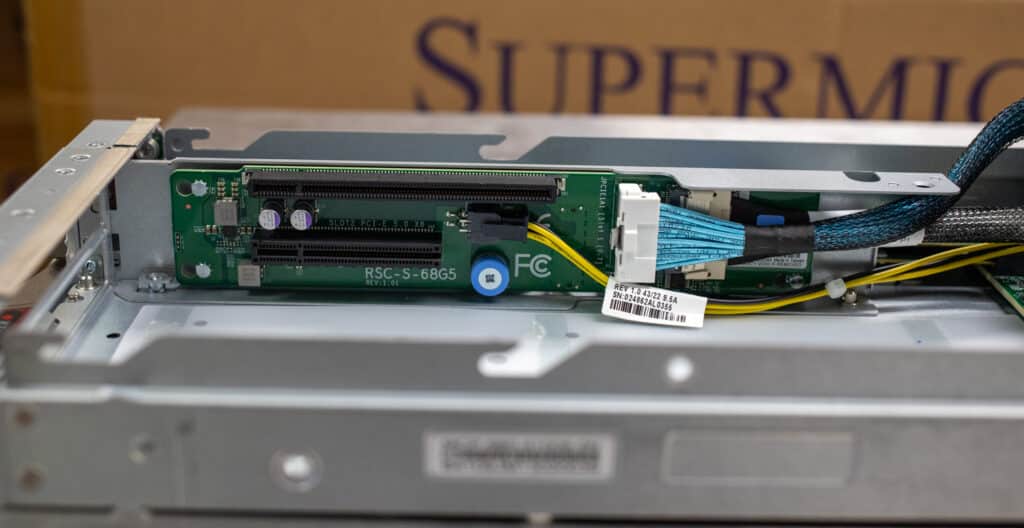
Na přední straně začínáme vidět různé implementace. Blade GPU má rozšiřující port PCIe, zatímco blade CPU má rozšiřující port U.2 PCIe a do svých slotů PCIe může pojmout různé komponenty. Šasi je navrženo pro optimální chlazení pasivních GPU tím, že nejprve nasává čerstvý vzduch do GPU.
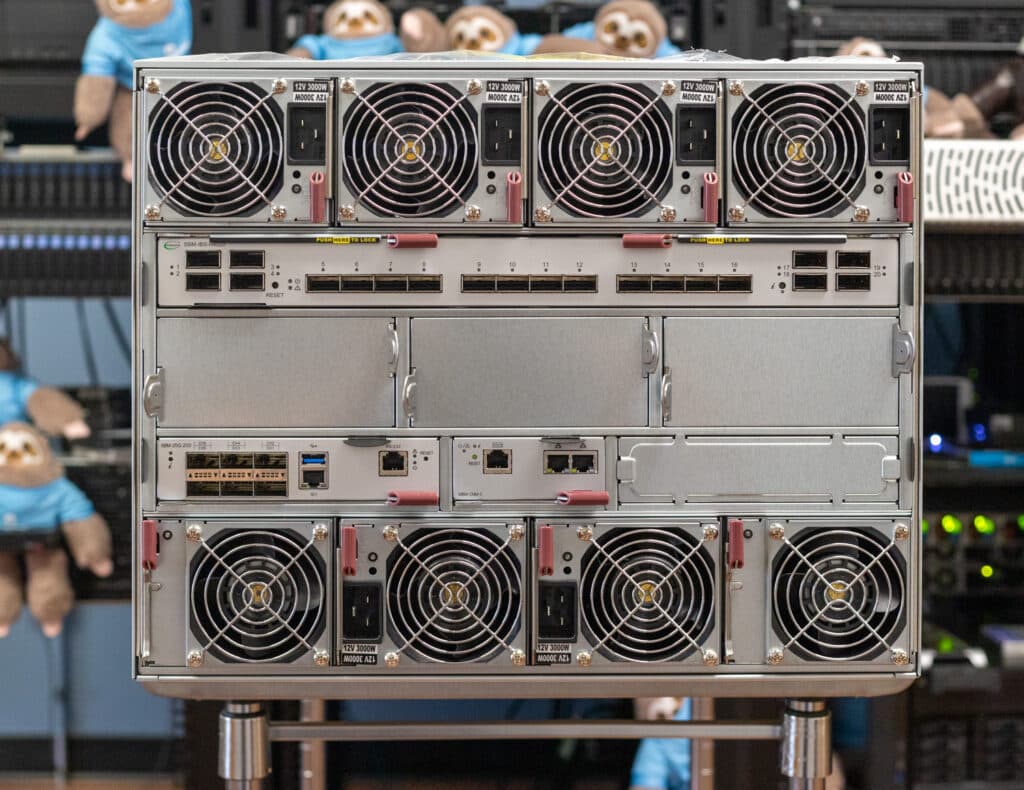
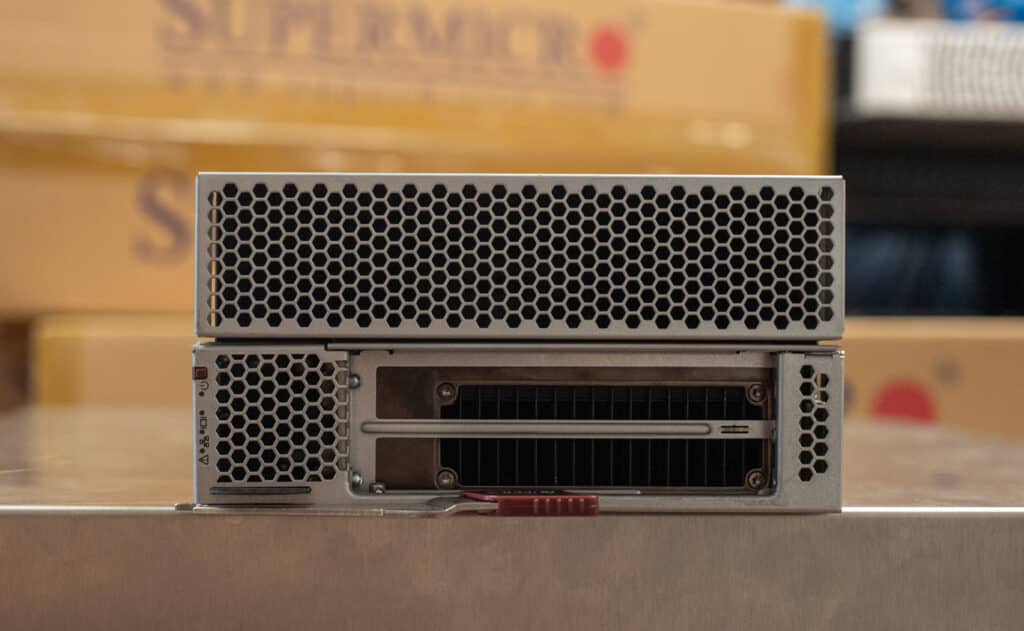
Dále, počínaje zadní částí šasi, vidíme zdroje a síťové připojení. Horní přepínač plné šířky je pro 200Gb NVIDIA Quantum InfiniBand. Větší ze dvou spodních přepínačů je 25G ethernet a malý modul uprostřed je pro modul správy šasi.
Správa a nasazení šasi Supermicro X13 SuperBlade
Integrace modulu pro správu šasi (CMM) do šasi Supermicro SuperBlade X13 nabízí řadu výhod, které sahají nad rámec jednotlivých blade serverů a zahrnují celý rack, čímž zvyšují celkovou efektivitu a spravovatelnost provozu datového centra. CMM slouží jako centralizovaný řídicí bod, který zefektivňuje správu systému SuperBlade X13.
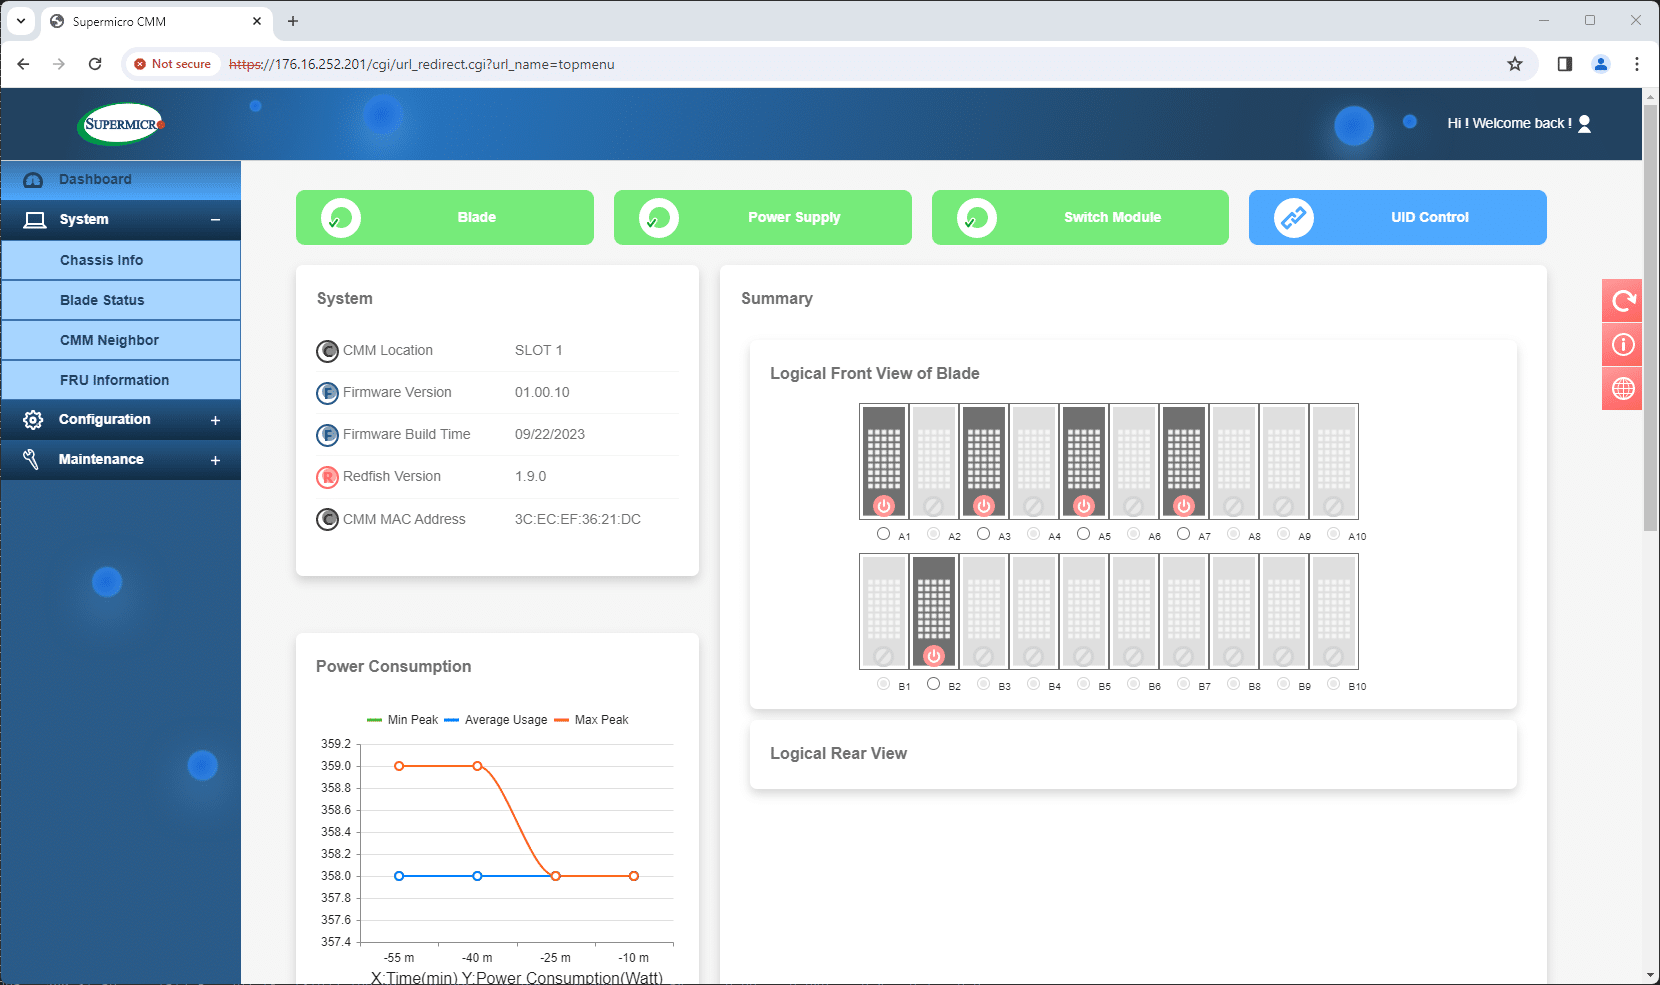
Jedna skleněná tabule pro všechny funkce šasi je zásadní pro integrované platformy, jako jsou blade šasi. Ačkoli pro některé může být schopnost cyklicky zapínat a vypínat jednotlivé blade servery důležitá, v každodenních rutinách správy hraje cennou roli řada dalších funkcí.
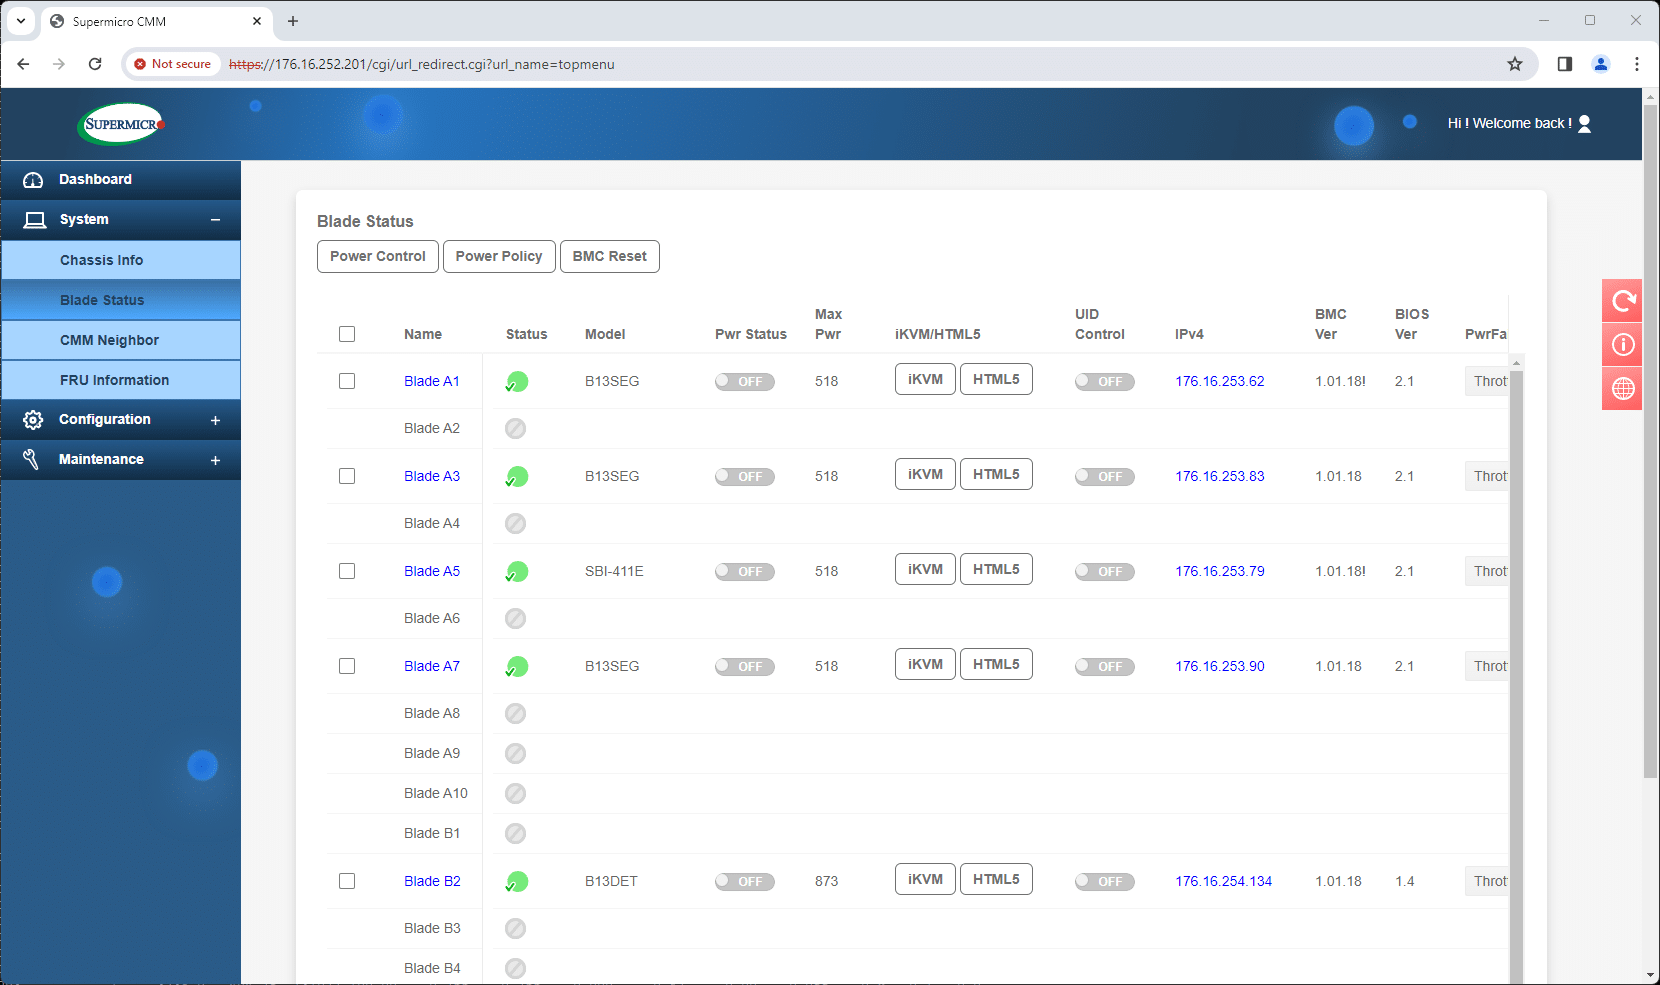
CMM od společnosti Supermicro nabízí centrální bod pro monitorování šasi, zobrazení instalovaných blade serverů a správu integrovaných přepínačů instalovaných v zadní části šasi. Tato správa mimo pásmo také načítá IP adresy zařízení, takže z tohoto centrálního bodu se můžete snadno připojit ke každému připojenému zařízení.
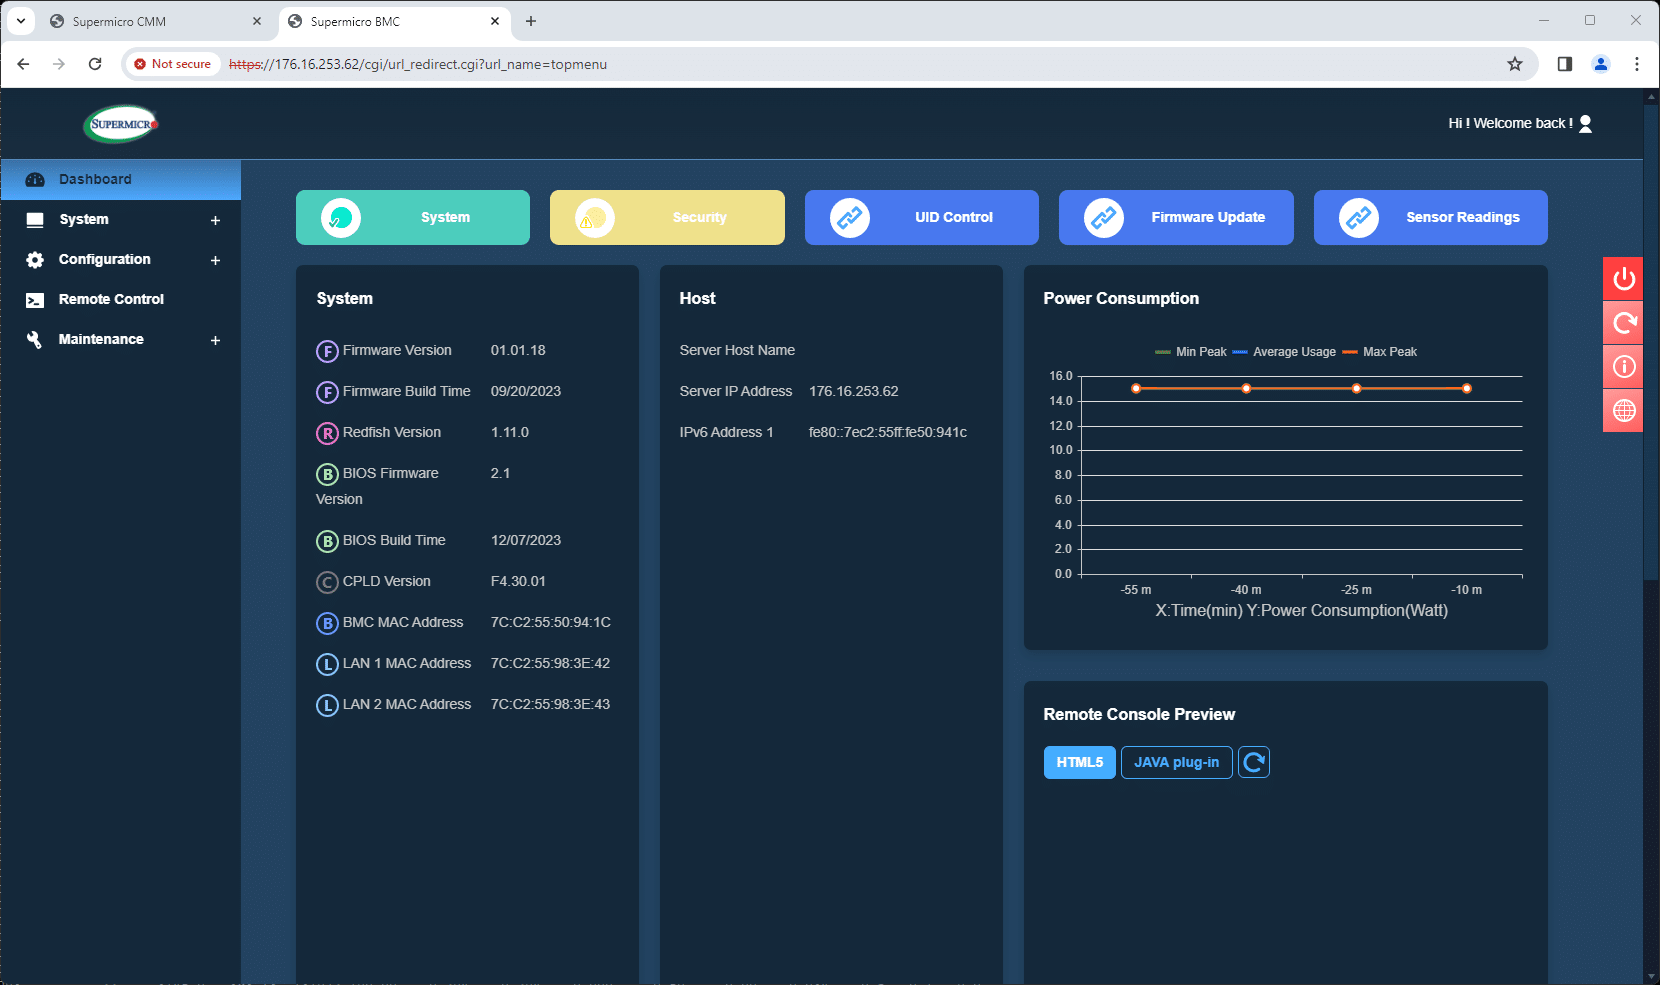
Správa každého nainstalovaného blade serveru je podobná jako u samostatného serveru Supermicro. Činnosti, jako jsou aktualizace BIOSu, se provádějí prostřednictvím jeho BMC, jak bylo zjištěno v předchozím experimentu . Tento centralizovaný přístup umožňuje rychlé nasazení a konzistentní aktualizace napříč všemi blade servery, čímž se zajišťuje, že každá komponenta pracuje s nejnovějším firmwarem a nastavením. Taková jednotnost je zásadní pro udržení stability a výkonu systému, zejména v hustých výpočetních prostředích, kde mohou rozdíly v konfiguraci vést k významné neefektivitě.
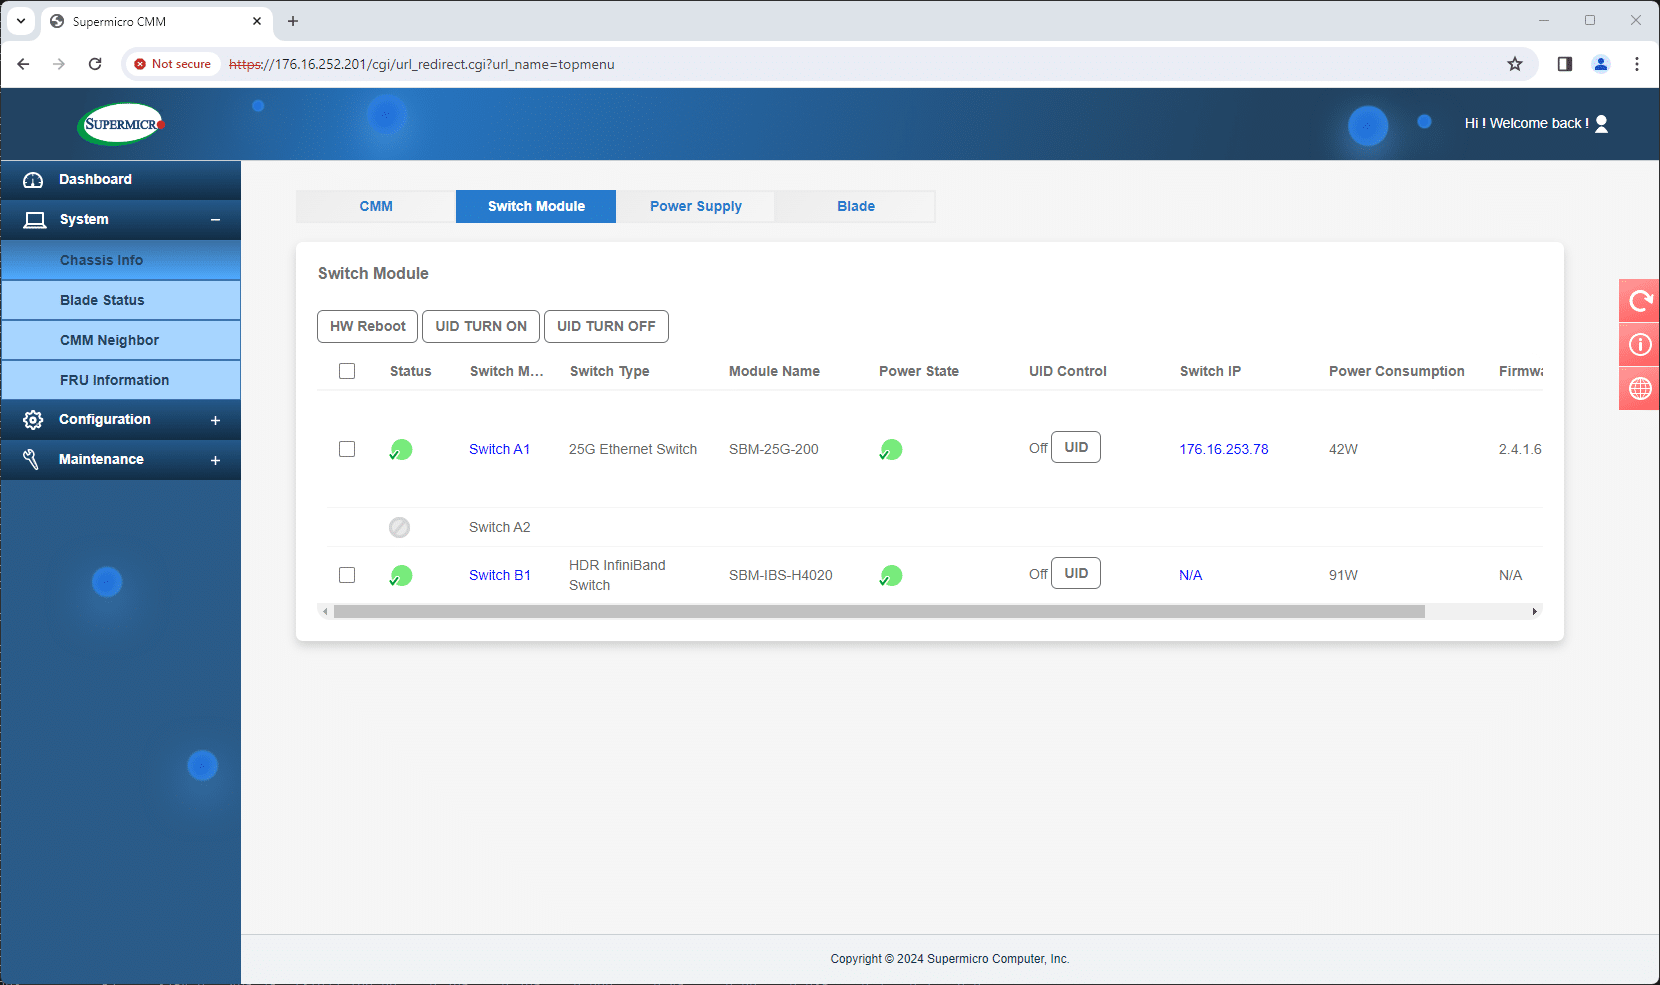
Role CMM ve správě systému SuperBlade X13 se rozšiřuje na monitorování a řízení stavu celého racku. Dohlíží na spotřebu energie, chlazení, síťové připojení a stav systému a poskytuje tak komplexní pohled na výkon racku. Tento dohled je klíčový pro identifikaci a řešení potenciálních problémů dříve, než se vyhrotí, minimalizaci prostojů a udržení optimální provozní efektivity.
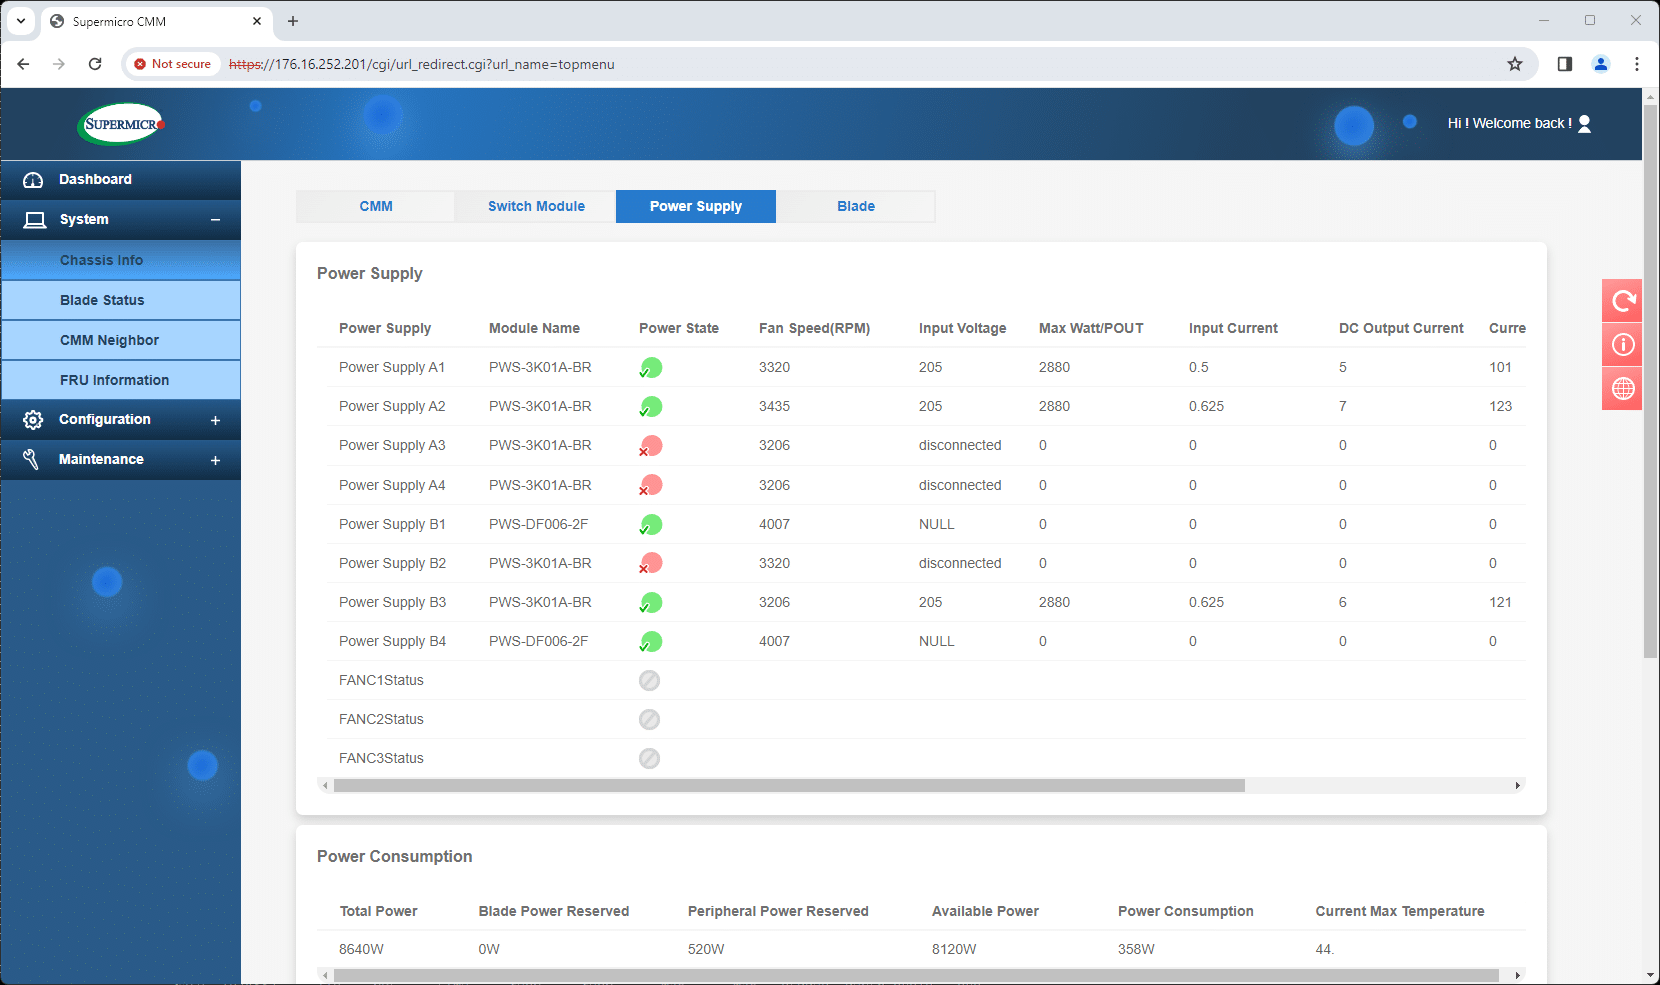
CMM kromě správy blade serverů také spravuje síť prostřednictvím jediného rozhraní. To uživatelům umožňuje snadný přístup a zobrazení obrazovek správy přepínačů obou připojených přepínačů se zobrazenými IP adresami. CMM může také komunikovat se sousedními systémy pro větší nasazení, což poskytuje komplexní balíček pro správu.
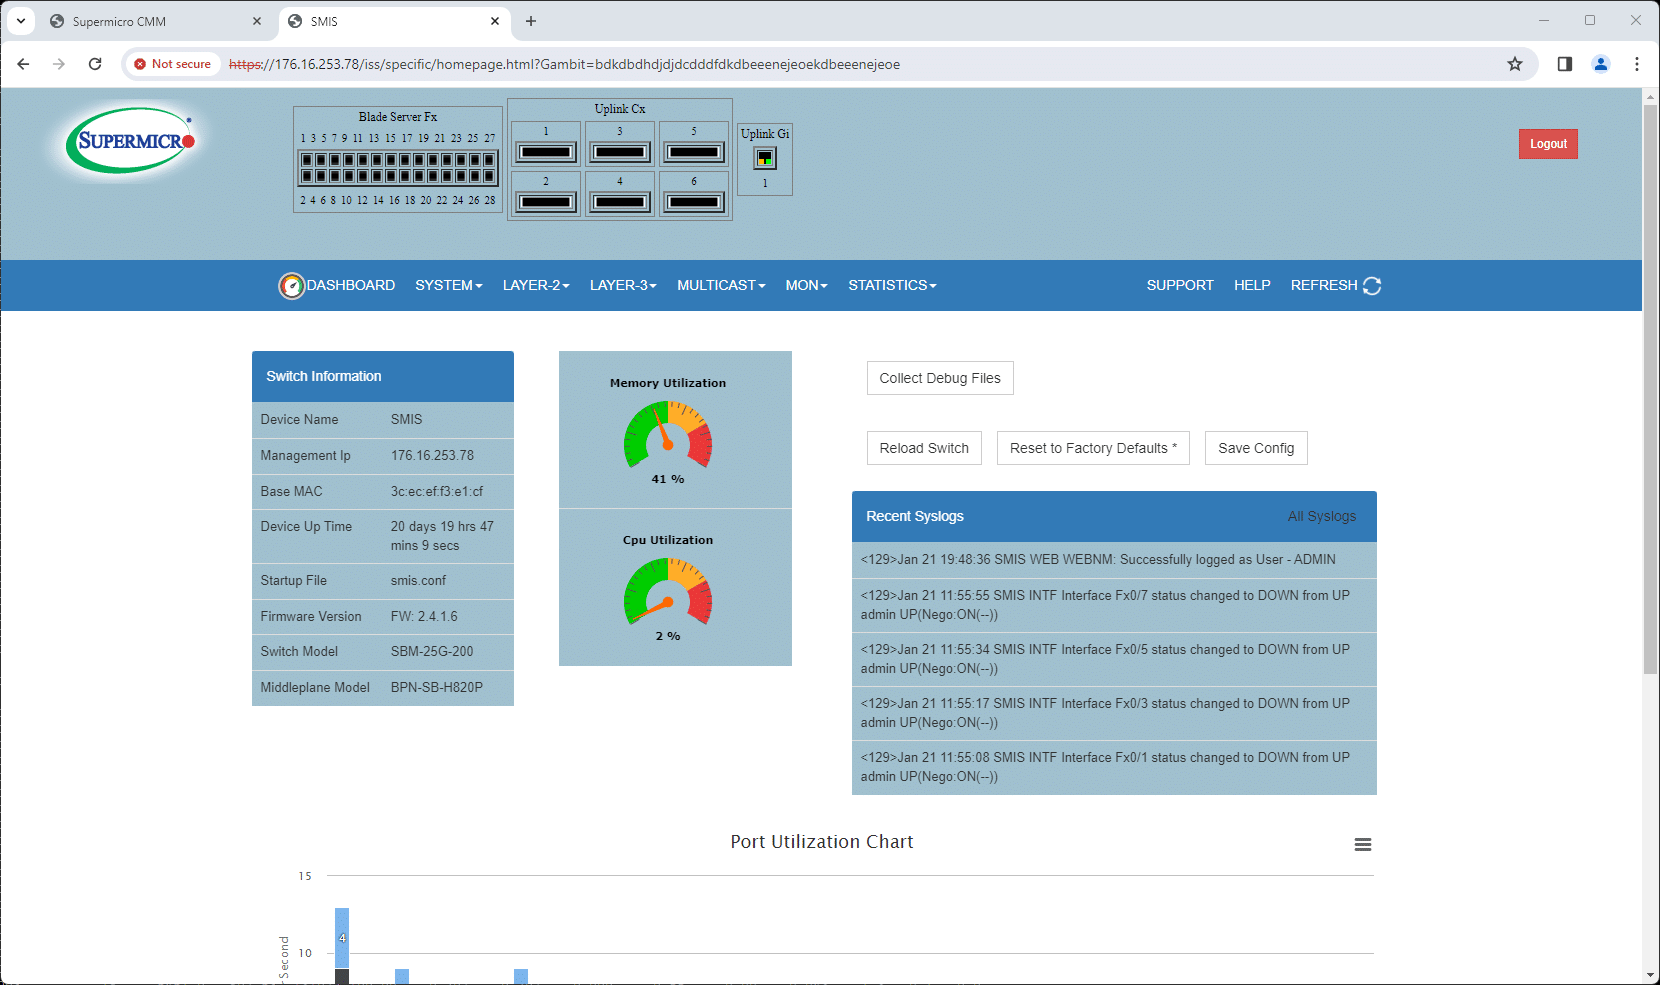
CMM v podstatě transformuje správu systému SuperBlade X13 z řady jednotlivých úkolů do uceleného a efektivního procesu. Je to podobné jako mít řídicí centrum, které zjednodušuje správu každého blade serveru a zvyšuje celkový výkon a spolehlivost celého racku. Tento přístup ke správě blade serverů a racků je užitečný pro týmy správy hardwaru, zejména v datových centrech, kde je škálovatelnost, spolehlivost a efektivní využití času prvořadé.
Supermicro SuperBlade SBI-411E-5G – výkon NVIDIA H100
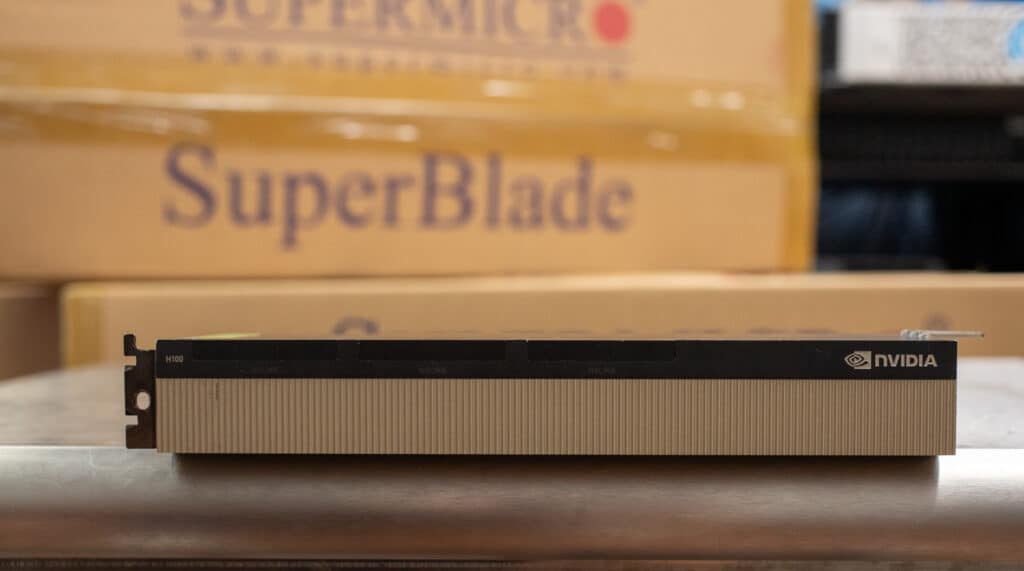
V oblasti vysoce výkonných výpočtů je SuperBlade SBI-411E-5G s grafickou kartou NVIDIA H100 všestranným a výkonným nástrojem pro distribuované trénování a inferenciaci jednotlivých blade serverů. Tato flexibilita je obzvláště patrná, když výpočetní nároky výrazně kolísají, například v datových centrech, která zvládají různé pracovní zátěže.
Distribuované scénáře školení
Uzly SuperBlade H100 vynikají v distribuovaném trénování, což je proces, který je zásadní pro komplexní modely umělé inteligence. Představte si scénář, kde je rozsáhlý model neuronové sítě trénován na obrovské datové sadě. Trénování modelu je distribuováno mezi několik blade serverů, z nichž každý využívá výkon pokročilých grafických procesorů H100. Toto rozdělení urychluje proces trénování a umožňuje práci s většími modely a nepraktickými datovými sadami na jednom počítači.
200G InfiniBand zde hraje klíčovou roli. Jeho vysokorychlostní komunikace s nízkou latencí je nezbytná pro distribuované školení, kde je rychlá a efektivní výměna dat mezi blade servery klíčová. Tato konektivita zajišťuje, že data a parametry učení jsou konzistentně a rychle synchronizovány napříč všemi blade servery, čímž se minimalizují úzká hrdla, která se často vyskytují při zpracování velkých objemů dat.
Distribuované školení v laboratoři
Distribuované školení způsobilo revoluci v našem přístupu k rozsáhlým úlohám strojového učení a hlubokého učení. Data jsou klíčová a schopnost efektivně zpracovávat obrovské množství tréninkových dat byla po nějakou dobu úzkým hrdlem. A právě zde se open-source knihovny a výkonný hardware, jako je Supermicro SuperBlade X13 se čtyřmi grafickými procesory PCIe, stávají převratnými, zejména při připojení přes vysokorychlostní síť 200G InfiniBand.
Open-source knihovny, jako jsou TensorFlow a PyTorch, se staly základem komunity strojového učení a jsou podporovány a ověřovány všemi výrobci. Nabízejí robustní, flexibilní a neustále se vyvíjející frameworky pro vývoj a škálování modelů strojového učení. Výpočetní nároky mohou být ohromující při trénování složitých modelů, jako jsou ty používané při zpracování přirozeného jazyka nebo počítačovém vidění. A právě zde přichází na řadu SuperBlade X13.
Blade X13 s podporou GPU
Platforma SuperBlade X13 je dobře známá svými výpočetními schopnostmi s vysokou hustotou, což z ní činí vynikající volbu pro HPC prostředí. Díky dvojitě širokým a polovičním blade serverům SBI-411E-5G vybaveným grafickými procesory H100 PCIe podporuje SuperBlade X13 až 10 GPU s vzduchovým chlazením a až 20 GPU s kapalinovým chlazením na šasi pro zvládání obrovského množství paralelních úloh. Důležité je, že blade servery lze kdykoli překonfigurovat, což je činí mimořádně flexibilními při změně pracovní zátěže umělé inteligence v podniku.
Zavedení technologie InfiniBand do šasi s extrémně nízkou latencí a vysokou propustností pomáhá s neustálým přenosem dat a parametrů modelu mezi uzly. Tato vysokorychlostní síť výrazně zkracuje dobu přenosu dat, která je v distribuovaných systémech často úzkým hrdlem, zejména při práci s rozsáhlými datovými sadami a složitými architekturami modelů.
Integrace open-source knihoven pro distribuované školení v tomto uspořádání zahrnovala několik klíčových kroků. Zaprvé jsme museli vybrat optimalizované kontejnery a knihovny pro plné využití možností GPU. To spočívá v použití verzí těchto knihoven s podporou CUDA, aby bylo zajištěno, že mohou přímo využívat výpočetní výkon GPU. Zadruhé, InfiniBand musí být propojen s NCCL (NVIDIA Collective Communications Library), což poskytuje optimalizované komunikační rutiny pro kolektivní komunikaci mezi více GPU/více uzly.
V praxi při nastavování distribuované tréninkové úlohy na této platformě každý uzel (v tomto případě každý SuperBlade) spouští část modelu. Parametry modelu jsou synchronizovány mezi uzly v reálném čase, což je usnadněno rychlostí a nízkou latencí sítě InfiniBand. Tato synchronizace je klíčová pro konvergenci a přesnost modelu.
TensorRT a LLM
Model TensorRT Large Language Model (LLM) od společnosti NVIDIA představuje významný pokrok v oblasti umělé inteligence a strojového učení. TensorRT LLM, navržený pro efektivitu a rychlost, je klíčovou součástí ekosystému blade serverů, známých svým výjimečným výkonem při zpracování složitých úkolů umělé inteligence. Jeho design splňuje potřeby technických profesionálů a IT manažerů a nabízí robustní řešení pro zvládání náročných výpočetních požadavků moderních datových center.
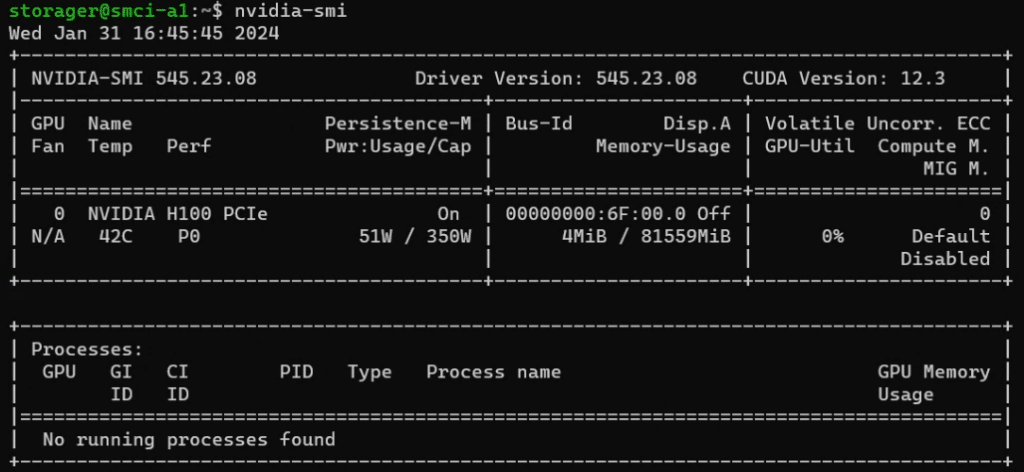
Technický rámec TensorRT LLM od společnosti NVIDIA je postaven tak, aby využil plný potenciál umělé inteligence a hlubokého učení. Je navržen pro optimalizaci inference neuronových sítí, což z něj činí ideální volbu pro vysoce výkonná výpočetní prostředí. TensorRT LLM dosahuje pozoruhodné efektivity díky své schopnosti převádět trénované modely do optimalizovaných běhových modulů, čímž výrazně snižuje latenci a zvyšuje propustnost. Tato funkce prospívá zejména systémům blade serverů, kde je klíčové rychlé zpracování dat a minimální doba odezvy. Navíc jeho kompatibilita s širokou řadou grafických procesorů NVIDIA zvyšuje jeho všestrannost, což z něj činí škálovatelné řešení v různých IT prostředích.
Jednou z výjimečných vlastností TensorRT LLM od NVIDIA je jeho schopnost distribuovaného trénování. Tento aspekt je obzvláště důležitý v prostředích, kde jsou normou rozsáhlé modely strojového učení. Distribuované trénování umožňuje TensorRT LLM využívat více systémů a efektivně rozdělovat výpočetní zátěž. To vede k významnému zkrácení doby trénování složitých modelů bez kompromisů v oblasti přesnosti nebo výkonu. Schopnost provádět distribuované trénování napříč různými uzly činí TensorRT LLM vysoce přizpůsobivým rozsáhlým IT infrastrukturám, které se často nacházejí ve velkých organizacích a výzkumných zařízeních. Tento distribuovaný přístup navíc usnadňuje práci s masivními datovými sadami, což je běžná výzva v pokročilých projektech umělé inteligence, a umožňuje tak robustnější a sofistikovanější vývoj modelů umělé inteligence.
Optimalizační a vysoce výkonné inferenční funkce TensorRT LLM jsou ideálně přizpůsobeny husté a propojené povaze blade serverů. Využitím TensorRT LLM mohou blade systémy efektivněji spouštět složité modely umělé inteligence, což vede k rychlejším dobám zpracování a nižší latenci. To je obzvláště důležité v situacích, kdy je nezbytná analýza dat a rozhodování v reálném čase, jako je finanční modelování nebo diagnostika ve zdravotnictví.
Kombinace Supermicro SuperBlade s distribuovanými možnostmi školení a adaptabilitou TensotRT LLM napříč různými systémy zvyšuje hodnotu tohoto aktiva pro technické profesionály a osoby s rozhodovací pravomocí v oblasti IT. Využitím této výkonné kombinace mohou organizace efektivně zpracovávat rozsáhlé projekty umělé inteligence, což zajišťuje rychlejší zpracování, sníženou latenci a škálovatelné nasazení umělé inteligence. K usnadnění tohoto cíle používáme v šasi síť Quantum InfiniBand.
Srovnávací test výkonu inferencingu pro jeden blade s MLPerf
Architektura jednoho CPU na jeden GPU na uzel v blade procesorech GPU nabízí potenciální výhody pro úlohy umělé inteligence a analýzy dat, zejména pro úlohy inference na jednom blade procesoru. Tato konstrukce poskytuje vyvážený poměr výpočetního výkonu, což umožňuje optimální využití možností GPU.
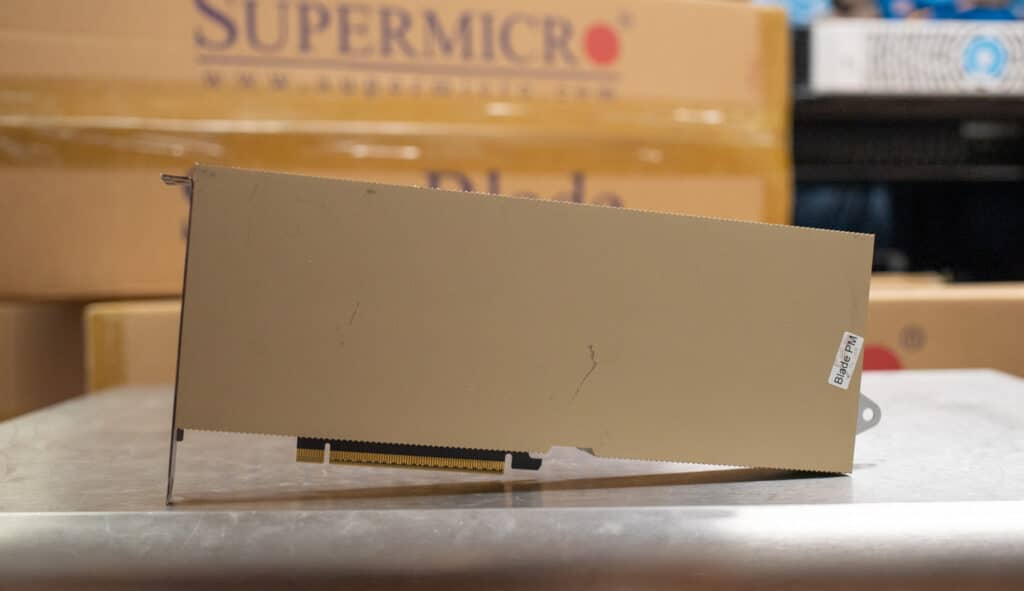
Pro otestování výkonu Single Blade Inferencing jsme spustili MLPerf 3.1 Inference, a to offline i na serveru. BERT (Bidirectional Encoder Representations from Transformers) je model založený na transformátoru, který se primárně používá pro úlohy zpracování přirozeného jazyka, jako je odpovídání na otázky, porozumění jazyku a klasifikace vět. ResNet-50 je model konvoluční neuronové sítě (CNN) široce používaný pro úlohy klasifikace obrázků. Jedná se o variantu modelu ResNet s 50 vrstvami, známou pro svou hlubokou architekturu a zároveň efektivní výkon.
| Inference z jednoho uzlu | |
|---|---|
| ResNet-50 – Offline: | 46,326.6 |
| ResNet-50 – Server: | 47,717.4 |
| BERT K99 – Offline: | 3,702.4 |
| BERT K99 – Server: | 4,564.11 |
- Offline režim: Tento režim měří výkon systému, když jsou všechna data k dispozici pro zpracování současně. Je to podobné dávkovému zpracování, kdy systém zpracovává velkou datovou sadu v jedné dávce. Tento režim je klíčový pro scénáře, kde latence není primárním problémem, ale propustnost a efektivita ano.
- Serverový režim: Naproti tomu serverový režim vyhodnocuje výkon systému ve scénáři napodobujícím reálné serverové prostředí, kde požadavky přicházejí jeden po druhém. Tento režim je citlivý na latenci a měří, jak rychle systém dokáže reagovat na každý požadavek. Je klíčový pro aplikace pracující v reálném čase, kde je nutná okamžitá reakce, například u webových serverů nebo interaktivních aplikací.
V úlohách inference je GPU primárně zodpovědný za těžkou výpočetní práci. Jeho spárováním s vyhrazeným CPU systém zajišťuje, že GPU může fungovat efektivně, aniž by byl omezován sdílenými zdroji CPU nebo platformy. To je klíčové v scénářích zpracování dat v reálném čase, jako je analýza živého videa nebo průběžný překlad jazyka.
Je zajímavé, že jsme pozorovali, že tento poměr CPU k GPU 1:1 umožňuje větší předvídatelnost výkonu. Každý uzel pracuje nezávisle, což zajišťuje konzistentní dobu zpracování a snižuje variabilitu v úlohách inference. Tato předvídatelnost je zásadní v prostředích, kde je doba odezvy kritická.
Celkově konfigurace jednoho CPU na jeden GPU v SuperBlade H100 maximalizuje efektivitu obou komponent. To zajišťuje, že každý uzel poskytuje optimální výkon pro inferenční úlohy, přičemž každý uzel provozuje nezávislé modely a procesy. Tato architektura zvyšuje schopnost systému efektivně a spolehlivě zpracovávat data v reálném čase.
Adaptivní správa pracovní zátěže
Po zvážení všech informací je zřejmé, že systém SuperBlade je vysoce adaptabilní. Během špičky, kdy je poptávka po inferencii vysoká, lze dynamicky alokovat více blade serverů s podporou GPU pro zpracování těchto úkolů, což zajišťuje efektivní zpracování požadavků v reálném čase. Naopak mimo špičku by se tyto zdroje mohly přesunout tak, aby se zaměřily na doladění modelů umělé inteligence nebo zpracování méně časově citlivých úkolů. Tato flexibilita umožňuje optimální využití zdrojů a zajišťuje, že systém SuperBlade je robustní a efektivní při zvládání proměnlivé výpočetní zátěže.
Výhody 200G NVIDIA Quantum InfiniBand v těchto scénářích
Zahrnutí 200G InfiniBand do systému SuperBlade H100 vylepšuje tyto scénáře tím, že poskytuje páteř pro vysokorychlostní přenos dat. Distribuované trénování umožňuje rychlejší synchronizaci dat mezi blade servery, což je nezbytné pro udržení konzistence a rychlosti trénovacího procesu. Inferencing na jednom blade serveru zajišťuje, že velké datové sady lze rychle přesunout na blade server ke zpracování, čímž se snižuje latence a zvyšuje propustnost.
Co se děje s Quantum InfiniBandem?
InfiniBand, základní kámen vysoce výkonných výpočtů, je vysokorychlostní propojovací technologie, která byla původně vyvinuta pro řešení stále rostoucích požadavků na přenos dat a komunikaci v rámci superpočítačových klastrů. Toto vysoce specializované síťové řešení se v průběhu let vyvíjelo a nabízí extrémně nízkou latenci a vysokou šířku pásma, díky čemuž je ideální pro propojení serverů, úložných systémů a dalších komponent v prostředích HPC.
Blade servery Supermicro X13, které nám byly dodány, byly vybaveny sítí 200G InfiniBand a ethernetovým připojením 25G. To bylo obzvláště užitečné při práci na distribuovaném trénování a dalších úlohách s vysokou latencí a daty. Po několika vysoce variabilních (a časově náročných) epochách výše zmíněného trénování jsme zjistili, že potřebujeme jinou metriku, která by poskytla reálné testovací metriky sítě InfiniBand skryté v nesčetných pinech šasi blade serverů. Vzhledem k extrémní variabilitě jemného ladění mezi jednotlivými běhy by bylo nezodpovědné pokoušet se kvantifikovat dopad, nebo naopak nedostatek, použití víceuzlového systému, jako je tento, pro tyto úlohy. Výsledky byly více než překvapivé.
Představujeme NVIDIA ClusterKit . NVIDIA ClusterKit je sada nástrojů navržená k otestování plného potenciálu víceuzlových GPU clusterů a nabízí odborníkům v oblasti umělé inteligence a HPC zajímavou sadu nástrojů pro měření výkonu, efektivity a škálovatelnosti jejich úloh.
Zaměřili jsme se na dva klíčové nástroje v ClusterKitu:
- Testování šířky pásma: Šířka pásma je v HPC kritickou metrikou, která odráží množství dat, která lze v daném čase přenést po síti. K měření obousměrné (duplexní) šířky pásma mezi uzly v konfiguraci Supermicro SuperBlade jsme použili NVIDIA ClusterKit. Duplexní měření jsou nezbytná, protože odrážejí reálný scénář, kdy data tečou současně v obou směrech.
- Testování latence: Latence, neboli doba, kterou potřebuje zpráva k přenosu z jednoho bodu v síti do druhého, je dalším klíčovým ukazatelem výkonu. Nízká latence je významná v úzce propojených HPC aplikacích. Schopnost NVIDIA ClusterKit přesně měřit duplexní latence poskytla cenné poznatky o odezvě sítě InfiniBand na SuperBlade.
Výsledky benchmarkingu grafických karet SuperBlade InfiniBand a H100 s ClusterKit
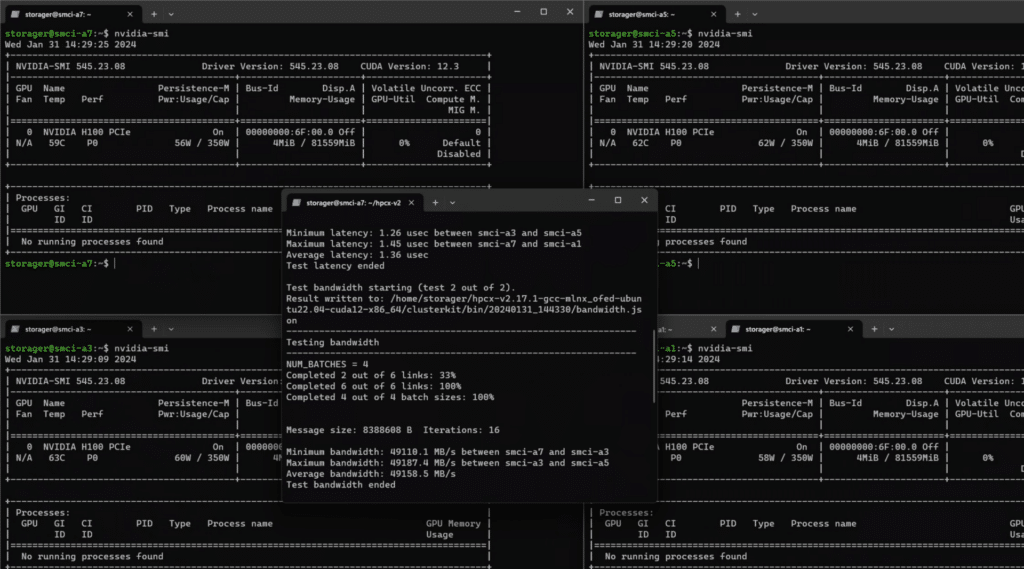
V této části je důležité si uvědomit, že každý uzel je identifikován jedinečným tagem (např. smci-a7, smci-a1 atd.). Označení -1, -3, -5 a -7 je název hostitele, který odráží fyzickou polohu blade serveru v šasi.
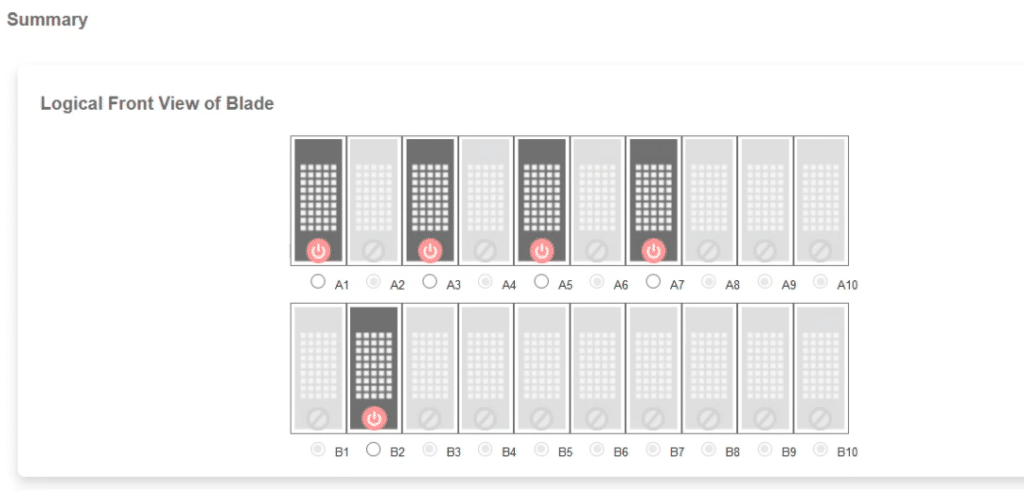
První test se zaměřil na měření obousměrné šířky pásma mezi různými uzly v clusteru. Test zahrnoval zprávu o velikosti 8 388 608 bajtů, iterovanou 16krát.
Přímé testy GPU
Nejprve se podíváme na testy GPU Direct. Ty uvádějí absolutní maximální propustnost blade platformy s využitím všech nejnovějších a nejlepších SDK a sad nástrojů dostupných v době psaní tohoto článku. Je důležité poznamenat, že test uvádí šířku pásma v duplexu, což znamená, že šířka pásma je součet v obou směrech. V jednom směru by to byla přibližně polovina. Klíčovým poznatkem je, že limitujícím faktorem pro šířku pásma je 200G InfiniBand, ale jak uvidíme později, to není velký důvod k obavám.
Testování Infiniband ClusterKit na Supermicro SuperBlades s Divyanshem Jainem
Níže uvedená matice ukazuje obousměrnou šířku pásma s využitím GPUDirect.
Matice šířky pásma MB/s
| Hodnost/Uzel | smci-a7 | smci-a1 | smci-a3 | smci-a5 |
|---|---|---|---|---|
| 0 (smci-a7) | 0.0 | 49,221.6 | 49,193.6 | 49,223.6 |
| 1 (smci-a1) | 49,221.6 | 0.0 | 49,219.5 | 49,142.7 |
| 2 (smci-a3) | 49,193.6 | 49,219.5 | 0.0 | 49,219.7 |
| 3 (smci-a5) | 49,223.6 | 49,142.7 | 49,219.7 | 0.0 |
Latence uSec
Dalším v pořadí byly pozoruhodné výsledky testů latence, které se měřily v mikrosekundách. Testy GPU Direct byly stejně dobré jako testy s více GPU lokálně připojenými k hostiteli.
| Hodnost | smci-a7 | smci-a1 | smci-a3 | smci-a5 |
|---|---|---|---|---|
| 0 (smci-a7) | 0.00 | 1.38 | 1.24 | 1.38 |
| 1 (smci-a1) | 1.38 | 0.00 | 1.25 | 1.36 |
| 2 (smci-a3) | 1.24 | 1.25 | 0.00 | 1.32 |
| 3 (smci-a5) | 1.38 | 1.36 | 1.32 | 0.00 |
Testy sousedních grafických procesorů
Přejdeme k testům sousedních GPU. Šířka pásma je opět uváděna v duplexu, což znamená, že šířka pásma je celková v obou směrech. V jednom směru by to byla přibližně polovina. Tato matice níže ukazuje obousměrnou šířku pásma mezi kartami H100 v každém ze čtyř uzlů. Nepoužívá se akcelerace knihoven GPUDirect. Čísla 1, 3, 5 a 7 představují název hostitele, který odráží fyzickou polohu blade serveru v šasi.
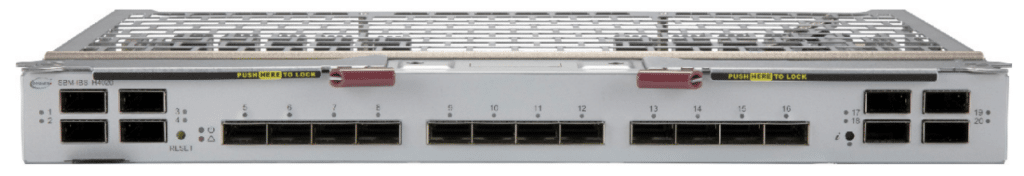
Přepínač SBS-IBS-H4020 HRD InfiniBand
Šířka pásma sousedního GPU (MB/s)
Test „Šířka pásma sousedních GPU“ měří rychlost přenosu dat mezi sousedními GPU v rámci stejného systému nebo uzlu. Tato metrika je klíčová pro aplikace vyžadující častou výměnu dat mezi GPU v těsné blízkosti, jako jsou například úlohy paralelního zpracování s více GPU. Čím vyšší je šířka pásma, tím rychlejší je přenos dat, což vede k potenciálně lepšímu výkonu v aplikacích náročných na GPU.
| GPU | Šířka pásma (MB/s) |
|---|---|
| smci-a7 s smci-a1 | 30,653.9 |
| smci-a3 s smci-a5 | 30,866.7 |
| Průměrný | 30,760.3 |
Šířka pásma paměti GPU (MB/s)
Test „Šířka pásma paměti GPU“ vyhodnocuje rychlost, s jakou může GPU číst data z paměti GPU nebo je do ní ukládat. Tato šířka pásma je kritickým aspektem výkonu, zejména pro aplikace, které zahrnují velké datové sady nebo vyžadují vysokou propustnost pro úkoly, jako je zpracování obrazu, simulace nebo hluboké učení. Vyšší šířka pásma paměti naznačuje lepší schopnost GPU efektivně zpracovávat velké objemy dat. Tento test nám ukazuje, že blade procesory X13 nemají problém s podporou GPU H100.
| GPU | Šířka pásma |
|---|---|
| smci-a7-GPU0 | 55,546.3 |
| smci-a1-GPU0 | 55,544.9 |
| smci-a3-GPU0 | 55,525.5 |
| smci-a5-GPU0 | 55,549.8 |
| Průměrný | 55,541.6 |
Šířka pásma mezi GPU (MB/s)
Tento test měří obousměrnou šířku pásma mezi různými grafickými procesory (GPU). Je nezbytný pro úlohy, které zahrnují složité výpočty distribuované mezi více grafických procesorů (GPU), kde rychlost přenosu dat mezi nimi může významně ovlivnit celkovou dobu zpracování. Vysoká šířka pásma mezi grafickými procesory (GPU-GPU) je výhodná pro urychlení pracovních postupů s více grafickými procesory (GPU) a paralelních výpočetních úloh.
| GPU | smci-a7 | smci-a1 | smci-a3 | smci-a5 |
|---|---|---|---|---|
| smci-a7-GPU0 | 0.0 | 30,719.8 | 30,817.7 | 30,823.8 |
| smci-a1-GPU0 | 30,719.8 | 0.0 | 30,710.0 | 30,670.9 |
| smci-a3-GPU0 | 30,817.7 | 30,710.0 | 0.0 | 30,835.1 |
| smci-a5-GPU0 | 30,823.8 | 30,670.9 | 30,835.1 | 0.0 |
| Průměrný | 30,762.9 |
Šířka pásma GPU0 k vzdálenému hostiteli (MB/s)
Test „GPU0 to Remote Host Bandwidth“ kvantifikuje rychlost přenosu dat mezi primárním GPU (GPU0) a vzdáleným hostitelským systémem. To je zásadní v distribuovaných výpočetních prostředích, kde je třeba data často přesouvat mezi hlavním GPU a dalšími částmi síťového systému, což ovlivňuje úkoly, jako je distribuované hluboké učení nebo analýza dat na vzdálených serverech.
| GPU | smci-a7 | smci-a1 | smci-a3 | smci-a5 |
|---|---|---|---|---|
| smci-a7 | 0.0 | 30,804.3 | 30,753.5 | 30,768.1 |
| smci-a1 | 30,804.3 | 0.0 | 30,732.9 | 30,679.7 |
| smci-a3 | 30,753.5 | 30,732.9 | 0.0 | 30,970.8 |
| smci-a5 | 30,768.1 | 30,679.7 | 30,970.8 | 0.0 |
Latence sousedních GPU (µs)
Test „GPU Neighbor Latency“ měří dobu, kterou potřebuje malé množství dat k přenosu z jedné GPU do sousední GPU. Nižší latence je žádoucí, zejména v aplikacích vyžadujících zpracování dat v reálném čase nebo vysokorychlostní komunikaci mezi GPU, jako je například renderování v reálném čase nebo složité vědecké simulace.
| GPU | Latence |
|---|---|
| smci-a7 s smci-a1 | 11.03 |
| smci-a3 s smci-a5 | 11.01 |
Latence GPU k vzdálenému hostiteli (µs)
Test „GPU0 to Remote Host Latency“ měří zpoždění v datové komunikaci mezi primárním GPU (GPU0) a vzdáleným hostitelským systémem. Tato latence je kritickým faktorem v distribuovaných výpočetních prostředích, který ovlivňuje odezvu a efektivitu aplikací, které se spoléhají na interakci mezi GPU a vzdálenými systémy, jako je například cloudové hraní her nebo vzdálené zpracování dat.
| GPU | smci-a7 | smci-a1 | smci-a3 | smci-a5 |
|---|---|---|---|---|
| smci-a7 | 0.00 | 3.35 | 3.36 | 3.33 |
| smci-a1 | 3.35 | 0.00 | 3.41 | 3.37 |
| smci-a3 | 3.36 | 3.41 | 0.00 | 3.37 |
| smci-a5 | 3.33 | 3.37 | 3.37 | 0.00 |
| Průměrný | 3.37 |
Testy NVIDIA ClusterKit odhalily působivé výkonnostní metriky sítě InfiniBand na Supermicro SuperBlade. Testy šířky pásma v duplexním režimu odhalily vysoké rychlosti přenosu dat, což naznačuje efektivní využití možností InfiniBand. Podobně testy latence vykazovaly minimální zpoždění, což podtrhuje vhodnost sítě pro náročné HPC úlohy. To znamená, že tato platforma má srovnatelný výkon se samostatnými systémy a nabízí mnohem vyšší hustotu výpočetních a síťových operací, to vše v jednotném řešení.
Testování samostatného GPU serveru
Dále jsme přesunuli 4 grafické karty NVIDIA H100 do serveru Supermicro 4U AMD EPYC GPU , který dokáže podporovat všechny 4 grafické karty současně, a snažili jsme se otestovat vzájemnou latenci grafických karet (GPU) a vzájemný výkon. Je důležité si uvědomit, že se pouze snažíme pochopit výkonnostní profil karet v tomto serveru, bez komunikace mezi blady. I když je tento server 4U flexibilní, co se týče podporovaných karet, nemá tak extrémní kompatibilitu, jakou nabízí šasi Supermicro X13 SuperBlade. Supermicro samozřejmě jako obvykle nabízí řešení pro každou aplikaci, včetně GPU s kapalinovým chlazením v socketu.
Nejprve se podívejme na peer-to-peer šířku pásma 4 GPU v jedné platformě.
Šířka pásma zápisu (GB/s) – jednosměrná
| GPU | GPU0 | GPU1 | GPU2 | GPU3 |
|---|---|---|---|---|
| GPU0 | 0.00 | 54.29 | 39.50 | 40.51 |
| GPU1 | 54.60 | 0.00 | 40.55 | 40.22 |
| GPU2 | 40.60 | 38.73 | 0.00 | 54.03 |
| GPU3 | 40.99 | 40.33 | 53.79 | 0.00 |
Šířka pásma pro čtení (GB/s) – jednosměrné
| GPU | GPU0 | GPU1 | GPU2 | GPU3 |
|---|---|---|---|---|
| GPU0 | 0.00 | 53.17 | 39.23 | 35.69 |
| GPU1 | 53.70 | 0.00 | 36.96 | 41.02 |
| GPU2 | 36.28 | 39.88 | 0.00 | 53.32 |
| GPU3 | 40.40 | 37.08 | 53.68 | 0.00 |
Je důležité si uvědomit, že grafické karty GPU0 a GPU1 jsou na jednom uzlu NUMA a GPU2 a GPU3 jsou na jiném uzlu NUMA. Zde je jasně vidět dopad přechodu přes uzel NUMA na výkon.
Kopírovací engine (CE) – Latence zápisu (USA)
Nakonec měření latence mezi grafickými kartami.
| GPU | GPU0 | GPU1 | GPU2 | GPU3 |
|---|---|---|---|---|
| GPU0 | 0.00 | 1.67 | 1.64 | 1.64 |
| GPU1 | 1.57 | 0.00 | 1.61 | 1.61 |
| GPU2 | 1.66 | 1.69 | 0.00 | 1.65 |
| GPU3 | 1.65 | 1.66 | 1.61 | 0.00 |
Jak se dalo očekávat, přesun všech GPU do jedné platformy nám poskytuje dvojnásobnou šířku pásma oproti 200G IB připojením Blade. Šířka pásma zde může být pro danou aplikaci faktorem, ale pokud jde o latenci v řádu mikrosekund, nedochází k výrazné změně – přechod z průměrné latence 1.6 us mezi GPU, když je vše v jednom šasi, na pouhých 1.5 us u blade serverů při nutnosti procházet sběrnicí PCIe, IB přepínačem a zpět ke GPU je pozoruhodný. To ale není celý příběh.
Závěr
Supermicro X13 SuperBlade s procesory Emerald Rapids a grafickými kartami NVIDIA H100 představuje vítaný vývoj toho, co blade servery mohou nabízet. Jeho možnosti sahají na různé výpočetně náročné úlohy, což z něj činí všestranné a robustní řešení pro různá odvětví od analýzy dat až po umělou inteligenci a cloud computing. Vzhledem k tomu, že poptávka po vysoce výkonných výpočtech neustále roste, je X13 připraven těmto výzvám čelit a demonstruje tak závazek společnosti Supermicro k inovacím a excelenci v serverových technologiích.
Po zvážení všech faktorů z testování nás tato platforma obzvláště zajímá díky její jedinečné a vysoce přizpůsobivé povaze z holistického hlediska. Je důležité zasadit aplikaci platformy do kontextu.
Představte si scénář ve výzkumném oddělení, kde máte ve svém racku systém Supermicro X13 Blade pro veškerý váš vysoce výpočetní výkon. Centralizovanou infrastrukturu správy zabudovanou v platformě můžete využít nejen k ovládání blade serverů a samotné platformy, ale také jako centrum pro řízení, síťování a správu dalších zařízení. Připojením dostatečně výkonného úložného serveru k SuperBlade serverům pro napájení datově náročných GPU můžete rychlostí linky přijímat všechny bity do svých modelů. V tomto fiktivním scénáři můžeme mít všechny naše GPU využívané během dne různými výzkumníky a pak, až přijde čas, propojit všechny blade servery přes InfiniBand a nechat je pracovat společně.
Testování šířky pásma vztahu jedna k jedné mezi CPU a GPU také ukázalo, že s plně vybaveným blade šasi můžete překonat jeden server s přídavnými grafickými kartami s blade systémem. S vhodně navrženým distribuovaným tréninkovým pracovním postupem byste mohli dosáhnout výkonu, který je v podstatě stejně dobrý nebo lepší než se všemi GPU v jednom uzlu, ale nyní získáte platformu, která dokáže snadno zvládnout dvojí úkol a snížit počáteční náklady na GPU na polovinu. Díky podpoře nejnovějších CPU se po implementaci těšíme na přechod z HDR InfiniBand na NDR, protože to by posunulo SuperBlade nad rámec výkonu, kterého byste mohli dosáhnout na serverové platformě s jednou GPU.
Šasi a blade procesory GPU Supermicro X13 SuperBlade představují vysoce přizpůsobivou a robustní volbu pro ty, jejichž potřeby v oblasti umělé inteligence se neustále vyvíjejí nebo se pravidelně mění. Během našeho delšího používání platformy jsme se setkali s potřebou změn paměti DRAM, CPU a GPU, nebo jak se tomu ve světě umělé inteligence říká, „další den“, to vše platforma s lehkostí zvládla. Celkově je platforma solidní a je zajímavým a výkonným zařízením pro oblast umělé inteligence, aniž by od ní bylo cokoli očekávat. Vzhledem k cenové hladině konkurenčních systémů, pokud můžete využít flexibility blade procesoru, je to téměř nepřekonatelné.


 Amazon