

Rychlý pokrok umělé inteligence v roce 2023 je bezkonkurenční a v centru veškeré této fanfáry (prosím, bubnování) jsou generativní modely umělé inteligence, přičemž ukázkovým příkladem je model velkých jazyků (LLM), jako je ChatGPT. Tyto LLM si získaly značnou pozornost pro svou schopnost generovat text podobný lidskému poskytováním odpovědí, generováním obsahu a pomáháním s širokou škálou úkolů. Stejně jako každý technologický zázrak však ani LLM nejsou bez nedokonalostí. Občas tyto modely vykazují chování, které se jeví jako nesmyslné nebo nesouvisející s kontextem. V laboratoři tento jev nazýváme „Quinnův efekt“.
Quinnův efekt zosobněný generativní umělou inteligencí
Definování Quinnova efektu
Quinnův efekt lze chápat jako zdánlivé vykolejení generativní umělé inteligence z její zamýšlené trajektorie, což má za následek výstup, který je buď irelevantní, matoucí, nebo dokonce vyloženě bizarní. Může se projevit jako jednoduchá chyba v reakci nebo jako proud nevhodných myšlenek.
Příčiny Quinnova efektu
Abychom plně pochopili, proč k Quinnovu efektu dochází, musíme se ponořit do světa generativních architektur umělé inteligence a trénovacích dat. Quinnův efekt může být způsoben několika chybnými kroky, včetně:
- Nejednoznačnost ve vstupu: LLM se snaží předpovědět další slovo v sekvenci na základě vzorců z obrovského množství dat. Pokud je dotaz nejednoznačný nebo nejasný, model může vrátit nesmyslnou odpověď.
- Převybavení: Dochází k tomu, když je jakýkoli model umělé inteligence příliš úzce přizpůsoben svým trénovacím datům. V takových případech může model produkovat výsledky konzistentní s drobnými detaily z trénovací sady, ale obecně ne logické nebo použitelné.
- Nedostatek kontextu: Na rozdíl od lidí nemají LLM kontinuální paměť ani pochopení širších souvislostí. Pokud se konverzace náhle zvrtne, model může ztratit nit, což vede k výstupům, které se zdají být vykolejené.
- Zkreslení dat: LLM, včetně architektur GPT, se učí z rozsáhlých datových sad. Umělá inteligence by mohla tyto vzorce replikovat, pokud tyto sady dat obsahují zkreslení nebo nesmyslná data.
- Jazyková složitost: Přirozený jazyk je složitý a plný nuancí. Někdy se model může potýkat s homonymy, idiomy nebo frázemi s více interpretacemi, což vede k neočekávaným výsledkům.
Zmírnění Quinnova efektu
I když úplné odstranění Quinnova efektu je náročný úkol, lze podniknout kroky ke zmírnění jeho výskytu, včetně:
- Pravidelné aktualizace a vylepšení: Neustálé trénování a zdokonalování modelu na rozmanitých a aktualizovaných datových sadách může snížit nepřesnosti.
- Zpětnovazební smyčky: Implementace systému, kde zpětná vazba od uživatelů pomáhá identifikovat a napravit případy, kdy se model odchýlí od správných kolejí, může být prospěšná.
- Vylepšené kontextové povědomí: Budoucí iterace modelů by mohly těžit z mechanismů umožňujících lepší zachování kontextu při střídání konverzací.
- Různé zdroje datových sad: Zajištění komplexnosti trénovacích dat, která pokrývají širokou škálu témat, tónů a nuancí, může pomoci zvýšit robustnost modelu.
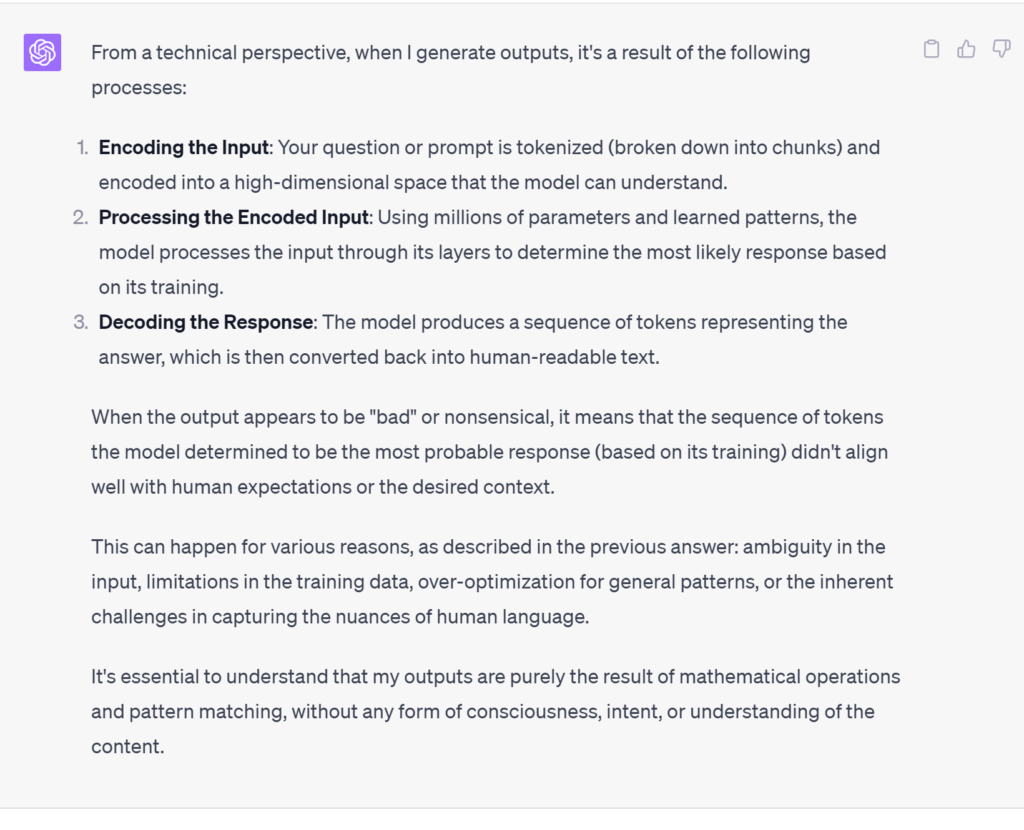
Dost spekulací, co si model „myslí“
Rozhodli jsme se požádat ChatGPT-4 o jejich pohled na to, co se děje.
Co bude dál
Quinnův efekt vrhá světlo na nedokonalosti, které jsou vlastní i těm nejpokročilejším modelům umělé inteligence. Uznání těchto omezení je prvním krokem k pochopení, zmírnění a potenciálnímu využití těchto nedostatků. Vzhledem k tomu, že oblast umělé inteligence pokračuje ve svém raketovém růstu, povědomí o těchto jevech se stává nezbytným pro uživatele i vývojáře, což pomáhá překlenout propast mezi očekáváním a realitou ve světě generativní umělé inteligence.
S tím, jak se neustále vyvíjí složitost a počet parametrů transformátorů, se nepochybně objeví další podobné výzvy, které bude třeba překonat. Je však také důležité poznamenat, že NVIDIA má SDK, které si s tím poradí . V dalším díle se podíváme na jemné doladění modelu a následné použití ochranných opatření v pseudoprodukčním prostředí.


 Amazon