

Wenn Sie StorageReview regelmäßig lesen, haben Sie vielleicht den Artikel über die OSU-Ozeanstudie live mitverfolgt. Wir sprachen mit Chris Sullivan, Forschungsdirektor und Leiter des Bereichs Akademisches Rechnen an der Oregon State University, um besser zu verstehen, wie Technologie Forschern bei der Erforschung des Meereslebens hilft und welche Auswirkungen dies auf die globale Umwelt hat.
Brian traf sich auf der SC25 mit Chris, um das Thema weiter zu besprechen. Wir berichten selten darüber, wie Technologie in realen Situationen wie der Planktonforschung der OSU eingesetzt wird, daher boten uns dieser Artikel und der Podcast die Gelegenheit dazu.
Während Brian und Chris über die an der OSU durchgeführten Forschungsarbeiten sprechen, ist ihre Begeisterung darüber, wie die Technologie die laufenden Meeresstudien unterstützt, deutlich spürbar. Chris ist seit über 24 Jahren an der Oregon State University tätig und leitet seit drei Jahren das Bioinformatik-Zentrum.
Dieser Live-Podcast verdeutlicht Chris' Begeisterung für Wissenschaft und Technologie. Er nannte die SC25 ein „Schatzparadies“.
Es handelt sich um eine lebhafte und offene Diskussion (mit etwas Humor), die authentische Einblicke in die Art und Weise bietet, wie Forschung Technologie nutzt, um Ergebnisse in Echtzeit zu liefern.
Es handelt sich um einen kurzen, aber hörenswerten Podcast. Falls Sie wenig Zeit haben, stellen wir Ihnen ein Transkript zur Verfügung, mit dem Sie direkt zu den wichtigsten Abschnitten springen können.
0:00 - 5:00
Umwandlung eines Forschungsschiffs in einen schwimmenden Supercomputer
Chris Sullivan von der Oregon State University erklärt, wie neue Technologien die Meeresforschung grundlegend verändern, insbesondere die massiven Planktonstudien, die von Schiffen aus durchgeführt werden, die im Grunde kleine, schwimmende Datenzentren sind.
- Technologie ist nicht nur „coole Ausrüstung“; sie verändert direkt Was ist wissenschaftlich möglich? und das Ausmaß der Verzerrung der Ergebnisse.
- Wissenschaftliche Voreingenommenheit: begrenzte oder verzerrte Stichproben, die zu ungenauen Schlussfolgerungen führen; die Lösung ist weitere Datenpunkte an mehr Standorten.
- Ziel: Sammlung riesiger, vielfältiger Datensätze, damit statistische Analysen nicht durch die Beschränkung auf nur einen Ort oder eine einzige Bedingung verzerrt werden.
- Traditionelle HPC-Setups erforderten einen Kompromiss: schnelle lokale NVMe/SSDs mit begrenzter Kapazität versus große, aber langsamere Tier-1-Speichersysteme.
- Für große Experimente musste Chris auf Tier-1-Speicher im gesamten Cluster zurückgreifen, da der On-Node-Speicher (Tier-Null-Speicher) zu klein war, um massive Datensätze aufzunehmen.
- Um die GPUs mit Strom zu versorgen, wurden große, gemeinsam genutzte Speichersysteme („Super-Pods“) notwendig, aber sie sind teuer und für den Einsatz im Feld oder auf See unrealistisch.
5:00 - 10:00
Meeresroboter, Plankton und eine Kreuzfahrt im Wert von einer Million Dollar
Dieser Abschnitt geht detailliert darauf ein, was an Bord des Schiffes tatsächlich geschieht – wie Instrumente geschleppt werden, wie enorme Mengen an Bilddaten erfasst werden und warum eine Verarbeitung in nahezu Echtzeit von entscheidender Bedeutung ist, wenn die Schiffszeit etwa 1 Million Dollar pro 10-tägiger Kreuzfahrt kostet.
- Das neue, von der NSF unterstützte Forschungsschiff ist wie eine „Mini-Star-Trek-Enterprise“ gebaut, vollgepackt mit Technologie und etwa 200 Meilen Kabeln auf einem 200 Fuß langen Boot.
- Zuvor musste Chris seinen besitzen Computerhardware an Bord des Schiffes, Glasfaserkabel durch die Gänge verlegen und ohne ein richtiges Bord-Rechenzentrum arbeiten.
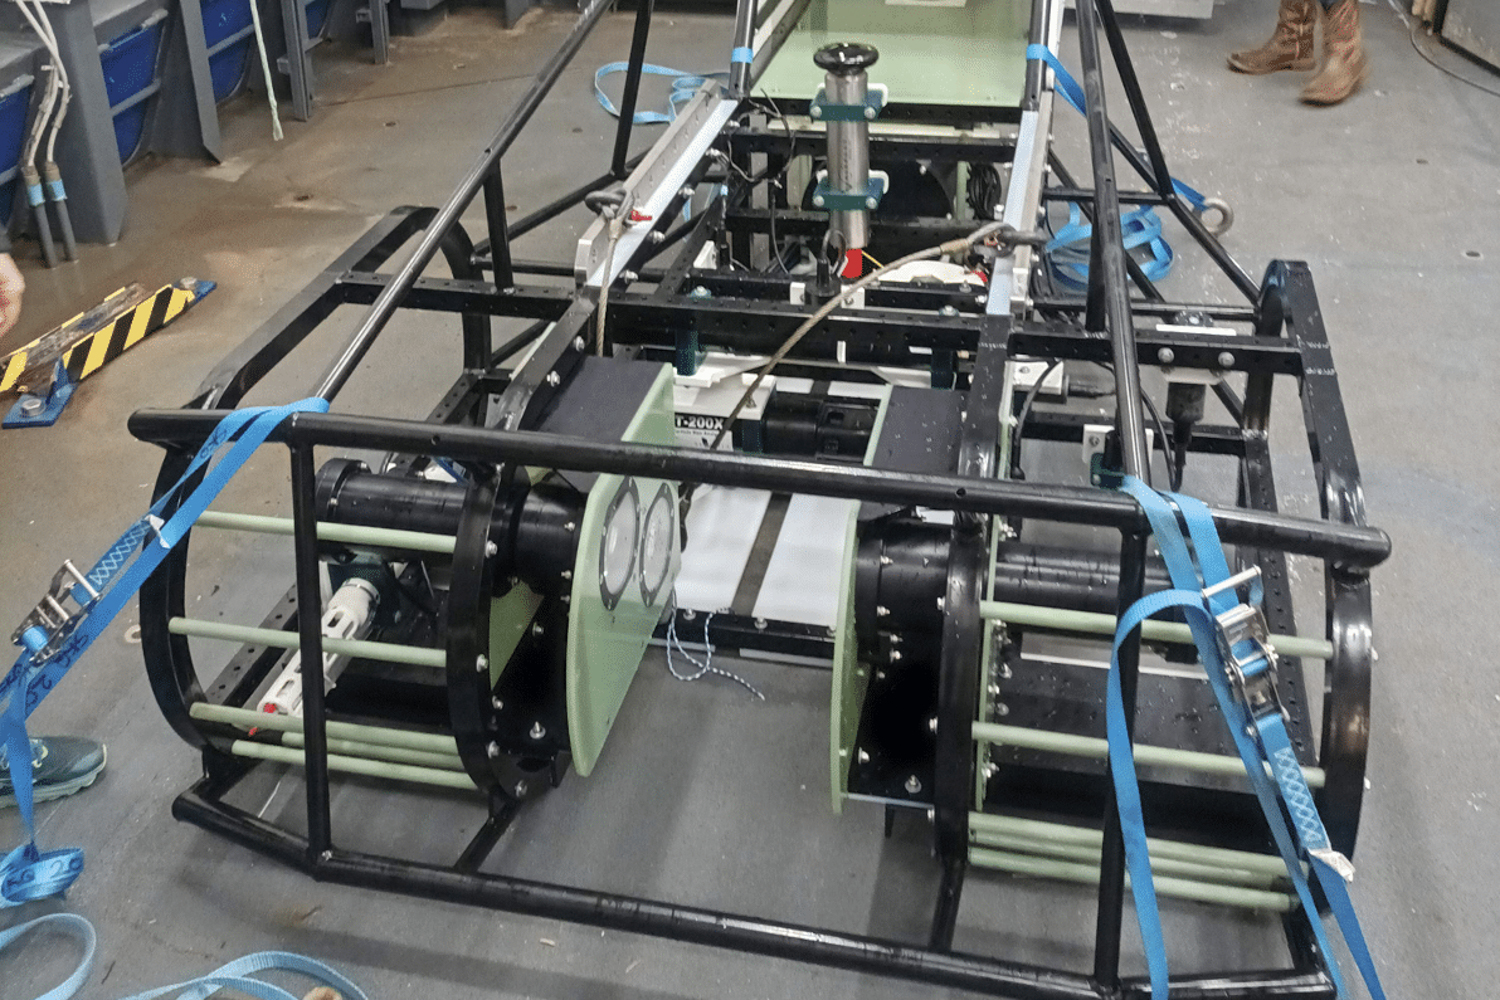
- Das Planktonsystem: Ein geschlepptes Gerät bewegt sich mit 5 Knoten durch das Wasser auf und ab, zieht dabei etwa 162 Liter Wasser pro Sekunde und erzeugt etwa 10 GB Bilddaten. pro Minute.
- Ein einzelnes 10-tägiges Planktonexperiment: ~100 TB Rohdaten; nach Verarbeitung, Segmentierung und Klassifizierung erholt sich das auf ~300–400 TB nutzbare Daten.
- Diese Daten müssen in nahezu Echtzeit verarbeitet werden; andernfalls könnte eine 1 Million Dollar teure, 10-tägige Kreuzfahrt mit fehlerhaften oder nutzlosen Daten zurückkehren, ohne dass die Möglichkeit bestünde, das Schiff umzuleiten.
- Plankton ist größtenteils den Strömungen ausgeliefert (es ist kein guter Schwimmer), dennoch ist es von entscheidender Bedeutung: Es produziert rund 50 % des Sauerstoffs der Erde, rund 25 % der Kohlenstoffsenke, rund 17 % der globalen Nahrungsmittel pro Kopf und bildet die Basis des marinen Nahrungsnetzes.
10:00 - 15:00
Edge-KI auf See und im Wald
Der Fokus verlagert sich vom Schiff hin zum umfassenderen „Randproblem“: Wie kann die Rechenleistung näher an den Ort gebracht werden, wo Daten entstehen – auf Booten, in Rangerstationen und in Wäldern voller autonomer Sensoren?
- Neue SSD-basierte Systeme mit hoher Kapazität ermöglichen es ihnen, ein was immer dies auch sein sollte. Tier Zero auf einem einzigen Gerät: Hunderte Terabyte an Daten speichern, in nahezu Echtzeit verarbeiten und nie wieder verschieben.
- Frühere Tests mit kleineren NVMe-Laufwerken erforderten ein ständiges Auslagern von Daten, um Speicherplatz zu schaffen, was wertvolle E/A-Bandbreite verbrauchte und die wissenschaftlichen Ergebnisse verlangsamte.
- Es gibt praktisch kein eigenes IT-Personal an Bord; eine Person bedient die Schiffssysteme und hält sich von Experimenten fern, sodass Doktoranden und Postdoktoranden Hardware und Pipelines selbst verwalten müssen.
- Daraus ergibt sich eine Designanforderung: einfache, robuste Pipelines und in sich geschlossene Geräte – kein fragiles Geflecht aus Arrays, Mounts und Volumes.
- Am Waldrand (z. B. im Rahmen des Owl-Projekts) betreiben sie rund 5,000 autonome Aufnahmegeräte und können allein anhand ihres Gesangs rund 130 Vogelarten identifizieren.
- Das Problem: Die SD-Karten müssen immer noch manuell eingesammelt werden; bis die Daten zurückkommen, ist ein Großteil ihres zeitlichen Wertes verloren. Edge-Computing zielt darauf ab, Erkenntnisse zu gewinnen. sofort am Punkt der Erfassung.
15:00 - 20:00
Die richtigen GPUs und Speicherlösungen für den jeweiligen Job auswählen
Hier erläutern sie die GPU-Strategie, das Omniverse-basierte Training und warum Flash-Speicher mit hoher Kapazität für KI und wissenschaftliche Visualisierung genauso wichtig ist wie reine Rechenleistung.
- Chris betont die Verwendung des ordnungsgemäße GPU für den Job: Große, teure Beschleuniger (z. B. H100/Hopper, „Grashüpfer“) sollten sich auf das Training konzentrieren, während kostengünstigere Karten wie die RTX 6000 die Inferenz in großem Umfang übernehmen.
- Historisch gesehen herrschte Verwirrung: zu viele sich überschneidende GPU-SKUs, unklare „Swimlanes“ und viel Geld, das für überdimensionierte Hardware für einfache Inferenz verschwendet wurde.
- RTX 6000-Grafikkarten erfüllen eine Doppelrolle: Hochleistungsfähige Inferenz sowie Grafik- und Rendering-Funktionen, die GPUs, die ausschließlich in Rechenzentren eingesetzt werden, fehlen.
- Sie bauen einen digitalen Zwilling des Schiffs im Omniverse-Universum, um:
- Studenten und Postdoktoranden virtuell ausbilden, während das Schiff auf See ist.
- Planung der räumlichen Anordnung und der Geräteverladung in beengten, sich bewegenden Räumen.
- Vermeiden Sie es, teure Schiffszeit mit Basisschulungen und dem Ausprobieren verschiedener Konfigurationen zu verschwenden.
- Auf einem fahrenden Schiff stellt alles mit beweglichen Teilen ein Risiko dar; Halbleiterspeicher werden aufgrund ihrer Zuverlässigkeit und Widerstandsfähigkeit bevorzugt.
- Hochleistungsfähige SSDs bei geringem Stromverbrauch schaffen mehr Energie für den Einsatz mit mehr GPUs, reduzieren den Bedarf an separaten Arrays und verringern den gesamten Hardware-Fußabdruck.
20:00 - 25:00
Von Aktenschränken bis hin zu glasfaservernetzten Ozeanen
Im größeren Zusammenhang betrachtet: Wie kostengünstiger Speicher die moderne KI ermöglichte, wie Meeresobservatorien Daten an Land streamen und warum Netzwerk und Speicher gemeinsam neue Arten von Wissenschaft ermöglichen.
- Chris argumentiert, dass der eigentliche Durchbruch der KI nicht in neuer Mathematik lag – die meisten Modelle stammen aus den 1950er- bis 70er-Jahren –, sondern in der billige Festplatte der 1990er Jahre, die Daten von Aktenschränken auf durchsuchbare, computerlesbare Datenträger übertrugen.
- Im Zeitalter der Aktenschränke verfügten sie zwar über Unmengen an Daten, waren aber „informationsarm“ – es gab keine Suchfunktion, keine Redundanz und keine skalierbare Verarbeitung.
- Es gab schon immer ein Wettrüsten zwischen Verarbeitungsgeschwindigkeit und Datenverfügbarkeit; SSDs mit hoher Kapazität verschieben das Gleichgewicht nun wieder, indem sie moderne GPUs mit weitaus mehr Daten versorgen.
- Oregon State ist federführend im Bereich der Cyberinfrastruktur für die Ocean Observatories Initiative (OOI), ein Milliarden-Dollar-Projekt der NSF/WHOI, das Gleiter, Bojen und Meeresbodenplattformen nutzt, um Ozeandaten zu streamen.
- Sie speichern rund 9 PB an OOI-Daten, wobei das Glasfaser-Backbone über Link Oregon von 200 Gbit/s auf 400 Gbit/s aufgerüstet wurde, was eine Echtzeit-Datenübertragung vom Ozean zum Rechenzentrum ermöglicht.
- Selbst mit Starlink auf dem Schiff und bei Landprojekten (wie dem Eulenprojekt) begrenzen die Satellitenbandbreite und die Kosten, was gesendet werden kann. Deshalb testen sie LoRaWAN und andere Mesh-Netzwerke, um Daten an eine einzige, mit Starlink verbundene Rangerstation zurückzusenden.
25:00 - 27:52
Lehren für Unternehmen: Ihr Rechenzentrum ist jetzt der Edge.
Das Gespräch schließt mit der Übertragung dieser Forschungserkenntnisse auf Unternehmen und der Hervorhebung der Hardware, die Chris von der Messe „stehlen“ würde.
- Kernbotschaft an Unternehmen: Wer seine Daten nicht direkt am Netzwerkrand verarbeitet, verschwendet Zeit und Arbeitskraft mit dem Hin- und Hertransportieren von Rohdaten und verpasst so Echtzeitchancen.
- Edge-KI und Agenten sollten Daten lokal vorverarbeiten, filtern und analysieren, um den menschlichen Aufwand von der Logistik auf höherwertige Aufgaben und Entscheidungsfindung umzuleiten.
- Analoge aus der realen Welt:
- Der Einzelhandel nutzt Edge-Analytics in den Geschäften, um den Kundenverkehr zu verfolgen, Empfehlungen auszusprechen und dynamische Erlebnisse zu bieten, ähnlich wie die Forstwirtschaft Edge-Inferenz einsetzt, um gefährdete Arten zu schützen und gleichzeitig die Holzernte zu ermöglichen.
- Die Fischereibehörden wünschen sich „intelligente Fallen“ und Bojen, damit sie nur dann Boote aussenden, wenn sich tatsächlich Krabben in den Fallen befinden.
- Für Chris ist das ideale Modell ein eigenes Rechenzentrum, das sich zu einem Rand Anlagen, die in die Cloud integriert sind und für große Trainingsläufe und längerfristige Arbeitslasten geeignet sind.
- Sein Lieblingshardware-Produkt der Messe: Dells PowerEdge 7745; er wünscht sich mehr davon für VR-Labore und Feldeinsätze, da sie die richtige Balance zwischen Leistung und Platzbedarf, Flexibilität und Fähigkeiten (Rendering + Inferenz + Edge-Arbeit) bieten.
- Er sieht Systeme wie den 7745 als Vorbild: flexibel genug, um in einem Rechenzentrum oder unter rauen Feldbedingungen eingesetzt zu werden und sowohl traditionelles HPC als auch fortschrittliche KI/Visualisierung am Netzwerkrand zu unterstützen.


 Amazon