

Updated November 12, 2026: The Lenovo ThinkPad T1g Gen 9 and ThinkPad X9-15p Gen 1 Aura Edition join Also Tested with their new-suite results; picks unchanged. On October 29, the Dell XPS 16 Creator Edition joined Also Tested in the RTX Spark section.
Alle hier aufgeführten Laptops wurden im StorageReview-Labor getestet. Wir messen die lokale KI-Leistung direkt: UL Procyon AI Text Generation verwendet dieselben Modelle auf jedem System, das diese unterstützt. Wo die Hardware es zulässt, gehen wir mit LM Studio und Ollama noch einen Schritt weiter. Die Rangliste basiert nicht auf technischen Daten, und jede Empfehlung verlinkt direkt zum entsprechenden Testbericht.
Es gibt zwei Möglichkeiten, KI-Modelle im Jahr 2026 auf einem Laptop auszuführen. Dedizierte NVIDIA RTX PRO GPUs liefern die höchste Token-Rate pro Sekunde, allerdings muss das Modell in den VRAM der Karte passen (8 GB bis 24 GB). Unified- und Shared-Memory-Designs, wie sie beispielsweise von AMDs Ryzen AI Max+ (Strix Halo) und Intels Core Ultra Shared-Memory-Plattformen LPCAMM2 genutzt werden, tauschen höhere Geschwindigkeit gegen mehr Speicherkapazität: Die GPU kann den Großteil des Systemspeichers nutzen, sodass größere Modelle überhaupt darauf zugreifen können. Die folgenden Empfehlungen decken beide Ansätze ab und bieten zusätzlich die effizienteste Lösung mit NPU.
Im Überblick
| Kategorie | System | KI-Engine | Schlüsselergebnis | Full Review |
|---|---|---|---|---|
| Bester Allround-Laptop für lokale KI | Dell Pro Max 18 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 185 tok/s (Phi, Procyon), schnellster Laptop, den wir getestet haben | Pro Max 18 Plus Testbericht |
| Ideal für große Modelle | HP ZBook Ultra G1a 14 | Ryzen AI Max+ PRO 395, bis zu 96 GB zuweisbarer gemeinsamer Speicher | Geladen: DeepSeek-R1 70 B; Gemma 3 27 B bei 9 tok/s | ZBook Ultra G1a Testbericht |
| Beste Balance für 16-Zoll-Modelle | Dell Pro Max 16 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 179 tok/s (Phi) mit 6 Std. 21 Min. Akkulaufzeit | Pro Max 16 Plus Testbericht |
| Bestes Ultraportable | Lenovo ThinkPad P14s Gen 7 | RTX PRO 1000 Blackwell 8GB / 64GB LPCAMM2 | 55 tok/s (Phi) bei 3.59 lb | P14s Gen 7 Testbericht |
| Am besten ohne dedizierte Grafikkarte | Dell Pro Precision 5 14s Intel | Intel Arc Pro B390 iGPU, 64 GB gemeinsam genutzter LPCAMM2 | Bei Modellen mit mehr als 8 GB VRAM betrug die Akkulaufzeit 23 Stunden und 50 Minuten. | Pro Precision 5 14s Testbericht |
| Bestes dünnes und leichtes NPU-System | HP EliteBook 6 G1q | Snapdragon X Plus, 45 TOPS Hexagon NPU, 32 GB | Llama 3.2 3B mit 37 Tok/s im LM Studio | EliteBook 6 G1q Testbericht |
| Bester RTX Spark Laptop | HP OmniBook Ultra 16 | RTX Spark N1X, 20-Kern-CPU / 6,144-Kern-Blackwell-GPU, 128 GB (64 GB für die GPU) | 35B-Codierungsagentenaufgabe in 72.0 s bei 89.5 tok/s abgeschlossen, 3 von 3 Läufen erfolgreich | OmniBook Ultra 16 Testbericht |
| Der kühlste RTX Spark Laptop | Lenovo Yoga 9n 2-in-1 16 | RTX Spark N1X, 20-Kern-CPU / 6,144-Kern-Blackwell-GPU, 64 GB (32 GB für die GPU) | 72 °C Spitzentemperatur bei 30-minütiger Dauerbelastung, im Vergleich zu 98 °C beim HP OmniBook Ultra 16 | Yoga 9n 2-in-1 16 Testbericht |
Die Auswahl
Bester Allround-Laptop für lokale KI: Dell Pro Max 18 Plus
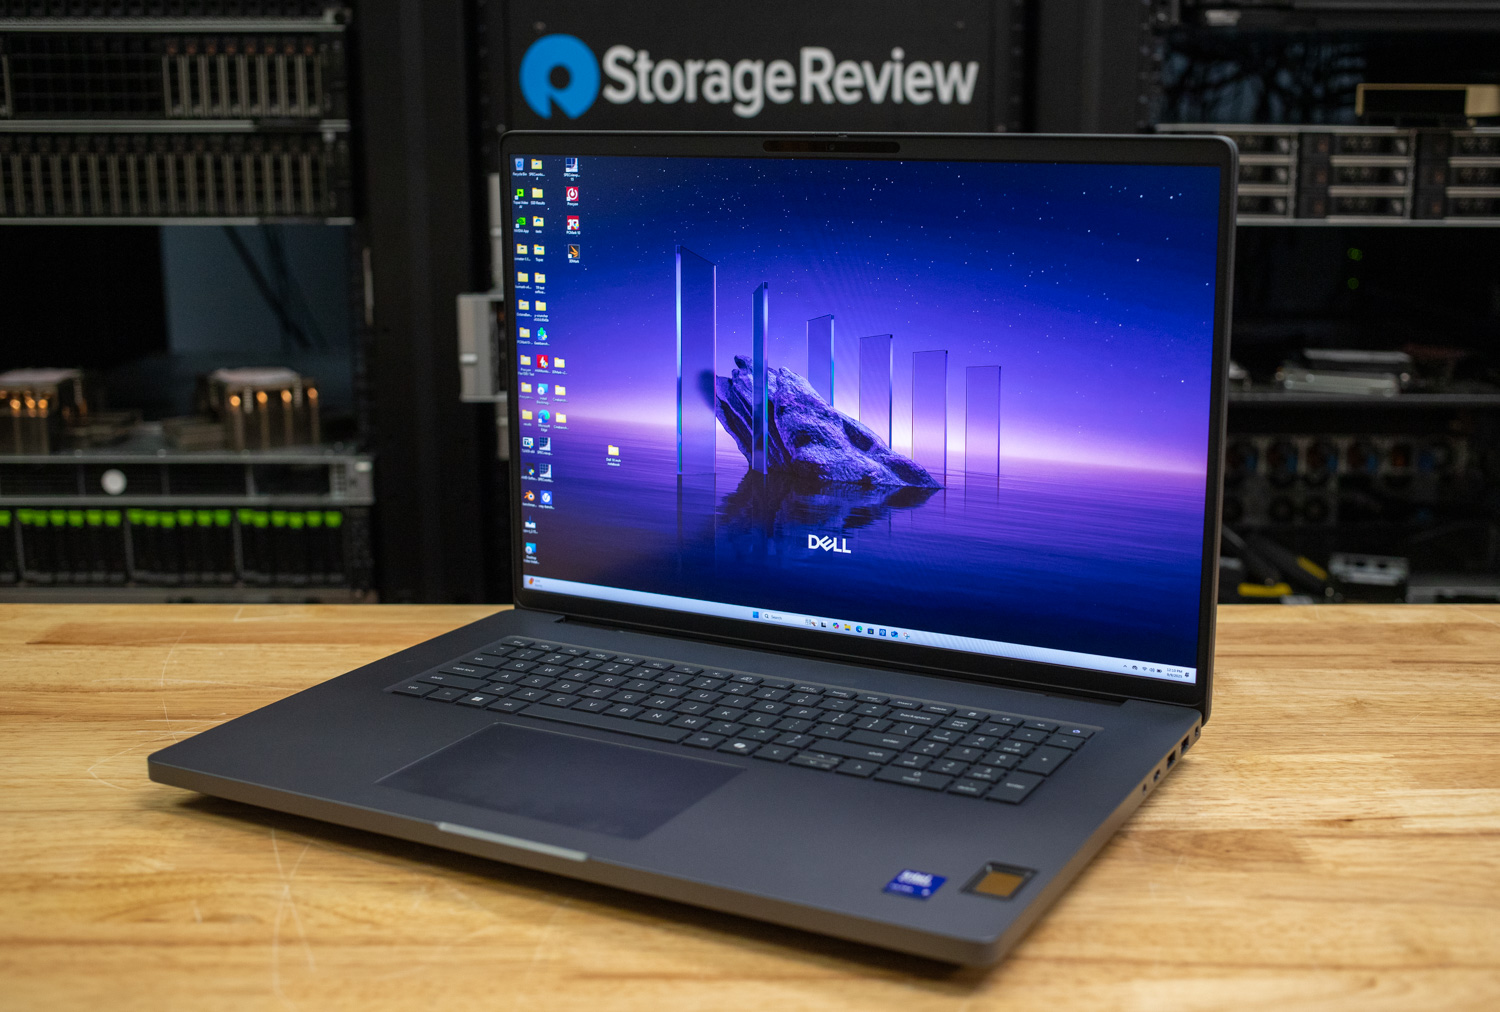
Das Pro Max 18 Plus erzielte im StorageReview-Labor die schnellsten lokalen KI-Ergebnisse aller Laptops. Im UL Procyon AI Text Generation-Test erreichte die RTX PRO 5000 Blackwell (24 GB GDDR7) bei Phi 185.1 Token pro Sekunde, bei Mistral 140.5 und bei Llama 3 119.7. Die Zeit bis zum ersten Token lag bei allen Modellen unter 0.35 Sekunden. Der Core Ultra 9 285HX und 128 GB CAMM2-Speicher sorgen für eine reibungslose Verarbeitung, und die 24 GB VRAM ermöglichen problemlos die Ausführung quantisierter Modelle der 20B-Klasse.
Die Kompromisse entsprechen genau den Erwartungen, die das Gehäuse weckt: 7.17 kg und eine gemessene Akkulaufzeit von 3 Stunden und 39 Minuten – die kürzeste Laufzeit aller Laptops in unserem Testfeld. Es handelt sich um ein Desktop-Gerät, das sich zusammenklappen lässt. Zum Testzeitpunkt kostete es 9,245 US-Dollar. Wenn es ausschließlich auf die Geschwindigkeit lokaler Inferenz ankommt, ist dies die Antwort.
Testbericht: Dell Pro Max 18 Plus: Leistung der Blackwell RTX PRO 5000 für unterwegs
Ideal für große Modelle: HP ZBook Ultra G1a 14
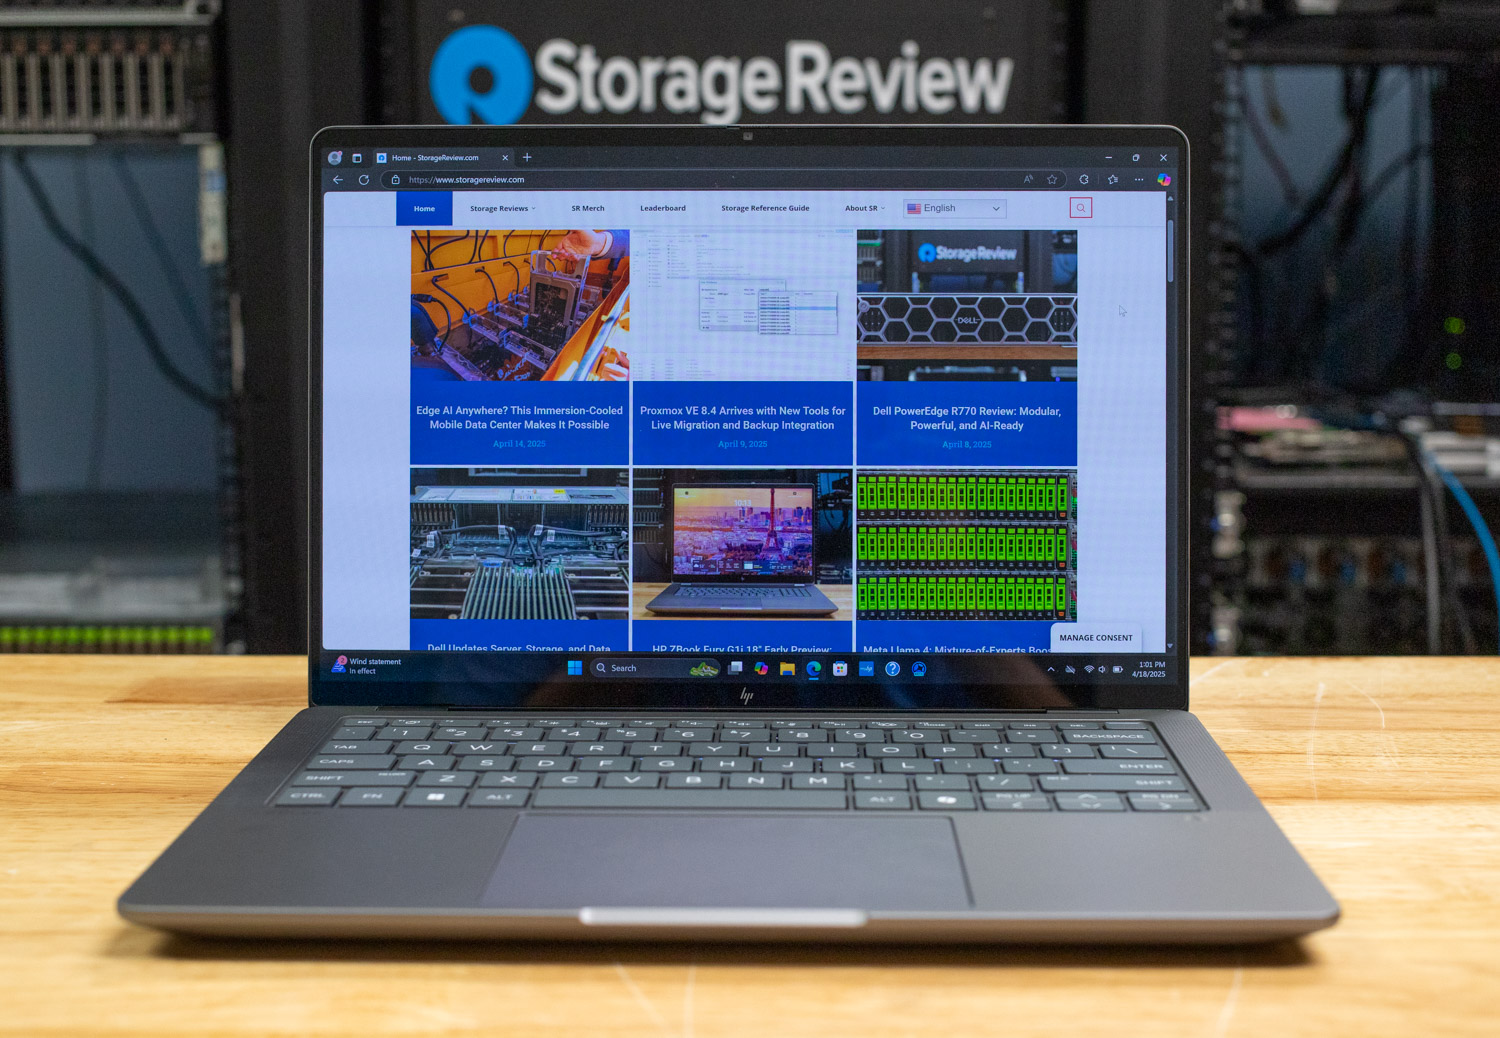
Geschwindigkeit ist die eine Achse, Kapazität die andere. Das ZBook Ultra G1a kombiniert AMDs Ryzen AI Max+ PRO 395 mit 128 GB LPDDR5X-Speicher, von dem bis zu 96 GB der Radeon 8060S GPU zugewiesen werden können. Mit diesem Speicherpool konnten wir Modelle laden, die kein Laptop mit dedizierter GPU erreichen kann: DeepSeek-R1 70B und QwQ 32B liefen beide lokal in LM Studio und Ollama, und Gemma 3 27B generierte 8.96 Token pro Sekunde mit einer Verarbeitungsgeschwindigkeit von 73 Token pro Sekunde.
Seine Procyon-Leistung bleibt hinter der aller RTX PRO-Geräte zurück (Phi mit 65 Tokens pro Sekunde), daher ist es nicht die beste Wahl für schnelle Chats auf kleinen Geräten. Es ist die richtige Wahl, wenn das Design an sich im Vordergrund steht, und das tut es mit einem Gewicht von nur 3.3 kg und einer Akkulaufzeit von 10 Stunden und 35 Minuten. Es bietet die gleiche einheitliche Speicherarchitektur wie AMDs Strix Halo auf dem Desktop-PC, nur eben in einem 14-Zoll-Gehäuse.
Testbericht: HP ZBook Ultra G1a 14
Am Horizont: HP ZBook Ultra G3a 16
Der oben genannte Testsieger unter den großen Modellen könnte bald von seinem Nachfolger abgelöst werden. Das ZBook Ultra G3a 16 bietet 192 GB LPDDR5X-8533 Arbeitsspeicher, von denen bis zu 160 GB der GPU zugewiesen werden können (das G1a 14 kommt auf maximal 128 GB bzw. 96 GB), einen Ryzen AI Max+ PRO 495 Prozessor und ein überarbeitetes Kühlsystem, das eine TDP von 100 W ermöglicht, während das G1a nur 55 W bot. Die Speicherkapazität sicherte dem G1a seinen Platz, der Stromverbrauch hingegen begrenzte seine Leistung; das G3a verbessert beides gleichzeitig.
HP hat im Oktober die US-Bestellungen für das G3a eröffnet, mit Konfigurationen ab 3,149 US-Dollar. Das G3a wird in die Rangliste aufgenommen, sobald die vollständigen Testläufe von Procyon und LM Studio abgeschlossen sind. Unser erster Eindruck umfasste die Hardware eines Vorserienmodells; Leistungstests waren nicht möglich. Der vollständige Testbericht folgt, sobald ein Serienmodell im Labor eintrifft.
Bestes 16-Zoll-Balance-Modell: Dell Pro Max 16 Plus
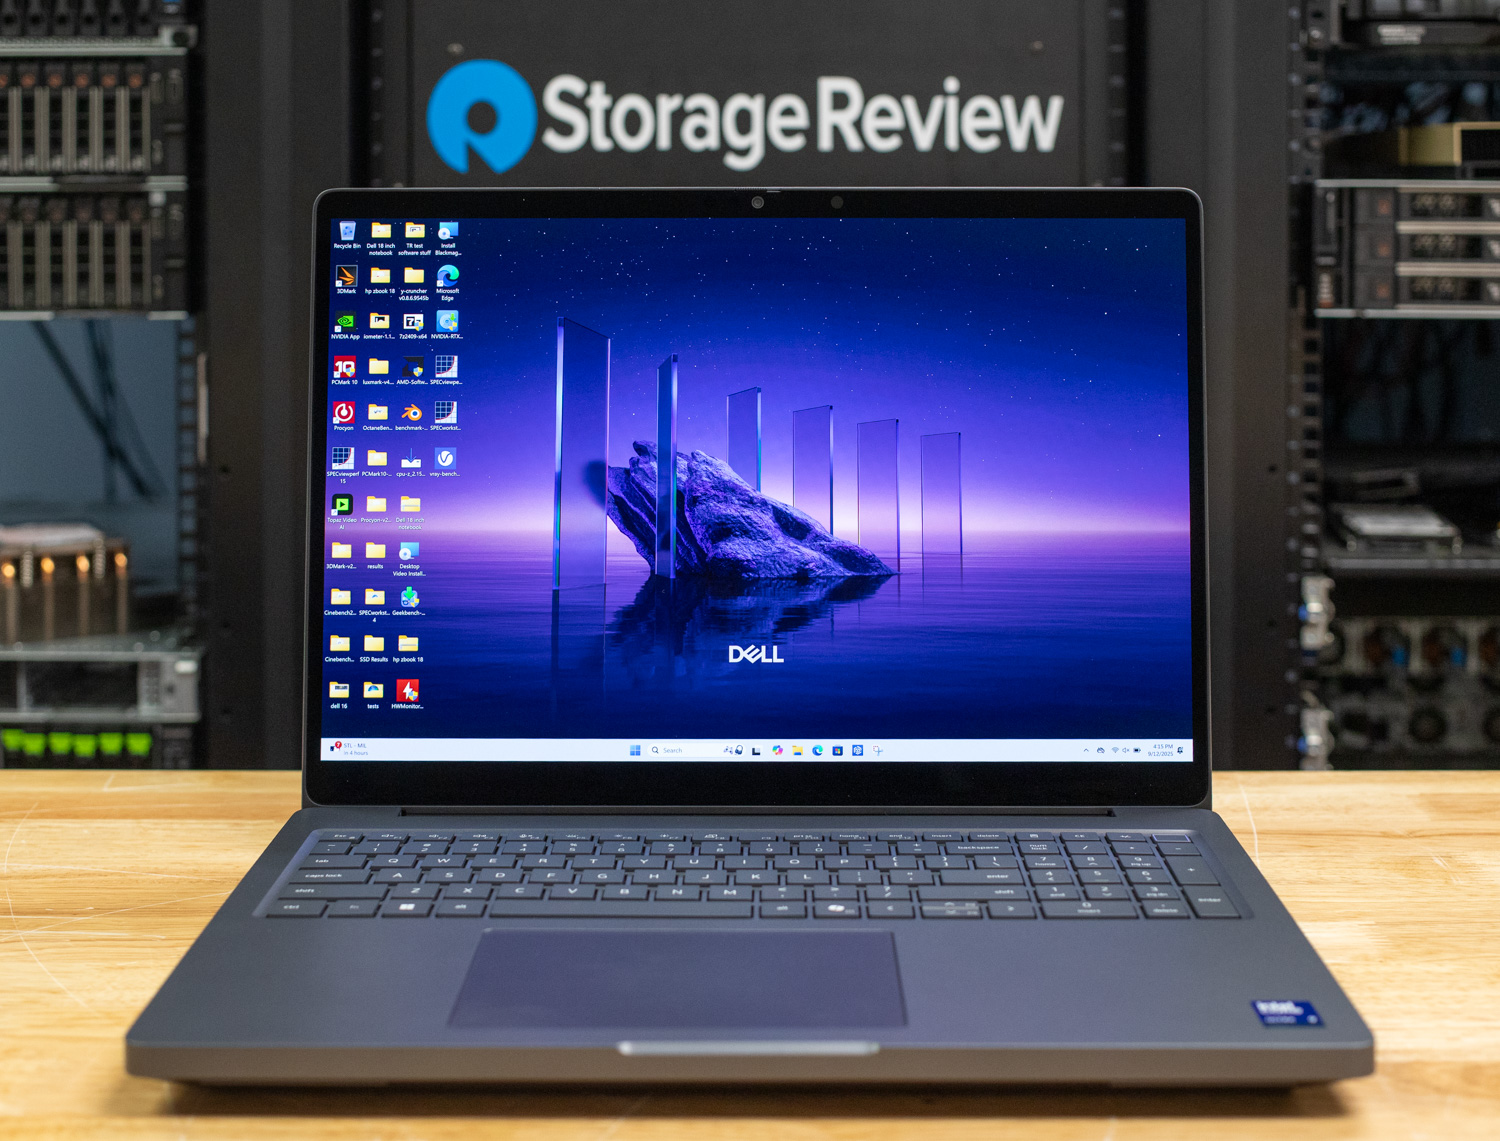
Das Pro Max 16 Plus ist mit derselben RTX PRO 5000 Blackwell 24GB wie das 18 Plus ausgestattet und steht dem in puncto Leistung kaum nach: Phi erreicht 178.6 Token pro Sekunde, Mistral 134.2 und Llama 3 114.7 – das entspricht etwa 96 Prozent der Leistung des Flaggschiffs. Dafür wiegt es nur 2,55 kg (5.63 Pfund) statt 3,25 kg (7.17 Pfund) und bietet mit 6 Stunden und 21 Minuten fast die doppelte Akkulaufzeit.
Für die meisten Anwender, die Wert auf professionelle lokale Inferenz legen, ist dieses Gerät die bessere Wahl. Es belegt zudem den ersten Platz in unserer Rangliste der besten mobilen Workstations , sodass die hohe KI-Geschwindigkeit bereits mit dem kompletten, validierten Anwendungsportfolio für professionelle Anwendungen einhergeht.
Testbericht: Dell Pro Max 16 Plus – Gebaut für lange Arbeitstage und anspruchsvolle Aufgaben
Bestes Ultraportable: Lenovo ThinkPad P14s Gen 7
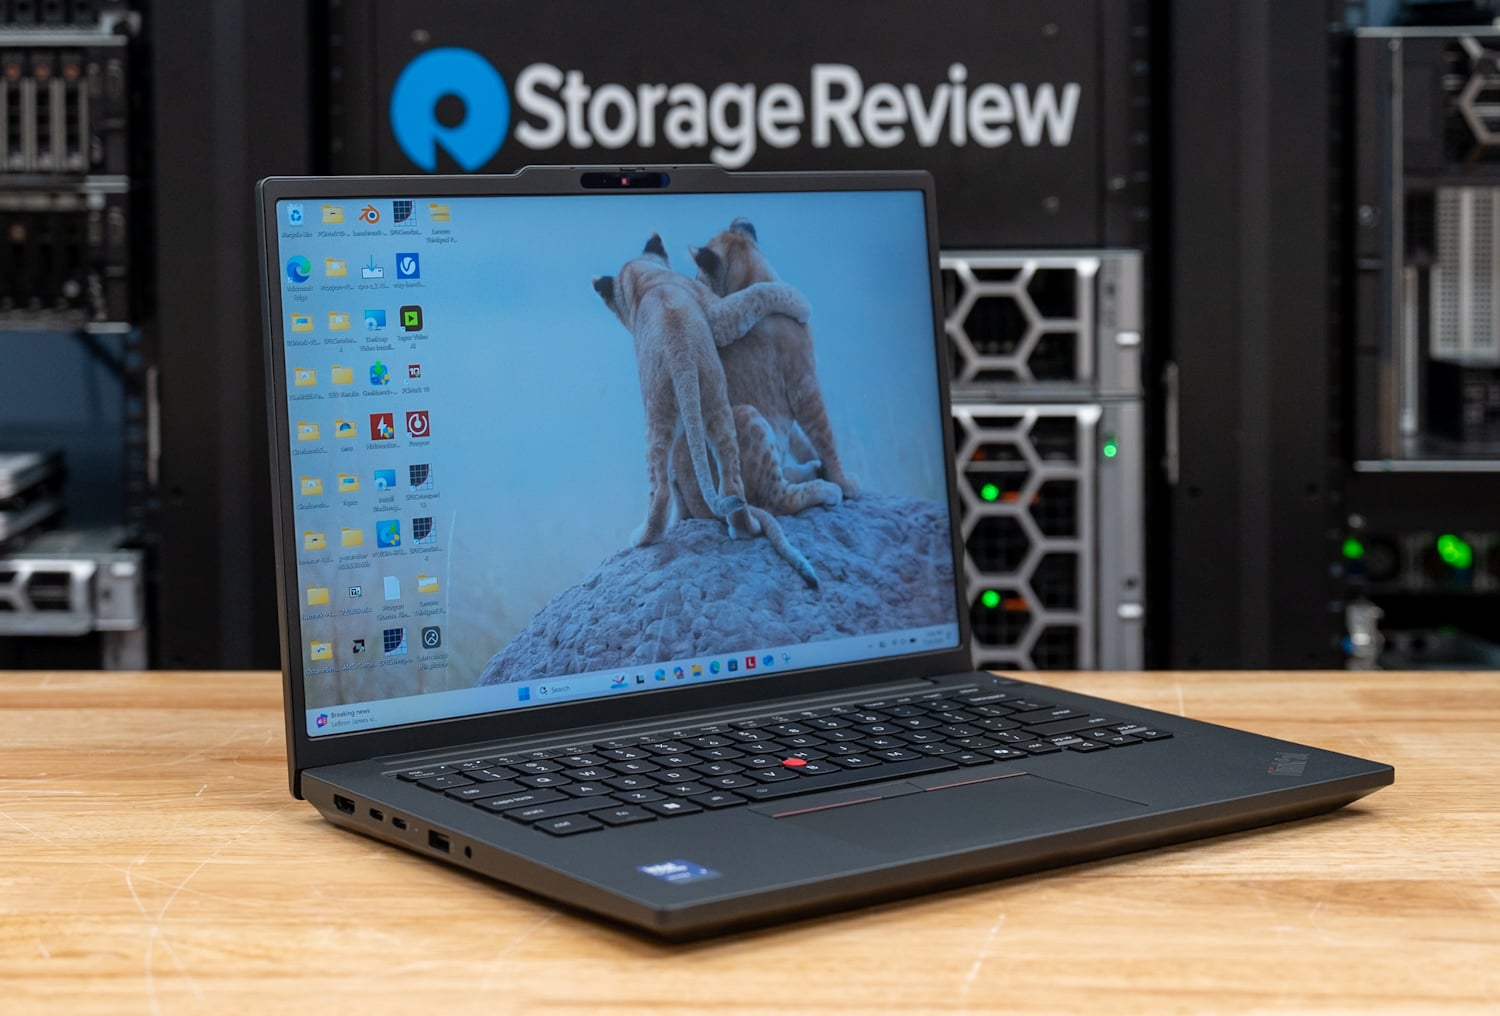
Mit nur 3.59 kg ist das P14s Gen 7 das leichteste Notebook mit dedizierter Blackwell-GPU. Die RTX PRO 1000 (8 GB GDDR7) erreichte in Phi 55.1 Token pro Sekunde und in Mistral 40.3 – beeindruckende Werte für ein Notebook der 7B-Klasse. Dank der 50 TOPS NPU von Panther Lake eignet es sich auch hervorragend für Copilot+. Die Akkulaufzeit von 15 Stunden und 52 Minuten sorgt dafür, dass die KI-Funktionen Ihren Arbeitstag nicht beeinträchtigen.
Informieren Sie sich vor dem Kauf über die maximale Speicherkapazität: Unser Test des Llama 2 13B wurde nicht abgeschlossen, da dieses Modell über den Procyon-Pfad etwa 12 GB Grafikspeicher benötigt, die GPU aber nur 8 GB hat. Für quantisierte Modelle mit 7 Byte und weniger ist dies ein hervorragendes Angebot; für leistungsstärkere Modelle schauen Sie bitte auf der nächsten Seite nach.
Testbericht: Lenovo ThinkPad P14s Gen 7
Bestes Modell ohne dedizierte Grafikkarte: Dell Pro Precision 5 14s Intel
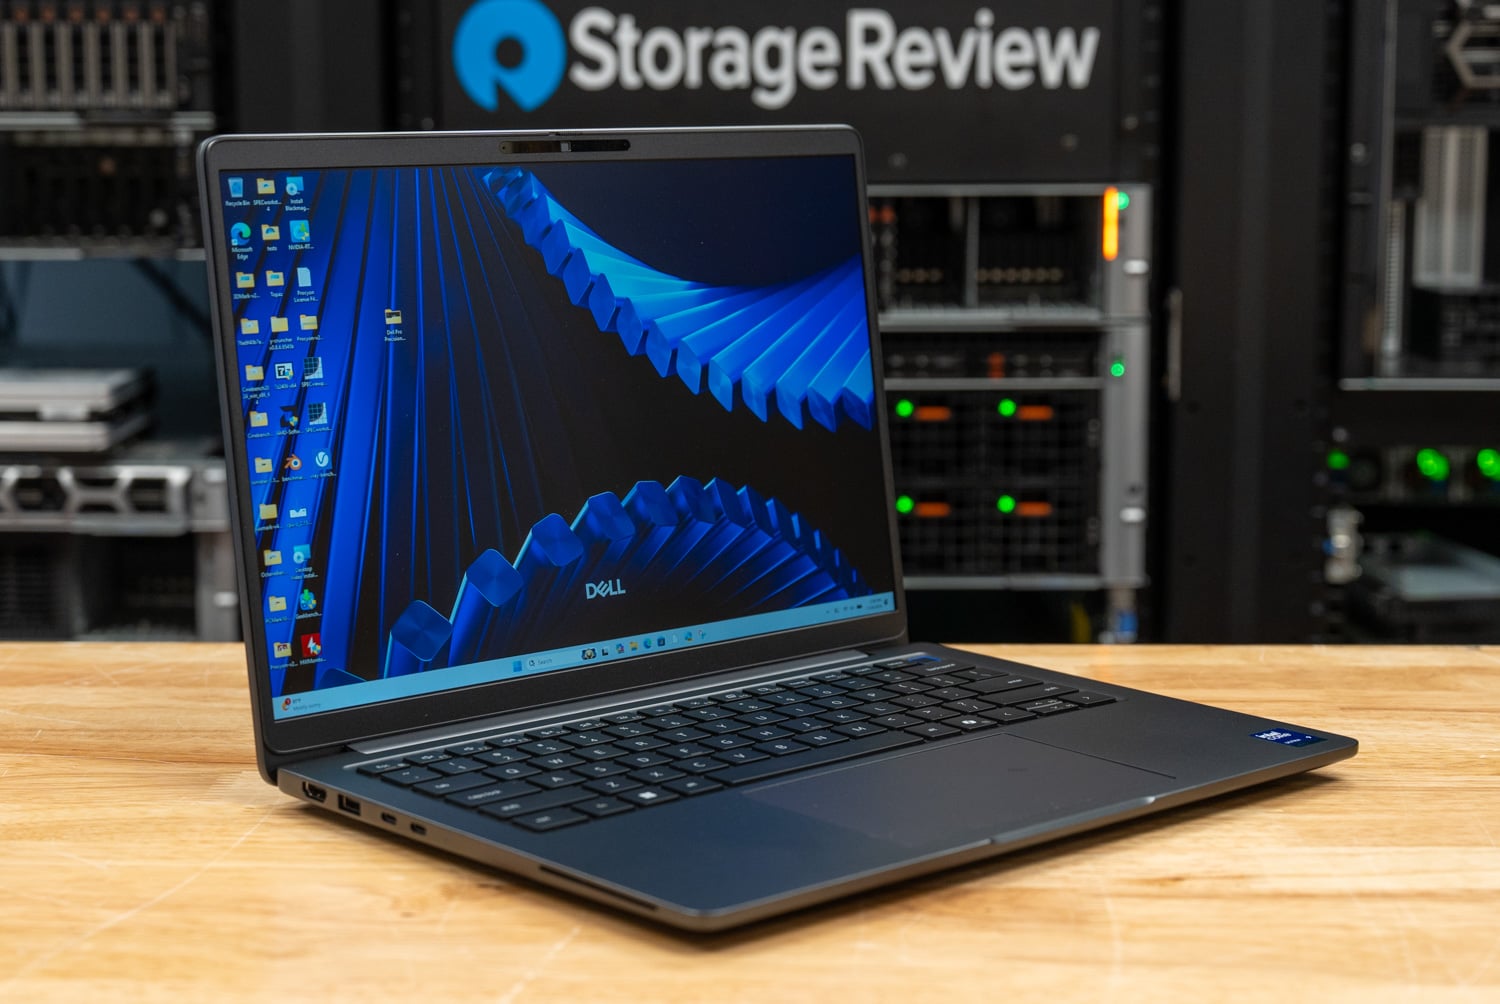
Eine dedizierte GPU ist im Rahmen des Zumutbaren kein Problem: Das Intel Pro Precision 5 14s kombiniert den Core Ultra X9 388H (50 TOPS NPU) mit der integrierten Intel Arc Pro B390-Grafik und nutzt einen 64 GB großen LPCAMM2-Shared-Memory-Pool. In unseren Tests bewältigte dieser Pool größere lokale KI-Workloads, als dedizierte Grafikkarten mit 8 GB VRAM bewältigen konnten. So wurde die komplette Procyon AI Text Generation Suite erfolgreich abgeschlossen (887 Punkte bei Phi und 786 Punkte bei Llama 2), während Systeme mit begrenztem VRAM fehlschlugen.
Die Grafikleistung ist im Vergleich zu RTX PRO-Chips eher moderat, daher eignet sie sich eher für Hintergrundprozesse als für rechenintensive interaktive Anwendungen. Die übrigen Eigenschaften sind bemerkenswert: 3.12 kg und eine gemessene Akkulaufzeit von 23 Stunden und 50 Minuten – die zweitlängste in unserem gesamten Datensatz. Sie belegt außerdem den ersten Platz in unserer Liste der besten mobilen Workstations.
Testbericht: Dell Pro Precision 5 14s Intel-Testbericht
Bestes dünnes und leichtes NPU-System: HP EliteBook 6 G1q
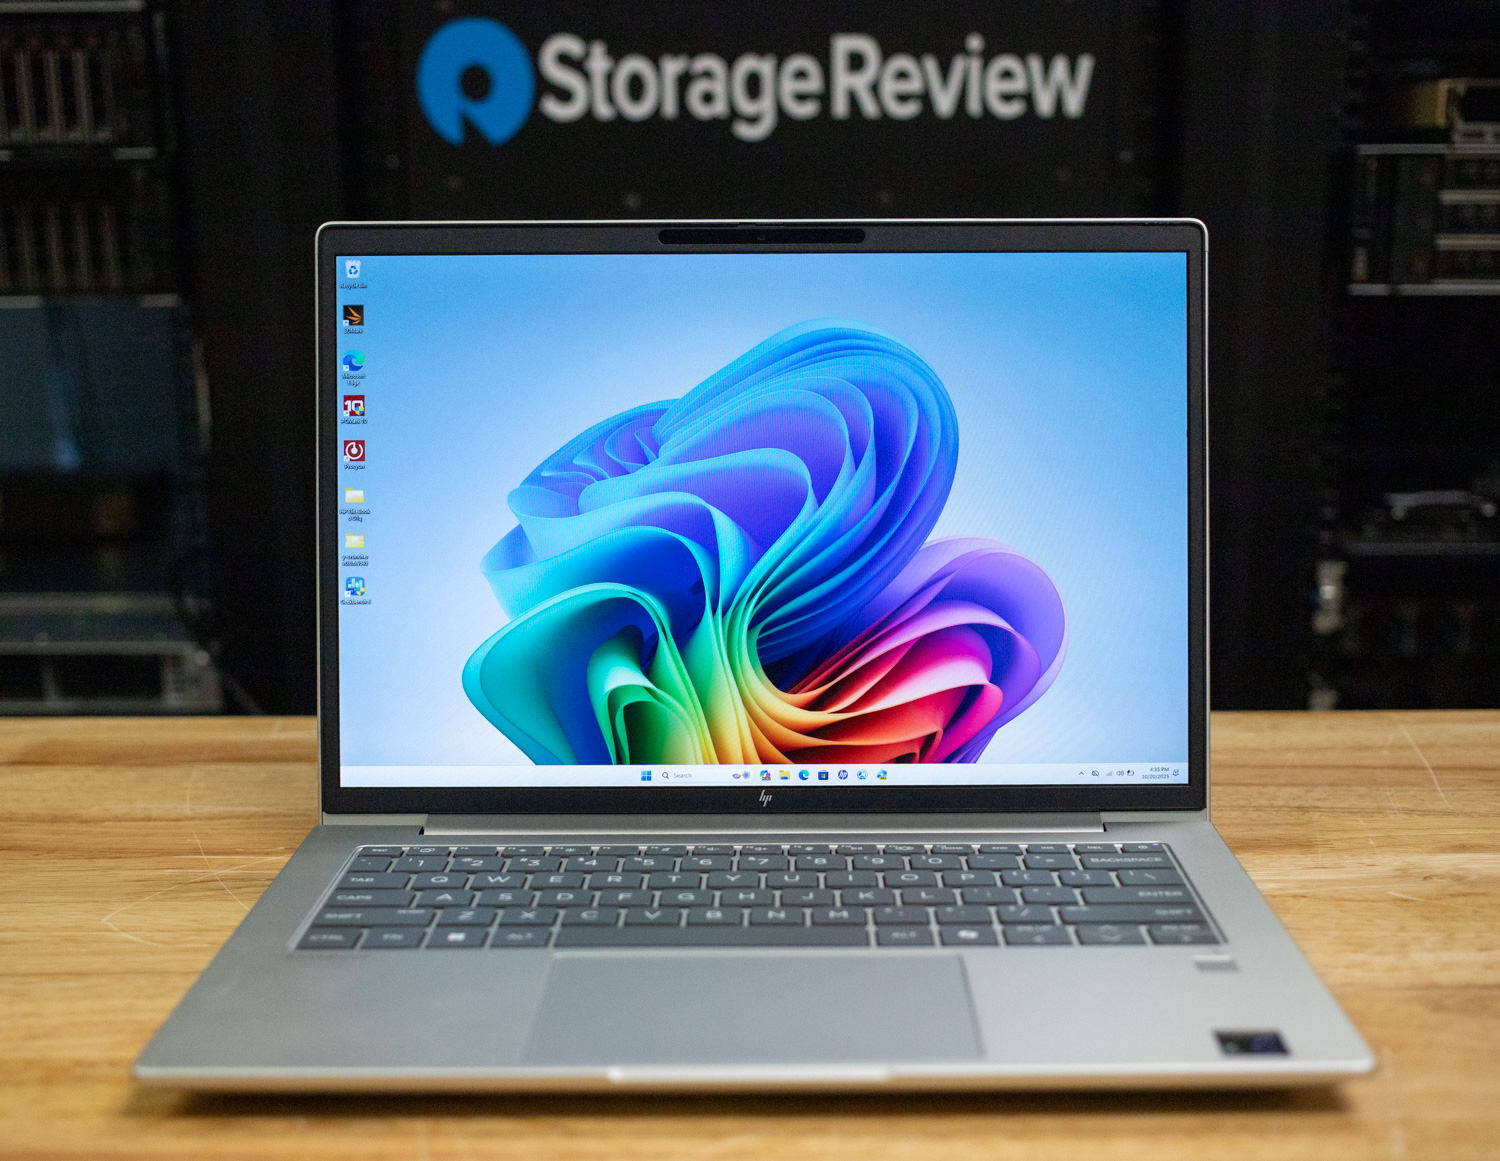
Das EliteBook 6 G1q beantwortet eine andere Frage: Wie klein muss die Hardware sein, um KI direkt auf dem Gerät effektiv nutzen zu können? Sein Snapdragon X Plus mit einer 45 TOPS Hexagon NPU erreichte in LM Studio bei Llama 3.2 3B 36.7 Token pro Sekunde und bei Gemma 3 4B 29.3 Token pro Sekunde. Die 1B-Modelle erzielten sogar über 62 Token pro Sekunde. Das sind nutzbare Chat-Geschwindigkeiten für ein nur 3.17 kg leichtes Gerät mit einer Akkulaufzeit von 19 Stunden und 35 Minuten.
Die Leistungsgrenze ist niedrig; das größte von uns getestete Modell hatte 4 Milliarden Parameter. Daher eignet es sich vor allem für lokale Chats, Zusammenfassungen und Offline-Assistenten; rechenintensive Modelle sind nicht realisierbar. Mit rund 3,100 US-Dollar in der Testkonfiguration war es zudem das günstigste System auf dieser Seite.
Testbericht: HP EliteBook 6 G1q – Leistung für den ganzen Tag in einem leichten Laptop
RTX Spark Laptops: Getestet auf unserer neuen Client-Suite
NVIDIAs RTX Spark N1X bringt den GB10-Superchip aus der DGX Spark in Windows-Laptops. Ein gemeinsamer LPDDR5X-Speicherpool wird von einer Grace-CPU und einer Blackwell-GPU genutzt. Die Laptops sind in zwei Varianten mit einer TDP von 45 bis 80 Watt erhältlich: eine 20-Kern-CPU mit einer 6,144-Kern-GPU und eine 18-Kern-CPU mit einer 5,120-Kern-GPU. Wir testen diese Systeme mit sr-client 1.2, unserer neuen, Arm64-nativen Client-Suite. Daher stimmen die Testergebnisse nicht direkt mit den Procyon-Werten der oben genannten Systeme überein. Alle Details zur Plattform finden Sie in unserem Artikel zum RTX-Spark-Launch.
Der Arbeitsspeicher bestimmt, welche Modelle in jeder Konfiguration ausgeführt werden können. Eine Firmware-Einstellung teilt den Speicherpool zwischen Windows und der GPU auf. Unsere kleinste lokale KI-Modellebene benötigt mindestens 16 GB GPU-Speicher. Daher kann ein System mit 32 GB Arbeitsspeicher, bei dem 12 GB für die GPU reserviert sind, das 12.8 GB große gpt-oss:20b-Modell nicht laden.
Bester RTX Spark Laptop: HP OmniBook Ultra 16
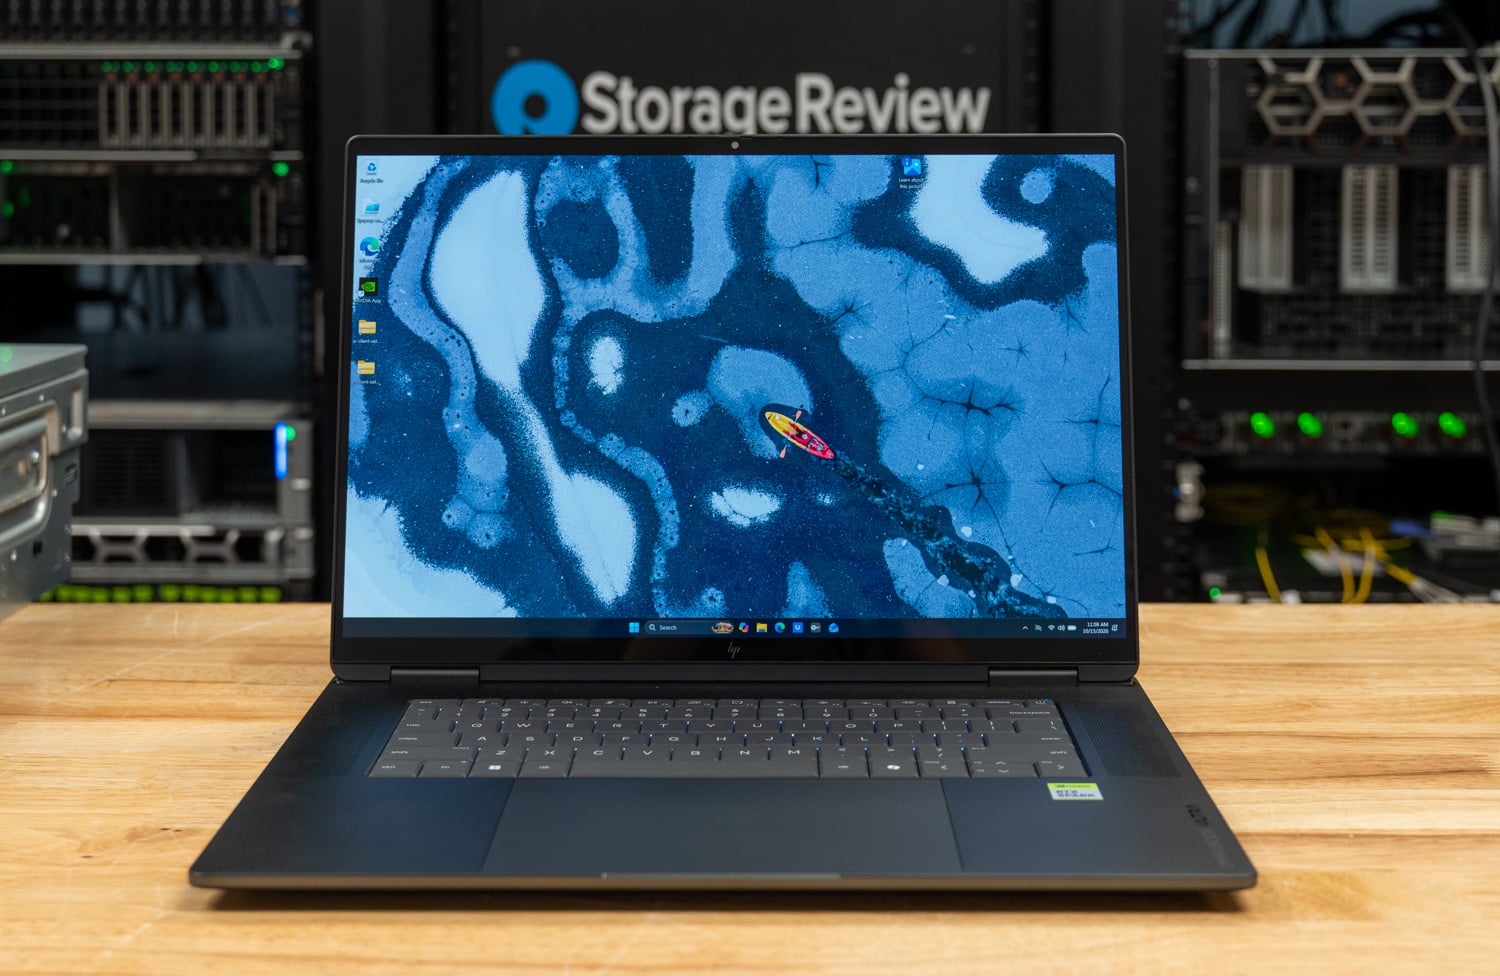
Das OmniBook Ultra 16 mit 128 GB ist das leistungsstärkste RTX-Spark-Notebook, das wir bisher getestet haben. Mit 62.5 GB nutzbarem GPU-Speicher führt es beide Stufen unseres lokalen KI-Modells aus und generiert dabei 58.0 Token pro Sekunde für gpt-oss:20b und 89.5 Token pro Sekunde für Qwen3.6-35B-A3B. Es bestand alle neun Coding-Agent-Testläufe und schloss die Qwen3.6-Aufgabe in 72.0 Sekunden ab – die schnellste Leistung in seiner Gruppe. Den OpenBLAS-Solve-Test mit allen Kernen absolvierte es bei 98 °C; dieser Test führte zum Ausfall zweier Surface Laptop Ultra-Geräte.
Mit 7,004 Punkten im Cinebench 2026 Multi-Core-Test erzielte das OmniBook das beste CPU-Ergebnis im Vergleich und lag 35 Prozent vor dem Razer Blade 16. Die RTX 5090 des Blade generiert Tokens auf Modellen mit 24 GB Arbeitsspeicher weiterhin 2.3-mal schneller, und der Browser des OmniBook verlangsamte sich um das 1.73-Fache, während der Codierungsagent auf der gemeinsam genutzten GPU lief. Das von uns getestete Modell mit 128 GB Arbeitsspeicher und 2 TB Speicher ist ausschließlich über HP.com erhältlich und kostet dort laut HP (Stand: 14. Oktober) 6,229.99 US-Dollar. Das 32-GB-Modell für 3,199.99 US-Dollar bietet die gleiche CPU-Geschwindigkeit, kann aber unsere Modelltests nicht durchführen; die Ergebnisse zum Akku stehen noch aus.
Testbericht: HP OmniBook Ultra 16 im Test: RTX Spark mit 128 GB Speicher erzielt Bestnote in unserem lokalen Coding-Agent-Test
Der kühlste RTX Spark Laptop: Lenovo Yoga 9n 2-in-1 16
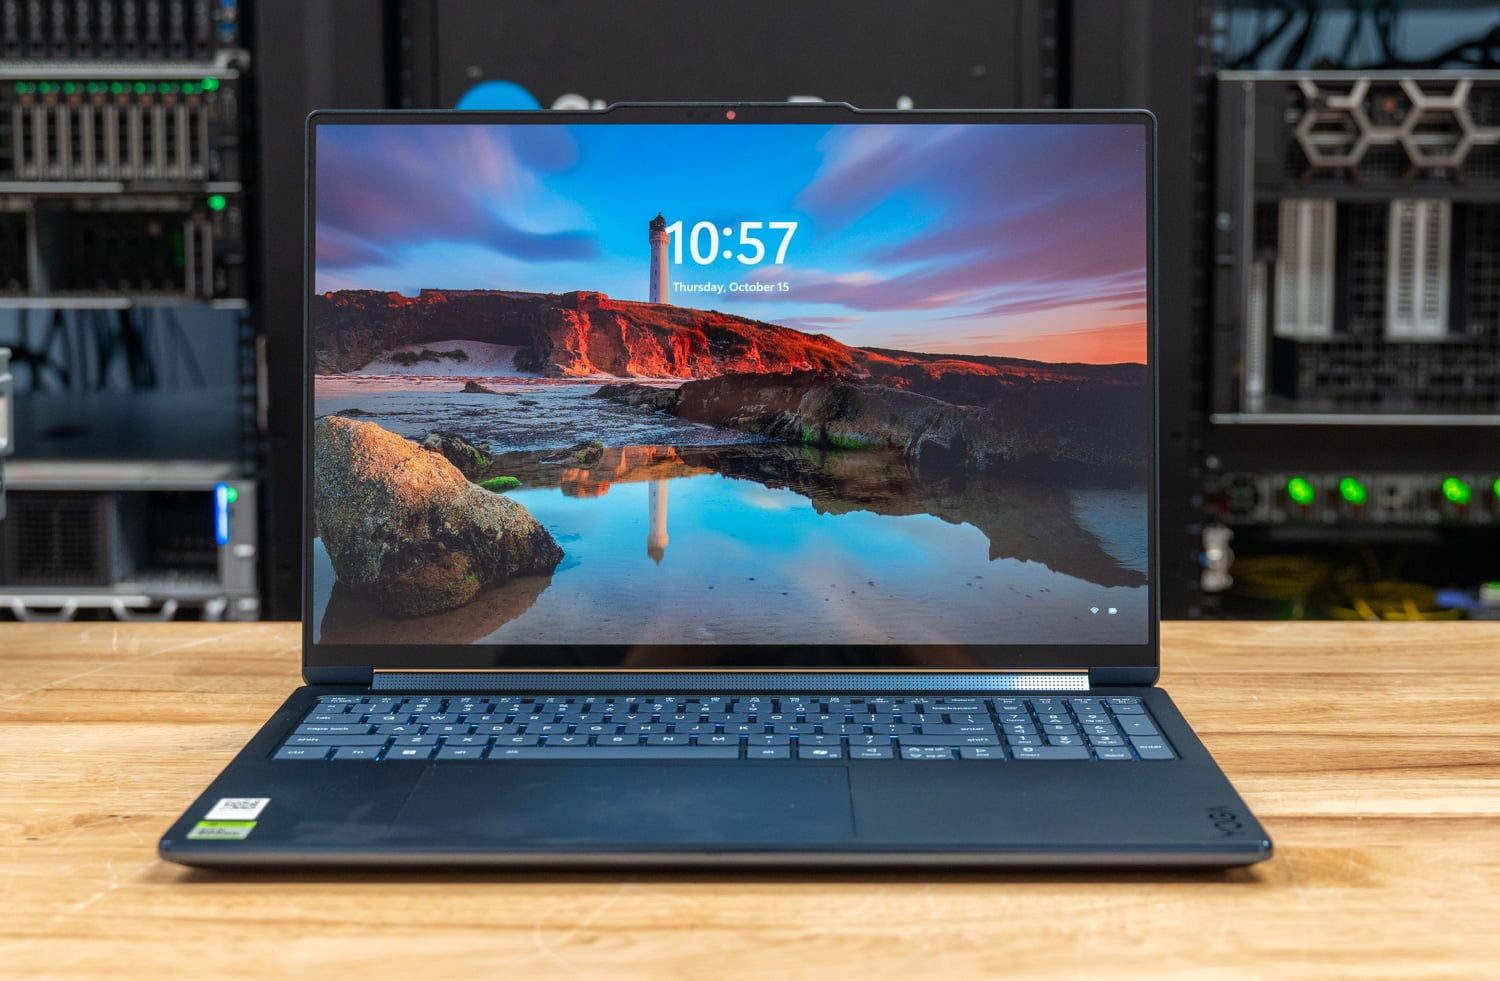
Das Yoga 9n 2-in-1 16 lief mit dem N1X-Prozessor kühler als jedes andere von uns getestete Notebook mit RTX Spark. In unserem 30-minütigen Dauertest erreichte die CPU eine maximale Temperatur von 72 °C und taktete mit 3,015 MHz. Sie beendete den Test mit 100.1 % ihrer ursprünglichen Leistung. Das HP OmniBook Ultra 16 und das Surface Laptop Ultra lagen bei 98 °C, das Lenovo Pro 9n 15 bei maximal 92 °C. Alle Werte wurden über die Windows-Temperaturzonen gemessen, dem einzigen CPU-Sensor dieser Systeme. Lenovo führt dies auf vergrößerte Lüftungsschlitze, einen erhöhten Wärmeleitkegel und ein Scharnier zurück, das hinter den Lüftungsschlitzen für eine bessere Luftzirkulation sorgt.
Die optimierte Kühlung des Yoga kostet im Vergleich zum HP etwas Leistung auf allen Kernen. Die Ergebnisse im Multithreading liegen in den meisten Tests 4 bis 10 Prozent hinter dem OmniBook zurück, und der Codierungsagent verlangsamte den Browser auf dem Yoga um das 2.44-Fache gegenüber dem 1.73-Fachen auf dem HP. Dank des 64-GB-Speichers stehen der GPU 32 GB zur Verfügung, was für gpt-oss:20b mit 58.0 Token pro Sekunde ausreicht, aber unter unserem 35B-Kriterium liegt. Für ein 16-Zoll-Convertible, das häufig als Tablet oder auf dem Schoß genutzt wird, ist dieser Kompromiss nachvollziehbar. Der Testpreis lag bei 3,749.99 US-Dollar, die Akku-Testergebnisse stehen noch aus.
Testbericht: Lenovo Yoga 9n 2-in-1 16 – Das kühlste RTX Spark Notebook
Ebenfalls auf der neuen Suite getestet:
- Dell XPS 16 Creator EditionDer 20-Kern-Prozessor N1X mit 64 GB Arbeitsspeicher und 32 GB GPU-Speicher erreichte im MLPerf Client eine Leistung von 55.7 Token pro Sekunde bei Llama 3.1 8B, 58.5 Token pro Sekunde beim gpt-oss:20b-Codierungsagenten und 31.9 Token pro Sekunde bei Qwen 3.8 27B für acht Benutzer. Die Ergebnisse lagen damit innerhalb von 2 bis 8 Prozent des Wertes des 128-GB-OmniBook bei lokaler KI. Der Prozessor hielt die volle Taktfrequenz bei 98 °C ohne Drosselung, erzielte die besten Ergebnisse hinsichtlich Single-Core- und Speicherbandbreite der RTX-Spark-Gruppe und ist am einfachsten zu warten. Dank seines GPU-Budgets von 30.5 GB gehört er nicht zur 35B-Agent-Klasse. Dell bietet dieses System für 4,799.99 US-Dollar an.
- Lenovo Pro 9n 15Der 18-Kern-Prozessor N1X mit 32 GB Arbeitsspeicher ist in einem 3.64 kg leichten Gehäuse verbaut. Llama 3.1 8B erreichte im MLPerf Client 55.1 Token pro Sekunde und lag damit nur 2 Prozent unter dem Wert eines 20-Kern-Prozessors N1X mit derselben 12-GB-GPU-Aufteilung. Dank des höheren All-Core-Takts blieb er beim Rendern und Kompilieren innerhalb von 8 bis 11 Prozent des Wertes des 20-Kern-Modells und erreichte dabei eine maximale Temperatur von 93 °C. Mit 12 GB GPU-Speicher konnte er in unseren Modell- und Codierungsagententests nicht berücksichtigt werden. Daher sollten KI-Nutzer in der Region mehr Arbeitsspeicher konfigurieren. Lenovo bietet das Modell mit 18 Kernen, 32 GB RAM und 512 GB Speicher ab 2,999.99 US-Dollar an.
- Microsoft Surface Laptop Ultra für Unternehmen (Im Test): Die 128-GB-Einheit generierte gpt-oss:20b und Qwen3.6-35B-A3B mit 58 bis 89 Token pro Sekunde und erzielte 6,963 Punkte im Cinebench 2026 Multi-Core-Test. Die Ergebnisse sind nur im Test sichtbar, da zwei Einheiten unter unserer OpenBLAS-Volllast ausfielen.
Die Akkulaufzeitergebnisse für jedes RTX Spark-System erwarten Sie in unserem neuen plattformübergreifenden Akkutest.
Ebenfalls getestet
Diese Systeme durchliefen den gleichen Laborprozess und sind für den richtigen Käufer einen Blick wert, auch wenn sie heute keinen festen Platz in ihrer Kategorie haben.
- Lenovo ThinkPad P16 der 3. Generation: die dritte RTX PRO 5000 Maschine in der Flotte (Phi bei 141.2 tok/s); unser Gerät wurde mit 32 GB RAM ausgeliefert, was den Rest der Workflow-Geschichte bremste.
- HP ZBook Fury G1i 18: gleiche 24GB Blackwell GPU-Klasse wie das Pro Max 18 Plus, einen Schritt zurück in der Durchsatzleistung (Phi bei 157.4 tok/s) und 11,687 US-Dollar in der getesteten Version.
- Dell Pro Precision 7 16 IntelDie RTX PRO 3000 Blackwell mit 12 GB VRAM liefert das stärkste Ergebnis einer Mittelklasse-GPU in diesem Bereich (Procyon-Textgenerierungs-Score von 2,244 auf Phi via DirectML); ihre 12 GB eröffnen die 14B-Klasse, die 8-GB-Karten nicht erreichen können.
- Lenovo ThinkPad P1 der 8. Generation: RTX PRO 2000 8GB in einem 4.06 Pfund schweren Gehäuse mit 12 Stunden 59 Minuten Akkulaufzeit; Phi bei 77.3 tok/s.
- Lenovo ThinkPad P1 der 9. GenerationIm Test mit unserer neuen Client-Suite erreichte die 50-Watt-RTX PRO 2000 im MLPerf Client 64.8 Token pro Sekunde bei Llama 3.1 8B – die schnellste RTX PRO 2000, die wir je getestet haben, und lag damit vor der RTX Spark HP OmniBook Ultra 16 mit 56.5 Token pro Sekunde bei diesem Modell; die 8-GB-Karte konnte unsere 20B- und höheren Modellstufen nicht laden.
- Lenovo ThinkPad T1g Gen 9: tested on our new client suite, its 12GB GeForce RTX 5070 generated Llama 3.1 8B at 66.2 tokens per second in MLPerf Client and served the Ministral 3 8B model that the P1 Gen 9’s 8GB card could not load. At 11.7GB usable it sits under the 16GB floor for our 20B-and-up model tiers. It holds Best Business Laptop with Discrete Graphics on our Die besten Business-Laptops Bestenliste.
- Lenovo ThinkPad X9-15p Gen 1 Aura Edition: tested on our new client suite, its Arc B390 with 18.1GB of usable shared memory completed our gpt-oss:20b coding agent test in 3 of 3 runs with 11 of 11 tests passing. Its token rates are roughly half those of the NVIDIA systems or lower, and the soldered 32GB configuration cannot reach our 27B and 35B tiers, so local AI buyers should order the 64GB option. It listed at $2,629 as tested at review time.
- Dell Pro Max 14 Premium: RTX PRO 2000 8GB bei 3.55 Pfund; Phi bei 54.1 tok/s.
- Dell Pro Max 16 (Ryzen): RTX PRO 1000 8GB mit einer Akkulaufzeit von 16 Stunden und 2 Minuten; Phi bei 61.9 tok/s.
- Lenovo ThinkPad P14s Gen 6: RTX PRO 500 6GB; Einstiegs-Blackwell AI mit 45.7 tok/s auf Phi.
- Dell Pro Precision 5 16s Intel: das 16-Zoll-Pendant unseres No-dGPU-Favoriten auf der gleichen Shared-Memory-Plattform, mit der längsten Workstation-Akkulaufzeit, die wir je gemessen haben: 24 Stunden 43 Minuten.
- Dell Pro Precision 5 14s AMD: 60 TOPS NPU und ein 64 GB großer gemeinsam genutzter Speicherpool; der Procyon INT8-Image-Pfad von AMD war zum Testzeitpunkt noch nicht verfügbar, was einen Vergleich einschränkt. Dell Pro Precision 5 16s AMD Bringt den gleichen Ryzen AI 9 HX PRO 475 und 60 TOPS NPU in ein 16-Zoll-Gehäuse und erzielte in unseren Tests den stärksten lokalen LLM-Durchsatz der Pro Precision-Reihe, deutlich vor seinem Intel-Geschwistermodell sowohl bei Llama3 als auch bei Llama2, was es zur ersten Wahl dieser Familie für lokale Inferenzarbeiten macht.
- HP EliteBook X G1a: Ryzen AI 9 HX 375 mit einer 55 TOPS NPU; wir haben unsere LLM-Suite noch nicht darauf ausgeführt.
Wie wir rangieren
UL Procyon AI Text Generation dient uns als plattformübergreifender Vergleichsmaßstab: Wir verwenden dieselben vier Modelle (Phi, Mistral, Llama 3 und Llama 2, sofern kompatibel) auf jedem Laptop, der sie unterstützt. Dadurch sind die Werte für Token pro Sekunde direkt vergleichbar. Bei leistungsstärkeren Modellen gehen wir mit LM Studio und Ollama noch einen Schritt weiter. Jeder Laptop wird pro Messkriterium einmal bewertet, und ein System erscheint nur dann auf dieser Seite, wenn es in unserem Labor brauchbare KI-Ergebnisse lieferte.
Auf den RTX Spark-Systemen lief sr-client 1.2, unsere neue Client-Suite. Daher werden sie auf dieser Seite untereinander verglichen und nicht mit den Procyon-Ergebnissen, die hinter den anderen Auswahlen stehen.
Die Preise in diesem Markt ändern sich schnell. Daher entspricht jeder hier angegebene Dollarbetrag dem zum Zeitpunkt der Veröffentlichung des Testberichts gültigen Preis. Wir geben keine Wertversprechen ab, ohne die aktuellen Preise der Konfiguratoren der Anbieter zu prüfen. In diesem Fall versehen wir die Prüfung mit dem entsprechenden Datum.
Häufig gestellte Fragen zu lokaler KI auf Laptops
Was ist für lokale KI auf einem Laptop wichtiger, der Videospeicher (VRAM) oder der Gesamtspeicher?
Beides aus unterschiedlichen Gründen: Ein Modell muss in den vom Grafikprozessor (GPU) zugänglichen Speicher passen. Bei dedizierten Grafikkarten ist das der Videospeicher (VRAM) (in diesem Bereich 8 bis 24 GB). Unser Llama 2 13B lief auf 8-GB-Karten nicht, da er etwa 12 GB benötigte. Bei Unified- und Shared-Memory-Architekturen ändert sich die Situation: AMDs Ryzen AI Max+ kann der GPU bis zu 96 GB Systemspeicher zuweisen, und Intels gemeinsam genutzte LPCAMM2-Speicherpools erreichen 64 GB. Dadurch lassen sich größere Modelle überhaupt laden, allerdings mit geringerer Geschwindigkeit. Die Kompatibilität entscheidet darüber, ob ein Modell läuft; die Chiptechnologie bestimmt die Geschwindigkeit.
Welches ist das größte Modell, das StorageReview jemals auf einem Laptop zum Laufen gebracht hat?
DeepSeek-R1 70B wurde lokal auf dem HP ZBook Ultra G1a 14 über dessen 96 GB großen, zuweisbaren Arbeitsspeicher geladen. Für die kontinuierliche Generierung von Tokens haben wir Gemma 3 27B mit 8.96 Tokens pro Sekunde auf demselben Rechner gemessen. Bei Desktop-Systemen ist die Messlatte höher; die Bestenliste der Desktop-Systeme für lokale KI umfasst Systeme, die deutlich größere Modelle unterstützen.
Sind die NPU TOPS-Bewertungen für die Durchführung von LLM-Studiengängen relevant?
Weniger als die Werbung heute suggeriert, da die meisten lokalen LLM-Laufzeitumgebungen stark auf die GPU angewiesen sind und alle Token-pro-Sekunde-Werte auf dieser Seite – mit Ausnahme des Snapdragon EliteBook, bei dem die KI-Architektur der Plattform im Vordergrund steht – auf GPU-Inferenz basieren. NPUs lohnen sich aktuell durch Effizienz und die Generierung von INT8-Bildern. Aufgrund ihrer Leistung qualifizieren sich einige dieser Geräte als Copilot+-PCs. Achten Sie daher beim Kauf primär auf GPU und Arbeitsspeicher.
Was passiert mit der Akkulaufzeit, wenn man Modelle lokal ausführt?
Inferenzberechnungen gehören zu den anspruchsvollsten Daueranwendungen für Laptops. Planen Sie daher für längere Sitzungen eine Stromversorgung ein. Die Akkulaufzeitangaben auf dieser Seite basieren auf den Ergebnissen des PCMark 10 Modern Office-Benchmarks, einem Produktivitätstest. Der Unterschied ist enorm: 3 Stunden und 39 Minuten bei unserem schnellsten KI-Laptop gegenüber fast 24 Stunden beim Dell-Laptop mit gemeinsamem Speicher. Unsere Bestenliste zur Akkulaufzeit von Laptops vergleicht alle Modelle.
Wie schneiden RTX Spark-Laptops im Vergleich zu den hier aufgeführten Laptops ab?
Die RTX Spark-Laptops nutzen NVIDIAs N1X-Architektur, die sich einen LPDDR5X-Speicherpool für eine Grace-CPU und eine Blackwell-GPU teilt. Wir testen sie mit sr-client 1.2, unserer neuen Client-Suite. Daher stimmen ihre Ergebnisse nicht direkt mit den Procyon-Ergebnissen der hier vorgestellten Geräte überein. Auf dem HP OmniBook Ultra 16 mit 128 GB RAM generierten gpt-oss:20b und Qwen3.6-35B-A3B 58.0 bzw. 89.5 Token pro Sekunde. Der 35B-Codierungstest wurde in drei von drei Durchläufen in 72.0 Sekunden abgeschlossen.
Die Speicheraufteilung entscheidet darüber, welche Modelle geladen werden: Das Lenovo Pro 9n 15 mit 32 GB RAM, das für die GPU auf 12 GB eingestellt war, konnte das 12.8 GB große gpt-oss:20b-System nicht laden. Das Lenovo Yoga 9n 2-in-1 16 blieb am kühlsten und erreichte unter 30-minütiger Dauerlast maximal 72 °C. Das Surface wird nur als getestet angezeigt, da sich zwei Geräte unter unserer OpenBLAS-Volllast abschalteten.
Sollte ich mir stattdessen einfach einen Desktop-PC für lokale KI kaufen?
Wenn das Gerät auf einem Schreibtisch stehen soll, ja, wahrscheinlich. Desktop-Systeme bieten mehr Speicher pro Euro, eine bessere Kühlung und keine Kompromisse bei der Akkulaufzeit; unsere Bestenliste der besten Desktop-PCs für lokale KI beginnt etwa beim Preis der hier vorgestellten Mittelklasse-Laptops. Die Laptops auf dieser Seite sind für Anwender gedacht, deren KI-Anwendungen mobil eingesetzt werden müssen.
RTX Spark vs. DGX Spark: Worin liegt der Unterschied?
Es handelt sich um denselben Siliziumchip, der für unterschiedliche Plattformen optimiert wurde. RTX Spark N1X-Laptops sind mit dem GB10-Superchip aus dem DGX Spark ausgestattet, einer Grace-CPU und einer Blackwell-GPU, die sich einen LPDDR5X-Speicherpool teilen. Die TDP liegt zwischen 45 und 80 W, verglichen mit den von NVIDIA für den GB10 im DGX Spark angegebenen 140 W. DGX Spark nutzt NVIDIAs Linux-Stack mit einheitlichem Speicher; RTX Spark-Laptops hingegen laufen mit Windows 11 auf Arm, wo der Speicherpool per Firmware-Einstellung vorab aufgeteilt wird. Das HP OmniBook Ultra 16 mit 128 GB Speicher stellt seiner GPU 62.5 GB zur Verfügung. Da wir die beiden Systeme mit unterschiedlichen Testumgebungen prüfen, vergleichen wir sie nicht direkt miteinander. DGX Spark-Systeme werden in der Liste der besten Desktop-PCs für lokale KI aufgeführt.


 Amazon