

Aktualisiert am 19. Oktober 2026: Open WebUI belegt mit messbaren Ergebnissen (115.32 und 75.06 Token pro Sekunde im RTX 5000 Ada-Benchmark, gegenüber 123 und 82 im Januar) den zweiten Platz. Der Eintrag umfasst nun die Windows-Desktop-App und den Server (Version 0.12.2), und die Rubrik „Anleitung“ verlinkt zum Open WebUI-Hands-on. Ursprünglich veröffentlicht am 19. August 2026.
Es gibt vier Gründe, ein Sprachmodell auf eigener Hardware auszuführen, und nur einer davon ist ideologischer Natur. Datenschutz: Ein Dokument, das Sie einem lokalen Modell übergeben, verlässt niemals den Rechner. Dies betrifft die gesamte Kommunikation bei Clientcode, Verträgen, Patientendaten und unveröffentlichten Produkten.
Kostenstruktur: Cloud-KI wird nutzungsabhängig abgerechnet, und agentenbasierte Workloads vervielfachen die Token-Anzahl so schnell, dass sich eine leistungsstarke Workstation amortisiert; Ihre eigene Hardware wird zum Strompreis betrieben. Verfügbarkeit: Keine Ratenbegrenzungen, keine Ausfälle, keine Benachrichtigungen über veraltete Funktionen, die Ihren Workflow mitten im Dienstag durcheinanderbringen. Und Kontrolle: Das validierte Modell bleibt so lange aktiv, bis Sie es ändern.
Demgegenüber steht, dass moderne Cloud-Modelle weiterhin leistungsfähiger sind, und bei langfristigen, agentenbasierten Aufgaben ist der Unterschied deutlich spürbar. Lokale Modelle haben bei begrenzten Aufgaben – wie Chat, Zusammenfassung, Code in einer einzigen Datei und Dokumenten-Fragen und -Antworten – Parität erreicht. Genau das macht den Großteil der täglichen Arbeit der meisten Menschen aus. Wenn maximale Leistungsfähigkeit um jeden Preis entscheidend ist, nutzen Sie die Cloud. Wenn Datenschutz, Kosten oder Kontrolle für Sie im Vordergrund stehen, sind lokale Lösungen heute noch eine sinnvolle Option – und diese Seite zeigt Ihnen, wie Sie diese nutzen können.
Diese Rahmenbedingungen sollten Ihr Hardwarebudget bestimmen, denn der lokale KI-Verbrauch hängt in erster Linie von der Speicherauslastung ab. 16 GB VRAM oder 32 GB Unified Memory decken die 7- bis 8-Byte-Klasse ab, die die oben genannten begrenzten Aufgaben bewältigt. 24 bis 32 GB VRAM oder 48 GB Unified Memory ermöglichen die 30-Byte-Klasse, in der agentenbasierte Codierung nicht mehr nur eine Demo ist. 96 bis 128 GB Unified Memory ermöglichen die Ausführung der über 100-Byte-Modelle, die sich der Spitzenklasse annähern. Zu viel Speicher bringt Geschwindigkeitsvorteile, die Sie möglicherweise nicht bemerken; zu wenig Speicher bedeutet, dass die gewünschte Modellklasse gar nicht erst geladen wird.
Unsere Bestenlisten für Laptops und Desktop- PCs für lokale KI ordnen die Geräte nach Leistungsklassen. Diese Seite erklärt, welche Anwendungen darauf laufen können.
Die Software hat sich nicht so reibungslos weiterentwickelt wie die Hardware. Rund ein Drittel der Tools, die heute in Suchergebnissen empfohlen werden, sind veraltet, und die meisten Seiten, die sie empfehlen, haben das noch nicht bemerkt.
Diese Seite dokumentiert, welche Tools auf welcher Hardware funktionieren (Stand: Oktober 2026). Aktuell verwenden wir GitHub-Sterne als Bewertungskriterium, da diese neutral und nachvollziehbar sind. Tools ohne Sternenanzahl werden entsprechend gekennzeichnet. Jeder Toolname in den Tabellen verlinkt zum offiziellen Download. Sobald ein Tool den Test durchlaufen hat, wird die Spalte „Anleitung“ mit einer praktischen Einrichtungsbeschreibung und unseren eigenen Bewertungen ergänzt (beginnend mit Januar).
Diese Seite basiert auf drei Regeln. Zunächst zur Unterscheidung zwischen einem lokalen Modell und einem lokalen Agenten . Einige Produkte laufen auf Ihrem Rechner, während jeder Inferenzaufruf an die Cloud eines Anbieters erfolgt. Dies dient dem Datenschutz und ist keine Offline-Funktion. Diese Tools sind unten separat aufgeführt, um die Unterscheidung zu verdeutlichen. Zweitens enthält jeder Eintrag realistische Mindestanforderungen an die Hardware, denn die Angabe „läuft auf einem Laptop“ ist ohne Angabe des Arbeitsspeichers bedeutungslos. Drittens dokumentieren wir in den FAQs, welche Produkte nicht mehr verfügbar sind, inklusive Datum.
Die Auswahl
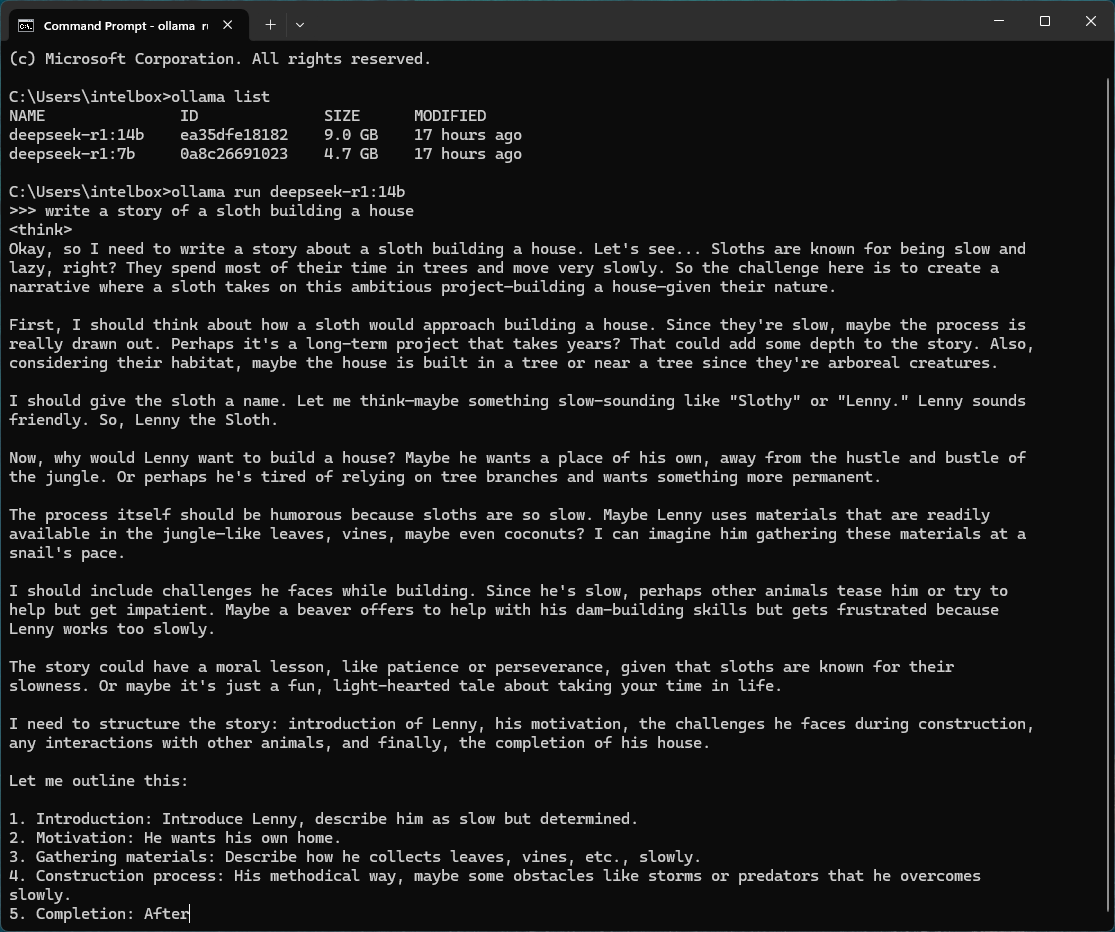
Beste lokale LLM-Laufzeit insgesamt: Ollama
Ollama ist die Standardlösung und die Plattform, mit der die meisten anderen Tools kommunizieren. Es ist unter der MIT-Lizenz lizenziert, hat rund 179,000 GitHub-Sterne und bietet neben der Kommandozeilenschnittstelle (CLI) nun auch eine Desktop-GUI. Modelle lassen sich mit einem einzigen Befehl abrufen, ein OpenAI-kompatibler Endpunkt wird auf localhost bereitgestellt, und seit Januar 2026 ist die Anthropic Messages API kompatibel. Dadurch können Nutzer Claude Code nun auf ein lokales Modell zugreifen. Mindestanforderungen: 8 GB Arbeitsspeicher (RAM) für ein 3B-Modell, 16 GB für 7-8B-Modelle und 24 GB Videospeicher (VRAM) für die 30B-Klasse.
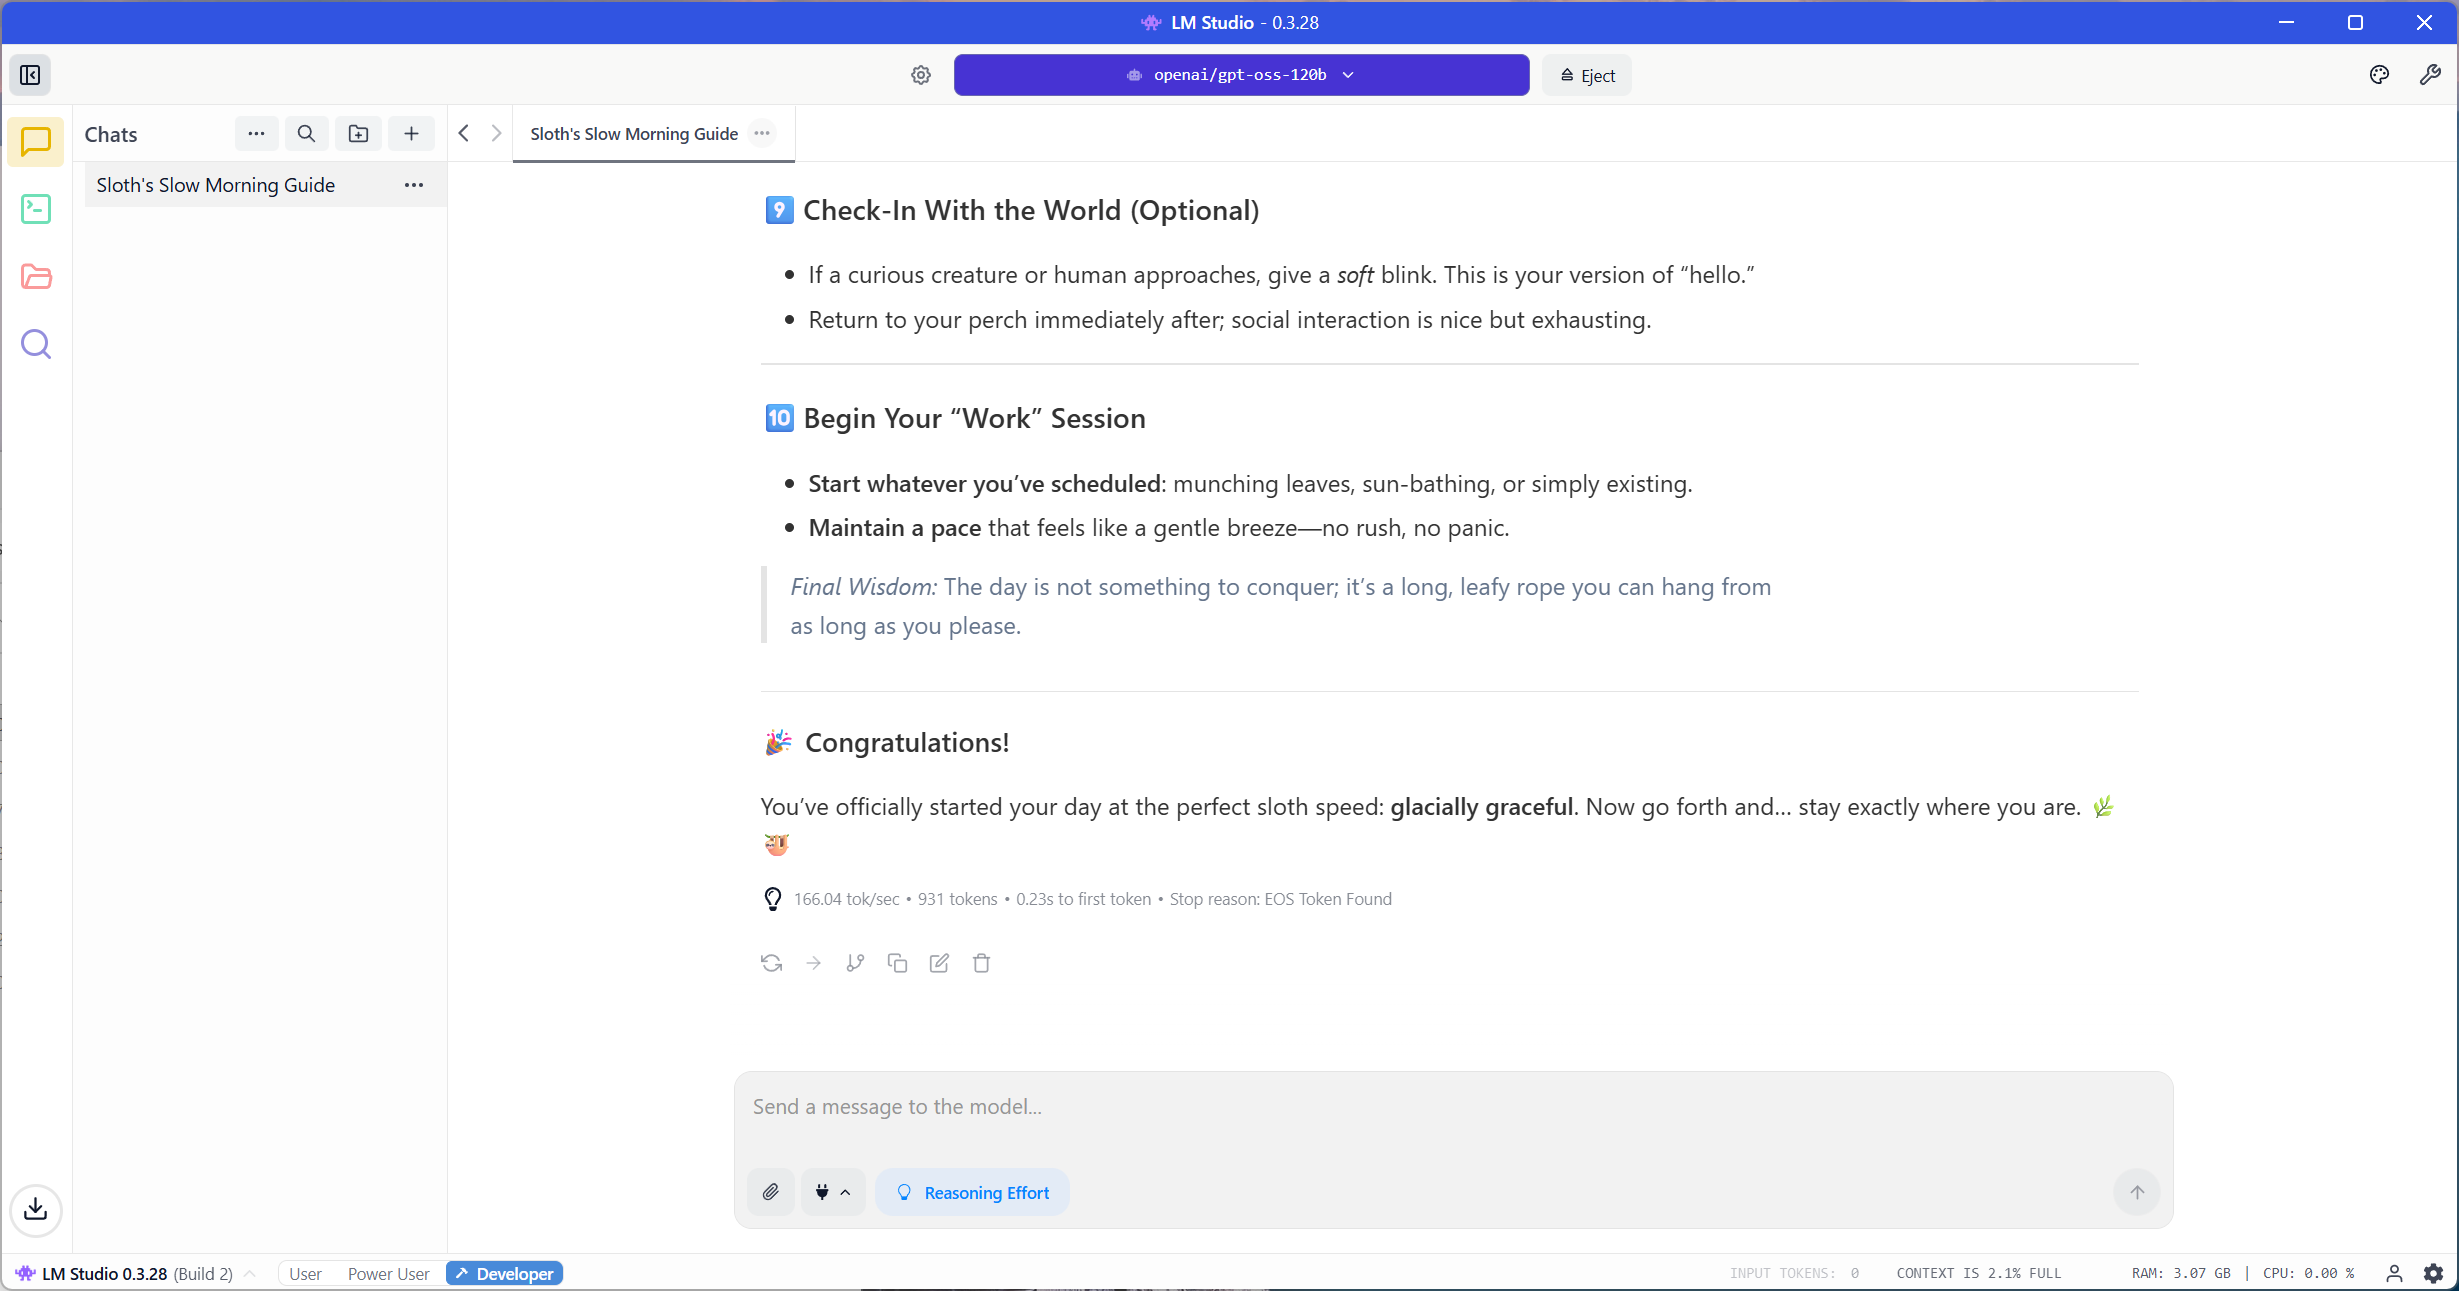
Am besten geeignet für Hardware-Benchmarking: LM Studio
Da es sich um Closed Source handelt, hat es keine Sternebewertung, ist aber dennoch empfehlenswert. LM Studio bündelt sowohl llama.cpp als auch MLX und stellt die relevanten Steuerelemente für die Messung eines Systems bereit, anstatt es selbst zu nutzen: GPU-Offload-Layer, Quantisierungsoptionen, Kontextlänge und Multi-GPU-Verhalten. Es ist seit Juli 2025 für die kommerzielle Nutzung kostenlos. Dieses Tool liefert die meisten Token-pro-Sekunde-Werte unserer Workstation- und Laptop-Boards. Mindestanforderungen: 16 GB RAM; 24 GB VRAM oder 32 GB Arbeitsspeicher für aussagekräftige Ergebnisse.
Beste zugrundeliegende Engine: llama.cpp
Nahezu alles andere auf dieser Seite basiert auf llama.cpp. Es ist unter der MIT-Lizenz veröffentlicht, hat rund 124,700 Sterne und täglich werden mehrere Builds mit Tags veröffentlicht. Für Hardware-Nutzer ist es aus einem bestimmten Grund relevant: Die Liste der unterstützten Backends ist enorm und umfasst CUDA, ROCm, Metal, Vulkan, SYCL, CANN und OpenCL. Entwickler von Herstellern tragen nun direkt Optimierungen dazu bei. Eine Verbesserung der Intel Arc-Vorverarbeitung in Build 8688 brachte etwa das Fünffache an Leistung, und jeder Ollama- und LM Studio-Nutzer erhielt sie ohne zusätzliche Installationen. Mindestanforderungen: Läuft nur auf der CPU; 8 GB RAM sind erforderlich.
Beste Desktop-App mit lokalem Fokus: Jan
Apache 2.0, ca. 44,100 Sterne, Version 0.8.6 (Stand: Oktober 2026). Jan bringt llama.cpp mit, sodass keine weiteren Installationen nötig sind. Es funktioniert sogar ohne Netzwerkkabel. Das klingt zunächst nach wenig, bis man sieht, wie viele Anwendungen in dieser Kategorie Cloud-Clients mit einem Ollama-Feld sind. Genau das Richtige für einen Kollegen, der nie ein Terminal öffnen wird.
Es ist außerdem die erste Plattform auf dieser Seite, deren Leistung durch eigene Messungen belegt ist: In unserem RTX 5000 Ada-Benchmark dekodierte Jan V3.5 4B mit durchschnittlich 123 Token pro Sekunde und Jan V2 VL High mit 82 Token pro Sekunde. Dabei wurden 4.8 GB bzw. 8.2 GB GPU-Speicher genutzt, die GPU-Beschleunigung war beim ersten Start aktiviert und CUDA war nicht eingerichtet. Die vollständige Anleitung, von der Installation bis zur OpenAI-kompatiblen API, finden Sie in unserem Jan-Hands-on-Guide . Dokument RAG ist der einzige Teil der Anwendung, der darin nicht behandelt wird. Mindestanforderung: 8 GB RAM.
Bestes lokales Dokument RAG: AnythingLLM
MIT-Lizenz, ca. 64,800 Sterne. Es enthält eine Vektordatenbank und übernimmt Chunking und Embedding ohne Konfiguration, was es zum unkompliziertesten Dokumenten-Chat-Tool für Desktop-Computer macht. Zwei wichtige Punkte: Eine Sicherheitslücke vom März 2026 (CVSS-Wert 9.6) ermöglichte die Ausführung von Remote-Code durch die gestreamte Antwort des Modells. Diese wurde in Version 1.11.2 behoben, daher unbedingt vor der Nutzung aktualisieren. Die Telemetrie ist standardmäßig aktiviert, obwohl die App als „lokal-primär“ beworben wird. Sie kann in den Einstellungen deaktiviert werden. Mindestanforderungen: 16 GB RAM für die Dokumentenbearbeitung.
Beste selbstgehostete Mehrbenutzerlösung: Open WebUI
Rund 149,000 Sterne und die umfassendsten Konfigurationsmöglichkeiten für die Suche – wir haben Serverversion 0.12.2 getestet. Ursprünglich als selbstgehosteter Server mit Docker als Einstiegspunkt gestartet, installiert ihn nun eine Windows-Desktop-App mit integrierter Python-Umgebung und eigener llama.cpp-Laufzeitumgebung. Wichtig zu wissen: Die Lizenz wurde im April 2025 von BSD-3 auf eine benutzerdefinierte, nicht OSI-konforme Lizenz umgestellt. Diese verbietet das Entfernen des Open WebUI-Brandings und sieht eine Ausnahme für Nutzer unter 50 innerhalb von 30 Tagen vor. Bei unverändertem Betrieb in kleinem Umfang ändert sich nichts.
Es handelt sich um die zweite Plattform auf dieser Seite mit unseren eigenen Ergebnissen. Auf unseren Jan-Benchmark- und Modelldateien dekodierte Open WebUI Desktop Jan V3.5 4B mit einem Median von 115.32 Token pro Sekunde und Jan V2 VL High mit 75.06, 6.2 bzw. 8.5 Prozent weniger als Jan auf einem anderen llama.cpp-Build. Die Unterschiede liegen in der Konfiguration: Wir verwendeten den llama.cpp-Build b11612, fügten die CUDA-Runtime-DLLs manuell hinzu und stellten einen 8,192-Token-Kontext wieder her, nachdem eine Neuinstallation die Zuweisung von bis zu 169,984 Token pro Slot ermöglicht hatte. Voreinstellungen, Bildeingabe, DDGS-Websuche und die lokale API funktionierten anschließend einwandfrei, wie unsere praktische Anleitung zu Open WebUI detailliert beschreibt . Mindestanforderungen: eine separate Runtime plus 4 GB für den Container oder die Desktop-Anwendung mit der zugehörigen llama.cpp-Datei.
Bester lokaler Kodierungsagent: Cline
Apache 2.0, ca. 63,900 Sterne. Cline hat im Vergleich zu anderen Anbietern mehr Entwicklungsarbeit im lokalen Bereich geleistet, darunter eine kompakte Systemeingabeaufforderung speziell für Ollama und LM Studio sowie den nativen Aufruf von Tools pro Modellfamilie. Die eigene Dokumentation ist ungewöhnlich offen, was die Vorteile der Cloud betrifft. Mindestanforderungen: 24 GB VRAM oder 36 GB Arbeitsspeicher, Kontext auf 32 KB oder höher einstellen.
Beste Offline-Terminalcodierung: Aider
Apache 2.0, mit rund 48,300 Sternen, ist architektonisch gesehen die zuverlässigste lokale Option – und das aus gutem Grund. Aider verzichtet vollständig auf JSON-Tool-Aufrufe. Es analysiert Diff- und Dateibearbeitungsformate aus Klartext und umgeht so genau die Fehlerquelle, die die meisten Agenten auf lokalen Modellen zum Absturz bringt. Der Haken an der Sache ist die Wartung: 96 Prozent der Commits stammen von einem einzigen Autor, und die Release-Frequenz hat sich auf etwa eine stabile Version im Jahr 2026 reduziert. Mindestanforderungen: 24 GB VRAM oder 36 GB kombinierter Speicher.
Beste selbstgehostete Agentenplattform: OpenHands
MIT-Lizenz, ca. 84,500 Sterne. OpenHands dokumentiert lokale Modelle gut und zeigt vor allem an, wenn das Problem nicht an der Konfiguration liegt: Laut Dokumentation ist das Modell die limitierende Größe, wenn sich der Agent wie ein Chatbot verhält oder ständig Tools versagt. Es benötigt mindestens 22 Kontexte und empfiehlt 32. Mindestens 24 GB VRAM für quantisierte Modelle oder 64 GB einheitlicher Speicher.
Die beste kostenlose Offline-Überraschung: GitHub Copilot CLI
Seit April 2026 läuft die Copilot-CLI mit Ollama, vLLM und Foundry Local. Die GitHub-Authentifizierung ist optional, und ein Copilot-Abonnement ist nicht erforderlich. Die Einstellung COPILOT_OFFLINE deaktiviert jegliche Telemetrie und Netzwerkkommunikation, und die zugehörigen Subagenten übernehmen Ihren lokalen Provider. Die meisten Vergleichsartikel führen Copilot weiterhin als reine Cloud-Lösung auf. Beachten Sie die Aufteilung: Die IDE-Erweiterung sendet Inline-Vervollständigungen auch bei Verwendung eines eigenen Schlüssels (BYOK) weiterhin an die Cloud. Mindestanforderungen: ein Modell mit einem Kontextfenster von 128 KB, also 32 GB VRAM oder 64 GB Unified-Speicher.
Bester vom Anbieter unterstützter Server: Lemonade
Apache 2.0, mit rund 5,400 Sternen, ist das einzige herstellerunabhängige Tool, das wir allein aufgrund seiner Qualität empfehlen würden. Es wird von AMD-Ingenieuren betreut und läuft auf NVIDIA CUDA, Apple Metal, Vulkan und herkömmlichen CPUs sowie auf Radeon- und Ryzen-AI-NPUs. Es erscheint etwa alle zwei Wochen und die Desktop-Anwendung wurde im April 2026 von Electron auf Tauri umgestellt. Mindestanforderungen: 16 GB RAM; Ryzen-AI-Prozessor der 300er-Serie oder höher für die NPU-Nutzung.
Beste lokale RAG-Tabelle für das gesamte Dateisystem: Nexa AI Hyperlink
Nexa AI Hyperlink ist proprietär und kostenlos. Es indiziert Ihr gesamtes Dateisystem auf dem Gerät und liefert Antworten mit Inline-Zitaten. Es ist in dieser Liste enthalten, da es das einzige neue lokale RAG-Tool mit veröffentlichten Beschleunigungswerten auf Consumer-Hardware ist: etwa dreimal schnellere Indizierung und doppelt so schnelle Inferenz auf einer RTX 5090, wodurch sich die Indizierungsdauer für einen 1-GB-Ordner von etwa 15 Minuten auf vier bis fünf Minuten verkürzt. Mindestanforderungen: eine moderne RTX-Grafikkarte und 16 GB RAM.
Laufzeiten: Was führt das Modell aus?
Diese fünf sind die Engines, und alles in den nächsten beiden Tabellen ist ein Frontend, das mit einer von ihnen kommuniziert, daher ist die Tabelle wie der Rest der Seite nach GitHub-Sternen sortiert.
Die Spalte „Anleitung“ überschneidet sich hier mit den Apps und ist daher entsprechend gegliedert: Ollama erhält eine eigene Anleitung, da es die bevorzugte Lösung ist und die meisten anderen Tools darauf verweisen. LM Studio erscheint in beiden Tabellen und erhält eine Anleitung. llama.cpp wird anhand der zugehörigen Apps behandelt, beginnend mit dem praktischen Test im Januar. MLX wird anhand von LM Studio auf Apple Silicon behandelt. vLLM ist eine Server-Engine, deren Test bereits in unserem Test des GB300-Clusters mit zwei Towern enthalten ist.
| Laufzeit | Sterne | Lizenz | Minimale Hardware | BESCHLEUNIGUNG | Guide |
|---|---|---|---|---|---|
| Ollama | ~ 179,000 | MIT | 8 GB RAM (3B), 16 GB (7-8B), 24 GB VRAM (30B-Klasse) | CUDA, ROCm, Metal, Vulkan | In Vorbereitung |
| lama.cpp | ~ 124,700 | MIT | 8 GB RAM, nur CPU funktioniert | CUDA, ROCm, Metal, Vulkan, SYCL, CANN, OpenCL | Durch die Januar und WebUI öffnen praktische |
| MLX / mlx-lm | ~ 27,500 | MIT | Apple Silicon, 16 GB Unified-Speicher | Metal; CUDA-Backend hinzugefügt 2026 | Über den LM Studio-Leitfaden (in Kürze verfügbar) |
| LM Studio | Geschlossene Quelle | Eigentumsrechtlich geschützt, kostenlos für die kommerzielle Nutzung | 16 GB RAM; 24 GB VRAM oder 32 GB unified | Bundles llama.cpp und MLX | In Vorbereitung |
| vLLM | Produktion dient | Apache 2.0 | 24 GB VRAM realistischer Boden | CUDA, ROCm | In unserem Test geprüft GB300 Cluster-Testbericht |
Desktop-Apps und lokales RAG
Dies sind die Apps, die ein Leser installiert, und die Spalte „Local-First“ sollte man besonders aufmerksam lesen: Sie unterscheidet zwischen Software, die ein Modell auf Ihrem Rechner ausführt, und Software, die ein Feld für eine Ollama-URL hinzugefügt hat.
| App | Sterne | Lizenz | Lokal zuerst | Minimale Hardware | Guide |
|---|---|---|---|---|---|
| WebUI öffnen | ~ 149,000 | Kundenspezifisch, nicht OSI-zugelassen | Funktioniert; Server, plus eine Windows-Desktop-App, die llama.cpp mitliefert. | Separate Laufzeitumgebung + 4 GB für Container oder Desktop-App | Open WebUI – Praktische Anleitung |
| Alles LLM | ~ 64,800 | MIT | Funktioniert; Telemetrie ist standardmäßig aktiviert. | 16GB RAM | In Vorbereitung |
| Januar | ~ 44,100 | Apache 2.0 | Ja, llama.cpp wird gebündelt. | 8GB RAM | Jans praktischer Leitfaden |
| LM Studio | Geschlossene Quelle | Proprietäre | Ja | 16 GB RAM; 24 GB VRAM wären interessant. | In Vorbereitung |
| Msty | Geschlossene Quelle | Proprietäre, kostenlose Stufe | Ja, Bundles Ollama, MLX, llama.cpp | 8GB RAM | In Vorbereitung |
| Nexa AI Hyperlink | Geschlossene Quelle | Proprietär, kostenlos | Ja, Indizierung auf dem Gerät. | Moderne RTX-Grafikkarte, 16 GB RAM | In Vorbereitung |
Codierungs- und Agentenwerkzeuge
Dies sind die hardwareintensivsten Einträge auf der Seite, da agentenbasierte Prozesse ein großes Kontextfenster und lange Sitzungen erfordern. Ab 32 GB VRAM oder 64 GB Arbeitsspeicher ist dies kein Demo mehr.
| Werkzeug | Sterne | Lizenz | Lokaler Pfad | Minimale Hardware | Guide |
|---|---|---|---|---|---|
| OpenHands | ~ 84,500 | MIT | LM Studio, Ollama, vLLM, SGLang | 24 GB VRAM oder 64 GB integrierter Speicher; 32K Kontext | In Vorbereitung |
| Cline | ~ 63,900 | Apache 2.0 | Ollama, LM Studio, OpenAI-kompatibel | 24 GB VRAM oder 36 GB einheitlicher Speicher | In Vorbereitung |
| Gans | ~ 52,900 | Apache 2.0 | Ollama erstklassig; jetzt Linux Foundation | 24 GB VRAM oder 36 GB einheitlicher Speicher | In Vorbereitung |
| Hilfe | ~ 48,300 | Apache 2.0 | Ollama, OpenAI-kompatibel; kein Tool-Aufruf erforderlich | 24 GB VRAM oder 36 GB einheitlicher Speicher | In Vorbereitung |
| Zed | Version 1.0, April 2026 | Apache 2.0 | LM Studio, Ollama, llama.cpp | 24 GB VRAM oder 36 GB einheitlicher Speicher | In Vorbereitung |
| GitHub Copilot-CLI | Geschlossene Quelle | Proprietär, kein Abonnement erforderlich | Ollama, vLLM, Foundry Local | 32 GB VRAM oder 64 GB integrierter Speicher; 128K Kontext | In Vorbereitung |
Lieferanteninitiativen
Jeder Chip- und Betriebssystemhersteller bietet etwas für lokale KI an, und diese Kategorie verdient einen eigenen Eintrag, da die Namensgebung verwirrend ist und die Produktpalette häufig nicht weiterentwickelt wird. Der Trend bis 2026 ist einheitlich: Die Hersteller haben aufgehört, mit Drittanbieter-Technologien zu konkurrieren, und beginnen nun, diese zu unterstützen. NVIDIA hat seine beiden eigenen Produkte für lokale KI eingestellt und veröffentlicht jetzt Optimierungen für Ollama, llama.cpp und ComfyUI. AMD kooperiert mit LM Studio. Qualcomm hat seine NPU-Funktionalität durch die Portierung einer fremden Anwendung bereitgestellt.
Die einzige Funktion, die Herstellertools gegenüber Ollama und LM Studio bieten: Zugriff auf die NPU . llama.cpp verfügt über kein NPU-Backend, daher bleibt die neuronale Engine auf einem Snapdragon- oder Ryzen-KI-System bei diesen Tools ungenutzt. Wer für 40 bis 60 TOPS bezahlt hat, kann diese Leistung nur über den Herstellerpfad nutzen. Erwarten Sie daher nicht zu viel, denn die NPU-Leistung ist aktuell auf etwa 7-Bit-Modelle begrenzt, und der Vorteil liegt eher in der Akkulaufzeit bei kontinuierlicher Nutzung kleiner Modelle als im Durchsatz. Eine dedizierte GPU ist der NPU in puncto Geschwindigkeit stets überlegen.
| Verkäufer | What It Is | Typ | Erforderliche Hardware | Status | Guide |
|---|---|---|---|---|---|
| AMD Limonade | Server, GUI und SDK; ~5,400 Sterne, Apache 2.0 | App + Server | 16 GB RAM; Ryzen AI 300+ für NPU. Läuft auch auf NVIDIA- und Apple-CPUs. | Aktiv, versendet ca. alle zwei Wochen | In Vorbereitung |
| Intel OpenVINO GenAI | Laufzeitumgebung und SDK; ~10,700 Sterne | SDK | Core Ultra, Arc A/B-Serie; 16 GB RAM | Aktiv, 2026.3 im August 2026 | Geführte Tour, keine Führung geplant |
| Apple Foundation Modelle | Vom Betriebssystem bereitgestellte On-Device-Modelle | OS-Framework | Apple Silicon; bereits installiert | Aktiv; offen für alle Anbieter auf der WWDC 2026 | Geführte Tour, keine Führung geplant |
| Microsoft Foundry Local | Lokales Inferenz-SDK und CLI; ~2,400 Sterne | SDK | Windows, macOS, Linux; NPU/GPU/CPU | GA April 2026; kuratierter Modellkatalog | Geführte Tour, keine Führung geplant |
| AMD GAIA | Lokale LLM-App für Ryzen AI; ca. 1,400 Sterne, MIT | App + SDK | Mindestens ein Prozessor der Ryzen AI 300-Serie; 16 GB RAM, 64 GB empfohlen | Aktiv, Version 0.20.0 Juni 2026 | Geführte Tour, keine Führung geplant |
| Intel AI-Spielplatz | Desktop-App; ~900 Sterne | App | Arc A-Serie 8GB+, Arc B-Serie, Core Ultra | Aktiv, aber nach zwei Jahren immer noch in der Beta-Phase. | Geführte Tour, keine Führung geplant |
| Qualcomm GenieX | On-Device GGUF-Laufzeitumgebung für Snapdragon NPU | Laufzeit | Snapdragon X / X Elite, 8 Elite | Entwicklervorschau, Juli 2026 | Geführte Tour, keine Führung geplant |
| NVIDIA-Projekt G-Assist | On-Device-Assistent 8B für die Systemsteuerung | App | RTX 20-Serie oder höher, 6 GB VRAM | Aktiv, aber noch als Vorabversion gekennzeichnet. | Geführte Tour, keine Führung geplant |
Die Namensgebung trägt zur Verwirrung bei, denn NVIDIAs „RTX AI Garage“ klingt zwar nach einem Produkt, ist aber keines; es handelt sich um eine Blogreihe. Microsofts Technologie-Stack wurde mehrfach umbenannt: Aus den Copilot Runtime APIs wurden die Windows AI APIs, aus der Azure AI Foundry die Microsoft Foundry, und DirectML befindet sich nun im Wartungsmodus und erhält lediglich Sicherheitsupdates. Qualcomm AI Hub ist ein Cloud-Dienst, der physische Geräte remote bereitstellt und nicht lokal ausgeführt wird.
Was normalerweise kaputt geht
Die meisten Meldungen über „nicht funktionierende“ lokale Modelle beziehen sich auf Konfigurationsprobleme, nicht auf Modellprobleme. Vier Faktoren sind hierfür besonders häufig verantwortlich, und alle vier sollten Hardware-Anwender kennen, bevor sie den Chip verantwortlich machen.
1. Ollama verwendet standardmäßig einen Kontext mit 4,096 Token. Wird dieser Wert überschritten, wird kein Fehler ausgegeben. Der Kontext wird stillschweigend abgeschnitten, und eine automatische Endlosschleife wird beendet. Jedes ernstzunehmende Harness benötigt mehr: OpenHands benötigt mindestens 22 Token und empfiehlt 32, Codex benötigt 32, Copilot CLI benötigt 128 und Cline setzt 262,144 Token ein. Diese einzelne Einstellung ist wahrscheinlich die häufigste Ursache für die online zu findenden Fehlerberichte.
2. Die KV-Cache-Quantisierung beeinträchtigt insbesondere den Aufruf von Tools , und zwar bevor die allgemeine Ausgabequalität sichtbar leidet. Die Dokumentation von llama.cpp weist direkt darauf hin. Wenn Sie einen Agenten verwenden, deaktivieren Sie ihn.
3. Die Anzahl der verwendeten Tools ist nicht gleichmäßig, sondern sprunghaft. Ab etwa fünf oder sechs Tools senden manche Modelle stillschweigend keine gültigen JSON-Tool-Aufrufe mehr und betten stattdessen XML in den Antworttext ein, was vom Testsystem als „kein Tool verwendet“ interpretiert wird. Ein beliebter Agent lieferte standardmäßig elf Tools aus und beeinträchtigte damit sein eigenes empfohlenes Modell bis Anfang 2026. Wir stießen in unseren Open-WebUI-Tests auf ein ähnliches Problem, bei dem die integrierten Tool-Anweisungen eine kurze Benchmark-Anfrage über einen Kontext von 8,192 Token hinaus verlängerten. Die praktische Konsequenz ist kontraintuitiv: Das Laden vieler MCP-Server wirkt sich negativ auf lokale Modelle aus, im Gegensatz zu Frontier-Modellen.
4. Q4_K_M ist die praktische Untergrenze. Darunter nimmt die Zuverlässigkeit der Werkzeugaufrufe schneller ab als die allgemeine Qualität, sodass das Modell zwar noch gut klingt, aber im Stillen nichts mehr bewirkt.
Speicher ist die Einschränkung
Bei allen Tools auf dieser Seite ist die entscheidende Frage für die Ausführung, wie viel Speicher der Beschleuniger erkennen kann. Dies sind die am häufigsten genannten Kombinationen für agentenbasierte Anwendungen, und diejenigen, die wir im Labor überprüfen wollen.
| Hardware | Modell | Fußabdruck | Gemeldeter Durchsatz |
|---|---|---|---|
| RTX 5090, 32 GB | Qwen3.6-35B-A3B Q4_K_M | ~ 21GB | 160–180 Token/s, 262K Kontext |
| RTX 5090, 32 GB | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19GB | 50-90 kb/s auf 24-GB-Geräten |
| RTX 5090, 32 GB | Devstral Small 24B Q4_K_M | ~ 14GB | Speziell für den Werkzeugeinsatz entwickelt |
| RTX PRO 6000, 96 GB | GPT-OSS 120B MXFP4 | ~ 63GB | Die 100B-Klasse auf einer einzelnen Workstation-Karte; die GPU aus unserem Labortest |
| Laptop mit RTX PRO 5000, 24 GB GDDR7 | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19GB | Die größte von uns getestete Laptop-GPU (ThinkPad P16 Gen 3); die 30-Bit-Klasse bietet ausreichend Platz und lässt keine Wünsche offen. |
| 96-128 GB einheitlicher Speicher, M-Serie | gpt-oss-120b Q6_K | ~ 93GB | 14–20 kJ/s; sauberste Tool-Aufruf-JSON-Daten aller Open-Weight-Modelle |
Wichtig zu erwähnen, da die Werbung dies verschweigt: Die größten Modelle mit freier Gewichtsverteilung sind keine Workstations. Die GLM-5.2 hat ungefähr die Parameter der 744B und benötigt in FP8, einem Rechenzentrumsknoten mit acht GPUs, etwa 744 GB Speicherplatz. Kimi K2 und DeepSeek V4 gehören zur selben Kategorie. Jede Anleitung, die empfiehlt, diese auf einem Desktop-PC zu betreiben, ist falsch.
Die oben genannten Durchsatzwerte stammen aus veröffentlichten Tests von Drittanbietern und Herstellerangaben und sind – mit Ausnahme der Werte für die Dekodierung von Jan und Open WebUI in den oben genannten Beispielen – noch keine Laborergebnisse von StorageReview. Wir werden diese Werte im Laufe der Überprüfung jedes Beispiels durch unsere eigenen Werte ersetzen.
Cloud-First-Tools und warum sie hier nicht gelistet sind
Ein lokaler Agent ist kein lokales Modell , und die folgenden Tools verdeutlichen den Unterschied: Jedes Tool läuft auf Ihrem Rechner, während jeder Inferenzaufruf an eine Anbieter-Cloud gesendet wird.
| Werkzeug | Unterstützung lokaler Modelle | Hinweis |
|---|---|---|
| Cursor | Nein | Laut offizieller Dokumentation werden alle Anfragen über Cursor-Server geleitet; benutzerdefinierte Tasten funktionieren nur mit großen Cloud-Anbietern, und die Tab-Vervollständigung verwendet immer Cursor-Modelle. Übernahme durch SpaceX im Jahr 2026. |
| Devin Desktop (ehemals Windsurf) | Nein | Umbenannt im Juni 2026. Alle Modelle werden in der Cloud gehostet. |
| Google Antigravitation | Nein | Die Dokumentation gibt ausdrücklich an, dass weder Ollama, LM Studio noch ein benutzerdefinierter Endpunkt verwendet werden kann. |
| Gemini-Befehlszeilenschnittstelle | Nein | Lokale Unterstützung existiert nur in Community-Forks. |
| Qodo | Nein | „On-Premise“ bezieht sich auf selbstgehostete Infrastruktur, die weiterhin als Cloud-Modelle bezeichnet wird. |
| GitHub Copilot in der IDE | Teilweise | Der Chat kann lokale Modelle verwenden; Inline-Vervollständigungen bleiben auch unter BYOM-Nutzung in der Cloud erhalten. |
| ChatGPT | Nein | Die Desktop- und Mobilanwendungen sind Clients für die Cloud-Modelle von OpenAI. Die Open-Weight-GPT-OSS-Modelle von OpenAI laufen zwar lokal, jedoch über die oben genannten Laufzeitumgebungen und nicht über die ChatGPT-App. |
| Claude | Nein | Claude-Apps und Cowork laufen auf den Cloud-Modellen von Anthropic. Claude Code kann über die Anthropic-kompatible API von Ollama auf ein lokales Modell verweisen; dies funktioniert zwar, ist aber eine nicht unterstützte Konfiguration. |
| Allgemeine Agenturassistenten | Nein | Die in dieser Klasse enthaltenen Tools laufen auf Ihrem Rechner, basieren aber für die Schlussfolgerungen auf einem Cloud-Modell. |
Es gibt unzählige Anleitungen zum Verbinden von Cursor mit Ollama. Die Cursor-Dokumentation selbst widerspricht diesen jedoch. Wenn Offline-Betrieb für Sie erforderlich ist, ist dieser Unterschied von entscheidender Bedeutung.
Wie sieht es mit der Bild- und Videogenerierung aus?
Die lokale Bildgenerierung ist eine der größten Communities im Bereich der lokalen KI. Allein ComfyUI übertrifft die meisten der oben genannten Tools nach GitHub-Sternen, und die lokale Videogenerierung entwickelt sich zur speicherintensivsten Anwendung für Endverbraucher. Sie verdient eine eigene Rangliste und wird auch eine erhalten; eine vierte Kategorie auf dieser Seite würde sie verdrängen. Bis dahin gilt die Hardwarelogik dieser Seite direkt: Bild- und Videoverarbeitung ist noch speicherintensiver als Sprachmodelle, und die gleichen Kategorien gelten.
So funktioniert diese Seite
Drei Regeln bestimmen das Ranking. Erstens erfolgt die Reihenfolge vorerst nach GitHub-Sternen. Das ist zwar nicht ideal, aber neutral, nachvollziehbar und erfordert keine vorgetäuschten Tests. Closed-Source-Tools werden entsprechend gekennzeichnet und erhalten keine fiktive Bewertung. Sobald unsere eigenen Tests klare Favoriten ergeben, wird sich die Reihenfolge entsprechend den Messergebnissen ändern, und wir werden dies bekanntgeben. Jan und Open WebUI verfügen nun über Laborwerte, diese Anpassung hat also bereits begonnen. Zweitens: Jeder Eintrag hat einen Mindestspeicherbedarf, da dieser darüber entscheidet, ob ein Modell geladen wird.
Drittens ist die Rubrik „Leitfaden“ eine Verpflichtung, die sich auf die Empfehlungen bezieht: Jede empfohlene Anwendung erhält eine praktische Einrichtungsanleitung mit unseren Ergebnissen auf unserer Hardware, die in einer App enthaltene Laufzeitumgebung wird im jeweiligen App-Leitfaden erläutert, und Initiativen der Anbieter werden in der entsprechenden Tabelle ohne weitere Informationen erfasst. Der Link erscheint hier, sobald ein Leitfaden veröffentlicht wird.
Häufig gestellte Fragen zu lokalen LLM-Tools
Mit welchem lokalen LLM-Tool sollte ich beginnen?
Ollama eignet sich für alle, die gerne im Terminal arbeiten, LM Studio für alle, die lieber ein Fenster mit Steuerelementen nutzen, und Jan für alle, die eine sofort einsatzbereite Lösung suchen, die keine zusätzlichen Installationen erfordert. Alle drei sind kostenlos, laufen komplett offline und basieren auf llama.cpp, sodass das Modellverhalten identisch ist. Der Unterschied liegt in der Benutzeroberfläche, nicht in der Geschwindigkeit.
Was geschah mit NVIDIA ChatRTX, GPT4All und Continue.dev?
Sie sind verschwunden, zusammen mit überraschend vielen vergleichbaren Produkten. Dies ist der wichtigste Hinweis, bevor man einer älteren Empfehlung folgt: NVIDIA ChatRTX wurde am 21. Januar 2026 eingestellt, das zugehörige Repository archiviert und das Supportforum gesperrt. Ein Nachfolger wurde nicht benannt.
GPT4All ist der kniffligste Fall: Seit zwölf Monaten gab es keine Commits mehr, und die letzte Version erschien im Februar 2025. Das Repository ist jedoch nicht archiviert und weist weiterhin eine hohe Anzahl an Sternen auf, was darauf hindeutet, dass es noch aktiv ist. Es unterstützte nur eine begrenzte Anzahl an Quantisierungsformaten und kann die meisten aktuellen Modellversionen nicht laden.
Continue.dev , zwei Jahre lang die Standardempfehlung für die lokale Modellprogrammierung, wurde von Cursor übernommen und im Juni 2026 eingestellt. Roo Code wurde im Mai 2026 abgeschaltet, Void im Juni 2026, Twinny im November 2025 und Reor im März 2026. Khoj stellte seinen gehosteten Dienst im April 2026 ein, die selbstgehostete Version ist jedoch weiterhin verfügbar. Auf Herstellerseite wurde Intel IPEX-LLM im Januar 2026 archiviert und aufgrund bekannter Sicherheitslücken ohne veröffentlichten Migrationspfad als veraltet gekennzeichnet. NVIDIA RTX AI Toolkit wurde im November 2025 als veraltet eingestuft.
Wie viel VRAM benötige ich, um einen lokalen LLM auszuführen?
Für Chat-Anwendungen läuft mit 8 GB Arbeitsspeicher ein 3-Bit-Modell, mit 16 GB ein 7- bis 8-Bit-Modell, das allein mit der CPU akzeptabel ist. Für optimale Geschwindigkeit empfiehlt sich das Modell im VRAM oder im integrierten Speicher: 16 GB bewältigen die 7- bis 14-Bit-Klasse, 24 GB erreichen im vierten Quartal die 30-Bit-Klasse, und ab 32 GB wird auch anspruchsvolles Programmieren nicht mehr frustrierend. Darüber hinaus ist die Speicherkapazität wichtiger als die Bandbreite. Deshalb laufen Systeme mit 96 bis 128 GB integriertem Speicher mit Modellen, die keine Grafikkarte für Endverbraucher bewältigen kann.
Nutzen die lokalen LLM-Tools meine NPU?
Normalerweise nicht, da llama.cpp kein NPU-Backend besitzt. Daher nutzen Ollama und LM Studio auf Snapdragon- oder Ryzen-KI-Systemen die Neural Engine nur zu null Prozent und verwenden stattdessen CPU oder GPU. Um die NPU zu nutzen, ist derzeit ein Herstellerpfad erforderlich: Qualcomm GenieX, AMD Lemonade mit seiner NPU-Laufzeitumgebung, Intel OpenVINO oder Apples Neural Engine über die Betriebssystem-Frameworks. Der Vorteil liegt in der längeren Akkulaufzeit und dem energiesparenden Dauerbetrieb, da NPUs aktuell ebenfalls ihre maximale Leistung bei Modellen mit etwa 7 Milliarden Bit erreichen und eine dedizierte GPU in puncto Durchsatz stets überlegen ist.
Soll ich die lokale KI unter Windows oder Linux ausführen?
Für die Desktop-Anwendungen auf dieser Seite bieten Windows und macOS die reibungslosere Lösung. LM Studio, Jan, AnythingLLM und Ollama lassen sich nativ installieren, GPU-Treiber sind von den üblichen Quellen verfügbar, und es wird kein Terminal benötigt. Linux hat hier einen entscheidenden Vorteil: Die Produktions-Server-Engines vLLM und SGLang sind primär für Linux entwickelt, Multi-GPU-Server setzen dies praktisch voraus, und einige der neuesten Beschleunigungspfade sind zuerst unter Linux verfügbar, darunter auch AMDs Ryzen AI NPU-Unterstützung, die unter Linux eingeführt wurde und einen sehr aktuellen Kernel voraussetzt.
Die Kluft ist geringer als früher. AMD hat seine ROCm-Releases 2026 für Windows und Linux vereinheitlicht, und WSL2 deckt den Großteil der verbleibenden Kompatibilität ab. Dadurch laufen Docker-basierte Tools wie Open WebUI problemlos auf Windows-Rechnern. Die Faustregel lautet: Wenn Sie Desktop-Anwendungen installieren, bleiben Sie bei Ihrem Betriebssystem. Wenn Sie hingegen einen dedizierten Server einrichten oder alle Beschleunigungsmöglichkeiten nutzen möchten, sollten Sie Linux verwenden.
Sind lokale Modelle ausreichend, um ein Cloud-Modell für die Codierung zu ersetzen?
Es hängt vollständig von der Aufgabe ab, und die Unterschiede sind deutlicher, als die meisten Berichte zugeben. Bei überschaubaren Aufgaben wie der Generierung von Einzeldateien, Unit-Tests, Boilerplate-Code und erklärendem Code sind aktuelle Open-Source-Modelle auf einer guten Workstation in etwa gleichwertig mit modernen Cloud-Modellen. Bei langfristigen, komplexen Aufgaben wie Refactoring mehrerer Dateien in einem großen Repository schneiden sie jedoch deutlich schlechter ab, und die Fehlerursachen sind unangenehm: unbemerkte, nicht ausgeführte Aktionen und fälschlicherweise gemeldete Arbeiten. Wenn Sie aus Gründen des Datenschutzes, der Trennung von Servern oder der Kosten lokal arbeiten möchten, ist dies aktuell eine sinnvolle Option. Wenn Sie hingegen Wert auf Leistung legen, ist dies noch nicht der Fall.
Ist die lokale Ausführung eines Modells sicherer als die Nutzung eines Cloud-Dienstes?
Für die Datenresidenz ist die Antwort ja, und das ist der Grund, warum die meisten Menschen lokale Lösungen bevorzugen. Was die Softwaresicherheit angeht, ist die Antwort standardmäßig nein: Eine lokale KI-Anwendung mit einem CVSS-Wert von 9.6 (Stand: März 2026) könnte durch die Ausgabe des Modells selbst dazu veranlasst werden, Code auf dem Host auszuführen, da die Desktop-Anwendung mit unsicheren Standardeinstellungen ausgeliefert wurde. Lokal bedeutet, dass Ihre Daten am selben Ort bleiben, aber nicht, dass die Software sicherer ist, da in dieser Kategorie viel schnelllebiger Code verarbeitet wird.
Was ist eine KI-Agenten-Sandbox und benötige ich eine für lokale KI?
Eine Sandbox ist eine isolierte Umgebung, üblicherweise ein Container oder eine schlanke virtuelle Maschine, in der ein KI-Agent die von ihm generierten Befehle und Codes ausführt. Dadurch können Fehler oder schädliche Anweisungen das Hostsystem nicht beeinträchtigen. Sie ist notwendig, da Agenten mehr tun, als nur Fragen zu beantworten: Sie führen Shell-Befehle aus, bearbeiten Dateien und navigieren im Internet. Jede dieser Aktionen basiert auf Modellausgaben, die manipuliert werden können. Die lokale Ausführung des Modells ändert daran nichts.
Sandboxing isoliert die Aktionen des Agenten, nicht den Speicherort des Modells. Die oben beschriebene Codeausführungs-Schwachstelle verdeutlichte genau dieses Problem bei einer lokal ausgeführten Anwendung. Einige der hier vorgestellten Tools bieten integriertes Sandboxing. Tools, die Agenten mit uneingeschränktem Hostzugriff ausführen, sollten besonders sorgfältig geprüft werden, bevor sie auf wichtigen Systemen eingesetzt werden. Mit zunehmender Verbreitung von Agenten im Unternehmensumfeld wird Sandboxing voraussichtlich zu einem wichtigen Ausstattungsmerkmal werden, und wir werden es künftig bei der Bewertung dieser Tools berücksichtigen.
Kann lokale Hardware agentenbasierte Workloads mit Dutzenden von Subagenten ausführen?
Dies ist die Grenze des Machbaren, und kurz gesagt: Der Speicherplatz einer einzelnen Workstation stößt schnell an seine Grenzen. Multiagenten-Workloads erzeugen Subagenten, die jeweils ihren eigenen Kontext verwalten. Auf der Inferenzseite bedeutet jeder aktive Kontext einen eigenen KV-Cache im Arbeitsspeicher, sodass der Speicherbedarf sowohl mit der Anzahl der gleichzeitigen Prozesse als auch mit der Modellgröße skaliert. Wohin diese Caches verschoben werden, wenn der Arbeitsspeicher nicht mehr ausreicht, ist ein eigenes technisches Problem. Unsere detaillierte Analyse des KV-Cache-Offloads auf Flash-Speicher , basierend auf Hardware von Dell und Solidigm, ist die beste bisher veröffentlichte Abhandlung zu diesem Thema.
Eine Maschine, die problemlos eine Agentensitzung der 30B-Klasse verarbeiten kann, kann typischerweise einige parallele Sitzungen über einen Batch-Server bewältigen, bevor die Latenz zunimmt. Dutzende gleichzeitig laufende Subagenten sind Serverbereich mit ausreichend Speicher für viele aktive Kontexte und einer Serving-Engine wie vLLM, die für kontinuierliches Batching ausgelegt ist. Es gibt auch eine Qualitätsgrenze, da lokale Modelle mit zunehmender Anzahl an Tools an Zuverlässigkeit verlieren und die Orchestrierung die Anzahl der Tools und Übergaben vervielfacht.
Wir vertreten die Auffassung, dass die Arbeit mit einem oder wenigen Agenten heutzutage eine legitime Aufgabe für einzelne Arbeitsstationen darstellt, während große Flotten von Subagenten eine Infrastrukturaufgabe sind. Diese Grenze und die dafür benötigte Hardware wollen wir noch genauer untersuchen.


 Amazon