

Die Acer Veriton GN100 AI Mini-Workstation ist eines von mehreren Spark-basierten Systemen, die wir evaluieren. Alle basieren auf NVIDIAs GB10 Grace Blackwell Superchip. Wie die anderen Systeme ist auch die GN100 darauf ausgelegt, KI-Rechenleistung der Rechenzentrumsklasse in einem kompakten Desktop-Gehäuse zu vereinen. So können Entwickler und Forscher Modelle lokal ausführen und optimieren, anstatt sich vollständig auf Cloud-Infrastruktur zu verlassen.
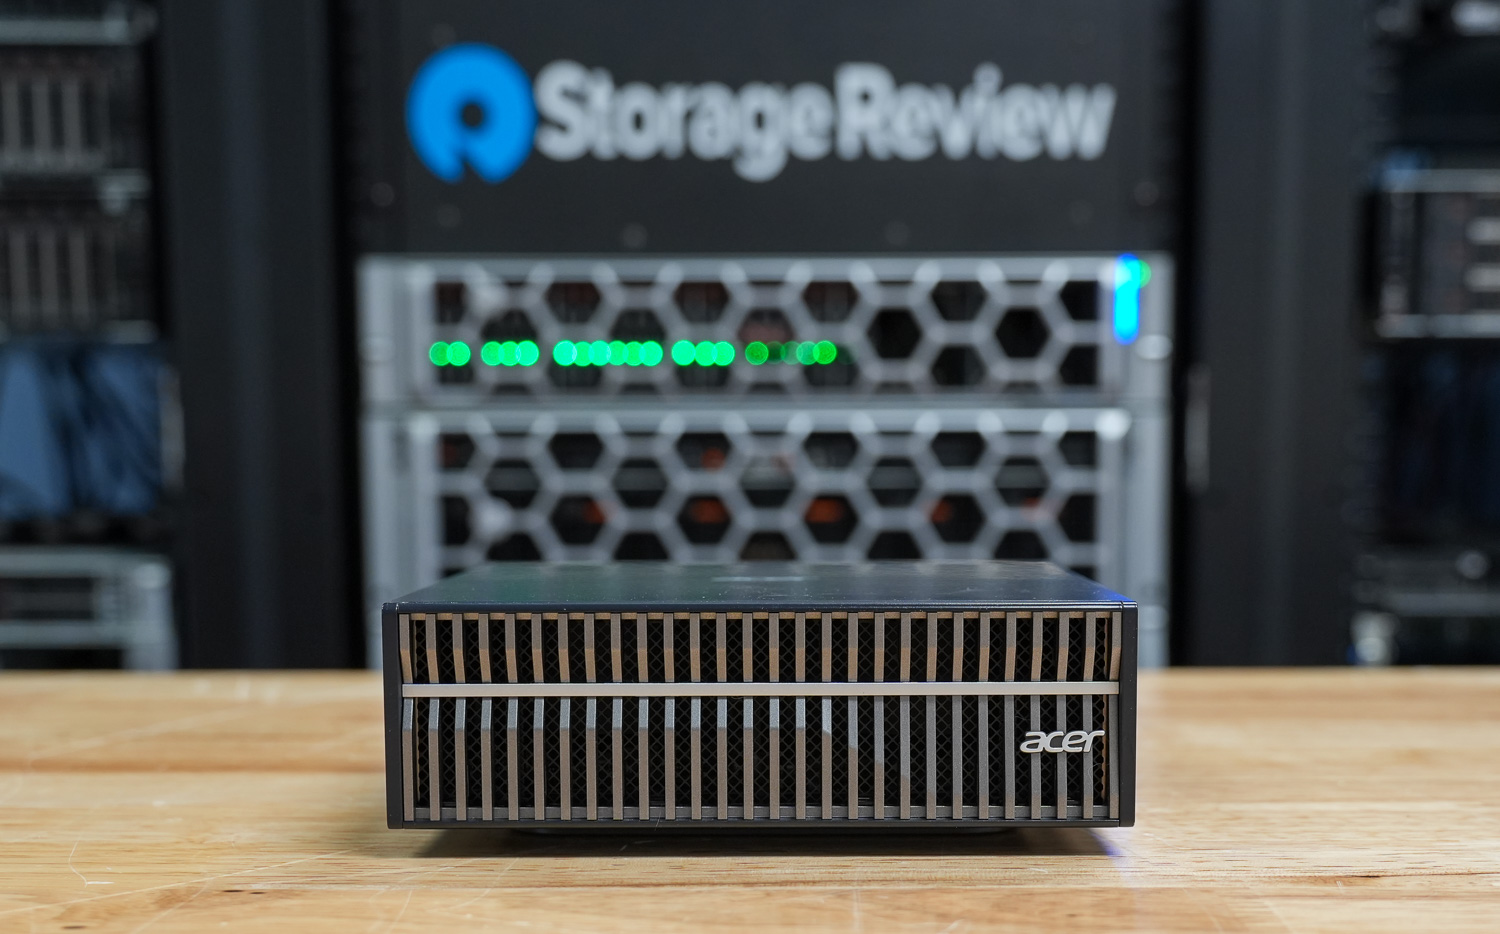
In dieser Konfiguration kombiniert der GN100 den 20-Kern-ARM-basierten GB10-Prozessor mit integrierter Blackwell-Grafik und liefert eine FP4-KI-Leistung von bis zu 1 PetaFLOP. Er ist mit 128 GB LPDDR5x-Speicher und einer 4 TB großen PCIe Gen5 NVMe SSD ausgestattet und bietet damit die für große Sprachmodelle, generative KI-Workflows und datenintensive Experimente benötigte Speicherbandbreite und den erforderlichen Datendurchsatz.
Wie die anderen Spark-Systeme dieser Gruppe unterstützt auch der GN100 die lokale KI-Ausführung und ermöglicht gleichzeitig die Systemerweiterung über die integrierte NVIDIA ConnectX-7 SmartNIC. Zwei Einheiten können miteinander verbunden werden, um größere Modellworkloads zu bewältigen, die über die Kapazität eines einzelnen Geräts hinausgehen.
Das System wird mit dem NVIDIA DGX-Betriebssystem und dem kompletten KI-Software-Stack vorinstalliert ausgeliefert und ist somit sofort für den Einsatz in Entwicklungs- und Forschungsumgebungen bereit.
Acer Veriton GN100 AI Spezifikationen
| Normen | Acer Veriton GN100 AI (GB10) |
|---|---|
| Abmessungen und Gewicht | |
| Höhe | 2 in |
| Länge | 5.9 in |
| Tiefe | 5.9 in |
| Gewicht | 2.65 g |
| Prozessor | |
| Prozessortyp | NVIDIA GB10 (Grace Blackwell Superchip) (20 Kerne) |
| Integrierte Graphiken | NVIDIA Blackwell GPU (integriert) |
| Memory | |
| Speichertyp | LPDDR5x (Unified System Memory) |
| Speicherkonfiguration | 128 GB LPDDR5x, einheitlicher Systemspeicher |
| Speicherbandbreite | 273 GB/s (8533 MT/s) |
| Betriebssystem | |
| Unterstützte Betriebssysteme | NVIDIA DGX-Betriebssystem |
| Externe Anschlüsse und Steckplätze | |
| Netzwerkanschlüsse | Ein RJ45-Anschluss (10GbE) NVIDIA ConnectX-7 NIC (200G × 2 QSFP) |
| USB-Ports | Drei USB 3.2 Gen 2×2 Typ-C (20 Gbit/s) Ein USB 3.2 Gen 2×2 Typ-C-Anschluss mit PD |
| Videoanschluss(e) | Ein HDMI 2.1a-Anschluss |
| Netzteilanschluss | USB Typ-C (PD IN) |
| Sicherheits-Slot | Ein Kensington-Schloss |
| Wireless | |
| WLAN | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Lagerung | |
| Speicheroptionen | Bis zu 4 TB NVMe SSD (PCIe Gen5) |
| Power Adapter | |
| Typ | 240-W-Netzteil (USB Typ-C) |
Acer Veriton GN100 AI Build And Design
Die Front des Veriton GN100 wird von einer Reihe vertikaler Lamellen dominiert, die sich über die gesamte Breite des Chassis erstrecken. Eine horizontale Akzentlinie durchzieht den Kühlergrill und verleiht ihm im Vergleich zu den anderen von uns betrachteten Spark-basierten Systemen ein einzigartiges Aussehen.
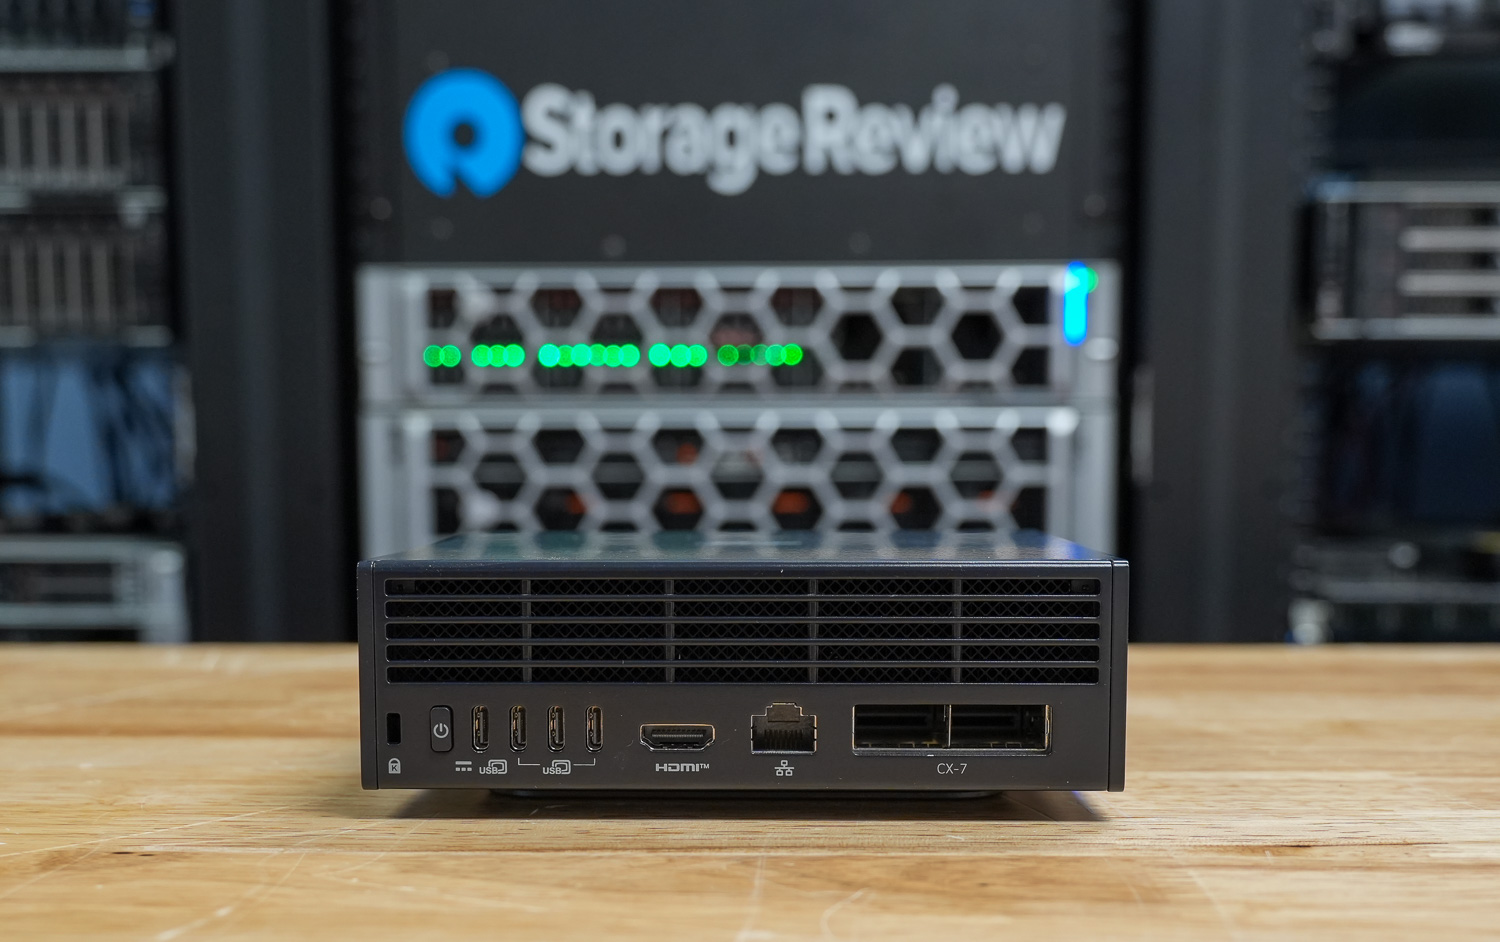
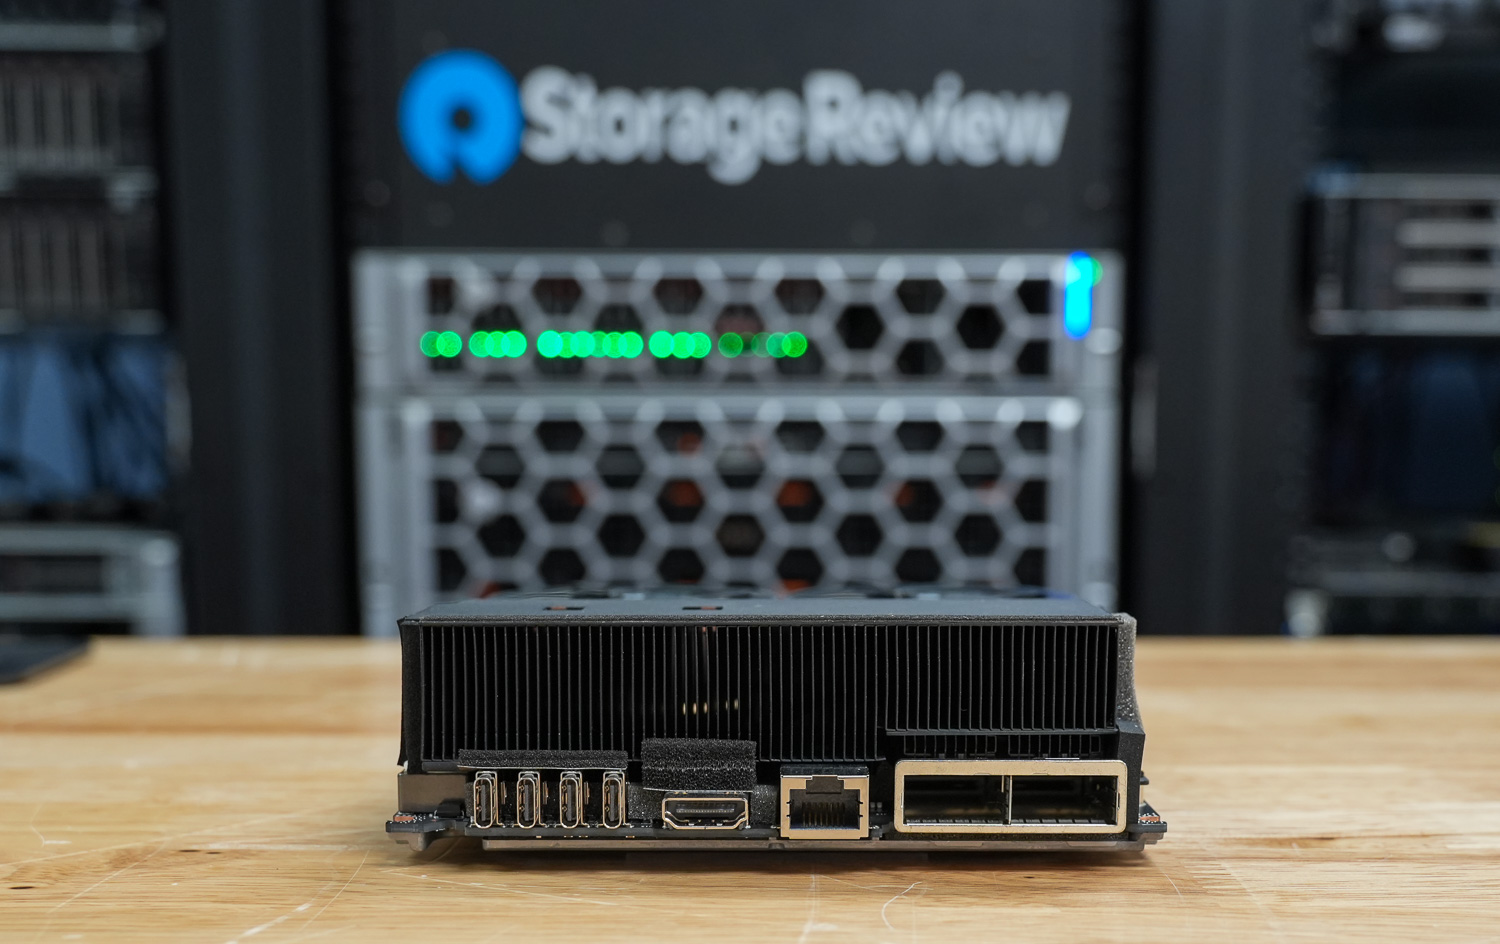
Alle primären Anschlüsse befinden sich an der Rückseite des Systems. Acer bietet vier USB 3.2 Typ-C-Anschlüsse, einer davon mit Stromversorgung, sowie einen HDMI 2.1b-Anschluss für die Bildausgabe. Für die Netzwerkverbindung stehen ein RJ-45-Ethernet-Anschluss und eine NVIDIA ConnectX-7 Smart NIC zur Verfügung, die schnelle Bandbreitenverbindungen und Systemvernetzung ermöglichen. Drahtlosverbindungen werden durch Wi-Fi 7 und Bluetooth 5.1 oder höher unterstützt. Ein Kensington-Schloss sorgt für zusätzliche Sicherheit.
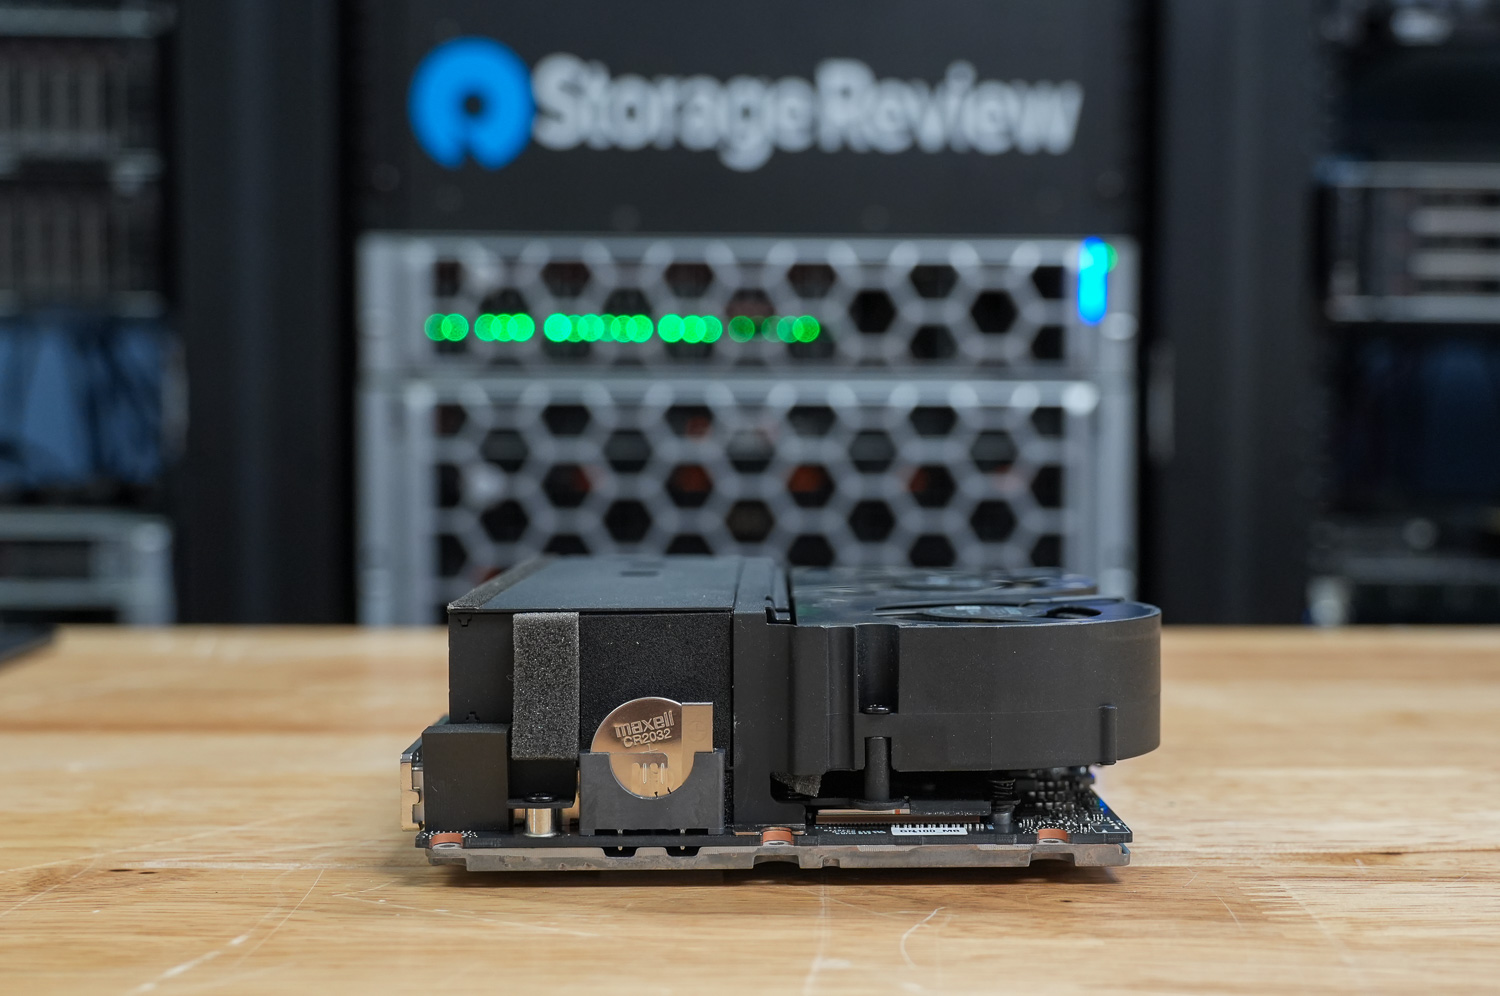
Hier sehen Sie die Metallabschirmung und die Strukturplatte, die sich über das gesamte Gehäuse erstreckt und sowohl als Verstärkungsrahmen als auch als Wärmeverteiler dient. Unten links befindet sich ein leicht zugänglicher M.2 2242 NVMe SSD-Steckplatz, der mit einer einzelnen Schraube befestigt und teilweise unter der Metallplatte verborgen ist.
Um an den unteren Teil des Acer-Geräts zu gelangen, entfernen Sie die umlaufenden Schrauben und heben Sie die Bodenplatte sauber ab. Im Inneren präsentiert sich das Layout übersichtlich und gut organisiert und bietet direkten Einblick in die Kühleinheit, den Speicherbereich und die Komponenten des Mainboards. Die Bodenplatte selbst wirkt robust und trägt zur Gesamtstabilität des Gehäuses bei.
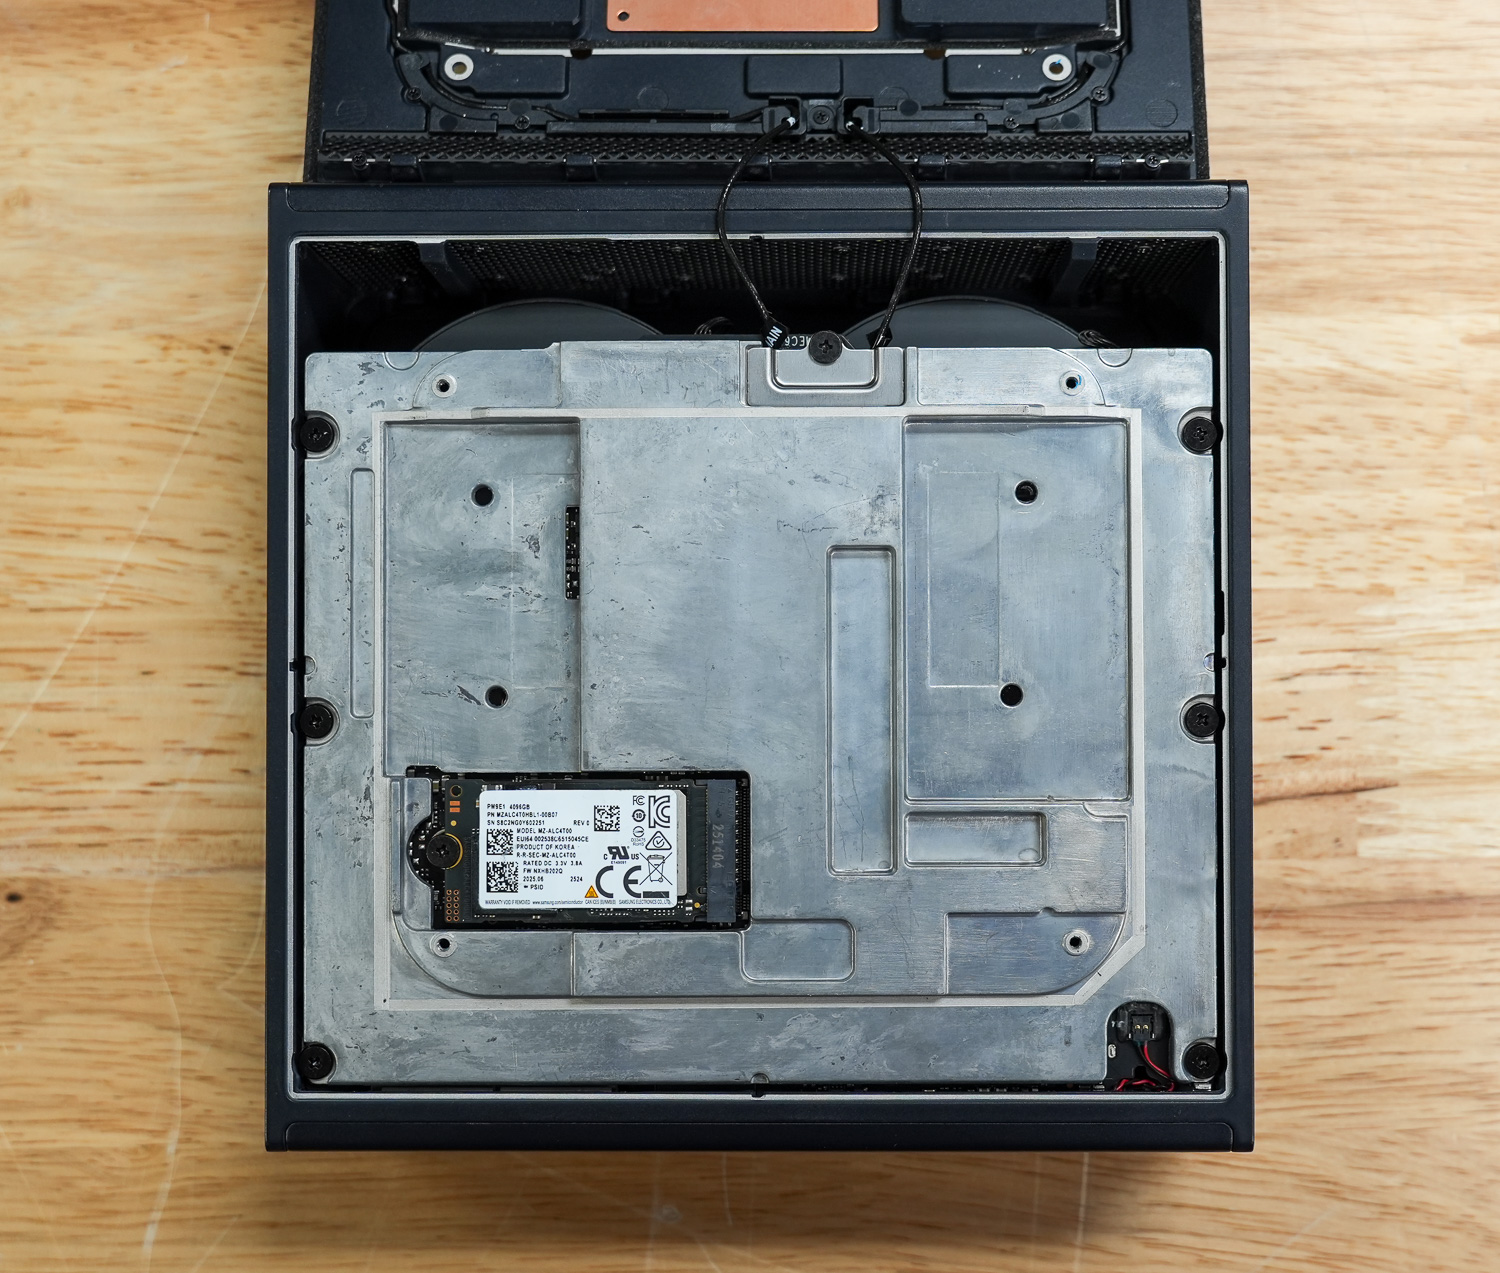
Im Vergleich zu den anderen von uns getesteten Spark-Systemen verfolgt Acer hier einen etwas anderen Ansatz. Anstelle der hochwertigeren, lackierten Metallbodenplatte, die wir von der Founders Edition und einigen OEM-Implementierungen kennen, verwendet Acer eine rohe, unbehandelte Gussmetallbodenplatte. Die Oberfläche ist weniger poliert und weist eine sichtbare Gussstruktur auf, die Platte ist jedoch dennoch dick und stabil. Funktionell erfüllt sie weiterhin denselben Zweck als Verstärkungsrahmen und zusätzlicher Wärmeverteiler, wobei die Wahl des Herstellungsverfahrens eindeutig eine andere Design- und Kostenphilosophie widerspiegelt.
Wärmetest des Acer Veriton GN100 AI
Um die Wärmeableitung des Acer Veriton GN100 AI zu testen, verglichen wir sie mit der Founders Edition und Geräten von OEMs wie Dell, ASUS und GIBABYTE. Eine detailliertere Analyse dieser Ergebnisse finden Sie in unserer Studie „Spark Thermal Testing“.
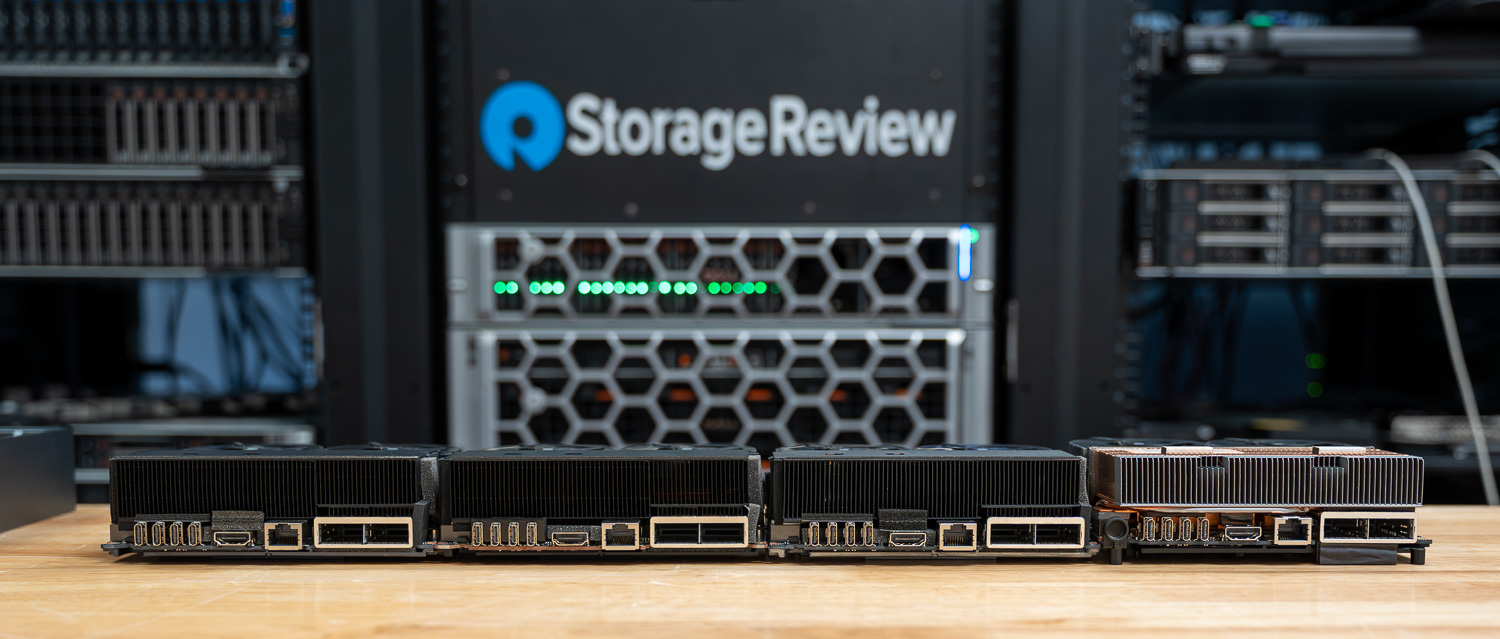
Wir überwachten die Komponenten des gesamten Stacks über einen festgelegten Zeitraum mit drei Auslastungsstufen, wobei die Nutzung über etwa eine Stunde hinweg schrittweise erhöht wurde. Dadurch konnten wir das Gerät im Dauerbetrieb und in verschiedenen Auslastungsstufen beobachten. Wir überwachten die Temperaturen von CPU, GPU, Netzwerk und NVMe sowie den Gesamtstromverbrauch.
CPU Temperatur
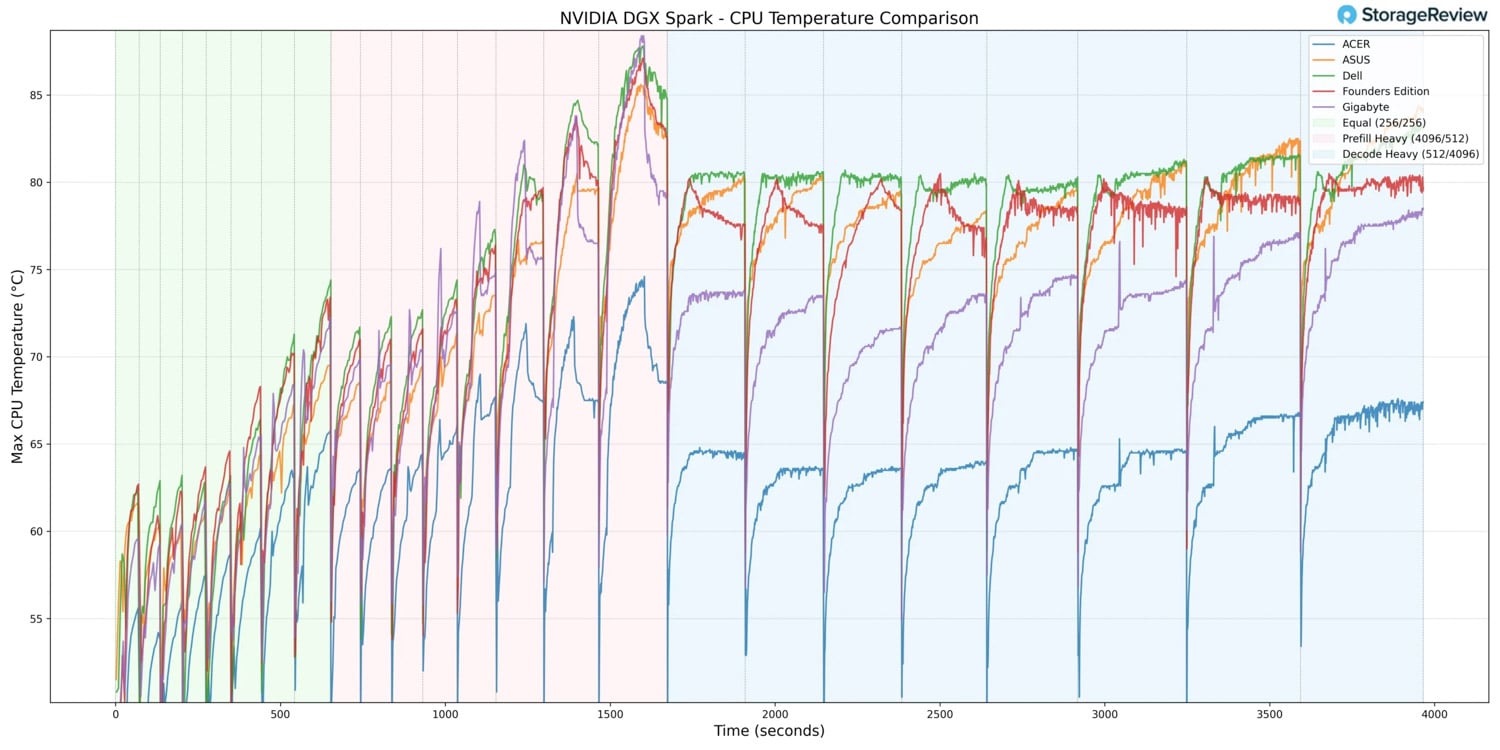
Bei thermischen Tests der CPU erreichte das Acer-System während intensiver Vorbefüllungsaktivitäten eine Spitzentemperatur von 74.7 °C. Dies ist eine der niedrigsten maximalen CPU-Temperaturen in der Vergleichsgruppe und deutet auf eine besonders effiziente und konservative Wärmeableitung hin.
Als die Arbeitslast auf gleichmäßige ISL/OSL-Berechnungen und anhaltende Phasen mit hoher Dekodierungslast umgeschaltet wurde, blieben die CPU-Temperaturen ohne aggressive Temperaturanstiege im optimalen Bereich. Anstatt die bei einigen Konkurrenzsystemen beobachteten Werte von über 80 °C zu erreichen, hielt Acer die Betriebstemperaturen in einem niedrigeren Bereich, was auf ausreichend Kühlreserven unter anhaltender Rechenlast hindeutet.
Im Leerlauf oder bei geringer Last erreichte die CPU eine minimale Temperatur von 37.8 °C. Dieser Wert entspricht dem der übrigen Komponenten und bestätigt die Wirksamkeit der Kühllösung von Acer sowohl im Leerlauf als auch unter Last.
Insgesamt bot Acer eines der kühlsten CPU-Wärmeprofile in der Gruppe, sowohl in Spitzenlast- als auch in Dauerlastphasen.
GPU-Temperatur
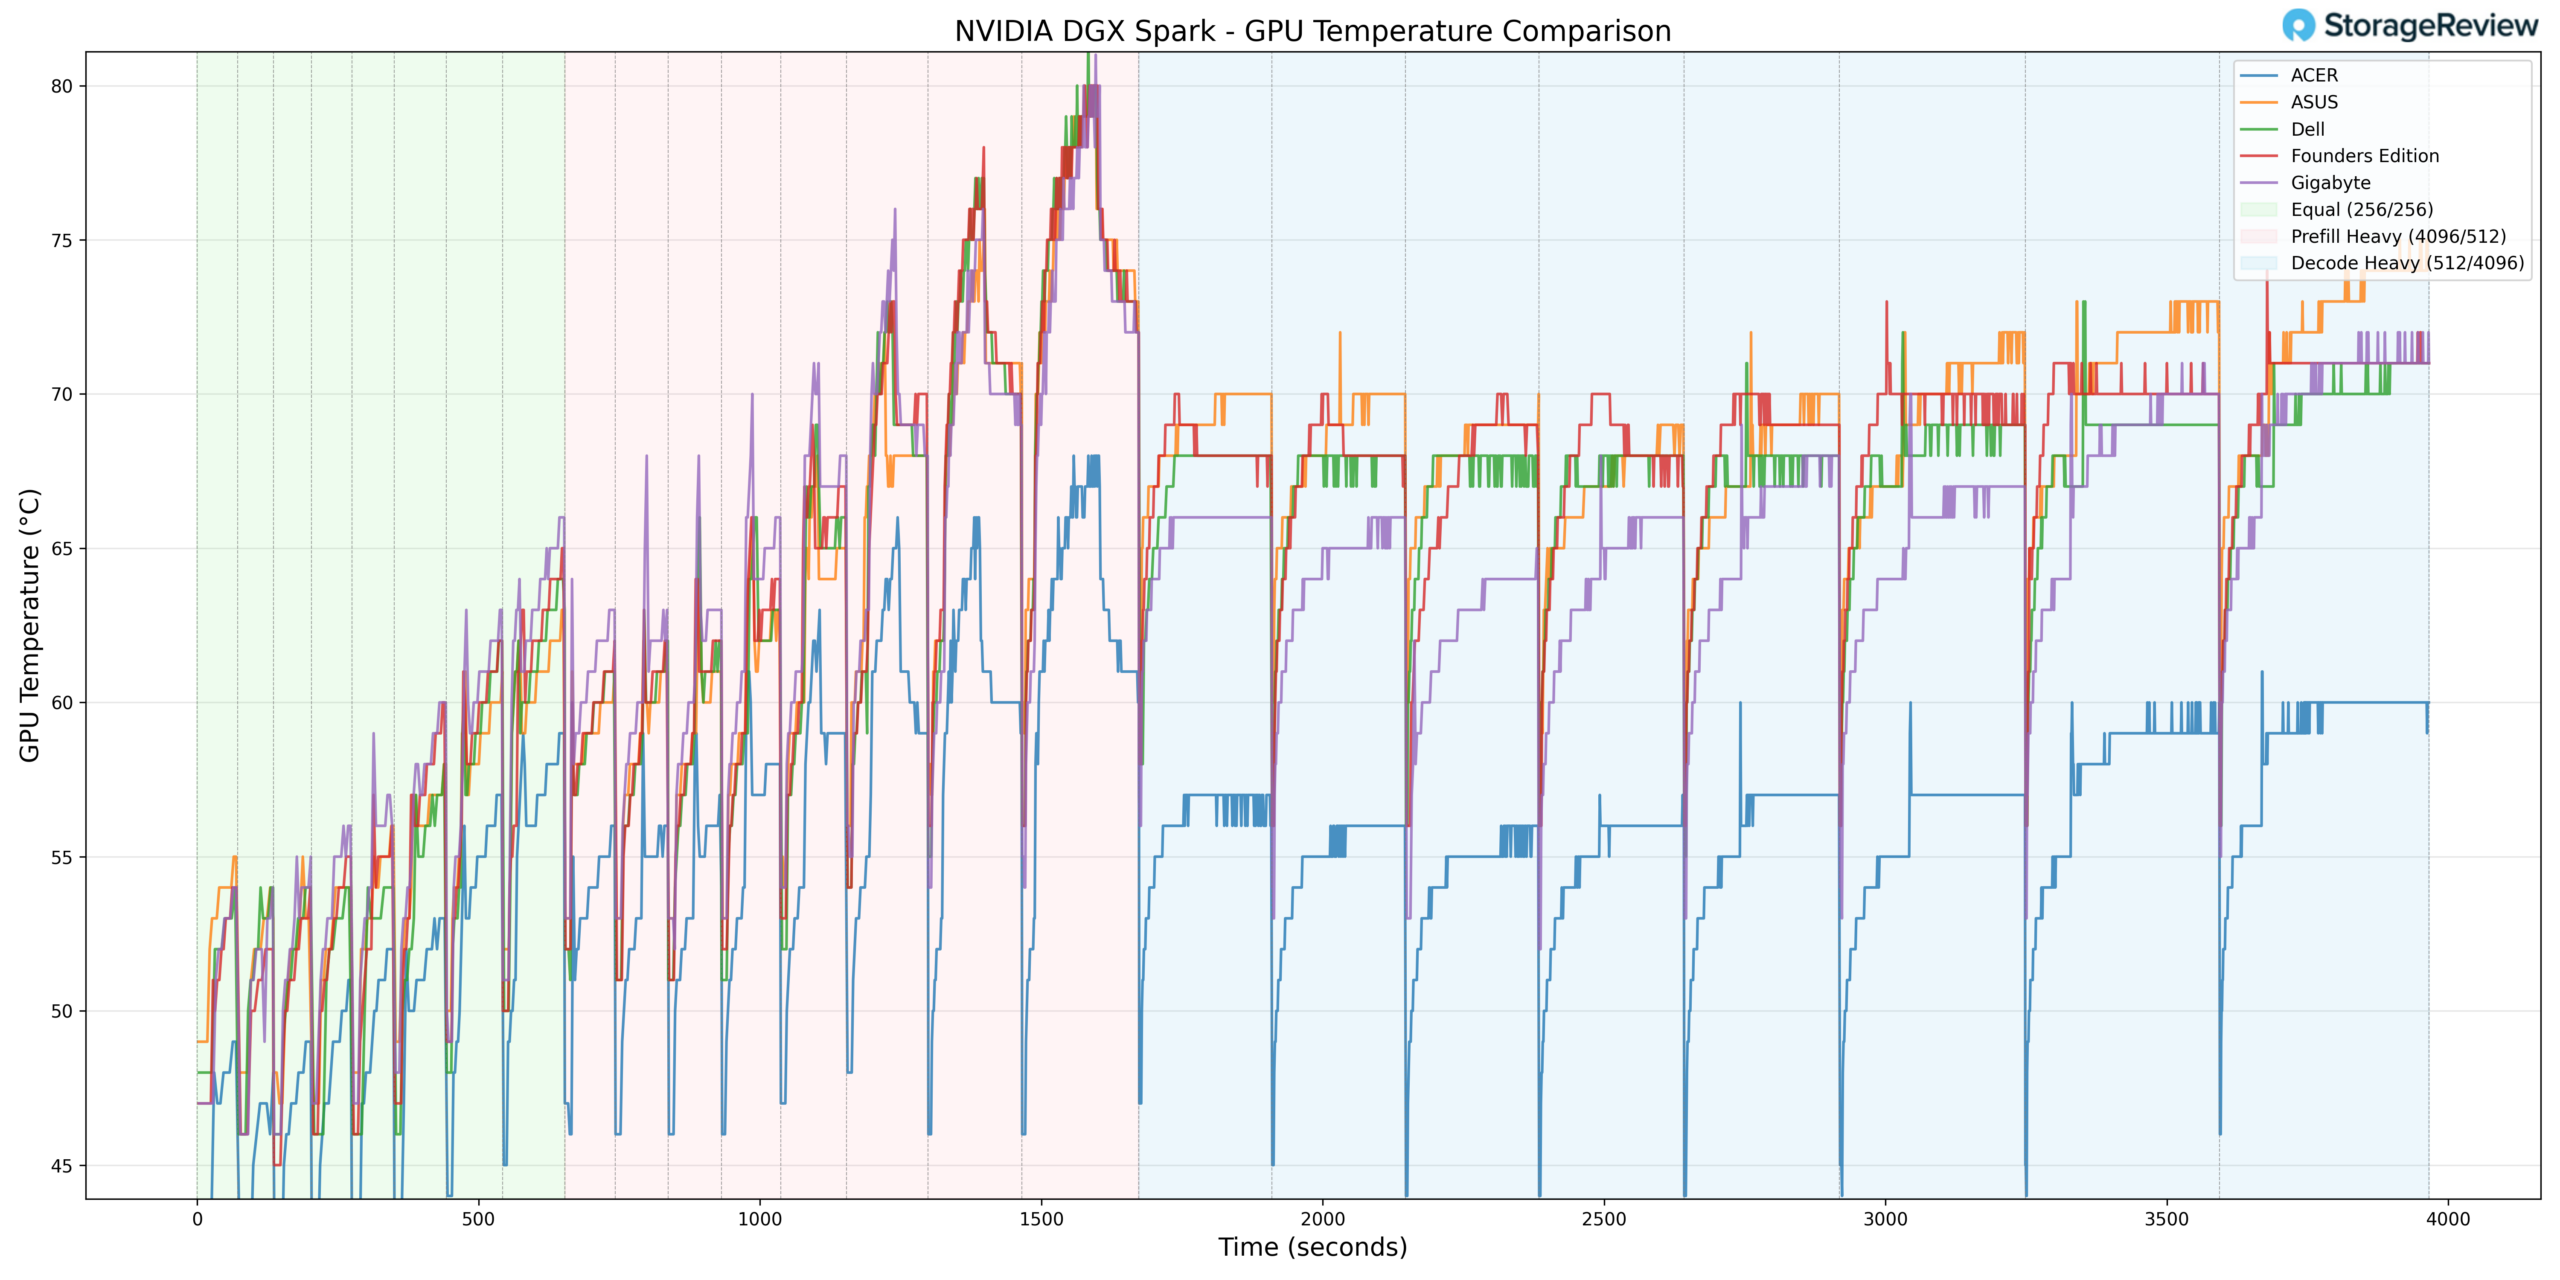
Die GPU-Temperaturen verhielten sich ähnlich moderat. Während der Prefill Heavy-Beschleunigung erreichte die GPU eine maximale Temperatur von 69 °C, was deutlich niedriger ist als bei einigen Konkurrenzprodukten während intensiver Belastung.
Mit zunehmender Auslastung in den Phasen „Equal ISL/OSL“ und „Decode Heavy“ stabilisierte sich die GPU in einem kontrollierten Bereich ohne nennenswerte Temperaturspitzen. Das System zeigte unter anhaltender Dekodierung ein konsistentes Verhalten und hielt einen deutlichen Abstand zu den oberen Betriebsgrenzen.
Die niedrigste gemessene GPU-Temperatur betrug 35°C während der weniger ausgelasteten Phasen und stellte damit einen der niedrigsten Leerlauf-Basiswerte im Stack dar.
Zusammengenommen bot Acer eine der insgesamt besten GPU-Implementierungen sowohl unter kurzzeitiger als auch unter dauerhafter Last.
NVMe-Temperatur
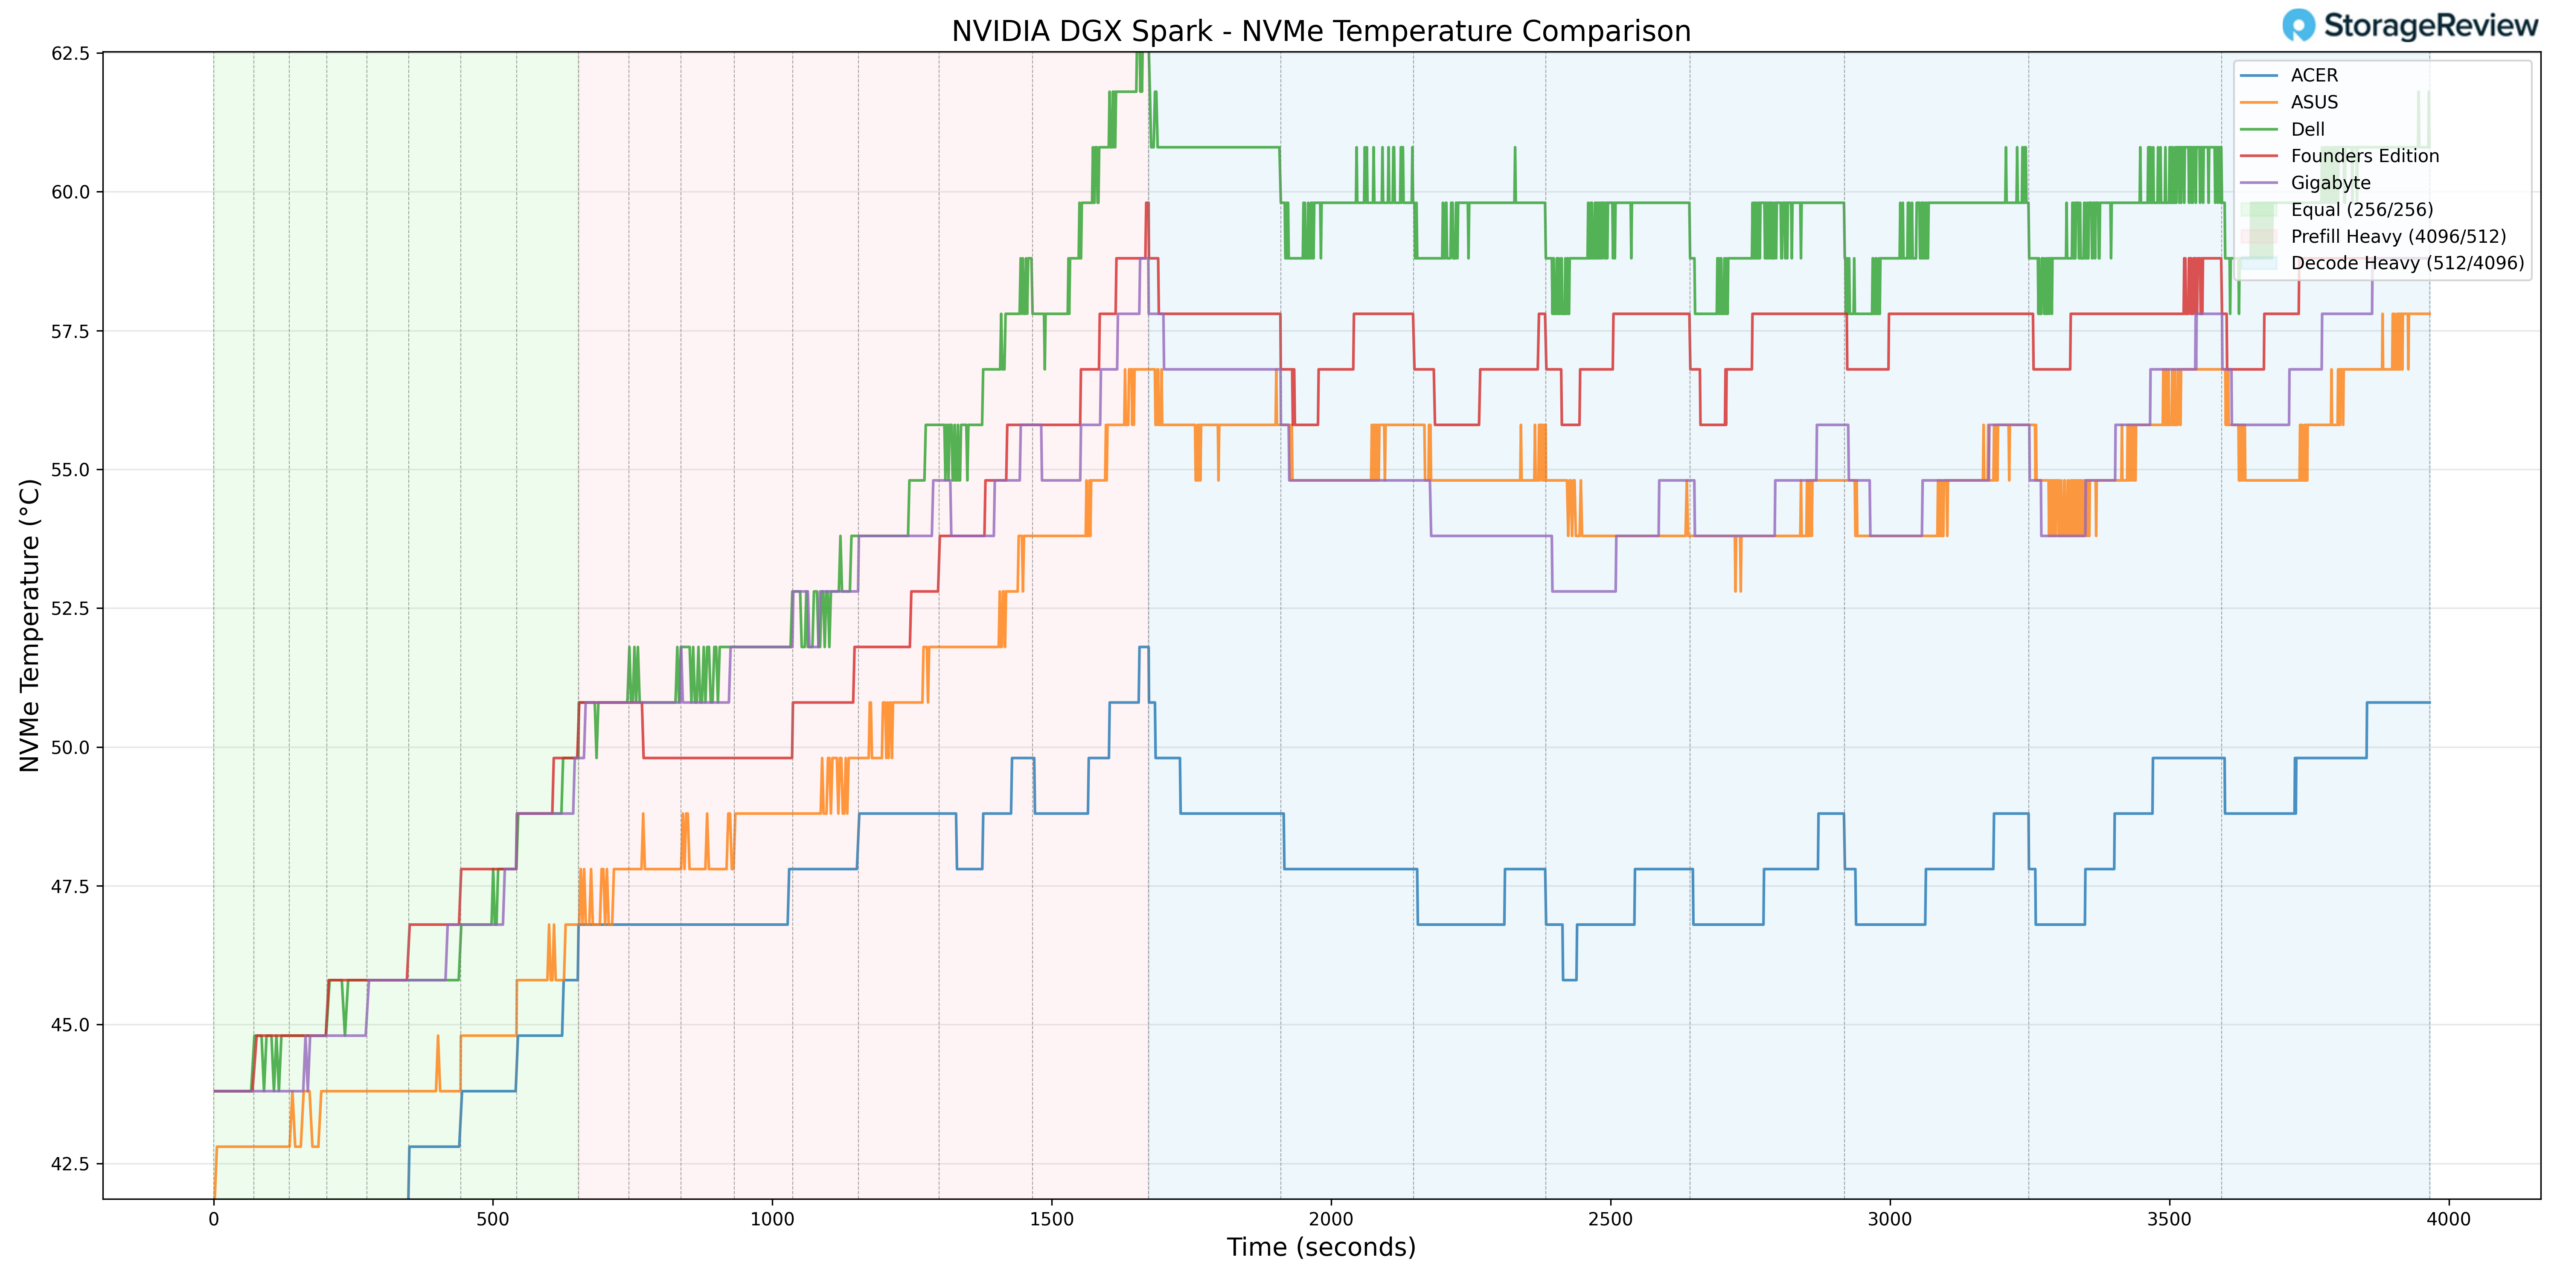
Die Wärmeentwicklung des Speichers blieb während der gesamten Testphase deutlich innerhalb der Spezifikationen. Die NVMe-SSD erreichte in Phasen höherer Auslastung einen Höchstwert von 56.8 °C und blieb damit deutlich unterhalb der üblichen Drosselungsschwellen. Dies entspricht den moderateren Speicherergebnissen der Vergleichsgruppe.
Im Leerlauf oder bei geringer Auslastung sank die NVMe-Temperatur auf 36.8°C, was darauf hindeutet, dass das Speichersubsystem bei geringer Last nicht thermisch eingeschränkt ist.
Insgesamt wies Acer wettbewerbsfähige NVMe-Temperaturen auf, die niedrige, anhaltende Temperaturen mit einem stabilen Basisverhalten verbanden.
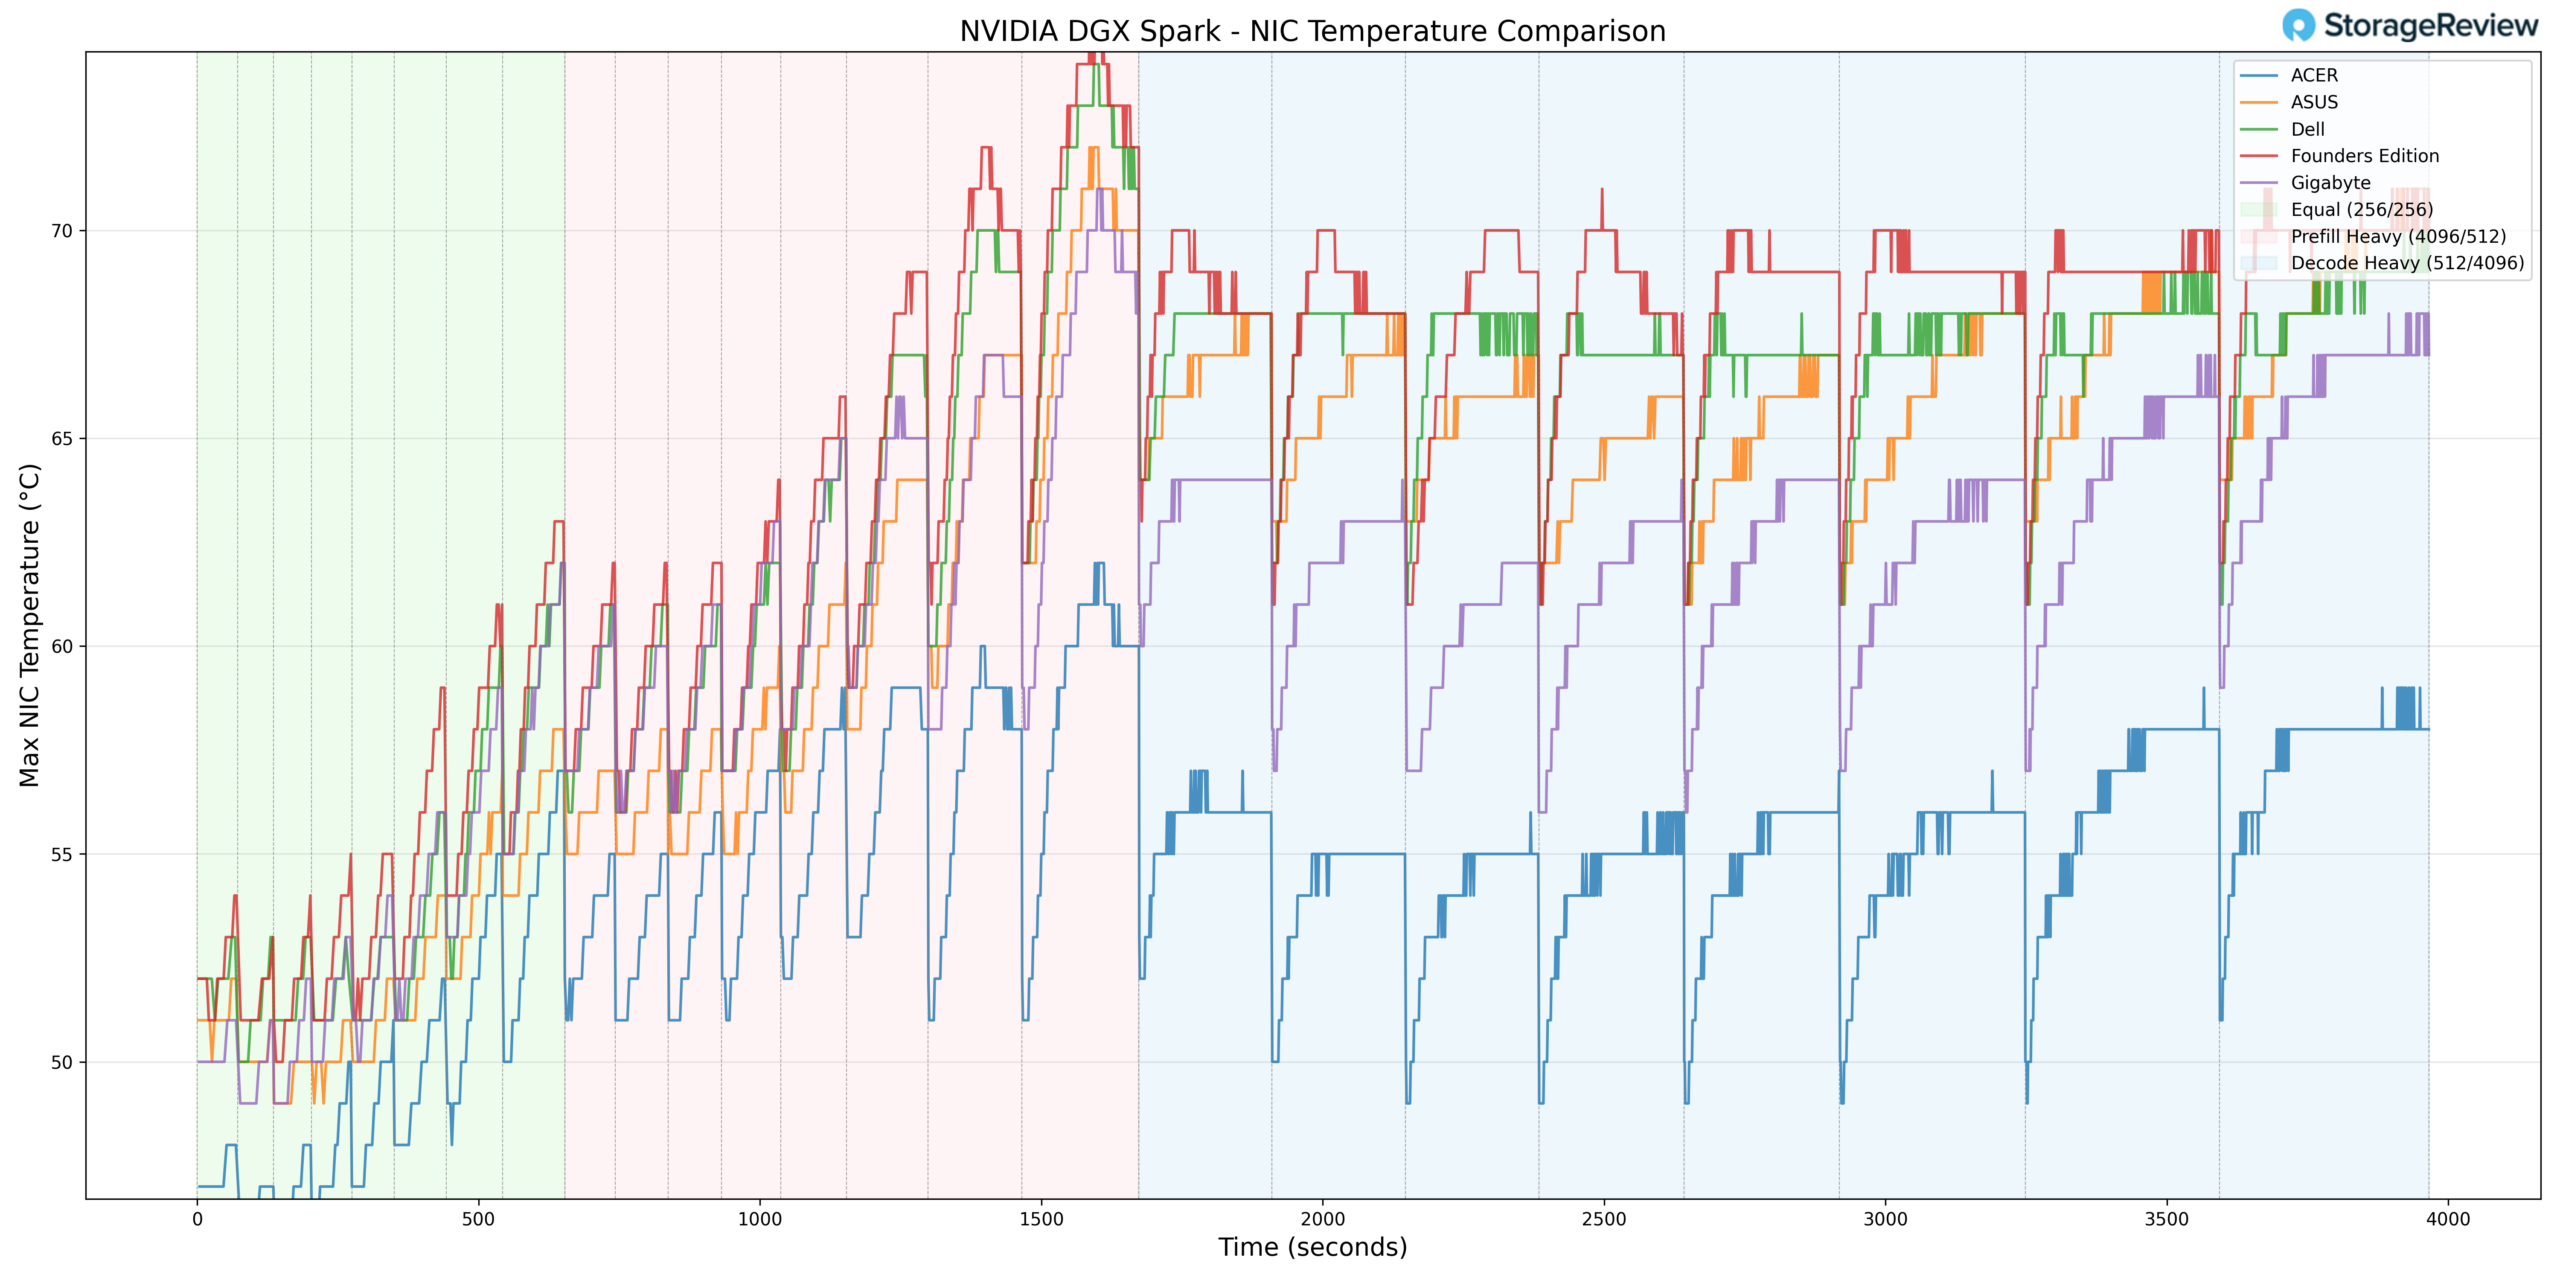
NIC-Temperatur
Die Temperatur des NIC erreichte während Phasen höherer Auslastung einen Spitzenwert von 61 °C. Dies stellt eine der niedrigsten maximalen NIC-Temperaturen in der Vergleichsgruppe dar und deutet auf eine effektive Luftzirkulation oder eine geeignete Komponentenplatzierung im Gehäuse hin.
Die niedrigste gemessene NIC-Temperatur betrug 39°C während der leichteren Phasen, was wiederum ein starkes thermisches Grundverhalten widerspiegelt.
Während der gesamten Testphase passte sich der Netzwerkcontroller proportional dem Arbeitslastbedarf an, ohne übermäßig zu skalieren.
GPU-Leistungsaufnahme
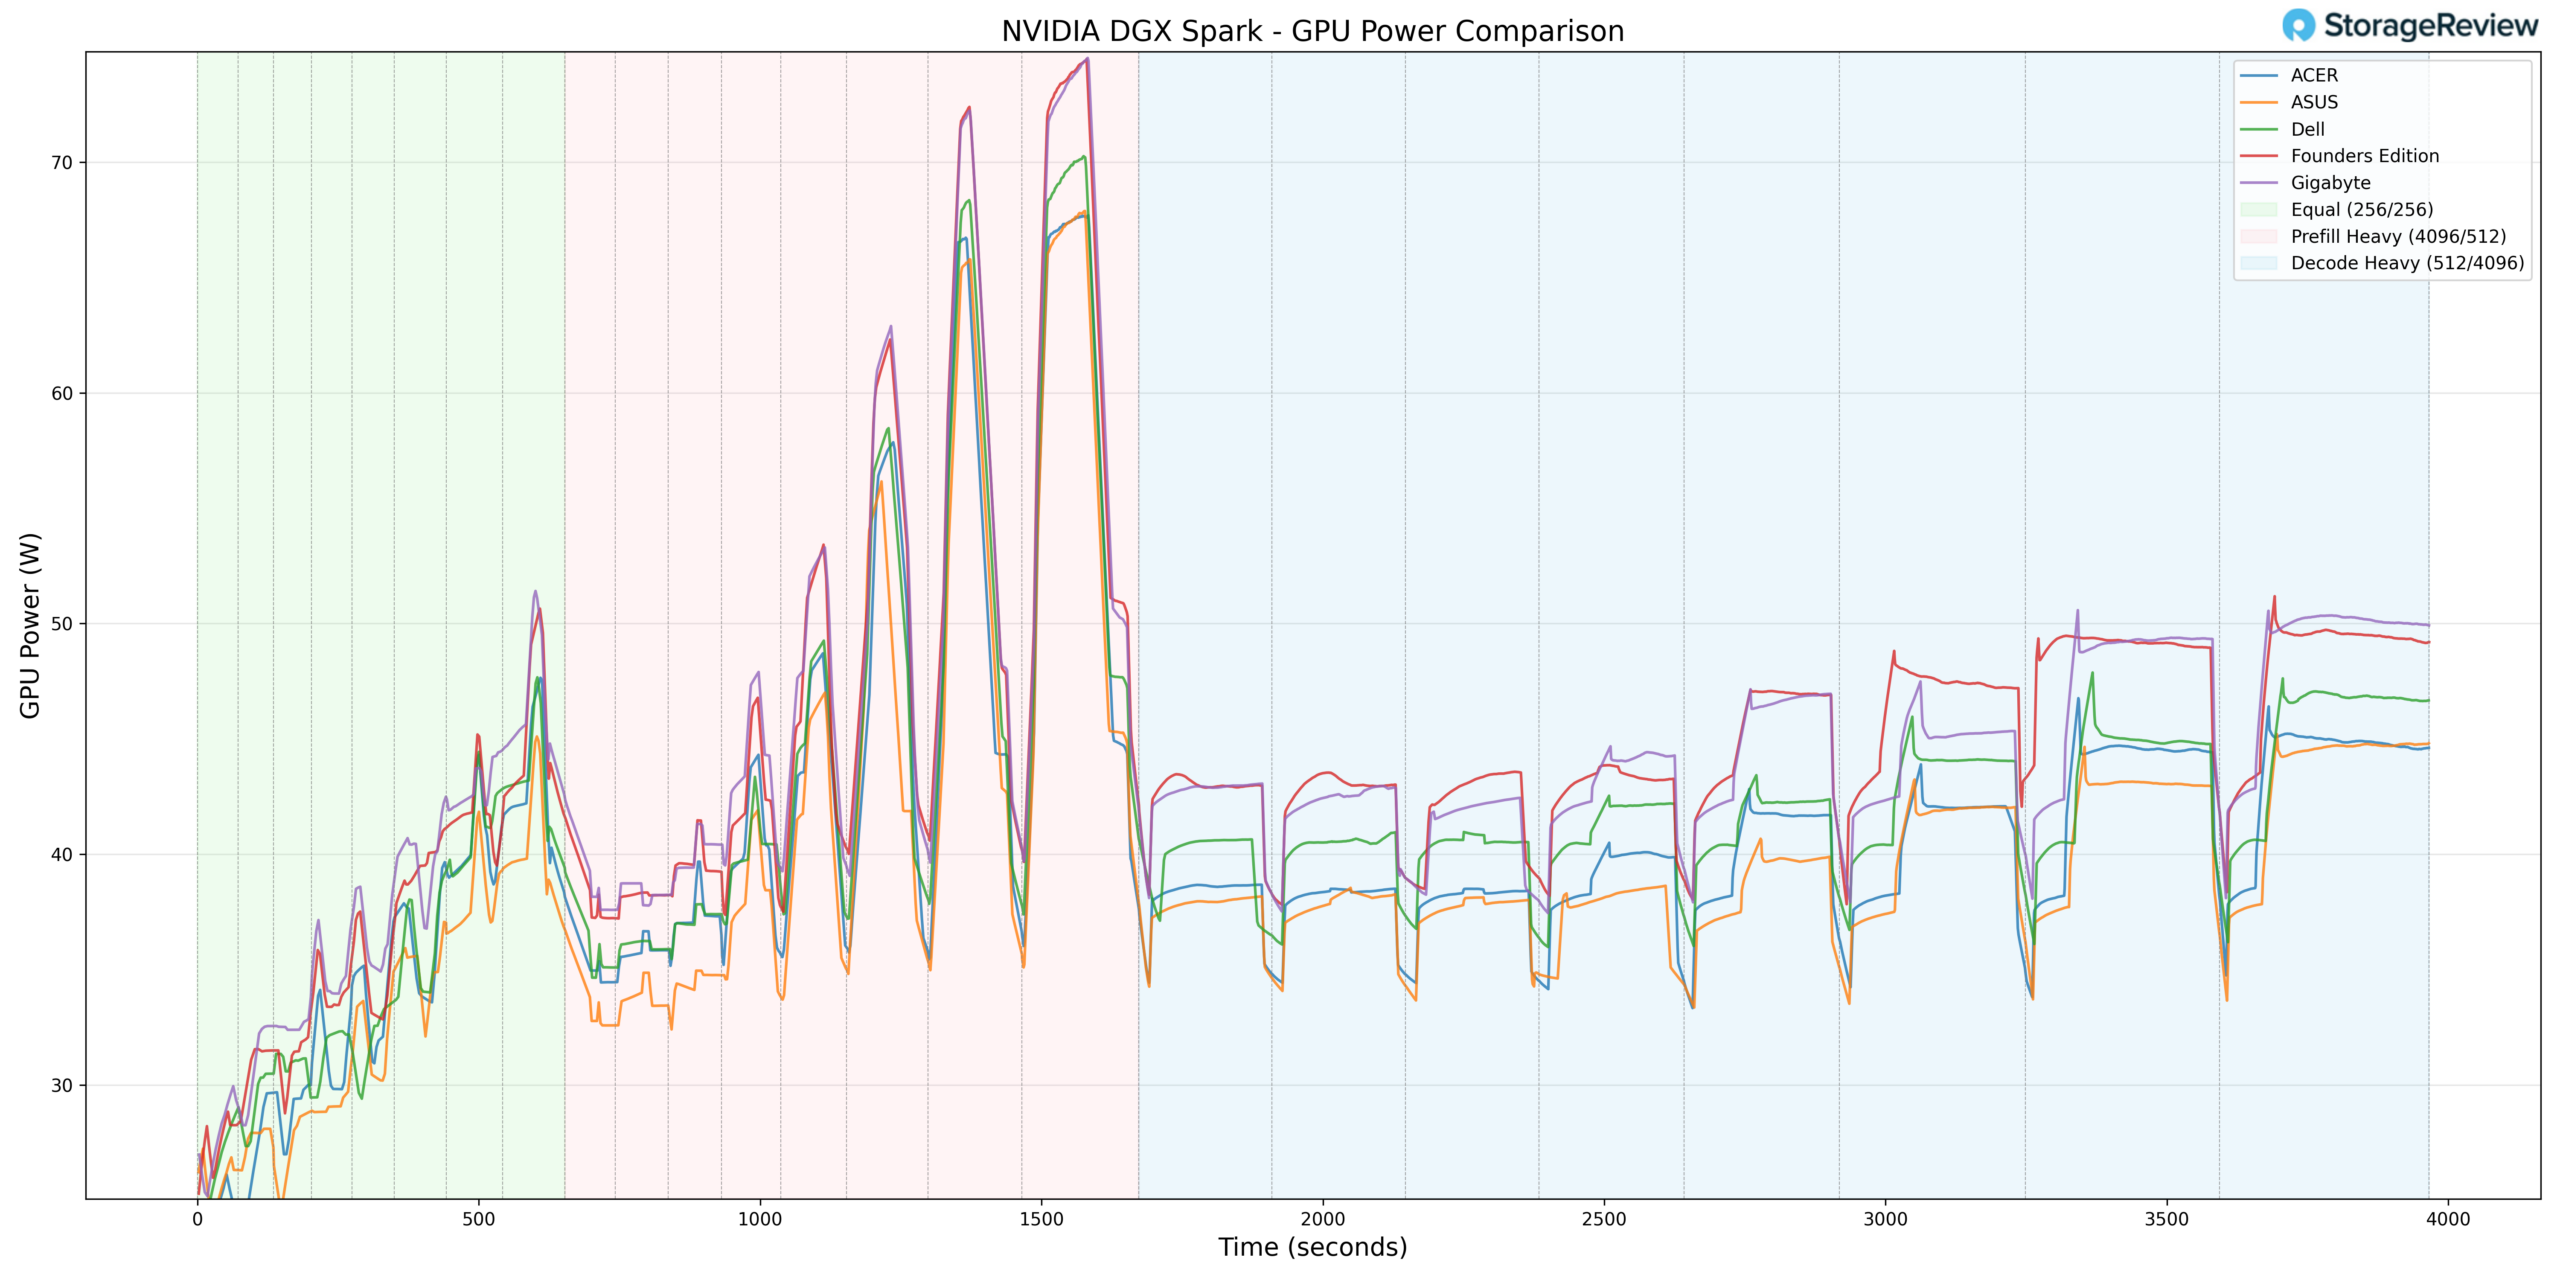
Die Leistungsaufnahme der GPU erreichte während der Prefill-Heavy-Übergänge einen Spitzenwert von 69.18 W. Damit liegt Acer leicht unter den höchsten Leistungsaufnahmewerten, die innerhalb der GB10-Prozessoren beobachtet wurden.
Die geringere Spitzenleistungsaufnahme korreliert direkt mit dem niedrigeren thermischen Profil der Acer-GPU. Anstatt die Leistungsaufnahme maximal auszureizen, scheint Acer ein ausgewogenes Verhältnis zwischen Leistung und thermischer Effizienz zu erzielen, was zu konstant niedrigeren Komponententemperaturen während der Spitzenlastphasen führt.
Bei anhaltender Decode-Last stabilisierte sich der Stromverbrauch im Einklang mit dem Lastbedarf und blieb vorhersehbar.
Thermische Zusammenfassung
Die Acer GB10 zeigte im Vergleich zu anderen Geräten das kühlste thermische Profil hinsichtlich CPU, GPU, NVMe und Netzwerkkarte. Die CPU erreichte bei Lastspitzen einen Höchstwert von 74.7 °C und die GPU 69 °C, während die NVMe unter 57 °C blieb und die Netzwerkkarte maximal 61 °C erreichte. Die Leistungsaufnahme der GPU lag bei maximal 69.18 W und damit etwas unter den höchsten gemessenen Werten.
Insgesamt legt Acer bei der Implementierung Wert auf thermische Effizienz und dauerhafte Stabilität, wodurch auch bei aggressiven Arbeitslastwechseln ein erheblicher Leistungsspielraum erhalten bleibt und gleichzeitig unter längerer Last eine gleichbleibende Leistung gewährleistet wird.
Leistungstests des Acer Veriton GN100
Zur Evaluierung des Acer Veriton GN100 testeten wir Spark-Einheiten mithilfe des vLLM Online Serving Benchmarks, der am weitesten verbreiteten Engine für Inferenz und Bereitstellung mit hohem Durchsatz für große Sprachmodelle. Der vLLM Online Serving Benchmark simuliert reale Produktionslasten, indem er gleichzeitig Anfragen an einen laufenden vLLM-Server sendet und wichtige Kennzahlen wie den gesamten Token-Durchsatz (Token pro Sekunde), die Zeit bis zum ersten Token und die Zeit pro ausgegebenem Token unter verschiedenen Lastbedingungen misst.
Unsere Tests umfassten verschiedene Modelle, von dichten Architekturen bis hin zu Datentypen im Mikromaßstab. Die Leistung wurde anhand von drei Workload-Szenarien bewertet: Gleichmäßige ISL/OSL-Last, hohe Prefill-Last und hohe Dekodierungslast. Diese Szenarien repräsentieren unterschiedliche reale Anwendungsmuster, von ausgewogener Eingabe- und Ausgabelast bis hin zu rechenintensiver Prompt-Verarbeitung und speicher- und bandbreitenbegrenzter Token-Generierung.
Zusätzlich zum Acer Veriton GN100 haben wir die NVIDIA Founders Edition Spark als Referenzgerät sowie OEM-Systeme von ASUS, Dell und GIGABYTE getestet. Dadurch konnten wir die Ergebnisse von Acer im breiteren Wettbewerbsumfeld einordnen und feststellen, wo das Unternehmen bei verschiedenen Modellen und Arbeitslasten führend ist, mit der Konkurrenz mithält oder hinterherhinkt.
GPT-OSS-120B
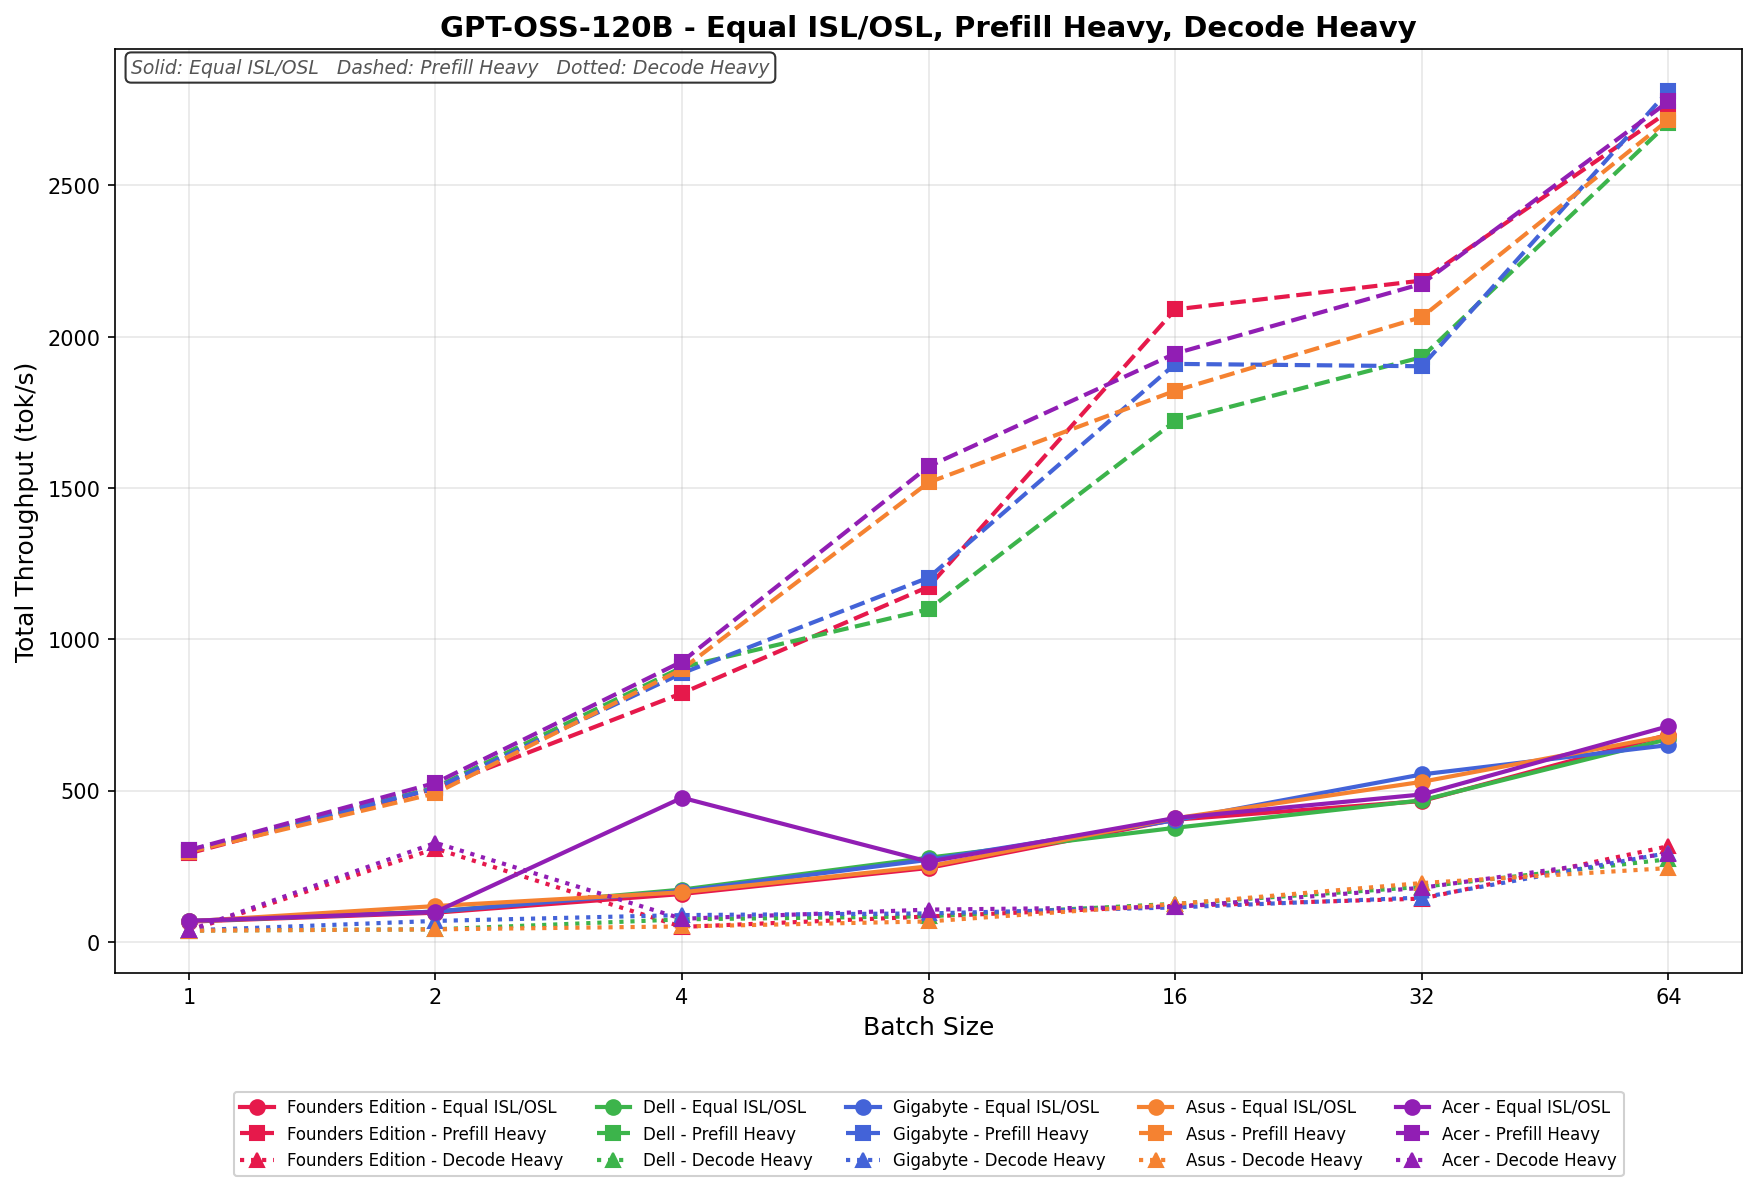
Im Equal-ISL/OSL-Verfahren skaliert der Acer-Durchsatz über den gesamten Batch-Sweep von 69.65 auf 713.18 t/s. Bei kleineren Batchgrößen zeigt der Durchsatz gewisse Schwankungen, bevor er sich stabilisiert und ab Batch 8 bis Batch 64 kontinuierlich ansteigt.
Die Produktion von Prefill Heavy beginnt bei 303.61 tk/s und steigt bis zur Chargengröße 64 auf 2,777.56 tk/s. Die Skalierung ist durchweg stark und progressiv, mit einem besonders aggressiven Wachstum bis zur Charge 8 und weiteren Zuwächsen bei größeren Chargengrößen.
Die Durchsatzrate von Decode Heavy liegt zwischen 38.38 und 292.41 tok/s und steigt über die Batch-Durchläufe hinweg stetig an. Bei kleineren Batch-Größen treten zunächst Schwankungen auf, bevor sich der Durchsatz stabilisiert und ab Batch 16 kontinuierlich zunimmt.
GPT-OSS-20B
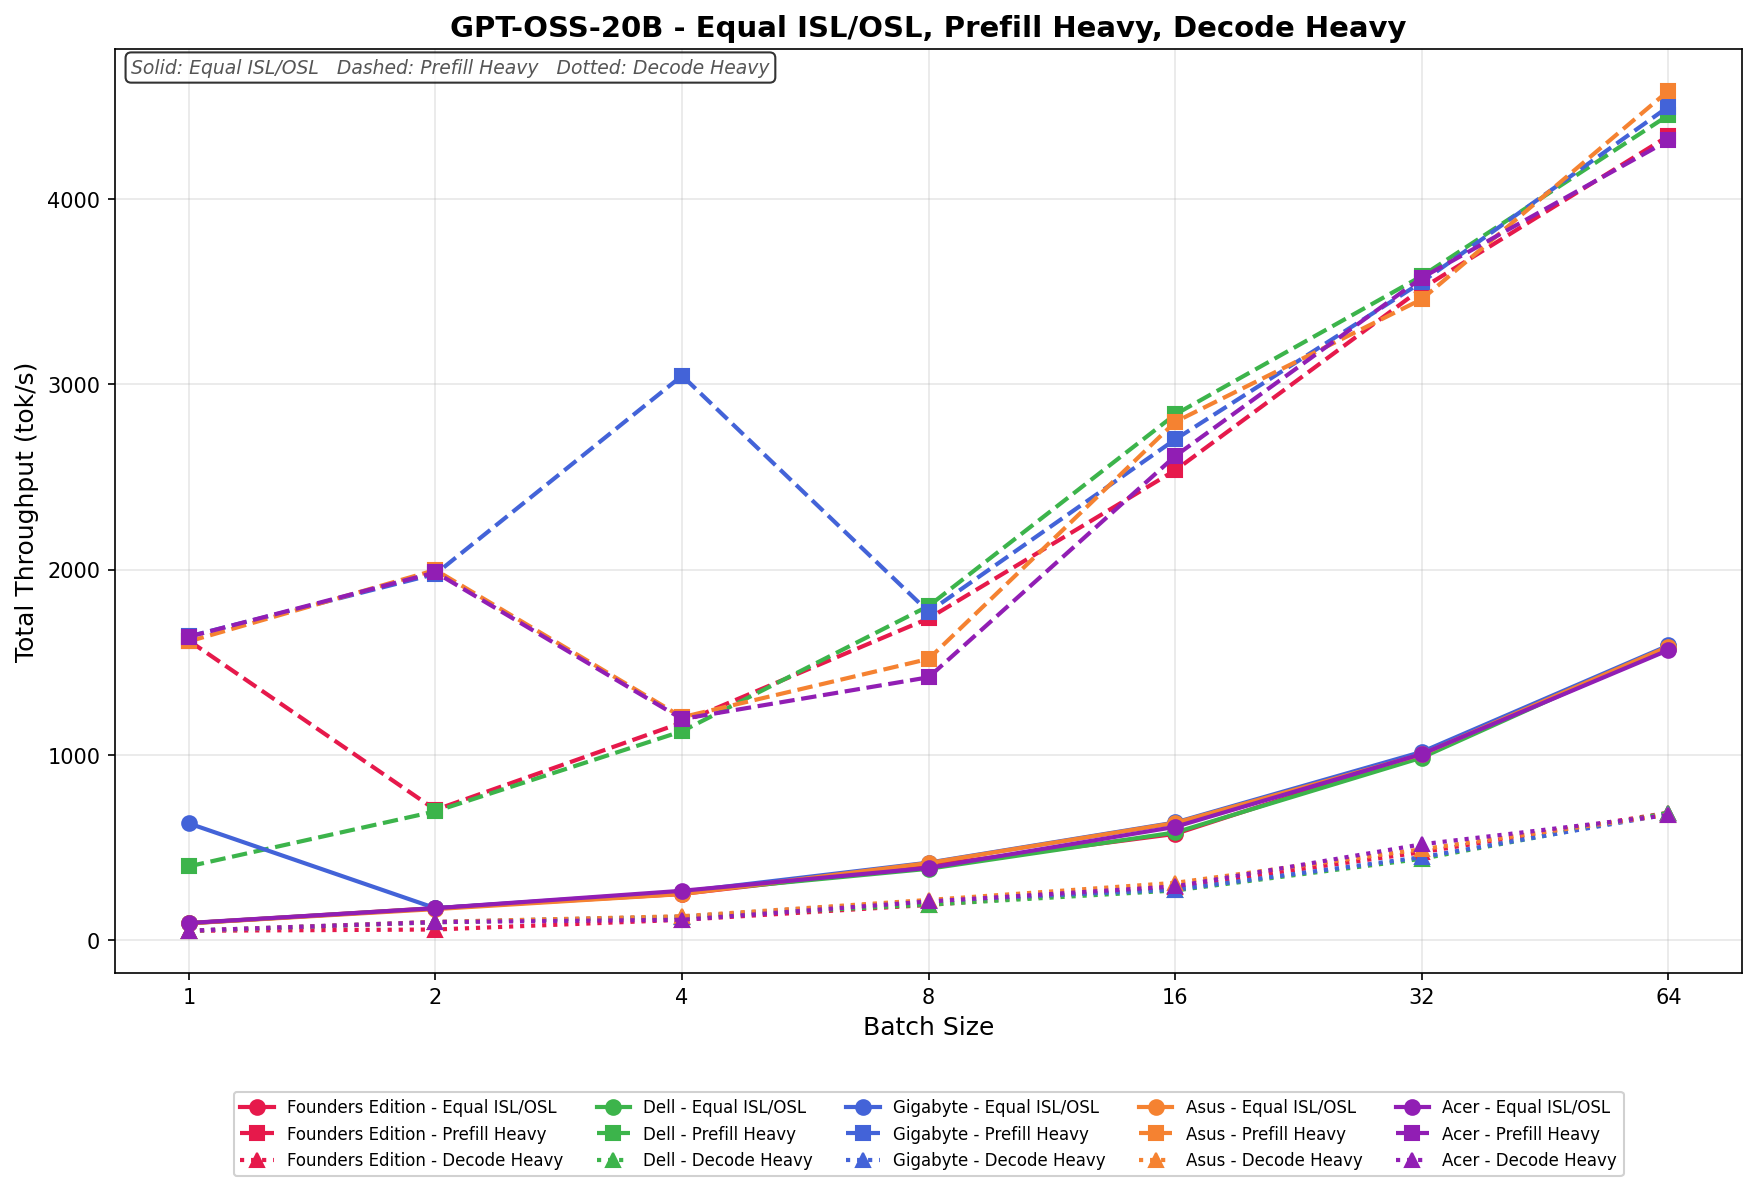
Im Equal-ISL/OSL-Verfahren skaliert der Acer von 91.91 auf 1,565.62 kbit/s mit deutlichen und konsistenten Zuwächsen über den gesamten Batch-Sweep. Der Durchsatz verdoppelt sich annähernd von Batch 1 bis Batch 4 und steigt dann bis zu den Batches 32 und 64 weiter an.
Die Vorfüllleistung (Prefill Heavy) beginnt bei 1,637.72 t/s und steigt auf 4,317.73 t/s, wenn die Chargengröße auf 64 erhöht wird. Das Wachstum ist bis zur zweiten Charge stark, verlangsamt sich im mittleren Bereich und beschleunigt sich dann bei den Chargen 32 und 64 wieder.
Die Decode Heavy-Werte liegen zwischen 50.55 und 674.26 tok/s, wobei eine allmähliche und gleichmäßige Skalierung über den gesamten Batch-Sweep hinweg erfolgt.
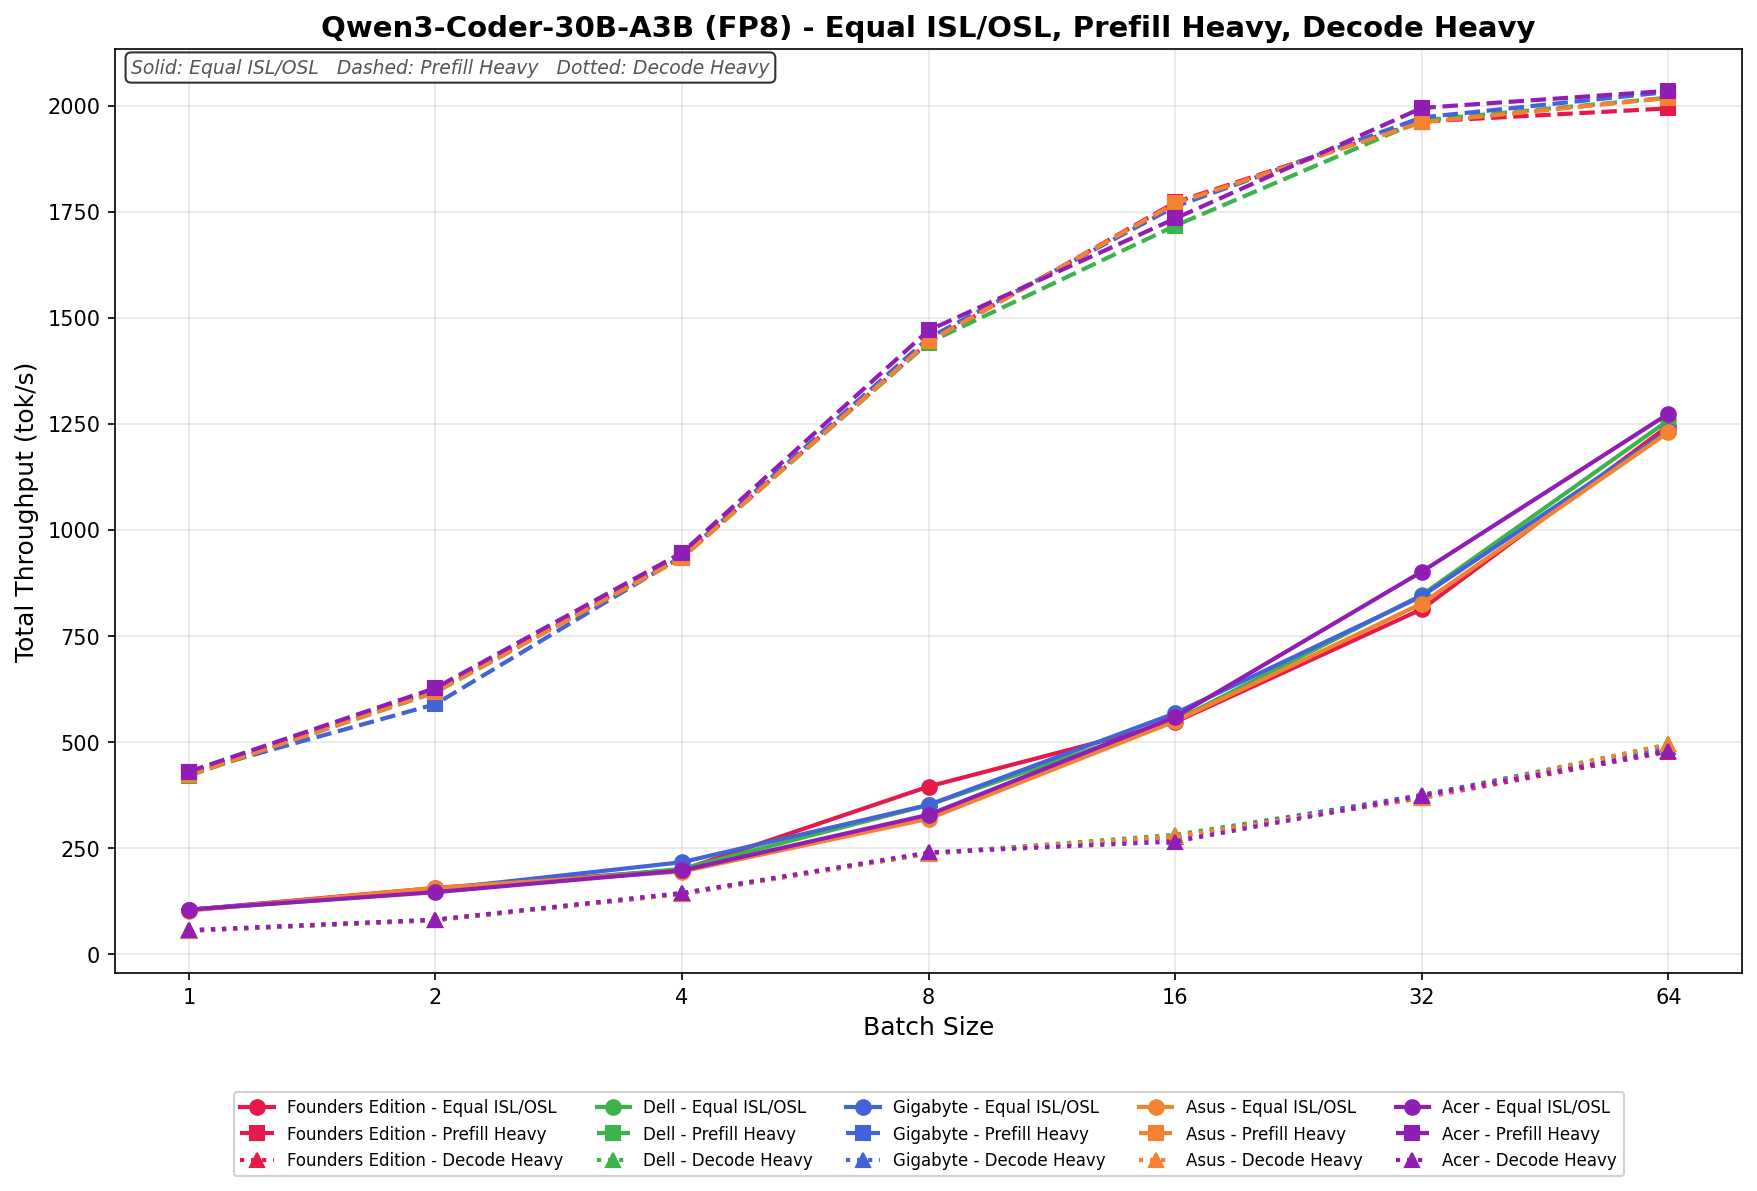
Qwen3-Coder 30B A3B FB8
Im Equal ISL/OSL-Verfahren skaliert der Acer von 104.64 auf 1,273.47 tk/s, mit einem stetigen und gleichmäßigen Wachstum über den gesamten Batch-Durchlauf. Der Durchsatz verdoppelt sich in etwa in jedem Schritt bis zum 16. Batch und steigt dann bis zum 32. und 64. Batch weiter an.
Die Vorfüllung von Schweröl beginnt bei 429.86 tk/s und steigt bis zur Chargengröße 64 auf 2,034.76 tk/s. Die Skalierung ist bis zur 8. Charge stark, flacht dann aber ab, wenn die Arbeitslast bei den Chargen 32 und 64 ein Plateau erreicht.
Die Decode Heavy-Werte liegen zwischen 55.94 und 478.59 tok/s, wobei eine allmähliche und gleichmäßige Skalierung über den gesamten Batch-Sweep hinweg erfolgt.
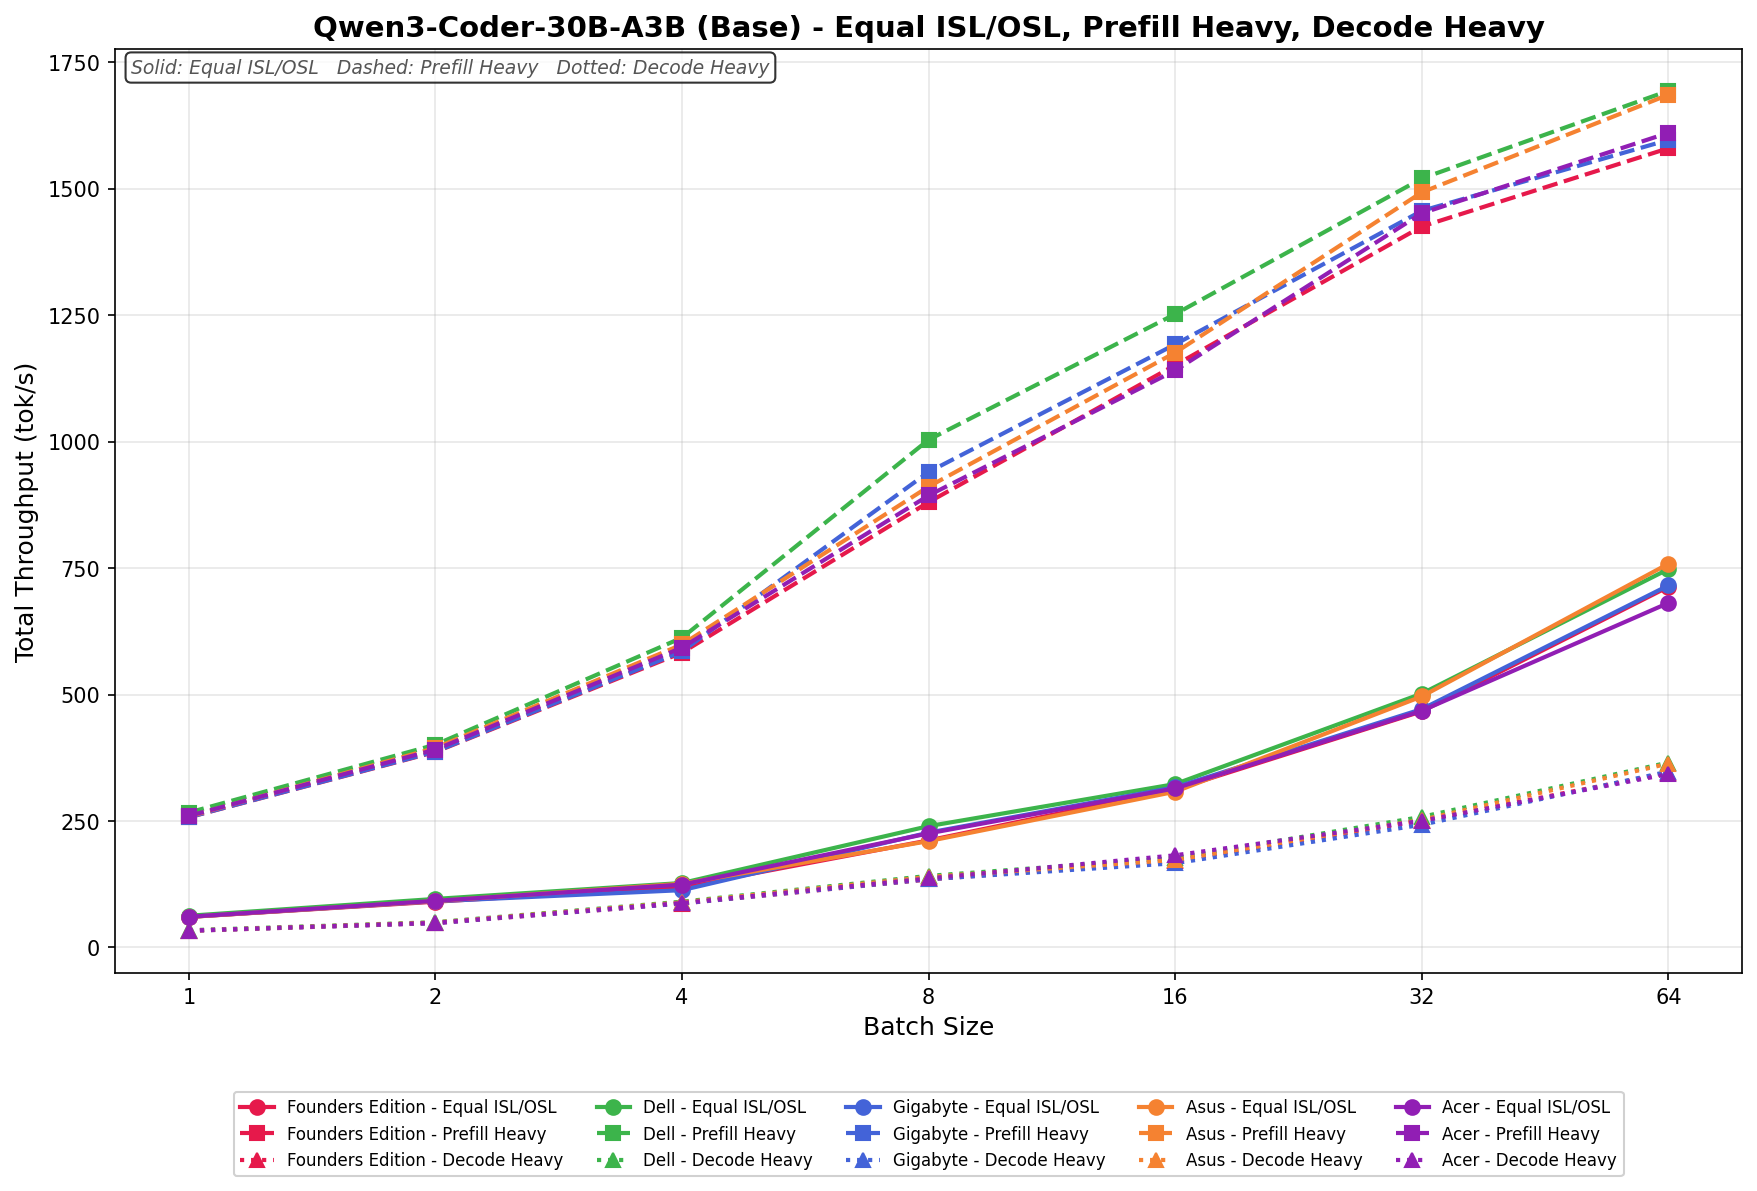
Qwen3-Coder 30B A3B Basis
Im Equal ISL/OSL-Verfahren skaliert der Acer von 60.71 auf 681.18 tok/s und liefert damit über alle Batchgrößen hinweg einen deutlich geringeren Durchsatz als die FP8-Variante. Das Wachstum verläuft über den gesamten Messzyklus hinweg stetig, der Abstand zur FP8-Variante vergrößert sich jedoch bei höheren Batchgrößen.
Prefill Heavy beginnt bei 260.11 tk/s und steigt bis zu einer Chargengröße von 64 auf 1,610.56 tk/s. Die Skalierung ist über den gesamten Messbereich hinweg konsistent, der Durchsatz liegt jedoch bei jeder Chargengröße deutlich unter dem des FP8-Pendants.
Die Decode Heavy-Variante liefert Daten zwischen 33.31 und 342.79 tok/s und weist im gesamten Messbereich eine geringere Leistung als die FP8-Variante auf. Das Wachstum ist über alle Batchgrößen hinweg stetig und gleichmäßig.
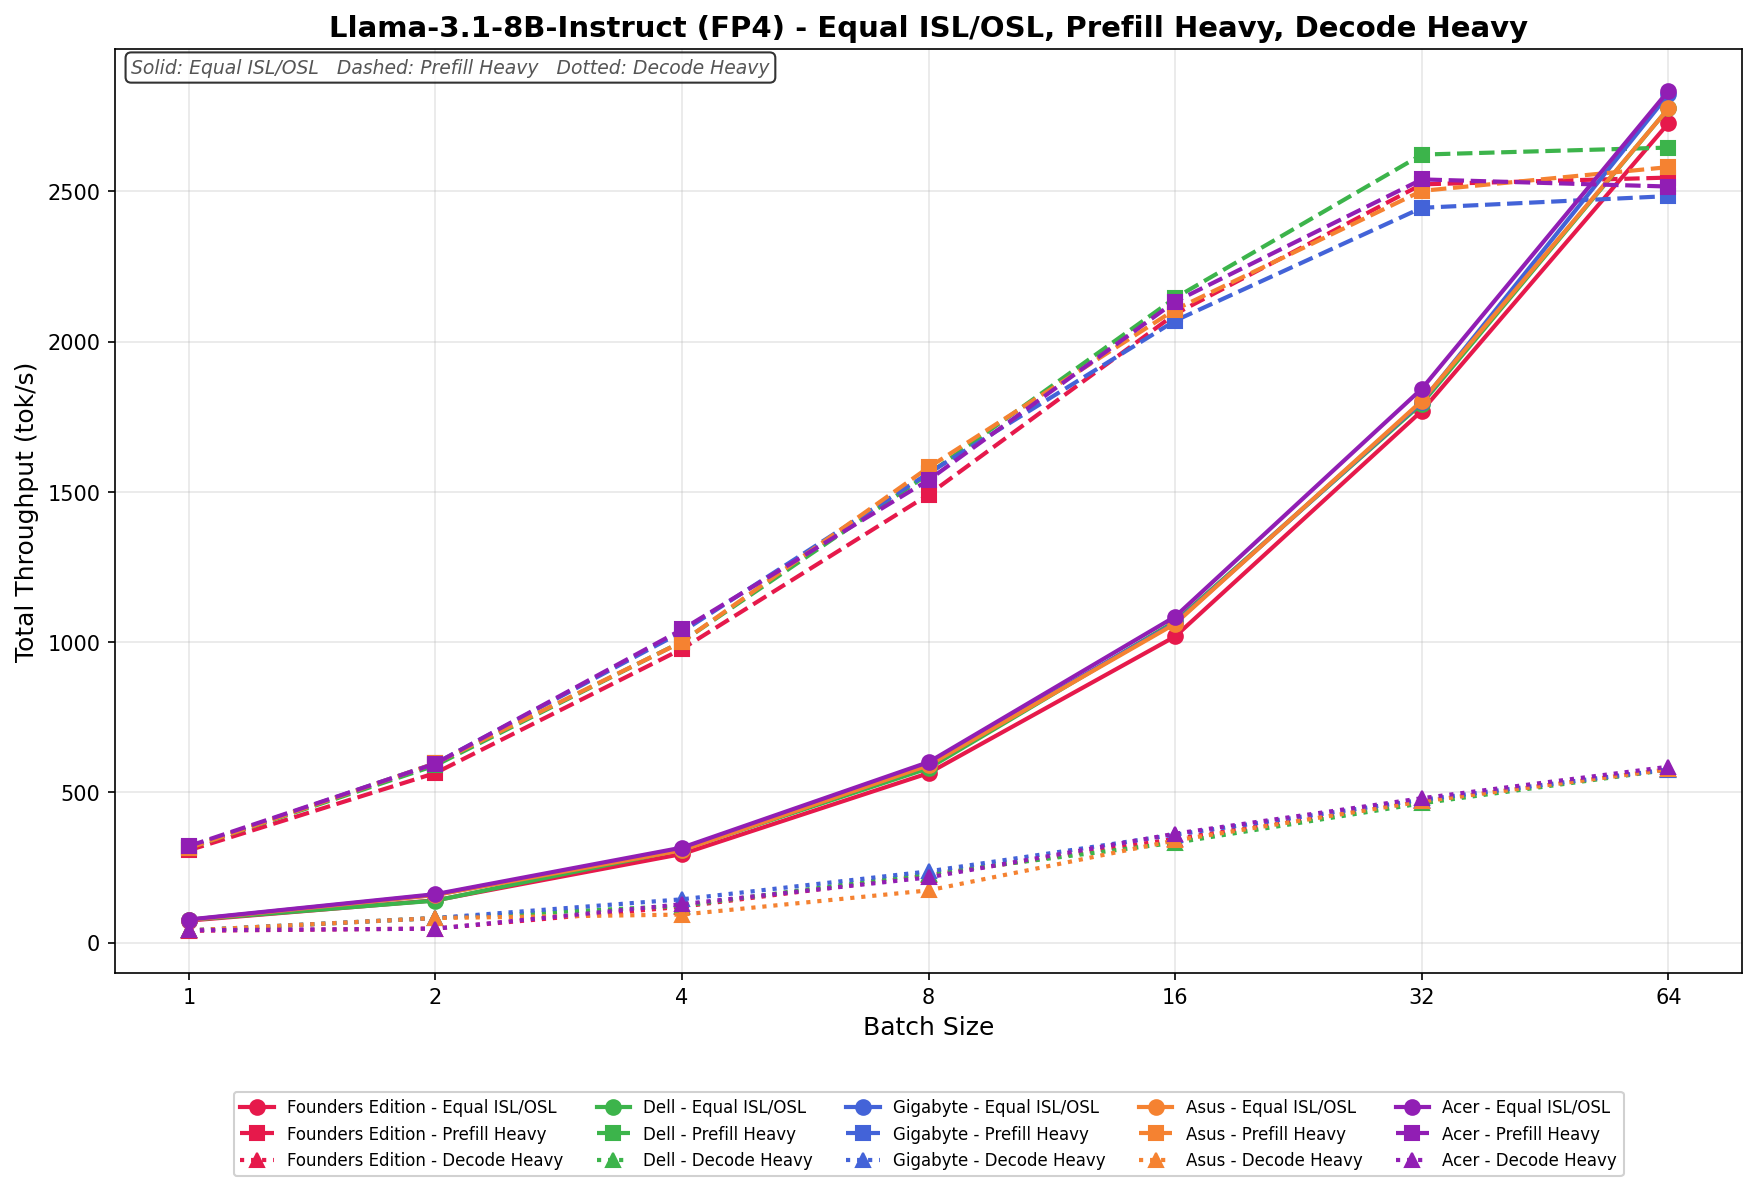
Llama 3.1 8B Instruct FP4
Im Equal-ISL/OSL-Verfahren skaliert der Acer von 77.15 auf 2,834.70 tok/s und bietet damit einen deutlichen Durchsatzvorteil gegenüber der FP8-Variante über alle Batchgrößen hinweg. Die Skalierung verläuft bis Batch 32 gleichmäßig und linear, mit weiterhin starken Zuwächsen bei Batch 64.
Die Durchsatzrate von Prefill Heavy beginnt bei 321.54 tk/s und steigt bei Charge 32 auf 2,539.85 tk/s, bevor sie bei Charge 64 bei 2,516.13 tk/s ein leichtes Plateau erreicht. Das FP4-Modell erzielt über mittlere und große Chargengrößen hinweg einen höheren Durchsatz als sein FP8-Pendant.
Die Decode Heavy-Variante liefert Daten zwischen 41.21 und 585.63 tok/s und erzielt damit über alle Batchgrößen hinweg eine deutlich höhere Leistung als die FP8-Variante. Das Wachstum ist über den gesamten Messzeitpunkt hinweg konstant.
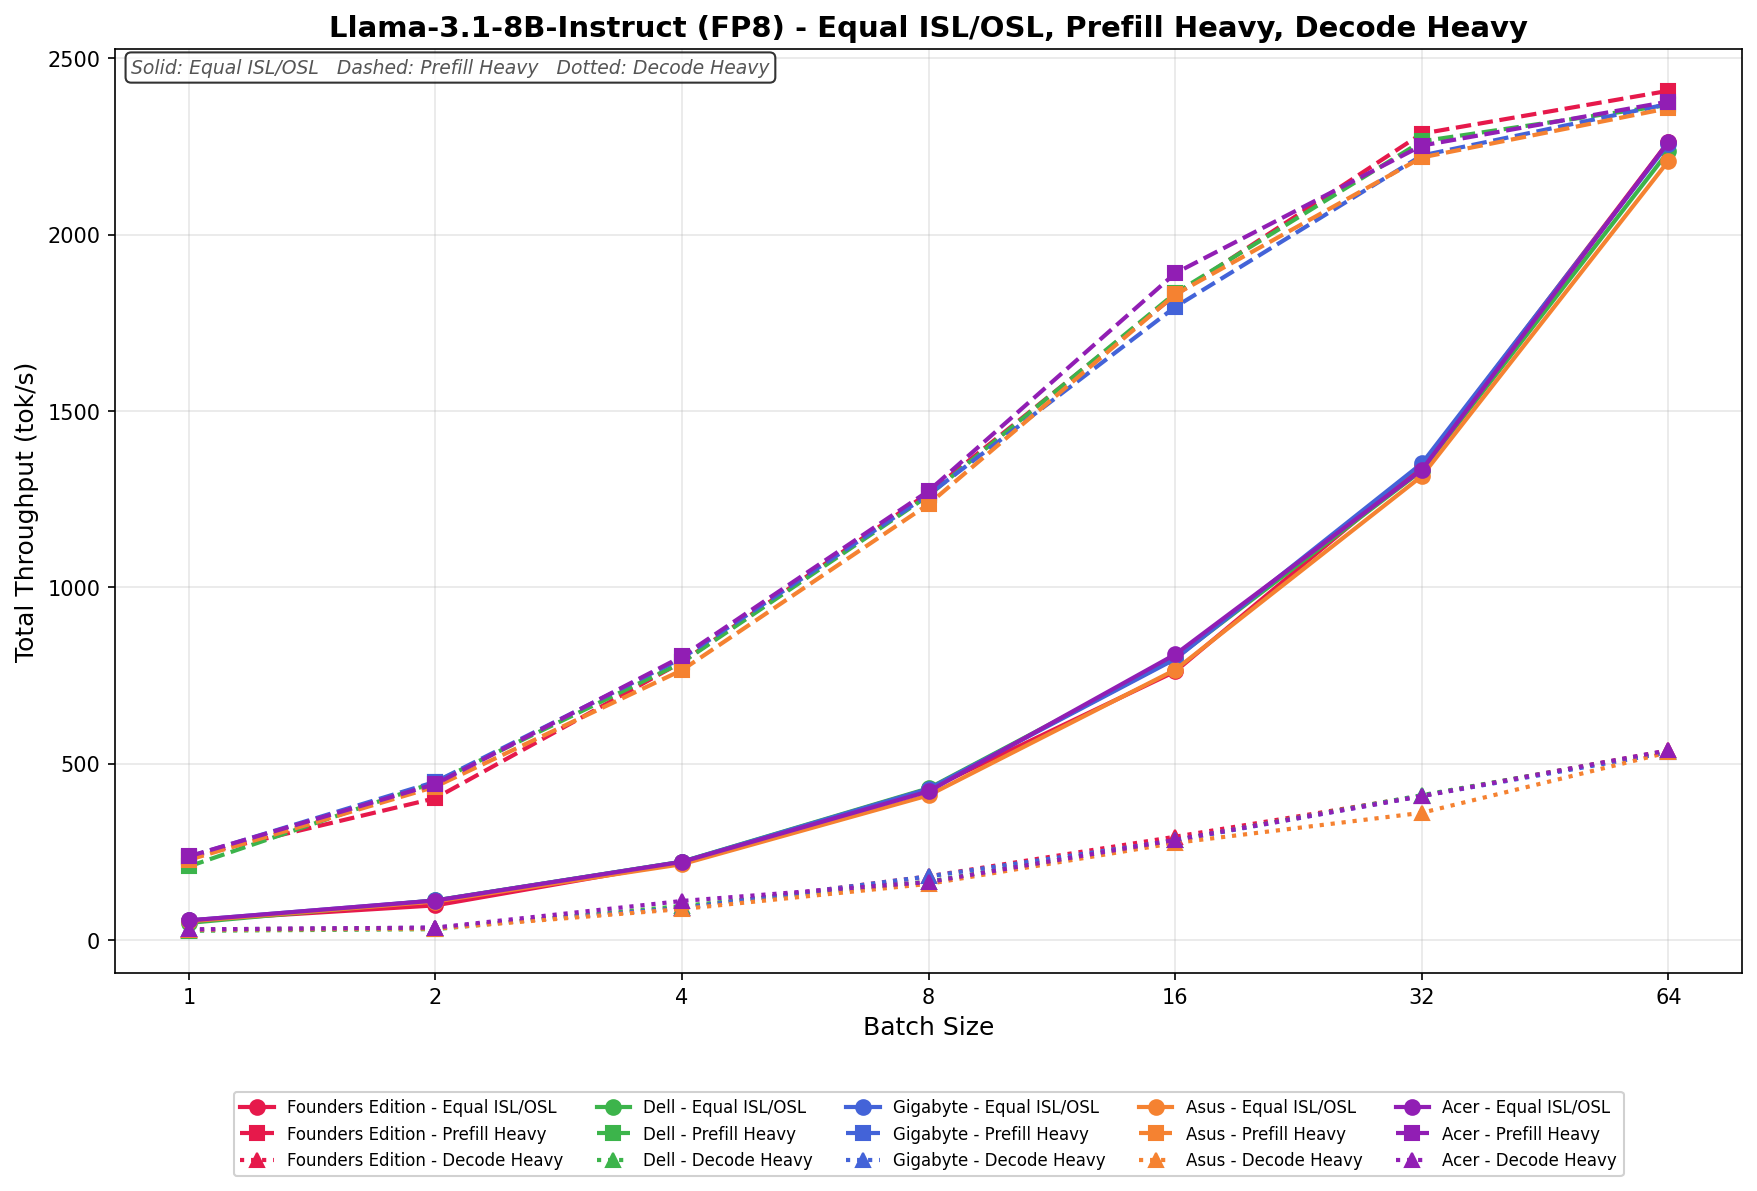
Llama 3.1 8B Instruct FP8
Im Equal ISL/OSL-Verfahren skaliert der Acer-Prozessor im Batch-Sweep von 55.93 auf 2,262.73 tok/s, mit stetigen und gleichmäßigen Zuwächsen in jedem Schritt. Der Durchsatz verdoppelt sich nahezu von Batch 1 bis Batch 8 und steigt bis Batch 32 und 64 weiter an, ohne dass Anzeichen einer Sättigung erkennbar sind.
Prefill Heavy beginnt bei 237.62 t/s und steigt bis zu einer Chargengröße von 64 auf 2,376.88 t/s. Die Skalierung ist durchweg stark und progressiv, wobei der Durchsatz über den gesamten Chargendurchlauf hinweg kontinuierlich zunimmt.
Die Decode Heavy-Werte liegen zwischen 30.39 und 538.18 tok/s, mit einem stetigen Anstieg während des gesamten Batch-Sweeps.
GPU-Direktspeicher
Einer der Tests, die wir mit dem Spark durchgeführt haben, war der MagnumIO GPU Direct Storage (GDS)-Test. GDS ist eine von NVIDIA entwickelte Funktion, die es GPUs ermöglicht, die CPU zu umgehen, wenn sie auf Daten zugreifen, die auf NVMe-Laufwerken oder anderen Hochgeschwindigkeitsspeichern gespeichert sind. Anstatt Daten über die CPU und den Systemspeicher zu leiten, ermöglicht GDS die direkte Kommunikation zwischen GPU und Speichergerät, wodurch die Latenz deutlich reduziert und der Datendurchsatz verbessert wird.
Acer verwendet im Veriton GN100 AI die 4 TB große Samsung PM9E1 Gen5 SSD, die bis dato die schnellste 2242 M.2-Festplatte ist, die wir auf dem Markt gesehen haben.
So funktioniert GPU Direct Storage
Traditionell müssen Daten, die auf einem NVMe-Laufwerk gespeichert sind, zunächst die CPU und den Arbeitsspeicher durchlaufen, bevor sie die GPU erreichen. Dieser Prozess führt zu Engpässen, da die CPU als Vermittler fungiert, was Latenzzeiten verursacht und wertvolle Systemressourcen verbraucht. GPU Direct Storage beseitigt diese Ineffizienz, indem es der GPU ermöglicht, über den PCIe-Bus direkt auf die Daten des Speichermediums zuzugreifen. Dieser direkte Pfad reduziert den Aufwand für die Datenübertragung und ermöglicht so schnellere und effizientere Datenübertragungen.
KI-Workloads, insbesondere solche mit Deep Learning, sind äußerst datenintensiv. Das Training großer neuronaler Netzwerke erfordert die Verarbeitung von Terabyte an Daten, und jede Verzögerung bei der Datenübertragung kann zu einer Unterauslastung der GPUs und längeren Trainingszeiten führen. GPU Direct Storage bewältigt diese Herausforderung, indem es sicherstellt, dass die Daten so schnell wie möglich an die GPU übermittelt werden, wodurch Leerlaufzeiten minimiert und die Rechenleistung maximiert werden.
Darüber hinaus ist GDS besonders vorteilhaft für Workloads, die das Streamen großer Datensätze beinhalten, wie etwa Videoverarbeitung, Verarbeitung natürlicher Sprache oder Echtzeit-Inferenz. Durch die Reduzierung der Abhängigkeit von der CPU beschleunigt GDS die Datenbewegung und gibt CPU-Ressourcen für andere Aufgaben frei, was die Gesamtsystemleistung weiter verbessert.
GDSIO-Lesedurchsatz 16k
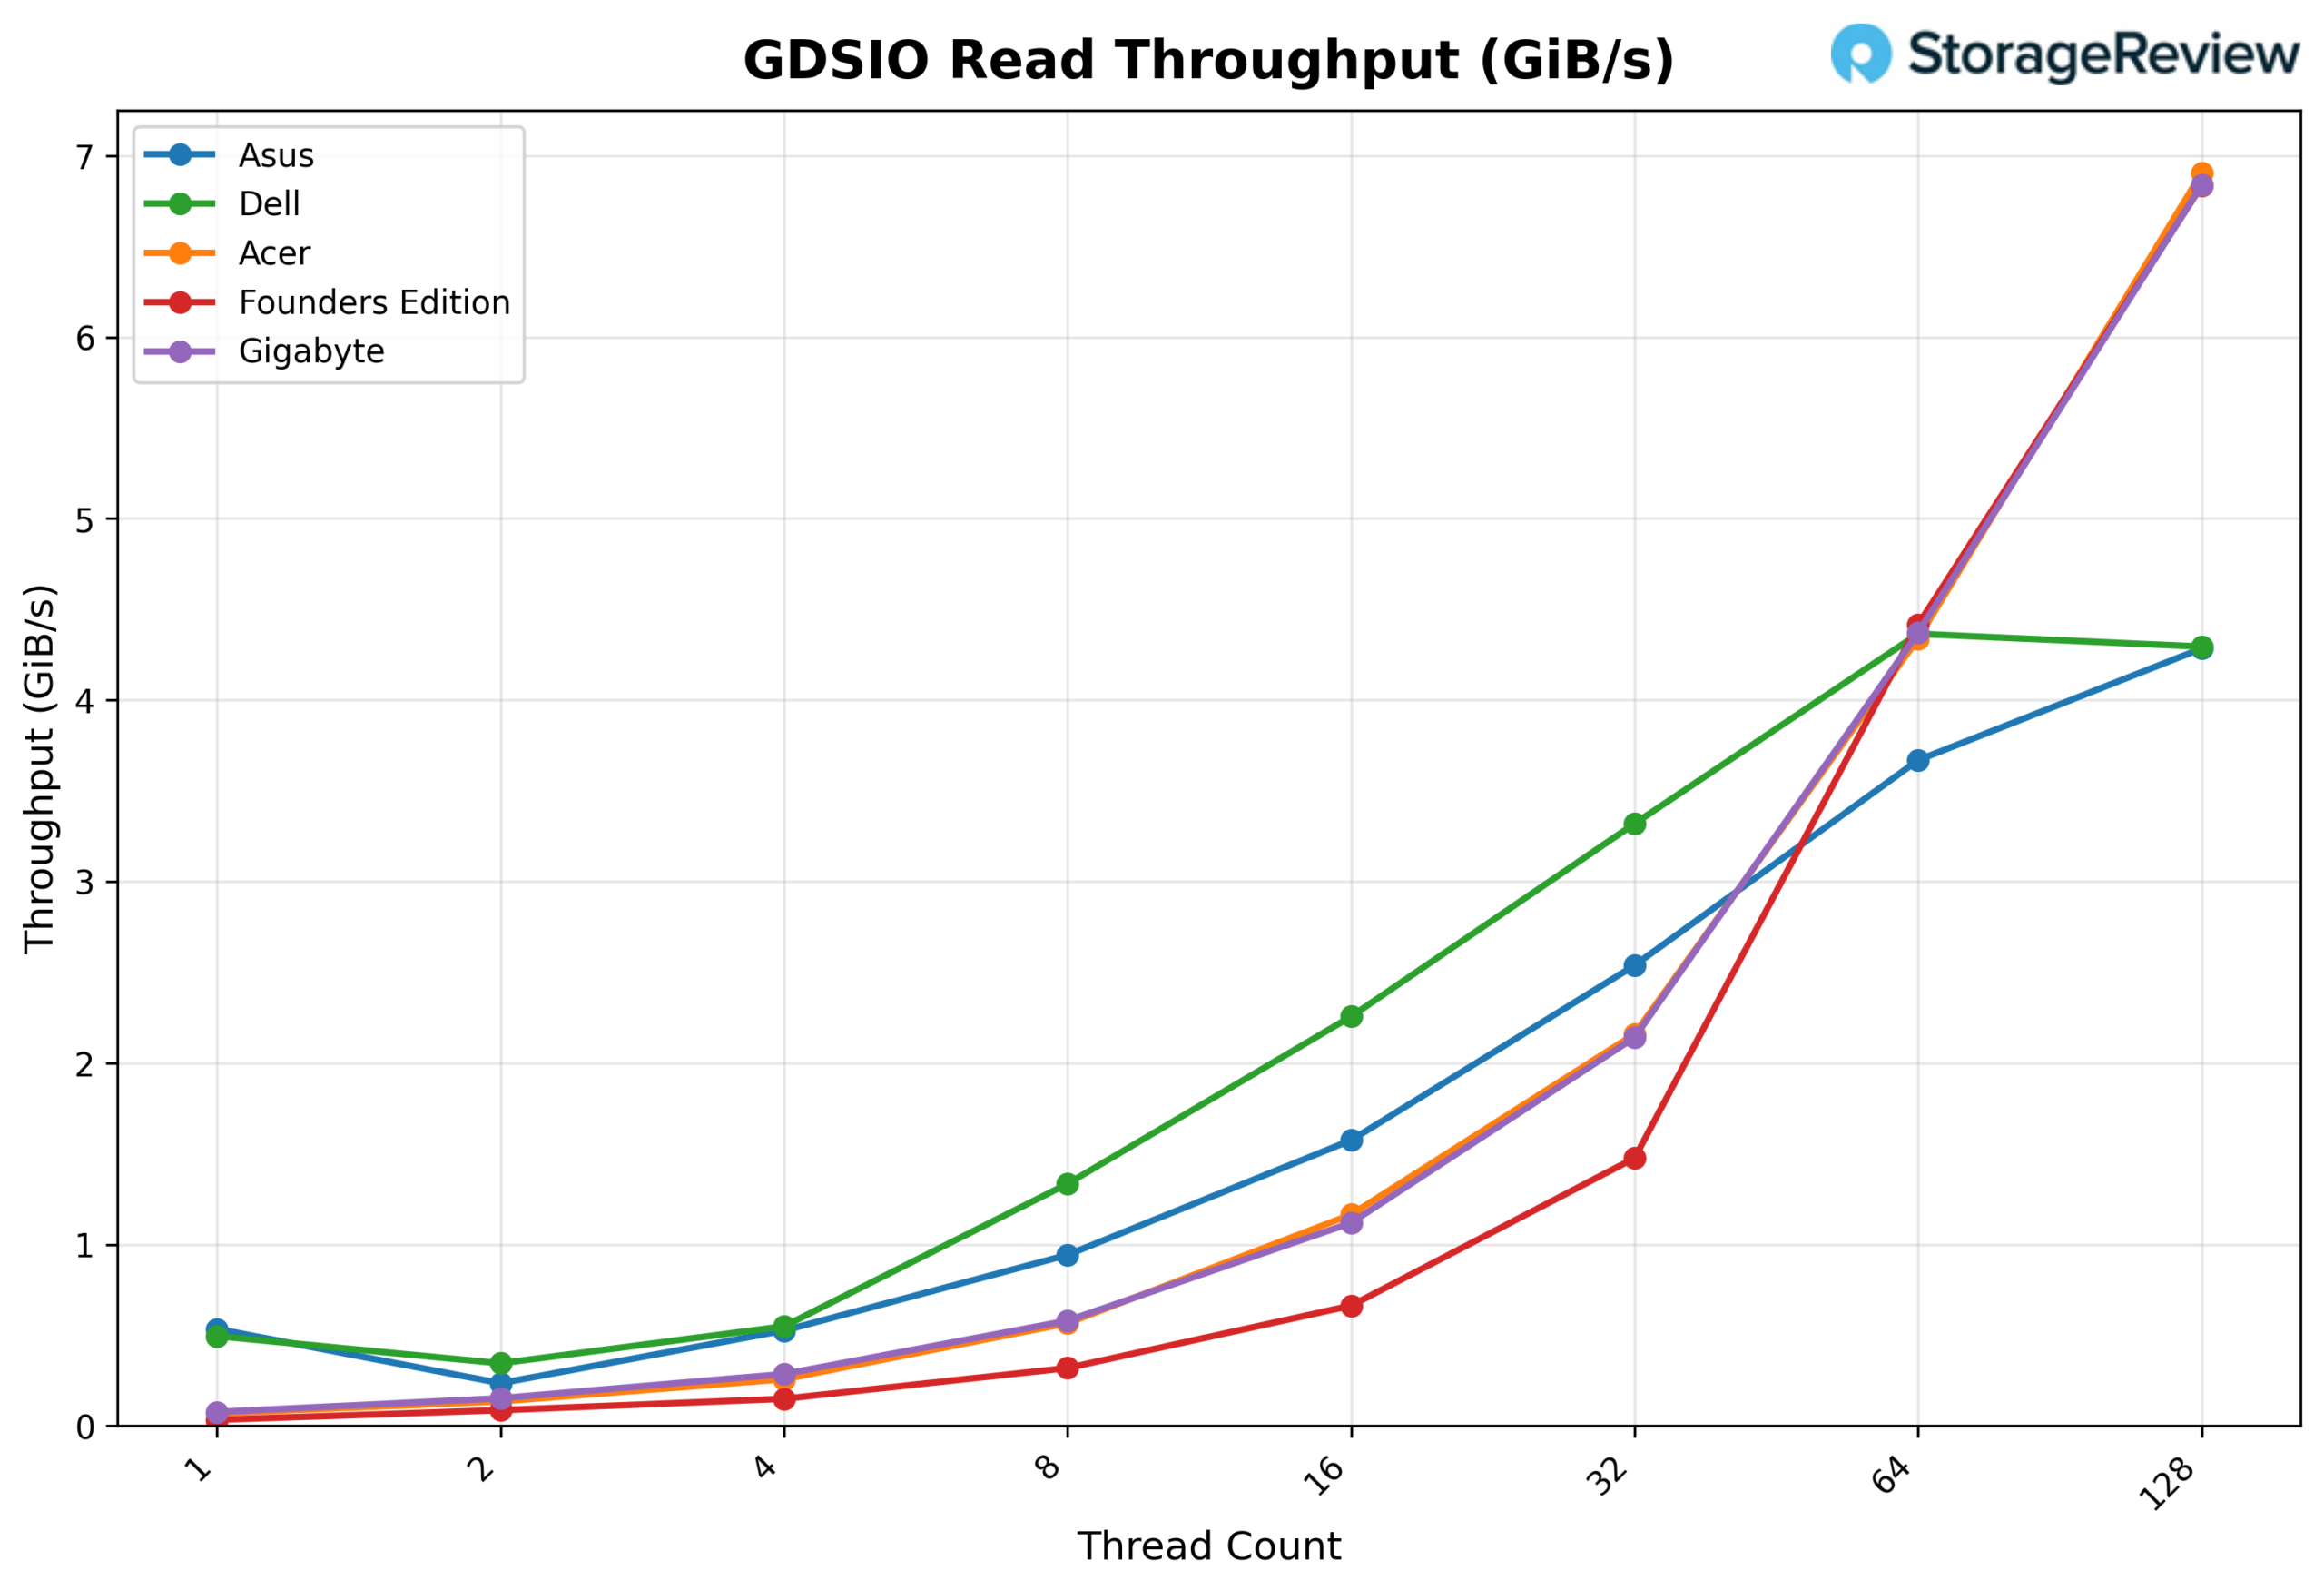
Betrachtet man den GDSIO-Lesedurchsatz von 16K, so beginnt der Acer bei 0.07 GiB/s mit einem Thread und skaliert linear über 2 Threads (0.13 GiB/s), 4 Threads (0.26 GiB/s) und 8 Threads (0.57 GiB/s). Der Durchsatz steigt weiter bei 16 Threads (1.16 GiB/s), 32 Threads (2.16 GiB/s) und 64 Threads (4.34 GiB/s). Bei 128 Threads erreicht der Durchsatz 6.91 GiB/s – den höchsten gemessenen Wert. Da kein klarer Sättigungspunkt erkennbar ist, skaliert die Plattform auch bei kleinen I/O-Größen weiter.
GDSIO-Lese-Durchschnittslatenz 16K
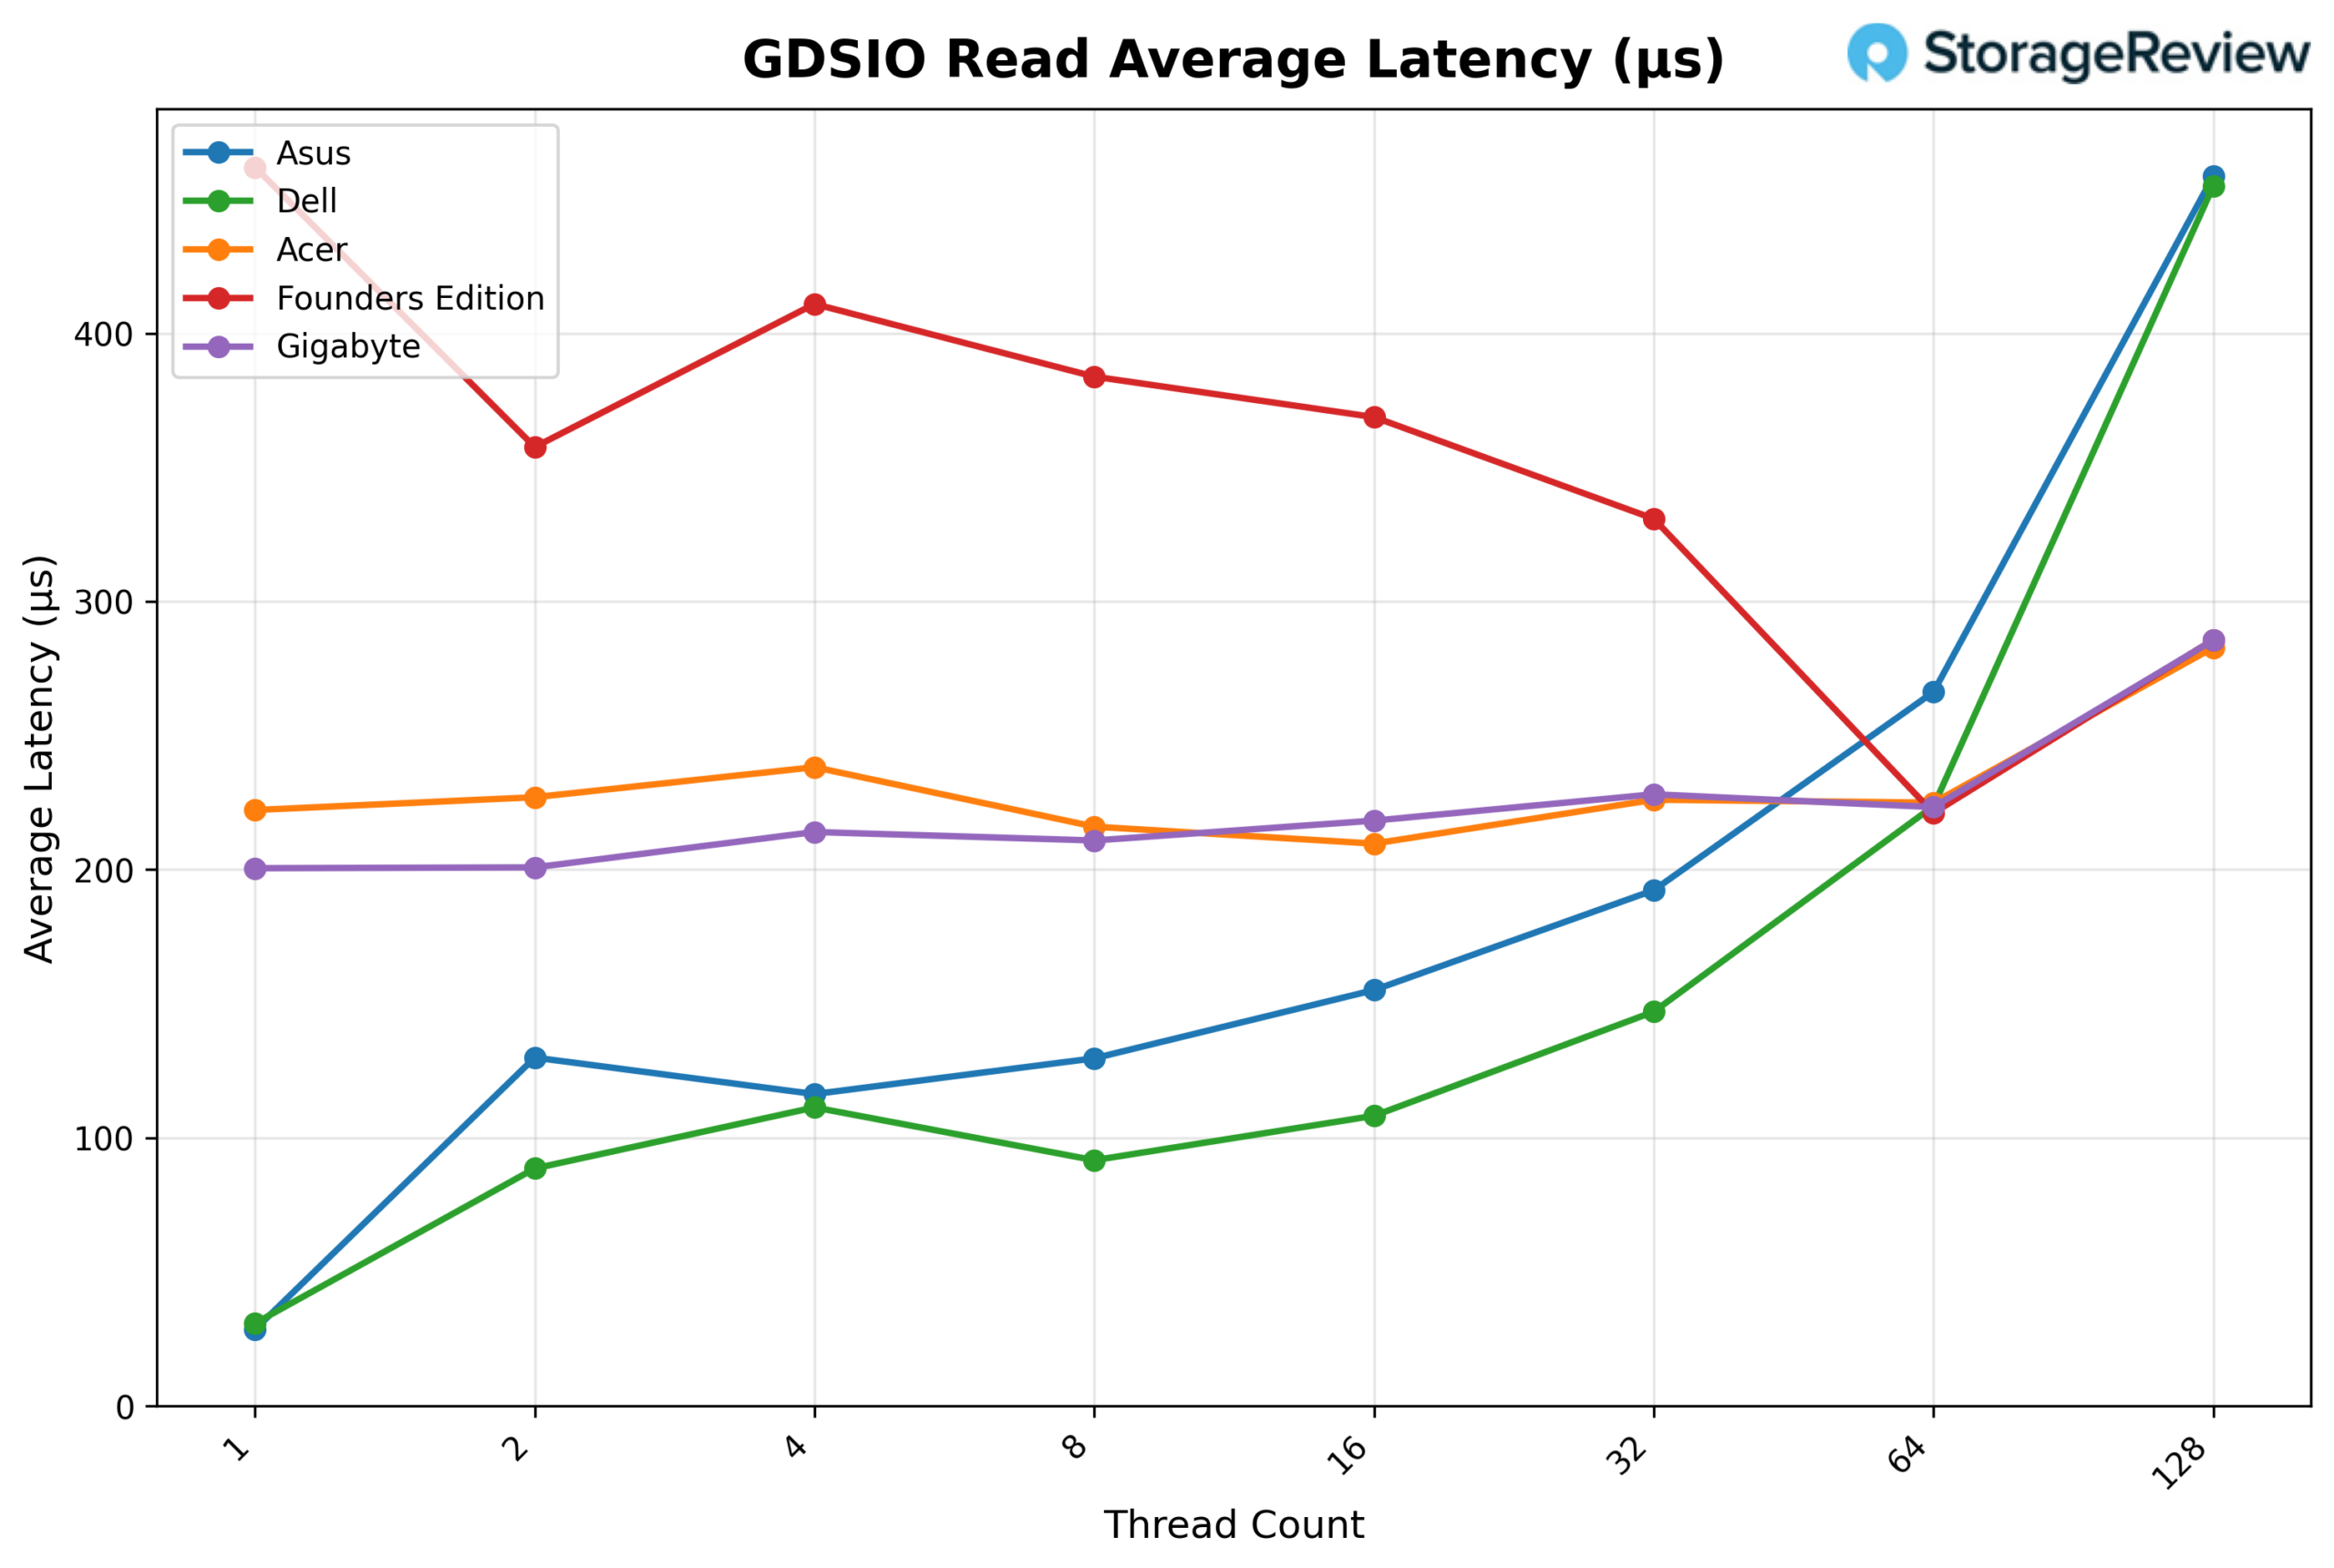
Betrachtet man die durchschnittliche Leselatenz (16K) von GDSIO, so beginnt der Wert bei Acer mit einem Thread bei etwa 0.22 ms und bleibt über den gesamten Messbereich bemerkenswert stabil: 0.23 ms bei zwei Threads, 0.24 ms bei vier Threads und 0.22 ms bei acht Threads. Die Latenz bleibt bei 16 Threads (0.21 ms), 32 Threads (0.23 ms) und 64 Threads (0.22 ms) ähnlich konstant, bevor sie bei 128 Threads leicht auf 0.28 ms ansteigt. Dieses nahezu konstante Latenzprofil über alle Thread-Anzahlen hinweg spiegelt das kontinuierliche Skalierungsverhalten des Durchsatzes wider.
GSDIO-Schreibdurchsatz 16K
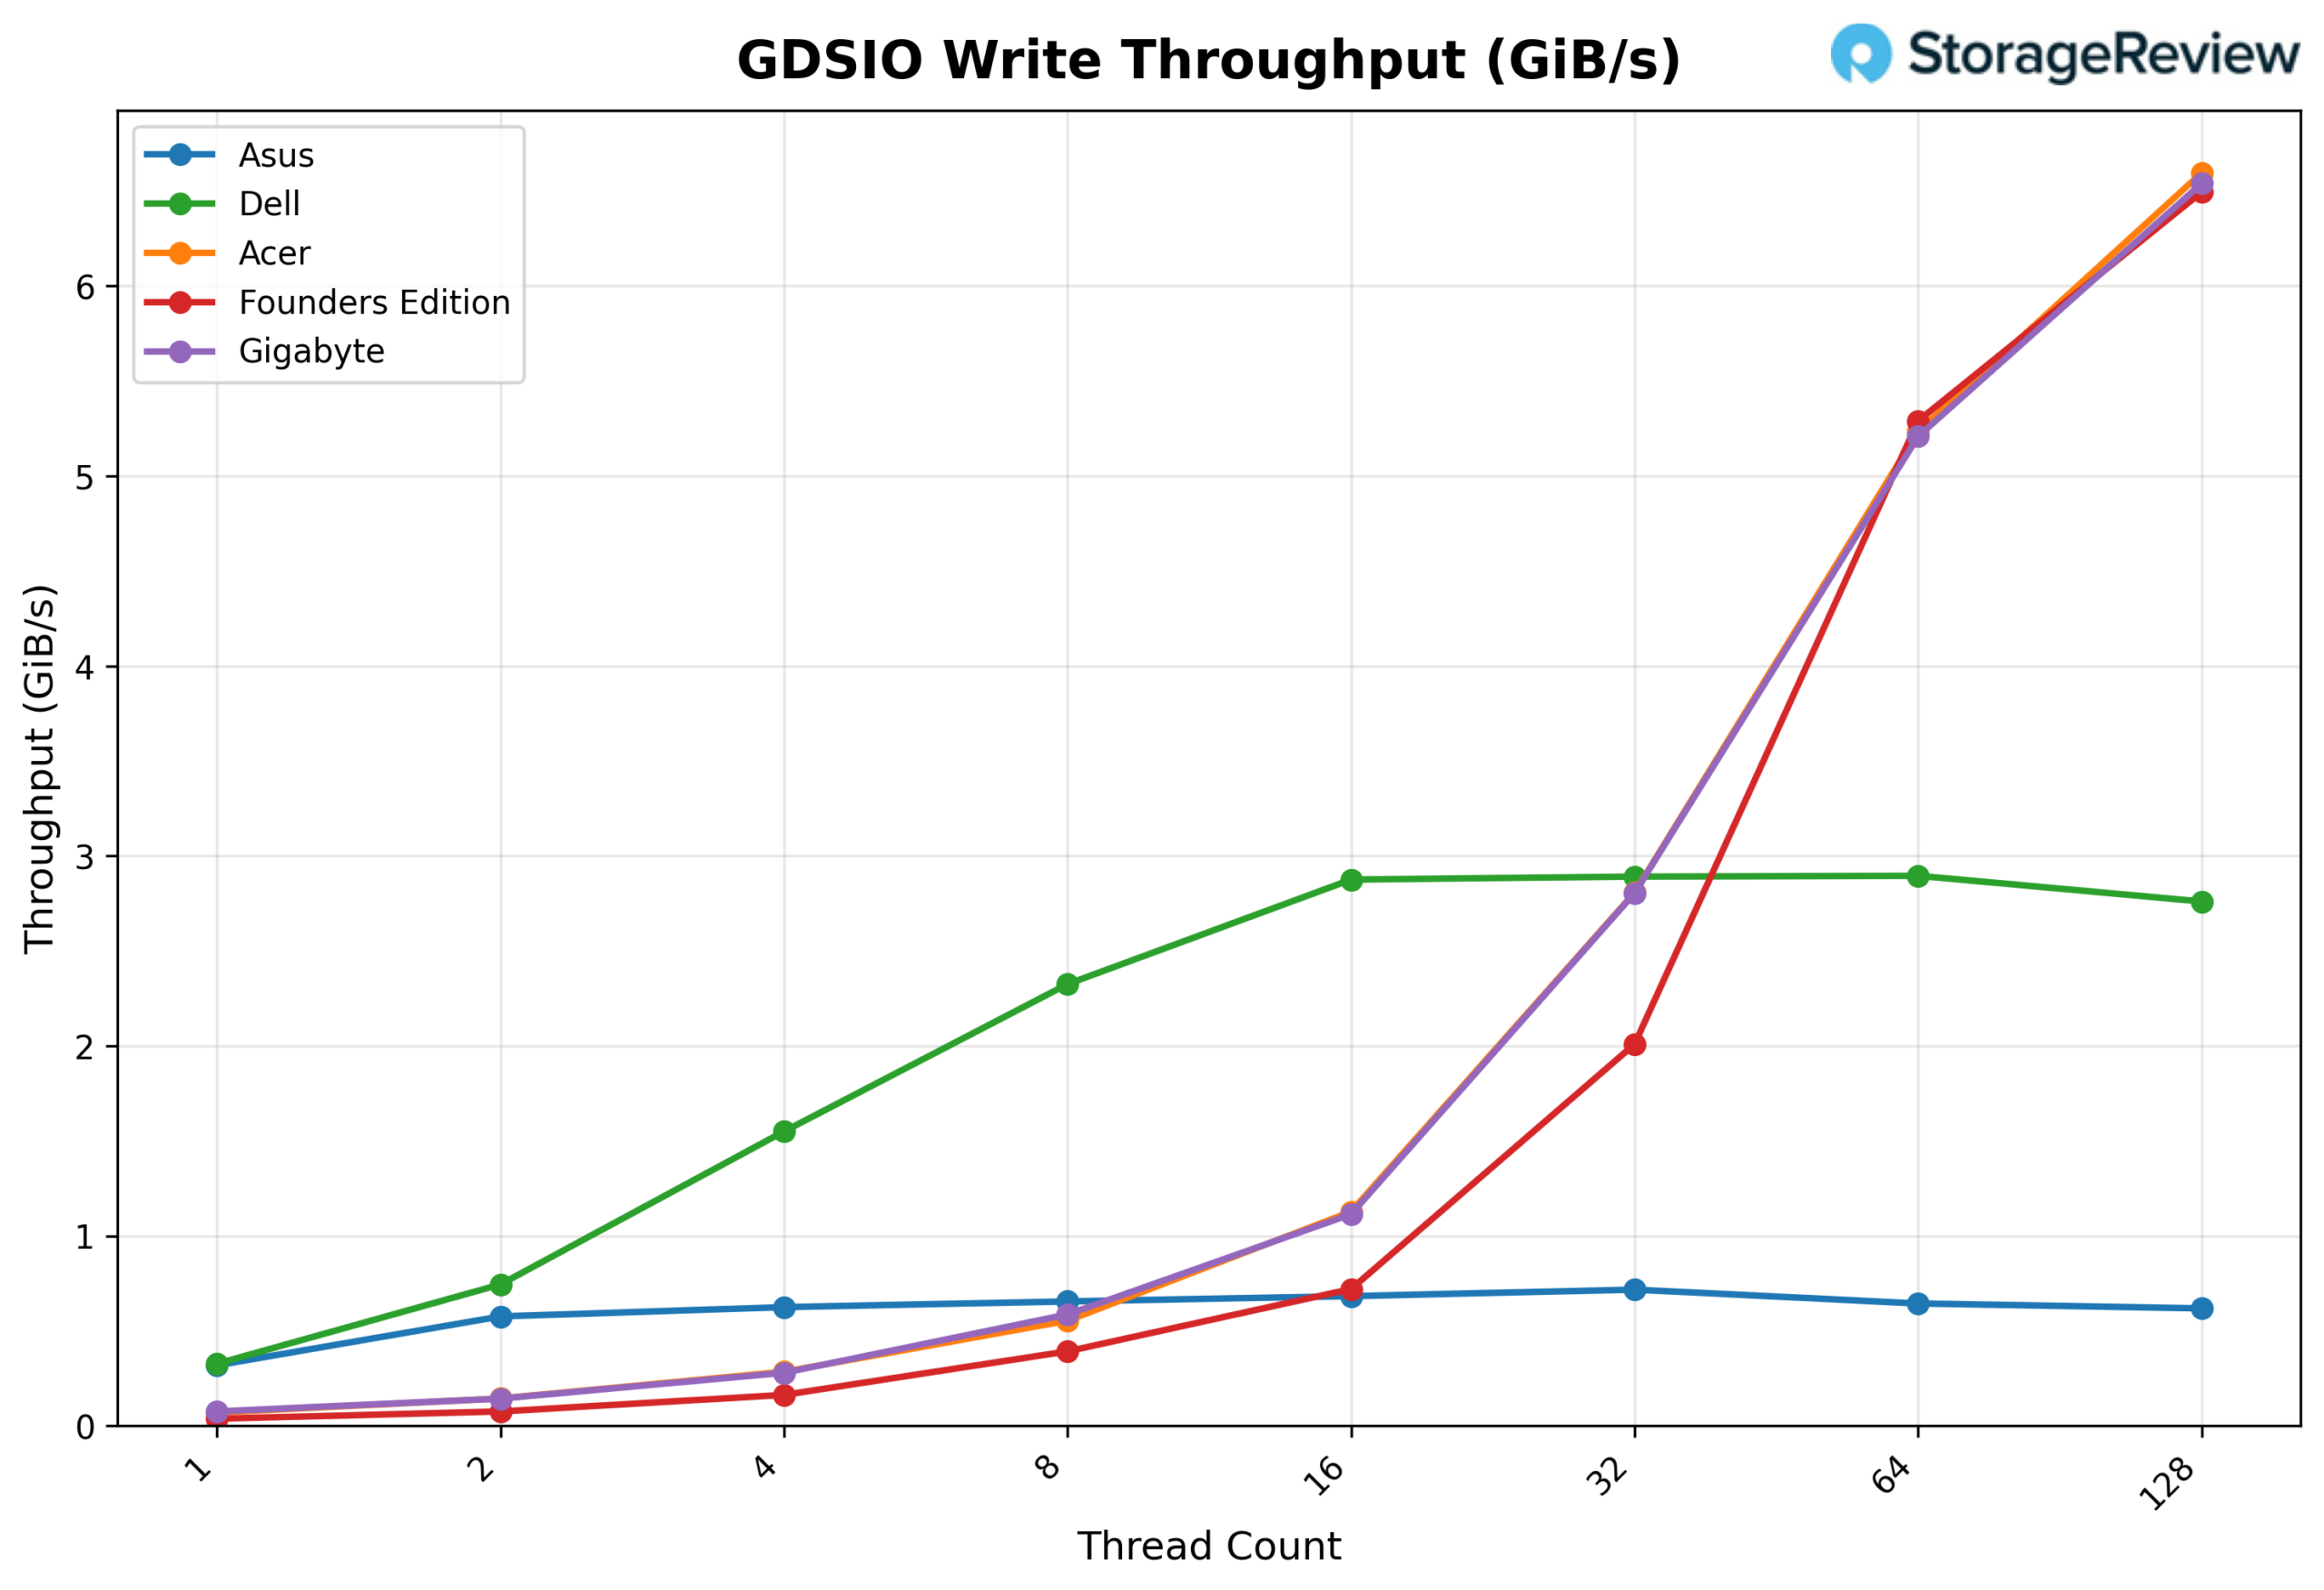
Betrachtet man den GDSIO-Schreibdurchsatz von 16K, so beginnt der Acer bei 0.07 GiB/s mit einem Thread und skaliert über 2 Threads (0.14 GiB/s), 4 Threads (0.28 GiB/s) und 8 Threads (0.55 GiB/s). Das Wachstum beschleunigt sich bei 16 Threads (1.13 GiB/s), 32 Threads (2.81 GiB/s) und 64 Threads (5.23 GiB/s). Bei 128 Threads erreicht der Durchsatz mit 6.60 GiB/s seinen Höchstwert, was erneut keine deutliche Sättigung und eine kontinuierliche Skalierung bei kleinen Blockgrößen zeigt.
GDSIO Schreiblatenz durchschnittlich 16K
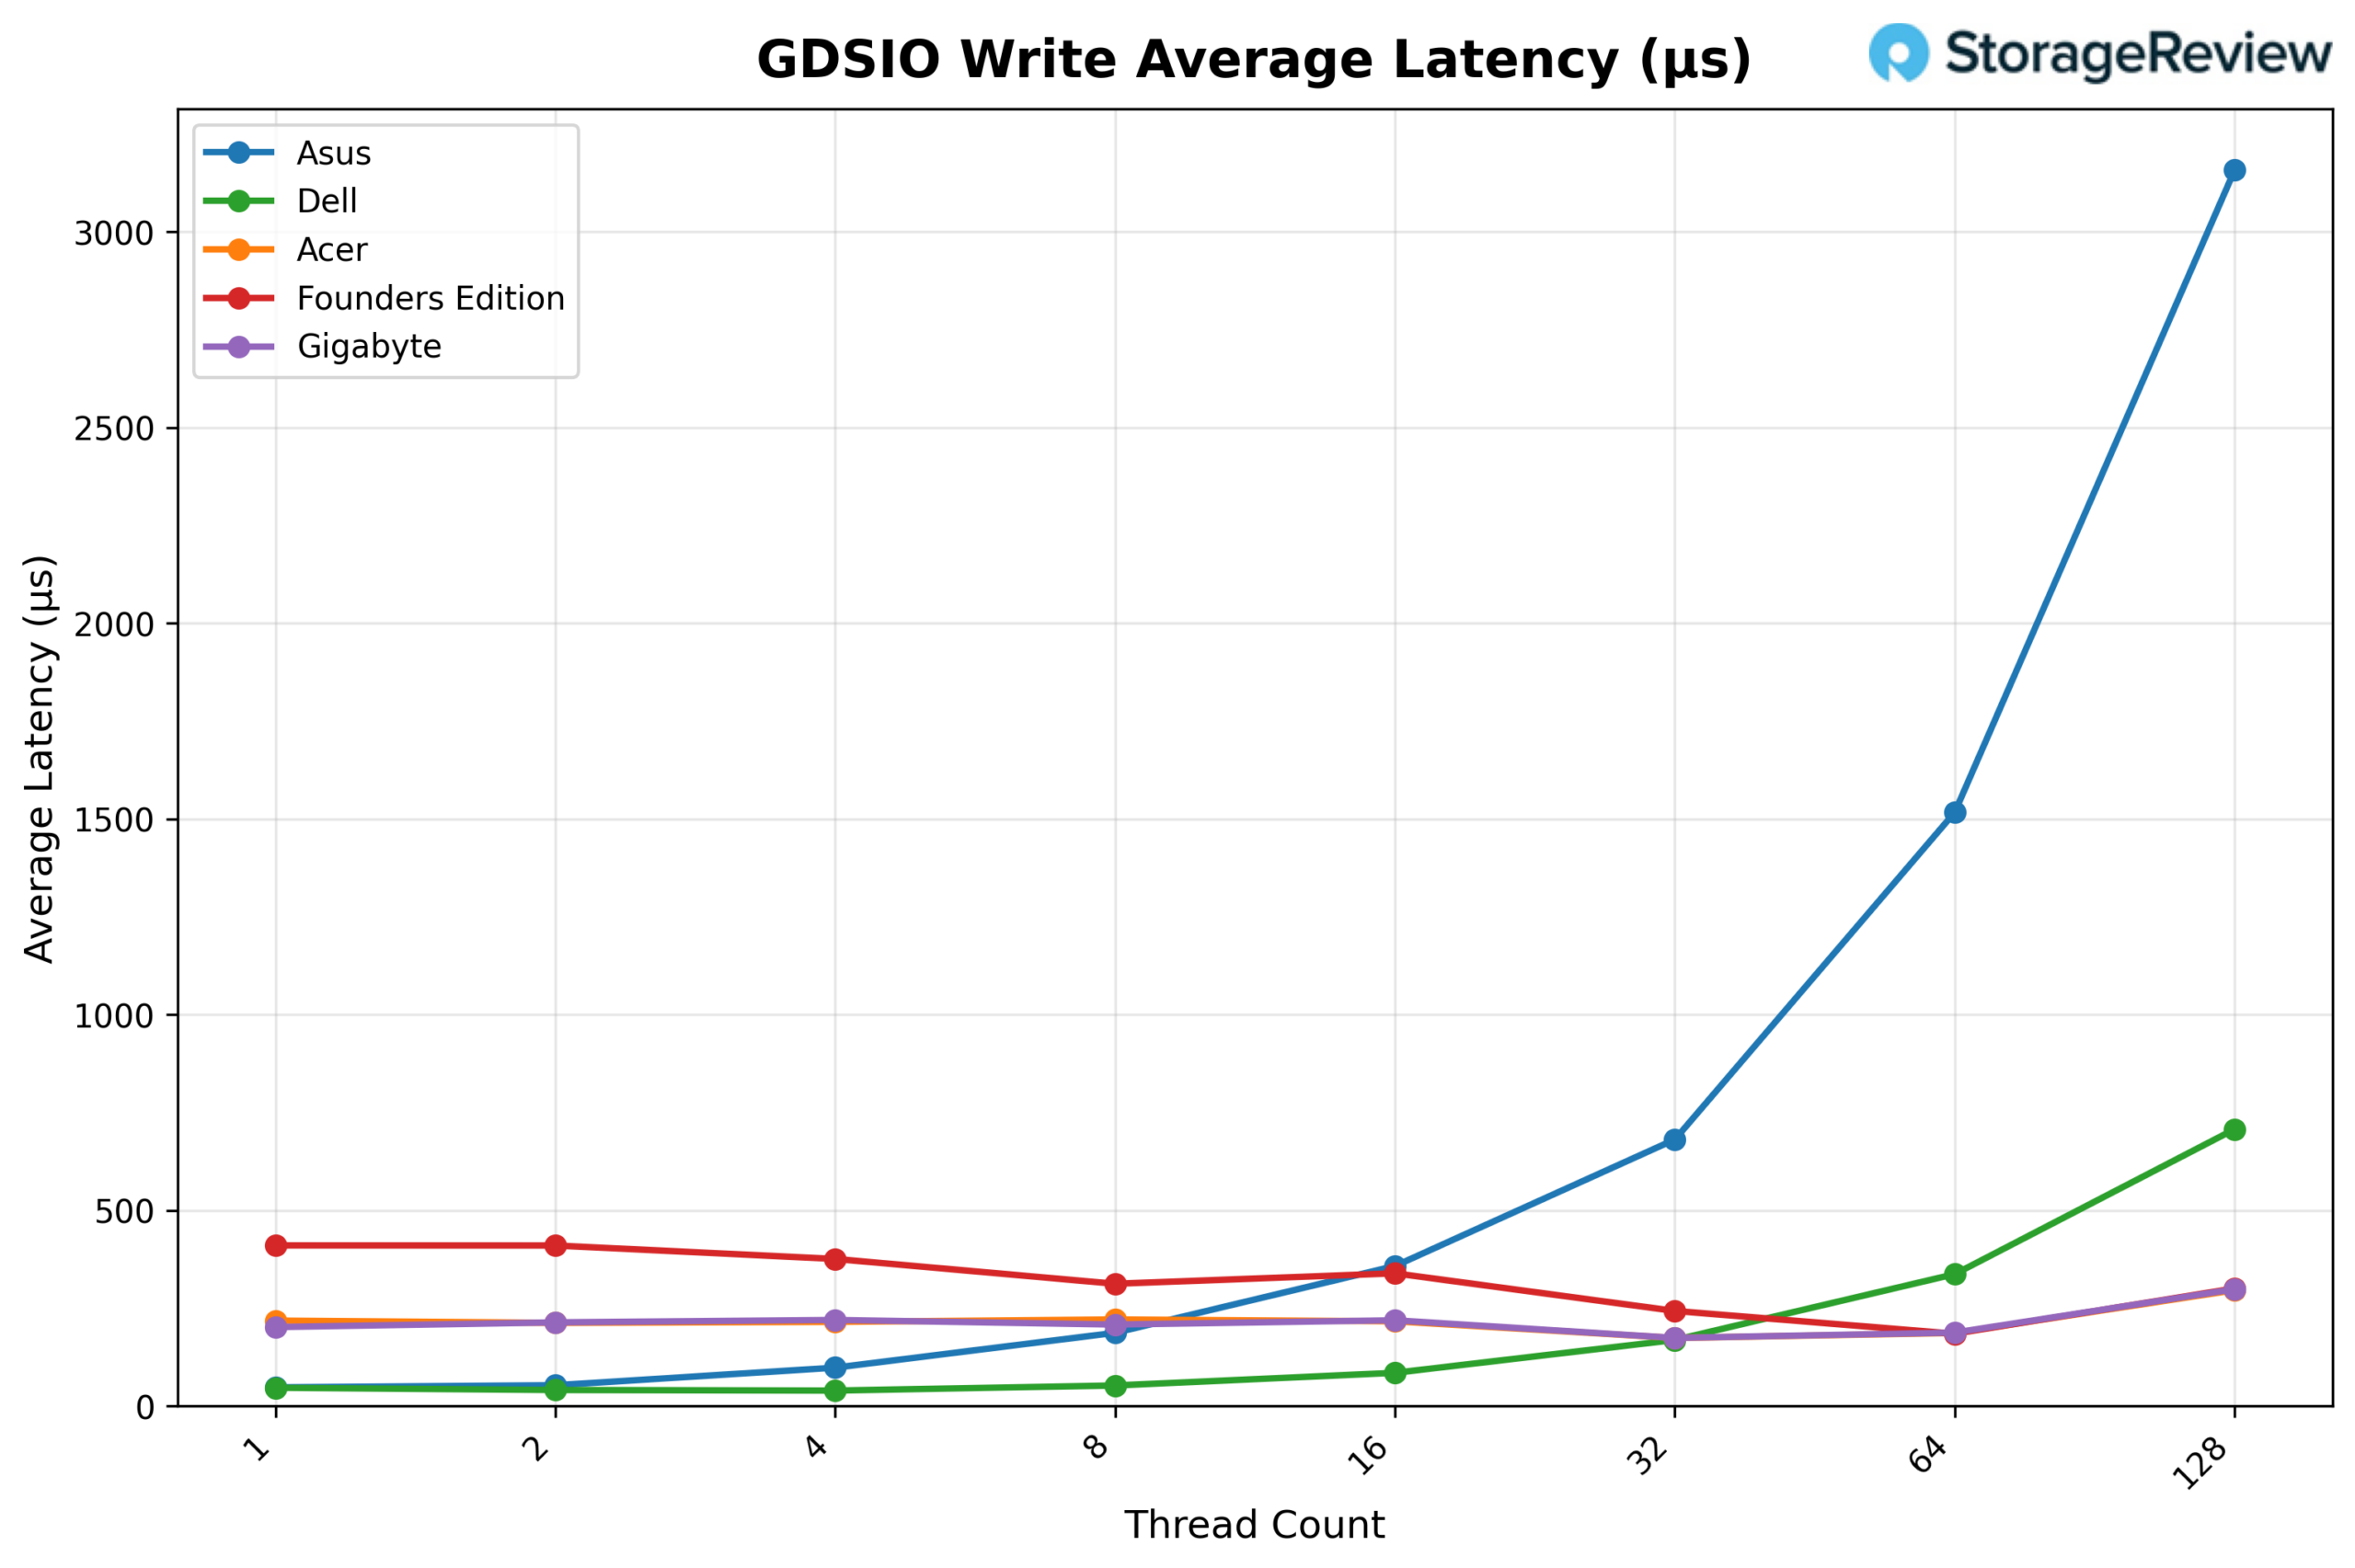
Betrachtet man die durchschnittliche Schreiblatenz (GDSIO Write Average Latency, 16K), so beginnt der Wert beim Acer mit einem Thread bei etwa 0.22 ms und bleibt bei zwei (0.21 ms), vier (0.22 ms) und acht Threads (0.22 ms) stabil. Die Latenz sinkt bei 32 Threads leicht auf 0.17 ms, bevor sie bei 64 Threads wieder leicht auf 0.19 ms ansteigt. Bei 128 Threads erreicht die Latenz 0.30 ms, was im Vergleich zu den Ergebnissen mit 1 Million Threads immer noch relativ niedrig ist und mit dem anhaltenden Skalierungsverhalten bei dieser kleineren I/O-Größe übereinstimmt.
GDSIO-Lesedurchsatz 1 Mio.
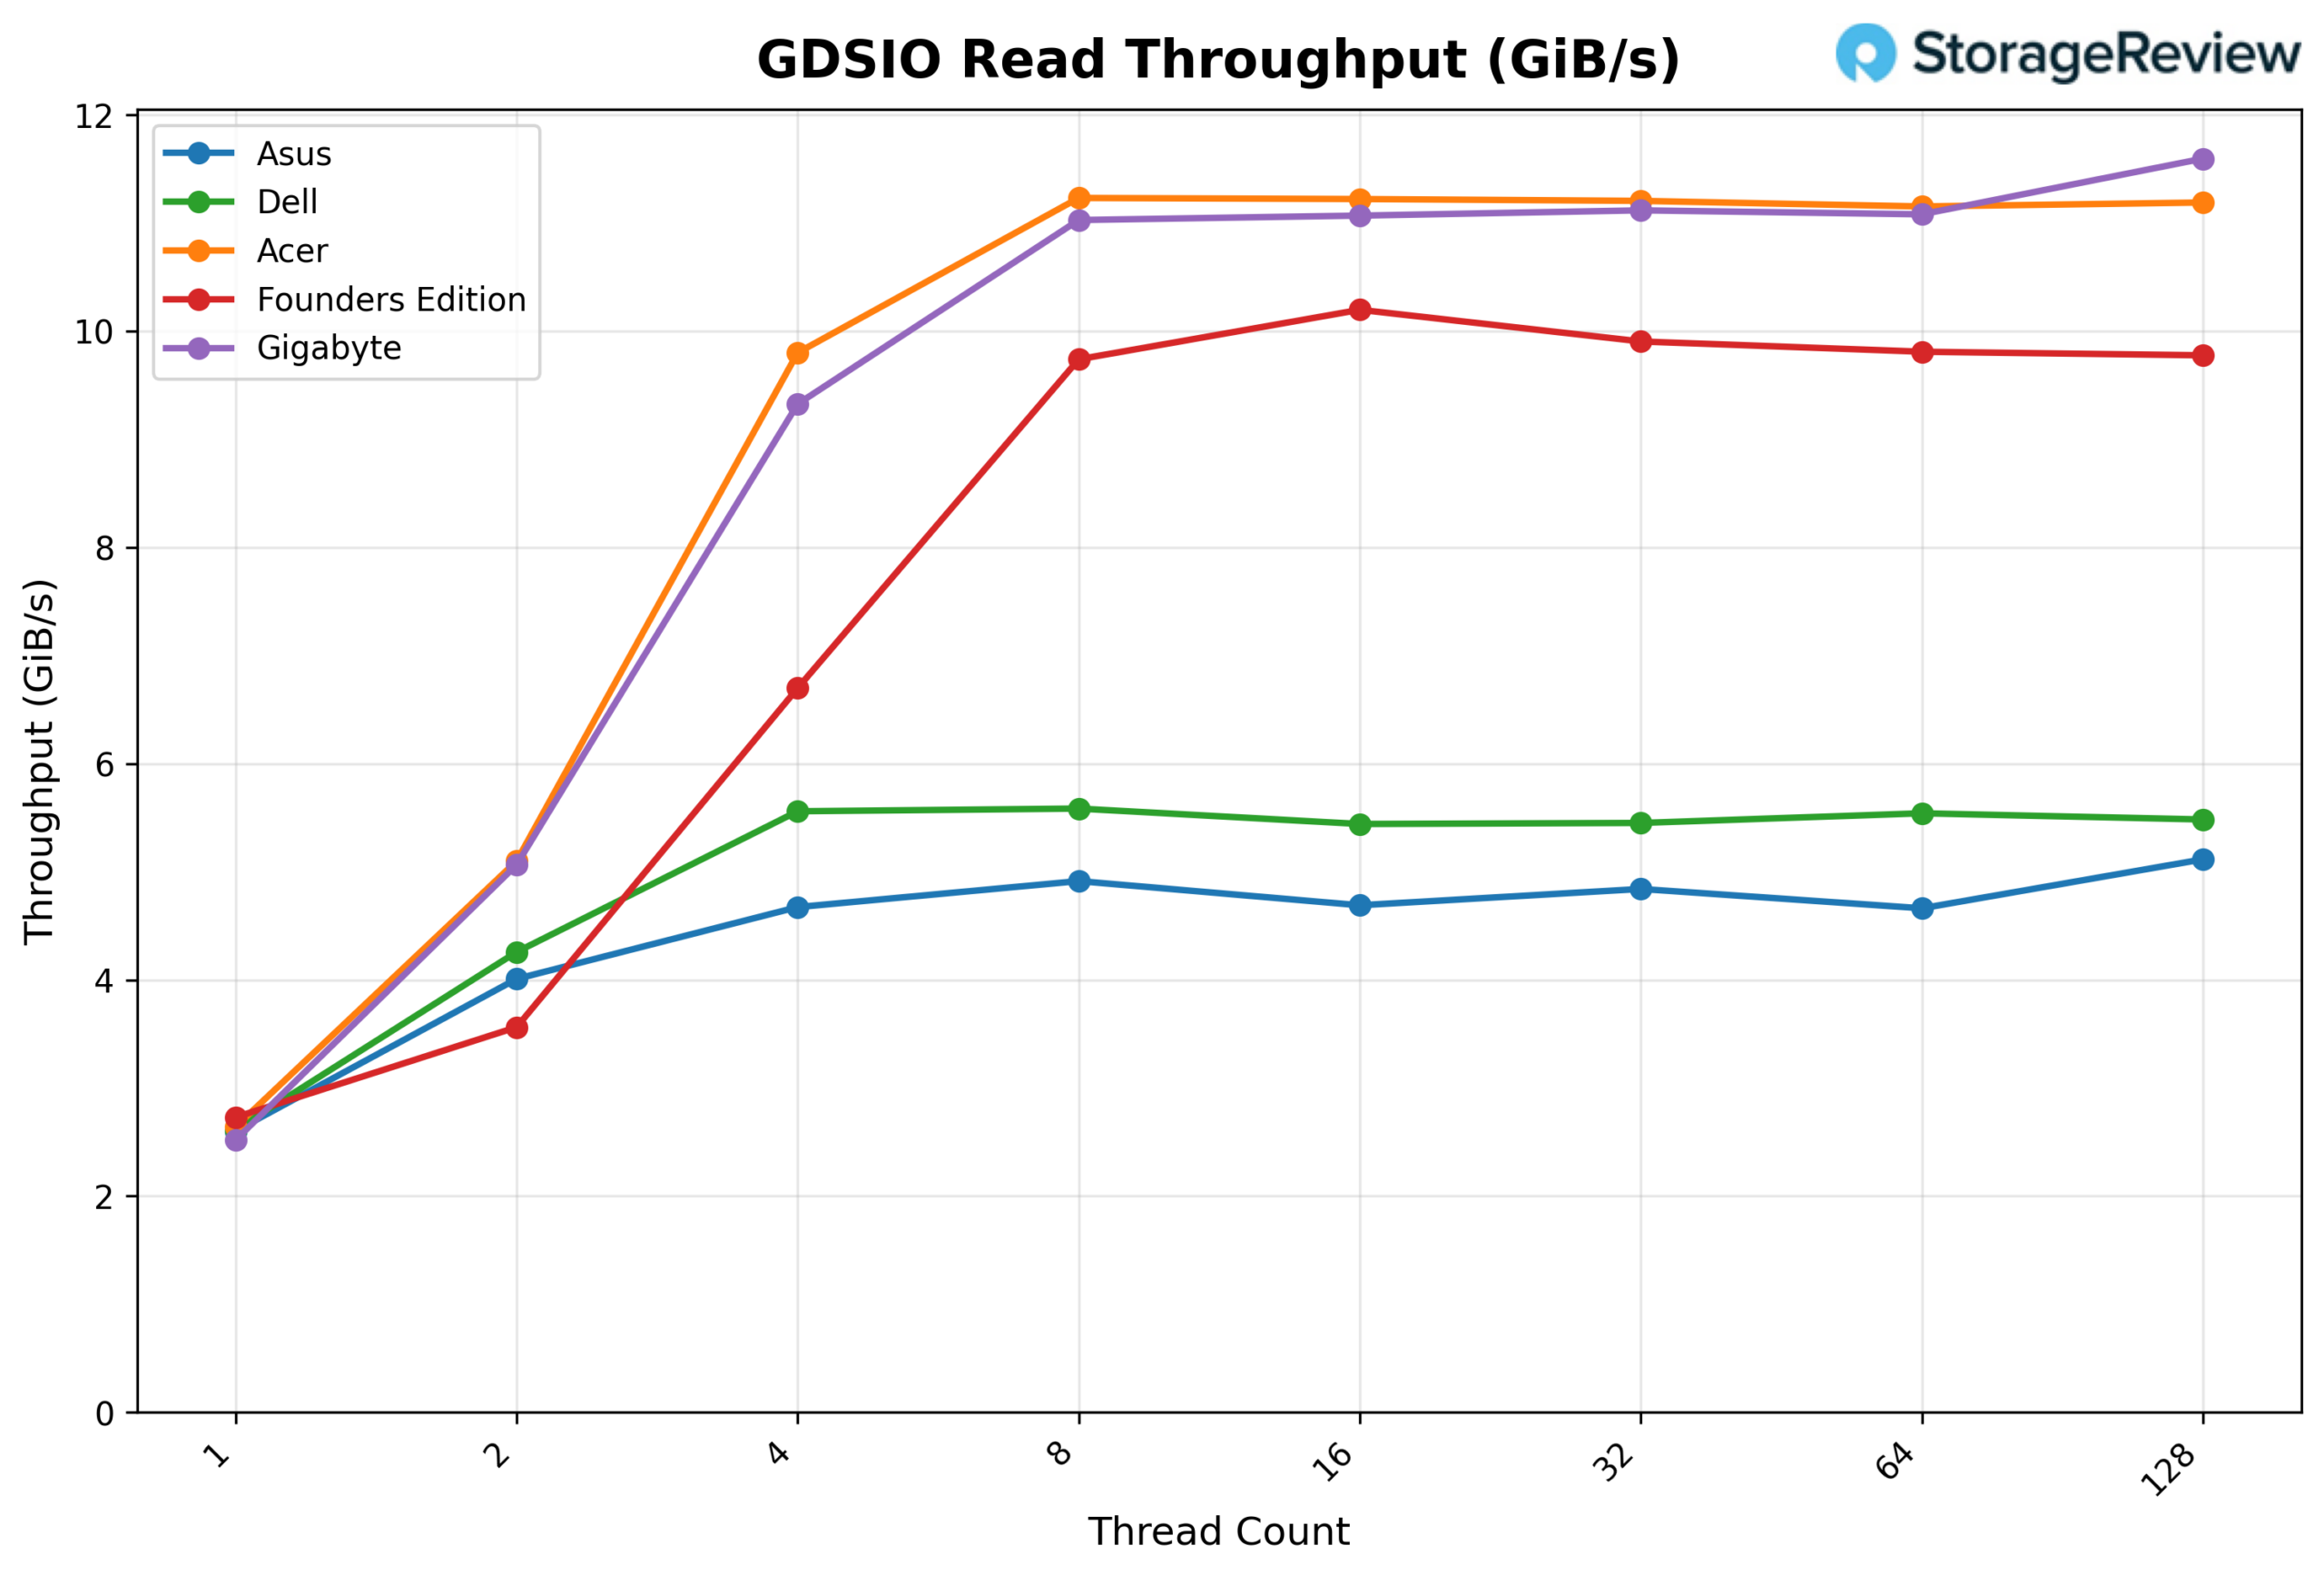
Betrachtet man den GDSIO-Lesedurchsatz (1M), so beginnt der Acer bei 2.64 GiB/s mit einem Thread, skaliert auf 5.10 GiB/s mit zwei Threads und 9.80 GiB/s mit vier Threads. Bei acht Threads erreicht der Durchsatz 11.23 GiB/s, ab dem die Plattform praktisch ihre Leistungsgrenze erreicht. Die Leistung bleibt bei 16 Threads (11.22 GiB/s), 32 Threads (11.21 GiB/s) und 64 Threads (11.15 GiB/s) konstant und zeigt ein stabiles Plateau. Bei 128 Threads bleibt der Durchsatz bei 11.19 GiB/s konstant, was die Sättigungsgrenze über den gesamten Bereich bestätigt.
GDSIO-Leselatenz durchschnittlich 1M
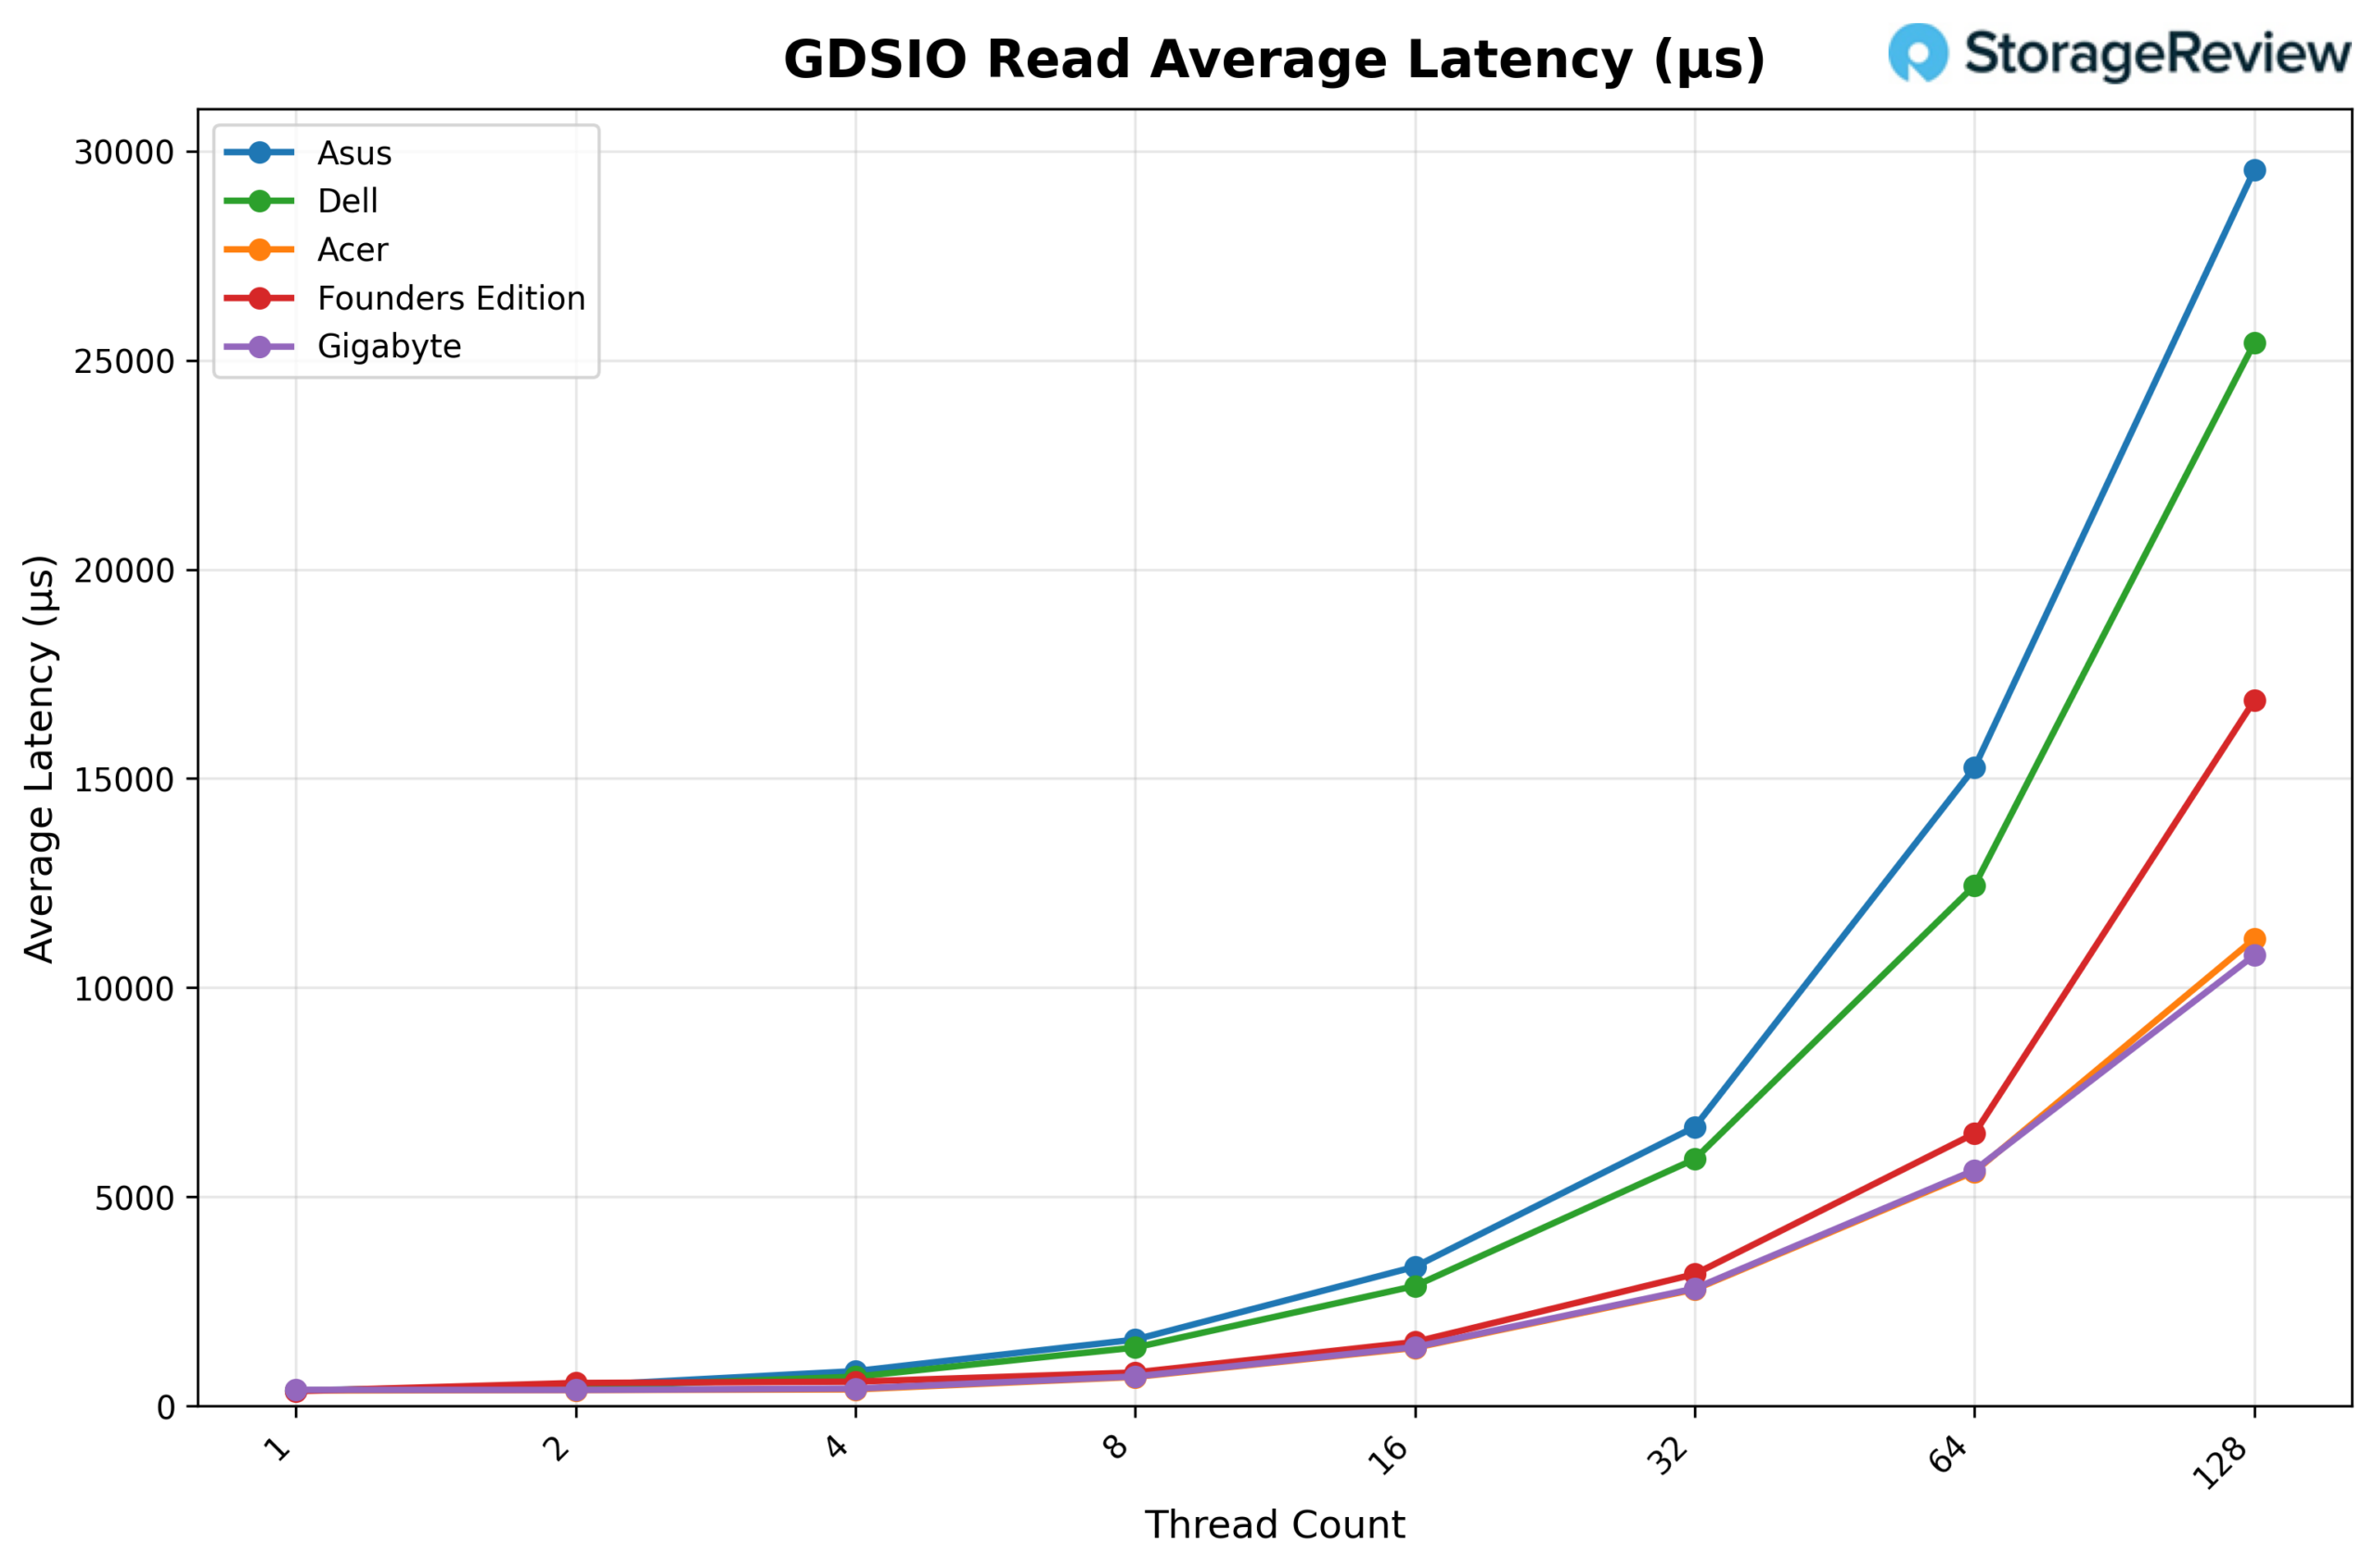
Betrachtet man die durchschnittliche Leselatenz (1M) von GDSIO, so beginnt der Wert beim Acer bei etwa 0.37 ms mit einem Thread und bleibt bei zwei Threads (0.38 ms) und vier Threads (0.40 ms) ähnlich. Die Latenz steigt mit zunehmender Anzahl gleichzeitiger Threads auf 0.70 ms bei acht Threads, 1.39 ms bei 16 Threads und 2.79 ms bei 32 Threads. Dieser Aufwärtstrend setzt sich bei 64 Threads (5.60 ms) fort und erreicht bei 128 Threads 11.17 ms, was den höchsten Werten für gleichzeitige Threads entspricht, während der Durchsatz weitgehend konstant bleibt.
GDSIO-Schreibdurchsatz 1M
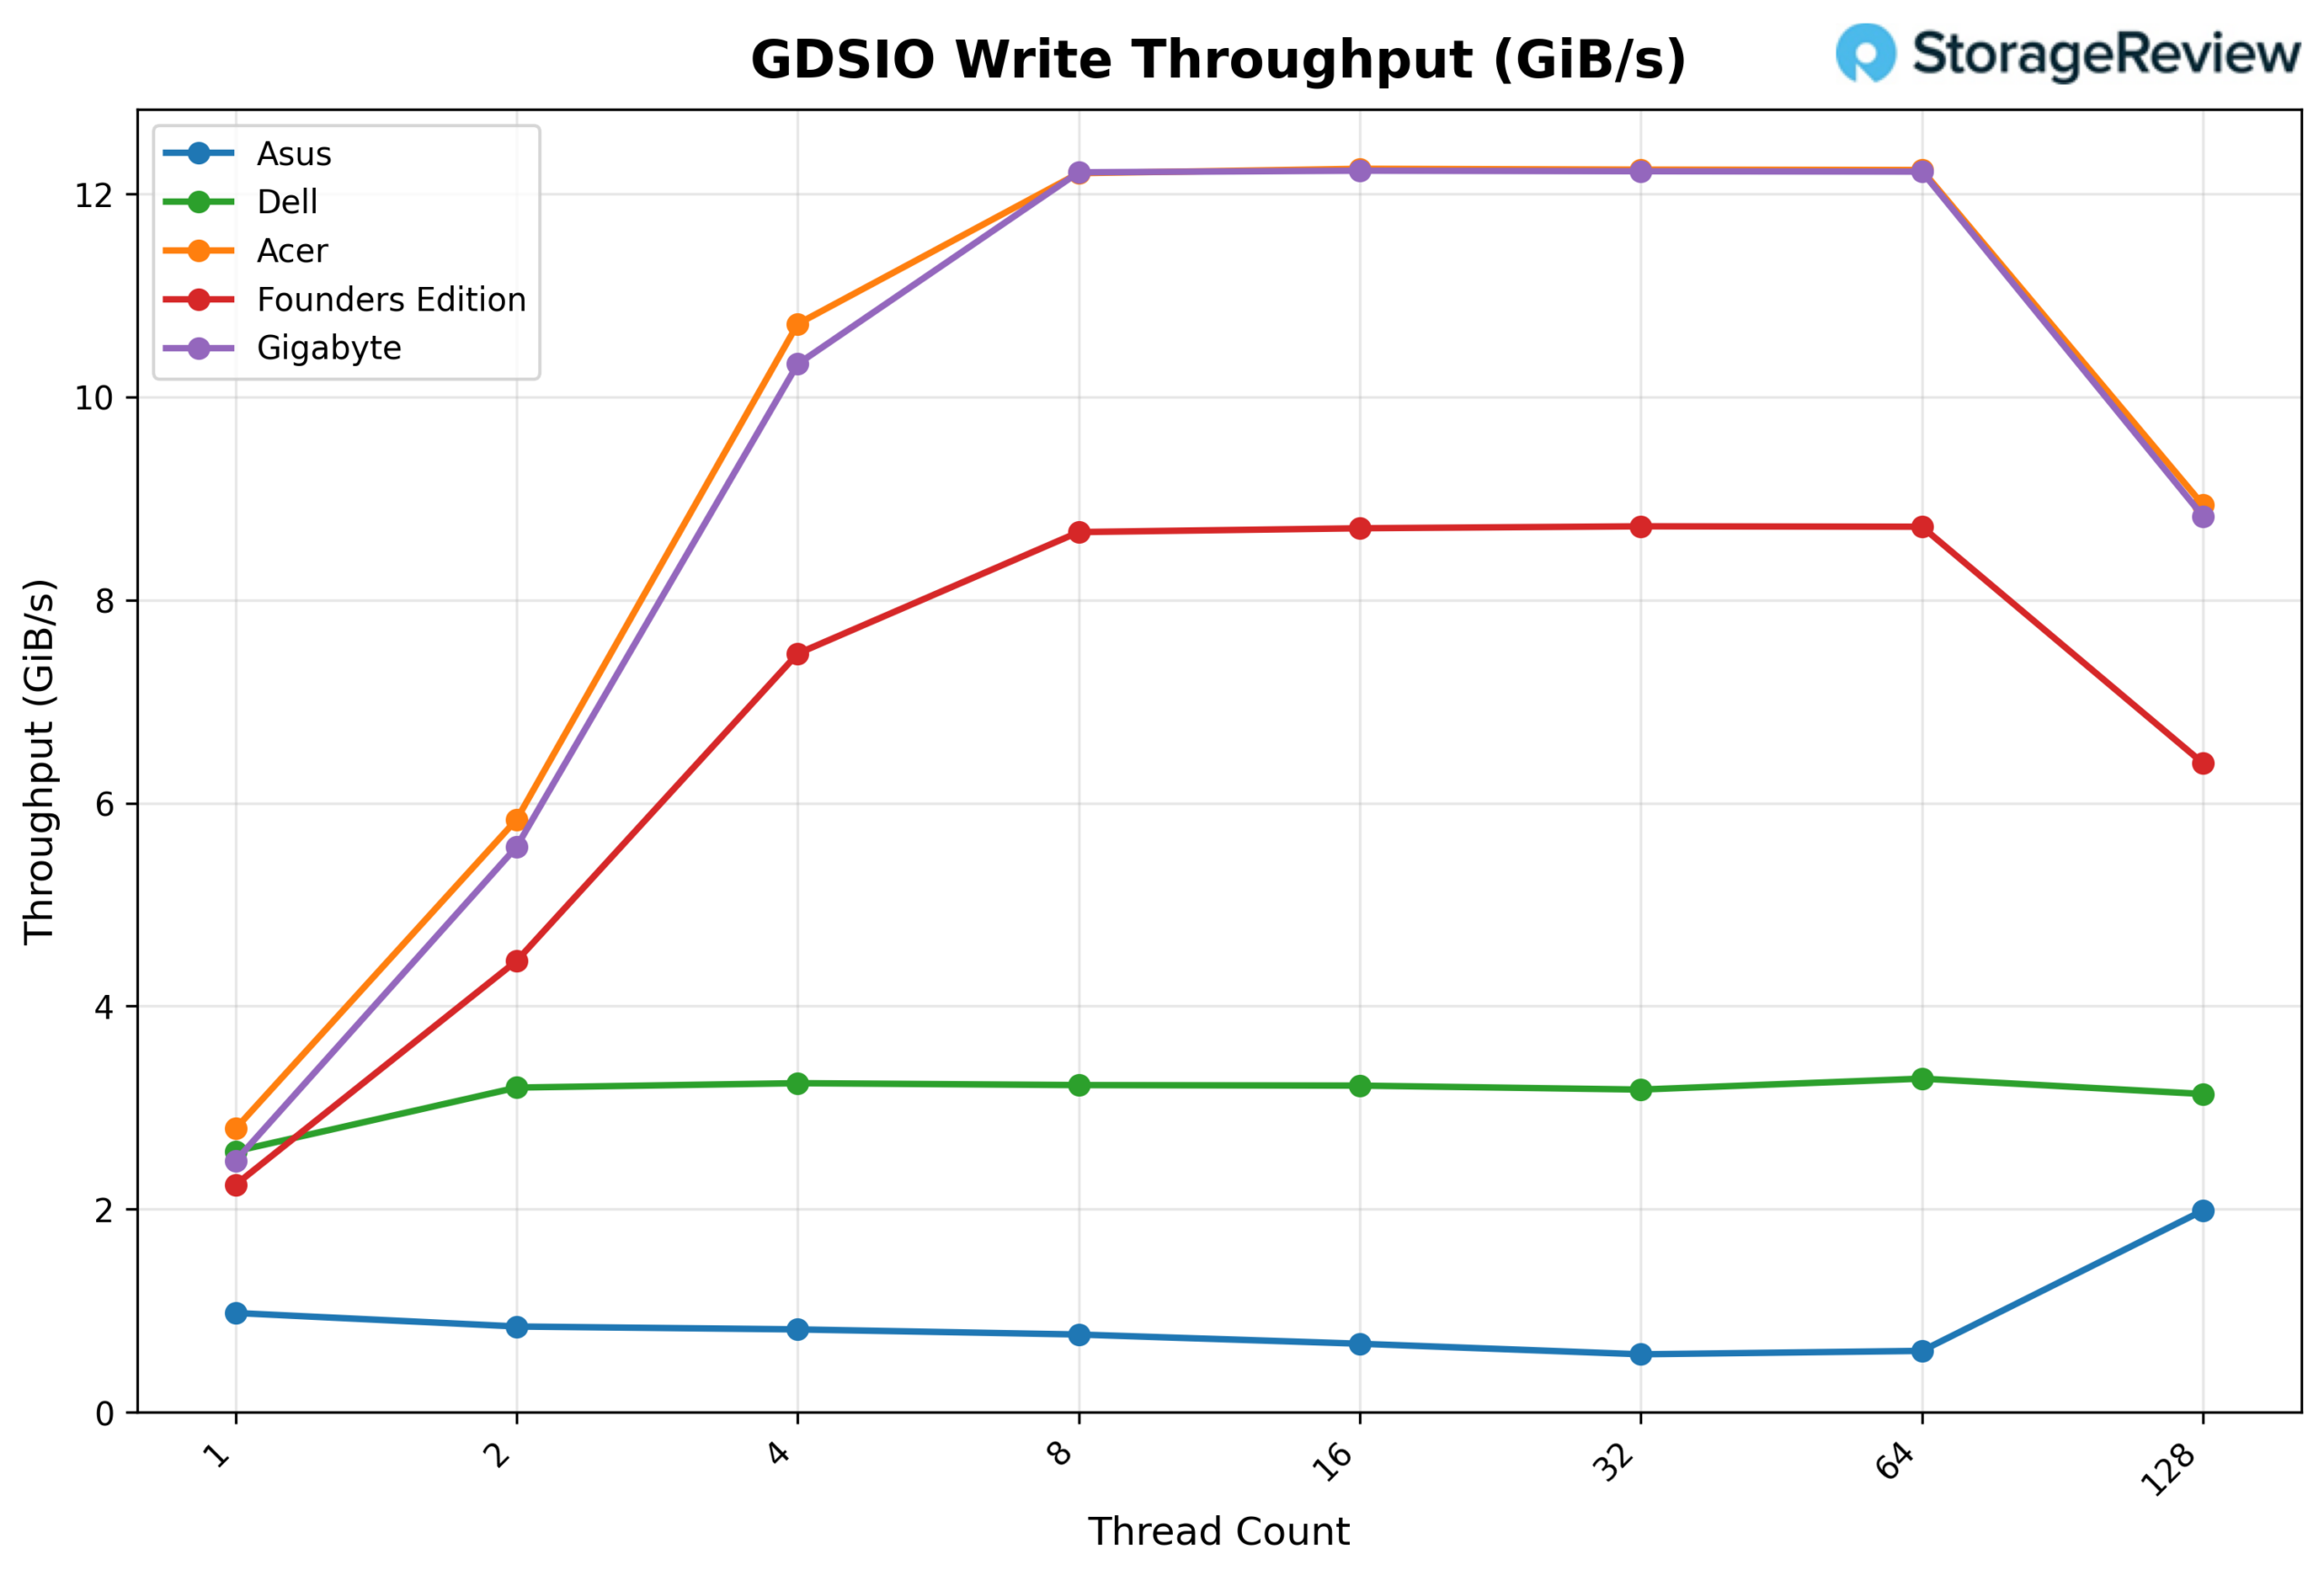
Betrachtet man den GDSIO-Schreibdurchsatz (1M), so beginnt der Acer bei 2.79 GiB/s mit einem Thread und skaliert stark auf 5.84 GiB/s mit zwei Threads und 10.72 GiB/s mit vier Threads. Bei acht Threads erreicht der Durchsatz 12.20 GiB/s, und die Plattform stößt an ihre Leistungsgrenze. Die Leistung bleibt bei 16 Threads (12.25 GiB/s), 32 Threads (12.24 GiB/s) und 64 Threads (12.23 GiB/s) konstant und zeigt ein stabiles Plateau. Bei 128 Threads sinkt der Durchsatz merklich auf 8.94 GiB/s, was auf Konflikte oder Ressourcenerschöpfung bei der höchsten Parallelitätsstufe hindeutet.
GDSIO Schreibdurchschnittslatenz 1M
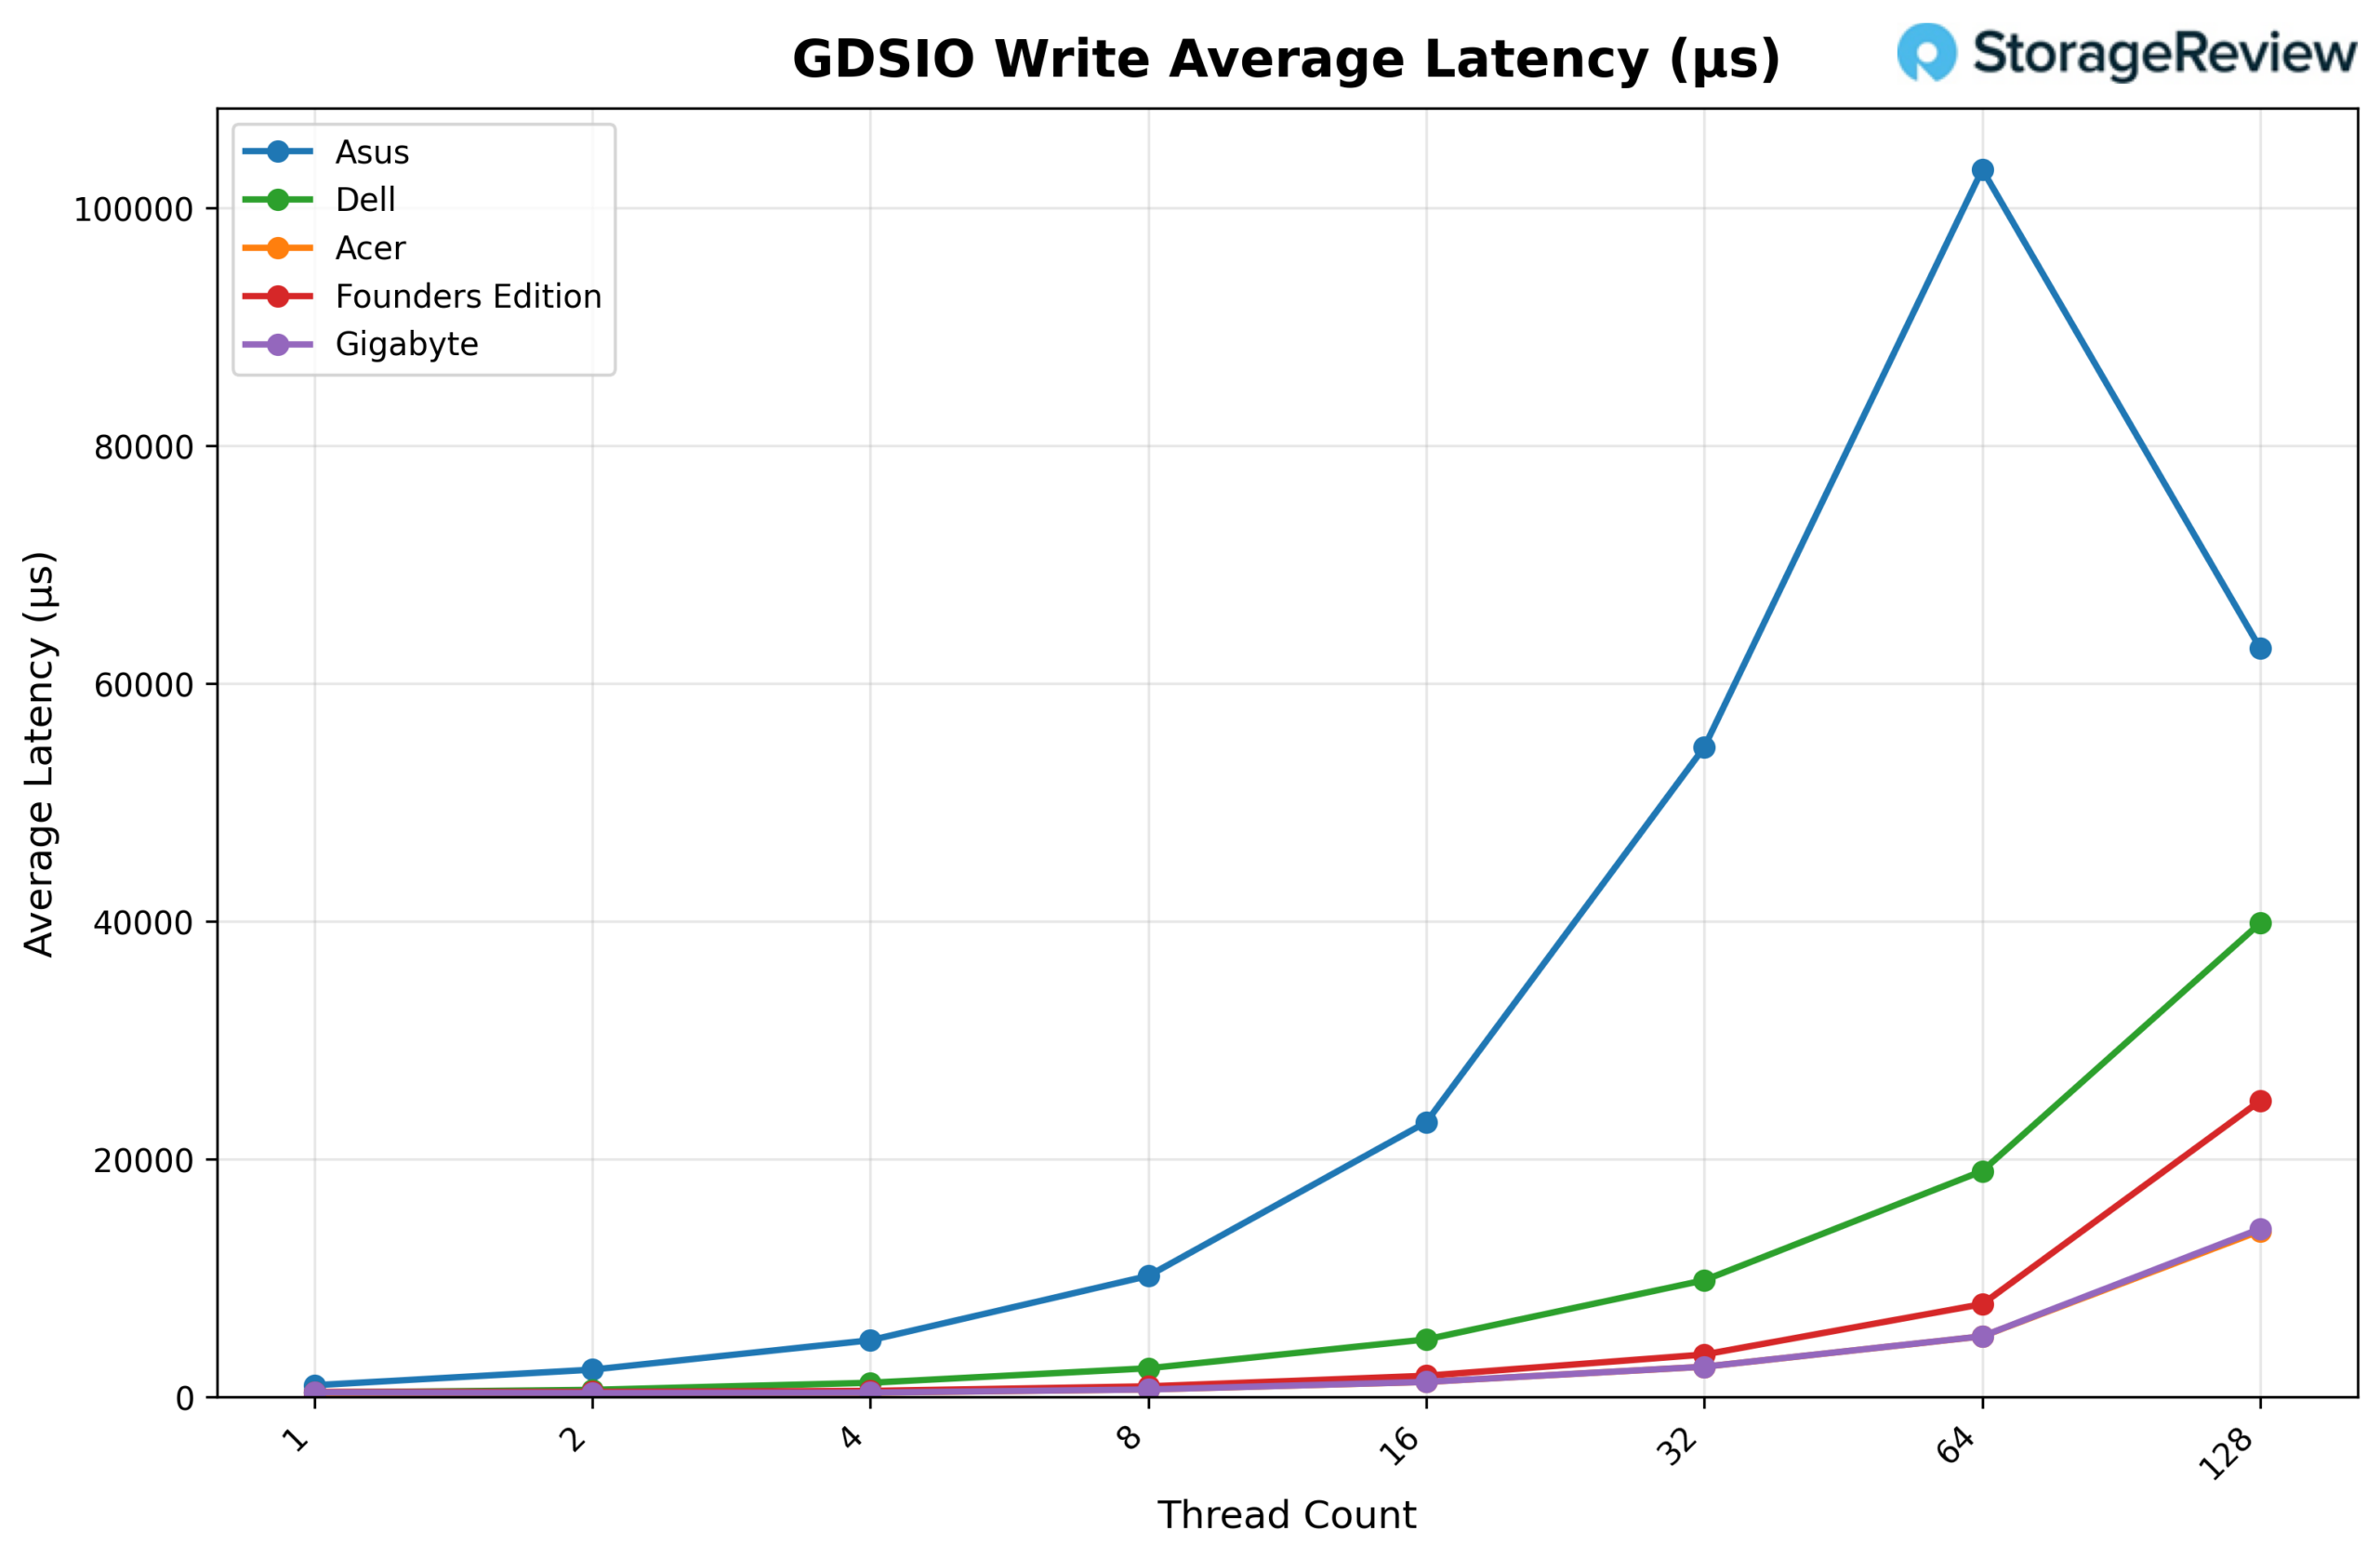
Betrachtet man die durchschnittliche Schreiblatenz (1M) von GDSIO, so beginnt der Wert bei Acer mit einem Thread bei etwa 0.35 ms und bleibt auch bei zwei (0.33 ms) und vier Threads (0.36 ms) niedrig. Mit zunehmender Parallelität steigt die Latenz und erreicht 0.64 ms bei acht Threads, 1.28 ms bei 16 Threads und 2.55 ms bei 32 Threads. Der Aufwärtstrend setzt sich bei 64 Threads (5.11 ms) fort und steigt bei 128 Threads sprunghaft auf 13.98 ms an, was mit dem beobachteten Durchsatzrückgang bei maximaler Parallelität übereinstimmt.
Fazit
Der Acer Veriton GN100 wies im Spark-Vergleich das insgesamt kühlste Temperaturprofil auf . Selbst bei rechenintensiven Prefill-Übergängen und anhaltender Dekodierungslast hielt er die Spitzentemperaturen von CPU und GPU konstant niedriger als die der anderen Geräte. Anstatt unter Last im oberen 80-°C-Bereich zu arbeiten, blieb er über längere Zeiträume in einem kontrollierten Betriebstemperaturbereich, was auf ein effektives Luftstromdesign und eine ausgewogene Leistungsabstimmung hindeutet.
Die Speicherleistung war eine weitere klare Stärke. Ausgestattet mit der 4 TB großen Samsung PM9E1 Gen5 SSD bot die GN100 die stärkste GPU-Direct-Storage-Skalierung für kleine Blöcke im Vergleich. Bei Blockgrößen von 16 KB blieb die Lese- und Schreiblatenz über alle Thread-Anzahlen hinweg bemerkenswert konstant, während der Durchsatz sauber bis an die Spitze skalierte. Bei 1 Million Übertragungen erreichte die Plattform schnell ihre Kapazitätsgrenze und hielt bis zu einer mittleren Thread-Anzahl wettbewerbsfähige Spitzenwerte, bevor die Leistung bei den höchsten Thread-Anzahlen abfiel.
Bei den vLLM-Inferenztests blieb die Leistung erwartungsgemäß eng mit der des breiteren Spark-Ökosystems verknüpft, da die Basis GB10 gemeinsam genutzt wird. Die Unterschiede zeigten sich nicht in der reinen Rechenleistung, sondern im Wärme- und Speicherverhalten unter Last.
Die einheitliche Architektur der Spark-Produktpalette sorgt für eine vergleichbare Inferenzleistung. Was die GN100 in dieser Runde auszeichnet, ist ihr dauerhaft niedriger Betriebstemperaturprofil in Kombination mit starker Gen5-NVMe-Leistung. Damit gehört sie zu den thermisch effizientesten und speicheroptimierten Implementierungen, die wir bisher getestet haben.
Produktseite – Acer Veritron GN 100 AI
Bestenliste: Der Acer Veriton GN100 belegt den Platz für die beste GB10-Implementierung in unserer Bestenliste der Desktop-PCs für lokale KI.


 Amazon