

Technologie bewegt sich in Zyklen, und kein Zyklus ist derzeit offensichtlicher als die Betonung der KI am Rande. Insbesondere stellen wir einen massiven Trend zur Kanteninferenz fest. NVIDIA ist maßgeblich an diesem Vorstoß beteiligt und möchte die Einführung seiner GPUs außerhalb des Rechenzentrums vorantreiben. Tatsache ist jedoch, dass Unternehmen schneller mehr Entscheidungen treffen müssen, sodass die KI-Infrastruktur näher an den Daten sein muss.
Erinnern Sie sich an Hub-and-Spoke?
Früher sprachen wir über den Vorsprung bei der Datenerstellung und darüber, wie man diese Daten mithilfe der traditionellen Hub-and-Spoke-Methodik schnell und effizient zurück ins Rechenzentrum bringen kann. Dieses Design wich dem hierarchischen Design, das auf Kern, Zugriff und Verteilung mit viel Redundanz und Hardware basiert und dem einzigen Zweck dient, Daten zurück zum primären Rechenzentrum zu bringen. All diese am Edge gesammelten Daten, nur um zur Verarbeitung zurück zum Hauptrechenzentrum transportiert und dann an die Edge-Geräte übertragen zu werden, erwiesen sich als ineffizient, kostspielig und zeitaufwändig.
Vielleicht war das Hub-and-Spoke-Design also doch nicht so schlecht. Angesichts des Bestrebens, mithilfe von KI mehr Intelligenz am Netzwerkrand bereitzustellen, und der disruptiven Wirkung des Cloud Computing scheint dieses Design einen erheblichen Einfluss auf Netzwerkdesign, Edge-Implementierungen und die Datenverarbeitung zu haben. Tatsächlich trug die diesjährige HPE Discover- Konferenz einen Slogan, der in jedem Jahr vor dem Cloud-Boom sehr vertraut gewesen wäre, wenn man einfach „Core“ durch „Cloud“ ersetzt hätte: „Die Edge-to-Cloud-Konferenz“.
Auf den Edge-Momentum springen
HPE war nicht der einzige Anbieter, der die Bedeutung von Edge-to-Cloud-Computing für die Branche erkannte. Dell Technologies lieferte während der Dell Technologies World-Veranstaltung eine ähnliche Geschichte. IBM, Lenovo, NetApp und Supermicro haben ebenfalls lautstark die Notwendigkeit zum Ausdruck gebracht, am Edge mehr zu leisten und gleichzeitig Cloud-Ressourcen effektiver zu nutzen.
Was treibt den Laserfokus des Edge Computing voran? Kunden generieren Datenmengen am Edge, die von Sensoren, IoT-Geräten und Datenerfassungen für autonome Fahrzeuge gesammelt werden. Die Nähe zu Daten an der Quelle bringt geschäftliche Vorteile, darunter schnellere Erkenntnisse mit genauen Vorhersagen und schnellere Reaktionszeiten bei besserer Bandbreitennutzung. KI-Inferenz am Edge (umsetzbare Informationen mithilfe von KI-Techniken) verbessert die Leistung, verkürzt die Zeit (Inferenzzeit) und verringert die Abhängigkeit von der Netzwerkkonnektivität, was letztendlich das Geschäftsergebnis verbessert.
Warum nicht Edge-Inferencing in der Cloud durchführen?
Warum kann Edge-Inferencing nicht in der Cloud durchgeführt werden? Dies ist möglich, und für Anwendungen, die nicht zeitkritisch sind und als unkritisch gelten, könnte Cloud-KI-Inferenz die Lösung sein. Echtzeit-Inferenzierung bringt jedoch viele technische Herausforderungen mit sich, darunter vor allem die Latenz. Darüber hinaus ist es angesichts der anhaltenden Zunahme von IoT-Geräten und zugehörigen Anwendungen, die eine Verarbeitung am Netzwerkrand erfordern, möglicherweise nicht möglich, allen Geräten eine Hochgeschwindigkeits-Cloud-Verbindung zur Verfügung zu stellen.
Edge Computing bringt seine eigenen Herausforderungen mit sich, darunter Vor-Ort-Support, physische und Anwendungssicherheit sowie begrenzter Platz, der zu begrenztem Speicherplatz führt. Heutige Edge-Server bieten ausreichend Rechenleistung für herkömmliche Edge-Workloads, wobei GPUs mehr Leistung ohne höhere Komplexität bieten.
Wachstum der Edge-Optionen
Interessanterweise dominieren vor allem die kleineren Systemanbieter den Edge-Infrastrukturmarkt. Supermicro beispielsweise spricht schon seit Jahren von 5G und Datenzentren auf Telefonmasten, und Advantech und viele andere Spezialserveranbieter tun dasselbe. Da sich die GPUs und, was noch wichtiger ist, die Software zu ihrer Unterstützung verbessert hat, wird die gesamte Vorstellung von KI am Rande immer realer.
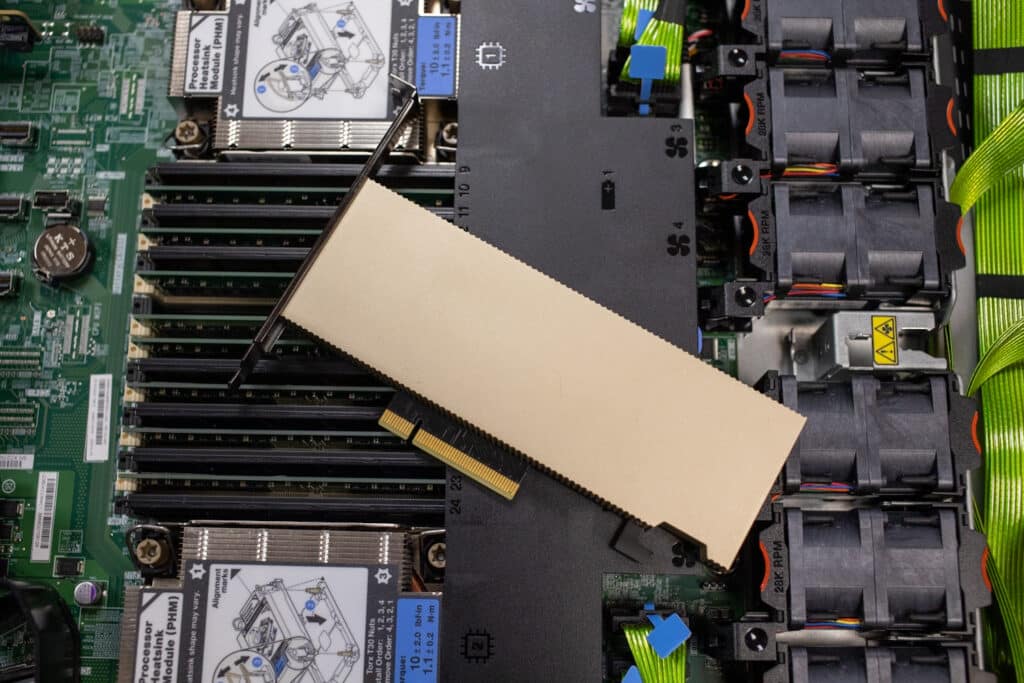
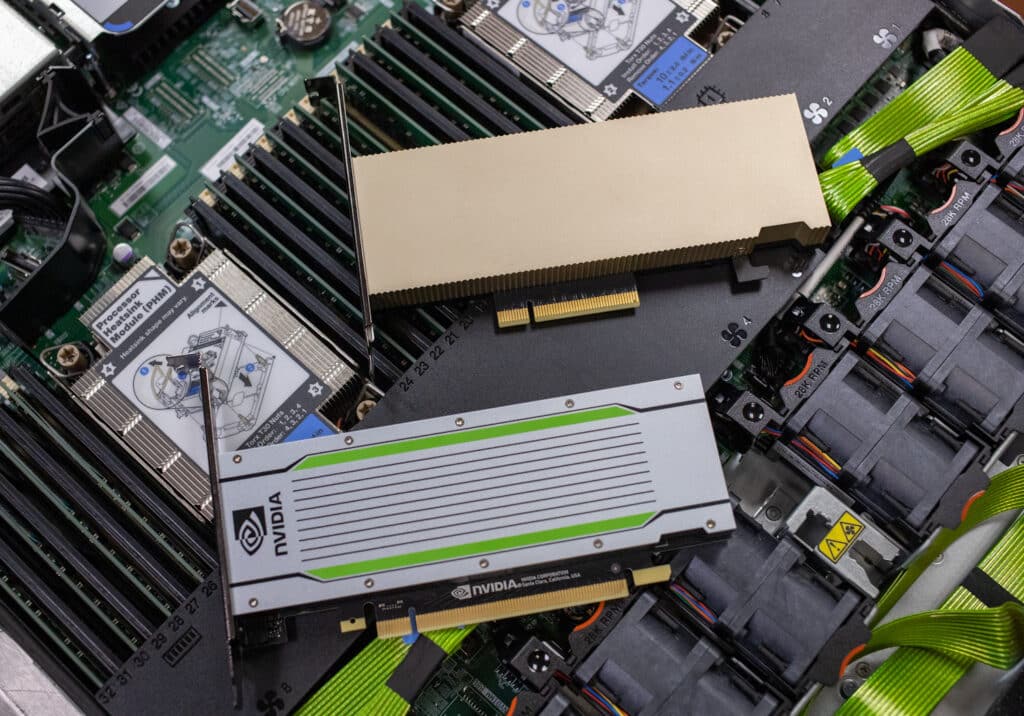
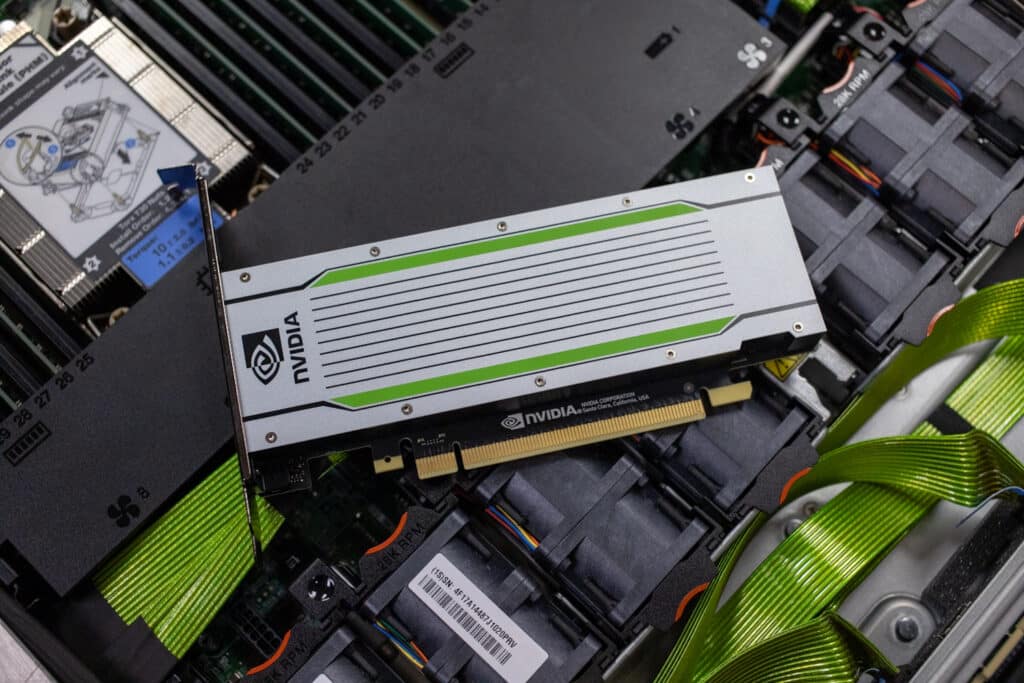
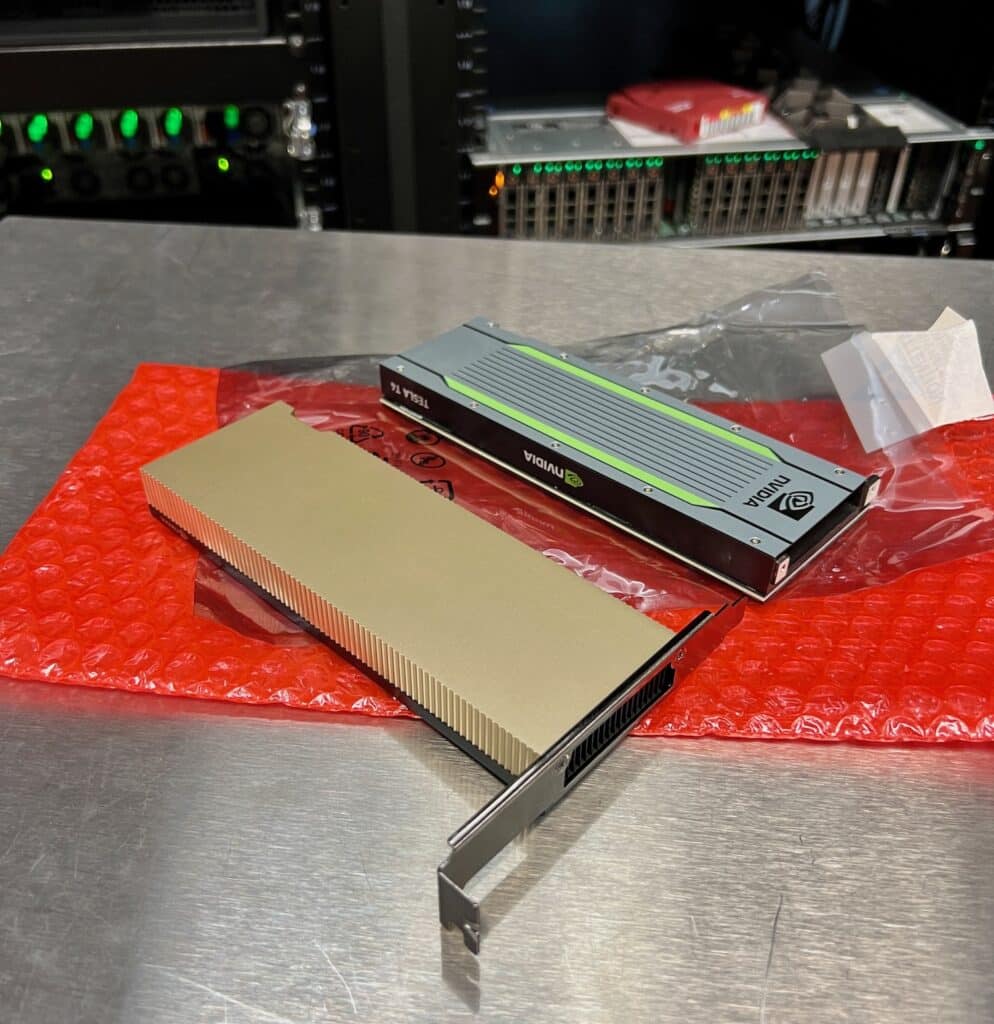
Wir haben diesen Übergang in unserem Labor kürzlich auf verschiedene Arten beobachtet. Erstens bringen neue Serverdesigns NVIDIAs Single-Slot-GPUs mit geringem Stromverbrauch wie den A2 und den allseits beliebten T4 mit. Kürzlich haben uns sowohl Lenovo als auch Supermicro Server zur Evaluierung geschickt, die diese GPUs integriert haben, und die Leistung war beeindruckend.
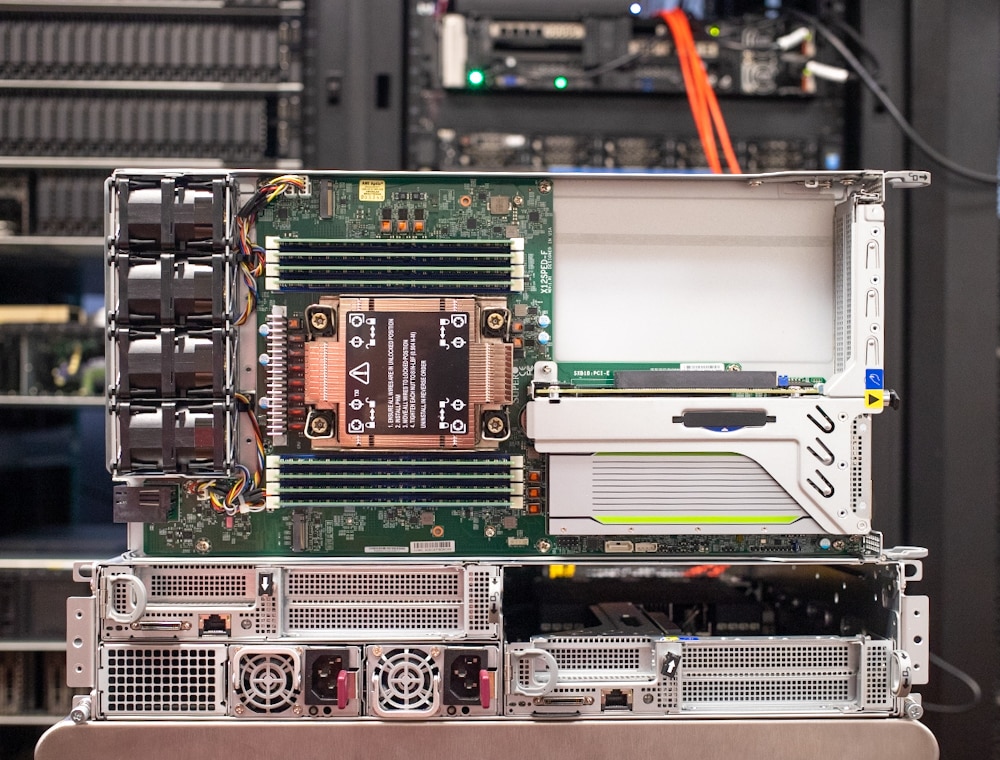 SuperMicro IoT SuperServer SYS-210SE-31A mit NVIDIA T4
Zweitens legen Infrastrukturanbieter großen Wert darauf, Edge-Lösungen mit Kennzahlen bereitzustellen, die direkt an grundlegende Rechenzentrumsfunktionen wie geringe Latenz und Sicherheit gekoppelt sind. Wir haben kürzlich einige dieser Anwendungsfälle mit dem Dell PowerVault ME5 untersucht . Obwohl der ME5 als Speicherlösung für kleine und mittlere Unternehmen (KMU) positioniert ist, stößt er aufgrund seines Preis-Leistungs-Verhältnisses auf großes Interesse für Edge-Anwendungen.
Letztendlich ist die Edge-Inferencing-Geschichte jedoch ziemlich einfach. Es kommt auf die Fähigkeit der GPU an, Daten zu verarbeiten, oft im laufenden Betrieb. Wir haben daran gearbeitet, unsere Tests zu erweitern, um eine bessere Vorstellung davon zu bekommen, wie diese neuen Server und GPUs für die Edge-Inferencing-Rolle funktionieren können. Insbesondere haben wir uns beliebte Edge-Workloads wie Bilderkennung und Modelle zur Verarbeitung natürlicher Sprache angesehen.
Testhintergrund
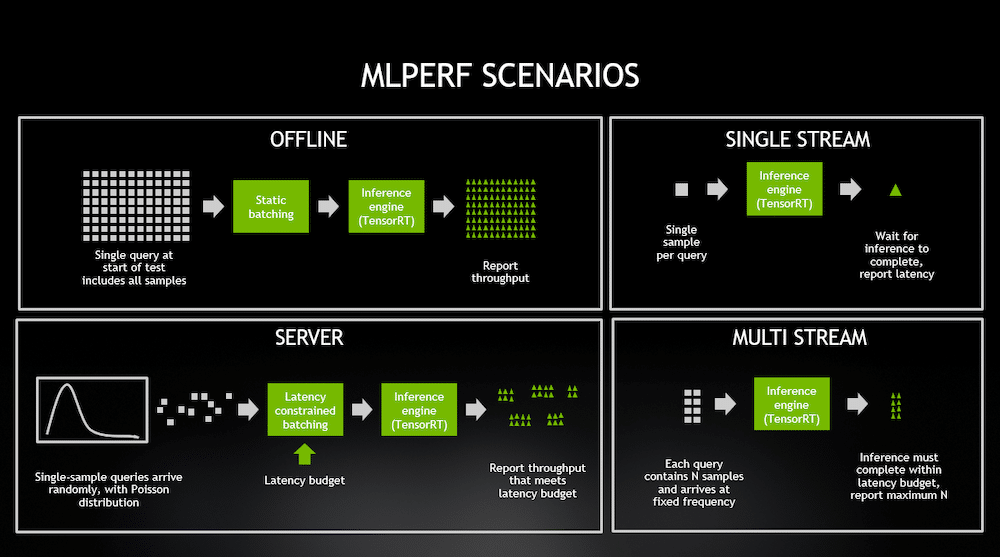
Wir arbeiten mit der Benchmark-Suite MLPerf Inference: Edge. Dieser Satz von Tools vergleicht die Inferenzleistung für gängige DL-Modelle in verschiedenen realen Edge-Szenarien. In unseren Tests haben wir Zahlen für das Bildklassifizierungsmodell ResNet50 und das NLP-Modell BERT-Large für Frage-Antwort-Aufgaben. Beide werden in Offline- und SingleStream-Konfigurationen ausgeführt.
Das Offline-Szenario bewertet die Inferenzleistung im „Batch-Modus“, wenn alle Testdaten sofort verfügbar sind und die Latenz keine Rolle spielt. Bei dieser Aufgabe kann das Inferenzskript Testdaten in beliebiger Reihenfolge verarbeiten. Ziel ist es, die Anzahl der Abfragen pro Sekunde (QPS = Durchsatz) zu maximieren. Je höher die QPS-Zahl, desto besser.
Im Gegensatz dazu verarbeitet die Single-Stream-Konfiguration jeweils eine Testprobe. Sobald die Inferenz für eine einzelne Eingabe durchgeführt wird (im Fall von ResNet50 handelt es sich bei der Eingabe um ein einzelnes Bild), wird die Latenz gemessen und das nächste Beispiel wird dem Inferenztool zur Verfügung gestellt. Das Ziel besteht darin, die Latenz für die Verarbeitung jeder Abfrage zu minimieren. Je geringer die Latenz, desto besser. Der Kürze halber wird die 90. Perzentillatenz des Abfragestroms als Zielmetrik erfasst.
Die Abbildung unten stammt aus einem Blogbeitrag von NVIDIA zur MLPerf-Inferenz 0.5 und veranschaulicht die Szenarien sehr gut. Weitere Informationen zu den verschiedenen Szenarien finden Sie im Original- Paper zur MLPerf-Inferenz (hier).
Edge-Inferenzierung – Lenovo ThinkEdge SE450
Nach unserem Test des ThinkEdge SE450 haben wir gemeinsam mit Lenovo MLPerf auf den NVIDIA A2- und T4-Grafikkarten des Systems ausgeführt. Ziel war es, die Leistungsfähigkeit des SE450 mit nur einer einzigen GPU zu ermitteln. Das System unterstützt bis zu vier der stromsparenden NVIDIA-GPUs. Daher ist es naheliegend, diese Werte auf die gewünschte Anzahl an Grafikkarten hochzurechnen.
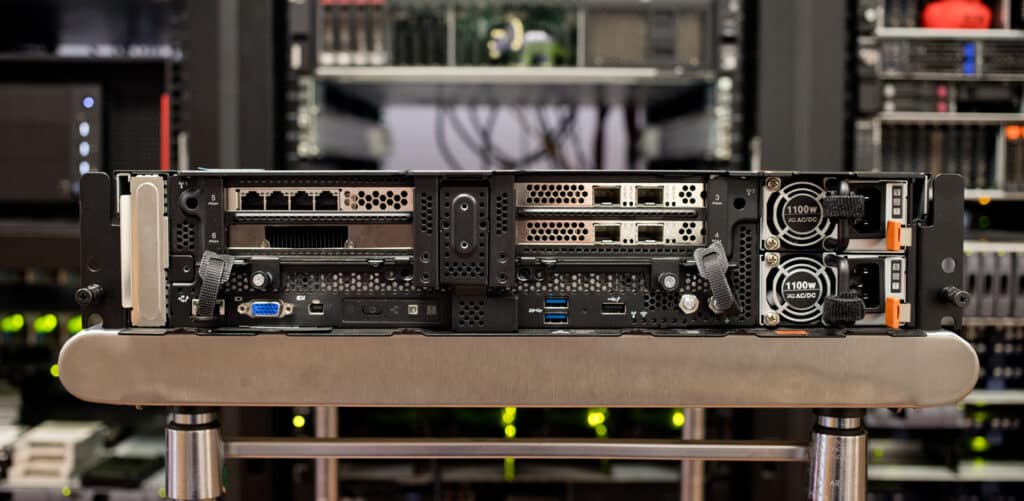
Für diesen Test haben wir direkt mit Lenovo zusammengearbeitet und die verschiedenen Konfigurationen in unserem Labor sowohl mit NVIDIA A2 als auch mit T4 getestet. Mit MLPerf verfügen Anbieter über ein spezifisches Testsystem, das auf ihre jeweilige Plattform abgestimmt ist. Für dieses Edge-Inferencing-Benchmarking haben wir die Testumgebung von Lenovo genutzt, um eine Vorstellung davon zu bekommen, wo diese beliebten GPUs abschneiden.
Die Ergebnisse der Tests für den A2 und T4 im SE450 in unserem Labor:
| Benchmark | NVIDIA A2 (40–60 W TDP) | NVIDIA T4 (70 W TDP) |
|---|---|---|
| ResNet50 SingleStream | 0.714 ms Latenz | 0.867 Latenz |
| ResNet50 offline | 3,032.18 Proben/s | 5,576.01 Proben/s |
| BERT SingleStream | 8.986 ms Latenz | 8.527 ms Latenz |
| BERT offline | 244.213 Proben/s | 392.285 Proben/s |
Interessanterweise schnitt der NVIDIA T4 durchweg wirklich gut ab, was für einige allein aufgrund seines Alters überraschend ist. Das Leistungsprofil des T4 ist ein ziemlich offensichtlicher Grund dafür, dass der T4 immer noch so beliebt ist. Allerdings hat der A2 bei der Echtzeit-Bildinferenz einen deutlichen Latenzvorteil gegenüber dem T4.
Letztendlich wird die Entscheidung für die GPU auf die konkrete Aufgabe abgestimmt. Der ältere NVIDIA T4 verbraucht mehr Strom (70 W) und verwendet einen PCIe Gen3 x16-Steckplatz, während der neuere A2 für den Betrieb mit weniger Strom (40–60 W) ausgelegt ist und einen PCIe Gen4 x8-Steckplatz verwendet. Wenn Unternehmen besser verstehen, was sie von ihrer Edge-Infrastruktur verlangen, werden die Ergebnisse aussagekräftiger und Edge-Inferencing-Projekte werden mit größerer Wahrscheinlichkeit erfolgreich sein.
Fazit
Anbieter liefern sich einen Wettlauf um die Entwicklung kleinerer, schnellerer und robusterer Server für den Edge-Markt. Organisationen vom Einzelhandel über Fabriken bis hin zum Gesundheitswesen fordern schnellere Einblicke in die an der Quelle gesammelten Daten. Die Verbesserung der Inferenzzeit, die Reduzierung der Latenz, Optionen zur Leistungssteigerung und die Nutzung neuer Technologien werden die Gewinner und Verlierer schnell trennen.
Der Edge-Markt steht nicht still, da Unternehmen neue Wege finden, die Erkenntnisse aus der ständig wachsenden Zahl von IoT-Geräten zu nutzen. Unser Team sieht eine große Chance für diejenigen, die in ihren jeweiligen Branchen schnell agieren können, die Vorteile von KI am Edge zu nutzen, wozu auch dieser Edge-Inferencing-Anwendungsfall gehört.
Wir erwarten, dass die führenden Anbieter von IT-Infrastrukturlösungen im Laufe des nächsten Jahres innovative Lösungen für diesen spezifischen Anwendungsfall entwickeln werden. Darüber hinaus – und das ist vielleicht noch wichtiger – erwarten wir zahlreiche Software-Fortschritte, die die Nutzung von GPUs in diesen Edge-Anwendungen demokratisieren werden. Damit diese Technologie wirklich transformativ ist, muss ihre Implementierung einfacher werden als bisher. Angesichts der Arbeit, die wir nicht nur von NVIDIA, sondern auch von Softwareunternehmen wie Vantiq , Viso.ai und vielen anderen beobachten, sind wir optimistisch, dass weitere Organisationen diese Technologie erfolgreich einsetzen können.



 Amazon