

Mit der Markteinführung der DGX Spark-Plattform von NVIDIA bieten nun verschiedene Hersteller ihre kompakten Desktop-Systeme auf Basis der GB10 Grace Blackwell-Architektur an. Während Mainboard und Chipsatz standardisiert bleiben, zeigen sich Unterschiede im Gehäusedesign, der Kühlung, der Speicherkonfiguration und der Gesamtleistung. In diesem Test konzentrieren wir uns auf die Implementierung von GIGABYTE im AI TOP ATOM.
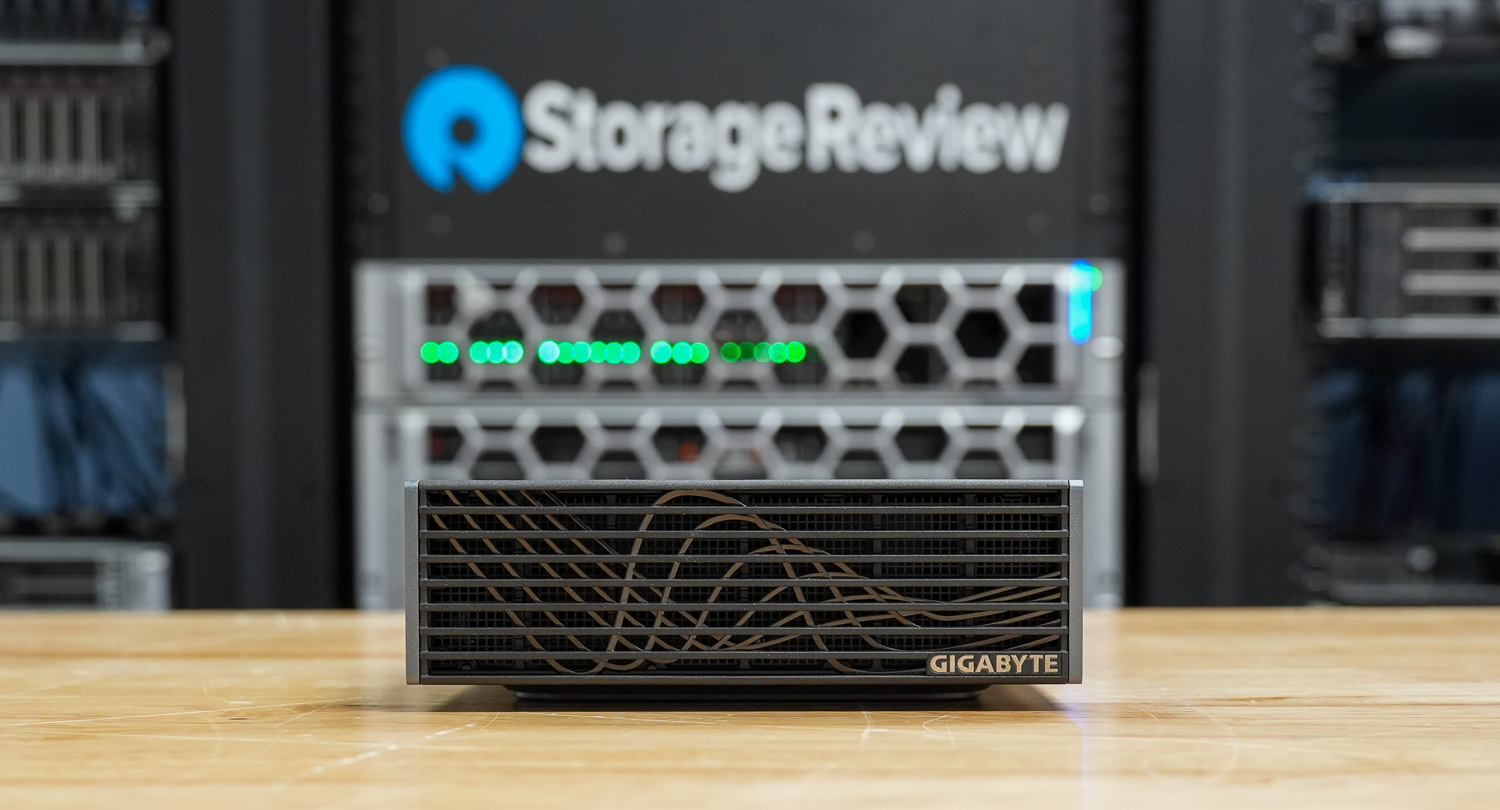
Im Inneren arbeitet der gleiche GB10 Superchip, der einen 20-Kern-Arm-Prozessor mit Blackwell-KI-Beschleunigung und 128 GB einheitlichem LPDDR5X-Speicher kombiniert. Diese Basis ermöglicht eine FP4-Rechenleistung von bis zu 1 Petaflop und die Modellierung von bis zu 200 Milliarden Parametern, wodurch sich das System klar im Bereich der KI-Workstations positioniert.
Der AI TOP ATOM ist in einem kompakten 1-Liter-Gehäuse mit den Abmessungen 150 x 150 x 50.5 mm untergebracht und wird über ein externes 240-W-Netzteil mit Strom versorgt. Obwohl der Rechenkern mit dem anderer Spark-Systeme identisch ist, untersuchen wir, wie sich die Designentscheidungen von GIGABYTE auf die Wärmeentwicklung, das Verhalten unter Dauerlast, die Speicherleistung und die alltägliche Bedienbarkeit auswirken.
Die Speicheroptionen sind auf bis zu 4 TB Gen5 NVMe skalierbar, und das System wird mit NVIDIA DGX OS auf Basis von Ubuntu ausgeliefert, wodurch es sofort für KI-Workloads geeignet ist. Kurz gesagt: Während die Kernhardware identisch mit der anderer Spark-Systeme ist, hängen Benutzererfahrung, Wärmeentwicklung, Geräuschentwicklung und Gesamtpräsentation von dem ab, was GIGABYTE in diesem kompakten Gehäuse bietet.
In diesem Testbericht untersuchen wir, wie sich GIGABYTEs Interpretation der Spark-Plattform im Hinblick auf dauerhafte Arbeitslasten, Kühlverhalten und alltägliche Benutzerfreundlichkeit schlägt und ob der kompakte Formfaktor irgendwelche spürbaren Kompromisse mit sich bringt.
| Normen | GIGABYTE AI TOP ATOM (GB10) |
|---|---|
| Abmessungen und Gewicht | |
| Höhe | 2 in |
| Länge | 5.9 in |
| Tiefe | 5.9 in |
| Gewicht | 2.64 g |
| Prozessor | |
| Prozessortyp | NVIDIA GB10 (Grace Blackwell Superchip) (20 Kerne) |
| Integrierte Graphiken | NVIDIA Blackwell GPU (integriert) |
| Memory | |
| Speichertyp | LPDDR5x (Unified System Memory) |
| Speicherkonfiguration | 128 GB LPDDR5x, einheitlicher Systemspeicher |
| Speicherbandbreite | 273 GB/s (8533 MT/s) |
| Betriebssystem | |
| Unterstützte Betriebssysteme | NVIDIA DGX-Betriebssystem |
| Externe Anschlüsse und Steckplätze | |
| Netzwerkanschlüsse | Ein RJ45-Anschluss (10GbE) NVIDIA ConnectX-7 NIC (200G × 2 QSFP) |
| USB-Ports | Drei USB 3.2 Gen 2×2 Typ-C (20 Gbit/s) Ein USB 3.2 Gen 2×2 Typ-C-Anschluss mit PD |
| Videoanschluss(e) | Ein HDMI 2.1a-Anschluss |
| Netzteilanschluss | USB Typ-C (PD IN) |
| Sicherheits-Slot | Keine Präsentation |
| Wireless | |
| WLAN | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Lagerung | |
| Speicheroptionen | Bis zu 4 TB Gen5 NVMe (Selbstverschlüsselung wird unterstützt) |
| Power Adapter | |
| Typ | 240-W-Netzteil (USB Typ-C) |
GIGABYTE AI TOP ATOM Design und Entwicklung
Der GIGABYTE AI TOP ATOM behält die bekannten Abmessungen von 150 x 150 mm bei, die wir von den Spark-basierten Systemen kennen, ist 50.5 mm hoch und wiegt 1.2 kg. Er ist kompakt genug für den Schreibtisch, fühlt sich aber dennoch robust und solide an. Die dunkle, matte Oberfläche verleiht ihm einen professionellen Workstation-Charakter.
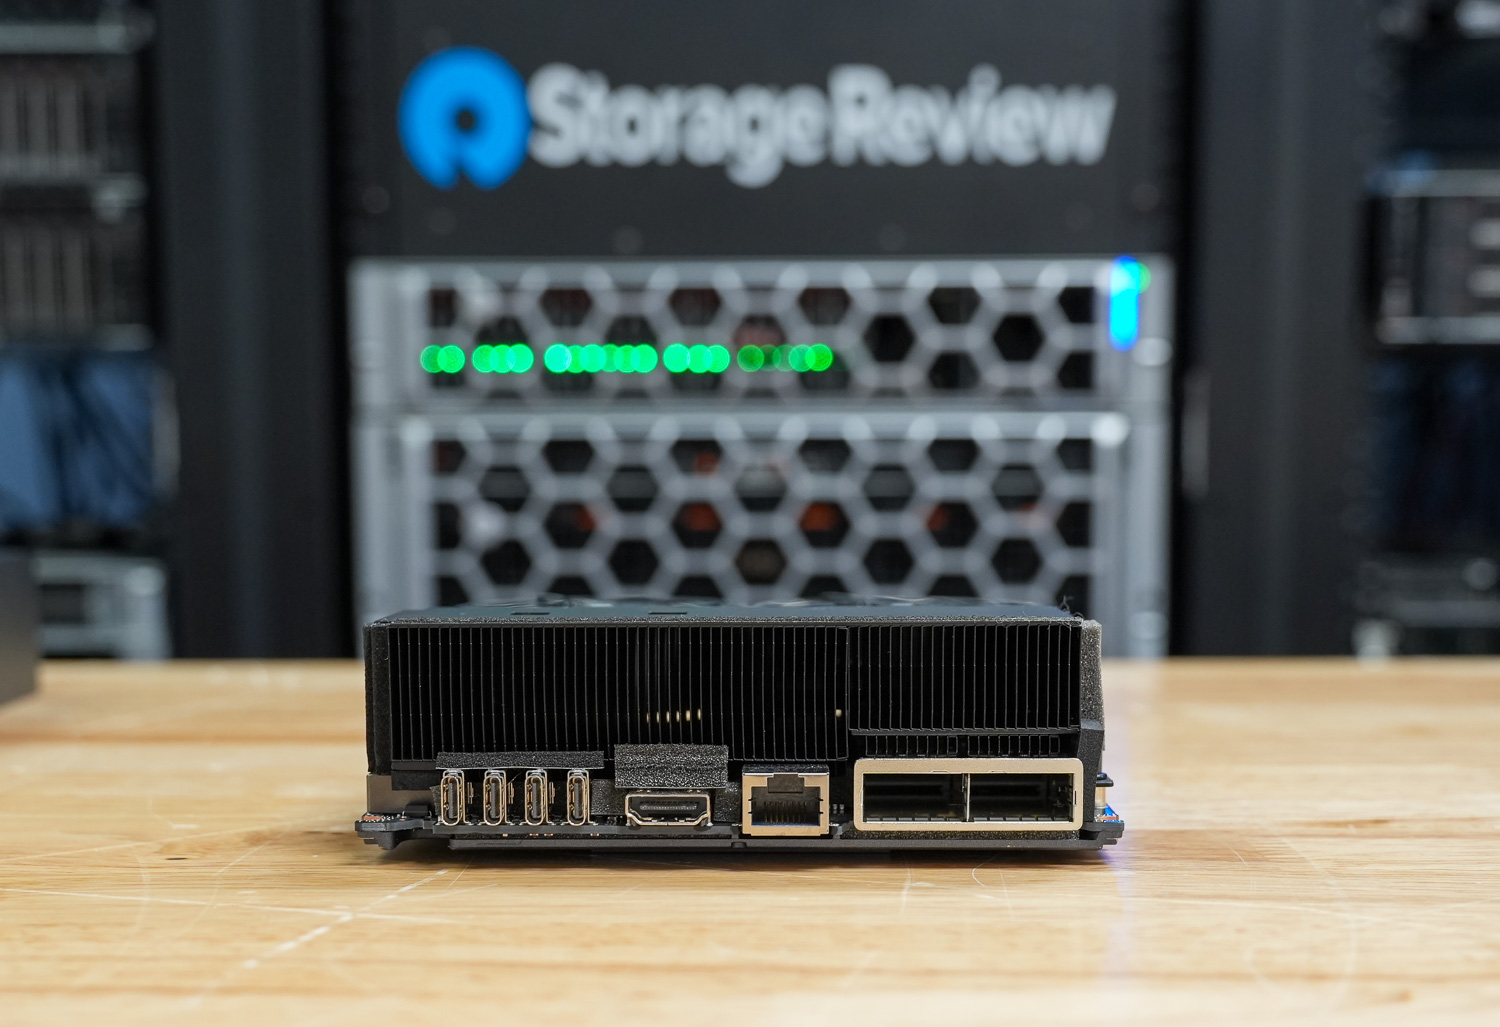
Statt eines einfachen, flachen Gitters auf der Vorderseite ist die gesamte Oberfläche mit horizontalen Lamellen und einem dezenten Wellenmuster dahinter versehen. Dies verleiht dem Gerät Tiefe und Struktur, je nach Blickwinkel. Das Design ist auf optimale Kühlung ausgelegt. Das GIGABYTE-Logo befindet sich in der unteren Ecke, und es gibt weder Datenanschlüsse noch einen Ein-/Ausschalter an der Vorderseite. So bleibt die Oberfläche aufgeräumt und der Luftstrom optimal.
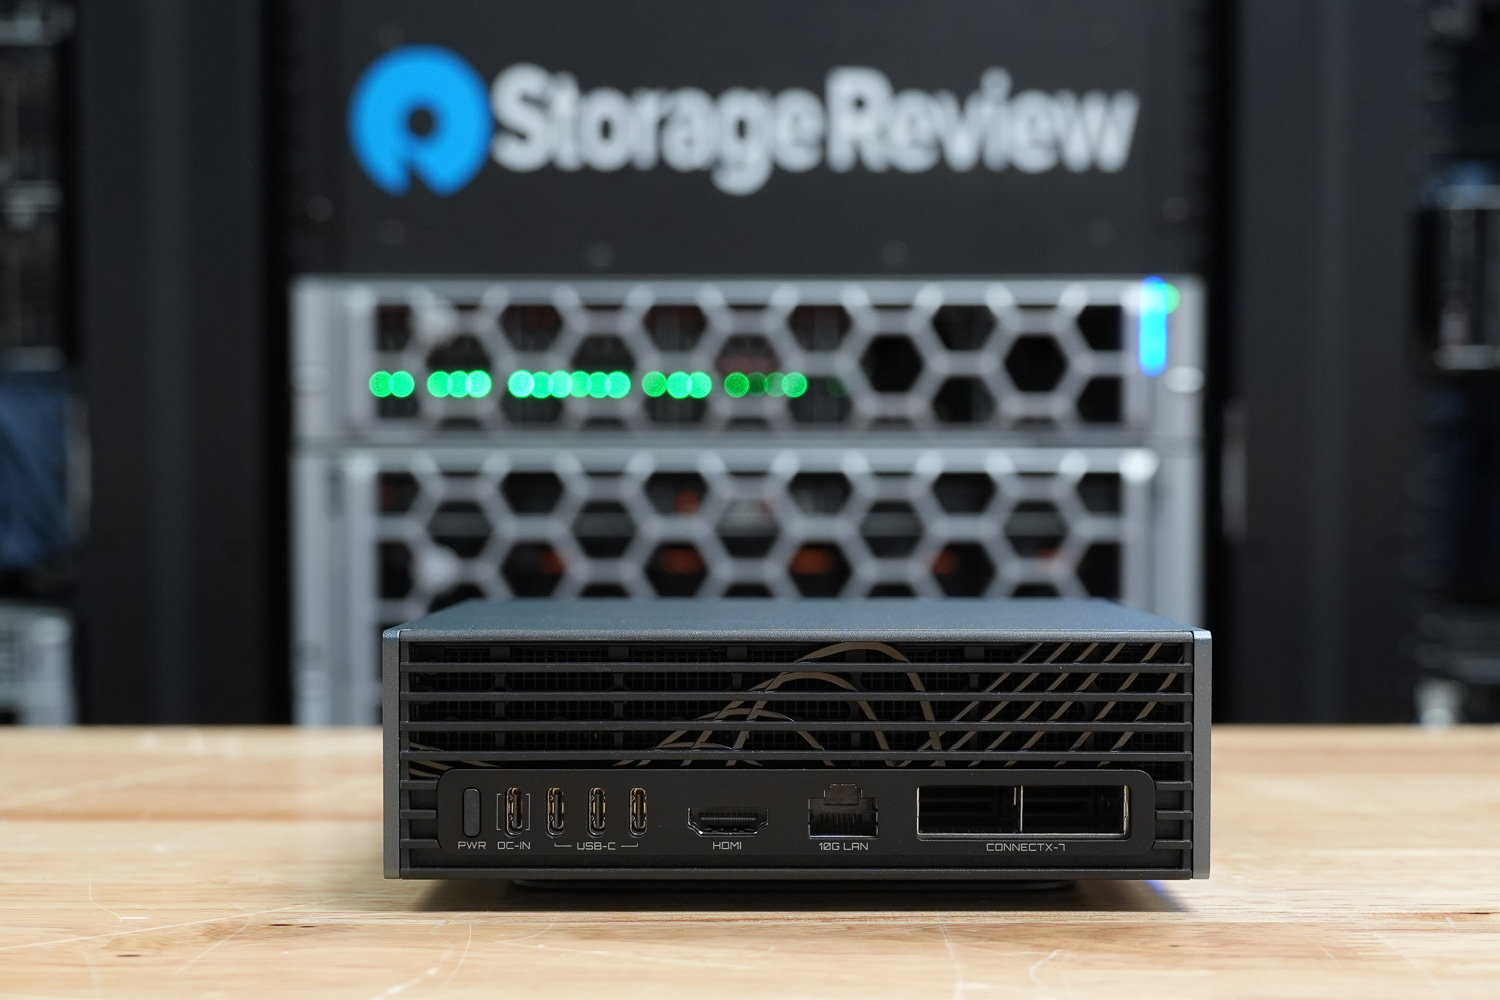
Alle Anschlüsse befinden sich auf der Rückseite. Dort finden sich drei USB 3.2 Gen 2×2 Typ-C-Anschlüsse mit einer Übertragungsrate von bis zu 20 Gbit/s sowie ein vierter USB Typ-C-Anschluss für die Stromversorgung. Für die Bildausgabe steht ein HDMI 2.1a-Anschluss zur Verfügung. Die Netzwerkverbindung umfasst einen 10-GbE-RJ-45-Anschluss sowie eine NVIDIA ConnectX-7 SmartNIC, die schnelle Datenübertragungen und die Vernetzung mehrerer Systeme für größere Systeme ermöglicht. An der Seite befindet sich ein Kensington-Nano-Sicherheitsschloss.
Im Inneren des AI TOP ATOM arbeitet NVIDIAs GB10 Grace Blackwell Superchip, der eine 20-Kern-Arm-CPU mit integrierter Blackwell-Grafik kombiniert. Er verfügt über 128 GB LPDDR5x-Speicher mit einer 256-Bit-Schnittstelle und einer Bandbreite von bis zu 273 GB/s. Wie bei den anderen GB10-Systemen teilen sich CPU und GPU denselben Speicherpool, was entscheidend für die Eignung dieser Maschinen zur Verarbeitung von KI-Workloads ist.
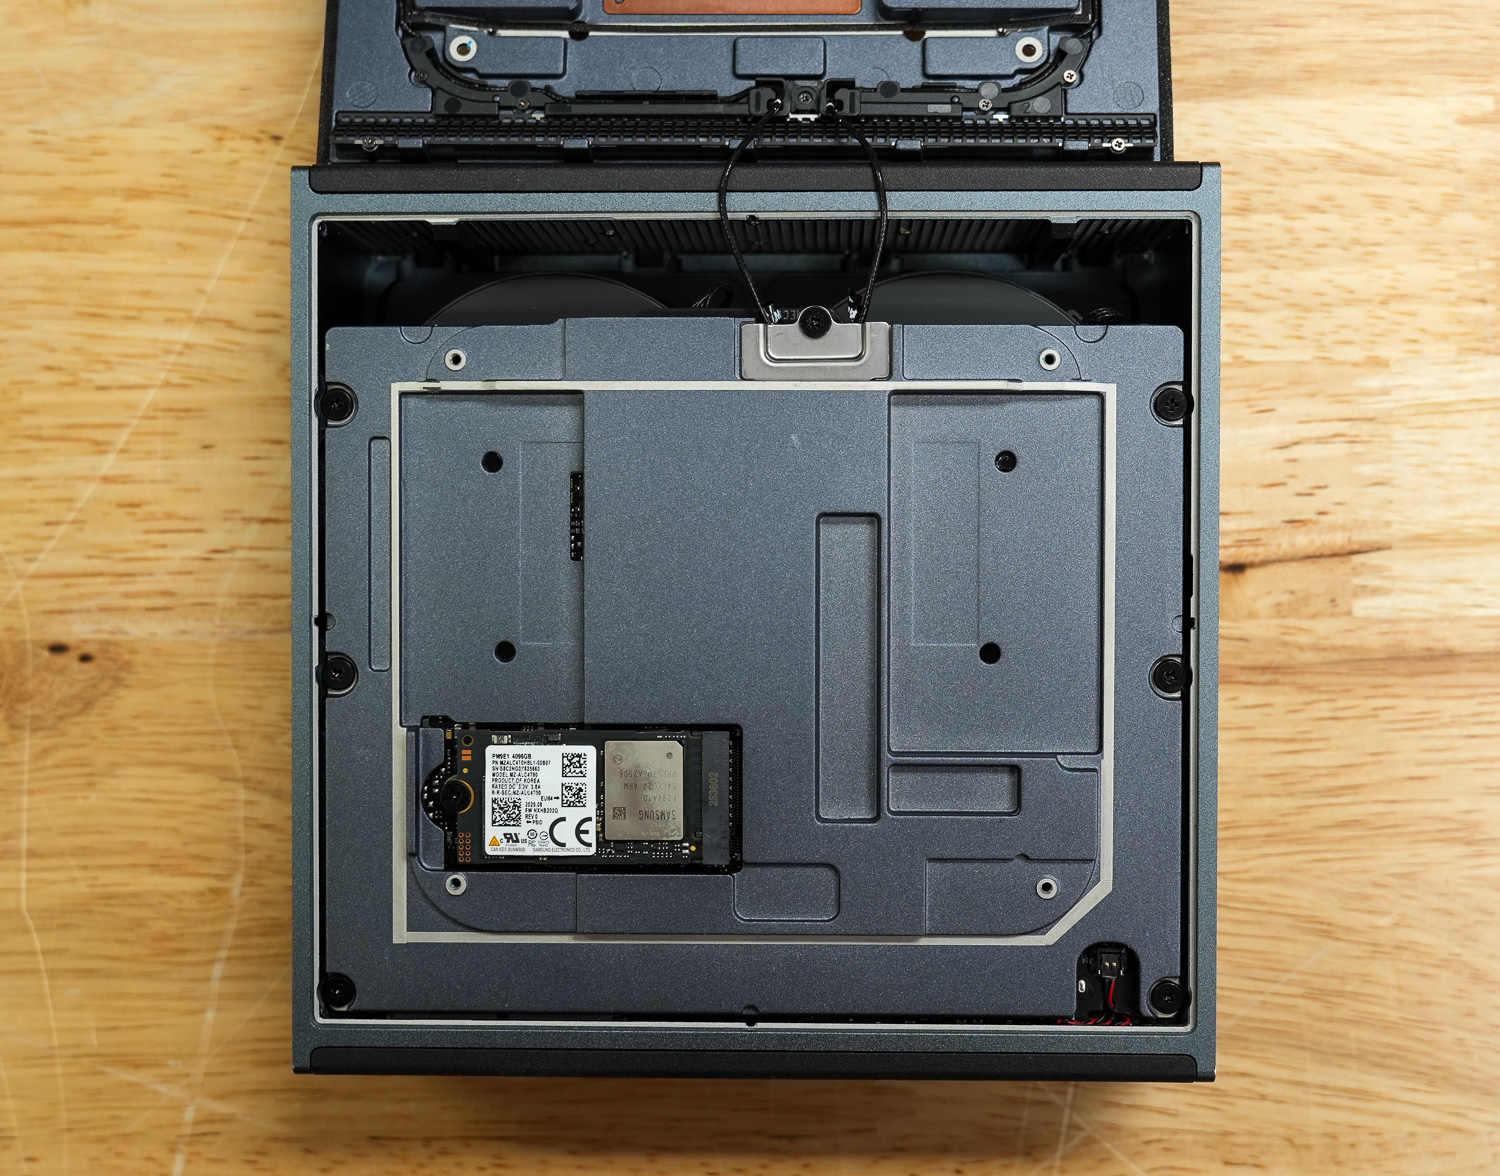
Die Speicherkapazität beträgt je nach Konfiguration bis zu 4 TB (NVMe-SSD der 5. Generation), die Stromversorgung erfolgt über ein externes 240-W-Netzteil. Zur drahtlosen Konnektivität gehören Wi-Fi 7 und Bluetooth 5.4 sowie die integrierte 10-GbE-Netzwerkschnittstelle für kabelgebundene Verbindungen.
GIGABYTE AI TOP ATOM Wärmetests
Um die Wärmeableitung der Komponenten im GIGABYTE AI TOP ATOM zu testen, verglichen wir sie mit der Founders Edition und Geräten von OEMs wie Asus, Acer und Dell. Eine detailliertere Analyse dieser Ergebnisse finden Sie in unserer Studie „Spark Thermal Testing“.
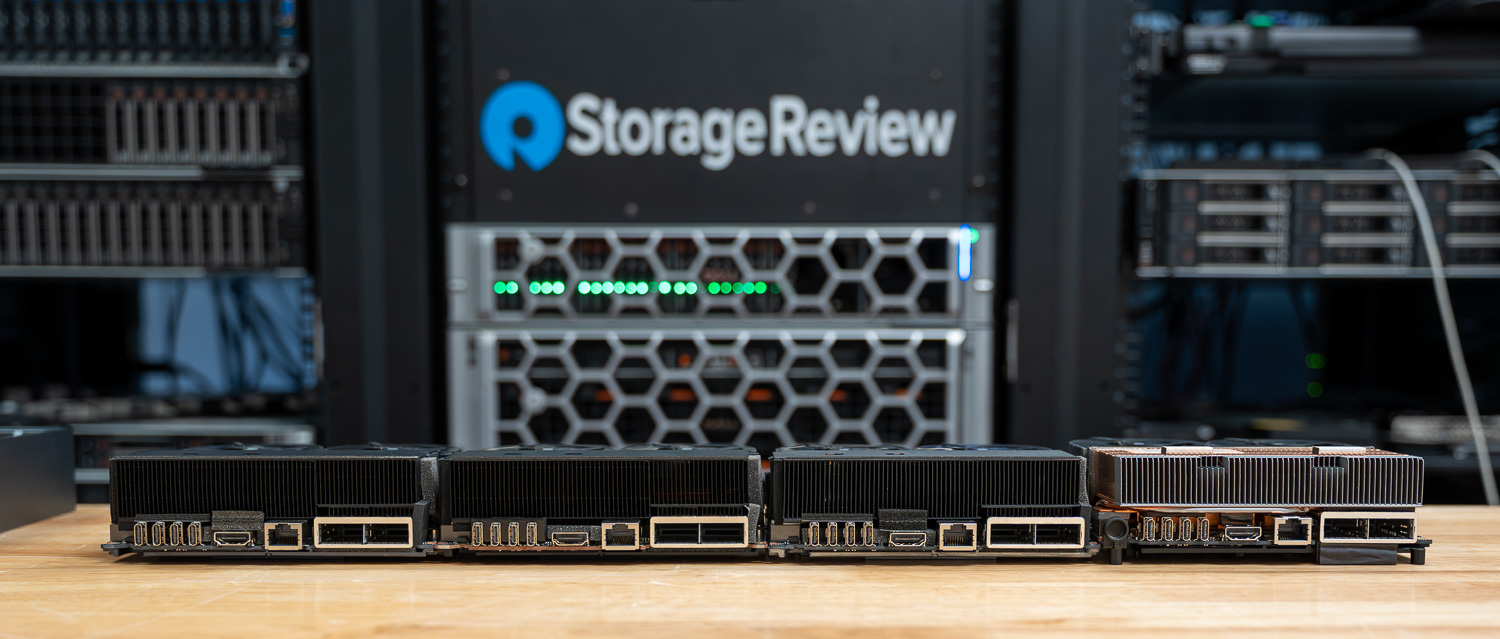
Wir überwachten die Komponenten des gesamten Stacks über einen festgelegten Zeitraum mit drei Auslastungsstufen, wobei die Nutzung innerhalb von etwa einer Stunde schrittweise erhöht wurde. Dadurch konnten wir das Gerät im Langzeitbetrieb und in verschiedenen Auslastungsstufen beobachten. Wir überwachten die Temperaturen von CPU, GPU, Netzwerk und NVMe sowie den Gesamtstromverbrauch.
CPU Temperatur
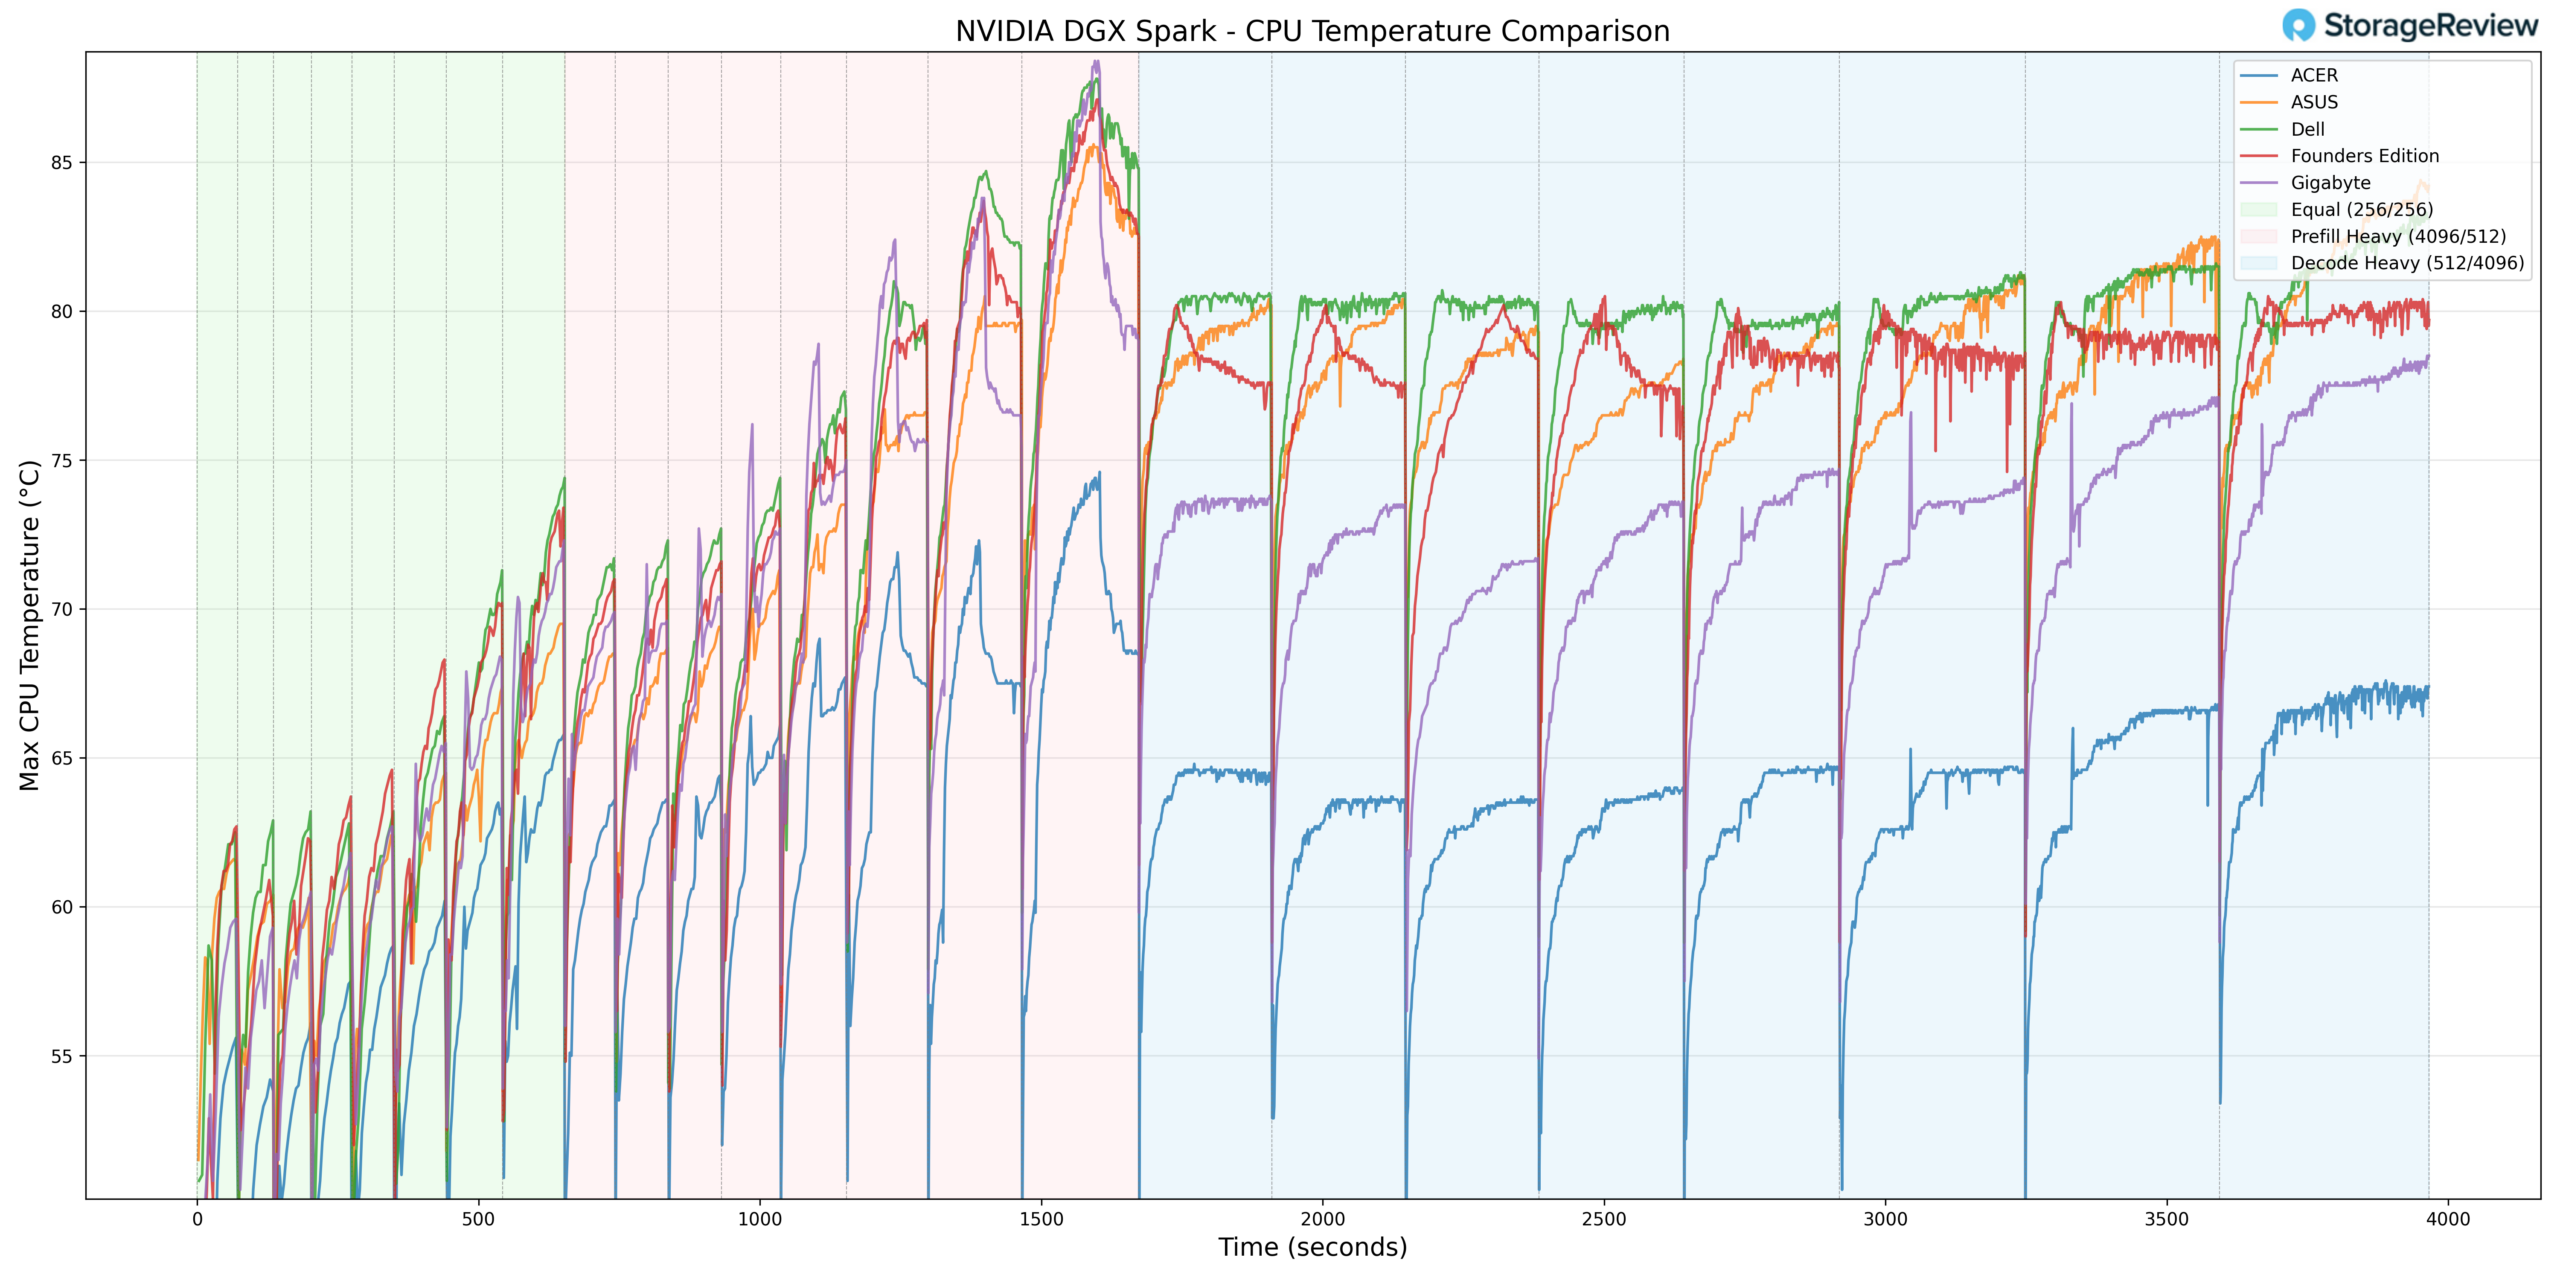
Bei thermischen Tests der CPU erreichte das GIGABYTE-System während intensiver Vorbefüllungsvorgänge eine Spitzentemperatur von 90 °C. Damit liegt es im oberen Bereich der beobachteten CPU-Spitzenwerte innerhalb der Vergleichsgruppe bei starker Laststeigerung.
Nach dem Übergang zu gleichmäßiger ISL/OSL-Last und schließlich zu anspruchsvollen Dekodierungslasten stabilisierte sich die Temperaturkurve, anstatt weiter anzusteigen. Unter Dauerlast blieb die CPU in einem kontrollierten Temperaturbereich, was zeigt, dass der höhere Spitzenwert auf kurzzeitige Lastspitzen und nicht auf eine unzureichende Langzeitkühlung zurückzuführen war.
Im unteren Temperaturbereich wurde bei Leerlauf oder geringer Last eine minimale CPU-Temperatur von 38.7 °C gemessen. Dieser niedrige Wert deutet auf eine effiziente Wärmeableitung im Ruhezustand hin und zeigt, dass die Kühlung auch außerhalb von Spitzenlastphasen ausreichend Reserve bietet.
Insgesamt wies GIGABYTE höhere kurzzeitige CPU-Temperaturen auf, behielt aber nach Normalisierung der Arbeitslasten ein stabiles Dauerverhalten bei.
GPU-Temperatur
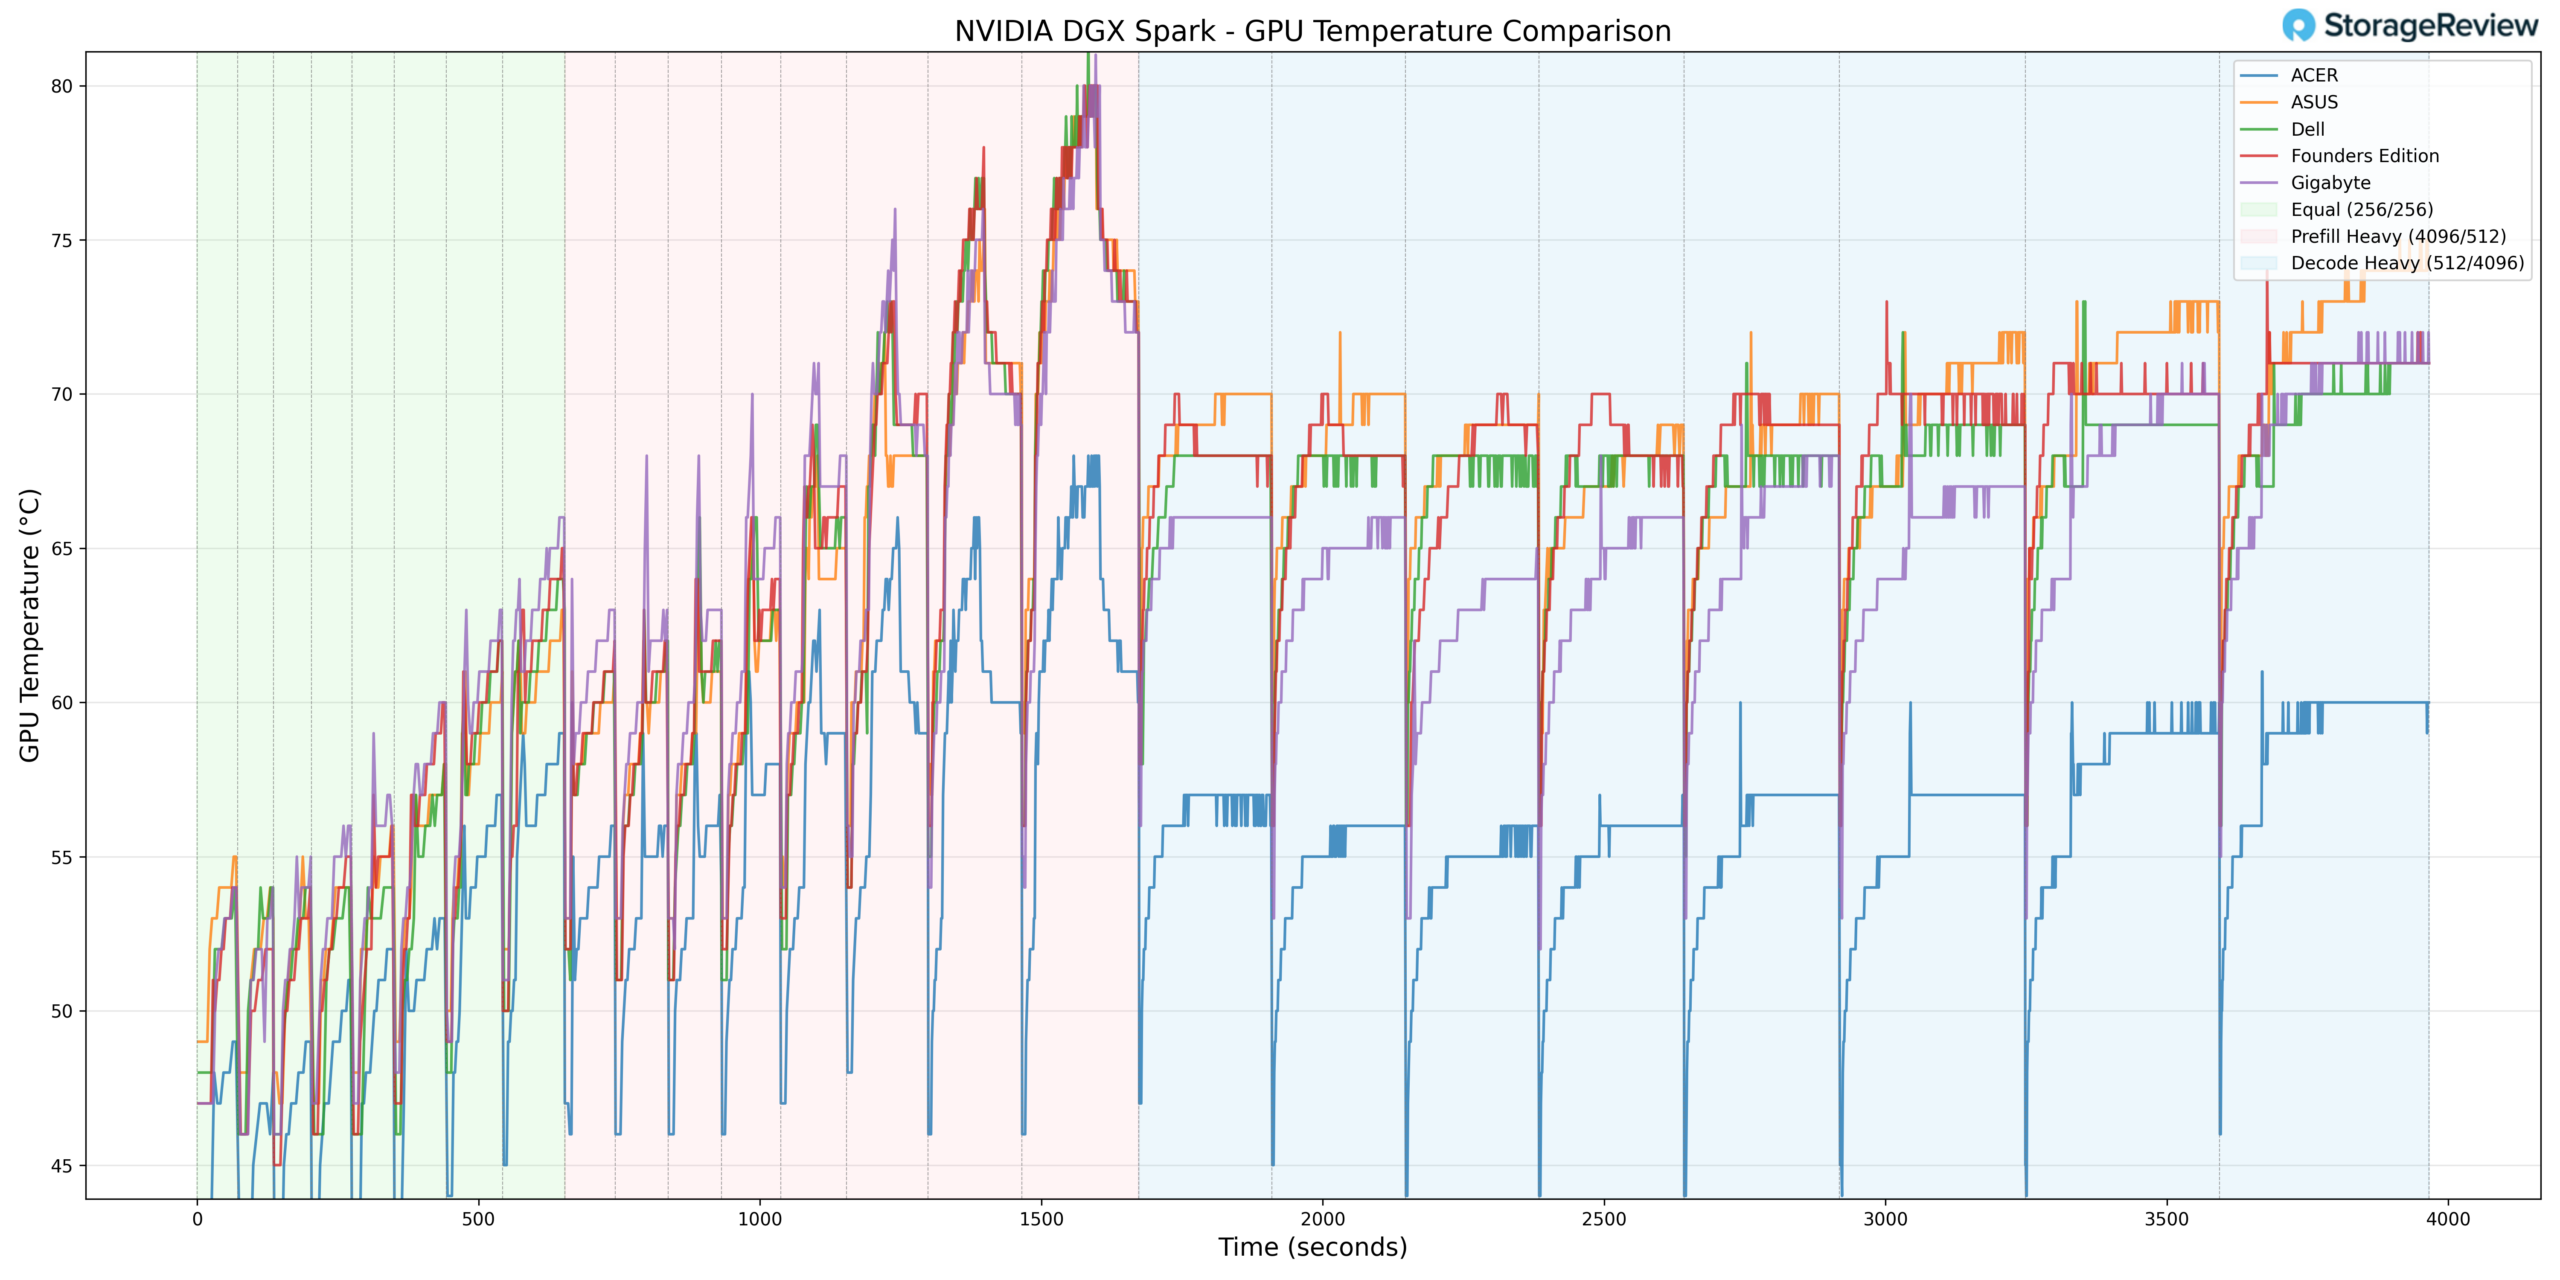
Die GPU-Temperaturen zeigten ein ähnliches Muster. Während der Prefill-Intensität erreichte die GPU eine maximale Temperatur von 81 °C. Damit liegt sie im oberen Bereich der Gruppe bei intensiver Beschleunigung, aber noch innerhalb der erwarteten Betriebsspezifikationen für die GB10-Plattform.
Als die Arbeitslast in die Phasen „Equal ISL/OSL“ und „Decode Heavy“ überging, stabilisierten sich die GPU-Temperaturen, anstatt weiter anzusteigen.
Im Leerlauf oder bei geringer Auslastung wurde von der GPU eine minimale Temperatur von 37°C gemessen, was auf eine solide thermische Grundregelung hinweist, wenn das System keiner Rechenlast ausgesetzt ist.
Zusammengenommen spiegelt das GPU-Verhalten von GIGABYTE eine aggressive Spitzenlastnutzung in Verbindung mit stabiler, anhaltender Wärmeentwicklung wider.
NVMe-Temperatur
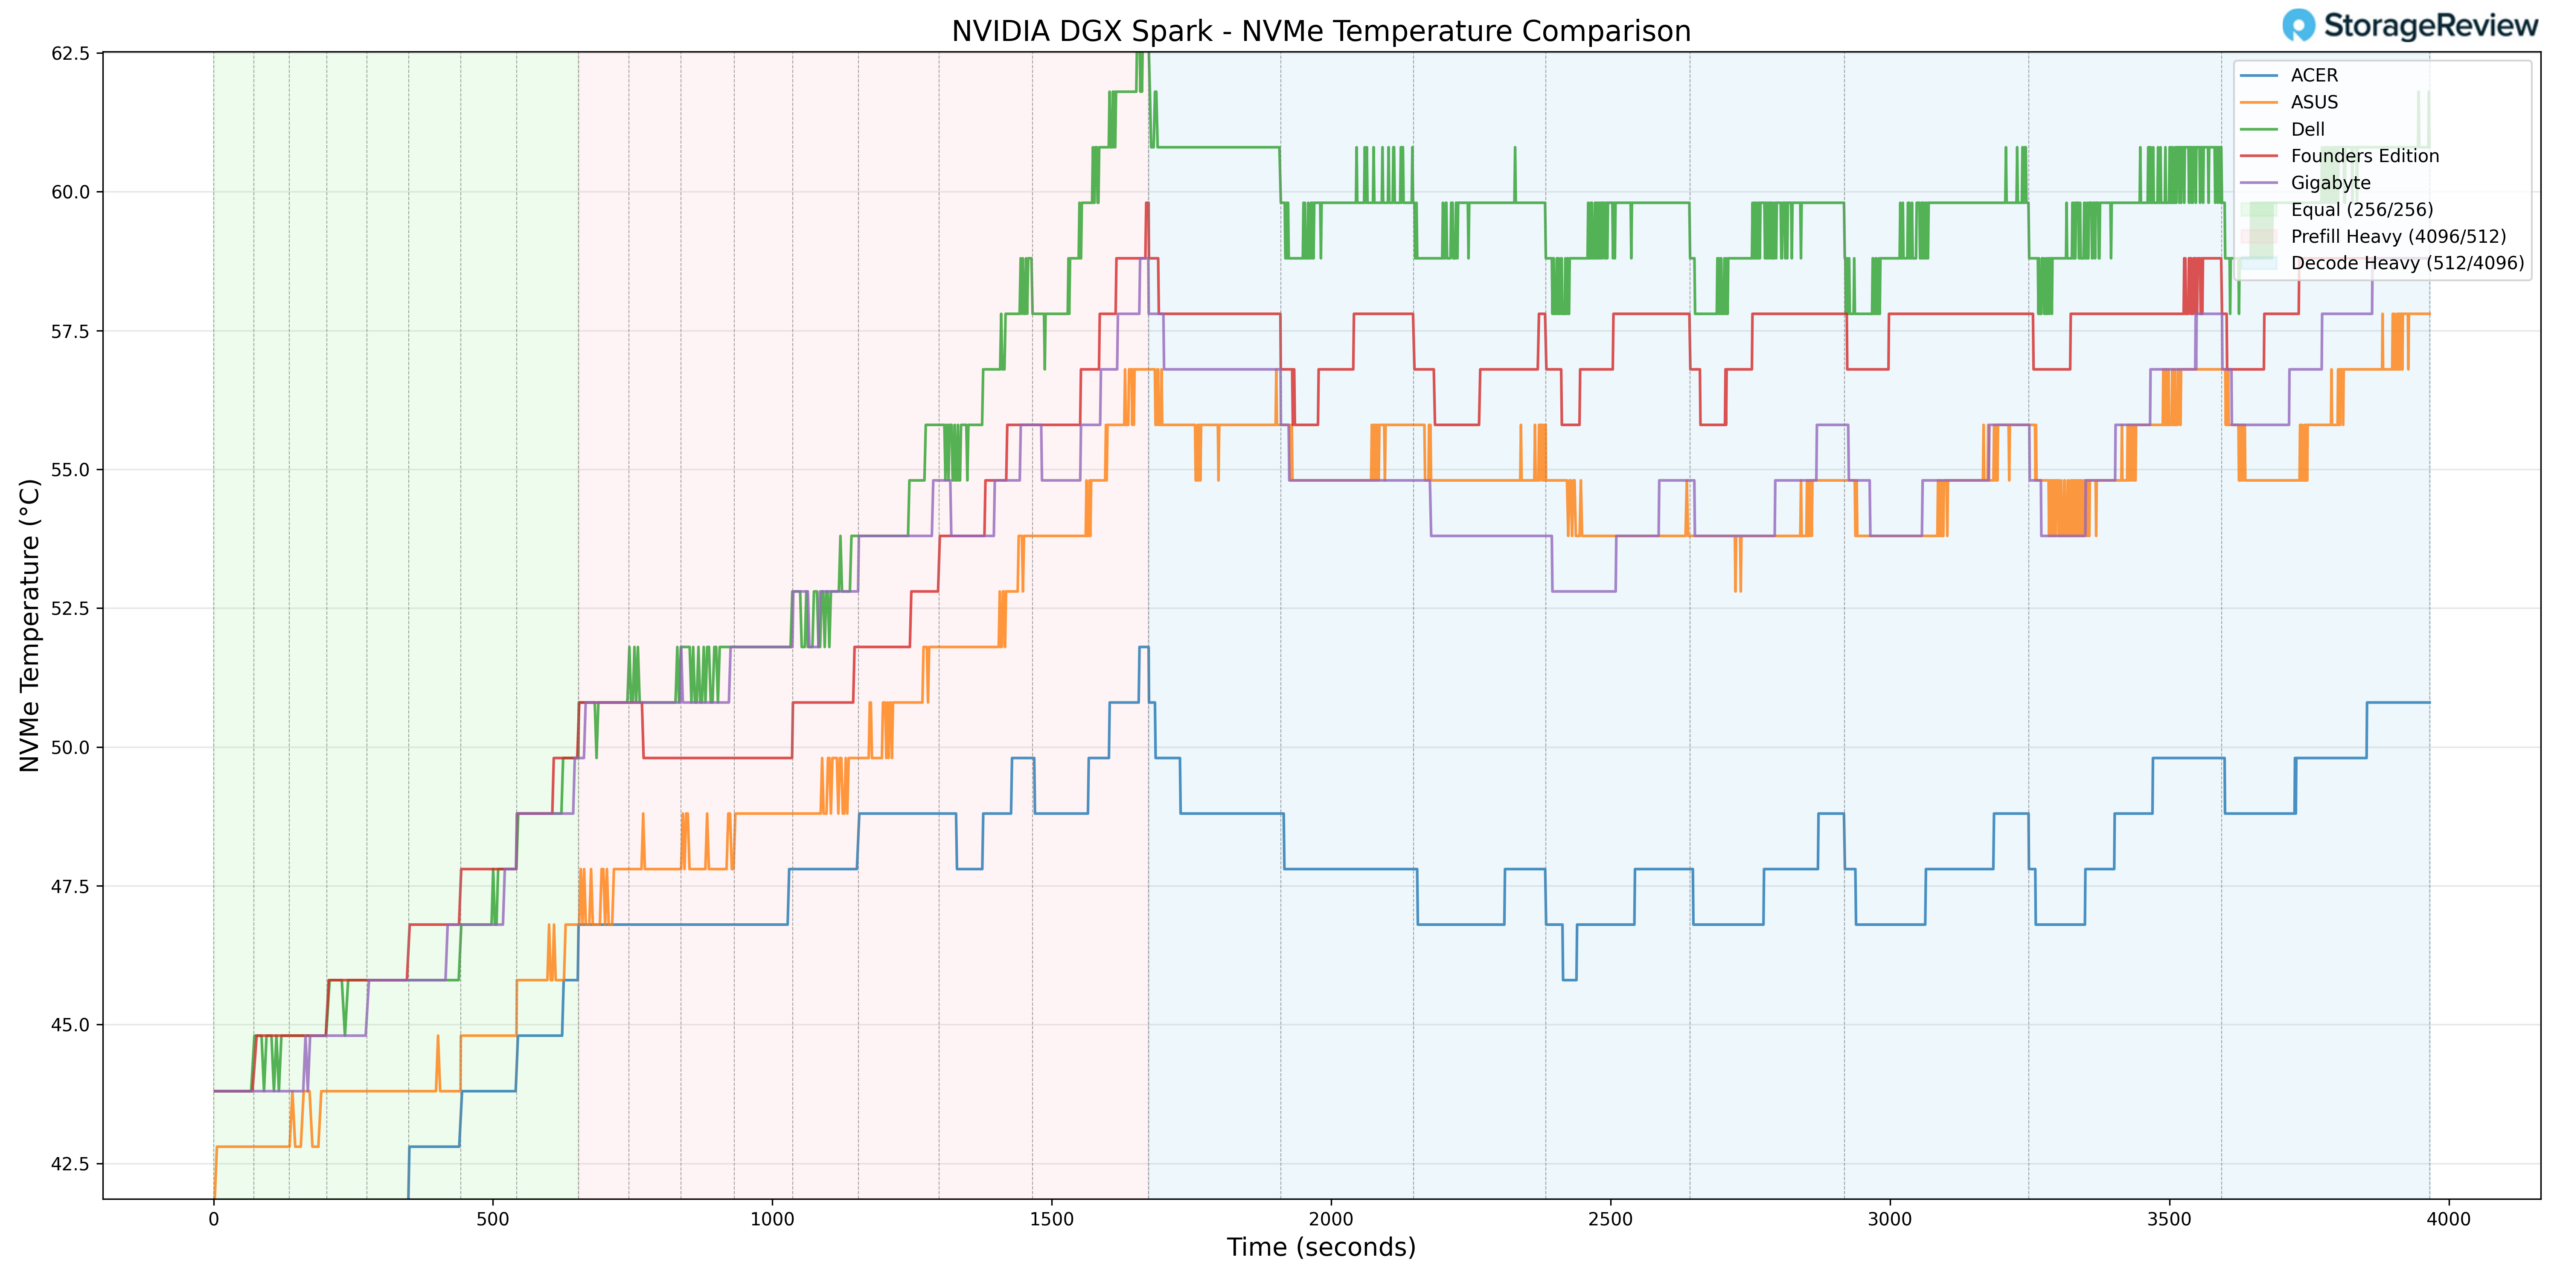
Die Wärmeentwicklung des Speichers blieb während der gesamten Testphase unter Kontrolle. Die NVMe-SSD erreichte in den Phasen mit höherer Auslastung eine maximale Temperatur von 59.8 °C. Dieser Spitzenwert lag deutlich unterhalb der üblichen Drosselungsschwellen, was auf eine ausreichende Luftzirkulation oder eine günstige Positionierung der SSD im Gehäuse hindeutet.
Bei geringerer Arbeitslast sank die Temperatur des NVMe-Laufwerks auf ein Minimum von 37.8°C, was unterstreicht, dass die Wärmeentwicklung des Speichers im Ruhezustand nicht begrenzt ist.
Im Vergleich zu einigen kompakten, desktoporientierten Lösungen zeugt die Tatsache, dass die Temperatur unter Last unter 60°C bleibt, von einem soliden Wärmemanagement des Speichers.
NIC-Temperatur
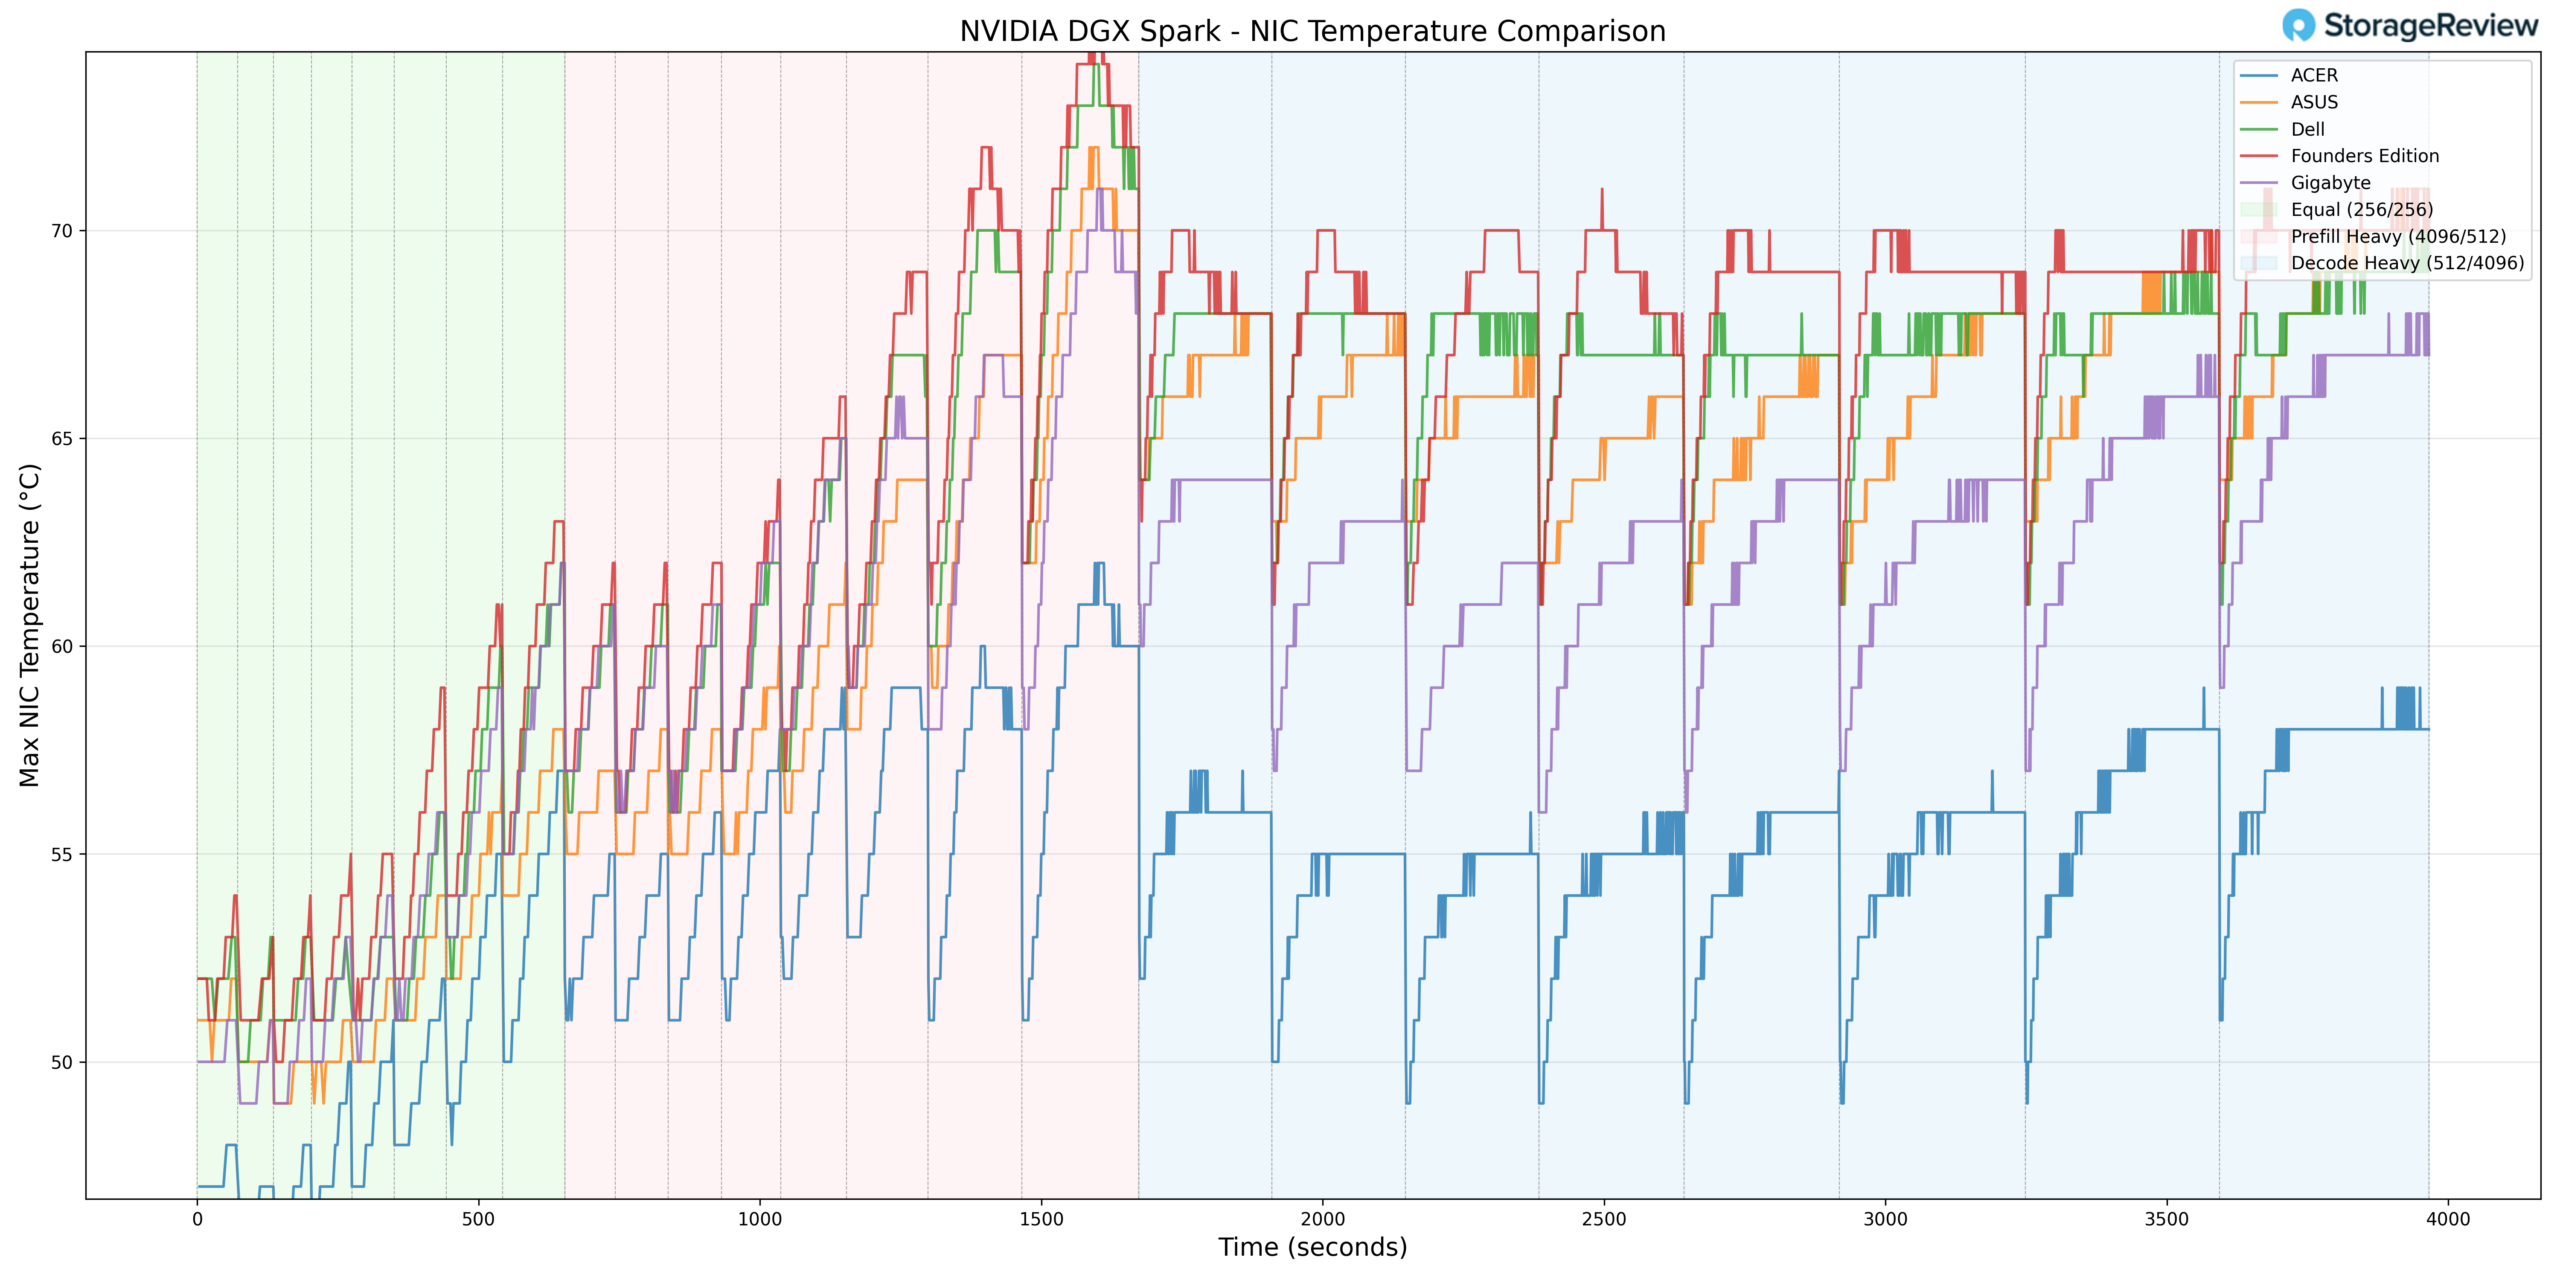
Die Temperatur der Netzwerkkarte erreichte während Phasen mit hoher Auslastung Spitzenwerte von 72 °C, was mit dem erhöhten Durchsatz während der Übergänge zwischen Vorbefüllung und Dekodierung übereinstimmte. Obwohl sich der Netzwerkcontroller dadurch während der Spitzenlast im wärmeren Bereich des Stacks befand, blieb die Temperatur innerhalb der zulässigen Toleranzen und wies keine Temperaturspitzen auf.
Die niedrigste gemessene NIC-Temperatur betrug 41°C und spiegelte das normale Ausgangsverhalten während der leichteren Phasen wider.
Insgesamt verhielt sich die NIC erwartungsgemäß im Verhältnis zur Gesamtsystemlast und wies keine anormale Skalierung auf.
GPU-Leistungsaufnahme
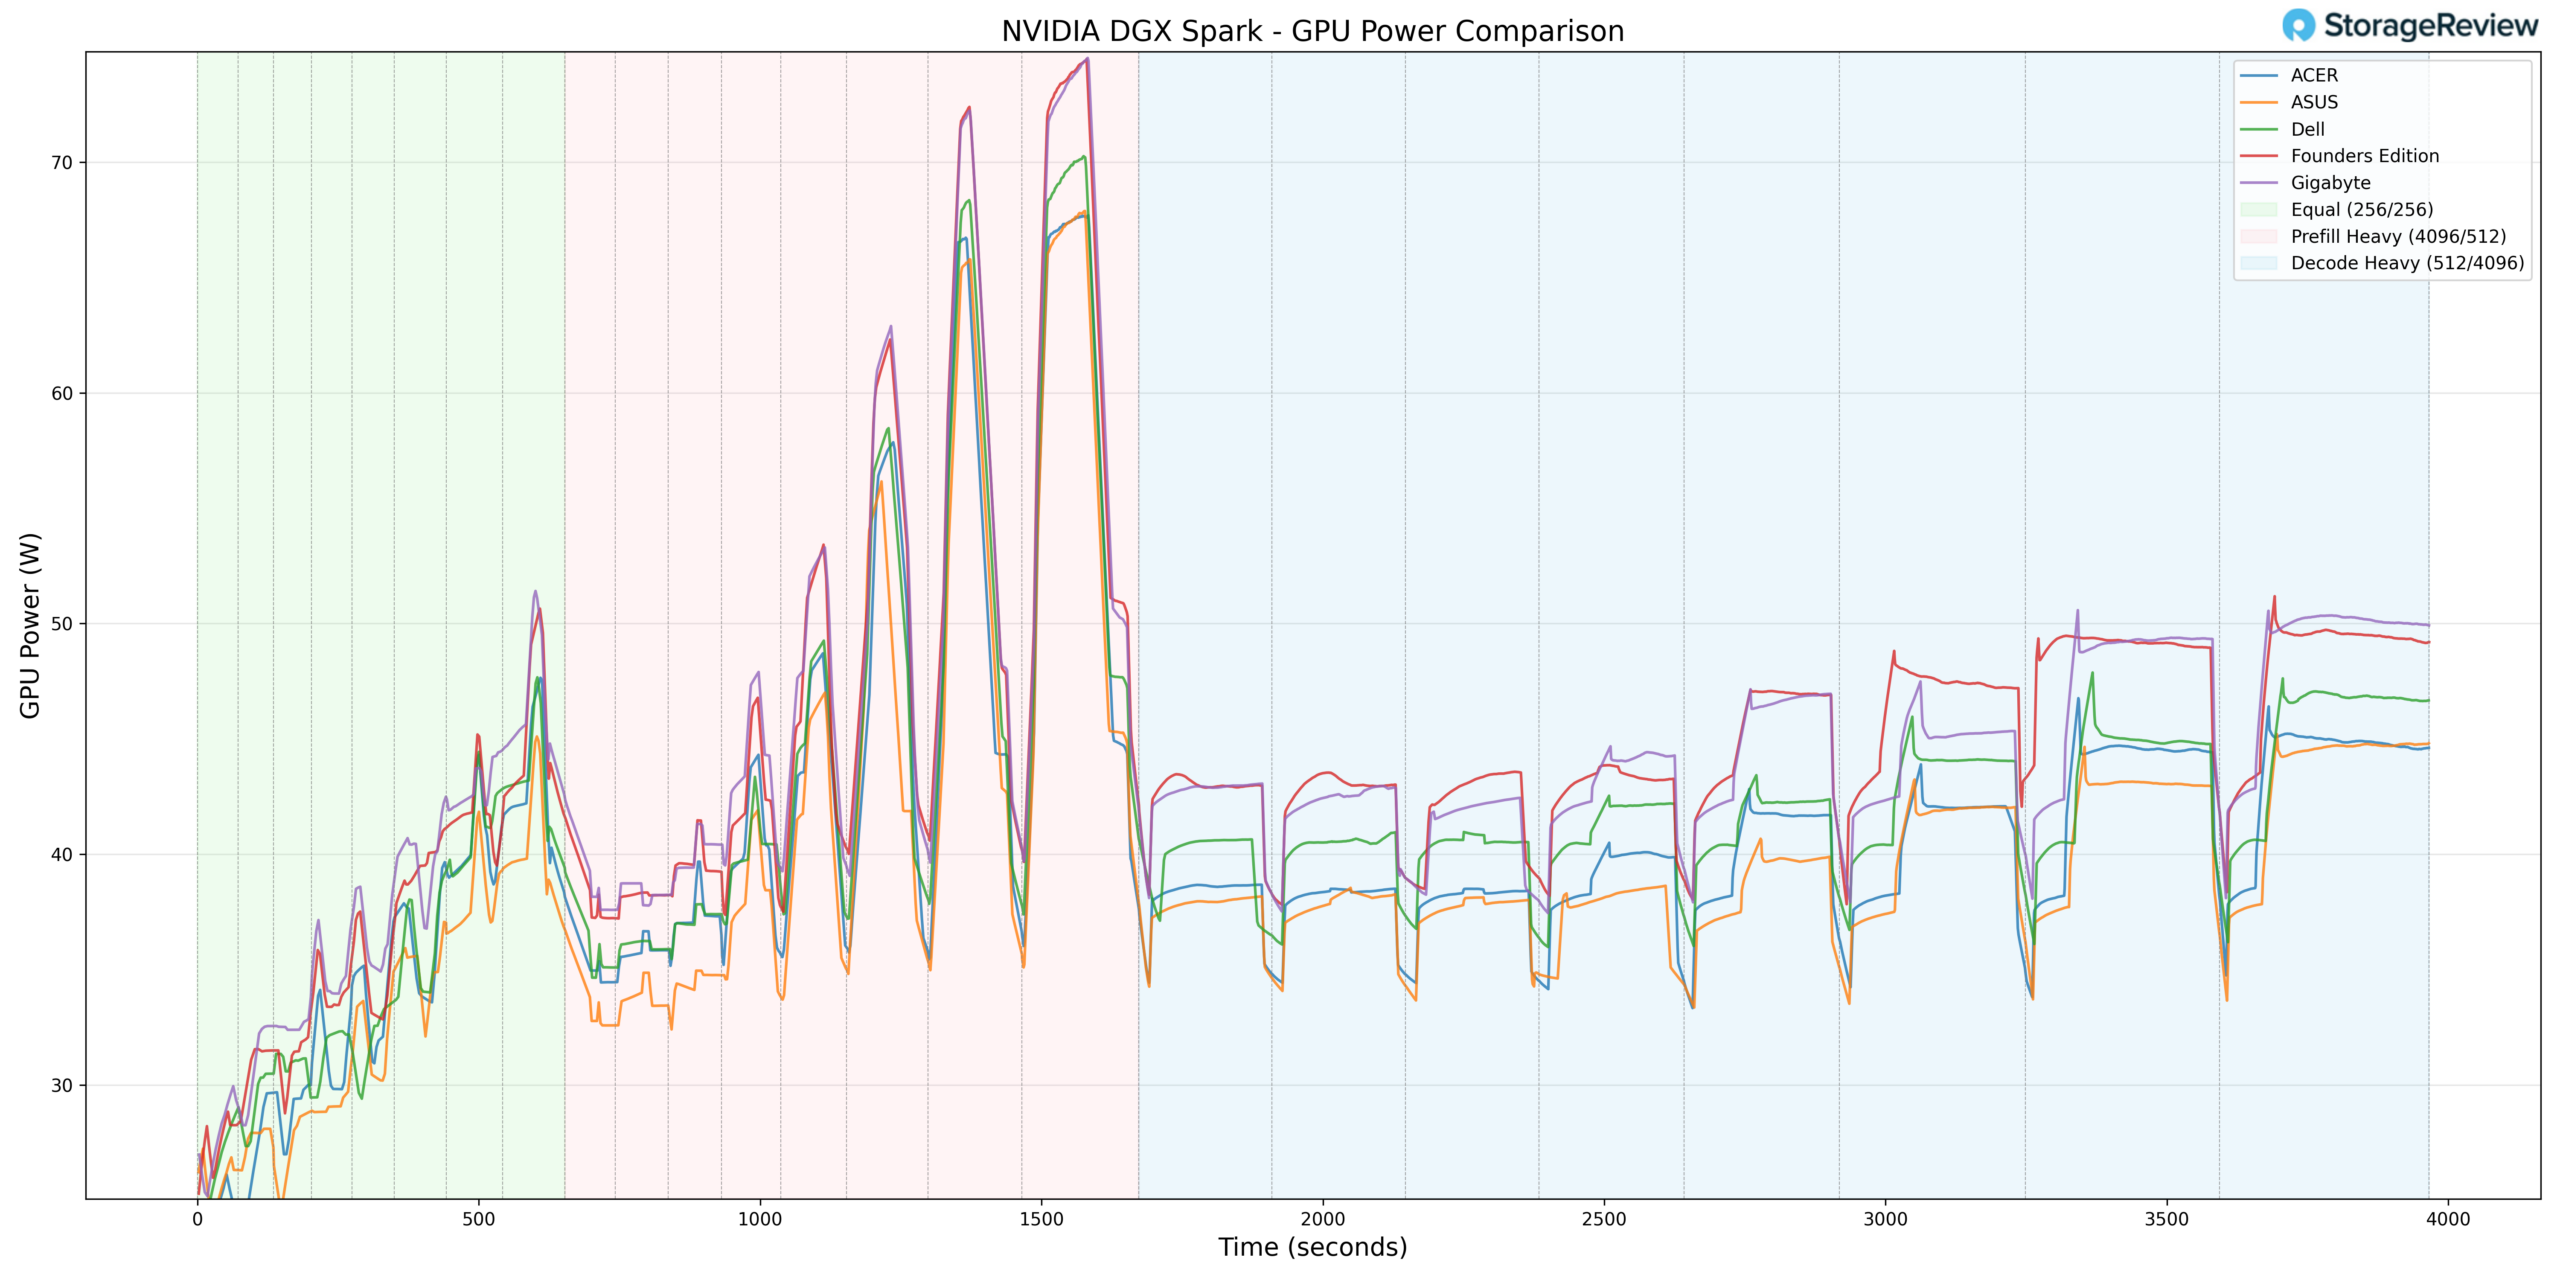
Das Leistungsverhalten der GPU hilft, die erhöhten Temperaturspitzen einzuordnen. GIGABYTE erreichte während der Übergänge mit starker Vorbefüllung eine maximale Leistungsaufnahme der GPU von 75.54 W. Damit liegt sie im oberen Bereich der beobachteten Leistungsaufnahmebereiche der getesteten GB10-Einheiten.
Anstatt die GPU-Leistung künstlich zu begrenzen, scheint GIGABYTE kurzzeitige Spitzenlasten zuzulassen, die direkt mit den höheren Spitzentemperaturen der GPU korrelieren. Mit dem Übergang der Arbeitslast in anhaltende Dekodierungsphasen stabilisierte sich der Stromverbrauch entsprechend.
Aus Sicht der Leistungsaufnahme scheint das GIGABYTE-System nicht übermäßig überlastet zu sein. Vielmehr korrespondieren die höheren thermischen Spitzenwerte während der Burst-Phasen mit einer leistungsorientierten Leistungsverteilung und nicht mit einem unkontrollierten thermischen Design.
Thermische Zusammenfassung
Die Überwachung von CPU, GPU, NVMe und Netzwerkkarte ergab für das GIGABYTE GB10 wettbewerbsfähige Leerlauftemperaturen und höhere Temperaturspitzen bei intensiven Prefill-Vorgängen. Die CPU erreichte unter maximaler Beschleunigung 90 °C und die GPU 81 °C, während die NVMe unter 60 °C blieb und die Netzwerkkarte 72 °C erreichte. Die Leistungsaufnahme der GPU erreichte maximal 75.54 W, was auf nahezu maximale Temperaturspitzen hindeutet.
Unter anhaltender Dekodierlast stabilisierten sich die Temperaturen ohne weiteren Anstieg, was darauf schließen lässt, dass GIGABYTE zwar eine aggressive Kurzzeitleistung ermöglicht, aber bei längerem Betrieb für vorhersehbare und kontrollierte Temperaturen sorgt.
GIGABYTE AI TOP ATOM Leistungstests
Zur Evaluierung des GIGABYTE AI TOP ATOM testeten wir Spark-Einheiten mithilfe des vLLM Online Serving Benchmarks, der am weitesten verbreiteten Engine für Inferenz und Bereitstellung mit hohem Durchsatz für große Sprachmodelle. Der vLLM Online Serving Benchmark simuliert reale Produktionslasten, indem er gleichzeitig Anfragen an einen laufenden vLLM-Server sendet und wichtige Metriken wie den gesamten Token-Durchsatz (Token pro Sekunde), die Zeit bis zum ersten Token und die Zeit pro ausgegebenem Token unter verschiedenen Lastbedingungen misst.
Unsere Tests umfassten verschiedene Modelle, von dichten Architekturen bis hin zu Datentypen mit minimaler Skalierung. Die Leistung wurde anhand von drei Workload-Szenarien bewertet: Gleichmäßige ISL/OSL-Last, hohe Prefill-Last und hohe Dekodierungslast. Diese Szenarien repräsentieren unterschiedliche reale Anwendungsmuster, von ausgewogener Eingabe- und Ausgabelast bis hin zu rechenintensiver Prompt-Verarbeitung und speicher- und bandbreitenbegrenzter Token-Generierung.
Zusätzlich zum GIGABYTE AI TOP ATOM haben wir die NVIDIA Founders Edition Spark als Referenzpunkt sowie OEM-Systeme von Asus, Acer und Dell getestet. Dadurch konnten wir die Ergebnisse von GIGABYTE im breiteren Wettbewerbsumfeld einordnen und feststellen, wo das Unternehmen bei verschiedenen Modellen und Arbeitslasten führend ist, mit der Konkurrenz mithält oder hinterherhinkt.
GPT-OSS-120B
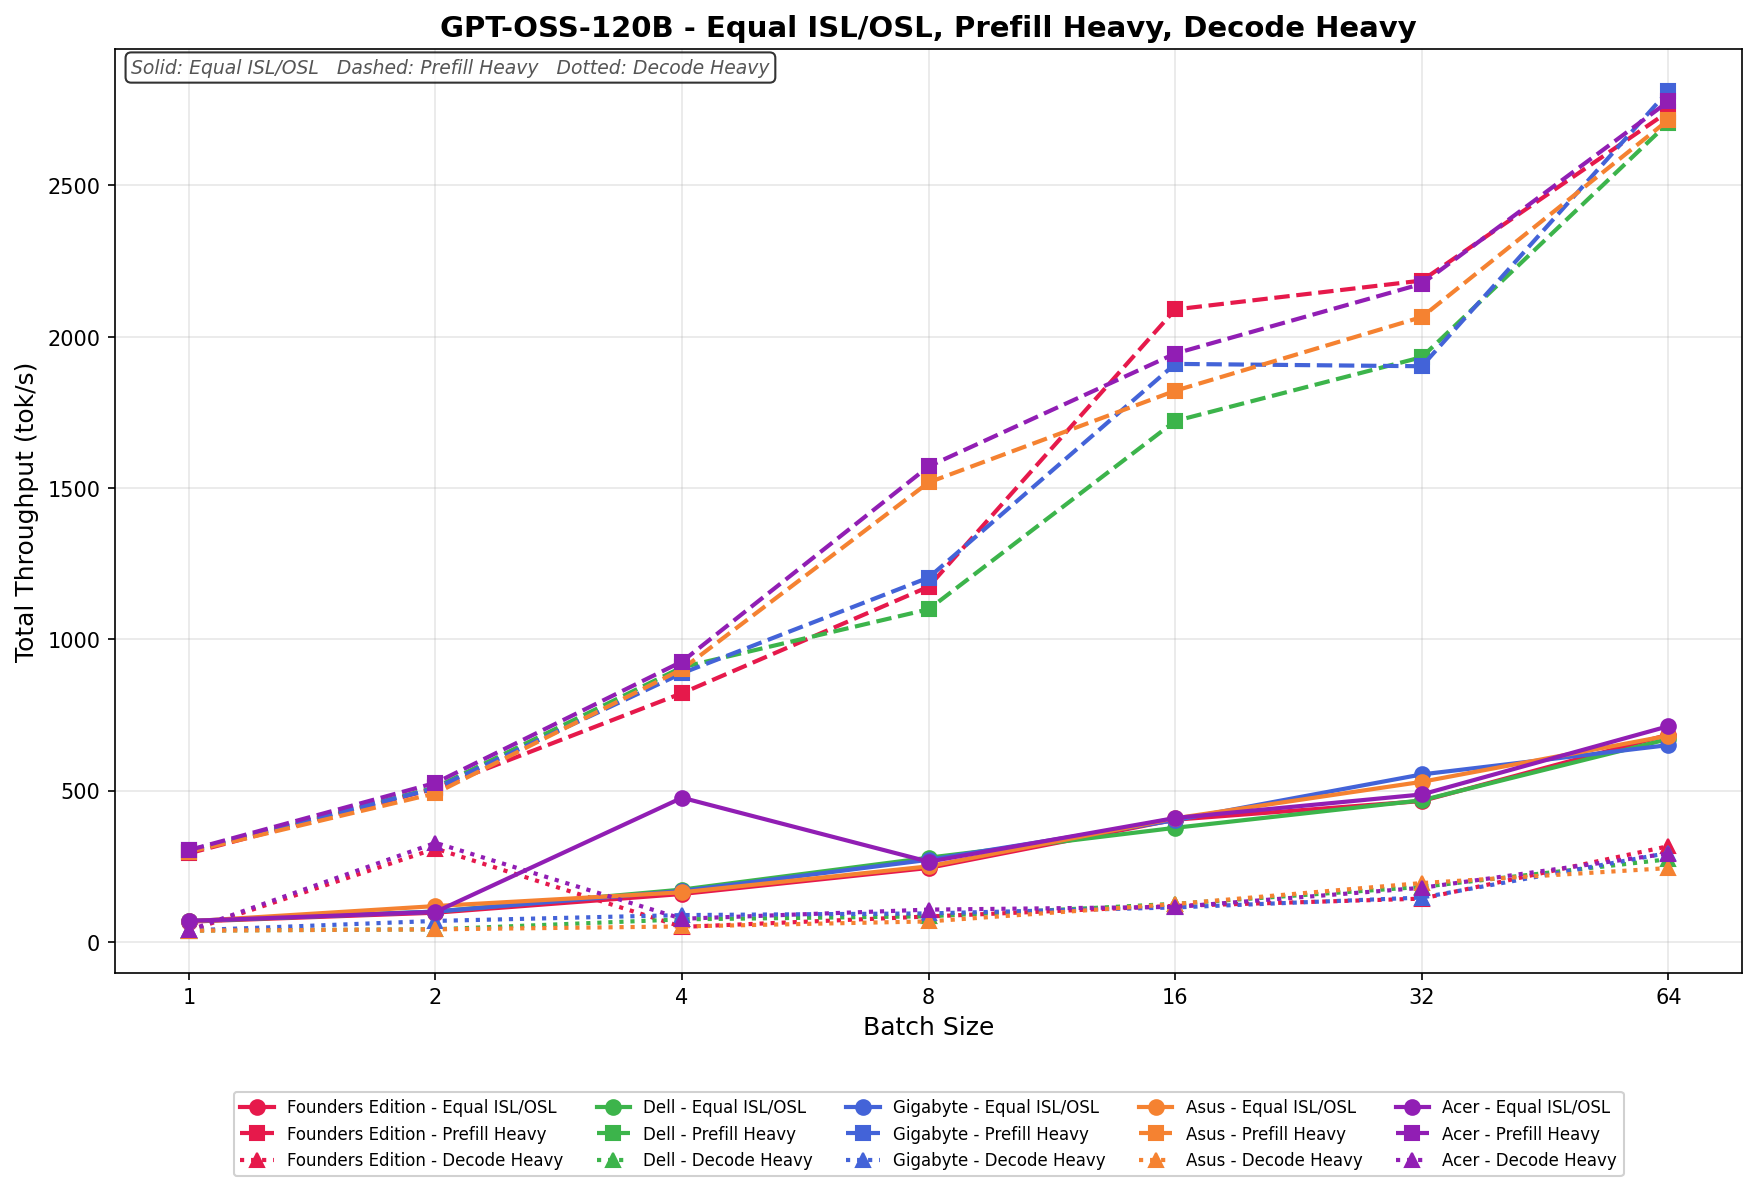
Im Equal ISL/OSL-Verfahren skaliert GIGABYTE von 60.71 auf 649.62 kbit/s und liegt damit konstant im Mittelfeld. Bei höheren Batchgrößen nähert sich das Unternehmen Dell und Asus an. Die Skalierung verläuft bis Batch 32 stetig und linear, mit weiteren Zuwächsen bei Batch 64, wobei die Spitzenreiter im oberen Bereich jedoch nicht ganz überholt werden.
Prefill Heavy startet bei 304.63 Tonnen/s und steigt bis zur Chargengröße 64 auf 2,771.38 Tonnen/s. Das Wachstum ist bis zur Charge 16 stark, wobei GIGABYTE kurzzeitig den dritten Platz unter den Spitzenreitern belegt, bevor es sich bei größeren Chargengrößen dem breiteren Markt annähert. Die Skalierung ist insgesamt aggressiv und wettbewerbsfähig, insbesondere bei mittleren Chargengrößen.
Die Decode Heavy-Werte liegen zwischen 47.01 und 299.41 tok/s, wobei eine allmähliche und gleichmäßige Skalierung über den gesamten Batch-Sweep hinweg erfolgt.
GPT-OSS-20B
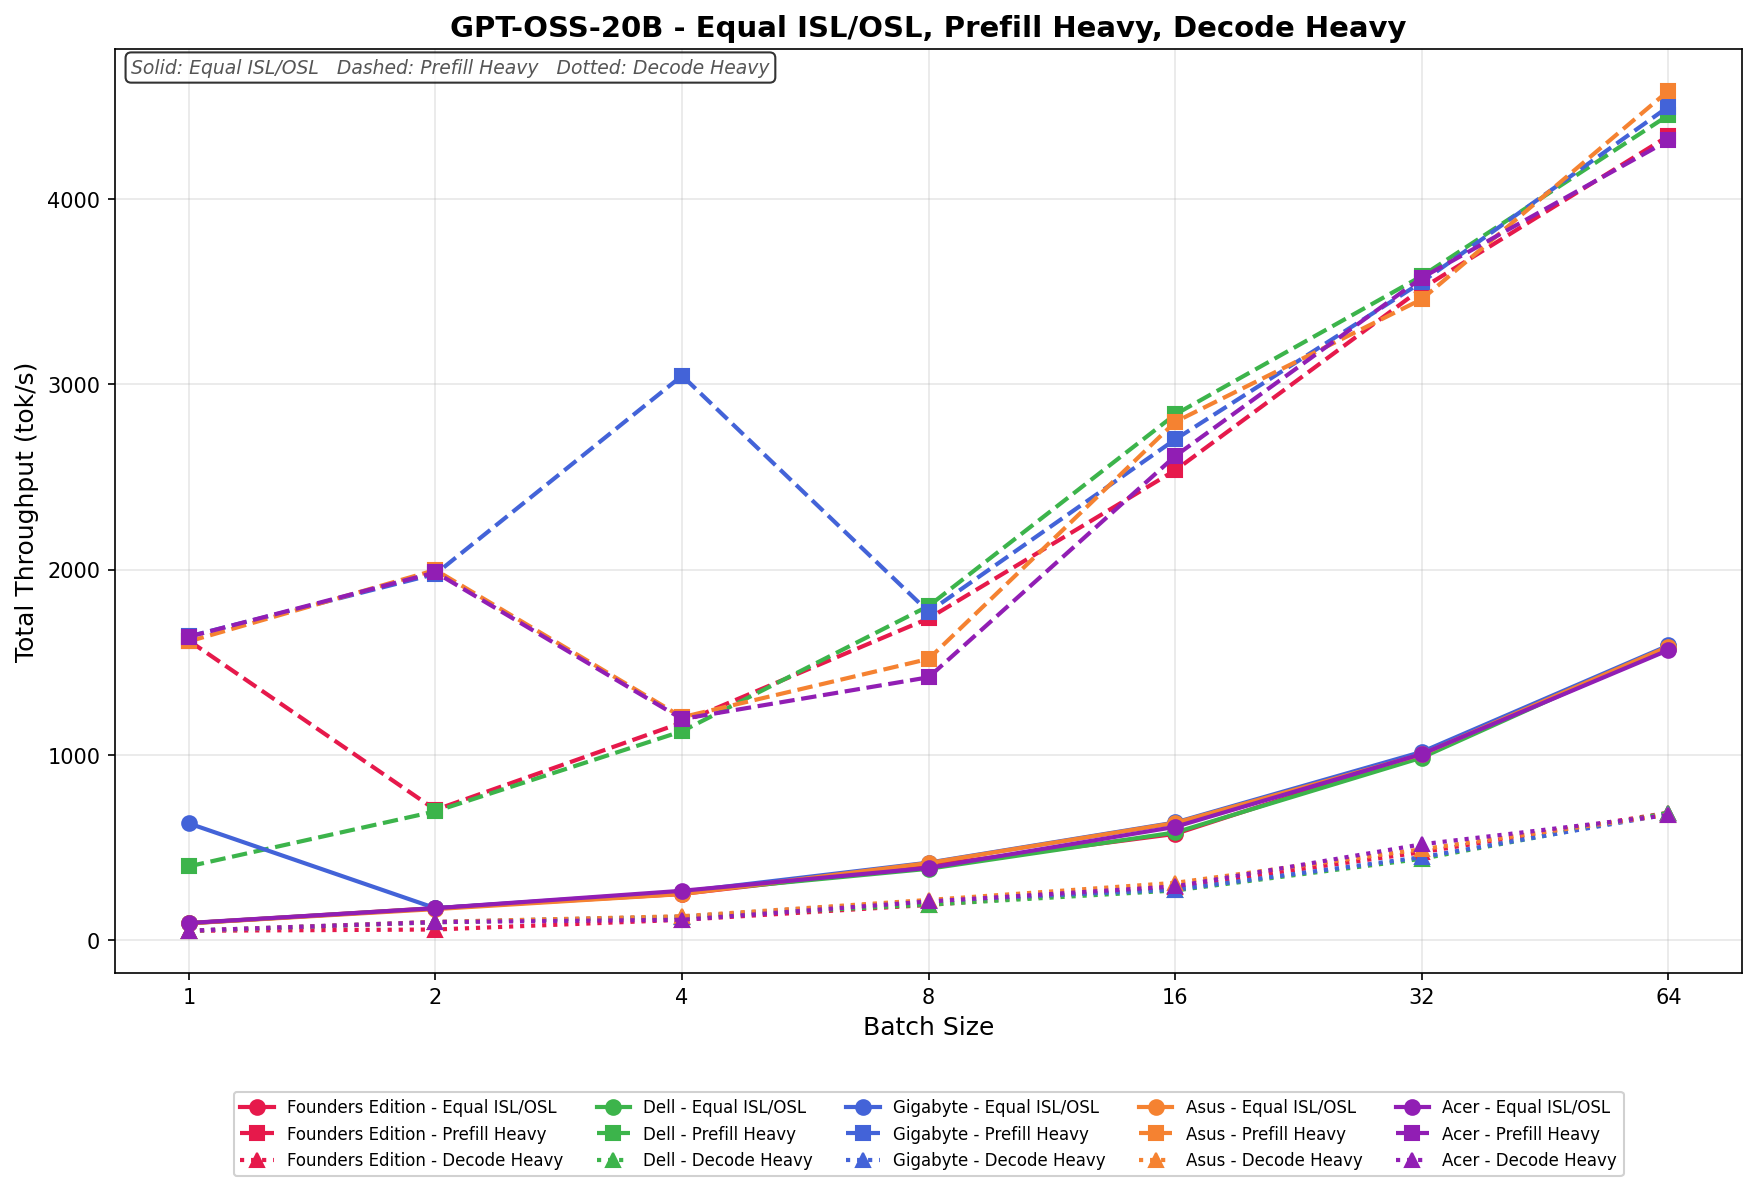
Im Equal ISL/OSL-Verfahren skaliert GIGABYTE von 641.73 auf 1,587.62 tok/s. Der Leistungsanstieg beginnt bei Batchgröße 1 stark, fällt bei Batchgröße 2 ab und steigt dann bei größeren Batchgrößen stetig an. Ab Batchgröße 8 normalisiert sich die Skalierung und verläuft nahezu parallel zum restlichen Feld. Bei Batchgröße 64 gehört GIGABYTE schließlich zu den Spitzenreitern.
Prefill Heavy beginnt bei 1,650.32 tok/s und erreicht bei einer Chargengröße von 64 einen Spitzenwert von 4,401.27 tok/s. Ab Charge 16 ist die Skalierung gleichmäßig und wettbewerbsfähig und hält bis zu den höheren Chargengrößen mit Dell und Asus Schritt.
Die Dekodierleistung (Heavy) liegt zwischen 63.18 und 688.44 tok/s und zeigt über den gesamten Bereich eine gleichmäßige lineare Skalierung. Die Leistungssteigerungen sind zwar inkrementell, aber konsistent, stimmen weitgehend mit den anderen Plattformen überein und spiegeln das für dekodierintensive Workloads typische, eingeschränktere Skalierungsverhalten wider.
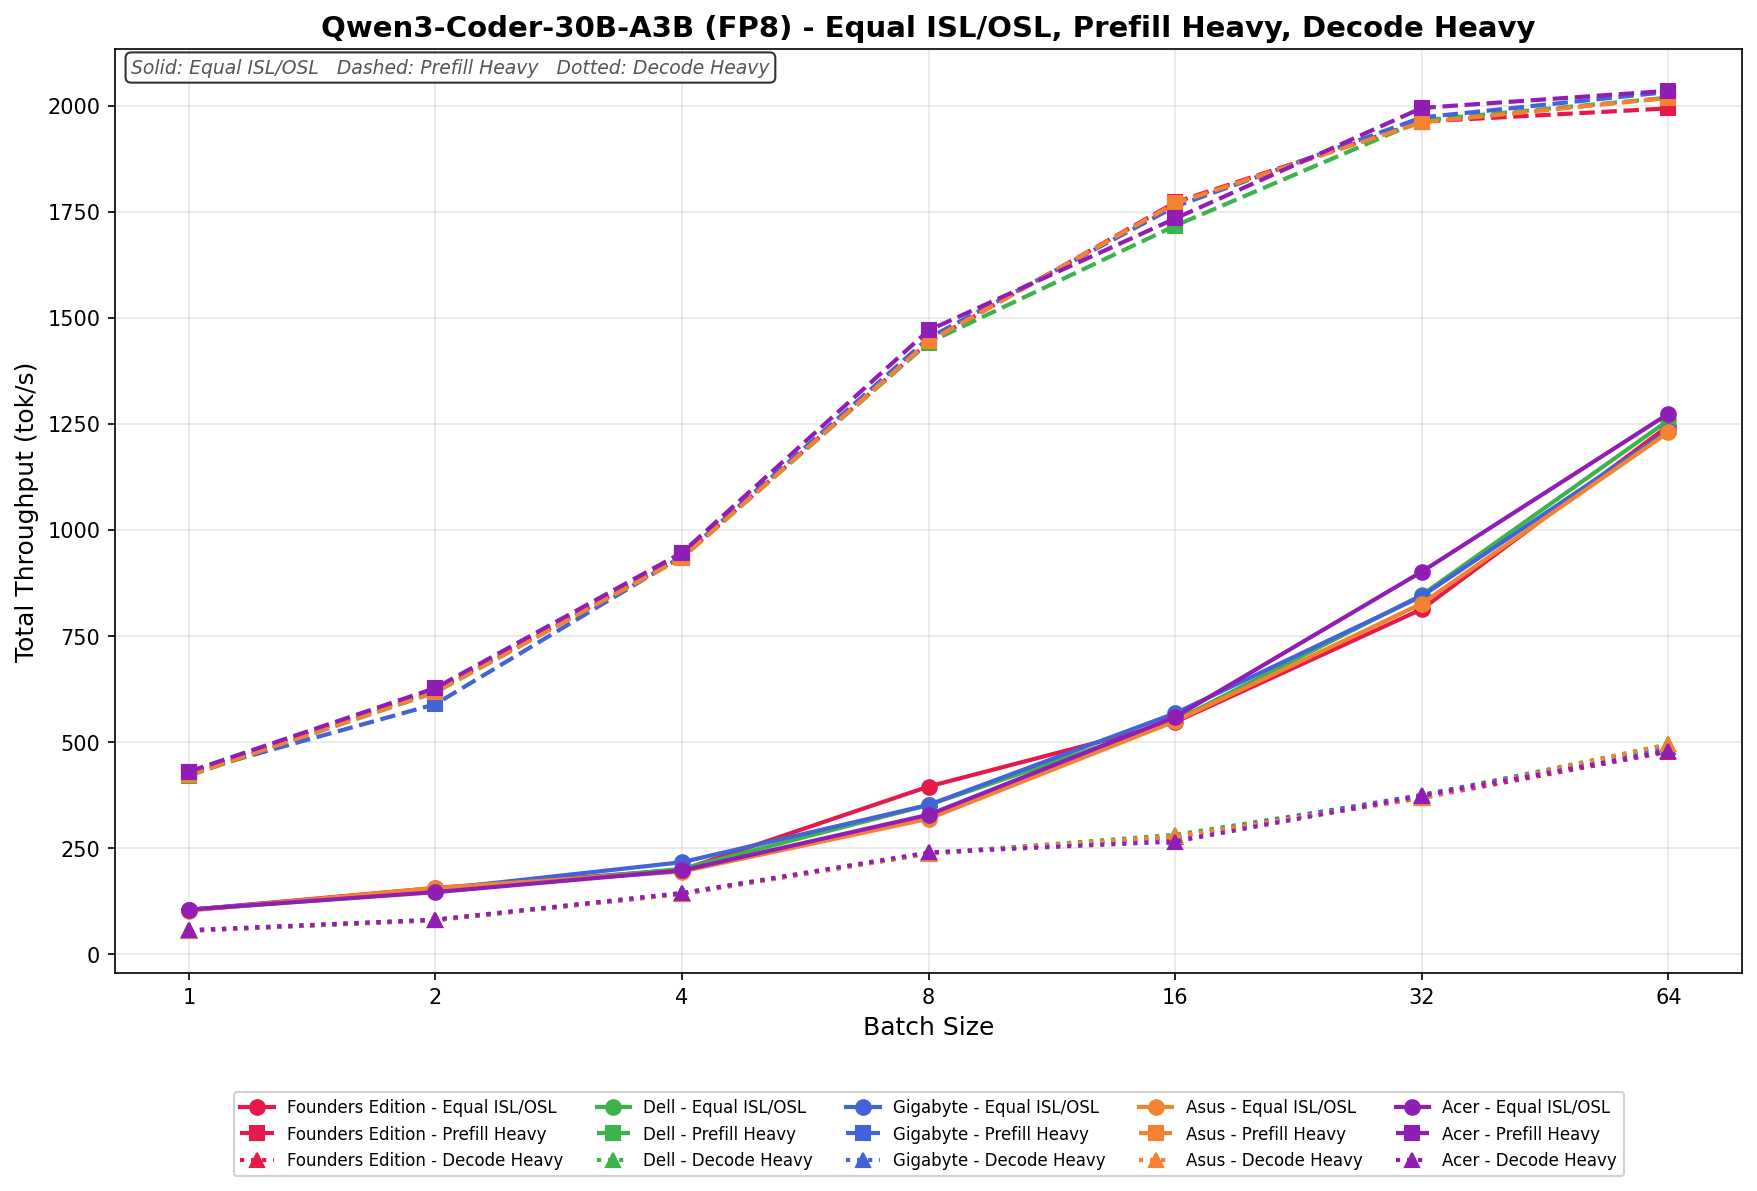
Qwen3-Coder 30B A3B FB8
Im Equal ISL/OSL-Test skaliert GIGABYTE von 101.27 auf 1,251.84 kbit/s und zeigt damit einen stetigen, linearen Anstieg über alle Testreihen hinweg. Die Leistung entspricht bis einschließlich Testreihe 16 weitgehend der von Dell und Asus und steigt dann bis Testreihe 64 kontinuierlich an, um schließlich ohne erkennbare Skalierungsanomalien im oberen Bereich zu landen.
Prefill Heavy beginnt bei 428.66 tk/s und skaliert auf 2,026.94 tk/s, wenn die Chargengröße auf 64 erhöht wird. Das Wachstum verläuft über alle Chargengrößen hinweg gleichmäßig und konsistent, wobei GIGABYTE eng mit dem breiteren Feld verwandt bleibt.
Die Decode Heavy-Werte liegen zwischen 61.18 und 482.73 tok/s, wobei mit zunehmender Batchgröße vorhersehbare, schrittweise Verbesserungen zu erwarten sind.
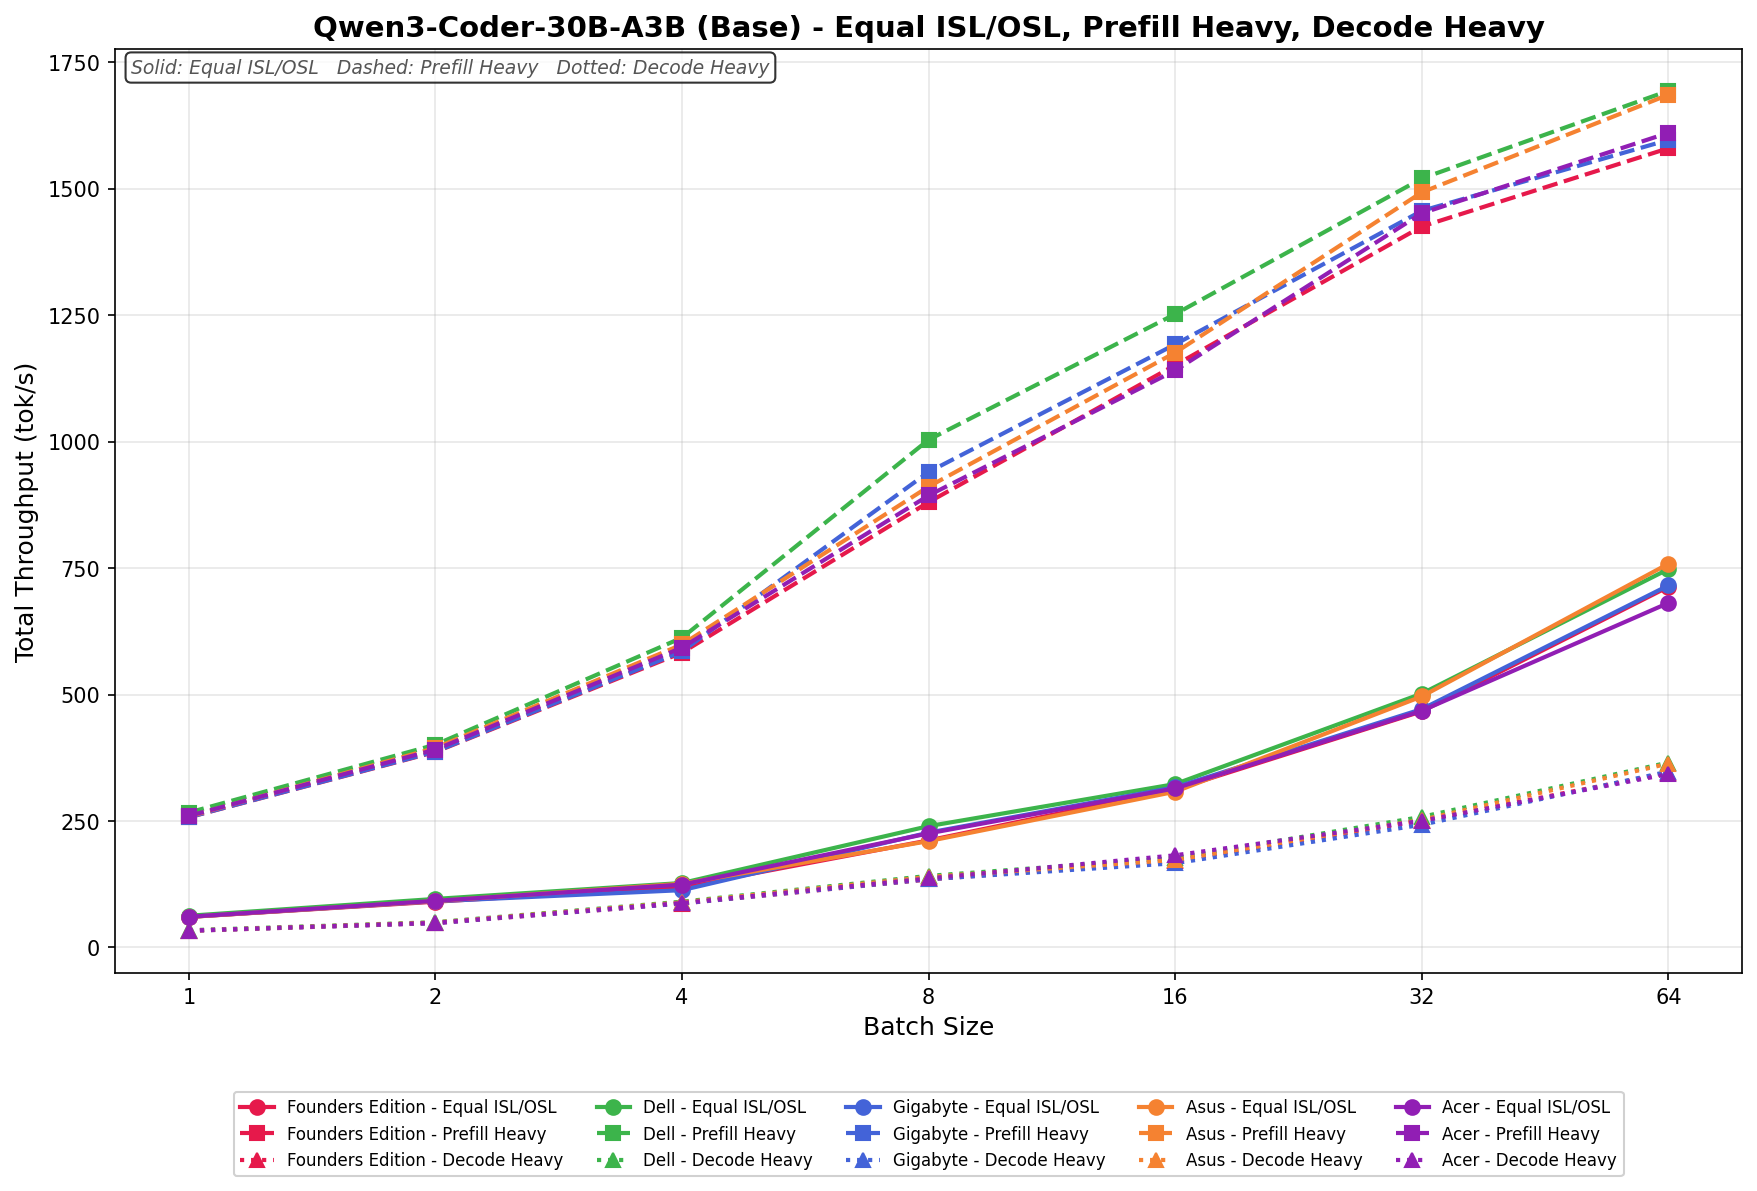
Qwen3-Coder 30B A3B Basis
Im Equal ISL/OSL-Verfahren skaliert GIGABYTE von 63.42 auf 721.08 tok/s und zeigt dabei über den gesamten Chargenbereich hinweg einen stetigen Anstieg. Die Leistung entspricht hier bis Charge 16 weitgehend dem Gesamtvergleich und skaliert bis Charge 64 weiterhin gleichmäßig. Abschließend bleibt die Leistung wettbewerbsfähig und weist keine nennenswerten Abweichungen vom linearen Verhalten auf.
Prefill Heavy beginnt bei 258.11 tk/s und steigt bis zur Chargengröße 64 auf 1,603.74 tk/s.
Decode Heavy liegt im Bereich von 33.57 bis 349.82 tok/s, mit inkrementeller, linearer Skalierung über den gesamten Bereich.
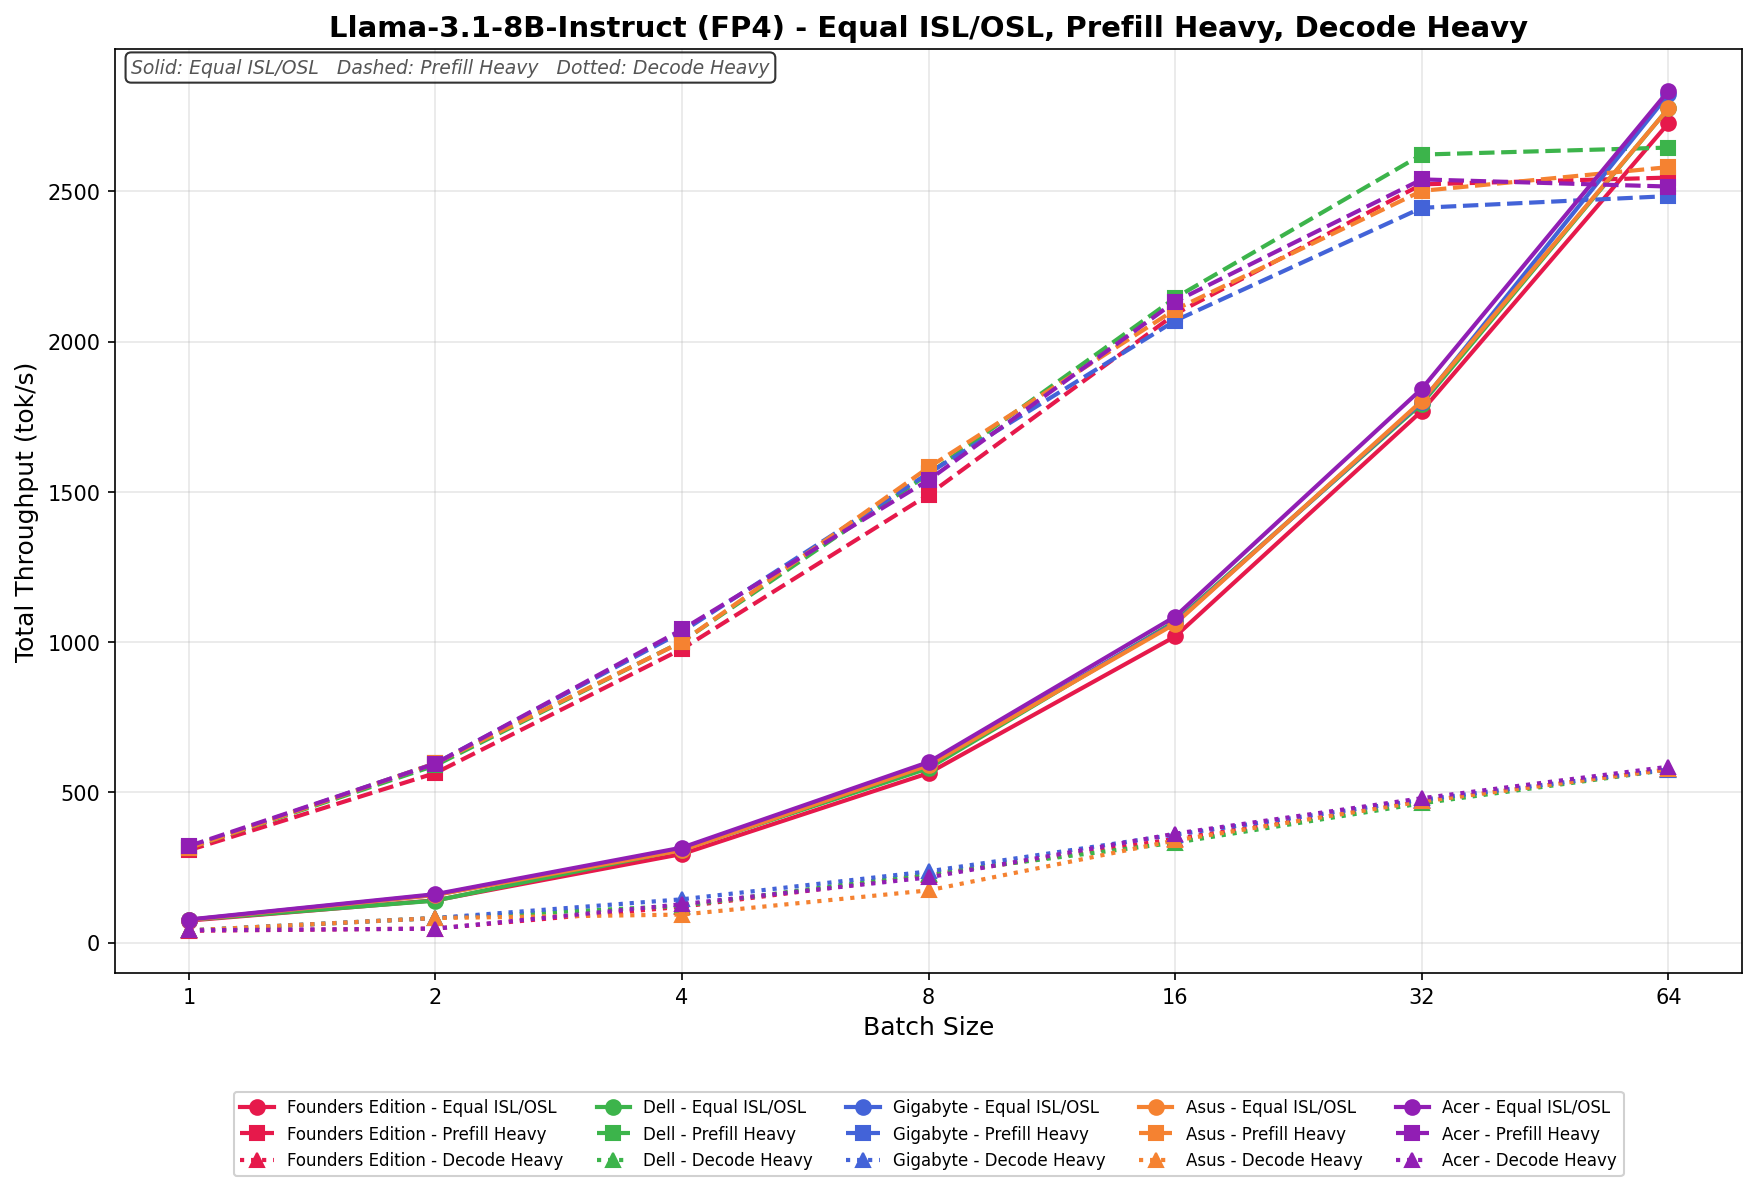
Llama 3.1 8B Instruct FP4
Bei gleicher ISL/OSL-Skalierung steigt der Durchsatz von GIGABYTE im Batch-Sweep von 69.84 auf 2,756.91 kB/s. Die Skalierung verläuft bis Batch 32 progressiv und ausgewogen, wobei der Durchsatz sich dem oberen Bereich annähert, bevor er bei Batch 64 einen deutlichen Sprung macht und das System damit zu den führenden Systemen bei höheren Parallelitätsstufen zählt.
Prefill Heavy beginnt bei 321.67 tk/s und erreicht bei einer Chargengröße von 64 tk/s 2,493.52 tk/s. Das Wachstum ist bis zur Charge 16 stetig, flacht dann aber bei höheren Chargengrößen im Vergleich zum Spitzenreiter leicht ab, was auf eine solide, aber nicht dominante Effizienz bei der Skalierung großer Chargen hindeutet.
Die Decode Heavy-Werte liegen zwischen 48.92 und 575.84 tok/s, wobei mit zunehmender Batchgröße stetige Zuwächse zu verzeichnen sind.
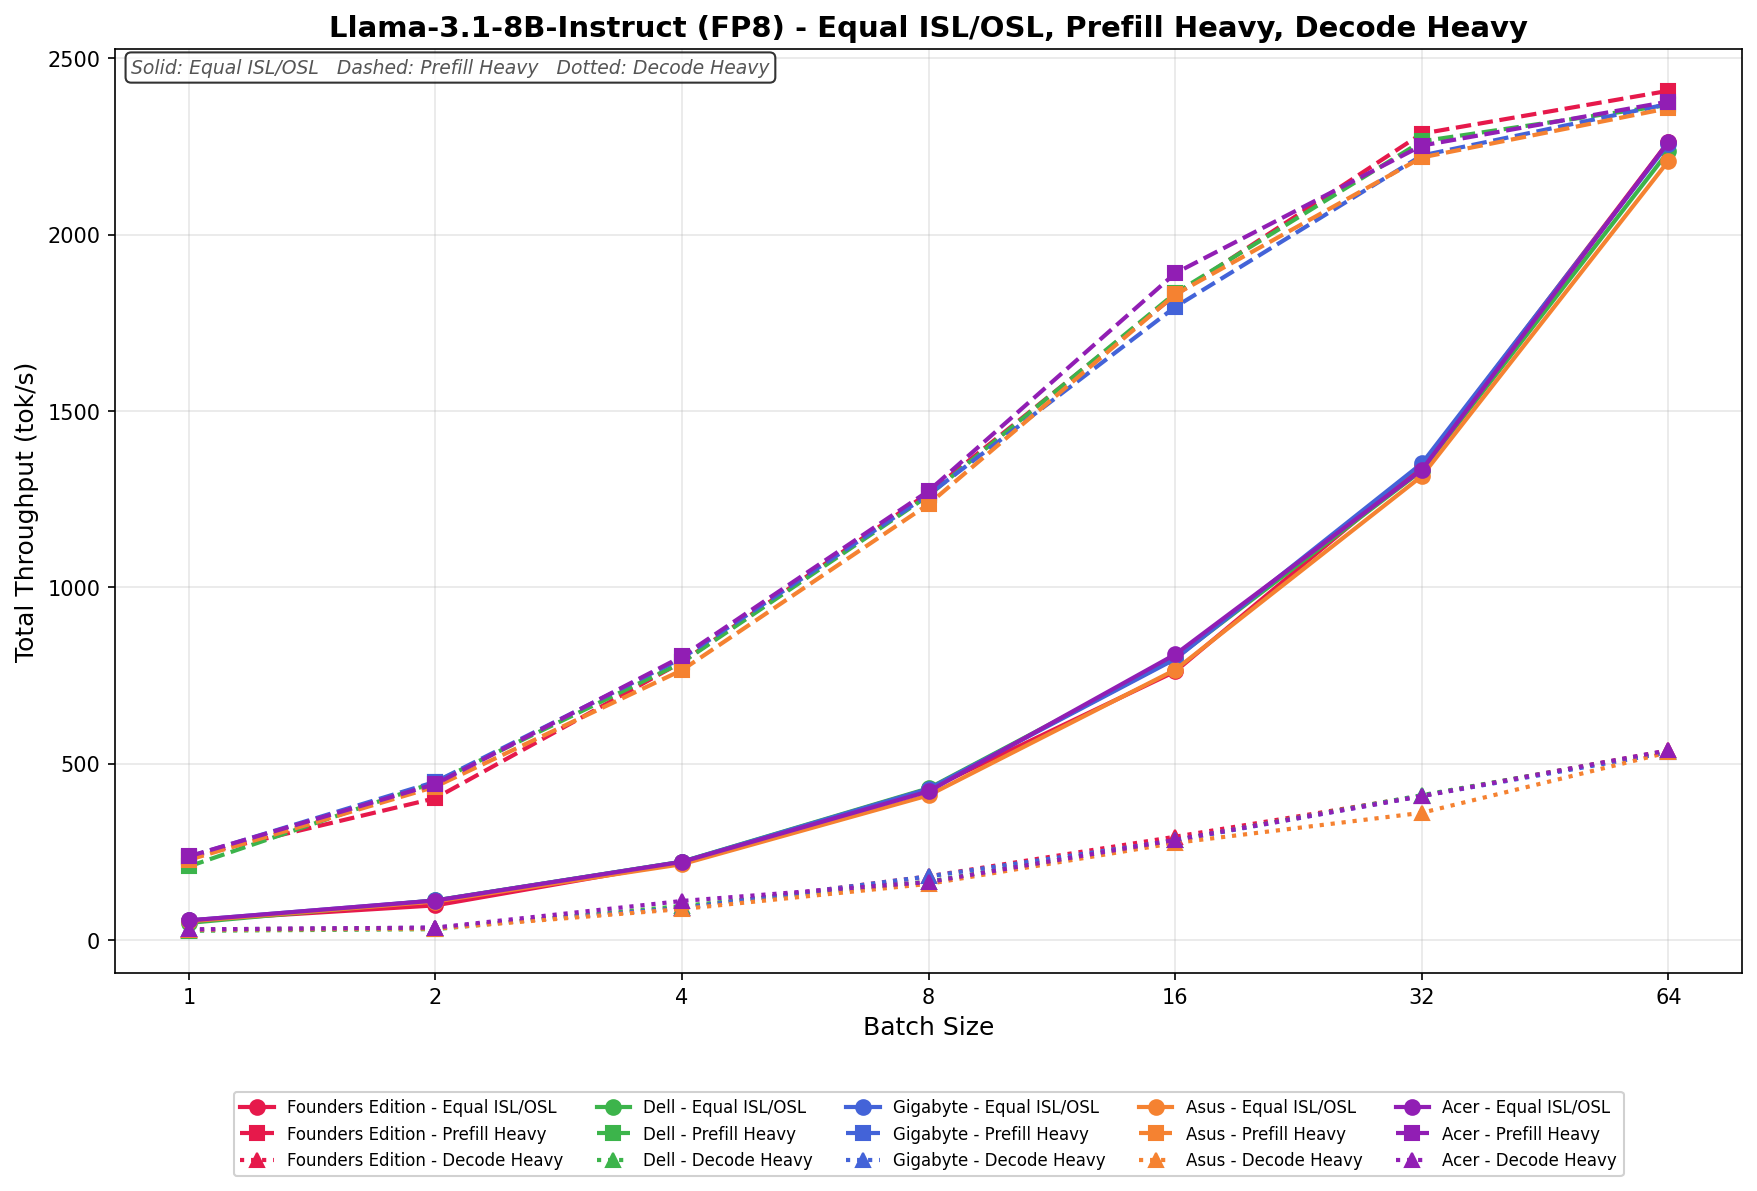
Llama 3.1 8B Instruct FP8
Bei gleicher ISL/OSL-Skalierung skaliert GIGABYTE von 54.12 auf 2,314.87 tok/s und zeigt ein gleichmäßiges, lineares Wachstum bis zum 32. Batch sowie einen starken Anstieg beim 64. Batch, der die Wettbewerbsfähigkeit auch bei höheren Parallelitätsniveaus sichert.
Die Vorfüllung von Schweröl beginnt bei 226.43 tk/s und erreicht bei einer Chargengröße von 64 tk/s 2,332.19 tk/s. Die Skalierung ist über den gesamten Messbereich hinweg konsistent, folgt eng dem breiteren Feld und gewährleistet eine solide Effizienz auch bei größeren Chargengrößen.
Die Decode Heavy-Werte liegen zwischen 32.88 und 522.41 tok/s, wobei mit zunehmender Batchgröße stetige Zuwächse zu verzeichnen sind. Wie erwartet, ist die Skalierung im Vergleich zu den Workloads Equal und Prefill weniger ausgeprägt.
GPU-Direktspeicher
Einer der Tests, die wir mit dem Spark durchgeführt haben, war der MagnumIO GPU Direct Storage (GDS)-Test. GDS ist eine von NVIDIA entwickelte Funktion, die es GPUs ermöglicht, die CPU zu umgehen, wenn sie auf Daten zugreifen, die auf NVMe-Laufwerken oder anderen Hochgeschwindigkeitsspeichern gespeichert sind. Anstatt Daten über die CPU und den Systemspeicher zu leiten, ermöglicht GDS die direkte Kommunikation zwischen GPU und Speichergerät, wodurch die Latenz deutlich reduziert und der Datendurchsatz verbessert wird.
Gigabyte verbaut im AI TOP ATOM die 4 TB große Samsung PM9E1 Gen5 SSD, die aktuell die schnellste 2242 M.2-SSD auf dem Markt ist. Dieselbe SSD kommt auch im FE Spark und im Acer Veriton GN100 zum Einsatz.
So funktioniert GPU Direct Storage
Traditionell müssen Daten, die auf einem NVMe-Laufwerk gespeichert sind, zunächst die CPU und den Arbeitsspeicher durchlaufen, bevor sie die GPU erreichen. Dieser Prozess führt zu Engpässen, da die CPU als Vermittler fungiert, was Latenzzeiten verursacht und wertvolle Systemressourcen verbraucht. GPU Direct Storage beseitigt diese Ineffizienz, indem es der GPU ermöglicht, über den PCIe-Bus direkt auf die Daten des Speichermediums zuzugreifen. Dieser direkte Pfad reduziert den Aufwand für die Datenübertragung und ermöglicht so schnellere und effizientere Datenübertragungen.
KI-Workloads, insbesondere solche mit Deep Learning, sind äußerst datenintensiv. Das Training großer neuronaler Netzwerke erfordert die Verarbeitung von Terabyte an Daten, und jede Verzögerung bei der Datenübertragung kann zu einer Unterauslastung der GPUs und längeren Trainingszeiten führen. GPU Direct Storage bewältigt diese Herausforderung, indem es sicherstellt, dass die Daten so schnell wie möglich an die GPU übermittelt werden, wodurch Leerlaufzeiten minimiert und die Rechenleistung maximiert werden.
Darüber hinaus ist GDS besonders vorteilhaft für Workloads, die das Streamen großer Datensätze beinhalten, wie etwa Videoverarbeitung, Verarbeitung natürlicher Sprache oder Echtzeit-Inferenz. Durch die Reduzierung der Abhängigkeit von der CPU beschleunigt GDS die Datenbewegung und gibt CPU-Ressourcen für andere Aufgaben frei, was die Gesamtsystemleistung weiter verbessert.
GDSIO-Lesedurchsatz 16k
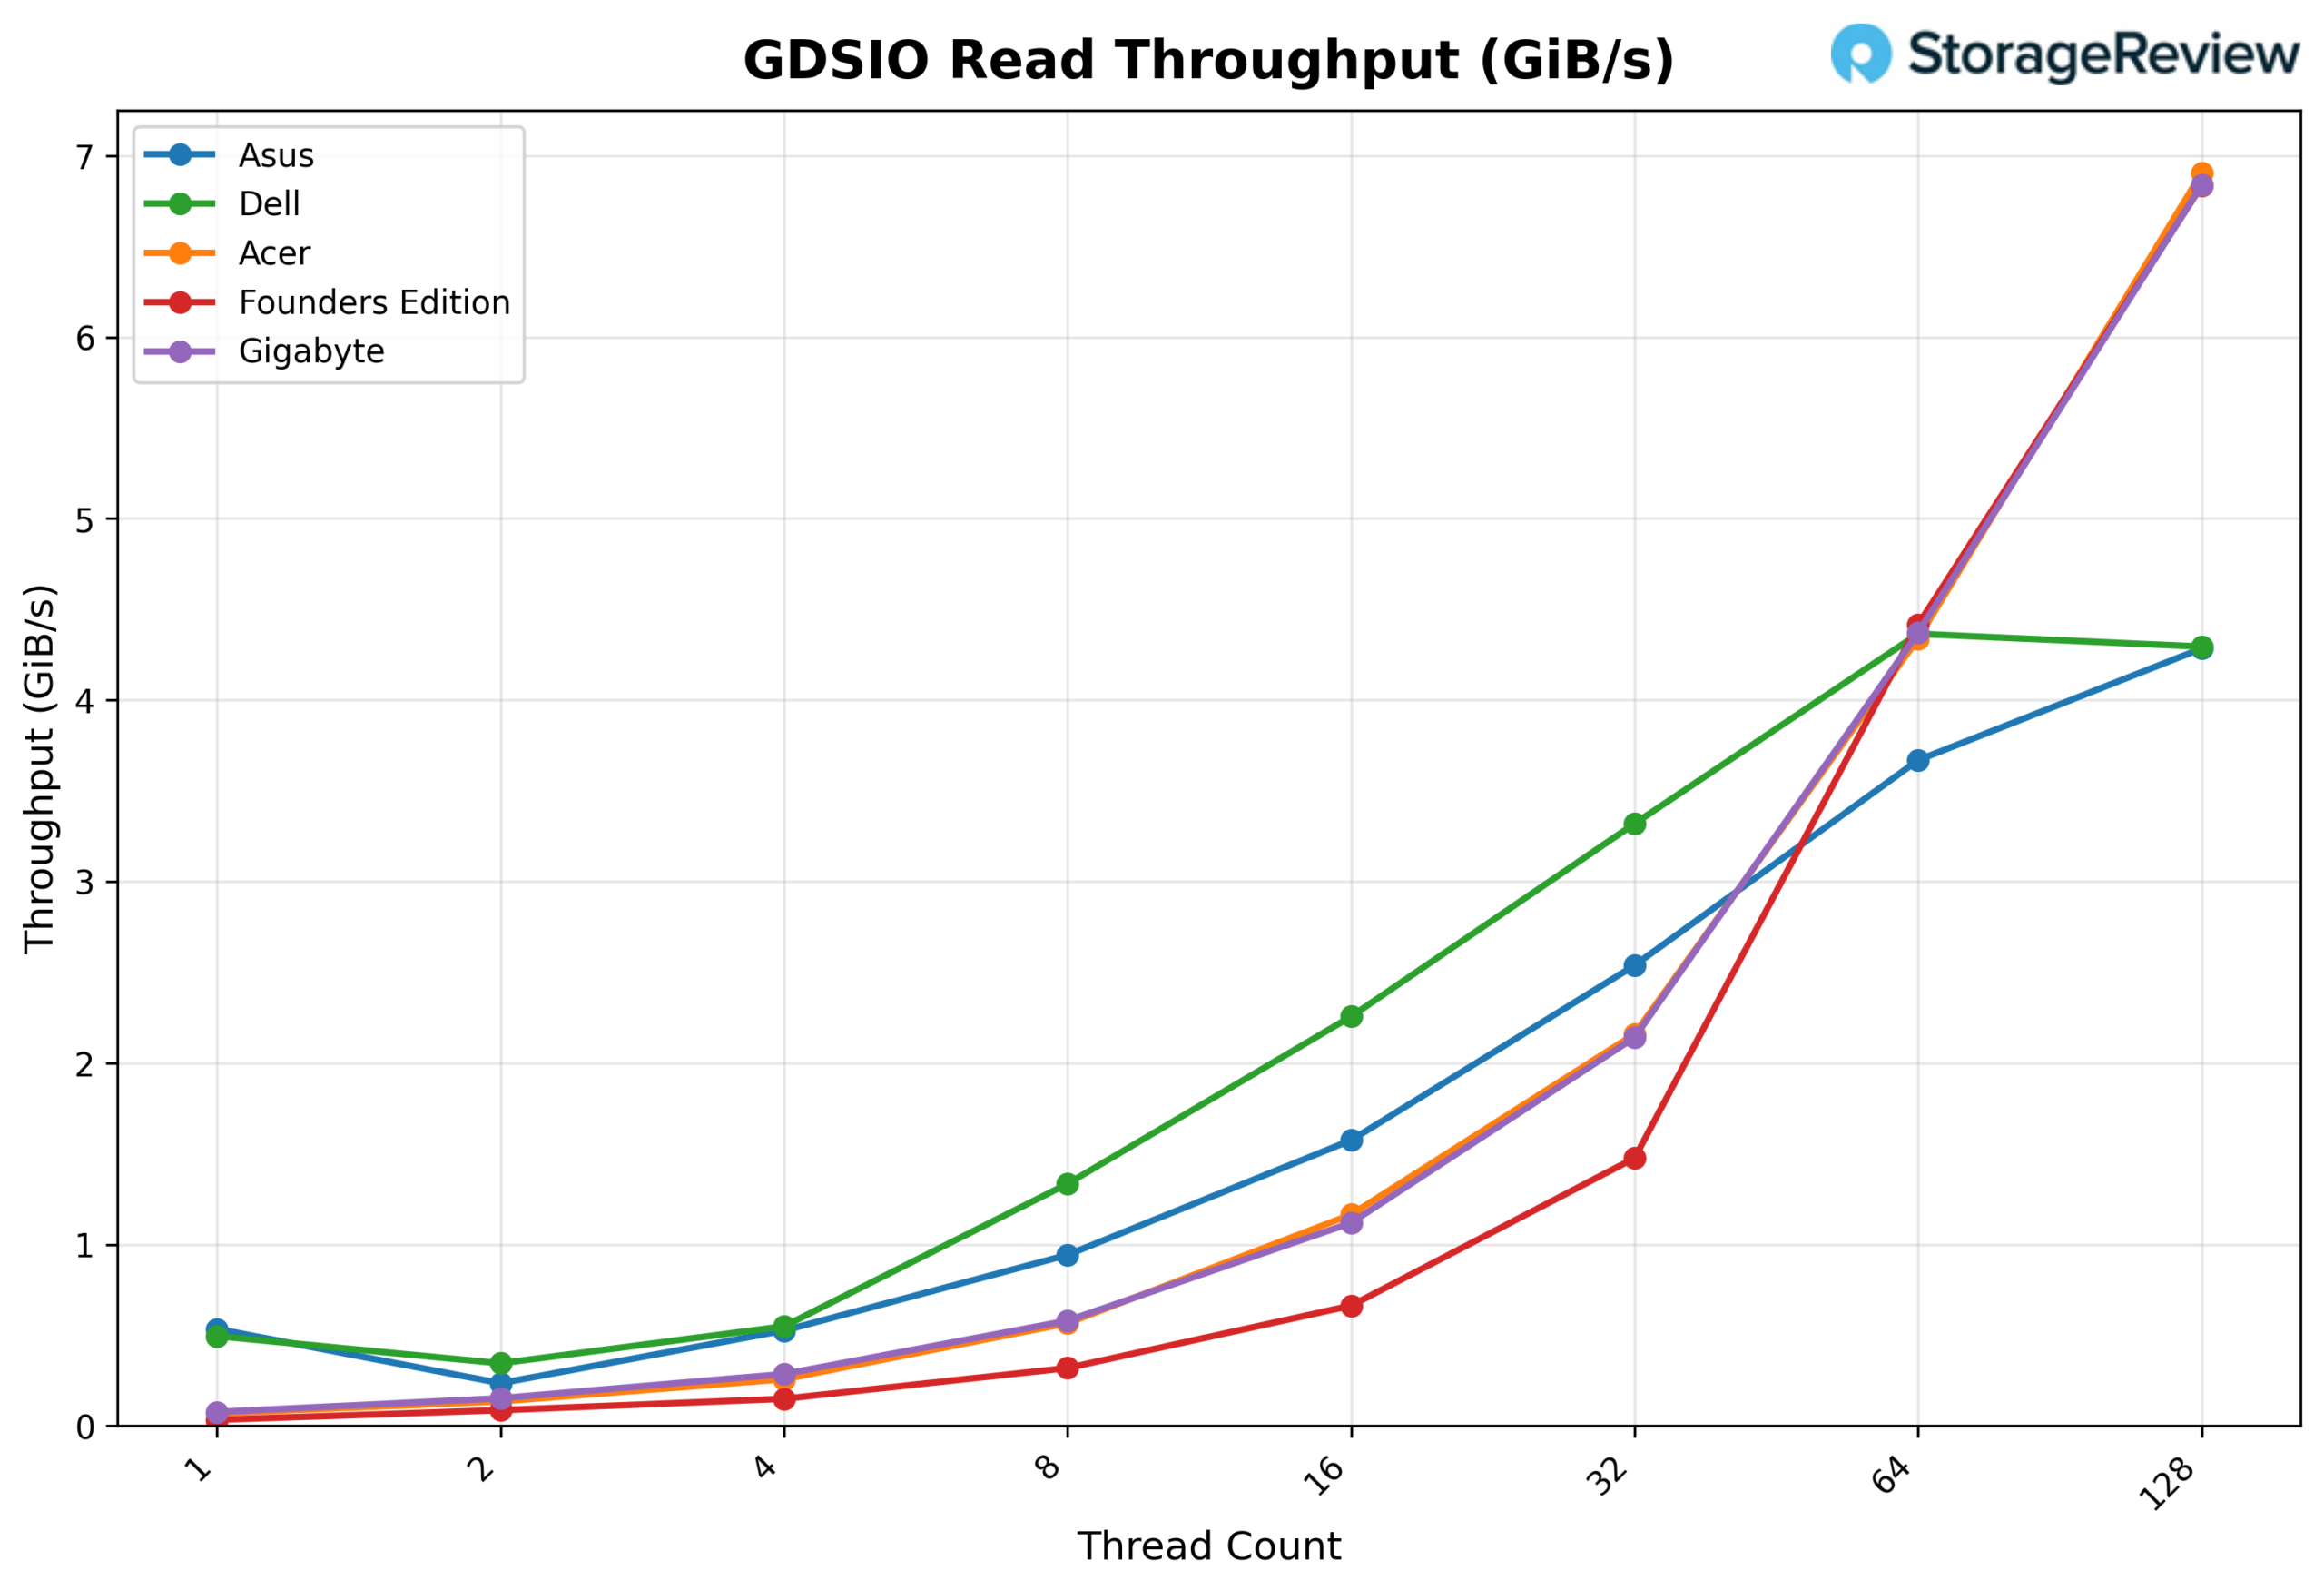
Betrachtet man den GDSIO-Lesedurchsatz (16K), so beginnt GIGABYTE bei etwa 0.08 GiB/s mit einem Thread und steigt auf 0.58 GiB/s bei acht Threads. Von dort skaliert die Geschwindigkeit weiterhin gleichmäßig auf 16 Threads (1.12 GiB/s) und 32 Threads (2.14 GiB/s), bevor sie bei 64 Threads sprunghaft auf 4.37 GiB/s ansteigt. Bei 128 Threads skaliert GIGABYTE weiter auf 6.84 GiB/s und zeigt keine Anzeichen einer Stagnation im oberen Bereich der Thread-Anzahl.
GDSIO-Leselatenz: Durchschnittlich 16K
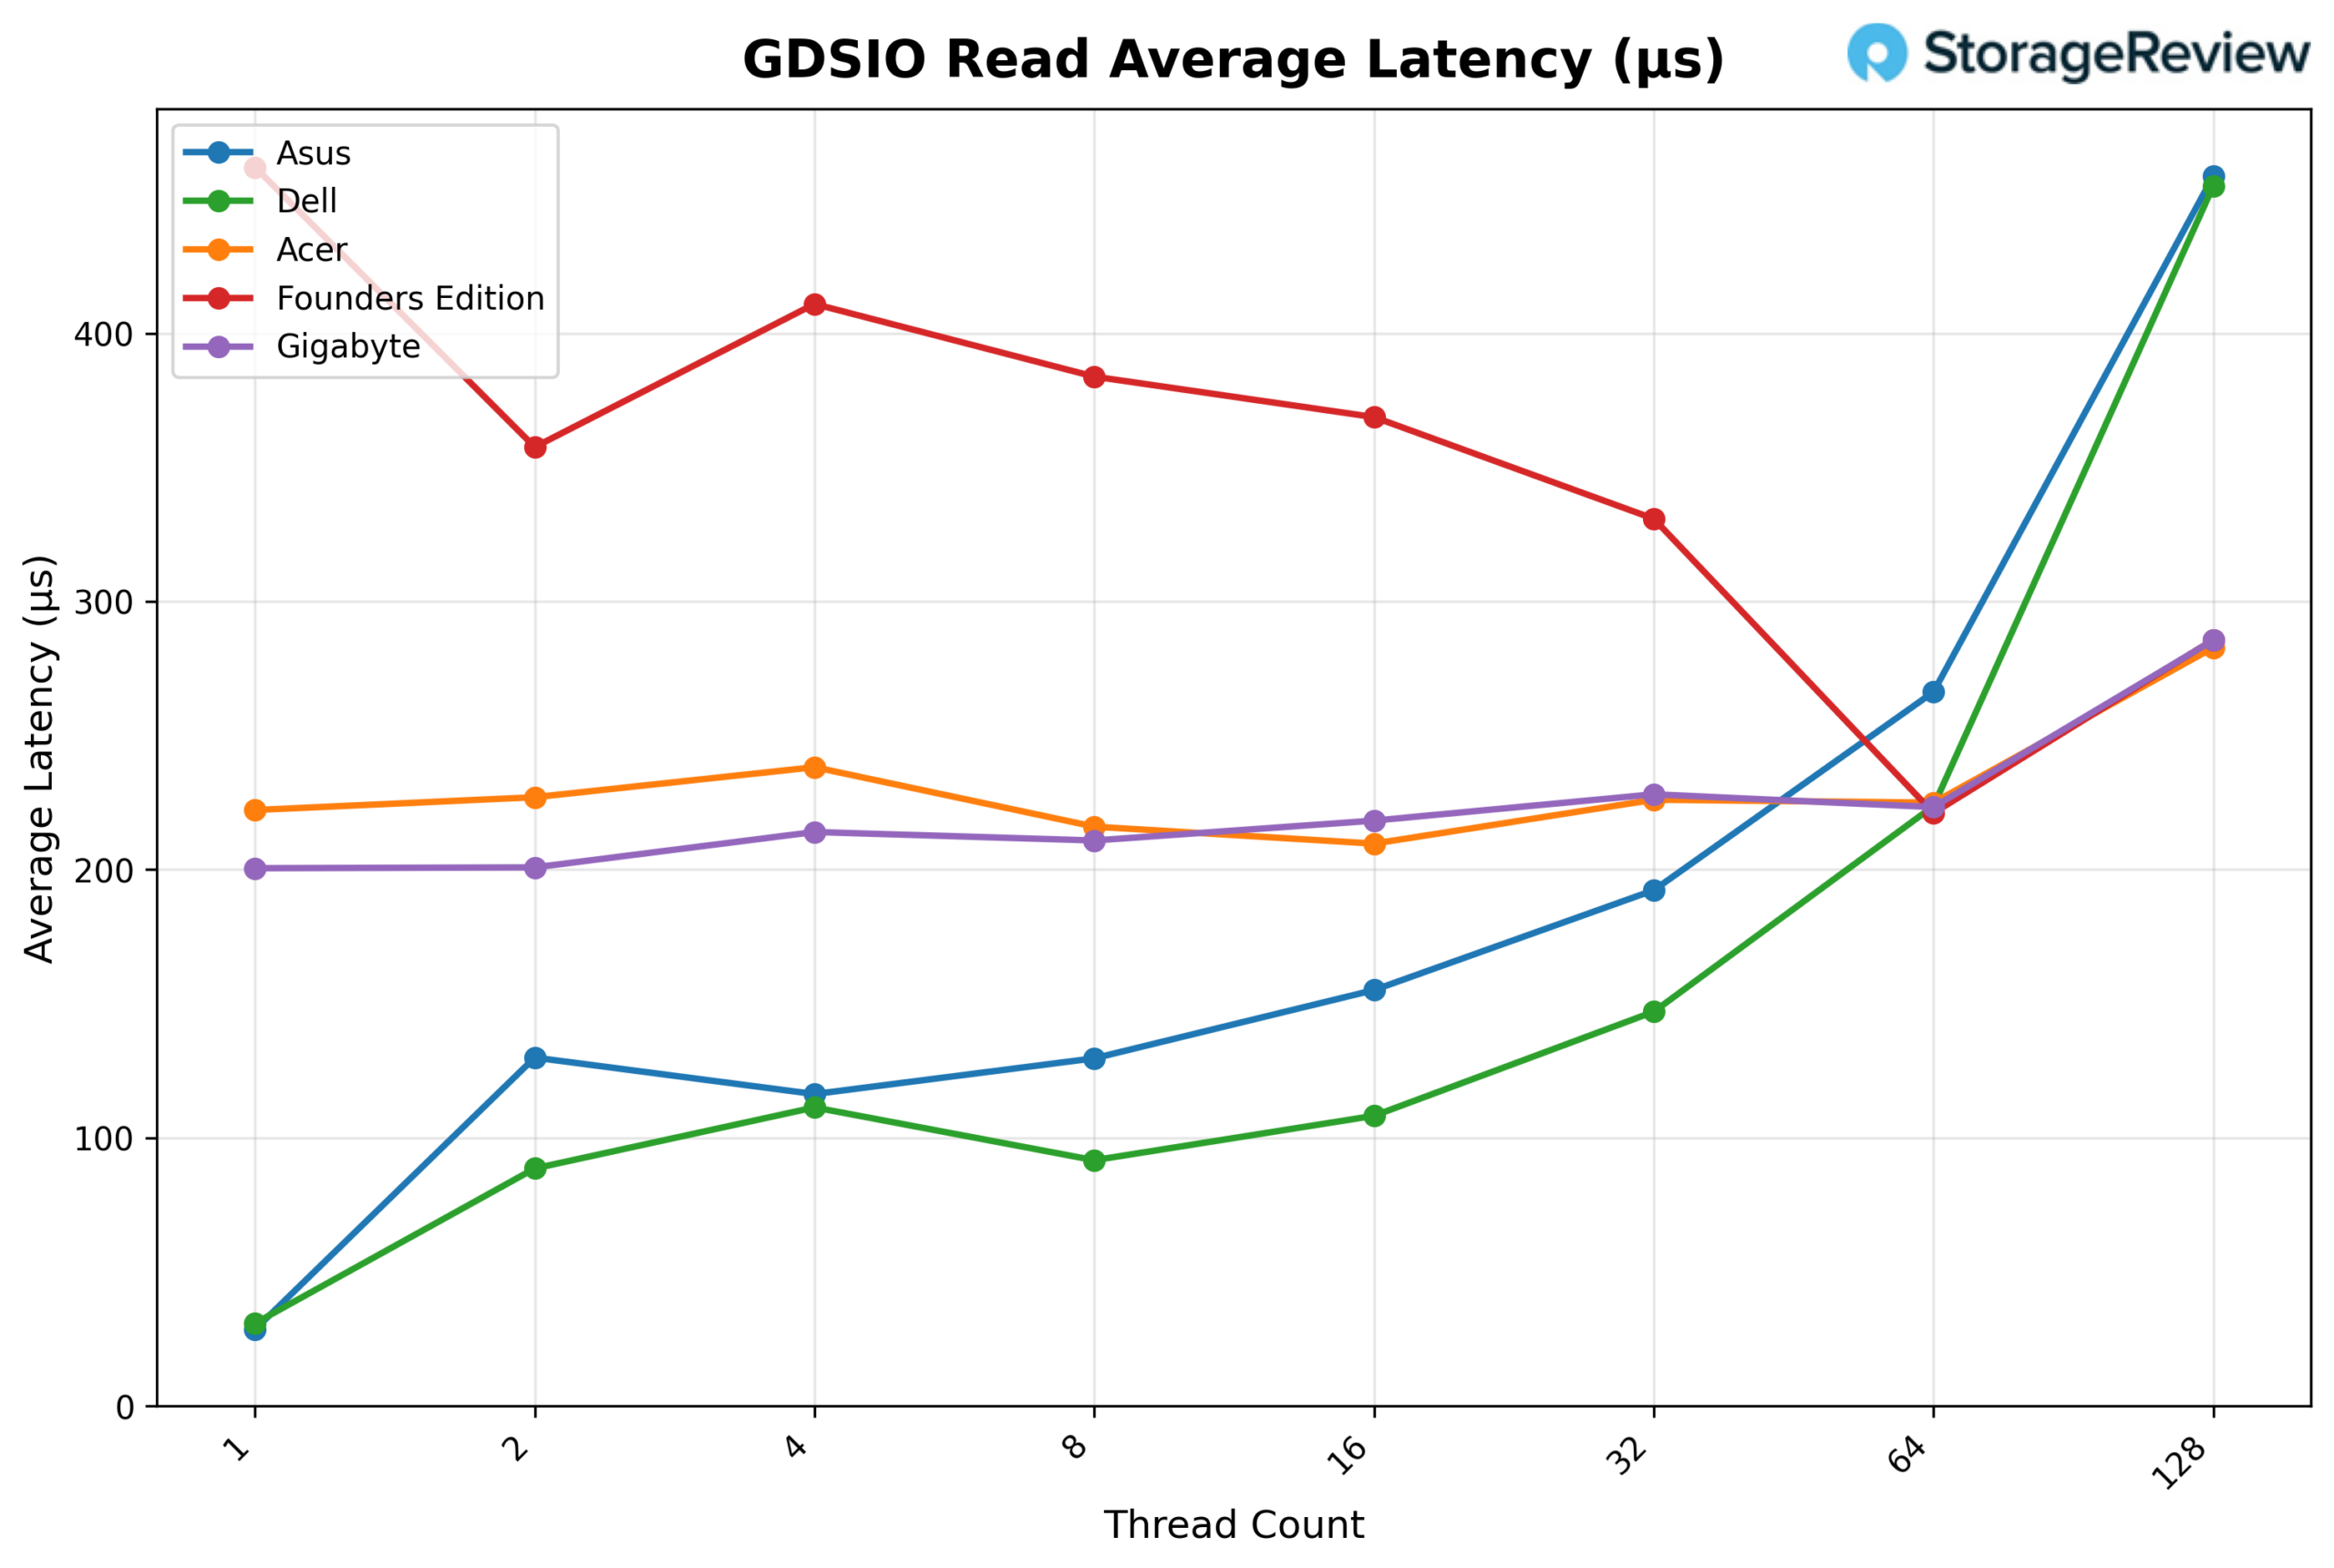
Betrachtet man die durchschnittliche Leselatenz (16K) von GDSIO, so zeigt GIGABYTE über den größten Teil der Kurve eine sehr konstante Latenz. Sie beginnt bei etwa 0.201 ms bei einem Thread und bleibt von 2 bis 64 Threads eng im Bereich von 0.21–0.23 ms (z. B. 0.211 ms bei 8 Threads, 0.218 ms bei 16 Threads, 0.228 ms bei 32 Threads und 0.223 ms bei 64 Threads). Erst bei 128 Threads steigt die Latenz merklich auf etwa 0.286 ms an, während der Durchsatz weiter zunimmt.
GSDIO-Schreibdurchsatz 16K
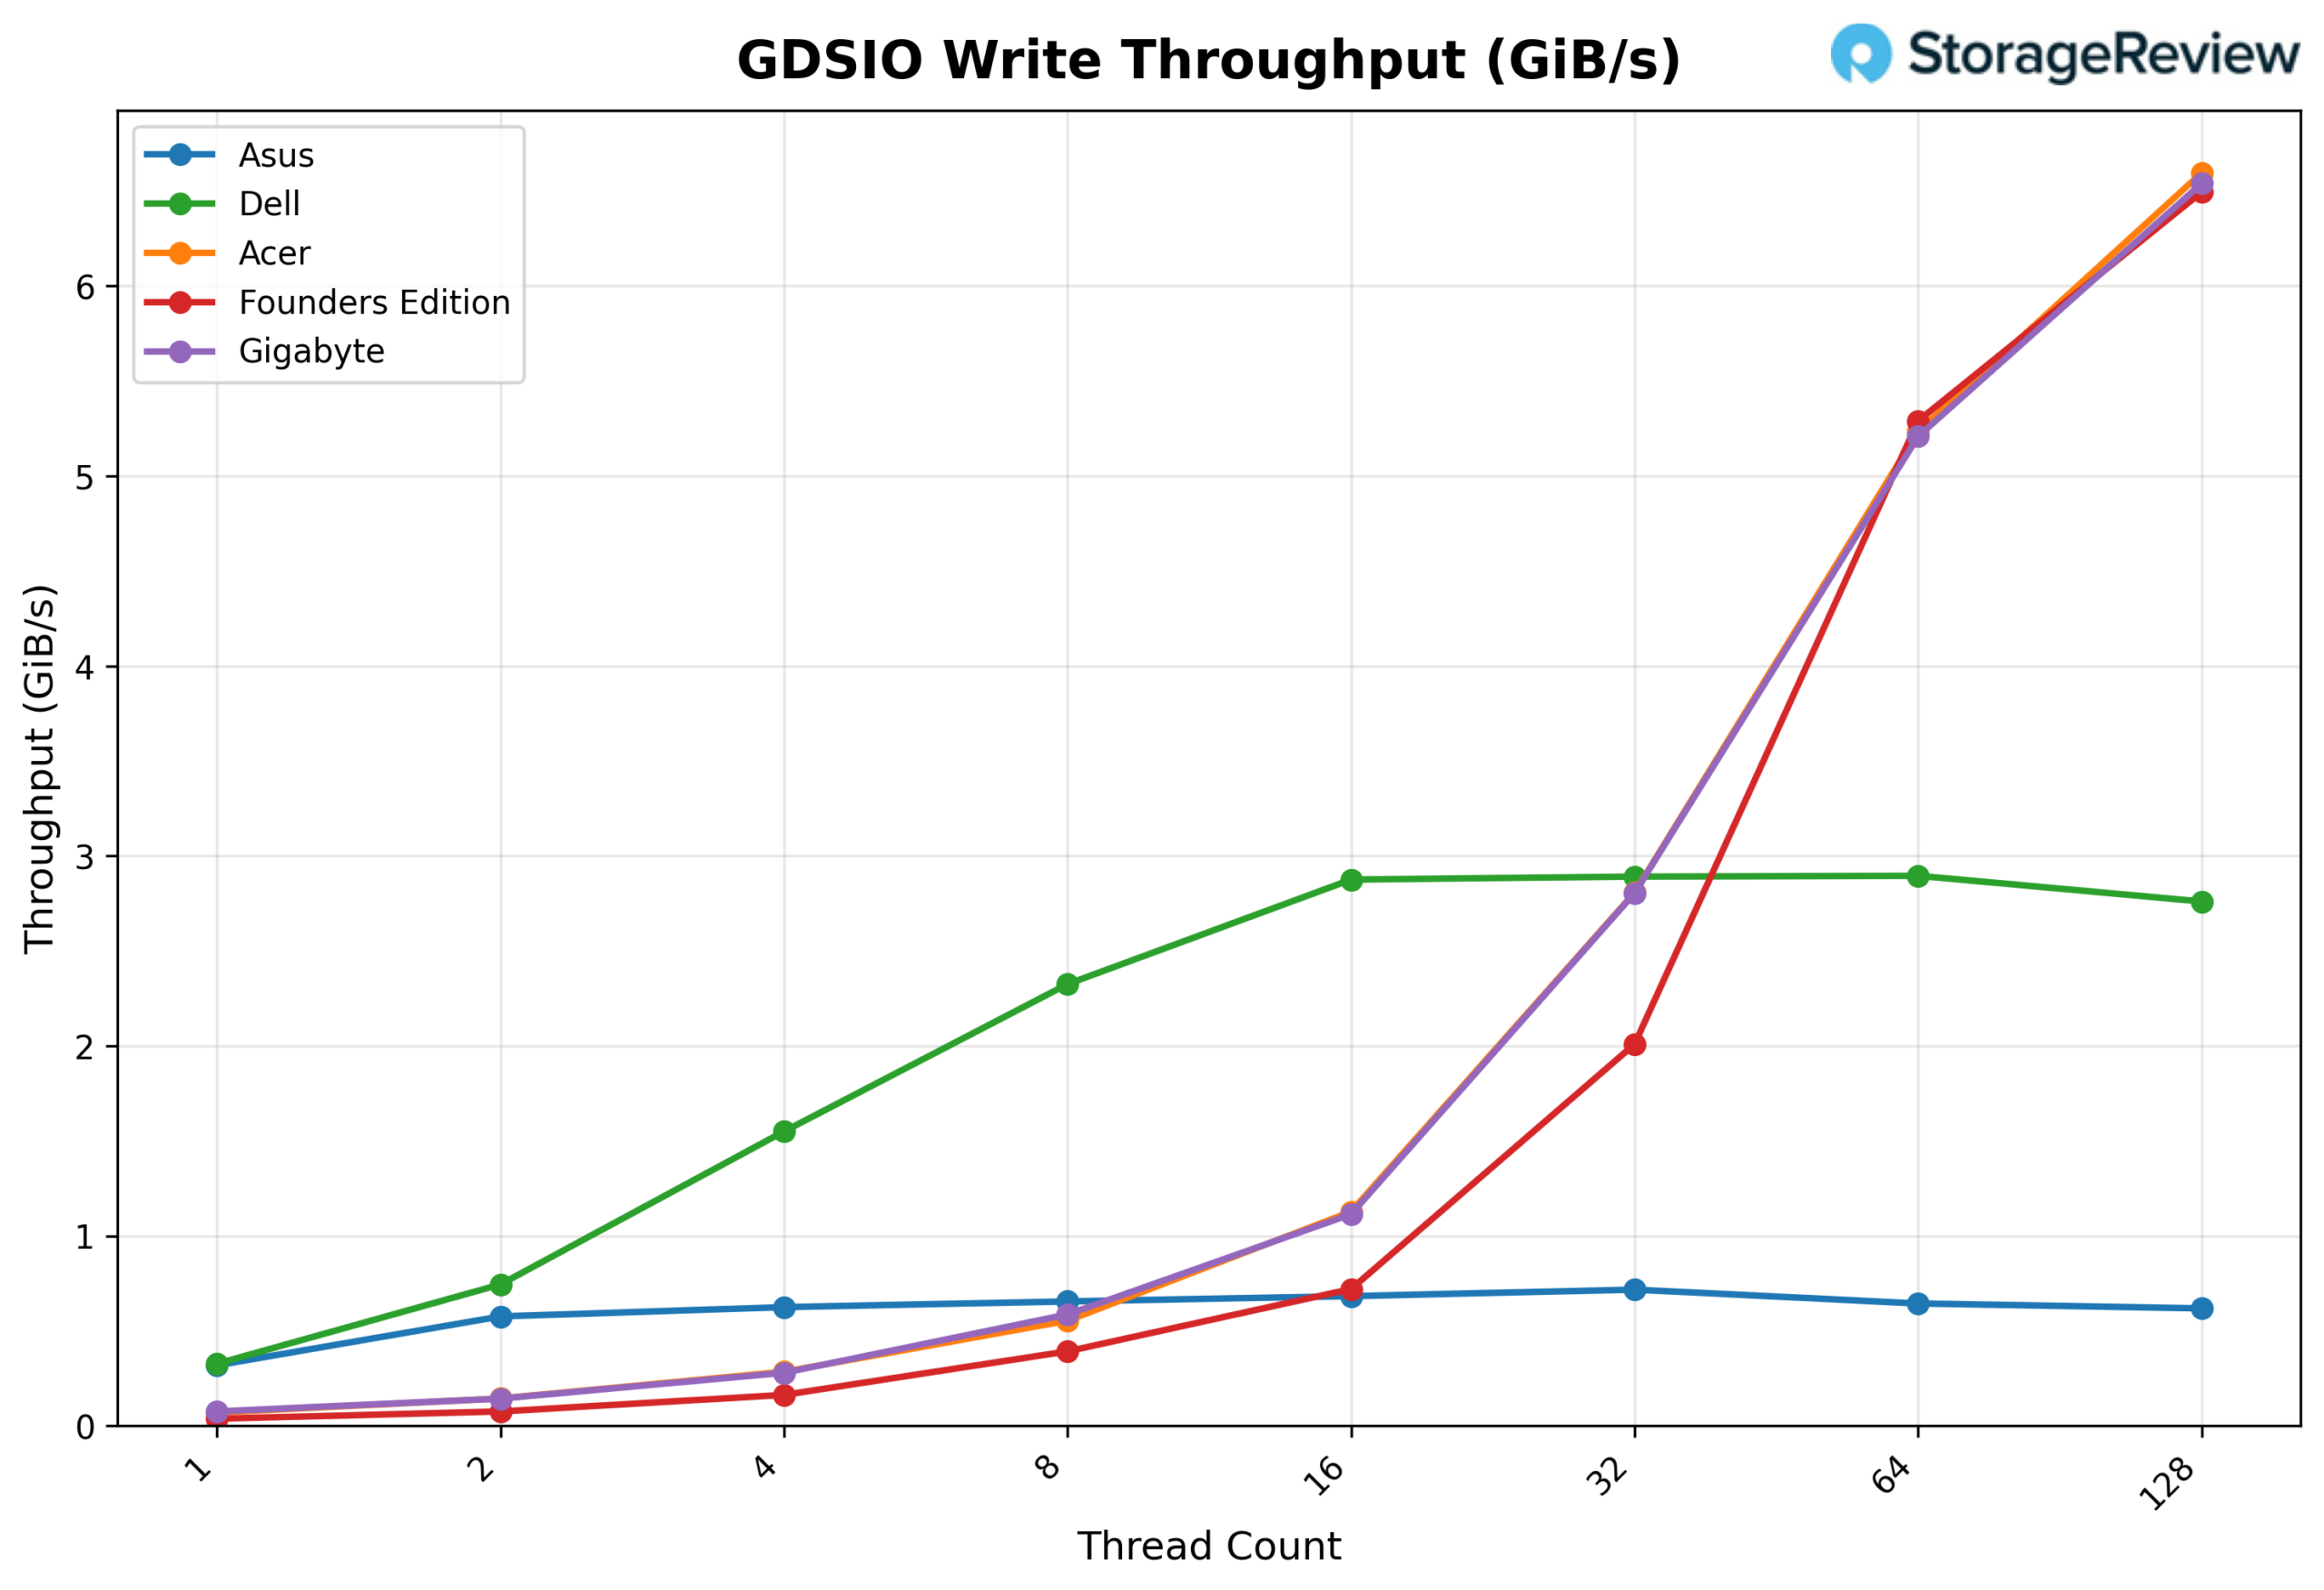
Betrachtet man den GDSIO-Schreibdurchsatz (16K), so beginnt der GIGABYTE-Prozessor bei etwa 0.08 GiB/s mit einem Thread, skaliert stetig auf 0.14 GiB/s mit zwei Threads und 0.28 GiB/s mit vier Threads. Die Leistung steigt kontinuierlich auf 8 Threads (0.59 GiB/s) und 16 Threads (1.11 GiB/s), bevor sie bei 32 Threads (2.80 GiB/s) deutlich zunimmt. Die Skalierung bleibt auch bei 64 Threads (5.21 GiB/s) stark und erreicht bei 128 Threads einen Spitzenwert von 6.54 GiB/s, was einen kontinuierlichen Aufwärtstrend ohne anfängliches Plateau zeigt.
GDSIO Schreiblatenz durchschnittlich 16K
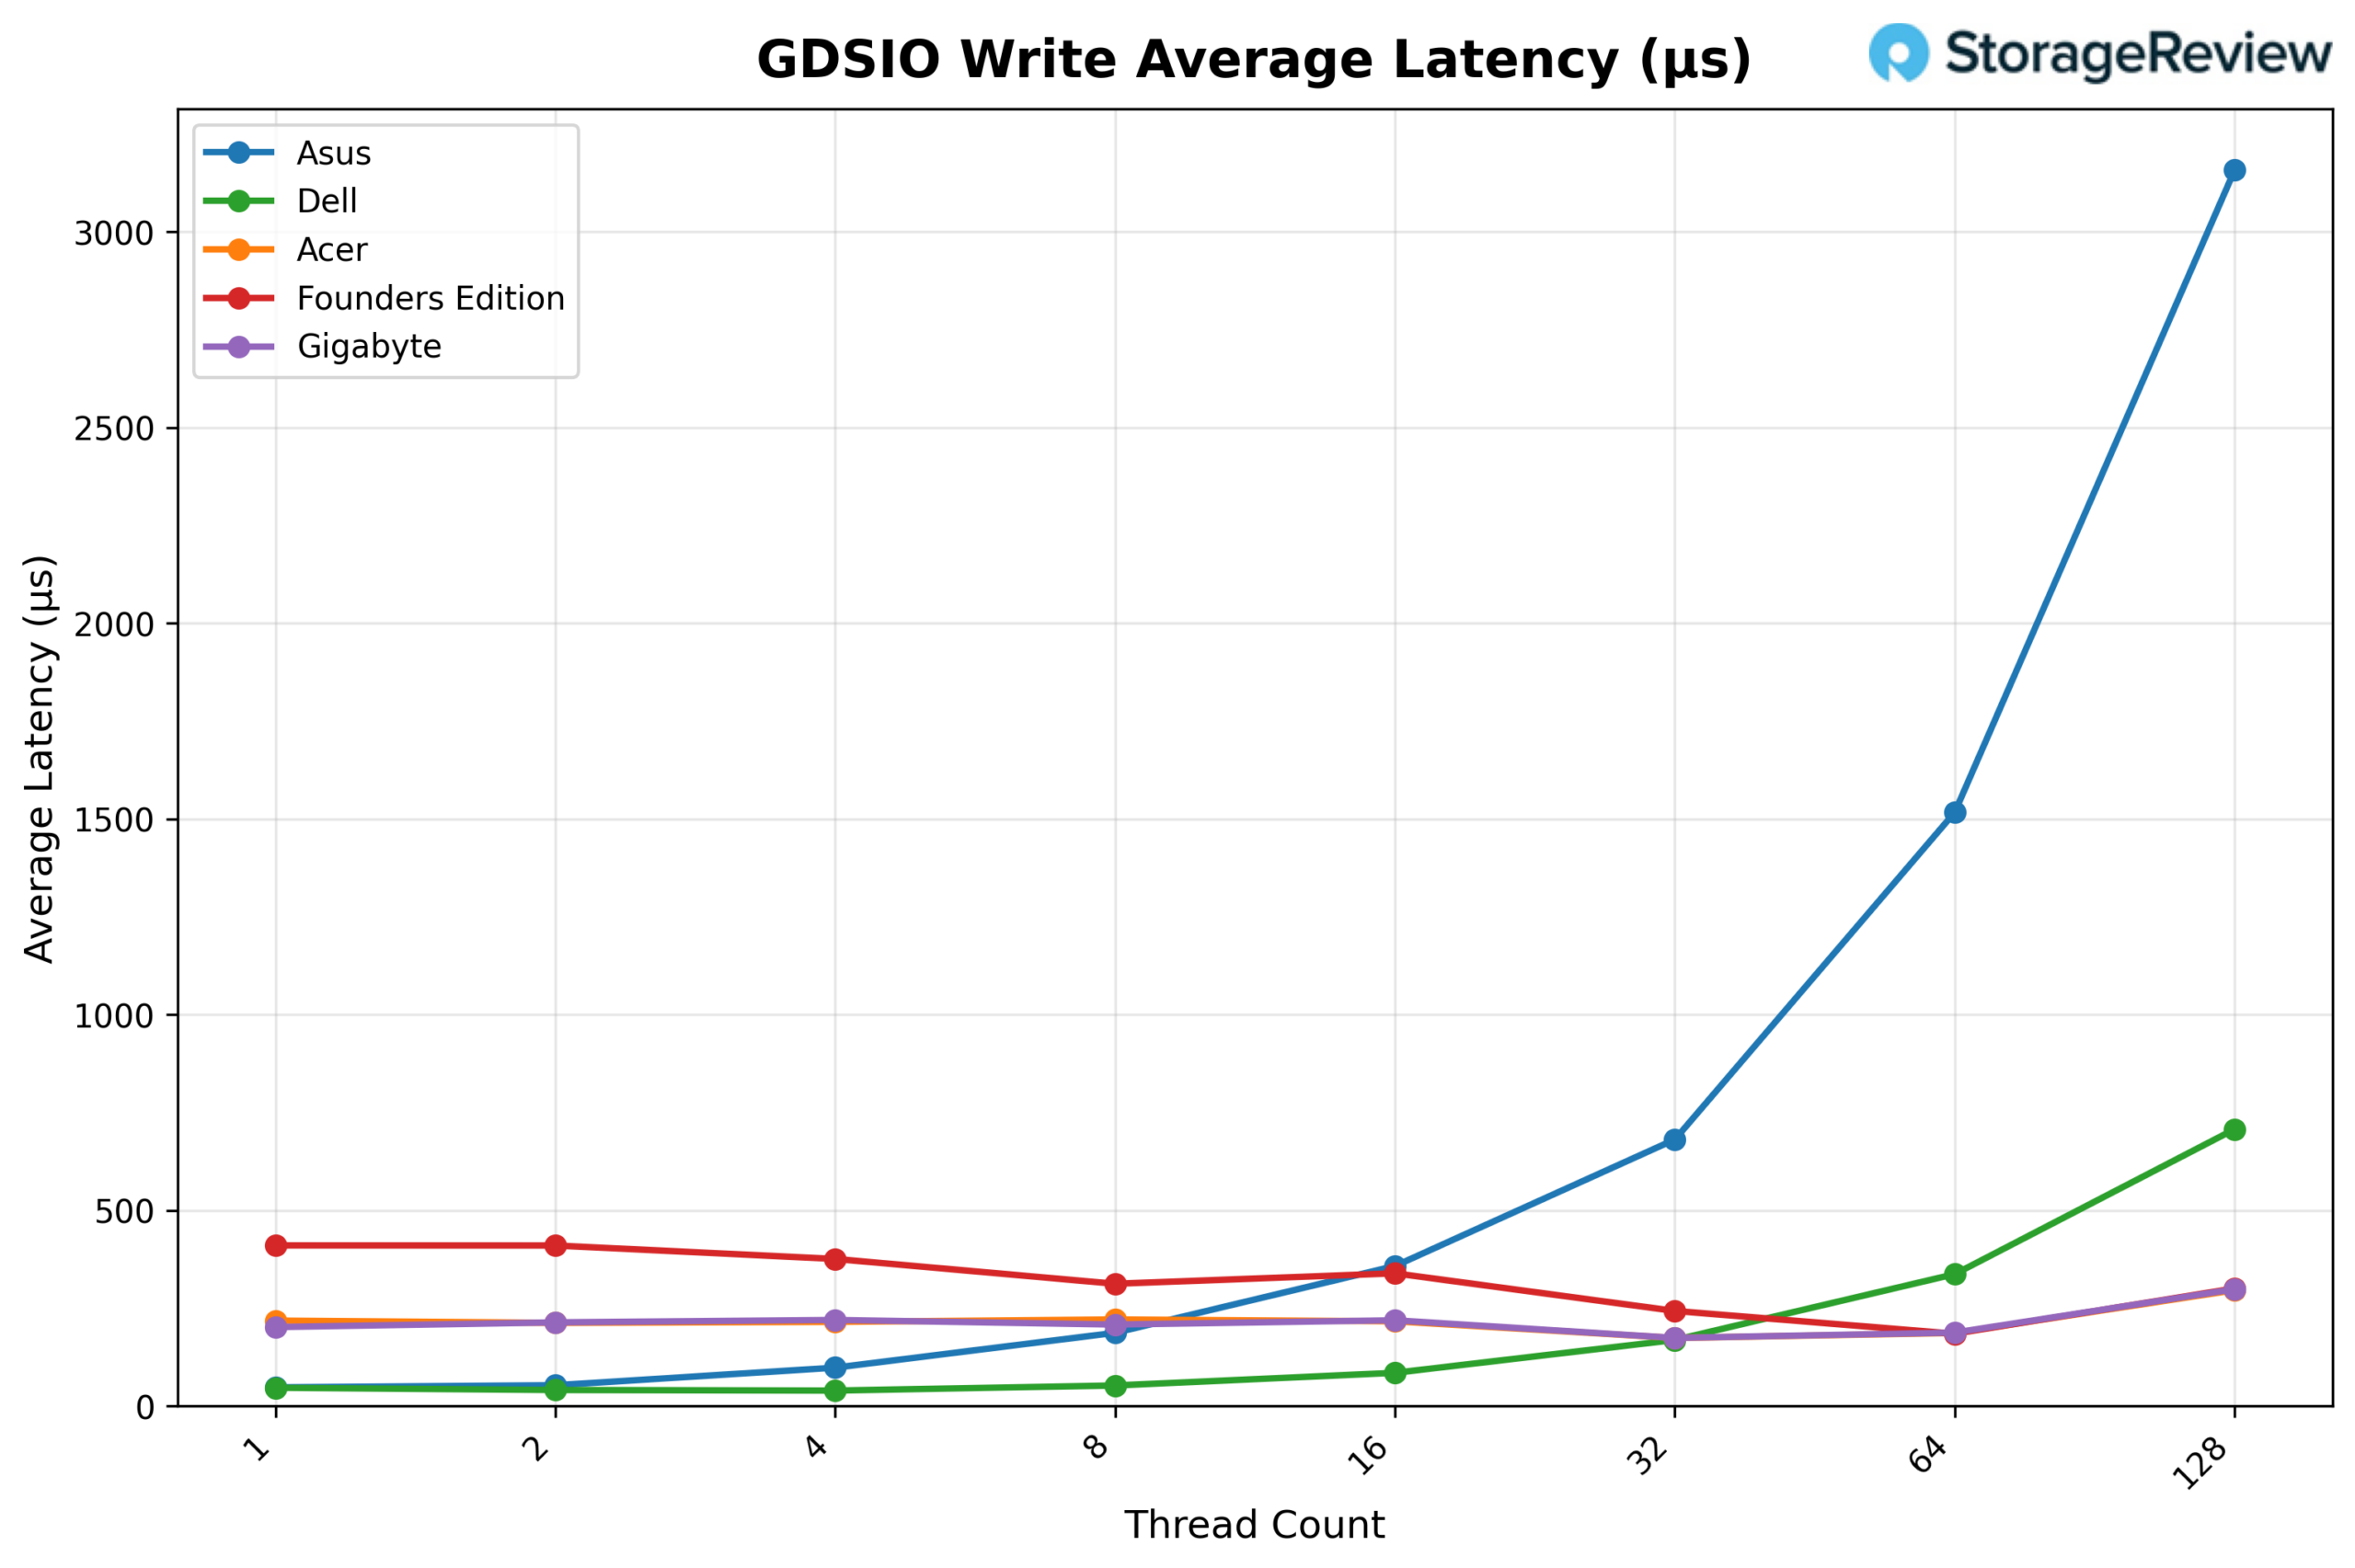
Betrachtet man die durchschnittliche Schreiblatenz (16K) von GDSIO, so zeigt sich, dass GIGABYTE über den größten Teil der Kurve eine relativ stabile Latenz aufweist. Sie beginnt bei etwa 0.20 ms bei einem Thread und bleibt bis zu 16 Threads im Bereich von 0.21–0.22 ms. Bei 32 Threads verbessert sich die Latenz leicht auf etwa 0.17 ms und steigt dann bei 64 Threads moderat auf 0.19 ms an. Erst bei 128 Threads steigt die Latenz merklich auf etwa 0.30 ms an, was dem höchsten Durchsatz entspricht.
GDSIO-Lesedurchsatz 1 Mio.
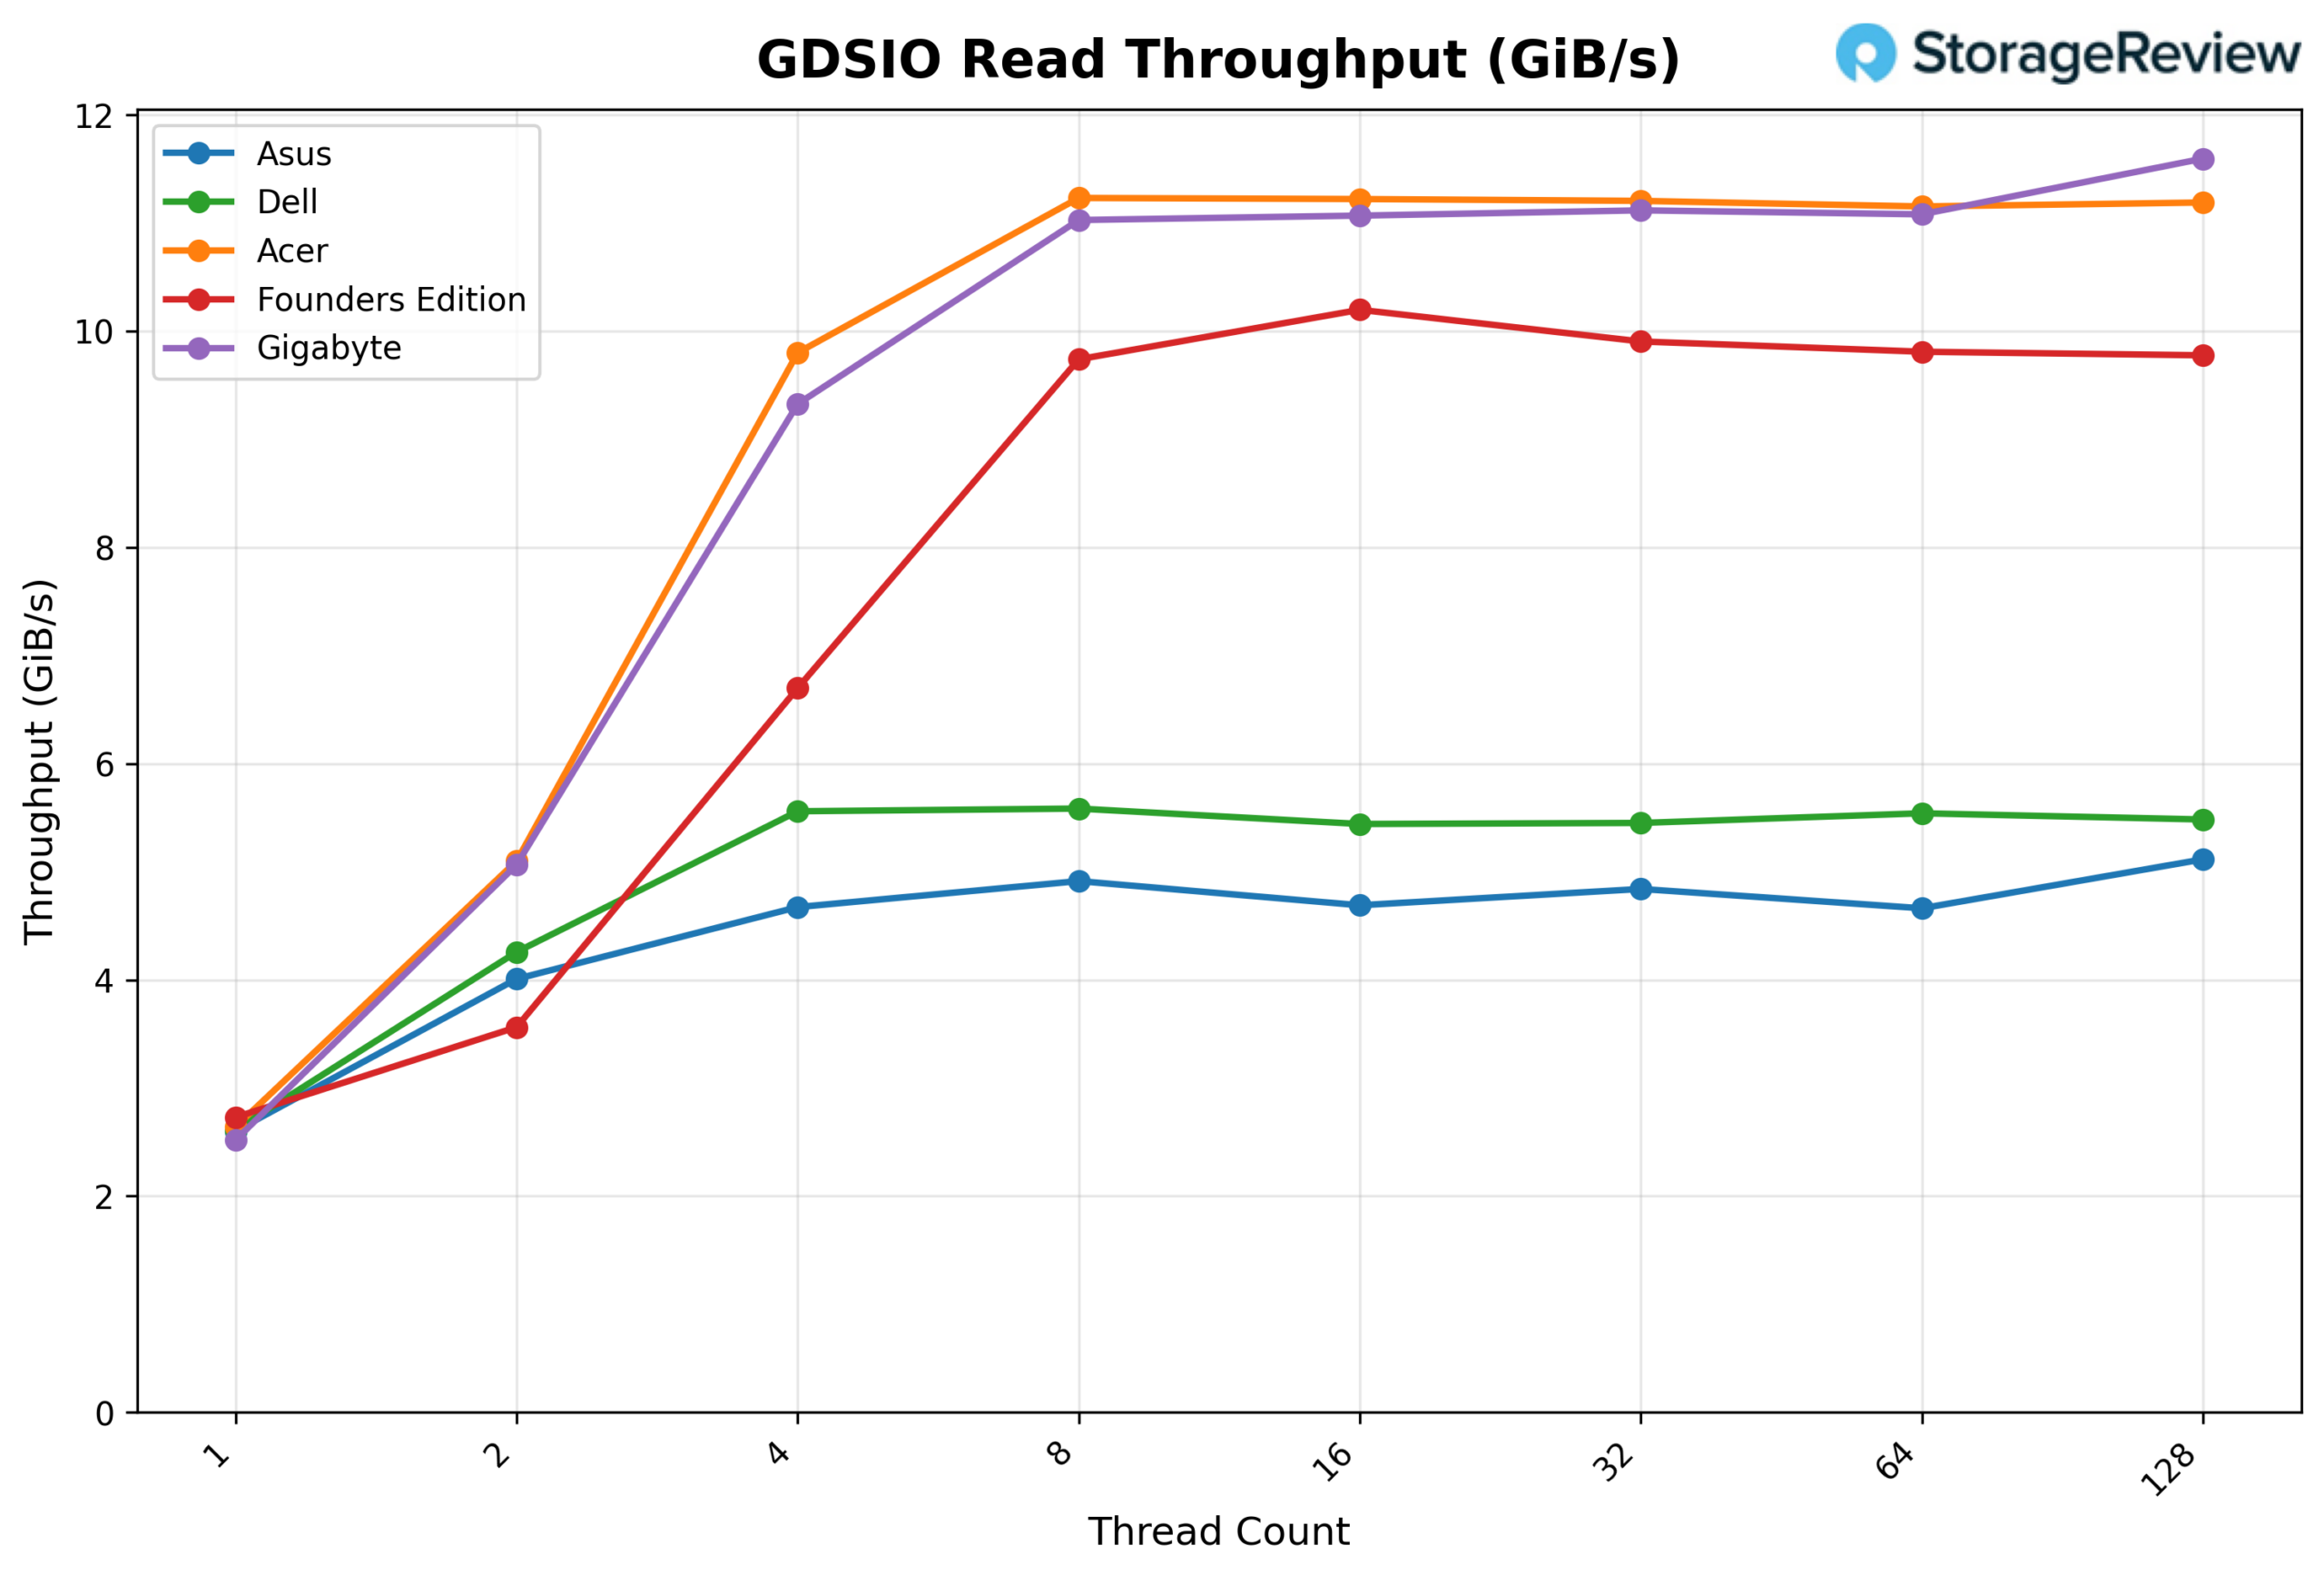
Betrachtet man den GDSIO-Lesedurchsatz (1M), so beginnt der GIGABYTE-Prozessor bei 2.52 GiB/s mit einem Thread und skaliert auf 5.07 GiB/s mit zwei Threads und 9.33 GiB/s mit vier Threads. Bei acht Threads erreicht der Durchsatz 11.03 GiB/s, ab dem die Plattform praktisch ihre Leistungsgrenze erreicht. Die Leistung bleibt bei 16 Threads (11.07 GiB/s), 32 Threads (11.12 GiB/s) und 64 Threads (11.08 GiB/s) konstant und bildet ein stabiles Plateau. Bei 128 Threads steigt der Durchsatz leicht auf 11.60 GiB/s an und stellt damit den höchsten im Test beobachteten Wert dar.
GDSIO-Leselatenz durchschnittlich 1M
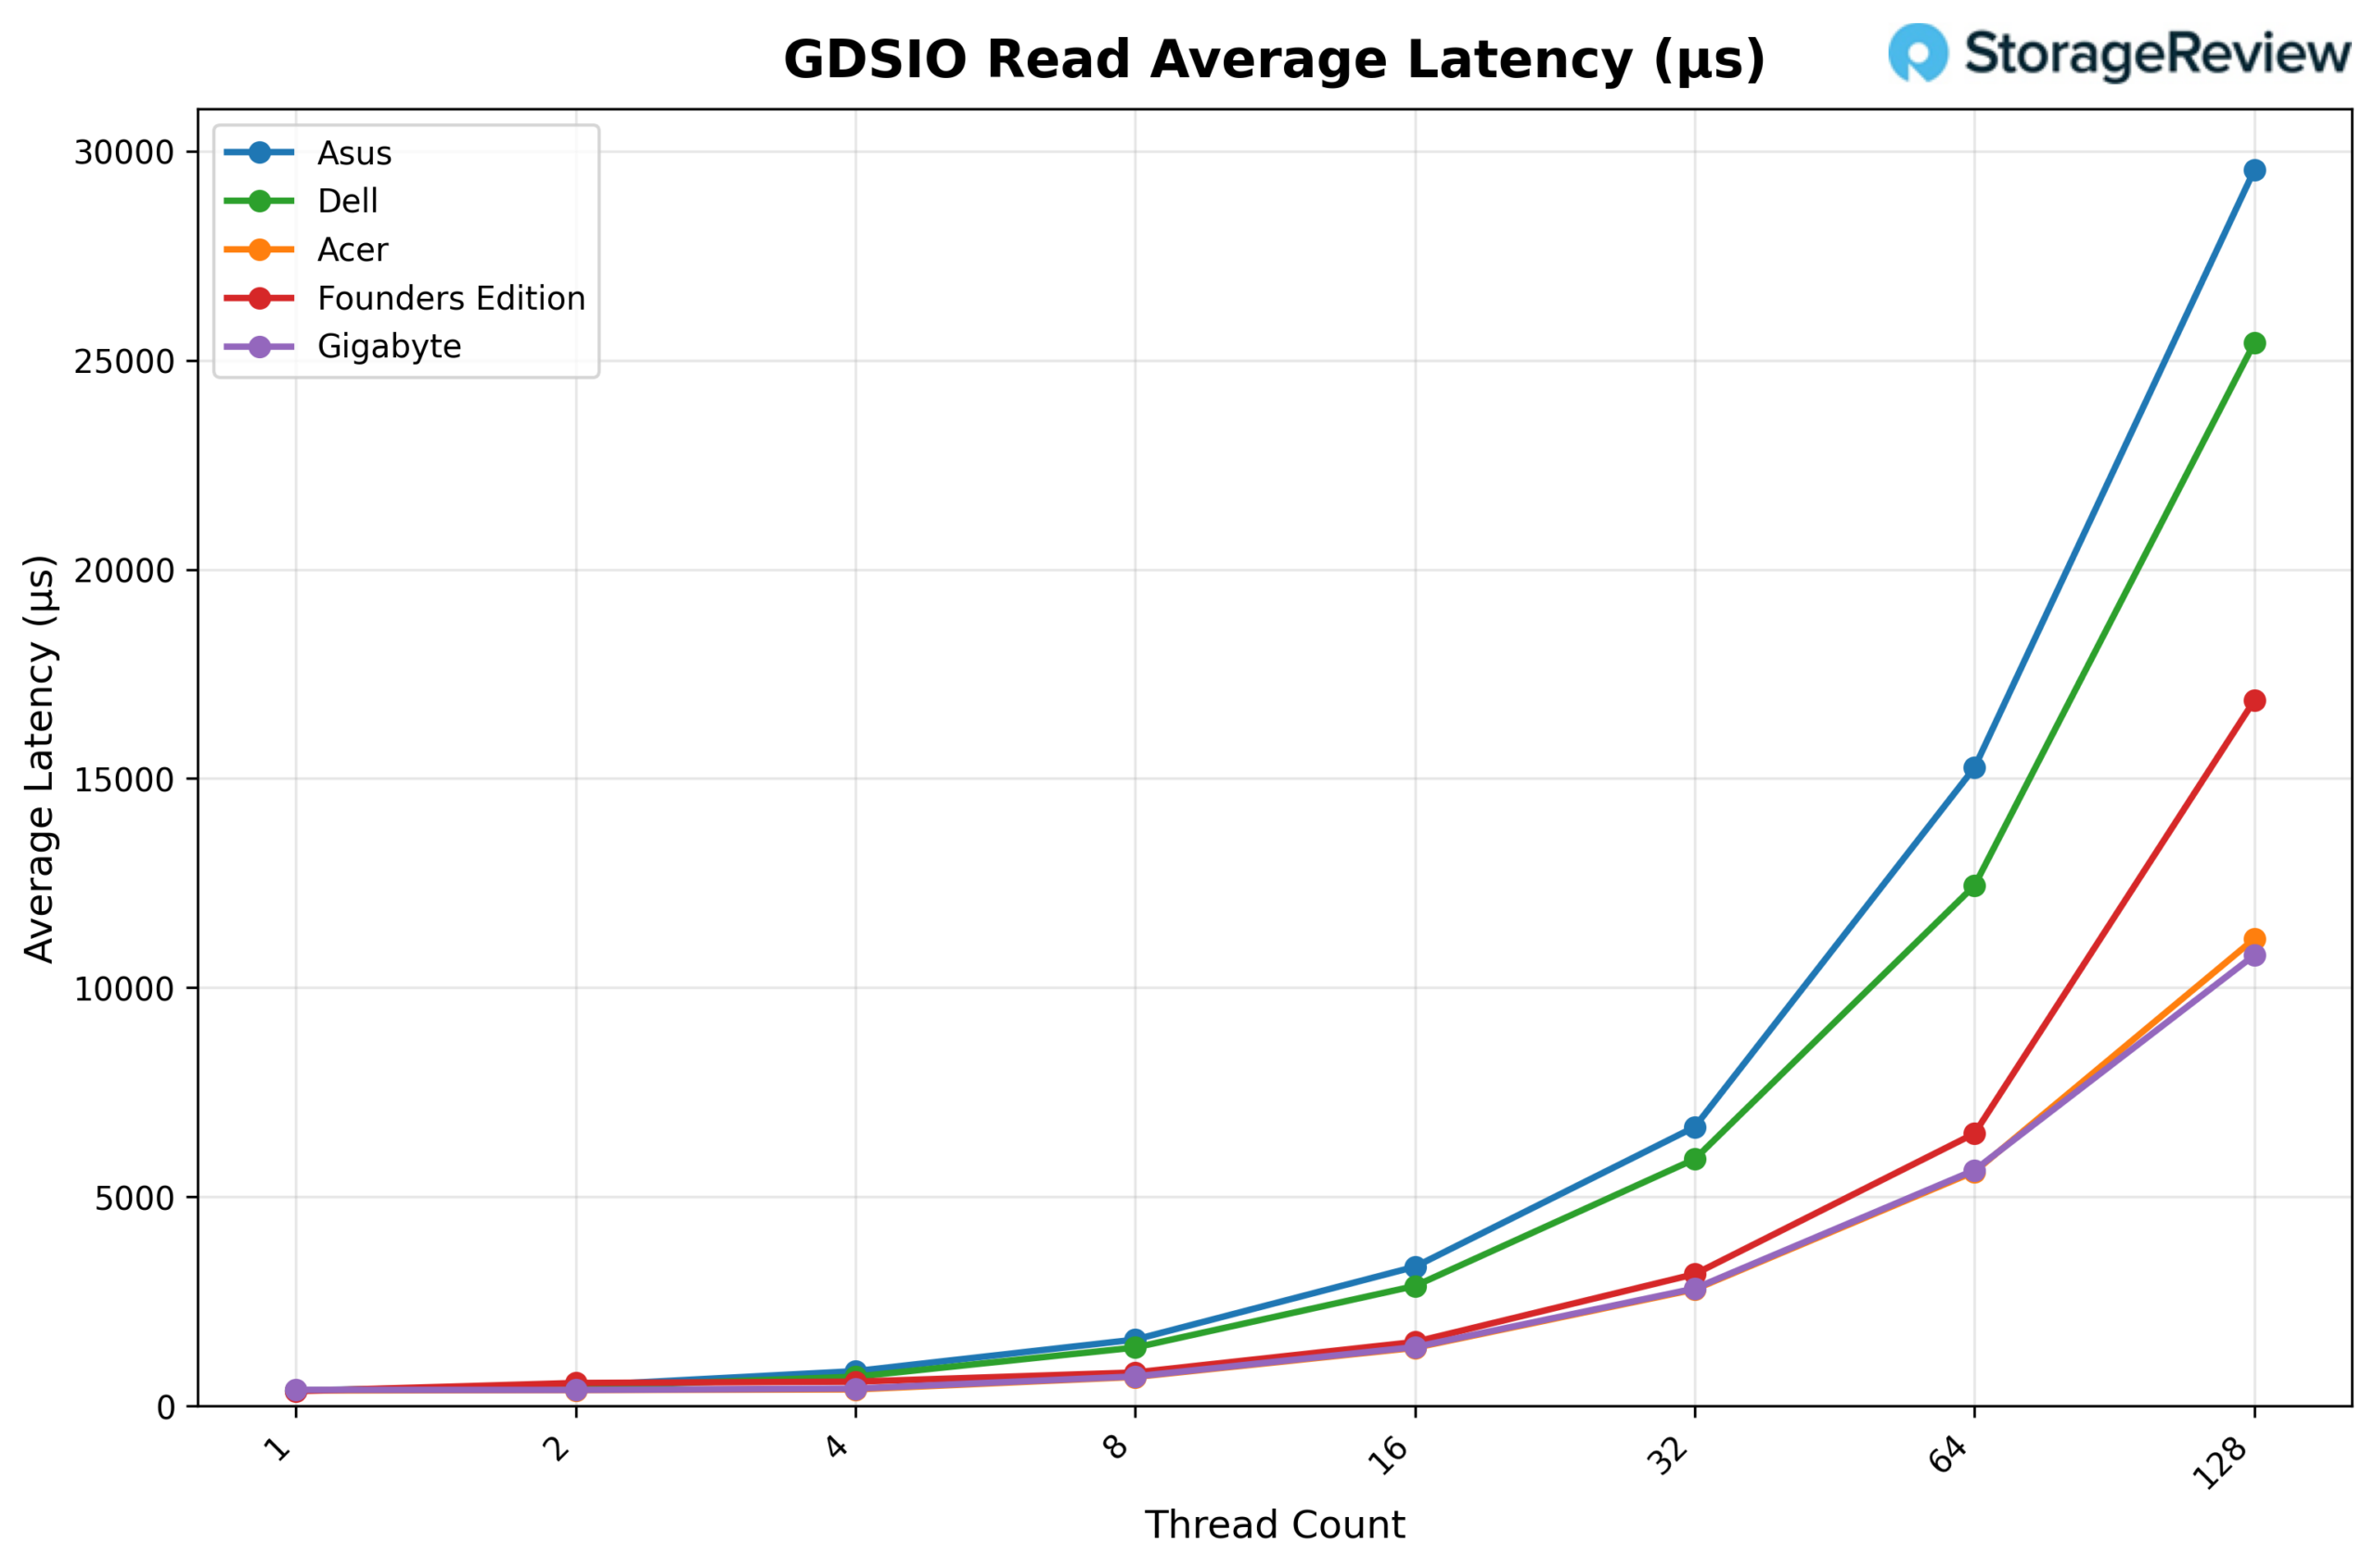
Betrachtet man die durchschnittliche Leselatenz (1M) von GDSIO, so beginnt diese bei GIGABYTE mit ca. 0.39 ms bei einem Thread und bleibt bei zwei Threads (0.39 ms) und vier Threads (0.42 ms) ähnlich. Die Latenz steigt mit zunehmender Parallelität auf 0.71 ms bei acht Threads, 1.41 ms bei 16 Threads und 2.81 ms bei 32 Threads. Dieser Aufwärtstrend setzt sich bei 64 Threads (5.64 ms) fort und erreicht bei 128 Threads 10.78 ms, was den höchsten Parallelitätswerten entspricht, während der Durchsatz weitgehend konstant bleibt.
GDSIO-Schreibdurchsatz 1M
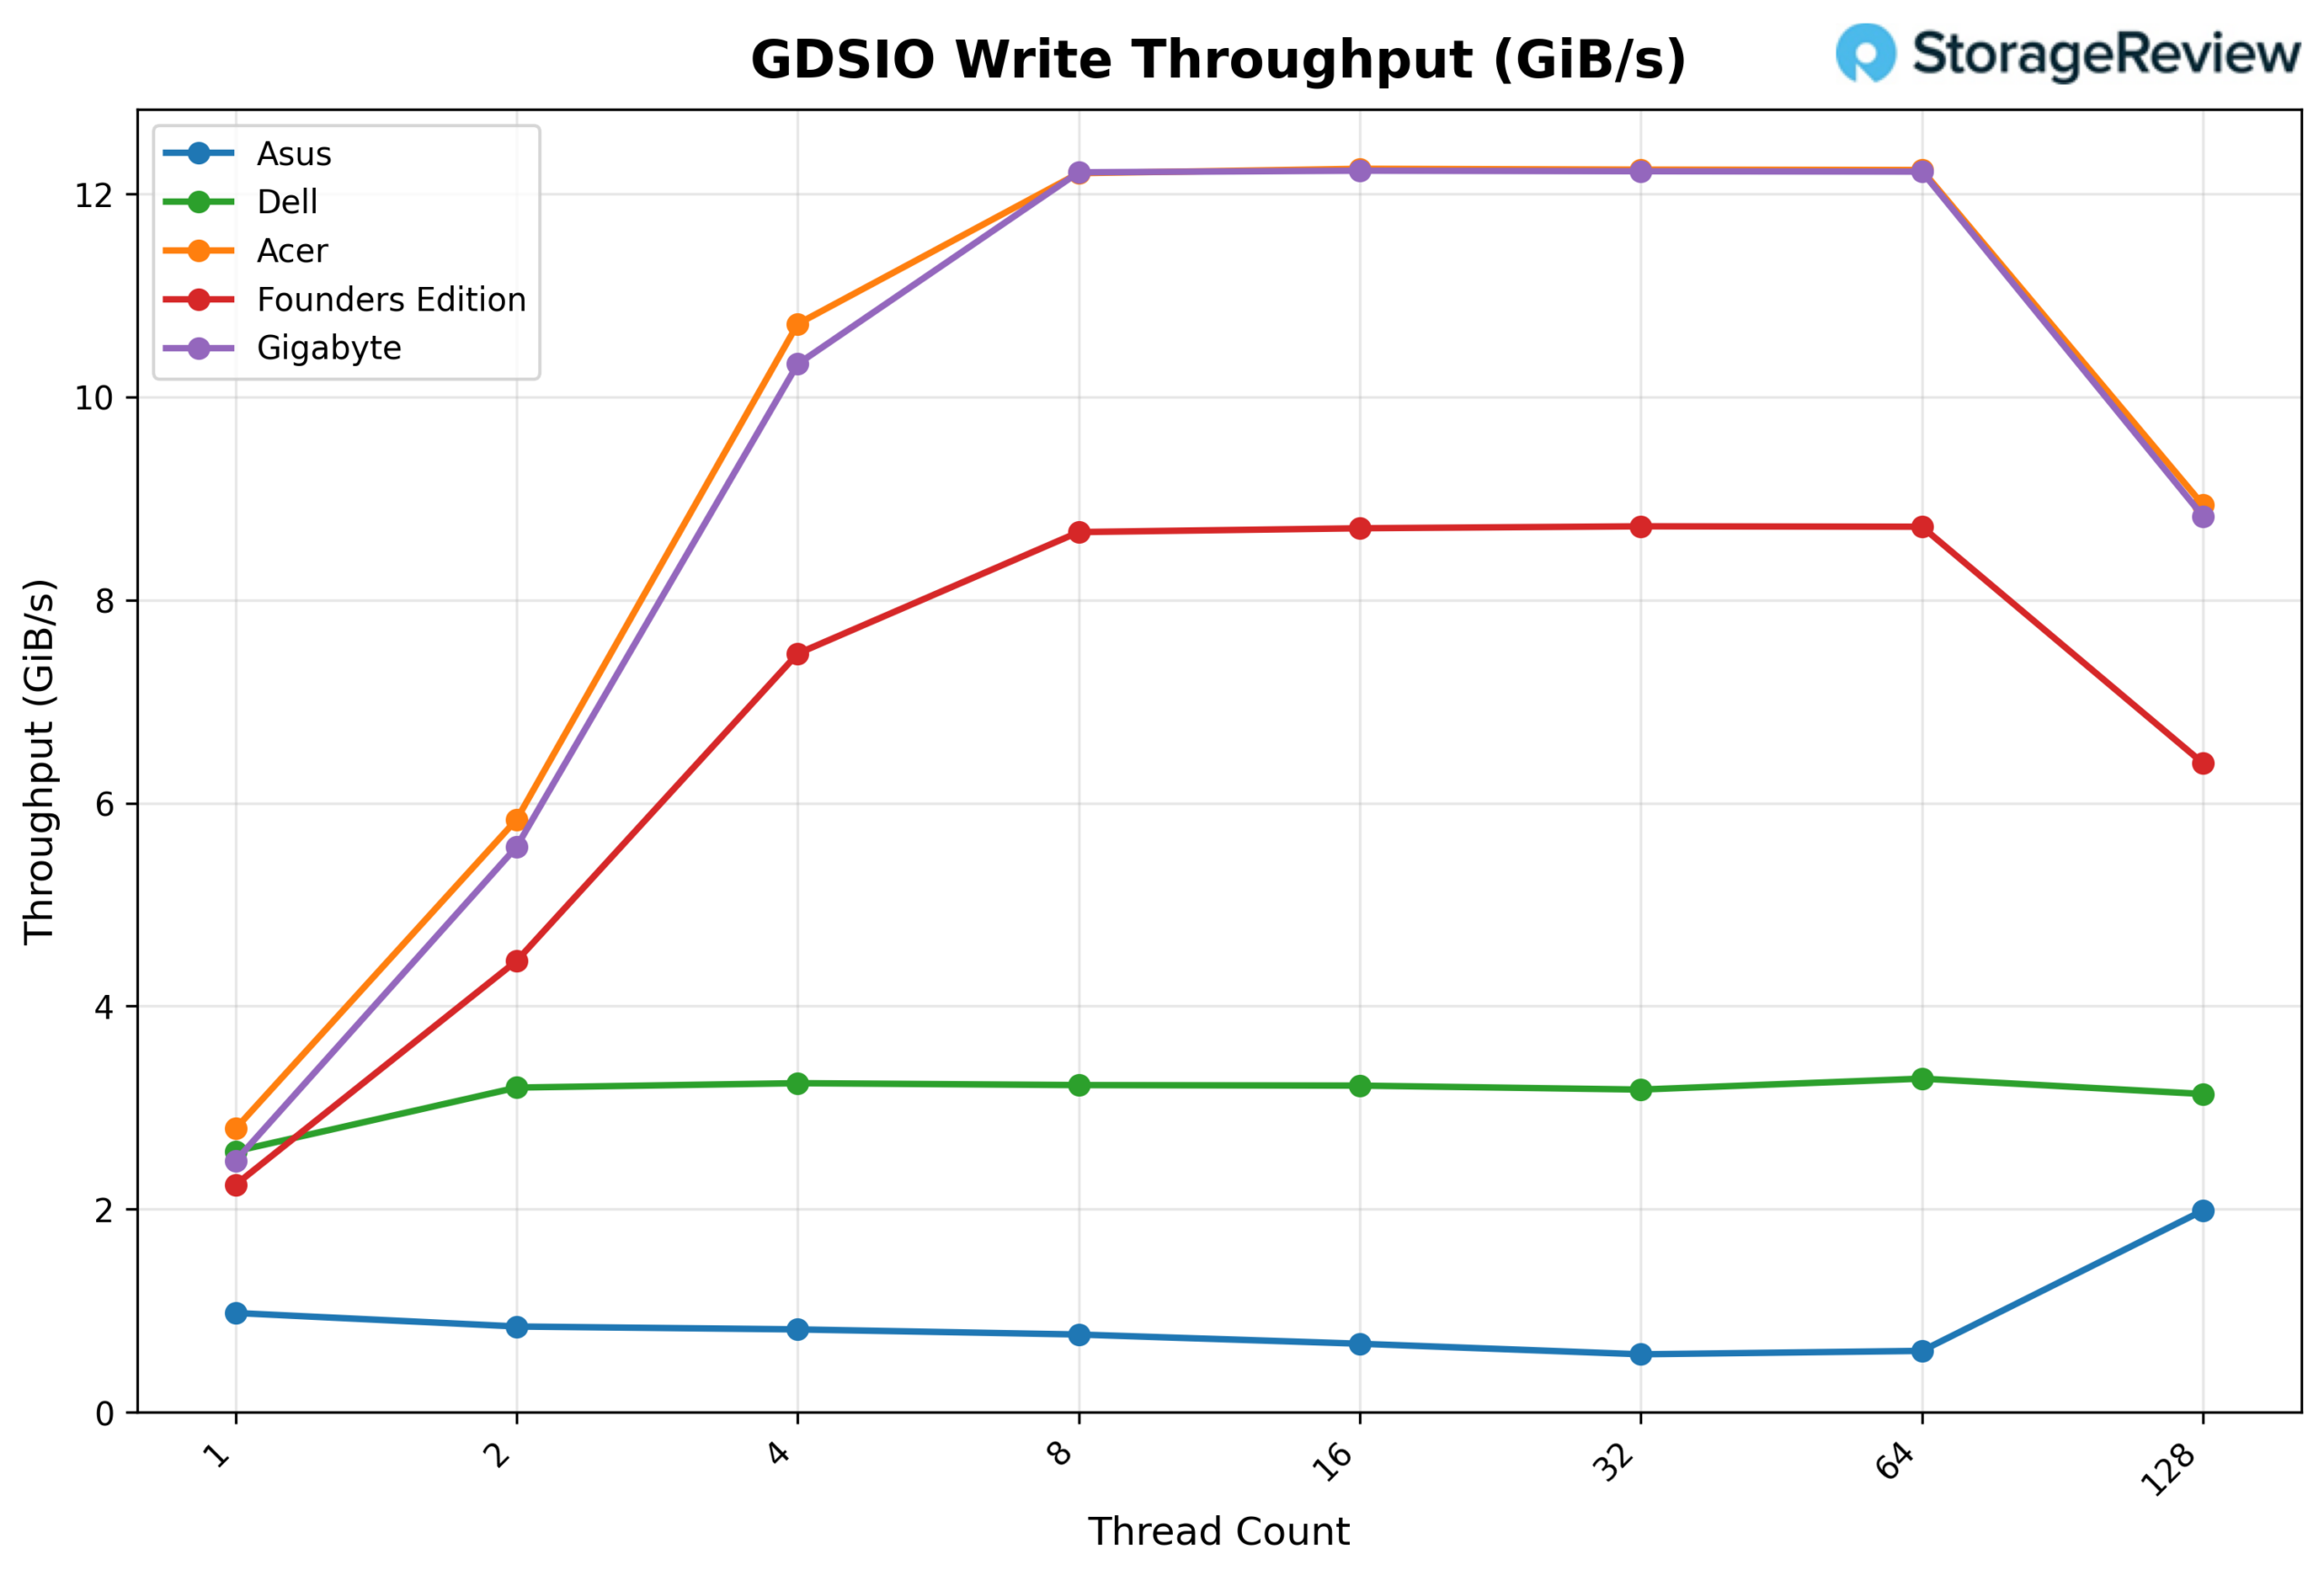
Betrachtet man den GDSIO-Schreibdurchsatz (1M), so beginnt der GIGABYTE-Prozessor bei 2.48 GiB/s mit einem Thread und skaliert steil auf 5.57 GiB/s bei zwei Threads und 10.32 GiB/s bei vier Threads. Bei acht Threads erreicht der Durchsatz 12.21 GiB/s und schöpft damit die Kapazität der Plattform effektiv aus. Die Leistung bleibt bei 16 Threads (12.23 GiB/s), 32 Threads (12.22 GiB/s) und 64 Threads (12.22 GiB/s) konstant, was auf ein frühes Plateau hindeutet. Bei 128 Threads sinkt der Durchsatz auf 8.82 GiB/s, was darauf schließen lässt, dass das System seinen optimalen Parallelitätsbereich überschritten hat.
GDSIO Schreibdurchschnittslatenz 1M
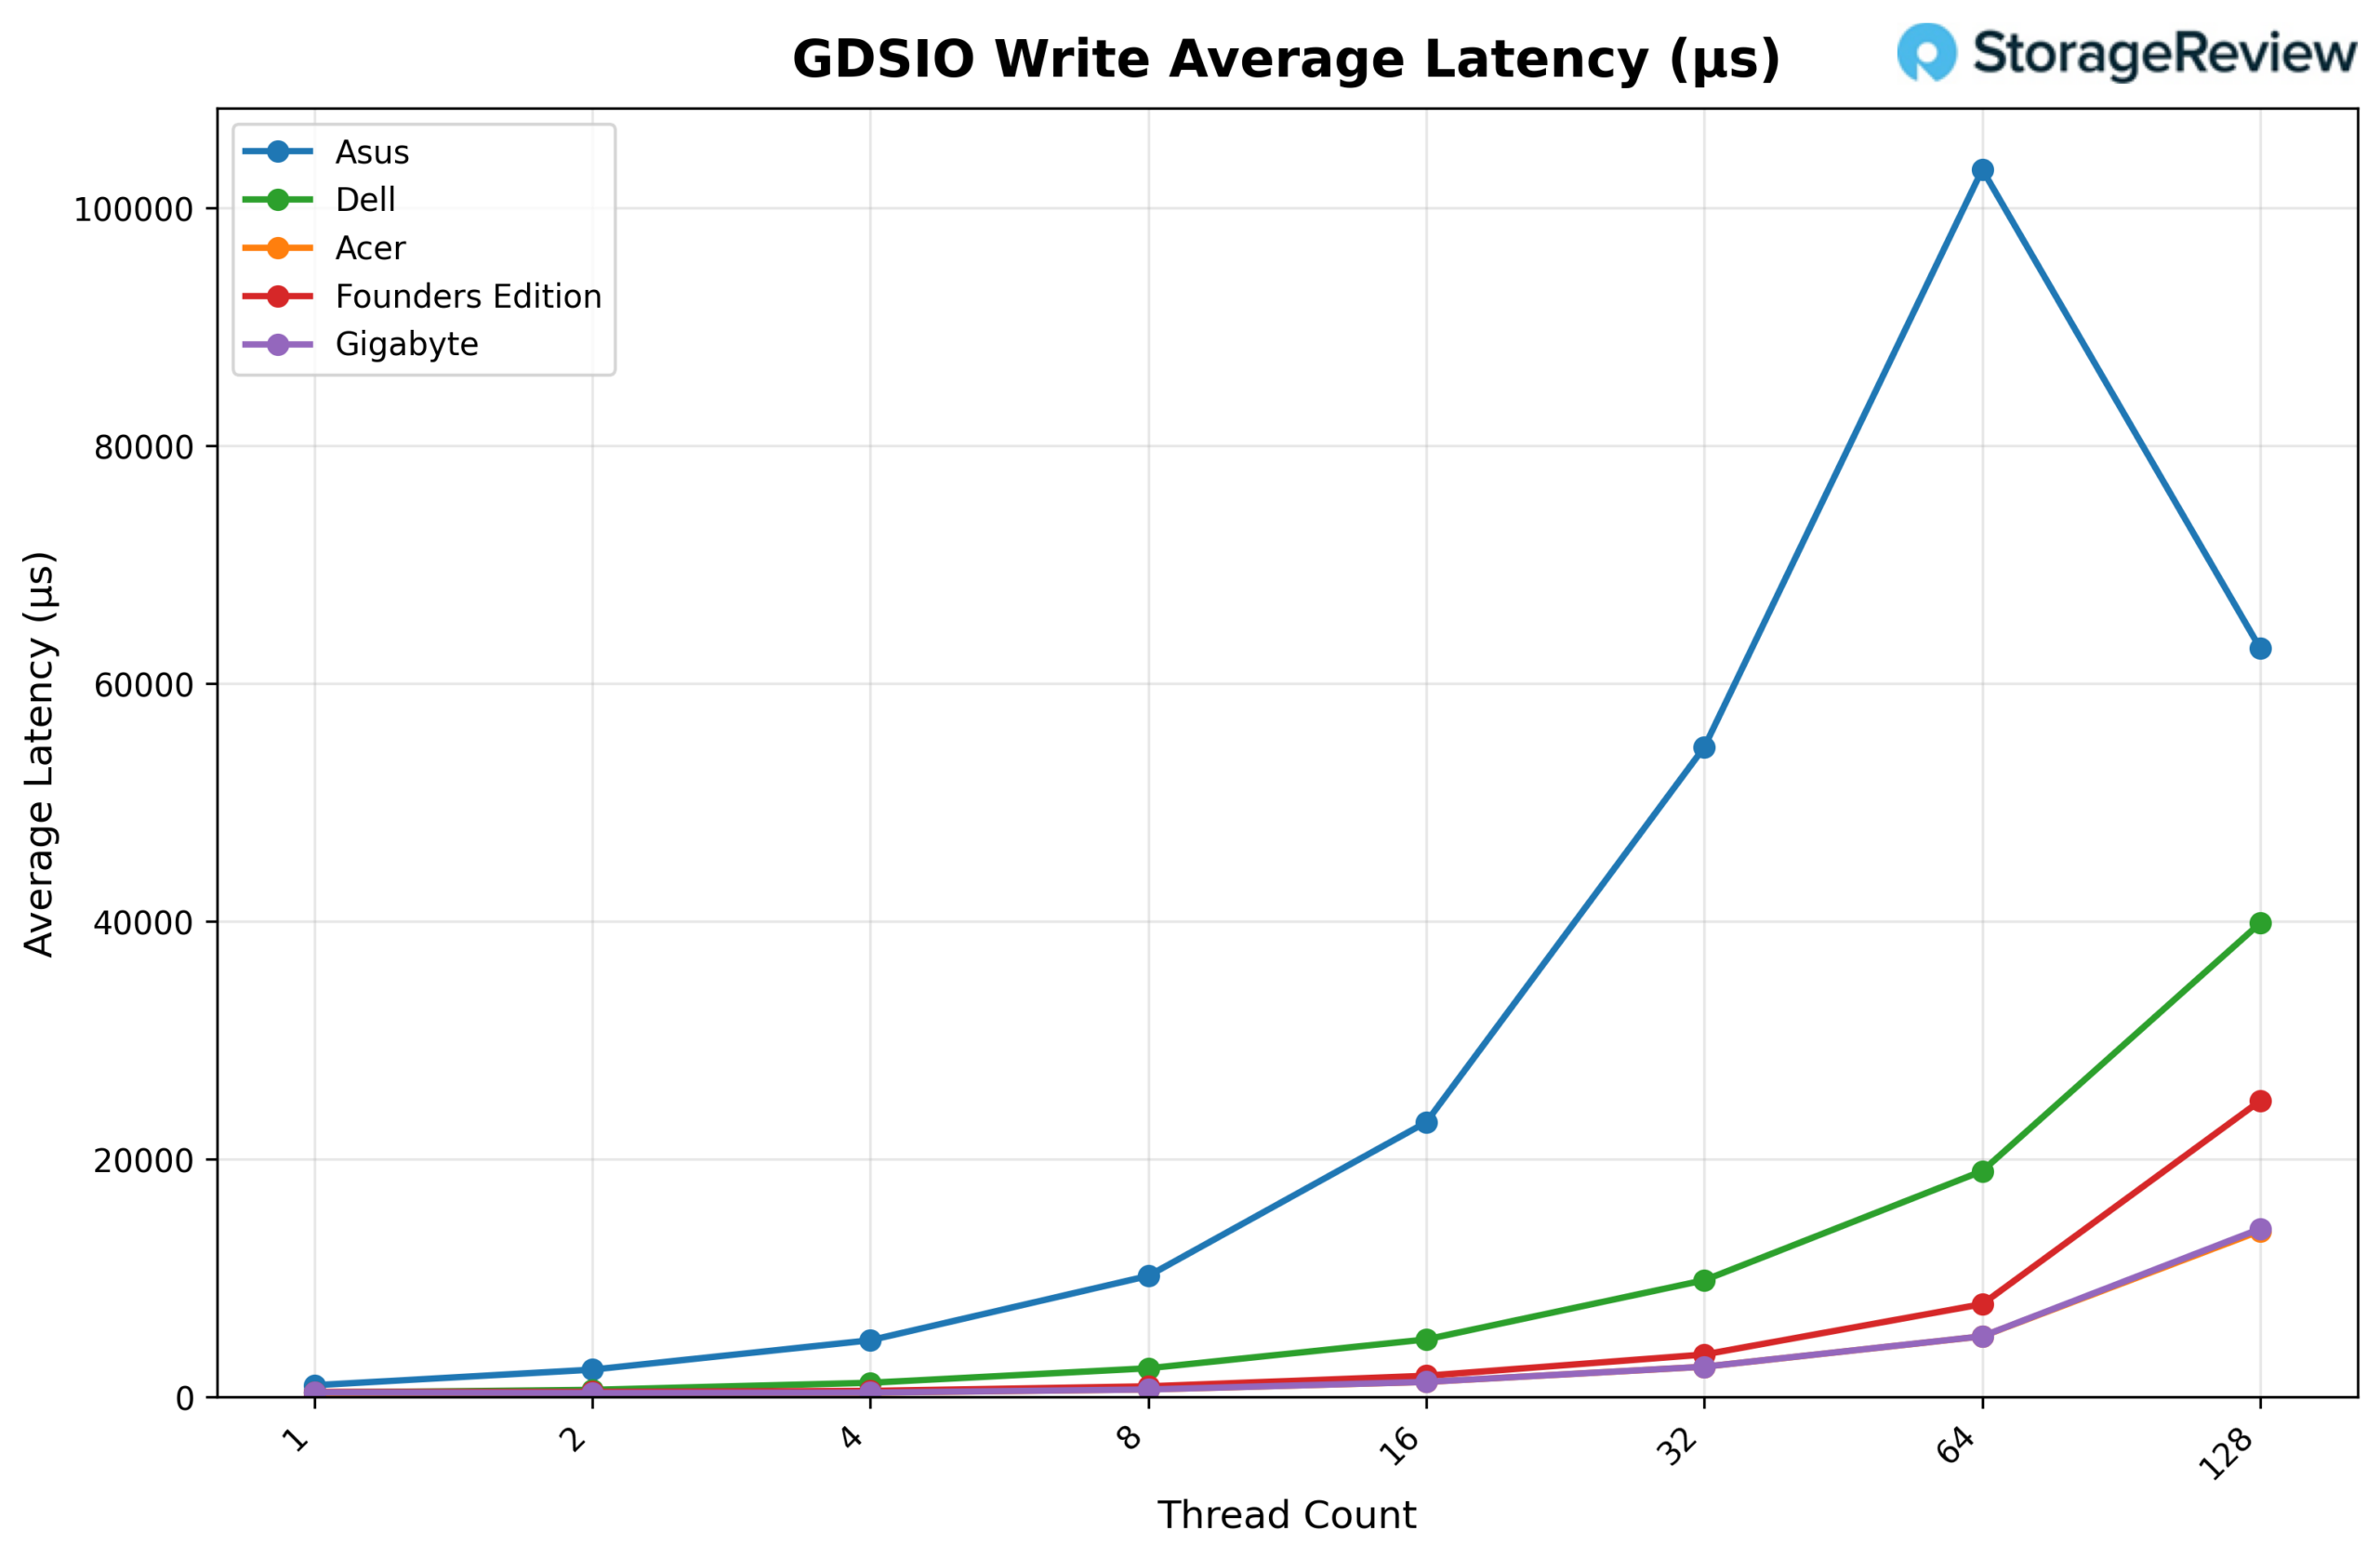
Betrachtet man die durchschnittliche Schreiblatenz (1M) von GDSIO, so beginnt diese bei GIGABYTE mit etwa 0.39 ms bei einem Thread und bleibt bis zu zwei Threads (0.35 ms) und vier Threads (0.38 ms) relativ niedrig. Die Latenz steigt bei höheren Thread-Anzahlen deutlich an und erreicht 0.64 ms bei acht Threads, 1.28 ms bei 16 Threads und 2.56 ms bei 32 Threads. Dieser Trend setzt sich bei 64 Threads (5.11 ms) fort, bevor die Latenz bei 128 Threads sprunghaft auf 14.16 ms ansteigt, was mit dem beobachteten Durchsatzabfall bei der höchsten Parallelität übereinstimmt.
Fazit
Der GIGABYTE AI TOP ATOM ist eine weitere Implementierung der GB10-basierten Spark-Plattform von NVIDIA und basiert auf demselben Board und Silizium, das wir für die gesamte Produktreihe getestet haben. Wie erwartet, entspricht die Kernrechenleistung in vLLM weitgehend der Leistung der übrigen Geräte. Bei den Modellen GPT-OSS, Qwen3-Coder und Llama 3.1 blieb das Skalierungsverhalten vorhersehbar: Hoher Durchsatz beim Prefill und stabile Leistung bei Equal und Decode auch bei steigender Parallelität.
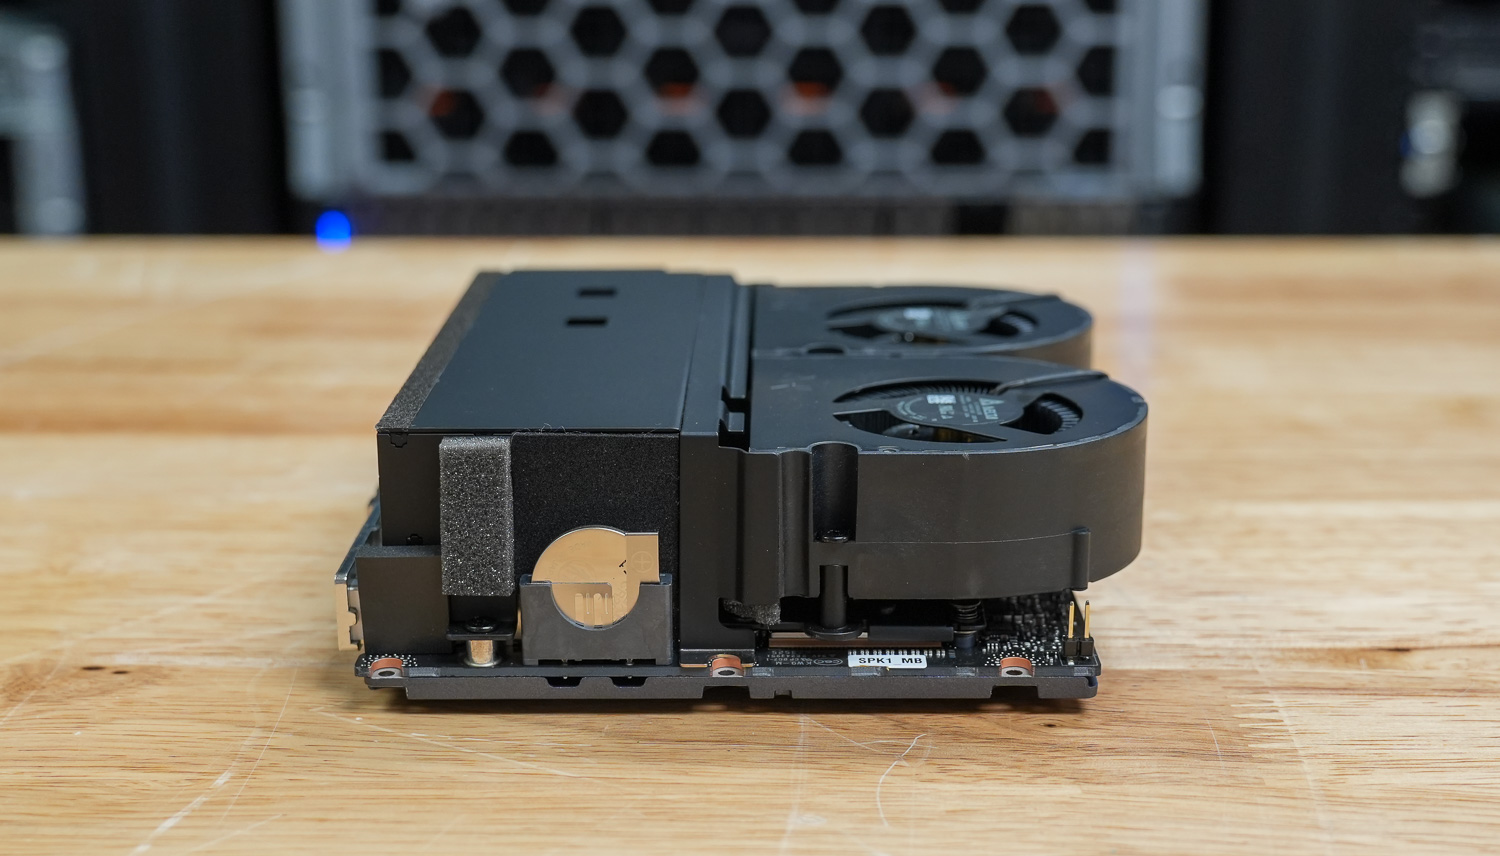
Thermisch gesehen erlaubte GIGABYTE ein etwas aggressiveres Burst-Verhalten. Die CPU erreichte während intensiver Prefill-Phasen Spitzenwerte von 90 °C und die GPU von 81 °C, wobei die GPU-Leistungsaufnahme 75.54 W erreichte. Nach Normalisierung der Arbeitslast stabilisierten sich die Temperaturen ohne Anzeichen anhaltender Drosselung. In der Praxis spiegeln die höheren Spitzenwerte eher kurzzeitige Leistungsanpassungen als Instabilität wider.
Die Stärke dieses Geräts liegt eindeutig im Speicherbereich. Mit der 4 TB großen Samsung PM9E1 Gen5 erzielte GIGABYTE einige der besten GDSIO-Ergebnisse im Spark-Test. Der Lese- und Schreibdurchsatz skalierte sowohl bei 16 als auch bei 1 Million Workloads reibungslos, wobei die erwartete Sättigung bei gleichbleibender Threadanzahl frühzeitig eintrat und die Latenz hauptsächlich bei der höchsten Threadanzahl anstieg.
Da alle Spark-Systeme auf derselben GB10-Plattform basieren, bleiben die Benchmark-Unterschiede bei KI-Inferenz gering. In der Praxis hängen die Auswahlkriterien eher vom Gehäusedesign, dem thermischen Verhalten bei Spitzenlasten, der Speicherkonfiguration und der Herstellerkompatibilität als von grundlegenden Rechenunterschieden ab.
Produktseite – GIGABYTE AI TOP ATOM
Bestenliste: Der GIGABYTE AI TOP ATOM ist Teil des Testfelds in unserer Bestenliste der Desktop-PCs für lokale KI.


 Amazon