

Während es zu Recht einen erheblichen Hype um dichte GPU-Server für KI gibt, ist die Realität so, dass die meisten KI-Trainingsprojekte auf Workstations beginnen. Obwohl wir jetzt bis zu vier NVIDIA A6000 Ada-GPUs in einer einzigen Workstation unterbringen können, ist es schwieriger, in diesen KI-Boxen robusten Speicher zu bekommen. Wir haben über dieses Problem nachgedacht und einen Plan entwickelt, um einige KI-Workstations optimal mit Hochgeschwindigkeitsspeicher auszustatten. Wir haben mit Supermicro und KIOXIA zusammengearbeitet, um einen Server mit 24 7.68-TB-Data-Center-NVMe-SSDs der XD7P-Serie zu füllen und so einen erstaunlich leistungsfähigen 1U-Speicherserver mit einem Inferenz-Trick im Ärmel zu schaffen.
Wir wissen, was Sie denken: Wie wollen Sie die Verbindung zwischen einer Serverplattform voller E1.S-SSDs, Workstations, die KI-Modelle trainieren, und Inferenz auf demselben Speicherserver herstellen? Lassen Sie etwas Spielraum zur Erklärung.
KI-Workstations müssen nicht unter einem Schreibtisch stehen
Mit wenigen Ausnahmen sollten leistungsstarke KI-Workstations mit teuren GPUs wahrscheinlich nicht am Rande oder sogar innerhalb eines Bürogebäudes verteilt werden. Die Probleme sind vielfältig. In erster Linie sind diese Endpunkte einem hohen Risiko von Sicherheitsbedrohungen und Datenlecks ausgesetzt und, was noch wichtiger ist, sie leiden unter einer Unterauslastung. Die meisten KI-Experten können aufgrund unzureichender LAN-Konfigurationen nicht auf die große Datenmenge zugreifen, die zum Trainieren ihrer Modelle erforderlich ist.
Wenn wir diese leistungsstarken Workstations hingegen im Rechenzentrum unterbringen würden, hätten wir jetzt mehrere Vorteile. Erstens wird die physische Sicherheit gelöst, und Bedenken hinsichtlich des Fernzugriffs können mit Thin Clients oder Zugriffen, die nur Pixel statt Daten über die Leitung übertragen, gemindert werden. In diesem Szenario befinden sich die Daten auf dem Server und nicht auf der Workstation. Zweitens lassen sich diese Systeme im Rechenzentrum schneller, wenn nicht sogar einfacher sichern. Drittens können wir mit intelligenter Bereitstellung die Auslastung im gesamten Unternehmen steigern, indem wir diese Systeme mit einer verteilten KI-Belegschaft teilen. Und schließlich verschafft uns der Aufenthalt im Rechenzentrum Zugriff auf das wertvollste KI-Asset: Daten.
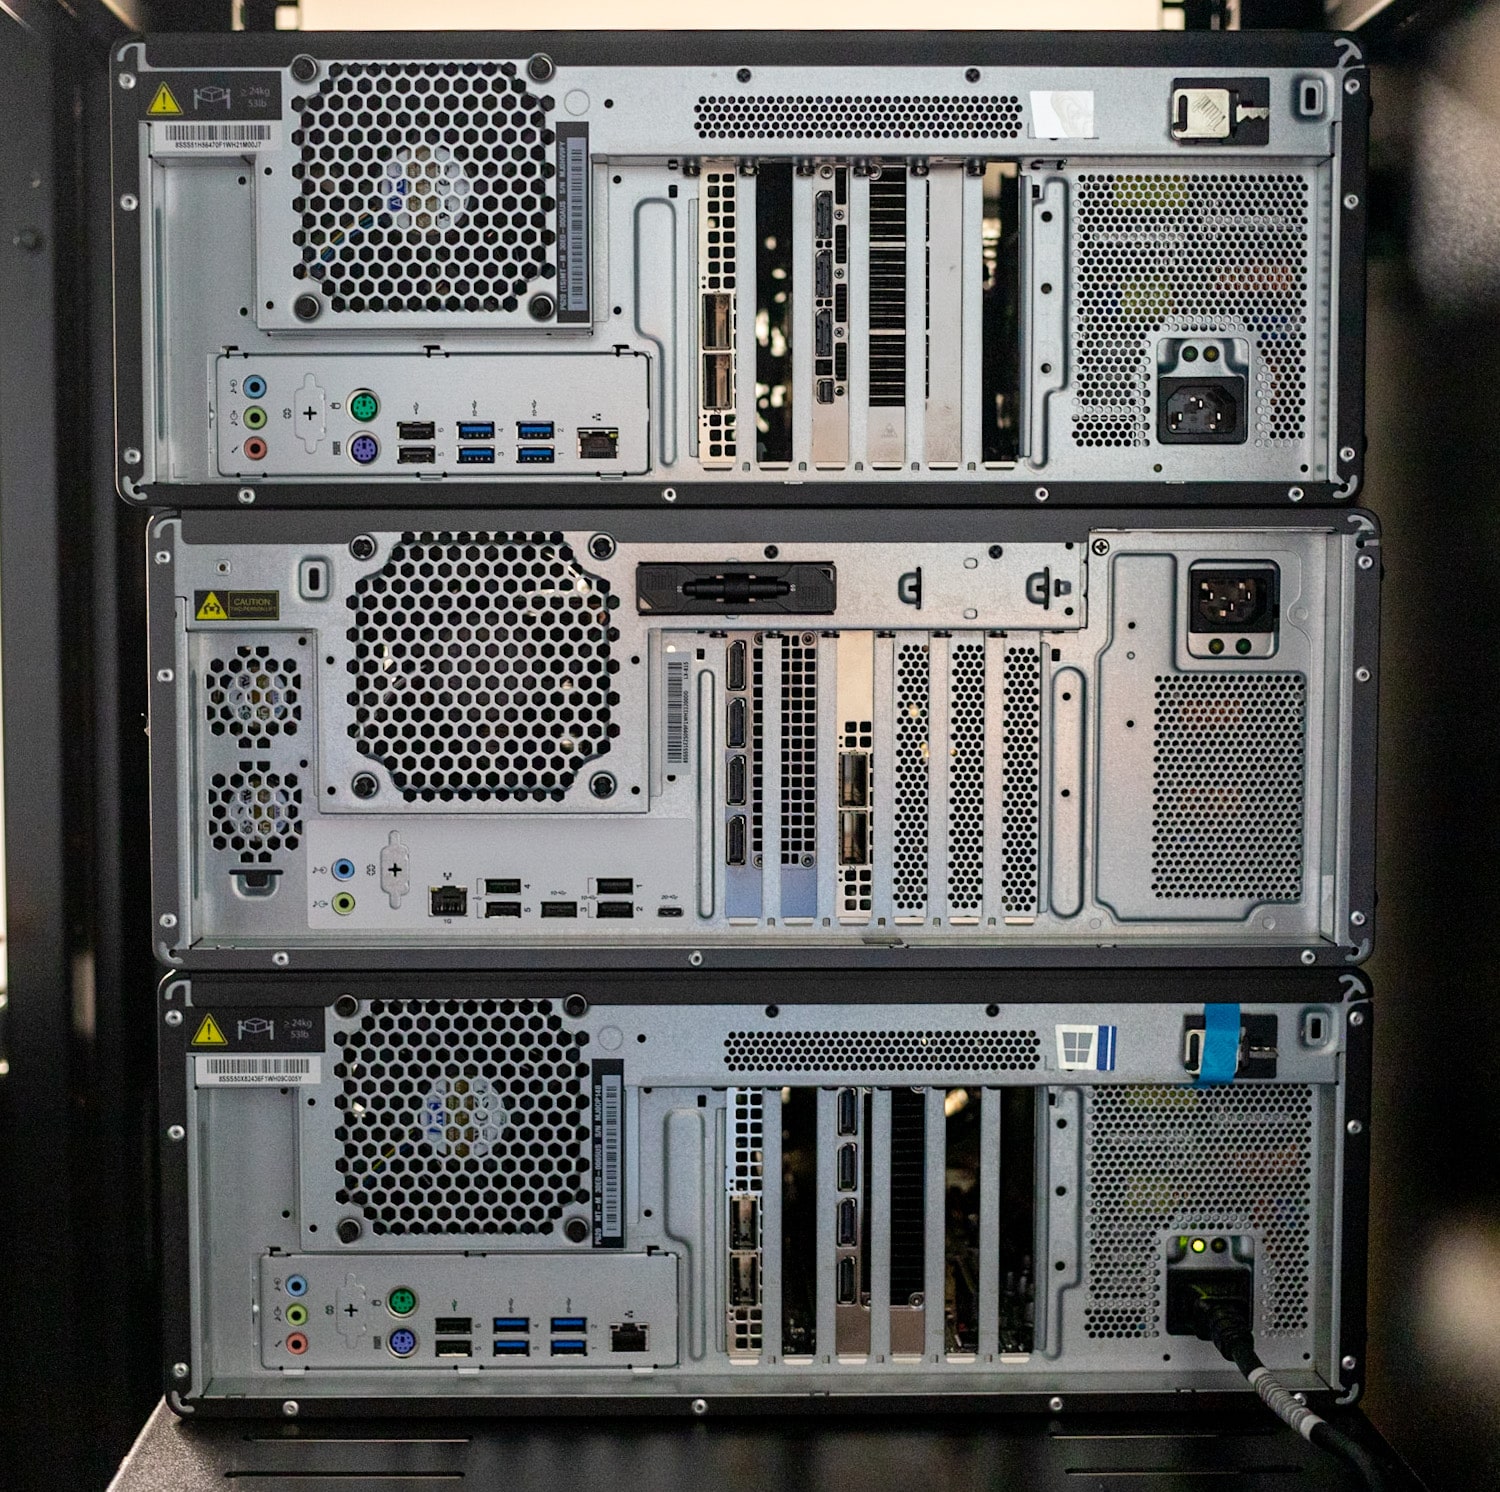
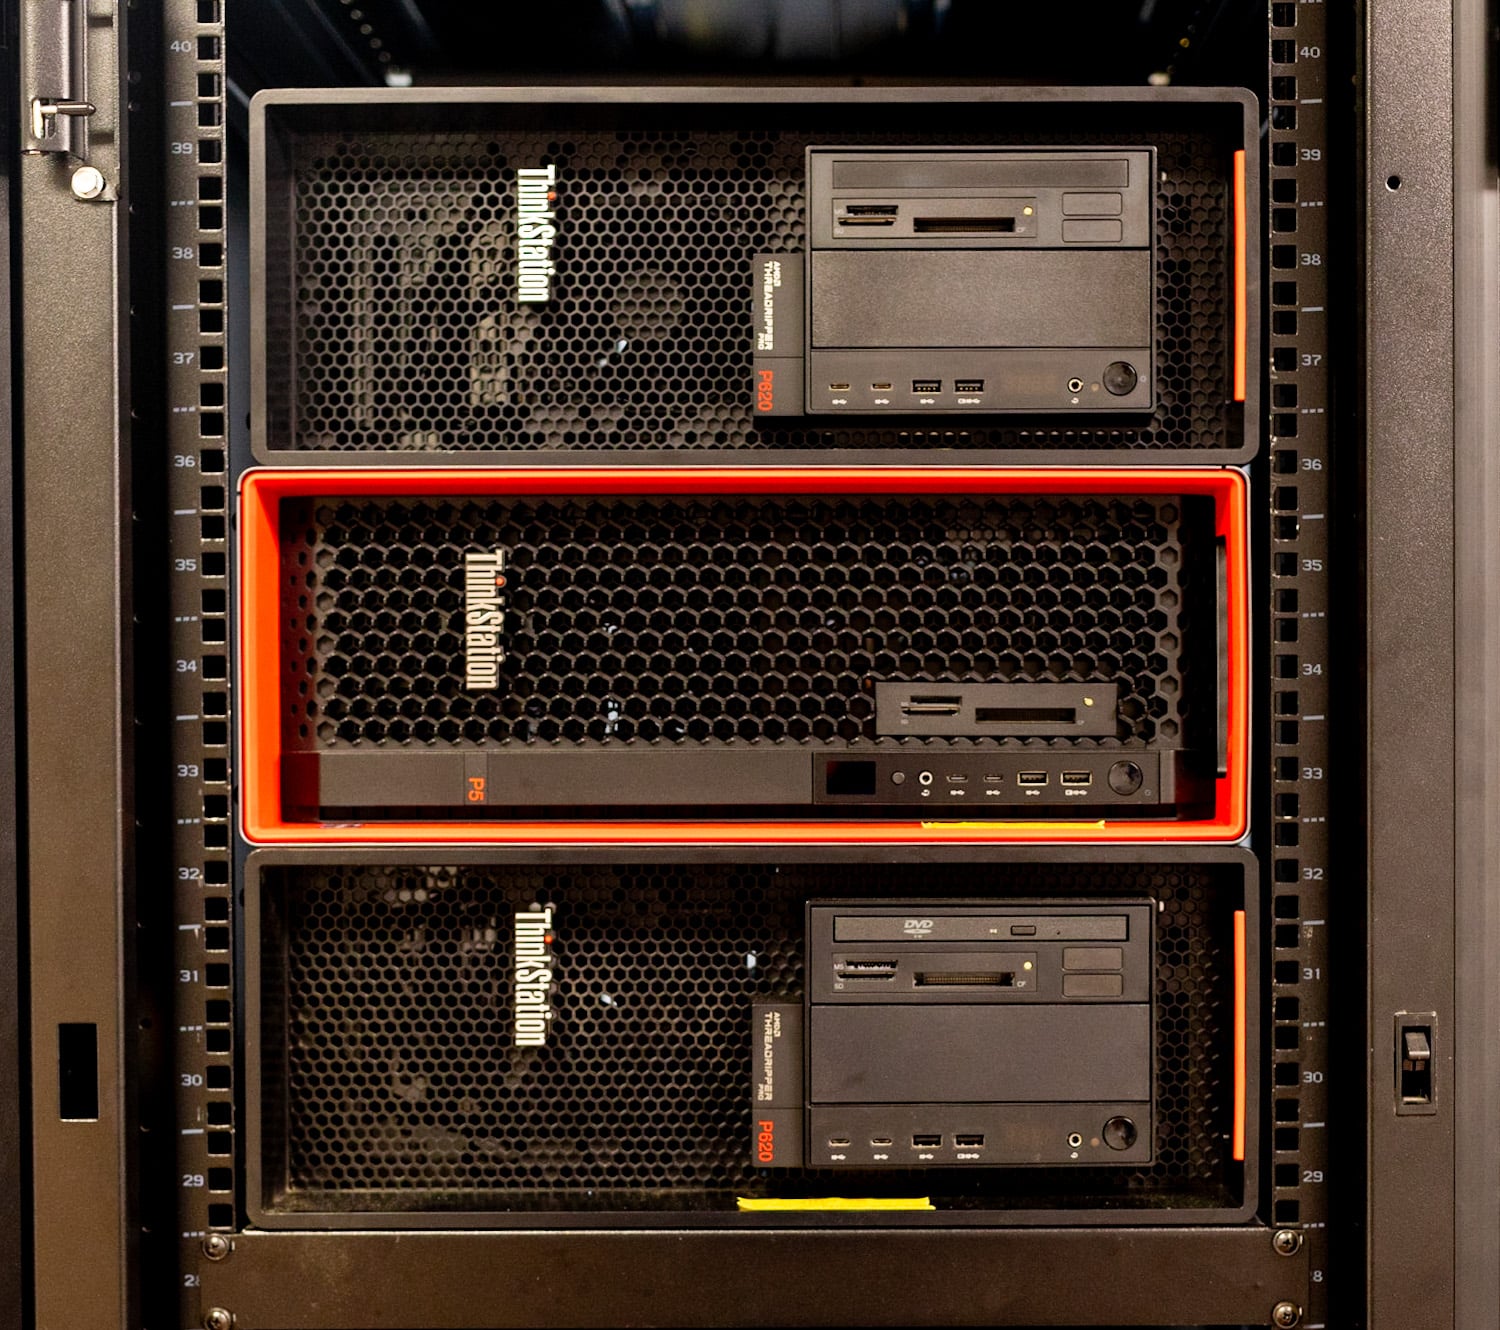
Für diese Arbeit stellten wir drei Lenovo-Workstations bereit, die wir im Labor hatten. Jedes ist etwas anders konfiguriert und nutzt sowohl AMD- als auch NVIDIA-GPUs, was Flexibilität bietet, da einige Modelle mit anderen Beschleunigern möglicherweise besser abschneiden. Auf jedem System ist eine NVIDIA ConnectX-6 100GbE-Karte installiert, was von grundlegender Bedeutung ist, um sicherzustellen, dass diese Systeme schnell auf den Speicher zugreifen können. Jedes System verbindet sich dann mit einem Dell Z9100 100GbE-Switch, an den auch der Speicherdienst angeschlossen ist.
| Teil | Workstation 1 | Workstation 2 | Workstation 3 |
| Modell | Lenovo P620 | Lenovo P620 | Lenovo P5 |
| CPU | AMD Ryzen Threadripper PRO 5995WX | AMD Ryzen Threadripper PRO 3995WX | Intel Xeon w7-2495X |
| Memory | 128GB DDR4 3200 | 32GB DDR4 3200 | 32GB DDR5 4800Mhz |
| GPU | AMD Radeon PRO W7900 | Nvidia RTX A6000 | Nvidia RTX A4500 |
Schneller KI-Speicher mit SSDs der KIOXIA XD7P-Serie
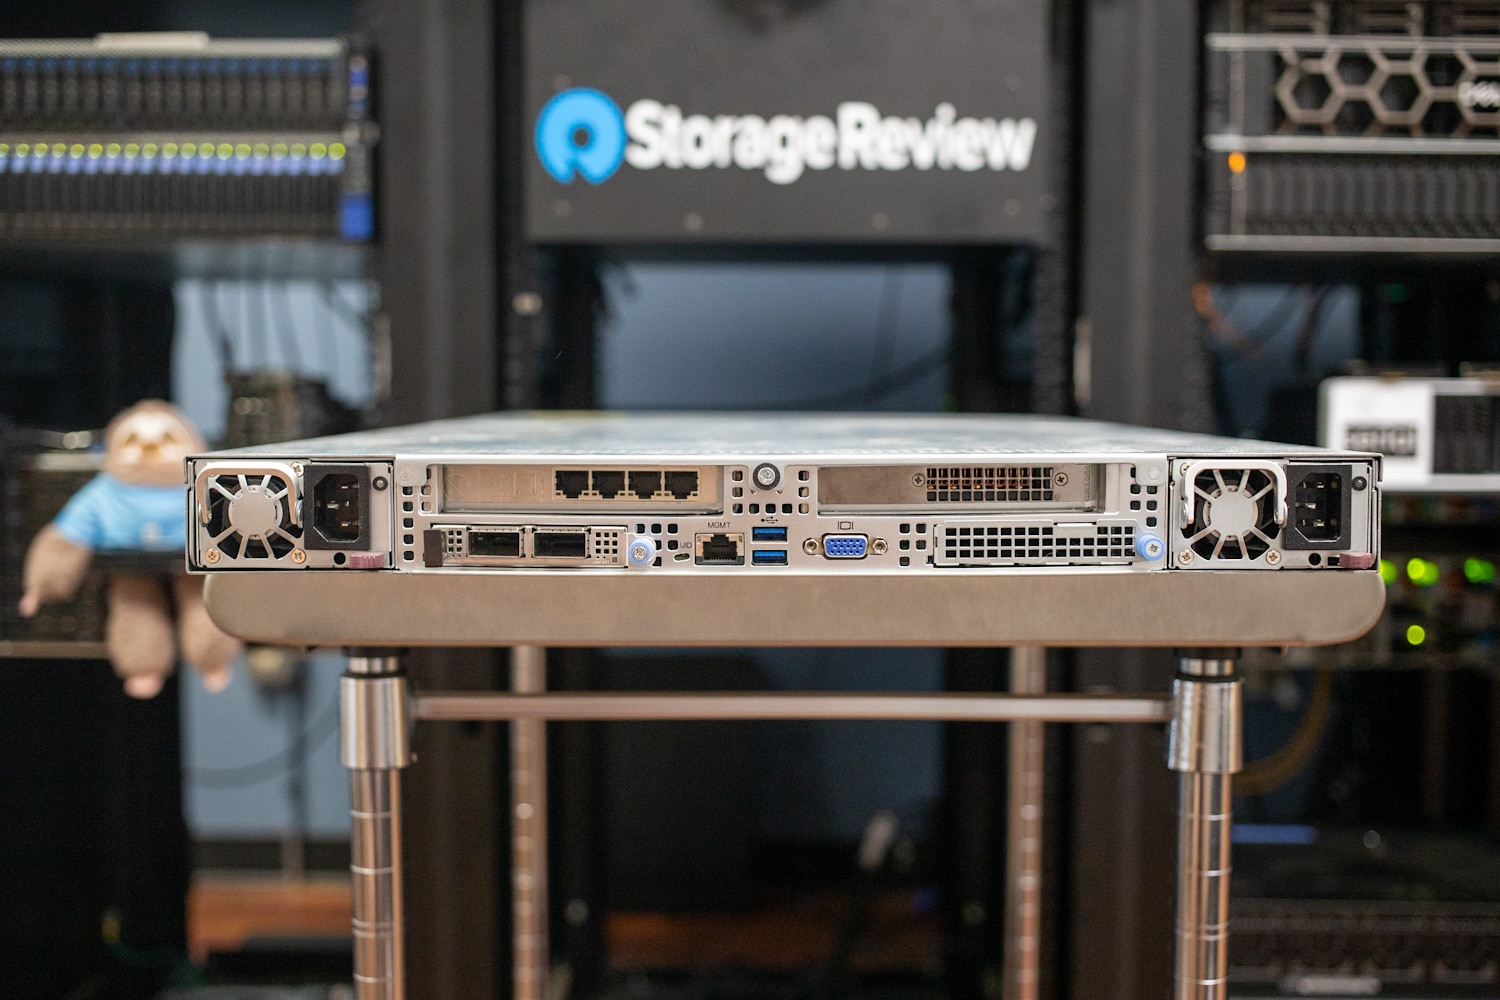
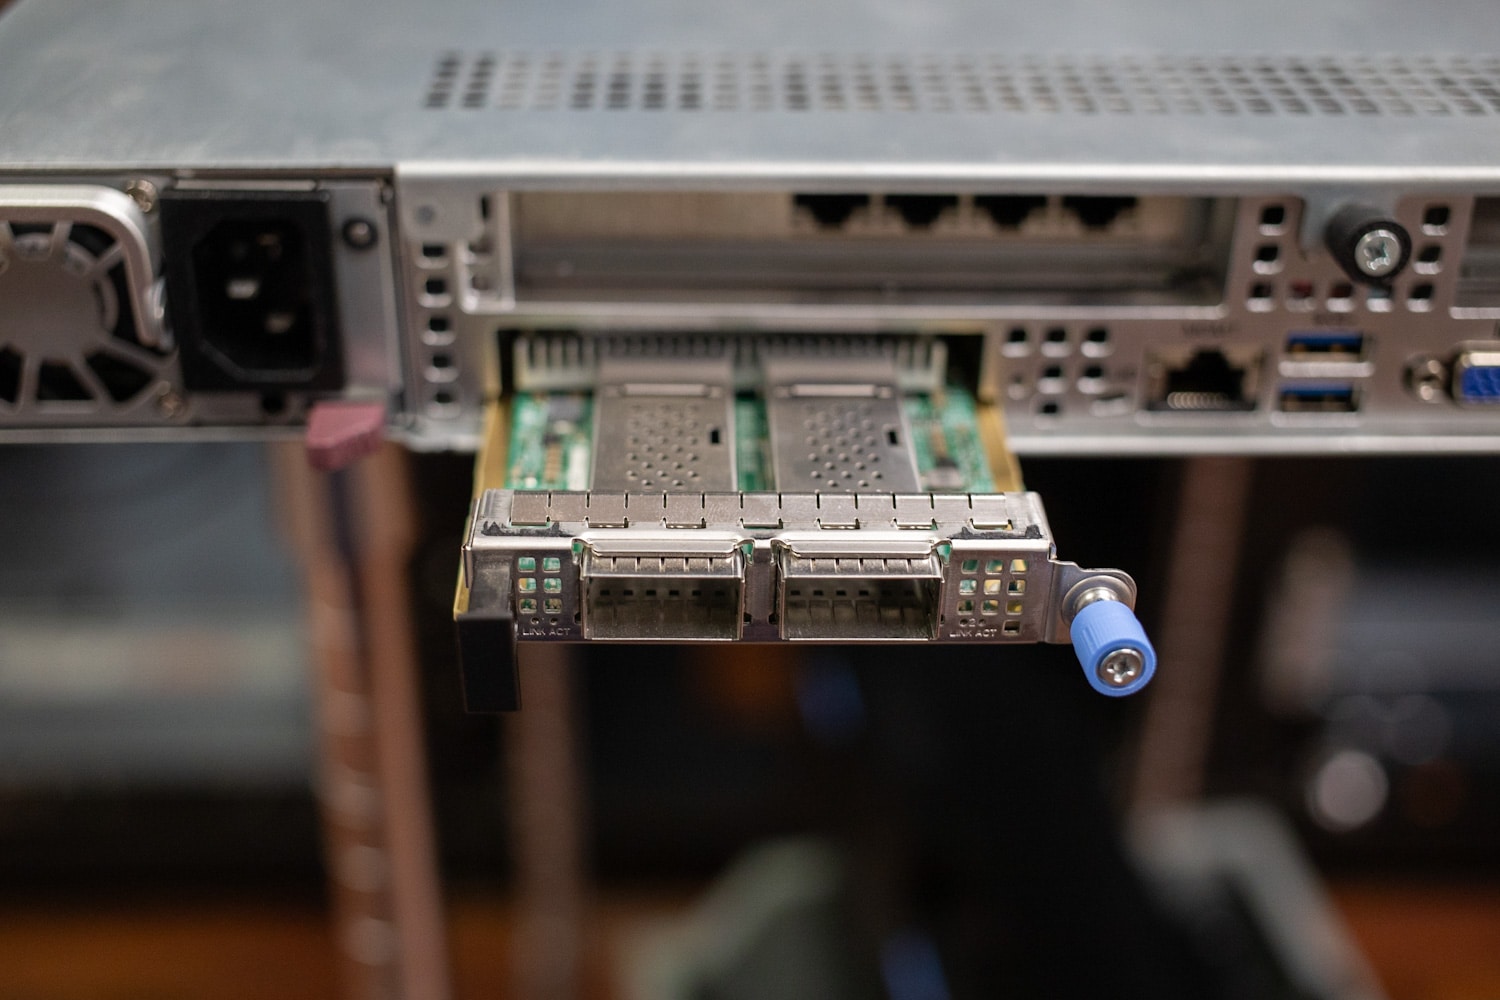
Nachdem die Testumgebung für die KI-Workstation eingerichtet ist, widmen wir uns dem Speicherserver. In diesem Fall verwenden wir einen Supermicro Storage SuperServer SSG-121E-NES24R . Dieser 1U-Server verfügt über zwei Intel Xeon Platinum 8450H Prozessoren mit 28 Kernen und 56 Threads bei einer Basisfrequenz von 2.00 GHz. Die 8450H Prozessoren erreichen eine maximale Turbofrequenz von 3.50 GHz und bieten einen Cache von 75 MB sowie eine TDP von 250 W. Die 512 GB DDR5-RAM stellen einen vergleichsweise geringen Arbeitsspeicherbedarf dar. Der Server nutzt dieselbe NVIDIA ConnectX-6 100GbE Netzwerkkarte wie die Workstations. Zusätzlich haben wir eine NVIDIA A2 GPU für Inferenzberechnungen installiert.
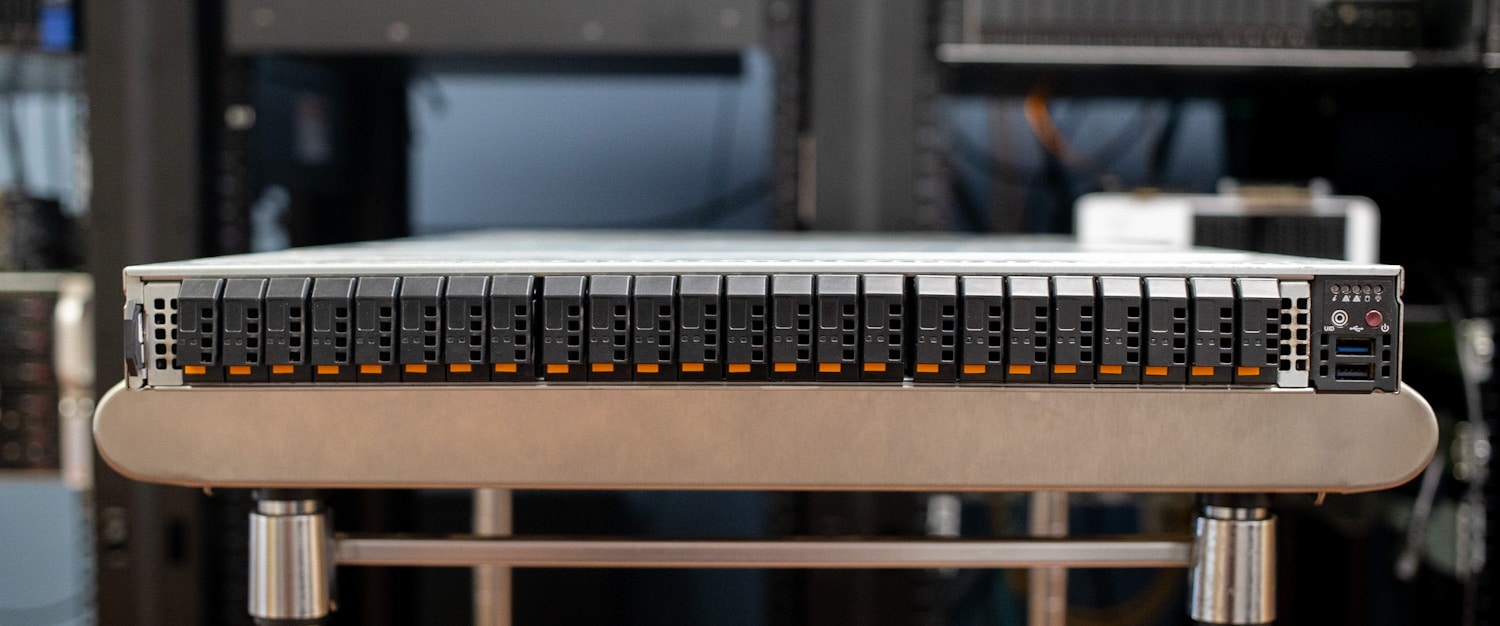
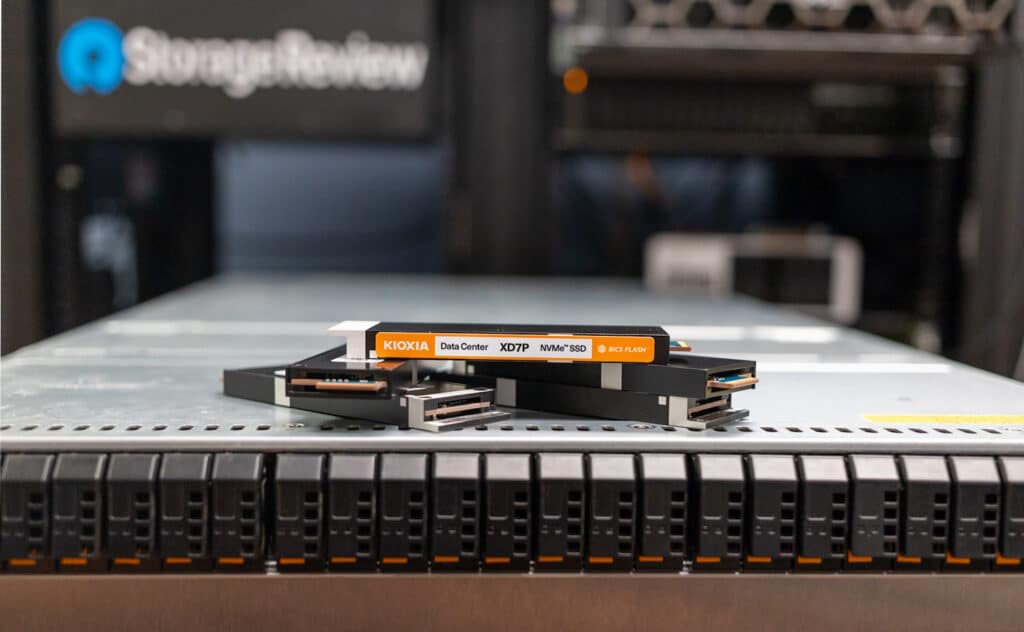
Was den Speicher betrifft, so hat uns KIOXIA 24 NVMe-SSDs für Rechenzentren der XD7P-Serie geschickt. Die E7.S-SSDs der KIOXIA
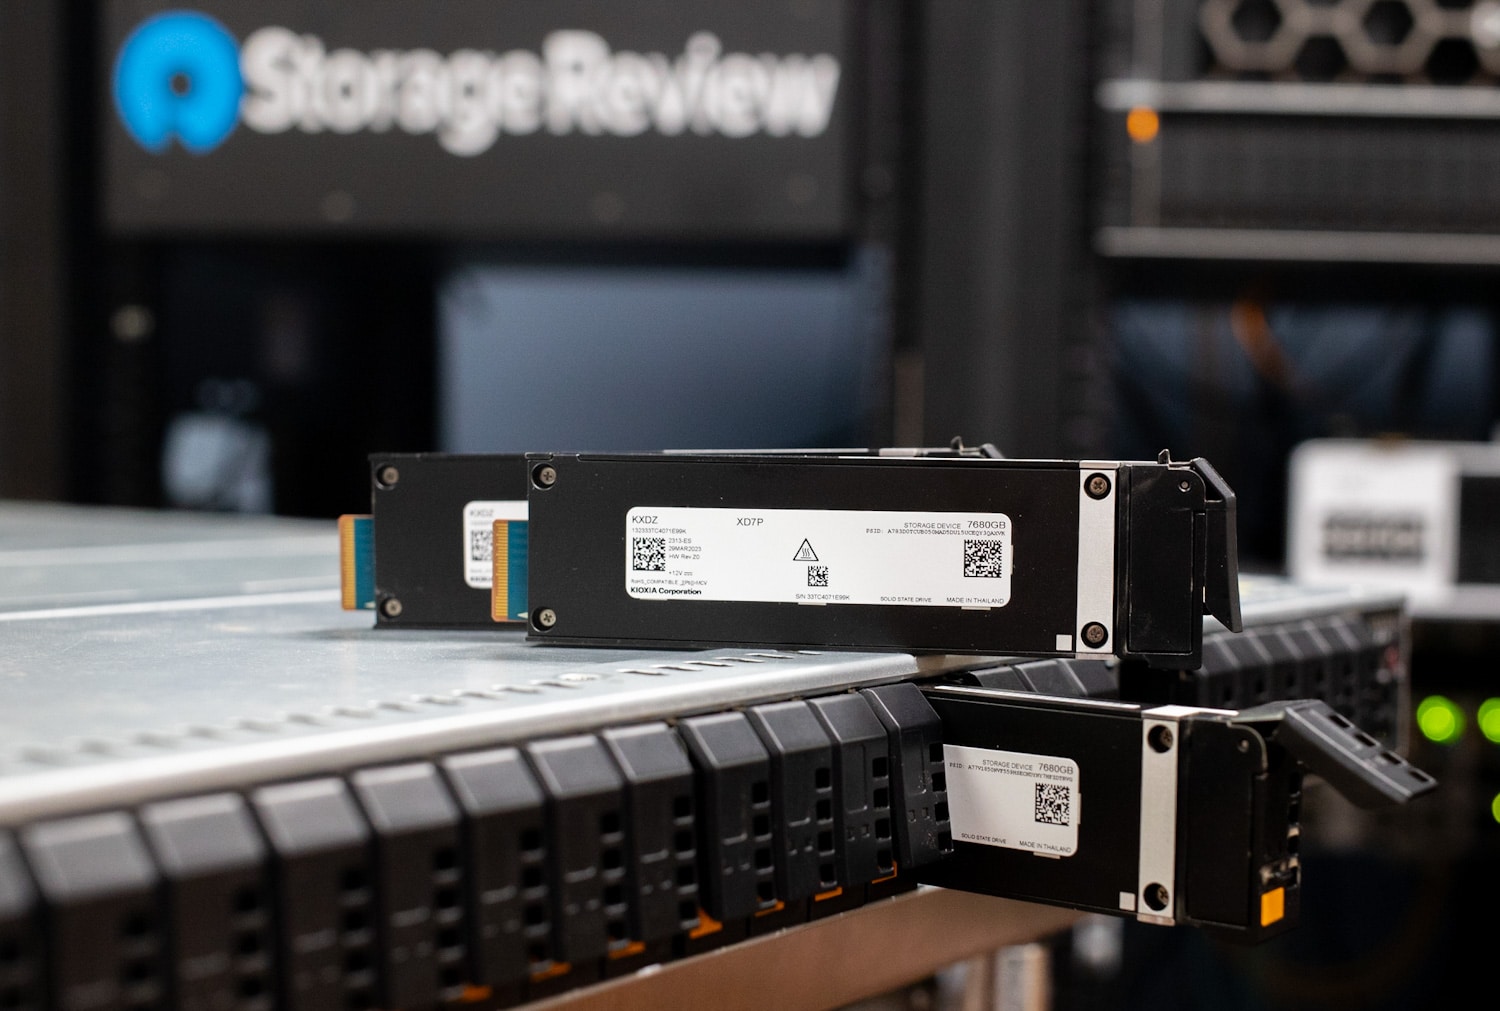
Diese SSDs sind in den 9.5 mm und 15 mm dicken E1.S-Varianten erhältlich, wobei die 15 mm dicke Variante über einen Kühlkörper zur verbesserten Wärmeableitung verfügt. Die von KIOXIA entwickelte Architektur der XD7P, bestehend aus Controller, Firmware und BiCS FLASH™ der 5. Generation , trägt maßgeblich zu Effizienz, Zuverlässigkeit und Leistung bei. Die neue Serie ist mit Speicherkapazitäten von 1.92 TB bis 7.68 TB erhältlich und deckt somit unterschiedliche Speicheranforderungen ab.
Zu den wichtigsten Funktionen gehören der Stromausfallschutz (PLP) und der End-to-End-Datenschutz, die für die Aufrechterhaltung der Datenintegrität in Szenarien mit unerwartetem Stromausfall von entscheidender Bedeutung sind. Darüber hinaus bietet die Verfügbarkeit der Self-Encrypting-Drive-Technologie (SED) eine zusätzliche Ebene der Datensicherheit.
Bezüglich der Leistung bieten die SSDs der KIOXIA XD7P-Serie ein beeindruckendes Potenzial über verschiedene Kapazitäten hinweg. Mit anhaltenden sequentiellen Lesegeschwindigkeiten von bis zu 7,200 MB/s und sequentiellen Schreibgeschwindigkeiten von bis zu 4,800 MB/s für größere Kapazitäten sind diese SSDs für die effiziente Bewältigung datenintensiver Aufgaben konzipiert. Darüber hinaus eignen sie sich aufgrund der anhaltenden zufälligen Lese- und Schreibgeschwindigkeiten von bis zu 1,650 IOPS bzw. 200 IOPS für Arbeitslasten, die hohe I/O-Vorgänge erfordern.
Der XD7P nutzt den E1.S-Formfaktor, um eine einzigartige Balance zwischen Leistung und Dichte zu erreichen. Dies positioniert die neuen Laufwerke als zukunftsweisende Lösung für Flash-Speicher in Cloud- und Hyperscale-Rechenzentren und wird den sich entwickelnden Anforderungen dieser anspruchsvollen Umgebungen gerecht. Die standardisierte Größe und die integrierten Kühlkörper des XD7P bieten eine effiziente Möglichkeit, unsere 24 vorne montierten Laufwerke im 1U SuperServer SSG-121E-NES24R unterzubringen und so die Serverdichte deutlich zu erhöhen. Darüber hinaus positioniert sich E1.S aufgrund seiner Hot-Swap-Fähigkeit und seiner Fähigkeit, Hochleistungs-Workloads ohne thermische Bedenken zu bewältigen, als praktischer Ersatz für den M.2-Anschluss in Rechenzentren mit verbesserter Effizienz und Leistung für Speicherlösungen wie Rechenzentren .
Der XD7P unterstützt PCIe Gen4 x4 Lanes. Das Laufwerk funktioniert gut mit Gen4- oder Gen5-Backplanes.
Kurzspezifikationen der KIOXIA XD7P-Serie
| Kapazität | 7,680 GB | 3,840 GB | 1,920 GB | 7,680 GB | 3,840 GB | 1,920 GB |
| Grundlegende Spezifikationen | ||||||
| Formfaktor | E1.S 15mm | E1.S 9.5mm | ||||
| Interface | PCIe 5.0, NVMe 2.0 | |||||
| Flash-Speichertyp | BiCS FLASH TLC | |||||
| Leistung (bis zu) | ||||||
| Kontinuierlicher sequenzieller Lesevorgang von 128 KiB | 7,200MB / s | |||||
| Kontinuierliches sequentielles Schreiben von 128 KiB | 4,800MB / s | 3,100MB / s | 4,800MB / s | 3,100MB / s | ||
| Dauerhafter zufälliger Lesevorgang von 4 KiB | 1,550K IOPS | 1,650K IOPS | 1,500K IOPS | 1,550K IOPS | 1,650K IOPS | 1,500K IOPS |
| Nachhaltiges zufälliges Schreiben von 4 KiB | 200K IOPS | 180K IOPS | 95K IOPS | 200K IOPS | 180K IOPS | 95K IOPS |
| Strombedarf | ||||||
| Versorgungsspannung | 12 V ± 10% | |||||
| Stromverbrauch (Aktiv) | 20 W typ. | 20 W typ. | 16 W typ. | 20 W typ. | 20 W typ. | 16 W typ. |
| Stromverbrauch (Bereit) | 5 W typ. | |||||
| Zuverlässigkeit | ||||||
| MTTF | 2,000,000 Stunden | |||||
| DWPD | 1 | |||||
Speicherserverleistung mit SSDs der KIOXIA XD7P-Serie
Um besser zu verstehen, wie gut diese Kombination funktionieren kann, haben wir zunächst den Speicherserver mit internen Leistungstests getestet. Bei der Betrachtung der Leistung des Speicherservers haben wir uns auf die volle Rohleistung in einer JBOD-Konfiguration in Ubuntu Linux konzentriert, um zu charakterisieren, wozu der Speicher in der Lage ist.
Wir haben den Spitzendurchsatz mit einer zufälligen Arbeitslast von 4 KB und dann die maximale Bandbreite mit einer sequenziellen Arbeitslast von 64 KB untersucht. Diese Tests wurden unter Nutzung von VDbench in einer Ubuntu 22.04-Umgebung durchgeführt.
| Arbeitsbelastung | Lesen Sie mehr | Schreiben |
|---|---|---|
| 64 KB sequentiell, 64-Thread-Last | 158GB / s | 64.1GB / s |
| 4K zufällig, 512-Thread-Last | 4.09 Mio. IOPS, 16 GB/s | 4.5 Mio. IOPS, 17.7 GB/s |
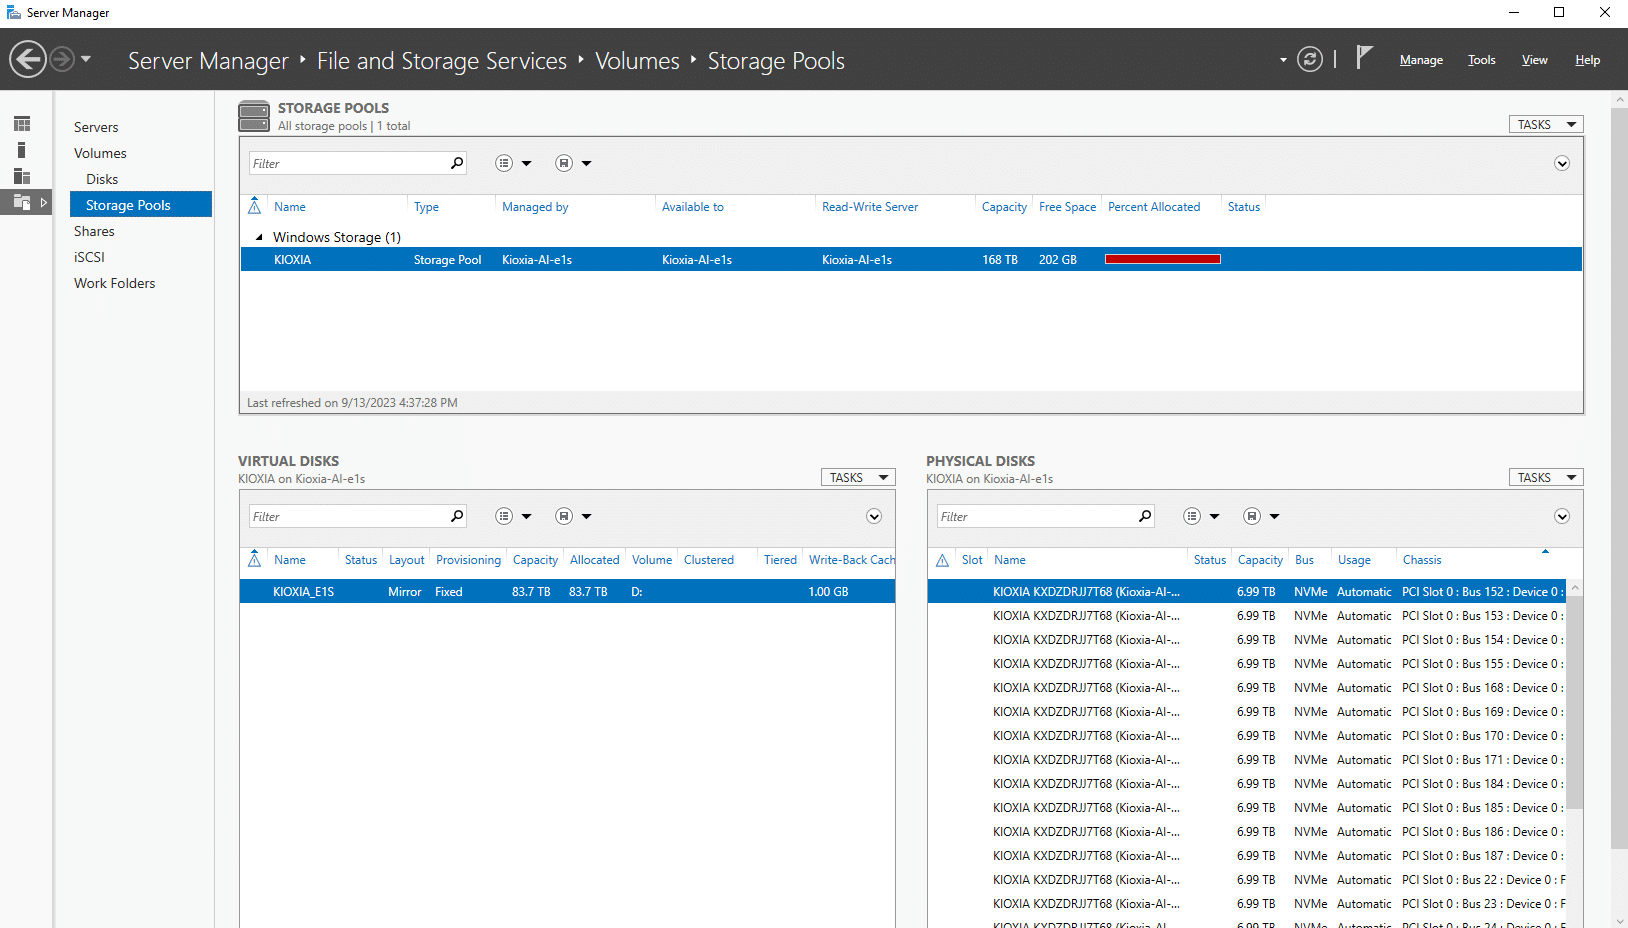
In unserem Versuchsaufbau haben wir uns entschieden, Windows Storage Spaces in Kombination mit dem SMB3-Protokoll zu nutzen, um die Hochgeschwindigkeitslaufwerke von KIOXIA zu nutzen. Durch die Nutzung von Storage Spaces zur Schaffung eines stabilen gespiegelten Speicherpools konnten wir die Datenintegrität sicherstellen und die I/O-Leistung optimieren.
Die erweiterten Funktionen von SMB3, wie Mehrkanalfunktionen und persistente Handles, ermöglichen das direkte Streaming großer Datenblöcke mit hohem Durchsatz an mehrere GPU-Workstations und umgehen so herkömmliche Engpässe, die oft mit langsamerem, CPU-gebundenem Speicher einhergehen. Dieses Setup hatte den doppelten Vorteil, dass es einen schnellen Datenabruf ermöglichte und gleichzeitig mehreren Workstations den gleichzeitigen Zugriff auf und das Laden von Daten in unseren KIOXIA-basierten gemeinsamen Speicher ermöglichte.
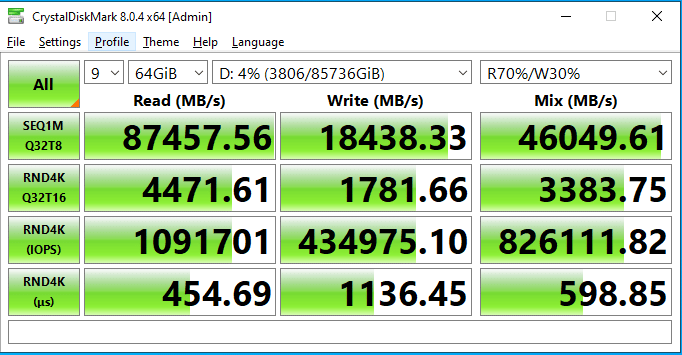
Während unsere vorherigen Tests die Rohleistung der SSDs der KIOXIA XD7P-Serie ohne vorhandenes Dateisystem gemessen haben, haben wir einen zweiten Blick auf die Leistung in der Windows Server 2022-Umgebung geworfen. In diesem Setup haben wir mit der gespiegelten virtuellen Festplatte in unserem großen Speicherpool das NTFS-Dateisystem verwendet.
Um die starke Leistung innerhalb unseres gespiegelten Volumes zu bestätigen, haben wir CrystalDiskMark lokal auf dem Server genutzt. Dieser Test wurde eingerichtet, um die sequentielle Lese- und Schreibleistung bei einer Übertragungsgröße von 1 MB sowie zufälligen 4K-Übertragungsgeschwindigkeiten zu messen. Hier haben wir bei einem Datei-Footprint von 64 GB eine Lesegeschwindigkeit von 87.4 GB/s und eine Schreibgeschwindigkeit von über 18.4 GB/s gemessen.
In diesem Artikel betrachten wir die Gesamtfähigkeiten der gesamten KI-Lösung. Obwohl ein solches Leistungsprofil beeindruckend ist, bietet KIOXIA uns eindeutig mehr, als wir benötigen. Das ist eine gute Sache, denn so können wir die Anzahl der KI-Workstations problemlos erhöhen oder dem Speicherserver zusätzliche Aufgaben zuweisen, sei es das Bereinigen und Bereinigen unserer Daten oder etwas ganz anderes.
Bietet KI-Workstations reichlich Hochgeschwindigkeitsspeicher
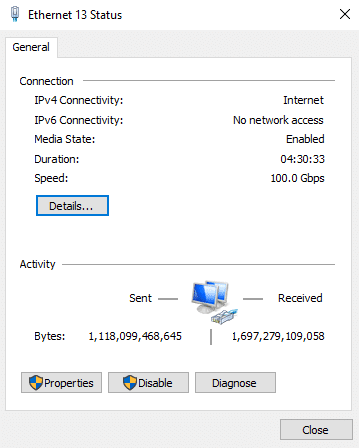
Nachdem sich unsere GPU-Workstations im Laborrack befanden, mit 100 GbE mit unserem KIOXIA-basierten All-Flash-1U-Dateiserver vernetzt und Freigaben eingerichtet waren, machten wir uns daran, dies in der Praxis zu testen. In unserem Testaufbau haben wir uns für eine einfache einzelne 100-GbE-Verbindung von jeder Workstation zu unserem Dell Z9100 100-GbE-Switch entschieden, der dann über eine weitere 100-GbE-Verbindung wieder eine Verbindung zum Speicherserver herstellte.
Hier konnten wir beeindruckende 11.4 GB/s Lese- und 11 GB/s Schreibgeschwindigkeit von einer Windows-Dateifreigabe auf unserem KIOXIA-Speicherserver messen.
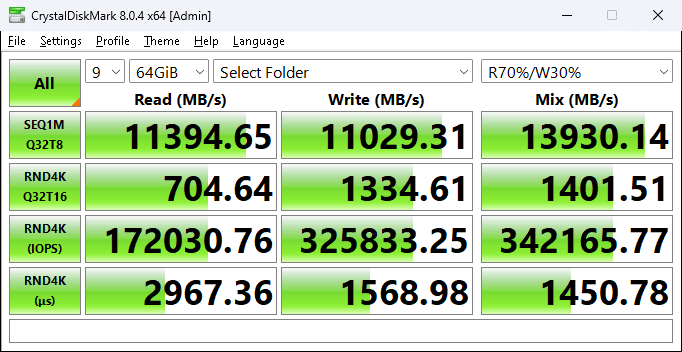
Dieses Maß an Leistung und Dichte über die Leitung zu den KI-Workstations wird einen enormen Mehrwert bieten. Anstatt zu versuchen, die KI-Arbeitsplätze mit lokalem Speicher zu füllen, können wir über 100 GbE noch leistungsfähigeren Speicher gemeinsam nutzen, dessen Kapazität mehr oder weniger unbegrenzt ist.
GenAI in der Praxis – LLM-Trainingsdatensätze
Große Sprachmodelle (LLMs) sind derzeit in der IT-Branche äußerst beliebt. Ihr Training und ihre Feinabstimmung sind jedoch ein Mammutprojekt, das riesige Datensätze und entsprechend hohe GPU-Leistung erfordert. Um GPU-Workstations auszulasten und praxisnahe Tests durchzuführen, haben wir alle Reddit-Beiträge und -Kommentare von 2012 bis 2021 (mit einigen Anpassungen) sowie den Stanford-Alpaca-Trainingsdatensatz in das LLaMa-Modell für mehrere Feinabstimmungsversuche eingespeist. Ziel war es, die Effizienz, Genauigkeit und Anwendbarkeit des LLaMa-Modells anhand umfangreicher, realer Datensätze zu evaluieren.
Von der Windows Server 2022-Plattform aus wurden die 24 SSDs der KIOXIA XD7P-Serie in einem 168-TB-Pool und dann in einem gespiegelten 83.7-TB-Volume gruppiert. Dieses Volumen wurde dann über das 100-GbE-Netzwerk mit einer Dateifreigabe für jede der drei Workstations zur Nutzung freigegeben. Der verwendete Supermicro Superserver-Speicherserver kann eine Datengröße verarbeiten, die das gesamte Volumen von 84 TB ausfüllt, ohne die Leistung zu beeinträchtigen. Die derzeit verwendete Datengröße beträgt 5.6 TB, das Volume kann jedoch eine viel größere Größe verarbeiten.
Jede GPU-Workstation wurde etwas anders konfiguriert, um eine vielfältige Umgebung bereitzustellen. Wir haben jede Maschine so behandelt, als wäre es ein einzelner Entwickler, der mit verschiedenen Modellen an einem gemeinsamen Datensatz arbeitet, und haben keine Schulung verteilt. Die Wahl von Windows erfolgte in diesem Zusammenhang, um ein frühes Forschungs- oder Entwicklungsszenario nachzuahmen.
Um den Umfang der Daten zu verdeutlichen, mit denen wir es zu tun haben: Unsere Datensätze für diesen Test umfassten 16,372 Dateien für LLM-Trainingsdaten, die 3.7 TB Speicherplatz belegten, und weitere 8,501 Dateien für Bild-Trainingsdaten, die 1.9 TB belegten. Insgesamt haben wir mit 24,873 Dateien mit einer Größe von 5.6 TB gearbeitet. Es ist wichtig zu beachten, dass wir die Größe unserer Datensätze bewusst eingeschränkt haben und nicht die gesamte Speicherkapazität für diese Experimente ausgenutzt haben; andernfalls wäre der Schulungs- oder Feinabstimmungsprozess für dieses Projekt zu zeitintensiv gewesen. Mit dieser Konfiguration konnten alle Workstations die Datensätze teilen und Checkpoints und Shards zur Zusammenarbeit auf dem Server speichern.
| Mappen | Größe auf der Festplatte | |
| LLM-Trainingsdaten | 16,372 | 3.7TB |
| Bildtrainingsdaten | 8,501 | 1.9TB |
| Gesamt | 24,873 | 5.6TB |
Der Software-Stack für beide Experimente war einfach konfiguriert, und wir nutzten die Leistungsfähigkeit von Anaconda und dem Windows-Subsystem für Linux (WSL). Anaconda bietet eine robuste Umgebung für die Verwaltung unserer Python-basierten Machine-Learning-Bibliotheken und -Abhängigkeiten und ermöglicht so ein modulares und leicht replizierbares Setup auf unseren GPU-Workstations. WSL schließt die Lücke zwischen Windows- und Linux-basierten Dienstprogrammen und bietet die Flexibilität, Linux-spezifische Tools zur Datenmanipulation und -orchestrierung nahtlos auf unseren Windows-Workstations auszuführen. Wir konnten Shell-Skripte zur Datenvorverarbeitung ausführen und Python-basierte Trainingsläufe innerhalb eines einheitlichen Workflows starten. Wir wählten diesen Ansatz nicht nur aufgrund der einfachen Konfiguration, sondern auch, um in unserer heterogenen GPU-Umgebung gleiche Wettbewerbsbedingungen zu schaffen.
Im Verlauf des Trainings wurden einige wichtige Beobachtungen gemacht:
- Datenvielfalt: Die Zusammenführung von Reddit-Einsendungen und -Kommentaren über fast ein Jahrzehnt präsentierte dem Modell eine vielseitige Mischung aus Themen, Lexika und Gesprächskontexten. Diese reiche Vielfalt bot dem Modell eine umfassende Plattform, um verschiedene Nuancen, Gefühle und kulturelle Veränderungen im Laufe der Zeit zu verstehen und sich daran anzupassen.
- Skalierbarkeit des Modells: Der Umgang mit solch einer immensen Datenmenge war ein Lackmustest für die Skalierbarkeit des LLaMa-Modells. Wir fanden heraus, dass sich die Fähigkeit des Modells, relevante Antworten vorherzusagen und zu generieren, mit zunehmender Trainingsepoche erheblich verbesserte, was sein Potenzial für groß angelegte Anwendungen unterstreicht. Überanpassung war nach etwa einem halben Dutzend ein Problem, war aber bei diesem Test nicht unbedingt ein Problem, da das Ziel darin bestand, unsere GPUs und Netzwerkfreigaben stärker zu belasten als ein allgemeines LLM-Modell zu erstellen.
- Ressourcenoptimierung: Angesichts der enormen erforderlichen GPU-Leistung war es von entscheidender Bedeutung, eine effiziente Nutzung der Rechenressourcen sicherzustellen. Um eine optimale Leistung sicherzustellen, wurden dynamischer Lastausgleich, regelmäßige Prüfpunkte und Techniken zur spontanen Datenerweiterung eingesetzt.
- Transfer-Lernfähigkeit: Die Verwendung des Stanford Alpaca-Trainingsdatensatzes in Verbindung mit Reddit-Daten war entscheidend für die Messung der Transfer-Lernfähigkeiten des Modells. Die inhärente Struktur und der akademische Charakter des Alpaca-Datensatzes stellten im Gegensatz zum informellen und vielfältigen Charakter der Reddit-Daten eine spannende Herausforderung dar. Die Ergebnisse zeigten, dass LLaMa Wissen aus unterschiedlichen Quellen nahtlos integrieren konnte und es so vielseitig und anpassungsfähig machte.
- Ethische Überlegungen: Auch wenn der riesige Reddit-Datensatz einen Schatz an Informationen bietet, muss unbedingt sichergestellt werden, dass personenbezogene Daten ausgeschlossen werden und die Daten ethisch und verantwortungsvoll verwendet werden. Für die Veröffentlichung des Modells müssten strenge Datenbereinigungs- und Anonymisierungsprozesse eingeführt werden, um die Privatsphäre der Benutzer zu wahren.
Diese Übung unterstrich die entscheidende Rolle, die die hochdichten Antriebe von KIOXIA bei der Verbesserung unserer Trainingseffizienz spielten. Angesichts der kolossalen Größe der Datensätze und der iterativen Natur des Modelltrainings stellen Speichergeschwindigkeit und -kapazität bei solchen Experimenten häufig Engpässe dar. Mit den Laufwerken von KIOXIA hatten wir den Luxus, mehrere Instanzen des Datensatzes, Zwischenmodellgewichte und Dutzende fein abgestimmter Prüfpunkte zu speichern. Ihre hohen Lese- und Schreibgeschwindigkeiten ermöglichten einen schnellen Datenabruf und ermöglichten uns die parallele Verarbeitung mehrerer Iterationen der Feinabstimmung mit unterschiedlichen Hyperparametern, wie unten dargestellt.
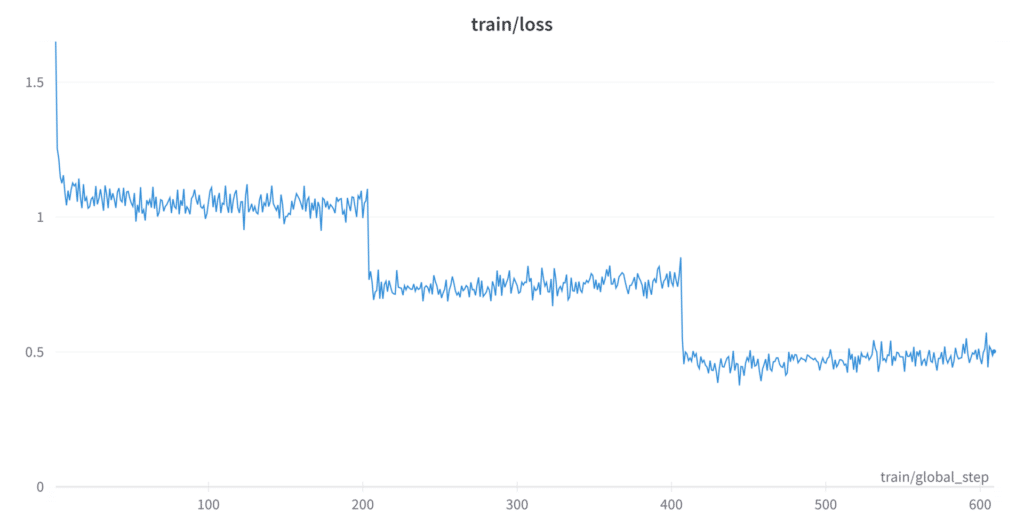
Dies war entscheidend für unser Bestreben, einen optimal funktionierenden Kontrollpunkt zu finden. Dank unseres neu gebauten KIOXIA-basierten Speicherservers konnten wir uns auf die Verfeinerung des Modells, die Optimierung von Parametern und die Bewertung der Ergebnisse konzentrieren, anstatt uns durch Speicherbeschränkungen einschränken zu lassen. Die High-Density-Laufwerke waren daher nicht nur eine Speicherlösung, sondern ein entscheidender Vorteil, der unsere Experimentierphase erheblich beschleunigte. Dies ermöglichte eine gründlichere und effizientere Erforschung des Potenzials des LLaMa-Modells und ermöglichte uns die Entwicklung unseres eigenen neuartigen Faltungs-Neuronalen Netzwerks (CNN).
Für Laien : Ein Convolutional Neural Network (CNN) ist eine spezielle Art von Deep-Learning-Architektur, die vorwiegend in der Bildverarbeitung und im Computer Vision eingesetzt wird. Sein besonderes Merkmal sind die Convolutional Layers, die automatisch und adaptiv räumliche Hierarchien von Merkmalen aus den Eingangsbildern lernen. Im Gegensatz zu traditionellen neuronalen Netzen, die auf vollständig verbundenen Schichten basieren, nutzen CNNs die räumliche Struktur der Daten durch die Anwendung von Convolutional Filtern. Diese verarbeiten die Eingangsdaten in kleinen Abschnitten oder rezeptiven Feldern. Dadurch entsteht ein Netzwerk, das komplexe Muster wie Kanten, Texturen und andere Strukturen erkennen kann, indem es auf einfacheren Mustern aufbaut. Je tiefer die Daten in das Netzwerk vordringen, desto abstrakter werden diese Muster. So können CNNs vielfältige und oft komplexe visuelle Elemente hierarchisch erkennen und klassifizieren.
Durch mehrere Feinabstimmungsversuche stellte das Modell seine Fähigkeit zur effizienten Verarbeitung riesiger Datensätze unter Beweis und hob sein Potenzial hervor, relevante, kontextbezogene und differenzierte Ergebnisse zu erzeugen. Während LLMs immer mehr an Bedeutung gewinnen, bieten solche Experimente unschätzbare Einblicke in ihre praktischen Anwendungen und Grenzen und ebnen den Weg für anspruchsvollere und benutzerzentrierte KI-Lösungen in der Zukunft.
Server-Inferenzfunktionen
Die Ausführung von Inferenzoperationen für denselben Datensatz bietet eine optimierte Struktur und vereinfacht die Datenverwaltungsfeinheiten. Unser Server ist nicht nur ein Speichertool – er ist für die Durchführung inferenzbezogener Aktivitäten, einschließlich der Datenaufnahme und -aufbereitung, ausgestattet.
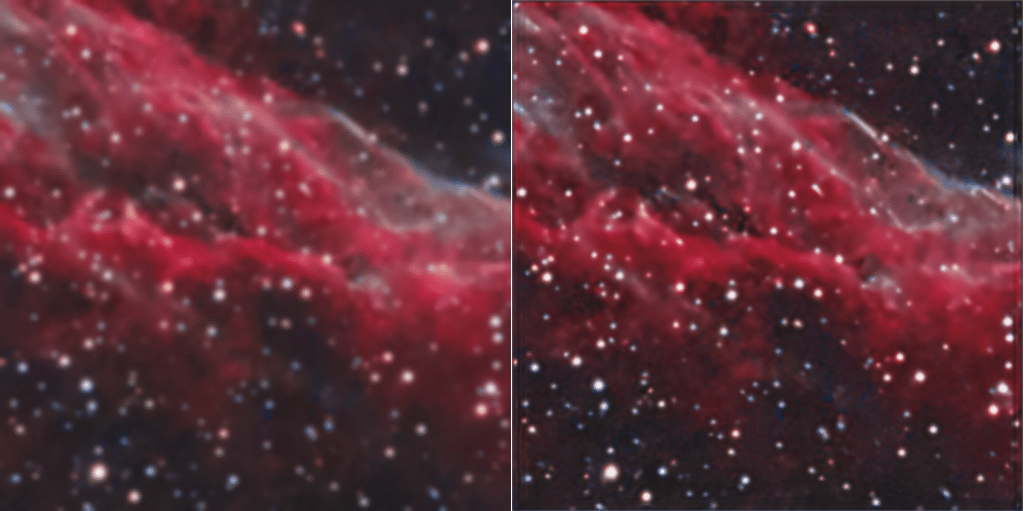
Um die Schlussfolgerung auf größere Datensätze zu testen, haben wir eine Reihe von Astrofotografiebildern mit einer Größe von etwa 1 MB bis 20 MB ausgewählt und ein neuartiges CNN, an dem wir arbeiten, mit ihnen verglichen. In unserem Szenario wird das Modell auf die GPU geladen und dann wird ein Bild oder eine Reihe von Bildern zur Verarbeitung durch das neuronale Netzwerk geladen.
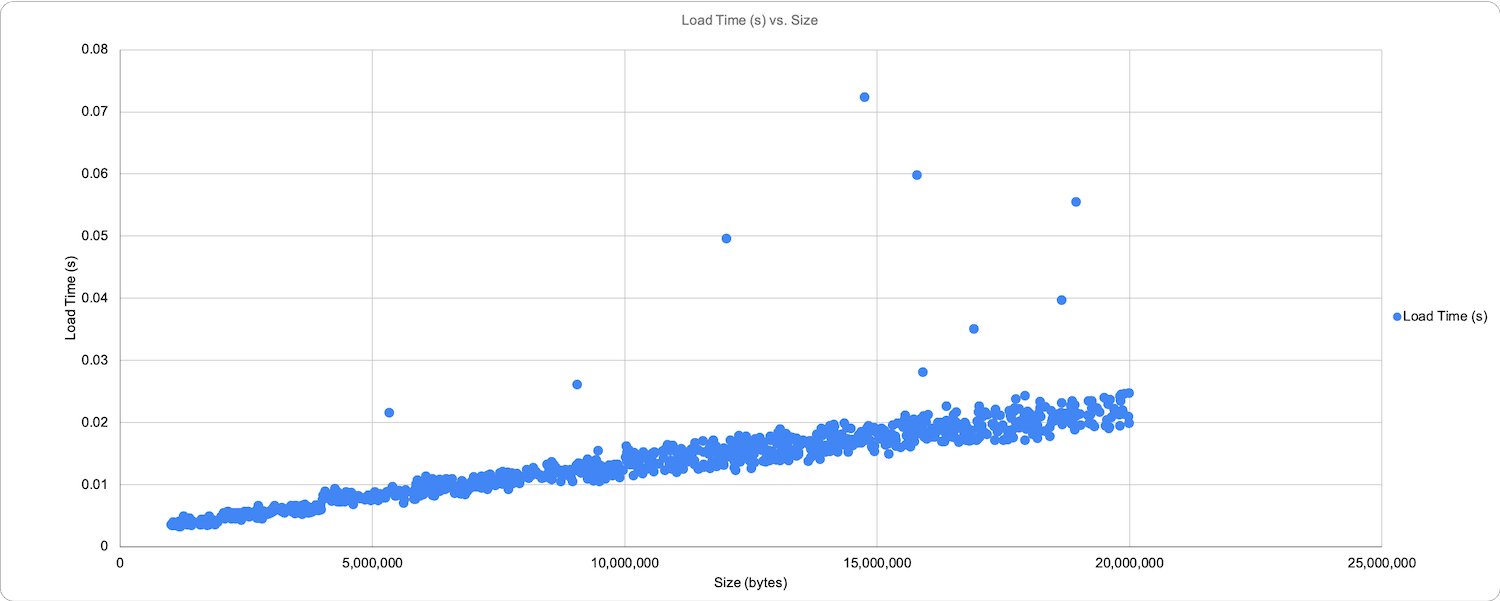
Dabei handelt es sich um ein breiteres Speicherbedarfsprofil, als Sie es bei einer Computer-Vision-Objektklassifizierung durch eine standardisierte Kamera vorfinden würden. Dennoch verdeutlichte es die Flexibilität und Konsistenz der Leistung der Plattform. In der folgenden Grafik, die nach Größe und nicht nach der Reihenfolge des Ladens sortiert ist (mit Ausnahme einiger Ausreißer), sind die Lese- und Rückschreibzeiten entsprechend skaliert.
Es ist wichtig zu bedenken, dass dieses Diagramm vom kleinsten zum größten sortiert ist, um die lineare Leistung der Laufwerke und des Servers zu veranschaulichen. Der tatsächliche Lauf und der Datensatz wurden zufällig ausgewählt, sodass eine 1-MB-Datei gelesen und geschrieben werden konnte, gefolgt von einer 20-MB-Datei. Die Art der eigentlichen Verarbeitung war in keiner bestimmten Reihenfolge. Die Lesezeiten lagen zwischen 10 ms und 25 ms, wobei Ausreißer im Bereich von über 70 ms lagen.
Das folgende Diagramm zeigt einen ähnlich linearen Verlauf des Schreibens mit geringerer Abweichung und zeigt die Schreibvorgänge derselben Dateien im Bereich von 12 ms bis 118 ms.
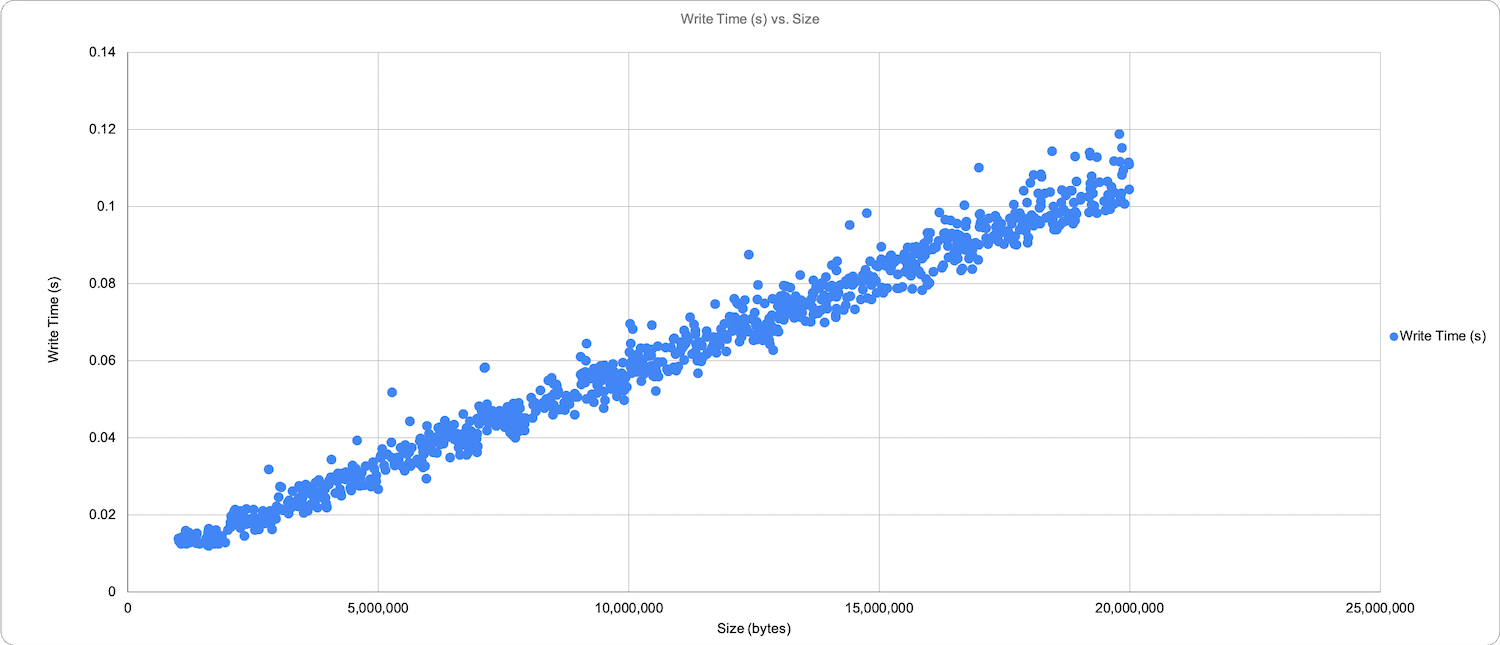
Eine weitere wichtige Information, die Sie sich merken sollten, ist, dass es sich bei diesem Diagramm um eine Zusammenfassung der Verfolgung über drei GPU-Workstations handelt, die gleichzeitig eine Schlussfolgerung auf denselben Datensatz ausführen. Die KIOXIA-Laufwerke waren in der Lage, beeindruckende 10.5 GB auf drei GPU-Workstations bereitzustellen und zurückzuschreiben, indem sie Rückschlüsse auf einen zufälligen Datensatz von 1000 Bildern ausführten, ohne die vom Modell verwendete serialisierte Verarbeitung. Der gesamte Vorgang dauerte nur 59.62 Sekunden oder 59 ms, um ein einzelnes Bild zu lesen und zurückzuschreiben.
Mehrere Optionen könnten Geschwindigkeit und Latenz verbessern, da dieses Design auf mehrere Workstations oder GPU-Server skaliert werden kann. Die Implementierung von NVIDIAs GPUDirect Storage in Kombination mit dem RDMA-Protokoll (Remote Direct Memory Access) würde eine nahtlose Datenübertragung vom gemeinsam genutzten Speicher mit hoher Dichte direkt in den GPU-Speicher ermöglichen. Dieser Ansatz würde CPU- und Systemspeicherengpässe effektiv umgehen. Durch die Nutzung von NVMe über Fabrics und NVIDIA-Netzwerkausrüstung können große Datenmengen nahezu in Echtzeit vorab in den GPU-Speicher geladen werden. Dies wäre insbesondere beim Umgang mit LLMs angesichts ihrer umfangreichen Datensätze und Rechenanforderungen von Vorteil. Eine solche Funktion könnte das Daten-Caching überflüssig machen und es mehreren Workstations ermöglichen, gleichzeitig Daten aus dem gemeinsam genutzten Speicherpool zu lesen und aufzunehmen.
Fazit
Die Behebung des I/O-Engpasses größerer Modelle ist für die Weiterentwicklung des maschinellen Lernens von entscheidender Bedeutung, insbesondere beim Umgang mit umfangreichen Datensätzen. Eine zentralisierte Hochgeschwindigkeits-Netzwerkfreigabe bietet einen dreifachen Vorteil gegenüber herkömmlicher lokaler Speicherung.
- Erstens rationalisiert es den Betrieb, da es nicht mehr erforderlich ist, riesige Datensätze zu Schulungszwecken auf einzelne Workstations zu migrieren. Dies bekämpft direkt die I/O-Engpässe, die maschinelle Lernprojekte lahmlegen können, insbesondere solche mit Deep-Learning-Modellen.
- Zweitens vermeiden Sie durch die Entscheidung für einen zentralisierten Ansatz, die wertvollen PCIe-Lanes der Workstation mit übermäßigen oder sogar unerreichbaren Mengen an lokalem Speicher zu überlasten. Dank der Hochgeschwindigkeitsverbindung könnten dadurch mehr GPUs in die Lage versetzt werden, Daten parallel effizienter zu verarbeiten, wodurch maschinelle Lernvorgänge schlanker und agiler werden.
- Drittens bringt eine zentrale Speicherung grundsätzlich bessere Sicherheitsmaßnahmen mit sich. Wenn Daten an einem sicheren, einzigen Ort gespeichert werden, ist es einfacher, Zugriffskontrollen zu verwalten und Sicherheitsprotokolle zu implementieren, wodurch das Risiko von Datenschutzverletzungen, physischen Bedrohungen oder unbefugtem Zugriff verringert wird.
Darüber hinaus sorgt die Zentralisierung der Daten für eine verbesserte Datenkonsistenz und eine zusätzliche Ebene der Datenredundanz. Workstations greifen auf die aktuellsten Daten aus einer einzigen Quelle zu und minimieren so Abweichungen in den Ergebnissen aufgrund veralteter oder inkonsistenter Trainings- oder Feinabstimmungsdaten oder Modellprüfpunkte. Dies vereinfacht auch die Datenverwaltung und spart Speicherplatz.
Da Skalierbarkeit, Effizienz und Sicherheit in der sich hyperschallentwickelnden Landschaft von KI und maschinellem Lernen immer wichtiger werden, ist die Umstellung auf zentralisierte, dichte Hochgeschwindigkeitsspeicherung durch Technologien wie die KIOXIA E1.S-Plattform ein überzeugendes Argument. Dies ist nicht nur für eine verbesserte Leistung von entscheidender Bedeutung, sondern auch für eine grundlegende Veränderung unserer Herangehensweise an Datenmanagement und Modelltraining.
Datenblatt für KIOXIA XD7P-Serie E1.S NVMe-Rechenzentrum
Dieser Bericht wird von KIOXIA America, Inc. gesponsert. Alle in diesem Bericht geäußerten Ansichten und Meinungen basieren auf unserer unvoreingenommenen Sicht auf das/die betrachtete(n) Produkt(e).


 Amazon