

En noviembre asistimos a la Conferencia internacional de computación, redes, almacenamiento y análisis de alto rendimiento de 2017, mejor conocida como la Conferencia de supercomputación de 2017 (SC17). Cada año, en la Supercomputing Conference, los investigadores y proveedores de la academia y la industria ensamblan SCinet: una supercomputadora y una estructura de red que sirve como banco de pruebas y prueba de concepto para nuevas tecnologías de computación, redes y almacenamiento de alto rendimiento. Premio es uno de los proveedores que contribuyó con hardware y experiencia al SCinet 2017 en forma de dos gabinetes de nodos de datos FlacheSAN1N4C-D4, con cada nodo evaluando un rendimiento de lectura sostenido de hasta 24 GB/s (168 Gbps) y hasta 3.6 millones de IOPS. Esto permitió que SCinet tuviera la capacidad de transferir grandes conjuntos de datos a una velocidad de caché rápida.
Los nodos del Premio FlacheSAN asumieron varios roles distintos durante la Conferencia de Supercomputación de 2017, incluido el punto de prueba para grandes proyectos de transferencia de datos, una plataforma para proyectos de gran flujo y un proveedor experimental de servicios de red tolerante a retrasos/interrupciones para la conferencia SC y SCinet WAN . Ese primer papel es probablemente el más importante para los observadores de la industria como nosotros, que este año examinamos SCinet en busca de indicaciones sobre el futuro de la tecnología de transferencia de datos de gran tamaño.
SCinet tiene un historial de demostración de tecnologías de red que posteriormente ingresaron al mercado de tecnología de la información empresarial, incluido el modo de transferencia asíncrona, la interfaz de datos distribuidos por fibra y la interfaz paralela de alto rendimiento (HiPPi). Durante SC17, Brian Beeler, editor en jefe de StorageReview, habló con miembros de un equipo de investigación de la Universidad Northwestern que trabaja con FlacheSAN1N4C-D4. Fuera de la Supercomputing Conference propiamente dicha, FlacheSAN1N4C-D4 de Premio se está utilizando para migrar conjuntos de datos a escala de petabytes del Gran Colisionador de Hadrones del CERN a medida que los datos se organizan en niveles desde el primer nivel del CERN en Chicago, Illinois, hasta Caltech en Pasadena, California.
El sector del almacenamiento empresarial ha estado trabajando durante años para estar preparado para la cantidad cada vez mayor de datos que se generan y procesan. Un desafío específico que está adquiriendo una importancia creciente en la actualidad es la necesidad de mover cantidades masivas de datos de forma rápida y fluida. En el futuro, será cada vez más común transferir grandes conjuntos de datos a través de largas distancias geográficas, entre plataformas diferentes y de formas que puedan manejar retrasos y otras interrupciones que son inherentes a la transferencia de datos compleja y a gran escala. En este sentido, SCinet está lidiando con las realidades de transferencia de datos que las empresas enfrentarán dentro de cinco a diez años.
Para usar el proyecto de investigación de Caltech como ejemplo, un experimento del Gran Colisionador de Hadrones puede generar fácilmente datos de sensores sin procesar en el vecindario de 25 petabytes que, a su vez, se distribuyen en niveles a instituciones de investigación afiliadas en todo el mundo para su análisis. De hecho, son las limitaciones de cómputo, redes y almacenamiento las que han demostrado ser obstáculos clave para la velocidad a la que se puede realizar la experimentación en el colisionador, por lo que mejorar el rendimiento en estas áreas es una preocupación crítica. En el lado empresarial, los avances recientes en Inteligencia Artificial y otros análisis de Big Data sugieren que no pasará mucho tiempo antes de que la transferencia de conjuntos de datos tan masivos se vuelva común en el sector privado (piense en todo, desde automóviles autónomos hasta sensores ambientales en sitios de recuperación de minería) .
El FlacheSAN1N4C-D4 está alimentado por dos procesadores Intel Xeon E5-2600v4/v3 Broadwell/Haswell, que administran una matriz de almacenamiento compuesta por cuatro unidades flash NVMe PCIe3 x8. FlacheSAN1N4C-D4 puede beneficiarse de la tecnología de procesador Intel Broadwell de 14 NM porque mejora el consumo de energía y mejora las frecuencias de reloj con un TDP equivalente o inferior al de su predecesor. El FlacheSAN1N4C-D4 se especifica para un rendimiento de lectura sostenido de 24 GB/s de 3.6 millones de IOPS, rendimiento que es esencial para mover las cantidades masivas de datos que requieren SCinet y otras redes informáticas de alto rendimiento de vanguardia.
Premio FlacheSAN1N4C-D4 Especificaciones
- CPU compatible: Dual Intel Xeon E5-2600v4/v3 Broadwell/Haswell hasta 135W TDP socket R3
- Conjunto de chips: Conjunto de chips Intel C612
- Soporte de memoria: 16x DDR4 ECC RDIMM/LRDIMM 1600/1866/2133/2400MT/s máx. 1 TB de capacidad
- Ranuras de expansión: admite hasta 2 módulos de E/S PCIe3 x16 de altura completa 1x PCIe3 x8
- Almacenamiento:
- 4x NVMe PCIe3 x8 intercambiables en caliente de bajo perfil
- 2 bahías internas de 2.5 pulgadas para sistema operativo
- Red:
- Doble GbE Intel i210
- FDR Infiniband QSFP+ de 56 Gb opcional o Ethernet doble de 40 GbE a través del módulo de E/S
- 1 puerto RJ45 de gestión de IPMI
- 2 ranuras PCIe3 x16 para otra opción de tarjeta NIC
- Alimentación: 1+1 fuente de alimentación redundante de 750 W CA/CC 80 Plus Platinum
- Seguridad: tecnología Intel Trusted Execution; TPM 1.2
- Sistema operativo compatible: Windows 2012 R2, RHEL 6.5, SLES 11 SP3, Windows 208 R2, VMWare ESXi 5.5, FreeBSD 9.2, Centos 6.5
- Panel frontal: encendido/apagado con LED, interruptor de reinicio, interruptor NMI, interruptor de localización con LED, 4x LAN LED, LED de advertencia
- E / S posterior:
- DB15 VGA, 2x RJ45 1GbE, 1x Serie DB9,
- 1 administrador RJ45, 2 USB 3.0, 2 USB 2.0
- 1 LED de identificación, QSFP+ dual opcional
- Enfriamiento: 3 ventiladores de enfriamiento de 97 mm
- Otras características: GbE dedicado para IPMI 2.0
- Peso
- Bruto: 23KG/50LBS
- Neto: 17KG/37.4LBS
- Dimensiones Sistema: 31.38”x19”x1.75” (LxAnxAl)
- Embalaje: 37.8”x 24”x9.45”(LxAnxAl)
- Código HTS Logístico: 8473 30 5100; ECCN: 4A994
- Temperatura de funcionamiento ambiental: 0 °C a 35 °C
- Temperatura no operativa: -20 °C a 70 °C
- Humedad: 5% a 95% sin condensación
- Conformidad Cumple con CE, FCC Clase A, RoHS 6/6
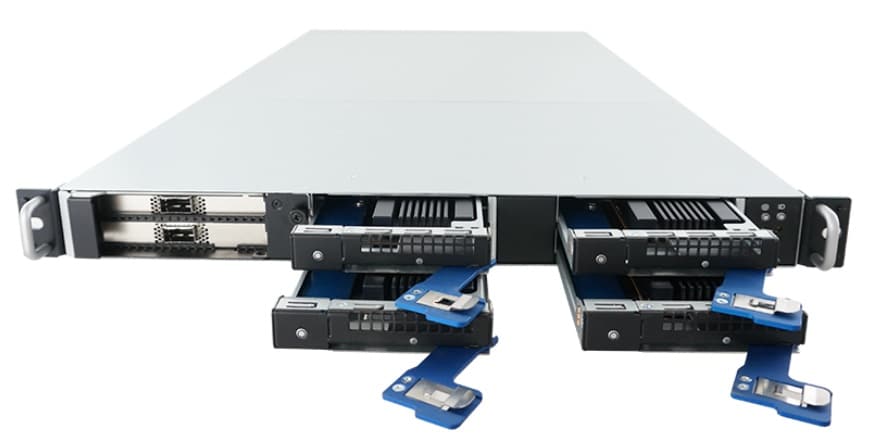
El FlacheSAN1N4C-D4 incorpora cuatro bahías de acceso frontal para almacenamiento PCIe3 x8 NVMe de bajo perfil. Estas ranuras NVMe comprenden el almacenamiento, que está disponible para uso de datos en tránsito en una implementación de nodo de transferencia de datos. Dos unidades internas de 2.5 pulgadas albergan el sistema operativo.
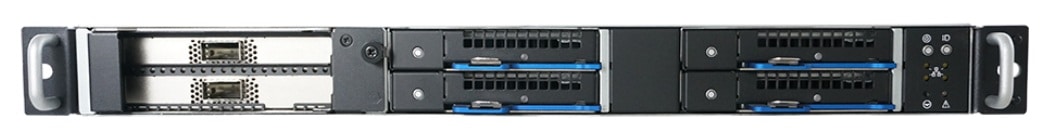
El conjunto de almacenamiento de esta matriz FlacheSAN es intercambiable en caliente y está certificado para su uso con diversos dispositivos de almacenamiento NVMe. Premio publica una lista de proveedores aprobados en la página de información del producto FlacheSAN1N4C-D4, basada en pruebas internas de laboratorio de Premio.
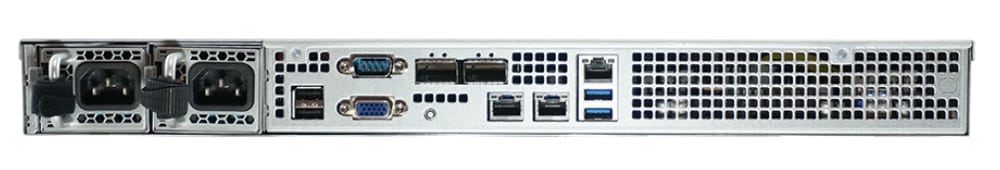
La parte posterior de la matriz brinda acceso a las interfaces integradas Dual GbE Intel i210. El arreglo se puede configurar opcionalmente con FDR Infiniband QSFP+ de 56 Gb o Ethernet doble de 40 GbE a través de módulos de E/S. También hay un puerto de administración IPMI RJ45 junto con dos ranuras PCIe3 x16 para otras opciones de NIC.
La línea de servidores FlacheStreams de Premio se centra en las matrices NVMe Flash como vehículo para la estrategia de eliminación de cuellos de botella de "arquitectura equilibrada" de Premio, que equilibra los recursos entre las unidades NVMe y las tarjetas Ethernet. Los sistemas FlacheStreams también pueden proporcionar acceso directo al almacenamiento NVMe de la matriz en toda la estructura de la red para reducir la latencia.
Sobre la base de la experiencia de Premio trabajando con Caltech para jerarquizar datos experimentales desde Chicago hasta Pasadena, la empresa contribuyó con dos arreglos FlacheSAN1N4C-D4 a SCinet para servir como servidores de Nodo de transferencia de datos (DTN). En conjunto, los dos Premio DTN ofrecieron 400 Gigabits de rendimiento de disco a disco para demostraciones de tecnología, incluida la interfaz Jupyter integrada para flujos de trabajo científicos con uso intensivo de datos, estructuras de red que requieren una API programable y la API de monitoreo DTN del arreglo.
Los tipos de cargas de trabajo que gestiona la red de distribución de datos experimentales del Gran Colisionador de Hadrones, así como las que SCinet modela en la Supercomputer Conference, son indicadores importantes de cómo se podría implementar la tecnología de transferencia de datos grandes en el sector privado en el futuro. Ya sea que se transfiera a través de grandes distancias o entre diferentes sistemas de administración de información, las grandes transferencias de datos serán la nueva realidad.


 Amazon