

Actualizado el 13 de noviembre de 2026: La Dell Pro Precision 9 T4 se suma como la mejor torre Xeon para IA local, la sección de torres ahora agrupa las selecciones por plataforma anfitriona y la sección "Cómo clasificamos" ahora incluye torres probadas con nuestra suite llama.cpp en Linux. El 24 de octubre, la respuesta de Mac Studio se actualizó para los modelos M5 Max y M5 Ultra que Apple comenzó a distribuir en septiembre.
Todos los sistemas clasificados en esta página han pasado por el laboratorio de StorageReview. Evaluamos directamente el rendimiento de la IA local: rendimiento de servicio en línea de vLLM, tiempo hasta el primer token y tiempo por token de salida en modelos como GPT-OSS-120B, Llama 3.1 8B, Mistral Small 3.1 24B y Qwen3 Coder 30B, además de la eficiencia de cómputo de MAMF y pruebas de almacenamiento GDSIO. Ningún sistema se clasifica a partir de una hoja de especificaciones.
La cuestión clave para un ordenador de sobremesa con IA local en 2026 es la memoria unificada frente a la VRAM discreta . Los dispositivos de sobremesa como el DGX Spark de NVIDIA, basado en GB10, y los sistemas Ryzen AI Max (Strix Halo) de AMD incorporan 128 GB de memoria unificada en un solo chip a precios de dispositivo, lo que permite ofrecer modelos que, de otro modo, requerirían varias GPU discretas.
Las torres de estaciones de trabajo responden con un rendimiento bruto: las tarjetas RTX PRO 6000 Blackwell ofrecen una tasa de bits por segundo mucho mayor, aunque a un costo y consumo de energía varias veces superiores. Esta página clasifica ambas, en niveles separados, a partir de un conjunto de pruebas consistente, ya que la respuesta correcta depende del modelo más grande que se pretenda utilizar y de la velocidad de respuesta requerida.
A simple vista
| Categoría | Sistema | Salud Cerebral | GPU (Probadas / Máx.) | Opinión completa |
|---|---|---|---|---|
| Mejor sistema de IA de escritorio en general | NVIDIA DGX Spark | 128 GB LPDDR5X unificado | GB10 integrado (fijo) | Reseña del DGX Spark |
| Mejor implementación de GB10 | Acer Veriton GN100 | 128 GB LPDDR5X unificado | GB10 integrado (fijo) | Análisis del Veriton GN100 |
| La mejor alternativa a x86 | AMD Ryzen AI Halo (Strix Halo) | Hasta 128 GB de memoria LPDDR5X unificada | Radeon 8060S integrada (fija) | Análisis de Ryzen AI Halo |
| Mejor sin una GPU dedicada | HP Z2 Mini G1a | Memoria LPDDR5X unificada (ejecutaba GPT-OSS 120B) | Integrada, sin GPU dedicada (fijo) | Análisis del Z2 Mini G1a |
| El mejor sistema GB300 | MSI XpertStation WS300 (alternativa: ASUS ET900N G3) | 748 GB coherentes (252 GB HBM3e + 496 GB LPDDR5X) | GB300 integrado (fijo) | Análisis de XpertStation WS300 |
| La mejor torre para IA local | Dell Precision 7875 | 192 GB GDDR7 (2 × 96 GB) | 2× RTX PRO 6000 / 2 máx. | Reseña de la Precision 7875 |
| La mejor torre Xeon para IA local | Dell Pro Precision 9 T4 | 192 GB GDDR7 (2 × 96 GB) | 2× RTX PRO 6000 Max-Q / 2 máx. | Análisis de la Pro Precision 9 T4 |
| La mejor plataforma multi-GPU | HP Z8 Fury G6i | 192 GB GDDR7 según las pruebas realizadas / hasta 384 GB | 2× RTX PRO 6000 probados / 4 máximo | Análisis del Z8 Fury G6i |
| La elección extrema | Comino Grando RTX PRO 6000 | 768 GB GDDR7 (8 × 96 GB) | 8× RTX PRO 6000 / 8 máx. | Reseña de Comino Grando |
Dispositivos de IA para escritorio
La gama de dispositivos, que Dell denomina IA de escritorio y NVIDIA la supercomputadora personal de IA , sacrifica rendimiento máximo a cambio de capacidad de modelos, eficiencia energética y precio. Con 128 GB de memoria unificada, estos sistemas pueden gestionar cómodamente modelos de clase 70B con alta cuantización y hasta cargas de trabajo de clase 120B que requerirían varias GPU independientes en una torre.
Lectura de laboratorio esencial para este nivel: nuestra prueba térmica DGX Spark compara los diseños de refrigeración de los fabricantes de equipos originales (OEM) en los sistemas GB10 que se detallan a continuación y se aplica a todas las unidades de esta clase hasta que estas plataformas se revisen.
Mejor sistema de IA de escritorio en general: NVIDIA DGX Spark
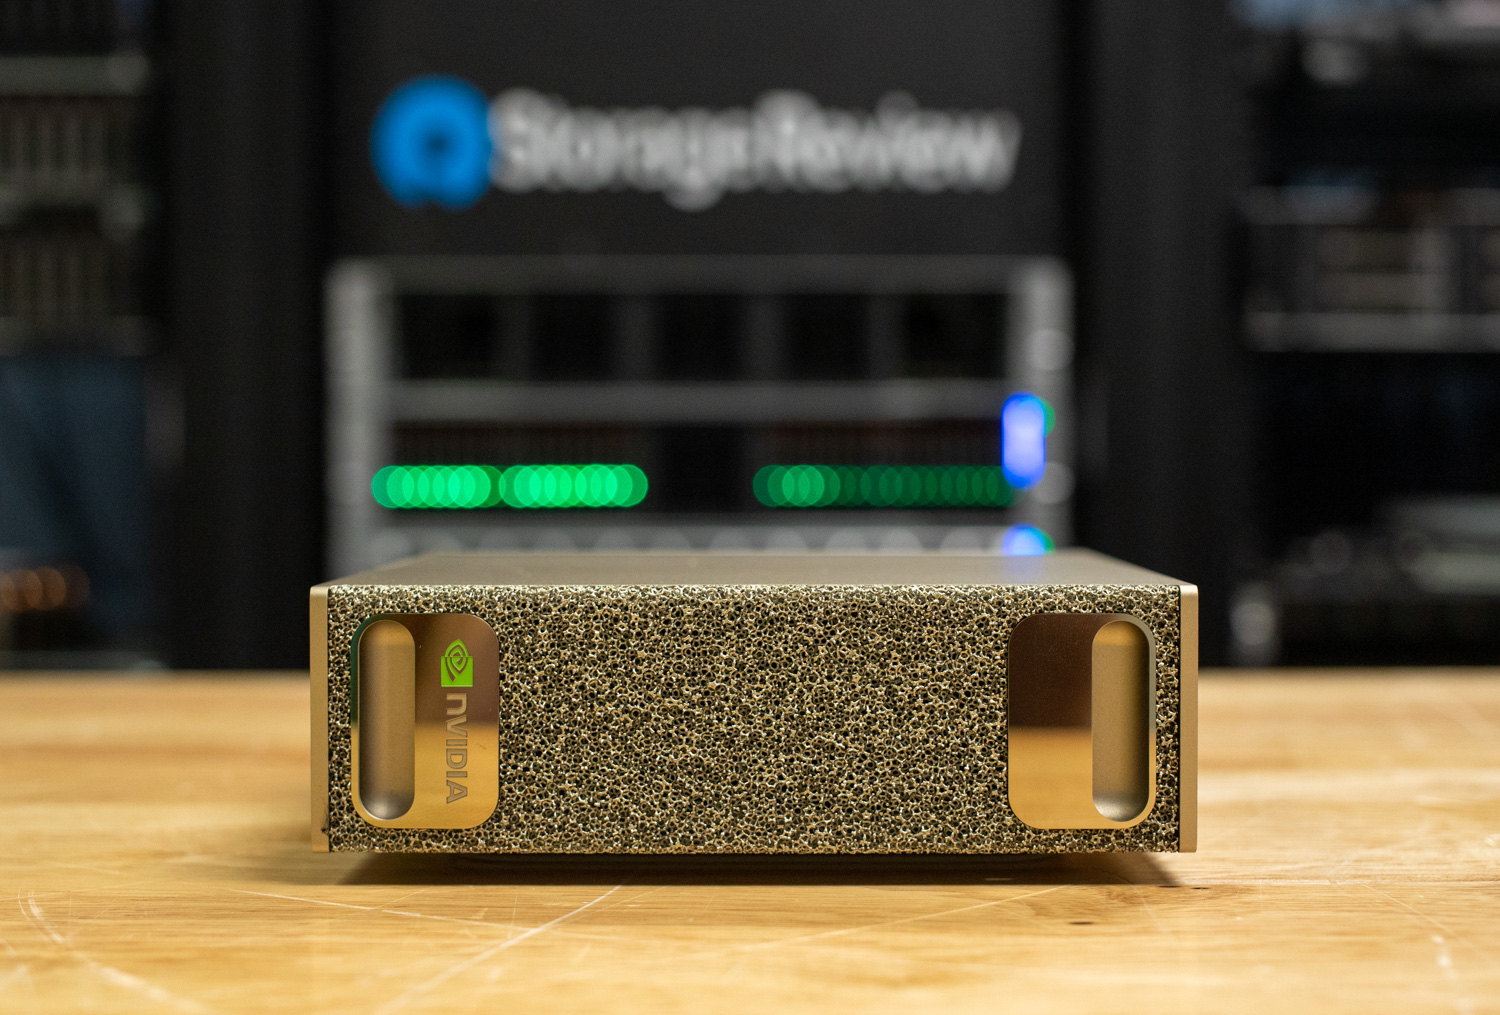
El DGX Spark es el referente con el que se comparan todos los demás equipos de IA de sobremesa. El superchip GB10 Grace Blackwell combina una CPU Arm de 20 núcleos con 128 GB de memoria LPDDR5X unificada, y sus dos puertos ConnectX-7 de 200 GbE lo convierten en el único dispositivo que hemos probado que se agrupa en clústeres de forma nativa: nuestras pruebas de inferencia distribuida de dos nodos ejecutaron cargas de trabajo en paralelo en paralelo en nodos Dell, GIGABYTE y HP a través de 200 GbE.
Esa historia de agrupamiento ahora tiene una vía de acceso más económica: NVIDIA lanzó una versión DGX Spark de 64 GB el 23 de octubre a $4,999 , vendida a través de los mismos seis fabricantes de equipos originales (OEM), y dos de ellas se combinan a través de un cable 200GbE para agrupar 128 GB; NVIDIA afirma que el par agrupado alcanza hasta 1.7 xa de una sola unidad de 128 GB en Qwen3.8 27B, una afirmación que aún no hemos probado. La pila de software CUDA sigue siendo la más completa del segmento.
La única limitación de la plataforma es el almacenamiento: cada sistema GB10 alcanza un máximo de aproximadamente 4 TB en una única ranura M.2 corta. Nuestra configuración de almacenamiento compartido de ocho Spark es la solución ideal: una única matriz QLC controlada que funciona a través de los puertos 100 GbE que ya incorpora cada Spark, donde un cliente lee a 10.8 GiB/s, igualando la velocidad de la M.2 interna más rápida que hemos medido en un sistema GB10, y un modelo de 78 GB alojado centralmente con una carga que se sitúa dentro del 13 % de la NVMe local.
Lee la reseña completa de DGX Spark.
Mejor implementación de GB10: Acer Veriton GN100
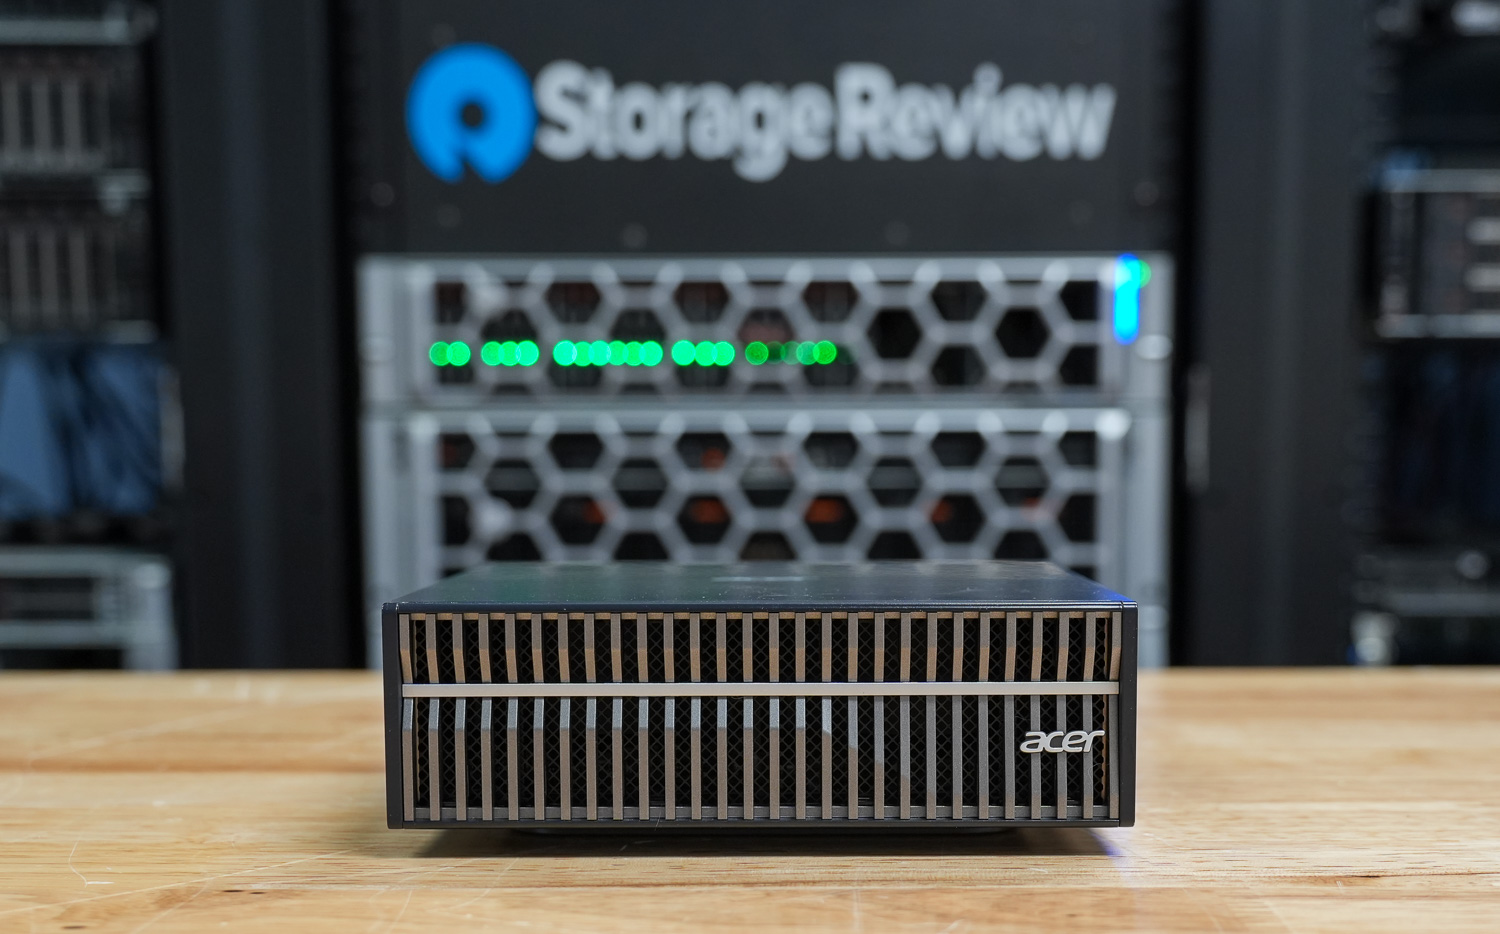
Entre los sistemas GB10 de fabricantes de equipos originales (OEM), el diseño térmico es el factor diferenciador clave, y el Veriton GN100 destacó en nuestras pruebas. Todos los equipos GB10 comparten la misma configuración de silicio y memoria, por lo que el rendimiento sostenido depende de la refrigeración. Nuestra comparativa térmica entre múltiples fabricantes de equipos originales es, hasta donde sabemos, la única de su tipo publicada.
Lee la reseña completa del Veriton GN100.
La mejor alternativa x86: AMD Ryzen AI Halo
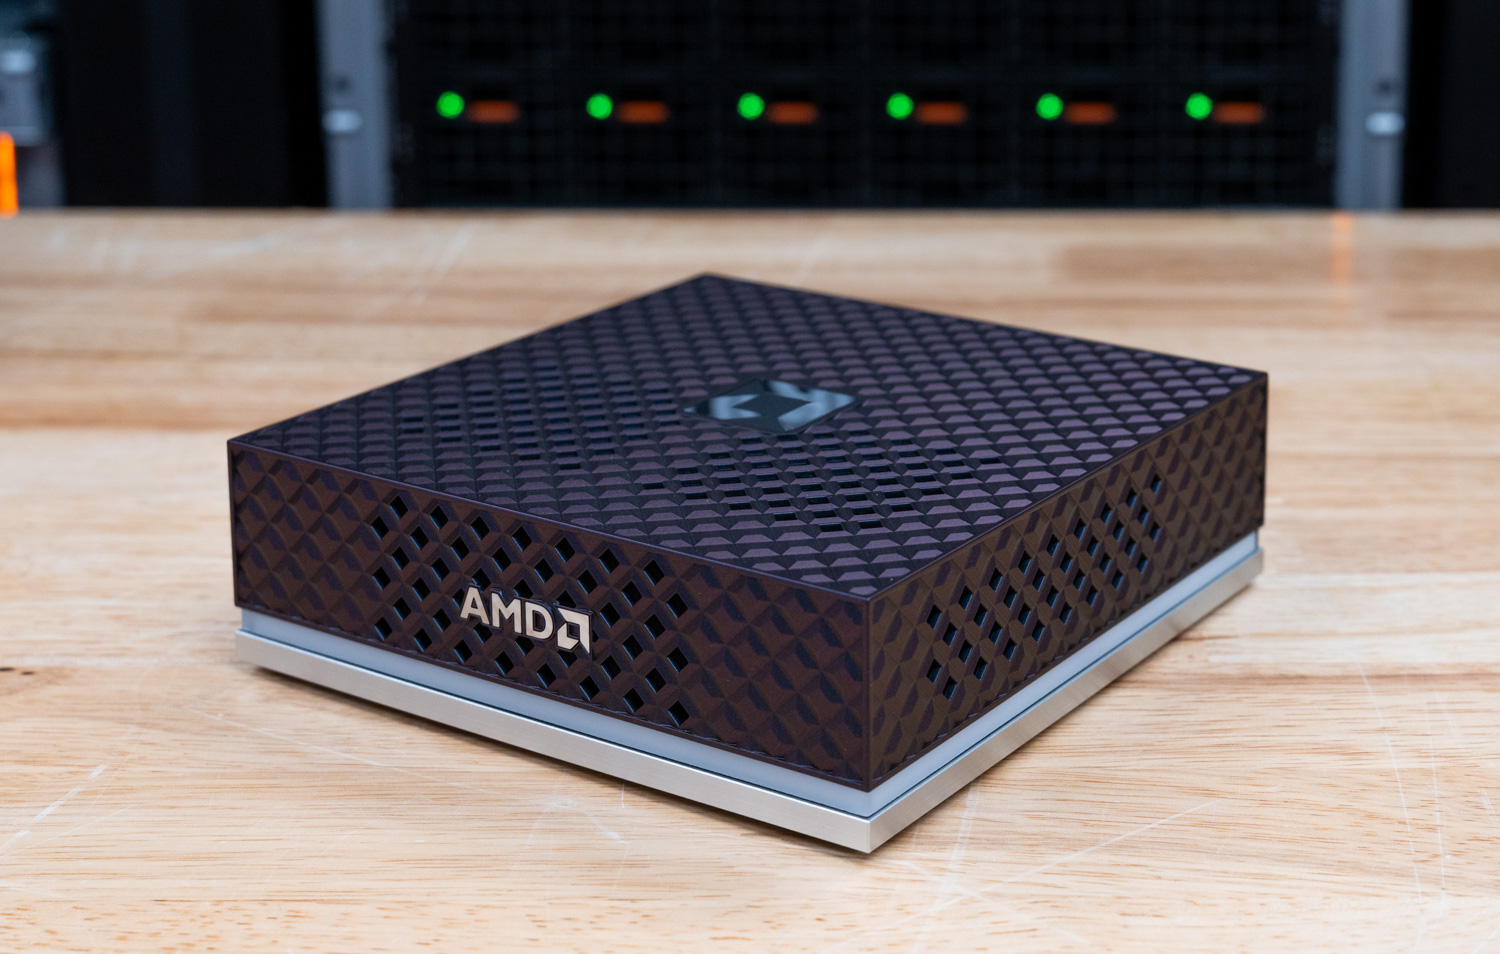
Si necesita Windows o una pila de software x86 estándar, Strix Halo es la solución ideal para su escritorio. La plataforma Ryzen AI Max+ 395 de AMD combina 128 GB de memoria unificada con una configuración de sistema operativo dual, y en nuestras pruebas manejó modelos de clase de 200 mil millones de parámetros, compitiendo directamente con el DGX Spark sin el compromiso del sistema operativo Arm/DGX.
Lee la reseña completa de Ryzen AI Halo.
Mejor opción sin tarjeta gráfica dedicada: HP Z2 Mini G1a
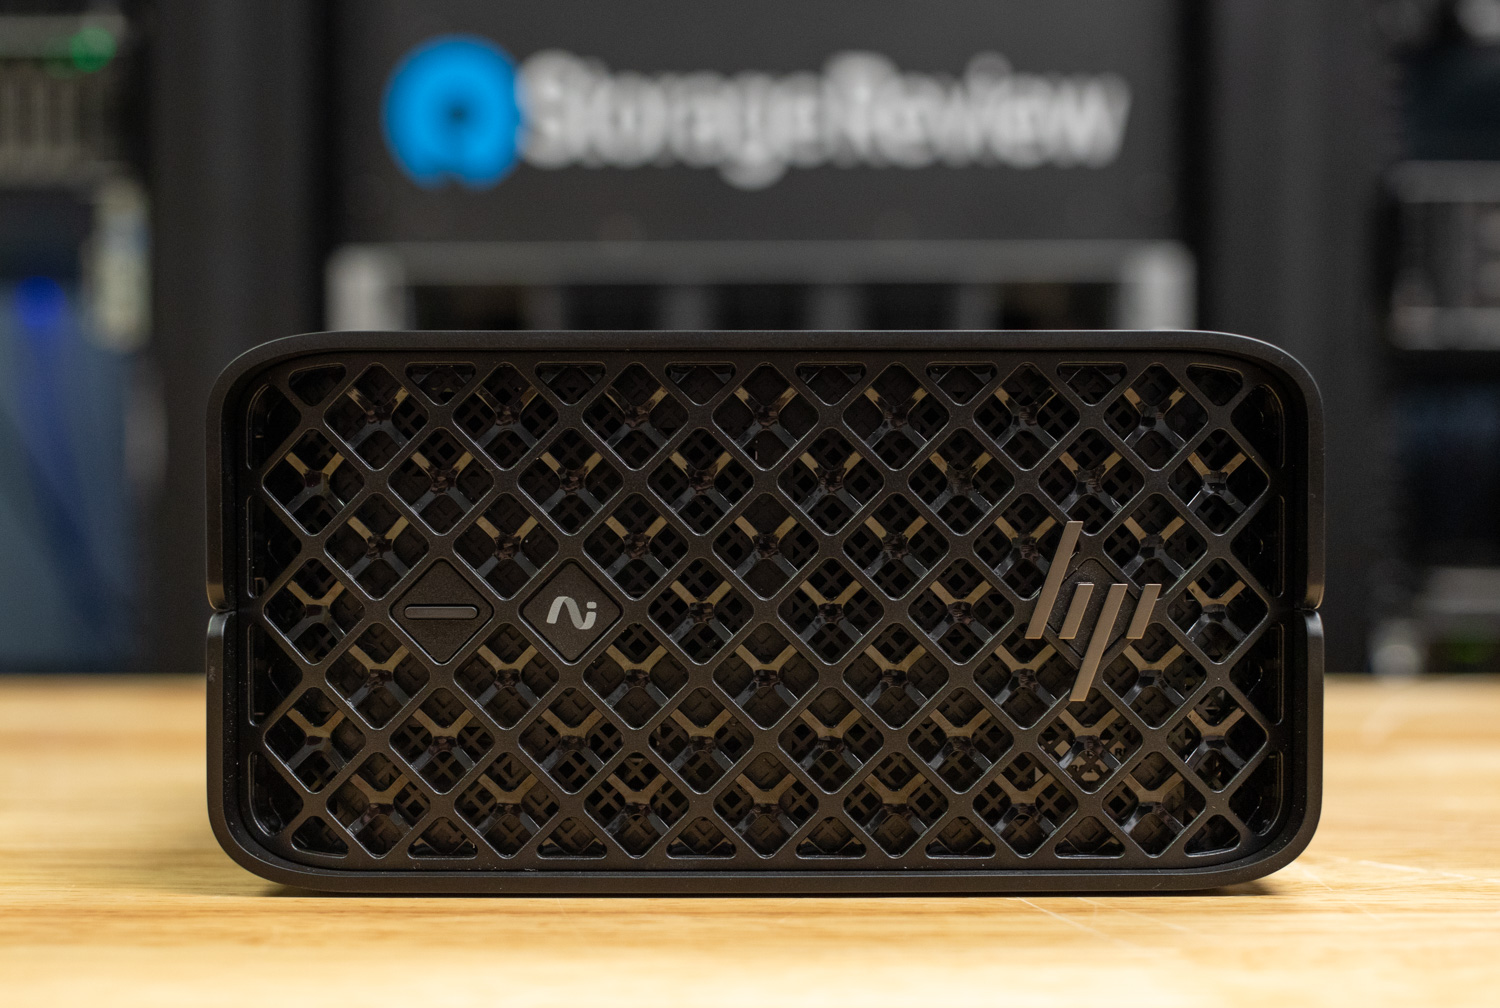
La Z2 Mini G1a ejecutaba GPT-OSS 120B sin tarjeta gráfica dedicada. Esta miniestación de trabajo de HP integra el procesador AMD Ryzen AI Max+ PRO en un chasis compacto, silencioso y apto para entornos informáticos, y sigue siendo la prueba más clara de que los sistemas x86 con memoria unificada han transformado las capacidades de un equipo de oficina compacto.
Lee la reseña completa del Z2 Mini G1a.
Mejor sistema GB300: MSI XpertStation WS300
La WS300 es la primera estación GB300 DGX que pasa por nuestro laboratorio y redefine el estándar para esta gama de dispositivos. El superchip Grace Blackwell Ultra integra 748 GB de memoria coherente (252 GB de HBM3e y 496 GB de LPDDR5X), con una capacidad de cómputo FP4 de 20 petaFLOPS. En nuestras pruebas, procesó un punto de control GLM-5.2 de 433 GB con 216 GB de pesos de expertos almacenados en la memoria Grace, un modelo que no debería funcionar junto a un escritorio. Como todos los sistemas de la clase DGX, utiliza el sistema operativo DGX en lugar de Windows; este es el compromiso que exige tal cantidad de memoria.
Su precio y potencia lo sitúan más cerca de los extremos de la gama de torres que de las cajas GB10 mencionadas anteriormente, pero ningún otro modelo de esta categoría ofrece un rendimiento tan elevado. La pregunta obvia de si un componente de 1,300 W se sobrecalienta en una torre ya tiene respuesta: nuestro análisis térmico exhaustivo del WS300 registró una prueba continua de 2.8 horas con el chip Blackwell Ultra a 60 °C, una frecuencia constante de 2.07 GHz sin caídas y un margen térmico de aproximadamente 20 °C a plena carga.
Alternativa a la GB300: la ASUS ExpertCenter Pro ET900N G3 es la segunda estación GB300 DGX que hemos probado y confirma la plataforma: en 14 modelos y dos cargas de trabajo, 24 de 28 comparaciones de rendimiento máximo se situaron dentro del 2 % de la WS300, y los modelos con coherent pool funcionaron a la par o mejor. ASUS añade asas de transporte a la torre de 27 kg, un ventilador dedicado sobre las jaulas de ópticas de 400 G y una fuente de alimentación 80 PLUS Titanium. Ambas torres ofrecen la plataforma; consulte nuestra reseña de la ET900N G3 para la comparación entre ambas.
Escalado de clúster: dos de estas torres conectadas por cable a través de sus propios puertos de 400G ahora se miden, no se prometen: nuestra prueba de clúster GB300 emparejó las estaciones ASUS y HP con dos DAC, alcanzó el 98 % de la velocidad de línea en los colectivos NCCL y convirtió a GLM-5.2, un modelo de 433 GB que una sola estación solo puede servir vertiendo 215 GB de pesos en la memoria Grace, de 139 tokens de salida por segundo a 32 flujos a 1,525, en camino a 3,141 a 256.
Los modelos que se ajustan a una escala de estación diferente: la desagregación de precarga/decodificación triplicó el rendimiento de mensajes cortos de GLM-5.3 Flash, y DeepSeek V4.1 Flash registró 5,248 tokens por segundo, la salida más alta del conjunto.
Lea la reseña completa de XpertStation WS300.
En el laboratorio: Estación de IA HP ZGX Fury
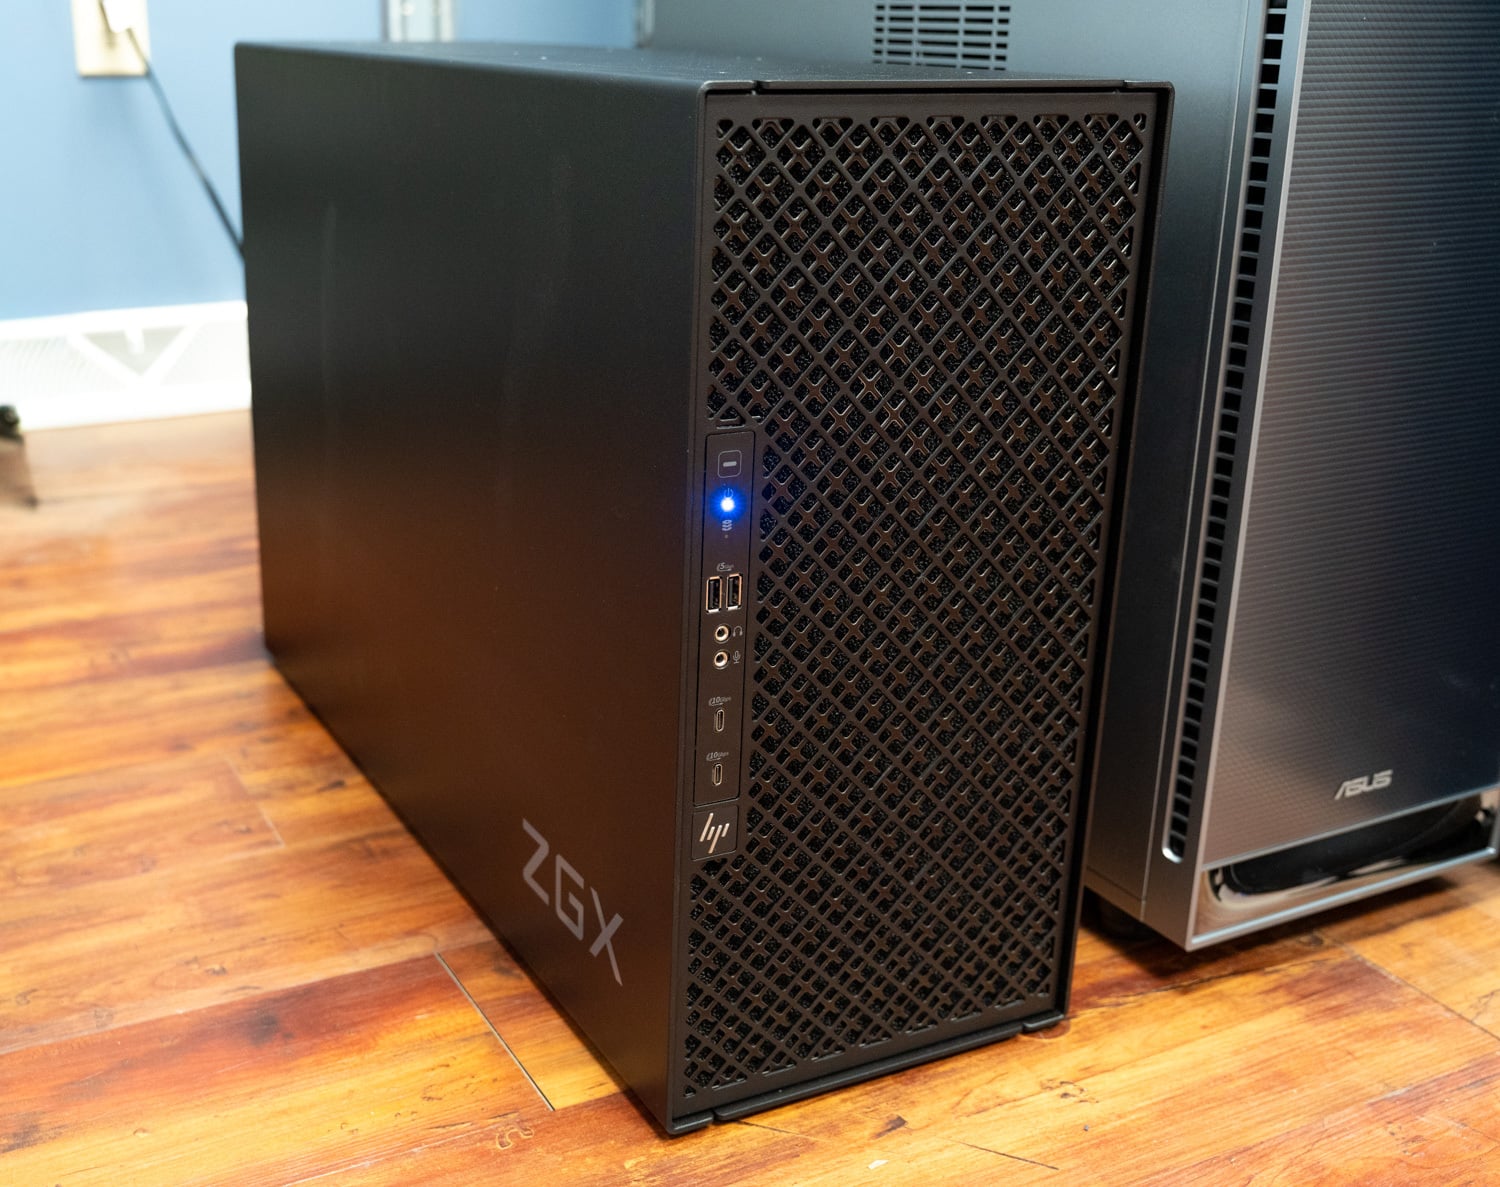
La estación de IA ZGX Fury de HP ya está en nuestro laboratorio. Está construida sobre la misma plataforma NVIDIA GB300 Grace Blackwell Ultra que la MSI XpertStation WS300 mencionada anteriormente, lo que nos brinda la primera oportunidad de ver cómo se comparan las implementaciones de la arquitectura DGX Station de dos fabricantes en el mismo banco de pruebas: temperatura, acústica, frecuencias de reloj sostenidas y la experiencia práctica de usar la máquina en el día a día.
Ya se han publicado sus primeras cifras: el ZGX Fury funcionó como segunda torre en nuestra prueba de clúster GB300 de dos estaciones , ejecutando la decodificación para la configuración Flash GLM-5.3 desagregada y la mitad de cada ejecución en paralelo de tensores. La revisión individual está en curso, y el ZGX Fury entrará en la clasificación cuando se publiquen sus propios resultados de pruebas.
El ZGX Fury es también uno de los dos primeros sistemas que Microsoft denominó DGX Station para Windows , junto con el Dell Pro Precision con GB300, y NVIDIA anunció la versión para Windows para el cuarto trimestre. El hardware coincide con el de las torres GB300 que hemos probado en Ubuntu, y la incógnita para esta versión es si las pilas de servidores se ejecutan de forma nativa en Windows o bajo WSL.
En el horizonte: AMD Threadripper Halo Station
Presentada en la IFA 2026 y aún no disponible en ningún laboratorio, la Threadripper Halo Station de AMD es la primera respuesta directa a la clase GB300 mencionada anteriormente. La propuesta invierte la apuesta de NVIDIA: en lugar de un gran pool de memoria coherente, AMD combina un Threadripper PRO de 96 núcleos en una plataforma con hasta 2 TB de DDR5 de ocho canales y 128 líneas PCIe 5.0 con dos aceleradores Instinct MI350P de 600 W con 144 GB de HBM3E cada uno, y una ruta declarada para cuatro tarjetas y 576 GB de HBM. Todo el sistema está refrigerado por líquido, y el host x86 evita la fricción de la cadena de herramientas Arm que señalamos en el análisis de la WS300.
La incógnita reside en la eficacia con la que los modelos gestionan las tarjetas conectadas por PCIe frente a la coherencia NVLink-C2C. AMD no ha presentado datos de rendimiento, precios ni disponibilidad, por lo que se trata de un producto a tener en cuenta, no de una elección definitiva. Encontrará más detalles en nuestra cobertura del anuncio ; entrará en la clasificación cuando el hardware llegue a los laboratorios.
También se probaron: Dispositivos de IA para escritorio
Estos sistemas han pasado por el mismo proceso de laboratorio y son opciones sólidas que no ocuparon un lugar en la categoría: Dell Pro Max con GB10 , ASUS Ascent GX10 , GIGABYTE AI TOP ATOM , HP ZGX Nano G1n y HP EliteDesk 8 Mini G1a.
Torres de estaciones de trabajo para IA local
Cuando el tiempo de respuesta importa más que el costo de adquisición (asistentes de codificación interactivos, servicio multiusuario, pipelines de agentes con largas cadenas de llamadas a herramientas), la VRAM discreta sigue siendo la mejor opción. Estas torres se clasifican aquí según el rendimiento de inferencia y el límite de memoria, y para cada una indicamos la configuración de GPU que probamos junto con el máximo del chasis, ya que lo que un chasis puede albergar en última instancia importa tanto como lo que venía en nuestra configuración; una torre necesita dos o más GPU para clasificarse en esta sección. Las torres de una sola GPU, incluidas aquellas con una RTX PRO 6000 de 96 GB, se clasifican en nuestra página de Mejores estaciones de trabajo de escritorio en nuestra suite de clientes de Windows, porque responden a una pregunta diferente.
También agrupamos las torres por plataforma anfitriona, ya que la CPU y la memoria de las tarjetas determinan cómo una torre gestiona los modelos que exceden la memoria de la GPU, la búsqueda vectorial y las simulaciones que suelen compartir la máquina. La Precision 7875 lidera la categoría Threadripper y es la torre preferida, la Pro Precision 9 T4 lidera la categoría Xeon, y la categoría Core Ultra queda disponible cuando una torre Core Ultra con doble GPU pasa por nuestro laboratorio.
Mejor torre para IA local: Dell Precision 7875
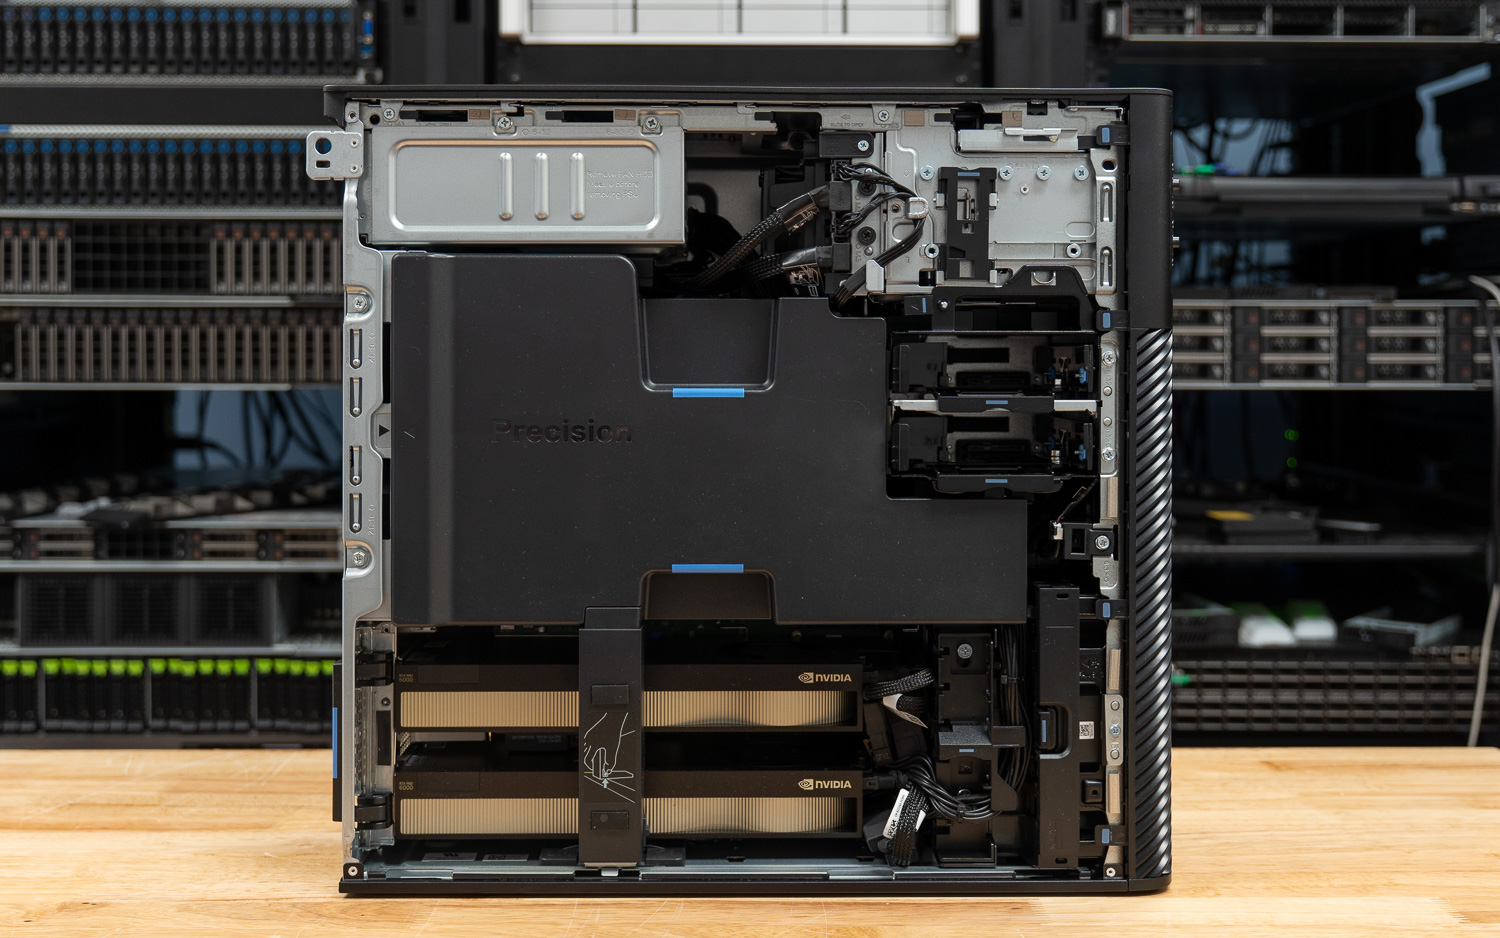
Las dos GPU RTX PRO 6000 Blackwell convierten a la Precision 7875 en el sistema de formato estándar más rápido que hemos probado para inferencia local. Con un Threadripper PRO 9995WX y 192 GB de VRAM combinada en dos tarjetas, ejecuta modelos de clase 100B completamente en memoria GPU, ofreciendo un tiempo de respuesta al primer token de nivel interactivo que ningún dispositivo de memoria unificada puede igualar. Sin embargo, tenga en cuenta el límite: el chasis 7875 admite un máximo de dos tarjetas de doble ancho, por lo que nuestra configuración de doble GPU es la configuración máxima; no es posible añadir una tercera posteriormente.
Lea la reseña completa de la Precision 7875.
Mejor torre Xeon para IA local: Dell Pro Precision 9 T4
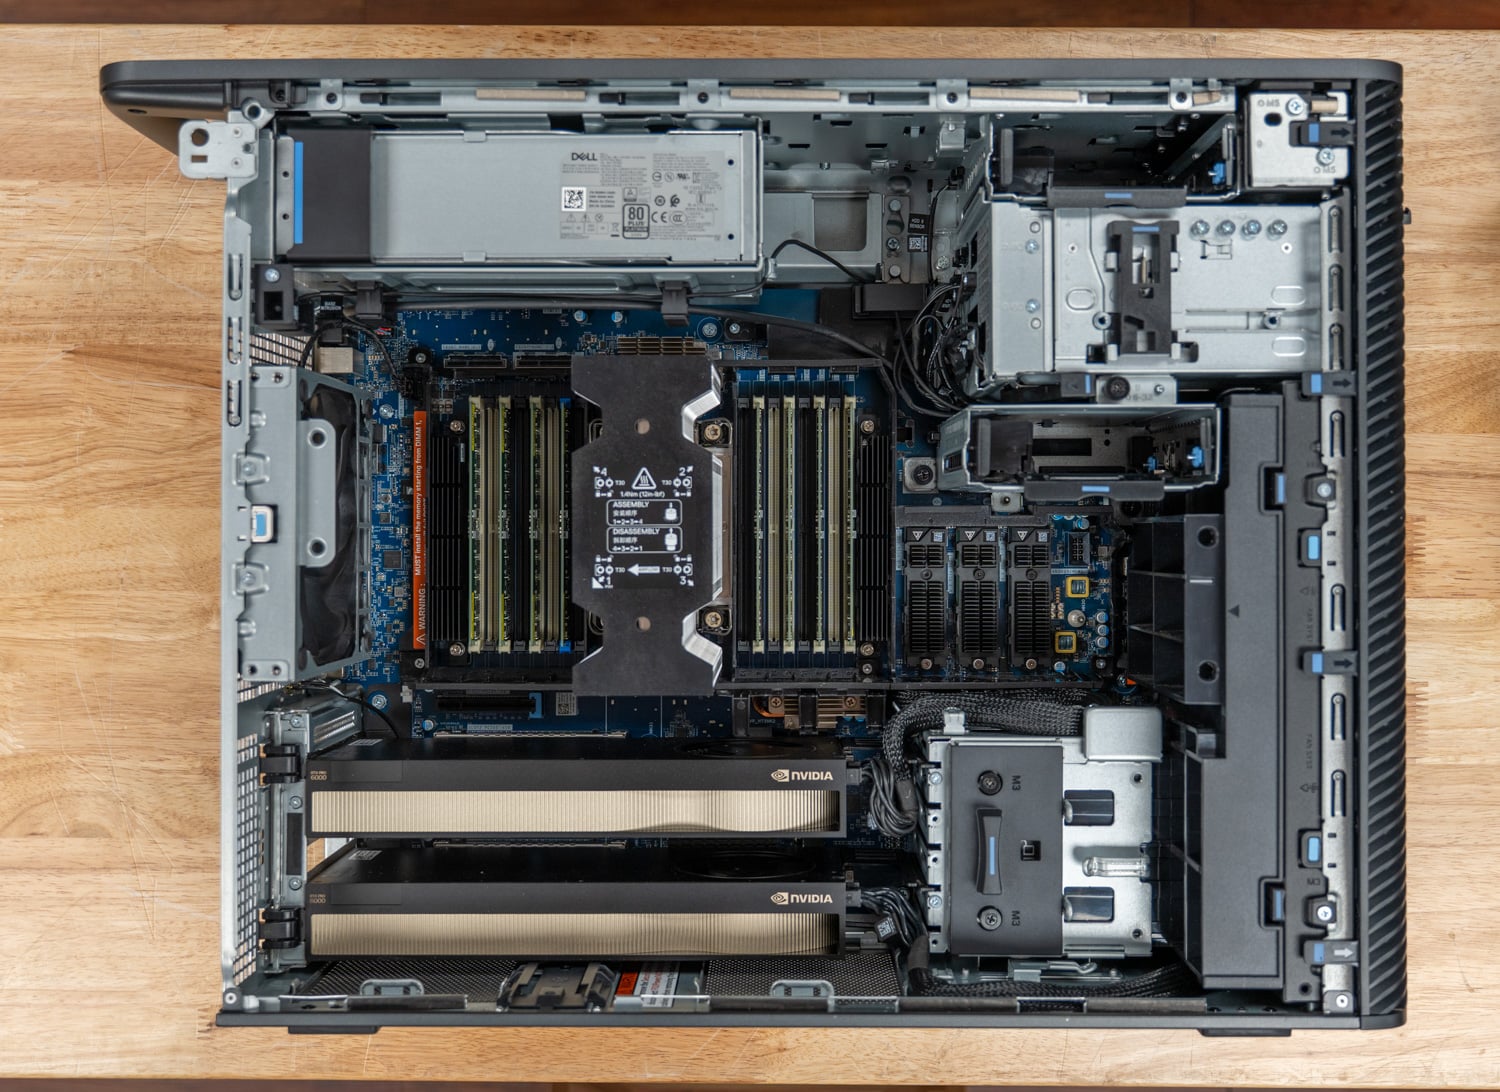
La Precision 9 T4 Pro iguala a la Precision 7875 en cuanto a GPU y la supera en todo lo que el procesador Xeon procesa. Sus dos tarjetas RTX PRO 6000 Max-Q funcionaron con un rendimiento entre un 1 % y un 9 % inferior al del par idéntico de la 7875 en el servicio con una sola GPU y con una diferencia del 10 % en la integración y el ajuste fino con dos GPU. Distribuida entre ambas tarjetas, la MiniMax M2.7, un modelo de 129.3 GB demasiado grande para una sola tarjeta, generó 83.7 tokens por segundo para un usuario, frente a los 85.0 de la 7875.
La diferencia radica en el sistema anfitrión: ocho canales de DDR5-6400 proporcionan al procesador Xeon 698X de 86 núcleos un ancho de banda de memoria de 328 GB/s, un 53 % más que el 7875, y esto se refleja en el rendimiento de los modelos. La búsqueda vectorial HNSW se ejecutó a 1.51 veces la velocidad del 7875, el índice se construyó en 27.3 segundos frente a 34.8, y la resolución de OpenFOAM drivAer finalizó en 293 segundos frente a 556. Su unidad de arranque Gen5 también cargó gpt-oss:120b en frío en 15.2 segundos frente a 25.8.
La 7875 se mantiene como la mejor opción general porque supera a la T4 en todas las pruebas de rendimiento que dependen de la GPU, y su procesador Threadripper ejecuta las tareas de renderizado y compilación que dependen del núcleo entre un 18 y un 38 por ciento más rápido. La T4 es la torre ideal para equipos que implementan modelos, simulaciones y análisis en una sola máquina, y el configurador de Dell la limita a dos tarjetas RTX PRO 6000. Su precio en Dell.com, con la configuración especificada, rondaba los 66,600 dólares en el momento de la reseña.
Lea la reseña completa de la Pro Precision 9 T4.
Mejor plataforma multi-GPU: HP Z8 Fury G6i
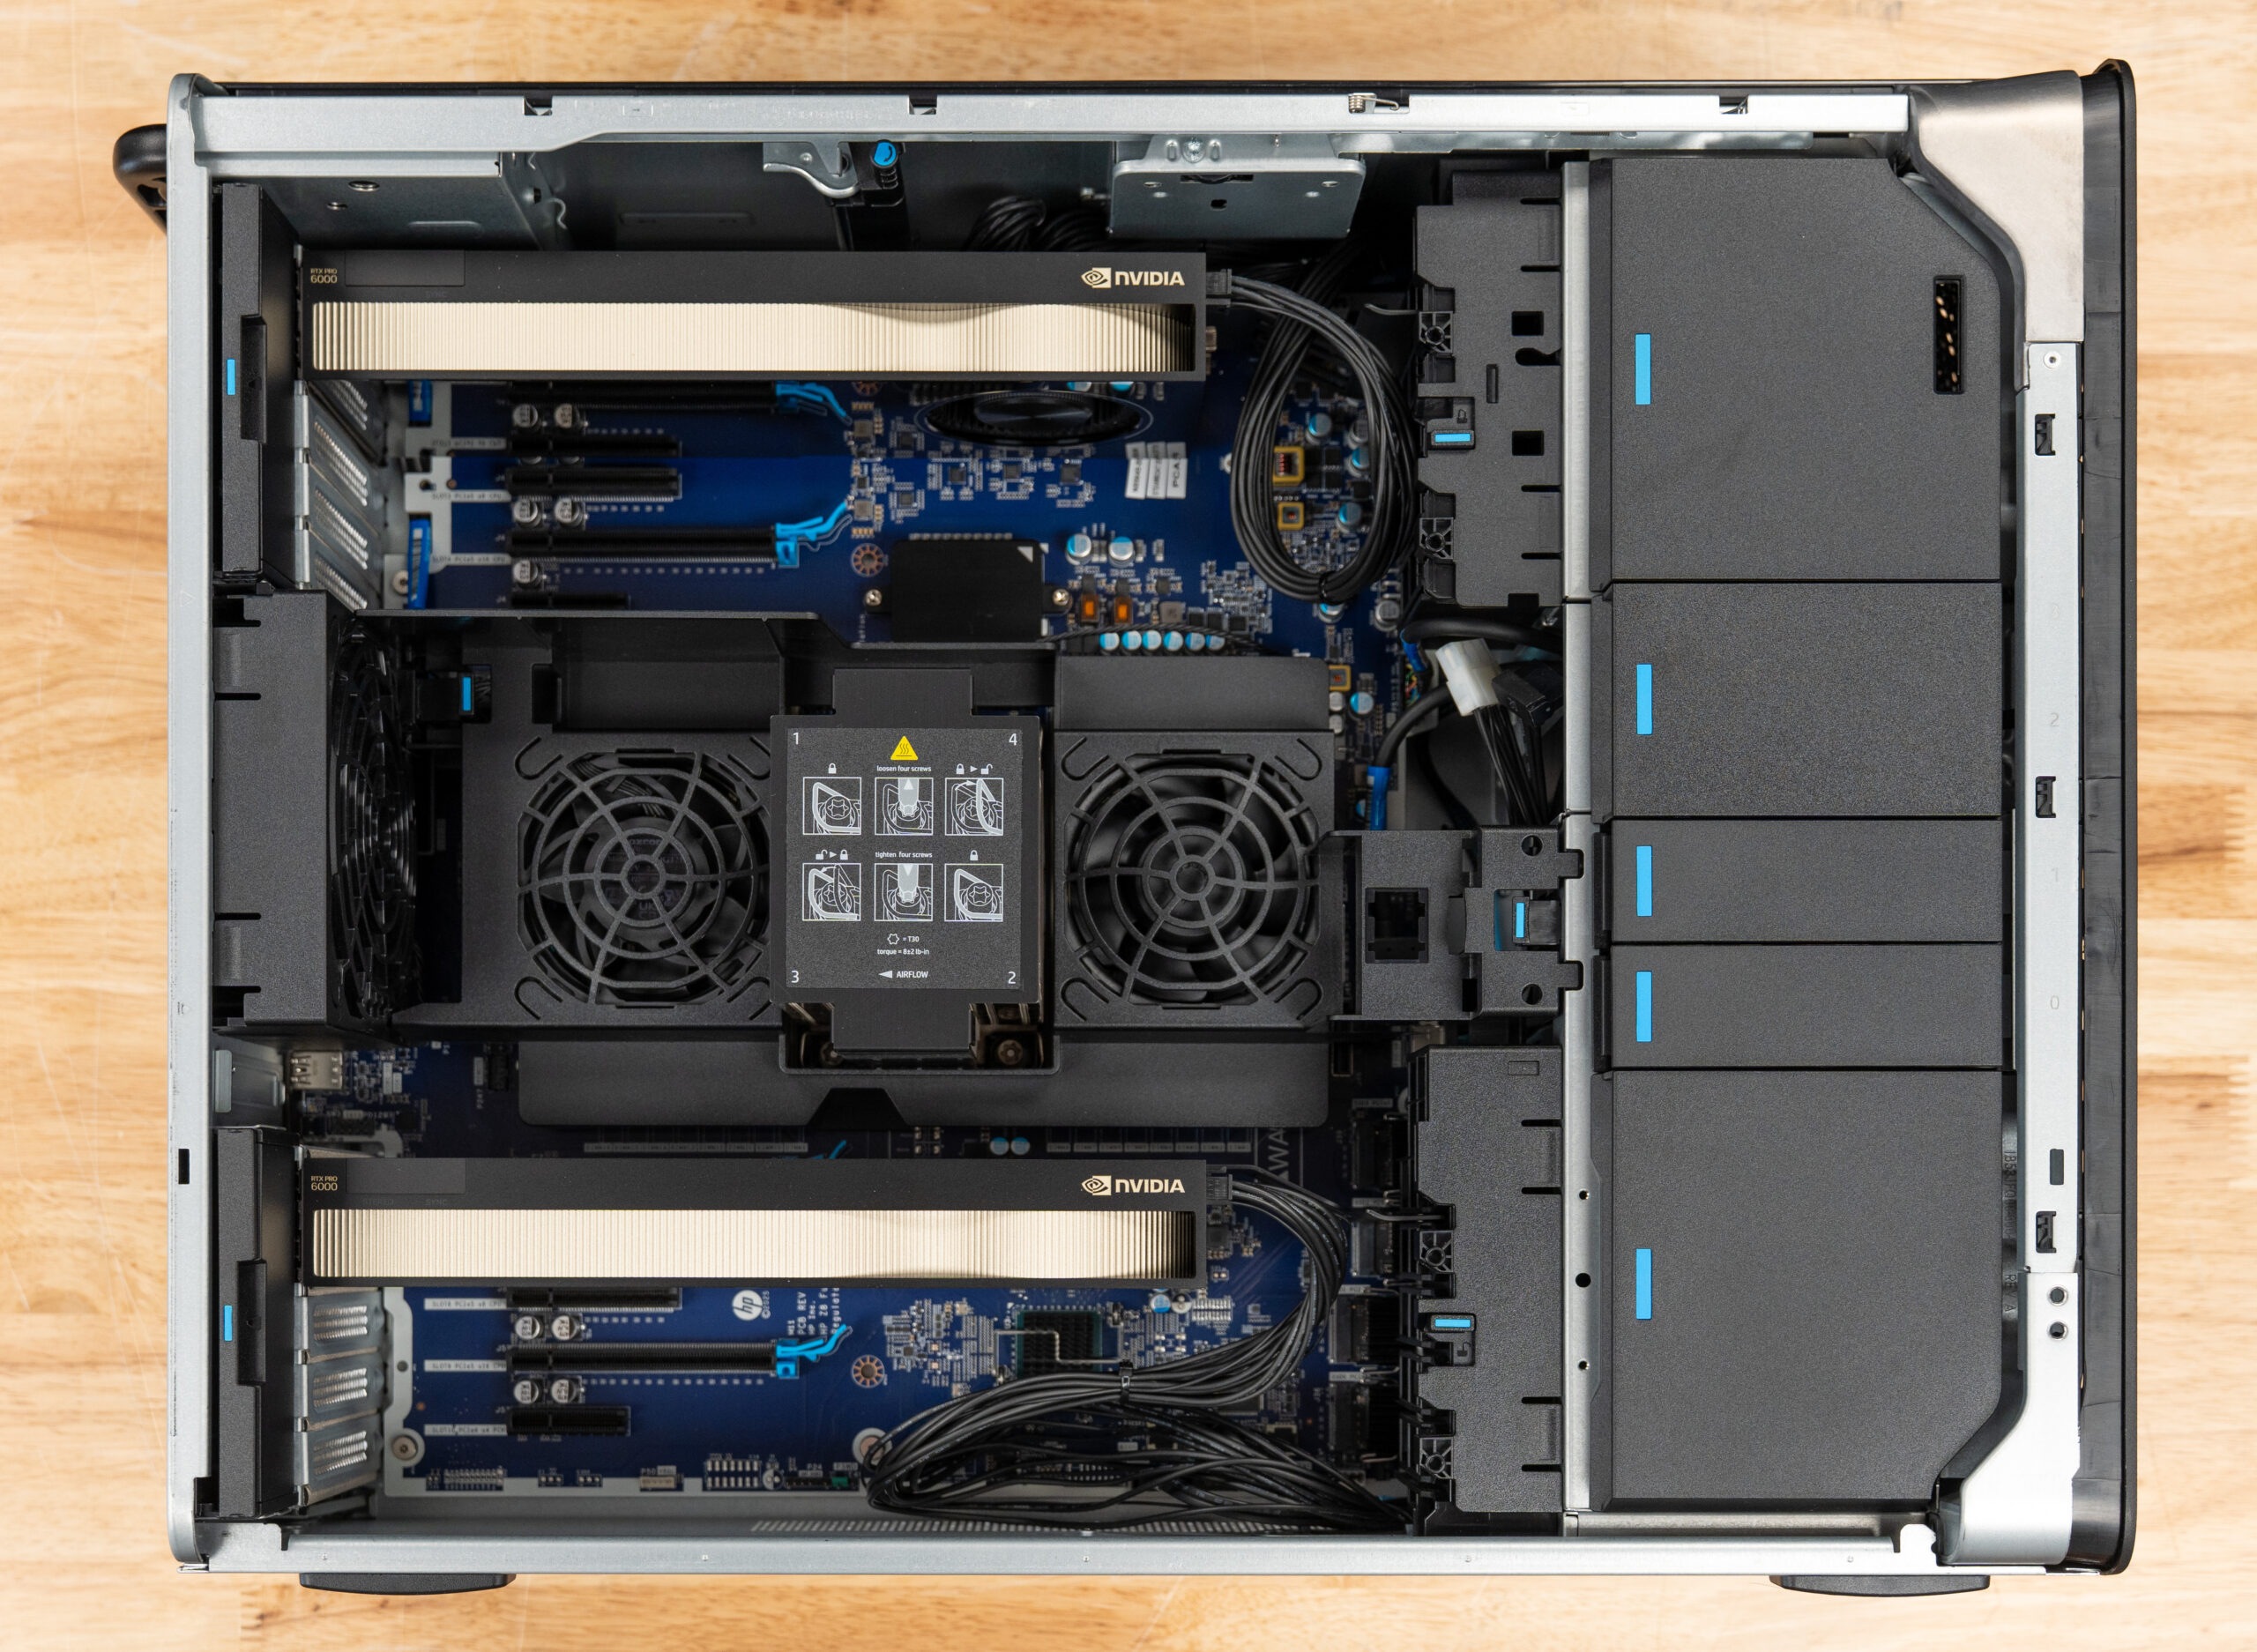
La Z8 Fury G6i es la torre ideal si planeas ampliar tu equipo con más tarjetas gráficas. En nuestra prueba, utilizamos dos tarjetas RTX PRO 6000 Max-Q con una VRAM combinada de 192 GB, pero el chasis, alimentado por dos fuentes de alimentación que suman hasta 2700 W, admite hasta cuatro tarjetas Blackwell y 384 GB de VRAM. La diferencia entre la configuración probada y la máxima capacidad es clave: ninguna torre OEM estándar que hayamos probado ofrece mayor capacidad para tarjetas gráficas, y pasar de dos a cuatro tarjetas no requiere cambiar el chasis.
Lee la reseña completa del Z8 Fury G6i.
La elección extrema: Comino Grando RTX PRO 6000
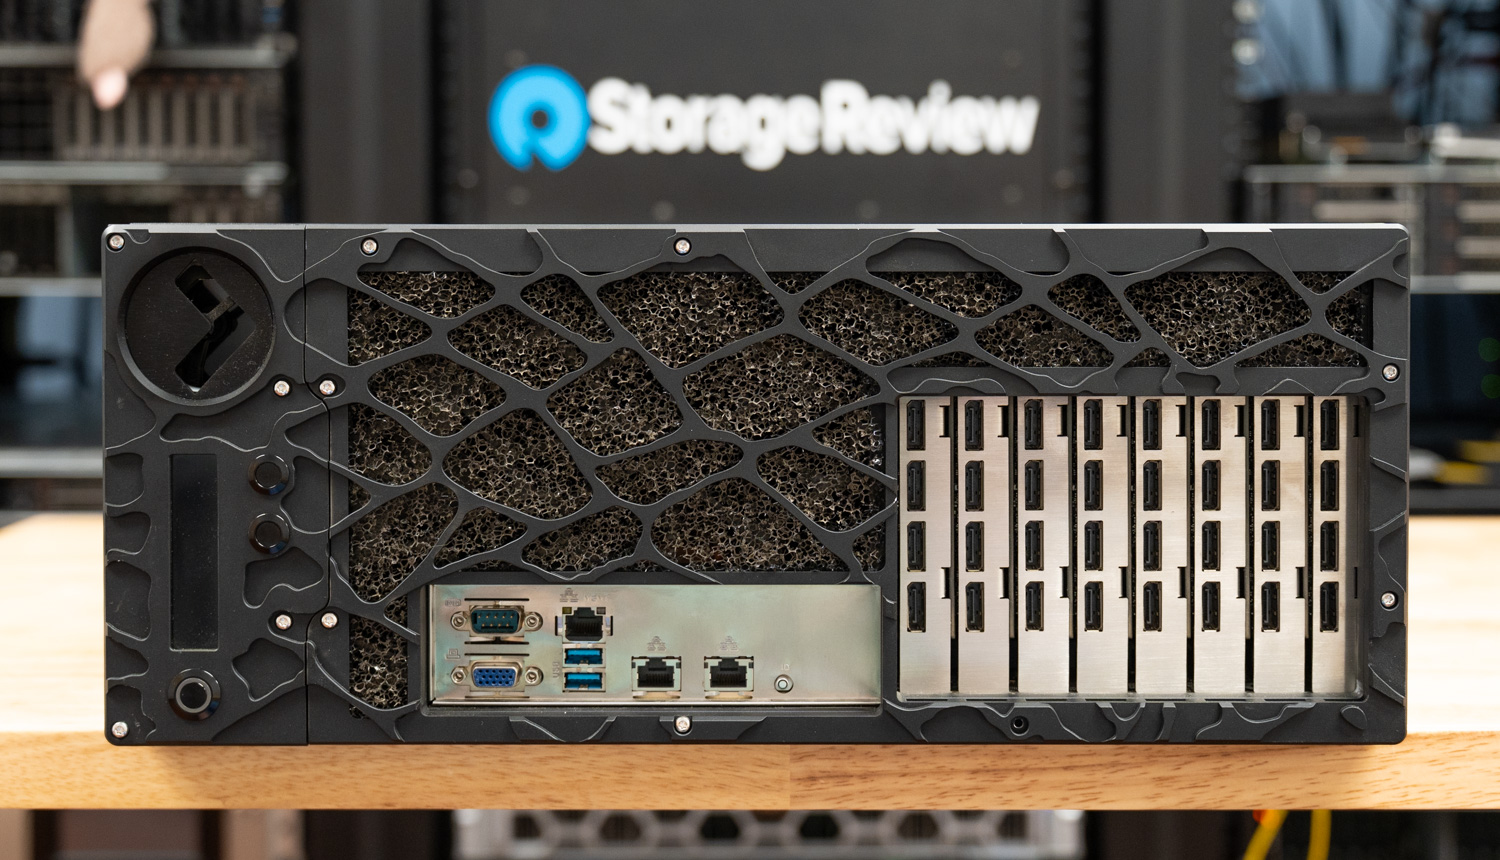
768 GB de VRAM en un chasis 4U con refrigeración líquida: el Grando existe para el comprador cuyo modelo no encaja en ningún otro lugar. Nuestra unidad de prueba venía con ocho tarjetas RTX PRO 6000 Blackwell de 96 GB cada una, el máximo del chasis, y la refrigeración líquida de Comino mantiene las ocho funcionando a su TDP máximo las 24 horas del día sin estrangulamiento térmico. Esto supone más memoria de GPU que muchos servidores de rack, en un dispositivo que aún puede colocarse junto a un escritorio. Su precio es elevado, no su acústica, y es deliberadamente la excepción en esta lista: prueba de hasta dónde llega el límite en el ámbito de los servidores de escritorio.
Lee la reseña completa de Comino Grande.
Cómo clasificamos
Cada clasificación de StorageReview se rige por tres reglas. La primera establece que solo se clasifican los sistemas probados en laboratorio : si no se han sometido a pruebas de rendimiento, se puede mencionar, pero no puede ocupar una categoría propia. En segundo lugar, los sistemas se clasifican una sola vez por cada criterio de medición. Los equipos mencionados anteriormente también figuraban en nuestra clasificación de estaciones de trabajo de escritorio según SPECworkstation y rendimiento de renderizado hasta octubre de 2026, fecha en la que dicha página pasó a incluir sistemas con una sola GPU. Sus resultados en esa página se conservan en sus respectivas reseñas, y aquí se clasifican según el rendimiento de inferencia y el límite de memoria.
En tercer lugar, existe un requisito mínimo: el sistema necesita dos o más GPU, probadas con vLLM Serving o nuestra suite llama.cpp en Linux, o un grupo de memoria compartida con al menos 96 GB disponibles para los modelos. Las torres con una sola GPU, incluso con una tarjeta de 96 GB, aparecen en nuestra página de Mejores Estaciones de Trabajo de Escritorio en nuestra suite de clientes para Windows.
Las clasificaciones se derivan de una combinación del rendimiento de servicio en línea de vLLM, el tiempo hasta el primer token, el tiempo por token de salida, la eficiencia de cómputo de MAMF, el rendimiento de almacenamiento de GDSIO y el precio de mercado. El criterio editorial resuelve los empates dentro de los rangos de puntuación. Las torres probadas en nuestra suite llama.cpp más reciente se clasifican según su rendimiento de servicio, tiempo hasta el primer token, carga del modelo, RAG y resultados de ajuste fino, y volvemos a probar las torres de comparación en esa suite cuando clasificamos una nueva. Los proveedores no ven las clasificaciones antes de su publicación, y ninguna aparición en esta página es remunerada.
Preguntas frecuentes sobre IA local para escritorio
¿Cuál es el mejor ordenador de sobremesa para la IA ámbrica?
Las cargas de trabajo de agentes, como agentes de codificación, pipelines de llamadas a herramientas y tareas autónomas de varios pasos, son sensibles al rendimiento y la latencia de una manera que el uso de un solo chat no lo es, porque los agentes encadenan muchas llamadas a modelos con un contexto extenso. Esto favorece la categoría de torre: la VRAM discreta de la Dell Precision 7875 proporciona el tiempo sostenido hasta el primer token que mantiene la capacidad de respuesta de largas cadenas de agentes. Para la experimentación de agentes con presupuesto limitado, un dispositivo de clase GB10 ejecuta las mismas pilas a menor velocidad. Nuestra guía completa de dimensionamiento se encuentra en RAM, GPU y almacenamiento para IA de agentes.
¿Cuánta memoria necesito para ejecutar un modelo 70B localmente?
Como regla general, un modelo 70B con cuantización de 4 bits necesita aproximadamente entre 40 y 48 GB de memoria accesible antes de la carga de contexto; para un uso interactivo cómodo con un contexto extenso se requiere más memoria. Por eso, los dispositivos con memoria unificada de 128 GB funcionan bien con los modelos de la clase 70B, y por eso las torres con una sola GPU aparecen en nuestra página de Mejores Estaciones de Trabajo de Escritorio.
¿Necesito poderes especiales para operar estos sistemas?
En cuanto a los electrodomésticos, no: los equipos GB10 y los sistemas Strix Halo funcionan sin problemas con una toma de corriente estándar de oficina. Las torres merecen una conversación seria con el propietario del edificio. Un HP Z8 Fury G6i completamente configurado puede soportar fuentes de alimentación duales que suman hasta 2700 W, más de lo que puede suministrar un circuito estándar de 15 amperios y 120 V, y el Comino Grando especifica fuentes de alimentación de 2000 W intercambiables en caliente que requieren una entrada de 180-264 V, reduciéndose a unidades de 1000 W con un servicio de 110 V.
Antes de comprar desde la parte superior de esta página, compruebe la capacidad de la toma de corriente; un circuito dedicado o un servicio de 208/240 V puede influir en el coste total de un sistema completo de GPU. El calor se calcula de la misma manera, ya que cada vatio consumido se disipa en la habitación.
¿Qué tal un Mac Studio?
Todavía no, porque no hemos realizado ninguna prueba de laboratorio. Apple comenzó a distribuir el Mac Studio con M5 Max y M5 Ultra el 22 de septiembre. El M5 Max ofrece hasta 128 GB de memoria unificada desde 2,499 $ y el M5 Ultra hasta 512 GB desde 5,499 $. La configuración de 512 GB, la más importante para los modelos de mayor capacidad, estará disponible a finales de octubre a un precio que Apple aún no ha anunciado. Si probamos alguno, lo clasificaremos según los resultados de las pruebas, como todos los sistemas de esta página.
¿Cuál es la mejor estación de trabajo Xeon para IA local?
La Dell Pro Precision 9 T4 , nuestra mejor torre Xeon para IA local. Con dos tarjetas RTX PRO 6000 Max-Q, funcionó entre un 1 y un 9 por ciento por debajo de la Precision 7875 basada en Threadripper en servicio de una sola GPU y dividió un modelo MiniMax M2.7 de 129.3 GB entre ambas tarjetas a 83.7 tokens por segundo, mientras que sus ocho canales de DDR5-6400 proporcionaron un 53 por ciento más de ancho de banda de memoria para búsqueda vectorial y simulación. La Precision 7875 sigue siendo nuestra torre preferida en rendimiento de GPU.


 Amazon