

Updated October 26, 2026: The Lenovo ThinkPad P1 Gen 9 joins Also Tested with its new-suite MLPerf Client results; picks unchanged. On October 16, RTX Spark laptops joined the page in a section of their own, led by the HP OmniBook Ultra 16 and the Lenovo Yoga 9n 2-in-1 16.
Todos los portátiles que aparecen en esta lista han pasado por el laboratorio de StorageReview. Medimos directamente el rendimiento de la IA local: UL Procyon AI Text Generation ejecuta los mismos modelos en todos los sistemas compatibles, y cuando el hardware lo permite, profundizamos con LM Studio y Ollama. Ninguna clasificación de esta página se basa en las especificaciones técnicas, y cada selección enlaza con la reseña que contiene los datos.
En 2026, existen dos caminos para ejecutar modelos de IA en un portátil. Las GPU NVIDIA RTX PRO dedicadas ofrecen la mayor velocidad de procesamiento, pero el modelo debe caber dentro de la VRAM de la tarjeta, que varía entre 8 GB y 24 GB. Los diseños de memoria unificada y compartida, liderados por las plataformas Ryzen AI Max+ (Strix Halo) de AMD y Core Ultra LPCAMM2 compartidas de Intel, priorizan la capacidad sobre la velocidad bruta: la GPU puede utilizar la mayor parte de la memoria del sistema, lo que permite que los modelos más grandes se carguen sin problemas. Las opciones que se presentan a continuación abarcan ambos caminos, además de la clase de eficiencia con prioridad en la NPU.
A simple vista
| Categoría | Sistema | Motor AI | Resultado clave | Opinión completa |
|---|---|---|---|---|
| Mejor portátil en general para IA local | Dell Pro Max 18 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 185 tok/s (Phi, Procyon), el portátil más rápido que hemos probado. | Análisis del Pro Max 18 Plus |
| Ideal para modelos grandes | HP ZBook Ultra G1a 14 | Ryzen AI Max+ PRO 395, hasta 96 GB de memoria unificada asignable | Cargando DeepSeek-R1 70B; Gemma 3 27B a 9 tok/s | Análisis del ZBook Ultra G1a |
| El mejor equilibrio de 16 pulgadas | Dell Pro Max 16 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 179 tok/s (Phi) con 6 h 21 min de batería | Análisis del Pro Max 16 Plus |
| El mejor ultraportátil | Lenovo ThinkPad P14s Generación 7 | RTX PRO 1000 Blackwell 8GB / 64GB LPCAMM2 | 55 tok/s (Phi) a 3.59 lb | Reseña de la P14s Gen 7 |
| Mejor sin una GPU dedicada | Dell Pro Precision 5 14s Intel | GPU integrada Intel Arc Pro B390, 64 GB de memoria LPCAMM2 compartida. | Ejecutó modelos que superan los 8 GB de VRAM, 23 h 50 min de batería | Análisis del Pro Precision 5 14s |
| El mejor sistema NPU delgado y ligero | HP EliteBook 6 G1q | Snapdragon X Plus, NPU hexagonal de 45 TOPS, 32 GB | Llama 3.2 3B a 37 tok/s en LM Studio | Análisis del EliteBook 6 G1q |
| Mejor portátil con RTX Spark | HP OmniBook Ultra 16 | RTX Spark N1X, CPU de 20 núcleos / GPU Blackwell de 6,144 núcleos, 128 GB (64 GB para la GPU) | Tarea del agente de codificación 35B en 72.0 s a 89.5 tok/s, 3 de 3 ejecuciones superadas | Análisis del OmniBook Ultra 16 |
| El portátil RTX Spark con menor temperatura de funcionamiento | Lenovo Yoga 9n 2 en 1 16 | RTX Spark N1X, CPU de 20 núcleos / GPU Blackwell de 6,144 núcleos, 64 GB (32 GB para la GPU) | 72 °C de pico durante una carga sostenida de 30 minutos, frente a 98 °C en el HP OmniBook Ultra 16 | Reseña de Yoga 9n 2 en 1 (16 sesiones) |
Las selecciones
Mejor portátil en general para IA local: Dell Pro Max 18 Plus
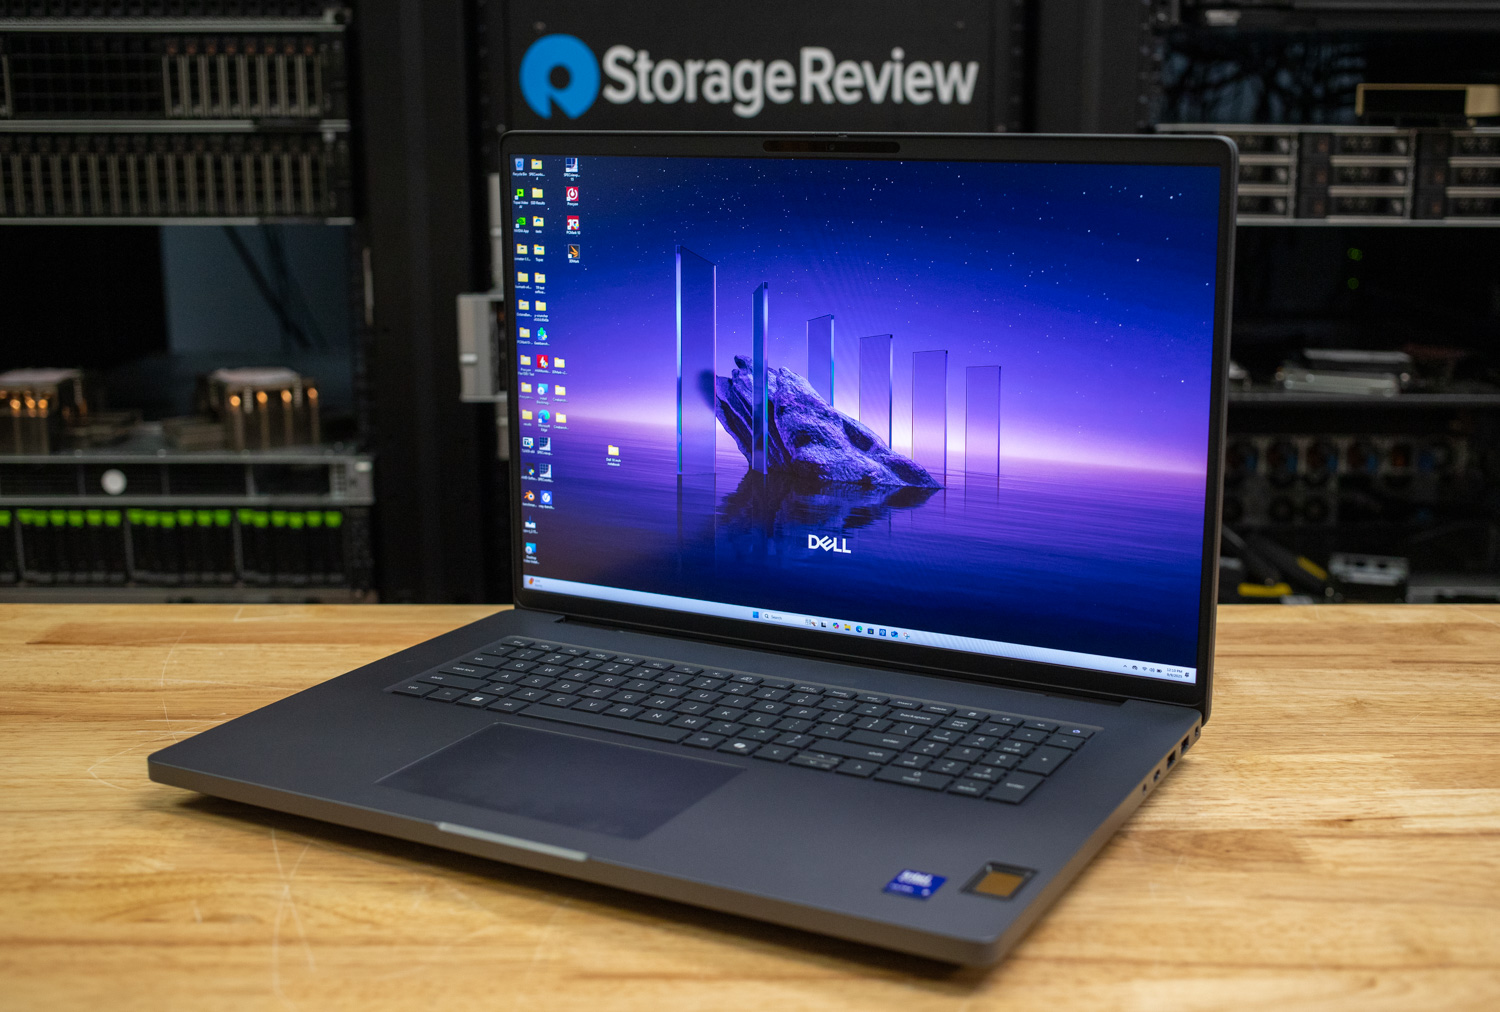
El Pro Max 18 Plus registró los mejores resultados locales de IA de cualquier portátil en el laboratorio de StorageReview. En UL Procyon AI Text Generation, su RTX PRO 5000 Blackwell (24 GB GDDR7) alcanzó los 185.1 tokens por segundo en Phi, los 140.5 en Mistral y los 119.7 en Llama 3, con un tiempo de respuesta inferior a 0.35 segundos en todos los modelos. El Core Ultra 9 285HX y los 128 GB de memoria CAMM2 gestionan el resto del pipeline sin interferir, y los 24 GB de VRAM soportan cómodamente modelos cuantizados de clase 20B.
Las ventajas y desventajas son exactamente las que sugiere el chasis: 7.17 kg y 3 horas y 39 minutos de autonomía, la menor de nuestra base de datos de portátiles. Se trata de un equipo de sobremesa plegable. Su precio de lista en el momento de la prueba era de 9,245 dólares. Si la velocidad de inferencia local es lo que importa, esta es la respuesta.
Análisis: Dell Pro Max 18 Plus: Rendimiento portátil con Blackwell RTX PRO 5000
Ideal para modelos grandes: HP ZBook Ultra G1a 14
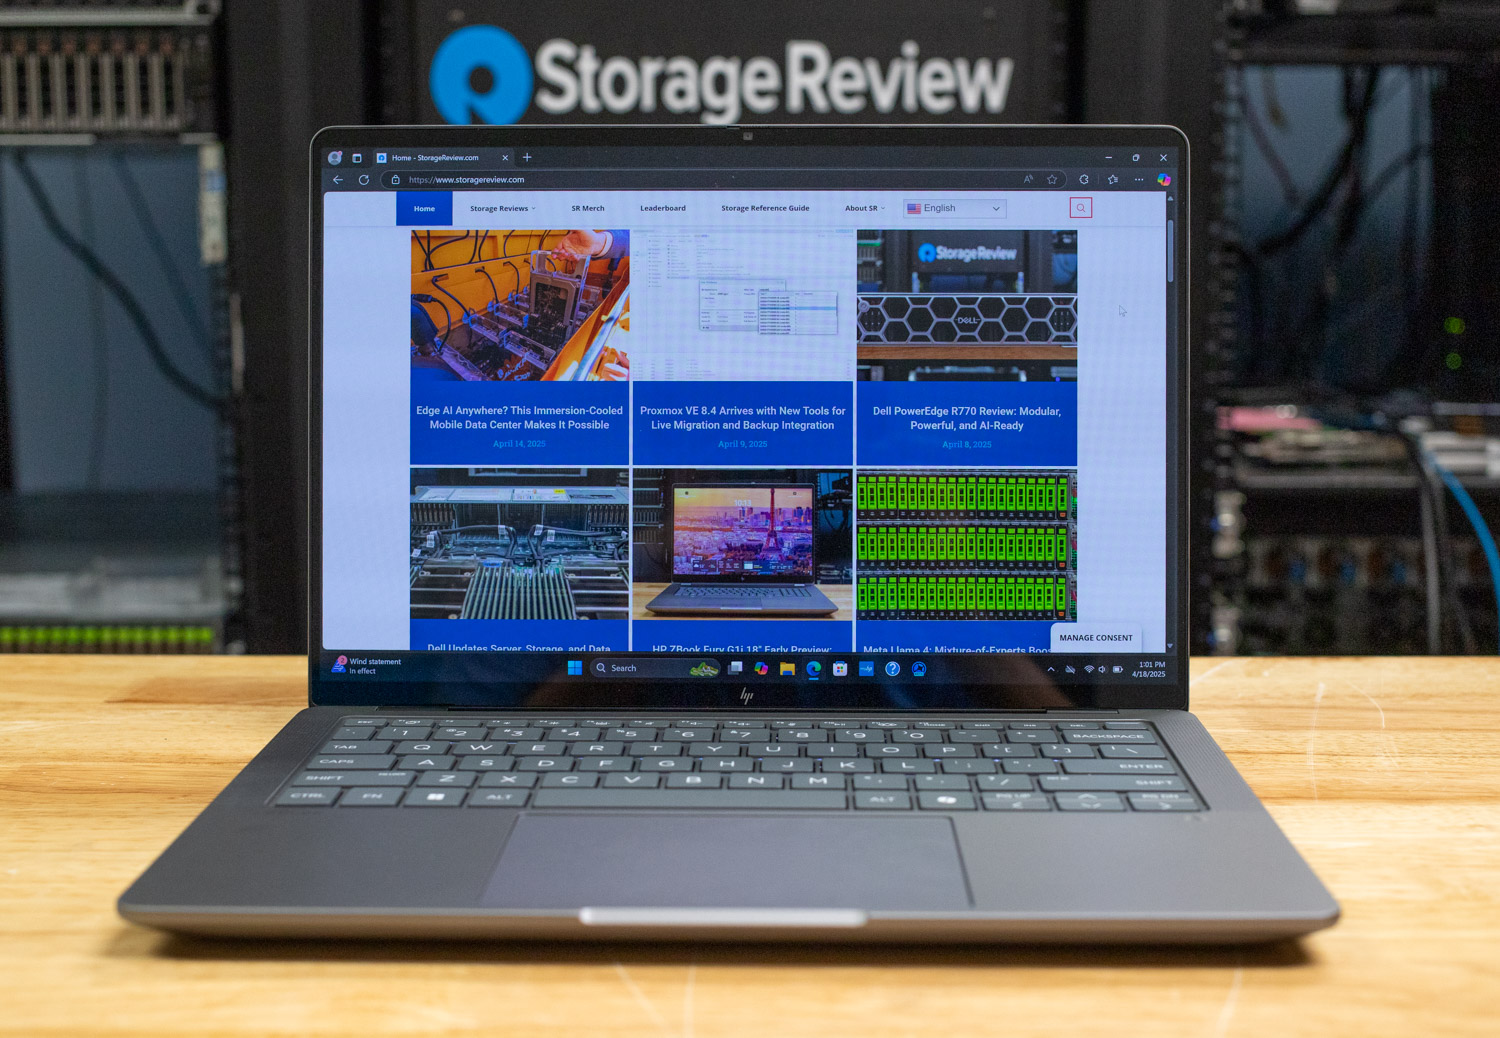
La velocidad es un factor clave; la capacidad, otro. El ZBook Ultra G1a combina el procesador AMD Ryzen AI Max+ PRO 395 con 128 GB de memoria unificada LPDDR5X, de los cuales hasta 96 GB son asignables a la GPU Radeon 8060S. Esta capacidad nos permitió cargar modelos que ningún portátil con GPU dedicada puede ejecutar: DeepSeek-R1 70B y QwQ 32B se ejecutaron localmente en LM Studio y Ollama, y Gemma 3 27B se generó a 8.96 tokens por segundo, con un procesamiento rápido de 73 tokens por segundo.
Sus cifras de Procyon son inferiores a las de cualquier máquina RTX PRO (Phi a 65 tokens por segundo), por lo que no es la opción ideal para chats rápidos en modelos pequeños. Es la opción ideal cuando lo importante es el modelo en sí, y lo demuestra con un peso de 3.3 kg y una autonomía de 10 horas y 35 minutos. Esta es la misma historia de memoria unificada que ofrece la AMD Strix Halo en nuestra gama de ordenadores de sobremesa, integrada en un chasis de 14 cm.
Análisis: Reseña del HP ZBook Ultra G1a de 14 pulgadas
En el horizonte: HP ZBook Ultra G3a 16
El modelo destacado como el mejor para portátiles grandes podría estar a punto de cederle el protagonismo a su sucesor. El ZBook Ultra G3a 16 incorpora 192 GB de memoria unificada LPDDR5X-8533, con hasta 160 GB asignables a la GPU (el G1a 14 alcanza un máximo de 128 GB y 96 GB), un procesador Ryzen AI Max+ PRO 495 y un rediseño térmico que permite un consumo de 100 W, mientras que el G1a consumía 55 W. La capacidad le valió al G1a su puesto, mientras que el consumo de energía limitó su rendimiento; el G3a supera ambos aspectos simultáneamente.
HP abrió los pedidos en EE. UU. en octubre, con configuraciones desde $3,149, y el G3a entrará en la clasificación una vez que se completen las pruebas con Procyon y LM Studio. Nuestra primera impresión se centró en el hardware de una unidad de preproducción, sin que se permitieran pruebas de rendimiento, y el análisis completo se publicará cuando una unidad comercial llegue al laboratorio.
El mejor equilibrio entre 16 pulgadas: Dell Pro Max 16 Plus
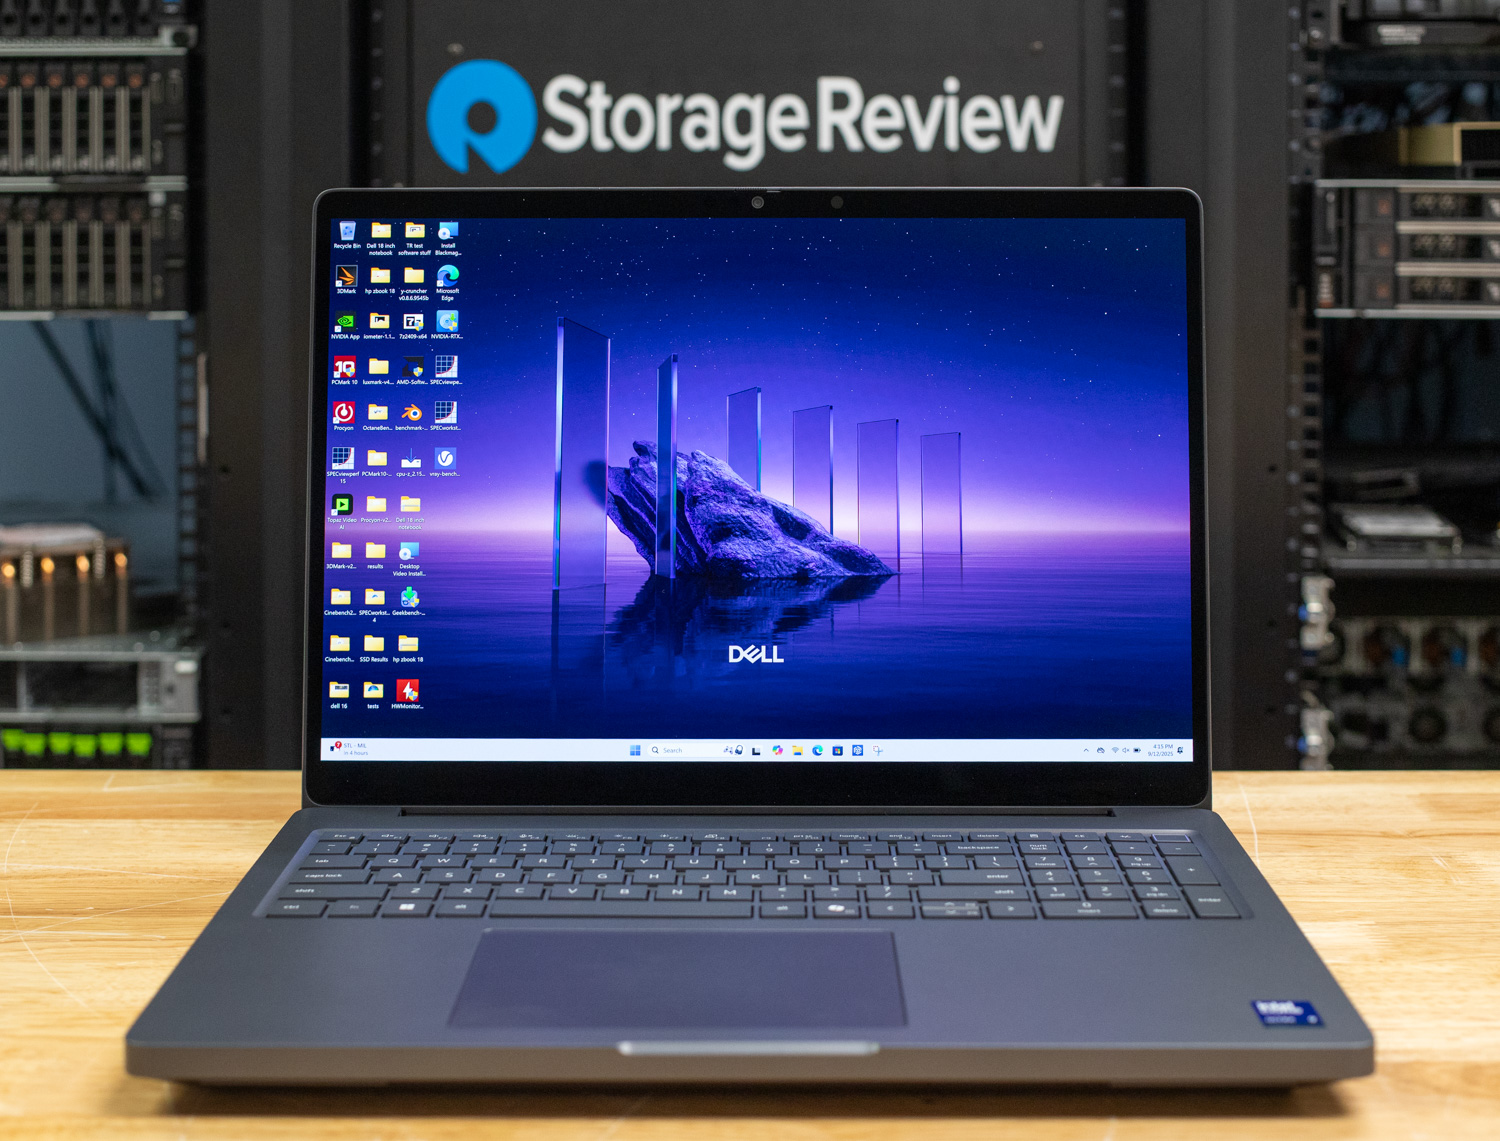
El Pro Max 16 Plus utiliza la misma RTX PRO 5000 Blackwell de 24 GB que el 18 Plus y prácticamente no tiene nada que envidiarle: Phi alcanza los 178.6 tokens por segundo, Mistral los 134.2 y Llama 3 los 114.7, lo que representa aproximadamente el 96 % del rendimiento del modelo insignia. A cambio, pesa 5.63 kg frente a los 7.17 kg del modelo anterior y casi duplica la duración de la batería, con 6 horas y 21 minutos.
Para la mayoría de las personas que buscan una inferencia local seria en un dispositivo portátil, esta es la mejor opción. Además, ocupa el primer puesto como Mejor Estación de Trabajo Móvil en nuestra clasificación general, por lo que la velocidad de la IA viene con un conjunto completo de aplicaciones profesionales ya validadas.
Análisis: Análisis del Dell Pro Max 16 Plus: Diseñado para largas jornadas y trabajos exigentes.
Mejor ultraportátil: Lenovo ThinkPad P14s Gen 7
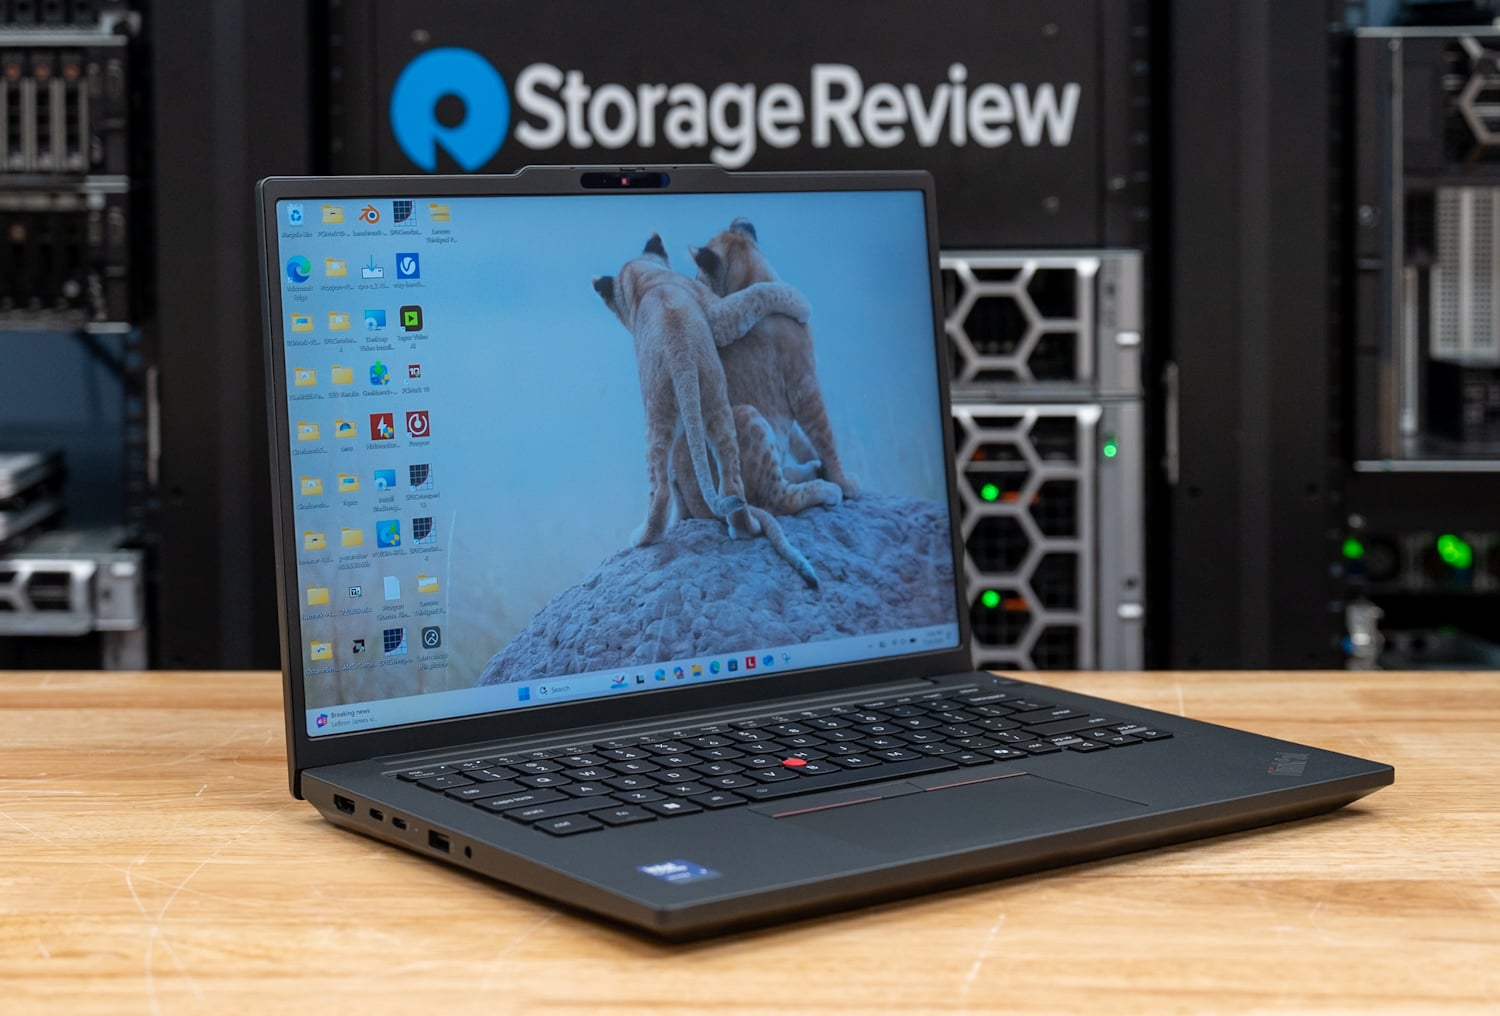
Con 1,63 kg (3.59 libras), la P14s Gen 7 es la laptop más ligera de esta comparativa con una GPU Blackwell dedicada. La RTX PRO 1000 (8 GB GDDR7) alcanzó 55.1 tokens por segundo en Phi y 40.3 en Mistral, velocidades interactivas reales para modelos de la serie 7B, y la NPU de 50 TOPS de Panther Lake la convierte en una máquina Copilot+. La duración de la batería, de 15 horas y 52 minutos, significa que la capacidad de IA no te costará una jornada laboral completa.
Conozca el límite antes de comprar: nuestra prueba con la Llama 2 13B no se completó porque ese modelo requiere aproximadamente 12 GB de memoria gráfica a través de la ruta Procyon y la GPU tiene 8 GB. Para modelos cuantizados de 7B o menos, esta es una excelente opción; para modelos más grandes, consulte la página anterior.
Análisis: Reseña del Lenovo ThinkPad P14s Gen 7
La mejor opción sin GPU dedicada: Dell Pro Precision 5 14s Intel
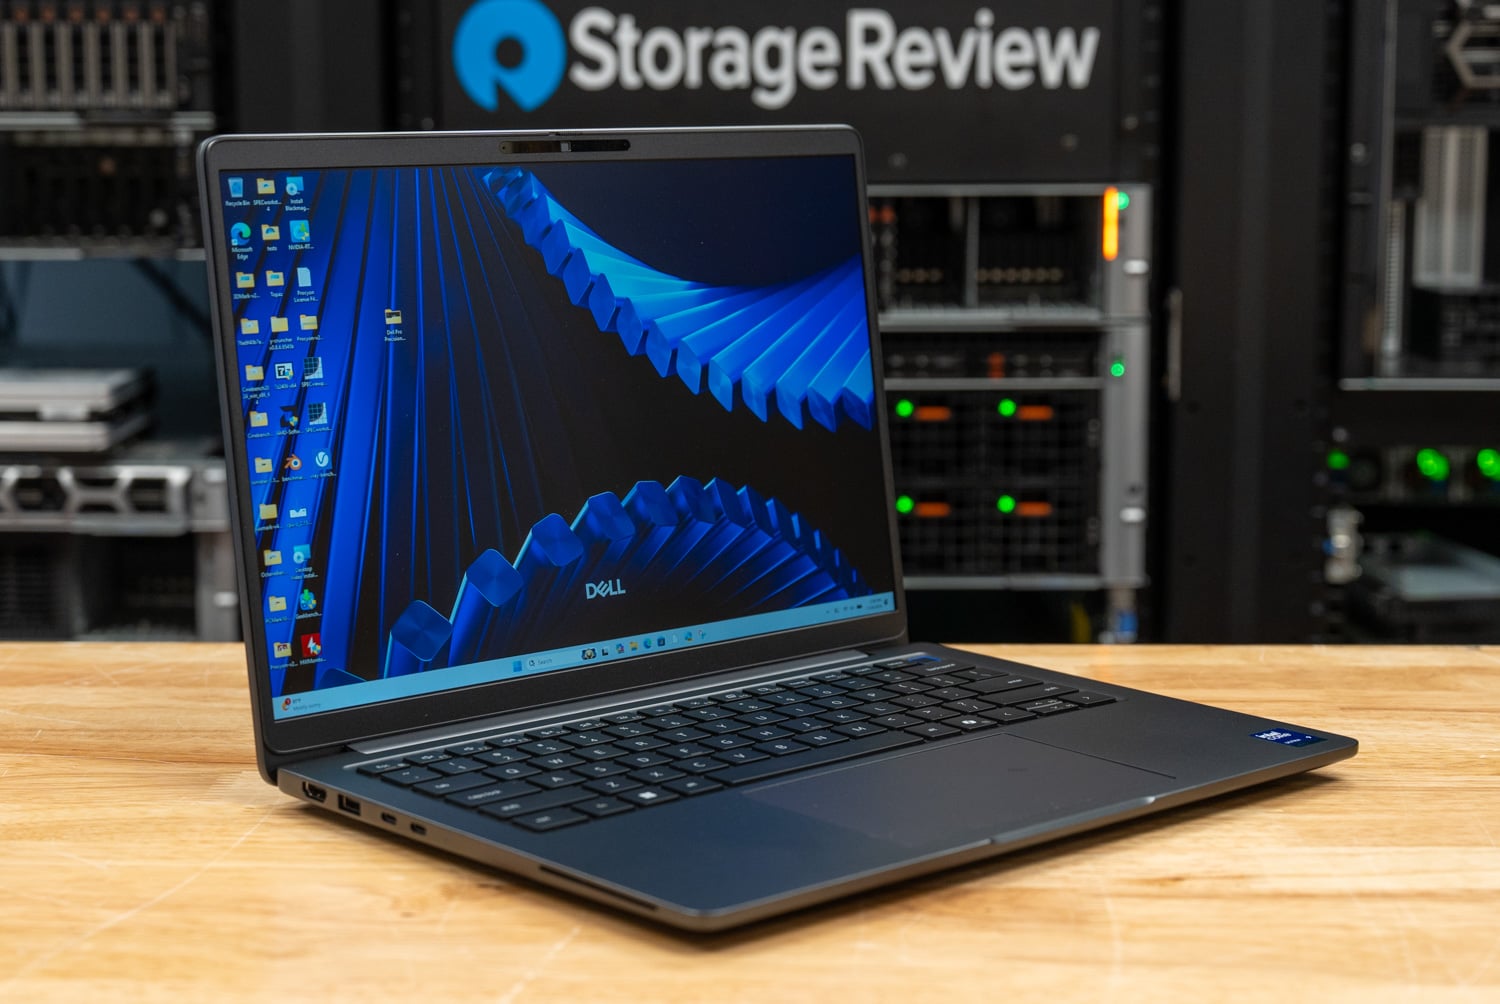
La ausencia de una GPU dedicada no supone ningún problema, dentro de lo razonable: la Pro Precision 5 14s de Intel combina el Core Ultra X9 388H (NPU de 50 TOPS) con los gráficos integrados Intel Arc Pro B390, que utilizan un pool de memoria compartida LPCAMM2 de 64 GB. En nuestras pruebas, este pool ejecutó cargas de trabajo de IA locales mayores de las que podían soportar las tarjetas dedicadas de 8 GB, completando la suite completa de generación de texto Procyon AI (puntuaciones de 887 en Phi y 786 en Llama 2), donde los sistemas con VRAM limitada registraron DNF (no finalizados).
La velocidad de generación es modesta en comparación con el chip RTX PRO, por lo que resulta más adecuada para tareas de asistente en segundo plano que para sesiones interactivas intensas. El resto del conjunto es excepcional: 3.12 kg y 23 horas y 50 minutos de autonomía, la segunda más larga de todo nuestro conjunto de datos. Además, ocupa el primer puesto en nuestra clasificación de Mejores Estaciones de Trabajo Ultraportátiles Móviles.
Análisis: Dell Pro Precision 5 14s Intel
Mejor sistema NPU delgado y ligero: HP EliteBook 6 G1q
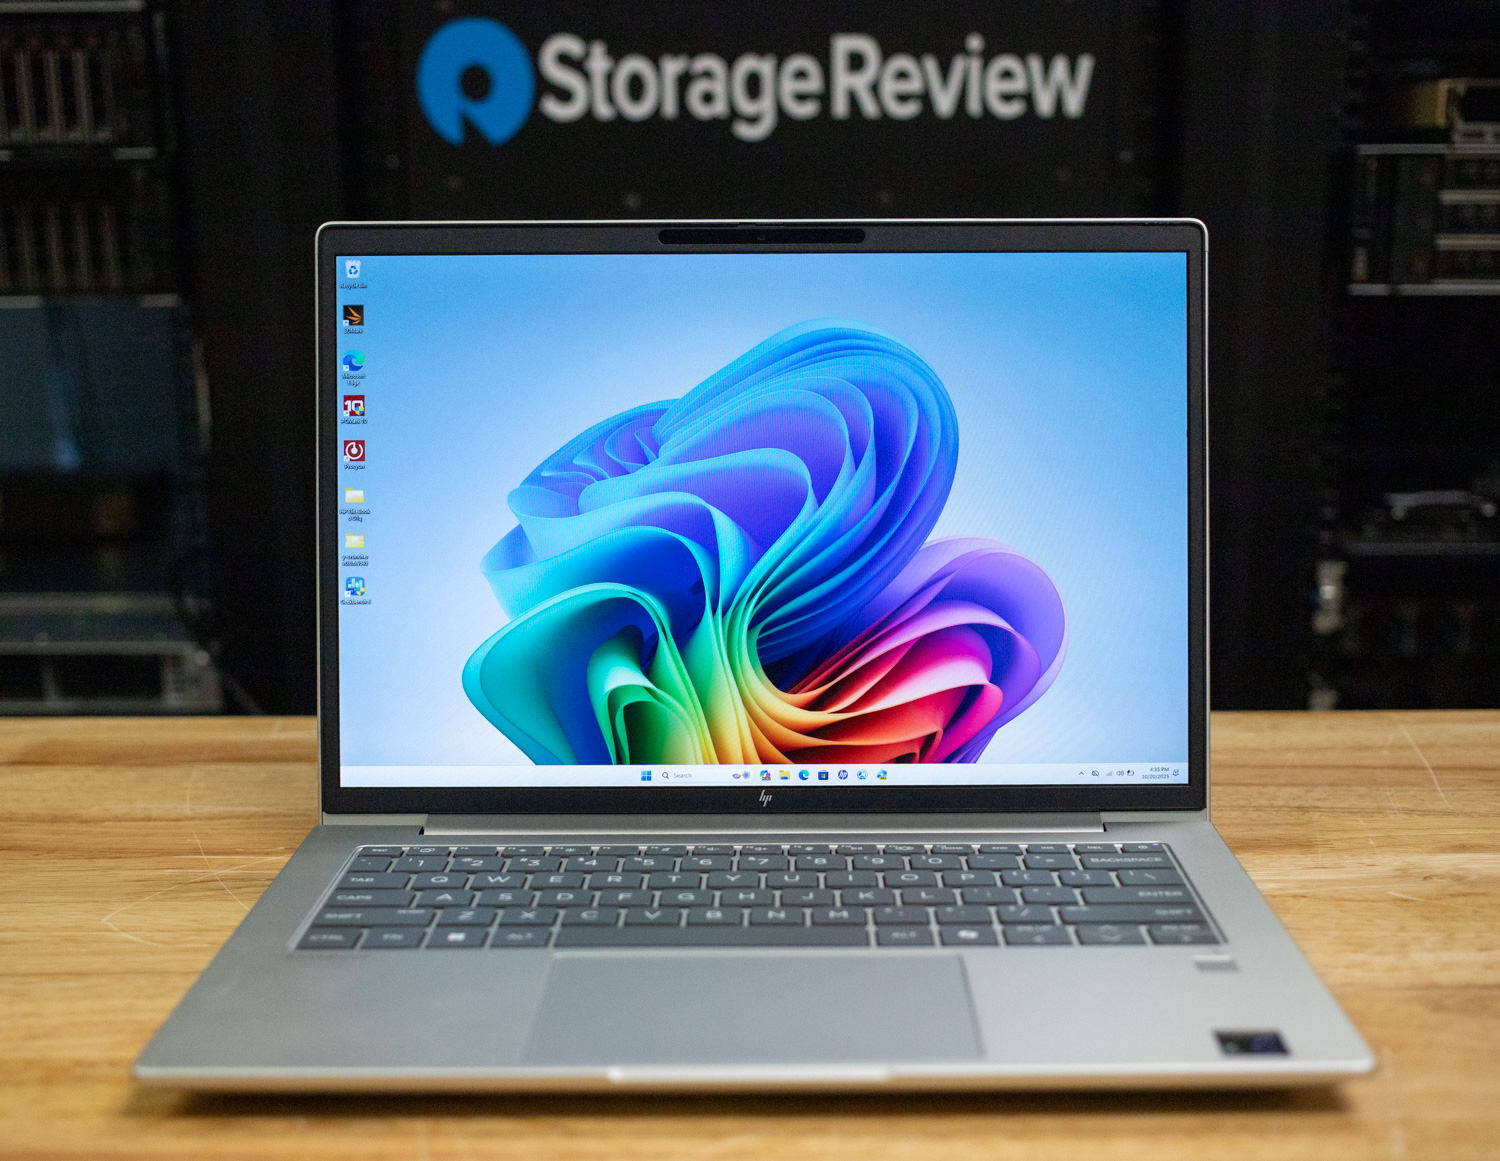
El EliteBook 6 G1q responde a una pregunta diferente: ¿qué tan poca potencia necesitas para una IA útil en el dispositivo? Su Snapdragon X Plus con una NPU Hexagon de 45 TOPS ejecutó Llama 3.2 3B a 36.7 tokens por segundo y Gemma 3 4B a 29.3 en LM Studio, con los modelos 1B superando los 62 tokens por segundo. Estas son velocidades de chat utilizables para un equipo de 1,44 kg (3.17 libras) con una autonomía de batería de 19 horas y 35 minutos.
El techo es bajo; el modelo de 4 mil millones de parámetros fue el más grande que probamos, por lo que está diseñado para chat local, resumen y asistentes sin conexión, ya que los modelos más complejos quedan fuera de nuestro alcance. Con un precio aproximado de 3,100 dólares en la configuración al momento de la revisión, también era el sistema menos costoso de esta página.
Análisis: HP EliteBook 6 G1q: Potencia para todo el día en un portátil ligero.
Portátiles RTX Spark: probados en nuestra nueva suite de clientes.
La NVIDIA RTX Spark N1X incorpora el superchip GB10 de la DGX Spark a los portátiles Windows, con un conjunto de memoria LPDDR5X compartida entre una CPU Grace y una GPU Blackwell. Los portátiles cuentan con dos variantes con un TDP de entre 45 y 80 W: una CPU de 20 núcleos con una GPU de 6,144 núcleos y una CPU de 18 núcleos con una GPU de 5,120 núcleos. Probamos estos sistemas con sr-client 1.2, nuestra nueva suite de clientes nativa para Arm64, por lo que sus resultados no coinciden exactamente con los de Procyon que aparecen en las selecciones anteriores. Nuestra cobertura del lanzamiento de la RTX Spark incluye todos los detalles de la plataforma.
La memoria determina qué modelos puede ejecutar cada configuración. Una configuración de firmware divide el conjunto entre Windows y la GPU, y nuestro nivel de modelo de IA local más pequeño necesita al menos 16 GB de memoria utilizable por la GPU, por lo que un sistema de 32 GB configurado a 12 GB para la GPU no puede cargar los 12.8 GB de gpt-oss:20b.
Mejor computadora portátil RTX Spark: HP OmniBook Ultra 16
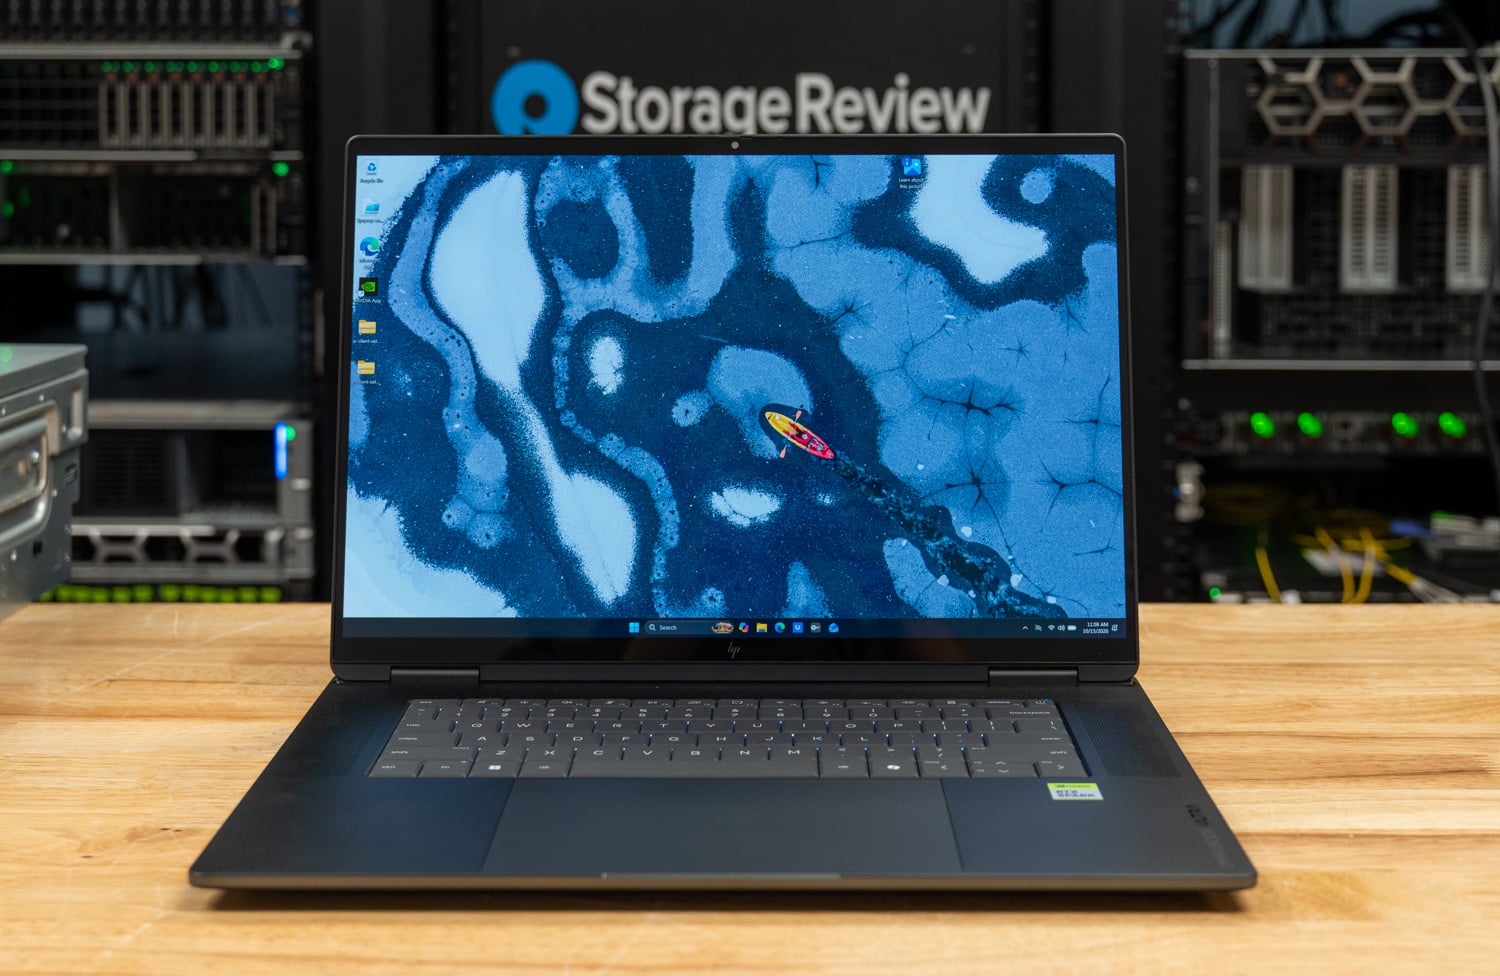
El OmniBook Ultra 16 de 128 GB es el portátil RTX Spark más completo que hemos probado. Con 62.5 GB de memoria utilizable por la GPU, ejecuta nuestros dos niveles de modelos de IA locales, generando gpt-oss:20b a 58.0 tokens por segundo y Qwen3.6-35B-A3B a 89.5. Superó las nueve ejecuciones del agente de codificación y finalizó la tarea Qwen3.6 en 72.0 segundos, el tiempo más rápido de su grupo, y completó la resolución de OpenBLAS en todos los núcleos a 98 °C, la prueba que apagó dos unidades Surface Laptop Ultra.
Su puntuación de 7,004 en Cinebench 2026 multicore fue el mejor resultado de CPU en esa comparación, un 35 por ciento por delante del Razer Blade 16. La RTX 5090 del Blade sigue generando tokens 2.3 veces más rápido en modelos que caben en sus 24 GB, y el navegador del OmniBook se ralentizó 1.73 veces mientras el agente de codificación se ejecutaba en la GPU compartida. La configuración de 128 GB y 2 TB que probamos se vende solo a través de HP.com, donde HP la puso a la venta por 6,229.99 dólares el 14 de octubre. El modelo de 32 GB de 3,199.99 dólares mantiene la velocidad de la CPU pero no puede cargar nuestros niveles de modelo, y los resultados de la batería están pendientes.
Análisis: HP OmniBook Ultra 16: RTX Spark con 128 GB supera nuestra prueba local de agentes de codificación.
Portátil RTX Spark con menor temperatura de funcionamiento: Lenovo Yoga 9n 2 en 1 de 16 pulgadas.
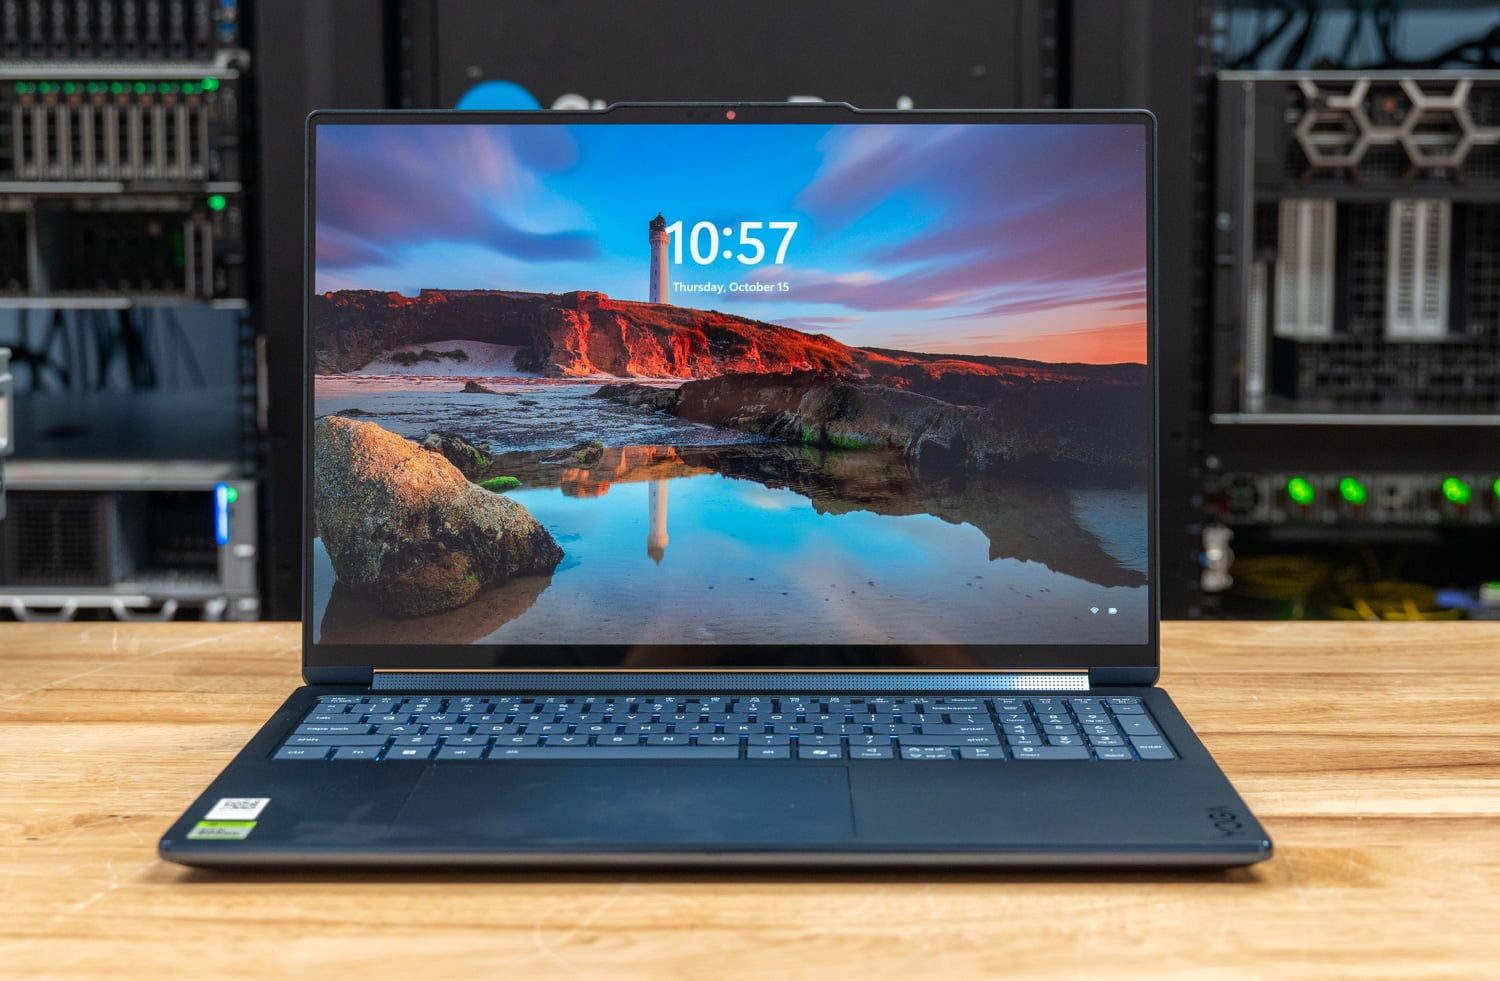
El Yoga 9n 2-en-1 16 mantuvo la temperatura del N1X más baja que cualquier portátil RTX Spark que hayamos probado. Durante nuestra prueba continua de 30 minutos, su CPU alcanzó un pico de 72 °C y mantuvo 3,015 MHz, finalizando al 100.1 % de su primera pasada. El HP OmniBook Ultra 16 y el Surface Laptop Ultra se mantuvieron en 98 °C, y el Lenovo Pro 9n 15 alcanzó un pico de 92 °C, todos medidos a través de las zonas térmicas de Windows, el único sensor de CPU que exponen estos sistemas. Lenovo atribuye este resultado a las rejillas de ventilación ampliadas, una protuberancia térmica elevada y una bisagra convertible que deja espacio detrás de las rejillas para que circule el aire.
La optimización del sistema de refrigeración reduce la velocidad del Yoga en todos los núcleos en comparación con el HP. Los resultados multihilo se sitúan entre un 4 y un 10 por ciento por debajo del OmniBook en la mayoría de las pruebas, y el agente de codificación ralentizó el navegador 2.44 veces en el Yoga frente a 1.73 veces en el HP. Su configuración de 64 GB proporciona a la GPU 32 GB, suficiente para gpt-oss:20b a 58.0 tokens por segundo, pero por debajo de nuestro nivel de 35B. Para un convertible de 16 pulgadas que se usa como tableta o sobre las piernas, esta compensación tiene sentido. Su precio de lista en el momento de la prueba fue de 3,749.99 dólares, y los resultados de la batería están pendientes.
También se probó en el nuevo conjunto de pruebas:
- Lenovo Pro 9n 15: el N1X de 18 núcleos con 32 GB de memoria en un chasis de 3.64 kg. Llama 3.1 8B funcionó a 55.1 tokens por segundo en MLPerf Client, dentro del 2 por ciento de un N1X de 20 núcleos en la misma división de GPU de 12 GB, y sus relojes más altos en todos los núcleos lo mantienen dentro del 8 al 11 por ciento de la parte de 20 núcleos en renderizado y compilaciones mientras que pico a 93 C. Con 12 GB para la GPU no entra en nuestras pruebas de carga de modelos y agente de codificación, por lo que los compradores locales de IA deberían configurar más memoria. Lenovo lo lista desde $2,999.99 para un modelo de 18 núcleos, 32 GB, 512 GB.
- Microsoft Surface Laptop Ultra para empresas (Según las pruebas realizadas): la unidad de 128 GB generó gpt-oss:20b y Qwen3.6-35B-A3B a una velocidad de entre 58 y 89 tokens por segundo, y obtuvo una puntuación de 6,963 en Cinebench 2026 multinúcleo. Esto se indica únicamente en las pruebas realizadas, ya que dos unidades se apagaron durante nuestra carga de OpenBLAS en todos los núcleos.
El Dell XPS 16 Creator Edition llegará pronto a nuestro laboratorio y se incluirá en esta sección una vez que lo hayamos probado. Los resultados de la batería para todos los sistemas RTX Spark están pendientes de nuestra nueva prueba de batería multiplataforma.
También probado
Estos sistemas pasaron por el mismo proceso de laboratorio y merece la pena que el comprador adecuado les eche un vistazo, aunque actualmente no ocupen un lugar destacado en su categoría.
- Lenovo ThinkPad P16 Generación 3: la tercera máquina RTX PRO 5000 de la flota (Phi a 141.2 tok/s); nuestra unidad venía con 32 GB de RAM, lo que limitó el resto del flujo de trabajo.
- HP ZBook Fury G1i 18: misma clase de GPU Blackwell de 24 GB que la Pro Max 18 Plus, un paso por detrás en rendimiento (Phi a 157.4 tok/s) y $11,687 según las pruebas realizadas en la reseña.
- Dell Pro Precision 7 16 Intel: RTX PRO 3000 Blackwell con 12 GB de VRAM, el resultado más potente en GPU de gama media en este campo (puntuación de generación de texto Procyon de 2,244 en Phi a través de DirectML); sus 12 GB abren la clase 14B que las tarjetas de 8 GB no pueden alcanzar.
- Lenovo ThinkPad P1 Generación 8: RTX PRO 2000 de 8 GB en un chasis de 4.06 libras con 12 horas y 59 minutos de batería; Phi a 77.3 tok/s.
- Lenovo ThinkPad P1 Generación 9: tested on our new client suite, its 50W RTX PRO 2000 generated Llama 3.1 8B at 64.8 tokens per second in MLPerf Client, the fastest RTX PRO 2000 we have tested and ahead of the RTX Spark HP OmniBook Ultra 16 at 56.5 on that model; its 8GB card could not load our 20B-and-up model tiers.
- Dell Pro Max 14 Premium: RTX PRO 2000 de 8 GB a 3.55 libras; Phi a 54.1 tok/s.
- Dell Pro Max 16 (Ryzen): RTX PRO 1000 de 8 GB con un resultado de batería de 16 horas y 2 minutos; Phi a 61.9 tok/s.
- Lenovo ThinkPad P14s Generación 6: RTX PRO 500 6GB; Blackwell AI de entrada a 45.7 tok/s en Phi.
- Dell Pro Precision 5 16s Intel: la versión de 16 pulgadas de nuestra elección sin GPU dedicada, en la misma plataforma de memoria compartida, con la batería de estación de trabajo de mayor duración que hemos medido, de 24 horas y 43 minutos.
- Dell Pro Precision 5 14s AMD: 60 TOPS NPU y un pool compartido de 64 GB; la ruta de imagen Procyon INT8 de AMD aún no estaba disponible en el momento de la prueba, lo que limita la comparación. Dell Pro Precision 5 16s AMD Incorpora el mismo Ryzen AI 9 HX PRO 475 y 60 TOPS NPU a un chasis de 16 pulgadas y registró el mayor rendimiento LLM local de la línea Pro Precision en nuestras pruebas, muy por encima de su hermano Intel tanto en Llama3 como en Llama2, lo que lo convierte en la mejor opción de esta familia para trabajos de inferencia local.
- HP EliteBook X G1a: Ryzen AI 9 HX 375 con una NPU de 55 TOPS; aún no hemos ejecutado nuestra suite LLM en él.
Cómo clasificamos
La generación de texto con IA de UL Procyon es nuestro referente para toda la flota: los mismos cuatro modelos (Phi, Mistral, Llama 3 y Llama 2, donde sea compatible) en todos los portátiles que pueden albergarlos, por lo que las cifras de tokens por segundo son directamente comparables. Cuando el hardware lo requiere, profundizamos con LM Studio y Ollama se ejecuta en modelos más grandes. Cada portátil se clasifica una vez por cada criterio de medición, y un sistema solo aparece en esta página si produjo resultados de IA locales utilizables en nuestro laboratorio.
Los sistemas RTX Spark ejecutaron sr-client 1.2, nuestra nueva suite de clientes, por lo que se comparan entre sí en esta página y no con los resultados de Procyon que aparecen detrás de las otras selecciones.
Los precios fluctúan rápidamente en este mercado, por lo que cualquier cifra en dólares que aparezca en esta página corresponde al precio de referencia vigente en el momento de la publicación de la reseña. No hacemos afirmaciones sobre el valor de los productos sin antes consultar los precios actuales del configurador del proveedor, y cuando lo hacemos, indicamos la fecha de la consulta.
Preguntas frecuentes sobre IA local para portátiles
¿Qué es más importante para la IA local en un portátil: la VRAM o la memoria total?
Ambos, por diferentes razones: un modelo debe caber en la memoria que la GPU puede alcanzar: en tarjetas discretas, eso es la VRAM (de 8 GB a 24 GB en este campo), y nuestra ejecución de Llama 2 13B falló en tarjetas de 8 GB porque necesitaba unos 12 GB. Los diseños de memoria unificada y compartida invierten la ecuación: Ryzen AI Max+ de AMD puede asignar hasta 96 GB de RAM del sistema a la GPU, y los grupos LPCAMM2 compartidos de Intel alcanzan los 64 GB, por lo que los modelos más grandes se cargan, pero a velocidades más bajas. El tamaño determina si un modelo se ejecuta; el silicio determina la velocidad.
¿Cuál es el modelo más grande que StorageReview ha ejecutado en una computadora portátil?
DeepSeek-R1 70B, cargado localmente en el HP ZBook Ultra G1a 14 a través de su grupo de memoria unificada asignable de 96 GB. Para la generación sostenida, medimos Gemma 3 27B a 8.96 tokens por segundo en la misma máquina. En nuestro lado de escritorio, el nivel es más alto; la clasificación de Mejores Escritorios para IA Local abarca sistemas que ejecutan modelos mucho más grandes.
¿Importan las calificaciones TOPS de NPU para la gestión de programas de LLM?
Menos de lo que sugiere el marketing actual, porque la mayoría de los entornos de ejecución LLM locales dependen de la GPU, y cada cifra de tokens por segundo en esta página proviene de la inferencia de GPU, excepto en el Snapdragon EliteBook, donde la pila de IA de la plataforma es lo importante. Las NPU actualmente justifican su rendimiento en eficiencia y en las rutas de generación de imágenes INT8, y son la razón por la que varias de estas máquinas califican como PC Copilot+, así que compre priorizando la GPU y la memoria.
¿Qué ocurre con la duración de la batería cuando se ejecutan los modelos localmente?
La inferencia es una de las tareas más exigentes que puede realizar un portátil de forma continua, así que planifica conectarlo a la corriente para sesiones largas. Los datos de batería que aparecen en esta página corresponden a los resultados de PCMark 10 Modern Office, una prueba de productividad, y la diferencia es enorme: 3 horas y 39 minutos en nuestro portátil de IA más rápido frente a casi 24 horas en el Dell con memoria compartida. Consulta nuestra clasificación de duración de la batería de portátiles para ver todos los modelos analizados.
¿Cómo se comparan los portátiles con RTX Spark con los portátiles que aparecen en esta clasificación?
Los portátiles RTX Spark utilizan la arquitectura N1X de NVIDIA, que comparte un conjunto de memoria LPDDR5X entre una CPU Grace y una GPU Blackwell. Los probamos con sr-client 1.2, nuestra nueva suite de clientes, por lo que sus resultados no coinciden exactamente con los de Procyon que aparecen en esta página. En el HP OmniBook Ultra 16 de 128 GB, gpt-oss:20b y Qwen3.6-35B-A3B se generaron a 58.0 y 89.5 tokens por segundo, respectivamente, y la tarea de codificación de 35 bytes se completó con éxito en tres de tres ejecuciones en 72.0 segundos.
La división de memoria determina qué modelos se cargan: el Lenovo Pro 9n 15 de 32 GB, configurado a 12 GB para la GPU, no pudo cargar los 12.8 GB de gpt-oss:20b. El Lenovo Yoga 9n 2-en-1 16 fue el que menos se mantuvo frío, alcanzando un máximo de 72 °C durante una carga sostenida de 30 minutos. El Surface aparece solo como probado, ya que dos unidades se apagaron bajo nuestra carga OpenBLAS de todos los núcleos.
¿Debería comprar un ordenador de sobremesa para usar la IA localmente?
Si la máquina va a estar en un escritorio, sí, probablemente. Los sistemas de sobremesa ofrecen más memoria por dólar, mejor disipación térmica y una batería de larga duración; nuestra clasificación de los mejores ordenadores de sobremesa para IA local comienza aproximadamente al precio de los portátiles de gama media que se muestran aquí. Los portátiles de esta página están pensados para usuarios que necesitan desplazarse para realizar tareas de IA.


 Amazon