

Actualizado el 21 de septiembre de 2026: Nueva sección de preguntas frecuentes sobre el cifrado SAN resistente a la computación cuántica, que abarca los plazos de la norma CNSA 2.0 y el estándar FC-SP-3 que ya se incluye en las HBA.
Todos los principales proveedores de almacenamiento afirman vender la mejor matriz de almacenamiento, y durante años, el indicador de lo mejor fue la velocidad. Casi ninguno permite pruebas independientes. Dell, Everpure (antes Pure Storage), VAST, Weka, IBM, NetApp y Huawei se promocionan como líderes en rendimiento, y casi todas las cifras que respaldan esas afirmaciones provienen de las pruebas internas del propio proveedor, con la nota al pie "el rendimiento real puede variar".
Esta página se dedica a aclarar este tema. Dividimos la evidencia de rendimiento del almacenamiento en tres categorías y etiquetamos cada dato en consecuencia: resultados de pruebas de rendimiento auditadas (MLPerf Storage, IO500, SPC-1, donde los proveedores envían resultados según las normas publicadas), afirmaciones de los proveedores (hojas de especificaciones y cifras de lanzamiento sin verificación independiente) y resultados de laboratorio de StorageReview (sistemas que hemos medido nosotros mismos). Cuando un proveedor no nos permite probar su sistema, lo indicamos; la ausencia de datos verificables forma parte de la explicación.
Los líderes en almacenamiento de IA
Estos son los proveedores que aparecen al construir un clúster de entrenamiento de IA o una neocloud. No los clasificamos porque no existe un método de medición consensuado. Lo que sí podemos hacer es proporcionarles a todos la misma información: qué es la plataforma, dónde se implementa bajo el nombre de un cliente, si NVIDIA la ha validado, si cuenta con un resultado de evaluación comparativa auditado y cuáles de sus afirmaciones de rendimiento aún no han sido verificadas. Cuando un proveedor genera noticias sobre cualquiera de estos aspectos, actualizamos su perfil.
Los cuatro primeros son especialistas en almacenamiento nativo para IA. El resto son proveedores consolidados de almacenamiento empresarial con líneas de productos de IA. Ambos grupos consiguen implementaciones reales; sin embargo, llegan con cantidades de evidencia muy diferentes.
Datos VAST
Plataforma: Sistema operativo VAST AI, basado en la arquitectura DASE (Disaggregated, Shared-Everything). Los contenedores de computación sin estado se conectan a un conjunto de gabinetes NVMe mediante NVMe-oF y presentan un único espacio de nombres para el acceso a archivos, objetos y bases de datos. Todos los medios son QLC y cuentan con un búfer de escritura de memoria de clase de almacenamiento.
Implementaciones destacadas: CoreWeave, en virtud de un acuerdo plurianual de 1.17 millones de dólares anunciado en noviembre de 2025, que VAST describe como su mayor cliente. VAST también se incorporó a la expansión de xAI Colossus Frontier AI Factory y proporciona infraestructura para las fábricas de IA de Mistral Compute que se ejecutan en NVIDIA GB300 NVL72.
Validación de NVIDIA: Socio de lanzamiento de almacenamiento certificado por NVIDIA y validado para DGX SuperPOD.
Resultado de la auditoría: Ninguno. VAST nunca se ha enviado a MLPerf Storage.
Afirmaciones abiertas: VAST y AMD afirman conjuntamente que el tiempo hasta el primer token es 9 veces más rápido gracias a la descarga de caché KV en Instinct, según pruebas del proveedor. La Serie F de abril de 2026, con una valoración de 30 mil millones de dólares, genera expectativas, pero no se trata de una cifra de rendimiento.
Nuestra cobertura del año pasado:
- VAST y AMD afirman que el tiempo hasta el primer token es 9 veces más rápido con la descarga de caché KV. (Jul 2026)
- Cloudera y VAST ponen en el punto de mira la escasez de GPU. (Jul 2026)
- VAST impulsa las fábricas de IA de Mistral Compute en GB300 NVL72. (Mayo 2026)
- VAST presenta su sistema operativo de IA con capacidad de agente. (Feb 2026)
- VAST Amplify pretende hacer que las unidades SSD existentes parezcan 6 veces más grandes. (Ene 2026)
- VAST introduce una arquitectura de inferencia nativa de DPU. (Ene 2026)
WEKA
Plataforma: NeuralMesh, el sistema de archivos paralelos definido por software anteriormente conocido como WekaFS, se vende como software y como dispositivos WEKApod. NeuralMesh Axon integra el mismo plano de datos dentro de los servidores GPU, de modo que las unidades NVMe locales se unen al clúster en lugar de permanecer inactivas.
Implementaciones específicas: Nebius utiliza NeuralMesh como el nivel premium de su nube de IA. Andromeda estandarizó NeuralMesh en aproximadamente 50 proveedores de GPU en julio de 2026. WEKA también forma parte de la pila de múltiples proveedores de CoreWeave.
Validación de NVIDIA: Socio de lanzamiento de almacenamiento certificado por NVIDIA, con validaciones para DGX SuperPOD y BasePOD.
Resultado de la auditoría: WEKA se sometió a MLPerf Storage v1.0 en septiembre de 2024, pero no se sometió a la versión 2.0 en agosto de 2025. Sus cifras auditadas más recientes son de una generación anterior.
Afirmaciones sin respaldo: WEKApod 3 con NeuralMesh 6 ofrece un rendimiento de 1.1 EB y 10.2 TB/s en un solo rack. Son cifras del proveedor, sin documentación auditada que las respalde.
Es importante saber que HPE finalizó sus acuerdos de colaboración con WEKA, Qumulo y Scality en noviembre de 2025, por lo que WEKA ya no llega a los compradores a través del canal de HPE.
Nuestra cobertura del año pasado:
- Andromeda estandariza NeuralMesh en más de 50 proveedores de GPU. (Jul 2026)
- WEKApod 3 rompe la barrera del exabyte en un solo rack. (Jul 2026)
- NeuralMesh AIDP ya está disponible para el público general. (Mar 2026)
- NeuralMesh se integra con NVIDIA STX para memoria de inferencia. (Mar 2026)
- Plataformas de próxima generación WEKApod Prime y Nitro (Nov 2025)
DDN
Plataforma: Dos líneas. EXAScaler, el sistema de archivos paralelo derivado de Lustre que sustenta los dispositivos AI400X3 y AI400X3M, se encarga del entrenamiento. Infinia, una plataforma de objetos clave-valor que incorporó compatibilidad con múltiples inquilinos y POSIX en la versión 2.4, está orientada a cargas de trabajo de inferencia y de fábricas de IA.
Implementaciones destacadas: xAI Colossus, anunciado en noviembre de 2024 con 200 000 GPU, en EXAScaler e Infinia. DDN también cuenta con una larga lista de instalaciones en laboratorios nacionales y sistemas HPC anteriores al ciclo de la IA.
Validación de NVIDIA: Socio de lanzamiento de almacenamiento certificado por NVIDIA, con validación de DGX SuperPOD.
Resultado auditado: Sí, y está actualizado. En MLPerf Storage v2.0, el AI400X3 mantuvo 120.68 GB/s en 3D U-Net a través de múltiples nodos y gestionó puntos de control Llama3-8b a 30.6 GB/s de lectura y 15.3 GB/s de escritura desde un dispositivo de 2RU. A juzgar por los resultados, DDN es la opción más potente de esta lista.
Afirmaciones abiertas: Aceleración de caché KV a través de NVIDIA Dynamo, validada conjuntamente con Nebul en lugar de por un organismo independiente.
Nuestra cobertura del año pasado:
- DDN lanza el AI400X3M en ISC 2026. (Jun 2026)
- Infinia 2.4 añade soporte para multiusuario y POSIX. (Jul 2026)
- DDN y Nebul validan la aceleración de caché KV. (Jul 2026)
DDN lideró MLPerf Storage v2.0 en densidad de rendimiento, pero no se presentó a la ronda v3.0.
espacio de martillo
Plataforma: La plataforma global de datos de Hammerspace, Tier 0, transforma la memoria NVMe local integrada en los servidores GPU en capacidad compartida con capacidad de punto de control. Está basada en estándares, utiliza NFS paralelo (NFS 4.2 con FlexFiles) y se ejecuta en servidores convencionales en lugar de un dispositivo propietario. No hay ningún dispositivo Hammerspace para fotografiar, que es precisamente la esencia de esta arquitectura.
Implementaciones con nombre: Meta documentó Hammerspace en dos clústeres H100 de 24 576 GPU en su propio blog de ingeniería. Este es el relato más específico de primera mano sobre una implementación de almacenamiento de IA a gran escala de cualquier proveedor en esta página, porque fue el operador quien lo escribió, no el proveedor.
Validación de NVIDIA: Ninguna. Hammerspace no posee las certificaciones DGX SuperPOD, DGX BasePOD, arquitectura de referencia NCP ni la designación de almacenamiento certificado por NVIDIA.
Resultado auditado: Sí, tanto en MLPerf Storage v1.0 como en v2.0. En v2.0, el Nivel 0 ofreció 420.8 GB/s en 3D U-Net a través de cinco nodos con una utilización del acelerador del 96.4 %, alimentando 140 H100 simulados. Hammerspace tiene el mejor historial de participación auditada en esta lista y el peor historial de validación de NVIDIA, lo contrario de casi todos los demás.
Nuestra cobertura: Hammerspace no ha pasado por el laboratorio de StorageReview, y nuestra cobertura reciente es escasa. Esto es una deficiencia por nuestra parte, no una crítica a la plataforma.
Hammerspace, que participó en la versión 2.0, tampoco participó en la ronda de la versión 3.0.
Tecnologías Dell
Plataforma: Tres componentes, orientados a diferentes partes del proceso. PowerScale es la línea NAS escalable, con nodos de la serie F totalmente flash. ObjectScale es la capa S3, que incorporó S3 sobre RDMA y descarga de caché KV en 2026. Lightning File System es un nuevo sistema de archivos paralelo que se lanzó oficialmente en abril de 2026 y es el componente con el que Dell compite con DDN, VAST y WEKA.
Implementaciones con nombre: No pudimos confirmar ninguna implementación a gran escala de entrenamiento de IA en almacenamiento Dell. La referencia pública más concreta es Subaru, que opera un laboratorio de IA para la seguridad del conductor en PowerScale. Para un proveedor de este tamaño, esto representa una notable brecha en comparación con los éxitos de la neocloud que publicitan los proveedores de IA nativa.
Validación de NVIDIA: PowerScale, socio de lanzamiento de NVIDIA-Certified Storage, obtuvo la certificación del programa NVIDIA Cloud Partner en julio de 2025.
Resultado de la auditoría: Ninguno. Dell nunca ha enviado datos a MLPerf Storage.
Afirmaciones abiertas: Dell afirma que Lightning es el sistema de archivos paralelos más rápido del mundo, basándose en análisis internos, y cita Exascale Storage con una velocidad de varios TB/s por rack. Ambas afirmaciones figuran en el registro de afirmaciones que aparece a continuación. Una advertencia práctica para los compradores: Lightning ya está disponible de forma general, pero su alcance se limita a las configuraciones de fábrica de IA, y la mayoría de los lectores no lo verán en un presupuesto estándar.
Nuestra cobertura del año pasado:
- Dell mantiene su posición de líder en el Cuadrante Mágico de Gartner de 2026 para almacenamiento empresarial. (Ago 2026)
- ObjectScale alcanza los 9.83 PB en 2U con SSD Kioxia de 245 TB y S3 sobre RDMA. (Ago 2026)
- Dell supera en ventas al resto de las cinco principales empresas de IDC combinadas en el segmento de almacenamiento externo del primer trimestre. (Jul 2026)
- Reinicio dentro de PowerStore Gen 3 (Mayo 2026)
- Sistema de archivos Lightning y almacenamiento a exaescala en GTC 2026 (Mar 2026)
- Nuestro análisis del PowerEdge R5715, un servidor 2U con enfoque en almacenamiento que probamos en la práctica. (Mar 2026)
HPE
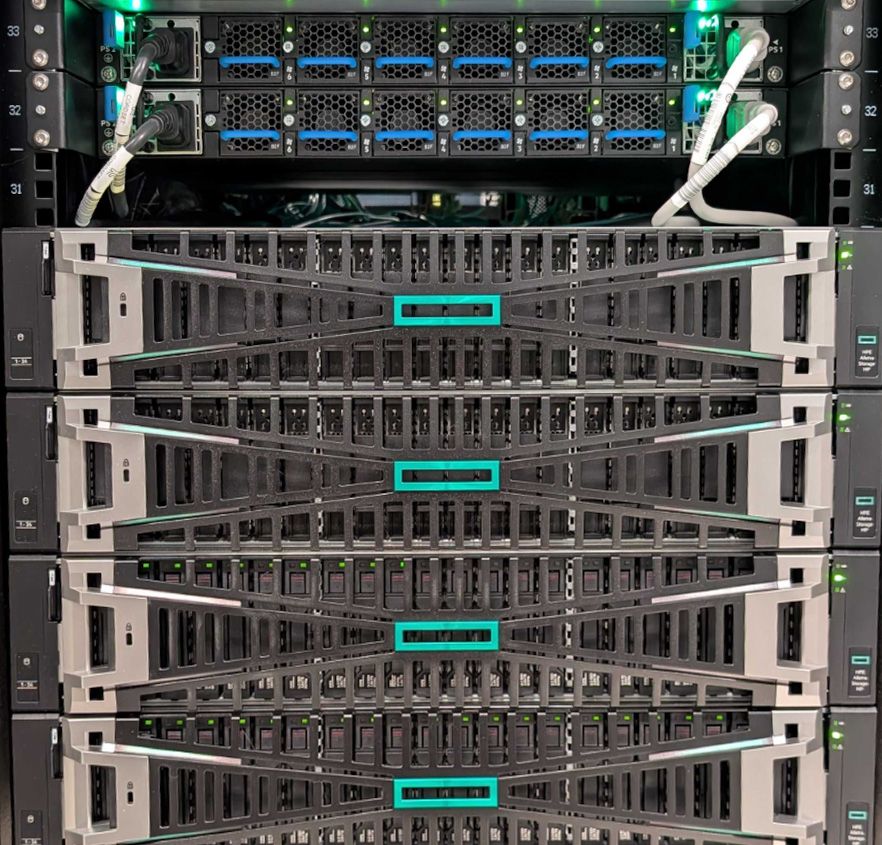
Plataforma: Alletra Storage MP, dividida en B10000 para bloques y X10000 para objetos, además de GreenLake para archivos. HPE también comercializa la infraestructura de computación y redes asociada, que es como se distribuye la mayor parte de su almacenamiento para IA.
Implementaciones con nombre: Compilaciones de IA soberana y fábrica de IA donde HPE proporciona la pila completa. No hay ninguna implementación de neocloud con nombre comparable a los ejemplos de VAST, WEKA o DDN mencionados anteriormente.
Validación de NVIDIA: Socio de lanzamiento de almacenamiento certificado por NVIDIA, con validaciones para DGX BasePOD y SuperPOD.
Resultado auditado: HPE ha participado en todas las rondas de MLPerf Storage, desde la versión 1.0 hasta la 3.0, lo que la sitúa por delante de Dell y NetApp en participación. Sin embargo, lea atentamente las entradas del lado del archivo: los mejores resultados de HPE en IA para archivos se obtuvieron mediante presentaciones conjuntas con WEKA, y HPE finalizó esa colaboración, junto con Qumulo y Scality, en noviembre de 2025. Dichos resultados ya no describen un producto que HPE pueda venderle hoy.
Nuestra cobertura del último año: Hemos probado la plataforma Alletra en la práctica.
- HPE mantiene su posición de líder en el Cuadrante Mágico de Gartner de 2026 para almacenamiento empresarial. (Ago 2026)
- Alletra Storage MP B10000 con NIST CSF 2.0, nuestras pruebas prácticas (Jun 2026)
- Sistema de almacenamiento Alletra MP X10000 con el nodo acelerador de protección de datos (Feb 2026)
- CloudCasa añade Kubernetes DR para el B10000 (Jun 2026)
- MLPerf Storage v3.0: 345.8 GiB/s en 3D U-Net con el K3000, uno de los dos únicos proveedores en esta página que presentaron su propuesta en esta ronda.
IBM
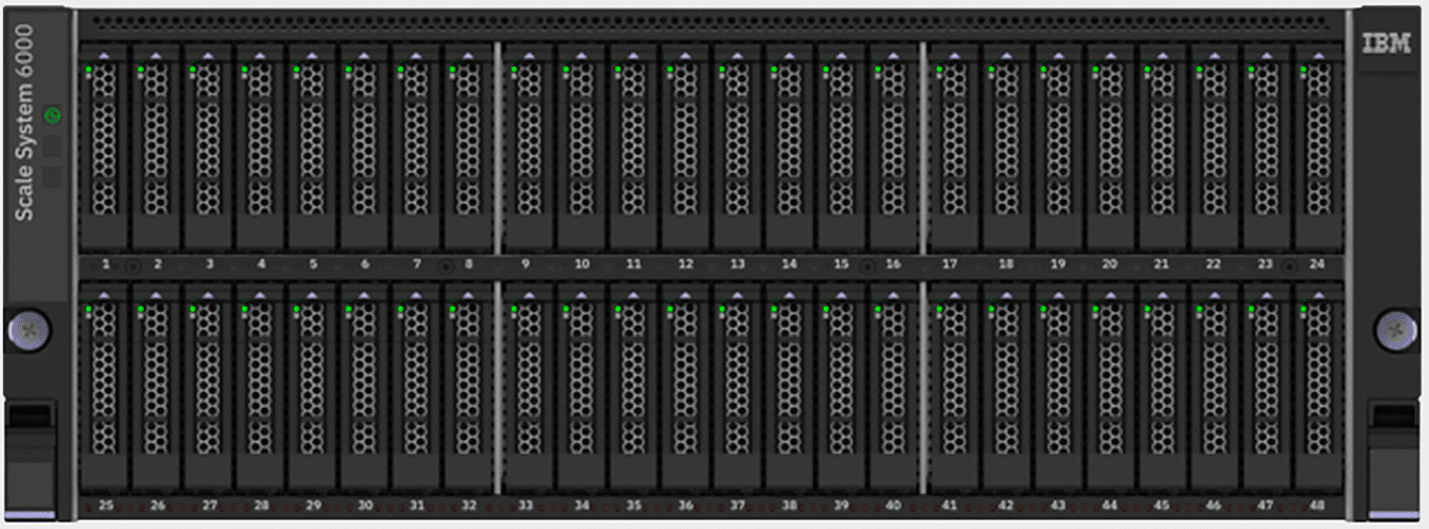
Plataforma: IBM Storage Scale, el sistema de archivos paralelo con linaje GPFS, que se vende como software y como dispositivos Storage Scale System, con Fusion empaquetándolo para Kubernetes y canalizaciones de IA.
Implementaciones específicas: Forman parte de la arquitectura multivendedor de CoreWeave. IBM Cloud también está construyendo un clúster de inferencia HGX B300 dedicado, valorado en 240 millones de dólares, con Together AI, anunciado en agosto de 2026, aunque no se han revelado los detalles de la capa de almacenamiento.
Validación de NVIDIA: Socio de lanzamiento de almacenamiento certificado por NVIDIA.
Resultado auditado: Sí, en MLPerf Storage v2.0, incluyendo la carga de trabajo de puntos de control, donde Storage Scale registró 656.7 GiB/s de lectura en un modelo Llama 3.1 de 1T. La restauración de puntos de control es la métrica que determina cuánto de una ejecución de entrenamiento fronterizo se pierde debido a un fallo, y muy pocos proveedores han publicado una cifra auditada al respecto.
Afirmaciones pendientes: Nada destacable en la categoría de matrices más rápidas. IBM comercializa Storage Scale basándose en la escalabilidad y la integración, en lugar de un récord de rendimiento.
Nuestra cobertura del año pasado:
- IBM mantiene su posición de líder en el Cuadrante Mágico de Gartner de 2026 para almacenamiento empresarial. (Ago 2026)
- IBM y Together AI invirtieron 240 millones de dólares en un clúster de inferencia HGX B300 dedicado. (Ago 2026)
- IBM presenta el almacenamiento con reconocimiento de contenido para cargas de trabajo RAG. (Abr 2026)
- Sistema Flash de última generación con IA agente (Feb 2026)
- Sistema de almacenamiento a escala 6000, almacenamiento unificado para IA y computación de alto rendimiento (HPC). (Nov 2025)
- Nuestro análisis del IBM FlashSystem 5300, una experiencia práctica con el sistema de almacenamiento compacto de IBM y una útil muestra de cómo se comportan los sistemas más grandes. (Sep 2024)
Everpure (anteriormente Pure Storage)
Plataforma: FlashBlade//EXA es la solución con IA, que divide las rutas de metadatos y datos para que el plano de datos se escale de forma independiente. FlashBlade//S y FlashArray cubren el resto. Everpure fabrica sus propios módulos DirectFlash en lugar de comprar SSDs ya terminados, por lo que sus cifras de densidad y durabilidad no coinciden con las del resto del mercado. La empresa se constituyó legalmente como Everpure el 23 de febrero de 2026.
Implementaciones con nombre: Forman parte de la pila de múltiples proveedores en CoreWeave. No pudimos confirmar una implementación de entrenamiento de IA con nombre específica en FlashBlade//EXA.
Validación de NVIDIA: Socio de lanzamiento de almacenamiento certificado por NVIDIA.
Resultado auditado: MLPerf Storage v3.0 (septiembre de 2026), primera presentación de Everpure: escritura de punto de control de 877.5 GiB/s con lectura de 833.0 GiB/s en 30 nodos de datos FlashBlade//EXA, los números de punto de control más altos de la ronda, además del mayor resultado de caché KV de la ronda en 1,623.4 GiB/s. También ostenta el récord de SPECstorage Solution 2020_ai_image con 6,300 trabajos de IA, publicado el 17 de febrero de 2026. Comparativa diferente, modelo de carga de trabajo diferente, pero es una presentación real bajo un conjunto de reglas publicado con un proceso de revisión, y cuenta.
Afirmaciones públicas: FlashBlade//EXA se comercializa como la plataforma de almacenamiento de datos de mayor rendimiento del sector, con un rendimiento proyectado superior a 10 TB/s en un único espacio de nombres. Proyectado, no medido.
Nuestra cobertura del año pasado:
- Everpure lidera ambos ejes del Cuadrante Mágico de Gartner 2026 por segundo año consecutivo. (Ago 2026)
- Everpure lanza Data Stream para canalizaciones de IA empresariales. (Jun 2026)
- Mejoras en la inteligencia de datos y la nube de datos empresariales (Jun 2026)
- Prueba de Emulex SecureHBA con Everpure XL130 R5: no se trata de una prueba de rendimiento de IA, sino de una experiencia práctica con el hardware de Everpure. (Mar 2026)
- MLPerf Storage v3.0 (septiembre de 2026): primera presentación, escritura de punto de control de 877.5 GiB/s y lectura de 833 GiB/s en FlashBlade//EXA, más lectura de caché KV de 1,623 GiB/s, las mayores cifras de punto de control e inferencia de la ronda. Cobertura completa de la versión 3.0.
NetApp
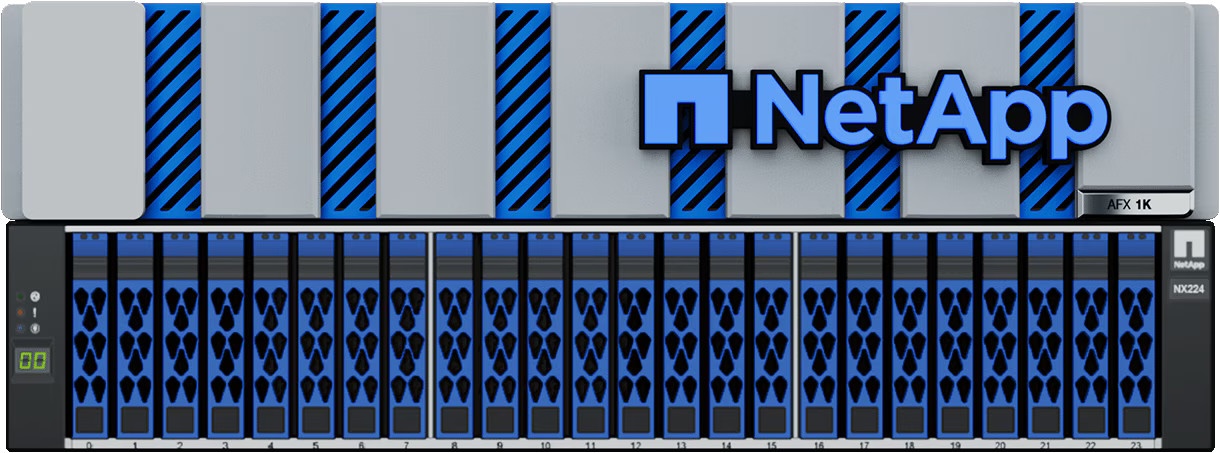
Plataforma: AFX, anunciada en octubre de 2025, es una plataforma ONTAP totalmente flash desagregada, diseñada para canalizaciones de datos de IA, con el motor de datos de IA integrado. AIPod es el diseño de referencia validado por NVIDIA.
Implementaciones identificadas: No podemos confirmar ninguna a escala de entrenamiento de IA. Los ejemplos públicos más sólidos son las arquitecturas validadas, más que los nombres de clientes, incluidos los diseños de IA de FlexPod con Cisco de junio de 2026.
Validación de NVIDIA: Socio de lanzamiento de almacenamiento certificado por NVIDIA, con certificación DGX SuperPOD.
Resultado de la auditoría: Ninguno. NetApp nunca ha enviado datos a MLPerf Storage.
Nuestra cobertura del año pasado:
- NetApp mantiene su posición de líder en el Cuadrante Mágico de Gartner de 2026 para almacenamiento empresarial. (Ago 2026)
- HCLTech combina Keystone con U4X para el almacenamiento de IA basado en el consumo. (Ago 2026)
- NetApp compra DataPelago para el procesamiento de datos mediante GPU. (Jul 2026)
- StorageGRID 12.1 añade un espacio de nombres federado y hasta 12 TB/s. (Jun 2026)
- FlexPod validó arquitecturas de IA con Cisco. (Jun 2026)
- El lanzamiento de AFX (Octubre 2025)
Una nota sobre Huawei
Huawei registró el mayor rendimiento absoluto en MLPerf Storage v2.0, 698 GiB/s en 3D U-Net con un OceanStor A800 de doble nodo 8U que alimentaba 255 H100 simulados, y aparece en la tabla auditada a continuación. Lo omitimos de los perfiles de líderes porque no es una compra práctica para los compradores en EE. UU., Europa ni la mayoría de los mercados a los que sirve esta página. La cifra es real; la disponibilidad no lo es. El Cuadrante Mágico de Gartner de 2026 alcanza el mismo equilibrio desde la otra dirección, manteniendo a Huawei en su cuadrante de Líderes gracias a la fortaleza de OceanStor fuera de Norteamérica.
Lo que dicen los analistas
La posición del analista es una clase de evidencia en sí misma: no es un punto de referencia auditado, sino una evaluación independiente de la ejecución y la visión, que se acerca más a cómo se compran realmente estos sistemas. En el Cuadrante Mágico de Gartner de 2026 para Plataformas de Almacenamiento Empresarial , los mismos seis proveedores mantienen el cuadrante de Líderes que el año pasado: Everpure, Huawei, HPE, NetApp, Dell e IBM, con Everpure a la cabeza en capacidad de ejecución y más avanzada en la amplitud de su visión por segundo año consecutivo. Dos notas de alcance son importantes para esta página. Gartner evalúa el mercado de almacenamiento primario y realiza un seguimiento del segmento de archivos y objetos de alto rendimiento en una investigación separada, que es donde se encuentran los especialistas nativos de IA mencionados anteriormente, por lo que su ausencia del Cuadrante es un límite de categoría, no un veredicto. Y cuando seis de los ocho proveedores evaluados obtienen la etiqueta de Líder, la etiqueta en sí misma dice poco a los compradores; la señal la transmiten las posiciones relativas.
¿Qué cambiaría esta lista?
Cuatro factores, ordenados según la importancia que les damos. Un proveedor nos permite probar su plataforma con nuestra metodología, ya sea mediante hardware que podamos alojar nosotros mismos o mediante el acceso a una implementación a mayor escala. Un proveedor participa en una ronda de auditoría reciente, como MLPerf Storage o SPECstorage. Un operador, en lugar de un proveedor, documenta una implementación, como hizo Meta con Hammerspace. O un proveedor pierde una designación o asociación de la que depende su posicionamiento actual, como sucedió con la separación de WEKA y HPE, que cambió la forma en que ambas compañías llegan a los compradores de IA. Actualizamos los perfiles a medida que esto ocurre.
Lo que realmente muestran los índices de referencia auditados.
El entrenamiento de IA y los proveedores de neocloud que lo respaldan son donde realmente se está librando la carrera por el rendimiento del almacenamiento en 2026, y es el único segmento con un sólido benchmark auditado: MLCommons MLPerf Storage. La ronda publicada actualmente es la v3.0 (septiembre de 2026), con 19 organizaciones participantes y 143 resultados. Por primera vez, el benchmark abarca todo el pipeline de IA: rendimiento del entrenamiento, puntos de control y dos nuevas pruebas de inferencia (Vector Database y KV Cache), además de la compatibilidad con el almacenamiento de objetos S3 que utilizó aproximadamente una sexta parte de las presentaciones. Debido a que la v3.0 cambió sus aceleradores simulados de H100 a B200, los resultados no son comparables con rondas anteriores. MLPerf Storage no corona a un único ganador; diferentes sistemas lideran diferentes cargas de trabajo y métricas.
| Sistema | Resultado auditado (MLPerf Storage v3.0) | Clase |
|---|---|---|
| Everpure FlashBlade//EXA | Escritura de punto de control de 877.5 GiB/s y lectura de 833 GiB/s en 30 nodos de datos; lectura de caché KV de 1,623 GiB/s. | Líder de puntos de control e inferencia |
| YanRongTech F9000X | 543.9 GiB/s en la red 3D U-Net alimentando 99 aceleradores B200 simulados. | Mayor rendimiento de entrenamiento presentado |
| Datos de Turing F9200 | 541.5 GiB/s en 3D U-Net desde tres nodos de almacenamiento; Checkpoint-70B a 539.9 GiB/s de lectura y 307.1 GiB/s de escritura. | Nuevo producto en densidad de rendimiento |
| Lustre administrado de Azure | Escritura de punto de control de 642.2 GiB/s desde una implementación en la nube administrada de 4,096 TiB. | Se ha presentado el primer servicio de nube hiperescalable. |
| NVIDIA AIStore | 20 envíos a través del almacenamiento de objetos S3 en OCI, AWS y GCP. | Almacenamiento de objetos en el territorio de los sistemas de archivos paralelos. |
En el ámbito de la computación de alto rendimiento (HPC), la lista IO500 (edición ISC 2026) está liderada por Sugon ParaStor en SCNet con 26,888 GiB/s de ancho de banda medido en 500 nodos cliente, con sistemas Intel DAOS (Argonne Aurora, LRZ) ocupando varios puestos destacados y Weka apareciendo a través de Samsung SSC-24. La renovación de la versión 3.0 es tan relevante como las cifras: los líderes de rendimiento de la versión 2.0, DDN, Huawei, Hammerspace y Lightbits, no participaron en esta ronda, mientras que 11 participantes nuevos se presentaron, entre ellos Azure y NVIDIA. Análisis completo en nuestra cobertura de MLPerf Storage v3.0.
¿Quién realmente alimenta las Neoclouds?
Los éxitos en la implementación no son indicadores de referencia, pero sí evidencia real de lo que compran los operadores cuando el rendimiento es su prioridad. Cabe destacar que las mayores fábricas de IA son multivendedor; ninguna empresa de almacenamiento es propietaria absoluta de ninguno de estos centros.
| Nube AI | Almacenaje | Detalles |
|---|---|---|
| Tejido central | VAST Data (además de WEKA, DDN, IBM Storage Scale y Everpure en la pila) | Acuerdo plurianual de 1.17 millones de dólares, noviembre de 2025, el mayor cliente de VAST. |
| Coloso xAI | DDN EXAScaler e Infinia, con VAST Data añadido en la expansión Frontier AI Factory. | DDN anunció en noviembre de 2024 una cifra de 100 GPU; será compatible con múltiples proveedores a finales de 2025. |
| Nebio | WEKA NeuralMesh | Nivel Premium de Nebius AI Cloud, anunciado en junio de 2025. |
| Juntos IA | IBM Cloud (sistemas HGX B300) | Se anunció un acuerdo de 240 millones de dólares en agosto de 2026; la capa de almacenamiento aún no se ha revelado. |
El rastreador de reclamaciones
Estas son las afirmaciones actuales sobre la mayor velocidad en el segmento de almacenamiento de IA. Ninguna ha sido verificada de forma independiente, y cada una está indicada por su proveedor como prueba interna.
| Reclamación del proveedor | Número | Estado |
|---|---|---|
| Everpure FlashBlade//EXA, “la plataforma de almacenamiento de datos de mayor rendimiento del sector” (marzo de 2025) | Lecturas proyectadas de más de 10 TB/s en un solo espacio de nombres | Proyección del proveedor; no se realizó ninguna auditoría. |
| Dell Lightning File System, “el sistema de archivos paralelo más rápido del mundo” (disponible a partir de abril de 2026). | Hasta 150 GB/s por unidad de rack, según análisis internos de Dell. | Reclamación del proveedor; no se ha presentado ninguna solicitud auditada. |
| Almacenamiento Dell Exascale (GTC 2026) | Hasta 6 TB/s por rack | Reclamación del proveedor; no se ha presentado ninguna solicitud auditada. |
| Huawei New-Gen OceanStor Dorado (septiembre de 2024) | Límite de 100 millones de IOPS según la hoja de especificaciones con una latencia de 0.03 ms. | Especificaciones del proveedor; una prueba de Omdia encargada por Huawei midió 2.58 millones de IOPS sostenidas a 70 microsegundos en una carga de trabajo real de Oracle RAC, una útil comprobación de la realidad sobre los máximos indicados en la hoja de especificaciones. |
| WEKA y WEKApod 3 con NeuralMesh 6 afirman que su capacidad es de un exabyte en un solo rack (julio de 2026). | 1.1 EB y 10.2 TB/s en un rack | Afirmación del proveedor: WEKA se envió por última vez a MLPerf Storage en la versión 1.0 y se omitió la versión 2.0. |
| VAST Data y AMD, descarga de caché KV en Instinct (julio de 2026) | Tiempo de obtención del primer token 9 veces más rápido | Pruebas conjuntas de proveedores; VAST nunca se ha sometido a MLPerf Storage. |
| DDN y Nebul, aceleración de caché KV con NVIDIA Dynamo (julio de 2026) | El proveedor afirma que la velocidad aumenta en las cargas de trabajo de inferencia. | Validación por parte del socio, no una auditoría independiente; DDN dispone de resultados actualizados de MLPerf Storage v2.0. |
¿Qué pasó con SPC-1?
SPC-1 era el referente de la industria en almacenamiento en bloques, y ahora está prácticamente inactivo: los proveedores estadounidenses lo abandonaron en torno a 2018, dejando un panorama dominado por los proveedores chinos. El récord actual no es el resultado de Huawei, ampliamente citado. ExponTech WDS V3 ostenta la puntuación más alta aceptada con 27.2 millones de IOPS de SPC-1 (aceptada en noviembre de 2023), por delante de Inspur con 23.0 millones, mientras que los famosos 21.0 millones de Huawei de 2020 ocupan ahora el cuarto lugar. Una presentación de FlashNexus superior, de 30.0 millones de IOPS, permanece sin aceptar en revisión desde febrero de 2025, y no la consideramos un récord hasta que el Storage Performance Council lo haga.
Cómo funciona esta página
Tres reglas. Primero, cada número está etiquetado según su clase de evidencia: envío auditado, declaración del proveedor o medición de StorageReview. Segundo, no repetimos superlativos que no podemos respaldar con datos actuales; varias afirmaciones famosas de "más rápido" en esta página tienen años de antigüedad y están marcadas como tales. Tercero, el camino hacia la sección verificada de esta página está abierto a cualquier proveedor: envíe su informe a MLPerf Storage o IO500, o permítanos realizar pruebas según nuestra metodología estándar. Esta página cubre únicamente el almacenamiento de IA y neocloud. El almacenamiento empresarial convencional de bloques y archivos, y el almacenamiento para pymes, tendrán sus propias páginas en lugar de estar integrados aquí, porque la evidencia disponible en cada segmento es diferente. Actualizamos los perfiles de los líderes a medida que surgen noticias y realizamos una revisión completa cuando se publica una nueva ronda auditada.
Preguntas frecuentes sobre el almacenamiento más rápido
¿Cuál es el sistema de almacenamiento más rápido del mundo?
No existe una única respuesta verificada, y quien la proporcione estará citando a un proveedor. Según datos auditados a septiembre de 2026: FlashBlade//EXA de Everpure registró el mayor valor de punto de control de MLPerf Storage v3.0 con 877.5 GiB/s de escritura; F9000X de YanRongTech lideró el rendimiento de entrenamiento con 543.9 GiB/s; Sugon ParaStor encabeza la lista de ancho de banda de IO500; y ExponTech ostenta el récord aceptado de IOPS de SPC-1. Las cifras más altas declaradas, incluidas las proyecciones de almacenamiento Exascale por rack de Dell, siguen sin verificarse de forma independiente.
¿Cuál es la forma más rápida de almacenamiento para el entrenamiento de IA?
Según MLPerf Storage v3.0, el único benchmark de almacenamiento de IA auditado, los líderes en rendimiento de entrenamiento son YanRongTech, TuringData y UBIX, mientras que Everpure lidera en puntos de control e inferencia de caché KV y Azure lidera entre los servicios en la nube. En cuanto a lo que implementan los operadores de IA más grandes, VAST, DDN y WEKA dominan los triunfos en la neocloud, aunque ninguno de los tres se sometió a la versión 3.0. Ambos tipos de evidencia aparecen arriba, etiquetados.
¿Por qué existen tan pocos estudios comparativos independientes sobre sistemas de almacenamiento empresariales?
Debido a que la mayoría de los proveedores de almacenamiento empresarial prohíben contractualmente la publicación de resultados de pruebas de rendimiento, y a que los principales fabricantes de matrices abandonaron las pruebas públicas que utilizaban anteriormente, en particular SPC-1, alrededor de 2018, los proveedores que ofrecen soluciones de IA han revertido parcialmente esta tendencia, ya que la participación en MLPerf Storage se convirtió en un requisito de venta. Actualizamos esta página a medida que se publican nuevos resultados auditados.
¿Debería tenerse en cuenta la encriptación resistente a la computación cuántica a la hora de comprar un sistema de almacenamiento?
Para las industrias reguladas, sí, y los plazos están más cerca de lo que parecen. La guía CNSA 2.0 de la NSA exige que las nuevas instalaciones del Sistema Nacional de Seguridad cumplan con la normativa antes de enero de 2027, con la desactivación de los sistemas que no la cumplan antes de finales de 2030, y los marcos NIS2 y DORA de la UE incluyen sus propios requisitos de cifrado. El estándar FC-SP-3, ya finalizado, convierte esto en un detalle de adquisición en lugar de un proyecto: las HBA compatibles con FC-SP-3 cifran el tráfico SAN en tránsito a velocidad de línea con algoritmos post-cuánticos, y dado que el cifrado se produce en la capa de transporte, la matriz sigue recibiendo datos que puede comprimir, deduplicar y analizar en busca de anomalías de ransomware, algo que el cifrado a nivel de aplicación de los servicios no logra. Especificar la conectividad FC-SP-3 en las compras de renovación habituales de tres a cinco años proporciona una SAN totalmente cifrada para 2030 como resultado secundario. Nuestro análisis en profundidad de FC-SP-3 abarca el estándar, los plazos y los modelos de implementación.


 Amazon