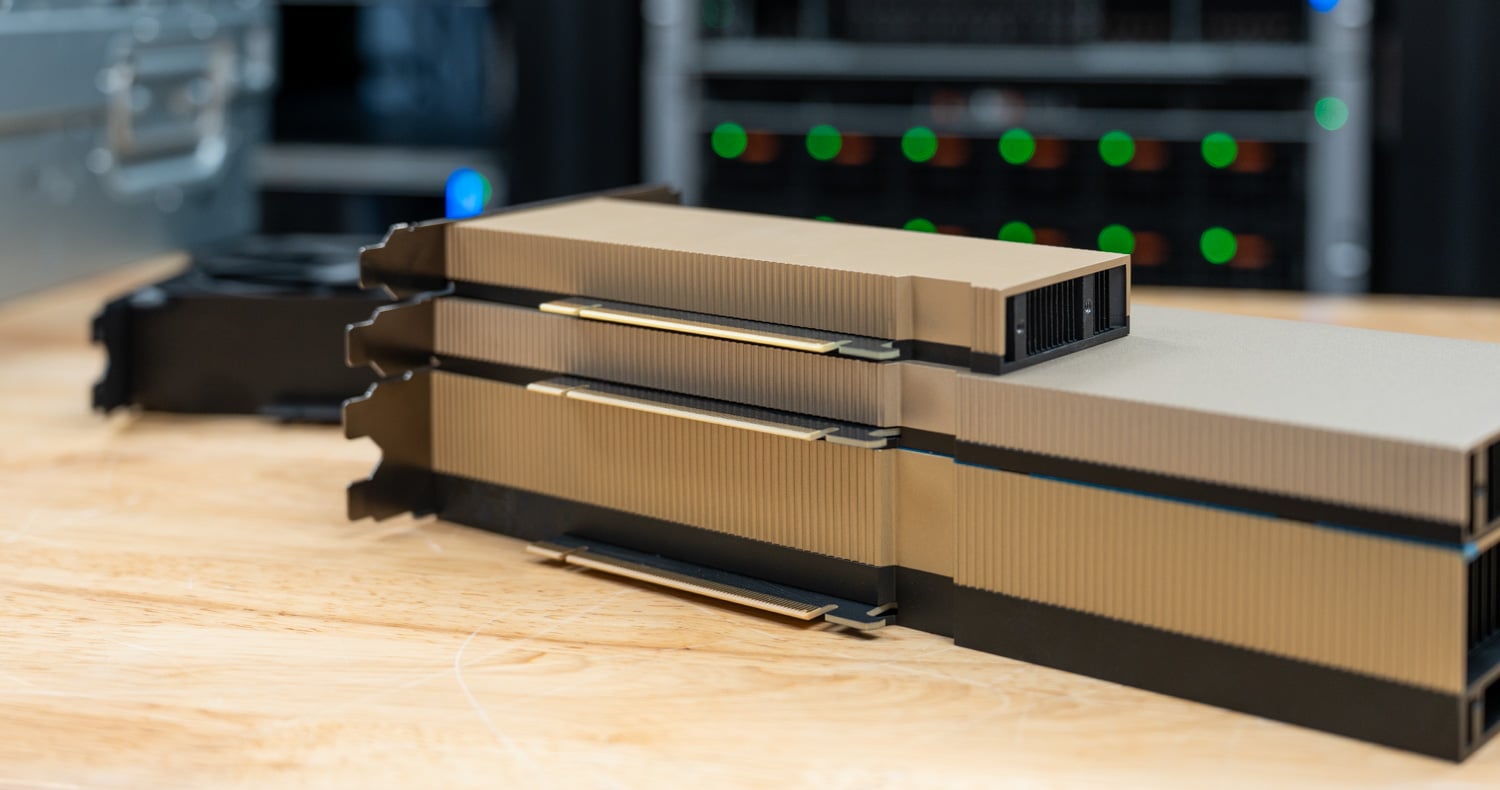
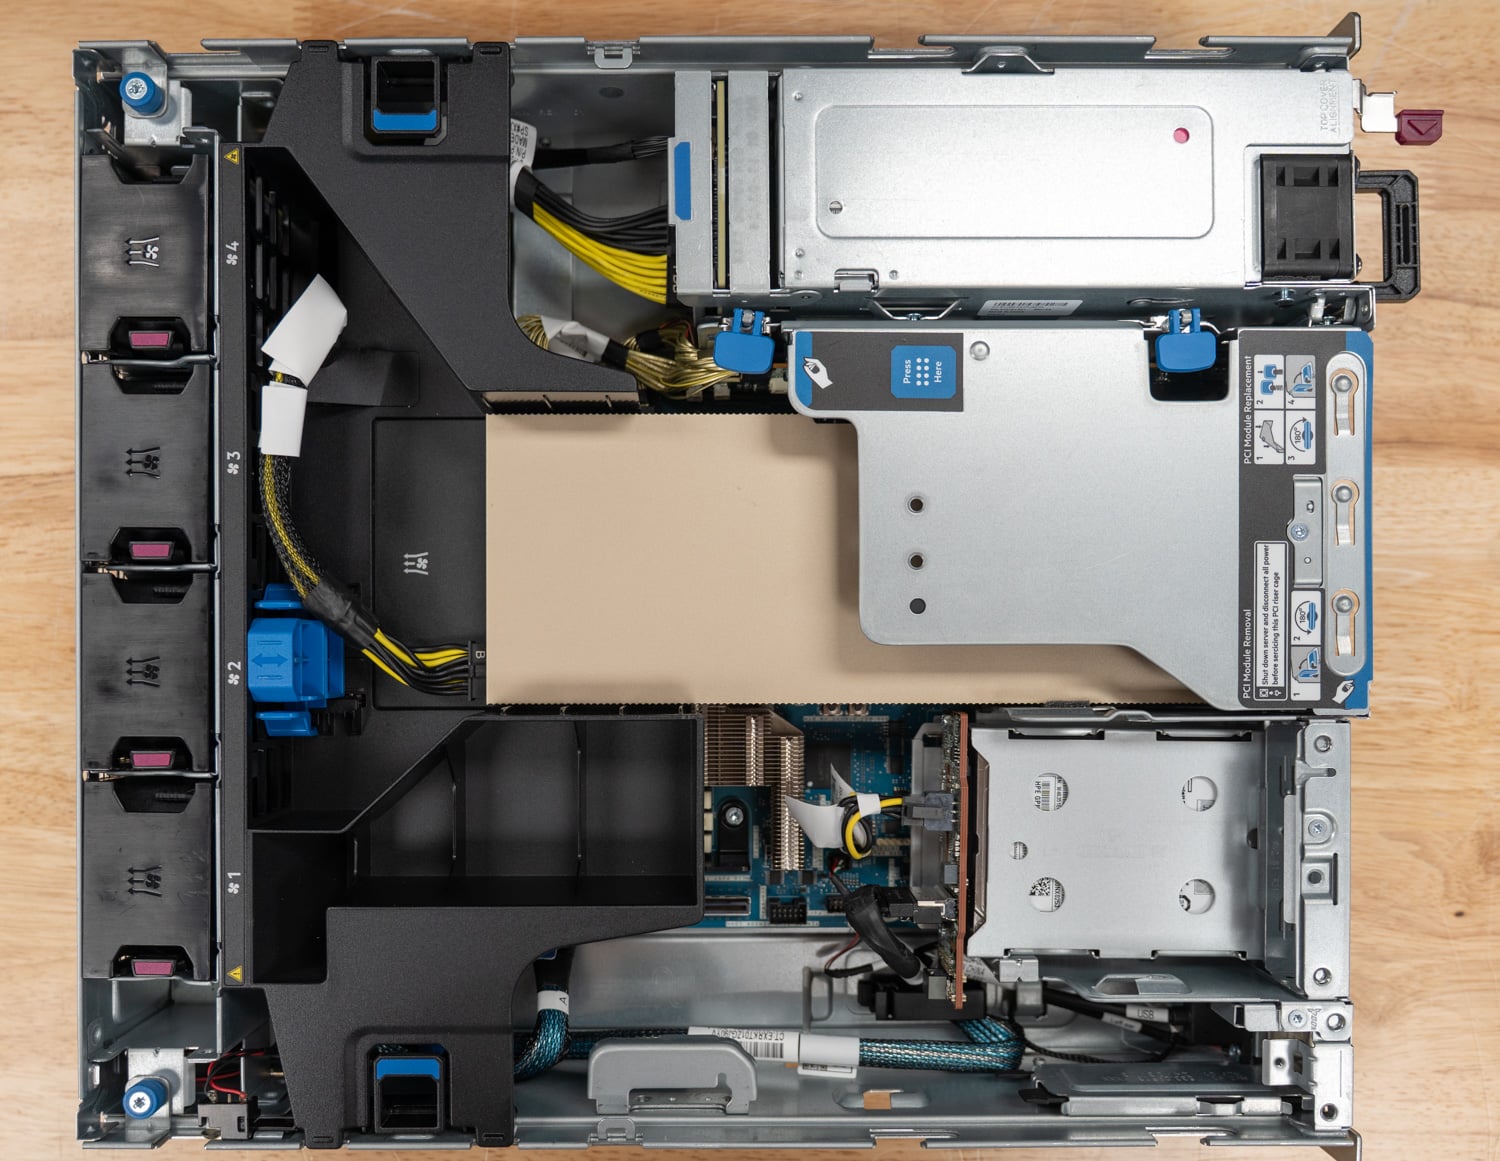
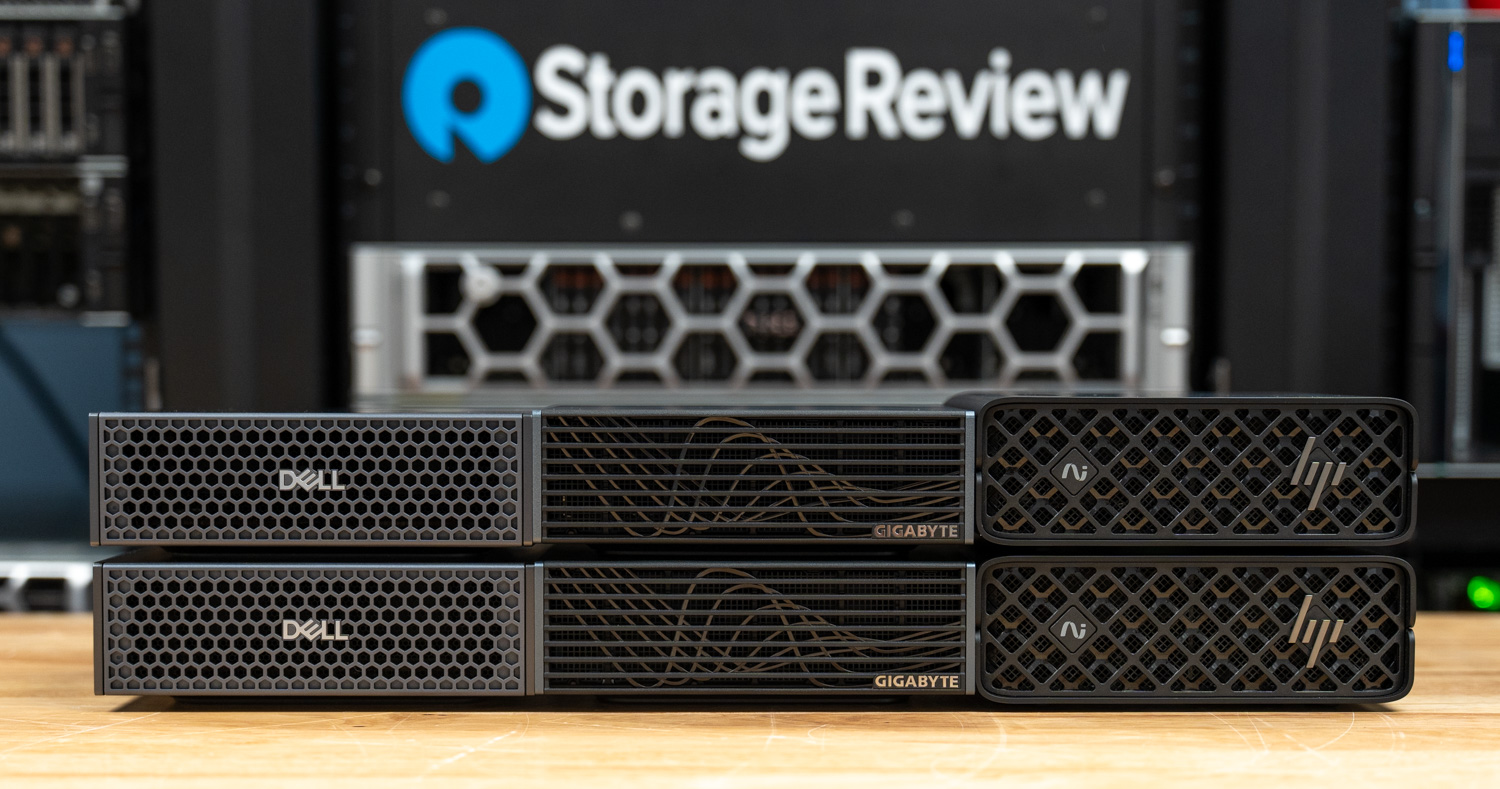
Nuestras revisiones actuales de sistemas de IA se centran en la inferencia en el laboratorio, con modelos de peso abierto de las familias Llama, Qwen, DeepSeek y gpt-oss que se ejecutan a través de vLLM o SGLang y se miden en función del rendimiento de salida y la latencia del primer token. La cobertura abarca desde el borde hasta el nodo GPU completo: la NVIDIA RTX PRO 4500 Server Edition ofreció una mediana de 2.7 veces los tokens de salida por segundo de la L4 que fue diseñada para reemplazar dentro de un HPE ProLiant DL145 Gen11, con un consumo de aproximadamente 105 W más; las versiones de Dell, GIGABYTE y HP de DGX Spark ejecutaron inferencia distribuida como clústeres de dos nodos sobre la estructura de 200 Gb; y Supermicro JumpStart nos permitió probar de primera mano un sistema NVIDIA HGX B200 y un sistema AMD Instinct MI350X. El almacenamiento recibe el mismo tratamiento porque la ruta de datos determina la carga de trabajo de las GPU, por lo que medimos el rendimiento del almacenamiento GPUDirect con GDSIO y probamos la descarga de caché KV a la memoria flash para cargas de trabajo de contexto largo y con agentes.
Si está dimensionando el hardware para IA, la página Mejores servidores enumera nuestras selecciones actuales de inferencia de IA y computación perimetral basadas en los datos de estas reseñas, Mejores SSD empresariales cubre las unidades que alimentan las GPU y Mejores matrices de almacenamiento cubre las plataformas de almacenamiento de IA detrás de los clústeres de entrenamiento y las neonubes.




 Amazon