

Nota del editor: Tuvimos la oportunidad de reunirnos y profundizar nuevamente en la plataforma NVIDIA Jetson con un nuevo miembro de nuestro equipo. Consulta nuestro artículo del año pasado donde ejecutamos un modelo de visión en una versión final del producto Jetson, el Lenovo SE70.
Con la plataforma Jetson de NVIDIA, los desarrolladores pueden explorar opciones de IA diseñadas específicamente para el desarrollo de IA de vanguardia. Estos sistemas permiten el rendimiento del servidor habilitado para GPU en un paquete que puede sostener con una mano. Muchas gracias a NVIDIA por brindarnos el kit de desarrollo Jetson AGX Orin para probarlo y ver lo fácil que puede ser tener su propio LLM local.
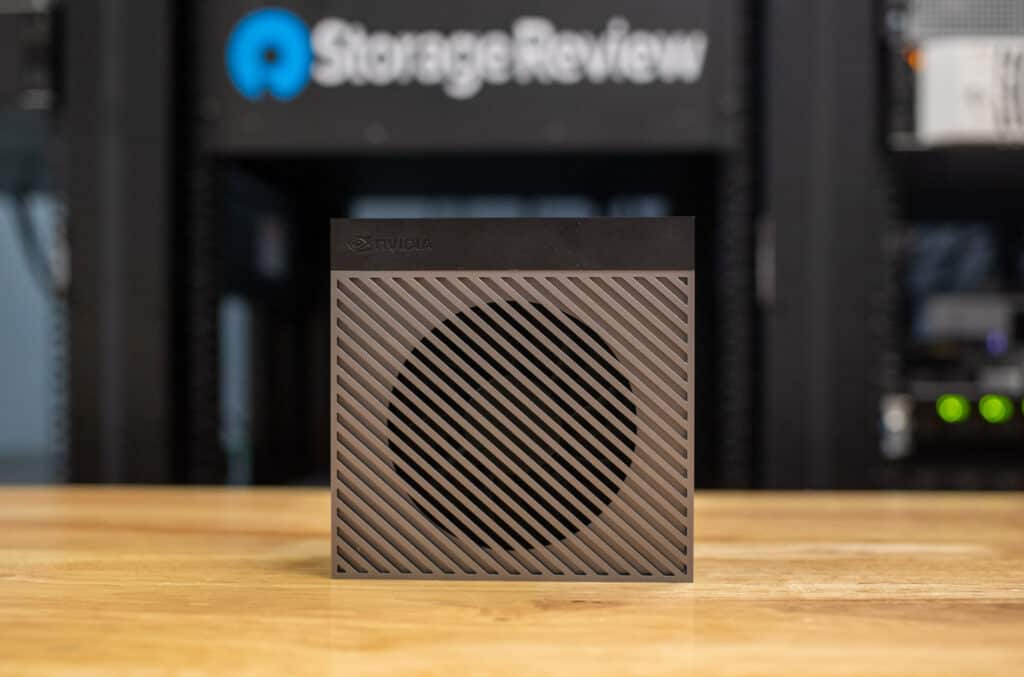 El Jetson AGX Orin DevKit viene en un diseño de factor de forma pequeño, solo 11 cm o aproximadamente 4.3 pulgadas de ancho y largo y 7.2 cm (aproximadamente 2.8 pulgadas) de alto. En el interior del Jetson AGX Orin Dev Kit, se encuentra una GPU con arquitectura NVIDIA Ampere de 2048 núcleos con 64 Tensor Cores y una frecuencia máxima de 1.3 GHz. También hay una CPU Arm Cortex de 12 núcleos A78AE v8.2 de 64 bits con caché L3 de 2 MB, caché L6 de 3 MB y una frecuencia máxima de 2.20 GHz.
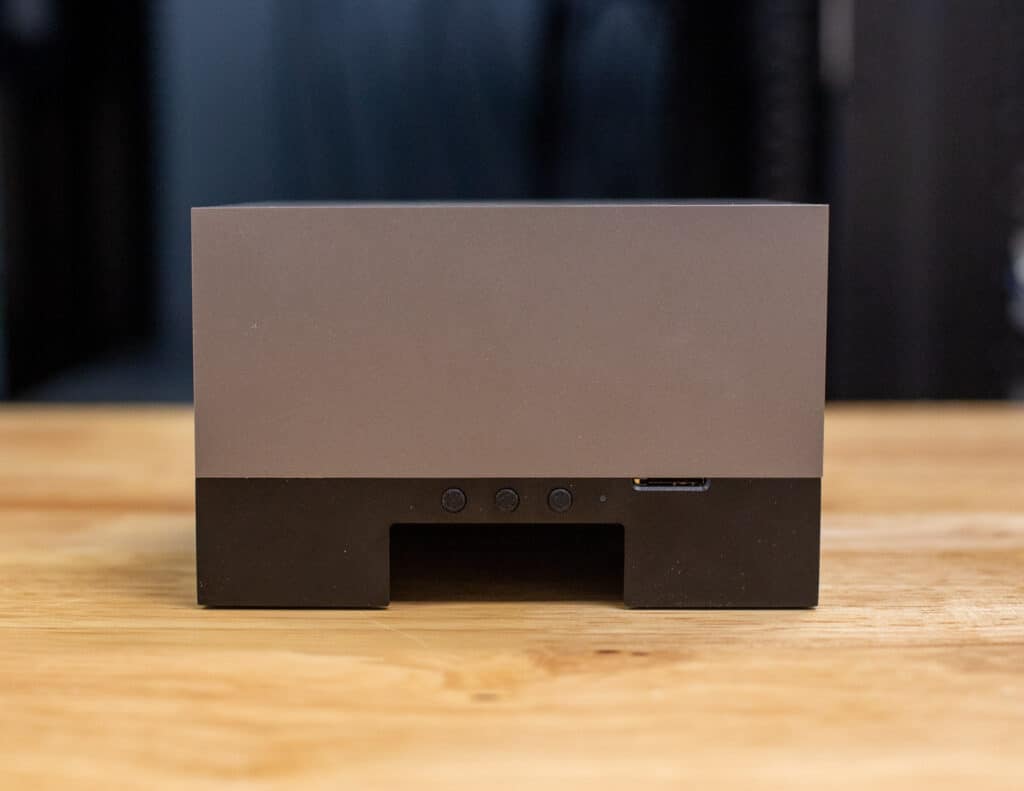
Esos dos componentes de potencia, junto con 64 GB de memoria unificada LPDDR5 con velocidades de 204.8 GB/s, se combinan para crear la hazaña más impresionante de esta pequeña máquina: 275 TOPS en modelos con 64 GB de la pequeña GPU y DLA. Eso es 8.6 veces el número de TOPS que el predecesor de NVIDIA, el Jetson AGX Xavier, que sólo entregó 32 TOPS.
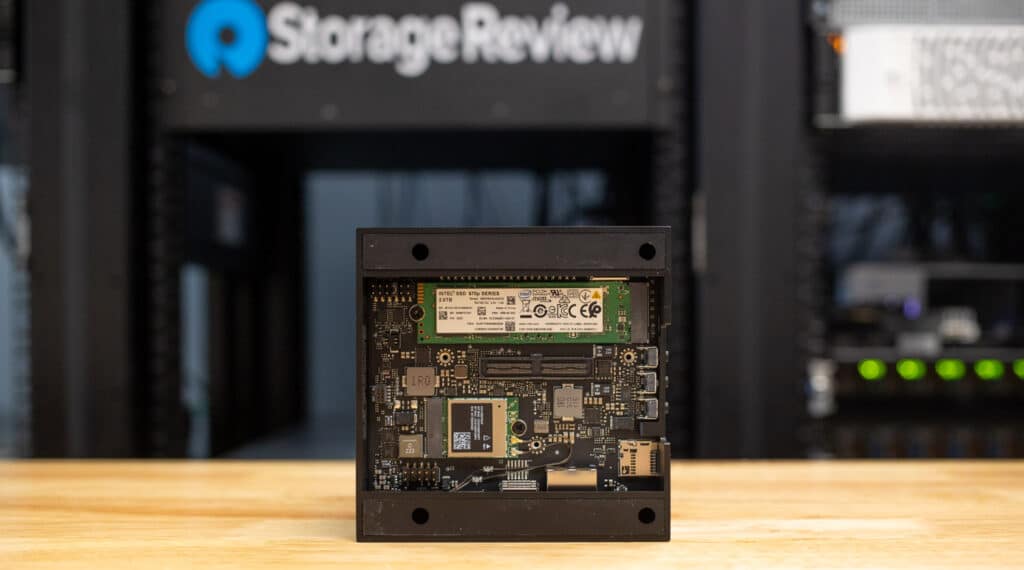
También debajo del capó hay dos ranuras M.2: una PCIe Gen 4×4 Key M para cualquier almacenamiento adicional más allá del eMMC de 64 GB y una Gen 4×1 Key E para conexiones inalámbricas. Sin embargo, la conectividad en línea no es un problema, con un conector RJ10 de 45 gigabits. Además, hay un encabezado de 40 pines (para UART, SPI, I2S, I2C, CAN, PWM, DMIC y GPIO), un encabezado de automatización de 12 pines, un encabezado de panel de audio de 10 pines, un encabezado JTAG de 10 pines, un Conector de ventilador de 4 pines, conector de respaldo de batería RTC de 2 pines, así como conector MIPI CSI-16 de 2 carriles para cámaras CSI.
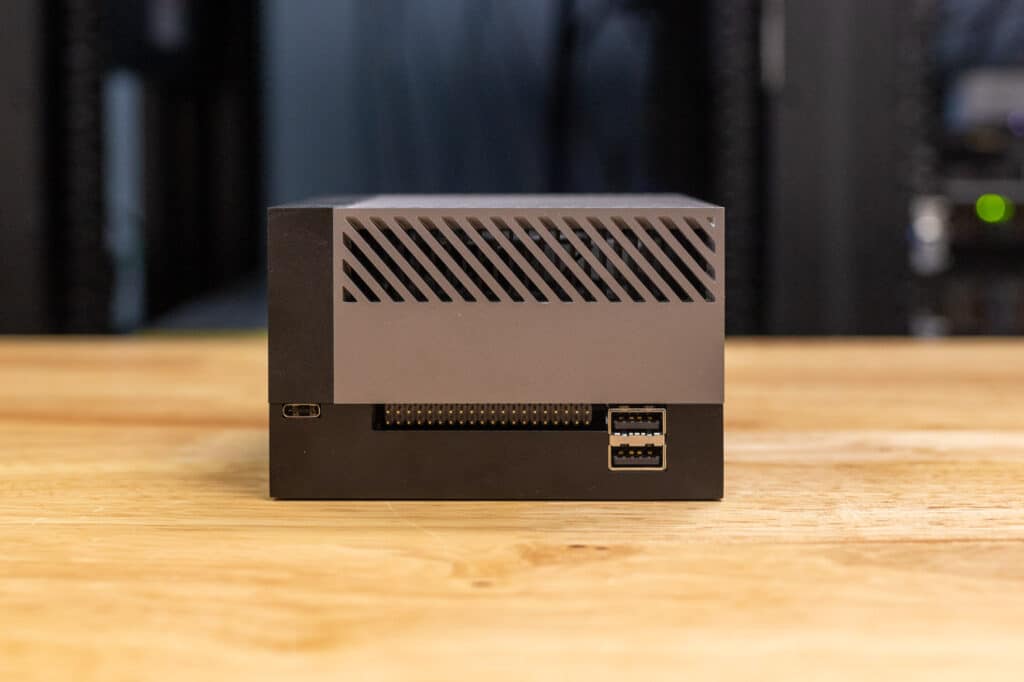 Tampoco falta conectividad externa. Hay seis puertos USB: dos puertos USB-A 3.2 Gen 2, dos puertos USB-A 3.2 Gen 1 y USB-C 3.2 Gen 2. De esos dos puertos USB-C, uno puede proporcionar velocidades de hasta 20 Gbps para flasheo y transferencia de datos, y el otro está dedicado a la fuente de alimentación de 60 W. Si necesita ese puerto USB-C adicional, hay una conexión de fuente de alimentación adicional a través de un conector de alimentación de CC. Sin embargo, el sistema sólo se envía con su fuente de alimentación USB-C. También hay una ranura para tarjeta micro SD para una opción de almacenamiento rápido y un puerto micro USB-B que sirve como puerto de depuración en serie.
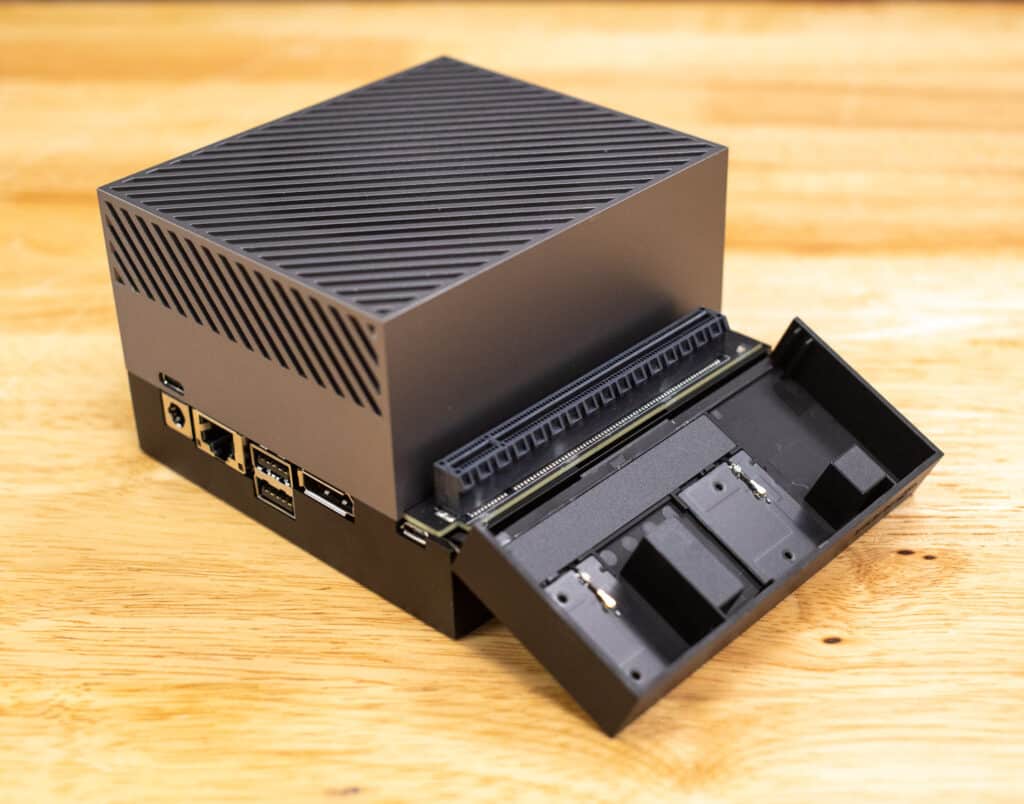
Oculta debajo de una cubierta magnética, se encuentra la ranura PCIe Gen 4×16 externa. Además, la ranura PCIe externa admite hasta una conexión PCIe 4×8. Sin forma de alimentar internamente una GPU, la ranura es más adecuada para algo como una NIC de alta velocidad. Para una opción de pantalla dedicada, Orin tiene un DisplayPort 1.4.
Jetson AGX Xavier vs. Jetson AGX Orin
| Elemento | Jetson AGX Xavier 64GB | Kit de desarrollo Jetson AGX Orin de 64 GB |
|---|---|---|
| Rendimiento de IA | 32 TOPS | 275 TOPS |
| GPU | GPU NVIDIA Volta de 512 núcleos con 64 núcleos tensoriales | GPU NVIDIA Ampere de 2048 núcleos con 64 núcleos Tensor |
| Frecuencia máxima de GPU | No se especifica | 1.3GHz |
| CPU | CPU NVIDIA Carmel Arm v8 de 8.2 núcleos y 64 bits, 8 MB L2 + 4 MB L3 | CPU Arm Cortex-A12AE v78 de 8.2 bits de 64 núcleos, 3 MB L2 + 6 MB L3 |
| Frecuencia máxima de CPU | 2.2GHz | 2.2GHz |
| Acelerador DL | 2x NVDLA v1 | No se especifica |
| Frecuencia máxima DLA | 1.4GHz | No se especifica |
| Acelerador de visión | 2x PVA | 1x PVAv2 |
| Salud Cerebral | LPDDR64x de 4 GB, 136.5 GB/s | LPDDR64 de 5 GB, 204.8 GB/s |
| Almacenaje | 32GB eMMC 5.1, 64GB disponible en versión industrial | No se especifica |
| Codificación de video | 4x 4K60 (H.265), 8x 4K30 (H.265), 16x 1080p60 (H.265), 32x 1080p30 (H.265) | No se especifica |
| Decodificar Vídeo | 2x 8K30 (H.265), 6x 4K60 (H.265), 12x 4K30 (H.265), 26x 1080p60 (H.265), 52x 1080p30 (H.265) | No se especifica |
| cámara CSI | Hasta 6 cámaras (36 a través de canales virtuales), 16 carriles MIPI CSI-2, 8 carriles SLVS-EC, D-PHY 1.2 (hasta 40 Gbps), C-PHY 1.1 (hasta 62 Gbps) | No se especifica |
| PCIe | 1×8, 1×4, 1×2, 2×1 (PCIe Gen4, puerto raíz y terminal) | Ranura PCIe x16 que admite x8 PCIe Gen4, ranura M.2 Key M con x4 PCIe Gen4, ranura M.2 Key E con x1 PCIe Gen4 |
| USB | 3x USB 3.2 Gen2 (10 Gbps), 4x USB 2.0 | USB-C para fuente de alimentación (15-60 W), USB-C único para flasheo y programación, Micro B para depuración en serie, 2x USB 3.2 Gen2 (USB Type-C), 2x USB 3.2 Gen2 (USB Type-A), 2x USB 3.2 Gen1 (USB tipo A), USB 2.0 (USB Micro-B) |
| Networking | 1x GBE | Conector RJ45 con hasta 10 GbE |
| Mostrar | 3 multimodo DP 1.4/eDP 1.4/HDMI 2.0 | 1 conector DisplayPort 1.4a (+MST) |
| Otras E / S | 5x UART, 3x SPI, 4x I2S, 8x I2C, 2x CAN, PWM, DMIC, GPIO | Conector de 40 pines (UART, SPI, I2S, I2C, CAN, PWM, DMIC, GPIO), conector de automatización de 12 pines, conector de panel de audio de 10 pines, conector JTAG de 10 pines, conector de ventilador de 4 pines, conector de 2 pines Conector de batería de respaldo RTC, ranura microSD, conector de alimentación de CC, botones de encendido, recuperación forzada y reinicio |
| Potencia | 10-30W | 15-60W (a través de USB-C) |
Configuración del lado AI/NVIDIA SDK
Los modelos de lenguaje grande (LLM) son IA, como ChatGPT u Ollama, que han sido entrenadas con grandes cantidades de datos. En un espacio tan pequeño, es difícil creer que se pueda ejecutar un modelo de IA privado y local. Actualmente, estamos viendo la aparición en el mercado de portátiles “AI PC” de Intel, AMD y Snapdragon con NPU dedicadas. Esos dispositivos, similares a la plataforma Jetson, ejecutan silicio dedicado en el chip, que tiene funciones adicionales de aceleración de IA. Conceptualmente, estos componentes están diseñados para funcionar de manera similar a nuestro cerebro (de ahí lo "neural" en NPU) y permiten procesar grandes cantidades de datos simultáneamente. La inclusión de NPU significa que la CPU y la GPU quedan liberadas para procesar otras tareas, lo que da como resultado una computadora mucho más eficiente, tanto en términos de energía como de procesamiento.
Sin embargo, los 40 TOPS producidos por Lunar Lake de Intel, o la plataforma 50 TOPS de AMD todavía no son tan buenos como la potencia combinada de la GPU y la CPU de Jetson Orin Devkits, lo que genera 275 TOPS anunciados. ¡Hay potencia más que suficiente para tener una IA localmente en su oficina, o incluso en su casa/laboratorio doméstico! Otros componentes que ayudan con la IA son los dos aceleradores NVDLA v2 Deep Learning (DL), que facilitan la velocidad a la que el sistema puede realizar procesos de IA; y un acelerador de visión único, que acelera la velocidad a la que Computer Vision puede procesar imágenes.
Las numerosas guías de NVIDIA simplifican la configuración del sistema para ejecutar IA. Para comenzar, debes asegurarte de actualizar tu Jetson con Ubuntu y luego seguir estos 6 pasos:
Paso 1: Instale el Administrador de SDK de NVIDIA
Las instrucciones completas y los archivos para descargar estarán disponibles en el sitio web del SDK de NVIDIA . Se requiere una cuenta de desarrollador gratuita para este proceso.
Paso 2: abra NVIDIA SDK Manager instalado en Ubuntu
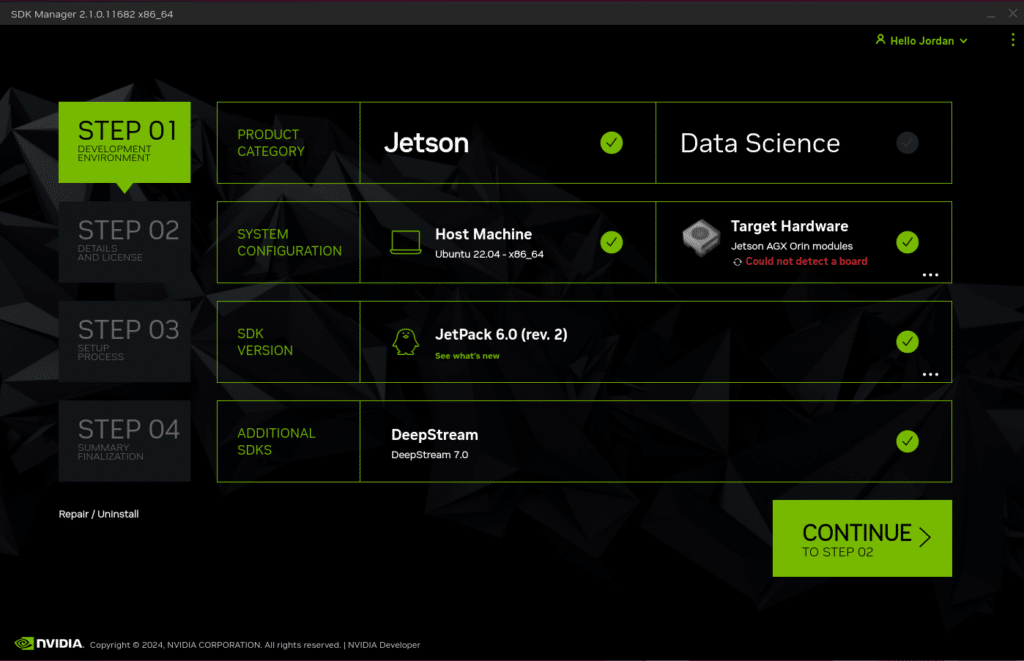
Paso 3: entorno de desarrollo
Este paso es para confirmar que tienes todos los patos en fila. Confirme su producto, configuraciones del sistema, versión del SDK y SDK adicionales. Para nuestra configuración, utilizamos el kit de desarrollo Jetson AGX Orin, Ubuntu 22.04, JetPack 6.0 y Deep Stream 7.0.
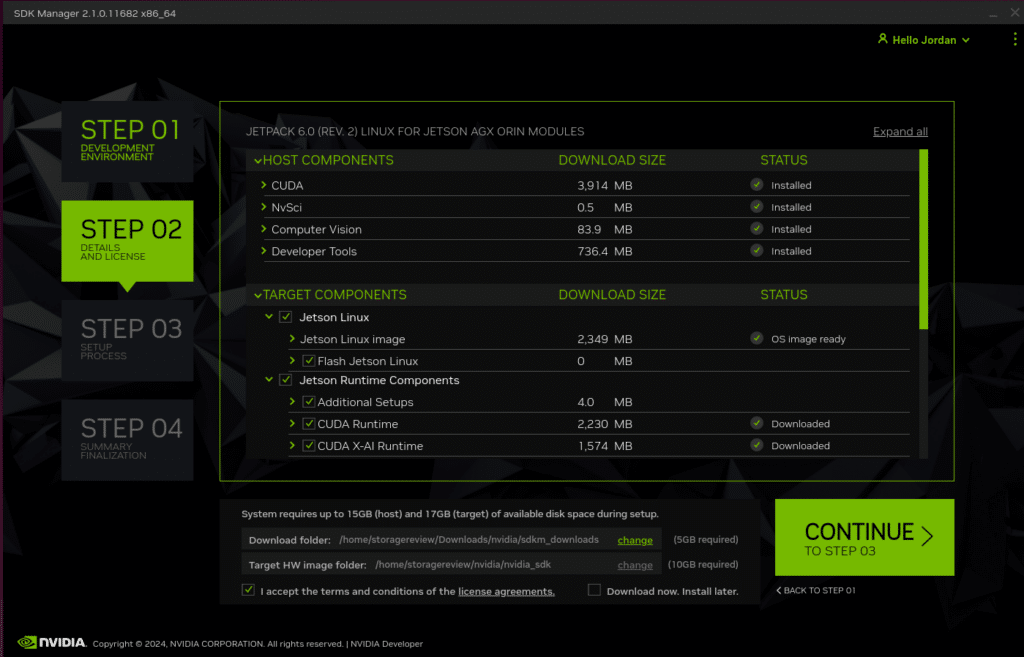
Paso 4: Detalles y licencia
Este paso sirve como pantalla de instalación, asegurando que todos los componentes del Host y los componentes de destino se descarguen e instalen. Este es también el lugar para seleccionar la ubicación de descarga adecuada. El sistema host requiere 15 GB de almacenamiento y el sistema de destino requiere 17 GB de almacenamiento.
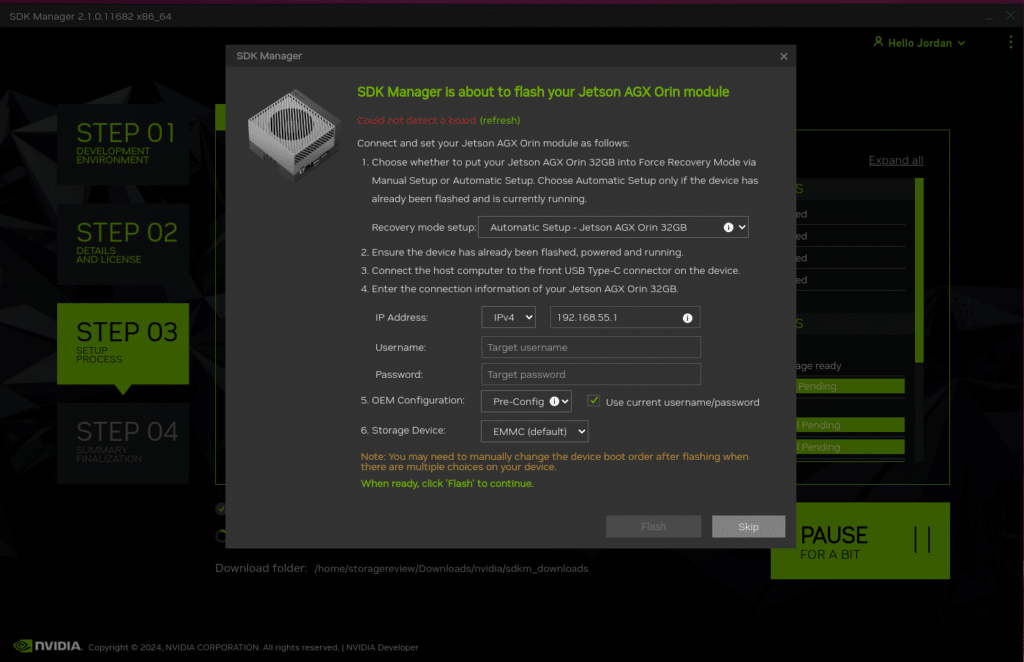
Paso 5: proceso de configuración
Este paso sirve como ventana de confirmación para finalizar la configuración. Aquí seleccionarás el modo Recovery, eligiendo si será un modo de recuperación forzada manual o automático, siendo automático para cuando ya hayas tenido el sistema flasheado y funcionando. Desde aquí, puede configurar/confirmar su dirección IP, agregar un nombre de usuario y contraseña, elegir su configuración OEM y el dispositivo de almacenamiento de destino. Una vez que todo eso esté configurado, podrá hacer clic en la opción Flash.
Paso 6: Finalización del resumen
Finalmente, este paso ejecutará el sistema. Después de esto, podrás ejecutar el código:
jetson-containers run --name ollama $(autotag ollama)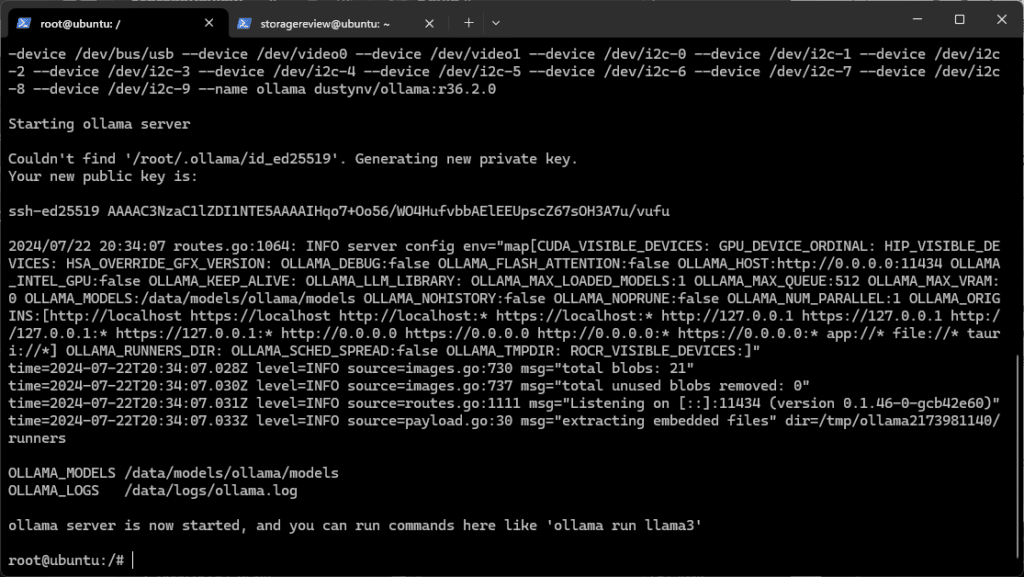
Al ejecutar la primera línea de código, se iniciará Ollama LLM. Ollama es una plataforma popular que simplifica la configuración y el desarrollo local de LLM, pudiendo incluso configurarse dentro o fuera del contenedor. Incluye una biblioteca de modelos integrada con pesos pre-cuantizados, que se descargará y ejecutará automáticamente mediante llama.cpp en segundo plano como inferencia. El contenedor de Ollama se compiló con soporte para CUDA, lo que lo hace perfecto para su uso en Jetson AGX Orin. A continuación, al ejecutar el código:
docker run -it --rm --network=host --add-host=host.docker.internal:host-gateway ghcr.io/open-webui/open-webui:main
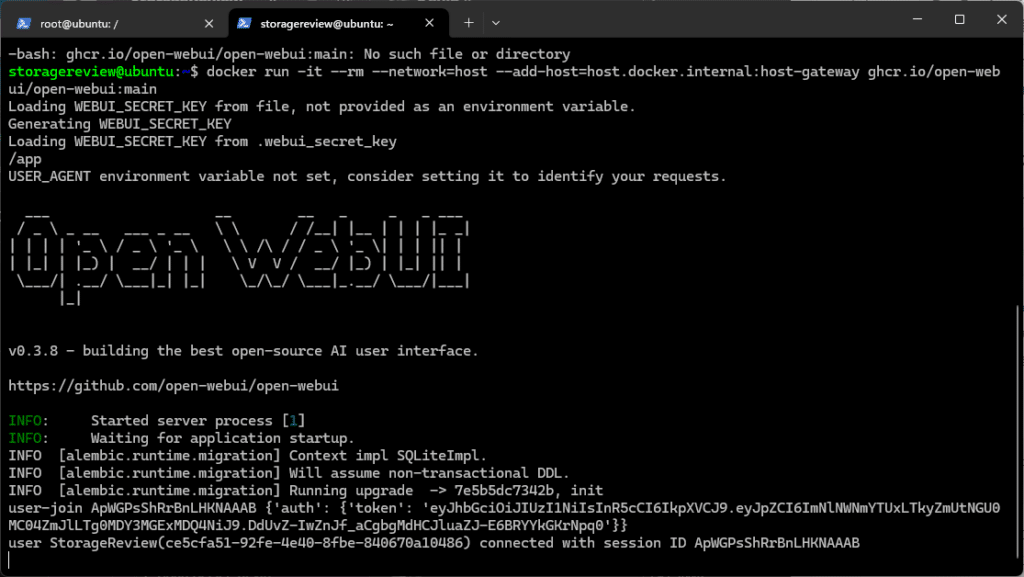
Luego podrá acceder a la interfaz de usuario web abierta (OWUI) en la dirección IP o DNS del dispositivo en el puerto 8080, que funcionará como un chatbot. OWUI sirve como complemento para la API del servidor Ollama, pero también puede usar ChatGPT de OpenAI, Llama-3 de Meta o Phi-3 Mini de Microsoft como complementos.
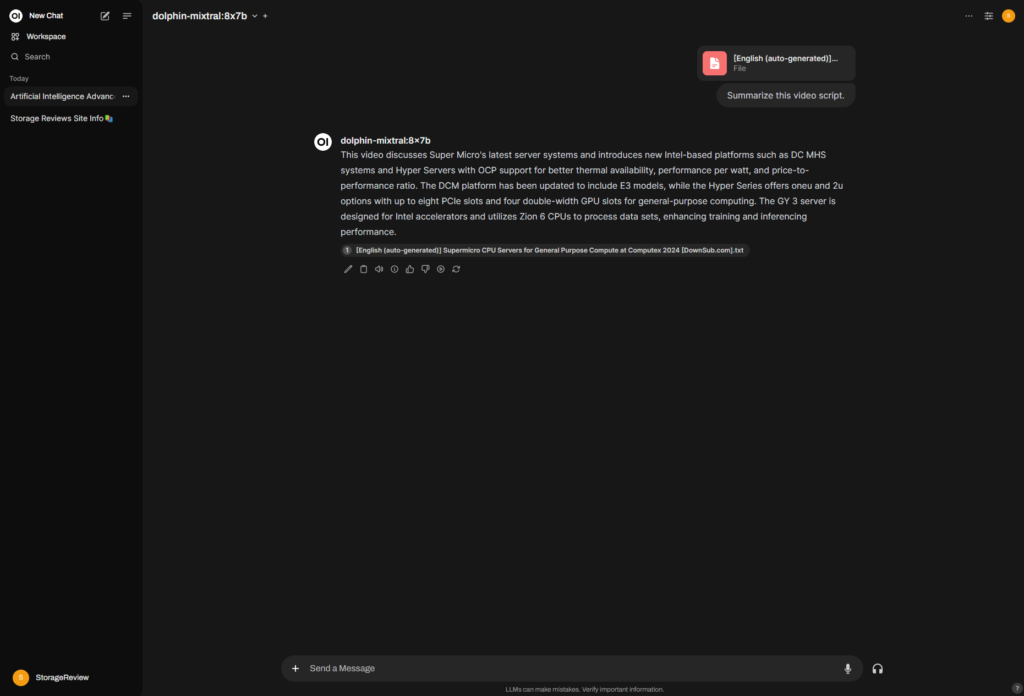
Si bien con un presupuesto de energía tan bajo, el tiempo para generar el primer token en los modelos más grandes es notablemente lento, la plataforma aún puede ofrecer un rendimiento aceptable una vez cargada.
Conclusión
El kit de desarrollo Jetson AGX Orin ofrece un rendimiento significativo en un formato compacto. A medida que las soluciones de PC con IA se vuelven cada vez más relevantes, la plataforma Jetson se destaca, especialmente si se consideran las limitaciones TOPS de las NPU integradas en las nuevas versiones de CPU. Jetson AGX Orin proporciona un sólido trampolín para los desarrolladores, particularmente aquellos que requieren aplicaciones nativas de ARM, ayudando en la validación y el refinamiento del modelo.
Si bien se trata de un kit de desarrollo, su facilidad de uso y su amplia potencia lo convierten en un excelente punto de partida para las empresas que se embarcan en su viaje hacia la IA. La plataforma Jetson muestra el inmenso potencial de las soluciones de IA de factor de forma pequeño: elegantemente diseñadas, extremadamente eficientes energéticamente y capaces de ofrecer 275 TOPS de rendimiento de IA. Esta combinación hace que la plataforma Jetson sea comparable a servidores de IA montados en bastidor mucho más grandes.
Las guías completas de NVIDIA simplifican el proceso de actualización e implementación de una variedad de modelos de IA, siendo la IA generativa solo una pieza del rompecabezas. Para las empresas que están listas para desarrollar e implementar IA, el kit de desarrollo Jetson AGX Orin ofrece una combinación perfecta de eficiencia energética, tamaño reducido y rendimiento de IA excepcional, lo que lo convierte en una opción ideal para explorar e implementar tecnologías de IA.


 Amazon