

La workstation Acer Veriton GN100 AI Mini è uno dei diversi sistemi basati su Spark che stiamo valutando, tutti costruiti attorno al superchip GB10 Grace Blackwell di NVIDIA. Come gli altri, la GN100 è progettata per portare la potenza di calcolo AI di livello data center in un formato desktop compatto, consentendo a sviluppatori e ricercatori di eseguire e perfezionare i modelli localmente anziché affidarsi completamente all'infrastruttura cloud.
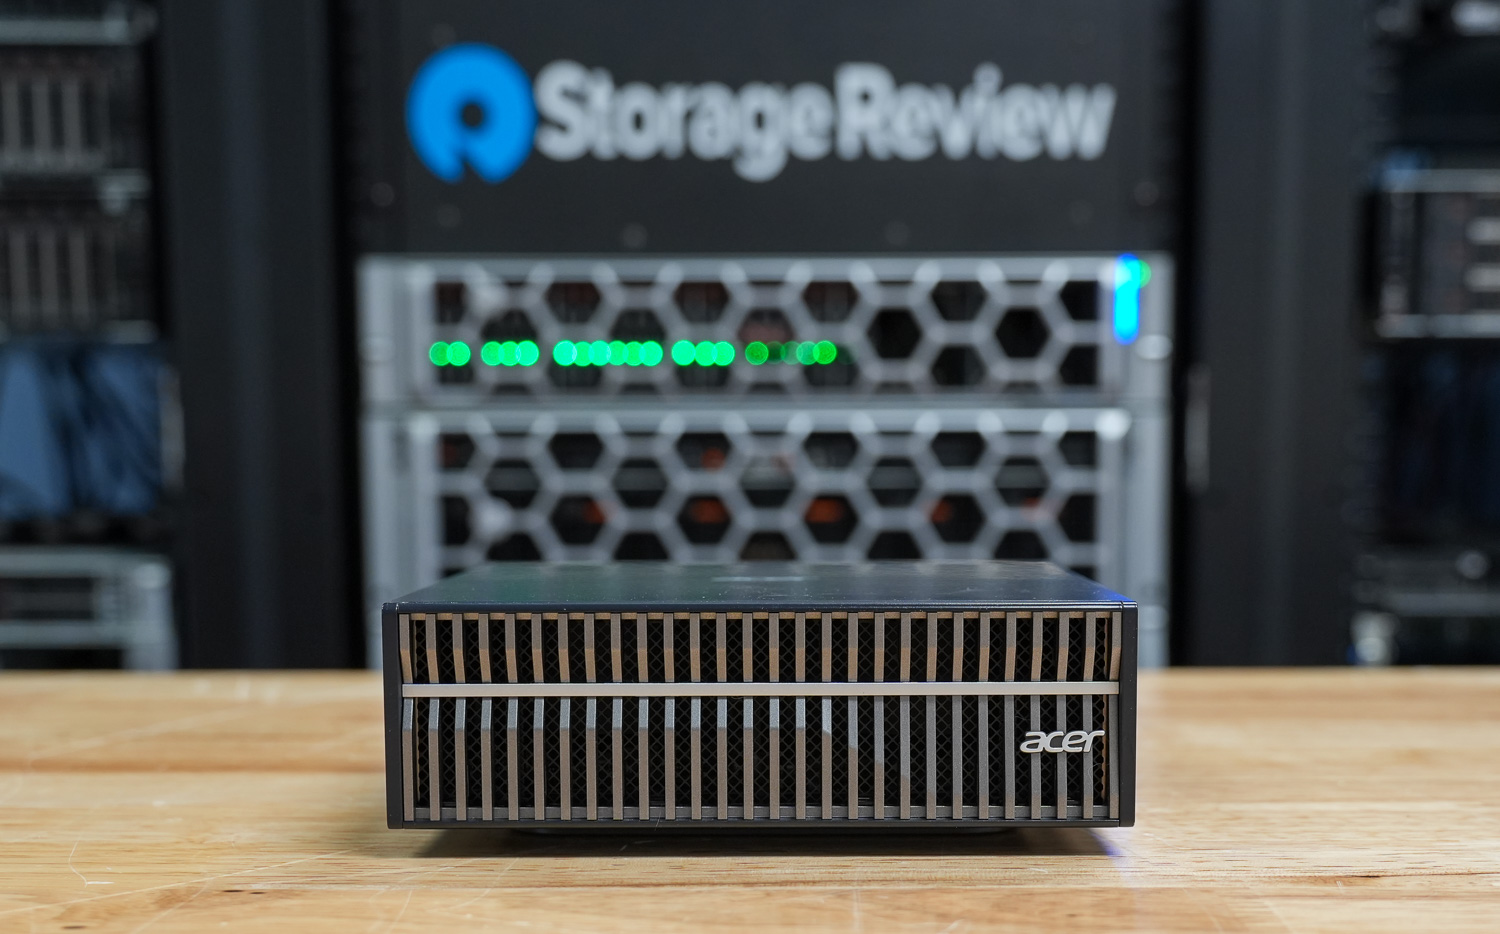
In questa configurazione, il GN100 combina il processore GB10 a 20 core basato su architettura Arm con la grafica integrata Blackwell, offrendo prestazioni AI in virgola mobile a 4 bit fino a 1 petaFLOP. È dotato di 128 GB di memoria unificata LPDDR5x e di un SSD NVMe PCIe Gen5 da 4 TB, fornendo la larghezza di banda della memoria e la velocità di trasmissione dati necessarie per modelli linguistici complessi, flussi di lavoro di intelligenza artificiale generativa e sperimentazione con grandi quantità di dati.
Come gli altri sistemi Spark di questo gruppo, il GN100 supporta l'esecuzione locale dell'IA, consentendo al contempo l'espansione da sistema a sistema tramite la SmartNIC NVIDIA ConnectX-7 integrata. È possibile collegare due unità per supportare carichi di lavoro di modellazione più complessi rispetto a una singola appliance.
Il sistema viene fornito con il sistema operativo NVIDIA DGX e l'intera suite software per l'intelligenza artificiale preinstallati, risultando quindi pronto per l'impiego immediato in ambienti di sviluppo e ricerca.
Specifiche tecniche dell'Acer Veriton GN100 AI
| Specificazione | Acer Veriton GN100 AI (GB10) |
|---|---|
| Dimensioni e peso | |
| Altezza | 2 in |
| Larghezza | 5.9 in |
| Profondità | 5.9 in |
| Peso | 2.65 lb |
| Processore | |
| Tipo di processore | NVIDIA GB10 (Grace Blackwell Superchip) (20 core) |
| Grafica integrata | GPU NVIDIA Blackwell (integrata) |
| Memorie | |
| Tipo di memoria | LPDDR5x (Memoria di sistema unificata) |
| Configurazione della memoria | 128 GB LPDDR5x, memoria di sistema unificata |
| Banda di memoria | 273 GB/s (8533 MT/s) |
| Sistema operativo | |
| Sistemi operativi supportati | Sistema operativo NVIDIA DGX |
| Porte e slot esterni | |
| Porte di rete | Una porta RJ45 (10GbE) Scheda di rete NVIDIA ConnectX-7 (200G × 2 QSFP) |
| Porte USB | Tre porte USB 3.2 Gen 2×2 Type-C (20 Gbps) Una porta USB 3.2 Gen 2×2 Type-C con PD in |
| Porta(e) video | Una porta HDMI 2.1a |
| Porta adattatore di alimentazione | USB Type-C (ingresso PD) |
| Slot di sicurezza | Una serratura di Kensington |
| Wireless | |
| WiFi | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Archiviazione | |
| Opzioni di storage | SSD NVMe fino a 4 TB (PCIe Gen5) |
| Adattatore di alimentazione | |
| Tipo | Adattatore esterno da 240 W (USB Type-C) |
Acer Veriton GN100 AI - Configurazione e design
Il frontale della Veriton GN100 è dominato da una parete di lamelle verticali che si estendono per tutta la larghezza del telaio. Una linea orizzontale decorativa attraversa la griglia, conferendole un aspetto unico rispetto agli altri sistemi basati sulla Spark che abbiamo esaminato.
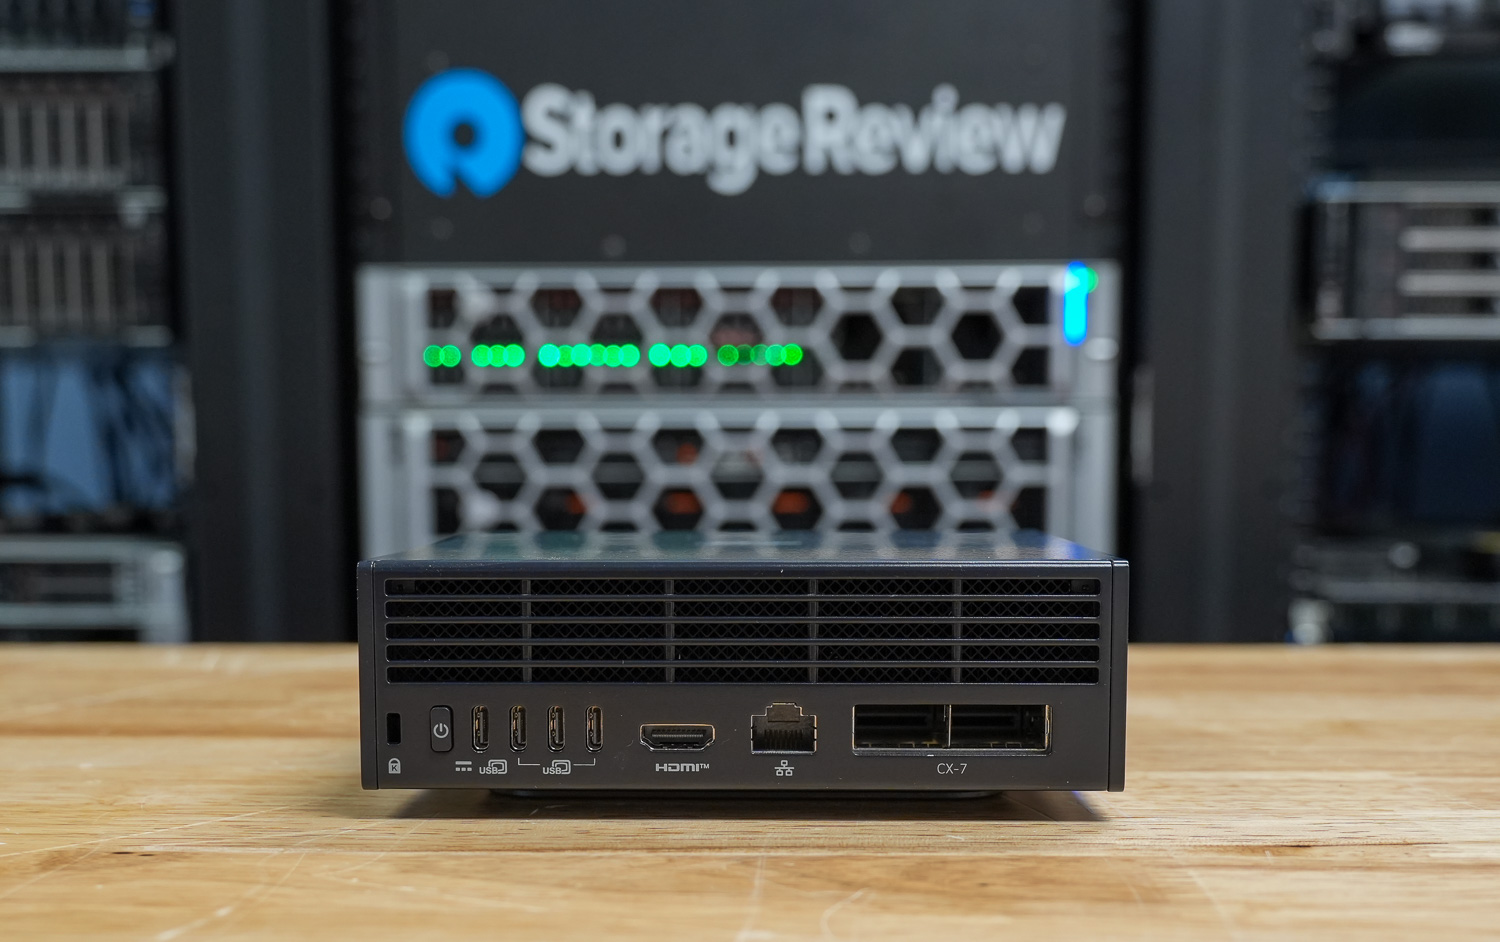
Tutte le principali porte di I/O sono situate sul retro del sistema. Acer include quattro porte USB 3.2 Type-C, una delle quali supporta l'alimentazione, insieme a una porta HDMI 2.1b per l'uscita video. La connettività di rete comprende una porta Ethernet RJ-45 e una scheda di rete intelligente NVIDIA ConnectX-7, che consentono una connettività ad alta larghezza di banda e il collegamento di sistemi. Il supporto wireless include Wi-Fi 7 e Bluetooth 5.1 o versioni successive. È presente uno slot per lucchetto Kensington per la sicurezza fisica.
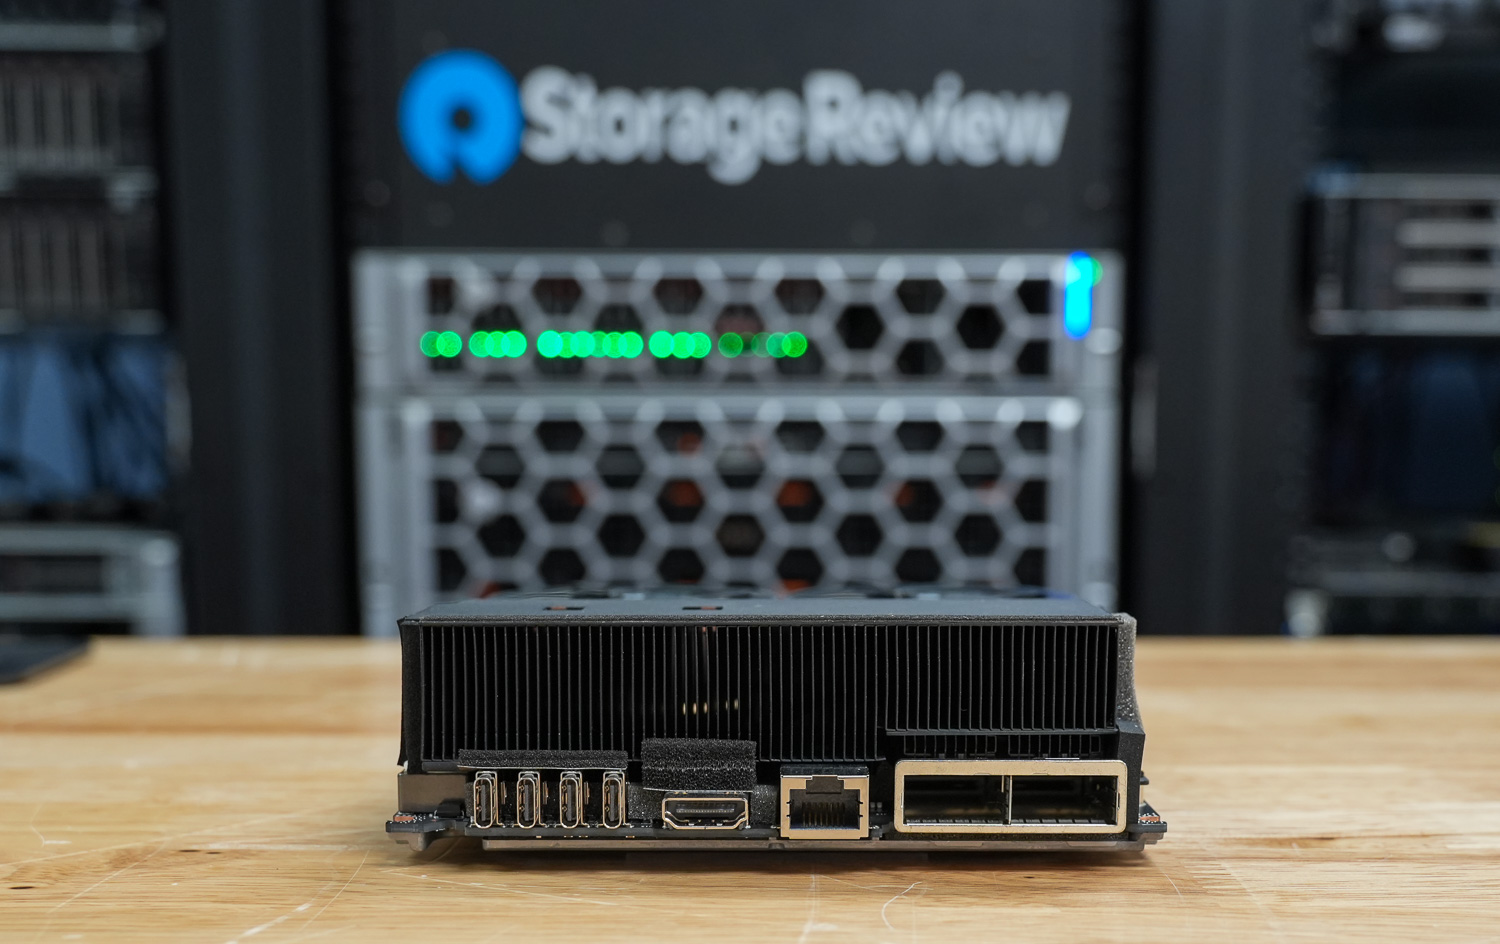
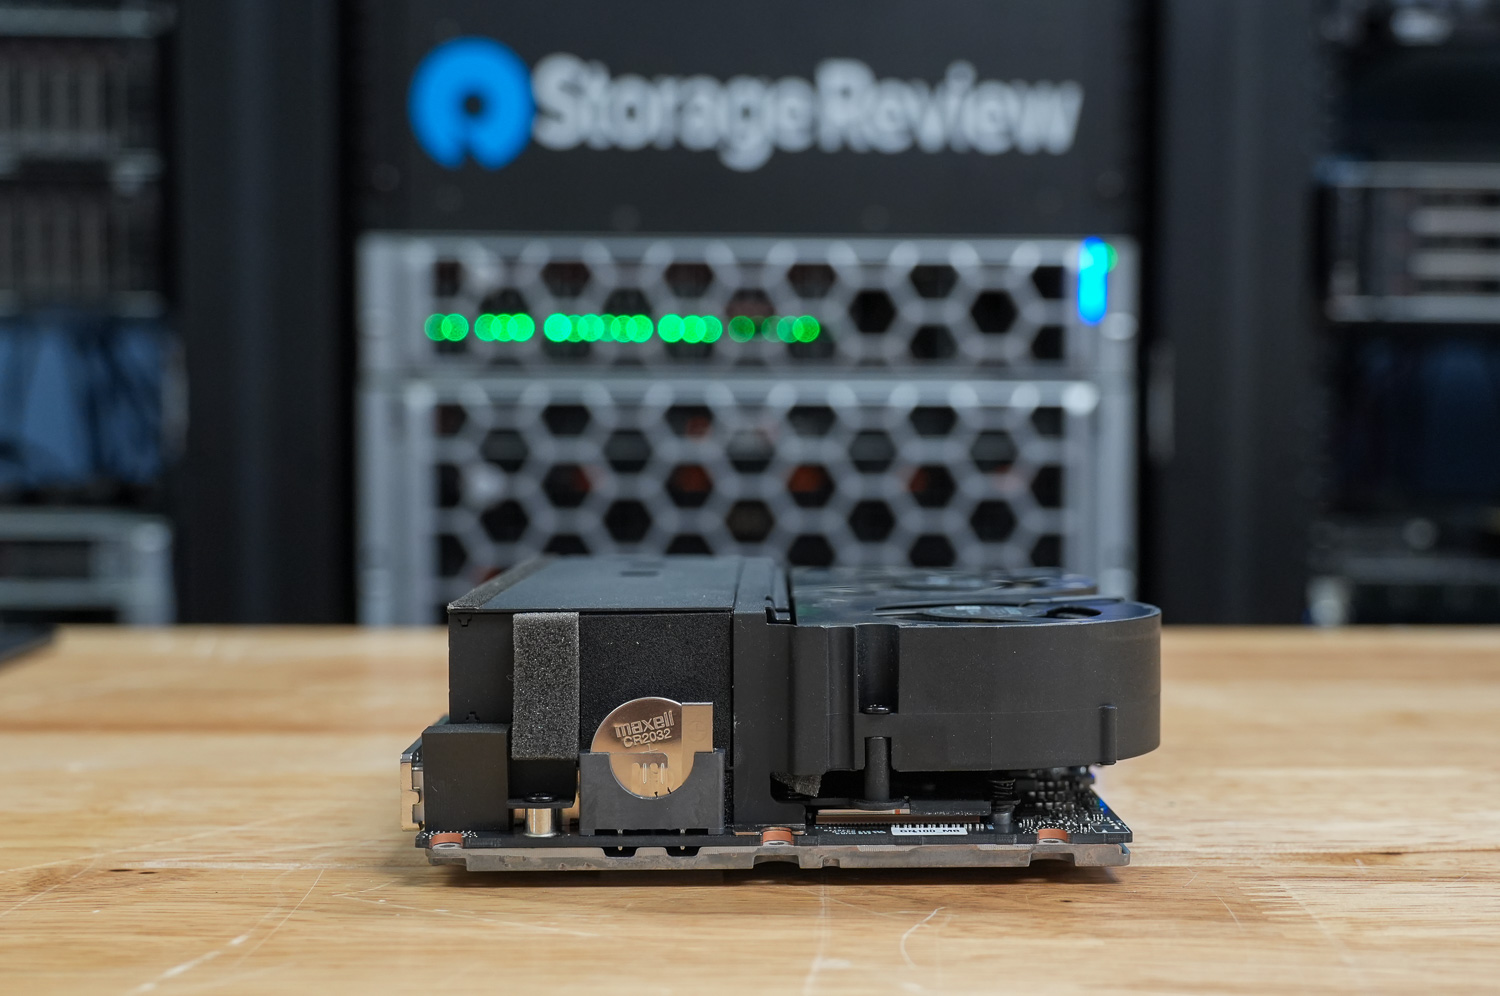
Qui si può notare la schermatura metallica e la piastra strutturale che si estendono per tutta la lunghezza dello chassis, fungendo sia da telaio di rinforzo che da dissipatore di calore. In basso a sinistra si trova uno slot per SSD M.2 2242 NVMe facilmente accessibile, fissato con una singola vite e parzialmente nascosto sotto la piastra metallica.
Per accedere alla parte inferiore dell'unità Acer, rimuovere le viti perimetrali per sollevare il pannello inferiore senza difficoltà. Una volta aperto, il layout è semplice e ben organizzato, offrendo una visibilità diretta sul sistema di raffreddamento, sull'area di archiviazione e sui componenti della scheda madre. La piastra inferiore stessa risulta robusta e contribuisce alla rigidità complessiva dello chassis.
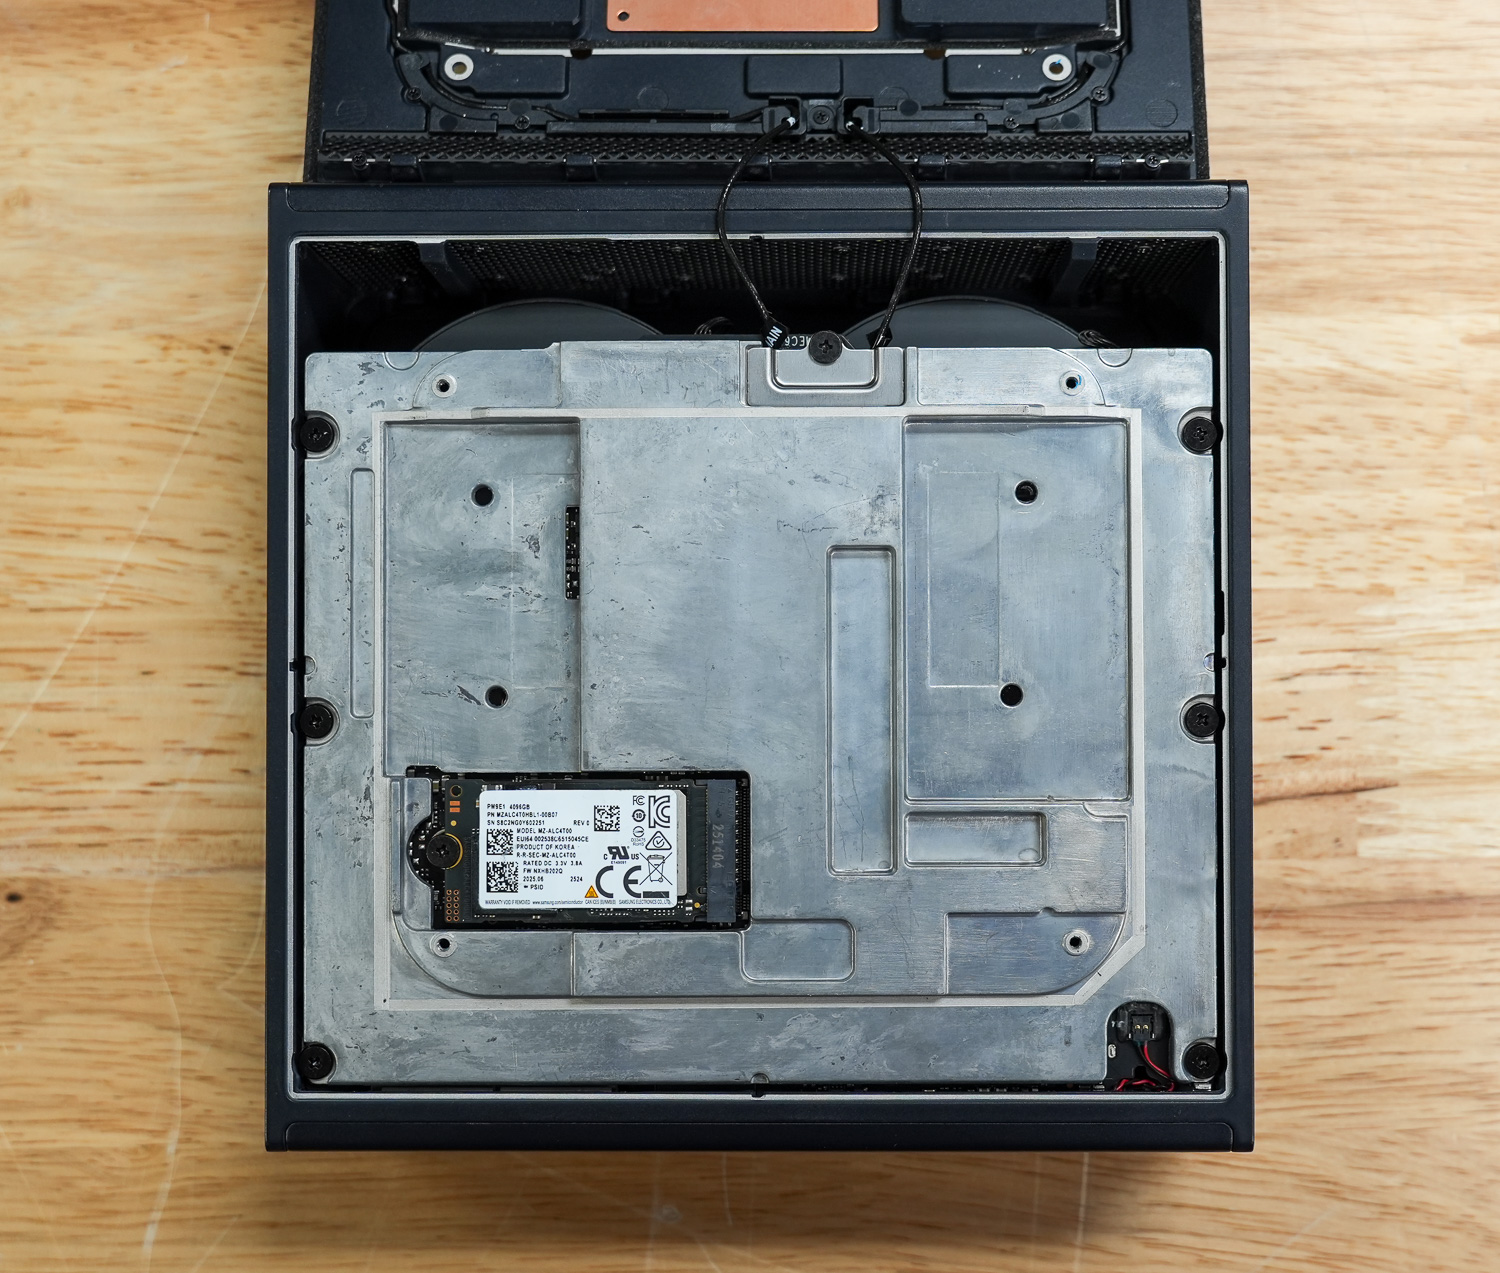
Rispetto agli altri sistemi Spark che abbiamo valutato, Acer adotta un approccio leggermente diverso. Invece della piastra inferiore in metallo verniciato più raffinata che abbiamo visto sulla Founders Edition e in diverse implementazioni OEM, Acer utilizza una piastra inferiore in metallo pressofuso grezzo e non rifinito. La finitura è meno lucida, con la texture della fusione visibile, ma rimane spessa e strutturalmente solida. Dal punto di vista funzionale, svolge comunque la stessa funzione di telaio di rinforzo e dissipatore di calore secondario, sebbene la scelta produttiva rifletta chiaramente una diversa filosofia di progettazione e di costo.
Test termici dell'Acer Veriton GN100 AI
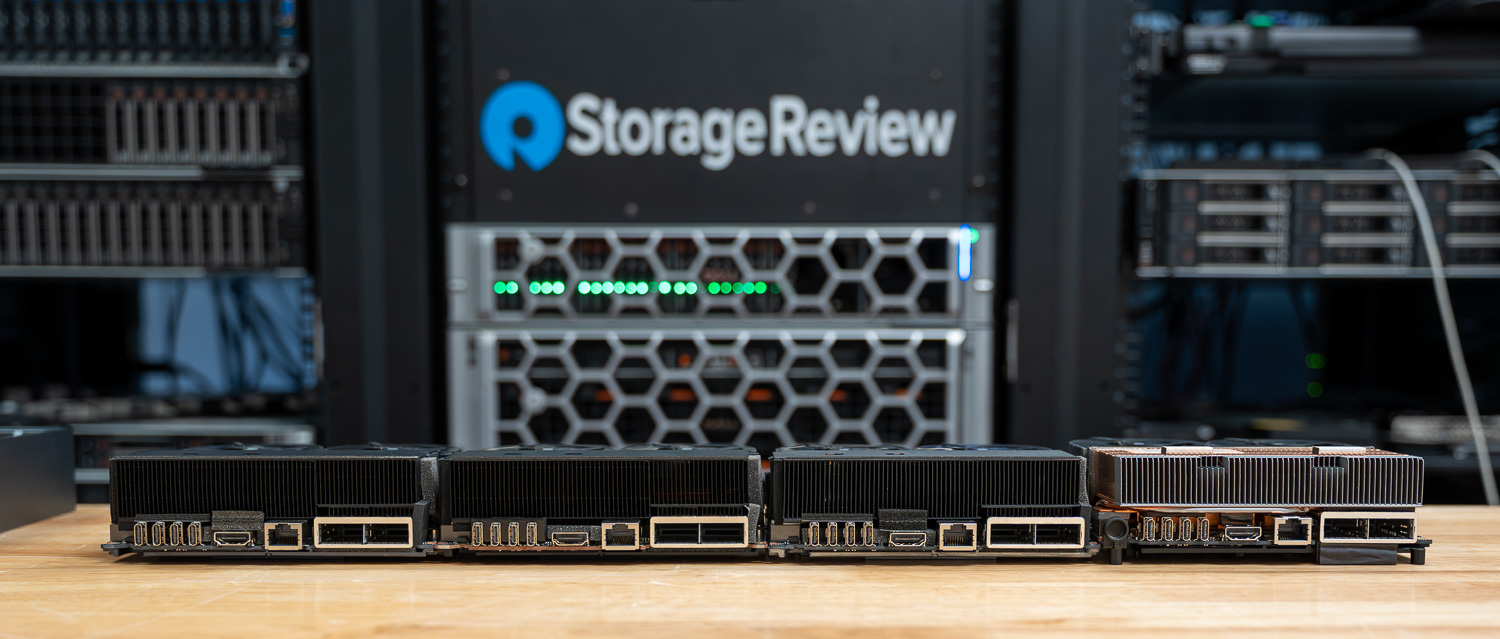
Per testare le prestazioni termiche dell'Acer Veriton GN100 AI, le abbiamo confrontate con quelle della Founders Edition e di altri produttori OEM come Dell, ASUS e GIBABYTE. Abbiamo approfondito ulteriormente l'argomento nel nostro documento Spark Thermal Testing.
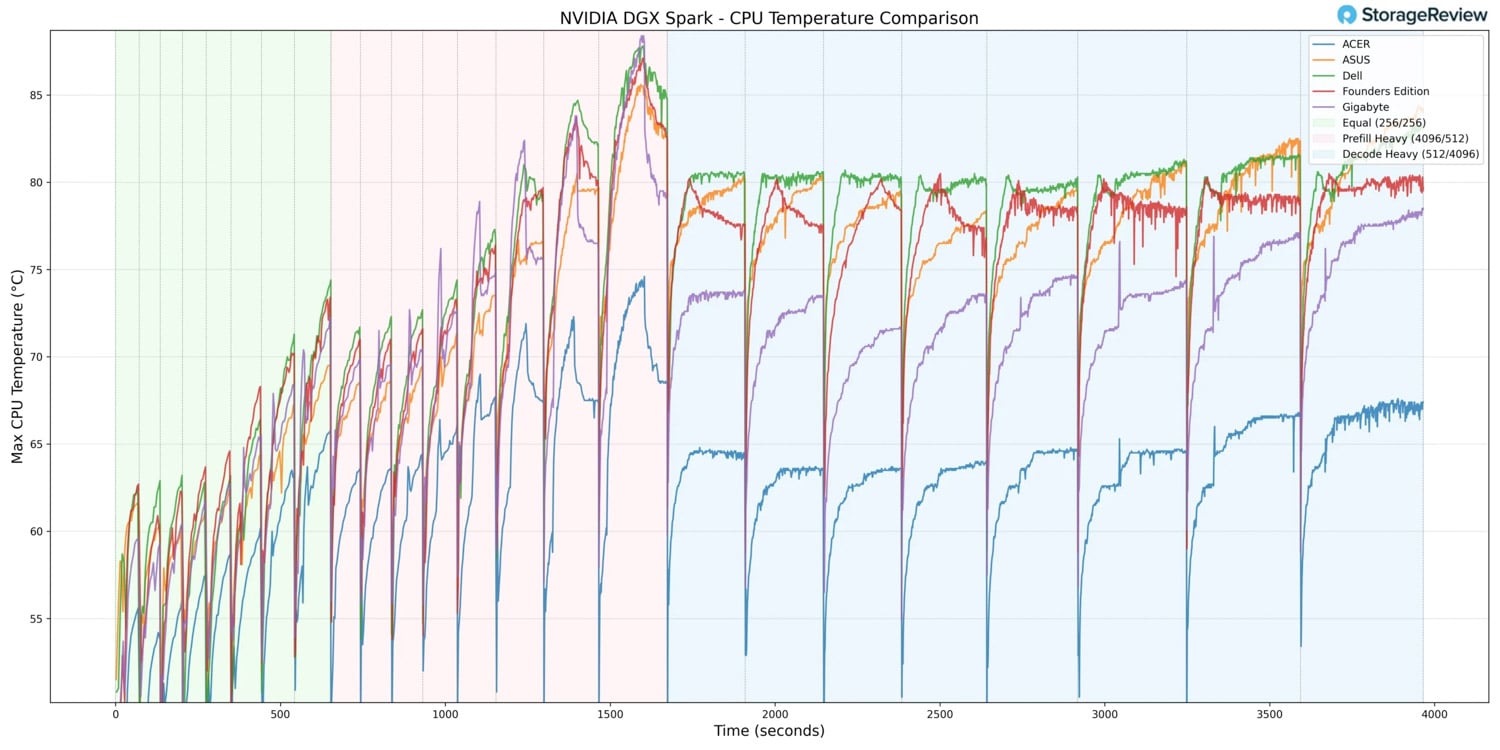
Abbiamo monitorato i componenti dell'intera architettura per un determinato periodo di tempo, suddividendo il carico di lavoro in tre fasi e aumentando gradualmente l'utilizzo nell'arco di circa un'ora. Questo ci ha permesso di osservare il dispositivo in condizioni di utilizzo prolungato e in diverse fasi di carico. Abbiamo monitorato le temperature di CPU, GPU, rete, NVMe e il consumo energetico totale.
Temperatura della CPU
Durante i test termici della CPU, il sistema Acer ha raggiunto una temperatura massima di 74.7 °C durante un'attività di precaricamento intensiva. Questo valore rappresenta una delle temperature massime della CPU più basse osservate nel gruppo di confronto, indicando un'implementazione termica particolarmente conservativa ed efficiente.
Con il passaggio del carico di lavoro alle fasi Equal ISL/OSL e alle fasi Decode Heavy prolungate, le temperature della CPU sono rimaste ben controllate senza improvvisi aumenti. Anziché raggiungere gli 80°C osservati in alcuni sistemi concorrenti, Acer ha mantenuto una temperatura operativa costante inferiore, a dimostrazione di un ampio margine di raffreddamento anche sotto carico di calcolo prolungato.
Nella fascia bassa, la CPU ha registrato una temperatura minima di 37.8 °C in condizioni di inattività o con carico leggero. Questo valore di riferimento è in linea con la media generale e conferma che la soluzione di raffreddamento di Acer rimane efficace sia a riposo che sotto carico.
Nel complesso, Acer ha registrato uno dei profili termici della CPU più bassi del gruppo, sia nelle fasi di picco che in quelle di funzionamento continuo.
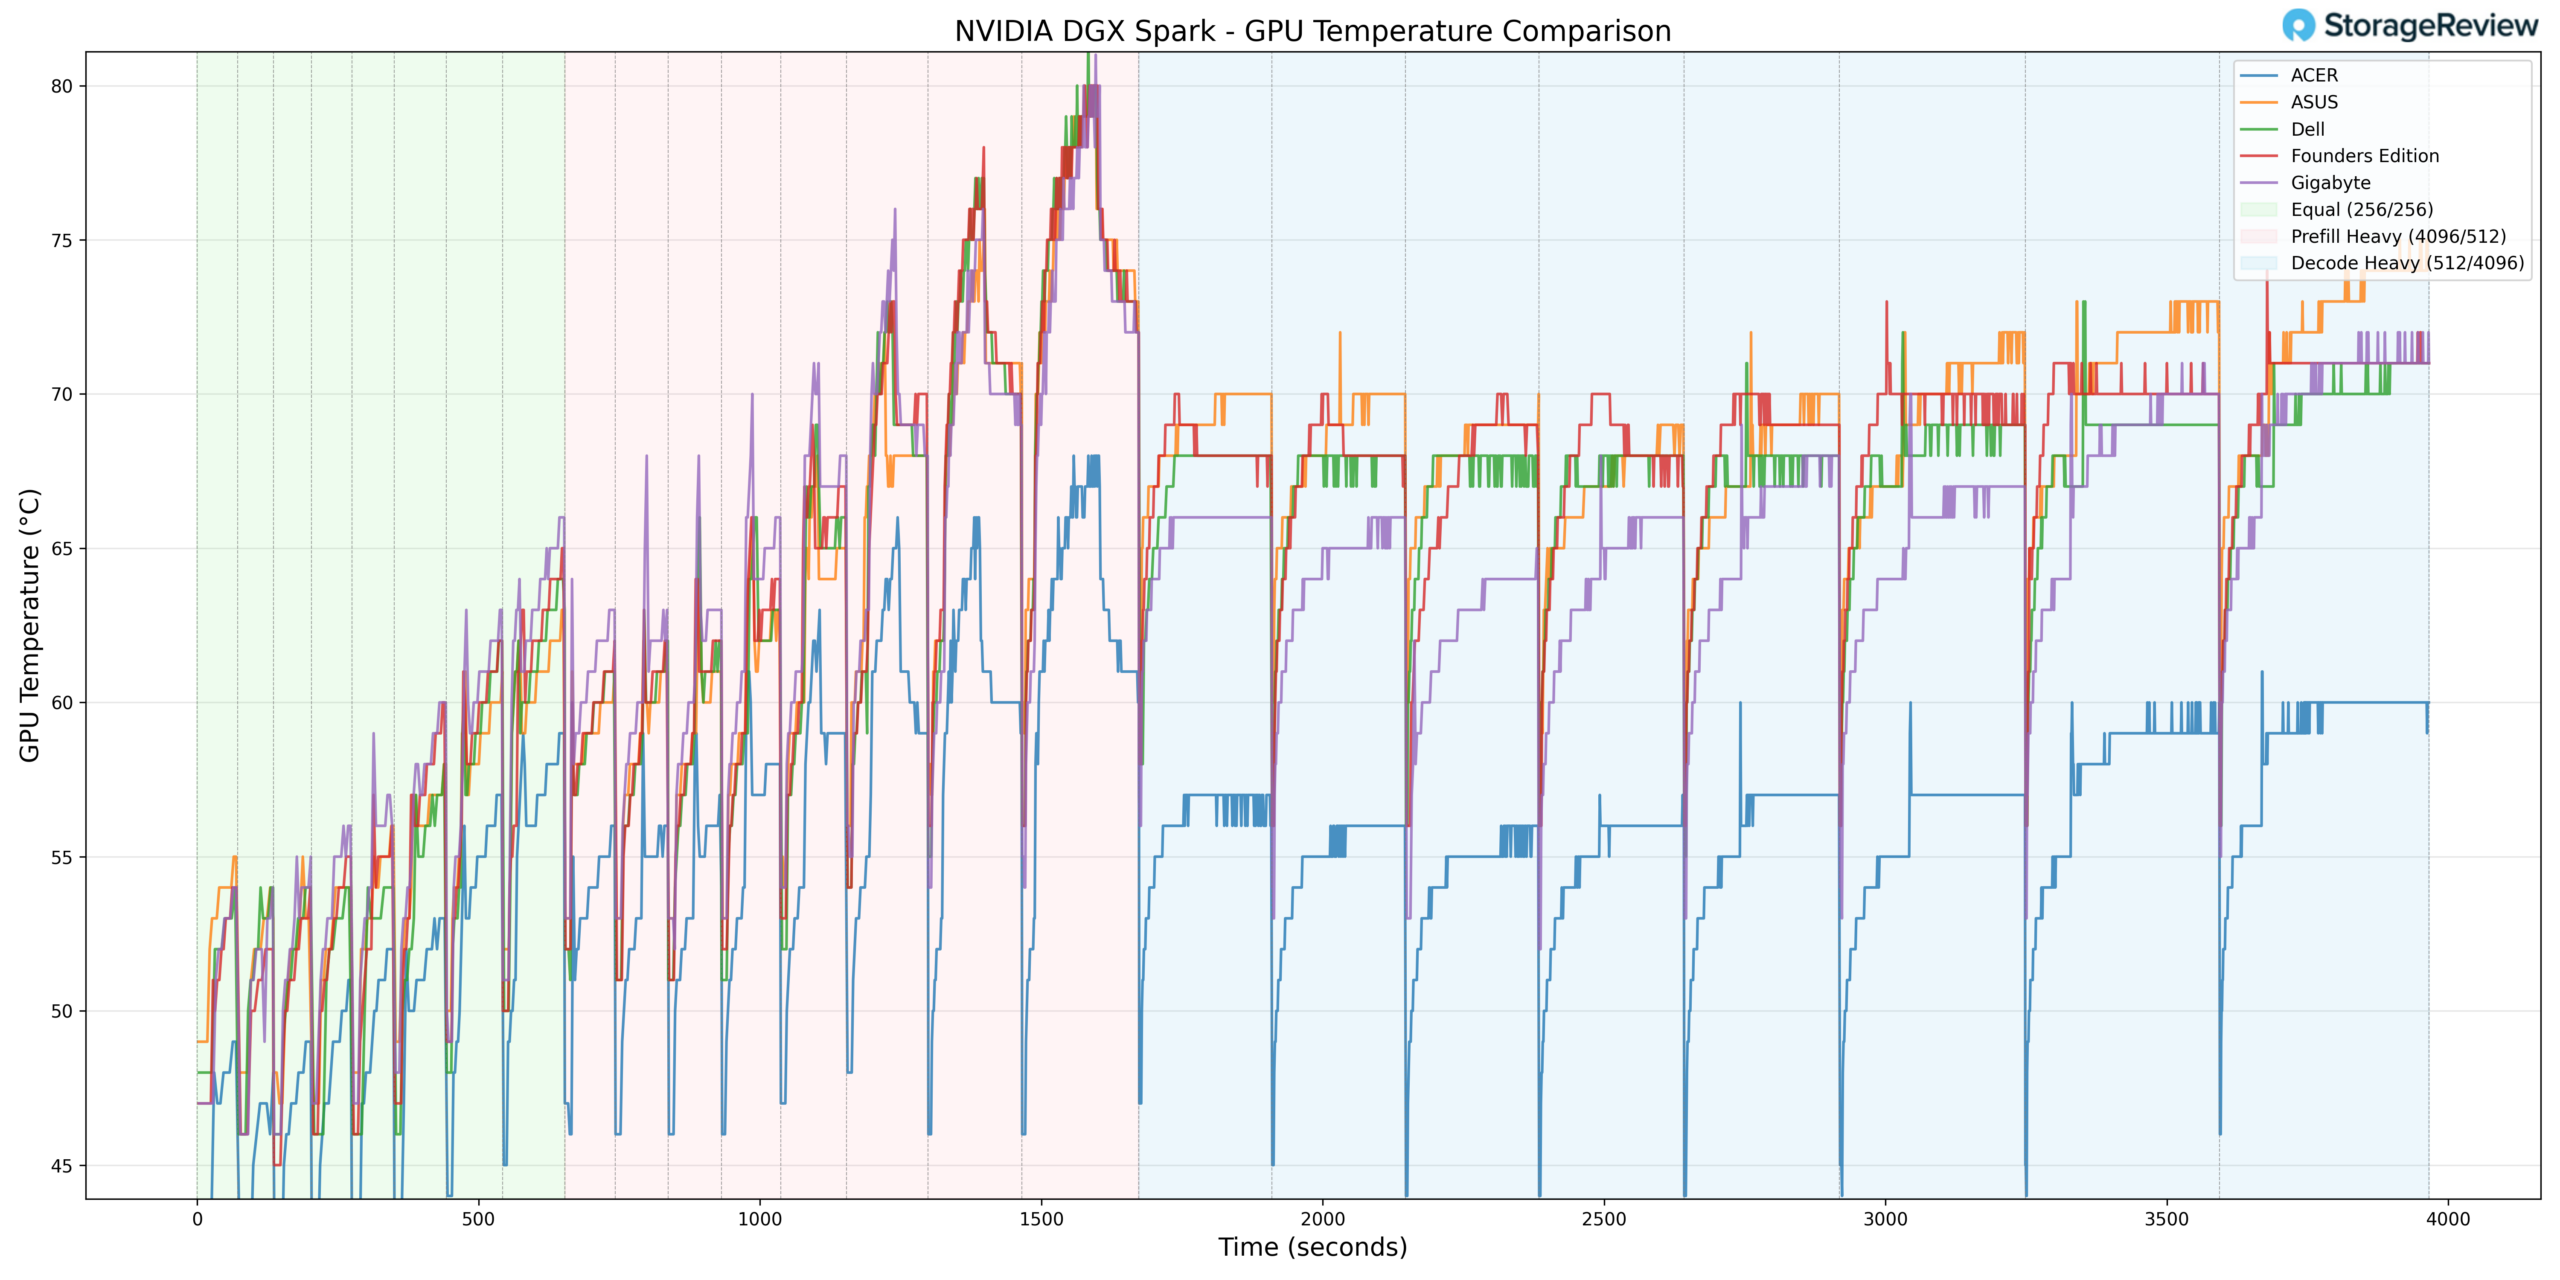
Temperatura GPU
Le temperature della GPU hanno seguito un andamento simile di moderazione. Durante l'accelerazione Prefill Heavy, la GPU ha raggiunto una temperatura massima di 69 °C, significativamente inferiore rispetto a quella di diverse implementazioni concorrenti durante picchi di attività.
Con l'avanzamento dei carichi di lavoro nelle fasi Equal ISL/OSL e Decode Heavy, la GPU si è stabilizzata in un intervallo controllato senza picchi termici significativi. Il sistema ha dimostrato un comportamento coerente durante la decodifica prolungata, mantenendo un ampio margine al di sotto dei limiti operativi superiori.
La temperatura minima della GPU registrata è stata di 35 °C durante le fasi di carico inferiore, rappresentando uno dei valori di riferimento più bassi in condizioni di inattività nell'intero stack.
Nel complesso, Acer ha dimostrato una delle implementazioni GPU più interessanti in assoluto, sia sotto carichi di lavoro intensivi che sostenuti.
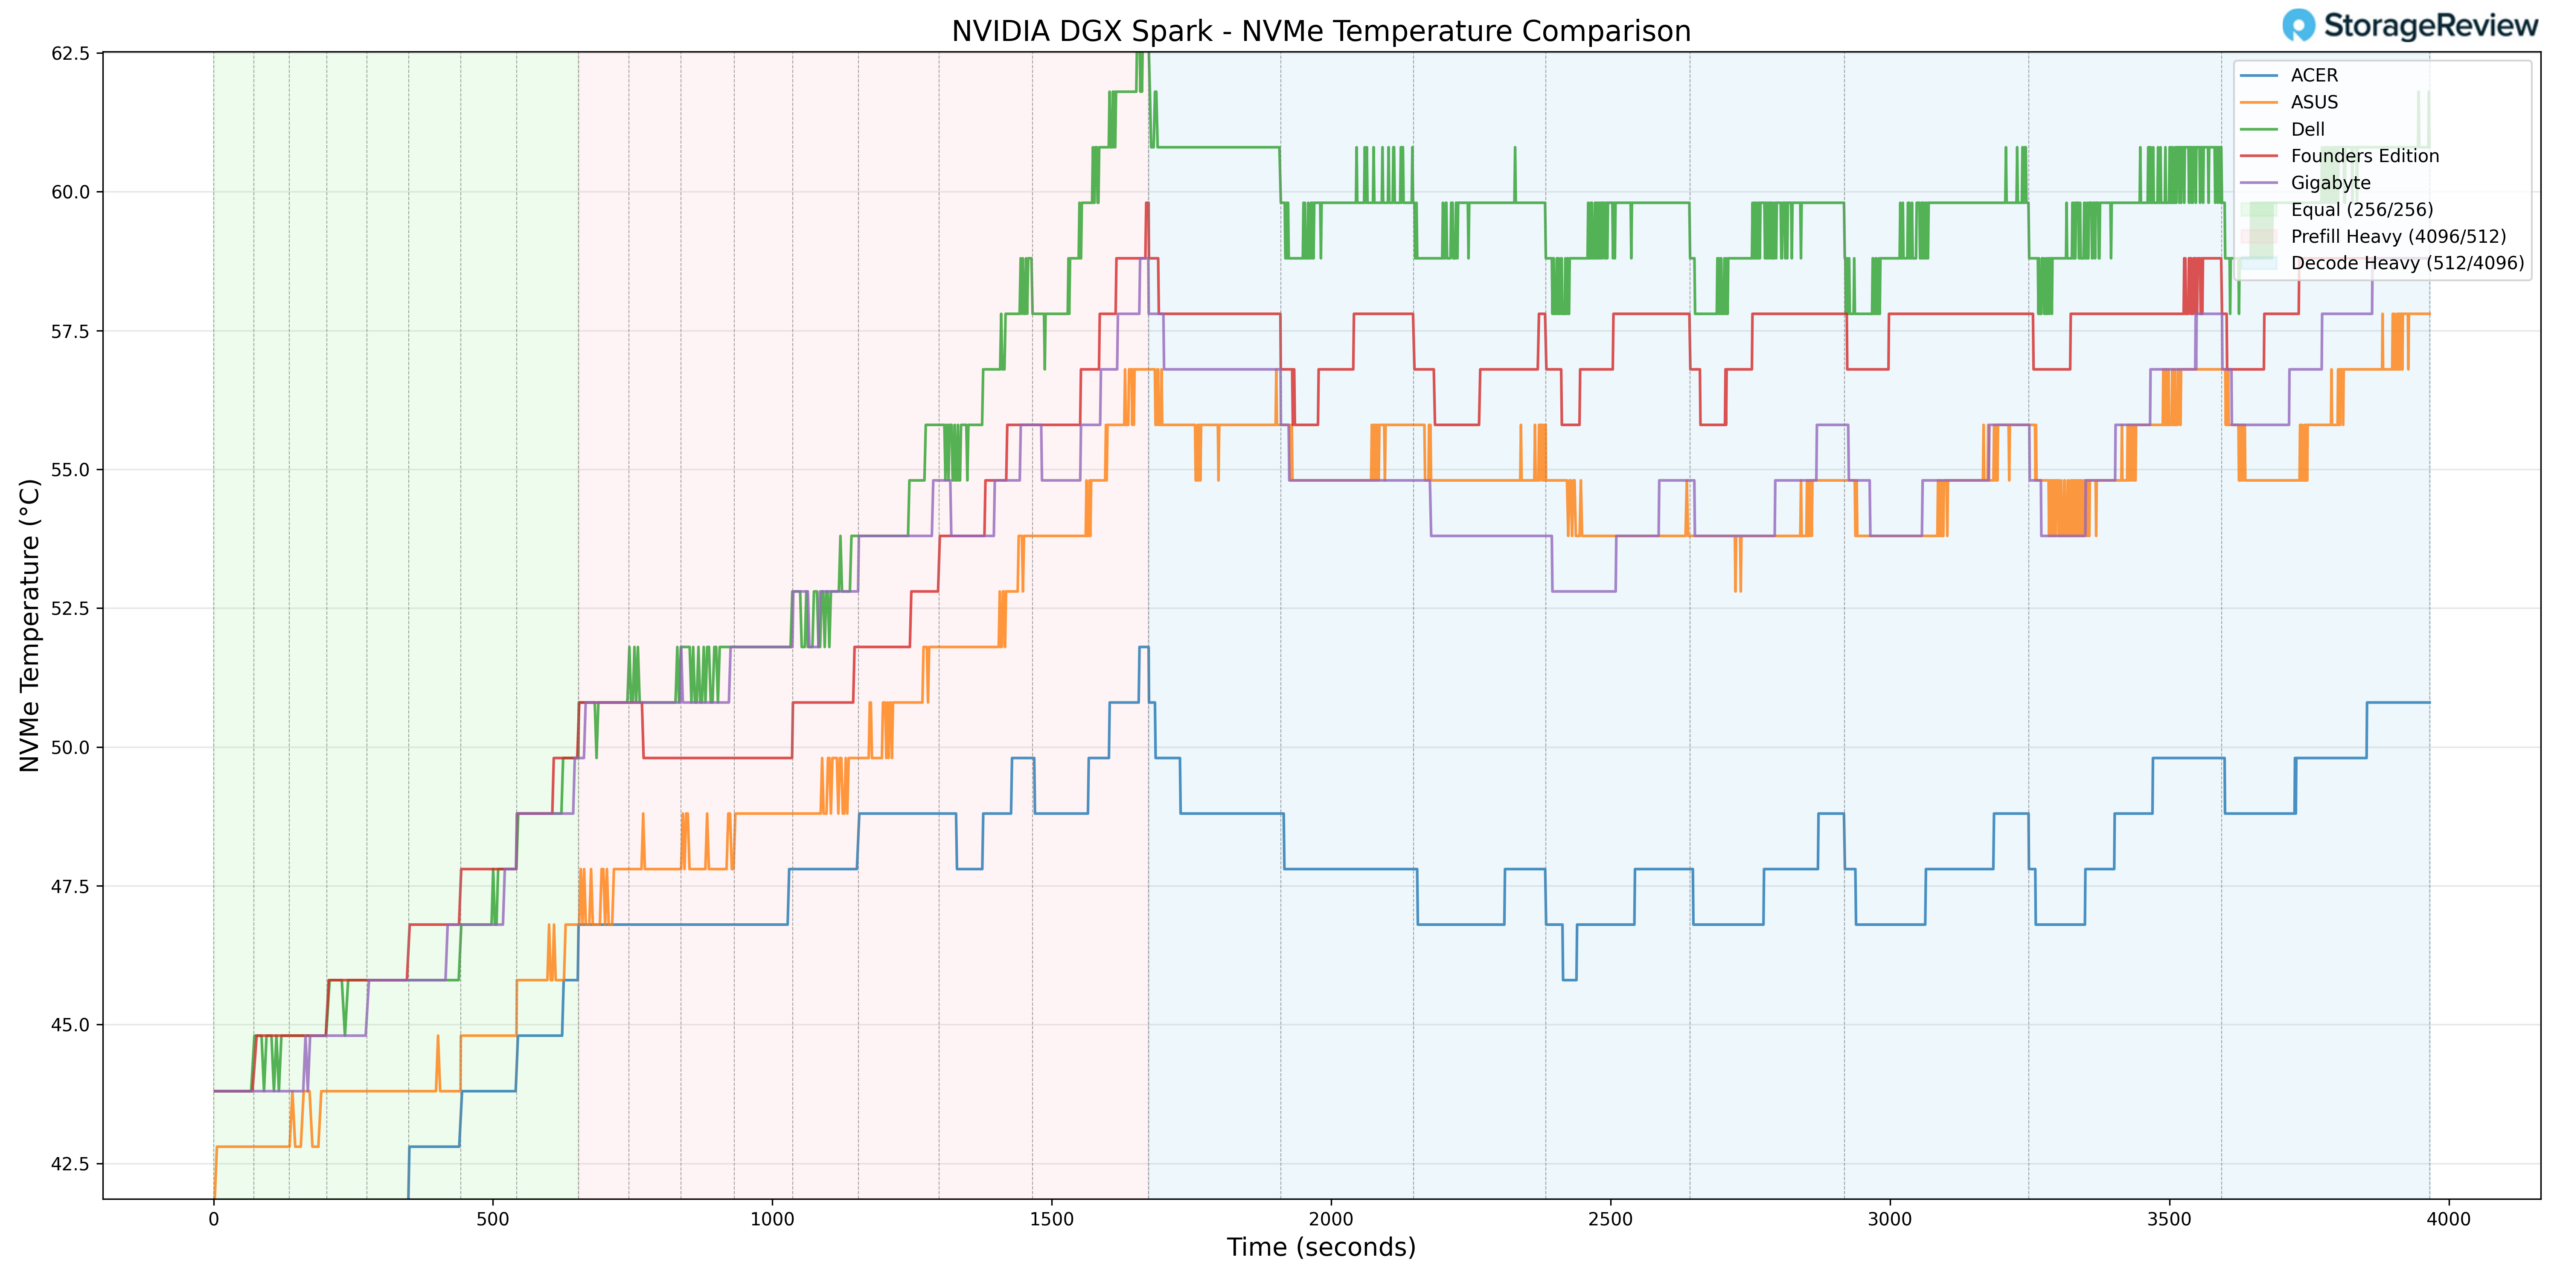
Temperatura NVMe
Durante i test, le temperature di archiviazione sono rimaste ampiamente entro le specifiche. L'unità NVMe ha raggiunto un picco di 56.8 °C durante le fasi di carico di lavoro più intenso, rimanendo comunque ben al di sotto delle soglie di throttling comuni e in linea con i risultati di archiviazione più moderati del gruppo.
In condizioni di inattività o con utilizzo leggero, la temperatura dell'NVMe è scesa a 36.8 °C, indicando che il sottosistema di archiviazione non presenta limitazioni termiche a basso carico.
Nel complesso, Acer ha mantenuto prestazioni termiche competitive per gli NVMe, combinando basse temperature costanti con un comportamento di base stabile.
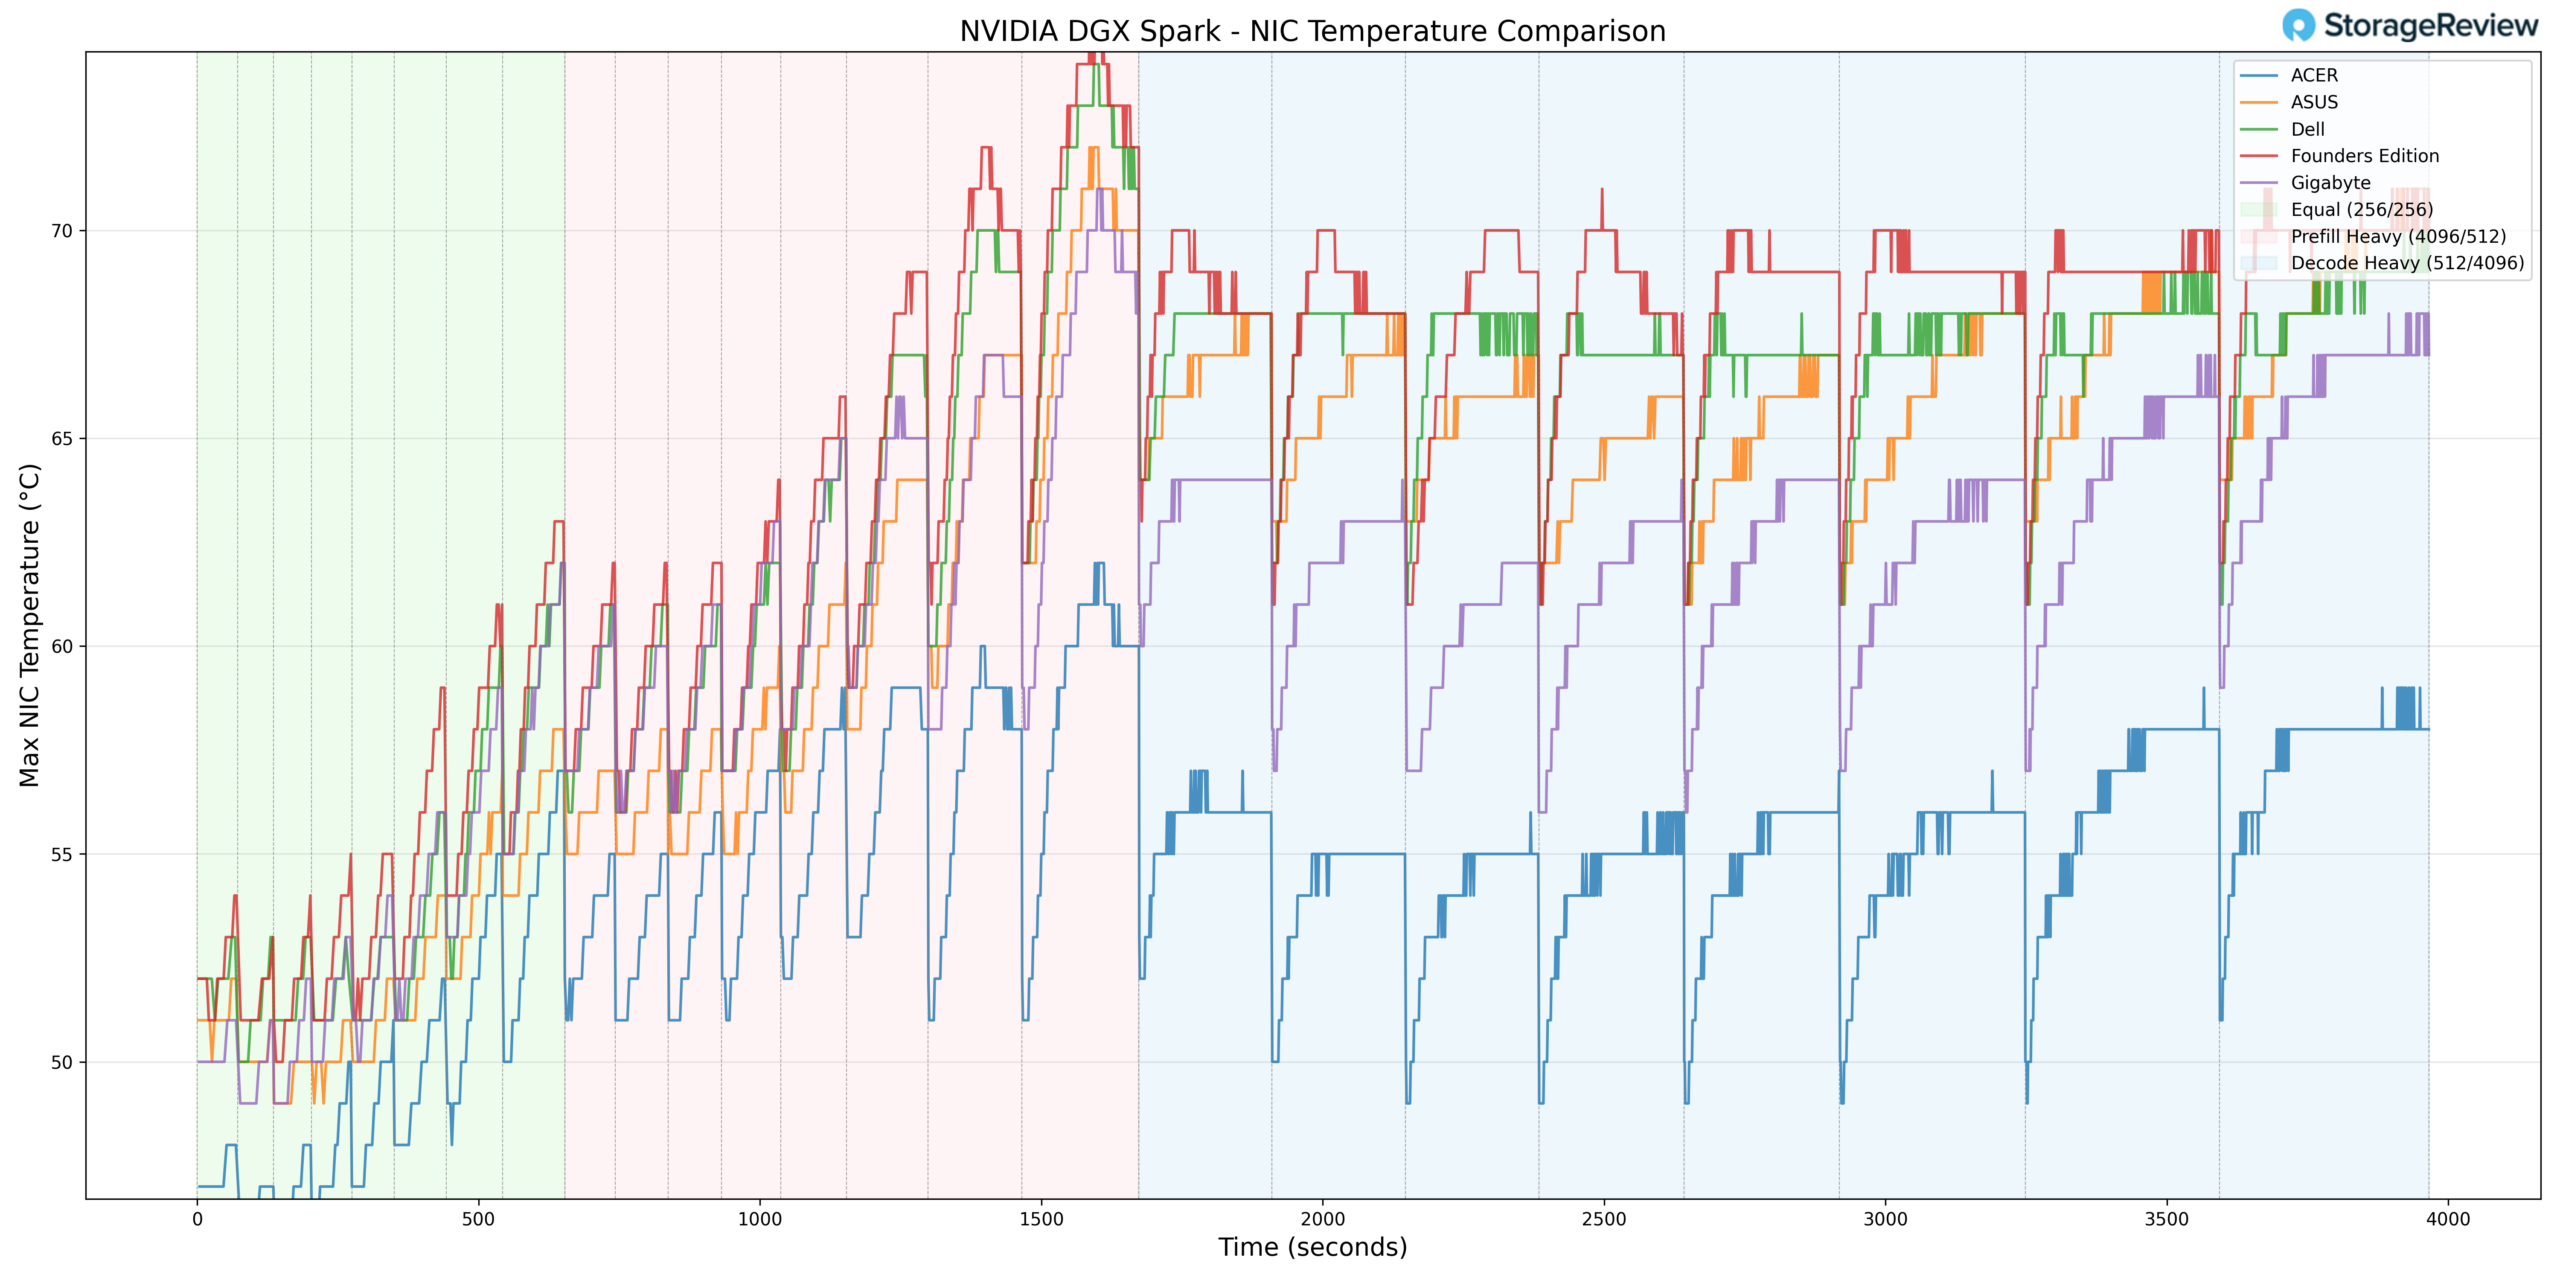
Temperatura NIC
Durante le fasi di carico di lavoro più intenso, la temperatura della scheda di rete ha raggiunto un picco di 61 °C. Questo valore rappresenta una delle temperature massime più basse osservate nel gruppo di confronto, suggerendo un flusso d'aria efficace o un posizionamento ottimale dei componenti all'interno dello chassis.
La temperatura minima registrata del NIC è stata di 39 °C durante le fasi più leggere, a conferma di un comportamento termico di base stabile.
Durante i test, il controller di rete si è adattato proporzionalmente alla domanda di carico di lavoro senza un eccessivo ridimensionamento.
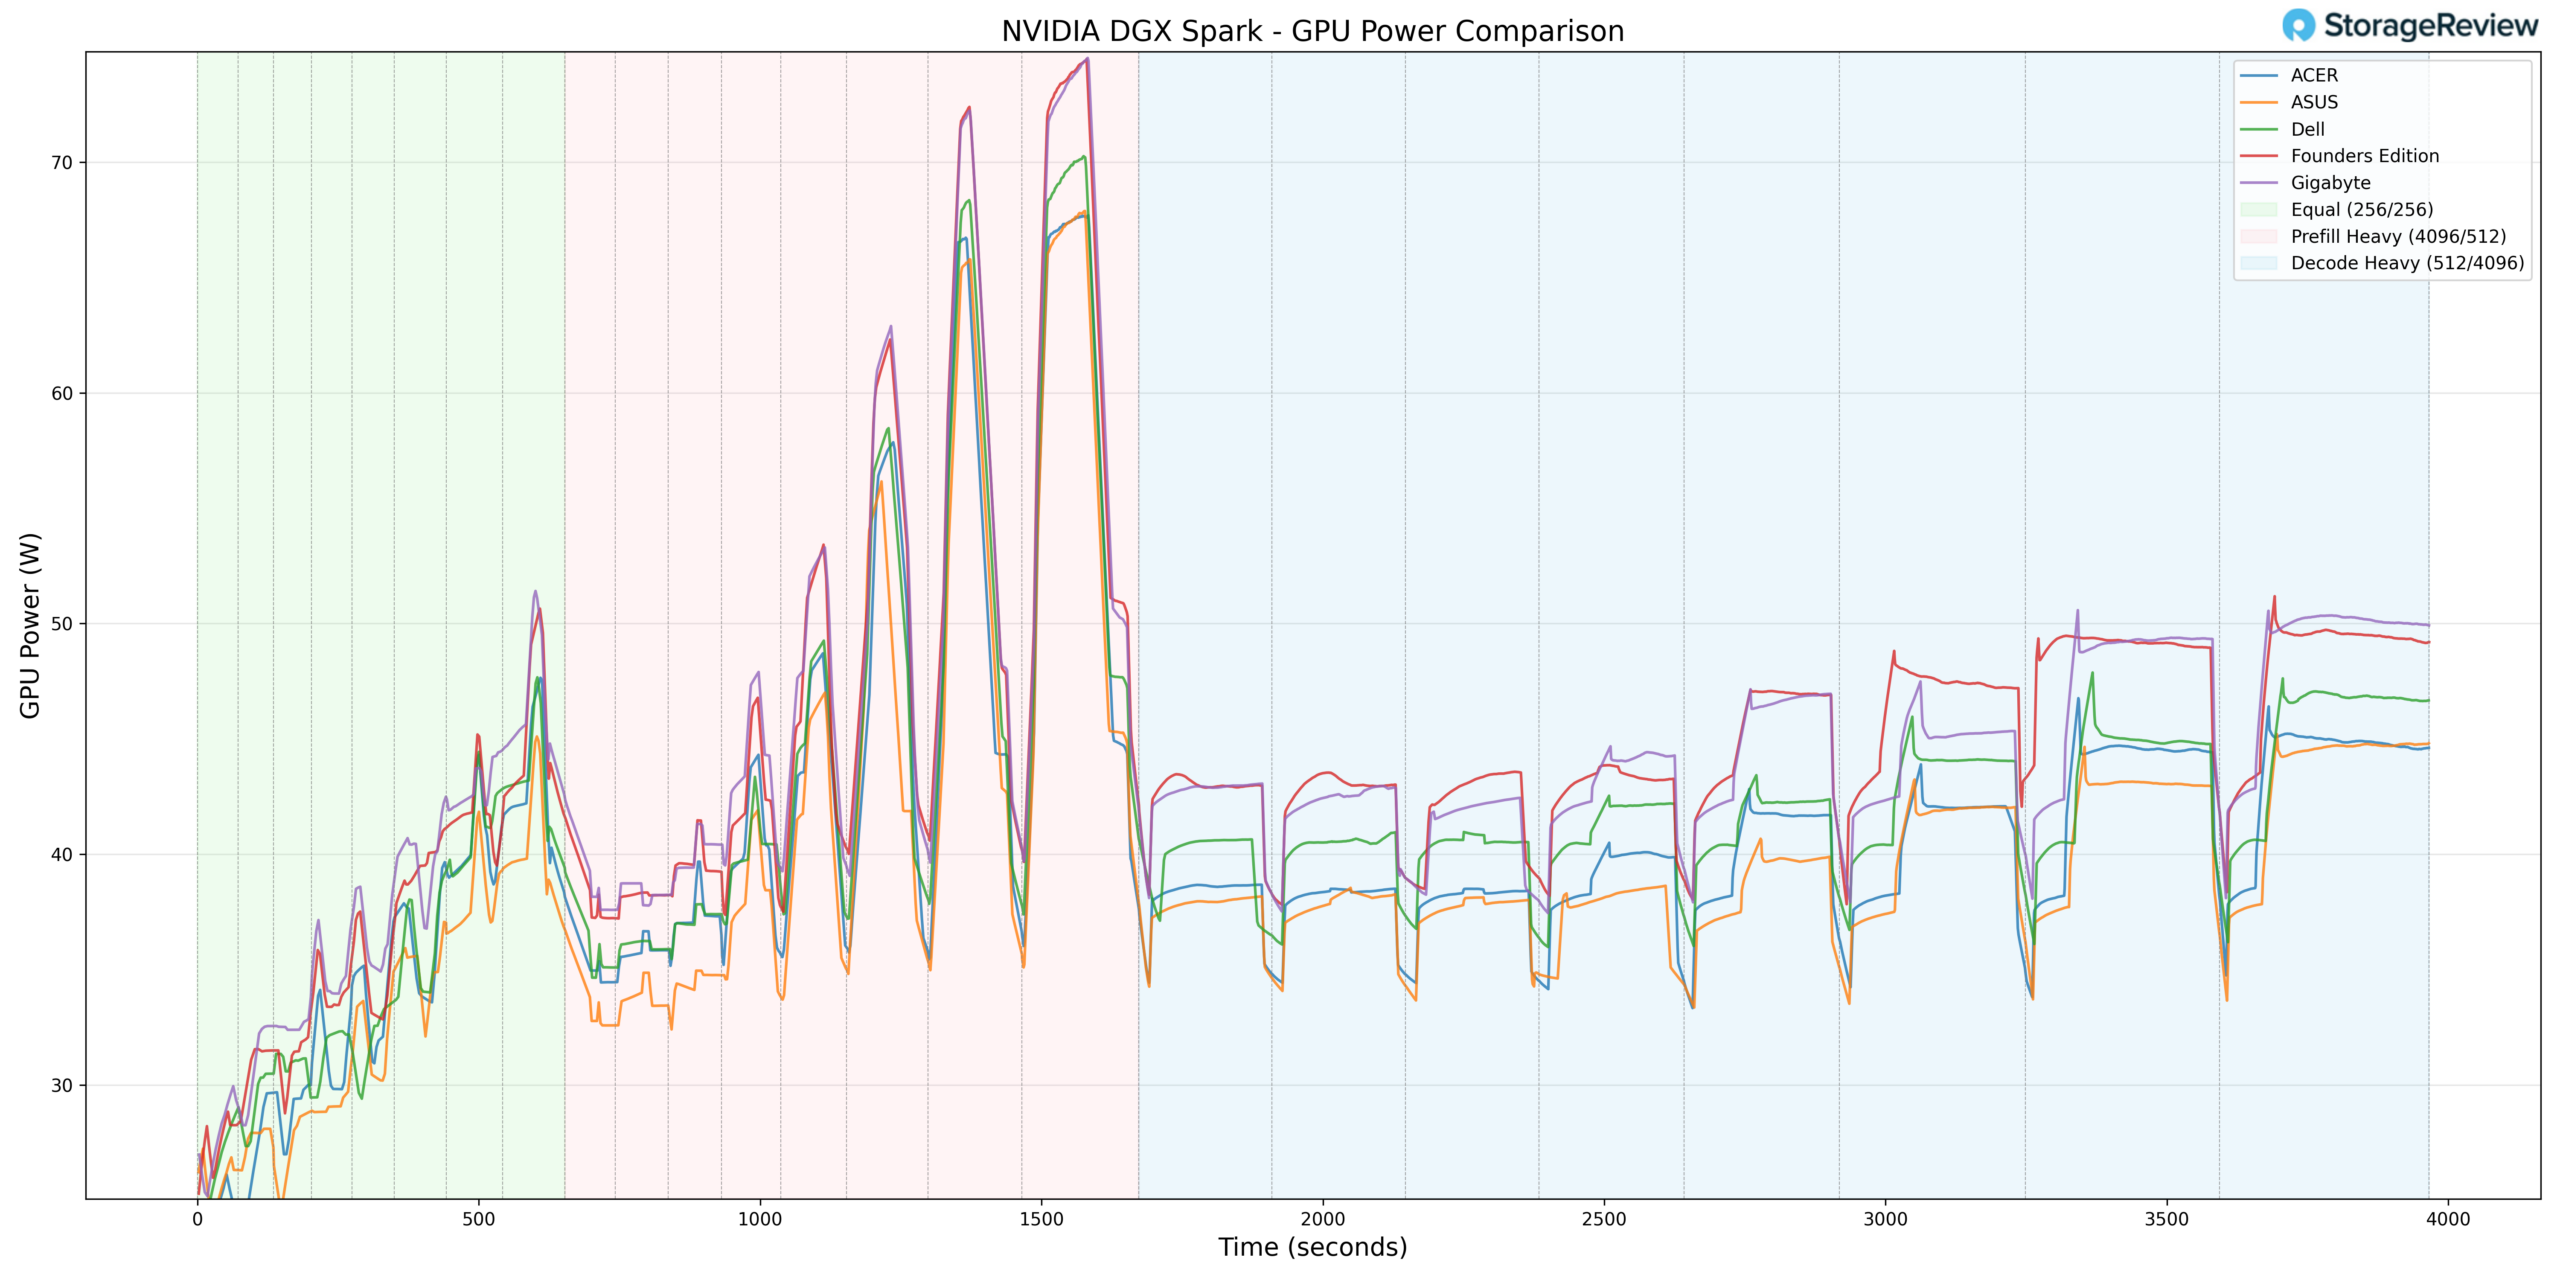
Consumo energetico della GPU
Il consumo energetico della GPU ha raggiunto un picco di 69.18 W durante le transizioni con elevato utilizzo di Prefill. Questo dato colloca Acer leggermente al di sotto dei valori massimi di consumo energetico osservati all'interno della suite GB10.
La minore allocazione di potenza di picco è direttamente correlata al profilo termico più basso della GPU di Acer. Invece di spingere aggressivamente verso il limite superiore dell'inviluppo di potenza, Acer sembra bilanciare prestazioni ed efficienza termica, ottenendo temperature dei componenti costantemente inferiori durante le fasi di picco.
Durante i carichi di lavoro di decodifica prolungati, il consumo energetico si è stabilizzato in linea con la domanda di lavoro ed è rimasto prevedibile.
Riepilogo termico
Monitorando CPU, GPU, NVMe e NIC, l'Acer GB10 ha dimostrato il profilo termico complessivo più basso del gruppo di confronto. La CPU ha raggiunto un picco di 74.7 °C e la GPU di 69 °C durante le transizioni con picchi di utilizzo intensivo, mentre l'NVMe è rimasto al di sotto dei 57 °C e la NIC ha raggiunto un picco di 61 °C. Il consumo energetico della GPU ha raggiunto un massimo di 69.18 W, leggermente inferiore ai valori più elevati osservati nell'intero gruppo.
Nel complesso, l'implementazione di Acer privilegia l'efficienza termica e la stabilità costante, mantenendo un margine di sicurezza considerevole durante le transizioni di carico di lavoro più intense e garantendo prestazioni costanti anche sotto carico prolungato.
Test delle prestazioni dell'Acer Veriton GN100
Per valutare l'Acer Veriton GN100, abbiamo testato le unità Spark utilizzando il benchmark vLLM Online Serving, il motore di inferenza e di gestione di applicazioni ad alto throughput più diffuso per modelli linguistici di grandi dimensioni. Il benchmark vLLM Online Serving simula carichi di lavoro di produzione reali inviando richieste simultanee a un server vLLM in esecuzione e misurando metriche chiave, tra cui il throughput totale dei token (token al secondo), il tempo al primo token e il tempo per token di output, in diverse condizioni di carico.
I nostri test hanno coperto una vasta gamma di modelli, dalle architetture dense ai tipi di dati a scalabilità ridotta. I test hanno valutato le prestazioni in tre scenari di carico di lavoro: ISL/OSL bilanciato, precaricamento intensivo e decodifica intensiva. Questi scenari rappresentano modelli di servizio reali distinti, da carichi di input e output bilanciati all'elaborazione intensiva dei prompt e alla generazione di token limitata dalla larghezza di banda della memoria.
Oltre all'Acer Veriton GN100, abbiamo utilizzato come punto di riferimento la scheda grafica NVIDIA Founders Edition Spark, insieme a sistemi OEM di ASUS, Dell e GIGABYTE. Questo ci ha permesso di contestualizzare i risultati di Acer nel panorama competitivo più ampio e di capire dove si posiziona, se tiene il passo con gli altri o se è in svantaggio, considerando diversi modelli e tipologie di carico di lavoro.
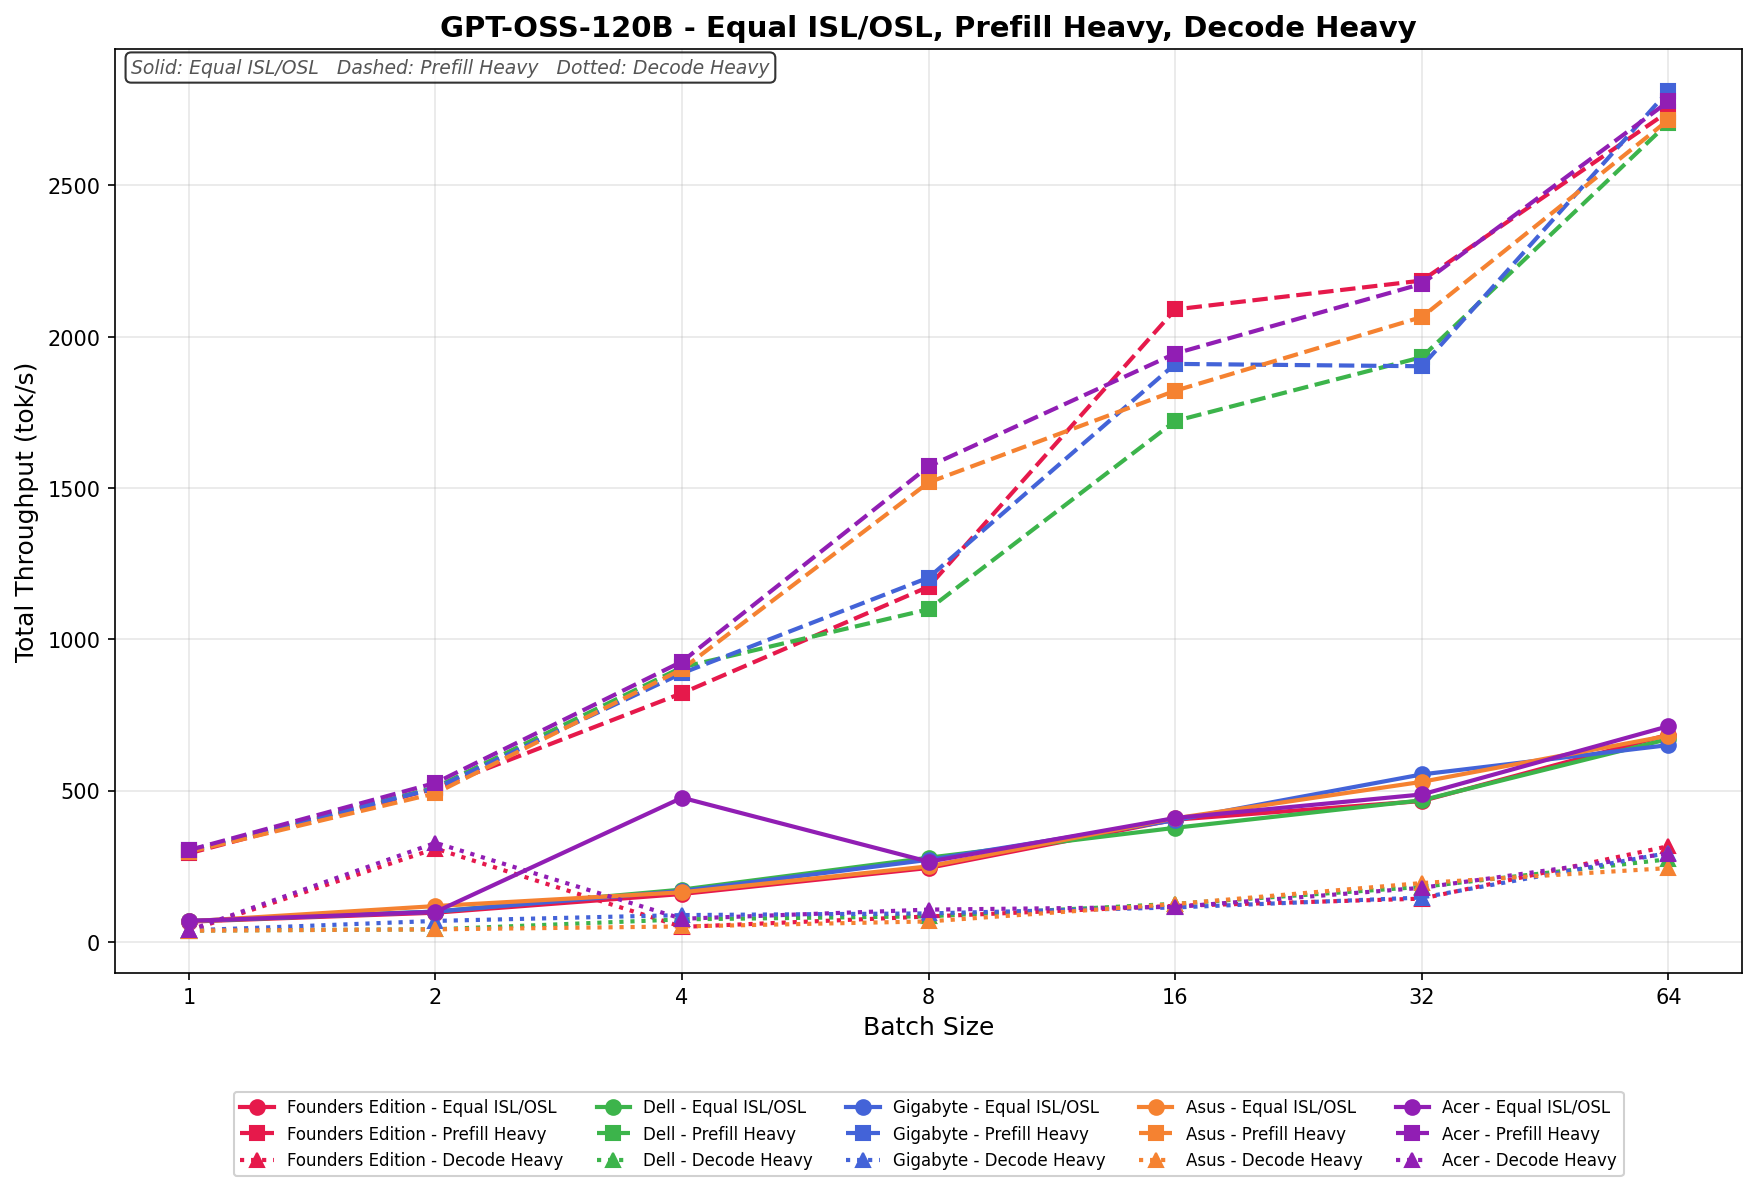
GPT-OSS-120B
In Equal ISL/OSL, la velocità di elaborazione di Acer varia da 69.65 a 713.18 tok/s nell'arco dell'intero ciclo di elaborazione. La velocità di elaborazione mostra una certa variabilità con lotti di dimensioni inferiori, prima di stabilizzarsi e crescere costantemente a partire dal lotto 8 fino al lotto 64.
Prefill Heavy parte da 303.61 tok/s e sale a 2,777.56 tok/s con la dimensione del lotto 64. La scalabilità è forte e progressiva in tutto il processo, con una crescita particolarmente aggressiva fino al lotto 8 e incrementi continui con lotti di dimensioni maggiori.
La velocità di elaborazione di Decode Heavy varia da 38.38 a 292.41 tok/s, con una scalabilità graduale e costante lungo tutta la scansione dei batch. Le dimensioni dei batch più piccole mostrano una certa variabilità prima che la velocità di elaborazione si stabilizzi e cresca costantemente a partire dal batch 16.
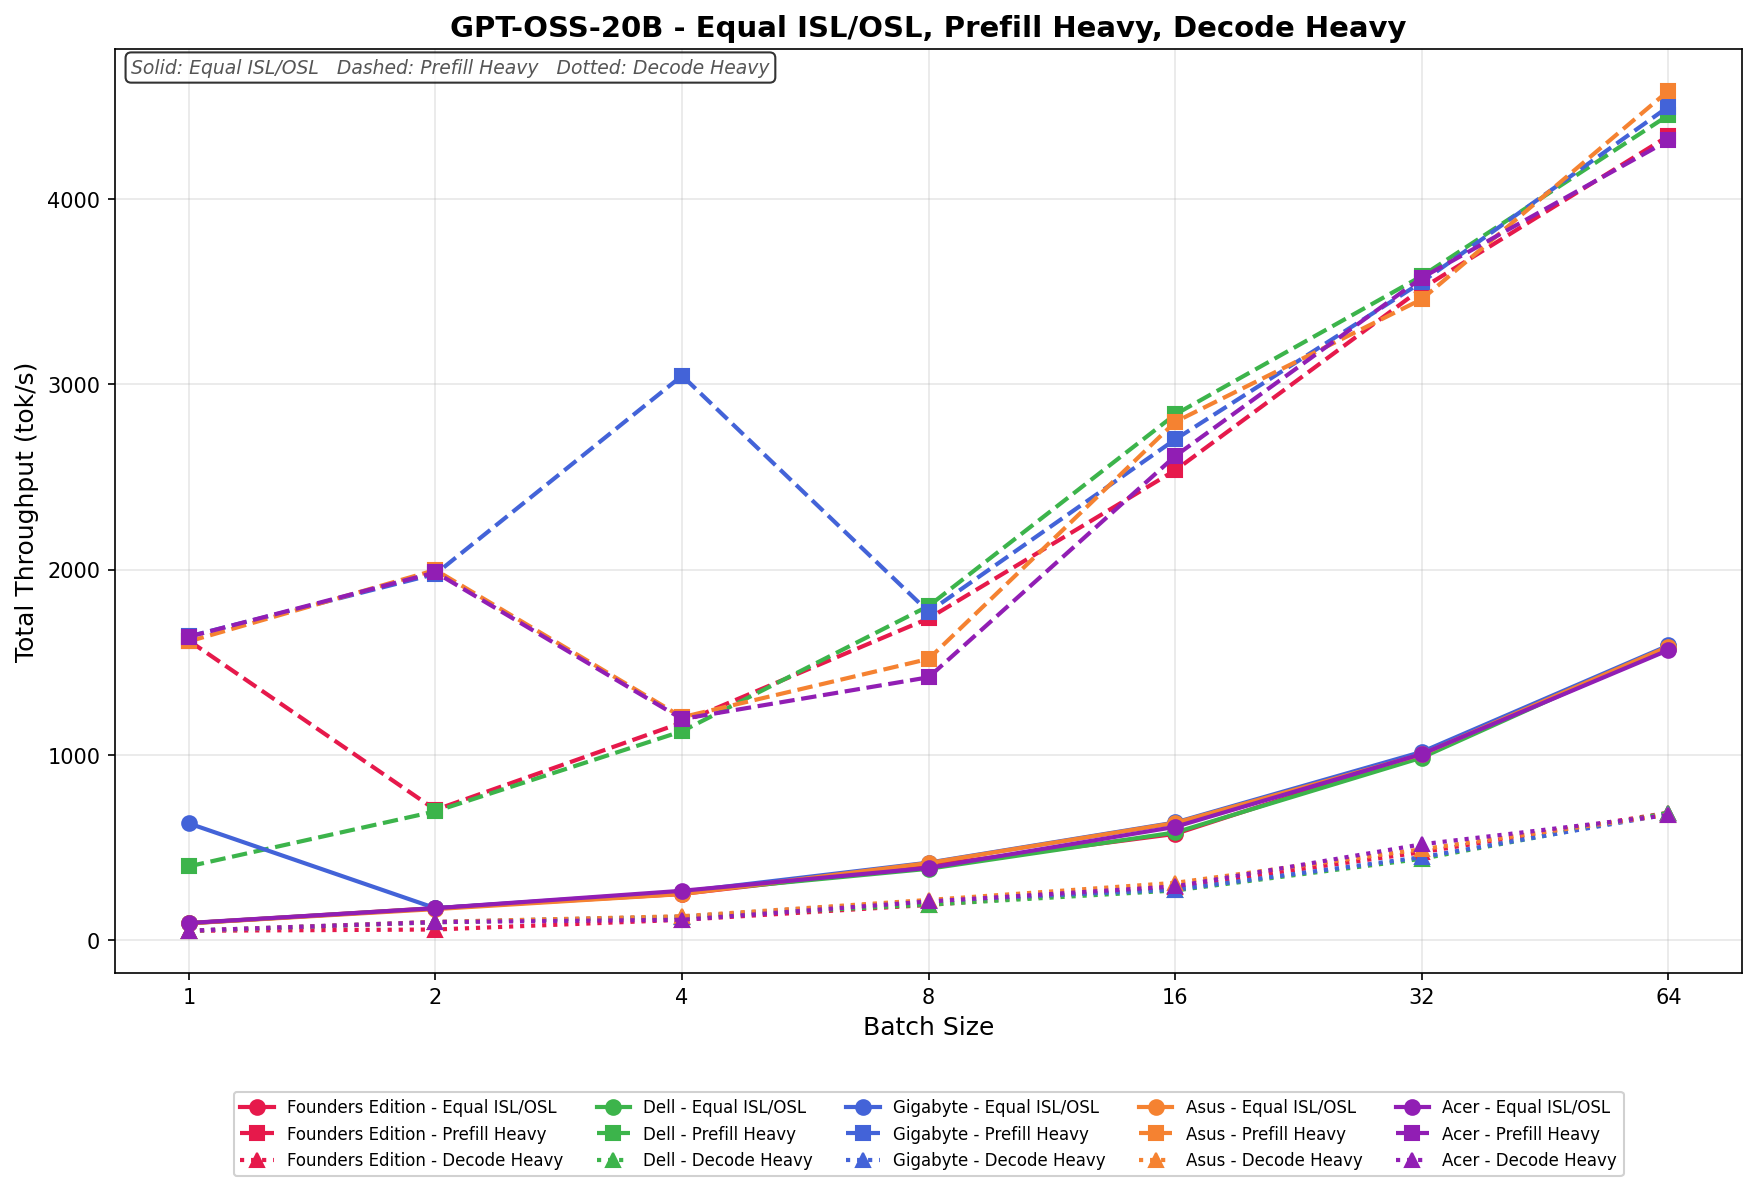
GPT-OSS-20B
In Equal ISL/OSL, l'Acer scala da 91.91 a 1,565.62 tok/s con incrementi consistenti e significativi lungo l'intero ciclo di elaborazione. La velocità di elaborazione raddoppia approssimativamente dal batch 1 al batch 4, per poi continuare a crescere nei batch 32 e 64.
Il pre-riempimento pesante inizia a 1,637.72 tok/s e sale a 4,317.73 tok/s all'aumentare della dimensione del lotto fino a 64. La crescita è forte fino al lotto 2, si modera nella fase intermedia, per poi accelerare nuovamente ai lotti 32 e 64.
La velocità di decodifica di Decode Heavy varia da 50.55 a 674.26 tok/s, con una scalabilità graduale e costante durante l'intero ciclo di elaborazione.
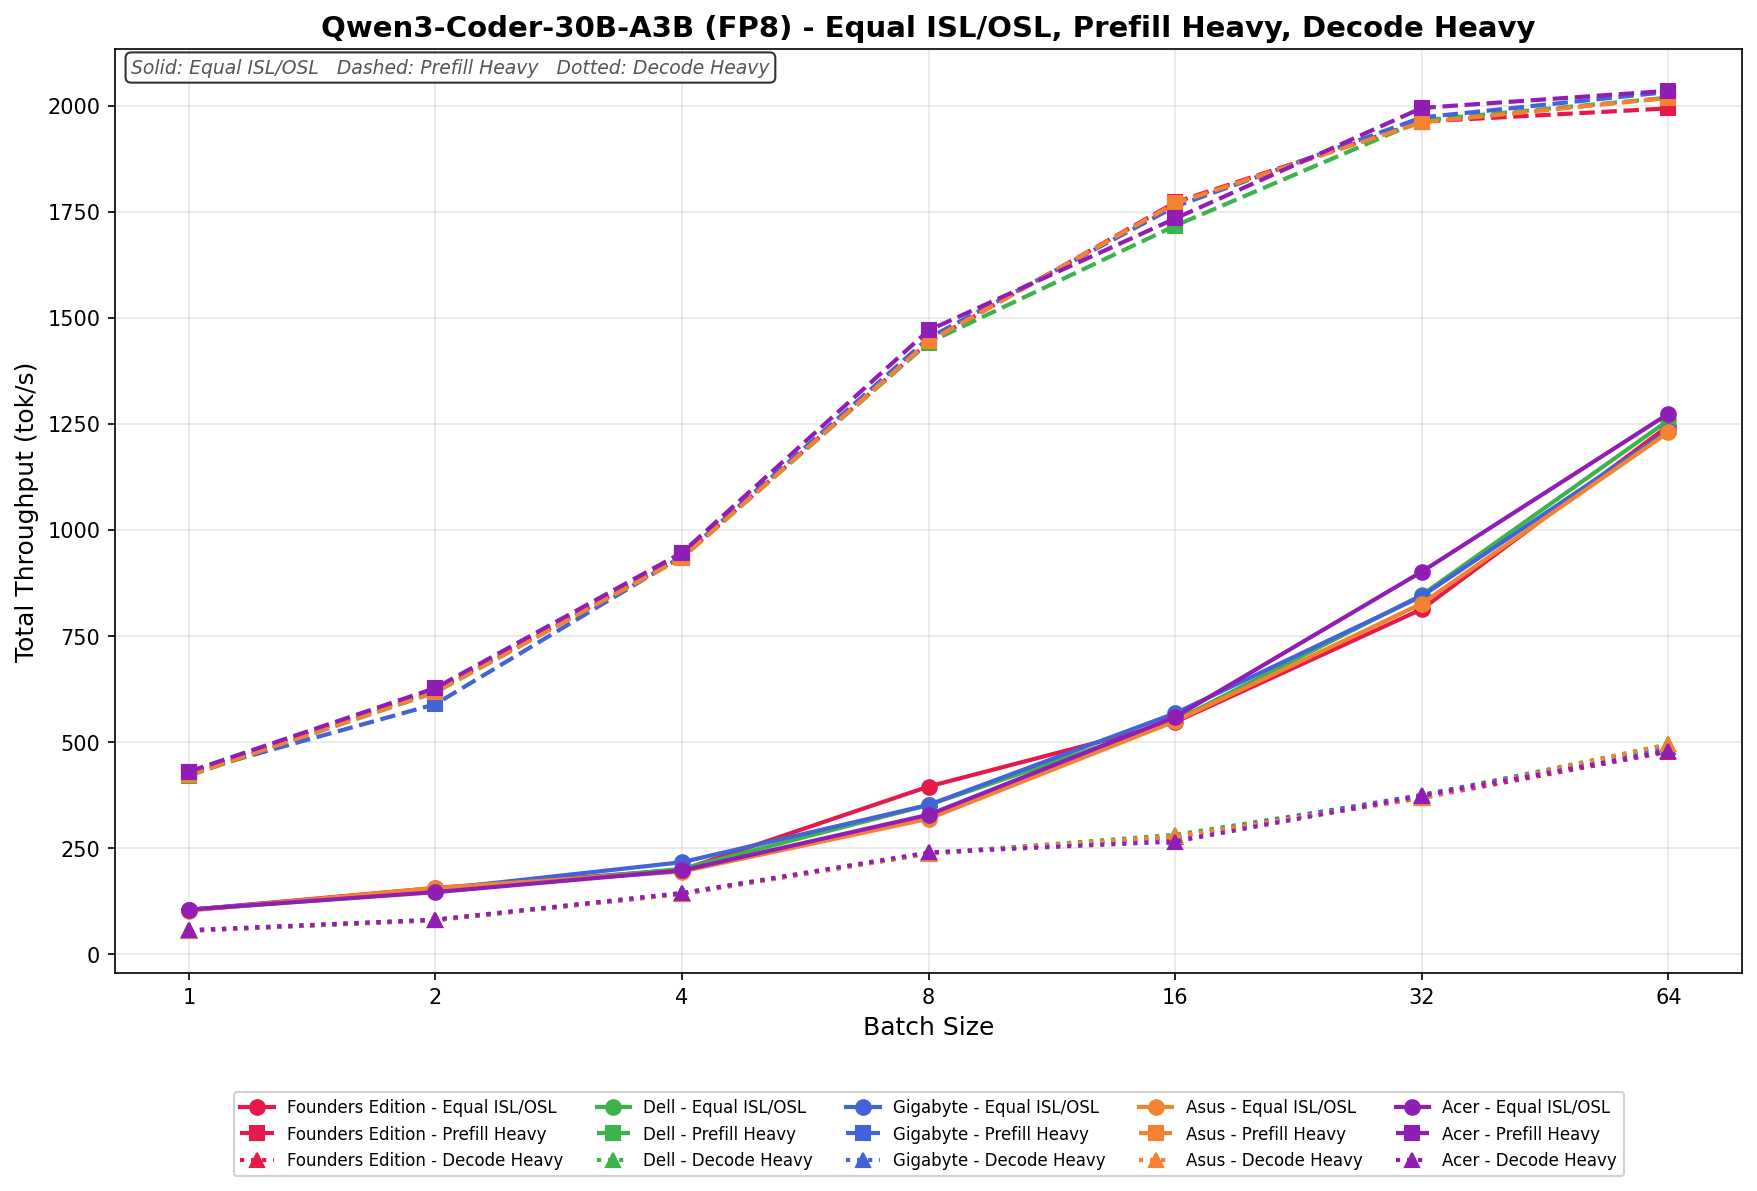
Codificatore Qwen3 30B A3B FB8
In Equal ISL/OSL, la velocità di elaborazione di Acer varia da 104.64 a 1,273.47 tok/s, con una crescita costante e uniforme lungo l'intero ciclo di elaborazione. La velocità di elaborazione raddoppia approssimativamente a ogni passaggio fino al batch 16, per poi continuare a crescere fino ai batch 32 e 64.
Il pre-riempimento pesante inizia a 429.86 tok/s e cresce fino a 2,034.76 tok/s entro la dimensione del lotto 64. La scalabilità è forte fino al lotto 8, poi si modera man mano che il carico di lavoro si avvicina a un plateau nei lotti 32 e 64.
La velocità di decodifica di Decode Heavy varia da 55.94 a 478.59 tok/s, con una scalabilità graduale e costante durante l'intero ciclo di elaborazione.
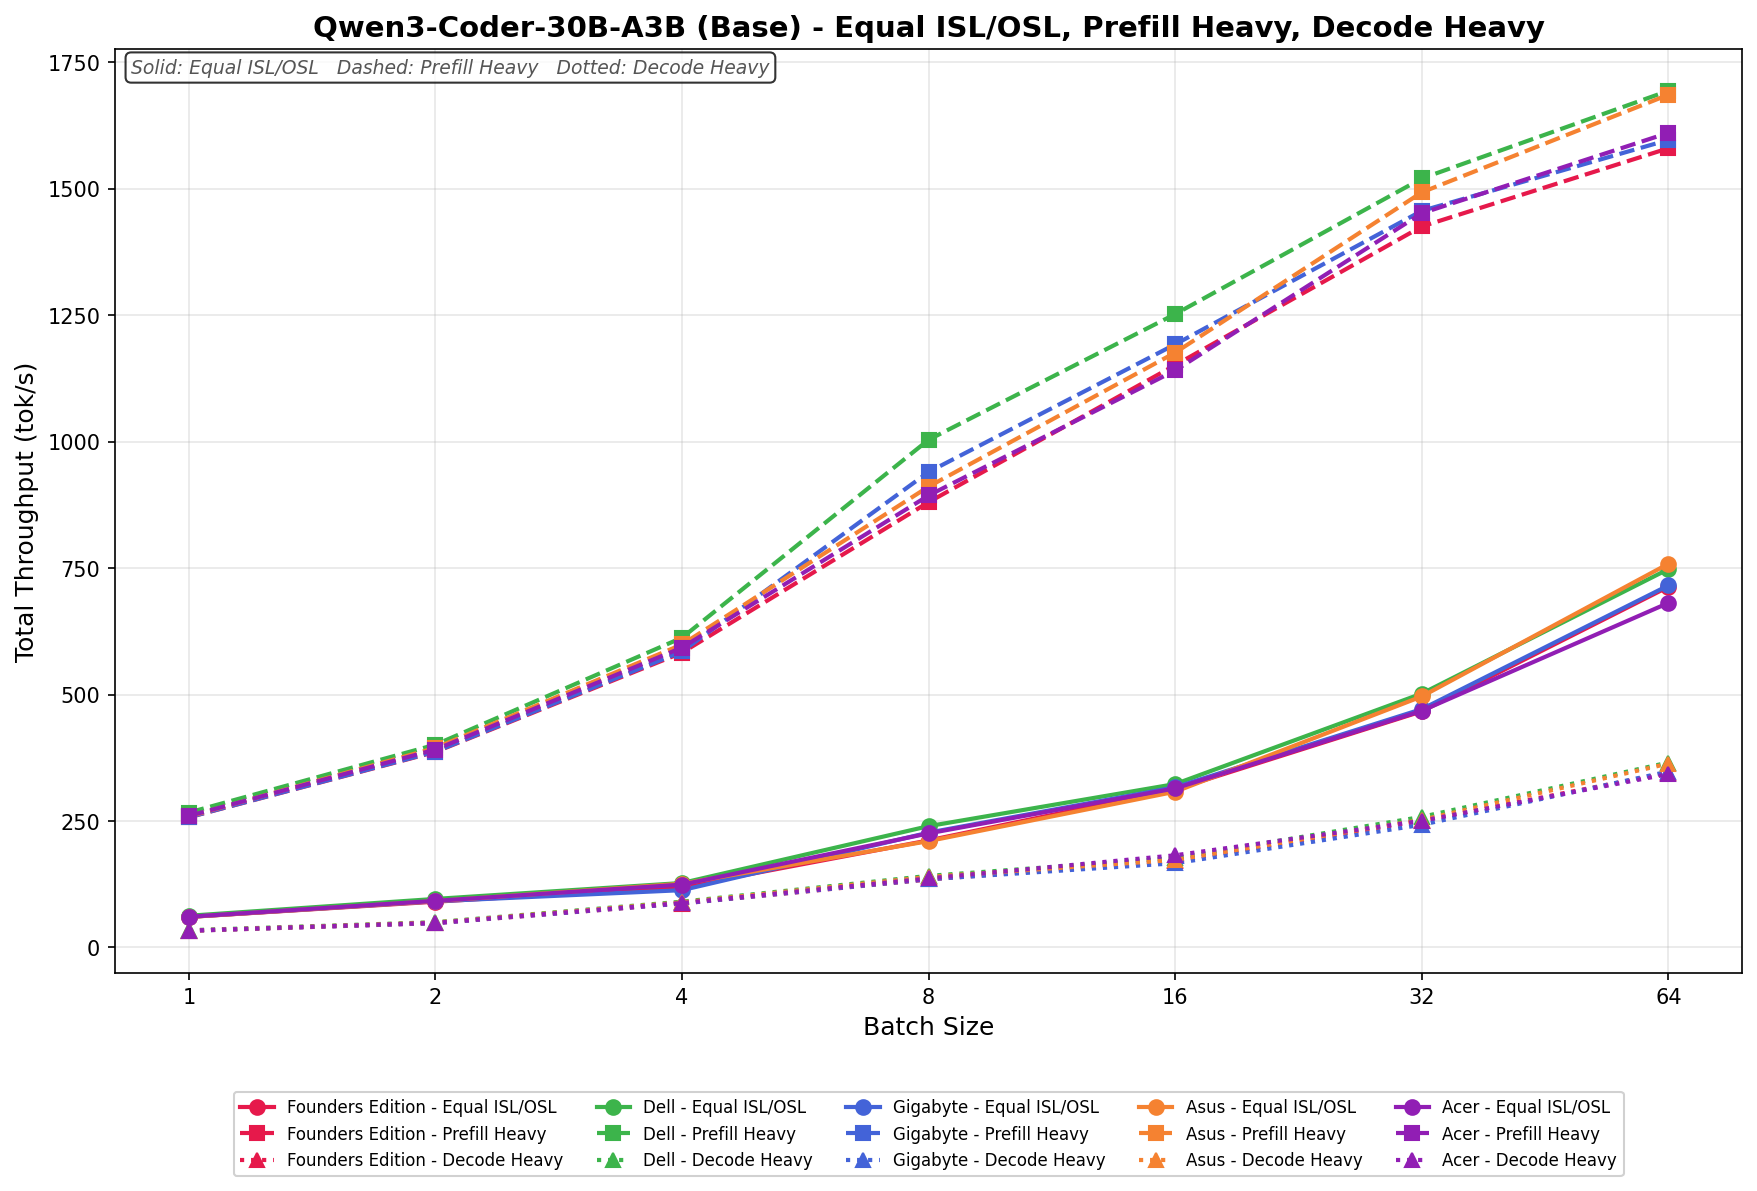
Codificatore Qwen3 30B A3B Base
In Equal ISL/OSL, l'Acer scala da 60.71 a 681.18 tok/s, offrendo una velocità di elaborazione significativamente inferiore rispetto alla variante FP8 per tutte le dimensioni del batch. La crescita è costante durante l'intero processo, sebbene il divario con l'FP8 si ampli con batch di dimensioni maggiori.
Prefill Heavy parte da 260.11 tok/s e sale a 1,610.56 tok/s con una dimensione del batch pari a 64. La scalabilità è coerente lungo tutta la scansione, sebbene la velocità di elaborazione rimanga ben al di sotto della controparte FP8 per ogni dimensione del batch.
La velocità di decodifica di Heavy varia da 33.31 a 342.79 tok/s, con un output inferiore rispetto alla variante FP8 durante l'intero ciclo di test. La crescita è graduale e costante per tutte le dimensioni del batch.
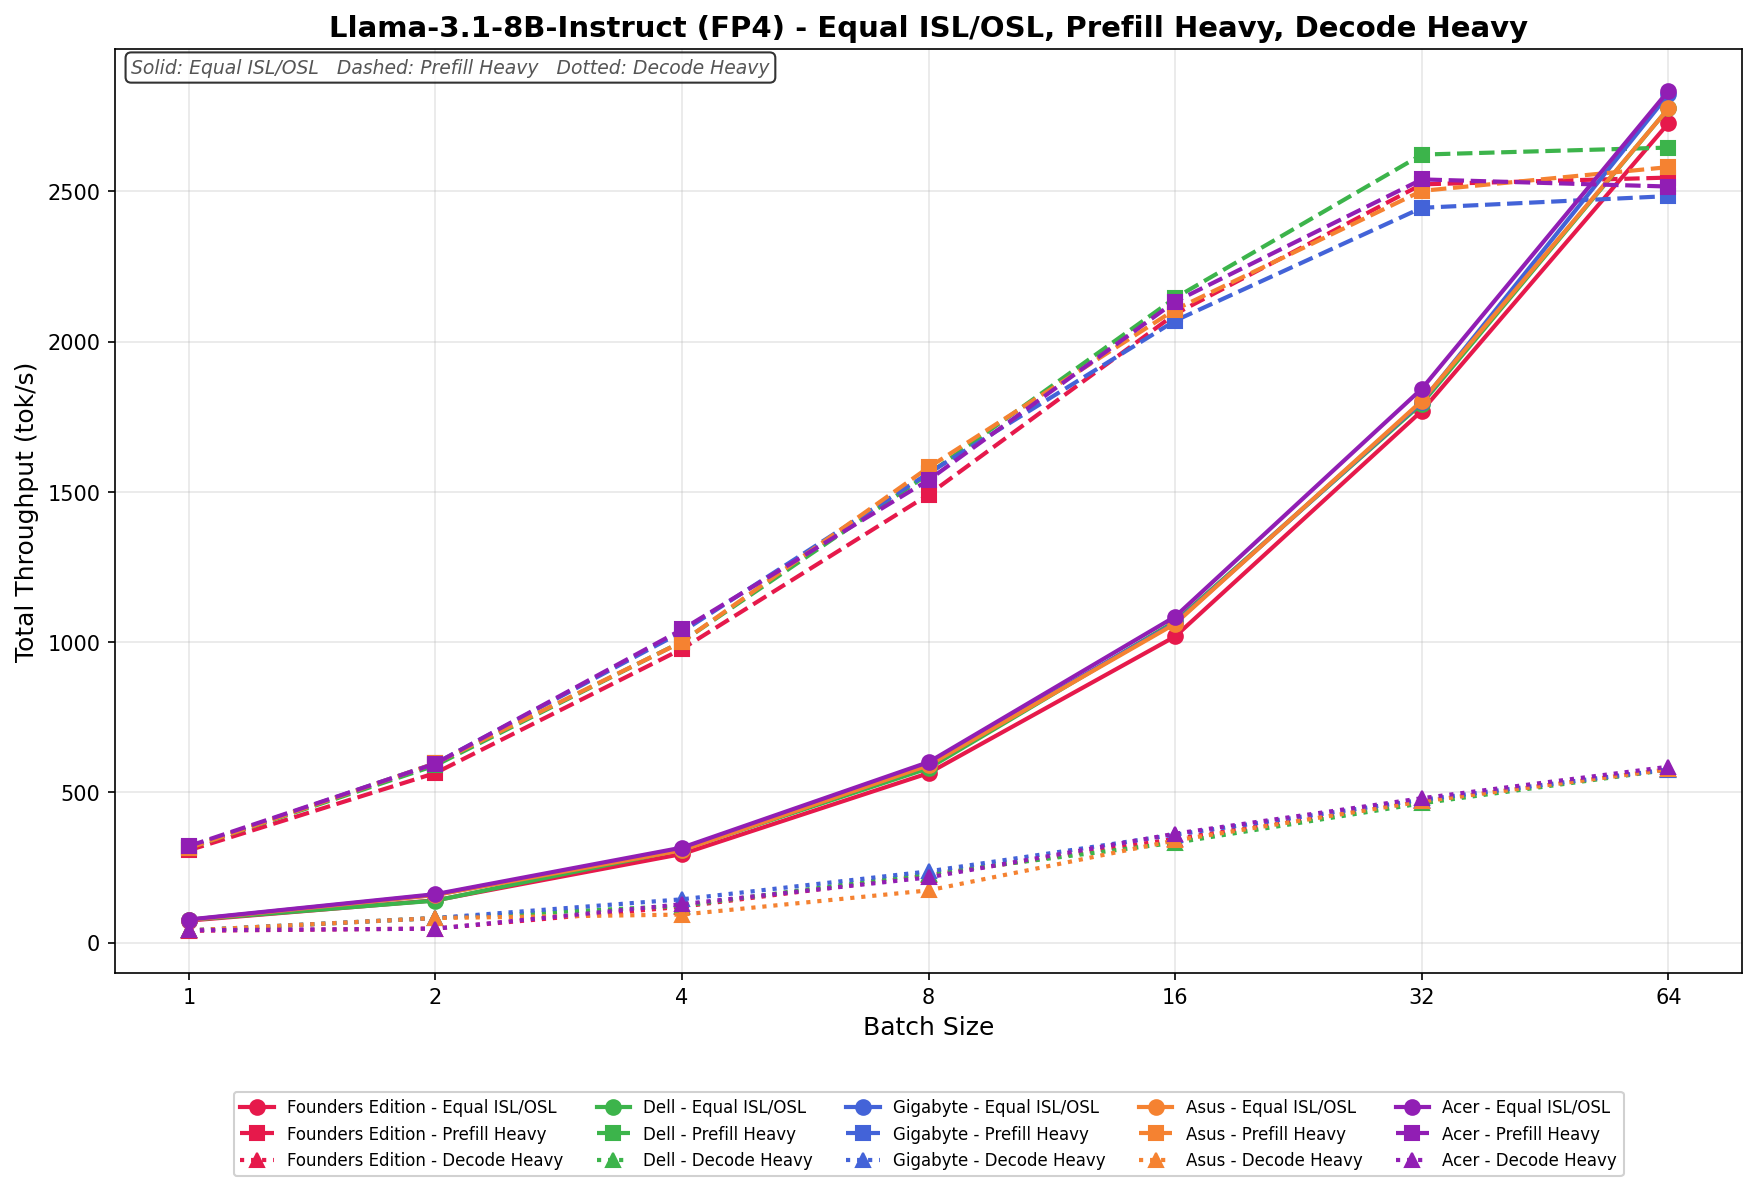
Llama 3.1 8B Istruzione FP4
In Equal ISL/OSL, la velocità di Acer passa da 77.15 a 2,834.70 tok/s, offrendo un netto vantaggio in termini di throughput rispetto alla variante FP8 per tutte le dimensioni di batch. La scalabilità è fluida e lineare fino al batch 32, con ulteriori e significativi incrementi al batch 64.
La velocità di pre-riempimento pesante parte da 321.54 tok/s e sale a 2,539.85 tok/s al lotto 32, per poi stabilizzarsi leggermente a 2,516.13 tok/s al lotto 64. Il modello FP4 mantiene una produttività superiore rispetto alla sua controparte FP8 per lotti di dimensioni medie e elevate.
La velocità di decodifica di Decode Heavy varia da 41.21 a 585.63 tok/s, con un output notevolmente superiore rispetto alla variante FP8 per tutte le dimensioni del batch. La crescita è costante lungo l'intera analisi.
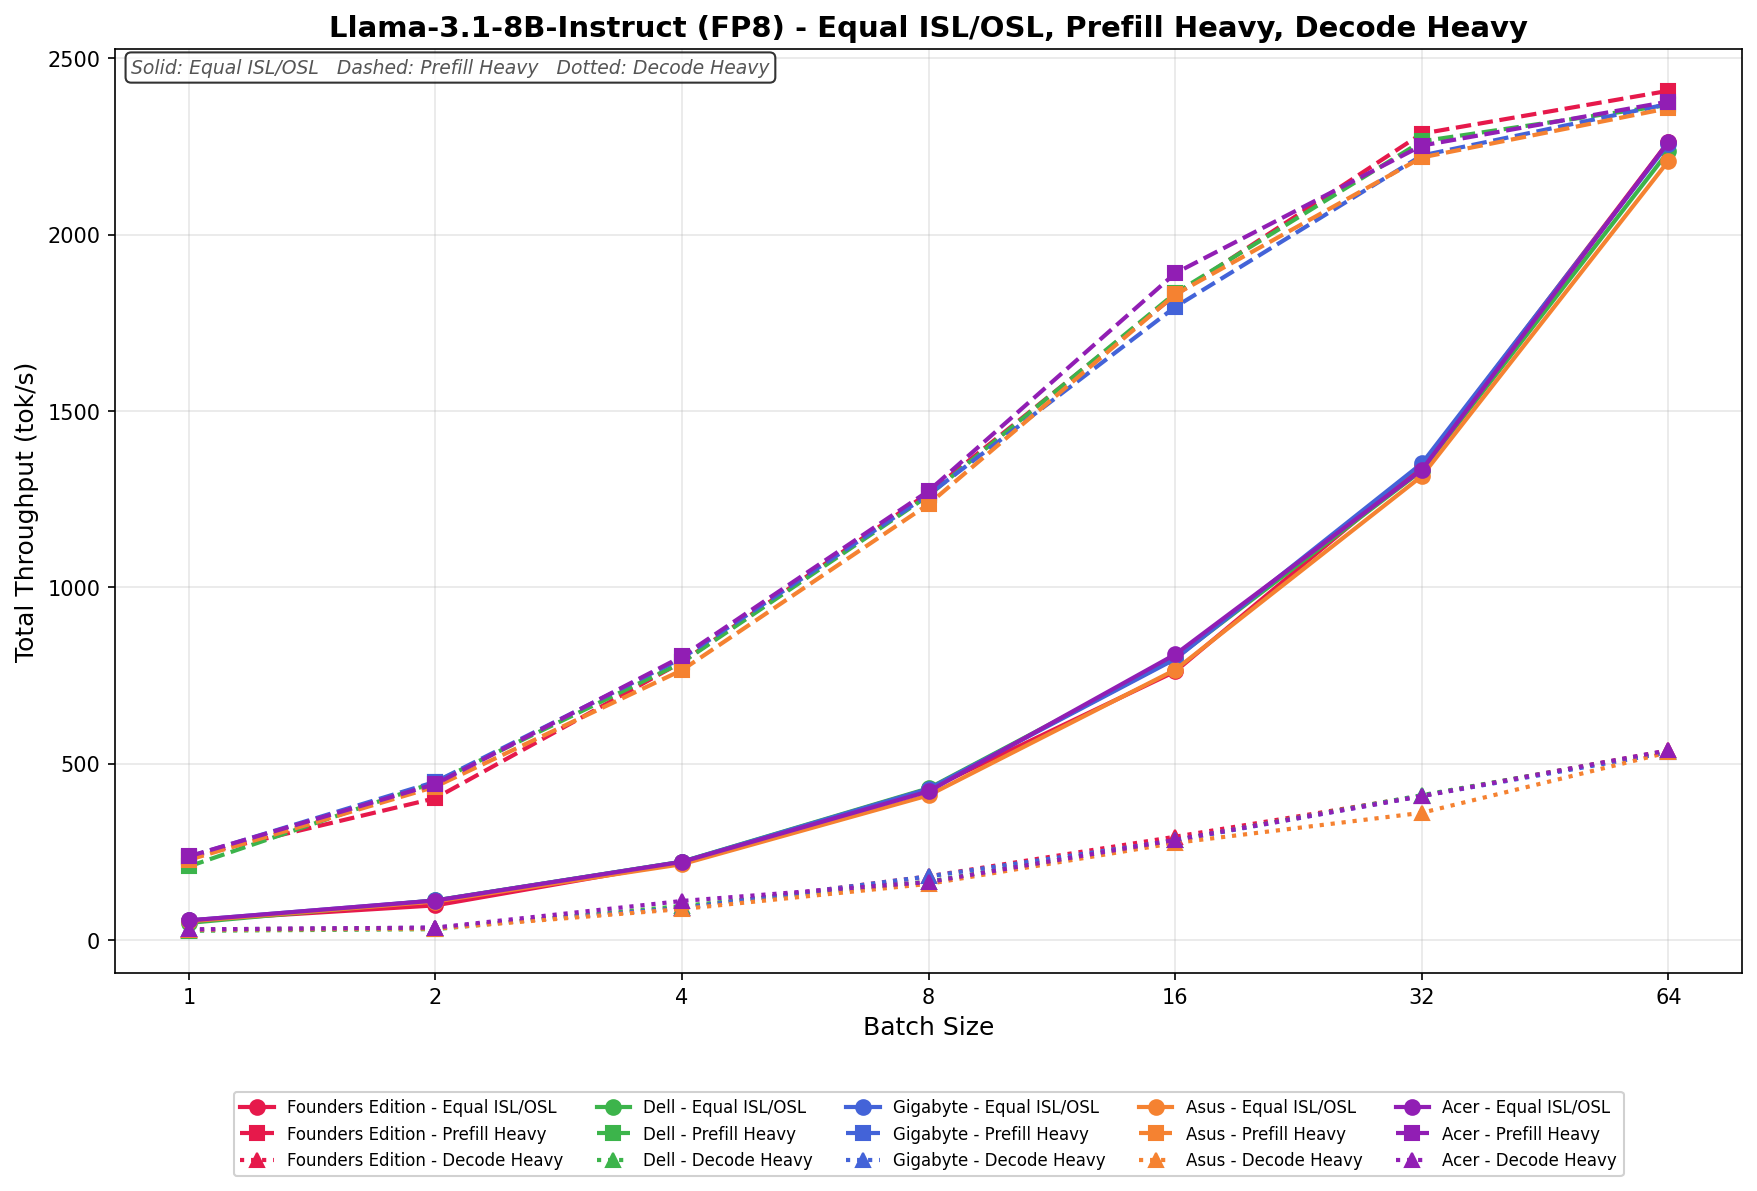
Llama 3.1 8B Istruzione FP8
In Equal ISL/OSL, l'Acer scala da 55.93 a 2,262.73 tok/s durante la scansione batch, con incrementi costanti e uniformi a ogni passaggio. La velocità di elaborazione quasi raddoppia dal batch 1 al batch 8 e continua a crescere fino ai batch 32 e 64 senza mostrare segni di saturazione.
Il processo Prefill Heavy inizia con una velocità di 237.62 tok/s e raggiunge i 2,376.88 tok/s con la dimensione del lotto pari a 64. La scalabilità è forte e progressiva, con una produttività che cresce costantemente lungo l'intero ciclo di produzione.
La velocità di decodifica di Heavy varia da 30.39 a 538.18 tok/s, con una crescita costante durante l'intero ciclo di elaborazione.
Archiviazione diretta GPU
Uno dei test che abbiamo condotto sullo Spark è stato il test MagnumIO GPU Direct Storage (GDS). GDS è una funzionalità sviluppata da NVIDIA che consente alle GPU di bypassare la CPU quando accedono ai dati archiviati su unità NVMe o altri dispositivi di archiviazione ad alta velocità. Invece di instradare i dati attraverso la CPU e la memoria di sistema, GDS consente la comunicazione diretta tra la GPU e il dispositivo di archiviazione, riducendo significativamente la latenza e migliorando la velocità di trasmissione dei dati.
Acer utilizza l'SSD Samsung PM9E1 Gen5 da 4 TB all'interno del Veriton GN100 AI, che ad oggi è l'unità M.2 2242 più veloce che abbiamo visto sul mercato.
Come funziona l'archiviazione diretta GPU
Tradizionalmente, quando una GPU elabora i dati memorizzati su un'unità NVMe, questi devono prima passare attraverso la CPU e la memoria di sistema prima di raggiungere la GPU. Questo processo introduce dei colli di bottiglia perché la CPU funge da intermediario, aggiungendo latenza e consumando preziose risorse di sistema. La tecnologia GPU Direct Storage elimina questa inefficienza consentendo alla GPU di accedere ai dati direttamente dal dispositivo di archiviazione tramite il bus PCIe. Questo percorso diretto riduce l'overhead di trasferimento dati, consentendo trasferimenti più rapidi ed efficienti.
I carichi di lavoro AI, in particolare quelli che coinvolgono il deep learning, sono altamente intensivi in termini di dati. L'addestramento di grandi reti neurali richiede l'elaborazione di terabyte di dati e qualsiasi ritardo nel trasferimento dei dati può portare a GPU sottoutilizzate e tempi di addestramento più lunghi. GPU Direct Storage affronta questa sfida assicurando che i dati vengano consegnati alla GPU il più rapidamente possibile, riducendo al minimo i tempi di inattività e massimizzando l'efficienza computazionale.
Inoltre, GDS è particolarmente utile per carichi di lavoro che comportano lo streaming di grandi set di dati, come l'elaborazione video, l'elaborazione del linguaggio naturale o l'inferenza in tempo reale. Riducendo la dipendenza dalla CPU, GDS accelera lo spostamento dei dati e libera risorse della CPU per altre attività, migliorando ulteriormente le prestazioni complessive del sistema.
Velocità di lettura GDSIO 16k
Analizzando il throughput di lettura GDSIO a 16 KB, l'Acer parte da 0.07 GiB/s con 1 thread e scala linearmente con 2 thread (0.13 GiB/s), 4 thread (0.26 GiB/s) e 8 thread (0.57 GiB/s). Il throughput continua a crescere con 16 thread (1.16 GiB/s), 32 thread (2.16 GiB/s) e 64 thread (4.34 GiB/s). Con 128 thread, il throughput raggiunge 6.91 GiB/s, il risultato più alto osservato durante la scansione, senza un chiaro punto di saturazione, il che indica che la piattaforma continua a scalare anche con dimensioni I/O ridotte.
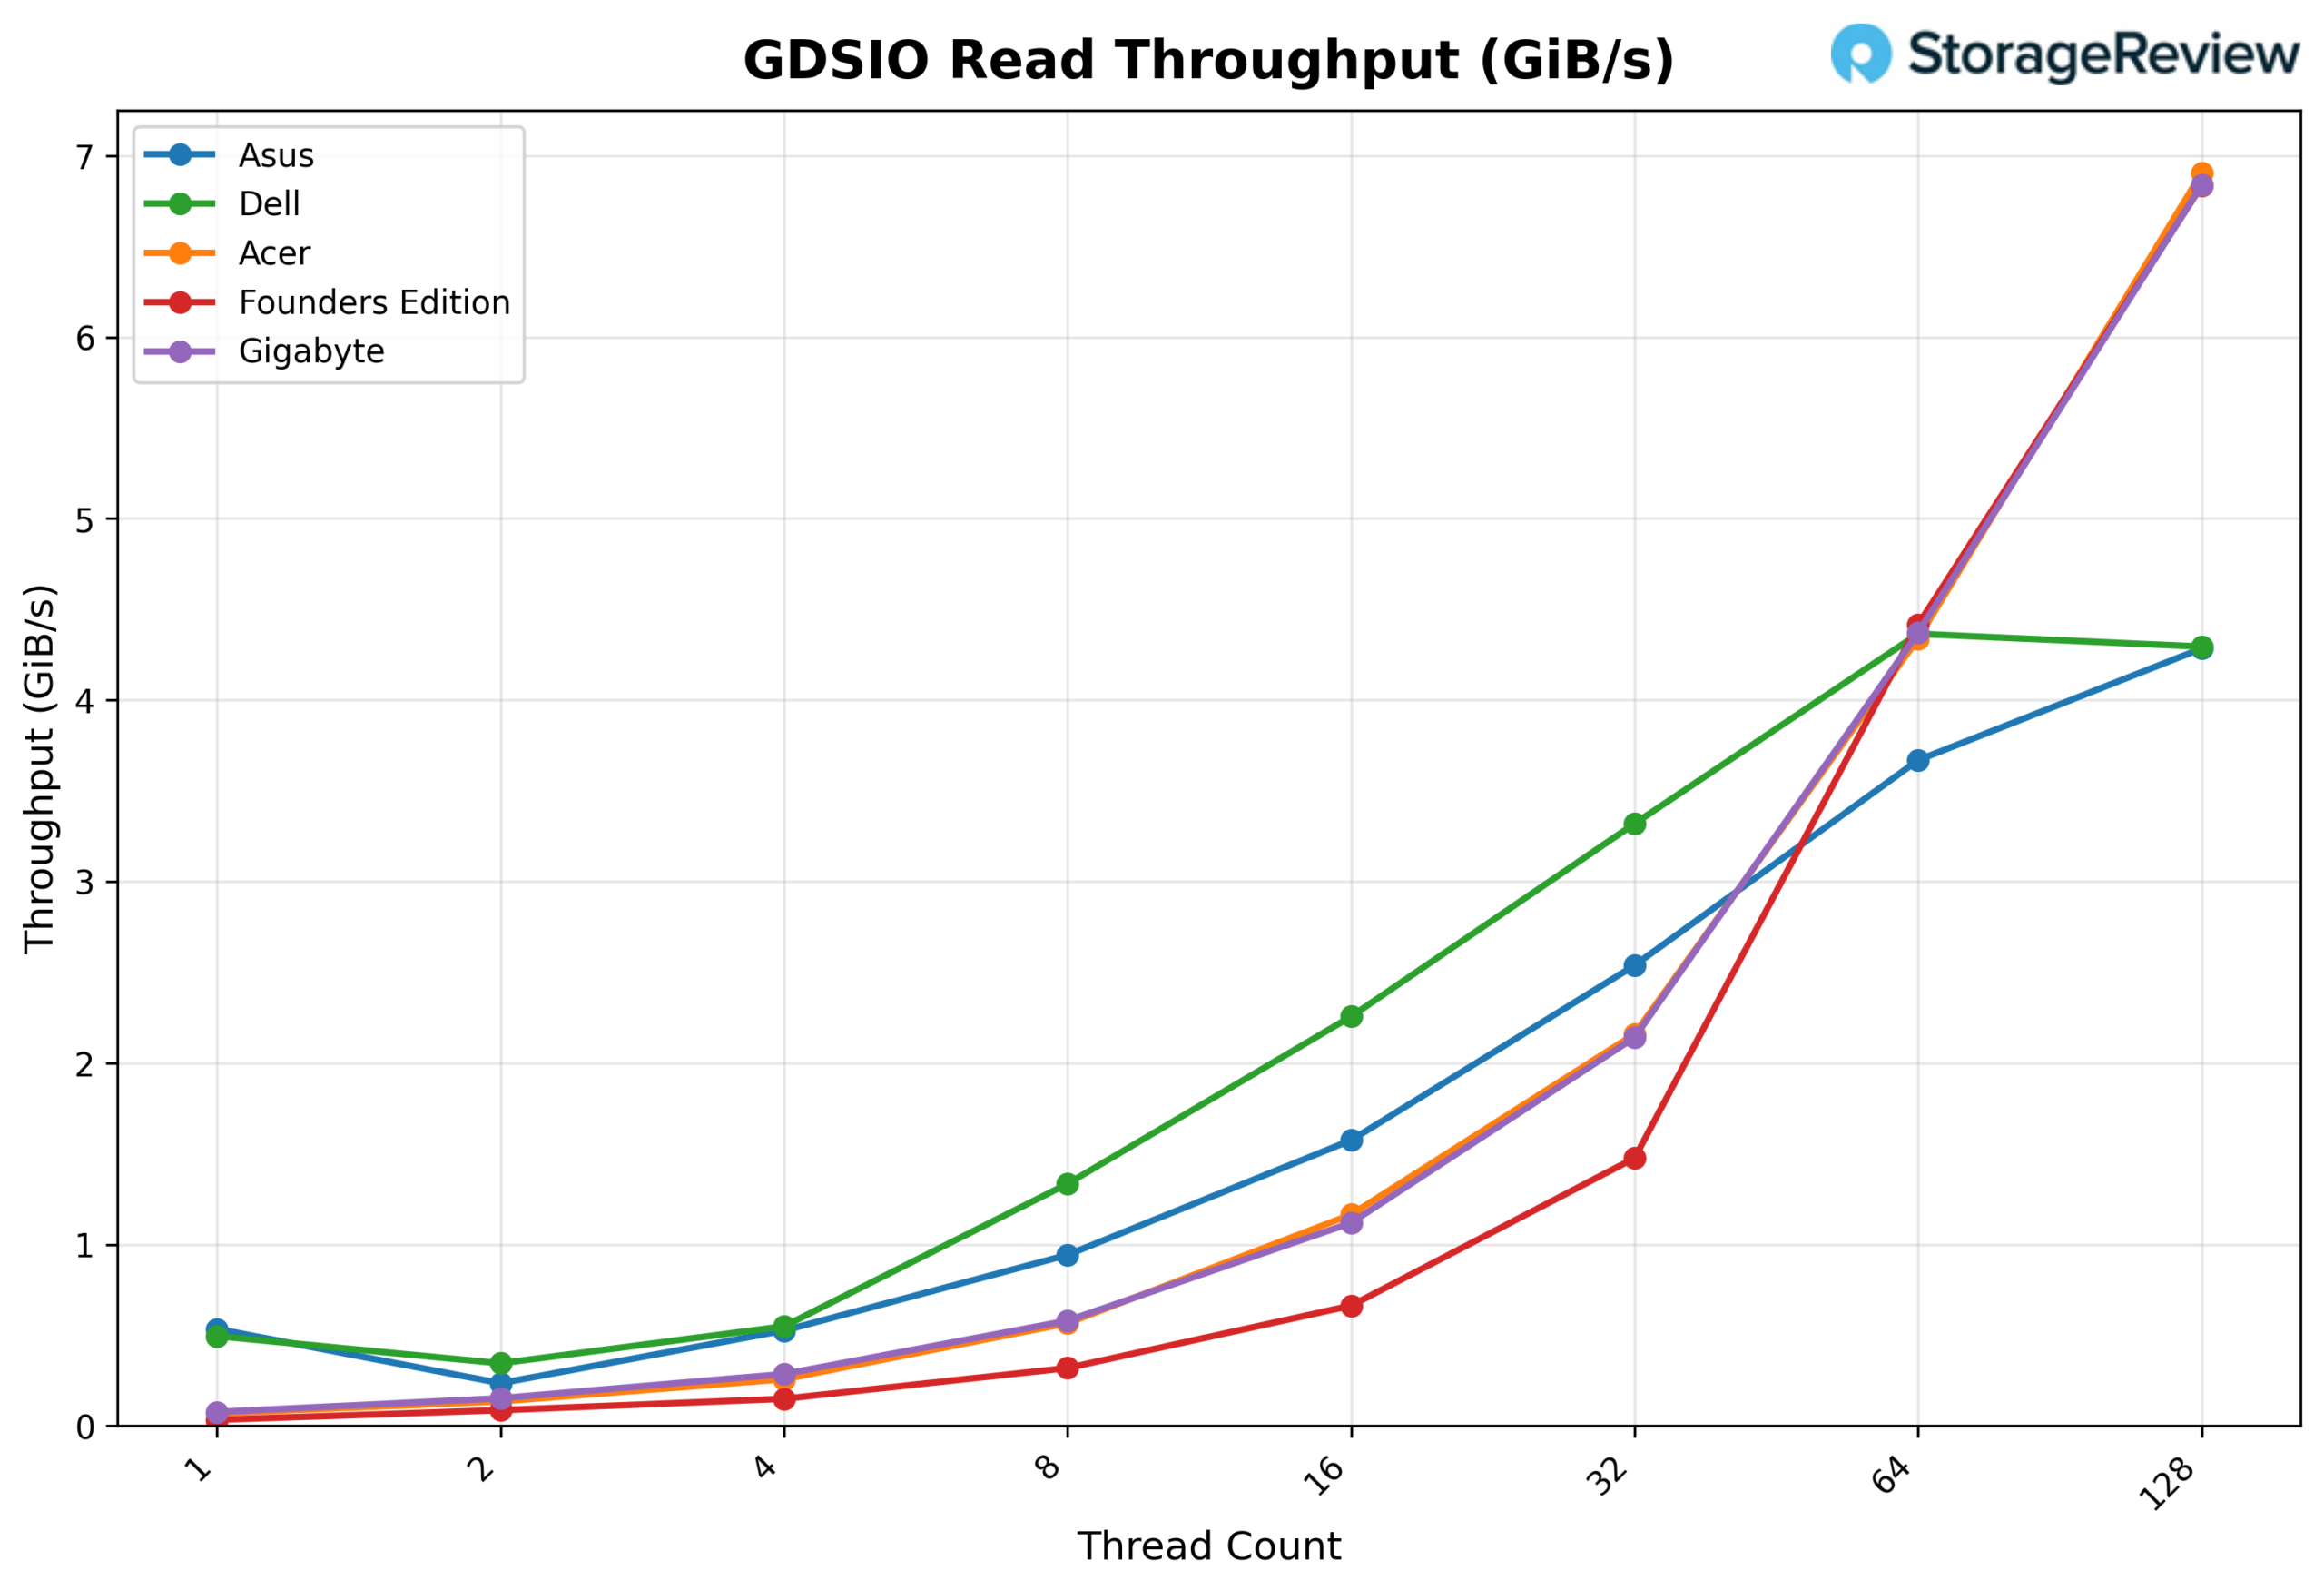
Latenza media di lettura GDSIO 16K
Analizzando la latenza media di lettura GDSIO (16K), l'Acer parte da circa 0.22 ms con 1 thread e rimane notevolmente stabile durante l'intero ciclo di test: 0.23 ms con 2 thread, 0.24 ms con 4 thread e 0.22 ms con 8 thread. La latenza si mantiene pressoché costante anche con 16 thread (0.21 ms), 32 thread (0.23 ms) e 64 thread (0.22 ms), prima di aumentare leggermente a 0.28 ms con 128 thread. Questo profilo di latenza pressoché piatto per tutti i conteggi di thread riflette il continuo miglioramento delle prestazioni osservato in termini di throughput.
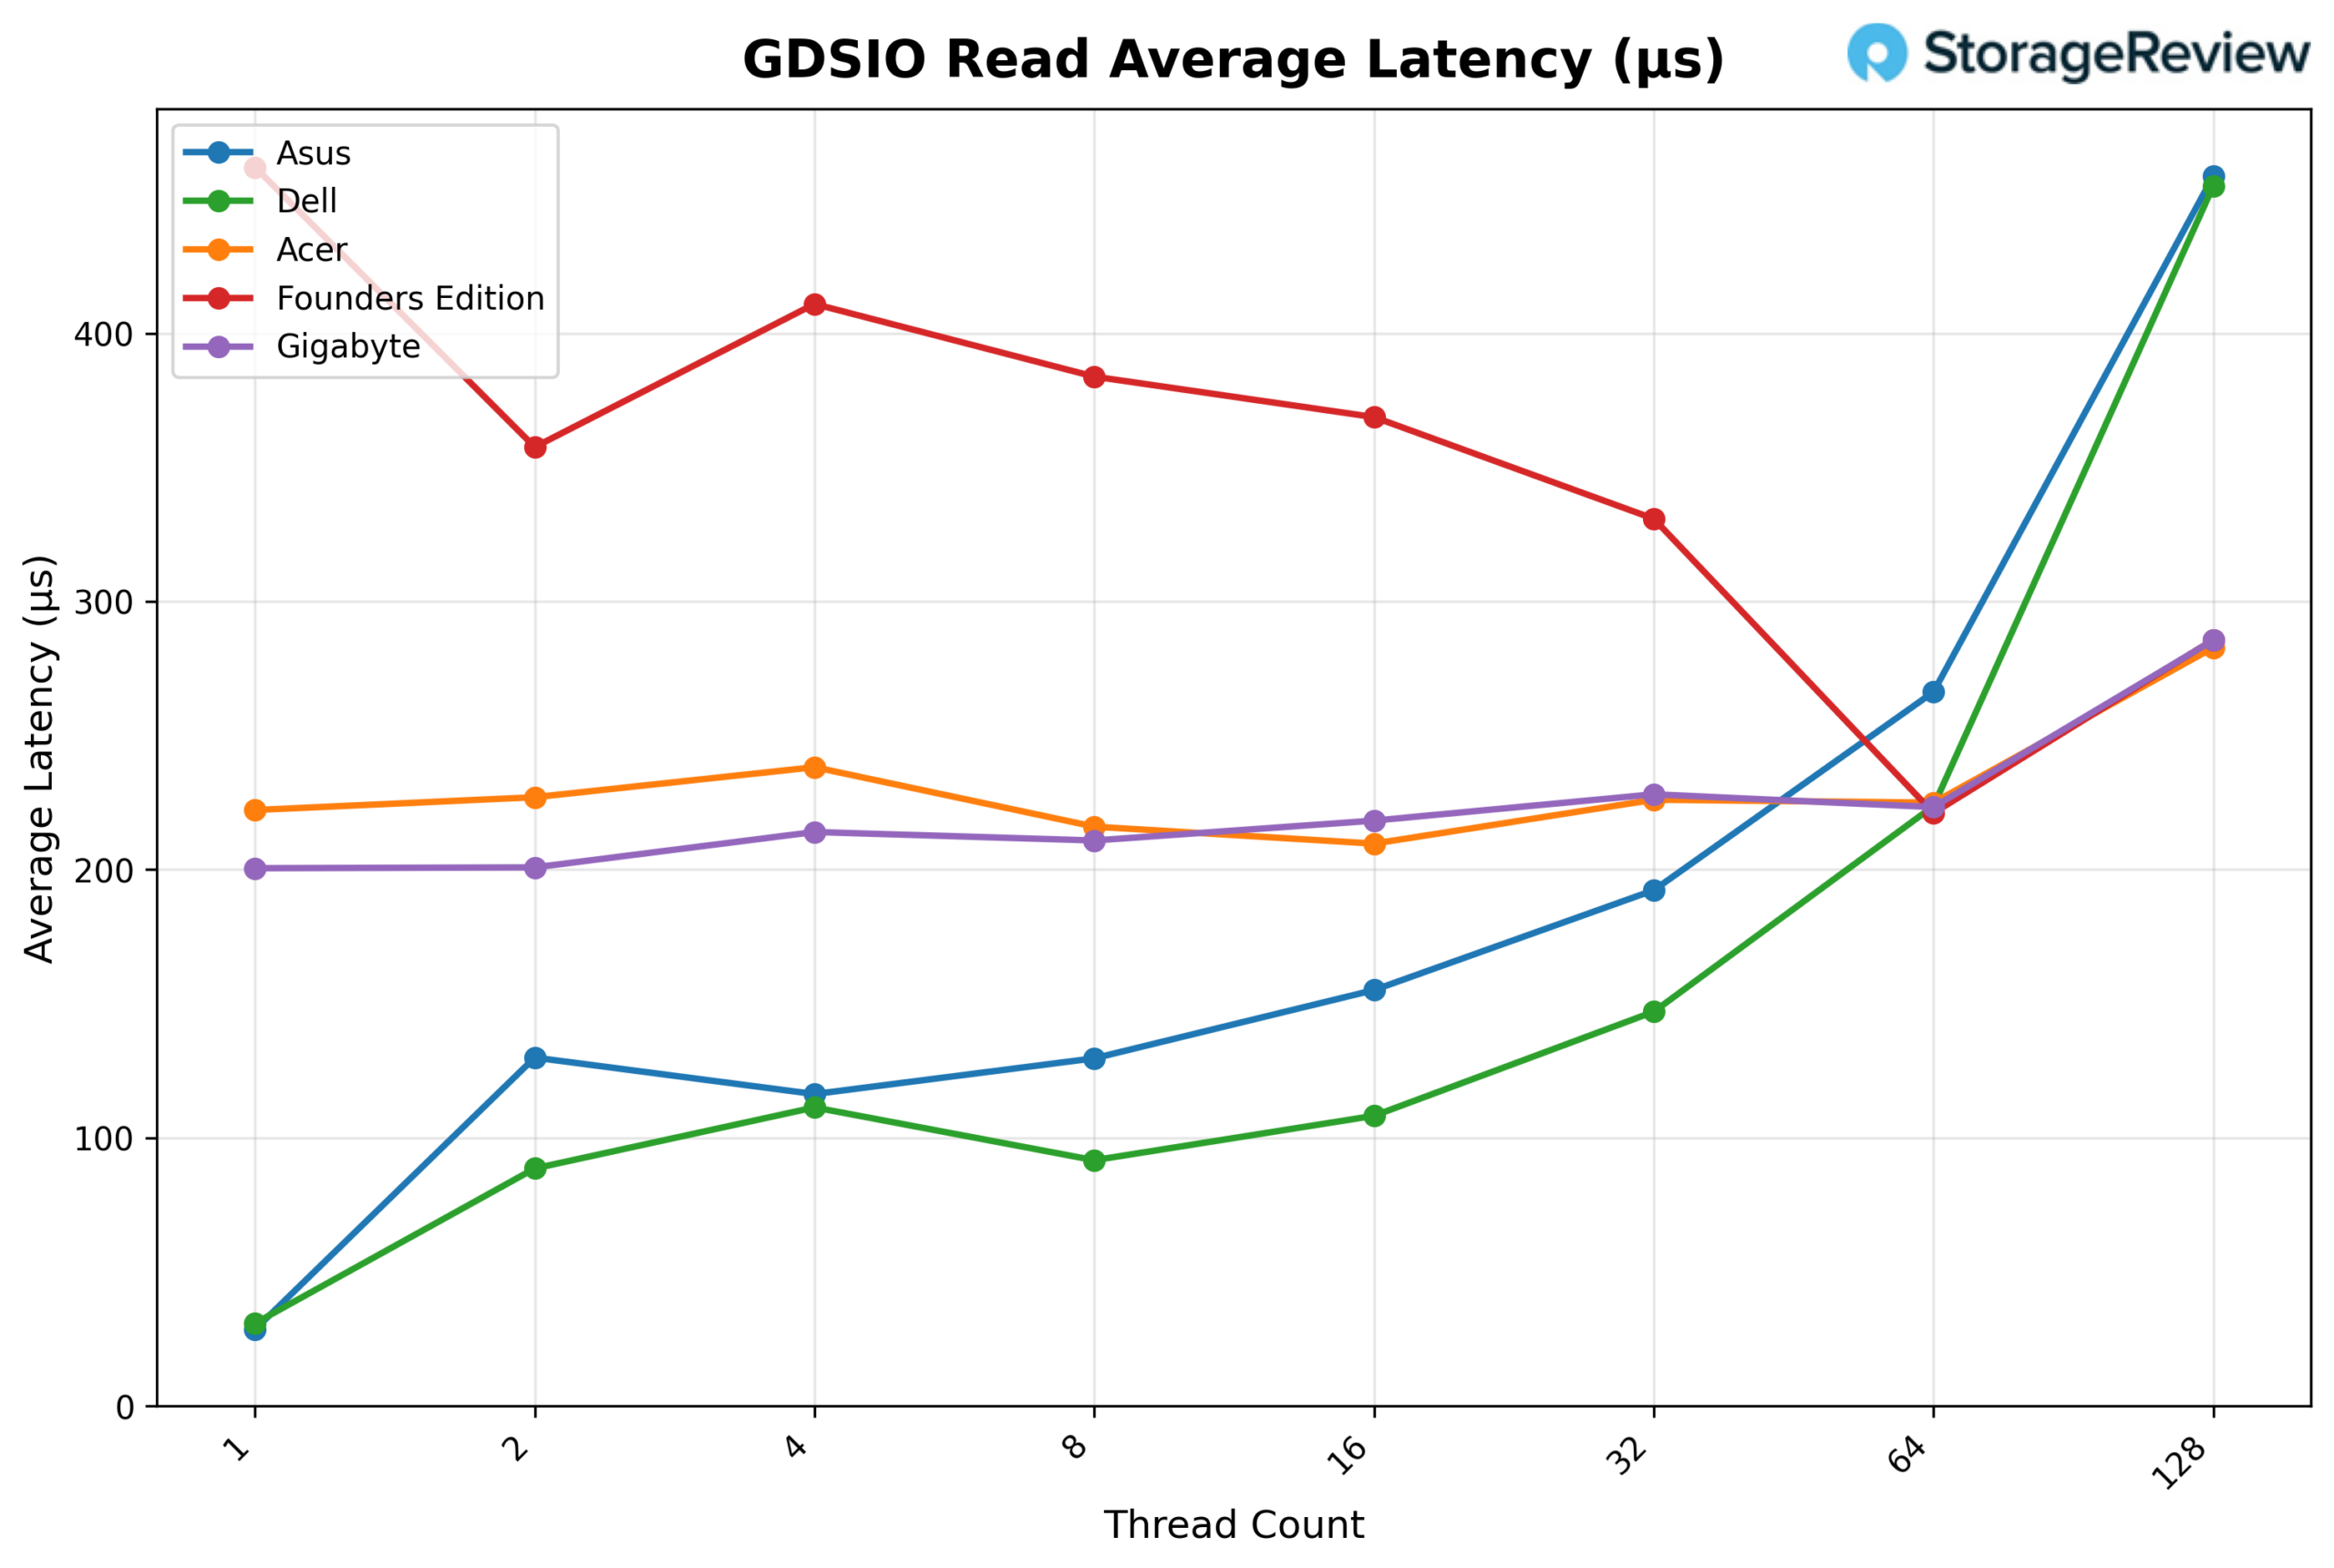
Velocità di scrittura GSDIO 16K
Analizzando il throughput di scrittura GDSIO a 16 KB, l'Acer parte da 0.07 GiB/s con 1 thread e aumenta gradualmente fino a 2 thread (0.14 GiB/s), 4 thread (0.28 GiB/s) e 8 thread (0.55 GiB/s). La crescita accelera a 16 thread (1.13 GiB/s), 32 thread (2.81 GiB/s) e 64 thread (5.23 GiB/s). A 128 thread, il throughput raggiunge i 6.60 GiB/s, il picco del test, dimostrando ancora una volta l'assenza di una chiara saturazione e una continua scalabilità anche con blocchi di piccole dimensioni.
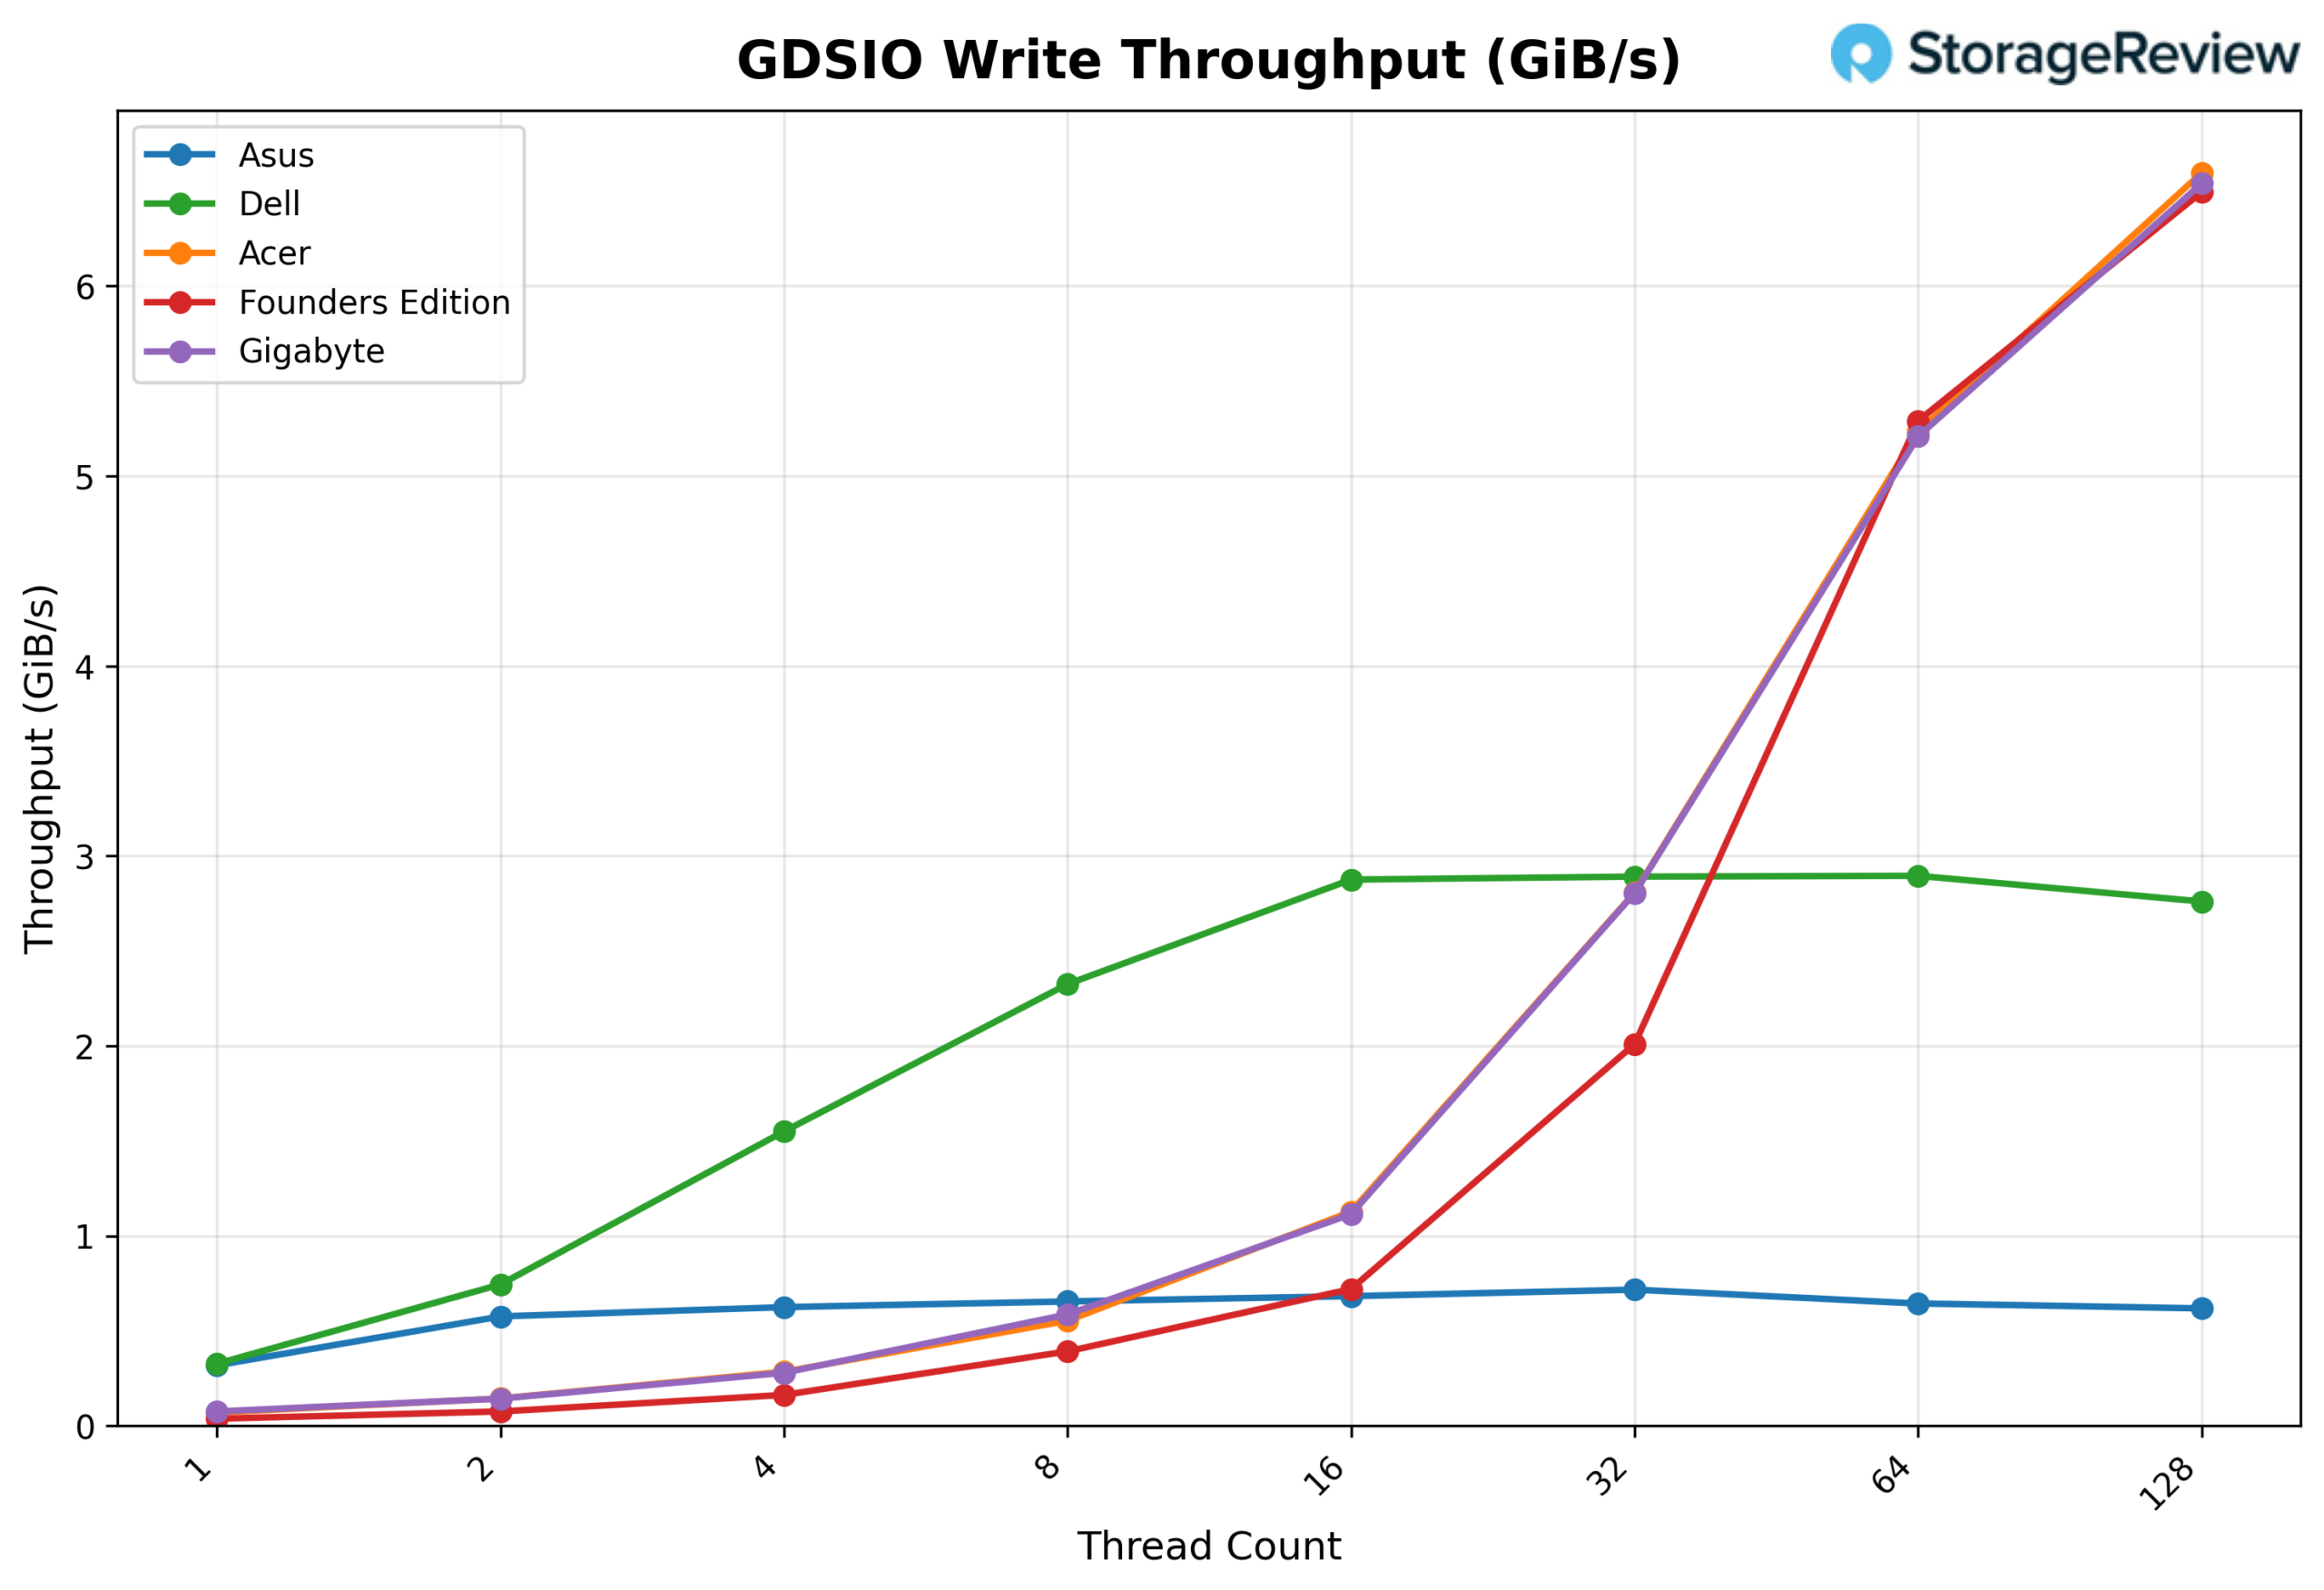
Latenza media di scrittura GDSIO 16K
Analizzando la latenza media di scrittura GDSIO (16K), l'Acer parte da circa 0.22 ms con 1 thread e rimane stabile a 2 thread (0.21 ms), 4 thread (0.22 ms) e 8 thread (0.22 ms). La latenza scende leggermente a 0.17 ms a 32 thread prima di risalire modestamente a 0.19 ms a 64 thread. A 128 thread, la latenza sale a 0.30 ms, ancora relativamente bassa rispetto ai risultati a 1 milione, in linea con il comportamento di scalabilità continuo a questa dimensione I/O ridotta.
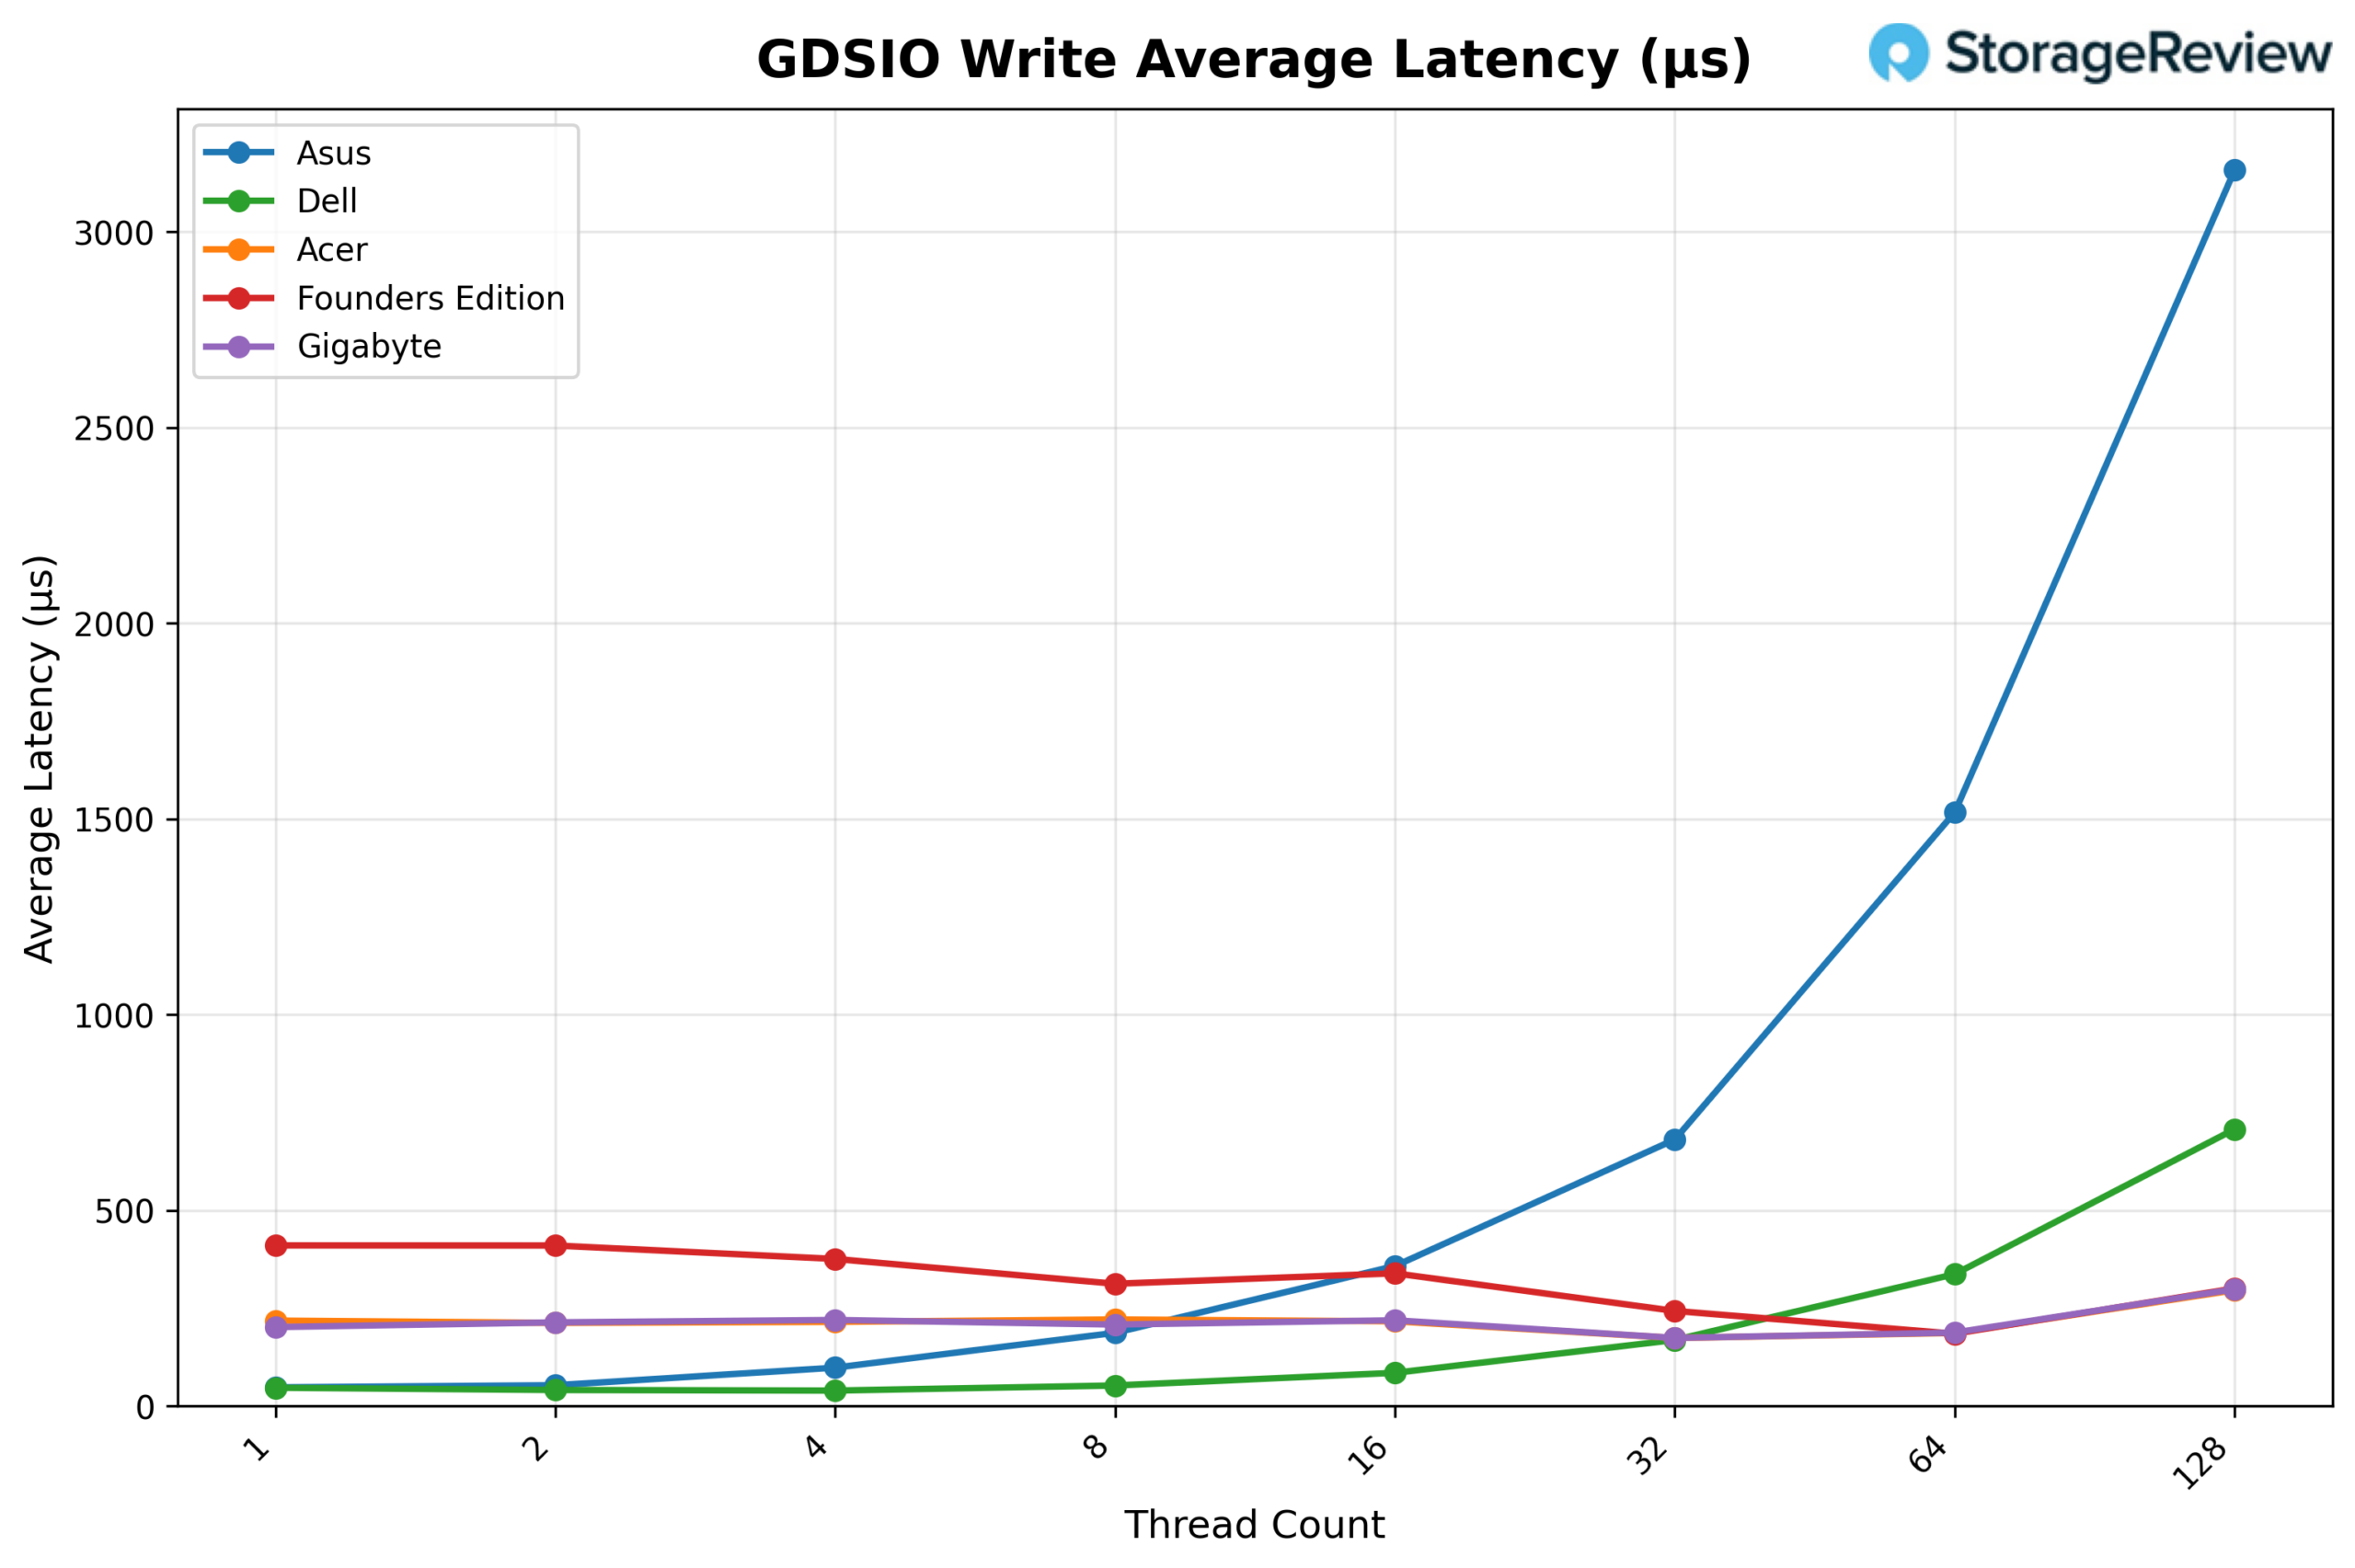
Velocità di lettura GDSIO 1M
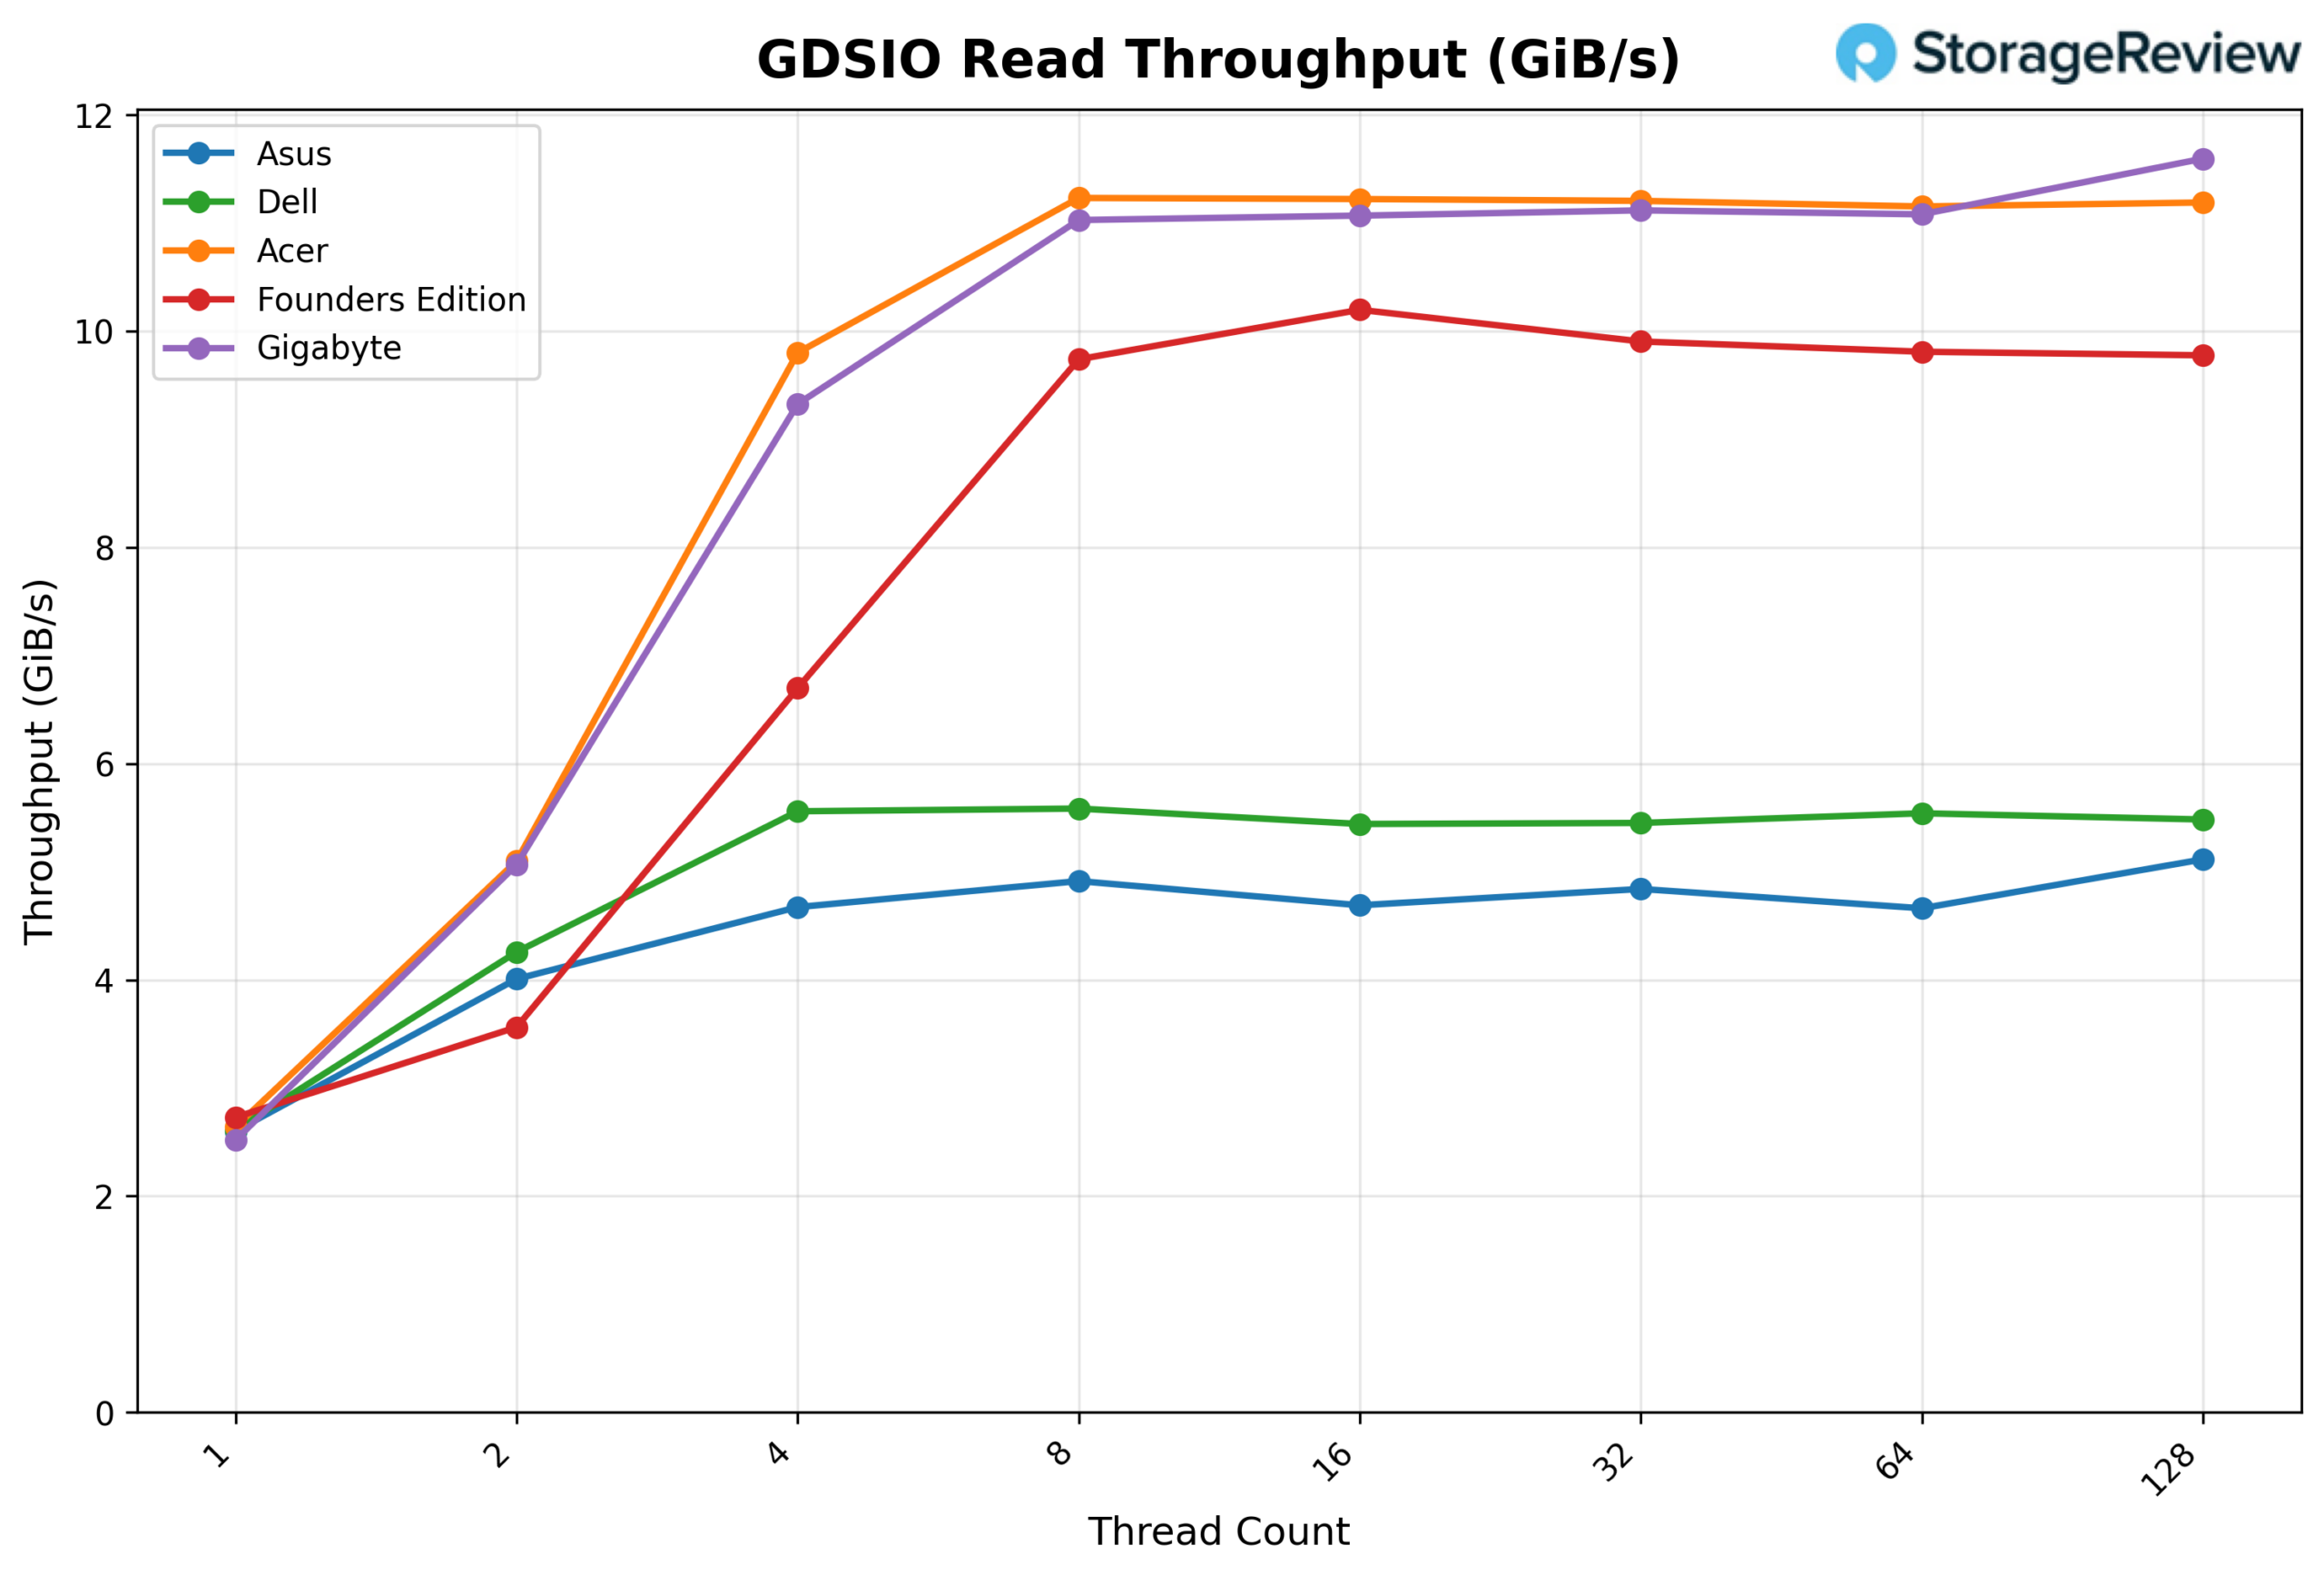
Analizzando il throughput di lettura GDSIO a 1 MB, l'Acer parte da 2.64 GiB/s con 1 thread, sale a 5.10 GiB/s con 2 thread e a 9.80 GiB/s con 4 thread. Con 8 thread, il throughput raggiunge 11.23 GiB/s, dopodiché la piattaforma si satura. Le prestazioni rimangono costanti a 16 thread (11.22 GiB/s), 32 thread (11.21 GiB/s) e 64 thread (11.15 GiB/s), mostrando un plateau stabile. A 128 thread, il throughput si mantiene stabile a 11.19 GiB/s, confermando il limite di saturazione raggiunto durante l'intero ciclo di test.
Latenza media di lettura GDSIO 1M
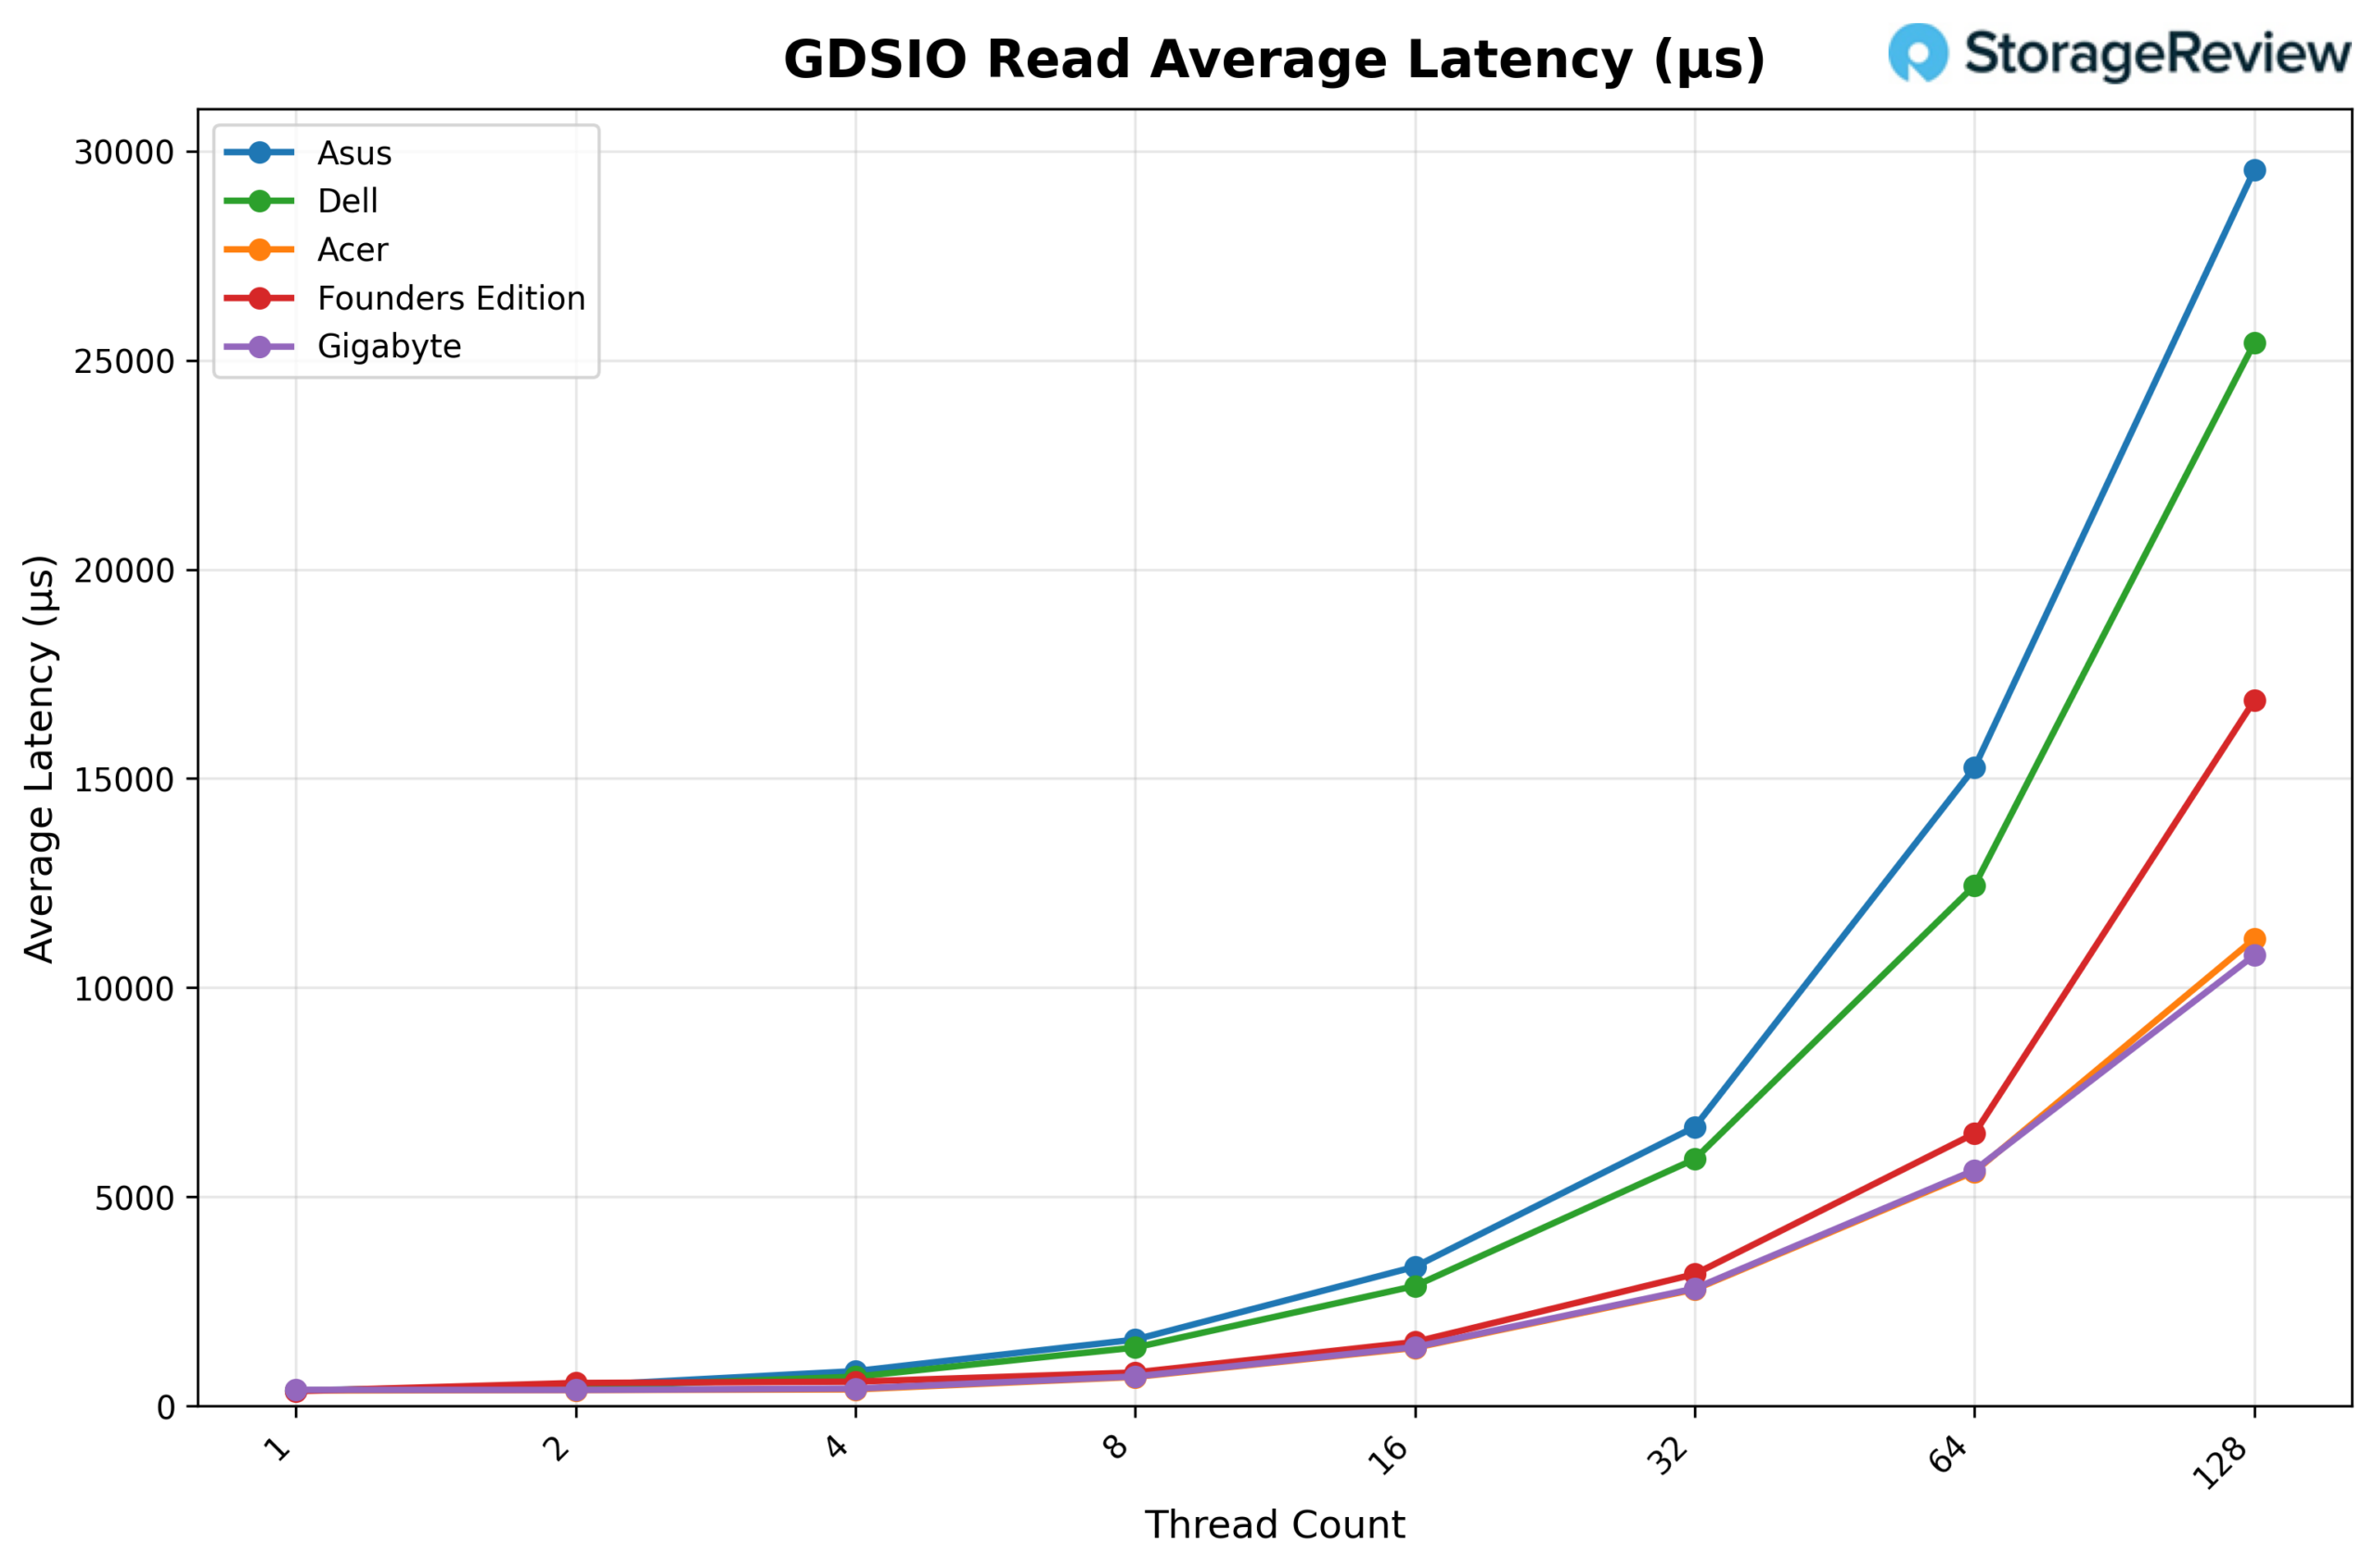
Analizzando la latenza media di lettura GDSIO (1M), l'Acer parte da circa 0.37 ms con 1 thread e rimane simile con 2 thread (0.38 ms) e 4 thread (0.40 ms). La latenza aumenta con la concorrenza, raggiungendo 0.70 ms con 8 thread, 1.39 ms con 16 thread e 2.79 ms con 32 thread. La tendenza al rialzo continua con 64 thread (5.60 ms) e raggiunge 11.17 ms con 128 thread, corrispondenti ai livelli massimi di concorrenza, mentre il throughput rimane sostanzialmente costante.
Velocità di scrittura GDSIO 1M
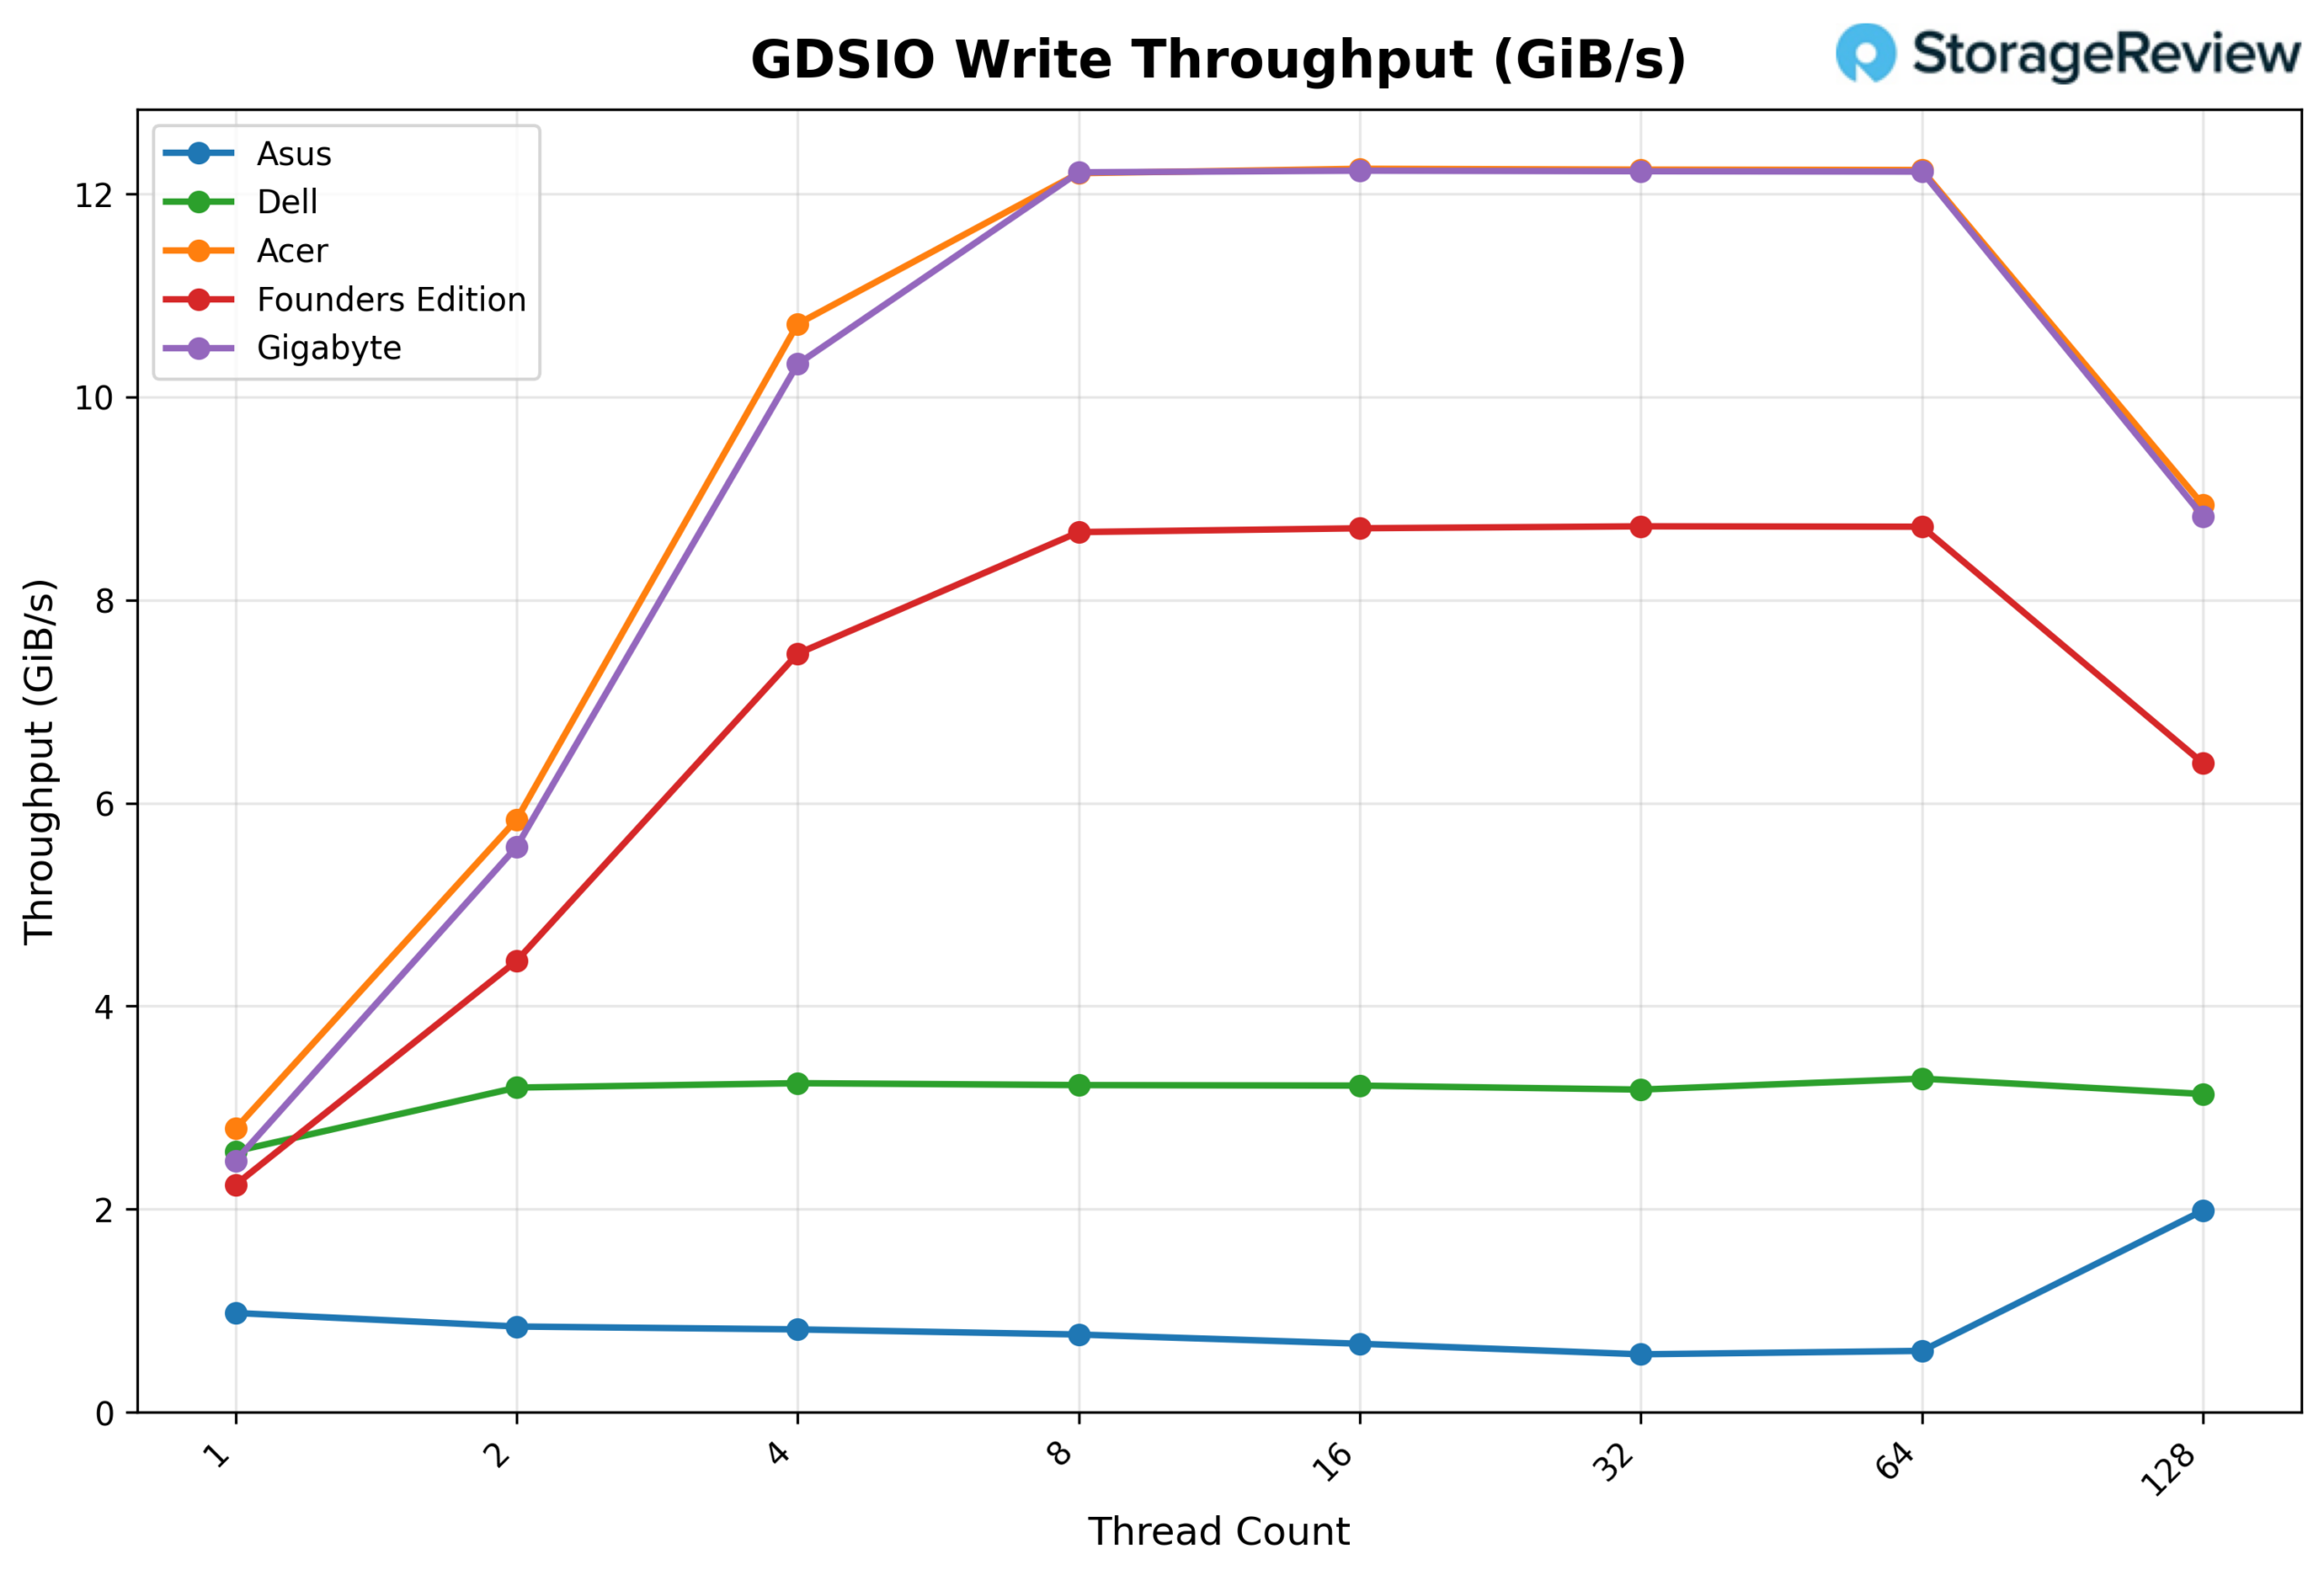
Analizzando il throughput di scrittura GDSIO a 1 MB, l'Acer parte da 2.79 GiB/s con 1 thread e scala rapidamente fino a 5.84 GiB/s con 2 thread e 10.72 GiB/s con 4 thread. Con 8 thread, il throughput raggiunge i 12.20 GiB/s e la piattaforma si satura efficacemente. Le prestazioni rimangono costanti a 16 thread (12.25 GiB/s), 32 thread (12.24 GiB/s) e 64 thread (12.23 GiB/s), mostrando un plateau stabile. A 128 thread, il throughput cala notevolmente a 8.94 GiB/s, suggerendo contesa o esaurimento delle risorse al livello di concorrenza più elevato.
Latenza media di scrittura GDSIO 1M
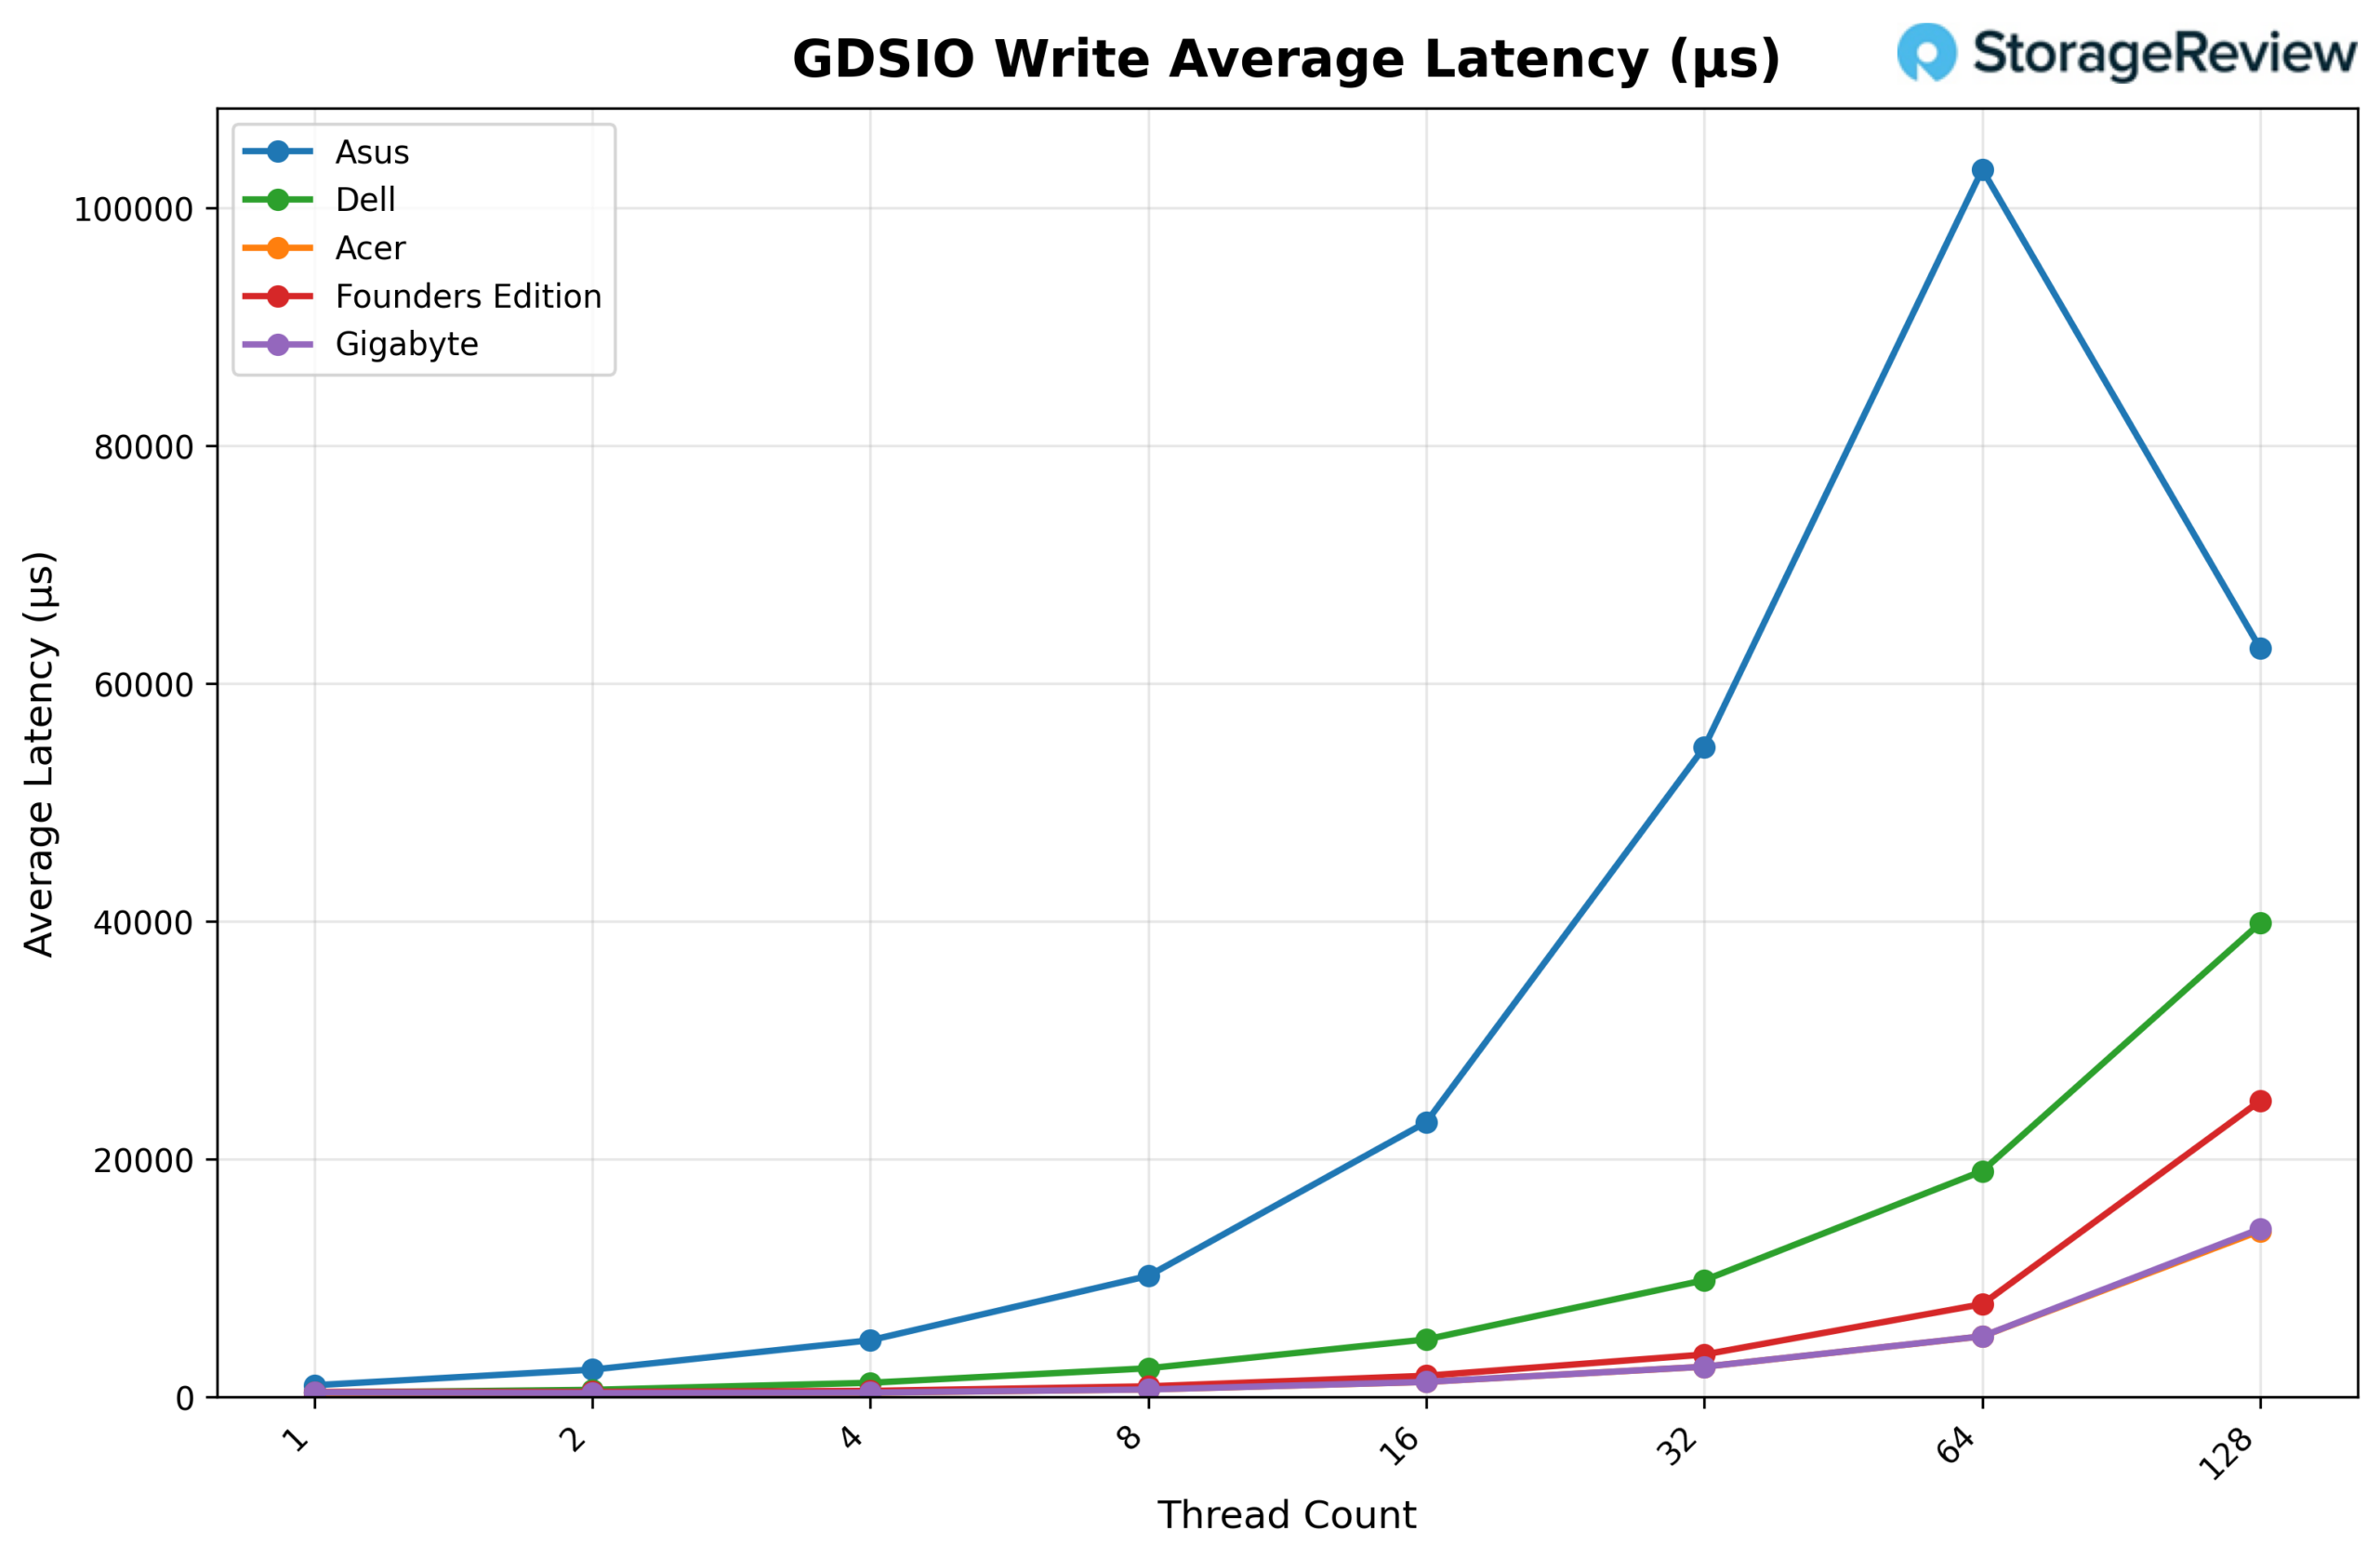
Analizzando la latenza media di scrittura GDSIO (1M), l'Acer parte da circa 0.35 ms con 1 thread e rimane bassa con 2 thread (0.33 ms) e 4 thread (0.36 ms). La latenza aumenta con l'aumentare della concorrenza, raggiungendo 0.64 ms con 8 thread, 1.28 ms con 16 thread e 2.55 ms con 32 thread. La tendenza al rialzo continua con 64 thread (5.11 ms) e sale bruscamente a 13.98 ms con 128 thread, in linea con il degrado del throughput osservato alla massima concorrenza.
Conclusione
Nel nostro confronto con Spark, l'Acer Veriton GN100 ha registrato il profilo termico complessivo più basso . Durante le transizioni di precaricamento con picchi elevati e i carichi di lavoro di decodifica prolungati, ha mantenuto costantemente temperature di picco di CPU e GPU inferiori rispetto agli altri modelli del gruppo. Anziché operare nella fascia superiore degli 80°C sotto carico, si è mantenuto entro un intervallo operativo più controllato durante le sessioni di test prolungate, a dimostrazione di un efficace sistema di flusso d'aria e di una gestione energetica bilanciata.
Le prestazioni di archiviazione rappresentavano un altro punto di forza evidente. Dotato dell'SSD Samsung PM9E1 Gen5 da 4 TB, il GN100 ha offerto la scalabilità più elevata per lo storage diretto GPU a blocchi di piccole dimensioni nel gruppo. Con blocchi da 16 KB, la latenza di lettura e scrittura è rimasta notevolmente costante al variare del numero di thread, mentre il throughput è aumentato in modo netto fino a raggiungere i valori massimi. Con 1 milione di trasferimenti, la piattaforma ha raggiunto rapidamente la saturazione e ha mantenuto livelli competitivi fino a un livello di concorrenza medio, prima di diminuire con il numero di thread più elevato.
Nei test di inferenza vLLM, le prestazioni sono rimaste strettamente allineate a quelle dell'ecosistema Spark più ampio, come previsto data la piattaforma GB10 condivisa. La differenza non è emersa nella potenza di calcolo grezza, bensì nel comportamento termico e di archiviazione sotto carico.
Nell'intera gamma Spark, la coerenza architetturale mantiene le prestazioni di inferenza pressoché uniformi. Ciò che distingue il GN100 in questo test è il suo profilo di temperatura operativa sostenuta più basso, abbinato alle elevate prestazioni NVMe di quinta generazione, che lo rendono una delle implementazioni più efficienti dal punto di vista termico e orientate allo storage che abbiamo testato finora.
Pagina prodotto – Acer Veritron GN 100 AI
Classifica: L'Acer Veriton GN100 si aggiudica il primo posto nella nostra classifica dei migliori desktop per l'intelligenza artificiale locale con la migliore implementazione di GB10.


 Amazon