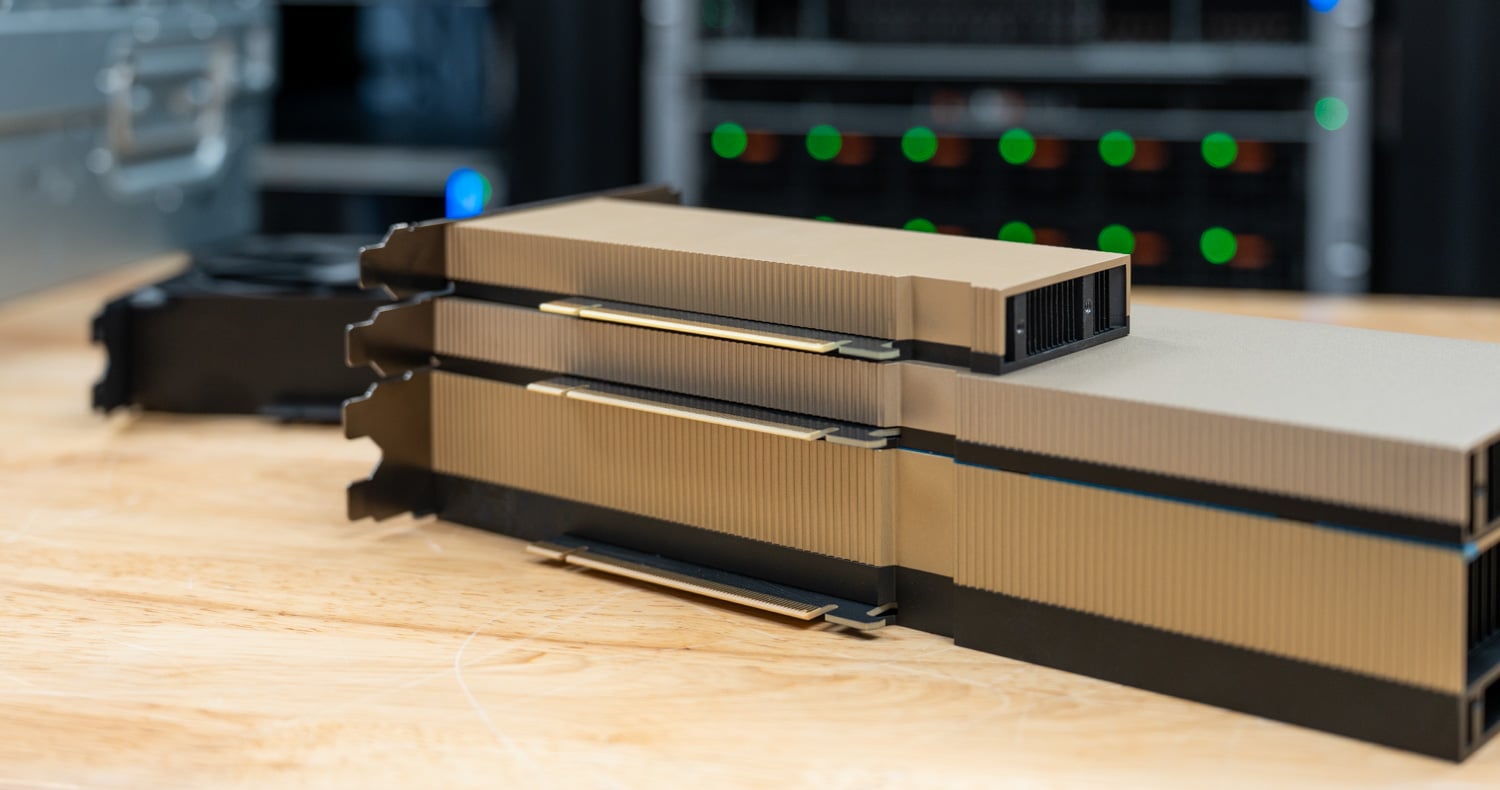
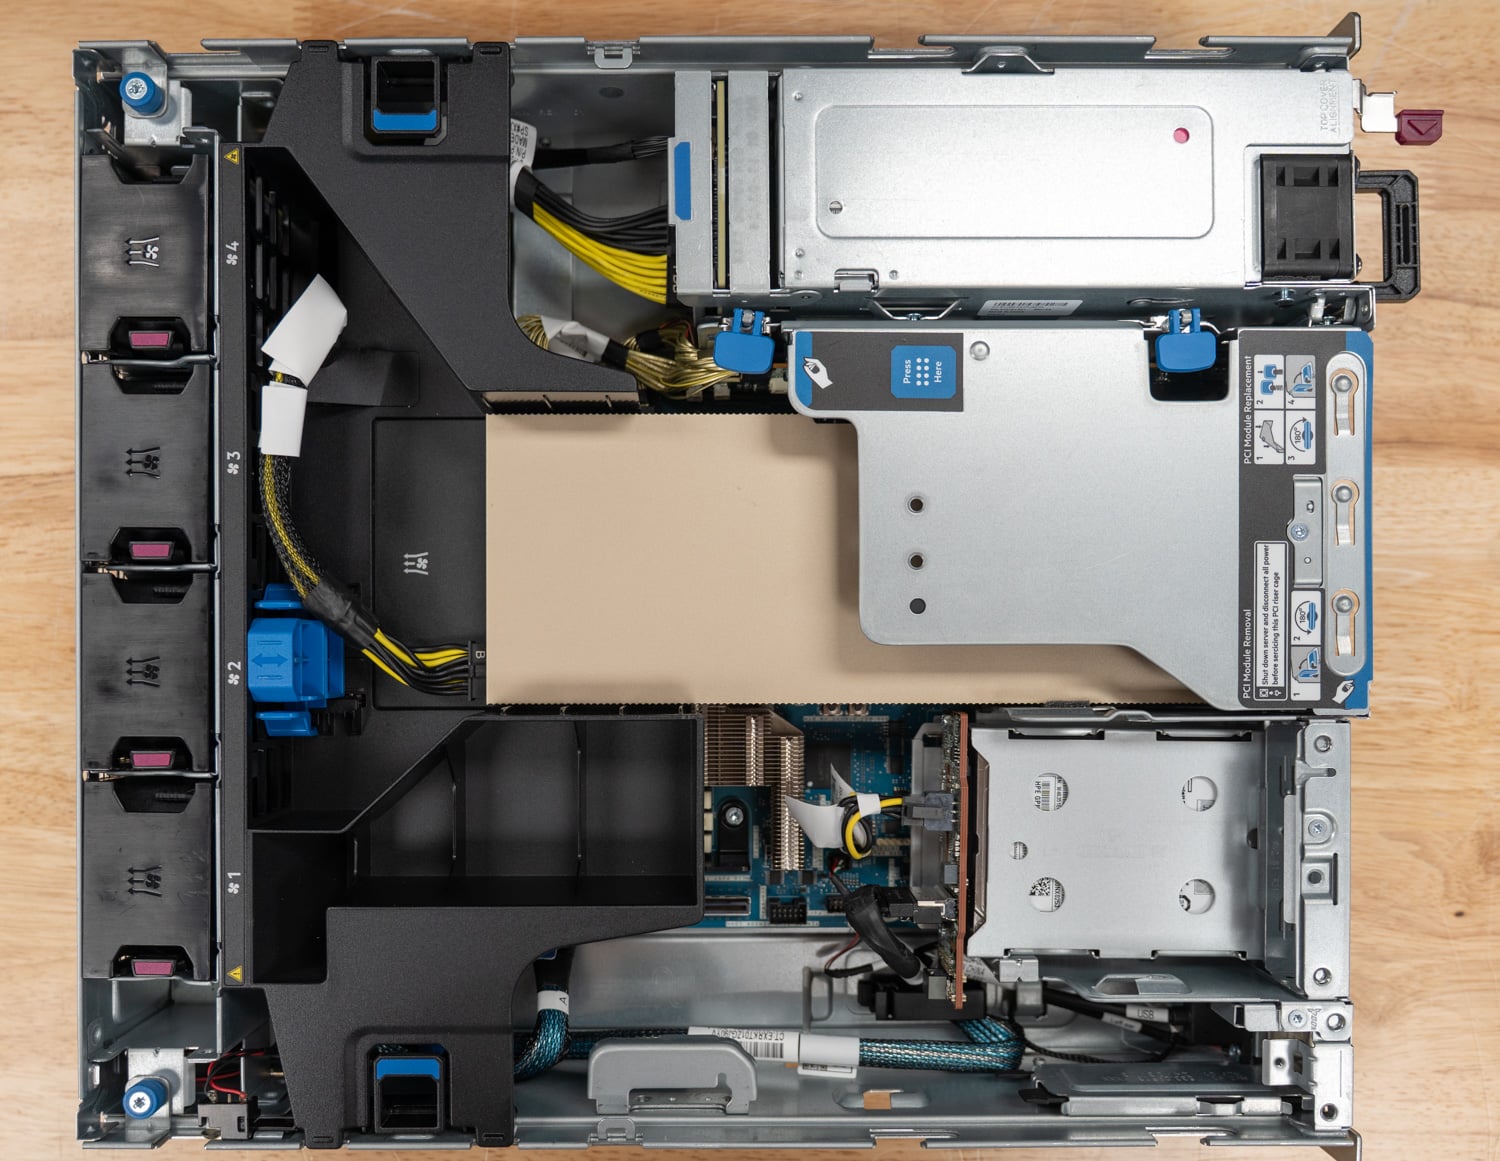
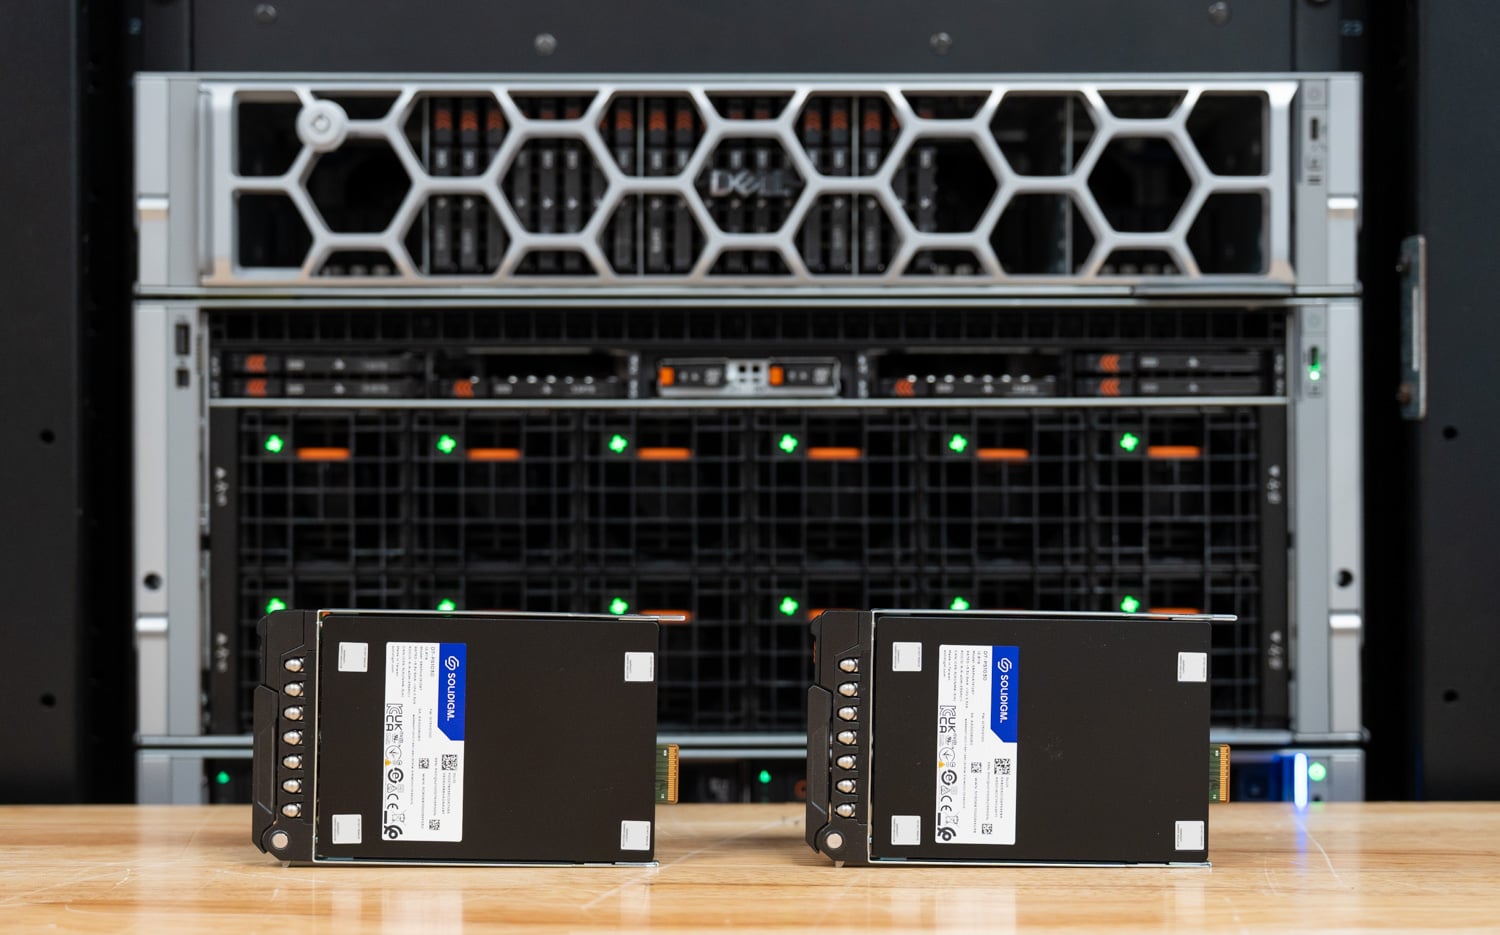
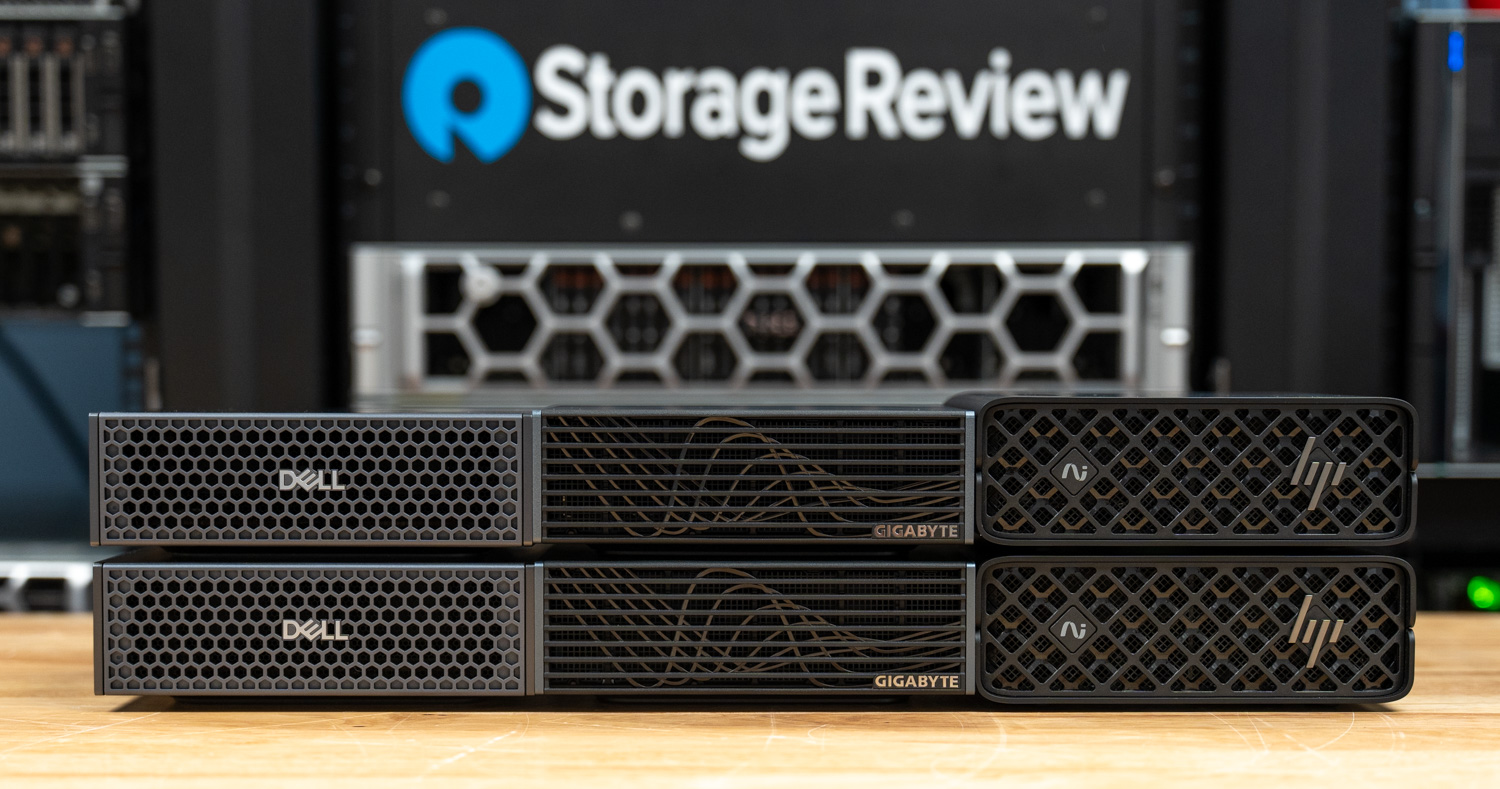
Le nostre attuali recensioni di sistemi di intelligenza artificiale si concentrano sull'inferenza in laboratorio, con modelli open-weight delle famiglie Llama, Qwen, DeepSeek e gpt-oss eseguiti tramite vLLM o SGLang e misurati in termini di throughput di output e latenza del primo token. La copertura spazia dall'edge al nodo GPU completo: la NVIDIA RTX PRO 4500 Server Edition ha fornito una media di 2.7 volte i token di output al secondo rispetto alla L4 che è stata progettata per sostituire all'interno di un HPE ProLiant DL145 Gen11, con un consumo di circa 105 W in più; le versioni Dell, GIGABYTE e HP di DGX Spark hanno eseguito l'inferenza distribuita come cluster a due nodi sulla rete a 200 Gb; e Supermicro JumpStart ci ha permesso di testare in prima persona un sistema NVIDIA HGX B200 e un sistema AMD Instinct MI350X. Anche lo storage riceve lo stesso trattamento, poiché il percorso dati determina il livello di utilizzo delle GPU; pertanto, misuriamo il throughput di GPUDirect Storage con GDSIO e testiamo l'offload della cache KV su memoria flash per carichi di lavoro a contesto lungo e agentici.
Se stai dimensionando l'hardware per l'IA, la pagina Migliori server elenca le nostre attuali scelte per l'inferenza IA e l'edge computing, basate sui dati di queste recensioni; la pagina Migliori SSD aziendali illustra le unità che alimentano le GPU; e la pagina Migliori array di storage illustra le piattaforme di storage per l'IA utilizzate nei cluster di training e nei neocloud.




 Amazon