

Updated October 2, 2026: NetApp’s card adds Novus — pNFS metadata split from AFF A90 data nodes, orderable now — the Claims Tracker logs its “fastest storage on the planet” claim with the Omdia projection behind it, and the tracker’s intro now distinguishes analyst-audited provenance from vendor-internal testing.
Ogni grande fornitore di soluzioni di storage afferma di vendere il miglior array di storage, e per anni il parametro di riferimento per il migliore è stato la velocità. Quasi nessuno consente test indipendenti. Dell, Everpure (precedentemente Pure Storage), VAST, Weka, IBM, NetApp e Huawei si vantano tutte di essere leader nel mercato delle prestazioni, e quasi tutti i dati alla base di queste affermazioni provengono da test interni del fornitore stesso, con la nota a piè di pagina "le prestazioni effettive possono variare".
Questa pagina serve proprio a fare chiarezza. Suddividiamo le prove delle prestazioni di storage in tre categorie e etichettiamo di conseguenza ogni valore presente in questa pagina: benchmark certificati (MLPerf Storage, IO500, SPC-1, in cui i fornitori inviano i risultati secondo regole pubblicate), dichiarazioni dei fornitori (schede tecniche e numeri di lancio senza verifica indipendente) e risultati dei test di laboratorio di StorageReview (sistemi che abbiamo misurato personalmente). Quando un fornitore non ci permette di testare il suo array, lo specifichiamo; l'assenza di dati verificabili è parte integrante del quadro generale.
I leader nell'archiviazione AI
Questi sono i fornitori che compaiono quando viene creato un cluster di training per l'IA o un neocloud. Non li classifichiamo perché non è stato ancora concordato un unico parametro di valutazione. Possiamo però fornire a ciascuno le stesse informazioni: cos'è effettivamente la piattaforma, dove viene implementata a nome di un cliente, se è stata convalidata da NVIDIA, se dispone di un risultato di benchmark certificato e quali delle sue dichiarazioni sulle prestazioni non sono ancora state verificate. Quando un fornitore pubblica notizie su uno qualsiasi di questi aspetti, aggiorniamo il profilo.
I primi quattro sono specialisti di storage nativo per l'IA. Gli altri sono fornitori affermati di storage aziendale con linee di prodotti basate sull'IA. Entrambi i gruppi ottengono implementazioni reali; si presentano con una quantità di prove molto diversa.
Dati VASTI
Piattaforma: sistema operativo VAST AI, basato sull'architettura DASE (Disaggregated, Shared-Everything). I container di calcolo stateless si interfacciano con un pool di enclosure NVMe tramite NVMe-oF e presentano un unico namespace per l'accesso a file, oggetti e database. Supporti interamente QLC con buffer di scrittura in memoria di classe storage.
Tra le implementazioni più significative: CoreWeave, nell'ambito di un accordo pluriennale da 1.17 miliardi di dollari annunciato nel novembre 2025, che VAST descrive come il suo cliente più importante. VAST è stata inoltre aggiunta all'espansione xAI Colossus Frontier AI Factory e alimenta le fabbriche di intelligenza artificiale di Mistral Compute in esecuzione su NVIDIA GB300 NVL72.
Convalida NVIDIA: partner di lancio certificato NVIDIA per lo storage e convalidato per DGX SuperPOD.
Risultato della verifica: Nessuno. VAST non ha mai inviato report a MLPerf Storage.
Affermazioni aperte: VAST e AMD dichiarano congiuntamente un time-to-first-token 9 volte più veloce grazie all'offload della cache KV su Instinct, secondo i test del fornitore. La Series F di aprile 2026, con una valutazione di 30 miliardi di dollari, definisce le aspettative, ma non si tratta di un dato prestazionale.
La nostra copertura giornalistica dell'ultimo anno:
- VAST e AMD affermano che il time-to-first-token è 9 volte più veloce grazie all'offload della cache KV. (Lug 2026)
- Cloudera e VAST puntano a risolvere il problema della carenza di GPU. (Lug 2026)
- VAST alimenta le fabbriche di intelligenza artificiale di Mistral Compute su GB300 NVL72 (Maggio 2026)
- VAST presenta il suo sistema operativo basato sull'intelligenza artificiale per agenti (Feb 2026)
- VAST Amplify punta a far sembrare gli SSD esistenti 6 volte più capienti (Jan 2026)
- VAST introduce un'architettura di inferenza nativa per DPU (Jan 2026)
WEKA
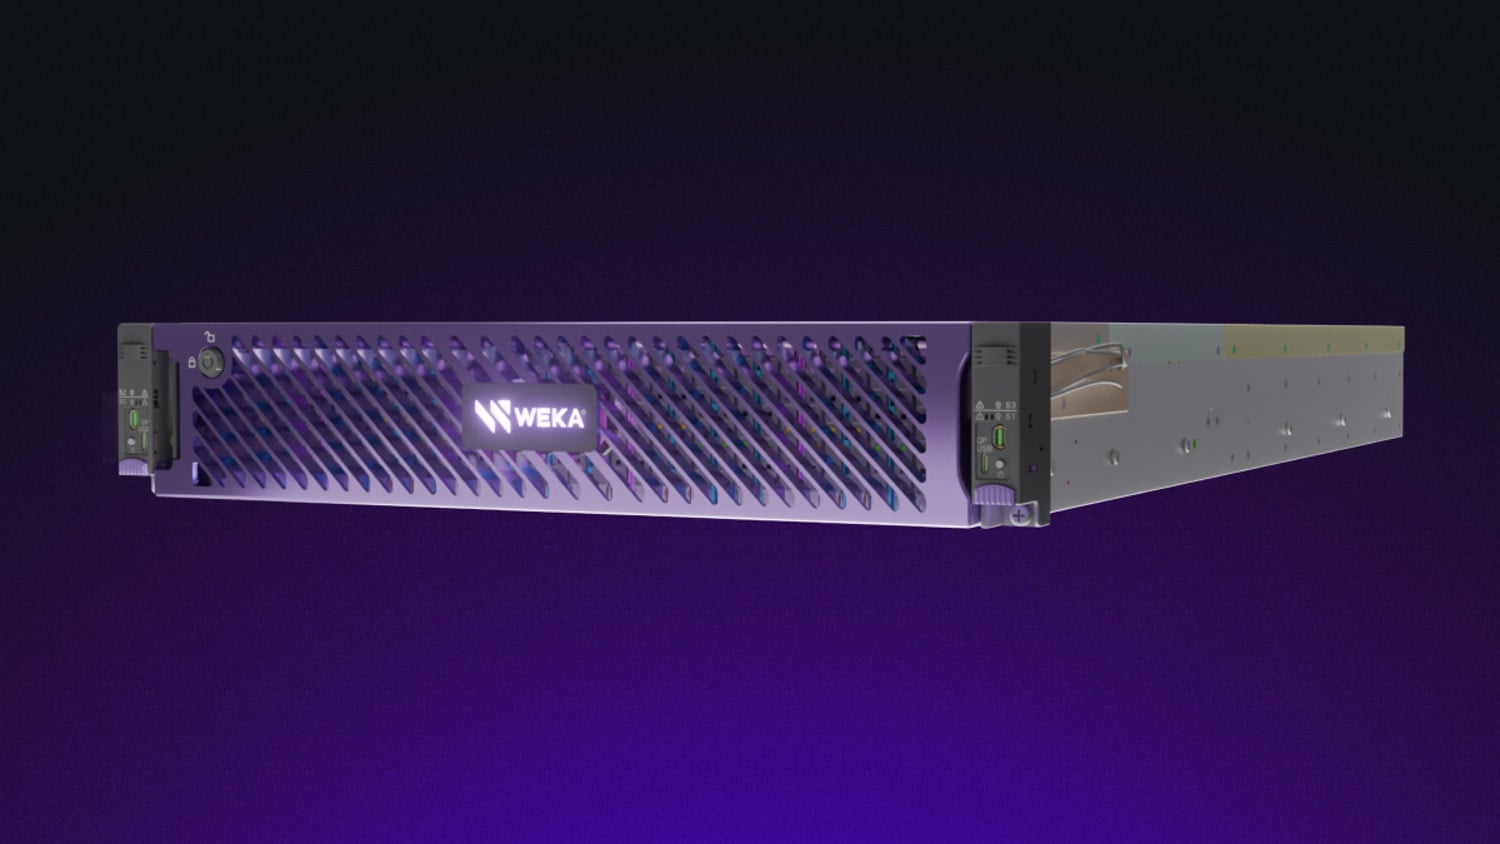
Piattaforma: NeuralMesh, il file system parallelo definito via software precedentemente noto come WekaFS, venduto come software e come appliance WEKApod. NeuralMesh Axon integra lo stesso piano dati all'interno dei server GPU, consentendo alle unità NVMe locali di unirsi al cluster anziché rimanere inattive.
Esempi di implementazione: Nebius utilizza NeuralMesh come livello premium del suo cloud per l'intelligenza artificiale. Andromeda ha adottato NeuralMesh come standard su circa 50 fornitori di GPU nel luglio 2026. WEKA fa inoltre parte dello stack multi-vendor di CoreWeave.
Validazione NVIDIA: partner di lancio certificato NVIDIA per lo storage, con validazioni DGX per SuperPOD e BasePOD.
Risultato della verifica: WEKA ha inviato i dati per MLPerf Storage v1.0 a settembre 2024, ma non ha inviato i dati per la v2.0 ad agosto 2025. I suoi dati più recenti verificati risalgono a una generazione fa.
Dati dichiarati: WEKApod 3 con NeuralMesh 6 raggiunge una velocità di 1.1 EB e 10.2 TB/s in un singolo rack. Si tratta di dati forniti dal produttore, non supportati da documentazione certificata.
Da sapere: HPE ha interrotto le sue partnership con WEKA, Qumulo e Scality nel novembre 2025, quindi WEKA non raggiunge più gli acquirenti attraverso il canale HPE.
La nostra copertura giornalistica dell'ultimo anno:
- Andromeda adotta NeuralMesh come standard su oltre 50 fornitori di GPU. (Lug 2026)
- WEKApod 3 supera la barriera dell'exabyte in un singolo rack. (Lug 2026)
- NeuralMesh AIDP è ora disponibile al pubblico. (Marzo 2026)
- NeuralMesh si integra con NVIDIA STX per la memoria di inferenza (Marzo 2026)
- Piattaforme di nuova generazione WEKApod Prime e Nitro (Nov 2025)
DDN
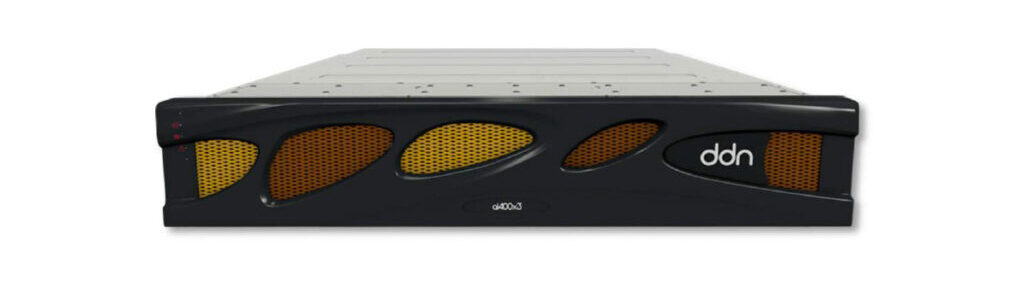
Piattaforma: Due linee. EXAScaler, il file system parallelo derivato da Lustre alla base degli appliance AI400X3 e AI400X3M, gestisce l'addestramento. Infinia, una piattaforma a oggetti chiave-valore che ha aggiunto il multi-tenancy e il supporto POSIX nella versione 2.4, è destinata ai carichi di lavoro di inferenza e di intelligenza artificiale.
Tra le implementazioni più significative: xAI Colossus, annunciato nel novembre 2024 con 200,000 GPU, su EXAScaler e Infinia. DDN vanta inoltre una lunga lista di installazioni in laboratori nazionali e centri di calcolo ad alte prestazioni (HPC) risalenti a prima dell'avvento dell'IA.
Validazione NVIDIA: partner di lancio certificato NVIDIA per lo storage, con validazione DGX SuperPOD.
Risultato verificato: Sì, ed è attuale. In MLPerf Storage v2.0, l'AI400X3 ha mantenuto 120.68 GB/s su 3D U-Net su più nodi e ha gestito i checkpoint di Llama3-8b a 30.6 GB/s in lettura e 15.3 GB/s in scrittura da un'appliance 2RU. Sulla base dei dati, DDN è la soluzione più performante in questo elenco.
Rivendicazioni aperte: accelerazione della cache KV tramite NVIDIA Dynamo, convalidata congiuntamente con Nebul anziché da un ente indipendente.
La nostra copertura giornalistica dell'ultimo anno:
- DDN lancia l'AI400X3M all'ISC 2026 (Giugno 2026)
- Infinia 2.4 aggiunge il supporto multi-tenant e POSIX. (Lug 2026)
- DDN e Nebul convalidano l'accelerazione della cache KV (Lug 2026)
DDN ha superato MLPerf Storage v2.0 in termini di densità di prestazioni, ma non ha partecipato alla fase successiva, quella della versione 3.0.
Spazio martello
Piattaforma: Hammerspace Global Data Platform, e Tier 0, che trasforma gli NVMe locali già presenti nei server GPU in capacità condivisa con funzionalità di checkpoint. È basata su standard, NFS parallelo (NFS 4.2 con FlexFiles) e funziona su server ordinari anziché su un'appliance proprietaria. Non c'è un dispositivo Hammerspace da fotografare, ed è proprio questo il punto dell'architettura.
Implementazioni specifiche: Meta ha documentato Hammerspace su due cluster H100 da 24,576 GPU sul proprio blog di ingegneria. Si tratta della descrizione più specifica e diretta di un'implementazione di storage AI su larga scala presente in questa pagina, in quanto redatta dall'operatore e non dal fornitore.
Convalida NVIDIA: Nessuna. Hammerspace non possiede le certificazioni DGX SuperPOD, DGX BasePOD, architettura di riferimento NCP né la designazione NVIDIA-Certified Storage.
Risultato verificato: Sì, sia in MLPerf Storage v1.0 che in v2.0. In v2.0, il Tier 0 ha erogato 420.8 GB/s su 3D U-Net su cinque nodi con un utilizzo dell'acceleratore del 96.4%, alimentando 140 H100 simulati. Hammerspace ha il miglior record di partecipazione verificato in questo elenco e la storia di convalida NVIDIA più debole, l'opposto di quasi tutti gli altri qui.
La nostra copertura: Hammerspace non è stata sottoposta ai test di StorageReview e la nostra copertura recente è limitata. Si tratta di una nostra lacuna, non di una critica alla piattaforma.
Hammerspace, che aveva presentato la versione 2.0, non ha partecipato alla versione 3.0.
Tecnologie Dell
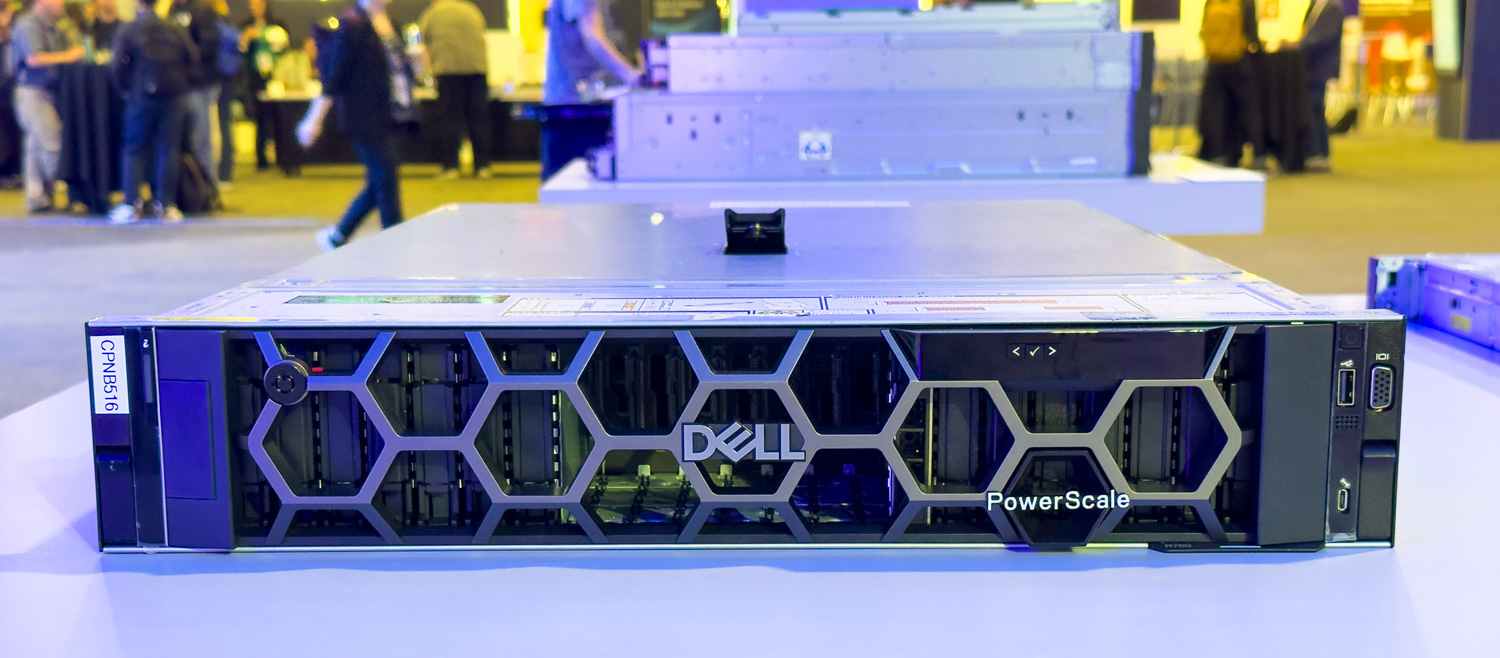
Piattaforma: Tre elementi, rivolti a diverse fasi della pipeline. PowerScale è la linea NAS scalabile, con nodi all-flash della serie F. ObjectScale è il livello S3, che ha integrato S3 su RDMA e l'offload della cache KV nel 2026. Lightning File System è un nuovo file system parallelo, reso disponibile a livello generale nell'aprile 2026, e rappresenta la soluzione con cui Dell si contrappone a DDN, VAST e WEKA.
Implementazioni specifiche: Non siamo riusciti a confermare un'implementazione specifica di addestramento AI su larga scala su storage Dell. Il riferimento pubblico più concreto è Subaru, che gestisce un laboratorio di intelligenza artificiale per la sicurezza alla guida su PowerScale. Per un fornitore di queste dimensioni, si tratta di una lacuna notevole rispetto ai successi nel neocloud pubblicizzati dai fornitori di soluzioni native per l'IA.
Validazione NVIDIA: PowerScale, partner di lancio del programma NVIDIA-Certified Storage, ha ottenuto la certificazione NVIDIA Cloud Partner nel luglio 2025.
Risultato della verifica: Nessuno. Dell non ha mai inviato dati a MLPerf Storage.
Affermazioni ufficiali: Dell definisce Lightning il file system parallelo più veloce al mondo, sulla base di analisi interne, e dichiara velocità di storage Exascale di diversi TB/s per rack. Entrambe le affermazioni sono riportate nel tracker delle affermazioni qui sotto. Un avvertimento pratico per gli acquirenti: Lightning è disponibile a livello generale, ma è limitato alle configurazioni di fabbrica per l'intelligenza artificiale e la maggior parte dei lettori non lo troverà in un preventivo standard.
La nostra copertura giornalistica dell'ultimo anno:
- Dell mantiene la sua posizione di leader nel Magic Quadrant 2026 di Gartner per lo storage aziendale. (Aug 2026)
- ObjectScale raggiunge 9.83 PB in formato 2U con SSD Kioxia da 245 TB e S3 su RDMA (Aug 2026)
- Nel primo trimestre, Dell ha superato nelle vendite di dispositivi di archiviazione esterna tutti gli altri cinque produttori della classifica IDC messi insieme. (Lug 2026)
- All'interno del ripristino PowerStore Gen 3 (Maggio 2026)
- Analisi approfondita di PowerStoreOS 5.0, la parte software del ripristino di terza generazione. (Settembre 2026)
- File system Lightning e storage exascale al GTC 2026 (Marzo 2026)
- La nostra recensione di PowerEdge R5715, un sistema 2U incentrato sullo storage che abbiamo testato a fondo (Marzo 2026)
HPE
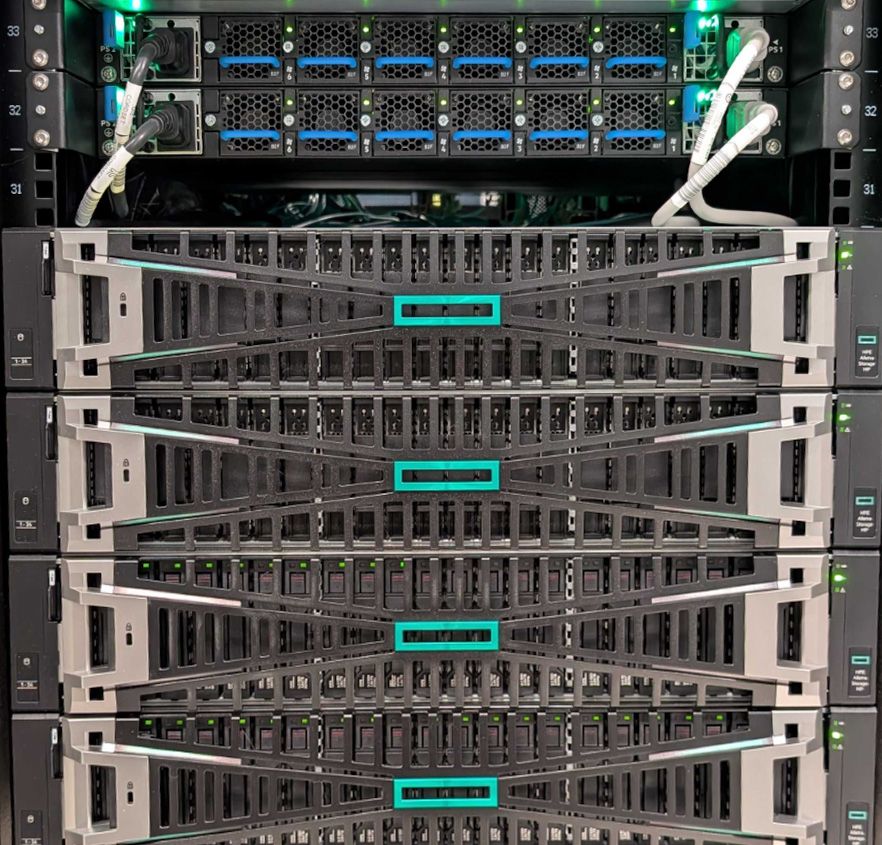
Piattaforma: Alletra Storage MP, suddivisa in B10000 per i blocchi e X10000 per gli oggetti, oltre a GreenLake per i file. HPE vende anche le risorse di calcolo e di rete necessarie, ed è così che viene commercializzata la maggior parte delle sue soluzioni di storage per l'intelligenza artificiale.
Implementazioni denominate: build di Sovereign AI e AI Factory in cui HPE fornisce l'intera infrastruttura. Nessuna vittoria su Neocloud denominata paragonabile agli esempi VAST, WEKA o DDN sopra menzionati.
Validazione NVIDIA: partner di lancio certificato NVIDIA per lo storage, con validazioni DGX BasePOD e SuperPOD.
Risultato verificato: HPE è stata presente in ogni round di MLPerf Storage, dalla v1.0 alla v3.0, superando Dell e NetApp in termini di partecipazione. Tuttavia, è importante leggere attentamente i risultati relativi ai file: i migliori risultati di HPE per i file con intelligenza artificiale sono stati ottenuti grazie a collaborazioni con WEKA, partnership che HPE ha interrotto, insieme a Qumulo e Scality, nel novembre 2025. Questi risultati non descrivono più un prodotto che HPE può offrire oggi.
La nostra copertura dell'ultimo anno: abbiamo testato la piattaforma Alletra in prima persona.
- HPE mantiene la sua posizione di leader nel Magic Quadrant 2026 di Gartner per lo storage aziendale. (Aug 2026)
- Alletra Storage MP B10000 con NIST CSF 2.0, i nostri test pratici (Giugno 2026)
- Alletra Storage MP X10000 con il nodo Data Protection Accelerator (Feb 2026)
- CloudCasa aggiunge Kubernetes DR per il B10000 (Giugno 2026)
- MLPerf Storage v3.0: 345.8 GiB/s su 3D U-Net con il K3000, uno dei soli due fornitori presenti in questa pagina ad aver partecipato a questo round.
IBM
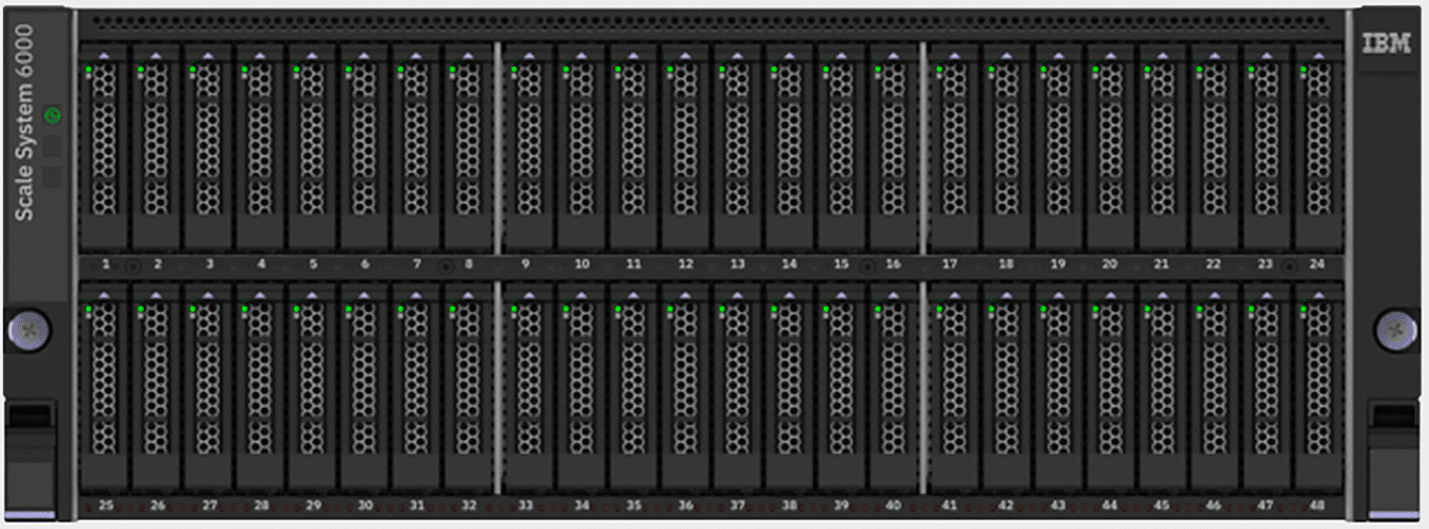
Piattaforma: IBM Storage Scale, il file system parallelo con derivazione GPFS, venduto come software e come appliance Storage Scale System, con Fusion che lo impacchetta per Kubernetes e pipeline di intelligenza artificiale.
Implementazioni denominate: Parte dello stack multi-vendor di CoreWeave. IBM Cloud sta anche realizzando un cluster di inferenza dedicato HGX B300 da 240 milioni di dollari con Together AI, annunciato nell'agosto 2026, sebbene il livello di storage non sia stato reso noto.
Certificazione NVIDIA: partner di lancio per la certificazione NVIDIA Certified Storage.
Risultato verificato: Sì, in MLPerf Storage v2.0, incluso il carico di lavoro di checkpointing, dove Storage Scale ha registrato 656.7 GiB/s in lettura su un modello Llama 3.1 da 1 TB. Il ripristino del checkpoint è la metrica che determina quanta parte di un'esecuzione di training di frontiera si perde a causa di un errore, e pochissimi fornitori hanno pubblicato un dato verificato a riguardo.
Reclami aperti: Nessun risultato eccezionale nella categoria degli array più veloci. IBM commercializza Storage Scale puntando su scalabilità e integrazione piuttosto che su un record di throughput.
La nostra copertura giornalistica dell'ultimo anno:
- IBM mantiene la sua posizione di leader nel Magic Quadrant 2026 di Gartner per lo storage aziendale. (Aug 2026)
- IBM e Together AI hanno investito 240 milioni di dollari in un cluster di inferenza dedicato HGX B300. (Aug 2026)
- IBM introduce lo storage basato sul contenuto per i carichi di lavoro RAG (Apr 2026)
- FlashSystem di nuova generazione con intelligenza artificiale agentiva (Feb 2026)
- Storage Scale System 6000, storage unificato per IA e HPC (Nov 2025)
- La nostra recensione di IBM FlashSystem 5300, con un'esperienza pratica con l'array compatto di IBM e utili informazioni sul comportamento dei sistemi più grandi. (Settembre 2024)
Everpure (precedentemente Pure Storage)
Piattaforma: FlashBlade//EXA è la soluzione basata sull'intelligenza artificiale, che separa i metadati dai percorsi dati in modo che il piano dati si adatti in modo indipendente. FlashBlade//S e FlashArray coprono il resto. Everpure produce i propri moduli DirectFlash anziché acquistare SSD già pronti, motivo per cui i suoi dati relativi a densità e durata non rispecchiano quelli del resto del mercato. L'azienda ha assunto legalmente la denominazione Everpure il 23 febbraio 2026.
Distribuzioni denominate: Parte dello stack multi-vendor di CoreWeave. Non siamo stati in grado di confermare una distribuzione specifica per l'addestramento AI su FlashBlade//EXA.
Certificazione NVIDIA: partner di lancio per la certificazione NVIDIA Certified Storage.
Risultato verificato: MLPerf Storage v3.0 (settembre 2026), prima presentazione di Everpure: 877.5 GiB/s di scrittura checkpoint con 833.0 GiB/s di lettura su 30 nodi dati FlashBlade//EXA, i numeri di checkpoint più elevati del round, oltre al risultato più alto del round per la cache KV a 1,623.4 GiB/s. Detiene anche il record SPECstorage Solution 2020_ai_image con 6,300 AI Job, pubblicato il 17 febbraio 2026. Benchmark diverso, modello di carico di lavoro diverso, ma si tratta di una presentazione reale secondo un set di regole pubblicato con un processo di revisione, e conta.
Affermazioni esplicite: FlashBlade//EXA viene commercializzato come la piattaforma di archiviazione dati con le prestazioni più elevate del settore, con una velocità di trasmissione prevista superiore a 10 TB/s in un singolo namespace. Prevista, non misurata.
La nostra copertura giornalistica dell'ultimo anno:
- Everpure si conferma al primo posto in entrambe le categorie del Magic Quadrant 2026 di Gartner per il secondo anno consecutivo. (Aug 2026)
- Everpure lancia Data Stream per le pipeline di intelligenza artificiale aziendali (Giugno 2026)
- Miglioramenti all'intelligence dei dati e al cloud dati aziendale (Giugno 2026)
- Emulex SecureHBA con Everpure XL130 R5: non si tratta di un benchmark basato sull'intelligenza artificiale, ma di un'esperienza pratica con l'hardware Everpure. (Marzo 2026)
- MLPerf Storage v3.0 (settembre 2026): prima presentazione, scrittura del checkpoint a 877.5 GiB/s e lettura a 833 GiB/s su FlashBlade//EXA, più lettura della cache KV a 1,623 GiB/s, i valori più alti per checkpoint e inferenze nel round. Copertura completa della versione 3.0.
NetApp
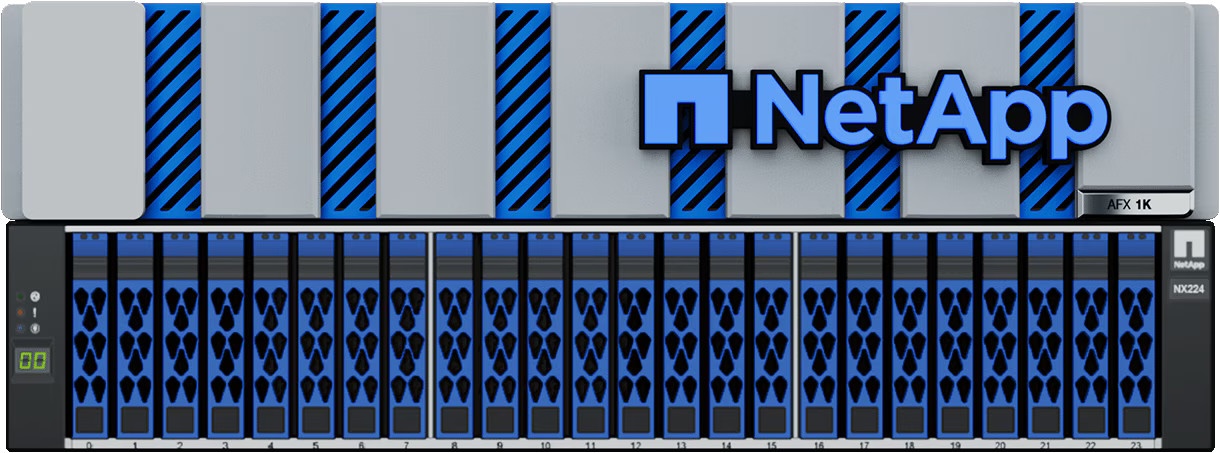
Piattaforma: AFX, announced in October 2025, is disaggregated all-flash ONTAP built for AI data pipelines, with the AI Data Engine layered on top. AIPod is the NVIDIA-validated reference design. Novus, announced at INSIGHT 2026 and orderable now, sits above AFX for AI factories: pNFS metadata moves onto Data Director nodes running on qualified Supermicro servers while AFF A90 HA pairs carry the data, and the clients are stock Linux pNFS, with no proprietary agent on the GPU servers.
Implementazioni specifiche: Nessuna che possiamo confermare su scala di addestramento AI. Gli artefatti pubblici più solidi sono architetture validate piuttosto che nomi di clienti, tra cui i progetti FlexPod AI con Cisco del giugno 2026.
Validazione NVIDIA: partner di lancio certificato NVIDIA per lo storage, con certificazione DGX SuperPOD.
Risultato della verifica: None in MLPerf Storage, which NetApp has never entered. Behind Novus, NetApp cites an Omdia-audited test showing near-linear scaling as ONTAP clusters joined one namespace; the 100 TB/s headline is Omdia’s modeling from that test, not a measured result.
La nostra copertura giornalistica dell'ultimo anno:
- Novus splits pNFS metadata from AFF A90 data nodes, targeting 100 TB/s (Ottobre 2026)
- NetApp mantiene la sua posizione di leader nel Magic Quadrant 2026 di Gartner per lo storage aziendale. (Aug 2026)
- HCLTech integra Keystone con U4X per l'archiviazione AI basata sul consumo. (Aug 2026)
- NetApp acquisisce DataPelago per l'elaborazione dati tramite GPU. (Lug 2026)
- StorageGRID 12.1 aggiunge uno spazio dei nomi federato e fino a 12 TB/s (Giugno 2026)
- FlexPod ha convalidato le architetture di intelligenza artificiale con Cisco (Giugno 2026)
- Il lancio di AFX (Ottobre 2025)
Una nota su Huawei
Huawei ha registrato il throughput assoluto più elevato in MLPerf Storage v2.0, pari a 698 GiB/s su 3D U-Net, da un OceanStor A800 a doppio nodo 8U che alimenta 255 H100 simulati, e questo dato è riportato nella tabella verificata qui sotto. Lo abbiamo escluso dai profili dei leader perché non rappresenta un acquisto pratico per gli acquirenti negli Stati Uniti, in Europa o nella maggior parte dei mercati a cui si rivolge questa pagina. Il dato è reale; la disponibilità non lo è. Il Magic Quadrant di Gartner del 2026 raggiunge lo stesso equilibrio dall'altro lato, mantenendo Huawei nel quadrante dei leader grazie alla forza di OceanStor al di fuori del Nord America.
Cosa dicono gli analisti
Il posizionamento degli analisti rappresenta di per sé una forma di valutazione: non un benchmark certificato, bensì una valutazione indipendente dell'esecuzione e della visione, più vicina al modo in cui questi sistemi vengono effettivamente acquistati. Nel Magic Quadrant 2026 di Gartner per le piattaforme di storage aziendale , gli stessi sei fornitori occupano il quadrante dei Leader dell'anno precedente: Everpure, Huawei, HPE, NetApp, Dell e IBM, con Everpure al primo posto per capacità di esecuzione e con la visione più completa per il secondo anno consecutivo. Due precisazioni sono importanti per questa pagina. Gartner valuta il mercato dello storage primario e monitora il mercato dello storage ad alte prestazioni per file e oggetti in ricerche separate, ambito in cui operano gli specialisti nativi dell'IA menzionati in precedenza; pertanto, la loro assenza dal Quadrante rappresenta un limite di categoria, non un giudizio definitivo. Inoltre, quando sei degli otto fornitori valutati si aggiudicano l'etichetta di Leader, l'etichetta in sé dice poco agli acquirenti; sono le posizioni relative a fornire il segnale più significativo.
Cosa cambierebbe questa lista?
Quattro elementi, in ordine di importanza. Un fornitore ci concede l'accesso per testare la sua piattaforma secondo la nostra metodologia, che si tratti di hardware che possiamo ospitare noi stessi o di accesso a un'implementazione più ampia. Un fornitore partecipa a un round di certificazione in corso, come MLPerf Storage o SPECstorage. Un operatore, anziché un fornitore, documenta un'implementazione, come ha fatto Meta con Hammerspace. Oppure un fornitore perde una certificazione o una partnership da cui dipende il suo posizionamento attuale, come è successo con la scissione tra WEKA e HPE, che ha cambiato il modo in cui entrambe le aziende si rivolgono agli acquirenti di soluzioni AI. Aggiorniamo i profili man mano che si verificano questi eventi.
Cosa mostrano realmente i parametri di riferimento verificati
L'addestramento dell'IA e i provider di neocloud che lo supportano sono il vero campo di battaglia per le prestazioni di storage nel 2026, ed è l'unico segmento con un benchmark certificato affidabile: MLCommons MLPerf Storage. L'edizione attualmente pubblicata è la v3.0 (settembre 2026), con 19 organizzazioni partecipanti e 143 risultati. Per la prima volta, il benchmark copre l'intera pipeline dell'IA: throughput di training, checkpointing e due nuovi test di inferenza (Vector Database e KV Cache), oltre al supporto per lo storage di oggetti S3, utilizzato da circa un sesto delle organizzazioni partecipanti. Poiché la v3.0 ha spostato gli acceleratori simulati da H100 a B200, i risultati non sono confrontabili con le edizioni precedenti. MLPerf Storage non incorona un singolo vincitore; sistemi diversi primeggiano in carichi di lavoro e metriche differenti.
| Sistema | Risultato della verifica (MLPerf Storage v3.0) | Classe |
|---|---|---|
| Everpure FlashBlade//EXA | 877.5 GiB/s in scrittura del checkpoint e 833 GiB/s in lettura su 30 nodi dati; 1,623 GiB/s in lettura della cache KV. | Responsabile del checkpoint e dell'inferenza |
| YanRongTech F9000X | 543.9 GiB/s su una rete U-Net 3D che alimenta 99 acceleratori B200 simulati. | Massima produttività di addestramento registrata |
| TuringData F9200 | 541.5 GiB/s su 3D U-Net da tre nodi di archiviazione; Checkpoint-70B a 539.9 GiB/s in lettura e 307.1 GiB/s in scrittura. | Nuovo arrivato nella densità delle prestazioni |
| Lustro gestito da Azure | Scrittura del checkpoint a 642.2 GiB/s da un'implementazione cloud gestita da 4,096 TiB | Primo servizio di cloud hyperscale presentato |
| NVIDIA AIStore | 20 invii tramite storage di oggetti S3 su OCI, AWS e GCP | Archiviazione di oggetti nel territorio dei file system paralleli |
Sul fronte HPC, la lista IO500 (edizione ISC 2026) è guidata da Sugon ParaStor di SCNet con 26,888 GiB/s di larghezza di banda misurata su 500 nodi client, con i sistemi Intel DAOS (Argonne Aurora, LRZ) che occupano diverse posizioni di vertice e Weka presente tramite Samsung SSC-24. Il ricambio nella v3.0 è tanto degno di nota quanto i numeri: i leader del throughput della v2.0, DDN, Huawei, Hammerspace e Lightbits, non hanno partecipato a questa edizione, mentre 11 nuovi partecipanti si sono presentati, tra cui Azure e NVIDIA. Analisi completa nella nostra copertura di MLPerf Storage v3.0.
Chi alimenta realmente i Neoclouds?
I successi in termini di implementazione non sono parametri di riferimento, ma rappresentano una prova concreta di ciò che gli operatori acquistano quando le prestazioni sono la loro priorità. Si noti che le più grandi infrastrutture per l'intelligenza artificiale sono multi-vendor; nessuna singola azienda di storage possiede interamente questi siti.
| AI Nube | Archiviazione | Dettagli |
|---|---|---|
| CoreWeave | VAST Data (con WEKA, DDN, IBM Storage Scale ed Everpure nello stack) | Accordo pluriennale da 1.17 miliardi di dollari, novembre 2025, il cliente più importante di VAST |
| Colosso xAI | DDN EXAScaler e Infinia, con l'aggiunta di VAST Data nell'espansione Frontier AI Factory. | DDN annunciato a novembre 2024 con 100 GPU; multi-vendor a partire dalla fine del 2025. |
| Nebio | WEKA NeuralMesh | Livello Premium di Nebius AI Cloud, annunciato a giugno 2025. |
| Insieme AI | IBM Cloud (sistemi HGX B300) | Accordo da 240 milioni di dollari annunciato nell'agosto 2026; il livello di archiviazione non è ancora stato reso noto. |
Il sistema di tracciamento dei sinistri
These are the current “fastest” claims in the AI storage segment. None has been independently verified at the claimed scale; most are footnoted by their vendors as internal testing, and the strongest provenance in the table is an analyst-audited test behind a projected headline.
| Reclamo del fornitore | Numero | Stato |
|---|---|---|
| Everpure FlashBlade//EXA, "la piattaforma di archiviazione dati con le prestazioni più elevate del settore" (marzo 2025) | Velocità di lettura previste di oltre 10 TB/s in un singolo namespace | Proiezione del fornitore; nessuna presentazione verificata |
| Dell Lightning File System, "il file system parallelo più veloce al mondo" (disponibilità generale ad aprile 2026) | Fino a 150 GB/s per unità rack, secondo un'analisi interna di Dell. | Richiesta del fornitore; nessuna presentazione verificata |
| Storage Dell Exascale (GTC 2026) | Fino a 6 TB/s per rack | Richiesta del fornitore; nessuna presentazione verificata |
| Huawei New-Gen OceanStor Dorado (settembre 2024) | Specifiche tecniche che indicano un limite massimo di 100 milioni di IOPS con una latenza di 0.03 ms. | Specifiche del fornitore; un test Omdia commissionato da Huawei ha misurato 2.58 milioni di IOPS sostenuti a 70 microsecondi su un carico di lavoro Oracle RAC reale, un utile controllo della realtà sui valori massimi indicati nelle specifiche. |
| WEKA, WEKApod 3 con NeuralMesh 6, dichiara una capacità di un exabyte in un singolo rack (luglio 2026) | 1.1 EB e 10.2 TB/s in un unico rack | Dichiarazione del fornitore: WEKA ha inviato i dati a MLPerf Storage per l'ultima volta nella versione 1.0 e ha saltato la versione 2.0. |
| VAST Data e AMD, offload della cache KV su Instinct (luglio 2026) | Tempo di ottenimento del primo token 9 volte più veloce | Test congiunti tra fornitori; VAST non ha mai inviato test di archiviazione a MLPerf |
| DDN e Nebul, accelerazione della cache KV con NVIDIA Dynamo (luglio 2026) | Accelerazione dichiarata dal fornitore per i carichi di lavoro di inferenza | Validazione da parte del partner, non audit indipendente; DDN dispone dei risultati aggiornati di MLPerf Storage v2.0 |
| NetApp Novus, “the fastest storage on the planet” (October 2026) | Projected 100 TB/s of sequential reads across a single pNFS namespace | Omdia-audited near-linear scaling on a smaller cluster; the 100 TB/s figure is Omdia’s projection from that test, not a measurement |
Che fine ha fatto SPC-1?
SPC-1 era il benchmark di riferimento del settore per lo storage a blocchi, ma ora è semi-dormiente: i fornitori statunitensi lo hanno di fatto abbandonato intorno al 2018, lasciando una classifica dominata dai fornitori cinesi. Il record attualmente accettato non è il risultato di Huawei, ampiamente citato. ExponTech WDS V3 detiene il punteggio più alto accettato con 27.2 milioni di IOPS SPC-1 (accettati a novembre 2023), davanti a Inspur con 23.0 milioni, mentre i famosi 21.0 milioni di Huawei del 2020 sono ora al quarto posto. Un risultato più alto di FlashNexus, pari a 30.0 milioni di IOPS, è rimasto in fase di revisione da febbraio 2025 e non lo considereremo un record finché lo Storage Performance Council non lo farà.
Come funziona questa pagina
Tre regole. Primo, ogni numero è etichettato con la sua categoria di prova: invio verificato, dichiarazione del fornitore o misurazione di StorageReview. Secondo, non ripetiamo superlativi per i quali non possiamo fornire dati aggiornati; diverse famose affermazioni di "più veloce" presenti in questa pagina risalgono a diversi anni fa e sono contrassegnate di conseguenza. Terzo, l'accesso alla sezione verificata di questa pagina è aperto a qualsiasi fornitore: inviare i dati a MLPerf Storage o IO500, oppure concederci l'accesso per eseguire i test secondo la nostra metodologia standard. Questa pagina riguarda esclusivamente lo storage AI e neocloud. Lo storage a blocchi e file per aziende tradizionali e lo storage per PMI avranno pagine dedicate anziché essere inclusi qui, poiché le prove disponibili in ciascun segmento sono diverse. Aggiorniamo i profili dei leader non appena riceviamo notizie ed effettuiamo una revisione completa quando viene pubblicato un nuovo ciclo di audit.
Domande frequenti sull'archiviazione più veloce
Qual è il sistema di archiviazione più veloce al mondo?
Non esiste una risposta univoca e verificata, e chiunque la fornisca cita un fornitore. Secondo i dati verificati a settembre 2026: FlashBlade//EXA di Everpure ha registrato il valore più alto di checkpoint in MLPerf Storage v3.0 con 877.5 GiB/s in scrittura, F9000X di YanRongTech ha guidato la classifica del throughput di training con 543.9 GiB/s, Sugon ParaStor è in cima alla lista della larghezza di banda IO500 e ExponTech detiene il record SPC-1 IOPS riconosciuto. I valori più elevati dichiarati, comprese le proiezioni di Dell per Exascale Storage per rack, non sono stati verificati in modo indipendente.
Qual è la soluzione di archiviazione più veloce per l'addestramento dell'IA?
Secondo i risultati di MLPerf Storage v3.0, l'unico benchmark di storage per l'IA con certificazione ufficiale, i leader in termini di throughput di training sono YanRongTech, TuringData e UBIX, mentre Everpure primeggia nel checkpointing e nell'inferenza della cache KV e Azure è leader tra i servizi cloud. Considerando le soluzioni implementate dai maggiori operatori di IA, VAST, DDN e WEKA dominano il mercato del neocloud, sebbene nessuno dei tre abbia partecipato al test v3.0. Entrambi i tipi di dati sono riportati sopra, opportunamente etichettati.
Perché esistono così pochi benchmark indipendenti per gli array aziendali?
Poiché la maggior parte dei fornitori di soluzioni di storage aziendali vieta contrattualmente la pubblicazione dei risultati dei benchmark e i principali produttori di array hanno abbandonato i benchmark pubblici che utilizzavano in passato, in particolare SPC-1, intorno al 2018, i fornitori di soluzioni per l'intelligenza artificiale hanno parzialmente invertito la tendenza, dato che la partecipazione a MLPerf Storage è diventata un requisito di vendita. Aggiorniamo questa pagina non appena vengono pubblicati nuovi risultati certificati.
La crittografia resistente ai computer quantistici dovrebbe essere un fattore da considerare nell'acquisto di un array?
Per i settori regolamentati, sì, e le scadenze sono più vicine di quanto sembri. Le linee guida CNSA 2.0 della NSA richiedono che le nuove installazioni del National Security System siano conformi entro gennaio 2027, con la dismissione dei sistemi non conformi entro la fine del 2030, e i framework NIS2 e DORA dell'UE prevedono requisiti di crittografia specifici. Lo standard FC-SP-3, ormai completato, rende questo un dettaglio di acquisto piuttosto che un progetto: gli HBA compatibili con FC-SP-3 crittografano il traffico SAN in transito alla velocità di linea con algoritmi post-quantistici e, poiché la crittografia avviene a livello di trasporto, l'array riceve comunque dati che può comprimere, deduplicare e analizzare per individuare anomalie da ransomware, servizi che la crittografia a livello applicativo non è in grado di proteggere. Specificare la connettività FC-SP-3 nei normali acquisti di aggiornamento triennali o quinquennali garantisce, come risultato secondario, una SAN completamente crittografata entro il 2030. L'hardware è già disponibile nella fascia media: ogni Dell PowerStore Gen 3 è dotato di schede Fibre Channel compatibili con EDIF negli slot OCP, e Dell ha previsto che la crittografia dei cavi venga implementata tramite un aggiornamento software non invasivo di PowerStoreOS 5.1, di cui abbiamo parlato in dettaglio nel nostro approfondimento su PowerStoreOS 5.0 . Il nostro approfondimento su FC-SP-3 illustra lo standard, le scadenze e i modelli di implementazione.


 Amazon