

Aggiornato il 26 ottobre 2026: il Lenovo ThinkPad P1 Gen 9 si unisce alla sezione "Altri test" con i risultati della nuova suite MLPerf Client; le scelte rimangono invariate. Il 16 ottobre, i laptop con RTX Spark sono entrati a far parte della pagina in una sezione dedicata, guidata dall'HP OmniBook Ultra 16 e dal Lenovo Yoga 9n 2-in-1 16.
Ogni laptop presente in questa classifica è stato testato nei laboratori di StorageReview. Misuriamo direttamente le prestazioni AI locali: UL Procyon AI Text Generation esegue gli stessi modelli su ogni sistema compatibile e, laddove l'hardware lo consenta, approfondiamo i test con LM Studio e Ollama. Nessuna delle classifiche in questa pagina si basa sulle specifiche tecniche e ogni prodotto selezionato rimanda alla recensione contenente i dati.
Nel 2026, per eseguire modelli di intelligenza artificiale su un laptop, esistono due strade principali. Le GPU dedicate NVIDIA RTX PRO offrono il maggior numero di token al secondo, ma il modello deve rientrare nella VRAM della scheda, che varia da 8 GB a 24 GB. Le architetture con memoria unificata e condivisa, guidate da AMD Ryzen AI Max+ (Strix Halo) e dalle piattaforme Intel Core Ultra con memoria condivisa LPCAMM2, privilegiano la capacità a scapito della velocità pura: la GPU può utilizzare gran parte della memoria di sistema, consentendo quindi il caricamento di modelli di dimensioni maggiori. Le soluzioni presentate di seguito coprono entrambe le strade, inclusa la classe di efficienza basata su NPU.
A prima vista
| Categoria | Sistema | Motore AI | Risultato chiave | Recensione Completa |
|---|---|---|---|---|
| Miglior laptop in assoluto per l'IA locale | Dell Pro Max 18 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 185 tok/s (Phi, Procyon), il laptop più veloce che abbiamo testato | Recensione del Pro Max 18 Plus |
| Ideale per modelli di grandi dimensioni | HP ZBook Ultra G1a 14 | Ryzen AI Max+ PRO 395, fino a 96 GB di memoria unificata assegnabile | DeepSeek-R1 caricato 70B; Gemma 3 27B a 9 tok/s | Recensione dello ZBook Ultra G1a |
| Miglior bilanciamento da 16 pollici | Dell Pro Max 16 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 179 tok/s (Phi) con 6 ore e 21 minuti di autonomia della batteria | Recensione del Pro Max 16 Plus |
| Miglior ultraportatile | Lenovo ThinkPad P14s Gen 7 | RTX PRO 1000 Blackwell 8GB / 64GB LPCAMM2 | 55 tok/s (Phi) a 3.59 libbre | Recensione del P14s Gen 7 |
| Ottimale senza scheda grafica dedicata | Dell Pro Precision 5 14s Intel | Intel Arc Pro B390 iGPU, 64 GB di memoria LPCAMM2 condivisa | Modelli testati con oltre 8 GB di VRAM, 23 ore e 50 minuti di autonomia della batteria | Recensione del Pro Precision 5 14s |
| Il miglior sistema NPU sottile e leggero | HP EliteBook 6 G1q | Snapdragon X Plus, NPU esagonale da 45 TOPS, 32 GB | Llama 3.2 3B a 37 tok/s in LM Studio | Recensione dell'EliteBook 6 G1q |
| Miglior laptop con RTX Spark | HP OmniBook Ultra 16 | RTX Spark N1X, CPU a 20 core / GPU Blackwell a 6,144 core, 128 GB (64 GB dedicati alla GPU) | Attività dell'agente di codifica 35B completata in 72.0 s a 89.5 tok/s, 3 esecuzioni su 3 superate. | Recensione dell'OmniBook Ultra 16 |
| Il laptop con RTX Spark che si surriscalda meno | Lenovo Yoga 9n 2-in-1 16 | RTX Spark N1X, CPU a 20 core / GPU Blackwell a 6,144 core, 64 GB (32 GB dedicati alla GPU) | Picco di 72 °C durante un carico continuo di 30 minuti, contro i 98 °C dell'HP OmniBook Ultra 16 | Recensione di Yoga 9n 2-in-1 16 |
Le scelte
Miglior laptop in assoluto per l'IA locale: Dell Pro Max 18 Plus
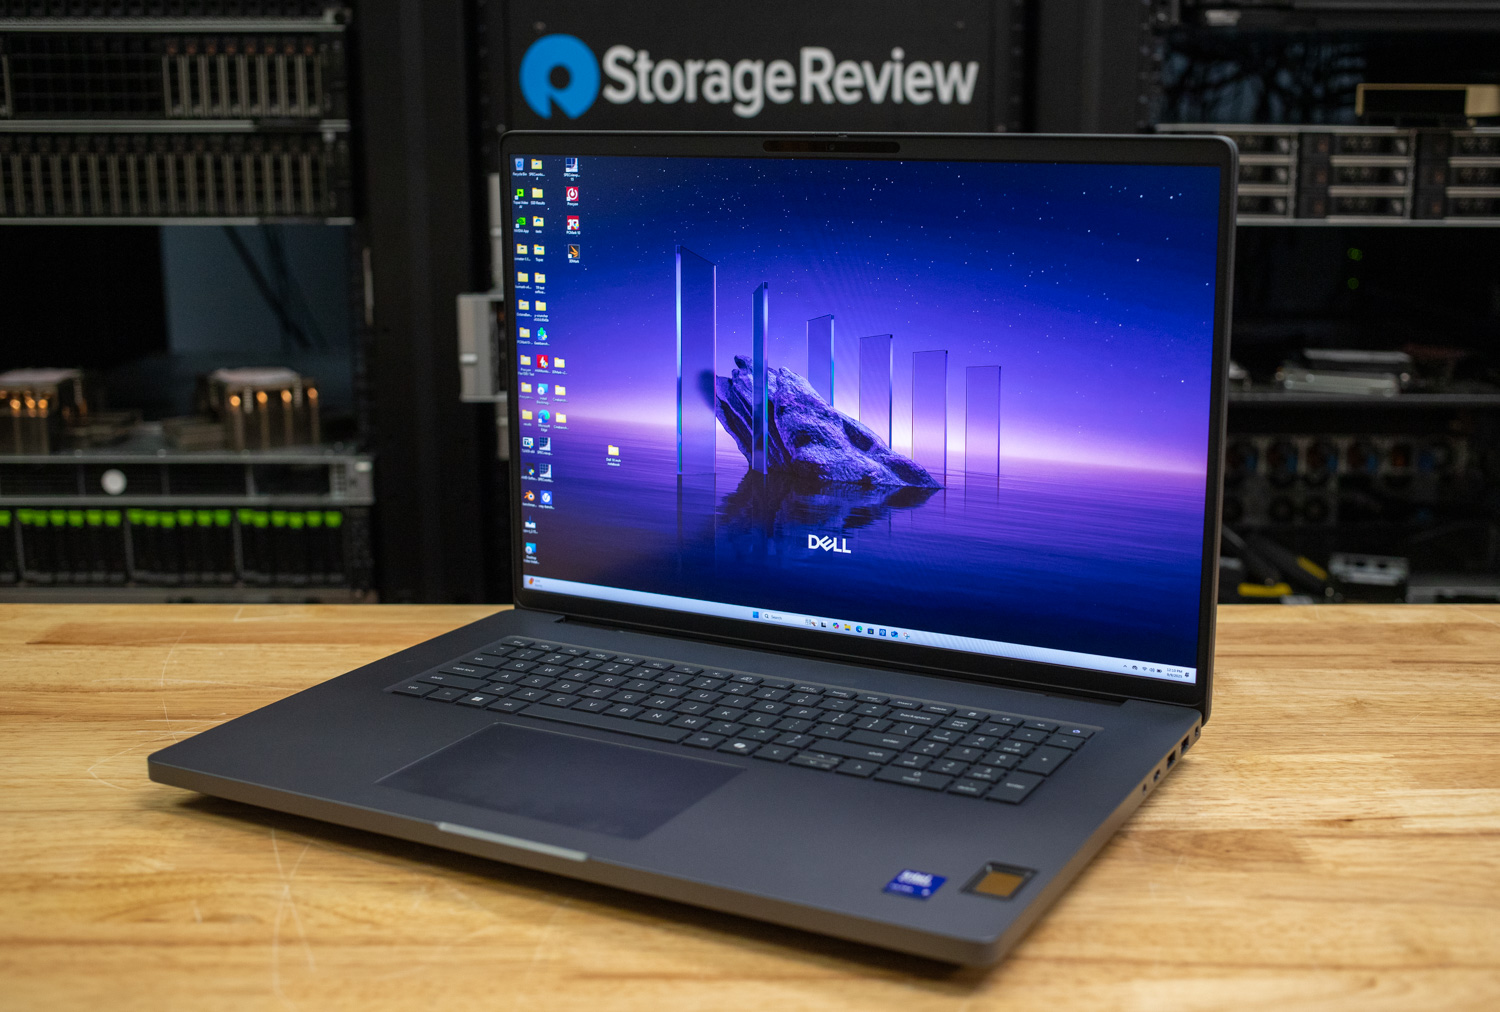
Il Pro Max 18 Plus ha registrato i risultati più veloci in termini di intelligenza artificiale locale tra tutti i laptop testati nei laboratori di StorageReview. Nel test UL Procyon AI Text Generation, la sua RTX PRO 5000 Blackwell (24 GB GDDR7) ha spinto Phi a 185.1 token al secondo, Mistral a 140.5 e Llama 3 a 119.7, con un tempo di generazione del primo token inferiore a 0.35 secondi su ogni modello. Il Core Ultra 9 285HX e i 128 GB di memoria CAMM2 mantengono il resto della pipeline a bassa velocità, mentre i 24 GB di VRAM supportano agevolmente modelli quantizzati di classe 20 miliardi.
I compromessi sono esattamente quelli che il telaio suggerisce: 7.17 kg e 3 ore e 39 minuti di autonomia misurata, la più breve nel nostro set di dati sui laptop. Si tratta di un computer fisso che per caso si può piegare. Il prezzo di listino al momento della recensione era di 9,245 dollari. Se la velocità di inferenza locale è l'aspetto più importante, questa è la risposta.
Recensione: Dell Pro Max 18 Plus: prestazioni Blackwell RTX PRO 5000 in mobilità
Ideale per modelli di grandi dimensioni: HP ZBook Ultra G1a 14
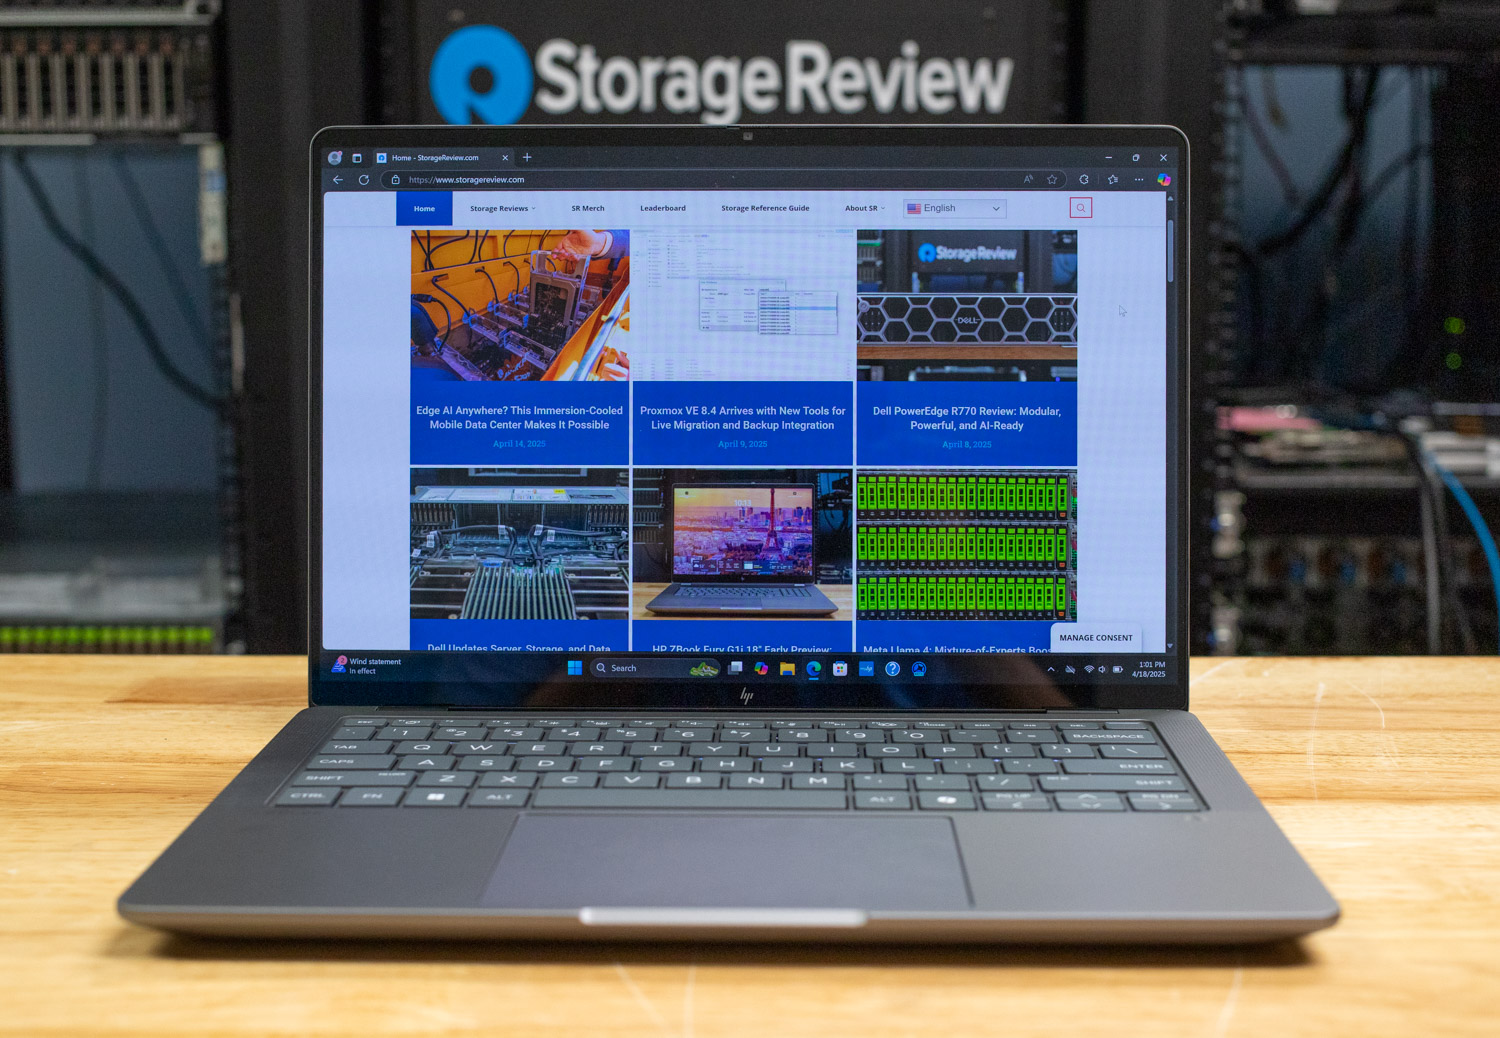
La velocità è un aspetto fondamentale, la capacità è l'altro. Lo ZBook Ultra G1a combina il processore AMD Ryzen AI Max+ PRO 395 con 128 GB di memoria unificata LPDDR5X, di cui fino a 96 GB assegnabili alla GPU Radeon 8060S. Questa configurazione ci ha permesso di eseguire modelli che nessun laptop con GPU dedicata è in grado di gestire: DeepSeek-R1 70B e QwQ 32B sono stati eseguiti localmente in LM Studio e Ollama, mentre Gemma 3 27B ha generato 8.96 token al secondo con un'elaborazione rapida a 73 token al secondo.
Le sue prestazioni con Procyon sono inferiori a quelle di qualsiasi altra macchina RTX PRO presente in questo confronto (Phi a 65 token al secondo), quindi non è la scelta ideale per chat veloci su modelli compatti. È invece la scelta giusta quando il design è l'elemento principale, e lo è con un peso di soli 3.3 kg e un'autonomia di 10 ore e 35 minuti. Si tratta della stessa architettura a memoria unificata che troviamo nell'AMD Strix Halo per desktop, racchiusa in un case da 14 pollici.
Recensione: HP ZBook Ultra G1a 14
All'orizzonte: HP ZBook Ultra G3a 16
Il modello più adatto alle grandi dimensioni, di cui sopra, potrebbe presto cedere il passo al suo successore. Lo ZBook Ultra G3a 16 offre 192 GB di memoria unificata LPDDR5X-8533 con fino a 160 GB assegnabili alla GPU (il G1a 14 si ferma a 128 GB e 96 GB), un processore Ryzen AI Max+ PRO 495 e un sistema di raffreddamento riprogettato che supporta 100 W, laddove il G1a si fermava a 55 W. La capacità ha permesso al G1a di conquistare la sua posizione, mentre il consumo energetico ne ha limitato le prestazioni; il G3a punta a risolvere entrambi i problemi contemporaneamente.
HP ha aperto gli ordini negli Stati Uniti a ottobre, con configurazioni a partire da 3,149 dollari, e il G3a entrerà in classifica una volta completati i test con Procyon e LM Studio. La nostra anteprima ha riguardato l'hardware di un'unità di pre-produzione, senza la possibilità di effettuare test prestazionali, e la recensione completa seguirà non appena un'unità destinata alla produzione arriverà in laboratorio.
Miglior equilibrio tra i notebook da 16 pollici: Dell Pro Max 16 Plus
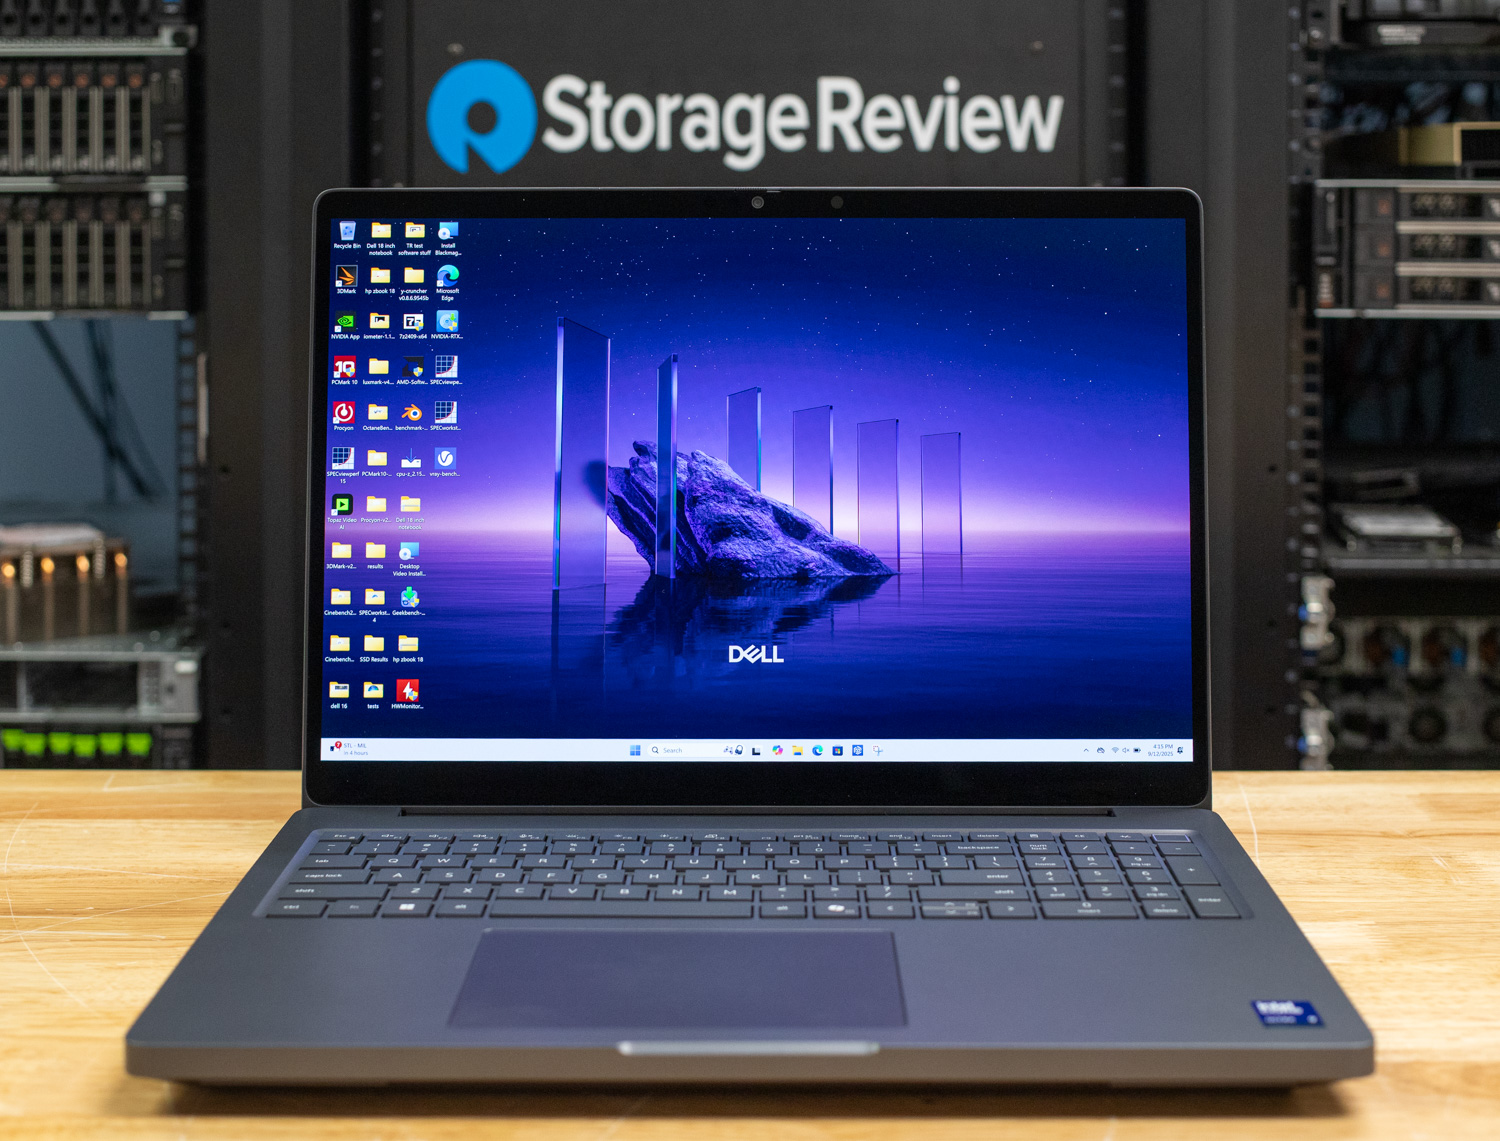
Il Pro Max 16 Plus monta la stessa RTX PRO 5000 Blackwell da 24 GB del 18 Plus e non ha praticamente nulla da invidiare alle prestazioni del modello di punta: Phi a 178.6 token al secondo, Mistral a 134.2, Llama 3 a 114.7, circa il 96% del throughput del modello di punta. In cambio, pesa 5.63 kg contro i 7.17 kg del modello di punta e offre quasi il doppio dell'autonomia, arrivando a 6 ore e 21 minuti.
Per la maggior parte delle persone che desiderano prestazioni di inferenza locale elevate in un unico dispositivo, questa è la scelta migliore tra le due. Inoltre, si aggiudica il primo posto nella nostra classifica delle migliori workstation mobili , quindi la velocità dell'IA è garantita dalla suite completa di applicazioni professionali già validate.
Recensione: Dell Pro Max 16 Plus: progettato per lunghe giornate e lavori impegnativi
Miglior ultraportatile: Lenovo ThinkPad P14s Gen 7
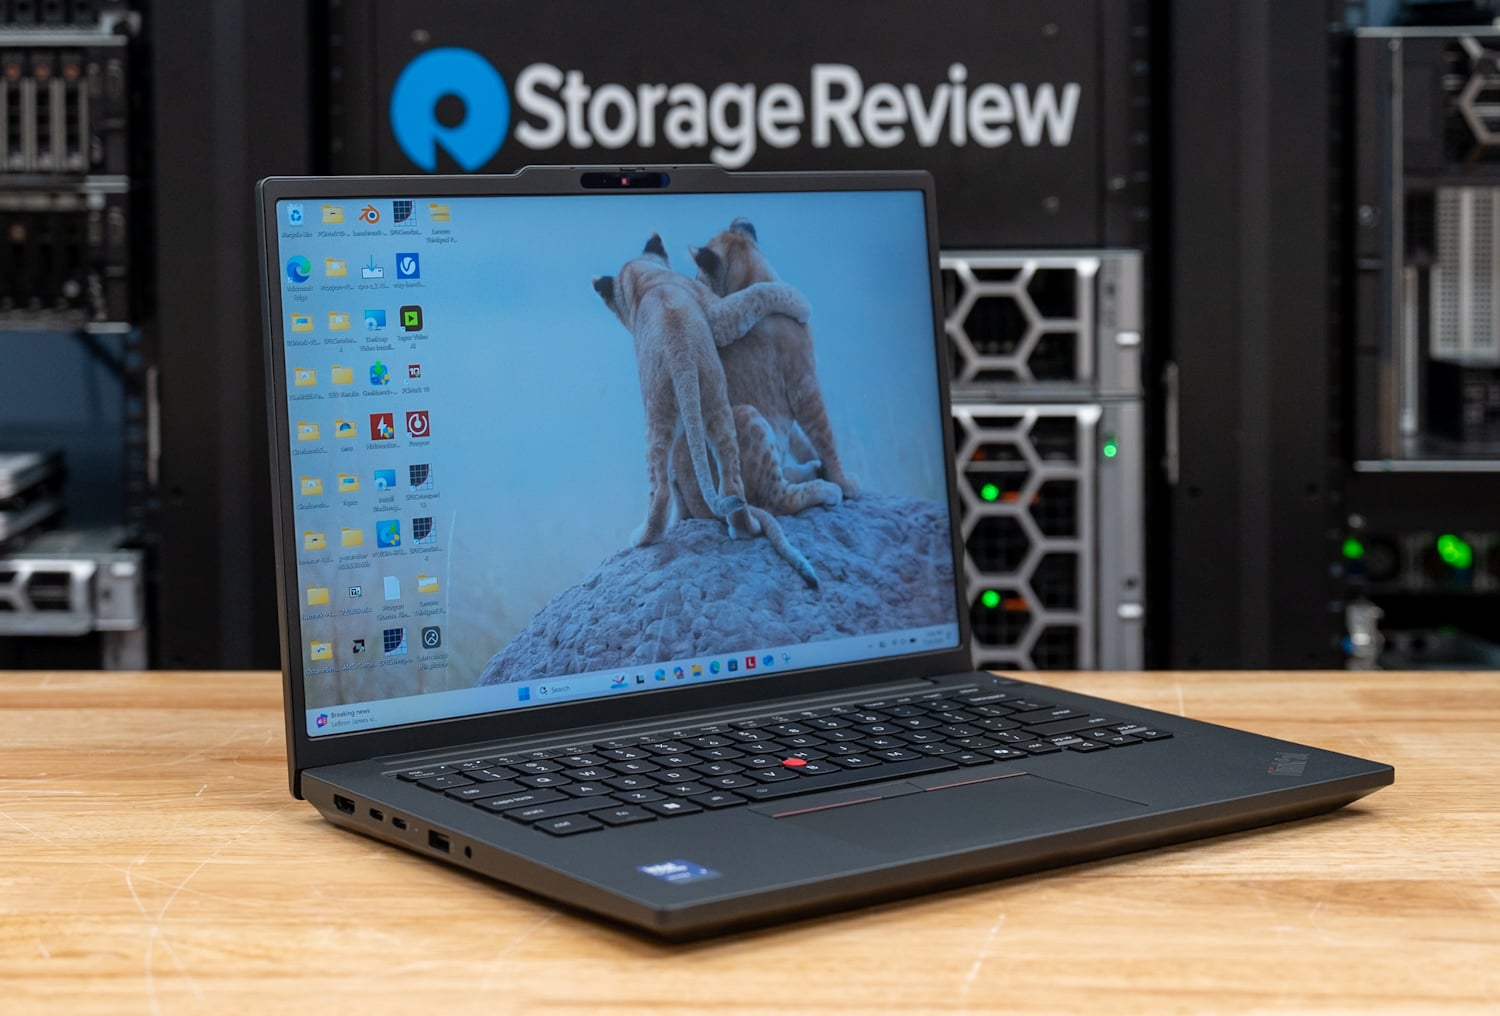
Con un peso di soli 3.59 kg, il P14s Gen 7 è il laptop più leggero tra quelli con GPU Blackwell dedicata. La RTX PRO 1000 (8 GB GDDR7) ha raggiunto 55.1 token al secondo in Phi e 40.3 in Mistral, velocità interattive reali per modelli di classe 7B, e la NPU Panther Lake da 50 TOPS lo rende una macchina Copilot+. L'autonomia della batteria di 15 ore e 52 minuti significa che le capacità di intelligenza artificiale non compromettono la tua giornata lavorativa.
Prima dell'acquisto, informatevi sui limiti: il nostro test con Llama 2 13B non è andato a buon fine perché quel modello richiede circa 12 GB di memoria grafica tramite il percorso Procyon, mentre la GPU ne ha solo 8 GB. Per i modelli con quantizzazione a 7B o inferiore, questa scheda è un'ottima soluzione; per modelli più grandi, consultate la pagina dedicata.
Recensione: Lenovo ThinkPad P14s Gen 7
Miglior modello senza scheda grafica dedicata: Dell Pro Precision 5 14s Intel
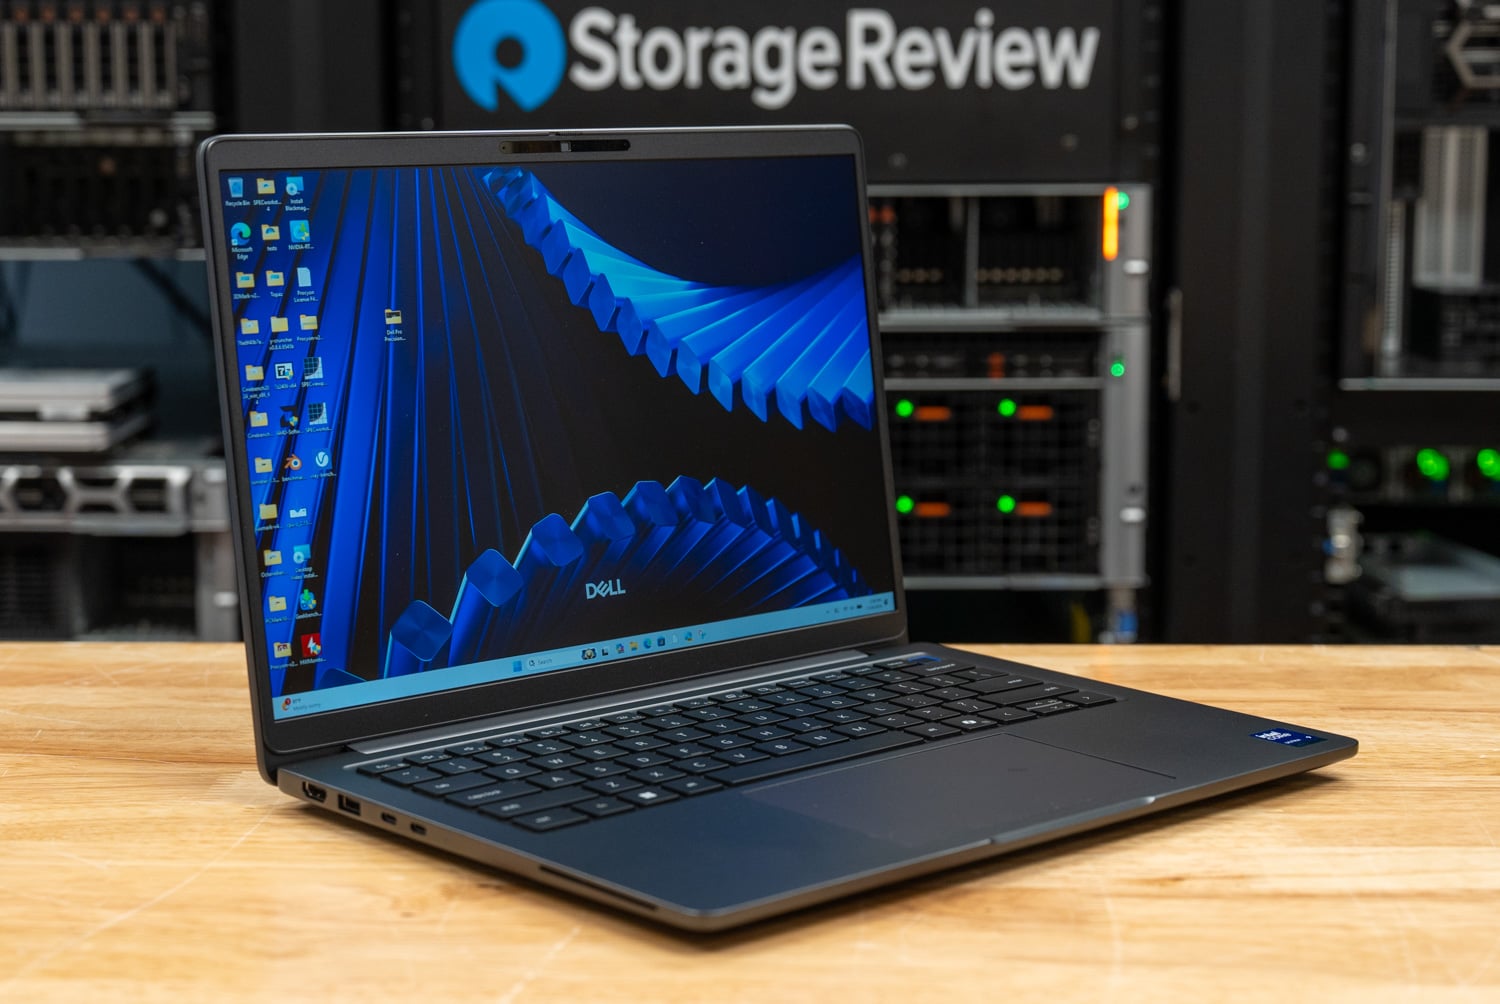
L'assenza di una GPU dedicata non rappresenta un problema, entro certi limiti: il Pro Precision 5 14s di Intel combina il Core Ultra X9 388H (NPU a 50 TOPS) con la grafica integrata Intel Arc Pro B390, utilizzando un pool di memoria condivisa LPCAMM2 da 64 GB. Nei nostri test, questo pool ha gestito carichi di lavoro AI locali più complessi di quelli che una scheda dedicata da 8 GB poteva supportare, completando l'intera suite Procyon AI Text Generation (punteggi di 887 su Phi e 786 su Llama 2), laddove i sistemi con VRAM limitata non sono riusciti a completare il test.
La velocità di generazione è modesta rispetto ai chip RTX PRO, quindi è più adatta ad attività di assistenza in background che a sessioni interattive intense. Il resto del pacchetto è notevole: 3.12 kg e 23 ore e 50 minuti di autonomia misurata, la seconda più lunga in tutto il nostro set di dati. Si aggiudica inoltre il primo posto nella nostra classifica delle migliori workstation ultraportatili.
Recensione: Dell Pro Precision 5 14s Intel
Miglior sistema NPU sottile e leggero: HP EliteBook 6 G1q
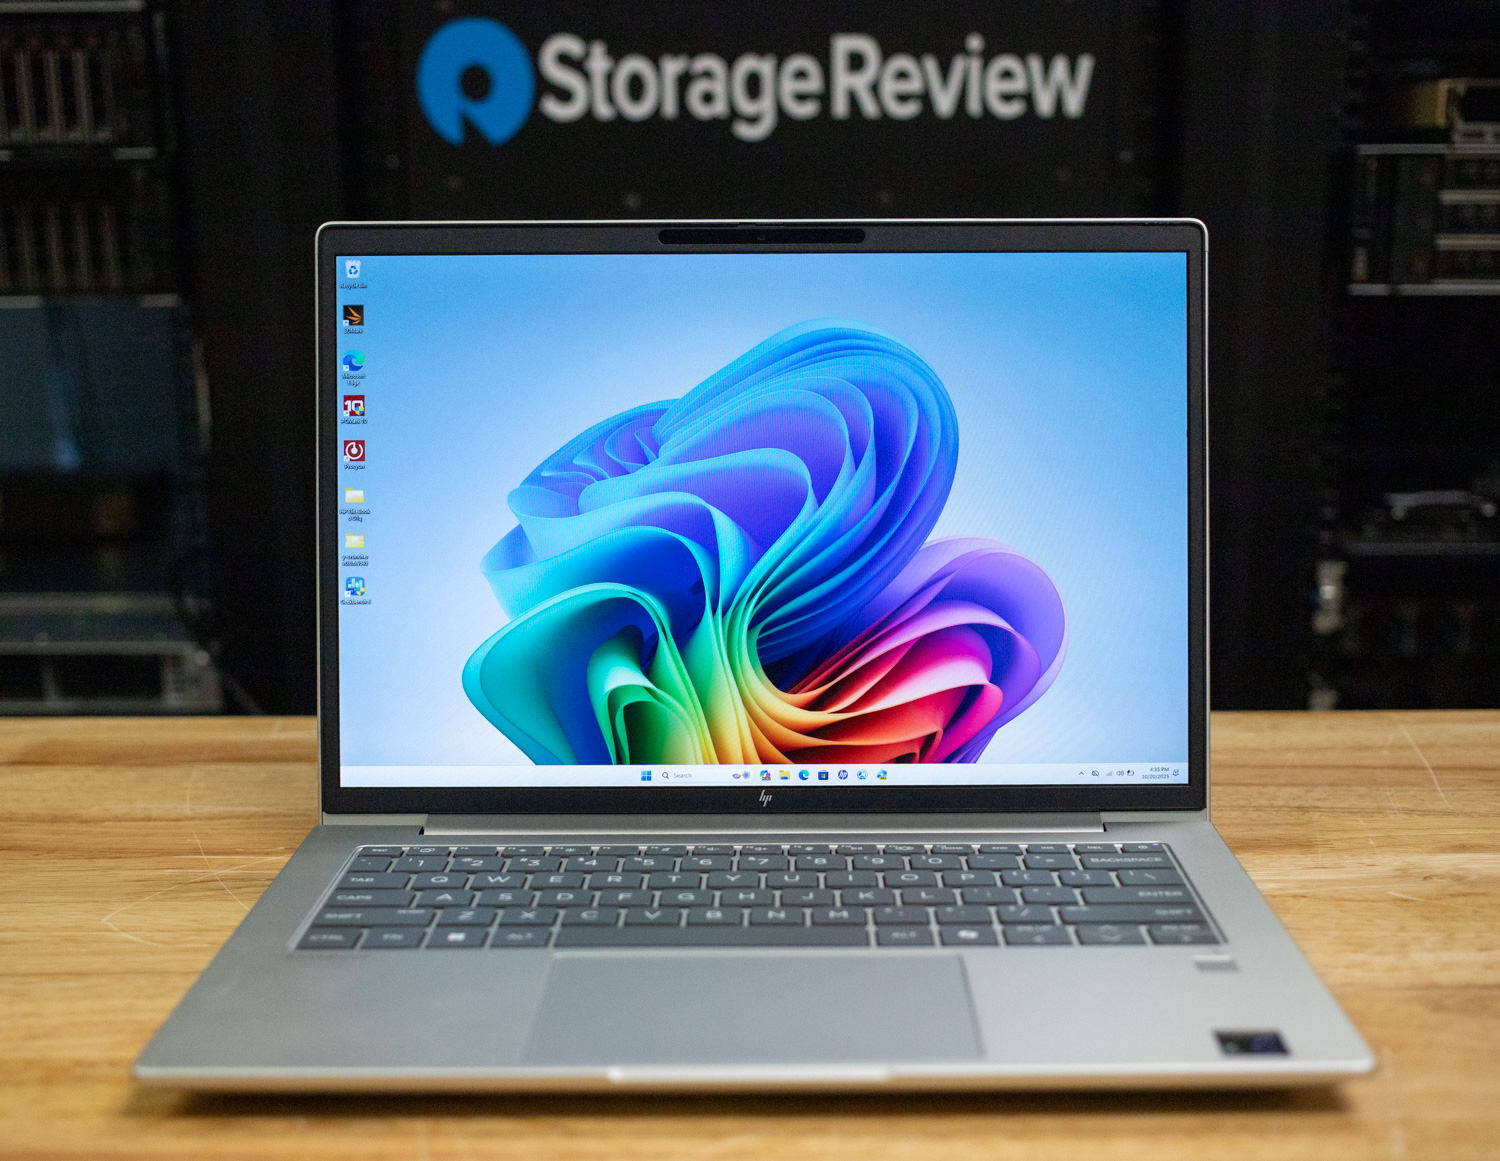
L'EliteBook 6 G1q risponde a una domanda diversa: di quanto poco dispositivo hai bisogno per un'intelligenza artificiale on-device davvero utile? Il suo Snapdragon X Plus con NPU Hexagon da 45 TOPS ha eseguito Llama 3.2 3B a 36.7 token al secondo e Gemma 3 4B a 29.3 in LM Studio, con i modelli da 1B che hanno superato i 62 token al secondo. Si tratta di velocità di chat utilizzabili per un dispositivo da 3.17 kg che ha registrato un'autonomia di 19 ore e 35 minuti.
Le capacità sono limitate: il modello con 4B parametri era il più grande che abbiamo testato, quindi è adatto per chat locali, riassunti e assistenti offline, mentre i modelli più complessi sono fuori portata. Con un prezzo di circa 3,100 dollari nella configurazione testata, era anche il sistema meno costoso di questa pagina.
Recensione: HP EliteBook 6 G1q: Autonomia per tutta la giornata in un laptop leggero
Laptop con processore RTX Spark: testati sulla nostra nuova suite di client.
La RTX Spark N1X di NVIDIA porta il superchip GB10 della DGX Spark sui laptop Windows, con un pool di LPDDR5X condiviso tra una CPU Grace e una GPU Blackwell. I laptop sono disponibili in due varianti con un TDP da 45 a 80 W: una CPU a 20 core con una GPU a 6,144 core e una CPU a 18 core con una GPU a 5,120 core. Testiamo questi sistemi su sr-client 1.2, la nostra nuova suite client nativa per Arm64, quindi i risultati non corrispondono esattamente a quelli di Procyon riportati sopra. La nostra copertura del lancio di RTX Spark contiene tutti i dettagli della piattaforma.
La memoria determina quali modelli ogni configurazione può eseguire. Un'impostazione del firmware suddivide il pool tra Windows e la GPU, e il nostro livello più piccolo di modelli AI locali richiede almeno 16 GB di memoria utilizzabile dalla GPU, quindi un sistema da 32 GB impostato a 12 GB per la GPU non può caricare il gpt-oss:20b da 12.8 GB.
Miglior laptop RTX Spark: HP OmniBook Ultra 16
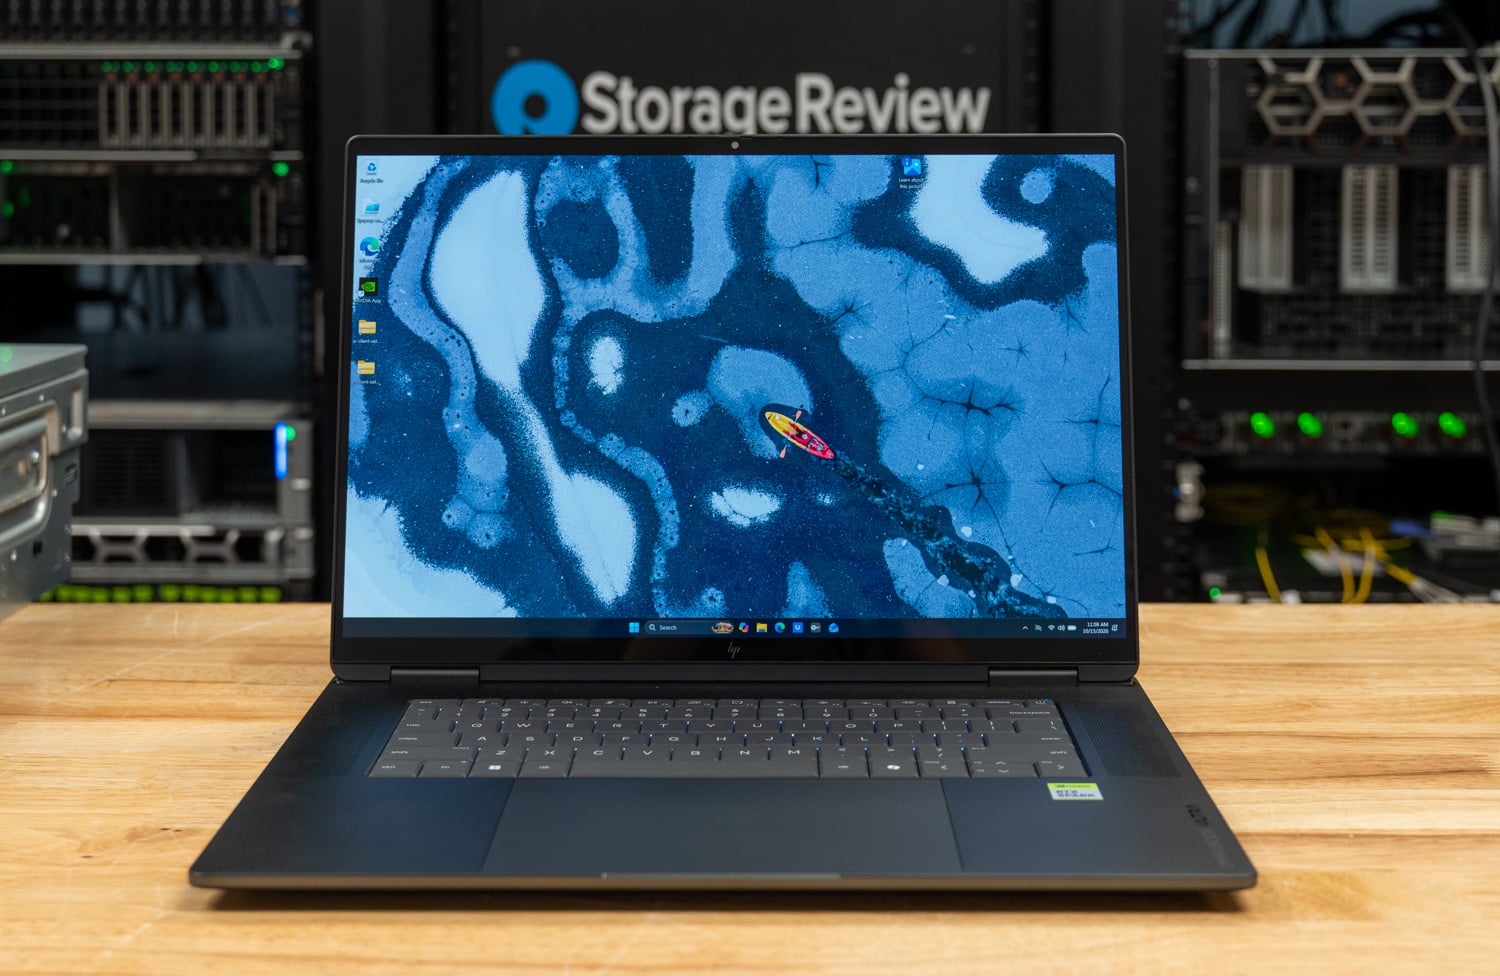
L'OmniBook Ultra 16 da 128 GB è il notebook con RTX Spark più completo che abbiamo testato. Con 62.5 GB di memoria utilizzabile dalla GPU, esegue entrambi i nostri modelli AI locali, generando gpt-oss:20b a 58.0 token al secondo e Qwen3.6-35B-A3B a 89.5. Ha superato tutte e nove le esecuzioni dell'agente di codifica e ha completato il task Qwen3.6 in 72.0 secondi, il più veloce del suo gruppo, e ha completato la risoluzione OpenBLAS su tutti i core a 98 °C, il test che ha spento due unità Surface Laptop Ultra.
Il suo punteggio di 7,004 in Cinebench 2026 multi-core è stato il miglior risultato della CPU in quel confronto, il 35% in più rispetto al Razer Blade 16. La RTX 5090 del Blade genera ancora token 2.3 volte più velocemente sui modelli che rientrano nei suoi 24 GB, e il browser dell'OmniBook è rallentato di 1.73 volte mentre l'agente di codifica era in esecuzione sulla GPU condivisa. La configurazione da 128 GB e 2 TB che abbiamo testato è venduta solo tramite HP.com, dove HP la proponeva a 6,229.99 dollari al 14 ottobre. Il modello da 32 GB a 3,199.99 dollari mantiene la velocità della CPU ma non può caricare i nostri livelli di modello e i risultati della batteria sono in attesa.
Recensione: HP OmniBook Ultra 16: RTX Spark con 128 GB al primo posto nel nostro test con agente di codifica locale
Il laptop con RTX Spark che si surriscalda meno: Lenovo Yoga 9n 2-in-1 16
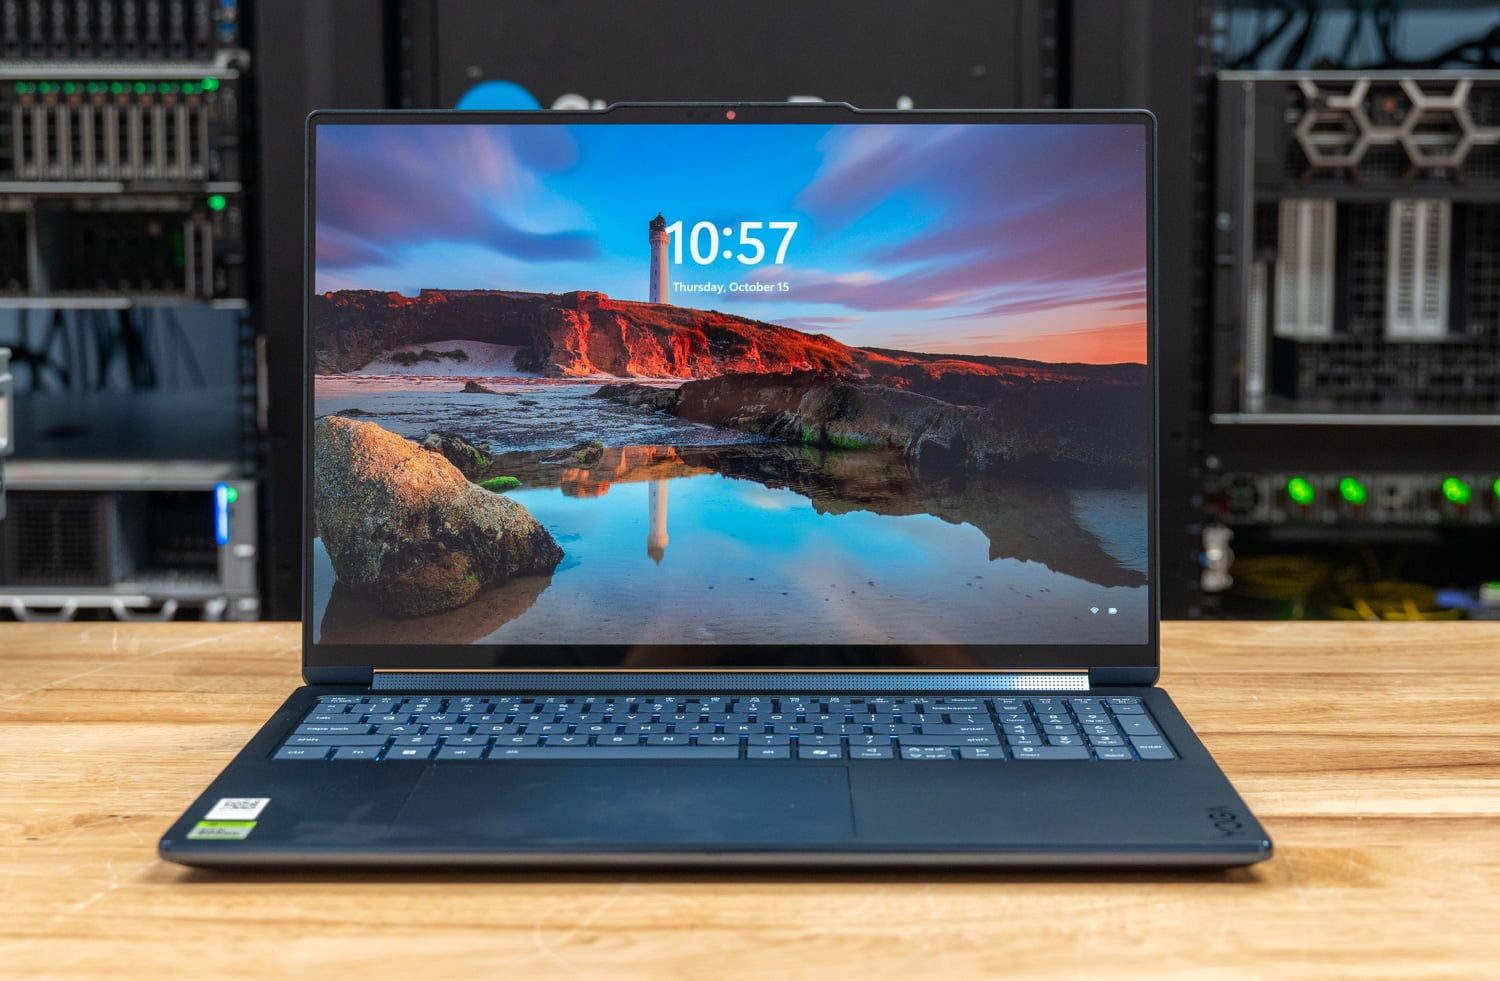
Il Yoga 9n 2-in-1 16 ha fatto funzionare l'N1X a temperature inferiori rispetto a qualsiasi notebook con RTX Spark che abbiamo testato. Durante il nostro ciclo di test continuo di 30 minuti, la sua CPU ha raggiunto un picco di 72 °C e ha mantenuto una frequenza di 3,015 MHz, completando il test al 100.1% della prima passata. L'HP OmniBook Ultra 16 e il Surface Laptop Ultra hanno raggiunto i 98 °C, mentre il Lenovo Pro 9n 15 ha toccato un picco di 92 °C, tutte misurazioni effettuate tramite le zone termiche di Windows, l'unico sensore della CPU esposto da questi sistemi. Lenovo attribuisce questo risultato a prese d'aria più grandi, a un rilievo termico e a una cerniera convertibile che lascia spazio dietro le prese d'aria per la circolazione dell'aria.
La configurazione con dissipatore di calore più basso penalizza lo Yoga in termini di velocità multi-core rispetto all'HP. I risultati multi-thread sono inferiori del 4-10% rispetto all'OmniBook nella maggior parte dei test, e l'agente di codifica ha rallentato il browser di 2.44 volte sullo Yoga contro 1.73 volte sull'HP. La configurazione da 64 GB offre alla GPU 32 GB, sufficienti per gpt-oss:20b a 58.0 token al secondo, ma inferiori al nostro livello da 35B. Per un convertibile da 16 pollici che viene utilizzato sia come tablet che sulle gambe, questo compromesso è sensato. Il prezzo di listino nella configurazione testata è di 3,749.99 dollari e i risultati relativi alla batteria sono in attesa di pubblicazione.
Recensione: Lenovo Yoga 9n 2-in-1 16: il notebook con RTX Spark che si mantiene più fresco
Testato anche sulla nuova suite:
- Lenovo Pro 9n 15: il N1X a 18 core con 32 GB di memoria in uno chassis da 3.64 kg. Il Llama 3.1 8B ha raggiunto 55.1 token al secondo in MLPerf Client, entro il 2% da un N1X a 20 core con la stessa suddivisione GPU da 12 GB, e le sue frequenze di clock più elevate su tutti i core lo mantengono entro l'8-11% della parte a 20 core nel rendering e nella compilazione, con un picco di 93 °C. Con 12 GB per la GPU non è incluso nei nostri test di carico del modello e di agente di codifica, quindi gli acquirenti di AI locale dovrebbero configurare più memoria. Lenovo lo propone a partire da $ 2,999.99 per il modello a 18 core, 32 GB e 512 GB.
- Microsoft Surface Laptop Ultra per aziende (come testato): l'unità da 128 GB ha generato gpt-oss:20b e Qwen3.6-35B-A3B a una velocità compresa tra 58 e 89 token al secondo e ha ottenuto un punteggio di 6,963 in Cinebench 2026 multi-core. Il risultato appare solo come testato, poiché due unità si sono spente durante il nostro carico OpenBLAS su tutti i core.
Il Dell XPS 16 Creator Edition arriverà presto nei nostri laboratori e verrà aggiunto a questa sezione non appena lo avremo testato. I risultati relativi alla durata della batteria per ogni sistema con RTX Spark saranno disponibili nel nostro nuovo test multipiattaforma.
Anche testato
Questi sistemi sono stati sottoposti allo stesso processo di laboratorio e meritano di essere presi in considerazione dall'acquirente giusto, anche se oggi non occupano una posizione specifica in una determinata categoria.
- Lenovo Think Pad P16 generazione 3: la terza macchina RTX PRO 5000 della flotta (Phi a 141.2 tok/s); la nostra unità è stata fornita con 32 GB di RAM, il che ha limitato il resto del flusso di lavoro.
- HP ZBook Fury G1i 18: stessa classe di GPU Blackwell da 24 GB del Pro Max 18 Plus, un gradino indietro in termini di velocità di elaborazione (Phi a 157.4 tok/s) e $ 11,687 nella configurazione testata durante la recensione.
- Dell Pro Precision 7 16 Intel: RTX PRO 3000 Blackwell con 12 GB di VRAM, il miglior risultato tra le GPU di fascia media in questo campo (punteggio di generazione di testo Procyon di 2,244 su Phi tramite DirectML); i suoi 12 GB aprono la classe 14B che le schede da 8 GB non possono supportare.
- Lenovo Think Pad P1 generazione 8: RTX PRO 2000 8GB in uno chassis da 4.06 libbre con 12 ore e 59 minuti di autonomia della batteria; Phi a 77.3 tok/s.
- Lenovo Think Pad P1 generazione 9: testata sulla nostra nuova suite client, la sua RTX PRO 2000 da 50 W ha generato Llama 3.1 8B a 64.8 token al secondo in MLPerf Client, la RTX PRO 2000 più veloce che abbiamo testato e davanti alla RTX Spark HP OmniBook Ultra 16 a 56.5 su quel modello; la sua scheda da 8 GB non è stata in grado di caricare i nostri modelli da 20B e superiori.
- Dell Pro Max 14 Premium: RTX PRO 2000 8GB da 3.55 libbre; Phi a 54.1 tok/s.
- Dell Pro Max 16 (Ryzen): RTX PRO 1000 8GB con un risultato di 16 ore e 2 minuti di autonomia della batteria; Phi a 61.9 tok/s.
- Lenovo ThinkPad P14s Gen 6: RTX PRO 500 6GB; Blackwell AI entry a 45.7 tok/s su Phi.
- Dell Pro Precision 5 16s Intel: il fratello da 16 pollici del nostro modello senza GPU dedicata, basato sulla stessa piattaforma a memoria condivisa, con la batteria per workstation che ha la durata maggiore che abbiamo mai misurato: 24 ore e 43 minuti.
- Dell Pro Precision 5 14s AMD: 60 TOPS NPU e un pool condiviso da 64 GB; il percorso immagine AMD Procyon INT8 non era ancora disponibile al momento del test, il che limita il confronto. Dell Pro Precision 5 16s AMD Offre lo stesso Ryzen AI 9 HX PRO 475 e la stessa NPU 60 TOPS in uno chassis da 16 pollici e ha registrato il throughput LLM locale più elevato della linea Pro Precision nei nostri test, nettamente superiore al suo omologo Intel sia su Llama3 che su Llama2, risultando la scelta migliore di questa famiglia per le attività di inferenza locale.
- HP EliteBook X G1a: Ryzen AI 9 HX 375 con NPU a 55 TOPS; non abbiamo ancora eseguito la nostra suite LLM su di esso.
Come siamo classificati
UL Procyon AI Text Generation è il nostro parametro di riferimento per la comparazione tra i vari modelli: gli stessi quattro modelli (Phi, Mistral, Llama 3 e Llama 2, laddove compatibile) su ogni laptop in grado di ospitarli, quindi i valori di token al secondo sono direttamente confrontabili. Laddove l'hardware lo consenta, approfondiamo le analisi con LM Studio e Ollama sui modelli più potenti. Ogni laptop viene valutato una sola volta per ciascun parametro di misurazione e un sistema compare in questa pagina solo se ha prodotto risultati di intelligenza artificiale utilizzabili nel nostro laboratorio.
I sistemi RTX Spark hanno eseguito sr-client 1.2, la nostra nuova suite client, quindi in questa pagina vengono confrontati tra loro e non con i risultati di Procyon riportati dietro le altre selezioni.
In questo mercato i prezzi variano rapidamente, quindi qualsiasi cifra in dollari presente in questa pagina si riferisce al prezzo effettivo rilevato al momento della pubblicazione della recensione. Non formuliamo affermazioni sul valore senza aver prima verificato i prezzi correnti sui configuratori dei fornitori e, quando lo facciamo, indichiamo la data della verifica.
FAQ sull'intelligenza artificiale locale del laptop
Per un'intelligenza artificiale locale su un laptop, cosa è più importante: la VRAM o la memoria totale?
Entrambi, per ragioni diverse: un modello deve rientrare nella memoria raggiungibile dalla GPU: sulle schede dedicate si tratta di VRAM (da 8 GB a 24 GB in questo ambito), e la nostra Llama 2 13B non è stata eseguita correttamente su schede da 8 GB perché richiedeva circa 12 GB. Le architetture con memoria unificata e condivisa ribaltano la situazione: i Ryzen AI Max+ di AMD possono assegnare fino a 96 GB di RAM di sistema alla GPU, e i pool di memoria condivisa LPCAMM2 di Intel raggiungono i 64 GB, quindi anche i modelli più grandi vengono caricati, seppur a velocità inferiori. La compatibilità determina se un modello viene eseguito; il silicio determina la velocità di esecuzione.
Qual è il modello più grande che StorageReview ha eseguito su un laptop?
DeepSeek-R1 70B, caricato localmente sull'HP ZBook Ultra G1a 14 tramite il suo pool di memoria unificata assegnabile da 96 GB. Per la generazione continua, abbiamo misurato Gemma 3 27B a 8.96 token al secondo sulla stessa macchina. Sul lato desktop, l'asticella è più alta; la classifica dei migliori desktop per l'IA locale comprende sistemi che supportano modelli molto più grandi.
Le valutazioni NPU TOPS sono rilevanti per l'esecuzione di LLM?
Meno di quanto suggerisca il marketing odierno, perché la maggior parte dei runtime LLM locali si basa sulla GPU e ogni valore di token al secondo in questa pagina proviene dall'inferenza GPU, ad eccezione dello Snapdragon EliteBook, dove il punto di forza è lo stack AI della piattaforma. Le NPU attualmente si distinguono per l'efficienza e per i percorsi di generazione di immagini INT8, ed è per questo che molti di questi computer sono qualificati come PC Copilot+, quindi conviene dare priorità alla GPU e alla memoria nell'acquisto.
Che impatto ha sulla durata della batteria l'esecuzione dei modelli in locale?
L'inferenza è uno dei carichi di lavoro più pesanti che un laptop possa gestire in modo continuativo, quindi è consigliabile utilizzare l'alimentazione di rete per sessioni di lavoro intense. I dati sulla durata della batteria riportati in questa pagina si riferiscono ai risultati di PCMark 10 Modern Office, un indicatore di produttività, e la differenza è enorme: 3 ore e 39 minuti sul nostro laptop AI più veloce contro quasi 24 ore sul Dell con memoria condivisa. La nostra classifica della durata della batteria dei laptop elenca tutti i modelli disponibili.
Come si confrontano i portatili con RTX Spark con i portatili presenti in questa classifica?
I laptop RTX Spark utilizzano la GPU N1X di NVIDIA, che condivide un pool di LPDDR5X tra una CPU Grace e una GPU Blackwell. Li testiamo con sr-client 1.2, la nostra nuova suite client, quindi i loro risultati non corrispondono esattamente a quelli di Procyon riportati in questa pagina. Sull'HP OmniBook Ultra 16 da 128 GB, gpt-oss:20b e Qwen3.6-35B-A3B hanno generato rispettivamente 58.0 e 89.5 token al secondo, e il task di codifica 35B ha superato tre esecuzioni su tre in 72.0 secondi.
La suddivisione della memoria determina quali modelli vengono caricati: il Lenovo Pro 9n 15 da 32 GB, impostato a 12 GB per la GPU, non è riuscito a caricare il gpt-oss:20b da 12.8 GB. Il Lenovo Yoga 9n 2-in-1 16 è risultato il più fresco, con una temperatura massima di 72 °C durante un carico continuo di 30 minuti. Il Surface appare solo come testato, poiché due unità si sono spente durante il nostro carico OpenBLAS su tutti i core.
Dovrei piuttosto acquistare un computer fisso per l'intelligenza artificiale locale?
Se il computer rimarrà su una scrivania, sì, probabilmente. I sistemi desktop offrono più memoria per dollaro, una migliore gestione termica e nessun compromesso sulla durata della batteria; la nostra classifica dei migliori desktop per l'IA locale parte da un prezzo simile a quello dei laptop di fascia media che trovate qui. I laptop in questa pagina sono pensati per chi deve svolgere attività di IA in mobilità.


 Amazon