

Aggiornato il 19 ottobre 2026: Open WebUI diventa la seconda scelta con risultati di guida misurati (115.32 e 75.06 token al secondo sul benchmark RTX 5000 Ada, contro 123 e 82 di gennaio), la sua voce ora include l'app desktop Windows e il server v0.12.2, e la colonna Guida rimanda alla prova pratica di Open WebUI. Pubblicato originariamente il 19 agosto 2026.
Esistono quattro motivi per eseguire un modello linguistico sul proprio hardware, e solo uno di questi è di natura ideologica. Privacy: un documento consegnato a un modello locale non lascia mai la macchina, e questo vale per l'intera conversazione relativa al codice client, ai contratti, ai dati dei pazienti e ai prodotti non ancora rilasciati.
Struttura dei costi: l'IA cloud è a consumo e i carichi di lavoro agentici moltiplicano il numero di token abbastanza velocemente da permettere a una workstation performante di ripagarsi da sola; l'hardware di proprietà funziona al costo dell'elettricità. Disponibilità: nessun limite di velocità, nessuna interruzione, nessuna email di dismissione che modifichi il flusso di lavoro di martedì. E controllo: il modello che hai convalidato è il modello che esegui finché non decidi diversamente.
Il rovescio della medaglia è che i modelli cloud di frontiera rimangono più performanti e, per il lavoro a lungo termine che richiede un'azione mirata, il divario è reale. I modelli locali hanno raggiunto la parità per attività circoscritte: chat, riassunti, codice in file singolo e domande e risposte su documenti. Queste sono, per la precisione, le attività che la maggior parte delle persone svolge quotidianamente. Se la vostra priorità è la massima capacità a qualsiasi costo, utilizzate il cloud. Se invece la priorità è la privacy, il costo o il controllo, le soluzioni locali sono ancora valide e questa pagina ne è la guida.
Questa definizione dovrebbe stabilire il budget hardware, perché la spesa per l'IA locale è una decisione che riguarda la memoria prima di ogni altra cosa. 16 GB di VRAM o 32 GB di memoria unificata coprono la classe da 7 a 8 miliardi, che gestisce il lavoro limitato di cui sopra. Da 24 a 32 GB di VRAM, o 48 GB di memoria unificata, raggiungono la classe da 30 miliardi, dove la programmazione agentica smette di essere una demo. Da 96 a 128 GB di memoria unificata gestiscono i modelli da oltre 100 miliardi che si avvicinano alla qualità di frontiera. Acquistare in eccesso garantisce una velocità che potresti non notare; acquistare in difetto significa che la classe di modelli che desideravi non verrà mai caricata.
Le nostre classifiche dei migliori laptop per l'IA locale e dei migliori desktop per l'IA locale suddividono i computer in categorie. Questa pagina illustra i programmi che è possibile eseguire su questi dispositivi.
Il lato software non è maturato con la stessa fluidità dell'hardware. Circa un terzo degli strumenti che vengono consigliati nei risultati di ricerca odierni non sono più supportati, e la maggior parte dei siti che li raccomandano non se n'è nemmeno accorta.
Questa pagina tiene traccia di ciò che funziona e su quale hardware, a ottobre 2026. Per ora classifichiamo in base alle stelle di GitHub, perché è un segnale neutrale e verificabile, e specifichiamo quando uno strumento è closed source e non ha un conteggio di stelle da assegnare. Ogni nome di strumento nelle tabelle rimanda al suo download ufficiale. Man mano che ogni strumento viene testato in laboratorio, la colonna Guida si aggiorna con una procedura pratica di configurazione e i nostri dati, a partire da gennaio.
Questa pagina è governata da tre regole, a cominciare dalla distinzione tra modello locale e agente locale . Diversi prodotti vengono eseguiti sulla tua macchina, mentre ogni chiamata di inferenza viene inoltrata a un cloud di un fornitore; si tratta di una questione di privacy, non di funzionalità offline, e questi strumenti sono elencati separatamente in fondo alla pagina per rendere la distinzione ben visibile. In secondo luogo, ogni voce riporta i requisiti hardware minimi realistici, perché "funziona su un laptop" è un'affermazione priva di significato senza un dato sulla memoria RAM. In terzo luogo, nella sezione FAQ, teniamo traccia dei prodotti che non sono più supportati, con le relative date.
Le scelte
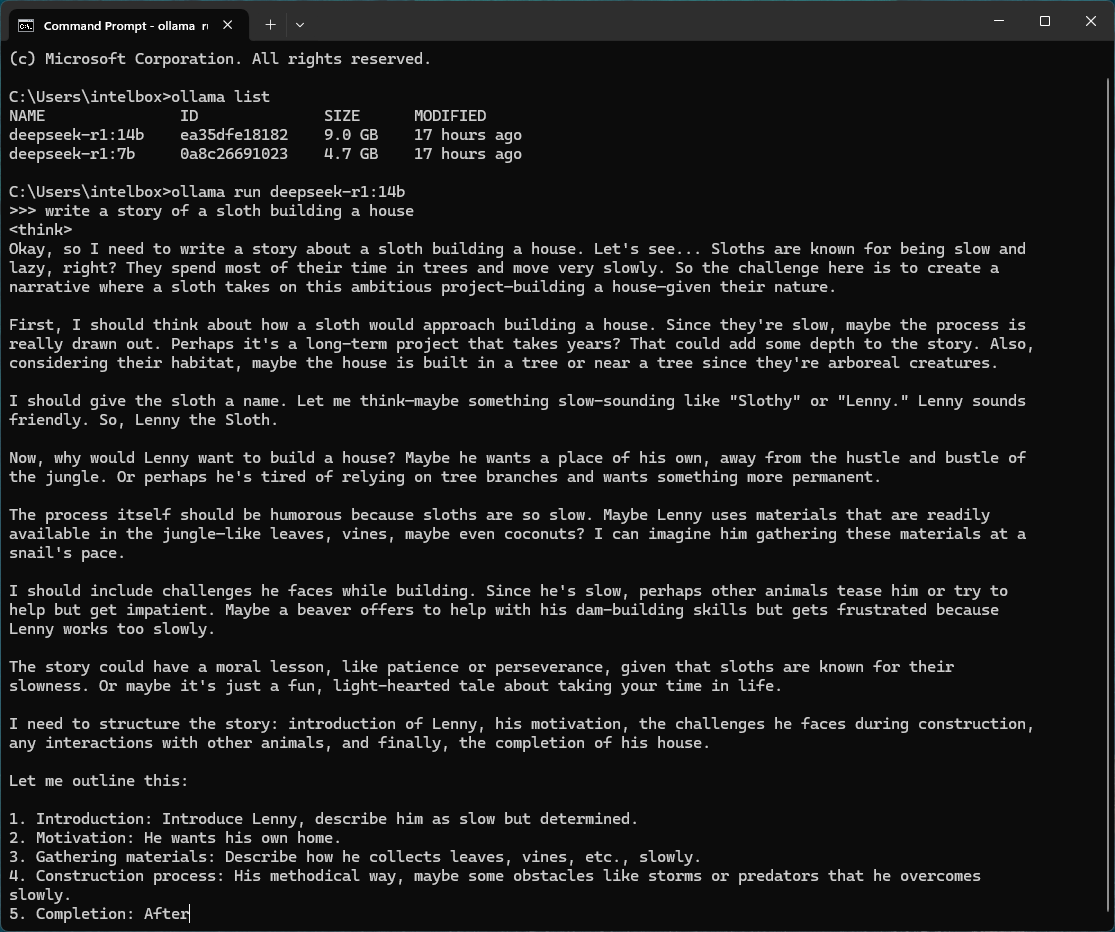
Miglior tempo di esecuzione complessivo del LLM locale: Ollama
Ollama è la risposta predefinita e quella con cui la maggior parte degli altri strumenti interagisce. È rilasciato con licenza MIT, ha circa 179,000 stelle su GitHub e ora include un'interfaccia grafica desktop oltre alla riga di comando. Scarica i modelli con un solo comando, espone un endpoint compatibile con OpenAI su localhost e, a gennaio 2026, ha aggiunto la compatibilità con l'API Anthropic Messages, che è il metodo utilizzato per indirizzare Claude Code a un modello locale. Requisiti minimi: 8 GB di RAM di sistema per un modello 3B, 16 GB per modelli 7-8B, 24 GB di VRAM per la classe 30B.
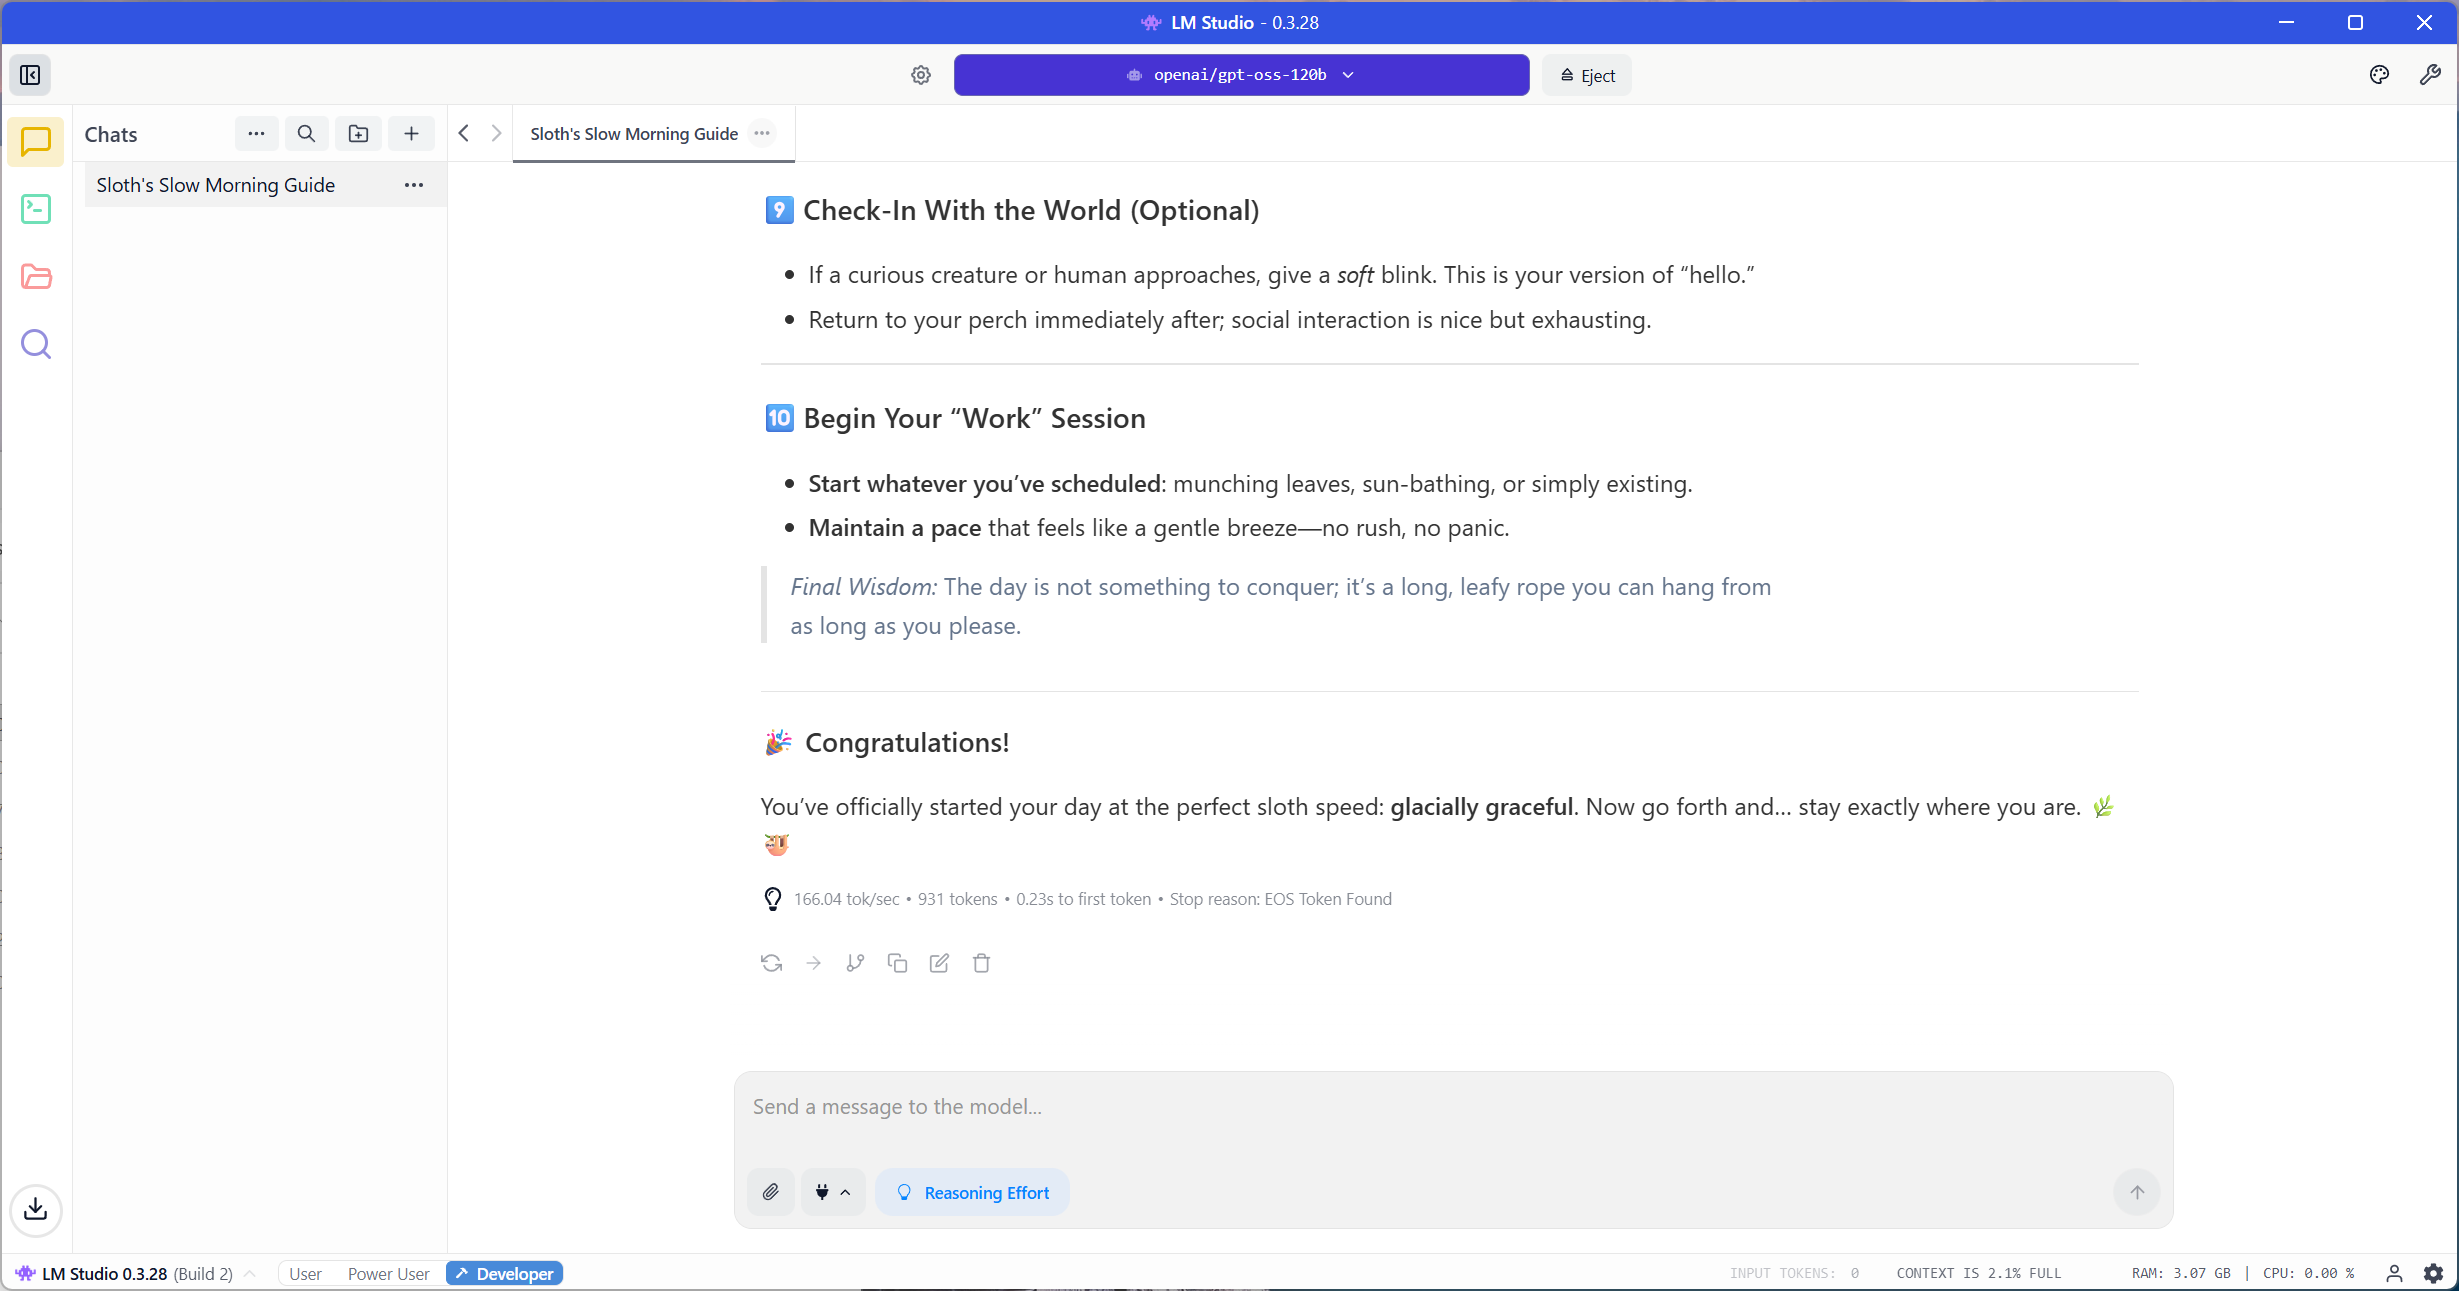
Ideale per il benchmarking hardware: LM Studio
Essendo un software closed source, non ha un sistema di valutazione a stelle, ma si merita comunque il suo posto. LM Studio include sia llama.cpp che MLX ed espone i controlli importanti quando si misura una macchina anziché utilizzarla: livelli di offload GPU, scelta della quantizzazione, lunghezza del contesto e comportamento multi-GPU. È disponibile gratuitamente per uso commerciale da luglio 2025. Questo è lo strumento alla base della maggior parte dei valori di token al secondo ottenuti sulle nostre schede di workstation e laptop. Requisiti minimi: 16 GB di RAM; 24 GB di VRAM o 32 GB di memoria unificata per prestazioni ottimali.
Miglior motore di base: llama.cpp
Quasi tutto il resto in questa pagina deriva da llama.cpp. Licenza MIT, circa 124,700 stelle, con diverse build taggate pubblicate ogni giorno. È importante per un pubblico di hardware per un motivo specifico: l'elenco dei backend è enorme e comprende CUDA, ROCm, Metal, Vulkan, SYCL, CANN e OpenCL, e gli ingegneri dei fornitori ora contribuiscono direttamente con ottimizzazioni. Un miglioramento del prefill di Intel Arc nella build 8688 ha avuto un valore circa 5 volte superiore, e ogni utente di Ollama e LM Studio lo ha ricevuto senza installare nulla. Requisiti minimi: funziona solo con la CPU; 8 GB di RAM per essere utilizzabile.
Migliore app desktop con priorità locale: gennaio
Apache 2.0, circa 44,100 stelle, v0.8.6 a ottobre 2026. Jan include llama.cpp, quindi non c'è altro da installare e funziona anche con il cavo di rete scollegato. Sembra un requisito minimo finché non si controlla quante app in questa categoria sono client cloud con un campo Ollama. Questa è la soluzione ideale per un collega che non aprirà mai un terminale.
È anche la prima piattaforma in questa pagina con i nostri dati di test: sul nostro benchmark RTX 5000 Ada, Jan V3.5 4B è stato decodificato a una media di 123 token al secondo e Jan V2 VL High a 82, utilizzando 4.8 GB e 8.2 GB di memoria GPU, con accelerazione GPU abilitata al primo avvio e senza configurazione CUDA. La procedura completa, dall'installazione all'API compatibile con OpenAI, è disponibile nella nostra guida pratica di Jan ; il documento RAG è l'unica parte dell'applicazione non trattata. Requisiti minimi: 8 GB di RAM.
Miglior RAG di documenti locali: AnythingLLM
MIT, circa 64,800 stelle. Include un database vettoriale e gestisce il chunking e l'incorporamento senza configurazione, il che lo rende la chat di documenti più intuitiva nella sua categoria desktop. Due cose che non tralasceremo: una vulnerabilità di marzo 2026, classificata CVSS 9.6, consentiva l'esecuzione di codice remoto attivata dalla risposta in streaming del modello stesso; corretta nella versione 1.11.2, quindi aggiornate prima di utilizzarla. Inoltre, la telemetria è attiva di default in un'app commercializzata come "local-first", che si può disattivare nelle Impostazioni. Requisiti minimi: 16 GB di RAM per lavorare con i documenti.
Migliore installazione multiutente self-hosted: Open WebUI
Circa 149,000 stelle e la massima configurabilità di recupero qui, e abbiamo testato il server v0.12.2. Inizialmente era un server self-hosted con Docker come punto di ingresso, e ora un'applicazione desktop per Windows lo installa con un ambiente Python integrato e il proprio runtime llama.cpp. Una cosa da sapere prima di svilupparci sopra: la licenza è cambiata nell'aprile 2025 da BSD-3 a una licenza personalizzata non approvata da OSI, che aggiunge una clausola contro la rimozione del marchio Open WebUI, con un'eccezione per gli utenti al di sotto dei cinquanta in un periodo di trenta giorni. Eseguendolo senza modifiche su piccola scala, non cambierà nulla per te.
It is the second platform on this page with our own numbers. On our Jan bench and model files, Open WebUI Desktop decoded Jan V3.5 4B at a median 115.32 tokens per second and Jan V2 VL High at 75.06, 6.2 and 8.5 percent behind Jan on a different llama.cpp build. Setup is where they diverge: we pinned llama.cpp build b11612, added CUDA runtime DLLs by hand, and restored an 8,192-token context after a reinstall let it allocate up to 169,984 tokens per slot.
Presets, image input, DDGS web search, and the local API then all worked, as our Guida pratica a Open WebUI dettagli. Minimo: un runtime separato più 4 GB per il container, oppure l'applicazione desktop con il suo llama.cpp incluso.
Miglior agente di codifica locale: Cline
Apache 2.0, circa 63,900 stelle. Cline ha investito più risorse ingegneristiche sul percorso locale di qualsiasi concorrente, tra cui un prompt di sistema compatto creato specificamente per Ollama e LM Studio e la chiamata di strumenti nativi per ogni famiglia di modelli. La loro documentazione è insolitamente schietta riguardo ai punti in cui il cloud è ancora vincente. Requisiti minimi: 24 GB di VRAM o 36 GB di memoria unificata e contesto impostato a 32 KB o superiore.
Miglior programma di programmazione per terminali offline: Aider
Apache 2.0, circa 48,300 stelle, e architettonicamente l'opzione locale più affidabile per un motivo che vale la pena comprendere. Aider non utilizza affatto chiamate di strumenti JSON. Analizza i formati di modifica diff e whole-file da testo semplice, aggirando così la modalità di errore che manda in crash la maggior parte degli agenti sui modelli locali. L'avvertenza riguarda la manutenzione: un singolo autore ha scritto il 96% dei commit e la cadenza di rilascio si è ridotta a circa una versione stabile nel 2026. Requisiti minimi: 24 GB di VRAM o 36 GB unificati.
Migliore piattaforma per agenti self-hosted: OpenHands
MIT, circa 84,500 stelle. OpenHands documenta correttamente i modelli locali e, cosa ancora più utile, ti dice quando il problema non è la tua configurazione: la sua stessa documentazione afferma che se l'agente si comporta come un chatbot o fallisce costantemente gli strumenti, il modello è il limite. Richiede un contesto minimo di 22K e raccomanda 32K. Minimo: 24 GB di VRAM per modelli quantizzati o 64 GB di memoria unificata.
La migliore sorpresa offline gratuita: GitHub Copilot CLI
Da aprile 2026, la CLI di Copilot funziona con Ollama, vLLM e Foundry Local. L'autenticazione GitHub è facoltativa e non è richiesto alcun abbonamento a Copilot. Impostando COPILOT_OFFLINE si interrompono tutti i dati di telemetria e i contatti di rete, e i suoi sub-agenti ereditano il provider locale. La maggior parte degli articoli di confronto lo elenca ancora come esclusivamente cloud. Da notare la distinzione: l'estensione IDE invia comunque i suggerimenti di completamento inline al cloud anche in modalità "porta la tua chiave". Requisiti minimi: un modello con una finestra di contesto di 128 KB, quindi 32 GB di VRAM o 64 GB unificati.
Miglior server supportato dal fornitore: Lemonade
Apache 2.0, con circa 5,400 stelle, è l'unico strumento di terze parti che raccomanderemmo basandoci esclusivamente sui suoi meriti. È gestito dagli ingegneri AMD e funziona su NVIDIA CUDA, Apple Metal, Vulkan e CPU standard, oltre che su NPU Radeon e Ryzen AI. Viene rilasciato all'incirca ogni due settimane e la sua applicazione desktop è passata da Electron a Tauri nell'aprile 2026. Requisiti minimi: 16 GB di RAM; Ryzen AI serie 300 o successiva per il percorso NPU.
Miglior RAG locale a livello di filesystem: Nexa AI Hyperlink
Nexa AI Hyperlink è un software proprietario e gratuito che indicizza l'intero filesystem del dispositivo e fornisce risposte con citazioni inline. È presente in questo elenco perché è l'unico nuovo strumento RAG locale con dati di accelerazione pubblicati su hardware consumer: circa 3 volte più veloce nell'indicizzazione e 2 volte più veloce nell'inferenza su una RTX 5090, con una cartella da 1 GB che passa da circa quindici minuti a quattro o cinque. Requisiti minimi: una GPU RTX moderna; 16 GB di RAM.
Tempi di esecuzione: cosa esegue il modello
Questi cinque sono i motori, e tutto ciò che si trova nelle due tabelle successive è un'interfaccia che comunica con uno di essi; pertanto, la tabella è ordinata in base alle stelle di GitHub, come il resto della pagina.
La colonna "Guida" si sovrappone alle app, quindi è strutturata di conseguenza: Ollama ha una guida dedicata perché è la scelta principale e il backend a cui fanno riferimento la maggior parte degli altri strumenti, LM Studio compare in entrambe le tabelle e ha una guida, llama.cpp è trattato attraverso le app che lo includono, a partire dalla prova pratica di gennaio, e MLX è trattato tramite LM Studio su Apple Silicon. vLLM è un motore di servizio e il suo test è già presente nella nostra recensione del cluster GB300 a due torri.
| Runtime | Stelle | Licenza | Hardware minimo | Accelerazione | alle taglie |
|---|---|---|---|---|---|
| Ollama | ~ 179,000 | CON | 8 GB di RAM (3B), 16 GB (7-8B), 24 GB di VRAM (classe 30B) | CUDA, ROCm, Metal, Vulkan | Presto disponibile |
| lama.cpp | ~ 124,700 | CON | 8 GB di RAM, funziona solo la CPU | CUDA, ROCm, Metal, Vulkan, SYCL, CANN, OpenCL | Coperto attraverso il Gen and Apri l'interfaccia utente Web attività pratiche |
| MLX / mlx-lm | ~ 27,500 | CON | Apple Silicon, 16 GB unificati | Metallo; backend CUDA aggiunto nel 2026 | Tramite la guida di LM Studio (disponibile a breve) |
| Studio LM | Fonte chiusa | Proprietà esclusiva, utilizzo gratuito per scopi commerciali. | 16 GB di RAM; 24 GB di VRAM o 32 GB unificati | Include i pacchetti llama.cpp e MLX | Presto disponibile |
| vLLM | Servizio di produzione | Apache 2.0 | 24 GB di VRAM, livello minimo realistico | CUDA, ROCm | Testato nel nostro Recensione del cluster GB300 |
Applicazioni desktop e RAG locale
Queste sono le app che un lettore installa, e la colonna "Local-First" è quella da leggere attentamente: distingue il software che esegue un modello sul tuo computer dal software che ha aggiunto un campo per un URL Ollam.
| App | Stelle | Licenza | Local-First | Hardware minimo | alle taglie |
|---|---|---|---|---|---|
| Apri l'interfaccia utente Web | ~ 149,000 | Personalizzato, non approvato da OSI | Capace; server, più un'applicazione desktop Windows che include llama.cpp | Runtime separato + 4 GB per il container o l'applicazione desktop | Guida pratica a Open WebUI |
| Qualunque cosaLLM | ~ 64,800 | CON | Funzionante; telemetria attiva per impostazione predefinita | RAM 16GB | Presto disponibile |
| Gen | ~ 44,100 | Apache 2.0 | Sì, bundle llama.cpp | RAM 8GB | Guida pratica di gennaio |
| Studio LM | Fonte chiusa | Proprietary | Si | 16 GB di RAM; 24 GB di VRAM per essere interessanti | Presto disponibile |
| Msty | Fonte chiusa | Livello gratuito proprietario | Sì, bundle Ollama, MLX, llama.cpp | RAM 8GB | Presto disponibile |
| Collegamento ipertestuale a Nexa AI | Fonte chiusa | Proprietà esclusiva, gratuito | Sì, indicizzazione sul dispositivo | GPU RTX moderna, 16 GB di RAM | Presto disponibile |
Strumenti di codifica e agenti
Queste sono le voci più esigenti in termini di hardware presenti nella pagina, poiché il lavoro con agenti richiede un'ampia finestra di contesto e sessioni lunghe. Considerate che 32 GB di VRAM o 64 GB di memoria unificata rappresentano il punto in cui questa non è più una demo.
| Chiavetta | Stelle | Licenza | Percorso Locale | Hardware minimo | alle taglie |
|---|---|---|---|---|---|
| ManiAperte | ~ 84,500 | CON | LM Studio, Ollam, vLLM, SGLang | 24 GB di VRAM o 64 GB unificati; contesto 32K | Presto disponibile |
| Cline | ~ 63,900 | Apache 2.0 | Ollama, LM Studio, compatibile con OpenAI | 24 GB di VRAM o 36 GB unificati | Presto disponibile |
| Oca | ~ 52,900 | Apache 2.0 | Ollama di prima classe; ora Linux Foundation | 24 GB di VRAM o 36 GB unificati | Presto disponibile |
| aider | ~ 48,300 | Apache 2.0 | Ollama, compatibile con OpenAI; nessuna chiamata di strumento | 24 GB di VRAM o 36 GB unificati | Presto disponibile |
| Zeta | v1.0, aprile 2026 | Apache 2.0 | LM Studio, Ollama, llama.cpp | 24 GB di VRAM o 36 GB unificati | Presto disponibile |
| CLI GitHub copilota | Fonte chiusa | Contenuto esclusivo, non è necessario alcun abbonamento. | Ollama, vLLM, Foundry Local | 32 GB di VRAM o 64 GB unificati; contesto 128K | Presto disponibile |
Iniziative dei fornitori
Ogni produttore di chip e sistemi operativi offre qualcosa per l'IA locale, e questa categoria merita una voce a sé stante perché la nomenclatura è confusionaria e il tasso di abbandono è elevato. Il modello che si è delineato nel 2026 è stato coerente: i produttori hanno smesso di competere con le soluzioni di terze parti e hanno iniziato a supportarle. NVIDIA ha abbandonato entrambi i suoi prodotti di IA locale e ora pubblica ottimizzazioni per Ollama, llama.cpp e ComfyUI. AMD collabora con LM Studio. Qualcomm ha implementato le sue funzionalità NPU adattando un'applicazione di terzi.
L'unica cosa che gli strumenti dei fornitori fanno e che Ollama e LM Studio non possono fare è accedere alla NPU . llama.cpp non ha un backend NPU, quindi su una macchina AI con Snapdragon o Ryzen, questi strumenti lasciano il motore neurale a un utilizzo pari allo zero percento. Se hai pagato per un TOPS di 40-60, solo un percorso del fornitore lo utilizza. Regola le tue aspettative di conseguenza, perché le NPU attualmente raggiungono al massimo circa 7 miliardi di modelli e il vantaggio è la durata della batteria in caso di lavoro continuo con modelli di piccole dimensioni, non la velocità di elaborazione. Una GPU dedicata batte la NPU in velocità ogni volta.
| Venditore | Cos'è | Tipo | Hardware richiesto | Stato | alle taglie |
|---|---|---|---|---|---|
| Limonata AMD | Server, interfaccia grafica e SDK; circa 5,400 stelle, Apache 2.0 | Applicazione + server | 16 GB di RAM; Ryzen AI 300+ per NPU. Funziona anche su CPU NVIDIA, Apple. | Attivo, spedizioni ogni due settimane | Presto disponibile |
| Intel OpenVINO GenAI | Tempo di esecuzione e SDK; ~10,700 stelle | SDK | Core Ultra, serie Arc A/B; 16 GB di RAM | Attivo, 2026.3 nell'agosto 2026 | Percorso tracciato, nessuna guida prevista |
| Modelli della Fondazione Apple | Modelli on-device esposti dal sistema operativo | framework del sistema operativo | Apple Silicon; già installato | Attiva; aperta a tutti i fornitori alla WWDC 2026 | Percorso tracciato, nessuna guida prevista |
| Microsoft Foundry Local | SDK e CLI per l'inferenza locale; circa 2,400 stelle | SDK | Windows, macOS, Linux; NPU/GPU/CPU | GA aprile 2026; catalogo modelli selezionato | Percorso tracciato, nessuna guida prevista |
| AMD GAIA | Applicazione LLM locale per Ryzen AI; circa 1,400 stelle, MIT | App + SDK | Processore Ryzen AI serie 300 minimo; 16 GB di RAM, 64 GB consigliati | Attiva, v0.20.0 giugno 2026 | Percorso tracciato, nessuna guida prevista |
| Intel AI Playground | Applicazione desktop; circa 900 stelle | App | Arc serie A 8GB+, Arc serie B, Core Ultra | Attivo ma ancora in versione beta dopo due anni | Percorso tracciato, nessuna guida prevista |
| Qualcomm GenieX | Runtime GGUF integrato per NPU Snapdragon | Runtime | Snapdragon X / X Elite, 8 Elite | Anteprima per sviluppatori, luglio 2026 | Percorso tracciato, nessuna guida prevista |
| Progetto NVIDIA G-Assist | Assistente 8B integrato nel dispositivo per il controllo del sistema | App | Scheda grafica RTX serie 20 o successiva, 6 GB di VRAM | Attivo ma ancora etichettato come pre-release | Percorso tracciato, nessuna guida prevista |
La denominazione contribuisce alla confusione, perché "RTX AI Garage" di NVIDIA sembra un prodotto, ma non lo è; si tratta di una serie di articoli su un blog. Lo stack di Microsoft è stato rinominato più volte: le API di Copilot Runtime sono diventate API di Windows AI, Azure AI Foundry è diventato Microsoft Foundry e DirectML è ora in modalità di manutenzione con solo correzioni di sicurezza. Qualcomm AI Hub è un servizio cloud che effettua il provisioning di dispositivi fisici da remoto, non qualcosa che si esegue localmente.
Cosa si rompe di solito
La maggior parte delle segnalazioni di malfunzionamenti dei modelli locali riguarda problemi di configurazione, non problemi del modello stesso. Quattro di questi problemi in particolare rappresentano una quota significativa, e si tratta di aspetti che un esperto di hardware dovrebbe conoscere prima di attribuire la colpa al silicio.
1. Ollama utilizza di default un contesto di 4,096 token. Non genera un errore quando si supera questo limite. Tronca silenziosamente il contesto e un ciclo agente termina senza generare errori. Ogni framework serio richiede un numero maggiore di token: OpenHands ne richiede almeno 22 e ne raccomanda 32, Codex ne richiede 32, Copilot CLI ne richiede 128 e Cline ne imposta 262,144. Questa singola impostazione è probabilmente la causa più comune dei problemi segnalati online.
2. La quantizzazione della cache KV degrada specificamente le chiamate agli strumenti , e lo fa prima che la qualità generale dell'output ne risenta visibilmente. La documentazione di llama.cpp lo segnala esplicitamente. Se stai eseguendo un agente, disattivalo.
3. Il numero di strumenti è un ostacolo insormontabile, non una pendenza graduale. Oltre i cinque o sei strumenti circa, alcuni modelli smettono silenziosamente di emettere chiamate JSON valide agli strumenti e iniziano invece a incorporare XML nel corpo della risposta, che il sistema interpreta come "nessuno strumento utilizzato". Un agente molto diffuso includeva undici strumenti di default e ha compromesso il proprio modello consigliato fino all'inizio del 2026. Abbiamo riscontrato una situazione simile nei nostri test con Open WebUI, dove le istruzioni degli strumenti integrati hanno spinto una breve richiesta di benchmark oltre un contesto di 8,192 token. La conseguenza pratica è controintuitiva: sovraccaricare molti server MCP è dannoso per i modelli locali, a differenza di quanto accade per i modelli di frontiera.
4. Q4_K_M rappresenta il limite minimo pratico. Al di sotto di esso, l'affidabilità delle chiamate agli strumenti diminuisce più rapidamente rispetto alla qualità generale, quindi il modello sembra ancora valido pur non riuscendo a fare nulla in modo silenzioso.
La memoria è il vincolo
Per ogni strumento presente in questa pagina, il fattore determinante per l'esecuzione è la quantità di memoria che l'acceleratore può visualizzare. Queste sono le combinazioni di valori più frequentemente citate per il lavoro con agenti e quelle che intendiamo verificare in laboratorio.
| Hardware | Modello | Orma | Throughput riportato |
|---|---|---|---|
| RTX 5090, 32 GB | Qwen3.6-35B-A3B Q4_K_M | ~21 GB | 160-180 tok/s, contesto 262K |
| RTX 5090, 32 GB | Qwen3-Coder-30B-A3B Q4_K_M | ~19 GB | 50-90 tok/s su classe 24GB |
| RTX 5090, 32 GB | Devstral Small 24B Q4_K_M | ~14 GB | Progettato appositamente per la chiamata degli utensili |
| RTX PRO 6000, 96 GB | GPT-OSS 120B MXFP4 | ~63 GB | La classe 100B su una singola scheda workstation; la GPU della nostra recensione di laboratorio |
| Laptop con RTX PRO 5000, 24 GB GDDR7 | Qwen3-Coder-30B-A3B Q4_K_M | ~19 GB | La GPU per laptop più potente che abbiamo testato (ThinkPad P16 Gen 3); la classe 30B ci sta a pennello, con spazio a sufficienza. |
| 96-128 GB unificati, serie M | gpt-oss-120b Q6_K | ~93 GB | 14-20 tok/s; JSON di chiamate di strumento più pulito di qualsiasi modello open-weight |
Vale la pena precisarlo, perché il marketing non lo specifica: i modelli open-weight più grandi non sono modelli per workstation. GLM-5.2 ha circa 744 miliardi di parametri e richiede circa 744 GB in FP8, che corrisponde a un nodo data center con otto GPU. Kimi K2 e DeepSeek V4 rientrano nella stessa categoria. Qualsiasi guida che suggerisca di eseguirli su un computer desktop è errata.
I dati relativi al throughput riportati sopra provengono da test di terze parti pubblicati e da materiale fornito dai produttori, e non sono ancora risultati di laboratorio di StorageReview, ad eccezione dei dati di decodifica di Jan e Open WebUI indicati sopra. Li sostituiremo con i nostri dati man mano che ogni soluzione selezionata verrà inclusa nella Guida.
Strumenti cloud-first e perché non sono inclusi in questa classifica.
Un agente locale non è un modello locale , e gli strumenti seguenti mostrano la differenza: ognuno di essi viene eseguito sulla tua macchina mentre invia ogni chiamata di inferenza a un cloud di un fornitore.
| Chiavetta | Supporto per modelli locali | Note: |
|---|---|---|
| Cursore | Nodo | La documentazione ufficiale afferma che tutte le richieste vengono instradate attraverso i server di Cursor; i tasti personalizzati funzionano solo con i principali provider di servizi cloud e il completamento automatico tramite tab utilizza sempre i modelli di Cursor. Acquisita da SpaceX nel 2026. |
| Devin Desktop (precedentemente Windsurf) | Nodo | Rinominato a giugno 2026. Ogni modello è ospitato nel cloud. |
| Google Antigravità | Nodo | La documentazione afferma esplicitamente che non è possibile utilizzare Ollama, LM Studio o un endpoint personalizzato. |
| Gemini CLI | Nodo | Il supporto locale esiste solo nei fork della community |
| Qodo | Nodo | Il termine "on-premise" si riferisce a un'infrastruttura self-hosted che continua a richiamare i modelli cloud. |
| GitHub Copilot nell'IDE | Parziale | La chat può utilizzare modelli locali; i completamenti in linea rimangono nel cloud anche con la modalità "porta la tua chiave" |
| ChatGPT | Nodo | Le applicazioni desktop e mobile sono client per i modelli cloud di OpenAI. I modelli gpt-oss open-weight di OpenAI vengono eseguiti localmente, ma tramite i runtime sopra menzionati, non tramite l'applicazione ChatGPT. |
| Claude | Nodo | Le app Claude e Cowork funzionano sui modelli cloud di Anthropic. Claude Code può essere indirizzato a un modello locale tramite l'API di Ollama compatibile con Anthropic, che funziona ma è una configurazione non supportata. |
| Assistenti di agenzia generali | Nodo | Gli strumenti di questa classe vengono eseguiti sulla tua macchina ma dipendono da un modello cloud per il ragionamento |
Esiste un genere di guide molto diffuso che spiega come "collegare Cursor a Ollama". La documentazione di Cursor stessa, tuttavia, le contraddice. Se il funzionamento offline è un requisito fondamentale, questa distinzione è di primaria importanza.
E per quanto riguarda la generazione di immagini e video?
La generazione locale di immagini è una delle comunità più numerose nell'ambito dell'IA locale. ComfyUI da solo supera la maggior parte degli strumenti classificati sopra in base alle stelle di GitHub, e la generazione locale di video si sta affermando come il carico di lavoro per utenti finali più esigente in termini di VRAM. Merita una classifica a parte, e l'avrà; aggiungere una quarta categoria a questa pagina la renderebbe inutilizzabile. Fino ad allora, la logica hardware qui descritta si applica direttamente: l'elaborazione di immagini e video è ancora più limitata dalla memoria rispetto ai modelli linguistici, e si applicano le stesse categorie.
Come funziona questa pagina
La classifica è stilata in base a tre regole, e la prima è che per ora l'ordinamento si basa sulle stelle di GitHub. Non è l'ideale, ma è neutrale, verificabile e non ci obbliga a fingere di aver testato cose che non abbiamo testato. Gli strumenti closed-source sono contrassegnati come tali e non ricevono un punteggio inventato. Man mano che i nostri test individueranno i preferiti, l'ordinamento cambierà per riflettere i risultati misurati e lo comunicheremo; Jan e Open WebUI ora hanno dati di laboratorio a supporto, quindi questo cambiamento è già iniziato. In secondo luogo, ogni voce riporta un requisito minimo di memoria, perché è questo il valore che determina se un modello viene caricato.
In terzo luogo, la colonna Guida rappresenta un impegno mirato alle scelte: ogni scelta classificata include una procedura di configurazione pratica con i nostri dati sull'hardware, un runtime incluso in un'app è trattato nella guida dell'app stessa, e le iniziative dei fornitori sono monitorate nella tabella corrispondente. Il link appare qui quando ogni guida viene pubblicata.
Domande frequenti sugli strumenti LLM locali
Da quale strumento LLM locale dovrei iniziare?
Ollama è l'ideale se preferisci lavorare da terminale, LM Studio se preferisci una finestra con i controlli, e Jan è perfetto se desideri un programma pronto all'uso che non richieda l'installazione di nulla. Tutti e tre sono gratuiti, funzionano completamente offline e utilizzano il file llama.cpp, quindi il comportamento del modello è identico. La differenza sta nell'interfaccia, non nella velocità.
Che fine hanno fatto NVIDIA ChatRTX, GPT4All e Continue.dev?
Sono scomparsi, insieme a un numero sorprendente di loro pari, e questa è la cosa più utile da sapere prima di seguire un vecchio consiglio. NVIDIA ChatRTX è stato deprecato il 21 gennaio 2026, il suo repository è stato archiviato e il suo forum di supporto è stato bloccato, senza che sia stato nominato un sostituto.
GPT4All è il caso più insidioso: non ha ricevuto commit negli ultimi dodici mesi e la sua ultima release risale a febbraio 2025, ma il repository non è archiviato e mostra ancora un elevato numero di stelle, quindi sembra attivo. Ha sempre supportato solo un insieme ristretto di formati di quantizzazione e non è in grado di caricare la maggior parte delle release di modelli più recenti.
Continue.dev , per due anni la raccomandazione standard per la programmazione con modelli locali, è stato acquisito da Cursor e chiuso nel giugno 2026. Roo Code ha cessato le attività nel maggio 2026, Void è stato archiviato nel giugno 2026, Twinny nel novembre 2025 e Reor nel marzo 2026. Khoj ha interrotto il suo servizio ospitato nell'aprile 2026, sebbene la versione self-hosted sia ancora disponibile. Per quanto riguarda i fornitori, Intel IPEX-LLM è stato archiviato nel gennaio 2026 e segnalato per problemi di sicurezza noti senza un percorso di migrazione pubblicato, e NVIDIA RTX AI Toolkit è stato deprecato nel novembre 2025.
Di quanta VRAM ho bisogno per eseguire un LLM locale?
Per la chat, 8 GB di RAM di sistema eseguono un modello da 3 miliardi, mentre 16 GB eseguono un modello da 7 a 8 miliardi in modo accettabile utilizzando solo la CPU. Per una velocità utile, è preferibile che il modello sia in VRAM o memoria unificata: 16 GB gestiscono la classe da 7 a 14 miliardi, 24 GB raggiungono la classe da 30 miliardi nel quarto trimestre e con 32 GB o più il lavoro di programmazione con agenti smette di essere frustrante. Oltre tale soglia, la capacità è più importante della larghezza di banda, motivo per cui i computer con 96-128 GB di memoria unificata eseguono modelli che nessuna scheda grafica consumer è in grado di gestire.
Gli strumenti LLM locali utilizzano la mia NPU?
Di solito no, perché llama.cpp non ha un backend NPU, quindi Ollama e LM Studio lasceranno il motore neurale allo 0% su una macchina AI con Snapdragon o Ryzen e funzioneranno invece sulla CPU o sulla GPU. Attualmente, per accedere all'NPU è necessario utilizzare soluzioni proprietarie: Qualcomm GenieX, AMD Lemonade con il suo runtime NPU, Intel OpenVINO o Neural Engine di Apple tramite i framework del sistema operativo. Il vantaggio è una maggiore durata della batteria e un funzionamento always-on a basso consumo, dato che le NPU oggi raggiungono al massimo i 7 miliardi di modelli e una GPU dedicata le supererà sempre in termini di throughput.
Devo eseguire l'IA in locale su Windows o su Linux?
Per le applicazioni desktop presenti in questa pagina, Windows e macOS offrono un'esperienza più fluida. LM Studio, Jan, AnythingLLM e Ollama si installano nativamente, i driver GPU provengono dalle fonti usuali e non è necessario utilizzare il terminale. Linux si distingue a un livello inferiore: i motori per la produzione, vLLM e SGLang, sono progettati principalmente per Linux, il supporto multi-GPU lo presuppone di fatto, e alcune delle più recenti tecnologie di accelerazione vengono implementate prima su Linux che altrove, incluso il supporto per le NPU AI di AMD Ryzen, disponibile su Linux e che richiede un kernel molto recente.
Il divario è più ridotto rispetto al passato. AMD ha unificato le sue release ROCm per Windows e Linux nel 2026 e WSL2 copre la maggior parte dei restanti sistemi, motivo per cui strumenti basati su Docker come Open WebUI funzionano senza problemi su una macchina Windows. La regola pratica è: se si installa dalla tabella delle applicazioni desktop, è meglio rimanere sul sistema operativo in uso; se invece si sta creando un server dedicato o si stanno sfruttando tutte le opzioni di accelerazione, è consigliabile installarlo su Linux.
I modelli locali sono sufficientemente validi per sostituire un modello cloud nella programmazione?
Dipende interamente dal compito, e la differenza è più netta di quanto la maggior parte delle analisi lasci intendere. Per lavori circoscritti, come la generazione di singoli file, i test unitari, il codice boilerplate e la spiegazione del codice, gli attuali modelli open-weight su una buona workstation sono più o meno alla pari con i modelli cloud di ultima generazione. Per lavori a lungo termine e complessi, come i refactoring di più file in un repository di grandi dimensioni, perdono nettamente, e le conseguenze sono spiacevoli: operazioni silenziose e lavoro segnalato con sicurezza che in realtà non è mai stato eseguito. Se la ragione per cui si opta per una soluzione locale è la privacy, i requisiti di isolamento dalla rete o i costi, oggi è fattibile. Se invece la ragione è la capacità, non lo è ancora.
È più sicuro eseguire un modello in locale piuttosto che utilizzare un servizio cloud?
Per quanto riguarda la residenza dei dati, sì, ed è questo il motivo per cui la maggior parte delle persone opta per una soluzione locale. Per quanto riguarda la sicurezza del software, la risposta è no per impostazione predefinita: un'applicazione di IA locale con classificazione CVSS 9.6 a marzo 2026 potrebbe essere indotta a eseguire codice sull'host dall'output in streaming del modello stesso, perché l'applicazione desktop è stata impacchettata con impostazioni predefinite non sicure. Locale significa che i dati rimangono nella stessa posizione, ma non significa che il software sia protetto, dato che questa categoria include molto codice in rapida evoluzione.
Cos'è una sandbox per agenti AI e ne ho bisogno per l'IA locale?
Una sandbox è un ambiente isolato, solitamente un container o una macchina virtuale leggera, in cui un agente di intelligenza artificiale esegue i comandi e il codice che genera, in modo che un errore o un'istruzione dannosa non possano intaccare il sistema host. La sua esistenza è dovuta al fatto che gli agenti non si limitano a rispondere alle domande: eseguono comandi di shell, modificano file e navigano, e ognuna di queste azioni è guidata dall'output del modello, che può essere manipolato. L'esecuzione del modello in locale non modifica minimamente questi calcoli.
Il sandboxing consiste nell'isolare le azioni dell'agente, non la posizione in cui risiede il modello, e la vulnerabilità di esecuzione del codice descritta in precedenza ha evidenziato proprio questo aspetto in un'applicazione local-first. Alcuni strumenti presenti in questa pagina includono il sandboxing integrato, e quelli che eseguono agenti con accesso illimitato all'host meritano un'analisi più approfondita prima di essere utilizzati su una macchina a cui tenete. Con la diffusione degli agenti in ambito aziendale, è lecito aspettarsi che il sandboxing diventi una funzionalità di primo piano e che inizieremo a tenerne conto nella valutazione di questi strumenti.
È possibile che l'hardware locale esegua carichi di lavoro agenti con decine di sub-agenti?
Questa è la frontiera, e in breve, una singola workstation esaurisce rapidamente lo spazio disponibile. I carichi di lavoro multi-agente generano sub-agenti, ognuno dei quali porta con sé il proprio contesto, e sul lato inferenza ogni contesto attivo implica la propria cache KV in memoria, quindi l'ingombro aumenta sia con la concorrenza che con le dimensioni del modello. Dove vengono spostate queste cache quando la memoria non è più sufficiente è un problema ingegneristico a sé stante; il nostro approfondimento sull'offload della cache KV su memoria flash , realizzato su hardware Dell e Solidigm, è la migliore trattazione di questo argomento che abbiamo pubblicato.
Una macchina in grado di gestire agevolmente una sessione agente di classe 30B può in genere gestire alcune sessioni parallele tramite un server di batching prima che la latenza si degradi; decine di sub-agenti simultanei sono invece compito di un server, con memoria sufficiente a contenere molti contesti attivi e un motore di servizio come vLLM progettato per il batching continuo. Esiste anche un limite di qualità, poiché i modelli locali perdono già affidabilità con l'aumentare del numero di strumenti, e l'orchestrazione moltiplica strumenti e passaggi di consegne.
A nostro avviso, il lavoro con un singolo agente o con pochi agenti è oggi un'attività legittima da svolgere in una postazione fissa, mentre le grandi flotte di sub-agenti rappresentano un'attività infrastrutturale. Questo confine, e l'hardware necessario per superarlo, è un aspetto che intendiamo esplorare in modo molto più approfondito.


 Amazon