

Comino ci ha recentemente inviato l'ultima versione del Comino Grando per la recensione, configurata con otto schede NVIDIA RTX PRO 6000 Blackwell, ciascuna con 96 GB di VRAM, per un totale di 768 GB di memoria GPU. Avevamo già recensito il Comino nel 2024, in una configurazione con 6 RTX 4090 , che offrivano 144 GB di memoria GPU totale, e in una versione con NVIDIA H100 . Questo ultimo aggiornamento rappresenta un sostanziale salto generazionale sia in termini di capacità di memoria pura che di gamma di carichi di lavoro che la piattaforma è in grado di gestire.
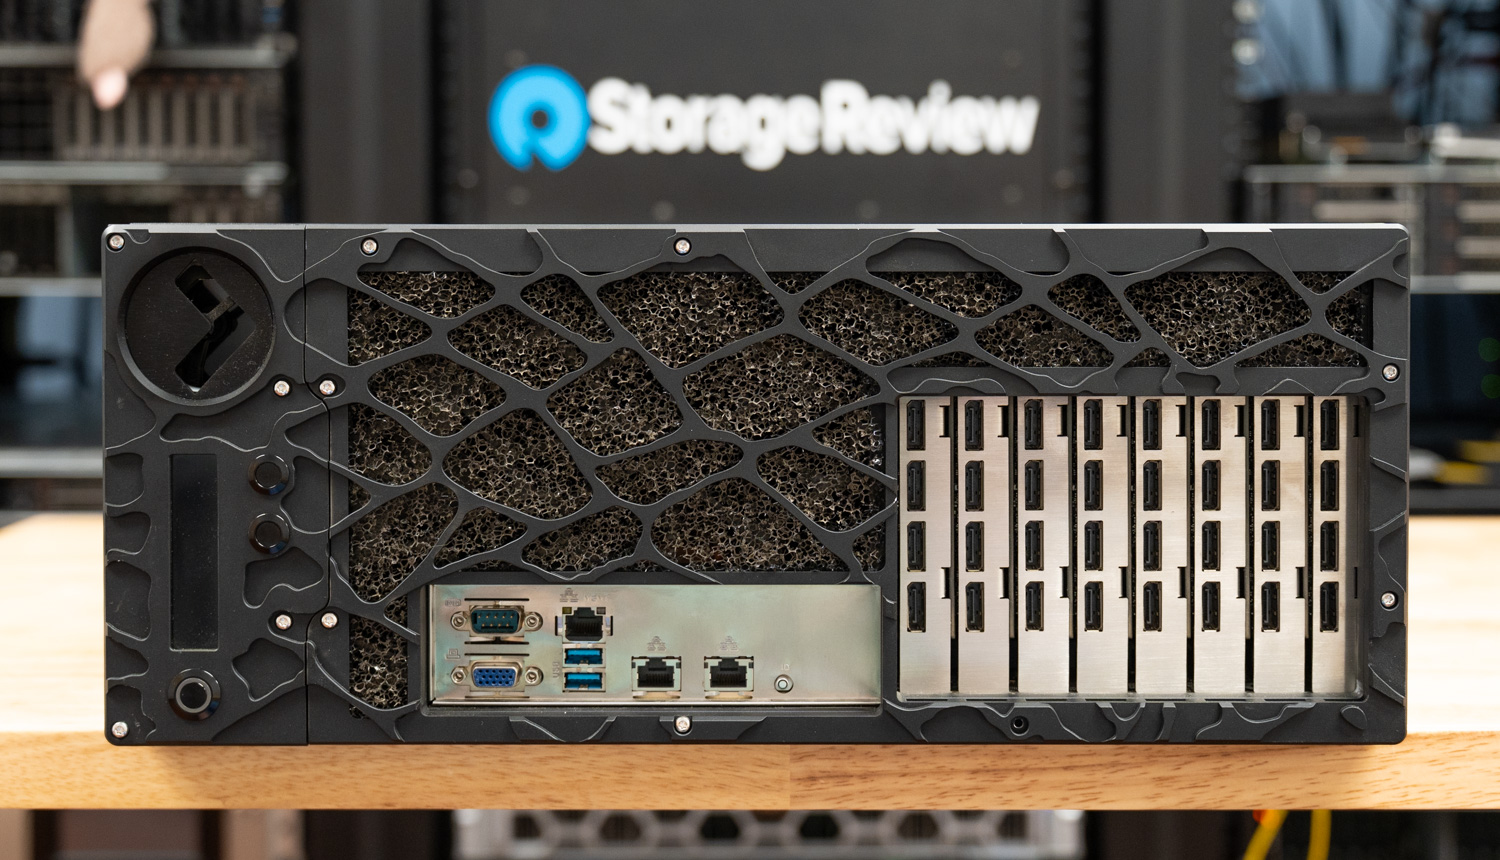
Grando è una piattaforma 4U progettata appositamente per risolvere il conflitto critico tra l'elevata densità di calcolo delle GPU e la gestione termica. Mentre i case standard con raffreddamento ad aria cedono sotto il peso delle elevate richieste di TDP (Total Distribution Phase) superiori a 600 W delle moderne schede professionali, Grando adotta un approccio radicalmente diverso, essendo stato costruito da zero attorno a un'architettura di raffreddamento a liquido in grado di dissipare ben 6.5 kW di calore continuo. Non si tratta di un adattamento successivo o di un'aggiunta posticcia; l'intero case, dalla disposizione invertita della scheda madre al sistema di collettori a sgancio rapido con codifica a colori, è stato progettato attorno al circuito di raffreddamento.
Il risultato è una piattaforma in grado di supportare otto GPU professionali a TDP completo in un singolo chassis 4U, funzionando 24 ore su 24, 7 giorni su 7, in ambienti con temperature comprese tra 3 e 38 °C, senza throttling termico, senza l'impatto acustico del raffreddamento ad aria ad alta velocità e senza compromettere la facilità di manutenzione. Per le organizzazioni che implementano inferenza AI, addestramento di machine learning o carichi di lavoro di simulazione ad alte prestazioni su larga scala, Grando offre qualcosa di veramente raro: un server che non obbliga a scegliere tra densità, dissipazione del calore e affidabilità.
Specifiche del Comino Pano
La tabella seguente mostra le specifiche fisiche e le configurazioni hardware supportate per la piattaforma Comino Grando.
| Specifica / Caratteristica | Comino Grande |
|---|---|
| Server Comino Grande e workstation rackable | |
| Capacità di raffreddamento | 6.5 kW (massimo 6.500 W a 20 °C di temperatura dell'aria in ingresso) |
| Schede madri | Fino a EATX e EBB |
| GPU (Server) | Fino a 8; NVIDIA: RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200 |
| GPU (Workstation rackable) | Fino a 6; NVIDIA: 3090, 4090, 5080, 5090, RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200; AMD: W7800, W7900 |
| CPU | Fino a 2; Socket singolo: Intel Xeon W-2400/2500 e 3400/3500, Intel Xeon Scalable di quarta generazione, quinta generazione, XEON 6, AMD Threadripper PRO 5000WX, 7000WX, 9000WX, AMD EPYC 9004/9005 Doppio socket: Intel Xeon Scalable di quarta e quinta generazione, Xeon 6, AMD EPYC 9004/9005 |
| RAM | Fino a 2TB |
| Unità M2 | Fino a 8x NVMe |
| Archiviazione | Alloggiamenti hot-swap sul pannello posteriore: fino a 4 SSD hot-swap (4 da 7 mm o 2 da 15 mm) e fino a 4 ulteriori SSD (4 da 7 mm o 2 da 15 mm) al posto del quarto alimentatore; Gabbia interna da 3.5" fino a 4 x 3.5" o 4 x 2.5" 15 mm o 12 x 2.5" 7 mm; Slot interni da 2.5": fino a 4 SSD da 2.5" da 7 mm |
| Alimentazione e tensione di funzionamento | Fino a 4 alimentatori CRPS hot-swap da 2000 W a 180-264 V Fino a 4 alimentatori CRPS hot-swap da 1000 W a 90-140 V Modalità di ridondanza: 4+0, 3+1, 2+2 |
| Livello di rumore | 39dB-70dB |
| Lan | Fino a 2 x 10 Gbit/s sulla scheda madre e fino a 400 Gbit/s su PCIe. |
| OS | Ubuntu / Windows 11 (Pro/Home) / Windows Server |
| Specifiche fisiche e di raffreddamento | |
| Raffreddamento a liquido | CPU con VRM e GPU con GDDR e VRM |
| Serbatoio | Comino personalizzato da 450 ml con dosatori integrati |
| Fan | 3x Flusso ultra elevato 6200 RPM (livello di rumorosità elevato) o 3x Flusso elevato 3000 RPM (basso livello di rumorosità) |
| Installazione | Montabile su rack da 19" o utilizzabile come workstation autonoma. |
| Spazio rack richiesto | 4U |
| Taglia | 439 x 681 x 177 mm (senza maniglie e parti sporgenti) |
| Peso | 4 GPU: 49 kg (netto), 67 kg (lordo) 6 GPU: 52 kg (netto), 70 kg (lordo) 8 GPU: 55 kg (netto), 72 kg (lordo) |
| Intervallo di temperatura di funzionamento e di conservazione | Conservazione: -5..50 °C / 23..122 °F Temperatura di esercizio: 3..38 °C / 38..100 °F |
| Sistema di monitoraggio Comino (CMS) | |
| Panoramica | Scheda di controllo con sensori e software per il monitoraggio in tempo reale |
| Vantaggi principali | Monitoraggio del sistema di raffreddamento e di CPU/GPU, interfaccia web, registro del sistema di raffreddamento, monitoraggio centralizzato per gruppi di lavoro. |
| Sensori e dispositivi connessi | Temperatura (aria e liquido di raffreddamento), % di umidità, tensione, flusso del liquido di raffreddamento, livello del liquido di raffreddamento nel serbatoio, ventole, pompe, scheda madre, display e pulsanti |
| Possibilità di integrazione | Configura il monitoraggio tramite un'API REST e invia i dati dei sensori al software di monitoraggio (ad esempio, Zabbix, Grafana) o ai database (ad esempio, InfluxDB). |
| Requisiti tecnici del CMS | |
| OS | Finestre 11 / 10 Ubuntu 22.04/20.4 (Requisito per Ubuntu: il sistema di destinazione deve avere installati nvidia-smi e le utilità sensors) |
| Browser Web | Mozilla Firefox, Google Chrome, Chromium, Apple Safari, Microsoft Edge (Attenzione: Internet Explorer 11 non è supportato) |
| Disco rigido | 300MB |
| Versione firmware del controller | 1.0.6 o più recente |
| Versione PCB del controller | 2.xx.xx |
Progettazione, costruzione e densità della GPU
Configurazione e implementazione del telaio
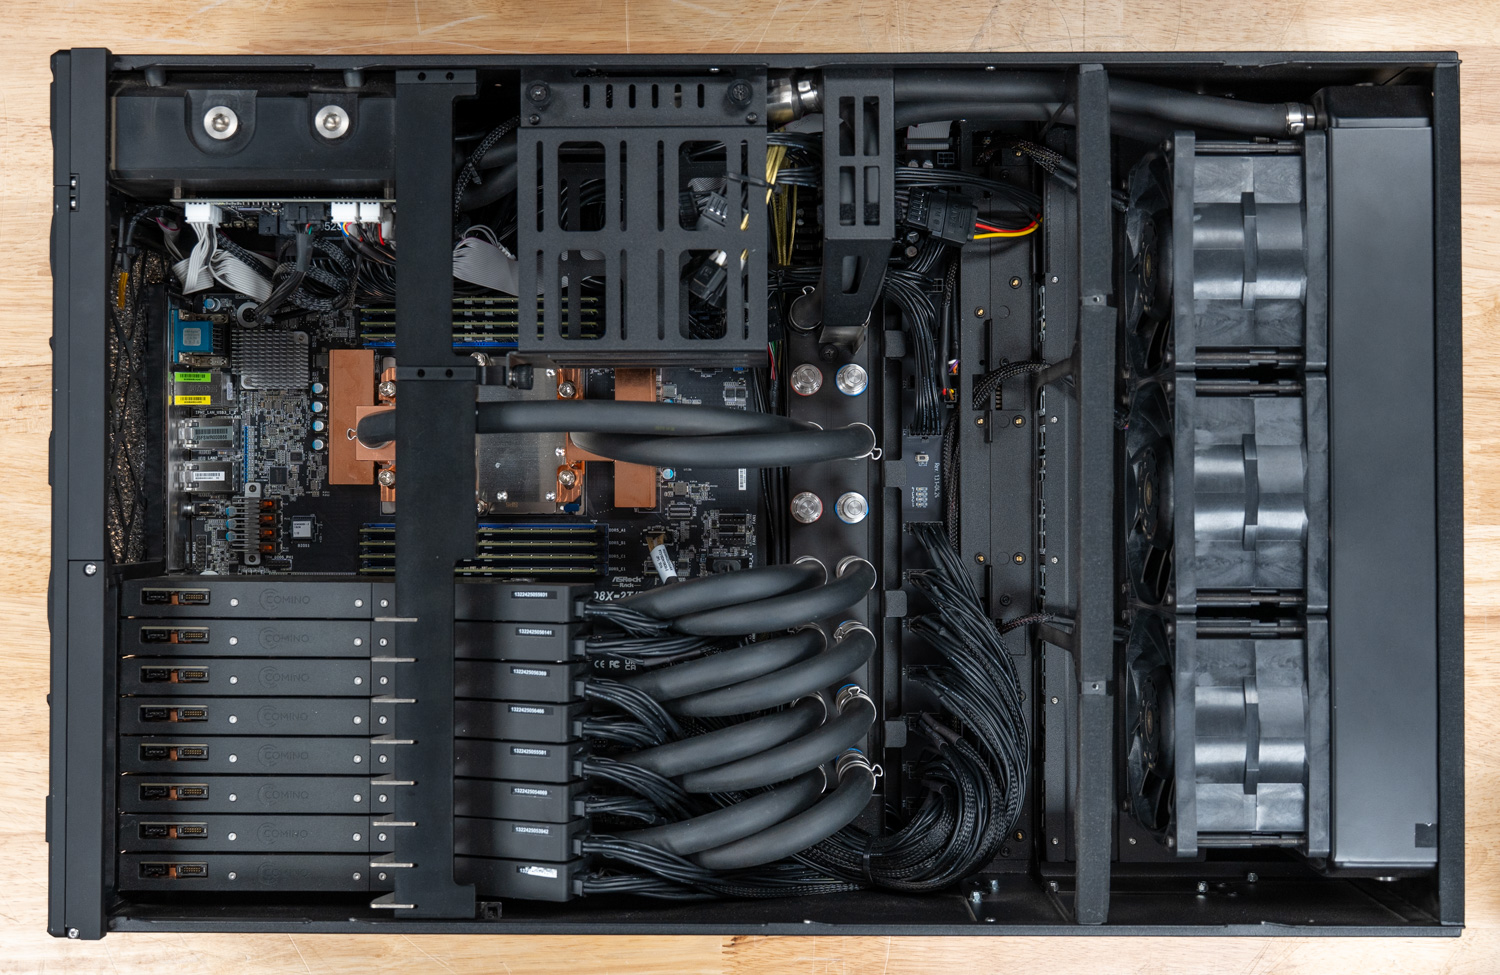
Il Grando Server è un capolavoro di ottimizzazione dello spazio, con dimensioni di 17.3 x 26.8 x 6.97 pollici (4U). A differenza dei server tradizionali, posiziona la parte posteriore della scheda madre nella parte anteriore dello chassis, invertendo la configurazione interna convenzionale. Ciò garantisce che i componenti raffreddati ad aria, come i moduli RAM e i VRM, ricevano l'aria in ingresso più fredda possibile prima che raggiunga il radiatore del sistema di raffreddamento a liquido nella parte posteriore.
Lo chassis stesso è costruito con gli stessi rigorosi standard, caratterizzato da una solida struttura in acciaio con finitura verniciata a polvere nera opaca, applicata sia all'interno che all'esterno. Questa scelta ponderata si estende a tubi, cavi, radiatore e maschera di saldatura del PCB, riflettendo una chiara intenzione di ottenere un'estetica pulita e professionale in tutto il sistema. Inoltre, il sistema supporta un'installazione versatile, funzionando perfettamente sia come unità montabile in rack da 19 pollici che come unità desktop autonoma. A seconda della configurazione, pesa tra 148 e 159 libbre.
Piastre di raffreddamento e waterblock per GPU
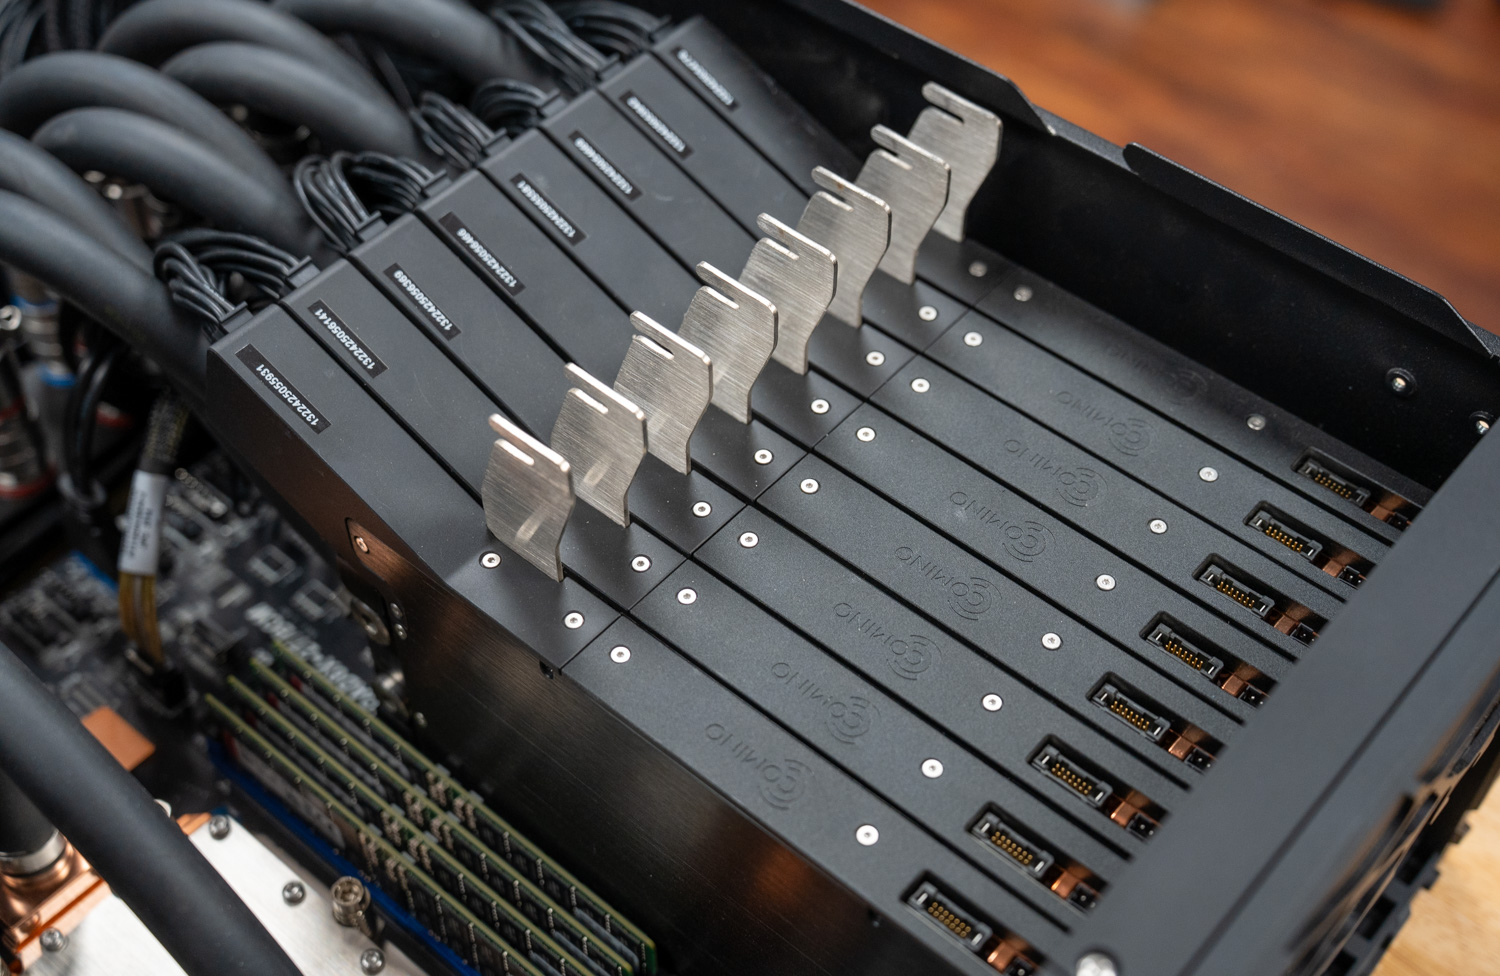
I waterblock in rame proprietari costituiscono il cuore della densità del Grando, raffreddando non solo il die della GPU, ma anche altri componenti come la memoria e i regolatori di tensione. Ogni GPU viene fornita come scheda standard, sulla quale Comino monta un sistema di raffreddamento a piastra personalizzato. In pratica, questo design a profilo sottile riduce ogni scheda a un singolo slot, consentendo di installare sei o addirittura otto GPU professionali una accanto all'altra all'interno di un singolo chassis 4U. L'unità che abbiamo testato era dotata di otto schede NVIDIA RTX PRO 6000 Blackwell, ciascuna con un TDP di 600 W, risultando in un fabbisogno di raffreddamento totale di 4,800 W a pieno carico.
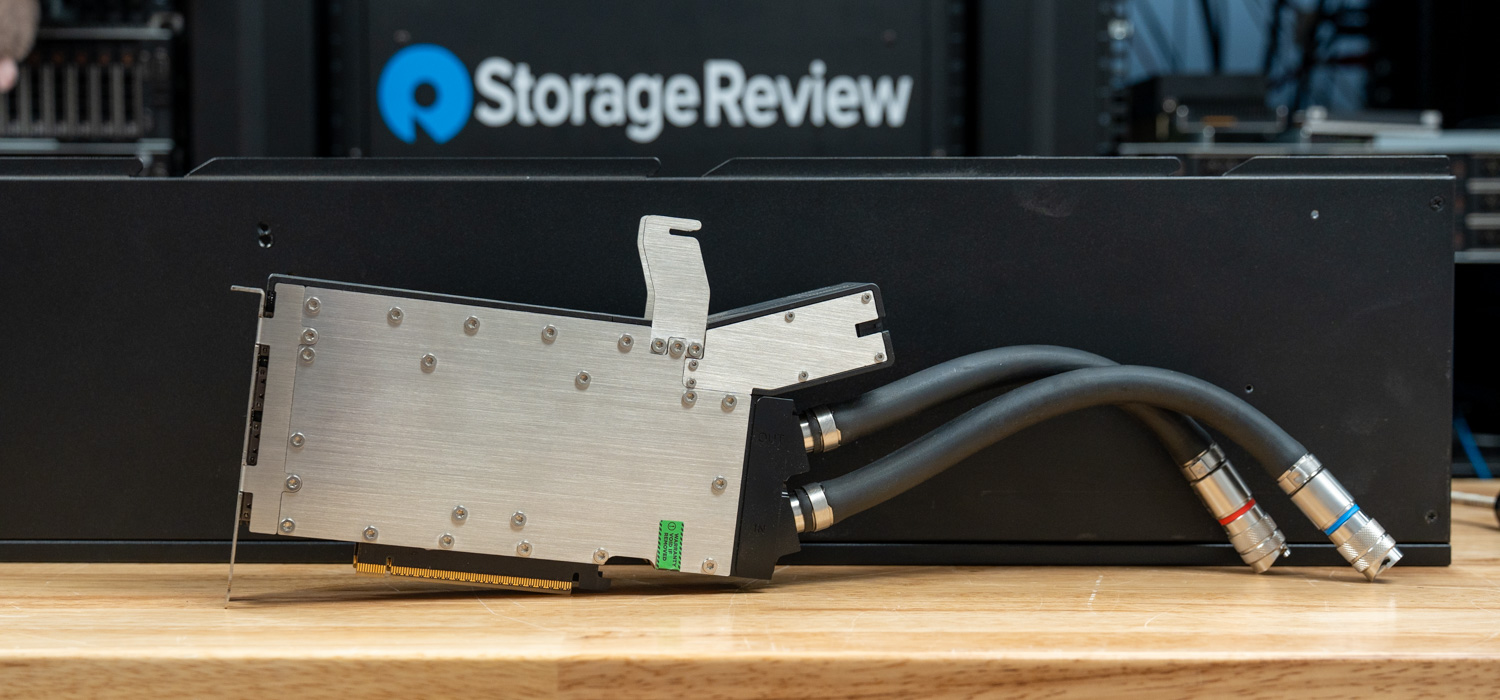
Raggiungere la densità di 8 GPU a singolo slot del Comino sarebbe quasi impossibile con il raffreddamento ad aria, poiché le schede NVIDIA RTX PRO 6000 standard occupano ciascuna due slot e richiedono un flusso d'aria considerevole. Al contrario, queste schede con raffreddamento personalizzato occupano un solo slot ciascuna. Le piastre di raffreddamento sono robuste e aggiungono un peso notevole a ciascuna scheda, ma questo peso riflette la qualità e le prestazioni di raffreddamento richieste a questo livello.
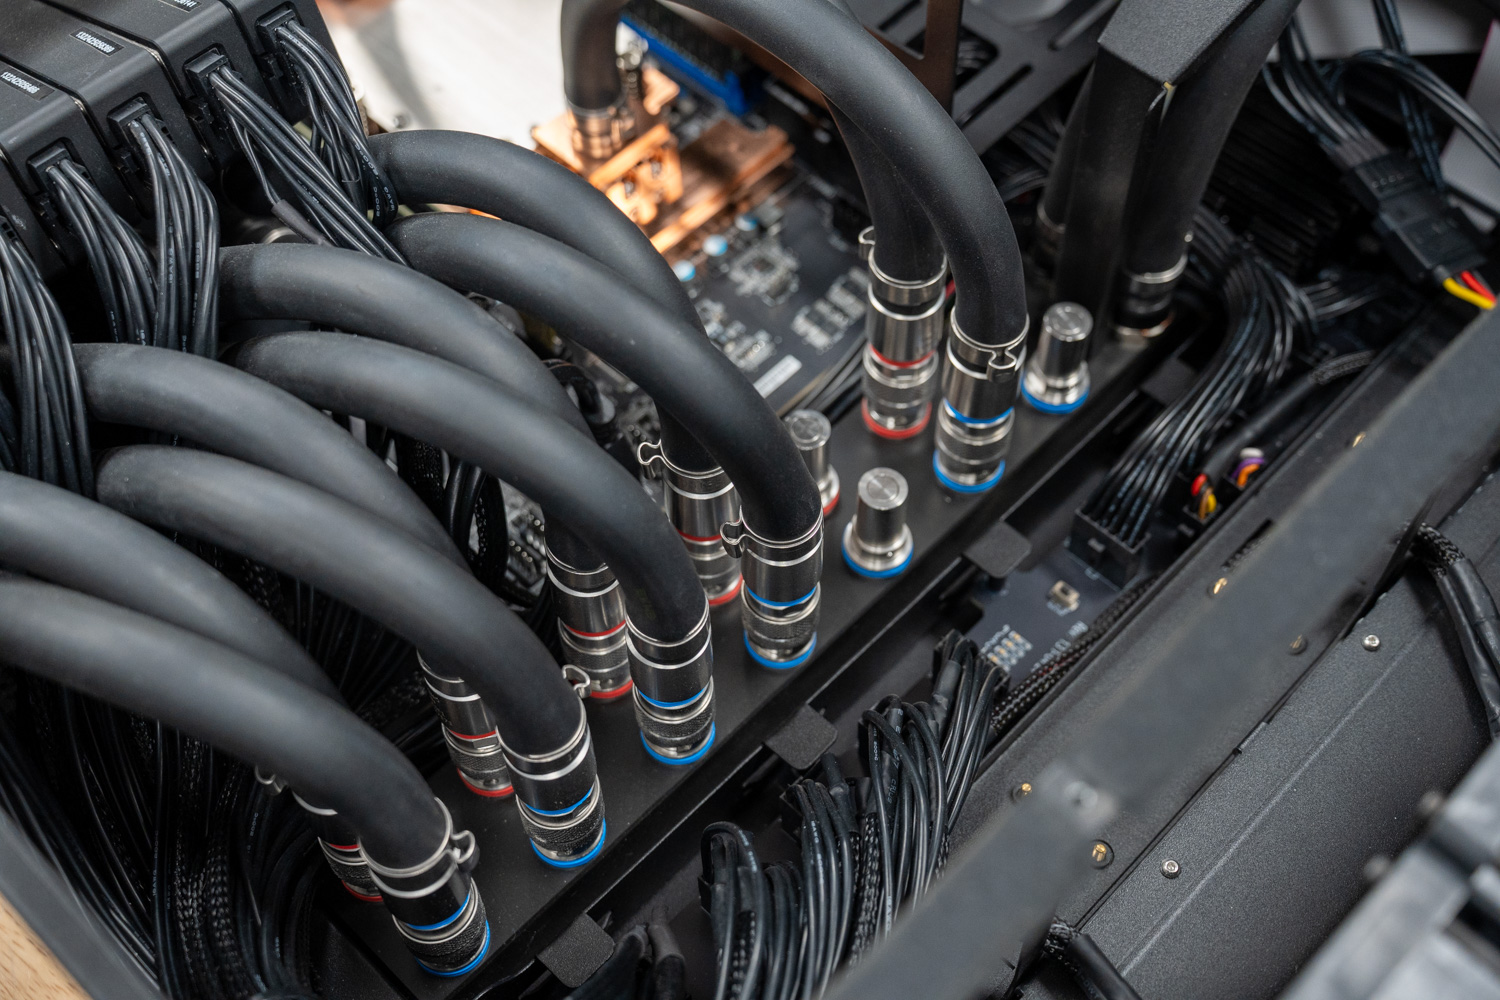
Ogni coppia di GPU è collegata tramite un collettore secondario dedicato che consolida entrambe le schede in un'unica connessione di ingresso e uscita al collettore principale del liquido di raffreddamento. Questo approccio a coppie semplifica l'architettura complessiva del circuito, riduce il numero di connessioni al collettore principale e consente a un tecnico di scollegare una singola coppia di raccordi a sgancio rapido per rimuovere due schede contemporaneamente, semplificando ulteriormente la manutenzione.
Distribuzione e collettore dell'acqua
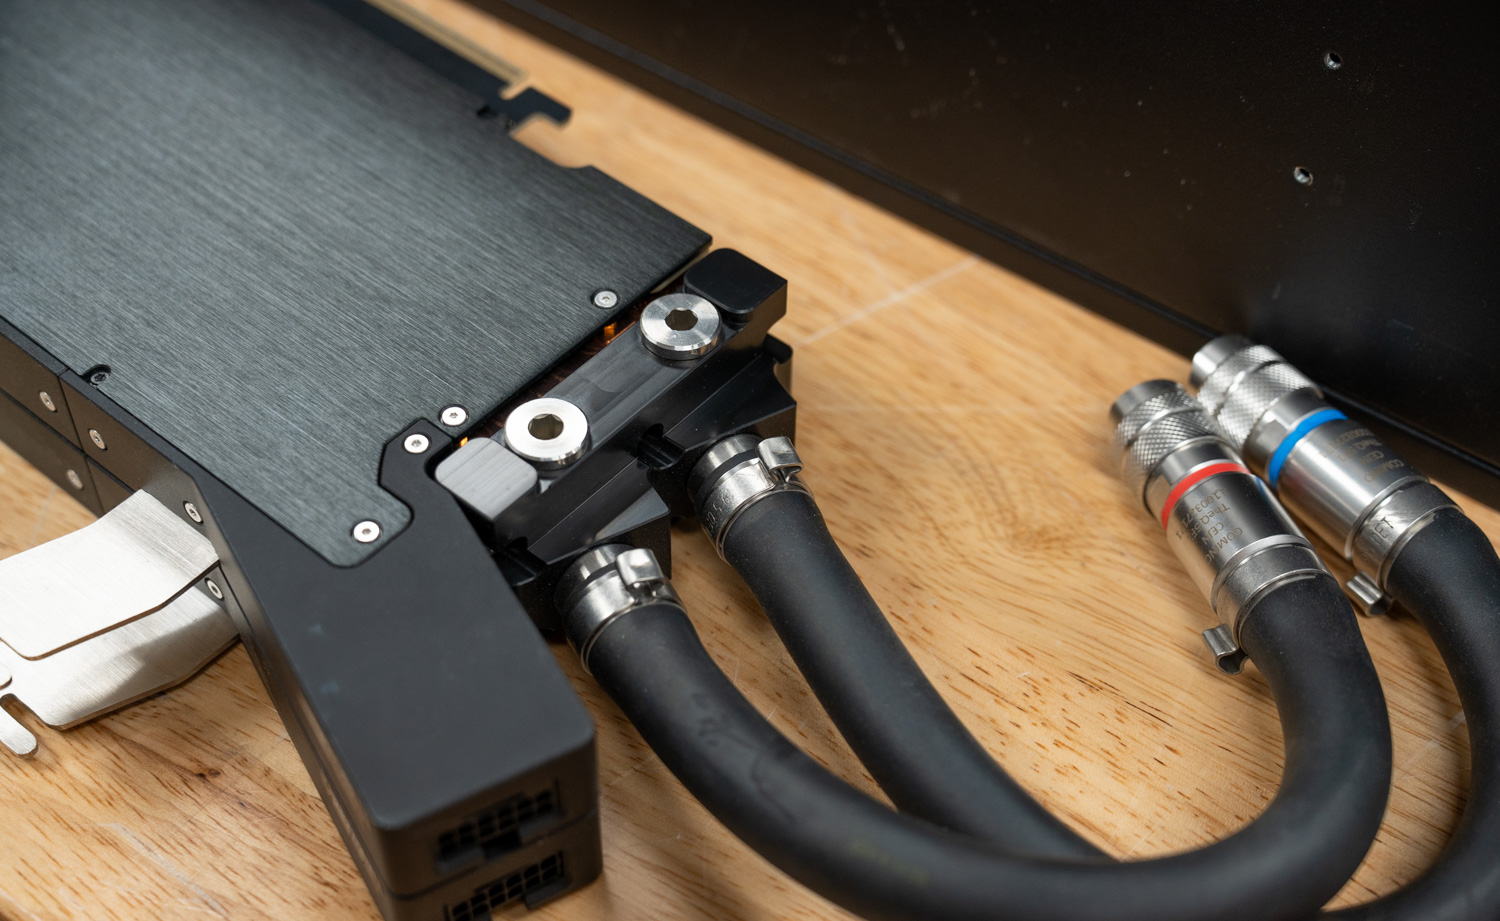
Al centro del sistema si trova un grande collettore di distribuzione dell'acqua che fornisce liquido di raffreddamento a ciascuna GPU e CPU, fungendo anche da percorso di ritorno al radiatore. Tutti i collegamenti tra il collettore e le GPU e CPU utilizzano i raccordi a sgancio rapido "TheQ" di Comino. Questi raccordi antigoccia in acciaio inossidabile sono codificati a colori con anelli rossi e blu per identificare chiaramente i lati caldo e freddo del circuito, eliminando qualsiasi ambiguità durante l'installazione o la manutenzione.
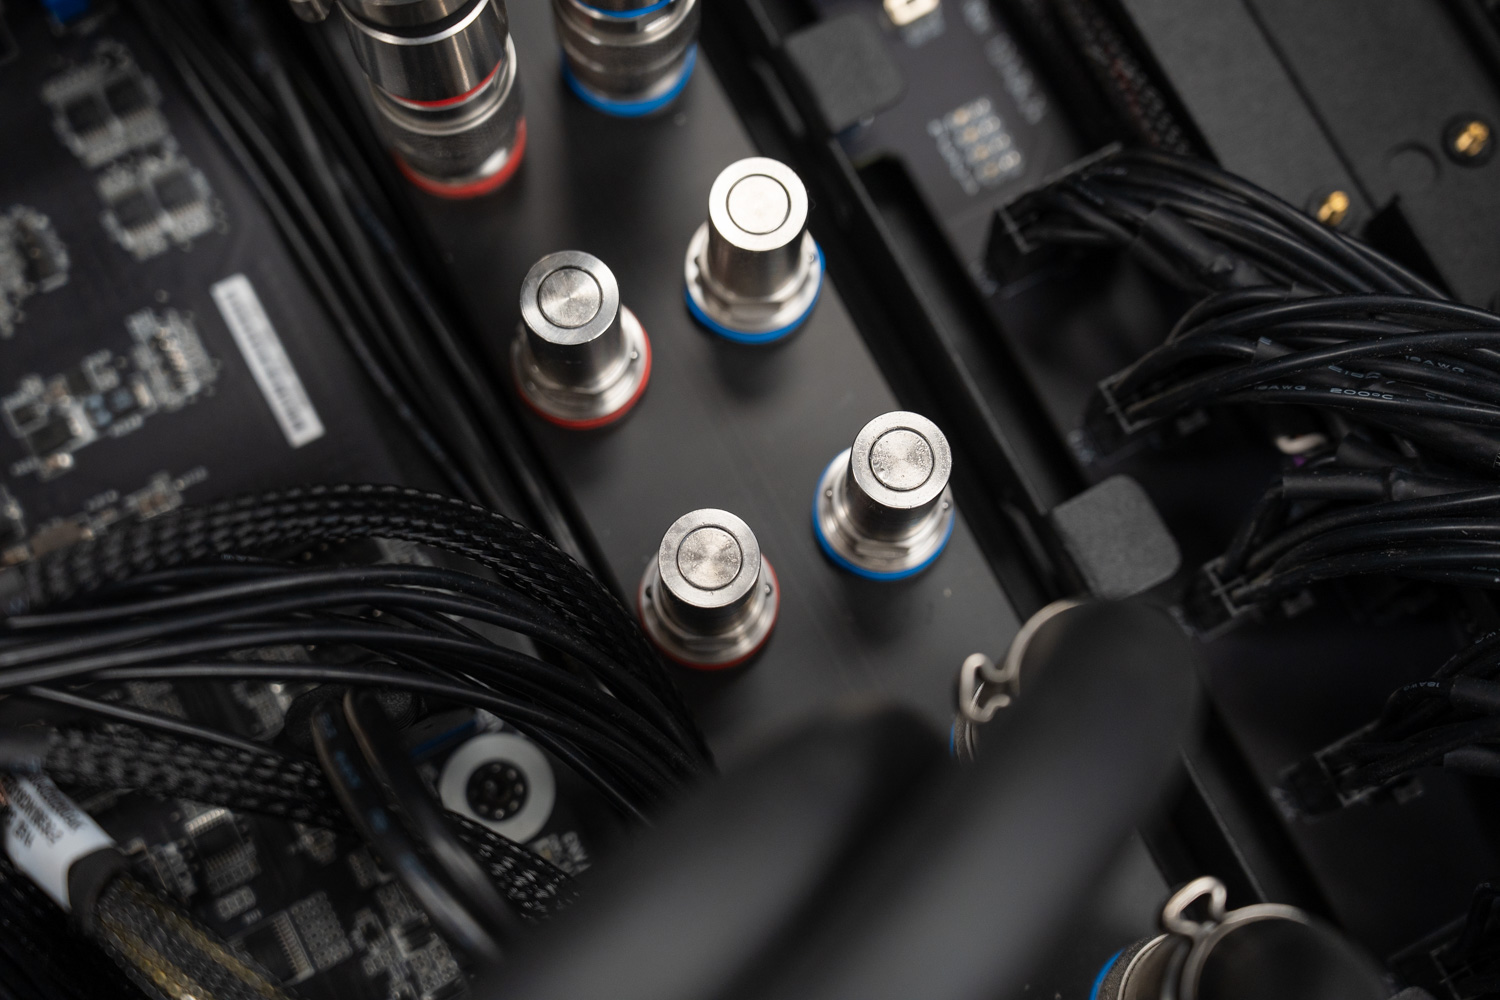
Quando vengono scollegate, lasciano residui minimi sulla superficie di contatto, consentendo ai tecnici di rimuovere o sostituire le singole GPU o la CPU senza svuotare il serbatoio da 450 ml o il resto del circuito. In questo modo, Grando porta la semplicità di manutenzione dei sistemi di raffreddamento ad aria su una piattaforma di raffreddamento a liquido ad alte prestazioni.
Raffreddamento della CPU e memoria
La CPU e i suoi regolatori di tensione beneficiano inoltre di una piastra di raffreddamento dedicata, collegata direttamente al circuito di raffreddamento, impedendo al processore di diventare un collo di bottiglia durante carichi di lavoro intensi con più GPU. L'unità che abbiamo testato era dotata di una scheda madre AMD Turin/Genoa con un singolo processore AMD EPYC 9474F a 48 core. La piastra di raffreddamento rispecchia la qualità delle piastre di raffreddamento della scheda, essendo realizzata in rame massiccio e fissata con viti in acciaio inossidabile.
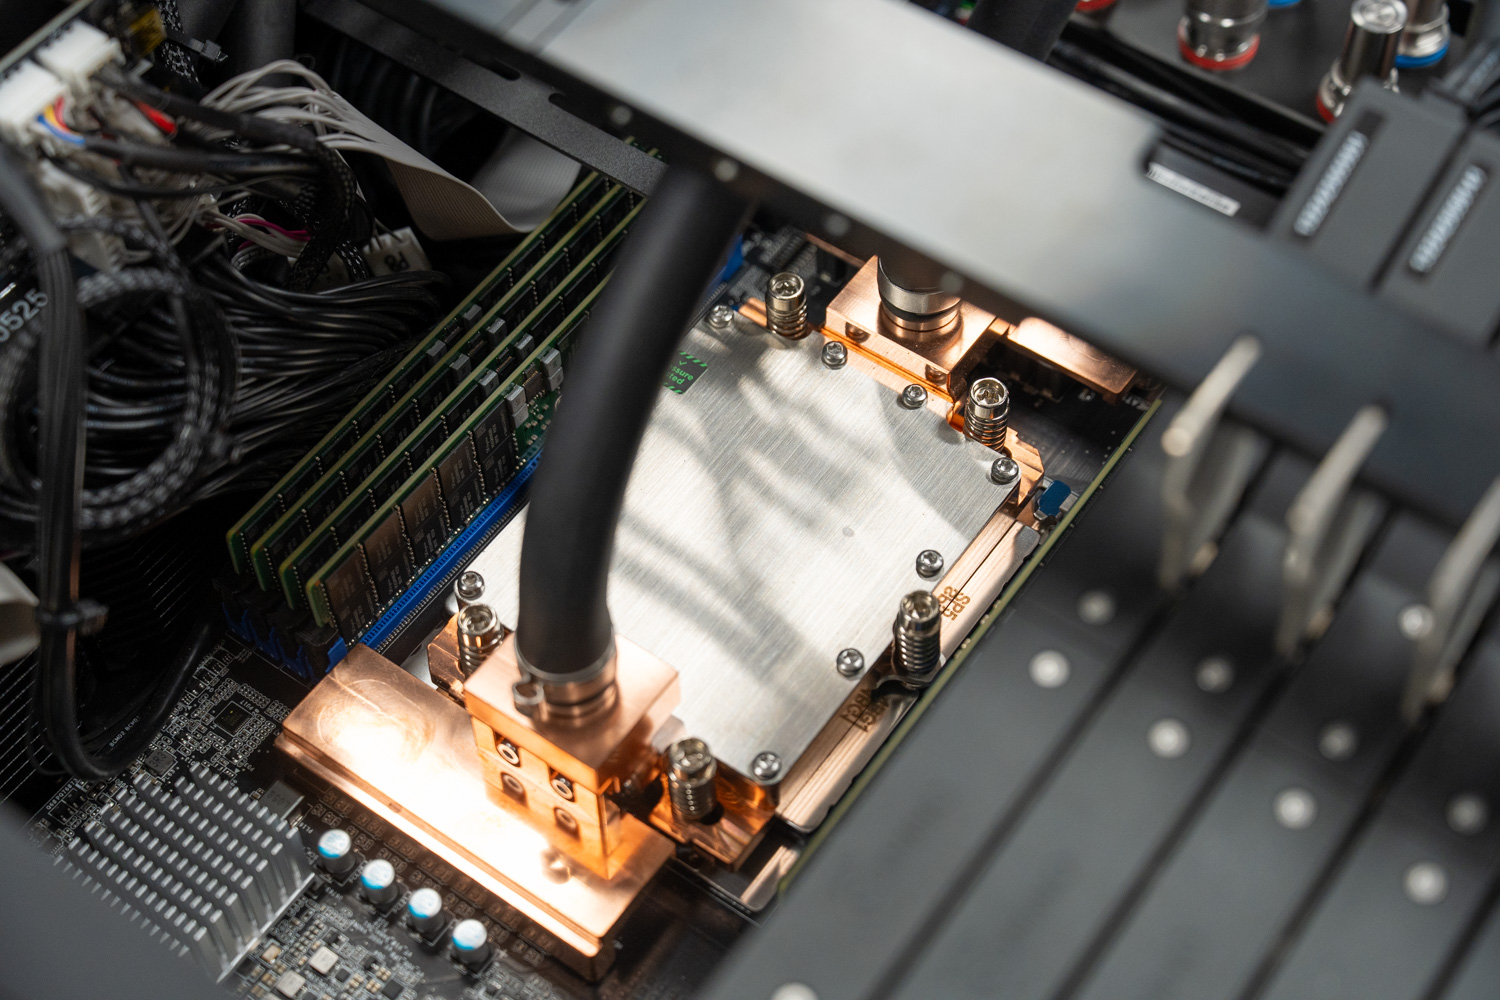
Ai lati della CPU sono presenti otto slot DRAM completamente occupati, che supportano configurazioni fino a 2 TB di RAM. L'unità in prova era dotata di 512 GB di RAM DDR5. Una barra di supporto si estende sopra l'area della GPU e della CPU del case, perpendicolarmente ad esse, fissando i componenti più delicati come la GPU e mantenendo la rigidità del case durante il trasporto.
Radiatore e ventole
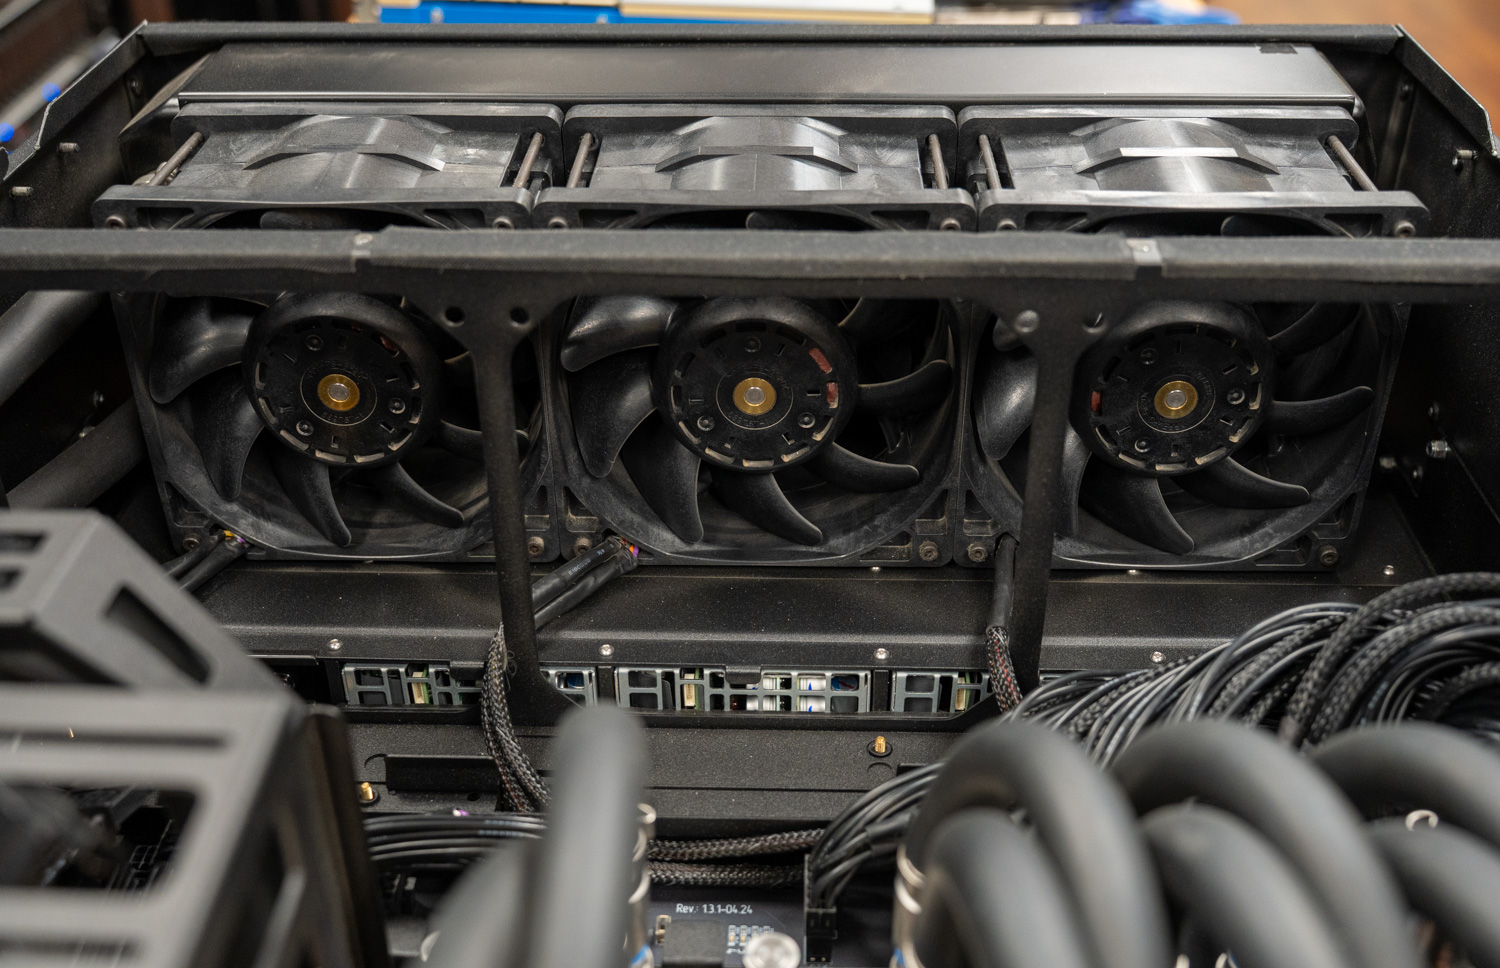
Il raffreddamento è affidato a un grande radiatore triplo da 140 mm montato sul retro del case, abbinato a tre ventole ad alta velocità da 140 mm in grado di raggiungere i 6,200 RPM e di movimentare fino a 1,000 m³/h di flusso d'aria. La fitta struttura a alette del radiatore di grandi dimensioni sottolinea il margine termico previsto nella piattaforma, progettata per dissipare fino a 6.5 kW di calore continuo nella nostra configurazione.
Ciò che forse sorprende di più è che, nonostante il carico di lavoro e la velocità delle ventole, l'unità riesca a rimanere entro limiti di rumorosità tollerabili, con livelli sonori superiori a 70 dB alla massima velocità. Si tratta di un valore elevato per gli standard delle workstation, ma notevolmente contenuto per un sistema che dissipa il calore prodotto da una piccola stufa elettrica, il che dimostra l'efficacia con cui il circuito a liquido del Comino trasferisce il calore dai componenti.
Pannello frontale e display di telemetria
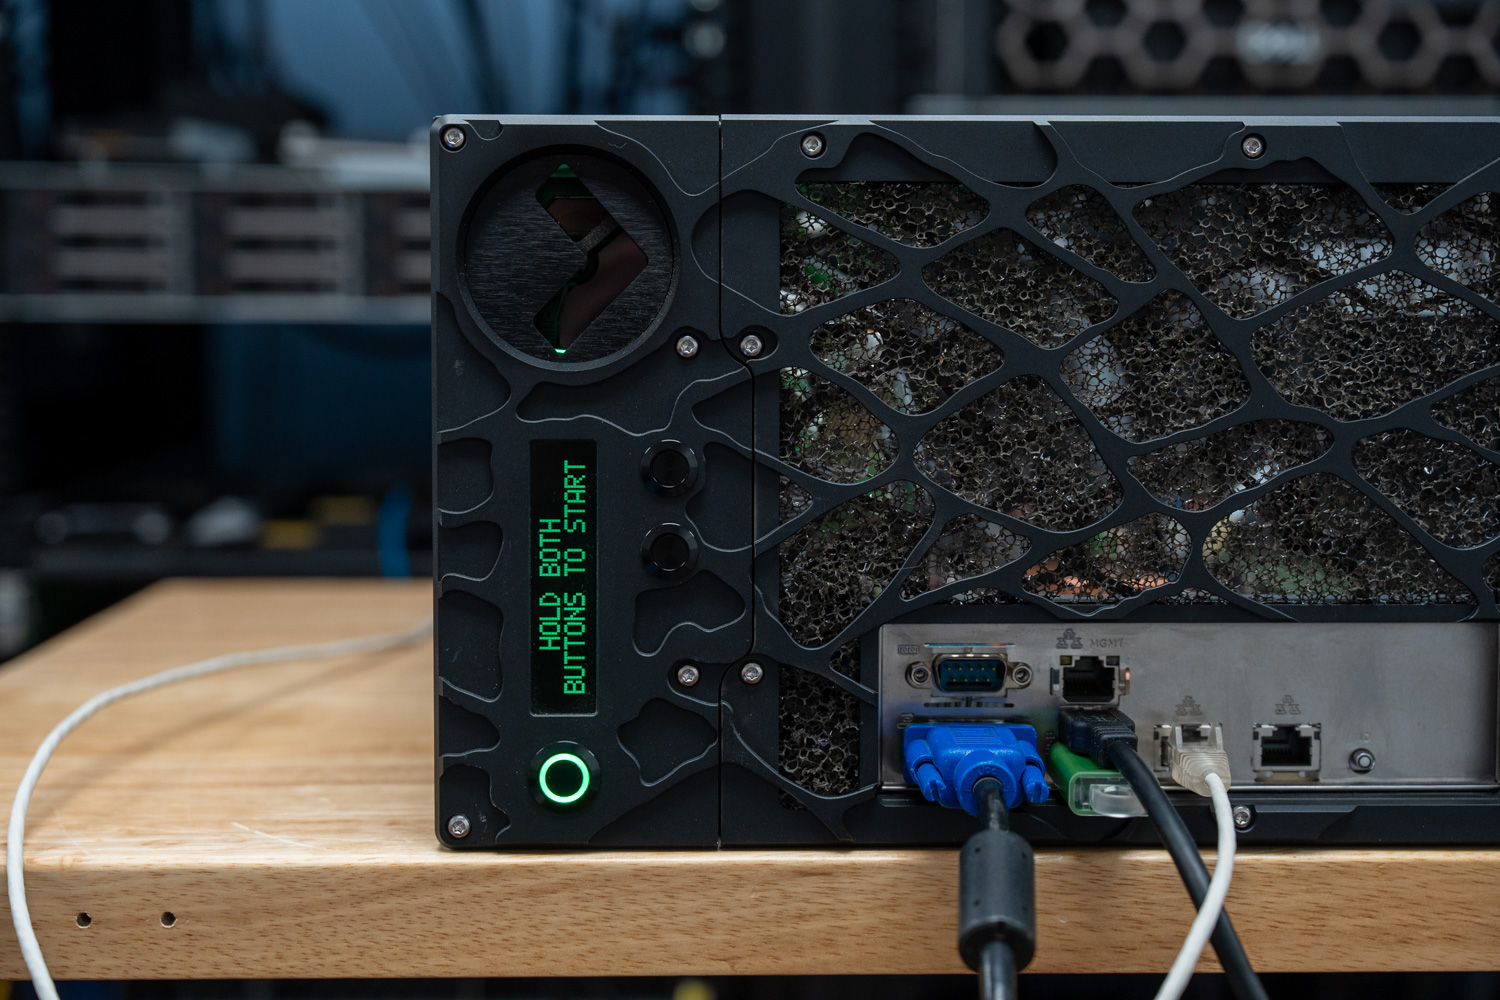
Sul pannello frontale, un display a LED fornisce una lettura in tempo reale dei principali dati di telemetria, tra cui lo stato della pompa, la temperatura dell'aria ambiente, la temperatura del liquido di raffreddamento e la velocità della ventola. Gli utenti navigano nel menu utilizzando i pulsanti illuminati sul modulo di raffreddamento, con pressioni brevi per scorrere i dati disponibili. Una pressione prolungata del pulsante PB2 apre ulteriori sezioni del menu, tra cui Comandi, Impostazioni di servizio e Registro eventi. Inoltre, il pannello I/O frontale include una porta VGA per l'uscita video, oltre a una porta seriale, diverse porte USB e connessioni di rete per la connettività di periferiche e dispositivi.
Architettura di alimentazione e archiviazione
Erogazione di potenza e ridondanza
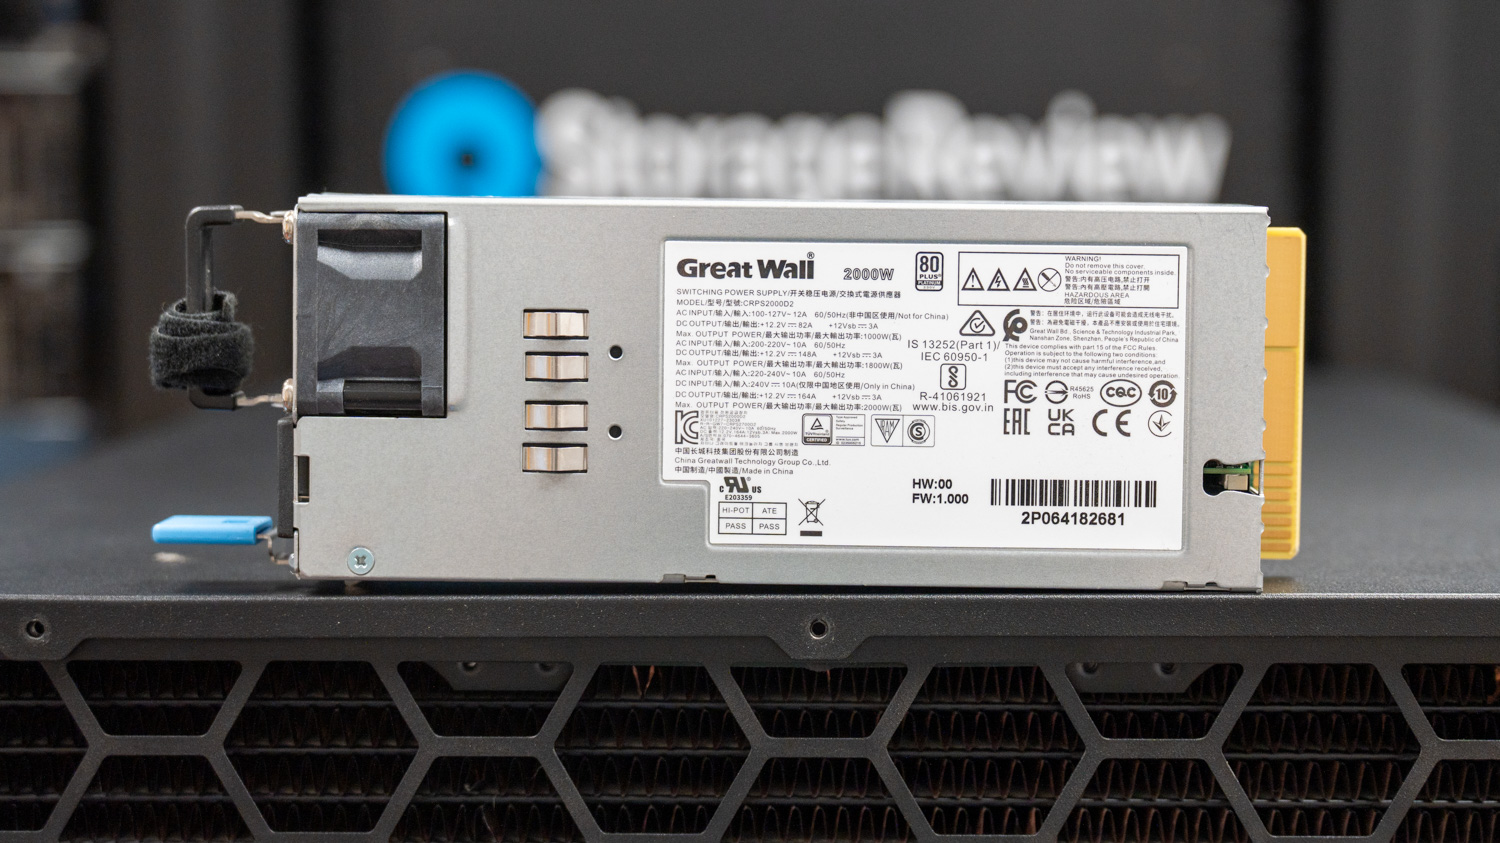
Per supportare questo livello di potenza di calcolo è necessaria un'alimentazione altrettanto robusta. Grando supporta fino a quattro moduli CRPS hot-swap da 1000 W o 2000 W in una configurazione ridondante, erogando fino a 8.0 kW a 180–264 V. Grazie al supporto per le modalità di ridondanza 4+0, 3+1 e 2+2, il sistema può tollerare guasti all'alimentatore mantenendo il funzionamento continuo per carichi di lavoro di IA e HPC 24 ore su 24, 7 giorni su 7.
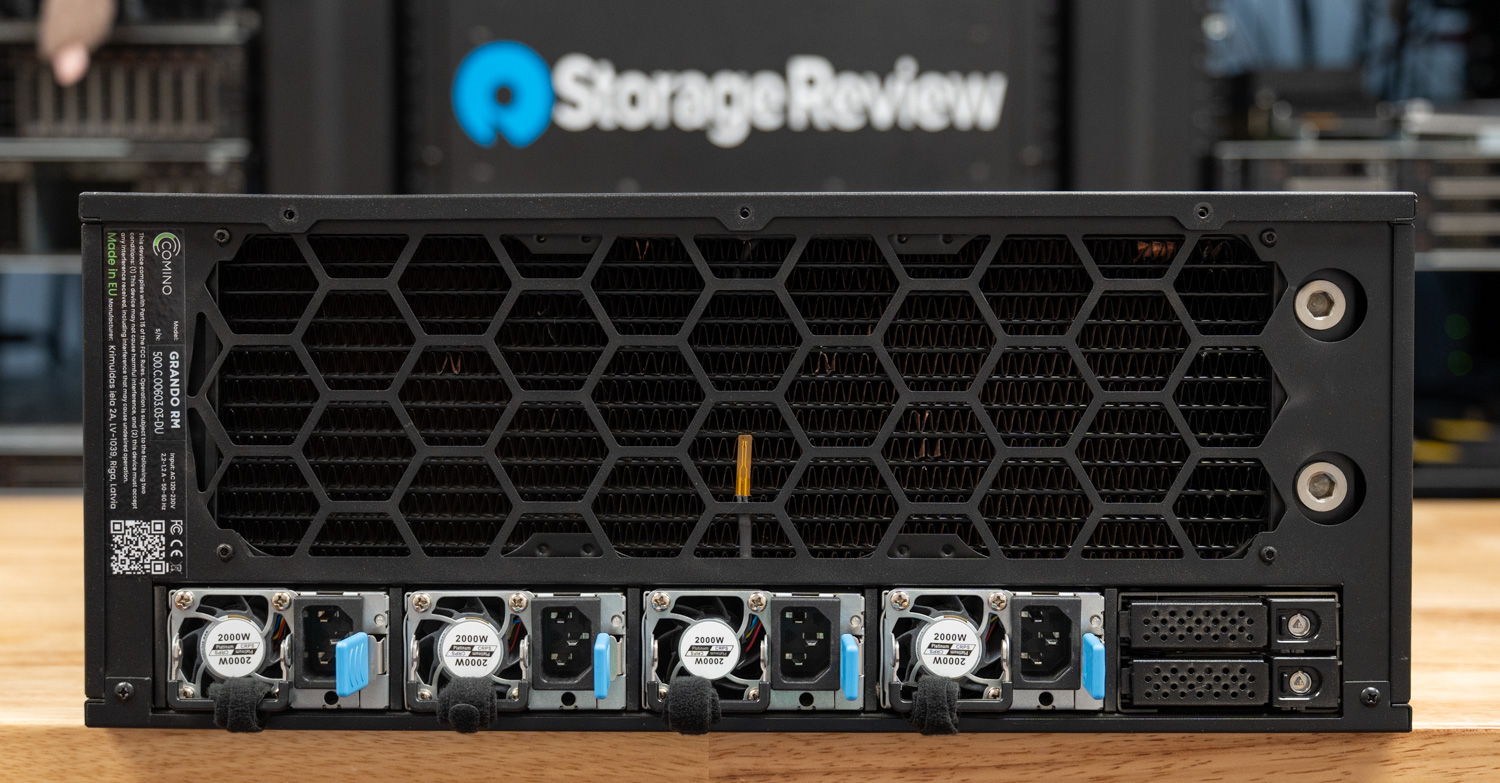
L'unità che abbiamo ricevuto per la recensione era dotata di quattro alimentatori hot-swap Great Wall da 2000 W con certificazione 80 Plus Platinum, che formavano la configurazione completa da 8.0 kW.
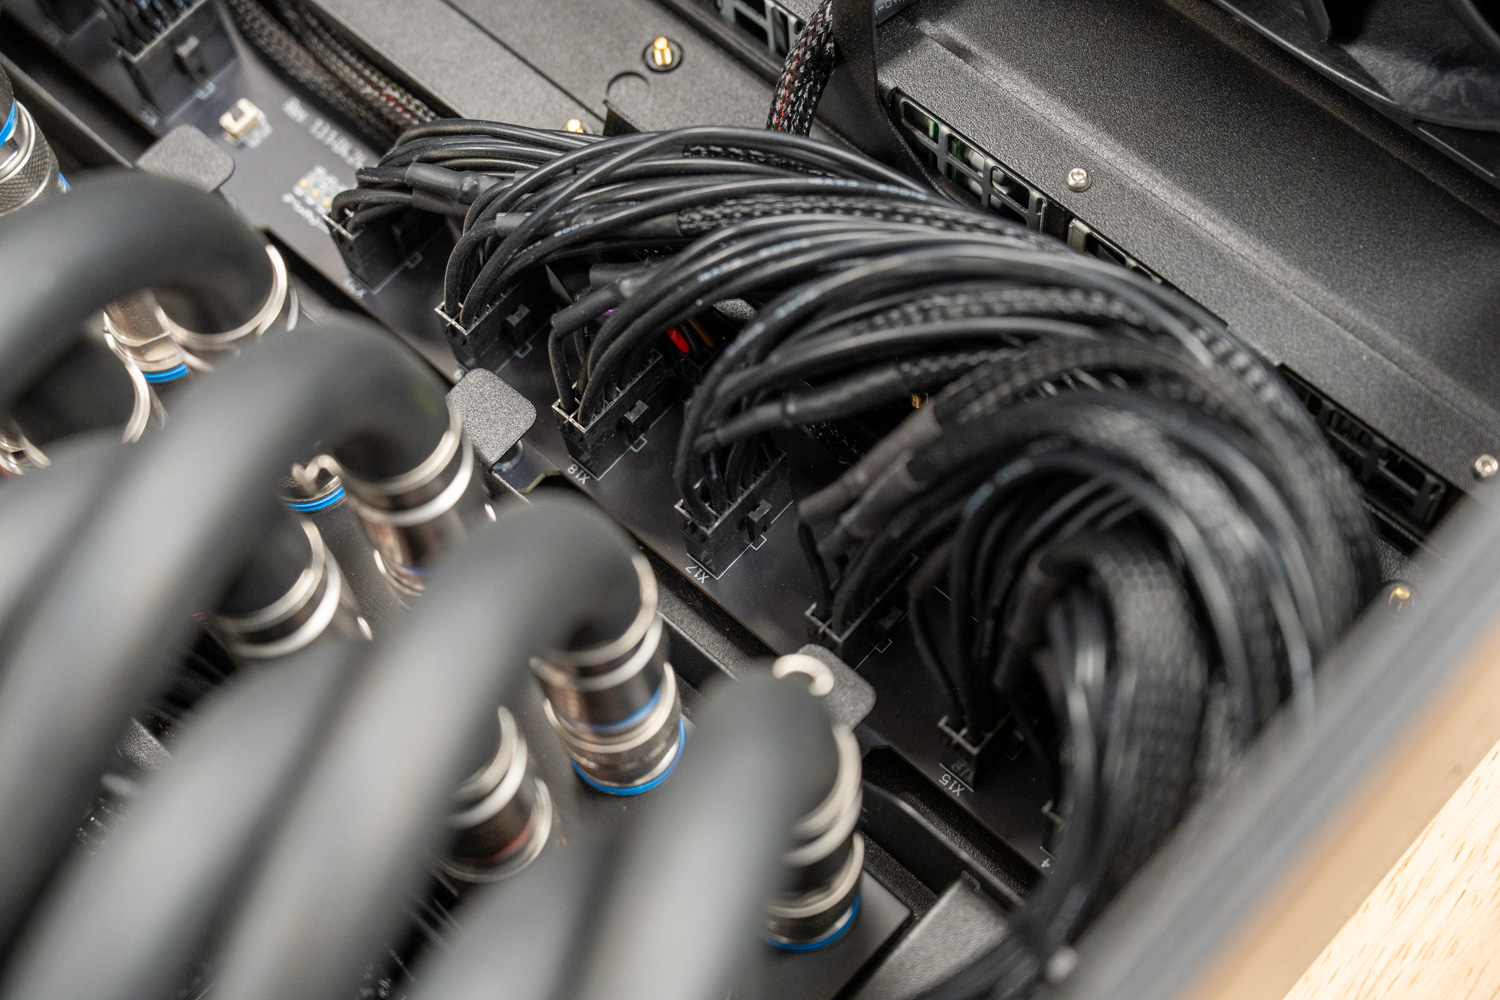
L'alimentazione di ciascuna GPU passa attraverso una scheda di distribuzione centralizzata a 12 pin, montata tra l'array di GPU e il cavo principale. Il Grando utilizza questa scheda di distribuzione per consolidare le alimentazioni in ingresso e poi diramarle a ciascuna GPU in modo organizzato e salvaspazio.
PCIe, archiviazione e rete
Il Grando supporta comodamente sei GPU senza compromettere la larghezza di banda degli slot e il case è scalabile fino a una configurazione completa di otto schede per la massima densità. La scheda madre ASRock Rack GENOAD8X-2T/BCM di Comino offre sette slot PCIe Gen 5 x16 e uno x8, il che significa che sette delle otto GPU funzionano a piena larghezza di banda x16, mentre l'ottava scheda opera a x8. Questo rappresenta un compromesso tra il numero di linee PCIe che una CPU a singolo socket può supportare e la riluttanza di Comino ad aggiungere l'ingombro, il costo e la complessità di una piastra switch PCIe. Il passaggio a una scheda madre a doppio socket fornirebbe più linee PCIe, ma offrirebbe ancora meno slot, poiché il secondo socket occuperebbe lo spazio altrimenti utilizzato dagli slot PCIe nel fattore di forma limitato.
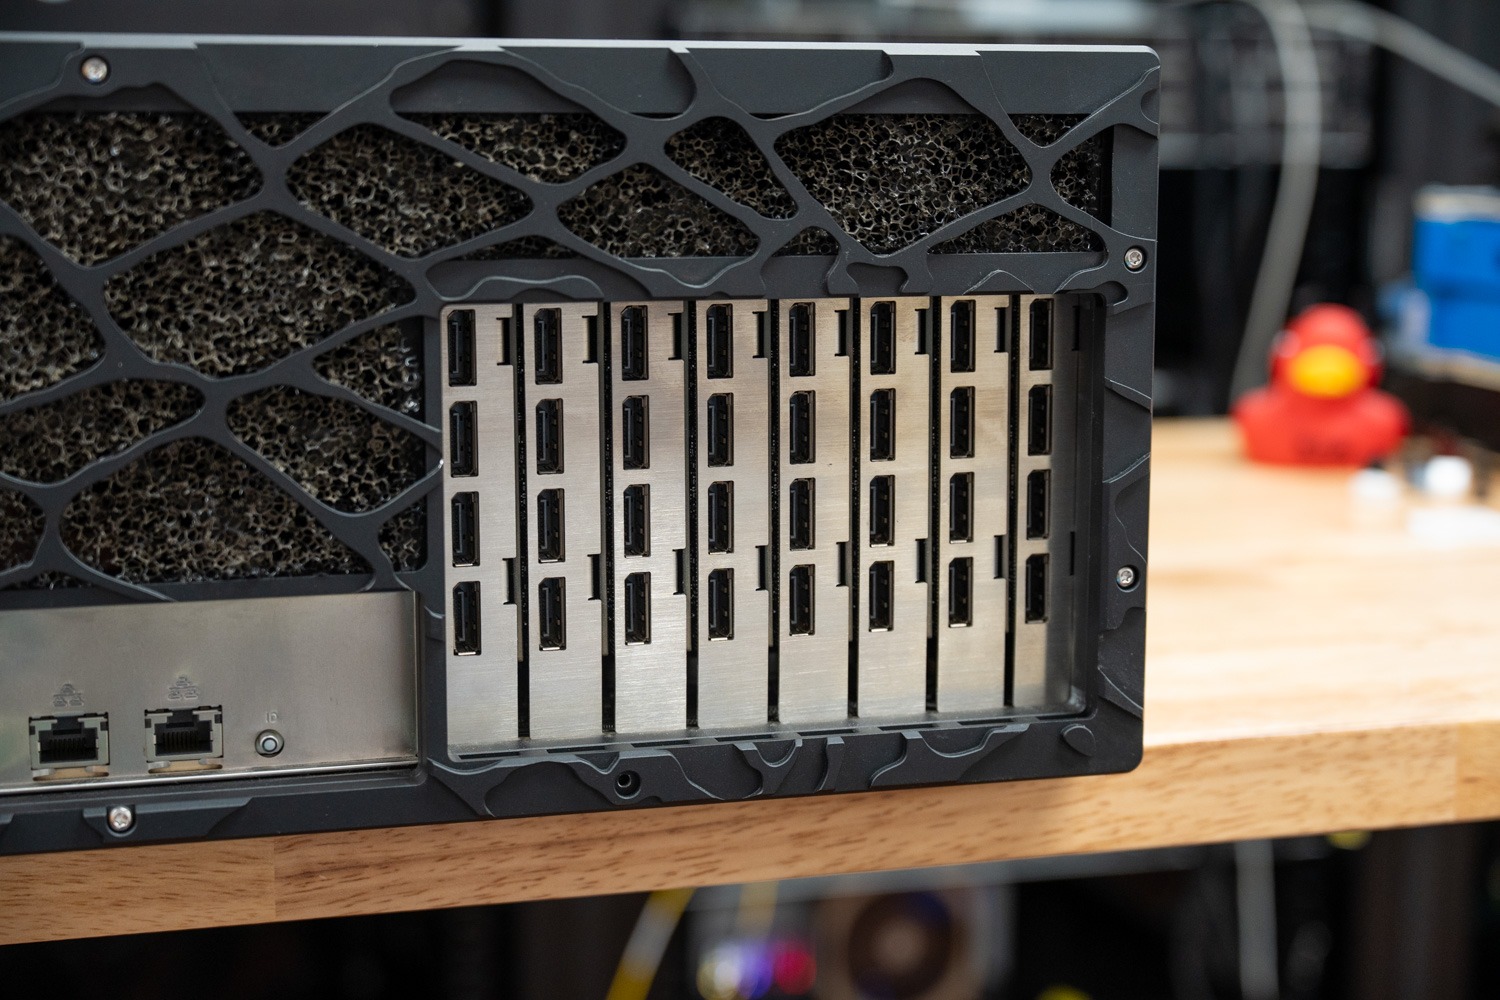
L'utilizzo di otto GPU in un sistema a singolo socket consuma la maggior parte delle linee PCIe disponibili, il che comporta dei compromessi. L'unità che abbiamo testato, basata su AMD Genoa, dispone di un totale di 128 linee PCIe Gen 5. Poiché otto GPU ne consumano 120, le restanti 8 vengono suddivise 4 volte per ogni slot SSD M.2, quindi non è possibile utilizzare contemporaneamente otto GPU e un set completo di unità NVMe nella parte posteriore del case collegate tramite i due connettori MCIO. Nella nostra configurazione completa a 8 GPU, solo 2 slot M.2 erano disponibili per l'archiviazione. Gli amministratori che necessitano di ulteriore capacità NVMe oltre alla massima densità di GPU devono essere consapevoli che l'aggiunta di unità di archiviazione NVMe hot-swap posteriori tramite gli appositi alloggiamenti sul pannello posteriore consumerà ulteriori linee PCIe e disabiliterà parte della capacità GPU del sistema.
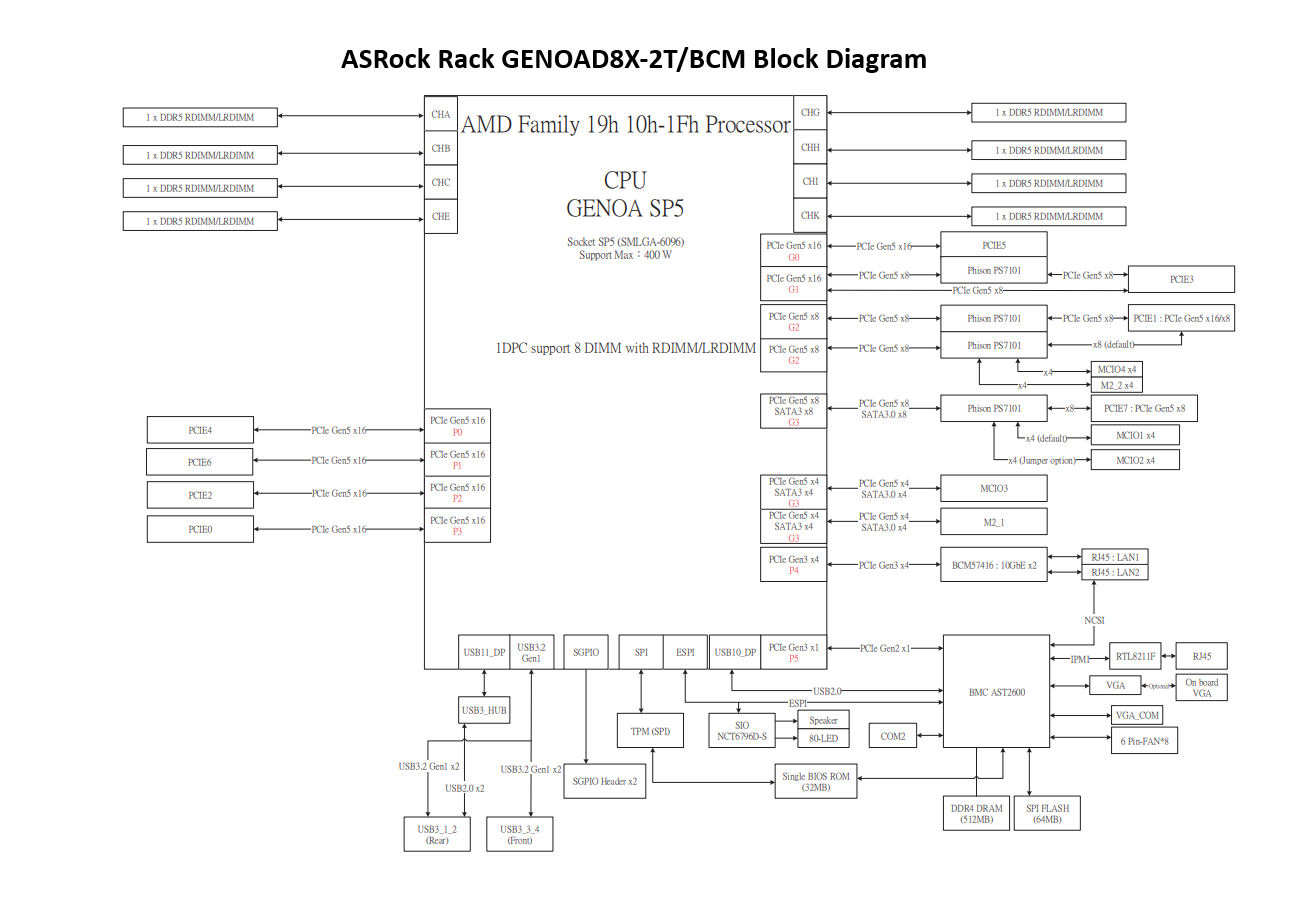
Diagramma a blocchi della scheda madre ASRock Rack GENOAD8X-2T/BCM che mostra la CPU, gli slot PCIe Gen 5, i canali DIMM, gli slot M.2, il BMC, le porte USB, SATA e le connessioni di rete.
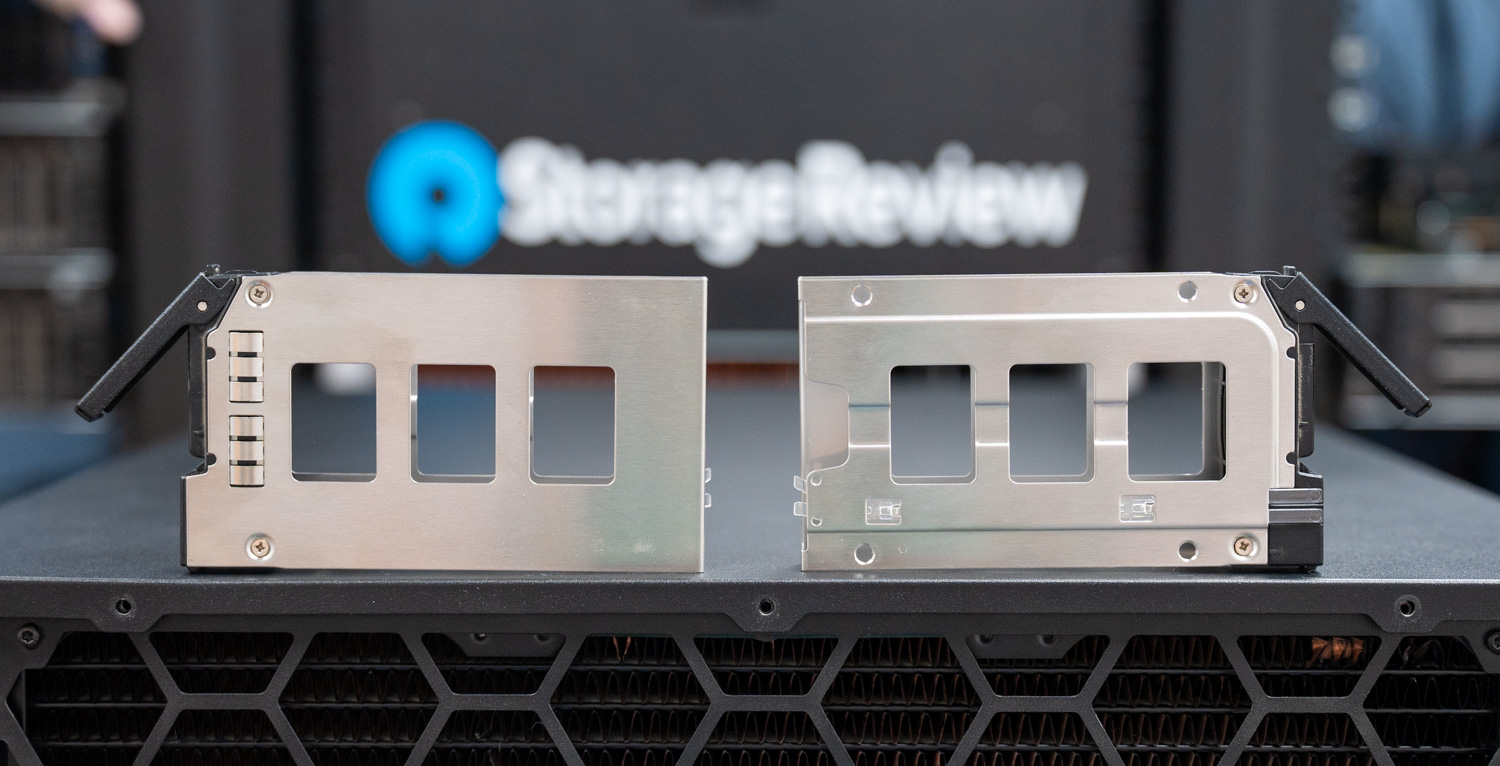
Detto questo, lo storage è altrettanto modulare ed espandibile, sebbene la configurazione influisca sul budget di linee PCIe per le GPU, un aspetto da tenere in considerazione in base all'utilizzo previsto. Il pannello posteriore dell'unità in prova presenta un alloggiamento per unità da 2.5" che supporta fino a quattro SSD da 2.5" in configurazioni 4x 7 mm o 2x 15 mm, con un secondo set opzionale di fino a quattro SSD disponibile al posto del quarto slot per l'alimentatore. Poiché l'unità in prova richiedeva tutti e quattro gli alloggiamenti per l'alimentatore per supportare la configurazione completa a 8 GPU, avevamo accesso solo al primo dei due alloggiamenti hot-swap. Internamente, il case può supportare un alloggiamento da 3.5" che può ospitare fino a quattro unità da 3.5", quattro unità da 2.5" da 15 mm o fino a dodici unità da 2.5" da 7 mm, oltre a quattro slot SSD interni aggiuntivi da 2.5" da 7 mm, se configurati.
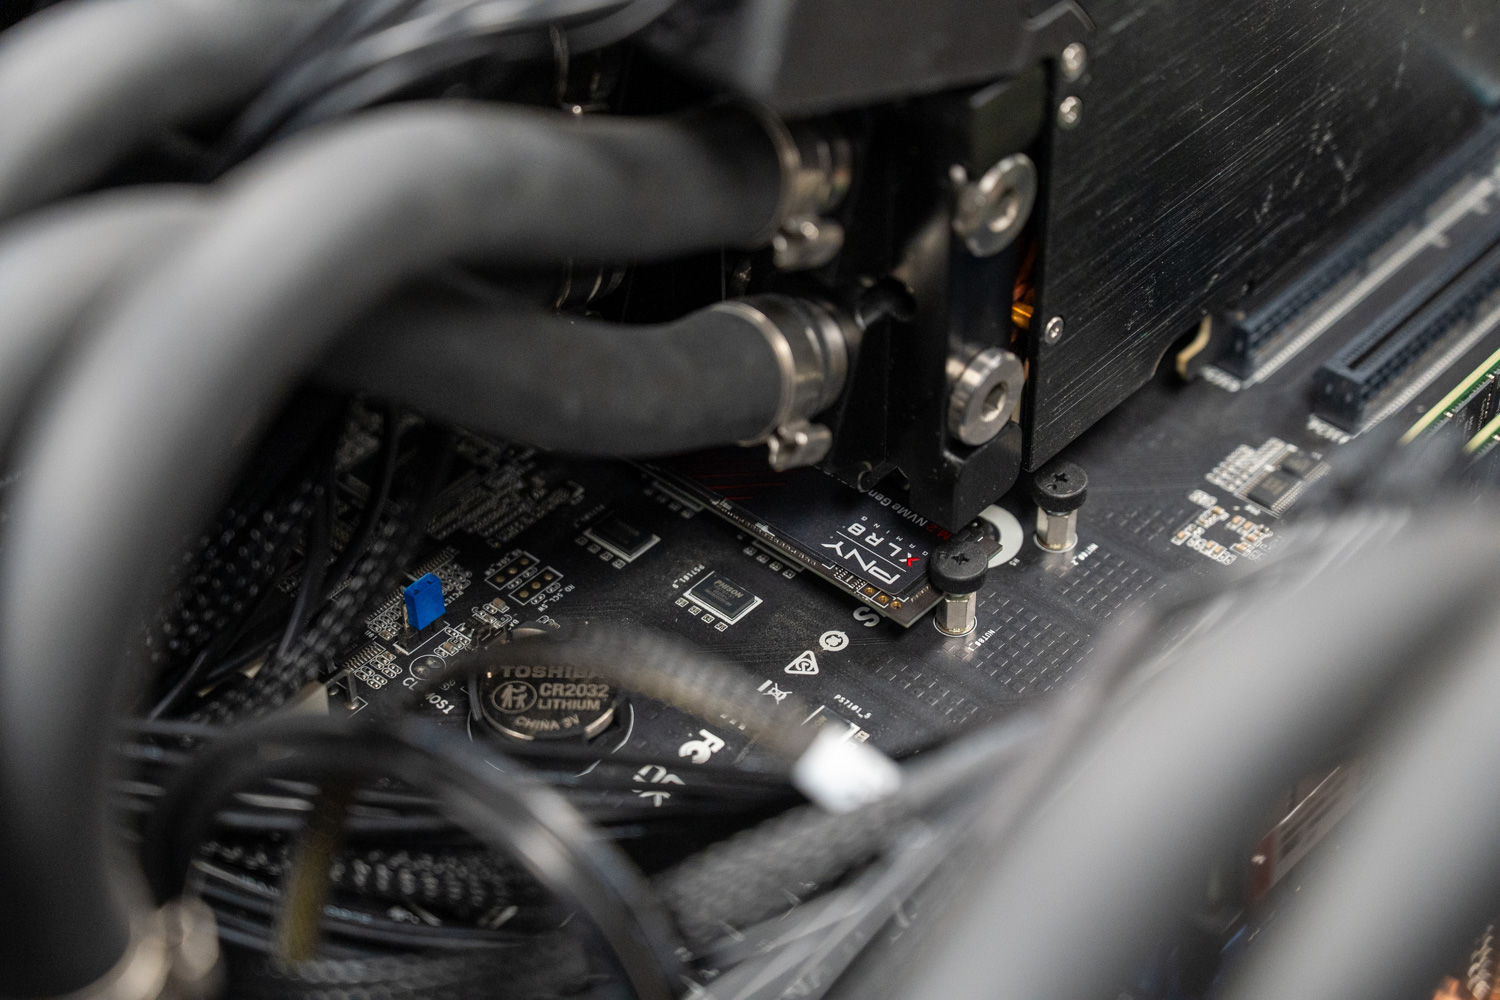
Per la connettività di rete, la scheda madre offre di serie due porte RJ45 da 10 Gb/s integrate, gestite dal Broadcom BCM57416, e una porta dedicata Gigabit Ethernet per la gestione IPMI. Gli amministratori possono ulteriormente incrementare la larghezza di banda installando schede di rete PCIe che supportano fino a 400 Gb/s per una connettività fabric ad alta larghezza di banda, tenendo presente che le schede di rete PCIe aggiuntive occupano gli slot GPU, riducendo il numero massimo di GPU che il sistema può ospitare.
Gestione remota e intelligenza di sistema
Per salvaguardare l'hardware e ottimizzare le prestazioni, il sistema include il Comino Monitoring System (CMS). Una scheda di controllo separata e autonoma gestisce il CMS e funge da "cervello" del server, indipendentemente dal sistema operativo principale. In pratica, questo controller legge una serie completa di sensori che monitorano in tempo reale le temperature dell'aria e del liquido di raffreddamento, i livelli di umidità, le portate del liquido di raffreddamento e i livelli dei serbatoi. Fondamentalmente, questa progettazione autonoma consente al CMS di eseguire un'autodiagnosi e di attivare arresti di emergenza in caso di rilevamento di perdite o guasti alle pompe, proteggendo così i costosi componenti hardware interni da eventuali danni.
Un'interfaccia grafica basata sul web gestisce le attività quotidiane, fornendo agli amministratori una chiara visibilità sulle prestazioni di raffreddamento, sul tempo di attività e sul consumo energetico in tempo reale di CPU e GPU. Per le implementazioni su scala aziendale, il CMS si connette anche a strumenti di monitoraggio centralizzati tramite API REST, come Zabbix, Grafana e InfluxDB. Insieme, queste funzionalità aiutano gli amministratori a mantenere un intervallo tra i servizi di 3 anni e a garantire che il server funzioni alla massima efficienza senza throttling termico, anche in ambienti con temperature ambiente elevate.
Oltre l'intelligenza artificiale: applicazioni creative e ingegneristiche.
Sebbene i nostri test si siano concentrati su carichi di lavoro di inferenza AI, Grando si rivela altrettanto utile per professionisti creativi e ingegneri che necessitano di una notevole potenza di calcolo GPU locale. I 768 GB di VRAM complessivi distribuiti su otto schede RTX PRO 6000 sbloccano capacità che le configurazioni workstation convenzionali non possono eguagliare.
Artisti di effetti speciali e professionisti della grafica animata possono renderizzare scene complesse con enormi set di texture interamente in VRAM, eliminando i colli di bottiglia dovuti allo scambio di dischi che affliggono le produzioni che utilizzano filmati 8K o ambienti ad alta risoluzione. Gli ingegneri CAD che eseguono simulazioni di fluidodinamica computazionale o strutturali possono gestire assemblaggi di complessità senza precedenti senza dover suddividere i loro modelli in più esecuzioni. I montatori video che lavorano con timeline RAW 8K multi-stream, i coloristi che applicano la riduzione del rumore basata sul machine learning a piena risoluzione e gli artisti 3D che renderizzano localmente i rendering finali con path tracing anziché attendere la disponibilità di un data center cloud, traggono tutti vantaggio da questa densità di memoria e potenza di calcolo della GPU.
Grando non richiede una configurazione completa a otto GPU. Comino offre la piattaforma in configurazioni a quattro, sei e otto GPU, tutte disponibili per la spedizione immediata. Studi più piccoli, creatori indipendenti e team di ingegneri possono dimensionare il proprio investimento in base alle esigenze attuali, mantenendo al contempo un chiaro percorso di aggiornamento man mano che i carichi di lavoro aumentano.
Compromessi tra piattaforme: densità vs. espandibilità
Il design compatto del Grando offre un'eccezionale densità di GPU e una gestione termica ottimale all'interno di un formato standard 4U, ma tale densità comporta dei compromessi architetturali che è bene comprendere prima dell'implementazione.
Lo chassis è compatibile con schede madri con fattori di forma EATX ed EEB, ma non con schede server estese presenti nelle tradizionali piattaforme a doppio socket. Ciò limita il numero totale di linee PCIe disponibili per le periferiche oltre l'array di GPU. Nella nostra configurazione a otto GPU, le 128 linee PCIe Gen 5 del processore AMD EPYC sono quasi interamente occupate dalle GPU, lasciando poca larghezza di banda per ulteriore storage NVMe o rete ad alta velocità oltre le porte 10GbE integrate.
Questo contrasta con le piattaforme a otto GPU che abbiamo recensito di Dell, HPE e Supermicro. Tali sistemi utilizzano chassis più grandi, configurazioni a doppio socket e topologie di switch PCIe per supportare una connettività periferica significativamente maggiore. In genere ospitano da quattro a otto schede di rete o DPU aggiuntive oltre al set completo di GPU, oltre a otto o più alloggiamenti NVMe hot-swap, il che li rende particolarmente adatti a carichi di lavoro di inferenza distribuita che richiedono interconnessioni di rete ad alta larghezza di banda.
Tuttavia, questa maggiore capacità ha un costo considerevole. Il consumo energetico supera gli 8 kW. I carichi termici richiedono un'infrastruttura di raffreddamento dedicata per i data center. I livelli di rumore impediscono l'installazione al di fuori di sale macchine appositamente costruite. Inoltre, i tempi di consegna si estendono spesso dai sei ai diciotto mesi a causa delle persistenti limitazioni di fornitura delle piattaforme GPU aziendali.
Grando occupa una posizione diversa. Per le organizzazioni che privilegiano la rapida implementazione, ambienti operativi gestibili e carichi di lavoro di inferenza o creativi rispetto alla formazione distribuita su larga scala, i compromessi sono spesso favorevoli. I team che necessitano dell'hardware immediatamente, in un ambiente con cui possono effettivamente lavorare, potrebbero trovare l'approccio di Grando alla densità più pratico rispetto all'attesa di una piattaforma che non sarebbero realisticamente in grado di implementare una volta disponibile.
Risultati dei test di performance di Comino Grande
Configurazione del sistema
- Chassis: Comino Grande
- Scheda madre: ASRock Rack GENOAD8X-2T/BCM
- CPU: AMD EPYC 9474F 48C
- Memoria: DDR512 da 5 GB
- GPU: 8 x NVIDIA RTX PRO 6000
- Memoria su disco: M.2 SSD
Claude Code Serving – MiniMax M2.5
Oltre ai tradizionali benchmark di inferenza LLM grezzi, volevamo valutare le prestazioni di questo hardware in un flusso di lavoro di programmazione agentiva, in particolare gestendo più sessioni simultanee di Claude Code utilizzando un modello ospitato localmente. Questo caso d'uso si traduce direttamente in produttività del team di sviluppo: quanti ingegneri possono utilizzare simultaneamente un assistente di programmazione basato sull'IA, erogato da un singolo nodo, prima che l'esperienza si degradi?
Per testare questa ipotesi, abbiamo creato un framework di benchmark che genera un dataset di problemi di programmazione di difficoltà moderata (come l'implementazione di una cache LRU, la creazione di un'applicazione CLI per la gestione delle attività, la scrittura di un convertitore Markdown e la costruzione di un'API REST) ed esegue ogni sessione di Claude Code in un container Docker separato, in parallelo al server vLLM locale. Un proxy trasparente si interpone tra le sessioni e l'endpoint di inferenza, acquisendo metriche per ogni richiesta e per ogni istanza di Claude Code. Il modello utilizzato è stato MiniMax M2.5, eseguito tramite vLLM sulle otto GPU NVIDIA RTX PRO 6000 del sistema. Pur non essendo il modello di programmazione più performante nelle classifiche pubbliche, M2.5 è un modello valido che molti utenti, inclusi i nostri amici sviluppatori, utilizzano localmente.
Come punto di riferimento, utilizziamo la velocità di elaborazione media di Claude Opus 4.6 di Anthropic tramite OpenRouter.ai, uno dei servizi di routing più diffusi per l'accesso alle API in produzione. Tale valore di riferimento si attesta a circa 37 token al secondo per richiesta API.
Abbiamo misurato due parametri chiave: la media dei token di output al secondo per sessione di Claude Code (ciò che ogni sviluppatore sperimenta) e la quantità totale di token di output al secondo su tutte le sessioni (il lavoro complessivo prodotto dal server).
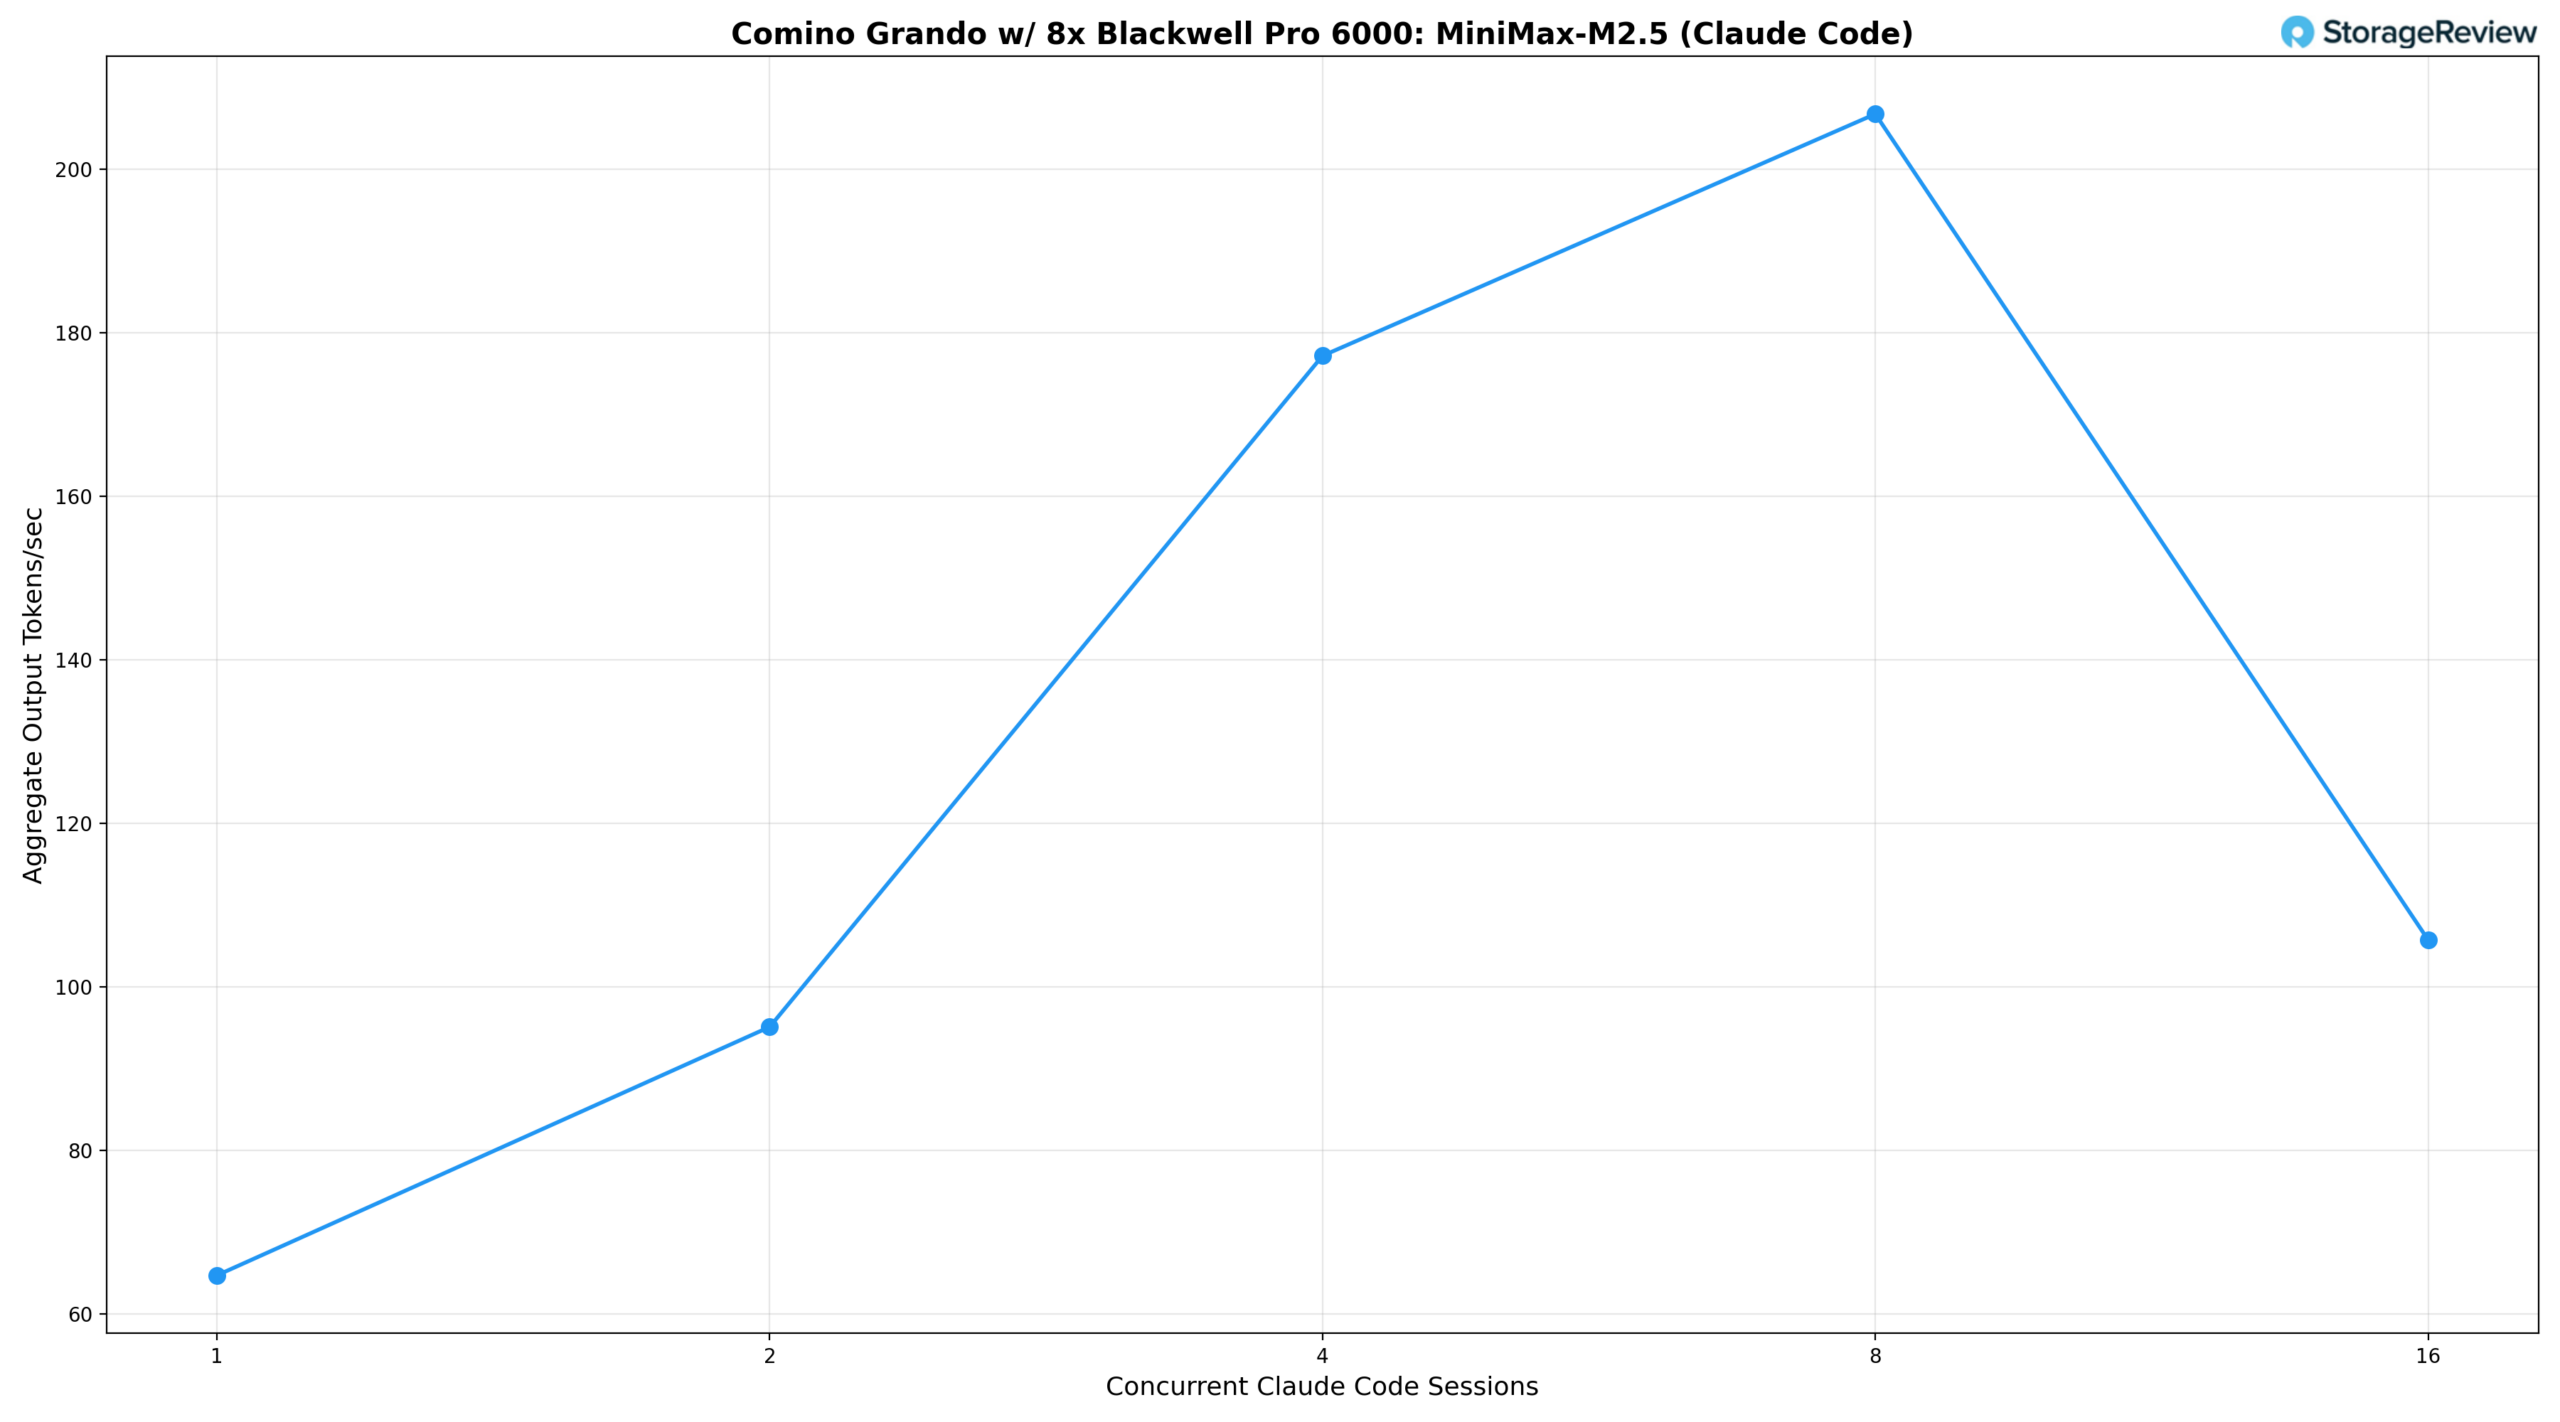
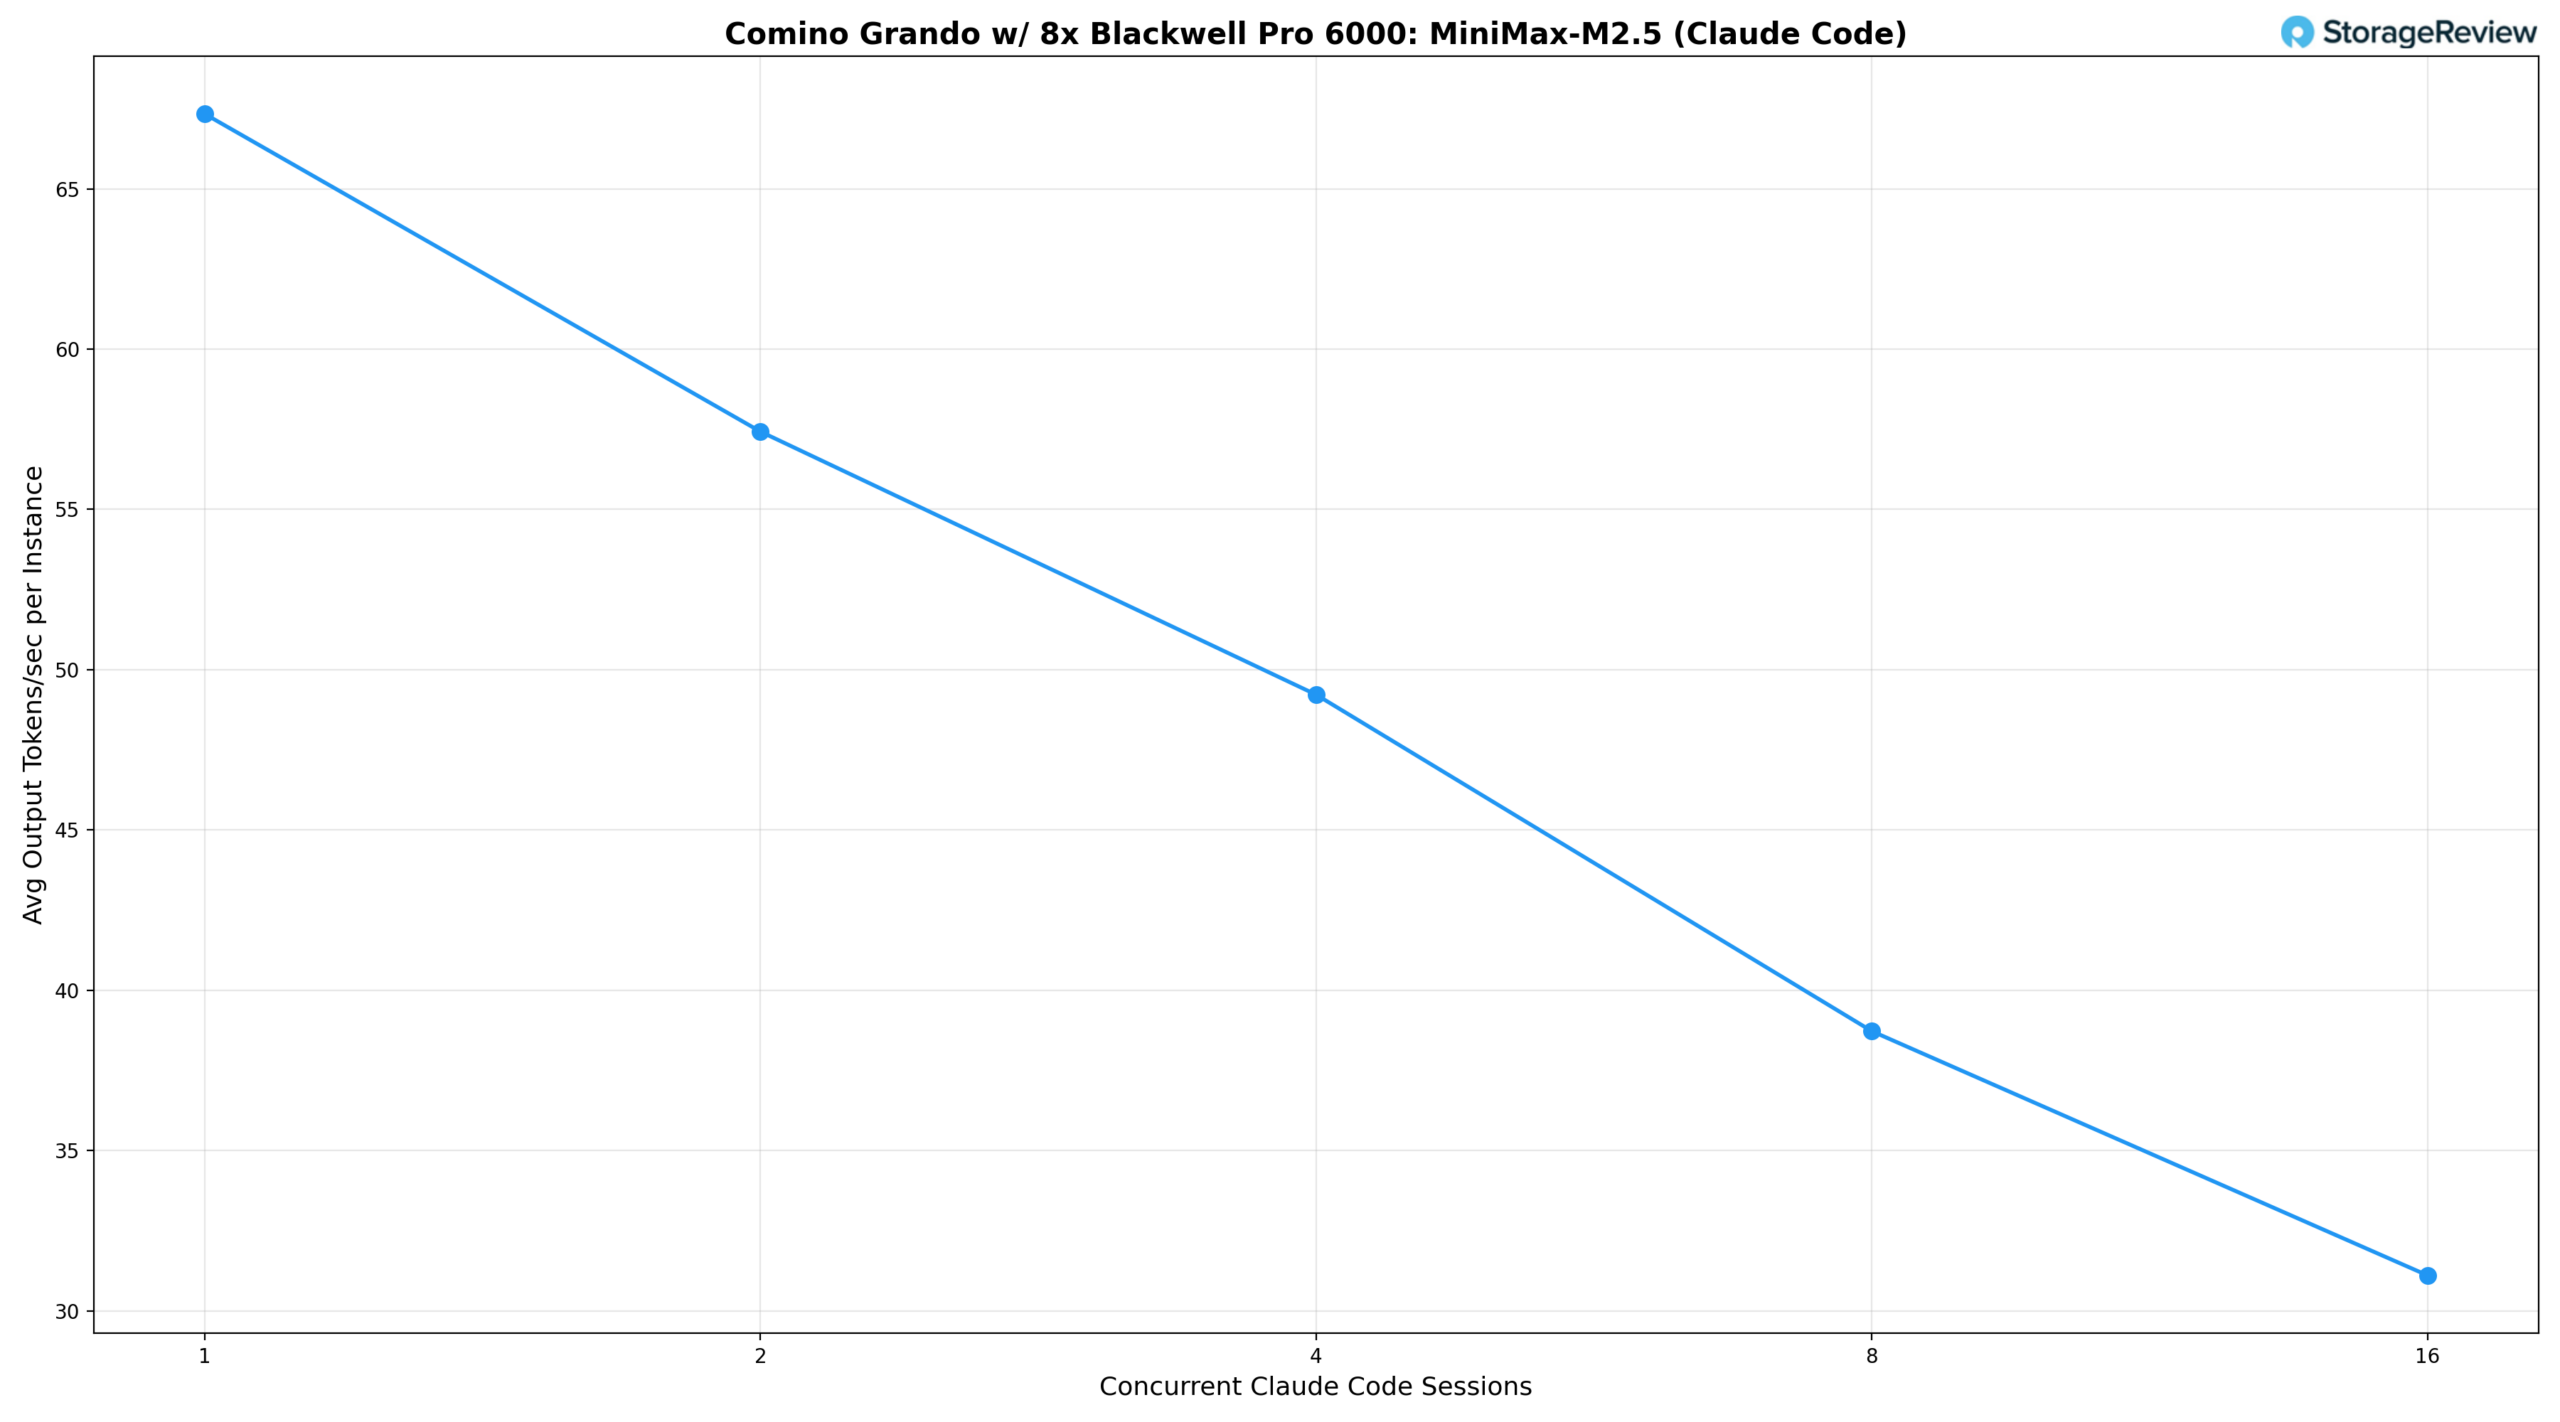
In base ai risultati, una singola sessione simultanea di Claude Code offre 67.3 tok/s per utente e un output aggregato di 64.7 tok/s. Con due sessioni, il throughput per istanza scende leggermente a 57.4 tok/s, mentre l'output aggregato sale a 95.1 tok/s quando il batching di vLLM inizia ad ammortizzare l'overhead. Quattro sessioni simultanee mantengono 49.2 tok/s per utente, un'esperienza comunque molto reattiva per i flussi di lavoro di programmazione interattiva, mentre il throughput aggregato raggiunge 177.2 tok/s. Otto sessioni rappresentano il punto ottimale per l'output aggregato, con un picco di 206.7 tok/s totali, mentre il throughput per istanza si stabilizza a 38.7 tok/s, un livello che rimane confortevole per la generazione e l'iterazione del codice in tempo reale.
Con 16 sessioni simultanee, il sistema mostra il classico compromesso del batching: la velocità di elaborazione per istanza scende a 31.1 tok/s e la velocità di elaborazione aggregata si riduce a 105.8 tok/s. Ciò suggerisce che, a questo livello di concorrenza, il modello 230B MiniMax M2.5 sta spingendo al limite le capacità di otto GPU senza introdurre una latenza significativa per ciascun utente. Il calo complessivo tra 8 e 16 sessioni riflette le esigenze di memoria e larghezza di banda di una grande architettura MoE sotto un carico di decodifica simultanea elevato, piuttosto che un'inefficienza di pianificazione.
Per le organizzazioni che valutano un'infrastruttura AI self-hosted per gli strumenti di sviluppo, Grando rappresenta una soluzione ideale. Basato su un modello 230B di ultima generazione, è in grado di gestire comodamente fino a otto sessioni simultanee di Claude Code con livelli di throughput che offrono un'esperienza davvero interattiva, con velocità per utente superiori a 38 token/s al picco di output aggregato. Team composti da quattro a otto ingegneri possono operare a un throughput quasi ottimale senza un degrado percepibile della reattività.
L'architettura a raffreddamento a liquido rende questo livello di potenza di calcolo pratico anche in ambienti in cui i server GPU tradizionali non possono operare. Il sistema è sufficientemente silenzioso da poter essere installato in un ufficio di una startup, in una piccola sala macchine o in un angolo dedicato di un open space. I sistemi a raffreddamento ad aria con una densità di GPU simile raggiungono in genere 90 dB o più, un livello di rumorosità tale da richiedere uno spazio dedicato in un data center o, come minimo, un armadio server chiuso con un adeguato trattamento acustico. Grando può coesistere con il team che lo utilizza. Grazie alla completa localizzazione dei dati, all'assenza di costi API per token e al controllo totale sulla selezione del modello, offre una soluzione self-hosted scalabile con un team di sviluppo in crescita, senza la necessità di infrastrutture in data center o aumenti di costo fissi.
vLLM Online Serving – Prestazioni di inferenza LLM
vLLM è uno dei motori di inferenza e di erogazione ad alto throughput più diffusi per i LLM. Il benchmark di erogazione online di vLLM valuta le prestazioni di questo motore di inferenza in condizioni di carico reale, con richieste simultanee. Simula carichi di lavoro di produzione inviando richieste a un server vLLM in esecuzione, con parametri configurabili come la frequenza delle richieste, la lunghezza degli input e degli output e il numero di client simultanei. Il benchmark misura metriche chiave, tra cui il throughput (token al secondo), il tempo al primo token e il tempo per token di output (TPOT), aiutando gli utenti a comprendere le prestazioni di vLLM in diverse condizioni di carico.
Abbiamo testato le prestazioni di inferenza su una suite completa di modelli che abbracciano varie architetture, scale di parametri e strategie di quantizzazione per valutare la produttività in base a diversi profili di concorrenza.
Riepilogo dei risultati
| Modello | Precisione | Uguale (256/256) | Preriempimento pesante (8k/1k) | Decodifica intensiva (1k/8k) |
|---|---|---|---|---|
| Comino Grando con 8× RTX PRO 6000 Blackwell — Risultati dell'inferenza vLLM (tok/s, picco a BS=256) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
| Lama 3.1 8B Istruzioni | FP8 | 12,109 | 20,137 | 7,353 |
| Lama 3.1 8B Istruzioni | FP4 | 11,954 | 20,206 | 7,239 |
| Lama 3.1 8B Istruzioni | BF16 | 11,752 | 17,346 | 6,155 |
| Qwen3 Coder 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Qwen3 Coder 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| Mistral Piccolo 3.1 24B | BF16 | 8,925 | 11,846 | 4,975 |
| MiniMax M2.5 (230B) | ep_dp1 | 5,753 | 7,357 | 2,555 |
| Tutti i valori sono espressi in tok/s, velocità di flusso massima a BS=256. *MiniMax M2.5 pre-riempito con elevata percentuale di riempimento ha raggiunto il picco a BS=128 (7,357 tok/s); a BS=256 la velocità era di 7,141 tok/s. | ||||
GPT-OSS 120B e 20B
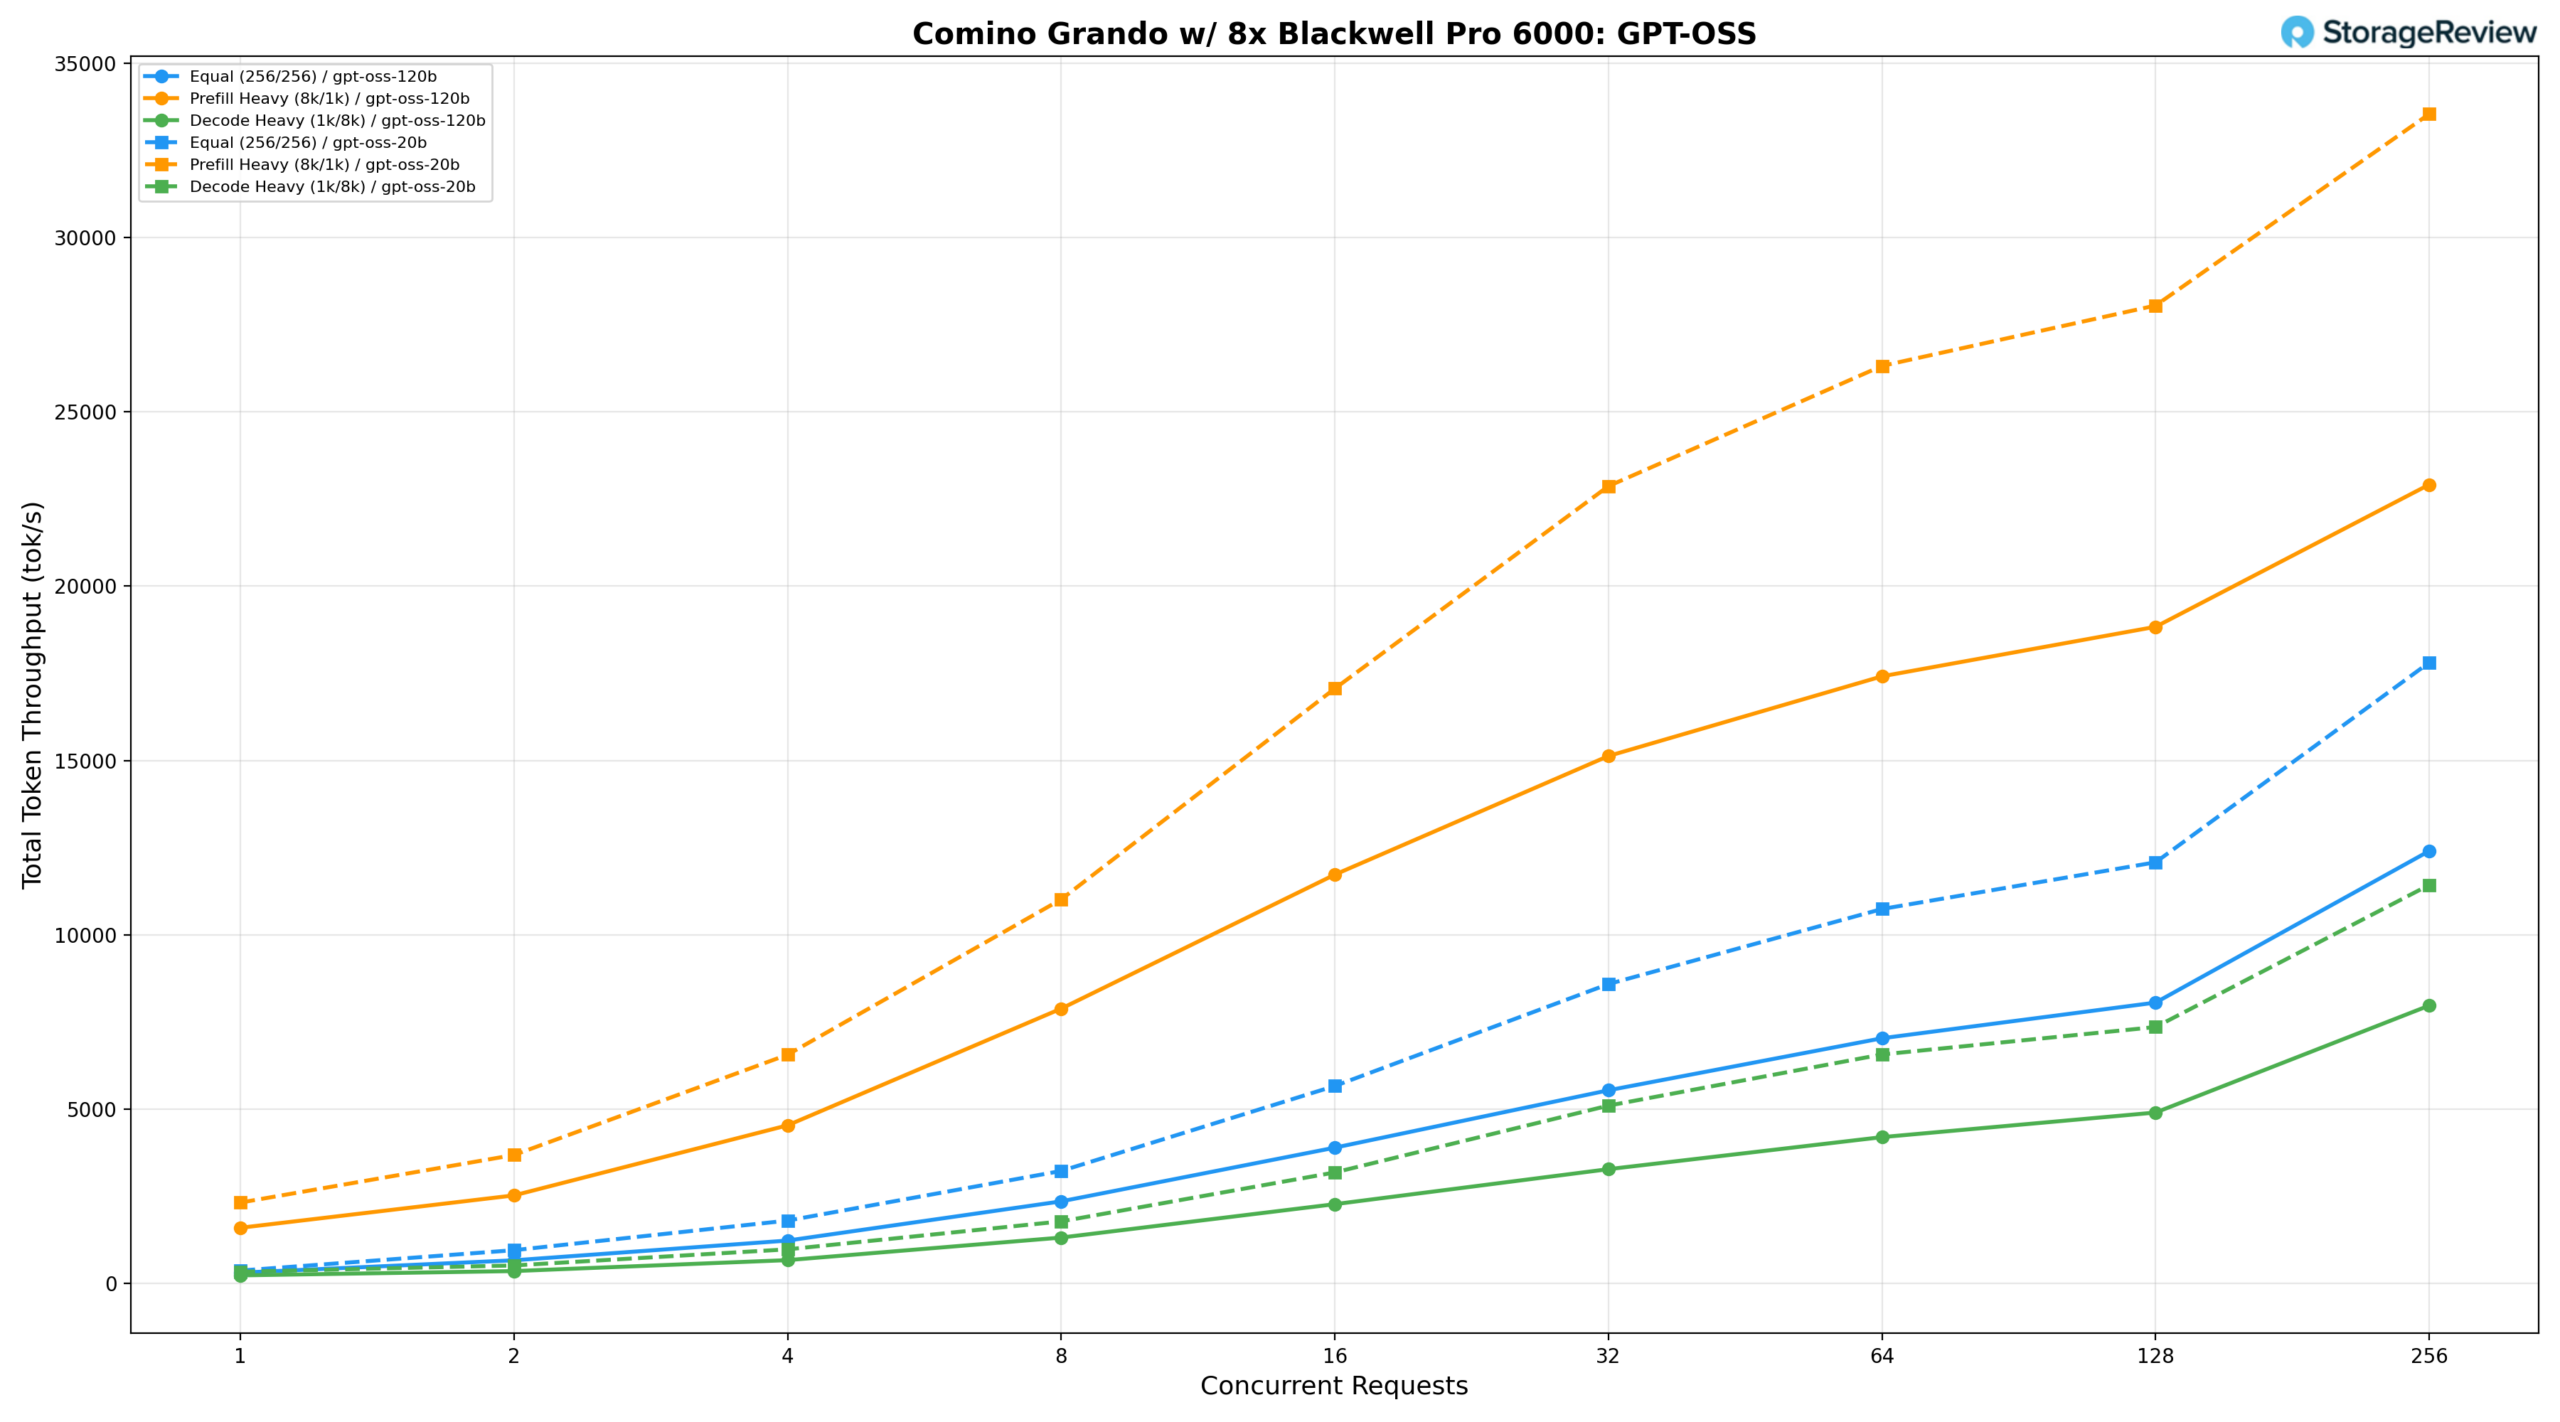
La famiglia di modelli GPT-OSS è stata testata sia nella configurazione a 120 bit che in quella a 20 bit sul Comino Grando.
GPT-OSS 120B
Con un carico di lavoro uguale (256/256), il modello 120B eroga 268.85 tok/s a BS=1, raggiunge 6,666.23 tok/s a BS=64 e un picco di 11,726.04 tok/s a BS=256. Con un carico di precarica elevato (8k/1k) parte da 1,375.69 tok/s, sale a 16,374.19 tok/s a BS=64 e 17,944.55 tok/s a BS=128, e raggiunge un picco di 21,636.41 tok/s a BS=256. Il valore di Decode-heavy (1k/8k) aumenta da 196.28 tok/s a BS=1 a 7,569.97 tok/s a BS=256, con una latenza ben controllata a livelli di concorrenza inferiori.
GPT-OSS 20B
Il modello 20B eroga 334.80 tok/s a BS=1 con lo stesso carico di lavoro, raggiunge 10,303.56 tok/s a BS=64 e un picco di 17,280.12 tok/s a BS=256. Con un elevato pre-riempimento, la velocità parte da 2,007.90 tok/s, sale a 24,990.46 tok/s a BS=64 e a 26,866.25 tok/s a BS=128, raggiungendo un picco di 32,060.72 tok/s a BS=256, la velocità di pre-riempimento assoluta più elevata registrata per entrambe le dimensioni del modello. La velocità di decodifica elevata passa da 286.08 tok/s a BS=1 a 11,187.36 tok/s a BS=256, offrendo una velocità di decodifica circa 1.5 volte superiore rispetto al 120B al picco di concorrenza, mantenendo al contempo una latenza inferiore.
Istruzioni Qwen3 Coder 30B A3B e FP8
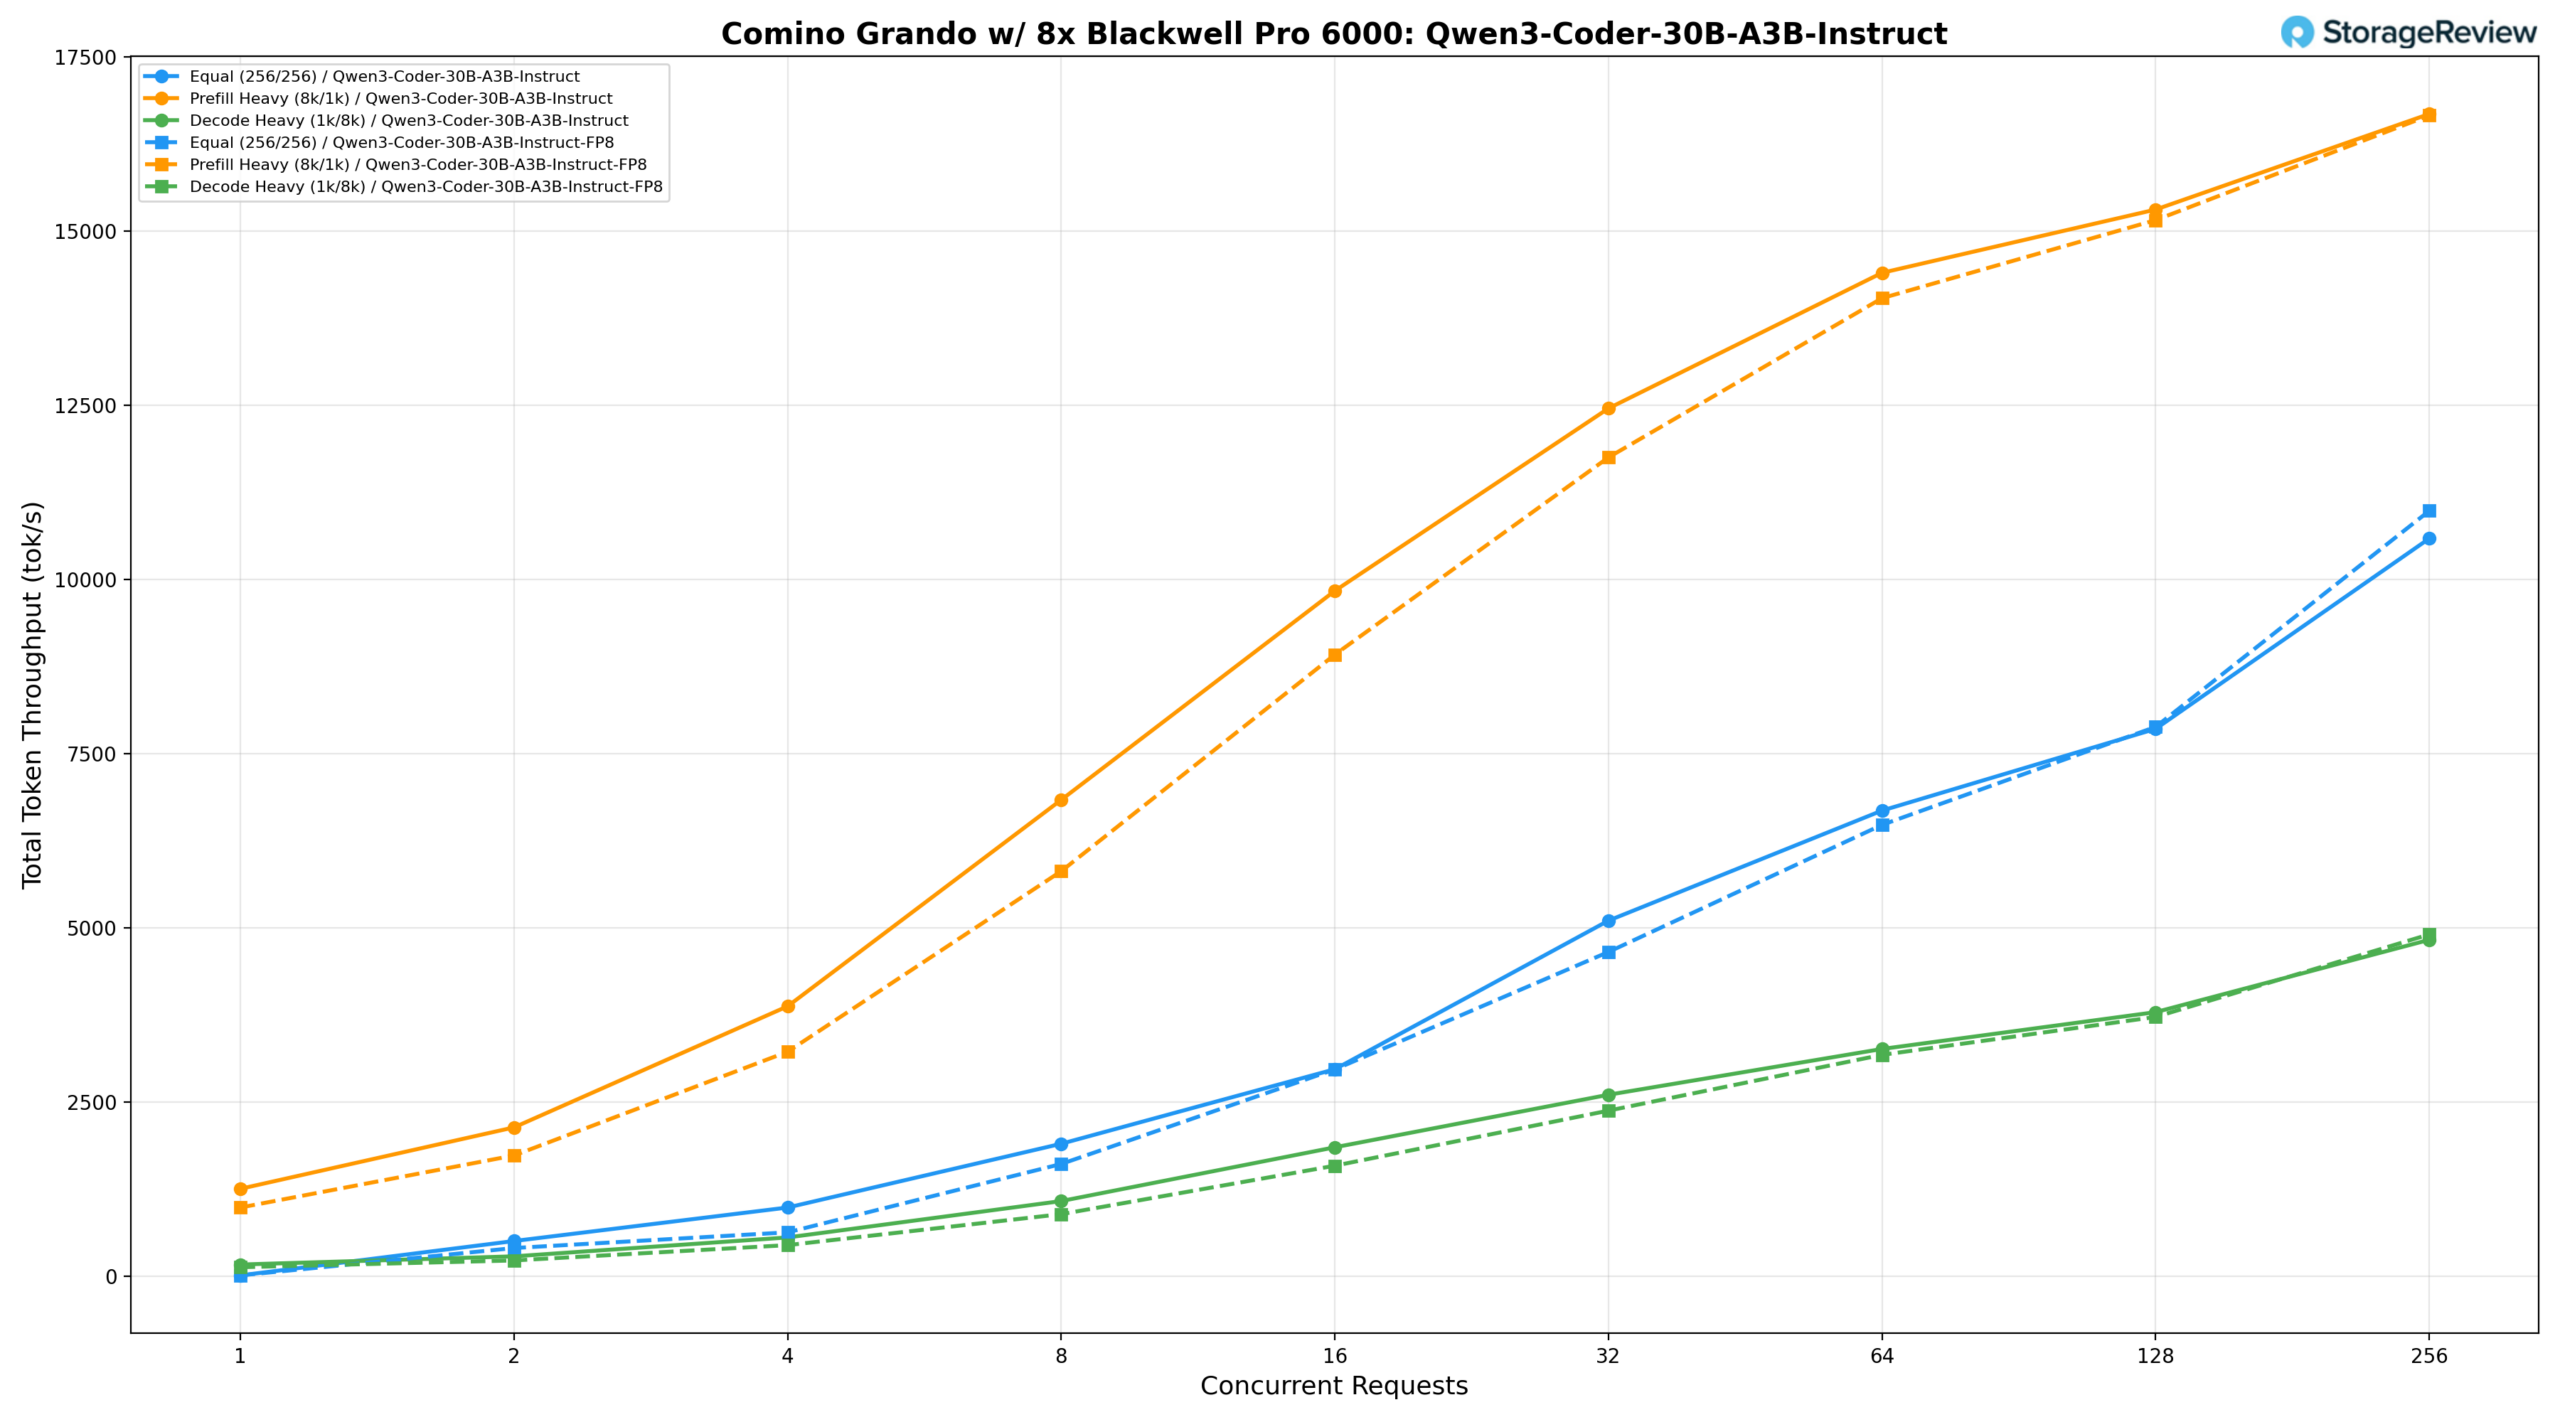
Il modello Qwen3-Coder-30B-A3B-Instruct è stato testato con precisione sia BF16 che FP8.
Qwen3-Coder-30B-A3B-Istruzione (BF16)
Con un carico di lavoro uguale (256/256), il modello BF16 eroga 1,902.32 tok/s a BS=8, raggiunge 6,683.58 tok/s a BS=64 e un picco di 10,587.56 tok/s a BS=256. Con un carico di precarica elevato (8k/1k) parte da 1,256.03 tok/s a BS=1, sale a 14,400.57 tok/s a BS=64 e 15,308.35 tok/s a BS=128, e raggiunge un picco di 16,679.52 tok/s a BS=256. La decodifica intensiva (1k/8k) passa da 169.19 tok/s a BS=1 a 4,828.82 tok/s a BS=256, con latenza ben controllata a livelli di concorrenza inferiori.
Qwen3-Coder-30B-A3B-Istruzione (FP8)
Il modello FP8 offre una velocità di elaborazione paragonabile a quella di BF16 nella maggior parte degli scenari, con un carico di lavoro equivalente che raggiunge 6,478.54 tok/s a BS=64 e un picco di 10,984.61 tok/s a BS=256, un leggero miglioramento rispetto a BF16 al picco di concorrenza. Il carico di lavoro con precaricamento elevato parte da 987.48 tok/s a BS=1, sale a 14,036.46 tok/s a BS=64 e 15,156.69 tok/s a BS=128, e raggiunge un picco di 16,658.98 tok/s a BS=256. La velocità di elaborazione con elevata intensità di decodifica passa da 130.70 tok/s a BS=1 a 4,906.51 tok/s a BS=256, superando di poco BF16 al picco di concorrenza, mentre le due configurazioni rimangono pressoché identiche per il resto dell'intervallo di concorrenza.
Mistral Small 3.1 24B Istruzioni 2503
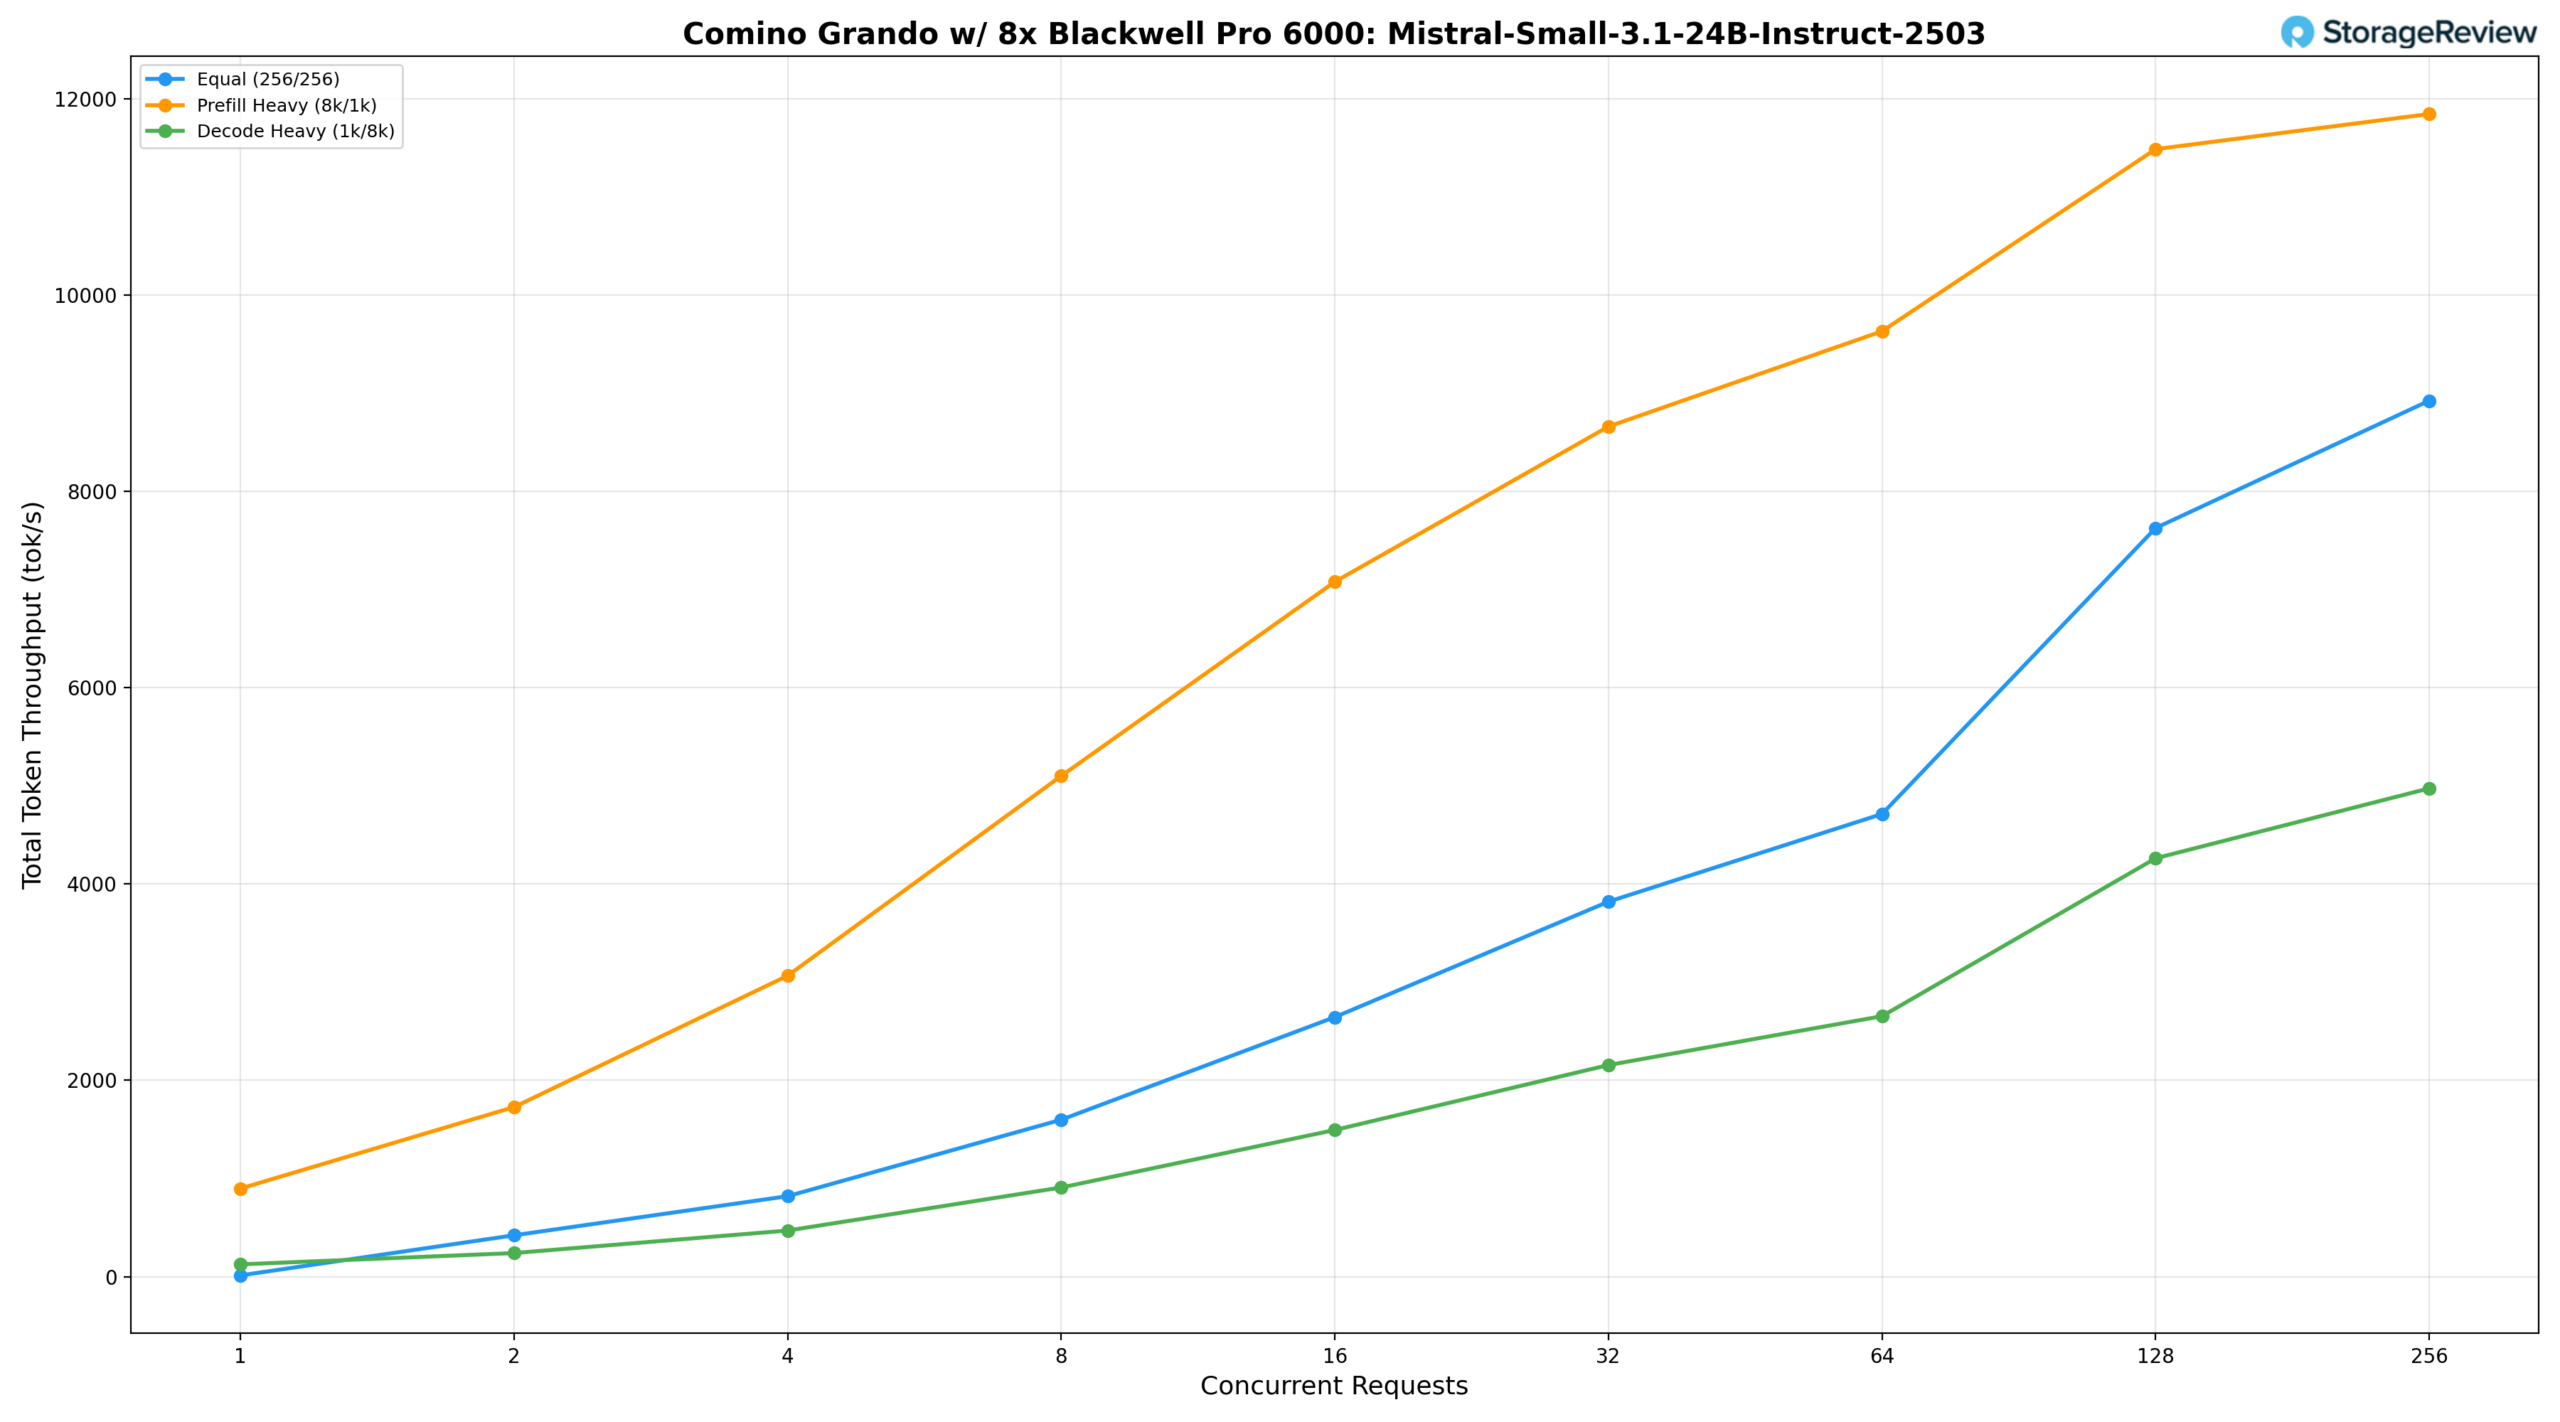
Con un carico di lavoro uguale (256/256), il modello eroga 1,598.79 tok/s a BS=8, raggiunge 4,713.84 tok/s a BS=64 e scala fortemente fino a 8,925.12 tok/s a BS=256. Con un carico di precaricamento elevato (8k/1k) parte da 897.84 tok/s a BS=1, sale a 9,632.58 tok/s a BS=64 e 11,488.13 tok/s a BS=128, raggiungendo un picco di 11,846.15 tok/s a BS=256. La velocità di decodifica elevata (1k/8k) passa da 124.98 tok/s a BS=1 a 2,653.82 tok/s a BS=64, per poi accelerare notevolmente a livelli di concorrenza più elevati, raggiungendo 4,262.53 tok/s a BS=128 e un picco di 4,975.06 tok/s a BS=256, a dimostrazione della capacità del modello di mantenere un throughput di decodifica elevato all'aumentare della concorrenza.
Lama 3.1 8B Istruzioni
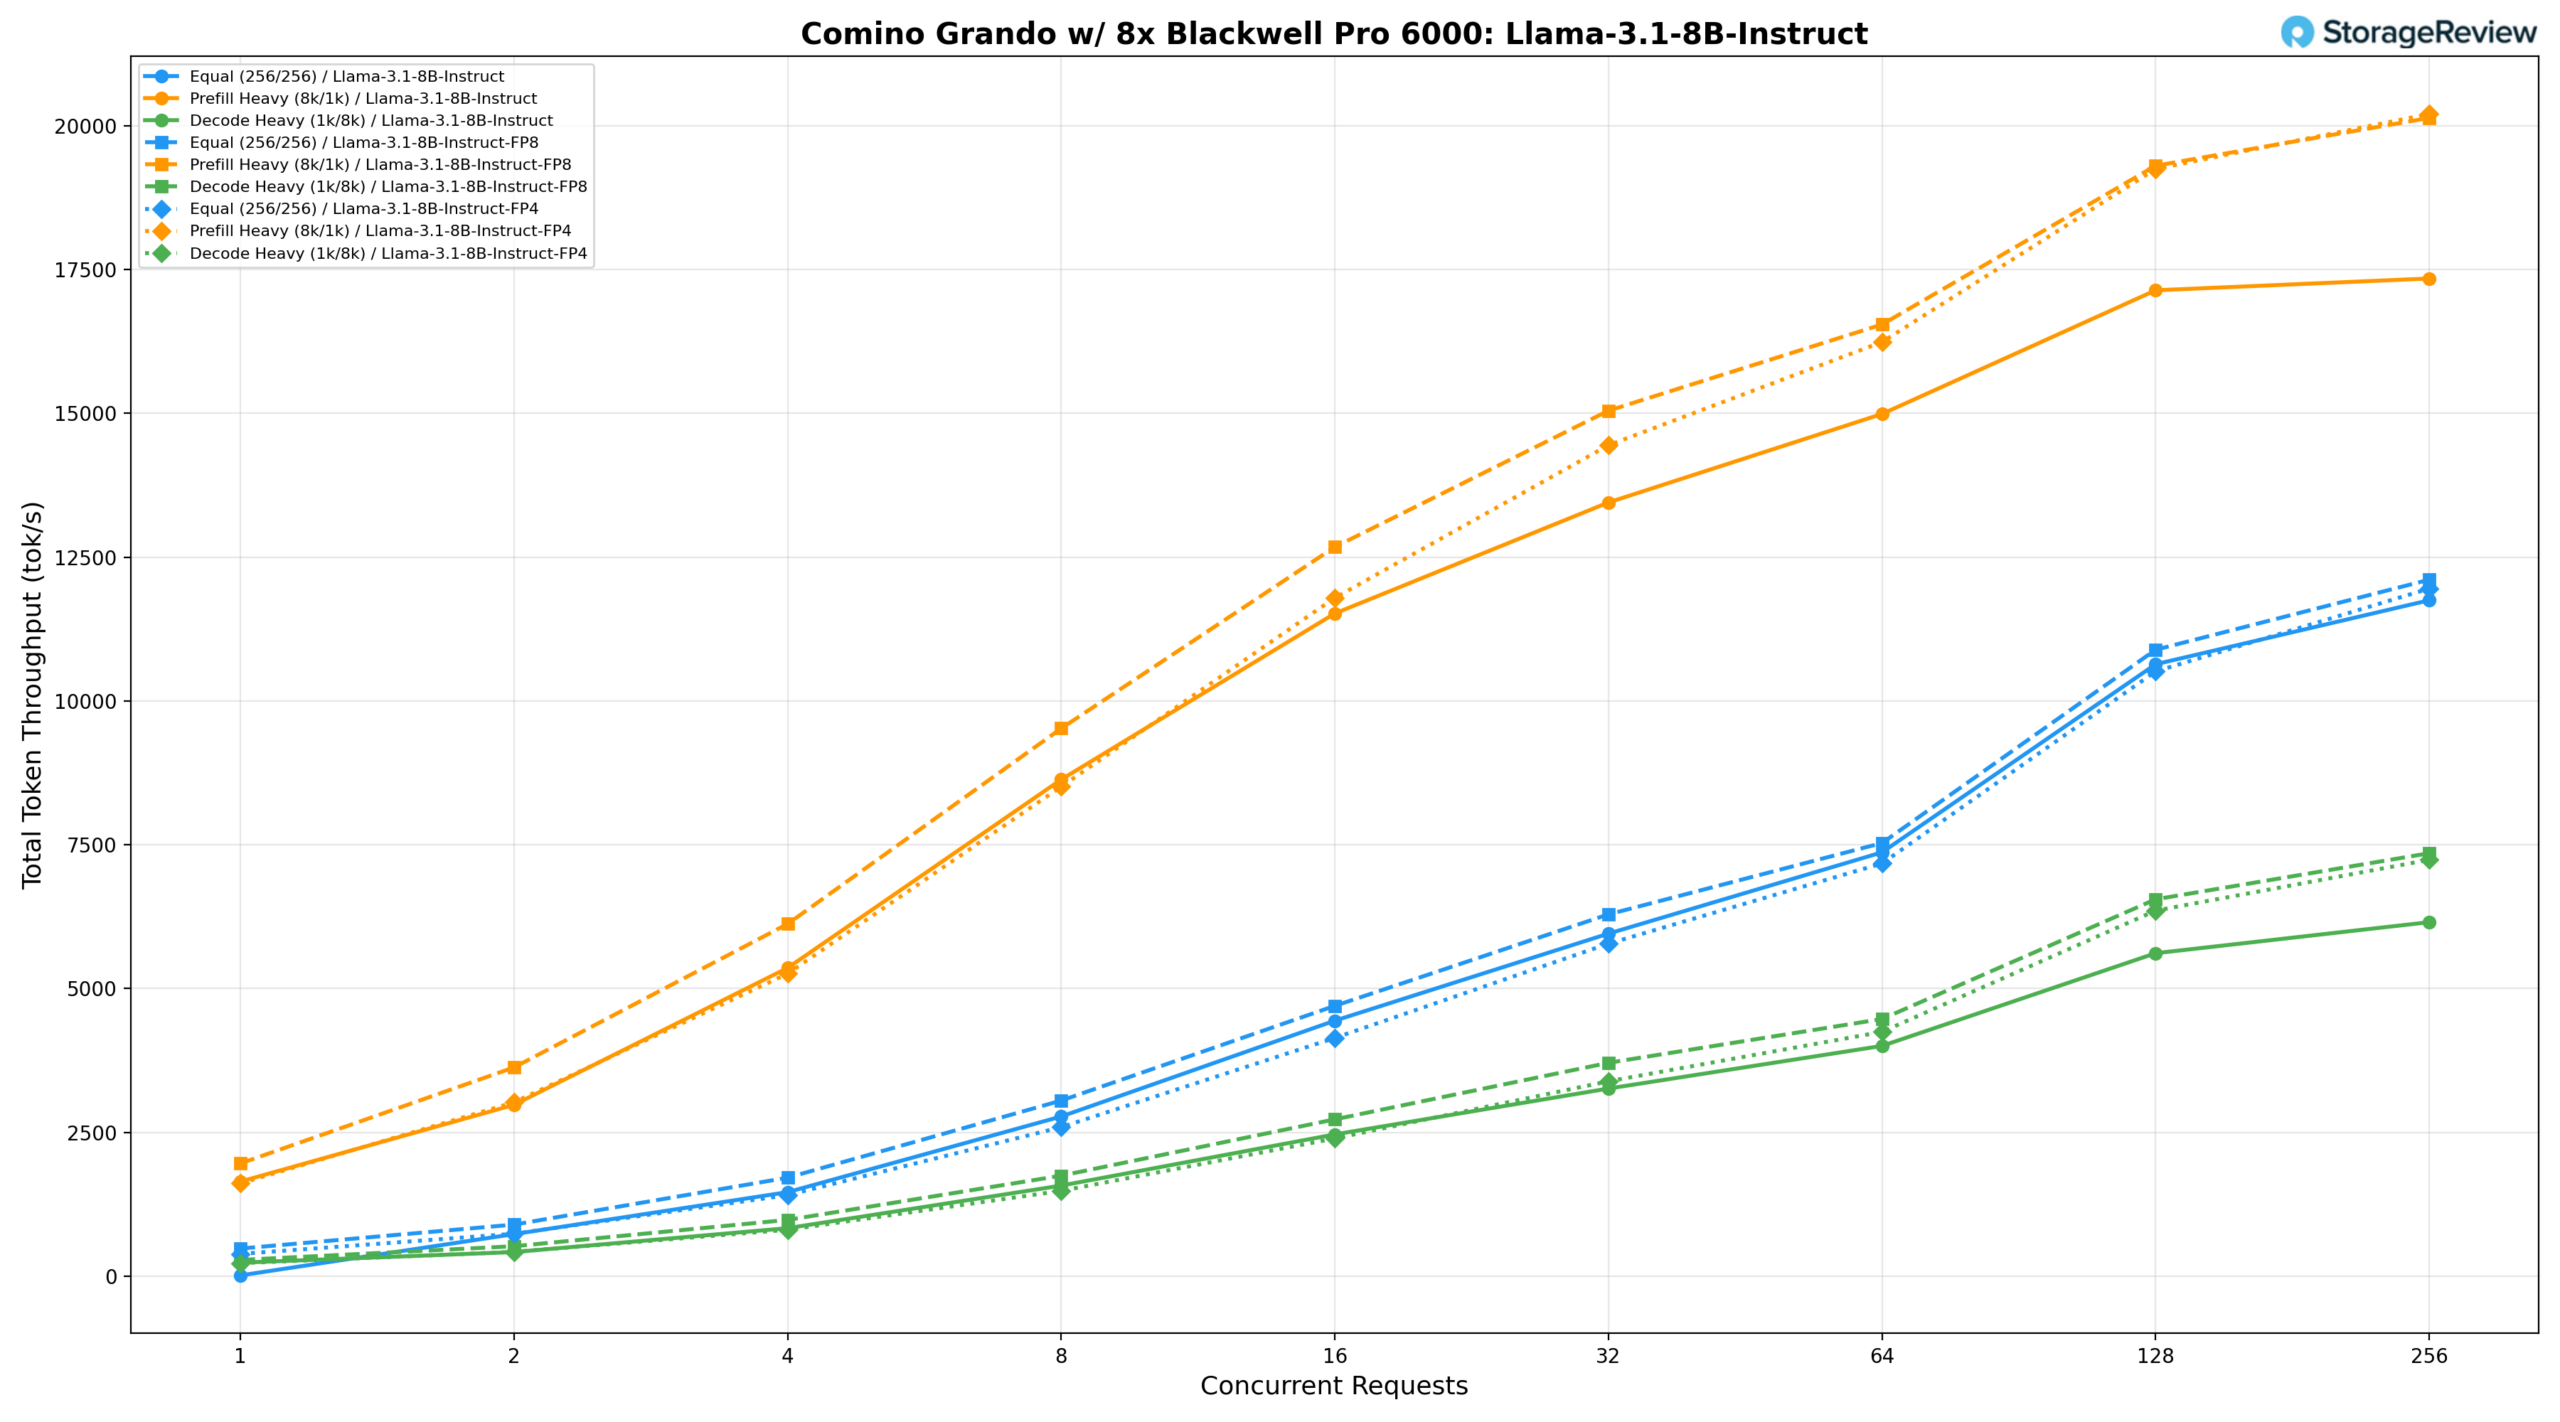
Il modello Llama-3.1-8B-Instruct è stato testato su tre diverse configurazioni di precisione sul Comino, fornendo una chiara visione di come la quantizzazione influisca sulla velocità di elaborazione per queste dimensioni del modello.
Llama 3.1 8B Istruzioni BF16
Con un carico di lavoro uguale (256/256), il modello BF16 eroga 2,776.42 tok/s a BS=8, raggiunge 7,369.01 tok/s a BS=64 e un picco di 11,751.56 tok/s a BS=256. Con un carico di precarica elevato (8k/1k) parte da 1,645.29 tok/s a BS=1, sale a 14,990.47 tok/s a BS=64 e 17,140.71 tok/s a BS=128, e raggiunge un picco di 17,345.80 tok/s a BS=256. La decodifica intensiva (1k/8k) aumenta da 234.78 tok/s a BS=1 a 6,154.73 tok/s a BS=256.
Llama 3.1 8B Istruzione FP8
La quantizzazione FP8 offre un significativo incremento in tutti gli scenari. Il carico di lavoro uniforme raggiunge 7,530.39 tok/s a BS=64 e un picco di 12,108.98 tok/s a BS=256. Il carico di lavoro con prefill elevato sale a 16,546.53 tok/s a BS=64 e 19,306.49 tok/s a BS=128, con un picco di 20,137.35 tok/s a BS=256, circa il 16% in più rispetto a BF16 al picco di concorrenza. Il carico di lavoro con decodifica elevata raggiunge un picco di 7,353.40 tok/s a BS=256, circa il 19% in più rispetto a BF16.
Llama 3.1 8B Istruzione FP4
FP4 offre un throughput molto competitivo con FP8 a livelli di concorrenza più elevati, sebbene risulti leggermente inferiore a dimensioni di batch inferiori. Il carico di lavoro equivalente raggiunge un picco di 11,954.40 tok/s a BS=256, mentre il prefill-heavy raggiunge il suo valore massimo di 20,205.57 tok/s a BS=256, superando di poco FP8 al picco di concorrenza. Il decode-heavy raggiunge un picco di 7,239.29 tok/s a BS=256, rimanendo entro pochi punti percentuali da FP8, rendendo FP4 un'opzione interessante quando l'efficienza della memoria è una priorità senza un significativo sacrificio in termini di throughput.
MiniMax M2.5
Il MiniMax-M2.5 230B, testato sul Comino Grando, è stato il modello più grande e impegnativo che abbiamo utilizzato.
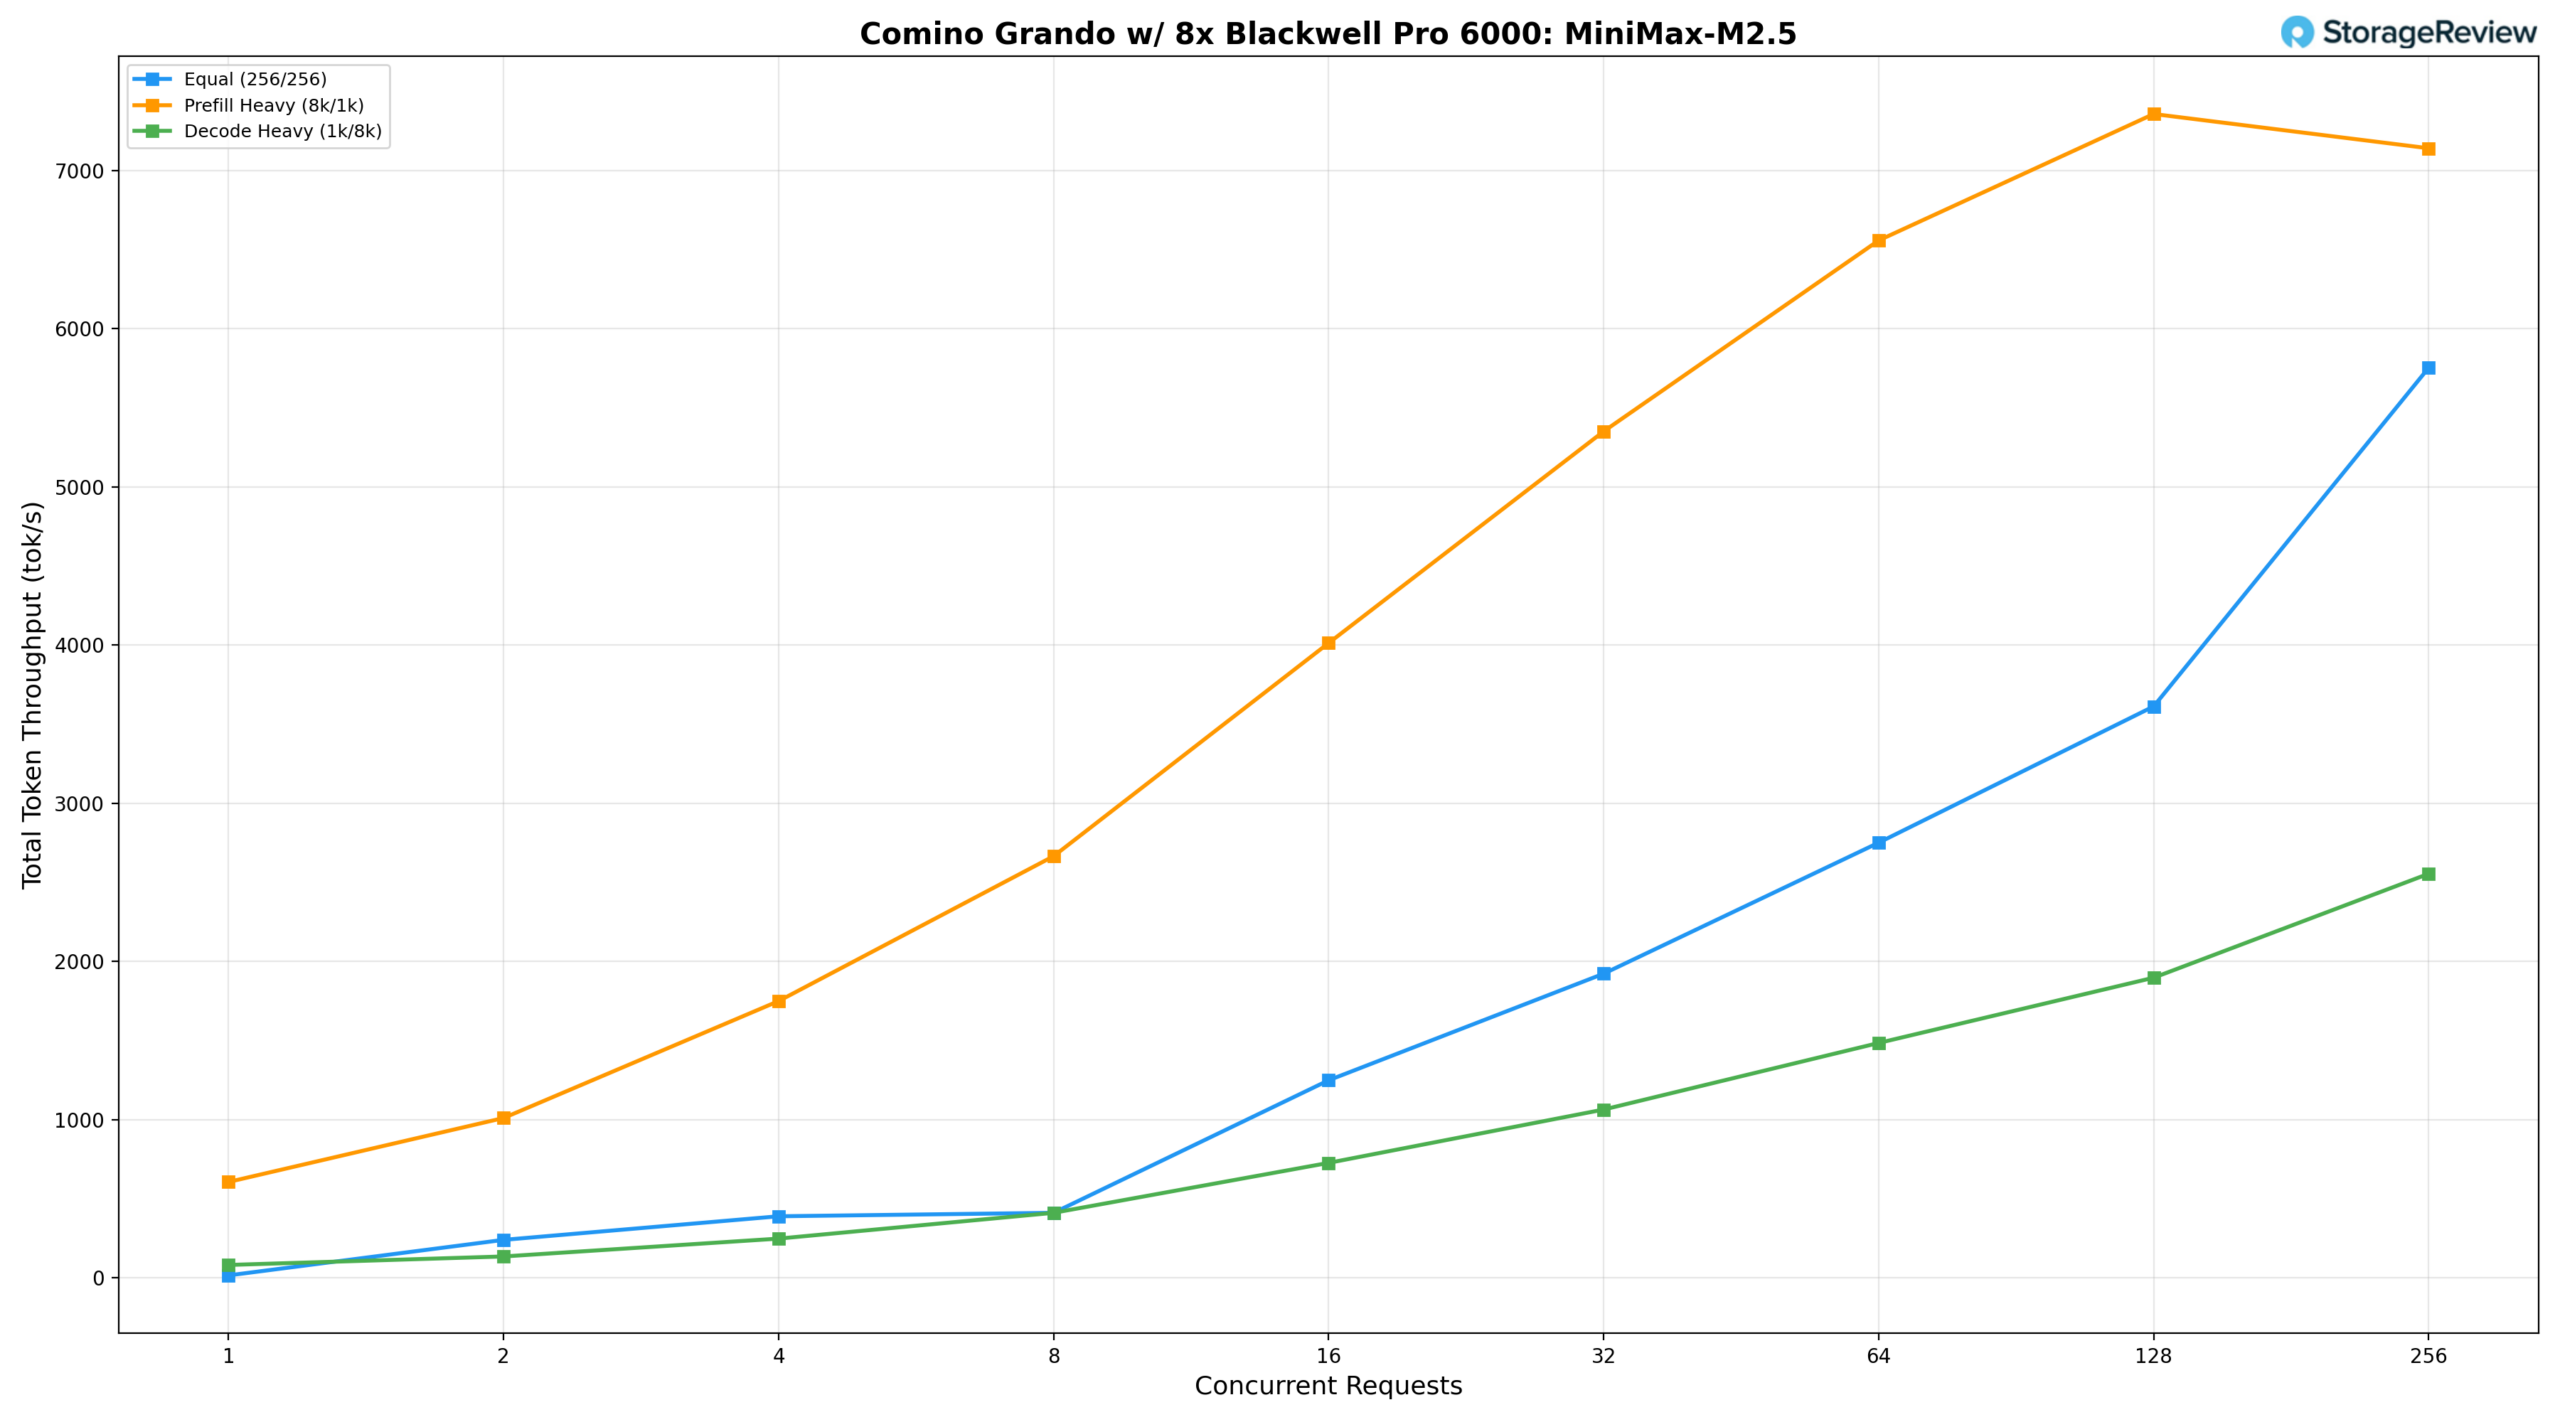
Con un carico di lavoro uguale (256/256), il modello parte da 16.35 tok/s a BS=1, raggiunge 2,751.25 tok/s a BS=64 e scala fortemente con una concorrenza più elevata, raggiungendo il picco di 5,753.24 tok/s a BS=256. Con un elevato pre-riempimento (8k/1k) parte da 606.97 tok/s a BS=1, sale costantemente a 5,351.02 tok/s a BS=32 e 6,557.92 tok/s a BS=64, raggiungendo il suo picco a 7,357.26 tok/s a BS=128 prima di diminuire leggermente a 7,140.74 tok/s a BS=256, suggerendo che il modello si avvicina alla saturazione nella velocità di pre-riempimento oltre BS=128. Il carico di lavoro di decodifica intensivo (1k/8k) aumenta costantemente da 82.21 tok/s a BS=1 a 1,485.28 tok/s a BS=64, raggiungendo un picco di 2,554.87 tok/s a BS=256, riflettendo le richieste di larghezza di banda della memoria previste per un'architettura MoE a 230 bit in presenza di carichi di lavoro di decodifica sostenuti.
Conclusione
Il Comino Grando è un sistema progettato specificamente per sfruttare appieno il potenziale di otto GPU NVIDIA RTX PRO 6000. Ogni decisione progettuale, dal layout invertito della scheda madre al circuito di raffreddamento e al sistema di monitoraggio integrato, è pensata per garantire che queste GPU possano funzionare ininterrottamente alla massima potenza di 600 W (TDP) senza limitazioni termiche o di alimentazione.
Ciò che rende la Grando così interessante non è una singola caratteristica isolata, ma la coerenza dell'intero sistema. Il raffreddamento a liquido non è un'aggiunta posticcia, ma parte integrante dell'architettura. L'alimentazione è ridondante, con schede sostituibili a caldo e dimensionata per supportare il carico di 4,800 W di otto schede da 600 W, con un margine di sicurezza ancora maggiore. Il sistema di monitoraggio va oltre la semplice segnalazione delle temperature: protegge autonomamente l'hardware in caso di problemi. Nulla sembra essere stato aggiunto in un secondo momento.
I dati sulle prestazioni confermano tale coesione. Su una vasta gamma di modelli, dal Llama 3.1 8B al 230B MiniMax M2.5, Grando ha fornito valori di throughput che si mantengono elevati per una piattaforma self-hosted. I test di concorrenza di Claude Code hanno ulteriormente evidenziato il valore pratico: otto ingegneri possono eseguire simultaneamente sessioni di programmazione agentica su un modello 230B ospitato localmente a velocità interattive, con un throughput per utente superiore a 38 token/s al picco di output aggregato. Team da quattro a otto persone possono operare a un throughput quasi ottimale senza degrado percepibile.
Il valore di questa configurazione va ben oltre l'inferenza AI. Con 96 GB di VRAM per GPU e la possibilità di scalare in configurazioni multi-GPU ad alta densità, la piattaforma è ugualmente adatta a carichi di lavoro creativi e ingegneristici di fascia alta, tra cui rendering VFX, simulazioni su larga scala e pipeline CAD complesse. Il sistema è scalabile fino a configurazioni a quattro o due GPU, rendendo questo livello di prestazioni accessibile anche a studi e team più piccoli che necessitano comunque di una densità di potenza paragonabile a quella di una workstation.
La principale differenza tra Grando e le piattaforme enterprise a otto GPU che abbiamo recensito risiede nella praticità di implementazione. Questi sistemi offrono maggiore spazio per le linee PCIe, più slot per schede di rete e una connettività di storage più ampia, ma richiedono anche un'infrastruttura dedicata per il data center, consumano ben oltre 8 kW e hanno tempi di consegna che possono superare un anno. Grando sacrifica parte di questa espandibilità periferica in cambio di un sistema sufficientemente silenzioso da poter essere utilizzato in una stanza con gli utenti, dissipa meno calore nell'ambiente circostante ed è disponibile da subito. Per le organizzazioni che privilegiano un'implementazione rapida e ambienti operativi gestibili rispetto alla massima connettività, questo compromesso è vantaggioso.
Pagina del prodotto – Comino Grando
Comino Configurator – Pagina
Classifica: Il Comino Grando RTX PRO 6000 si aggiudica il primo posto nella nostra classifica dei migliori desktop per l'intelligenza artificiale locale.


 Amazon