

Oggi sul mercato sono disponibili diverse opzioni per lo stoccaggio. La maggior parte degli elementi di differenziazione disponibili riguardano velocità diverse, più 9 nella disponibilità o supporto GUI variabile. Tutto sommato gli array sono molto simili; offrono semplicemente prezzi diversi, supporto o funzionalità rivolte a un determinato gruppo di clienti. DataGravity è entrato in scena offrendo qualcosa di veramente diverso. L'attenzione di DataGravity non è sulla velocità con cui i dati possono essere archiviati o recuperati, né sul numero di unità che è possibile inserire in un fattore di forma 2U; Almeno non ancora comunque. DataGravity significa essere in grado di comprendere i tuoi dati e aiutare i clienti a trovarli facilmente, segnalarli e garantire la conformità con le politiche interne o di settore.
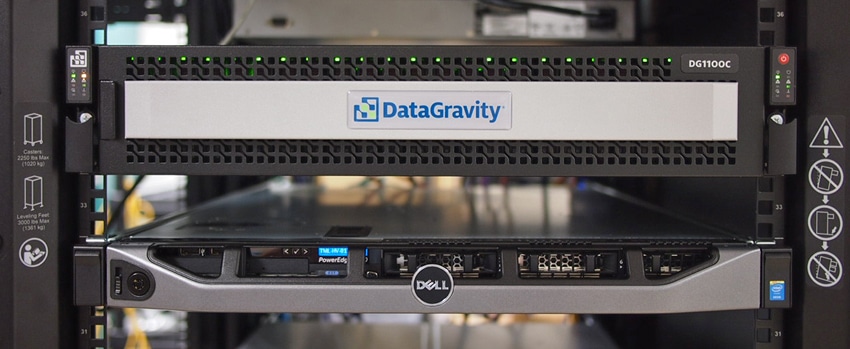
Comprendere le sfumature di dove si inserisce DataGravity è importante. All'interno dell'azienda ci sono spesso team di analisi e sicurezza dei big data incaricati di trovare e proteggere i dati, ma non è questo il mercato che DataGravity sta cercando. DataGravity si rivolge al mercato di fascia media che nella maggior parte dei casi ha uno staff IT limitato, ma affronta le stesse sfide relative ai dati delle grandi aziende. Perché DataGravity dovrebbe concentrare un processo così complicato su qualcuno che sembra non attrezzato per usarlo? Perché come afferma Paula Long, fondatrice di DataGravity, se sai navigare sul Web, puoi utilizzare questo prodotto. L’automazione è la chiave per risolvere questi problemi.
La famiglia DataGravity Discovery Series funziona comprendendo i dati all'interno dei file. Essendo in grado di sondare un documento Word, ad esempio, per verificare i numeri di previdenza sociale, l'array DataGravity offre visibilità immediata sui file archiviati da un'azienda. DataGravity può quindi comprendere questi dati, segnalarli e garantire che le informazioni sensibili non vengano condivise con parti inappropriate. Oltre a comprendere i dati archiviati sull'array, tutti gli accessi ai file e l'attività degli utenti vengono controllati, aiutando le aziende a soddisfare i propri requisiti di conformità e sicurezza. Questa è una distinzione importante per capire cosa è DataGravity e cosa non lo è. DataGravity è molto concentrato su questo caso d'uso dei dati non strutturati, che è un terreno di gioco comune per NAS e simili. Sebbene supportino iSCSI, NFS e SMB, il caso d'uso principale di DataGravity non sono i casi d'uso delle applicazioni aziendali tradizionali come la posta elettronica, il database transazionale e simili. La piattaforma prima o poi potrebbe arrivarci, e probabilmente lo farà, ma oggi il loro obiettivo è estremamente ben definito.
Dati come numeri di previdenza sociale, ID paziente, numeri di telefono, numeri di carta di credito e simili sono facili da definire e comprendere. In effetti, DataGravity supporta immediatamente molti tag di conformità comuni. Tuttavia non è limitato a quelli. Per le organizzazioni che hanno esigenze specifiche, come fanno molte aziende, DataGravity offre un editor che consente alle organizzazioni di stabilire i propri tag. Ciò garantisce che gli utenti della piattaforma saranno in grado di rispondere rapidamente ai requisiti di sicurezza, conformità ed eDiscovery specifici del loro settore. La visibilità dei dati archiviati fornisce inoltre un migliore valore aziendale rendendo tutto ricercabile, ovviamente in base alle regole di accesso.
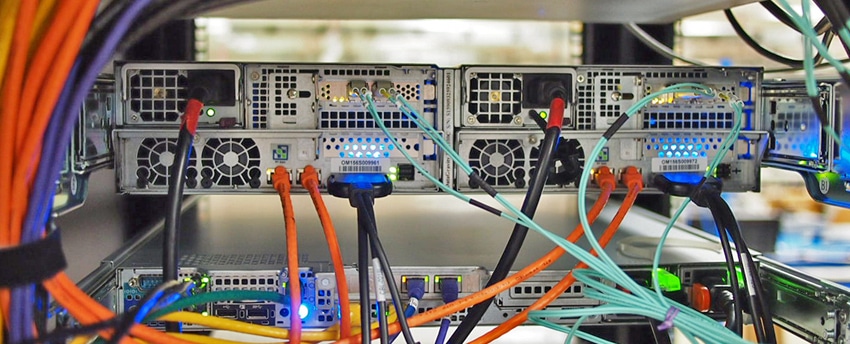
DataGravity offre array in diverse configurazioni che sfruttano gli HDD Nearline per la capacità e flash come cache di lettura. Le unità sono a doppio controller, con ciascun controller "attivo" e che svolge un lavoro specifico di cui parleremo più approfonditamente di seguito. Il DG1100 è disponibile con una capacità del disco raw di 18 TB, mentre il DG1200 ne ha 36 TB. Il DG2200 offre 48TB e il DG2400 porta 96TB sul tavolo. Attualmente questi non sono espandibili, tuttavia DataGravity vede chiaramente la necessità di affrontare questo problema; probabilmente con scaffali di espansione e/o un'interfaccia di gestione che federa più sistemi in un'unica vista di gestione. I nostri test per questa recensione sono interamente incentrati sull'usabilità; abbiamo trascorso due giorni con DataGravity nel loro ufficio di Nashua, NH e abbiamo concluso il lavoro di follow-up da remoto. Questo ci ha dato un po' di tempo pratico con un'unità DG1100.
Architettura
DataGravity ha doppi controller attivo-attivo con una novità. Normalmente un doppio controller attivo-attivo significa che entrambi i controller sono attivi con l'elaborazione I/O. Tuttavia con DataGravity l'architettura imita l'attivo-passivo, con il nodo primario che serve i dati e il nodo di intelligence che gestisce l'analisi dei dati. DataGravity lo chiama "attivo-proattivo". La configurazione di base è simile a questa: più GB di DRAM, NVRAM con batteria tampone, SSD per metadati e cache e quindi HDD quasi in linea.
Con una quantità non così insignificante di dati che fluiscono attraverso DRAM e NVRAM supportata da batteria, i mirror DataGravity scrivono tra il nodo primario e il nodo di intelligence come primo ordine del giorno. Ciò avviene tramite un bridge PCIe interno, che offre larghezza di banda elevata e comunicazione a bassa latenza. Questo collegamento veloce viene sfruttato nell'architettura DataGravity per la protezione continua dei dati e l'analisi dei dati. Viene eseguito il mirroring dei dati in transito finché il nodo primario non è in grado di eseguirne il commit su disco. Mettendo in funzione entrambi i controller, la serie Discovery sfrutta un nodo di storage primario per l'I/O di produzione e fa sì che il nodo secondario, solitamente inattivo, funzioni come nodo di intelligence. Il nodo di intelligence sfrutta i metadati e le scritture a grana fine rispecchiate su questo controller per una protezione continua e un'elaborazione analitica sensibile ai dati.
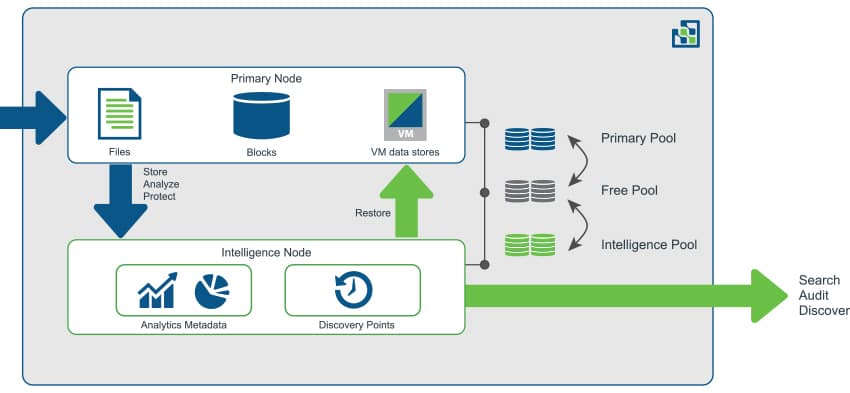
Sebbene l'attivo-attivo (o attivo-proattivo in questo caso) abbia il vantaggio di utilizzare ciò per cui è stato pagato (rispetto all'attivo-passivo in cui il secondo nodo rimane inattivo finché il primario non fallisce), una domanda che tende sempre a sorgere: cosa succede alle prestazioni se un nodo fallisce? Se DataGravity ha bisogno di due nodi per far funzionare la sua magia e uno viene perso, dove finiscono i clienti? In caso di guasto di un nodo, il nodo rimanente assume le basi per la produzione. Gli utenti potranno comunque accedere e utilizzare i file come farebbero nelle normali operazioni quotidiane. Tuttavia, la maggior parte delle analisi viene sospesa finché il nodo guasto non viene ripristinato. In altre parole, la disponibilità rimane ma le funzionalità incentrate sui metadati vengono ridotte fino al ripristino del nodo.
usabilità
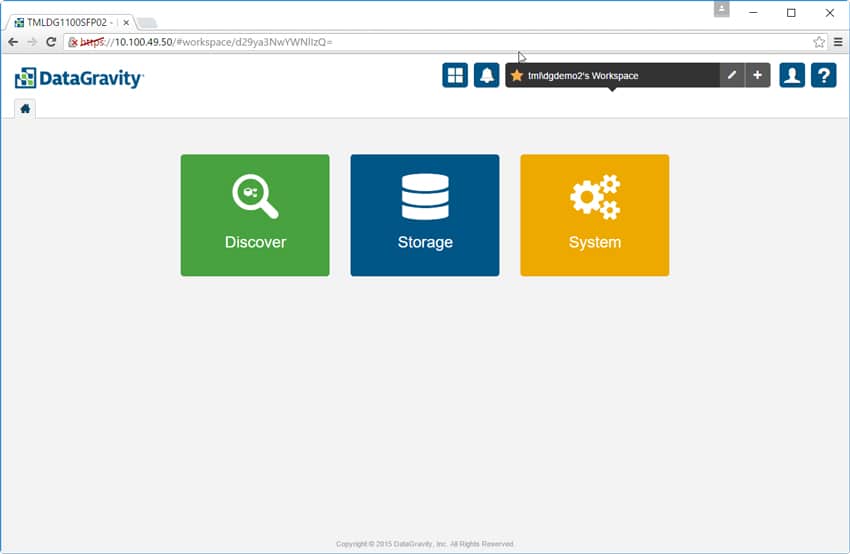
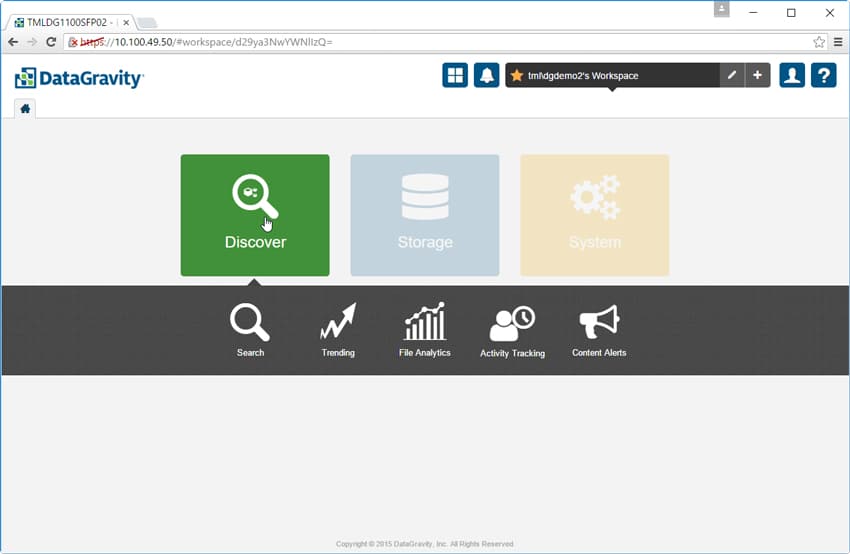
La GUI DataGravity è basata su HTML 5 e presenta un layout molto semplice e utilizzabile. La scheda Home ha solo tre opzioni tra cui scegliere: Scopri, Archiviazione o Sistema. Correndo in alto a destra vediamo il pannello di accesso globale, che contiene le icone per la dashboard del sistema e gli avvisi, l'area di lavoro, il profilo e la guida in linea.
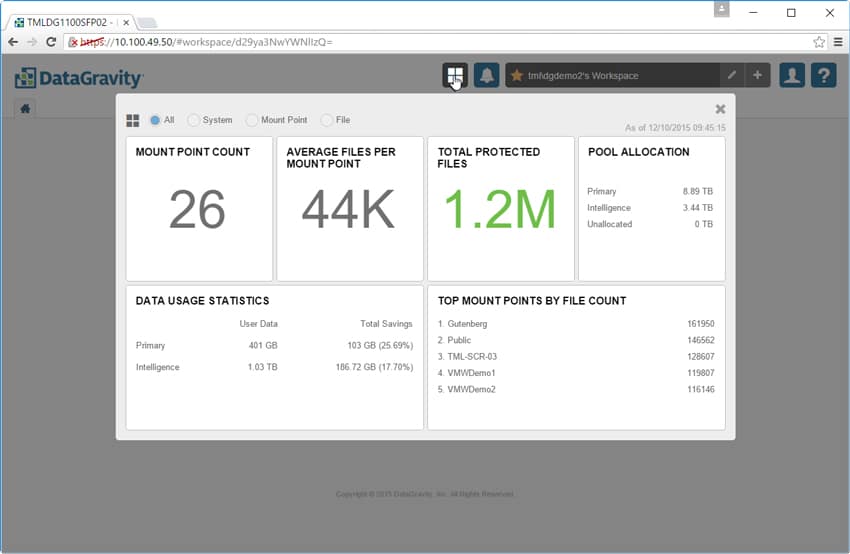
La dashboard del sistema offre agli utenti una rapida occhiata a statistiche come il numero di punti di montaggio, il totale dei file protetti, l'allocazione del pool e le statistiche sull'utilizzo dei dati.
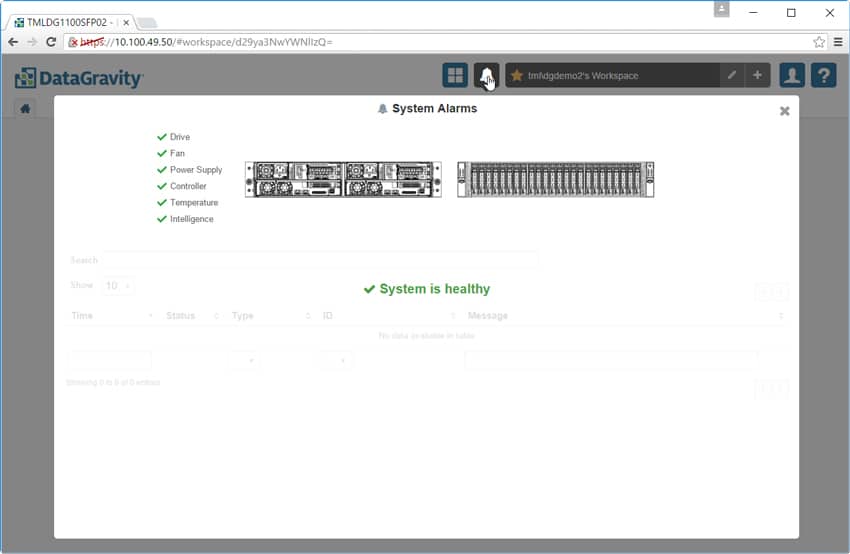
La scheda degli allarmi di sistema è come sembra e fornisce agli utenti un elenco di allarmi e la posizione in cui si sono verificati all'interno del sistema.
A destra della scheda Allarme c'è la scheda Area di lavoro. Qui gli utenti possono rinominare o aggiungere aree di lavoro. Le aree di lavoro consentono agli utenti di configurare e gestire la propria visualizzazione privata del sistema. Gli utenti possono configurare più aree di lavoro a seconda delle loro esigenze.

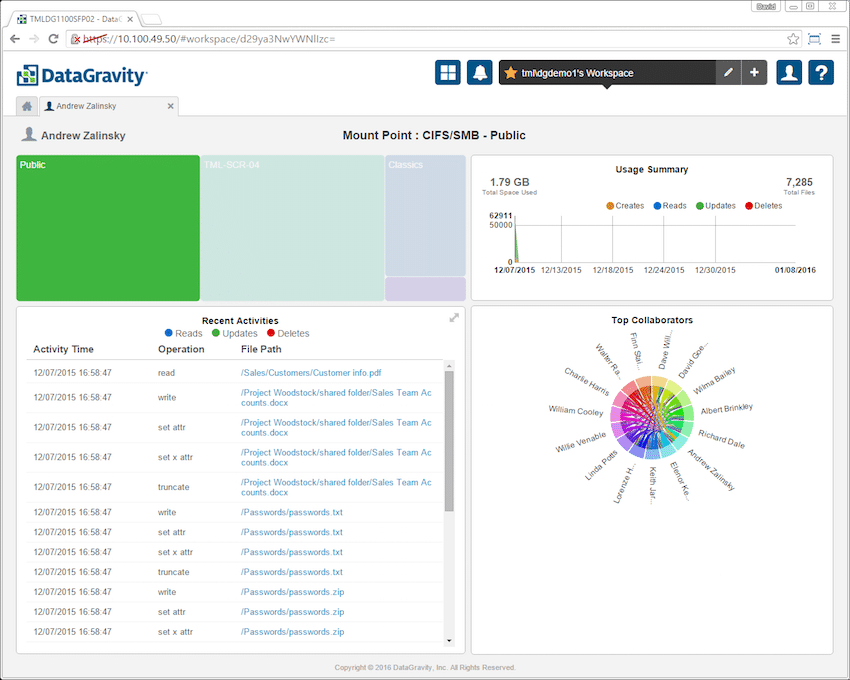
L'icona successiva è l'icona Profili. Facendo clic sull'icona Profili, un utente autorizzato ha la possibilità di gestire il proprio profilo; abbonamenti e-mail per ricerche salvate e possibilità di disconnettersi dal sistema. Dopo l'accesso, la GUI fornisce diversi riquadri che mostrano informazioni come il riepilogo dell'utilizzo nel tempo e l'attività recente (ognuno suddiviso per letture, aggiornamenti, eliminazioni e, in caso di utilizzo, creazioni). È inoltre presente un diagramma degli accordi che mostra chi è ciascun utente sta collaborando e in quale veste.
Tornando alla scheda Home, l'icona più a sinistra è il pane quotidiano di DataGravity, la scheda Scopri. Facendo clic sulla scheda vengono offerte agli utenti opzioni quali ricerca, tendenze, analisi dei file, monitoraggio delle attività e avvisi sui contenuti.
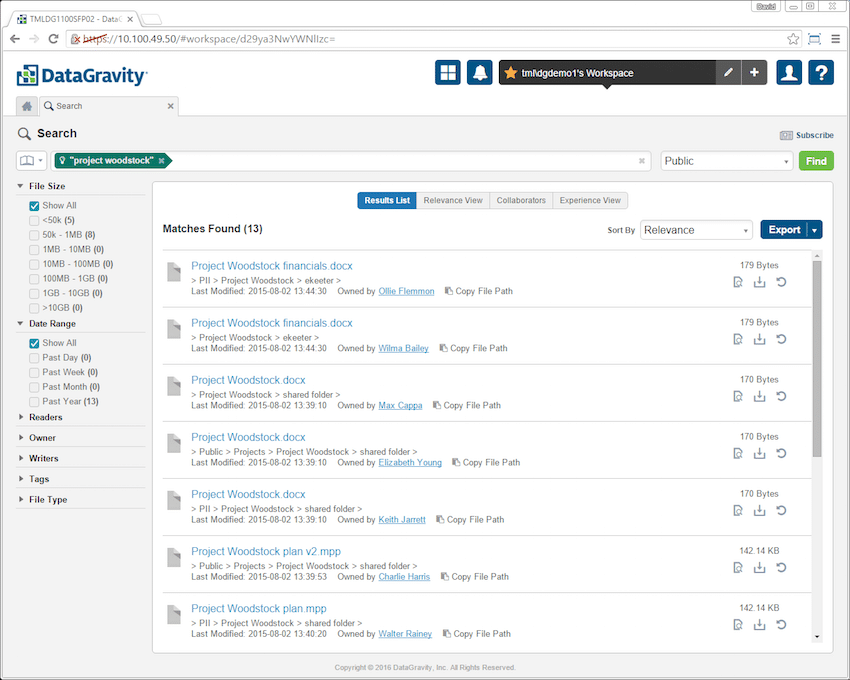
La ricerca è come sembra. Viene visualizzata una barra di ricerca e gli utenti devono solo inserire la parola chiave o il nome del file che stanno cercando. Prima di cercare gli utenti devono selezionare il punto di montaggio in cui desiderano effettuare la ricerca. Nell'immagine sotto la ricerca è per "progetto woodstock". Ciò ha restituito tutti i file nel punto di montaggio pubblico che contenevano tali termini. I filtri a sinistra consentono di restringere ulteriormente i risultati.
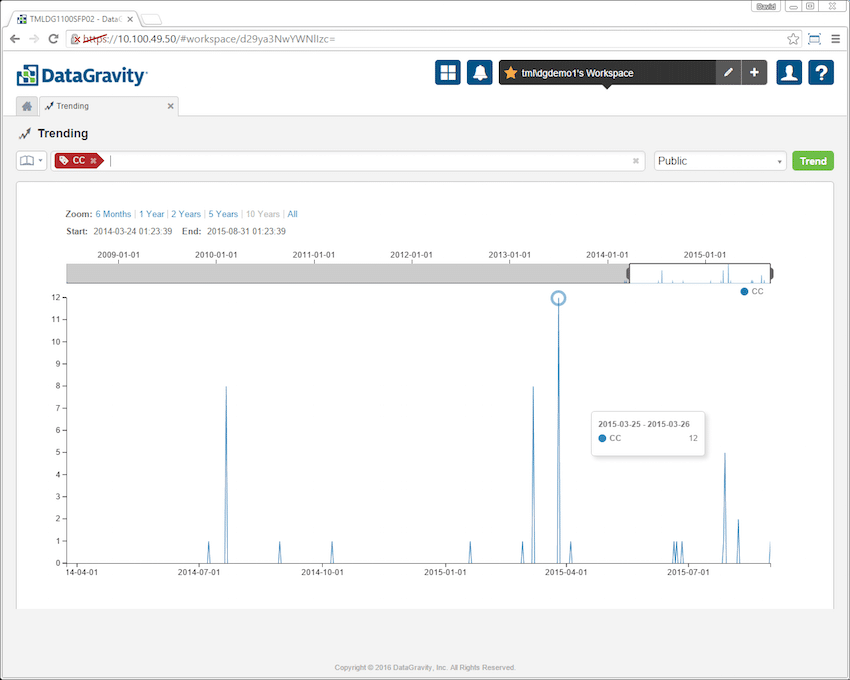
La tendenza è simile alla ricerca, solo qui gli utenti inseriscono la parola chiave o il tag che stanno cercando e la soluzione fornirà loro una rappresentazione grafica dei dati. Ciò consente alle aziende di vedere come si accede ai dati sia nei file attivi che in quelli eliminati nel tempo. Nella schermata sottostante il tag della carta di credito (CC) è stato inserito in trend. I risultati mostrano l'andamento dei numeri delle carte di credito nel tempo nel punto di montaggio pubblico.
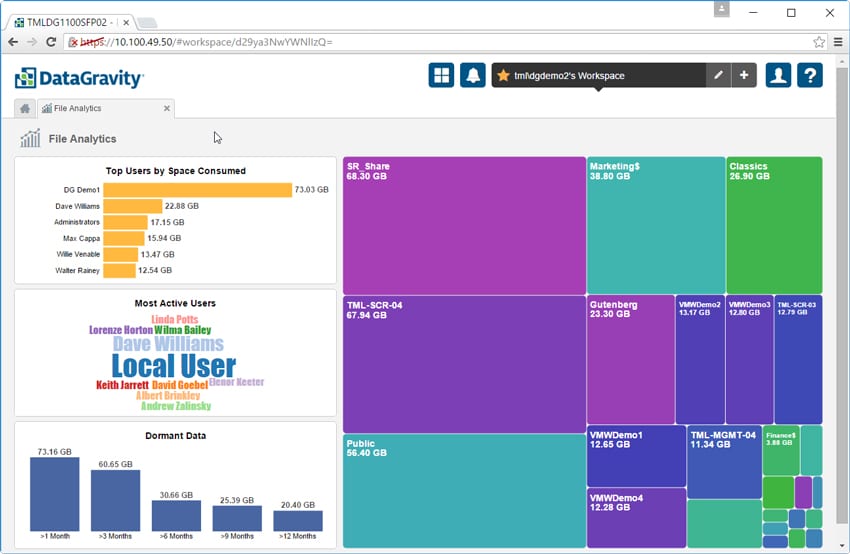
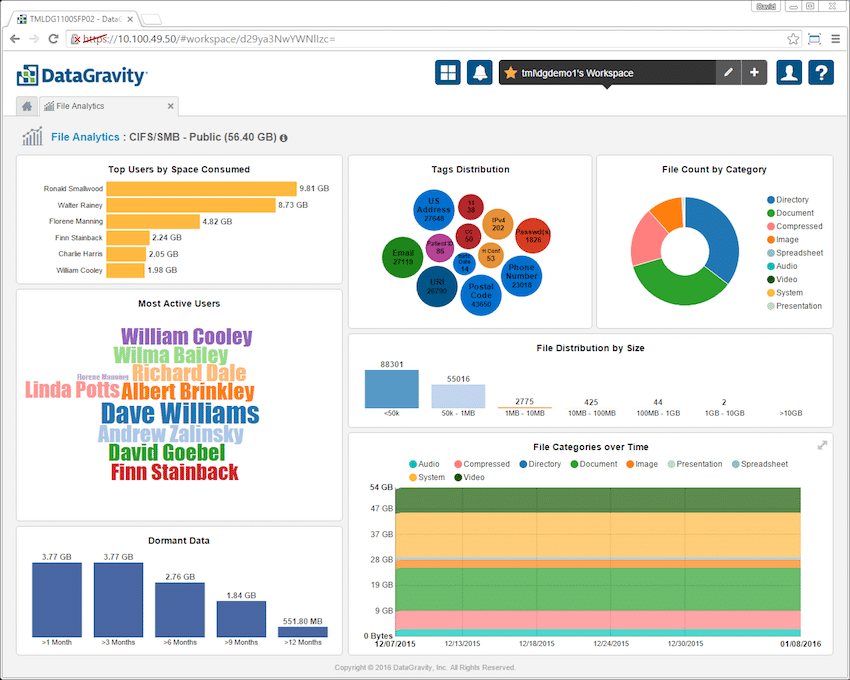
File Analytics è un altro luogo in cui DataGravity si distingue dal resto dei fornitori di storage. Attraverso questa dashboard gli utenti possono facilmente vedere le condivisioni di file e le macchine virtuali rappresentate da blocchi colorati sul lato destro. Maggiore è la quota, in termini di capacità consumata, più grande è il blocco colorato. Gli utenti possono anche vedere i primi 10 utenti in base allo spazio consumato in un grafico a barre, gli utenti più attivi (più attivo è l'utente più grande appare il suo nome) e i dati dormienti e per quanto tempo i dati sono rimasti inattivi raggruppati per 1, 3, 6 , categorie 9 e 12 mesi.
Facendo clic su una singola condivisione di file o su una VM, queste informazioni vengono suddivise ulteriormente. A sinistra sono presenti informazioni sugli utenti più attivi (misurati dalle operazioni di lettura/scrittura/eliminazione) e sugli utenti principali per spazio all'interno della condivisione o della VM. C'è anche un elenco per i dati dormienti. A destra ci sono quattro riquadri aggiuntivi: distribuzione dei tag, conteggio dei file per categoria, distribuzione dei file per dimensione e categorie di file nel tempo. Facendo clic su ciascun riquadro vengono forniti maggiori dettagli.
La scheda successiva nella sezione Scopri è Monitoraggio attività. Come suggerisce il nome, gli amministratori e gli utenti della sicurezza possono vedere rapidamente quale utente ha eseguito quale attività durante un periodo di tempo specifico. Gli amministratori devono solo scegliere quale punto di montaggio cercare, l'utente e l'intervallo di date.

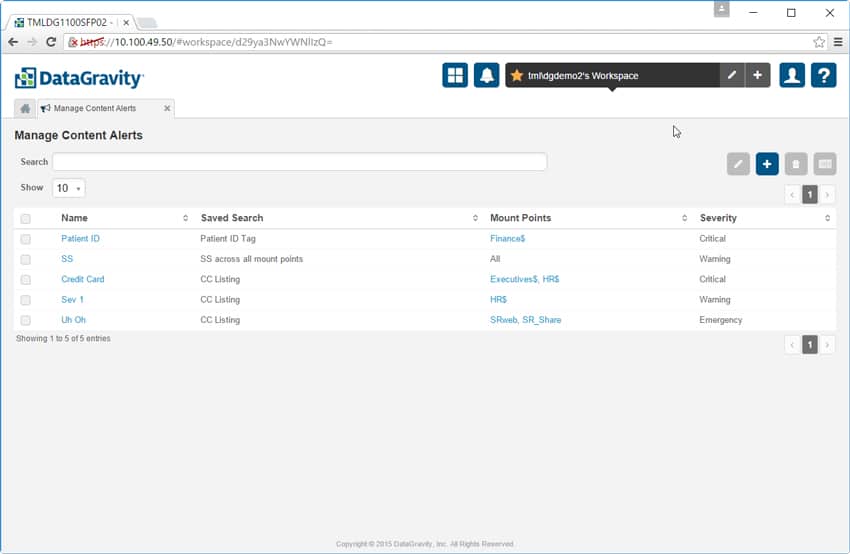
La scheda finale nella sezione Scopri consente agli amministratori di gestire gli avvisi sui contenuti. Nell'esempio seguente l'amministratore imposta avvisi per essere avvisato quando i numeri di previdenza sociale o di carta di credito vengono trovati in testo aperto, formati non crittografati e in luoghi a cui non appartengono. Ciò offre alle aziende la possibilità di trovare e spostare rapidamente i dati critici che sono stati collocati in posizioni non protette.
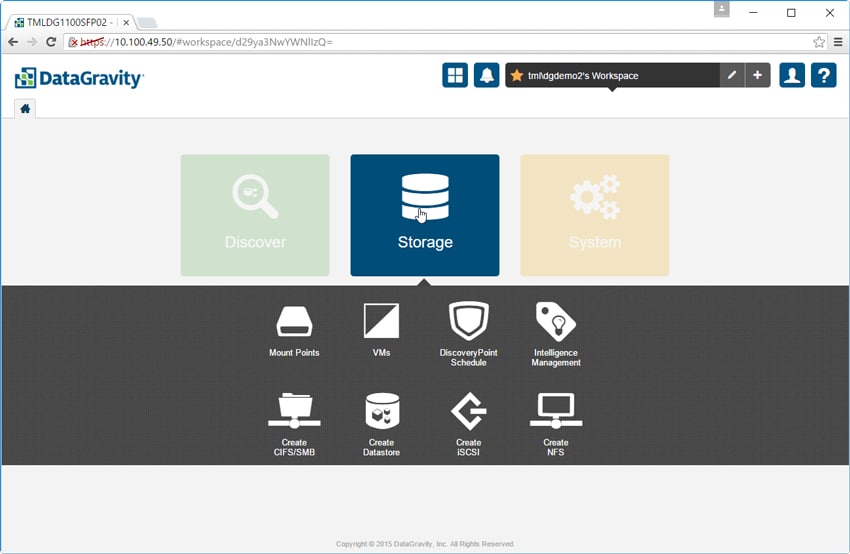
La scheda principale successiva è la scheda Archiviazione. Qui sono presenti 8 sottoschede: Punti di montaggio, VM, Pianificazione DiscoveryPoint, Gestione intelligence, Crea CIFS/SMB, Crea archivio dati, Crea iSCSI e Crea NFS.
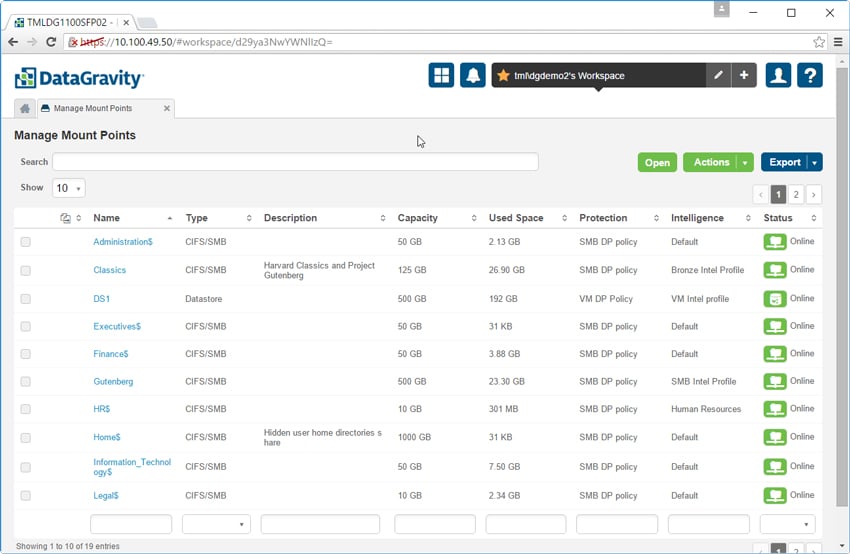
La scheda Gestisci punti di montaggio consente agli utenti di visualizzare le impostazioni di ciascun punto di montaggio e di crearne di nuovi. Qui gli utenti possono vedere la capacità di ciascun punto di montaggio (nonché la quantità utilizzata), una breve descrizione di ciascuno, la sua politica di protezione e il suo stato. Per ogni nuovo punto di montaggio creato qui è possibile regolare queste impostazioni secondo necessità.
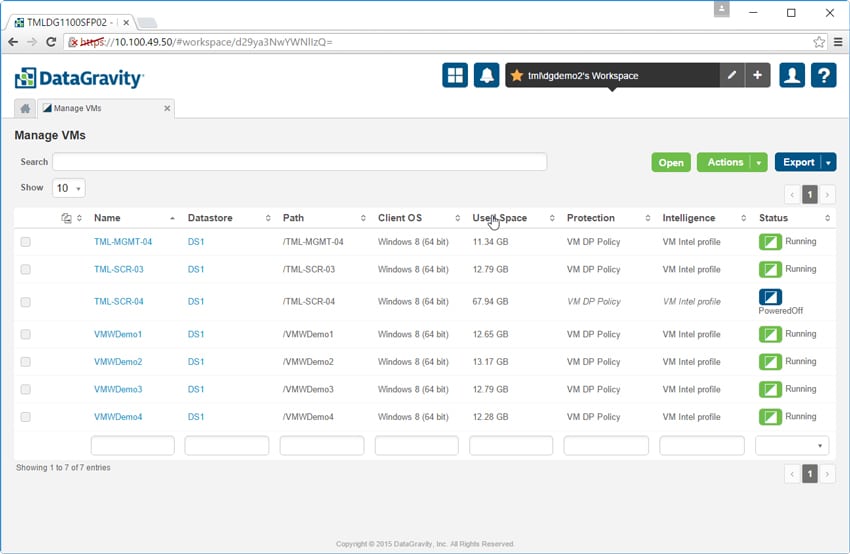
La scheda Gestisci VM è simile alla precedente. Qui è possibile visualizzare e configurare le informazioni sulle VM. Viene elencato il nome della VM, nonché la sua posizione, il sistema operativo, la capacità utilizzata, la policy di protezione, il profilo di intelligence e se la VM è in esecuzione o spenta. Facendo clic su una VM vengono forniti ulteriori dettagli.
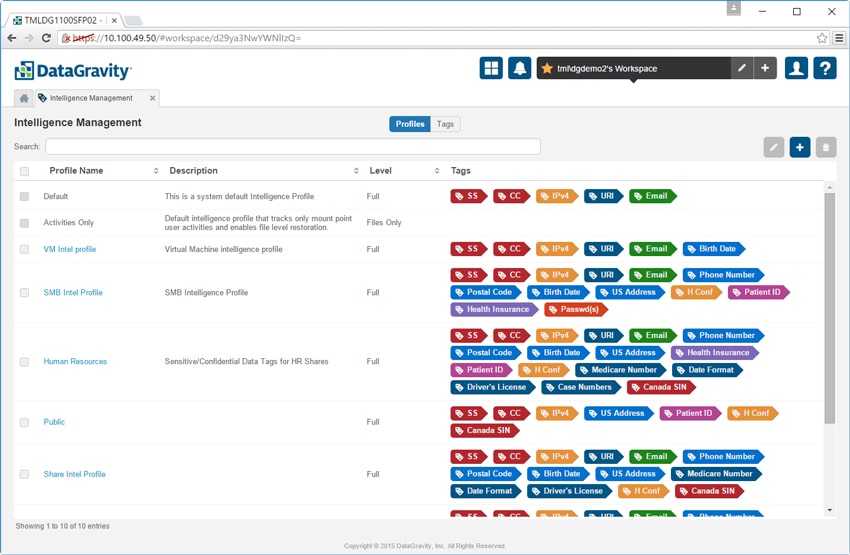
La scheda Gestione intelligence consente agli amministratori di configurare i profili di intelligence per casi d'uso specifici e di applicarli a punti di montaggio e VM. Il pulsante Tag consente agli amministratori di definire modelli o frasi di contenuto che contengono dati sensibili utilizzando un editor di espressioni regolari integrato.
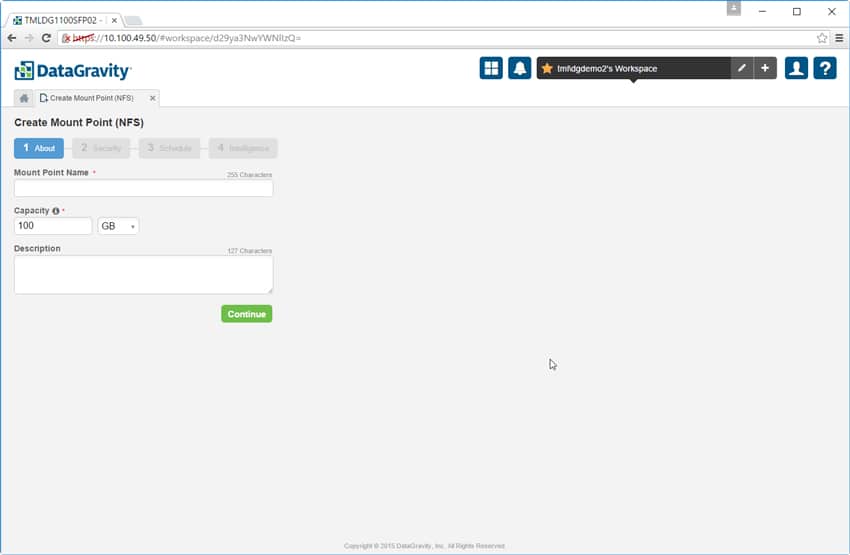
Le quattro schede successive riguardano tutte la creazione di un punto di montaggio e del relativo protocollo di accesso, sia esso CIFS/SMB, NFS DataStore compatibile con VM, iSCSI o NFS (nella foto sotto). Gli amministratori aggiungono un nome per il punto di montaggio, aggiungono una descrizione se lo desiderano, selezionano la capacità, impostano i criteri di sicurezza, definiscono la pianificazione di DiscoveryPoint e scelgono il profilo intelligence.
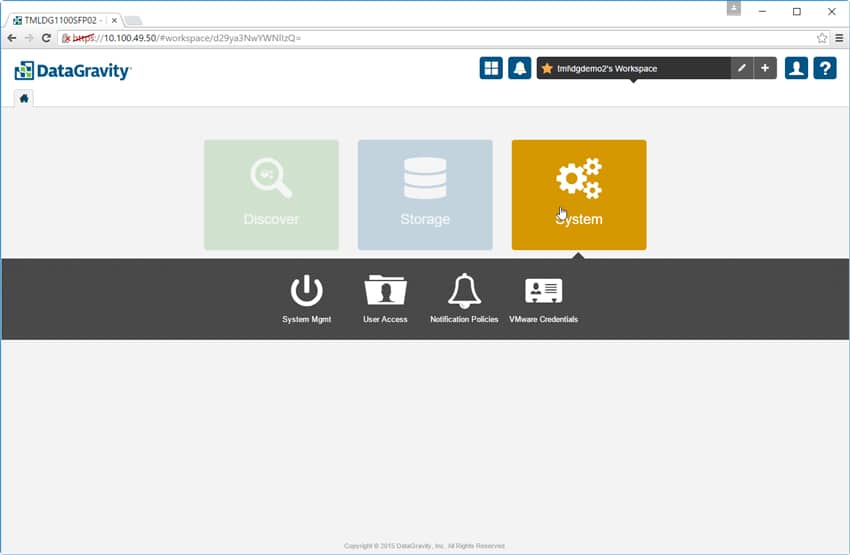
L'ultima sezione principale è la scheda Sistema. Facendo clic su di esso ci vengono visualizzate quattro sottoschede: Gestione del sistema, Accesso utente, Criteri di notifica e Credenziali VMware.
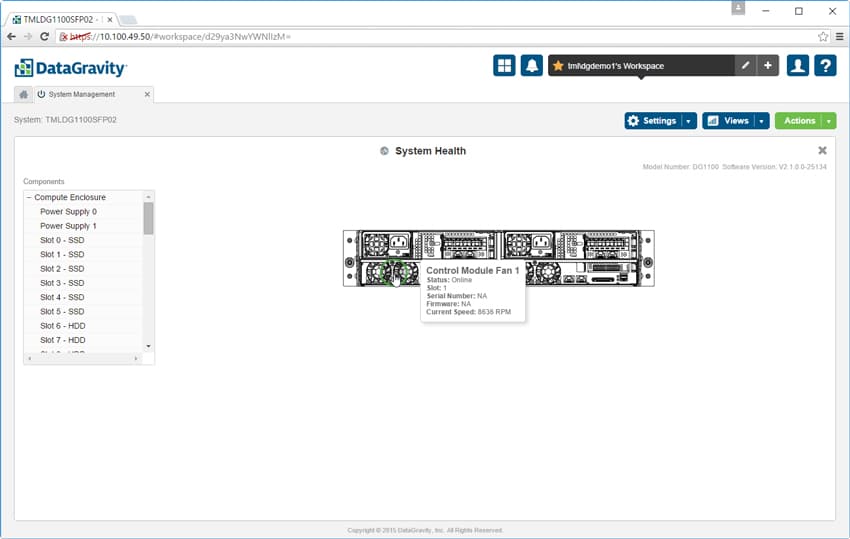
La scheda Gestione sistema presenta più opzioni, tra cui Integrità del sistema che fornisce una visualizzazione dello stato del sistema fisico. A sinistra c'è un elenco di tutti i componenti della soluzione. A destra c'è una rappresentazione grafica che fornirà all'utente maggiori informazioni passando il mouse sopra di essa.
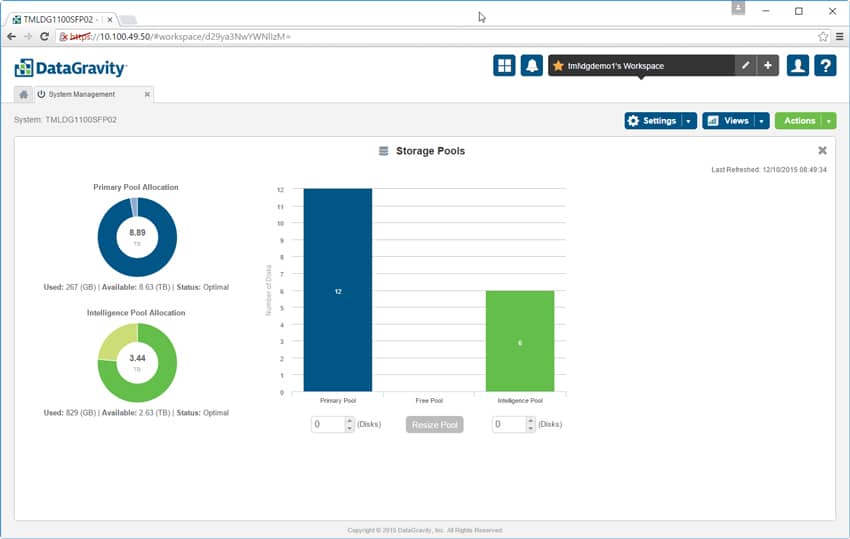
All'interno di System Mgmt c'è anche la sezione Storage Pools, che offre una visione di tre diversi pool nel sistema DataGravity: il pool primario o il pool allocato per l'uso quotidiano, l'intelligence pool e il pool gratuito per l'archiviazione che ha ancora da assegnare. Da questa schermata gli utenti possono ridimensionare i pool secondo necessità.
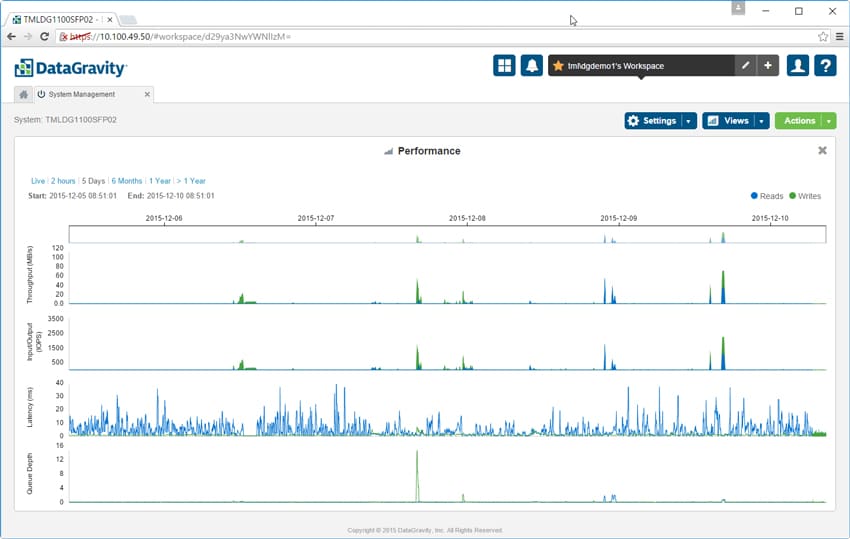
C'è anche un'opzione per vedere le prestazioni del sistema. La visualizzazione delle prestazioni mostra l'I/O di lettura e scrittura e fornisce dettagli come velocità effettiva in MB/s, IOPS, latenza e profondità della coda. Gli utenti possono osservare le prestazioni in un periodo di tempo o visualizzare una lettura delle prestazioni in tempo reale.
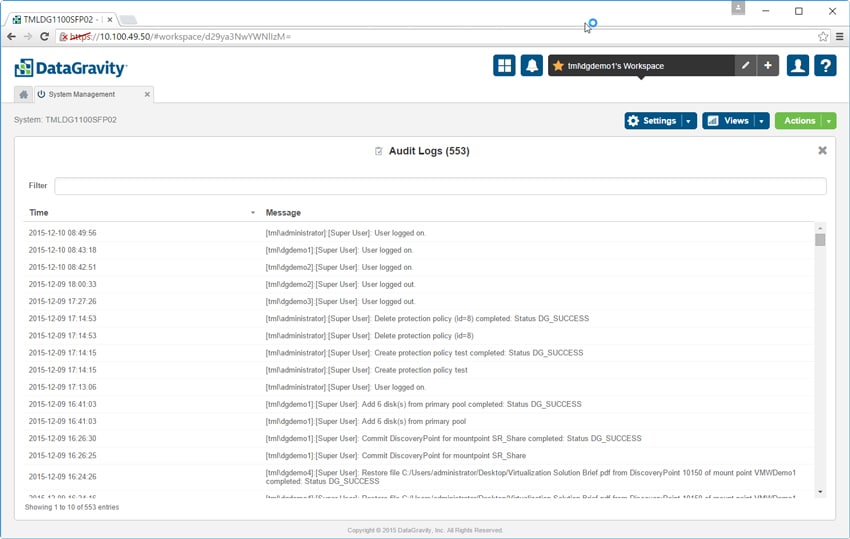
Infine, in Gestione sistema, gli amministratori possono visualizzare i registri di controllo. Non solo possono vedere chi ha effettuato l'accesso e cosa stavano facendo, ma i registri possono essere filtrati per un accesso più semplice e inoltrati a un altro sistema per un'ulteriore elaborazione.
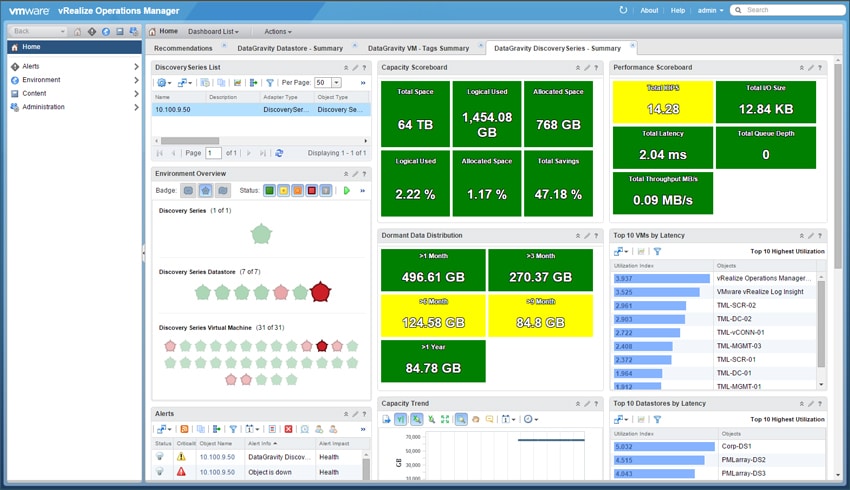
DataGravity si integra anche con VMware vRealize Operations Manager (vROPS) per far emergere le analisi del sistema DataGravity nella console centralizzata fornita da vROPS. DataGravity non ha una presenza virtuale di per sé, quindi questa integrazione consente all'amministratore della virtualizzazione di visualizzare il sistema senza essere loggato nell'interfaccia utente di DataGravity. Sebbene tutte le informazioni siano presenti, le visualizzazioni dei dati sono limitate rispetto alla GUI DataGravity.
L'integrazione vROPS mostra visualizzazioni di riepilogo di Discovery Series, DataStore o VM. Di seguito è riportata una vista del dashboard di riepilogo di Discovery Series che mostra la capacità e le prestazioni complessive del sistema, nonché la latenza per gli archivi dati e le VM archiviate nel sistema con il punteggio di rischio per ciascuno.
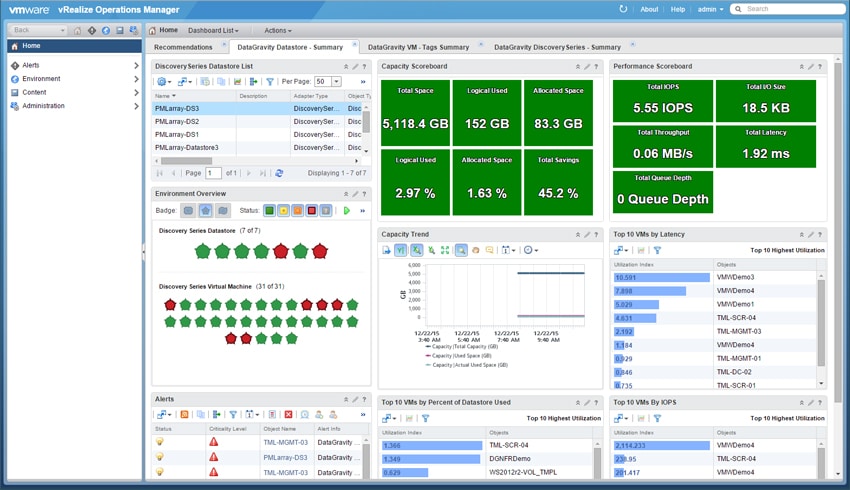
Quando si visualizza il dashboard Riepilogo DataGravity Datastore, vengono visualizzati parametri simili per i datastore DataGravity data-aware e NFS.
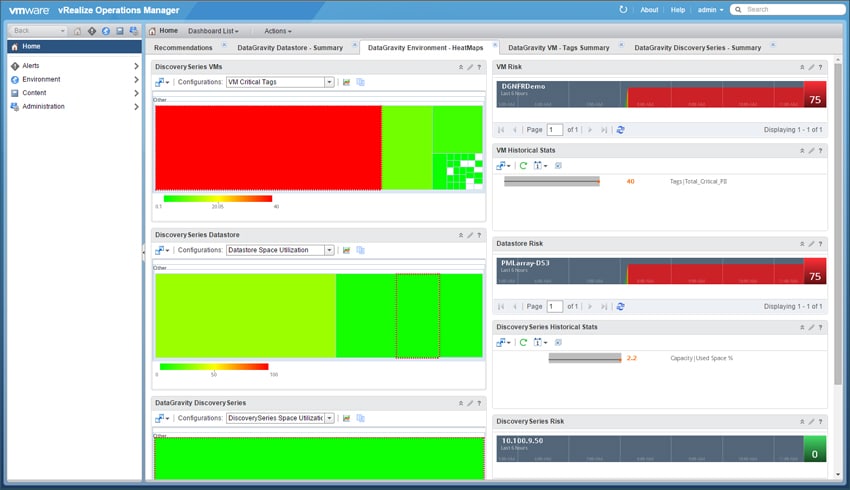
L'integrazione vROPS visualizza anche mappe "calde" che mostrano potenziali aree problematiche in base a valori predefiniti per l'utilizzo dello spazio e tag di intelligence critici presenti all'interno di VM, archivi dati e sistema Discovery Series.
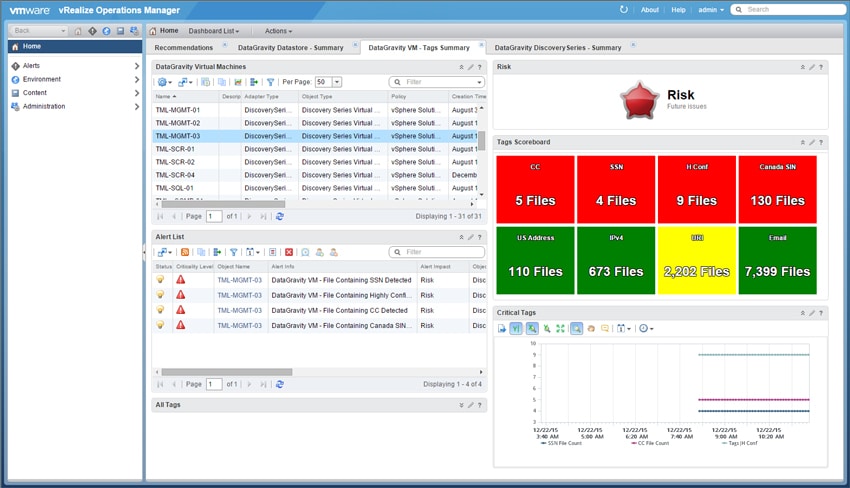
E gli amministratori della virtualizzazione possono vedere quali dati in cui la VM è a rischio. Attraverso il sistema di tagging possono anche vedere in modo più specifico il tipo di dati a rischio.
Conclusione
La serie Discovery di DataGravity è un array di storage che sposta l'attenzione dalle prestazioni pure e dalle finestre di backup e ripristino alla consapevolezza dei dati. In altre parole, DataGravity ha creato un sistema che offre agli utenti visibilità su tutti i propri dati attraverso una GUI di facile utilizzo. Non solo consente agli utenti di vedere dove risiedono i loro dati nel sistema, ma fornisce loro un metodo approfondito per tracciarli, chi vi accede e se i dati sensibili possono essere esposti. DataGravity consente agli utenti di taggare la maggior parte dei tipi di file, aiutando a individuare e monitorare rapidamente file di dati specifici. Ciò non solo può rendere i dati di un'azienda più sicuri individuando problemi (non intenzionali o dolosi), ma consente anche a un'azienda di utilizzare appieno tutti i dati archiviati comprendendo la posizione dei dati, l'accesso, le esigenze di conservazione e la conformità.
Normalmente su StorageReview esaminiamo l'hardware sottostante e ne testiamo le prestazioni attraverso una serie di benchmark. Nel caso di DataGravity il software è il punto di forza più forte. Sebbene l'azienda offra capacità multiple da 18 TB a 96 TB e disponga di una combinazione di RAM, NVRAM, SSD e HDD nearline nella sua soluzione, l'hardware sottostante esiste per supportare la piattaforma di analisi DataGravity. Naturalmente tutto l'hardware esiste per supportare il software, tuttavia la maggior parte dei fornitori li utilizza insieme per fornire funzionalità di storage classiche. DataGravity non afferma di avere le prestazioni più elevate o la latenza più bassa. Il focus di DataGravity è invece sulla consapevolezza dei dati e sulla facilità d'uso. Su questo punto l’azienda eccelle chiaramente.
Il team di StorageReview si è recato sul posto per testare la soluzione. Poiché questa volta il nostro focus era sull'usabilità, non avevamo bisogno di un dispositivo fisico nel nostro laboratorio su cui eseguire i nostri test sulle prestazioni. Prima del nostro arrivo, DataGravity ha inserito gran parte dei contenuti del nostro sito web nel loro array fornendoci dati per la ricerca con cui avevamo molta familiarità. Con solo una panoramica di base del sistema siamo stati in grado di iniziare a utilizzare in modo intuitivo la soluzione per cercare parole chiave in vari tipi di file, creare condivisioni, riassegnare pool di dati e vedere come veniva monitorato il nostro utilizzo della soluzione.
In definitiva, ciò che sta facendo DataGravity è eccezionalmente diverso dal resto del settore dello storage. Il team di veterani ha deciso di risolvere innanzitutto i legittimi problemi aziendali, utilizzando come gancio la visibilità sulla conformità dello storage. Questa enfasi sull'intelligenza è fondamentale per ciò che riguarda DataGravity, che varia notevolmente dagli acquisti di storage tradizionali basati su esigenze di capacità o throughput. Sebbene l'approccio DataGravity abbia molto senso nei settori regolamentati, anche il caso d'uso della nostra piccola impresa ha visto vantaggi immediati una volta che siamo stati in grado di avere una visione approfondita anche di una parte dei nostri contenuti rivolti all'esterno. Se aggiungi queste informazioni alle stesse per le home directory degli utenti, le cartelle condivise per i gruppi di lavoro e il resto delle risorse aziendali, i vantaggi si aumenteranno rapidamente. È anche molto intuitivo da usare, rendendo DataGravity una buona soluzione per negozi IT piccoli o sovraccarichi.
Conclusione
La serie Discovery di DataGravity consente alle aziende di sfruttare appieno tutti i propri dati mantenendoli sicuri e utilizzabili tramite un'interfaccia facile da usare. L'enfasi sull'analisi e sulla visibilità dei dati è davvero unica nel settore dello storage, conferendo a DataGravity un importante punto di differenziazione in un settore che spesso manca di creatività.


 Amazon