

Il controller RAID Dell H975i della serie PERC13 rappresenta il più significativo passo avanti compiuto dall'azienda nel RAID hardware in oltre un decennio. Sebbene Dell abbia rilasciato aggiornamenti regolari alla sua linea PERC, questi sono stati in gran parte incrementali, focalizzati sulla messa a punto del controller e sul miglioramento della larghezza di banda con l'avanzare delle generazioni PCIe. Tuttavia, l'architettura di base è rimasta legata all'eredità SATA e SAS che ha definito il RAID aziendale per anni. Il PERC H975i interrompe definitivamente questo ciclo. Basato sulla linea di chipset SAS51xx di Broadcom, questo controller segna una transizione definitiva verso un design flash-first e NVMe-native. Supportando esclusivamente unità NVMe ed eliminando il supporto per le tradizionali tecnologie HDD e SATA, l'H975i incorpora un approccio lungimirante all'infrastruttura di storage, ottimizzato per le esigenze di alte prestazioni e bassa latenza dei moderni carichi di lavoro ad alta intensità di dati e AI-first.
Punti chiave
- RAID NVMe flash-first: PERC13 H975i abbandona completamente SAS/SATA ed è basato su Broadcom SAS51xx per un'architettura nativa NVMe e pronta per l'intelligenza artificiale.
- Grande salto generazionale: PCIe Gen5 x16 con un massimo di 16 unità NVMe per controller (32 con due) ha fornito 52.5 GB/s e 12.5 milioni di IOPS per controller nei test, con guadagni rispetto a PERC12 tra cui +88% di larghezza di banda in lettura, +318% di larghezza di banda in scrittura, +31% di IOPS in lettura 4K e +466% di IOPS in scrittura 4K.
- Adattamento del server AI: Il design integrato frontalmente libera gli slot PCIe posteriori per le GPU, riduce i tempi di esecuzione MCIO e consente un canale di archiviazione dedicato per ogni acceleratore, per un throughput più stabile e deterministico senza sovraccarico della CPU.
- Resilienza sotto stress: La cache protetta da supercondensatore e le ricostruzioni più rapide riducono i tempi fino a 10 min/TiB, mantenendo al contempo prestazioni elevate durante le ricostruzioni (fino a 53.7 GB/s di lettura, 68 GB/s di scrittura, 17.3 M/5.33 M 4K IOPS).
- Sicurezza end-to-end: Root of Trust hardware, identità del dispositivo SPDM e crittografia a spettro completo che copre unità, dati in transito e cache del controller.
PERC H975i offre prestazioni e innovazioni architetturali senza pari. Sfruttando un'interfaccia host PCIe Gen 5 x16 e supportando fino a 16 unità NVMe (32 unità NVMe per sistema con due controller), H975i, nei nostri test, ha raggiunto un throughput massimo di 52.5 GB/s e 12.5 milioni di IOPS per controller. Ciò rappresenta un aumento delle prestazioni di quasi il doppio in ogni categoria chiave rispetto a PERC2, che ha raggiunto un massimo di 12 milioni di IOPS e un throughput di 6.9 GB/s. Oltre alle prestazioni pure e semplici, PERC27 introduce un meccanismo di protezione della cache basato su supercondensatori (in sostituzione dei tradizionali sistemi con batteria tampone), garantendo l'integrità dei dati senza compromettere l'affidabilità operativa. Basandosi sulle funzionalità di sicurezza del suo predecessore, H13i ora estende le funzionalità di crittografia a spettro completo, crittografando i dati all'interno della cache e offrendo una protezione completa sia in transito che a riposo.
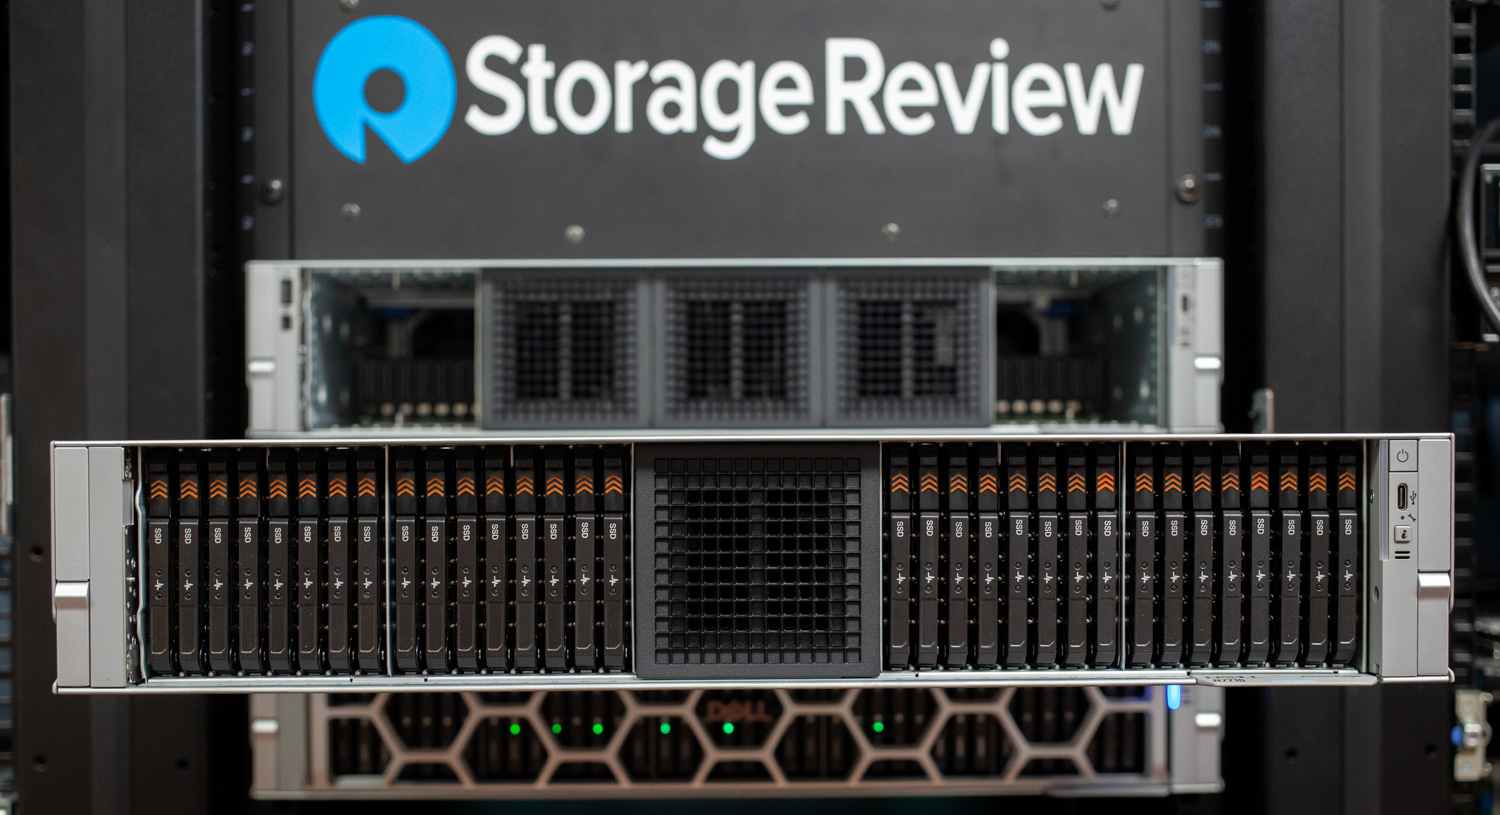
PERC H975i si presenta come un acceleratore di storage appositamente progettato per soddisfare le esigenze computazionali senza precedenti dei carichi di lavoro di intelligenza artificiale. Offre sia alta densità che prestazioni elevate, oltre a uno storage a bassa latenza senza sovraccarico della CPU. In pratica, l'abbinamento di una scheda RAID PCIe Gen5 in grado di saturare un'interfaccia x16 con una GPU Gen5 fornisce a ciascun acceleratore una propria pipeline di storage dedicata. Ciò semplifica la topologia PCIe/NUMA, prevenendo gli effetti di rumore e mantenendo le attività di ricostruzione o in background isolate al dominio I/O di quella GPU.
Applicando questa soluzione a due schede RAID su due GPU, si mantengono prestazioni lineari evitando conflitti su canali o cache condivisi. Il risultato è una larghezza di banda in ingresso più stabile per training e inferenza ad alto consumo di dati (batch di grandi dimensioni, shuffle rapidi, letture rapide dei checkpoint) con distribuzioni di latenza più rigide sotto carico e durante le ricostruzioni. Questa architettura non si limita a raggiungere picchi di dati più elevati, ma rende anche il throughput più deterministico, che è esattamente ciò di cui i server AI multi-GPU hanno bisogno per mantenere un elevato utilizzo.
Specifiche Dell PERC12 H965i e PERC13 H975i
| Caratteristica | PERC12 H965i anteriore | PERC13 H975i anteriore |
|---|---|---|
| Livelli RAID | 0, 1, 5, 6, 10, 50, 60 | 0, 1, 5, 6, 10, 50, 60 |
| Non RAID (JBOD) | Si | Si |
| Tipo di bus host | PCIe Gen4x16 | PCIe Gen5x16 |
| Gestione della banda laterale | I2C, PCIe VDM | I2C, PCIe VDM |
| Recinti per porta | Non applicabile | Non applicabile |
| Processore/Chipset | Broadcom RAID-on-Chip, SAS4116W | Broadcom RAID-on-Chip, SAS5132W |
| Pacchetto energetico / Backup di potenza | batteria | Supercondensatore |
| Sicurezza della gestione delle chiavi locali | Si | Si |
| Secure Enterprise Key Manager | Si | Si |
| Profondità della coda del controller | 8,192 | 8,192 |
| Cache non volatile | Si | Si |
| Cache Memory | 8 GB DDR4 3200 MT/s | Cache RAID integrata |
| Funzioni della cache | Riscrivi, leggi in anticipo, scrivi attraverso, riscrivi sempre, nessuna lettura in anticipo | Write-back, write-through, write-back sempre, nessuna lettura anticipata |
| Numero massimo di dischi virtuali complessi | 64 | 16 |
| Numero massimo di dischi virtuali semplici | 240 | 64 |
| Gruppi di dischi massimi | 64 | 32 |
| Numero massimo di VD per gruppo di dischi | 16 | 8 |
| Numero massimo di dispositivi hot-spare | 64 | 8 |
| Dispositivi hot-swap supportati | Si | Si |
| Configurazione automatica (primaria ed esecuzione una volta) | Si | Si |
| Motore XOR hardware | Si | Si |
| Espansione della capacità online | Si | Si |
| Hot Spare dedicato e globale | Si | Si |
| Tipi di unità supportati | NVMe Gen3 e Gen4 | NVMe Gen3, Gen4 e Gen5 |
| Dimensione dell'elemento della striscia VD | 64KB | 64KB |
| Supporto NVMe PCIe | Gen4 | Gen5 |
| Configurazione Max NVMe Drives | 8 unità per controller | 16 unità per controller |
| Dimensioni dei settori supportate | 512B, 512e, 4Kn | 512B, 512e, 4Kn |
| Supporto per l'avvio dell'archiviazione | Solo UEFI | Solo UEFI |
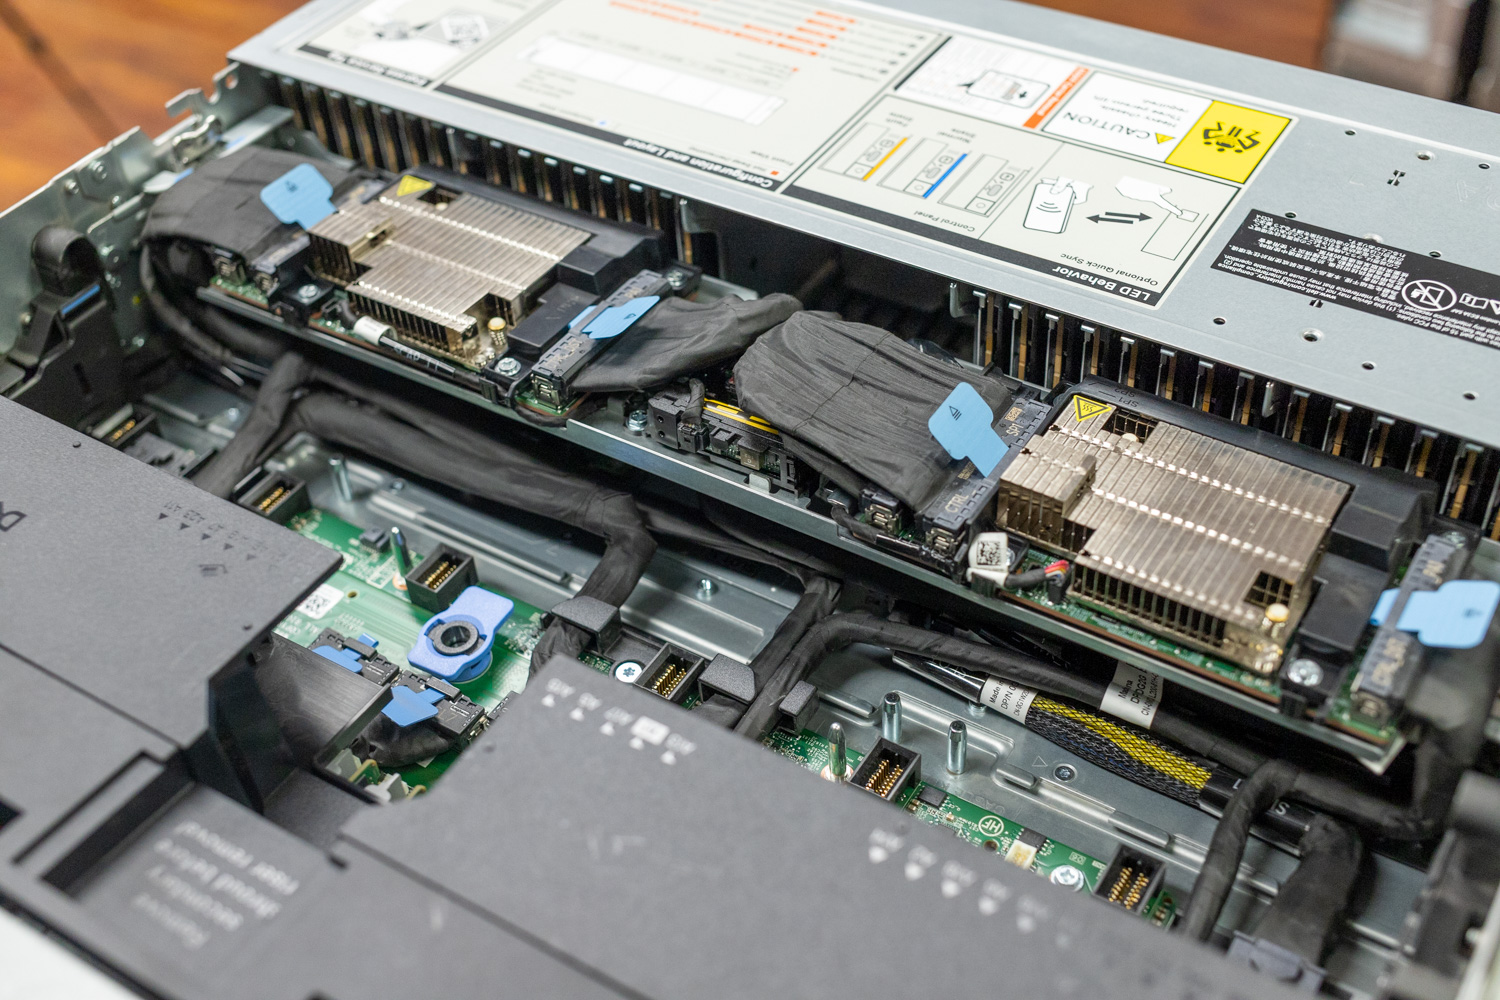
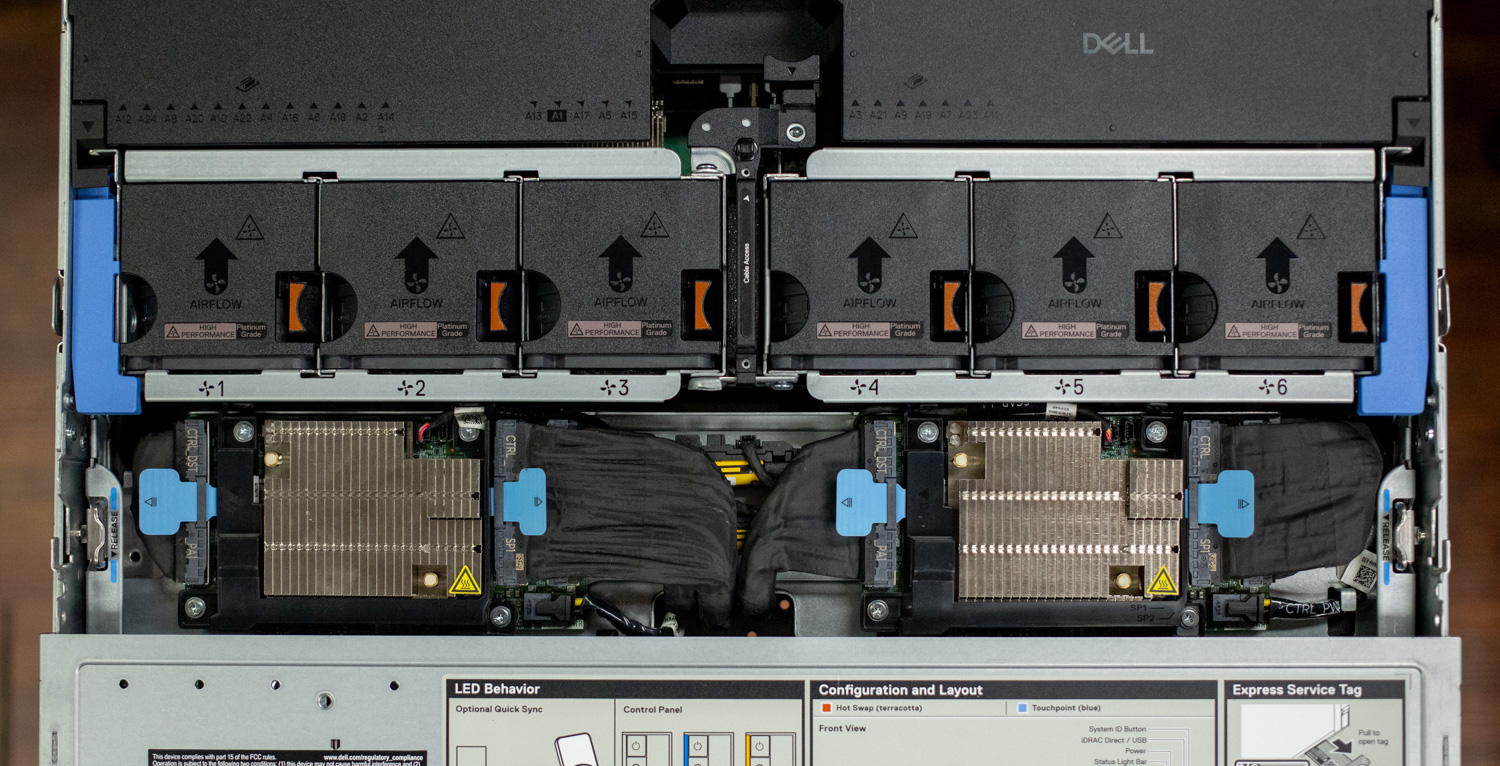
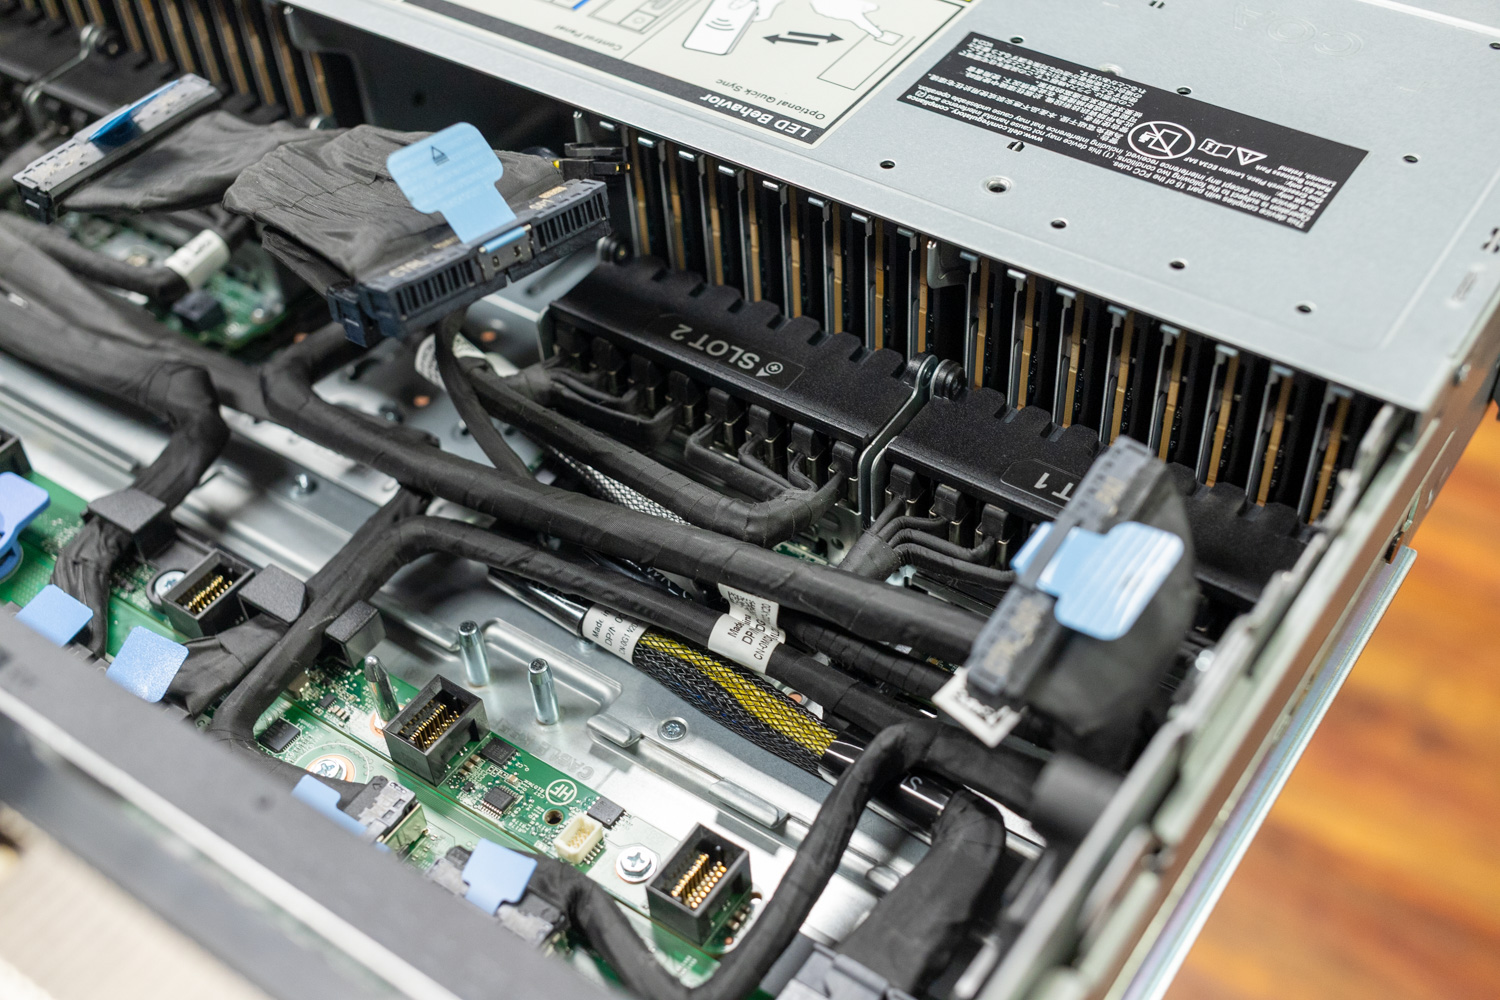
Il controller frontale PERC13 H975i nei server Dell PowerEdge è progettato per una perfetta integrazione nell'architettura di sistema. A differenza delle tradizionali schede aggiuntive che occupano gli slot PCIe posteriori, l'H975i si collega direttamente al backplane dell'unità anteriore e si interfaccia con i connettori MCIO anteriori sulla scheda madre tramite interfacce PCIe 5.0 dedicate. Questo design integrato preserva gli slot PCIe posteriori per GPU ad alte prestazioni e ulteriore espansione PCIe, riducendo significativamente la lunghezza dei cavi. Ciò contribuisce a mantenere l'integrità del segnale, rendendo il sistema più affidabile e facile da manutenere. Il risultato è un layout interno più pulito e un flusso d'aria migliorato per implementazioni dense e ad alta intensità di elaborazione.
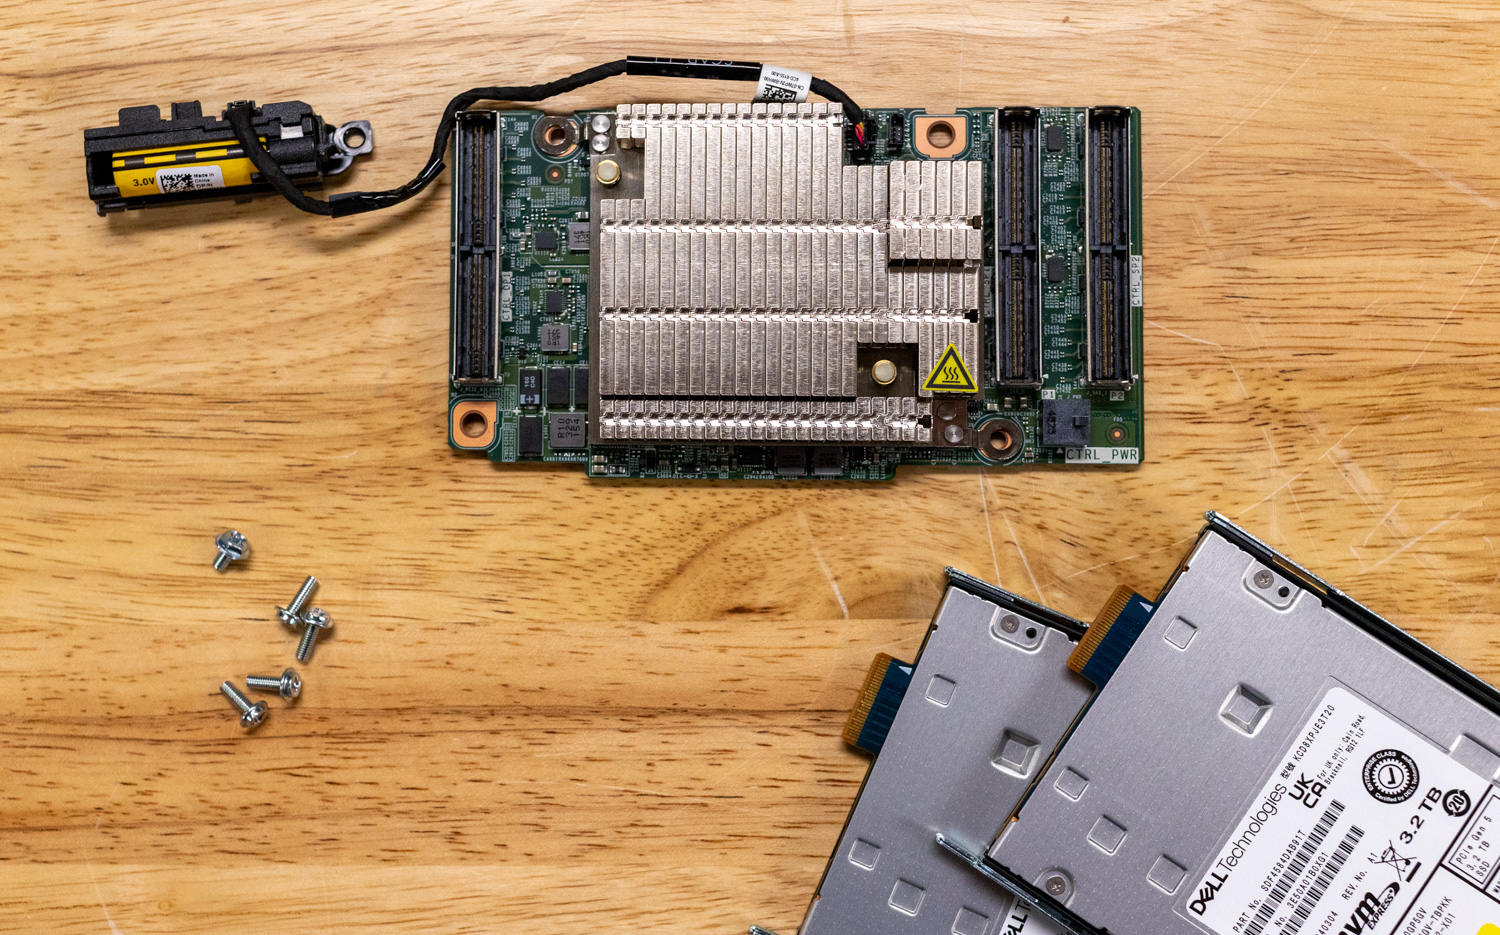
L'H975i implementa un'architettura di sicurezza completa che spazia dall'attestazione hardware a livello di silicio alla crittografia completa dei dati in uso con le unità SED. Alla base, l'Hardware Root of Trust stabilisce una catena immutabile di verifica crittografica dalla ROM di avvio interna a ciascun componente firmware, garantendo che solo il firmware certificato Dell autenticato possa essere eseguito sul controller. Questa sicurezza basata su hardware si estende all'implementazione del Security Protocol and Data Model (SPDM), in cui ogni controller contiene un certificato di identità del dispositivo univoco che consente a iDRAC di eseguire la verifica dell'autenticazione in tempo reale. Il controller estende la protezione crittografica oltre i tradizionali scenari di dati a riposo, includendo la memoria cache. Mantiene le chiavi di crittografia in regioni di memoria sicure, inaccessibili al firmware non autorizzato. Di conseguenza, i dati sensibili rimangono protetti, sia che risiedano sulle unità sia che vengano elaborati attivamente nella cache.
La protezione dell'alimentazione nell'H975i rappresenta un'ulteriore significativa evoluzione rispetto ai tradizionali sistemi a batteria, grazie all'integrazione di un supercondensatore. Il supercondensatore fornisce un'erogazione di potenza istantanea in caso di interruzioni di corrente impreviste, garantendo uno svuotamento crittografato e completo della cache su un dispositivo di archiviazione non volatile, dove i dati rimangono protetti a tempo indeterminato. Inoltre, a differenza dei sistemi a batteria che richiedono 4-8 ore per i cicli di apprendimento, il supercondensatore dell'H975i completa il suo ciclo di apprendimento trasparente in 5-10 minuti, senza alcun degrado delle prestazioni durante la calibrazione. Questa progettazione elimina i costi di manutenzione e i problemi di degrado tipici delle soluzioni a batteria, garantendo al contempo un'affidabilità superiore per la protezione dei dati mission-critical.
Monitoraggio e gestione integrati
Il controller RAID PERC13 di Dell, come molte delle soluzioni RAID di Dell, può essere gestito e monitorato in molti modi, tra cui durante l'avvio della piattaforma tramite System Setup nel BIOS, tramite l'interfaccia utente grafica Web iDRAC, l'utilità PERC12 e persino l'interfaccia utente e la CLI di Dell OpenManage.
Gestione del controller iDRAC
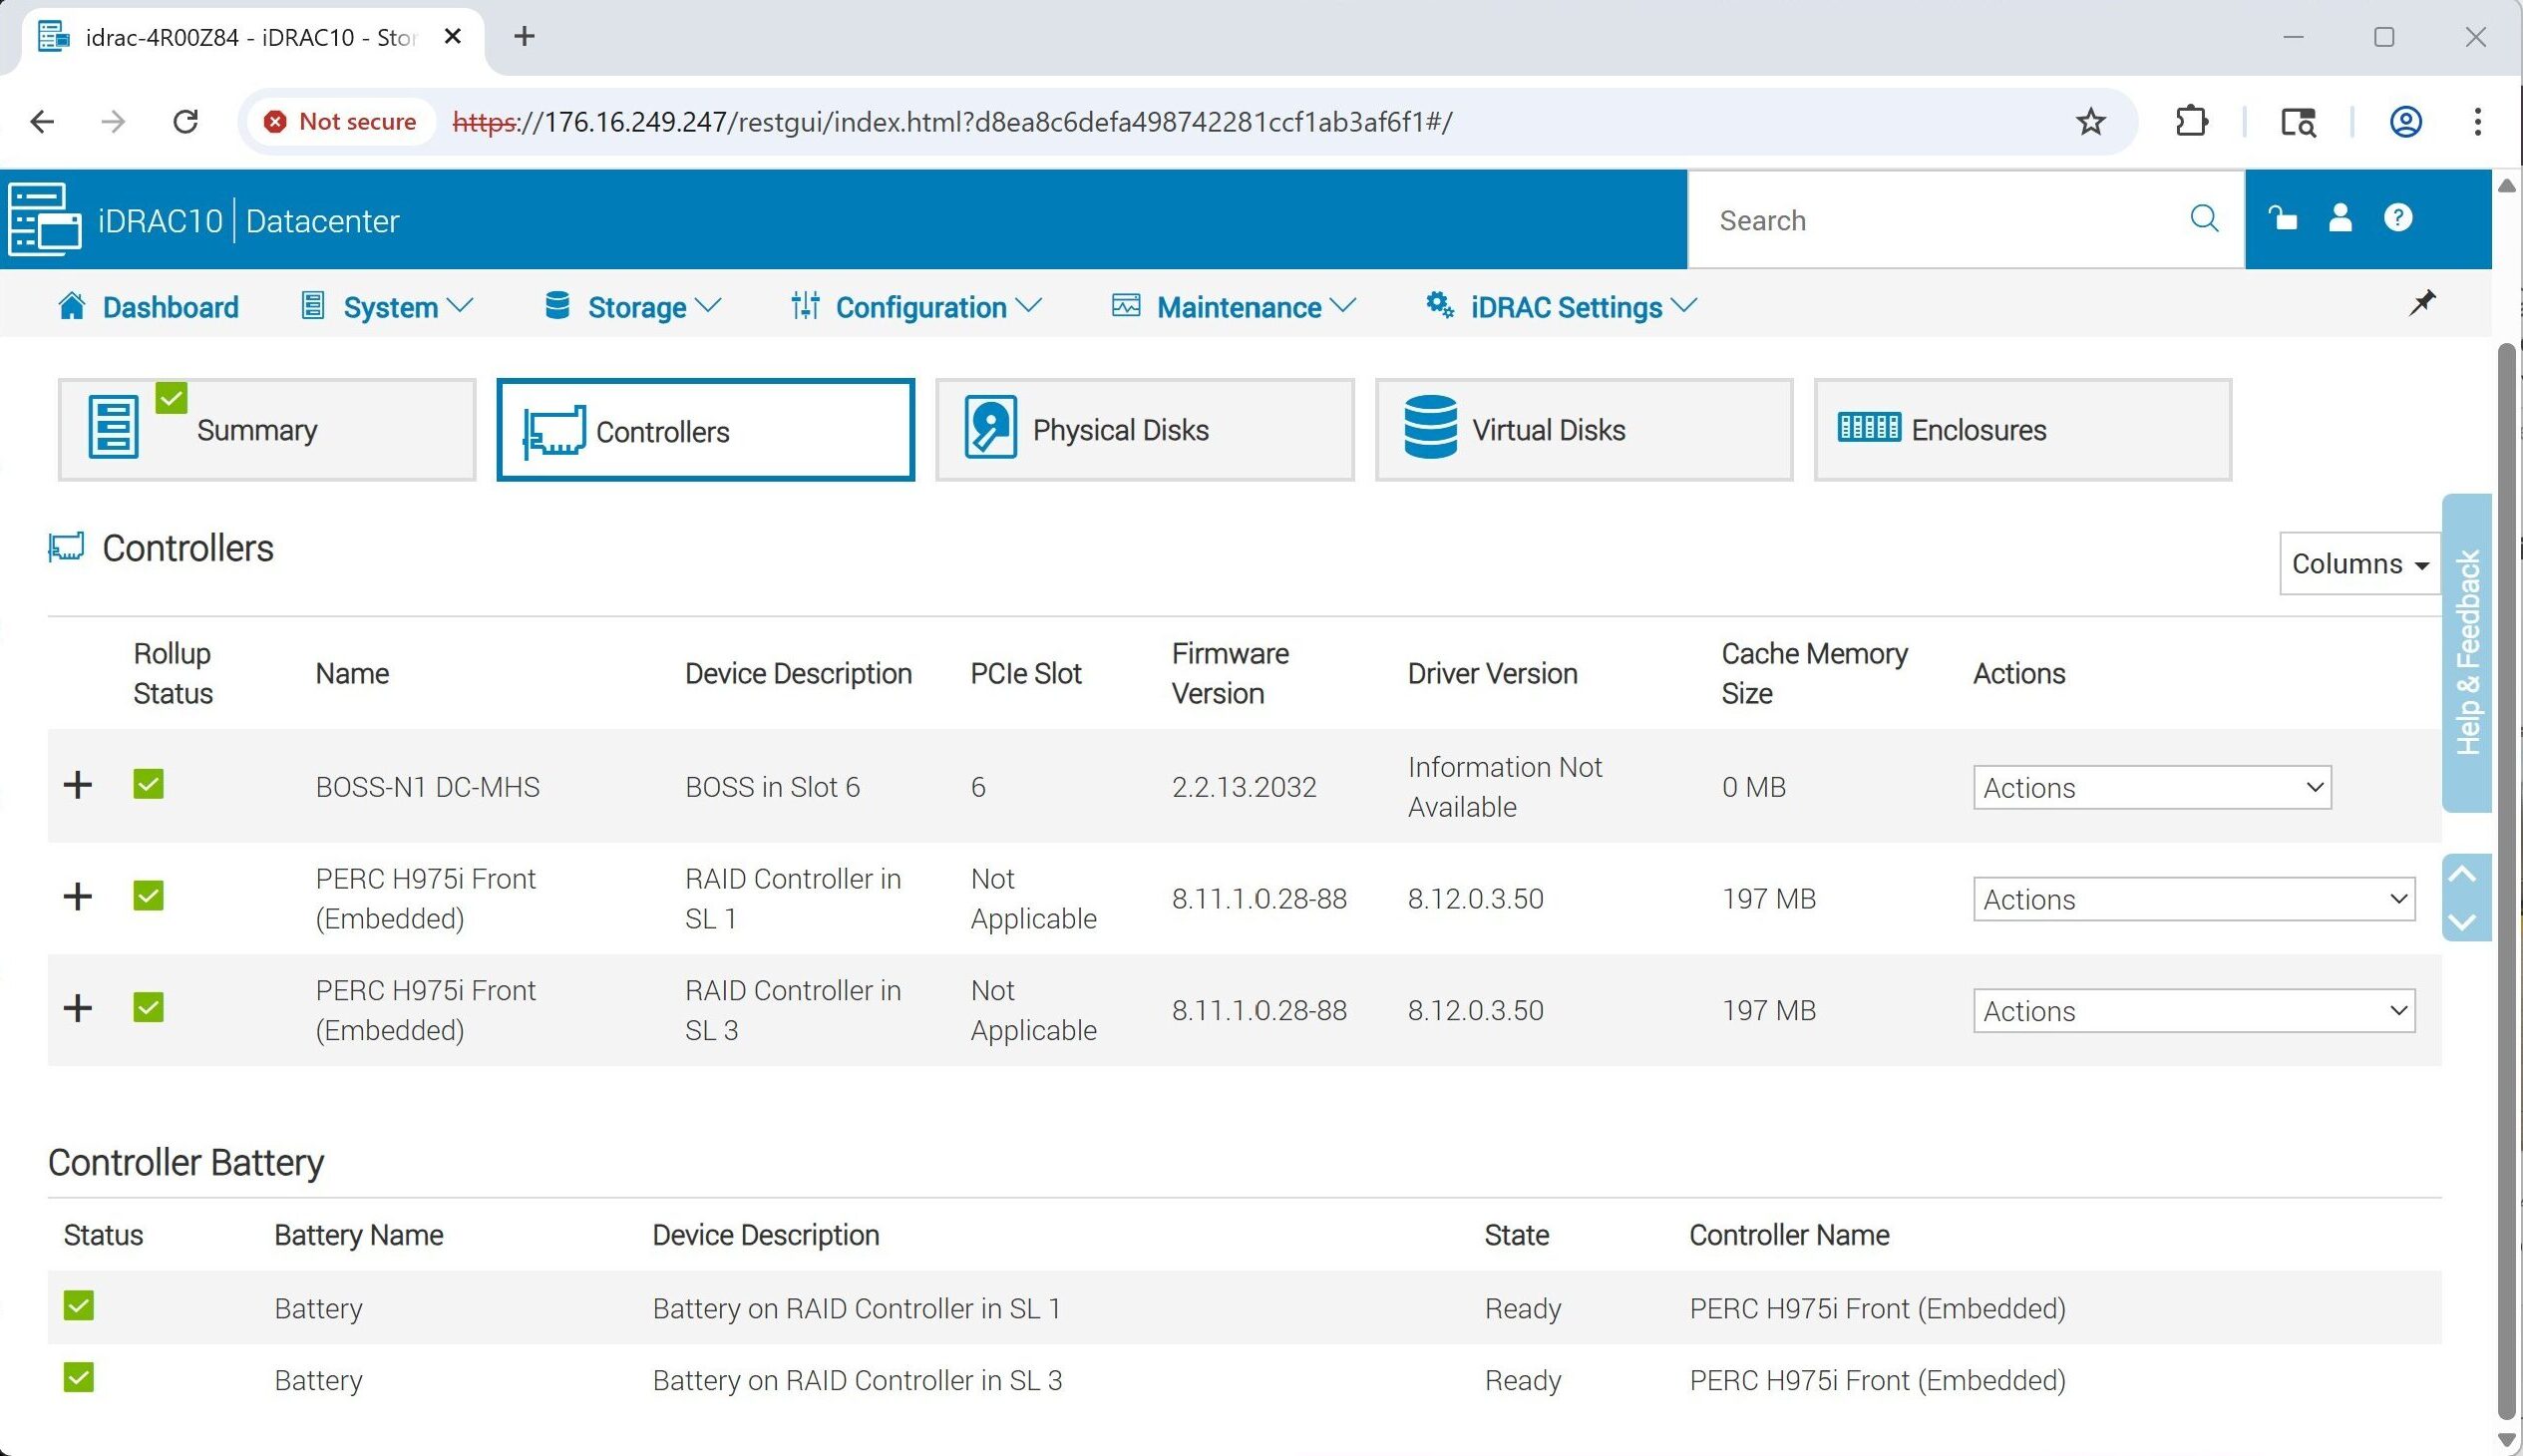
Quando si visualizza l'interfaccia di gestione di iDRAC, la scheda Controller offre una panoramica dell'hardware di storage del server. Oltre alla scheda BOSS, sono visibili i due controller PERC H975i, completi di informazioni su versioni del firmware, memoria cache e stato della batteria. Questo riepilogo consente di verificare rapidamente la disponibilità e la configurazione dei controller senza dover accedere al BIOS o utilizzare strumenti CLI.
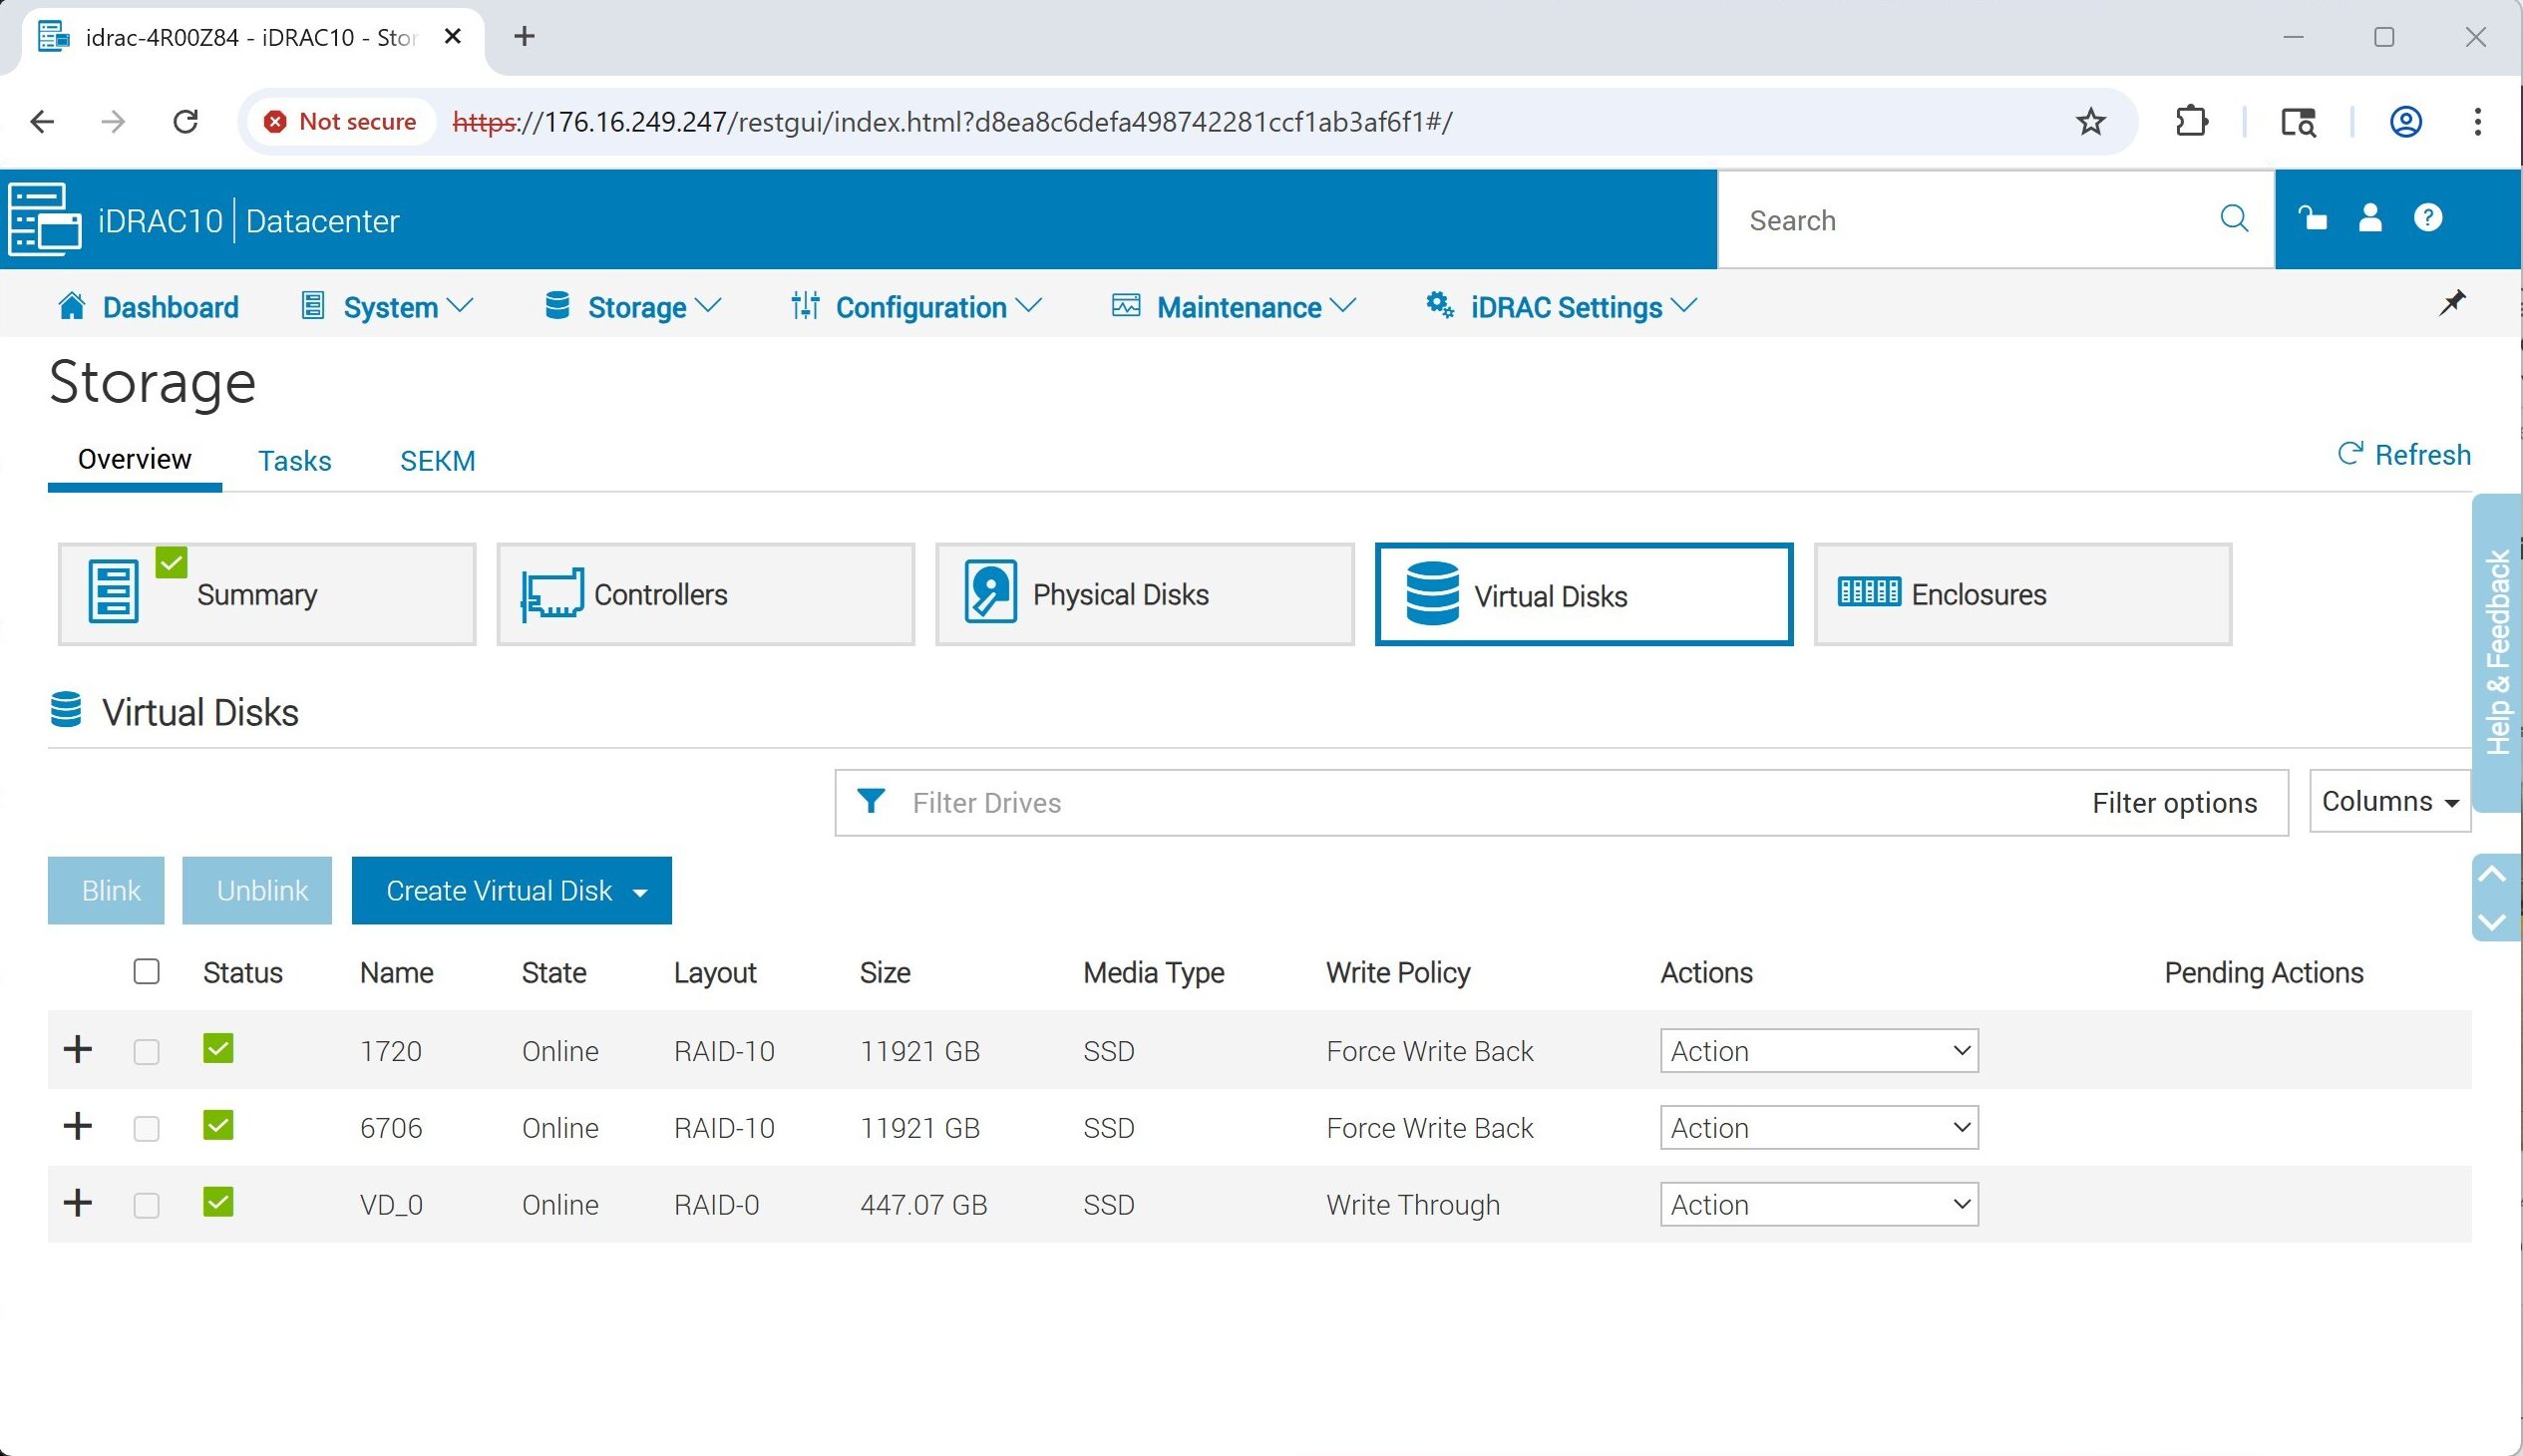
La scheda "Dischi virtuali" di iDRAC mostra gli array di storage creati, inclusi il livello RAID, le dimensioni e i criteri di caching. In questo sistema, sono elencati due gruppi RAID-10, tutti basati su SSD. Da questa vista, gli amministratori possono confermare che i volumi siano online, creare nuovi dischi virtuali o utilizzare il menu "Azioni" per modificare o eliminare le configurazioni esistenti.
Utilità di configurazione del controller RAID
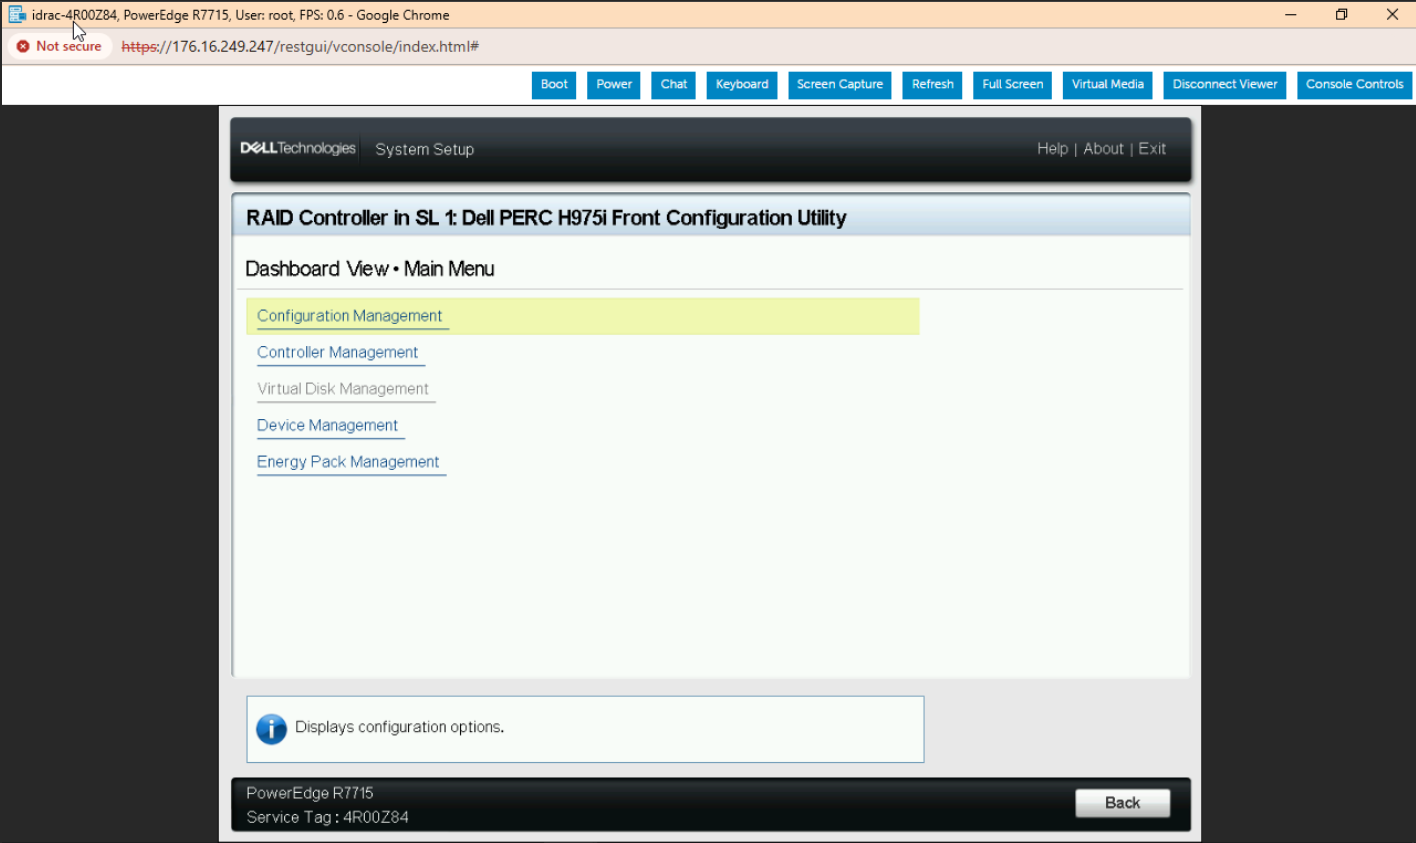
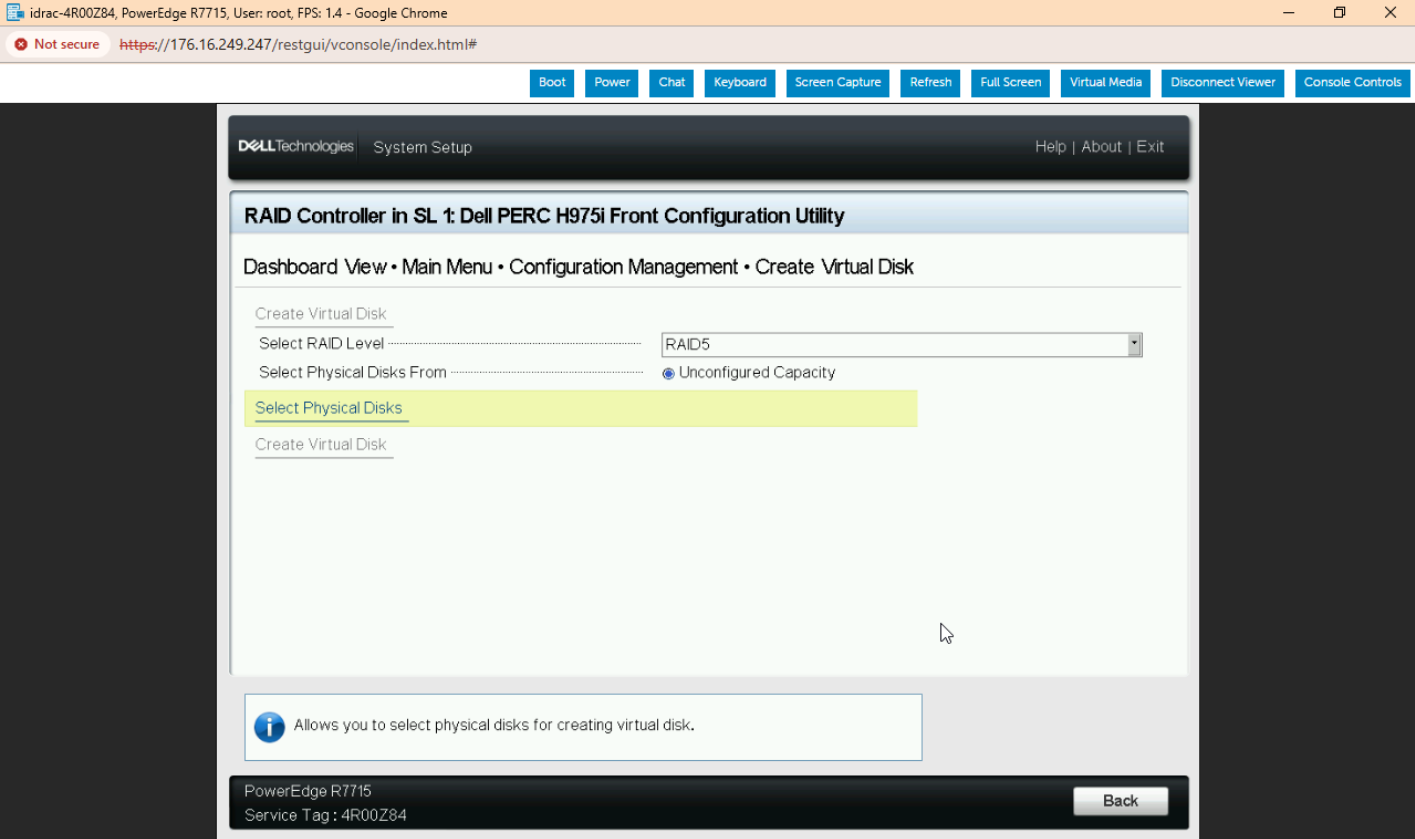
L'immagine sopra mostra un esempio di accesso all'utility di configurazione frontale PERC H975i System Setup sulla piattaforma PowerEdge R7715. Da questa interfaccia è possibile gestire tutte le impostazioni chiave del controller RAID, tra cui Gestione della configurazione, Gestione del controller, Gestione dei dispositivi e altro ancora. Questa utility offre un modo semplificato per configurare dischi virtuali e monitorare i componenti hardware direttamente durante il processo di avvio della piattaforma.
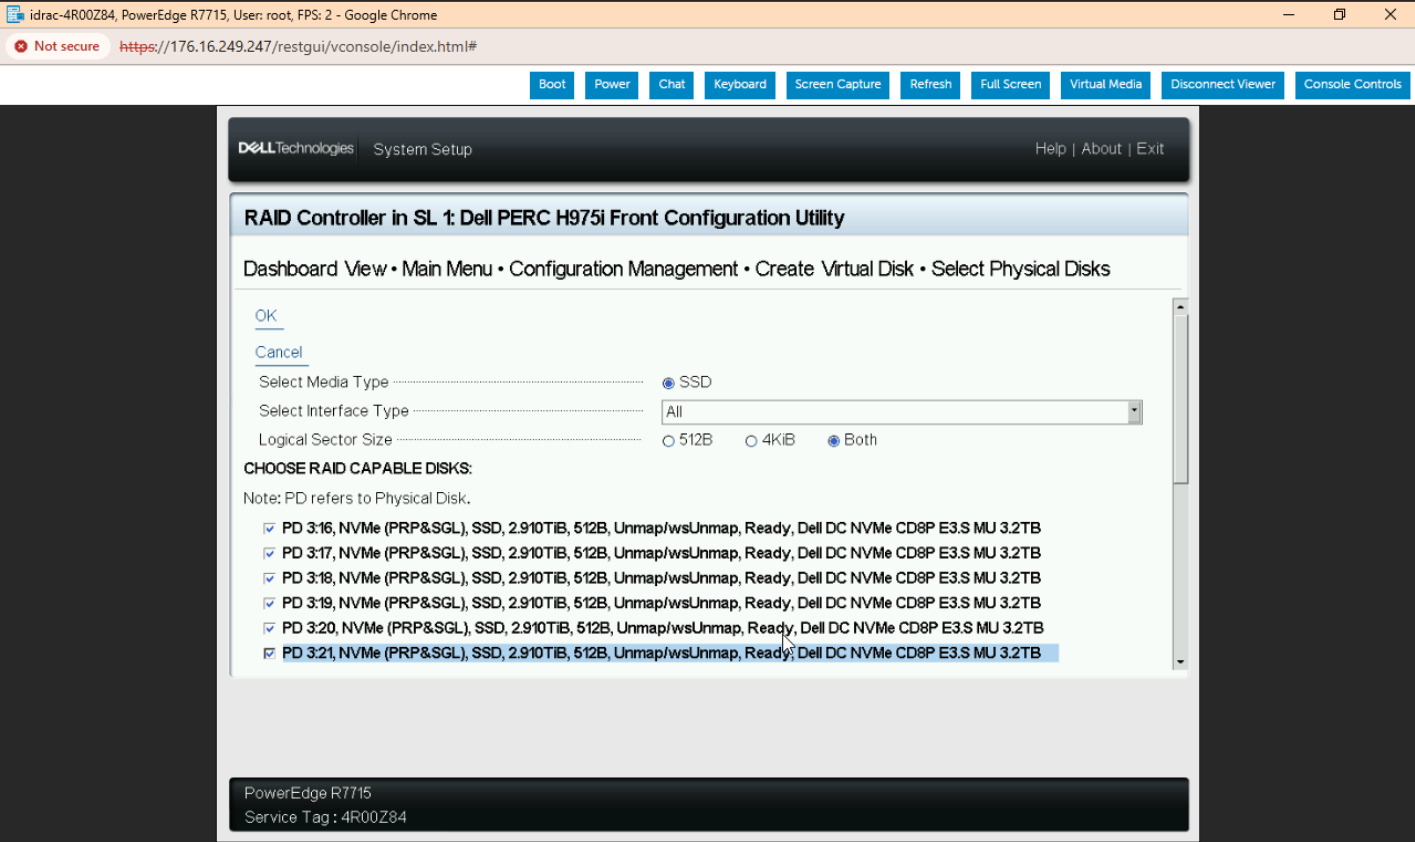
Dopo aver selezionato il livello RAID, passiamo alla scelta dei dischi fisici per l'array. In questo esempio, tutti gli SSD NVMe disponibili sono elencati e contrassegnati come compatibili con RAID. Selezioniamo più unità Dell DC NVMe da 3.2 TiB dal pool di capacità non configurato. Filtri come tipo di supporto, interfaccia e dimensione del settore logico aiutano a restringere la selezione. Una volta selezionate le unità desiderate, possiamo procedere cliccando su "OK" per finalizzare la selezione dei dischi e continuare a creare il disco virtuale.
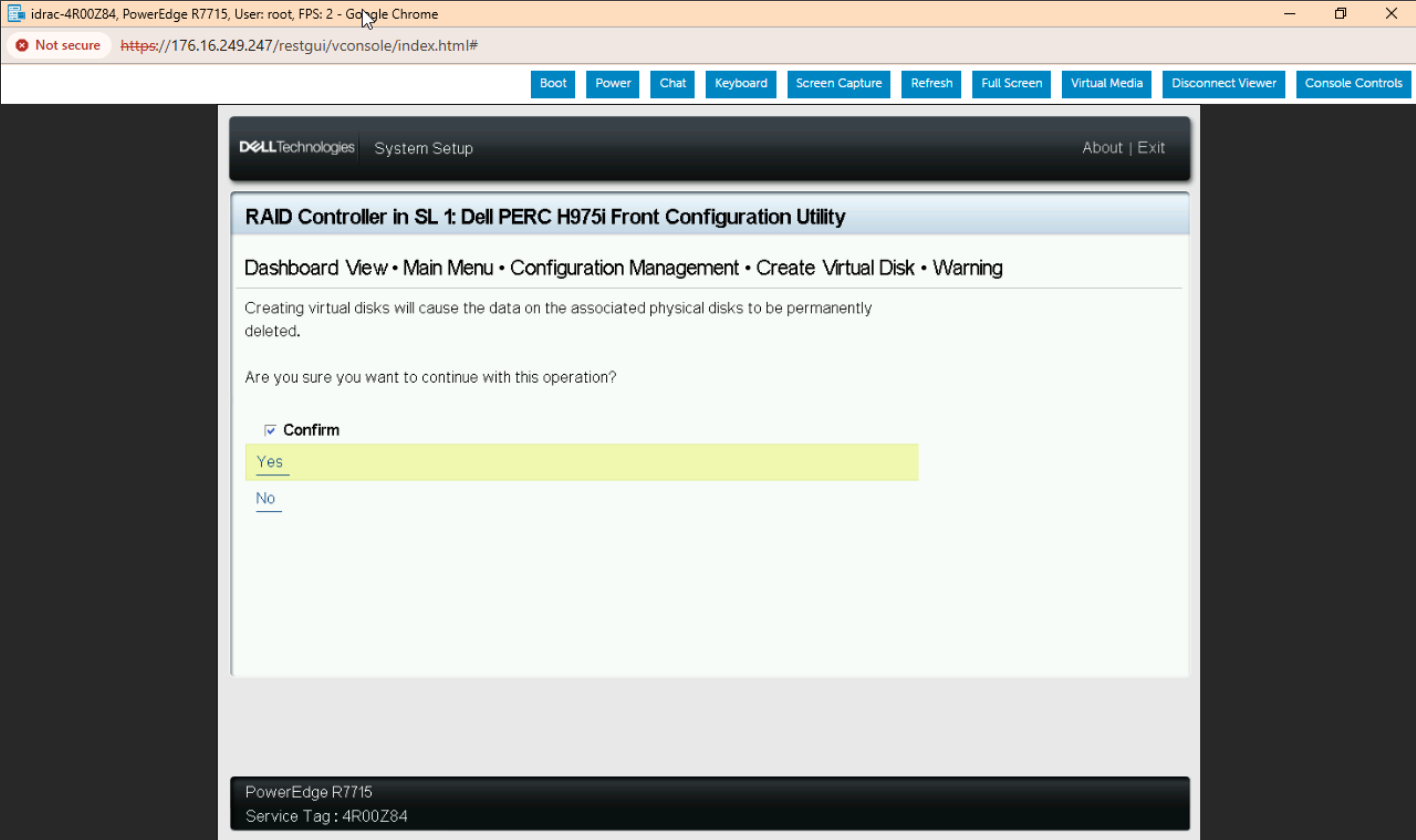
Prima di finalizzare la creazione del disco virtuale, il sistema visualizza un avviso che conferma che tutti i dati sui dischi fisici selezionati verranno eliminati definitivamente. Per procedere, selezioniamo la casella "Conferma" e selezioniamo "Sì" per autorizzare l'operazione. Questa protezione aiuta a prevenire la perdita accidentale di dati durante il processo di creazione del RAID.
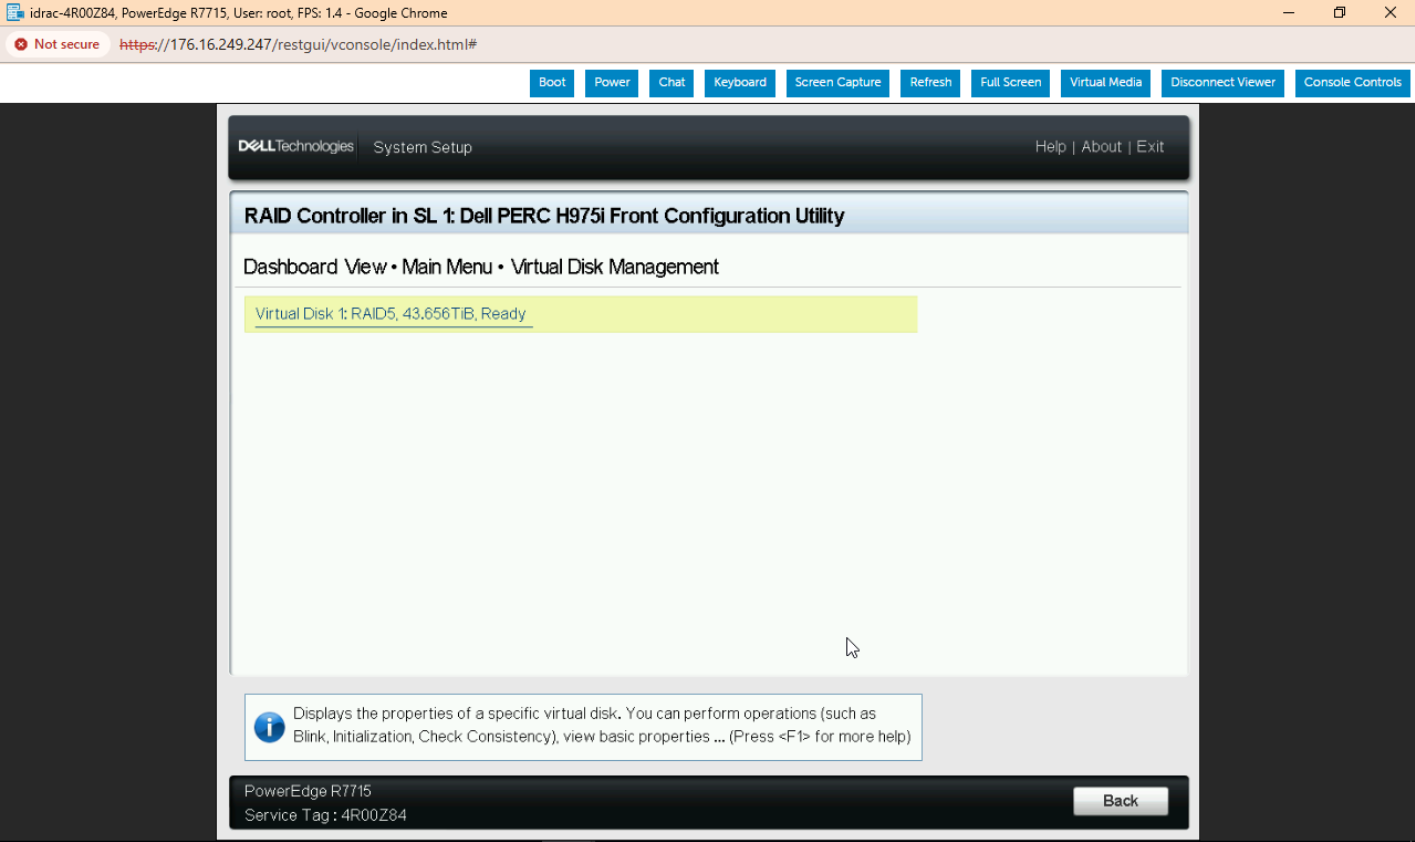
Una volta creato, il disco virtuale appare nel menu "Gestione Disco Virtuale". In questo esempio, il nostro nuovo disco virtuale RAID 5 è elencato con una capacità di 43.656 TiB e lo stato "Pronto". Con pochi semplici passaggi, lo storage è configurato e pronto all'uso.
Sebbene l'utilità di configurazione del BIOS PERC e l'interfaccia iDRAC offrano opzioni intuitive per la gestione locale e remota, Dell mette a disposizione anche un potente strumento da riga di comando chiamato PERC CLI (perccli2). Questa utility supporta Windows, Linux e VMware, risultando ideale per la creazione di script, l'automazione o la gestione dei controller PERC in ambienti senza interfaccia grafica. Dell fornisce inoltre una documentazione dettagliata sull'installazione e sull'utilizzo dei comandi di PERC CLI sul proprio sito di supporto.
Test delle prestazioni Dell PERC13
Prima di immergerci nei test delle prestazioni, abbiamo preparato il nostro ambiente utilizzando la piattaforma Dell PowerEdge R7715 configurata con due controller frontali PERC H975i. Questi sono stati abbinati a trentadue unità Dell NVMe da 3.2 TB, ciascuna con velocità di lettura sequenziale fino a 12,000 MB/s e scrittura sequenziale fino a 5,500 MB/s, utilizzando blocchi da 128 KiB. Questa base ad alte prestazioni ci ha permesso di spingere al limite il throughput del controller PERC13 e di valutare il comportamento RAID su larga scala.
- Piattaforma: Dell PowerEdge R7715
- CPU: Processore AMD EPYC 9655P a 96 core
- Ram: 768 GB (12 x 64 GB) DDR5-5200 ECC
- Controllore Raid: 2 x PERC13 H975i
- Memoria su disco: 32 unità Dell CD3.2P NVMe da 8 TB
- Acceleratori PCIe: 2 GPU NVIDIA H100
NVIDIA Magnum IO GPU Direct Storage: l'intelligenza artificiale incontra lo storage
Le moderne pipeline di intelligenza artificiale sono spesso vincolate all'I/O, non al calcolo. Batch di dati, incorporamenti e checkpoint devono essere trasferiti dallo storage alla memoria GPU con una velocità sufficiente a mantenere occupati gli acceleratori. Magnum IO GDS di NVIDIA (tramite cuFile) elimina il tradizionale percorso "SSD → DRAM CPU → GPU" e consente il DMA dei dati direttamente da NVMe alla memoria GPU. Ciò elimina l'overhead del bounce buffer della CPU, riduce la latenza e rende il throughput più prevedibile sotto carico, il che si traduce in un maggiore utilizzo della GPU, tempi di epoca più brevi e cicli di salvataggio/caricamento dei checkpoint più rapidi.
Il nostro test GDSIO è progettato per misurare il percorso dati dallo storage alla GPU, analizzando le dimensioni dei blocchi e il numero di thread per mostrare la velocità con cui un set NVMe basato su PERC13 può trasmettere in streaming nella memoria H100. Con ogni H975i su un collegamento PCIe 5.0 x16 (teorico ~64 GB/s per controller, unidirezionale), due controller impostano un limite aggregato vicino a ~112 GB/s; il punto in cui le nostre curve raggiungono un plateau indica se si è limitati dal collegamento o dal supporto. Per i professionisti, i grafici sono da considerare come proxy per carichi di lavoro reali: letture sequenziali di grandi dimensioni vengono mappate sullo streaming del dataset e sui ripristini dei checkpoint; scritture sequenziali di grandi dimensioni vengono mappate sui salvataggi dei checkpoint; trasferimenti più piccoli con concorrenza riflettono le operazioni di shuffle e prefetch del dataloader. In breve, un forte ridimensionamento GDSIO si traduce in meno blocchi della GPU e prestazioni più costanti sia durante l'addestramento che durante l'inferenza ad alto throughput.
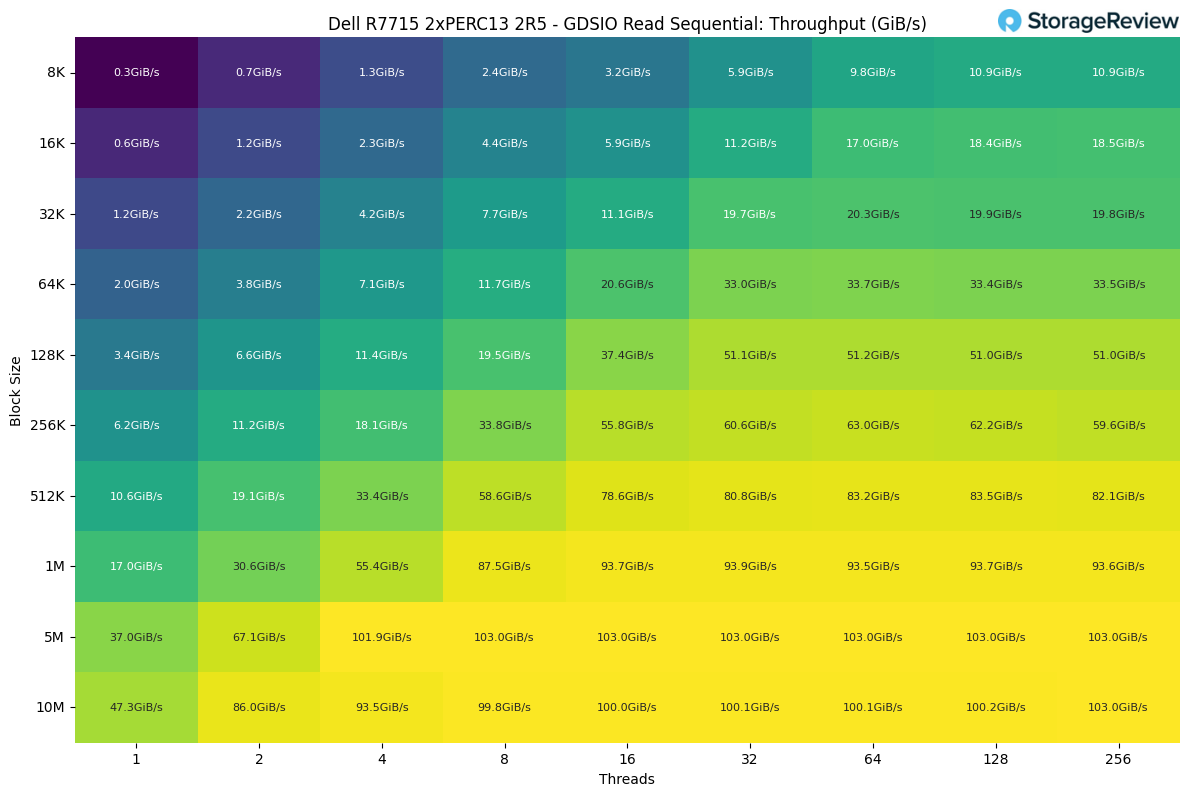
Velocità di lettura sequenziale GDSIO
A partire dalla lettura sequenziale, il throughput è iniziato in modo modesto con blocchi di dimensioni e conteggi di thread inferiori, partendo da circa 0.3 GiB/s a blocchi da 8K con un singolo thread. Le prestazioni sono aumentate drasticamente tra blocchi da 16K e 512K, in particolare aumentando il numero di thread da 4 a 16. I miglioramenti più sostanziali si sono verificati con blocchi di dimensioni pari a 1M, 5M e 10M, dove il throughput è aumentato drasticamente, raggiungendo un picco di 103 GiB/s a blocchi di dimensioni pari a 10M con 256 thread. Questa progressione mostra che l'array PERC13 trae vantaggio da blocchi di dimensioni maggiori e dal parallelismo multithread, con una saturazione ottimale intorno a 64-128 thread, oltre i quali i guadagni si stabilizzano.
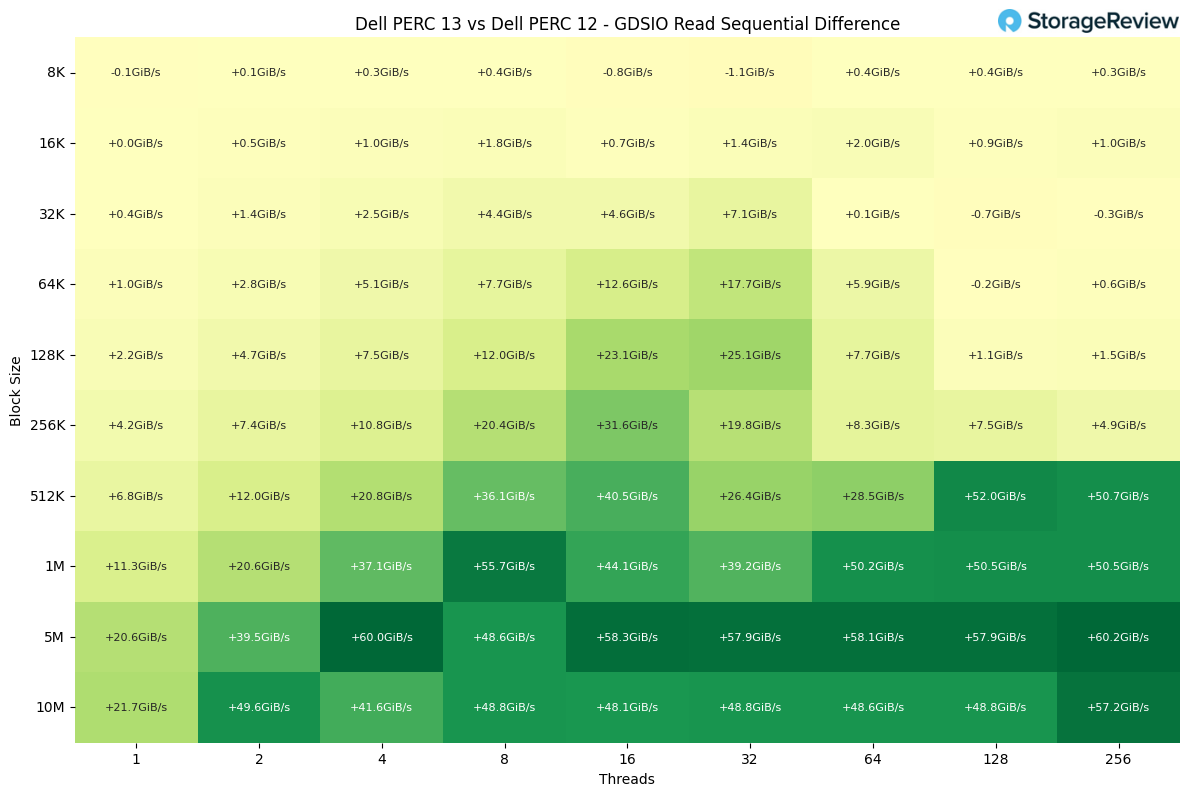
Differenziale di throughput sequenziale di lettura GDSIO
Nei test di lettura sequenziale su blocchi di dimensioni comprese tra 8K e 10M, il PERC13 (H975i) ha costantemente superato il PERC12 (H965i), con guadagni percentuali che aumentano notevolmente con blocchi di dimensioni maggiori e conteggi di thread più elevati.
Con blocchi di dimensioni inferiori (8K-16K), i miglioramenti sono stati modesti (in genere compresi tra 0 e 20%) e, in alcuni casi isolati, l'H975i ha registrato un leggero ritardo a causa della variabilità dei test a basse profondità di coda. Con blocchi di dimensioni comprese tra 32K e 64K, il vantaggio è diventato più costante, con l'H975i che ha offerto un throughput superiore del 30-50% sulla maggior parte dei thread.
Le differenze più significative sono state osservate con blocchi di dimensioni maggiori (da 128K a 10M), dove il controller PERC13 ha liberato l'intero potenziale di lettura sequenziale del sistema. In questo caso, l'H975i ha mostrato guadagni del 50-120% rispetto all'H965i. Ad esempio, con blocchi di dimensioni pari a 1M e 8-16 thread, il throughput è risultato superiore di oltre 55 GiB/s, pari a un incremento di circa il 90%. Con blocchi di dimensioni pari a 5M e 10M, i miglioramenti hanno regolarmente superato il 100%, con alcune configurazioni che hanno mostrato prestazioni quasi doppie rispetto alla generazione precedente.
Nel complesso, il PERC13 (H975i) ha stabilito un primato assoluto nei carichi di lavoro di lettura sequenziale, soprattutto con l'aumento delle dimensioni dei blocchi e del numero di thread. Sebbene le dimensioni dei blocchi più piccole abbiano mostrato un miglioramento incrementale, a partire da 256K, il nuovo controller ha costantemente offerto prestazioni superiori del 50-100%, evidenziando chiaramente i progressi architettonici della più recente piattaforma RAID di Dell.
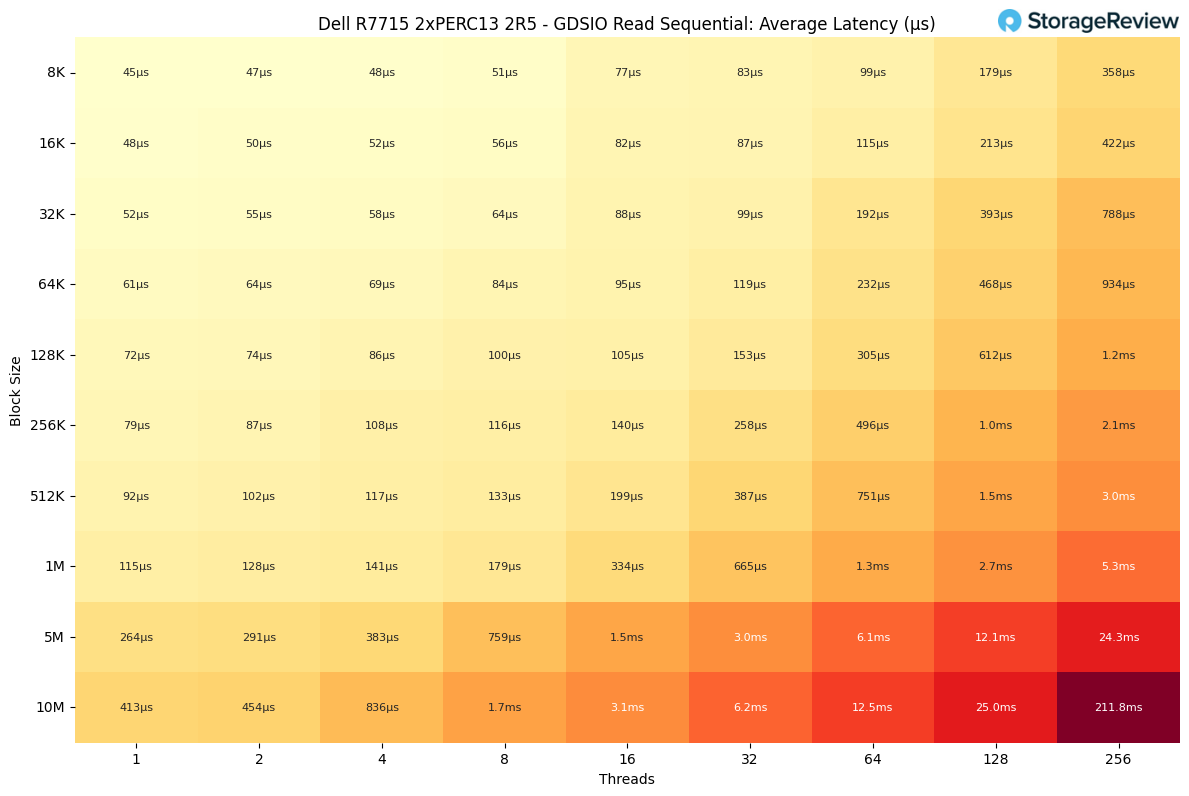
Latenza sequenziale di lettura GDSIO
Con l'aumento della velocità di lettura sequenziale, la latenza è rimasta gestibile anche con blocchi di dimensioni inferiori e un numero inferiore di thread. Ad esempio, la latenza è rimasta al di sotto di 100 µs fino a blocchi da 64K e 16 thread, dimostrando una gestione efficiente delle letture in tale intervallo. Con l'aumento delle dimensioni dei blocchi e del numero di thread, in particolare a 5M e 10M con 64 o più thread, la latenza è aumentata rapidamente, raggiungendo un picco di 211.8 ms con blocchi di dimensioni pari a 10M e 256 thread. Questo evidenzia come i colli di bottiglia del controller o delle code emergano in presenza di carichi di lavoro estremi, nonostante la velocità di lettura rimanga elevata.
Il miglior equilibrio tra prestazioni ed efficienza è stato osservato con blocchi da 1M con 8-16 thread, dove l'array ha mantenuto una velocità di trasmissione di 87.5-93.7 GiB/s, mantenendo una latenza compresa tra 179 e 334 µs. Questa zona rappresenta il punto ottimale per massimizzare la larghezza di banda mantenendo i ritardi ben al di sotto del millisecondo.
Velocità di scrittura sequenziale GDSIO
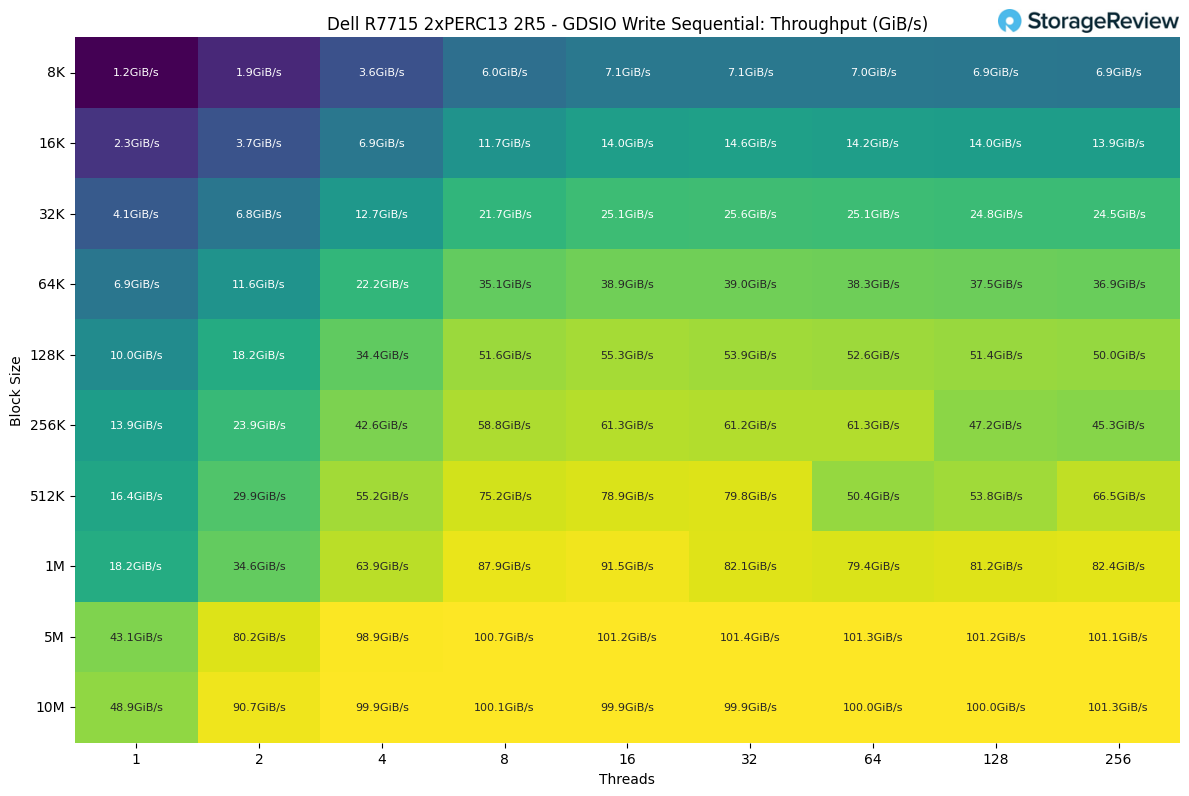
Le prestazioni di scrittura hanno mostrato un forte ridimensionamento iniziale con l'aumento delle dimensioni dei blocchi, con un throughput che è salito da 1.2 GiB/s a 8K e 1 thread a 13.9 GiB/s a 256K. La crescita più sostanziale si è verificata tra le dimensioni dei blocchi da 128K e 1M, dove il throughput ha raggiunto oltre 80 GiB/s con 8-16 thread. Le prestazioni di picco si sono raggiunte con dimensioni dei blocchi da 5M e 10M, mantenendo 100-101 GiB/s da 8 thread in poi.
Le prestazioni si sono stabilizzate tra 8 e 64 thread per questi blocchi più grandi, indicando che i controller hanno raggiunto la saturazione all'inizio della curva di ridimensionamento. A numeri di thread più elevati, in particolare 128 e 256 thread, la stabilità del throughput è variata, rimanendo stabile per blocchi di grandi dimensioni da 5 M e 10 M a 101 GiB/s, ma in calo per blocchi di dimensioni medie, come 256 K, passando da 61.2 GiB/s a 32 thread a 45.3 GiB/s a 256 thread.
Differenziale di throughput sequenziale di scrittura GDSIO
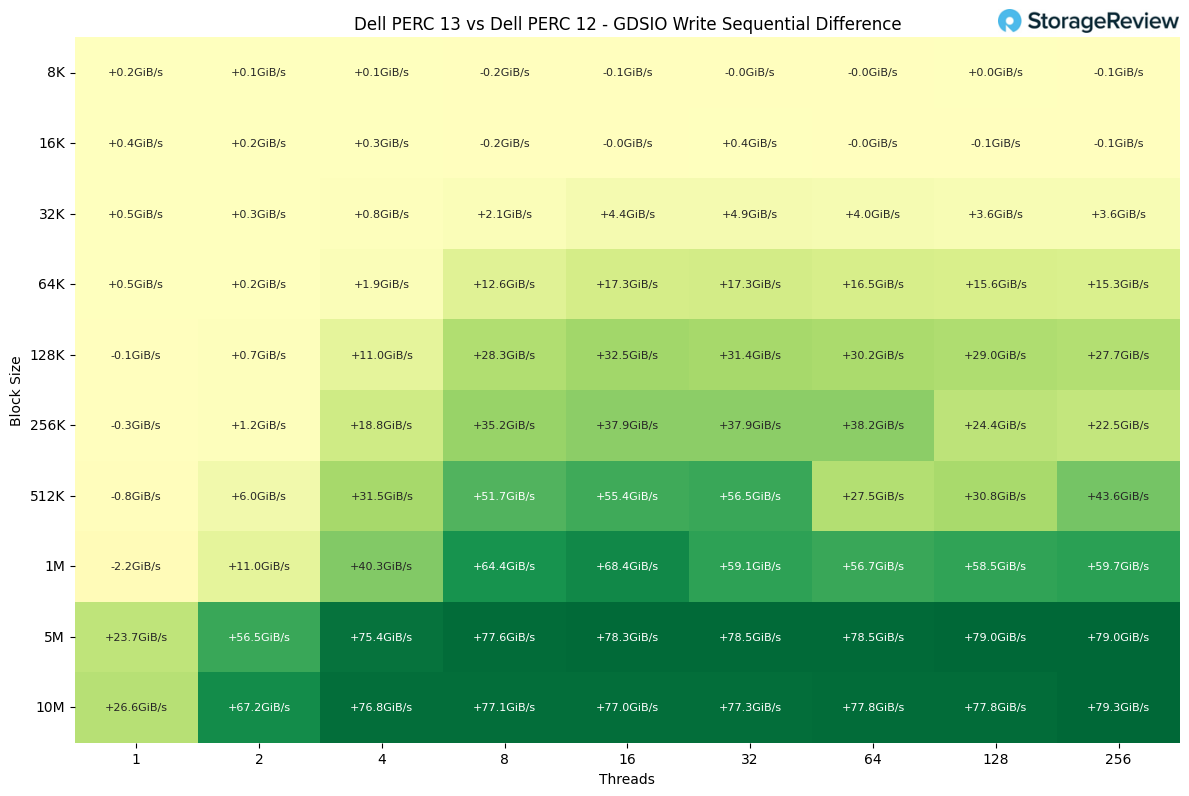
Nei test di scrittura sequenziale, il PERC13 (H975i) ha ottenuto miglioramenti sostanziali rispetto al PERC12 (H965i), in particolare con l'aumento delle dimensioni dei blocchi e del numero di thread. A blocchi di piccole dimensioni (8K-32K), i miglioramenti sono stati modesti, generalmente compresi tra 0 e 10%, con occasionali differenze trascurabili dovute al rumore di prova.
A partire da 64K, il vantaggio dell'H975i è diventato più pronunciato. Con blocchi da 64K, i miglioramenti hanno raggiunto il 40-70%, con un aumento della produttività di oltre 12-17 GiB/s rispetto all'H965i. A 128K-256K, l'aumento è stato più significativo, con l'H975i che ha costantemente offerto una produttività superiore del 50-70% con un numero di thread da moderato ad alto.
Il divario prestazionale più significativo si è verificato con blocchi di dimensioni maggiori (da 512K a 10M). A 512K, l'H975i ha ottenuto guadagni da +31 a +56 GiB/s, equivalenti a un miglioramento del 60-80% rispetto all'H965i. A blocchi di dimensioni pari a 1M, il vantaggio si è ulteriormente esteso, con incrementi di throughput da +40 a +68 GiB/s, pari a guadagni del 70-90%. Infine, a blocchi di dimensioni pari a 5M e 10M, il PERC 13 ha quasi raddoppiato il throughput rispetto al PERC 12, con delta da +75 a +79 GiB/s, che si sono tradotti in un miglioramento del 100% in alcuni scenari con un elevato numero di thread.
Nel complesso, il controller PERC 13 ha mostrato un netto salto generazionale nelle prestazioni di scrittura sequenziale. Sebbene le differenze siano minime alle dimensioni di blocco più piccole, una volta che i carichi di lavoro superano i 64K, l'H975i offre costantemente un throughput superiore del 50-100%, affermando saldamente la sua superiorità rispetto all'H965i nei carichi di lavoro sequenziali ad alta intensità di scrittura.
Latenza sequenziale di scrittura GDSIO
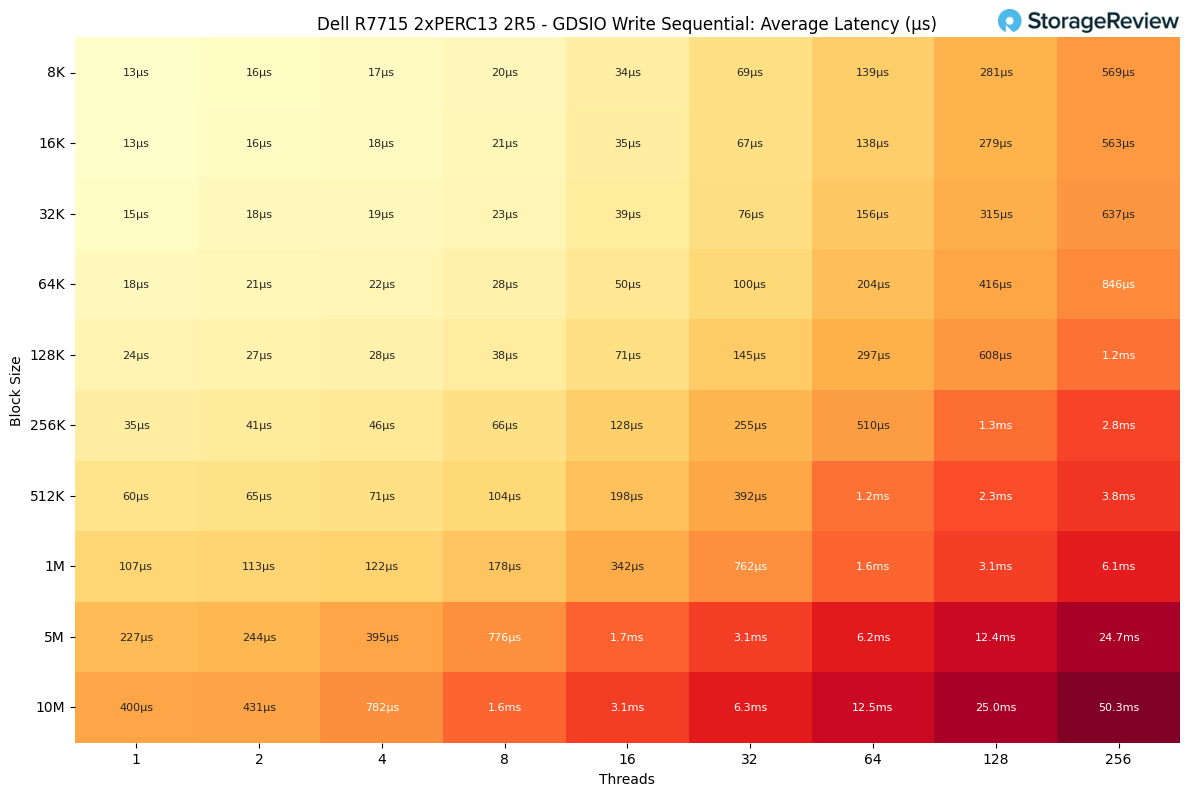
La latenza durante le scritture sequenziali è rimasta sorprendentemente bassa con blocchi di dimensioni inferiori e un numero inferiore di thread, spesso rimanendo sotto i 50 µs su blocchi da 128K con un massimo di 8 thread. Con l'aumentare del numero di thread, la latenza è aumentata in modo più evidente. Ad esempio, la latenza ha raggiunto 392 µs a 512K con 32 thread e ha superato 1 ms con blocchi di dimensioni pari a 1M con 64 thread.
Gli effetti di saturazione sono diventati più evidenti alle dimensioni dei blocchi più grandi e ai livelli di concorrenza più elevati. La latenza è salita a 12.4 ms a 5M con 128 thread e ha raggiunto il picco di 50.3 ms a 10M con 256 thread.
Il punto operativo più efficiente per i carichi di lavoro di scrittura sequenziale si è verificato con blocchi da 1M o 5M con 8-16 thread, dove la produttività ha raggiunto 87.9-101.2 GiB/s mentre la latenza è rimasta compresa tra 178 µs e 1.7 ms, garantendo prestazioni elevate e sostenute senza innescare ritardi eccessivi nella coda di scrittura.
Prestazioni di MLPerf Storage 2.0
Per valutare le prestazioni reali negli ambienti di training dell'intelligenza artificiale, abbiamo utilizzato la suite di test MLPerf Storage 2.0. MLPerf Storage è specificamente progettato per testare i pattern di I/O in carichi di lavoro di deep learning simulati e reali. Fornisce informazioni su come i sistemi di storage gestiscono sfide come il checkpointing e il training dei modelli.
Punto di riferimento del checkpoint
Durante l'addestramento di modelli di machine learning, i checkpoint sono essenziali per salvare periodicamente lo stato del modello. Questo aiuta a prevenire la perdita di progressi dovuta a interruzioni, come guasti hardware, consente l'interruzione anticipata durante l'addestramento e consente ai ricercatori di passare da diversi checkpoint per esperimenti e ablazioni.
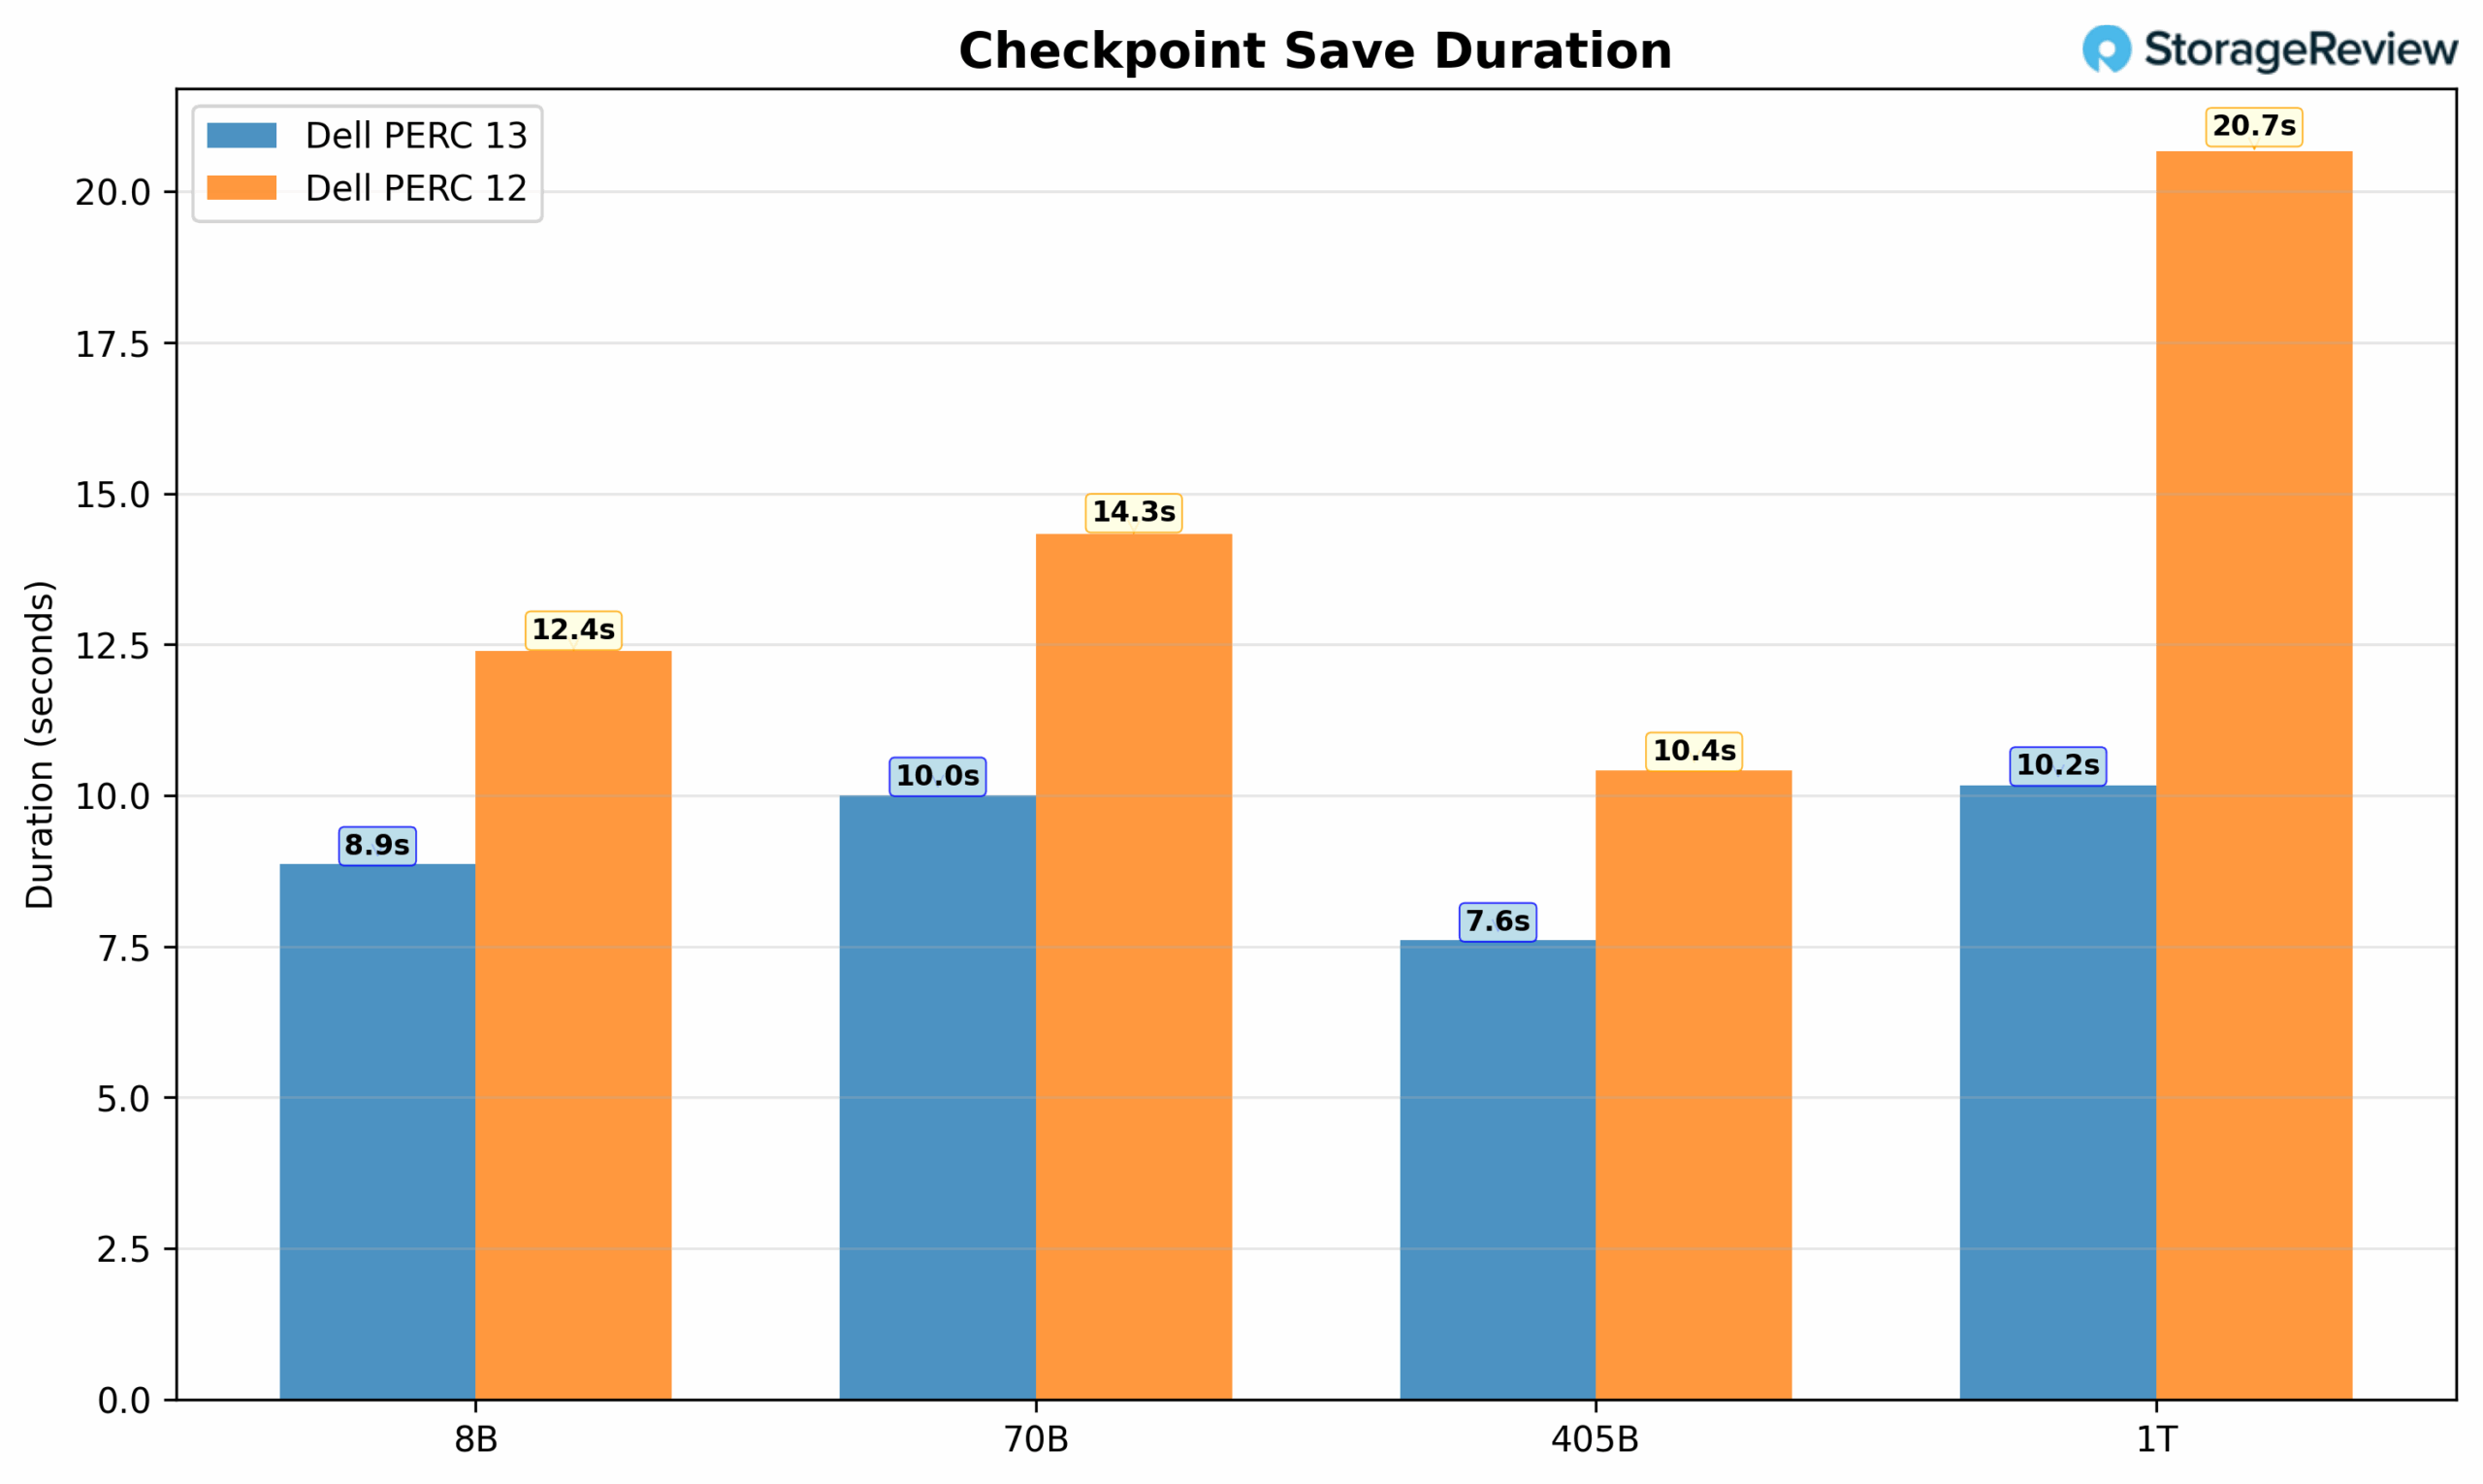
Il confronto della durata del salvataggio al checkpoint ha rivelato che Dell PERC13 ha costantemente superato PERC12 in tutte le configurazioni del modello. PERC 13 ha ottenuto tempi di salvataggio compresi tra 7.61 e 10.17 secondi, mentre PERC12 ha richiesto da 10.41 a 20.67 secondi per le stesse operazioni. Il divario prestazionale è stato più pronunciato con il modello a parametri 1T, dove PERC13 ha completato i salvataggi in poco più di 10 secondi rispetto agli oltre 12 secondi di PERC20. Ciò rappresenta una riduzione di circa il 50% dei tempi di salvataggio per i modelli più grandi.
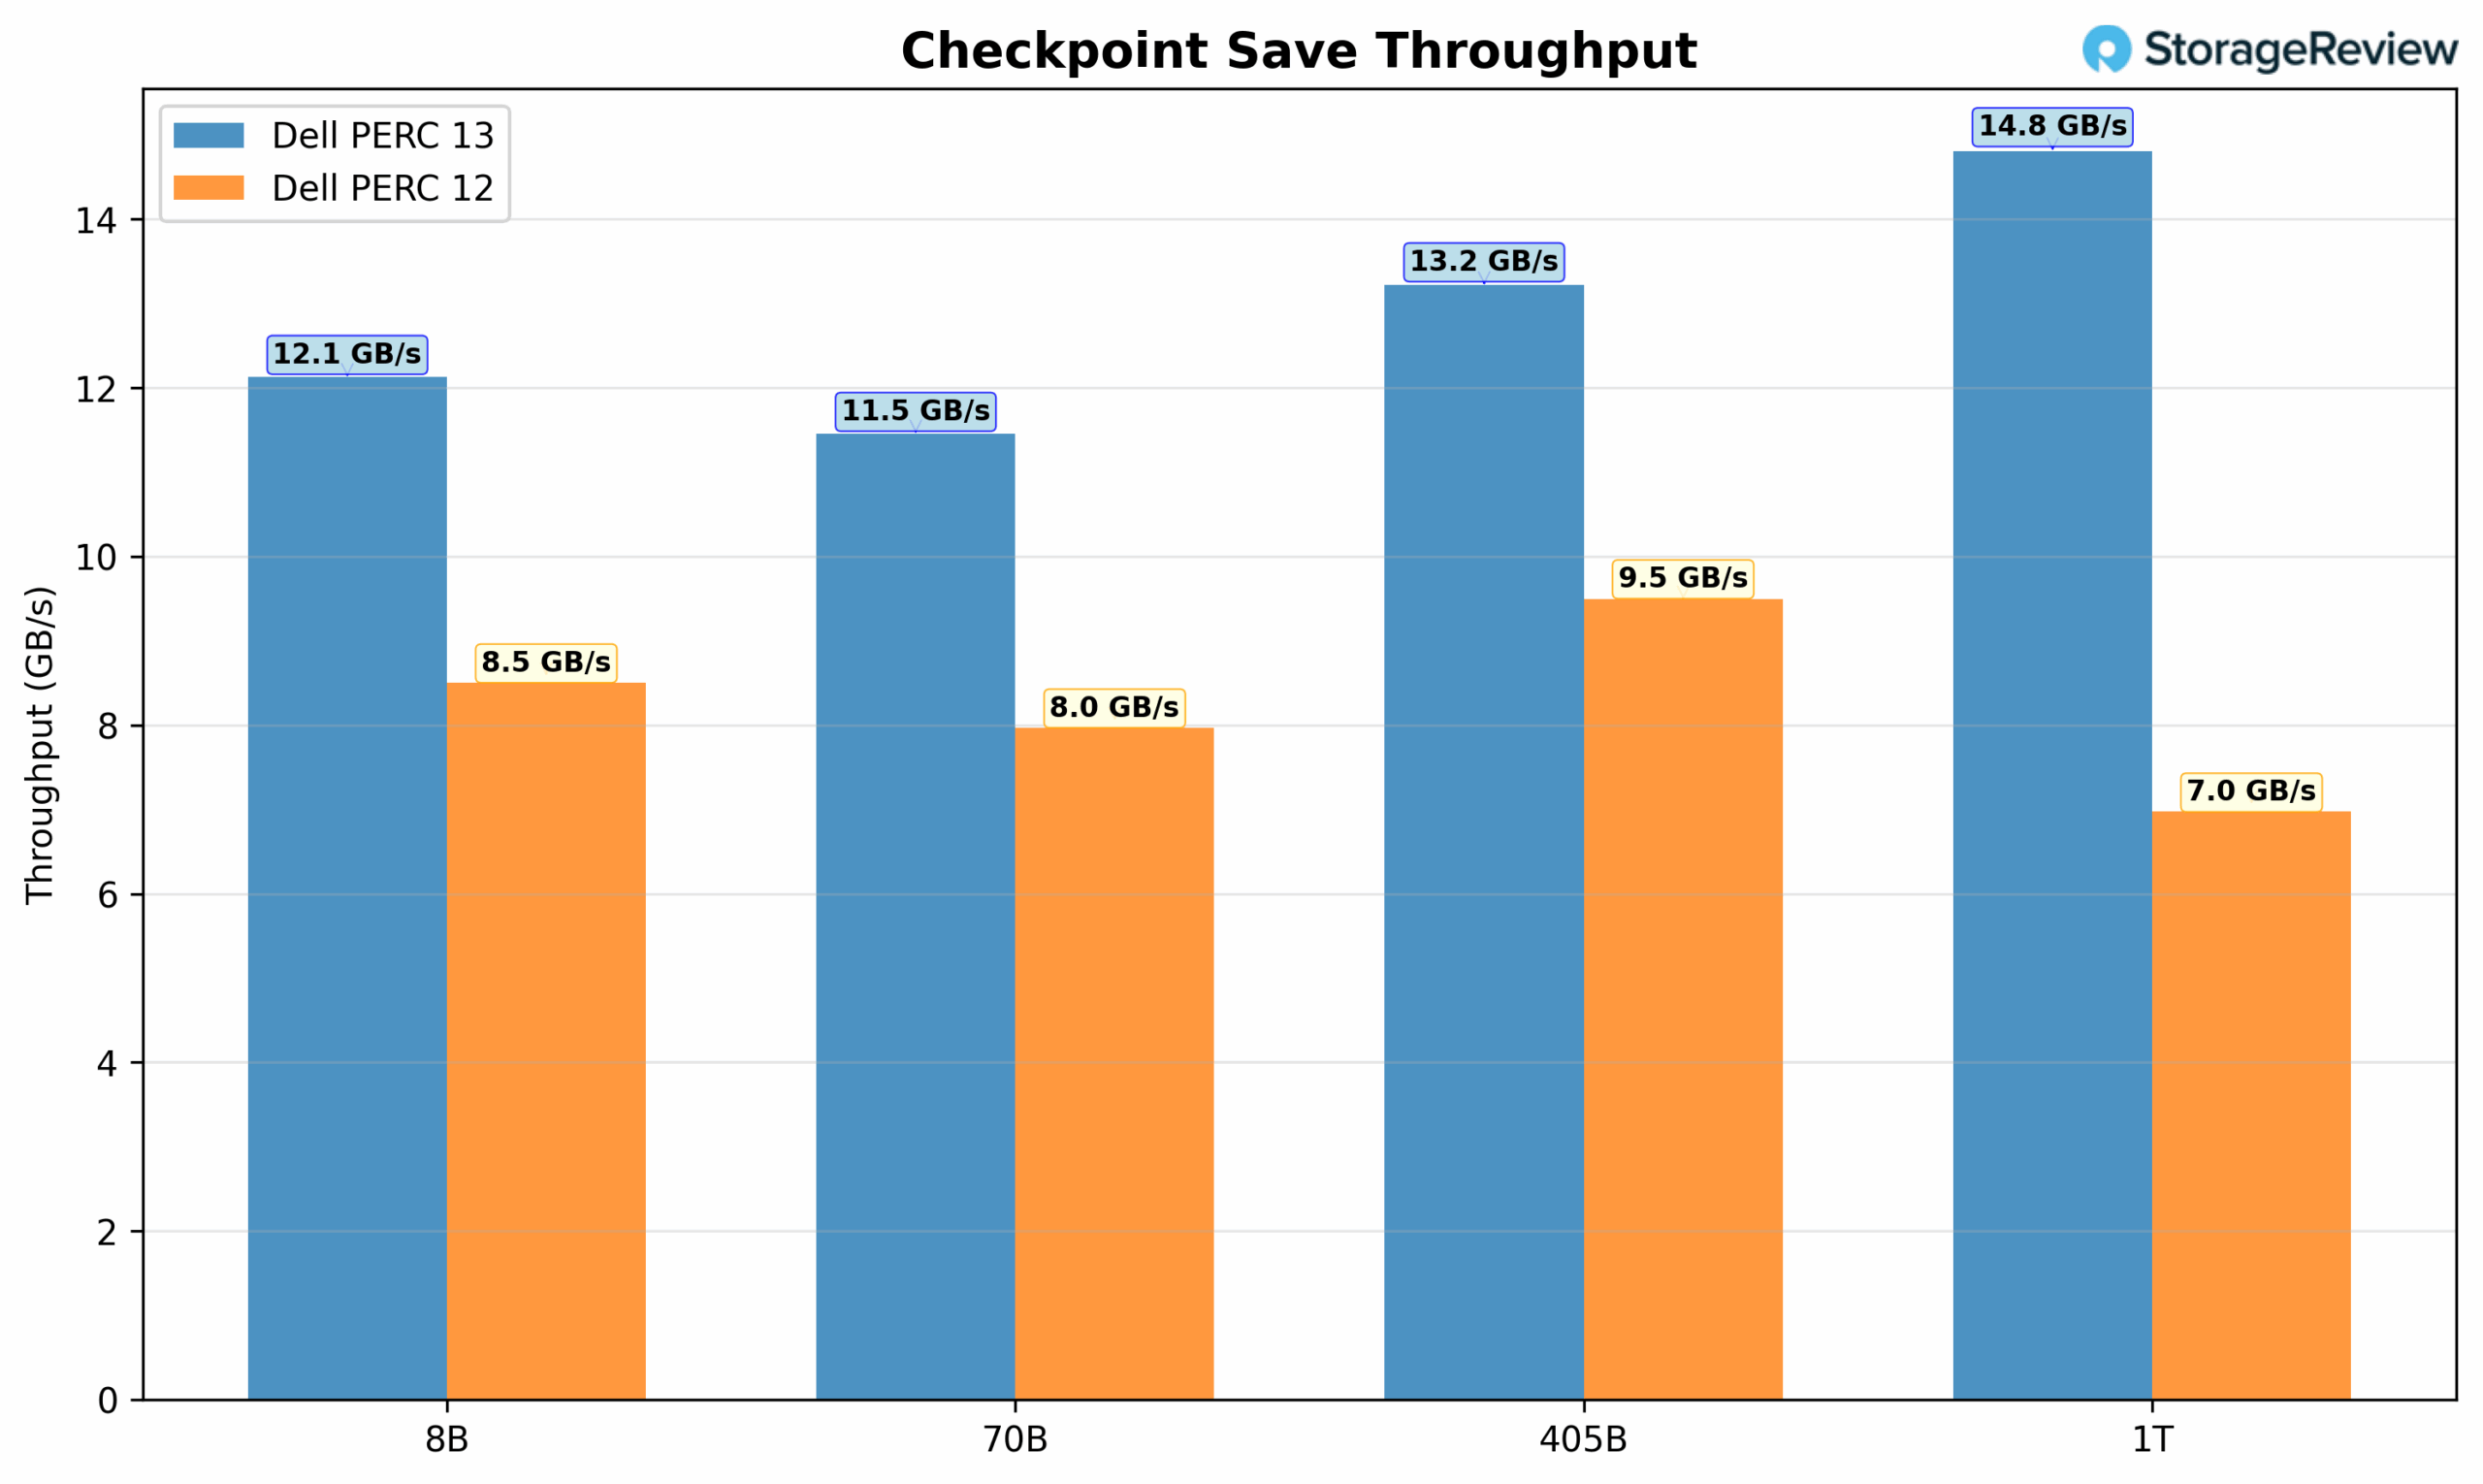
Esaminando i risultati del throughput di Save, i dati evidenziano l'eccellente utilizzo della larghezza di banda di PERC13, che offre costantemente velocità di trasferimento dati più elevate. PERC13 raggiunge un throughput compreso tra 11.46 e 14.81 GB/s, con prestazioni di picco sul modello da 1T. Al contrario, PERC12 raggiunge un massimo di 9.49 GB/s e scende a 6.98 GB/s per la configurazione più grande. Il controller più recente mantiene prestazioni più stabili su diverse dimensioni di modello, suggerendo una migliore ottimizzazione per la gestione di scritture sequenziali di grandi dimensioni tipiche delle operazioni di checkpoint.
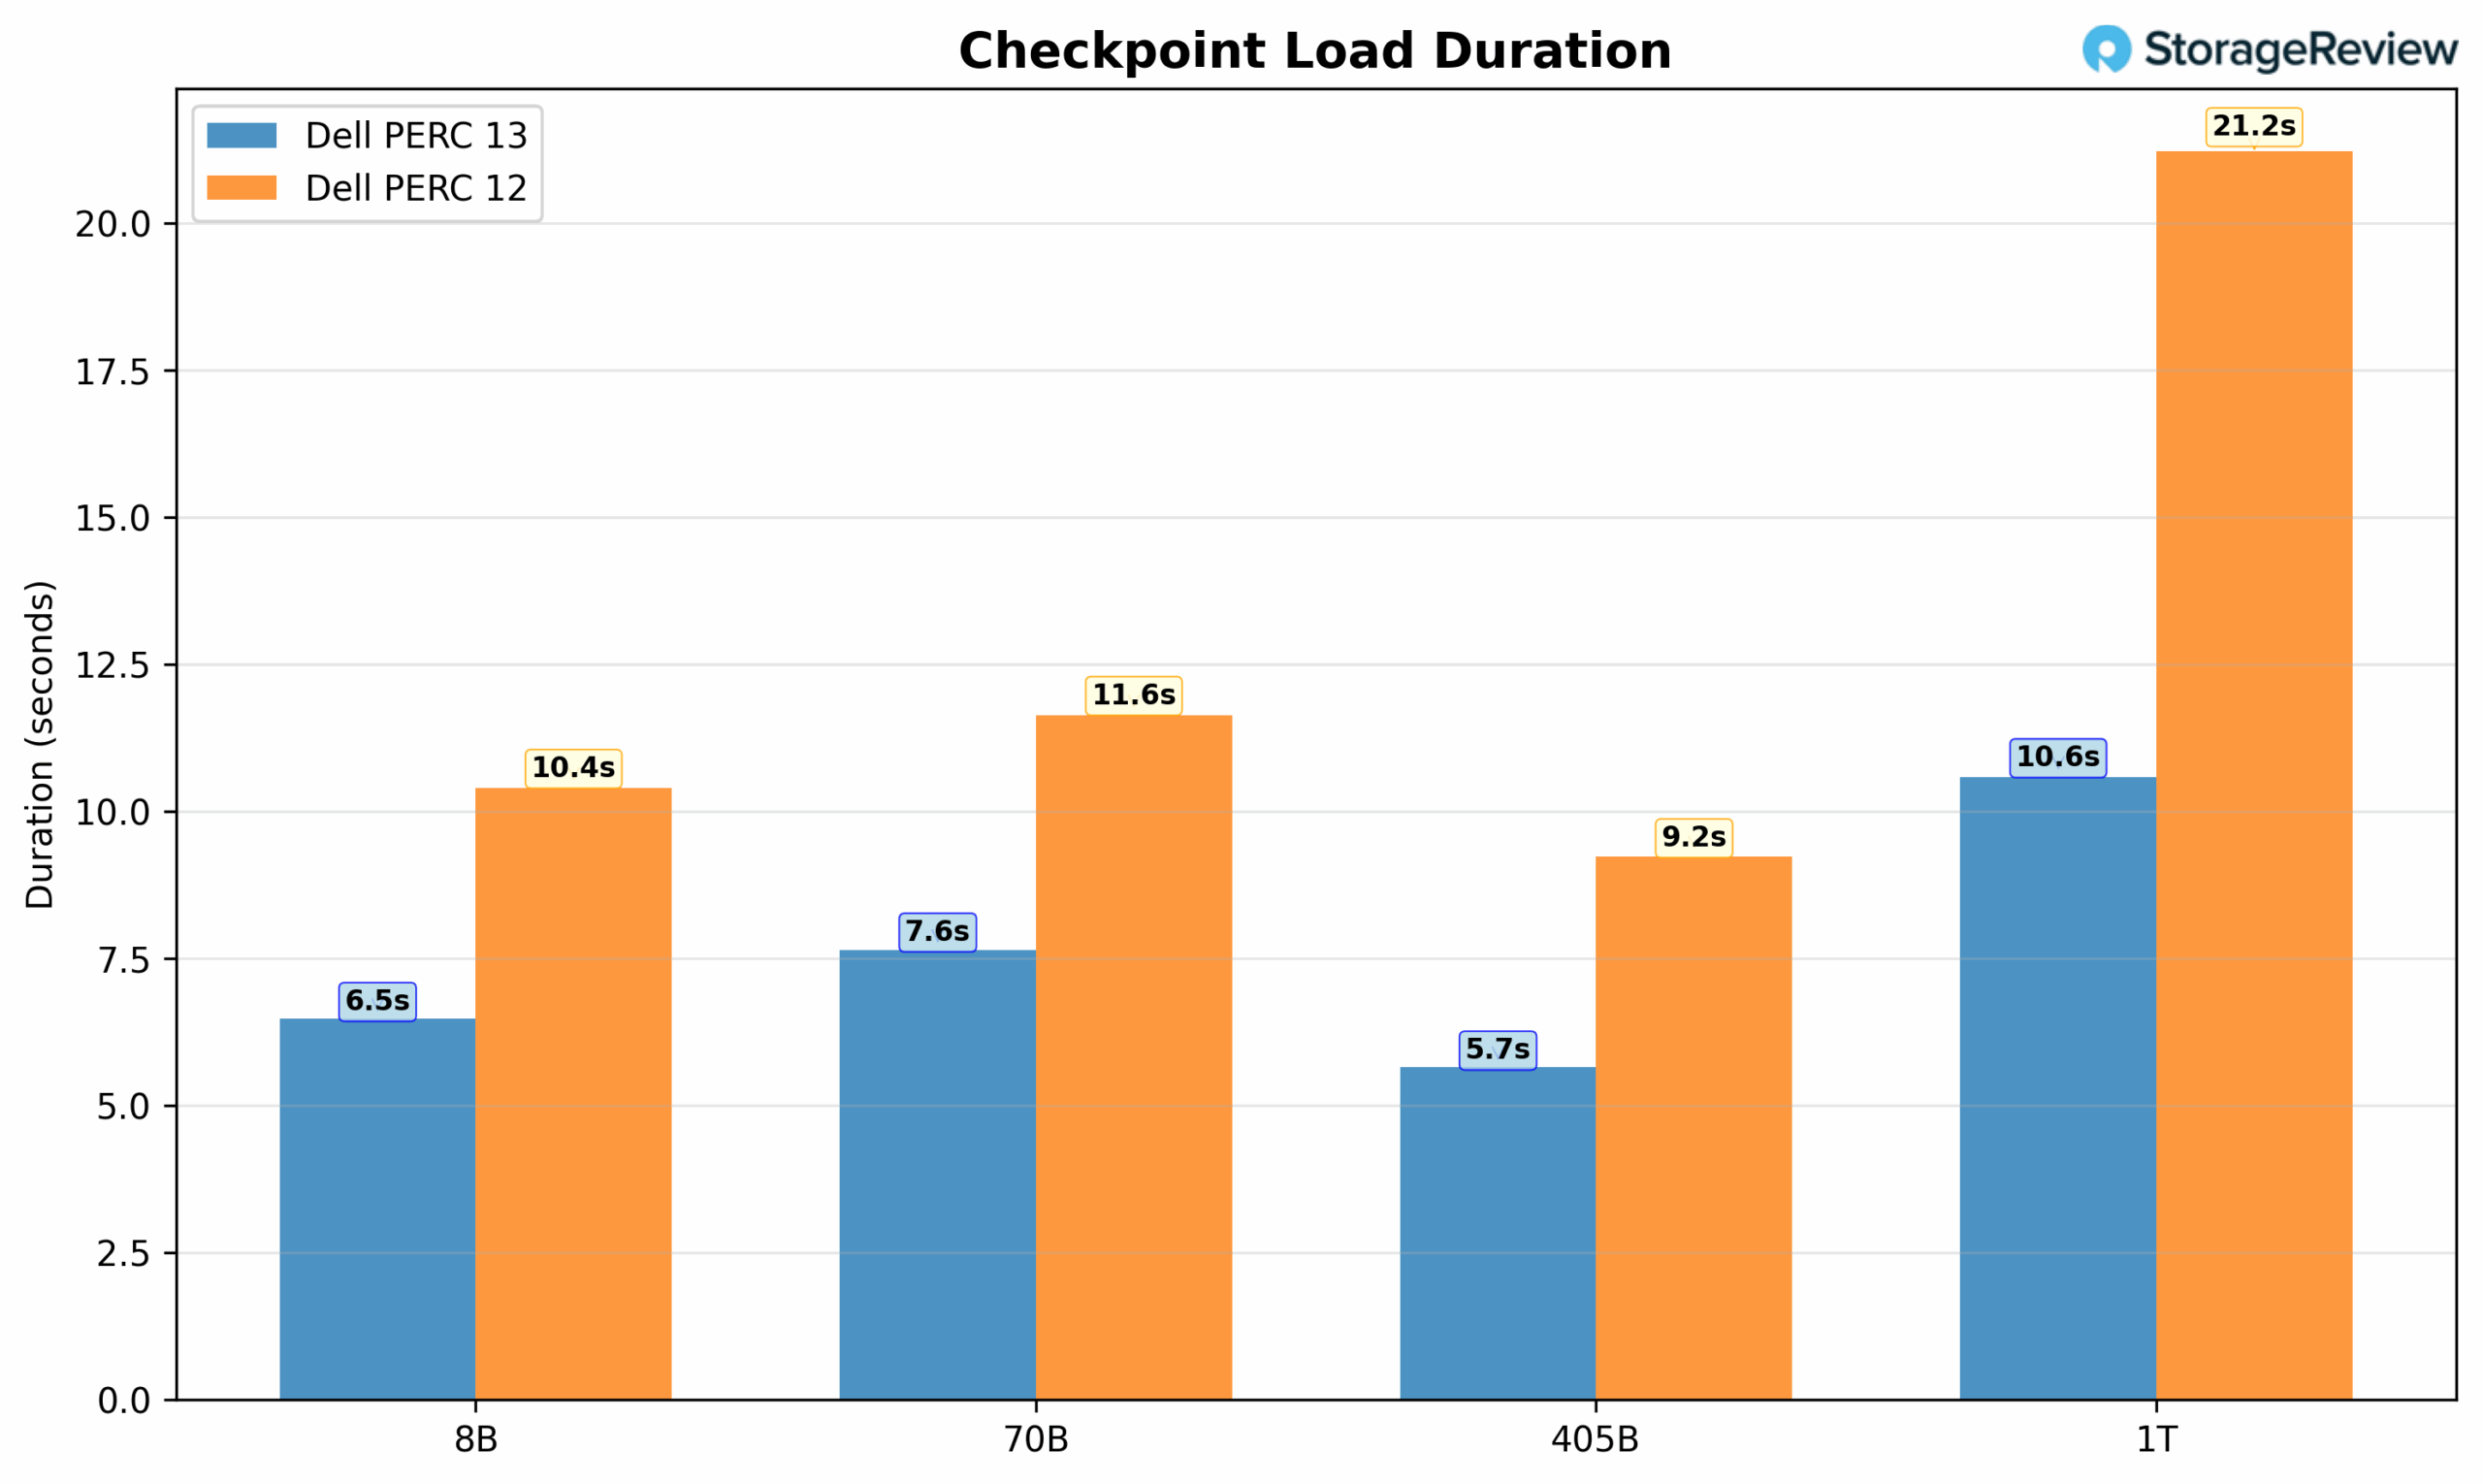
I confronti della durata del carico mostrano vantaggi simili per PERC13, sebbene la differenza di prestazioni vari a seconda delle dimensioni del modello. Per i modelli più piccoli (8B, 70B), PERC 13 ha caricato i checkpoint circa il 35-40% più velocemente di PERC12. Tuttavia, ancora una volta abbiamo riscontrato il miglioramento più significativo con il modello 1T, dove PERC13 ha caricato in 10.58 secondi rispetto ai 12 secondi di PERC21.22 (una riduzione di quasi il 50%). Questo tempo di recupero più rapido è fondamentale per ridurre al minimo i tempi di inattività quando si riprende l'allenamento dai checkpoint dopo un'interruzione.
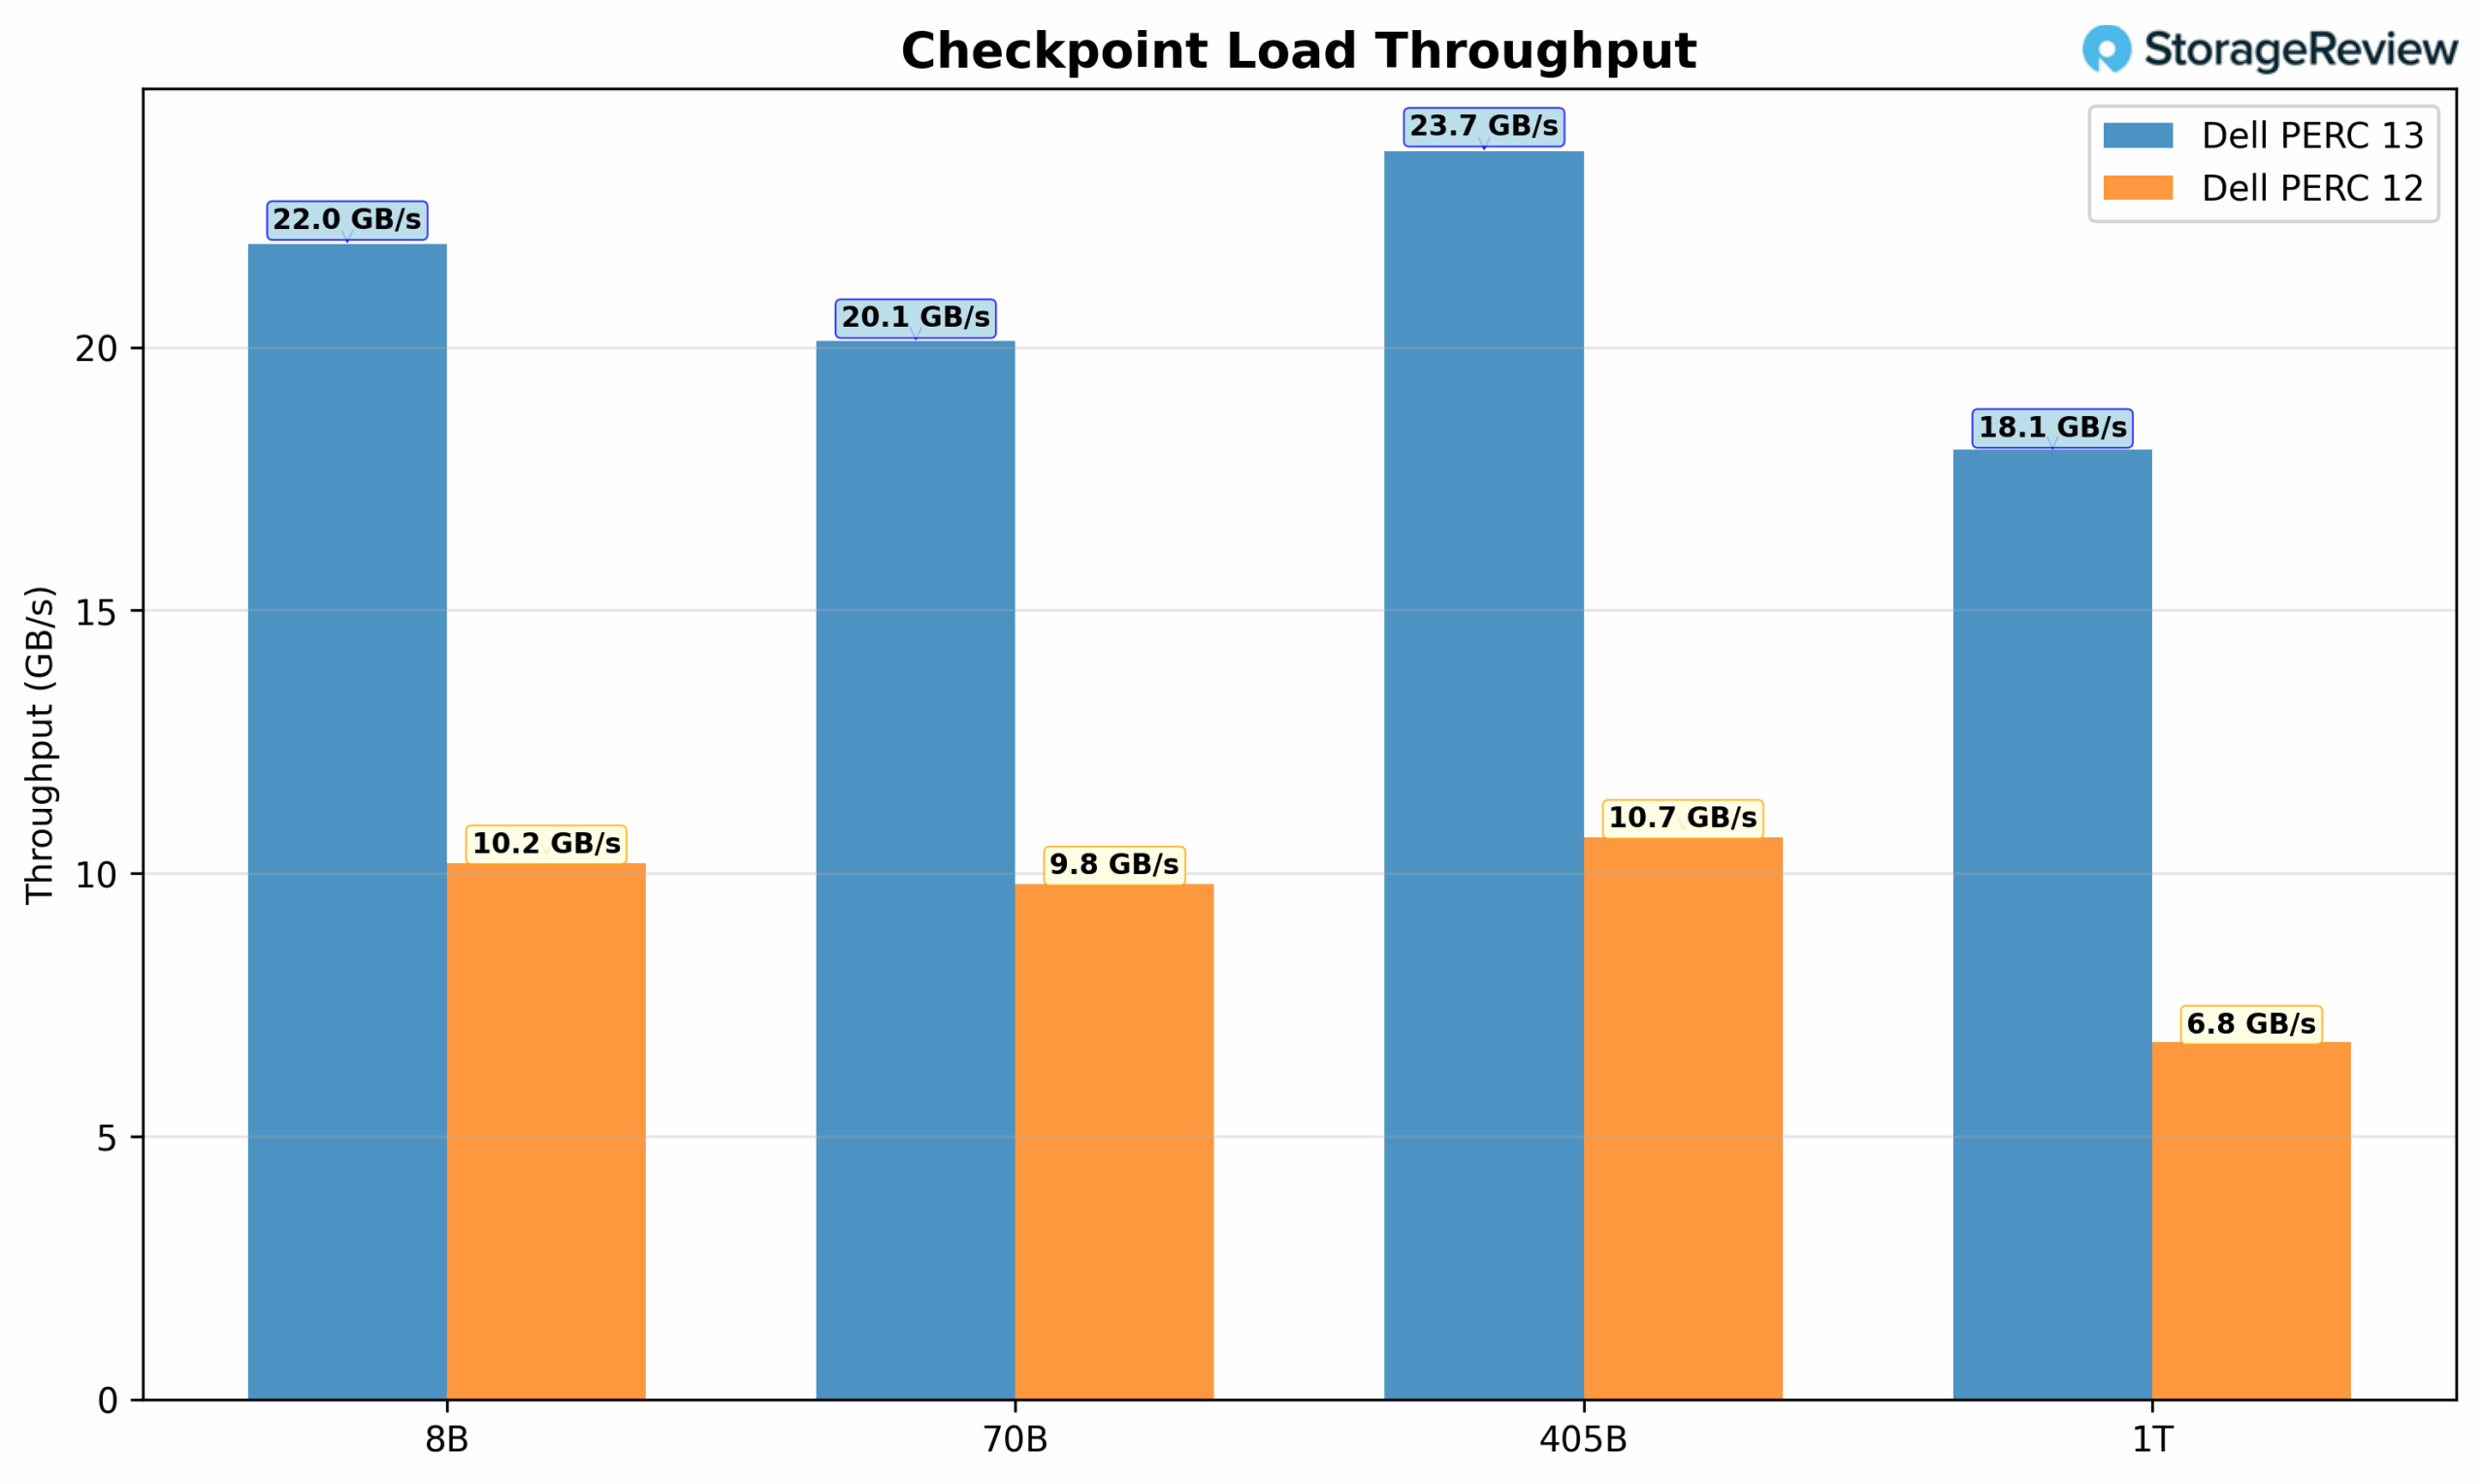
Infine, esaminando le metriche di throughput del carico, PERC13 dimostra un chiaro vantaggio in termini di prestazioni, mantenendo costantemente un throughput superiore a 18 GB/s in tutte le configurazioni e raggiungendo un picco di 23.73 GB/s sul modello 405B. Al contrario, PERC12 ha mostrato prestazioni inferiori, comprese tra 6.8 GB/s e 10.68 GB/s.
FIO Benchmark delle prestazioni
Pur avendo integrato nuove metodologie di test in questa recensione, per evidenziare i miglioramenti abbiamo riproposto alcuni dati del nostro precedente articolo sul controller PERC12 di Dell, mostrando la differenza tra larghezza di banda di picco e velocità di trasmissione di picco.
Dire che PERC13 apporta miglioramenti è riduttivo. Con un singolo volume RAID5 su ciascun controller, abbiamo misurato un aumento dell'88% nella larghezza di banda in lettura, un aumento del 318% nella larghezza di banda in scrittura, un aumento del 31% nelle prestazioni di lettura casuale 4K e un sorprendente aumento del 466% nelle prestazioni di scrittura casuale 4K. Queste non sono le prestazioni di picco assolute del controller PERC 13; velocità più elevate sono possibili con più dischi virtuali. Tuttavia, questo risultato riflette le prestazioni del singolo namespace quando si massimizza la capacità totale.
| Carico di lavoro | Doppio PERC 12 (2 x RAID5) | Doppio PERC 13 (2 x RAID5) | Aumento delle prestazioni |
|---|---|---|---|
| 128K letture sequenziali | 56,107 (MB/s) | 105,227 (MB/s) | 88% |
| 128K scritture sequenziali | 24,351 (MB/s) | 101,723 (MB/s) | 318% |
| Letture casuali da 4 KB | 13,205,656 (IOP) | 17,342,057 (IOP) | 31% |
| Scritture casuali da 4 KB | 1,725,198 (IOP) | 9,758,677 (IOP) | 466% |
Ci siamo concentrati sulle prestazioni dei controller Dell PERC H975i e PERC H965i, sfruttando il RAID 5, che offre un eccellente mix di capacità e protezione della parità. Abbiamo esaminato diverse configurazioni di dischi virtuali (VD) sul Dell PERC H975i: 8 VD in RAID 5 (8R5), 4 VD in RAID 5 (4R5) e 2 VD in RAID 5 (2R5). Abbiamo anche testato due configurazioni sul Dell PERC H965i: 4 VD in RAID 5 (4R5) e 2 VD in RAID 5 (2R5). Le configurazioni sono state scelte in base al numero di SSD che ciascun controller può gestire. Il più recente controller PERC 13 può gestire fino a 16 SSD, che possono essere facilmente suddivisi in un massimo di 4 gruppi RAID 5 da 4 SSD ciascuno. Il vecchio PERC 12 poteva gestire solo 8 SSD, il che lo limitava a testare al massimo 2 gruppi SSD RAID5. Questa configurazione significa che nel caso di un sistema 8R5, abbiamo quattro RAID 4 da 5 unità su ciascun controller RAID PERC.
Ogni configurazione è stata sottoposta a un identico processo di benchmarking, a partire da una fase di precondizionamento consistente in due scritture complete del dispositivo utilizzando carichi di lavoro sequenziali. Dopo aver raggiunto lo stato stazionario, abbiamo misurato le prestazioni attraverso una varietà di modelli di accesso. Prima di ogni nuovo test del carico di lavoro, abbiamo riemesso un ciclo di precondizionamento utilizzando la dimensione di trasferimento corrispondente per garantire la coerenza dei risultati.
Larghezza di banda di scrittura sequenziale 128K
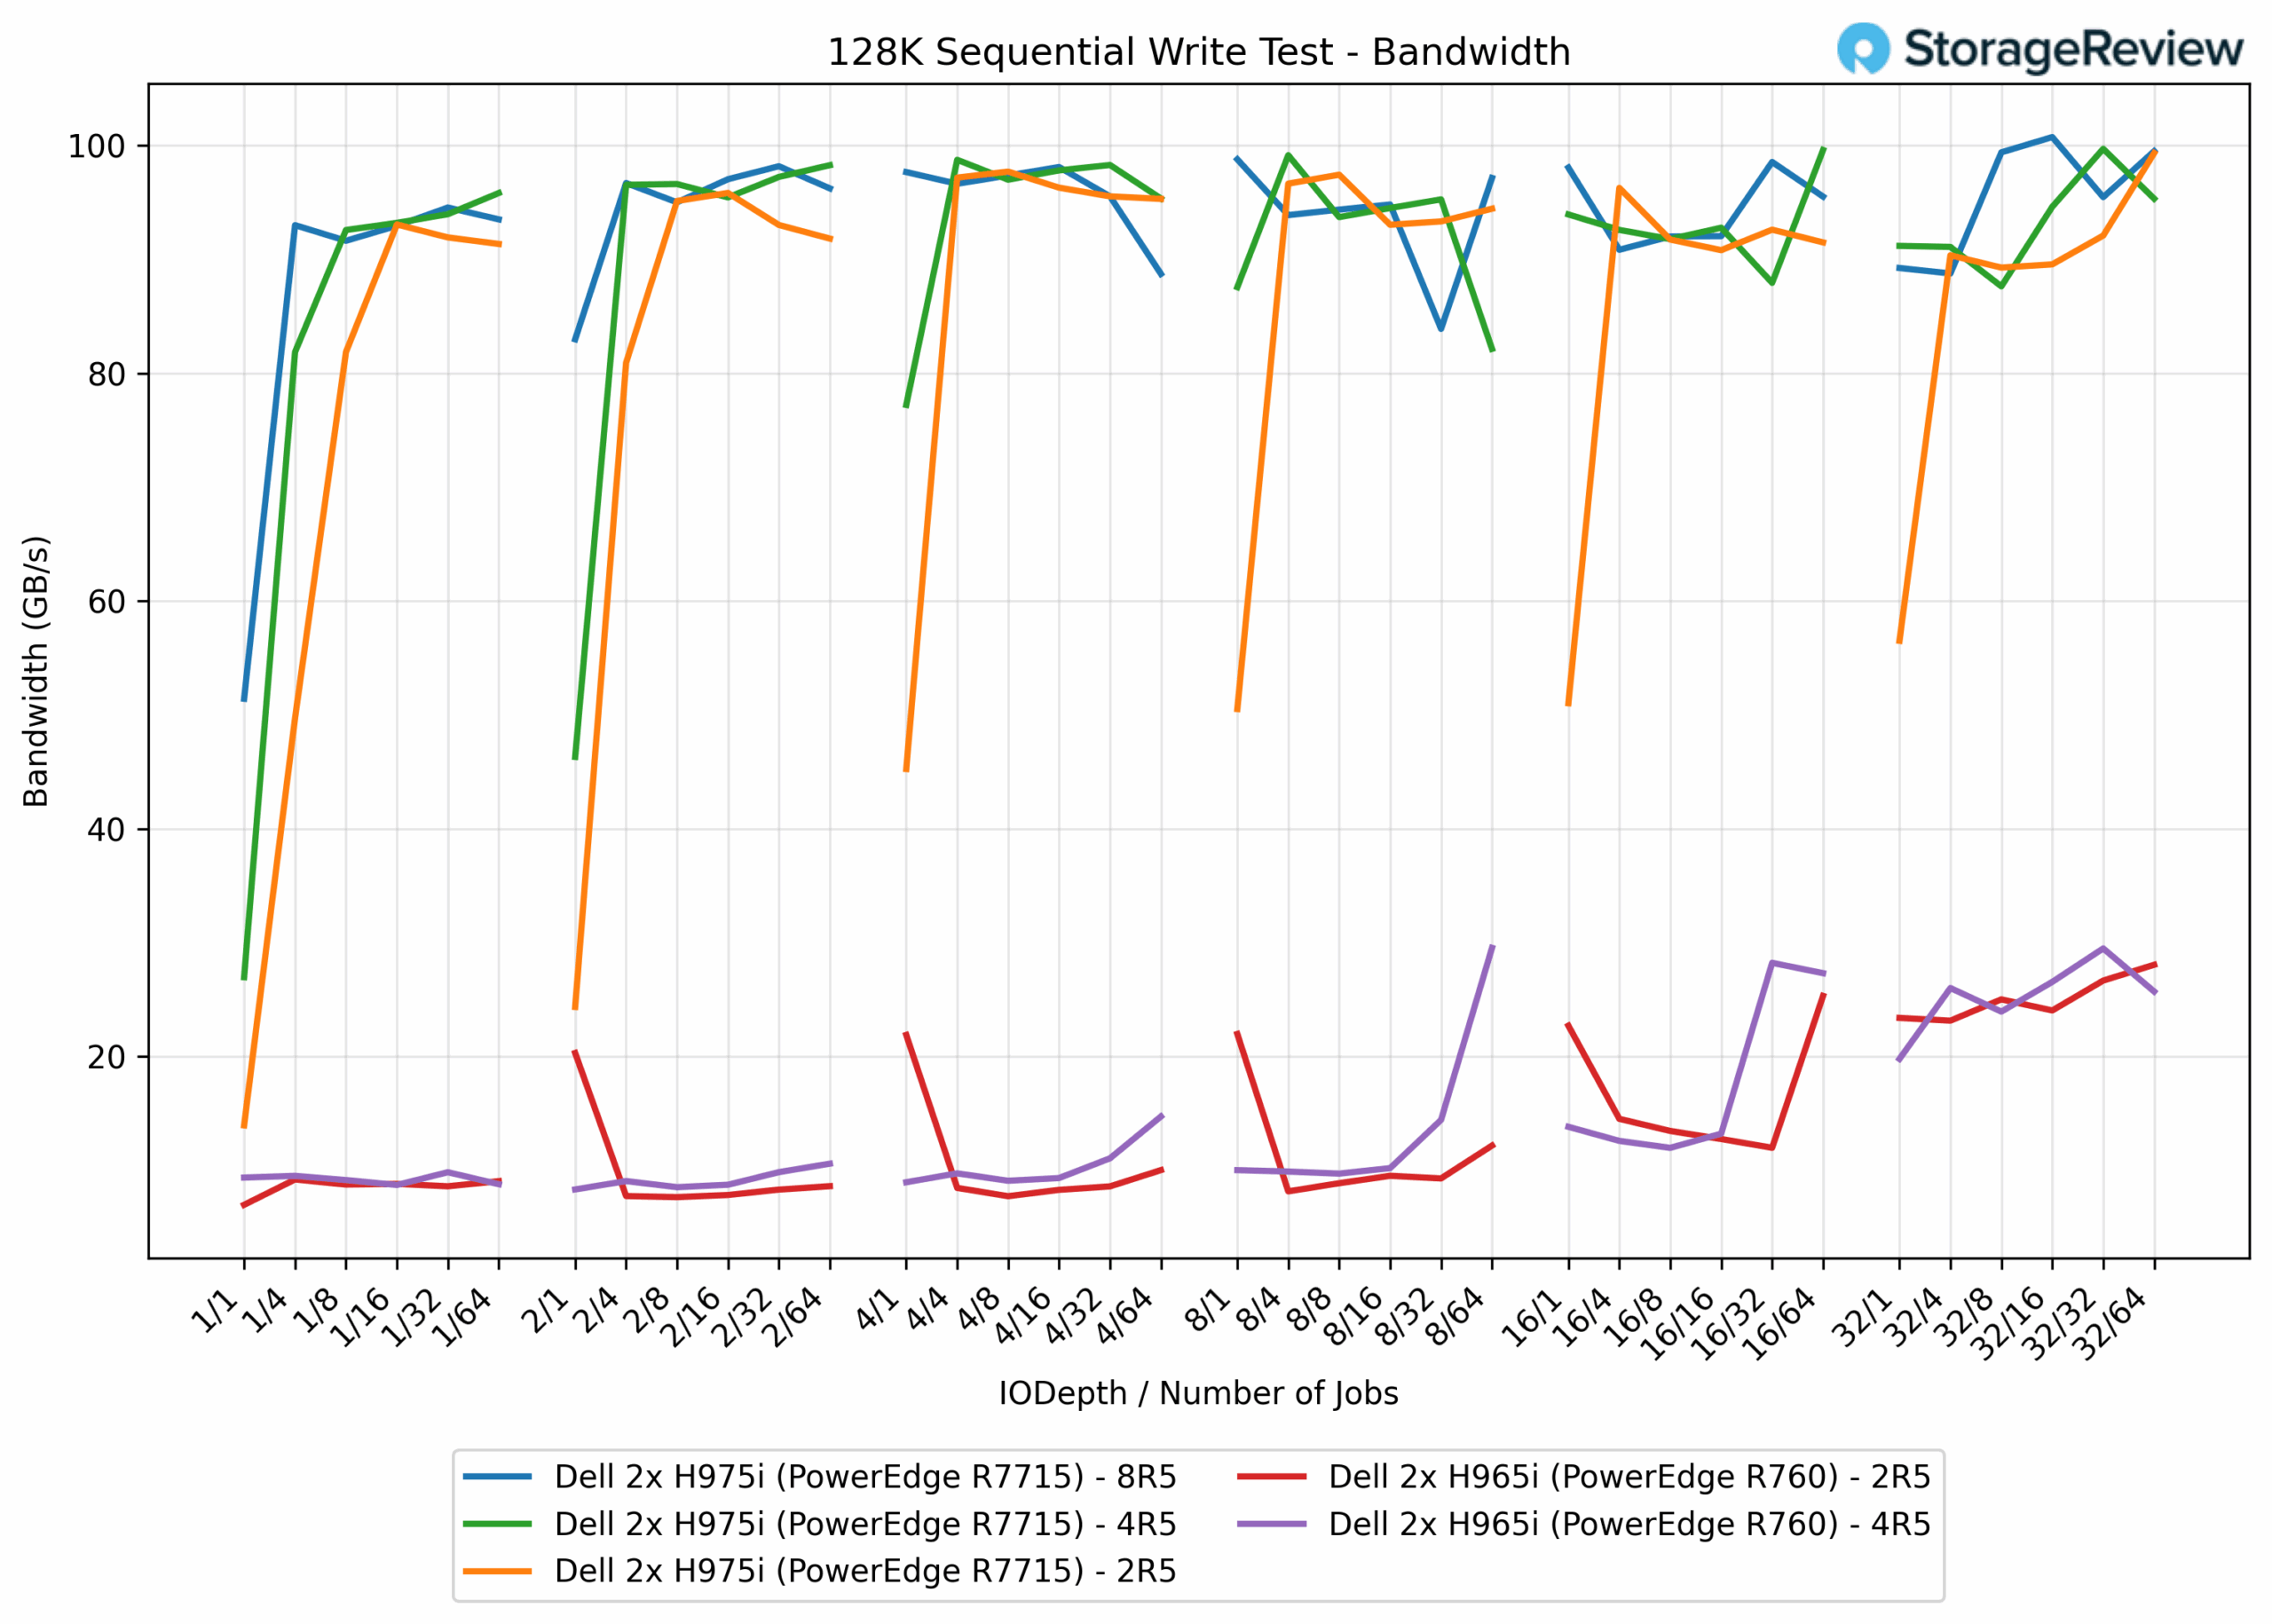
Nei test di scrittura sequenziale a 128K, è emersa una differenza di prestazioni significativa tra le generazioni di controller. Gli array PERC H965i hanno offerto un throughput modesto, con la configurazione 2R5 che ha raggiunto 28.1 GB/s e la configurazione 4R5 che ha raggiunto 29.5 GB/s, mostrando un ridimensionamento minimo dovuto all'aggiunta di dischi RAID. In netto contrasto, il controller PERC H975i ha offerto prestazioni eccezionali in tutte le configurazioni: l'array 2R5 ha raggiunto 99.3 GB/s (253%), la configurazione 4R5 ha raggiunto 99.7 GB/s (238%) e la configurazione 8R5 ha raggiunto un picco di 101.3 GB/s (243% rispetto a H965i 4R5). Nel complesso, l'H975i si è attestato su un clustering ristretto intorno ai 100 GB/s indipendentemente dal numero di dischi, indicando che il limite di larghezza di banda del controller per scritture sequenziali a 128K era stato raggiunto.
Latenza di scrittura sequenziale 128K
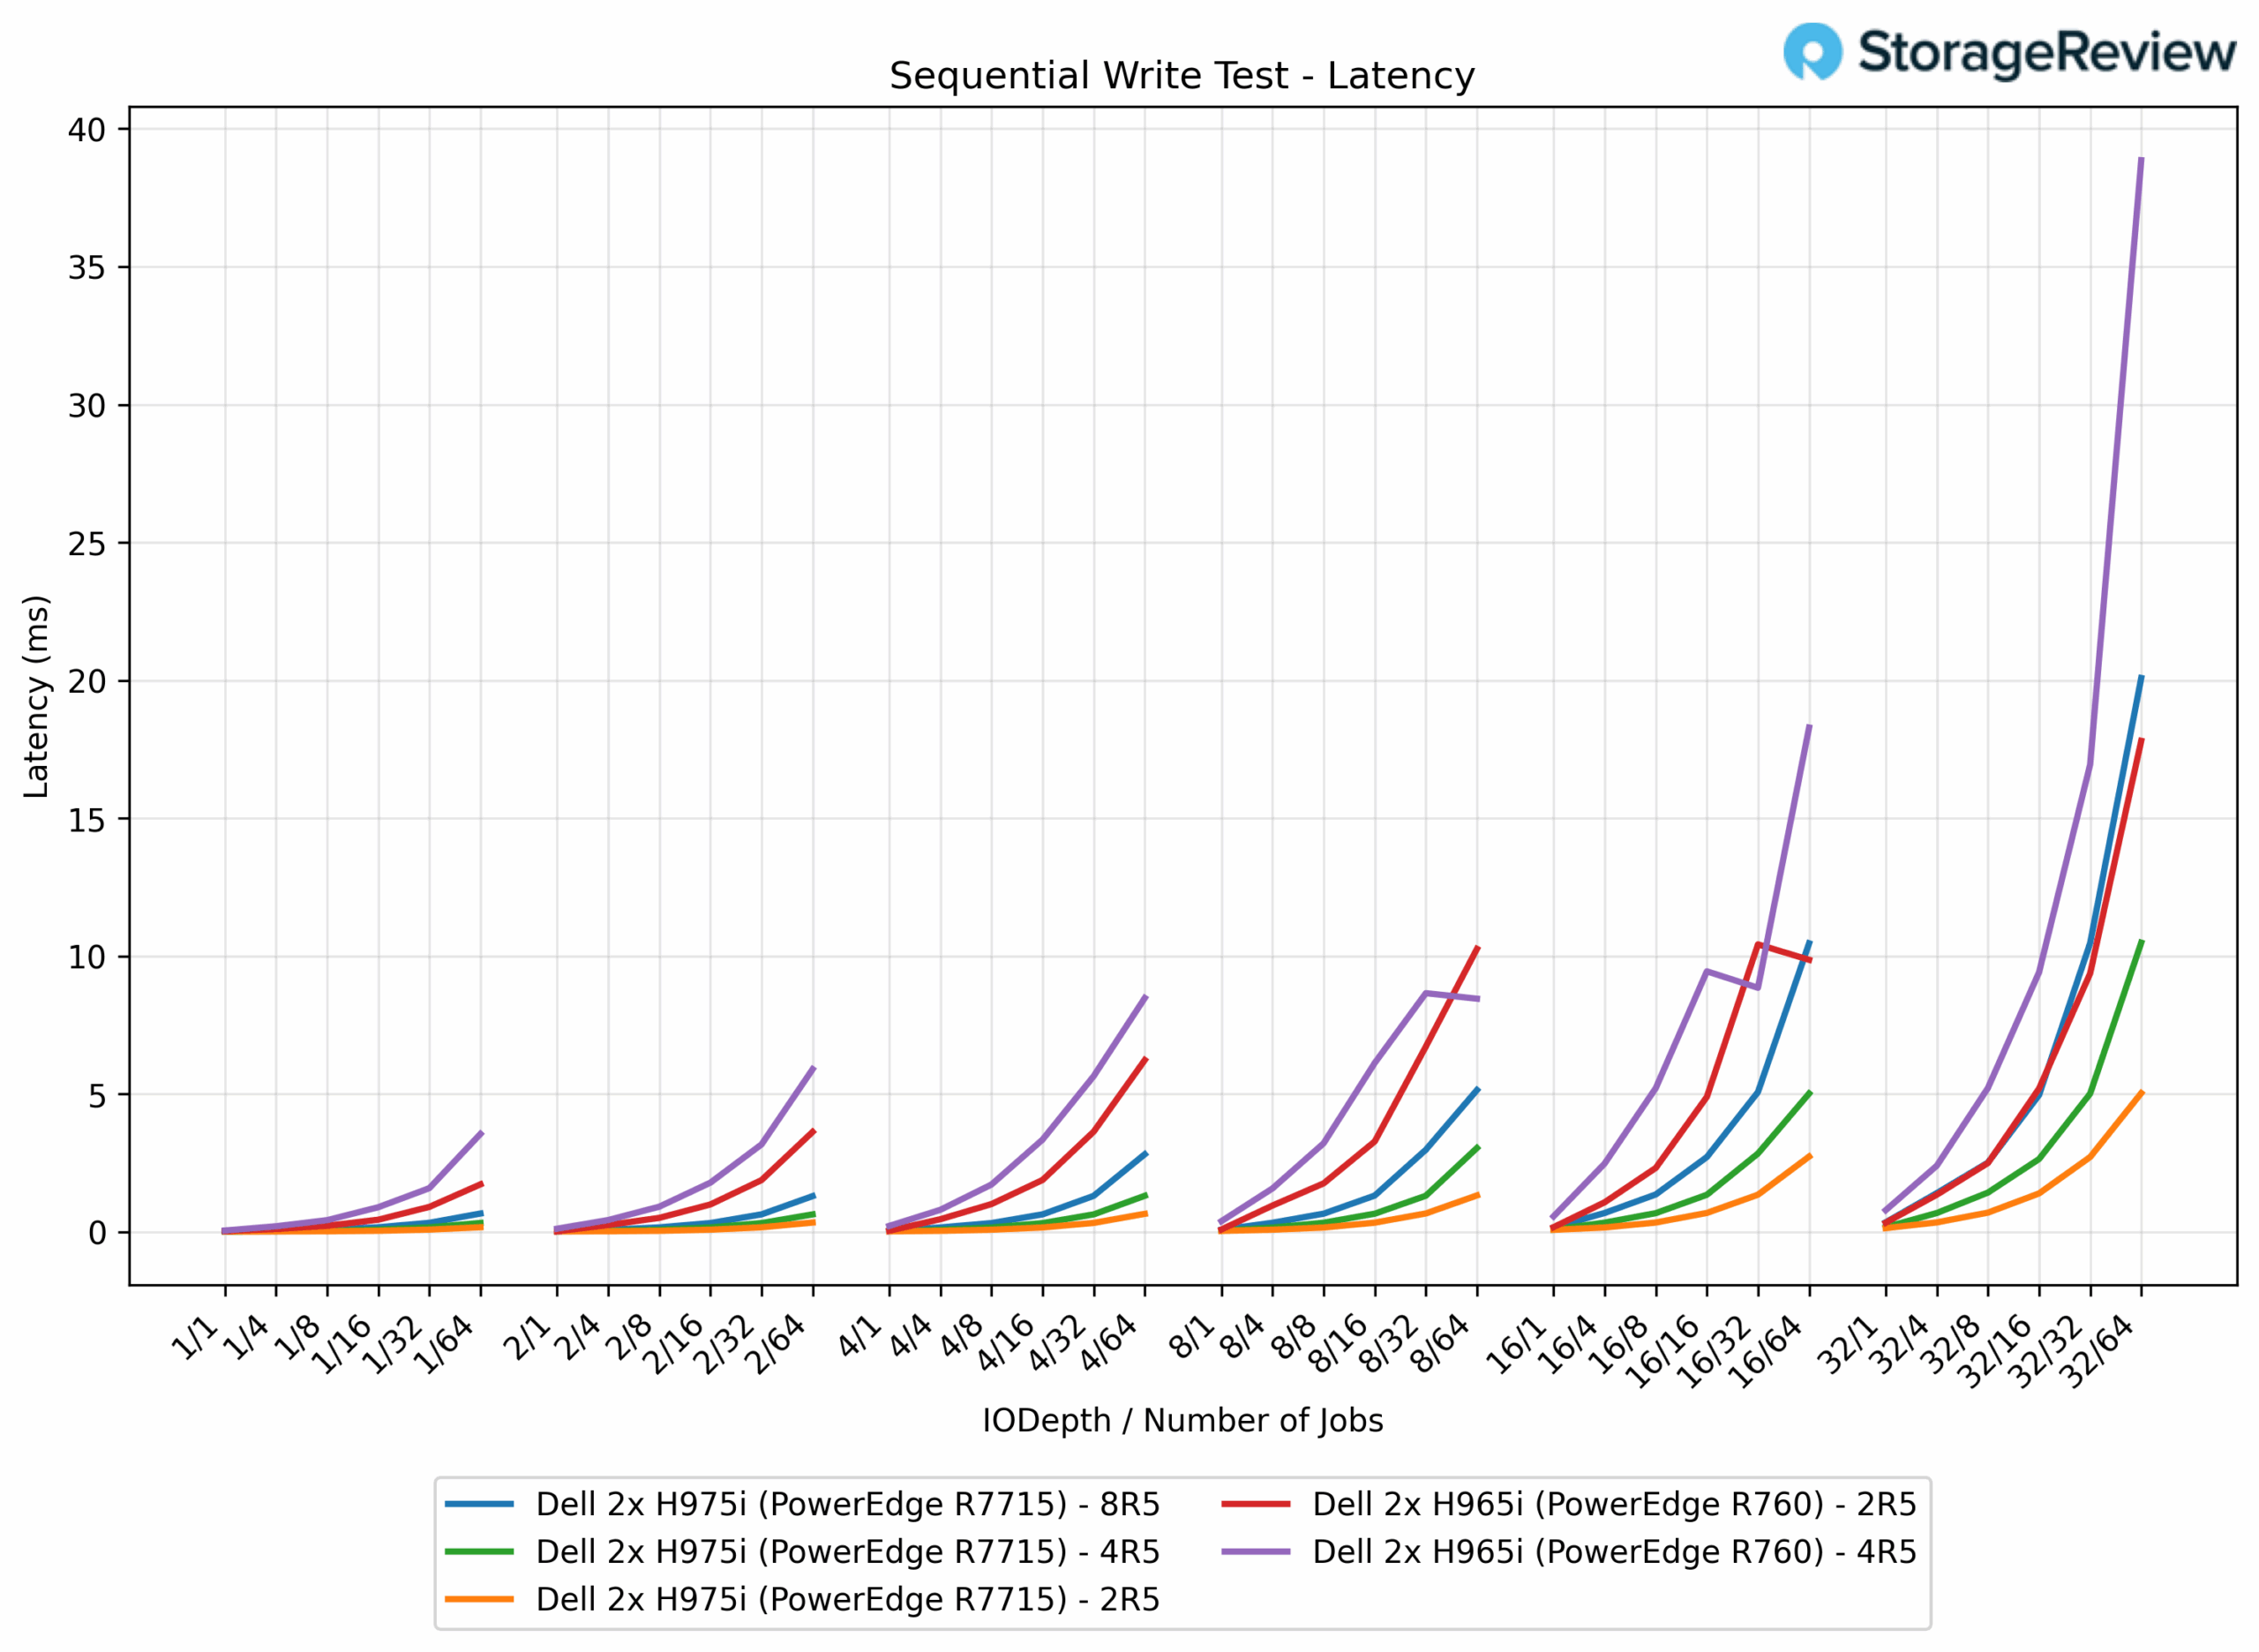
Nei test di latenza in scrittura sequenziale a 128K, è emersa una netta differenza tra le generazioni di controller. Gli array PERC H965i hanno mostrato latenze più elevate, con la configurazione 2R5 che variava da 0.0238 ms a 17.8 ms e la configurazione 4R5 che si estendeva a 38.9 ms, mostrando un beneficio minimo dall'aggiunta di dischi RAID. Al contrario, il controller PERC H975i ha ottenuto latenze notevolmente inferiori in tutte le configurazioni: l'array 2R5 variava da 0.0173 ms a 5.0 ms (latenza di picco inferiore del 72%), la configurazione 4R5 da 0.0179 ms a 10.5 ms (inferiore del 73%) e la configurazione 8R5 da 0.0188 ms a 20.1 ms (inferiore del 48% rispetto a H965i 4R5).
Larghezza di banda di lettura sequenziale 128K
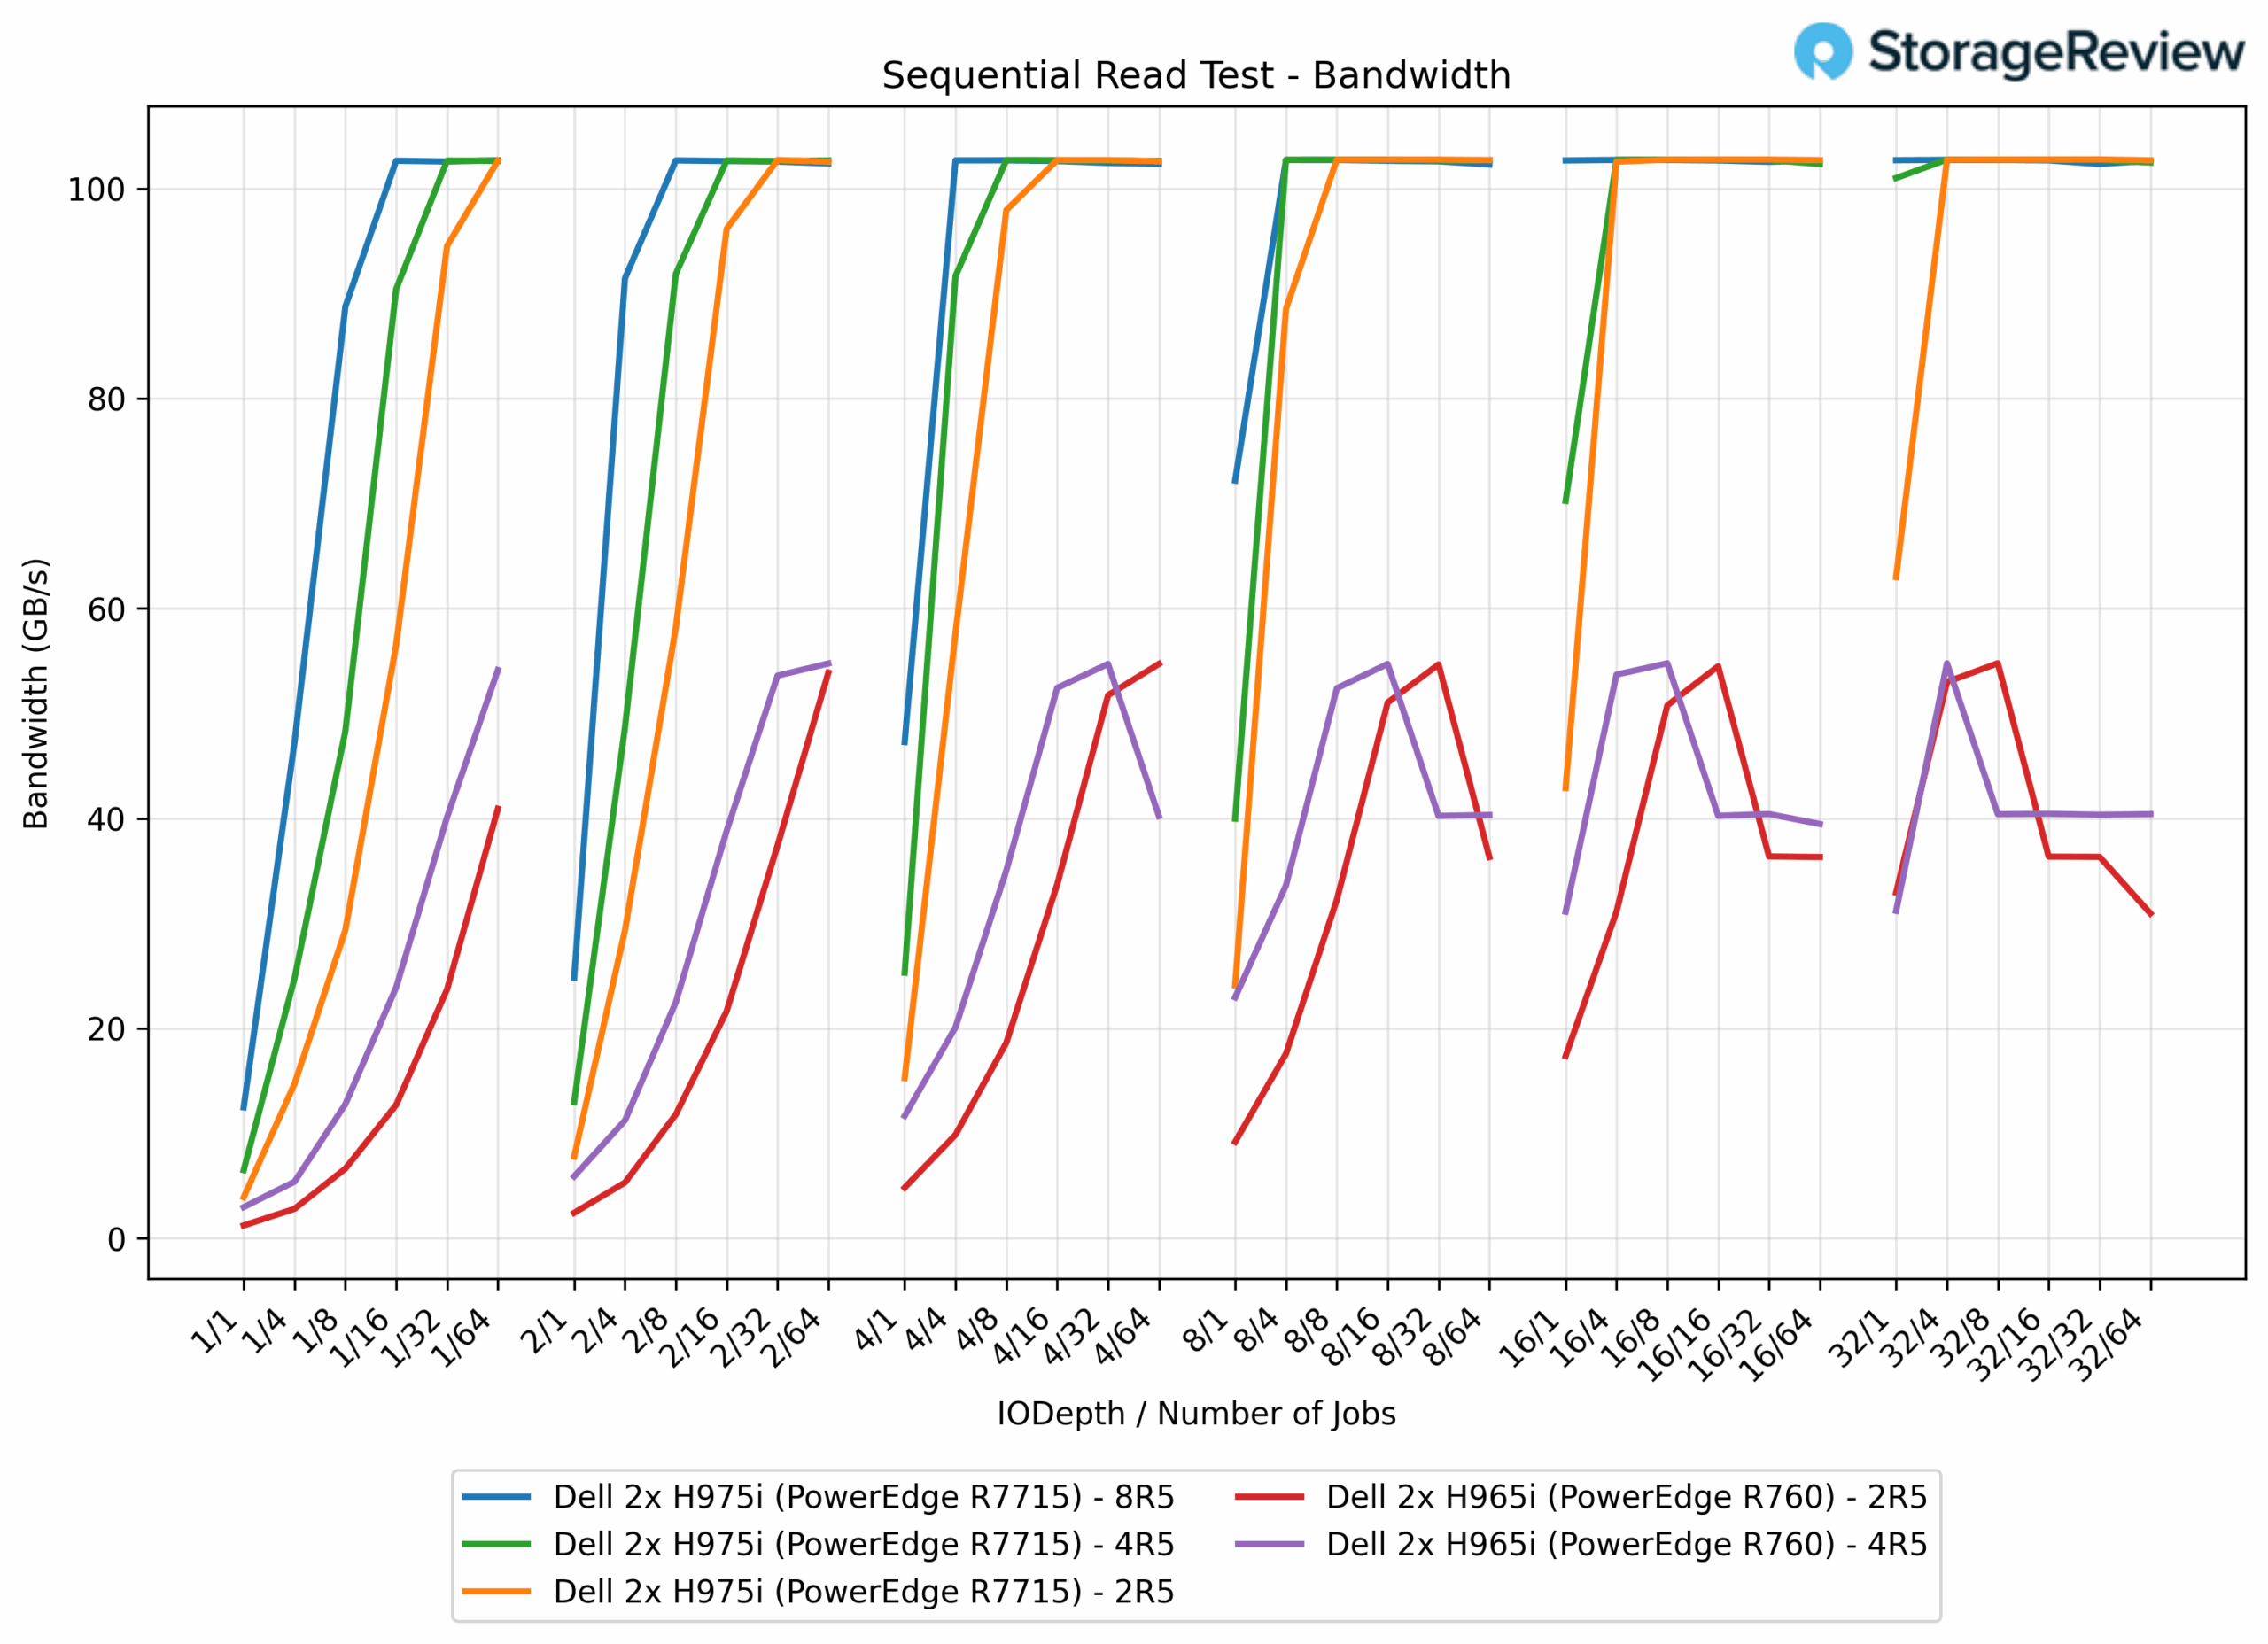
Nei test di lettura sequenziale a 128K sui sistemi Dell, i controller PERC H965i hanno mostrato prestazioni costanti in entrambe le configurazioni. L'array 2R5 ha raggiunto una larghezza di banda massima di 54.8 GB/s, mentre la configurazione 4R5 ha raggiunto anch'essa 54.8 GB/s. Al contrario, i controller PERC H975i hanno dimostrato prestazioni significativamente superiori, con tutte e tre le configurazioni che hanno raggiunto una larghezza di banda di picco compresa tra circa 102.7 e 102.8 GB/s. L'array H975i 2R5 ha raggiunto 102.8 GB/s (miglioramento dell'87%), la configurazione 4R5 ha raggiunto 102.7 GB/s (miglioramento dell'87%) e la configurazione 8R5 ha raggiunto 102.7 GB/s (miglioramento dell'87%). In particolare, mentre i controller H965i non hanno mostrato alcun significativo ridimensionamento delle prestazioni tra le configurazioni 2R5 e 4R5, i controller H975i hanno mantenuto prestazioni elevate e costanti in tutte le configurazioni RAID 5, con il limite di larghezza di banda che sembrava essere raggiunto indipendentemente dal numero di unità nell'array.
Latenza di lettura sequenziale di 128K
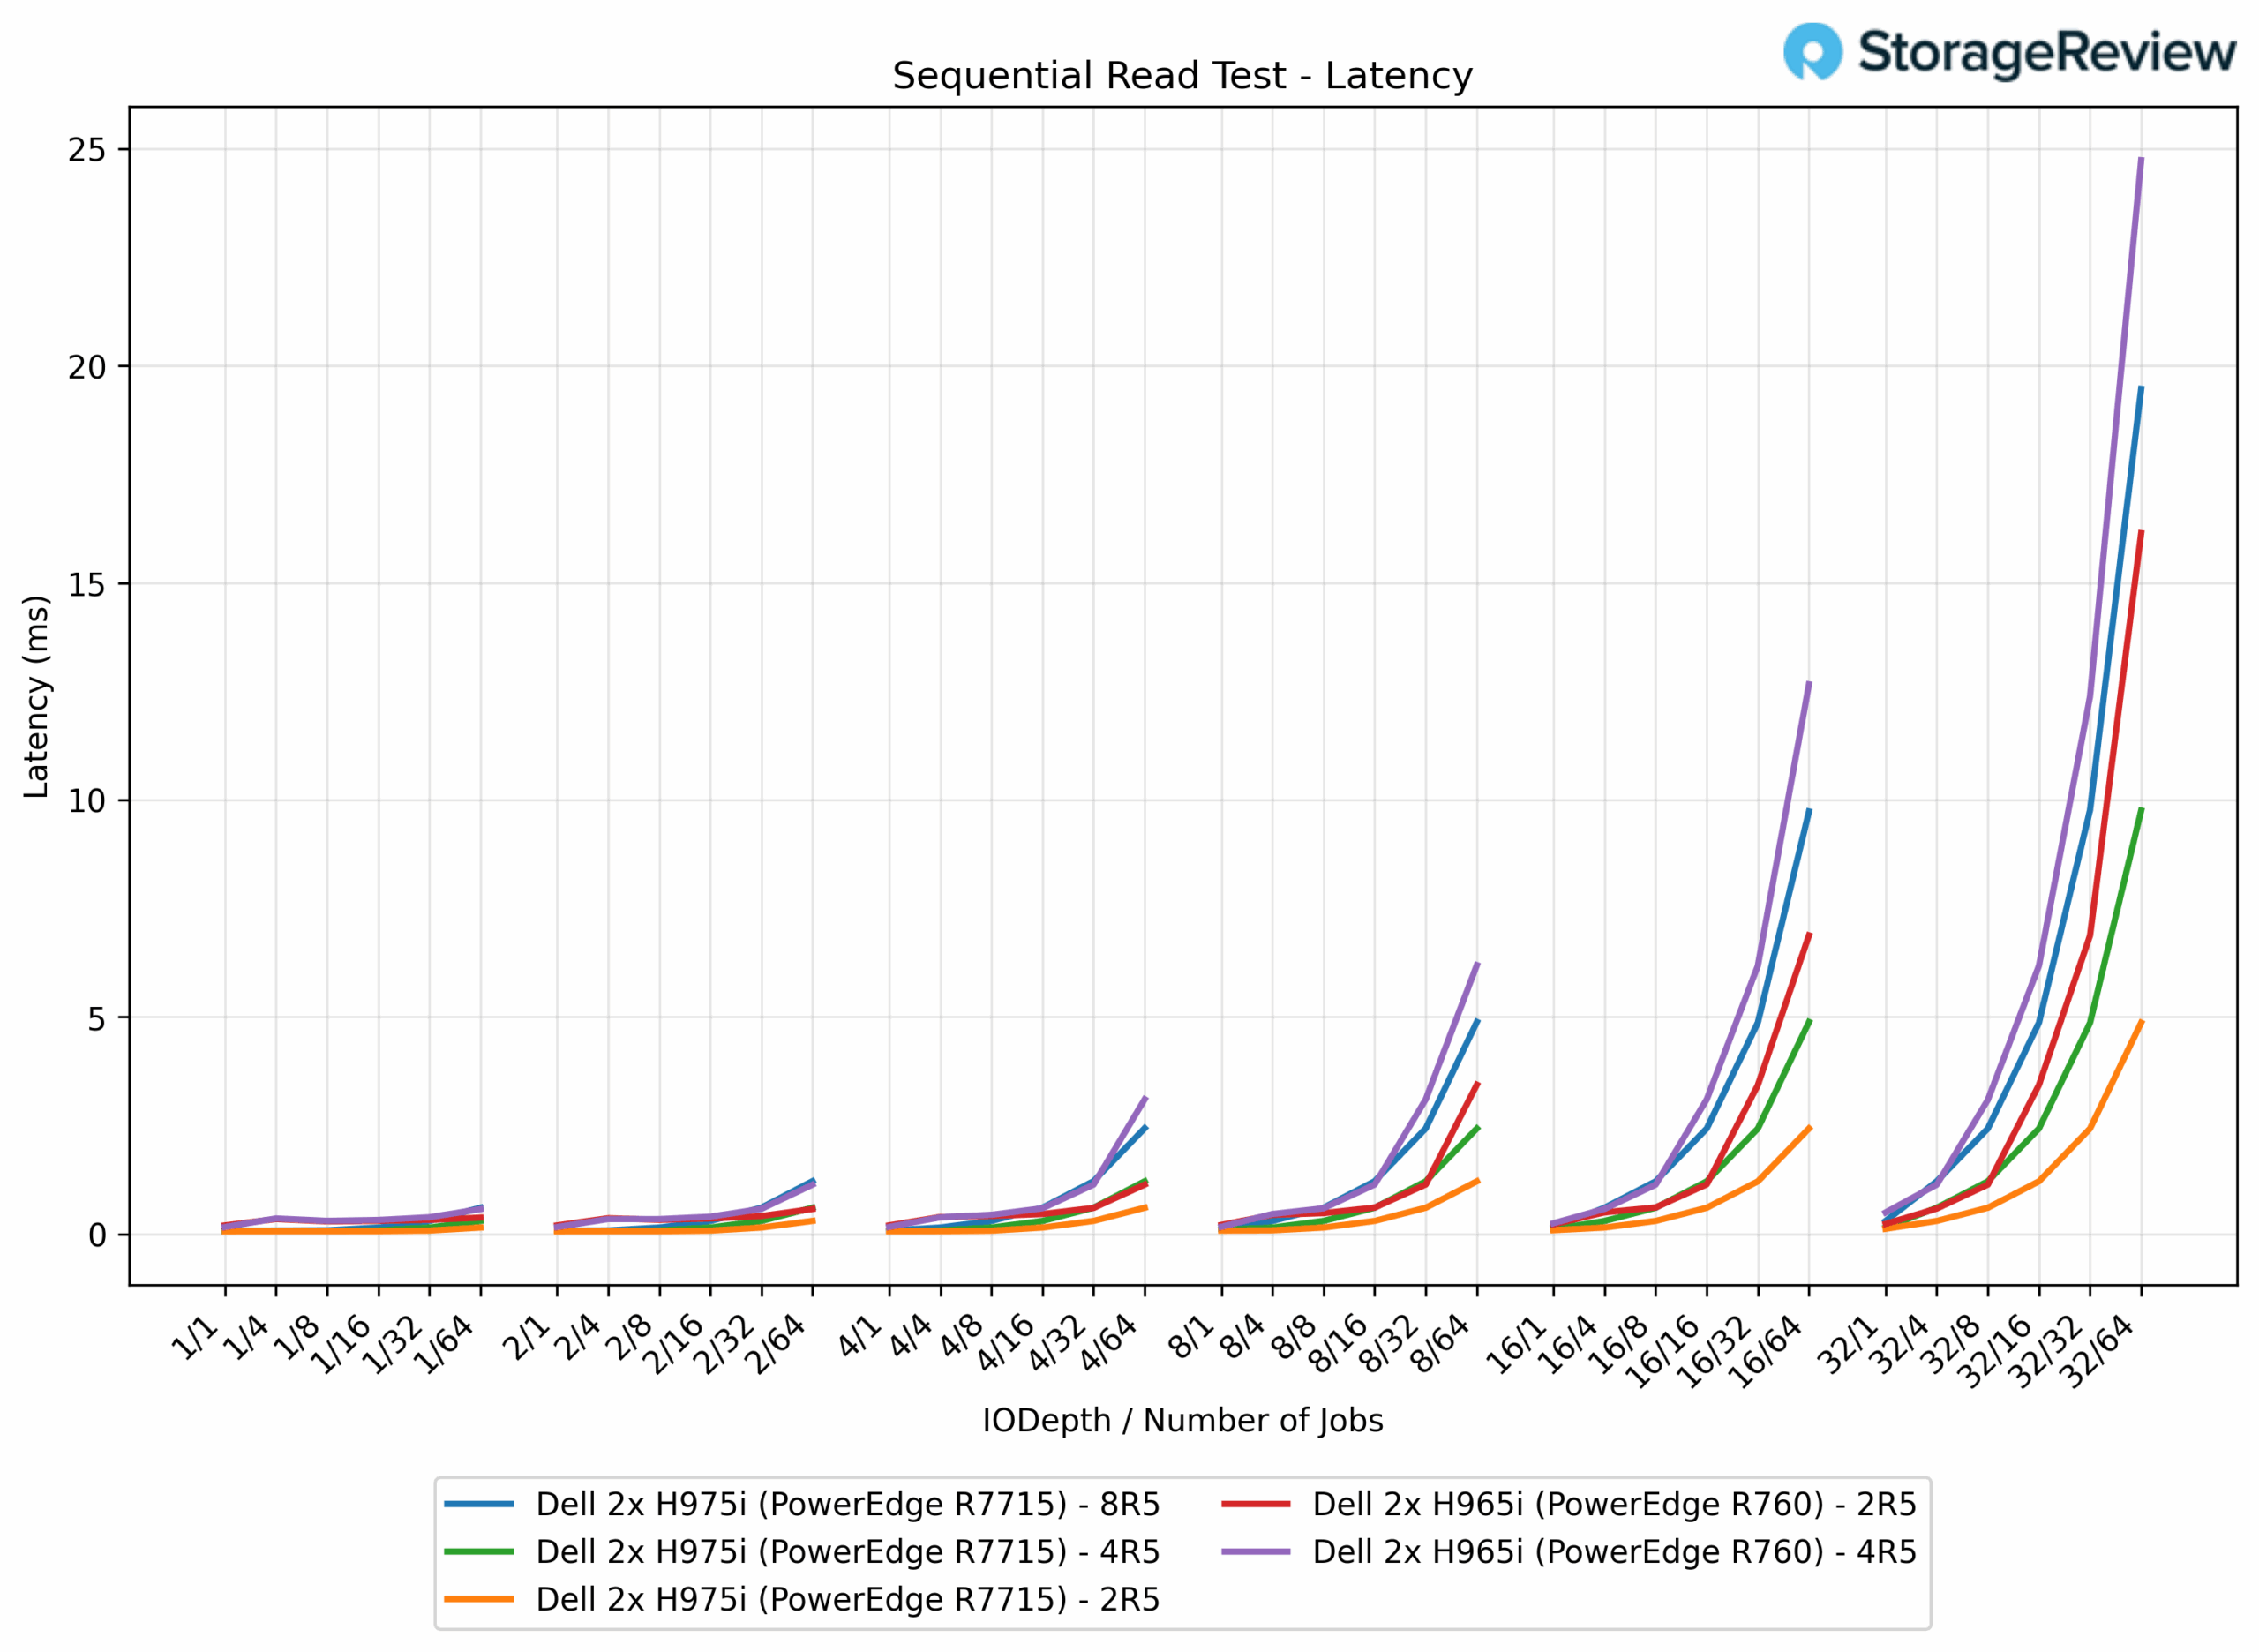
Nei test di latenza di lettura sequenziale a 128K, il PERC H965i ha ottenuto latenze comprese tra 0.2006 ms e 16.1 ms su 2R5 e tra 0.1644 ms e 24.7 ms su 4R5, mostrando una maggiore variabilità con l'aumentare della scalabilità delle unità. In confronto, il PERC H975i si è dimostrato molto più efficiente, con la configurazione 2R5 che ha registrato latenze comprese tra 0.062 ms e 4.9 ms (80% in meno di latenza di picco), la configurazione 4R5 che ha registrato latenze comprese tra 0.075 ms e 9.8 ms (60% in meno) e la configurazione 8R5 che ha raggiunto un picco di 19.5 ms (21% in meno rispetto a H965i 4R5).
Larghezza di banda di scrittura casuale 64k
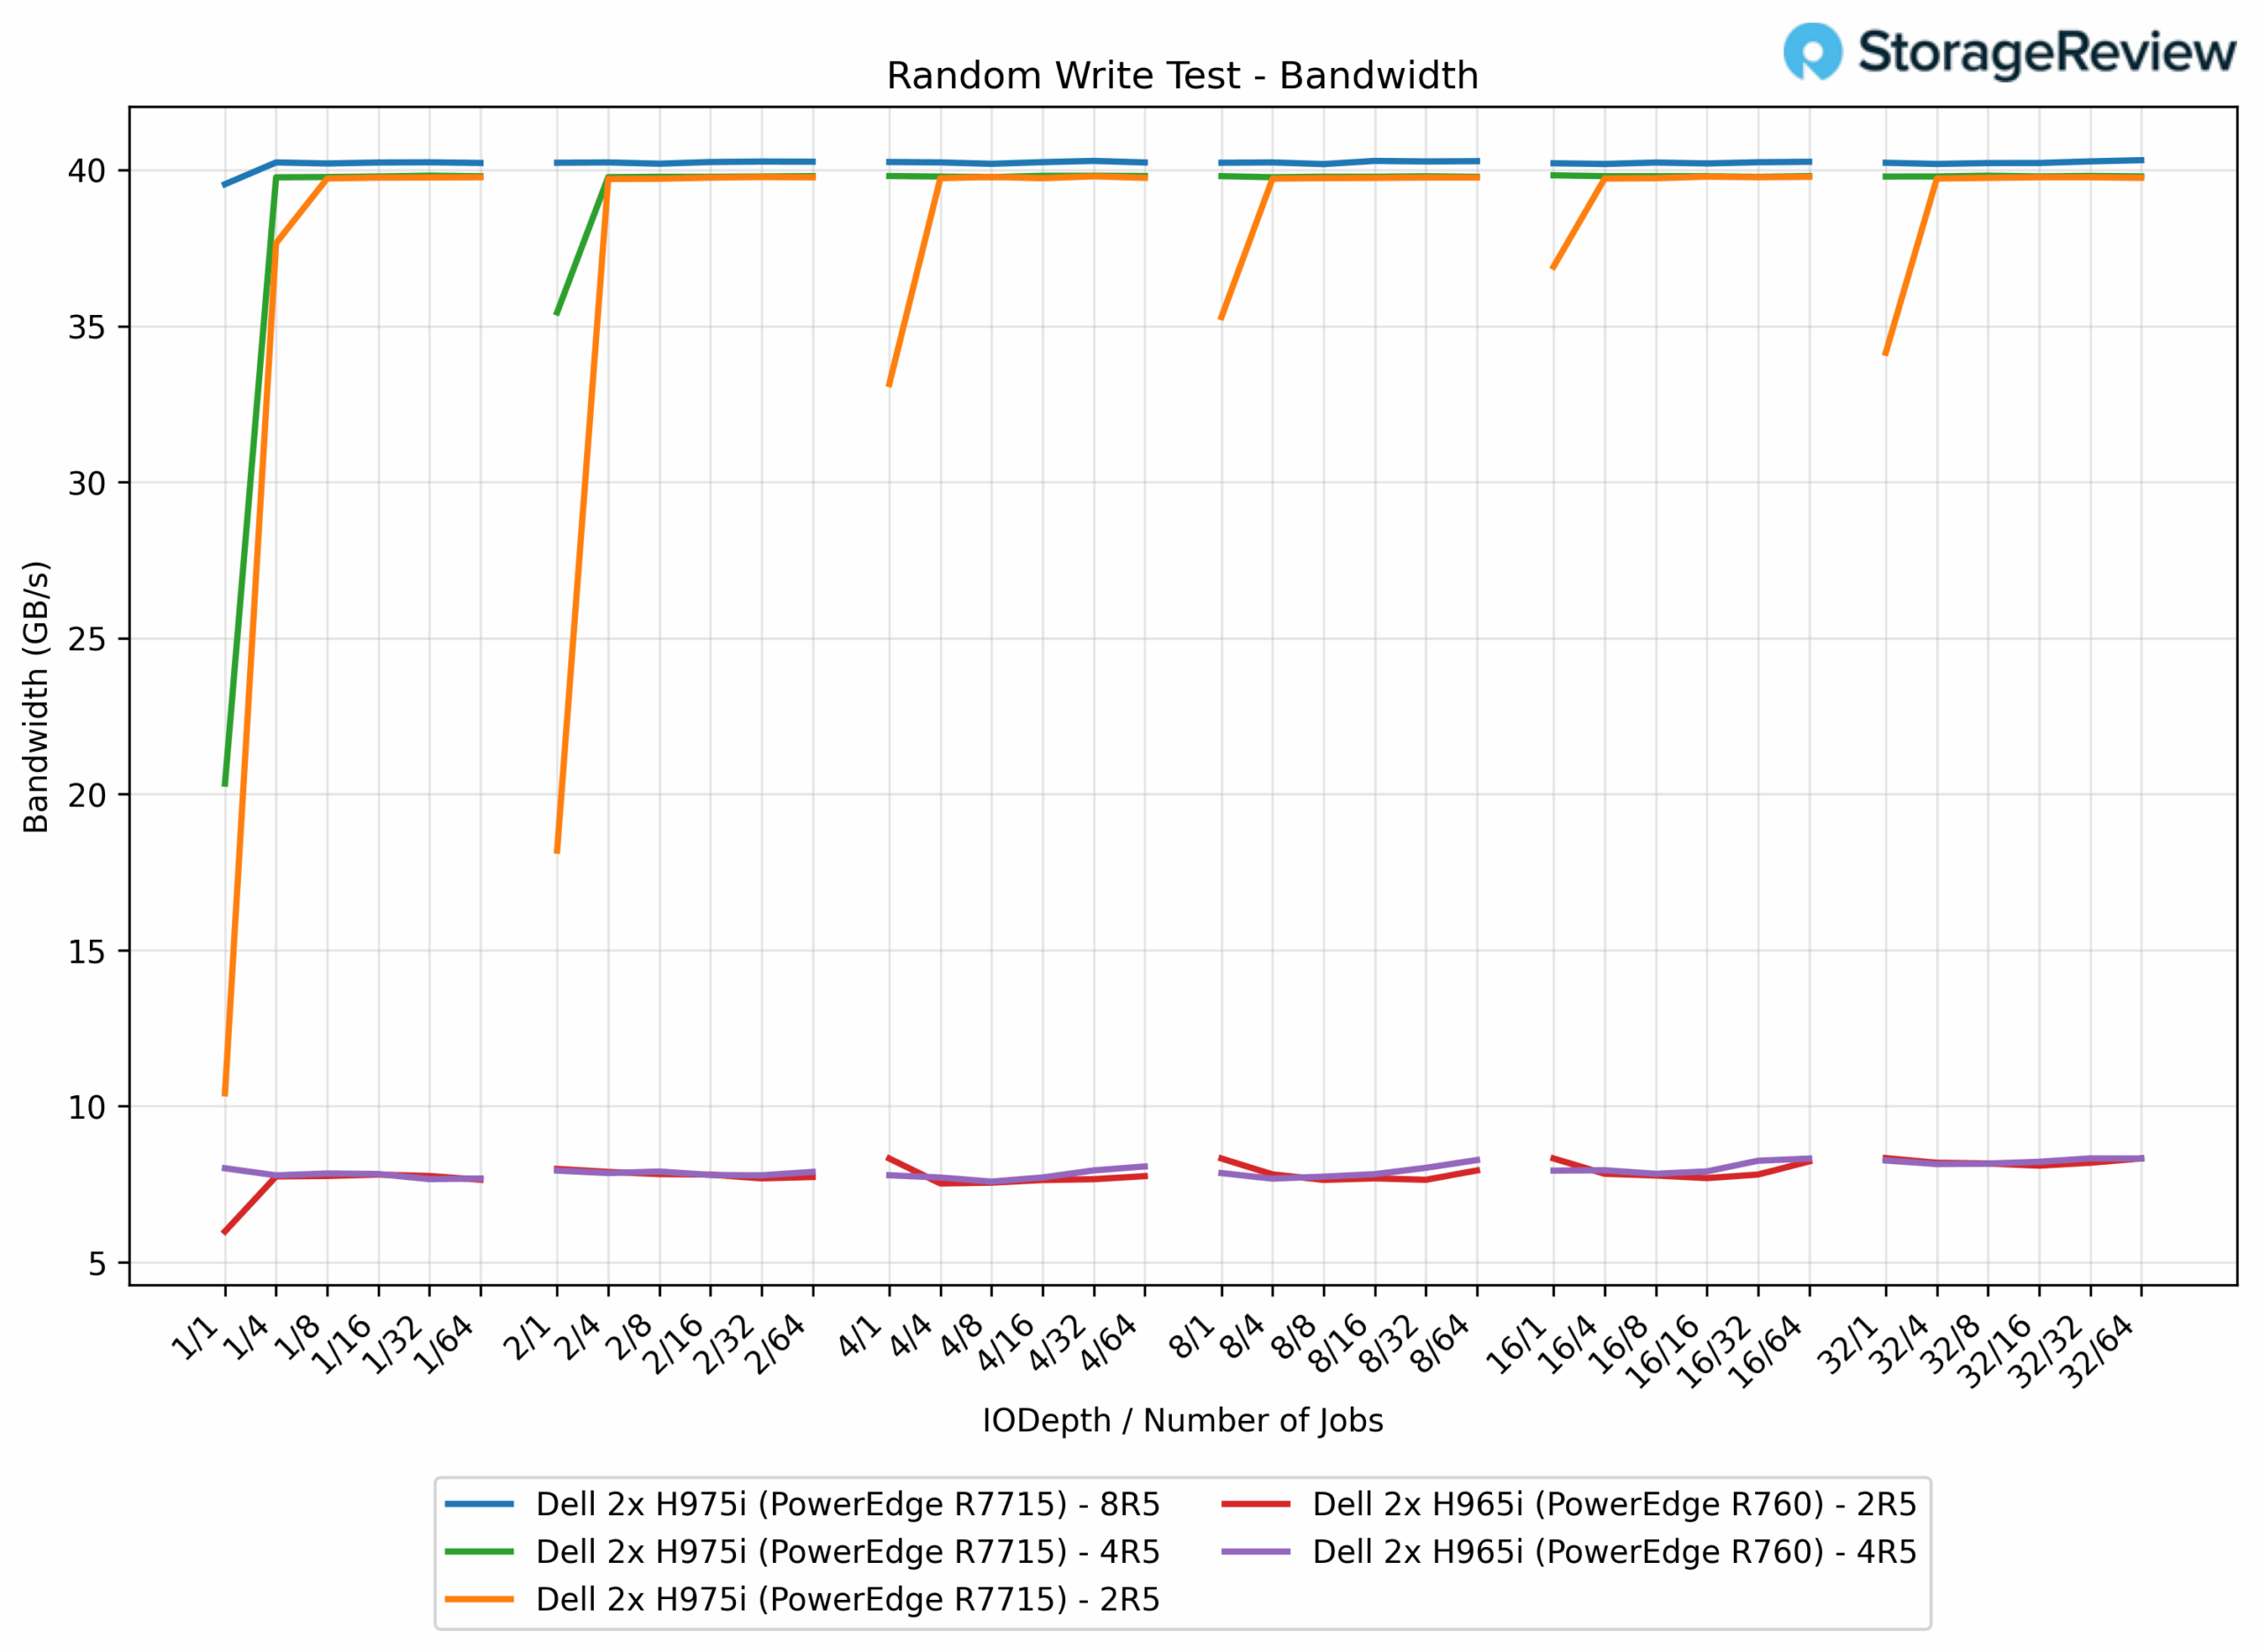
Nei test di scrittura casuale a 64K, il vecchio controller PERC H965i ha dimostrato prestazioni costanti ma limitate, con entrambe le configurazioni 2R5 e 4R5 che hanno raggiunto un throughput quasi identico di 8.3 GB/s indipendentemente dal numero di dischi. In netto contrasto, il controller PERC H975i ha offerto miglioramenti prestazionali eccezionali: la configurazione 2R5 ha raggiunto 39.8 GB/s (miglioramento del 379%), mentre la configurazione 4R5 ha mantenuto la stessa larghezza di banda di picco di 39.8 GB/s (miglioramento del 379%). L'array 8R5 sull'H975i ha leggermente superato i 40.3 GB/s (miglioramento del 386%).
Latenza di scrittura casuale 64k
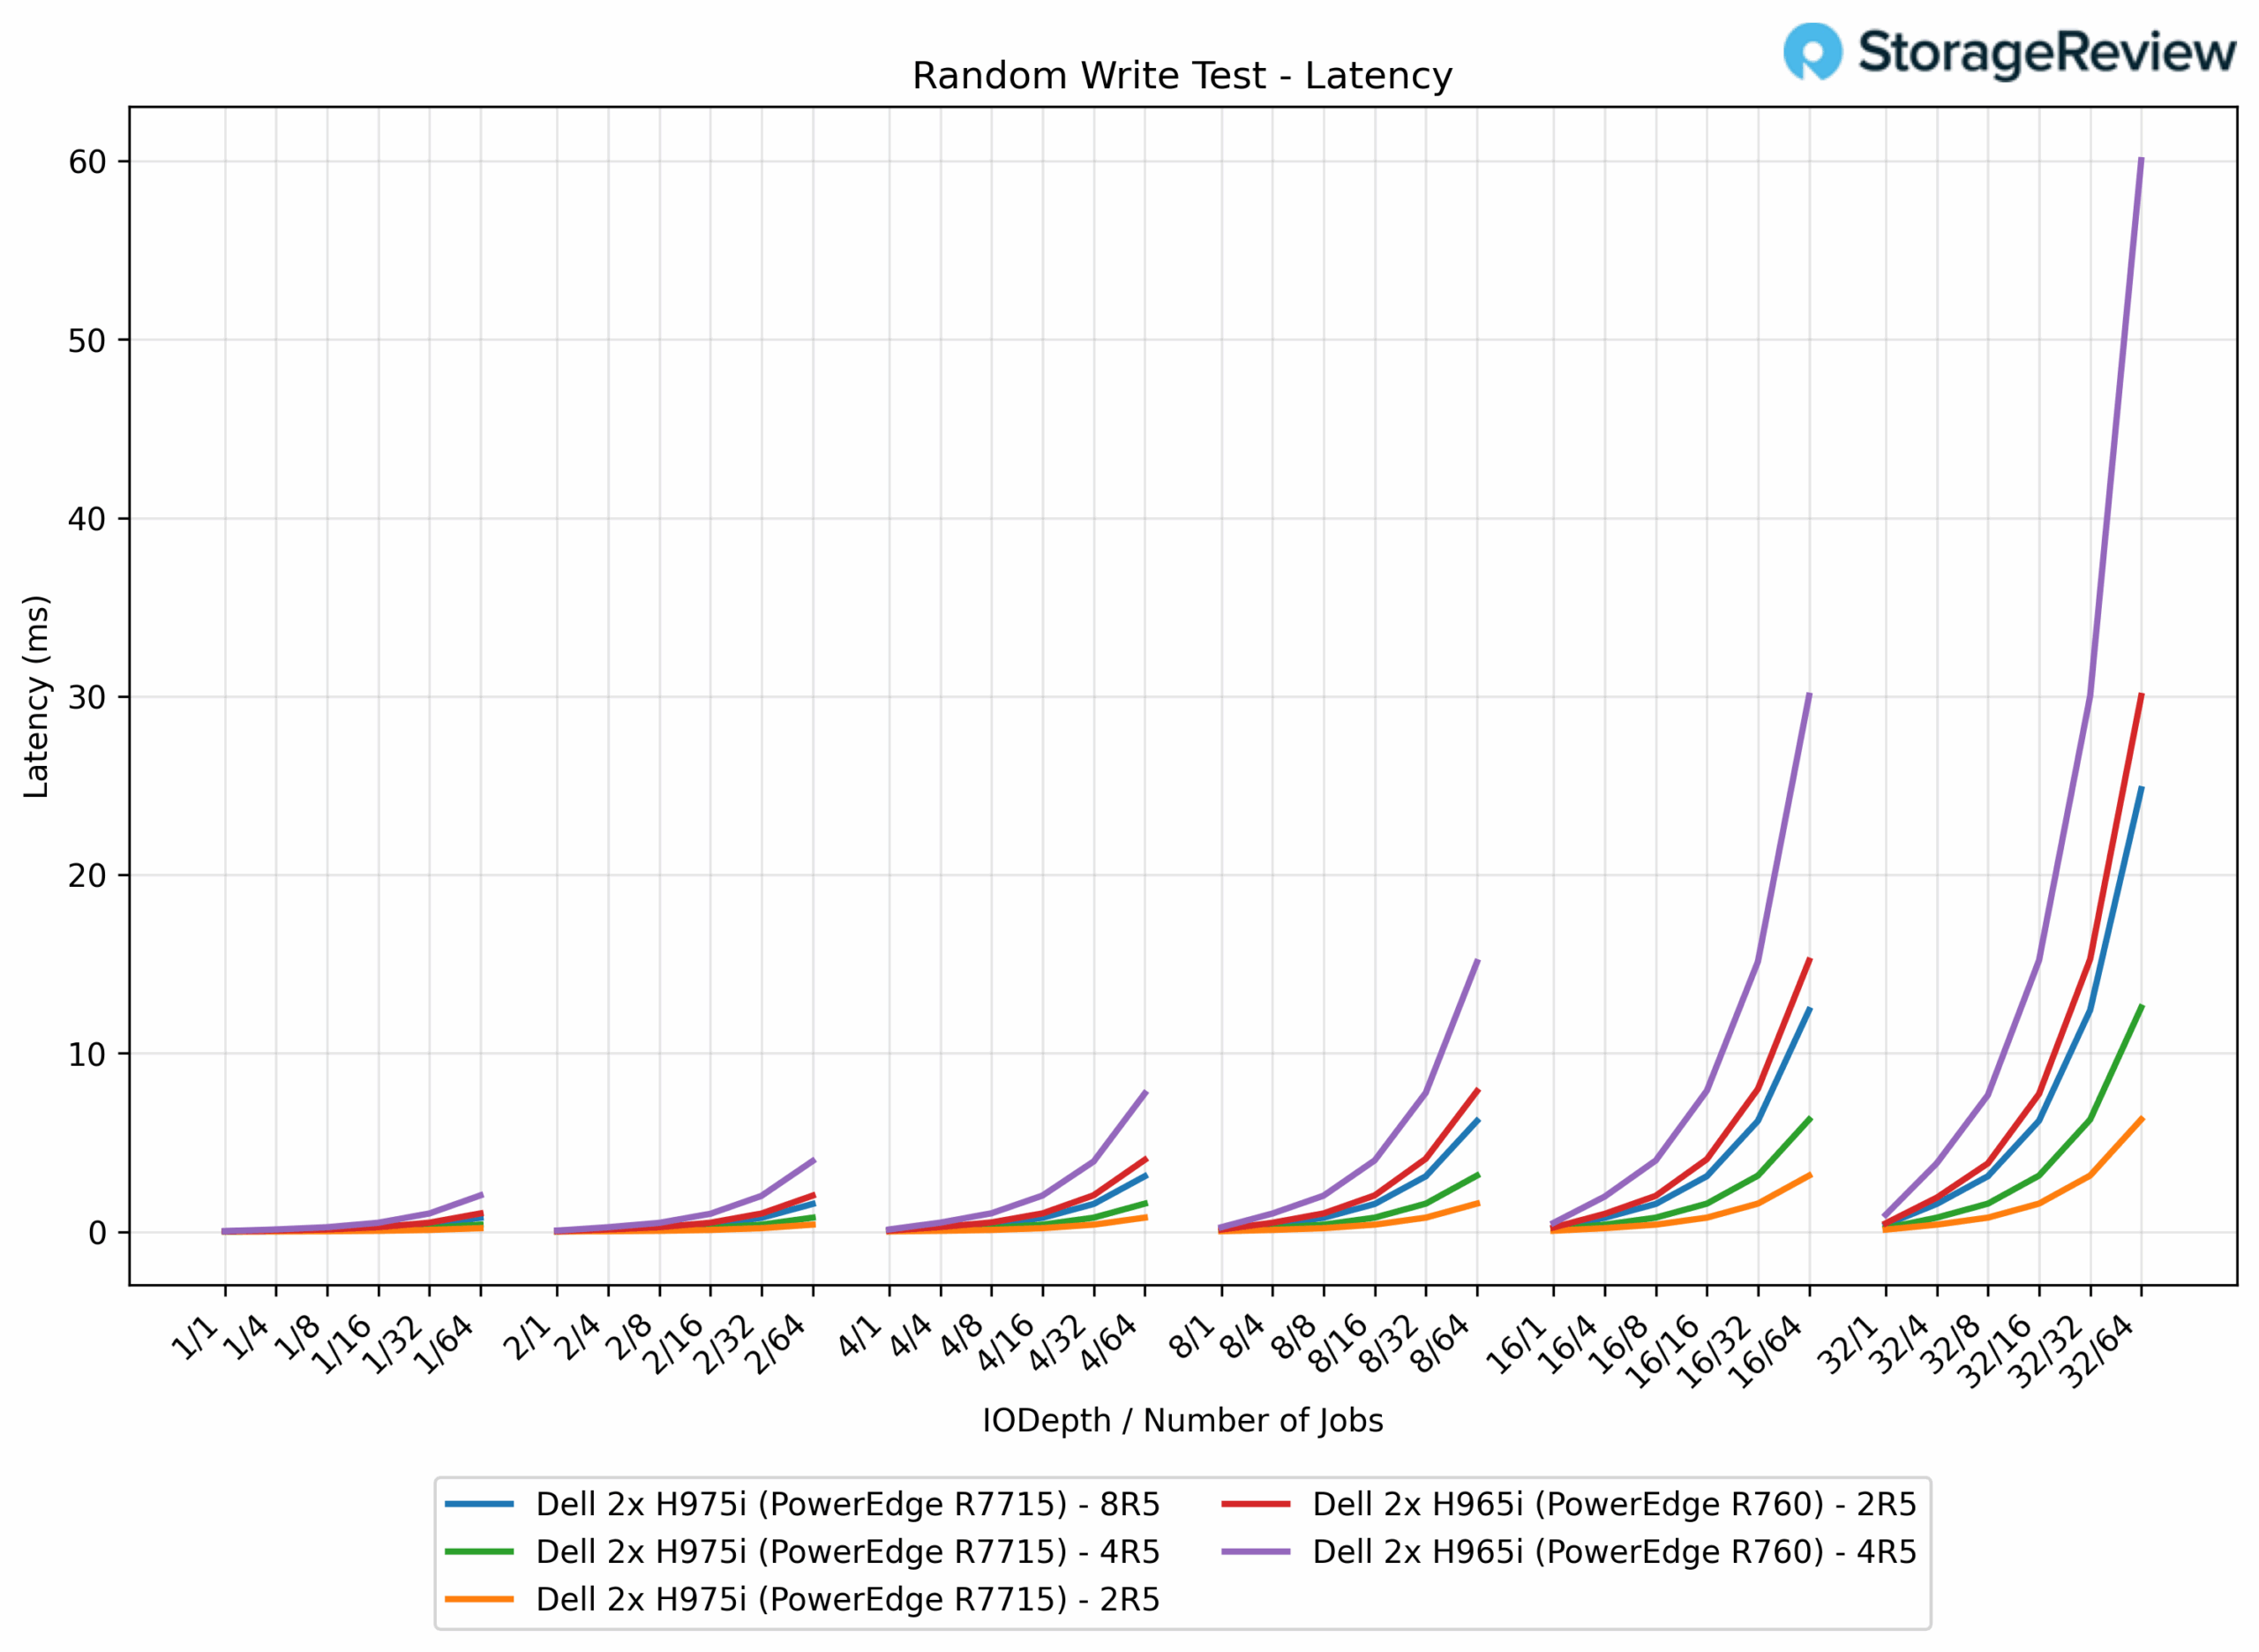
Nei test di latenza in scrittura casuale a 64K, l'H965i ha faticato sotto carichi più pesanti, con 2R5 che andava da 0.020 ms a 30.0 ms e 4R5 che arrivava fino a 60.0 ms. In netto contrasto, il controller H975i ha ottenuto prestazioni nettamente migliori: 2R5 andava da 0.0115 ms a 6.3 ms (latenza di picco inferiore del 79%), 4R5 ha raggiunto solo 12.6 ms (79% in meno) e 8R5 ha raggiunto un picco di 24.8 ms (59% in meno rispetto a 965R4 dell'H5i).
Larghezza di banda di lettura casuale 64k
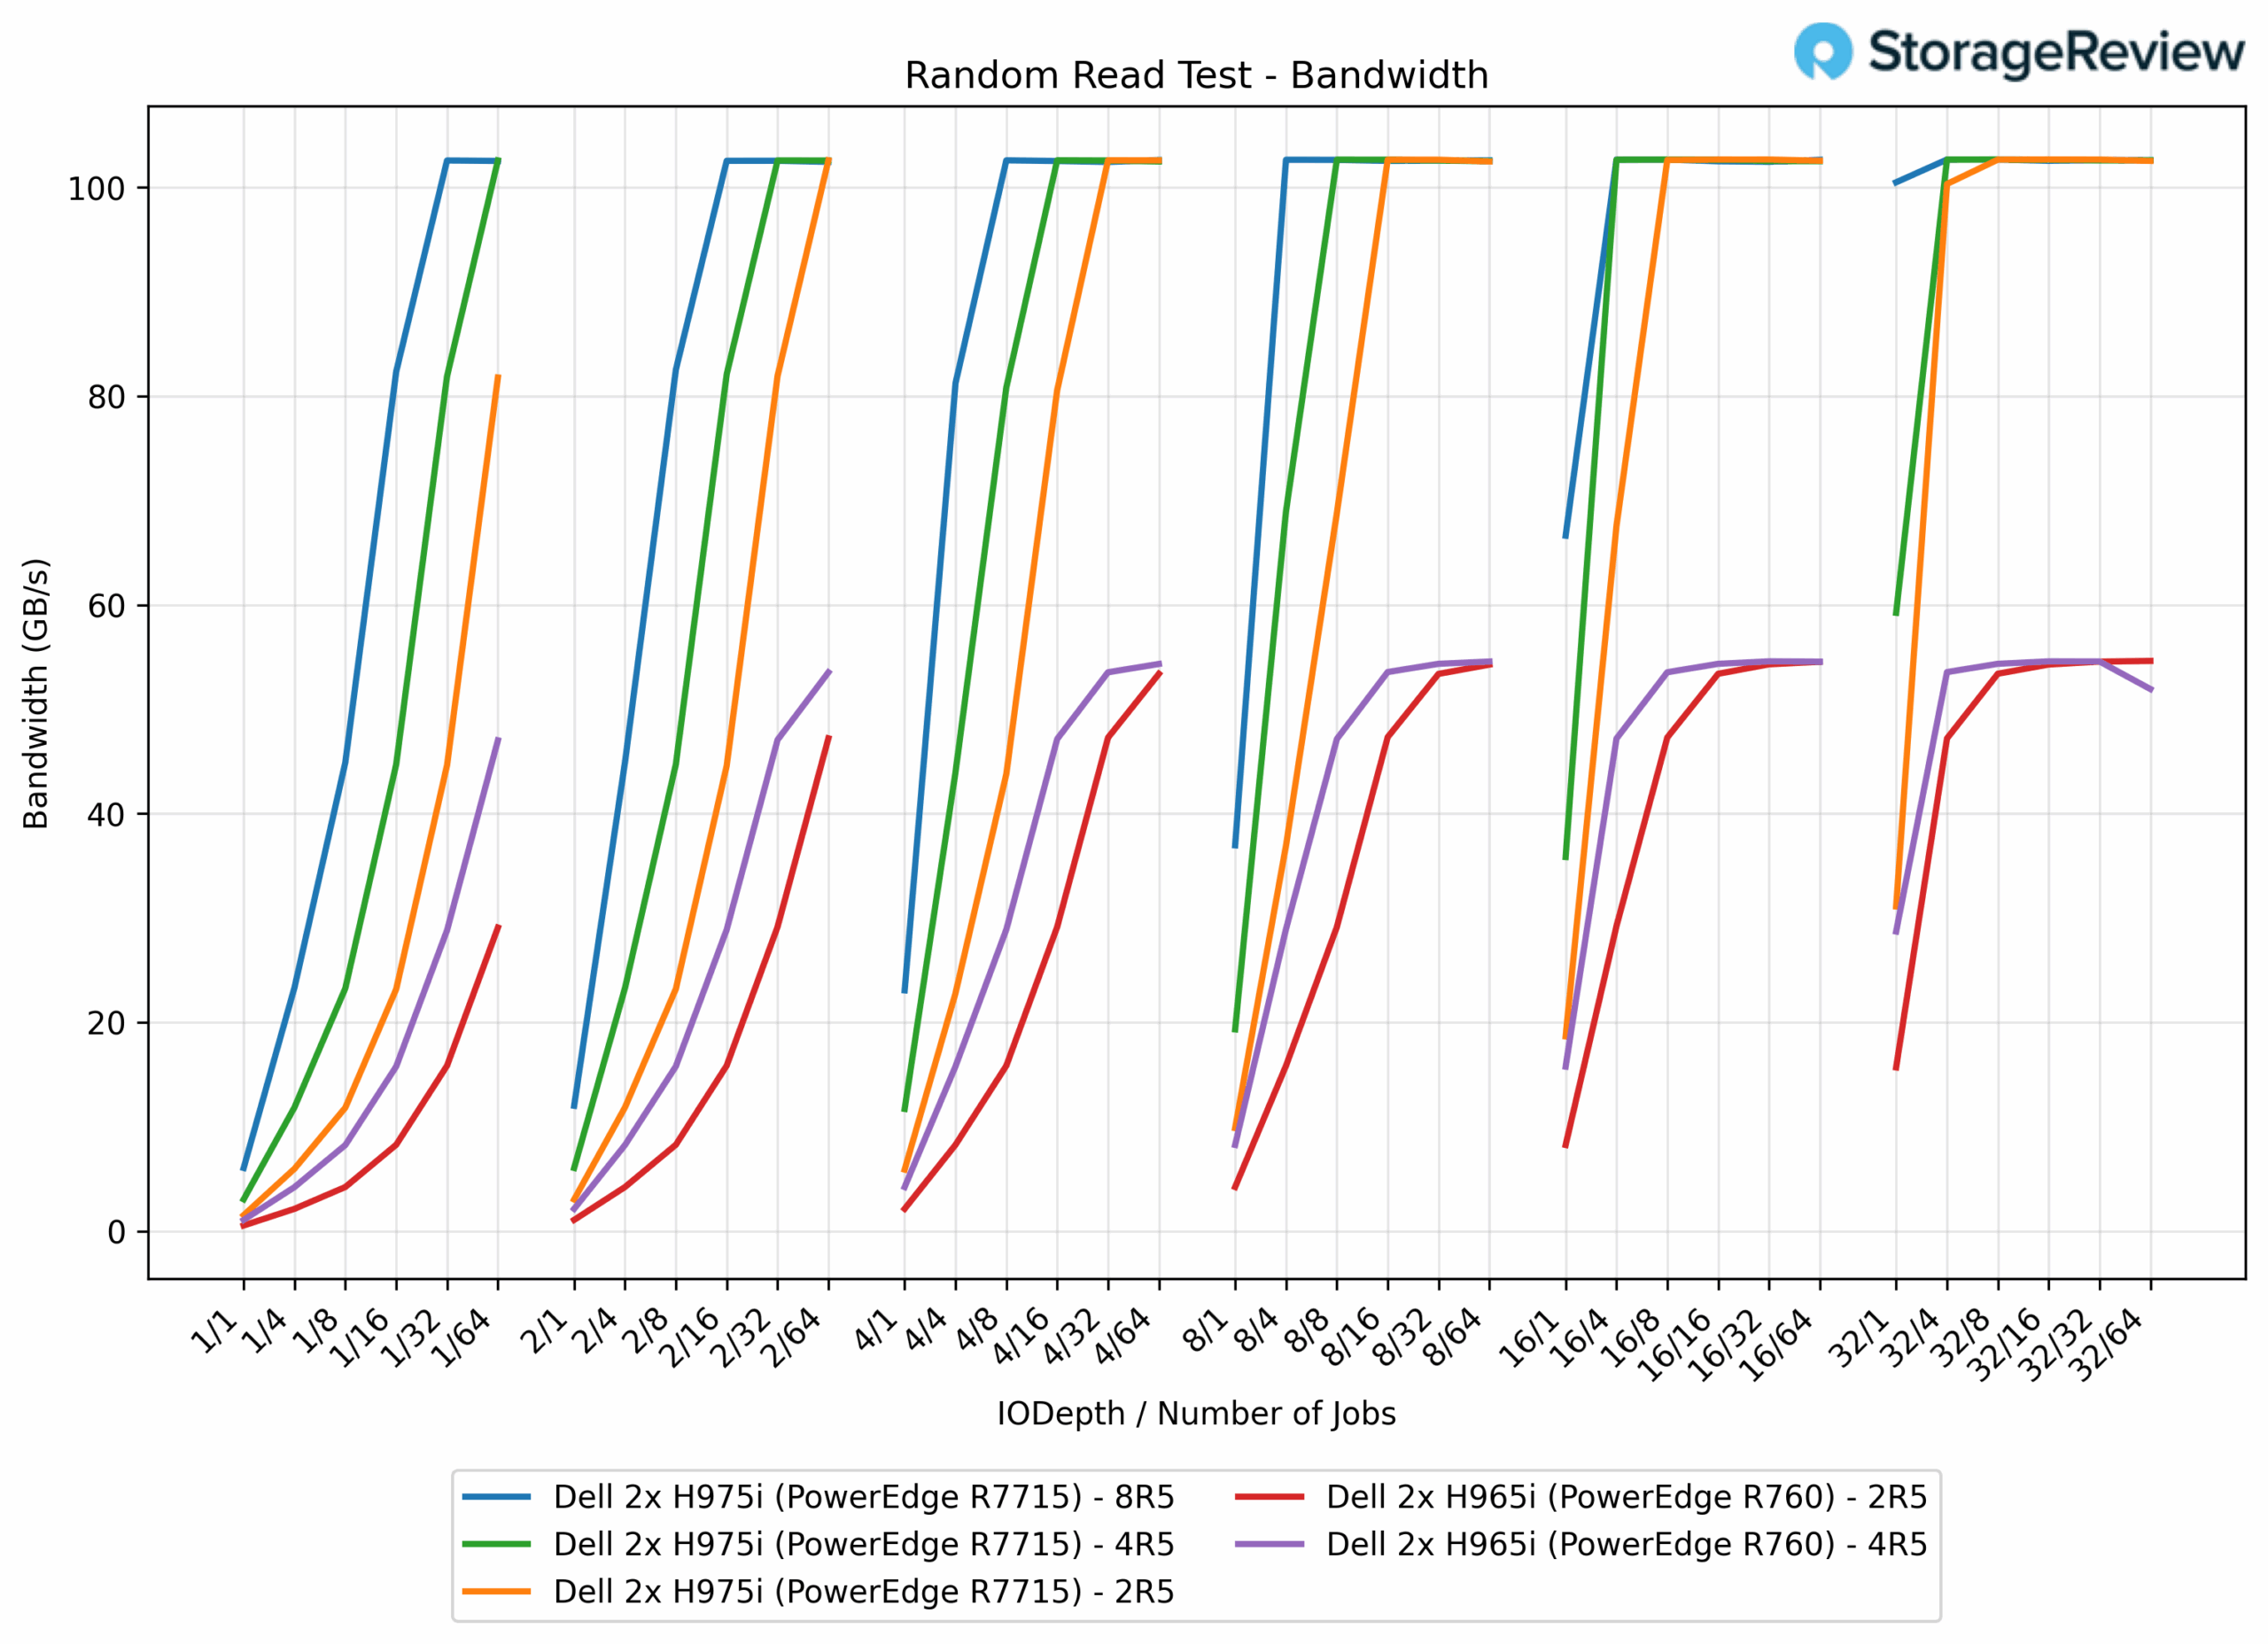
Nei test di lettura casuale a 64K, il controller PERC H965i con array 2R5 e 4R5 ha raggiunto un throughput pressoché identico di 54.6 GB/s. In netto contrasto, il controller PERC H975i si è dimostrato ancora una volta nettamente superiore, con tutte e tre le configurazioni che hanno raggiunto circa 102.7 GB/s, con un miglioramento delle prestazioni dell'88% rispetto all'H965i. In particolare, le configurazioni dell'H975i hanno mostrato una notevole coerenza tra diverse dimensioni di array RAID, con una larghezza di banda di picco compresa tra 102.7 GB/s e 102.7 GB/s, indipendentemente dall'utilizzo di 2, 4 o 8 unità nell'array RAID-5. Ciò suggerisce che, con un carico di lavoro di lettura casuale a 64K, siamo in grado di saturare completamente il controller e non siamo limitati dalle unità sulla nuova piattaforma H975i.
Latenza di lettura casuale 64k
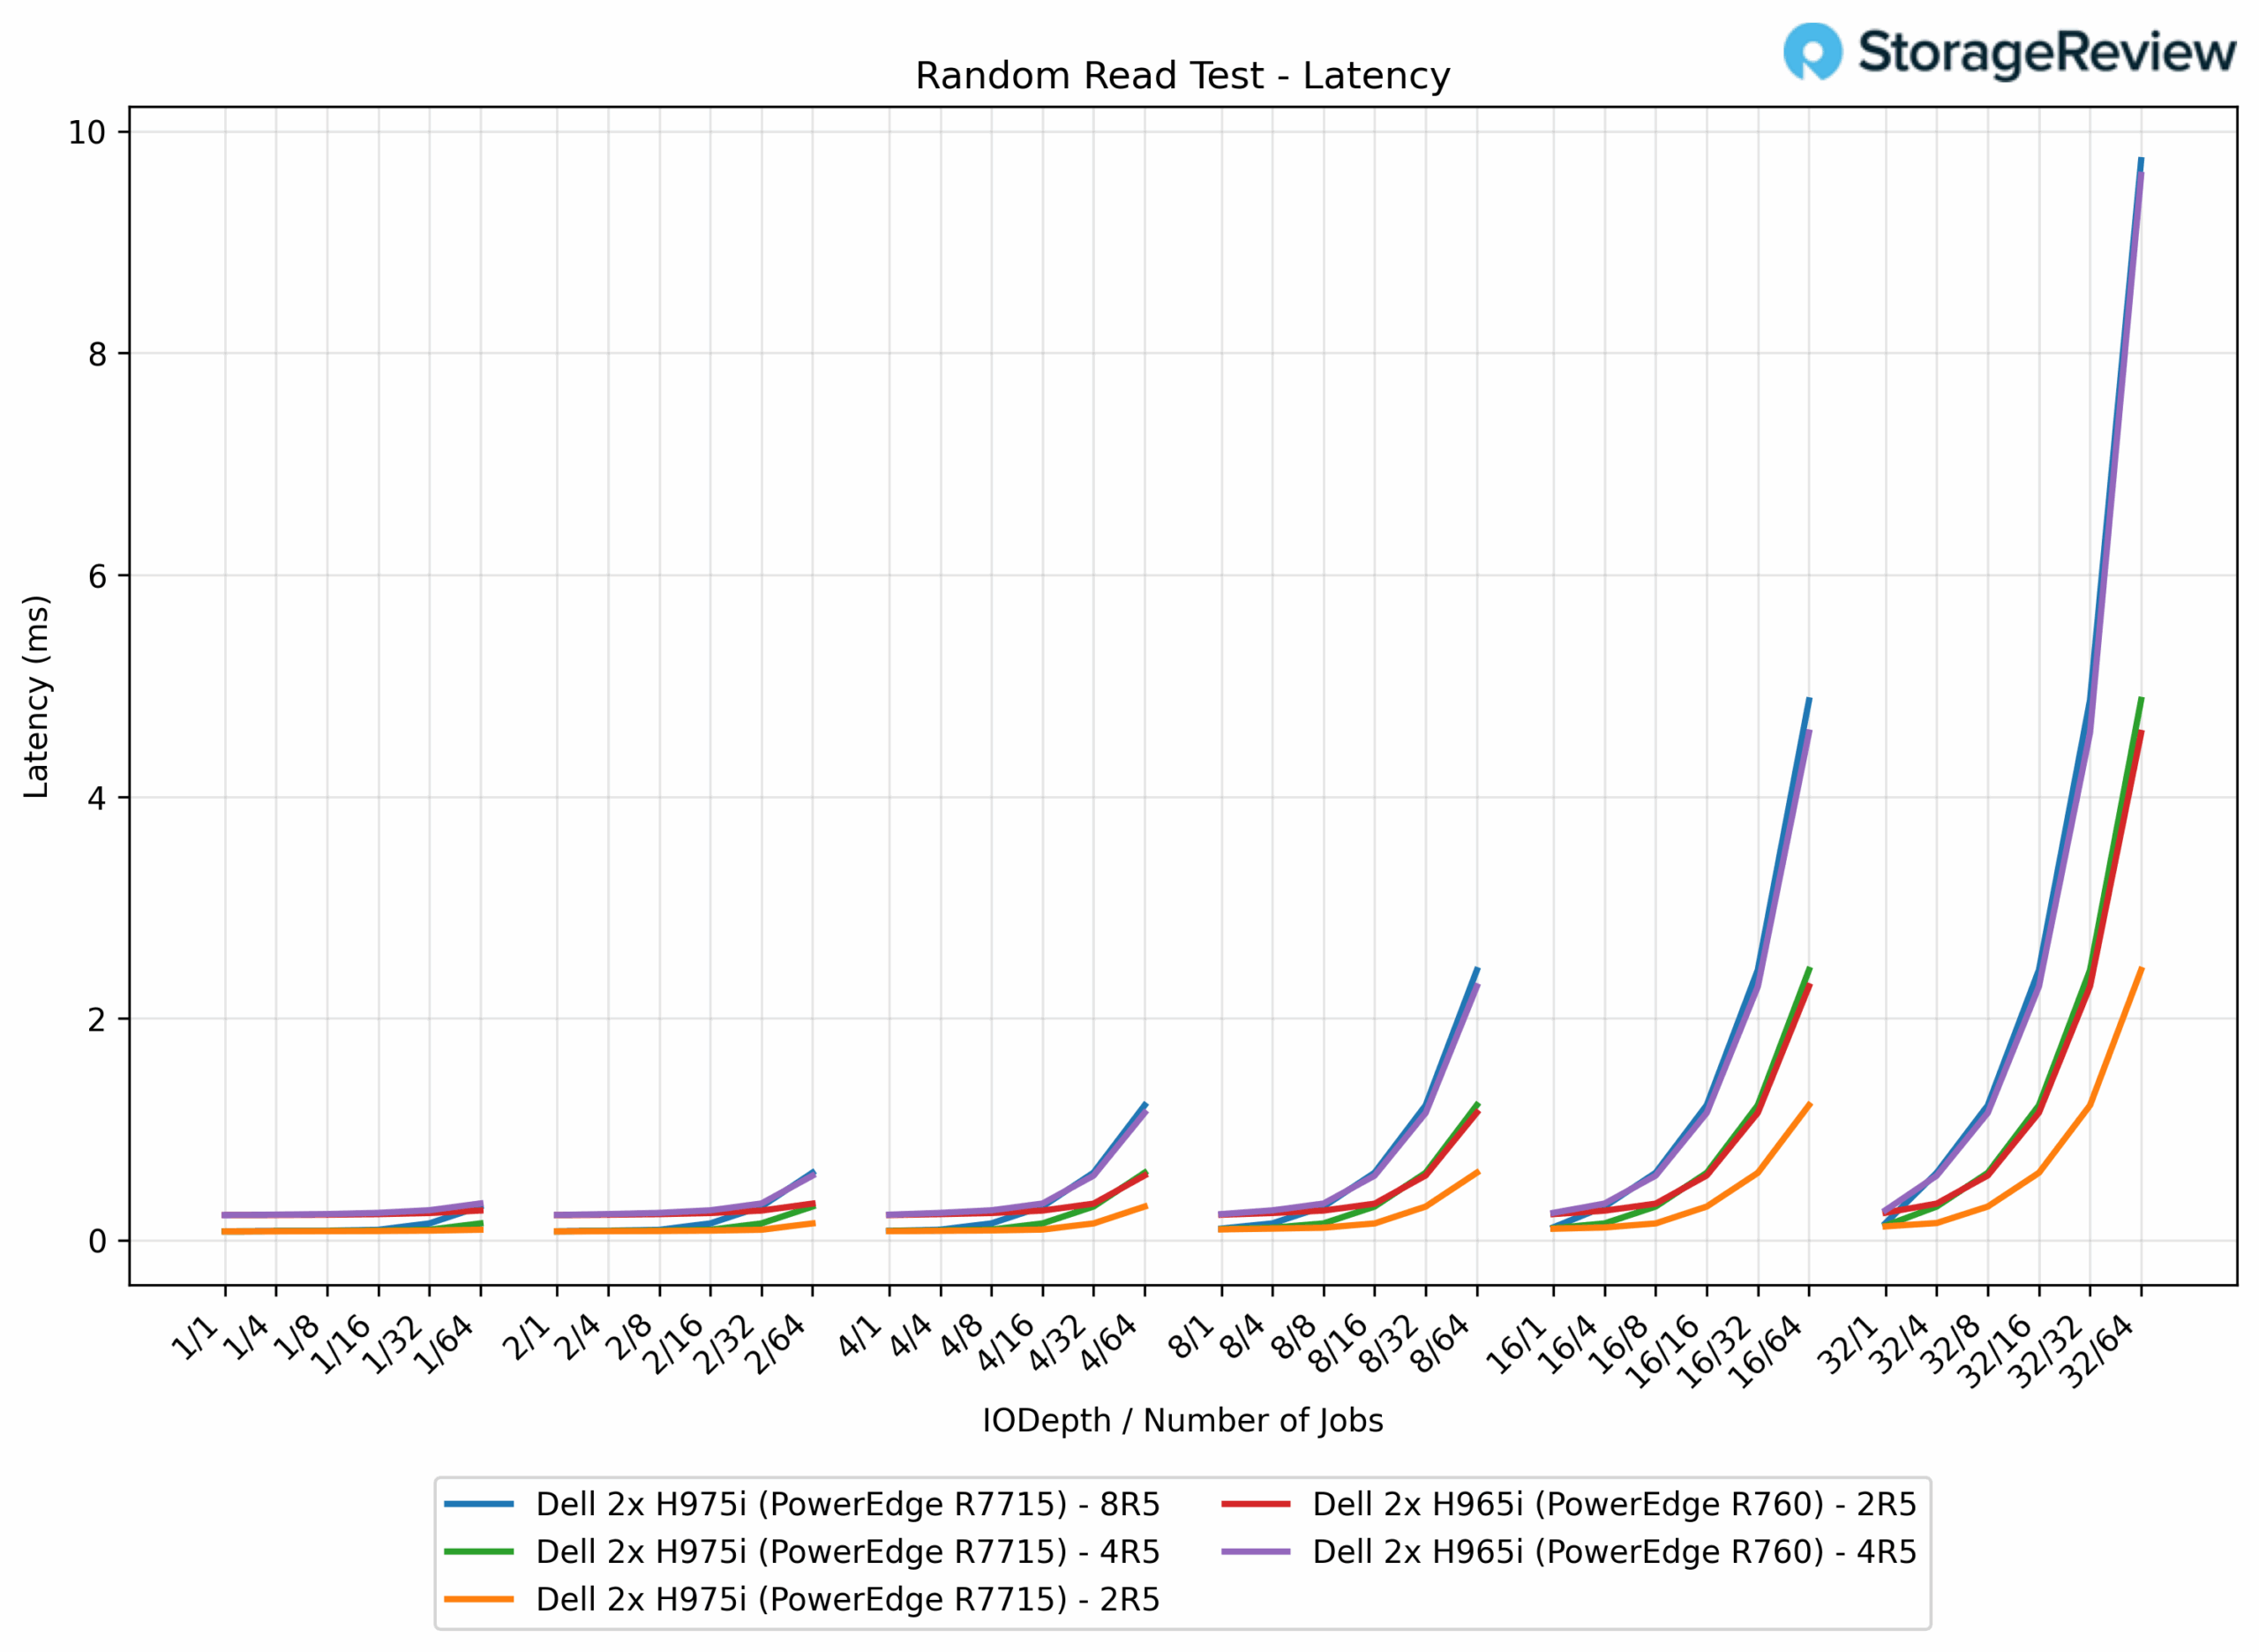
Per letture casuali da 64K, l'array H965i 2R5 ha registrato tempi compresi tra 0.226 ms e 4.6 ms, mentre la configurazione 4R5 si è estesa a 9.6 ms. Il passaggio all'H975i ha ridotto notevolmente le latenze, con 2R5 che ha misurato da 0.080 ms a 2.4 ms (latenza di picco inferiore del 48%), 4R5 da 0.080 ms a 4.9 ms (inferiore del 49%) e 8R5 da 0.080 ms a 9.7 ms (alla pari con H965i 4R5). Nel complesso, l'H975i ha mostrato un controllo più rigoroso e limiti di latenza più bassi tra i gruppi RAID.
16k IOPS di scrittura sequenziale
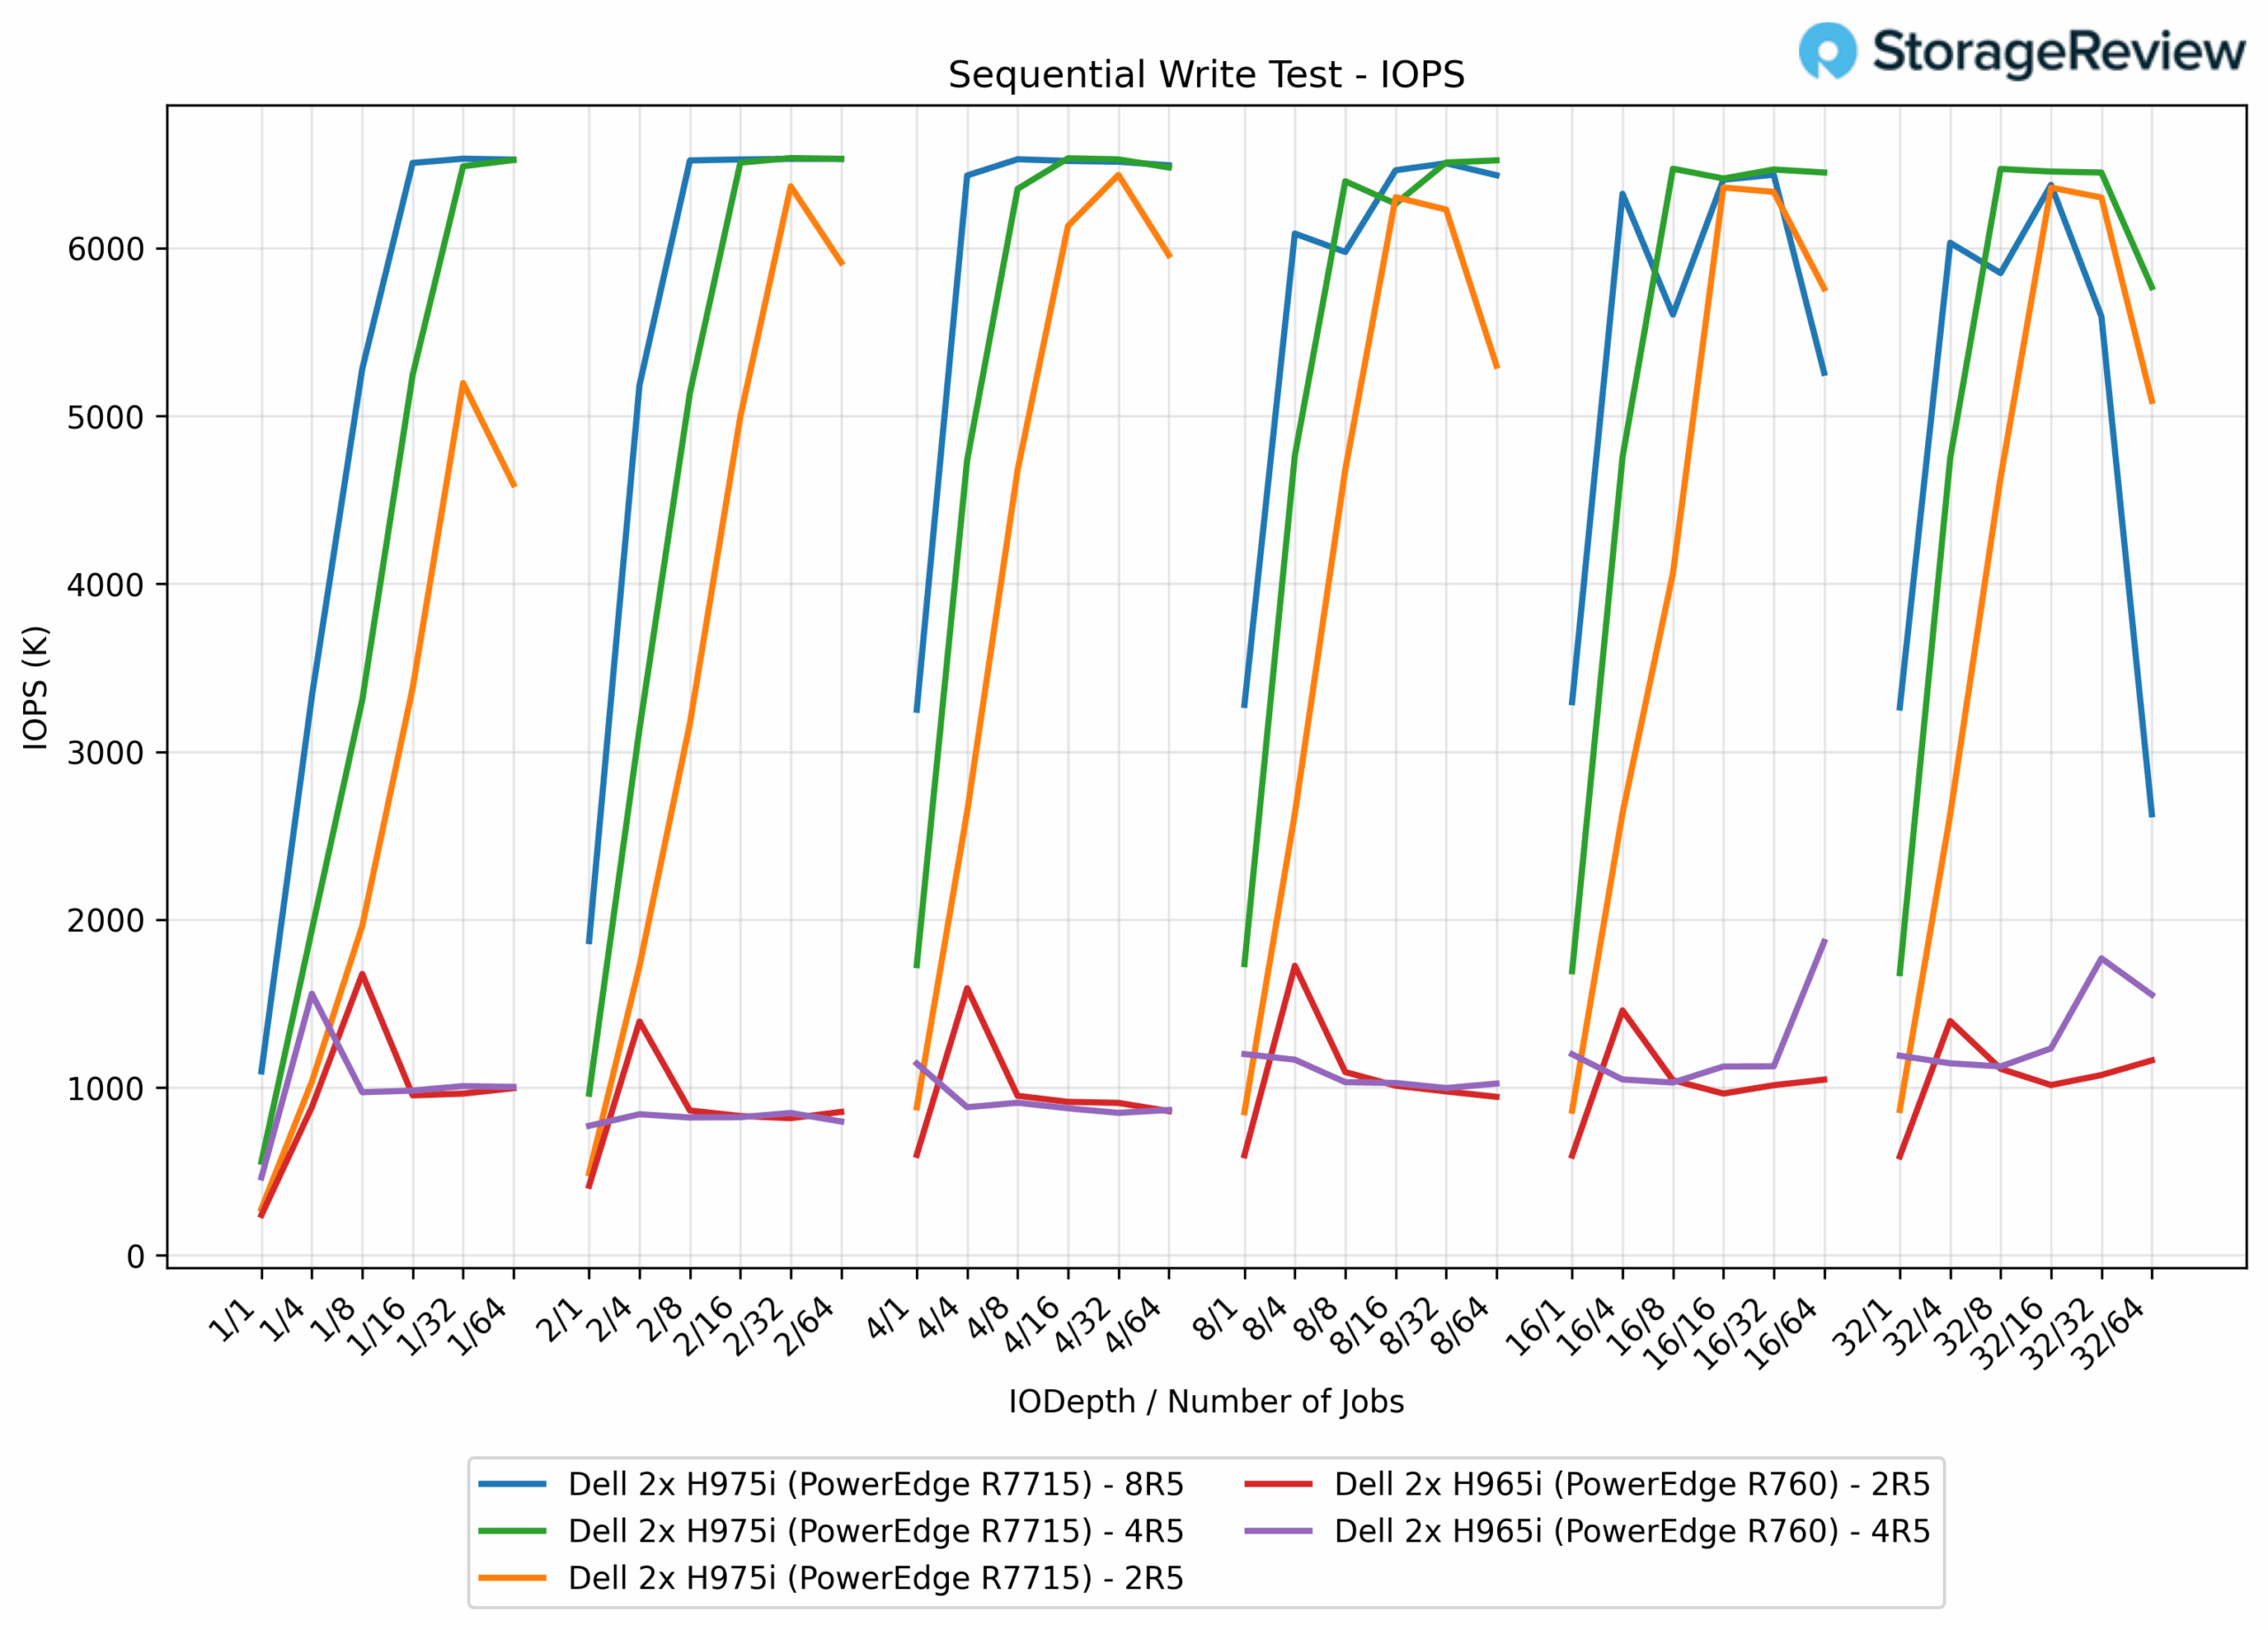
Nei test di scrittura sequenziale a 16K, il controller PERC H965i ha offerto prestazioni modeste, con la configurazione 2R5 che ha raggiunto 1.73 milioni di IOPS e la configurazione 4R5 che ha raggiunto 1.87 milioni di IOPS. Il PERC H975i, al contrario, ha ottenuto un netto miglioramento, con la configurazione 2R5 che ha raggiunto 6.44 milioni di IOPS (un miglioramento del 272% rispetto all'H965i). L'array 975R4 dell'H5i ha raggiunto un picco di 6.54 milioni di IOPS (un miglioramento del 250%), mentre la configurazione 8R5 ha raggiunto 6.53 milioni di IOPS (un miglioramento del 249% rispetto all'H965i 4R5), dimostrando ancora una volta che i controller saturano circa 6.5 milioni di IOPS con blocchi da 16K.
Latenza di scrittura sequenziale 16k
Nelle scritture sequenziali da 16K, gli array H965i hanno prodotto 0.0080-3.5 ms su 2R5 e 0.0083-5.3 ms su 4R5. L'H975i ha mostrato un'efficienza superiore, con 2R5 che variava da 0.0070 ms a 0.80 ms (inferiore del 77%), 4R5 che arrivava fino a 1.42 ms (inferiore del 73%) e 8R5 che raggiungeva un picco di 6.2 ms (inferiore del 17% rispetto a H965i 4R5). 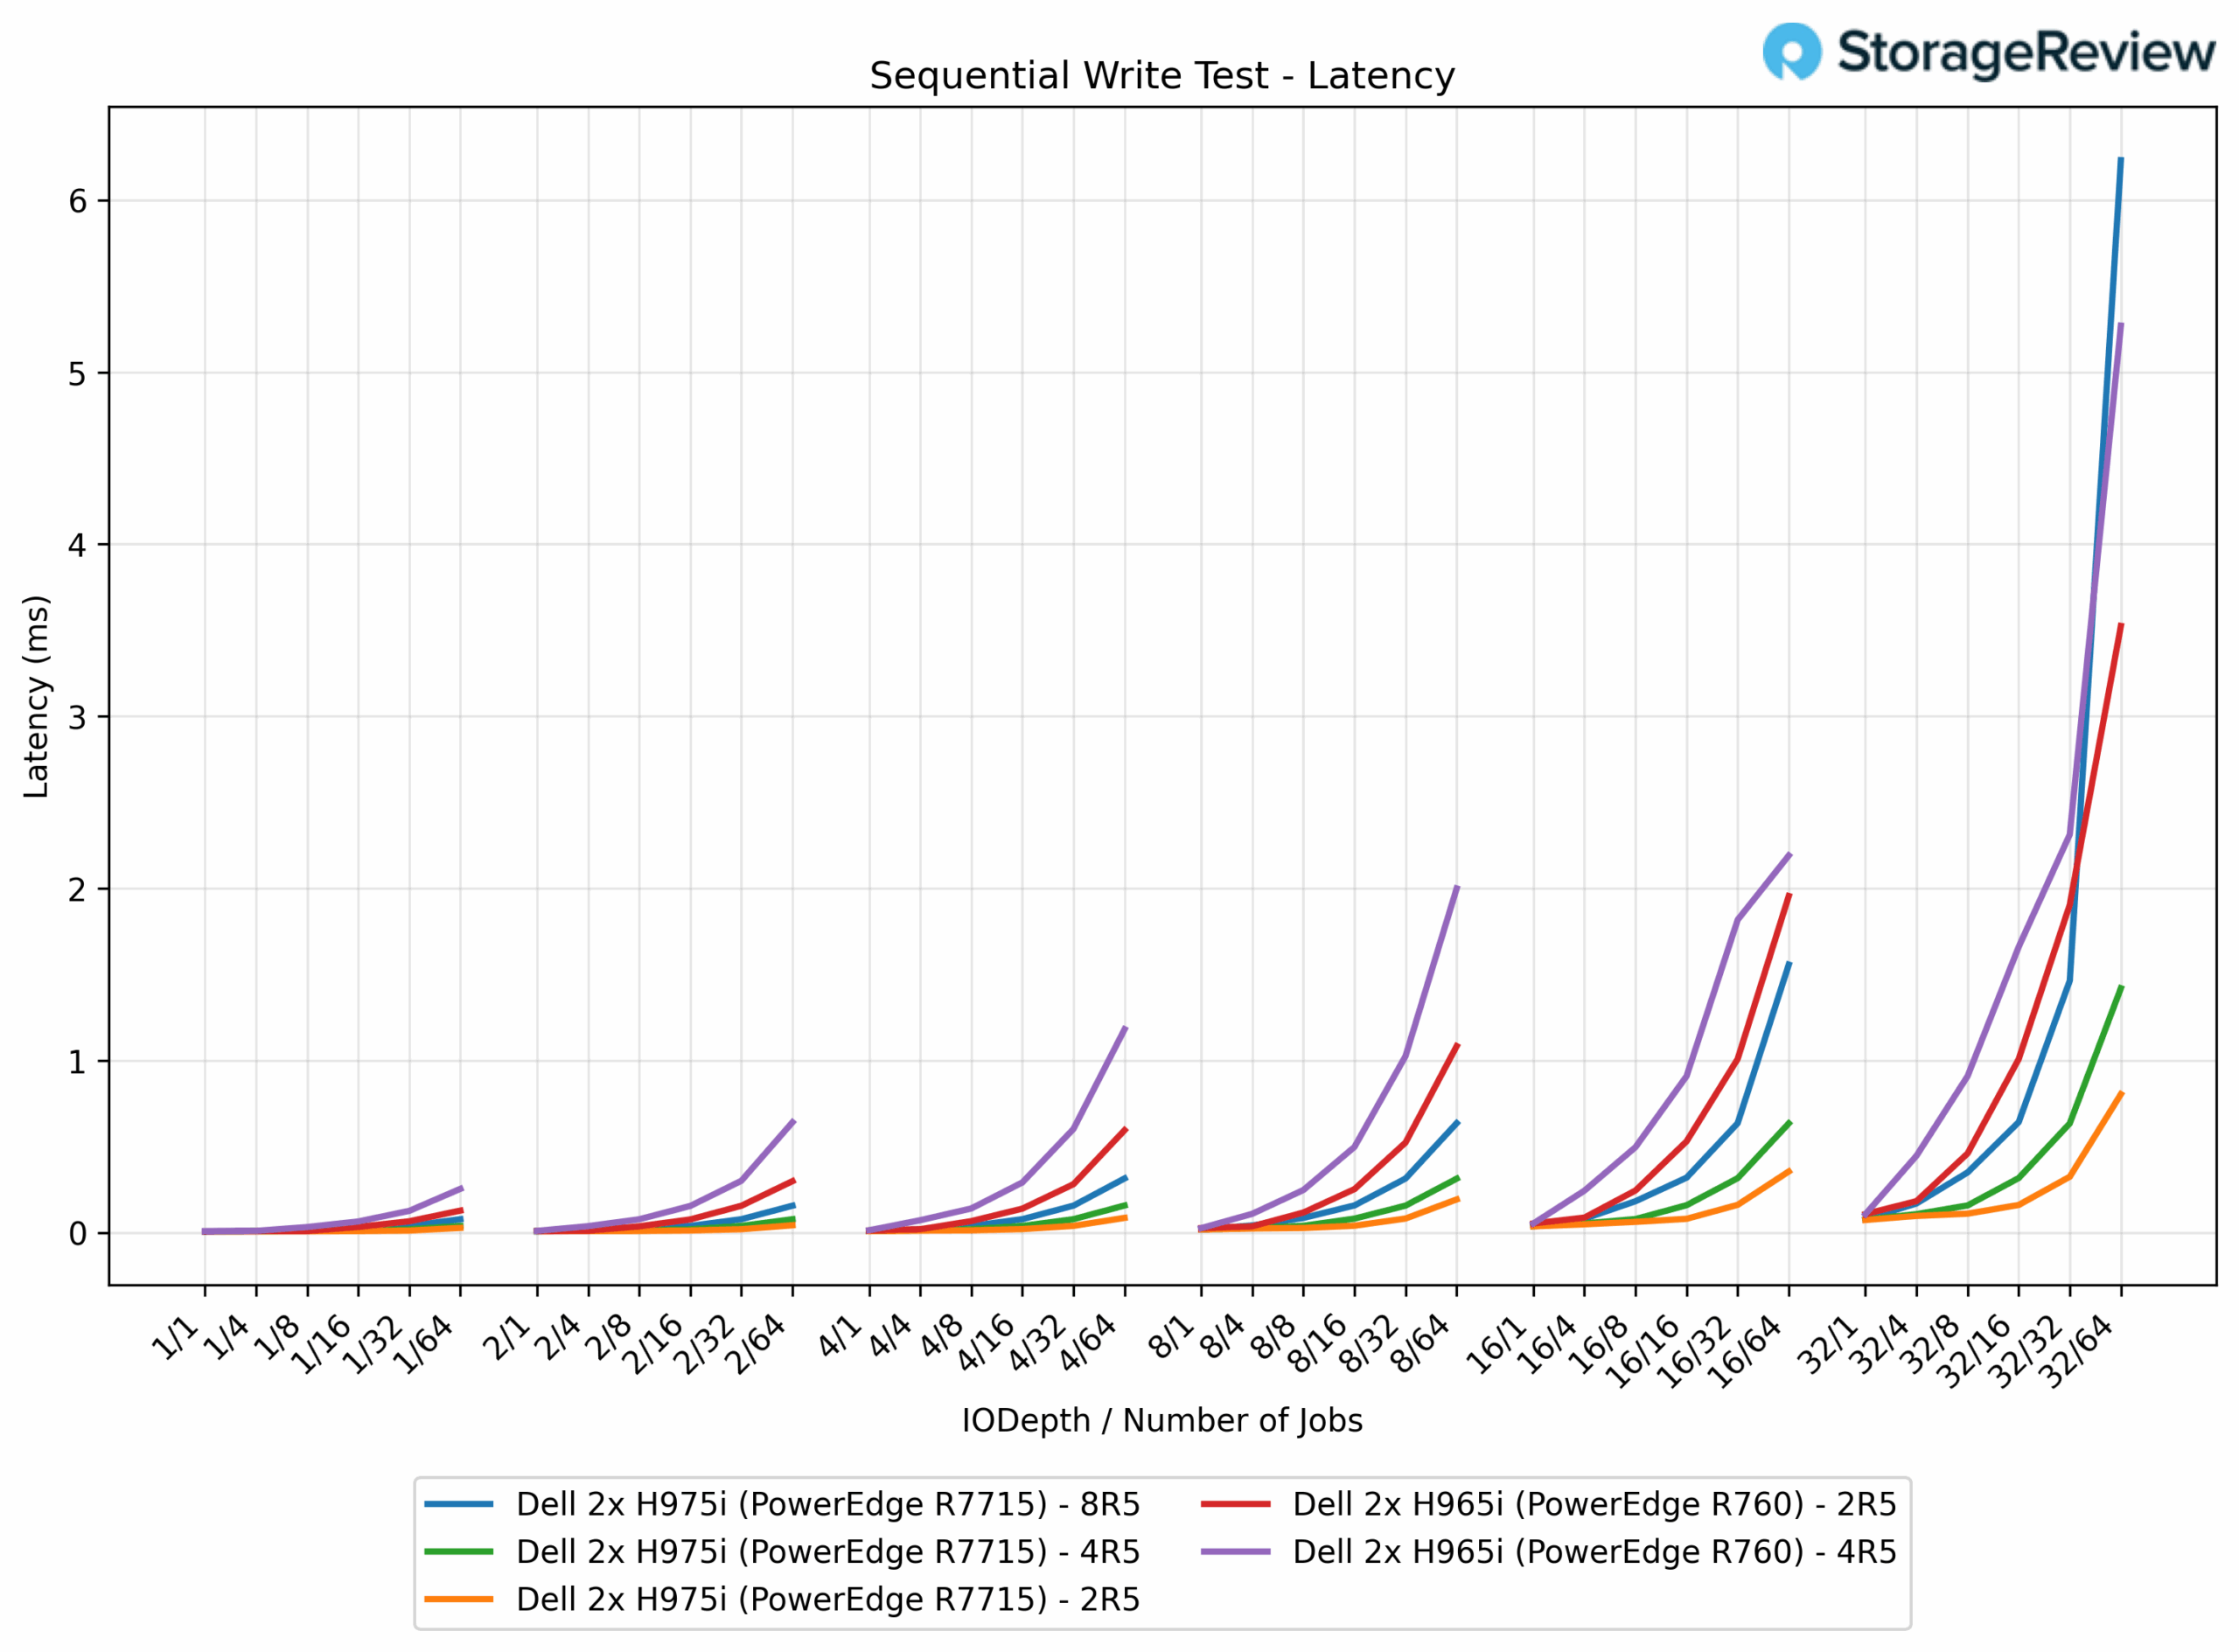
16k IOPS di lettura sequenziale
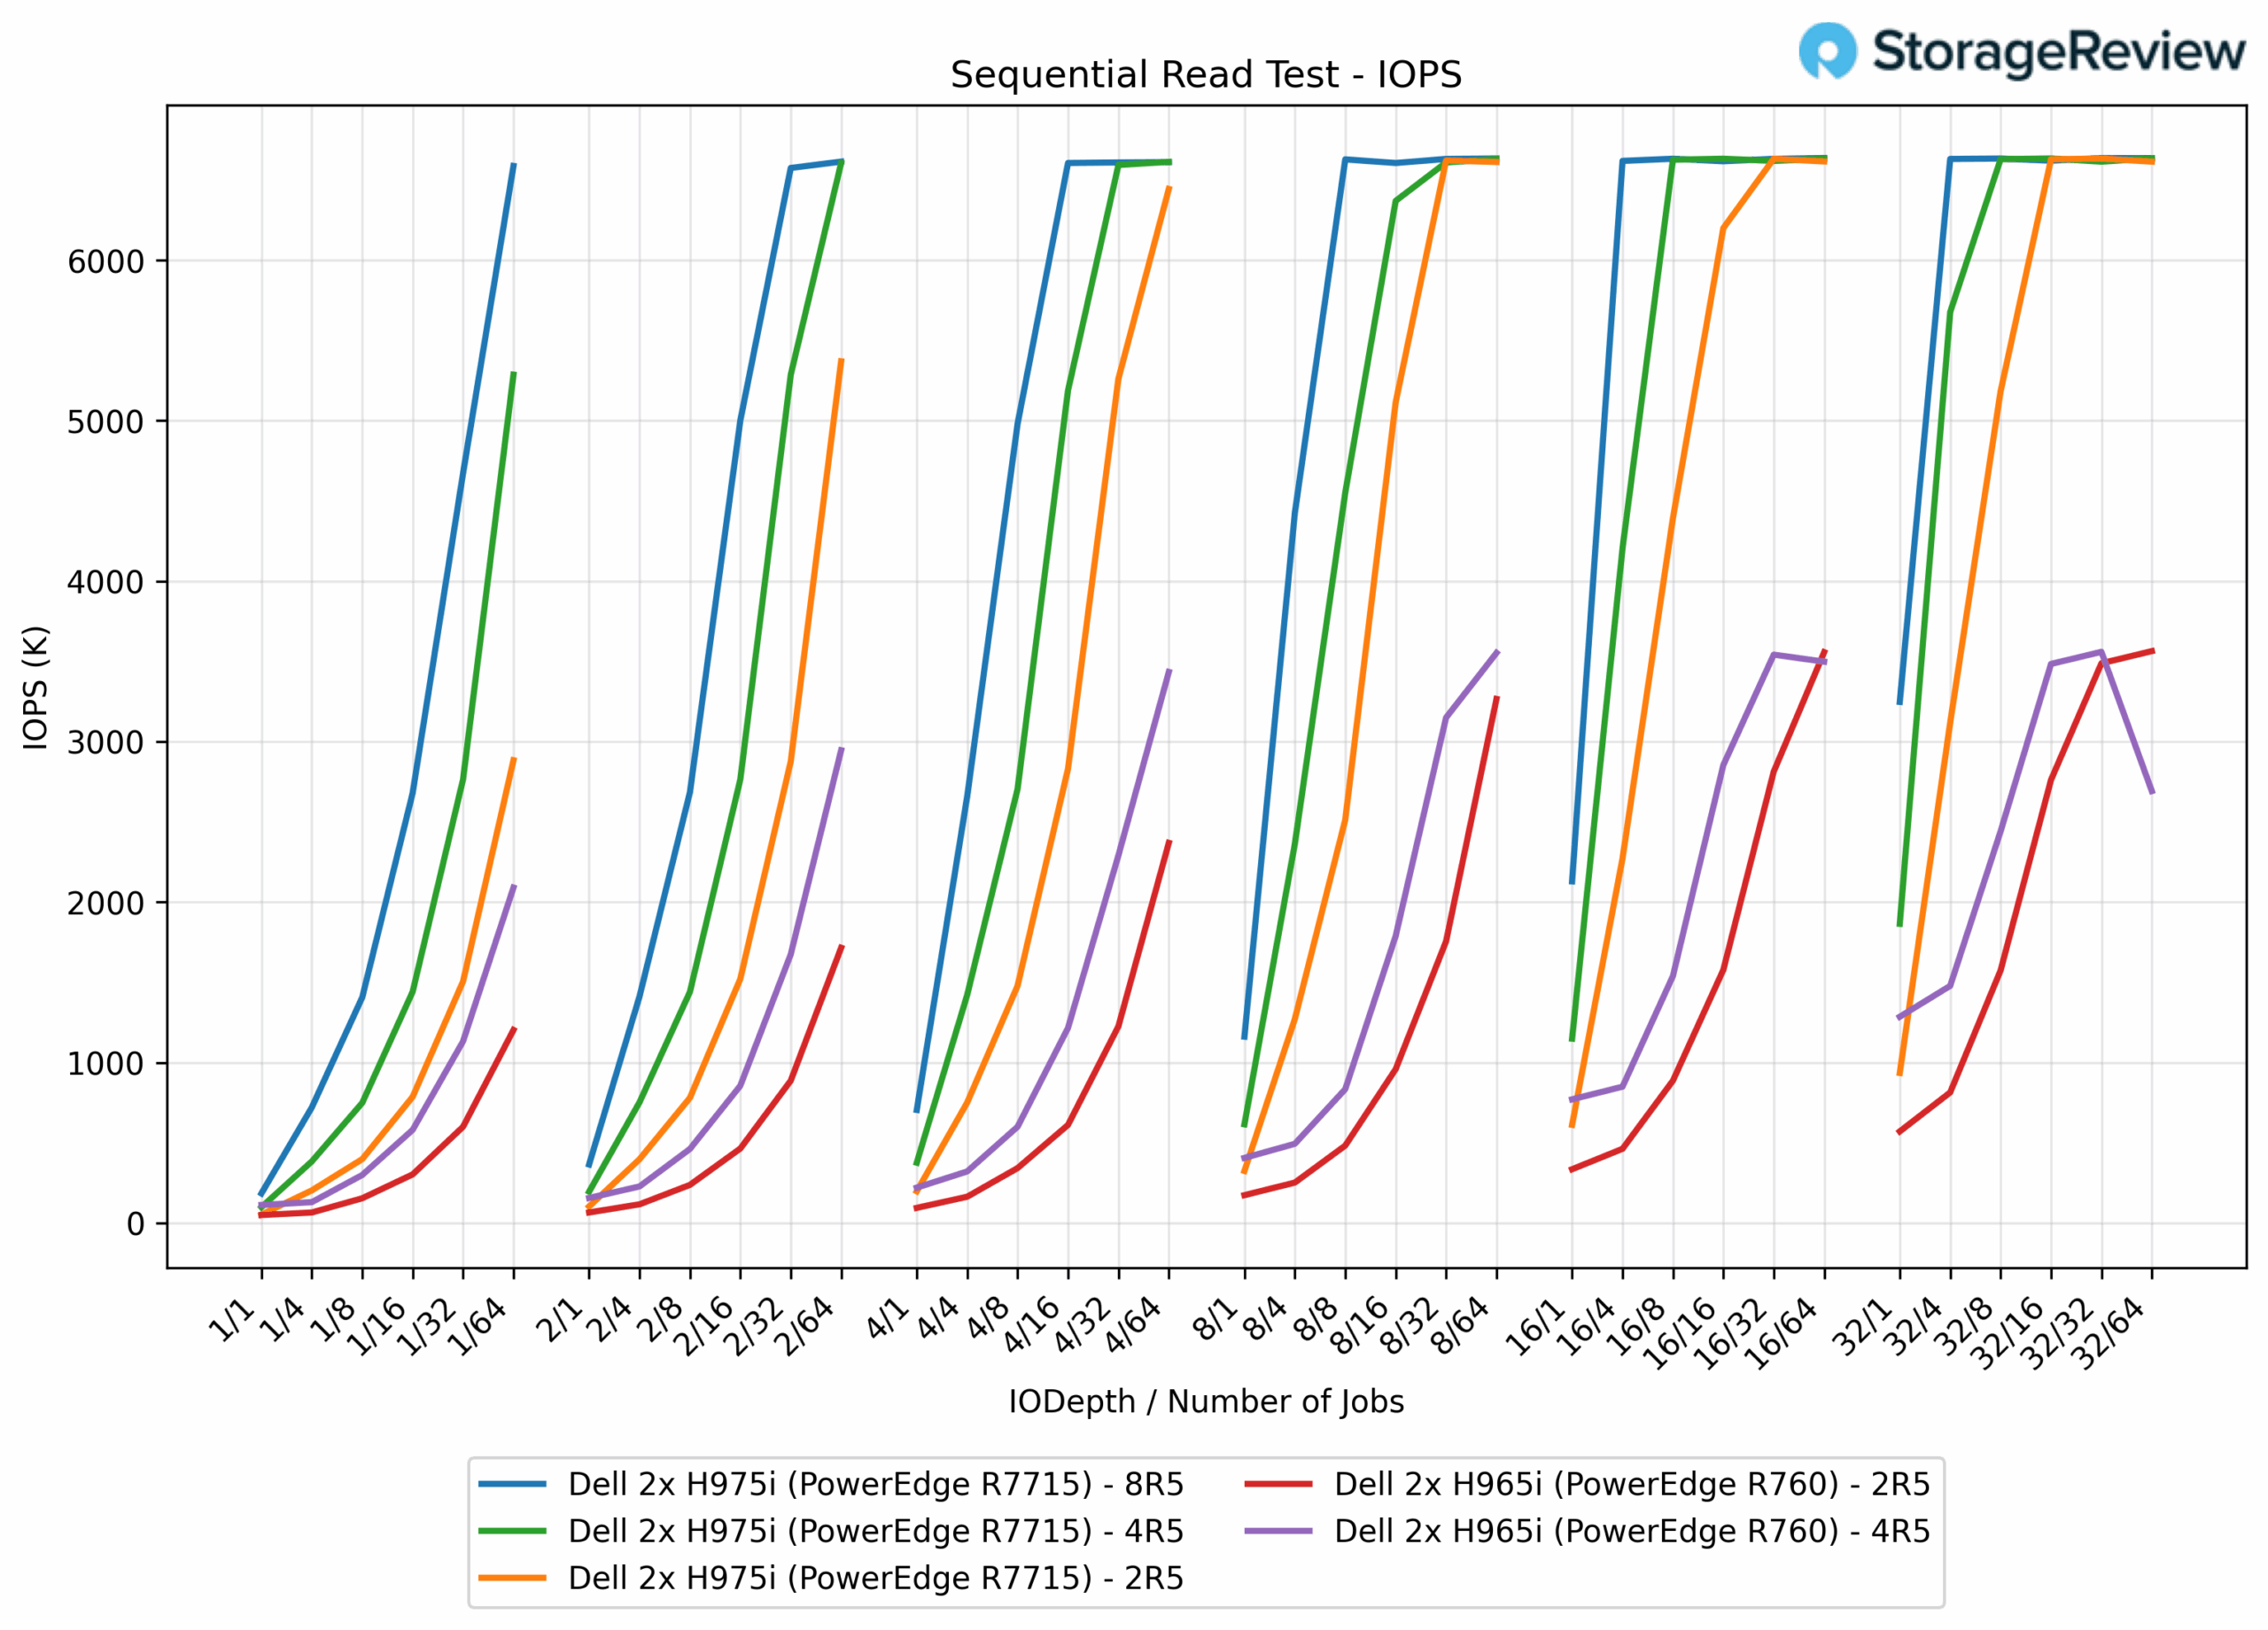
Nei test di lettura sequenziale a 16K, i controller PERC H965i hanno fornito risultati coerenti, con la configurazione 2R5 che ha raggiunto 3.56 milioni di IOPS e anche la configurazione 4R5 ha raggiunto 3.56 milioni di IOPS. A titolo di confronto, i controller PERC H975i hanno visto tutte le configurazioni raggrupparsi attorno a 6.64 milioni di IOPS, con un miglioramento dell'86% rispetto all'H965i.
Latenza di lettura sequenziale 16k
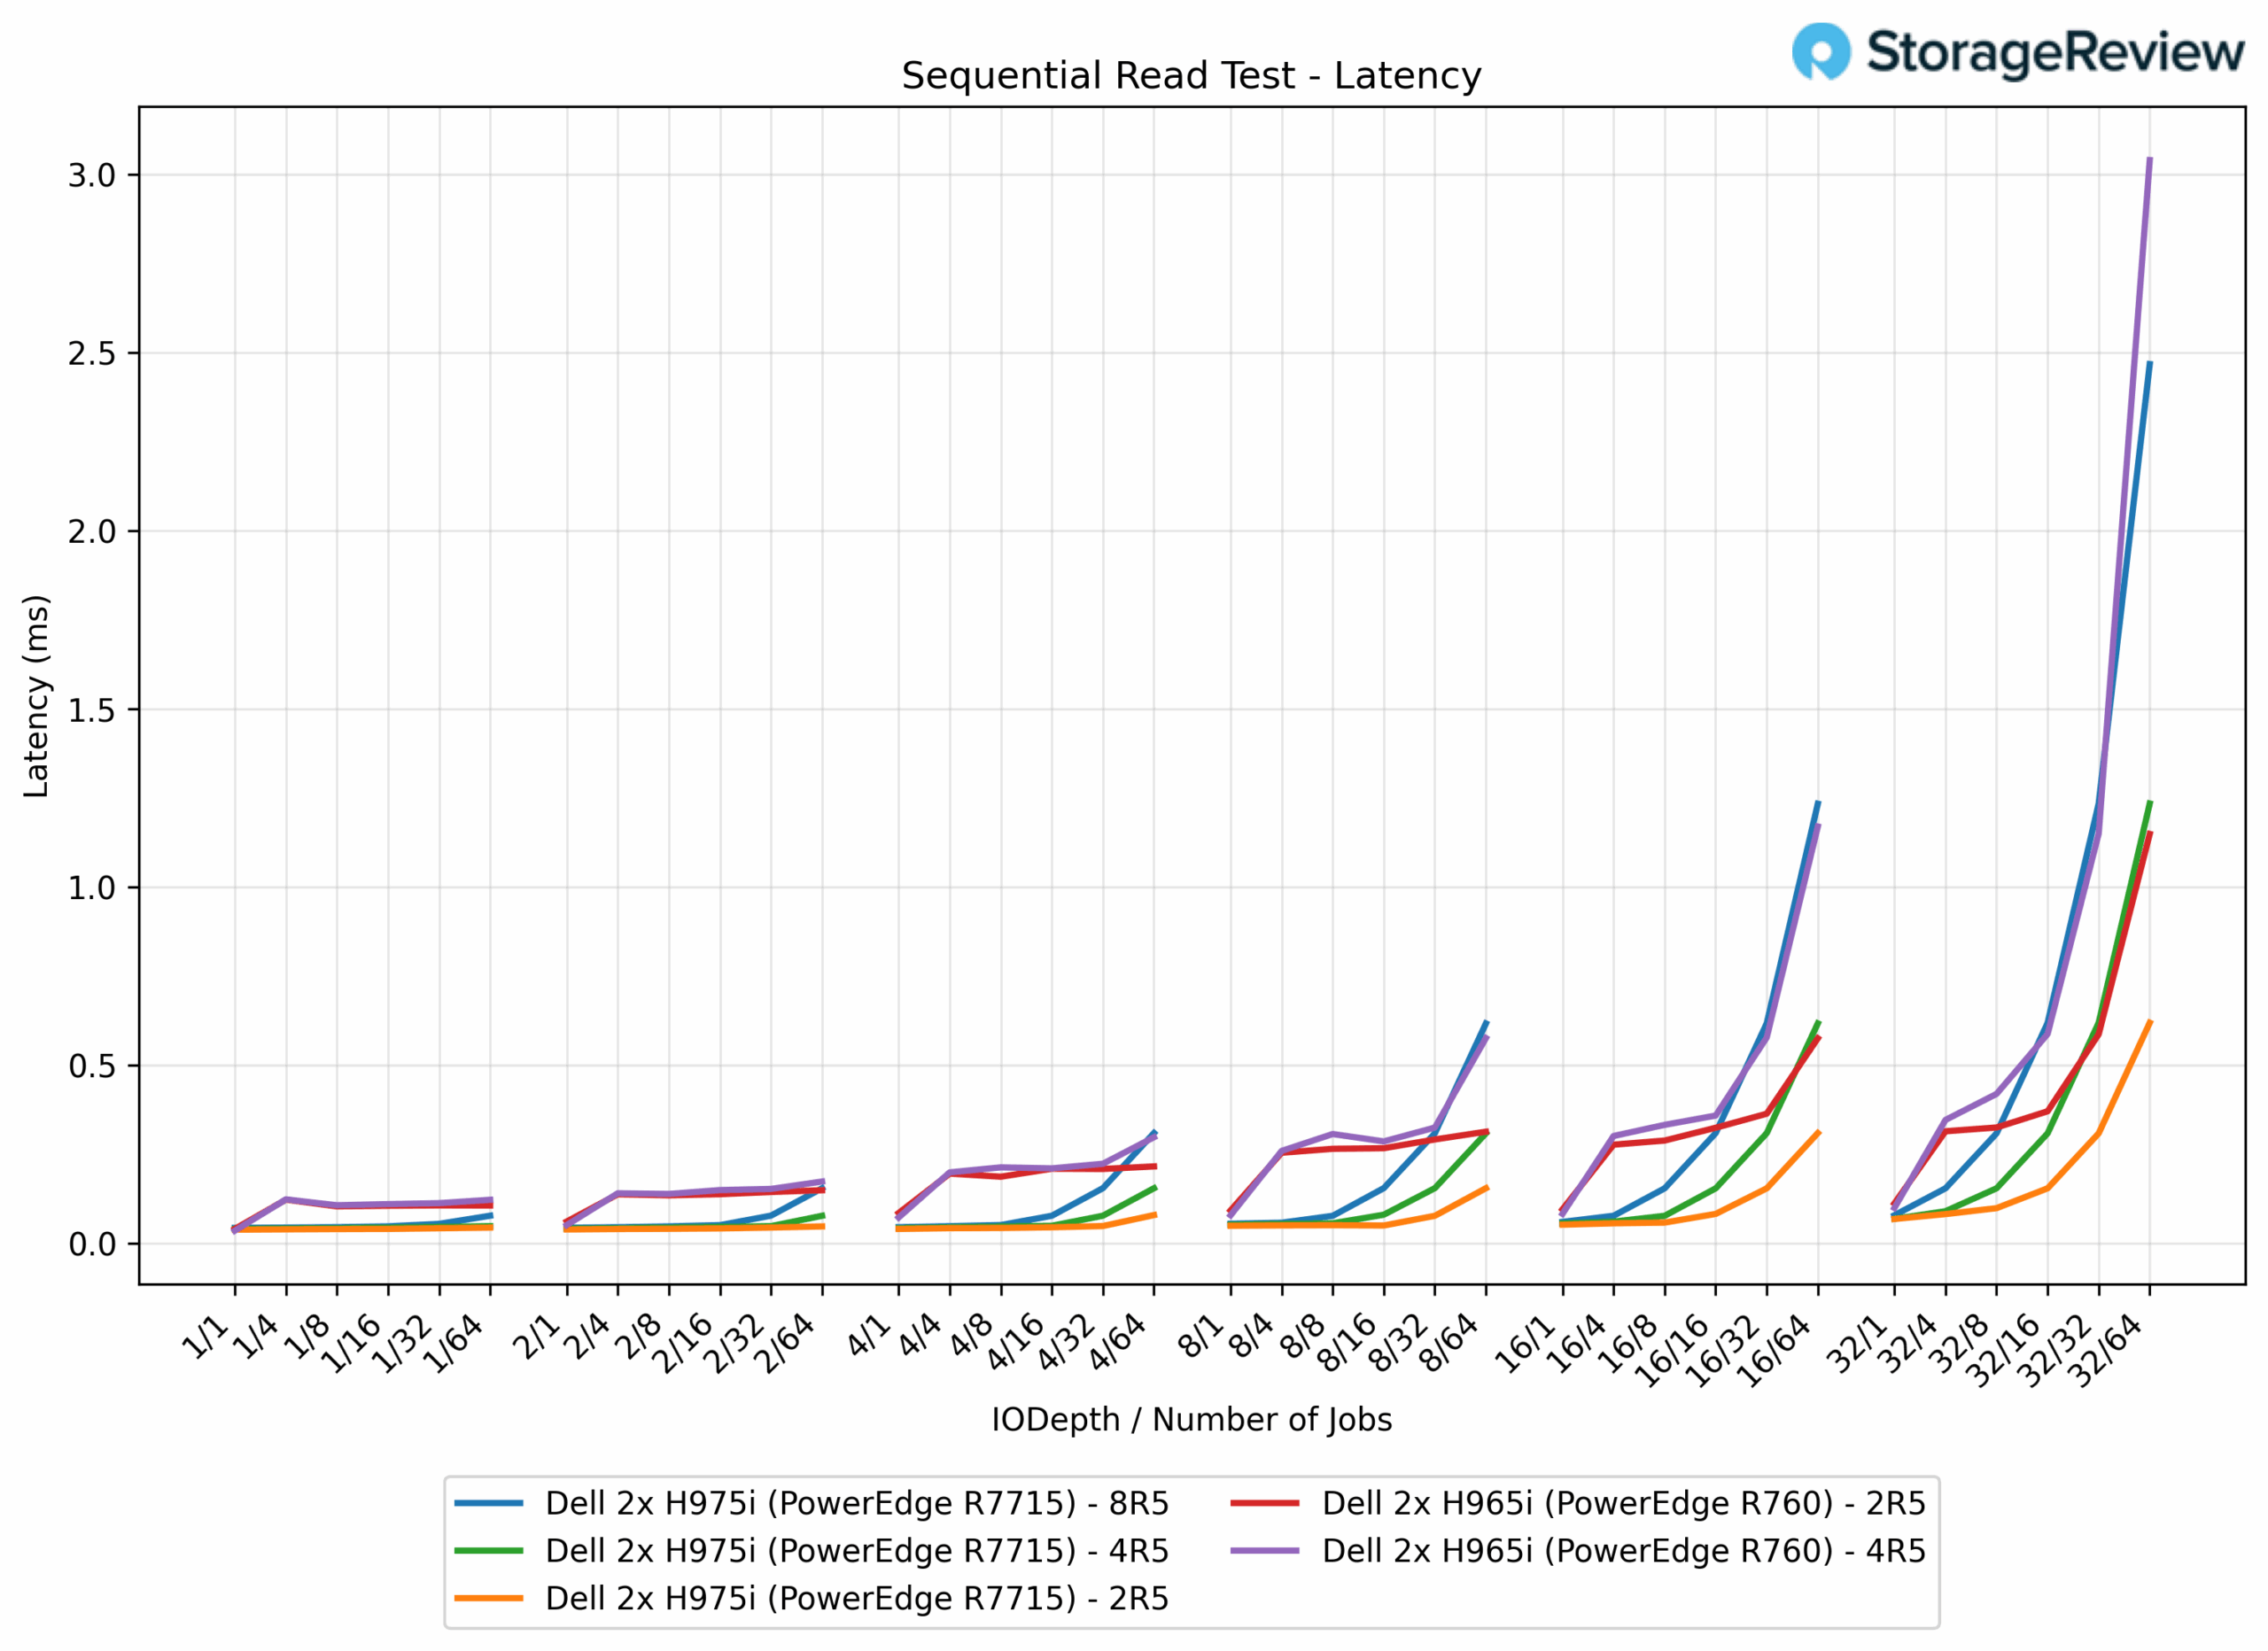
Nelle letture sequenziali da 16K, l'array 965R2 dell'H5i variava da 0.040 ms a 1.15 ms, mentre quello del 4R5 arrivava fino a 3.0 ms. Sull'H975i, le latenze sono migliorate: il 2R5 si attestava su 0.038-0.62 ms (46% in meno), il 4R5 raggiungeva il picco a 1.23 ms (59% in meno) e l'8R5 raggiungeva 2.47 ms (19% in meno rispetto all'H965i 4R5).
IOPS in scrittura casuale 16k
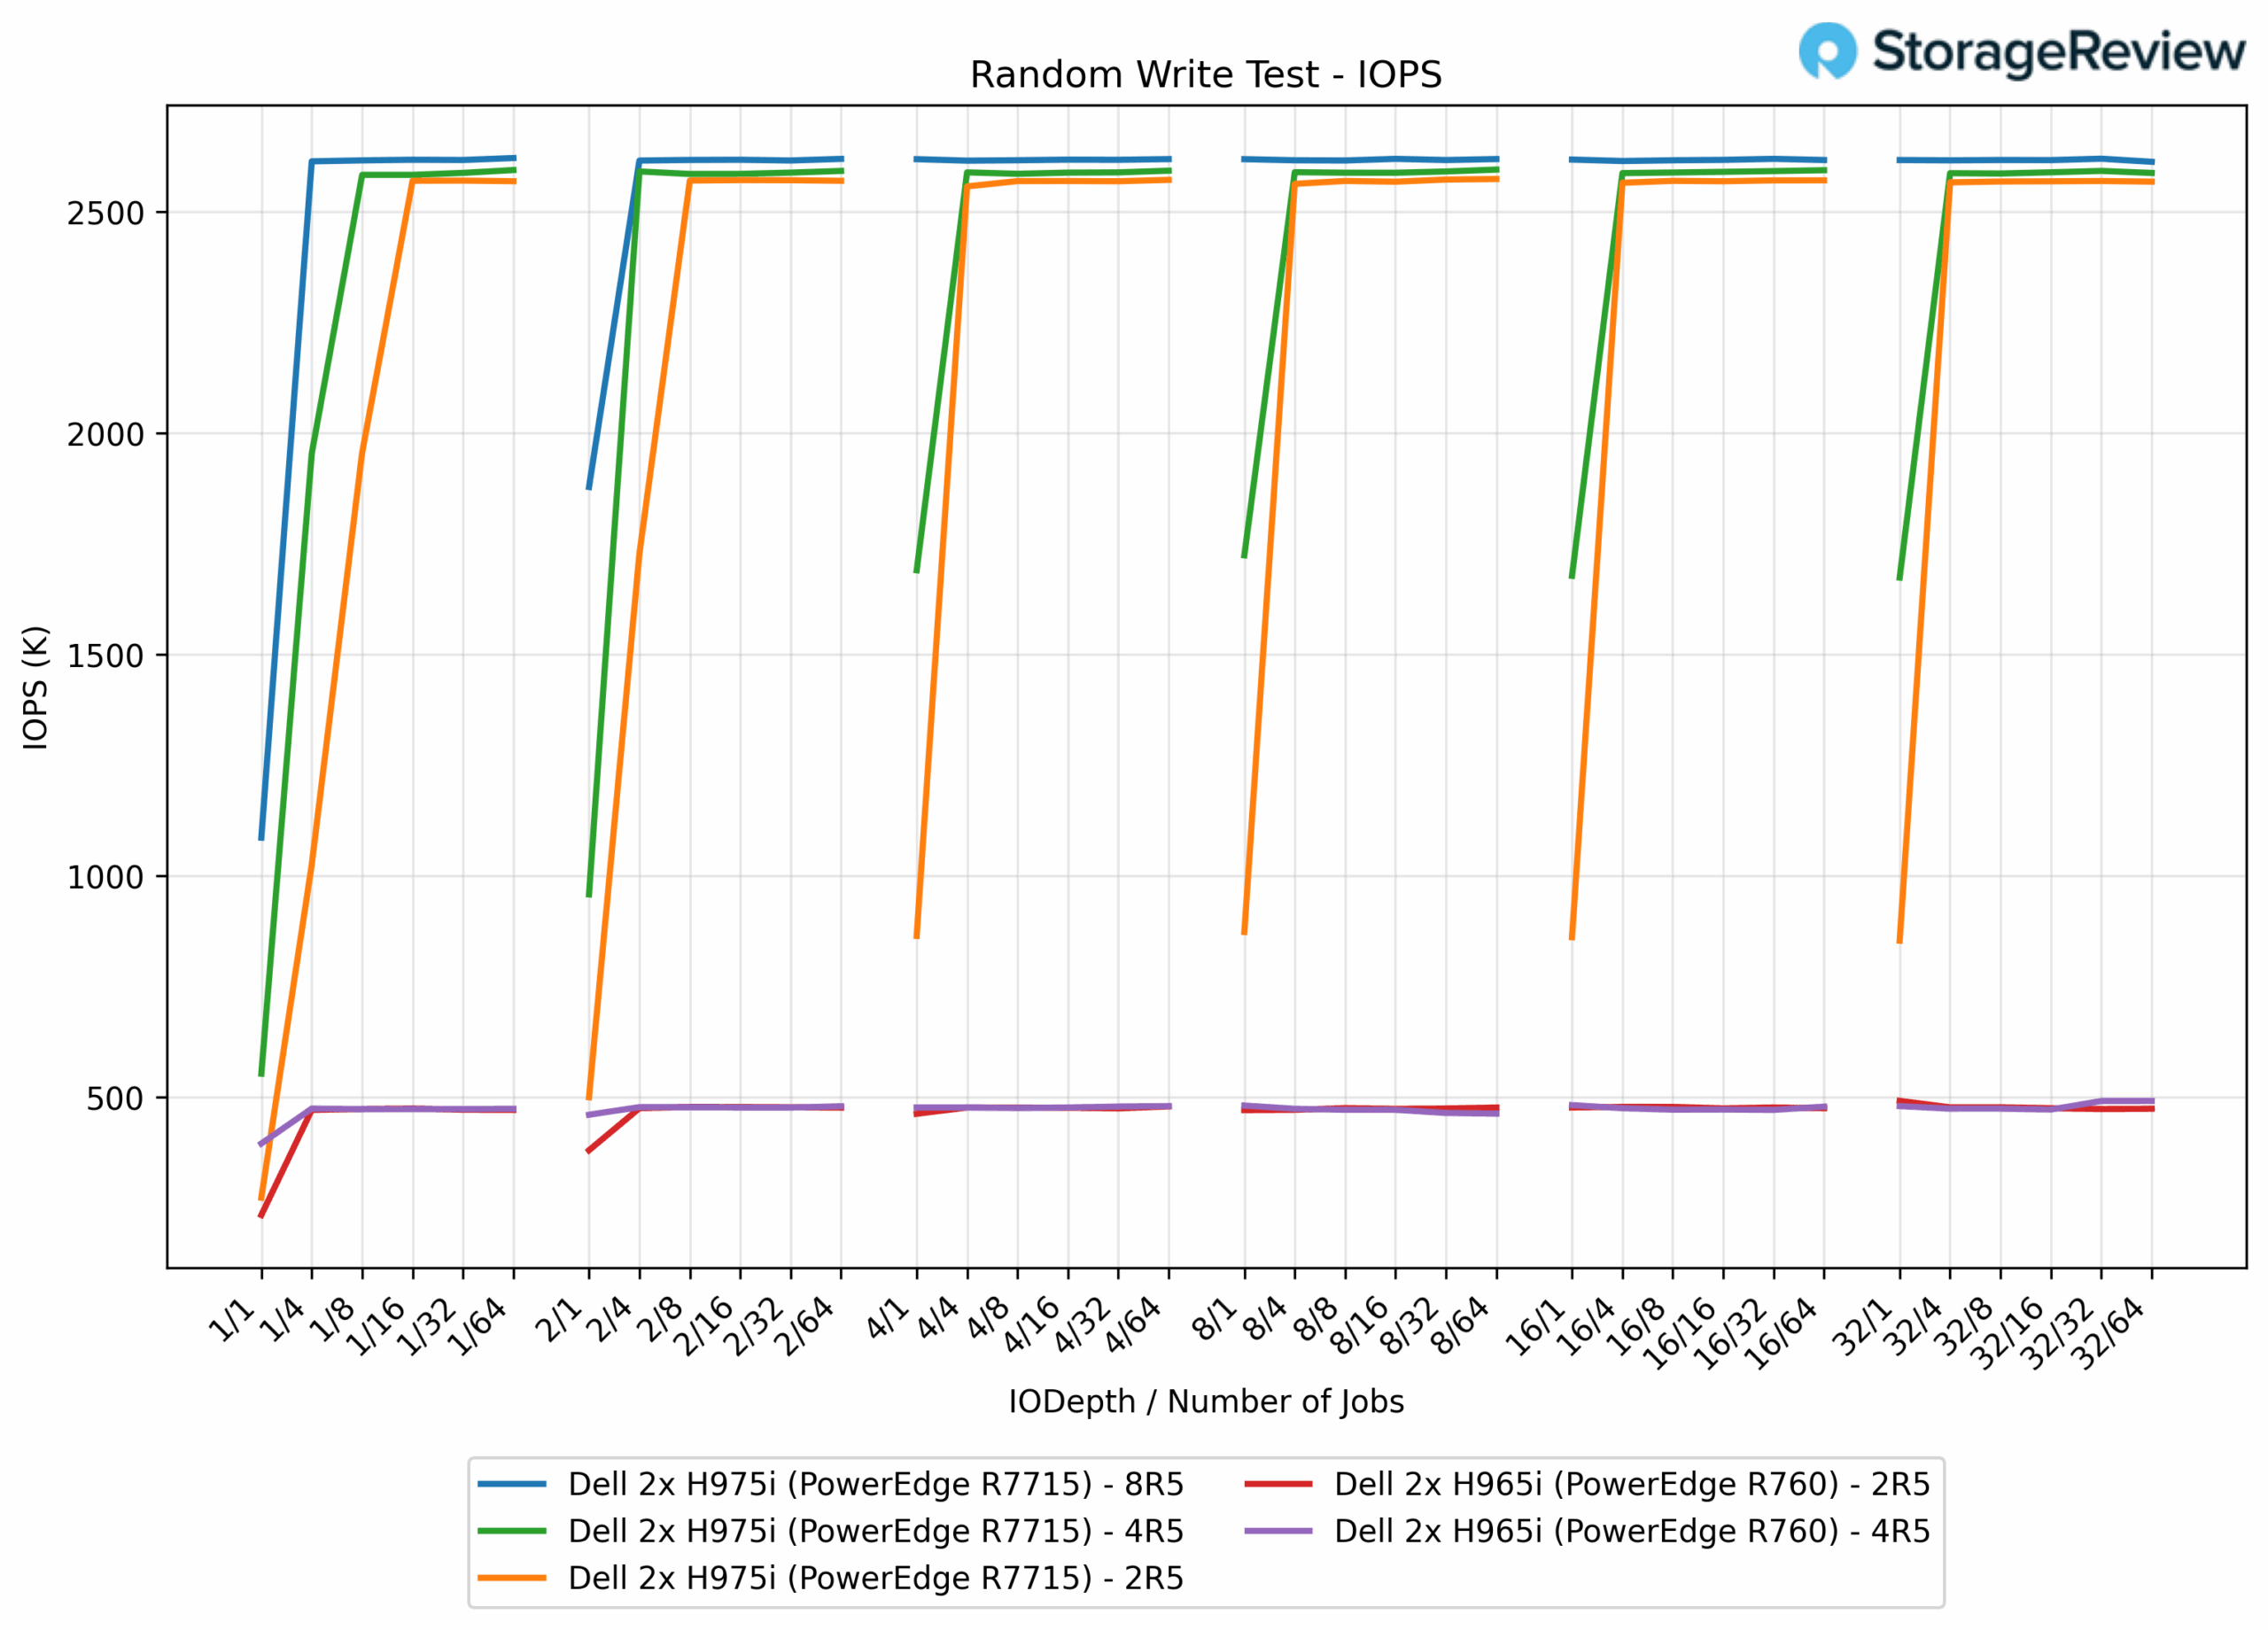
Con IO casuali a blocchi da 16K, abbiamo visto il punto di saturazione raggiunto molto presto nei test. Entrambe le configurazioni PERC H965i (2R5 e 4R5) hanno offerto prestazioni pressoché identiche, con circa 492,000 IOPS. I controller PERC H975i con array 2R5 hanno raggiunto 2.57 milioni di IOPS (miglioramento del 422%). Le configurazioni H975i 4R5 e 8R5 hanno ottenuto risultati leggermente superiori, con circa 2.60 milioni di IOPS (miglioramento del 428%).
Latenza di scrittura casuale 16k
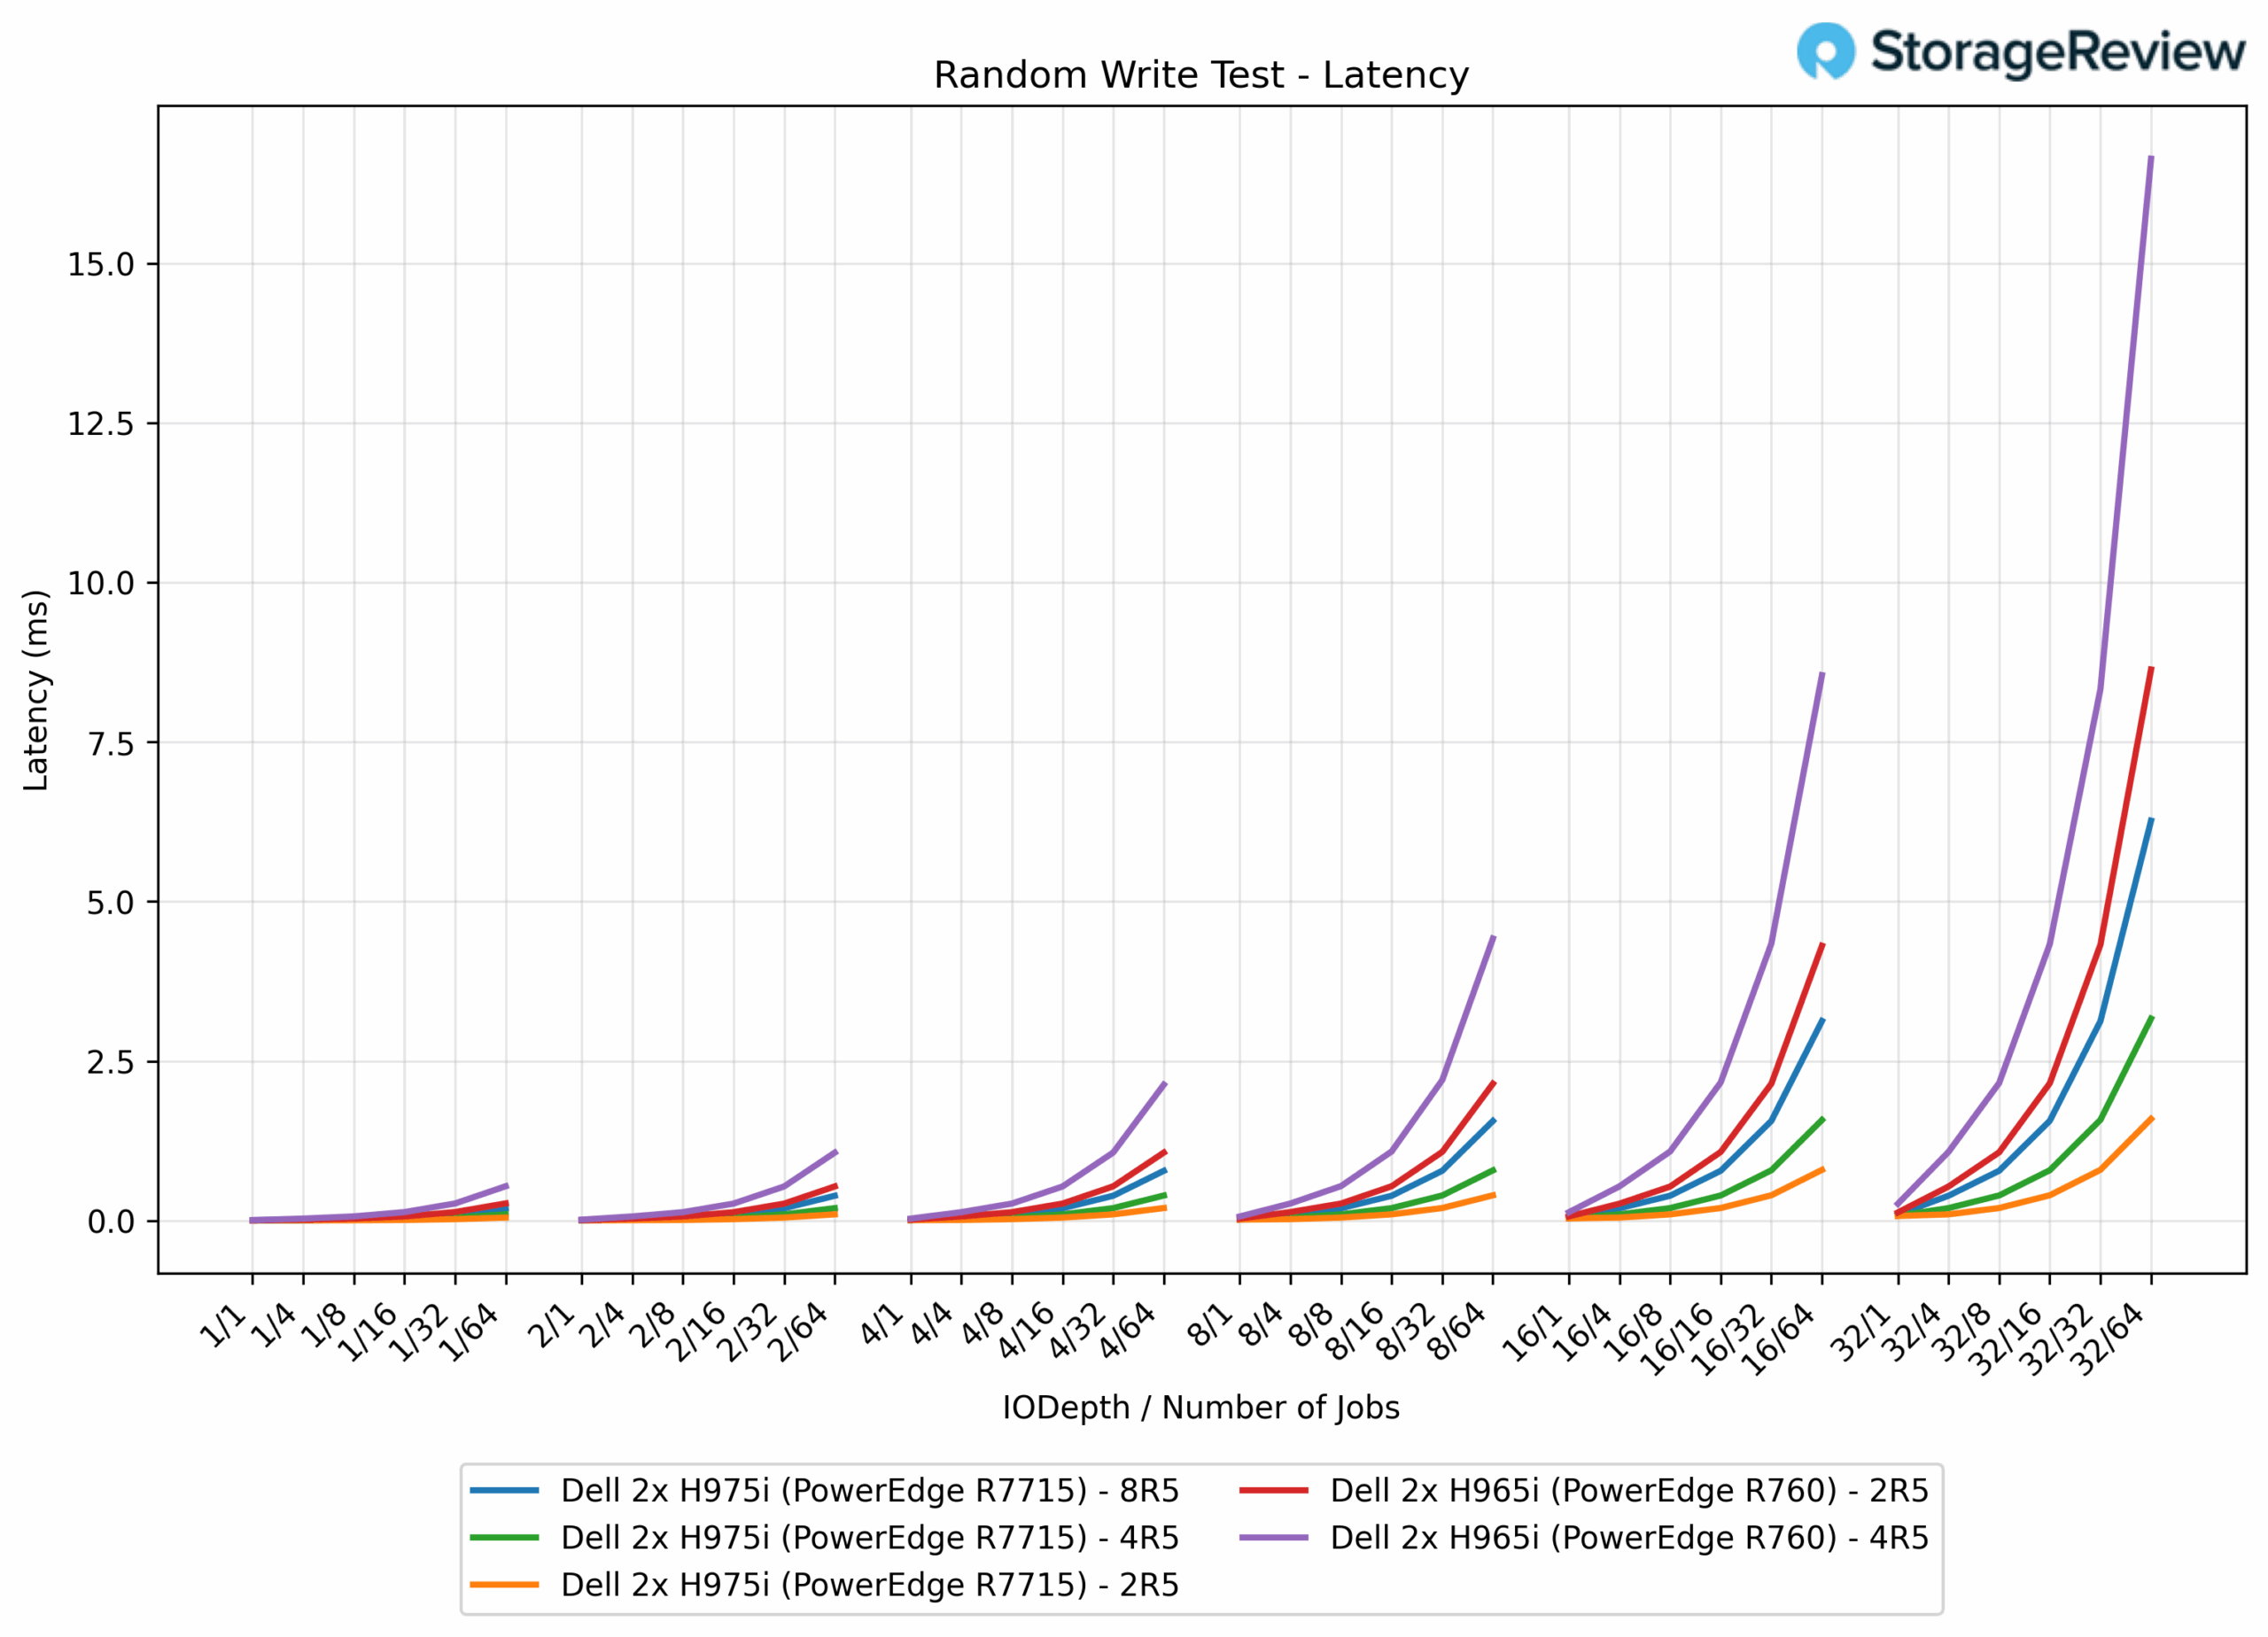
Con 16K di scritture casuali, l'H965i ha registrato una latenza maggiore, con 2R5 che si estendeva da 0.0082 a 8.6 ms e 4R5 che arrivava a 16.6 ms. L'H975i ha registrato un netto miglioramento, con 2R5 tra 0.0070 e 1.59 ms (inferiore dell'82%), 4R5 fino a 3.17 ms (inferiore dell'81%) e 8R5 che raggiungeva un massimo di 6.27 ms (inferiore del 62% rispetto a 965R4 dell'H5i).
IOPS in lettura casuale 16k
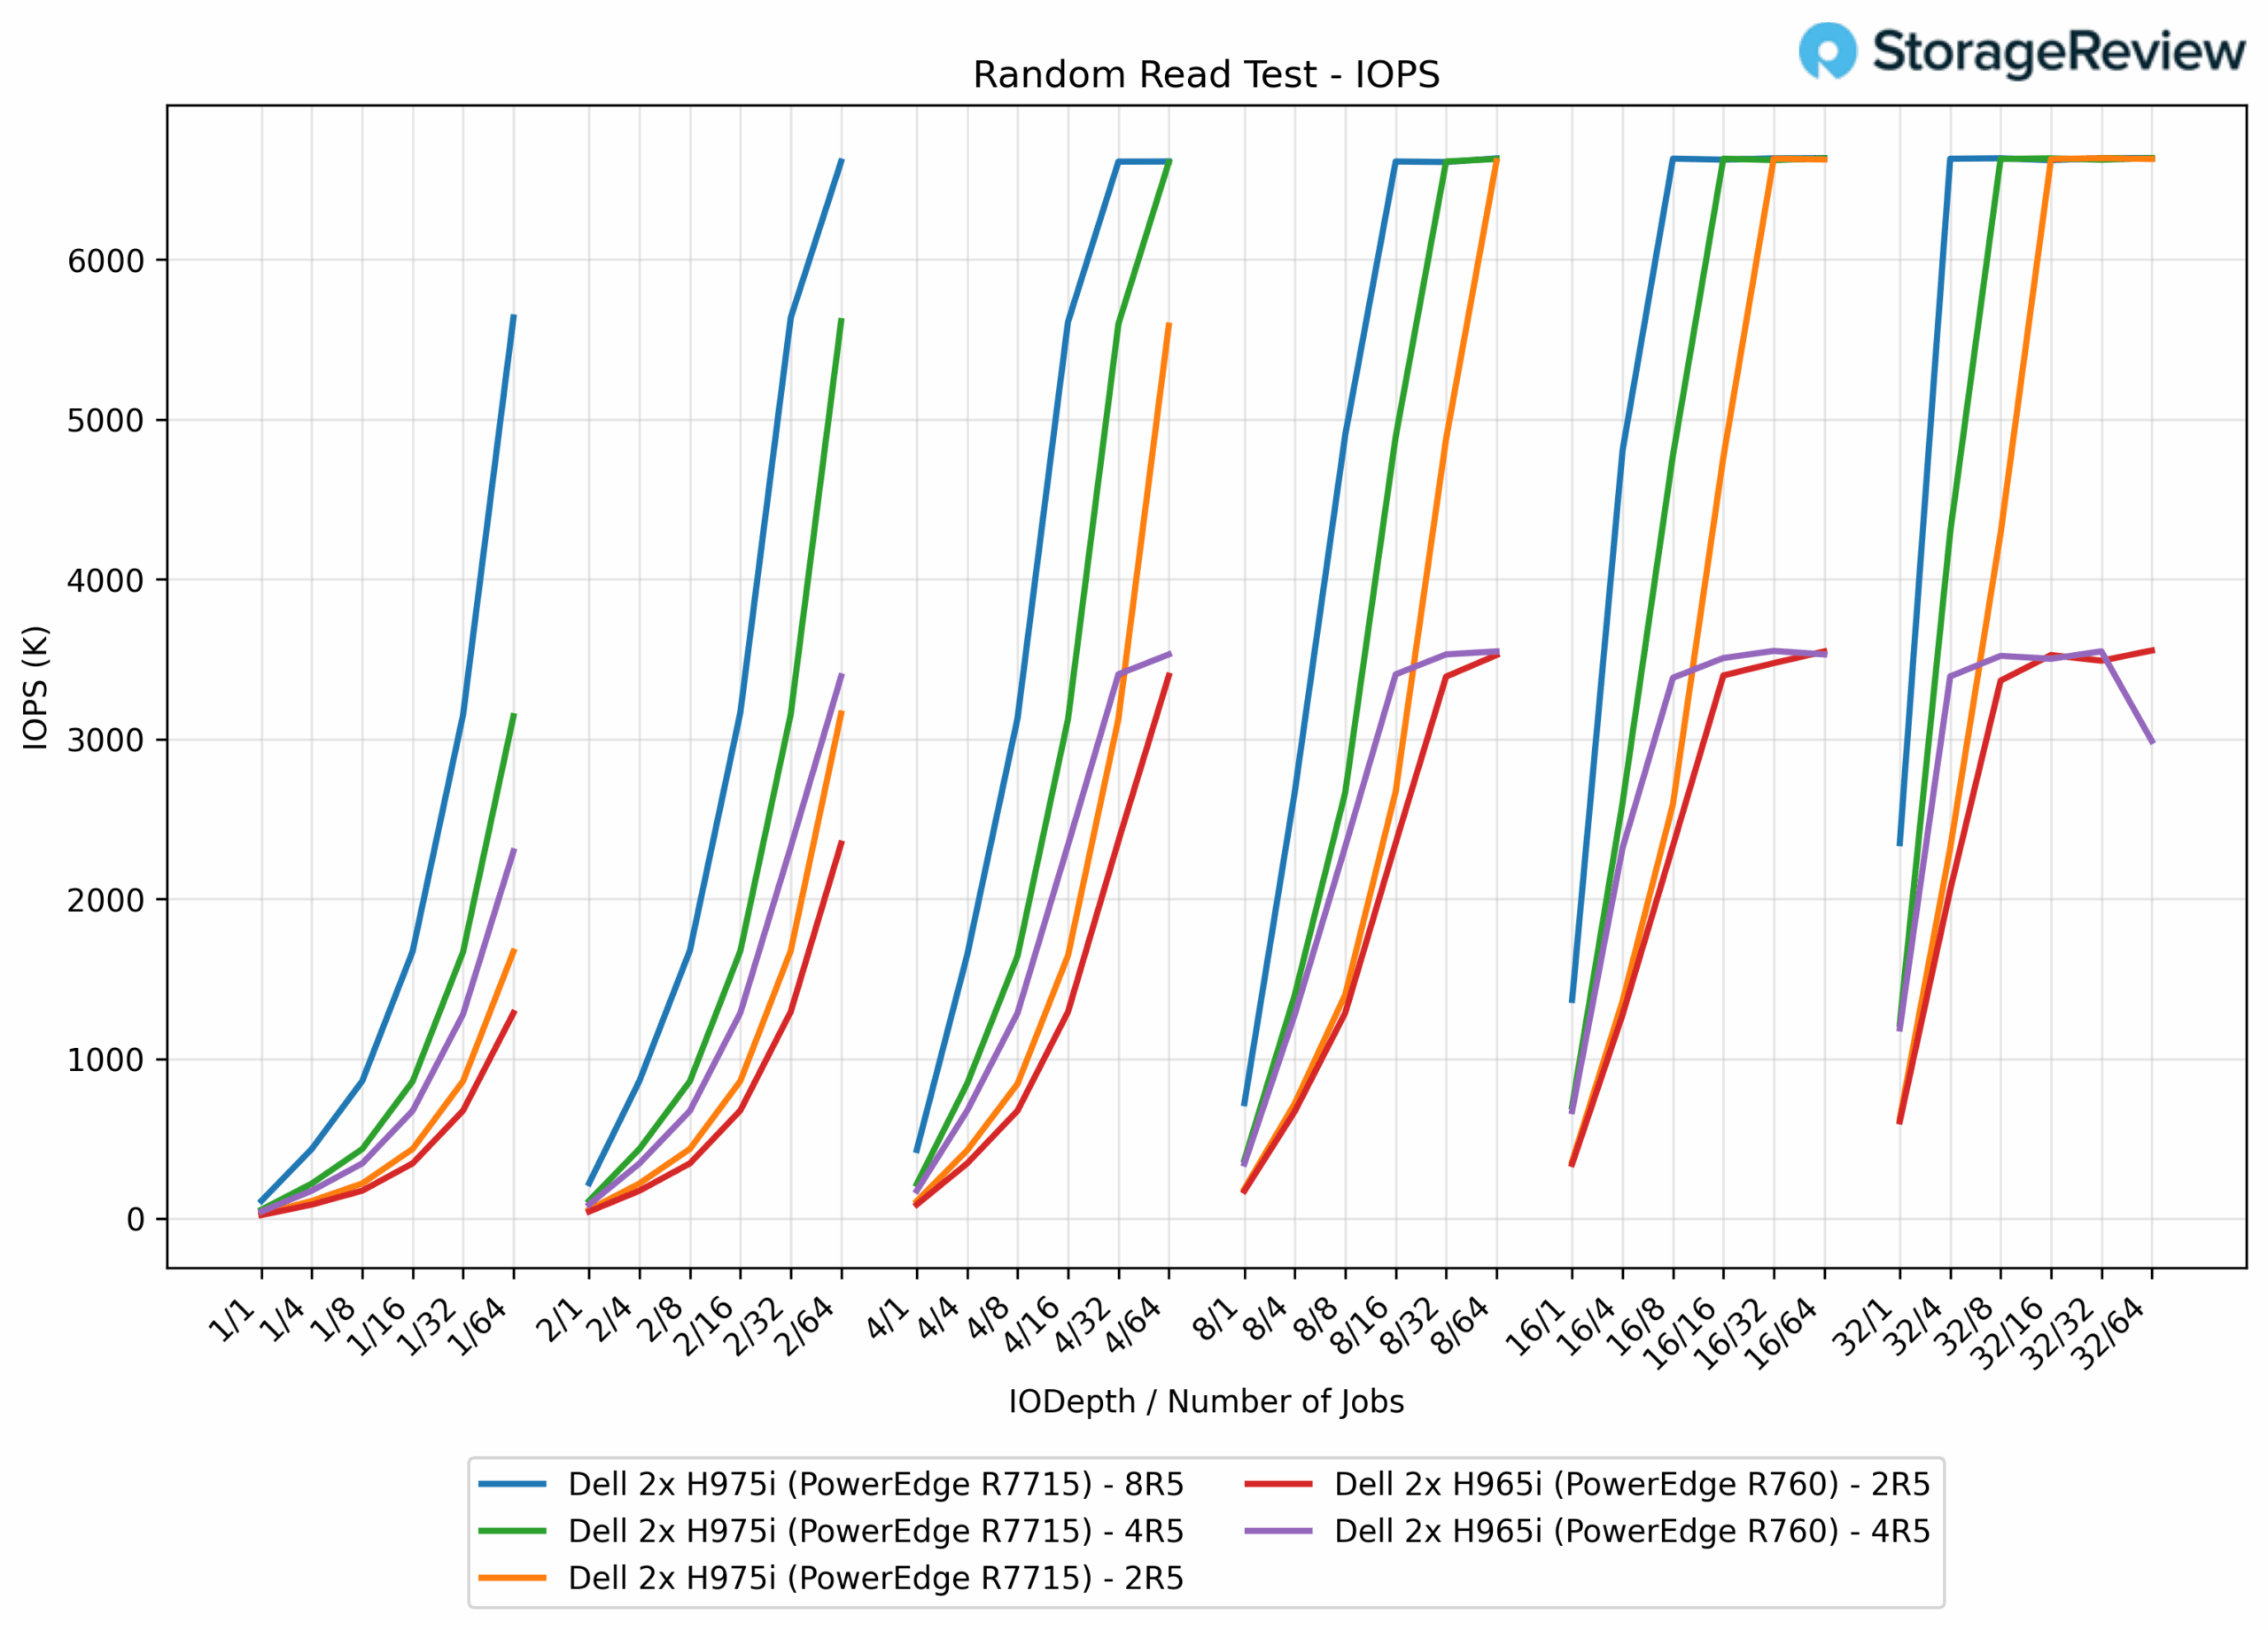
Nella lettura casuale a 16K, le configurazioni PERC H965i hanno offerto prestazioni costanti, con l'array 2R5 che ha raggiunto 3.55 milioni di IOPS e l'array 4R5 che ha raggiunto 3.55 milioni di IOPS. Le configurazioni PERC H975i 2R5, 4R5 e 8R5 hanno raggiunto prestazioni di picco pressoché identiche, pari a circa 6.64 milioni di IOPS, con un miglioramento dell'87% rispetto alla generazione H965i.
Latenza di lettura casuale 16k
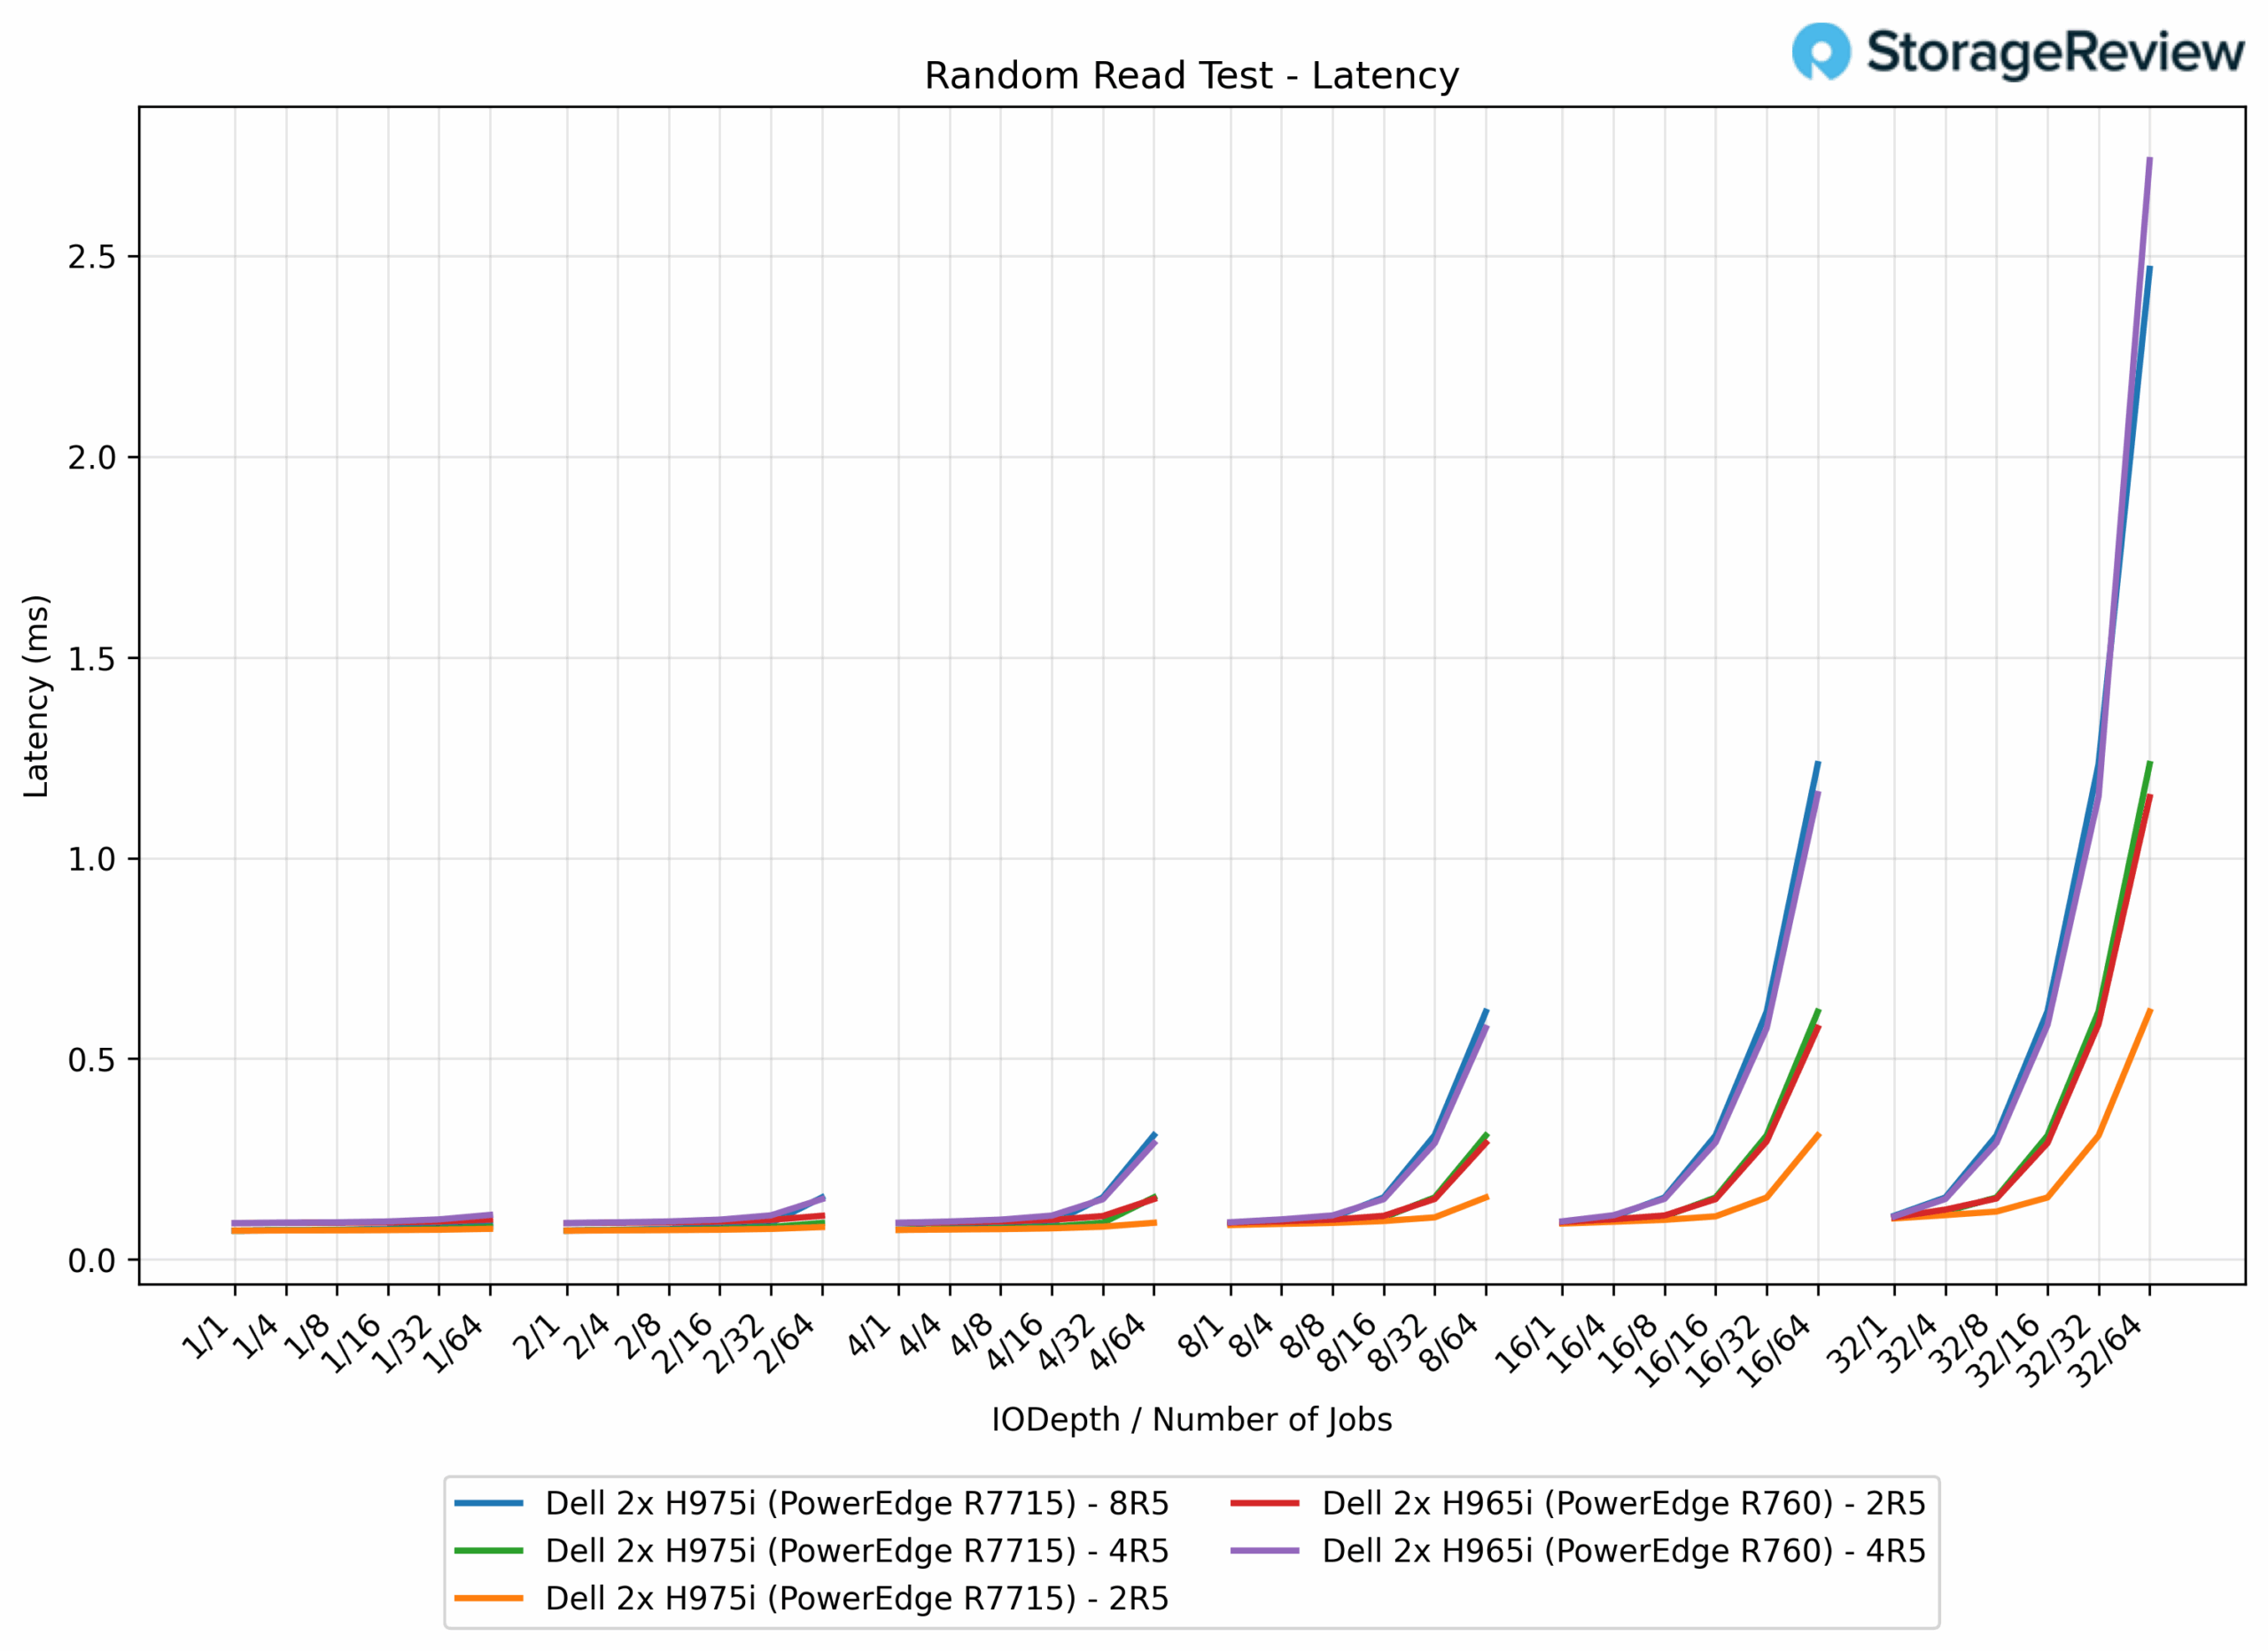
In letture casuali da 16K, gli array H965i hanno fornito 0.0906–1.15 ms per 2R5 e fino a 2.74 ms per 4R5. L'H975i ha nuovamente ridotto la latenza, con 2R5 a 0.072–0.62 ms (46% in meno), 4R5 fino a 1.23 ms (55% in meno) e 8R5 con picco a 2.47 ms (10% in meno rispetto a H965i 4R5).
IOPS in scrittura casuale 4K
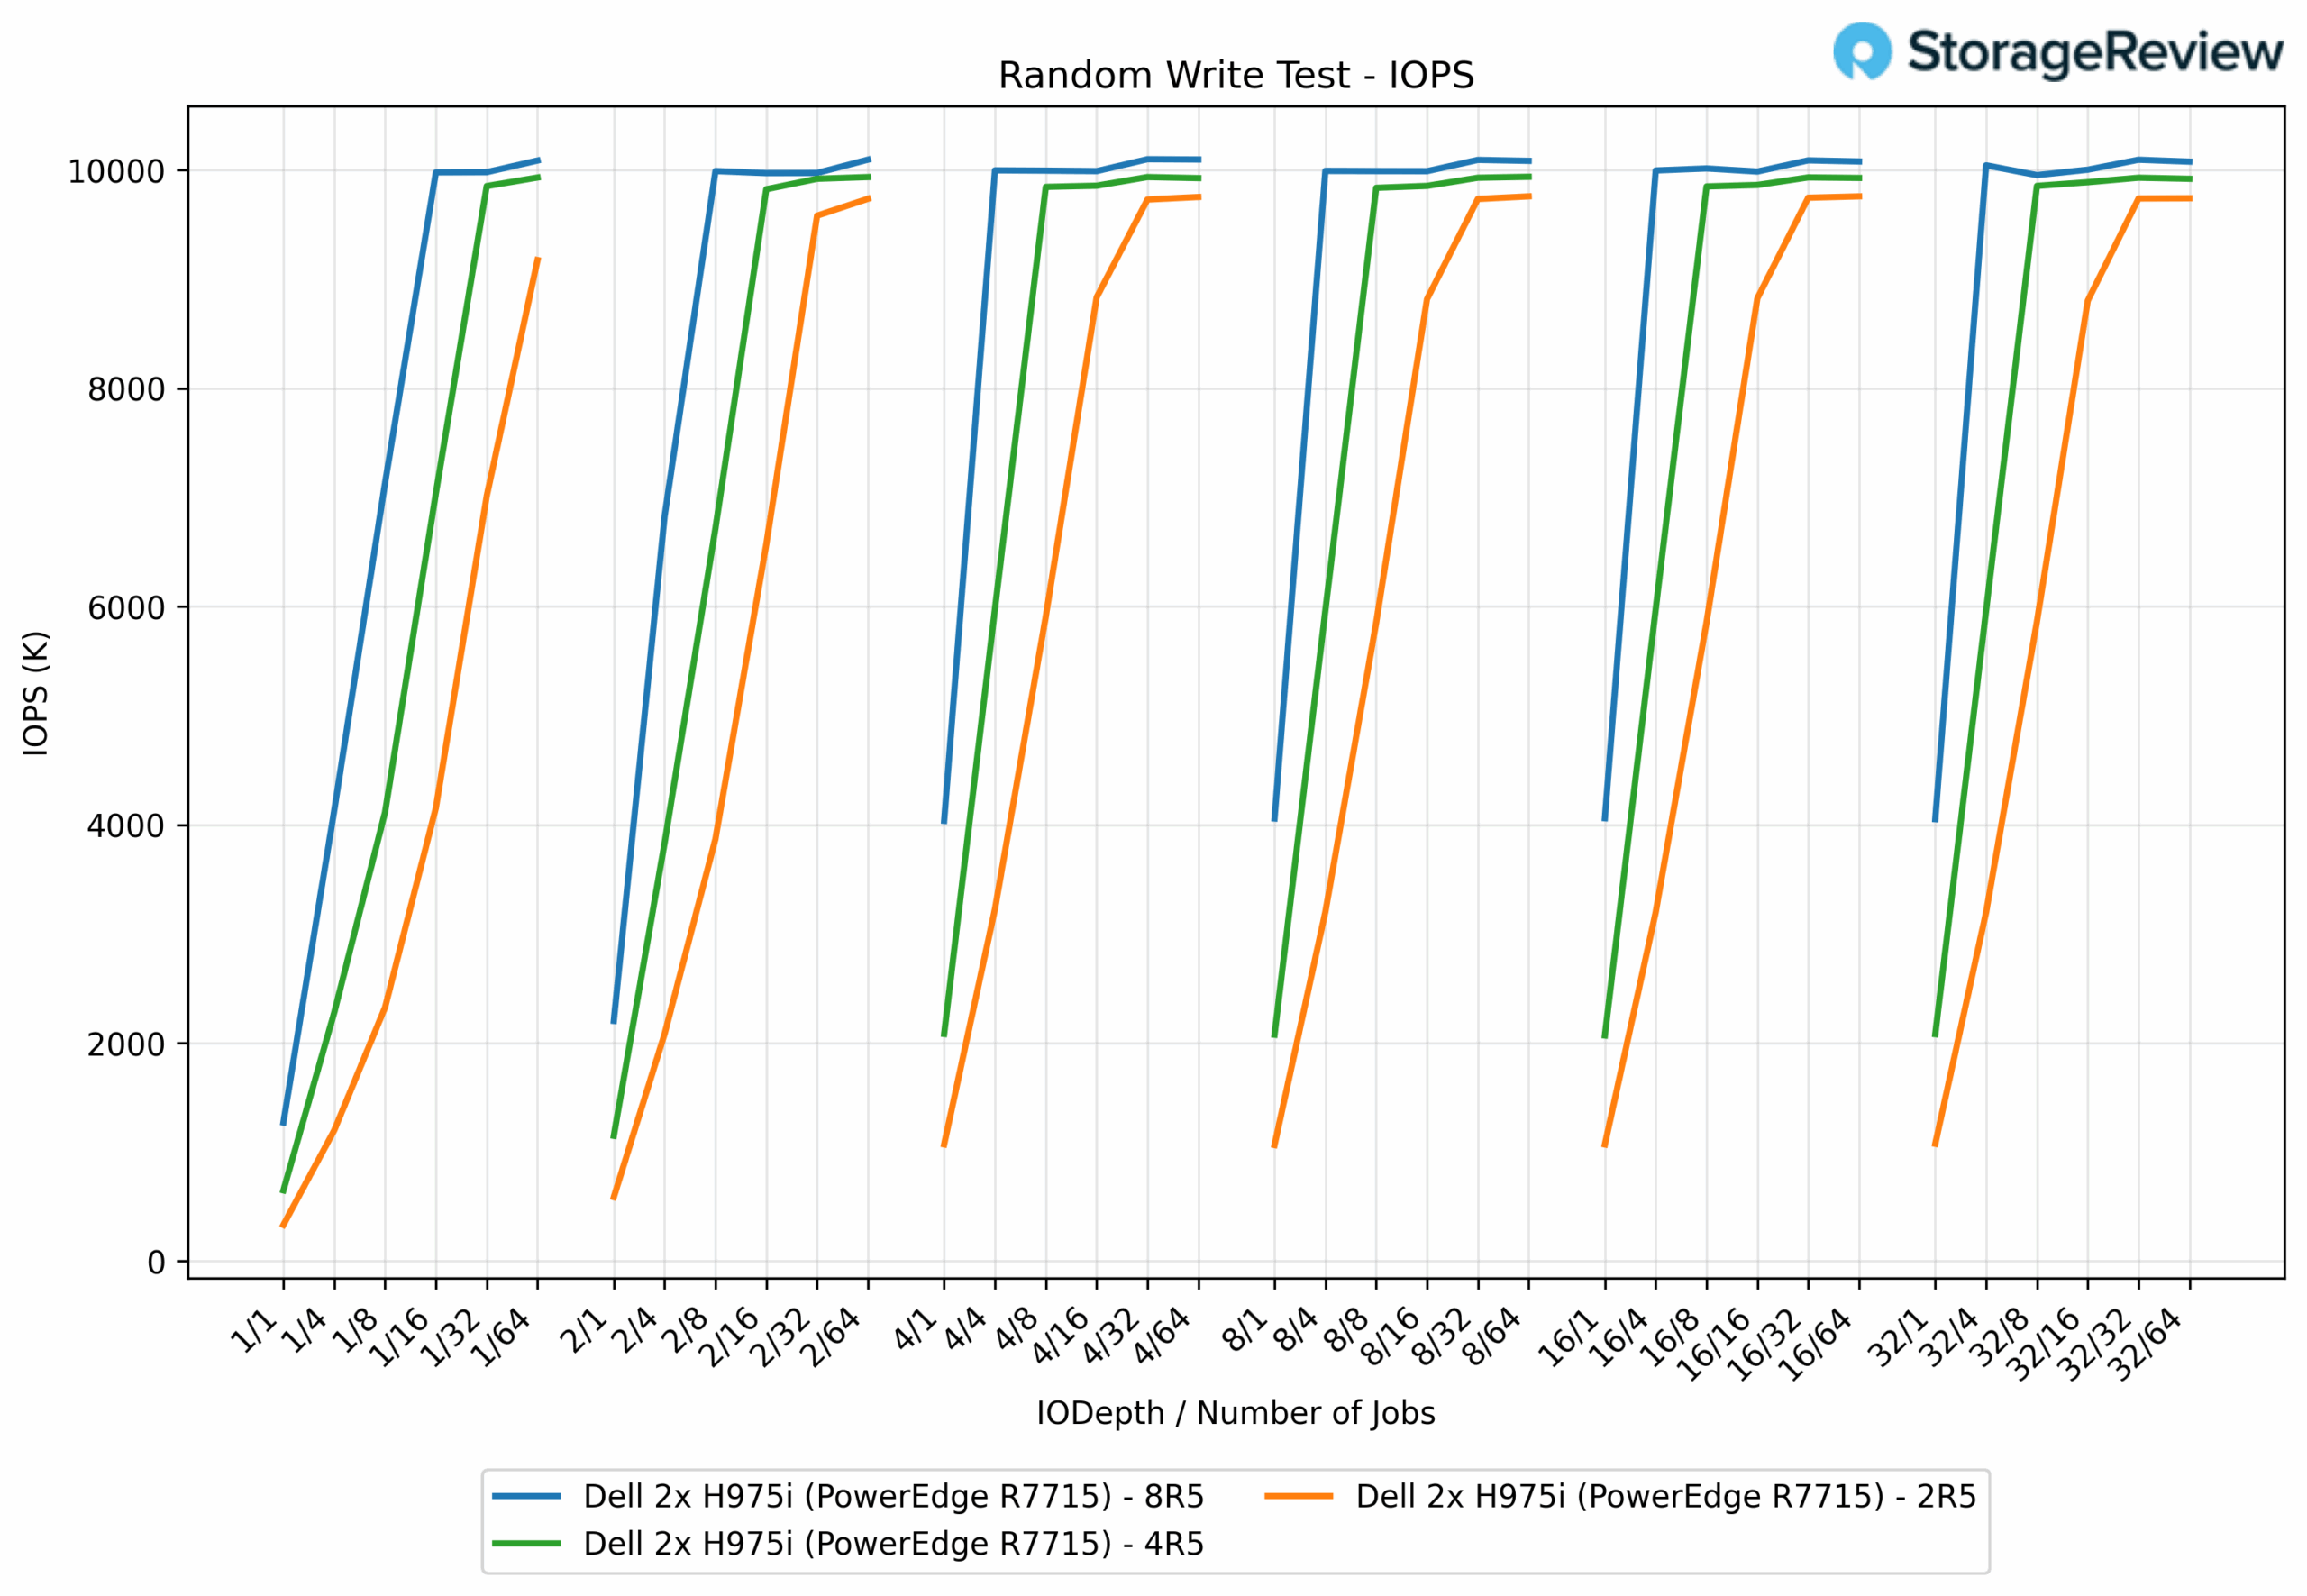
Nei test di scrittura casuale 4K, i controller PERC H975i con configurazione 2R5 hanno raggiunto un picco di 9.76 milioni di IOPS, mentre l'array 4R5 ha offerto prestazioni leggermente superiori, pari a 9.94 milioni di IOPS. La configurazione 8R5 ha dimostrato le prestazioni migliori, raggiungendo 10.10 milioni di IOPS.
Latenza di scrittura casuale di 4K
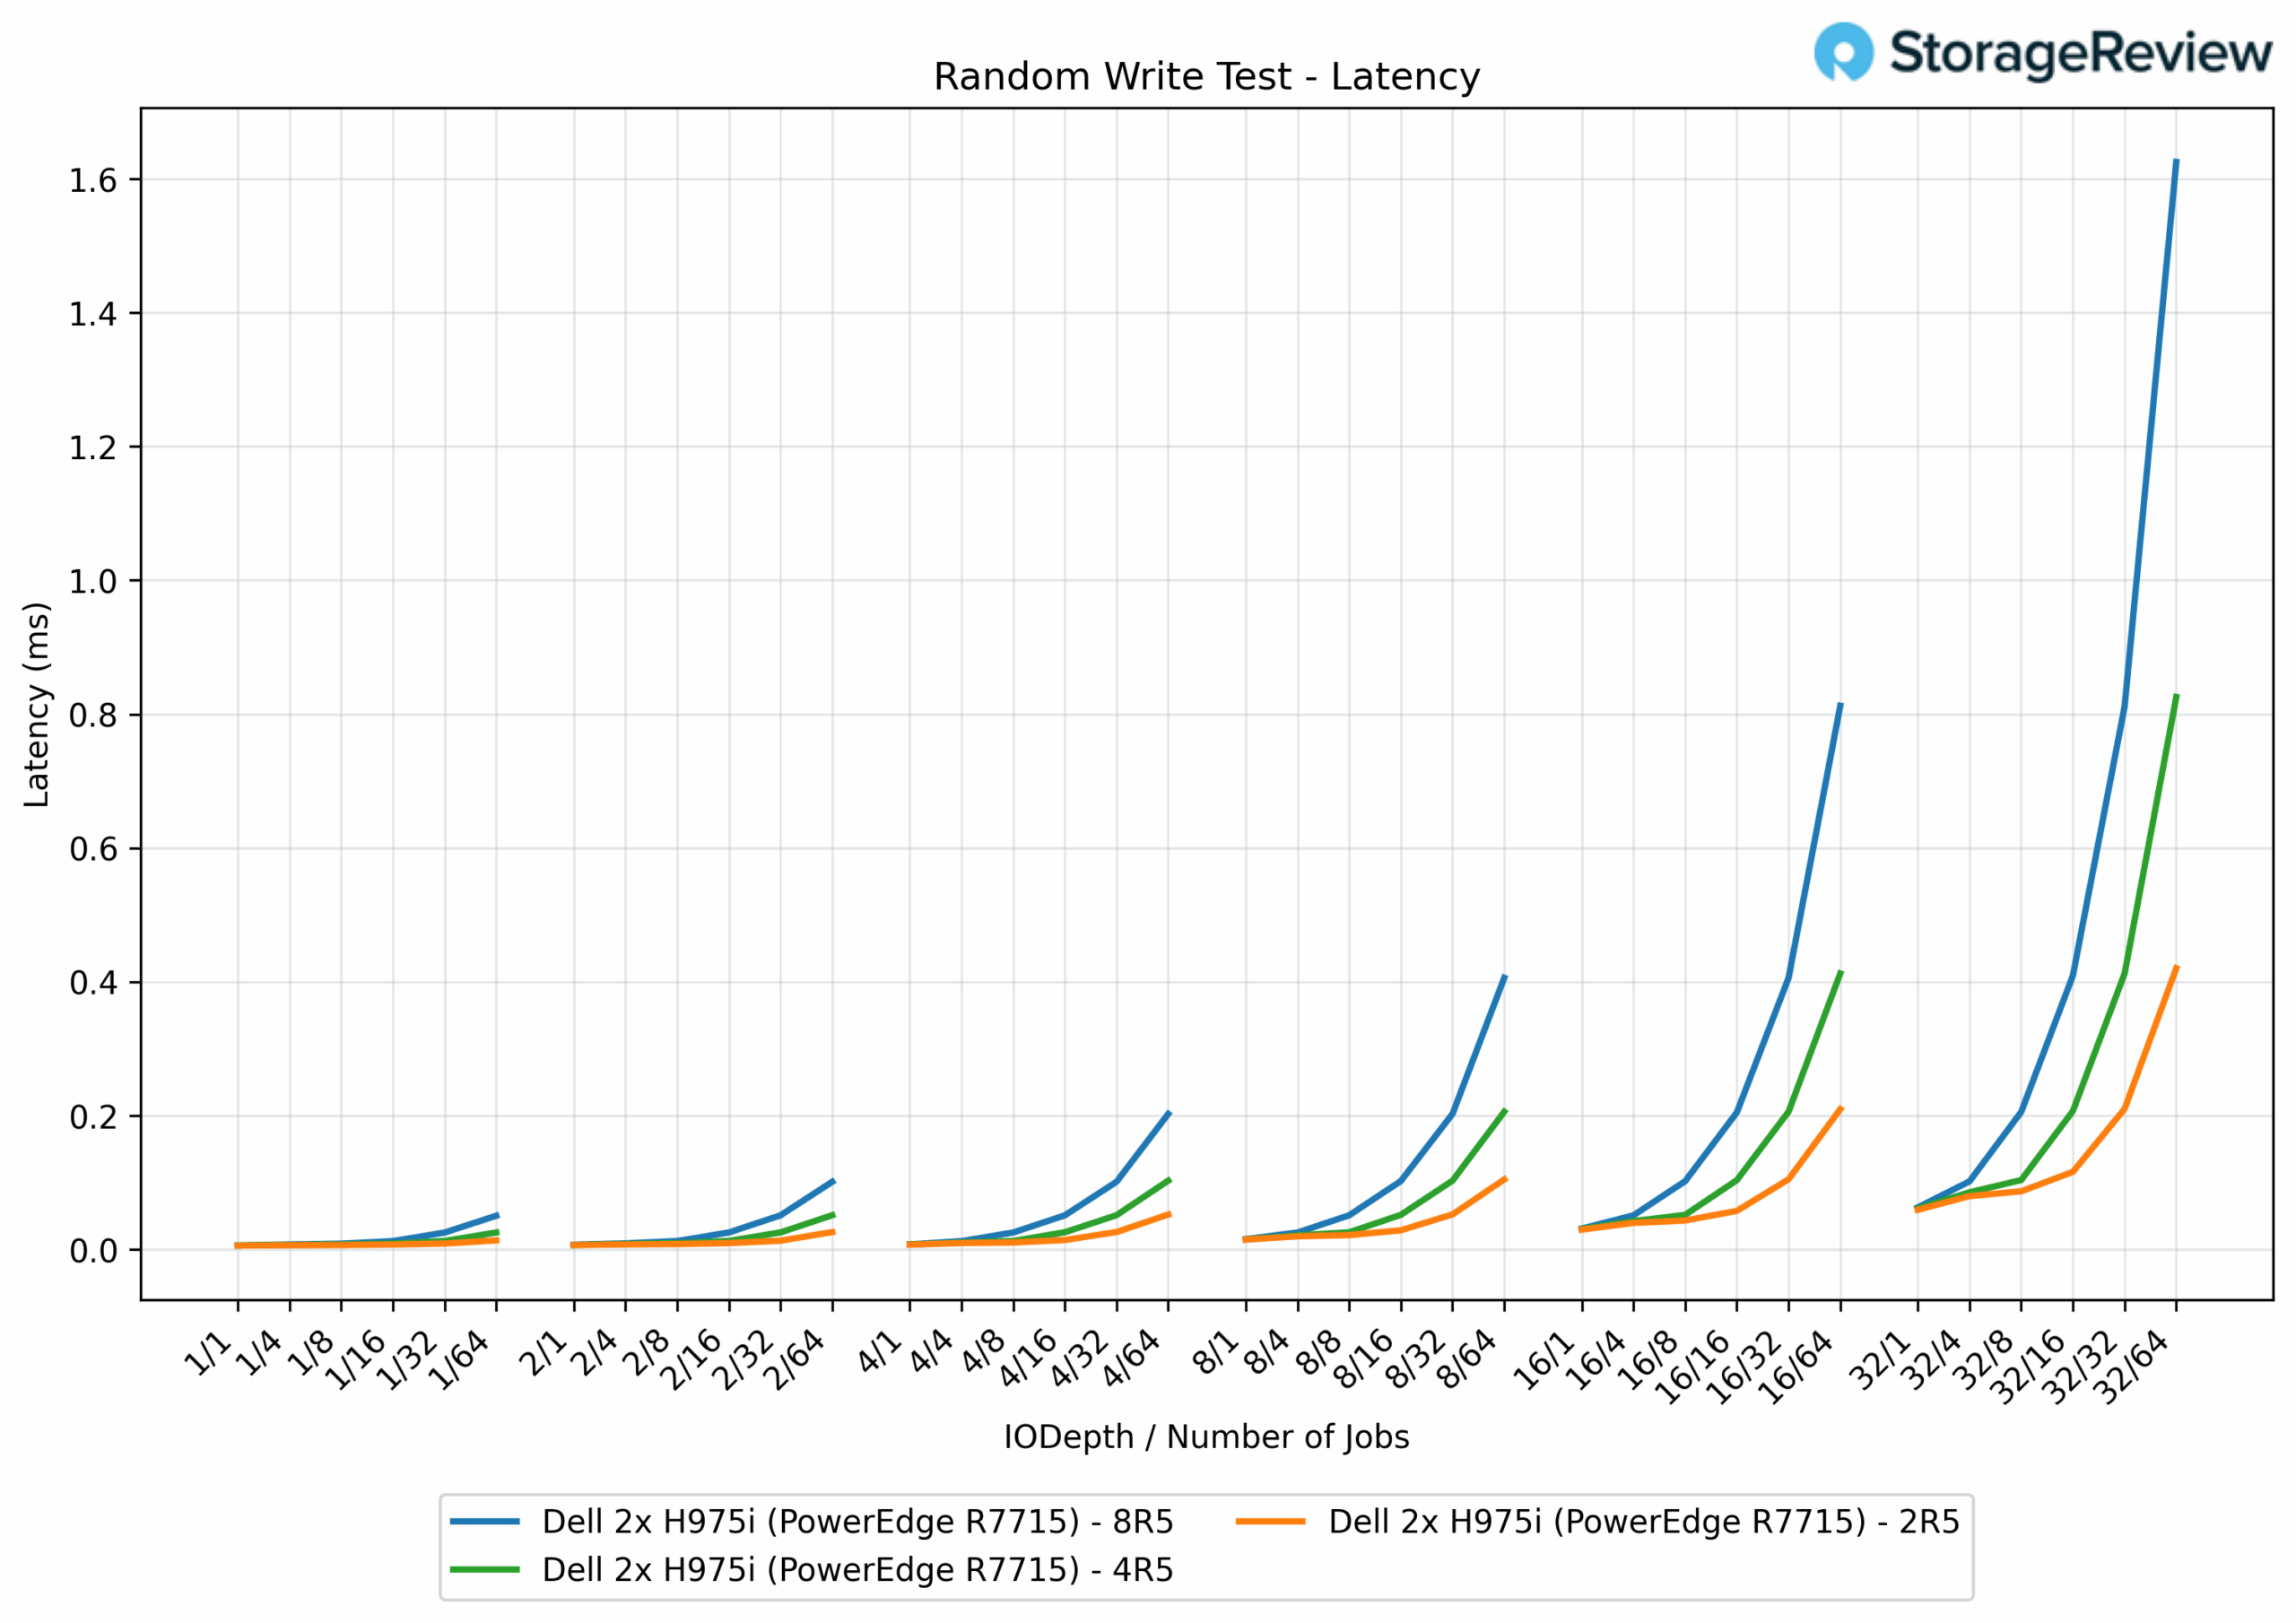
Per i test 4K, abbiamo valutato esclusivamente l'H975i per le massime prestazioni. La latenza è stata eccellente su tutti gli array: 2R5 variava da 0.0058 ms a 0.47 ms, 4R5 ha raggiunto un picco di 0.88 ms e 8R5 ha raggiunto 1.63 ms. Questi risultati dimostrano che, con la dimensione di blocco più piccola, l'H975i ha mantenuto latenze eccezionalmente basse, costantemente inferiori a 2 ms.
IOPS di lettura casuale 4K
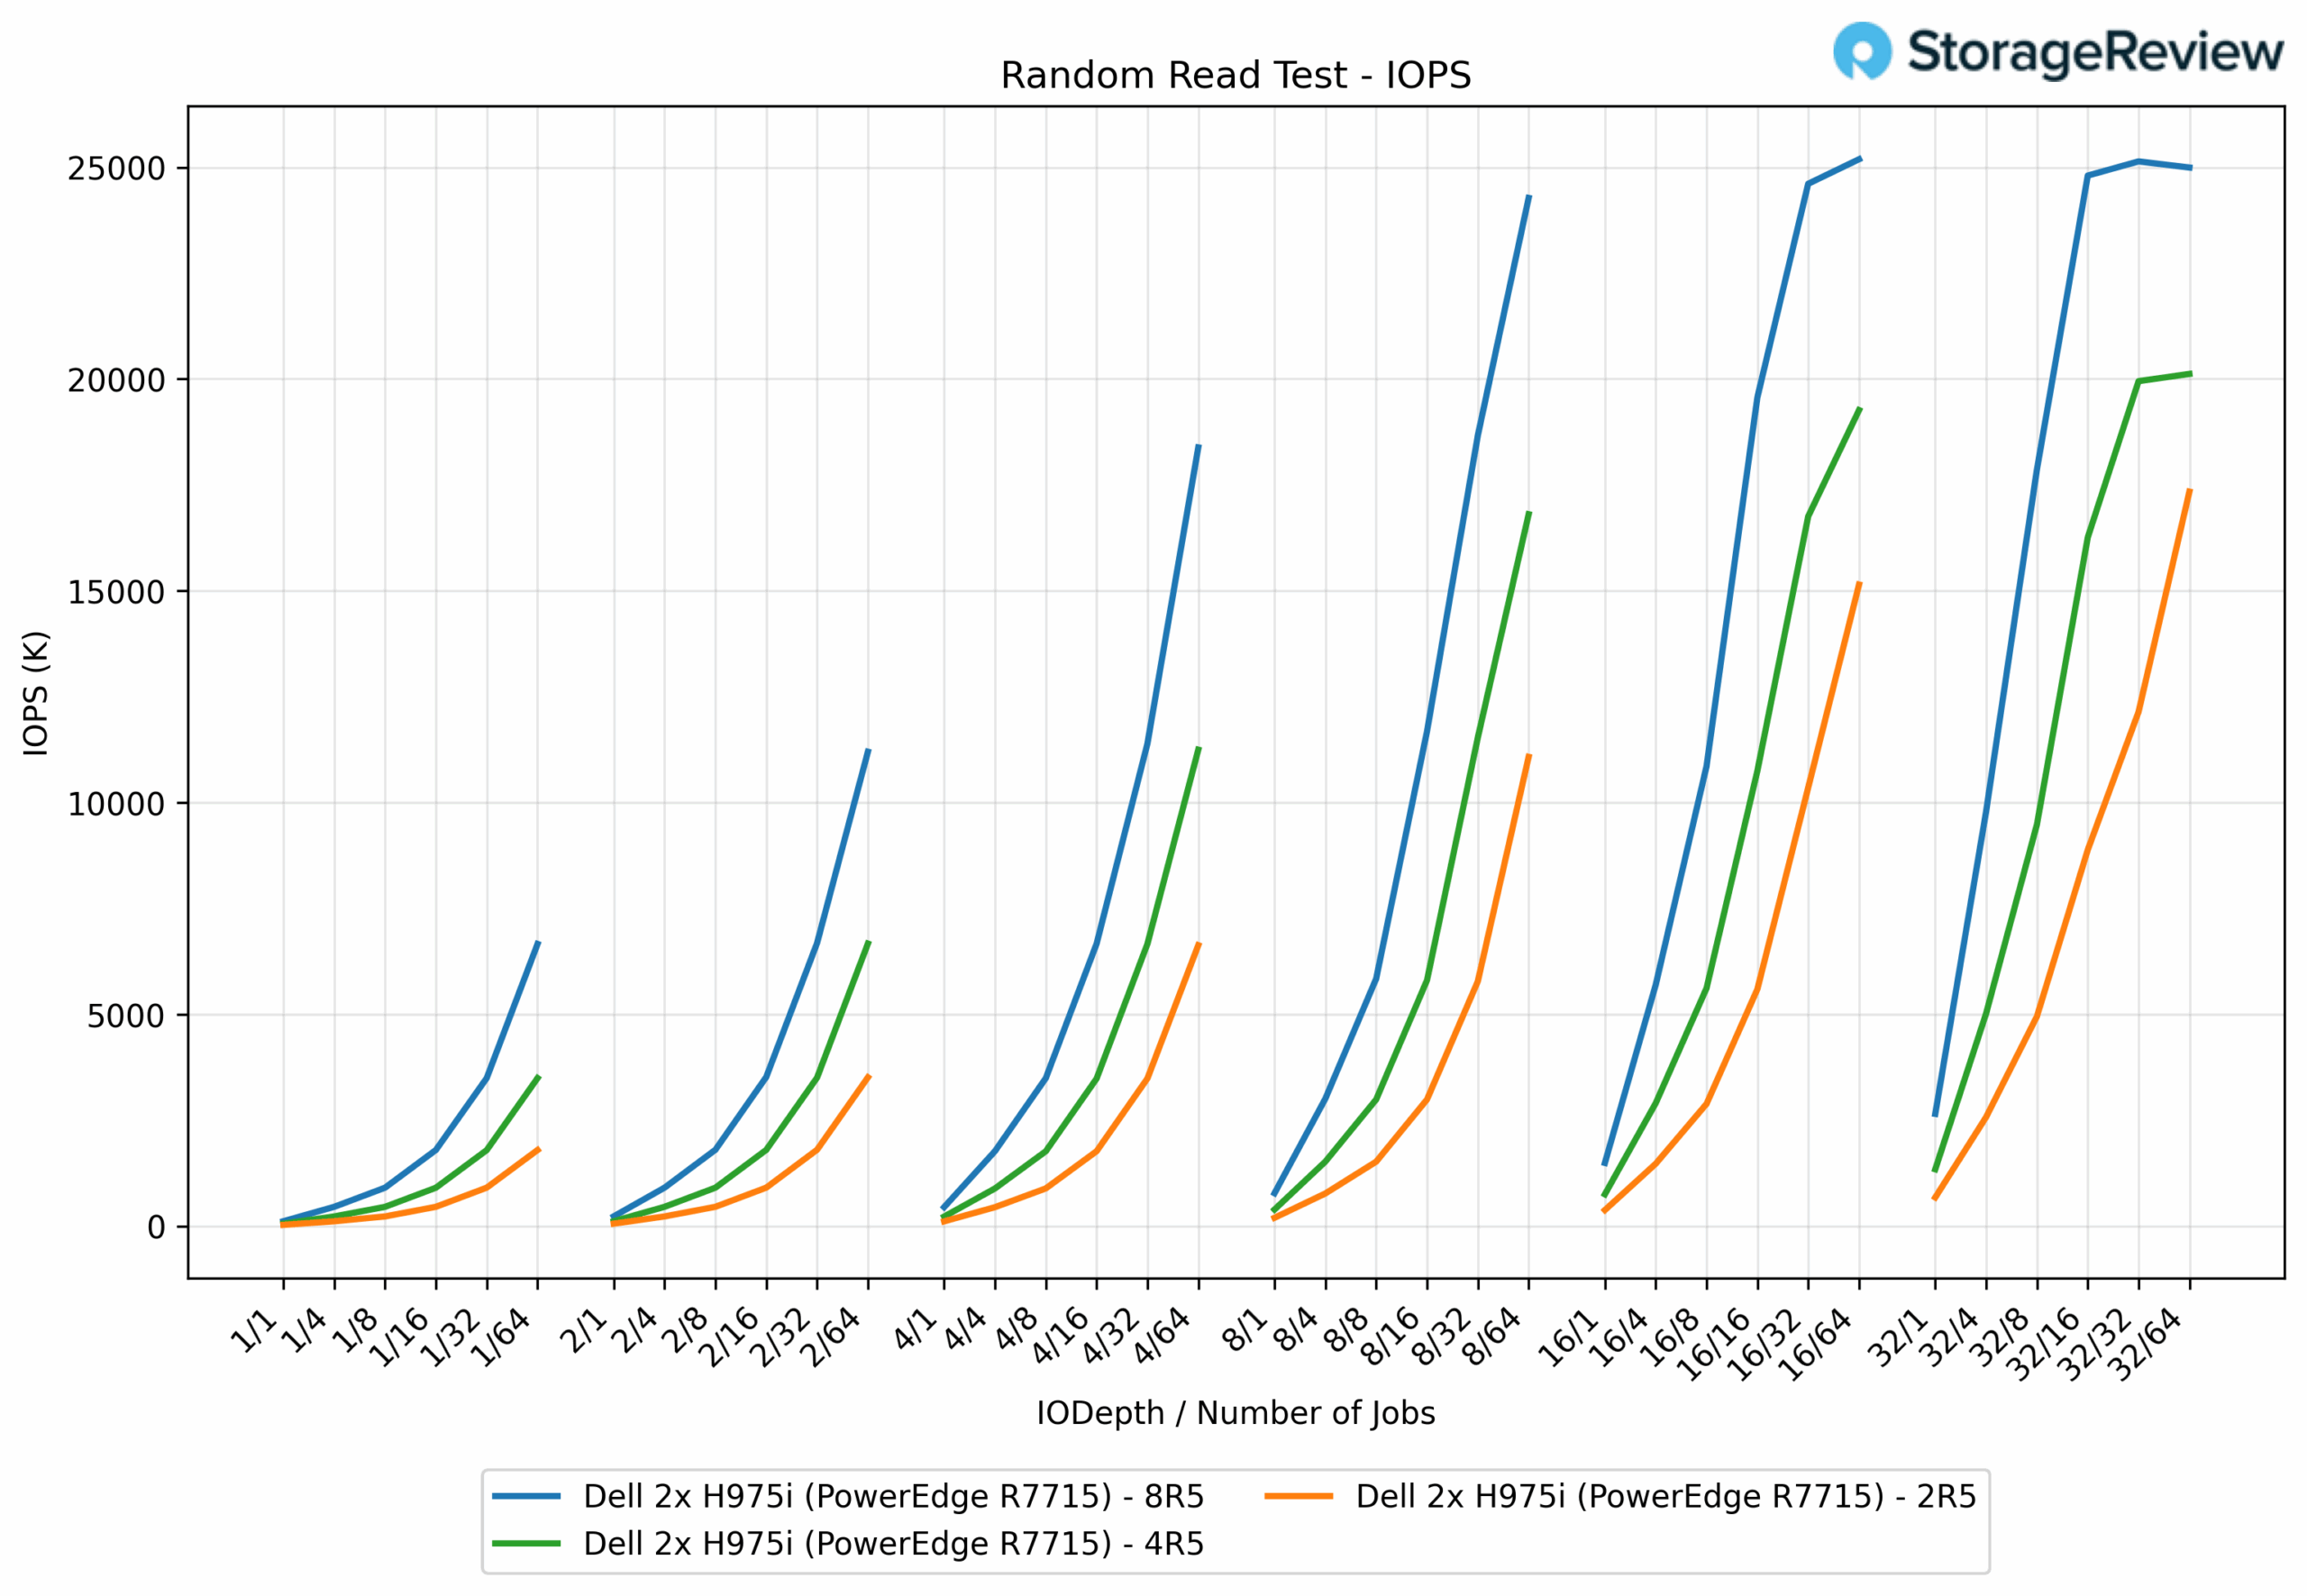
Abbiamo riservato per ultimo uno dei grafici più interessanti: nei test di lettura casuale 4K, l'H975i con configurazione 2R5 ha raggiunto l'impressionante valore di 17.3 milioni di IOPS. L'array H975i 4R5 ha raggiunto 20.1 milioni di IOPS, mentre la configurazione 8R5 ha raggiunto il throughput più elevato, pari a 25.2 milioni di IOPS.
Latenza di lettura casuale di 4K
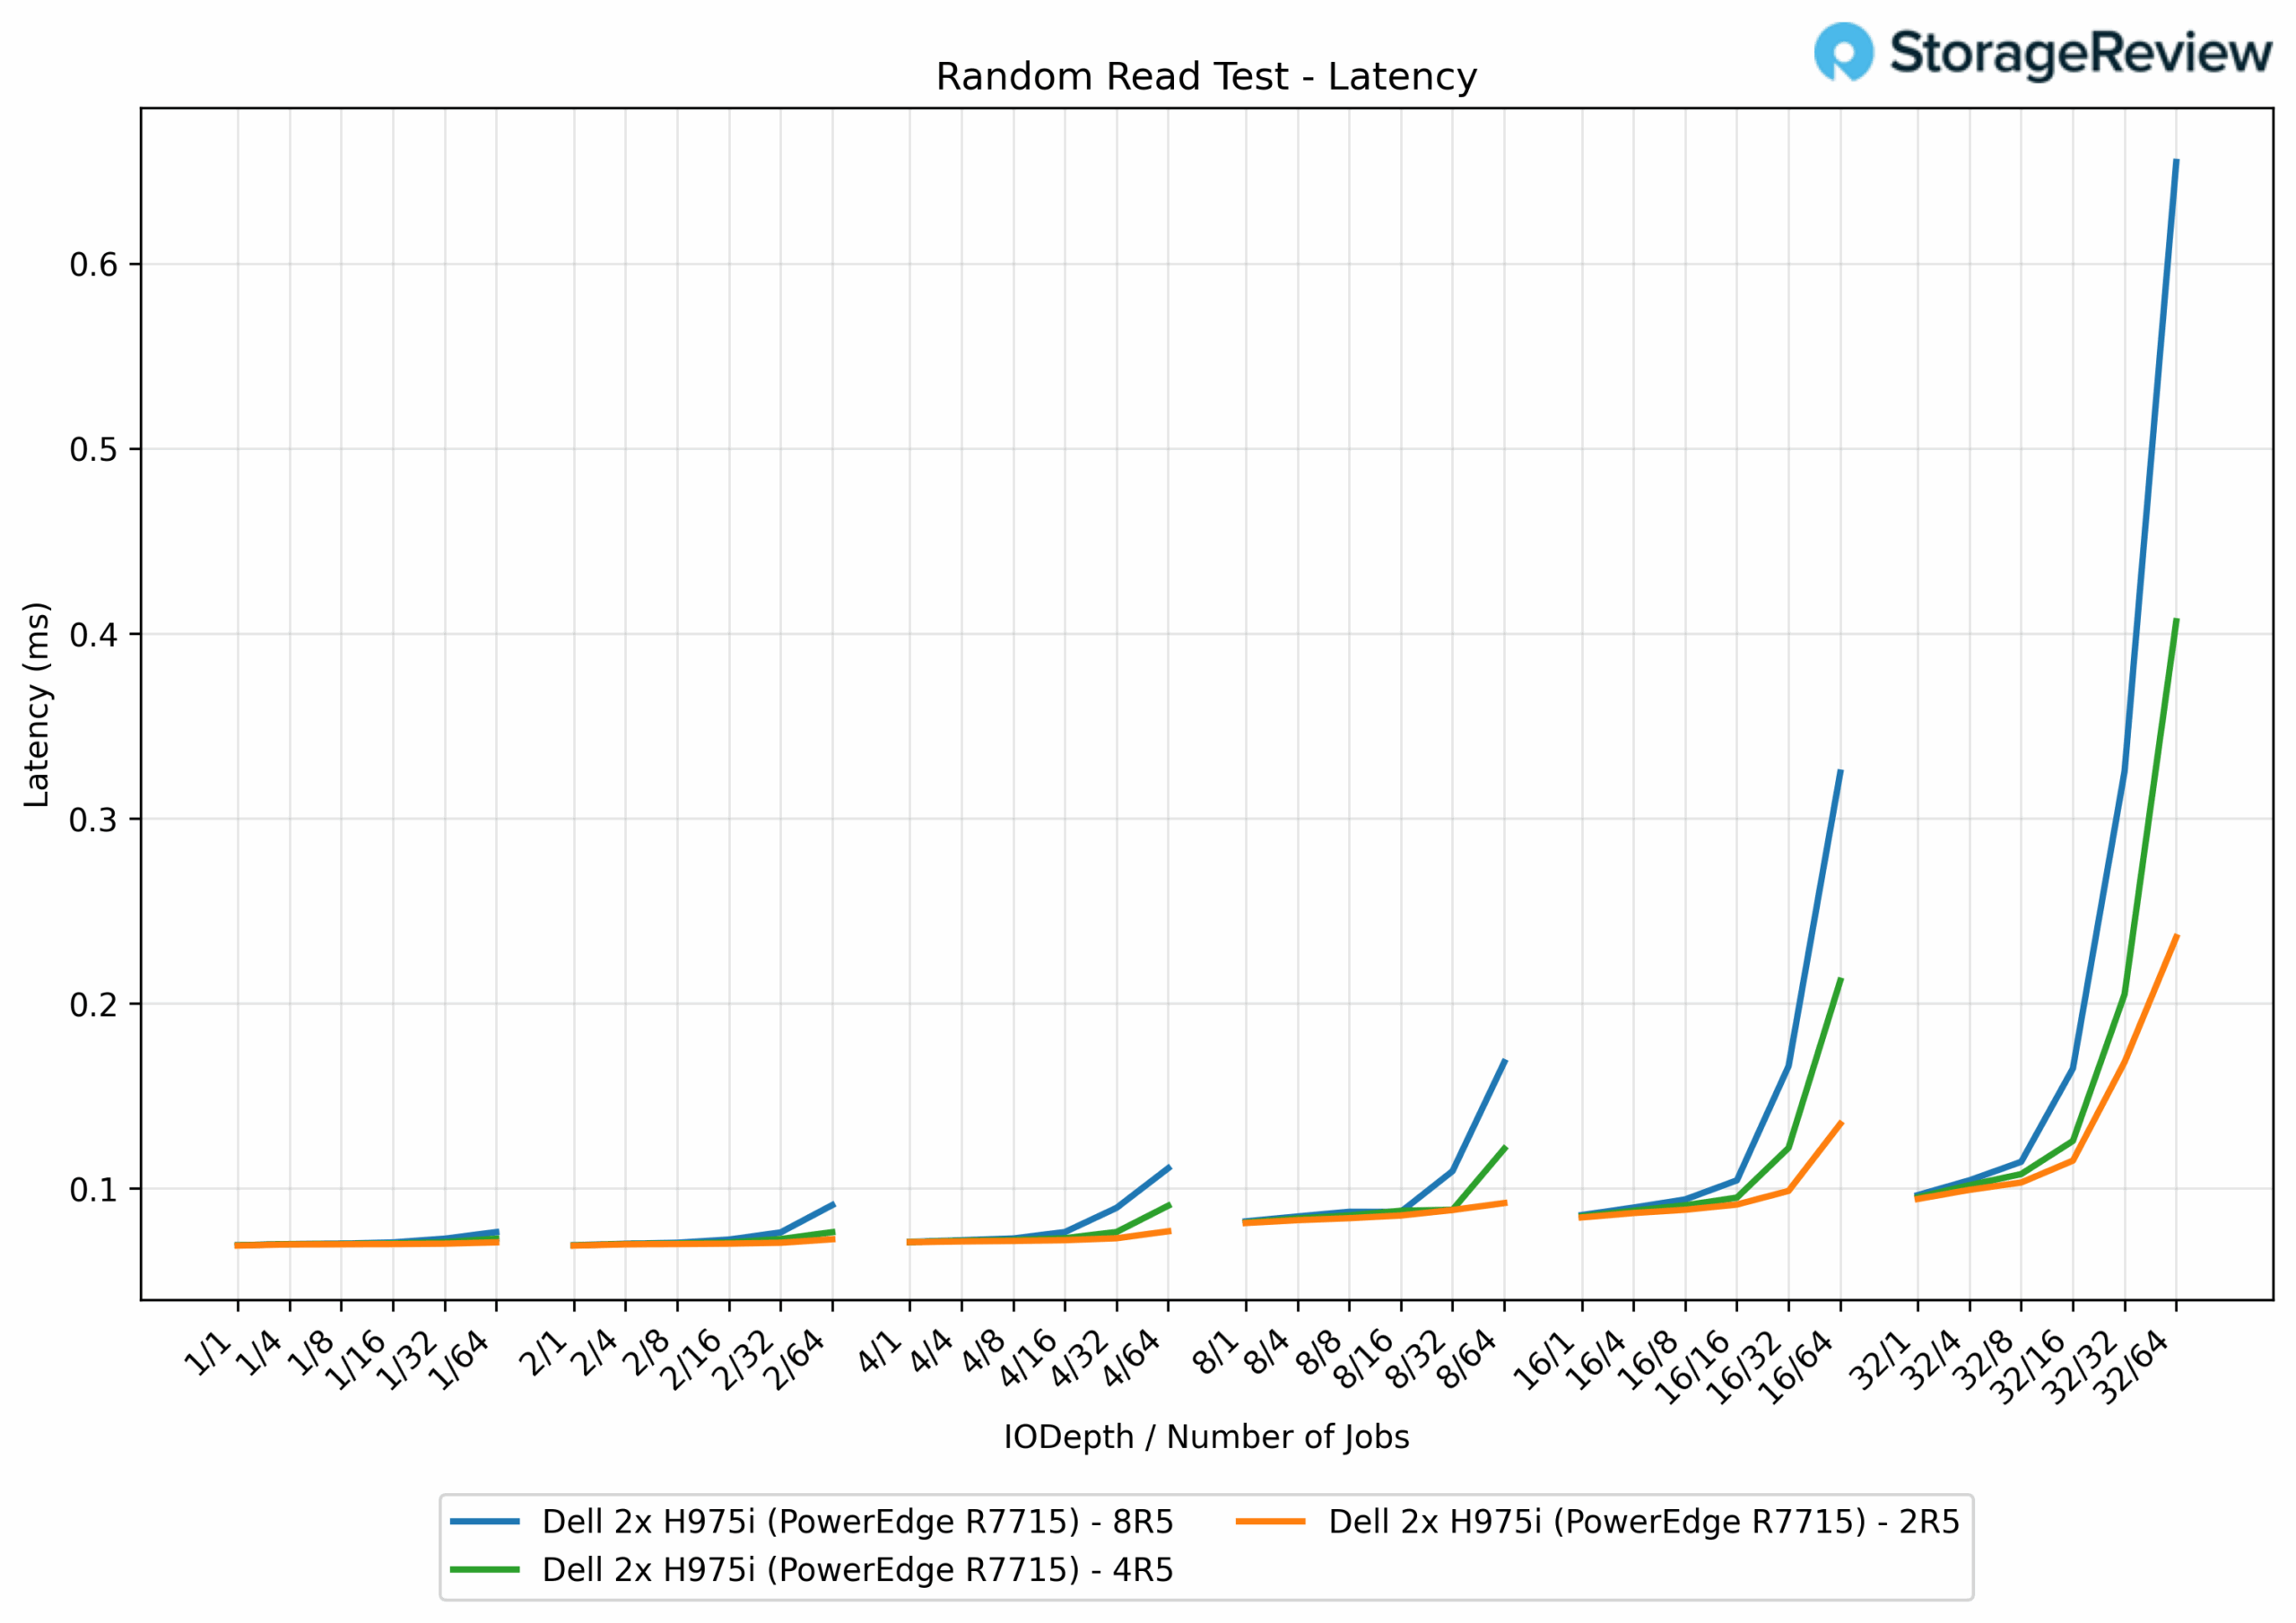
Nelle letture casuali 4K, le latenze sono iniziate a 0.069 ms su tutti gli array, con un picco di 2R5 a 0.29 ms, 4R5 a 0.53 ms e 8R5 a 0.65 ms. Il basso limite su tutti i gruppi RAID evidenzia la capacità dell'H975i di gestire piccole letture casuali con notevole efficienza.
Nessun compromesso sulle prestazioni durante la ricostruzione
Rispetto a PERC12, il controller Dell PERC13 offre un throughput sostanzialmente più elevato per ogni carico di lavoro durante la ricostruzione degli array. Le letture sequenziali sono più che raddoppiate, passando da 53.7 GB/s a 25 GB/s (in aumento del 114.7%), e le scritture sequenziali sono passate da 68 GB/s a 14.6 GB/s (in aumento del 363.7%). Le prestazioni dei blocchi di piccole dimensioni ampliano ulteriormente il divario: le letture casuali 4K salgono a 17.33 milioni di IOPS da 4.68 milioni (in aumento del 270.4%), mentre le scritture casuali 4K aumentano vertiginosamente da 5.33 milioni di IOPS a 0.48 milioni (in aumento del 1013.1%). In breve, PERC13 riduce al minimo l'impatto della ricostruzione e preserva l'headroom dell'host anche durante le finestre di manutenzione più impegnative.
| Carico di lavoro | Doppio PERC 12 (2 × RAID5) – Ricostruzione | Doppio PERC 13 (2 × RAID5) – Ricostruzione | % Miglioramento |
|---|---|---|---|
| Larghezza di banda di lettura sequenziale | 25 (GB/s) | 53.7 (GB/s) | 114.7% |
| Larghezza di banda di scrittura sequenziale | 14.7 (GB/s) | 68 (GB/s) | 363.7% |
| Letture casuali da 4 KB | 4,676,748 (IOPS) | 17,326,888 (IOP) | 270.4% |
| Scritture casuali da 4 KB | 479,144 (IOP) | 5,333,783 (IOP) | 1013.1% |
Ricostruisci rapidamente senza rallentare i carichi di lavoro
Dell dichiara inoltre notevoli miglioramenti in termini di resilienza e prestazioni di ricostruzione, citando una riduzione del tempo di ricostruzione dell'array da oltre 80 minuti per terabyte con PERC12 a soli 10 minuti per terabyte con PERC13. Questo tipo di velocità riduce le finestre di rischio e testimonia la maturità del motore XOR hardware del controller, dell'accelerazione della cache e dell'ottimizzazione del percorso dati.
Nei test di ricostruzione RAID5, PERC13 ha costantemente offerto tempi di ricostruzione più brevi rispetto a PERC12 quando al controller è stato consentito di dare priorità alla ricostruzione, con l'avvertenza che una pressione di scrittura estremamente elevata può annullare tale vantaggio. Abilitando la funzione Priority Rebuild, il controller assegna la priorità alle attività di ricostruzione sulle risorse. Ciò ha permesso al controller PERC13 di ridurre significativamente i tempi di ricostruzione in condizioni di pressione di lettura sequenziale. Al carico host più basso (125 MB/s), il tempo di ricostruzione è sceso da 11.53 a 5.32 min/TiB. Anche al carico più elevato, il tempo di ricostruzione è stato ridotto da 16.96 a 7.73 min/TiB, mantenendo al contempo una velocità di lettura host molto più elevata (22.4 GB/s rispetto a 60 GB/s).
Con una pressione di scrittura sequenziale, il PERC13 ha migliorato la ricostruzione a basso carico da 7.51 a 4.98 min/TiB, ma con il carico di scrittura più pesante, il tempo di ricostruzione è salito a 15.29 min/TiB rispetto ai 760 min/TiB dell'R13.09. Questo può essere visto da due prospettive: il PERC13 aveva una velocità di ricostruzione più lenta, ma manteneva velocità di scrittura prossime ai livelli di produzione rispetto al PERC13 (12 GB/s contro 62.5 GB/s). In altre parole, la ricostruzione prioritaria mantiene la promessa di una finestra di ricostruzione più rapida, soprattutto per attività prevalentemente in lettura. L'unica eccezione si verifica quando il sistema è sottoposto contemporaneamente a scritture molto pesanti; la maggiore capacità di throughput dell'host del PERC12 può prolungare il tempo di ricostruzione.
| Scenario | Doppio PERC 12 (2 × RAID5) | Doppio PERC 13 (2 × RAID5) | ||
|---|---|---|---|---|
| Min/TiB | Larghezza di banda totale | Min/TiB | Larghezza di banda totale | |
| Lettura sequenziale – Attività leggera | 11.53 | 0.125 GB / s | 5.32 | 0.125 GB / s |
| Lettura sequenziale – Attività intensa | 16.96 | 22.4 GB / s | 7.73 | 60 GB / s |
| Scrittura sequenziale – Attività leggera | 7.51 | 0.125 GB / s | 4.98 | 0.125 GB / s |
| Scrittura sequenziale – Attività intensa | 13.09 | 12 GB / s | 15.29 | 62.5 GB / s |
Passando a Priority Host, che protegge intenzionalmente l'I/O delle applicazioni a scapito della velocità di ricostruzione, le prestazioni sono simili in lettura e più sfumate in scrittura. Con i carichi di lavoro in lettura, il controller PERC13 completa nuovamente le ricostruzioni significativamente più velocemente rispetto al precedente PERC12, riducendo il tempo di carico leggero da 11.23 a 6.70 min/TiB e quello di carico pesante da 38.44 a 19.75 min/TiB, il tutto gestendo un maggiore traffico host (46.2 GB/s contro 24.1 GB/s nel punto più pesante). Per i carichi di lavoro in scrittura, Priority Host mantiene le prestazioni di produzione in primo piano: il PERC13 è più veloce con il carico più basso (7.80 contro 5.67 min/TiB), ma con il carico di scrittura più pesante, la sua ricostruzione si estende a 32.81 min/TiB rispetto ai 12 min/TiB del PERC25.40. Il tempo di ricostruzione si allunga leggermente, ma il PERC13 fornisce all'host una larghezza di banda di scrittura host molto più elevata (62.4 GB/s contro 12.5 GB/s).
| Scenario | Doppio PERC 12 (2 × RAID5) | Doppio PERC 13 (2 × RAID5) | ||
|---|---|---|---|---|
| Min/TiB | Larghezza di banda totale | Min/TiB | Larghezza di banda totale | |
| Lettura sequenziale – Attività leggera | 11.23 | 0.125 GB / s | 6.70 | 0.125 GB / s |
| Lettura sequenziale – Attività intensa | 38.44 | 24.1 GB / s | 19.75 | 46 GB / s |
| Scrittura sequenziale – Attività leggera | 7.80 | 0.125 GB / s | 5.67 | 0.125 GB / s |
| Scrittura sequenziale – Attività intensa | 25.40 | 12.5 GB / s | 32.81 | 62.4 GB / s |
Dal punto di vista dell'implementazione, la scelta è semplice. Quando è necessario ridurre al minimo la finestra di vulnerabilità e si può tollerare una certa deprioritizzazione dell'I/O, la priorità di ricostruzione su PERC13 riduce i tempi di ricostruzione, soprattutto negli scenari con elevata richiesta di lettura. Quando il mantenimento della reattività dell'applicazione è imprescindibile, Priority Host fa proprio questo; PERC13 eccelle comunque per le ricostruzioni in lettura, mentre periodi di scrittura intensi possono giustificare una pianificazione o un modesto throttling se il tempo di ricostruzione assoluto è un problema.
Conclusione
Il Dell PERC H975i afferma il RAID hardware come una soluzione interessante per i data center aziendali basati su NVMe. Sebbene le implementazioni JBOD e RAID software abbiano guadagnato terreno negli ambienti scale-out, questi approcci introducono complessità operativa, sovraccarico della CPU e tempi di ripristino prolungati in caso di guasti delle unità. Il modello H975i offre un'accelerazione hardware specifica con motori di parità dedicati, operazioni di ricostruzione accelerate e funzionalità di gestione integrate all'interno dello stack infrastrutturale Dell.
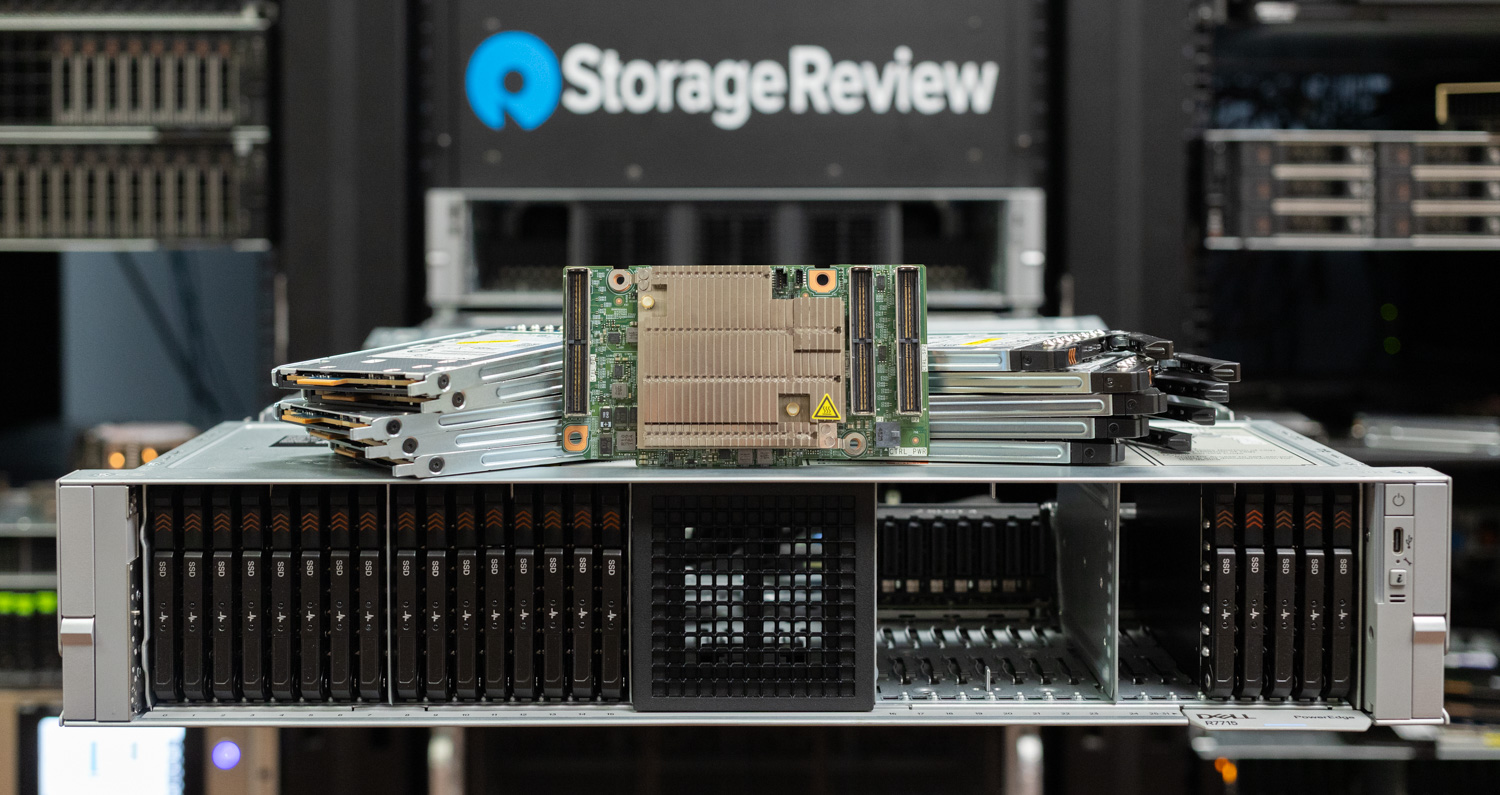
Per carichi di lavoro di intelligenza artificiale e apprendimento automatico che richiedono caratteristiche di throughput coerenti, minima variazione di latenza e massima affidabilità in termini di uptime, le architetture RAID gestite tramite hardware offrono sia prestazioni di calcolo che resilienza operativa senza consumare risorse di elaborazione host critiche.
I test delle prestazioni convalidano i miglioramenti architetturali, con l'H975i che offre una larghezza di banda in lettura sequenziale superiore dell'88% e una larghezza di banda in scrittura sequenziale superiore del 318% rispetto alla generazione PERC12. Le misurazioni di picco di throughput di 103 GB/s e 25.2 milioni di IOPS dimostrano le capacità del controller per carichi di lavoro ad alta intensità di dati. Inoltre, i tempi di ricostruzione sono scesi da oltre 80 minuti per terabyte a soli 10 minuti per terabyte, mantenendo livelli di prestazioni prossimi a quelli di produzione durante le operazioni di ripristino.
Le interfacce PCIe Gen975 x5 e il design integrato frontalmente dell'H16i supportano distribuzioni GPU dense senza conflitti di storage, consentendo un ridimensionamento prevedibile delle prestazioni in configurazioni multi-acceleratore. Con molti server PowerEdge che offrono sia i controller RAID H965i che H975i, non c'è dubbio che le organizzazioni che sfruttano carichi di lavoro emergenti dovrebbero optare per la nuova offerta. Se si implementa un'infrastruttura di intelligenza artificiale su larga scala, l'H975i fornisce le basi di storage ad alta larghezza di banda e bassa latenza necessarie per massimizzare l'utilizzo delle risorse di calcolo.


 Amazon