

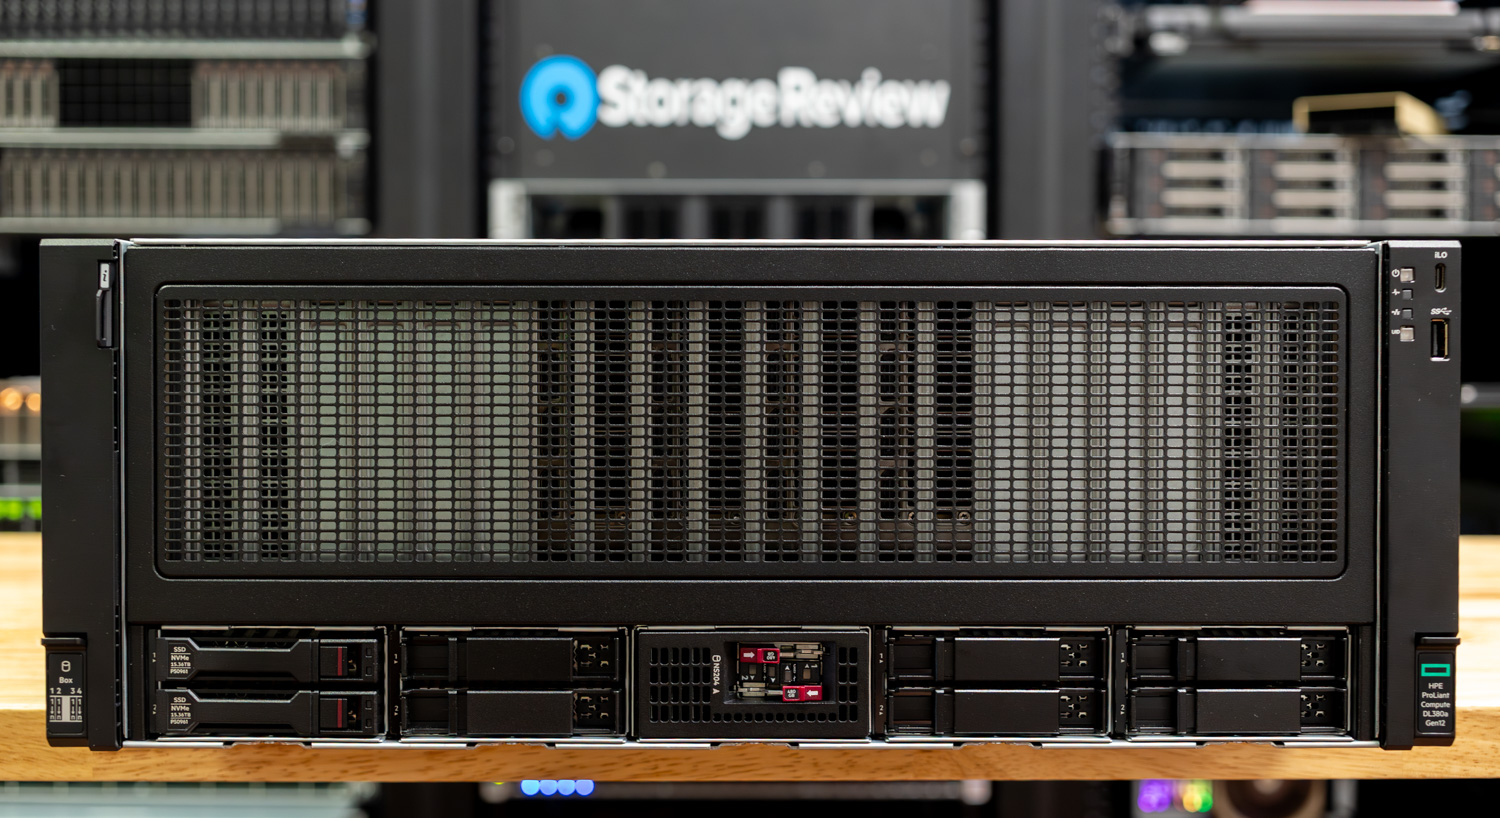
HPE ProLiant Compute DL380a Gen12 si rivolge ai team di intelligenza artificiale aziendali mainstream che desiderano densità senza modificare le configurazioni dei rack. Questo chassis 4U raffreddato ad aria si integra perfettamente, supporta fino a otto GPU a doppia larghezza e offre PCIe Gen5 su tutta la superficie. Può essere configurato con due CPU Intel Xeon 6, ciascuna con un massimo di 144 core, 4 TB di DDR5 su 32 DIMM e sedici alloggiamenti NVMe E3.S per throughput e capacità elevati. L'obiettivo è semplice: ottenere inferenza di livello produttivo e un fine-tuning mirato su larga scala senza avventurarsi nel territorio del raffreddamento a liquido.
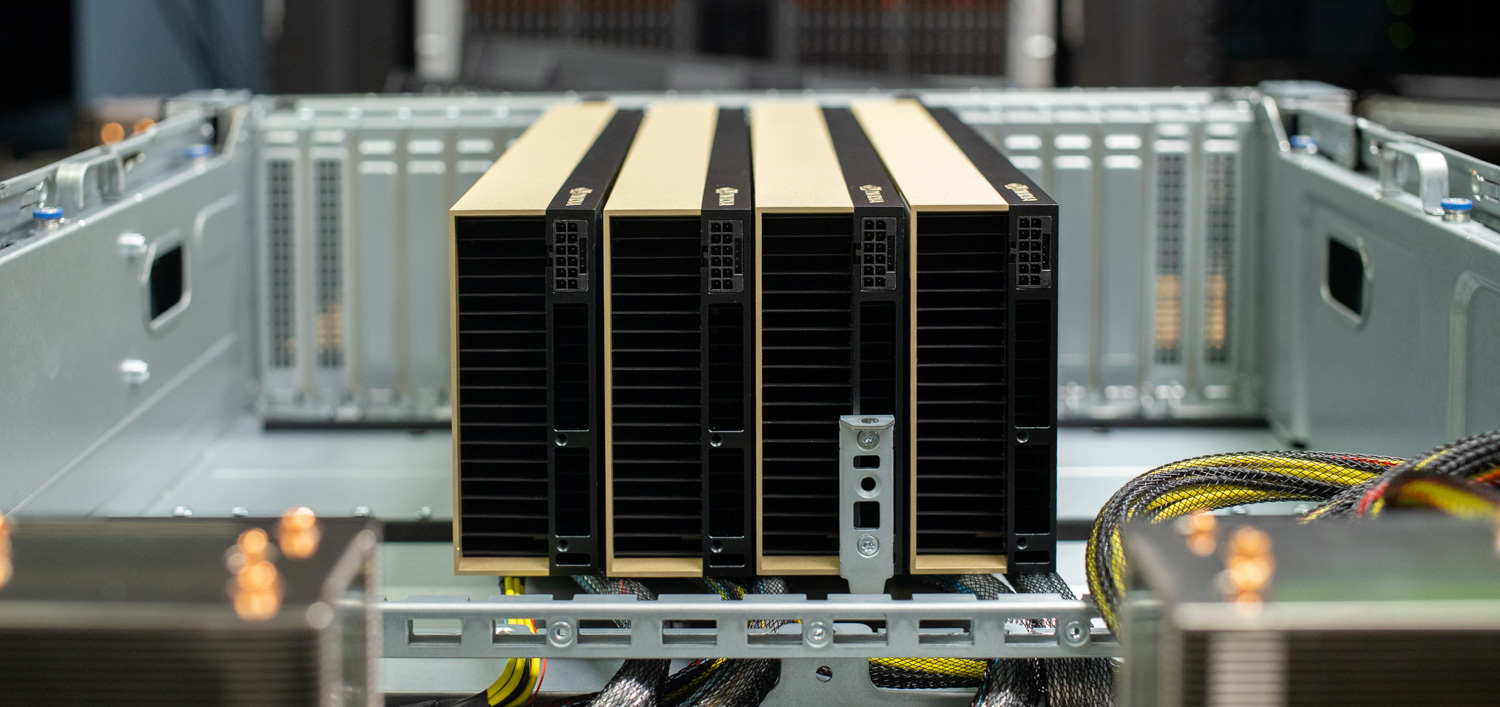
Per gli acceleratori, HPE convalida un ampio stack che comprende NVIDIA H200 NVL, H100 NVL, L40S, L20, L4 e RTX PRO 6000 Blackwell Server Edition, con opzioni di alimentazione che supportano componenti ad alto consumo. Per questa recensione, ci concentriamo sulla RTX PRO 6000 Server, che rappresenta un punto di forza pratico per l'intelligenza artificiale aziendale. Ogni scheda offre 96 GB di ECC GDDR7, PCIe Gen5 x16, core Tensor compatibili con FP4 e un'inviluppo da 600 W che funziona in rack raffreddati ad aria. Il nostro rig è stato fornito con quattro schede, un punto di partenza sensato per l'inferenza ad alto throughput e la messa a punto mirata, con margine di scalabilità.
HPE completa la piattaforma con i componenti operativi più importanti. iLO 7 gestisce la configurazione out-of-band, lo stato di salute e il controllo dell'alimentazione, grazie alla Silicon Root of Trust, un'enclave sicura per l'integrità del firmware, al supporto per RSA a 4096 bit e a un modulo iLO DC-MHS rimovibile che rafforza la verifica della supply chain. Il server si integra inoltre nel framework di intelligenza artificiale per il cloud privato di HPE per una governance multi-team e distribuzioni ripetibili su larga scala.
HPE ProLiant Compute DL380a Gen12 – Specifiche tecniche
| Categoria | Specificazione |
|---|---|
| tipo di processore | Processore HPE ProLiant Compute DL380a Gen12 |
| Famiglia processore | Processori scalabili Intel® Xeon® di sesta generazione |
| Core del processore disponibili | Da 64 a 144 core, a seconda del processore |
| Numero di processori | 2 |
| Velocità del processore | Fino a 2.4 GHz, a seconda del processore |
| La memoria massima | RDIMM da 4 TB (2 TB per processore) |
| Slot di memoria | 32 slot DIMM |
| tipo di memoria | Memoria intelligente HPE DDR5 |
| Protezione della memoria | RAS: ECC avanzato, spare online, mirroring, funzionalità di canale combinato (lockstep), HPE Fast Fault Tolerant Memory (ADDDC) |
| Supporto di guida | SFF NVMe e EDSFF |
| Sicurezza | Cornice di bloccaggio opzionale, rilevamento delle intrusioni e HPE TPM 2.0 integrato |
| Gestione dell'infrastruttura | HPE iLO Standard con Intelligent Provisioning (incorporato), HPE OneView Standard (richiede il download) • Facoltativo: HPE iLO Advanced e HPE OneView Advanced (licenze richieste) |
| Alimentazione elettrica | Fino a 8 M-CRPS. Ridondanza singola 1+1 per la scheda di sistema. Doppia ridondanza 2+1 per le GPU. |
| Slot di espansione | 6 |
| Ventole di sistema | Sono incluse 4 ventole hot-plug a doppio rotore e 8 a rotore singolo |
| Fattore di forma | Rack 4U |
| Garanzia | 3/3/3: Garanzia del server |
Progettazione e costruzione di HPE ProLiant DL380a Gen12
HPE ProLiant Compute DL380a Gen12 è un server rack 4U a doppio socket, progettato per distribuzioni scalabili e ad alte prestazioni. Con dimensioni di 17.63 x 6.88 x 31.60 cm, combina la potenza di elaborazione di CPU e GPU ad alta densità con un efficiente raffreddamento ad aria per un funzionamento affidabile anche in presenza di carichi di lavoro intensi.
Con un peso compreso tra 82.7 e 137.8 kg, a seconda della configurazione, lo chassis supporta componenti ad alta capacità, alimentazione ridondante e facile accesso frontale per la manutenzione. Il suo design privilegia prestazioni, espandibilità e una solida gestione termica, rendendolo adatto ad ambienti aziendali e data center.
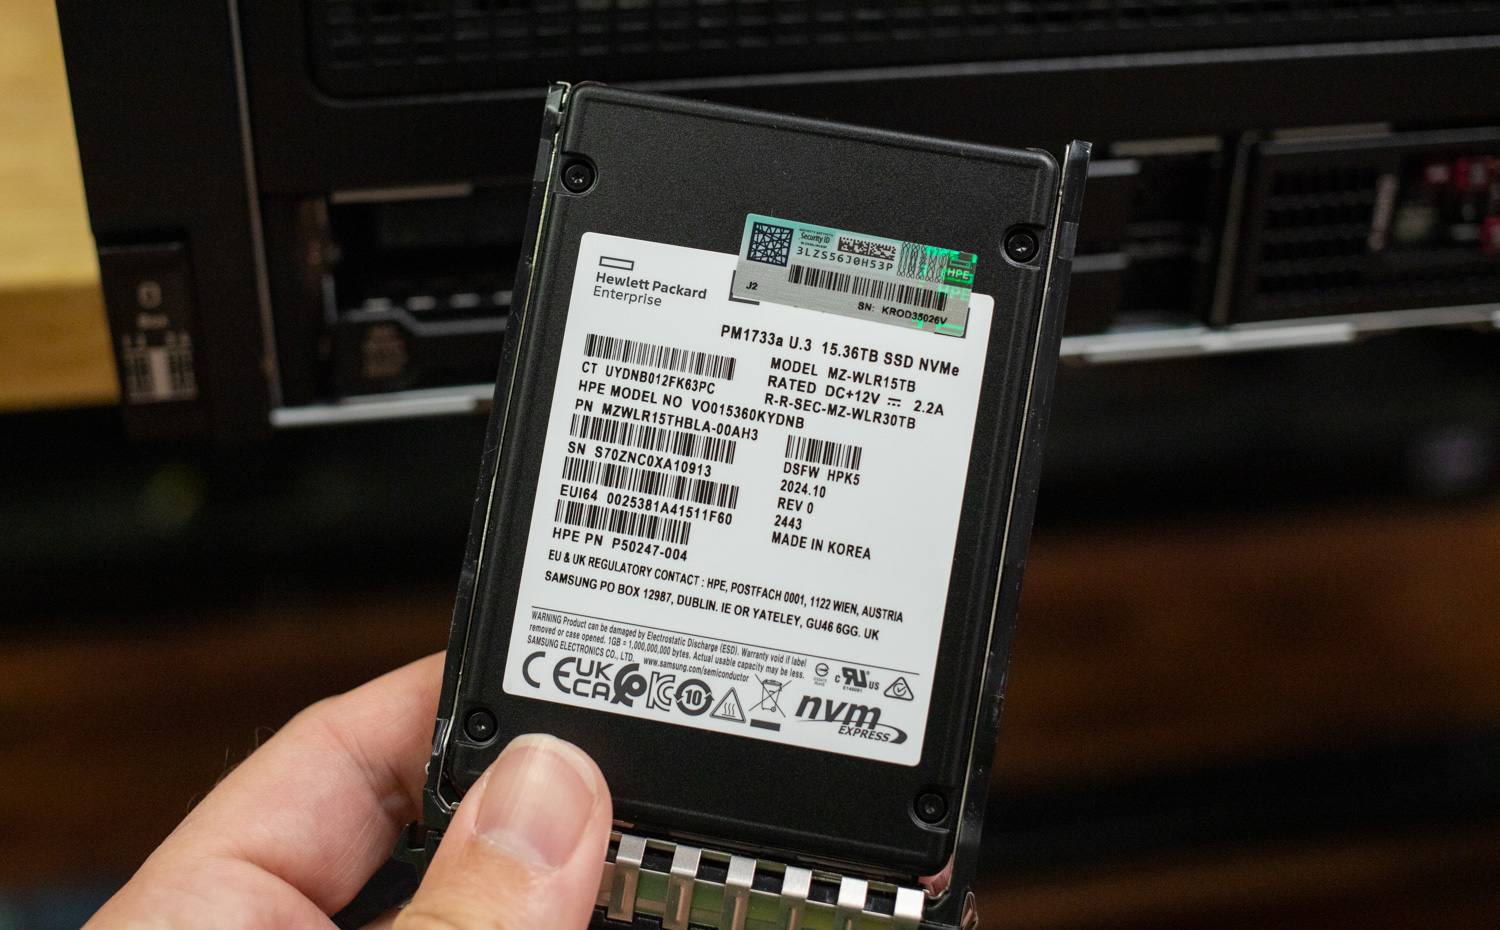
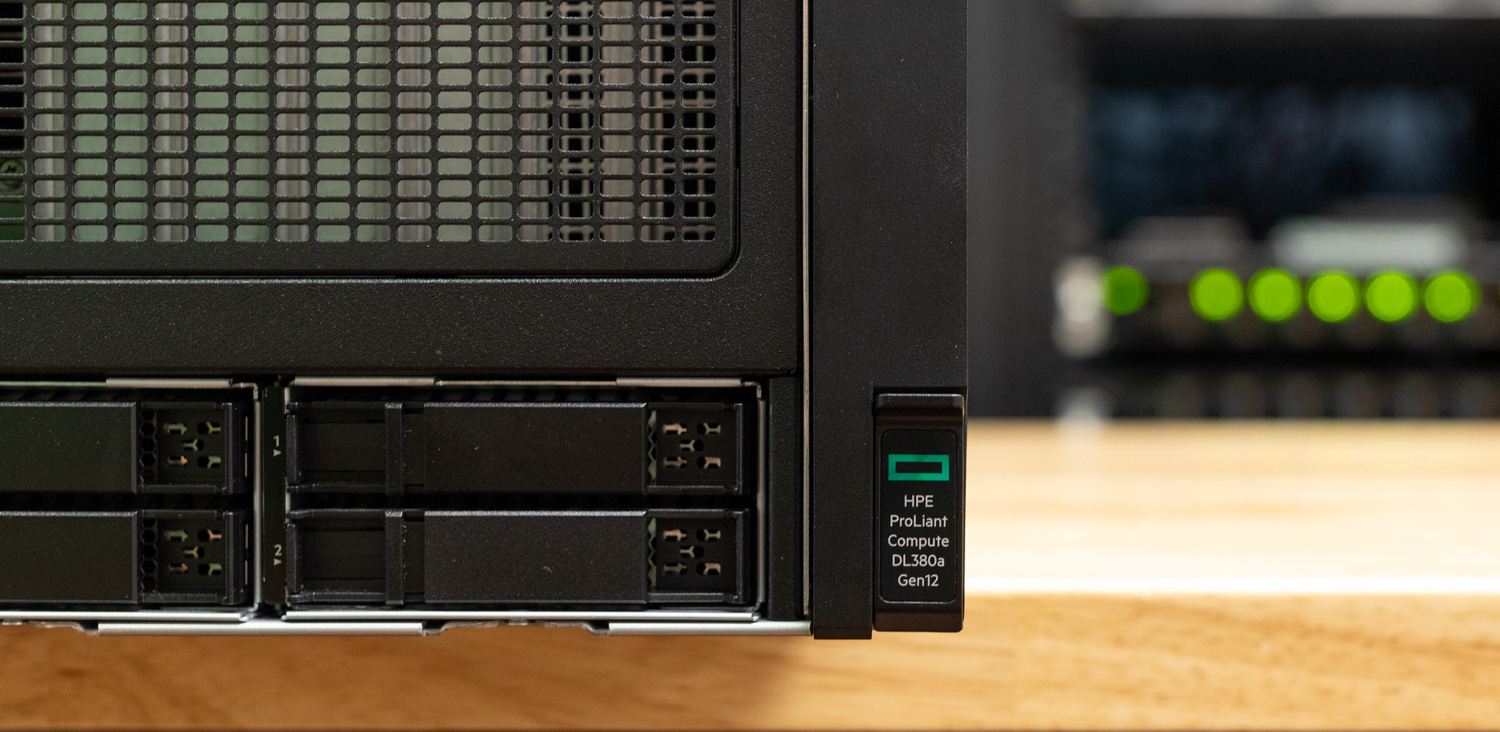 Passando allo storage, HPE ProLiant DL380a Gen12 offre configurazioni a 4 e 8 alloggiamenti nei formati SFF o EDSFF. La nostra unità di prova è stata fornita configurata con il kit HPE DL380a Gen12 NS204i-u Front Cage, che supporta due dispositivi di avvio NVMe M.2 hot-plug. Lo chassis includeva anche otto alloggiamenti da 2.5 pollici, popolati da due SSD U.3 a marchio HPE con una capacità di 15.36 TB. HPE offre diverse opzioni di alloggiamenti frontali, consentendo una scalabilità flessibile per diverse esigenze di implementazione.
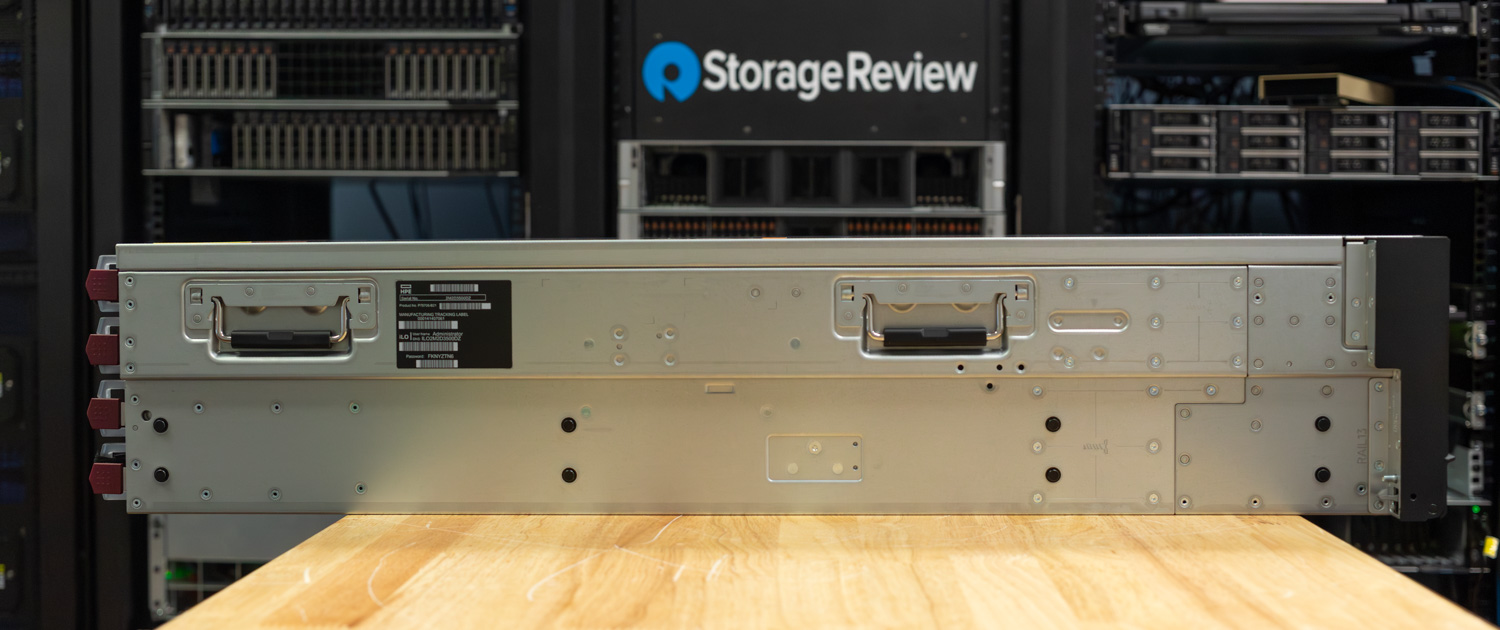
L'unità può essere trasportata utilizzando due maniglie su ciascun lato, il che significa che richiede almeno due persone per il montaggio e l'installazione in sicurezza. Utilizza un kit di guide 2U con guide telescopiche, che consente un'installazione agevole e la manutenzione nel rack senza dover rimuovere completamente il rack.
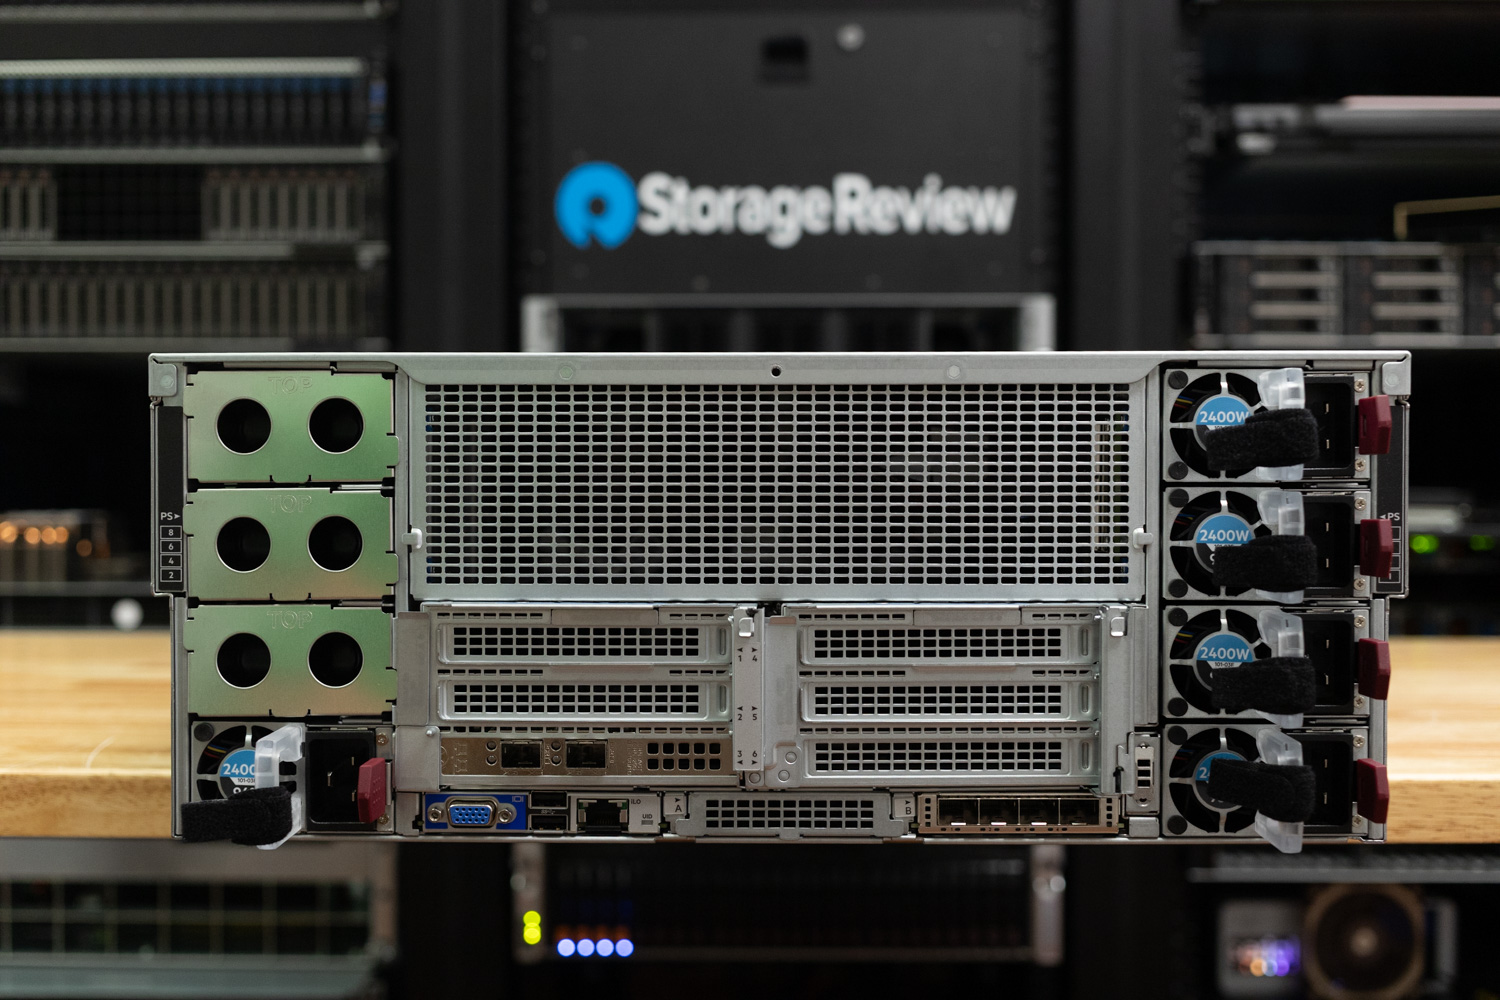
 Sul retro dell'HPE ProLiant DL380a Gen12, troverete un layout ben organizzato incentrato su flusso d'aria, espandibilità e facilità di manutenzione. Il sistema supporta fino a otto alimentatori MCRPS (1-8) con una parete di ventilazione integrata, mantenendo un raffreddamento ottimale sotto carico. L'espansione è ampia, con più slot PCIe Gen5 x16 (slot 1-6) che ospitano sia riser captive predefiniti che opzionali, nonché slot OCP A e B per configurazioni flessibili delle schede di rete.
La connettività include una porta di rete iLO dedicata, diverse porte USB 3.2 Gen 1 e una porta VGA per la gestione locale. È importante notare che lo Slot 1 è disponibile solo quando è installato il cavo diretto HPE DL380a Gen12 4EDSFF per NVD (P74716-B21) e non può essere utilizzato con unità SFF NVMe, mentre lo Slot 4 non è supportato nelle configurazioni con 4 o 8 GPU DW.
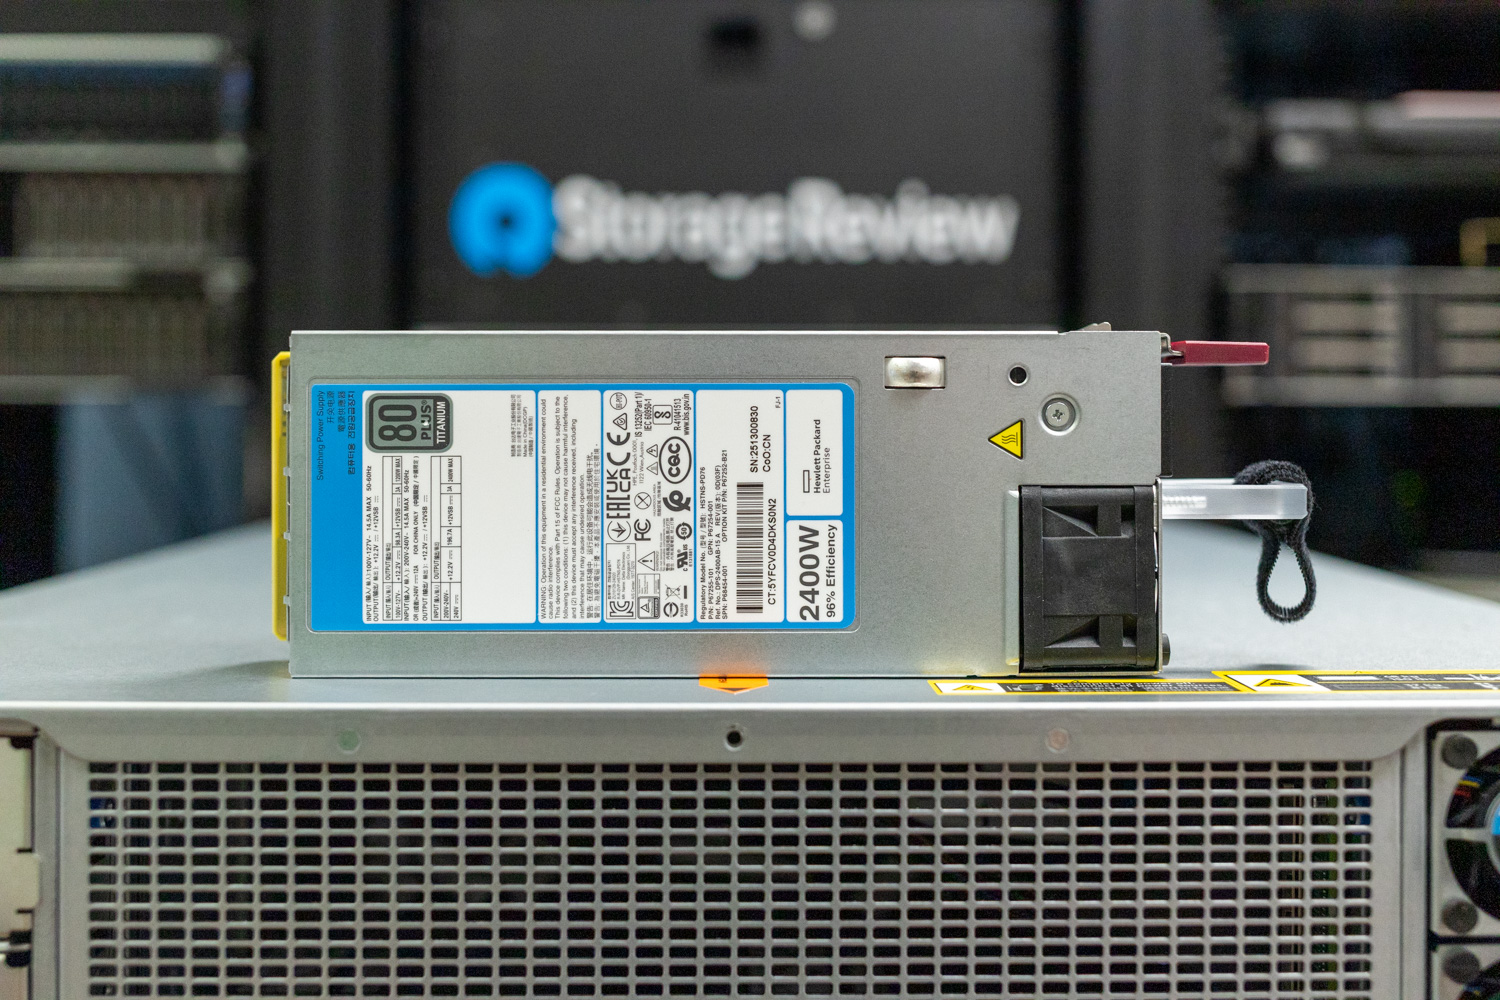
L'alimentazione per HPE ProLiant DL380a Gen12 è fornita tramite kit di alimentazione hot-plug M-CRPS Titanium modulari, con opzioni supportate tra cui i modelli da 1500 W (P67244-B21), 2400 W (P67252-B21) e 3200 W (P67248-B21). Il sistema supporta fino a otto alimentatori, consentendo la ridondanza N+1 per garantire il funzionamento continuo anche in caso di guasto di un modulo di alimentazione. A seconda della configurazione della GPU, i requisiti di alimentazione e la distribuzione possono variare. La nostra unità di prova era dotata di cinque alimentatori M-CRPS da 2400 W, che fornivano una capacità sufficiente a supportare le quattro GPU da 600 W TDP del sistema, mantenendo al contempo una ridondanza affidabile.
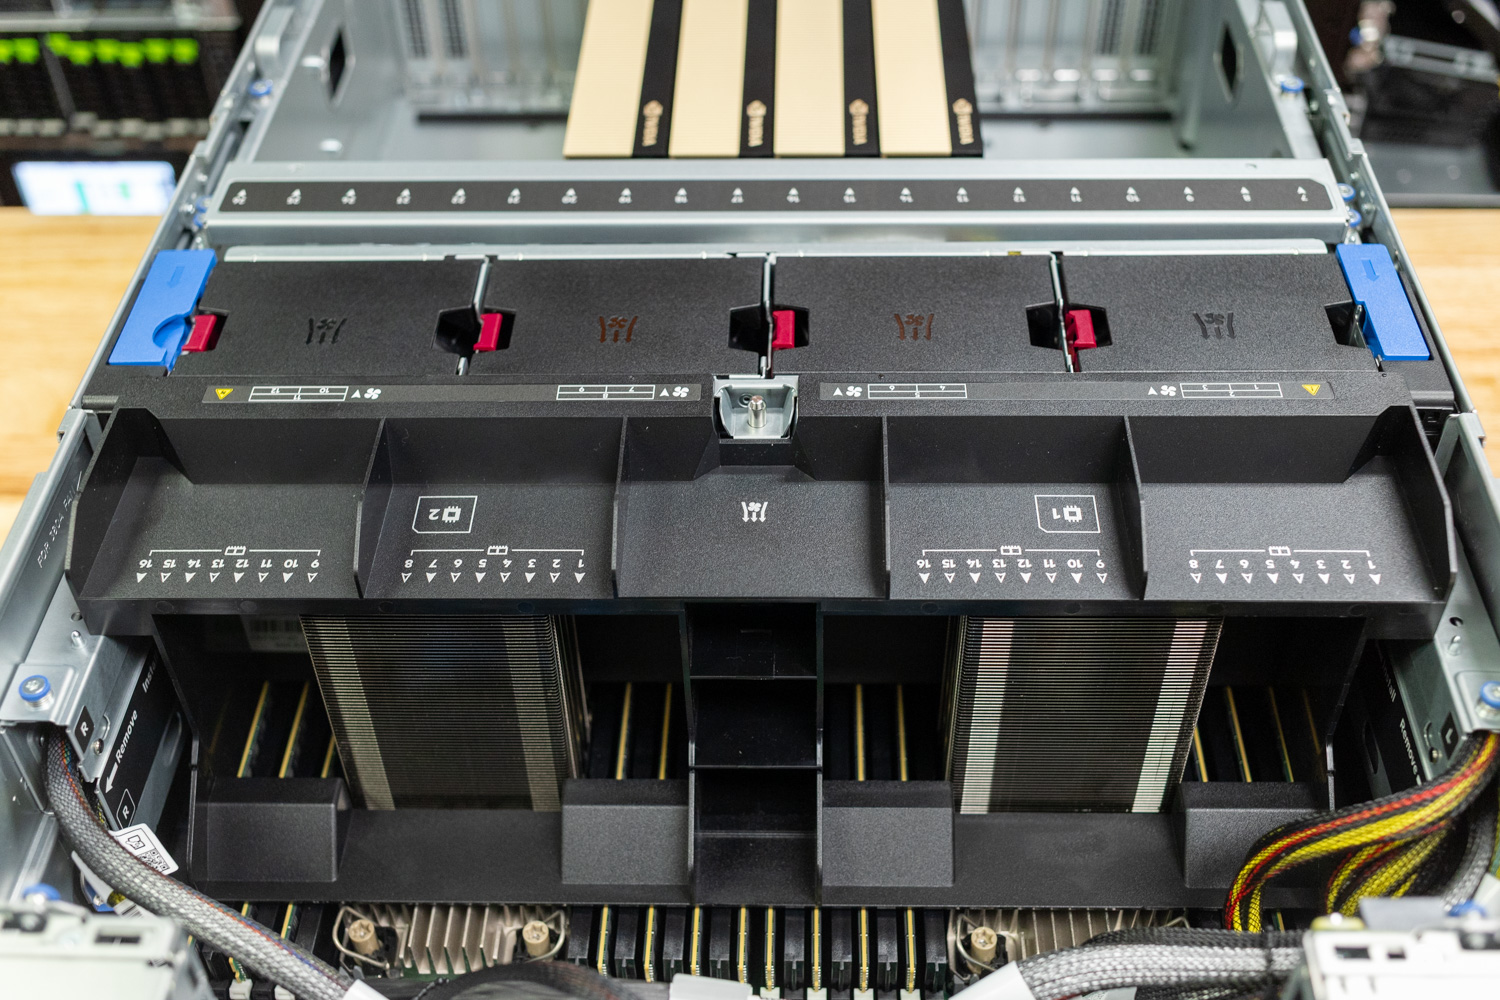
 Osservando dall'alto l'interno dell'HPE ProLiant DL380a Gen12, è evidente che HPE ha progettato questo chassis con una strategia termica incentrata sulle GPU, posizionando le GPU nella parte anteriore del sistema per ricevere un flusso d'aria diretto e senza ostacoli. Il sistema di raffreddamento è dotato di quattro gruppi di ventole hot-plug, ciascuno dotato di una ventola a doppio rotore da 92x56 mm e due ventole a singolo rotore da 40x28 mm. Le ventole più piccole concentrano il flusso d'aria sulla CPU e sui moduli di memoria, garantendo una gestione termica efficiente per i componenti inferiori. Al contrario, le ventole a doppio rotore più grandi sono progettate specificamente per indirizzare un flusso d'aria ad alto volume direttamente attraverso l'array di GPU. Questo design bilanciato garantisce un raffreddamento ottimale sia per i componenti di elaborazione che per quelli dell'acceleratore, anche in caso di carichi di lavoro ad alta potenza sostenuti.
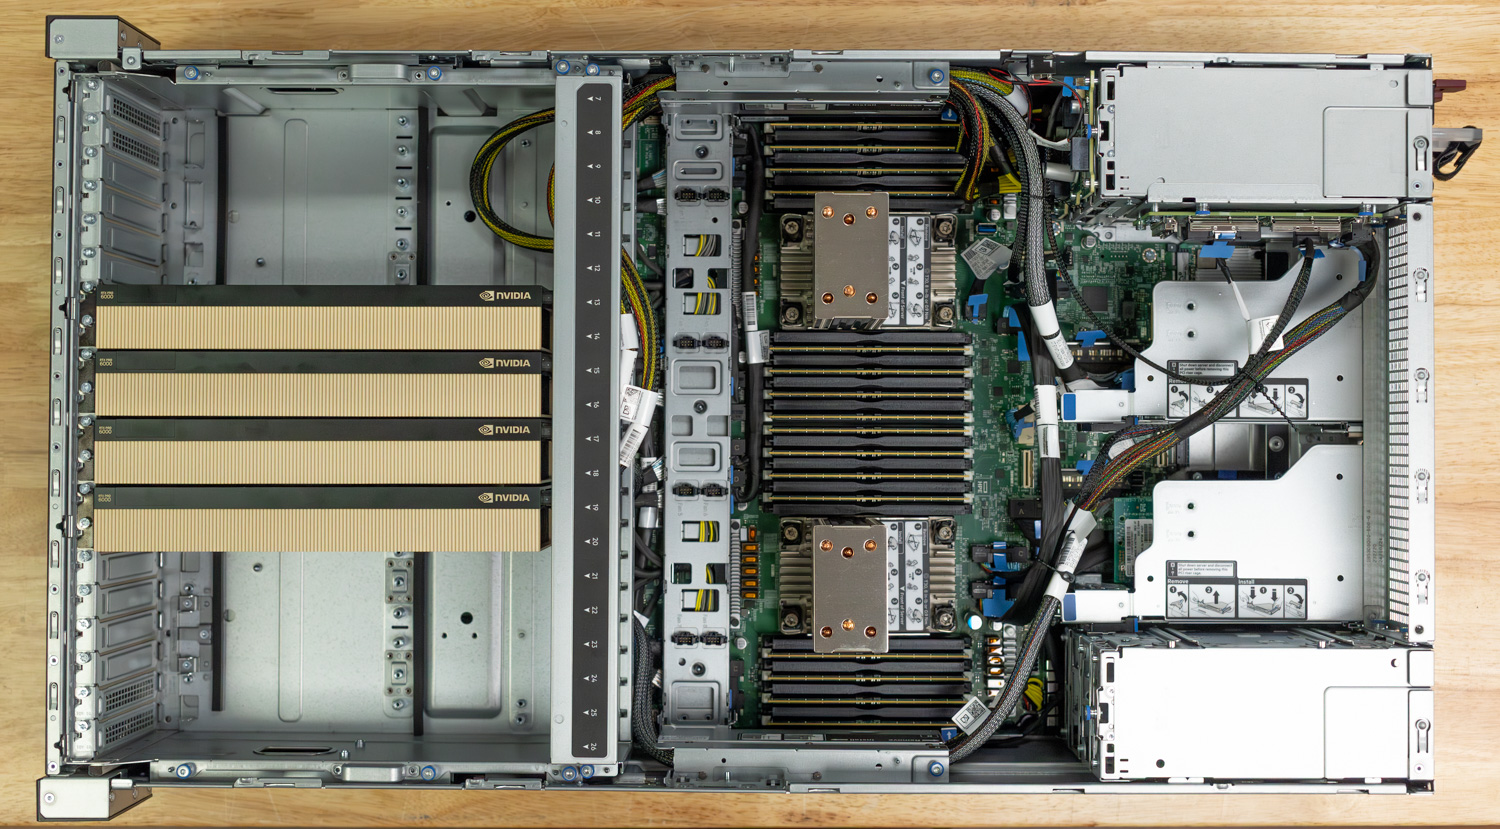
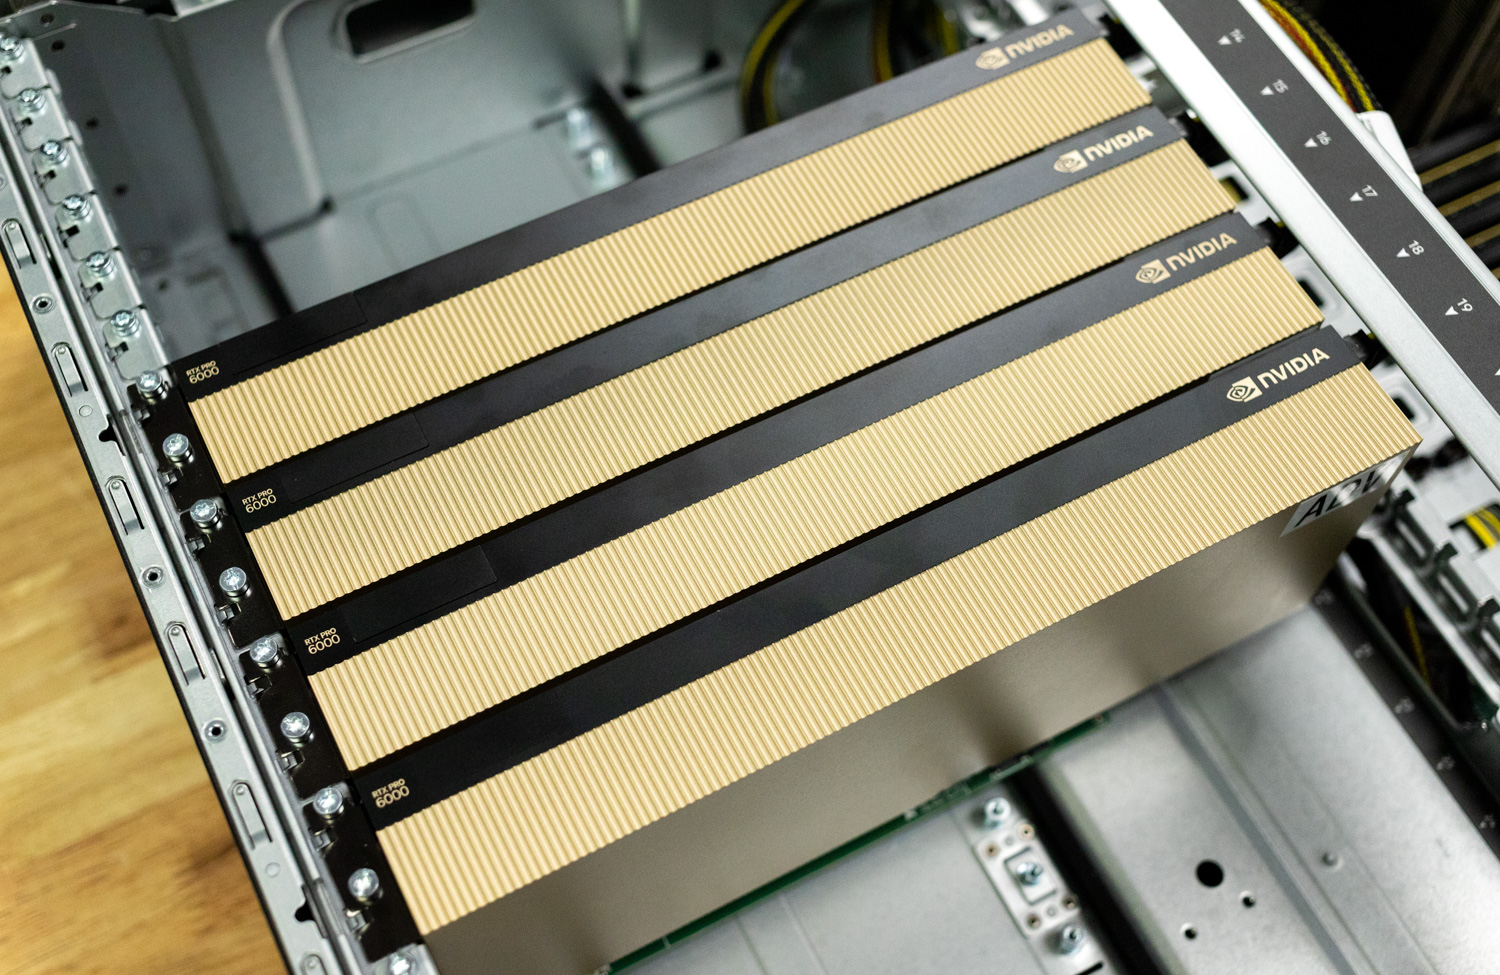
Dopo aver esaminato la configurazione della GPU, la nostra unità era precablata per quattro GPU PCIe 5.0, ciascuna installata in modo ordinato all'interno del vano GPU anteriore. Il sistema era configurato con GPU NVIDIA RTX PRO 6000 (Blackwell Server Edition, 96 GB), parte della nuova gamma professionale di NVIDIA ottimizzata per carichi di lavoro di intelligenza artificiale, rendering e calcolo. A seconda della configurazione, il DL380a Gen12 può supportare 4 o 8 GPU a doppia larghezza o fino a 16 acceleratori a larghezza singola, offrendo flessibilità per un'ampia gamma di implementazioni aziendali e di intelligenza artificiale.
Le GPU supportate per questa piattaforma includono:
- NVIDIA RTX PRO 6000 Server Edition (96 GB)
- NVIDIA H200 NVL (141 GB)
- NVIDIA H100 NVL (94 GB)
- NVIDIA L40S (48 GB)
- NVIDIA L20 (48 GB)
- NVIDIA L4 (24 GB)
Questo layout GPU flessibile, abbinato a linee PCIe Gen5 ad alta larghezza di banda, garantisce che il DL380a Gen12 sia pronto sia per attività di inferenza complesse che per ambienti di training AI su larga scala. Spostandosi più indietro nello chassis, con la copertura di raffreddamento installata, possiamo osservare l'approccio ingegneristico ponderato di HPE alla gestione del flusso d'aria. La copertura presenta un design a deflettore modellato con precisione che dirige l'aria in modo efficiente attraverso CPU, moduli di memoria e VRM, garantendo un raffreddamento uniforme in tutto il sistema.
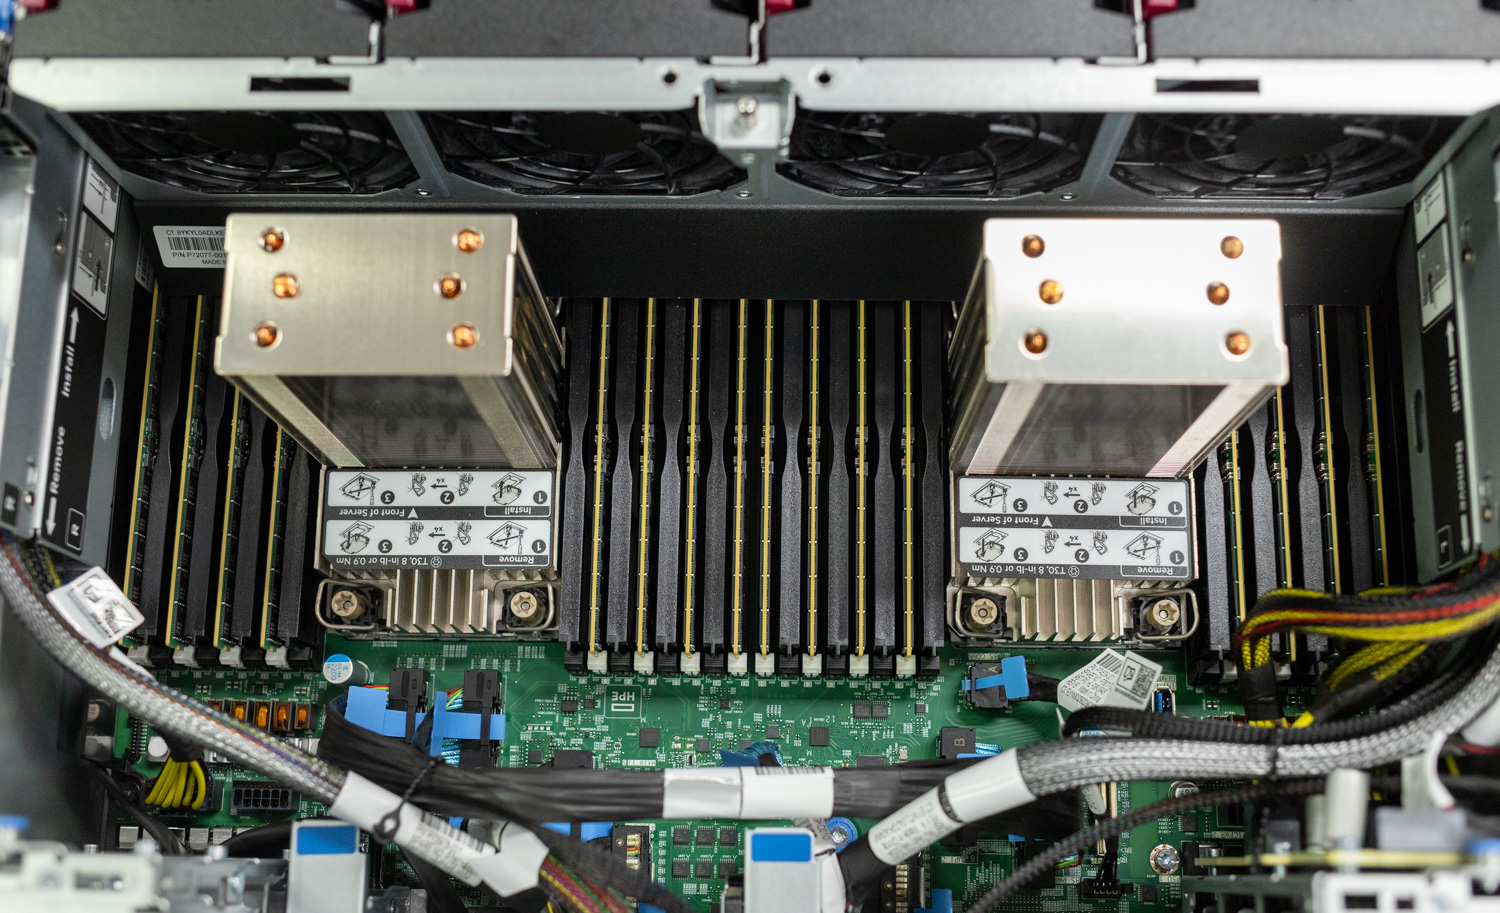
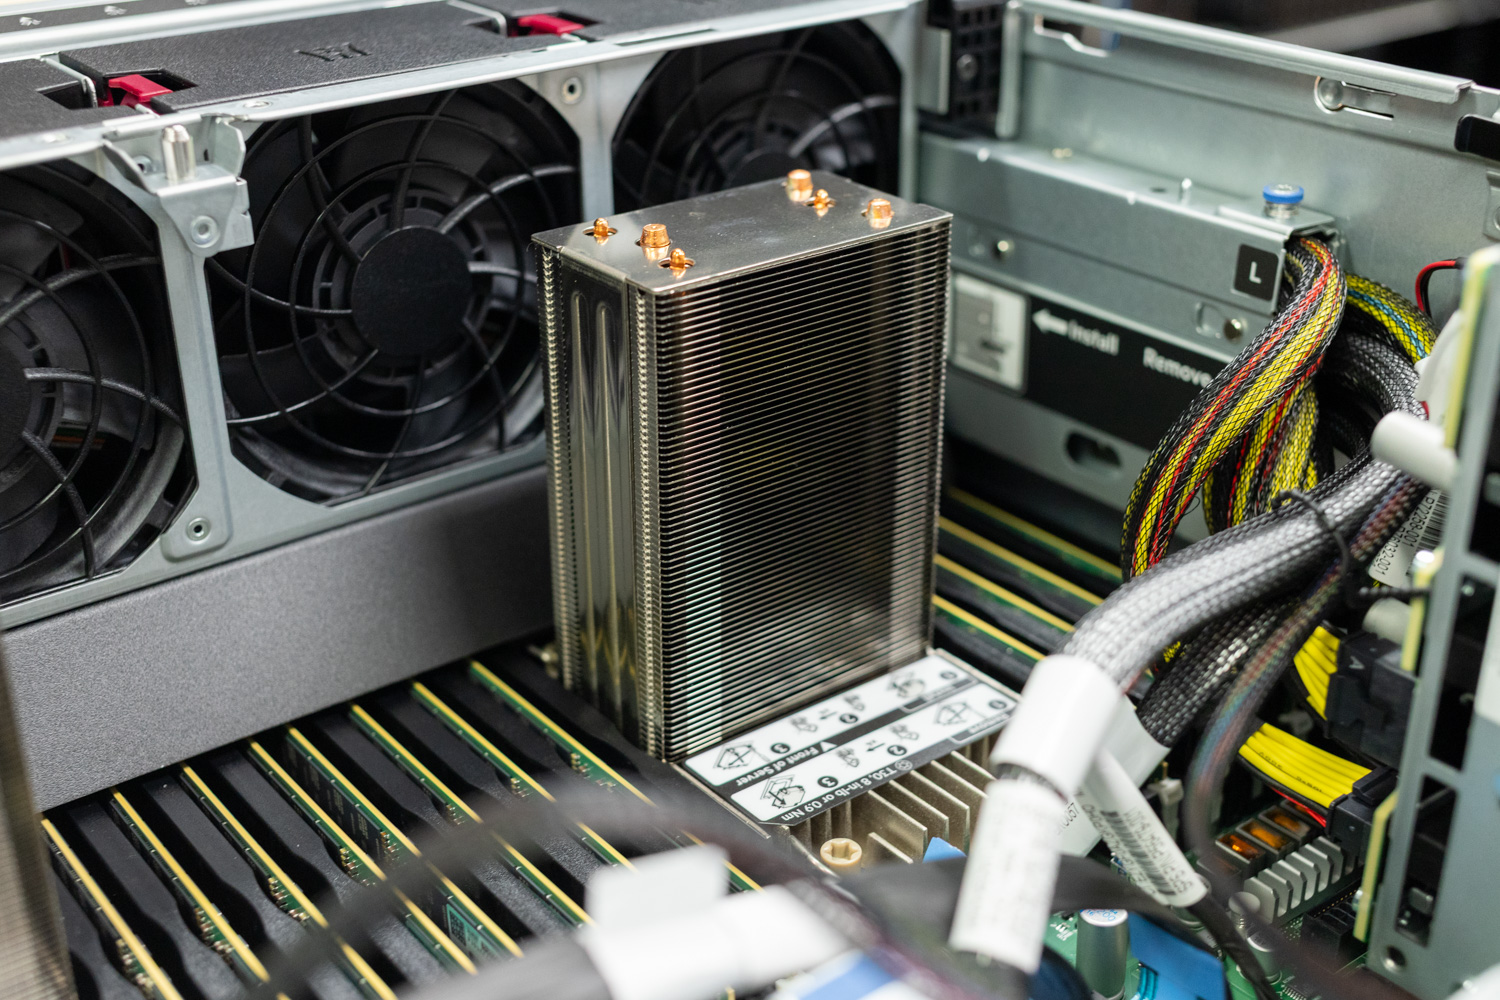
 Per quanto riguarda i dissipatori della CPU, HPE ha progettato il DL380a Gen12 tenendo conto dell'equilibrio termico. Ogni processore Xeon 6 è dotato di un dissipatore di calore alto e ad alta densità, progettato per gestire la potenza termica della CPU e il calore aggiuntivo generato dalle GPU posizionate nella parte anteriore dello chassis. Questo design garantisce prestazioni di raffreddamento costanti anche in caso di carichi di lavoro misti pesanti, in cui lo scarico della GPU può aumentare la temperatura ambiente intorno alla CPU. Quando si utilizzano GPU ad alta potenza, la combinazione di dissipatori di calore più alti e il design del flusso d'aria anteriore-posteriore di HPE fornisce la superficie e l'efficienza di raffreddamento necessarie per gestire efficacemente il carico termico aggiuntivo.
Panoramica dell'ILO 7
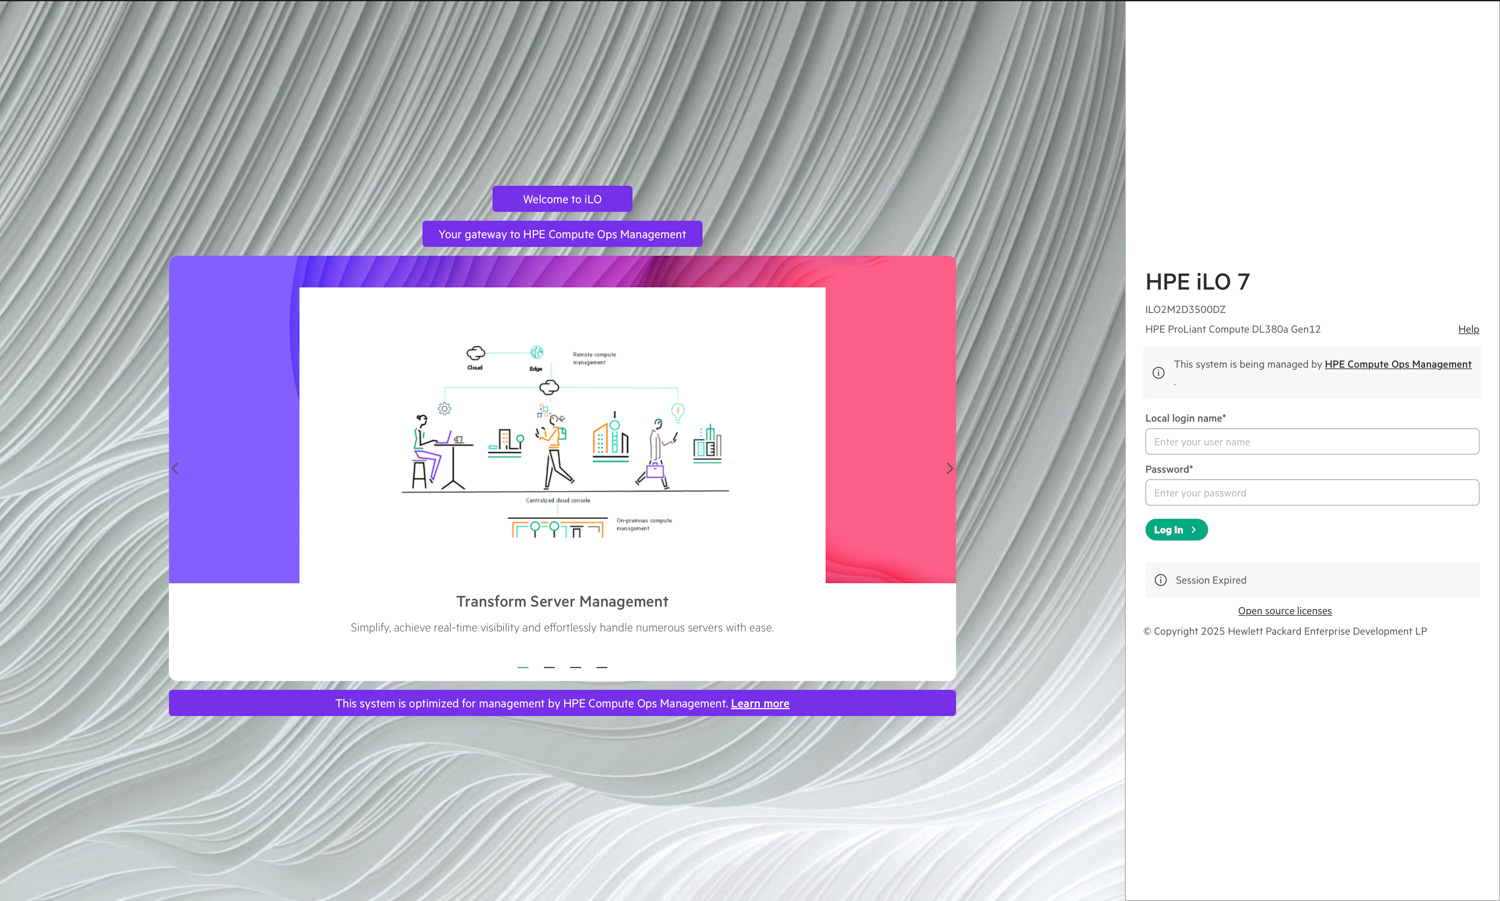
Come accennato, il sistema include una porta iLO dedicata che fornisce funzionalità di gestione out-of-band per il controllo e il monitoraggio completi del server. Questo box è dotato della nuova interfaccia HPE iLO 7, che offre agli amministratori l'accesso a un'interfaccia rinnovata e a funzionalità migliorate, integrate con HPE Compute Ops Management per una configurazione, un monitoraggio e una gestione del ciclo di vita semplificati. Di seguito è riportata la nuova schermata di accesso a HPE iLO 7 del nostro sistema di esempio.
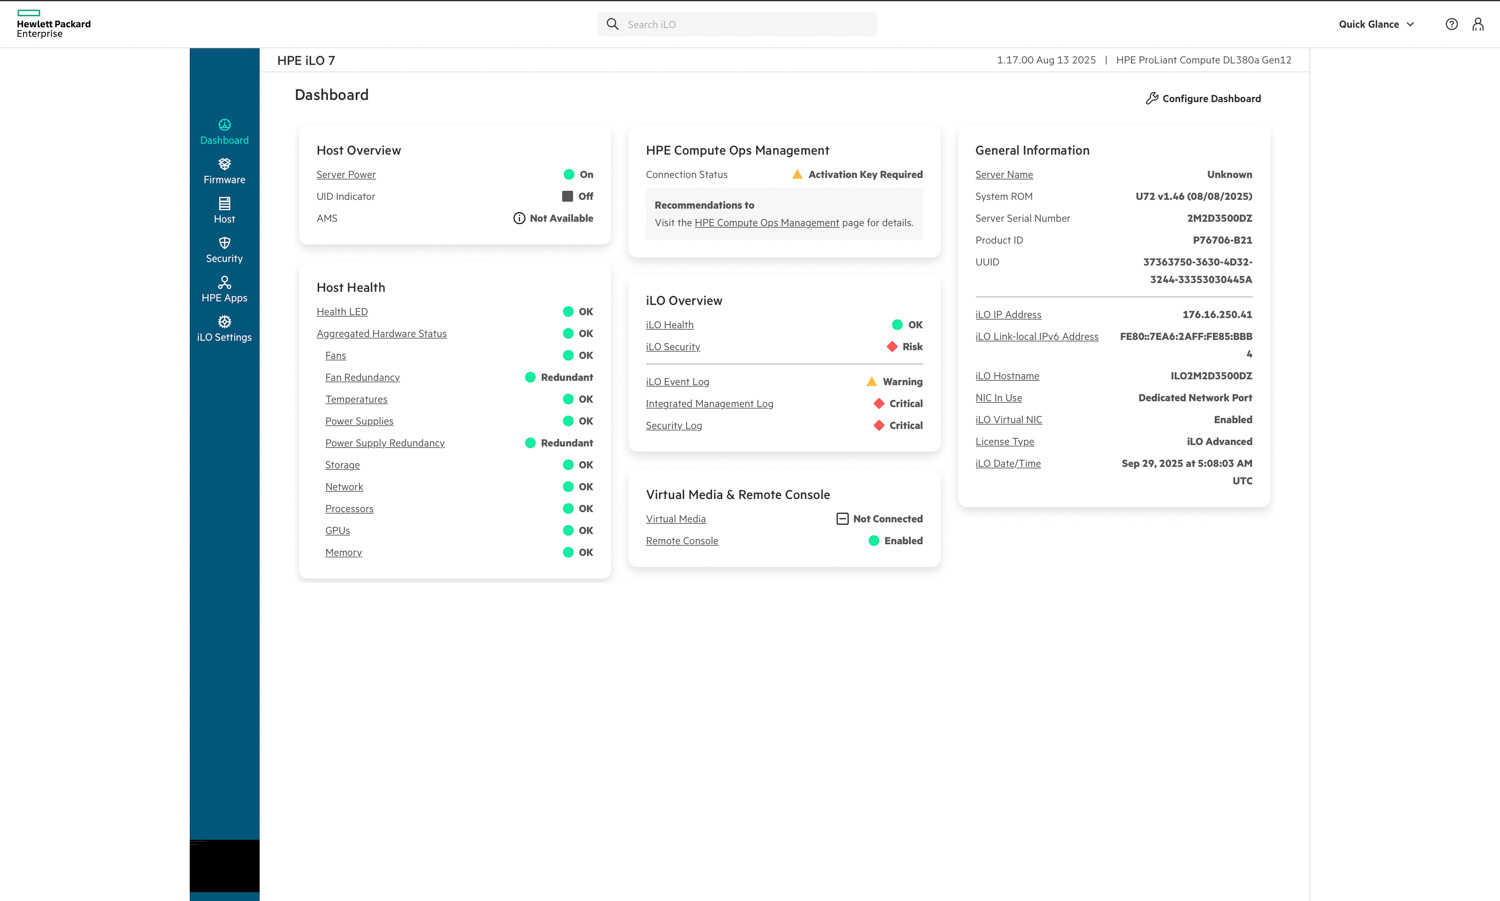
Partendo dalla dashboard, possiamo vedere che HPE iLO 7 presenta un'interfaccia modernizzata che evidenzia immediatamente lo stato del sistema e gli indicatori chiave di integrità. Il pannello principale fornisce una panoramica dello stato di alimentazione, integrità e connessione dell'host con HPE Compute Ops Management. Sulla destra, vengono visualizzate informazioni generali sul sistema, come l'indirizzo IP di iLO, il nome host e il tipo di licenza, per una rapida consultazione.
La dashboard consolida le metriche essenziali, come la ridondanza delle ventole, lo stato dell'alimentatore e le letture della temperatura, in un layout chiaro e codificato a colori, semplificando la valutazione delle condizioni del server a colpo d'occhio. Anche i supporti virtuali e l'accesso alla console remota sono accessibili direttamente dalla pagina principale, semplificando le comuni attività di gestione remota senza ulteriori operazioni di navigazione.
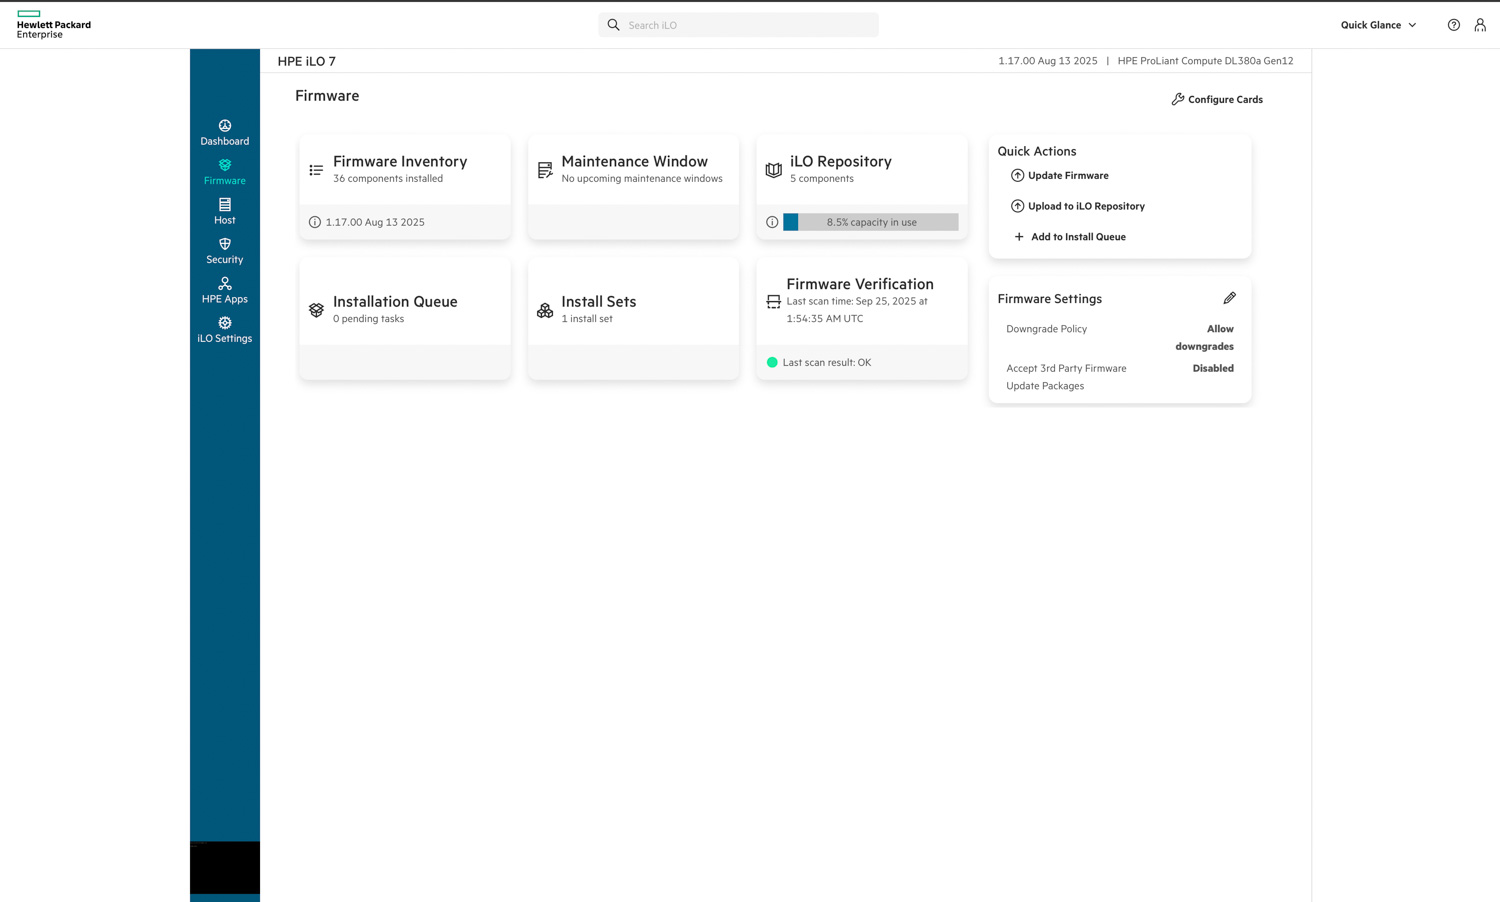
Nella scheda Firmware, HPE iLO 7 offre una visualizzazione chiara e organizzata di tutti i componenti e delle attività di gestione degli aggiornamenti. L'interfaccia elenca l'inventario del firmware, le code di installazione attive e i risultati delle verifiche in un layout basato su schede, facile da navigare. Gli amministratori possono avviare rapidamente gli aggiornamenti, caricare pacchetti nel repository iLO o creare set di installazione per la distribuzione in batch.
La verifica del firmware e la gestione del repository sono integrate direttamente in questa vista, consentendo agli utenti di confermare l'integrità e mantenere la coerenza delle versioni tra i componenti. Il menu Azioni rapide sulla destra semplifica le attività essenziali, come l'aggiornamento del firmware o il caricamento di nuovi file. La scheda Impostazioni firmware fornisce il controllo sulle policy di downgrade e sull'accettazione di pacchetti di terze parti.
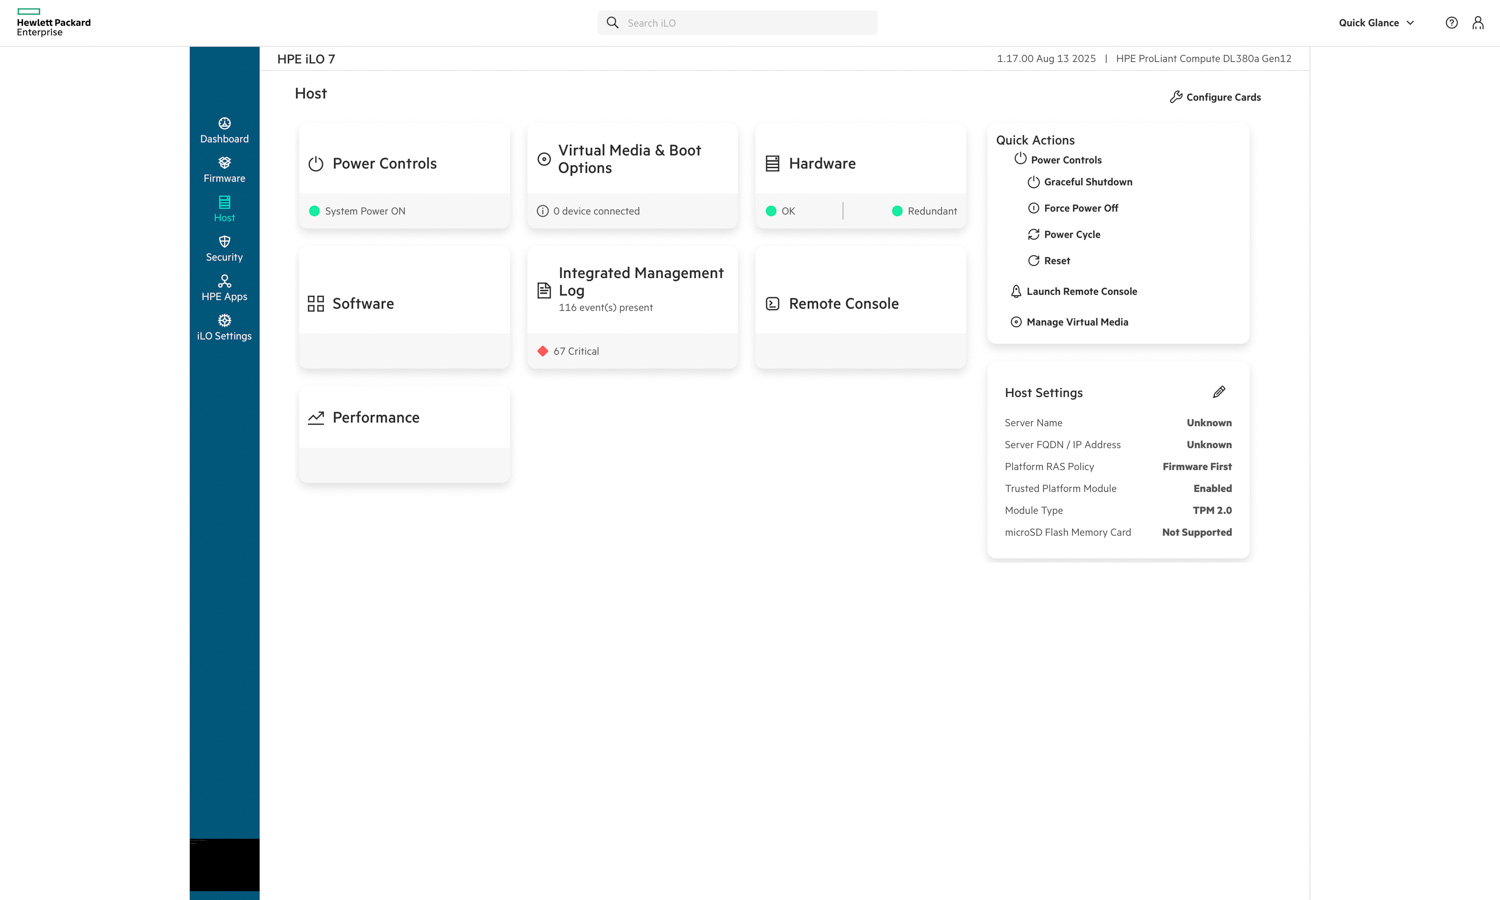
Nella sezione Host, HPE iLO 7 offre un rapido accesso alle funzioni critiche di gestione del server, tra cui controlli di alimentazione, supporti virtuali, stato dell'hardware e prestazioni del sistema. Gli amministratori possono visualizzare lo stato di ridondanza hardware in tempo reale, accedere al registro di gestione integrato o avviare la console remota direttamente da questa interfaccia. Il layout include anche azioni rapide come l'arresto normale, il riavvio e il ripristino, consentendo il controllo remoto completo del sistema senza accesso fisico.
Il pannello di destra mostra le impostazioni dell'host, tra cui lo stato del TPM, la configurazione delle policy della piattaforma e le informazioni sui moduli hardware. Nel complesso, questa sezione evidenzia il ruolo di iLO 7 come hub di controllo centralizzato, consentendo agli amministratori di gestire in modo sicuro l'alimentazione, monitorare gli eventi e mantenere la supervisione operativa in un'unica vista.
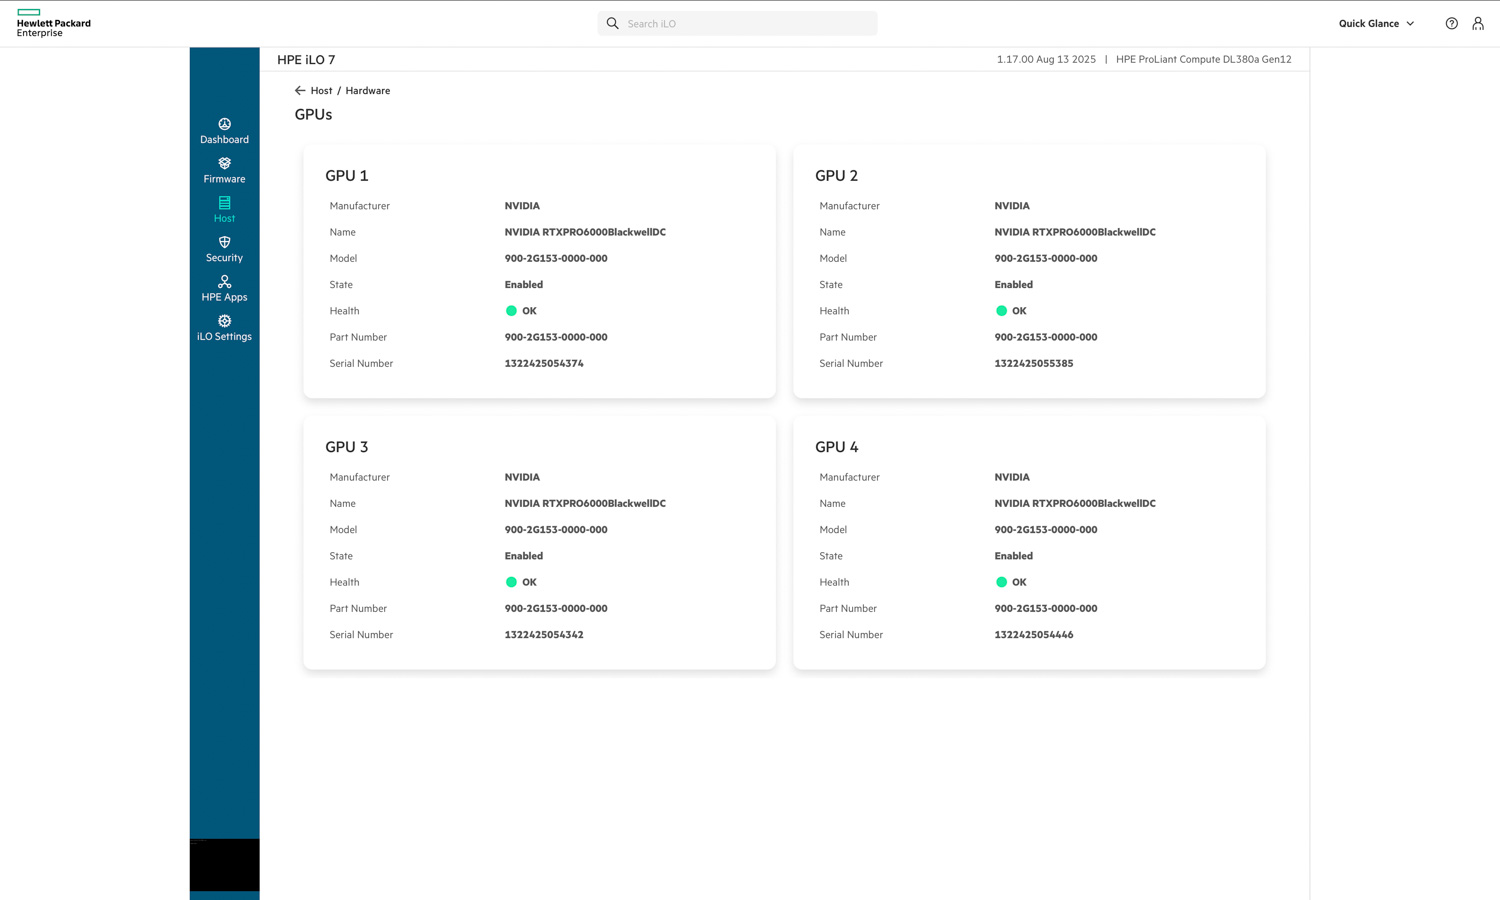
 Dalla vista Host > Hardware, possiamo vedere le GPU installate nel sistema. Come notato, l'unità è dotata di quattro GPU NVIDIA RTX PRO 6000 Blackwell, ciascuna segnalata come abilitata e funzionante normalmente. iLO 7 fornisce informazioni hardware dettagliate, inclusi numeri di modello, codici prodotto e numeri di serie, consentendo agli amministratori di verificare a colpo d'occhio lo stato dei componenti.
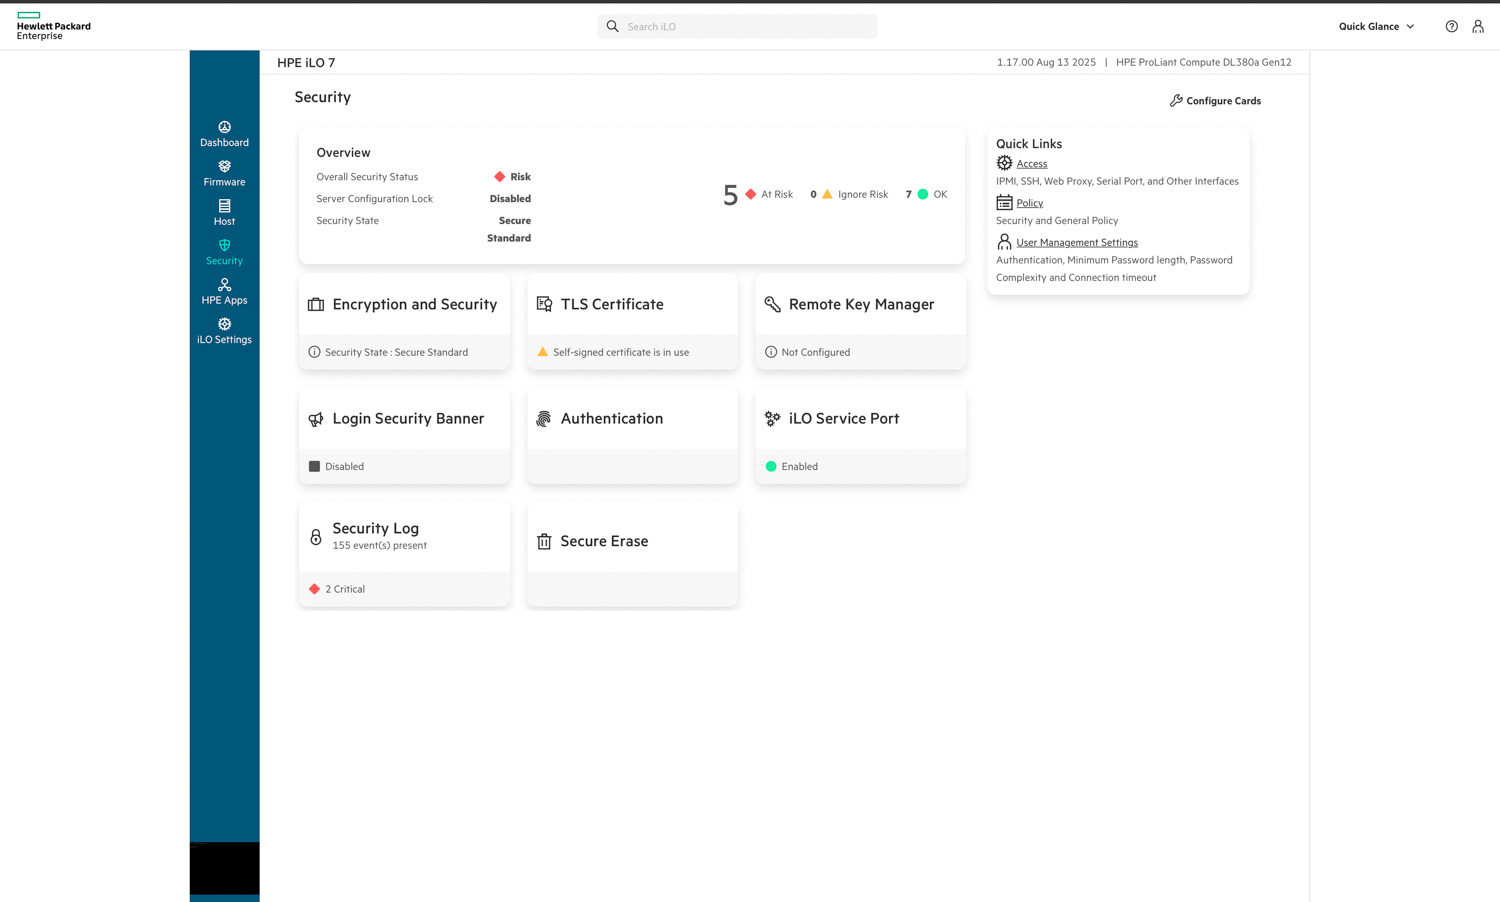
Nella scheda Sicurezza, HPE iLO 7 consolida tutti i controlli chiave relativi alla protezione del sistema e alla gestione degli accessi. Il pannello di panoramica offre una panoramica generale dello stato di sicurezza, evidenziando i livelli di rischio, i blocchi di configurazione e lo stato dei certificati. Da qui, gli amministratori possono gestire le impostazioni di crittografia, i metodi di autenticazione e i certificati TLS, nonché configurare la cancellazione sicura e la gestione remota delle chiavi.
L'interfaccia indica chiaramente le aree che richiedono attenzione, come i certificati autofirmati o la gestione delle chiavi non configurata, confermando comunque il funzionamento sicuro, ove applicabile. I registri di sicurezza, le policy di gestione degli utenti e i controlli di accesso sono facilmente accessibili, offrendo agli amministratori una visione completa dello stato di sicurezza del sistema direttamente dall'ambiente iLO.
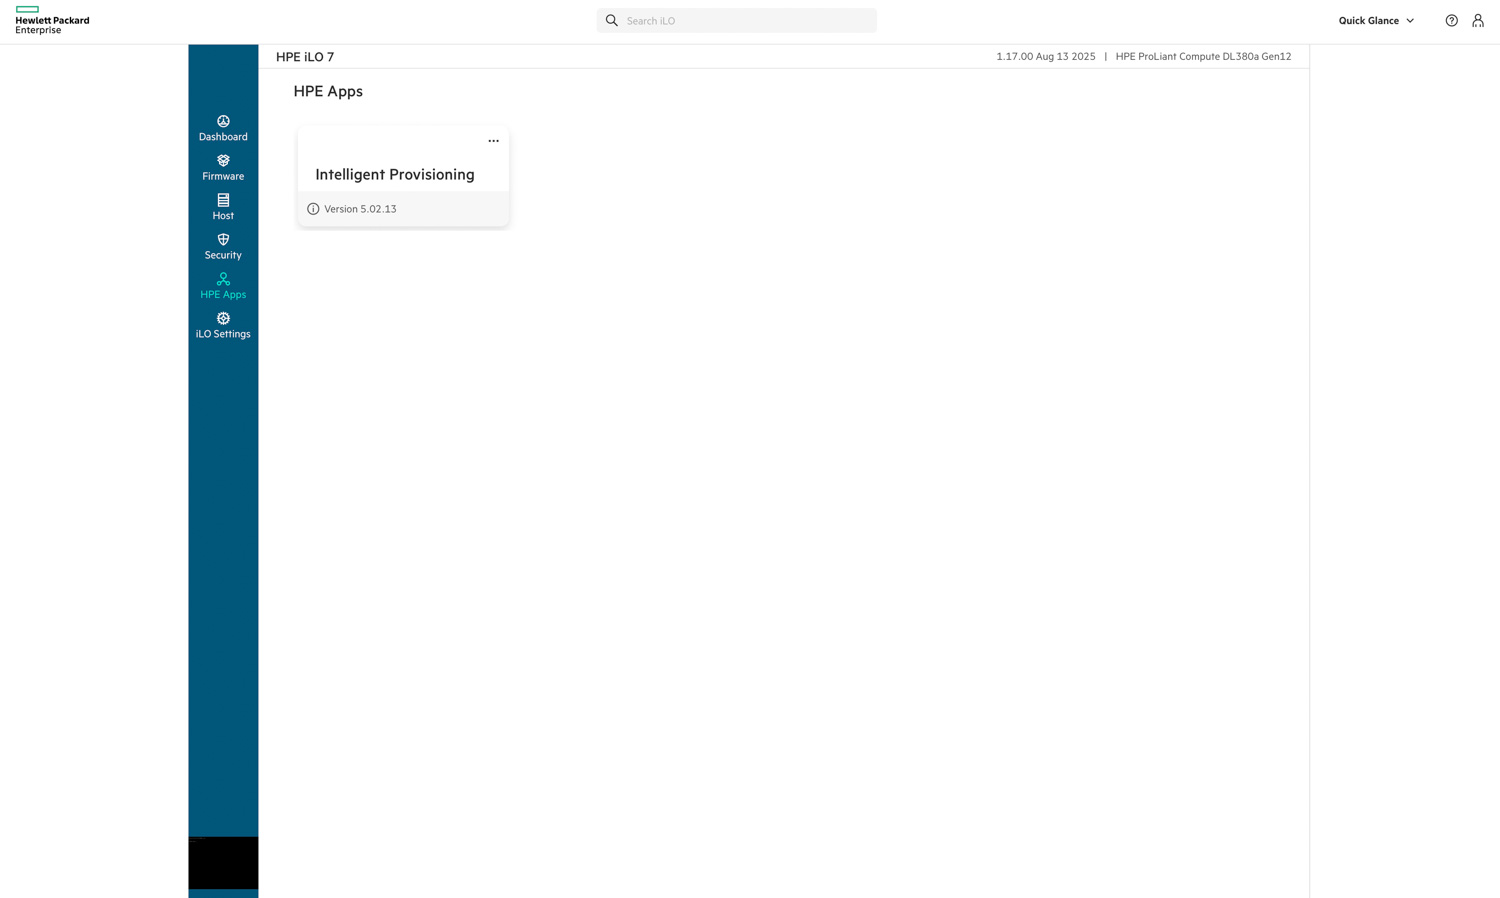
Nella scheda HPE Apps, iLO 7 offre accesso a strumenti integrati che migliorano l'implementazione e la gestione del ciclo di vita dei server. Da questa schermata, gli amministratori possono avviare Intelligent Provisioning, un'utilità integrata progettata per semplificare l'installazione del sistema operativo, gli aggiornamenti del firmware e la configurazione del sistema senza la necessità di supporti esterni.
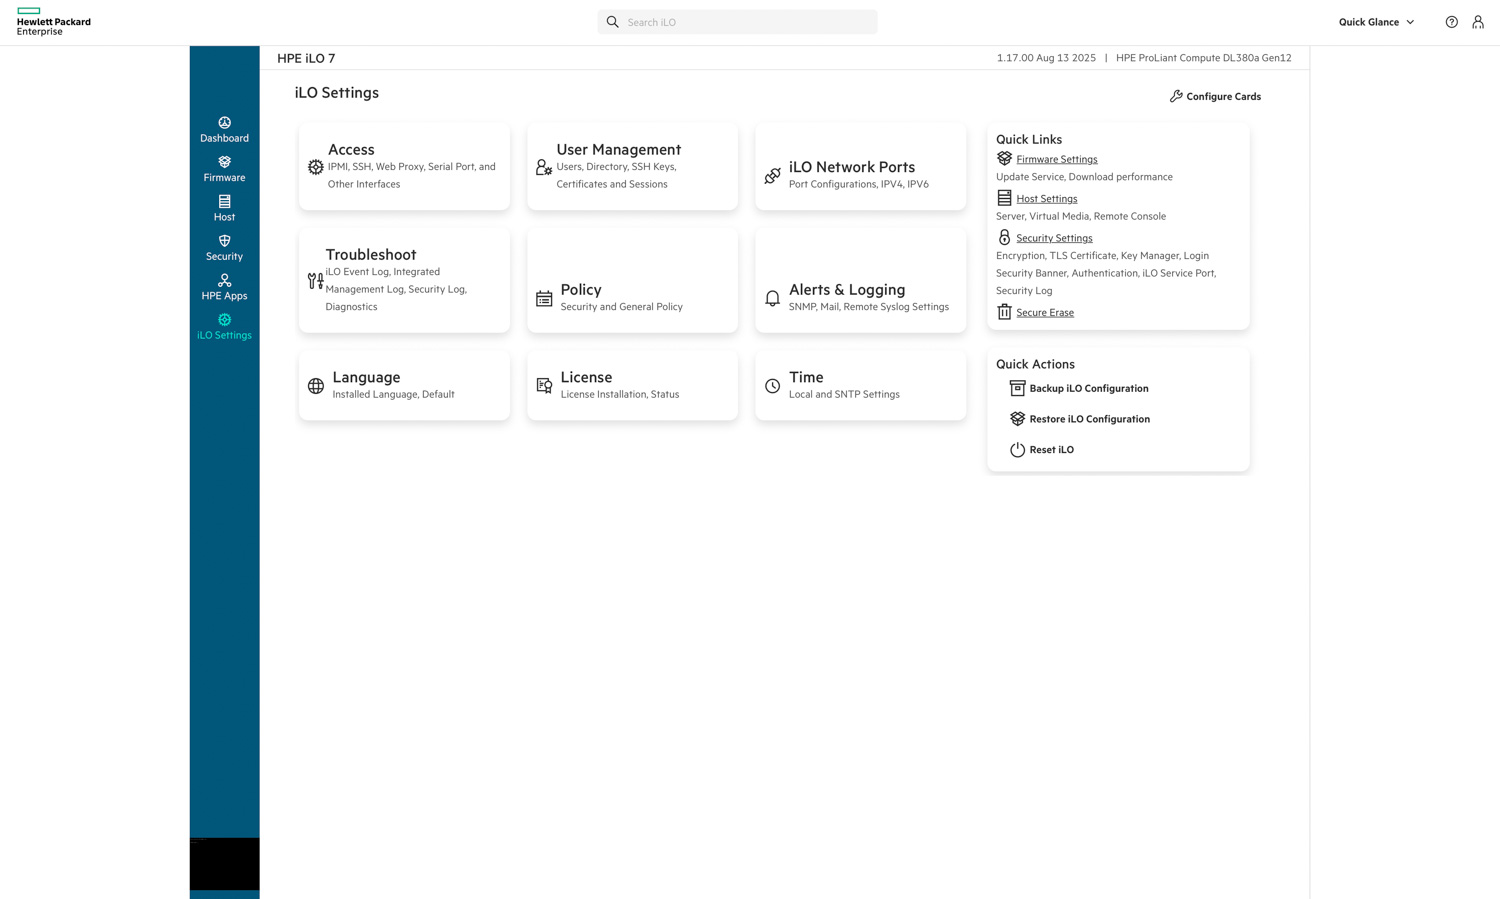
La scheda Impostazioni iLO consolida tutte le opzioni di configurazione e amministrazione per la gestione dell'interfaccia iLO. Da qui, gli amministratori possono controllare l'accesso degli utenti, le configurazioni delle porte di rete, i metodi di autenticazione e il comportamento di registrazione. Il menu include anche opzioni per la risoluzione dei problemi, l'applicazione delle policy, la gestione delle licenze e la sincronizzazione oraria.
Azioni rapide, come il backup o il ripristino della configurazione di iLO e l'esecuzione di un reset, sono comodamente disponibili sulla destra, contribuendo a semplificare le attività di manutenzione. Il layout rispecchia il resto della moderna interfaccia basata su schede di iLO 7, offrendo un modo chiaro e organizzato per gestire sicurezza, connettività e parametri operativi da un'unica posizione centralizzata.
Test di Performance
Per valutare le capacità reali del DL380a Gen12, abbiamo condotto una serie completa di test prestazionali che hanno coperto sia l'inferenza AI che i carichi di lavoro di elaborazione generali. Questi includono benchmark di servizio online vLLM per modelli linguistici di grandi dimensioni (LLM) e benchmark di Phoronix Test Suite per misurare il throughput della CPU, la larghezza di banda della memoria, l'efficienza del servizio web e le prestazioni crittografiche.
Configurazione del sistema
- CPU: 2 CPU Intel Xeon 6527P
- Memoria: Kit intelligente HPE da 16 x 64 GB 2Rx4 PC5-3400B-R
- GPU: 4 schede grafiche NVIDIA RTX PRO 6000 (96 GB)
- Memoria su disco: 2 x 15.63 TB PM1733a U.3
vLLM Online Serving – Prestazioni di inferenza LLM
vLLM è il motore di inferenza e di servizio ad alta velocità più diffuso per gli LLM. Il benchmark di servizio online vLLM è uno strumento di valutazione delle prestazioni che misura le capacità di servizio reali di questo motore di inferenza in caso di richieste simultanee. Simula carichi di lavoro di produzione inviando richieste a un server vLLM in esecuzione con parametri configurabili, tra cui frequenza di richiesta, lunghezza di input/output e numero di client simultanei. Il benchmark misura metriche chiave, tra cui throughput (tok/s), tempo al primo token e tempo per token di output, aiutando gli utenti a comprendere le prestazioni di vLLM in diverse condizioni di carico.
Abbiamo testato le prestazioni di inferenza su tre modelli rappresentativi che coprono diverse scale e approcci di quantizzazione, valutando il modo in cui le quattro GPU NVIDIA RTX PRO 6000 di HPE ProLiant DL380a Gen12 gestiscono i carichi di lavoro di inferenza di produzione.
Prestazioni del modello denso
I modelli densi rappresentano l'architettura LLM convenzionale, in cui tutti i parametri e le attivazioni vengono coinvolti durante l'inferenza. Abbiamo valutato due configurazioni di modelli densi: Llama-2-70b-chat-hf e Llama-3.2-90B-Vision-Instruct.
Llama-2-70B-Chat Performance
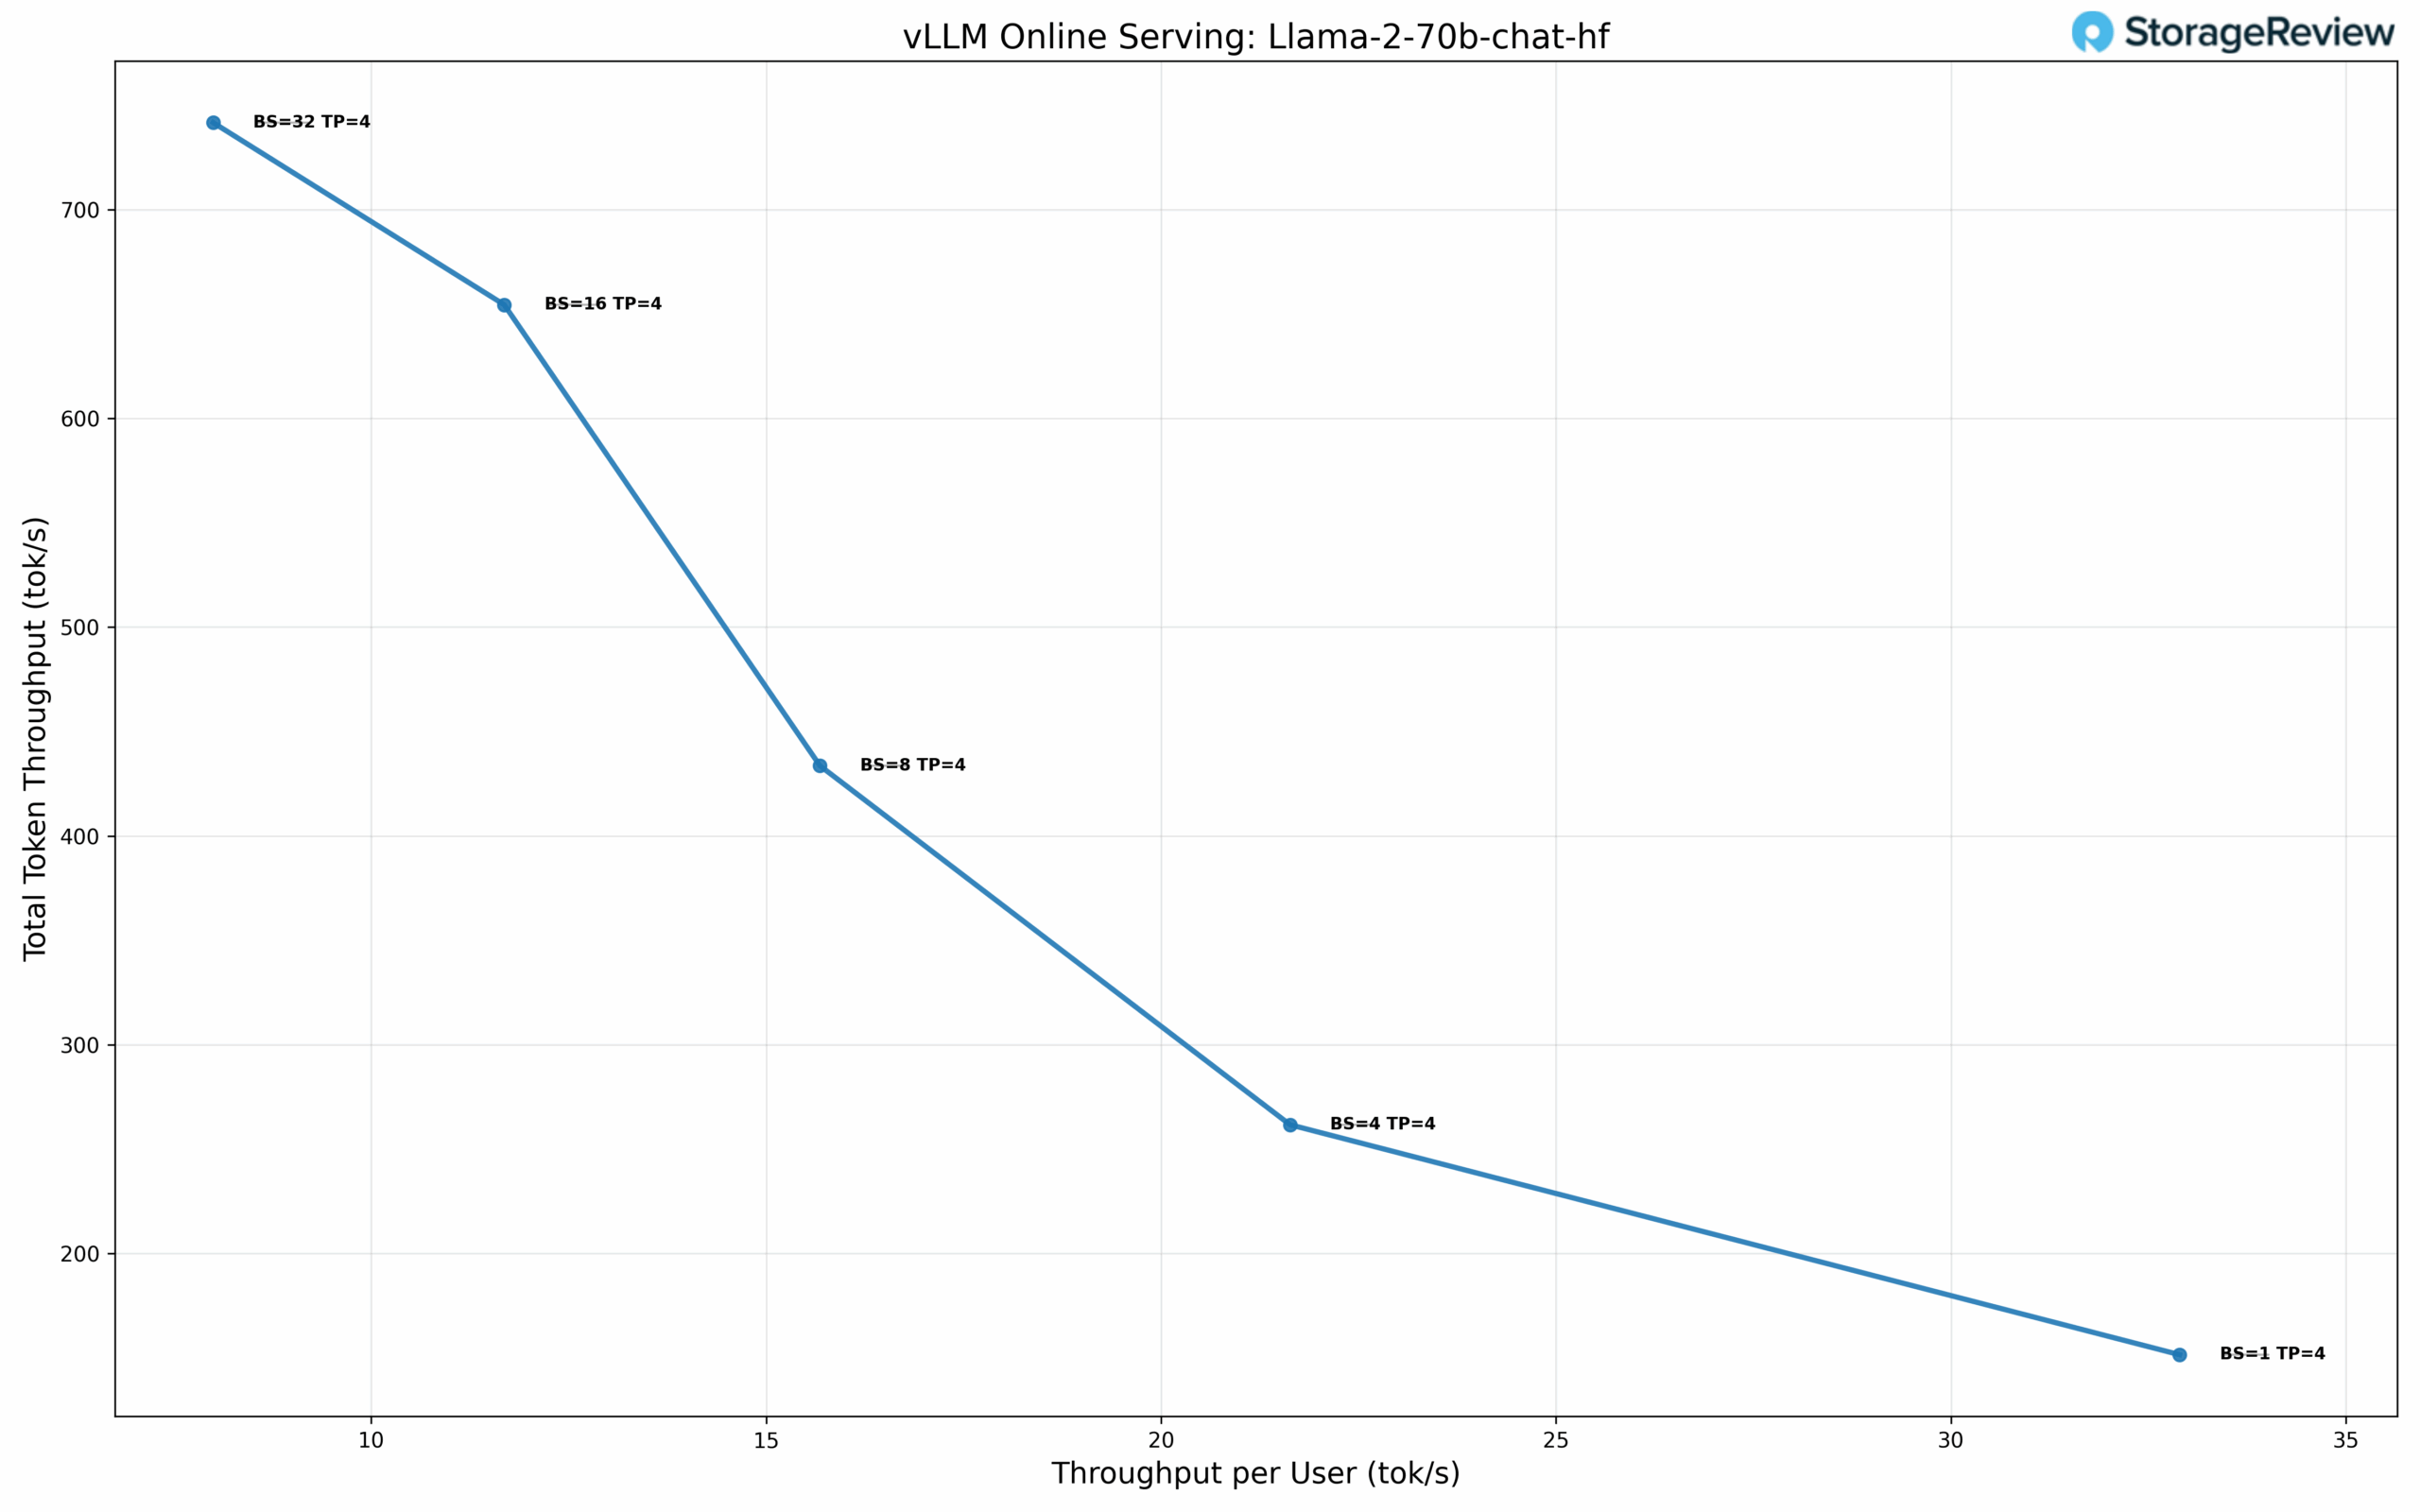
Con concorrenza monoutente (BS=1) e TP=4, il modello raggiunge 32.89 tok/s per utente con un TPOT di 30.18 ms. Con BS=8, le prestazioni raggiungono 15.68 tok/s per utente con una produttività totale di 433.62 tok/s e un TPOT di 35.98 ms. Scalando a BS=32, la produttività totale raggiunge 741.62 tok/s, mantenendo 8.00 tok/s per utente con un TPOT di 43.44 ms.
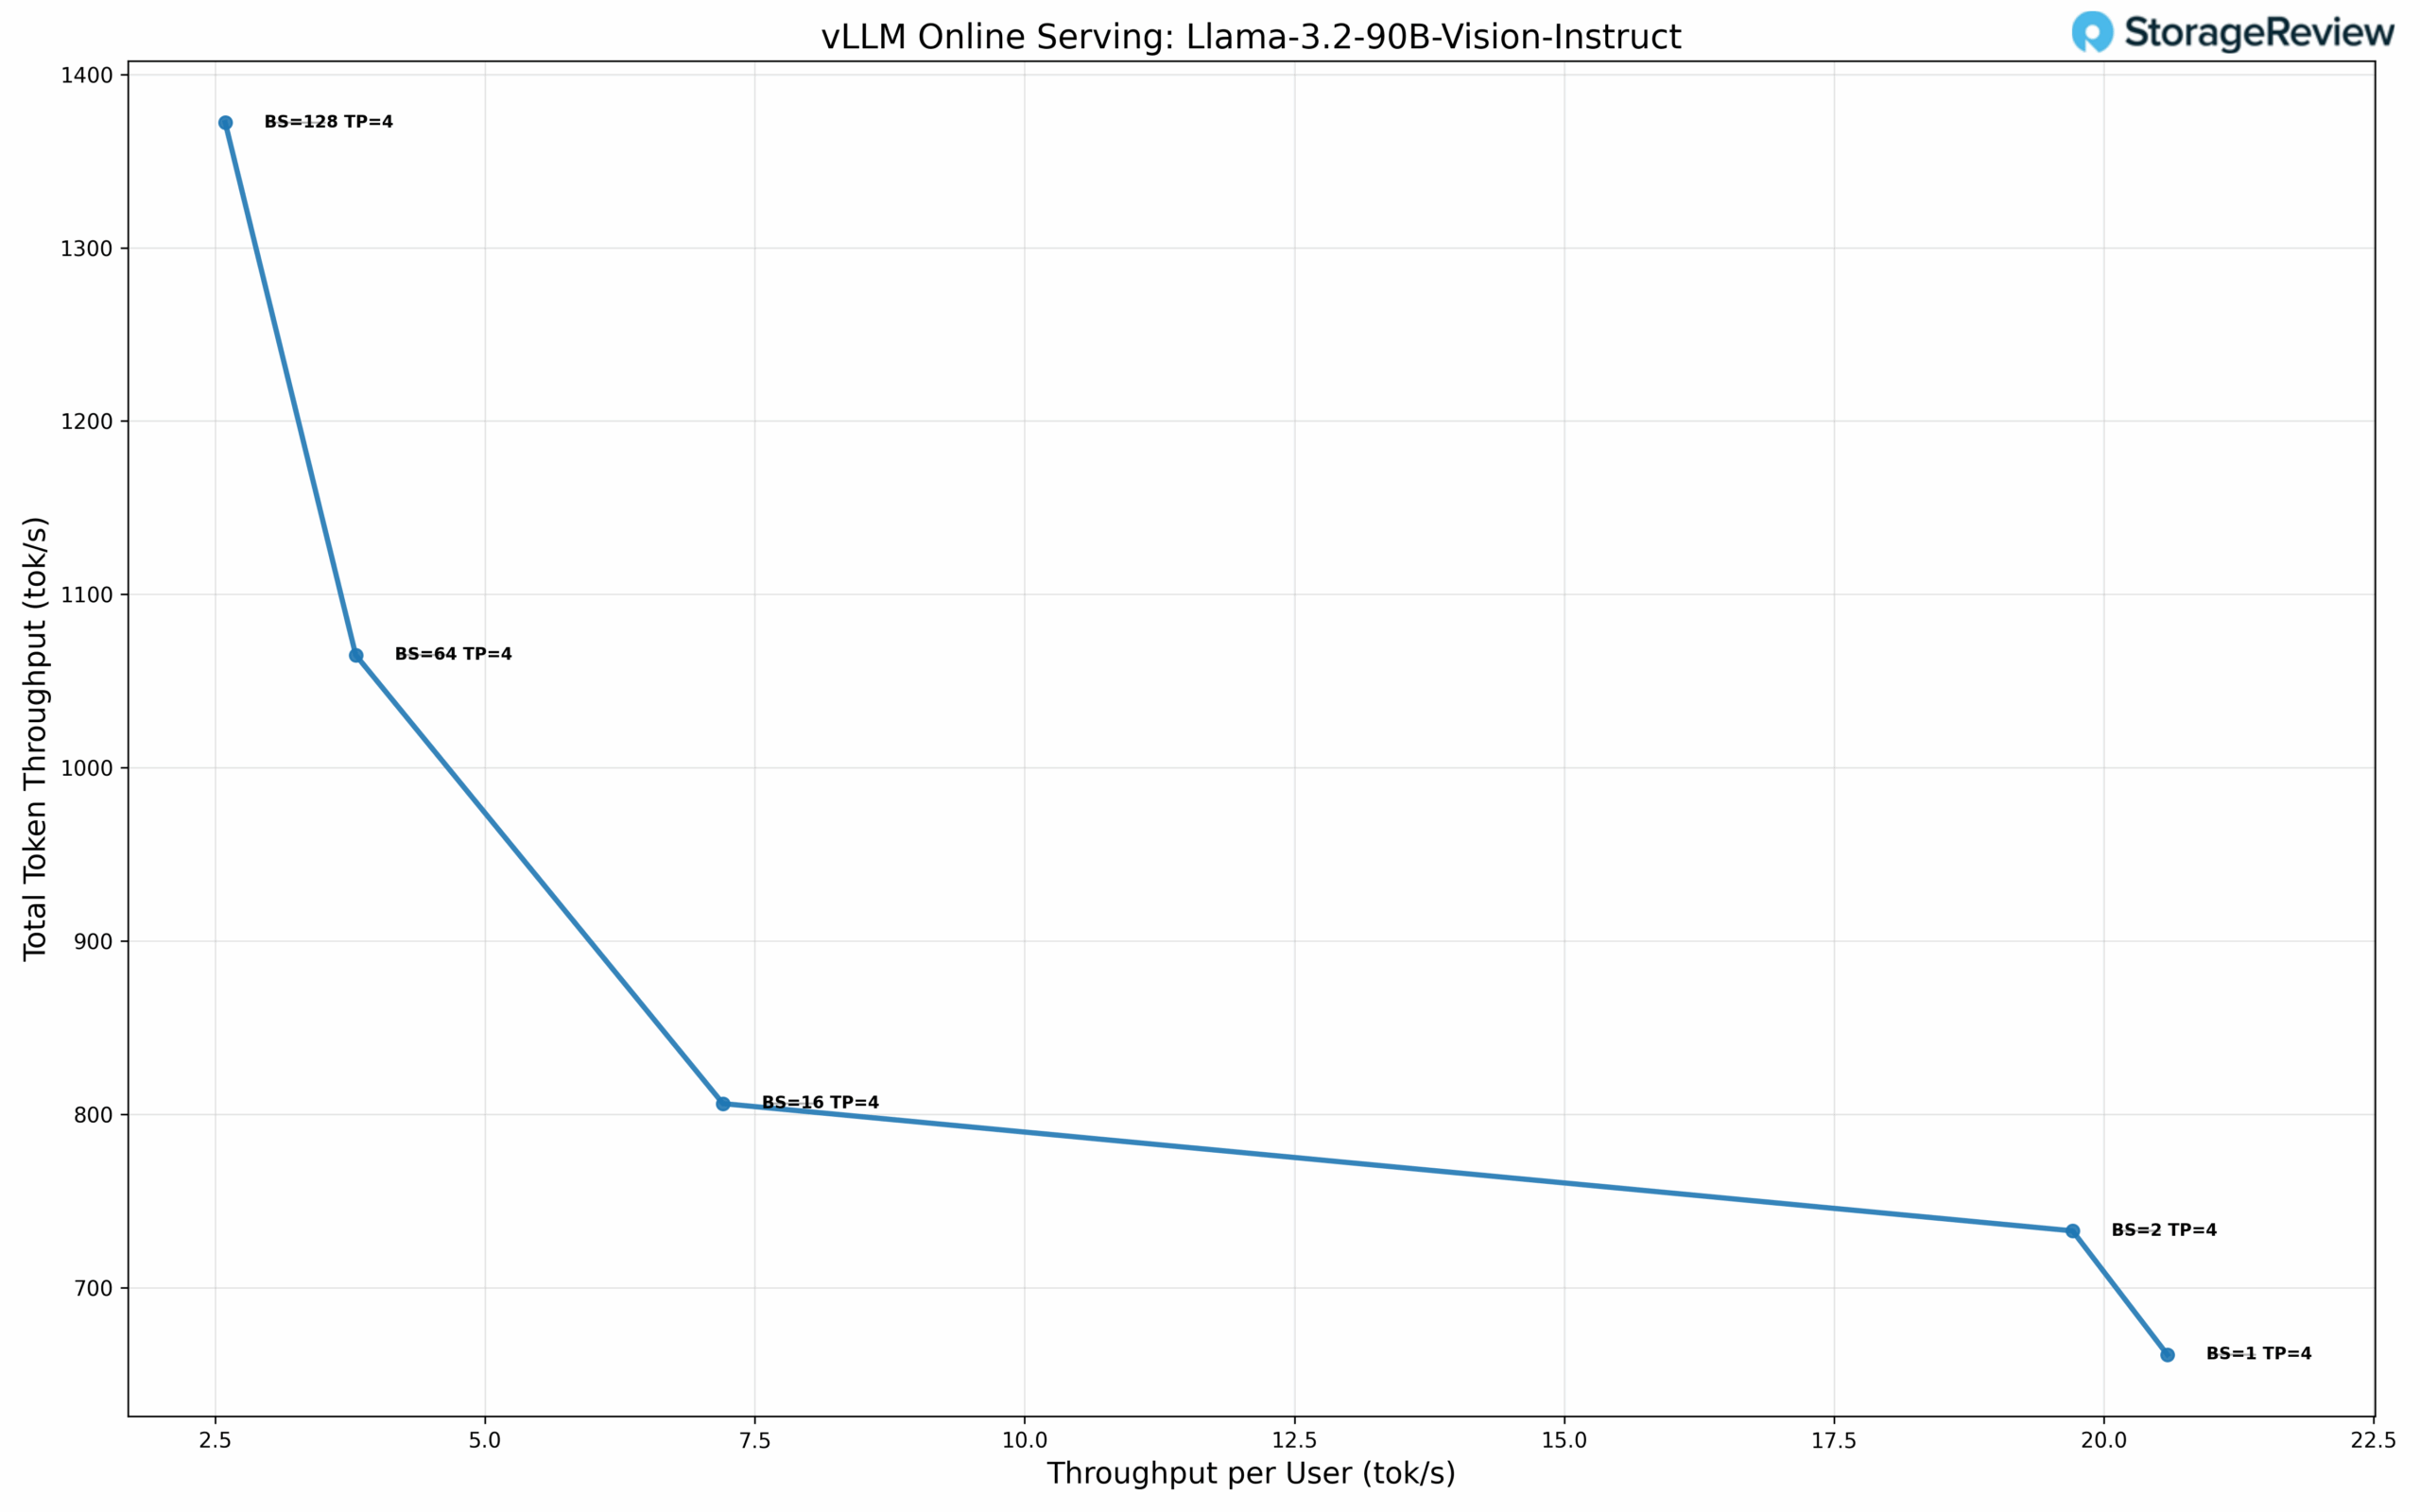
Llama-3.2-90B-Vision-Instruct Performance
Con BS=1 e TP=4, il modello fornisce 20.59 tok/s per utente con 38.27 ms TPOT. Con BS=16, le prestazioni aumentano a 7.20 tok/s per utente con una velocità di trasmissione totale di 806.14 tok/s e 54.98 ms TPOT. La velocità di trasmissione totale massima di 1372.21 tok/s si ottiene con BS=128, fornendo 2.59 tok/s per utente con 122.75 ms TPOT.
Prestazioni del tipo di dati di microscalatura
Il microscaling rappresenta un approccio di quantizzazione avanzato che applica fattori di scala a grana fine a piccoli blocchi di pesi anziché una quantizzazione uniforme su grandi gruppi di parametri. Il formato NVFP4 di NVIDIA implementa questa tecnica attraverso una rappresentazione in virgola mobile bloccata in cui ogni blocco di microscala di 8-32 valori condivide un esponente comune come fattore di scala. Questo approccio granulare preserva la precisione numerica ottenendo al contempo una rappresentazione a 4 bit, mantenendo la gamma dinamica critica per le architetture a trasformatore. Il formato si integra con l'architettura Tensor Core di NVIDIA sulla RTX PRO 6000, consentendo un calcolo efficiente a precisione mista con decompressione al volo durante le operazioni sulla matrice.
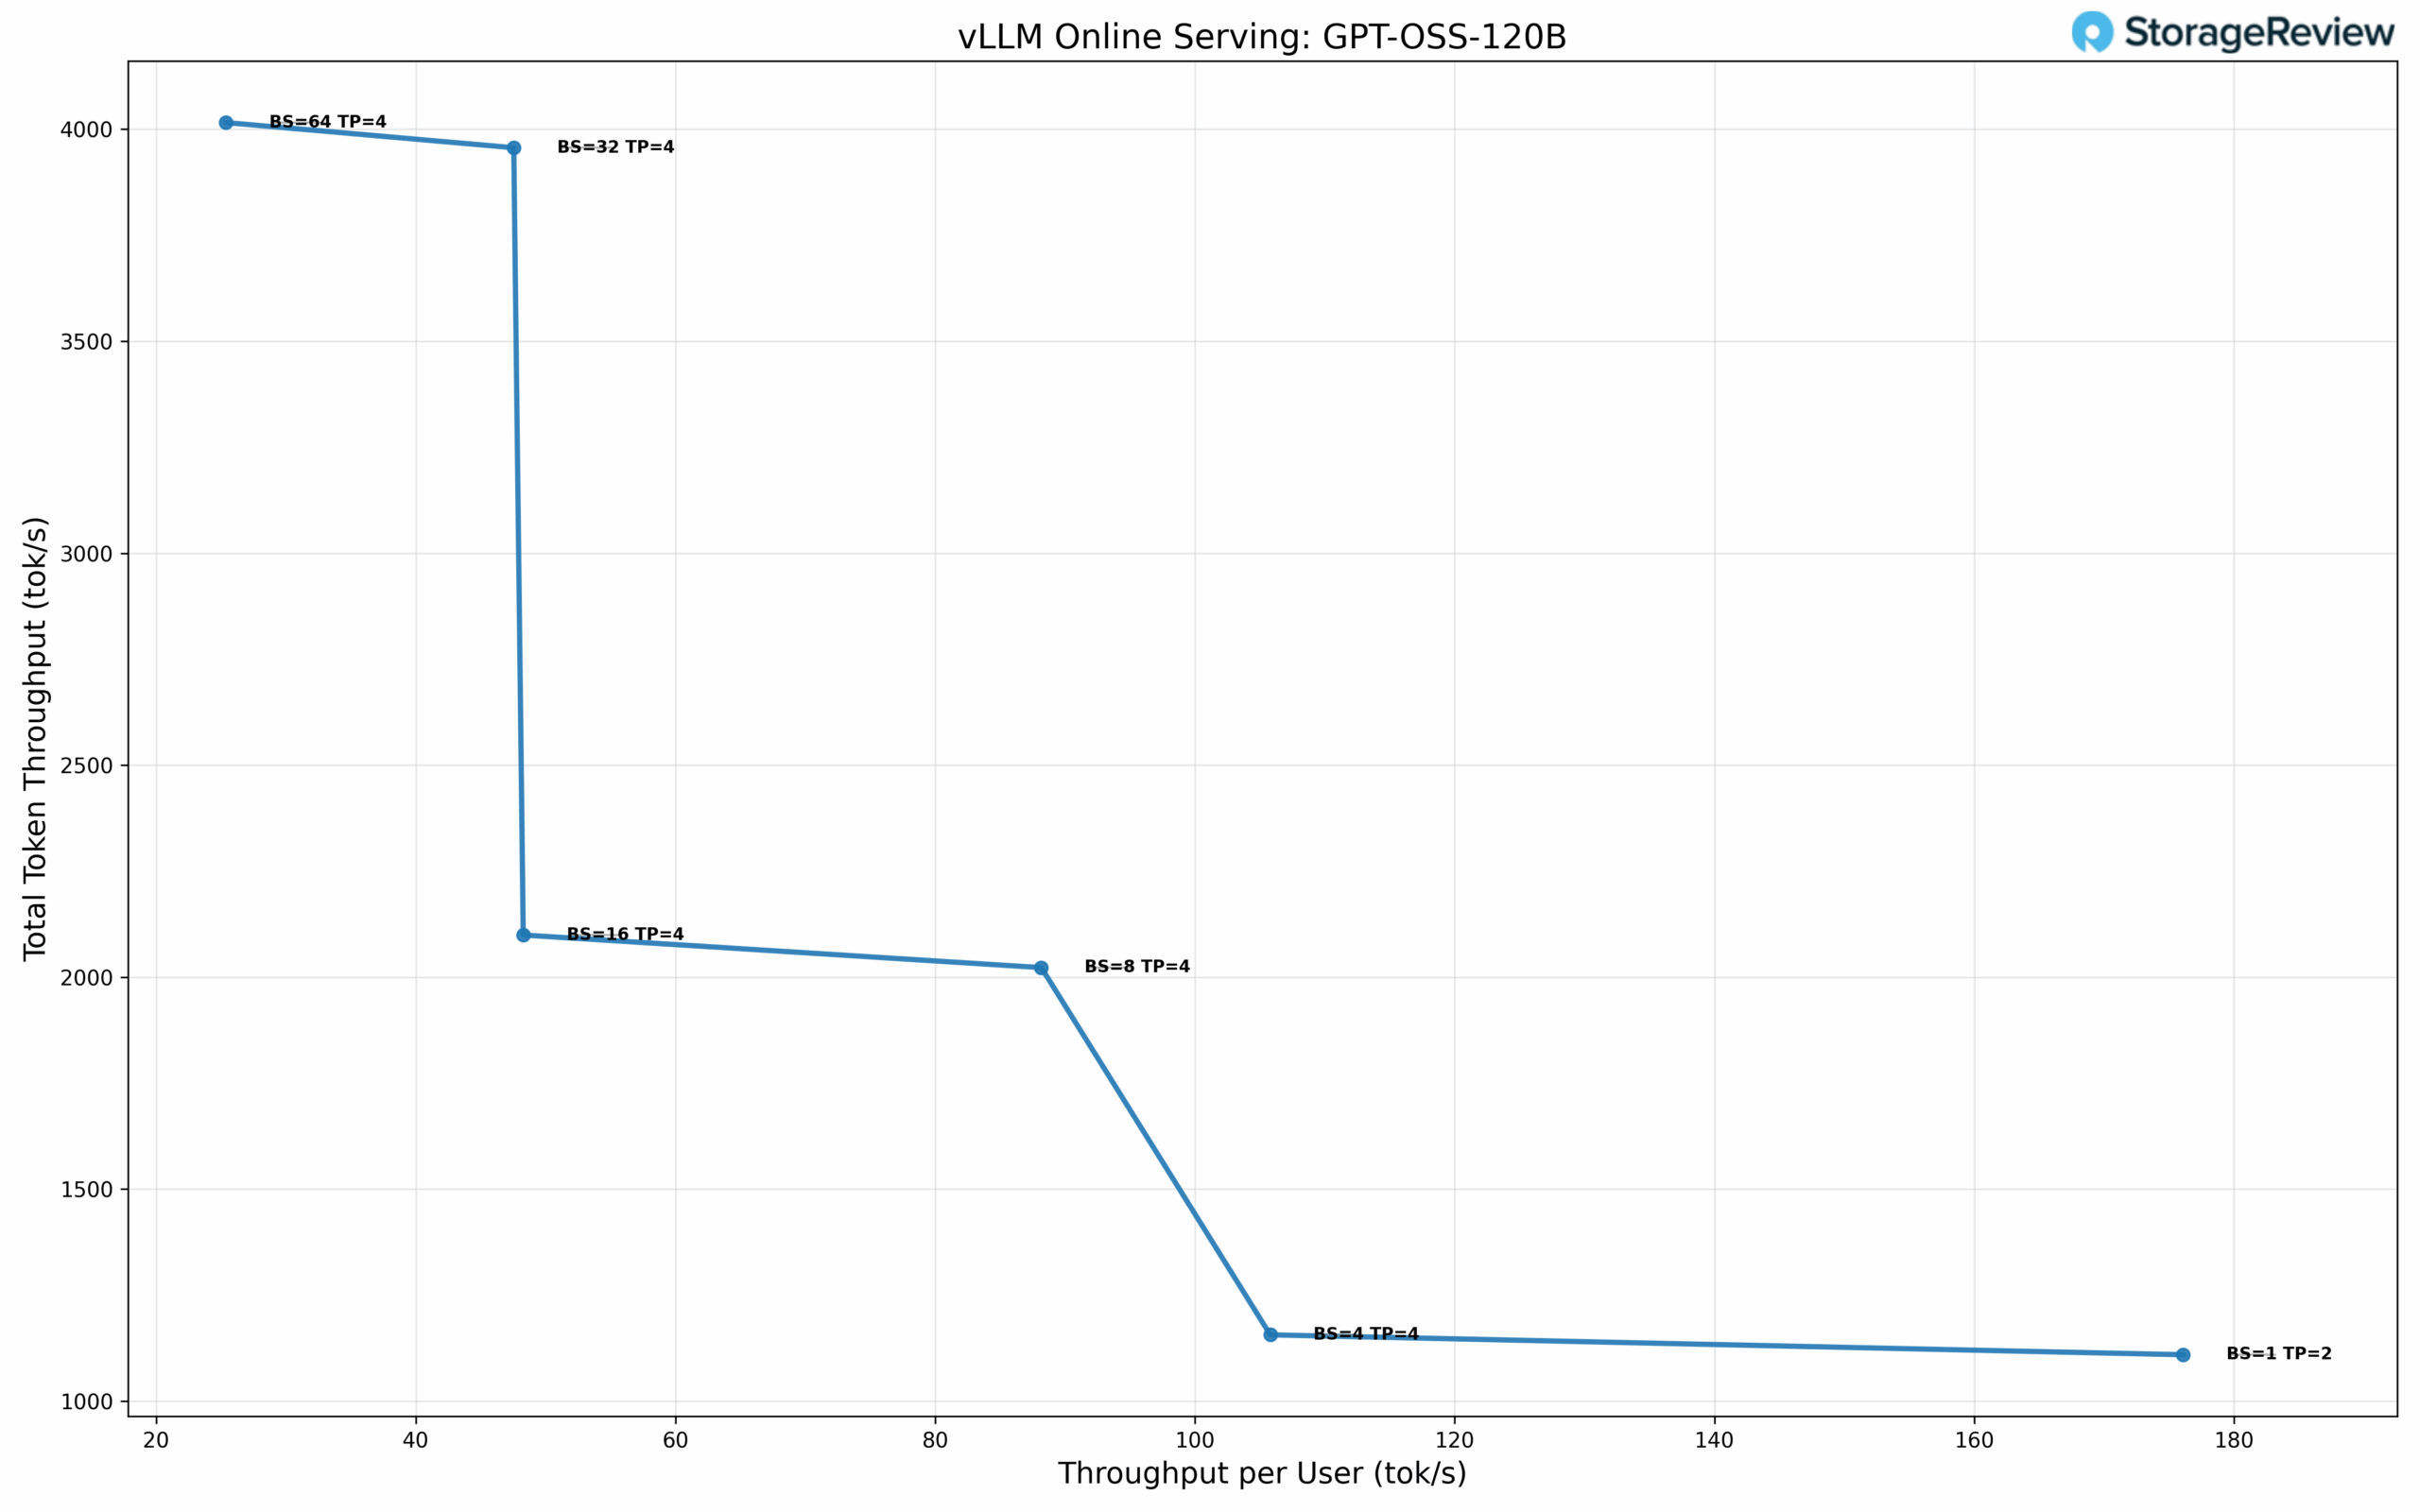
Prestazioni GPT-OSS-120B
Abbiamo valutato il modello GPT-OSS-120B di OpenAI utilizzando la quantizzazione NVFP4. Con concorrenza a singolo utente e TP=2, il modello raggiunge 176.09 tok/s per utente con 5.46 ms di TPOT, la latenza più bassa nella nostra suite di test. Con BS=4 e TP=4, le prestazioni raggiungono 105.79 tok/s per utente, con un throughput totale di 1155.94 tok/s e 7.79 ms di TPOT. Con BS=32 e TP=4, il throughput sale a 47.54 tok/s per utente e 3956.44 tok/s totali con 13.86 ms di TPOT. Il throughput totale massimo di 4015.77 tok/s si ottiene con BS=64, con un throughput di 25.38 tok/s per utente e 14.78 ms di TPOT.
Benchmark Phoronix
Phoronix Test Suite è una piattaforma di benchmarking automatizzata e open source che supporta oltre 450 profili di test e più di 100 suite di test tramite OpenBenchmarking.org. Gestisce tutto, dall'installazione delle dipendenze all'esecuzione dei test e alla raccolta dei risultati, rendendola ideale per confronti delle prestazioni, convalida hardware e integrazione continua. Ci concentreremo sui seguenti test: Stream, 7-Zip, build del kernel Linux, Apache e OpenSSL.
Larghezza di banda della memoria di flusso
Nel benchmark Stream, che misura il throughput di memoria raw, HPE DL380a Gen12 ha raggiunto un'impressionante velocità di 542 GB/s, dimostrando la capacità della piattaforma di sostenere elevate velocità di trasferimento dati sotto carico continuo. Questo livello di larghezza di banda rende il sistema particolarmente efficace per carichi di lavoro come la modellazione dei dati, la simulazione e l'inferenza AI, in cui grandi set di dati devono spostarsi rapidamente tra memoria e risorse di elaborazione.
Compressione a 7 zip
Il test di compressione 7-Zip ha misurato 305 k MIP, evidenziando la solida efficienza multithread del sistema per operazioni di compressione e decompressione ad alta intensità di calcolo. Questi risultati rendono il DL380a Gen12 ideale per ambienti che prevedono frequenti attività di packaging dei dati, attività di archiviazione o flussi di lavoro di backup che si basano su prestazioni della CPU costanti e ripetibili.
Compilazione del kernel
Compilando un kernel Linux completo (allmodconfig), il DL380a Gen12 ha completato l'attività in 316 secondi. Questo benchmark riflette la capacità del sistema di gestire con facilità carichi di lavoro parallelizzati e ad alto contenuto di codice. Prestazioni di compilazione più rapide si traducono direttamente in tempi di build più brevi e una maggiore velocità di iterazione per gli sviluppatori che lavorano in ambienti software o CI/CD su larga scala.
Apache Web Server
In termini di prestazioni di web-serving, il DL380a Gen12 ha sostenuto 94,348 richieste al secondo nel benchmark Apache. Questo risultato dimostra una gestione I/O bilanciata e un'elevata efficienza della cache, fornendo la velocità di elaborazione e la reattività necessarie per applicazioni web aziendali, front-end di virtualizzazione o hosting di servizi interni.
Verifica OpenSSL
Anche le prestazioni crittografiche sono state eccellenti: il DL380a Gen12 ha verificato 803 miliardi di operazioni al secondo in OpenSSL. Questo dimostra la capacità del sistema di gestire carichi di lavoro di crittografia, autenticazione e comunicazioni sicure su larga scala.
| Benchmark Phoronix | HPE ProLiant DL380a Gen 12 (2x Intel Xeon 6527P) |
| Bacheca | 542,720.7 MB / s |
| 7-ZIP | 304,907 MIP/s |
| Compilazione del kernel (allmod) | secondi 316.166 |
| Apache (richieste al secondo) | 94,347.52 rupie |
| OpenSSL | 803,597,895,087 Verifica/e |
Conclusione
HPE ProLiant DL380a Gen12 si distingue come uno dei server AI più pratici e ben bilanciati, progettati per il mercato AI aziendale mainstream. Il suo design 4U raffreddato ad aria offre un'elevata densità di elaborazione con due CPU Xeon 6, supporto per un massimo di 8 GPU a doppia larghezza o 16 GPU a larghezza singola e 16 alloggiamenti NVMe E3.S, il tutto mantenendo affidabilità e semplicità di manutenzione. L'approccio ingegneristico di HPE al flusso d'aria e al bilanciamento termico garantisce prestazioni costanti anche in presenza di carichi di lavoro pesanti, dimostrando che l'accelerazione AI avanzata può ancora prosperare negli ambienti tradizionali raffreddati ad aria.
L'inclusione di iLO 7 offre un significativo miglioramento della gestibilità, un enorme vantaggio per i fornitori di server di livello 1 come HPE. L'interfaccia modernizzata, l'integrazione con HPE Compute Ops Management e la telemetria hardware dettagliata rendono l'amministrazione remota intuitiva ed efficiente. Ogni sezione, Dashboard, Firmware, Host, Sicurezza, App e Impostazioni, riflette il passaggio di HPE a un'esperienza più pulita e integrata nel cloud, senza sacrificare il controllo on-premise da cui dipendono i team aziendali.
Nei test delle prestazioni, il server ha ottenuto risultati eccellenti. Le quattro GPU RTX PRO 6000 hanno raggiunto un throughput impressionante sia nei modelli LLM densi che in quelli microscalari, con vLLM che offre prestazioni in grado di competere con i sistemi raffreddati a liquido. I benchmark della CPU di Phoronix ne evidenziano ulteriormente l'equilibrio, con oltre 540 GB/s di larghezza di banda di memoria, 94 RPS in Apache e oltre 800 miliardi di verifiche OpenSSL al secondo, dimostrando la sua efficacia sia nell'ambito dell'intelligenza artificiale che in quello del calcolo generico.
L'obiettivo di progettazione di HPE è chiaro: fornire prestazioni di intelligenza artificiale ad alta densità e pronte per la produzione, utilizzando un sistema di raffreddamento ad aria che si adatti alle infrastrutture rack e di alimentazione esistenti. Per i team di data center che cercano un'elaborazione affidabile, sicura e di facile gestione in un fattore di forma raffreddato ad aria, il DL380a Gen12 è una soluzione efficiente e lungimirante per il crescente mercato dell'intelligenza artificiale mainstream.


 Amazon