

Lenovo ThinkSystem SR650 V4 è un server rack 2U a 2 socket, flessibile e potente, progettato per soddisfare le esigenze di settori come i servizi cloud, le telecomunicazioni e l'elaborazione ad alte prestazioni (HPC). Che si tratti di ottimizzare carichi di lavoro scalabili o di preparare il data center al futuro con elaborazione ad alta densità, l'SR650 V4 offre significativi aggiornamenti rispetto al suo predecessore, l'SR650 V3.

Differenze tra Lenovo SR650 V4 e SR650 V3
Processori
Le capacità del processore rappresentano uno degli aggiornamenti più significativi dell'SR650 V4. Mentre l'SR650 V3 si basava sui processori scalabili Intel Xeon di quarta generazione, l'SR650 V4 introduce la piattaforma Intel Xeon 6 (precedentemente nome in codice "Granite Rapids"). La nostra recensione si concentra sull'architettura P-core (Performance-core), progettata specificamente per carichi di lavoro ad alta intensità di calcolo. L'SR4 V4 supporta uno o due processori con un massimo di 86 P-core per socket (fino a 172 thread), offrendo velocità di core più elevate (fino a 4 GHz) e TDP fino a 350 W.
Questa transizione consente alle organizzazioni di gestire applicazioni più esigenti per server, riducendo l'ingombro fisico. L'architettura crea una solida base per la virtualizzazione e le operazioni di database complesse. Inoltre, l'architettura V4 supporta un'ampia larghezza di banda PCIe, con un massimo di 88 linee PCIe 5.0 per processore, essenziale per alimentare i moderni adattatori di rete ad alta velocità e gli array di storage NVMe senza colli di bottiglia.
| Modello CPU | Anime / fili | Base Freq | Max Turbo | L3 Cache | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6781P | 80 / 160 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6767P | 64 / 128 | 2.4 GHz | 3.9 GHz | 336 MB | 350 W |
| 6761P | 64 / 128 | 2.5 GHz | 3.9 GHz | 336 MB | 350 W |
| 6760P | 64 / 128 | 2.2 GHz | 3.8 GHz | 320 MB | 330 W |
| 6747P | 48 / 96 | 2.7 GHz | 3.9 GHz | 288 MB | 330 W |
| 6745P | 32 / 64 | 3.1 GHz | 4.3 GHz | 336 MB | 300 W |
| 6741P | 48 / 96 | 2.5 GHz | 3.8 GHz | 288 MB | 300 W |
| 6740P | 48 / 96 | 2.1 GHz | 3.8 GHz | 288 MB | 270 W |
| 6737P | 32 / 64 | 2.9 GHz | 4.0 GHz | 144 MB | 270 W |
| 6736P | 36 / 72 | 2.0 GHz | 4.1 GHz | 144 MB | 205 W |
| 6732P | 32 / 64 | 3.8 GHz | 4.3 GHz | 144 MB | 350 W |
| 6731P | 32 / 64 | 2.5 GHz | 4.1 GHz | 144 MB | 245 W |
| 6730P | 32 / 64 | 2.5 GHz | 3.8 GHz | 288 MB | 250 W |
| 6724P | 16 / 32 | 3.6 GHz | 4.3 GHz | 72 MB | 210 W |
| 6714P | 8 / 16 | 4.0 GHz | 4.3 GHz | 48 MB | 165 W |
| 6530P | 32 / 64 | 2.3 GHz | 4.1 GHz | 144 MB | 225 W |
| 6527P | 24 / 48 | 3.0 GHz | 4.2 GHz | 144 MB | 255 W |
| 6521P | 24 / 48 | 2.6 GHz | 4.1 GHz | 144 MB | 225 W |
| 6520P | 24 / 48 | 2.4 GHz | 4.0 GHz | 144 MB | 210 W |
| 6517P | 16 / 32 | 3.2 GHz | 4.2 GHz | 72 MB | 190 W |
| 6515P | 16 / 32 | 2.3 GHz | 3.8 GHz | 72 MB | 150 W |
| 6511P | 16 / 32 | 2.3 GHz | 4.2 GHz | 72 MB | 150 W |
| 6507P | 8 / 16 | 3.5 GHz | 4.3 GHz | 48 MB | 150 W |
| 6505P | 12 / 24 | 2.2 GHz | 4.1 GHz | 48 MB | 150 W |
Memorie
Per quanto riguarda la memoria, l'SR650 V4 migliora significativamente le capacità del V3, massimizzando le prestazioni del sottosistema. Supporta velocità di memoria DDR5 fino a 6400 MHz (1 DIMM per canale), un notevole passo avanti rispetto al limite di 4800 MHz della generazione precedente. Il sistema è dotato di 32 slot DIMM (16 per processore) disposti su otto canali di memoria per processore. Supporta moduli RDIMM standard, 3DS RDIMM e i nuovi moduli Multiplexed Rank DIMM (MRDIMM), che possono funzionare a velocità fino a 8000 MHz per applicazioni che richiedono molta larghezza di banda. Utilizzando moduli 3DS RDIMM da 256 GB, il server supporta ben 8 TB di memoria di sistema totale.

Inoltre, la V4 introduce il supporto per l'espansione di memoria CXL 2.0 (Compute Express Link). Gli amministratori possono installare fino a 12 moduli di memoria CXL negli alloggiamenti per unità E3.S (in particolare nel fattore di forma E3.S 2T). Ciò consente al sistema di scalare la capacità di memoria e la larghezza di banda oltre i tradizionali limiti dei processori, riducendo la latenza di elaborazione per i carichi di lavoro di nuova generazione e abbassando il costo totale di proprietà (TCO) grazie all'utilizzo di meno memoria.
Archiviazione
Le capacità di storage del Lenovo SR650 V4 dimostrano un passaggio verso la densità NVMe ad alte prestazioni e fattori di forma flessibili. Pur supportando le unità legacy da 3.5 pollici e 2.5 pollici, il V4 introduce un ampio supporto per il fattore di forma E3.S NVMe. Il sistema può ospitare fino a 32 unità E3.S 1T o 12 unità E3.S 2T, offrendo una densità maggiore e una migliore gestione termica rispetto ai tradizionali SSD U.2.

Fondamentalmente, la V4 supporta la connettività NVMe diretta senza sovrapprezzo (1:1), garantendo che l'archiviazione ad alta velocità non subisca colli di bottiglia dovuti alla condivisione delle linee PCIe. L'inclusione di opzioni di unità di avvio M.2 hot-swap migliora ulteriormente la facilità di manutenzione.
Networking
Per il networking, l'SR650 V4 è dotato di due slot OCP 3.0 dedicati, entrambi con supporto PCIe Gen 5 x16. Si tratta di un aggiornamento fondamentale che consente un networking ridondante ad alta velocità (ad esempio, 200 GbE a doppia porta o 400 GbE a porta singola) senza occupare gli slot riser PCIe standard. Il passaggio a PCIe 5.0 raddoppia la larghezza di banda teorica (32 GT/s contro 16 GT/s), rendendo il V4 in grado di gestire il traffico di rete cloud e AI più esigente.

Alimentazione e raffreddamento
L'SR650 V4 offre opzioni di alimentazione avanzate, da 800 W a 3200 W, disponibili nei livelli di efficienza Titanium e Platinum. Il sistema supporta anche opzioni -48 V CC e HVAC/HVDC per soddisfare i requisiti specifici dei data center.

Per gestire il calore generato da processori e memorie ad alto TDP, Lenovo introduce le opzioni di raffreddamento a liquido Neptune. Il "Compute Complex Neptune Core Module" utilizza il raffreddamento a liquido a circuito aperto per rimuovere il calore da processori, memorie e regolatori di tensione, in grado di catturare oltre l'80% del calore del server e ridurre significativamente i costi di raffreddamento del data center.
Nel complesso, l'SR650 V4 rappresenta un notevole passo avanti in termini di prestazioni, densità ed efficienza termica per gli ambienti aziendali moderni.
Specifiche Lenovo ThinkSystem SR650 V4
| Specificazione | Dettagli |
|---|---|
| Specifiche del sistema | |
| Fattore di forma | Rack 2U |
| Processore | Fino a 2x Intel Xeon serie 6700/6400 (P-core); Fino a 86 core per CPU; Fino a 350 W TDP |
| Memorie | 32 slot DIMM (16 per processore); supporta TruDDR5 RDIMM fino a 6400 MHz e MRDIMM fino a 8000 MHz |
| Espansione della memoria | Supporta moduli di memoria CXL 2.0 nel fattore di forma E3.S 2T (fino a 12x DIMM) |
| Memoria massima | Fino a 8 TB di memoria di sistema (utilizzando 256 GB 3DS RDIMM) |
| Alloggiamenti per unità disco | Anteriore: Fino a 24x 2.5″ NVMe/SAS/SATA, 16x 3.5″ SAS/SATA o 32x E3.S NVMe Mid: Fino a 8x 2.5″ simple-swap Posteriore: Fino a 8x 2.5″ o 4x 3.5″ hot-swap |
| Controller di archiviazione | Fino a 36 porte NVMe integrate (connettività 1:1); supporto RAID/HBA |
| Interfacce di rete | Due slot OCP 3.0 SFF con interfaccia host PCIe 5.0 x16 |
| Slot di espansione PCI | Fino a 10 slot PCIe 5.0 (posteriori); slot PCIe anteriori opzionali |
| Supporto GPU | Fino a 10 GPU a larghezza singola o 2 GPU a larghezza doppia |
| porte | Anteriore: Porta di diagnostica esterna, USB opzionale e Mini-DP Posteriore: 2x USB 3.0, 1x VGA, 1x gestione RJ-45, seriale opzionale |
| Raffreddamento | Fino a 6 ventole hot-swap (ridondanza N+1); moduli di raffreddamento a liquido Neptune opzionali |
| Alimentazione di laboratorio | Fino a due alimentatori AC/DC ridondanti hot-swap (800W–3200W) |
| sistemi di Gestione | XClarity Controller 3 (XCC3); XCC3 Premier opzionale |
| Caratteristiche di sicurezza | TPM 2.0, PFR Root of Trust (NIST SP800-193), intrusione nel telaio, cornice bloccabile |
| Sistemi Operativi | Microsoft Windows Server, RHEL, SLES, Ubuntu Server |
| Garanzia | Garanzia di base di 3 anni (configurabile) |
| Dimensioni | 87 mm (3.4 pollici) A x 440 mm (17.3 pollici) L x 800 mm (31.5 pollici) P |
| Peso | Peso massimo: 38.8 kg (85.5 libbre) |
Progettazione e costruzione di Lenovo ThinkSystem SR650 V4
Lenovo ThinkSystem SR650 V4 è una piattaforma 2U standard che sfrutta in modo efficiente lo spazio fisico, bilanciando la densità dei componenti con il flusso d'aria e la facilità di manutenzione. Lo chassis misura 3.4 cm di altezza, 17.3 cm di larghezza e 31.5 cm di profondità, con un peso massimo configurato di 85.5 kg. Queste dimensioni lo collocano perfettamente in linea con altri server aziendali 2U, offrendo al contempo una profondità sufficiente per CPU ad alte prestazioni, configurazioni di memoria ad alta densità e backplane di storage flessibili.
Il consolidato design industriale ThinkSystem di Lenovo è immediatamente riconoscibile, con un telaio rigido in acciaio e un'etichettatura chiara e funzionale. Internamente, il layout è pulito e funzionale, con un flusso d'aria diretto, zone componenti modulari e accesso senza utensili per la manutenzione di routine. La struttura complessiva trasmette un senso di robustezza e di progettazione impeccabile, a dimostrazione di una piattaforma progettata per il funzionamento continuo in ambienti data center, piuttosto che per un'estetica accattivante.
Pannello frontale
Il pannello frontale è altamente configurabile. Il nostro sistema di test è dotato di un backplane per unità da 2.5 pollici a 8 alloggiamenti, ma lo chassis può essere facilmente ampliato fino a 16 o persino 24 alloggiamenti con il minimo sforzo. I clienti possono anche optare per alloggiamenti da 3.5 pollici per una maggiore capacità grezza o per le più recenti opzioni di backplane E3.S per una densità NVMe ad alte prestazioni. Il supporto AnyBay consente la coesistenza di unità SAS, SATA e NVMe all'interno dello stesso alloggiamento, offrendo una notevole flessibilità per le implementazioni di storage miste.

Il pannello frontale include i controlli operatore essenziali: un pulsante di accensione, un pulsante ID e LED di stato che indicano lo stato del sistema e l'attività di rete. Una linguetta informativa estraibile fornisce un rapido accesso all'etichetta di accesso alla rete XCC e al numero di serie. La connettività locale opzionale include una Mini DisplayPort e porte USB per l'accesso al crash-cart, una caratteristica preziosa per la risoluzione dei problemi nei data center "lights-out".
Pannello posteriore
La parte posteriore dello chassis è progettata per la massima densità di I/O. Può ospitare fino a 10 slot PCIe Gen 5, a seconda della configurazione del riser. L'inclusione di due slot OCP 3.0 libera i riser PCIe standard per altre schede aggiuntive, come GPU o controller di storage.
Oltre all'espansione, il pannello posteriore ospita la porta di rete di gestione BMC integrata, due porte USB-A e un'uscita VGA per l'accesso alla console locale. Due alimentatori hot-swap sono montati sul retro, mantenendo la facilità di manutenzione senza compromettere il flusso d'aria o i layout di espansione.
Interno
Internamente, il layout è pulito e ottimizzato per il flusso d'aria. 32 slot DIMM affiancano due socket CPU, disposti in modo da mantenere un raffreddamento senza ostacoli dalla parte anteriore a quella posteriore grazie a un banco di sei ventole hot-swap ad alte prestazioni nella parte anteriore dello chassis. Le ventole sono completamente sostituibili senza utensili e l'intero vassoio è rimovibile senza attrezzi. La rimozione del vassoio offre un accesso diretto e senza ostacoli all'area di archiviazione AnyBay, semplificando la manutenzione, gli aggiornamenti e le sostituzioni del backplane.

Il cablaggio di storage è disposto ordinatamente lungo i lati dello chassis per evitare di ostruire il flusso d'aria verso CPU e memoria. Per le configurazioni che utilizzano moduli di raffreddamento a liquido Neptune, il layout interno cambia leggermente per ospitare i circuiti di raffreddamento, ma la facilità di manutenzione del core rimane elevata. Il modulo dell'unità di avvio M.2 è montato sul deflettore d'aria o sul vano unità, consentendo un facile accesso senza dover rimuovere altri componenti.
Controller XClarity 3
Il server SR650 V4 è dotato del nuovo XClarity Controller 3 (XCC3). Questo motore di gestione offre un significativo miglioramento delle prestazioni rispetto alle generazioni precedenti, con tempi di avvio più rapidi e un'interfaccia HTML5 più reattiva. Platform Resource Manager fornisce dati di telemetria dettagliati sullo stato di alimentazione e termico, aiutando gli amministratori a ottimizzare l'efficienza del data center.
XCC3 supporta un'ampia gamma di funzioni di gestione remota, tra cui controllo remoto (KVM), montaggio di supporti virtuali e aggiornamenti del firmware. L'interfaccia è intuitiva e fornisce una dashboard con una panoramica sullo stato del sistema, sugli eventi attivi e sull'inventario hardware. Per quanto riguarda l'automazione, XCC3 supporta pienamente le API REST di Redfish.
Prestazioni Lenovo ThinkSystem SR650 V4
Questa sezione esamina i risultati dei benchmark di Blender, y-cruncher, vLLM e Phoronix. I test iniziali sono stati condotti sul Lenovo ThinkSystem SR650 V4 dotato di processori Intel Xeon 6740P, consentendoci di valutare l'architettura P-core incentrata sulle prestazioni della piattaforma e il throughput complessivo sotto carichi di lavoro legati alla CPU. A metà della revisione, abbiamo modificato la configurazione del sistema per abilitare i test accelerati dalla GPU. La transizione è stata semplice, agevolata dal kit di aggiornamento per l'abilitazione GPU di Lenovo, che include ventole ad alte prestazioni, dissipatori di calore aggiornati, una copertura del flusso d'aria rivista e riser compatibili con GPU progettati per supportare acceleratori ad alta potenza. L'installazione non ha richiesto modifiche significative allo chassis e si è integrata perfettamente con il layout del sistema esistente.
Con l'installazione dei componenti di raffreddamento e flusso d'aria aggiornati, abbiamo aggiunto una singola GPU NVIDIA L40S alla piattaforma. Questo ci ha permesso di espandere i test per includere carichi di lavoro accelerati da GPU, come il rendering GPU di Blender e benchmark incentrati sull'inferenza, mantenendo al contempo temperature stabili e un comportamento del sistema coerente. La natura modulare dell'aggiornamento evidenzia la flessibilità dell'SR650 V4, consentendogli di passare facilmente da una configurazione CPU orientata all'efficienza a una piattaforma CPU+GPU bilanciata, adatta a carichi di lavoro di elaborazione misti.
Configurazione Lenovo ThinkSystem SR650 V4:
- CPU: 2x Intel Xeon 6740P
- Memoria: 1 TB di RAM
- Memoria su disco: 4 SSD da 960 GB
- GPU: Scheda grafica NVIDIA L40S
Blender 4.5
Blender è un'applicazione open source per la modellazione 3D. Questo benchmark è stato eseguito utilizzando l'utility Blender Benchmark. Il punteggio è misurato in campioni al minuto, con valori più alti che indicano prestazioni migliori.
Nel benchmark CPU di Blender, il Lenovo ThinkSystem SR650 V4 offre prestazioni di rendering solide in tutte le scene, con un punteggio di 1136.99 campioni al minuto in Monster, 707.60 in Junkshop e 562.53 in Classroom. I risultati riflettono un'elevata scalabilità multithread grazie ai due processori Intel Xeon 6740P, con prestazioni costanti all'aumentare della complessità della scena.
| CPU Blender (campioni al minuto; un valore più alto è meglio) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1 TB di RAM) |
|---|---|
| Mostro - Monster | 1136.99 |
| Rigattiere | 707.60 |
| Aula | 562.53 |
Nel benchmark Blender CPU no SMT, l'SR650 V4 mostra un significativo aumento della velocità di rendering, raggiungendo 4686.40 campioni al minuto in Monster, 2223.96 in Junkshop e 2385.98 in Classroom. I risultati della GPU evidenziano la capacità del sistema di accelerare carichi di lavoro di rendering complessi, offrendo una velocità di rendering sostanzialmente superiore rispetto al rendering basato solo sulla CPU.
| CPU Blender (senza SMT) (campioni al minuto; un numero più alto è meglio) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1 TB di RAM) |
|---|---|
| Mostro - Monster | 4686.40 |
| Rigattiere | 2223.96 |
| Aula | 2385.98 |
y-cruncher
y-cruncher è un programma multithread e scalabile che calcola Pi greco e altre costanti matematiche con una risoluzione di migliaia di miliardi di cifre. Dal suo lancio nel 2009, è diventato un'applicazione di benchmarking e stress test molto popolare tra overclocker e appassionati di hardware.
In y-cruncher, Lenovo scala in modo pulito all'aumentare delle dimensioni del problema, evidenziando le elevate prestazioni di elaborazione multithread e la larghezza di banda di memoria della piattaforma. Con due processori Intel Xeon 6740P e 1 TB di RAM, il sistema completa un calcolo Pi a 1 miliardo di cifre in poco più di 20 secondi e mantiene un'efficienza costante fino a 25 miliardi di cifre, impiegando 362 secondi. I risultati mostrano una scalabilità prevedibile sotto pressione sostenuta di CPU e memoria, rendendo l'SR650 V4 adatto a carichi di lavoro matematici pesanti e scenari di stress test.
| Y-Cruncher (tempo di calcolo totale) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1 TB di RAM) |
|---|---|
| 1 Billion | 20.715 s |
| 2.5 Billion | 44.412 s |
| 5 Billion | 81.937 s |
| 10 Billion | 152.743 |
| 25 Billion | 362.566 |
vLLM Online Serving LLM Inference Performance
vLLM è il motore di inferenza e di servizio ad alta produttività più diffuso per gli LLM. Il benchmark di servizio online vLLM è uno strumento di valutazione delle prestazioni che misura le capacità di servizio reali di questo motore di inferenza in caso di richieste simultanee. Simula carichi di lavoro di produzione inviando richieste a un server vLLM in esecuzione con parametri configurabili, tra cui frequenza di richiesta, lunghezza di input/output e numero di client simultanei. Il benchmark misura metriche chiave, tra cui throughput (token al secondo), tempo per il primo token e tempo per token di output (TPOT), aiutando gli utenti a comprendere le prestazioni di vLLM in diverse condizioni di carico.
Abbiamo testato le prestazioni di inferenza su una suite completa di modelli che abbracciano varie architetture, scale di parametri e strategie di quantizzazione e valutato la produttività in base a diversi profili di concorrenza.
Prestazioni del modello denso
I modelli densi seguono l'architettura LLM convenzionale, in cui tutti i parametri e le attivazioni vengono utilizzati durante l'inferenza, con conseguente elaborazione più intensiva dal punto di vista computazionale rispetto alle controparti sparse. Per valutare in modo completo le caratteristiche prestazionali su diverse scale di modelli e strategie di quantizzazione, abbiamo confrontato diverse configurazioni di modelli densi della famiglia Llama 3.1 8B.
Llama 3.1 8B Precision FP8
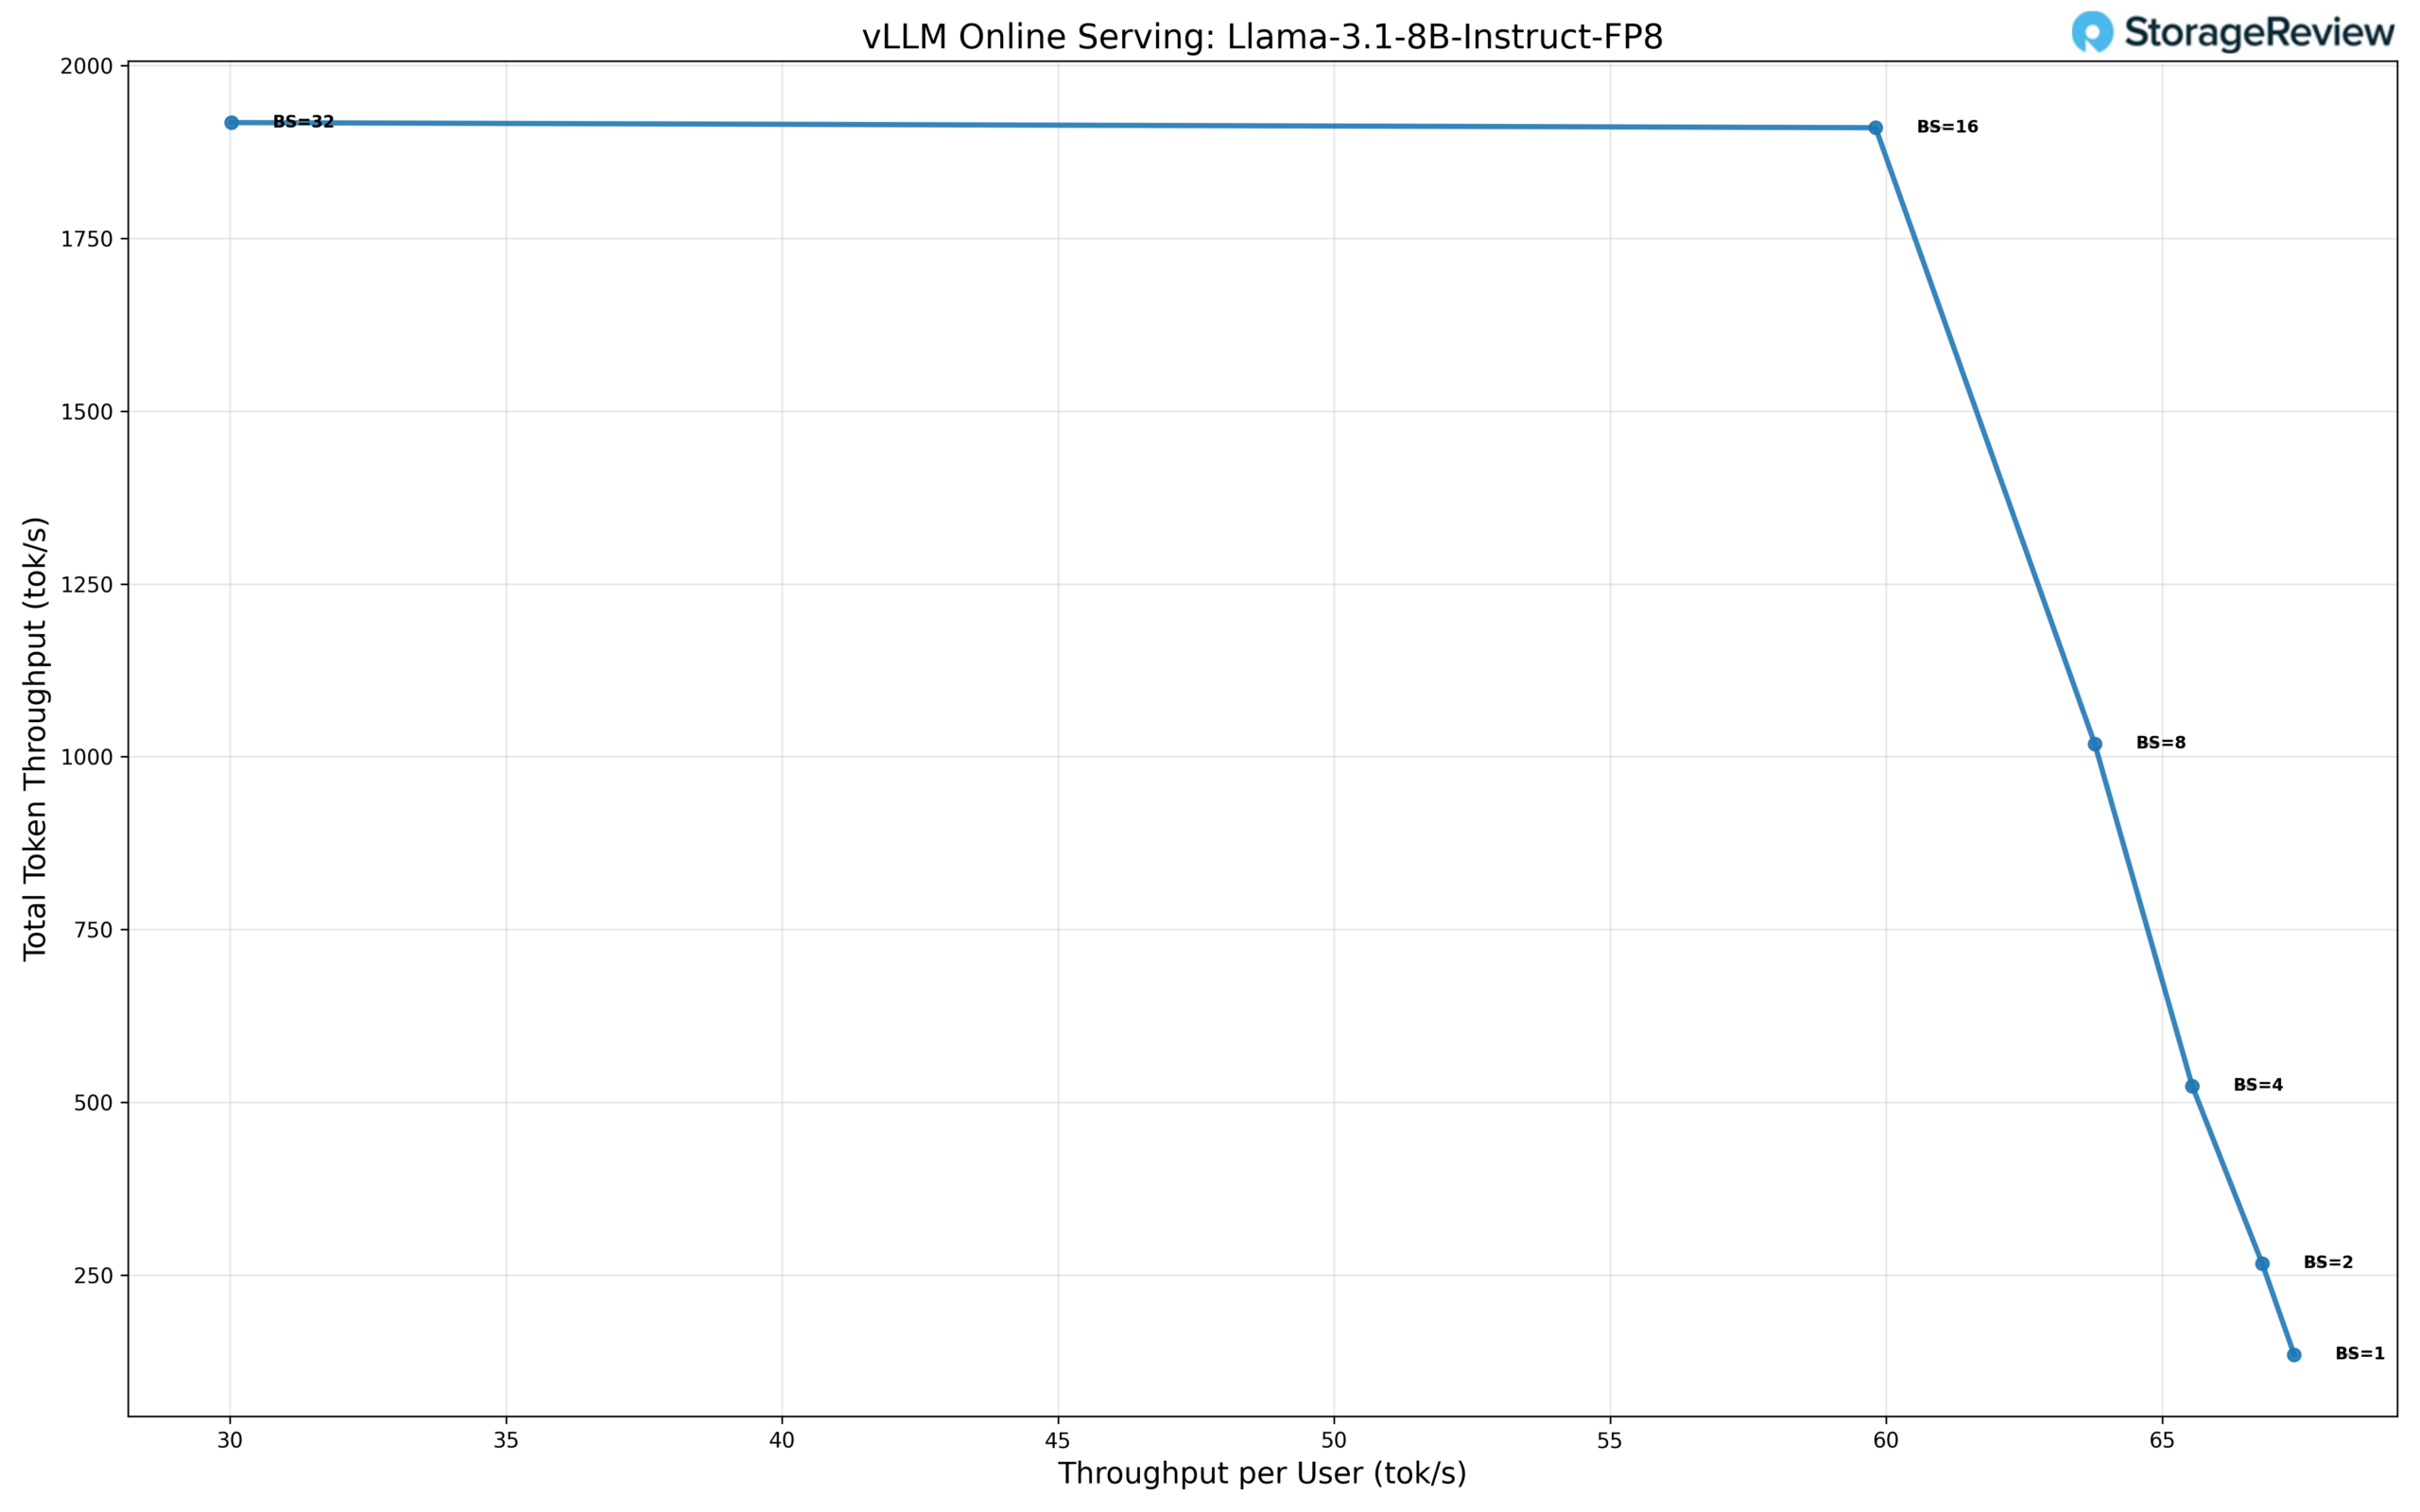
Il modello Llama 3.1 8B in esecuzione con precisione FP8 mostra un profilo di scala diverso rispetto alla configurazione a precisione standard, privilegiando l'efficienza a livelli di concorrenza moderati e bilanciando la produttività fuori picco a batch di dimensioni maggiori. Con concorrenza a singolo utente (BS=1), il modello fornisce 67.8 tok/s per utente, con una produttività totale di 135.6 tok/s e un TPOT di circa 3.1 ms, stabilendo una baseline a flusso singolo inferiore rispetto alla precisione completa.
All'aumentare delle dimensioni del batch, la produttività totale aumenta rapidamente, mentre la produttività per utente diminuisce in modo controllato. Con BS=2, la produttività aumenta a 271 tok/s totali, con 66.8 tok/s per utente. Con BS=4, la produttività totale raggiunge 523 tok/s e, con BS=8, il modello fornisce 1,017 tok/s, con 63.6 tok/s per utente. La latenza rimane stabile nonostante questi livelli di concorrenza inferiori, rendendo FP8 adatto a scenari di inferenza multiutente leggeri.
Il ridimensionamento continua fino a BS=16, dove il modello mantiene una produttività totale di 1,918 tok/s, con 60.0 tok/s per utente. A BS=32, la produttività totale si stabilizza a circa 1,920 tok/s, con una produttività per utente che scende a 30.0 tok/s. Questo plateau indica che la configurazione FP8 raggiunge il punto di saturazione prima della precisione standard, privilegiando l'efficienza e la prevedibilità rispetto alla produttività aggregata massima.
Nel complesso, FP8 ottiene un aumento di circa 14 volte della produttività totale da BS=1 al suo picco a BS=16-32. La latenza rimane costante fino a BS=16, per poi appiattirsi parallelamente alla produttività a livelli di concorrenza più elevati, evidenziando FP8 come una scelta pratica per carichi di lavoro di inferenza bilanciati e sensibili alla latenza, piuttosto che per un ridimensionamento batch estremo.
Llama 3.1 8B Standard Precision
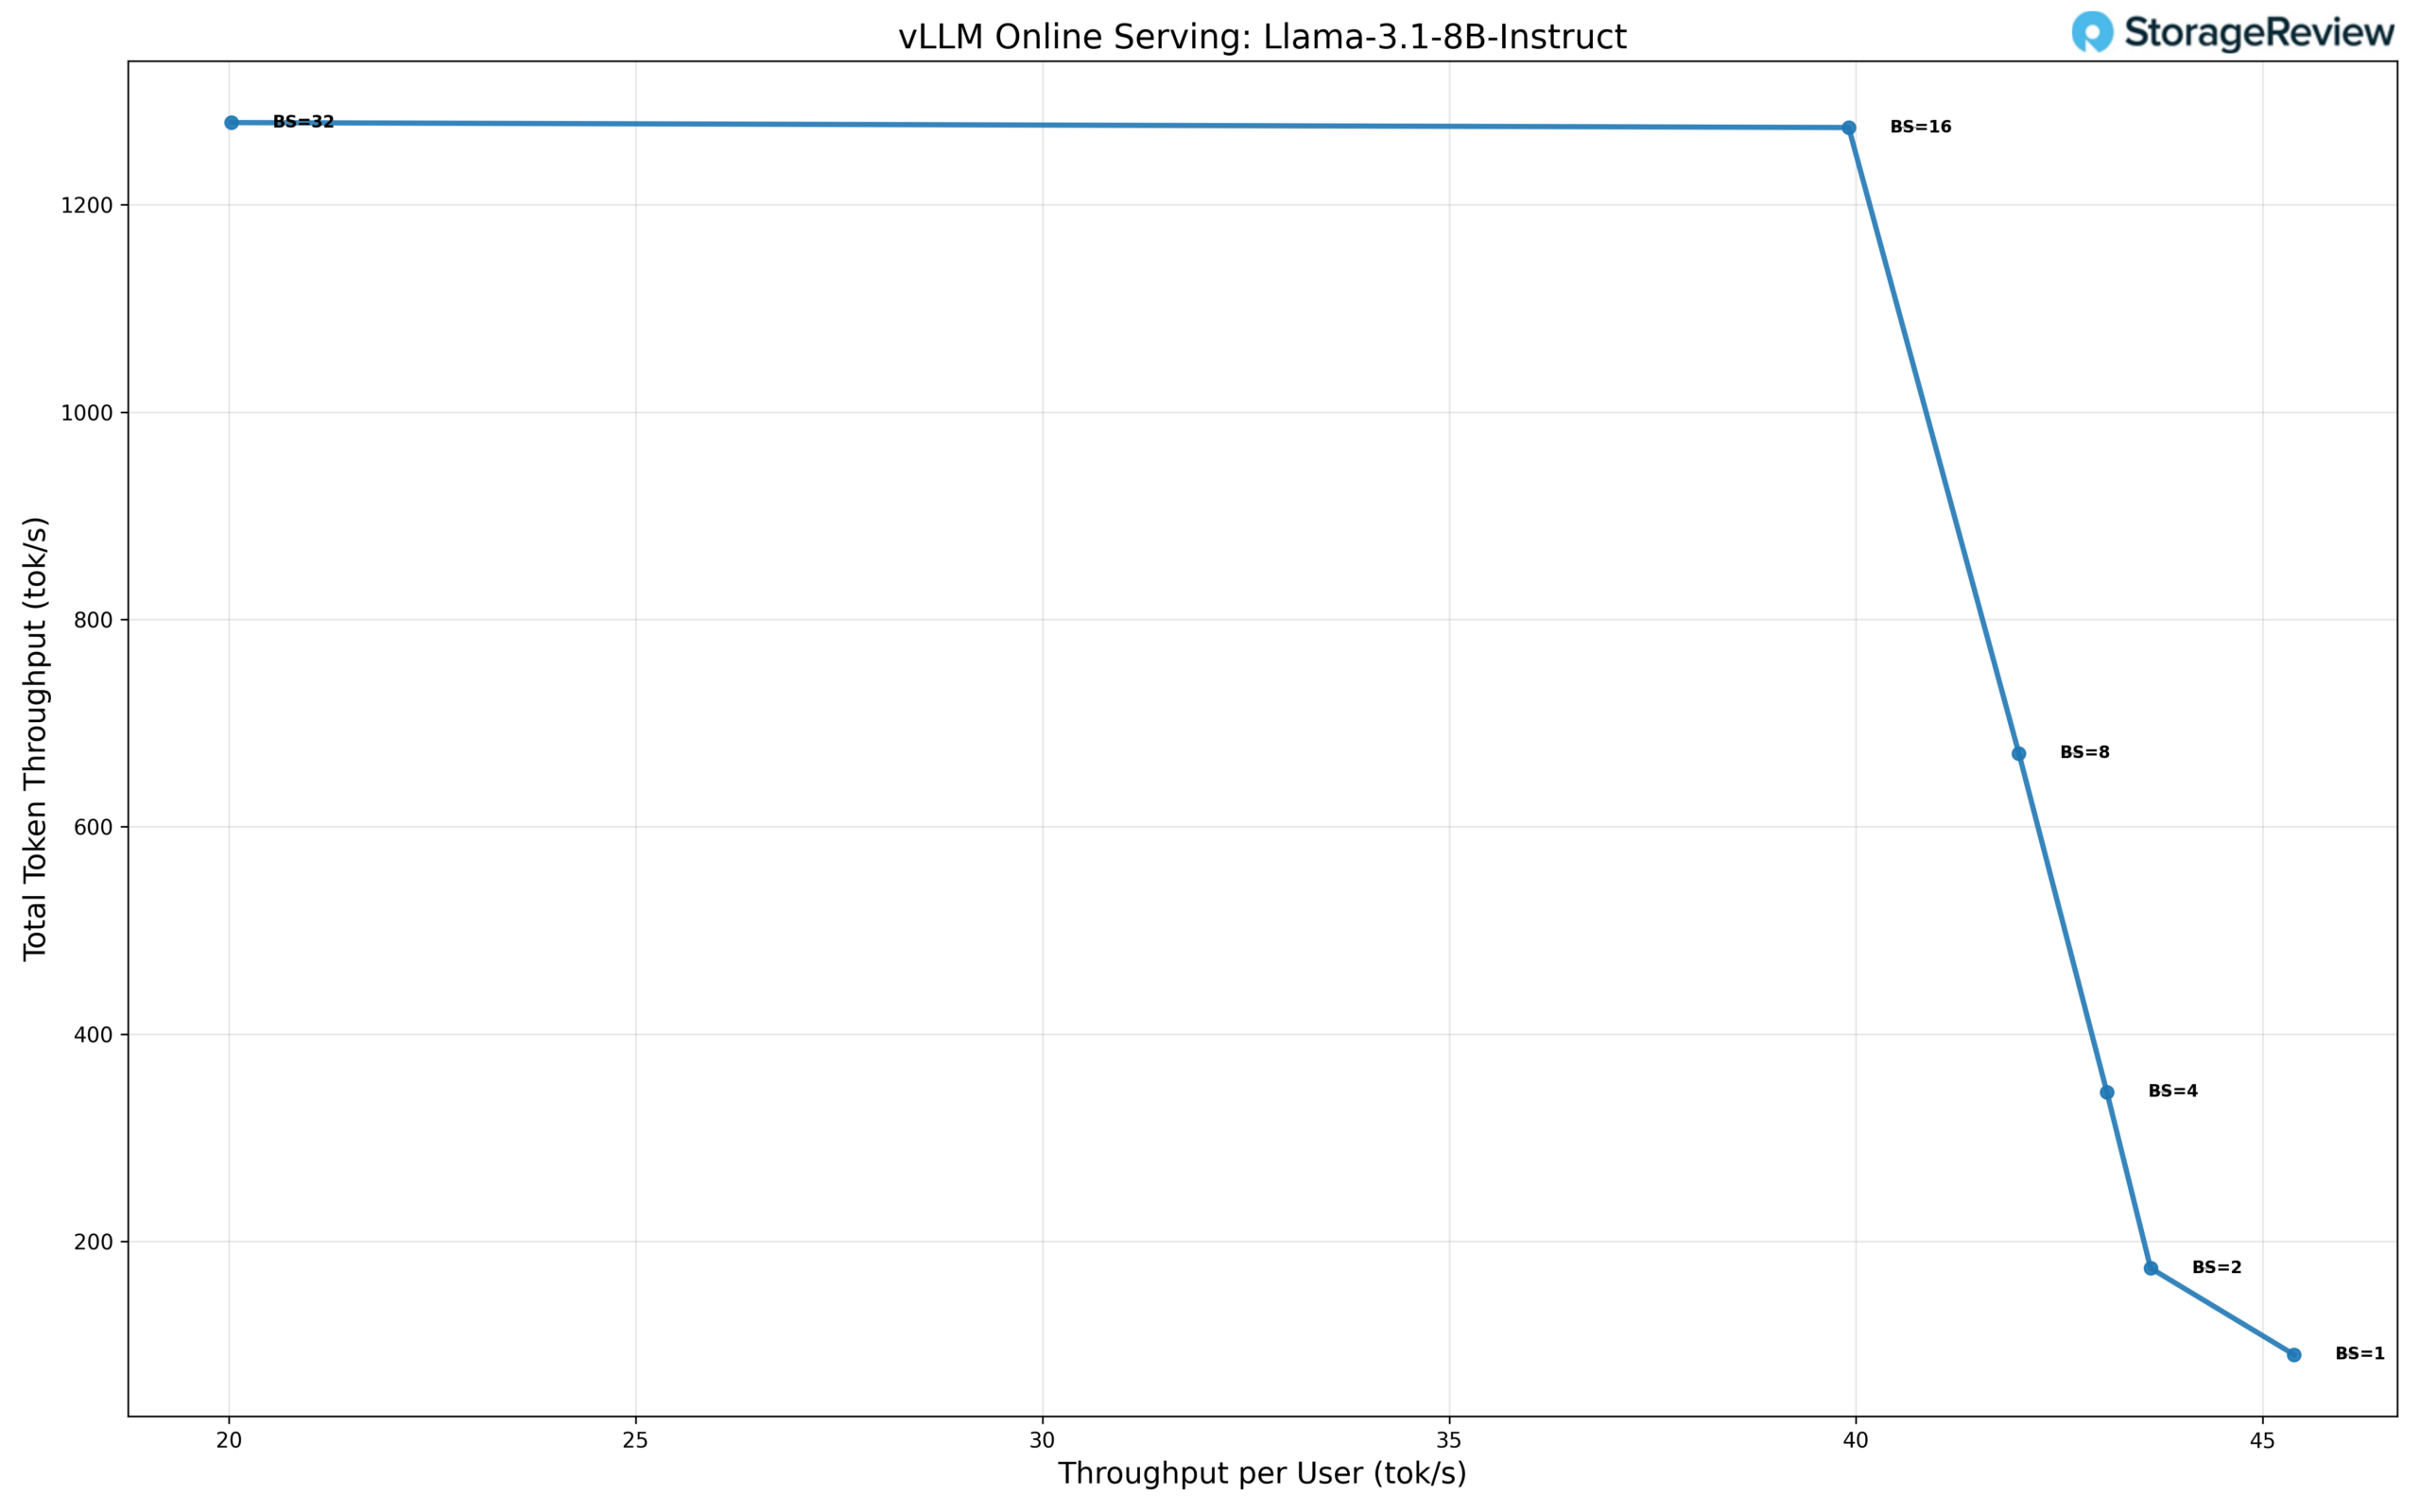
A precisione standard, il modello Llama 3.1 8B dimostra un comportamento di scalabilità prevedibile a livelli di concorrenza inferiori, con elevate prestazioni per utente a batch di piccole dimensioni e un throughput aggregato in costante aumento all'aumentare della concorrenza. In modalità monoutente (BS=1), il modello fornisce circa 45.8 tok/s per utente, generando un throughput totale di 91.6 tok/s e stabilendo una solida base di riferimento per carichi di lavoro sensibili alla latenza.
Con l'aumentare della concorrenza, la produttività totale scala in modo efficiente, mentre la produttività per utente diminuisce gradualmente. A BS=2, la produttività totale sale a 176 tok/s, con 44.0 tok/s per utente, e a BS=4, la produttività raggiunge 344 tok/s, con 43.0 tok/s per utente. Questo comportamento continua fino a BS=8, dove il modello mantiene una produttività totale di 672 tok/s, con 42.0 tok/s per utente, indicando un buon utilizzo senza un degrado significativo per utente.
Il ridimensionamento continua fino a BS=16, dove la produttività totale raggiunge un picco di circa 1,280 tok/s, con 40.0 tok/s per utente. A BS=32, la produttività totale rimane sostanzialmente stabile a circa 1,280 tok/s, mentre la produttività per utente scende a 20.0 tok/s, segnalando la saturazione della pipeline di esecuzione. Questo plateau suggerisce che, a precisione standard, il modello raggiunge il suo punto operativo ottimale intorno a BS=16, bilanciando produttività e reattività.
Nel complesso, la precisione standard consente di ottenere un aumento di circa 14 volte della produttività totale da BS=1 al picco massimo, con prestazioni stabili per utente attraverso livelli di concorrenza moderati. Questo profilo rende la precisione standard adatta per le distribuzioni che privilegiano latenza costante e scalabilità prevedibile rispetto a un'espansione batch aggressiva.
Prestazioni del modello sparso
I modelli sparsi, in particolare le architetture Mixture of Experts (MoE), rappresentano un approccio emergente per scalare in modo efficiente i modelli linguistici. Queste architetture mantengono un numero elevato di parametri totali attivando solo un sottoinsieme di parametri per token, offrendo potenzialmente prestazioni migliori per parametro attivo.
Prestazioni Qwen3-Coder-30B-A3B FP8
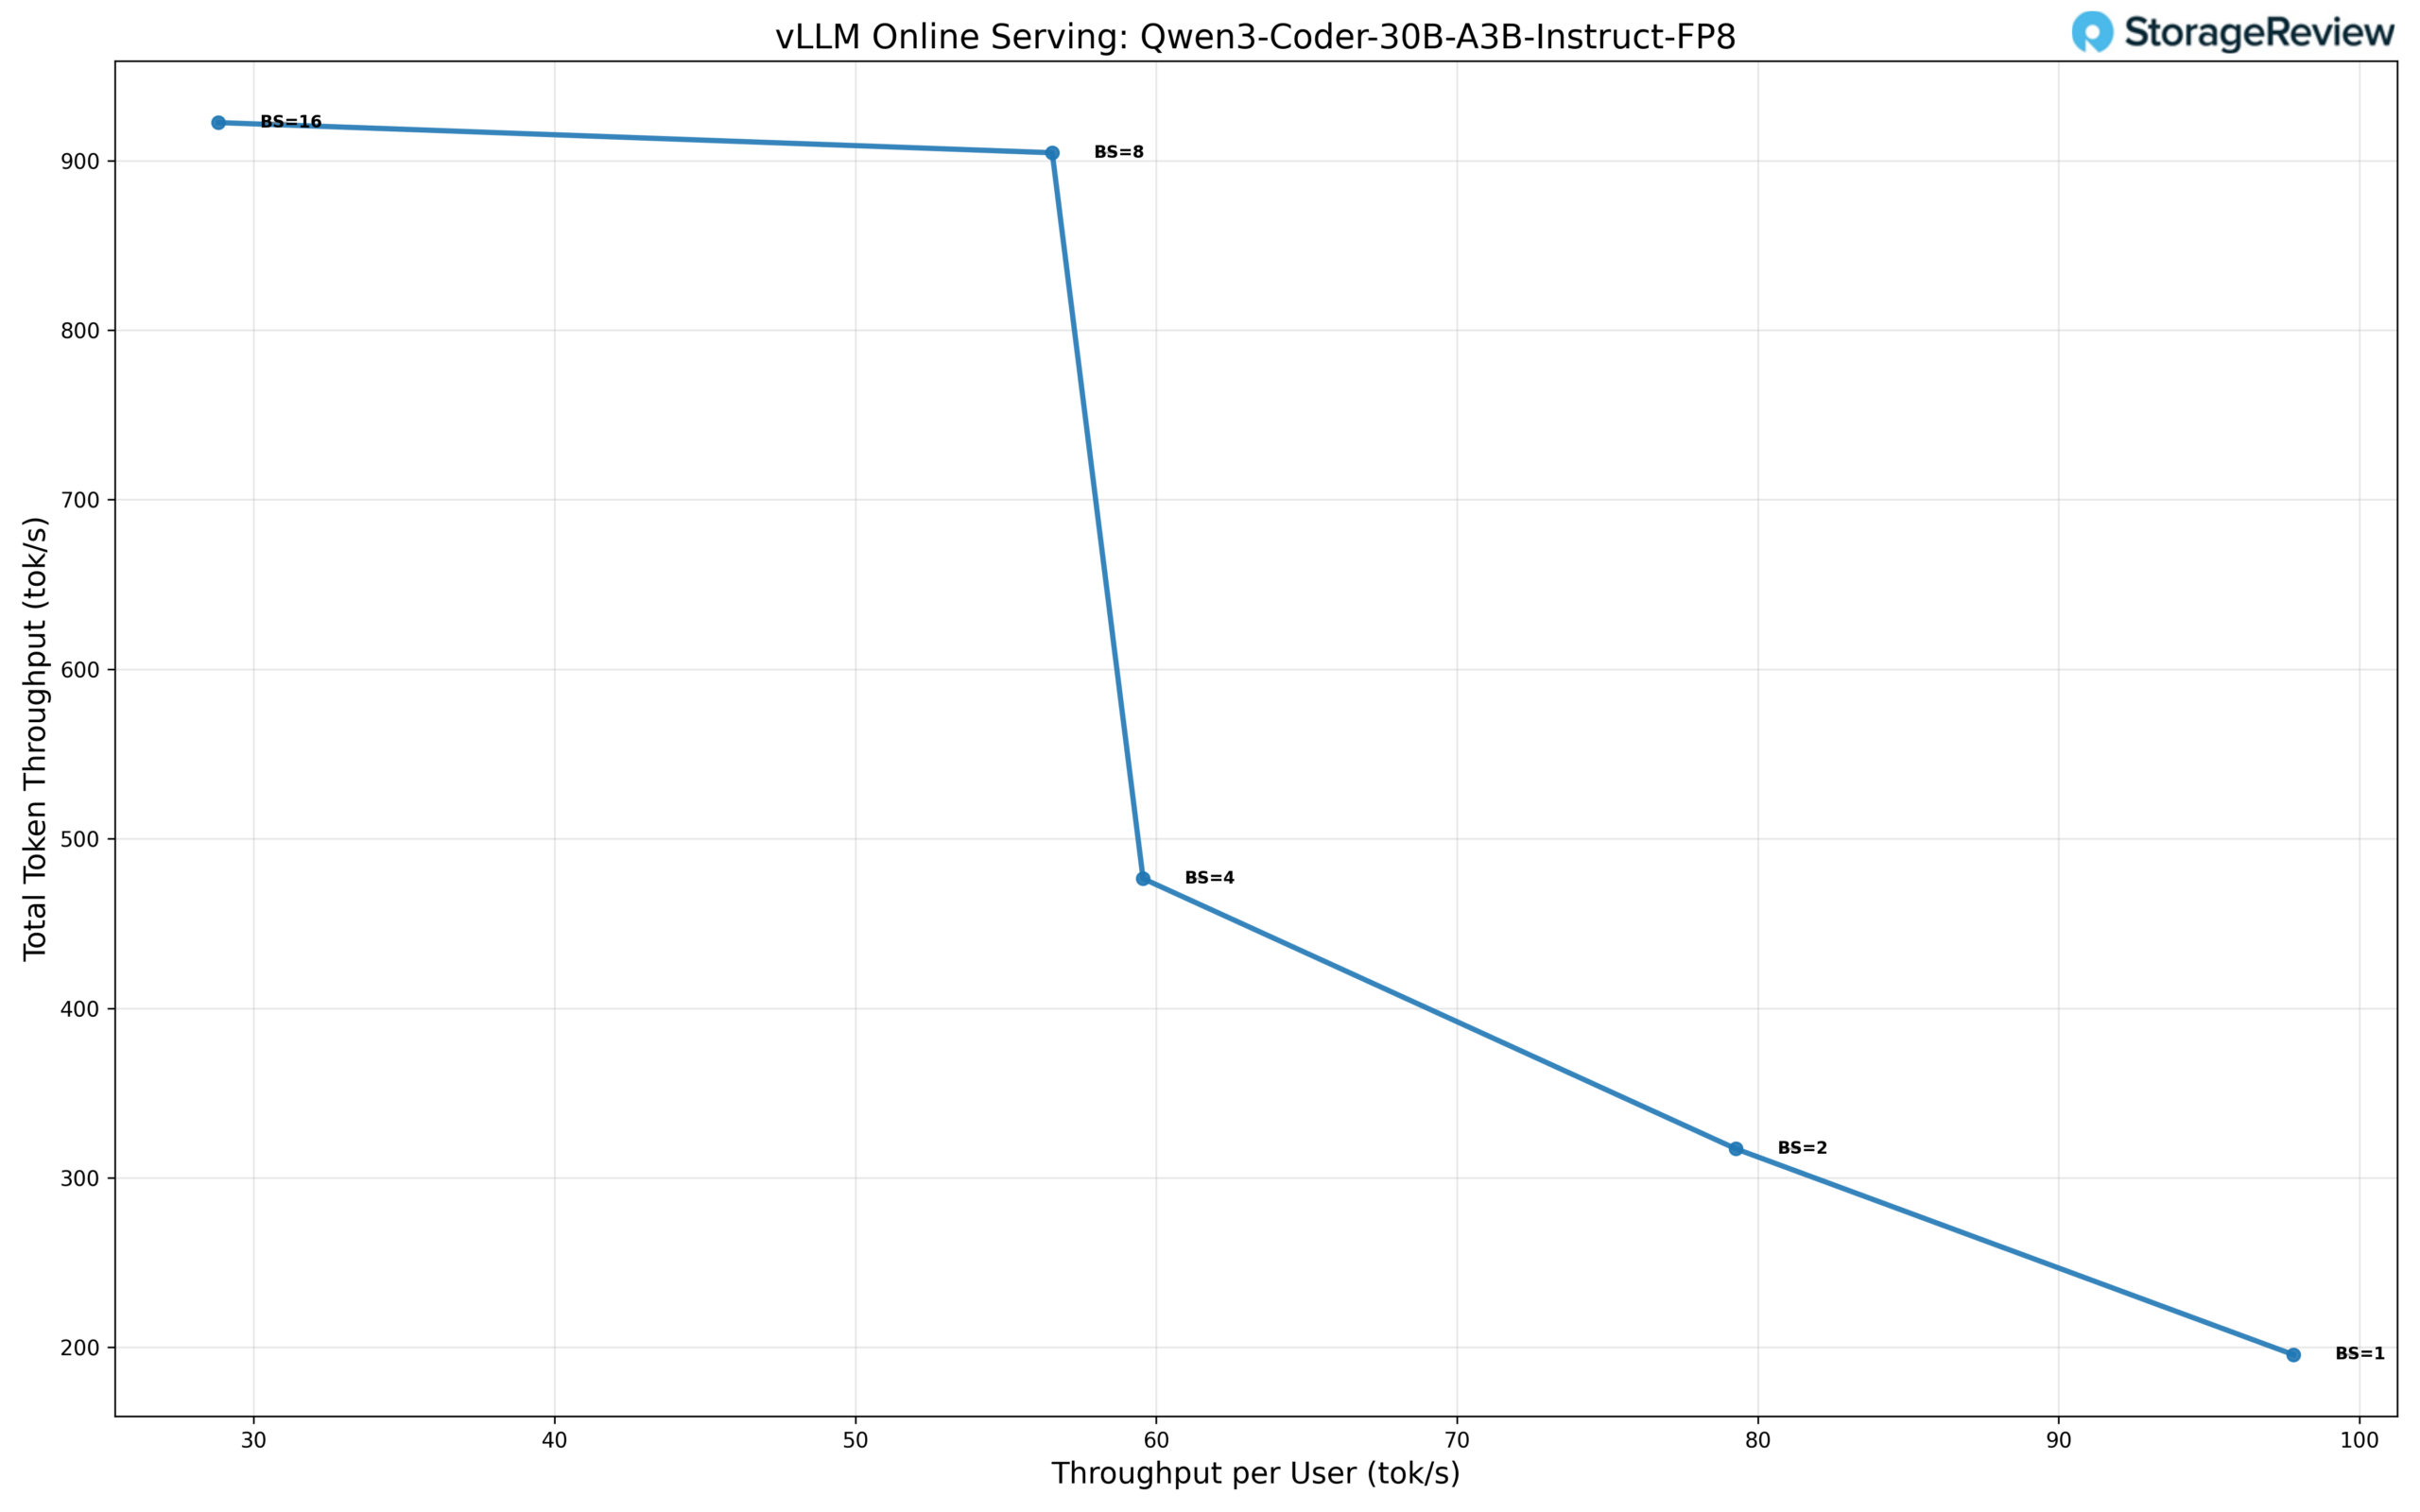
Il modello Qwen3-Coder-30B-A3B, eseguito con precisione FP8, presenta un profilo di scalabilità ottimizzato per una concorrenza moderata, offrendo elevate prestazioni per utente e raggiungendo la saturazione prima rispetto ai modelli più piccoli. Con un funzionamento monoutente (BS=1), il modello raggiunge circa 98 tok/s per utente, con una produttività totale di 196 tok/s, stabilendo un'elevata baseline a flusso singolo che riflette l'ottimizzazione del modello per i carichi di lavoro di generazione di codice.
All'aumentare della concorrenza, la produttività totale scala in modo efficiente, mentre la produttività per utente diminuisce in modo controllato. Con BS=2, la produttività totale sale a 317 tok/s, con 79 tok/s per utente, e con BS=4, il modello fornisce una produttività totale di 477 tok/s, con 59 tok/s per utente. Questi risultati mostrano un utilizzo efficace delle risorse di elaborazione disponibili tramite batching da basso a moderato, senza un brusco degrado della reattività per utente.
Il modello raggiunge il suo picco di throughput aggregato a BS=8, mantenendo un throughput totale di circa 905 tok/s, con 56 tok/s per utente. La scalabilità continua marginalmente fino a BS=16, dove il throughput totale aumenta leggermente a 920 tok/s, mentre il throughput per utente scende a 29 tok/s, indicando la saturazione della pipeline di inferenza. Oltre questo punto, un'ulteriore concorrenza fornisce guadagni minimi nel throughput totale, pur avendo un impatto significativo sulle prestazioni per utente.
Nel complesso, Qwen3-Coder-30B-A3B FP8 offre un aumento di circa 4.7 volte della produttività totale, passando da BS=1 al picco massimo a BS=16. Le caratteristiche di latenza e produttività suggeriscono che questa configurazione sia la più adatta per carichi di lavoro di codifica multiutente moderati che richiedono elevate prestazioni per richiesta. Tuttavia, il ridimensionamento estremo dei batch non è l'obiettivo primario.
Prestazioni del tipo di dati di microscalatura
Il microscaling rappresenta un approccio di quantizzazione avanzato che applica fattori di scala a grana fine a piccoli blocchi di pesi anziché una quantizzazione uniforme su grandi gruppi di parametri. Il formato NVFP4 di NVIDIA implementa questa tecnica attraverso una rappresentazione in virgola mobile bloccata in cui ogni blocco di microscala di 8-32 valori condivide un esponente tipico come fattore di scala. Questo approccio granulare preserva la precisione numerica ottenendo al contempo una rappresentazione a 4 bit, mantenendo la gamma dinamica critica per le architetture a trasformatore. Il formato si integra con l'architettura Tensor Core di NVIDIA, consentendo un calcolo efficiente a precisione mista con decompressione al volo durante le operazioni sulla matrice.
Prestazioni GPT-OSS-20b
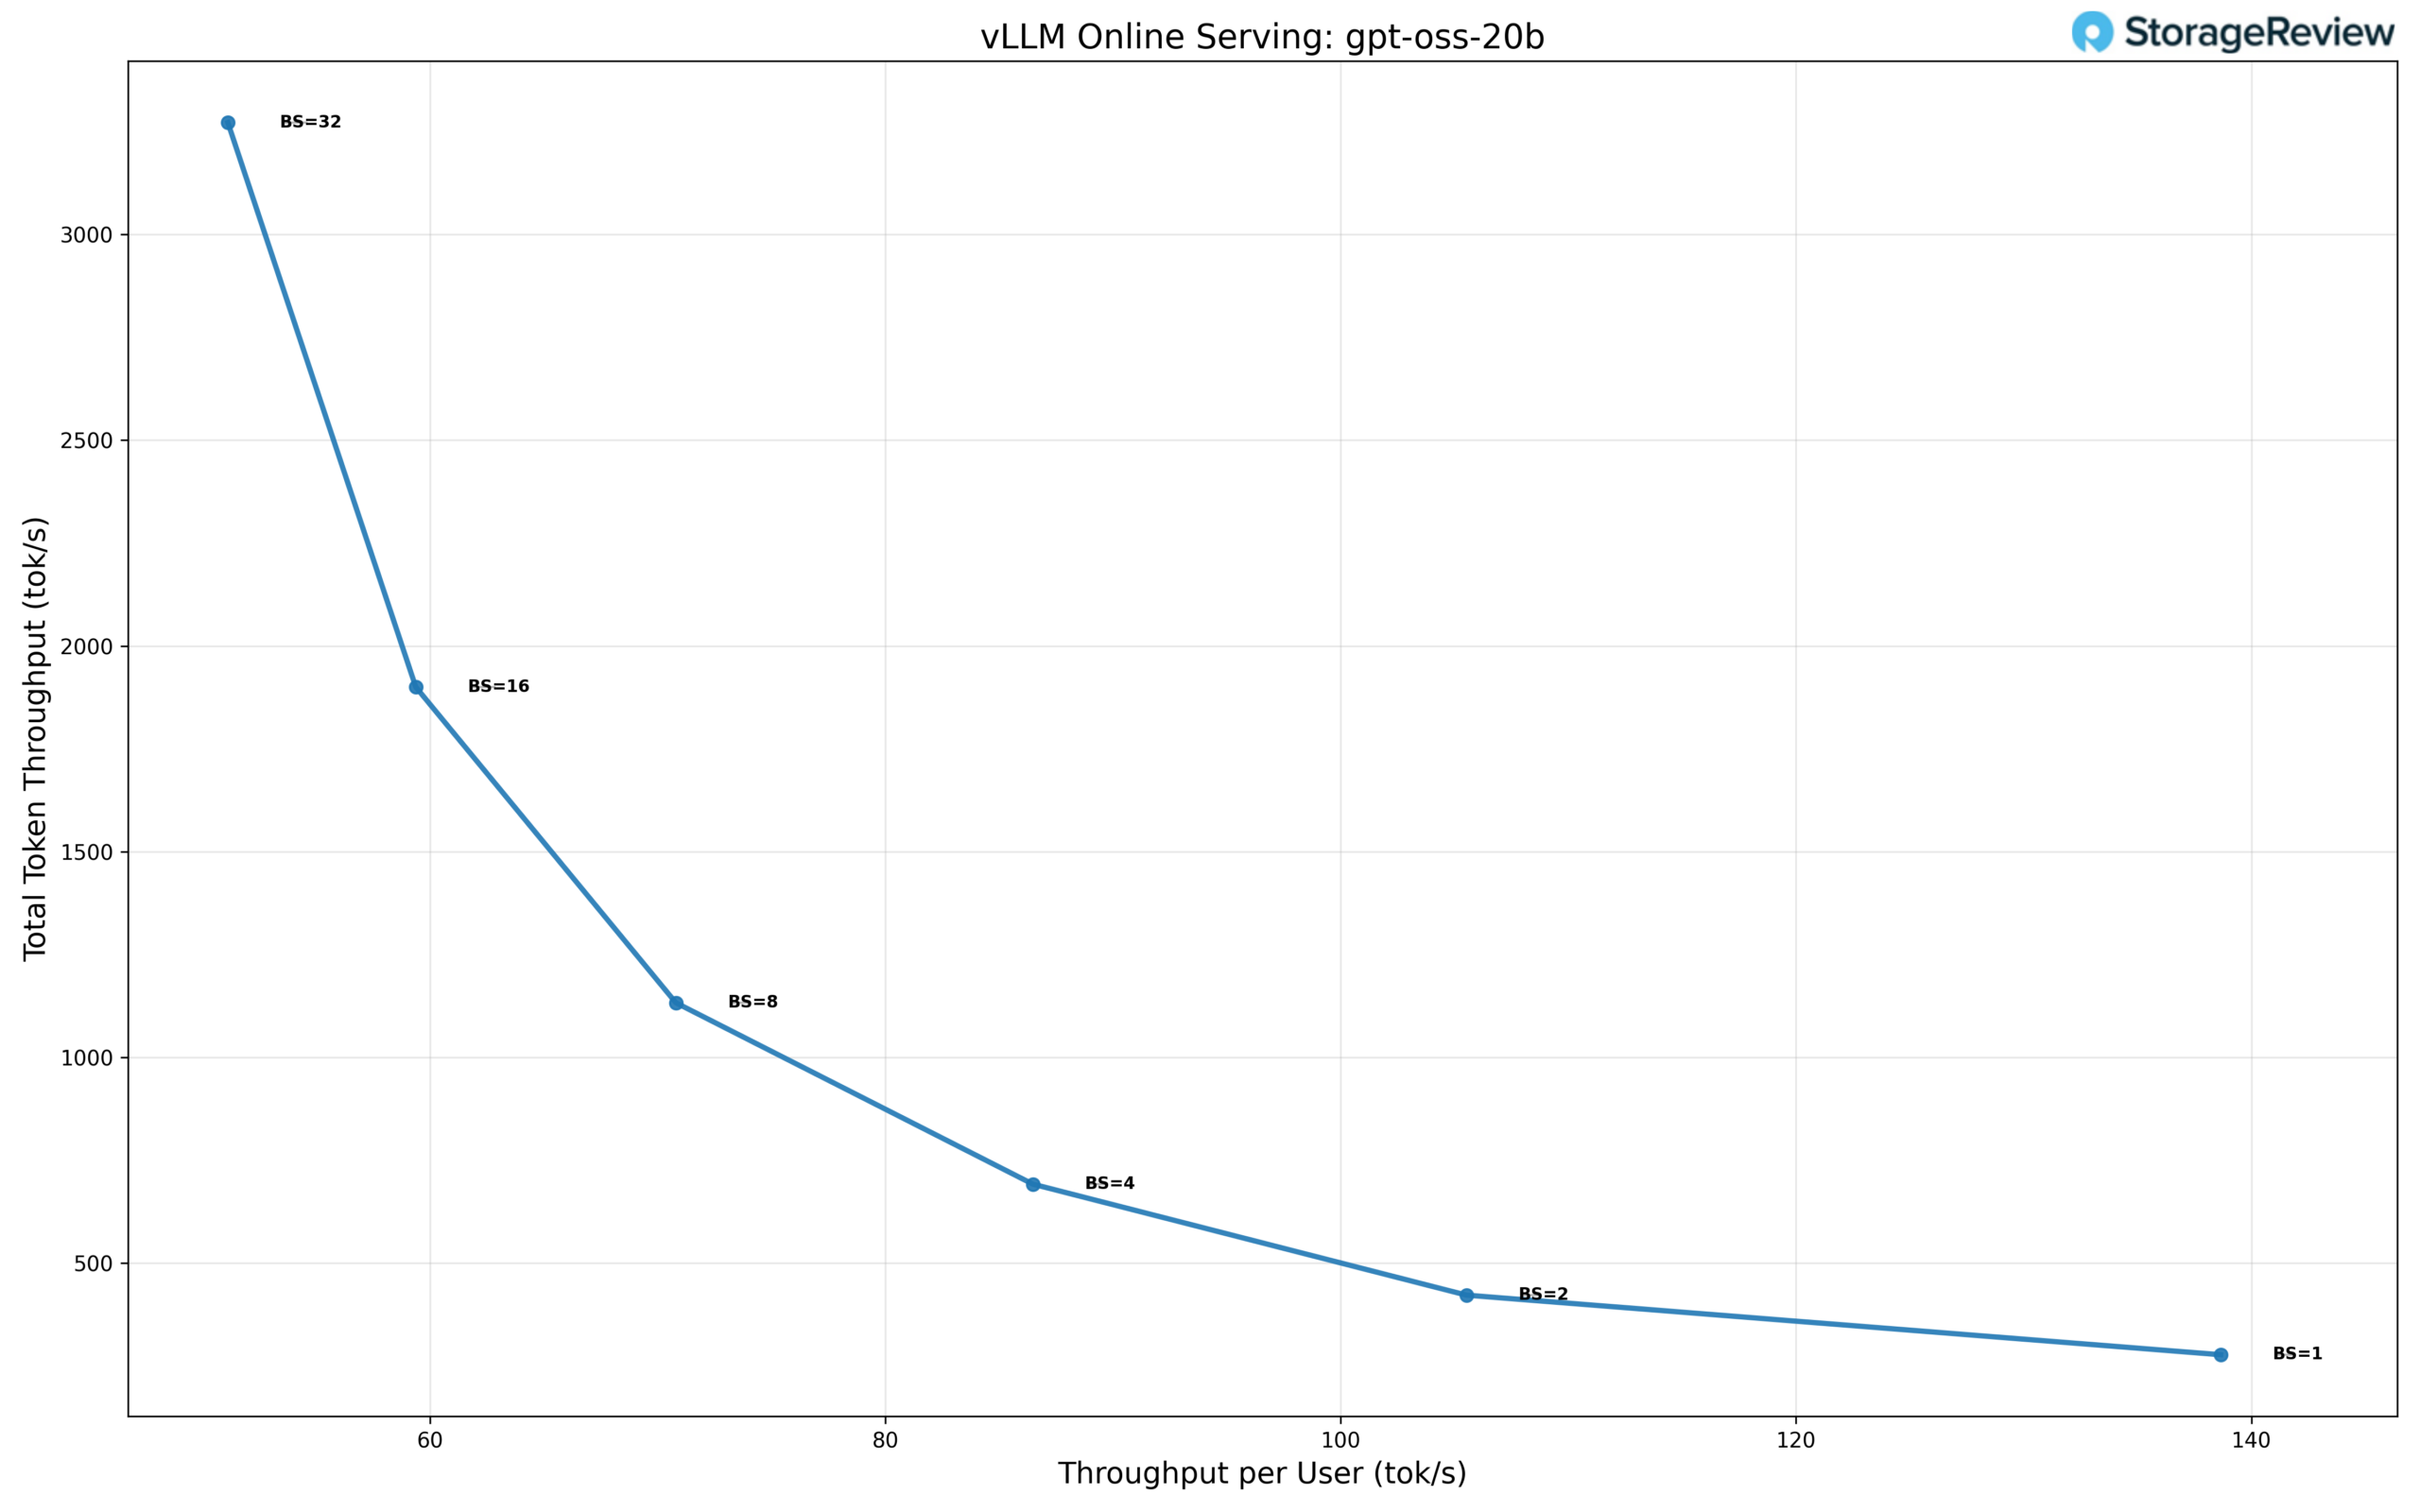
Il modello gpt-oss-20b dimostra solide caratteristiche di scalabilità con livelli di concorrenza crescenti, con un throughput aggregato particolarmente elevato a batch di dimensioni maggiori. Con concorrenza a singolo utente (BS=1), il modello fornisce circa 138 tok/s per utente, con un throughput totale di 276 tok/s, stabilendo una solida base di riferimento per l'inferenza a flusso singolo.
Con l'aumentare della concorrenza, la produttività totale aumenta in modo aggressivo, mentre la produttività per utente diminuisce come previsto. Con BS=2, la produttività totale sale a 420 tok/s, con 105 tok/s per utente, e con BS=4, la produttività raggiunge 690 tok/s totali, con 86 tok/s per utente. Questa progressione costante indica un utilizzo efficiente delle risorse di elaborazione disponibili attraverso un batching da basso a moderato.
La scalabilità continua con BS=8, dove il modello raggiunge una produttività totale di circa 1,120 tok/s a 70 tok/s per utente, e BS=16, dove la produttività totale aumenta a 1,900 tok/s, con 60 tok/s per utente. Questi risultati mostrano che gpt-oss-20b mantiene prestazioni per utente relativamente elevate anche con l'aumento della concorrenza, rendendolo adatto a scenari di distribuzione multiutente.
Il modello raggiunge il suo massimo throughput aggregato a BS=32, offrendo un throughput totale di circa 3,250 tok/s, con un throughput per utente che scende a 50 tok/s. Ciò rappresenta un aumento di 11.8 volte del throughput totale rispetto alle prestazioni per utente singolo. Mentre il throughput per utente continua a diminuire con batch di dimensioni maggiori, l'efficienza di scalabilità complessiva rimane elevata, indicando che il modello beneficia di una maggiore concorrenza senza incontrare un punto di saturazione precoce.
Nel complesso, gpt-oss-20b presenta un profilo di scalabilità bilanciato, combinando elevate prestazioni monoutente con un'elevata scalabilità in batch. Questo lo rende un'opzione interessante per le distribuzioni che richiedono sia un'inferenza individuale reattiva sia un throughput aggregato elevato in presenza di carichi multiutente più pesanti.
Benchmark Phoronix
Phoronix Test Suite è una piattaforma di benchmarking automatizzata e open source che supporta oltre 450 profili di test e più di 100 suite di test tramite OpenBenchmarking.org. Gestisce ogni aspetto, dall'installazione delle dipendenze all'esecuzione dei test e alla raccolta dei risultati, rendendola ideale per confronti delle prestazioni, convalida hardware e integrazione continua.
Larghezza di banda della memoria di flusso
L'SR650 V4 ha fornito 369.6 GB/s di larghezza di banda di memoria, dimostrando un throughput elevato per carichi di lavoro ad alta intensità di dati e confermando ottime prestazioni di memoria multicanale.
Compressione a 7 zip
Con 584,499 MIPS, il sistema ha registrato eccellenti prestazioni di compressione e decompressione, riflettendo una solida efficienza multi-core e una forte capacità di elaborazione di numeri interi.
Compilazione del kernel
Il server ha completato la compilazione del kernel allmod in 256.175 secondi, un risultato rispettabile che evidenzia la sua capacità di gestire in modo efficiente la compilazione parallela e i flussi di lavoro degli sviluppatori.
Apache Web Server
A 61,654 R/s, l'SR650 V4 ha mostrato ottime prestazioni di web serving, mantenendo un'elevata capacità di elaborazione delle richieste adatta all'hosting front-end o a stack di virtualizzazione leggeri.
Verifica OpenSSL
Raggiungendo 712.6 miliardi di byte al secondo, la piattaforma ha dimostrato solide prestazioni di verifica crittografica, confermando la capacità della CPU di effettuare operazioni sicure e basate su certificati.
| Benchmark Phoronix | Lenovo Think System SR650 V4 |
|---|---|
| Bacheca | 369,58.3 MB / s |
| 7-ZIP | 584,499 MIPS |
| Compilazione del kernel (allmod) | secondi 256.175 |
| Apache (richieste al secondo) | 61,654.47 rupie |
| SSL aperto | 712,633,776,990 byte/s |
Conclusione
ThinkSystem SR650 V4 è il tipo di aggiornamento della piattaforma che conta perché non si limita a sostituire la CPU. Lenovo ha utilizzato questa generazione per apportare miglioramenti significativi in aree che limitano le implementazioni nel mondo reale: larghezza di banda della memoria, disponibilità delle linee PCIe, densità di storage e possibilità di adattare la configurazione al variare delle esigenze. Il passaggio a Intel Xeon 6 offre più opzioni di core e maggiore margine di I/O per socket, e il lavoro sulla piattaforma circostante, tra cui DDR5 più veloce con supporto MRDIMM ed espansione CXL opzionale, offre a SR650 V4 la possibilità di rimanere rilevante anche quando i carichi di lavoro diventano più esigenti in termini di memoria.
Sul fronte storage, nonostante la nostra configurazione di prova limitata con U.2, la spinta di Lenovo verso E3.S offre una maggiore densità NVMe con connettività 1:1 e caratteristiche termiche più pulite, in linea con il modo in cui vengono costruite le infrastrutture moderne, in particolare per gli stack di virtualizzazione che richiedono più flash locale e per le pipeline adiacenti all'intelligenza artificiale in cui l'alimentazione delle GPU è importante quanto l'elaborazione grezza. I doppi slot OCP 3.0 Gen5 x16 rappresentano anche un pratico upgrade: è possibile implementare reti di livello avanzato senza sacrificare gli slot PCIe che si preferisce riservare ad acceleratori, storage o adattatori speciali.
Se utilizzate il modello SR650 V3 e vi sentite limitati dalla velocità della memoria, dal margine PCIe o dalla densità NVMe, il modello SR650 V4 rappresenta un importante passo avanti. Mantiene la facilità di manutenzione e la configurabilità che hanno reso popolare la linea SR650, aggiungendo al contempo il tipo di piattaforma di supporto che aiuta i team IT a evitare di mettersi con le spalle al muro. Che stiate creando un cluster di virtualizzazione, modernizzando servizi di scalabilità orizzontale o assemblando un nodo CPU/GPU bilanciato, il modello SR650 V4 soddisfa i requisiti essenziali e lascia spazio per le esigenze future.


 Amazon