

La gamma Pascari X-Series di Phison è sviluppata per soddisfare diverse esigenze di storage aziendale, offrendo soluzioni personalizzate per carichi di lavoro ad alta intensità di lettura e scrittura. L'X200P è il modello ad alta capacità, che supporta fino a 30.72 TB con un DWPD (Drive Writes Per Day). Utilizza PCIe Gen5, NAND TLC ed è disponibile nei formati U.3, U.2 ed E3.S. L'X200P è progettato per un'ampia gamma di casi d'uso, tra cui la distribuzione di contenuti su larga scala, l'inferenza AI e l'archiviazione di dati a freddo.
Phison offre anche i modelli X200E ad alta resistenza, ottimizzati per carichi di lavoro ad alta intensità di scrittura, che supportano fino a tre DWPD e capacità che vanno da 1.6 TB a 25.6 TB, rendendoli adatti per database transazionali, analisi in tempo reale ed elaborazione dei log.
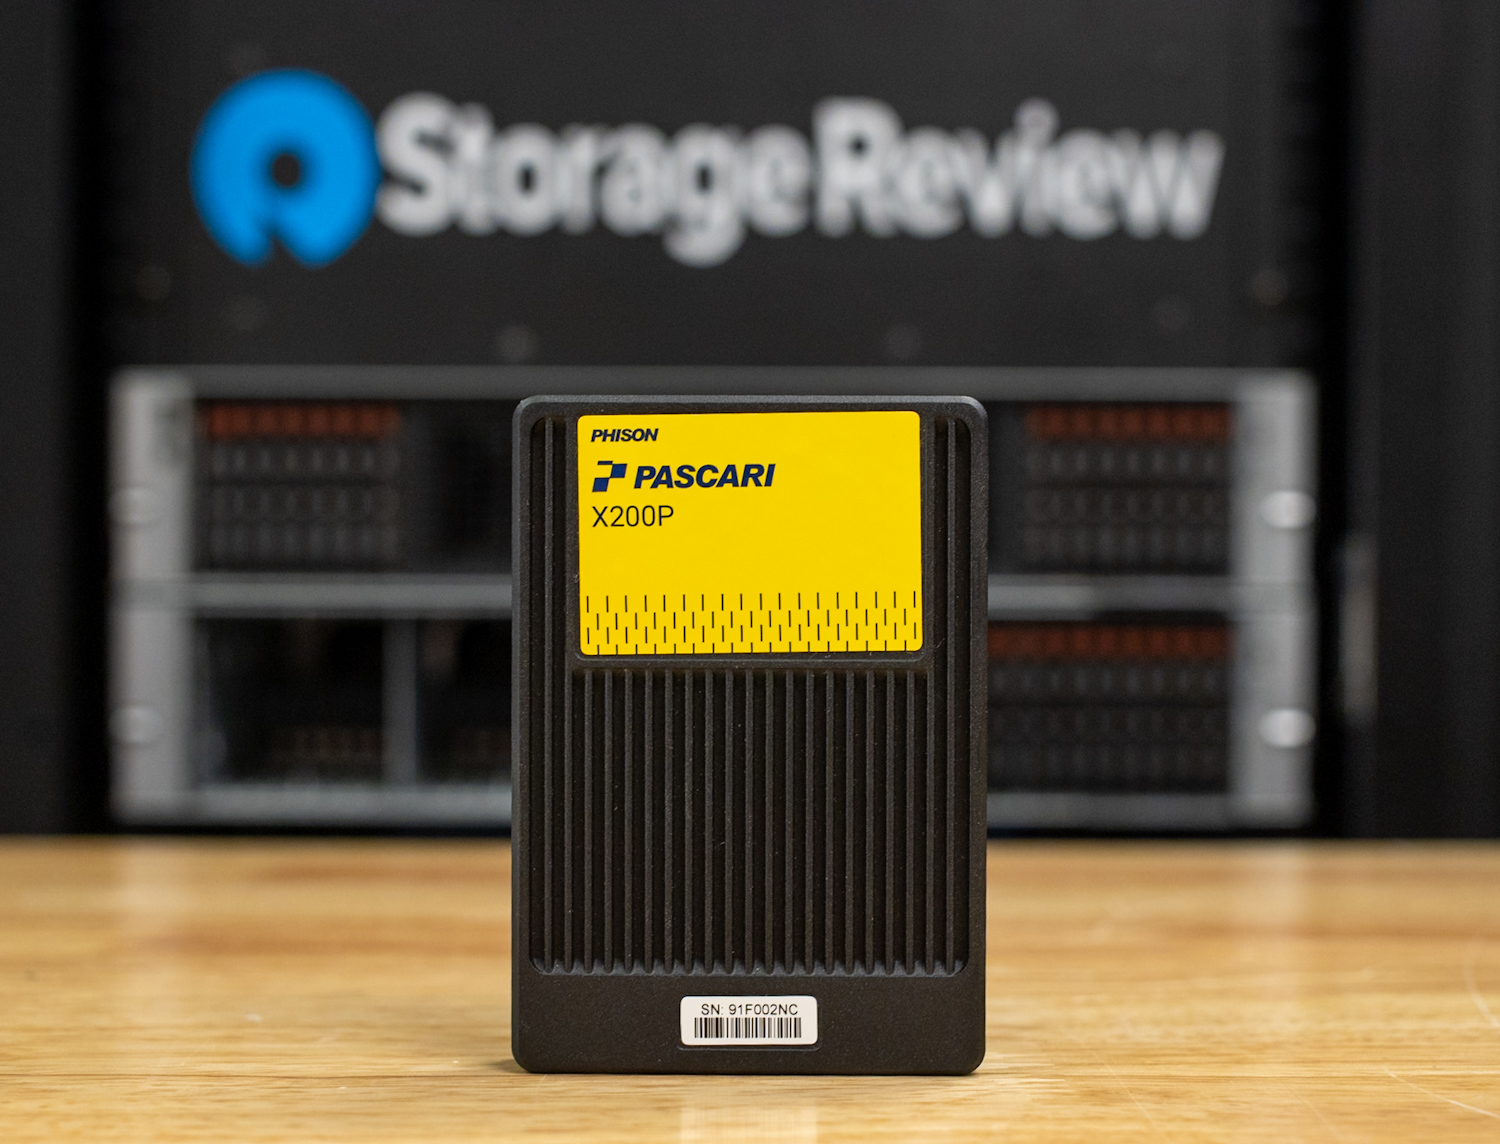
Per questa recensione, Phison ci ha inviato il modello X7.68P U.200 da 2 TB. Lo abbiamo sottoposto alla nostra suite completa di benchmark aziendali per valutarne le prestazioni sotto pressione.
Phison Pascari X200P Campionati Specifiche
| Specifiche Phison Pascari X200P Series | 1.92TB | 3.84TB | 7.68TB | 15.36TB | 30.72TB |
|---|---|---|---|---|---|
| Fattore di forma | U.2 | ||||
| Interfaccia | PCIe 5.0 x4, 2×2 | ||||
| NVMe | 2.0 | ||||
| NAND Flash | 3D TLC | ||||
| Lettura sequenziale (MB / s) | 14,800 | 14,800 | 14,800 | 14,800 | 14,000 (stima) |
| Scrittura sequenziale (MB / s) | 4,300 | 8,600 | 8,700 | 8,350 | 7,500 (stima) |
| Lettura casuale 4K (IOPS) | 2,400K | 3,000K | 3,000K | 3,000K | 2,300 mila (stimato) |
| Scrittura casuale 4K (IOPS) | 170K | 380K | 500K | 500K | 283 mila (stimato) |
| Latenza di lettura (μs) | 60 | ||||
| Latenza di scrittura (μs) | 10 | ||||
| Potenza – Attiva (W) | <25 | ||||
| Potenza – Inattivo (W) | 5 | ||||
| Dipartimento di Polizia di Washington (7) | 1 | ||||
| UBER | <1 settore su 1018 bit letti | ||||
| MTBF (milioni di ore) | 2.5 | ||||
| Garanzia limitata (anni) | 5 | ||||
| Temp di funzionamento. (° C) | 0 a 70 | ||||
| Temperatura non operativa (°C) | -40 a 85 | ||||
| Dimensioni (mm) | 100.10 (L) x 69.85 (P) x 15.00 (A) | ||||
| Peso (g) | 188 | 199 | 201 | 168 | <250 |
Costruisci e progetta Pascari X200P 7.68 TB
La nostra unità di test è la versione U.7.68 da 2 TB dell'X2.5P da 200", progettata per applicazioni di storage aziendale ad alte prestazioni. Utilizza un'interfaccia PCIe 5.0, pienamente conforme alle specifiche NVMe 2.0. L'unità è basata su tecnologia NAND 3D TLC ad alta resistenza e supporta capacità fino a 30.72 TB.
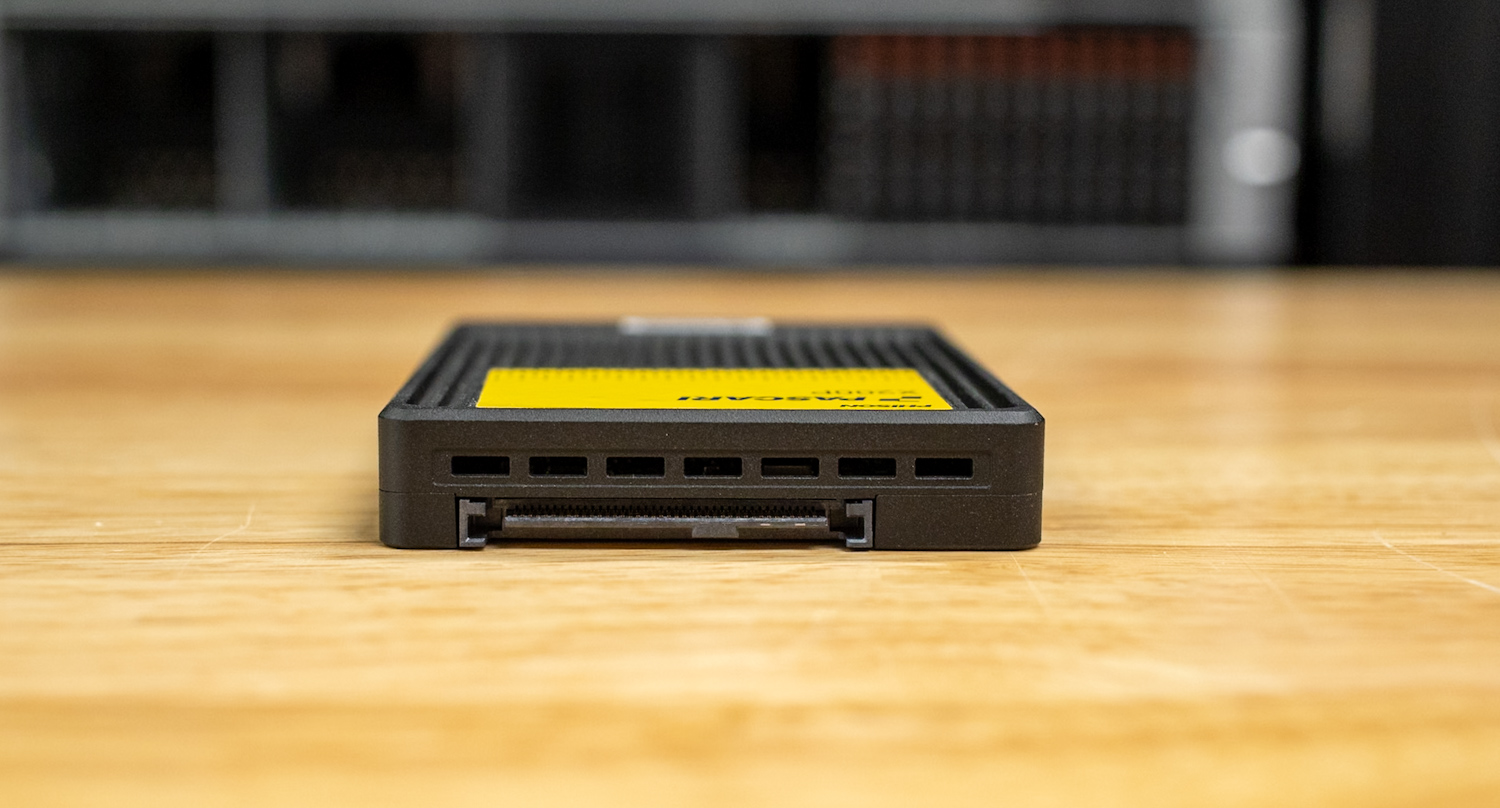
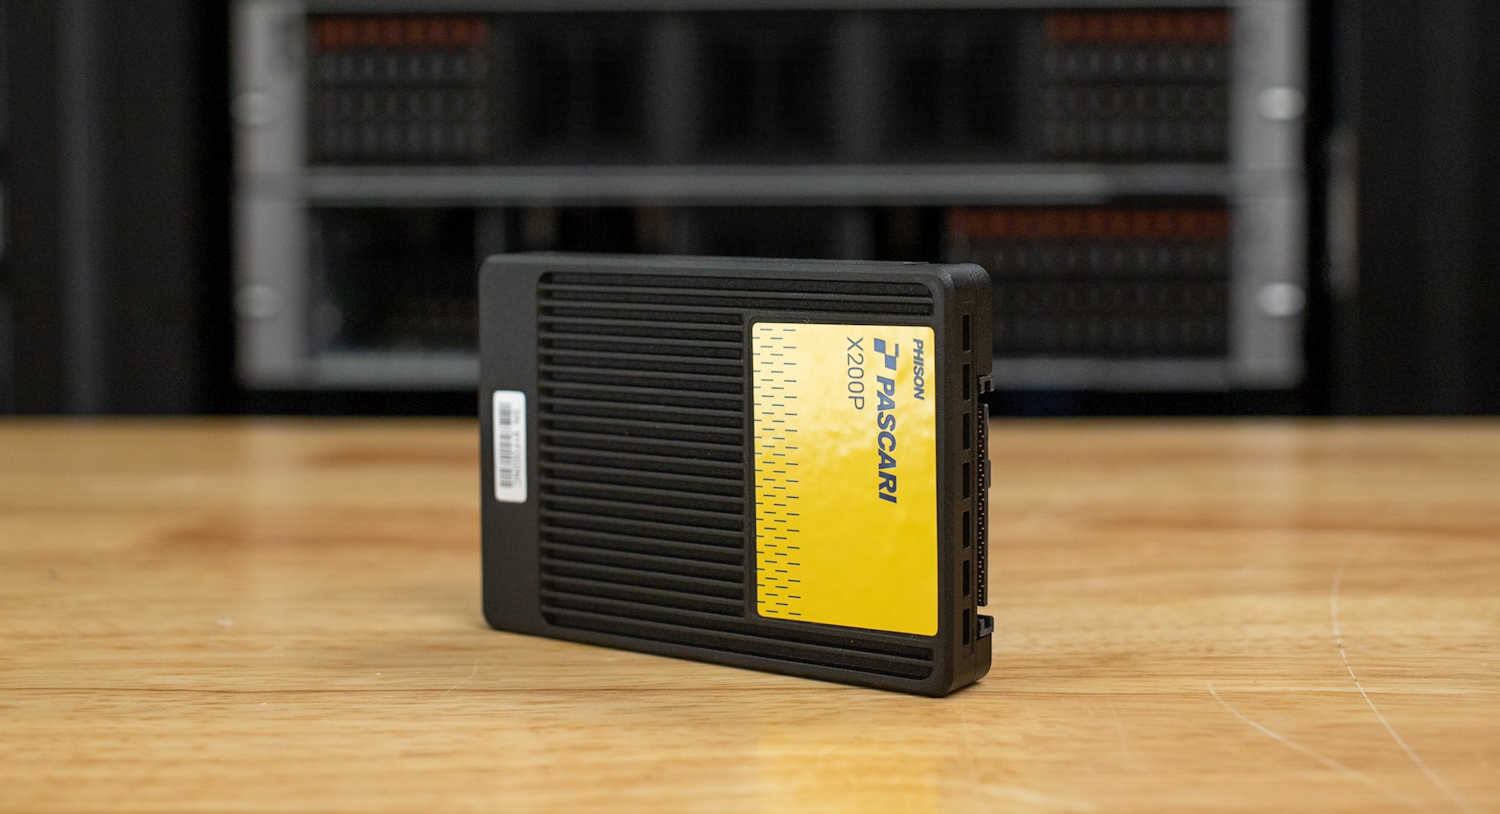
Fisicamente, l'X200P presenta un fattore di forma U.2.5 standard da 2", con dimensioni di 100.10 mm di lunghezza, 69.85 mm di larghezza e 15.00 mm di altezza, per un peso di 201 grammi. L'intero sistema è alloggiato in un elegante case in alluminio nero con raffreddamento passivo integrato, progettato per gestire in modo efficiente le temperature in caso di carichi di lavoro intensi e prolungati. L'unità supporta anche configurazioni E3.S per la massima flessibilità in ambienti di storage ad alta densità.
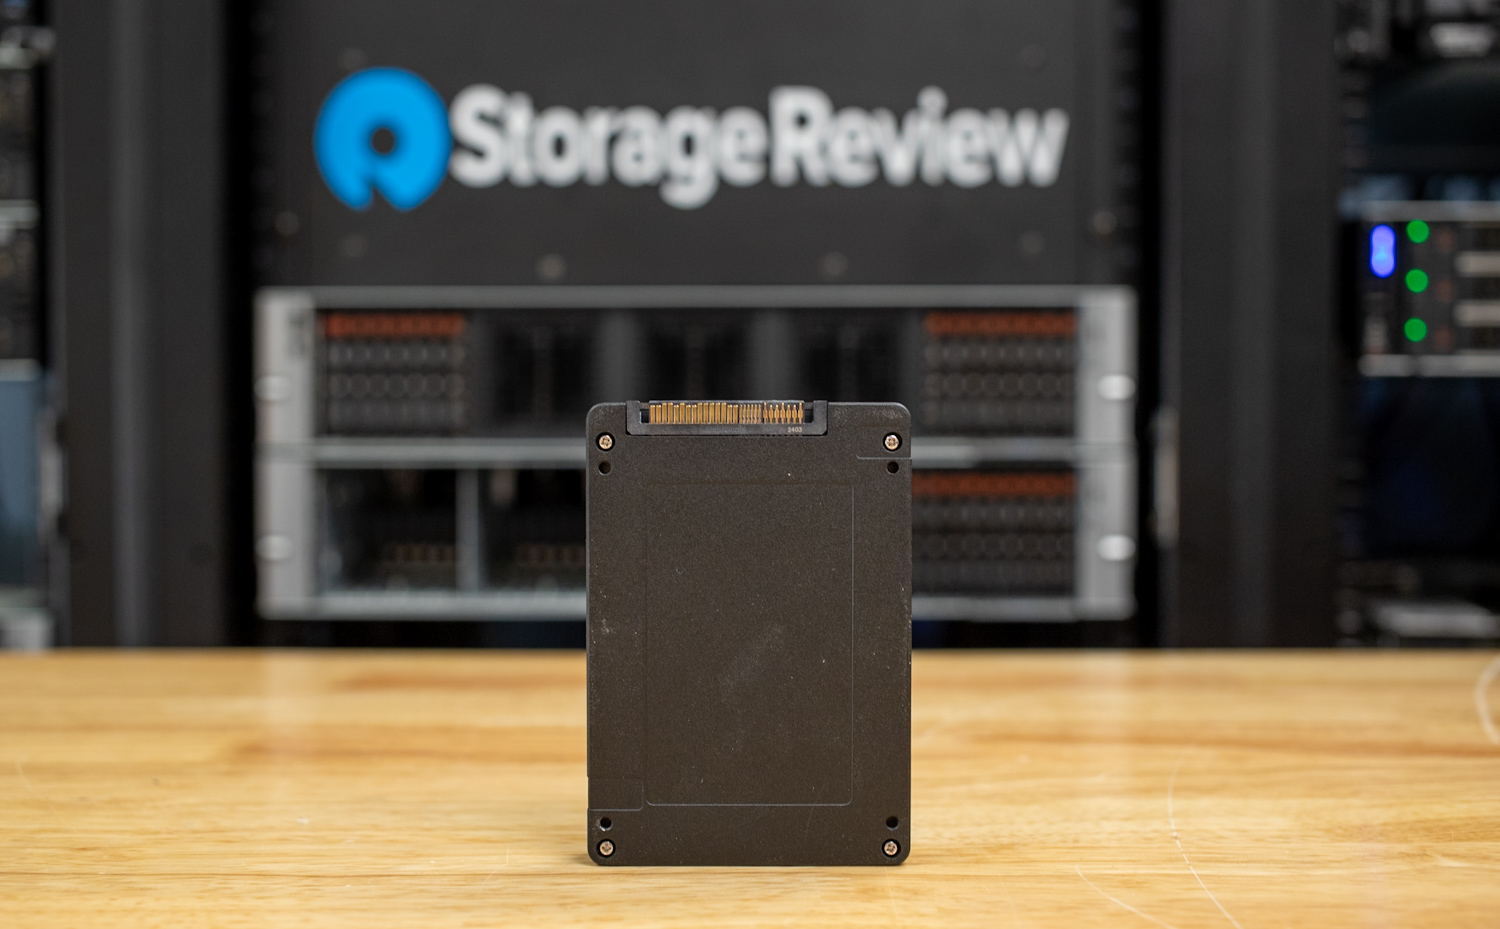
Dal punto di vista delle prestazioni, è progettato per velocità di lettura sequenziale fino a 14,800 MB/s, scrittura sequenziale fino a 8,700 MB/s e fino a 3 milioni di IOPS in lettura casuale e 500 IOPS in scrittura casuale. L'unità mantiene un consumo energetico in modalità attiva inferiore a 25 W e in modalità inattiva di soli 5 W, il che lo rende un'opzione efficiente per operazioni ad alta produttività prolungate.
La resistenza è di 1 DWPD, con un MTBF di 2.5 milioni di ore e una garanzia limitata di 5 anni. È progettato per carichi di lavoro aziendali 24 ore su 7, 0 giorni su 70, con un intervallo di temperatura operativa da XNUMX °C a XNUMX °C.
Phison include un set completo di funzionalità di protezione e gestibilità dei dati di livello aziendale:
- Protezione contro la perdita di potenza (PLP)
- ISE (cancellazione sicura istantanea), supporto TCG Opal 2.0
- Crittografia AES-XTS a 256 bit
- Protezione del percorso dati end-to-end
- Protezione dei metadati
- SECDED (Correzione di un singolo errore, rilevamento di un doppio errore)
- Sanificare le operazioni
- NVMe-MI (interfaccia di gestione)
- Compatibilità SMBus
- Supporto per un massimo di 128 namespace
Nel complesso, la gamma Pascari X200P unisce una solida qualità costruttiva di livello industriale a prestazioni all'avanguardia e affidabilità di livello aziendale, rendendola un candidato ideale per ambienti di storage esigenti come cloud, AI/ML e infrastrutture virtualizzate.
Test di Performance
Piattaforma di test di guida
In questa recensione, utilizziamo come piattaforma di test un Dell PowerEdge R760 con Ubuntu 22.04.02 LTS per tutti i carichi di lavoro. Dotato di un JBOF Serial Cables Gen5 , offre un'ampia compatibilità con SSD U.2, E1.S, E3.S e M.2. La configurazione del nostro sistema è descritta di seguito:
- 2 x Intel Xeon Gold 6430 (32 core, 2.1 GHz)
- 16 x 64GB DDR5-4400
- SSD Dell BOSS da 480 GB
- Cavi seriali Gen5 JBOF
Unità a confronto
- Pascari X200P 7.68 TB
- Micron 9550 da 7.68 TB
- SanDisk SN861 da 7.68 TB
- Solidigm PS1010 7.68 TB
- Kingston DC3000ME 7.68 TB
Abbiamo confrontato Pascari X200P con un gruppo di SSD PCIe Gen7.68 NVMe da 5 TB di dimensioni simili e con memoria flash NAND TLC. Il confronto ha incluso Micron 9550, SanDisk SN861, Solidigm PS1010 e Kingston DC3000ME. Queste unità rappresentano soluzioni di classe enterprise di media capacità, progettate per ambienti ad alte prestazioni. I test sono stati condotti utilizzando una serie di benchmark reali e sintetici, tra cui CDN, FIO e GDSIO, per misurare le prestazioni in termini di throughput sostenuto, latenza, modelli di I/O misti e carichi di lavoro accelerati da GPU. Standardizzando capacità, interfaccia e tipo di NAND, questa valutazione fornisce un chiaro confronto delle prestazioni di Pascari X200P rispetto ai suoi concorrenti in condizioni impegnative.
Prestazioni della CDN
Per simulare un carico di lavoro CDN realistico a contenuto misto, gli SSD sono stati sottoposti a una sequenza di benchmark multifase progettata per replicare i modelli di I/O di server edge ad alto contenuto. La procedura di test comprende una gamma di dimensioni di blocchi, sia grandi che piccole, distribuiti tra operazioni casuali e sequenziali, con diversi livelli di concorrenza.
Prima dei test principali delle prestazioni, ogni SSD ha completato un riempimento totale del dispositivo con una scrittura sequenziale al 100% utilizzando blocchi da 1 MB. Questo processo ha utilizzato I/O sincrono e una profondità di coda di quattro, consentendo quattro processi simultanei. Questa fase garantisce che l'unità entri in una condizione di stato stazionario rappresentativa dell'utilizzo reale. Dopo il riempimento sequenziale, è stata eseguita una fase secondaria di saturazione in scrittura randomizzata di tre ore utilizzando una distribuzione ponderata della dimensione dei blocchi (dimensione dei blocchi/percentuale), favorendo fortemente i trasferimenti a 128 K (98.51%), con contributi minori dai blocchi inferiori a 128 K fino a 8 K. Questa fase emula modelli di scrittura frammentati e irregolari spesso osservati negli ambienti con cache distribuita.
La suite di test principale si è concentrata su operazioni di lettura e scrittura casuali scalate per misurare il comportamento dell'unità in presenza di profondità di coda variabili e di processi concorrenti. Ogni test è durato cinque minuti (300 secondi) ed è stato seguito da un periodo di inattività di tre minuti, consentendo ai meccanismi di ripristino interni di stabilizzare le metriche prestazionali.
- Eseguito utilizzando una distribuzione di dimensioni di blocco fisse che privilegiava 128K (98.51%), con il restante 1.49% di operazioni composto da dimensioni di trasferimento inferiori, comprese tra 64K e 8K. Ogni configurazione variava tra 1, 2 e 4 job simultanei, con profondità di coda di 1, 2, 4, 8, 16 e 32, per profilare la scalabilità del throughput e la latenza in tipiche condizioni di edge-write.
- È stato utilizzato un profilo di dimensione dei blocchi fortemente misto, che imitava il recupero dei contenuti CDN, partendo da una componente dominante di 128K (83.21%) e proseguendo con una coda lunga di oltre 30 blocchi di dimensioni inferiori, che vanno da 4K a 124K, ciascuno con rappresentazione di frequenza frazionaria. Questa distribuzione riflette i diversi modelli di richiesta riscontrati durante il recupero dei segmenti video, l'accesso alle miniature e la ricerca dei metadati. Questi test sono stati eseguiti anche sull'intera matrice dei conteggi dei job e delle profondità di coda.
Questa combinazione di test di precondizionamento, saturazione e accesso randomizzato di dimensioni miste è progettata per rivelare come gli SSD gestiscono ambienti simili a CDN sostenuti, enfatizzando la reattività e l'efficienza in scenari ad alta larghezza di banda e altamente parallelizzati.
Lettura del carico di lavoro CDN 1
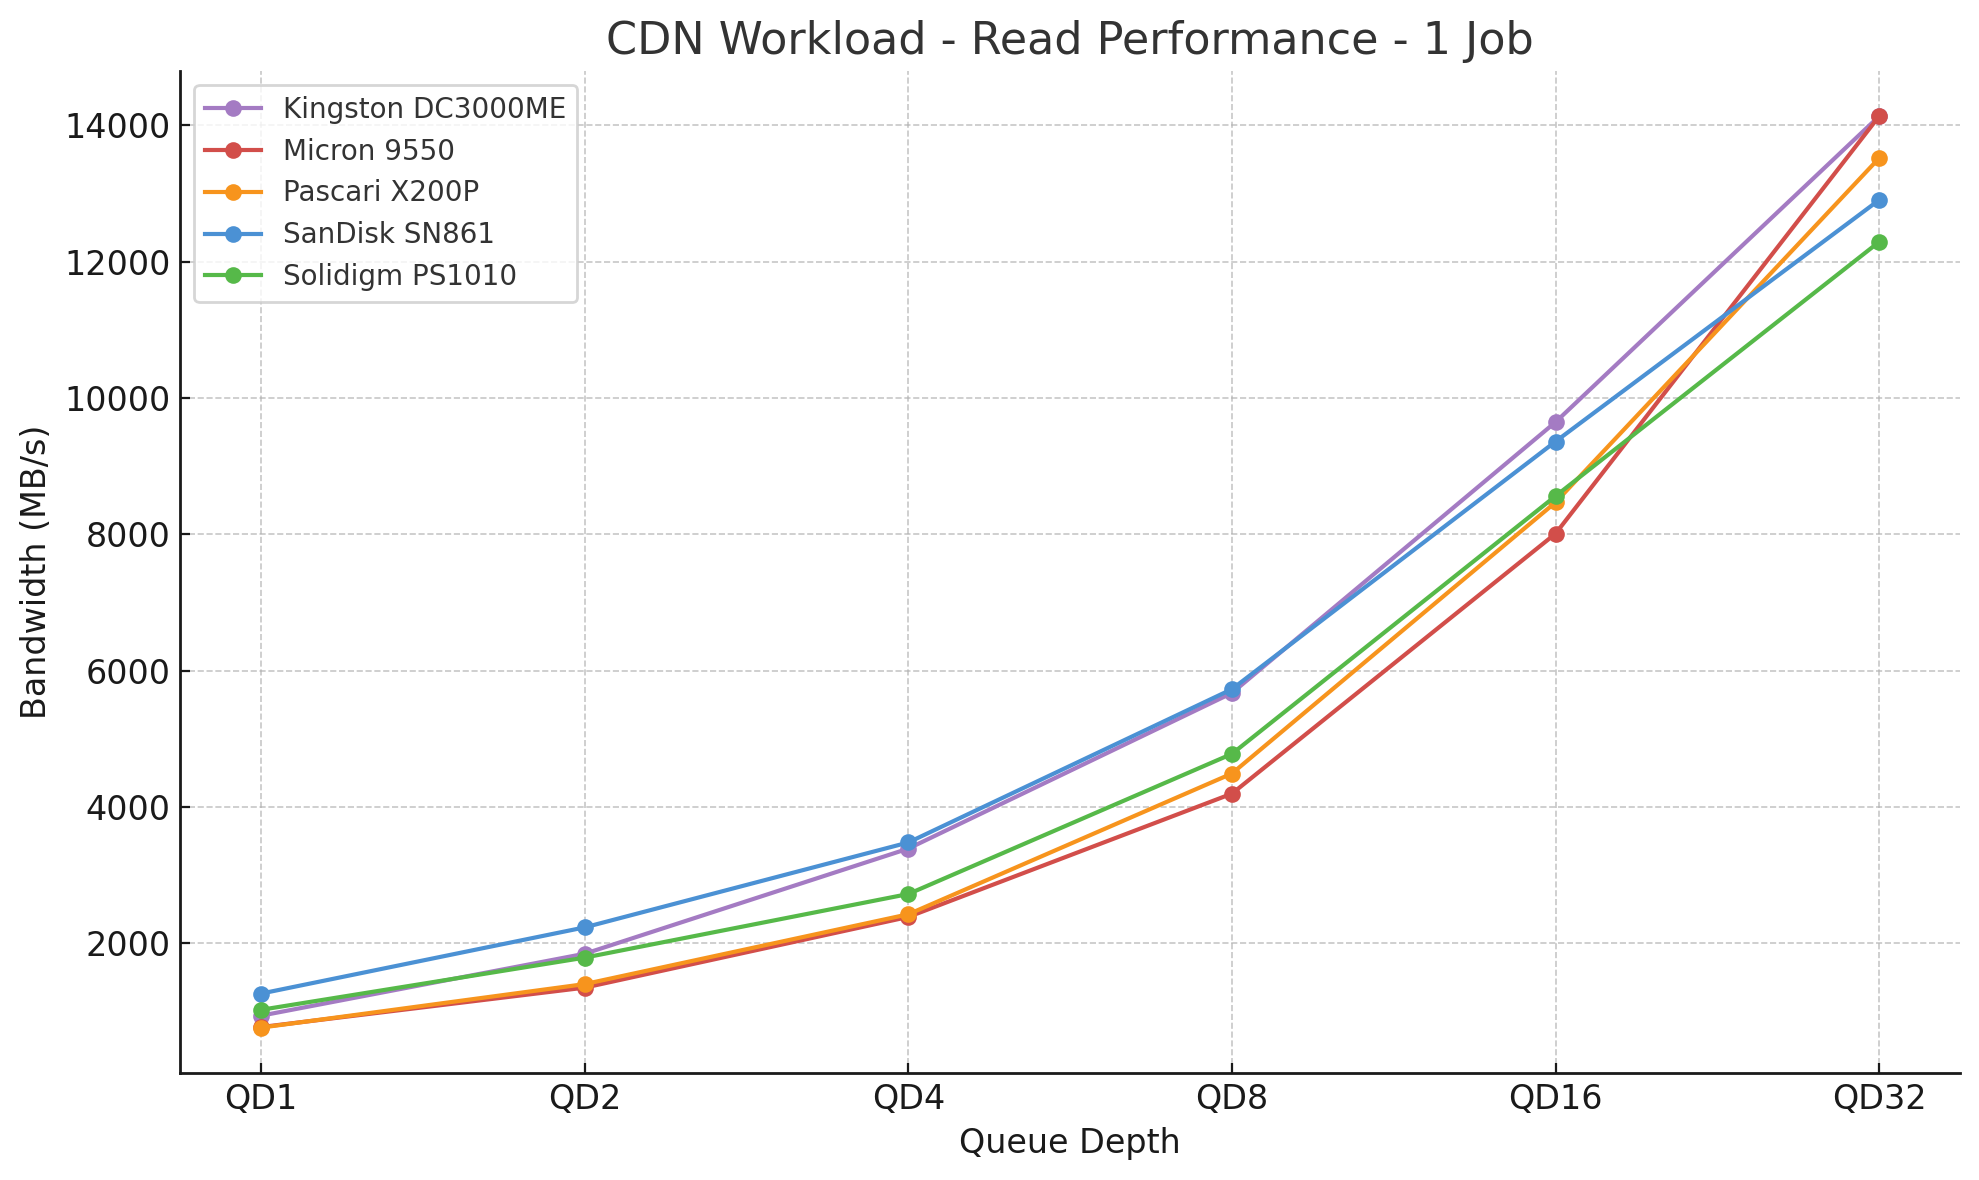
In questo test di lettura a singolo job che simula un traffico di contenuti leggero, il Pascari X200P parte in fondo al gruppo a QD1 con 765 MB/s e a QD2 con 1,403 MB/s. Con l'aumentare della profondità di coda, l'unità scala in modo efficiente, posizionandosi a metà classifica tra QD8 e QD16. A QD32, l'X200P raggiunge 13,516.8 MB/s, classificandosi terzo in classifica generale dietro a Kingston DC3000ME e Micron 9550, superando al contempo SanDisk SN861 e Solidigm PS1010 nella fascia alta.
Lettura del carico di lavoro CDN 2
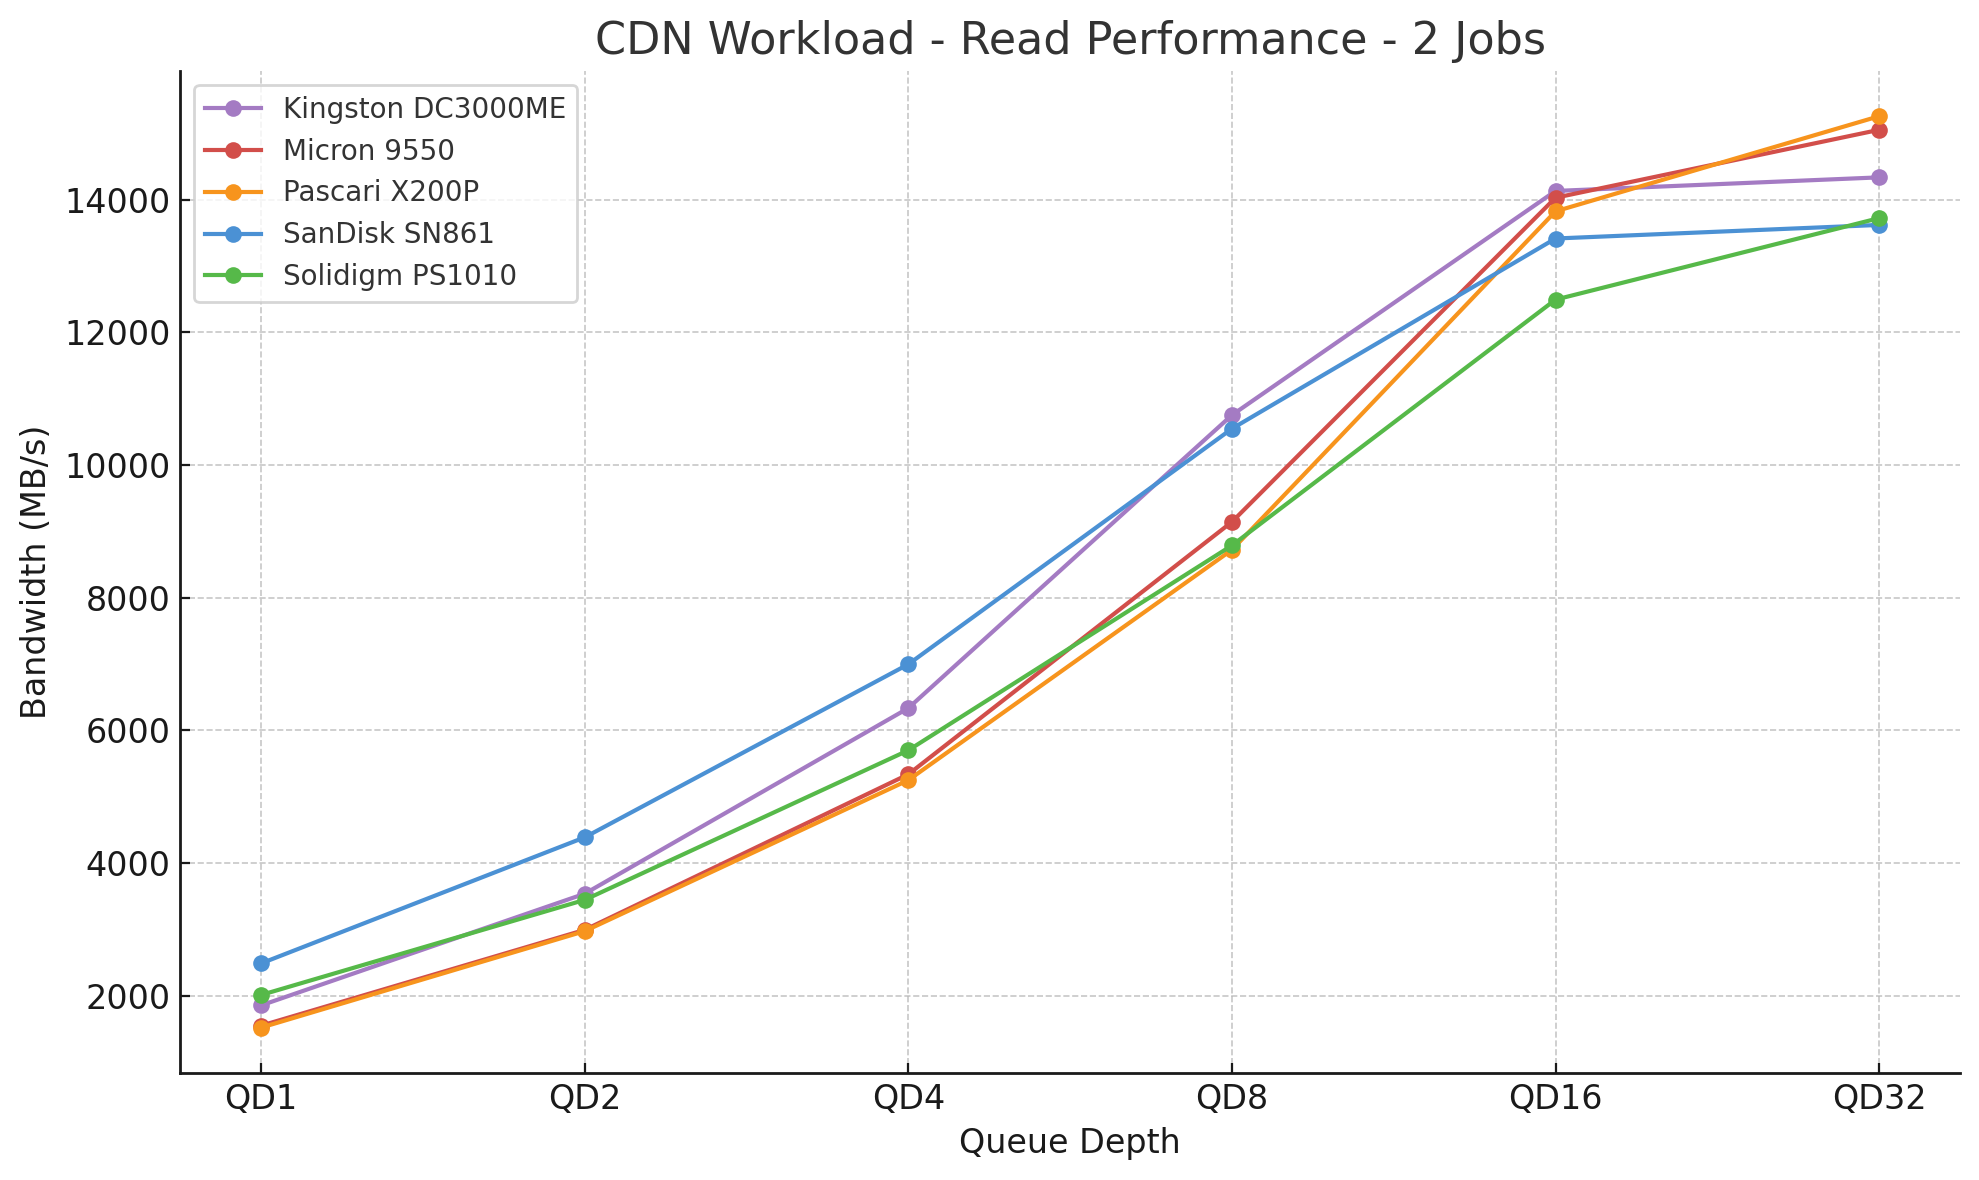
Con due processi applicati, il Pascari X200P parte dal fondo della classifica al QD1 con 1,519 MB/s, ma scala costantemente all'aumentare della profondità della coda. L'unità continua a migliorare nei QD2 e QD4 e, all'8° QD, riduce il distacco dai leader. Al QD32, il Pascari X200P si classifica al primo posto assoluto con 15,257.6 MB/s, davanti a Micron 9550, Kingston DC3000ME, Solidigm PS1010 e SanDisk SN861.
Lettura del carico di lavoro CDN 4
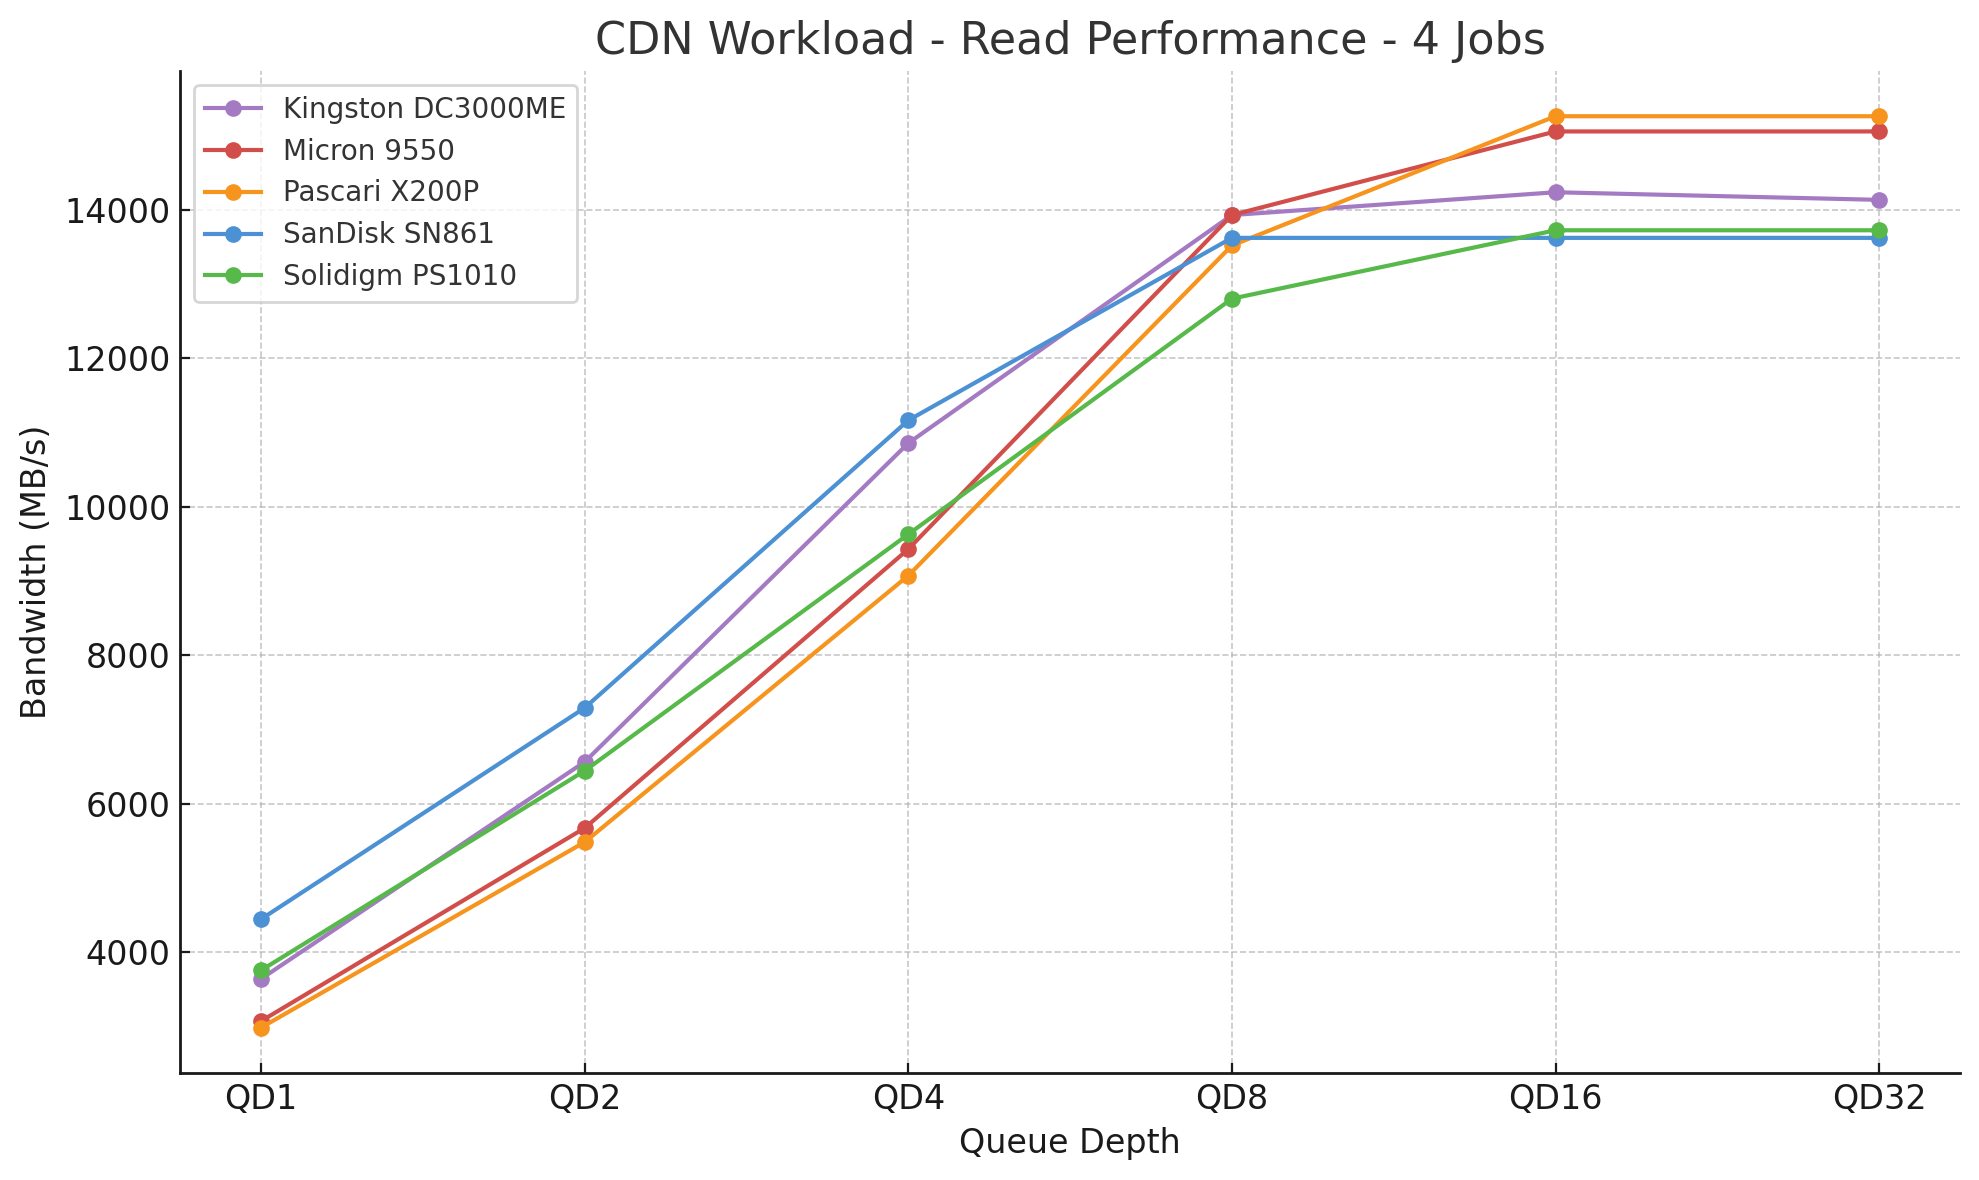
Con quattro processi applicati, il Pascari X200P mostra ancora una volta un'ottima scalabilità nelle profondità di coda. L'unità raggiunge una velocità massima di 2,982 MB/s a QD1, in ritardo rispetto a tutte le unità testate, ma guadagna costantemente terreno nelle QD2 e QD4. A QD8, l'X200P inizia a posizionarsi in testa al gruppo e mantiene questa posizione fino a QD16 e QD32. Il Pascari X200P si classifica primo assoluto a QD32 con 15,257.6 MB/s, davanti al Micron 9550 e al Kingston DC3000ME.
Scrittura del carico di lavoro CDN 1
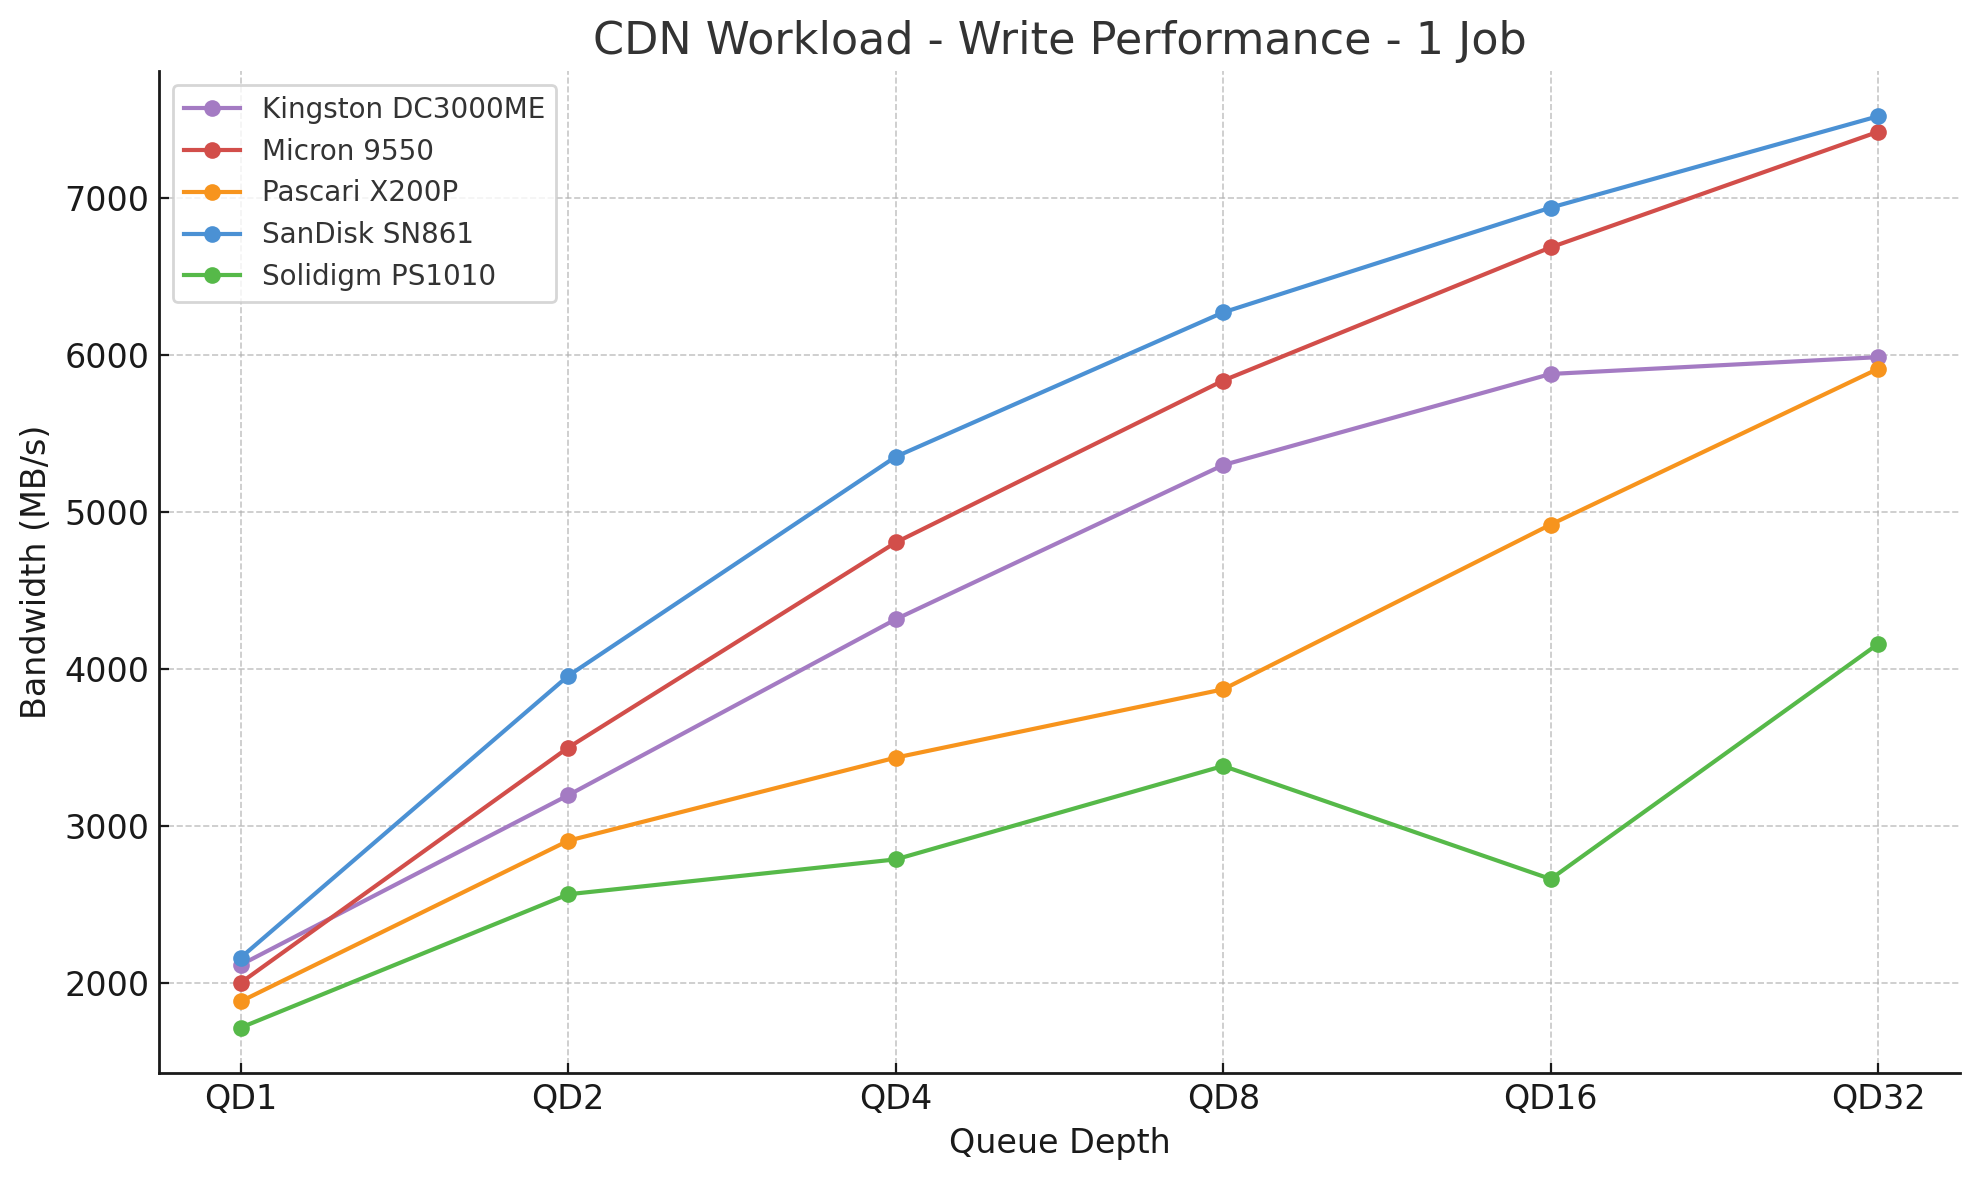
Passando alla scrittura CDN, con un solo processo applicato, il Pascari X200P si posiziona alle spalle del gruppo in questo test di scrittura. L'unità raggiunge una velocità massima di 1,885 MB/s a QD1 e scala gradualmente fino a QD32, classificandosi infine al quarto posto assoluto con 5,913 MB/s. SanDisk SN861 e Micron 9550 guidano questo gruppo, seguiti dal Kingston DC3000ME. Il Pascari X200P mantiene una posizione stabile al quarto posto, con una scalabilità costante, ma mostra prestazioni di scrittura meno aggressive in questo scenario a basso thread.
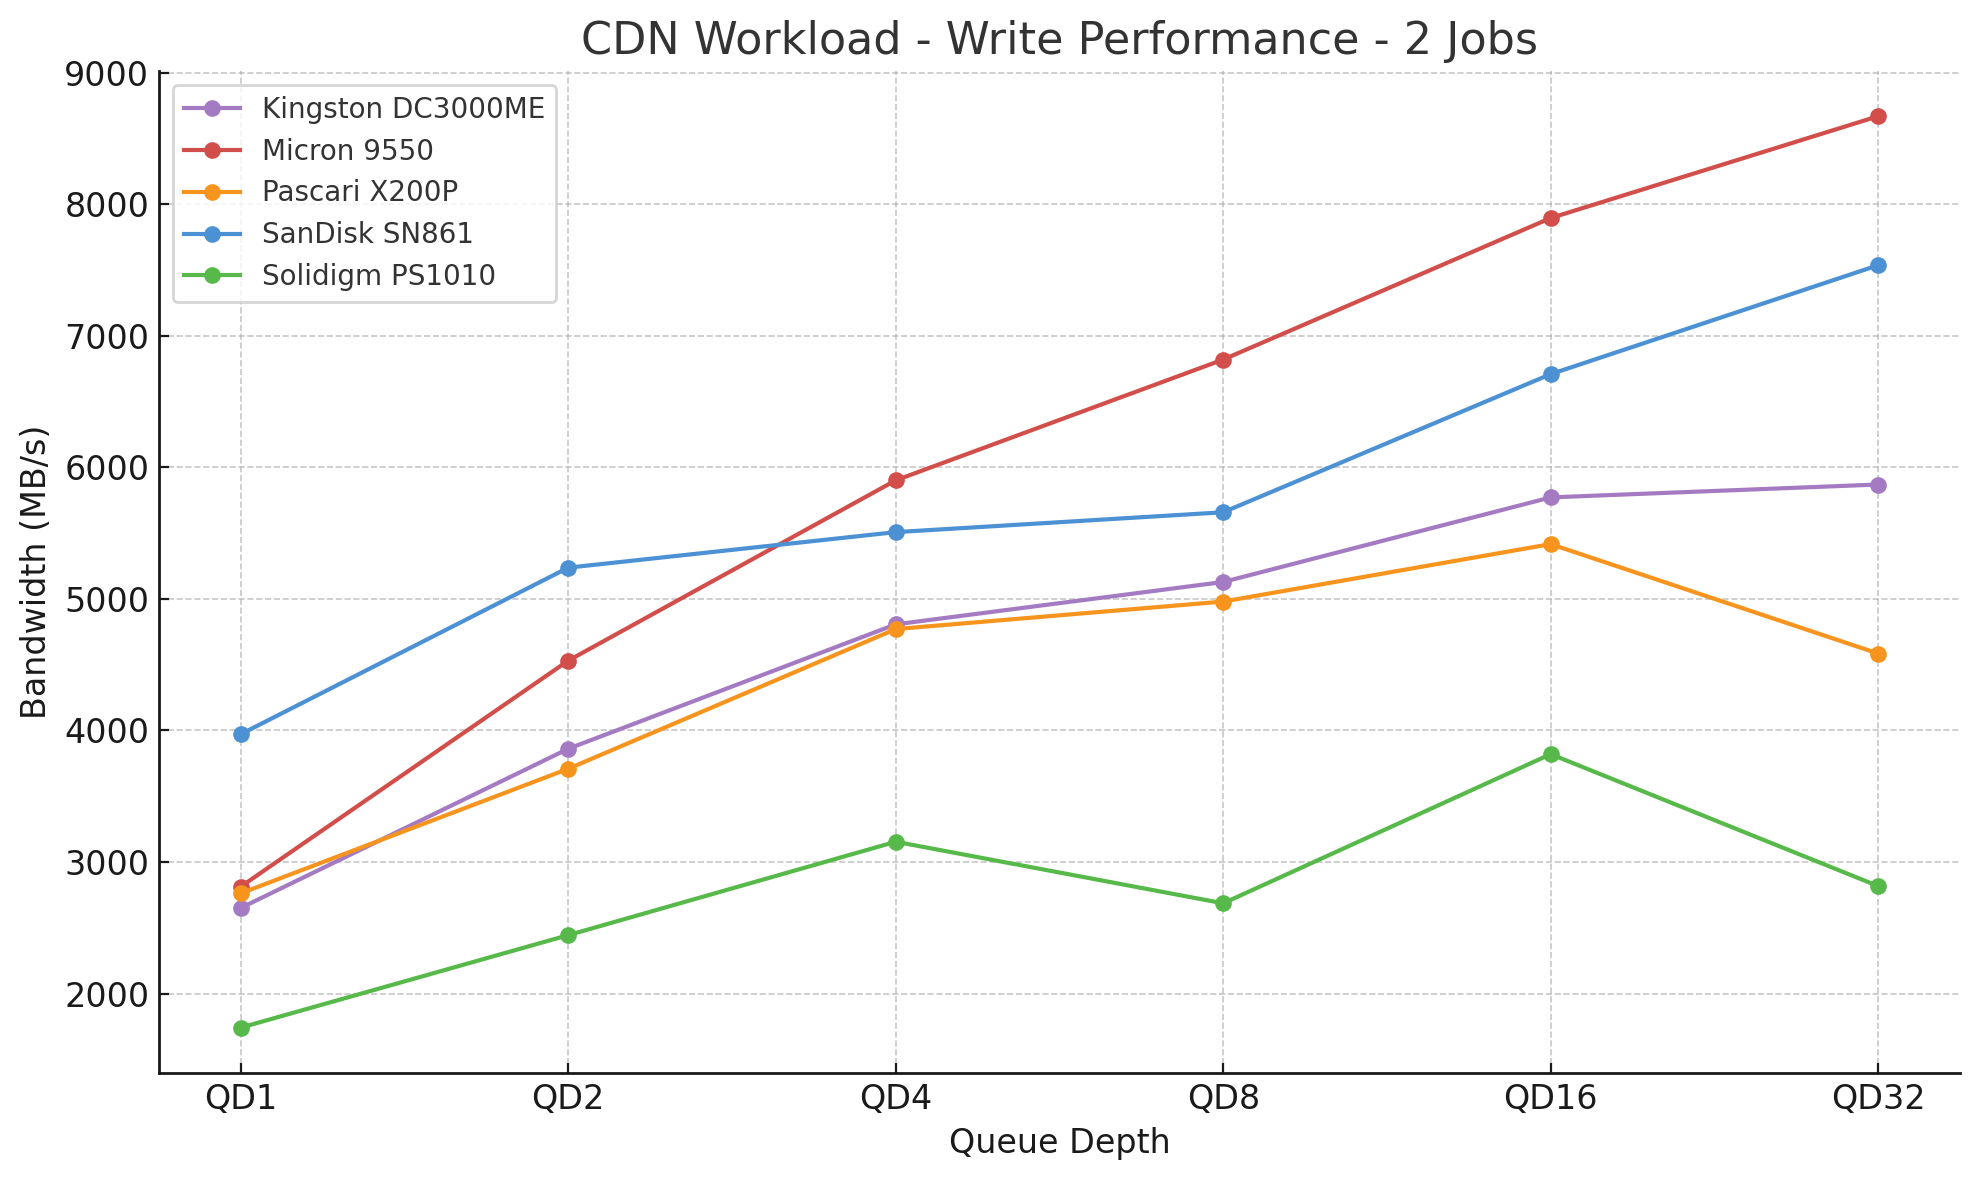
Con due processi applicati, il Pascari X200P si classifica quarto in questo test di scrittura CDN. L'unità raggiunge una velocità massima di 2,762 MB/s a QD1 e scala fino a QD16, ma mostra un certo rallentamento a QD32, dove raggiunge una velocità massima di 4,585 MB/s. Il Micron 9550 e il SanDisk SN861 sono in testa, seguiti dal Kingston DC3000ME. L'X200P mantiene prestazioni stabili fino a profondità di coda intermedie, ma insegue i leader in questo carico di scrittura a due thread.
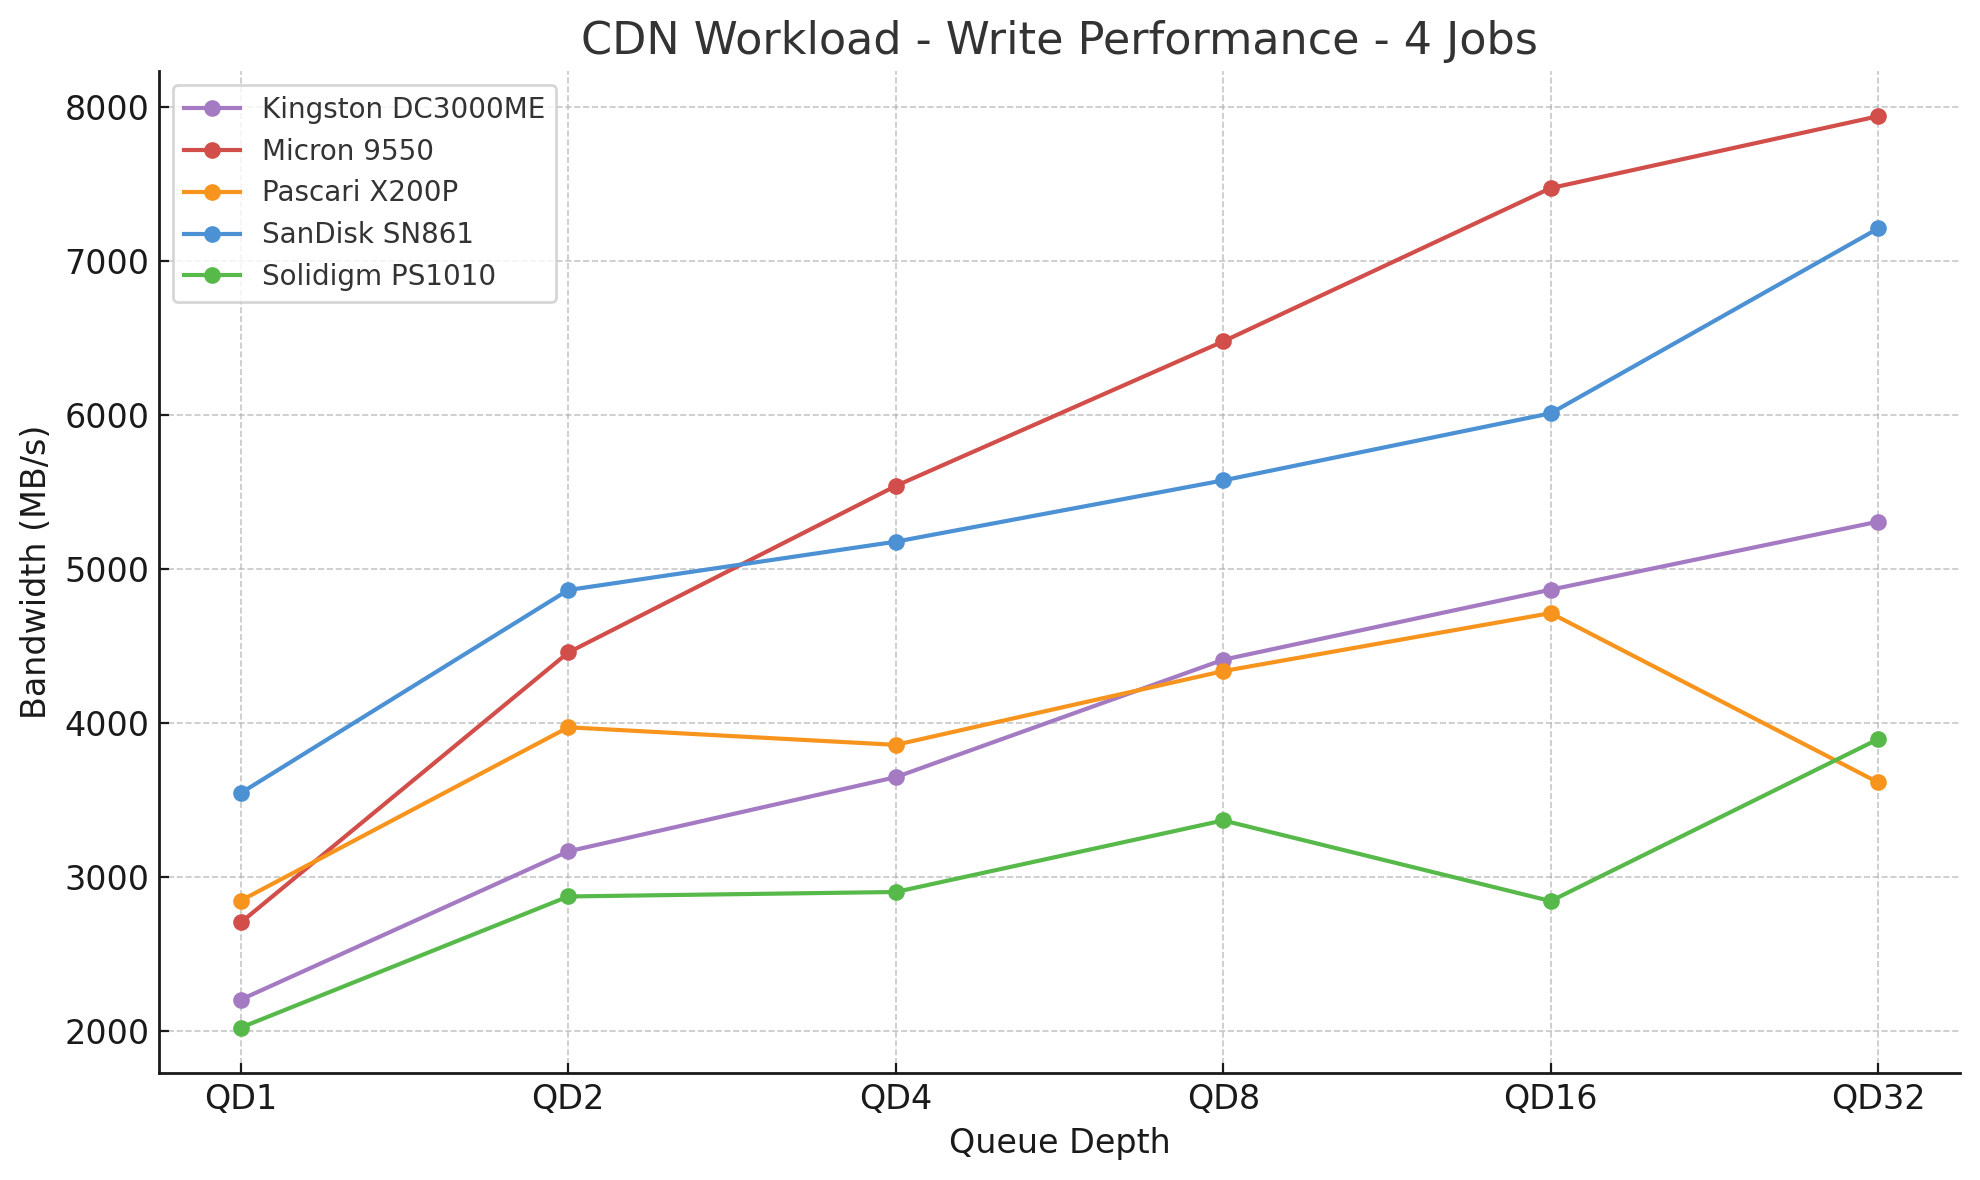
Con quattro processi applicati, il Pascari X200P mantiene prestazioni di fascia media per la maggior parte di questo test di scrittura CDN. L'unità raggiunge un throughput massimo di 2,845 MB/s a QD1 e rimane competitiva con il Kingston DC3000ME e il Solidigm PS1010 fino a profondità di coda intermedie. A QD32, l'X200P cala leggermente, classificandosi quinto nella classifica generale con 3,613 MB/s. Il Micron 9550 e il SanDisk SN861 guidano la classifica, mentre il Kingston DC3000ME si mantiene al terzo posto. Nell'intera gamma, l'X200P offre una scalabilità in scrittura costante con carichi moderati, ma mostra alcuni limiti a profondità di coda più elevate in questo carico di lavoro a quattro thread.
Benchmark di checkpointing DLIO
Per valutare le prestazioni reali degli SSD in ambienti di training AI, abbiamo utilizzato lo strumento di benchmark Data and Learning Input/Output (DLIO). Sviluppato dall'Argonne National Laboratory, DLIO è specificamente progettato per testare i pattern di I/O nei carichi di lavoro di deep learning. Fornisce informazioni su come i sistemi di storage gestiscono sfide come il checkpointing, l'ingestione dei dati e il training dei modelli. Il grafico seguente illustra come entrambe le unità gestiscano il processo attraverso 36 checkpoint. Durante il training di modelli di machine learning, i checkpoint sono essenziali per salvare periodicamente lo stato del modello, prevenendo la perdita di progressi durante interruzioni o interruzioni di corrente. Questa esigenza di storage richiede prestazioni elevate, soprattutto in caso di carichi di lavoro sostenuti o intensivi. Abbiamo utilizzato il benchmark DLIO versione 2.0, rilasciato il 13 agosto 2024.
Per garantire che il benchmarking riflettesse scenari reali, abbiamo basato i test sull'architettura del modello LLAMA 3.1 405B. Abbiamo implementato il checkpointing utilizzando torch.save() per acquisire parametri del modello, stati dell'ottimizzatore e stati dei layer. La nostra configurazione simulava un sistema a otto GPU, implementando una strategia di parallelismo ibrido con parallelismo tensoriale a 4 vie ed elaborazione parallela a pipeline bidirezionale distribuita sulle otto GPU. Questa configurazione ha prodotto dimensioni dei checkpoint pari a 2 GB, rappresentative dei moderni requisiti di addestramento di modelli linguistici di grandi dimensioni.
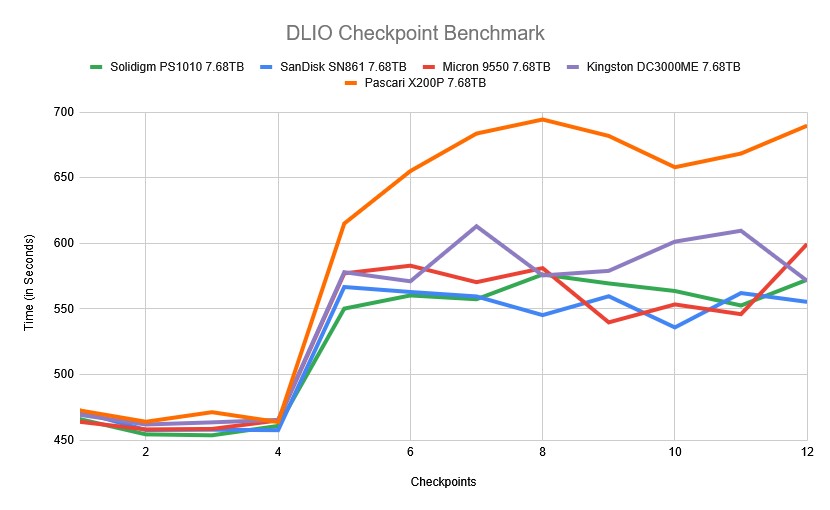
Nel benchmark DLIO Checkpoint, l'SSD Pascari X200P dimostra un'ottima reattività iniziale, ma mostra tempi di checkpoint più lunghi con l'intensificarsi del carico di lavoro. Nei primi passaggi (Checkpoint 1–4), l'X200P si mantiene vicino al resto del gruppo, con una media di 467 secondi, tenendo il passo con unità come Solidigm PS1010 e Micron 9550.
Tuttavia, a metà del benchmark (Checkpoint 5-9), le prestazioni dell'X200P iniziano a divergere. I tempi di checkpoint dell'unità aumentano bruscamente, raggiungendo un picco di 689.68 secondi al Checkpoint 12, il più alto del gruppo. Negli ultimi tre checkpoint, l'X200P registra una media di 672 secondi, circa il 19.3% in meno rispetto all'unità successiva più lenta (Kingston DC3000ME) e il 23% in meno rispetto alla media del gruppo.
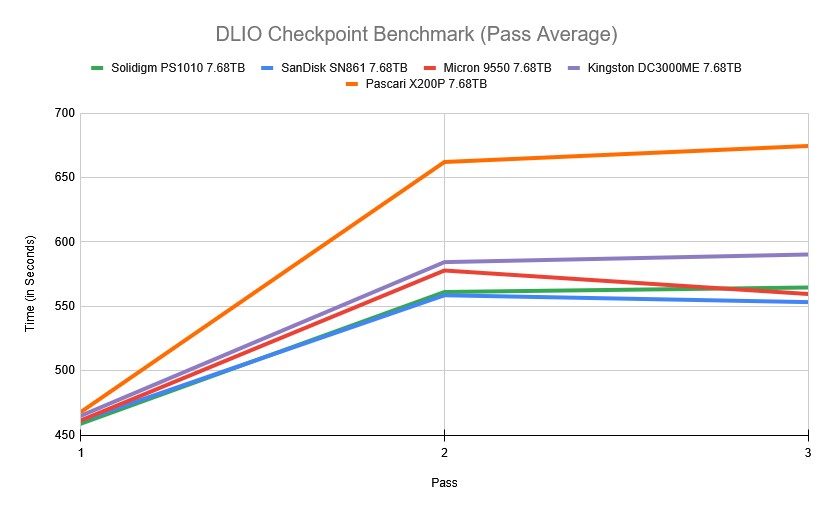
Osservato attraverso la lente delle medie dei passaggi, l'X200P illustra una chiara traiettoria di degrado delle prestazioni nel tempo. Nel Passaggio 1, il drive ha registrato una media di 467.93 secondi, posizionandosi leggermente dietro al resto del gruppo, ma comunque entro un margine competitivo.
Nel secondo passaggio, l'X2P si è nettamente discostato dal gruppo, registrando 200 secondi, ovvero il 662.04% in meno rispetto al secondo disco più lento (Kingston DC14.5ME) e il 3000% in meno rispetto alla media del gruppo per quel passaggio. Questa tendenza è continuata anche nel terzo passaggio, dove ha registrato 17.4 secondi, mantenendo la posizione di disco più lento. Rispetto alla media degli altri quattro dischi (circa 3 secondi), l'X674.48P è stato più lento del 567%.
Benchmark delle prestazioni FIO
Per misurare le prestazioni di storage di ogni SSD in base a parametri di settore comuni, utilizziamo FIO. Ogni unità viene sottoposta allo stesso processo di test, che include una fase di precondizionamento con due riempimenti completi dell'unità con un carico di lavoro di scrittura sequenziale, seguita dalla misurazione delle prestazioni in stato stazionario. Man mano che il tipo di carico di lavoro misurato cambia, eseguiamo un altro riempimento di precondizionamento con la nuova dimensione di trasferimento.
In questa sezione ci concentreremo sui seguenti benchmark FIO:
- Sequenziale 128K
- 64K casuale
- 16K casuale
- 4K casuale
Precondizione sequenziale 128K (IODepth 256 / NumJobs 1)
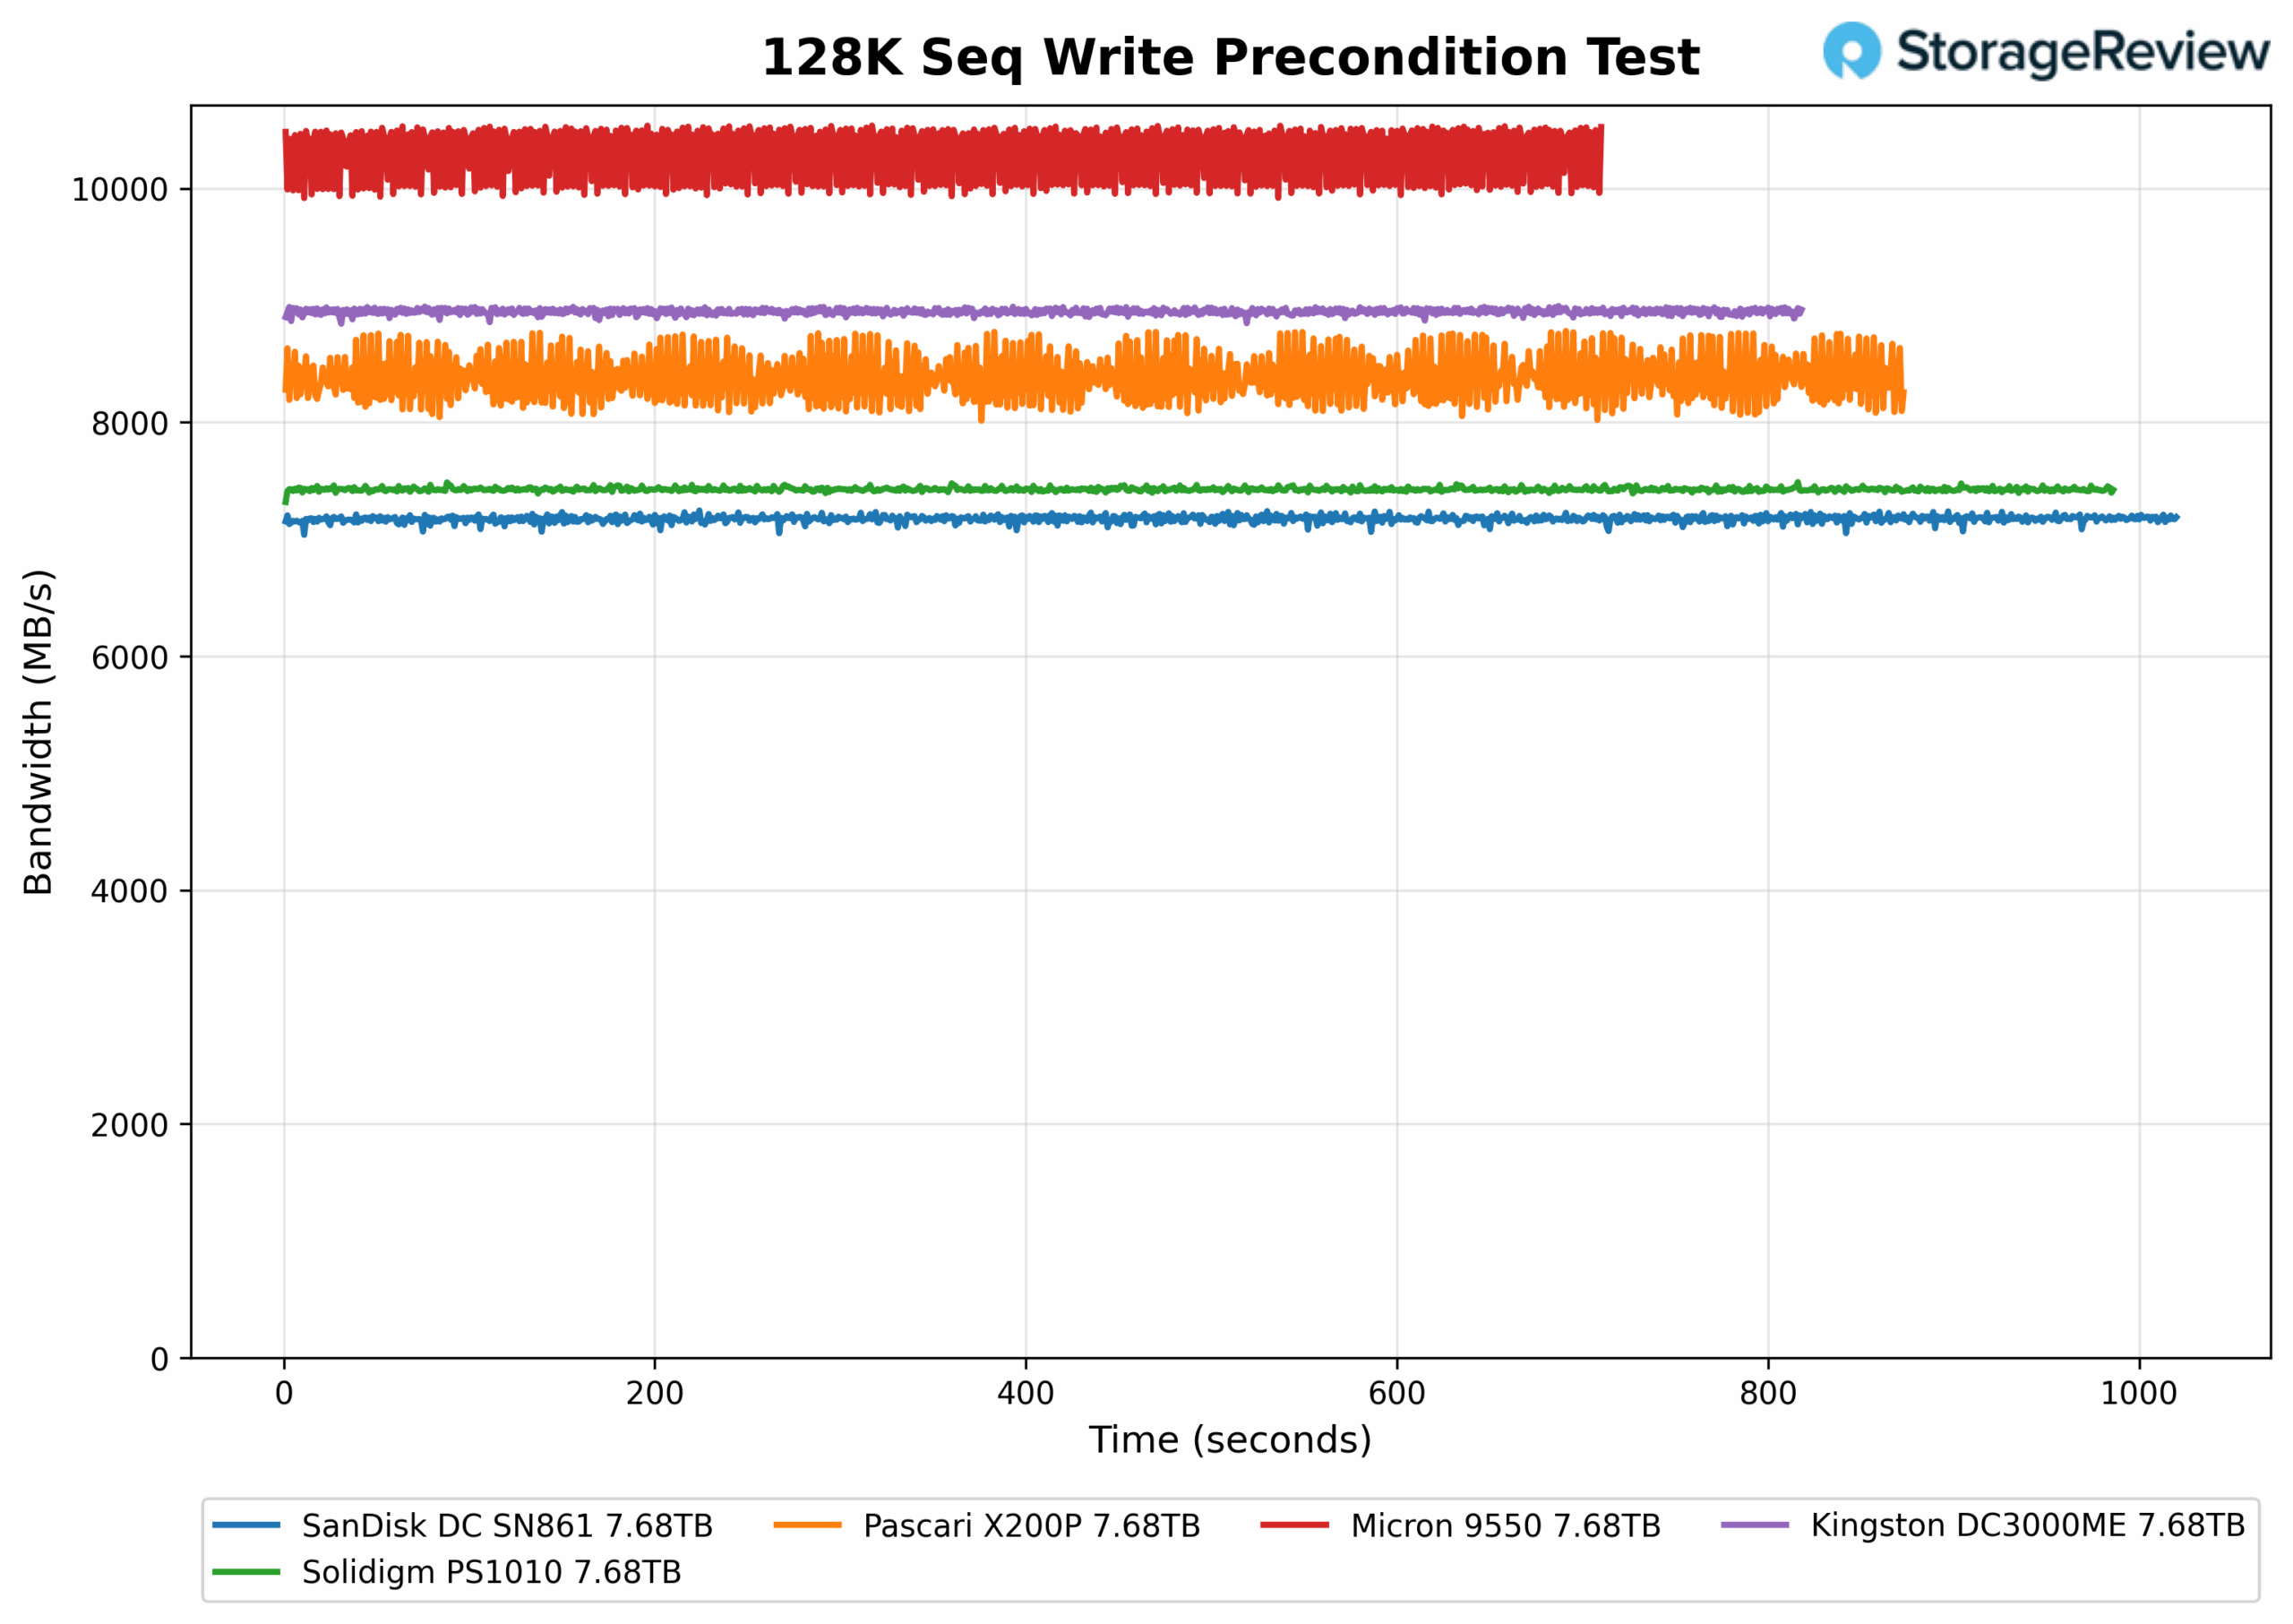
Nel test di precondizione della scrittura sequenziale a 128K, l'X200P si classifica terzo nella classifica generale, con una larghezza di banda media di 8,371 MB/s. Pur mantenendo ottime prestazioni, l'unità mostra una leggera e ricorrente fluttuazione della larghezza di banda, a indicare una minore costanza rispetto alle linee più piatte e stabili del Micron 9550 e del Kingston DC3000ME, che lo precedono.
Latenza precondizione sequenziale 128K (IODepth 256 / NumJobs 1)
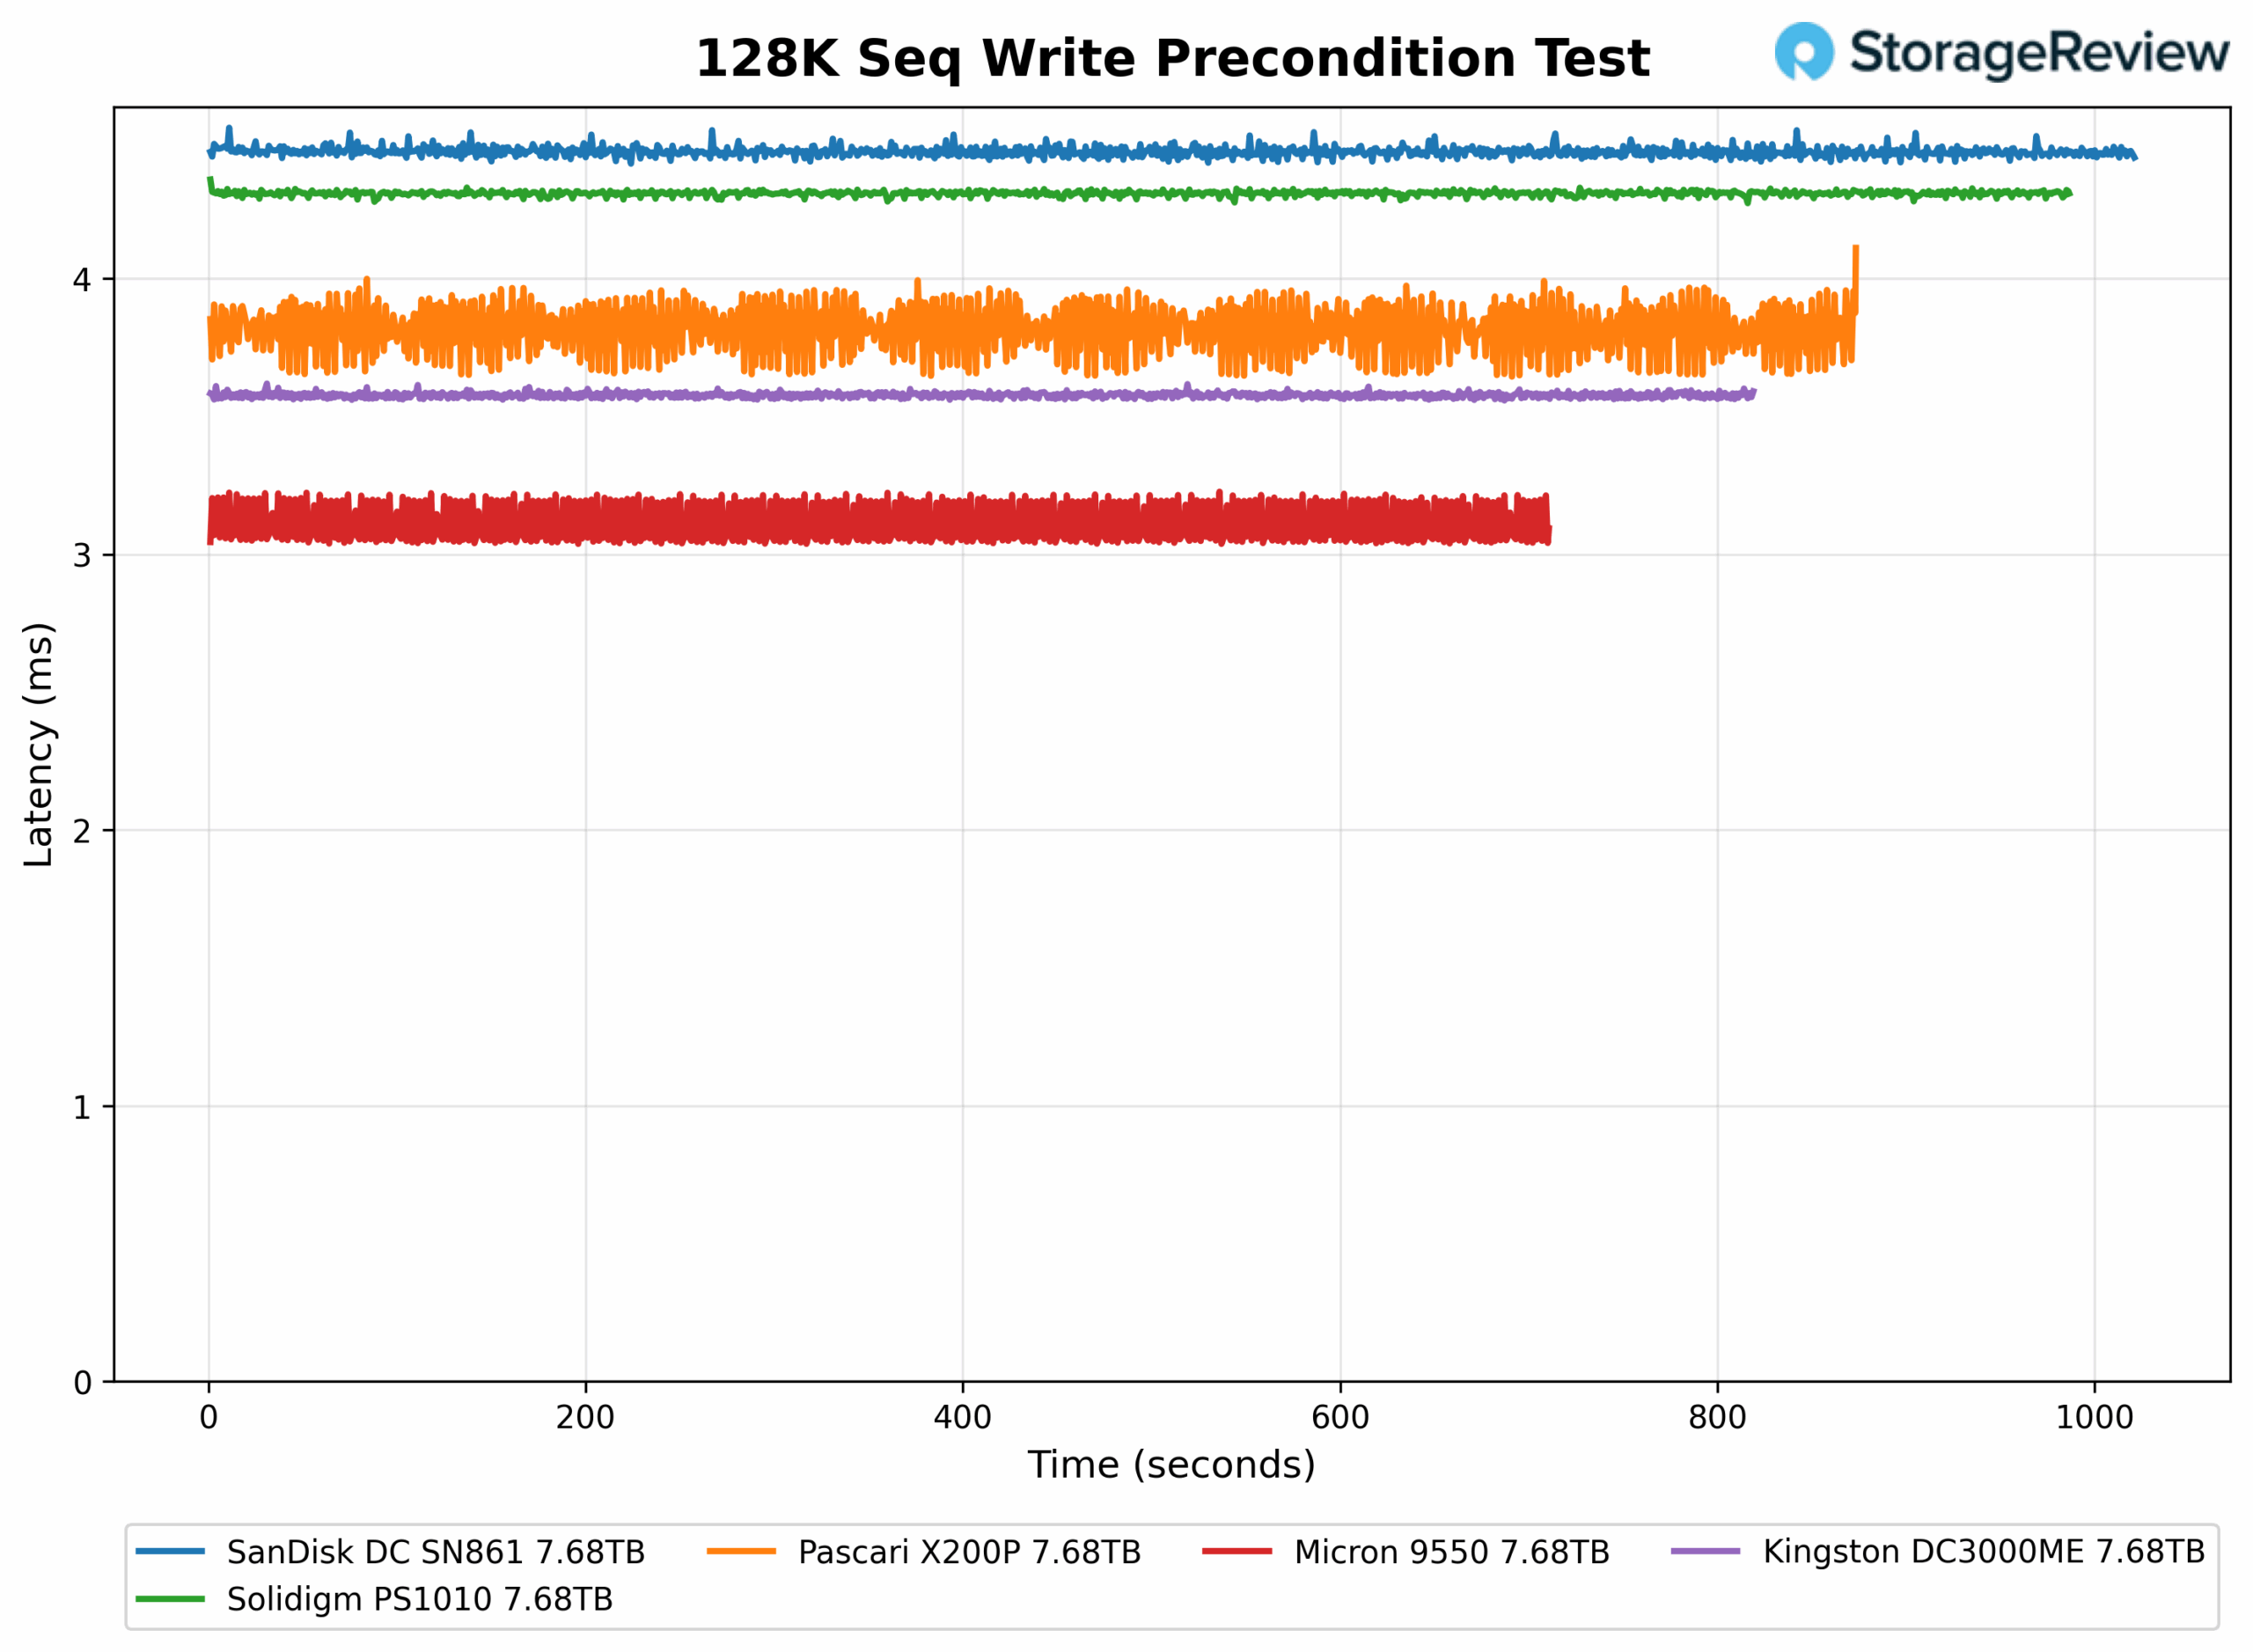
Nel test di latenza delle precondizioni di scrittura sequenziale a 128K, l'X200P ha registrato una latenza media di 3.822 ms, posizionandosi al terzo posto assoluto. Si posiziona dietro al Micron 9550 e al Kingston DC3000ME. Analogamente al suo andamento della larghezza di banda, il Pascari mostra lievi fluttuazioni di latenza, a indicare una certa variabilità durante le scritture prolungate, pur mantenendo una solida posizione di livello superiore.
Scrittura sequenziale 128K (IODepth 16 / NumJobs 1)
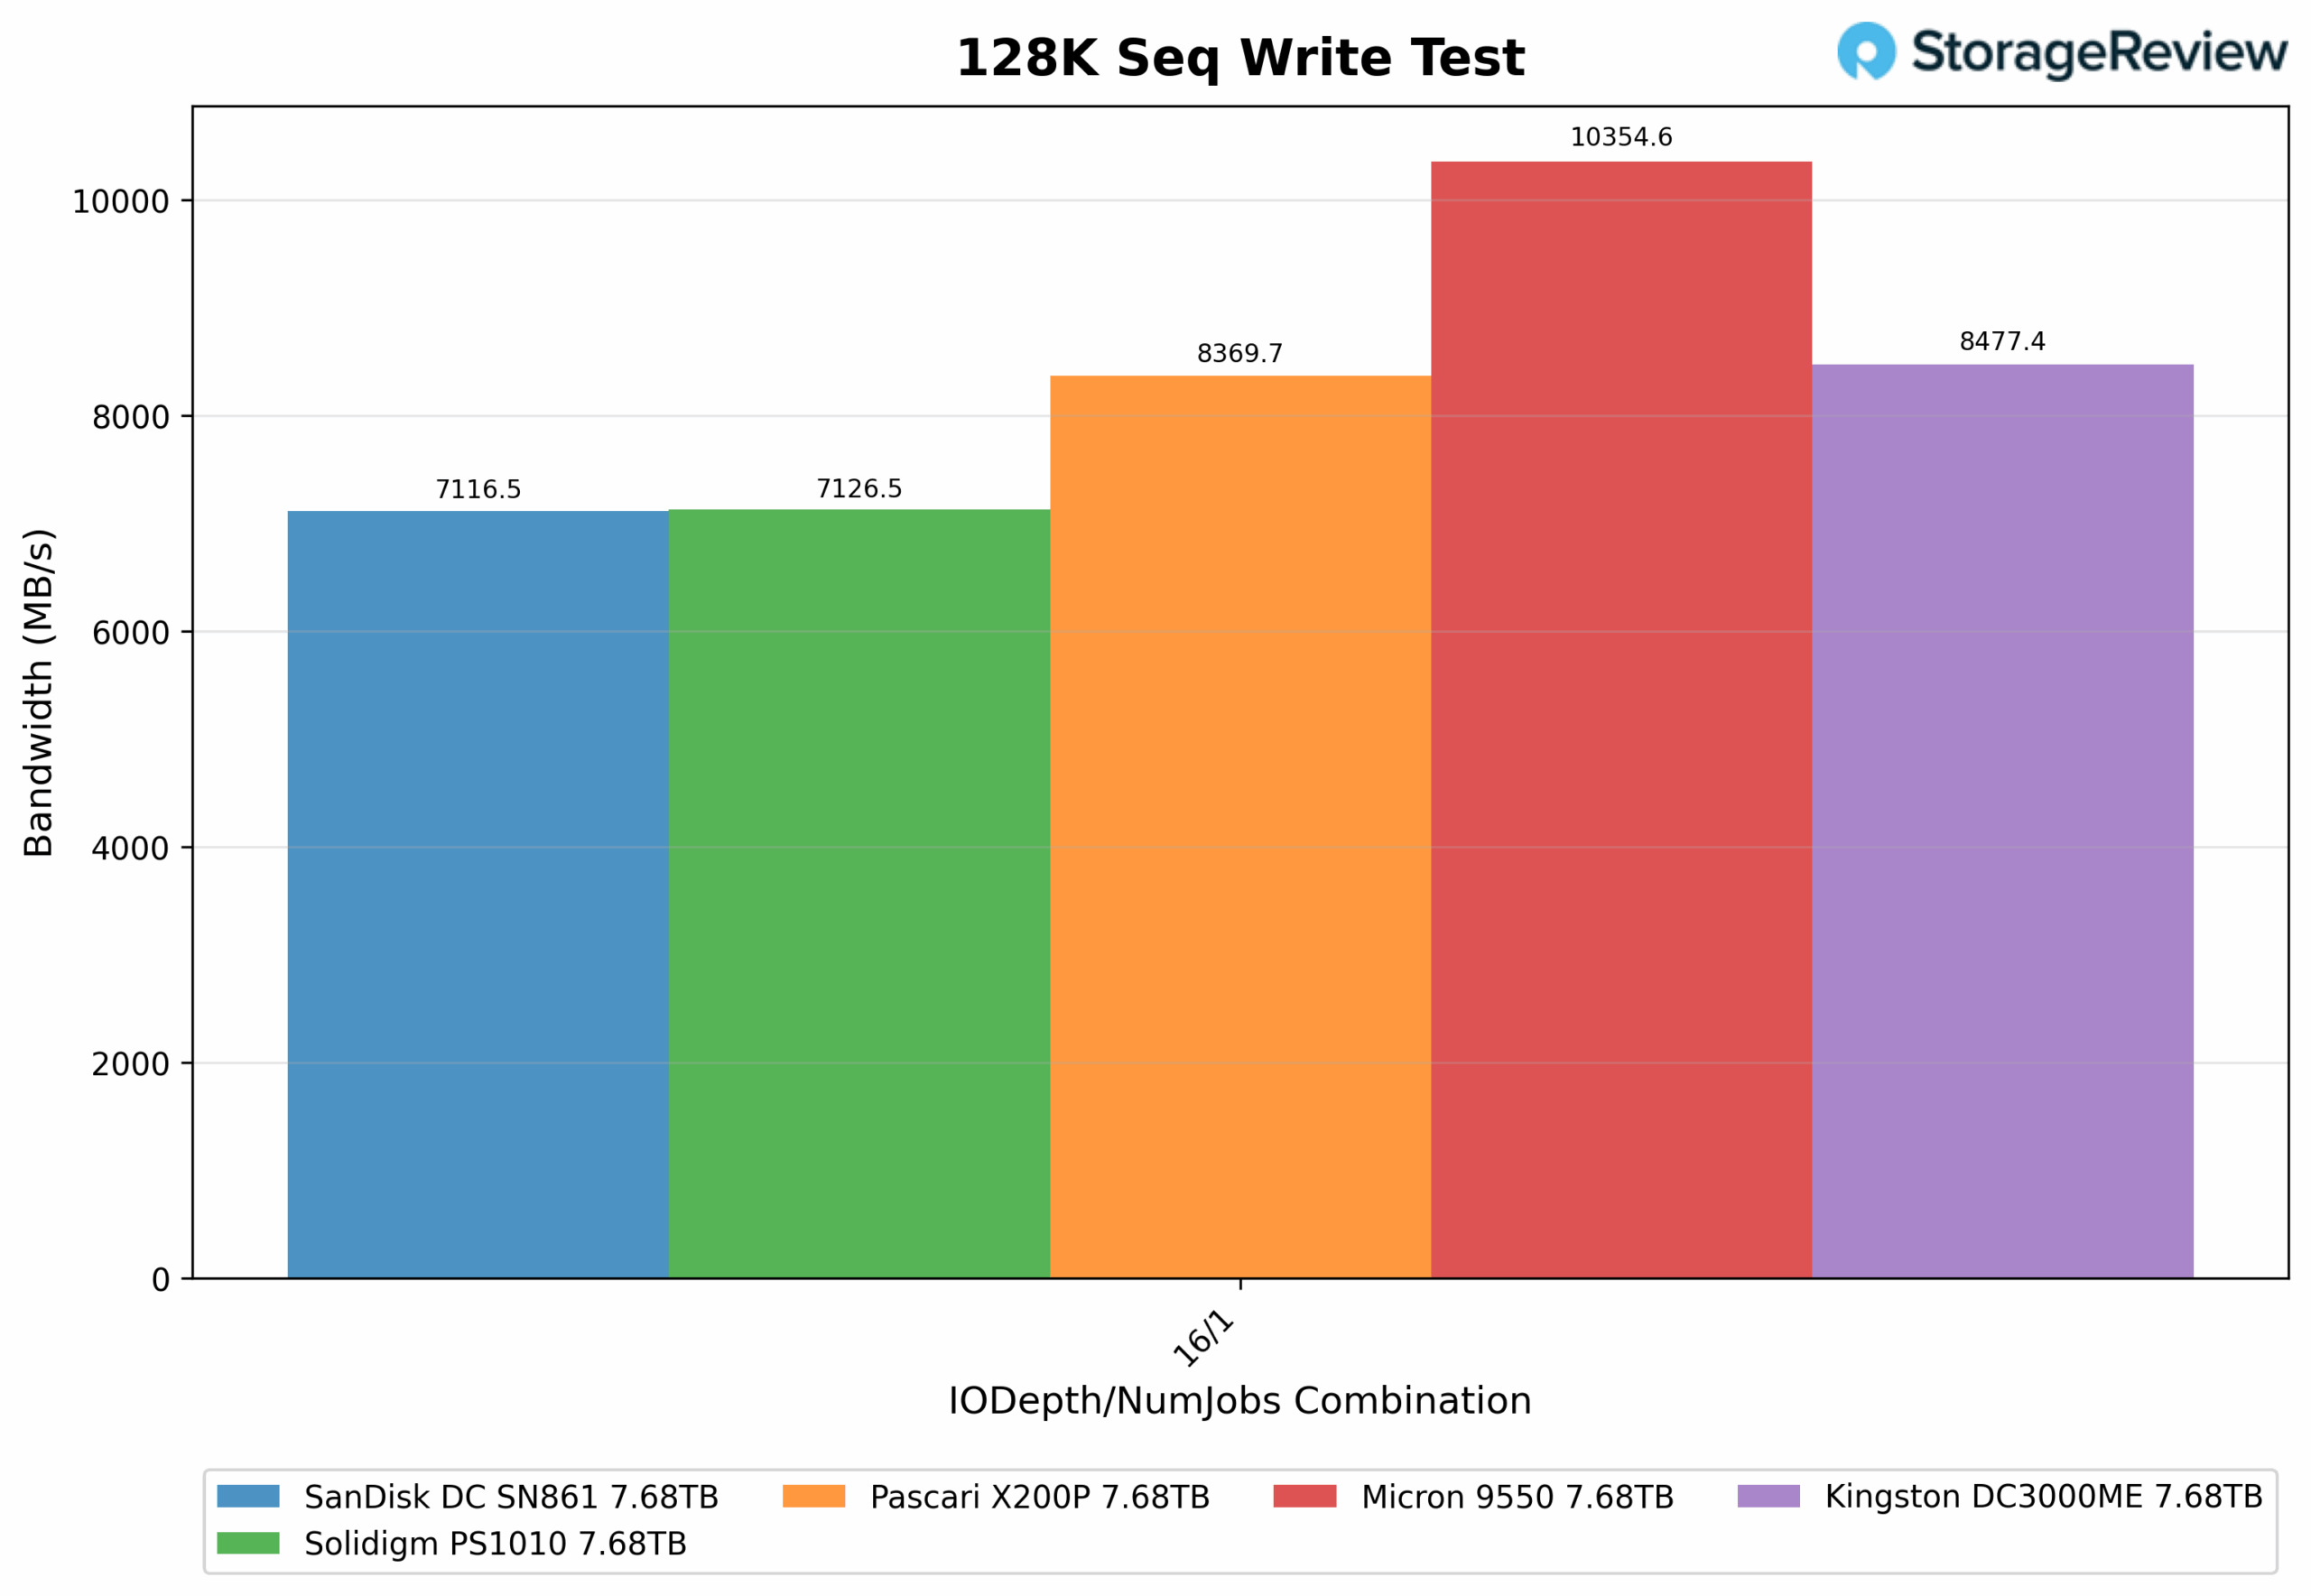
Nel test di scrittura sequenziale a 128K, l'X200P ha raggiunto una larghezza di banda media di 8369.7 MB/s, posizionandosi al terzo posto nella classifica generale. Si piazza dietro al Micron 9550 e al Kingston DC3000ME, ma davanti al Solidigm PS1010 e al SanDisk SN861.
Latenza di scrittura sequenziale 128K (IODepth 16 / NumJobs 1)
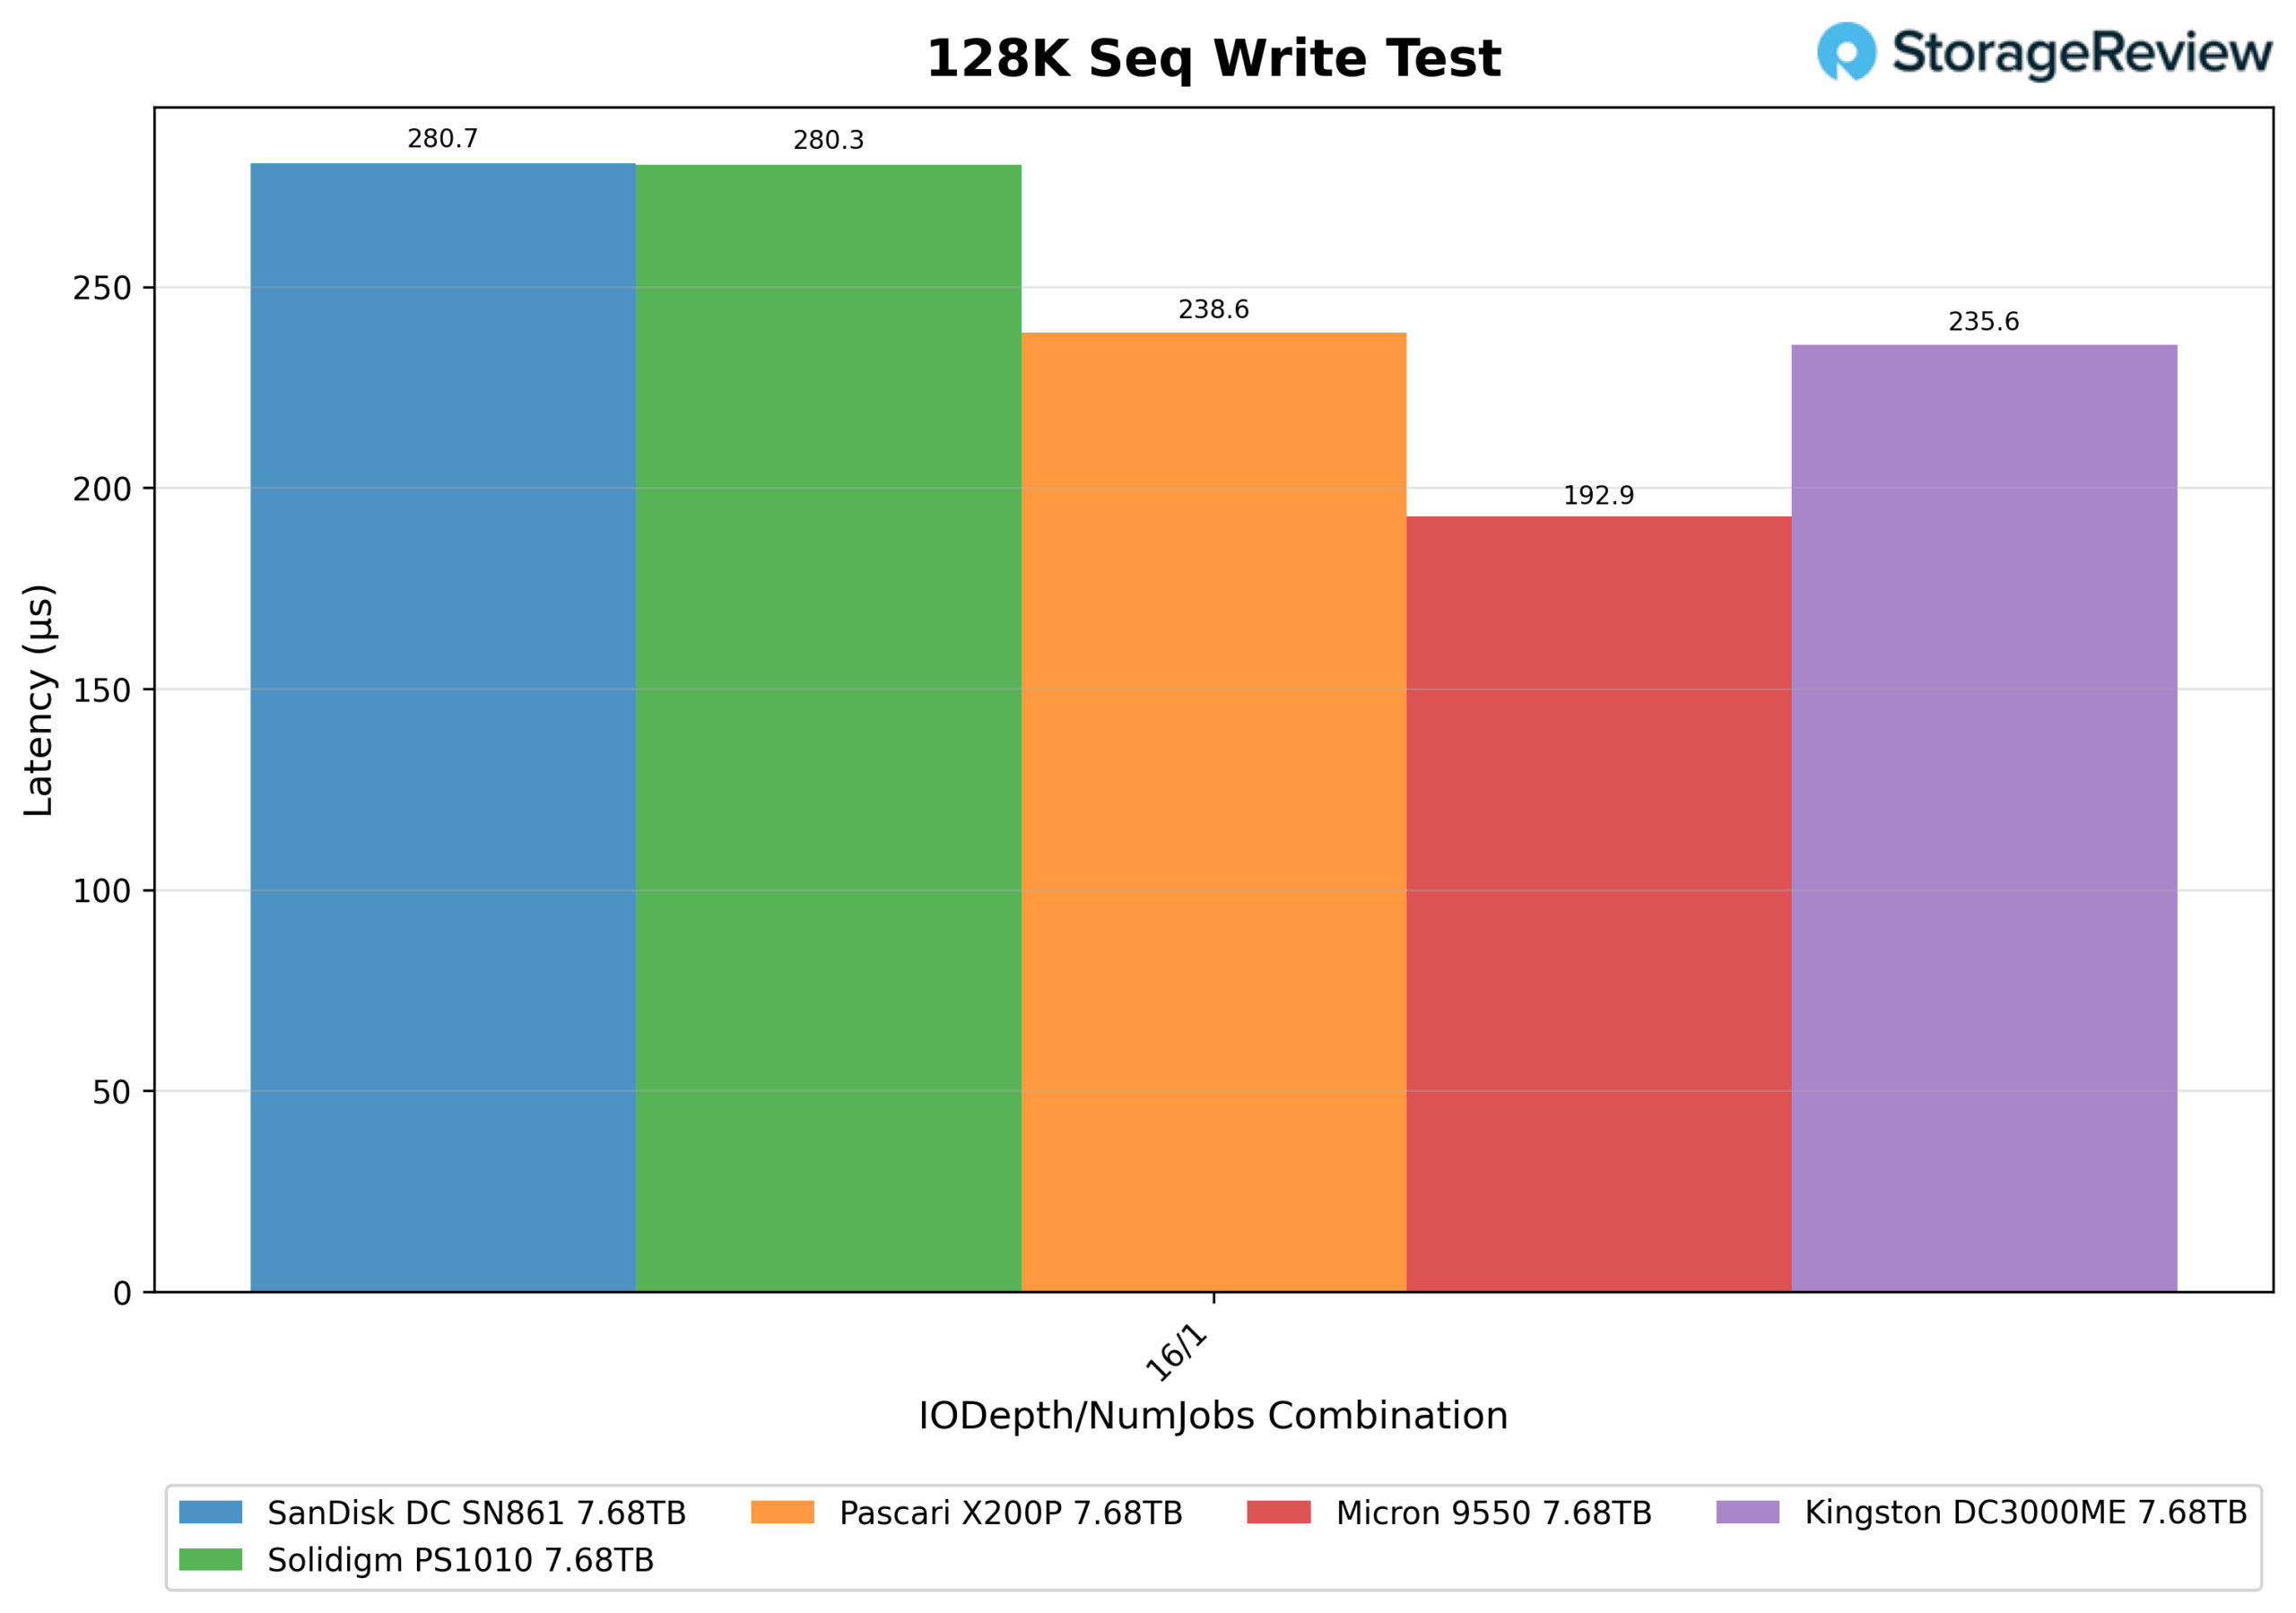
Nella classifica di latenza del test di scrittura sequenziale a 128K, l'X200P ha registrato una latenza media di 0.238 ms. Questo lo colloca al quarto posto assoluto, subito dietro al Kingston DC3000ME (0.235 ms) e davanti al Solidigm PS1010 e al SanDisk SN861. Sebbene la sua latenza sia inferiore alla maggior parte, rimane comunque dietro al Micron 9550, il migliore in termini di prestazioni.
Lettura sequenziale 128K (IODepth 64 / NumJobs 1)
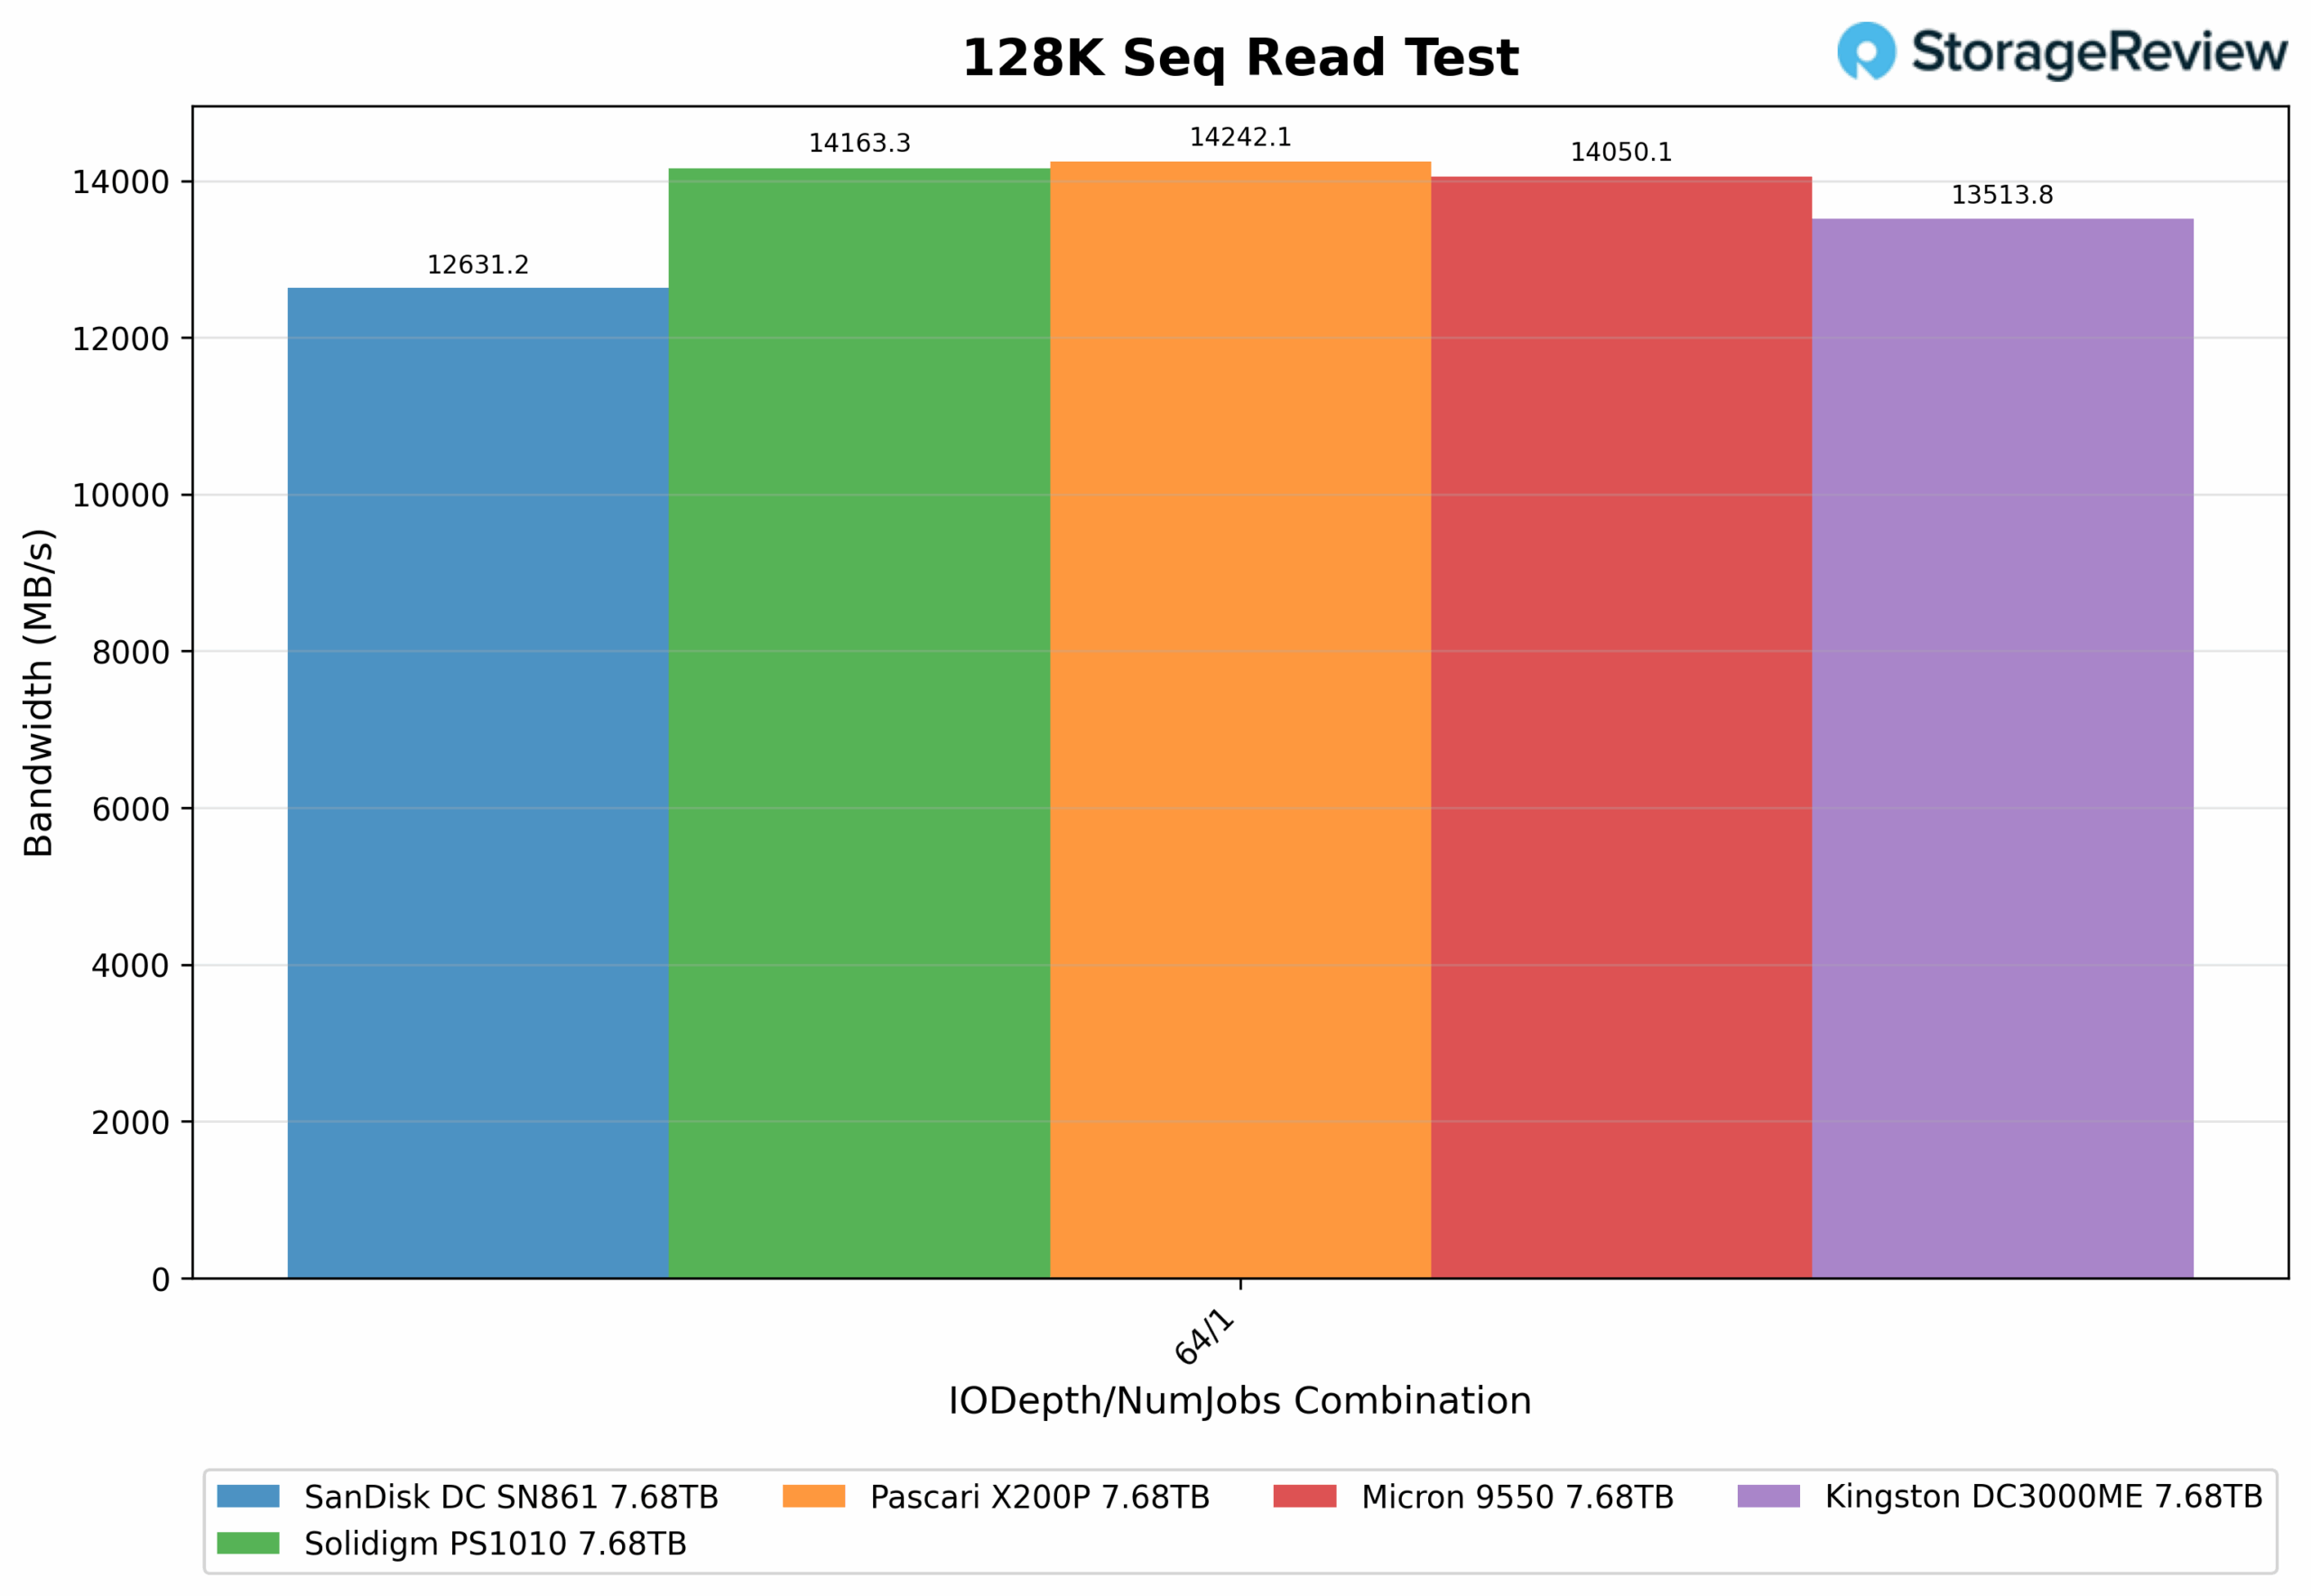
Nel test di lettura sequenziale a 128K, l'X200P si è classificato al primo posto assoluto con una larghezza di banda di 14,242.1 MB/s, superando di poco il Solidigm PS1010 e il Micron 9550. È al primo posto in termini di throughput di lettura, mostrando prestazioni eccellenti anche con profondità di coda elevate.
Latenza di lettura sequenziale 128K (IODepth 64 / NumJobs 1)
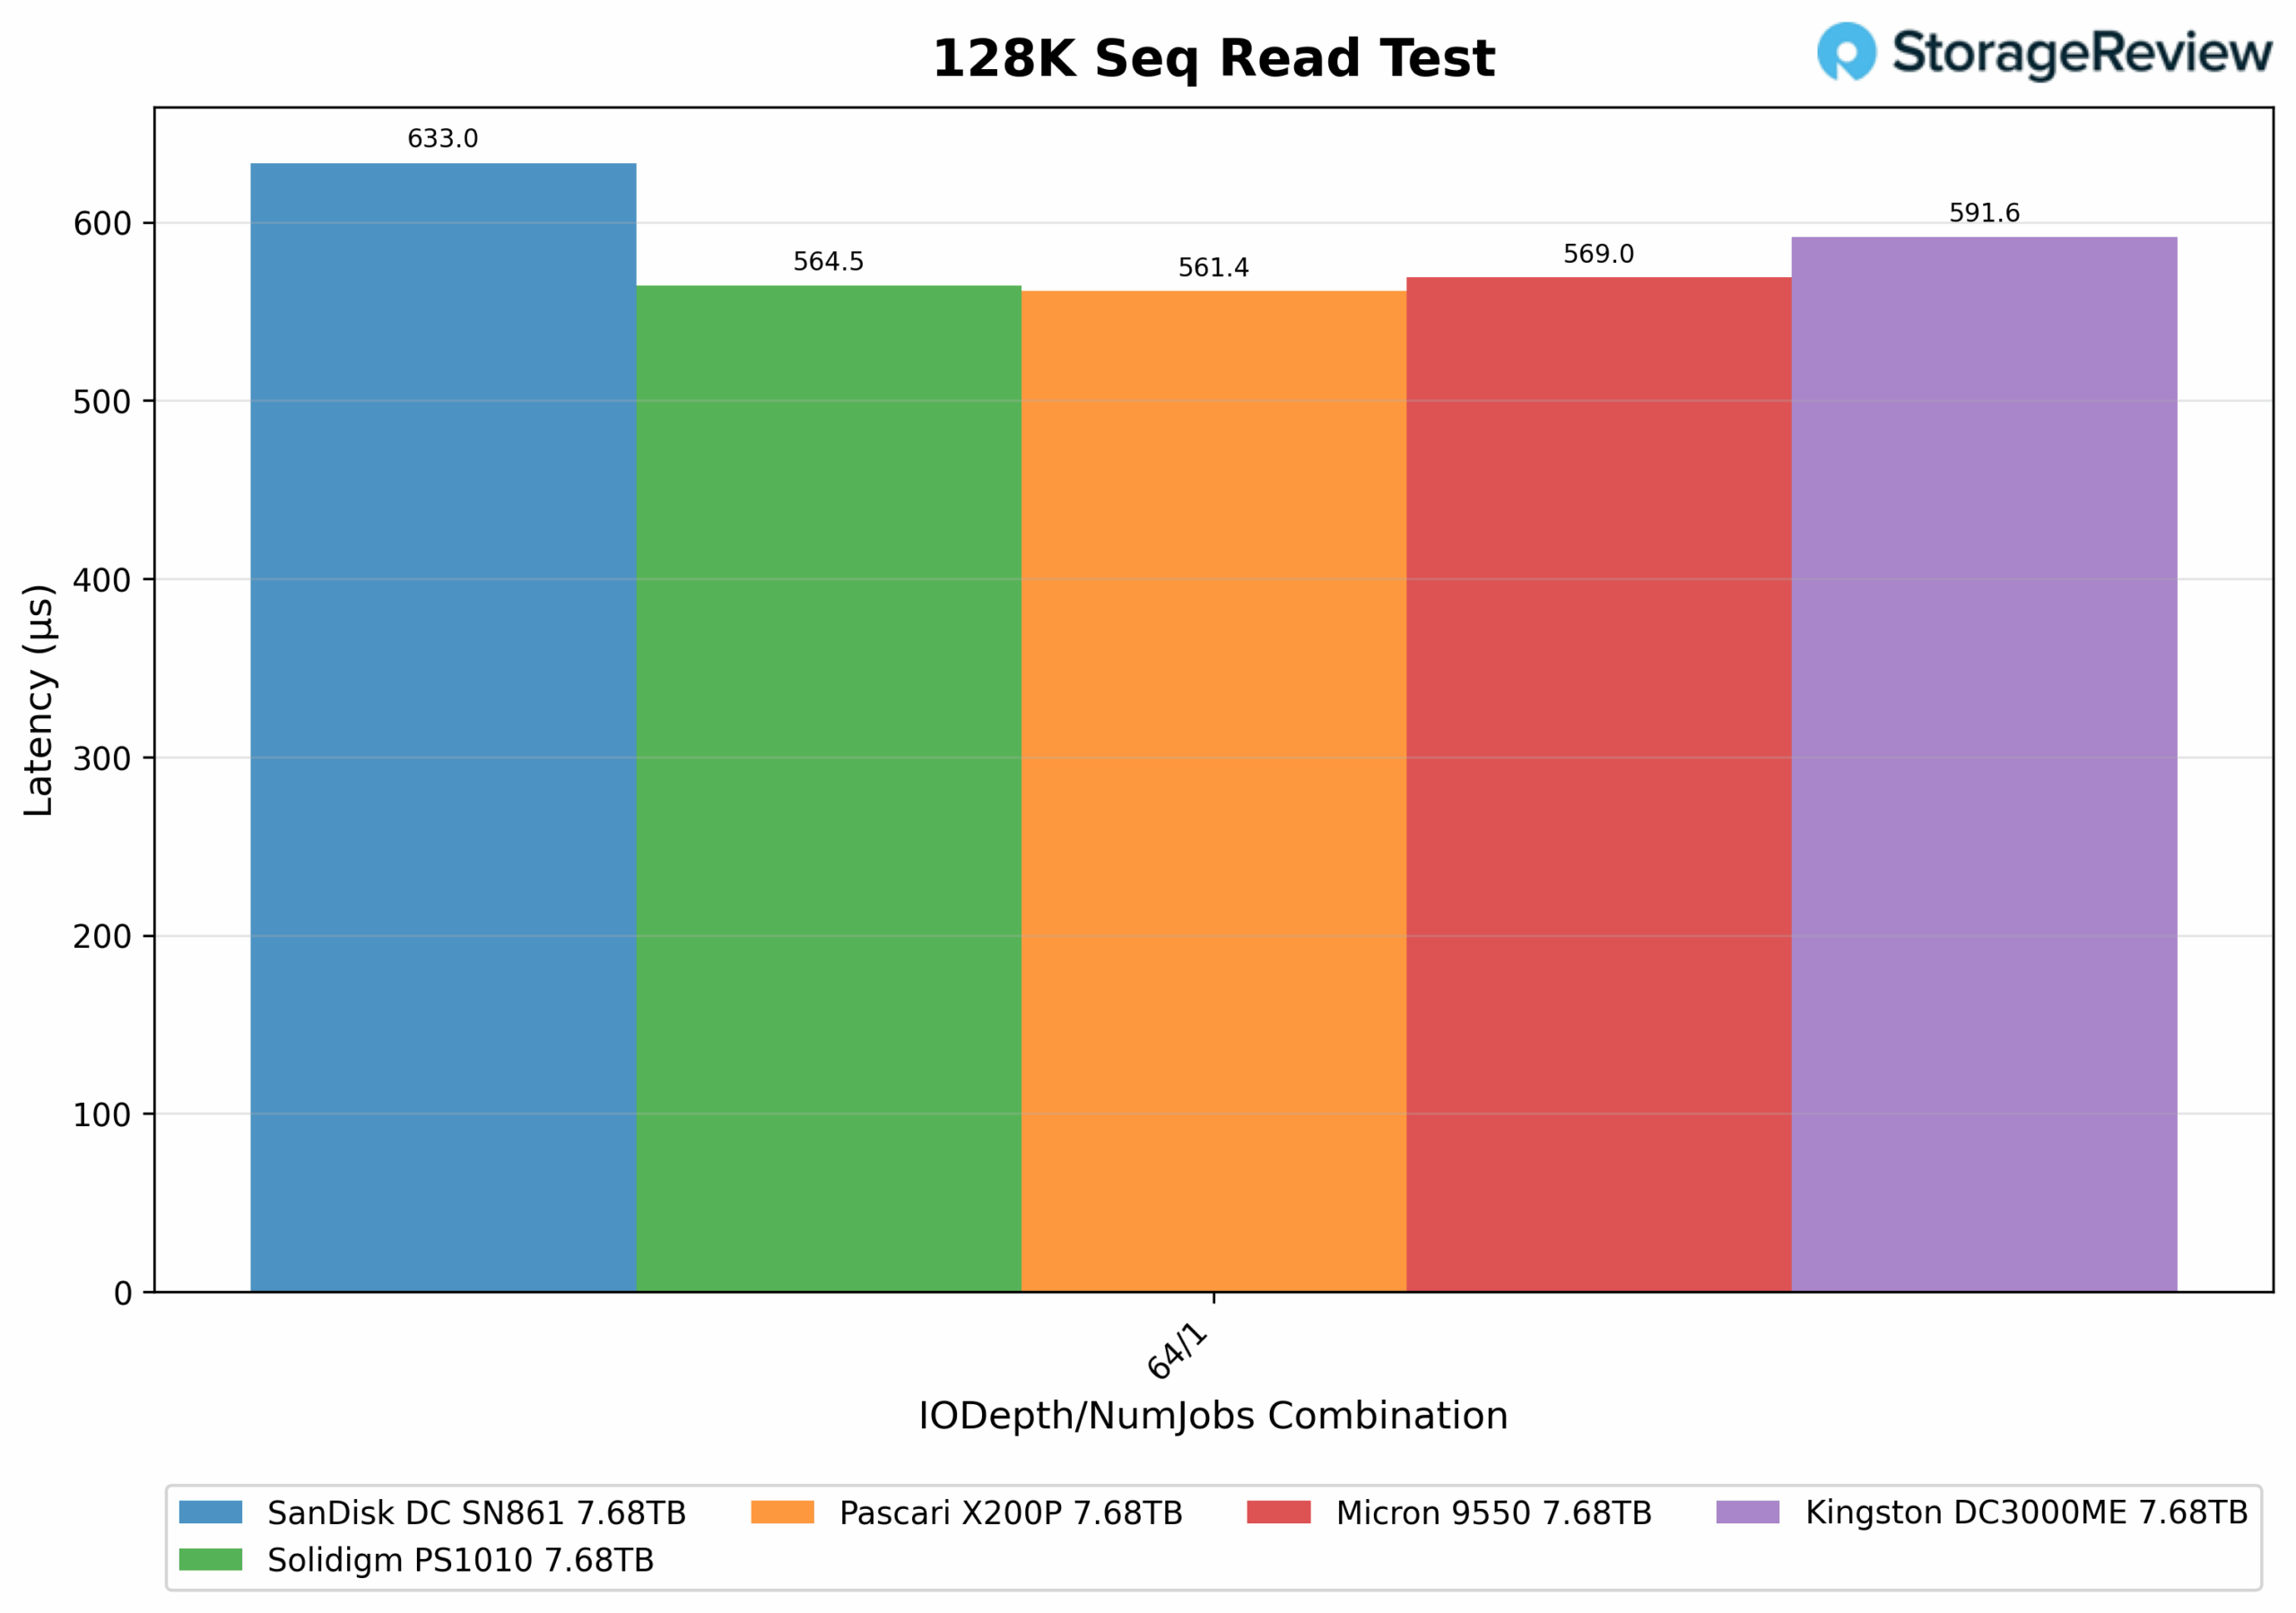
Nel grafico di latenza del test di lettura sequenziale a 128K, l'X200P ha registrato una latenza media di 561.4 ms, posizionandosi al secondo posto in termini di latenza complessiva. È leggermente inferiore al Solidigm PS1010 e supera Micron 9550, Kingston DC3000ME e SanDisk SN861.
Scrittura casuale 64K
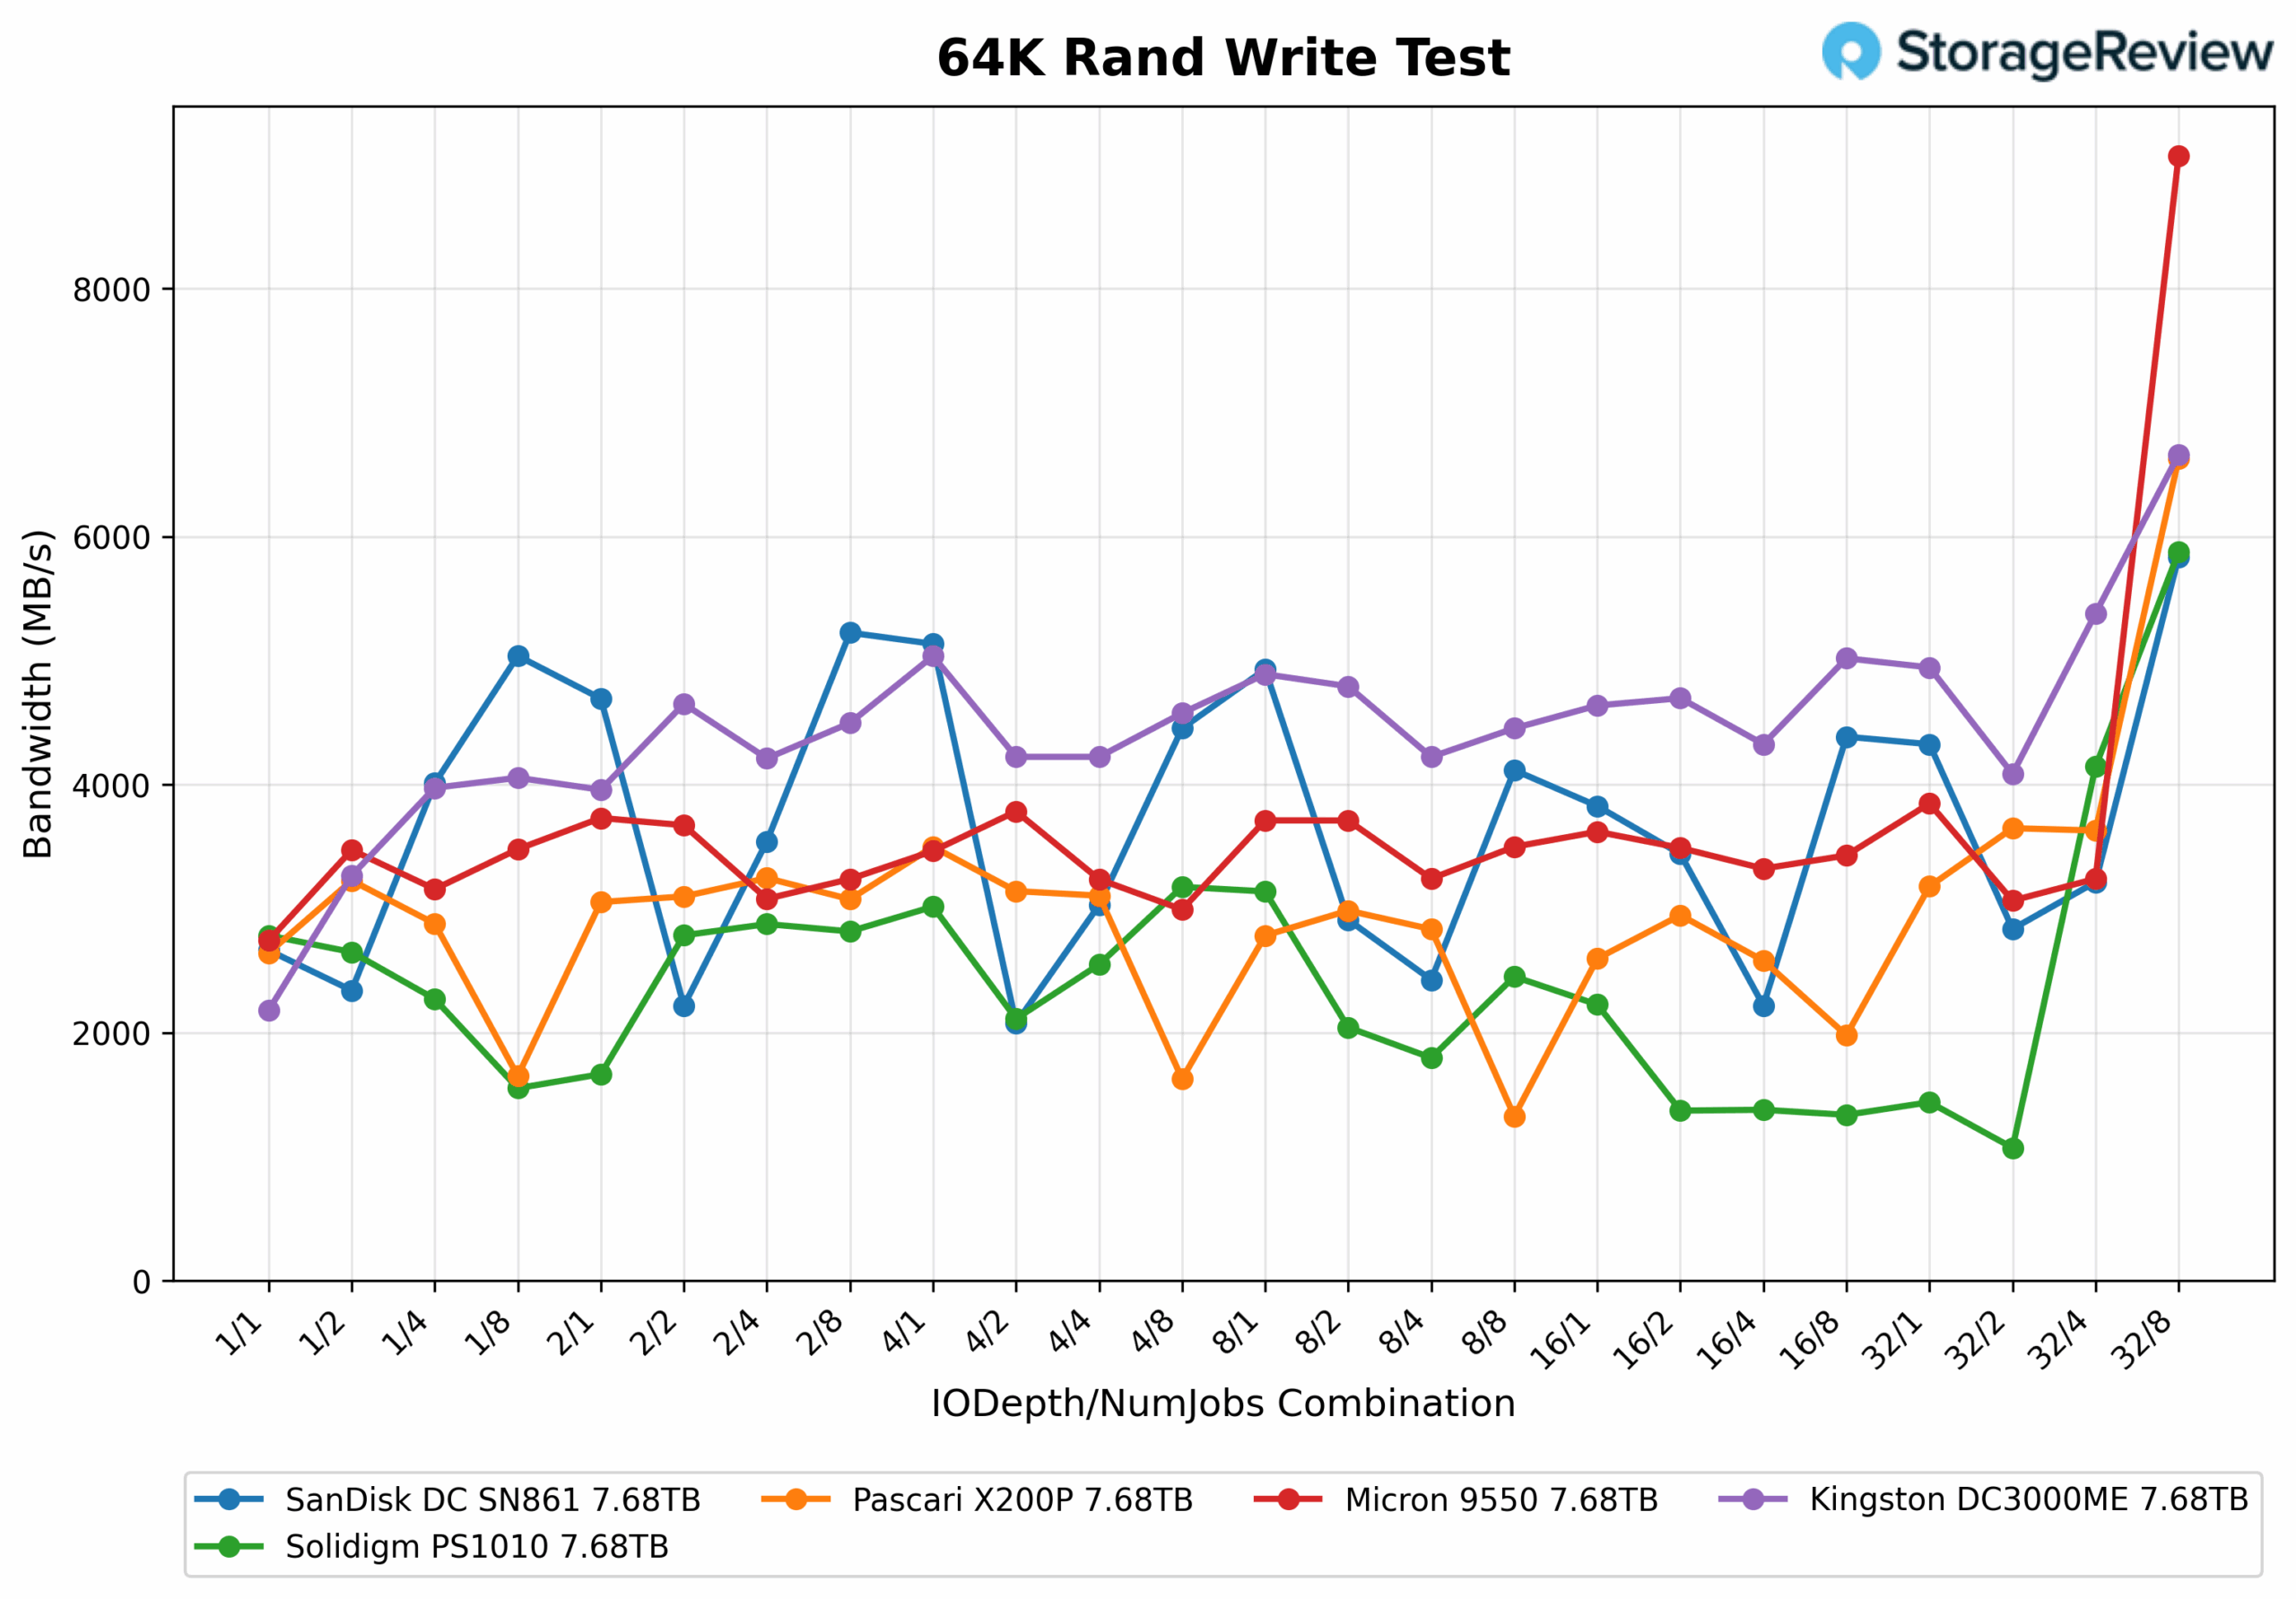
Nel test di scrittura casuale a 64K, l'X200P mostra prestazioni complessive di fascia media, con alcune fluttuazioni a seconda della profondità di coda e delle combinazioni di thread. L'unità non produce risultati entro un intervallo specifico, ma mantiene prestazioni generalmente stabili tra 2,500 MB/s e 3,600 MB/s nella maggior parte del set di test. La sua larghezza di banda di picco raggiunge 6,625.92 MB/s con la combinazione 32/8 IODepth/NumJobs, che è tra i punti più alti del test e gli conferisce un ottimo risultato.
Sebbene non sia il più costante in assoluto, l'unità Pascari mantiene la sua posizione anche con carichi di thread più pesanti e offre prestazioni migliori verso profondità di coda più elevate.
Latenza di scrittura casuale di 64K
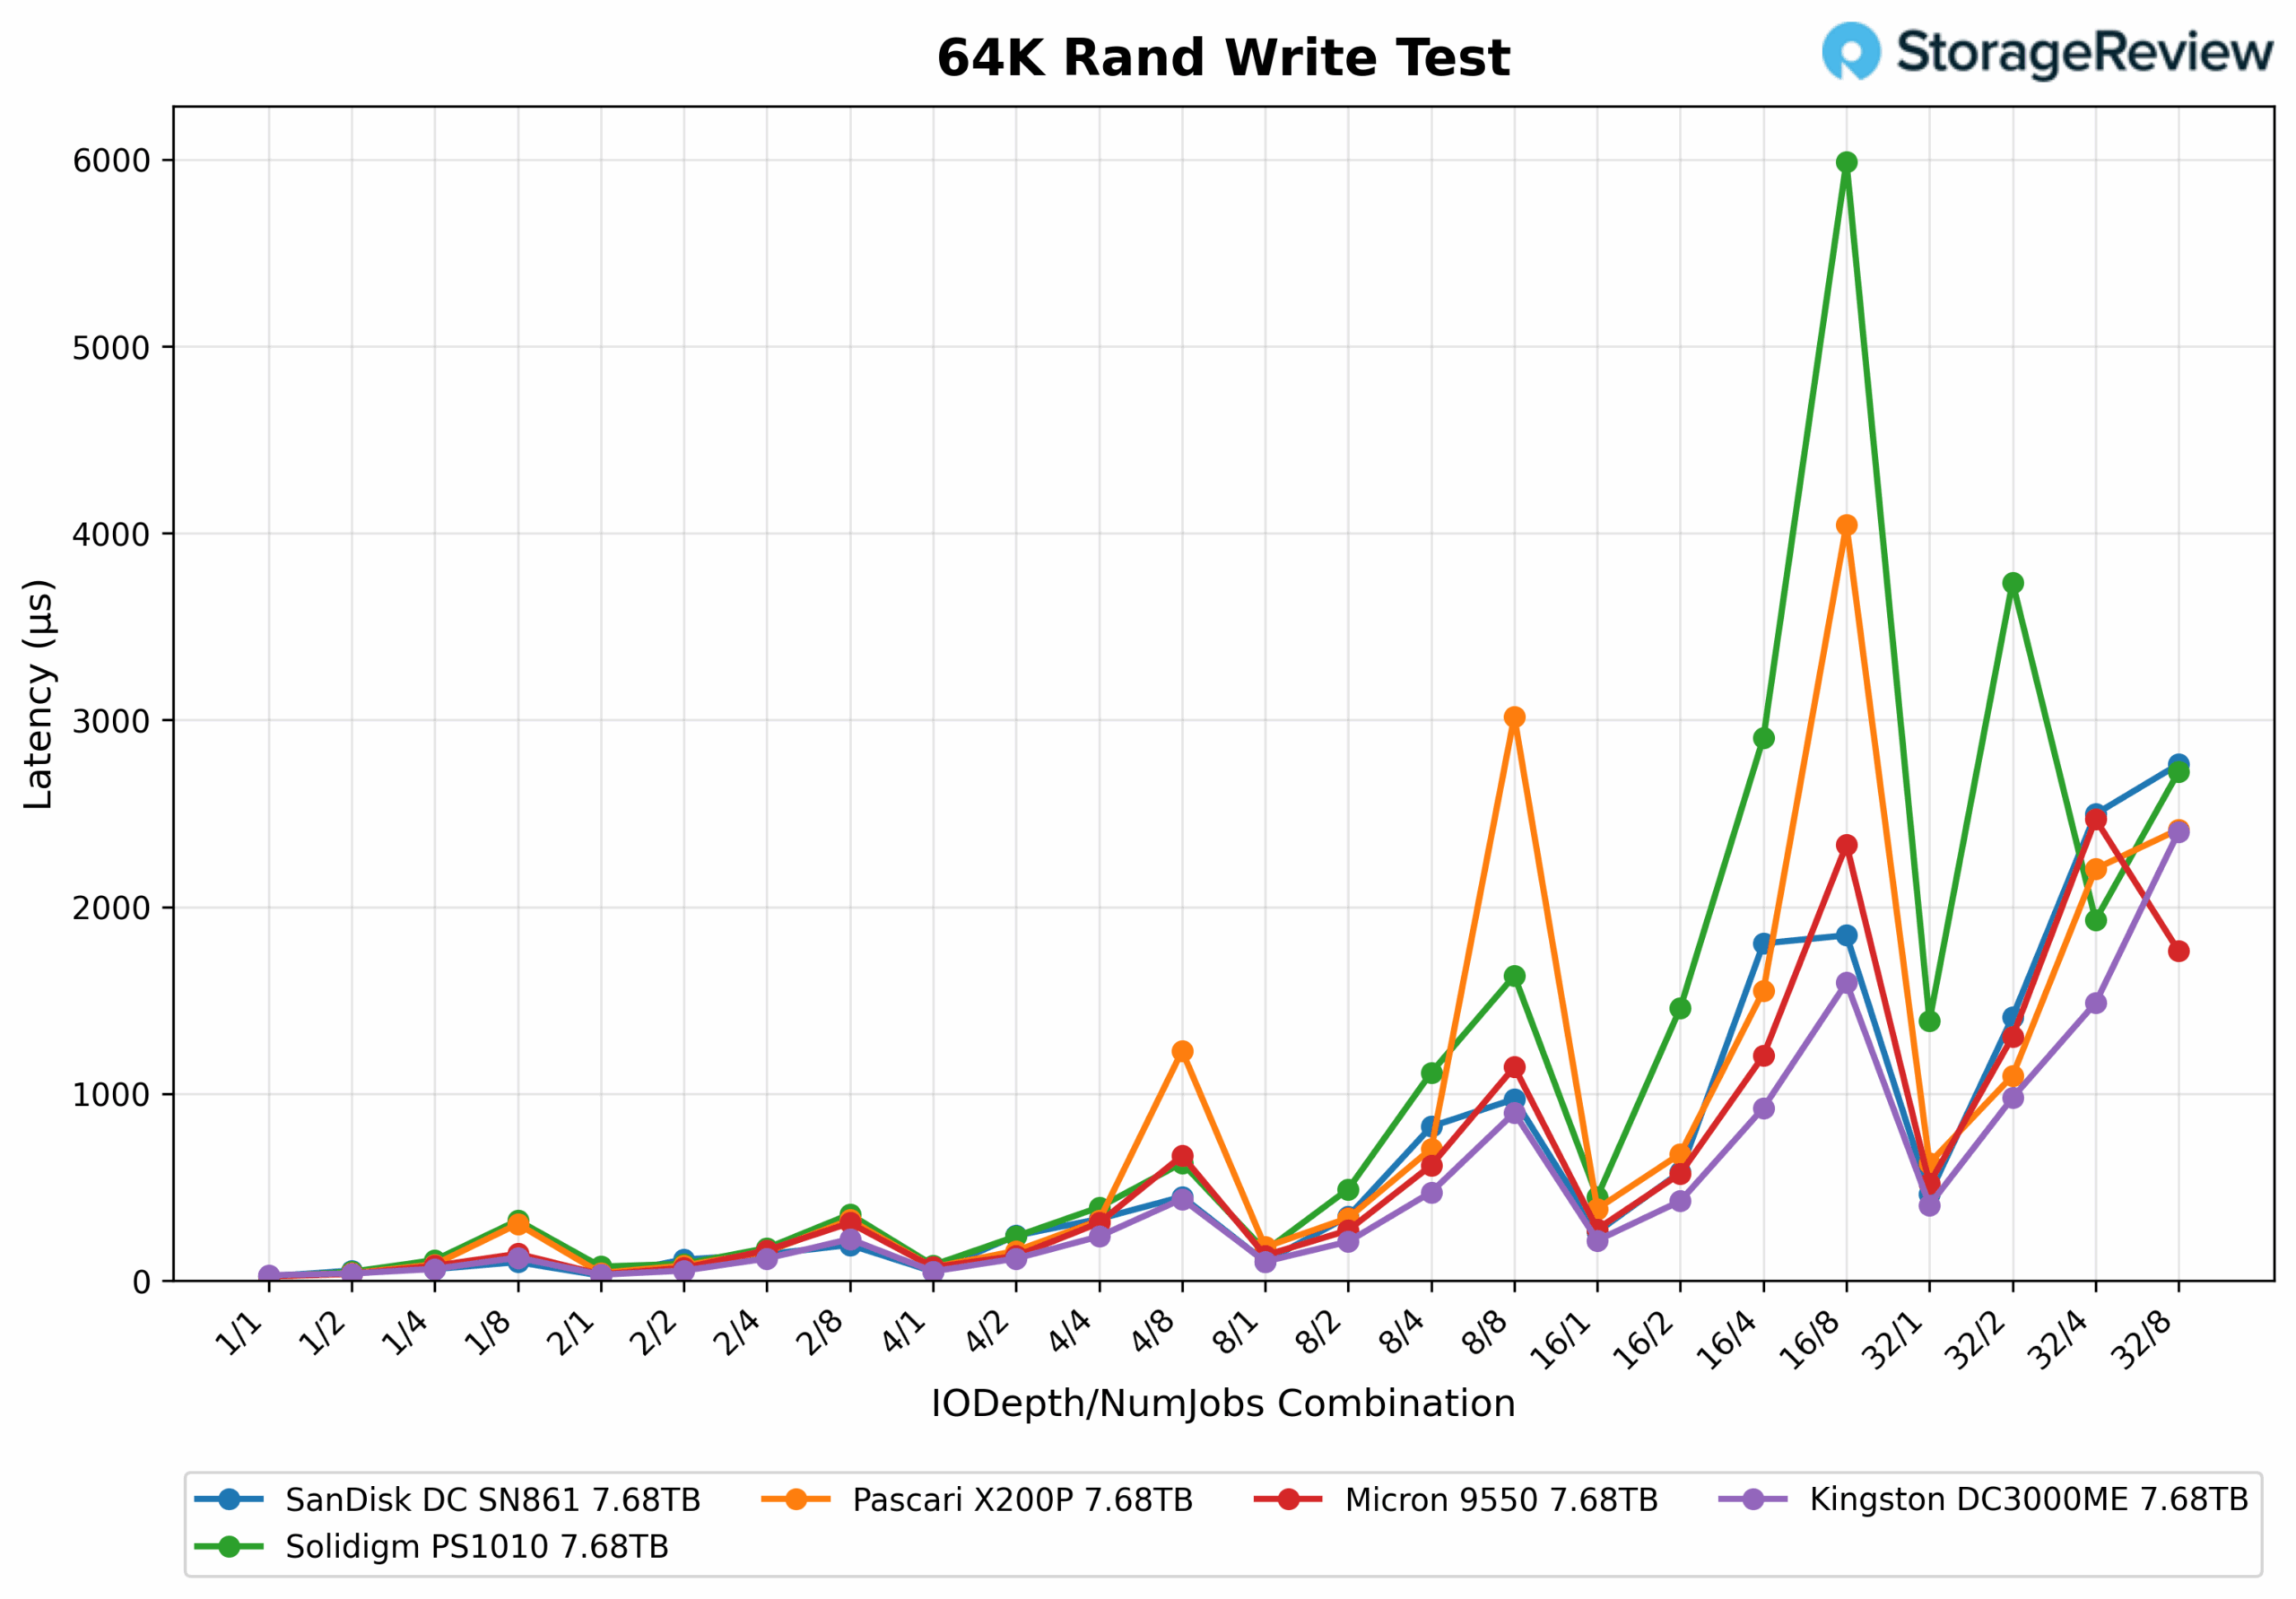
Nel test di latenza di scrittura casuale a 64K, l'X200P mostra generalmente una bassa latenza con profondità di coda da leggere a moderate, con valori eccezionali di 0.023 ms a 1/1 e 0.041 ms a 2/1. Tuttavia, con combinazioni di thread e code più pesanti, come 16/8 e 8/8, la latenza aumenta significativamente, raggiungendo rispettivamente 4.045 ms e 3.019 ms.
Lettura casuale 64K
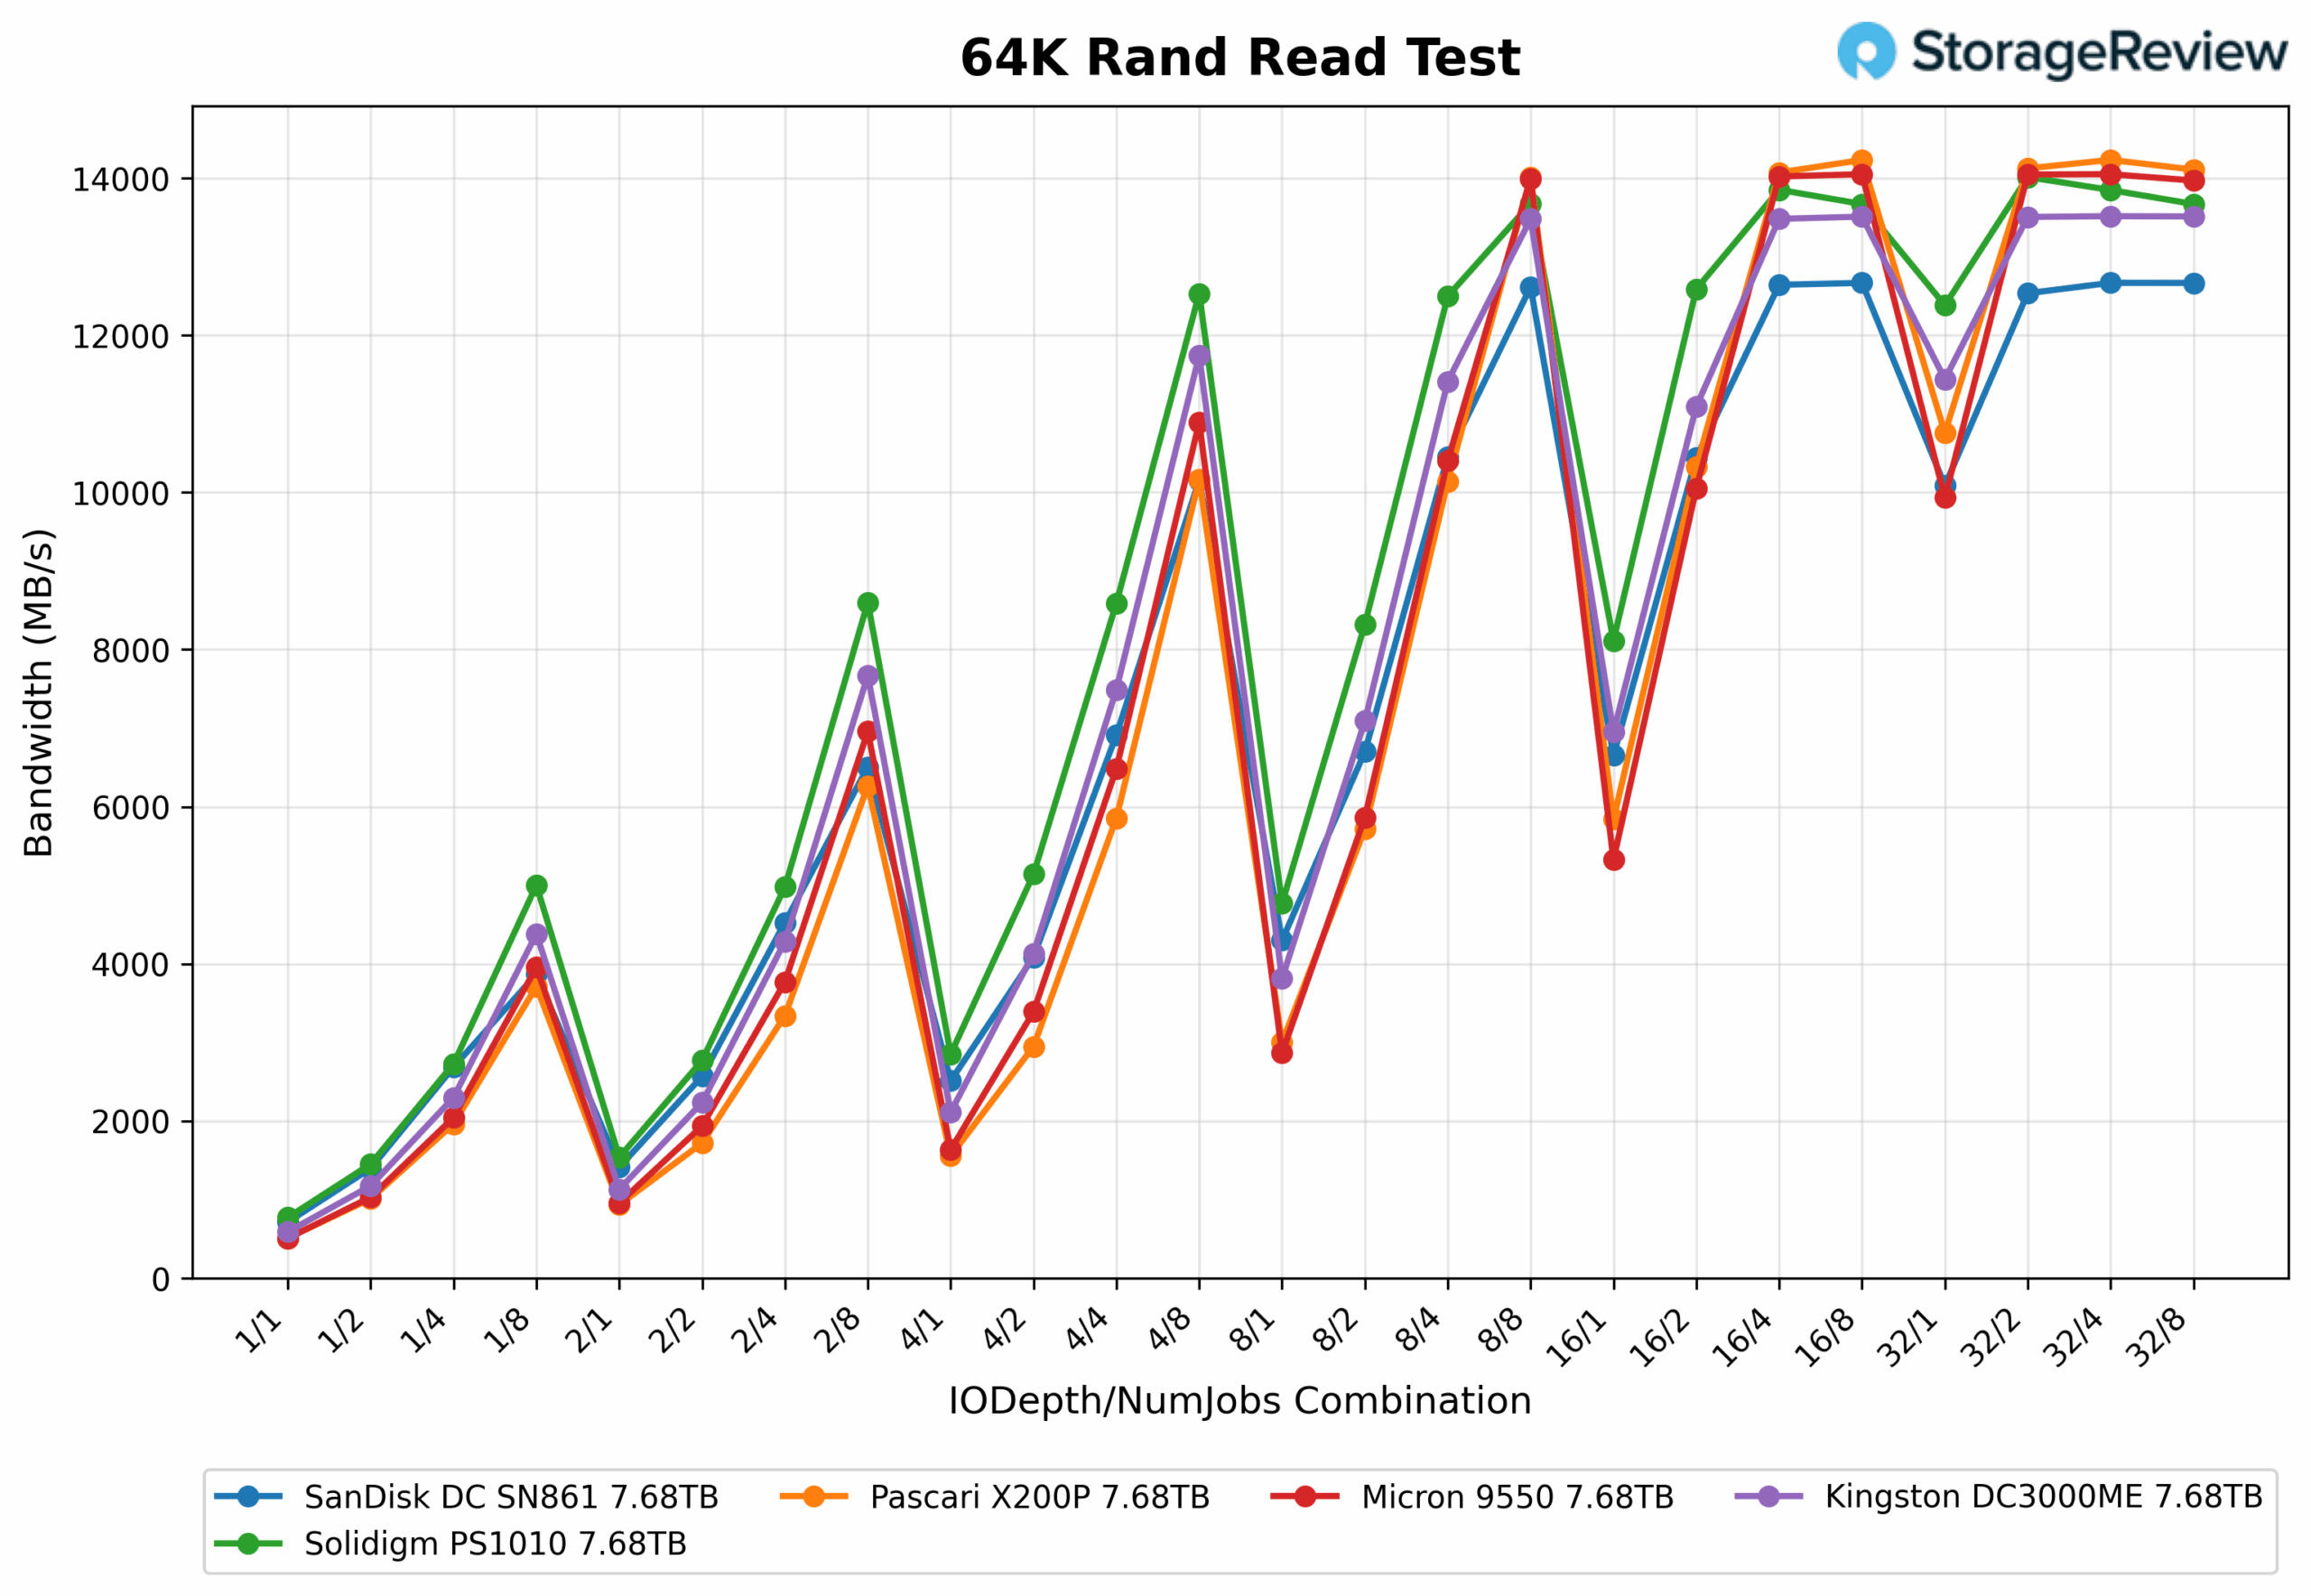
Nel test di lettura casuale a 64K, l'X200P offre prestazioni costantemente elevate su tutta la gamma di profondità di coda e numero di thread, mantenendosi in linea con le unità più performanti. Pur non conquistando inizialmente il primo posto, si impone a QD 16/8 e 32/8, raggiungendo una larghezza di banda di picco di 14,232 MB/s, pareggiando o superando la concorrenza ai massimi livelli di carico. Ciò dimostra la capacità dell'unità di scalare in condizioni di accesso parallelo intensivo.
Latenza di lettura casuale di 64K
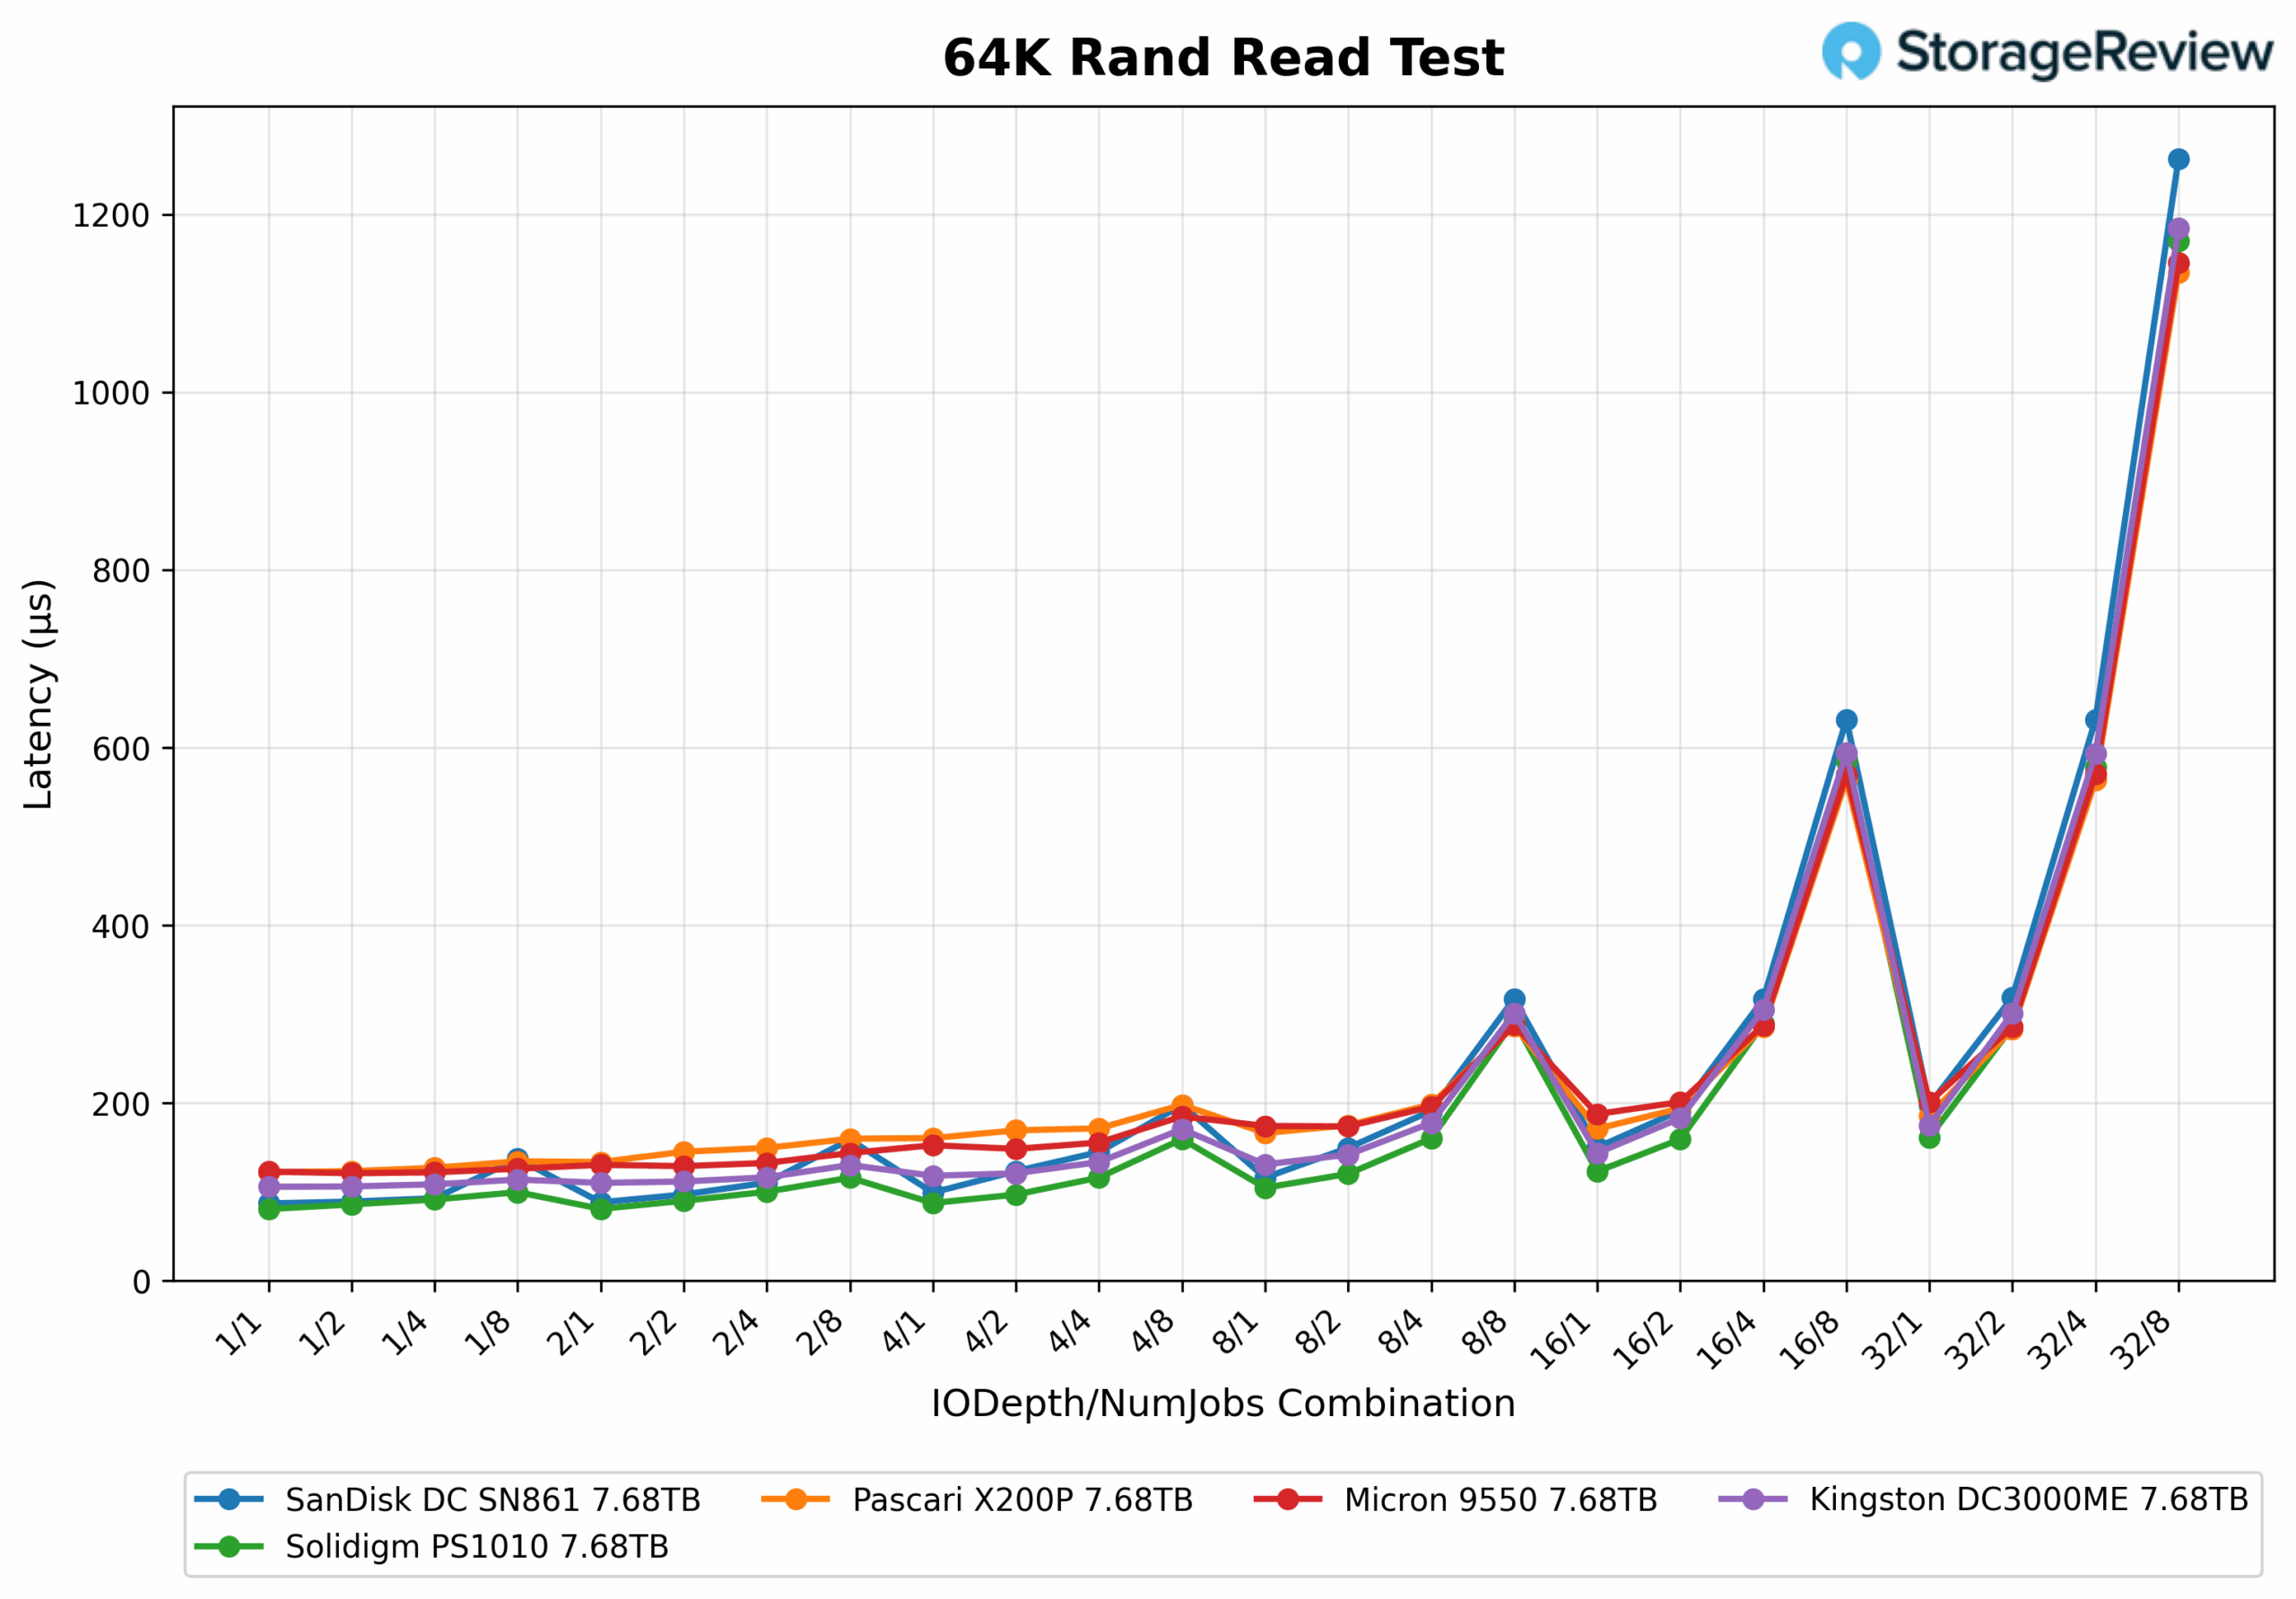
Nel test di latenza di lettura casuale a 64K, l'X200P mantiene costantemente una bassa latenza con profondità di coda e conteggi di thread da leggeri a moderati, attestandosi in genere al di sotto di 0.2 millisecondi. La latenza inizia ad aumentare in modo più evidente a QD16/4, raggiungendo 0.285 ms, per poi aumentare ulteriormente a QD32/4 fino a 0.563 ms. L'aumento più significativo si verifica a QD32/8, dove la latenza raggiunge il picco a 1.135 ms.
Scrittura casuale 16K
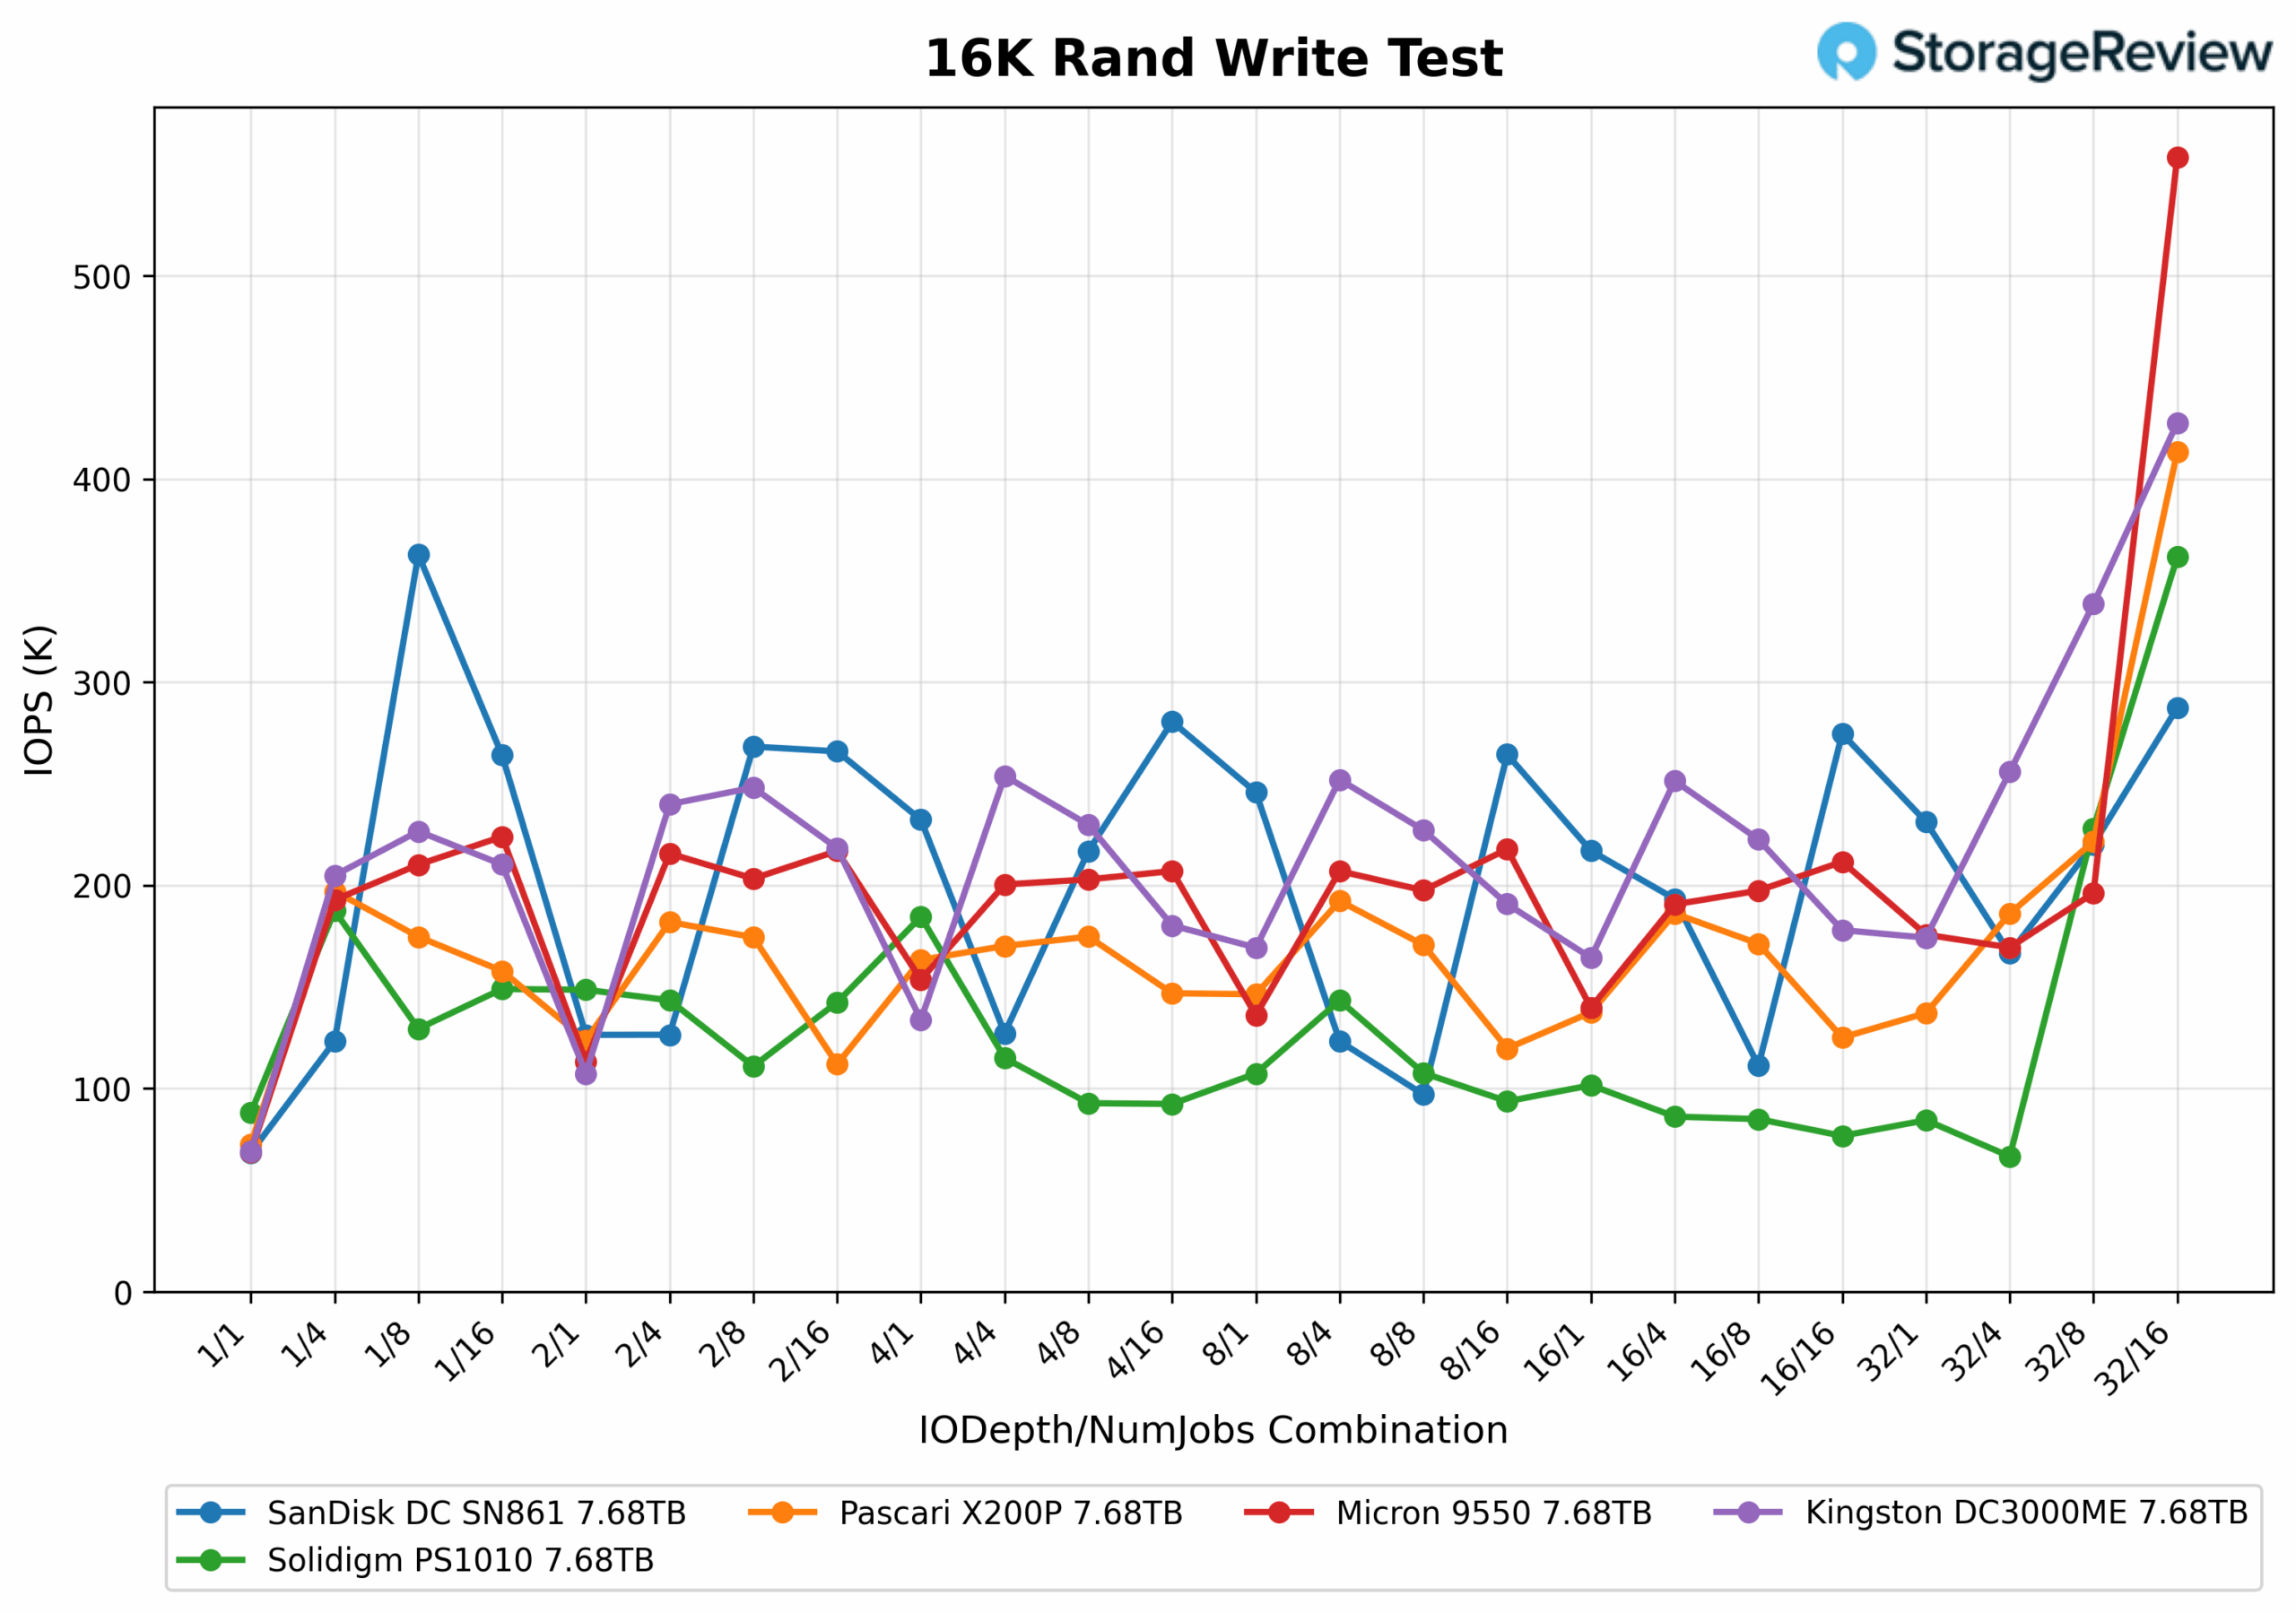
Nel test di scrittura casuale a 16K, l'X200P mantiene una solida posizione intermedia nella maggior parte delle combinazioni di code e thread, offrendo tra 170K e 190K IOPS in configurazioni tipiche come 4/4, 8/4 e 4/8. Le prestazioni iniziano a scalare in modo significativo con carichi più pesanti, raggiungendo 221K IOPS a 32/8 e un picco di 413K IOPS a 32/16. A quel punto, si posiziona appena sotto il Kingston DC3000ME (428K IOPS), che lo precede di poco. Questo ottimo piazzamento dimostra la capacità di Pascari di scalare efficacemente sotto la massima pressione di scrittura, anche se non conquista la prima posizione.
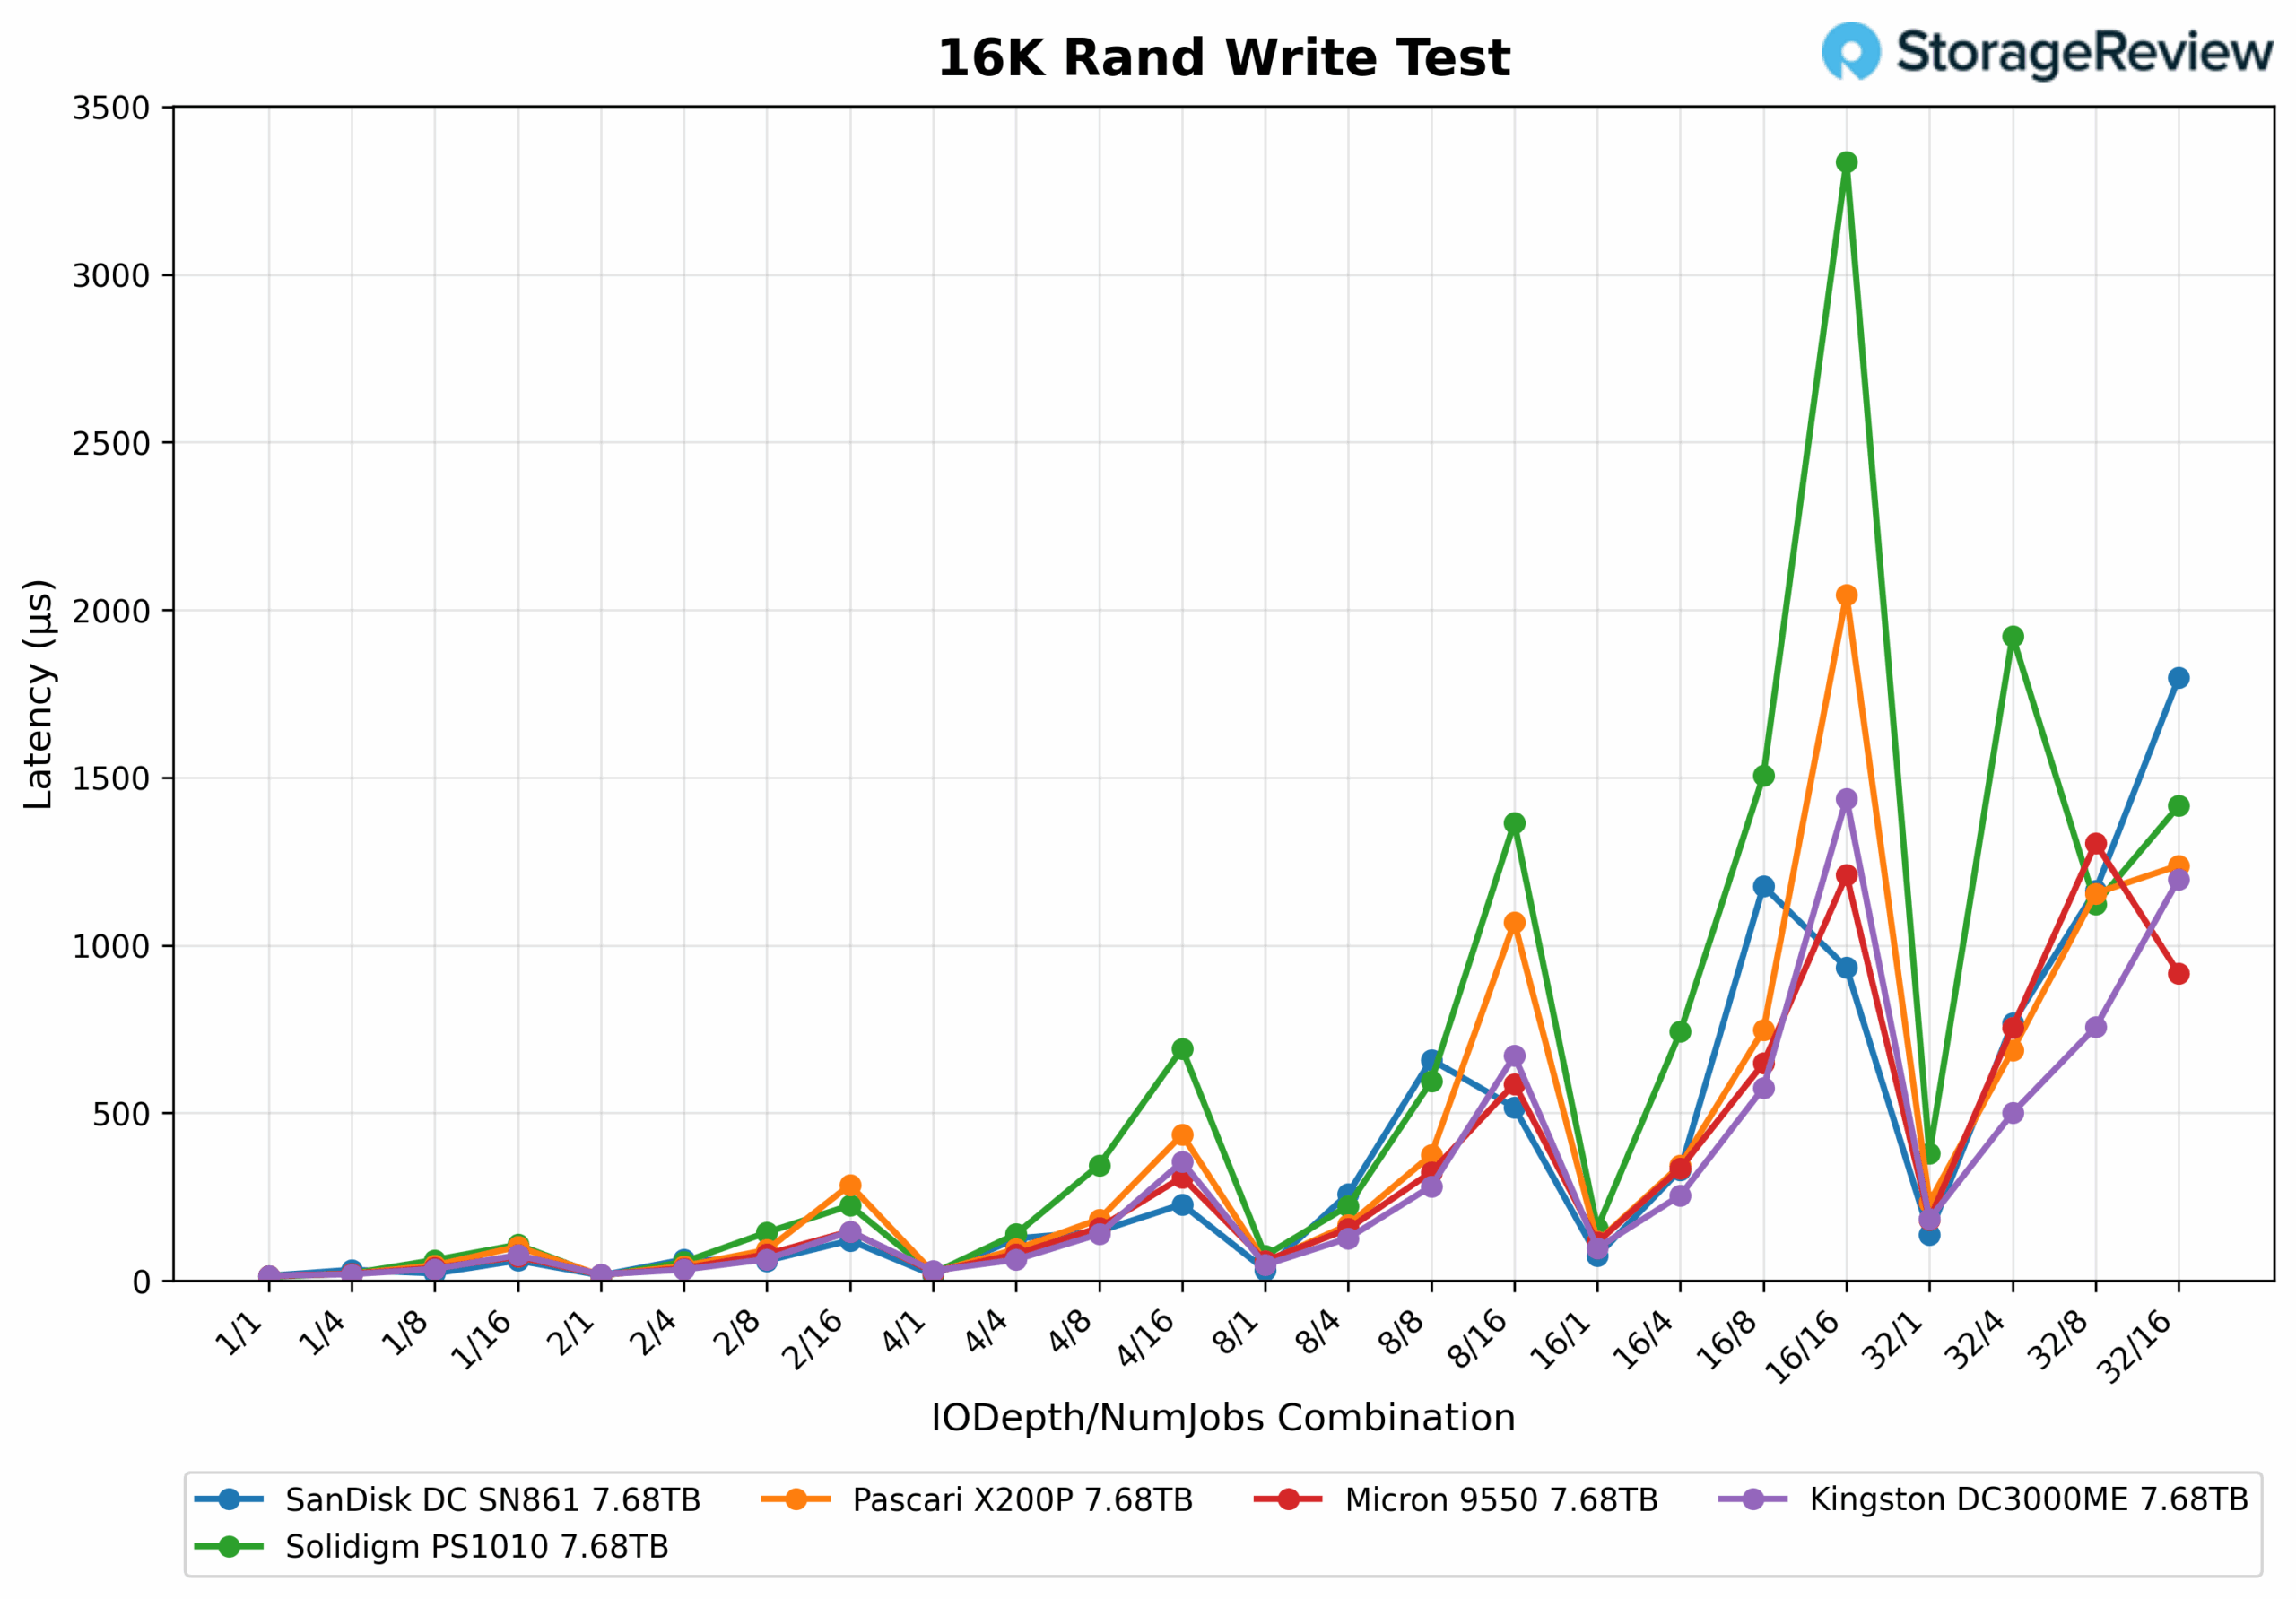
Nel test di latenza in scrittura casuale a 16K, l'X200P mantiene una latenza molto bassa nella maggior parte delle configurazioni, attestandosi in genere al di sotto di 0.2 ms in impostazioni come 4/4, 8/4 e 2/8. Inizia a salire moderatamente a QD16/4, raggiungendo 0.343 ms, e più bruscamente a QD32/4, dove raggiunge 0.687 ms. Ai carichi più elevati, QD16/16 e QD32/8 mostrano ulteriori aumenti di latenza, rispettivamente a 1.068 ms e 1.155 ms. La latenza massima si verifica a QD16/16 con 2.045 ms, prima di stabilizzarsi leggermente a QD32/16 con 1.238 ms. Nel complesso, il Pascari non presenta la curva di latenza più piatta, ma mantiene un controllo ragionevole, posizionandosi subito dietro Kingston in cima alla classifica.
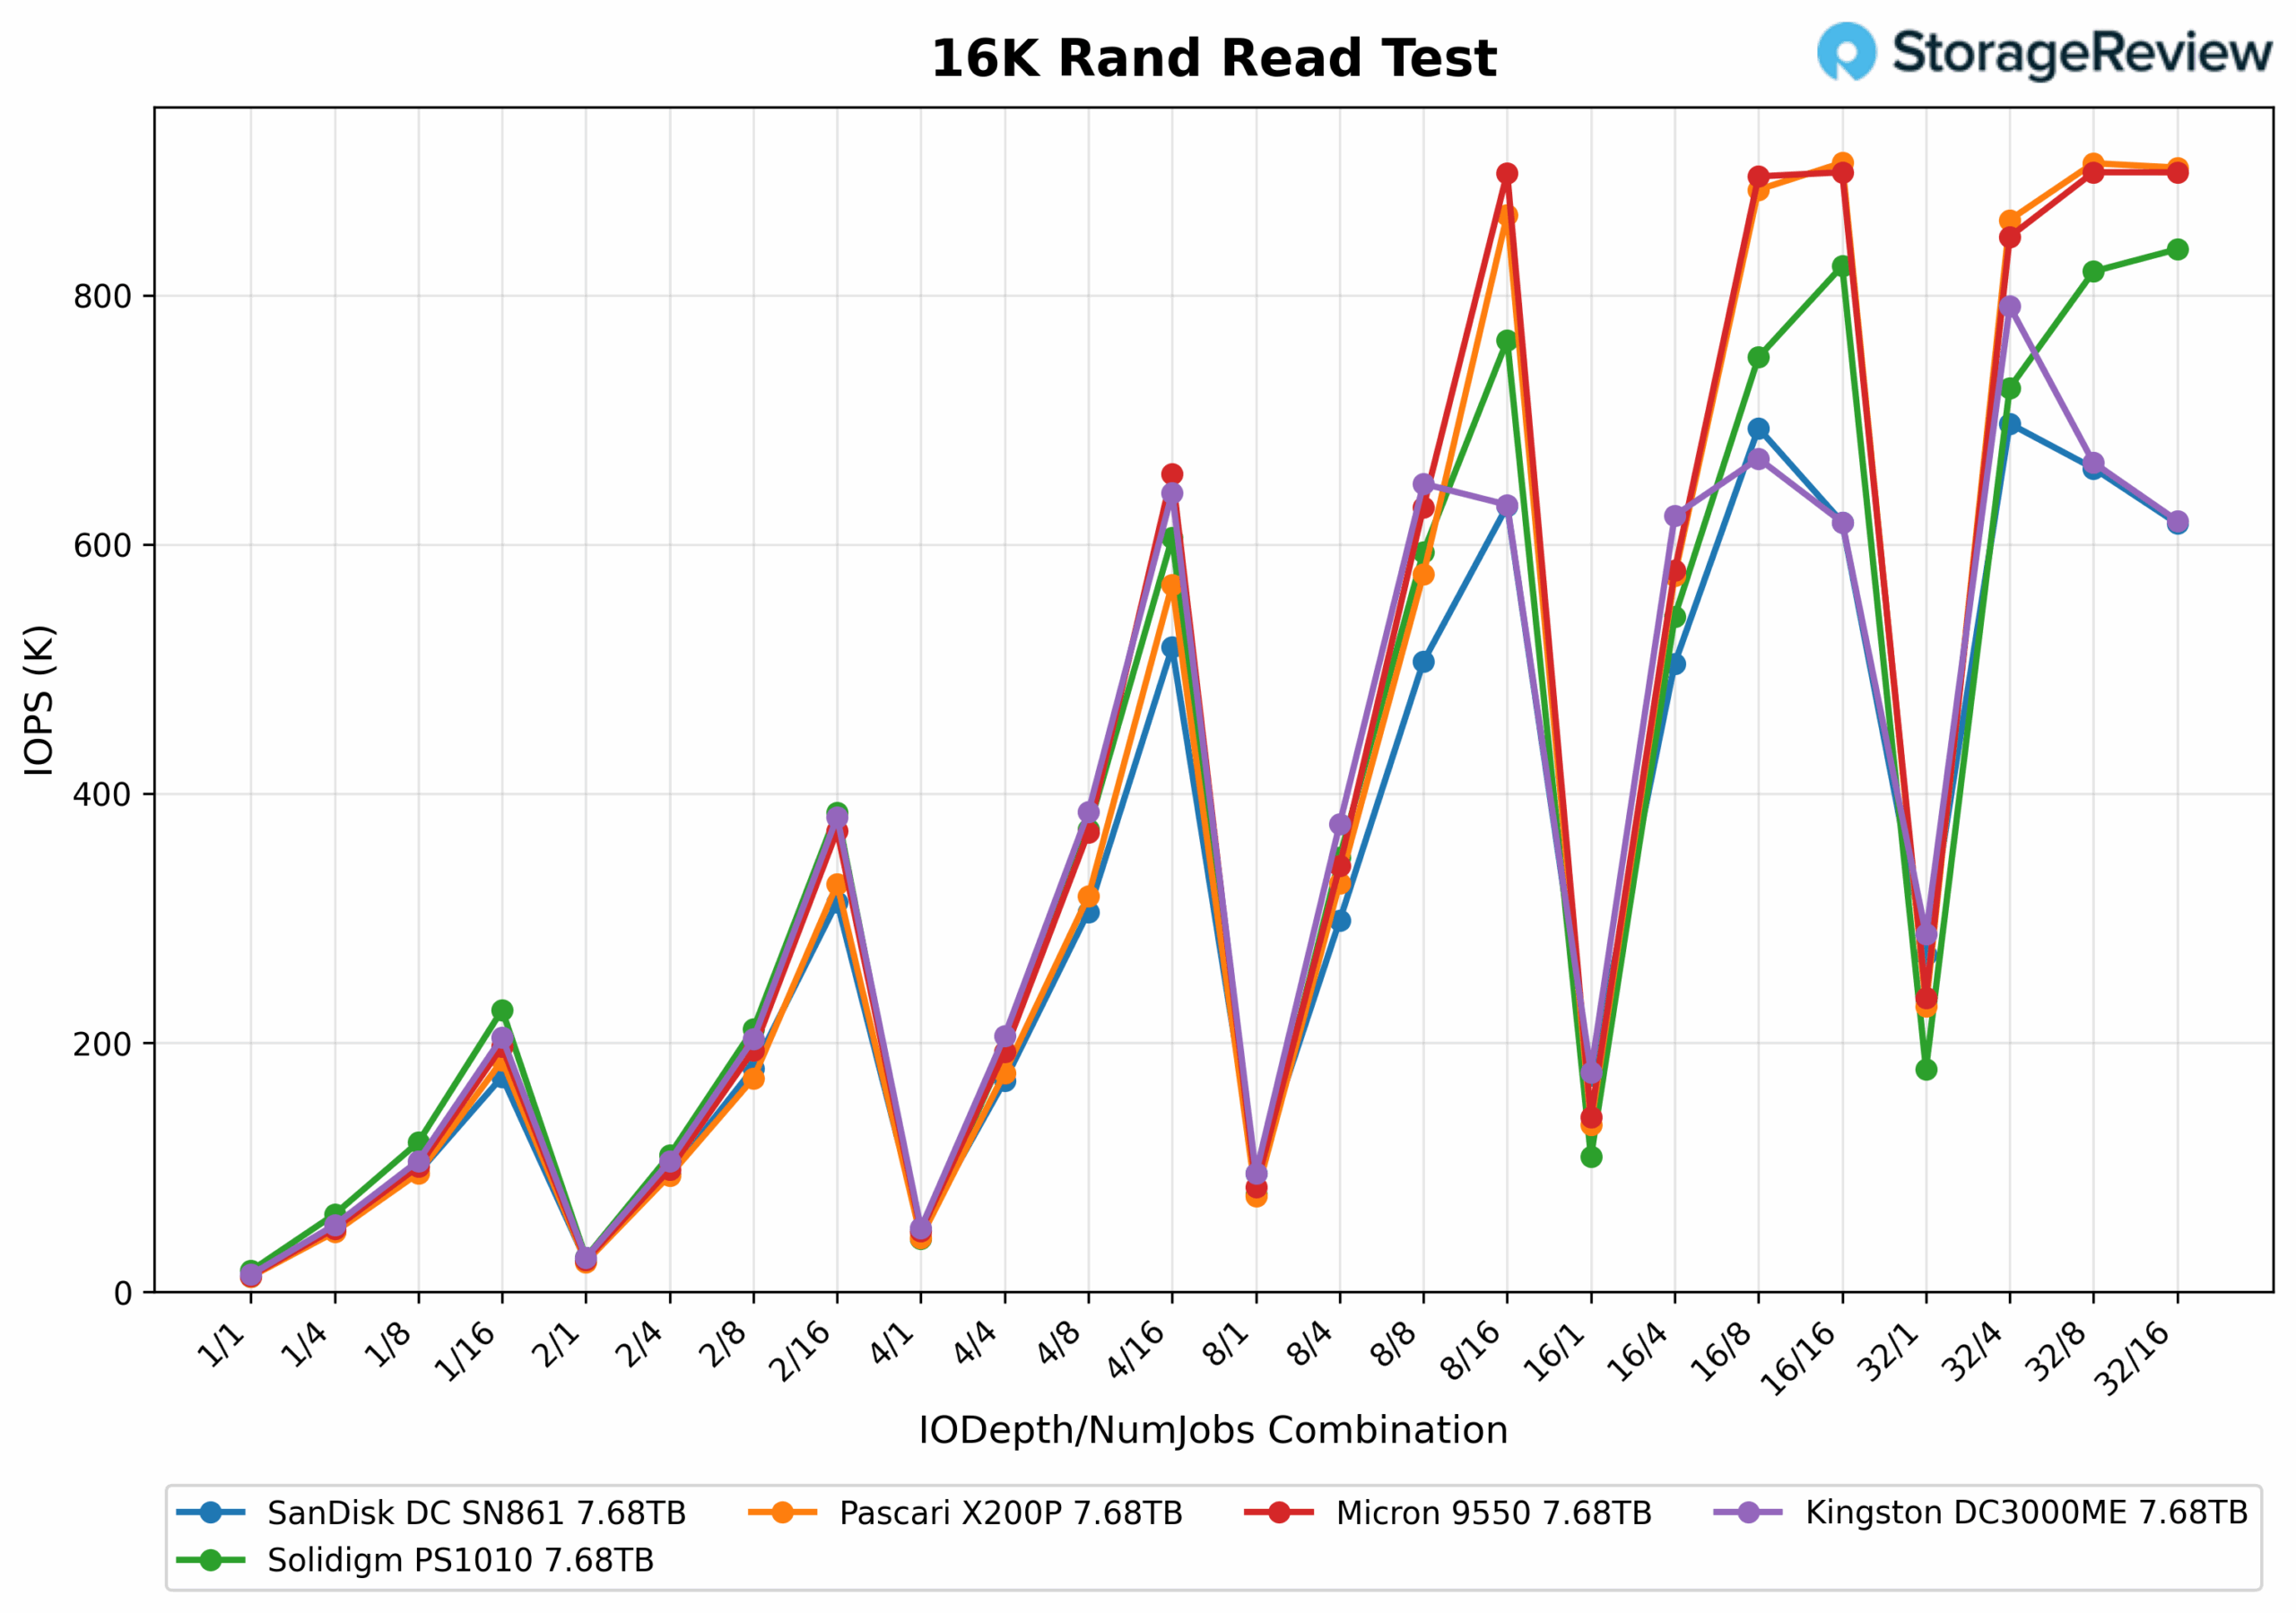
Nel test di lettura casuale a 16K, l'X200P offre prestazioni solide, scalando in modo pulito tra profondità di coda e numero di thread. Raggiunge un picco di 906K IOPS a QD16/16, con un risultato quasi identico di 905.9K IOPS a QD32/8. Mantiene inoltre un output elevato a QD32/16 con 902.4K IOPS, posizionandosi saldamente tra i migliori. Pur non essendo leader a profondità di coda inferiori, Pascari sale costantemente e mantiene la sua posizione tra i migliori in condizioni di lettura prolungata, dimostrando sia un throughput elevato che una scalabilità efficace.
Latenza di lettura casuale di 16K
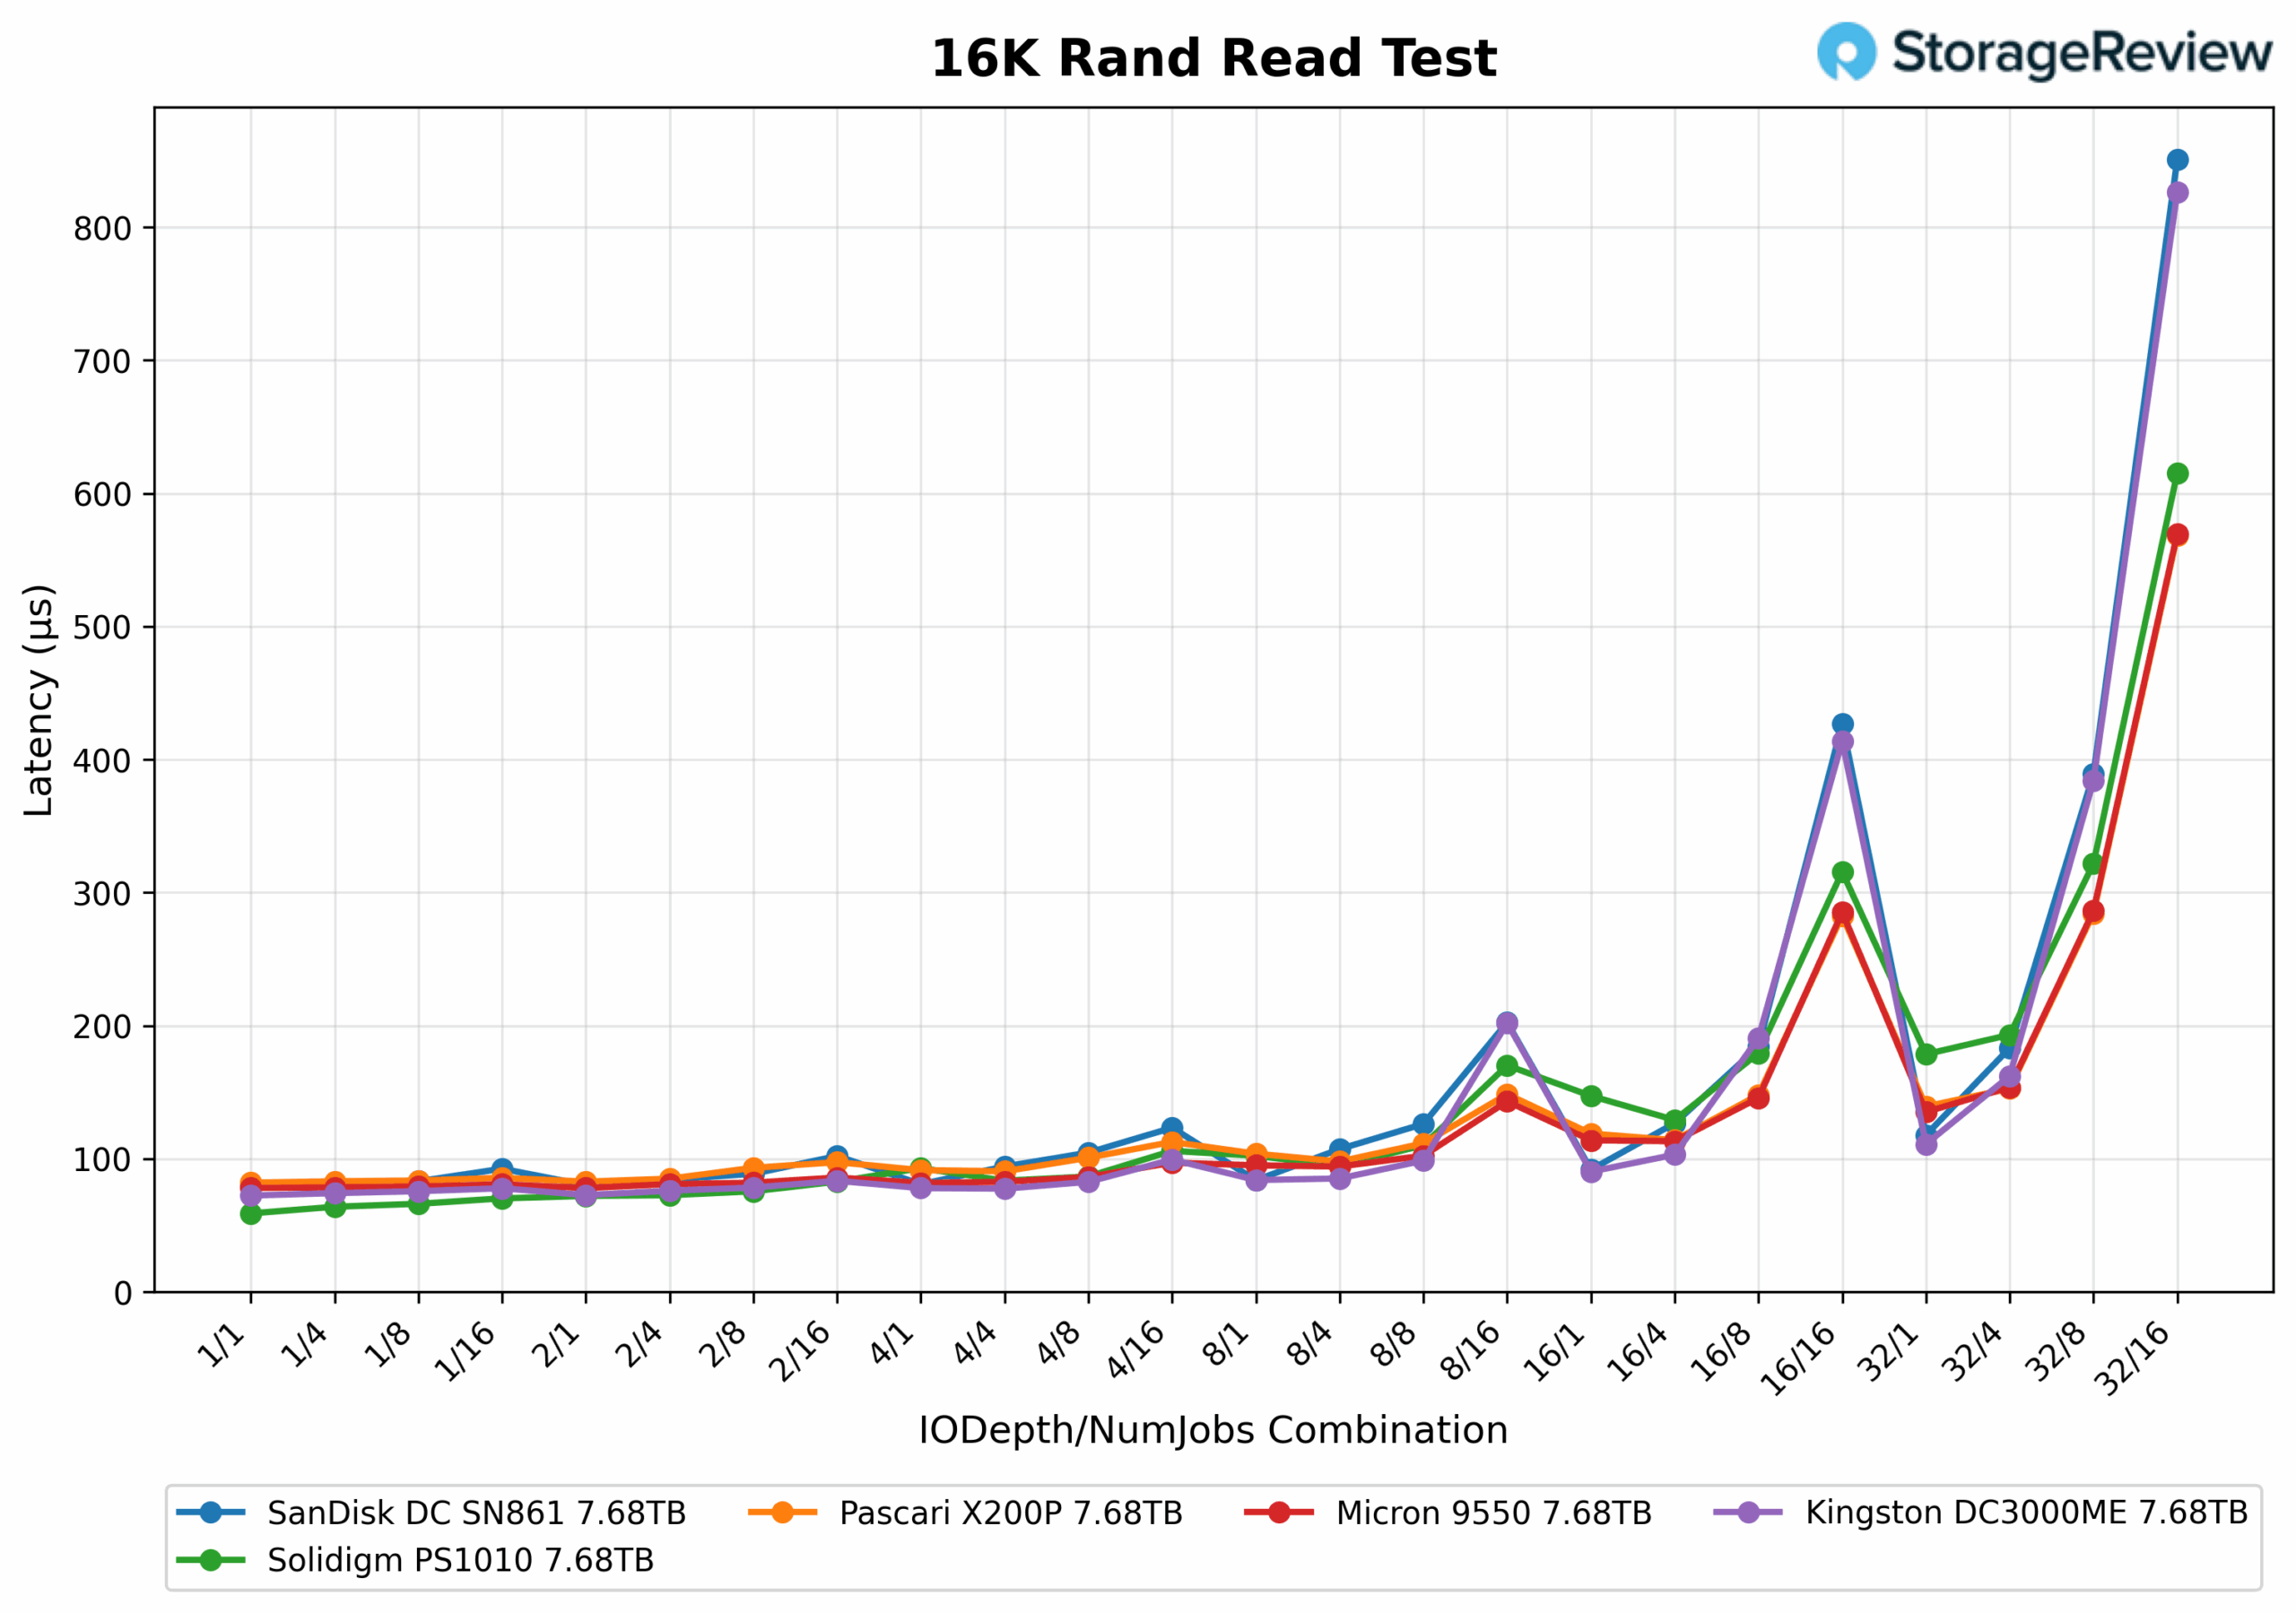
Nel test di latenza di lettura casuale a 16K, l'X200P ha mantenuto una latenza bassa e costante nella maggior parte delle profondità di coda e dei thread. Ha iniziato a soli 0.082 ms a QD1/1 ed è rimasto al di sotto di 0.1 ms in molte combinazioni di medie dimensioni, inclusi 0.091 ms a QD4/1 e QD4/4, e 0.093 ms a QD2/8. Con l'aumentare del carico, la latenza ha iniziato ad aumentare leggermente, raggiungendo 0.114 ms a QD16/4 e 0.148 ms a QD16/8. La latenza più elevata è stata osservata a QD32/16, con 0.568 ms, dove l'unità ha comunque mantenuto 902K IOPS.
Scrittura casuale 4K
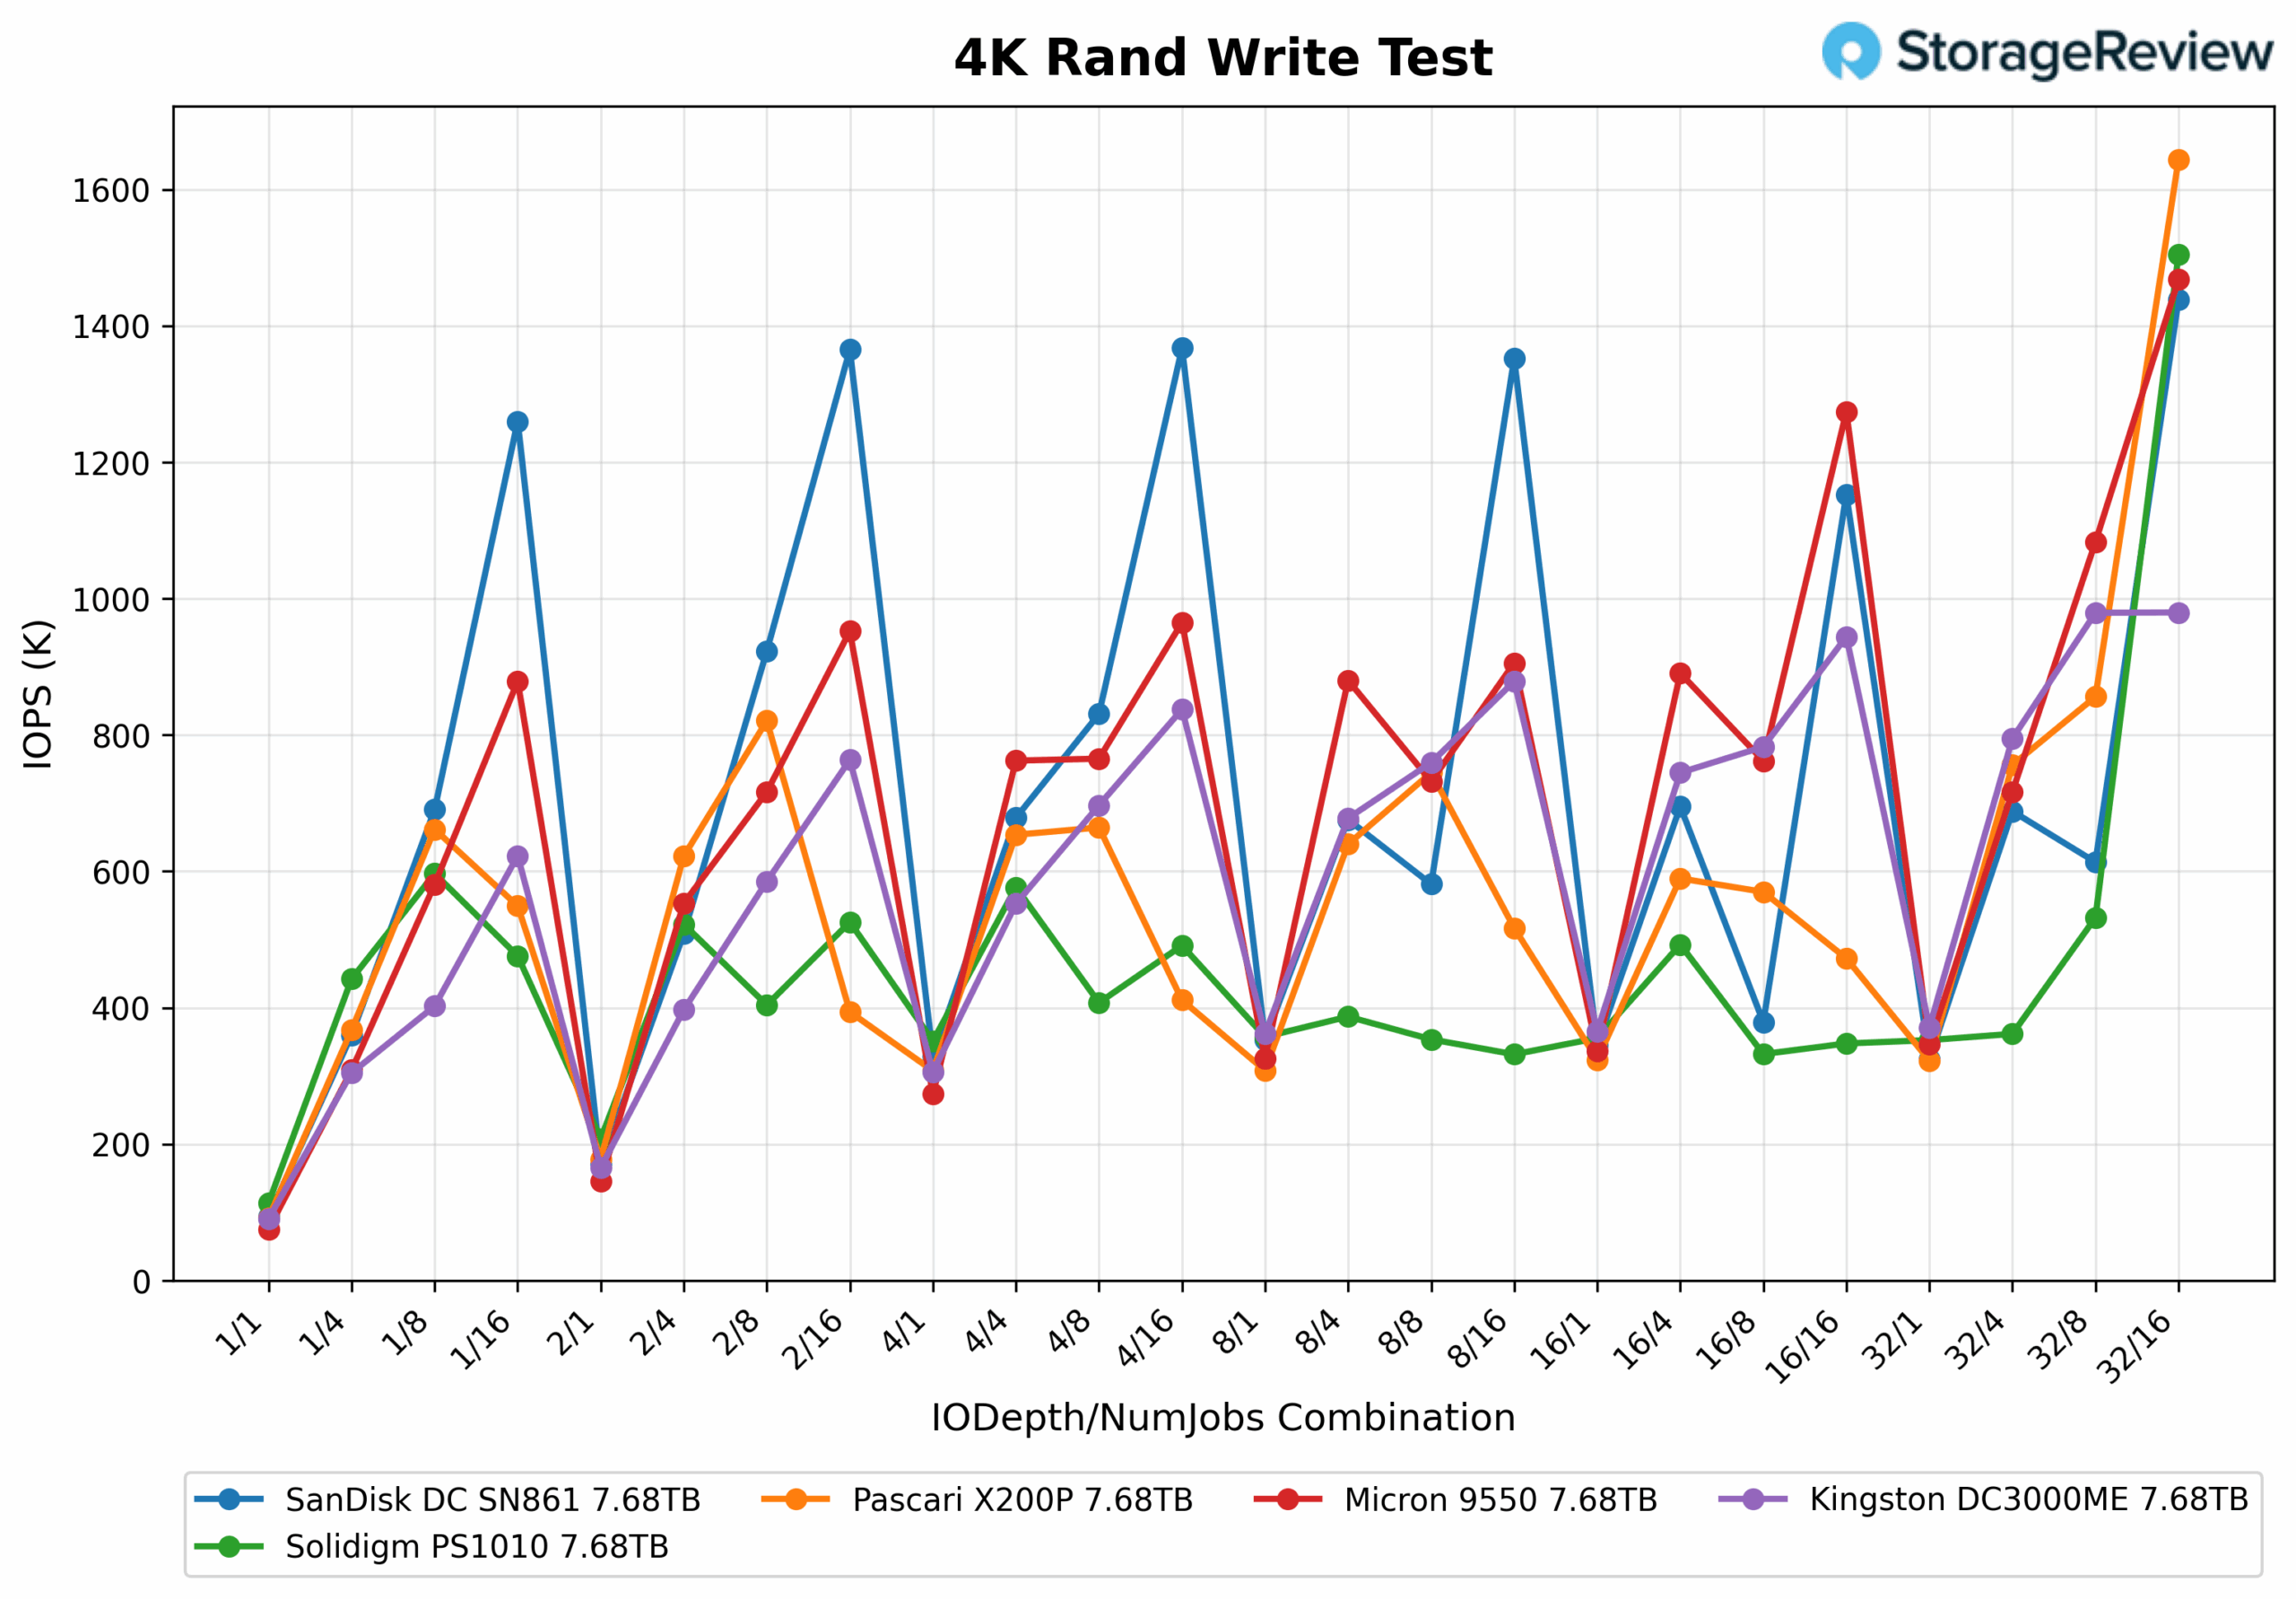
Nei nostri test di scrittura casuale 4K, l'X200P ha fornito risultati stabili a partire da profondità/Job 1/1. L'unità ha raggiunto 91.9K IOPS; in genere si è posizionata nella fascia medio-bassa del gruppo nella maggior parte delle profondità di coda e delle combinazioni di thread. Il suo throughput massimo ha raggiunto 1.64 milioni di IOPS a 32/16, un risultato competitivo ma inferiore ai migliori risultati di SanDisk e Micron in alcuni punti.
Latenza di scrittura casuale di 4K
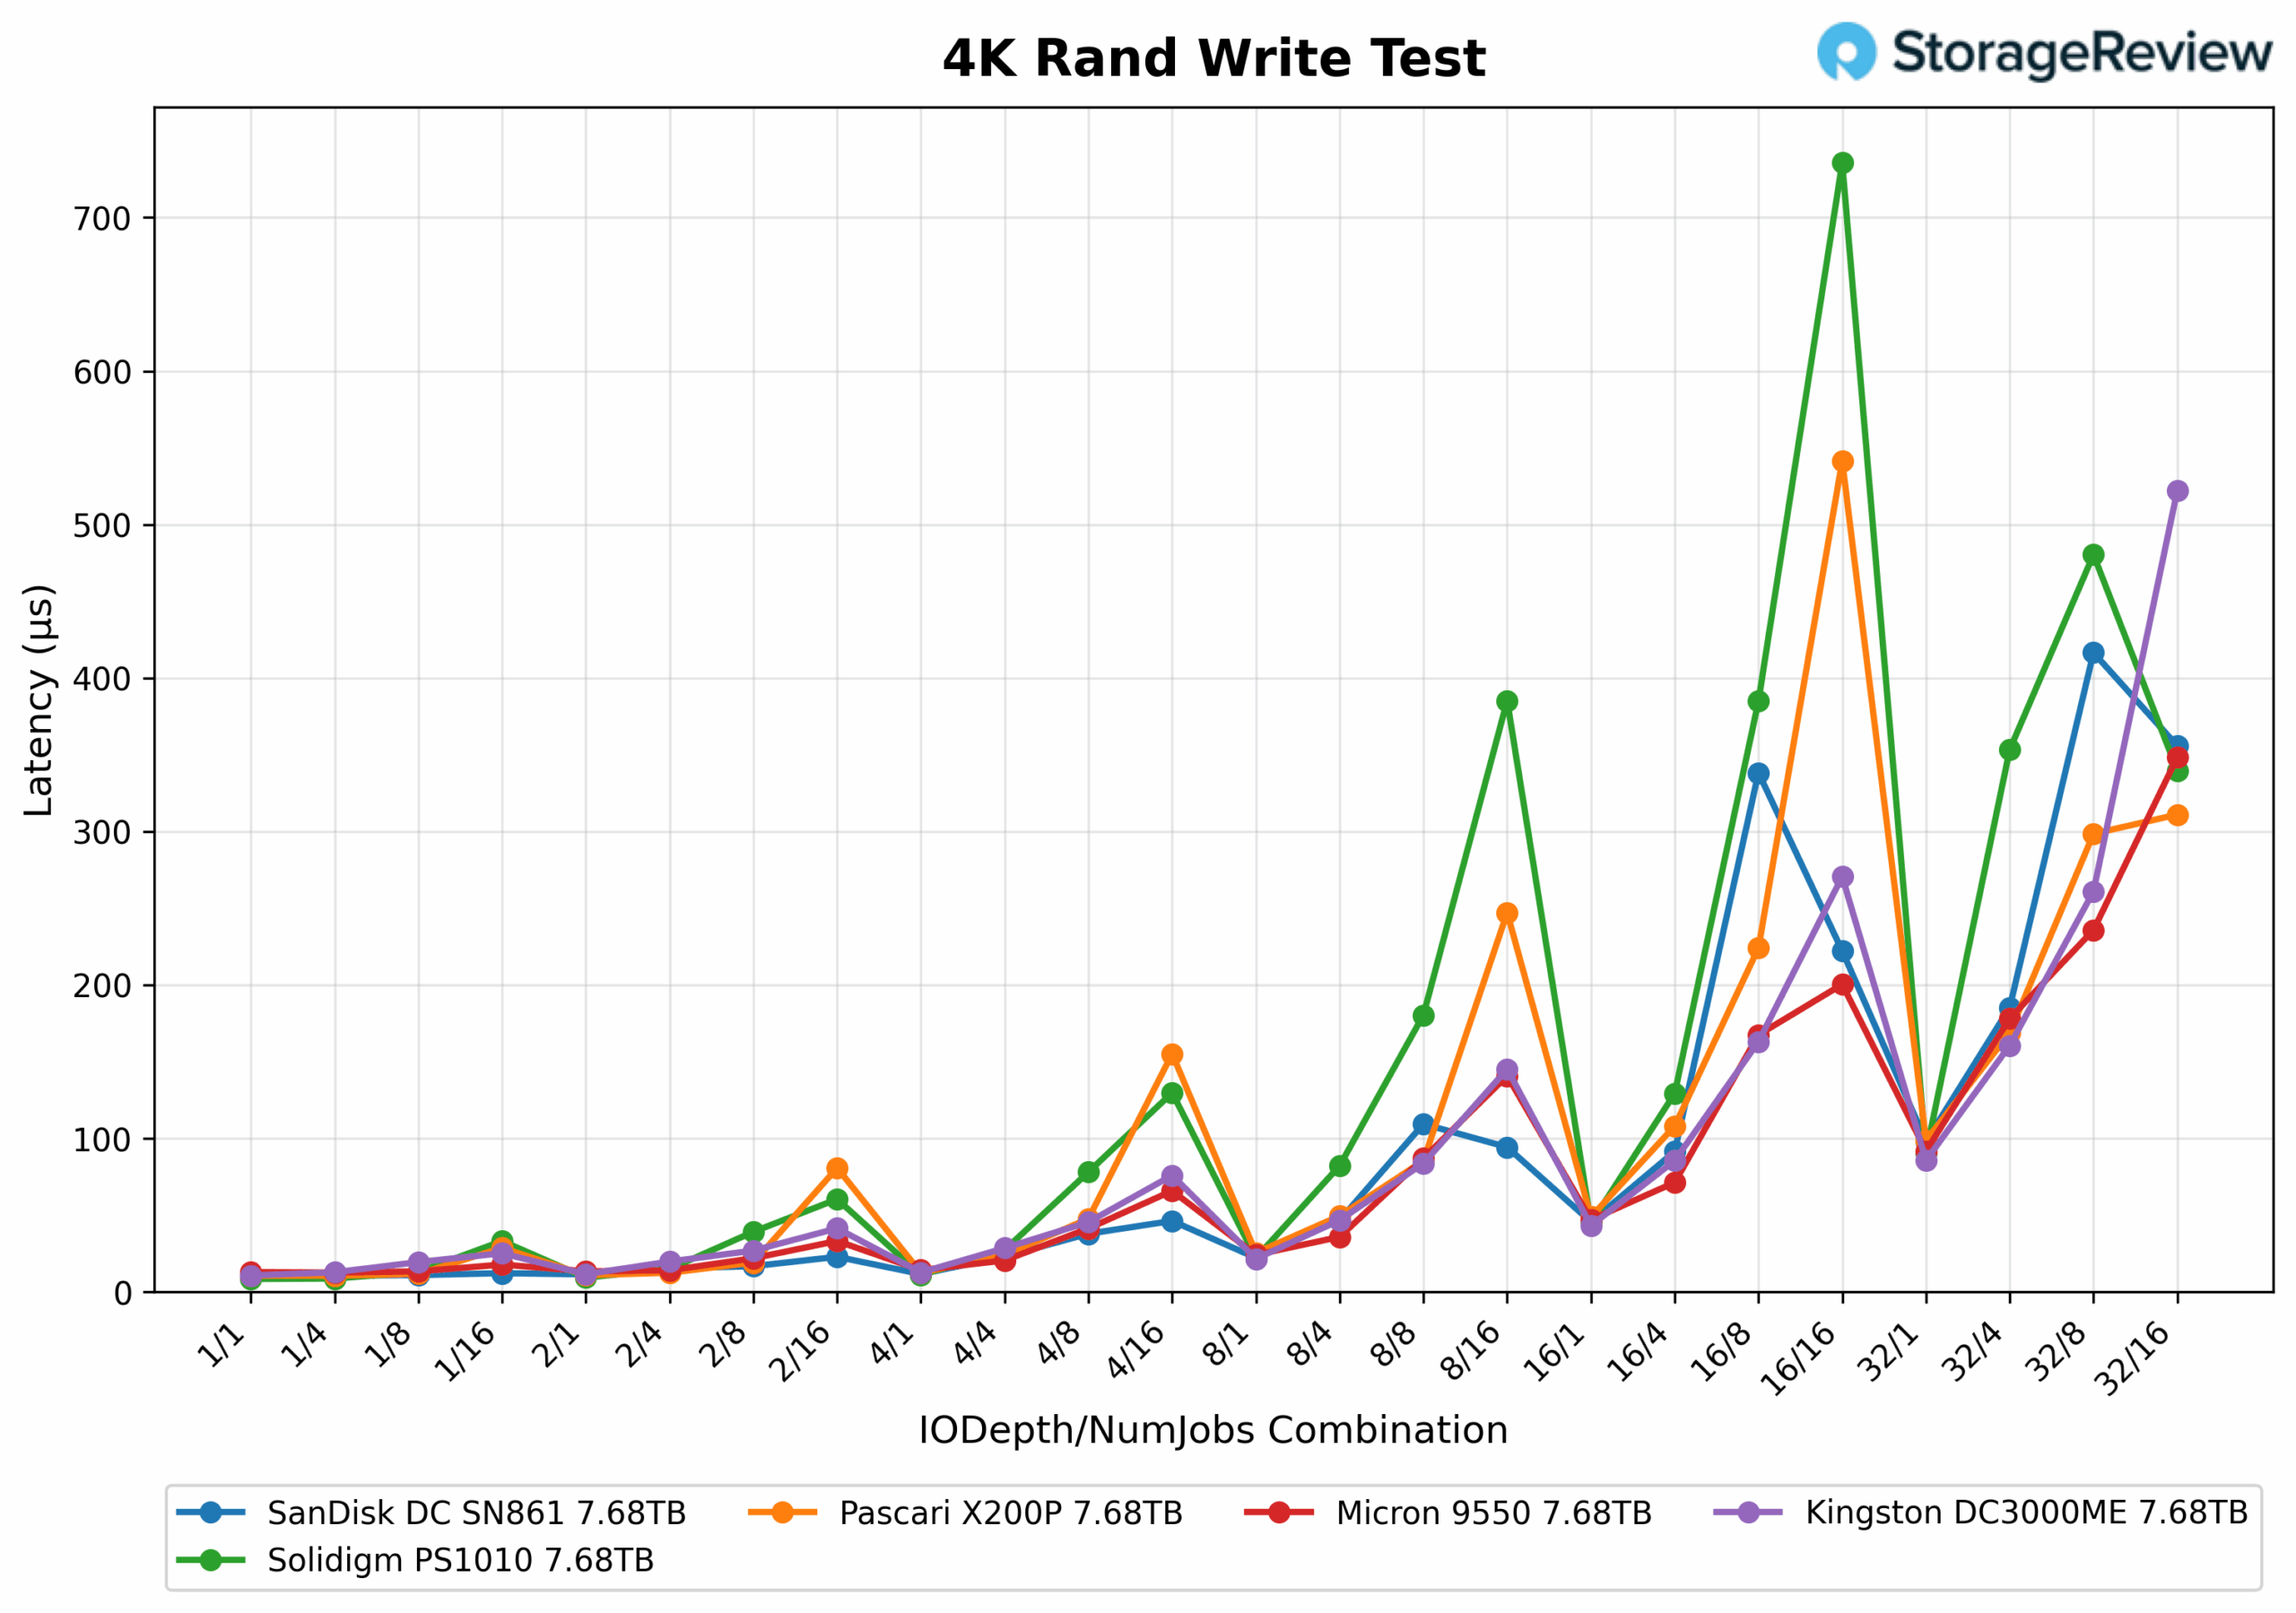
Con una latenza di scrittura casuale 4K, l'X200P offre buone prestazioni con carichi di lavoro leggeri, raggiungendo i livelli delle unità più performanti con soli 0.010 ms. Tuttavia, la latenza è aumentata rapidamente con carichi più pesanti, raggiungendo 0.247 ms a 8/16 e un picco di 0.541 ms a 16/16, il secondo valore più alto del gruppo.
Lettura casuale 4K
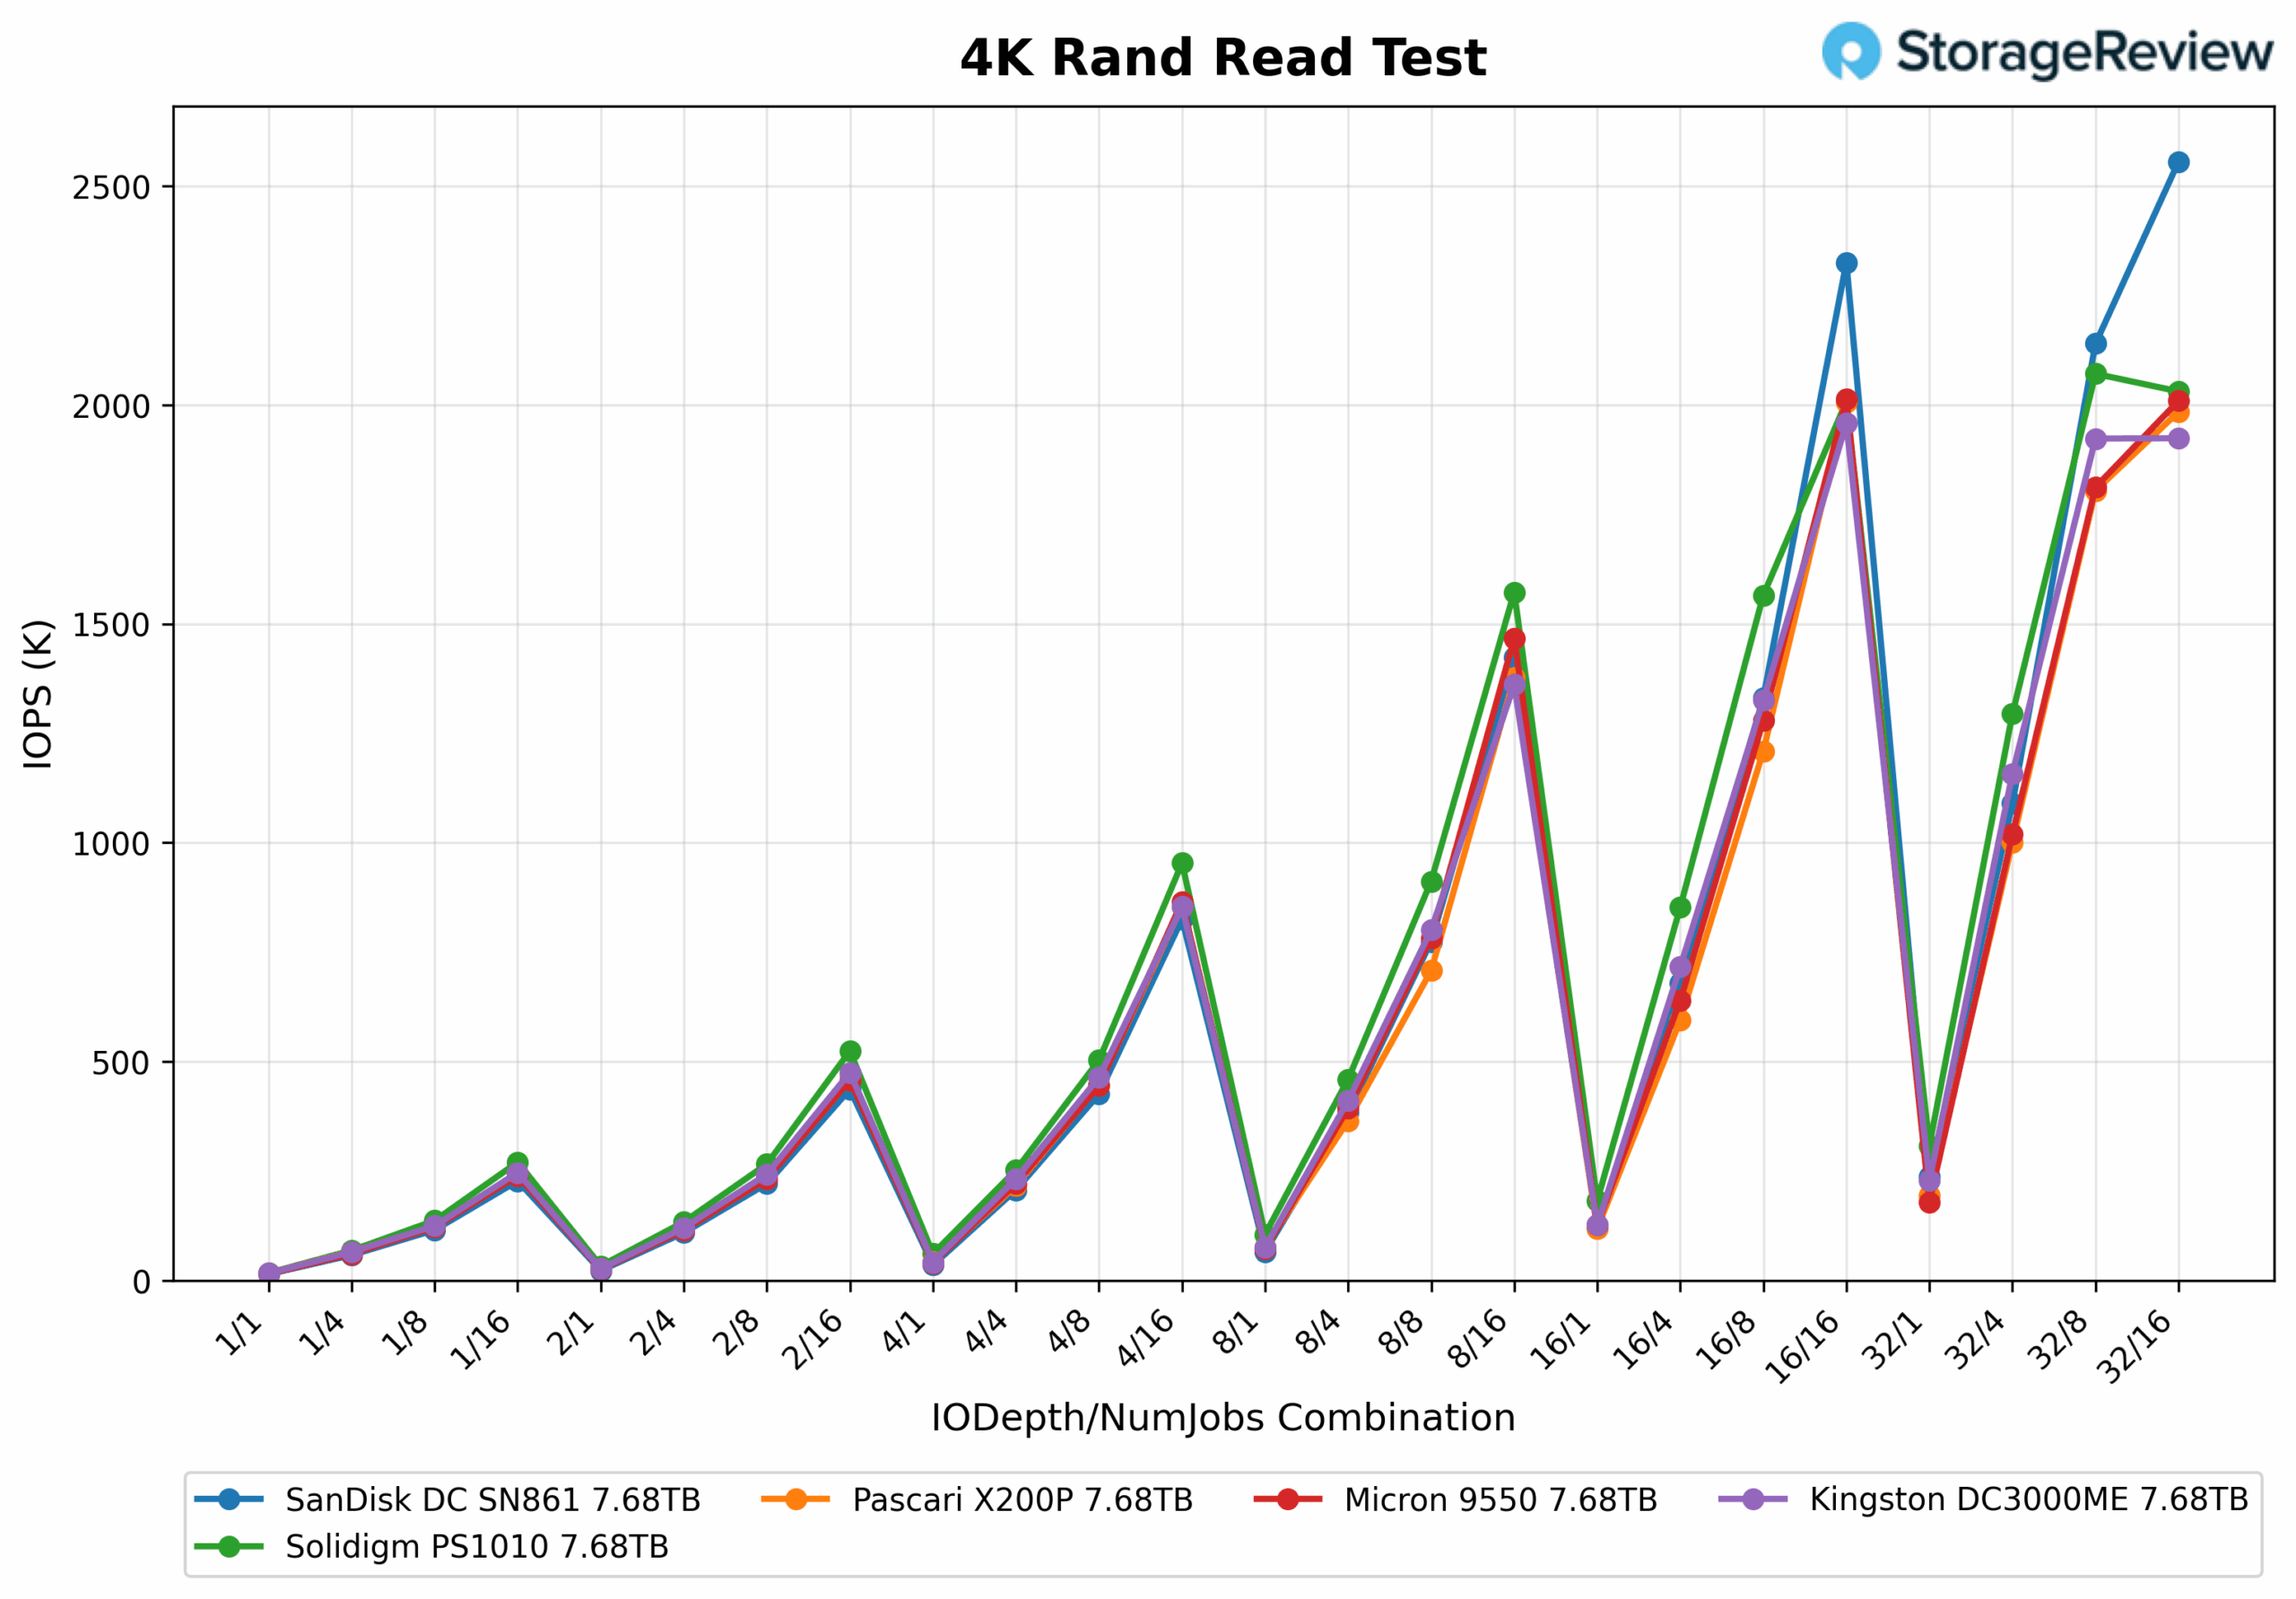
Nella curva delle prestazioni di lettura casuale 4K, l'X200P parte dal limite inferiore con 16.6K IOPS a 1/1, ma scala in modo prevedibile fino alla fascia media, registrando 365K IOPS a 8/4 e 707K IOPS a 8/8. Dimostra un'accelerazione costante verso profondità di coda più elevate, raggiungendo 1.2M IOPS a 16/8 e proseguendo fino a 2M IOPS a 16/16. In particolare, Pascari si posiziona appena sotto Kingston a 32/16 con 1.98M IOPS, posizionandosi a metà classifica. L'unità mantiene un forte slancio positivo a partire da 8/16, raggiungendo gradualmente il livello del milione di IOPS e offrendo prestazioni costanti anche con i carichi di lavoro più impegnativi.
Latenza di lettura casuale di 4K
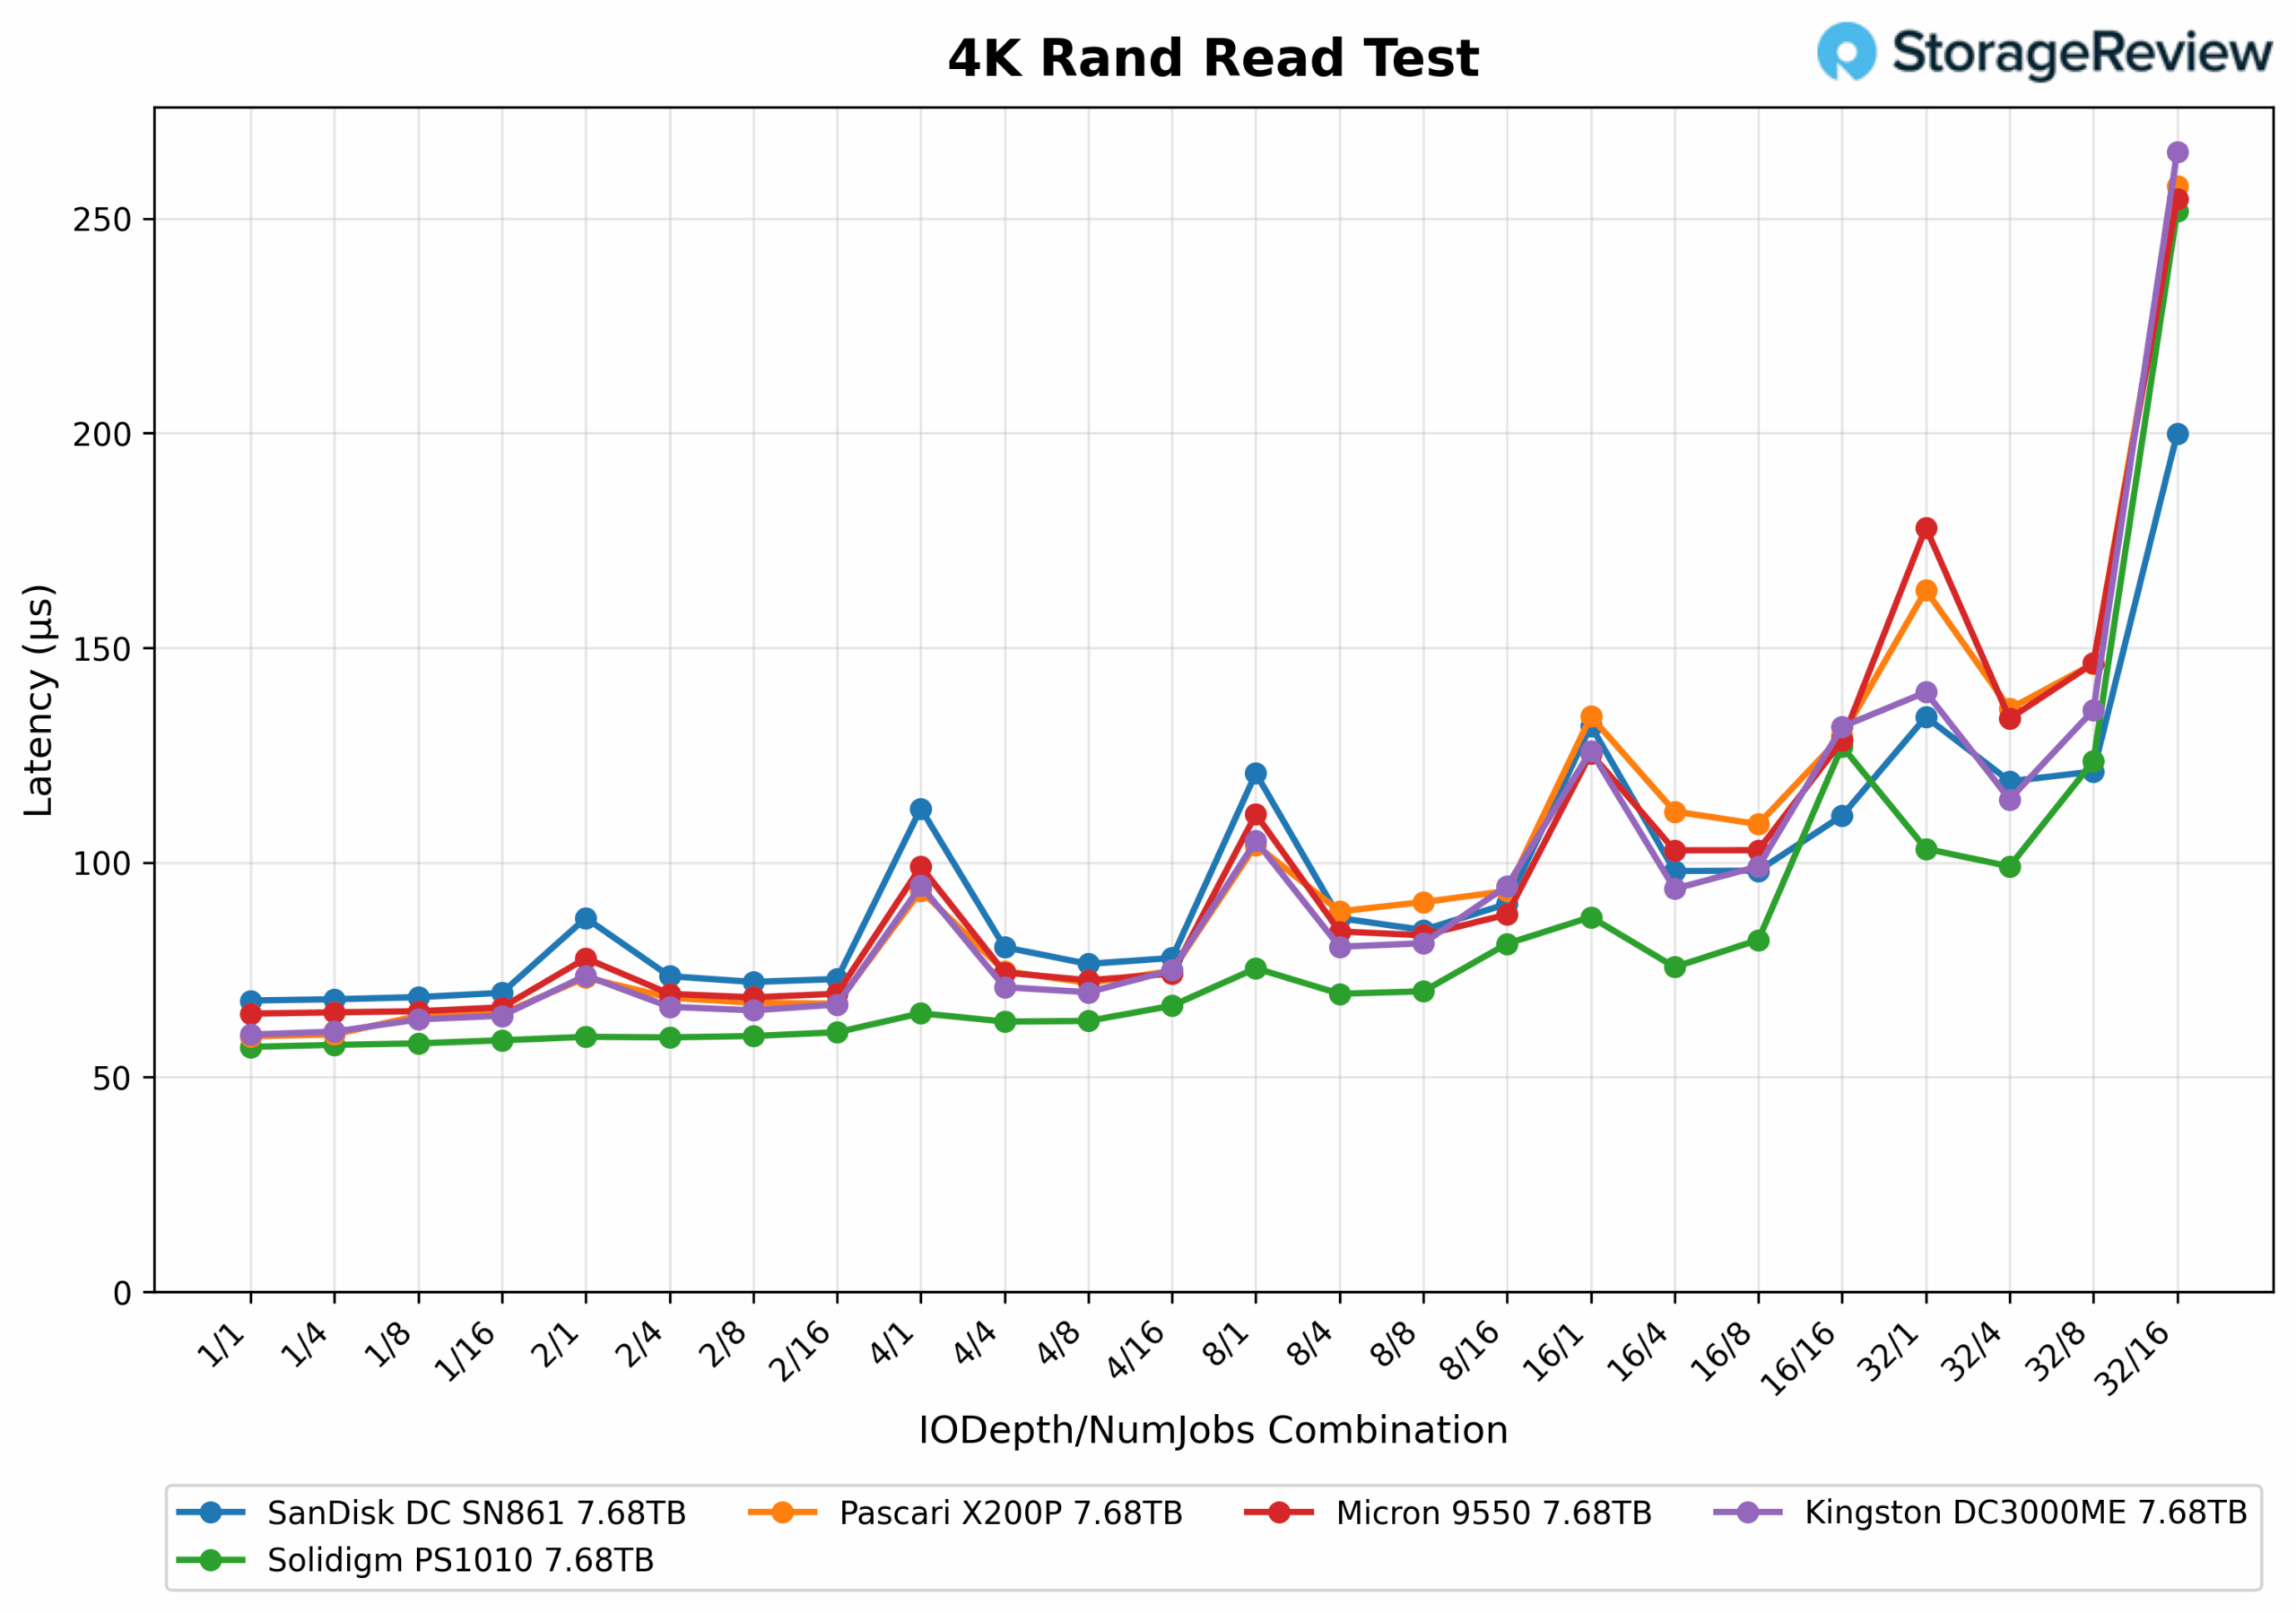
Nel test di latenza di lettura casuale 4K, X200P mantiene prestazioni competitive lungo tutta la curva del carico di lavoro. Inizia con soli 0.059 ms a 1/1 e prosegue in modo efficiente con 0.060 ms a 1/4, 0.064 ms a 1/8 e 0.067 ms a 2/8. All'aumentare della profondità della coda, Pascari rimane in linea con altre unità aziendali, registrando 0.075 ms a 4/4, 0.089 ms a 8/4 e 0.109 ms a 16/8. Con carichi di lavoro più pesanti, come 32/4, ha raggiunto 0.136 ms e 0.163 ms a 32/1. La latenza di picco arriva a 32/16 con 0.258 ms, leggermente superiore a Solidigm ma simile e intermedia tra Kingston e Micron.
Archiviazione diretta GPU
Uno dei test che abbiamo condotto su questo banco di prova è stato il test Magnum IO GPU Direct Storage (GDS). GDS è una funzionalità sviluppata da NVIDIA che consente alle GPU di bypassare la CPU quando accedono ai dati archiviati su unità NVMe o altri dispositivi di archiviazione ad alta velocità. Invece di instradare i dati attraverso la CPU e la memoria di sistema, GDS consente la comunicazione diretta tra la GPU e il dispositivo di archiviazione, riducendo significativamente la latenza e migliorando la velocità di elaborazione dei dati.
Come funziona l'archiviazione diretta GPU
Tradizionalmente, quando una GPU elabora dati archiviati su un'unità NVMe, i dati devono prima passare attraverso la CPU e la memoria di sistema prima di raggiungere la GPU. Questo processo introduce colli di bottiglia, poiché la CPU diventa un intermediario, aggiungendo latenza e consumando preziose risorse di sistema. GPU Direct Storage elimina questa inefficienza consentendo alla GPU di accedere ai dati direttamente dal dispositivo di archiviazione tramite il bus PCIe. Questo percorso diretto riduce il sovraccarico associato allo spostamento dei dati, consentendo trasferimenti di dati più rapidi ed efficienti.
I carichi di lavoro AI, in particolare quelli che coinvolgono il deep learning, sono altamente intensivi in termini di dati. L'addestramento di grandi reti neurali richiede l'elaborazione di terabyte di dati e qualsiasi ritardo nel trasferimento dei dati può portare a GPU sottoutilizzate e tempi di addestramento più lunghi. GPU Direct Storage affronta questa sfida assicurando che i dati vengano consegnati alla GPU il più rapidamente possibile, riducendo al minimo i tempi di inattività e massimizzando l'efficienza computazionale.
Inoltre, GDS è particolarmente utile per carichi di lavoro che comportano lo streaming di grandi set di dati, come l'elaborazione video, l'elaborazione del linguaggio naturale o l'inferenza in tempo reale. Riducendo la dipendenza dalla CPU, GDS accelera lo spostamento dei dati e libera risorse della CPU per altre attività, migliorando ulteriormente le prestazioni complessive del sistema.
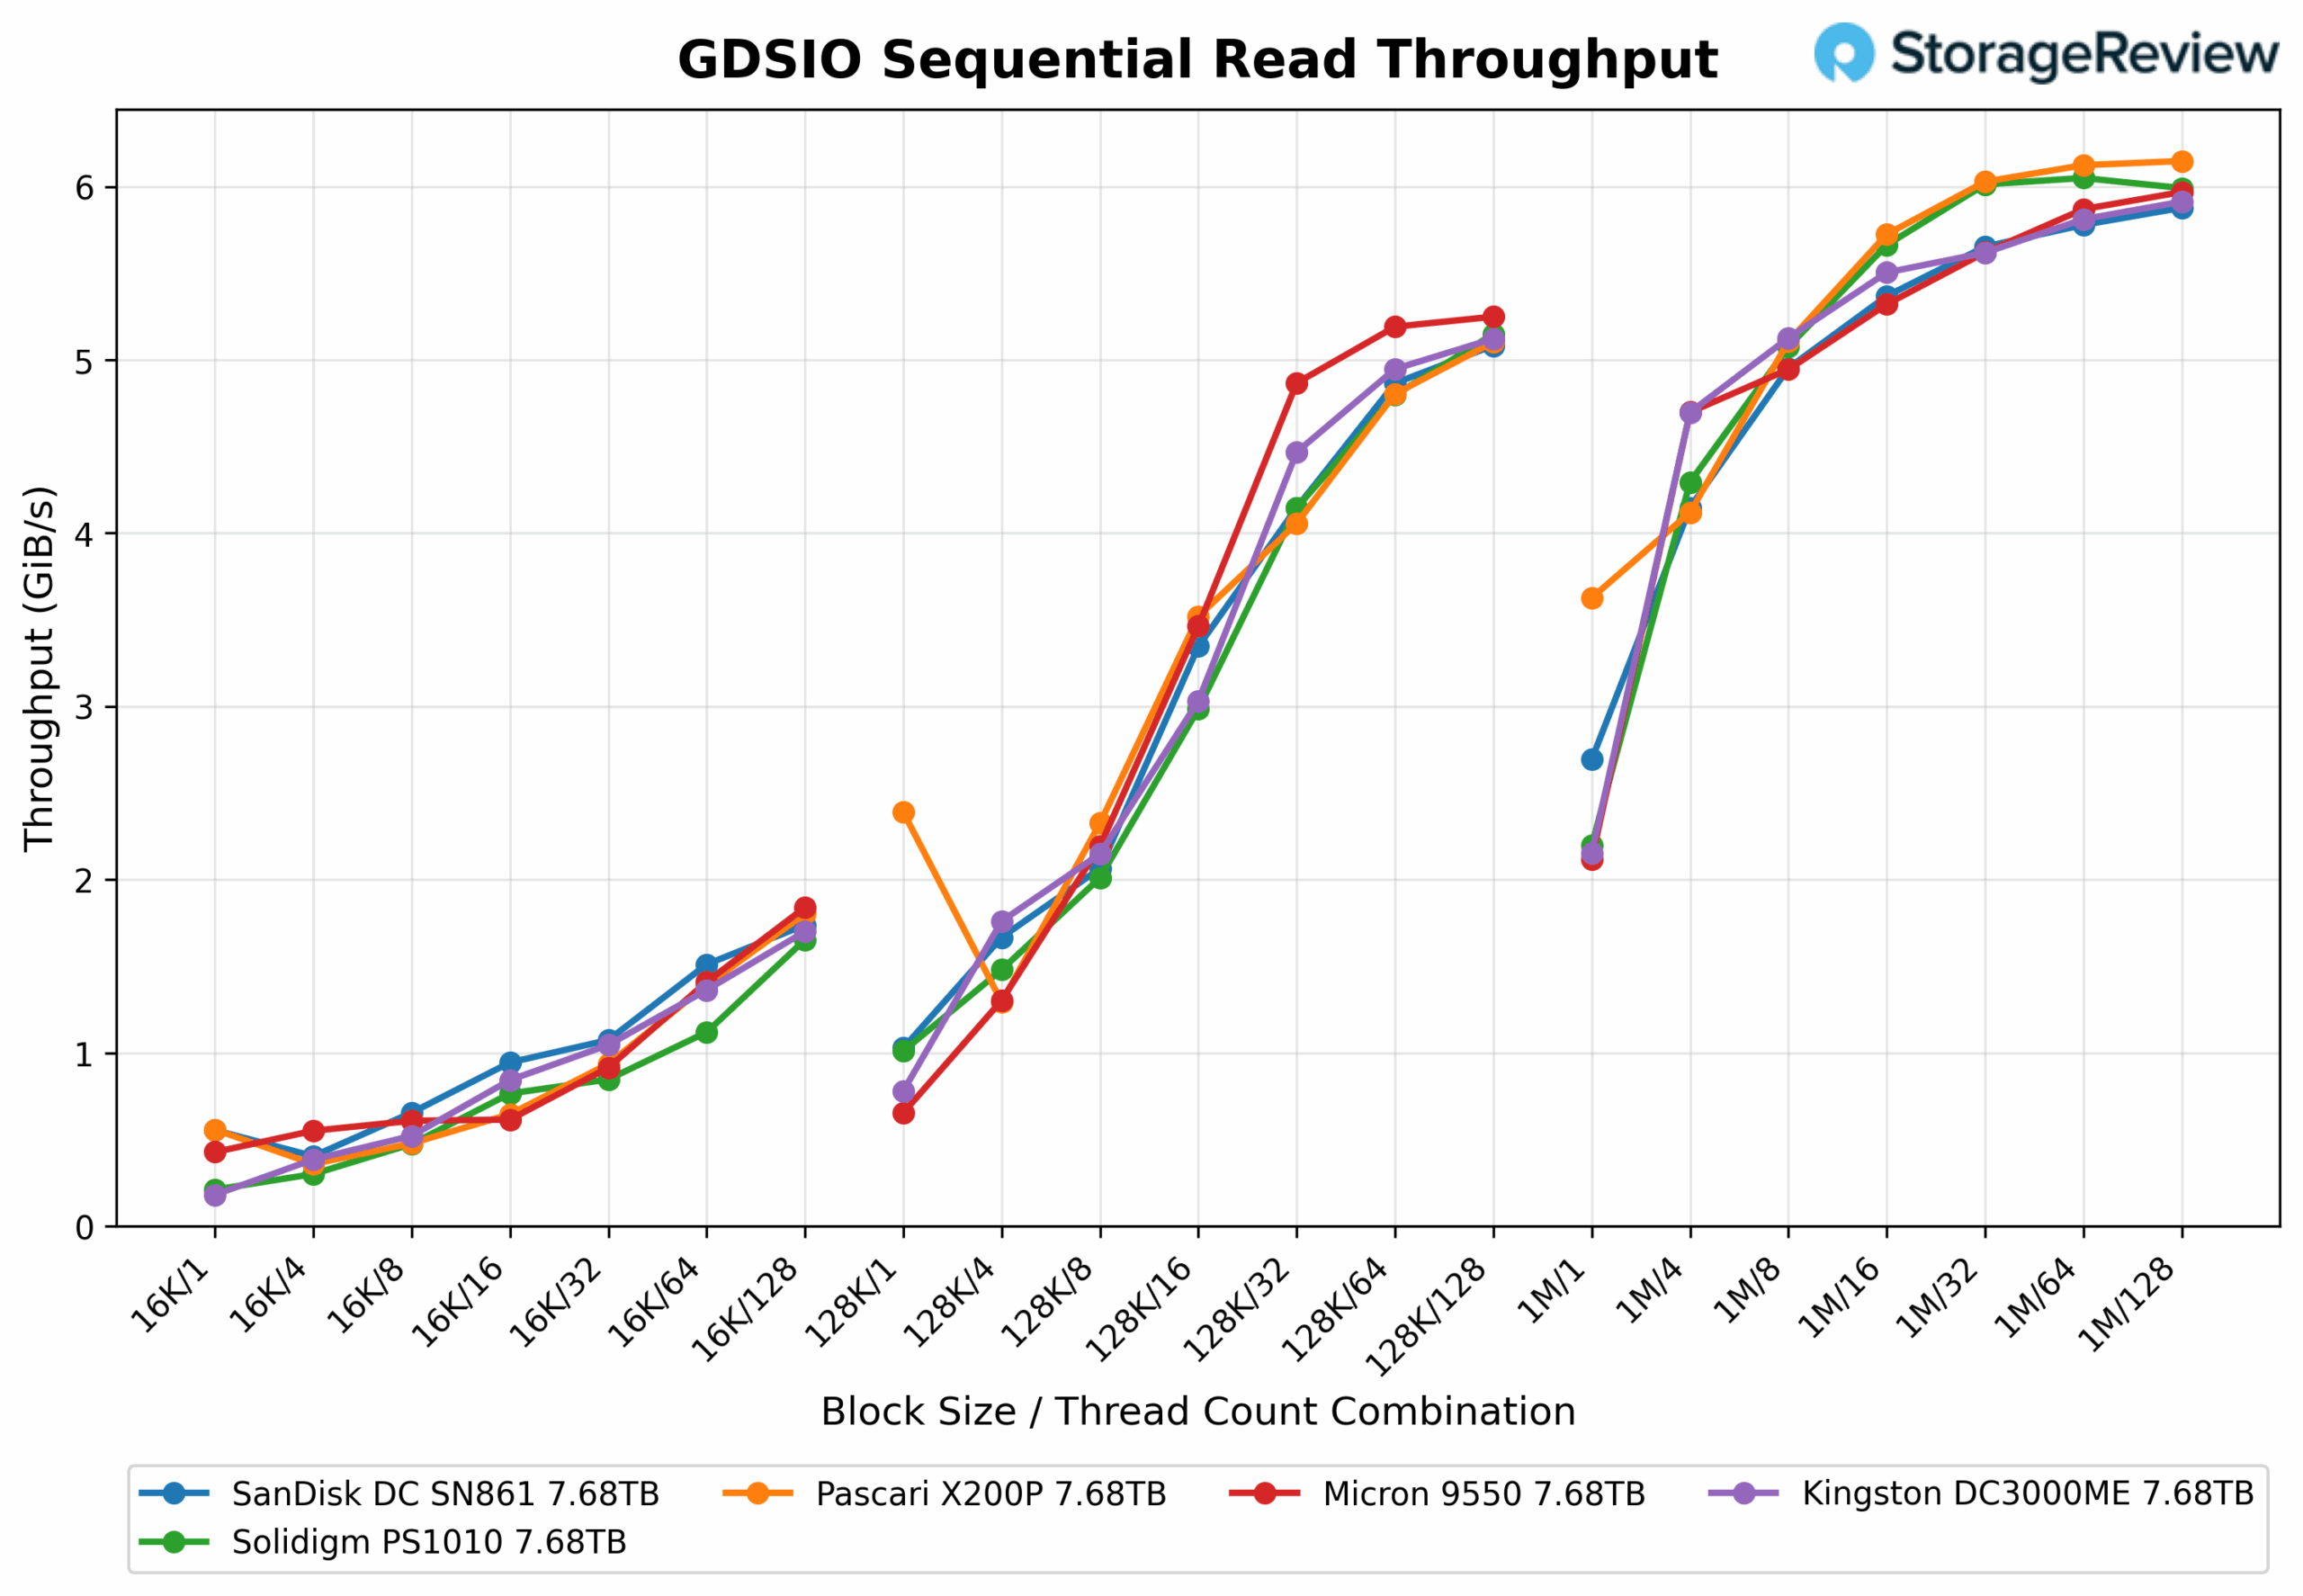
La velocità di trasmissione parte da 0.56 GiB/s (QD1) e aumenta a 1.80 GiB/s a QD128. La scalabilità è modesta ma costante, riflettendo prestazioni accettabili anche con dimensioni di trasferimento inferiori.
Le prestazioni migliorano notevolmente, passando da 2.39 GiB/s a QD1 a 5.10 GiB/s a QD128. Questo dimostra una migliore efficienza di scalabilità e un utilizzo più consistente, poiché l'unità gestisce letture più voluminose.
La velocità di trasmissione parte da 3.63 GiB/s e arriva fino a 6.15 GiB/s a QD128. I guadagni sono meno significativi in questo caso, ma l'unità offre la larghezza di banda in lettura assoluta più elevata in questo intervallo, rendendola ideale per trasferimenti sequenziali di grandi dimensioni.
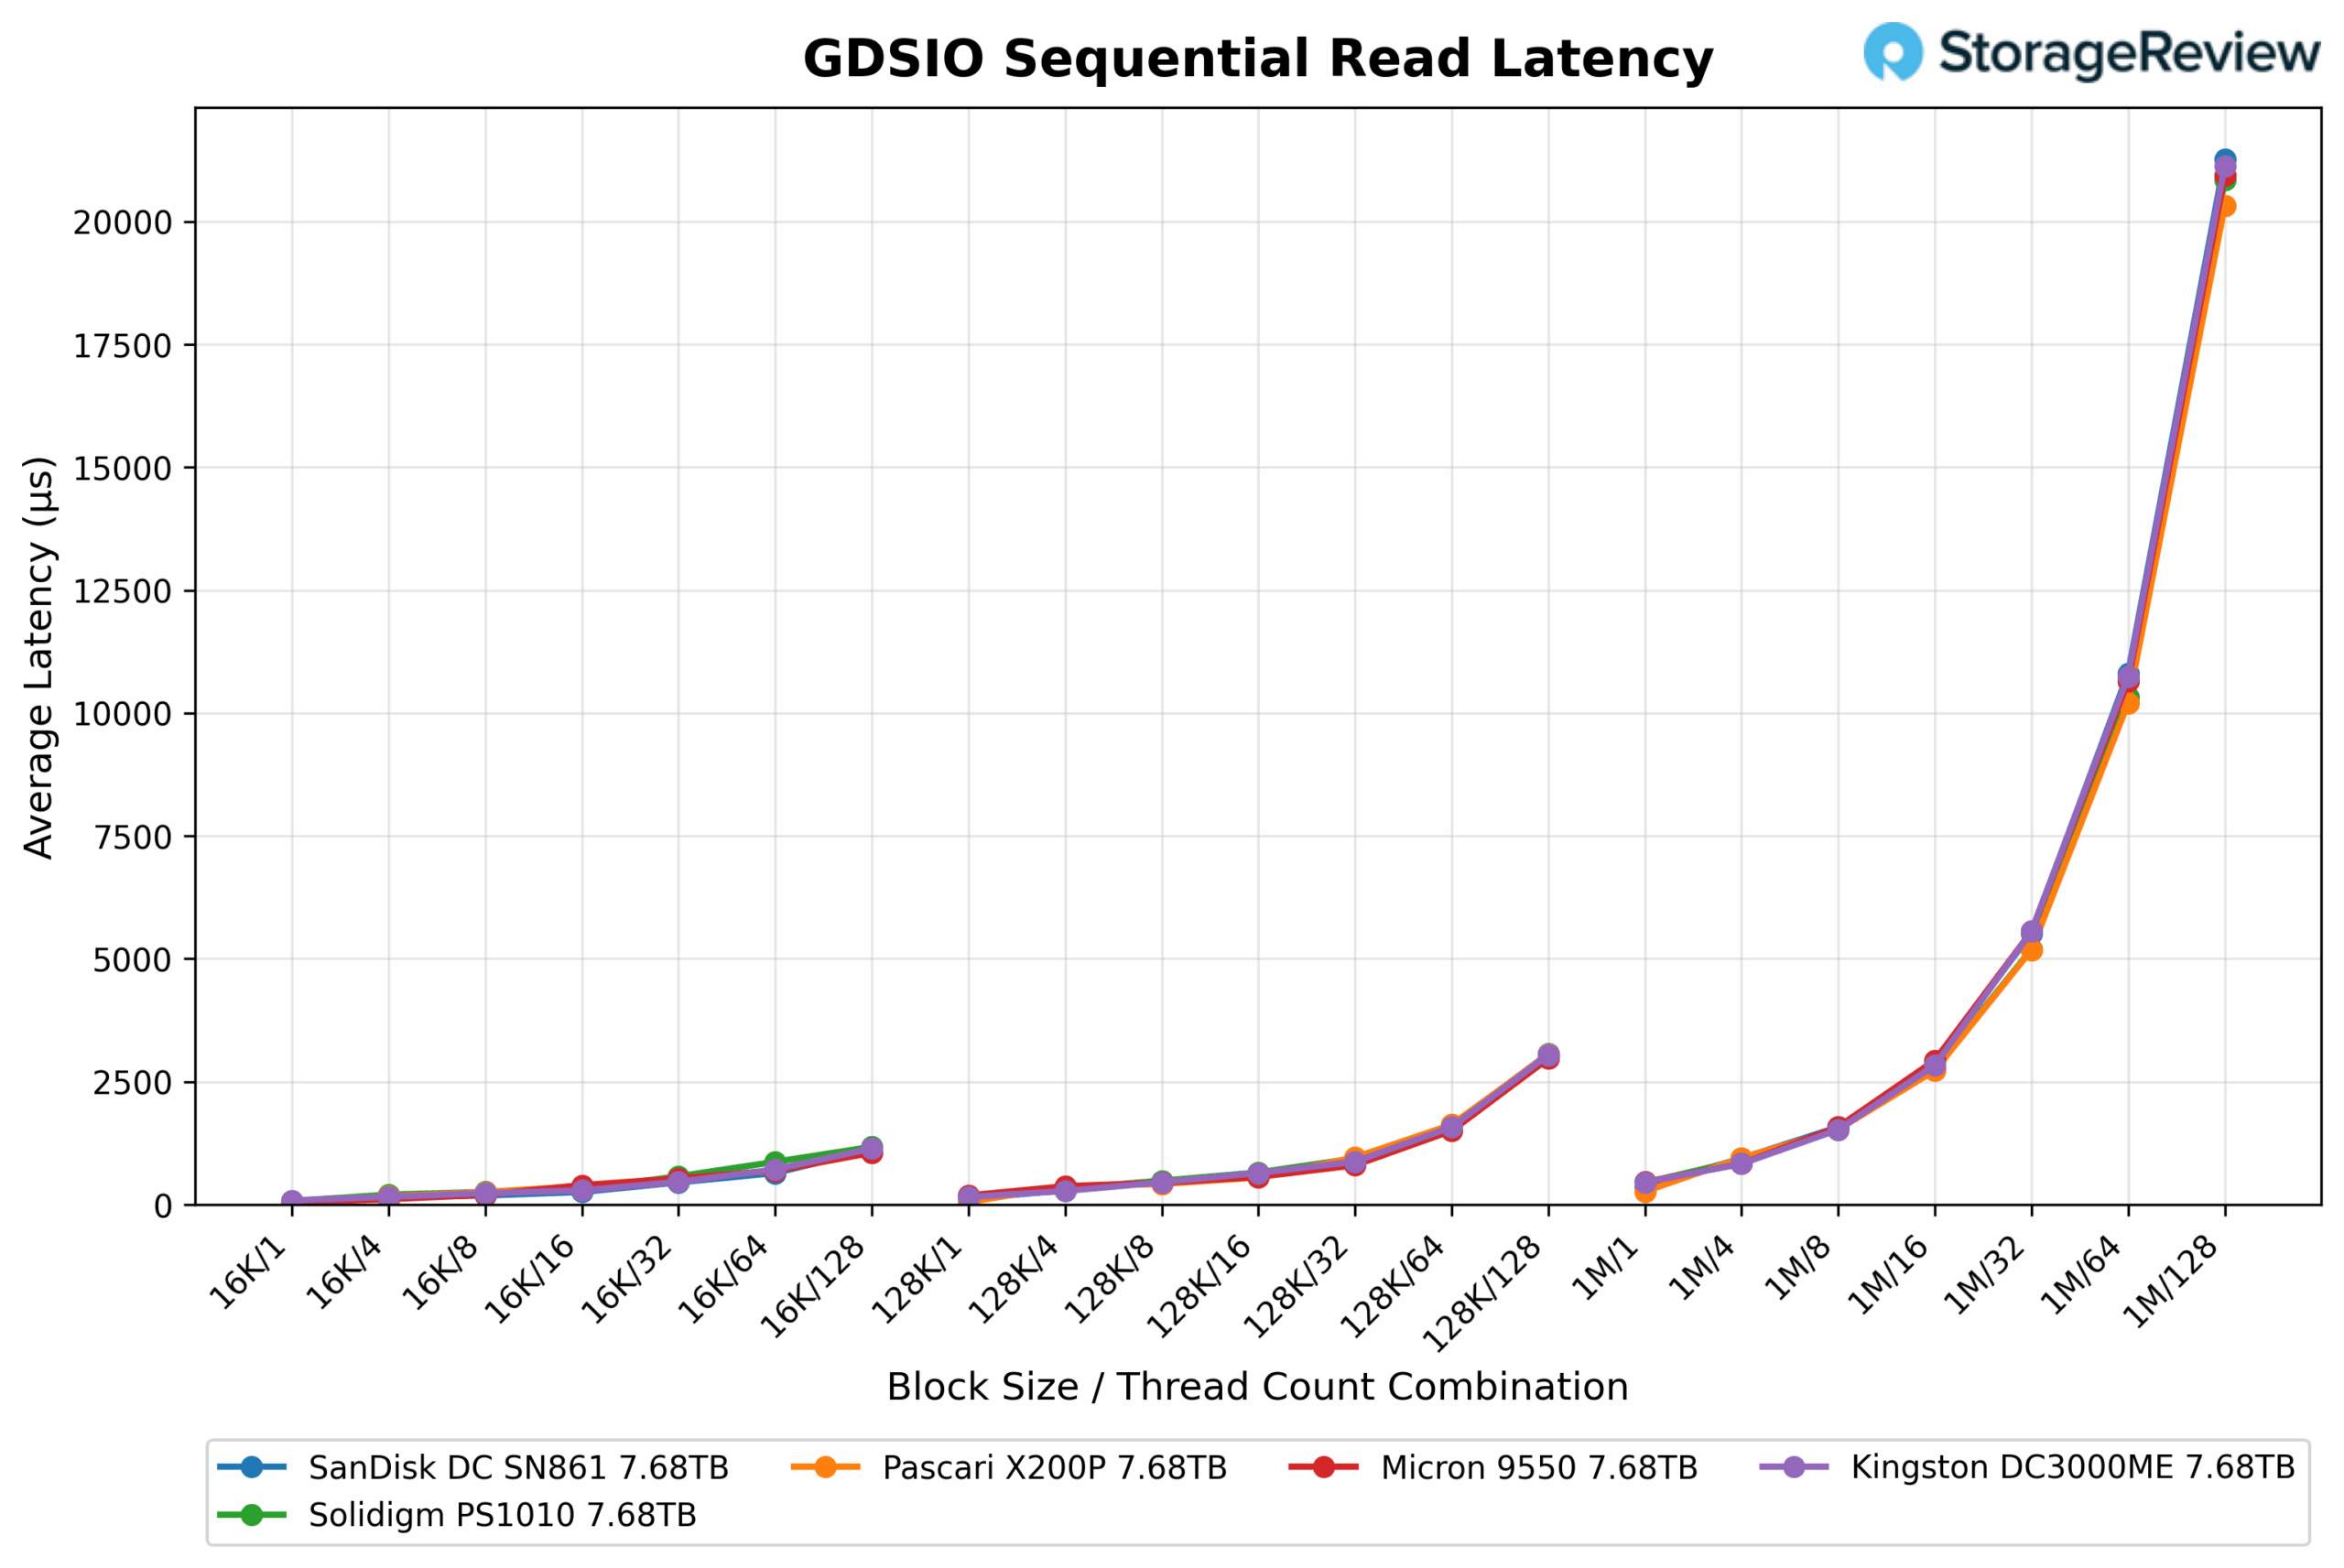
I risultati della latenza di lettura GDSIO per Pascari X200P evidenziano una chiara relazione tra dimensione del blocco, numero di thread e latenza. Con una dimensione del blocco inferiore di 16K e un singolo thread, l'unità raggiunge una latenza media di soli 0.026 ms. Tuttavia, scalando a 128 thread con la stessa dimensione del blocco, la latenza aumenta significativamente fino a 1.076 ms. Con blocchi da 128K, la latenza è di 0.050 ms con un singolo thread e sale a 3.056 ms con 128 thread. Per blocchi più grandi da 1M, la latenza inizia a 0.268 ms con un singolo thread e raggiunge picchi di 20.324 ms con il parallelismo massimo.
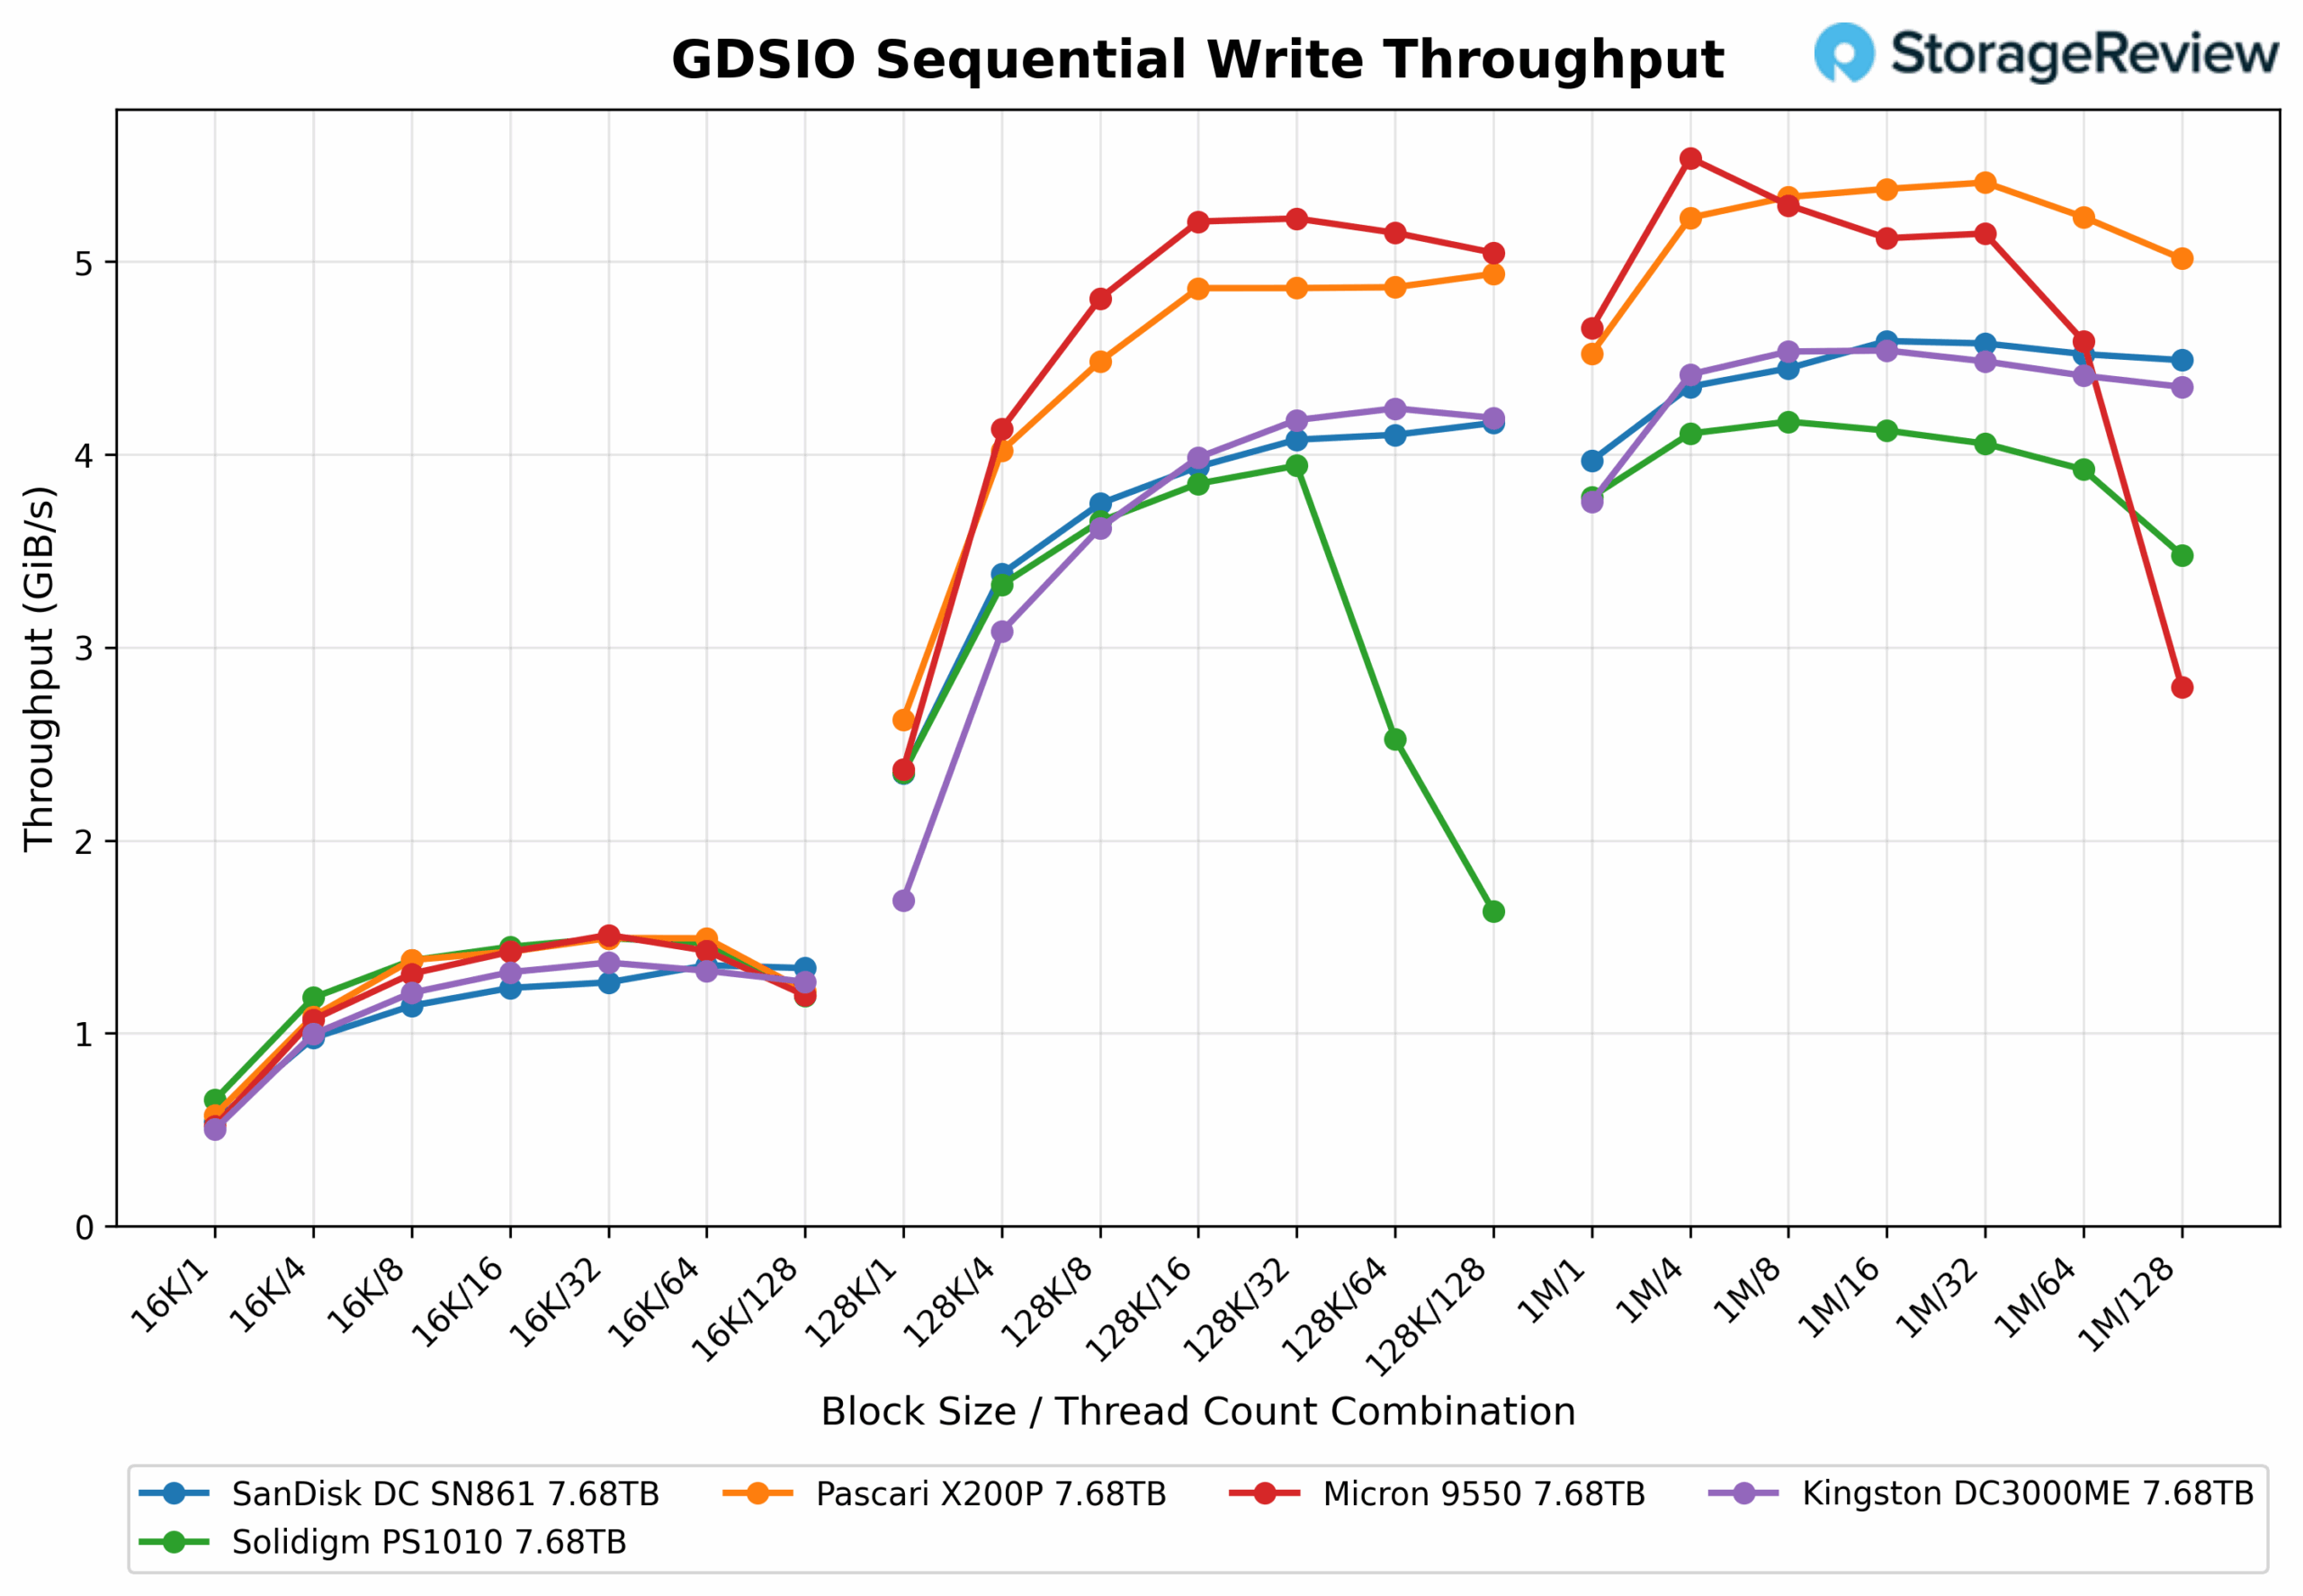
Con blocchi da 16K, il throughput di X200P parte da 0.58 GiB/s (latenza di 25.17 µs) al QD1 e sale a 1.22 GiB/s (latenza di 1.59 ms) al QD128. Questo rappresenta un modesto guadagno di larghezza di banda, ma con un forte aumento della latenza, suggerendo una saturazione precoce a queste ridotte dimensioni di I/O.
A 128K, le prestazioni scalano meglio, partendo da 2.63 GiB/s (45.55 µs) e aumentando fino a 4.94 GiB/s (3.16 ms) a QD128. Questo rappresenta un notevole aumento della produttività, ma anche in questo caso la latenza aumenta drasticamente, indicando un sovraccarico crescente in condizioni di elevata profondità di coda.
Con una dimensione di blocco di 1M, l'unità parte da 4.52 GiB/s (215 µs) e raggiunge il picco a 5.02 GiB/s (24.9 ms) a QD128. Il guadagno in termini di throughput è minimo rispetto a 128K e la latenza a QD128 diventa la più alta tra tutti i test, segnalando guadagni di efficienza limitati da trasferimenti di dimensioni superiori a 128K in code profonde.
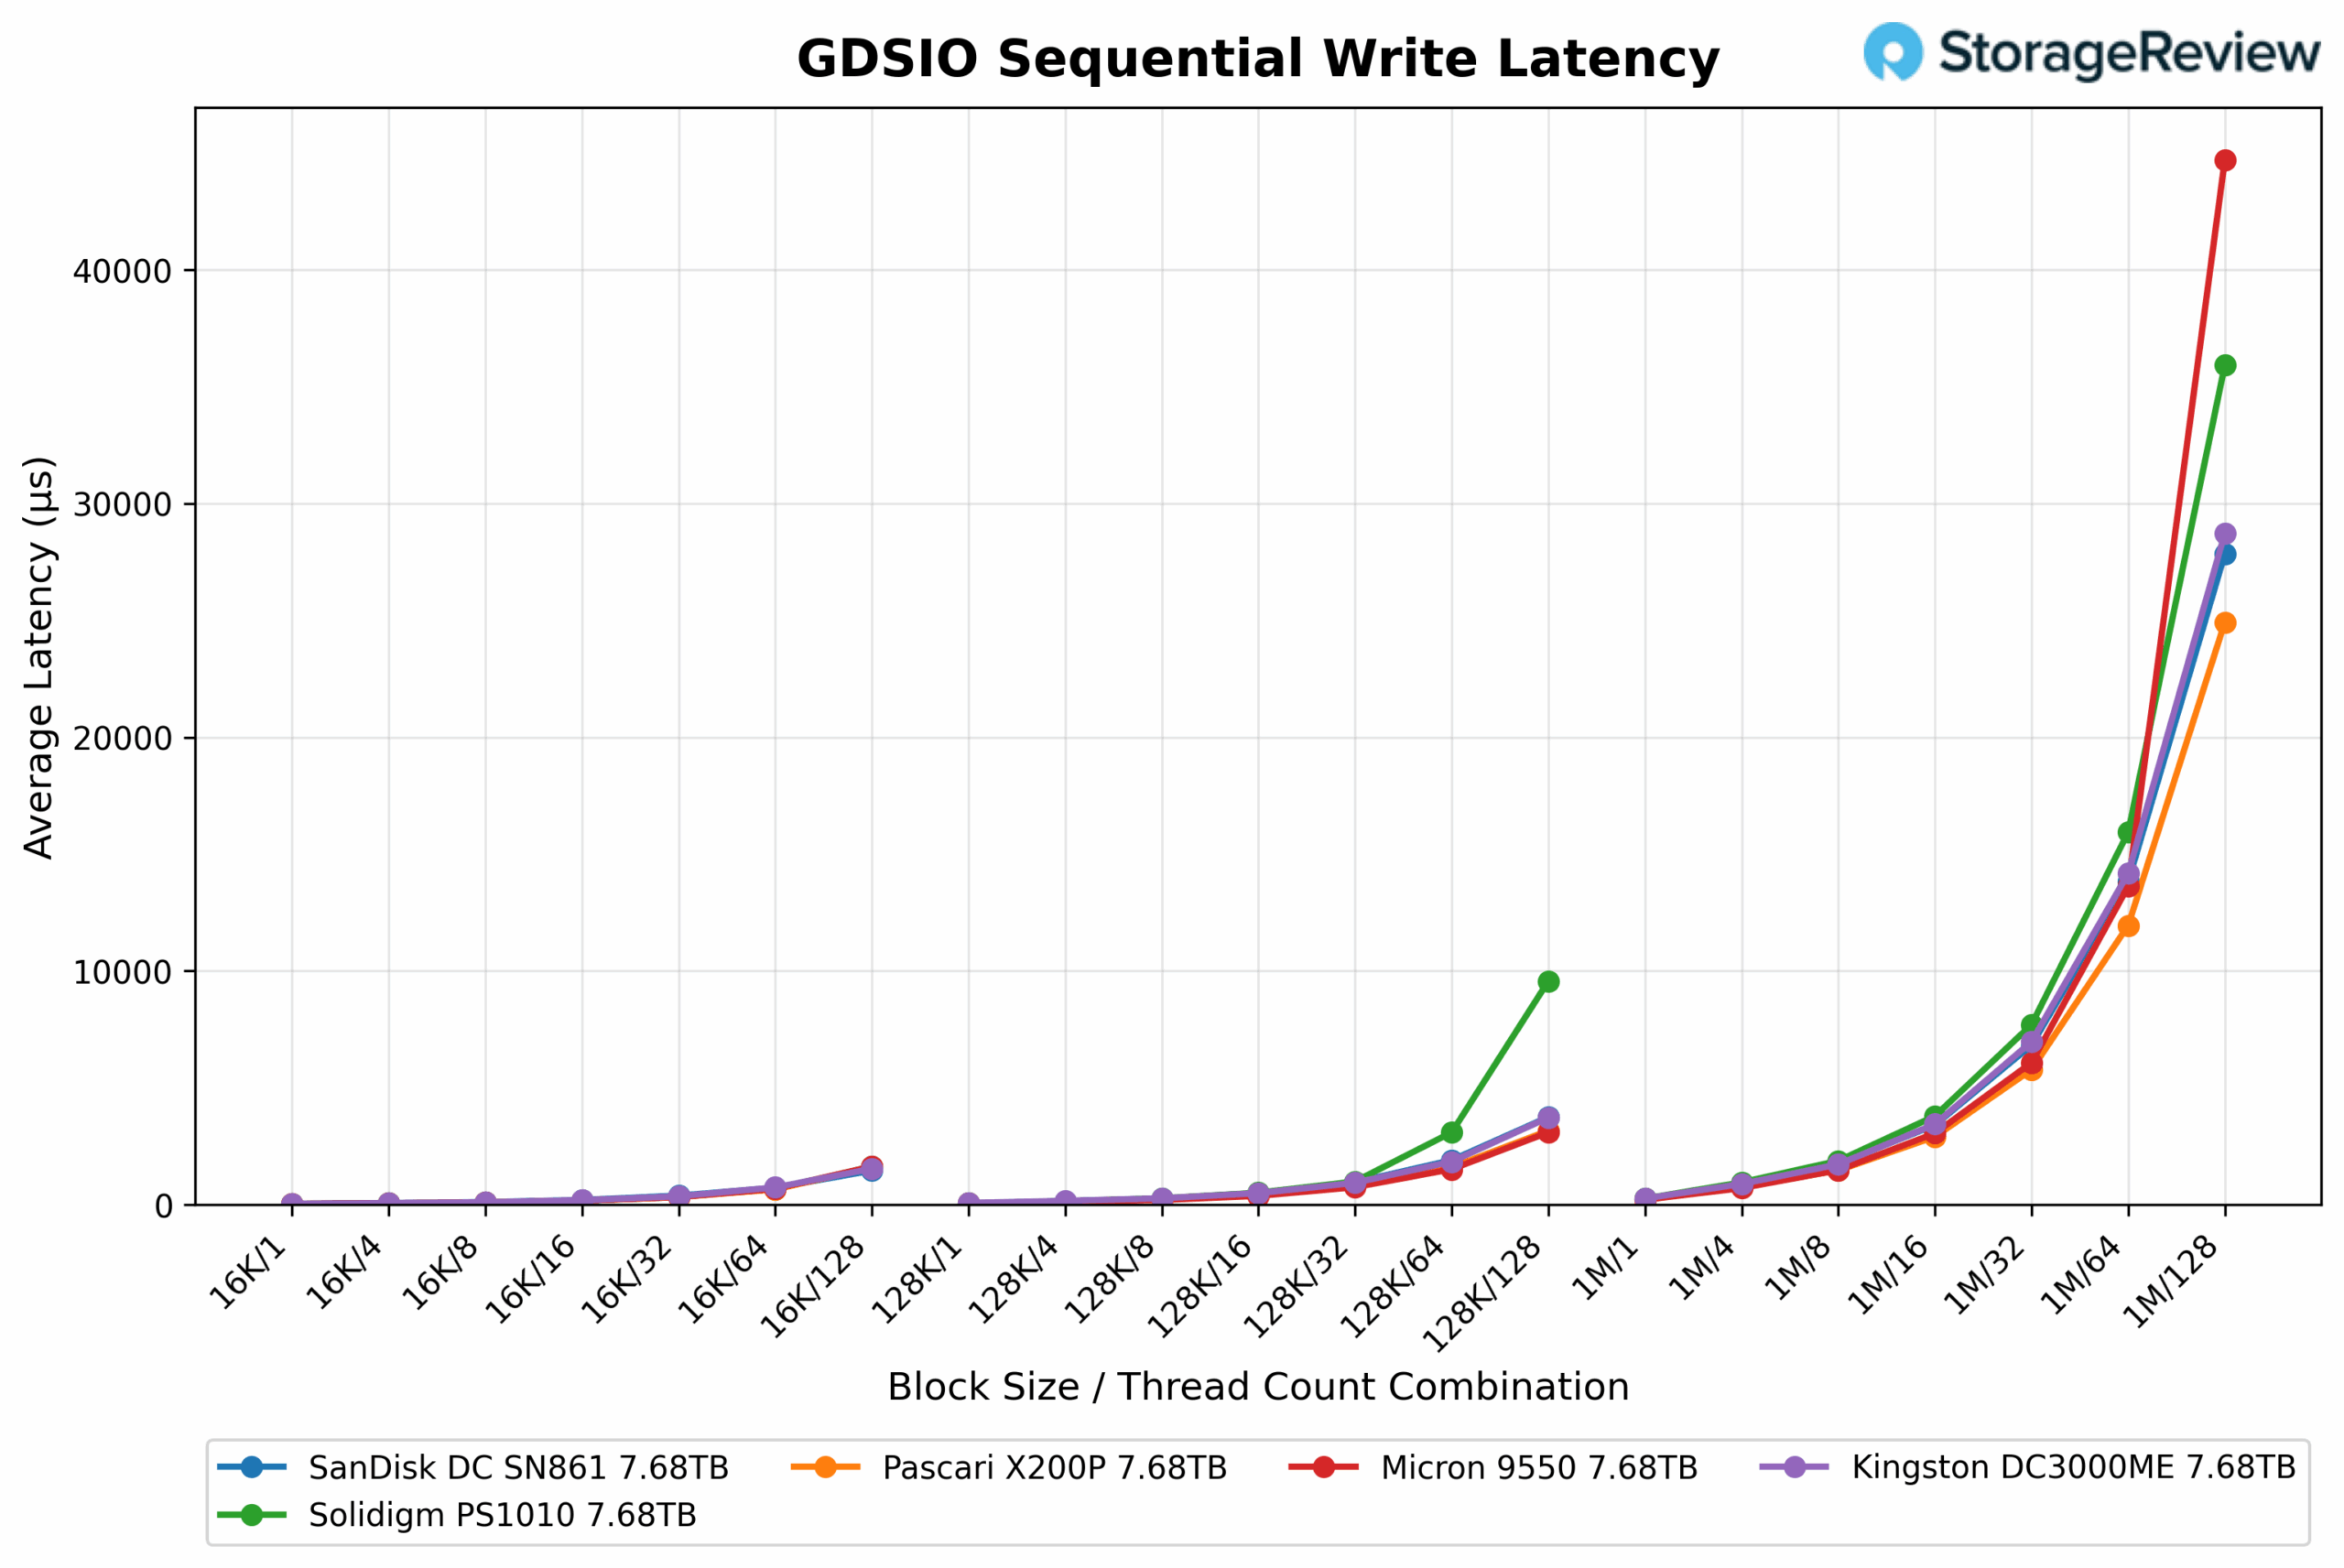
I risultati della latenza di scrittura GDSIO per Pascari X200P mostrano un andamento di scalabilità costante, con la latenza che aumenta all'aumentare delle dimensioni dei blocchi e del numero di thread. Con blocchi da 16K e un singolo thread, l'unità registra una latenza media di 0.025 ms, che sale a 1.595 ms a 128 thread. Con blocchi da 128K, la latenza passa da 0.046 ms a 3.159 ms nelle stesse condizioni. Alla dimensione massima dei blocchi, pari a 1M, la latenza parte da 0.215 ms e raggiunge i 24.917 ms alla massima profondità di thread. Nonostante l'aumento previsto della latenza, Pascari X200P è in testa al gruppo per dimensioni dei blocchi e numero di thread più elevati, mantenendo la latenza più bassa in presenza di carichi di lavoro di scrittura parallela elevati.
Conclusione
L'SSD Phison Pascari X200P da 7.68 TB è un'unità di livello enterprise con memoria NAND TLC e ottimizzata per le prestazioni PCIe Gen5, ideale per carichi di lavoro generici e ad alto contenuto. È progettata per ambienti in cui l'elevata produttività, la solida scalabilità e la flessibilità di implementazione hanno la priorità sull'ottimizzazione specifica per l'iperscalabilità. Grazie al supporto per i formati U.2, U.3 ed E3.S, insieme a funzionalità come la protezione dalle interruzioni di corrente, la crittografia AES-XTS a 256 bit e la gestione NVMe-MI, l'X200P fornisce una solida base per l'infrastruttura di storage.
In termini di prestazioni, l'X200P eccelle in scenari sequenziali e ad alta intensità di lettura, posizionandosi costantemente tra i migliori nei test a 128K e 64K e scalando efficacemente sotto carichi di lavoro CDN. I test FIO confermano la sua eccellenza nelle letture sequenziali e mostrano prestazioni competitive nei carichi di lavoro di lettura casuale. Pur risultando inferiore a unità di fascia alta come Micron e SanDisk in condizioni di scrittura intensiva e altamente simultanee, il suo comportamento di scrittura prevedibile ed efficiente lo rende adatto a un'ampia gamma di implementazioni aziendali di medie dimensioni.
I test GDSIO evidenziano ulteriormente i punti di forza dell'unità nelle applicazioni incentrate sulla produttività. L'X200P mantiene un'eccellente latenza anche con blocchi di dimensioni ridotte e si distingue in caso di accesso parallelo intensivo con trasferimenti di blocchi di grandi dimensioni. Sebbene la latenza aumenti a code più lunghe, l'ottimizzazione di Phison garantisce che l'unità rimanga stabile e reattiva anche sotto pressione prolungata.
Nel complesso, Pascari X200P è un SSD aziendale completo, con prestazioni elevate e un set di funzionalità pensato per carichi di lavoro reali. Sarà interessante vedere se Phison riuscirà a trasformarsi da un'azienda focalizzata sui controller a un'azienda che offre una vasta gamma di soluzioni di storage integrate. Finora, l'X200P sembra un inizio promettente in questa direzione.


 Amazon