

L'alta disponibilità, un tempo lusso riservato ai data center, è diventata una voce di spesa essenziale nella pianificazione della resilienza. Le piccole imprese e le sedi periferiche gestiscono ormai sistemi POS, videosorveglianza e storage condiviso, che comportano costi aggiuntivi per ogni minuto di inattività. Eppure, la soluzione classica, un array enterprise a doppio controller, è dimensionata e prezzata per i data center piuttosto che per un locale tecnico o un rack a parete. Questa discrepanza ha lasciato i piccoli reparti IT con backup e snapshot per la protezione dei dati, ma senza alcuna soluzione per la continuità operativa: un NAS a singolo controller, per quanto ben progettato, rimane un singolo punto di guasto.
L'alta disponibilità non è una novità per QNAP, che offre da tempo hardware a doppio controller e percorsi di ripristino basati sulla replica. La novità di QuTS hero h6.0 risiede nell'efficienza. Il nuovo High Availability Manager integra il clustering nel sistema operativo su hardware standard, consentendo a due unità NAS identiche di formare un cluster attivo-passivo dietro un singolo indirizzo IP, in modo che quando una delle unità si guasta, l'altra subentra e i client non se ne accorgono quasi. Per un'organizzazione che cerca di ottimizzare il proprio investimento IT, questo si traduce in alta disponibilità al costo di un secondo NAS anziché di una seconda classe di infrastruttura.
Ecco l'idea: per verificarne la validità nella pratica, abbiamo creato un cluster HA in laboratorio utilizzando due sistemi QNAP TS-h765eU dotati di hard disk Seagate IronWolf Pro e SSD QNAP E1.S per la cache. Abbiamo quindi cercato di metterlo in crisi simulando i guasti che si verificano nelle sedi periferiche. Abbiamo interrotto l'alimentazione del nodo attivo a metà trasferimento e abbiamo disconnesso la sua connessione di rete, mantenendo però attivo il segnale di heartbeat. In entrambi i casi, la domanda era la stessa: il trasferimento dei file è andato a buon fine e come si è svolto il ripristino al ritorno del nodo guasto?
Panoramica del QNAP TS-h765eU
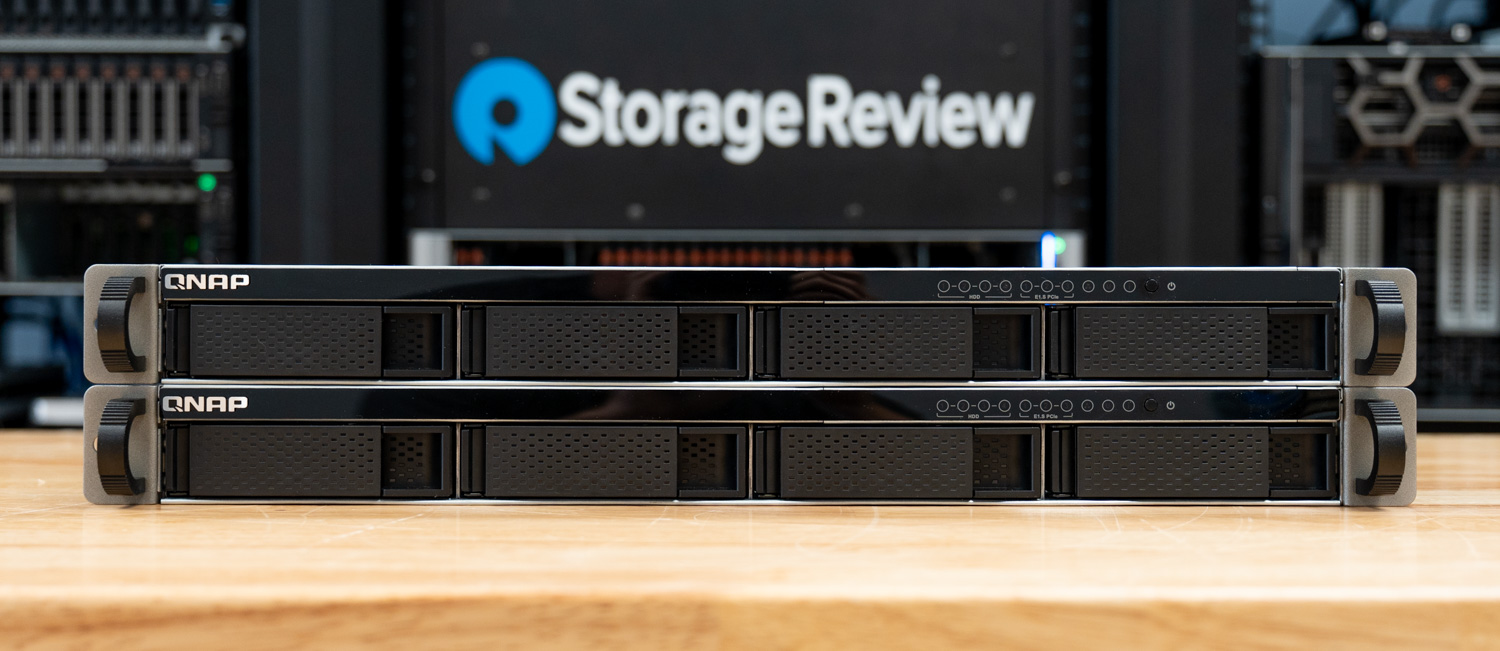
Il TS-h765eU è una scelta interessante come componente per soluzioni HA proprio per la sua relativa semplicità hardware. Si tratta di un NAS rackmount 1U a profondità ridotta, con una profondità di soli 292.1 mm (12 pollici), progettato per piccoli armadi multimediali, rack di rete a parete e implementazioni edge in cui uno chassis a profondità standard non troverebbe spazio. Ogni unità offre quattro alloggiamenti per unità SATA da 3.5 pollici sul pannello frontale, oltre a tre slot PCIe NVMe E1.S/M.2 sul retro, conferendogli una configurazione di storage ibrida: dischi rigidi per la capacità di archiviazione e memoria flash per la cache o per livelli di storage veloci.
QNAP l'ha inoltre designato come modello di fornitura a lungo termine con disponibilità garantita fino al 2031, un aspetto importante per le organizzazioni che standardizzano la piattaforma su tutte le sedi.
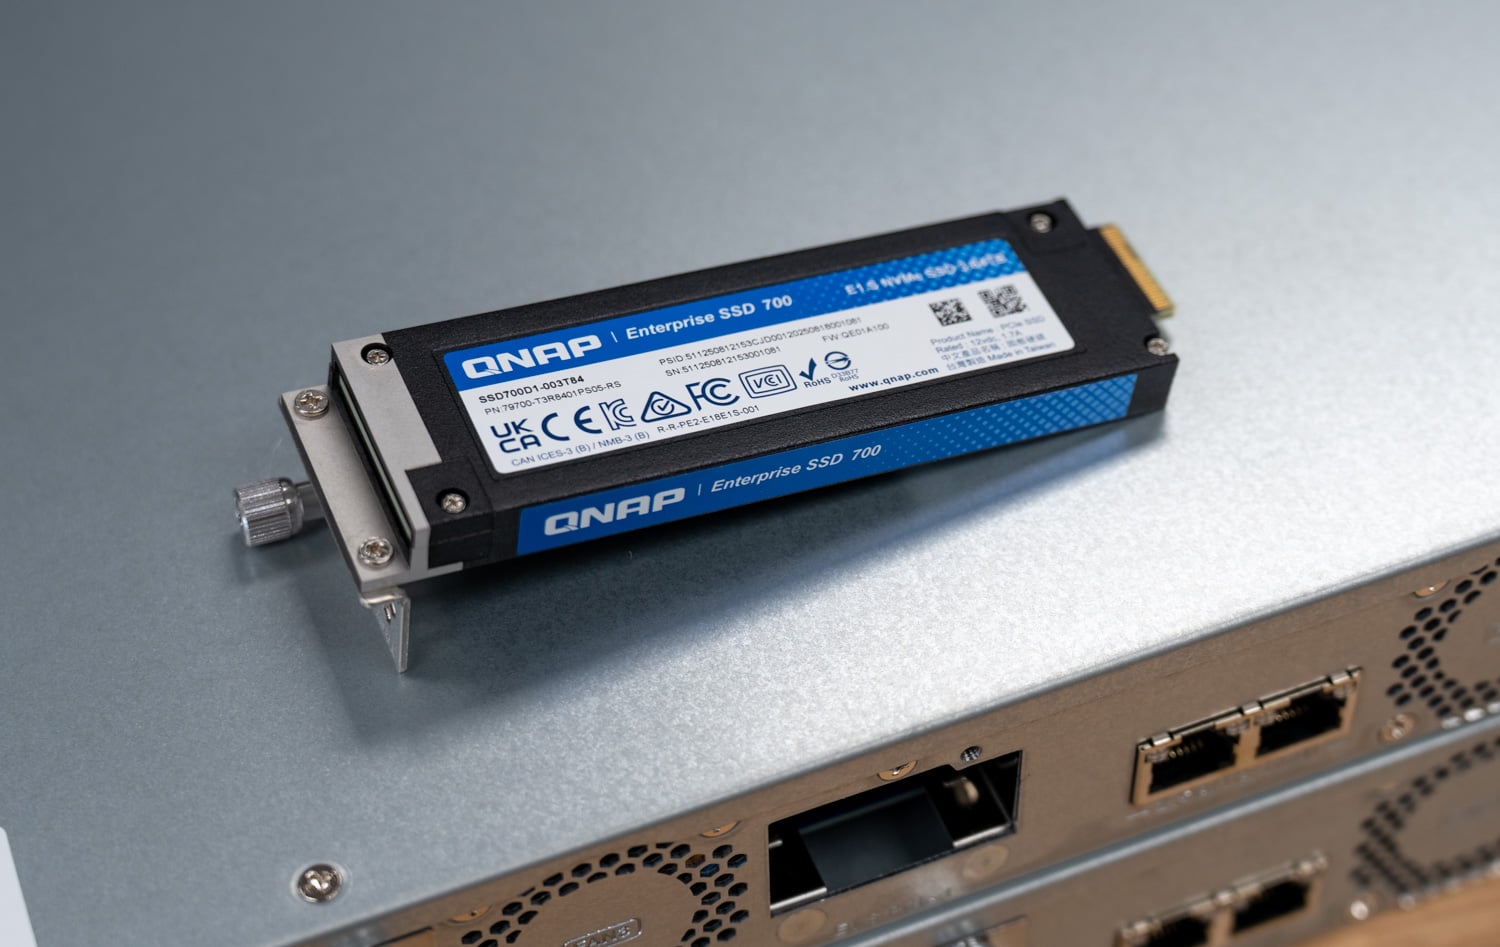
All'interno, il TS-h765eU monta un processore Intel Atom x7405C quad-core con frequenza fino a 3.4 GHz, abbinato a 8 GB di memoria DDR5, espandibile fino a 16 GB, con ECC In-Band. La connettività di rete è garantita da due porte 2.5GbE, con la possibilità di raggiungere i 10GbE sostituendo uno slot E1.S con il modulo QNAP QXG-ES10G1T.
| Specificazione | QNAP TS-h765eU |
|---|---|
| CPU | Processore Intel Atom x7405C quad-core, fino a 3.4 GHz |
| Memorie | 8 GB di memoria DDR5, espandibile fino a 16 GB (In-Band ECC) |
| Alloggiamenti per unità | SATA da 4 x 3.5 pollici |
| Flash Slots | 3 x E1.S / M.2 PCIe NVMe |
| Networking | 2 x 2.5 GbE, 10 GbE tramite modulo opzionale QXG-ES10G1T E1.S |
| Fattore di forma | Montaggio su rack 1U a profondità ridotta, 292.1 mm (12 pollici) di profondità |
| Sistema operativo | QuTS hero h6.0 (basato su ZFS) |
| Disponibilità | Modello di approvvigionamento a lungo termine fino al 2031 |
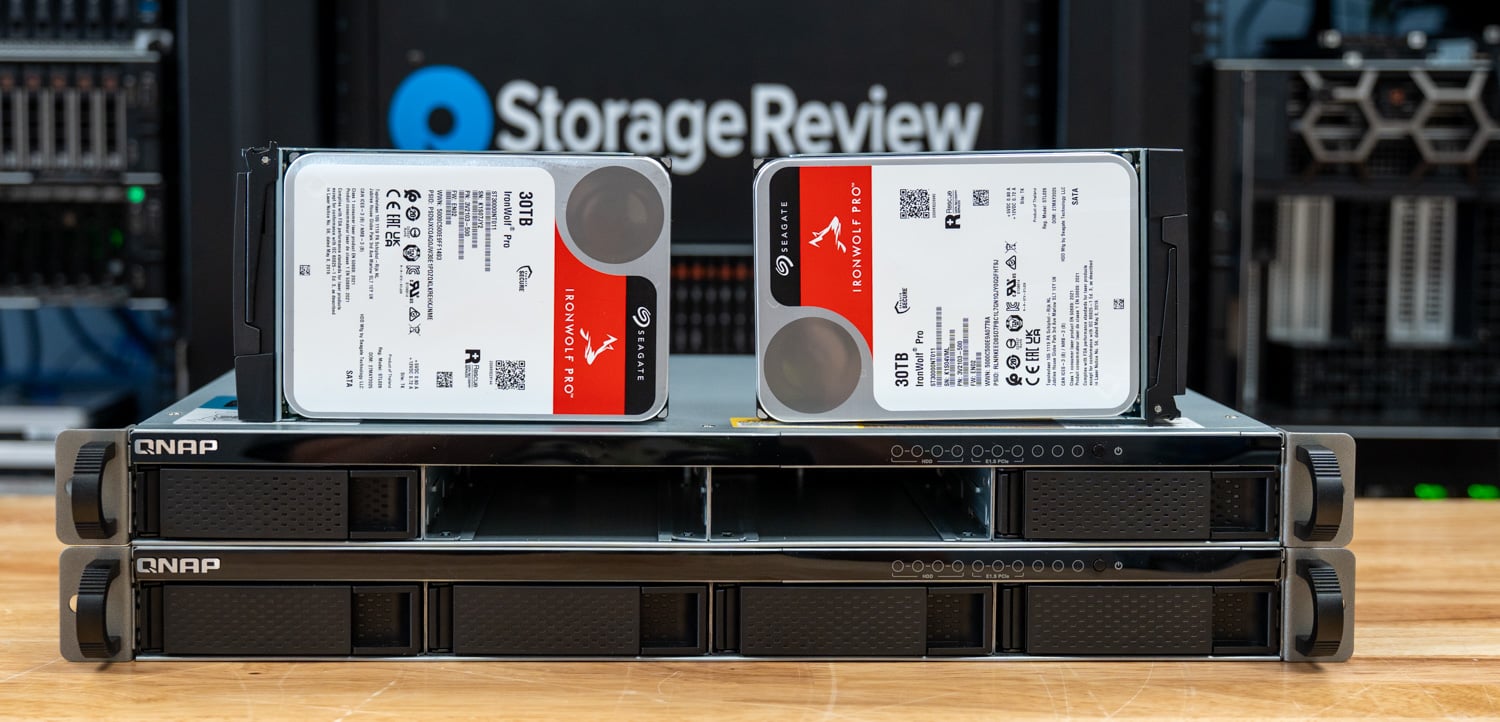
Per questa valutazione, ogni nodo è stato equipaggiato con quattro dischi rigidi Seagate IronWolf Pro da 30 TB (ST30000NT011) in un pool di storage RAID 5, oltre a due unità SSD QNAP SSD700 E1.S da 3.84 TB (SSD700D1-003T84) in RAID 0 come cache. Entrambi i sistemi eseguivano QuTS hero h6.0.0.3500 con High Availability Manager 2.0.421.
QuTS hero h6.0 e l'architettura di HA Manager
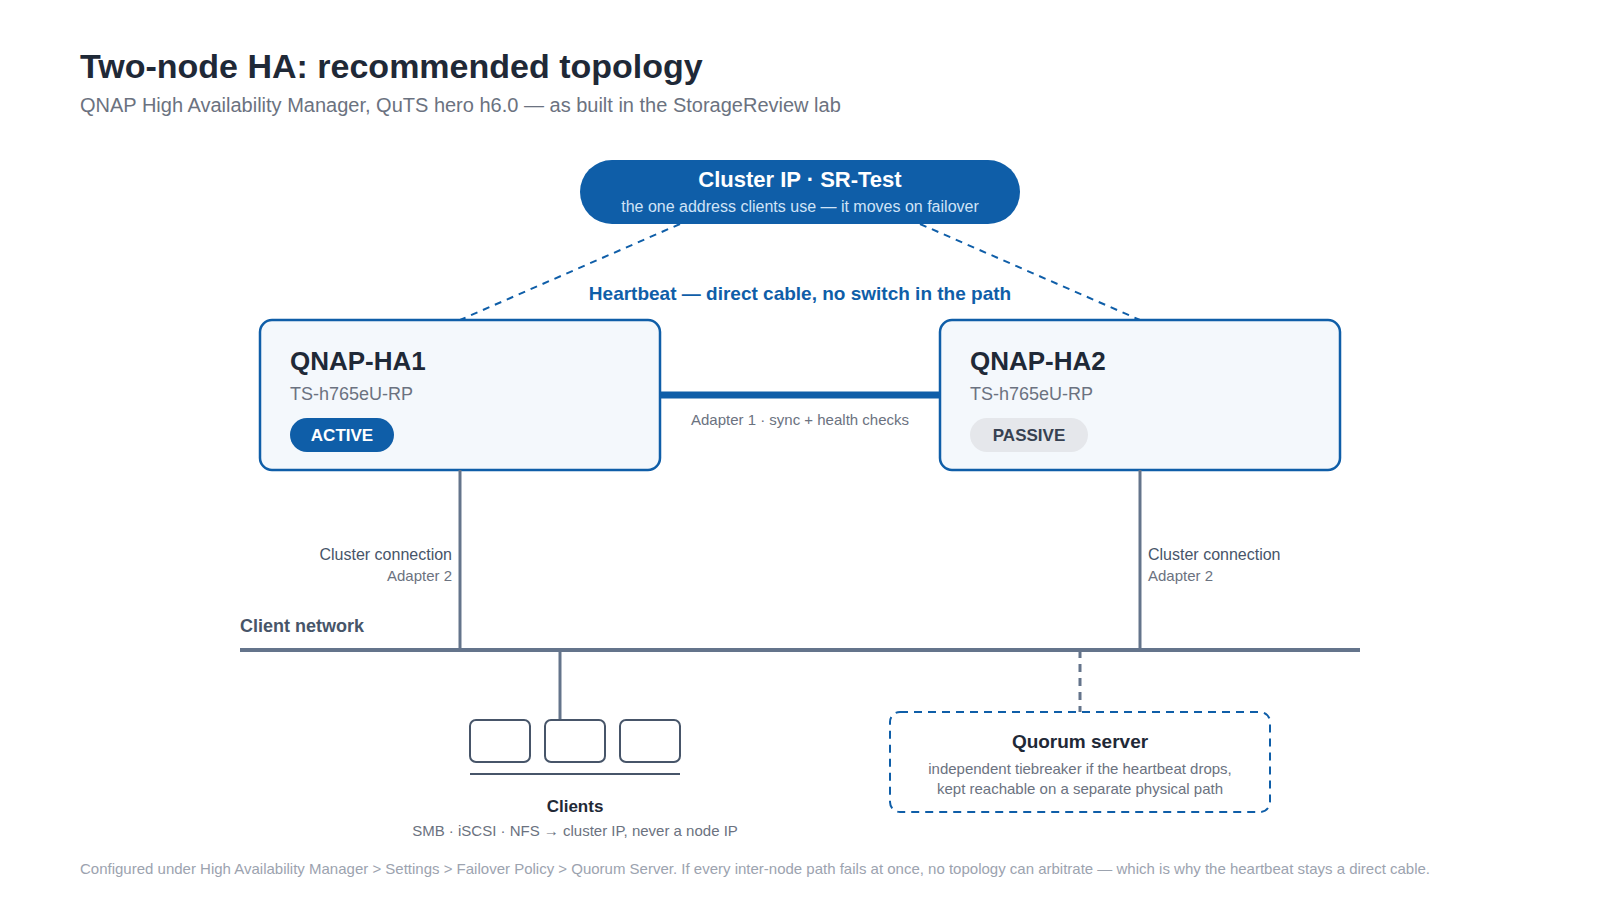
High Availability Manager è la funzionalità principale di QuTS hero h6.0, che implementa una classica architettura attivo-passivo. Un NAS, il nodo attivo, gestisce tutti i dati e i servizi. Il secondo NAS, il nodo passivo, si sincronizza continuamente con il nodo attivo tramite una connessione heartbeat dedicata ed è pronto a subentrare. I client non comunicano mai direttamente con nessuno dei due nodi; il cluster presenta invece un singolo indirizzo IP e un nome host, e il nodo attivo in quel momento risponde a tale indirizzo. In caso di failover, l'indirizzo IP del cluster reindirizza il traffico sul backend, in modo che le unità mappate, gli iniziatori iSCSI e i processi di backup non debbano essere riconfigurati.
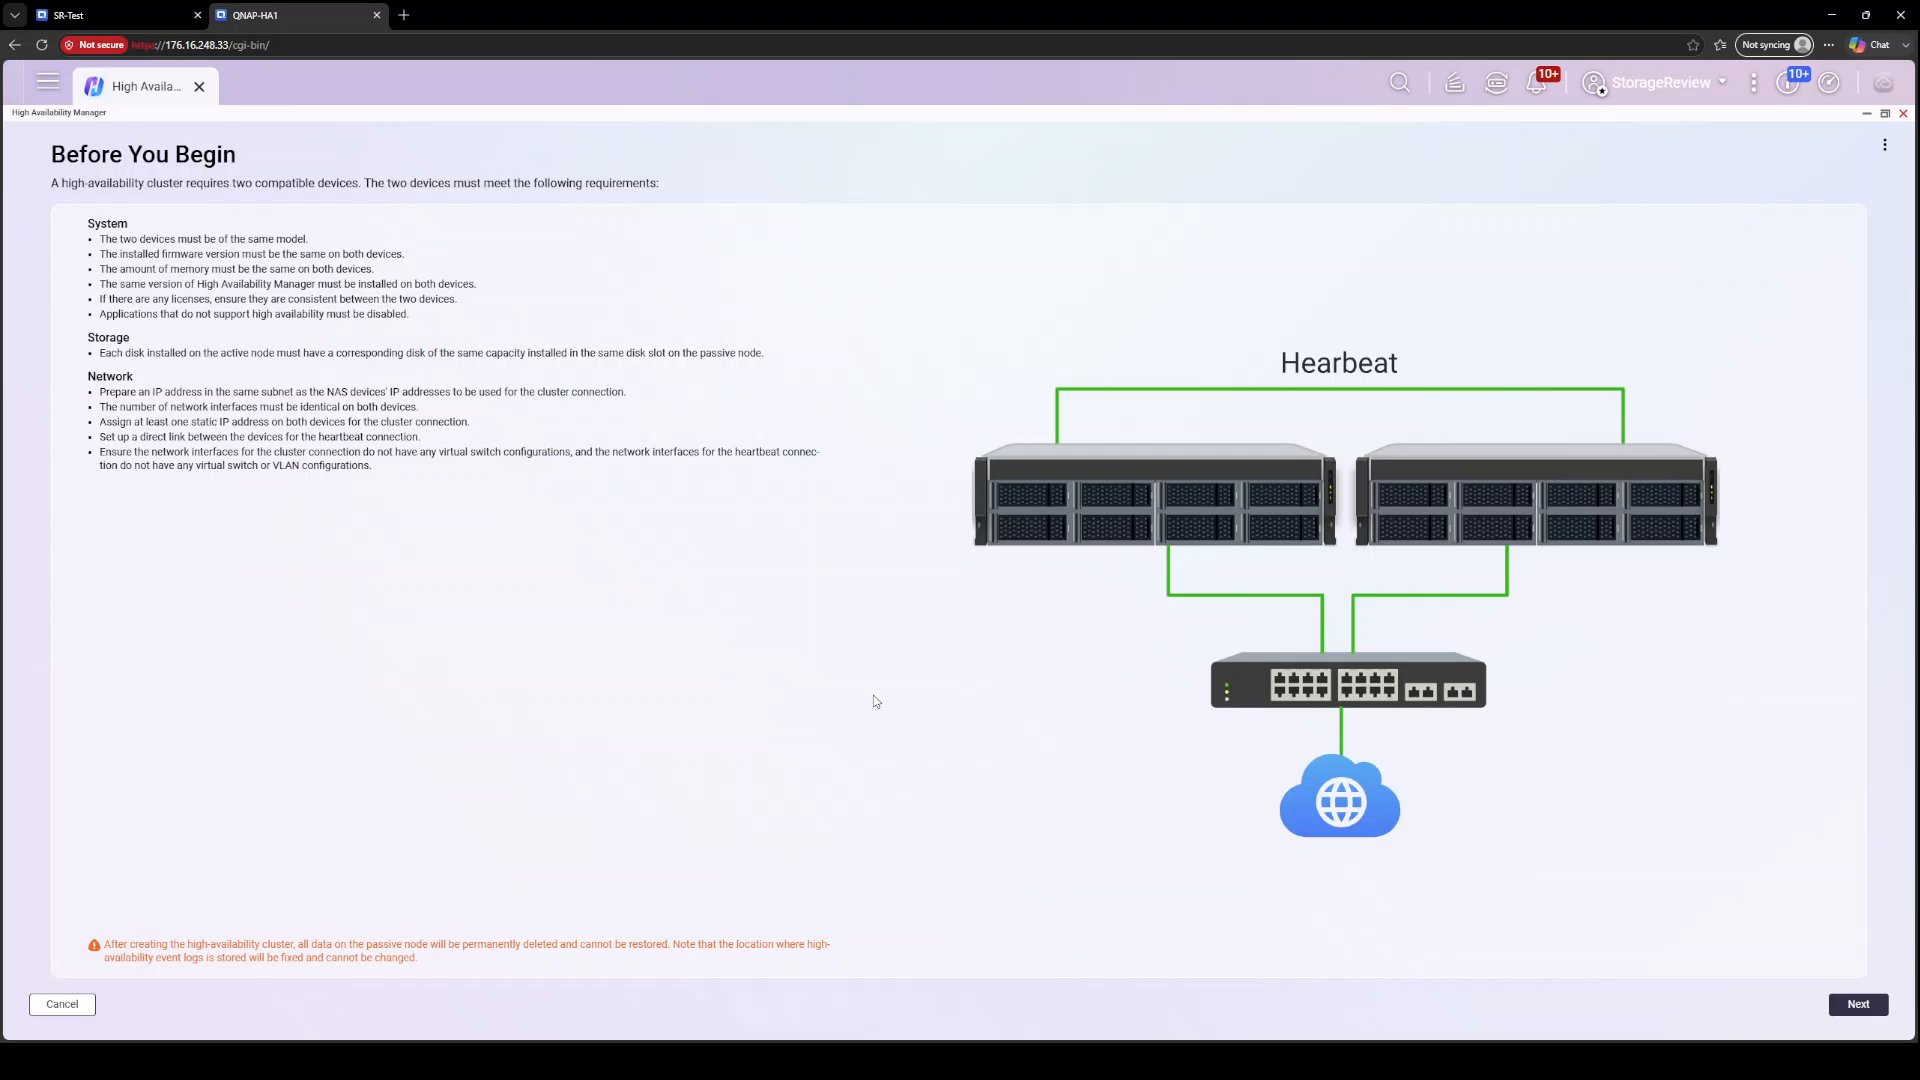
Il collegamento heartbeat è la spina dorsale dell'architettura. QNAP richiede una connessione diretta tra le due unità, senza switch intermedi, e gestisce sia il traffico di controllo dello stato di salute che la sincronizzazione dei dati a livello di blocco tra i nodi. Una connessione cluster separata gestisce il traffico rivolto ai client attraverso la rete normale. A completare la protezione contro lo split-brain c'è un server di quorum, un terzo testimone sulla rete che aiuta un nodo a determinare se deve promuoversi quando il segnale heartbeat si interrompe. Tratteremo in dettaglio lo split-brain e la topologia di implementazione che lo previene più avanti in questa recensione.
QNAP afferma che oltre il 90% dei servizi NAS sono predisposti per l'alta disponibilità (HA) in h6.0 e che il cluster può essere esteso con enclosure di espansione JBOD. Ci sono tuttavia delle limitazioni. Gli snapshot immutabili, un'altra caratteristica di spicco di h6.0, non sono attualmente supportati all'interno di un cluster HA, quindi per ora gli amministratori dovranno scegliere tra le due protezioni. L'HA richiede inoltre due sistemi identici, con modello e firmware corrispondenti, requisito che la procedura guidata di abbinamento impone prima di consentire di procedere.
Creazione del cluster HA di QNAP
La creazione del cluster inizia con due unità TS-h765eU configurate in modo indipendente con hardware identico. Dal nodo attivo designato, la procedura guidata di High Availability Manager illustra un breve processo di abbinamento. La procedura guidata rileva il nodo passivo tramite il collegamento heartbeat, quindi richiede di assegnare i ruoli alle interfacce di rete: una connessione cluster che funge da canale di comunicazione per l'accesso al cluster e la connessione heartbeat, che, come specificato da QNAP, è dedicata alla sincronizzazione dei dati e deve essere un collegamento diretto tra i dispositivi. Nella nostra configurazione, la procedura guidata ha assegnato la connessione heartbeat all'Adattatore 1 e la connessione cluster all'Adattatore 2.
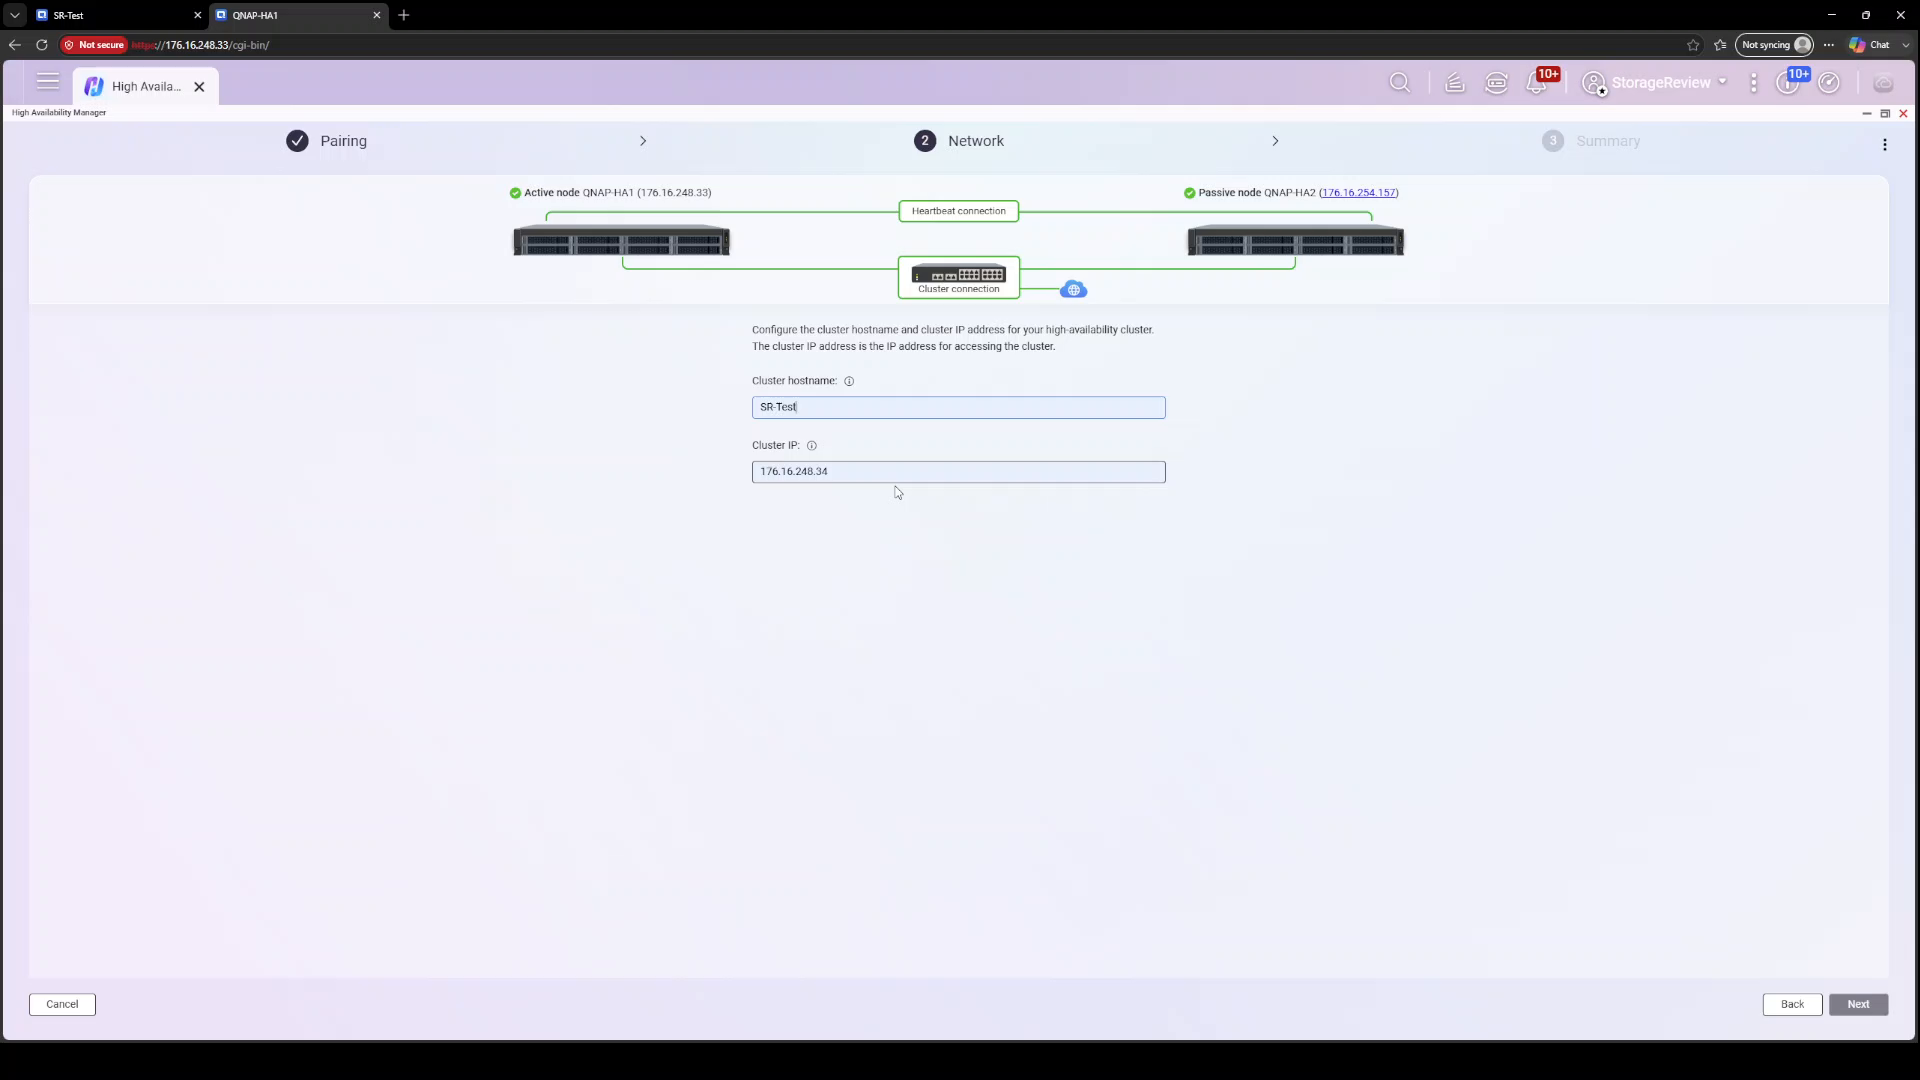
Successivamente si procede all'identità del cluster. Si assegna un nome host e un indirizzo IP al cluster, che diventeranno l'unico indirizzo utilizzato dai client da quel momento in poi. Il nostro cluster si chiamava SR-Test e aveva indirizzo IP 176.16.248.34, posizionato davanti ai nodi QNAP-HA1 (176.16.248.33) e QNAP-HA2 (176.16.254.157), i due nodi situati in sottoreti /24 diverse della rete di laboratorio; la procedura guidata li ha accoppiati senza problemi.
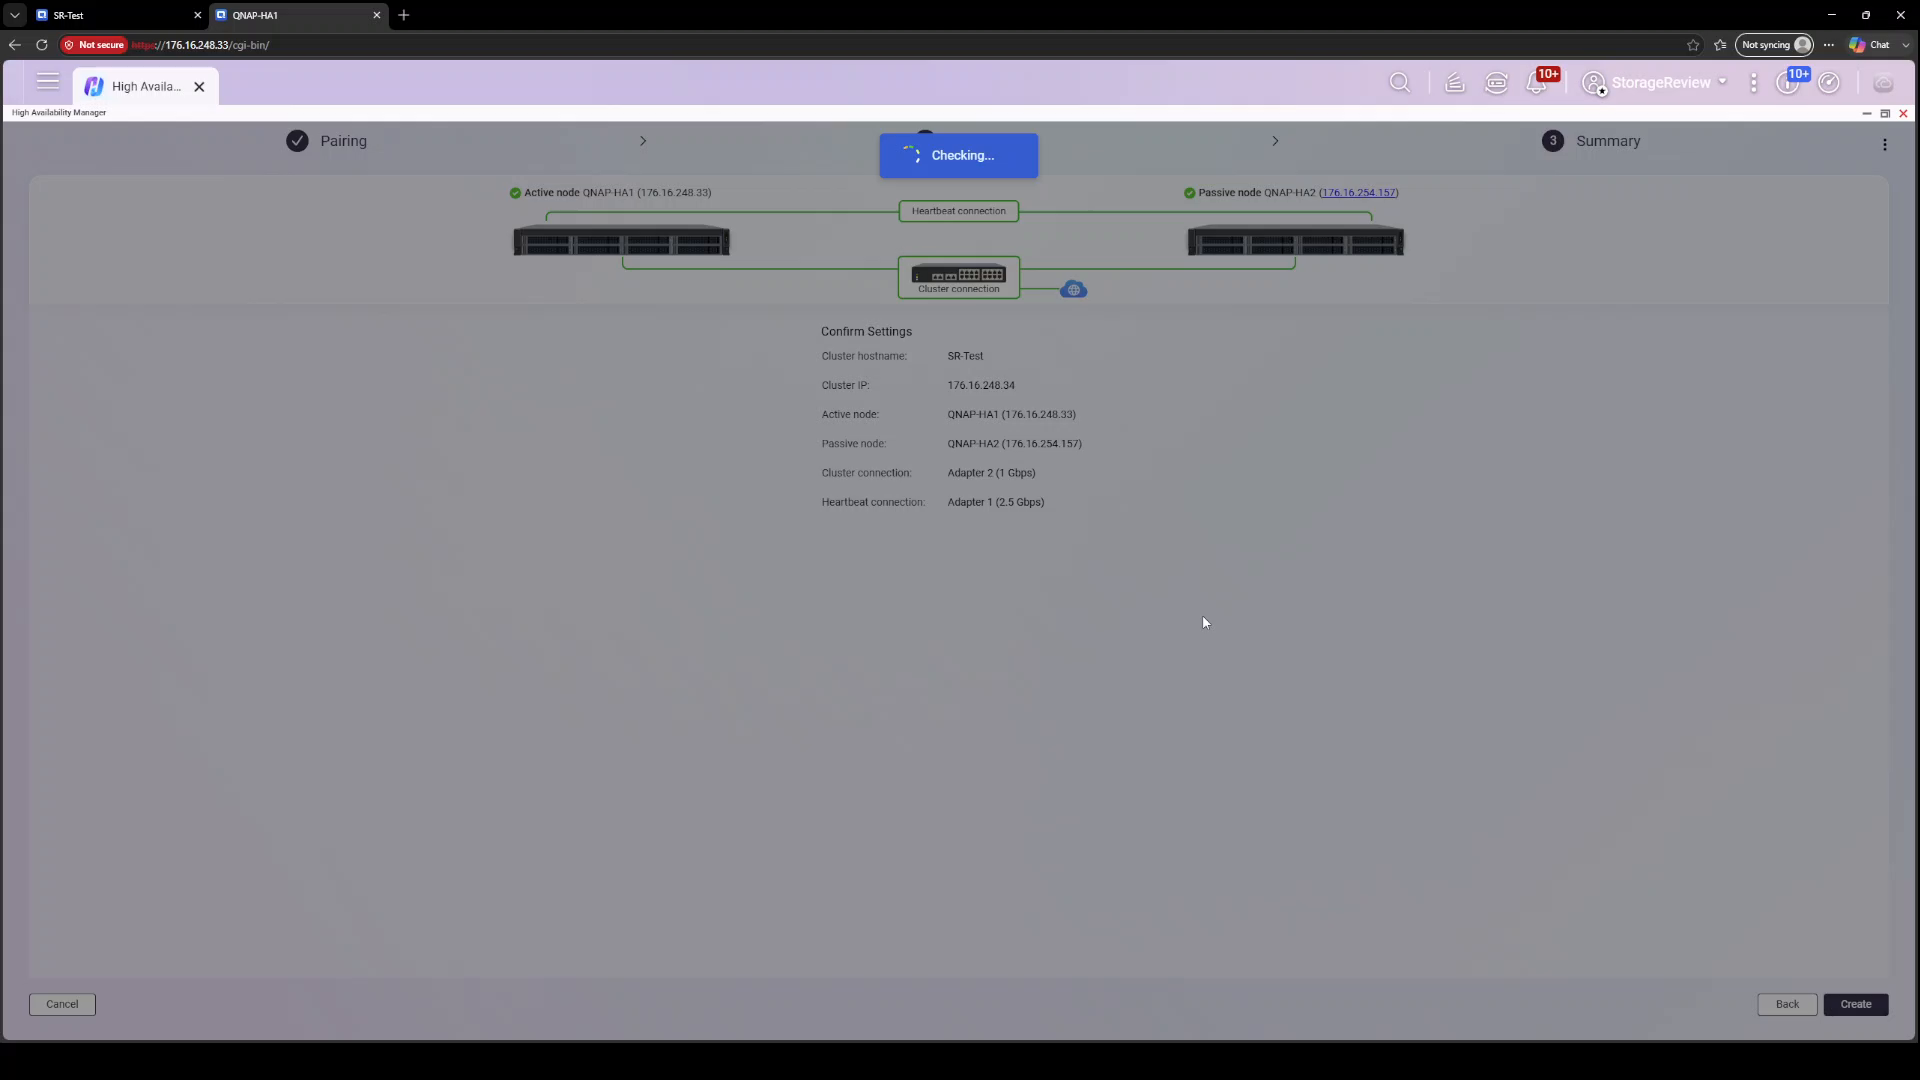
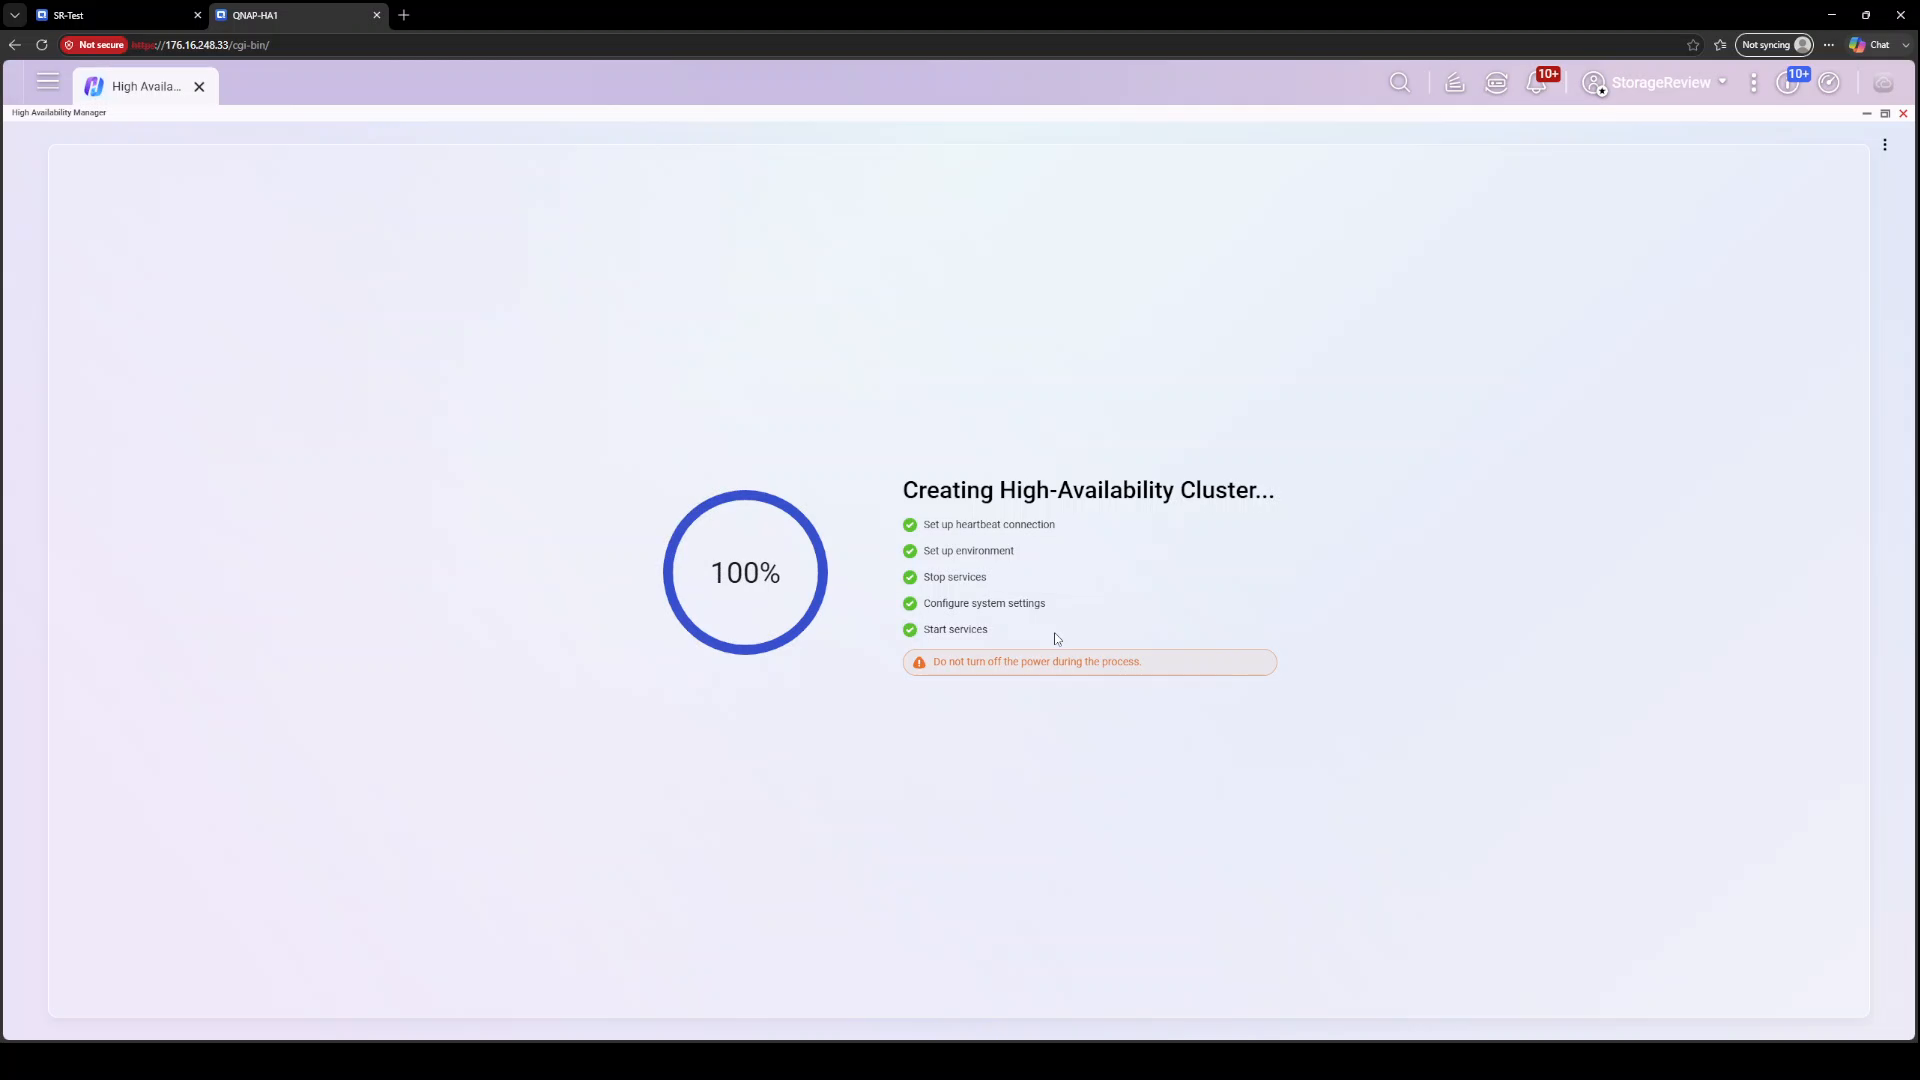
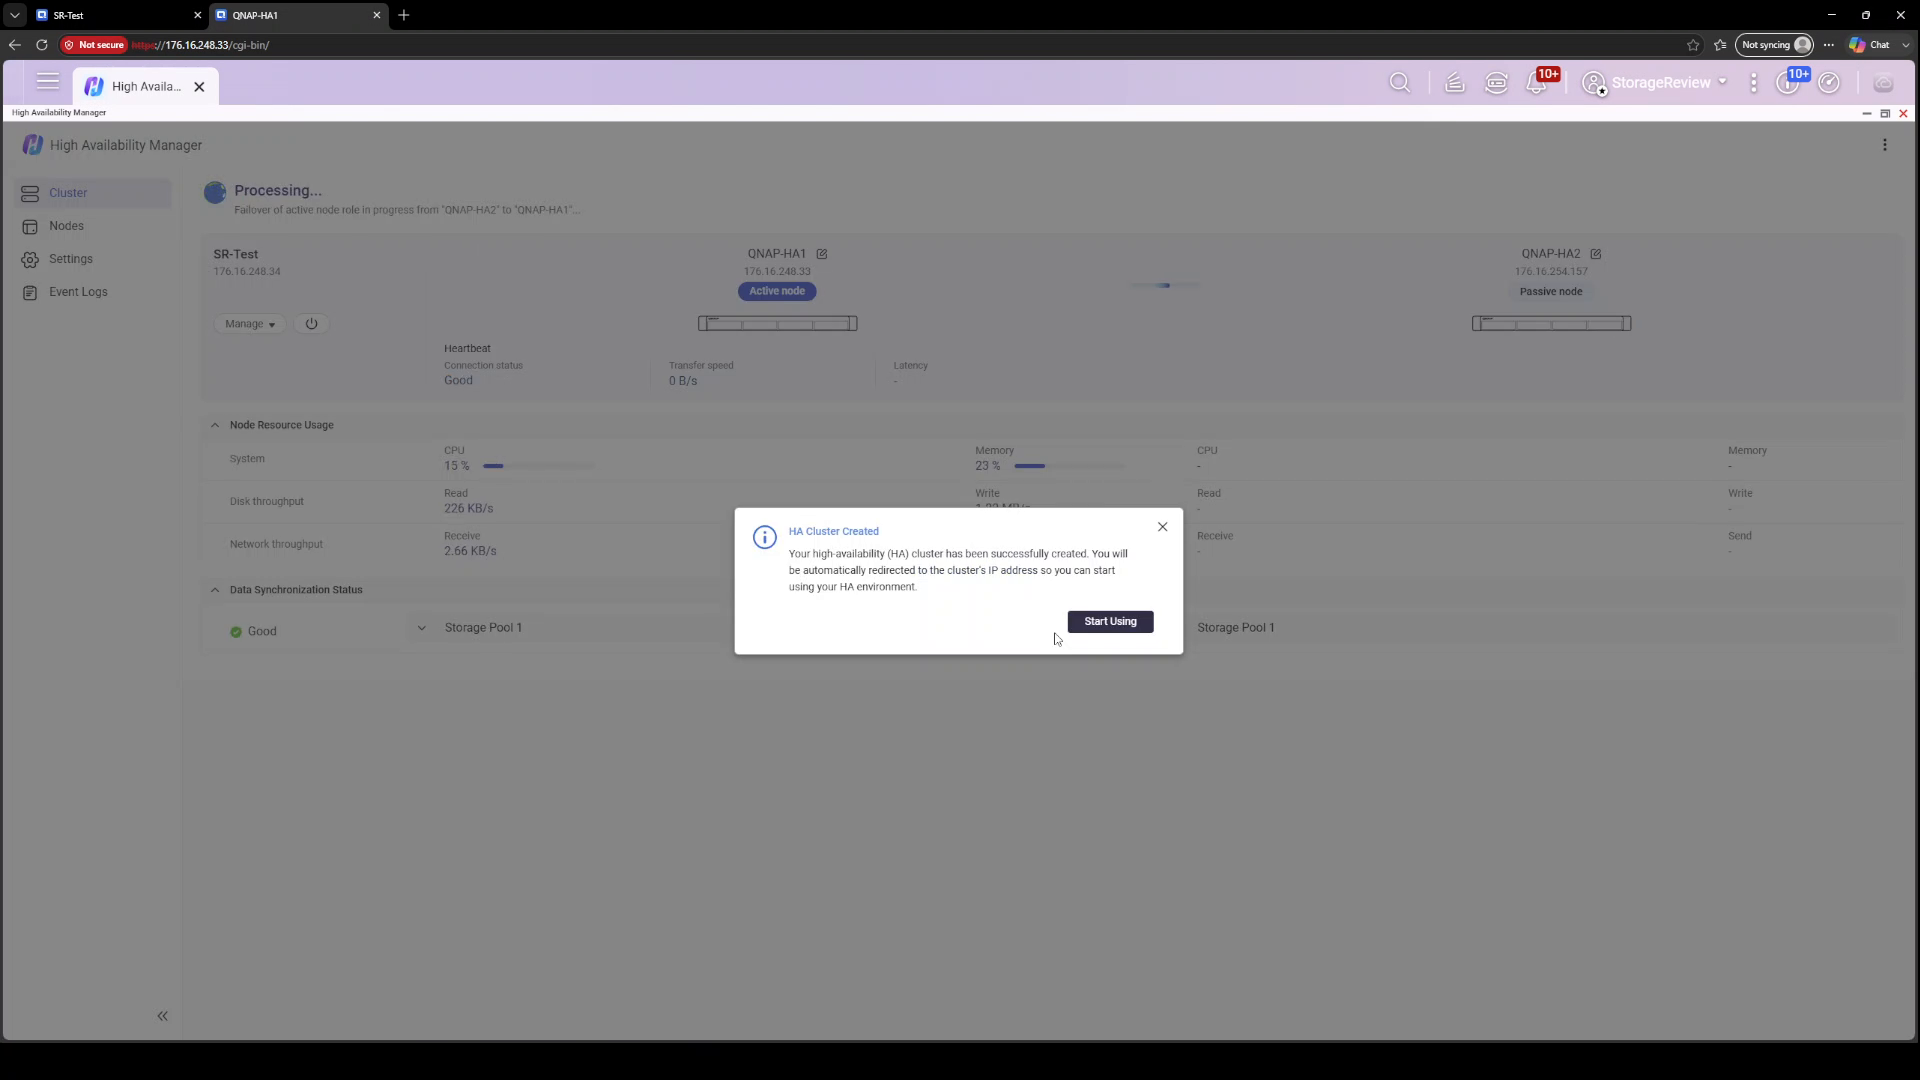
Una volta confermate le impostazioni, la procedura guidata esegue una configurazione in cinque fasi: impostazione della connessione heartbeat, configurazione dell'ambiente, arresto dei servizi, configurazione delle impostazioni di sistema e avvio dei servizi. L'interfaccia utente sottolinea che non bisogna spegnere nulla durante questa fase. Sui nostri sistemi, la configurazione si è completata in circa cinque minuti e mezzo, dopodiché HA Manager ha segnalato la creazione del cluster e ci ha reindirizzato all'indirizzo IP del cluster. Dall'inizio alla fine, la trasformazione da due unità NAS standalone a un cluster di server ha richiesto meno di dieci minuti di tempo di esecuzione della procedura guidata.
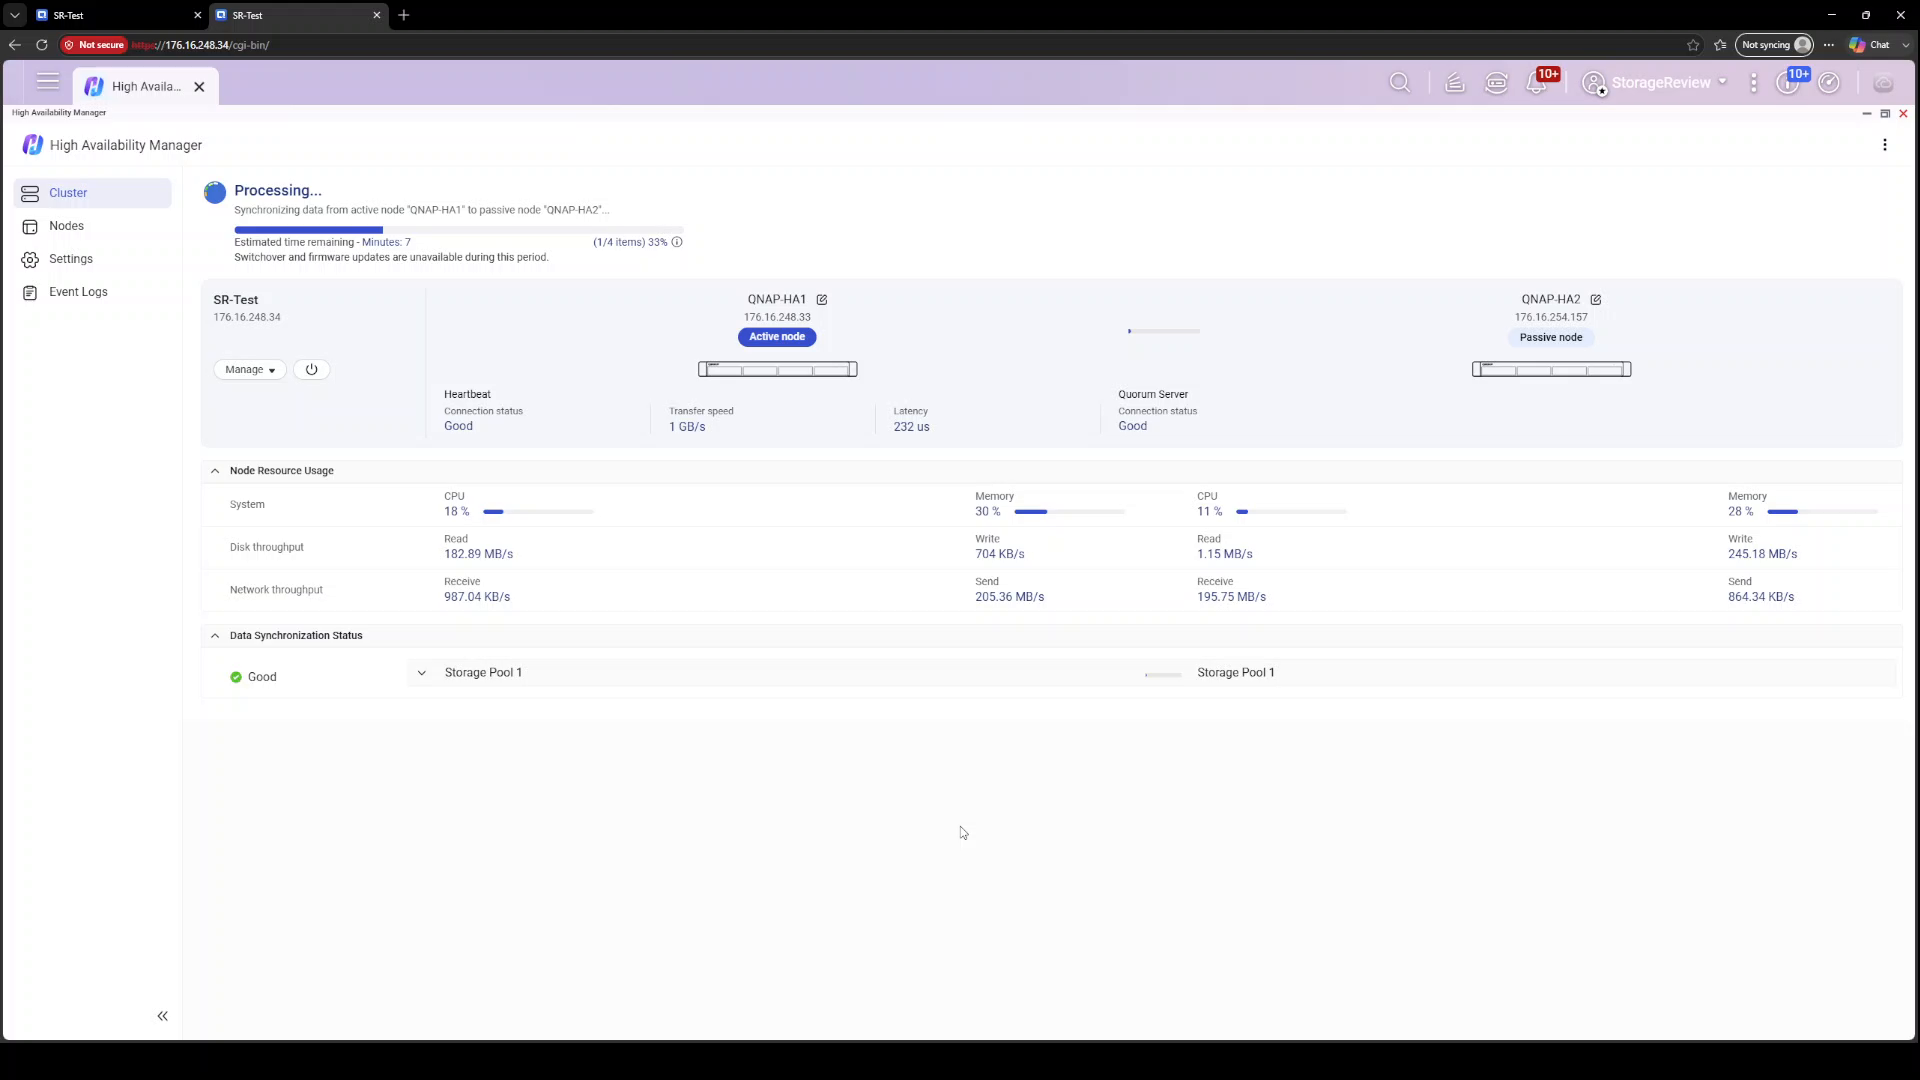
La fase più complessa è la sincronizzazione iniziale, in cui il nodo attivo replica il proprio pool di archiviazione sul nodo passivo, blocco per blocco. HA Manager visualizza chiaramente questo processo con una barra di avanzamento, il conteggio degli elementi e una stima del tempo nella parte superiore della dashboard, insieme a un avviso che il passaggio al nodo attivo e gli aggiornamenti del firmware non saranno disponibili fino al completamento della sincronizzazione. Monitorare le statistiche del heartbeat durante questa fase è stato uno degli aspetti più impressionanti del processo: le velocità di trasferimento variavano da circa 900 MB/s a 1.2 GB/s, con una latenza di centinaia di microsecondi, incluso un valore rappresentativo di 1 GB/s a 232 microsecondi. La nostra sincronizzazione iniziale si è completata in circa dieci minuti, esattamente in linea con la stima iniziale di nove minuti fornita dalla dashboard.
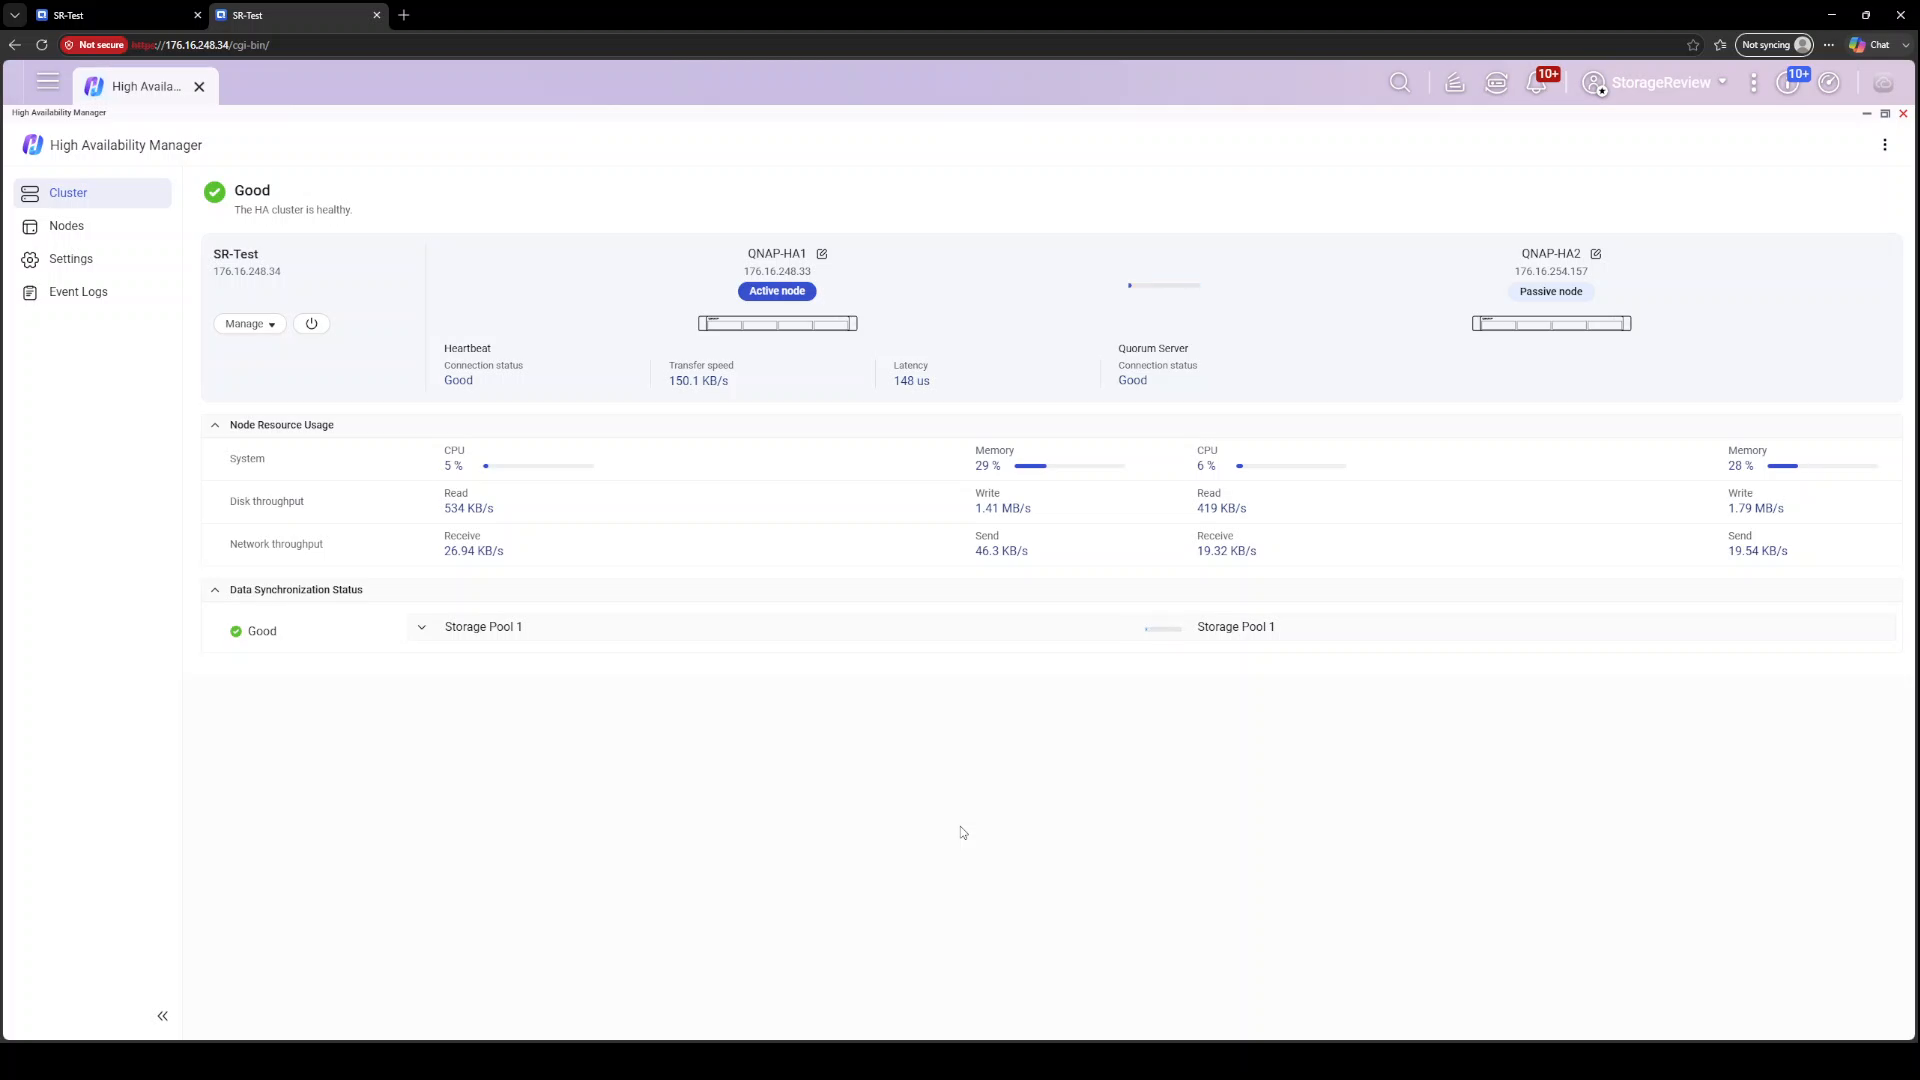
Una volta completata la sincronizzazione, la dashboard si stabilizza sullo stato "Buono": cluster integro, heartbeat connesso, entrambi i nodi visibili con statistiche in tempo reale su CPU, memoria, throughput del disco e rete, visualizzate una accanto all'altra, e lo stato di sincronizzazione per pool in basso. Si tratta di una visualizzazione chiara e ricca di informazioni che risponde alle due domande che un amministratore si pone realmente: il cluster è integro e i miei dati sono sincronizzati?
Test di failover 1: Interruzione di corrente sul nodo attivo
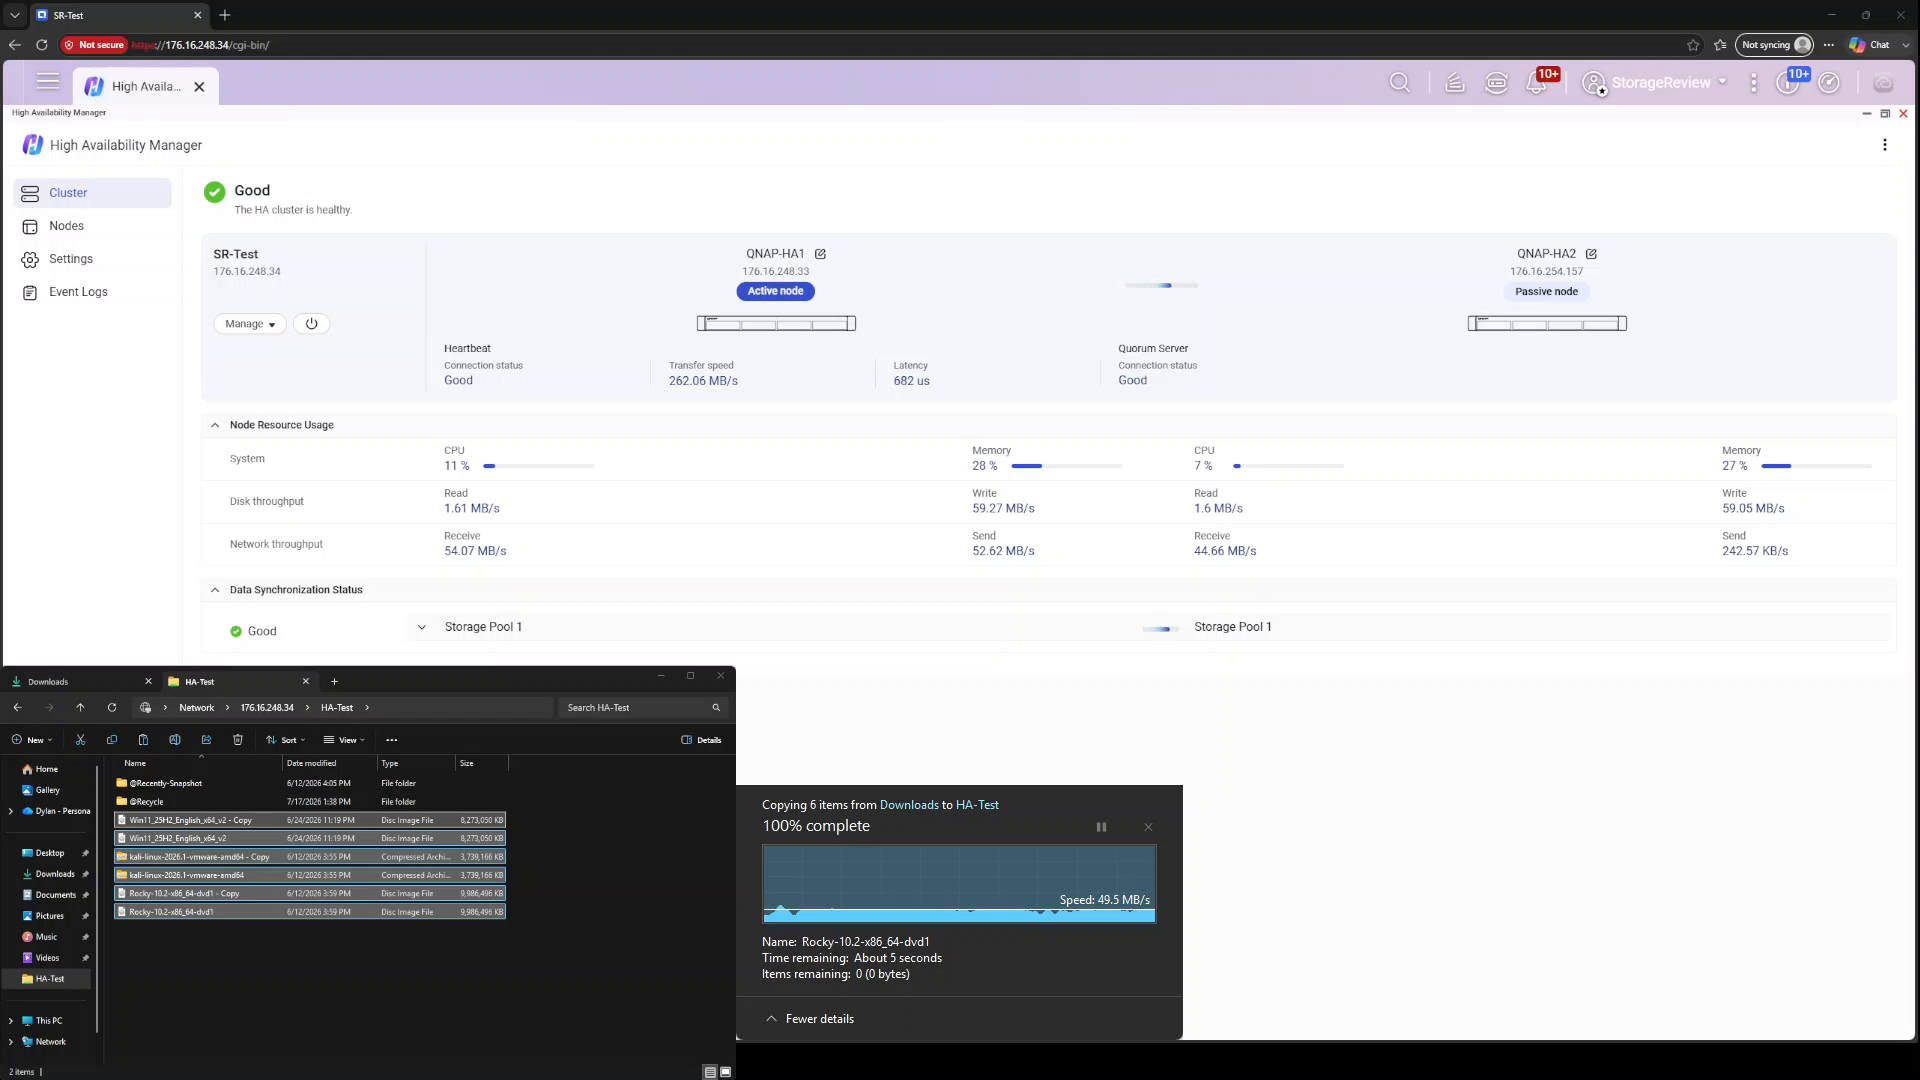
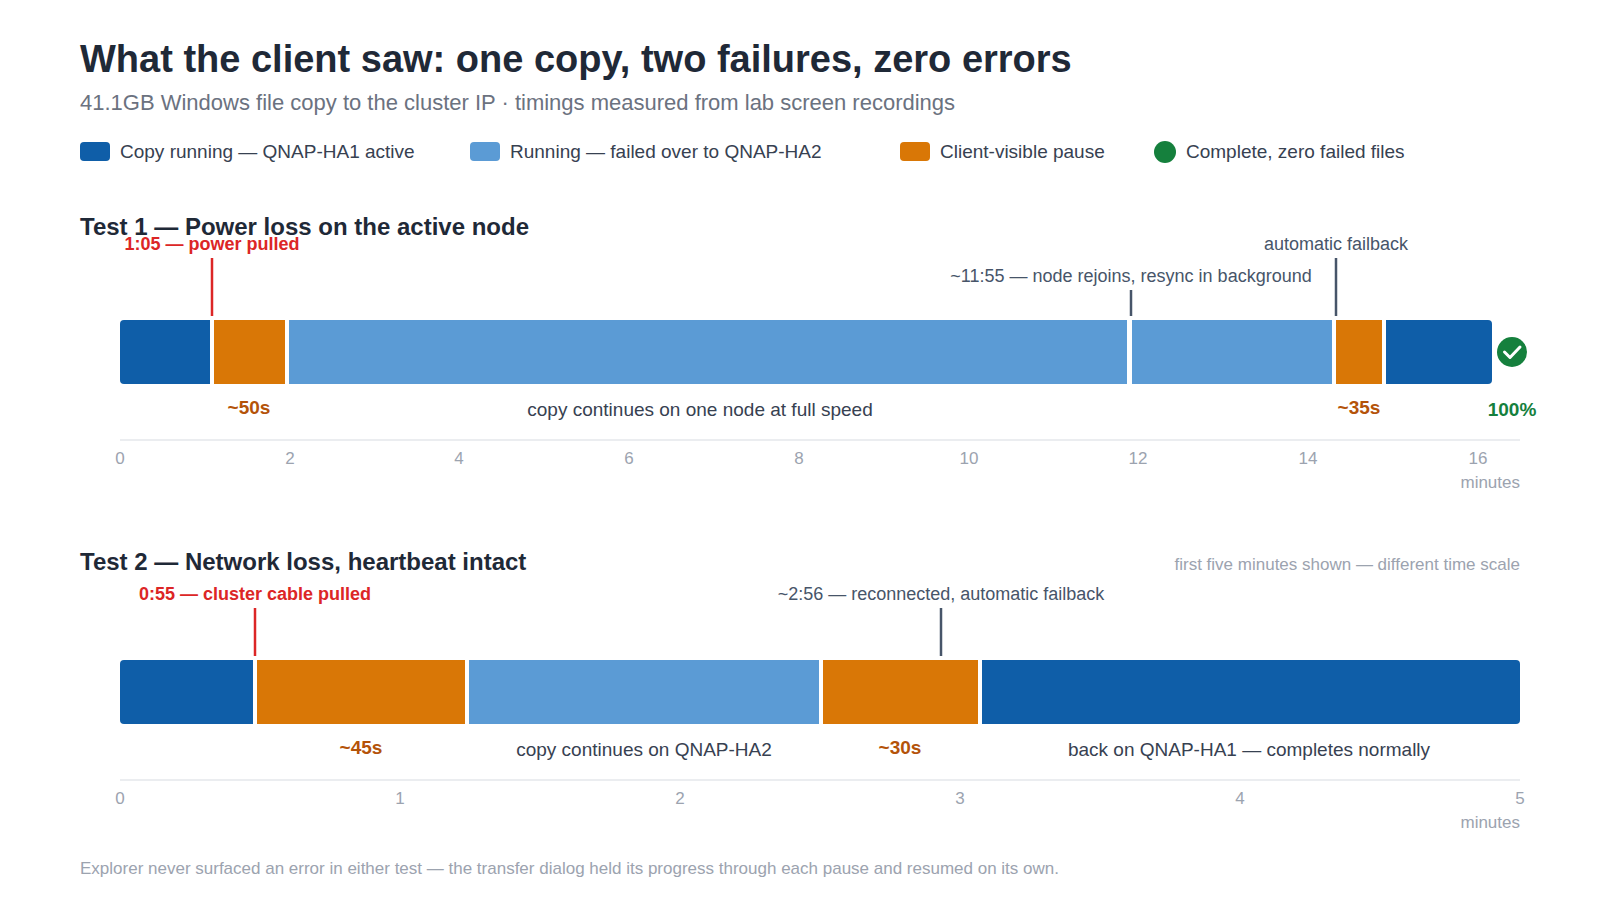
Il nostro primo scenario di errore è quello più semplice: interruzione totale dell'alimentazione sul nodo attivo. Abbiamo avviato la copia di un file Windows da un client a una condivisione SMB sull'indirizzo IP del cluster, un batch di 41.1 GB contenente sei file, tra cui ISO di Windows 11 e Rocky Linux e un paio di archivi di macchine virtuali Kali Linux, e abbiamo interrotto l'alimentazione del QNAP-HA1 a metà del trasferimento.
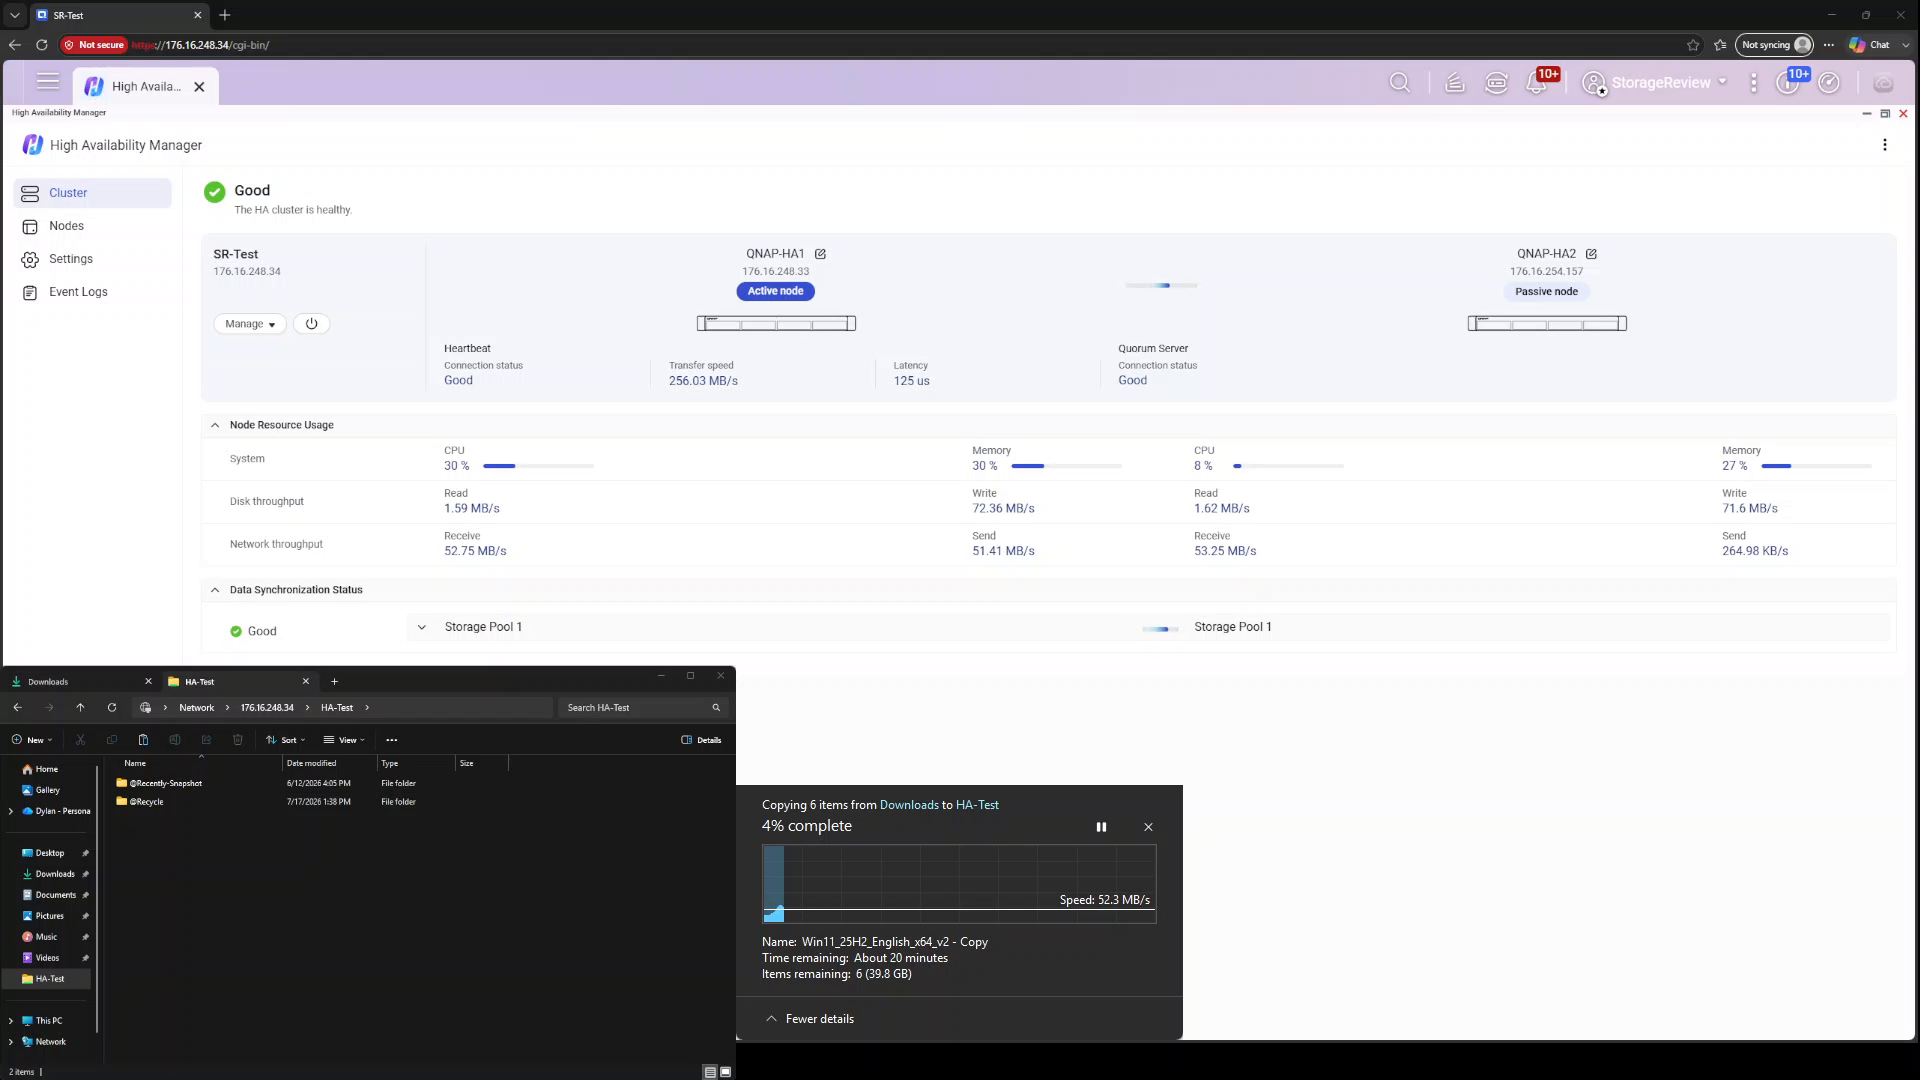
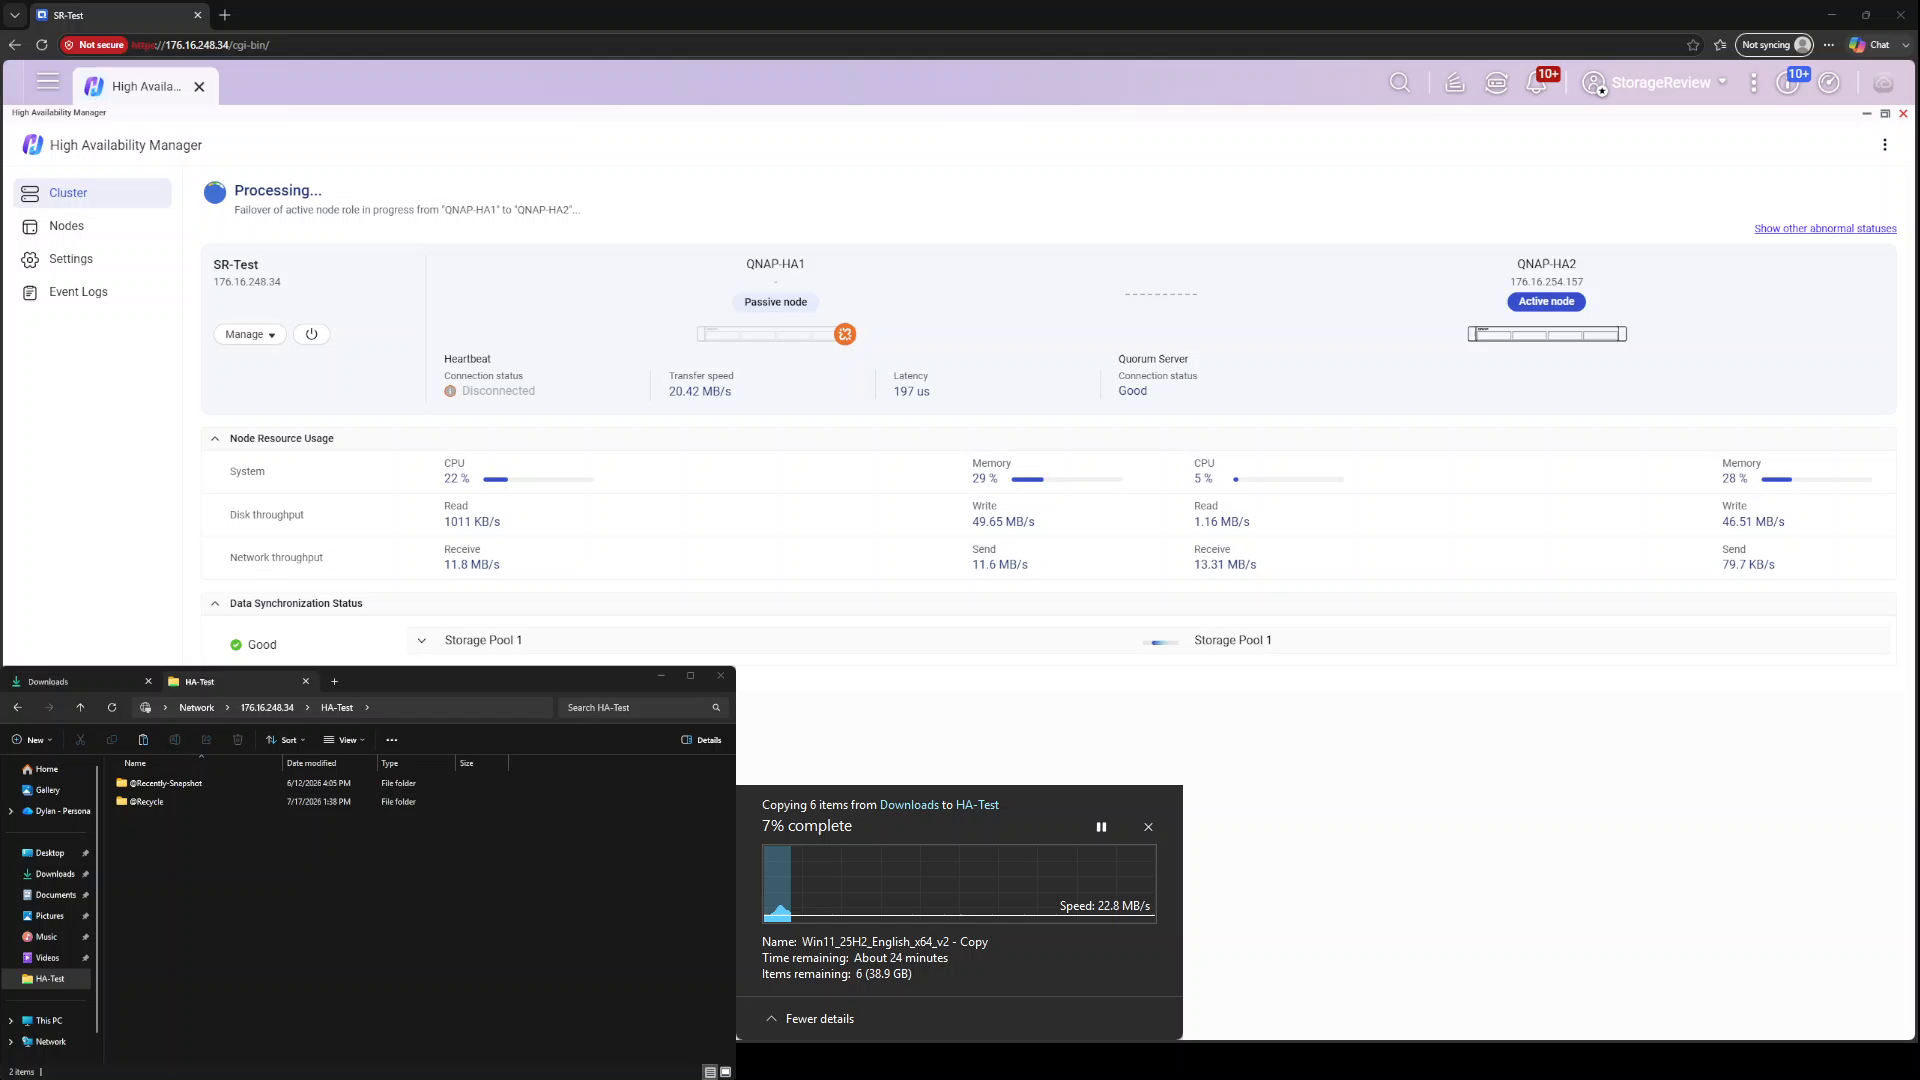
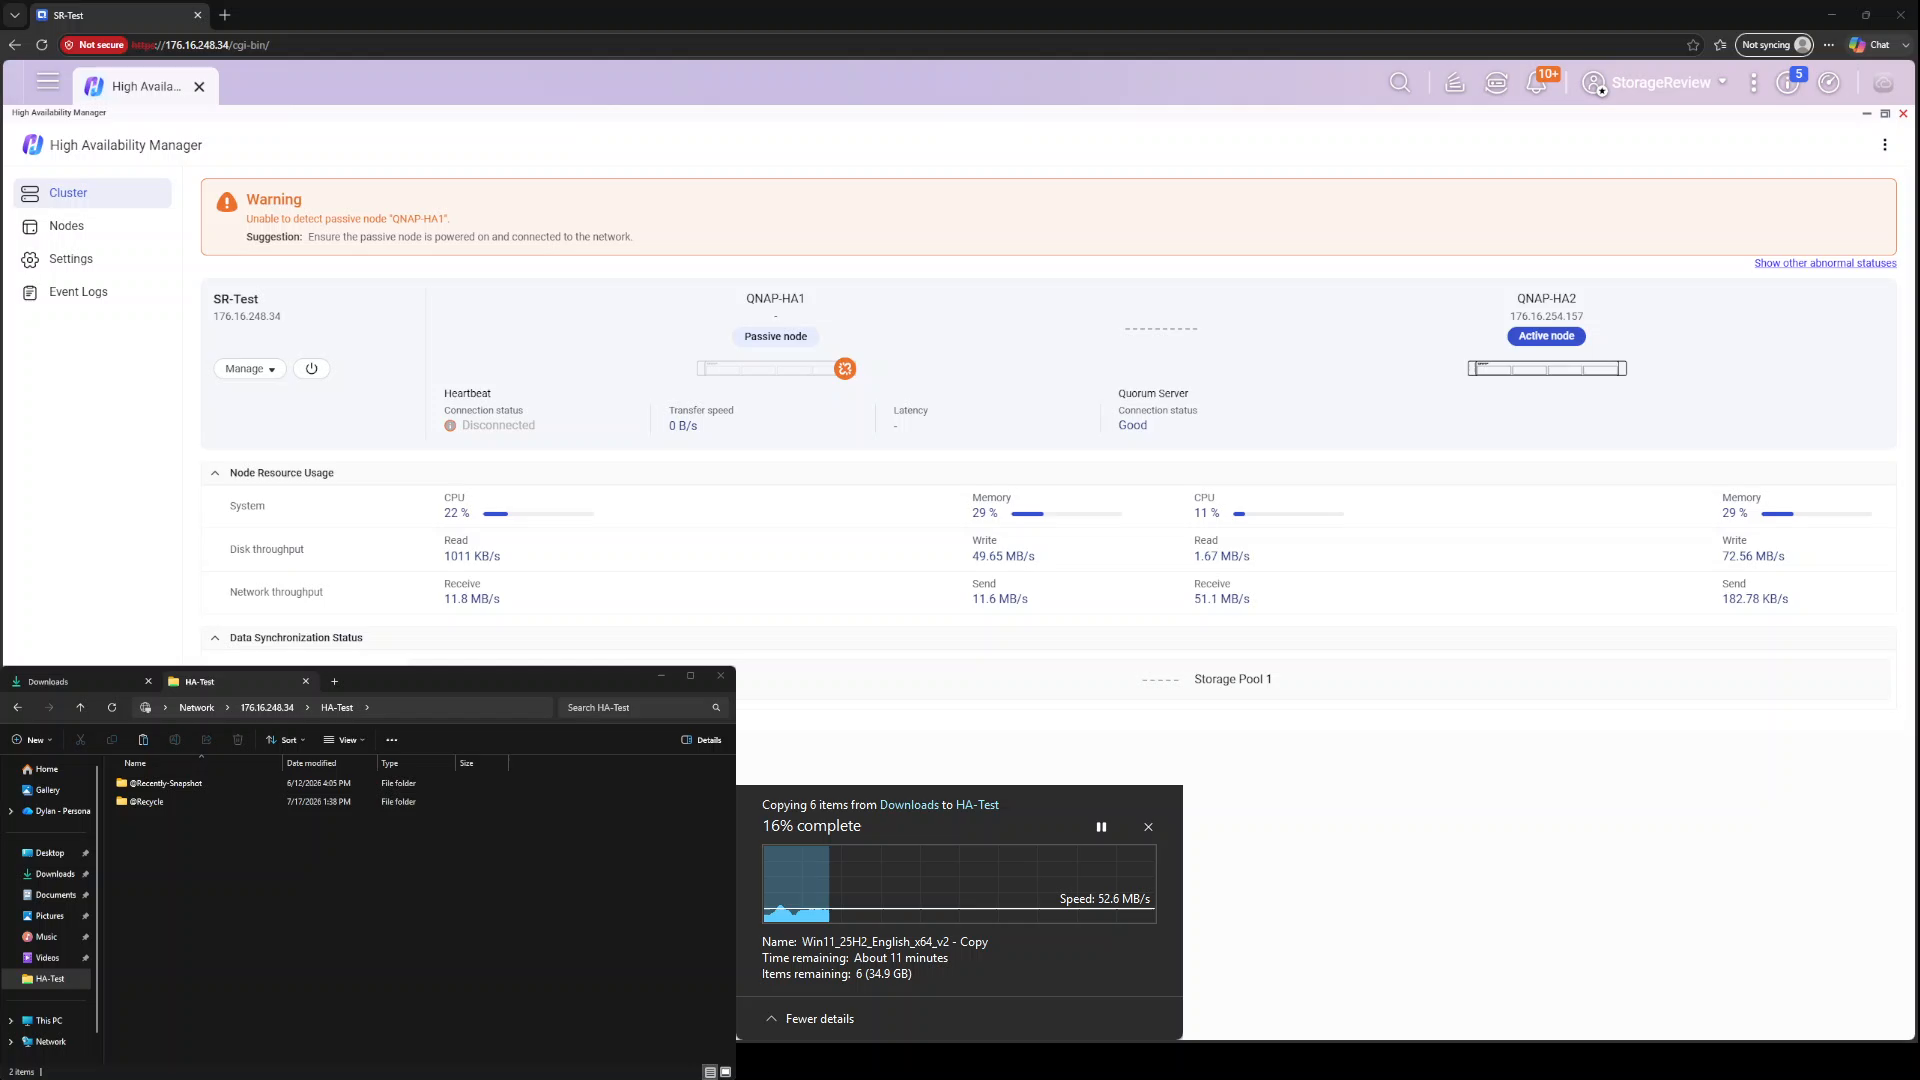
Dal punto di vista del client, la copia si è bloccata per poco meno di un minuto, circa 50 secondi, tra l'interruzione di corrente e la ripresa del trasferimento dati, e Explorer non ha mai segnalato alcun errore; la finestra di dialogo del trasferimento ha mantenuto l'avanzamento, per poi riprendere quando QNAP-HA2 si è promosso ad attivo. HA Manager ha brevemente segnalato il failover del ruolo di nodo attivo in corso, quindi ha visualizzato un avviso: impossibile rilevare il nodo passivo QNAP-HA1, con il suggerimento di assicurarsi che il nodo sia acceso e connesso alla rete. Il trasferimento è proseguito verso lo stesso IP del cluster a piena velocità mentre il cluster era in esecuzione su un nodo, che è esattamente lo stato degradato ma operativo promesso da HA.
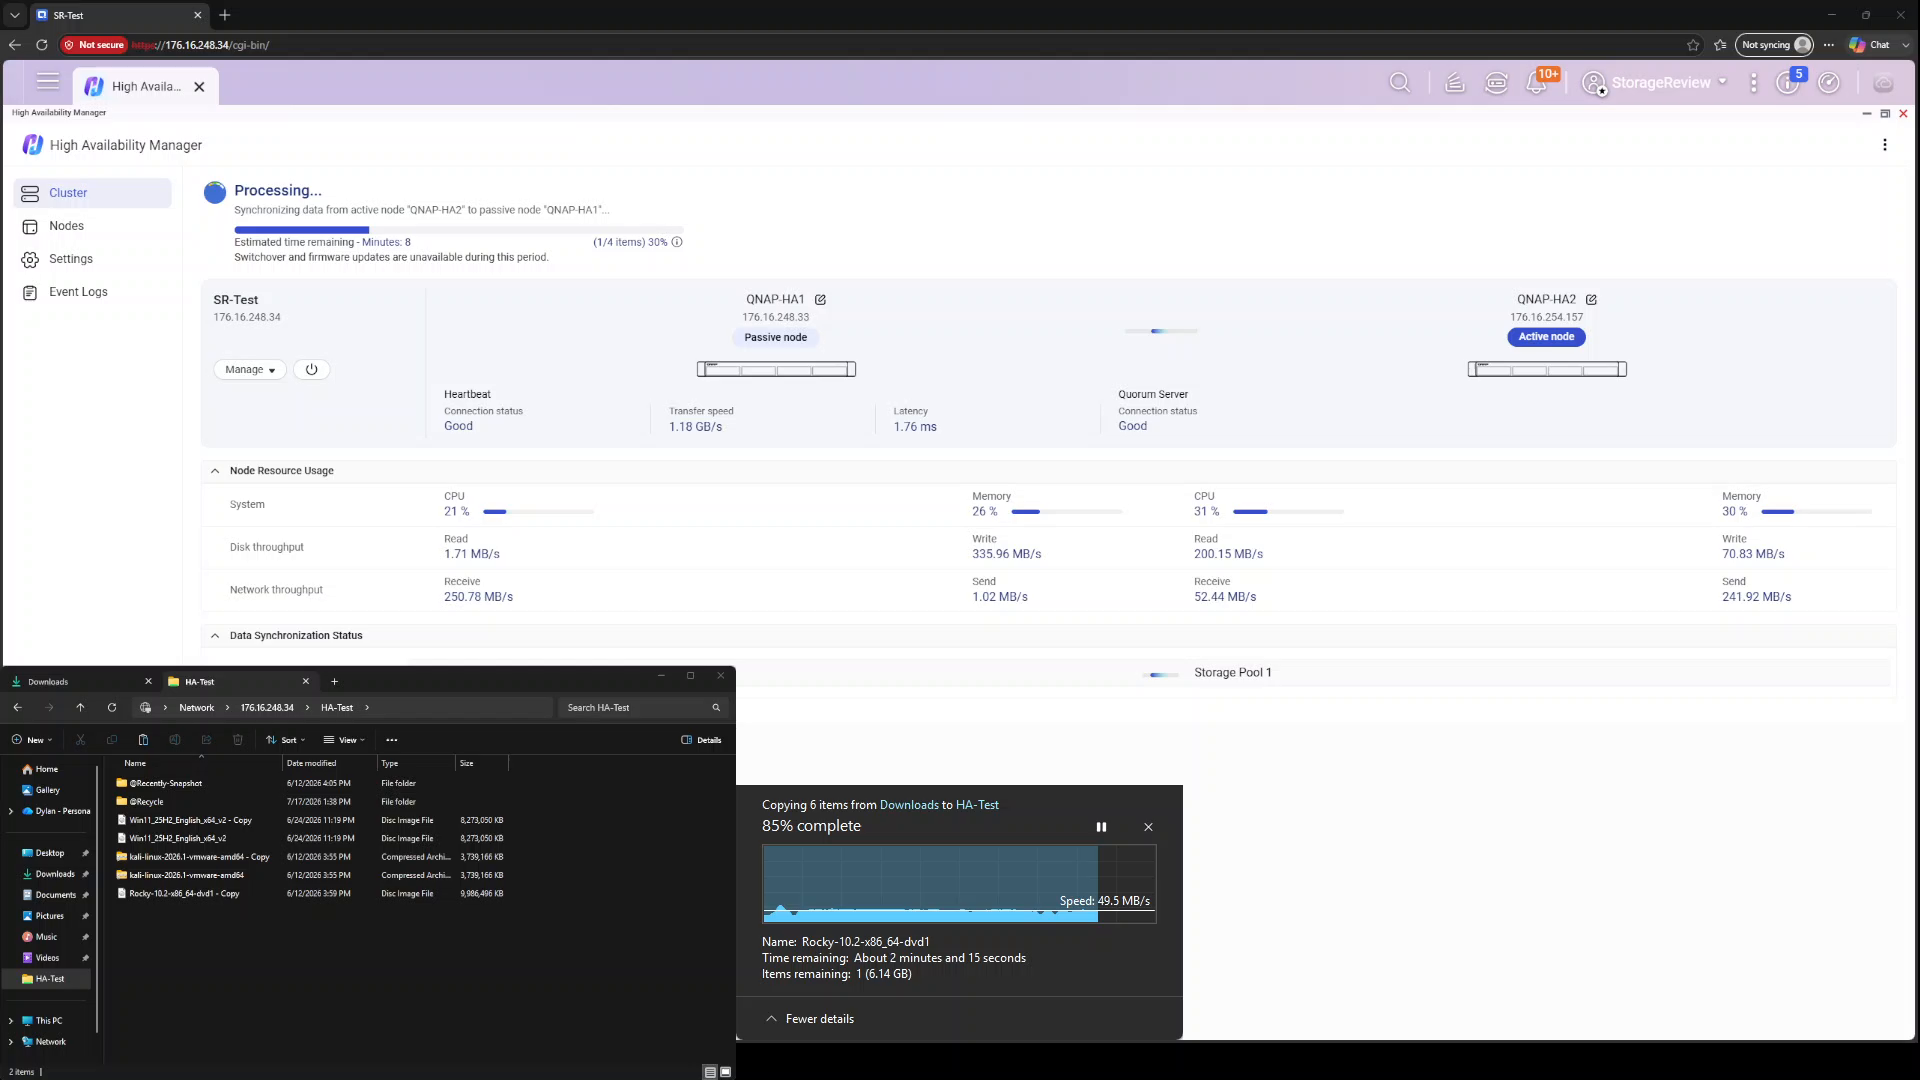
Il ripristino dell'alimentazione al QNAP-HA1 ha attivato automaticamente il processo inverso. Il nodo si è avviato e si è riunito al cluster come membro passivo circa dieci minuti dopo l'interruzione di corrente, e HA Manager ha iniziato a sincronizzare i dati dal nodo attivo QNAP-HA2 al QNAP-HA1, con avanzamento e stime dei tempi visibili sulla dashboard, mentre la copia dei file continuava senza interruzioni. Il failback non ha richiesto alcun intervento: una volta completata la risincronizzazione, il cluster ha messo in pausa il trasferimento per circa 35 secondi, ripristinando il ruolo attivo al QNAP-HA1, per poi lasciare che la copia venisse completata. Al termine dell'operazione, il cluster è tornato allo stato "Buono" con il trasferimento al 100%, avendo superato un'interruzione di corrente, un periodo con un solo nodo, il ripristino di un nodo e un failback all'interno di un'unica operazione di copia.
Test di failover 2: Perdita di rete con heartbeat intatto
Il secondo scenario è più complesso e probabilmente più comune nella realtà: il nodo attivo perde la connessione di rete con il client (a causa di una porta dello switch guasta, un cavo scollegato o un ricetrasmettitore difettoso), mentre il nodo stesso continua a funzionare e il collegamento heartbeat rimane attivo. In questo caso, la protezione contro lo split-brain è fondamentale perché entrambi i nodi sono attivi e possono comunicare tra loro, e il cluster deve decidere a quale nodo debba essere assegnato l'indirizzo IP del cluster.
Abbiamo ripetuto la stessa copia del file di Windows sull'indirizzo IP del cluster e abbiamo disconnesso l'interfaccia di rete del cluster sul nodo attivo. Il trasferimento si è interrotto per circa 45 secondi mentre il cluster spostava i servizi sull'altro nodo, quindi è ripreso senza errori. HA Manager ha segnalato l'errore in modo preciso, avvertendo che l'adattatore 2 dell'interfaccia di rete del cluster sul nodo era disconnesso e suggerendo un controllo della connessione dello switch, e poi ha fatto un ulteriore passo avanti, notando che il nodo disconnesso non poteva più raggiungere il server di quorum tramite tale interfaccia. Questa specificità, che nomina con precisione l'interfaccia, il nodo e la conseguenza, è più diagnostica del generico flag di degrado che alcune implementazioni di HA utilizzano.
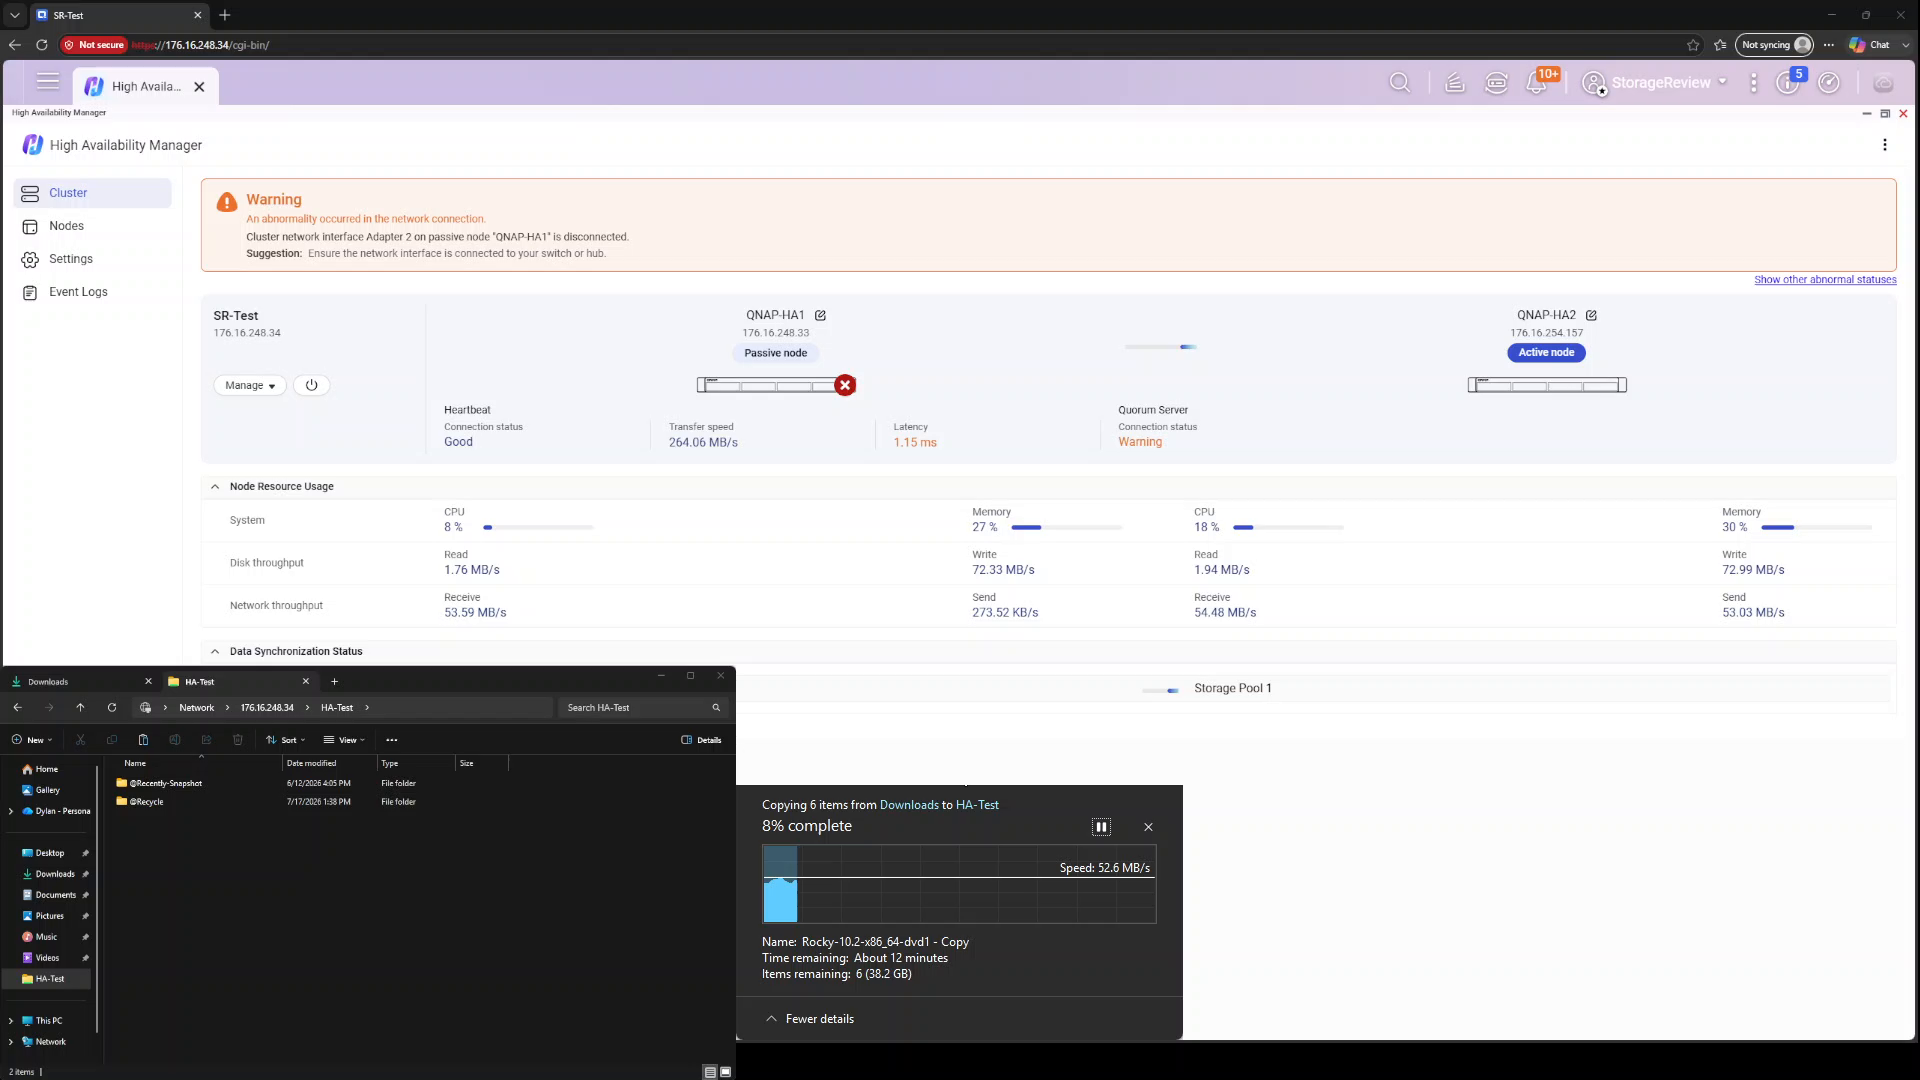
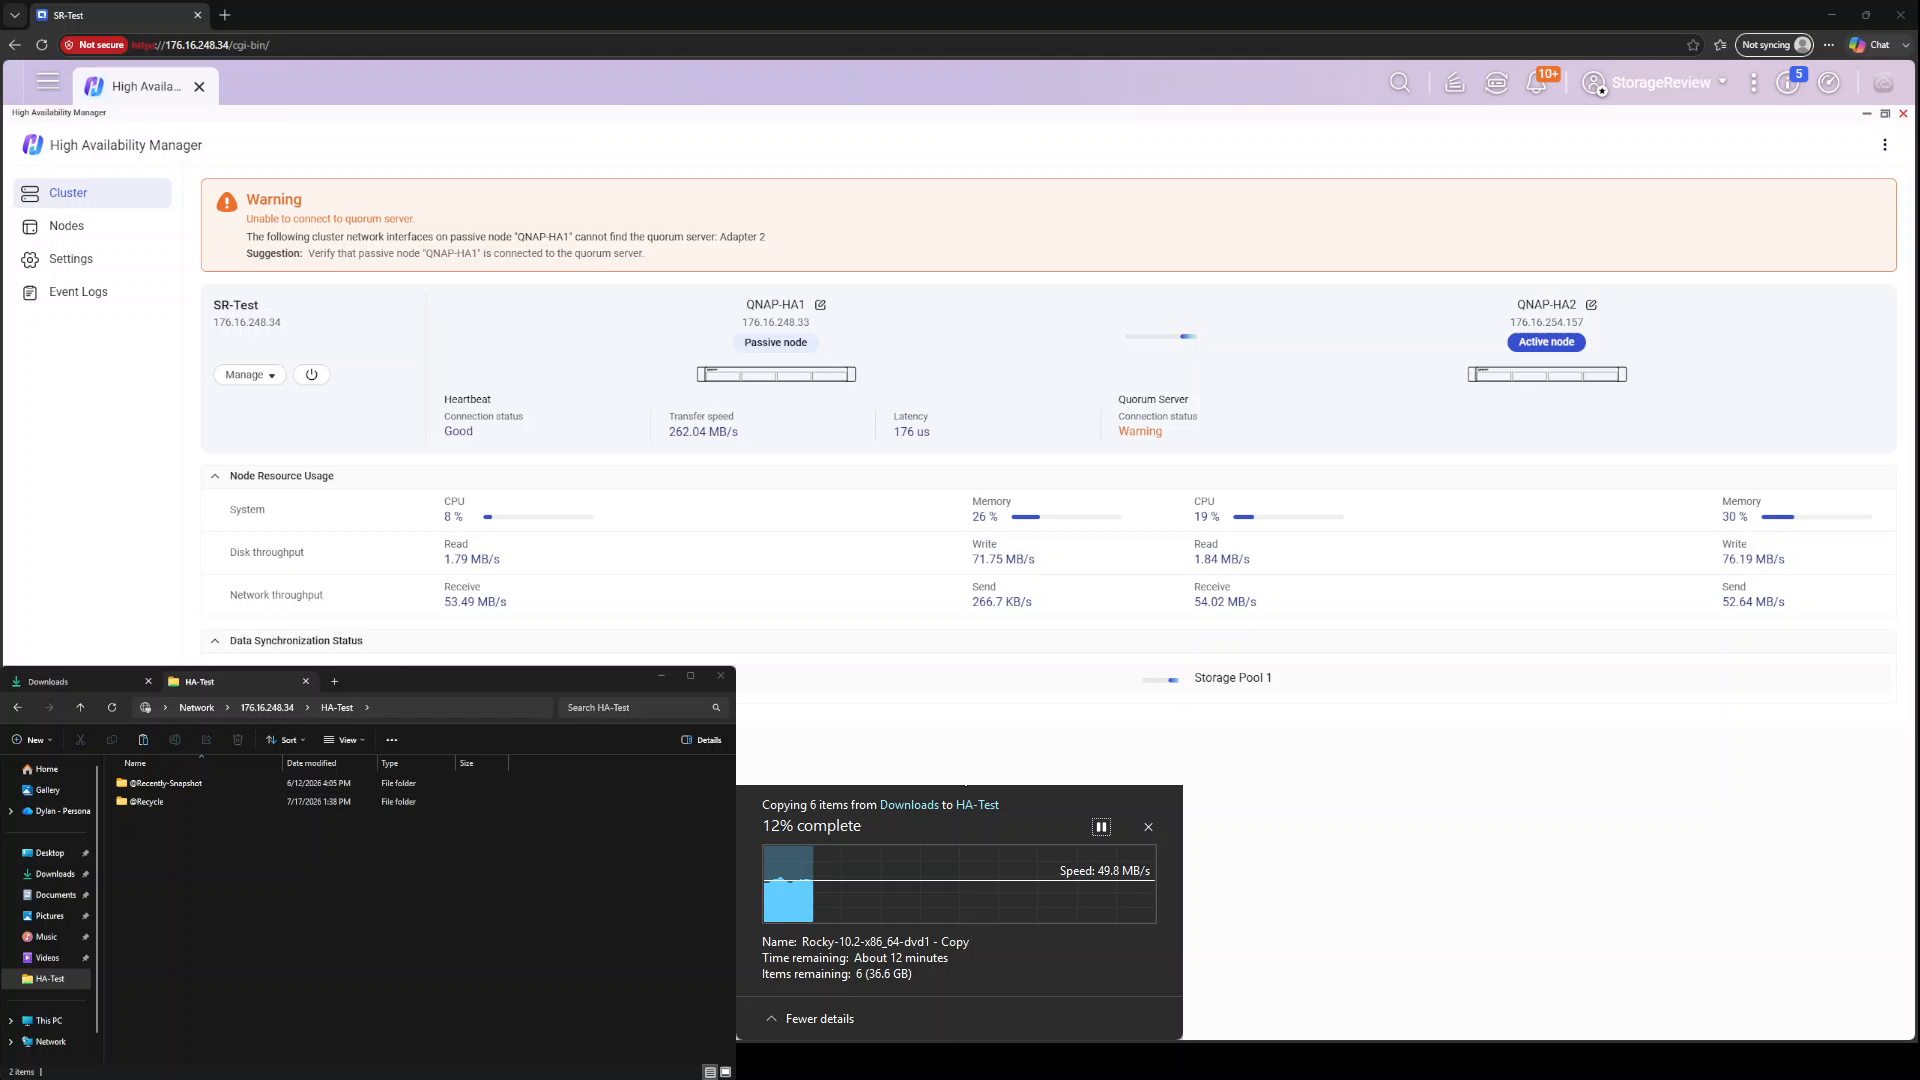
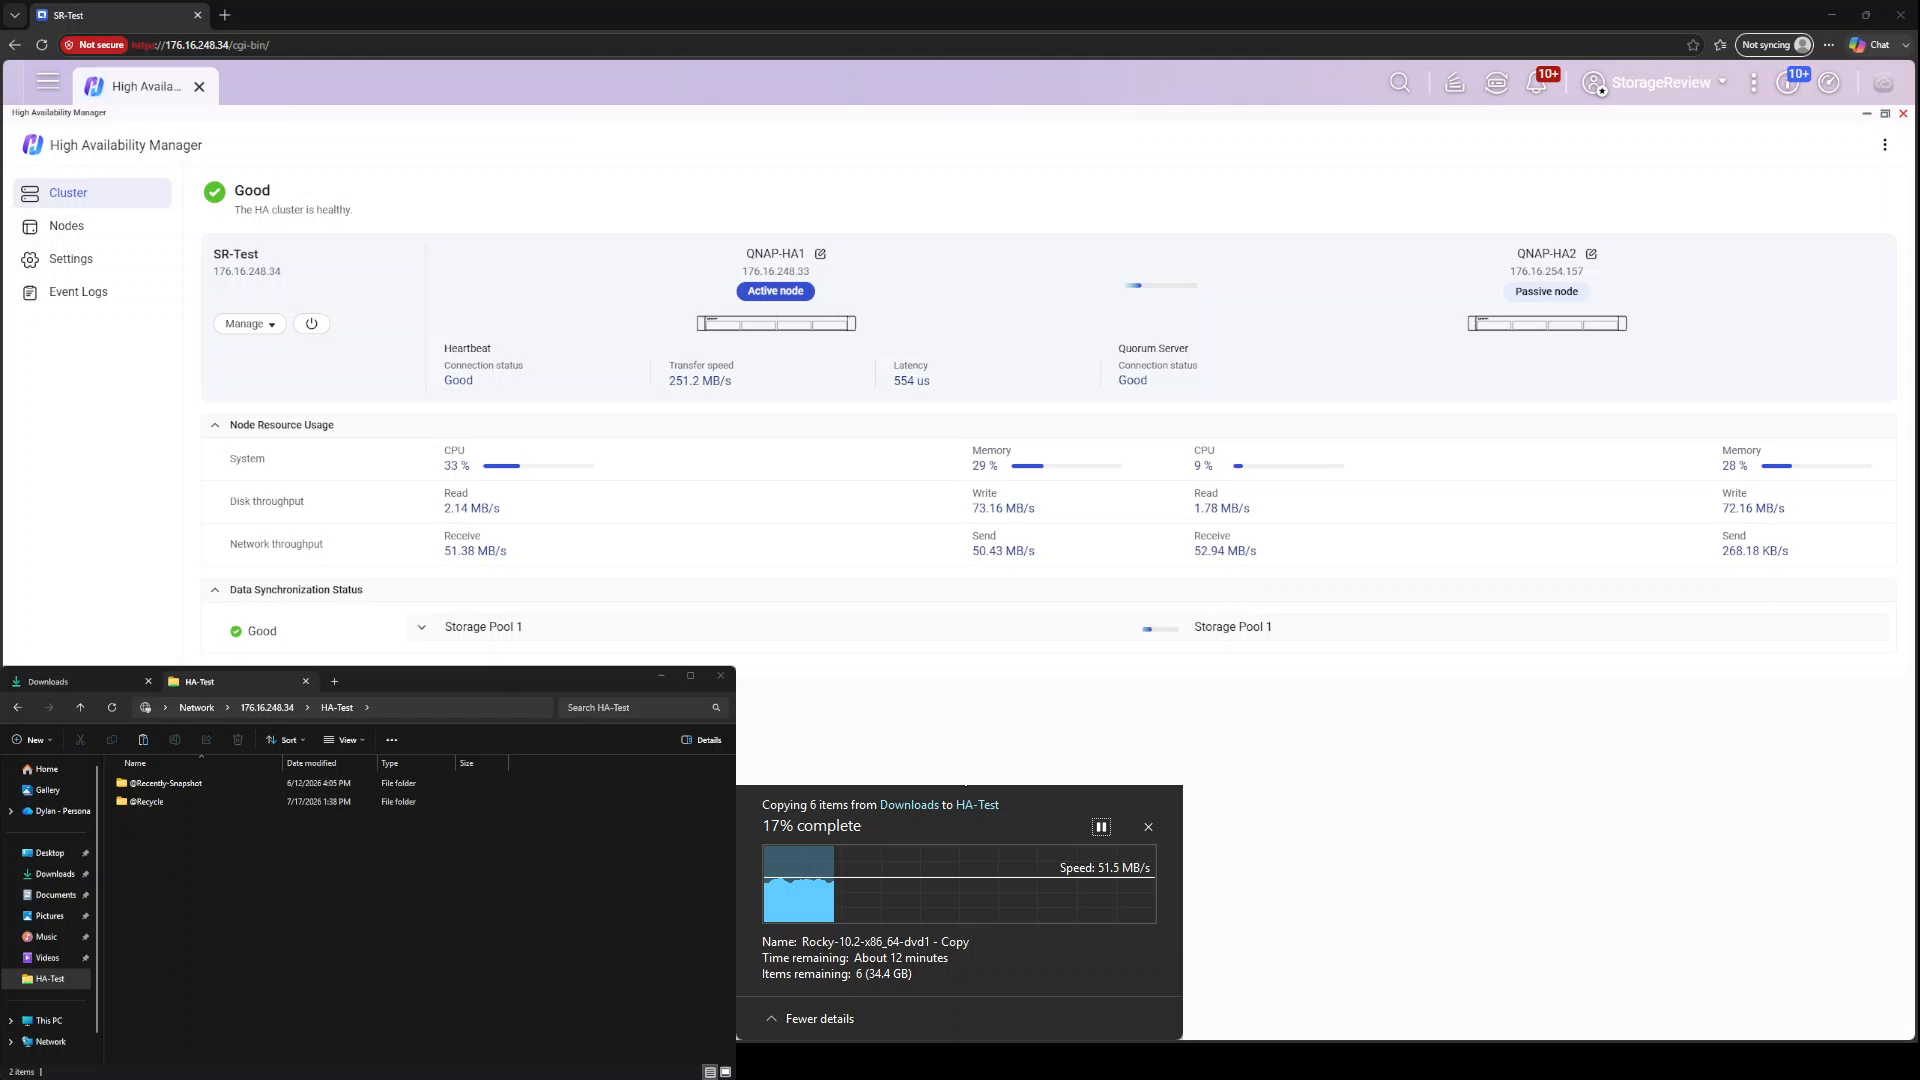
Riconnettendo la rete, il nodo è tornato nel cluster e il failback è avvenuto automaticamente entro un minuto: una seconda pausa di circa 30 secondi, durante la quale il ruolo attivo è tornato a QNAP-HA1, è stata l'unica prova visibile al client che qualcosa fosse successo. Lo stesso processo di copia è sopravvissuto a due switchover consecutivi senza un singolo file danneggiato. Per chiunque abbia visto una sessione SMB interrompersi per molto meno, questo è il risultato principale di tutta questa operazione.
Implementare l'alta disponibilità nel modo corretto: split-brain e topologia di rete
I test di failover come i nostri dimostrano che il cluster funziona, ma la tenuta di una coppia HA in produzione dipende tanto dalla rete circostante quanto dalle unità NAS stesse. Gli scenari per cui HA Manager è progettato (un nodo guasto, una porta dello switch non funzionante, un collegamento uplink interrotto) condividono tutti un presupposto: almeno un percorso di comunicazione tra i due nodi sopravvive al guasto. Proteggere questo presupposto è la decisione più importante in una distribuzione HA, perché l'alternativa è la condizione che ogni architettura ad alta disponibilità è progettata per evitare: lo split-brain.
QNAP documenta lo scenario. Il fenomeno dello split-brain si verifica quando entrambi i nodi perdono la comunicazione tra loro, ma rimangono operativi in modo indipendente, assumendo ciascuno il ruolo attivo. Due nodi, ognuno dei quali crede di essere il proprietario del cluster e disposto ad accettare operazioni di scrittura, rappresentano una ricetta per l'incoerenza dei dati o il danneggiamento dello storage, poiché ciascuno potrebbe tentare di controllare simultaneamente le risorse condivise. Le cause documentate sono esattamente quelle che ci si aspetterebbe: disconnessioni di rete tra i nodi, errori di heartbeat e percorsi di rete instabili. Si noti cosa hanno in comune. Lo split-brain non viene innescato dal guasto di un singolo nodo; viene innescato quando tutti i percorsi tra due nodi funzionanti falliscono simultaneamente. Questo è un problema di topologia, e ha una soluzione topologica.
Le regole di implementazione si sono rivelate come previsto:
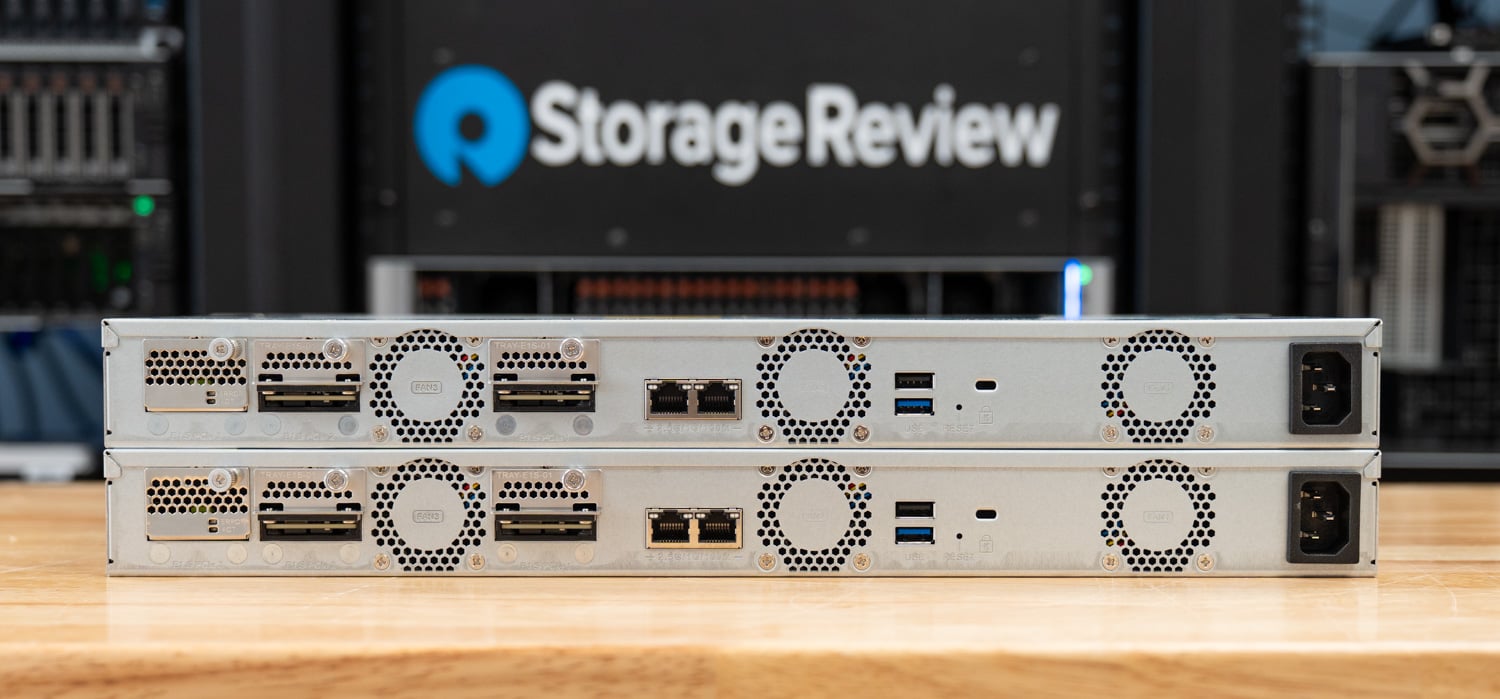
Il segnale di heartbeat viene trasmesso tramite un cavo diretto tra i due nodi. QNAP richiede un collegamento diretto per l'heartbeat, ed ecco perché. Senza switch, ricetrasmettitori o infrastrutture condivise lungo il percorso, l'unico elemento in grado di interrompere l'heartbeat è il nodo stesso, che è esattamente l'evento per cui è stato progettato il failover. In una configurazione con server nello stesso rack, dove queste unità TS-h765eU a profondità ridotta sono solitamente posizionate una accanto all'altra, non c'è motivo di fare diversamente.
Se i nodi sono separati, è fondamentale che il traffico heartbeat e quello dei client seguano percorsi fisicamente indipendenti. Laddove un collegamento diretto non sia pratico, instradare il traffico heartbeat attraverso switch diversi da quelli utilizzati per la connessione del cluster. Nel momento in cui entrambe le connessioni attraversano lo stesso switch, quest'ultimo diventa un singolo punto di guasto in grado di interrompere simultaneamente tutti i percorsi tra i nodi, trasformando un normale guasto dello switch in un potenziale evento di split-brain. L'intero scopo dell'acquisto di due unità NAS viene vanificato se un singolo componente dell'infrastruttura condivisa può isolarle l'una dall'altra. Questa è la logica alla base della nostra metodologia di test di failover di rete: scollegare il cavo lato client mentre il traffico heartbeat rimane connesso simula il guasto dello switch o del cablaggio che una topologia correttamente separata subirebbe, con il traffico heartbeat attivo per gestire il passaggio di consegne in modo pulito.
Abilita il server di quorum. La terza misura di sicurezza di QNAP è un witness sulla rete, configurabile in High Availability Manager > Impostazioni > Criteri di failover > Server di quorum. Se i nodi perdono il collegamento diretto ma riescono comunque a raggiungere la rete, il server di quorum continua a monitorarli entrambi e a comunicarne lo stato, fornendo a ciascun nodo un criterio di spareggio indipendente prima che si promuova come nodo principale. Lo stato della connessione del server di quorum viene visualizzato in modo permanente nella dashboard di HA Manager insieme all'heartbeat, consentendo di monitorarne lo stato a colpo d'occhio.
Qualora si verificasse comunque il peggio, QuTS hero gestisce lo split-brain in modo difensivo. Una volta ripristinata la connettività e ripristinata la comunicazione tra i nodi, questi si scambiano informazioni sullo stato, riconoscono che entrambi hanno ricoperto il ruolo attivo e arrestano deliberatamente la maggior parte dei servizi, inclusi SMB e iSCSI, per evitare di unire due dataset divergenti. HA Manager presenta quindi una procedura guidata di ripristino dallo split-brain con due percorsi. La prima opzione preserva i dati su un singolo nodo selezionato; l'altro nodo viene formattato, reimpostato come membro passivo e risincronizzato, la soluzione più rapida quando si sa quale lato contiene i dati corretti. La seconda opzione preserva i dati su entrambi i nodi riprendendo i servizi su un nodo e rimuovendo completamente l'altro dal cluster, consentendo di verificare e riconciliare i dati prima di ricollegarlo manualmente. Si tratta di un modello di ripristino efficace, ma il ripristino implica comunque tempi di inattività e una risincronizzazione completa. Lo split-brain è una condizione che si previene attraverso la progettazione dell'implementazione, non da cui si prevede di riprendersi, e le tre regole sopra descritte non comportano alcun costo aggiuntivo oltre a un cavo e cinque minuti di configurazione.
Monitoraggio e gestione
Le operazioni del secondo giorno sono gestite tramite l'app HA Manager, che consolida in un unico pannello lo stato del cluster, l'utilizzo delle risorse per nodo, i registri degli eventi e la gestione dei nodi, incluso il passaggio manuale. I banner di avviso della dashboard si sono rivelati sufficientemente specifici da risultare diagnostici durante i nostri test, indicando con precisione l'interfaccia e il nodo in errore anziché un generico indicatore di degrado.
QNAP ha integrato la funzionalità HA anche nell'hardware stesso. In un cluster HA, il pannello LCD di ciascun NAS può visualizzare il nome del cluster, il ruolo corrente del nodo e l'indirizzo IP del cluster, mentre il LED di stato indica a colpo d'occhio lo stato HA: verde fisso per il nodo attivo, verde lampeggiante per il nodo passivo e rosso fisso in caso di errore HA. In un rack pieno di unità identiche a profondità ridotta, la possibilità di identificare il nodo attivo senza dover aprire un browser è un piccolo dettaglio che i tecnici apprezzeranno. Per le implementazioni in flotta, AMIZcloud aggiunge il monitoraggio centralizzato dei gruppi HA tramite cloud, visualizzando lo stato del cluster, la latenza e gli avvisi in tutte le sedi.
Considerazioni finali
High Availability Manager ha mantenuto la sua promessa principale in entrambe le modalità di errore che gli abbiamo sottoposto. Un'interruzione di corrente sul nodo attivo ha causato un blocco di circa 50 secondi durante la copia dei file Windows, senza alcun errore; l'interruzione della connessione di rete di un client ha causato un blocco di circa 45 secondi. In entrambi i casi, lo stesso processo di copia è stato completato con successo, dopo il ripristino del nodo e il failback automatico, con una pausa massima di meno di un secondo. I client non hanno mai dovuto riconfigurare nulla. Applicazioni, condivisioni di file e flussi di lavoro degli utenti hanno continuato a funzionare tramite un singolo indirizzo IP e nome host prima, durante e dopo il failover. Anche la configurazione è semplice: due unità standalone sono diventate un cluster di server in meno di dieci minuti grazie alla procedura guidata, più dieci minuti per la sincronizzazione iniziale, e la dashboard ci ha indicato con precisione quale interfaccia, nodo e connessione controllare ogni volta che si verificava un problema.
L'intera configurazione HA: due unità TS-h765eU e le unità IronWolf Pro che le ospitavano.
Tuttavia, non bisogna ignorare i costi dell'HA. Si acquistano due unità di ogni componente e il nodo passivo rimane inutilizzato fino al giorno in cui non viene riattivato. Gli snapshot immutabili, l'altra caratteristica distintiva di protezione di h6.0, non sono attualmente disponibili all'interno di un cluster HA, quindi gli amministratori devono scegliere tra le due opzioni. Inoltre, il requisito di hardware identico implica che gli aggiornamenti avvengano a coppie, il che potrebbe limitare i budget.
Il risultato finale dipende dal dimensionamento ottimale, e HA Manager si rivela particolarmente adatto alle piccole imprese e alle implementazioni edge. Rispetto agli array enterprise a doppio controller, una coppia di unità TS-h765eU a profondità ridotta offre un quadro finanziario completamente diverso, coprendo al contempo lo scenario di guasto, ovvero la perdita del controller, che è il principale fattore che spinge la maggior parte degli acquisti di array a doppio controller nel segmento SMB. Rispetto a schemi di replica fai-da-te, snapshot, processi rsync e backup e ripristino, la differenza sta nei tempi di ripristino: questi schemi proteggono i dati ma costringono a ricostruire le connessioni client per ore, mentre il peggior evento visibile ai client riscontrato da HA Manager nei nostri test è stata una pausa di un minuto. Altrettanto importante è il fatto che il guasto che non è in grado di gestire, ovvero il blocco simultaneo di tutti i percorsi tra i nodi, può essere evitato con un cavo heartbeat diretto, percorsi di rete separati e un server quorum abilitato: una configurazione topologica che richiede un solo cavo e cinque minuti di configurazione.
Un ultimo punto specifico per una configurazione a due nodi: il momento più vulnerabile del cluster è la fase di risincronizzazione, quando un nodo detiene l'unica copia valida dei dati e le unità sottostanti sono sottoposte al massimo carico di lavoro. Questo è un valido motivo per cui la scelta delle unità è fondamentale in una configurazione HA, ed è il motivo per cui dischi di livello NAS come le unità Seagate IronWolf Pro da 30 TB utilizzate nella nostra configurazione sono più importanti in questo caso che in un sistema standalone: il loro compito è quello di garantire che tale fase si svolga senza intoppi.
I router QNAP TS-h765eU e QuTS hero h6.0 sono ora disponibili. Per maggiori informazioni, visita la pagina del prodotto QNAP TS-h765eU.
Questo report è sponsorizzato da QNAP. Tutte le opinioni espresse in questo report si basano sulla nostra valutazione imparziale del/dei prodotto/i in esame.


 Amazon