

AMDはMLPerf Inference v6.0の結果を公表し、Instinct MI355X GPUをシングルノード、マルチノード、および異種環境における拡張性の高い推論プラットフォームとして位置づけました。今回の提出資料は、新たなワークロードの追加、1秒あたり100万トークンを超えるクラスタ規模のスループットの実証、そして拡大を続けるパートナーエコシステム全体での再現性の検証など、単なる性能向上にとどまらない内容となっています。
cDNA 4アーキテクチャは高容量推論をターゲットとする
Instinct MI355X GPUは、 TSMCの3nm | 6nm FinFETプロセスで構築されたAMDのCDNA 4アーキテクチャに基づいています(デュアルプロセスチップレット設計を採用しており、演算ダイ(XCD)はTSMCの3nmノードを使用し、I/Oダイは6nmを使用しています)。1850億個のトランジスタを統合し、FP4およびFP6データフォーマットをサポートしています。これは、モノリシックダイではなく、マルチチップレットパッケージ全体での数値であることに注意が必要です。各GPUには最大288GBのHBM3Eメモリが搭載されており、1つのデバイスで最大5200億個のパラメータを持つモデルをサポートできます。AMDは、この演算密度とメモリ容量の組み合わせが、過剰なモデル分割なしに大規模モデルの推論を行う上で重要であると位置付けています。
このプラットフォームは、データセンターの導入要件に合わせて、空冷式と直接液冷式の両方のオプションを備えたUBB8構成で提供されます。
マルチノードのスループットが毎秒1万トークンを超える
今回のラウンドにおける重要な成果の一つは、AMDがクラスタ規模で毎秒1万トークンを超える処理能力を達成したことです。AMDはInstinct MI355X GPUを使用し、Llama 2 70Bではサーバー環境とオフライン環境の両方で、またGPT-OSS-120Bではオフライン環境で、この目標を達成しました。
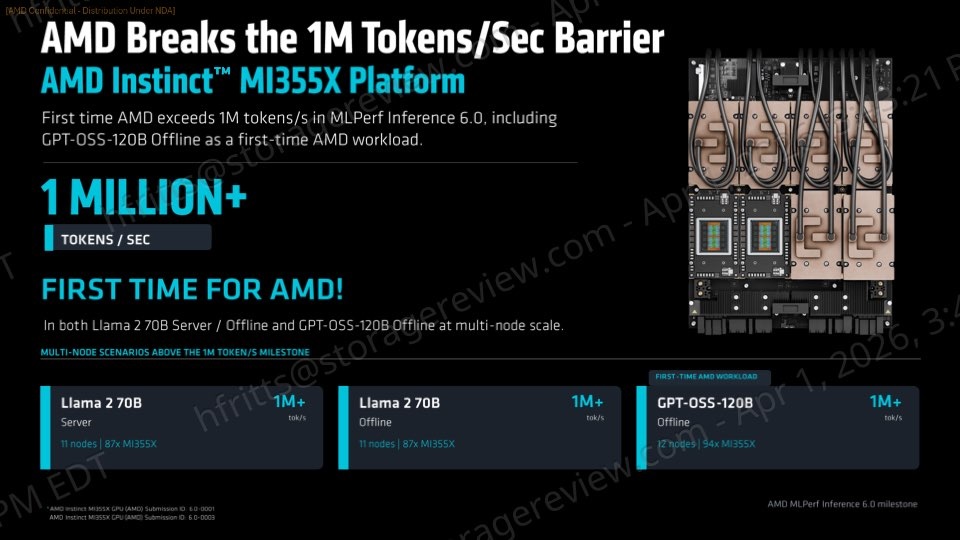
これらの結果は、推論性能の評価基準がアクセラレータ単位ではなくクラスタレベルへと移行していることを反映している。大規模なAI導入における本番環境への準備状況を判断する指標として、総スループットとサービス提供時間がますます活用されている。
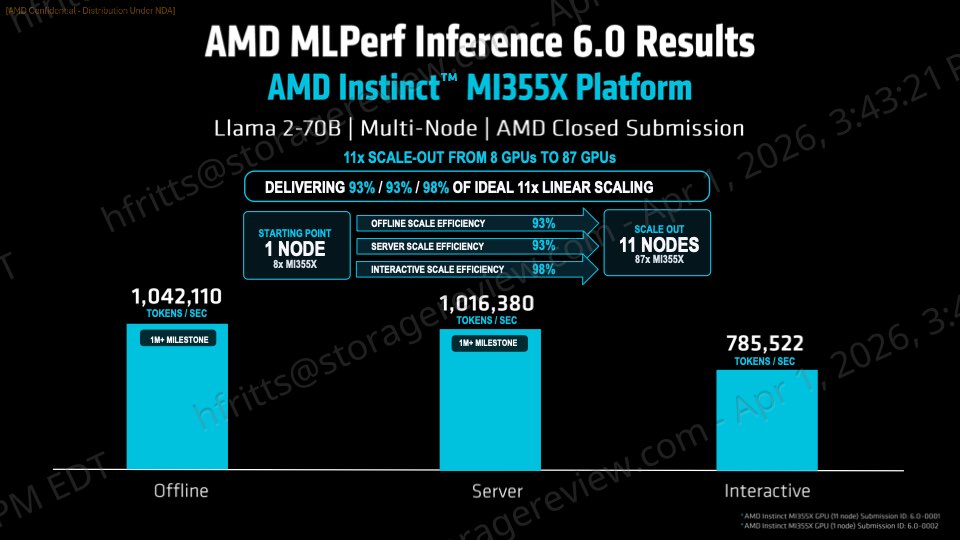
AMDは効率的なスケーリングも実証しました。Llama 2 70Bでは、11ノード、87GPUの構成で、オフライン、サーバー、インタラクティブの各シナリオにおいて毎秒1万トークンを超える処理能力を実現し、スケールアウト効率は93%から98%に達しました。GPT-OSS-120Bでは、12ノード、94GPUのクラスタで同様のスループットを達成し、スケーリング効率は90%を超えました。これらの結果は、単一システムを超えて展開規模を拡大しても、パフォーマンスの向上が効果的に実現されることを示しています。
世代交代による性能向上と、シングルノードにおける競争力のあるパフォーマンス
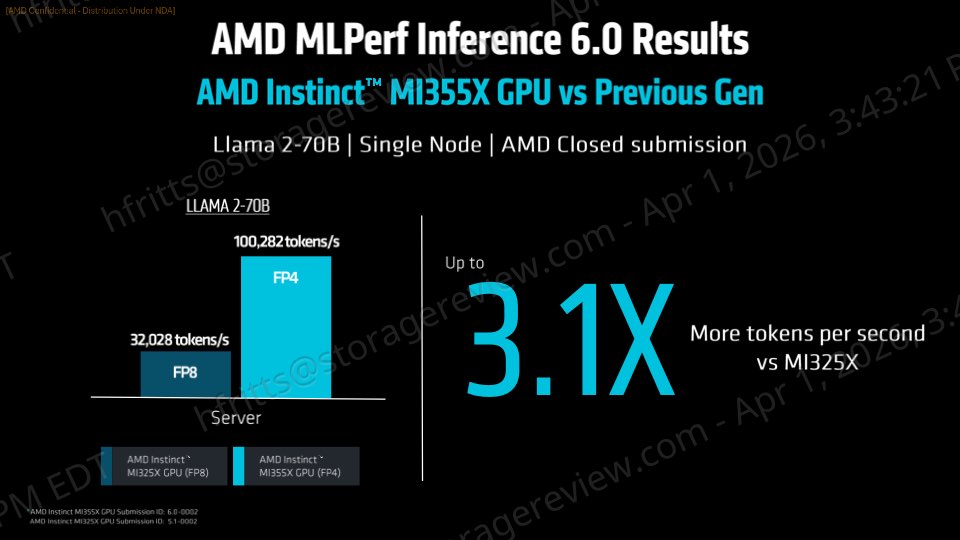
AMDは、Llama 2 70B Serverのパフォーマンスが前世代のInstinct MI325Xと比較して3.1倍向上し、毎秒100,282トークンに達したと報告した。この改善は、アーキテクチャの変更とROCmソフトウェアの最適化の両方を反映している。オフラインスコアは前ラウンドと比較して4.4倍、サーバースコアは4.8倍向上した。これらの向上は主にFP4量子化によるものである。
シングルノード比較において、MI355XはNVIDIAプラットフォームに対して競争力のある性能を発揮しました。Llama 2 70Bでは、AMDはオフラインスループットでNVIDIA B200と同等の性能を実現し、サーバー性能ではほぼ同等、インタラクティブ性能ではNVIDIA B200を上回りました。NVIDIA B300と比較すると、AMDのGPUはオフラインモードで92%、サーバーモードで93%の性能を発揮し、インタラクティブモードでは104%とNVIDIAを上回りました。
初回モデル有効化により適用範囲が拡大
MLPerf Inference v6.0にはいくつかの新しいワークロードが含まれており、AMDはこのテストラウンドでモデルの迅速な有効化を実証しました。エキスパート混合モデルであるGPT-OSS-120Bが初めて導入され、オフラインとサーバーの両方のシナリオでNVIDIAシステムと比較して遜色のない結果を達成しました。
AMDはWAN-2.2のテキストからビデオへの変換に関する結果も提出し、マルチモーダルおよび生成型ビデオ推論分野への参入を示した。公式提出ではシングルストリームのレイテンシに重点が置かれていたが、その結果は既存プラットフォームと同等の性能を示した。提出後のチューニングによりパフォーマンスはさらに向上し、ソフトウェアの成熟に伴い最適化の余地があることが示された。
これらの追加機能は、AMDが従来のLLMベンチマークの枠を超え、新たなAIワークロードをサポートすることに注力していることを示しています。
ROCmソフトウェアはスケーリングと異種推論を可能にする
AMDは、パフォーマンスと拡張性の大部分をROCmソフトウェアスタックによるものとしている。強化された機能には、最適化されたFP4実行、分散推論のためのGPU間通信の改善、異種環境全体にわたる動的なワークロード分散のサポートなどが含まれる。
最初のMLPerf異種環境テストは、AMD Instinct GPUの3つのモデル(MI300X、MI325X、MI355X)を使用して開発されました。DellとMangoBoostが提出したこの構成は、Llama 2 70B Serverで毎秒141,521トークン、Llama 2 70B Offlineで毎秒151,843トークンを達成しました。
特筆すべき点として、AMD Instinct MI355Xプラットフォームは米国のデルの研究所に設置されていた一方、Instinct MI300XおよびMI325Xプラットフォームは韓国に設置されていた。これは、地理的に異なる場所に分散したシステムを連携させる能力を示している。
生態系の成長と再現性
今回のMLPerfテストでは、AMDのパートナーエコシステムが拡大し、複数のInstinct GPU世代にわたる結果を提出した企業が9社に上った。参加ベンダーには、Cisco、Dell、Giga Computing、HPE、MangoBoost、MiTAC、Oracle、Supermicro、Red Hatが含まれる。
パートナー企業からの提出データは、AMDの社内結果とほぼ一致しており、通常は4%以内、場合によっては1%以内の誤差に収まっていました。この一貫性は、OEMプラットフォームとクラウドプラットフォーム全体でパフォーマンスが再現可能であることを示しており、導入リスクを低減し、実環境での結果に対する信頼性を高めます。


 Amazon