

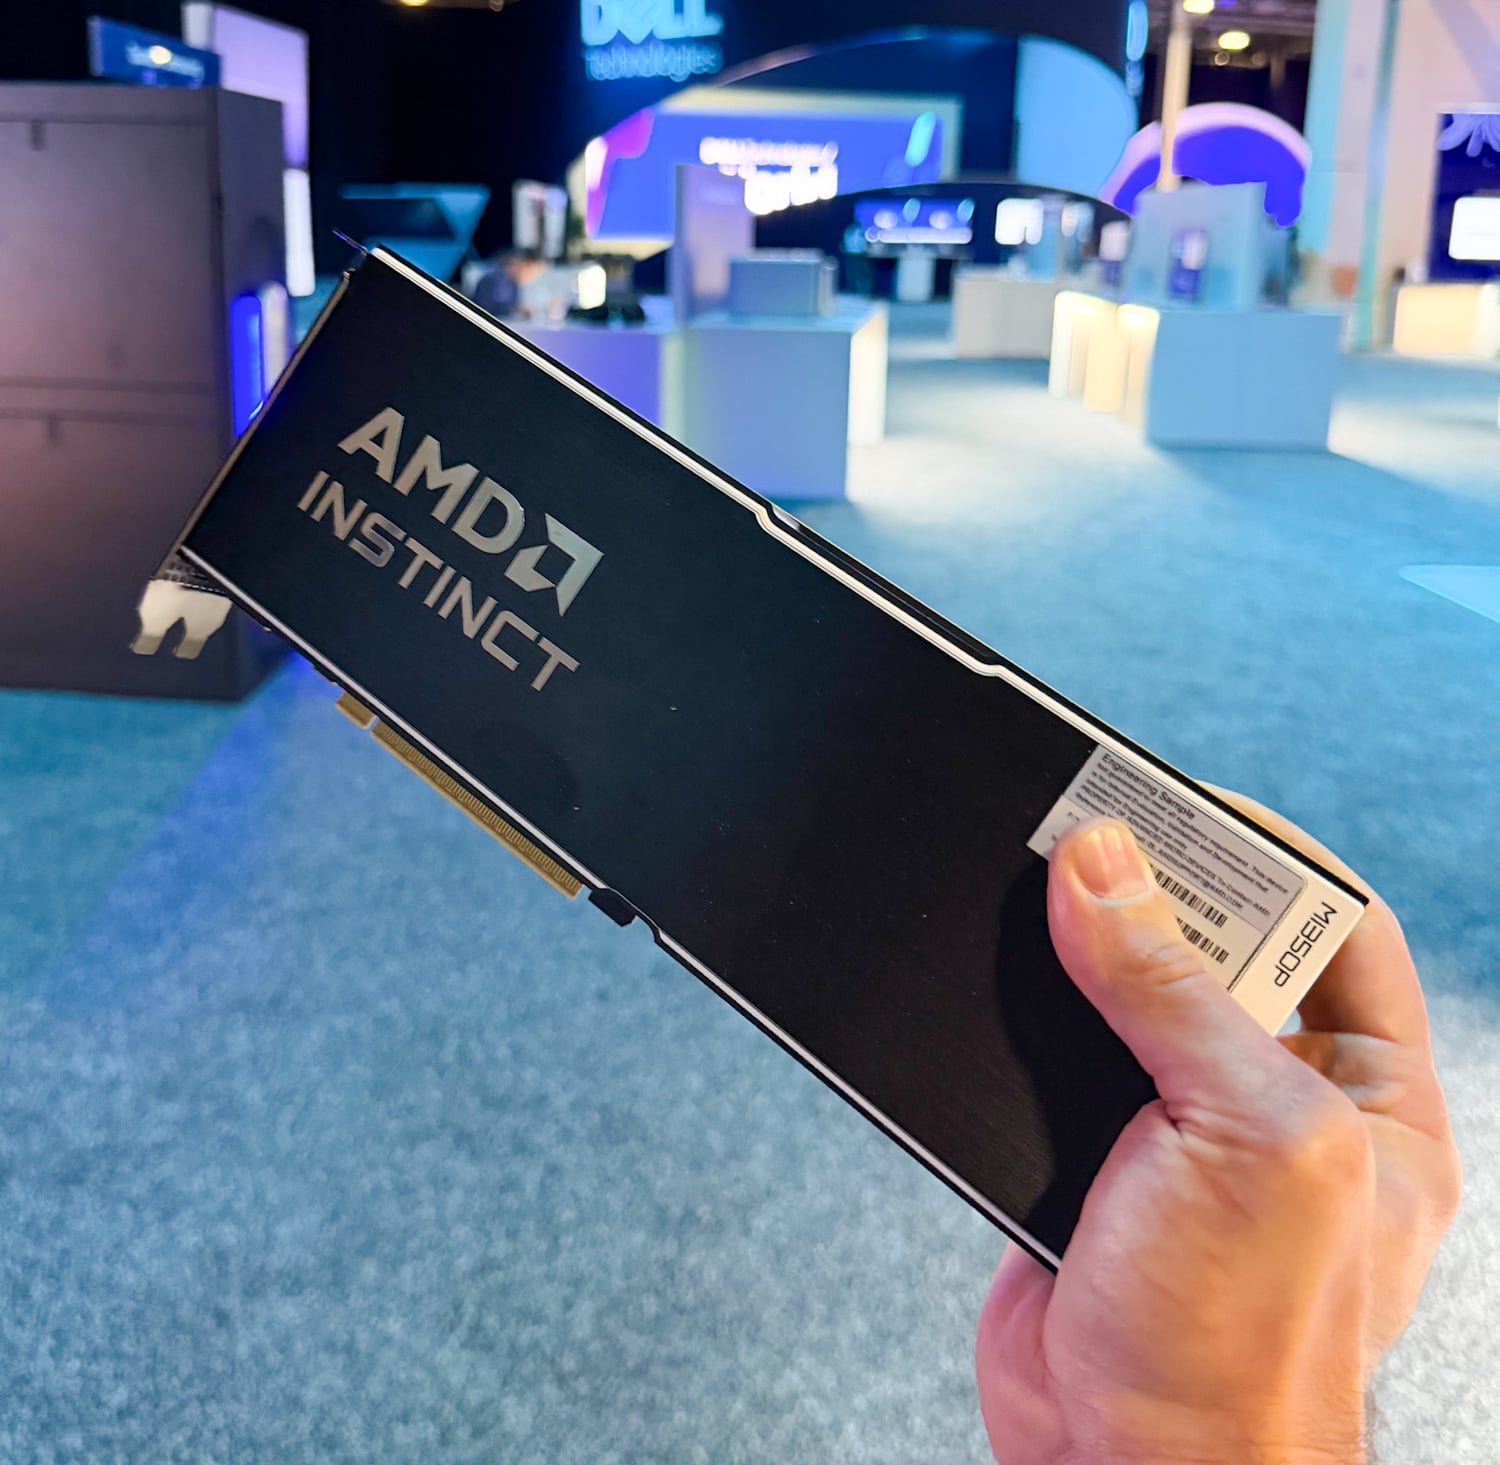
7月下旬、LiqidはAMD Instinct MI350P PCIe GPUをベースとしたスケールアップ型AIプラットフォームを発表した。UltraStack 30は、Liqidの構成可能なGPUプーリング技術とAMDアクセラレータを組み合わせることで、従来のサーバーのアクセラレータ数やメモリ容量を超える拡張性を必要とする企業やクラウドにおけるAI推論の展開に対応する。
UltraStack 30: 30個のAMD MI350P GPUをプールする
提案されたアーキテクチャでは、最大30個のAMD Instinct MI350P GPUを単一のサーバー環境内でプールすることが可能です。Liqid社によると、これにより大規模モデル、検索拡張型生成デプロイメント、および長コンテキスト推論ワークロード向けに、合計4.3TBのHBM3E容量を提供できるとのことです。このプラットフォームは、GPUリソースを個々のサーバーに固定するのではなく、動的に割り当てることを可能にすることを目的としており、並列モデルデプロイメントのためのネイティブなKubernetesサポートを備えています。
この提携は、AI推論におけるインフラストラクチャの課題、すなわち生成されるトークンのコストを抑えつつ、アクセラレータの有効利用率を最大化するという課題に対応するものです。Liqidは、同社のGPUプール方式により、従来のサーバー構成と比較して、トークンのスループットが最大3.7倍、1ドルあたりのトークン数が2.1倍、1ワットあたりのトークン数が1.8倍向上すると主張しています。また、大規模モデルの導入においては、導入コストを最大65%、消費電力を最大50%削減できるとしています。これらの数値は、構成やワークロードによって変動する社内予測に基づくものだとしています。
「LiqidはGPUプーリングとスケーリングの分野でリーダーとしての地位を確立してきました。AMD Instinct MI350Pシリーズは、次世代AIインフラストラクチャを構築するための理想的なPCIeベースのGPUであり、利用率とトークンあたりのコストが経済性を左右するエンタープライズAI推論向けに最適化されたソリューションを提供することを可能にします」と、LiqidのCEOであるリック・ヘグバーグ氏は述べています。
| Liqid UltraStack 30: AMD MI350P | |
| 製品仕様 | |
| サーバー | AMD EPYC™ 9005シリーズCPU、デュアルソケット |
| GPU | 30× AMD Instinct™ MI350P PCIe |
| AIパフォーマンス | 69 PFLOPS (FP8) |
| GPU HBMメモリ | 4.3 TB |
| 総システム電力 | ~22kW |
| 主要な指標 | 値 |
| kWあたりの性能 | 約3.14 PFLOPS/kW |
| HBM/kW | 約195 GB/kW |
| PFLOPあたりのHBM | 約62 GB/PFLOP |
MI350Pの内部
AMDはMI350Pを、特別な冷却や大規模なデータセンターの再設計を必要とせずにAI推論パフォーマンスを実現するように設計されたPCIeベースのアクセラレータとして位置付けています。AMDの仕様書には、このカードは144GBのHBM3E、4TB/sのメモリ帯域幅、CDNA 4アーキテクチャによる2.3 PFLOPSの高密度FP8演算、パッシブ冷却のダブルスロットPCIe 5.0フォームファクタで標準600Wのボード電力(450W構成可能)と記載されています。UltraStackの4.3TBと69 PFLOPSの合計数値は、まさにこのカード30枚から来ています。Liqidのファブリックと組み合わせることで、GPUは必要に応じて追加および拡張でき、推論需要の変化に対応し、遊休GPU容量を削減し、システムあたりのモデル密度を高めることができます。
「AMD Instinct MI350P PCIe GPUは、特別なインフラストラクチャを必要とせずに、卓越したAI推論性能を実現します。LiqidのGPUプーリングソリューションと組み合わせることで、お客様はGPUリソースをオンデマンドで拡張し、利用率の向上、インフラストラクチャコストの削減、そして業界をリードするAI推論の経済性を実現できます」と、AMDのコンピューティングおよびエンタープライズAIグループ担当コーポレートバイスプレジデント、スレシュ・アンダニ氏は述べています。
プラットフォームの対象者
このソリューションは、企業AIチーム、NeoCloudプロバイダー、AIサービスプロバイダー、HPCおよび研究機関を対象としています。想定されるユースケースとしては、営業、人事、マーケティング、法務、コーディングなどの業務を担うオンプレミス型のプライベート企業アシスタント、RAGおよびロングコンテキスト推論、創薬や材料科学などの科学的ワークロード、共有アクセラレータープールから複数のモデルサイズに対応する混合モデル群などが挙げられます。
GPUプーリングからCXLメモリプーリングまで
CXLの部分はもはや理論上の話ではありません。8 月初旬、Liqid は EX-5410C メモリ プラットフォームを発表しました。同社はこれを、業界初にして唯一の完全分離型ソフトウェア定義メモリ プーリング ソリューションと呼んでいます。CXL 2.0 をベースに構築され、Liqid Matrix ソフトウェアで管理される EX-5410C は、シャーシあたり最大 40TB の DRAM をプールし、160TB を超える統合プールに拡張可能で、Liqid が「無駄な容量ゼロ」と表現する状態で、最大 16 台のサーバー ノードにメモリを動的に割り当てます。
Liqidは、グラフ分析ワークロードの処理速度が最大30倍速く、プラットフォーム上の特定のKVキャッシュワークロードでは1秒あたりのトークン数が最大7倍増加すると主張しており、初期のテストベッドがすでにパシフィック・ノースウェスト国立研究所で稼働しており、AMAISイニシアチブを通じてDOEの資金提供を受けた研究者が利用できる。UltraStackにとって重要なのは方向性だ。LiqidがGPU容量に適用しているのと同じ構成モデルがシステムメモリにも拡張され、将来の展開では、プールされたアクセラレータと並んで、 KVキャッシュやその他のメモリ集約型AIワークロードに共有メモリを割り当てることができるようになる。
LiqidとAMDの共同ソリューションに関する詳細は、両社が開発および顧客への導入活動を進めるにつれて明らかになる見込みです。


 Amazon