

従来、GPUが読み込むストレージデータはすべてホストCPUを経由しており、ホストCPUはファイルシステムを管理し、コマンドを送信し、データを返す役割を担っていました。このオーバーヘッドは、大規模なシーケンシャル転送では無視できる程度ですが、毎秒数百万件の512バイト操作を処理する際にはボトルネックとなります。NVIDIAは、サンタクララで開催されたFMS 2026において、このボトルネックを解消するための新しいソフトウェアと業界イニシアチブを発表しました。
今回の発表の中心はcuFileです。cuFileは、GPUがストレージに直接読み書きできるようにするAPIです。NVIDIAはcuFileとそのサポートソフトウェアスタック全体をオープンソース化し、コードはGitHub上の新しいXIO-SIG組織でホストされています。創設メンテナーには、Google、Intel、Meta、NVIDIAが含まれます。さらに、NVIDIAは、少なくともGTC 2025から公に議論されてきたStorage-Nextイニシアチブを正式に立ち上げました。Storage-Nextには現在、DDN、KIOXIA、Micronなどの40社以上のストレージおよびフラッシュベンダーに加え、コントローラーメーカー、冷却スペシャリスト、標準化団体が参加しています。これらの参加者は、CPUではなくGPUがクライアントである場合にストレージデバイスがどのように動作すべきかを共同で定義しています。
問題点:ホストを介したI/O
GPUシステムは従来、ホスト中心のI/Oモデルで動作してきました。CPUはGPUタスクのスケジュール設定、データのステージング、GPUとネットワークまたはストレージ間のすべての転送の開始を行います。各操作は、GPUカーネルの処理完了、CPUへの制御の復帰、CPUによる転送設定、そして次のカーネルの起動という一連の流れで行われます。操作ごとのコストは、主にカーネル起動とCPU-GPU間の同期オーバーヘッドであり、マイクロ秒単位で計測されます。大量のデータ転送ではこのオーバーヘッドは無視できる程度ですが、きめ細かな処理では無視できないほど大きくなります。
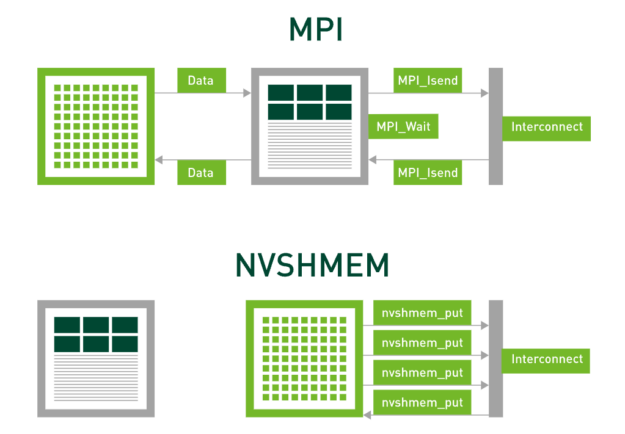
GPU間通信において、NVIDIAはNVSHMEMによってホスト側の関与を排除しました。これにより、デバイスコードが直接転送を開始し、計算処理とオーバーラップさせることが可能になりました。その効果は絶大です。GROMACSがハロー交換通信をMPIからNVSHMEMに移行した際、通信処理はクリティカルパスから除外され、計算処理と完全にオーバーラップするようになりました。
ストレージはホストを介したモデルを維持します。NVMe ドライブからの読み取りは依然として CPU に制御を戻し、ファイルシステムを実行して完了を待ちます。トレーニングでは読み取りが大規模で頻度が低いため、これは許容されます。推論では許容されません。KV キャッシュエントリ、埋め込み、およびベクトル検索結果の提供は、毎秒数百万の小さなランダム読み取りを生成し、そのすべてにおいて CPU が処理経路に含まれます。
GPU主導のI/OとSCADA
SCADA(スケーリングされた高速データアクセス)は、NVSHMEMモデルをストレージに適用することで、GPUが独自のストレージI/Oを開始および管理できるようにします。
基盤となる研究は、NVIDIA、IBM、イリノイ大学、バッファロー大学がASPLOS 2023で発表したBaM(Big Accelerator Memory)です。BaMは、NVMeドライブを直接管理するGPUを実証し、ホストの介入なしに、スレッド全体で生成される小さなリクエストを統合してキャッシュすることで、ドライブが飽和するキュー深度を維持します。同一のハードウェア上で、BaMはCPU主導のアクセスよりも5.3倍高速にデータ分析ワークロードを実行し、同じデータをホストメモリに保存する場合よりも最大21.7倍低いハードウェアコストでフラッシュからグラフワークロードを実行しました。
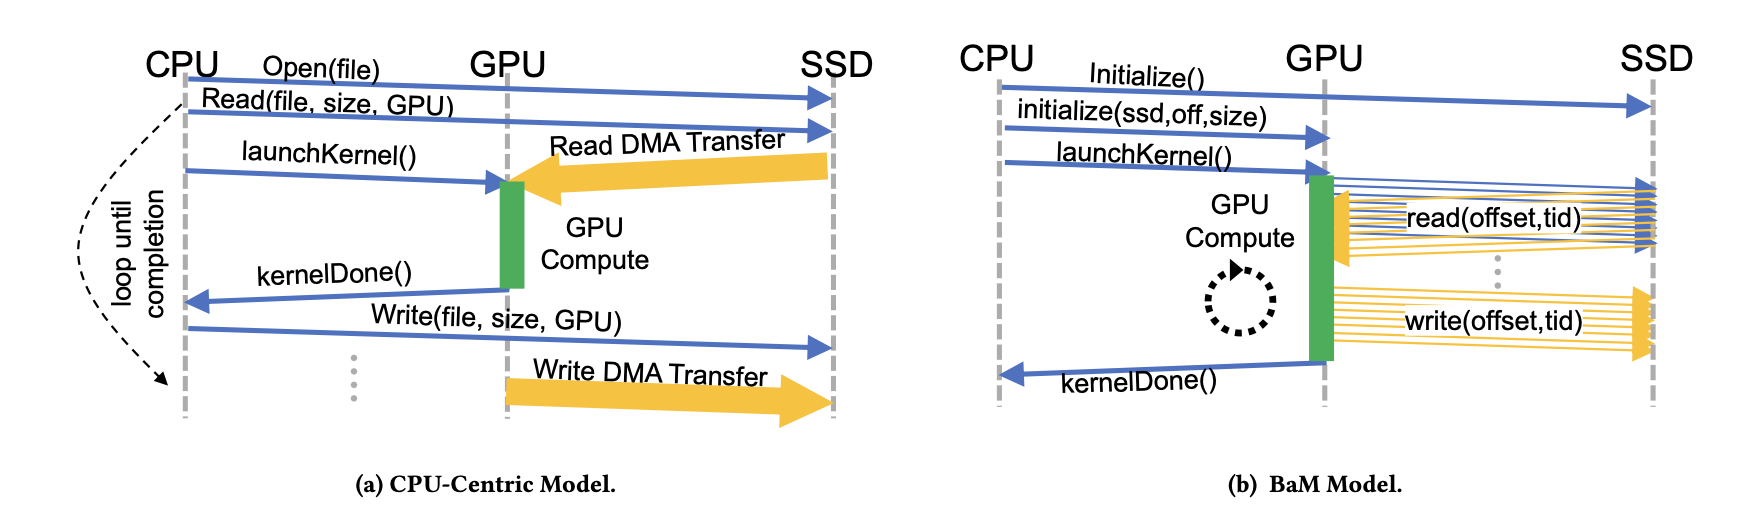
SCADAは製品化された形態です。GPU上のランタイムは、カーネルのスレッドとストレージの間に位置し、散在する小さなリクエストを統合して、GPU上のキャッシュから提供される読み取り、またはローカルNVMeやリモートストレージサーバーなどのドライブに発行される読み取り処理を行います。
直接デバイスへのアクセスは制限する必要があります。共有ドライブへの生アクセスは、あるアプリケーションが別のアプリケーションのデータを読み取ったり、破損させたりする可能性があるためです。NVIDIA の設計では、特権レベルを分離しています。アプリケーションのパフォーマンスが重要な部分は、信頼されたコンピューティング基盤の外で、特権なしで実行されます。特権コンポーネントは、標準的な Linux セキュリティ メカニズムを使用して、セットアップ時に各アプリケーションと承認されたストレージとの間の保護されたアクセスを構成します。NVIDIA は、この分離と Linux ベースの相互運用性こそが、スタックをクローズドな CUDA コンポーネントではなくオープンソースとしてリリースする理由だと述べています。
SCADAとGPUDirectストレージの違い
すべてのストレージ操作には、データパス(移動するバイト)と制御パス(リクエストの構築、送信、完了処理)があります。2019 年に導入され、2021 年以降出荷されている GPUDirect Storage (GDS) は、データパスから CPU を排除しました。cuFile を介して、データはホスト RAM にバウンス バッファなしで、ドライブと GPU メモリ間で DMA によって移動します。NVIDIA の発表資料では、DGX-2 の CPU パスの上限を 50GB/s とし、GDS はパスを組み合わせて上限を 200GB/s 近くまで引き上げることができ、DDN、VAST、WEKA、Pure Storage、およびその他の主要な AI ストレージ ベンダーがこれに対して認証されています。制御パスは CPU 上に残っています。ホスト ソフトウェアは引き続きフェッチするものを決定し、すべてのリクエストを発行し、GPU はイニシエータではなく DMA ターゲットになります。
転送サイズが大きい場合、この分割は適切です。1MBの読み込みで制御パスのコストはほぼゼロになります。512バイトになると、この比率は逆転します。リクエストごとの固定コストが支配的になり、ドライブが飽和するずっと前にCPUが飽和します。SCADAは制御パスをGPUに移行し、GPUは何十万もの操作を同時に実行することで、メモリの遅延を吸収するのと同じように、操作ごとの遅延を吸収します。
この2つは共存している。cuFileは大量データ転送用、SCADAは大量の小さなランダム読み取り用だ。
Storage-Nextと512バイト問題
SCADAはGPU側を担当し、Storage-Nextはドライブ側を担当します。ドライブ側は現在、異なるワークロード向けに最適化されています。
エンタープライズ向けSSDは、データベースや仮想化のアクセスパターンに合わせて、10年以上にわたり4KBランダム読み取りに最適化されてきました。ほとんどのコントローラは、512バイトの読み取りと4KBの読み取りを処理する際にほぼ同じ処理を行うため、4KB未満のリクエストは4KBのコストで実行されます。推論アクセスパターンはより小さく、埋め込みは数百バイト、KVキャッシュブロックは1キロバイト未満です。これらを4KB最適化ドライブから処理すると、読み取り増幅が8倍になり、帯域幅とコントローラキャッシュが無駄になります。数十テラバイトの小さなオブジェクトを扱う場合、この増幅がフラッシュをメモリ層として使用できるかどうかを左右します。
Storage-Nextは、より小型のユニットを中心にドライブ、コントローラ、システムを再構築する取り組みです。GTC 2025で既に開始され、電力とテールレイテンシーの制約の下でGPUあたり512バイトのIOPSを最大化することを目標としています。FMSでは、NVIDIAは40社以上のストレージおよびフラッシュベンダーに会員番号を付与し、SCADAを構築の基盤として指定しました。
参考となる結果は、SCADAプログラミングモデルに基づき、MicronがSC25で実証した、単一サーバーからの512バイトランダム読み取りIOPSが2億3000万というものです。これは、H3 Platform Falcon 6048シャーシに搭載された3台のH100で駆動される3台のBroadcom PEX90000 Gen6スイッチの背後に44台のMicron 9650 PCIe Gen6 SSDを配置した構成です。この数値は、44台のドライブの合計IOPS定格である550万の約95%に相当します。
その数値の内訳が重要だ。2億3000万回の512バイトの読み取りは、およそ118GB/秒のペイロードに相当し、これは4台か5台のドライブで順次処理できる量だ。重要なのは操作回数である。ホストソフトウェアでこれを維持するには、送信と完了の処理だけで数十個のCPUコアを消費するが、デモで使用された単一のCPUは実質的にアイドル状態だった。GPUの10万以上のスレッドに分散処理すれば、負荷は1スレッドあたり毎秒数千回の操作となる。
SSDの性能が今やゲートファクターとなっている。Micronの9650は、初のPCIe Gen6 SSDで、シーケンシャル28GB/s、ランダム読み取りIOPSは記録的な5.5万IOPSを誇る。Micronはデモで、1台から44台のドライブまで線形スケーリングを実現したと報告している。KioxiaのGPシリーズは、512バイトアクセス用に設計されたXLフラッシュSSDで、Storage-Nextの下で開発されている。NVIDIAのStorage-Nextロードマップでは、PCIe Gen7 SSDがそれぞれ100億IOPSを維持することを目標としており、Marvellを含むコントローラーベンダーは現在その目標に向けて設計を進めている。これらの数値を達成するには、コントローラーの再設計、小さなペイロードに合わせたエラー訂正、GPUネイティブのドライブ動作を定義する標準規格が必要となる。
トレーニングと推論へのマッピング
この2つのパスは、2つのアクセスパターンに対応しています。トレーニングは帯域幅に依存します。大きな連続したシャードをストリーミングし、定期的に数テラバイトのチェックポイントを書き込みます。この間、GPUはアイドル状態になります。これらの転送サイズではCPUのオーバーヘッドは無視できるほど小さいため、GDSと新たにオープンソース化されたcuFileスタックは、GPUあたりのGB/sとチェックポイントの所要時間で測定した場合、依然として適切なインターフェースです。
推論は IOPS に依存します。会話で既に処理されたすべてのトークンの注意状態であるKV キャッシュは、コンテキストの長さに応じて増加します。エージェント展開では、数千の同時会話が実行されます。これはすぐに GPU メモリを超え、追い出されたエントリを再計算するには、それらを読み戻すよりも多くの GPU 時間を要します。標準的な設計は、GPU メモリからシステム メモリ、そしてフラッシュへと流れる階層型キャッシュで、大量の小さなランダム読み取りによって補充されます。ベクトル検索と埋め込みルックアップでも同じパターンが生成されます。これが SCADA が対象とするアクセス形状であり、NVIDIA が帯域幅ではなく 512 バイト IOPS を提示する理由です。メモリではなくフラッシュから KV キャッシュを提供すると、各 GPU がサポートするコンテキストと同時ユーザー数が増加し、ユーザーあたりの提供コストが決まります。
ハードウェア:Vera BlueField-4 STXおよびCMX
プラットフォーム層は、GTC 2026で発表され、今週拡張されたラック規模のストレージアーキテクチャであるNVIDIA Vera BlueField-4 STXです。STXは、Vera RubinプラットフォームとBlueField-4ストレージプロセッサを組み合わせたもので、各プロセッサはVera Armコアと800Gb/sの統合ネットワークを搭載し、BlueField-3の約6倍の演算能力を備えています。
FMSでNVIDIAはこれらのコアのベンチマークを公開した。すべてのトラフィックに適用されるインラインデータサービスストレージシステムを代表する2段階の圧縮および暗号化パイプラインは、Vera上のx86 CPUの最大3.21倍のスループットで実行された。暗黙の主張は、現在ストレージコントローラでx86コアを消費している暗号化、圧縮、検証を、より低い電力でVeraシリコンに移行できるということである。BlueField用のNVIDIAのソフトウェアフレームワークであるDOCAは、データパスでセキュリティポリシーを適用する。STX上に構築されたCMX Context Memory Storageは、BlueField-4の背後でフラッシュをプールし、ロングコンテキスト推論用の共有KVキャッシュ層として機能させる。DDN、Dell、HPE、IBM、VAST Data、WEKAなどのパートナーシステムは、2026年後半に登場予定である。
閉じた思考
戦略的な構造は明確だ。NVIDIAはGPUがストレージにアクセスするために使用するインターフェースを公開し、実装をオープンソース化し、40社以上のベンダーを組織してその下のハードウェア動作を標準化しようとしている。cuFileを公開することは、このレイヤーをCUDA内に保持するというNVIDIAの慣例から逸脱する。しかし、GPU主導のストレージインターフェースは、ドライブ、コントローラ、アレイのベンダーがそれに合わせて構築した場合にのみ効果を発揮する。インテルがメンテナーとして参加したことは注目すべきシグナルだ。現在のストレージシステムでx86シリコンの主要サプライヤーであるインテルが、そのシリコンをI/Oパスから排除するように設計されたソフトウェアを支援しているのだ。
Micronのデモンストレーションは、実現可能性を実証しました。3つのGPUが、業界では後回しにされてきたブロックサイズで、44台のGen6ドライブを合計定格限界の約95%まで駆動しました。残る課題は実行です。GitHubにコードを公開し、SCADAがフレームワークからCUDA対応コンポーネントへと成熟し、ベンダーが小容量読み取りに最適化されたSSDを大量出荷することです。上記の数値はNVIDIAとそのパートナーによるものであり、独立した測定値ではありません。STXシステムが今年後半にラボに届き次第、これらの数値を検証します。


 Amazon