

WEKAは、同社のNeuralMeshプラットフォームとNVIDIA STXリファレンスアーキテクチャの統合を発表し、同社の拡張メモリグリッドを次世代AIインフラストラクチャの中核コンポーネントとして位置づけました。この統合ソリューションは、大規模推論環境における主要な制約の一つであるメモリ制限(パフォーマンス、コスト、拡張性に影響を与える)を解消することを目的としています。
NeuralMesh上で動作するWEKAの拡張メモリグリッドは、キーバリューキャッシュを外部化して永続化することでGPUメモリを拡張します。NVIDIA STXの展開では、このアーキテクチャはエージェントAIワークロード向けの高スループットコンテキストメモリストレージをサポートし、セッション、ツール、ワークフローを横断したロングコンテキスト推論を可能にします。同社によれば、NVIDIA Vera Rubin NVL72システム、BlueField-4 DPU、Spectrum-X Ethernetを活用した構成では、コンテキストメモリトークンのスループットを4倍から10倍に向上させることができます。また、このプラットフォームは、少なくとも320 GB/sの読み取りスループットと150 GB/sの書き込みスループットを実現すると予想されており、従来のAIストレージシステムの2倍以上のパフォーマンスを発揮します。

メモリインフラストラクチャが推論のボトルネックになる
WEKAは、AI導入における大きな制約であるメモリ不足という問題を中心に統合を進めています。最新の推論パイプラインでは、GPU上の高帯域幅メモリが限られているため、キーバリューキャッシュの頻繁な削除が発生し、再計算と効率低下につながります。並列処理が増加するにつれて、これらの非効率性は累積し、インフラコストの上昇とシステム予測性の低下を招きます。
同社は、共有KVキャッシュインフラストラクチャを解決策として提唱しています。共有キャッシュは、ユーザーとセッション間で永続的なコンテキストを維持することで、冗長な計算を排除し、トークンのスループットを安定させます。NVIDIA STXは、このモデルを実装するためのリファレンスアーキテクチャを提供し、WEKAはストレージおよびメモリ拡張レイヤーを提供します。
ニューラルメッシュと拡張メモリグリッドアーキテクチャ
NeuralMeshはWEKAの分散ストレージプラットフォームとして機能し、NVIDIA STXスタック全体で動作するように設計されています。このシステムはAIワークロードに特化した高性能データサービスを提供し、拡張メモリグリッドはGPUメモリ外にKVキャッシュをプールする専用のメモリ拡張レイヤーとして機能します。
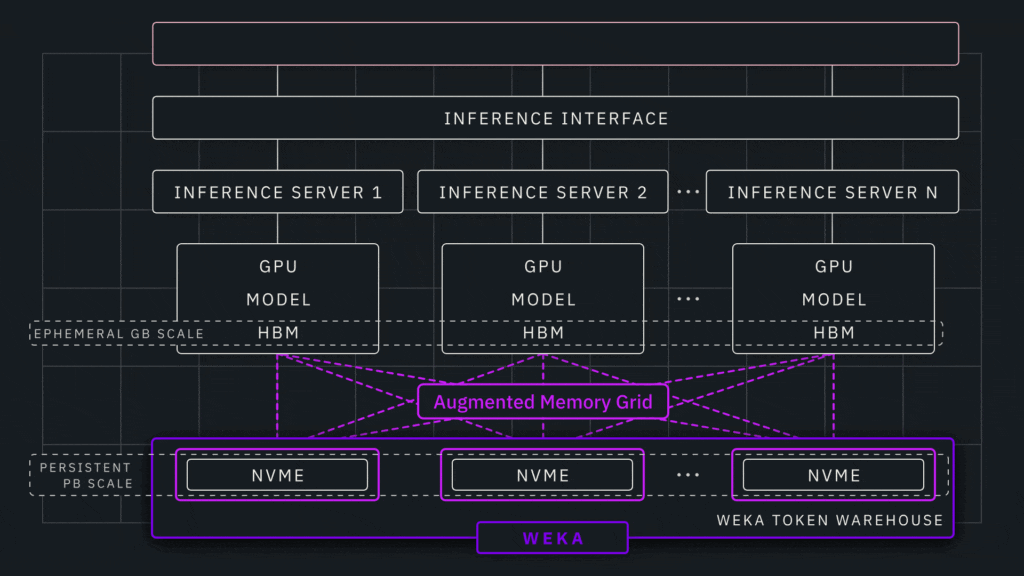
このアプローチにより、推論環境はGPUリソースを枯渇させることなく、長時間のコンテキストセッションを維持できます。キャッシュ状態を保持し、ワークロード間で再利用を可能にすることで、このプラットフォームは、展開規模が拡大しても高い利用率と安定したパフォーマンスを維持することを目指しています。
WEKAは、GTC 2025で初披露され、現在一般提供されている拡張メモリグリッドが、BlueField DPUを搭載したNVIDIA Grace CPUプラットフォームで検証されたと報告しています。このアーキテクチャは、推論効率において測定可能な改善をもたらし、初回トークン取得までの時間の著しい短縮、GPUあたりのトークンスループットの向上、並列処理の増加に伴うパフォーマンスの持続性などを実現しています。ストレージデータパスをBlueField-4にオフロードすることで、CPUオーバーヘッドがさらに削減され、I/Oボトルネックが最小限に抑えられます。
パフォーマンスと効率の向上
本番環境に近い環境では、このプラットフォームは応答性とインフラストラクチャの効率性を向上させるように設計されています。WEKAによると、拡張メモリグリッドは最初のトークン取得までの時間を最大4倍から20倍短縮し、GPUあたりのトークン出力を最大6.5倍増加させることができます。これらの改善は、KVキャッシュヒット率の向上と再計算の削減によって実現され、コンテキストウィンドウやユーザー数の増加に伴ってシステムのパフォーマンスを維持することを可能にします。
AIインフラストラクチャプロバイダーであるFirmusは、NVIDIAと連携したインフラストラクチャでNeuralMeshをいち早く導入した企業として挙げられています。同社は、トークンのスループットが向上し、レイテンシが大規模環境で低減したと報告しており、その要因はハードウェアの拡張ではなく、既存のGPUリソースをより効率的に活用したことにあるとしています。
AIインフラストラクチャ設計への影響
この統合は、AIシステムアーキテクチャにおける変化を浮き彫りにしている。メモリとストレージの設計が、全体的なパフォーマンスとコスト効率をますます左右するようになっているのだ。エージェント型AIのワークロードが拡大し、コンテキストウィンドウが大きくなるにつれて、再計算のオーバーヘッドの増加とGPUの活用不足により、DRAMのみのアプローチは次第に有効ではなくなっていく。
WEKAは、永続的で共有可能なKVキャッシュをAIファクトリーの基盤機能として位置付けています。このモデルを採用する組織は、GPU利用率を高め、推論タスクあたりのエネルギー消費量を削減し、より予測可能なスケーリング特性を実現できます。逆に、ローカルGPUメモリのみに依存し続ける環境では、ワークロードの規模拡大に伴い、運用コストの増加と収益の減少に直面する可能性が高くなります。
利用状況
WEKAの拡張メモリグリッドは、NeuralMeshプラットフォームの一部として一般提供されています。


 Amazon