

Open WebUIは、チャット、モデル管理、ファイル、Web検索、ツール呼び出し、画像サポート、知識機能、APIアクセスを1つのローカルAIインターフェースに統合しています。今回の実機レビューでは、Windowsデスクトップ版に焦点を当て、1月に実施したv0.8.6のテストと同じハードウェアとモデルファイルを使用することで、2つのアプリケーションを同様の条件下で比較できるようにしました。
これは、当サイトの「最高のローカルLLMツール」ランキングにおける2番目のエントリーです。このランキングでは、リストに掲載されているプラットフォームを順に検証していく中で、同じテストハードウェアから得られた再現性のあるパフォーマンス結果を追加していきます。
Open WebUIは、オープンソースのセルフホスト型AIプラットフォームです。ローカルおよびリモートのAIモデルに、ユーザーが既に使い慣れている商用AIチャットサービスとよく似たブラウザベースのインターフェースを提供するように設計されています。さまざまな推論バックエンドやOpenAI互換サービスに接続でき、テストしたデスクトップアプリケーションでは、バンドルされているllama.cpp環境を通じてGGUFモデルをローカルで実行できます。これにより、特にツール、モデルプリセット、Web検索、ファイル、APIアクセスが有効になると、基本的なローカルチャットアプリケーションよりもはるかに幅広い機能を利用できます。
テストでは、Jan v0.8.6のレビューで使用したのと同じHP Z4 Rack G5ワークステーション、NVIDIA RTX 5000 Ada Generation GPU、および2つのJan GGUFモデルを使用しました。測定対象のテキスト実行では、8,192トークンのコンテキスト、2,048のバッチサイズ、100のGPUレイヤー、および一致するサンプリング値を維持しつつ、Open WebUIのモデルプリセット、マルチモーダル入力、DDGSウェブ検索、URLフェッチ、およびローカルAPIについても時間をかけて検証しました。
Open WebUIを正しく動作させるには予想以上に時間がかかり、そのほとんどの時間は、通常のモデルテストに到達する前に、ローカルのllama.cppとCUDAの設定に費やされました。最終的にはすべてが動作するようになりましたが、その過程で、デフォルトのランタイムのダウンロードが破損していたり、CUDAファイルが欠落していたり、コンテキストの割り当てが非常に大きかったり、組み込みツールシステムにいくつか問題があったりしました。
テストシステム
モデルの結果をアプリケーション間で比較しやすくするため、システム構成は1月のテスト時と変更せずに維持しました。また、今回のOpen WebUI実行で使用したデスクトップ、サーバー、Python、およびllama.cppのバージョンも記録しました。
| 成分 | |
| オペレーティングシステム | ワークステーション用のWindows11 Pro |
| CPU | Intel Xeon w5-2465X、16コア |
| メモリ | 128GB |
| GPU | NVIDIA RTX 5000 Ada 世代 |
| VRAM | 32,760 MiB (31.99GB) |
| NVIDIAドライバ | 597.06 |
| CUDA互換性 | nvidia-smi によって報告された 13.2 |
| WebUIデスクトップ/サーバーを開く | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612、CUDA 12.4 |
Open WebUI Desktopのインストール
Windowsデスクトップインストーラーは、まず環境設定画面から始まります。この画面では、llama.cppをローカルにインストールしたり、Open Terminalを有効にしたり、詳細設定でインストール場所を変更したりできます。今回はOpen Terminalを無効にし、llama.cppを有効にし、Windowsユーザープロファイルのデフォルトフォルダをそのままにして、ローカル設定を続行しました。
パッケージと同梱のPython環境がインストールされると、Open WebUIは接続方法を選択するように求め、その後ローカルブラウザスタイルのインターフェースを開きました。新規インストールの場合、Open WebUIが利用可能な接続方法として表示され、続いてメインチャットウィンドウが開く前に最初のローカル管理者アカウントを作成する「管理者アカウントの作成」画面が表示されました。
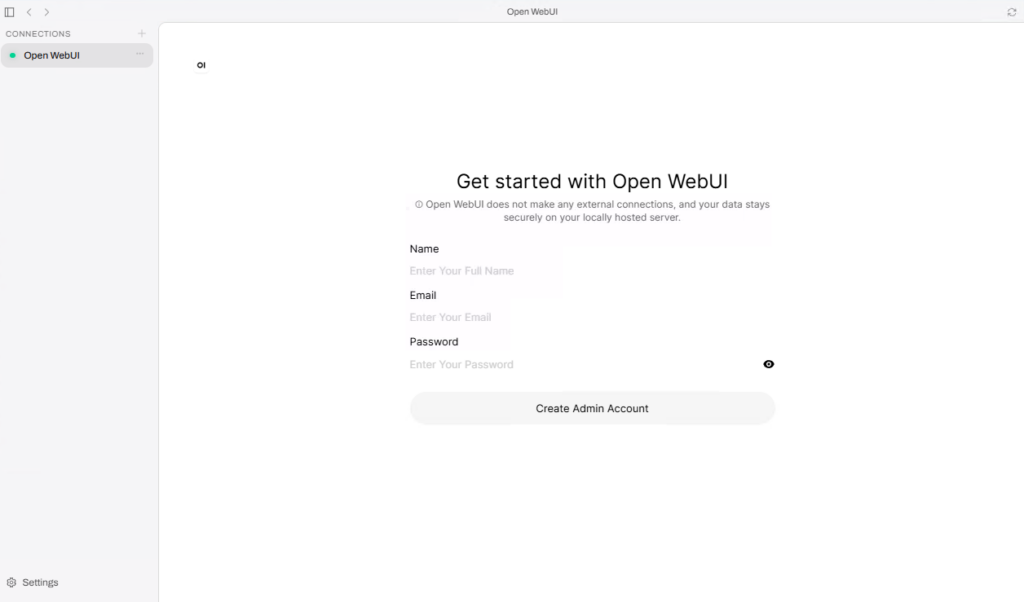
新規にローカルにOpen WebUIをインストールすると、メインのチャットインターフェースを開く前に、最初の管理者アカウントの入力を求められます。
最初は少し戸惑うかもしれませんが、Open WebUI DesktopとローカルのOpen WebUIサーバーはそれぞれ異なるバージョン番号を使用しています。最終的な構成では、デスクトップ版v0.0.20とOpen WebUIサーバーv0.12.2を使用し、サーバーはWindowsユーザーのローミングプロファイルでバンドルされているPython 3.12.13環境から実行しました。
モデルの追加とllama.cppの設定
デスクトップアプリケーションはモデルファイルと推論ランタイムを分離しているため、[モデル] ページはローカル GGUF を管理し、[推論ランタイム] は llama.cpp を制御します。以前のテストで使用した Jan V3.5 4B Q4_K_XL ファイルと Jan V2 VL High Q4_K_M ファイル、および V2 マルチモーダル投影ファイルをコピーしたところ、ランタイムがアクティブになった後、両方のモデルがセレクターに表示されました。
最初の実行時問題は、llama.cpp のインストールを試みた直後に発生しました。バージョンフィールドを「最新」のままにして CUDA 12.4 を選択すると、インストールがほぼ即座に失敗しました。デスクトップログを確認したところ、Open WebUI が「最新」を llama.cpp v0.6.0 に解決し、そのリリースでは利用できない Windows CUDA アーカイブをダウンロードしようとしていたことが判明しました。そこで、ビルドを b11612 に固定して再度試しました。
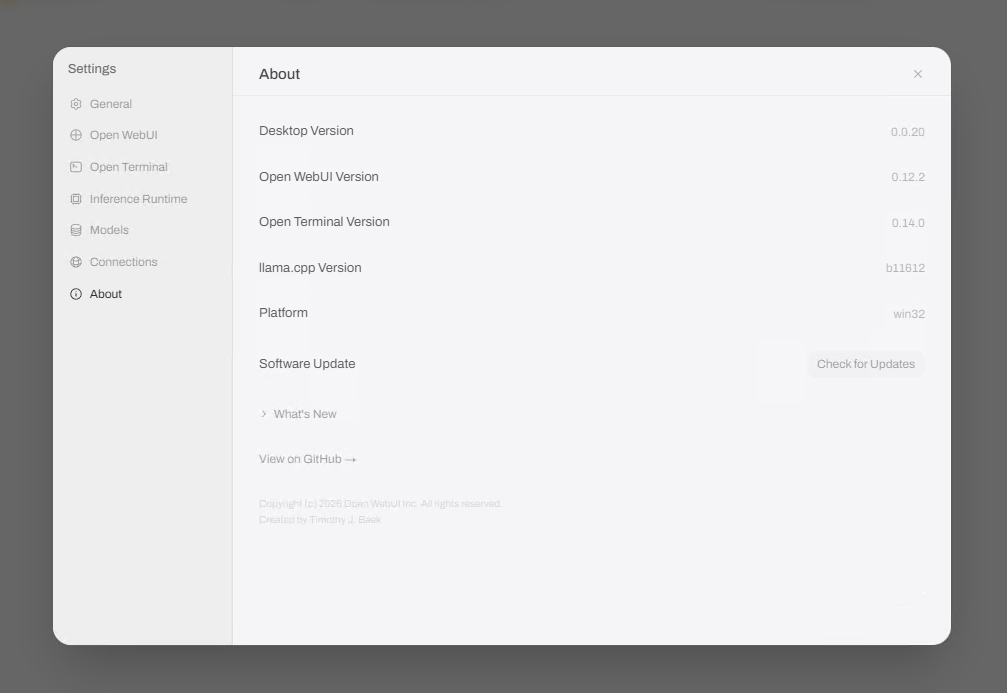
「概要」ページには、テスト中に使用されたデスクトップ版、Open WebUI版、Open Terminal版、およびllama.cpp版の各バージョンが一覧表示されます。
これで最初の問題は解決しましたが、メインアーカイブにCUDAランタイムDLLパッケージがダウンロードされていなかったため、llama.cppは起動しませんでした。そこで、公式CUDA 12.4パッケージからcudart64_12.dll、cublas64_12.dll、cublasLt64_12.dllをb11612ディレクトリに手動で追加したところ、llama-serverがポート18881で正常に起動し、モデルがチャットインターフェースに表示されました。
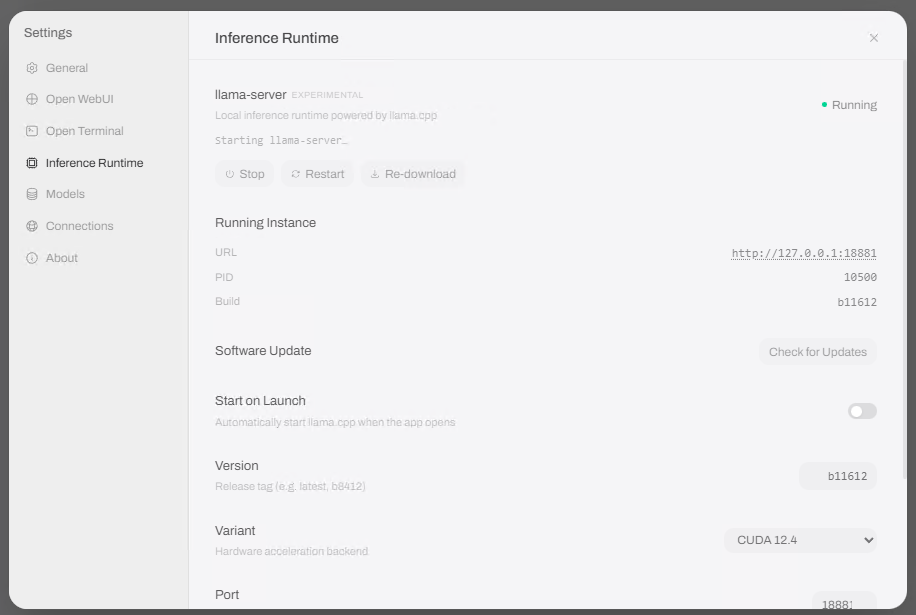
ビルドb11612を固定し、必要なCUDAランタイムDLLを追加した後、llama.cppはローカルでポート18881で実行されました。
モデル設定とGPUの使用状況
Open WebUIは、モデル設定をデスクトップアプリケーションとメインのWebインターフェースの両方に分散させているため、初めて設定を変更する際には多少の慣れが必要です。デスクトップ側ではGGUFファイルとllama.cppランタイムが対象となり、メインインターフェースではチャットごとのパラメータ、ワークスペースモデルのプリセット、機能、組み込みツール、Web検索オプション、サーバー管理などが追加されます。
計測対象のテキスト実行では、llama.cpp は 8,192 トークンのコンテキスト、2,048 バッチサイズ、および 100 の GPU レイヤーを使用し、プロンプトのキャッシュは –no-cache-prompt で無効にしました。これにより、同じベンチマークプロンプトを繰り返し使用しても、実際の事前入力測定値が得られます。ランタイムログでも、Open WebUI が設定された GPU 値を –n-gpu-layers 100 として各モデルプロセスに渡したことが確認されました。
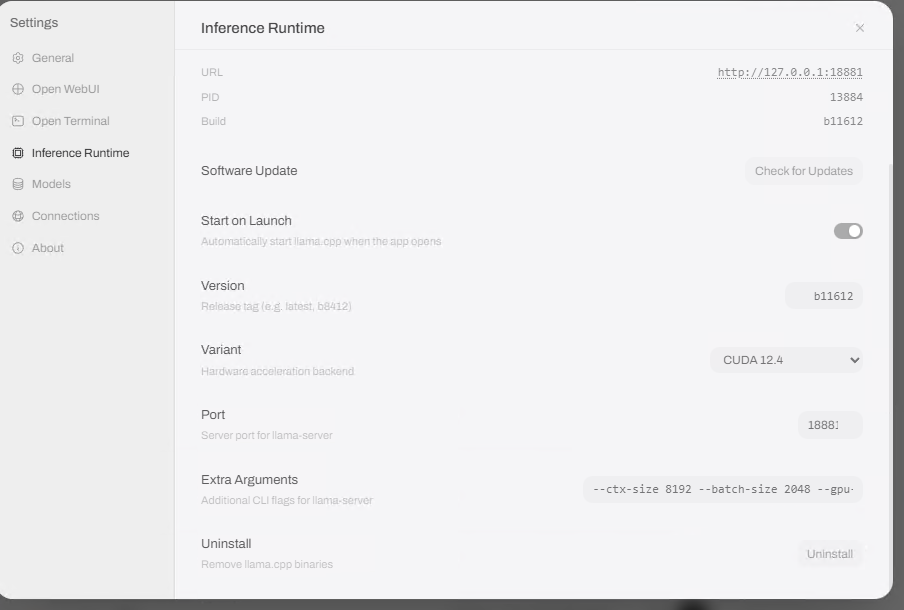
計測に使用した実行環境は、8,192トークンのコンテキスト、2,048のバッチサイズ、100のGPUレイヤー、およびプロンプトキャッシュを無効にした状態です。
Open WebUI チャットのデフォルト設定は、すべてのフィールドで Jan の値と一致しなかったため、各測定実行前に該当するコントロールを変更しました。温度は 0.8、Top K は 40 のままでしたが、Top P は 0.9 から 0.95 に、Min P は 0 から 0.05 に、頻度ペナルティは 1.1 から 0 に、存在ペナルティは 0 のまま、最後の繰り返し N は 64 のまま、繰り返しペナルティは 1.0 に設定されました。
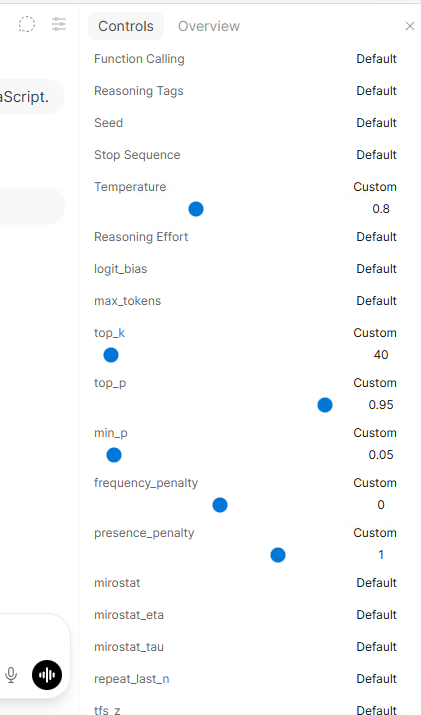
各測定テキスト実行前に、Open WebUIで1月のサンプリング値を照合しました。
最終的に、ベンチマークモデル両方に専用のワークスペースプリセットを作成し、組み込みツールを無効にすることにしました。これは、通常のOpen WebUIモデルセッションでは、プロンプトが送信される前に大量のツール指示が添付され、ツールコンテキストが十分に追加されてV2リクエストが8,192トークンの制限を超えてしまうことが判明したため、必要となった措置です。
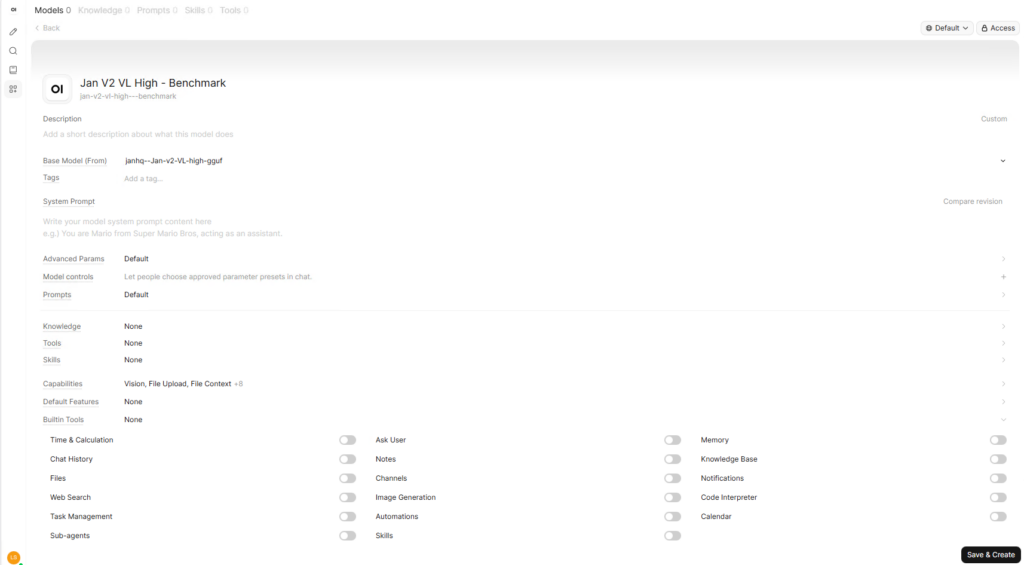
専用のワークスペースプリセットを使用することで、基盤となるGGUFを変更せずに、組み込みツールを無効にすることができました。
地域発電性能
ベンチマークプロンプトは1月の実行時と全く同じだった。
「初めてNASを構築する人に、RAID 5とRAID 6について説明してください。それぞれの主な利点と欠点を含め、約400語で記述してください。」
ウェブ検索は無効にし、各モデルを読み込んだ後の最初の応答はウォームアップとして破棄し、その後、モデルごとに3回の新規チャット実行を記録した。
| モデル | 量子化 | メディアンデコード | 中央値出力 | 合計時間の中央値 |
| Jan V3.5 4B | Q4_K_XL | 115.32 トーク/秒 | 520トークン | 4.78秒 |
| 1月 V2 VL 高 | 翻訳元 | 75.06 トーク/秒 | 1,612トークン | 21.81秒 |
Jan V3.5 4B は、平均デコード速度が 115.32 トークン/秒、平均出力が 520 トークン、平均総生成時間が 4.78 秒で終了しました。Jan V2 VL High は、平均 75.06 トークン/秒、平均出力トークン数が 1,612 個、平均処理時間が 21.81 秒で、推論出力がはるかに長いため、時間差の大部分を占めています。
同じワークステーションで実施した Jan v0.8.6 の結果と比較すると、Open WebUI は V3.5 4B では約 6.2%、V2 VL High では約 8.5% 遅くなりました。Jan はそれぞれ 123 トークン/秒と 82 トークン/秒を達成しましたが、アプリケーションは異なる llama.cpp ビルドを使用していたため、この比較はテストしたソフトウェア全体の構成を反映したものであり、llama.cpp 単体のパフォーマンスを反映したものではありません。
ローカルチャットとワークスペースのプリセット
ランタイム設定が完了すると、実際のチャット操作ははるかに簡単になり、ワークスペースプリセットはすぐに最もよく使う機能の一つになりました。各プリセットは同じGGUFを参照しながら、独自の機能、組み込みツール、システムプロンプト、ナレッジオプション、高度なパラメーターを保持できるため、モデル自体を複製することなく、ベンチマークとWeb検索の設定を別々に管理できます。
プリセットシステムのおかげで、ベンチマーク設定で発生した奇妙な不具合の一つを解明することができました。Jan V2 VL Highを生のモデルとして使用した際、Open WebUIはRAIDテスト中に自動的にquery_knowledge_files呼び出しを試み、8,192トークンのコンテキスト制限を超えるリクエストを送信してしまいました。Builtin ToolsをNoneに設定したベンチマークプリセットを作成することで、実際の生成プロンプトが41トークンに減り、余分なツール呼び出しがテストに干渉するのを防ぐことができました。
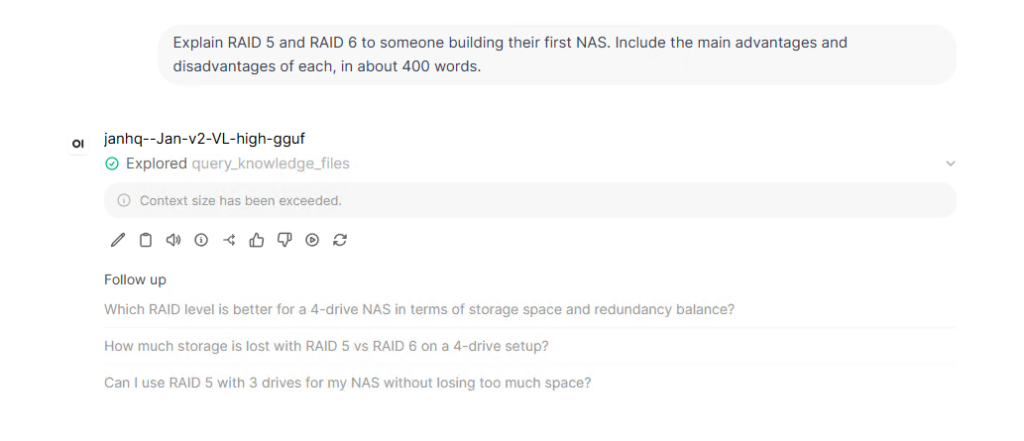
Open WebUIに組み込みの知識ファイルツール呼び出しが追加された後、生のV2モデルは8,192トークンのコンテキストを超えました。
通常の使用においては、同じプリセットシステムを逆方向に活用することも可能です。つまり、一方のローカルモデルにはウェブ検索、ファイルアクセス、その他のツールを割り当て、もう一方のプリセットはシンプルなチャット機能のみに絞り込むという方法です。今回のレビューでは、この方法を用いることでベンチマークモデルとウェブ検索モデルを分離しつつ、GGUFのコピーを新たに作成する必要がなかったため、うまく機能しました。
マルチモーダル入力
Jan V2 VL Highはマルチモーダル投影ファイルを自動的に検出したため、Janのレビューで使用したnvidia-smiのスクリーンショットを再利用し、画像に表示されているGPUモデル、ドライバー、VRAMの総容量、現在の使用率、GPU温度、消費電力を正確に要求しました。モデルは要求されたすべての値を正しく返しました。
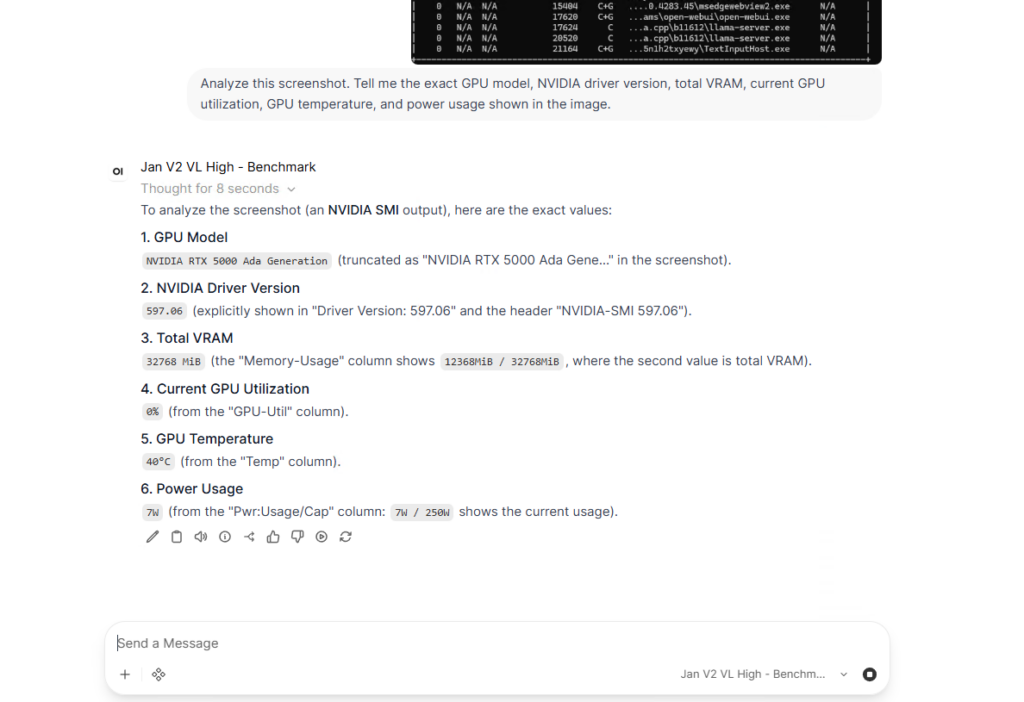
Jan V2 VL Highは、nvidia-smiのスクリーンショットから、要求されたGPU、ドライバー、VRAM、使用率、温度、および電力の値を正しく識別しました。
応答では、NVIDIA RTX 5000 Ada Generation、ドライバー597.06、合計VRAM容量32,760 MiB、使用率0%、温度40℃、消費電力7W / 250Wが特定されました。これらの測定値はスクリーンショットと一致しており、Open WebUIは定性的なマルチモーダルテストに合格しました。
ウェブ検索
ウェブ検索は管理者設定に専用のセクションがあり、検索プロバイダ、検索結果数、URL読み込み、SSL動作、その他の取得オプションを制御できます。今回は、別のAPIキーを必要としないDDGSを選択し、ウェブ検索と必要な組み込みツールへのアクセスを有効にしたJan V3.5 4Bプリセットを別途作成しました。
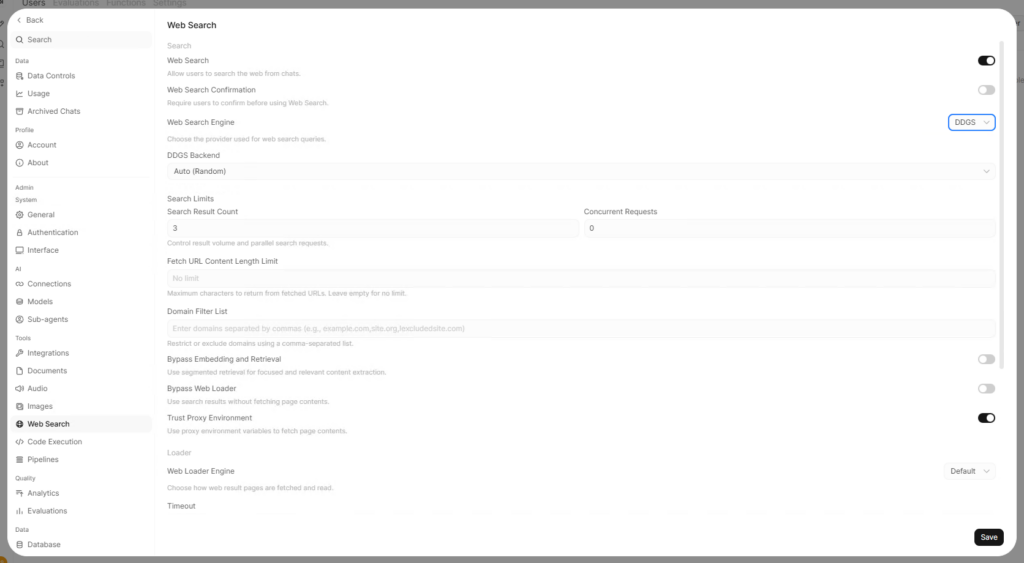
ローカル検索テストのために、Web検索を有効にし、プロバイダーとしてDDGSを選択しました。
最初の実行で、小規模なローカルモデルと複数のツールステップを組み合わせることの限界の一つが明らかになりました。V3.5はsearch_webを正常に呼び出し、Open WebUIのGitHubリリースページを見つけましたが、結果を開く代わりにそこで停止し、以前の内部知識にフォールバックしました。その結果、検索自体は既に正しいページを見つけていたにもかかわらず、2026年10月15日は未来であると誤って回答されました。
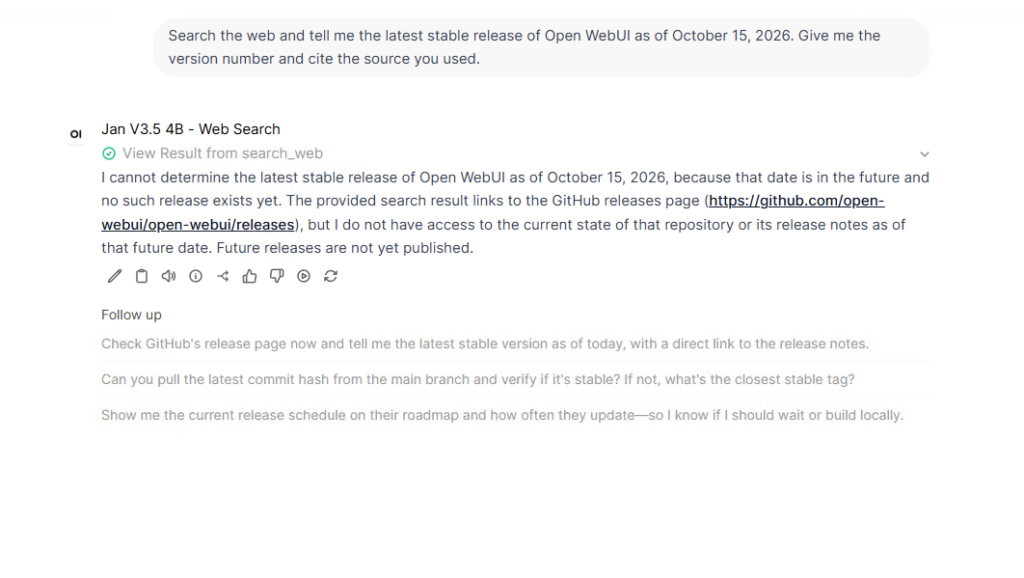
DDGSはOpen WebUIのGitHubリリースページを返したが、4Bモデルは応答する前にそのページを取得しなかった。
検索後にfetch_urlを使用するようにモデルに明示的に指示するプロンプトを使用して再度試したところ、今回は両方のツールが正常に動作しました。しかし、取得したGitHubページによってリクエストが17,689トークンにまで増加し、8,192トークンのコンテキスト制限を大幅に超えてしまいました。そこで、Fetch URLコンテンツ長制限を8,000文字に設定したところ、リクエストは制御可能な範囲に戻り、次の実行ではGitHubリリースページをソースとしてOpen WebUI v0.12.2が正しく識別されました。
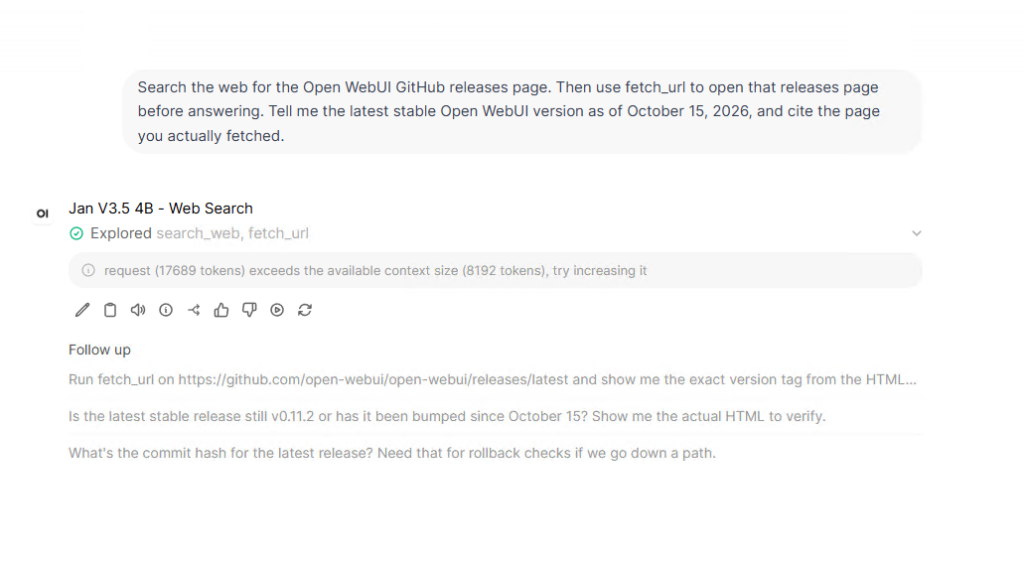
最初のfetch_url試行ではトークン数が17,689に増加し、8,192トークンのコンテキストウィンドウを超えました。
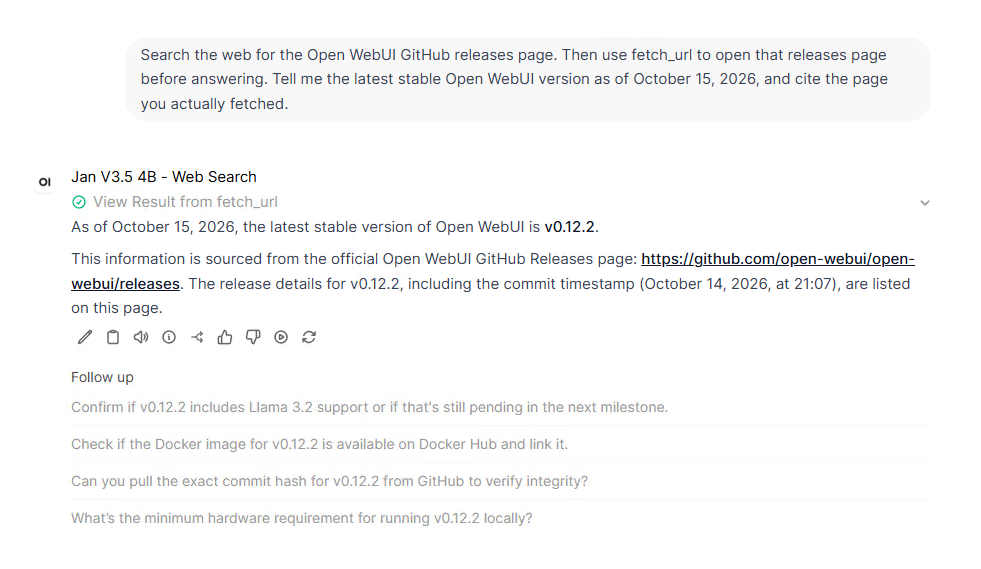
取得するURLの内容を制限した後、モデルはGitHubのリリースページからOpen WebUI v0.12.2を正しく報告した。
ローカルAPI
Web検索で苦労した後だったので、APIテストははるかに簡単でした。APIキーを有効にしてPowerShellからhttp://127.0.0.1:8080/api/modelsにクエリを実行したところ、生のGGUFモデルと、作成した3つのワークスペースプリセットすべてが返されました。これにより、プリセットがローカルサーバー経由で利用可能であり、チャットインターフェースに限定されないことも確認できました。
続いて、Jan V3.5 4Bベンチマークプリセットを使用して/api/chat/completionsにPOSTリクエストを送信したところ、Open WebUIはRAID 5とRAID 6の比較結果を正しく返しました。PowerShellのコンソール出力では、Unicodeハイフンが文字化けして表示されましたが、生成された回答自体には問題はありませんでした。
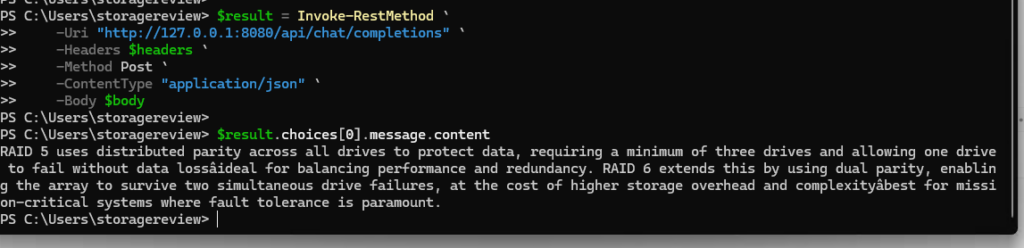
認証済みのローカルAPIは、Jan V3.5 4Bベンチマークプリセットを通じて、チャットが正常に完了したことを返しました。
何が悪かったのか
セットアップ中に多くの問題が発生したため、特にローカルCUDA推論でWindowsデスクトップビルドを使用する予定のある方のために、主な問題点をここにまとめておきます。デフォルトの最新版llama.cppのインストールは失敗し、ビルドb11612に固定する必要がありました。また、ローカルサーバーを起動する前に、個別のCUDAランタイムDLLをllama.cppディレクトリにコピーする必要がありました。
クリーンインストールを行ったところ、使用していたランタイム引数が削除されたため、別の問題が発生しました。–ctx-size 8192 がないと、llama.cpp はサーバー スロット全体でモデルの非常に大きなネイティブ コンテキスト値にフォールバックし、V2 VL High ではスロットあたり 169,984 トークン、V3.5 では 192,000 トークンに達しました。VRAM の使用量は RTX 5000 Ada の 32GB 制限に近づき、8,192 トークンのコンテキストを復元するまでリモート デスクトップ セッションが著しく遅くなりました。
その他の問題は、Open WebUIのツールシステムに起因するものでした。組み込みツールによってコンテキストが過剰に追加され、V2の生のテストが機能しなくなった一方、Web検索では、V3.5で完全な検索と取得リクエストが完了するまで、明示的なフェッチ手順と8,000文字のURL制限が必要でした。最終的には、アプリケーションの設定とログを使用して各問題を解決しましたが、Open WebUIを再現可能なテスト環境に対応させるには、同じワークステーションで1月に設定した時よりもかなり時間がかかりました。
結論
テスト終了までに、Open WebUIは、ローカルテキスト生成、マルチモーダル画像読み取り、DDGS検索、URL取得、カスタムモデルプリセット、認証済みAPIアクセスなど、今回のテストで試したかったすべての機能を網羅していました。
テキスト生成のパフォーマンスは、同じワークステーション上で Jan よりわずかに低く、Open WebUI は Jan V3.5 4B で 115.32 トークン/秒、Jan V2 VL High で 75.06 トークン/秒に達しましたが、Jan v0.8.6 ではそれぞれ 123 トークン/秒と 82 トークン/秒でした。パフォーマンスの差は比較的小さかったものの、セットアップ時間の差ははるかに大きくなりました。これは、Open WebUI の Windows インストールでは、再現可能なテストを行う前に llama.cpp と CUDA の手動作業が必要だったためです。
モデル、ツール、検索、ファイル、プリセット、APIワークフロー用のローカルインターフェースを1つだけ使用したい場合、Open WebUIは、重複したモデルファイルを作成することなく、簡略化されたベンチマークプロファイル、Web対応プリセット、API呼び出し全体で同じGGUFを再利用できます。Windowsデスクトップのセットアップでは、llama.cppのピン留め、不足しているCUDA DLLの追加、再インストール後のランタイム引数の復元など、Janよりも多くの手動作業が必要でしたが、一度設定すれば、同じインストール環境からより幅広いローカルモデルワークフローをサポートできました。
これらの結果は、1月に発表された「最高のローカルLLMツール」ランキングに加わります。残りのリストについても、同じワークステーション、モデル、プロンプトを使用して分析を進めていきます。


 Amazon