

多くの企業が来年下す最大のAIインフラストラクチャに関する決定は、GPUへの投資ではなく、データベースのアップグレードとなるでしょう。Oracle AI Database 26aiは、Oracleが19cのインストールベースに向けて推進している長期サポートリリースです。26aiでは、ベクトル検索がトランザクションを保持するエンジンと同じエンジンに組み込まれます。ベクトルインデックスがデータベース内に存在する場合、ブロックアレイとその背後にあるSANファブリックはAIインフラストラクチャとなり、既に処理しているトランザクションと並行して検索トラフィックを処理できるようになります。
AIの下でデータベースが変わった
Oracleは、このアイデアに基づいて26aiを構築しました。ネイティブのVECTORデータ型、SQLベクトル検索機能、ONNXによるデータベース内モデル実行、自然言語クエリ用のSELECT AIなど、300を超える新機能をLTSリリースに搭載しています。実際には、DBAは埋め込みを生成し、それが記述する行の隣に保存し、注文検索と同じトランザクションスコープ内で類似性検索を実行できます。別途ベクトルストアを実行する必要も、同期パイプラインを維持する必要も、監査証跡の外に規制対象データの2つ目のコピーが存在することもありません。
IBMは、この傾向についてIDCの見解を引用している。「統合型ベクトルデータベースは、ベクトル埋め込みの保存とクエリのための最適なプラットフォームであり、組織はエージェント型AI向けに統一された統制環境を好む傾向にある。」IBMとBroadcomの顧客は、既存の信頼できるデータベースを拡張してから、新しいデータベースを並行して構築したいと考えている。
この方向性で進んでいるのはOracleだけではありません。DB-Enginesの2026年10月の人気ランキングでは、リレーショナルおよびマルチモデルエンジンの上位4つとしてOracle、MySQL、Microsoft SQL Server、PostgreSQLが挙げられており、これら4つすべてが、ネイティブまたはpgvectorなどの拡張機能を通じて、ベクトル型またはベクトル検索機能を追加しています。IBMが検証作業をOracleから開始することを選んだ主な理由は、Oracleが市場をリードしているからですが、この記事で述べたストレージに関する議論は他のエンジンにも当てはまります。

AI の導入後も、ブロック ストレージをオンプレミスに維持する理由に変わりはありません。AI の導入に役立つデータ、例えば患者記録、請求、注文、取引などは、外部に持ち出すことはできません。専用の AI プラットフォームにコピーすると、ストレージ料金を二重に支払うことになり、コピーが本番環境のクラスタからずれることを容認し、元のデータを法的に保護していたガバナンス コントロールを失うことになります。データベース内でデータ取得を維持することで、これら 3 つの問題をすべて回避できます。1 ミリ秒未満の行検索を提供するアレイは、臨床医向けのベクトル類似性スキャンとバックアップ ストリームを同時に処理します。
IBM StorageとBroadcomのファイバーチャネル(FC)グループは、この混合ワークロードのケースを検証するために、BroadcomのBrocade Gen 8 SANファブリックとEmulex 64G SecureHBAを備えたIBM FlashSystem上のOracle AI Database 26aiを中心とした環境を構築しました。そして、インフラストラクチャチームが抱えていた疑問点、すなわち、ベクターワークロードが隣接して開始された場合のトランザクション遅延への影響、ファブリック速度がベクター検索スループットに与える影響、埋め込みによって消費される容量、RMANバックアップボリュームをターゲットとしたランサムウェア検出の有効性、ゾーニングチケットなしでSANにホストを追加するための要件などについて検討しました。
データは既にブロックストレージに保存されており、今やAIがそこにやってくる
こうしたことは、AIワークロード全般がブロックストレージに配置されるべきだという意味ではありません。企業は、ドキュメント、画像、ビデオ、トレーニングセット、モデルチェックポイントなど、データベースに保存されたことがなく、今後も保存される可能性が低い非構造化データのために、ファイルおよびオブジェクトアレイを保持します。後述する医療分野のデモンストレーションでは、IBMは生のX線画像をオブジェクトストレージに保存し、埋め込みと症例メタデータのみをOracleに保存します。変化するのはアレイへの負荷であり、I/Oプロファイルが大きく異なる複数のワークロードが同時に処理されることになります。
リレーショナル層は最もよく知られた層です。毎秒数百万回のランダムな4KBから16KBのI/O、マイクロ秒単位で完了する必要のある行検索とコミット、リドゥ、アンドゥ、チェックポイントのトラフィックによる大量の書き込み同時実行、そしてユーザー向けアプリケーションが待機しているため予測可能なテールレイテンシが特徴です。OracleのバックアップユーティリティであるRMANは正反対で、最初のワークロードを妨げることなくウィンドウ内で完了するための余裕が必要なシーケンシャルストリームです。どちらもよく理解されており、IBMのアレイはそれらに合わせて最適化されています。
ベクトル層の特性評価はより困難です。なぜなら、ベクトル埋め込みの大きなテーブルでは、ベクトル検索が帯域幅を大量に消費するワークロード、つまり大規模なシーケンシャルスキャンのように見えることがあるからです。IBMによるOracle 26aiのベクトルパスの特性評価は、OLTPに近いものです。インデックスを通過する各ホップは、およそ4KBのランダム読み取りです。クエリパスはIOPSに制約され、レイテンシに敏感です。書き込みは別の取り込みおよびインデックス構築フェーズで行われるため、読み取りが支配的です。
インデックスの構築やコーパスの再埋め込みといったバースト的な処理では帯域幅が重要になりますが、こうしたバーストは非常に大規模になる傾向があります。この分割こそが混合I/O問題の核心です。クエリパスでは、ベクトルワークロードがトランザクションと同じキューを巡って競合するため、分離がサービス品質上の懸念事項となります。そして、このバースト的なフェーズこそ、ファブリック帯域幅が上限となる場面であり、本稿後半で示す32Gと64Gの比較結果がそれを物語っています。
検証済みアーキテクチャ
IBMとBroadcomは、BroadcomのコロラドAIラボにこの検証環境を構築しました。ストレージは、IBM Storage Virtualize 9.1.3を実行するIBM FlashSystem 9000シリーズアレイで、24個のFlashCoreモジュールを搭載し、64Gファイバーチャネルポートを介して2台のBrocade Gen 8 G820 SANスイッチに接続されています。データベースホストは、2ポートのEmulex LPe38102 64G SecureHBAを2台搭載したデュアルソケットIntel Xeon 6767Pサーバーで、ストレージパスにGPUを使用せずにASM上でOracle AI Database 26aiを実行しています。IBM Storage Insightsがアレイを監視しています。

ファブリックと容量の結果、32G 対 64G ベクトル検索の比較、および VectorDBBench を使用して BioASQ 1M データセットに対するフットプリント測定をそのホストのみで実行しました。同じ構成でアプリケーションのワークロードもサポートしています。2 つの Xeon Platinum 8470 プロセッサと 8 つの NVIDIA H100 80GB GPU を搭載した Supermicro 821GE-TNHR が、ヘルスケア アプリケーションとその言語モデルをホストしています。ソフトウェア スタックには、Oracle のデータベース内 ONNX 埋め込み、Llama 3 を提供する Ollama、および NVIDIA cuVS が含まれています。Broadcom Tomahawk 5 スイッチと Thor 2 400GbE NIC が 2 つのサーバーを接続しています。I/O QoS、マルチテナンシー、ランサムウェア検出、およびヘルスケアのデモンストレーションはこの環境で実行されました。

IBMによると、FlashSystemファミリー(5300および5600、7300および7600、9500および9600)はすべて同じStorage Virtualizeソフトウェアを実行しており、ここで紹介するI/Oスロットリング、AutoZoning、ランサムウェア検出、ポリシーベースのHA、ストレージパーティション移行などの機能は、同じコードレベルのいずれのアレイでもOracle AI Database 26aiと同じように動作します。パフォーマンスと密度はモデルとFlashCoreモジュールの世代によって異なるため、この記事のすべての数値は測定対象のシステムに属します。
I/O QoSによる最適なOLTPおよびベクトルワークロードパフォーマンスの確保
IBMとBroadcomが最初に答えようとした質問は、本番環境のアレイにベクトルワークロードが提案されたときにすべてのDBAが尋ねる質問、つまりコアトランザクションはどうなるのか、というものでした。IBMは、ボリュームレベルのI/Oスロットル(IBMがI/O QoSと呼ぶメカニズム)を使用して、FlashSystem 9000シリーズアレイ上で2つのデモとして実行しました。データベースは30ボリュームに分割され、15ボリュームは192ユーザーのSwingbench Order Entryの下にあるOLTPテーブルスペース(ORCL16からORCL30)用、残りの15ボリュームは、上位k個の500件の類似性クエリを実行する200スレッドの合成ジェネレータの下にあるベクトルテーブル(ORCL31からORCL45)用で、Storage Insightsが各ボリュームグループをグラフ化しました。
OLTP を単独で実行した場合、各 OLTP ボリュームは 20,500 ops/s で一定でした。ベクトル生成器が起動すると、ベクトルボリュームは 1 分以内にそれぞれ約 73,000 ops/s まで上昇し、OLTP ボリュームは約 13,000 ops/s まで低下しました。これはトランザクション側で何も変更がないにもかかわらず、37% の減少です。ベクトル検索パスはトランザクションと同じブロックサイズで 4KB のランダム読み取りを行うため、同じキューにアクセスし、配列が提供するものを取得します。

各ベクトルボリュームに45,000 IOPSの上限、1行の mkthrottle CLI でベクターボリュームを上限まで引き上げると、OLTP は約 17,000 ops/s まで回復しました。上限を解除すると、この状態は逆転し、ベクター実行が終了すると、OLTP は 20,500 に戻りました。ダッシュボードでは、合計で同じことが追跡されました。スロットリングなしで 1.28 万 IOPS、上限以下で約 950,000 IOPS であり、これは数パーセントの誤差で、ボリュームあたりのレートに 30 ボリュームを掛けた値に相当します。

2番目のデモは、IBMが本番環境での展開を想定している構成です。まず、ベクターボリュームあたり45,000 IOPS、OLTPボリュームあたり20,000 IOPSの上限を設定し、次に両方のワークロードを同時に起動します。ベクターボリュームは上限まで稼働し、OLTPボリュームは約12,200 ops/sで安定し、実行中ずっと横ばい状態を維持しました。アレイは、377マイクロ秒で870,000 IOPS(読み取り800,000、書き込み70,000)を6.9GB/sでCPU使用率25%で保持しました。OLTPの上限はワークロードの要求を上回っており、作動することはありませんでした。これは、どちらかのワークロードが暴走しても、もう一方のワークロードが不足しないようにするためのものです。
Swingbenchは、実行時間中、192人のユーザーを毎分約1.19万トランザクション(約19,500 TPS)で維持しました。ジェネレーターはボリュームを飽和させるように調整されているため、クエリごとのレイテンシはアプリケーションのベンチマークではありません。30分間の実行で、1秒あたり19.8件のクエリで35,672件のクエリを完了し、中央値のレイテンシは約10秒、p99は15秒のアプリケーションタイムアウトに対して14.3秒でした。99件のクエリ(0.28%)がタイムアウトに達しましたが、トランザクションはそれを全く認識しませんでした。


FlashSystem のスロットルは、ホストやパスに関係なくアレイで適用されるボリューム上限であり、IOPS 制限に加えてオプションで帯域幅制限も設定できます。これはネイバーを制限し、何も予約しません。この上限はサイジングの作業です。45,000 IOPS のベクターボリューム 15 個は、ベクターの余裕が 675,000 IOPS あり、このアレイの OLTP ボリュームに必要な容量が確保されています。アレイや構成が異なると、この数値は多少変動します。トランザクションのレイテンシが収まる範囲でベクター上限を設定すると、ベクターワークロードはそれを超えるすべての容量を利用できます。
稼働中のOracleボリュームにおけるランサムウェア検出
Sophosが2024年に実施した、ランサムウェアの被害を受けた2,974の組織を対象とした調査では、94%の組織が攻撃者がバックアップを狙っているのを目撃し、その試みが57%の確率で成功し、成功した場合の復旧コストの中央値は8倍になったことが判明しました。IBMは、バックアップを優先し、本番環境を後回しにするという同じ前提でテストを構築し、データベースボリュームには手をつけずにRMANバックアップをターゲットに攻撃を行いました。RMANはバックアップセットをFlashSystemボリュームに書き込み、ランサムウェアシミュレーターをそれらに対して実行し、ホストエージェントを介さずにアレイが独自に検知するようにしました。
検出はドライブ内部で行われます。FCM4およびFCM5 FlashCoreモジュールは、書き込みが行われるたびに、ブロックサイズ、アドレス、書き換えパターンとともにエントロピーと圧縮率を計算し、2秒ごとにボリュームごとのサマリーをStorage Virtualize(FCMファームウェア4.1以降を搭載した8.6.3以降)内の推論エンジンに渡します。このモデルはFlashSystem GUIおよびIBM Storage Insights Proでアラートを生成し、Storage DefenderまたはSIEMに転送します。また、モデル自体にパッチを適用できるため、再学習済みのモデルはファームウェアのアップグレードなしで小さなセキュリティアップデートとして提供されます。
分析はモジュール上で実行されるため、ホストが侵害された場合でも動作し続けます。暗号化された出力はエントロピーが高くなり、圧縮が停止します。攻撃者がファイル拡張子を変更したり、ブロックごとに暗号化したり、エンドポイントエージェントから身を隠すためにレートを下げたりしても、そのことは統計情報に反映されます。
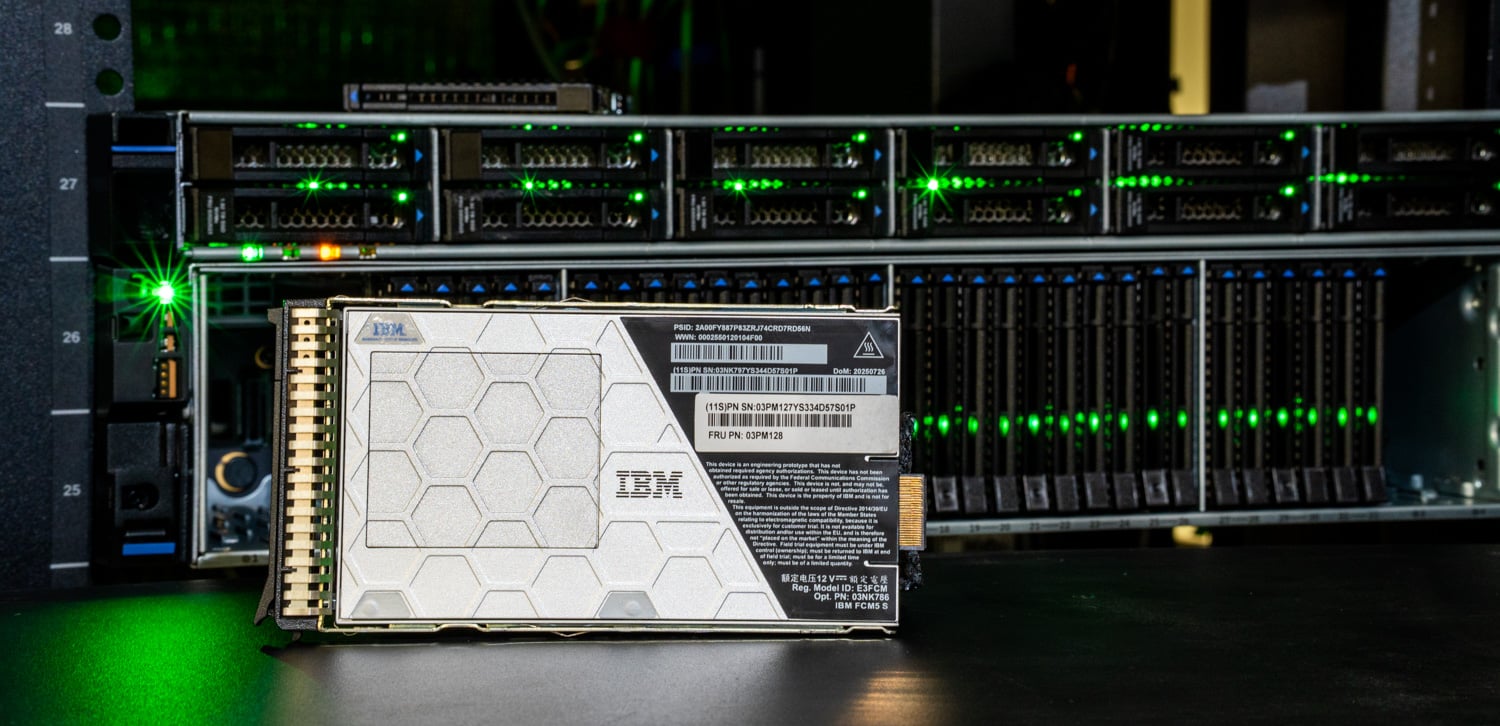
検証中、RMANは16個の並列チャネルにバックアップを書き込み、各バックアップセットのサイズは150GBに制限されました。データベースは、OLTPデータとベクターデータ用に、ASMディスクグループごとに15個の200GBディスク上に配置されました。IBMはこのバックアップ対象に対して攻撃を実行し、アラートは60秒以内にStorage Insightsに到達しました。これは、IBMがこの機能について公開している検出ウィンドウ内です。1つのボリュームでアラートが発生するとグループ全体が脅威としてマークされるため、Storage Insightsはボリュームグループ内の31個のボリュームすべてにフラグを立てました。
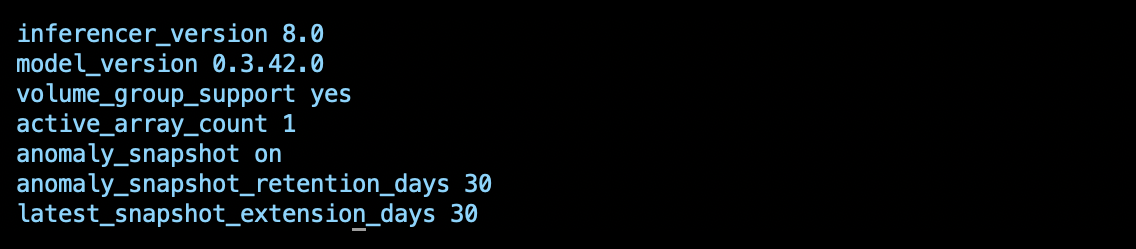
応答はセーフガードコピーであり、配列は演算子なしでそれを処理しました。FlashSystemは、脅威が発生した瞬間に影響を受けるボリュームグループの不変のスナップショットを取得し、同時に最後に確認された正常なスナップショットの保持期間を延長しました。 lsanomalydetection 配列からの出力には、その背後にある構成が示されています。推論エンジンは8.0、モデルは0.3.42.0、anomaly_snapshotは有効、新しいスナップショットの保持期間は30日間、そして最後に正常に取得できたスナップショットに30日間が追加されています。Storage Virtualizeは、疑わしいスナップショットをマークして、そこから復元されないようにすることで、暗号化が始まる前のクリーンな復元ポイントを残します。
このファブリックにはセキュリティ層も備わっています。BroadcomはBrocade Gen 8にポスト量子暗号技術を組み込み、Emulex SecureHBAはホストとファブリック間のデータ転送を暗号化し、FCIAの新しいFC-SP-3規格はファイバーチャネル全体の量子対応セキュリティ基準を定めています。
ゾーニングチケットなしでSANを拡張:Broadcomターゲット駆動型ゾーニングを使用したIBM FlashSystem AutoZoning
ファイバーチャネルSANにホストを追加するには、通常、チケットを発行し、2つのチームを編成する必要があります。サーバー管理者がHBAのWWPNを収集し、SAN管理者が両方のファブリック上にゾーンを手動で構築し、ストレージ管理者がホストを適切なターゲットポートにマッピングします。WWPNの入力ミスが1つでもあれば、新しいOracle RACノードはパスを持たない状態になります。AutoZoningでは、この作業をアレイ側で行います。FlashSystemがファブリックと直接通信し、イニシエータのWWPNを識別し、ターゲットポートを選択し、スイッチにログインすることなくゾーンを自動的に作成します。

この機能は Brocade Target Driven Zoning (TDZ) に基づいて構築されており、FlashSystem ソフトウェア 9.1.2 で導入されました。この機能を使用するには、Fabric OS 9.1.1 以降を実行している Brocade スイッチが必要で、ファブリック管理者が FlashSystem ターゲット ポートに面するスイッチ ポートで TDZ を有効にする必要があります。この有効化は SAN チームが担当する唯一の手順であり、有効化が完了するまで AutoZoning はポートに対して何も操作を行いません。その後、FlashSystem はピア ゾーンを構築し、ホスト イニシエータがターゲット ポートには到達できるものの、ホスト イニシエータ同士は到達できないようにします。このゾーンは、アレイ管理対象であることを示す予測可能な IBM_SV_ 名で識別されます。
セットアップはファイバーチャネルポートビューから始まります。このビューには、各ポートが接続されているスイッチ、ポートがAutoZoneに対応しているかどうか、接続が対称であるかどうか(つまり、すべてのノードの同じポートIDが同じファブリックに接続されているかどうか)が表示されます。トポロジービューでは、これが色分けされて表示され、アクティブでAutoZoneに対応し、かつ対称な緑色のポートのみがAutoZoneをサポートします。非対称ポートは、たとえ他の機能が有効であっても、冗長性とフェイルオーバーを損なう可能性があるとGUIが警告するため、除外されます。

ホストの作成は、FDMI を介して入力される未構成ホストのリストから始まります。FDMI は、各 HBA のホスト名、オペレーティングシステム、およびポートをファブリックに報告します。IBM のチュートリアルでは、まだゾーンが設定されていないホストのサーバー名、オペレーティングシステム、および両方の HBA ポートが表示されたホストの追加ダイアログが開きます。管理者は、ホストが到達可能なターゲット ポートを定義する AutoZone 対応ポート セットを選択し、[追加] をクリックします。FlashSystem はターゲット ポートをホスト イニシエータとペアリングし、ゾーンを両方のスイッチにプッシュし、ホストは 2 つのファブリックにまたがる 4 つのパスでオンラインになります。

Oracleの場合、IBMはAutoZoningをRACノードの追加やHBAの交換に活用できると位置付けています。この機能はホストやストレージの接続状況の変化を追跡し、ゾーン定義をそれに合わせて調整するため、HBAを交換しても手動でのゾーン再設定は不要です。ストレージパーティションの移行やポリシーベースHA(PBHA)のために、ホストが2つ目のアレイへのパスを必要とする場合にも、同様の自動化が適用されます。SANチームは、TDZを有効にするまでポート上で何も起こらないため、どのターゲットポートが参加するかを引き続き制御できます。結果として、ホストの追加時にゾーニングの変更を待つ必要がなくなります。
運用範囲:PBHA、グリッド移行、マルチテナント、および配置
ポリシーベースHA(PBHA)は、メトロ距離にある2つのFlashSystemアレイ間でストレージパーティションを同期的に複製し、両サイトでアクティブ/アクティブ構成のホストアクセスを実現します。IBMによると、この機能はRPOゼロ、そして適切にクラスタ化されたOracle環境であればデータ損失なしでストレージフェイルオーバーを乗り切れるように設計されているとのことです。障害が発生したサイトが復旧すると、データが再同期され、ワークロードは停止することなく元の位置に戻ります。
FlashSystem Grid 機能では、最大 32 台の FlashSystem アレイを 1 つの管理ビューに統合し、ストレージ パーティションの移行では、アプリケーションのダウンタイムなしに、ボリューム、ボリューム グループ、ホストを含むパーティションをあるアレイから別のアレイに移動します。Oracle の場合、IBM はハードウェアの更新、ファームウェア アップデート前のシステムのドレイン、埋め込みセットの拡大に伴うベクター パーティションの容量増加に伴うシステムへの移動を挙げています。システムは、ファイバー チャネルまたは高速イーサネット経由で一度に 1 つのパーティションを移行します。ホストは、ファイバー チャネル、iSCSI、または NVMe/TCP 経由で接続できますが、PBHA 用に既に構成されているパーティションは移行の対象外です。
Storage Insightsの配置アドバイザーは、同じグリッドの計画を処理します。ワークロードの容量、成長率、I/Oプロファイル、レイテンシ目標に基づいて、グリッド内のすべてのシステムをスコアリングし、プロビジョニング前に最適なシステムをランク付けします。また、CPUまたはIOPSの不均衡を検出した場合は、移行を推奨することもできます。移行と配置の両方でStorage Insights Proを使用し、すべてのグリッドシステムは同じStorage Insightsテナントに登録されます。

マルチテナンシーでは、DBA チームと AI チームが管理を共有することなく、そのグリッドを共有できます。IBM のチュートリアルでは、管理者が同じアレイ上に 2 つのテナント (Tenant_Scale と Tenant_oracle_ai) を作成し、それぞれにシステム、テナント ロールを持つユーザー グループ、および最初のユーザーを割り当てました。次に、それぞれに個別のボリューム グループ、ボリューム、およびホスト マッピングを持つストレージ パーティションを作成しました。GUI では、新しいパーティションが存在するとすぐにレプリケーションを構成するように促されます。Tenant_Scale ユーザーとしてログインすると、GUI にはそのテナントのパーティションとリソースのみが表示され、Tenant_oracle_ai に属するものは何も表示されませんでした。Tenant_oracle_ai 側から同じチェックを行っても同じ結果が返されました。
ファブリックの優位性:ベクトル検索における32G対64Gファイバーチャネル
IBMとBroadcomがこのテストで意図的に変更した唯一の変数はファブリックでした。同じアレイ、ホスト、およびEmulex LPe38102 SecureHBAを使用して、BioASQ 1Mデータセット(生物医学質問応答コーパスからの100万個の1,024次元ベクトル)に対してVectorDBBenchを2回実行しました。1回目は2つのHBAポートを32Gで、2回目は64Gで、いずれも同じBrocade G820スイッチを介して実行しました。16個のASMボリュームから4GBのSGAまで、その他すべては変更されていないため、2回の実行の違いはファイバーチャネルの世代のみであり、それ以外に違いはありません。

このベンチマークの検索フェーズは読み取り専用スキャンです。Oracle の IVF_FLAT インデックスは、各クエリをパーティションのクラスタにルーティングして完全に読み取りますが、1,024 次元の FLOAT32 ベクトルでは、帯域幅の負荷が高くなります。2 つの 32G ポートでは、ホスト側の読み取りは 6.3GB/s で安定し、これはペアのライン レートです。検索曲線は、20 スレッドで 43.7 クエリ/秒で平坦化しました。2 つの 64G ポートでは、同じホストが 12.5GB/s で読み取り、80 スレッドで 85.0 QPS までスケーリングを続け、同じストレージから 95% 高いスループットを実現しました。

レイテンシは、64G のもう 1 つの側面を示しています。1 つのスレッドでは、2 つのファブリックのレイテンシは 8% 以内の差で、0.107 秒と 0.099 秒になります。これは、単一のクエリがどちらのパイプも満杯にしないためです。しかし、5 つのスレッドを超えると、32G の実行はキューイングします。平均レイテンシは、ステップごとに 64G の 2 倍になり、80 スレッドでは p99 が 1.14 秒に対して 4.08 秒に達します。飽和状態の FC ファブリックは、障害を起こすのではなく、すべてのクエリをキューイングし、その待機時間がテール レイテンシとして現れます。

ロードフェーズも変化しました。100万個のベクトルを取り込むのに、32Gでは94.1秒、64Gでは84.5秒かかり、IVF_FLATインデックスの構築には、108.4秒に対して139.6秒かかり、低速なファブリックでは28.8%長くなりました。合計ロード時間は、193.0秒に対して233.7秒でした。リコールとNDCGは、2回の実行で0.1%以内の差でした(32Gでは83.81%と84.42%、64Gでは83.95%と84.56%)。つまり、ファブリックによって回答の到着速度が変わるということです。導入以来32Gで運用されているデータベースの場合、HBAとスイッチのアップグレードは、パフォーマンスを向上させる絶好の機会です。
ベクター能力増強計画
ベクトル検索は、パフォーマンスに影響を与える前に、容量計算方法を変更します。埋め込みとは、ソースデータのチャンクを固定幅の数値コピーにしたものであり、テキストの場合、そのコピーは通常、それが記述するチャンクよりも大きくなります。1,000バイトのパッセージは、データベースがそれを格納するための行を追加する前に、4,096バイトの1,024次元FLOAT32ベクトルになります。研究チームはこれをベクトルストレージ増幅と呼び、ファブリック比較で使用したのと同じBioASQ 1Mデータセットで測定しました。
100万個のベクトルの元となるソーステキストは0.90GBです。Oracle 26aiでは、約0.3GBの行オーバーヘッドを含めて7.67GBのベクトルテーブルとなり、さらにIVF_FLATインデックスによって8.57GBが追加されました。これは、各ベクトルのクラスタ化されたコピーを2つ保持し、さらに約4MBのセントロイドを保持するためです。SAN上の永続的なフットプリントは16.24GBで、ソーステキストの18倍です。これは、Oracleが必要とする運用領域(インデックス構築中の15~23GBのTEMP、取り込み中の4~8GBのUNDO、約15GBのREDO)を除いたものです。

乗数は埋め込みモデルに応じて変化します。Broadcom は同じ方法から外挿し、768 次元の Cohere v3 モデル (測定済み) をソースの 4.8 倍、384 次元の MiniLM を 9.6 倍、4,096 次元の Mistral モデルを 32.5 倍としています。チャンクサイズは幅と同じくらい重要です。長いパスにわたる幅の広いベクトルは、短いパスにわたる同じベクトルよりも増幅率が低く、量子化されたインデックスはインデックスのシェアを縮小します。
これはFlashSystemやOracleに特有のものではありません。増幅はアレイがバイトを認識する前にデータベース内部で行われ、すべてのプラットフォーム上のすべてのベクターインデックスはベクターのコピーを保持しているため、ベクタープロジェクトが承認された時点でGPUと並んで容量予算に含まれます。アレイが決定するのは、その成長をどれだけ保持できるかです。IBMの第5世代FlashCoreモジュールはモジュールあたり105.6TBで、最大のFlashSystemモデルでは2Uエンクロージャに3.3PBの生データ、IBMの数値では実効11.8PBが収まるため、ベクター層はパーティションを移動する必要が生じるまで何年もその場で拡張できます。
IBM のヘルスケア アプリケーション向けサイジング モデルでは、画像の場合、逆の傾向が見られます。100 GB の X 線画像の場合、データベース内には埋め込みと症例メタデータのみが格納されるため、約 2 GB になります。テキストの場合はコストがかかります。100 GB のチャンク化された臨床テキストは 860 GB から 1.2 TB になり、そのほとんどは HNSW インデックスです。サイジングの入力はチャンク数とモデル幅であり、ソース コーパスは適切なガイドではありません。また、IBM の経験によると、埋め込みは行よりも圧縮率が低く、リレーショナル データの場合は 2 倍から 4 倍であるのに対し、1.2 倍から 2 倍であるため、FlashCore モジュールのデータ削減では増加分をあまり回収できず、再埋め込みのたびに TEMP 領域が再び必要になります。
IBMの実践的なルールは、コミットする前に測定することです。実際のコーパスの1~5%を、本番環境の埋め込みモデルとチャンキング設定でロードし、ベクトルあたりの実際のバイト数を測定します。その後、線形的にスケーリングし、モデル、次元数、またはチャンキングポリシーが変更されるたびにこの作業を繰り返します。
エンドツーエンドのAI推論:ヘルスケア分野への応用
IBMはこの検証のために、放射線科および消化器科のアシスタントアプリケーション「RAD-AI」を開発しました。これは実運用レベルの要件を満たすサンプルアプリケーションであり、本稿では、前述のセクションで測定したのと同じアレイとファブリック上で、完全な推論パイプラインを実証します。臨床医は患者の年齢、性別、主訴を入力し、胸部X線画像または内視鏡画像をアップロードすると、アーカイブ内の最も類似した過去の症例に基づいて作成された構造化レポートを受け取ります。
このアーカイブには、NIH ChestX-ray14データセットからの112,120枚の胸部X線画像と、HyperKvasirからの10,000枚以上の消化器内視鏡画像(367本の内視鏡動画からのフレームごとのベクトルを含む)が格納されており、172,000件以上の症例が事前に埋め込まれています。各画像は、ONNXランタイムを介してOracle AI Database 26ai内で実行されるCLIP ViT-L/14モデルから768次元ベクトルに変換されるため、埋め込みは、それを保持する行と同じトランザクションに書き込まれます。生の画像はオブジェクトストレージに保持され、ベクトルと症例メタデータはOracleに格納されます。

クエリ実行時、Oracleはアーカイブ全体に対してコサイン距離による近似最近傍検索を実行し、最も近い症例とその元の所見、診断、および結果を返します。取得されたデータセットは、SupermicroサーバーのH100 GPUの1つでOllamaによって提供されるLlama 3のコンテキストとなり、臨床上の優先順位、所見の概要、ランク付けされた鑑別診断、推奨される処置、およびそれらに一致する症例のリストを含むレポートを作成します。内視鏡検査も同様の手順を踏み、臨床メモを追加します。ビデオの場合、パイプラインはフレームごとに埋め込み、消化管に沿った病変を追跡できるようにします。
このアプリケーションは、同じ FlashSystem ボリュームに対して 2 つのワークロードを実行します。トランザクション ワークロードは、ログイン、レポートの保存、監査ログ、およびセッションを対象とし、ベクター ワークロードは、埋め込みテーブルとケース メタデータ全体にわたってファンアウトの高いランダム読み取りを実行し、I/O QoS デモのジェネレータ プロファイルに一致します。IBM のデプロイメントでは、前述のボリューム スロットルが設定されているため、バッチ再埋め込みジョブによって臨床医がケースを入力する速度が低下することはありません。また、上記で示したランサムウェア検出とパーティション移行は、これらのボリュームにそのまま適用されます。

リソースを大量に消費するステップはアーカイブの構築であり、IBM はこれを、同じモデルと VECTOR(768, FLOAT32) ターゲットを使用して、112,120 枚の胸部 X 線画像セット全体を 2 回埋め込むことで測定しました。ホスト CPU 上のデータベース内で ONNX モデルを実行すると、パイプラインは 1 秒あたり 3.41 枚の画像(埋め込み 1 回あたり 0.272 秒)を維持し、セット全体で 9.1 時間かかりました。モデルを 2 台目のサーバー上の Oracle の Private AI Services コンテナに移動すると、スループットは 1 秒あたり 8.55 枚の画像(画像 1 回あたり 0.097 秒)に向上し、同じ取り込みが 3.6 時間で完了しました。

前処理(画像1枚あたり約0.019秒)とOracleへの挿入(1ミリ秒未満)はどちらの実行でも同じだったので、2.5倍の速度向上は完全にモデルの実行場所によるものです。プライベートAIサービス埋め込みサービスはCPU ONNXランタイム上で動作するため、このサーバーのH100はこのテストには参加していません。速度向上はモデルをデータベースホストから切り離したことによるもので、パイプラインにおけるGPUの役割は、次に説明するインデックス構築で明らかになります。
IBMはコロラド州の研究所でこれらの数値を測定しました。弊社はテストの実施や監査は行っていません。実用的な観点から言えば、アーカイブの最初の埋め込み、およびモデル変更後の再埋め込みは、数時間単位のバッチ処理であるのに対し、その後の取得は、ミリ秒単位のCPUおよびストレージ処理であるということです。
同じコンテナはインデックスの構築も処理します。Oracle 26ai は HNSW ビルドをコンテナの Vector Index Service に送信でき、そこでは GPU 上の NVIDIA cuVS を使用してネイバーグラフを構築してから、完成したインデックスをデータベースに返します。その後、検索は GPU を使用せずに実行されます。IBM の記録では、ベースラインの HNSW ビルド (32 ネイバー、efConstruction 200) はデータベースで 8.47 秒、オフロードを使用すると 2.26 秒かかり、3.7 倍の短縮となりました。この実行では小さなデモテーブルが使用されたため、この構成でパスが機能することが確認されましたが、臨床規模の数値を測定する必要があります。
このアプリケーションは、本論文の中核をなす分業体制を実証するものです。GPUサーバーは言語モデルをホストし、アーカイブの構築または再構築時には埋め込みサービスとインデックス作成サービスも提供します。データベースは、記述対象のレコードとともにベクトルを格納し、配列とファブリックは検索読み取りとトランザクションを処理します。検索パスのどの段階でも外部APIは使用されず、患者データはデータセンターから外部に持ち出されることはありません。
IBMは、このコンセプトを実証する分野としてヘルスケアを選びましたが、そのパターンはヘルスケアに特有のものではありません。X線アーカイブを請求履歴、保守記録、製品カタログなどに置き換えても、同じ3つの要素がそのまま適用されます。つまり、記述対象のレコードの横に格納されるベクトル、GPUサーバー上での生成、そして1つのアレイ上での検索とトランザクションです。既に保有しているデータに対して推論を実行するあらゆる業界が、同じアーキテクチャを採用できます。
次は何が来るのか
検証は同じハードウェア上で継続されます。フェーズ 2 では、推論エンジンの KV キャッシュを GPU メモリから同じファイバー チャネル ファブリック上の FlashSystem に移動することで、ロング コンテキスト モデルがワーキング セットのより多くの部分をアクセス可能な状態に維持できるようにします。このシリーズの次の論文では、その作業について説明します。IBM はまた、コンテンツ認識型のリフレッシュ パイプラインを構築しており、IBM Storage Scale AFM と Kafka が新しいドキュメントを到着時にデータベース内の ONNX ベクトル化に供給することで、ベクトル インデックスがバッチ再埋め込みなしでソースを追跡します。IBM はまた、ベクトル検索を追加した他のマルチ モデル データベースにも同じストレージ検証を拡張する予定です。
フェーズ2では、セキュリティ層が新しいデータにも適用されます。KVキャッシュがFlashSystemに移動すると、医療モデルの作業コンテキスト(患者の履歴を含む)は、ベクターインデックスやトランザクションレコードと同じファイバーチャネルリンクを経由します。Emulex SecureHBAはホストとファブリック間の転送中にデータを暗号化し、Brocade Gen 8のポスト量子暗号化がスイッチ側をカバーします。各フェーズでは、データが平文で伝送される経路を追加することなく、ファブリックにワークロードが追加されます。
ランキング:弊社の「ベストストレージアレイ」ページにあるIBMのプロフィールに、Storage Scaleに加えてFlashSystemブロックストレージも掲載されるようになりました。
このレポートは Broadcom がスポンサーとなっています。このレポートで表明されたすべての見解および意見は、検討中の製品に対する当社の偏りのない見解に基づいています。



 Amazon