

データセンターにおけるNVIDIAの事業展開期間の大半において、CPUはGPUにデータを供給するチップに過ぎないと考えられていた。同社初のサーバープロセッサであるGraceも、まさにその典型だった。GraceはArmの市販のNeoverse V2コアを使用し、主にGrace HopperおよびGrace BlackwellスーパーチップのCPU部分として出荷された。これらのスーパーチップは、プラットフォームの重要な要素であるNVLink-C2Cを導入した。これは、CPUとGPUが互いのメモリにPCIeよりもはるかに高い帯域幅でコヒーレントにアクセスできるようにするリンクである。
後継機種であるVeraは、はるかに野心的な製品です。NVIDIA独自のArmコアであるOlympusを中心に、ゼロから設計されています。OlympusはArmv9.2を実装しており、各Vera CPUは88コア176スレッドを搭載しています。新しいコアに加え、メモリサブシステムも注目すべき点です。各CPUはSOCAMMモジュール上で最大1.5TBのLPDDR5Xをサポートし、公称ピーク帯域幅は1.2TB/sです。これにより、VeraはモバイルクラスのDRAMと同等の電力効率を実現しながら、メモリの現場交換を可能にしています。
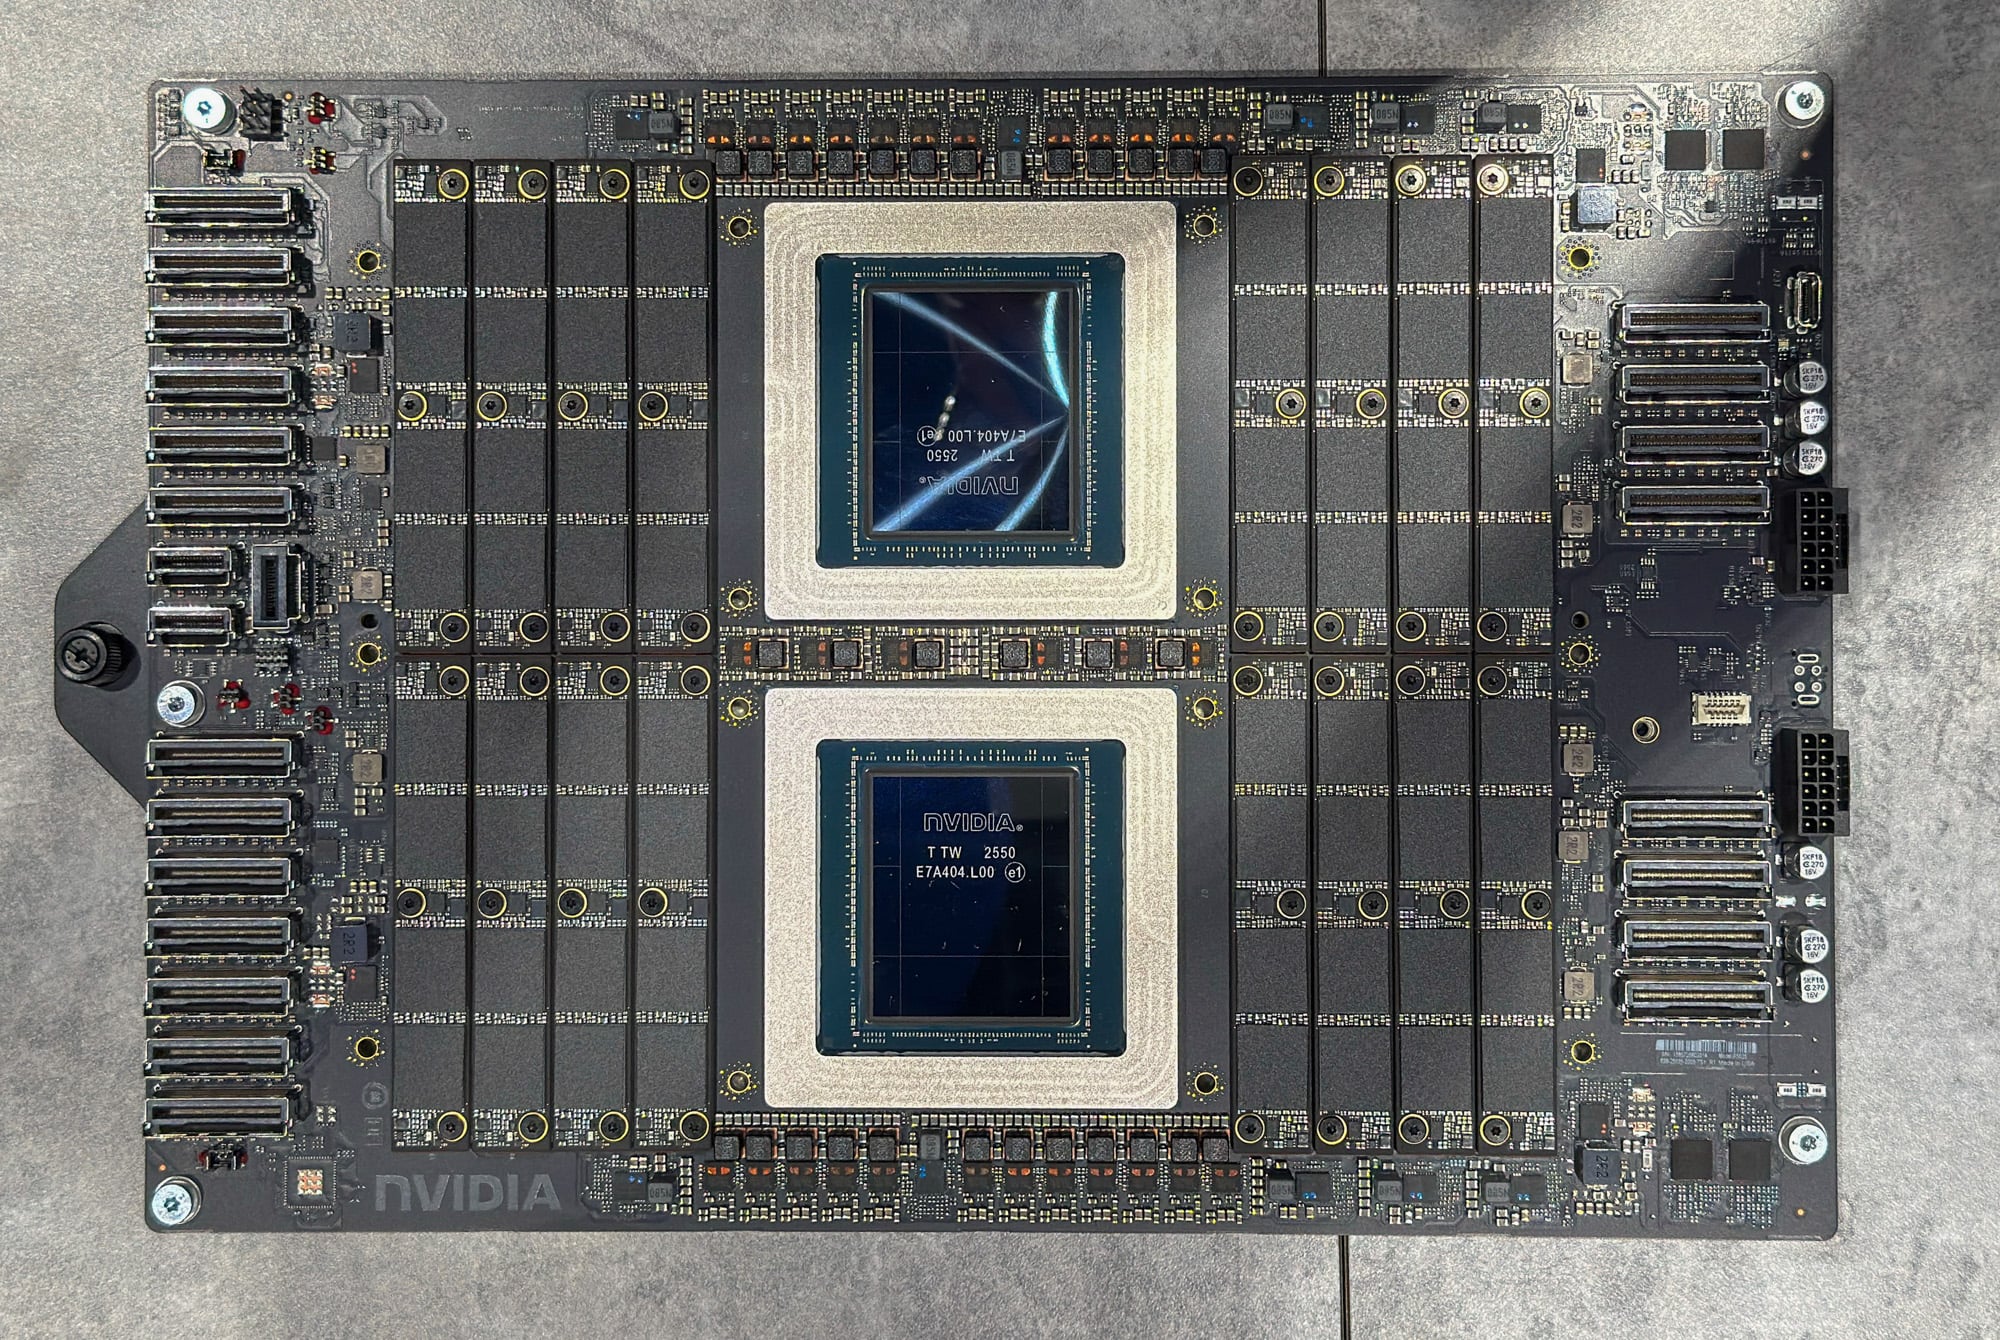
その野心は、Veraの展開先にも及んでいます。Veraは依然としてVera Rubinシステムのスーパーチップの一部として出荷されていますが、NVIDIAはBlueField-4 STXストレージプラットフォームや、エージェントサンドボックス用のスタンドアロンCPUサーバーにもVeraを拡張しました。VeraはOEM、ハイパースケーラー、NCPからも幅広い支持を得ています。Dell、HPE、SupermicroはVeraサーバーを製品ラインナップに追加し、ハイパースケーラーとNCPはVeraを主流製品にしようとしています。この幅広い入手可能性は重要です。なぜなら、後述するように、Veraはx86の競合製品に対して有力な競争相手であり、組織がサプライチェーンを多様化するのに役立つ3番目のCPUベンダーとなるからです。
主要なポイント(要点)
- メモリ帯域幅は、あらゆるx86システムにおいて2倍以上になる。 STREAM Triad上で2つのVeraソケットが2TB/sを超える速度を維持し、これはテストしたDDR5サーバーの中で最高の2.3倍の速度でした。NVLink-C2C経由で他のソケットのメモリを読み取った場合でも、Veraのコアはどのx86ソケットよりもローカルメモリから多くの帯域幅を引き出し、hugepagesを使用したローカルレイテンシはEPYC 9175Fよりも13%低くなりました。
- 幅広い中間層市場向けにバランス良く設計されたチップ。 3.4GHzのOlympusコア1つで、7-Zipでの圧縮速度が5.0GHzのEPYC 9175Fより12%速く、シングルスレッドのPythonテスト3つのうち2つでEPYC 9175Fに勝利しました。フルロード時、VeraはEPYC 9965の7-Zipスループットの63%~72%に達し、コア数は半分以下で、シングルスレッドではAMDのコアあたりの性能に匹敵し、システム全体ではスループットに優れた性能を発揮しました。
- ベクトル解析と暗号技術は、明らかに弱点である。 6 つの 128 ビット SVE2 パイプでは、それ用に書かれたコードでは 512 ビット AVX-512 に匹敵できません。 16 コアを揃えた Vera では、GROMACS benchMEM の実行速度が EPYC 9175F の半分、EPYC 9965 の 3 分の 2 であり、シングル コアでは AES-256-GCM の暗号化速度が 9175F の約 3 分の 1 でした。 システム全体では、384 コアの EPYC 9965 が GROMACS benchPEP と AES の両方で約 3 倍の性能を発揮しました。
- メモリ制約のあるHPCは、帯域幅を速度に変換する。 大規模なOpenFOAMメッシュでは、Veraは384コアのEPYC 9965よりも1.44倍、240コアのXeon 6978Pよりも1.20倍高速でした。より小規模なメッシュでは、より大きなx86 L3キャッシュが問題の大部分を占めますが、Veraは9965と12%以内の差で2位となりました。
- データベースと分析の分野は既に競争が激化している。 HammerDB TPROC-C の 1 つのソケットにおいて、88 個の Vera コアは 192 個の EPYC 9965 ソケットを PostgreSQL で 26%、MariaDB で 8% 上回りましたが、MySQL では 19%、VillageSQL では 15% 劣りました。Xeon 6787P は、5 つのエンジンすべてで Vera に劣りました。また、Vera は ClickBench のホット ランを EPYC 9965 より 23% 短い時間で完了し、256GB の Valkey ワーキング セットで 34% 多いリクエストを処理しました。
技術仕様
| 製品仕様 | NVIDIA Vera CPU |
|---|---|
| コンピューティングと電力 | |
| ペース: | NVIDIA Olympus、Armv9.2、SVE2およびFP8対応 |
| ソケットあたりのコア数とスレッド数 | 88コア、176スレッド(NVIDIA空間マルチスレッディング) |
| クロック速度(実測値) | 3.41GHz |
| TDP | 250W~450Wまで設定可能 |
| 冷却 | 空気または液体 |
| キャッシュ | |
| L1命令 | コアあたり 64KB |
| L1データ | コアあたり96KB、6ウェイ |
| L2 | コアあたり2MB、プライベート |
| システムレベルキャッシュ(L3) | ソケットあたり164MB、Arm MPAMパーティショニング |
| ファブリック | 第2世代スケーラブルコヒーレンシーファブリック、3.4TB/sバイセクション |
| メモリ | |
| タイプ | ソケットあたり8個のSOCAMM2モジュールにLPDDR5Xを搭載 |
| コントローラ | 8x 128ビット(合計1,024ビット) |
| 速度 | 最大9,600MT/秒 |
| 帯域幅 | ソケットあたり最大1.2TB/秒(ベンダー公称値) |
| 容量 | ソケットあたり256GB~1.5TB |
| I / O | |
| PCIe | Gen6、ソケットあたり88レーン(CPUのみのプラットフォーム) x16、x8、x4、x2分岐 |
| CXL | 3.1、タイプ3メモリ拡張とプーリング |
| NVLink-C2C | 第2世代、1.8TB/秒双方向、コヒーレント、認証付き暗号化 |
| セキュリティ | |
| 機密コンピューティング | Arm CCAレルム、RME-DAおよびRME-CDA、TDISP、VMごとのキー |
NVIDIAがCPU事業に参入したい理由
VeraがNVIDIAにとってなぜ重要なのかを理解するには、同社の成長の軌跡を辿る必要があります。NVIDIAはGPUを中心にデータセンター事業を構築し、その後、GPUの稼働に必要なインフラストラクチャへと事業を拡大しました。ハードウェア面では、2020年のMellanox買収により、サーバーを接続し、サーバー間でデータを転送するネットワーク技術を獲得しました。ソフトウェア面では、CUDA、DOCA、そしてより広範なソフトウェアスタックによって、NVIDIAはハードウェアのプログラミングと運用方法にまで影響力を拡大しました。これらの要素が一体となって、NVIDIAは高速コンピューティングプラットフォームの大部分を制御できるようになったのです。
しかし、このプラットフォームには汎用CPUが依然として必要だった。オペレーティングシステムを実行し、データを準備し、アプリケーションを管理し、アクセラレータに送られる処理を調整する何かが必要だったのだ。NVIDIAの事業拡大の大部分において、その役割はIntelとAMDが担っていた。そのため、NVIDIAは厄介な立場に置かれることになった。GPU、ネットワーク、そして多くのソフトウェアを自社で提供できる一方で、サーバーの中核となるプロセッサは他社製に依存していたのだ。
Graceは、その状況を変えるための最初の大きな一歩でした。Arm Neoverse V2コアをベースに構築されたGraceは、NVIDIAにデータセンター向けCPUと、NVLink-C2Cを介してGPUとより密接に接続する方法をもたらしました。しかし、Graceには埋めるべき性能ギャップが残されていました。メモリ帯域幅と効率性により、AIホストCPUとしては競争力がありましたが、他のほとんどのワークロードでは、主要なx86プロセッサが依然として大きな優位性を維持していました。この性能のばらつきが、EPYCやXeonサーバーの汎用代替品としてGraceを選択する根拠を弱めていました。
Veraは、GraceのNeoverse V2コアをNVIDIA独自のOlympus設計に置き換え、メモリ帯域幅と容量を大幅に増加させることで、そのギャップの多くを埋めています。GPU、DPU、ネットワーク機器に加えて競争力のあるCPUを提供することで、NVIDIAは各サーバーにおける支出のより大きなシェアを獲得できます。また、これにより同社はエコシステムとコンポーネントの連携方法をより詳細に制御できるようになります。CPUコア、メモリサブシステム、インターコネクト、GPUを同じ要件に基づいて設計できるのです。現在最大1.8TB/sの速度を誇るVeraのコヒーレントなCPU-GPUリンクは、この統合の具体的な例です。
各システムの支出をより多く取り込むことは、全体像の一部に過ぎません。強化学習(RL)とエージェント型AIは、NVIDIAがスタンドアロンCPUシステムを提供するもう一つの理由となります。エージェントは応答を生成するだけでなく、ツールを呼び出し、情報を取得し、コードを実行し、結果を確認してから次の行動を決定します。これらの実行の多くはCPU上で行われ、次のモデルステップがCPUタスクの結果に依存する場合、実行速度が遅いと一連の処理全体が遅延します。そのため、コアごとのパフォーマンス、メモリレイテンシ、負荷がかかった状態での予測可能な動作が、エージェントの応答性にとって重要になります。
オリンパス・コア
これらの要件は、Veraの88個のOlympusコアの設計と密接に一致しています。Olympusコアは、ソケット全体がビジー状態のときでも各コアから高いパフォーマンスを維持するという明確な優先事項に基づいて構築されています。Olympusは、NVIDIAがArmv9.2命令セットを実装したもので、Graceで使用されていたNeoverse V2コアに取って代わります。この違いは重要です。Armはプロセッサが実行する命令を定義し、NVIDIAはそれらの命令のフェッチ、スケジューリング、および実行を行うメカニズムを設計しました。この制御により、NVIDIAはコアを自社の目標に合わせて調整できます。つまり、多くのタスクを同時に実行しながら、個々のタスクを迅速に完了させるということです。
その目標の前半は、1サイクルあたりの命令数(IPC)から始まります。これは、コアが1クロックサイクルあたり平均で何命令を完了するかを示す指標です。クロック速度はこれらのサイクルの発生頻度を決定し、マイクロアーキテクチャはそれらのサイクルにどれだけの有効な処理を組み込めるかを決定します。NVIDIAは、前世代と比較してIPCが1.5倍向上したと主張しています。観測された最高クロックは3.41GHzでしたが、Veraのアーキテクチャは、1サイクルあたりの処理量を増やし、負荷がかかった状態でもその進捗を維持することに重点を置いています。この重点は重要です。なぜなら、依存関係のある一連のステップが長いコンパイラ、インタプリタ、またはデータベース操作の場合、コア数を増やすだけでは、その一連の処理を高速化することはできないからです。
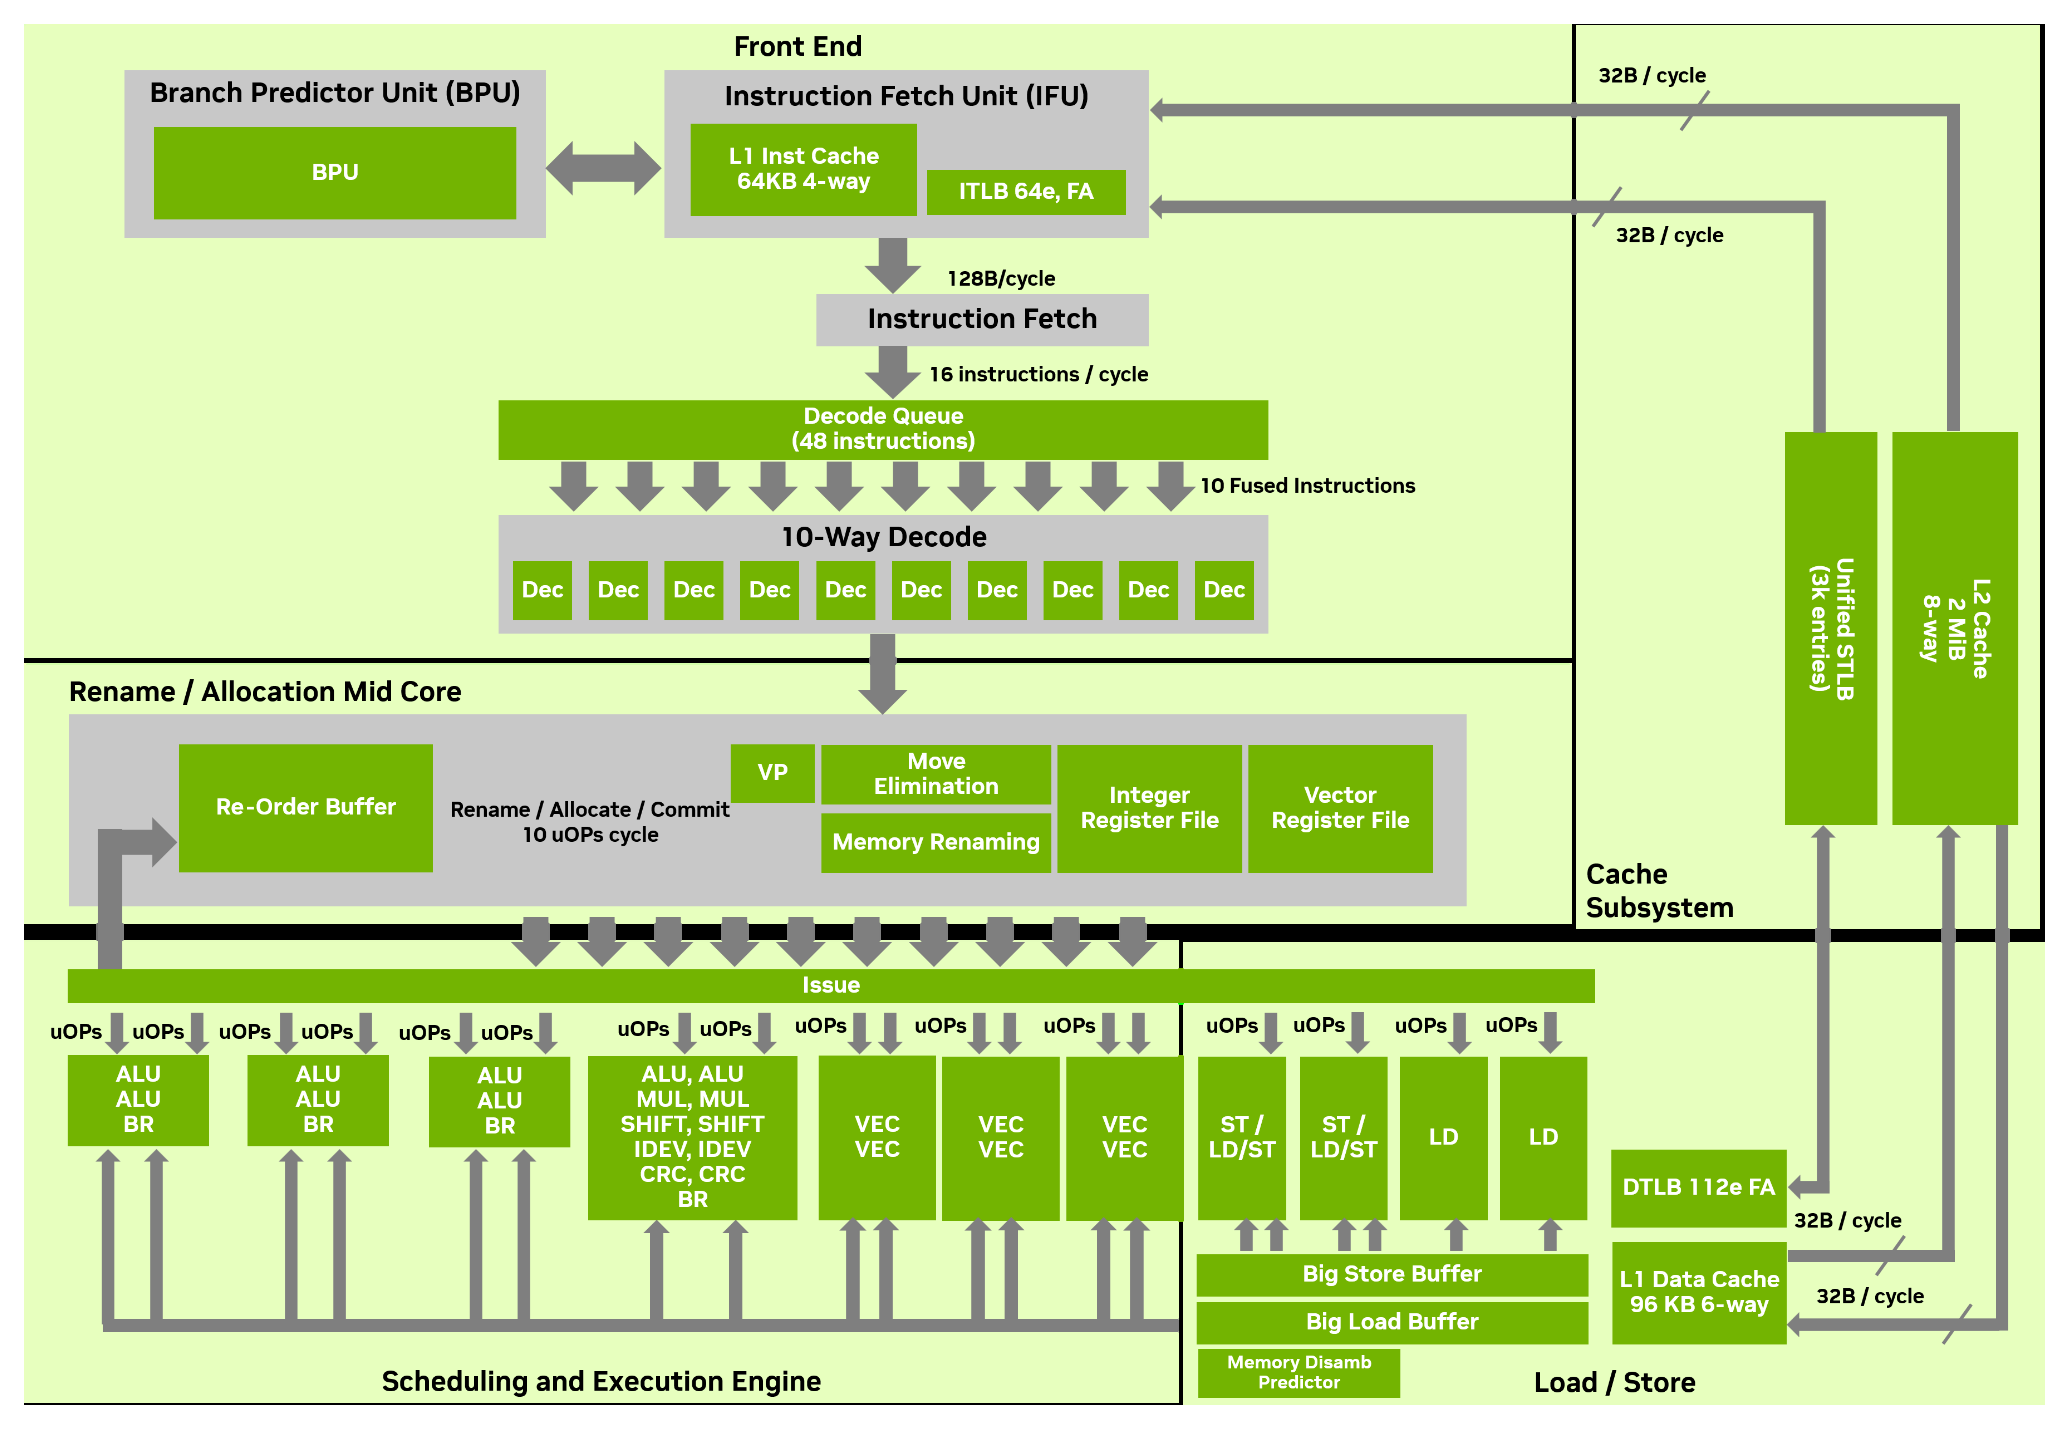
そのIPCを実現するには、まず有用な命令を安定的に供給することから始めなければなりません。オリンパスのフロントエンド(コアの中でプログラム命令のフェッチとデコードを行う部分)は、1サイクルあたり最大10個の命令をデコードできます。この幅は、命令が安定して供給される場合にのみ意味を持ちますが、ソフトウェアがコードパス間で頻繁に分岐する場合、安定供給は困難になります。そのため、オリンパスはニューラル分岐予測器と他の特殊な予測器を組み合わせ、1サイクルあたり最大2つの分岐をサポートしています。予測精度が向上することで、コアは必要な命令をフェッチできるようになり、誤ったパスの実行やエラー後の再起動に費やす時間を削減できます。
これらの命令がフェッチされ、デコードされると、オリンパスはアウトオブオーダー実行を使用して、先行する命令が待機している間に実行できる処理を見つけ出します。たとえば、ある演算がメモリ待ちの状態であれば、独立した計算を先に実行できます。命令ウィンドウが大きいほど、プロセッサはそのような独立した処理を見つける機会が増えます。
とはいえ、上記で説明した依存関係のある処理チェーンのように、各ステップが前のステップの結果を必要とするため、このアプローチが適用できないシーケンスも存在します。そのような場合、オリンパスは値予測機能も活用し、依存関係のある処理を予測値から開始させ、実際の結果が得られた時点でその予測値を確認します。予測が正しければ、これらの依存関係チェーンにおける実効的な待ち時間を短縮できますが、予測が間違っていた場合は、予測処理を修正して再計算する必要があります。
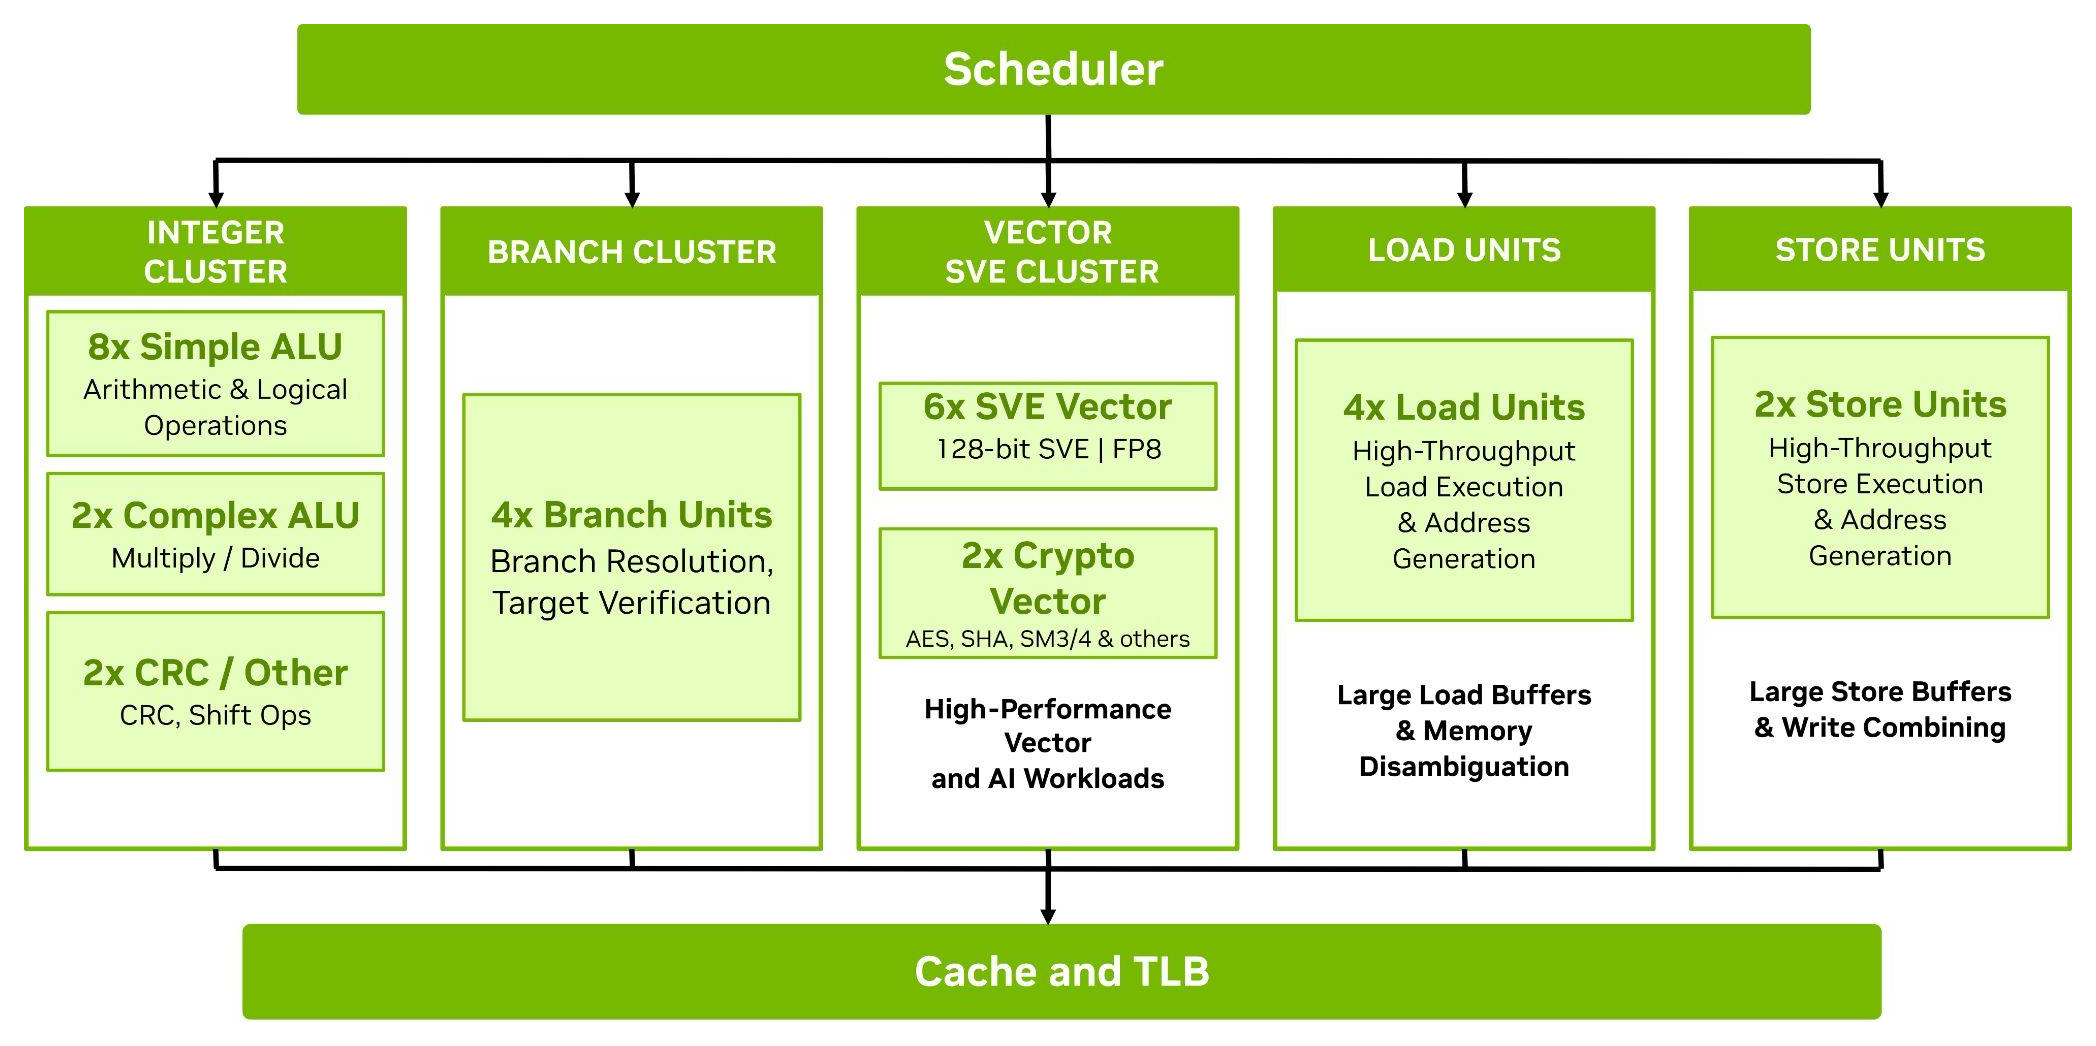
実行エンジンは、その命令供給を完了済みの処理に変換するのに十分な能力を必要とします。オリンパスは、広範な整数実行リソースと専用の分岐ユニット、4つのロードパイプライン、および2つのストアパイプラインを組み合わせています。これらのリソースはそれぞれ異なる要求に対応します。整数ユニットは算術演算、比較、および論理演算を処理し、分岐ユニットは制御フローを解決し、ロード/ストアパイプラインはコアとそのキャッシュ間でデータを移動します。命令が実行またはメモリのボトルネックの背後で滞留するだけであれば、デコーダの容量を大きくしてもほとんどメリットがないため、このバランスが重要です。
オリンパスは、これらのスカラーリソースに加え、SVE2をサポートする6つの128ビットベクトルパイプラインを備えており、そのうち2つのパイプラインはFP8をサポートし、暗号化機能も搭載しています。ベクトル命令は複数のデータ要素に演算を適用するため、数値計算、圧縮、データ処理に役立ちます。
これはオリンパスが明確なトレードオフを行っている分野の一つです。同社の128ビットのベクトル幅は、競合するx86プロセッサのAVX-512で利用可能な512ビット幅よりも小さいのです。この差は、最適化された数値カーネルやトークナイザにも影響を与えますが、アプリケーションのパフォーマンスは、特定の命令のスループット、生成されるコード、およびデータの供給量にも左右されます。そのため、GROMACSのような科学アプリケーションは、この設計の強みを検証する上で、別途のテスト対象となります。
スカラーであれベクトルであれ、これらの実行リソースはいずれもデータが時間通りに到着することに依存するため、頻繁に使用されるデータを実行エンジンの近くに保持することが同様に重要です。各コアには、64KBの命令キャッシュ、96KBのデータキャッシュ、および2MBのプライベートL2キャッシュがあります。小さな第1レベルキャッシュは、最もすぐに役立つ命令とデータへの高速アクセスを提供します。より大きなL2は、アクセスがプロセッサ内をさらに移動する必要が生じる前に、コアのワーキングセットをより多く保持します。各コアに十分なプライベートL2を与えることで、コアごとの同じ目標がサポートされます。つまり、より多くの作業をローカルで処理できるため、共有キャッシュとメインメモリへの負荷が軽減されます。
プリフェッチは、命令がデータを要求する前にデータを取り込むことで、これらのキャッシュを補完します。オリンパスは、通常のアクセスパターンに対応するプリフェッチャに加え、A[B[i]]のような間接アクセスに対応するグラフプリフェッチャも搭載しています。このグラフでは、一方のルックアップがもう一方のルックアップのインデックスを提供します。ハードウェアはこの関係性を学習することで、プログラムが要求する前に2番目のデータのフェッチを開始できます。これは、グラフ処理やその他の不規則なワークロードでよく見られる問題、つまりプロセッサの実行能力は十分であるものの、処理の進行が次のデータの発見に依存するという問題を解決するのに役立ちます。
Olympusの最後の要素は、その目標のもう半分、つまり多数のタスクを同時に実行することに対応しています。各コアは2つのハードウェアスレッドをサポートしており、Veraはソケットあたり176スレッドを実現しています。NVIDIAはこの方式を「空間マルチスレッド」と呼んでいます。コアは、1つのアクティブなスレッドにリソースを割り当てることも、2つのアクティブなスレッド間でリソースを分割することも可能で、1つの命令ストリームに実行能力を集中させるか、より多くの同時処理をサポートするかを選択できます。
NVIDIAの目標は、2つのスレッド間の干渉を減らし、両方のスレッドがビジー状態にあるときのパフォーマンスをより予測可能にすることであり、これは負荷がかかった状態でのエージェントワークロードが依存する予測可能性と同じです。2つのスレッドは依然として物理コアとより広いメモリシステムを共有しているため、リソースを分割してもアプリケーションのレイテンシが固定されるわけではありません。
ファブリック、メモリ、およびI/O
個々のコアに加えて、88個のワイドコアの生産性を維持するには、DRAMへの高速接続だけでは不十分です。コアはデータの交換、共有キャッシュへのアクセス、接続されたデバイスとの通信も行う必要があります。Veraは、NVIDIAの第2世代スケーラブルコヒーレンシーファブリックを介してこれらのリソースを接続します。これは、共有データのキャッシュされたコピーの一貫性も維持する内部メッシュです。コア、ファブリック、および164MBのシステムレベルキャッシュは1つの演算ダイ上にあり、メモリコントローラとI/Oは隣接するチップレット上にあります。NVIDIAは、ファブリックのバイセクション帯域幅を3.4TB/sと評価しています。これは、メインメモリの帯域幅とは別に、メッシュ全体のトラフィック容量を示す指標です。
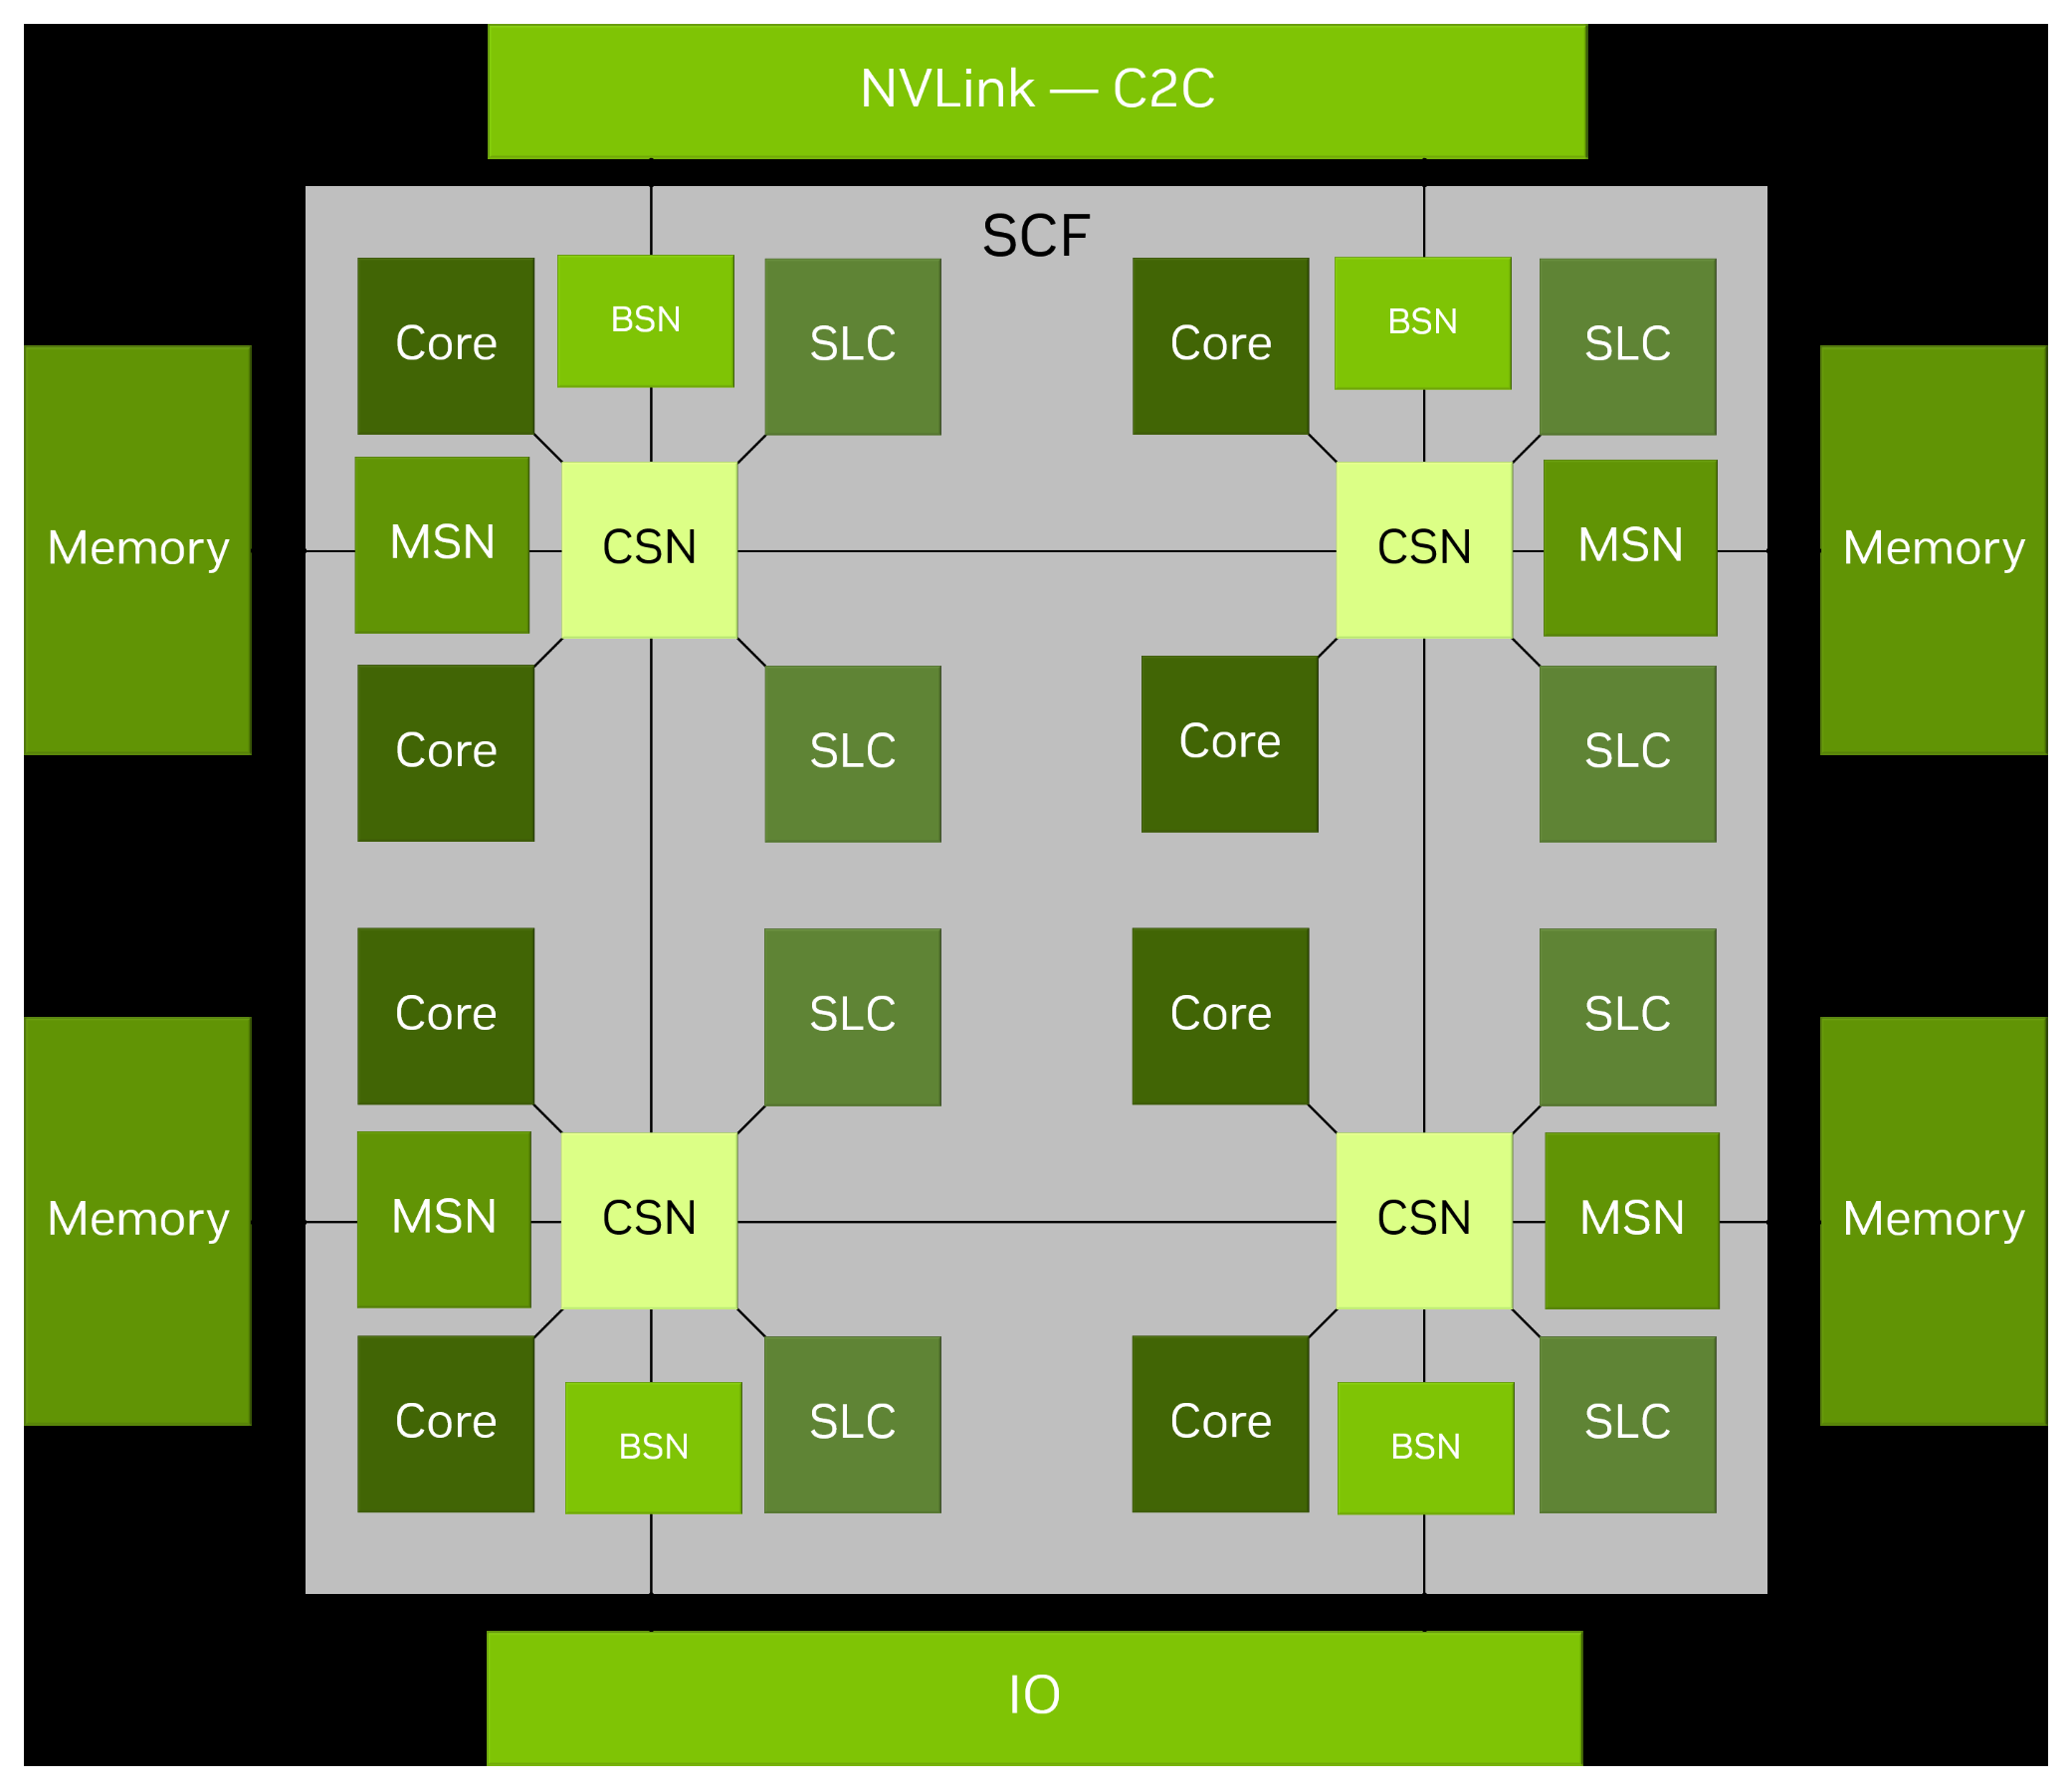
このシングルダイ構成により、コア間の通信や共有キャッシュへのアクセス時に、別々の演算ダイ間でのデータ転送が回避されます。ソフトウェア面では、Veraはソケットごとに1つのNUMAノードを提供します。オペレーティングシステムは、各ソケットをコアとローカルに接続されたメモリの1つのグループとして認識します。これにより、ソケット内の配置が簡素化されますが、メッシュを介したすべてのパスのレイテンシが同一になるわけではありません。2つのソケットを持つサーバーは依然として2つのNUMAノードを持ち、もう一方のソケットのメモリへのアクセスは、ローカルメモリへのアクセスとは異なります。
各ソケット内には、先に説明したプライベートL2キャッシュのさらに上位に、共有システムレベルキャッシュ(L3)が配置されています。これにより、コアはDRAMにアクセスすることなくデータを再利用する機会を得ることができ、ソケット全体でアクセス可能な共有容量が提供されます。164MBという容量は十分ですが、競合するプロセッサの中には、これよりもはるかに大きなL3を提供するものもあります。これは、繰り返しアクセスされるワーキングセットがコアのL2キャッシュには大きすぎるものの、より大きな共有キャッシュに収まる場合に重要になります。DRAMの帯域幅が大きいほど、データがメモリから取得する必要がある場合に役立ちますが、そもそもメモリへのアクセスを回避するという利点が損なわれるわけではありません。
その容量は共有されるため、VeraはArm MPAMもサポートしており、システムソフトウェアが共有キャッシュ容量を分割し、ワークロード間でメモリ帯域幅の割り当てを管理できる。
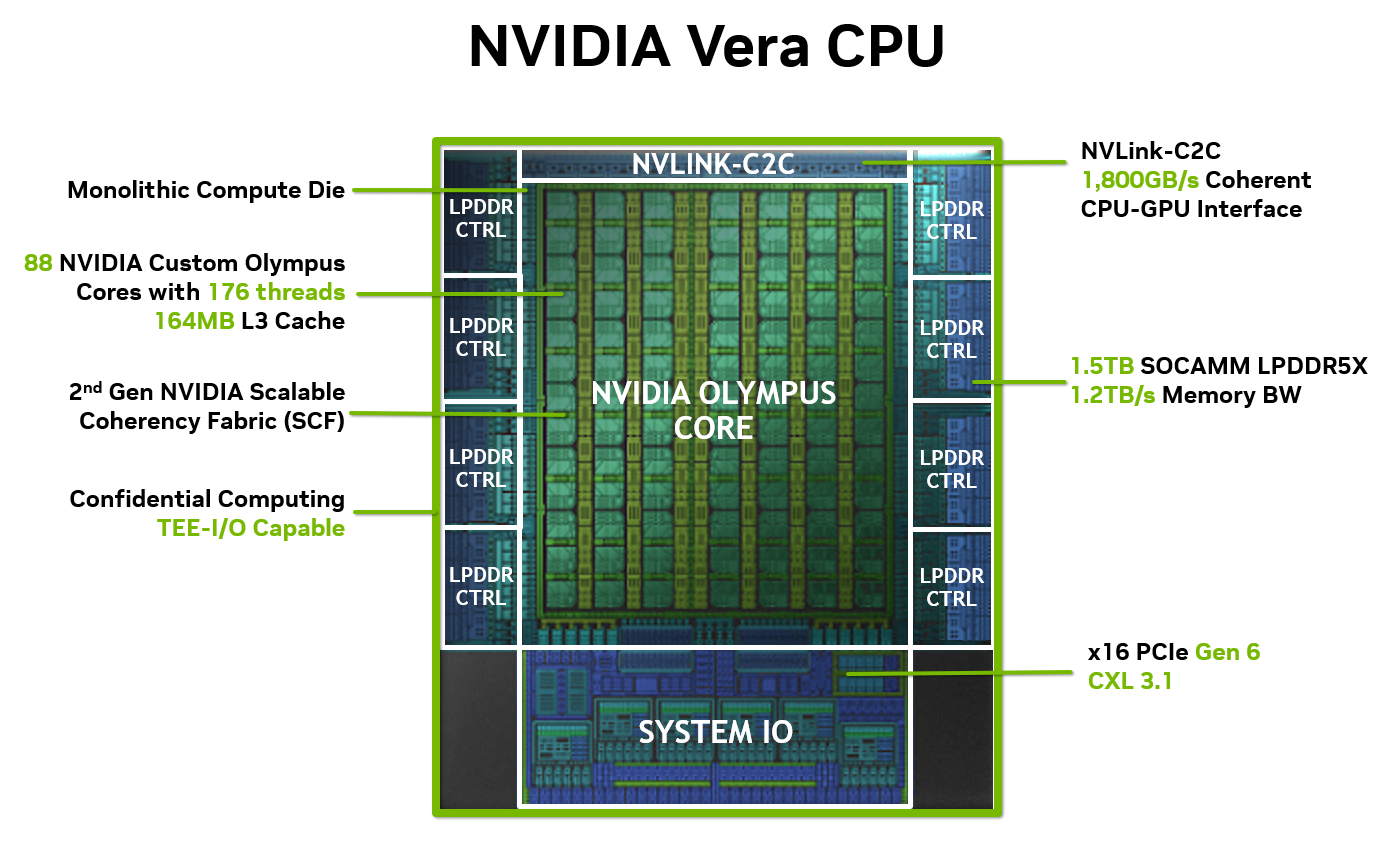
メインメモリへのアクセス時には、Veraは十分な帯域幅を備えています。8つの128ビットLPDDR5Xコントローラが1,024ビットの集約インターフェースを提供し、メモリは最大9,600MT/sで動作し、ソケットあたり定格1.2TB/sの帯域幅を実現します。メモリは8つの着脱式SOCAMM2モジュールに搭載されており、LPDDR5Xと現場交換可能なモジュールを組み合わせています。これにより、Veraはメモリをはんだ付けすることなく、広帯域で高速なメモリインターフェースを実現しています。
しかし、生の帯域幅は全体像の一部に過ぎません。より有用な関係は、その帯域幅とそれを共有するコア数との関係です。定格1.2TB/sを88コアで割ると、物理コアあたり約13.6GB/sになります。これはプロセッサのバランスを表す方法であり、各スレッドが受け取る帯域幅の専用割り当てや保証ではありません。メモリ帯域幅の増加を伴わずにコア数を増やすと、この比率は低下します。
測定したSTREAM帯域幅を物理コア数で割ると、Veraではコアあたり11.8GB/sとなり、240コアのXeon 6978Pシステムでの3.8GB/sと比較して大幅に向上しています。これは、Veraがその演算リソースに対して相当なメモリスループットを提供していることを示す具体的な例です。
電力効率も同じ設計上の選択の一部です。NVIDIAは、容量にもよりますが、フル構成のLPDDR5Xメモリサブシステムの消費電力を約30Wから40Wと見積もっています。LPDDR5Xの魅力は、この帯域幅を提供しながら、サーバー全体の消費電力に占めるメモリの負担を低く抑え、システムの電力と冷却予算をより多く計算処理に充てられるようにすることです。
帯域幅と効率性だけでは、どれだけのデータが格納されるかは分かりません。容量は依然として別の考慮事項です。NVIDIAは、ソケットあたり最大1.5TB、2つのソケットで合計3TBのLPDDR5Xメモリを直接接続できると規定しています。ワーキングセットをメモリ内に常駐させる必要があるワークロードの場合、転送速度を上げて容量不足を補うことはできません。
直接接続された容量が十分でない場合、VeraのI/Oはデバイス接続とともに、より多くの容量へのパスを提供します。スタンドアロンCPUプラットフォームは、ネットワーク、ストレージ、アクセラレータ用にソケットあたり88のPCIe Gen6レーンを提供し、Vera Rubin構成では96レーンが利用可能です。メモリ側では、CXL 3.1サポートにはタイプ3メモリデバイスとメモリプーリングが含まれており、SOCAMM2モジュールを超えて容量を拡張できます。この拡張メモリは、直接接続されたLPDDR5Xとは異なるアクセスパスを使用するため、そのパフォーマンスは個別に評価する必要があります。
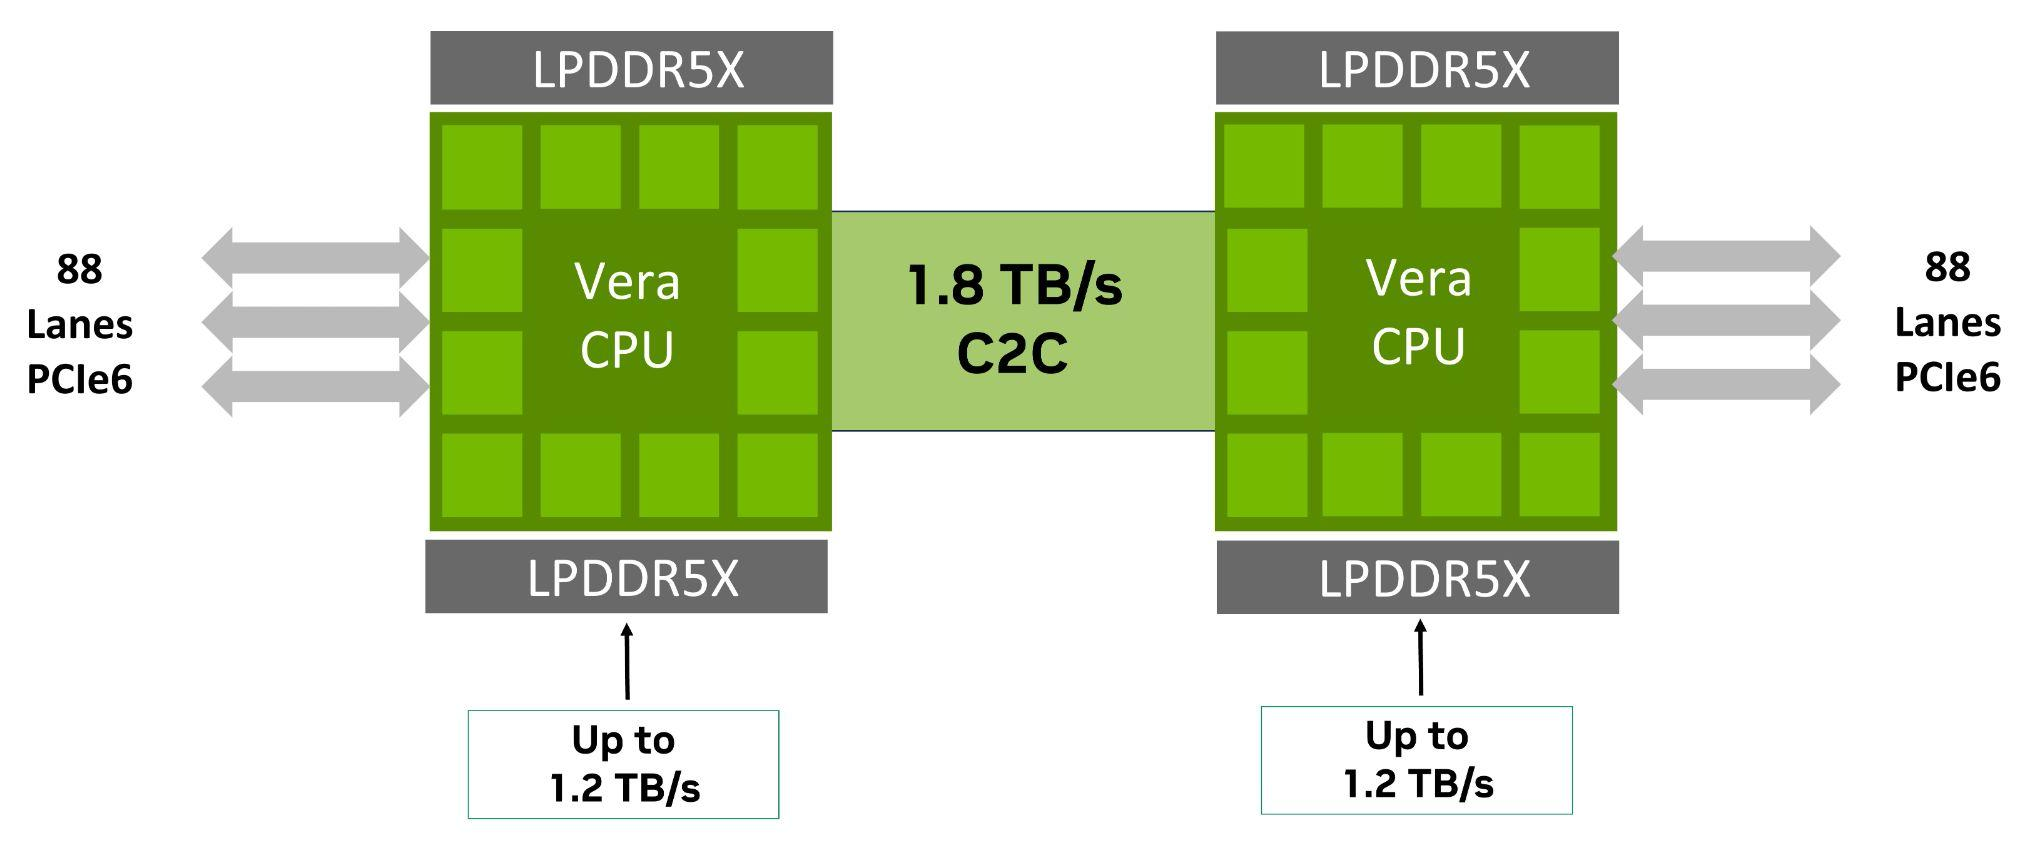
最後に、プロセッサ間の通信には、Veraは第2世代のNVLink-C2Cを採用しています。これは、Graceのスーパーチップで導入されたリンクの後継規格です。デュアルソケットサーバーでは2つのVera CPUを接続し、スーパーチップではVeraとRubin GPUを接続します。このリンクは、双方向で最大1.8TB/s、つまり各方向で900GB/sの帯域幅を提供し、NVIDIAがCPU事業に参入する原動力となった、CPUとGPUの緊密な統合を反映しています。
MGX Vera C2リファレンスサーバーの内部
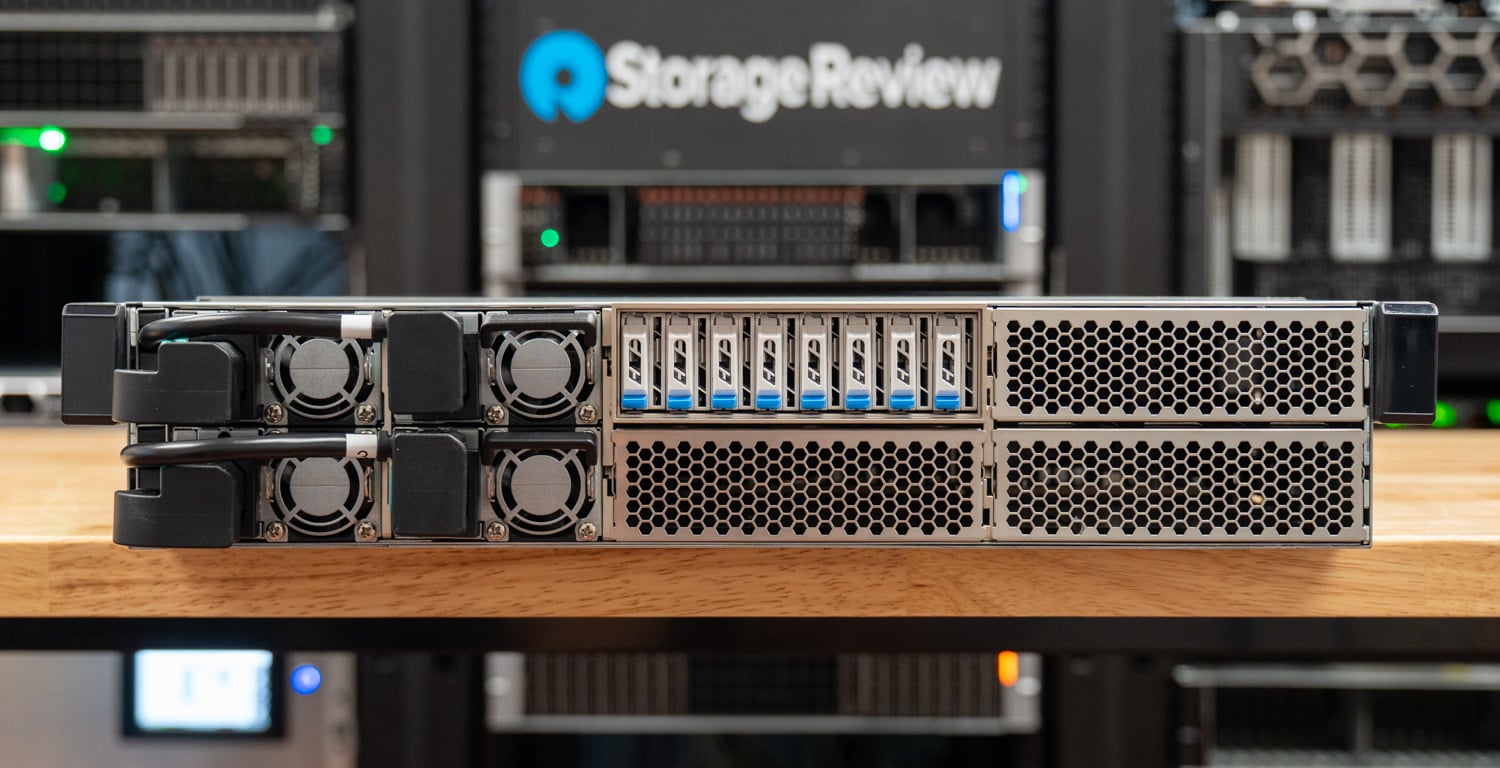
今回レビューするのは、NVIDIAのMGX Vera C2です。これは、NVIDIAのパートナー企業が最初のVeraシステムのベースとして使用している、デュアルソケットの空冷式2Uリファレンスサーバーです。フロントパネル上部には8つのE1.Sベイが並び、その横には4つのホットスワップ対応Delta電源が搭載されています。残りの部分はハニカム構造の吸気口で覆われています。電源は前面からロードされるため、背面はラック内のI/Oケーブル配線に十分なスペースが確保され、PCIeライザーと管理I/Oに利用されています。
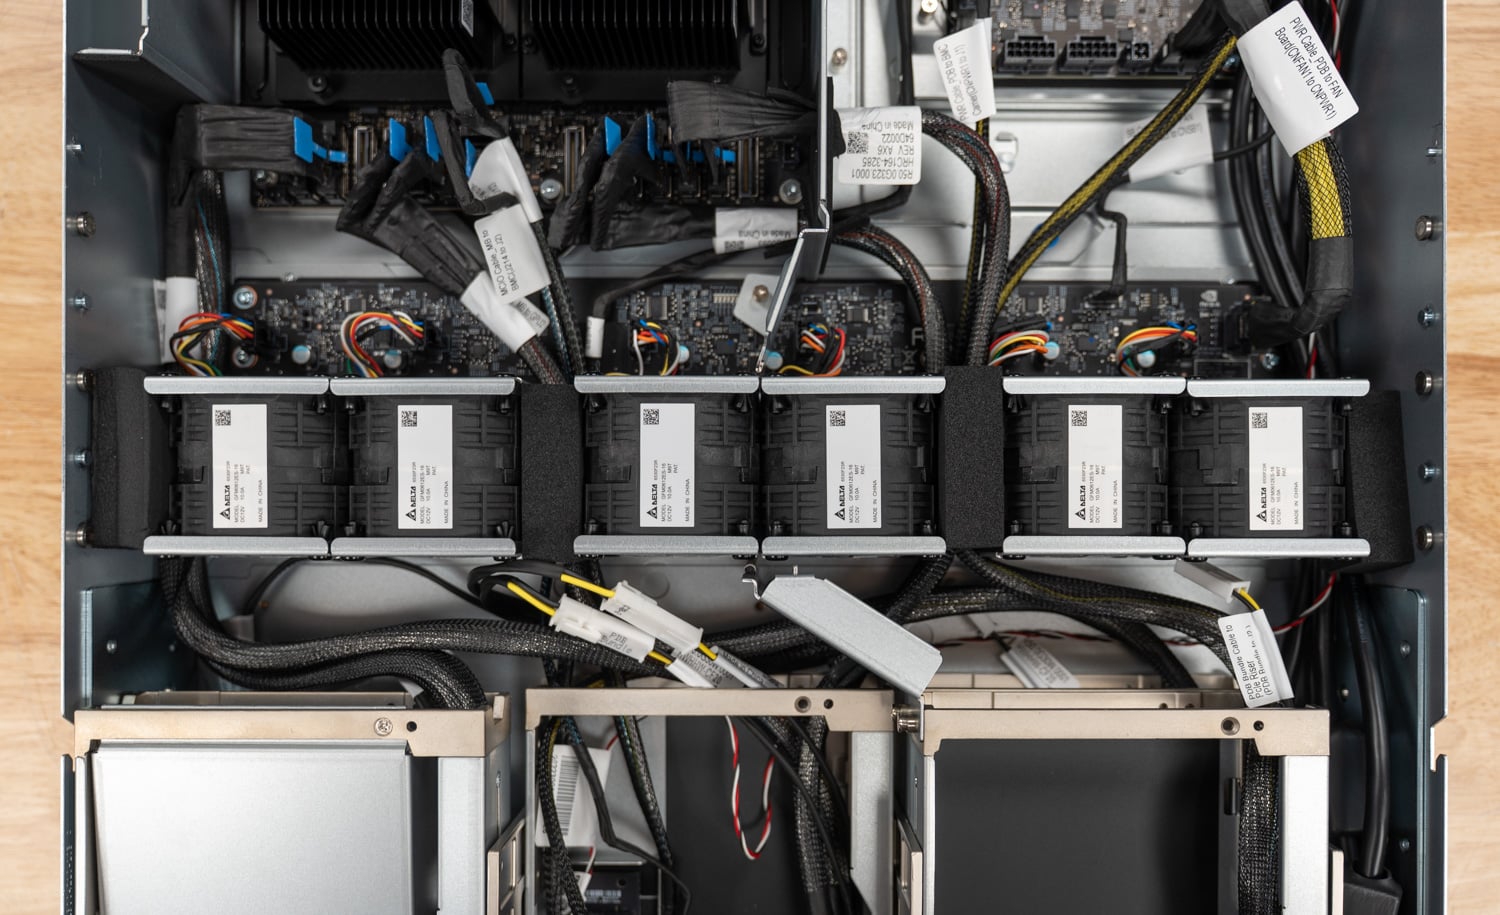
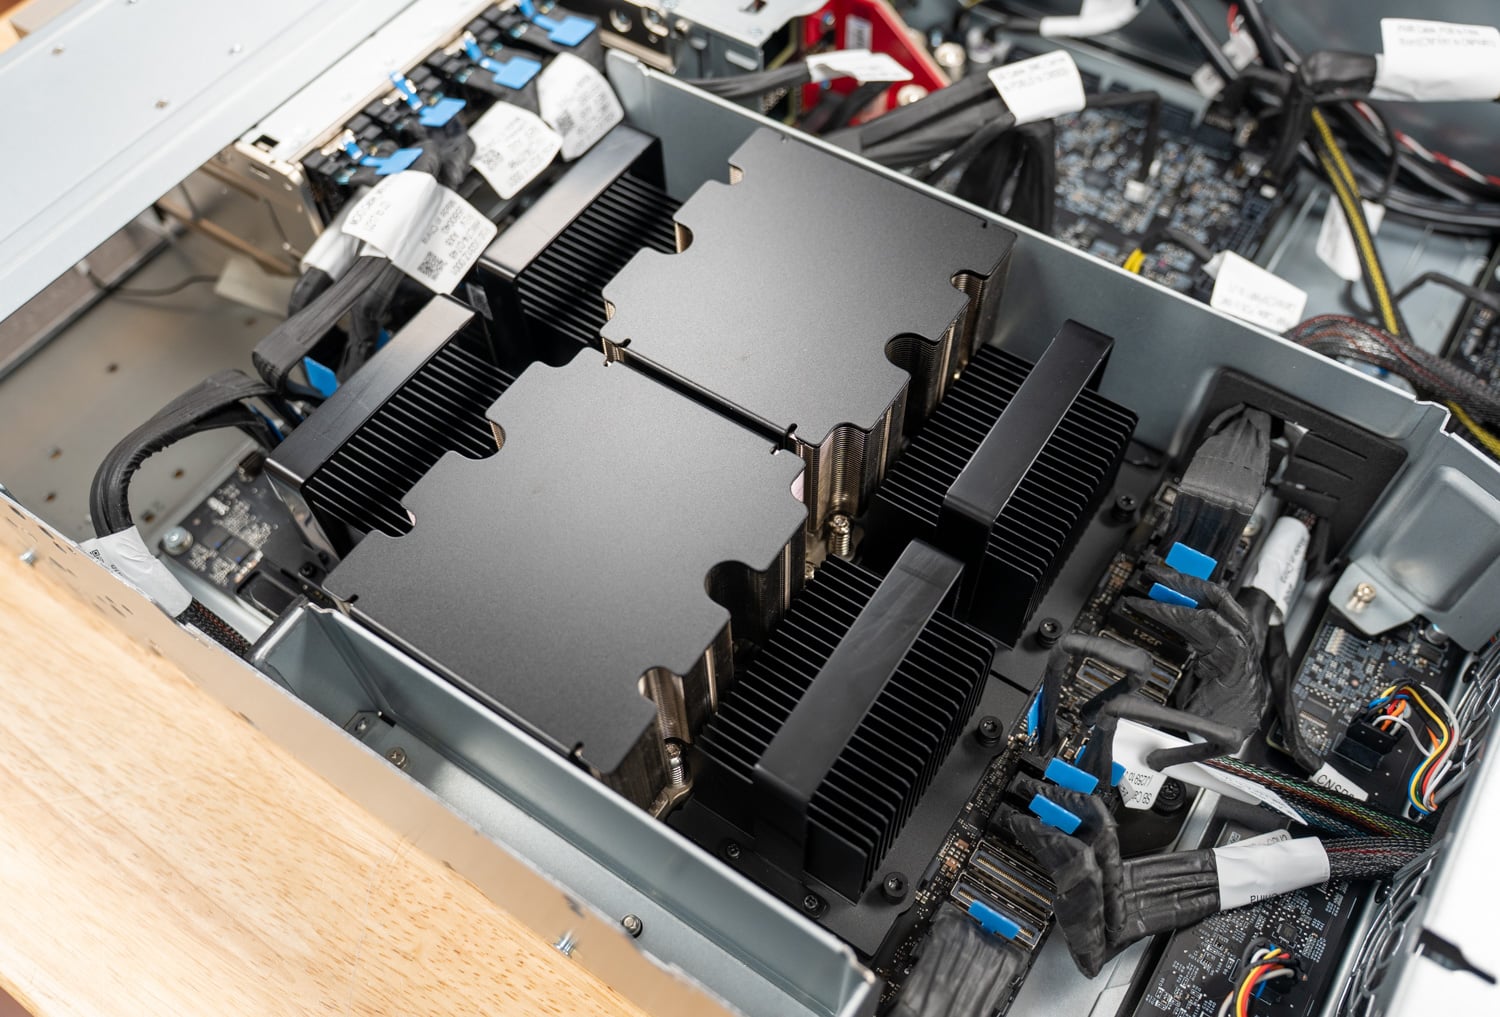
内部では、2つのVera CPUがパッシブヒートシンクの下に並んで配置され、その両側にはSOCAMM2モジュールが取り付けられている。シャーシ中央、ドライブベイのすぐ後ろには6つのファンモジュールが壁のように並び、両方のソケットに空気を送り込む。各ファンの間には発泡スチロール製のブロックが配置され、気流を誘導する。冷却の観点から見ると、このレイアウトはよく考えられている。
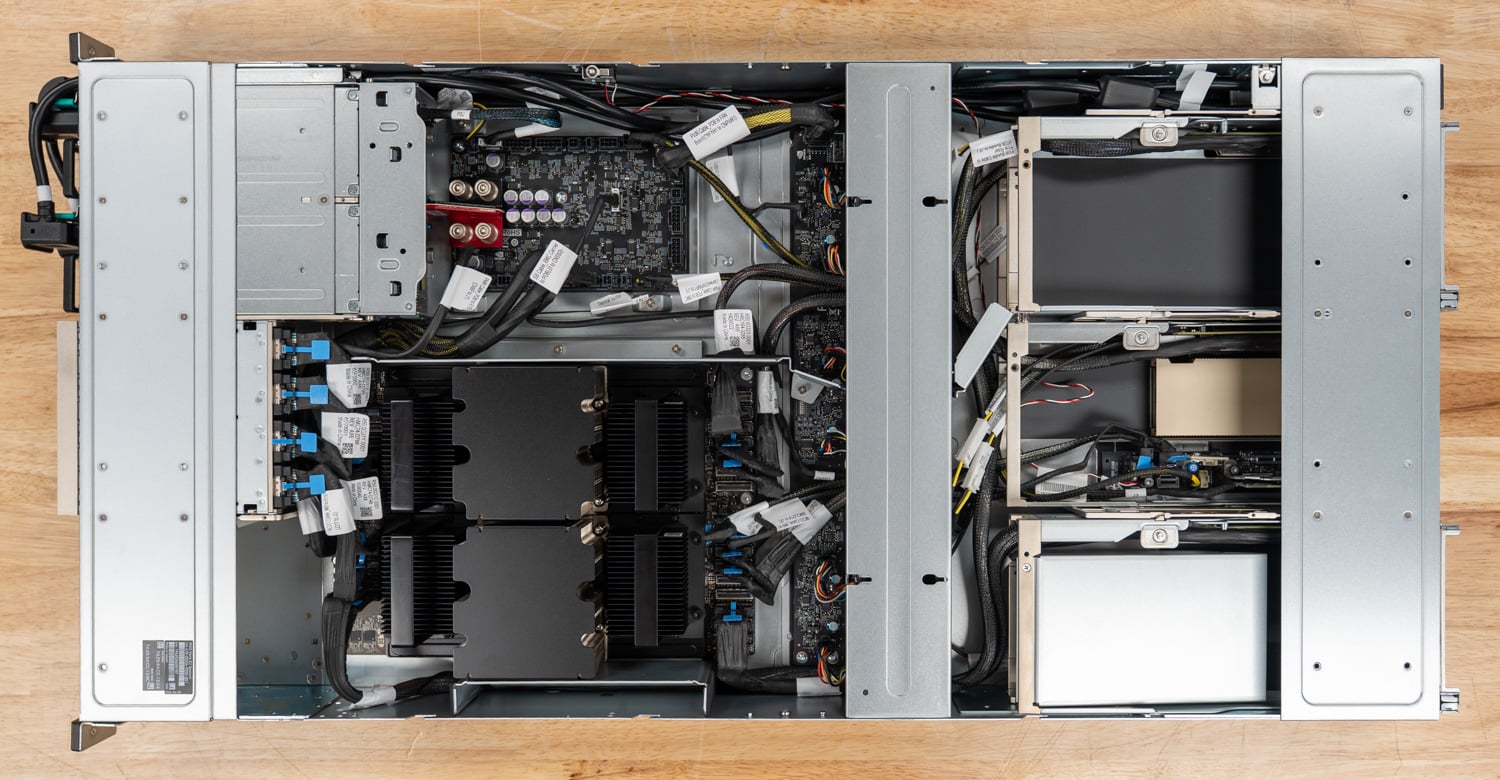
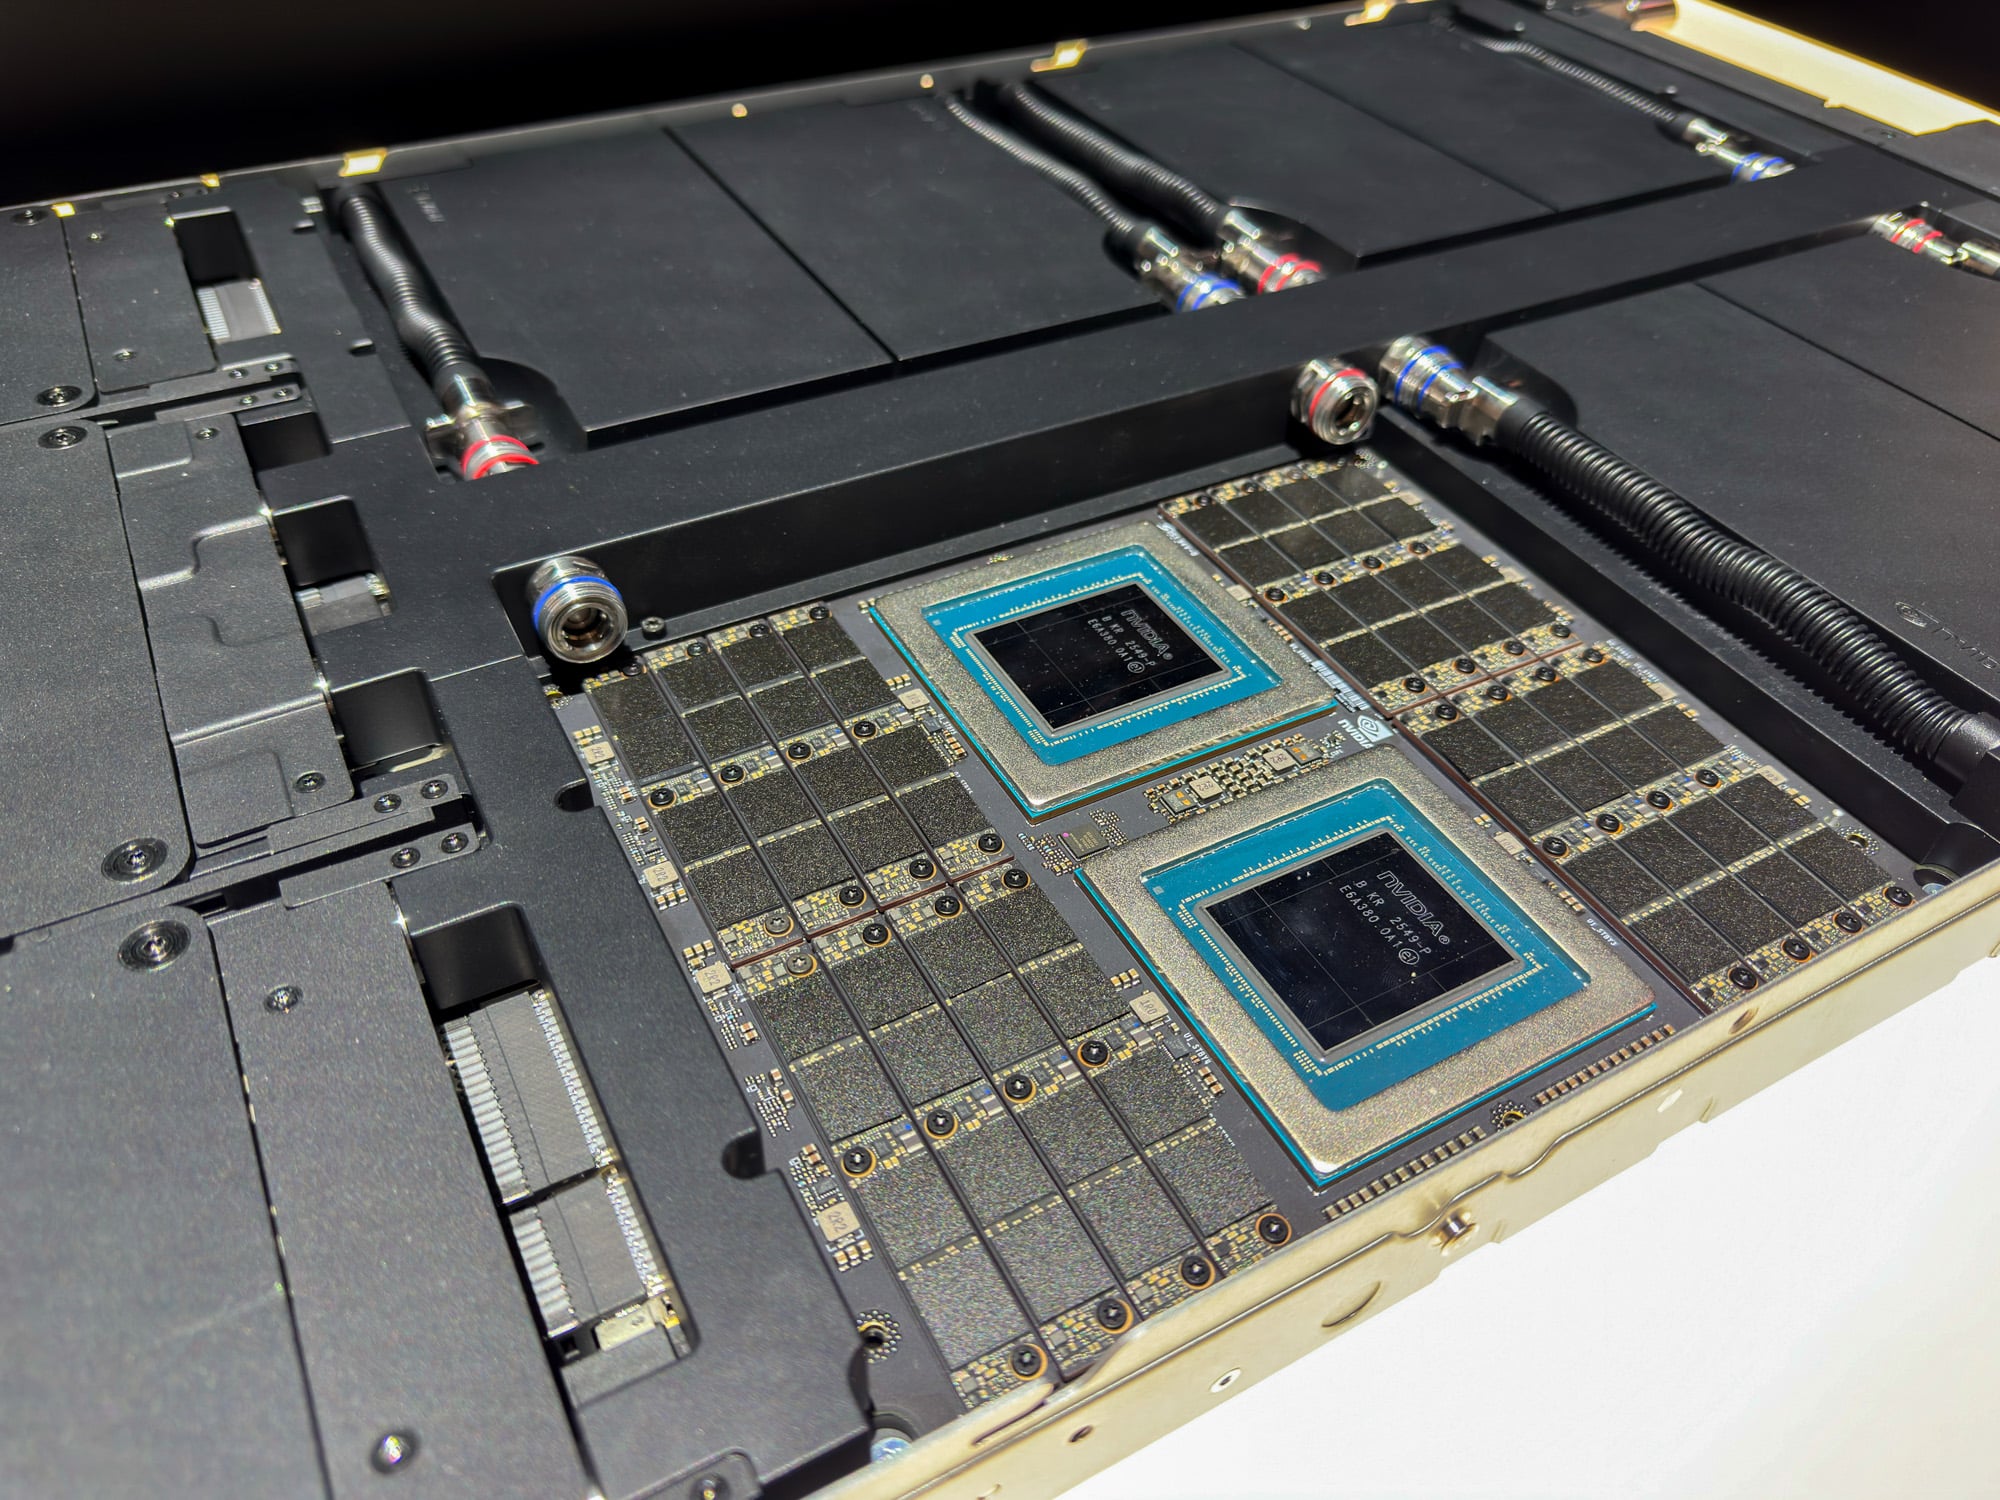
両方のプロセッサはソケットなしでPCBに直接取り付けられており、NVIDIAがVeraをスーパーチップに搭載して出荷するのと同じ方式です。16個のSOCAMM2スロットが2つのパッケージを囲んでいるため、プロセッサは交換できませんが、メモリは現場で交換可能です。CPUを交換するには、ボードを交換する必要があります。この夏、私たちは同じボードの液冷バージョンも調査しました。液冷バージョンでは、ボード上部にクイックディスコネクト式の冷却液ラインが通っており、プロセッサのコールドプレートまで冷却液が供給され、SOCAMM2モジュールは空冷式になっています。
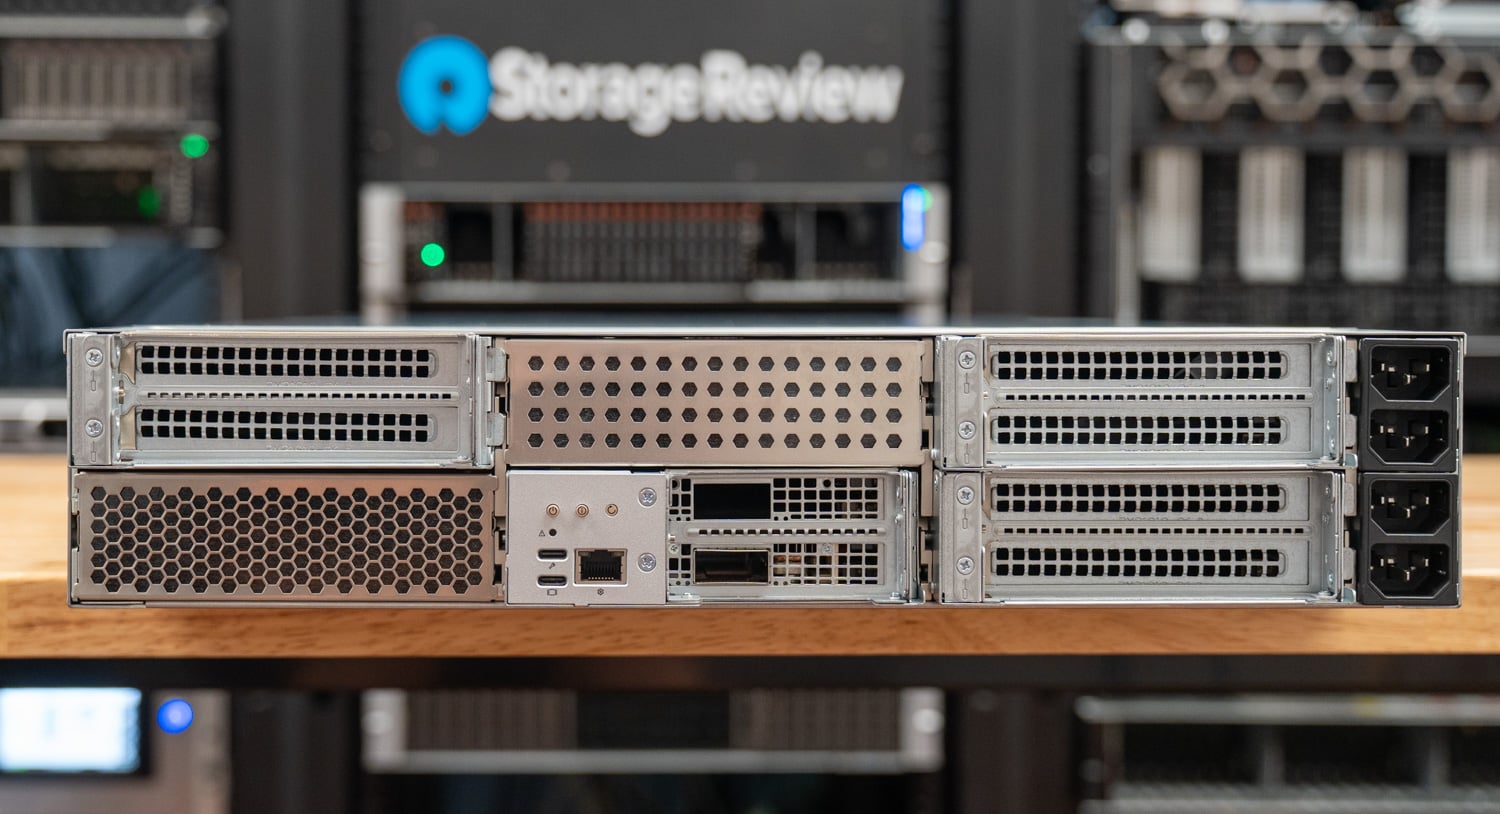
中央のライザーには最大800Gのネットワーク接続に対応するNVIDIA ConnectX-8アダプターが搭載されており、背面パネルにはUSBポート、DisplayPort、および帯域外管理専用のネットワークポートが備えられています。
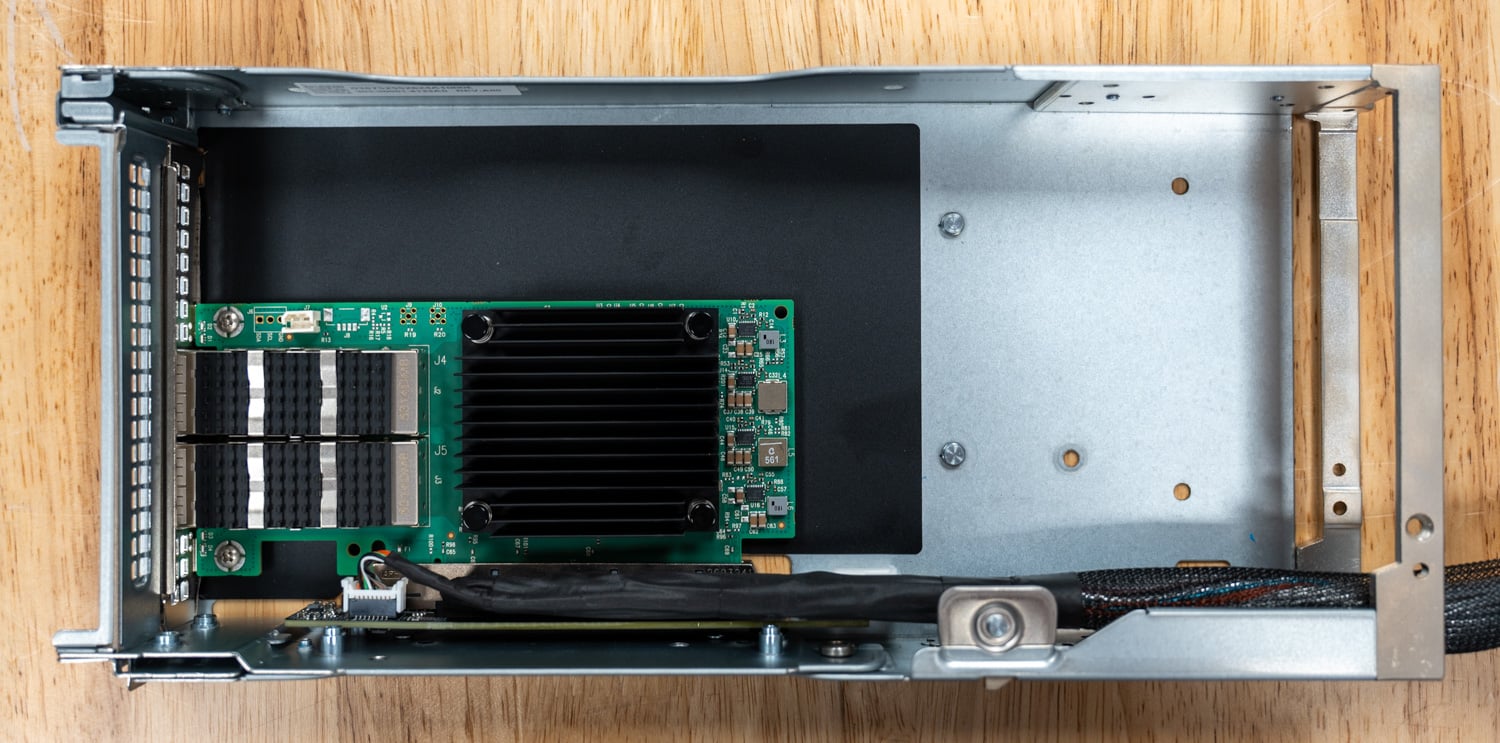
このプラットフォームはモジュール性が高く、さまざまなストレージ構成や背面PCIe構成に対応していますが、その柔軟性はサービス時間の増加という代償を伴います。3つのFHFL PCIeライザーは一見するとメンテナンスが容易そうに見えます。一般的なサーバーでは、カードの交換はライザーを解放し、サポートタブを跳ね上げるかネジを外し、カードをスライドさせて取り出すだけです。
Veraサーバーでは、まずファンカバーを外し、発泡スチロール製のブロックを1つ以上取り外し、ライザーの電源ケーブルとPCIeケーブルを外して持ち上げます。そうして初めて、ライザーアセンブリ全体をシャーシ背面から引き出すことができます。スレッドが外れたら、カードにアクセスするために分解し、交換後に再び組み立てる必要があります。従来のサーバーでは数秒で済む作業が、ここではスレッド1つにつき5~10分かかります。
実際には、ラック内での保守作業は、サーバーをラックと作業台の間を行ったり来たりする覚悟がない限り不可能なので、ほとんどのコンポーネント交換作業では、サーバーを作業台に移動させて保守作業を行う必要がある。
パフォーマンスとベンチマーク
このベンチマークテストでは、Veraの設計が個々のスレッドからシステム全体を使用するワークロードまで、パフォーマンスにどのように反映されるかを検証します。テスト対象は、メモリ帯域幅とレイテンシ、科学計算、汎用ソフトウェア、データベースなど多岐にわたり、プロセッサがコアとメモリシステムに対するさまざまな要求にどのように対応するかを示します。
テストシステム
| システム | NVIDIA MGX Vera C2 | デル PowerEdge R7725 | デル PowerEdge R7725 | デル パワーエッジ R770AP | デル PowerEdge R770 | デル PowerEdge R760 |
|---|---|---|---|---|---|---|
| プロセッサ | ||||||
| CPU | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC 9175F | インテル Xeon 6978P | インテル Xeon 6787P | インテル Xeon プラチナ 8592+ |
| ソケット | 2 | |||||
| CPUあたりのコア数/スレッド数 | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| ベースクロック | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| 最大時計 | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| メモリ | ||||||
| 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | ||
| タイプ/速度 | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| キャパシティ | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Storage | ||||||
| SSD | Solidigm D7-PS1010 7.68TB | Solidigm D7-PS1030 12.8TB | Micron 9550 PRO 7.68TB | Solidigm D7-PS1010 7.68TB | サムスン PM1745 6.4TB | Solidigm D7-P5520 3.84TB |
| SSDリンク | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| ファームウェア | ||||||
| システムBIOS | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| BIOSプロファイル | デフォルト | パフォーマンス | ||||
| ソフトウェアスタック | ||||||
| OS | Ubuntu 26.04.1, XNUMX, XNUMX LTS | Ubuntu 24.04.5, XNUMX, XNUMX LTS | ||||
| カーネル | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibcの | 2.43 | 2.39 | ||||
| 5.0.10 | 4.1.6 | |||||
| OpenJDK | 11.0.32 | |||||
我々はVeraを、理想的なメモリ構成を備えた5つのDell PowerEdge構成と比較し、AMDのコア数と周波数が最適化されたEPYCプロセッサに加え、現行世代および前世代のXeonプロセッサを含む同じテストスイートを使用してテストを行った。
OlympusのサポートがGCC 15で初めて導入されたため、Veraは上記のとおり、x86システムよりも新しいソフトウェアスタックで動作しました。ベンチマークのバージョン、入力、ビルドフラグは、それ以外はすべてのシステムで同一でした。
メモリ帯域幅
Veraがx86と最も異なるのはメモリなので、まずはメモリからテストを開始します。16GiBのアレイ上で、物理コアごとに1つのOpenMPスレッドを使用してSTREAM Triadをテストしました。メインの実行では、システム内のすべてのコアを使用し、各スレッドのデータは同じソケットに配置されます。次に、ソケット0のコアが最初にローカルメモリを読み取り、次にリモートソケットのメモリを読み取り、すべてのコアが両方のソケットにまたがってページをインターリーブして読み取るようにして、同じテストを繰り返します。下のグラフは、SMTをオフにした状態で、各サーバーのシステム全体のTriadの結果を示しています。
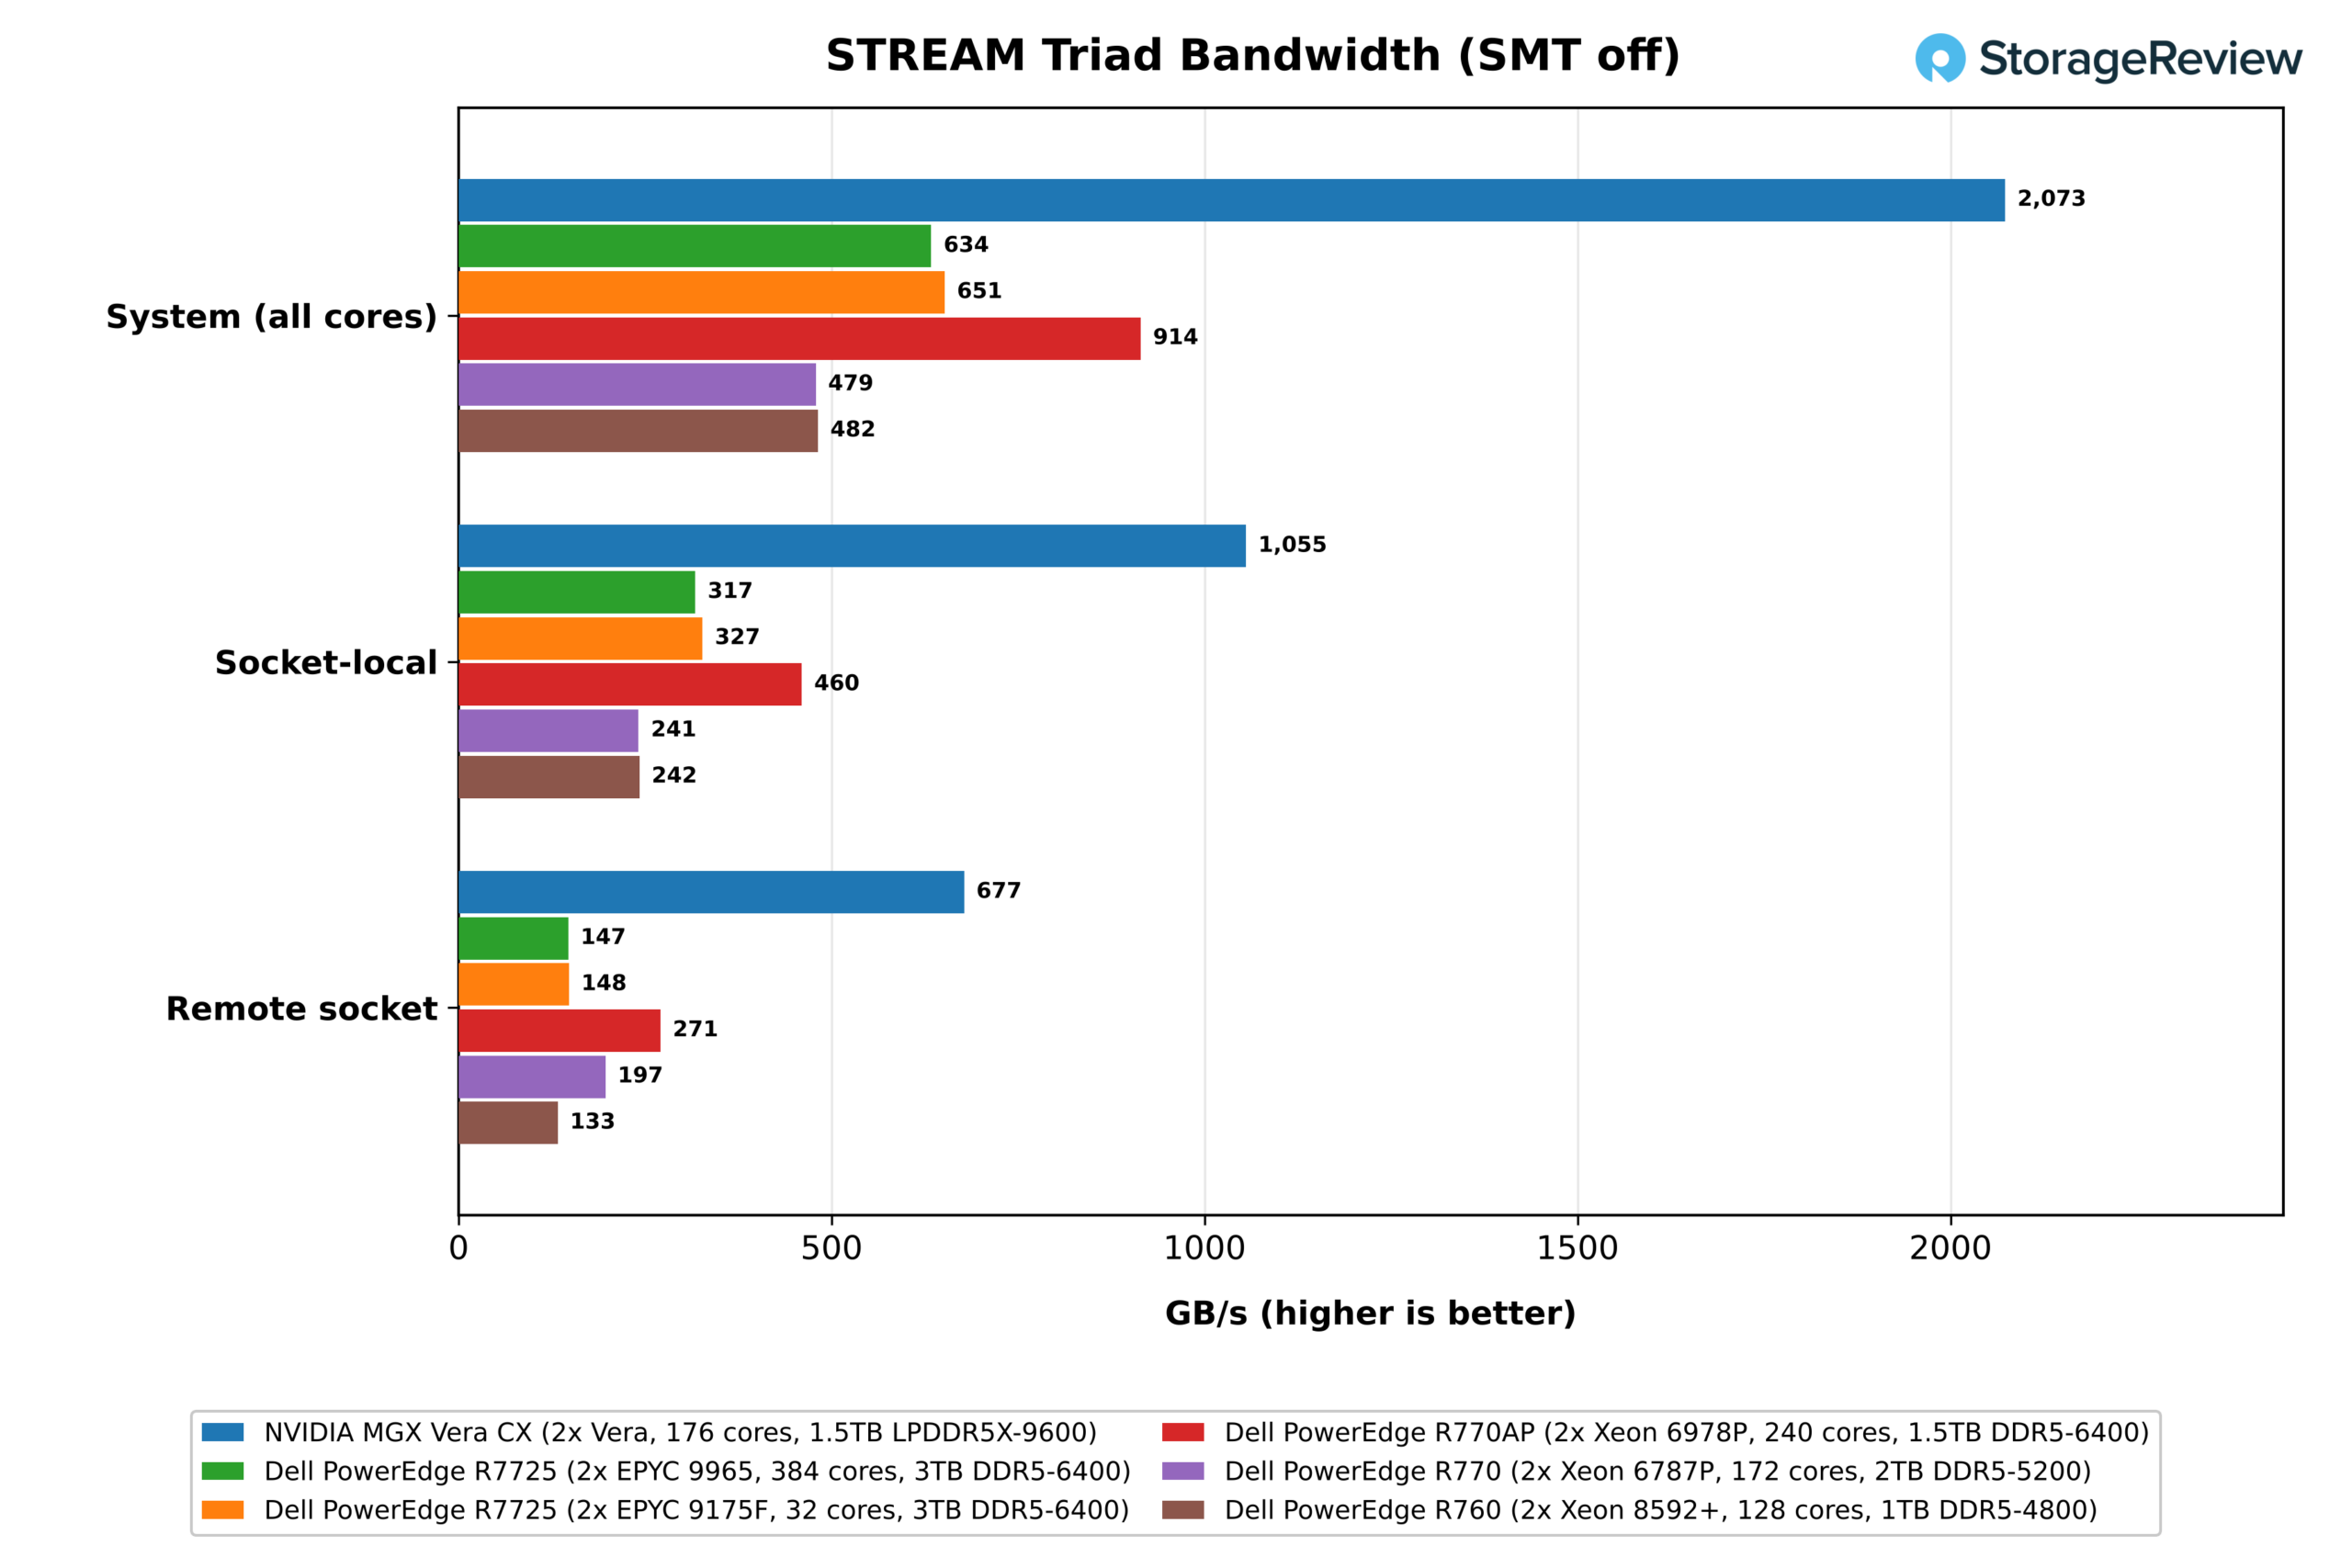
Veraは2,073GB/sを維持し、2ソケット構成時の定格2.4TB/sの86%を達成した。最も近いx86システムはXeon 6978Pで、24チャネルのDDR5-6400により914GB/sを実現し、理論上のピーク値1,229GB/sの74%となり、Veraを2.3倍上回った。2つのEPYCシステムは同じ24チャネルのDDR5-6400を使用しているが、それよりもはるかに低い値となった。32コアの9175Fは651GB/s、384コアの9965は634GB/sで、ピーク値のわずか52%であり、Veraを3.3倍上回った。最後に、Xeon 6787Pと8592+は、より低速なDDR5-5200とDDR5-4800で動作し、それぞれ479GB/sと482GB/sにとどまり、他のプロセッサに後れを取っています。
EPYCの性能不足の一因は、STREAMがトラフィックをカウントする方法にある。このスイートは、ストリーミングストアを出力しない通常のGCCを使用してSTREAMを構築しているため、キャッシュミスが発生したストアは、まずメモリから宛先行を読み込む。STREAMはこの読み込みをカウントしないため、Triadはトラフィックがどこで発生しても、転送されたトラフィックを4分の1過小評価することになる。AMDのZenコアは、すべてのストアでこの処理を実行する。NVIDIAの以前のGraceなどのArmコアは、フルライン書き込みを検出して読み込みをスキップし、Intelの最近のXeonは、メモリ負荷が高い場合にそのほとんどをスキップすることができる。
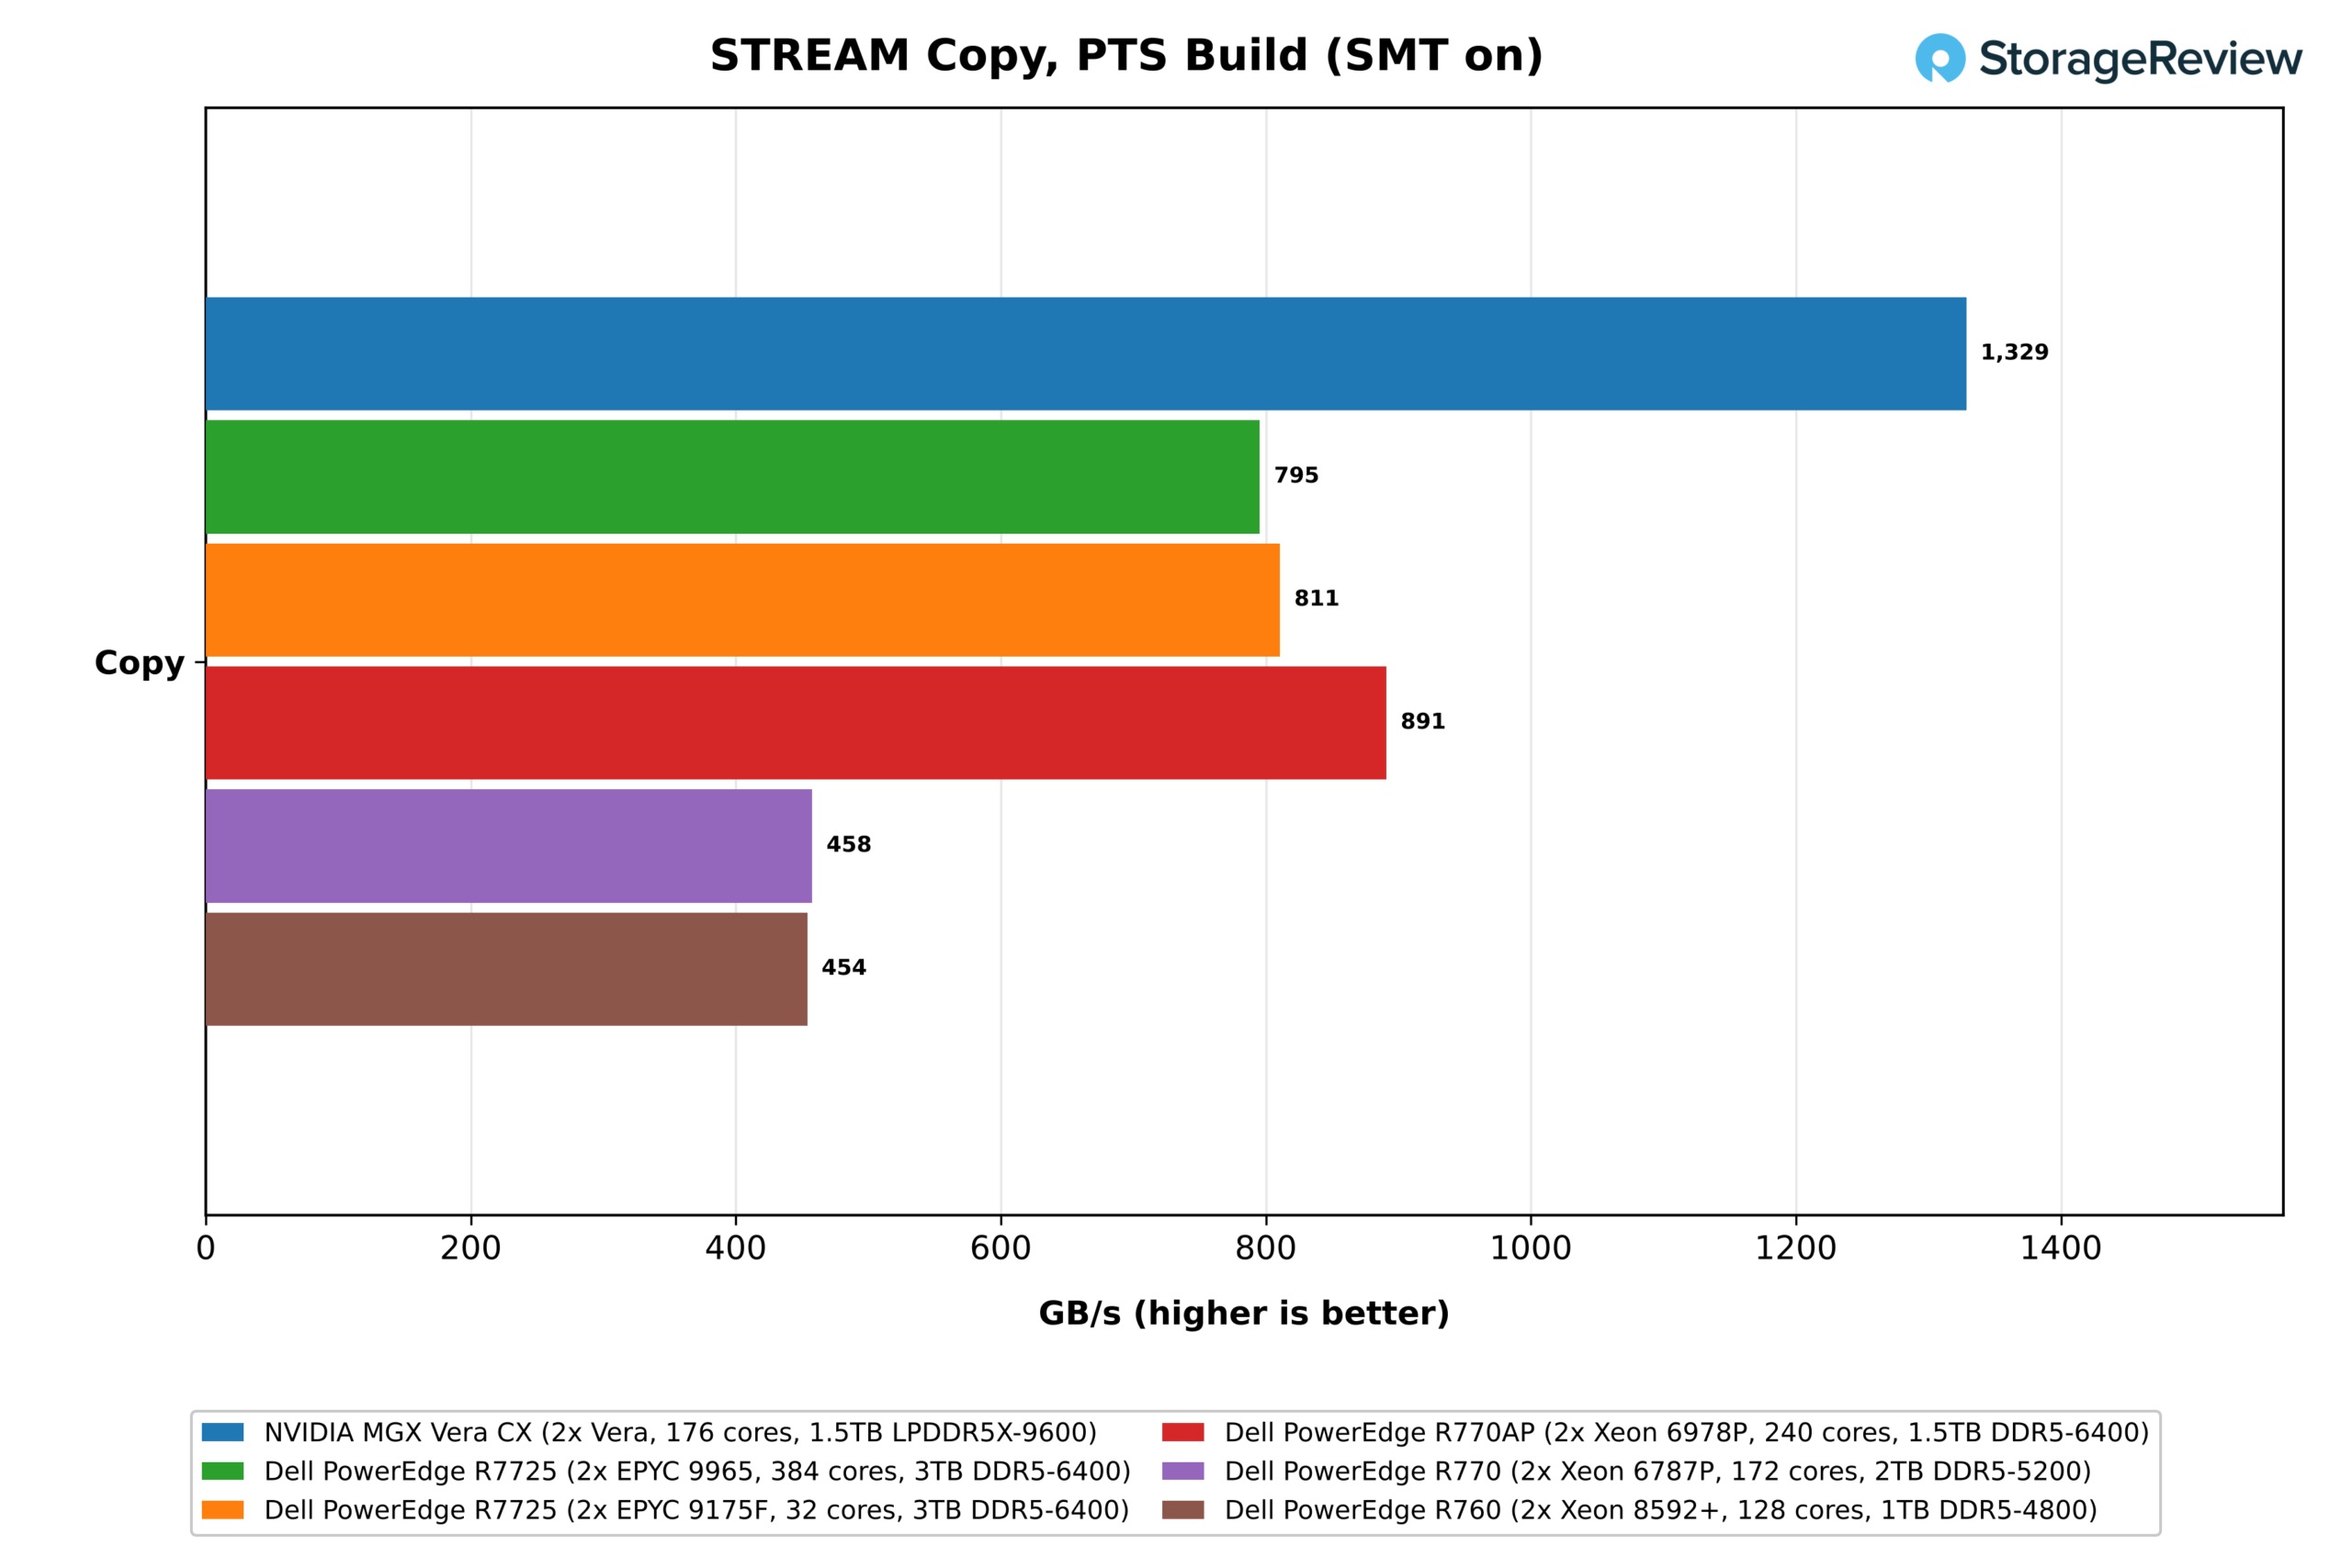
別途作成されたPhoronix Test SuiteのSTREAMビルドも同様の結果を示しています。SMTをオフにした場合、コピー速度は9965で832GB/s、9175Fで873GB/sに達し、スイートビルドの551GB/sと570GB/sの約1.5倍となり、余分な読み取りがなくなった後にコピー速度が向上すると予想される値と一致しています。Xeonでは、2つのビルドの差は9%以内でした。
カウントされていない読み取り回数を調整すると、9965は毎秒約845GBのデータを転送し、これはピーク時の約69%に相当する。転送バイト数におけるVeraのリードは約2.5倍に縮まる。6978Pは補正がはるかに少なくて済むため、その2.3倍という数値は、このセットの中で最も控えめな比較となる。
テストをソケットごとに分割すると、ファブリックがコアにローカルではないデータをどのように処理するかがわかります。ソケット 0 のコアがローカル メモリを読み取ると、1,055GB/s に達し、ソケットあたり 1.2TB/s の定格の 88% となり、セット内のどの x86 サーバーよりも高速です。NVLink-C2C を介して他のソケットのメモリを読み取ると、同じコアが 677GB/s を維持し、ローカル値の 64% となりました。これは、Xeon 6978P の 59%、EPYC 9175F の 45% (リモート 148GB/s、ローカル 327GB/s) と比較して高い値です。したがって、間違ったソケットにワークロードを配置した場合でも、どの x86 ソケットがローカル メモリから読み取るよりも多くの帯域幅が得られます。ローカル メモリの読み取り速度は、6978P で最大 460GB/s です。
Veraの最終テストとして、NUMA非対応アプリケーションが遭遇するケースである、STREAM Triadインターリーブページを両方のソケットに分散させてテストしたところ、Veraは1,372GB/sという結果となり、6978Pのシステム全体の結果の1.5倍となった。
レイテンシ
メモリの性能は帯域幅だけでは決まりません。レイテンシは、コアがキャッシュミスを繰り返すたびに待機する時間を決定づける要素であり、メモリ内のポインタを追跡するコードにとって特に重要です。このレイテンシはtinymembenchを用いて測定します。tinymembenchは、ソケット0上の単一スレッドから1GiBのバッファに対してランダムな読み取りを行う時間を計測します。EPYC 9175Fは、このテスト結果が得られた唯一のx86システムであるため、ここではEPYC 9175Fを比較対象とします。
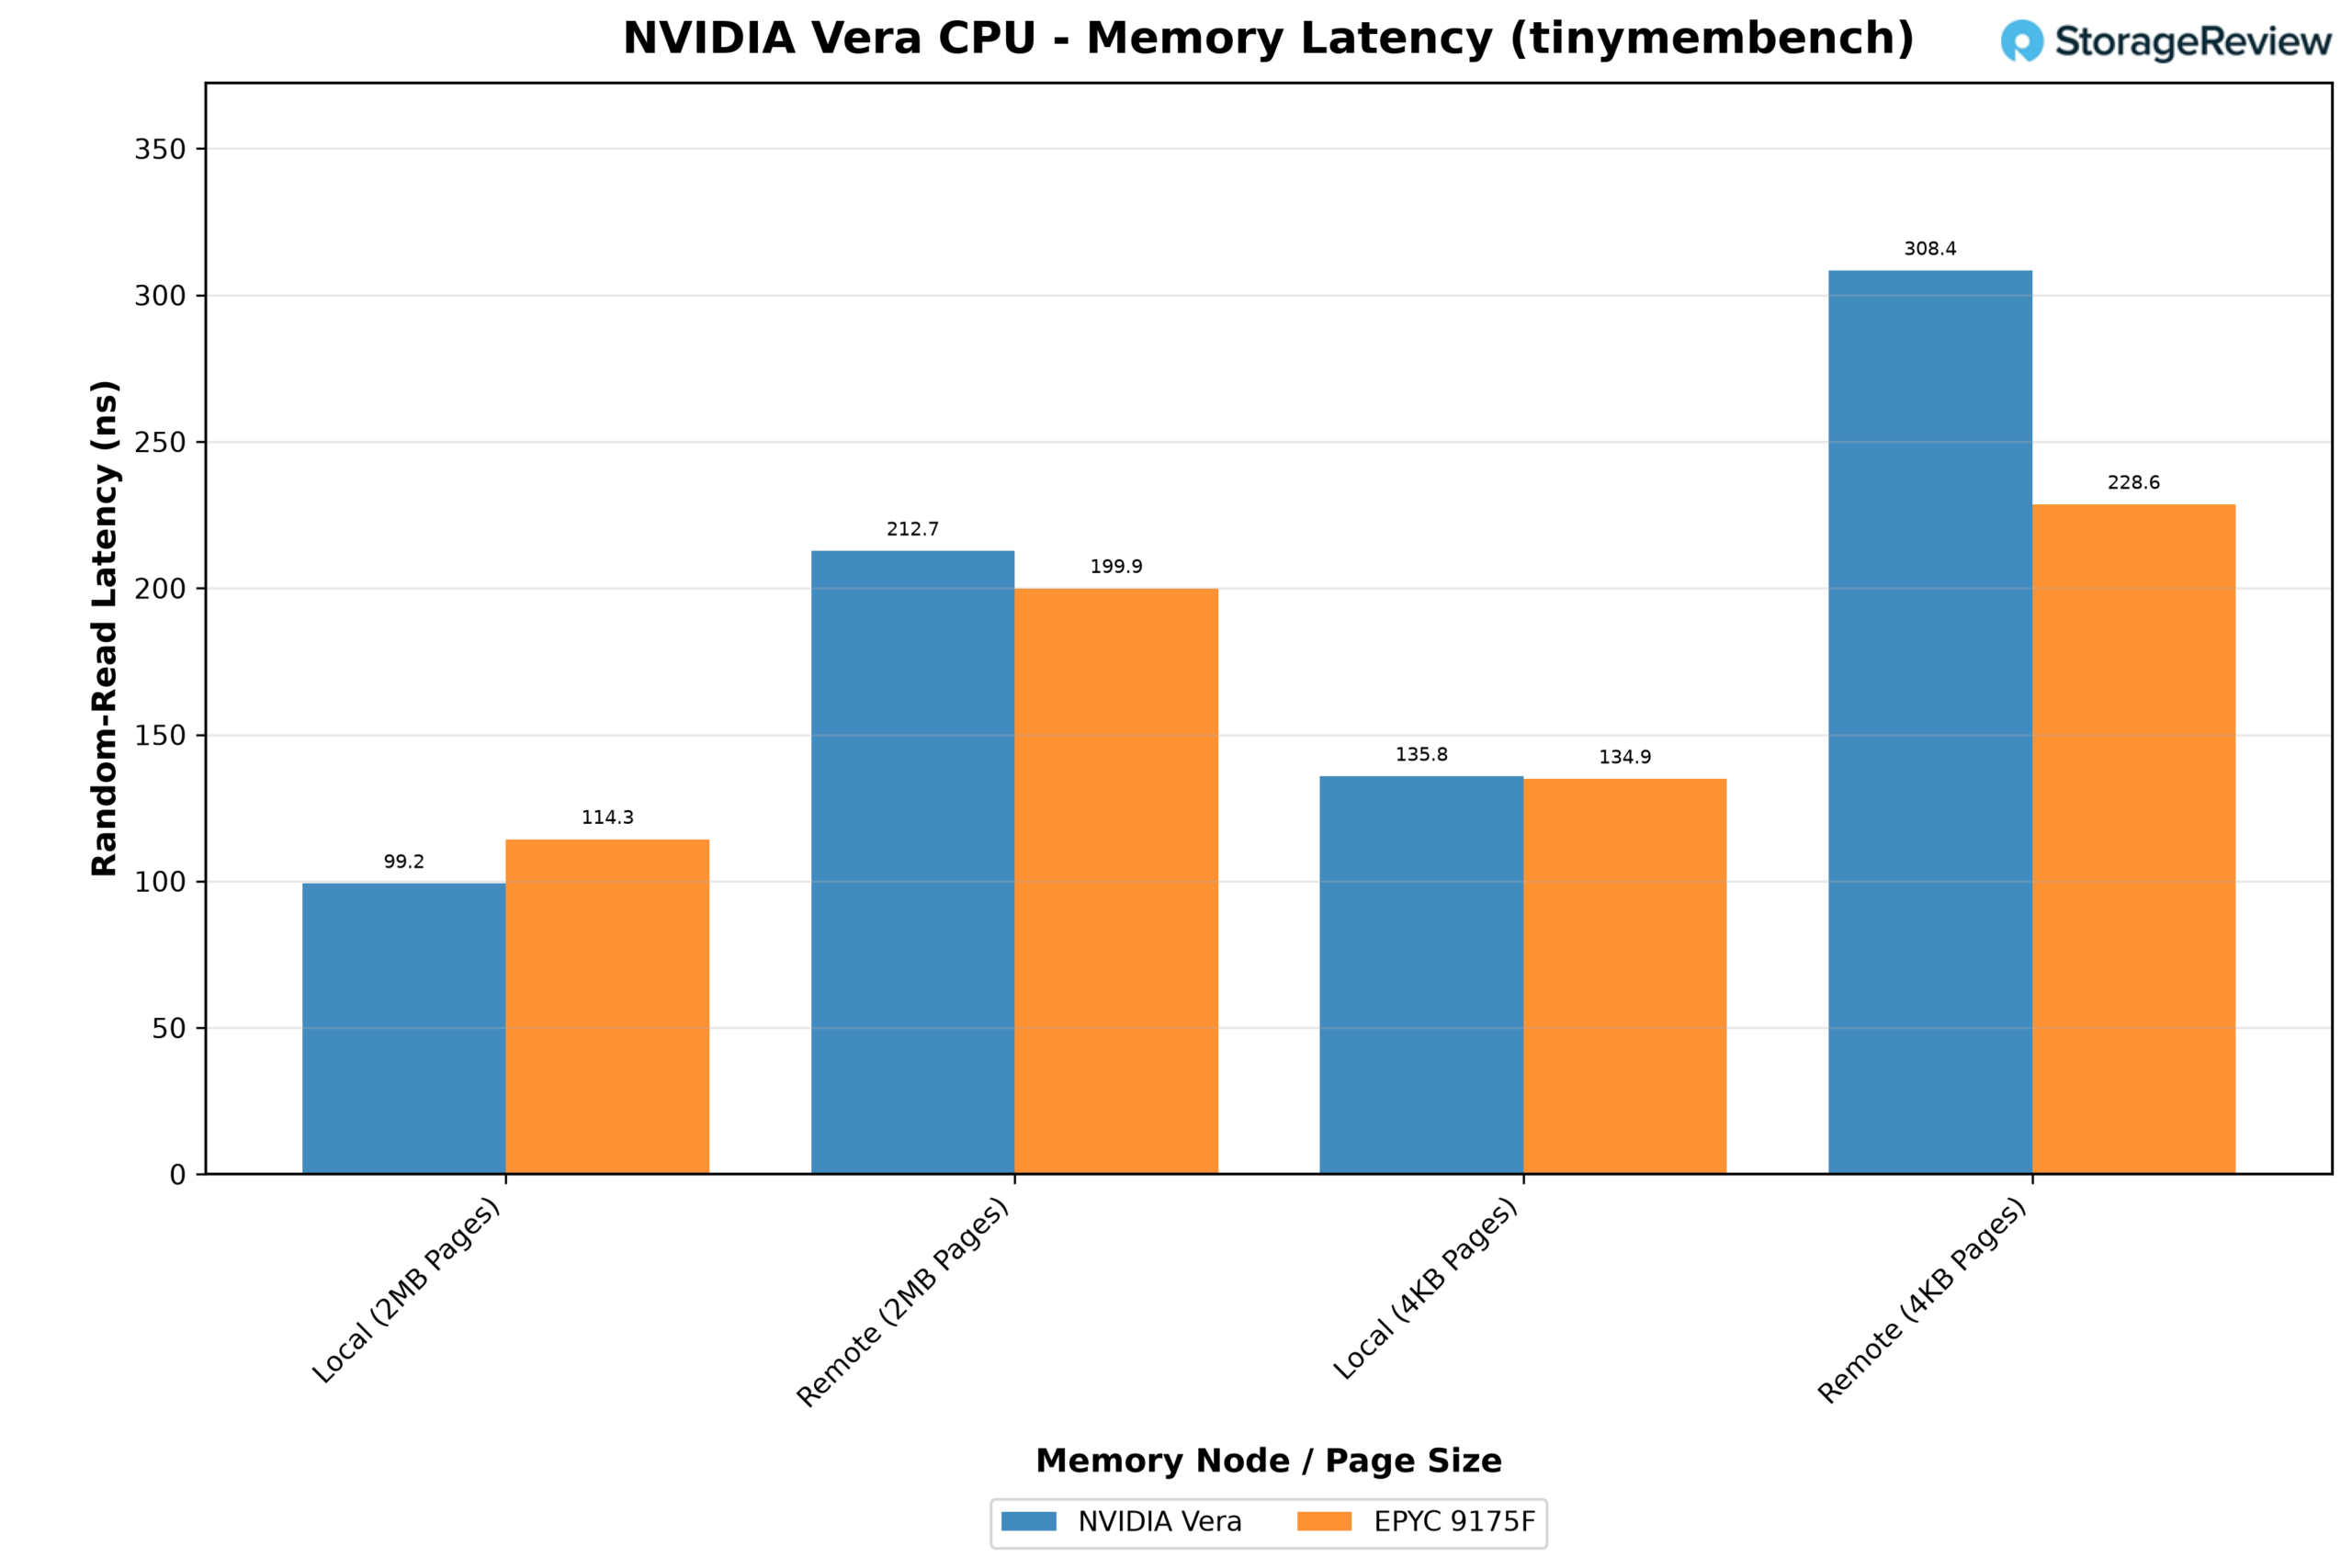
ローカルメモリの読み取りに関しては、Vera は EPYC より高速です。2MB の巨大ページを使用した場合、ローカル読み取りは Vera では 99.2ns、9175F では 114.3ns で、13% 高速でした。標準の 4KB ページでは、両者とも約 135ns で同等でした。NVLink-C2C のコストが顕著になるのは、もう一方のソケットにアクセスする場合です。リモート読み取りは Vera では 212.7ns で、ローカル時間の約 2.1 倍でしたが、EPYC では 199.9ns で、ローカル時間の 1.75 倍にとどまりました。
Veraはページサイズにも敏感です。アドレス変換のミスが読み取りごとに加算される4KBページの場合、ローカルレイテンシは37%上昇し、リモートレイテンシは308.4nsに達しました。これはEPYCの18%上昇と228.6nsと比較して高い値です。Veraではhugepagesを実行します。
(HPC)
帯域幅とレイテンシは、メモリシステム単体の状態を表す指標です。科学計算アプリケーションでは、メモリシステムとコアが連携して動作する場合に何が起こるかが示され、今回実施した2つのHPCテストは、CPU設計の全く異なる部分に焦点を当てています。
分子動力学コードであるGROMACSは、ほとんどの時間をベクトル演算に費やし、各SIMD幅ごとにホットループを手書きで記述しています。そのため、オリンパスセクションで説明したトレードオフ、つまりx86パーツ上の6つの128ビットSVE2パイプと512ビットAVX-512ユニットとの比較を最も直接的にテストできます。計算流体力学ソルバーであるOpenFOAMは、大きな疎行列を処理し、メモリ待機に多くの時間を費やすため、上記で測定した帯域幅が実際のアプリケーションにも適用されるかどうかを示します。
GROMACS
GROMACS 2025.3をbenchPEPでテストしました。benchPEPは、サーバー内のすべての物理コアで実行される12万原子規模の処理です。ビルドでは、VeraではARM_SVE、すべてのx86システムではAVX-512を使用しました。また、スイートの入力が固定され、PMEチューニングが無効になっているため、すべてのプラットフォームで同じ処理が実行されました。
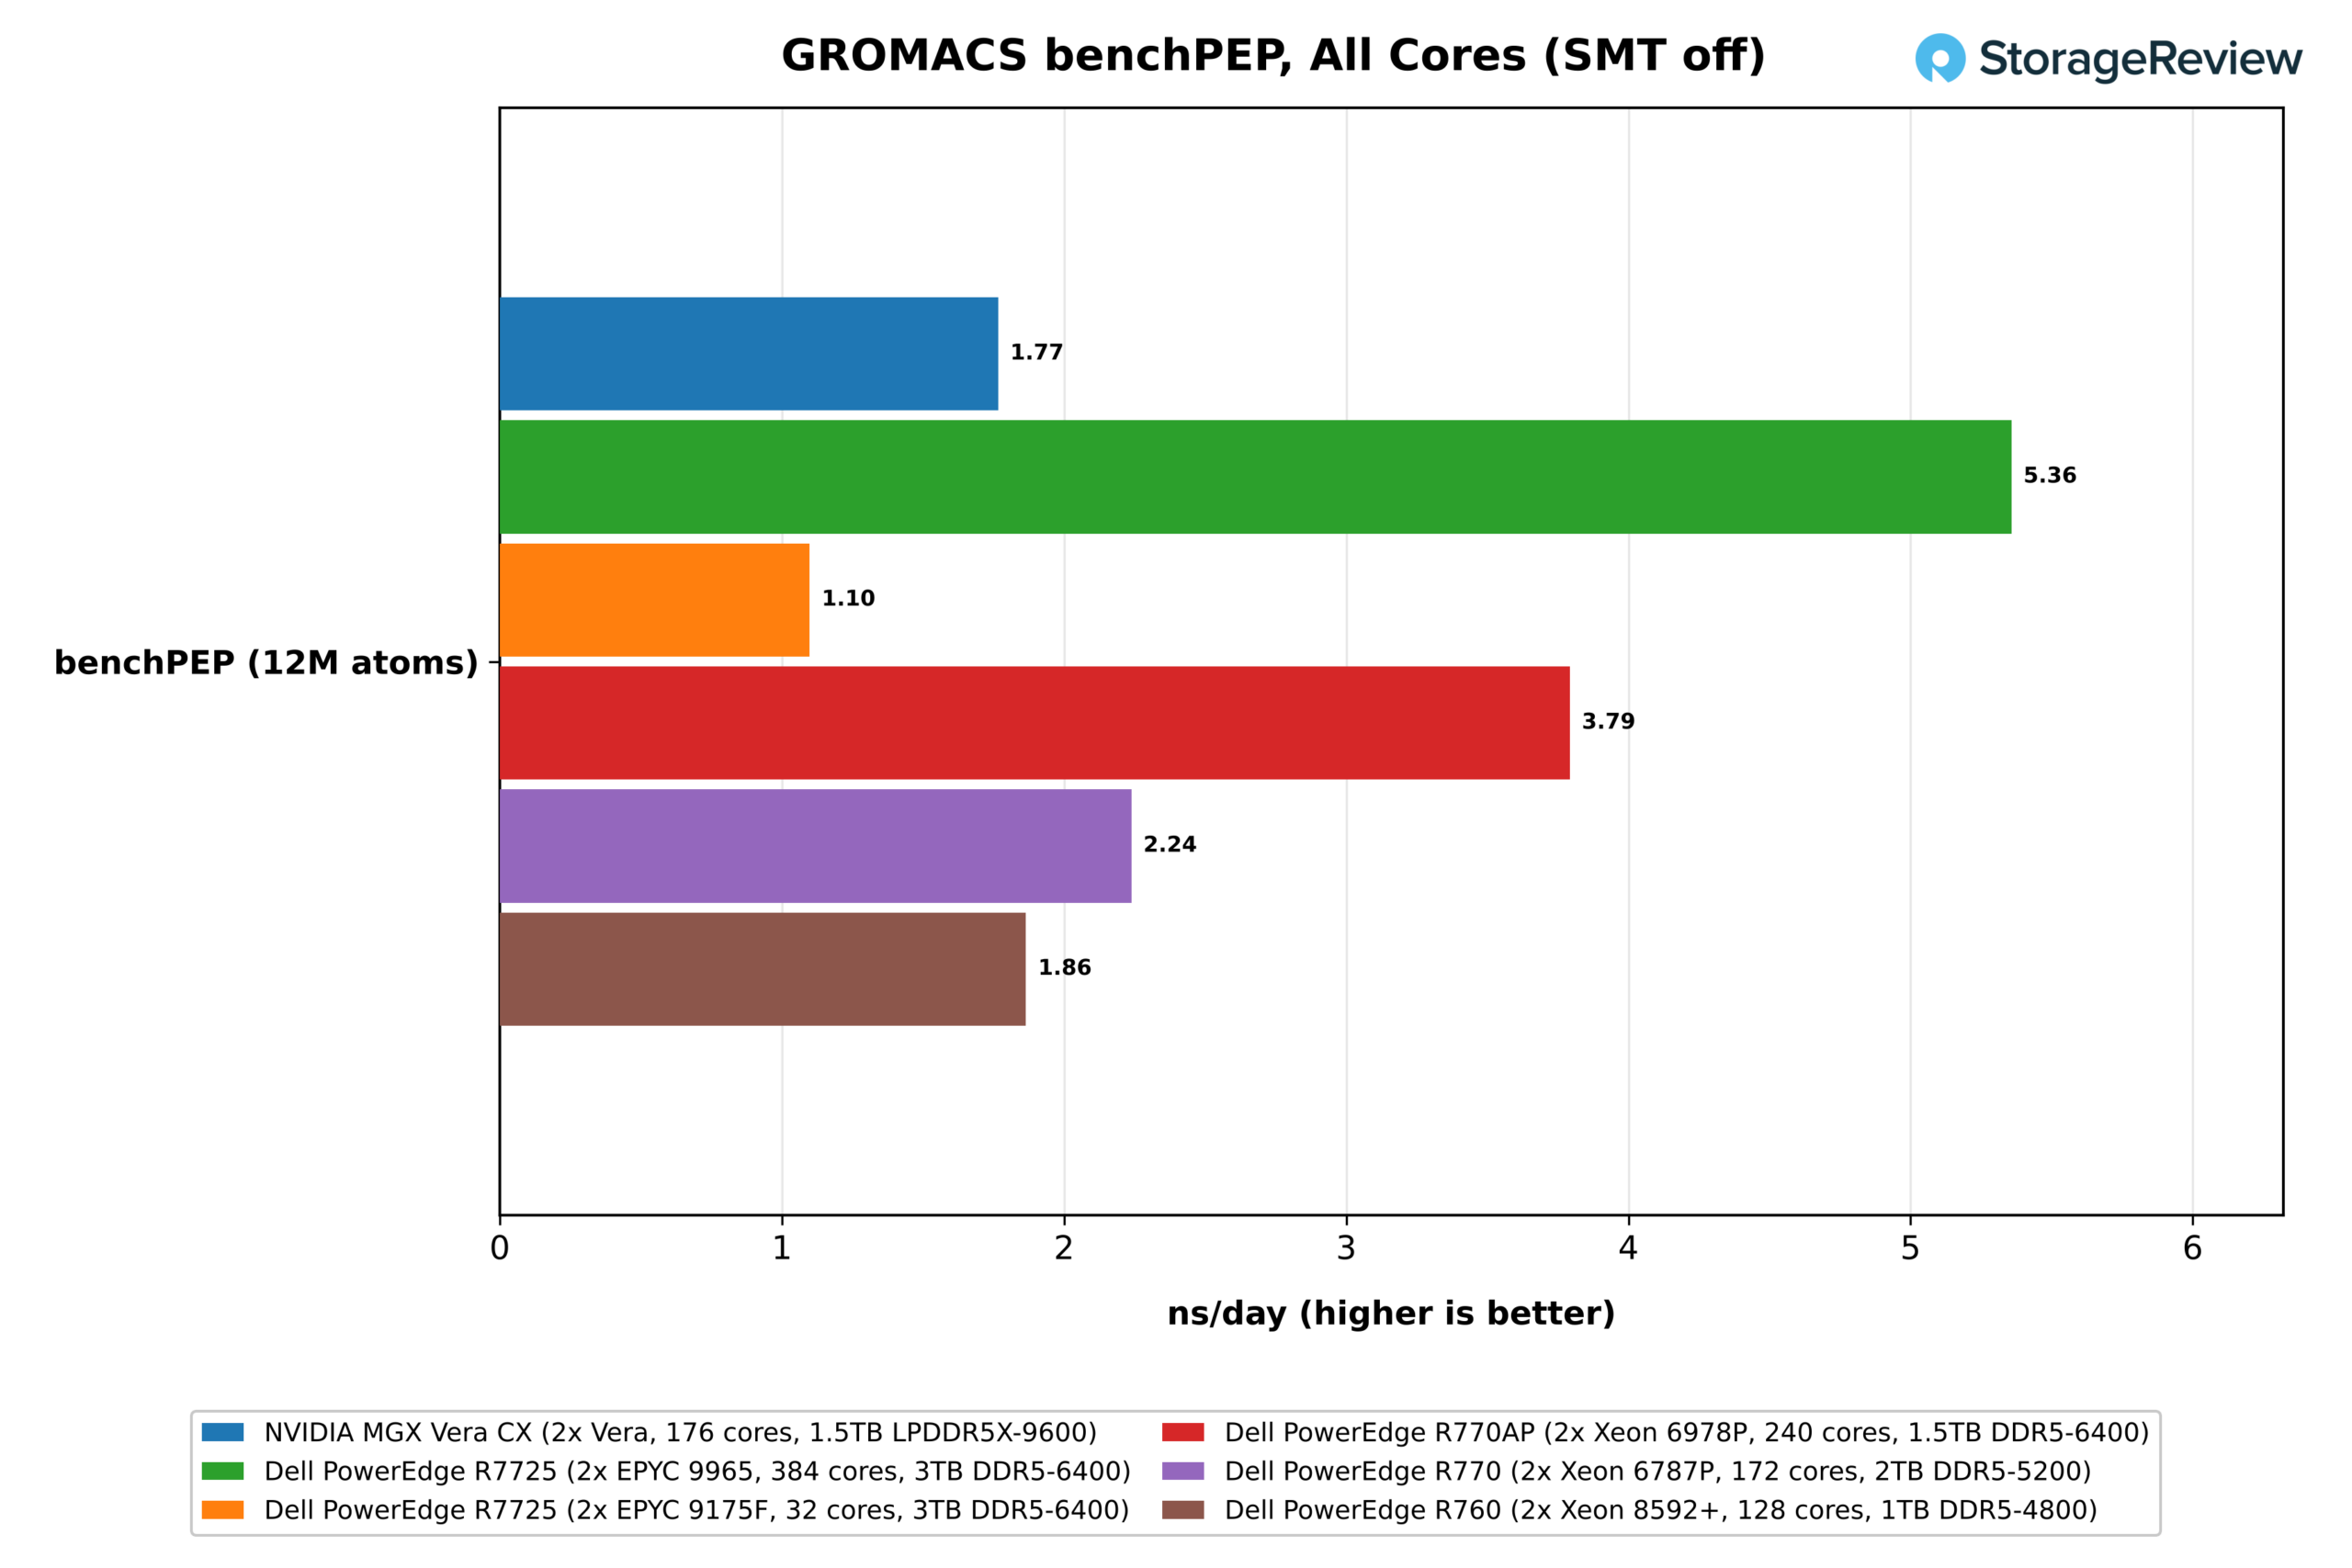
SMT をオフにした場合、Vera は benchPEP で 1.77 ns/day を達成しました。384 コアの EPYC 9965 が 5.36 ns/day で Vera の 3.0 倍でトップとなり、続いて 240 コアの Xeon 6978P が 3.79 (2.1 倍)、172 コアの Xeon 6787P が 2.24 (1.27 倍) となりました。128 コアの Xeon 8592+ も 1.87 でトップとなり、32 コアの EPYC 9175F (1.10) だけが Vera に次ぐ結果となりました。コア数で正規化すると、この差のうちアーキテクチャによるものがどれくらいあるかがわかります。 Veraはコアあたり0.0100 ns/日という計算結果となり、6787Pの0.0130 ns/日、9965の0.0140 ns/日、8592+の0.0146 ns/日、6978Pの0.0158 ns/日と比較すると、大型のx86プロセッサとの差は、コア数とコアあたりのスループットの差によるものと考えられる。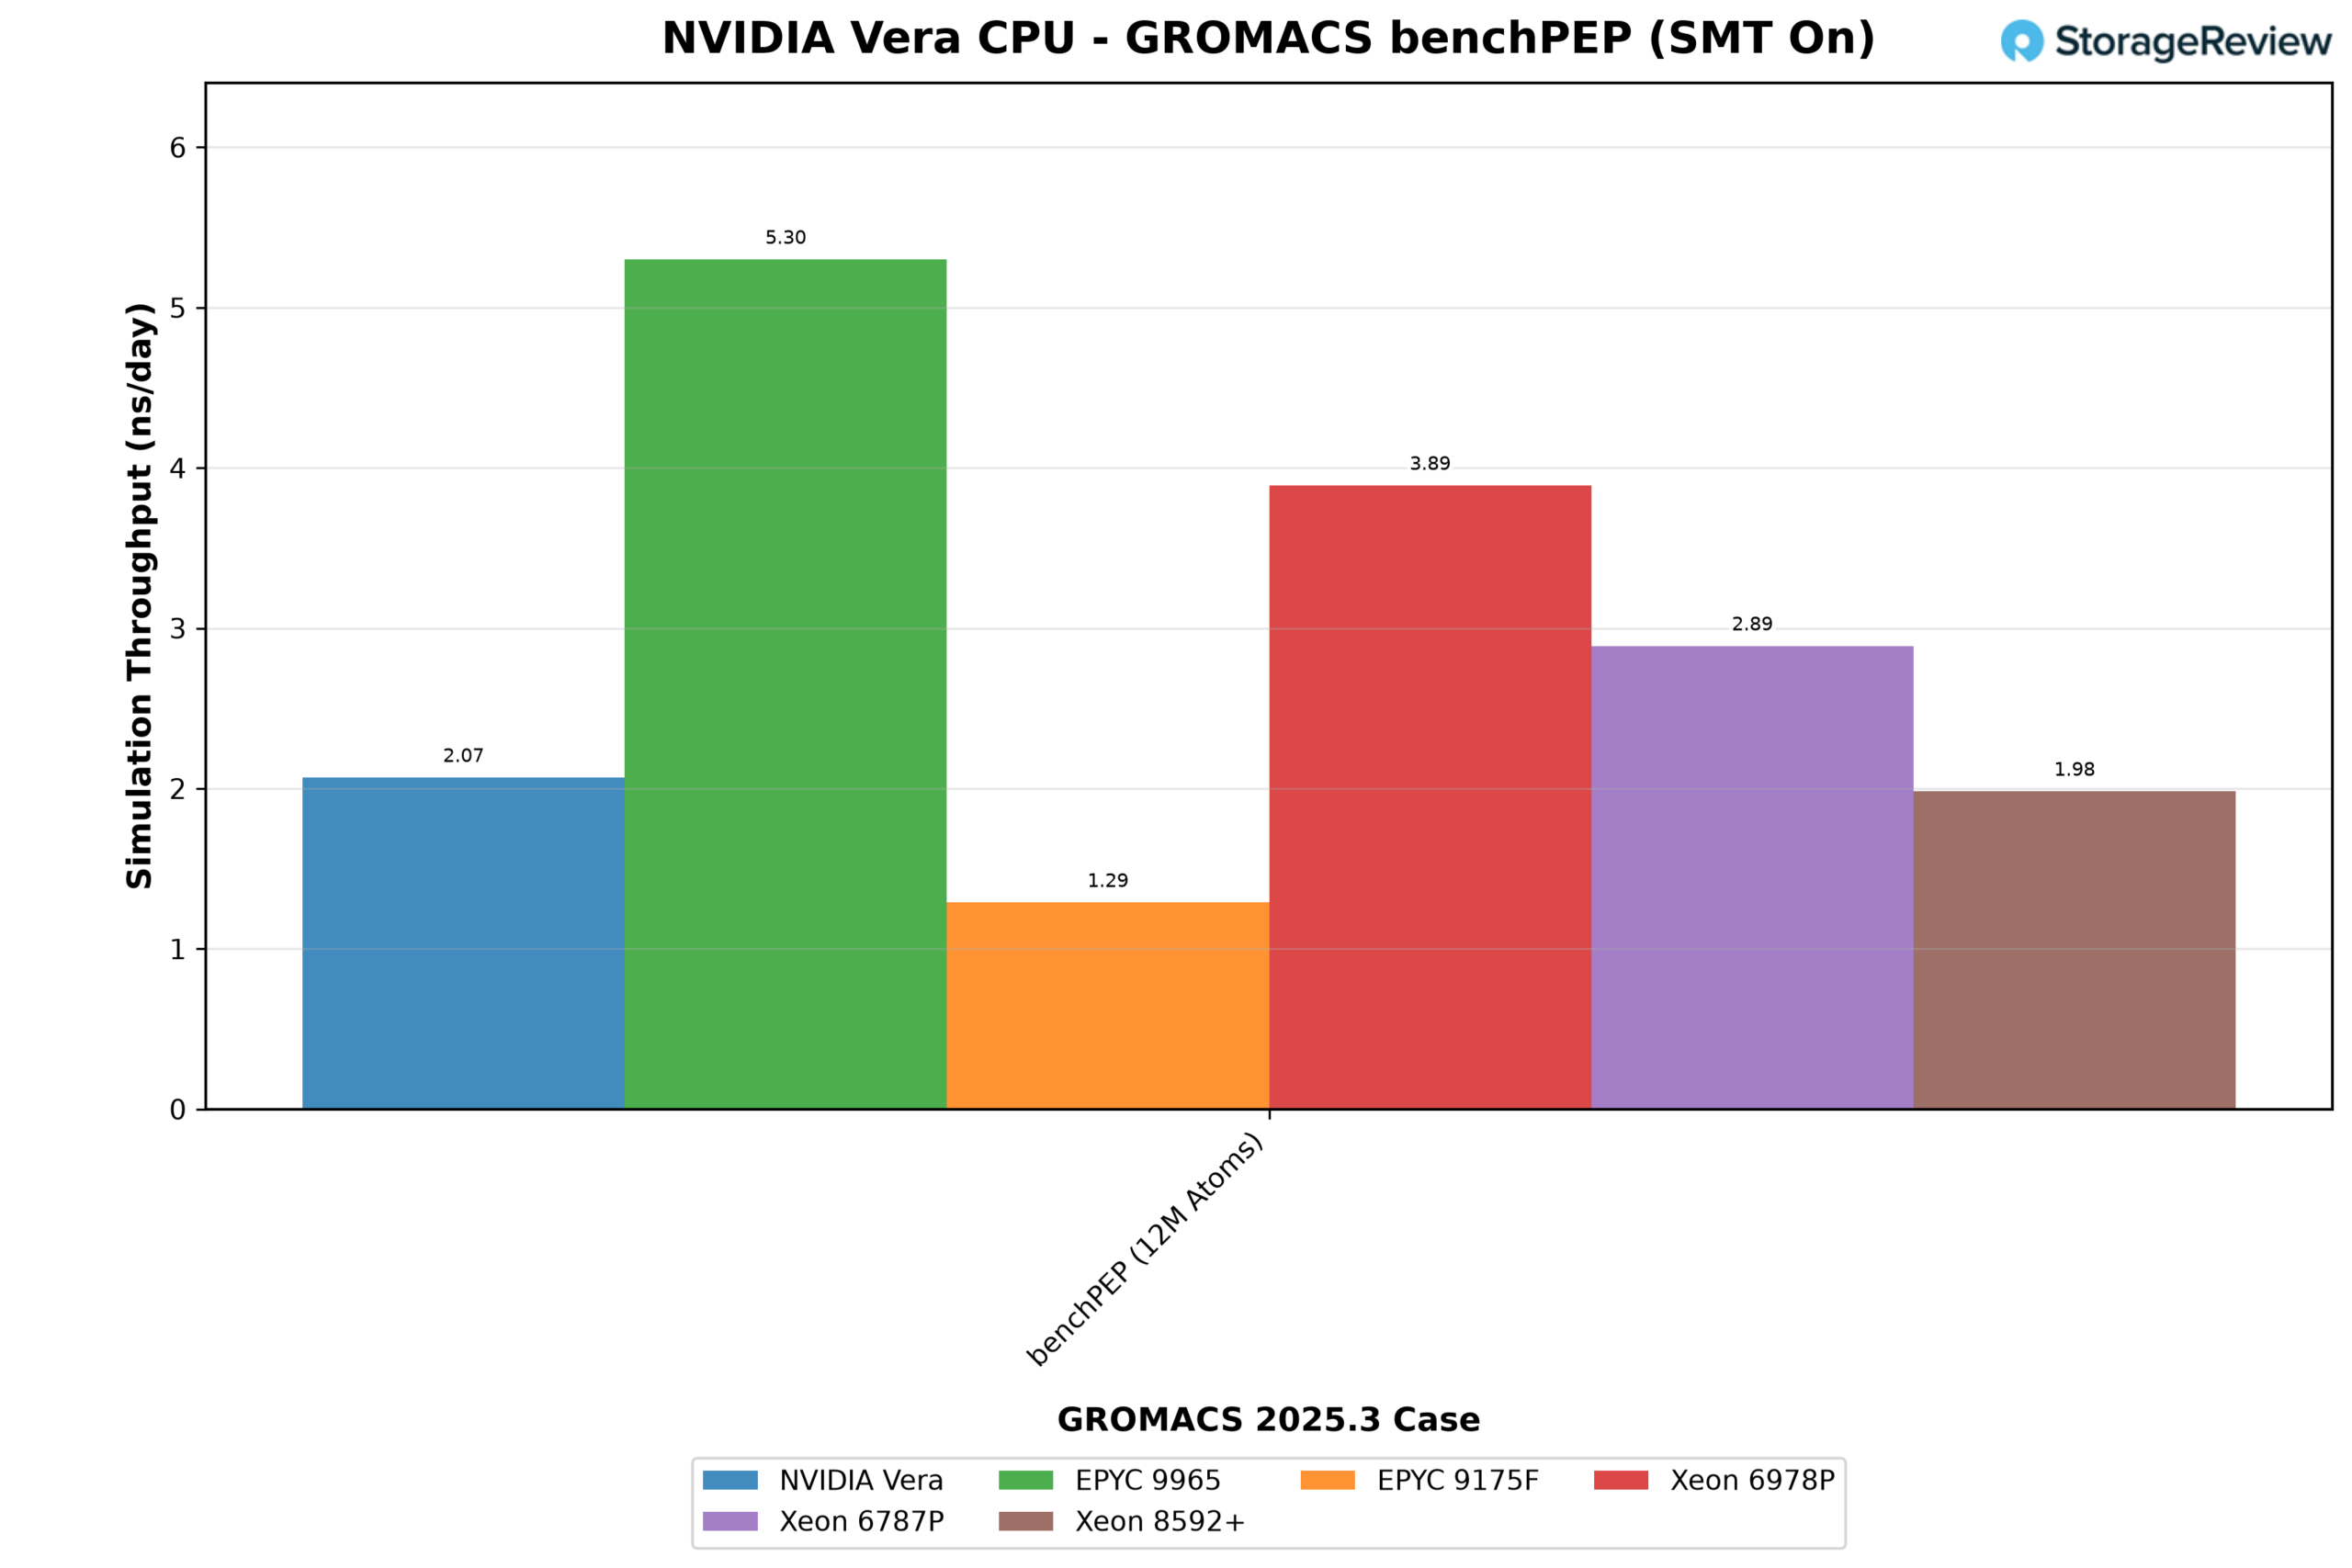
空間マルチスレッドは、その差をいくらか取り戻します。これを有効にすると、Vera の結果が 17% 向上して 2.07 ns/日となり、最適なレイアウトでは 352 個のハードウェア スレッドすべてをスレッド MPI ランクとして実行します。これは、以前の実行で Xeon 6978P (3%) や 8592+ (11%) に SMT がもたらした向上よりも大きく、EPYC 9965 では有効にすると 3.5% 低下しました。リソースが 2 つのスレッド間で分割されているため、各ランクはコアの一部を取得し、ソルバーのベクトル演算とメモリ停止の組み合わせは、単一のランクよりもこれらの部分をうまく埋めているようです。
benchMEMのケースでは、82,000原子のシステムをすべてのプラットフォームのソケット0の16個の物理コアで実行することで、コアごとの性能差を分離しています。そのため、コア数は考慮から除外され、結果はベクトルスループット、キャッシュ、およびローカルメモリを反映したものとなります。
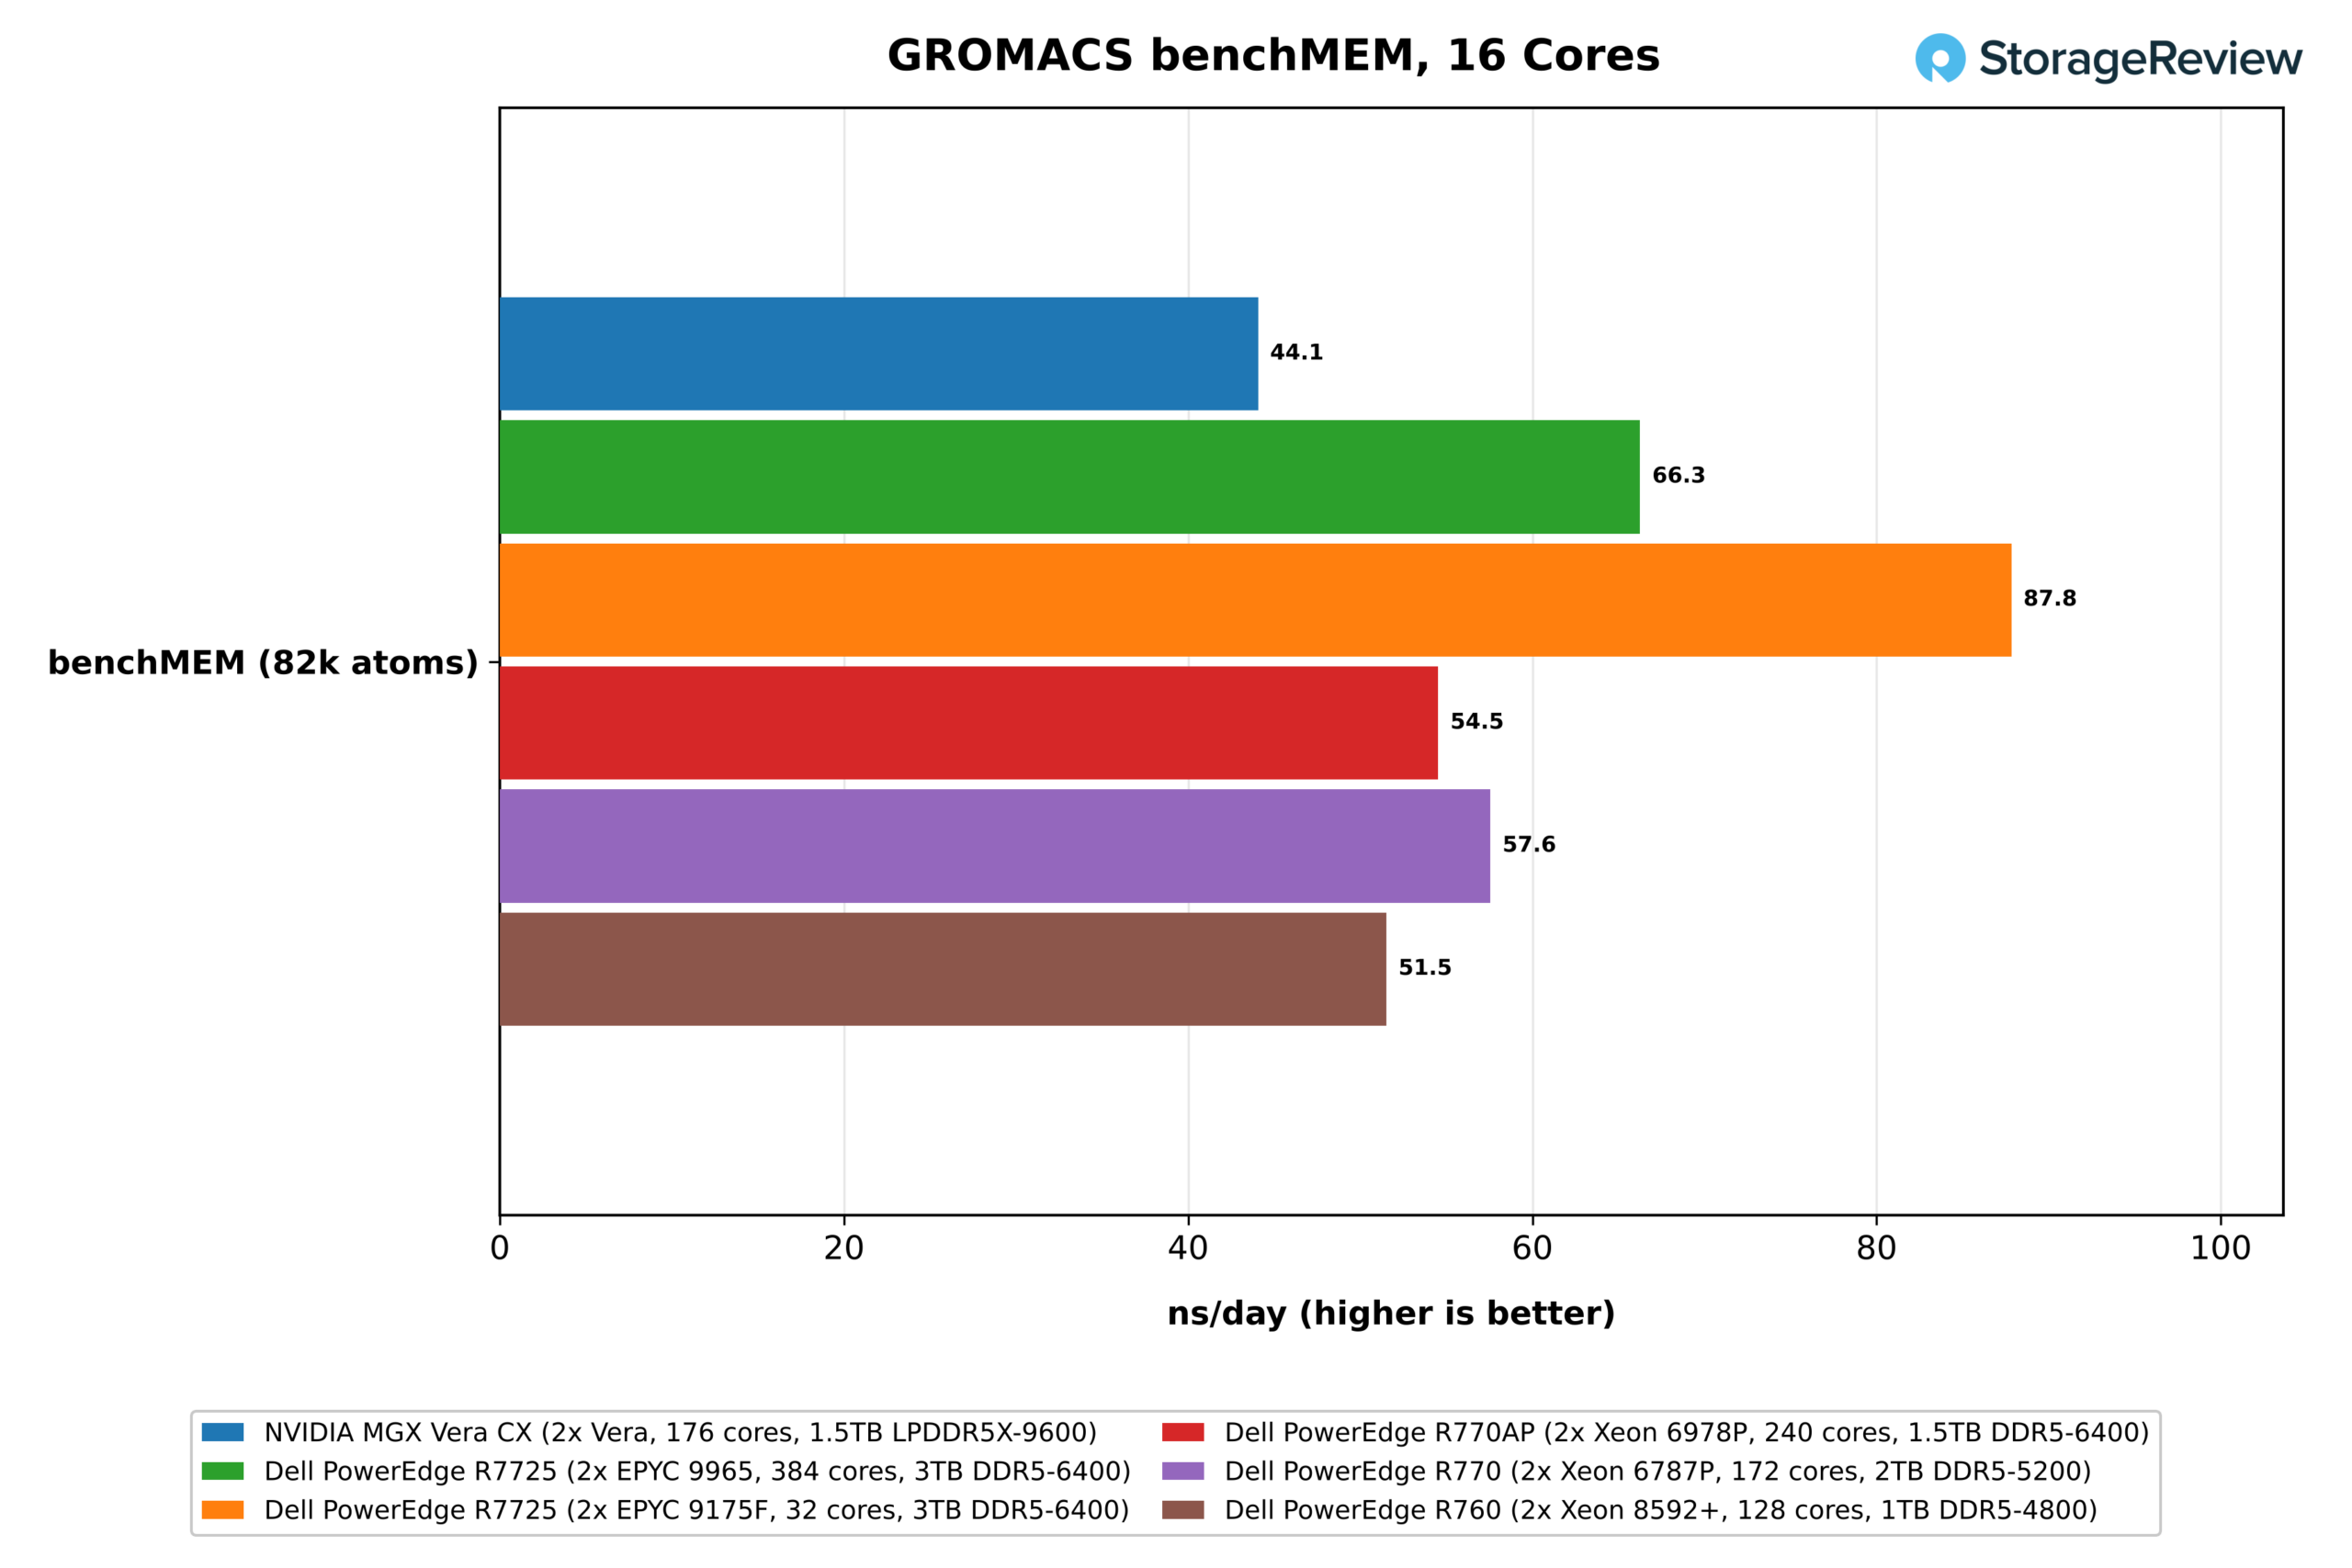
ここでVeraは44.1 ns/日を記録した。5.0GHzのEPYC 9175Fはそれを倍の87.8 ns/日とし、EPYC 9965は66.3 ns/日(Veraの1.5倍)に達し、Xeon 6787Pの57.6 ns/日、6978Pの54.5 ns/日、8592+の51.5 ns/日を上回った。
したがって、Veraの16コアのスライスは、Zen 5cの16コアのスライスの約3分の2の作業を実行します。これは、Zen 5cの16コアが単一の32MB L3を共有するのに対し、Veraは164MBのシステムレベルキャッシュを利用できるにもかかわらずです。これにより、512ビットのベクトル用に書かれたコードで128ビットのベクトルがどれだけのコストがかかるかを示す最も明確な測定値が得られます。9175Fの9965に対するさらなるリードは、5.0GHz対3.7GHzというクロックの優位性とほぼ一致しています。
OpenFOAM
OpenFOAMは、圧力をベクトルユニットからメモリシステムに移行します。私たちは、DriverFastback自動車空力ケース上でOpenFOAM 13を実行し、物理コアごとに1つのMPIランクを使用し、2.98万セルの中規模メッシュと2260万セルの大規模メッシュの2種類のメッシュサイズで計算を行いました。
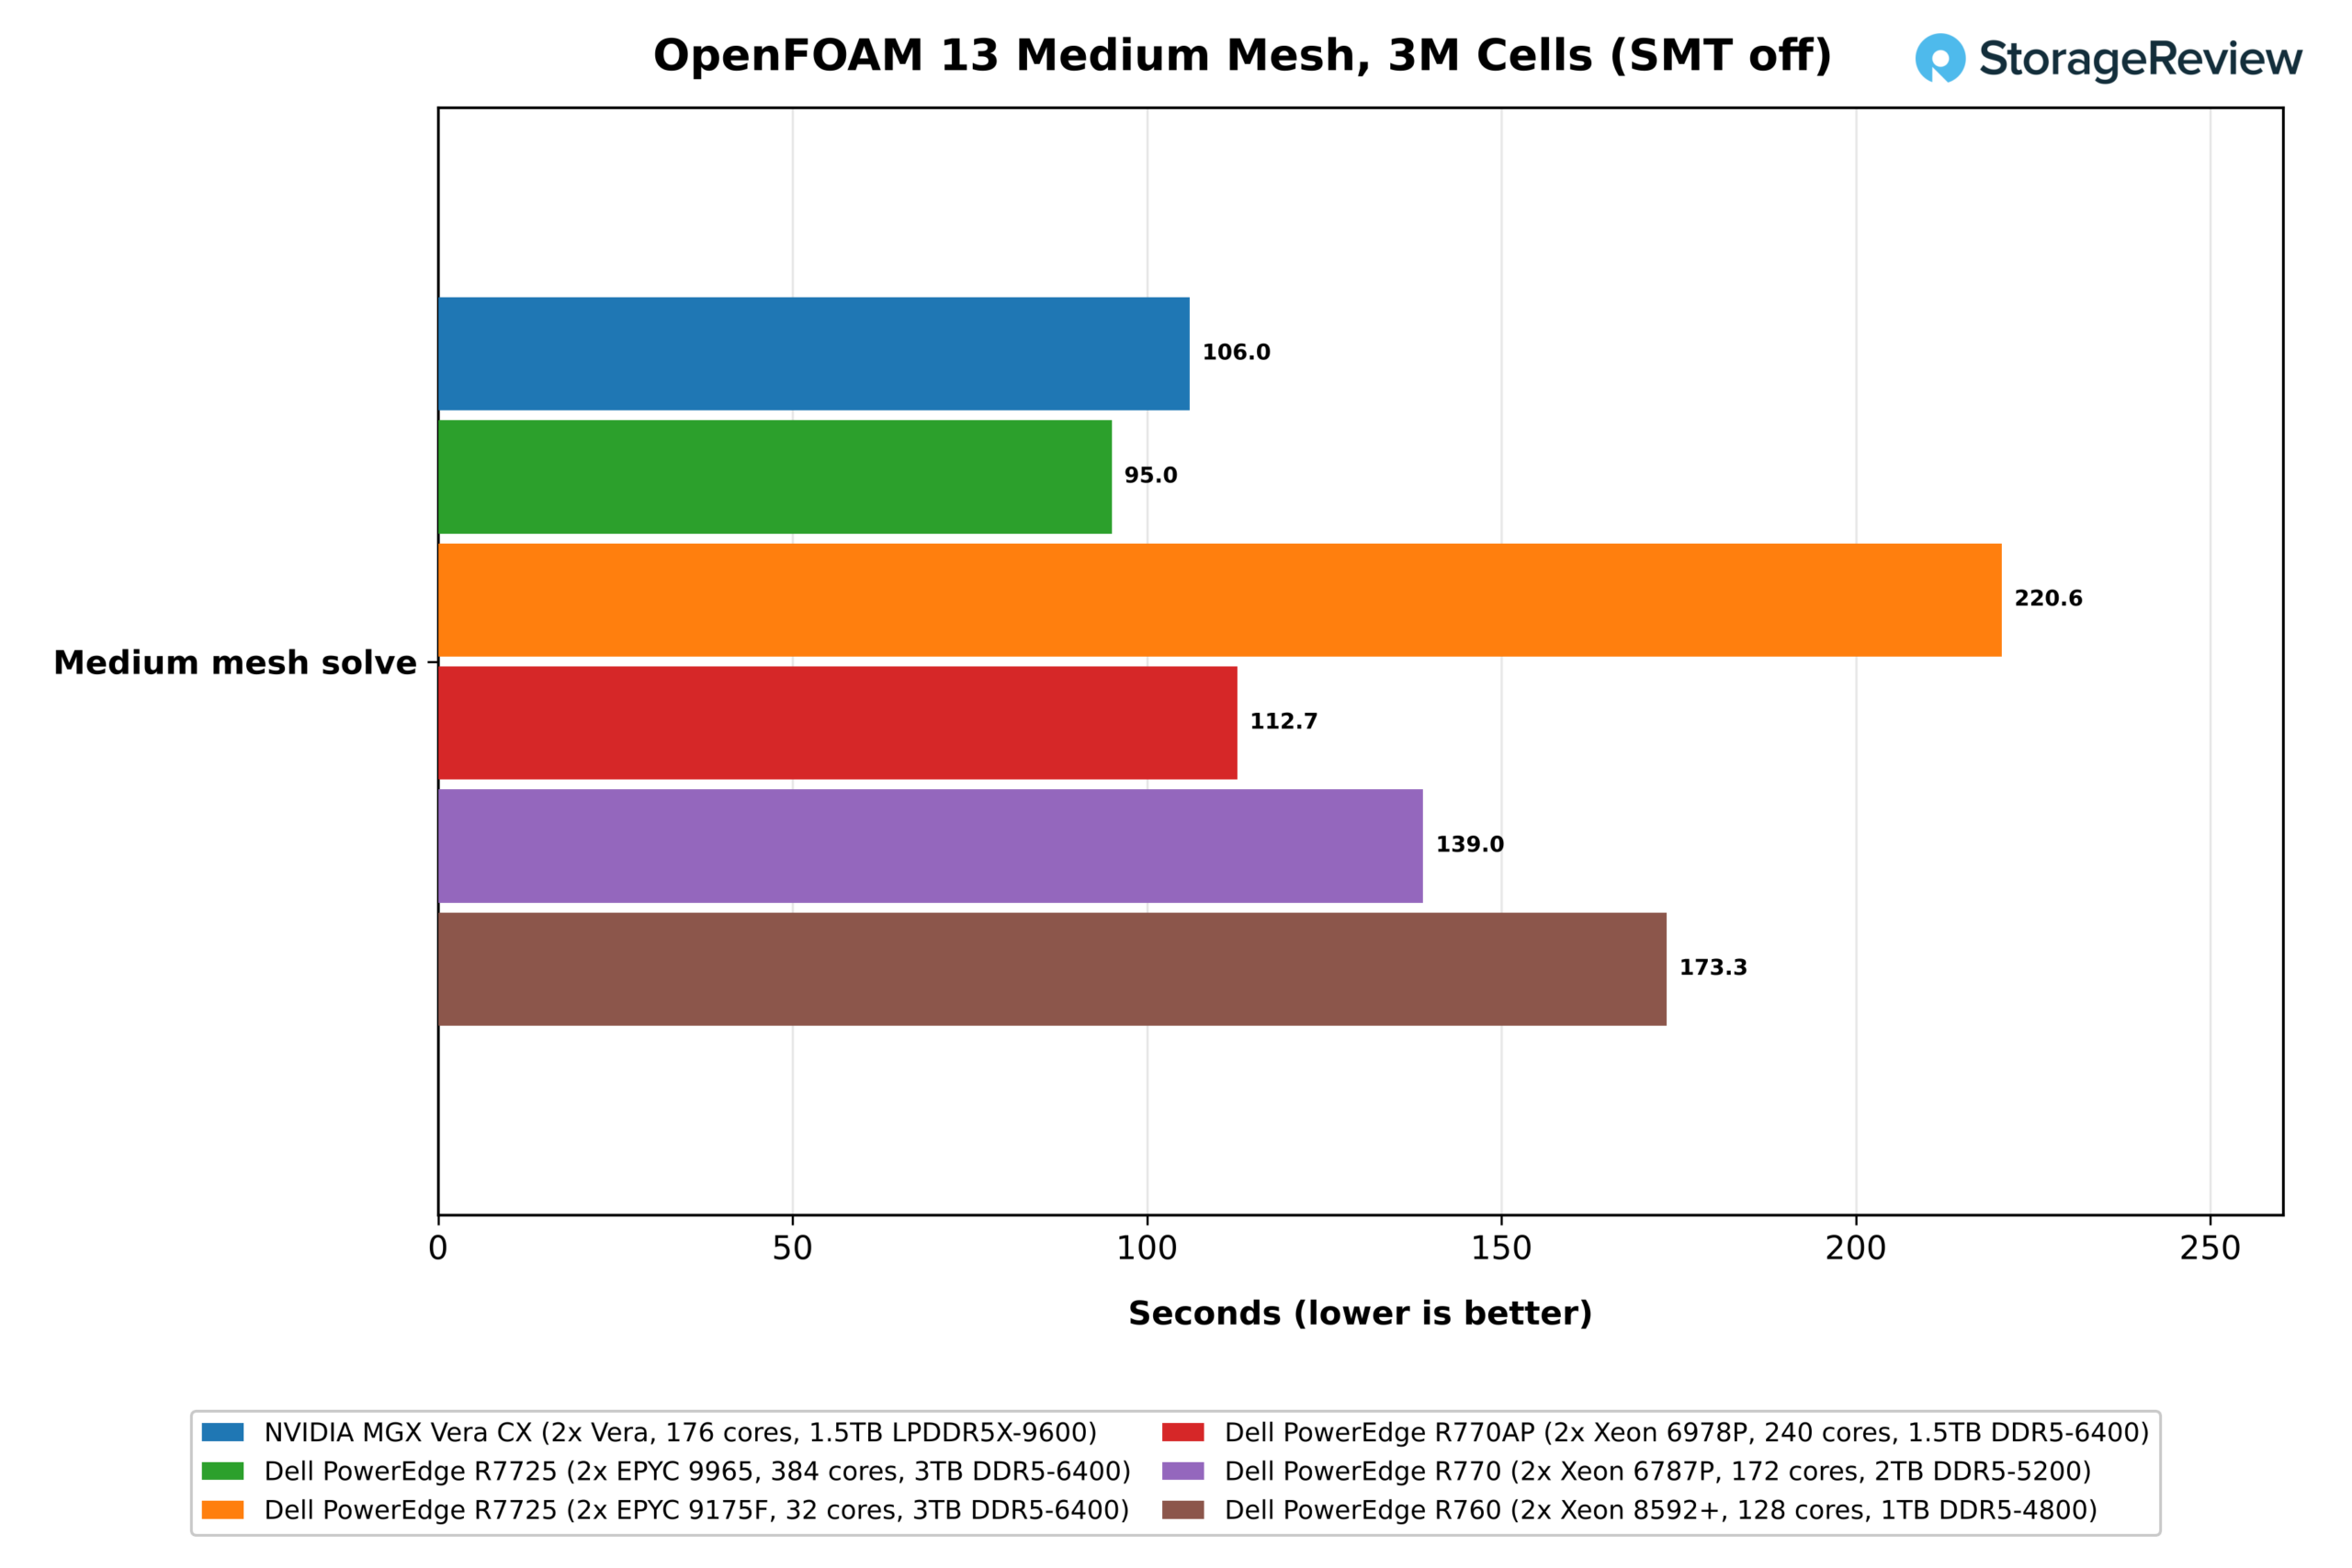
中規模のメッシュは Vera で 106.0 秒で解決し、EPYC 9965 では 95.0 秒、Xeon 6978P では 112.7 秒、6787P では 139.0 秒、8592+ では 173.3 秒、32 コアの 9175F では 220.6 秒でした。このサイズでは、9965 の 384 コアが勝利し、Vera は 12% 長くかかりますが、240 コアの Xeon より 6% 早く 2 位になりました。セルが 300 万しかないため、x86 パーツのより大きな L3 キャッシュが問題の大部分を占めている可能性が高く、コア数が優位に立っています。
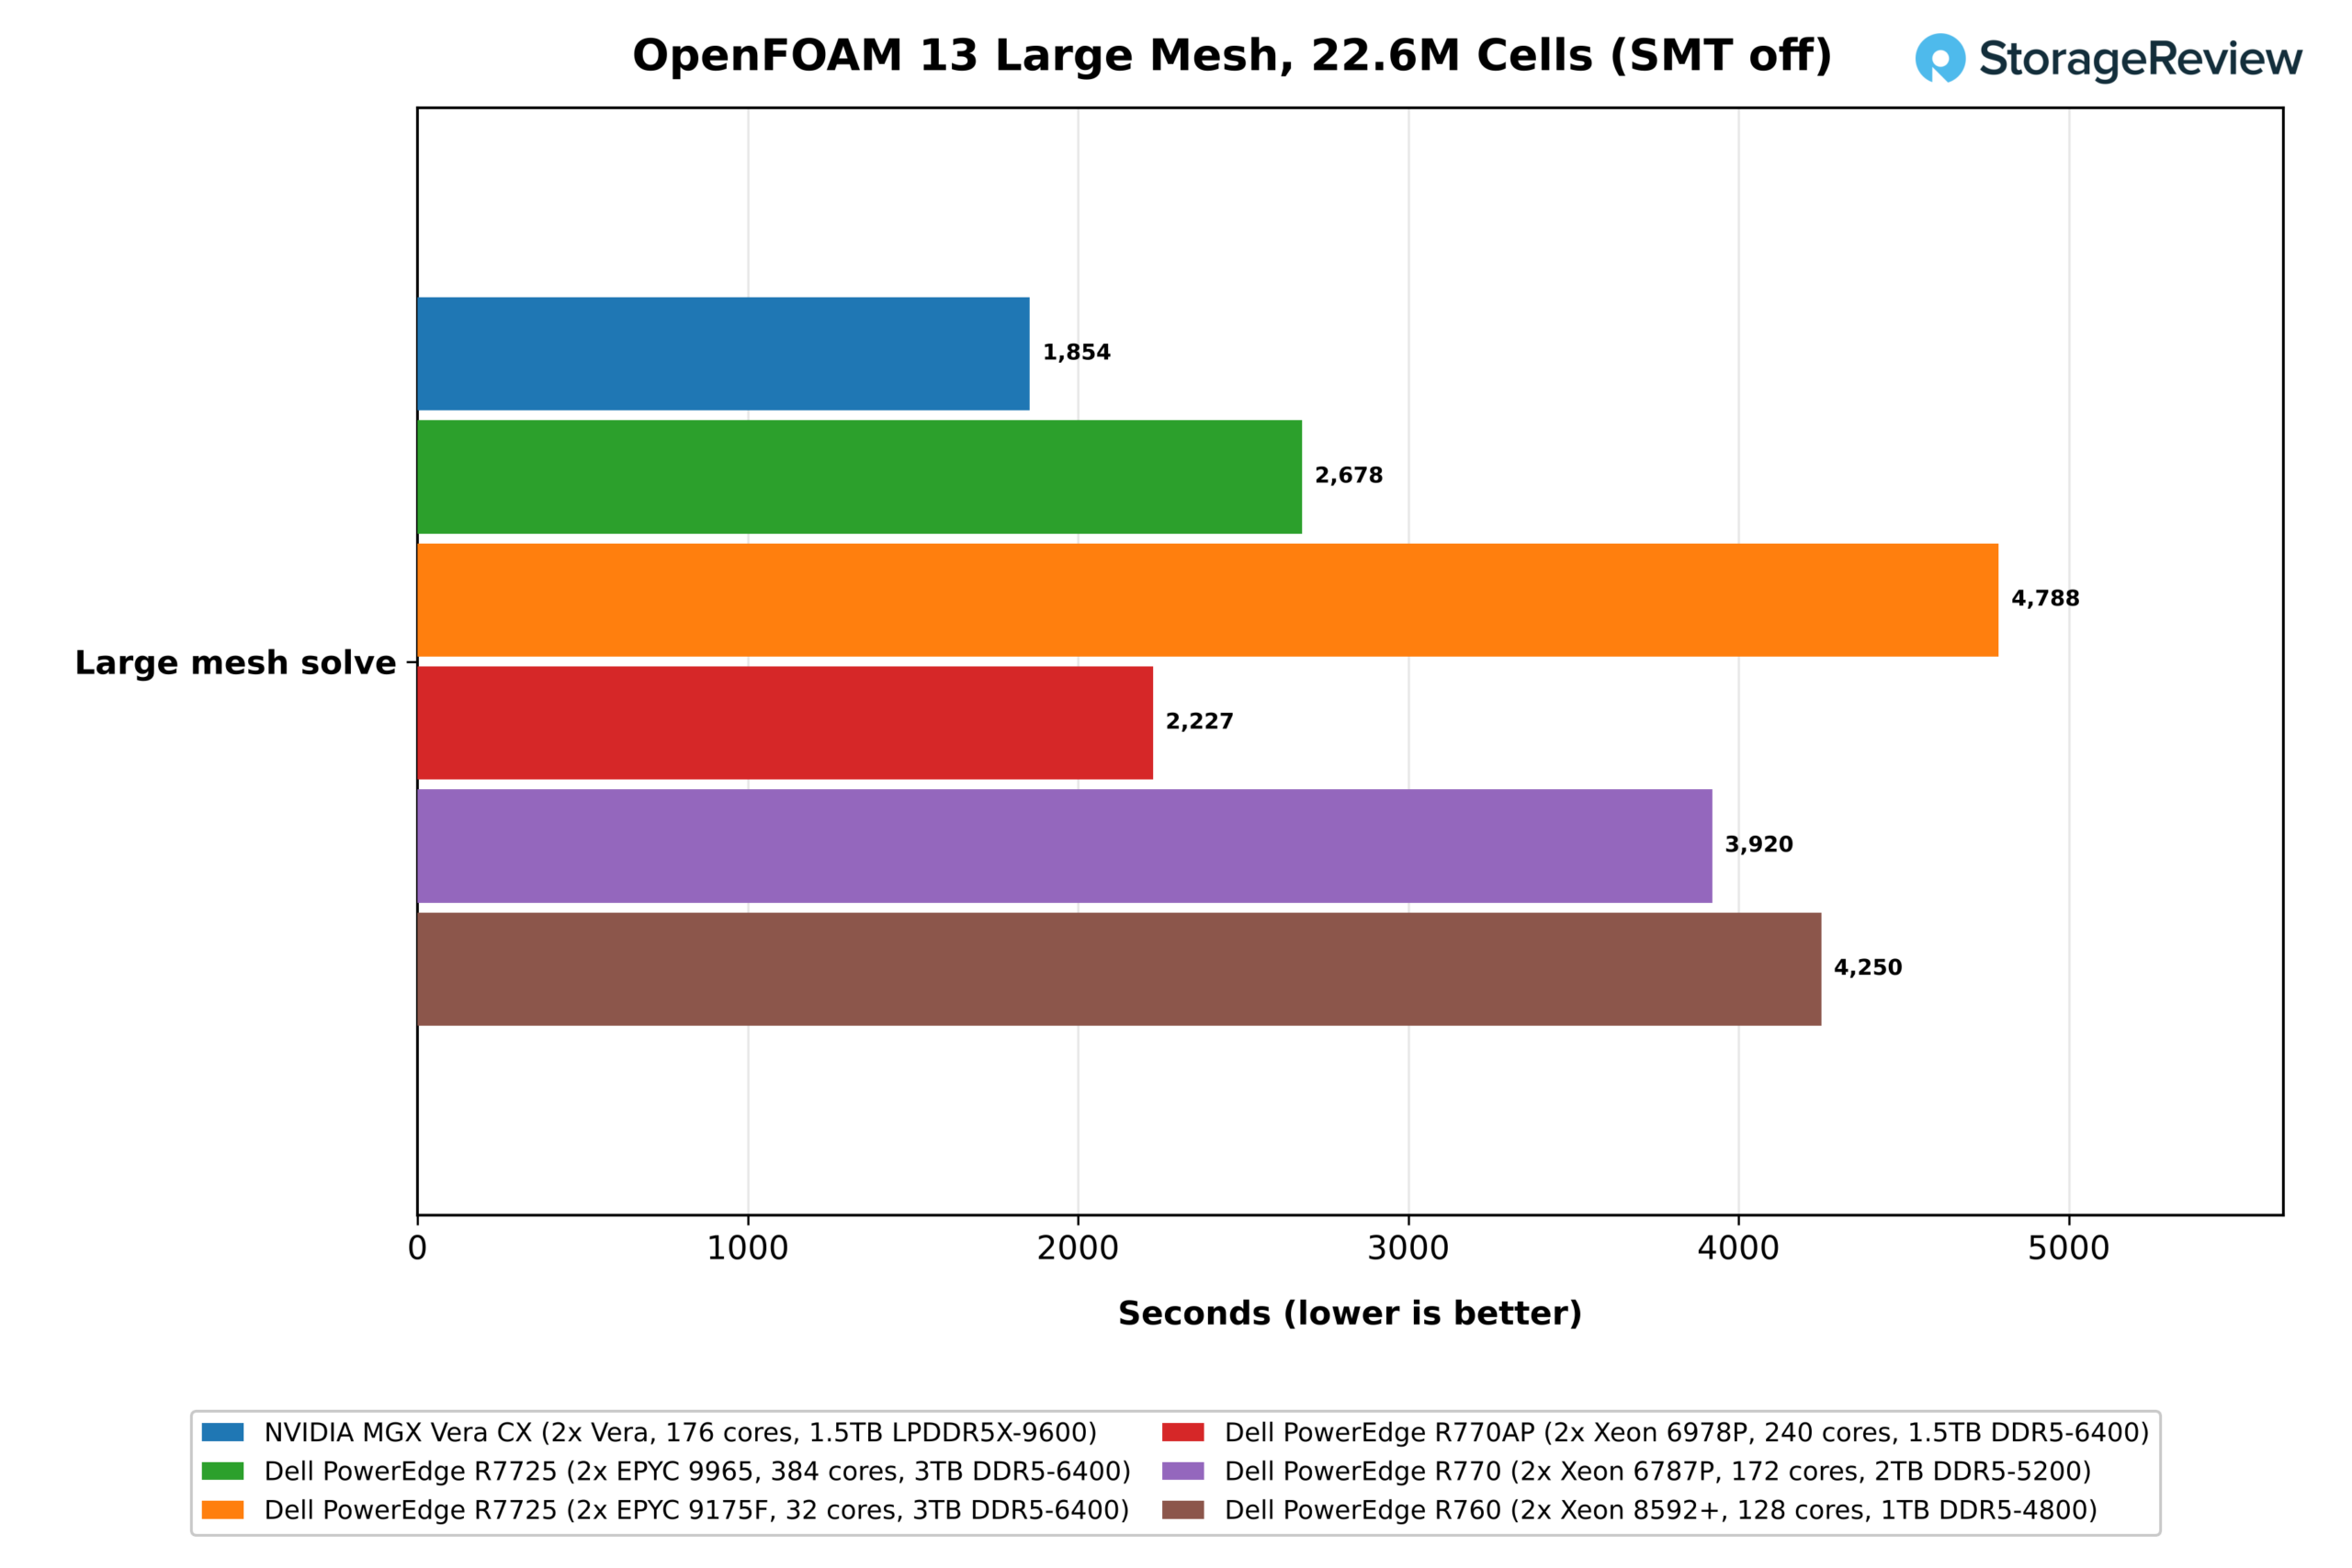
大規模メッシュでは順序が逆転し、Vera は 1,854 秒で解決します。これは Xeon 6978P の 2,227 秒、EPYC 9965 の 2,678 秒、6787P の 3,920 秒、8592+ の 4,250 秒、9175F の 4,788 秒と比較して、384 コアの AMD サーバーより 1.44 倍、240 コアの Intel サーバーより 1.20 倍高速です。また、Vera はソケットあたり最大定格電力 450W に収まっており、9965 の 500W と比較して高速です。
分析とインメモリデータ
HPC の結果は、Vera の帯域幅が科学ソルバーにどのような影響を与えるかを示しました。データ サービスでは同じメモリ システムが異なる方法で使用され、2 つのテストではそのメモリ システムに対して正反対の負荷をかけます。ClickBench は、大量のデータ列をスキャンして集計する分析クエリを実行し、各クエリをすべてのコアに分散させるため、多くのコアとそれらにデータを供給する帯域幅を組み合わせたシステムが有利になります。インメモリ キーバリュー ストアである Valkey は、数百万個の小さなリクエストを処理し、各リクエストは単一の値を読み書きするため、個々のコアがリクエストをどれだけ迅速に処理できるか、そしてデータがキャッシュを超えるとメモリのレイテンシと帯域幅に大きく依存します。
クリックベンチ
ClickHouse 26.8 上で、100億行のウェブ分析テーブルに対して 43 個のクエリを使用して ClickBench のテストを実施しました。ホットサムは、すべてのクエリがページキャッシュから読み込むことで、システムが列指向スキャンと集計にどれだけのコアを提供できるか、そしてメモリがそれらをどれだけ効率的に供給できるかを測定します。コールドサムは、各クエリの最初の実行前にサーバーの再起動と SSD からの読み取りを追加して測定します。
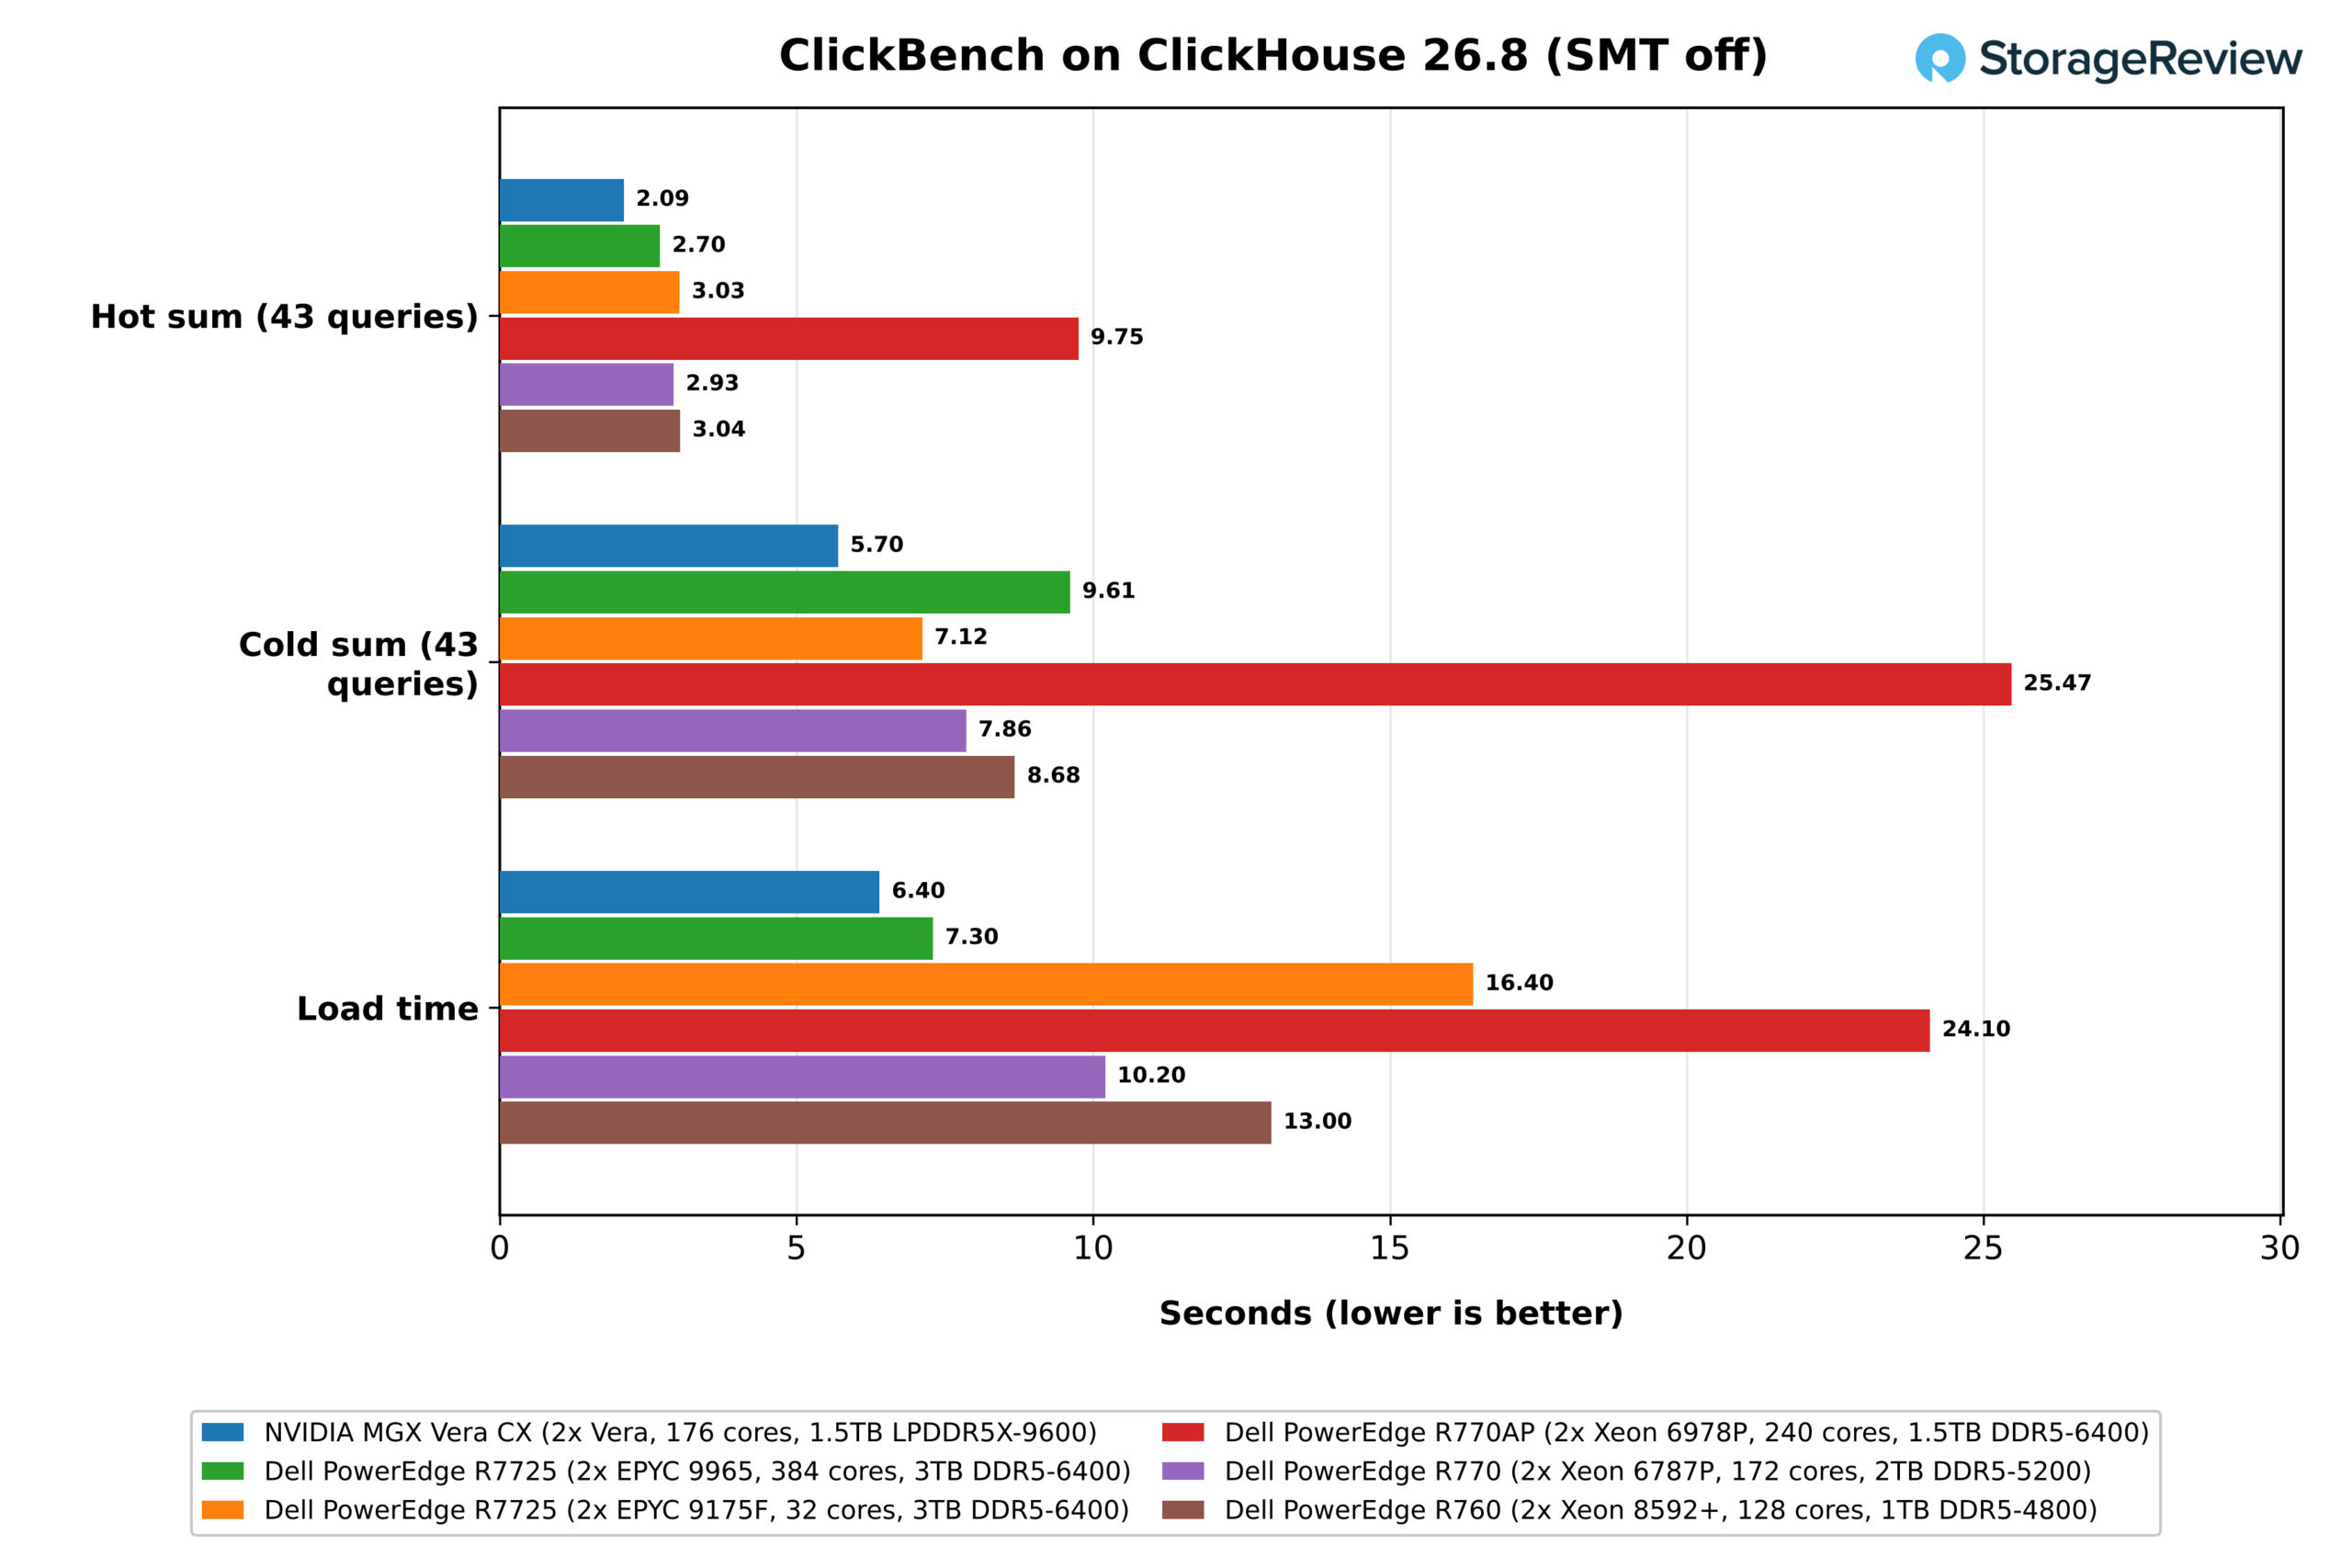
SMTをオフにした状態で、Veraはホットランを2.09秒で完了し、今回のテストセットで最速の結果となった。EPYC 9965は2.70秒でそれに続き、1.29倍の時間を要した。一方、Xeon 6787P、EPYC 9175F、Xeon 8592+は2.93秒から3.04秒でほぼ同タイムだった。この差は、コア数と帯域幅のバランスを反映している。384コアの9965はコア数は多いものの、コアあたりの帯域幅は少ない。32コアの9175Fはその逆で、Veraは176コアで、どちらの3倍以上の帯域幅を備えている。
Veraはコールドランでも5.70秒でトップとなり、7.12秒の9175F、7.86秒の6787P、8.68秒の8592+、9.61秒の9965を上回った。コールドサムはストレージに大きく依存しており、ドライブリンクはVeraと6787PではGen5 x4、両方のEPYCシステムではx2、8592+ではGen4となっている。
Veraは15GBのデータセットを最速で6.4秒でロードしました。これは9965の7.3秒、その他のプロセッサの10.2秒から16.4秒と比較しても速い結果です。Xeon 6978Pは、ホット時9.75秒、コールド時25.47秒と、他のXeonプロセッサとは大きくかけ離れた結果となりましたが、その理由は不明です。そのため、ランキングからは除外しました。
空間マルチスレッドを有効にすると、Veraの処理速度はホット時2.31秒、コールド時6.09秒に低下し、ホット時の合計処理速度が10%低下しました。各コアのリソースを2つのスレッドに分割すると、ClickHouseのスキャン処理において得られるメリットよりもコストの方が大きくなりました。
ヴァルキー
Valkeyは単一のメインスレッドでコマンドを実行し、I/Oスレッドは一定の範囲でしか補助しないため、インスタンスにコアを追加しても効果がほとんどないため、デプロイメントはシャードを追加することで拡張されます。そこで、Valkeyを2つの方法で検証します。1つは、マッチングされたコア上で単一のシャードがどのようなパフォーマンスを発揮するか、もう1つは、ソケットに複数のシャードが詰め込まれた場合に各シャードがどのようなパフォーマンスを発揮するかです。どちらのテストでも、クライアントは同じマシンの別のソケットで実行されるため、ネットワークカードは関係ありません。
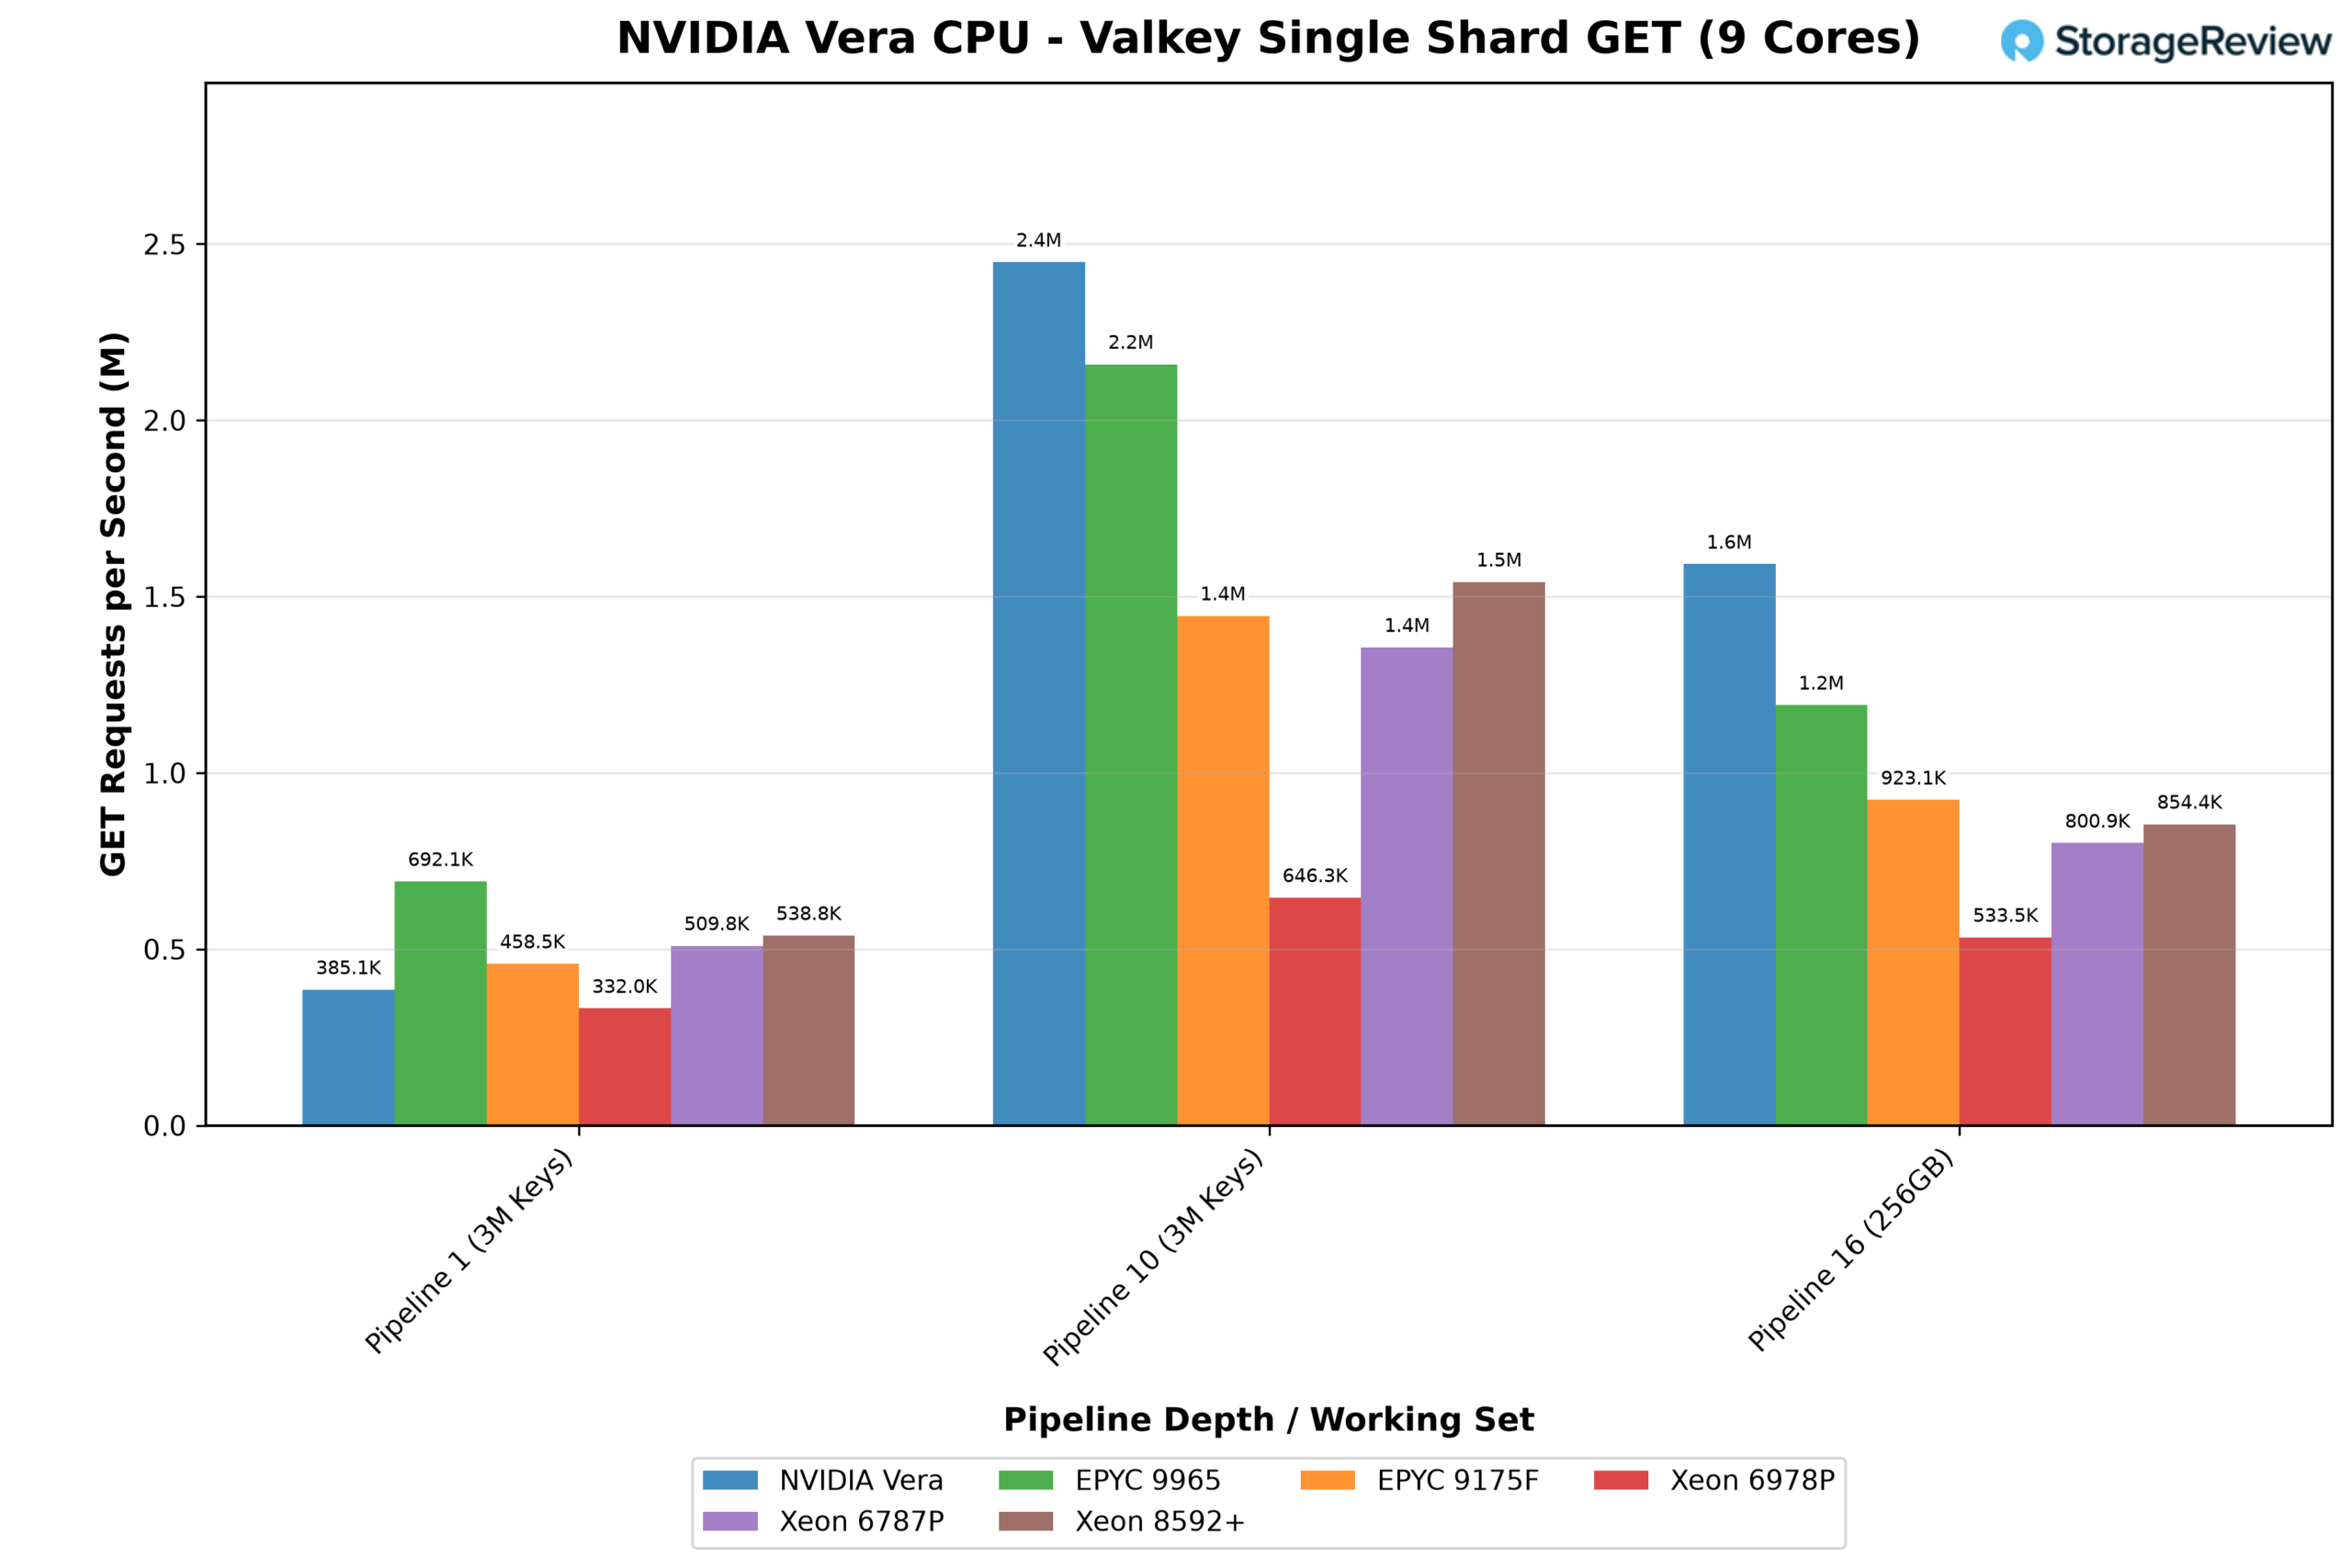
シングルシャードテストでは、Valkeyサーバー1台に各プラットフォームで9つの物理コアが割り当てられます。300万キーのデータセットを、リクエストを1つずつ送信して処理し、次に10個のバッチで送信し、最後にキャッシュには大きすぎる256GBのデータセットを16個のバッチで処理します。1つずつ送信されるため、各リクエストは次のリクエストが送信される前に往復を完了する必要があり、これがVeraの弱点です。Veraのシャードは毎秒385,000のGETリクエストを処理し、Xeon 6978Pをわずかに上回りましたが、EPYC 9965は692,000でトップでした。Veraのp99レイテンシも高く、9965の1.08msに対して1.76msでした。
バッチ処理によって往復コストの大部分が削減され、Vera がトップに躍り出た。バッチサイズを 10 にすると、Vera のシャードは毎秒 2.45 万件の GET リクエストを処理し、9965 より 13% 多く、すべての Xeon を大きく上回った。256GB のデータセットでは、その差はさらに広がった。ほぼすべてのリクエストがメモリに送られたため、Vera は毎秒 1.59 万件の GET リクエストを処理し、9965 より 34% 多く、他の製品は 0.53M~0.92M の範囲だった。SET の結果は、両方のテストで同じパターンを示した。
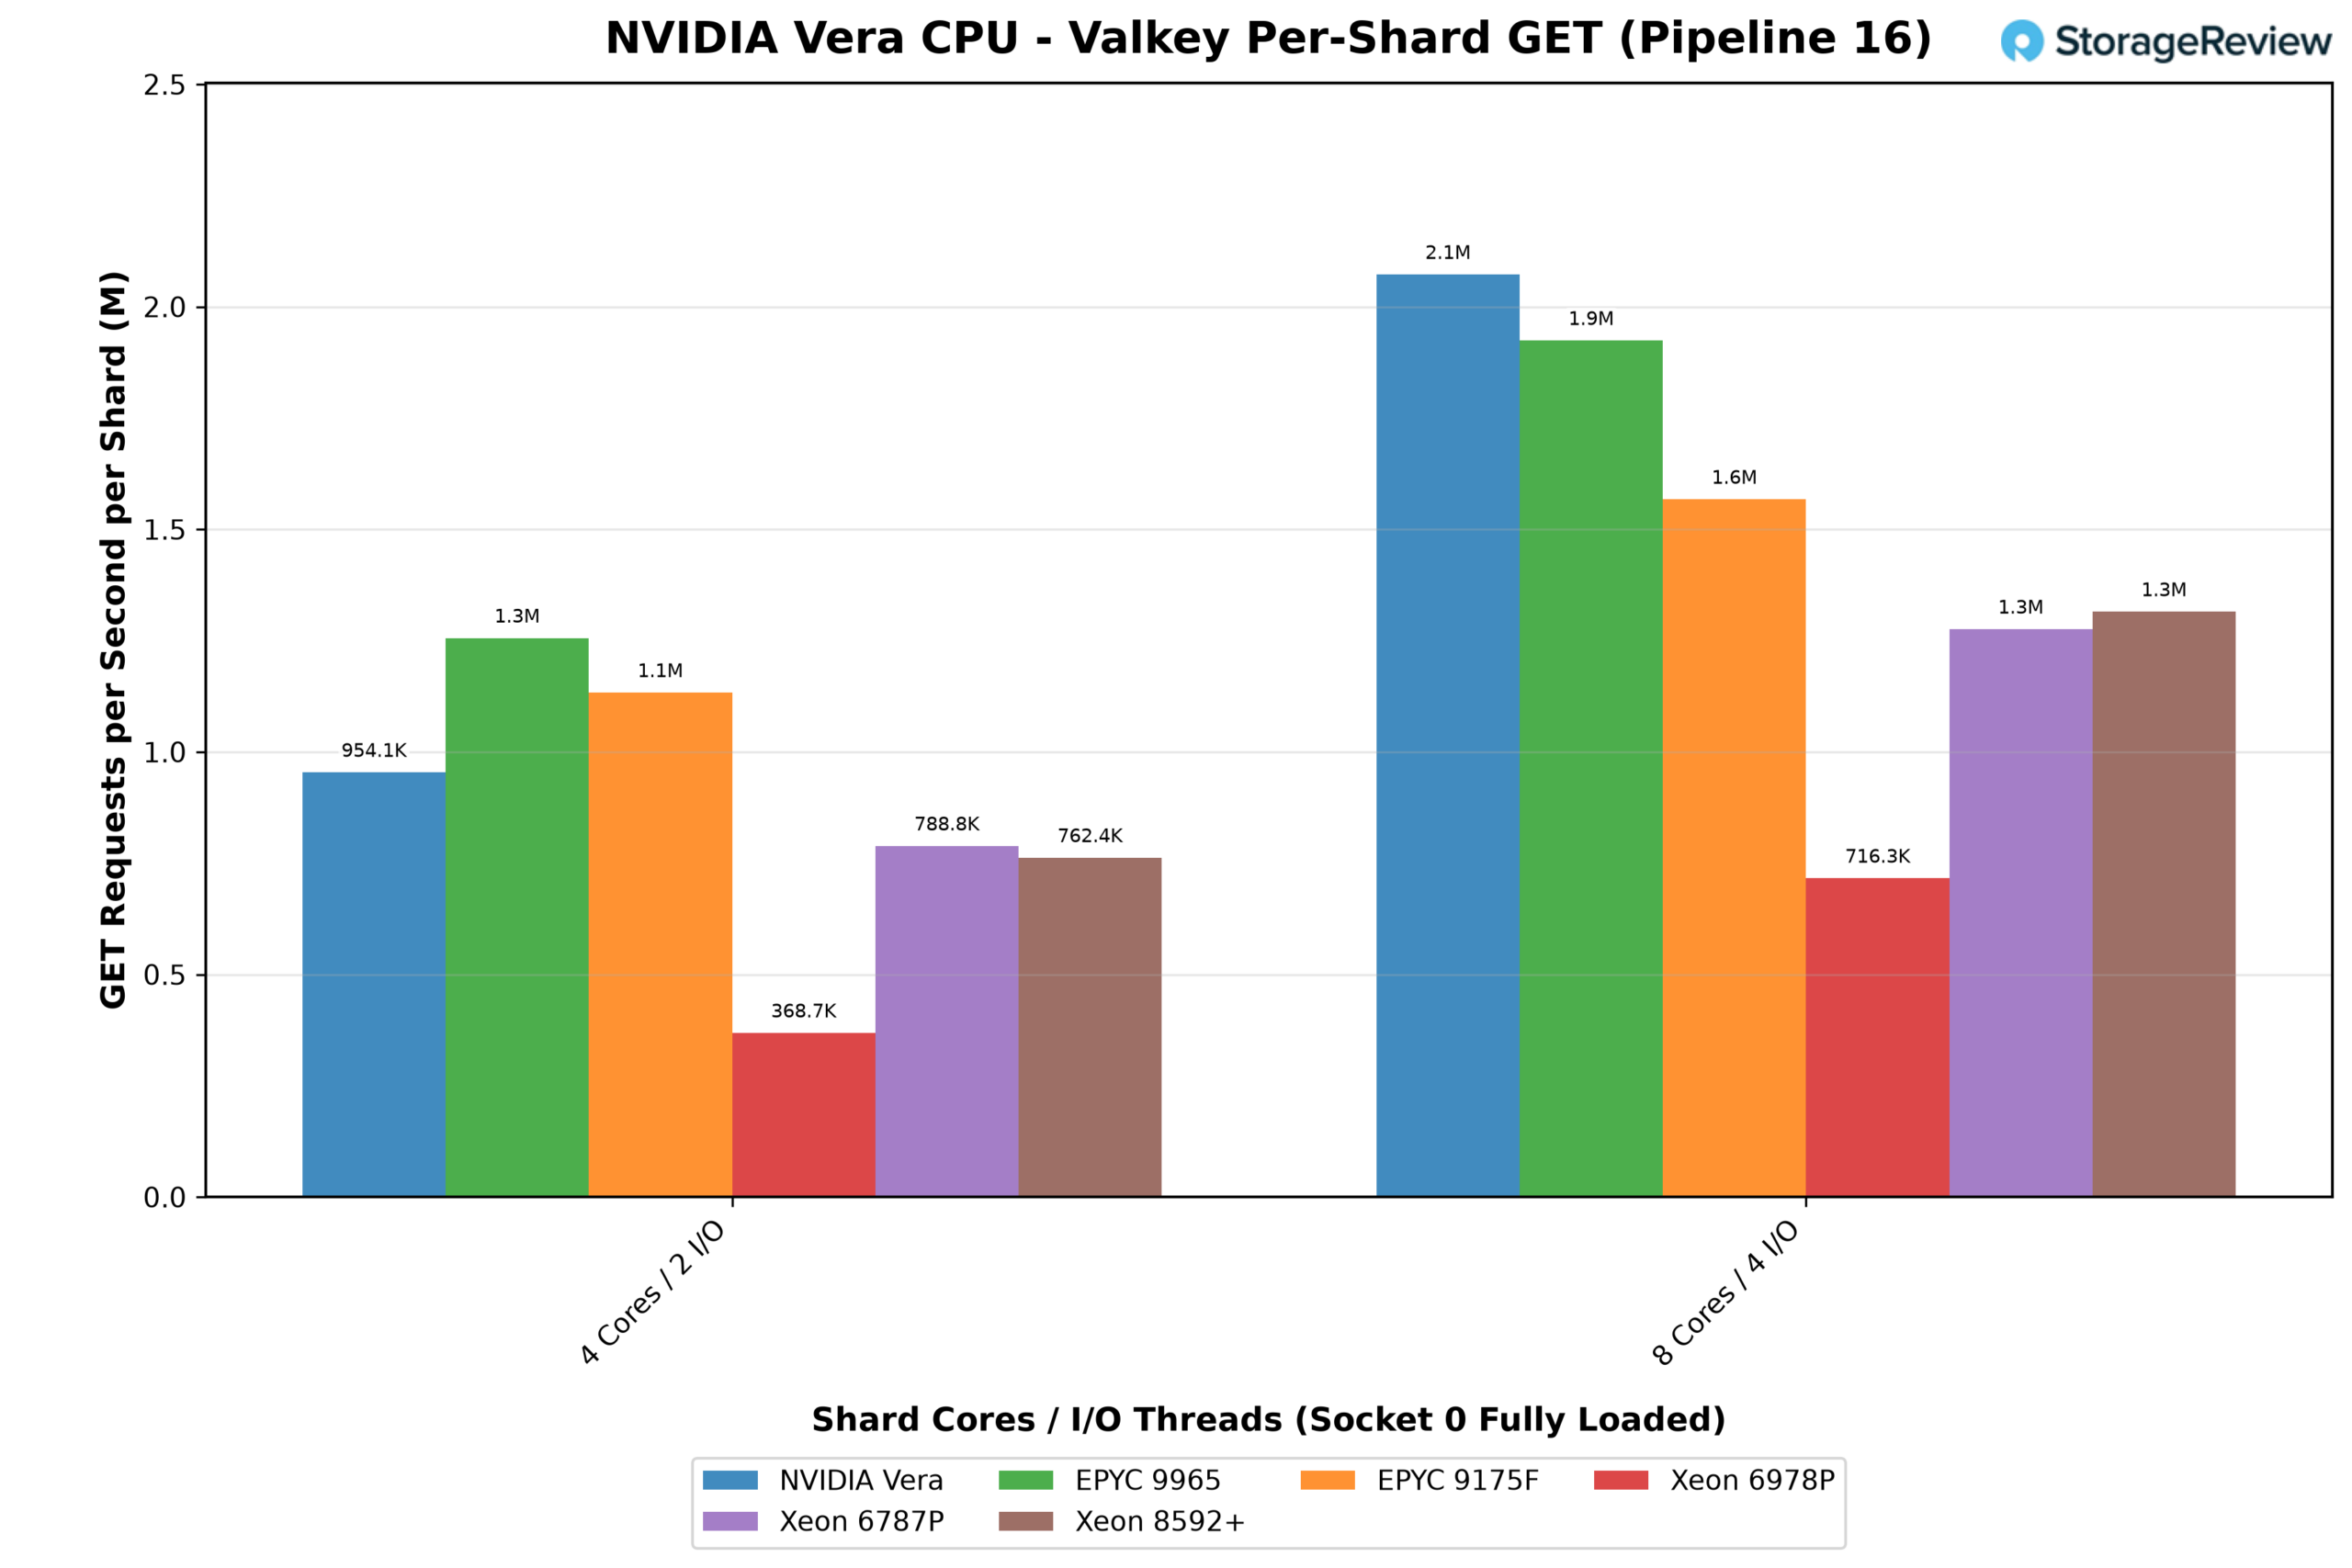
ソケットモードでは、ソケット0に4コアまたは8コアの同一のシャードがパックされ、すべてが同時にトラフィックを処理します。これは、専用のValkeyホストの動作方法に近いものです。8コアのシャードと16のバッチを使用すると、各Veraシャードは毎秒2.07万件のGETリクエストを配信し、9965の1.92万件を上回り、Xeon 6787Pおよび8592+の約1.6倍となりましたが、p99レイテンシは9965の約0.5msに対し、2.2msに上昇しました。
より小さな4コアのシャードでは、AMDが優位に立ちました。9965は1シャードあたり1.26M GETに対し、Veraは0.95Mでした。ただし、Veraは依然としてすべてのXeonの中でトップでした。リクエストを1つずつ送信した場合、9965のシャードはどちらのサイズでもVeraのシャードよりも1.5倍から1.7倍高速で、6787Pと8592+も8コアのシャードで優位に立ちました。
ソケットの総数は密度によって決まります。Veraのソケットは8コアのシャードを11個保持し、毎秒2280万件のGETリクエストを処理しましたが、9965の192コアは4コアのシャードを48個保持し、毎秒6030万件を処理しました。各シャードが8コア以上になり、リクエストがバッチ処理されると、Veraは今回比較した中で最速のシャードを提供しますが、9965はソケットに2倍以上のシャードを収容できます。
シングルスレッドとスループット
ValkeyとClickBenchは、コアだけでなくメモリシステムにも大きく依存していました。このセクションでは、コア自体と、先に述べたOlympusの2つの目標、つまり個々のタスクを迅速に完了することと、ソケット全体がビジー状態のときにその速度を維持することに焦点を当てます。7-Zip、OpenSSL、およびPythonはそれぞれ1つのコアに固定された単一スレッドとして実行され、Olympusコアが単独で何ができるかを示します。次に、7-ZipとOpenSSLをシステム内のすべてのスレッドで再度実行し、すべてのコアが同じキャッシュとメモリを競合するようになったときに、コアごとの速度がどの程度維持されるかを示します。
7-Zip
7-ZipのLZMA圧縮は、分岐が多く、メモリへのアクセスが予測不可能な整数コードであり、オリンパスの10幅フロントエンドとグラフプリフェッチャが設計された種類の処理である。
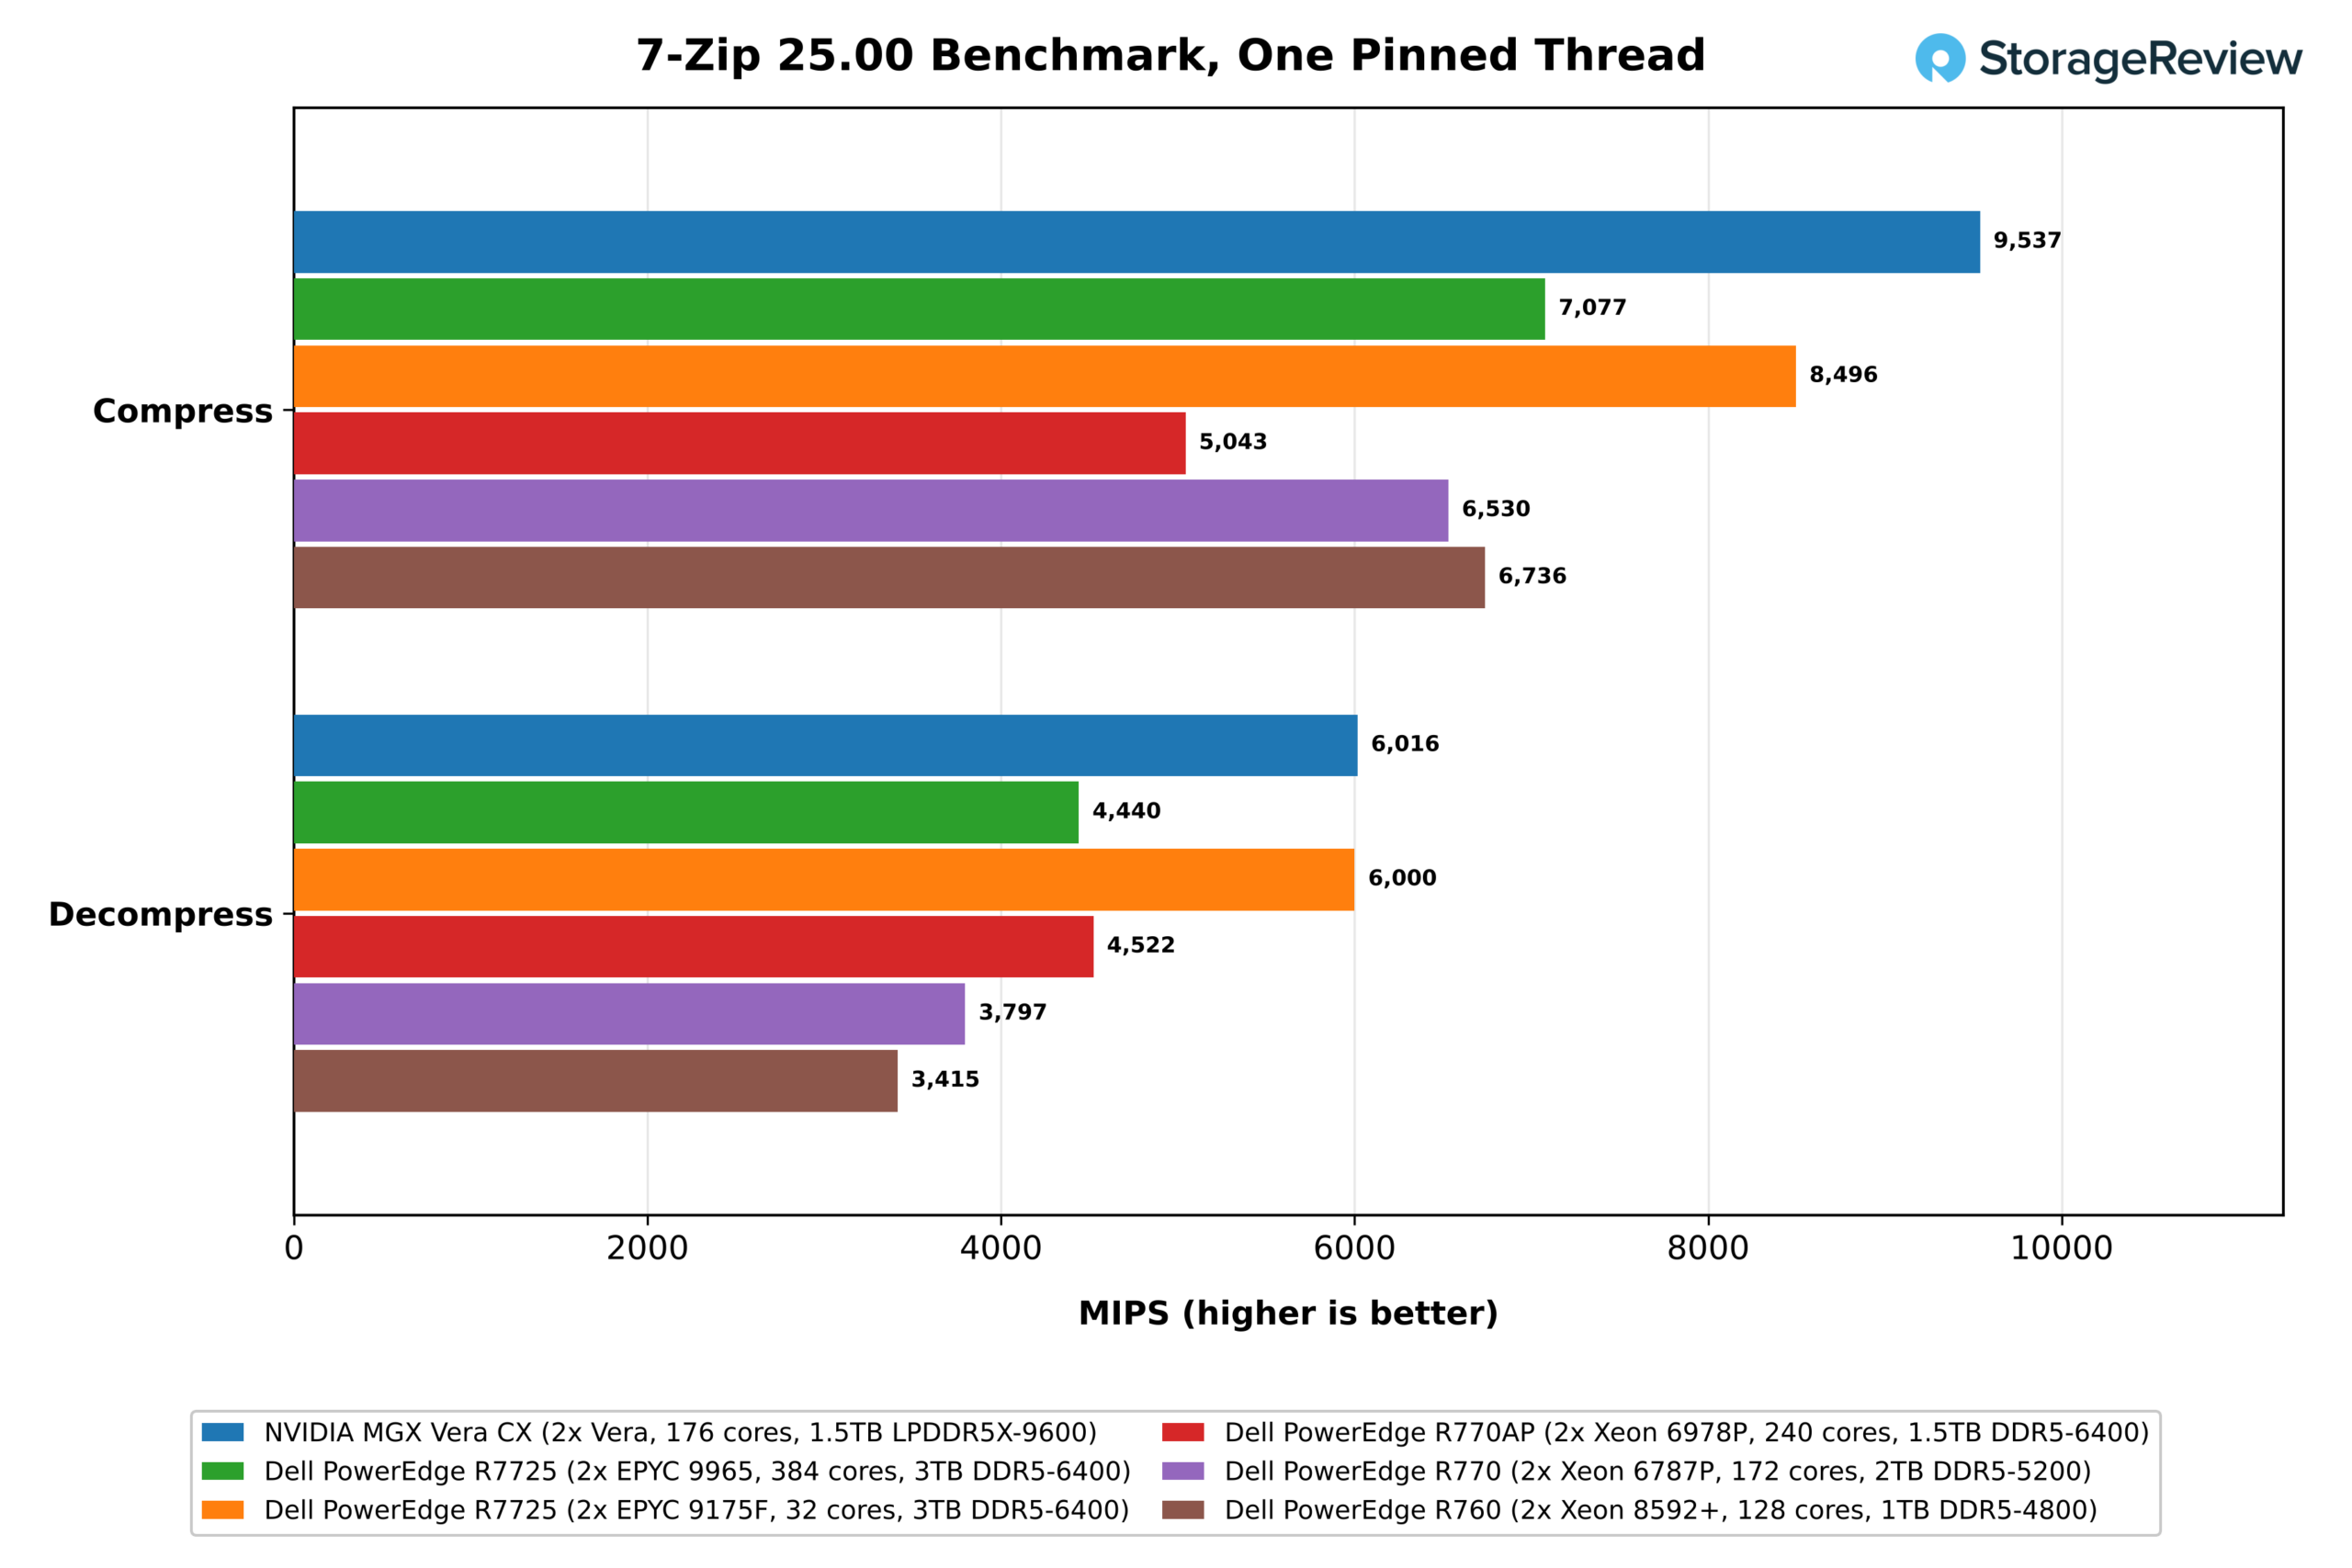
シングルスレッドでは、Olympusが今回のテスト対象の中で最速の圧縮性能を発揮しました。9,537 MIPSに達し、5.0GHzのEPYC 9175F(今回テストしたx86コアの中で最速)を12%上回り、EPYC 9965やすべてのXeonを大きく引き離しました。一方、解凍性能は両者ほぼ互角で、Veraが6,016 MIPS、9175Fが6,000 MIPSでした。他のシステムは20%以内の差はありませんでした。
すべてのスレッドを横断的に実行することで、システム全体がビジー状態のときに、そのリードがどれだけ残っているかがわかります。
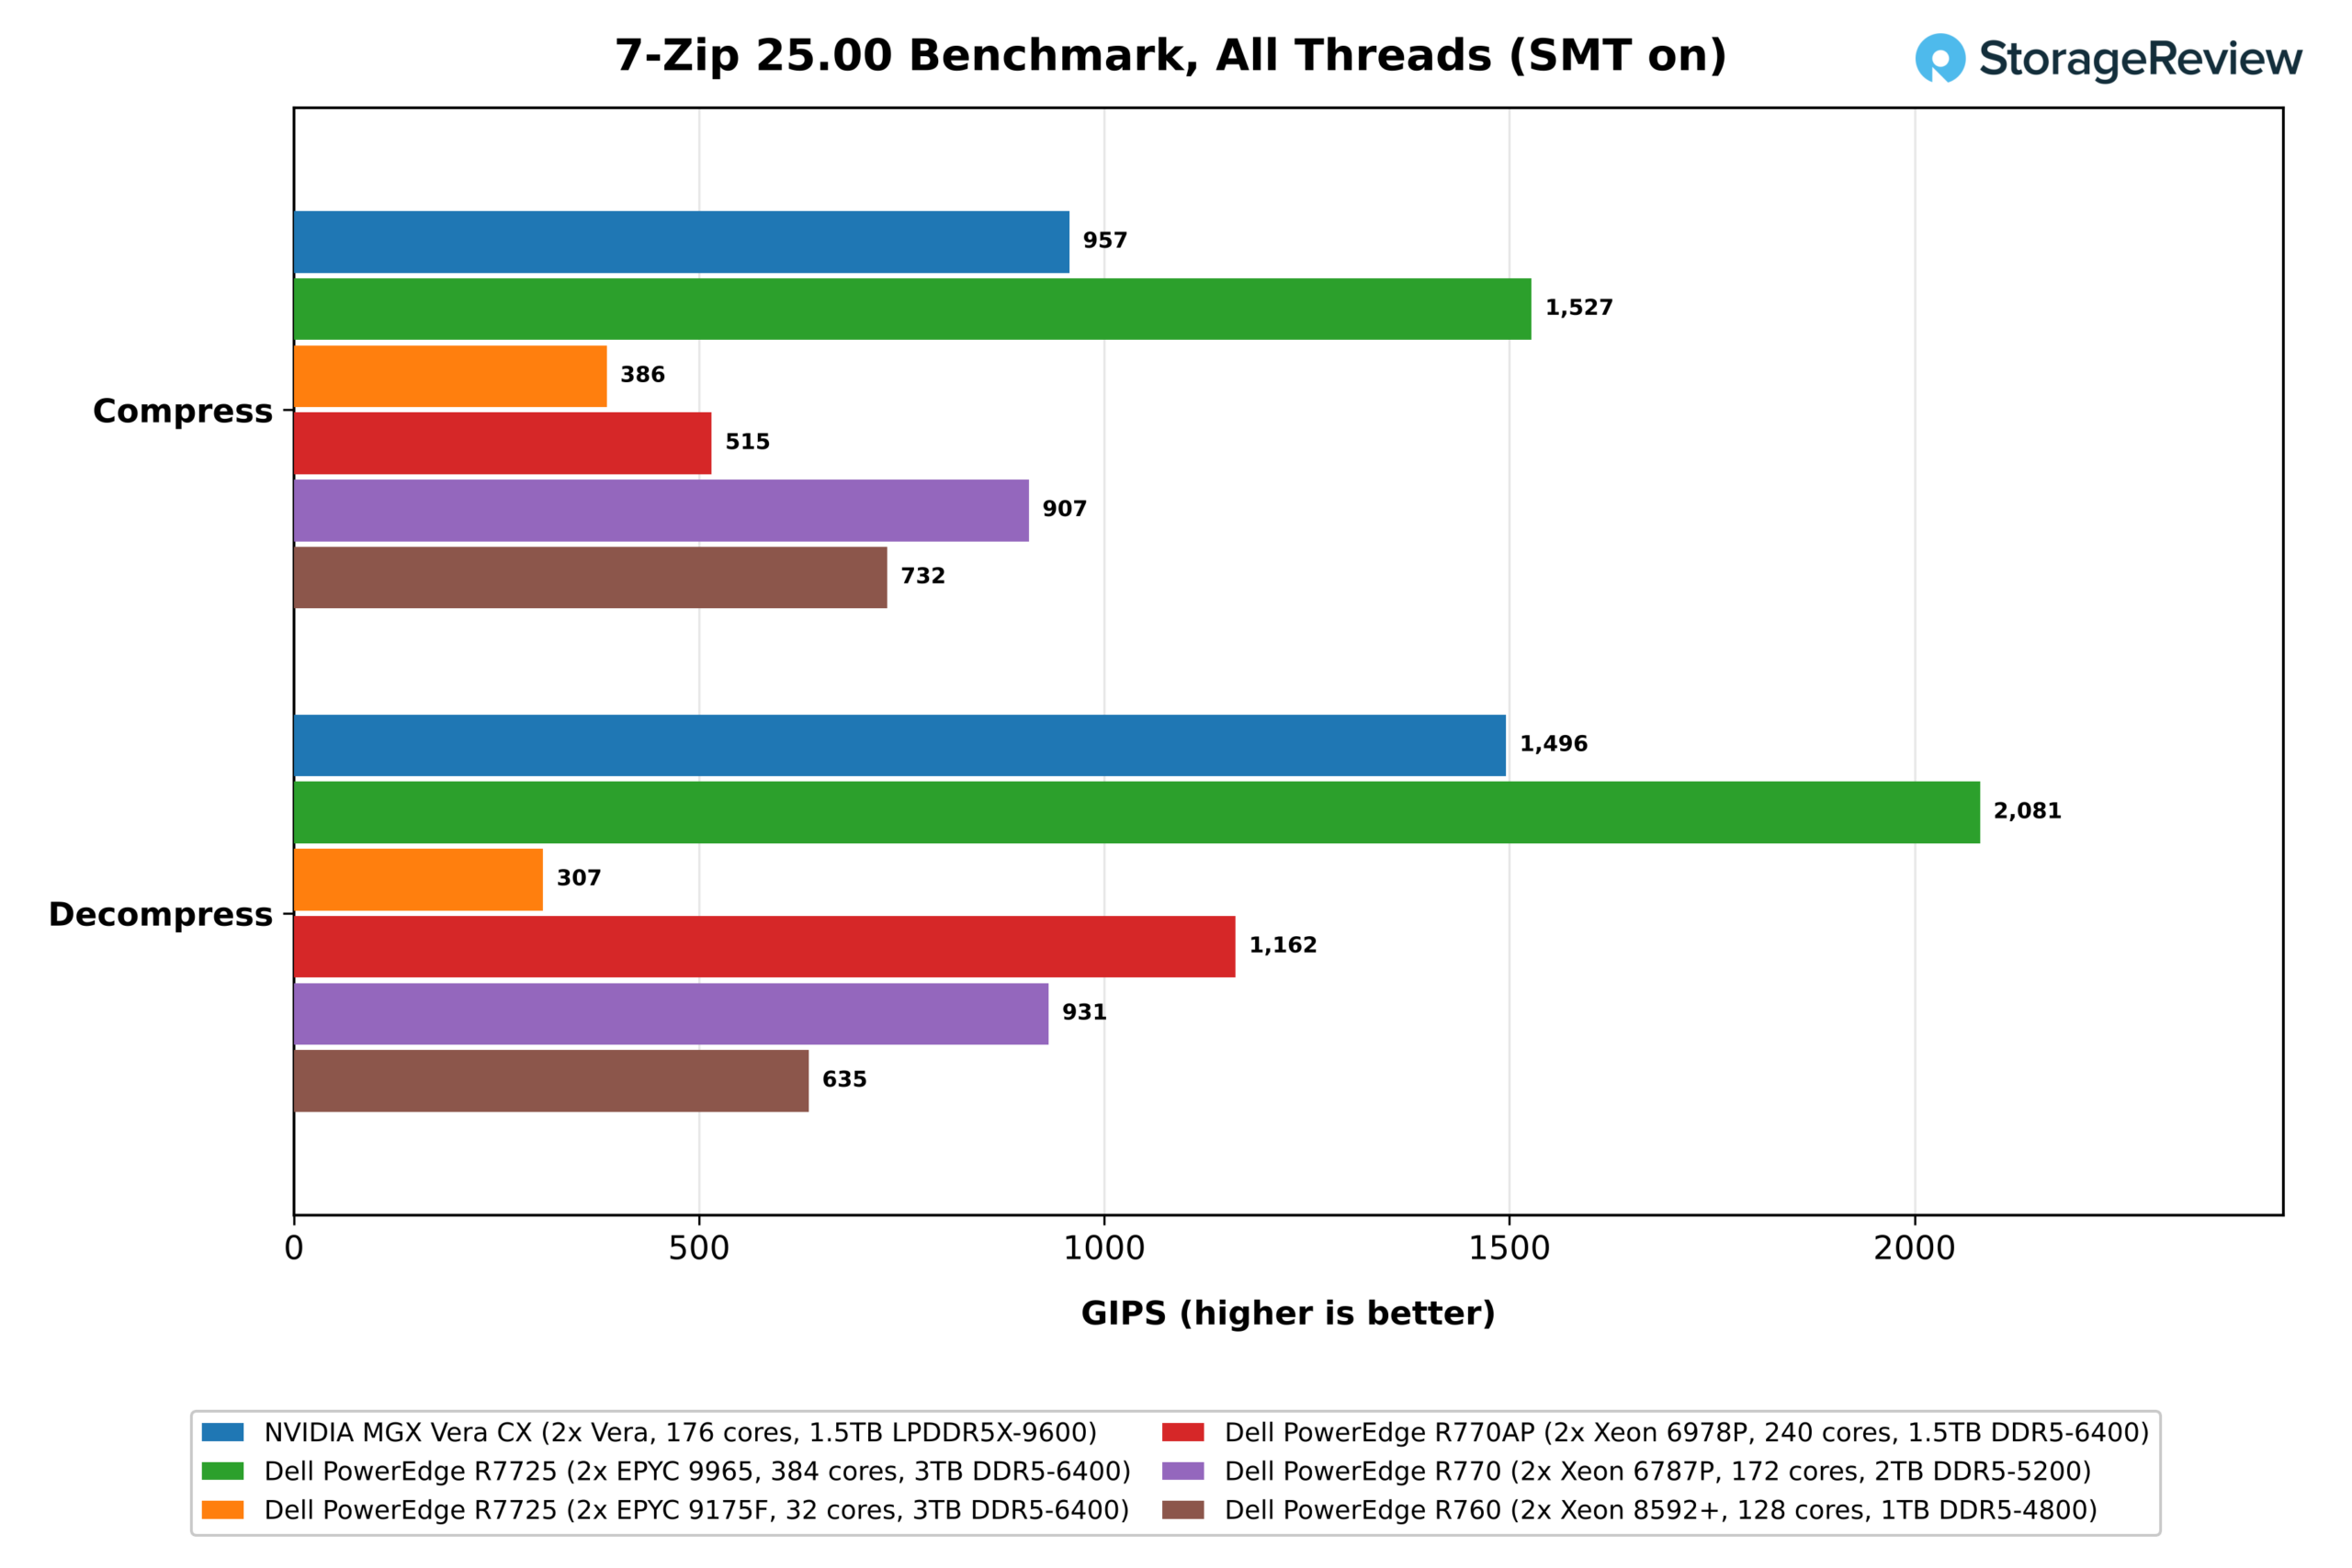
すべてのスレッドがビジー状態の場合、EPYC 9965 の 768 スレッドが圧縮で 1,527 GIPS、解凍で 2,081 GIPS でトップの座を獲得しました。Vera の 352 スレッドは、それぞれ 957 GIPS と 1,496 GIPS で 2 位となり、すべての Xeon を上回り、最も近い 6787P が 907 GIPS と 931 GIPS でした。物理コアあたりで測定すると、Vera は健闘しています。コアあたりの圧縮 5.4 GIPS は 6787P と 8592+ と同等で、9965 の 4.0 を上回り、コアあたりの解凍 8.5 GIPS は 9965 より 57% 高く、すべての Xeon を上回ります。各ソケットのキャッシュとメモリを共有するコア数がはるかに少ない 32 コアの 9175F だけが、両方のコアでより高いパフォーマンスを発揮しました。
OpenSSLの
OpenSSLのAES-256-GCMテストにおいて、Veraは最も劣勢に立たされる。Olympusの6つの128ビットSVE2パイプのうち、暗号化命令を実行できるのは2つだけであり、一方、x86アーキテクチャのVeraはVAESを使用して512ビットレジスタ上でAESを実行できる。
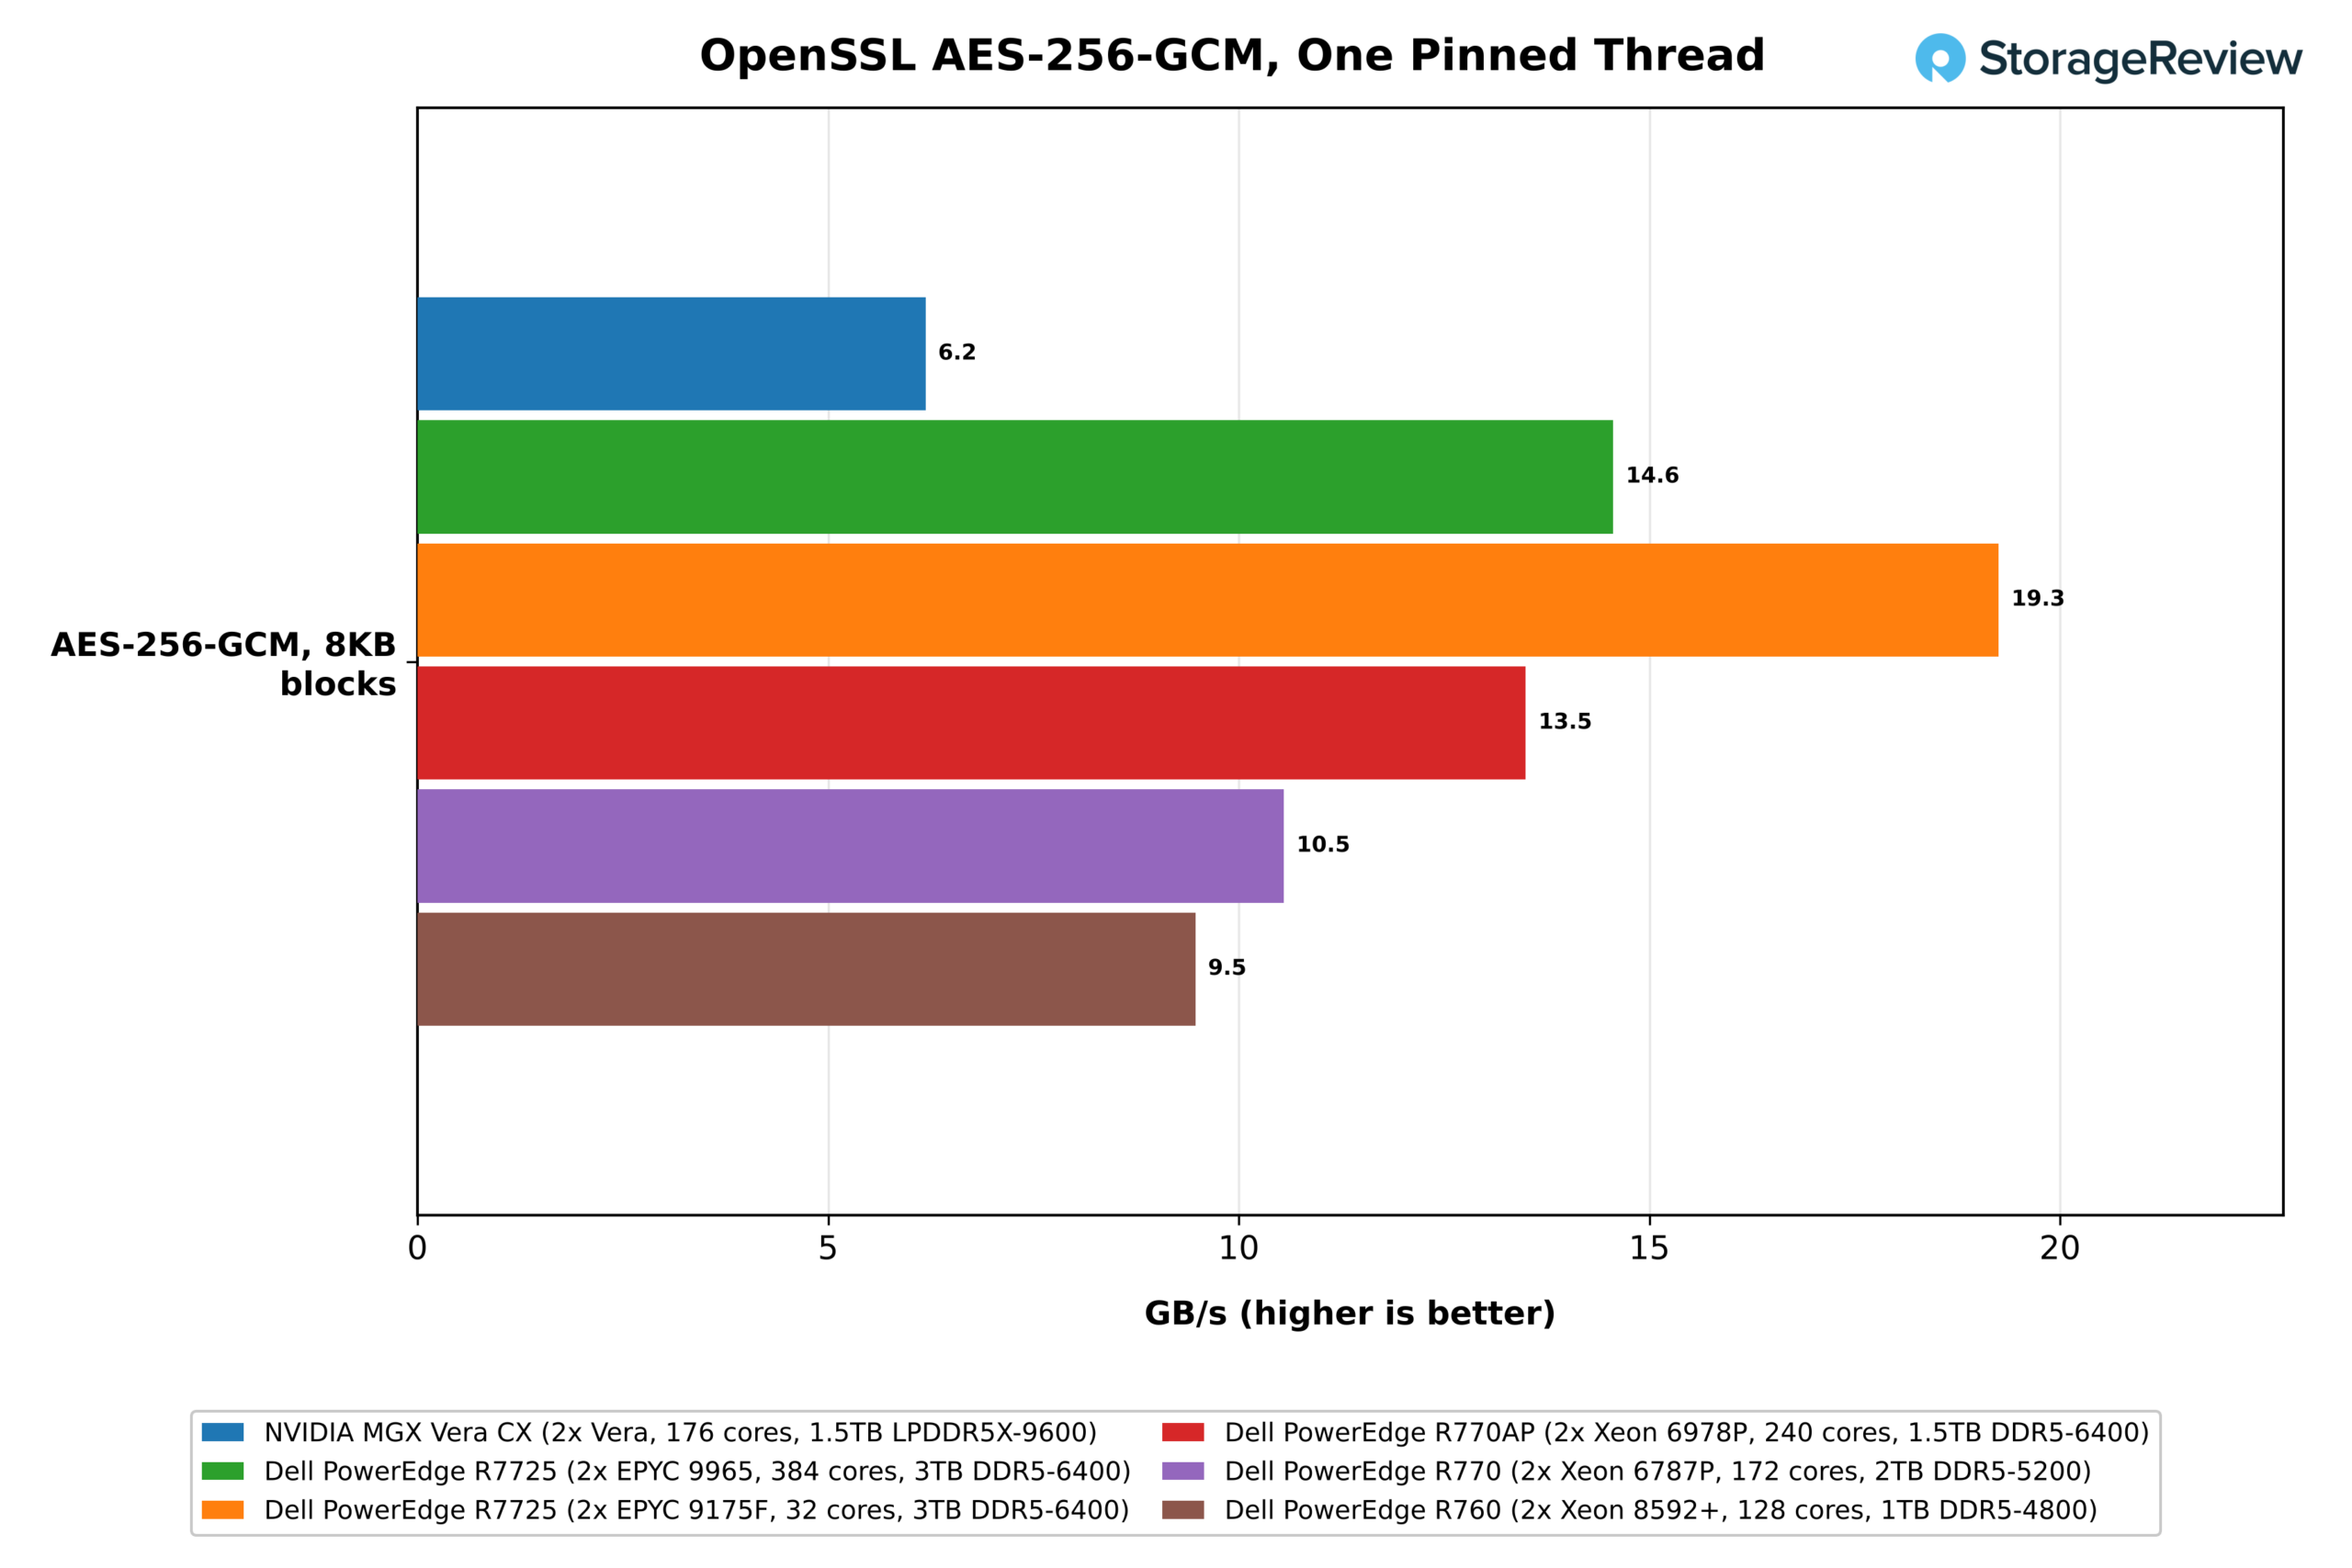
その差はシングルスレッドで最も顕著に表れる。オリンパスのコア1つは6.2GB/sで暗号化されたが、これはEPYC 9175Fの19.3GB/sの約3分の1であり、EPYC 9965の14.6GB/sやXeon 6978Pの13.5GB/sを大きく下回っている。
あらゆるスレッドにおいて、x86システムはコア数順に並べられており、コアあたりの性能不足がVeraにどのような影響を与えるかが明らかになっている。
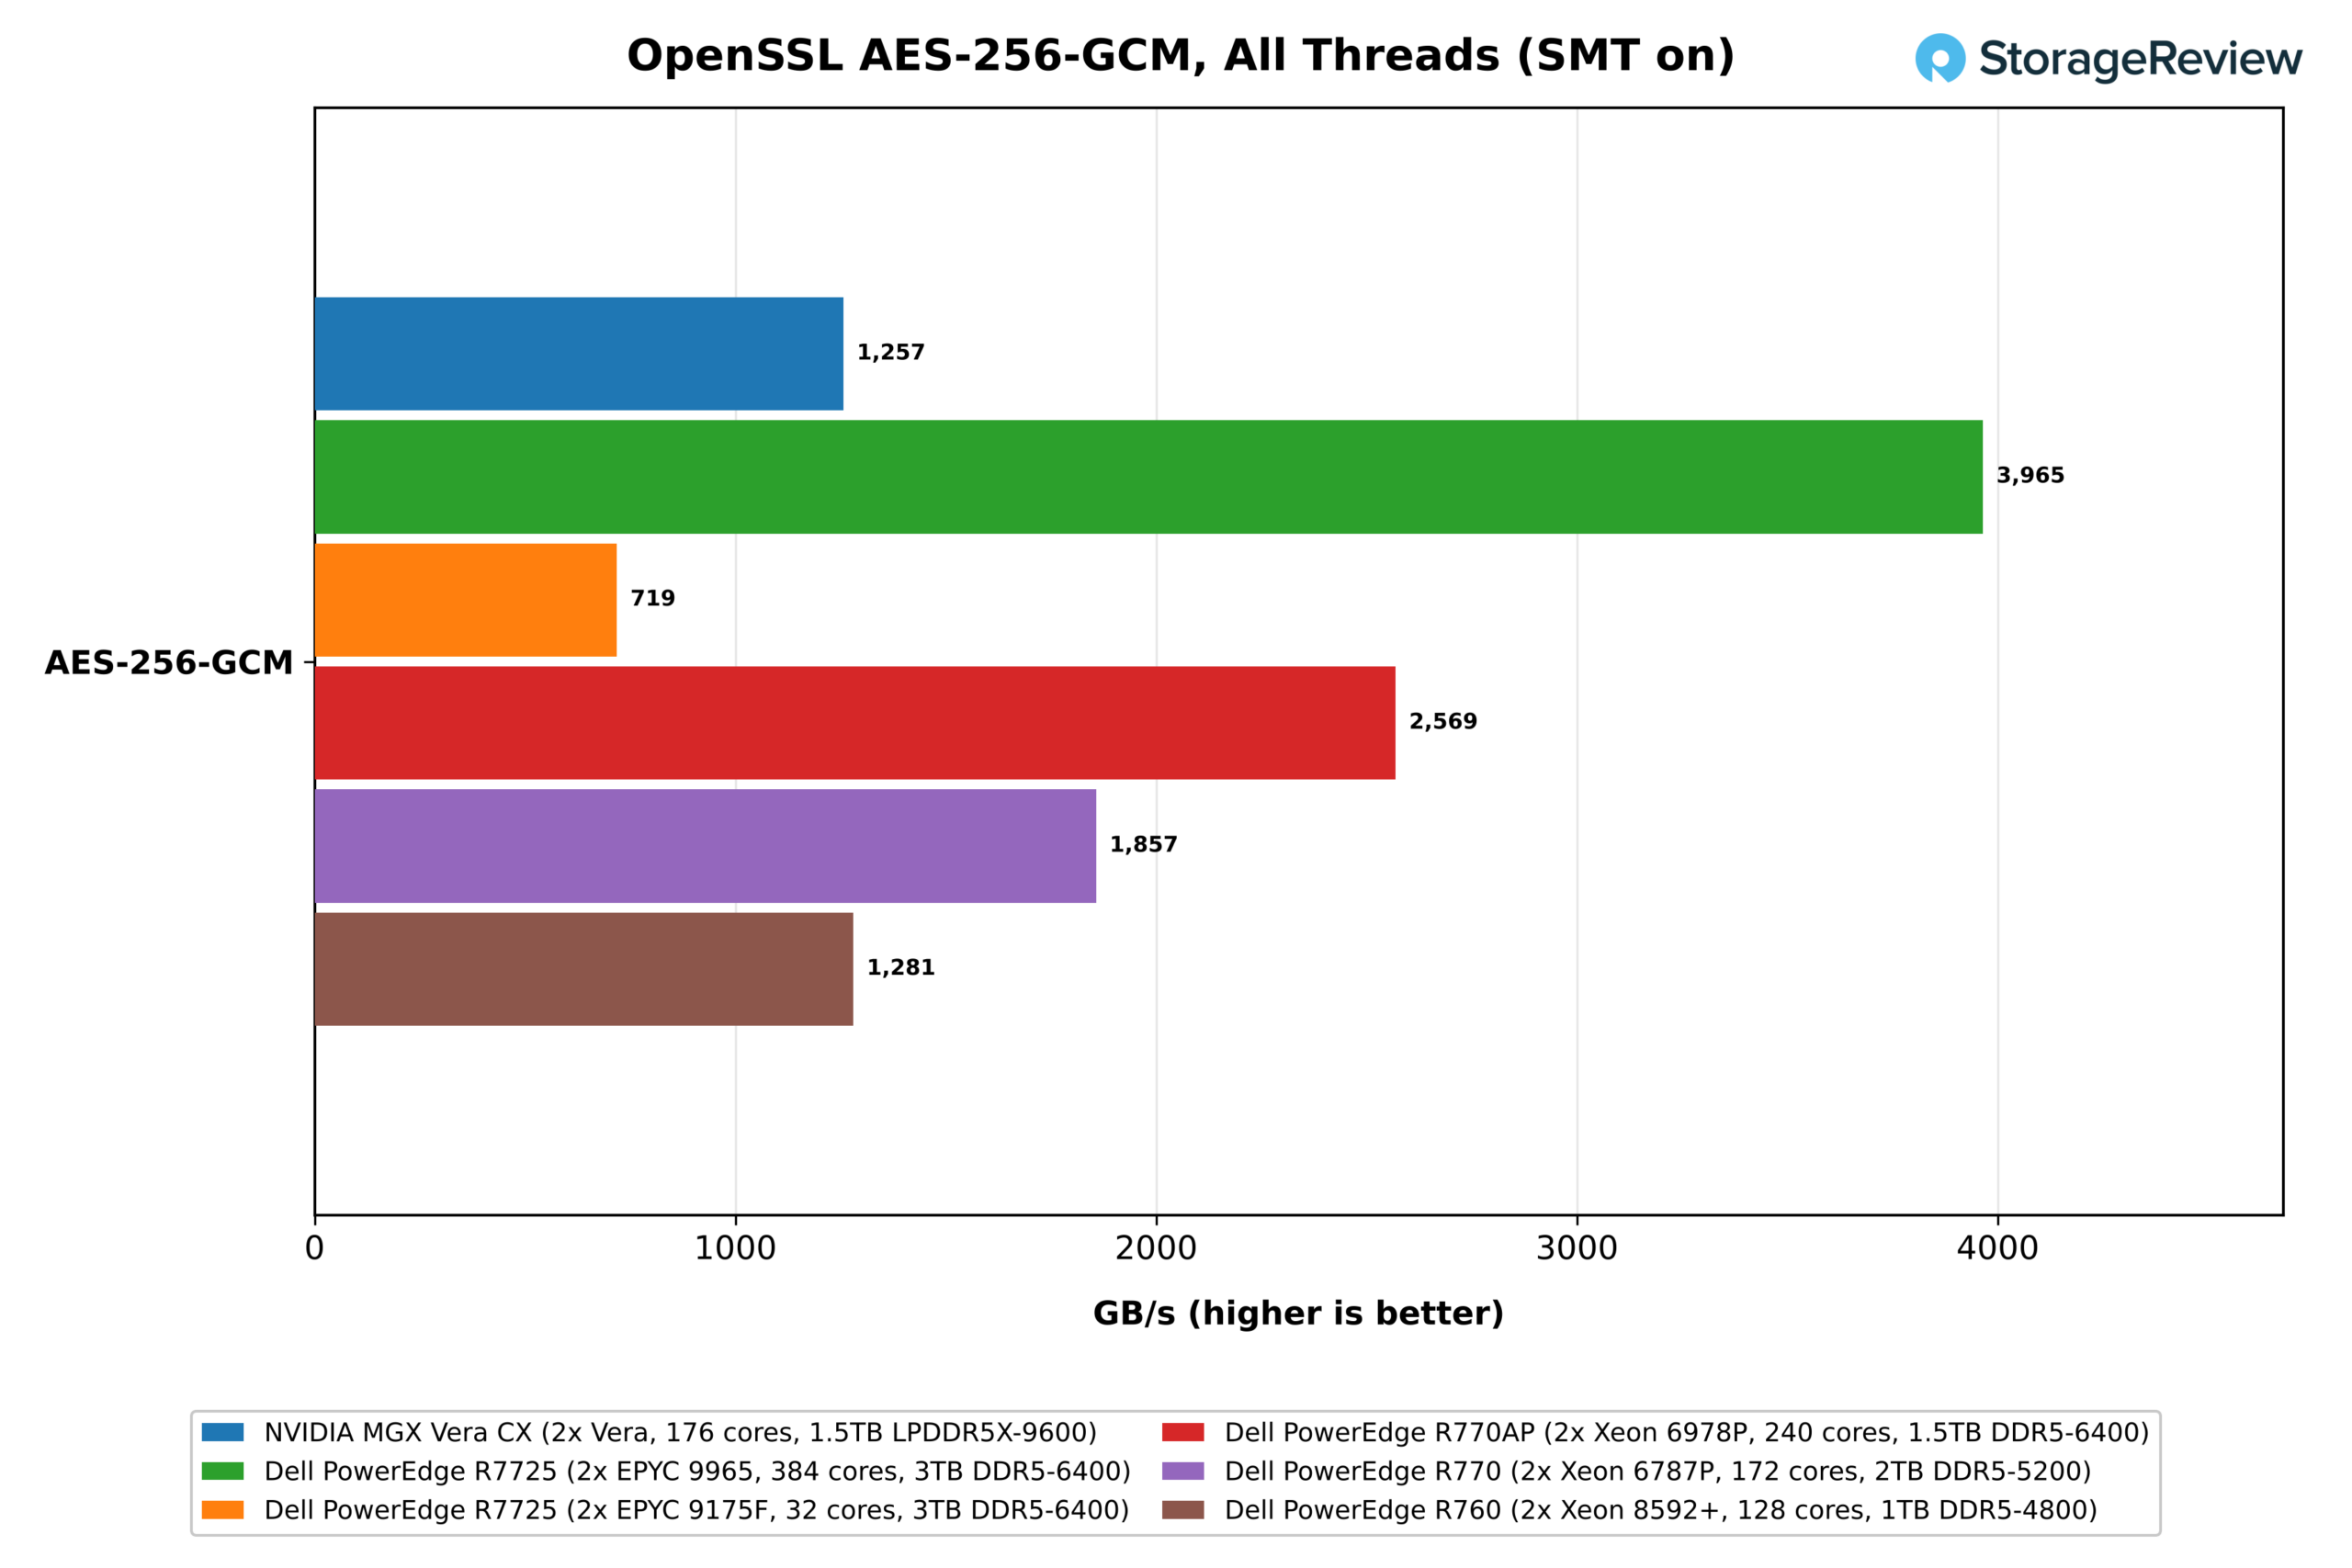
352個のスレッドすべてが稼働している状態で、Veraは1.26TB/sの速度を達成し、128コアのXeon 8592+の1.28TB/sと同等の性能を示し、32コアのEPYC 9175Fをわずかに上回りました。EPYC 9965は3.96TB/sでトップとなり、Veraの約3倍の速度を記録しました。続いてXeon 6978Pが2.57TB/s、6787Pが1.86TB/sとなりました。
Python
Pythonは、NVIDIAがVeraでターゲットとしているエージェントサンドボックスの中核を成す言語であり、pyperformanceは、オブジェクトを多用するゲームツリー検索であるgo、正規表現をコンパイルするregex_compile、浮動小数点物理シミュレーションであるnbodyという、3つの固定シングルスレッドテストを提供しています。ここでソフトウェアの違いが1つあります。VeraはUbuntu 26.04のPython 3.14.4を実行しましたが、x86システムはUbuntu 24.04の3.12.3を実行しました。新しいリリースでは、インタープリタの速度が向上しています。
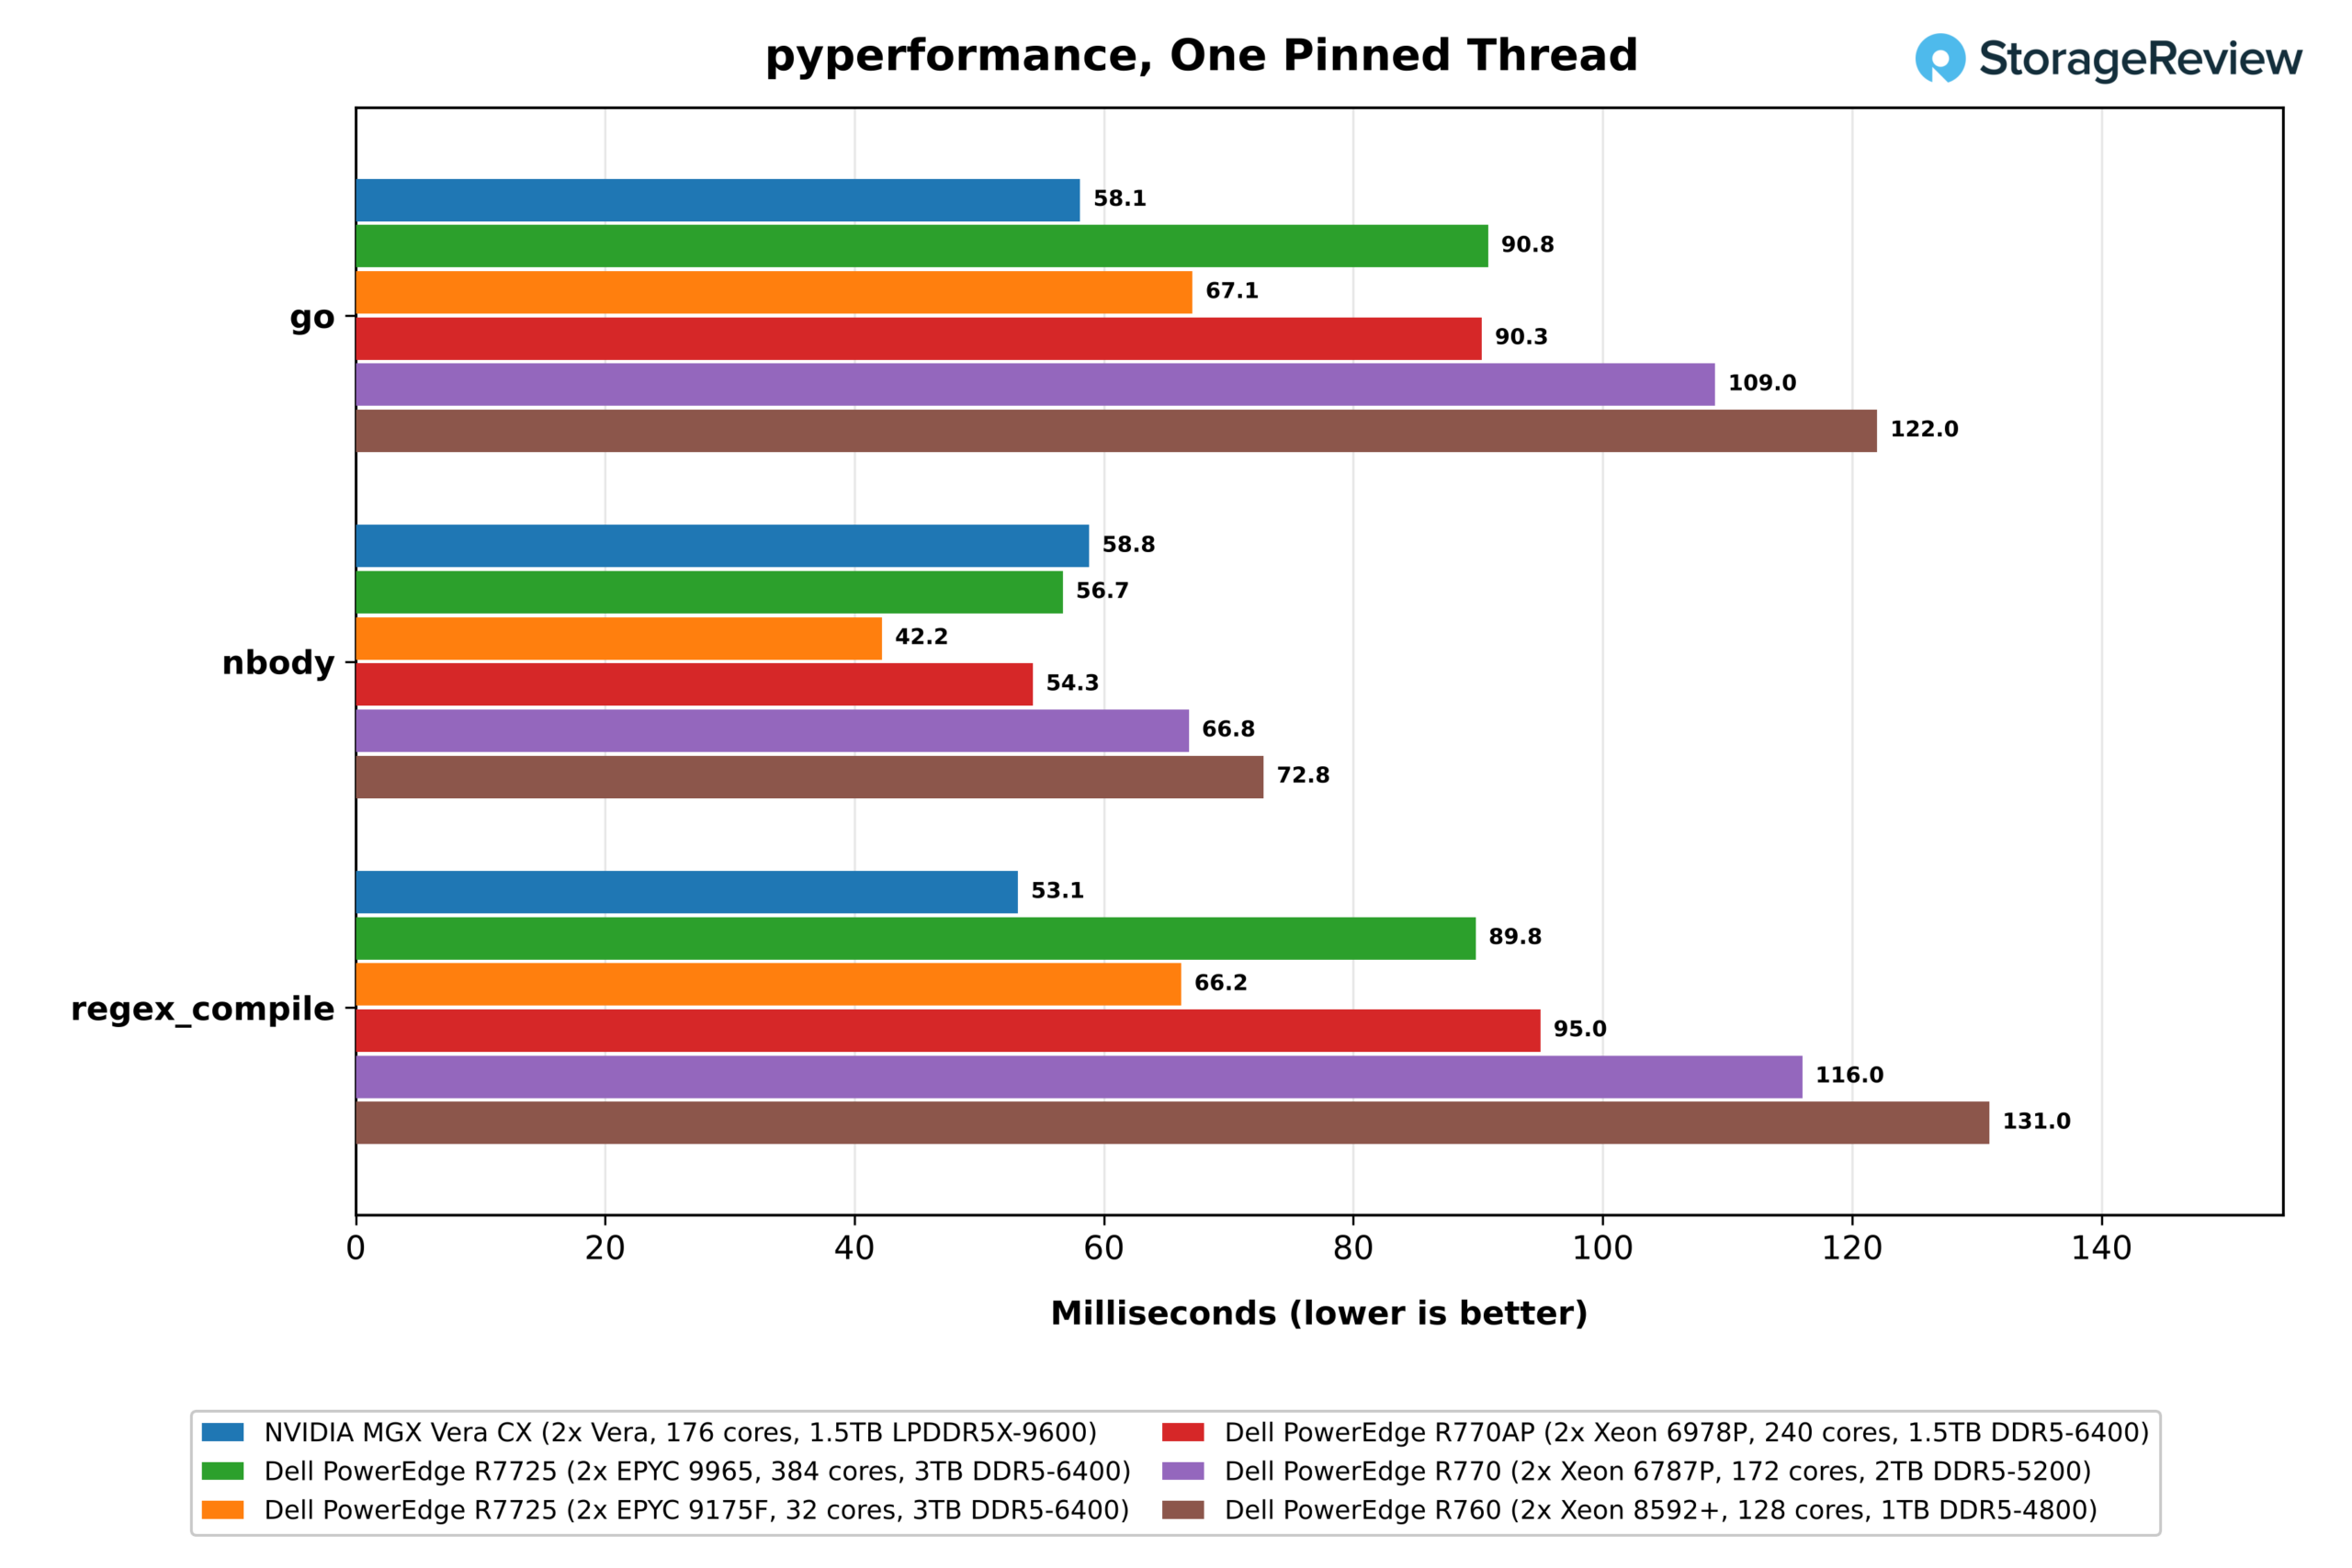
Veraは、分岐が多くオブジェクト指向コードが多用される2つのテストで勝利しました。goは58.1msで完了し、最速のx86コアであるEPYC 9175Fよりも15%速く、他のコアよりも1.6倍から2.1倍高速でした。regex_compileはさらに大きな差を示し、53.1msで完了し、9175Fよりも25%速く、EPYC 9965よりも1.7倍高速でした。Veraにはより新しいPythonも搭載されているため、両方の差は上限値として読み取ってください。
誰も逆の方向へ進むことはなかった。短い浮動小数点ループと小さなワーキングセットは高クロックを有利にする傾向があり、5.0GHzの9175Fは42.2msで勝利し、Veraの58.8msよりも39%高速だった。Xeon 6978PとEPYC 9965も、Veraの新しいPythonを使用した場合でも、54.3msと56.7msでVeraを上回った。
ウェブサーバー、JVM、およびスケジューラのレイテンシ
最後のハーネステスト群は、アプリケーションを取り巻くソフトウェア、すなわちWebスタック、Java仮想マシン、Linuxスケジューラ、コンパイラツールチェーンを対象としています。これらの結果は、各システムが実行するスレッド数と各コアの処理速度に大きく依存するため、以前のセクションほどOlympus自体の性能を示すものではありませんが、Veraサーバーが一般的なサーバーソフトウェア環境下でどのように動作するかを示しています。
nginxの
NGINXはHTTPSリクエストを同じマシン上で動作するwrk負荷ジェネレーターに処理するため、クライアントとサーバーは同じコアを競合し、その結果は生のコア数よりもTLSおよびHTTPスタックをより反映するものとなる。
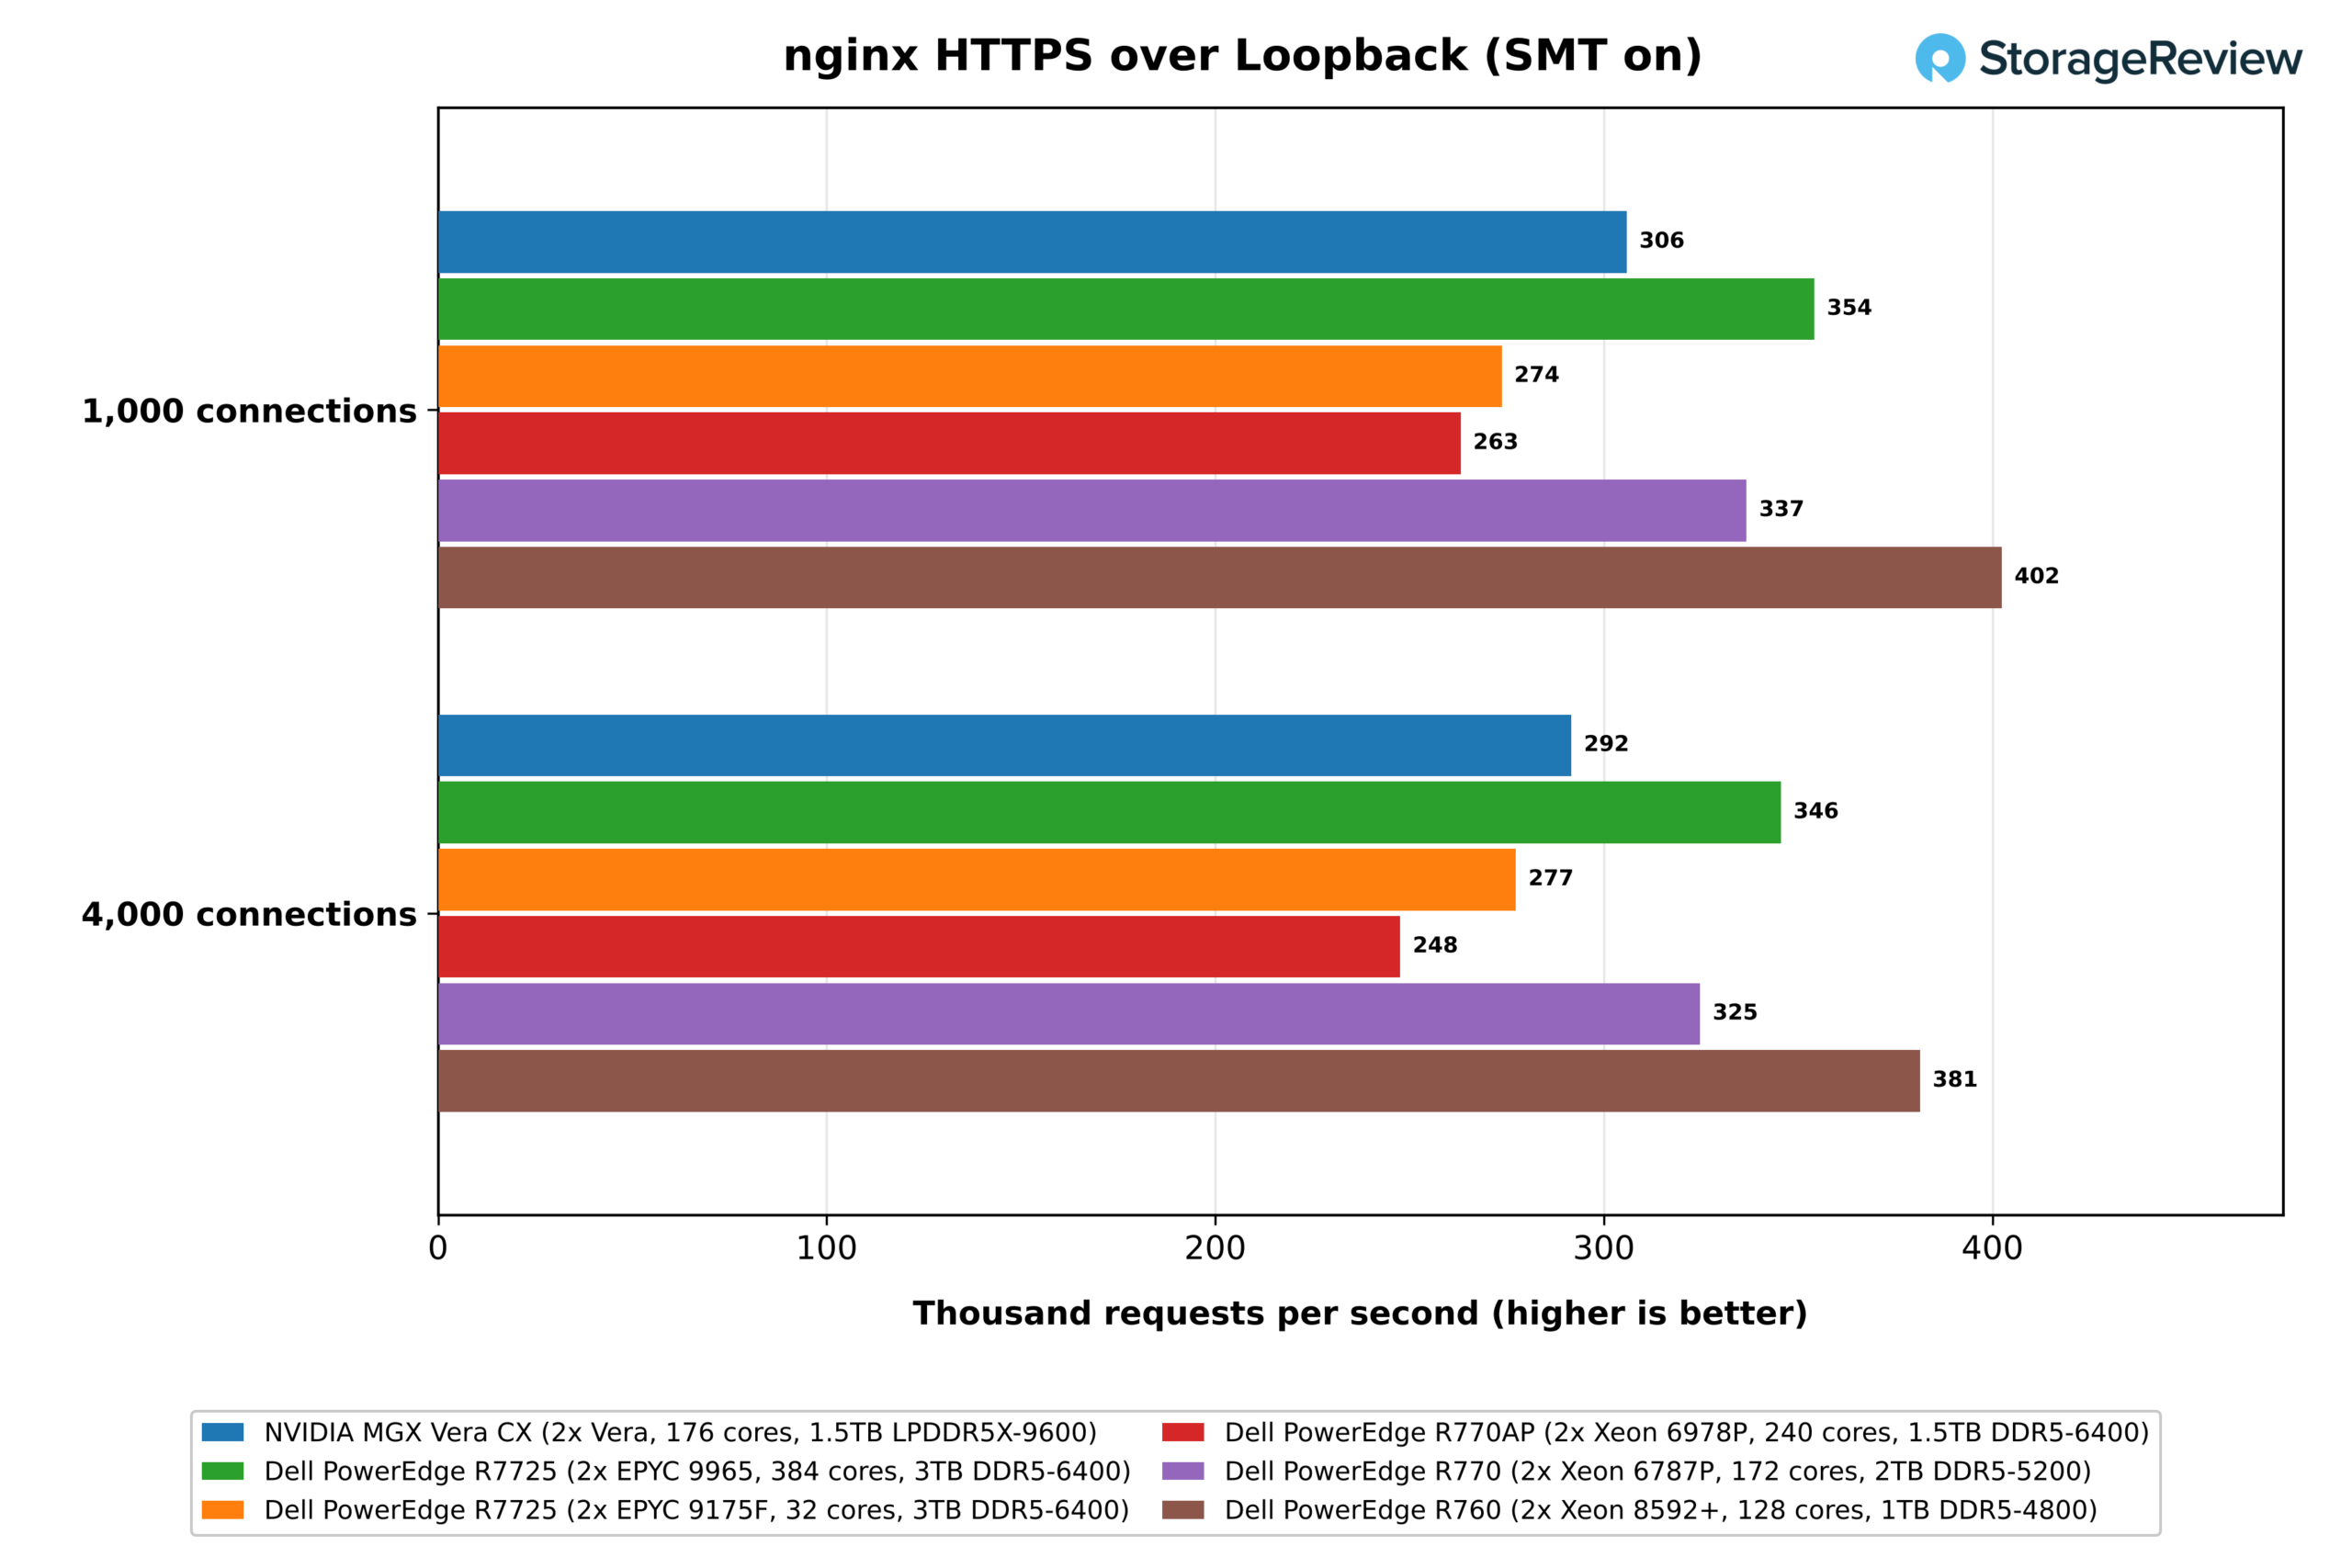
SMT をオンにした状態で、Vera は 1,000 接続で毎秒 306,000 リクエスト、4,000 接続で毎秒 292,000 リクエストを処理しました。これは、Xeon 6978P の 263,000 から Xeon 8592+ の 402,000 までの範囲の中間に位置します。EPYC 9965 は 354,000、Xeon 6787P は 337,000 に達し、SMT をオフにすると Vera は 330,000 まで向上しました。Vera のネットワーク スタックは、x86 システムと遜色ありません。
復元力
RenaissanceはOpenJDK 11上でJavaワークロードを実行します。Finagle HTTPテストはScalaネットワークスタックを、Akkaテストはアクターモデル並行処理フレームワークをテストします。どちらのテストもJVMが認識できるすべての論理CPUに処理を分散させるため、SMTを有効/無効にして実行しました。
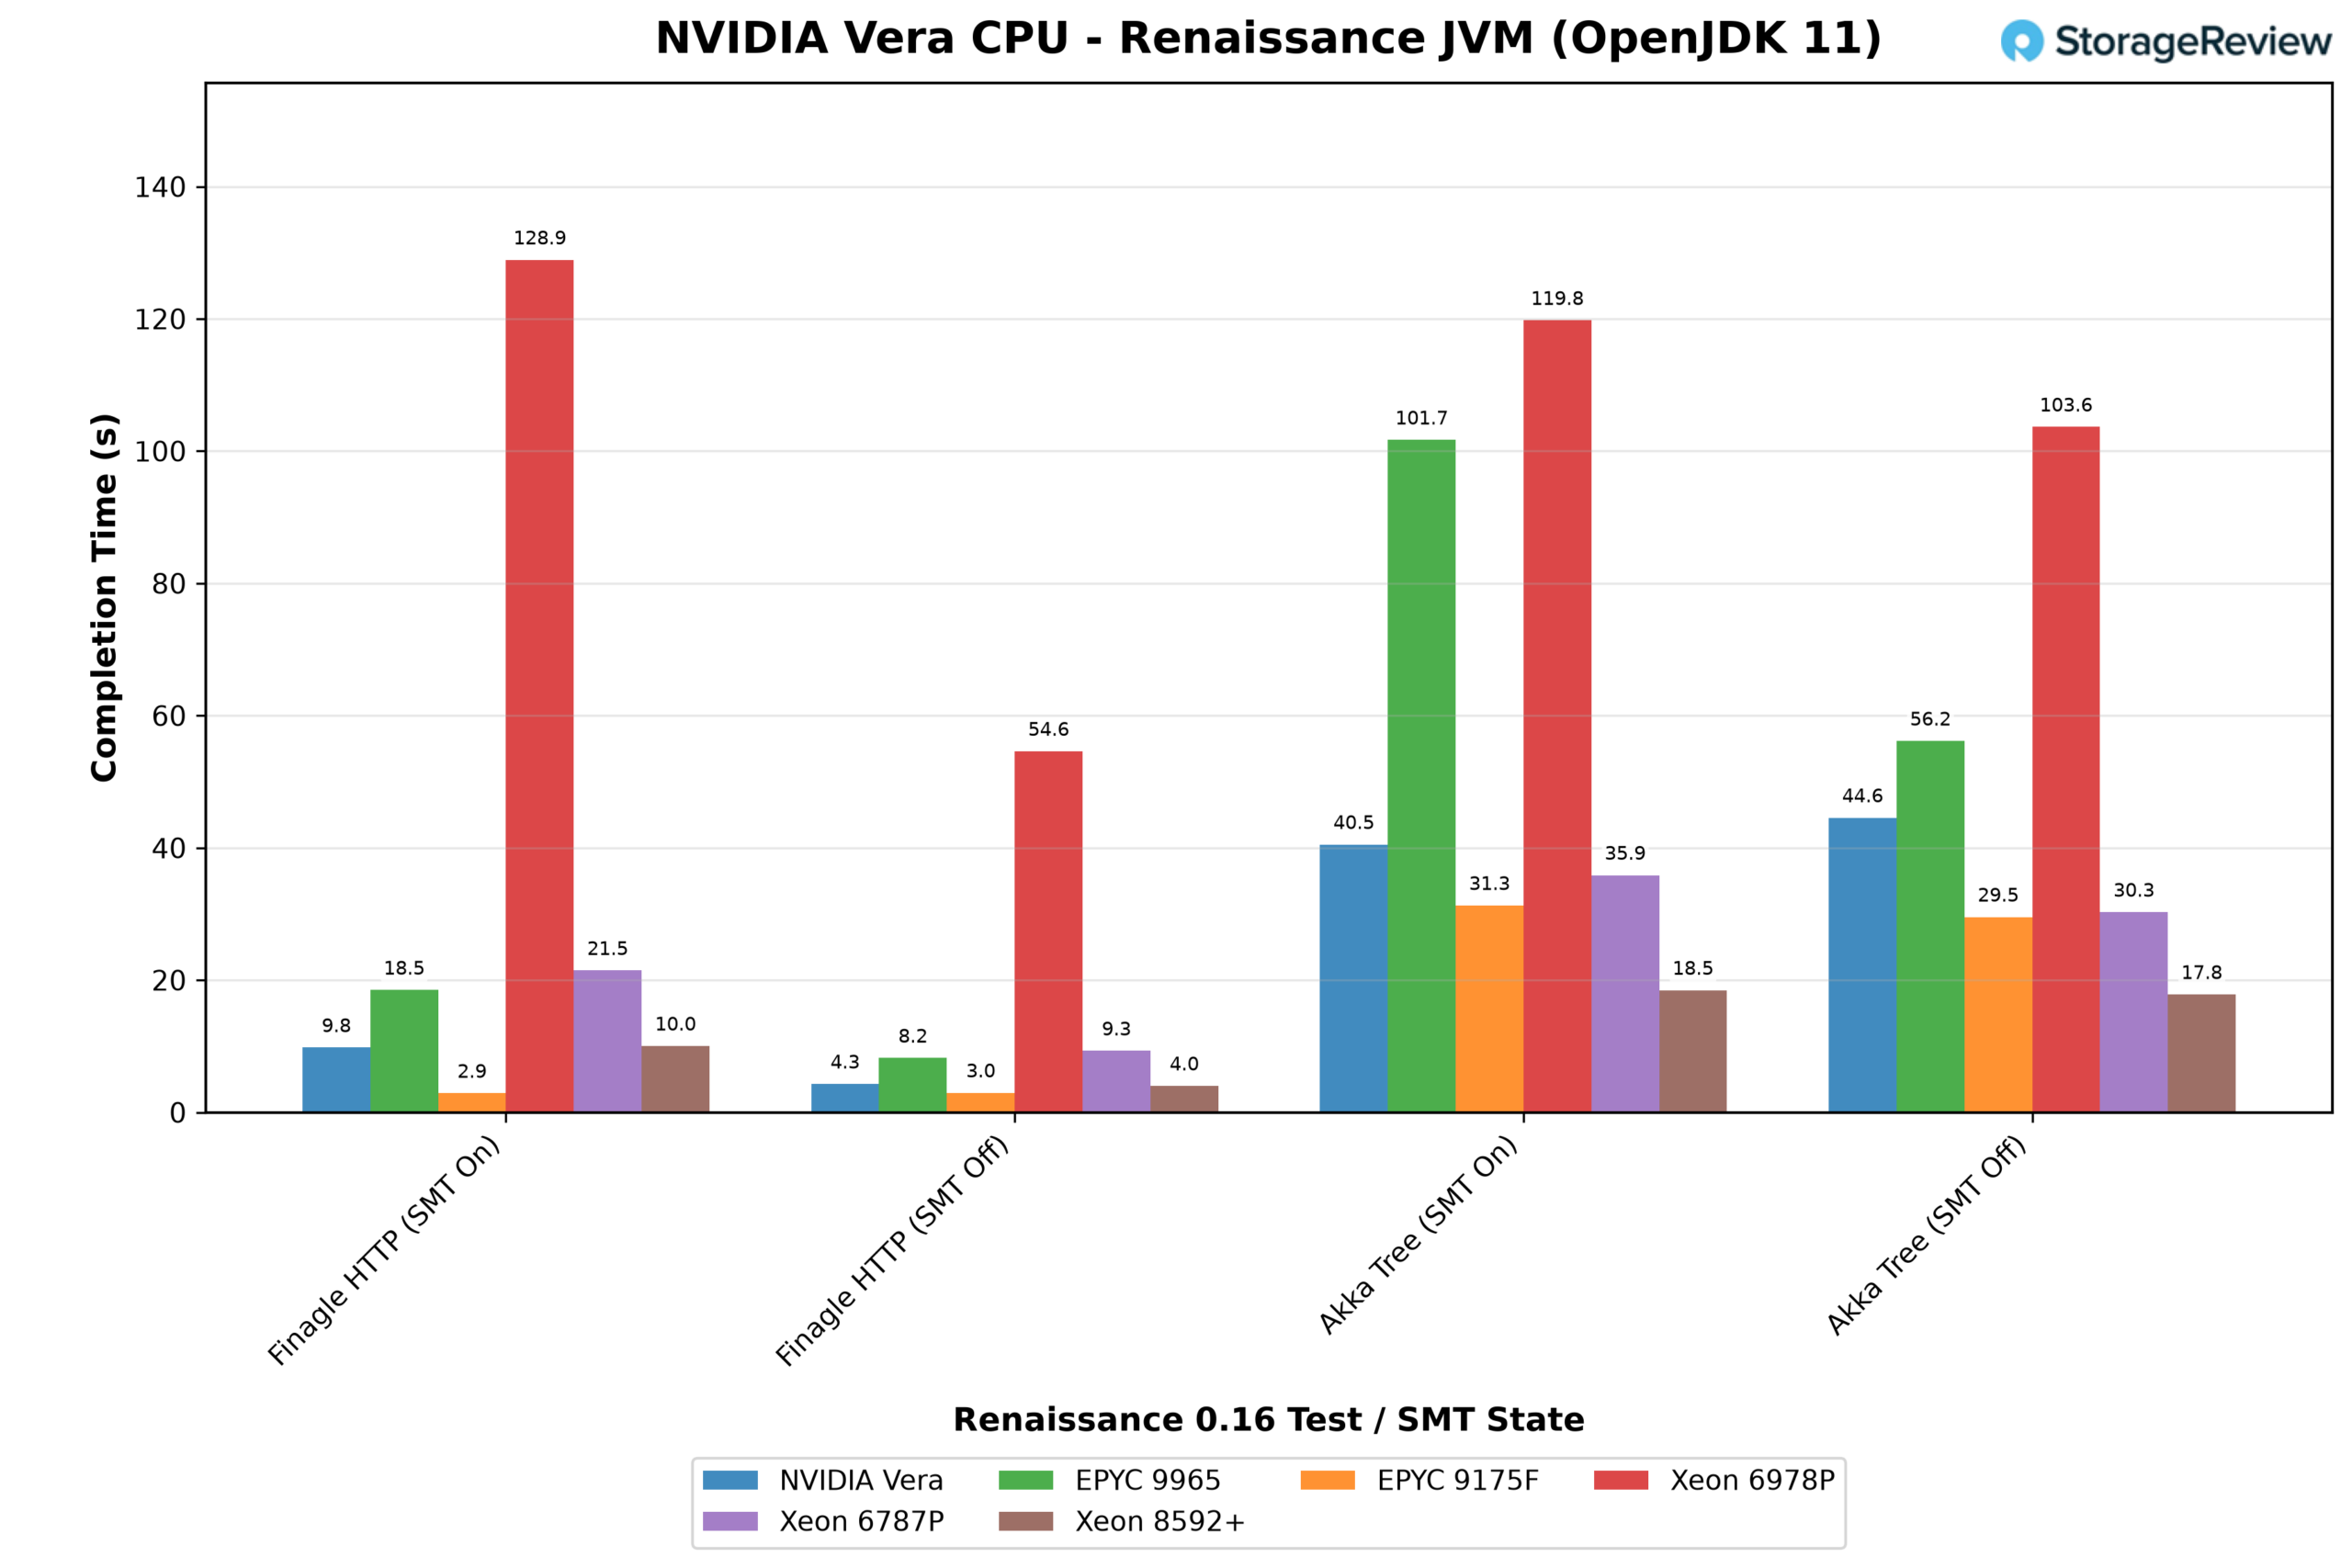
Finagleはスレッド数を減らすと高速化します。SMTをオフにするとスレッド数が半分になり、Veraの処理時間は9.8秒から4.3秒に短縮され、より大規模なx86システムでも同様に2.3倍から2.5倍の高速化が実現しました。元々スレッド数が少ない32コアのEPYC 9175Fは、いずれの場合も約3秒でトップでした。
AkkaはXeon 8592+を最も有利とし、SMTのオン/オフに関わらず約18秒で完了した。一方、VeraはSMTオンで40.5秒かかり、最も規模の大きい2つのシステムであるEPYC 9965とXeon 6978Pはそれぞれ101.7秒と119.8秒と最も遅かった。3番目のRenaissanceテストである遺伝的アルゴリズムは、6978Pを除くすべてのシステムでSMTオンで1.6秒から2.6秒で完了し、Veraは2.6秒だった。
シュベンチ
schbenchは、Linuxスケジューラがワーカー スレッドを起動する速度を測定します。4 つのメッセージ スレッドでは、論理 CPU あたり約 1 つのワーカー、32 のメッセージ スレッドでは、CPU あたり約 8 つのワーカーが実行されます。ワーカーの数はシステム規模に応じて増加するため、大規模なサーバーほど多くの処理を実行します。したがって、これらの結果は各マシンでフルロード時のレイテンシを表しており、単純な比較ではありません。
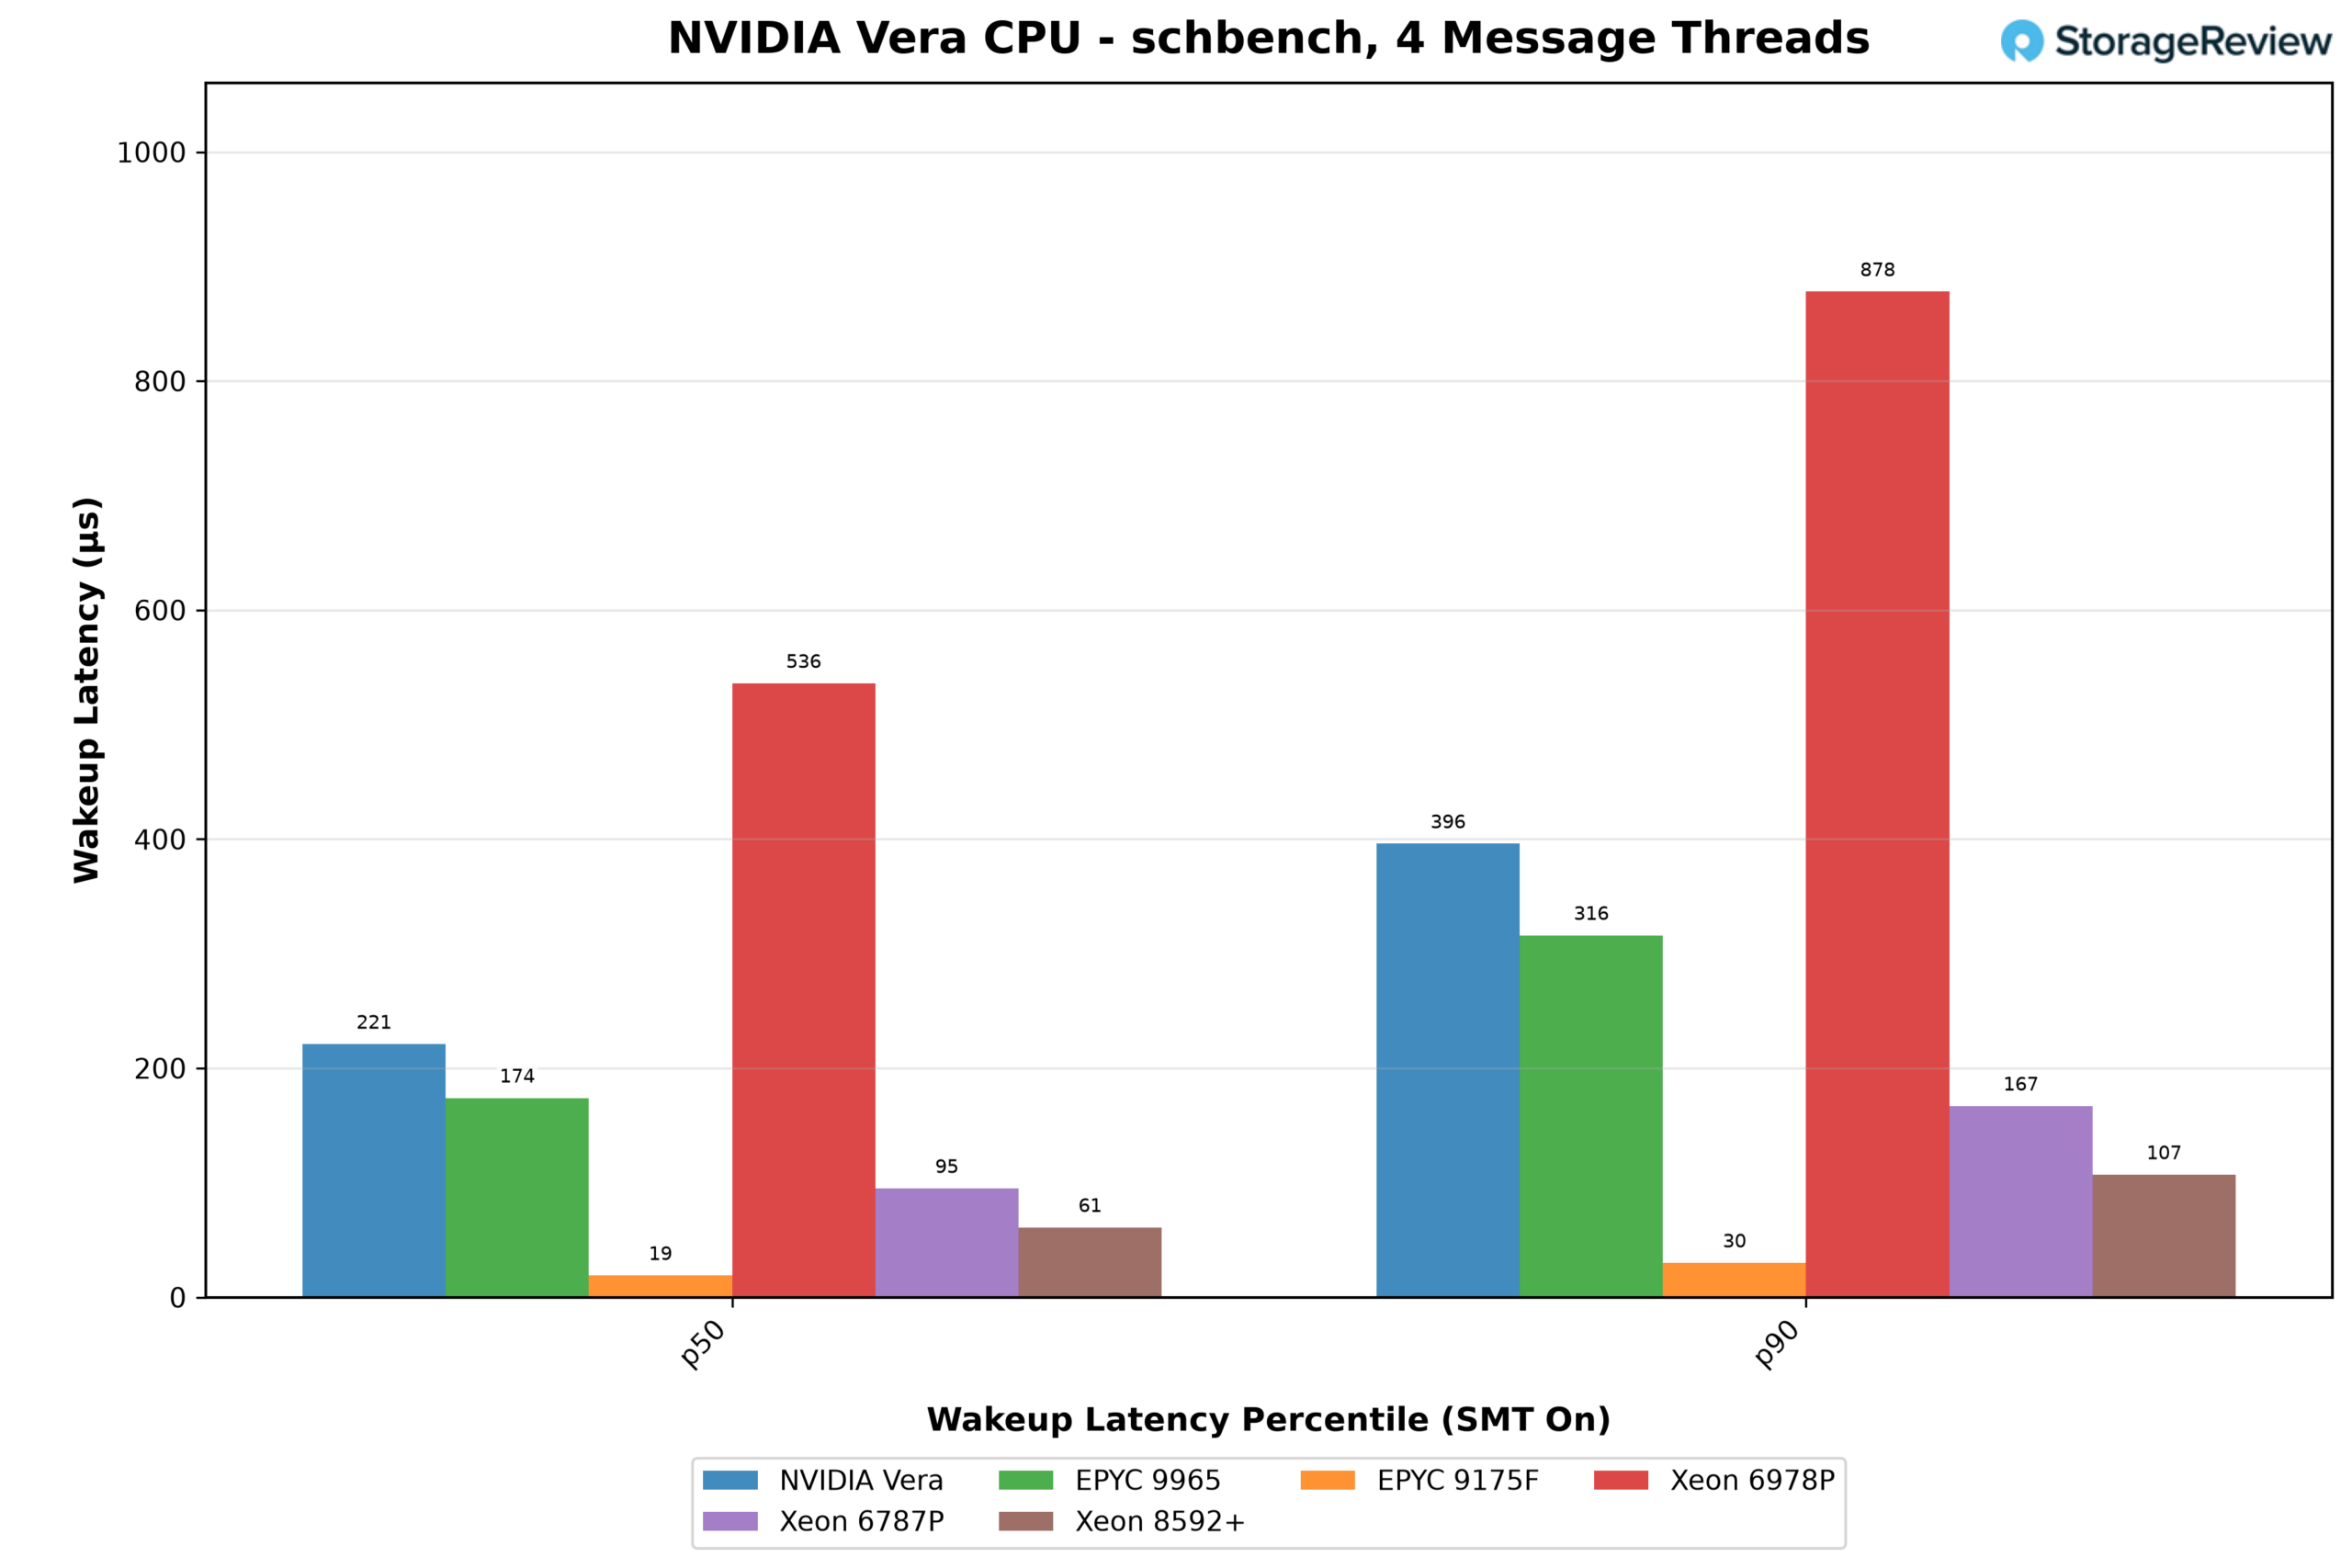
4つのメッセージスレッドを使用した場合、Veraのウェイクアップレイテンシの中央値は221µs、p90値は396µsで、Xeon 6978Pの536µsと878µsを除くすべてのシステムよりも高かった。最小構成のマシンではスレッドのウェイクアップが最も速く、32コアのEPYC 9175Fが19µs、128コアのXeon 8592+が61µsだった。
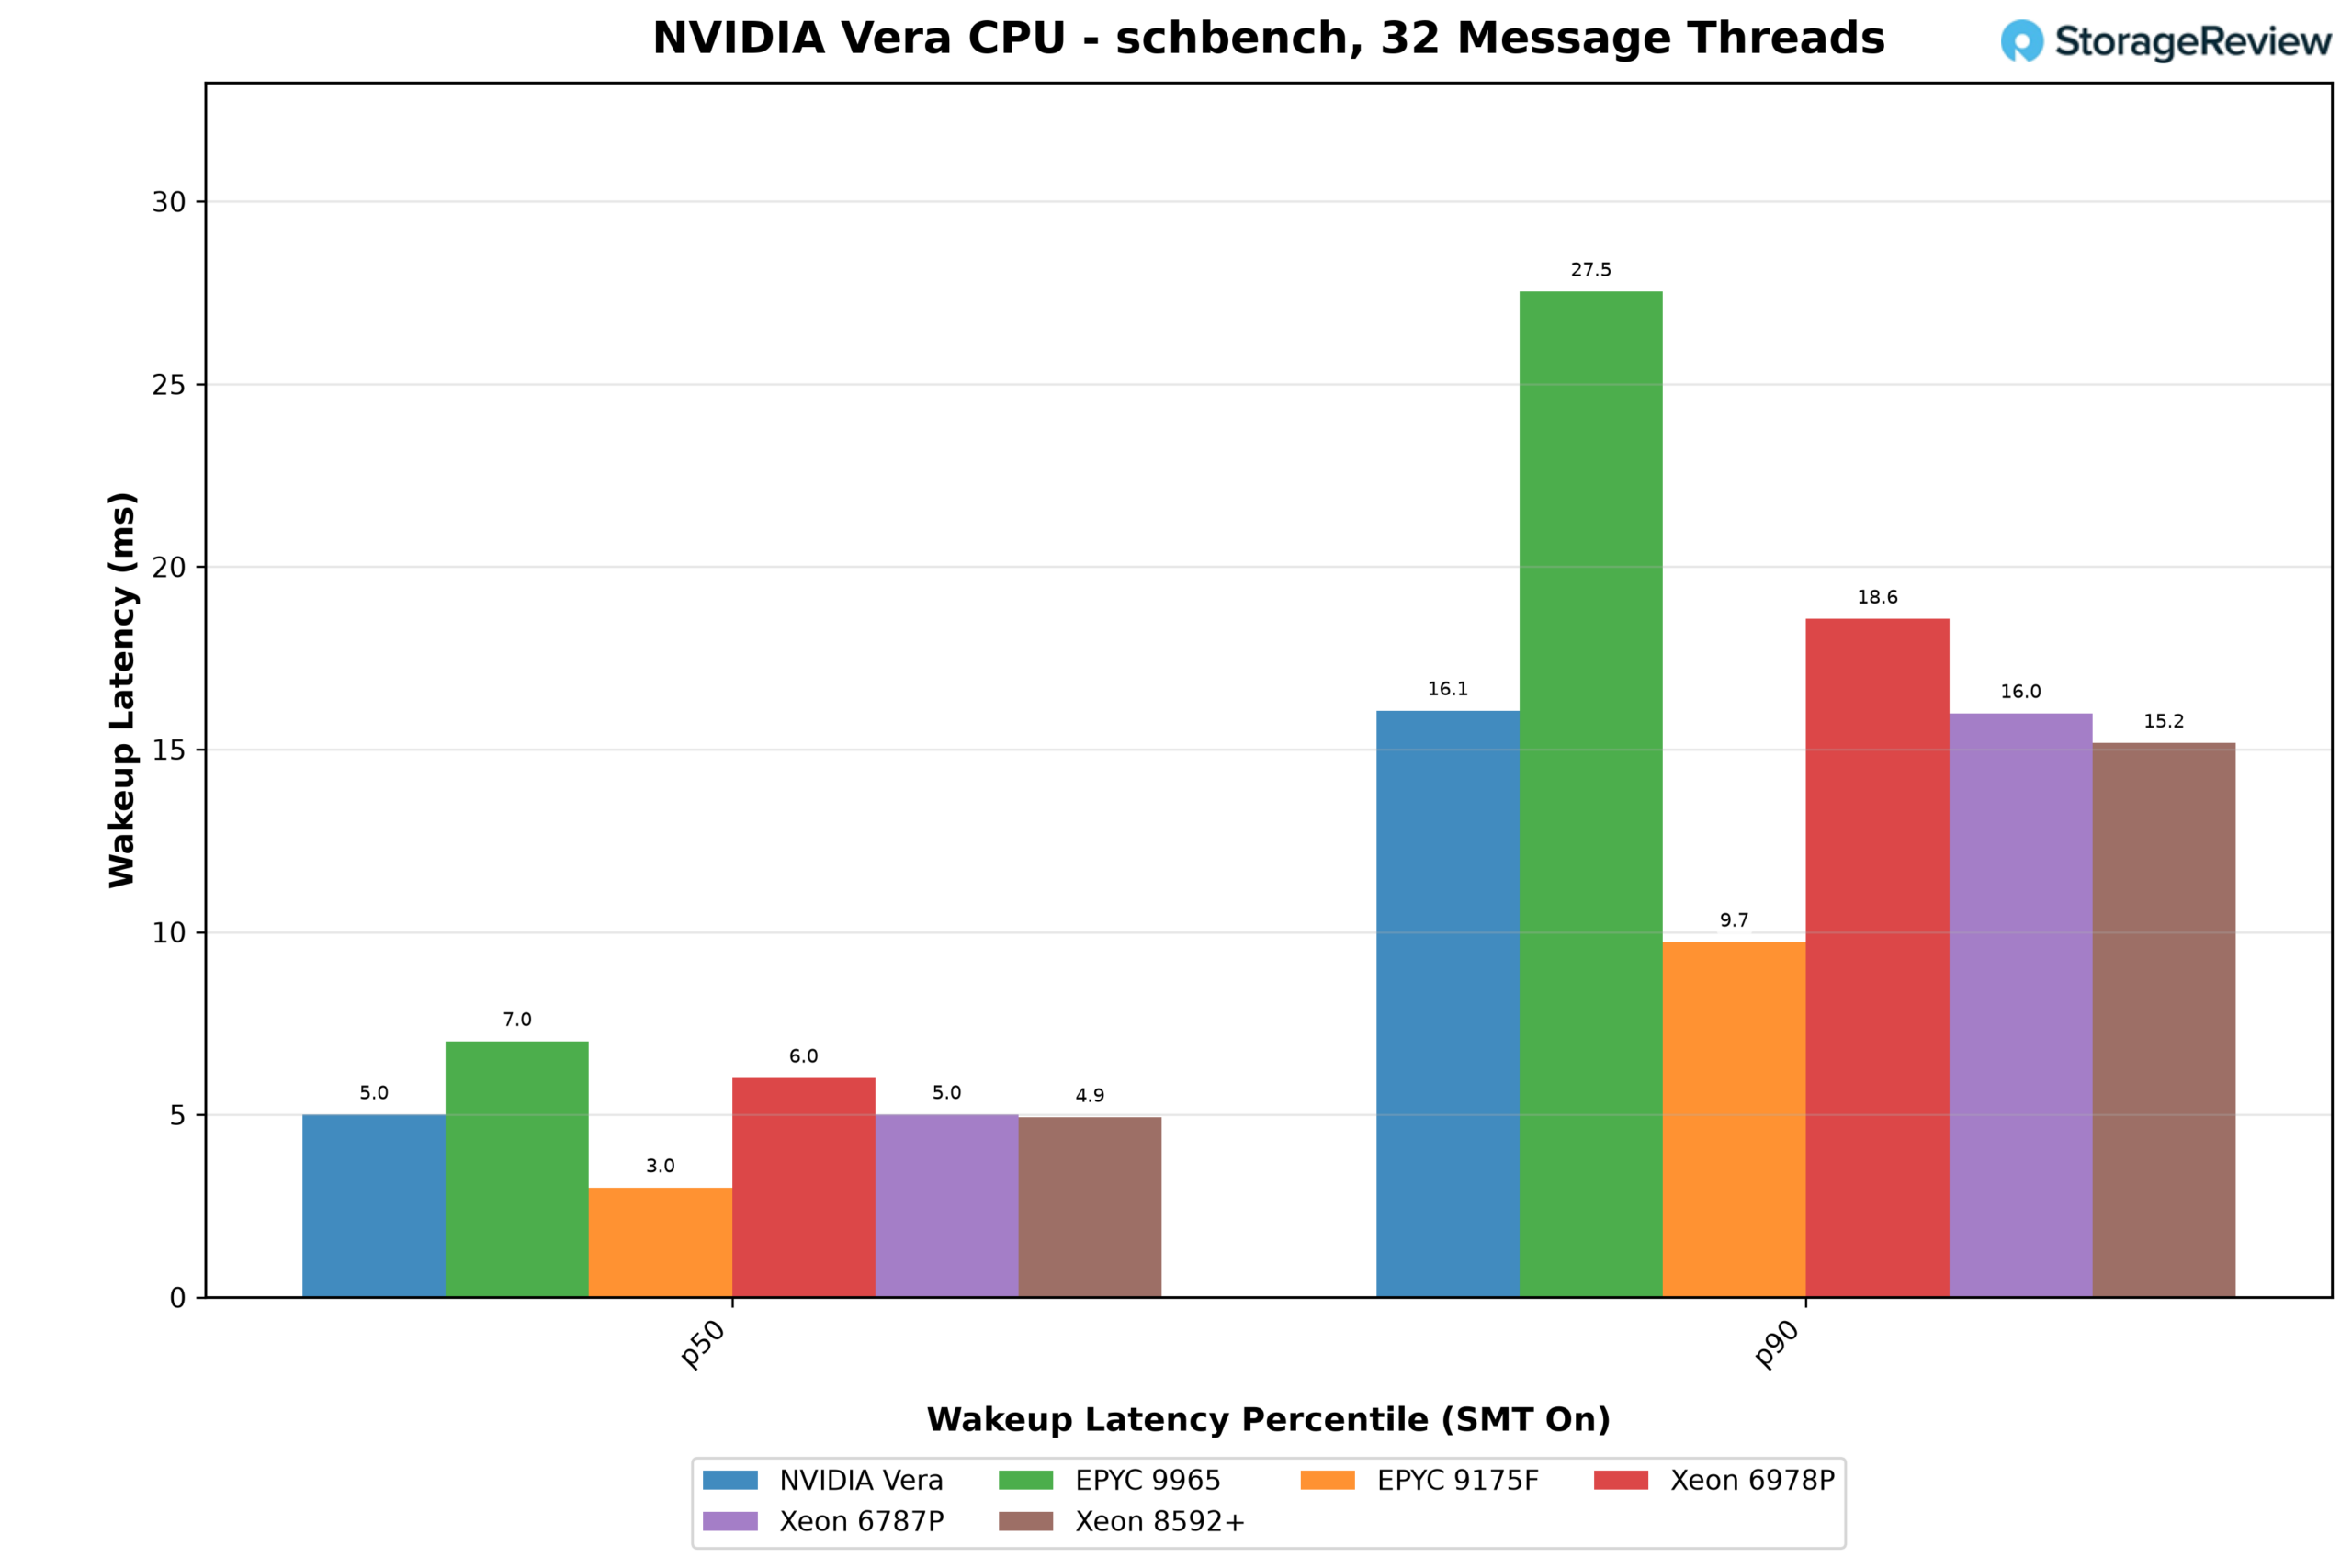
32個のメッセージスレッドで処理能力がオーバーサブスクライブされたVeraは、中位に位置づけられた。その平均応答時間5.0ms、p90応答時間16.1msは、Xeon 6787Pおよび8592+と同等であり、Xeon 6978PとEPYC 9965(p90応答時間27.5ms)の両方を上回った。明らかに高速だったのは9175Fのみで、応答時間は3.0ms、p90応答時間は9.7msだった。
Linuxカーネルのビルド
Linuxカーネルのallmodconfigビルドは、このセクションでランキング付けしない唯一の結果です。Veraはarm64カーネルツリーをコンパイルしますが、これは他のシステムがビルドするx86-64ツリーとは異なるモジュールとドライバのセットを含んでおり、クロスコンパイルは試みませんでした。
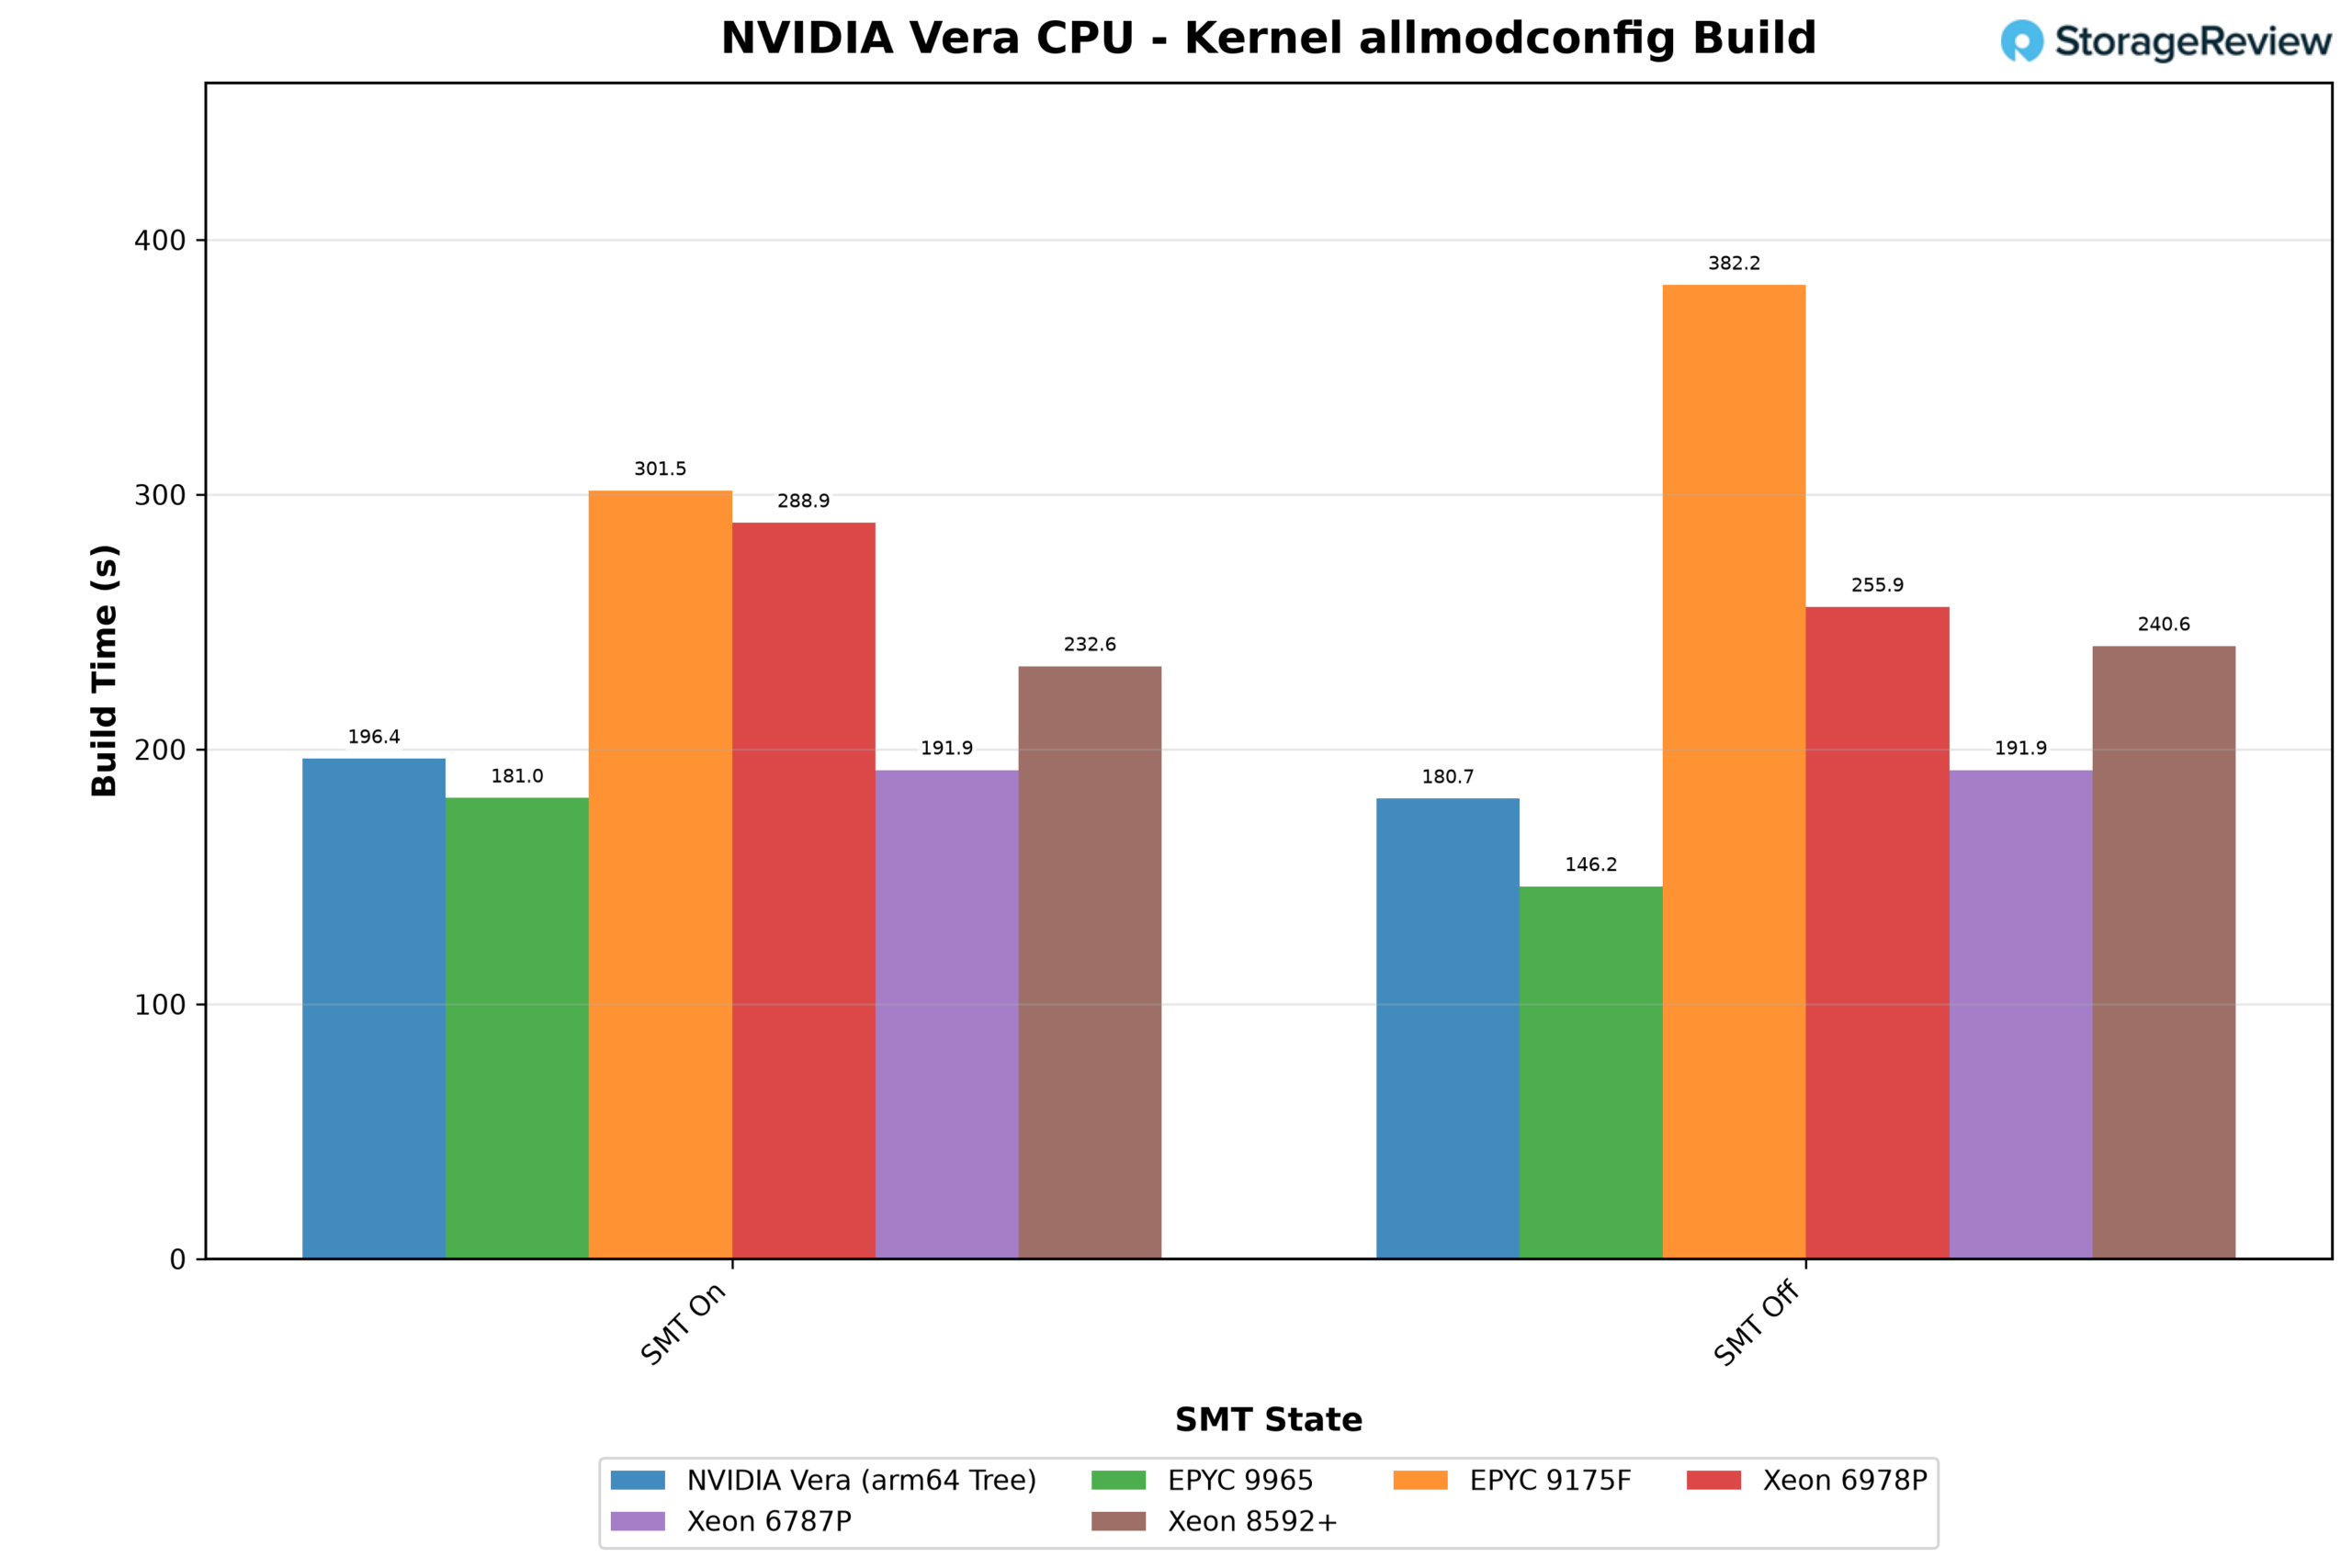
VeraはSMTオフで180.7秒、SMTオンで196.4秒でツリーを構築したため、スレッド数の増加が構築速度を低下させた。x86システム全体では、それぞれネイティブツリーを構築した場合、SMTオフのEPYC 9965の146.2秒から、32コアのEPYC 9175Fの382.2秒まで、所要時間は幅があった。
ハンマーDB
データベースのテストでは、HammerDB の作成者兼メンテナーである Steve Shaw 氏に協力を依頼しました。Shaw 氏は、TPC-C から派生した OLTP ベンチマークである HammerDB の TPROC-C ワークロードを、Vera サーバー、EPYC 9965 を搭載した Dell PowerEdge R7725、および Xeon 6787P を搭載した PowerEdge R770 で実行しました。各サーバーで、MariaDB 12.3.3 および 13.0.2、MySQL 26.7.0、VillageSQL 0.0.7、PostgreSQL 18.6 の 5 つのオープンソース エンジンをテストしました。データベースのサイズは、物理コアあたり 16 ウェアハウス、または単一の Vera ソケットで 1,408 ウェアハウスというように、コア数に応じてスケーリングされました。
各エンジンは、1 つのソケットと 2 つのソケットで実行され、シングル ソケット実行時には 2 番目のソケットの CPU がオフラインにされました。すべてのシステムで、データベースのパフォーマンスとしては一般的であるように、1 つのソケットでより良いパフォーマンスが得られました。 15 組すべてにおいて、2 番目のソケットを追加すると、ピーク スループットが 23% ~ 47% 低下し、Vera では 29% ~ 45% 低下しました。 Shaw は、オープンソース データベースはコアが不足する前にスケーリングの上限に達することを長年発見してきました。その点を超えると、2 つのソケット間でキャッシュの一貫性を維持するコストが、追加されるコアのコストよりも高くなります。そのため、以下のグラフに示すように、シングル ソケットの結果に焦点を当てます。
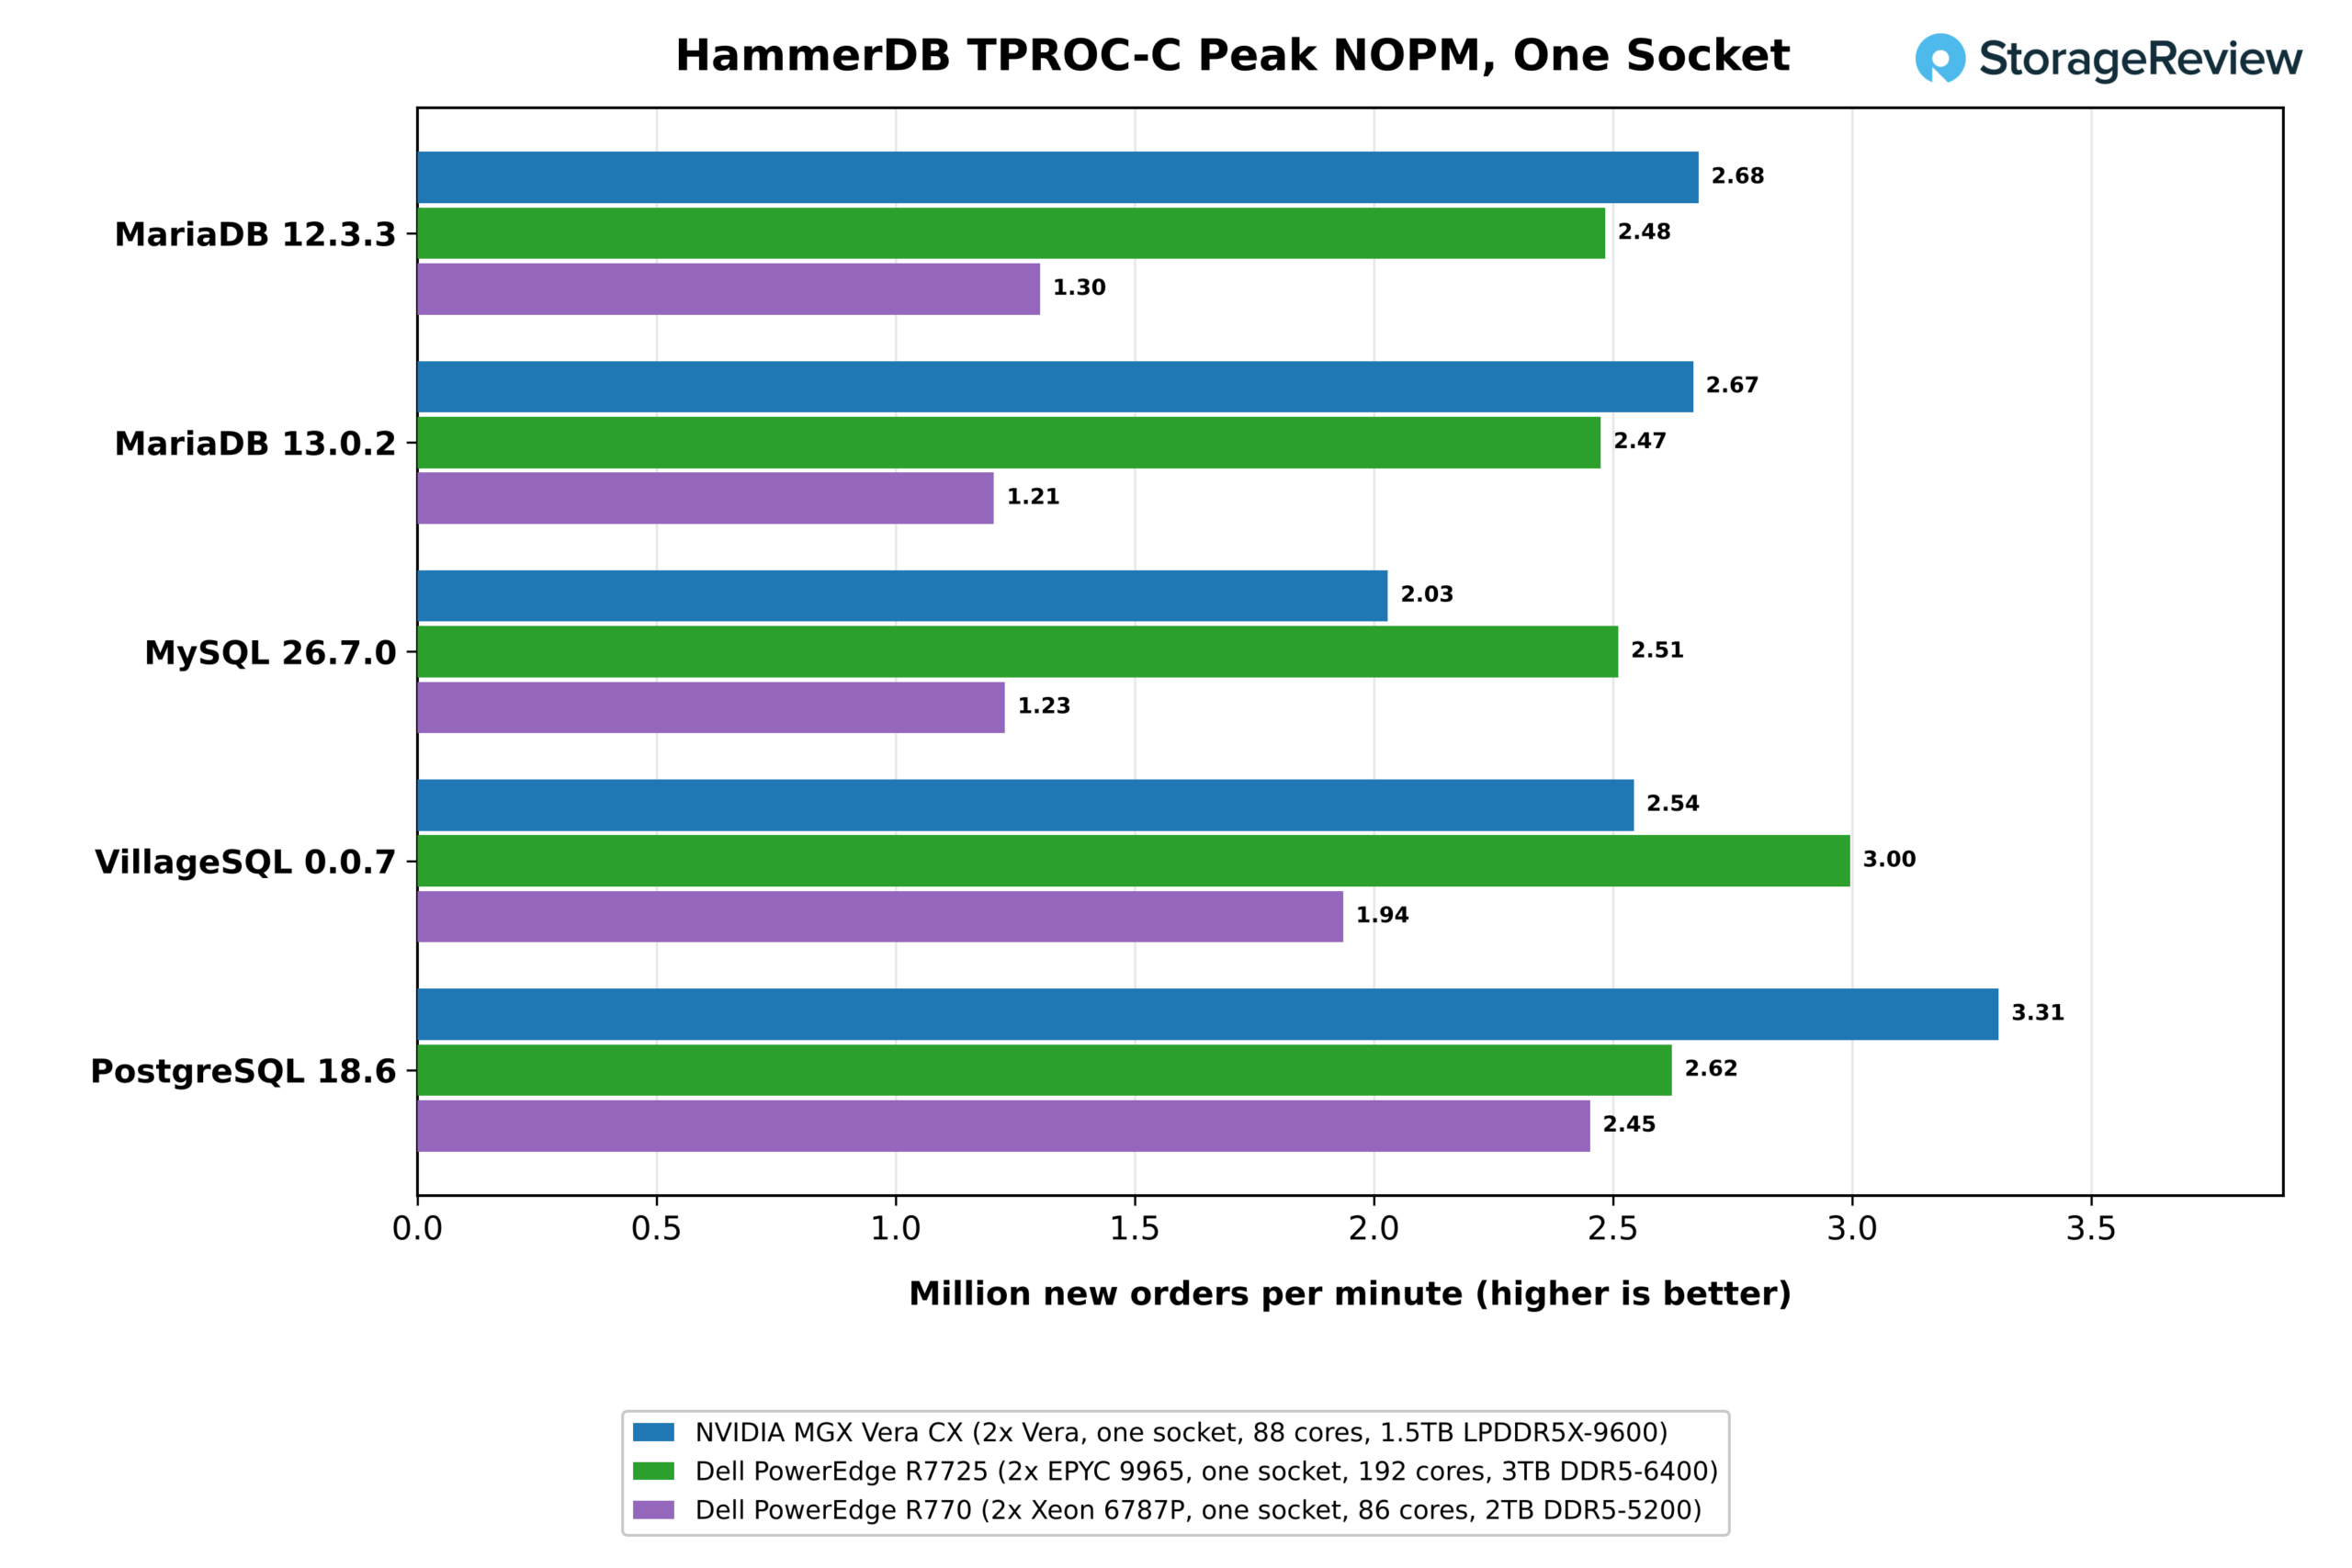
あるソケットでは、88個のVeraコアが5つのエンジンのうち3つでリードしました。PostgreSQL 18.6では、128人の仮想ユーザーで1分あたり3.31万件の新規注文(NOPM)を記録し、Veraが最大の差をつけました。これは、192コアのEPYC 9965ソケットでの2.62万件、86コアのXeon 6787Pでの2.45万件と比較したものです。MariaDBの2つのリリースもVeraが優位に立ち、それぞれ2.68万件と2.67万件を記録しました。これは、EPYCでの2.48万件と2.47万件と比較したものです。AMDはMySQL 26.7.0で2.51万件を記録し、Veraの2.03万件を上回りました。VillageSQLでは、VMDが3.00万件を記録し、Veraの2.54万件を上回りました。Xeonは5つのエンジンすべてで1.21万件から2.45万件の差で後れを取り、MariaDBの結果はVeraの半分以下でした。
この差は、各エンジンのスケーリング方法に起因するものと考えられる。PostgreSQLのプロセス/接続モデルとMariaDBのInnoDBは、共有メモリトラフィックが多い多数のコアに処理を分散させるため、STREAMで各Veraソケットが維持した1TB/秒を超えるローカル帯域幅が活きる。MySQLとVillageSQLは内部ロック競合に早く陥るため、結果は各コアがクリティカルセクションをどれだけ早くクリアできるかに大きく依存し、そこで9965が優位に立つ。10月のラウンド後、ShawはArmを全体的に最速のプラットフォームと判断し、「Armは間違いなく競争力のあるデータベースサーバーとして登場した」と述べたが、以前テストしたシングルソケットの96コアEPYCがわずかに上回る可能性もあると付け加えた。
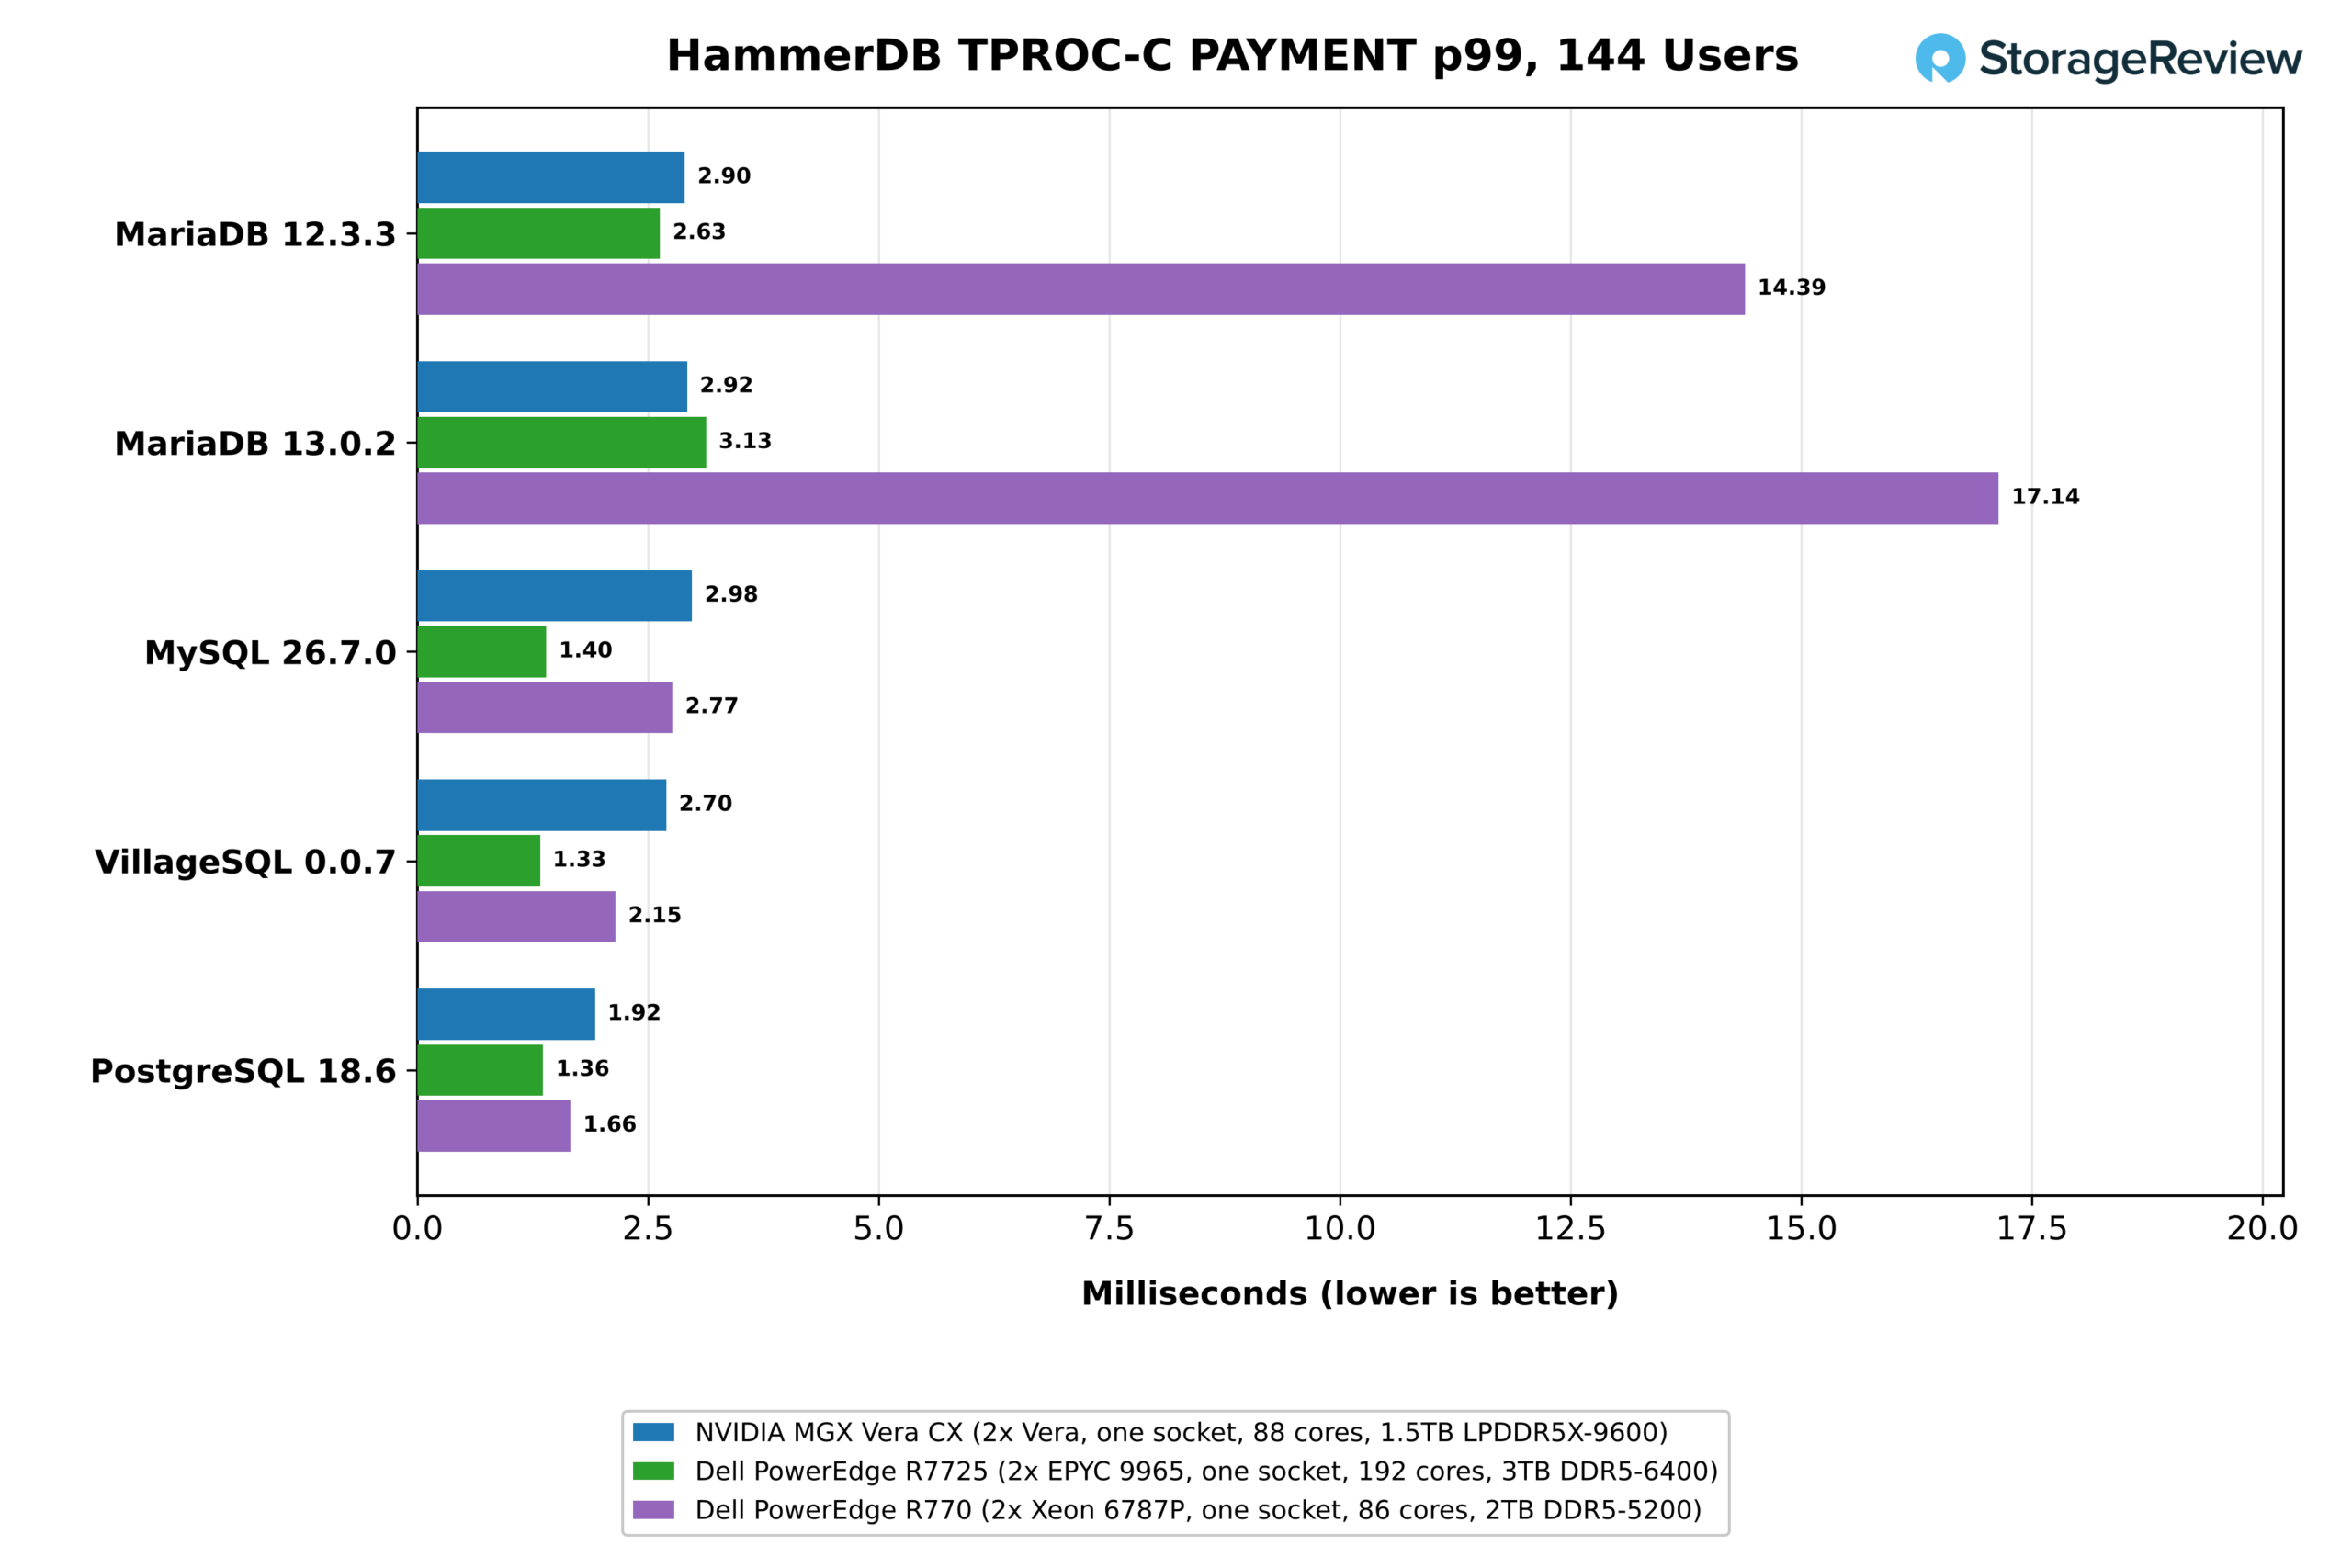
144 人の仮想ユーザーで負荷を合わせた場合のテールレイテンシは、同じ分割を示しています。Vera の PAYMENT p99 レイテンシは、PostgreSQL で 1.92 ms、MySQL で 2.98 ms でした。EPYC 9965 は、MySQL、VillageSQL、PostgreSQL で 1.33 ms ~ 1.40 ms で、Vera より 29% ~ 53% 低い値でしたが、MariaDB 13.0.2 での 3.13 ms は Vera の 2.92 ms を下回りました。Xeon 6787P の MariaDB テールは 14.4 ms と 17.1 ms で、どちらも数倍高く、同じ負荷でのスループットがはるかに低いことと一致しています。エンジン内部のロックハンドオフが Vera のテールが高くなっている原因である可能性が高く、これは、リクエストを 1 つずつ送信した場合にも AMD が有利だった Valkey の結果と一致しています。
11月のテストでは、ショー氏の直感が試されました。彼は、AMDの新しい256コアEPYC 9996のソケットと96コアEPYC 9686Fのソケットで同じワークロードを実行し、比較対象としてVeraのソケットも使用しました。9996とVeraはエンジンを交換し、VeraはPostgreSQLとMariaDBで優位に立ち、EPYCはテールレイテンシでリードしましたが、PostgreSQLでは96コアのEPYCがVeraをわずかに上回りました。詳細な結果は、AMD EPYC Veniceのレビューをご覧ください。
「NVIDIA Vera上でのオープンソースデータベースのパフォーマンスには本当に感銘を受けました。Armがデータベース性能の最高峰で競争し、エンタープライズ市場に魅力的な代替案をもたらしているのを見るのは素晴らしいことです」と、HammerDBの開発者兼メンテナーであるスティーブ・ショー氏は、今回の資金調達ラウンド後に語った。
結論
Veraはあらゆるカテゴリーで最速のプロセッサというわけではありません。AMDは市場のあらゆるニーズにそれぞれ専用のプロセッサで応えているからです。周波数最適化されたEPYC 9175Fはコアあたりの速度を重視して設計されており、PythonのnbodyやシングルスレッドAES、一度に1つのValkeyリクエストなど、高速クロックが有利なワークロードで優れた性能を発揮します。一方、EPYC 9965はスループットを重視して設計されており、GROMACS、オールスレッド7-ZipとAES、ソケットに収まるValkeyシャードの数など、コア数に応じて性能が向上するワークロードで優れた性能を発揮します。
Veraが際立っているのは、中間的な性能、つまりそれぞれの専門分野でどれだけそれらのスペシャリストに近づけるかという点です。シングルスレッドでは、整数演算と3つのPythonテストのうち2つで9175Fと同等かそれ以上の性能を発揮し、7-Zipでの圧縮速度は12%速く、goとregex_compileの実行速度はそれぞれ15%と25%速かったものの、浮動小数点演算と暗号化では劣っていました。
システム全体で、9965の全スレッド7-Zipレートの63%~72%に達し、中程度のOpenFOAMメッシュでは12%以内の差で完了しました。その後、メモリが処理を担うようになると、大規模メッシュとClickBenchでは9965を上回りました。1スレッドあたりのコア性能とシステム全体のスループットにおいて、トップクラスのプロセッサにこれほど近い性能を維持できることが、Veraを非常に強力な汎用プロセッサにしている理由です。幅広いミドルレンジ市場に対応しつつ、両極端の性能をほとんど犠牲にしないプラットフォームを求めるユーザーにとって、Veraは非常に魅力的な選択肢となるでしょう。
Veraは、テストしたどのx86システムよりもはるかに広いメモリ帯域幅を提供します。2つのVeraソケットはSTREAM Triadで2,073GB/sを維持し、これはここで最高のDDR5サーバーの2.3倍です。また、NVLink-C2Cにより、ソケット間でもこの帯域幅を維持できます。Veraのコアは、もう一方のソケットのメモリを677GB/sで読み取り、これはどのx86ソケットがローカルメモリから読み取るよりも高速です。
メモリバウンドなワークロードでは、大規模な OpenFOAM メッシュは EPYC 9965 より 1.44 倍速く解決され、ClickBench のホットランは 2.70 秒に対し 2.09 秒で完了し、256GB の Valkey ワーキングセットは 34% 高速化され、1 つのソケットでは Vera が PostgreSQL と MariaDB の両方のリリースで HammerDB をリードしました。リンクのコストはレイテンシです。リモート読み取りはローカル読み取りの約 2.1 倍かかりますが、EPYC 9175F では 1.75 倍なので、NUMA 対応の配置と巨大ページは Vera でも依然として重要です。
弱点は驚くほど小さく、設計に直接起因するものです。6つの128ビットSVE2パイプは、それら用に記述されたコード上で512ビットAVX-512ユニットと一致しないため、16コアのVeraはGROMACS benchMEMを9175Fの半分の速度、9965の3分の2の速度で実行しました。これらのパイプのうち2つだけが暗号化処理を担当したため、単一のOlympusコアはAES-256-GCMを9175Fの約3分の1の速度で暗号化しました。
Vera がどのように展開していくかは、主に OEM パートナー次第です。Dell のPowerEdge R8822 は10 月に出荷が開始され、M9882 Vera CPU ラックは 2027 年第 1 四半期に発売予定です。HPE のProLiant Compute DL394 Gen12 は今秋に発売されます。Supermicro は、256 CPU 対応の Vera ラックの見積もりを提供しており、ラインナップには空冷式の 1U および 2U Vera システムが含まれています。ASUS、ASRock Rack、QCT、GIGABYTE、MSI、Compal、Foxconn、Pegatron、Wistron、Lenovo も Vera 設計を発表しています。Oracle Cloud は Vera インスタンスを一般提供しており、CoreWeave、Nebius、Lambda などがそれに続きます。
Veraは、汎用作業においてx86フラッグシップと肩を並べる性能を持つ、当社がテストした初のArmサーバープロセッサであり、また、空冷式の2ソケット筐体で2TB/sのメモリ帯域幅を実現した初のベンダー製プロセッサです。幅広いミドルレンジ市場においては、現時点で信頼できる選択肢であり、NVIDIAは他社にはないメモリサブシステムを搭載したCPU市場に参入しました。ベクトル演算を多用するHPCや暗号化処理に特化したサービスにおいては、x86のスペシャリストが引き続き優位性を維持します。当社では、OEMシステムがラボに到着次第、NVIDIAがこのプロセッサの目的として構築したエージェントサンドボックスの役割から始め、同じテストスイートでテストを実施します。
このレビュー以降、AMDのEPYC Veniceが当社のラボに届き、AMD EPYC Venice SP7のレビューとDell PowerEdge R9825のレビューでは、256コアのEPYC 9996を、最新ファームウェアを搭載したVeraに対して同じテストスイートでテストしました。
ランキング: NVIDIA Veraは、当社のベストサーバーランキングにおいて、最高のArm実装として評価されています。


 Amazon