

컴퓨텍스 2026이 타이베이에서 개막했습니다. 엔비디아는 늘 그렇듯 젠슨 황 CEO의 기조연설을 통해 회사의 로드맵을 전면에 내세우며 행사의 분위기를 주도했습니다. 연설의 상당 부분은 이미 공개된 데이터센터용 GPU 관련 내용이었으며, 베라 루빈(Vera Rubin)이 정식 출시되었고, 에이전트가 컴퓨팅의 모든 계층을 혁신할 것이라는 익숙한 메시지가 다시 한번 강조되었습니다. 하지만 여기서는 그 모든 내용을 다시 언급하지는 않겠습니다.
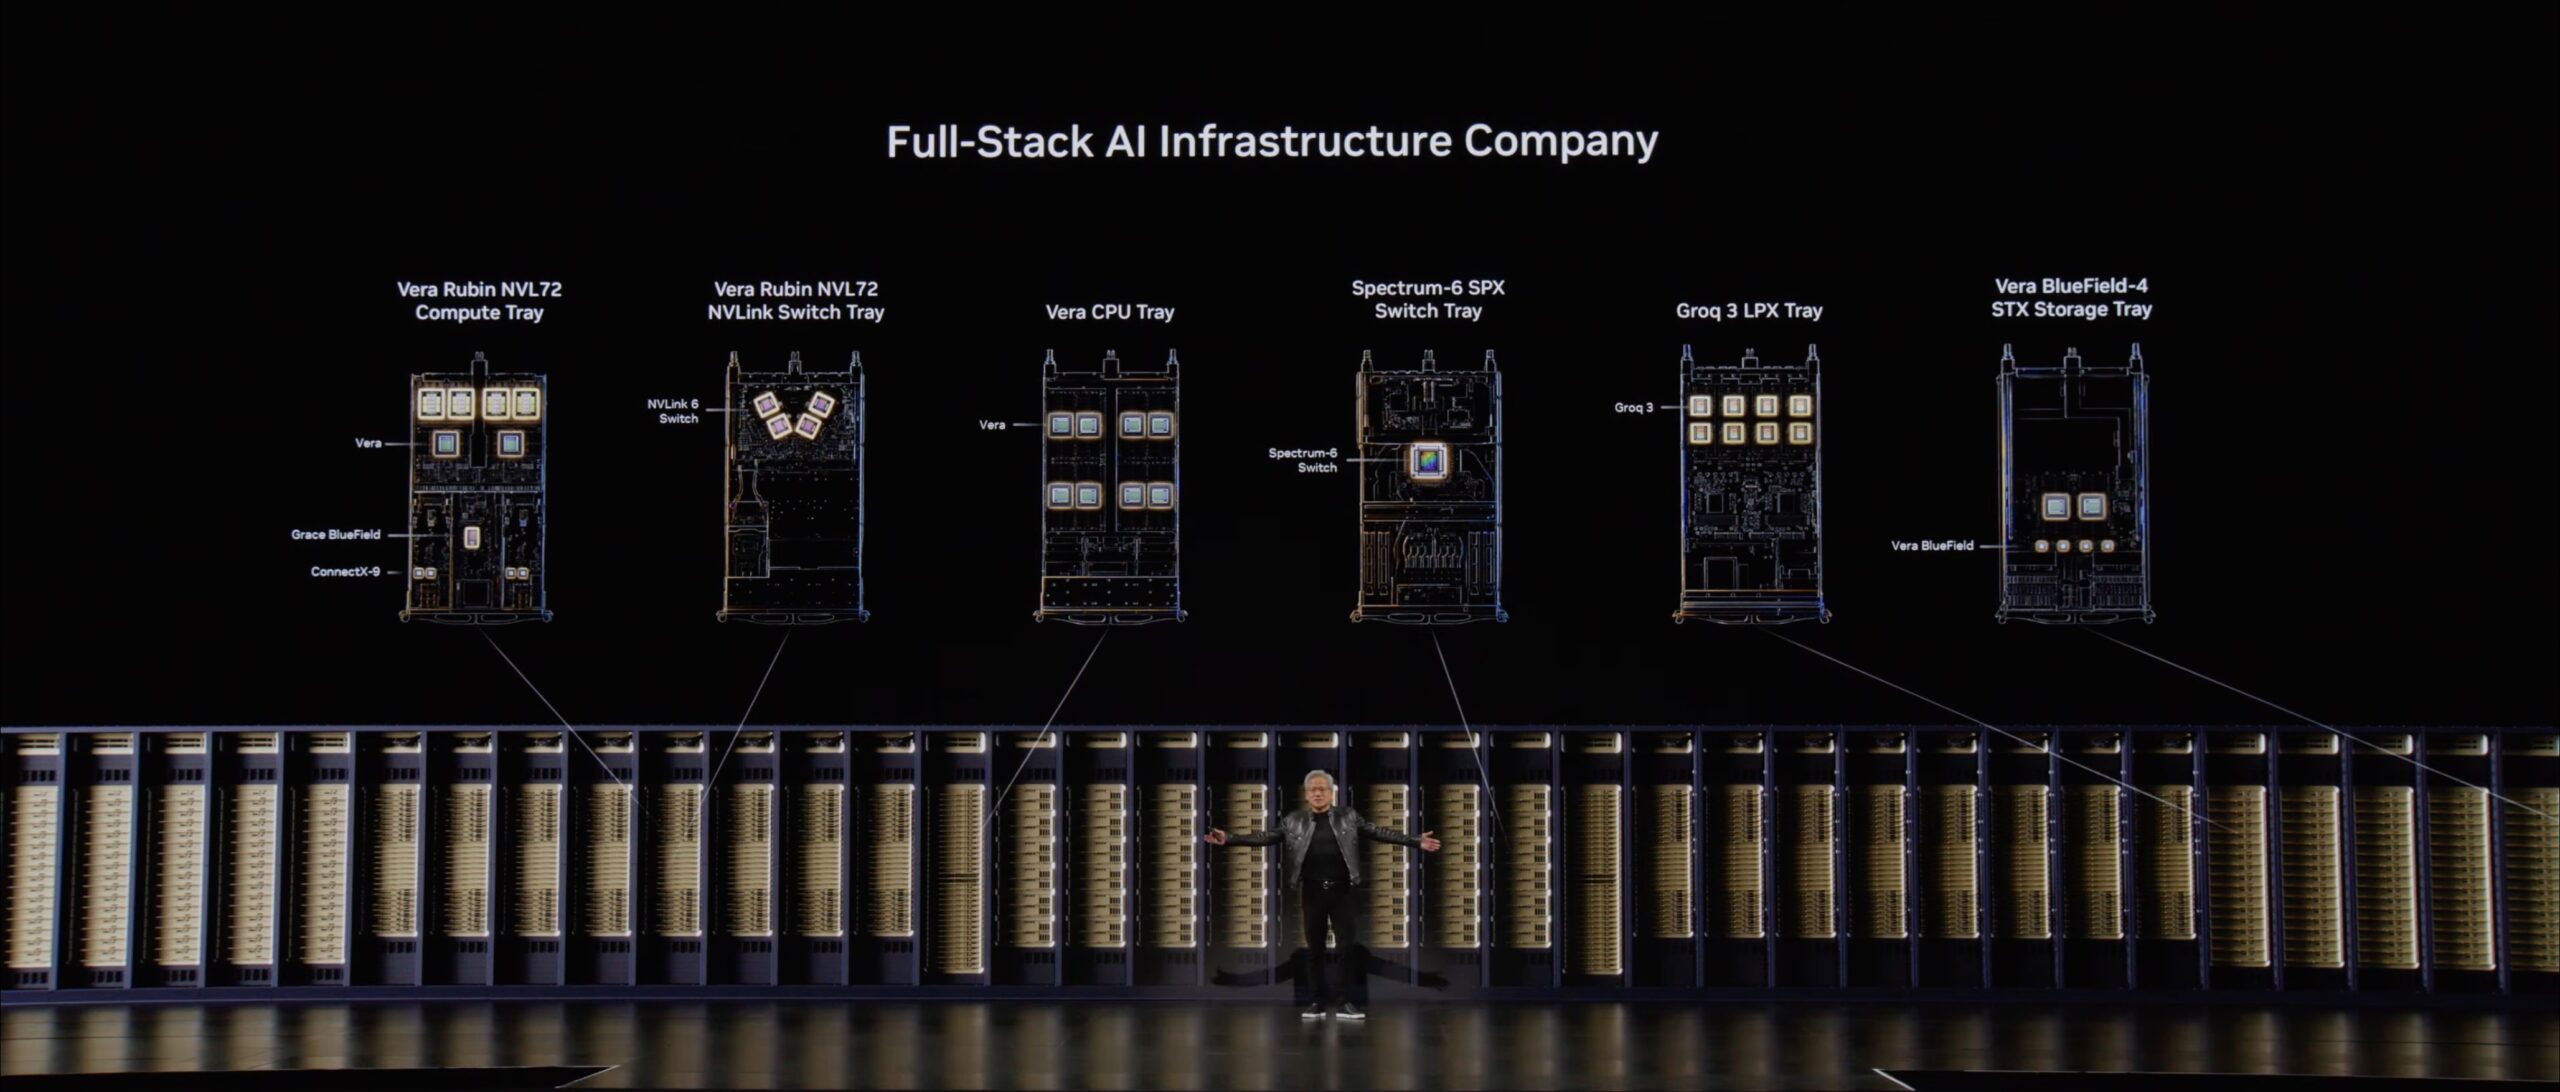
이번 기조연설의 진정한 핵심이자 클라이언트 측 담당자들에게 중요한 이유는 바로 PC였습니다. NVIDIA와 Microsoft는 컴퓨텍스에서 단일 기기가 아닌 전체 제품군에 걸쳐 윈도우 머신을 재창조하겠다고 발표했습니다. 하지만 그 전에 데이터 센터와 관련된 한 가지 중요한 부분을 먼저 살펴보겠습니다.
LPX 랙을 자세히 살펴보겠습니다.
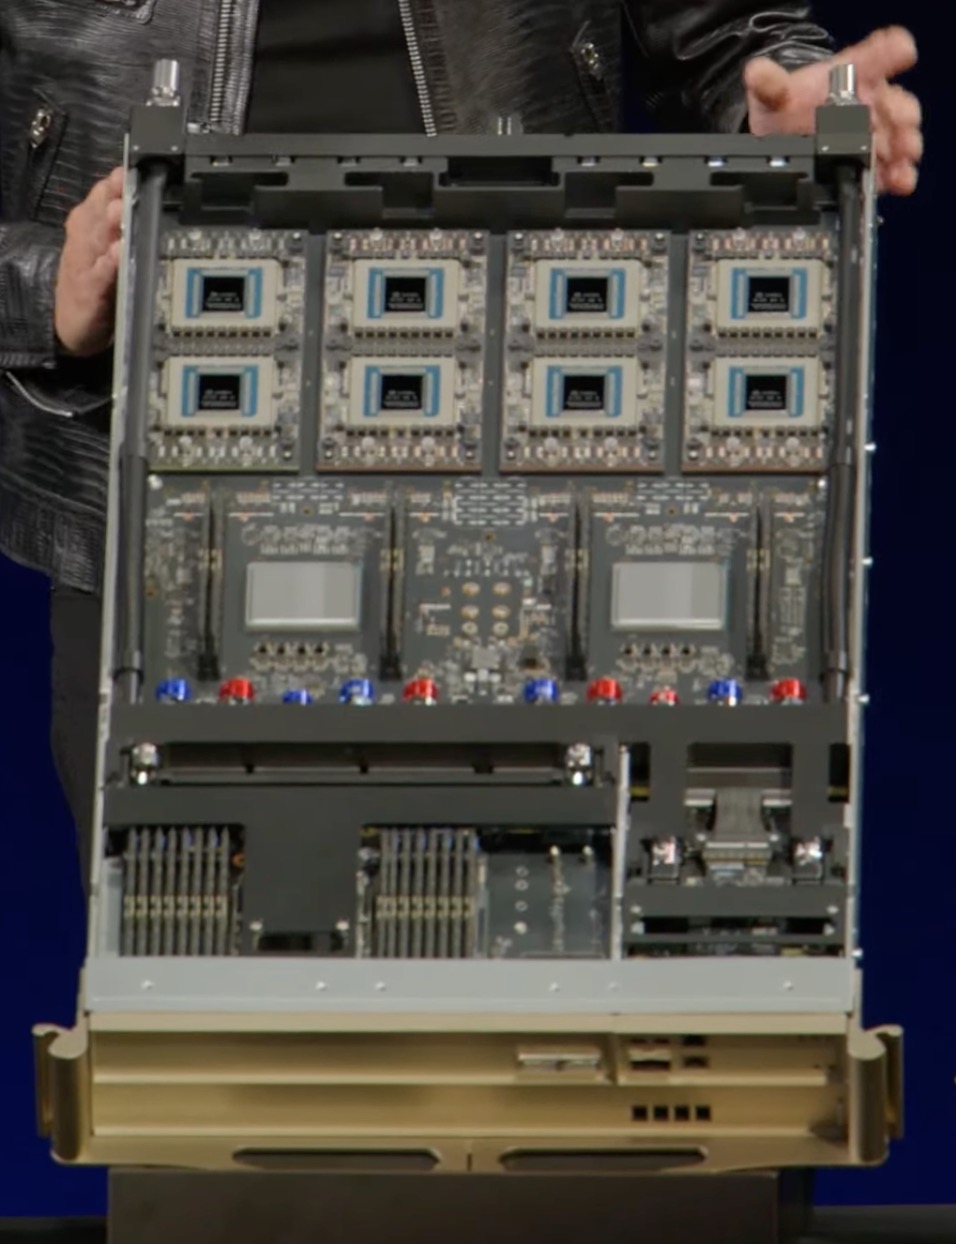
데이터센터에서 한 가지 눈에 띄는 점이 있었습니다. 바로 LPX 랙의 변화입니다. 시스템들이 1개 OU에서 2개 OU로 이동한 것으로 보이며, 4개의 Groq C2C 링크도 이전 LPX 관련 기사 에서 봤던 것과는 외형적으로 다릅니다 . 이번에 NVIDIA는 랙을 더욱 자세히 살펴볼 수 있도록 해주었습니다. 이 두 가지 변화 외에는 외관상 눈에 띄는 차이점이 없었기에, 두 번째 레이어에 실제로 무엇이 탑재되어 있는지 매우 궁금해졌습니다.
3단계 PC 제품군
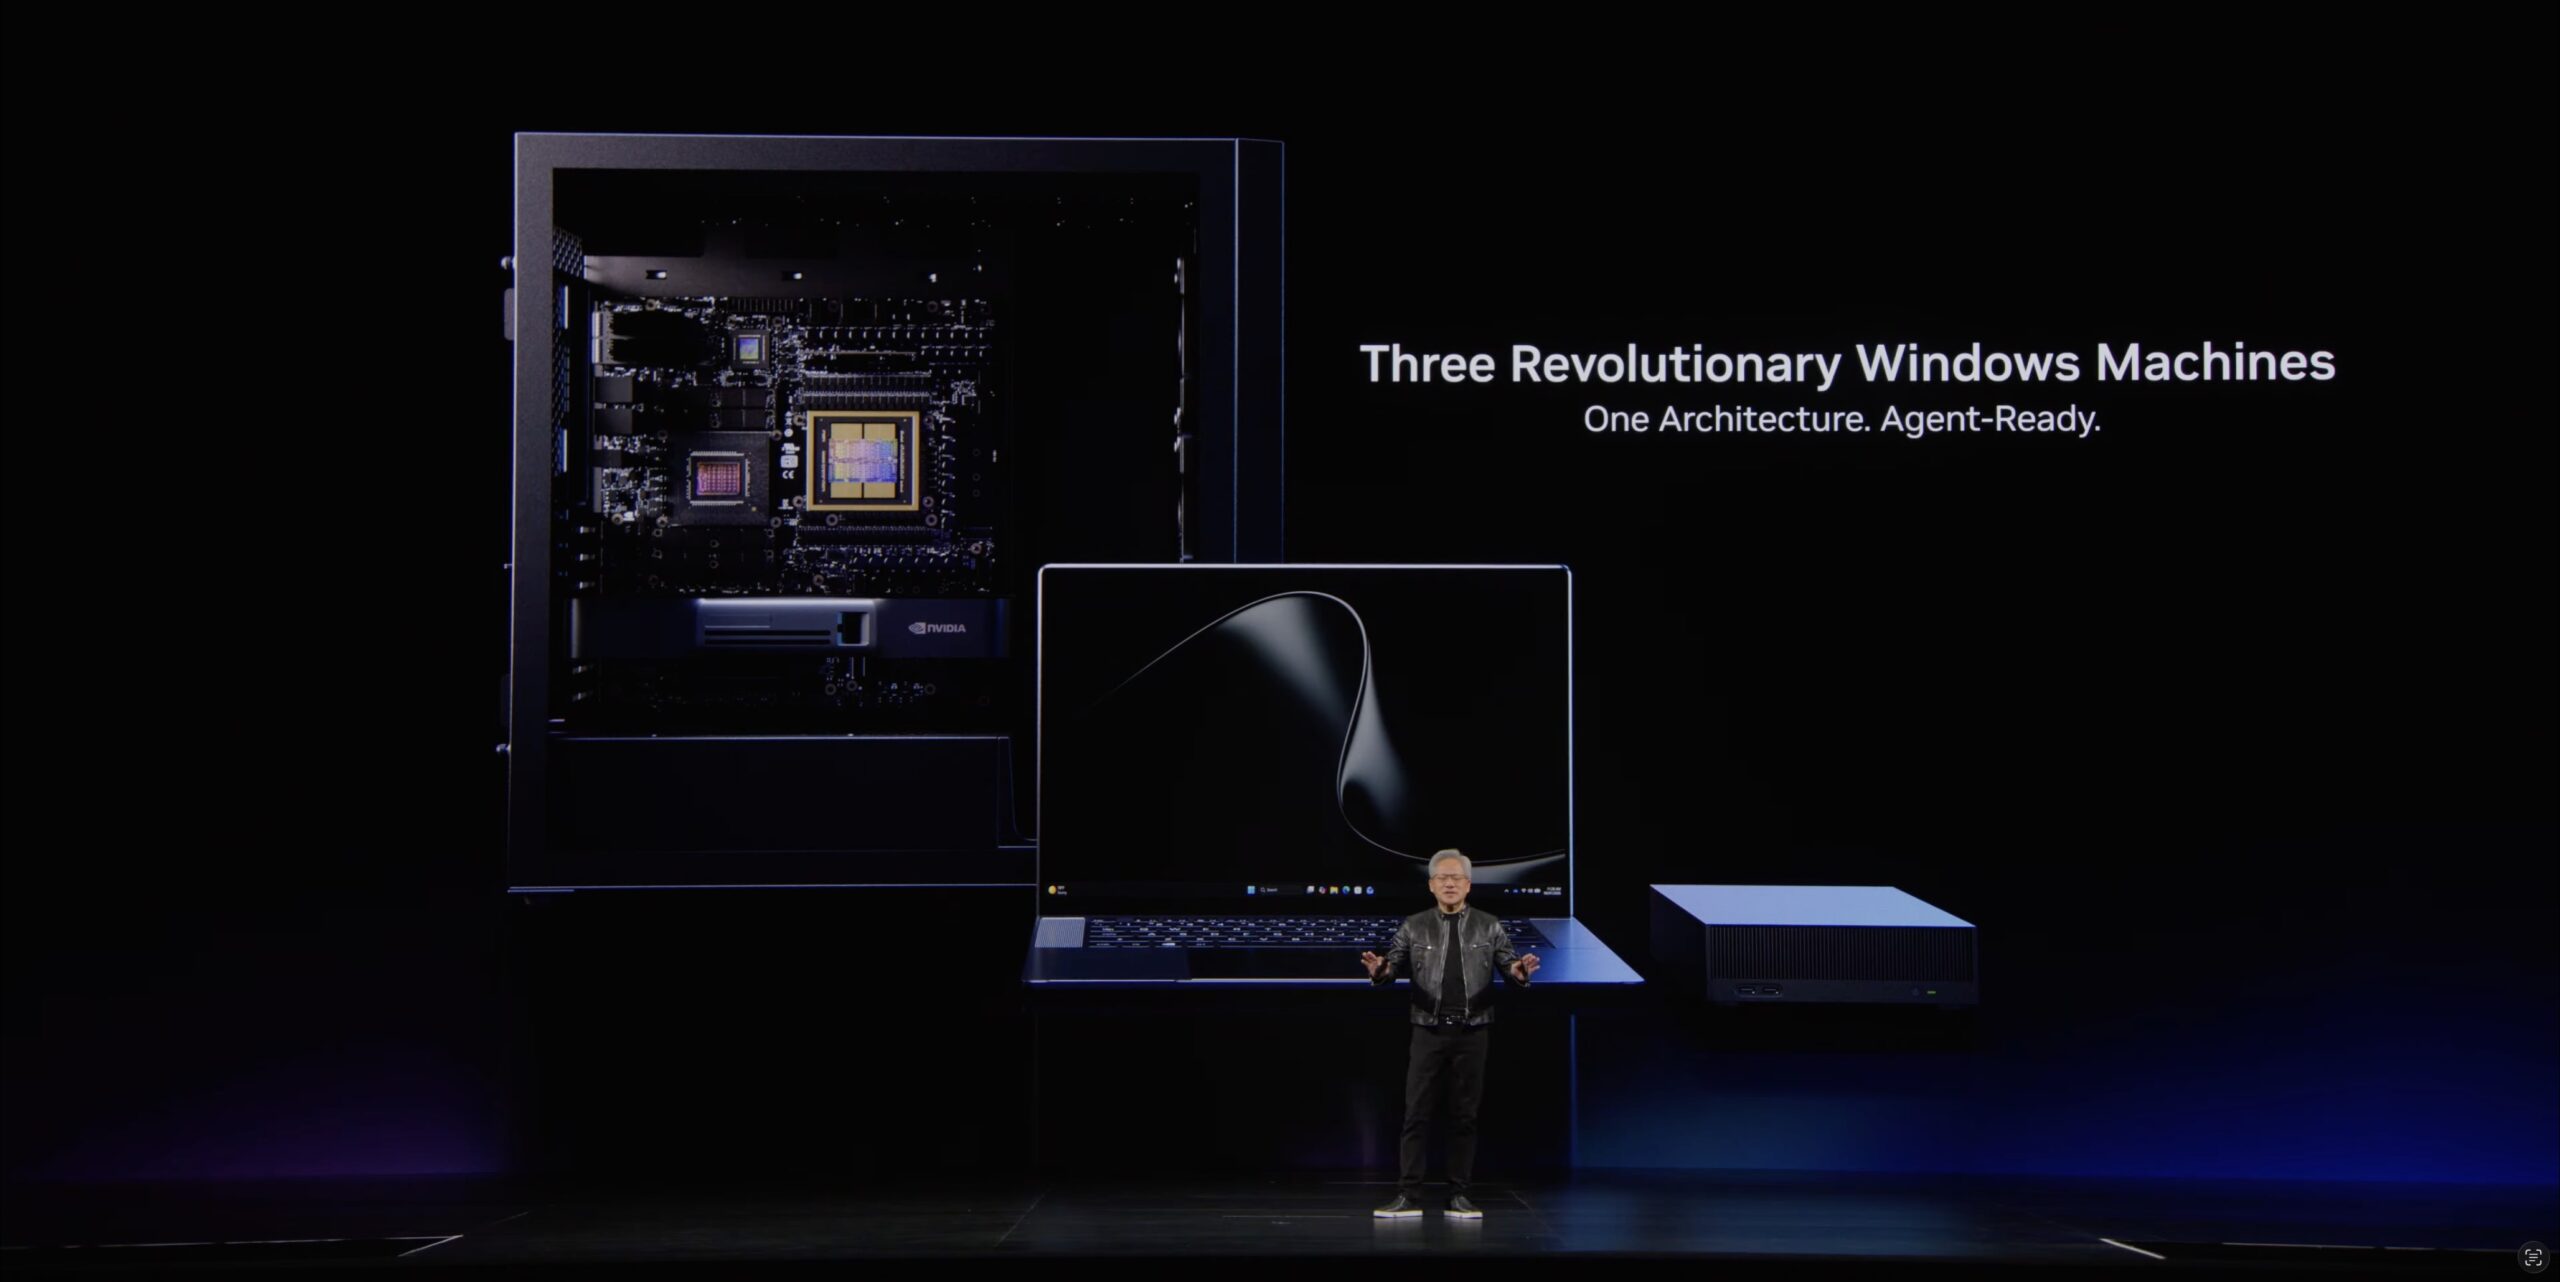
NVIDIA는 Spark 및 Blackwell 플랫폼을 기반으로 하고 Windows를 지원하는 노트북, 데스크톱, 워크스테이션으로 구성된 새로운 클라이언트 제품군을 발표했습니다. 젠슨은 이를 40년 만에 완전히 새롭게 설계된 PC 라인이라고 설명했습니다. 이러한 설명에 동의하든 그렇지 않든, 각 제품군이 매우 다른 구매층을 겨냥하고 있기 때문에 그 구조를 이해하는 것은 중요합니다. 이제 각 제품군을 순서대로 살펴보겠습니다.
RTX Spark 노트북
이 노트북의 핵심은 NVIDIA가 미디어텍과 협력하여 코드명 N1X로 공개한 RTX Spark 슈퍼칩입니다. TSMC 3nm 공정으로 제작된 이 칩은 700억 개의 트랜지스터로 구성되어 있으며, 두 개의 칩렛을 하나의 SoC로 통합한 것입니다. GPU는 6,144개의 CUDA 코어와 FP4 정밀도를 지원하는 5세대 텐서 코어를 탑재한 대형 블랙웰(Blackwell) 설계로, FP4 AI 성능은 1페타플롭에 달합니다. 이 GPU는 NVLink-C2C를 통해 600GB/s의 속도(NVIDIA 발표 수치는 PCIe Gen 5의 약 5배에 해당하며 전력 소모는 훨씬 적음)로 20코어 Grace CPU에 연결됩니다. 메모리는 최대 128GB의 통합 메모리를 300GB/s의 대역폭으로 제공합니다.
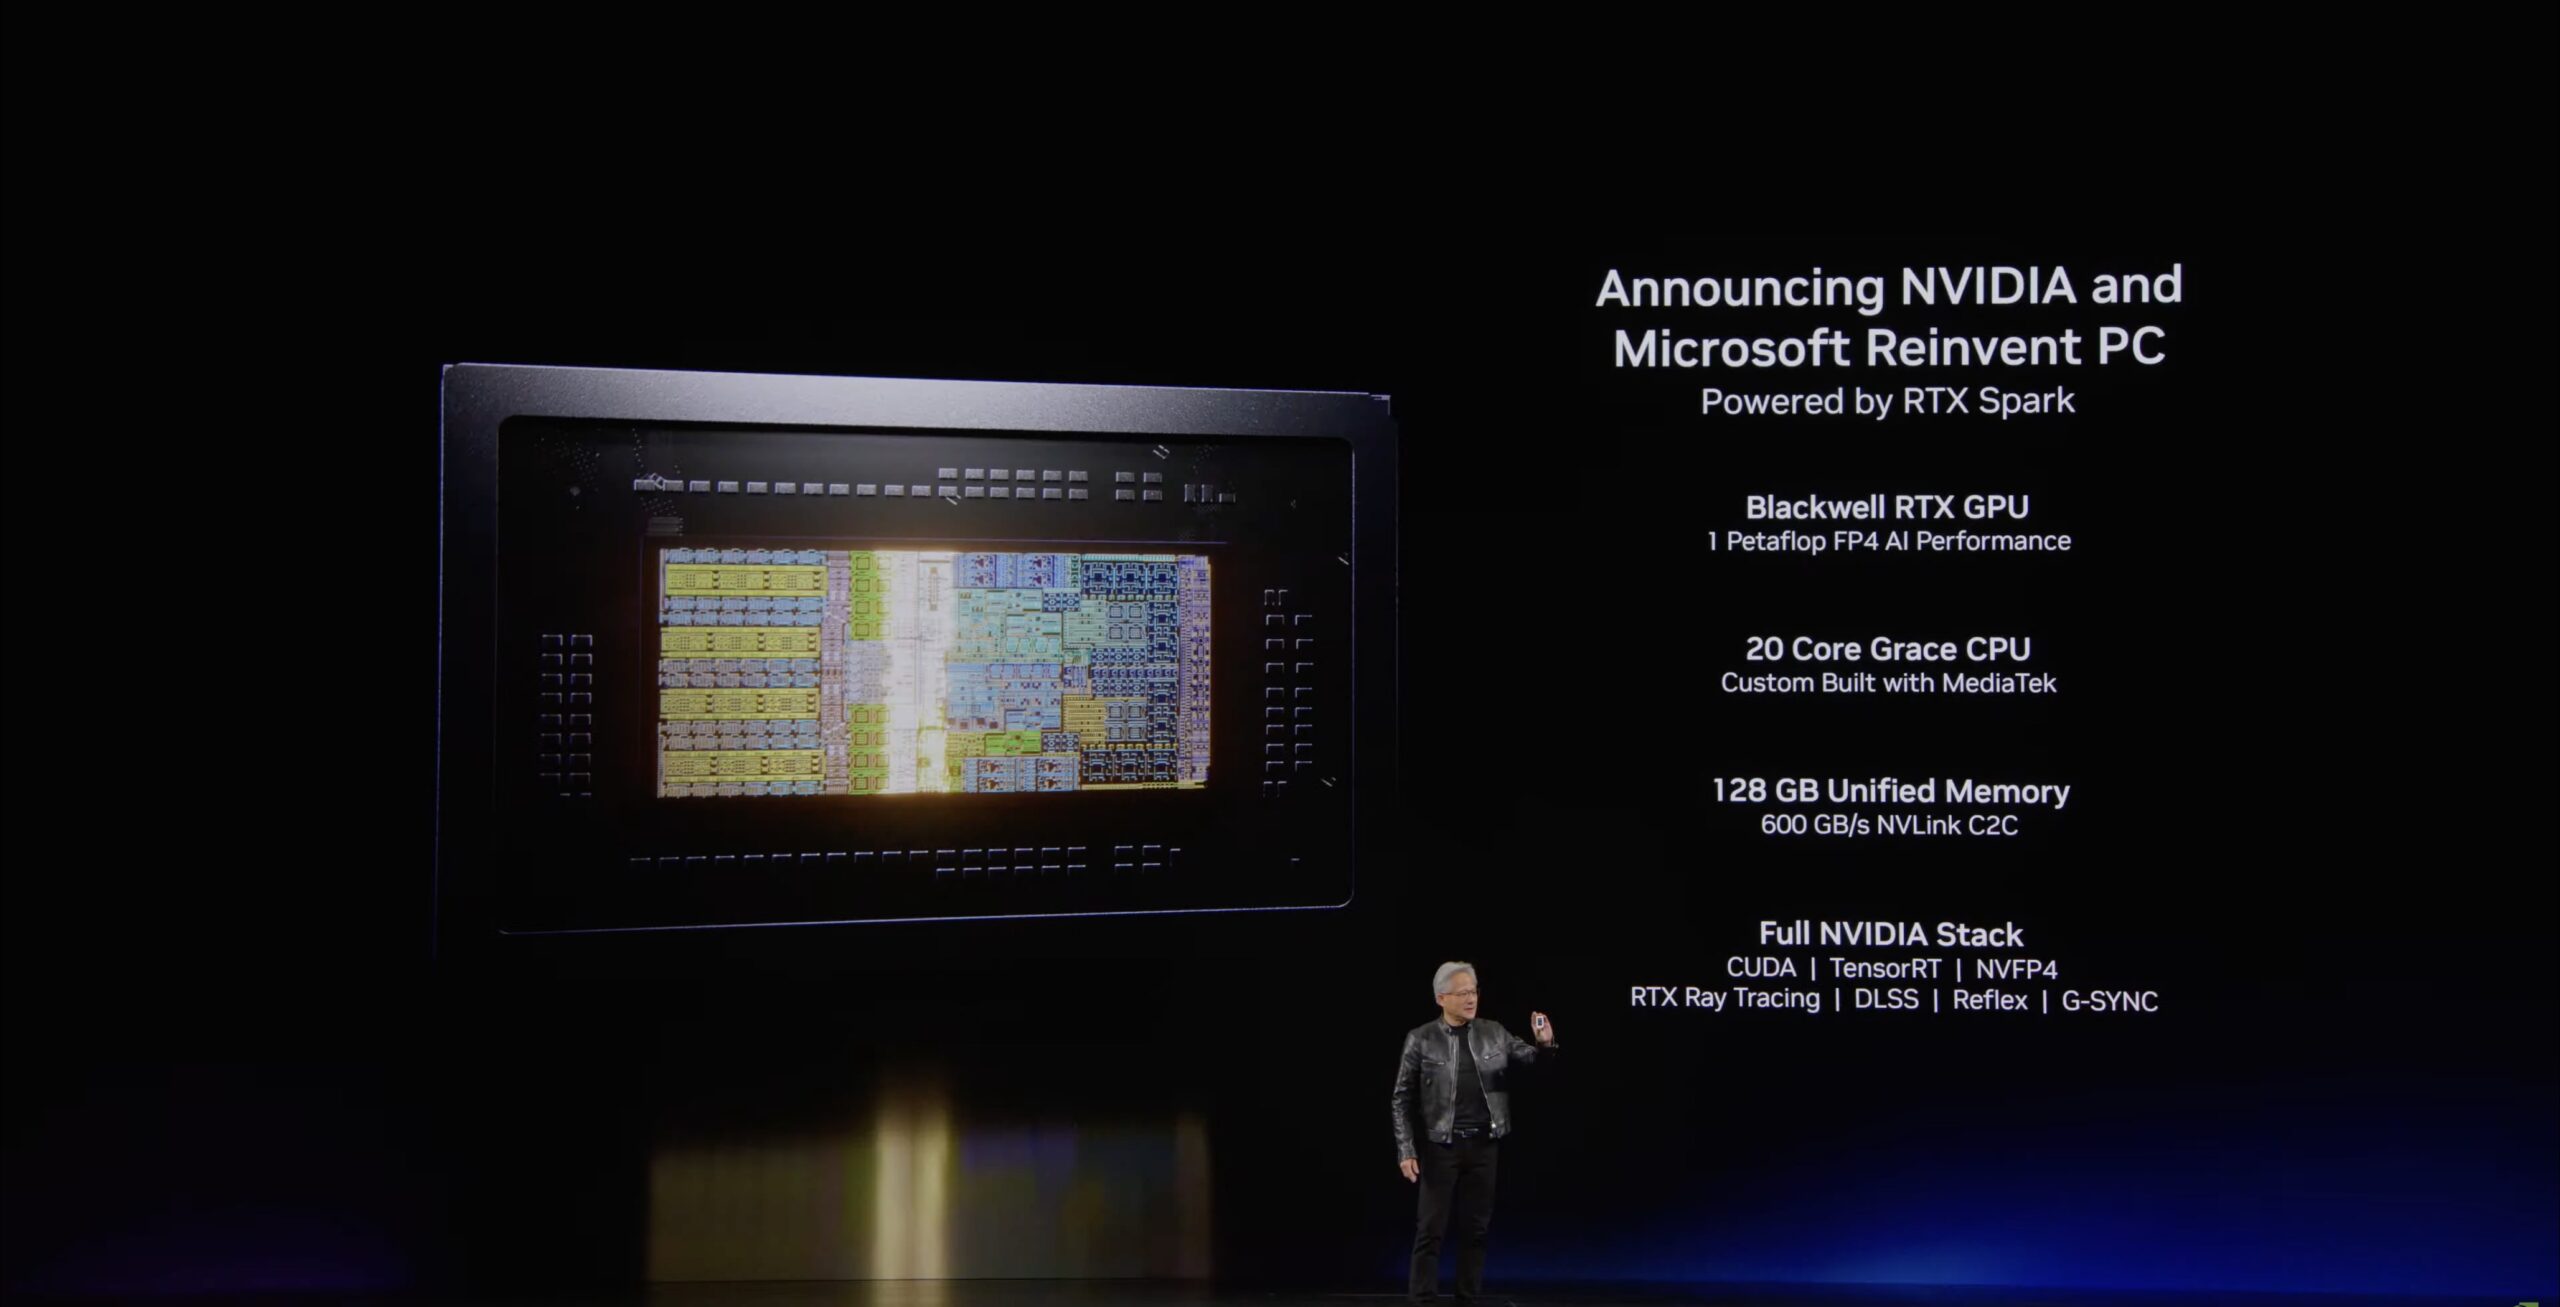
이 내용이 DGX Spark 사양표처럼 보인다면, 그건 실제로 거의 같기 때문입니다. NVIDIA는 언론 질의응답에서 이 칩이 DGX Spark와 "동일한 시스템을 기반으로 하지만 하드웨어와 소프트웨어 모두 다른 플랫폼에 최적화되어 있다"고 밝혔습니다. 즉, DGX Spark는 Linux 및 AI 개발자를 위해 설계되었고, RTX Spark는 동일한 실리콘 위에 RTX 게임 및 콘텐츠 제작 스택을 얹은 Windows 우선 제품이라는 것입니다. NVIDIA는 성능을 "RTX 5070 노트북 GPU와 같은 수준"이라고 설명하지만, 통합 메모리를 사용하는 SoC가 PCIe를 통한 외장 GPU와는 매우 다르게 작동하기 때문에 작업 부하에 따라 비교가 달라질 수 있다는 점을 강조합니다. 바로 이 부분이 DGX Spark 테스트에서 가장 궁금했던 부분이며, 이번 출시가 지난번과 어떻게 다를지 예상하는 부분이기도 합니다. DGX Spark 테스트에서 가장 일관되게 나타난 결과 중 하나는 다양한 OEM 설계들이 서로 매우 근접한 성능을 보였다는 점입니다. 일부 구현은 다른 구현보다 설계가 더 우수했지만, 모든 장치가 기본적으로 동일한 전력 및 열 설계를 갖춘 동일한 NVIDIA 레퍼런스 플랫폼을 기반으로 제작되었기 때문에 실제 성능은 매우 유사하게 나타났습니다.
하지만 여기서는 그런 상황이 유지될 거라고는 예상하지 않습니다. RTX Spark는 노트북에 탑재될 예정인데, 두께가 14mm에 불과하고 무게는 3kg 정도로 가벼운 제품도 있습니다. NVIDIA는 이 칩이 최고 사양 구성에서는 최대 80W까지, 최소 몇 와트 정도의 전력을 소비할 것이라고 밝혔으며, 각 OEM은 증기 챔버부터 고급 히트 파이프까지 자체적인 냉각 방식을 선택할 수 있습니다. 이렇게 얇은 섀시에서는 칩의 전력 소비가 제한될 가능성이 매우 높고, 이는 결국 열 및 주파수 제한으로 이어집니다. 이는 단점이 아니라 물리적인 한계입니다. 하지만 더 나은 열 관리 솔루션을 제공하고, 칩에 더 높은 지속 전력 예산을 할당하고, 팬 곡선을 잘 조정하는 OEM은 동일한 실리콘을 사용하는 더 얇고 조용한 경쟁 제품보다 실질적인 성능 격차를 벌릴 수 있다는 것을 의미합니다. 동일한 칩과 메모리를 사용하는 두 노트북이라도 지속적인 처리량에서 눈에 띄는 차이를 보일 수 있으며, 어떤 OEM이 칩의 잠재력을 최대한 발휘할 수 있도록 하는지 알아내는 것이 바로 우리가 추구하는 테스트입니다. RTX Spark는 또한 전체 칩 제품군을 아우릅니다. NVIDIA는 최고 사양 모델(CPU 코어 20개, 최대 128GB)을 포함한 여러 SKU가 출시될 것이라고 밝혔습니다. 전체 제품군은 16GB에서 128GB까지 다양한 메모리 용량을 제공하며, NVIDIA는 초기 출시 물량에서만 주요 OEM 업체들을 통해 30개 이상의 노트북과 10개 이상의 데스크톱 제품이 출시될 것으로 예상하고 있습니다. 여기에는 Dell XPS 16 Creator Edition, HP OmniBook, Microsoft Surface Laptop Ultra와 같은 유명 모델들이 포함됩니다.
하드웨어 관련 두 가지 세부 사항이 우리에게 낙관적인 전망을 제시합니다. 첫 번째는 네트워킹, 또는 오히려 네트워킹 기능의 부재입니다. DGX Spark는 NVIDIA의 ConnectX-7 네트워킹과 200GbE 연결을 내장하여 출시되었는데, 이는 개발자 클러스터 박스에는 훌륭했지만 보드 공간, 전력 소모, 그리고 비용 측면에서 부담이 컸습니다. NVIDIA는 RTX Spark 노트북에는 CX7 패키지를 탑재하지 않을 것이라고 확인했습니다. 일반 소비자용 Windows 노트북에는 이러한 결정이 옳으며, 확보된 보드 공간과 전력을 활용하여 훨씬 더 나은 스토리지를 탑재할 수 있기를 기대합니다. DGX Spark의 스토리지는 쓸만했지만, 결코 핵심적인 성능은 아니었습니다. 네트워킹 칩에 전력을 공급할 필요가 없는 소비자용 노트북이라면 더 빠르고 용량이 큰 NVMe 스토리지를 탑재할 충분한 이유가 있습니다. 두 번째는 I/O입니다. 모든 DGX Spark는 동일한 레퍼런스 보드를 사용했기 때문에 모든 제품에 동일한 포트가 탑재되었습니다. DGX Spark의 이러한 획일성에서 벗어나, OEM별로 다양한 I/O 포트를 제공하는 것이 바람직할 것입니다.
노트북의 마지막 관건은 배터리 수명이며, 저희 벤치마크의 핵심입니다. NVIDIA는 생산성 작업과 웹 브라우징에는 하루 종일 사용할 수 있는 배터리를 약속했지만, 게임이나 고성능 AI 작업을 할 경우 어떤 노트북이든 45분에서 1시간 안에 배터리가 소모될 것이라고 솔직하게 밝혔습니다. 저희가 정말로 확인하고 싶은 것은 실제 AI 작업을 할 때의 배터리 수명입니다. 사용자가 컴퓨터를 사용하지 않을 때도 실행되는 에이전트는 매력적인 마케팅 문구이지만, 배터리로 작동하는 로컬 추론은 진정한 경쟁력입니다. 하루 종일 이메일을 확인하는 것과 120B 규모의 모델을 하루 종일 실행하는 것 사이의 배터리 수명 차이는 엄청날 수 있습니다. 저희는 이러한 플랫폼에 최적화된 맞춤형 개인 AI 컴퓨팅 벤치마크 세트를 준비했으며, 마케팅 수치를 액면 그대로 받아들이는 것이 아니라 실제 생산성 향상을 측정할 계획입니다.
RTX Spark 데스크탑
NVIDIA는 소형 폼팩터 RTX Spark 데스크톱이 노트북과 함께 올 가을 출시될 예정임을 확인하고, MSI에서 제작한 제품을 공개했습니다. 솔직히 말해서, 처음 봤을 때는 DGX Spark와 비슷해 보였지만, 그 외에는 알려진 정보가 거의 없습니다. 외관 디자인은 이전에 리뷰했던 DGX Spark와 달라 보이지만, NVIDIA는 그 외에는 거의 정보를 공개하지 않았습니다.
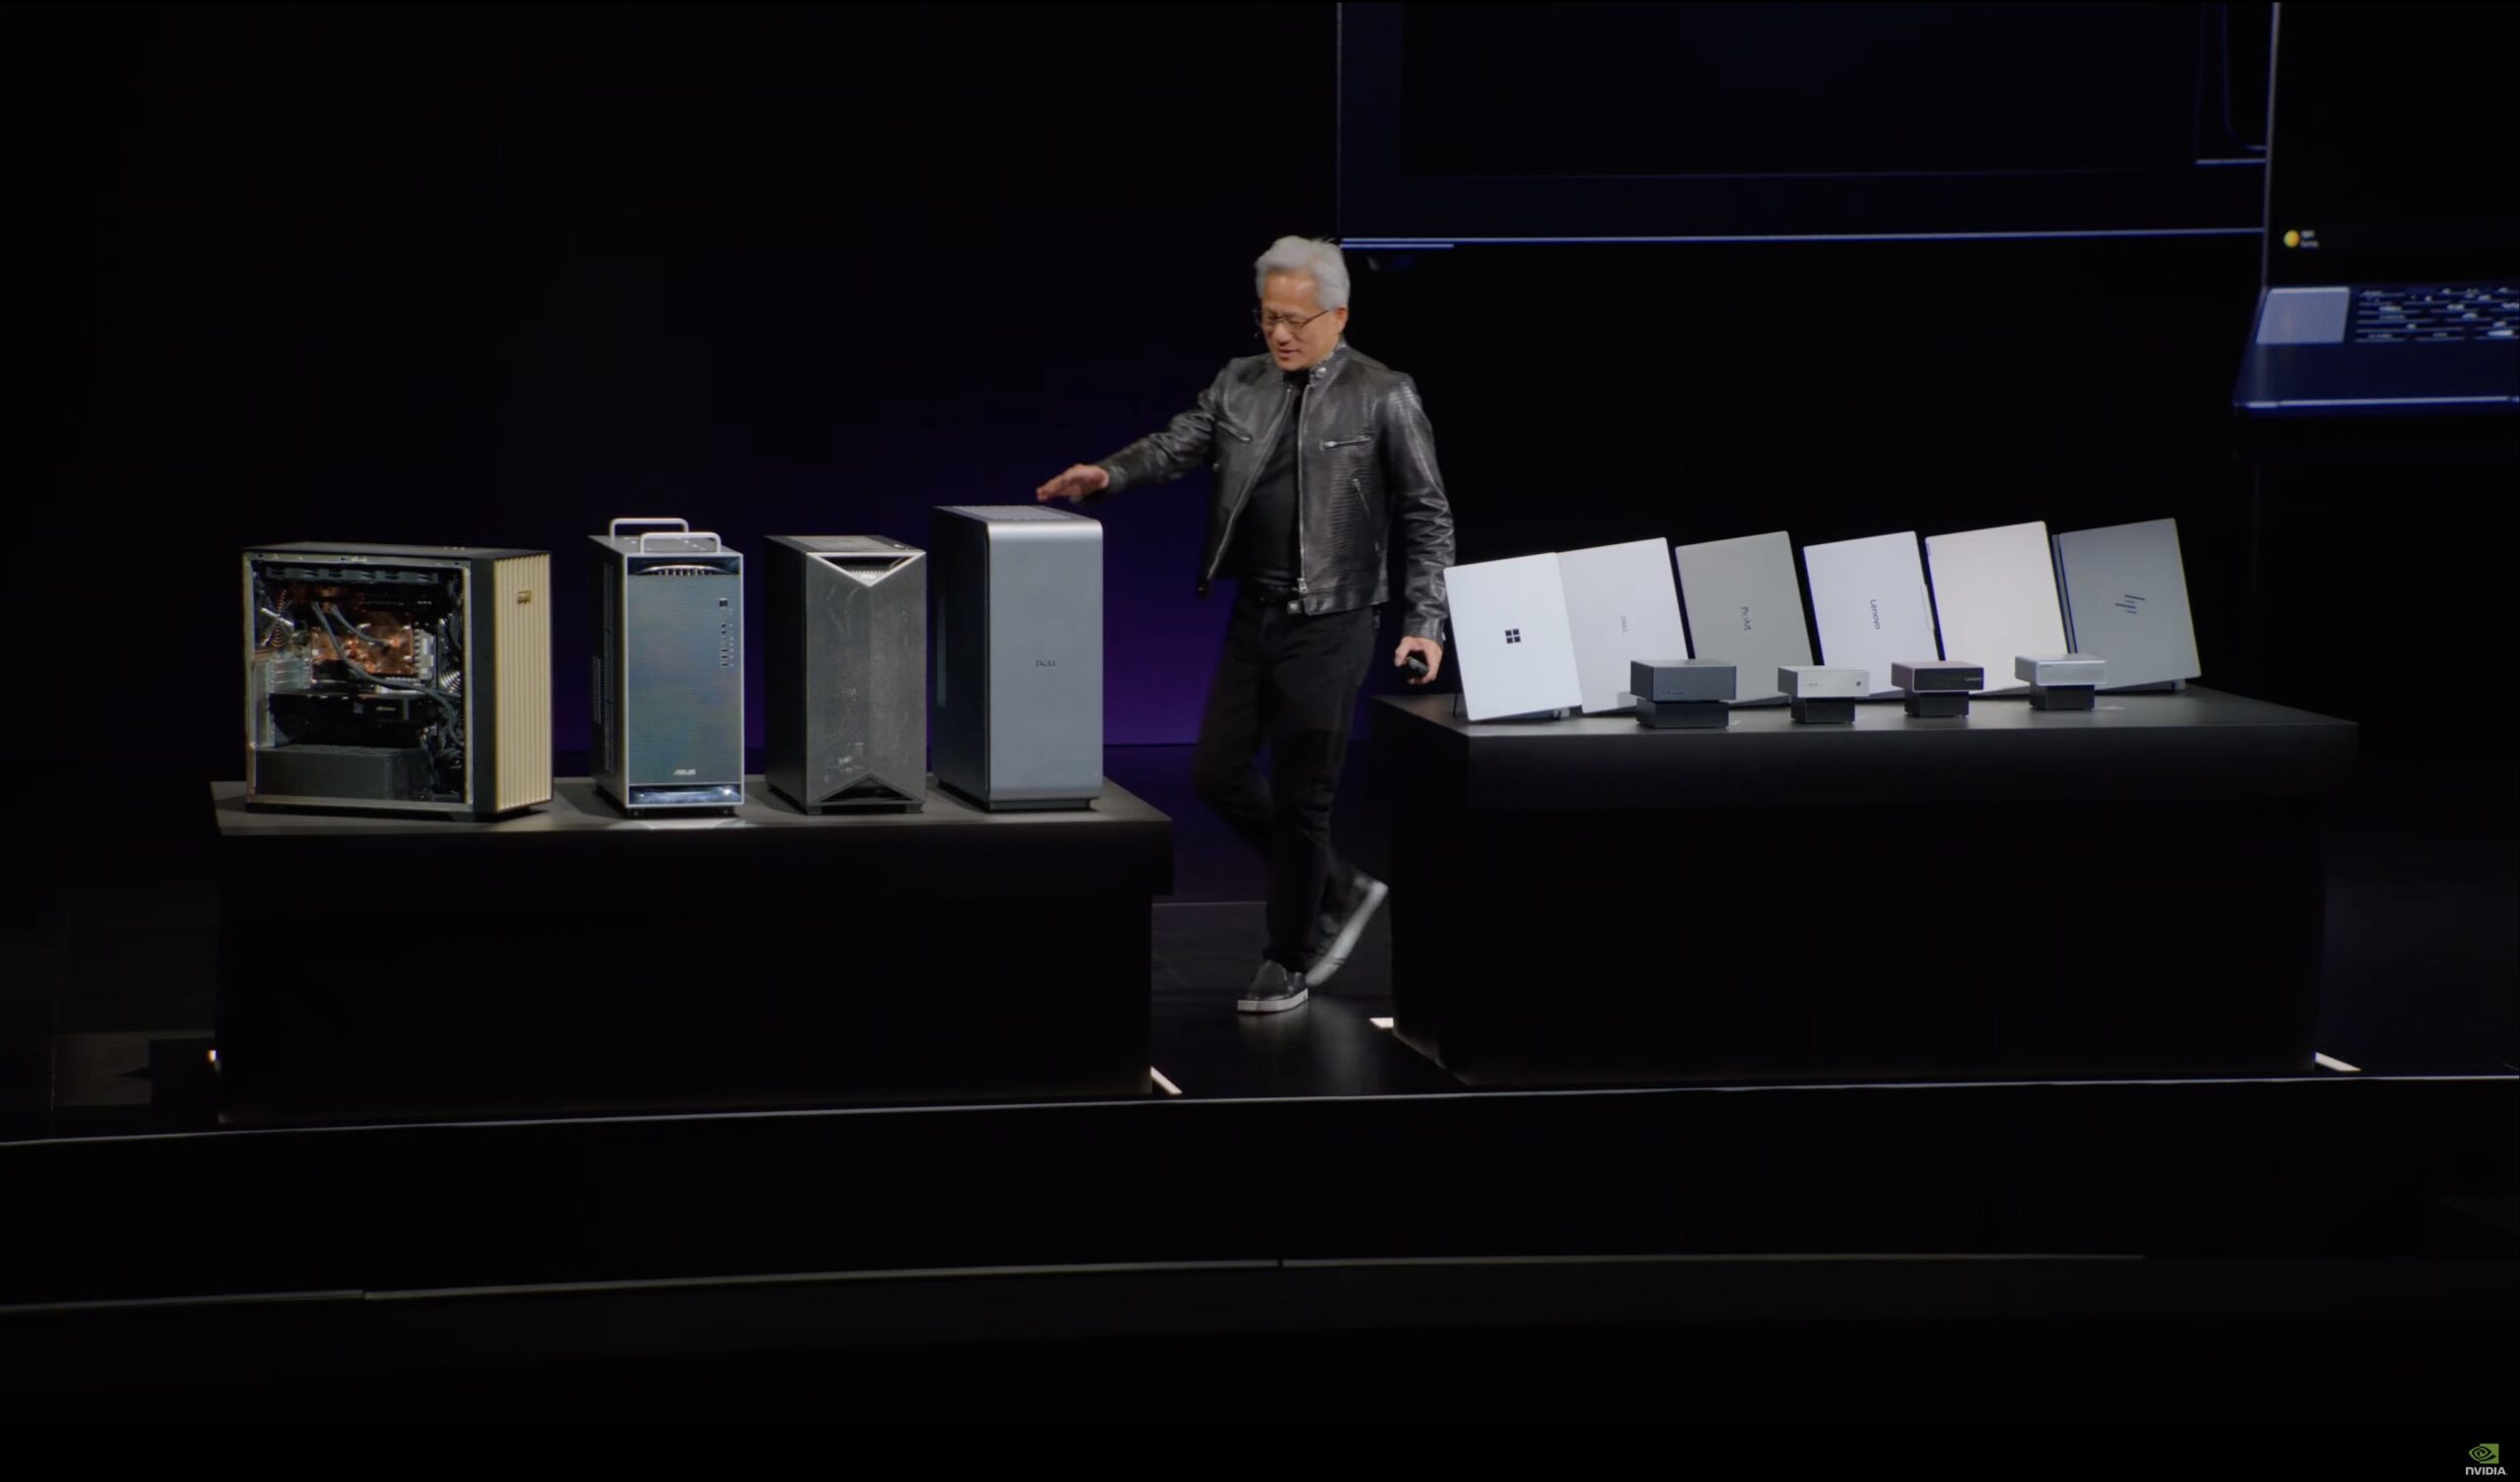
우리의 질문은 당연한 것들이지만, 실제 하드웨어를 테스트해 봐야 알 수 있을 것입니다. 14mm 두께의 노트북보다 훨씬 더 큰 발열 관리 여유 공간을 확보했을 데스크톱의 지속적인 성능은 노트북 및 DGX Spark와 비교했을 때 어떨까요? 그리고 데스크톱은 DGX Spark의 특징이었던 200G 네트워킹 기능을 유지할까요, 아니면 노트북처럼 CX7 패키지를 제외하고 소비자 가격을 낮출까요?
DGX 역
세 번째 단계는 가장 중요한 단계이며, 이미 잘 알려진 제품입니다. NVIDIA는 이전에 DGX Station을 공개한 적이 있으며, 저희도 최근 직접 사용해 볼 기회를 가졌습니다. 주요 사양은 이미 공개되었으므로 자세한 내용은 여기서 다루지 않고, 곧 공개될 리뷰에서 더 자세히 설명하겠습니다.
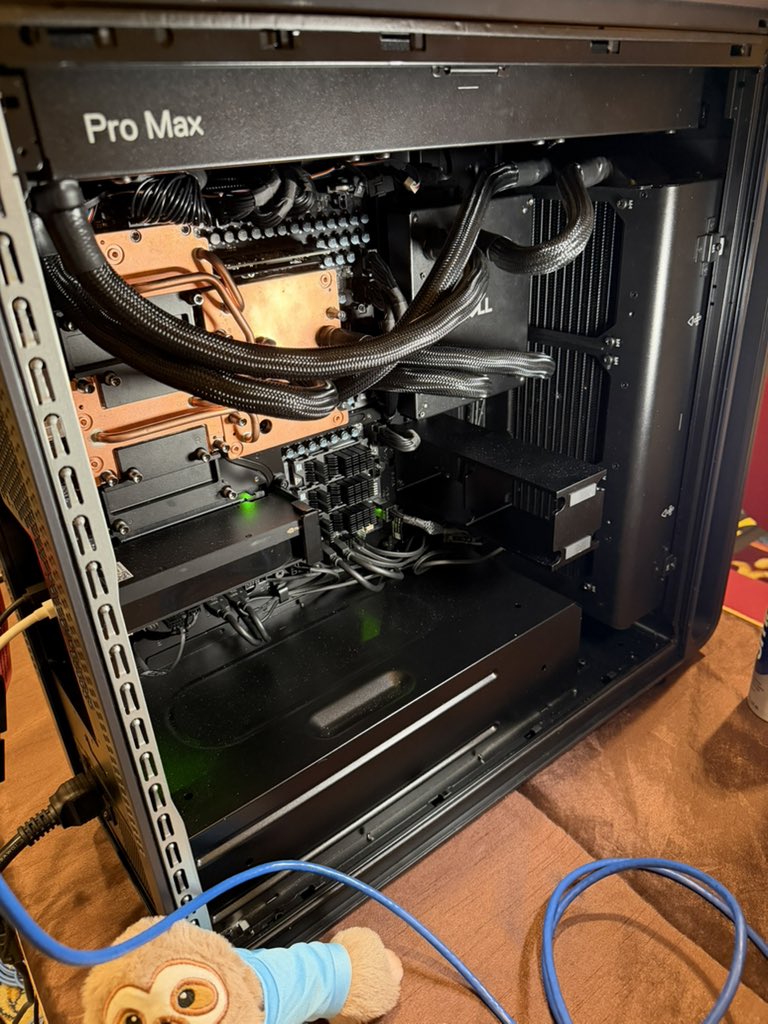
간략히 설명하자면, DGX Station for Windows는 GB300 Grace Blackwell Ultra 데스크톱 슈퍼칩을 기반으로 하며, Blackwell Ultra GPU와 72코어 Grace CPU를 결합했습니다. 최대 748GB의 일관성 메모리와 최대 20페타플롭스의 FP4 처리 능력을 갖추고 있어, 수조 개의 매개변수를 가진 모델을 로컬에서 실행하고 NVIDIA의 설명에 따르면 수백 개의 에이전트를 동시에 실행할 수 있습니다. 일반 소비자용 Spark 머신과 달리, 이 제품은 최대 800Gb/s의 속도를 지원하는 ConnectX-8 SuperNIC을 통한 빠른 네트워킹을 제공하며, 옵션으로 RTX PRO 6000 Blackwell 워크스테이션 GPU를 추가할 수 있습니다.
가장 큰 관건은 마이크로소프트가 이를 성공적으로 해낼 수 있을지 여부입니다.
우리의 입장을 분명히 밝히겠습니다. DGX Spark는 NVIDIA에게 큰 성공을 가져다주었고, 우리는 이 제품군 전체에 대해 매우 낙관적입니다. 하드웨어는 완벽하고, 효율성도 뛰어나며, NVIDIA는 이미 실리콘 성능을 입증했습니다. 다만 마이크로소프트가 이러한 장치들을 제대로 지원할 수 있을지에 대해서는 회의적입니다.
최근 마이크로소프트는 윈도우의 방향성에 대한 사용자 불만이 커지면서 좋지 않은 소식으로 언론의 헤드라인을 장식하고 있습니다. 일부 사용자들은 이를 "마이크로슬롭(Microslop)"이라고 부르기까지 합니다. 불만 사항은 낯설지 않습니다. 코파일럿(Copilot)을 운영체제 곳곳에 공격적으로 도입하고, AI를 스택 전반에 수직적으로 통합하며, 원드라이브(OneDrive)를 사실상 강제로 사용하게 하는 오랜 관행 등이 대표적입니다. 게다가 윈도우 온 암(Windows on Arm) 플랫폼은 아직 성숙 단계라고 할 수 없습니다. 엔비디아(NVIDIA)는 이번에는 다를 것이라고 확신하며, 프리즘(Prism) 에뮬레이터 개발에 수년간 협력해 온 경험과 주요 안티 치트 업체들과의 협업을 그 근거로 들고 있습니다. 엔비디아는 "윈도우 온 암이 왜 지금 성공할 것인가?"라는 질문에 "모두가 마침내 전폭적으로 지원하고 있기 때문"이라고 답합니다. 이는 사실일 수도 있지만, 지난번에도 들었던 답변과 크게 다르지 않습니다.
개인적으로 마이크로소프트가 기대에 부응하기를 바랍니다. RTX Spark는 RTX 5070급에 버금가는 성능의 게이밍 노트북입니다. 에뮬레이션과 드라이버 문제가 해결된다면, NVIDIA의 외장 GPU 노트북보다 저렴하고 효율적인 게임 대안이 될 수 있습니다. 또한 리눅스와의 호환성도 무시할 수 없습니다. 동일한 칩셋을 사용하므로 RTX Spark 역시 DGX Spark처럼 강력한 리눅스 지원을 받을 것으로 예상되며, 윈도우 스택에 적용된 게임 및 그래픽 관련 개선 사항들이 리눅스 환경에서도 게임 성능 향상으로 이어질지 매우 궁금합니다. 만약 마이크로소프트가 이처럼 훌륭한 플랫폼에서 실패하더라도, 리눅스와의 강력한 호환성을 바탕으로 이번 출시를 통해 리눅스 데스크톱이 대중화되는 시대가 열릴 수도 있을 것입니다.
저희에게 더 큰 놀라움은 NVIDIA가 DGX Station에 Windows를 탑재하기로 결정했다는 점입니다. 2025년 이 제품이 처음 발표되었을 때, 저희를 비롯한 많은 언론사 기자들은 이것이 정말 탁월한 전략이라고 생각했습니다. 소프트웨어 지원은 일반적으로 새로운 하드웨어보다 몇 년씩 뒤처져 왔습니다. 커널과 툴이 실리콘의 잠재력을 제대로 활용할 수 있을 만큼 성숙해지기 전까지 말이죠. DGX Station은 최고의 AI 연구소, 연구원, 그리고 기업들이 최신 아키텍처를 기반으로 개발을 시작할 수 있도록 설계된 장비였습니다. 데이터센터가 제대로 구축되기 훨씬 전부터 말이죠. 하지만 문제는 이 제품이 그 시점에 1년이나 늦었다는 것입니다. 저희는 이 시스템을 사용하는 동안 여러 가지 사소한 문제점들(몇 가지는 악몽을 꿀 정도였습니다)을 제외하고는 매우 만족스러웠지만, 이렇게 하드코어 AI를 위해 설계된 장비에 Windows를 탑재한 것은 쉽게 납득하기 어렵습니다. B300에는 RT 코어가 없기 때문에 NVIDIA의 워크스테이션 워크로드 대부분은 옵션 사양인 RTX PRO 외장 그래픽 카드에 의존하게 되고, B300은 AI 작업에만 사용되어야 할 것입니다. 저희는 DGX 스테이션에서 윈도우 지원이 실제로 얼마나 잘 작동할지 매우 궁금하며, 솔직히 마이크로소프트가 여기서 좋은 사용자 경험을 제공하고 단일 호스트에서 B300과 800G ConnectX-8 네트워킹을 제대로 활용할 수 있을지에 대해 회의적입니다.
세대마다 새로운 제품군이 등장합니다.
기조연설에서 우리에게 가장 인상 깊었던 부분은 사양서가 아니었습니다.
젠슨은 이 PC 라인업을 영구적인 제품군으로 발표하며, 향후 모든 아키텍처 세대에 맞는 데스크톱, 노트북, 워크스테이션을 제공할 것이라고 약속했고, PC 업계의 100%가 이 계획에 동참했다고 주장했습니다.
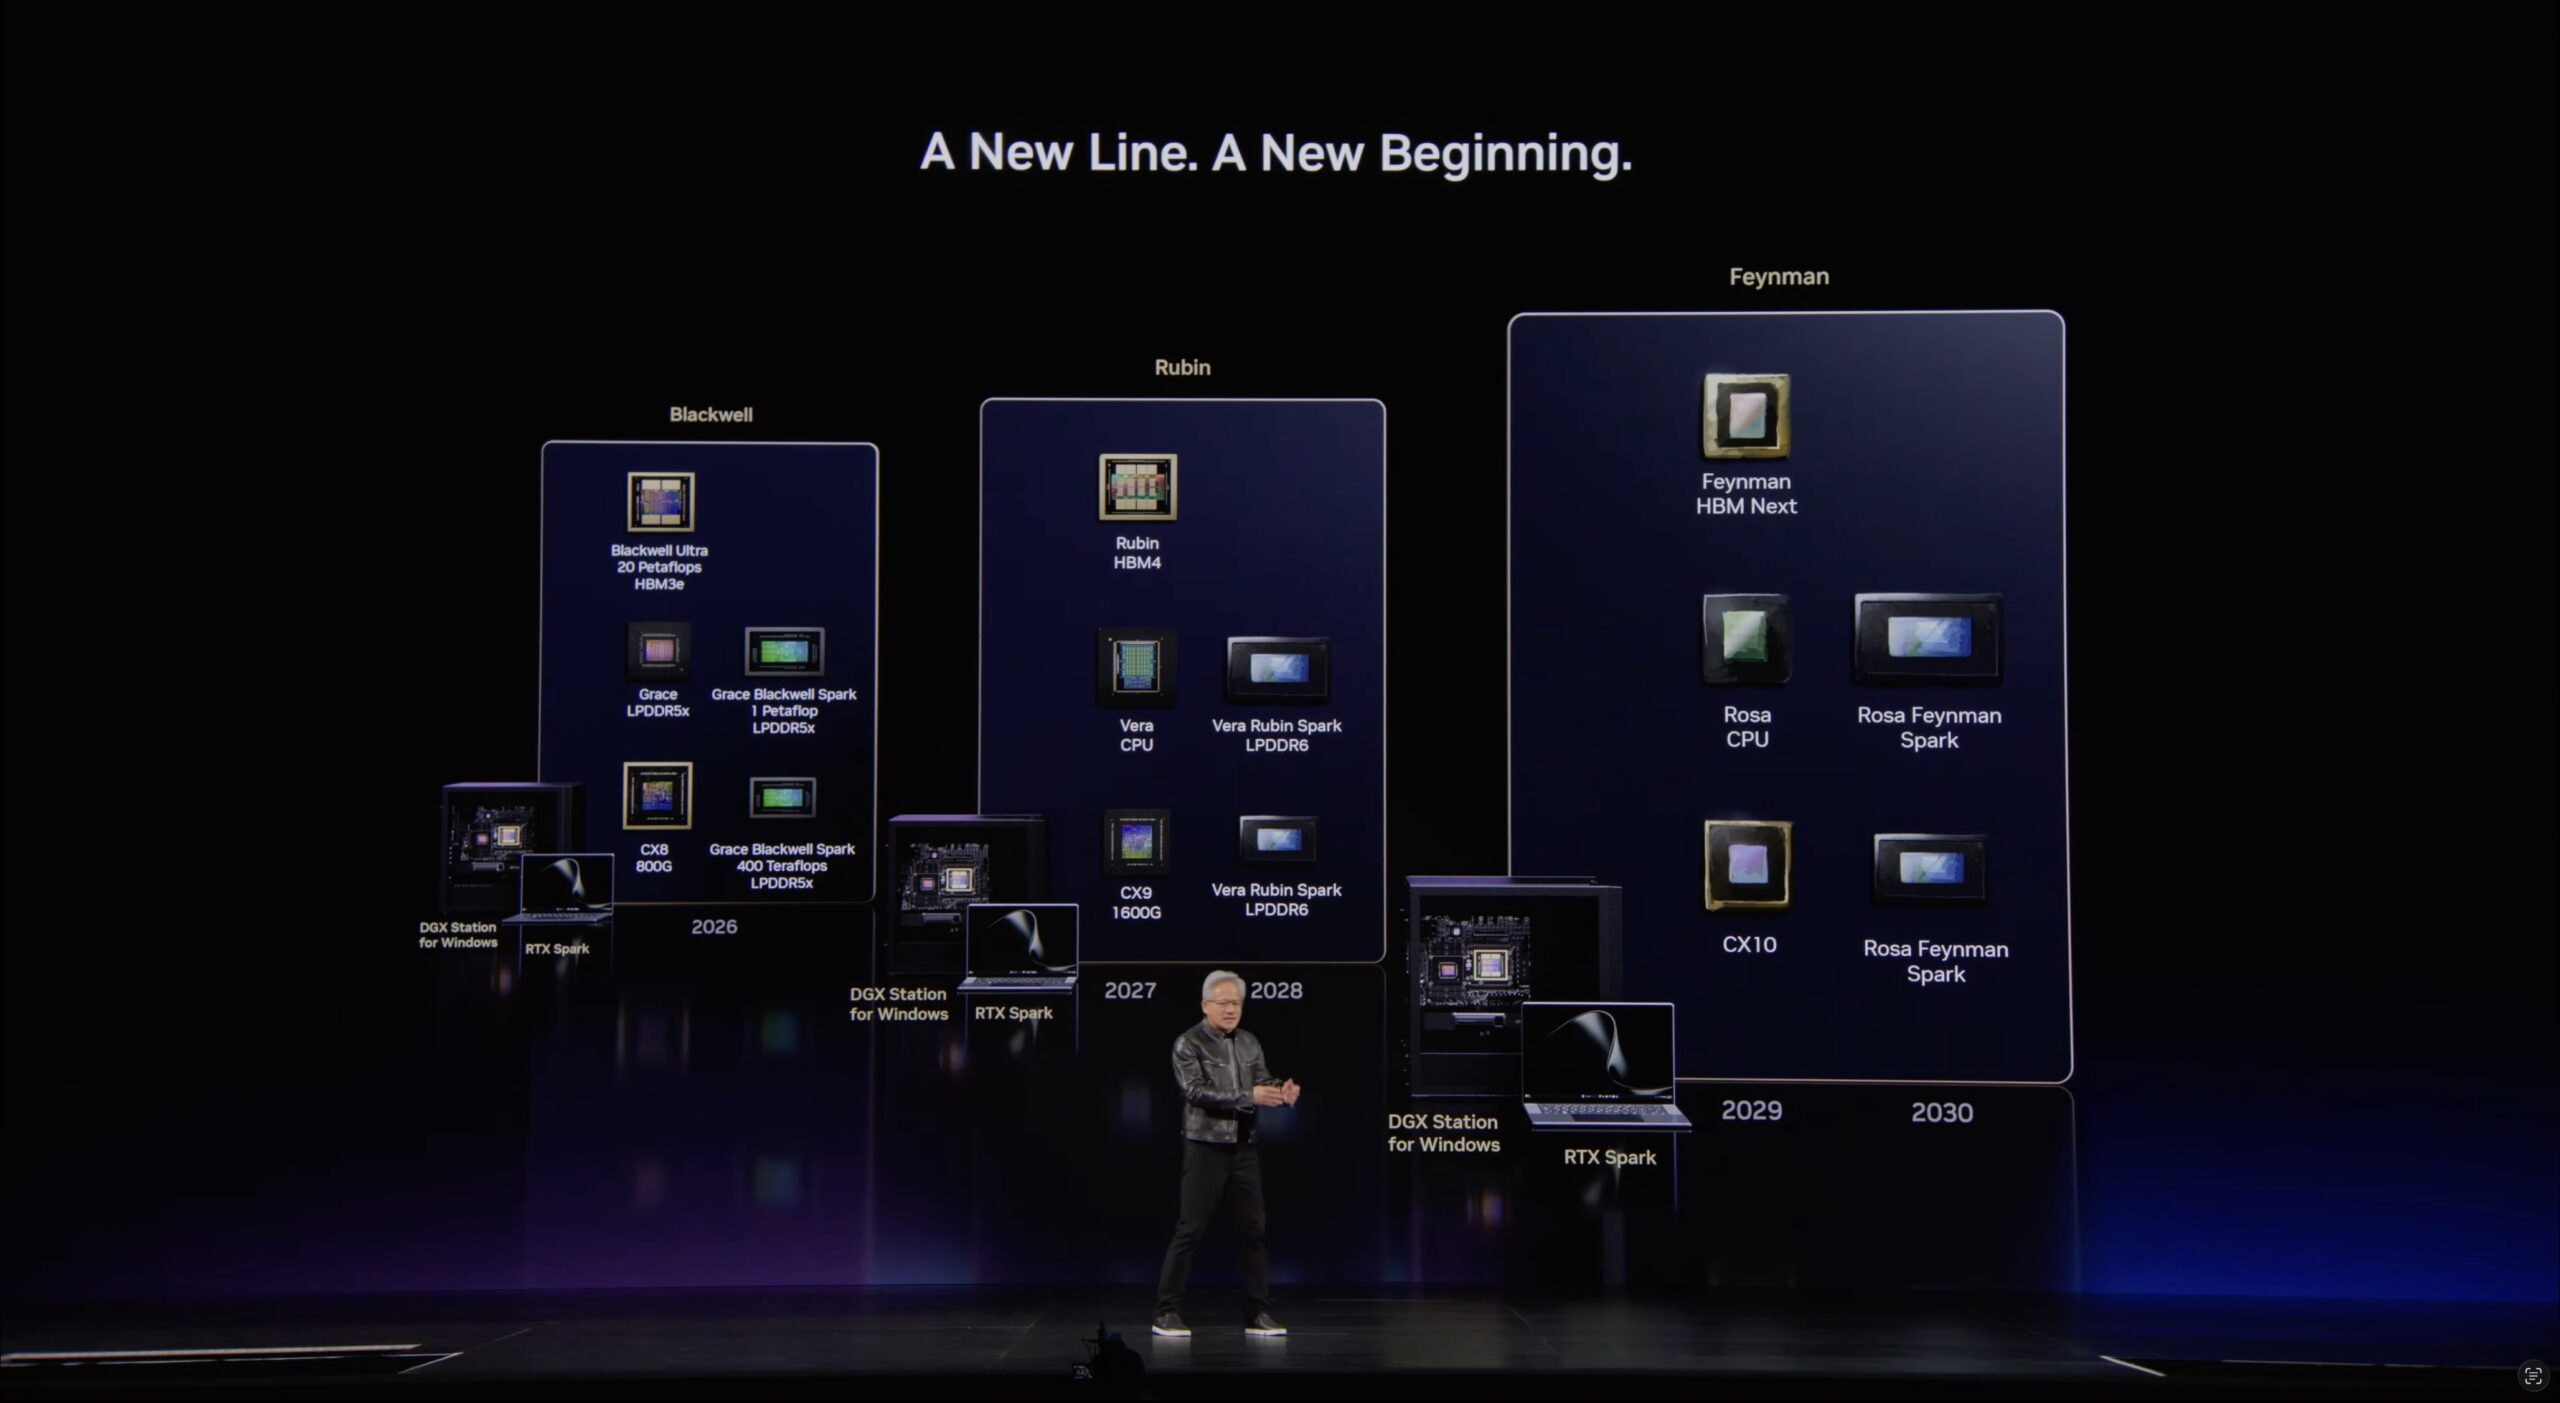
덧붙여 말씀드리자면, 여기서 언급되었던 소형 400테라플롭(TFlop) N1 그레이스 블랙웰 스파크 슈퍼칩이 드디어 공개되었습니다. 이 칩이 탑재된 기기가 어떤 모습일지 기대됩니다.
PC를 넘어서: 물리적 AI
기조연설 후반부는 물리적 AI에 대한 논의로 집중되었습니다. 앞서 다룬 클라이언트 하드웨어와는 완전히 다른 분야이지만, 컴퓨텍스의 전체적인 그림을 완성하는 중요한 부분입니다. NVIDIA는 이번 행사를 통해 물리적 AI 에이전트 도구 및 스킬 모음을 오픈소스로 공개했습니다. 해당 툴 및 스킬은 github.com/NVIDIA/skills에 게시되었으며, 신경 재구성, 비디오 증강, 결함 이미지 생성과 같은 합성 데이터 기반 스킬이 포함되어 있습니다. TSMC, 폭스콘, SK하이닉스 등 제조 파트너사들은 이미 이러한 스킬들을 공장 생산 라인에서 활용하고 있습니다. 주요 플랫폼은 아래와 같습니다.
아이작 GR00T 레퍼런스 휴머노이드 로봇
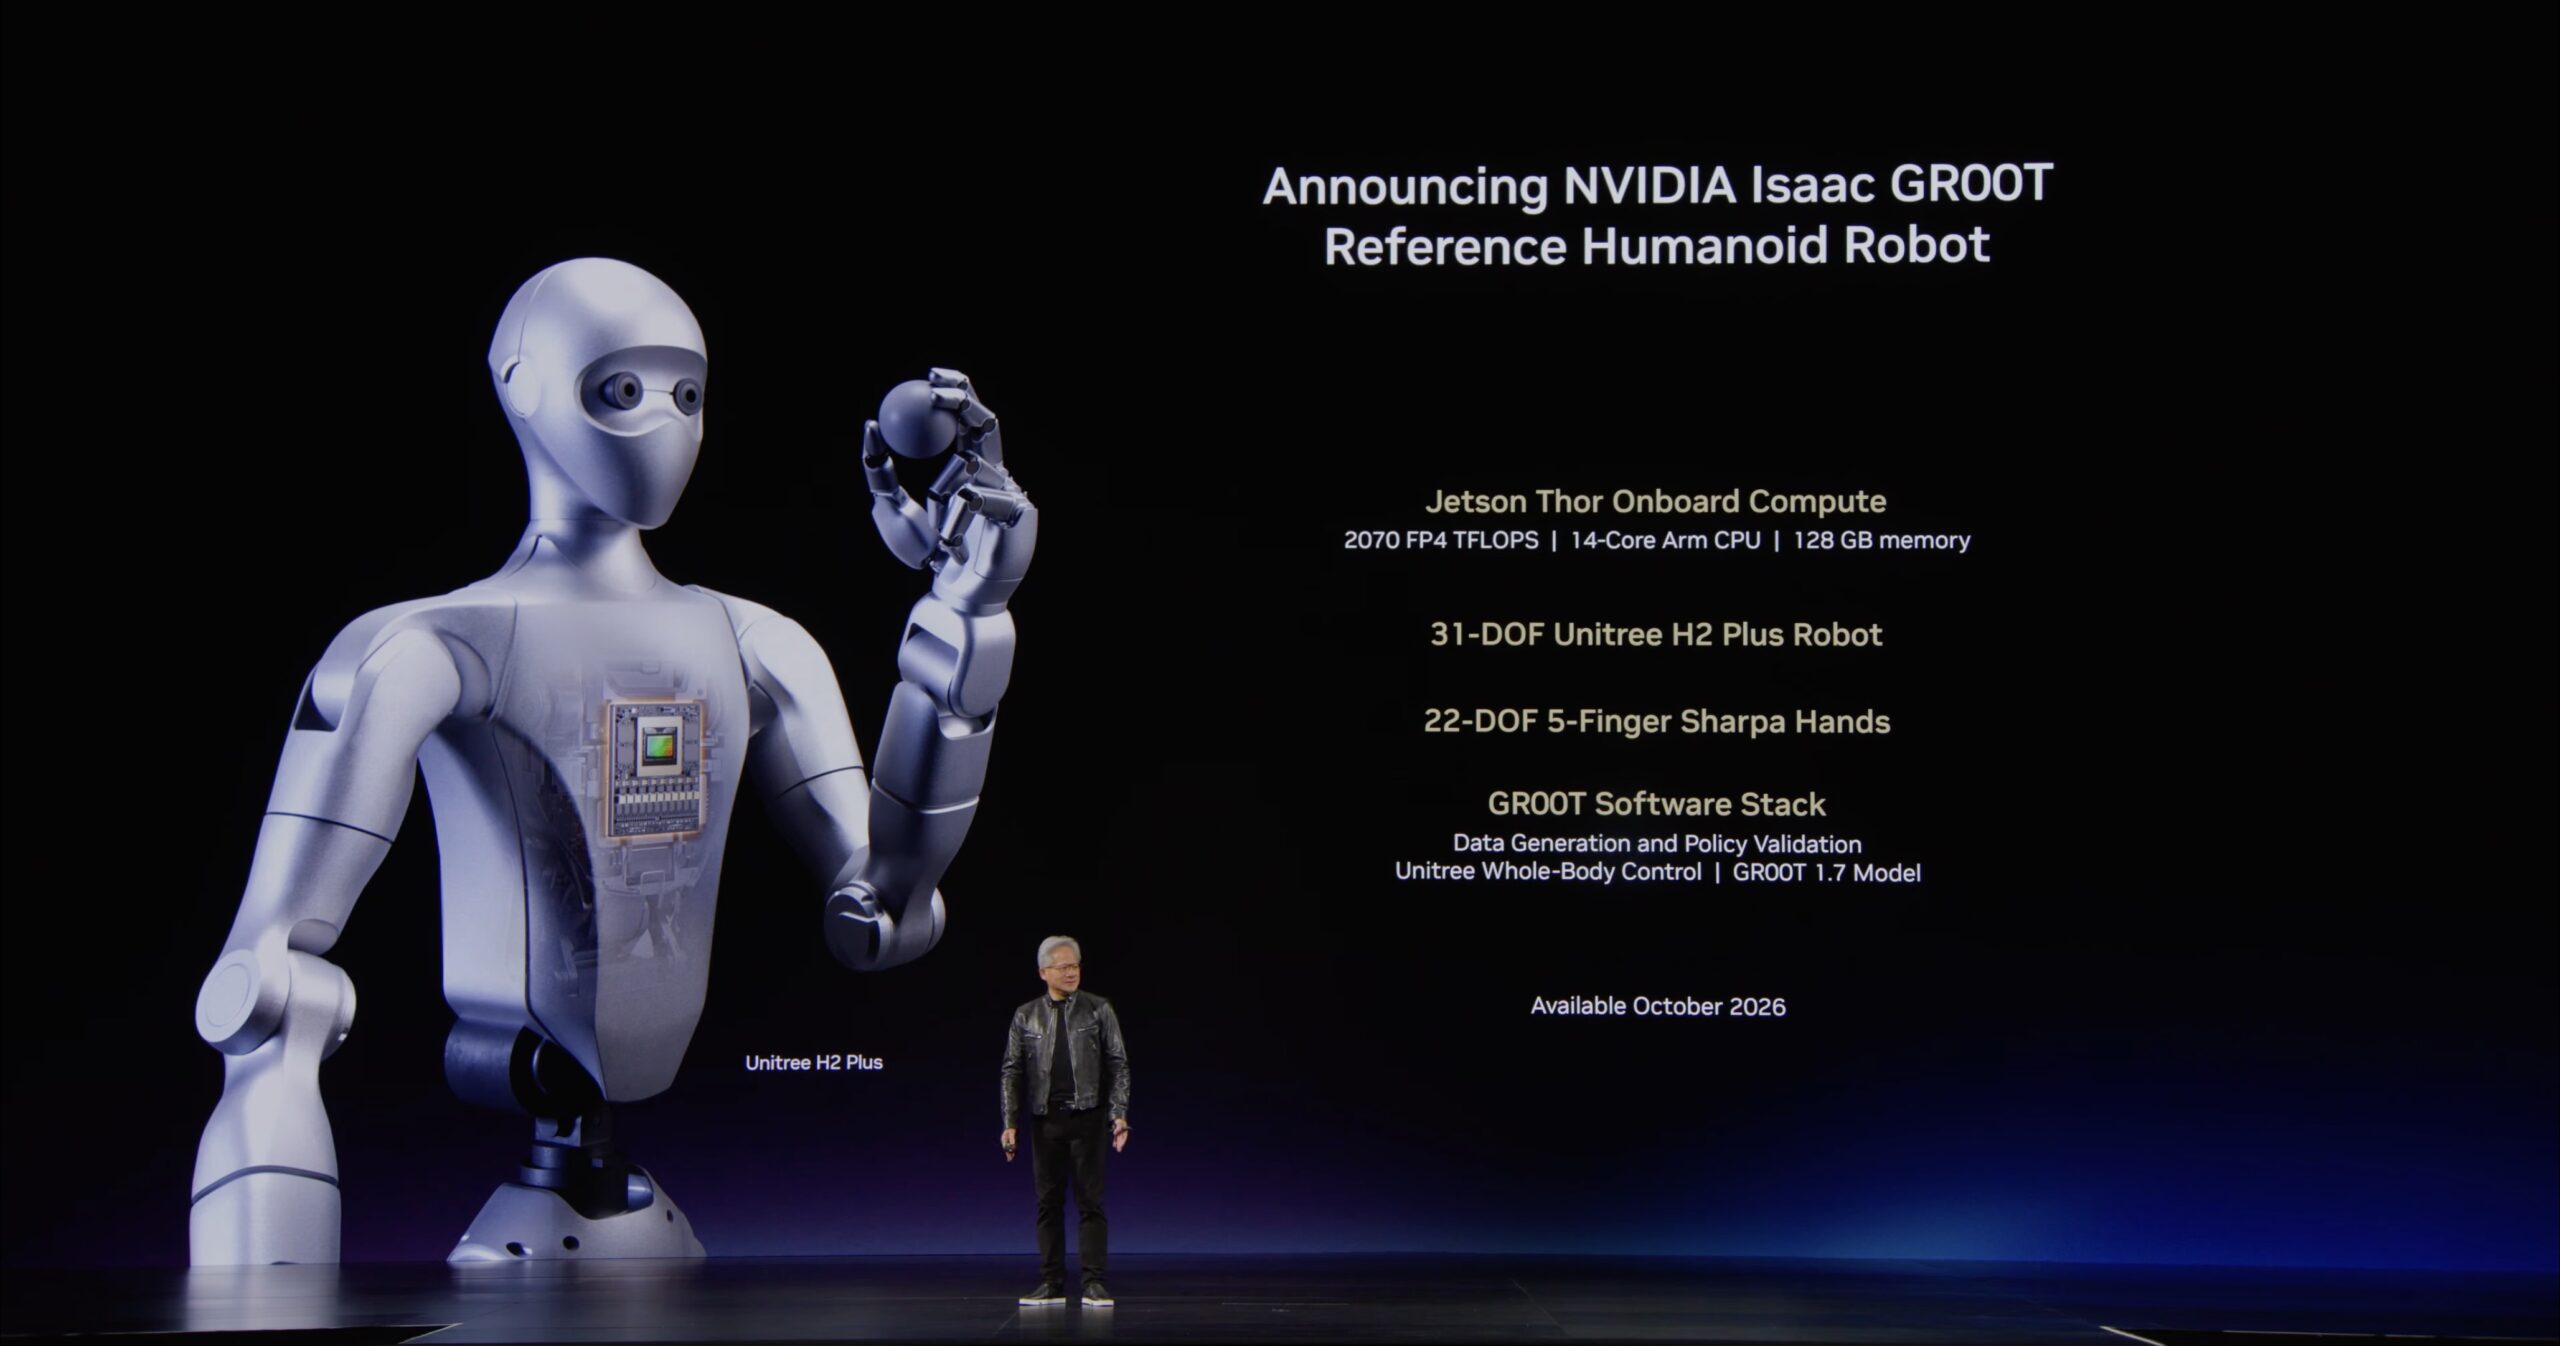
NVIDIA는 유니트리 H2 플러스 섀시를 기반으로 제작된 휴머노이드 로봇의 오픈 레퍼런스 디자인을 공개했습니다. 이 로봇은 높이가 약 183cm(6피트)에 달하고 무게는 68kg(150파운드)이며, 샤르파 웨이브(Sharpa Wave) 촉각 센서가 탑재된 5개의 손가락으로 구성된 듀얼 핸드 덕분에 총 75개의 자유도를 자랑합니다. 강력한 액추에이터는 팔 토크 최대 120Nm, 다리 토크 최대 360Nm를 제공하며, 정격 7kg, 최대 15kg의 하중을 견딜 수 있습니다. 센싱을 위해 140도 수평 시야각을 제공하는 헤드 마운트 스테레오 카메라, 조작용 손목 카메라, 관성 측정 장치(IMU), 그리고 일반적인 Wi-Fi 6 및 블루투스 5.2 연결 기능을 갖추고 있습니다. 이 시스템의 핵심은 NVIDIA의 Jetson AGX Thor T5000으로, 2,070 FP4 테라플롭스의 Blackwell GPU, 14코어 Arm CPU, 128GB의 통합 메모리를 갖추고 있으며, 40~130와트의 전력을 소비하고 약 1kWh 배터리로 약 3시간 동안 작동합니다. 데이터 수집을 위한 Isaac Teleop부터 Isaac Sim, Isaac Lab, GR00T 기반 모델, 그리고 배포를 위한 Isaac ROS 미들웨어에 이르기까지 전체 스택은 오픈 소스이며, 연구원들은 자신의 데이터에 대한 통제권을 유지합니다. 스탠포드, 취리히 연방 공과대학, 캘리포니아 대학교 샌디에이고, Ai2 등이 초기 도입 기관이며, Unitree는 2026년 말에 하드웨어를 출시할 예정이고, Unitree G1 레퍼런스 워크플로는 곧 GitHub와 Hugging Face에 공개될 예정입니다. 젠슨은 특유의 거시적인 표현으로 휴머노이드 로봇의 가능성을 강조하며, 이를 "수조 달러 규모의 경제적 기회"라고 불렀습니다.
코스모스 3
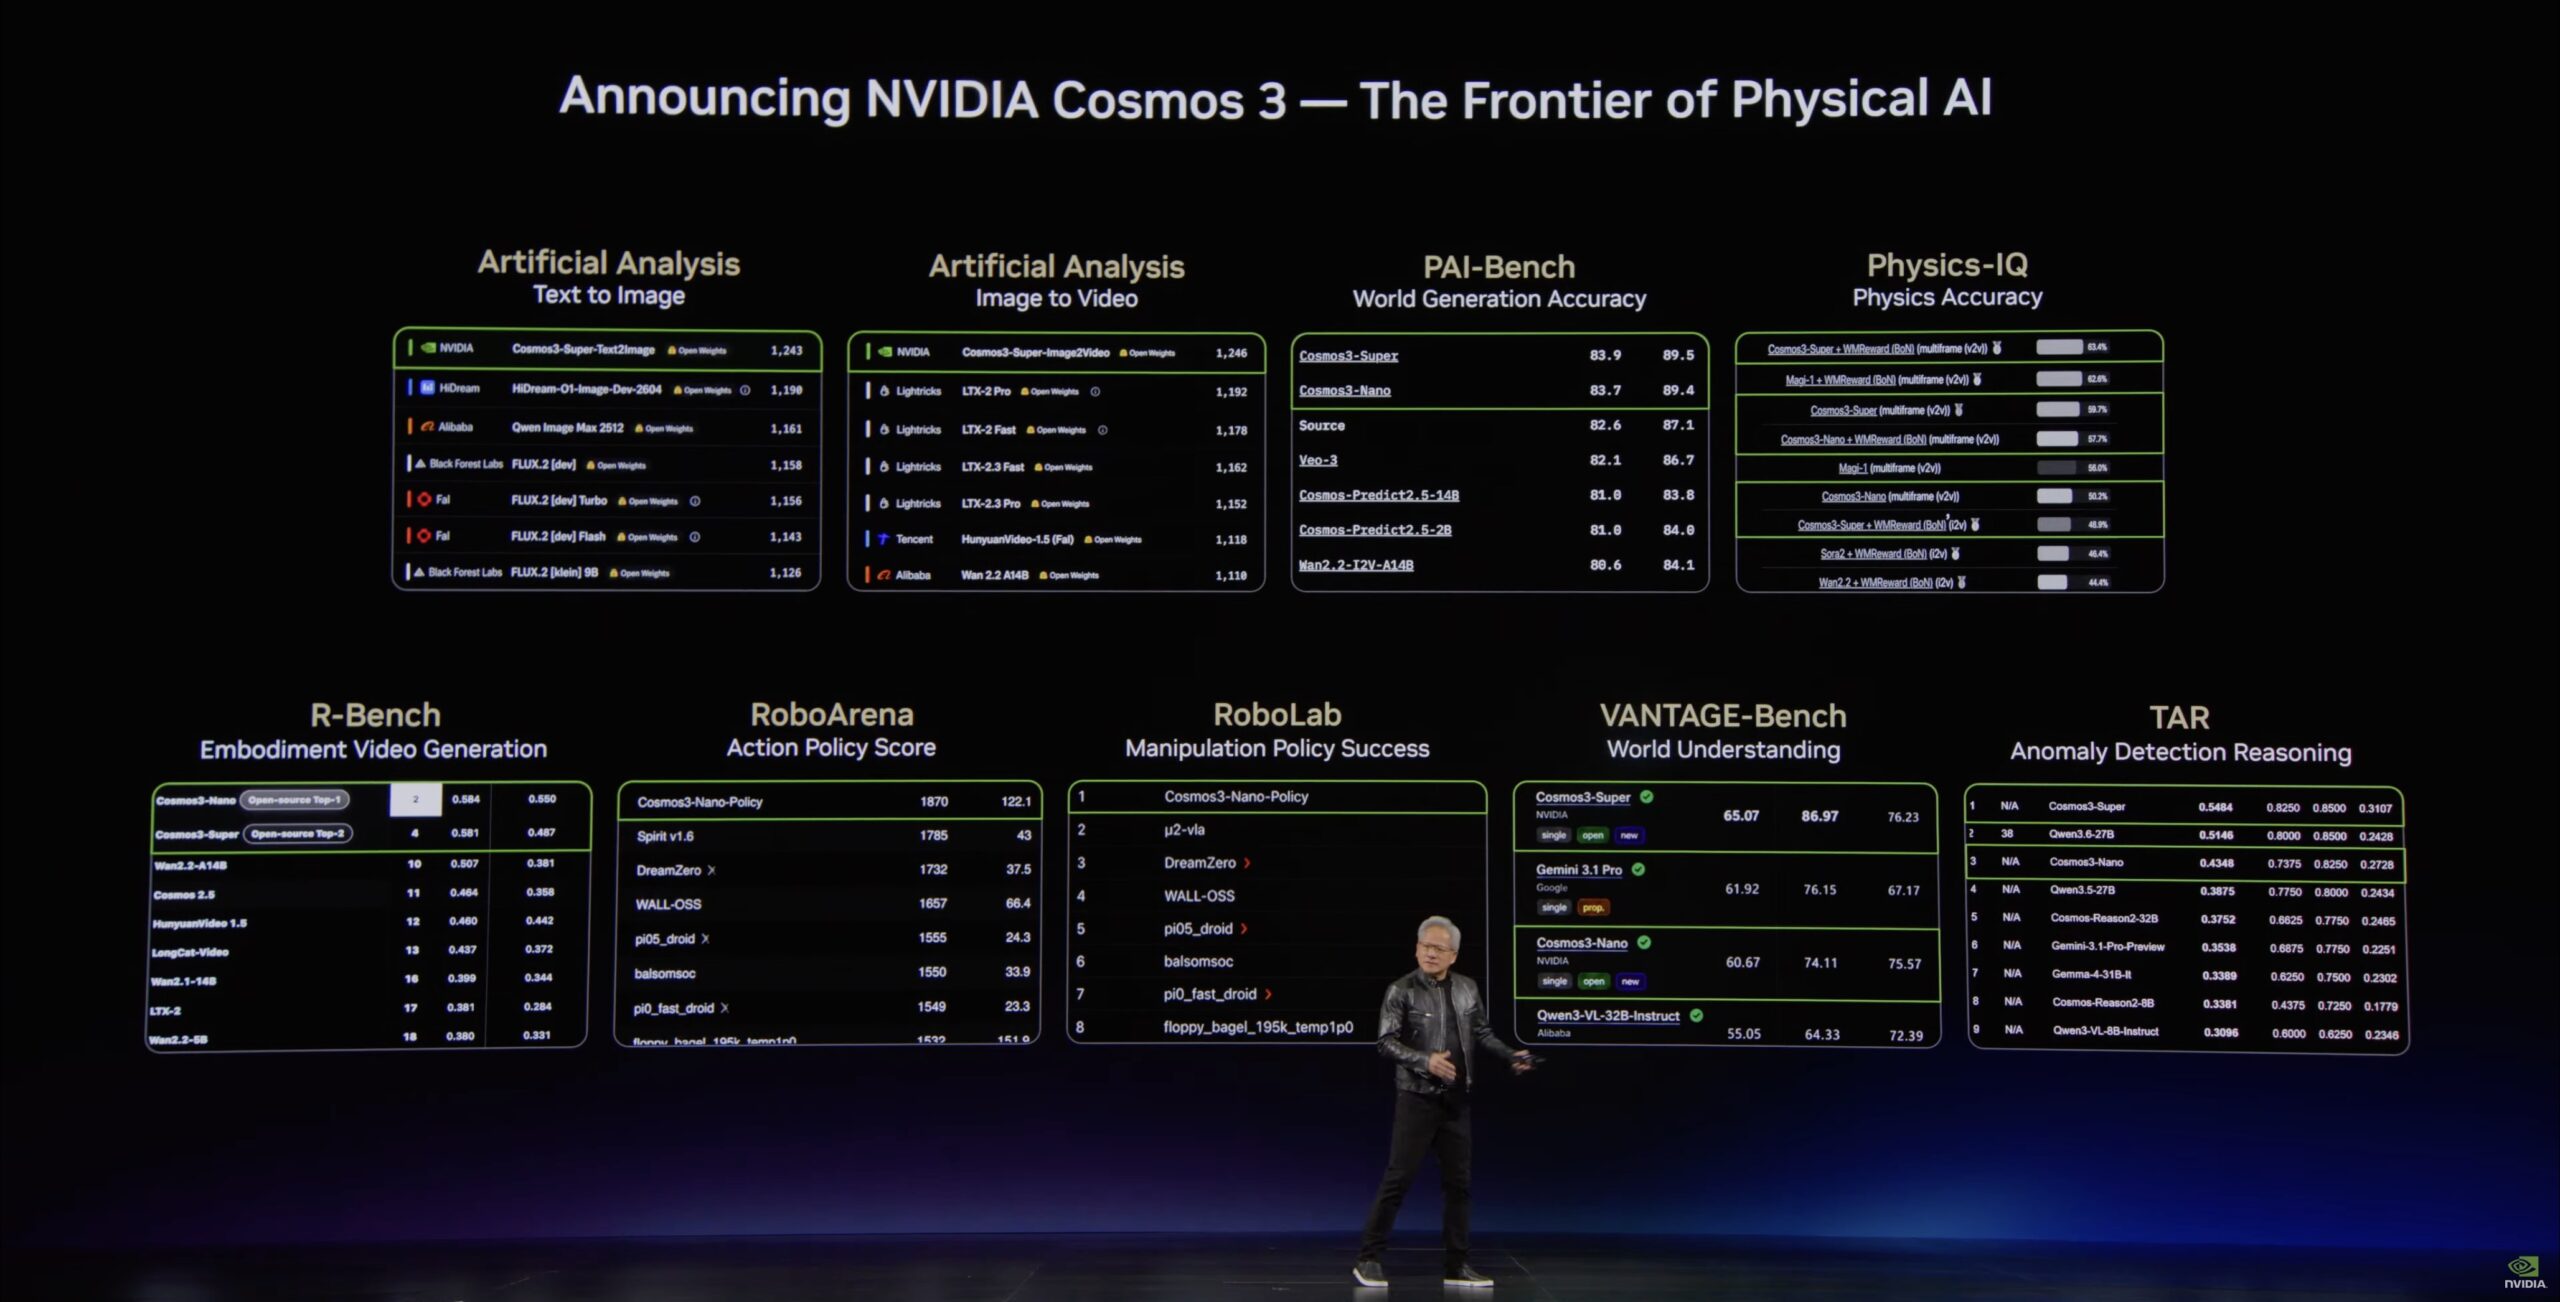
Cosmos 3는 NVIDIA의 물리적 AI를 위한 개방형 프론티어 기반 모델입니다. 이 혼합형 트랜스포머 옴니모델은 텍스트, 이미지, 비디오, 주변 소리, 동작을 하나의 스택에서 처리하며 수십억 개의 멀티모달 샘플로 학습되었습니다. Cosmos 3는 멀티모달 추론을 위한 비전-언어 모델, 물리적 환경 시뮬레이션을 위한 월드 모델, 그리고 특정 작업을 수행하는 로봇을 훈련하는 월드-액션 모델의 백본이라는 세 가지 역할을 수행합니다. Cosmos 3 Super는 고정밀 로봇 공학 및 자율주행(AV) 사후 학습을 위해, Cosmos 3 Nano는 빠른 비디오 및 동작 추론을 위해, 그리고 Cosmos 3 Edge는 실시간 추론을 위해 곧 출시될 예정입니다. NVIDIA는 Cosmos 3가 월드 생성을 위한 Physics-IQ 및 R-Bench, 동작 정책을 위한 RoboLab 및 RoboArena, 비전 이해를 위한 VANTAGE-Bench 등 다양한 벤치마크에서 개방형 모델 분야를 선도하고 있으며, 물리적 AI 학습 및 평가 주기를 몇 달에서 며칠로 단축할 수 있다고 밝혔습니다. 이 기술은 Hugging Face, GitHub 및 build.nvidia.com에서 NIM 마이크로서비스로 제공되며, Agile Robots, Black Forest Labs, Runway 및 Skild AI를 포함하는 연합체와 삼성, LG전자, LiAuto 및 Doosan Robotics와 같은 도입 기업들이 이를 활용하고 있습니다.
알파마요 2 슈퍼
NVIDIA는 자율 주행을 위해 Alpamayo 2 Super를 발표했습니다. 이는 Cosmos 세계 기반 모델을 바탕으로 구축된 320억 개의 파라미터를 가진 개방형 비전-언어-행동 모델로, 레벨 4 개발을 위한 전체 주행 스택에 걸쳐 추론, 계획 및 행동을 수행합니다. 이전 100억 개의 파라미터 버전에서 확장되어 360도 전방위 인식을 지원합니다. 또한, 거시적인 주행 결정과 그 결정을 설명하는 인과 관계 추적 기능을 제공하며, 추론 자동 라벨링 기능을 통해 어노테이션 주기를 수개월에서 며칠로 단축할 수 있습니다. NVIDIA는 Alpamayo 2 Super를 DRIVE AGX Thor에 차량 내 배포를 위해 더 작은 네트워크로 분할되는 교사 모델로 포지셔닝하고 있으며, 폐쇄 루프 강화 학습을 위한 AlpaGym, 생성형 시나리오 생성을 위한 OmniDreams, 그리고 차량 데이터를 3D 장면으로 변환하는 Omniverse NuRec 기반의 신경 재구성 도구와 함께 제공합니다. 알파마요의 이전 버전은 약 40만 번 다운로드되었습니다. 새로운 모델은 컴퓨텍스 베스트 초이스 상을 수상했으며, 올여름 깃허브와 허깅페이스에서 이용 가능할 예정입니다.
드라이브 하이페리온
알파마요(Alpamayo)가 두뇌라면, DRIVE Hyperion은 그 두뇌가 구동하는 자동차와 같습니다. Hyperion에 대해서는 이미 다룬 적이 있으므로, 여기서는 플랫폼 자체에 대한 자세한 설명은 생략하겠습니다. 다만, Hyperion은 NVIDIA의 레벨 4 자율주행 레퍼런스 플랫폼으로, Halos 안전 시스템과 DriveOS, 그리고 DRIVE AGX 컴퓨팅 성능을 기반으로 구축되었다는 점만 언급하겠습니다. 이번에 더 흥미로운 점은 Hyperion을 도입하려는 파트너사들입니다. 우버는 뮌헨 로보택시 프로그램을 포함하여 여러 Hyperion 기반 차량을 운영하고 있으며, 뮌헨 로보택시 프로그램은 올해 말에 시작될 예정입니다. 폭스콘과 폭스트론은 2028년 대만 가오슝을 시작으로 아시아 전역으로 로보택시 서비스를 확대할 계획입니다. 빈패스트(VinFast)는 동남아시아에 레벨 4 자율주행 차량을 도입하고 있으며, 오토브레인즈(Autobrains)는 빈패스트와 우버 모두와 협력하고 있습니다. 휴메인(HUMAIN)은 사우디아라비아에 Hyperion을 선보일 예정입니다. 이처럼 강력한 파트너사들이 Hyperion을 주목하게 만드는 요소이며, 특정 사양 하나보다도 더 중요한 의미를 지닙니다.
생각을 폐쇄
NVIDIA는 이미 칩을 확보했고, 14mm 노트북부터 데스크탑 GB300, 심지어 휴머노이드 로봇의 가슴 부분까지 모든 곳에 이 칩을 탑재하고 있습니다. (이 부분은 믿을 만하다고 생각합니다.) 하지만 사양표만으로는 알 수 없는 것이 있습니다. 마이크로소프트가 Arm 기반 윈도우를 하드웨어 비용만큼의 가치를 지닌 제품으로 만들 수 있을지, OEM 업체들이 Spark 칩의 잠재력을 최대한 발휘할 수 있도록 할지 아니면 너무 얇은 섀시에 억눌리게 할지, 그리고 페타플롭스와 배터리 성능 주장이 실제 측정 결과와 일치하는지 여부입니다. 우리는 하드웨어에 대해서는 낙관적이지만 소프트웨어(마이크로소프트, 리눅스는 아님)에 대해서는 회의적이며, 실제 기기가 연구실에 도착할 때까지 이러한 입장을 유지할 것입니다. 기기가 도착하면 벤치마크 결과를 공개하겠습니다.


 아마존