

NVIDIA는 스탠포드 핫 칩스 컨퍼런스에서 명확한 메시지를 전달합니다. 데이터 센터는 컴퓨터이며, 그 성능 한계는 순수 FLOPS(플롭스)보다는 상호 연결 구조에 의해 결정된다는 것입니다. NVIDIA는 5개 세션에 걸쳐 Spectrum-XGS 이더넷, NVLink Fusion을 탑재한 5세대 NVLink, CPO 기반 광자 스위치, 그리고 새로운 DGX Spark 데스크톱 슈퍼컴퓨터가 어떻게 함께 작동하는지 시연할 예정입니다. 이러한 통합을 통해 수만 개의 GPU를 수익을 창출하는 단일 AI 팩토리로 전환하는 것이 목표입니다.
AI 공장을 위한 3중 구조 패브릭
최신 LLM은 암묵적으로 분산된 애플리케이션입니다. GPU 전반에 걸쳐 수조 개의 매개변수를 스트리밍하고, 마이크로초 단위로 그래디언트 업데이트를 동기화하며, 하트비트보다 짧은 시간 내에 사용자에게 첫 번째 토큰을 반환해야 합니다. 이러한 워크로드는 상호 연결 계층을 구동합니다.
- 랙 내에서 확장이 가능하므로 GPU는 단일 대형 프로세서의 코어처럼 작동합니다.
- 여러 랙에 걸쳐 확장하여 클러스터가 통합된 시스템으로 작동하도록 합니다.
- 지리적 중복성, 용량 공유, 규정 준수를 위해 전체 데이터 센터에 걸쳐 확장합니다.
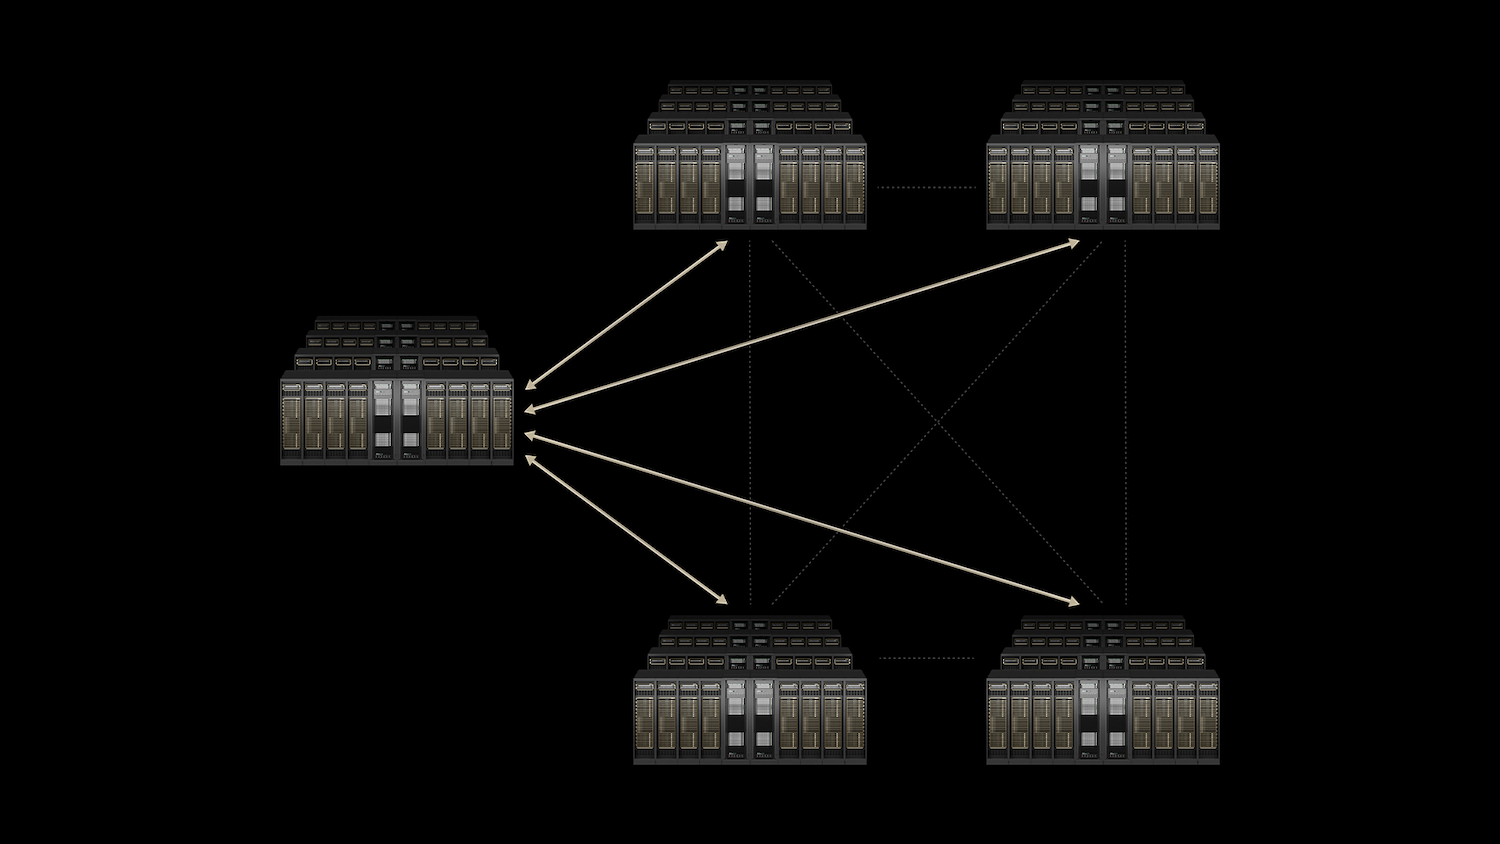
NVIDIA의 해답은 수직 통합 스택입니다. NVLink와 NVLink Switch는 스케일업 영역을 담당하고, Quantum InfiniBand와 Spectrum-X는 스케일아웃 영역을 담당합니다. 새로운 Spectrum-XGS 이더넷은 데이터센터 전반에 걸쳐 무손실 AI 튜닝 네트워킹을 확장합니다. Co-Packaged Optics(CPO)는 수백만 개의 GPU 클러스터가 직면할 수 있는 전력 및 밀도 한계를 줄여줍니다.
스펙트럼-XGS 이더넷
기존 이더넷 기술은 주로 최선형 트래픽 처리에 중점을 두고 설계되었기 때문에 단일 서버 기반 단순 통신에 적합했습니다. 그러나 AI에 대한 의존도가 점점 높아지는 세상으로 나아가면서 우리는 새로운 과제에 직면하게 됩니다.
AI 집단과 멀티 테넌트 추론 시스템의 등장으로 네트워크 성능에 대한 요구 사항이 크게 증가했습니다. 이러한 최신 애플리케이션은 기존 이더넷으로는 제공할 수 없는 수준의 안정성과 속도를 요구합니다.
특히, 지터(jitter)가 없어야 하며, 이는 지연 시간 변동이 없음을 의미하는데, 이는 실시간 처리에 필수적입니다. 또한, 결정론적 지연 시간은 응답의 예측 가능성과 일관성을 보장하며, 이는 즉각적인 피드백에 의존하는 애플리케이션에 필수적입니다. 마지막으로, 데이터 트래픽이 예상치 못하게 급증할 수 있는 마이크로버스티 부하 중에 처리되는 대량의 데이터를 처리하기 위해서는 거의 회선 속도에 가까운 처리량이 필수적입니다.
Spectrum-X는 데이터 센터 내에서 원활하게 작동하는 솔루션이며, Spectrum-XGS는 이러한 혁신을 한 단계 더 발전시켜 여러 데이터 센터에 걸쳐 기능을 확장합니다. Spectrum-XGS는 고급 Spectrum-6 또는 Spectrum-4 ASIC 기반 스위치와 초고속 800Gb/s SuperNIC(특히 BlueField-3 또는 ConnectX-8)를 통합합니다. 이러한 기술들은 함께 작동하여 혼잡을 효율적으로 관리하고 패킷 순서를 재정렬함으로써 원활한 데이터 흐름을 보장합니다.
이 시스템의 차별점은 모든 포트에서 데이터를 수집하여 스위치 내 혼잡 제어 로직에 입력하는 지능형 원격 측정 기능으로, 실시간 트래픽 재조정을 지원합니다. 운영 클러스터에서는 이를 통해 놀라운 성능을 발휘하여 95k GPU 규모에서도 이론 용량의 32% 이상의 처리량을 유지합니다. 반면, 기존 800G 이더넷은 집단 충돌 발생 시 처리량의 약 60% 정도만 달성하는 데 그칩니다.
또한 Spectrum-XGS는 표준 준수를 보장하여 SONiC과 Cumulus Linux를 자사 생태계의 필수 구성 요소로 만듭니다. 즉, 클라우드 및 엔터프라이즈 운영자는 기존 자동화 스택을 유지하면서 InfiniBand의 뛰어난 결정성을 활용할 수 있습니다. 이러한 향상된 기능은 GPU 활용도를 높이고 지연 시간을 줄여 와트당 토큰 수를 늘리고 서비스 수준 목표를 더욱 엄격하게 달성합니다. 또한, 운영자는 성능 저하 없이 동일한 시스템에 새로운 테넌트를 온보딩할 수 있어 업계의 판도를 바꿀 것입니다.
NVLink와 NVLink Fusion: 하나의 거대한 GPU로서의 랙
1.8세대 NVLink는 NVL130 랙 내에서 72TB/s의 인상적인 지점 간 대역폭과 XNUMXTB/s의 놀라운 총 대역폭을 제공합니다. 이러한 향상된 연결성 덕분에 모든 GPU가 단 한 번의 홉으로 다른 모든 GPU와 직접 통신할 수 있으며, 이를 통해 전체 랙을 일관된 메모리 도메인으로 효과적으로 전환할 수 있습니다. XNUMX년간 정교하게 개발된 NVIDIA Collective Communications Library(NCCL) 덕분에 애플리케이션 개발자는 다양한 토폴로지에 대한 맞춤형 통신 코드를 작성하지 않고도 거의 유선에 가까운 속도를 손쉽게 구현할 수 있습니다.
또한, 최근 발표된 NVLink Fusion은 하이퍼스케일러에게 흥미로운 가능성을 열어줍니다. 이 혁신을 통해 맞춤형 CPU 또는 XPU는 가속기용 UCIe 또는 CPU용 NVLink-C2C를 통해 NVLink SERDES 또는 칩렛을 원활하게 통합하여 이러한 구성 요소를 NVLink 패브릭에 직접 배치할 수 있습니다. Fusion의 가장 큰 장점은 완벽하게 검증된 공급망을 갖춘 모듈식 MGX 랙 사양입니다. 즉, 현재 NVL72 랙을 공급하는 공급업체가 Fusion 랙도 공급할 수 있어 이 기술을 구현하려는 기업의 출시 기간을 크게 단축할 수 있습니다.
추론 경제 측면에서 NVLink의 영향은 기존의 와트당 처리량 대 지연 시간 파레토 프런티어에 분명히 나타납니다. PCIe 메시에서 NVLink 스위치 노드로 전환하면 처리량과 지연 시간이 모두 향상되며, NVLink 랙으로 업그레이드하면 더욱 향상된 성능을 얻을 수 있습니다. 이를 통해 킬로와트시당 더 많은 사용자 쿼리를 처리하는 동시에 생성된 토큰당 상각된 자본 지출을 줄일 수 있어 NVLink는 운영 효율성을 향상시키는 강력한 도구가 됩니다.
1.8세대 NVLink는 NVL130 랙 내에서 72TB/s의 지점 간 대역폭과 XNUMXTB/s의 총 대역폭을 제공합니다. NVLink 스위치를 사용하면 모든 GPU가 단일 홉에서 다른 GPU를 인식하여 전체 랙을 일관된 메모리 도메인으로 만듭니다. 모든 상상 가능한 토폴로지에 맞춰 조정되고 토폴로지를 자동으로 인식하는 NCCL 라이브러리를 통해 공동 작업이 실행됩니다. 따라서 애플리케이션 개발자는 거의 유선에 가까운 속도를 달성하기 위해 사용자 지정 통신 코드가 필요하지 않습니다.
공동 패키지 광학(CPO): 800Gb/s 이상에서 전력 장벽을 깨다
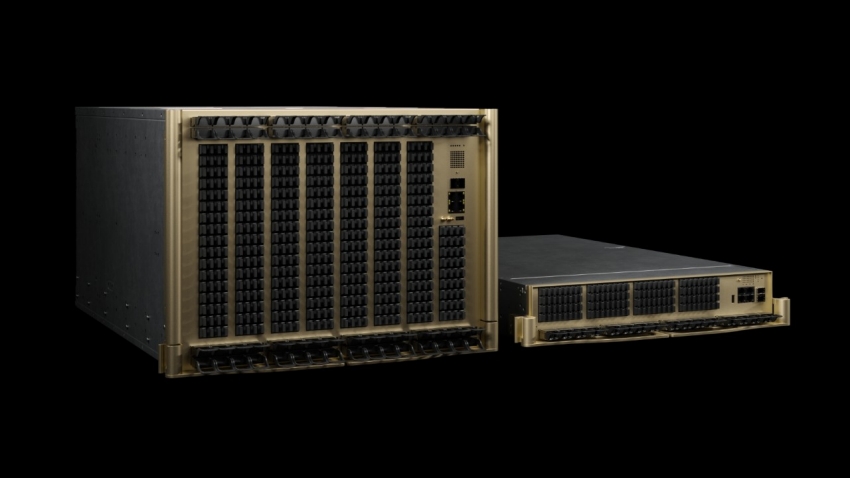
기존의 플러그형 모듈 스위치는 한동안 네트워킹 표준으로 자리 잡았습니다. 그러나 이러한 시스템에 내재된 비효율성은 점점 더 두드러지고 있습니다. 데이터가 ASIC을 빠져나가면 긴 PCB 트레이스를 따라 이동하고 여러 커넥터를 거쳐 DSP가 집약된 광 모듈에 도달합니다. 이러한 이동 과정에서 전기적 손실이 최대 22dB에 달하며, 신호 복구에만 포트당 무려 30W의 전력을 소모합니다. 현재 200G PAM4, 그리고 가까운 미래에는 1.6T와 같은 더 높은 데이터 전송 속도를 목표로 하고 있는 상황에서, 이러한 아키텍처의 한계는 명확해지고 있으며, 이는 폭발적인 전력 예산과 페이스플레이트 밀도의 제약으로 이어집니다.
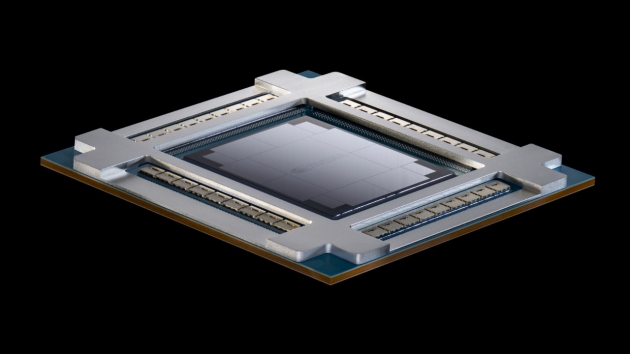
NVIDIA의 혁신적인 솔루션, InfiniBand용 Quantum-X Photonics와 이더넷용 Spectrum-X Photonics를 소개합니다. 광학 엔진을 스위치 패키지에 직접 통합하여 전기 경로 길이를 대폭 줄였습니다. 이를 통해 손실을 약 4dB로 최소화할 뿐만 아니라 포트 전력 소비도 약 9W로 대폭 줄여 놀라운 개선 효과를 거두었습니다.
다음 주에는 두 가지 최첨단 수냉식 섀시가 출시됩니다. 128포트 모델은 무려 102.4Tb/s의 처리량을 자랑하고, 512포트 모델은 그 한계를 409.6Tb/s까지 확장합니다. 3.5포트 모델은 통합 파이버 셔플 기능을 탑재하여 번거로운 수동 패치 작업 없이 모든 포트가 올바른 파이버 번들에 원활하게 연결되도록 합니다. 초기 현장 데이터는 기존 플러그형 모델보다 전력 효율이 10배, 평균 고장 간격(MTBF)이 약 1.3배 향상되어 매우 고무적입니다. 또한, 클러스터당 브링업 윈도우(bring-up window)가 XNUMX배 빨라 구축 과정이 간소화됩니다.
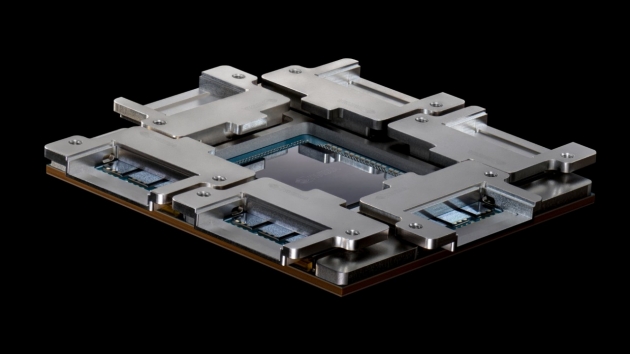
이러한 고급 솔루션은 2026년까지 출시되지 않겠지만, 이미 설계가 진행 중입니다. 이는 기가와트급 시설을 계획하는 운영자나 수백만 개의 GPU를 탑재한 국립 연구소 설립을 고려하는 정부에게 매우 중요합니다. NVIDIA의 CPO(Coherent Photonics Optics) 기술은 전력 소비량을 제한하고 광학 장치 유지 보수의 악몽을 피할 수 있는 방법을 명확하게 제시하여 고성능 네트워킹의 더욱 효율적이고 강력한 미래를 향한 길을 열어줍니다.
DGX Spark 및 시스템: 데스크톱 프로토타입에서 랙 스케일 생산까지
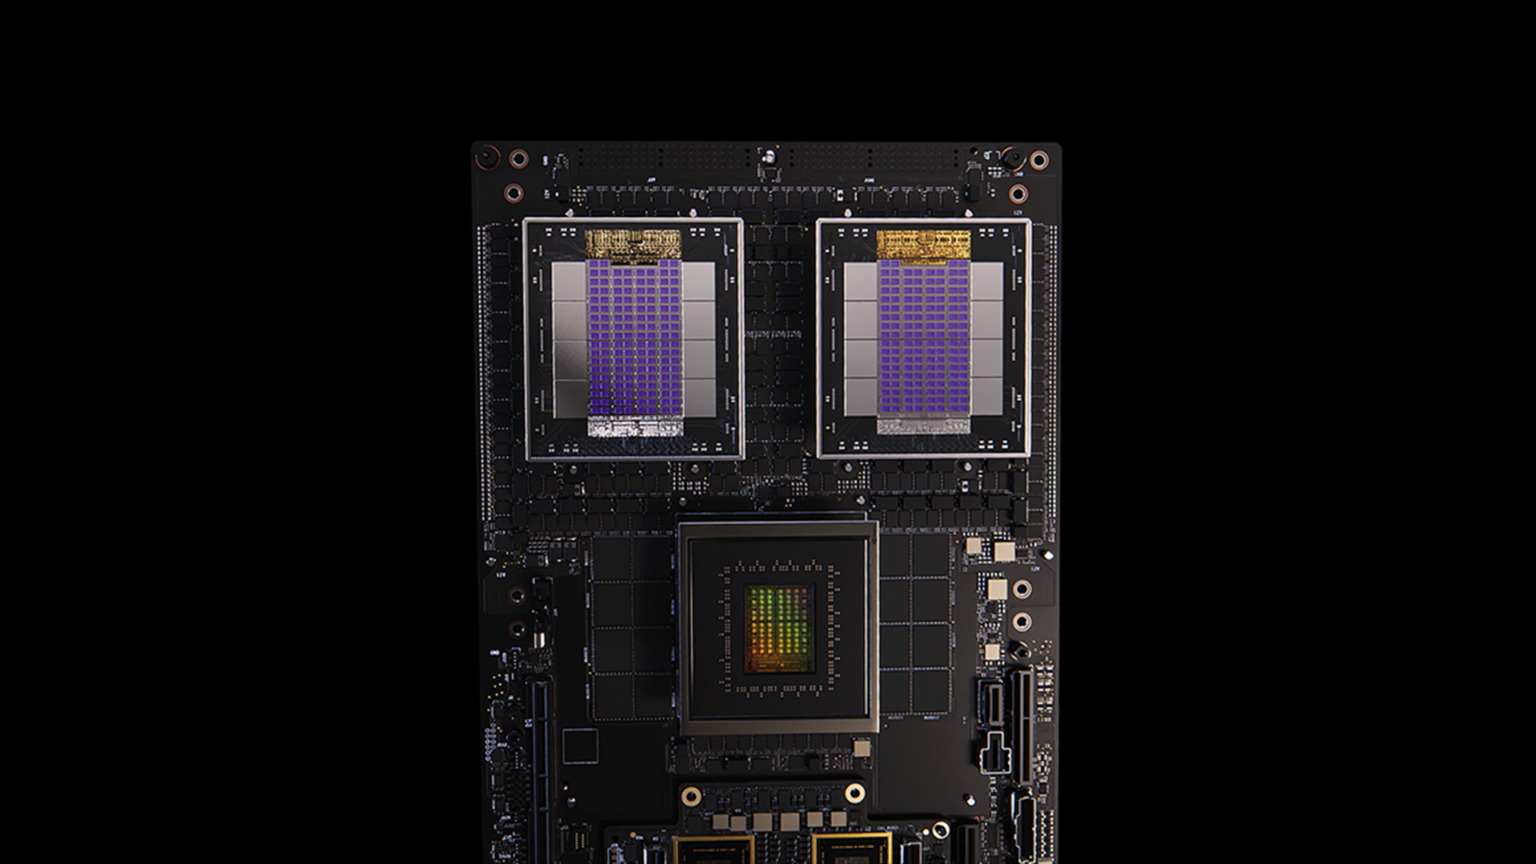
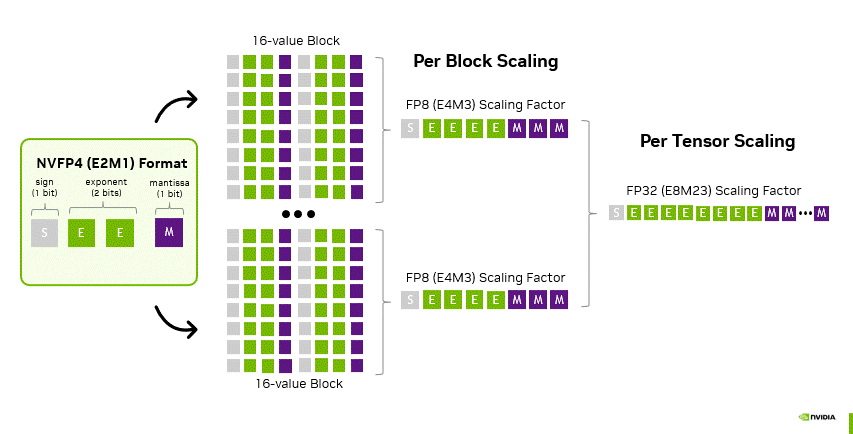
모든 워크로드가 하이퍼스케일에서 시작되는 것은 아닙니다. 새로운 GB10 슈퍼칩으로 구동되는 DGX Spark 는 Blackwell Tensor 코어, NVFP4(4비트 부동 소수점) 추론 및 모든 CUDA-X 라이브러리를 데스크톱 섀시에 통합했습니다. 개발자는 로컬에서 학습, 미세 조정 및 RAG 구성을 수행한 다음 워크로드가 성숙해지면 동일한 컨테이너를 GB200 또는 GB300 NVL72 랙으로 옮겨 사용할 수 있습니다.
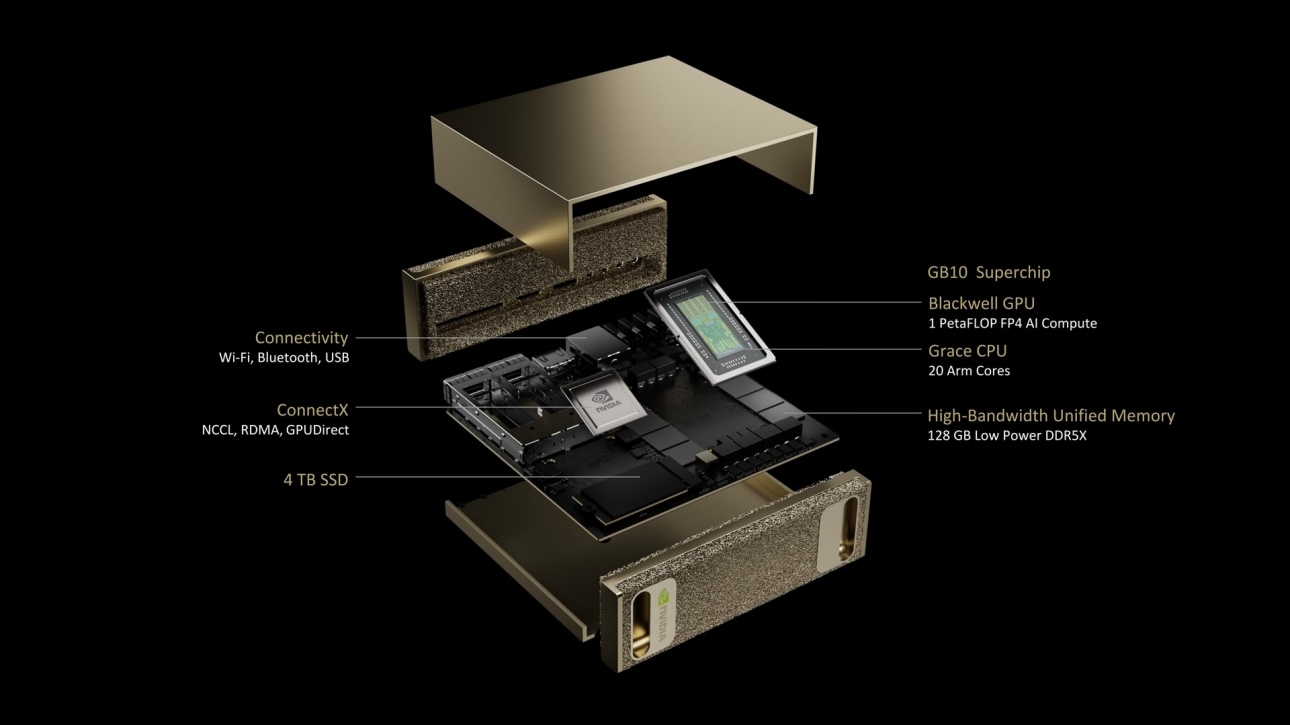
이러한 연속성을 통해 기업은 클러스터 슬롯을 차단하지 않고 에이전트 AI, 로봇 인식 또는 다중 모드 생성 작업을 시범 운영할 수 있습니다. 현장에서 Spark는 트로이 목마와 같습니다. 고객 연구실에 Spark를 설치하고 연구원들이 4비트 추론 속도 향상을 직접 확인하게 하면 확장이 뒤따릅니다.
소프트웨어 멀티플라이어: TensorRT-LLM, Dynamo 및 NIM 마이크로서비스
하드웨어 상호 연결은 한계를 설정하고, 소프트웨어는 실제 워크로드가 얼마나 가까이 도달하는지를 결정합니다. NVIDIA는 NVFP120에서 4억 개의 매개변수를 가진 GPT-OSS 모델을 실행하는 TensorRT-LLM을 시연하여 긴 컨텍스트에서 기본 TorchServe보다 200배 높은 상호 작용을 달성할 예정입니다. GB1 랙에서 671B의 DeepSeek-R2.5은 Dynamo의 분산 파이프라인 스케줄러를 통해 쿼리당 비용을 증가시키지 않고도 GPU당 XNUMX배 더 높은 처리량을 달성합니다. 이 모든 것은 NIM 마이크로서비스, 즉 쿠버네티스 클러스터 또는 온프레미스 베어메탈 스택에 모두 적용되는 컨테이너화된 엔드포인트로 제공됩니다.
오픈소스가 스택의 근간을 이룹니다. RAPIDS는 GPU에서 ETL(End-to-End)을 가속화하고, CUTLASS 템플릿은 맞춤형 고성능 커널을 지원합니다. NeMo와 BioNeMo는 100% OSS(Open Source Software)를 유지하면서도 최첨단 LLM 및 단백질 폴딩 학습을 위해 PyTorch를 확장합니다. 록인(Lock-in)에 대한 우려를 가진 구매자들에게 NVIDIA는 "중요한 부분은 개방적이고, 중요한 부분은 최적화되어 있습니다."라는 메시지를 전달합니다.
경쟁 및 상업적 영향
엔비디아는 수직 통합 방식을 통해 기술 분야에서 독보적인 입지를 구축해 왔으며, 특히 상용 실리콘 스위치 공급업체나 분산형 가속기 스타트업과는 확연히 대조적인 모습을 보입니다. 이러한 전략을 통해 엔비디아는 단순한 개별 구성 요소뿐 아니라 참조 아키텍처를 아우르는 포괄적인 솔루션을 제공할 수 있습니다. 이 아키텍처는 검증된 공급망, 명확하게 정의된 2개년 로드맵, 그리고 개발자의 복잡한 배선 작업을 간소화하는 NIM이라는 고급 API 인터페이스를 통해 지원됩니다.
하이퍼스케일러에게 NVIDIA의 솔루션은 결정론적 서비스 수준 계약(SLA)과 최소한의 운영 위험에 중점을 두어 매력적인 선택입니다. NVLink 랙을 구현함으로써 하이퍼스케일러는 빠른 데이터 처리가 필요한 애플리케이션에 필수적인 프리미엄 추론 기능을 확보할 수 있습니다. 또한, Spectrum-X 기술은 용량 확장을 용이하게 하여 하이퍼스케일러가 인프라를 원활하게 확장할 수 있도록 지원합니다. Spectrum-XGS 도입으로 리전 통합이 가능해져 지리적으로 분산된 데이터 센터에서 리소스 할당의 효율성이 향상됩니다. 이러한 통합은 표준 이더넷 제어 플레인의 운영을 지원하여 기존 인프라 내에서 호환성과 관리 용이성을 보장합니다.
기업에게 엔비디아 기술의 매력은 랙당 수익을 극대화할 수 있다는 점입니다. 예를 들어 Spectrum-X 시스템은 GPU 사이클의 효율성을 최대 35%까지 크게 향상시킨다고 합니다. 즉, 기업은 자본 지출을 늘리지 않고도 토큰, 이미지 또는 자동화된 작업의 형태로 더 많은 성과를 달성할 수 있습니다. 결과적으로 기업은 기존 투자에서 더 많은 가치를 창출하고, 경쟁이 치열한 시장에서 효율성과 비용 효율성에 대한 현대적 요구에 부응할 수 있습니다.
히프 라인
Hot Chips를 둘러싼 이야기는 컴퓨팅 기술, 특히 인공지능(AI) 분야에서 주목할 만한 변화를 시사합니다. 이 이야기는 네트워킹이 이제 컴퓨팅의 근본적인 가속기로 여겨지고 있으며, 텐서 코어와 같은 기술의 발전과 그 중요성이 유사함을 강조합니다.
NVLink와 같은 기술은 서버 랙을 하나의 응집력 있는 논리 칩으로 변환하여 성능과 효율성을 향상시키는 핵심적인 역할을 합니다. Spectrum-X는 광범위한 네트워크에서 밀리초 미만의 콜렉티브(collective)를 구현하는 데 중요한 역할을 하며, Spectrum-XGS는 이러한 고성능 패브릭을 전 세계로 확장합니다. 또한, CPO는 전력 및 밀도 요구 사항을 미래 지향적으로 설계하여 끊임없이 변화하는 AI 애플리케이션의 요구에 부응합니다. 반면, DGX Spark는 이러한 기술 도입을 촉진하고 기업의 혁신적인 솔루션 도입을 장려하는 데 중요한 역할을 합니다.
이러한 발전은 추론 및 학습 프로세스 모두의 경제적 역학 관계를 변화시킬 잠재력을 가지고 있습니다. 특히 기업들이 현재 새로운 인프라 구축, 기존 솔루션 임대, 또는 대규모 AI 역량에 대한 투자 연기 사이에서 고민하는 기로에 서 있는 상황에서 이는 더욱 중요합니다. 엔비디아의 입장은 명확합니다. 기업은 자체 인프라 구축에 투자해야 하지만, 구리 스파인부터 광자 스위치까지 AI 기반 공장이 주도하는 미래 시대를 지원하기 위해 세심하게 설계된 네트워킹 프레임워크에 중점을 두어야 합니다.


 아마존