

우리가 Solidigm 61.44TB U.2 NVMe SSD의 엄청난 밀도를 좋아한다는 것은 비밀이 아닙니다. 우리는 수많은 내구성 및 성능 테스트를 수행하고 과학적 발견을 달성했으며 세계 기록 계산을 새롭고 놀라운 수준으로 끌어 올렸습니다. 따라서 우리 주변에서 AI 열풍이 맹렬한 속도로 급증하는 가운데 다음 논리적 단계는 Solidigm NVMe 드라이브가 AI 2024의 역동적인 세계에서 어떻게 스택되는지 확인하는 것이었습니다.
극한의 스토리지 밀도의 이점 이해
Solidigm의 61.44TB QLC SSD는 놀라운 저장 용량이 돋보이며 데이터 센터에서 더 적은 수의 드라이브에 더 많은 저장 공간을 담을 수 있습니다. 이러한 극도의 밀도는 데이터 세트가 기하급수적으로 증가하고 효율적인 스토리지 솔루션이 가장 중요한 AI 서버에 특히 유리합니다. 이러한 대용량 SSD를 사용하면 데이터 센터에서 물리적 드라이브 수를 줄이고, 설치 공간을 줄이고, 전력 소비를 줄이고, 유지 관리를 단순화할 수 있습니다.
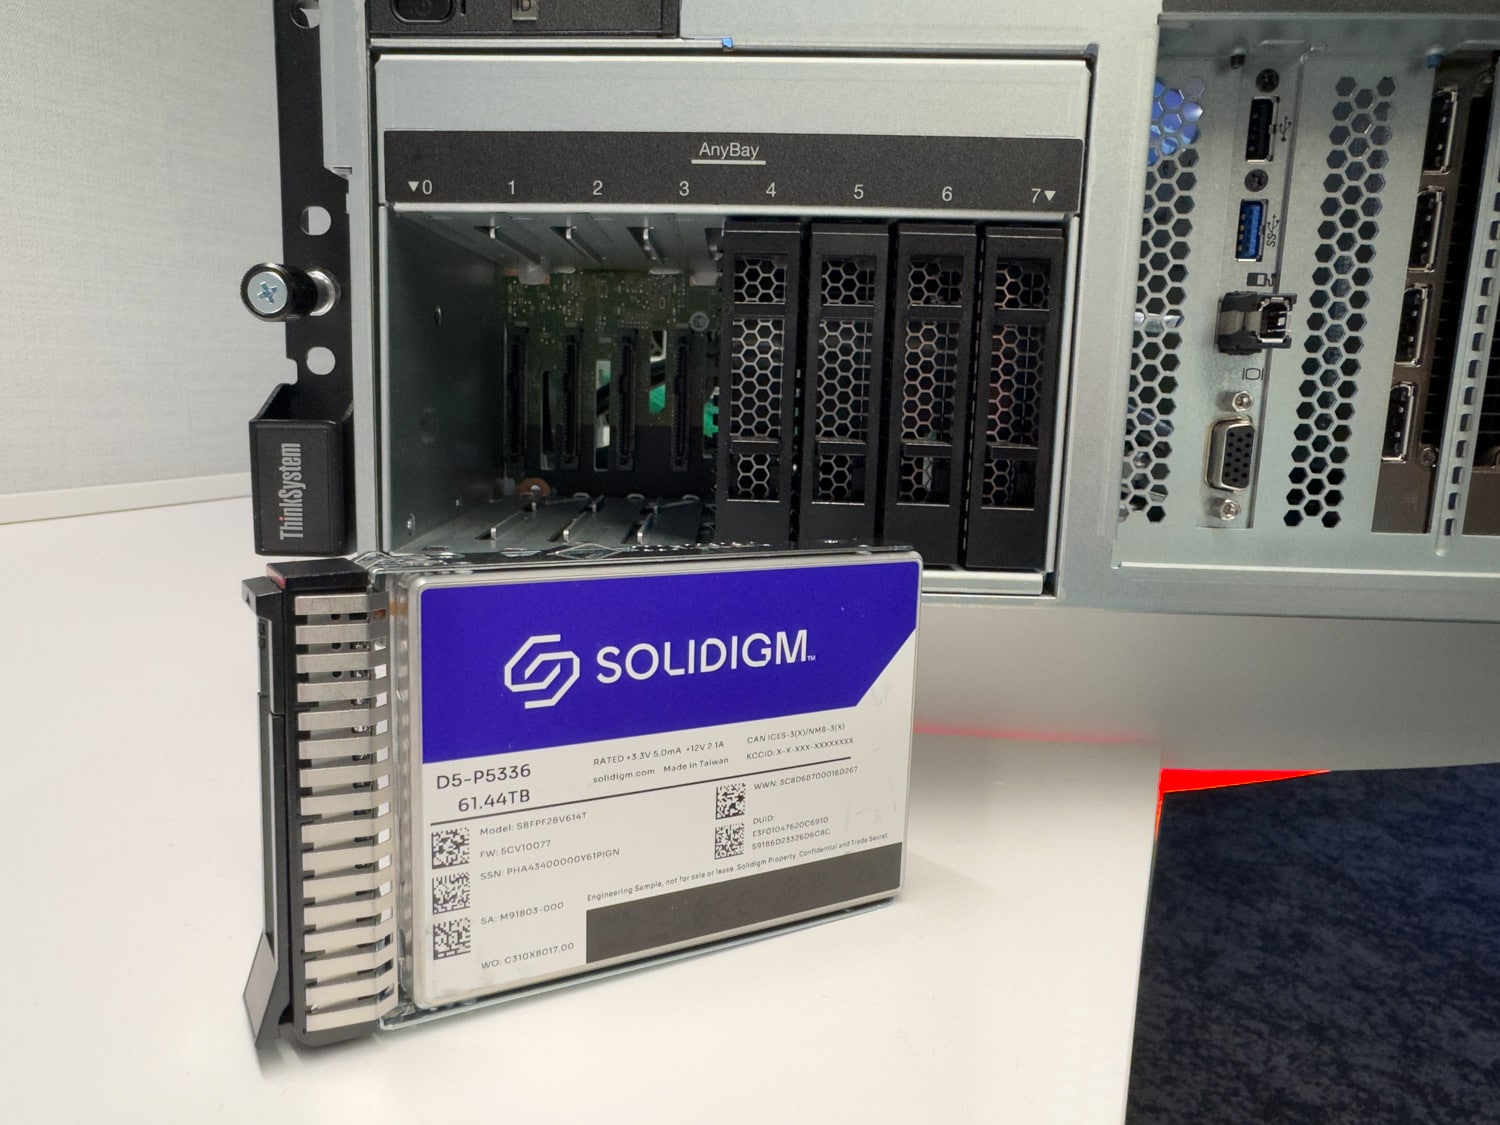
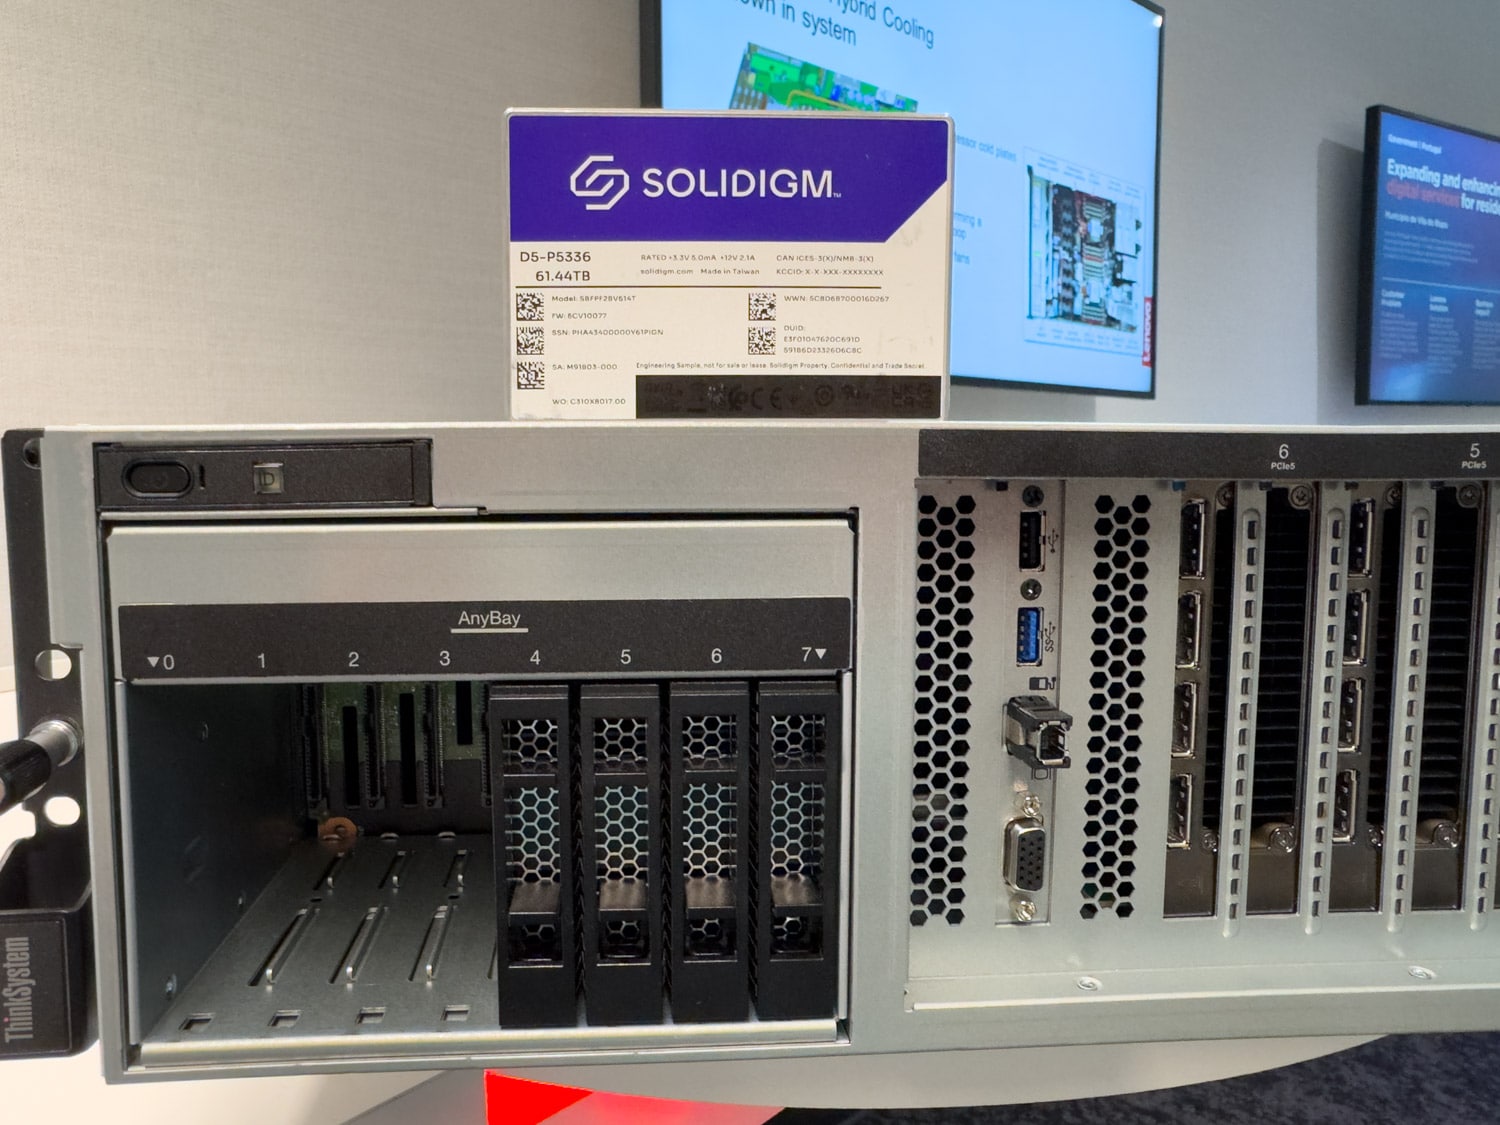
Solidigm SSD가 표시된 Lenovo ThinkSystem SR675 V3의 전면 모습
GPU 서버의 제한된 PCIe 레인
최신 GPU 서버의 주요 과제 중 하나는 GPU가 공유한 후 사용할 수 있는 PCIe 레인 수가 제한되어 있다는 것입니다. AI 워크로드에 중요한 GPU에는 상당한 PCIe 대역폭이 필요하므로 스토리지 장치 및 네트워킹을 포함한 다른 구성 요소에 대한 레인이 제한된 경우가 많습니다. 이러한 제약으로 인해 사용 가능한 PCIe 레인의 사용을 최적화하는 것이 필수적입니다. Solidigm의 61.44TB QLC SSD는 단일 드라이브에 대용량 저장 용량을 제공하고, 여러 드라이브의 필요성을 줄이고, GPU 및 기타 필수 구성 요소를 위한 PCIe 레인을 보존함으로써 솔루션을 제공합니다.
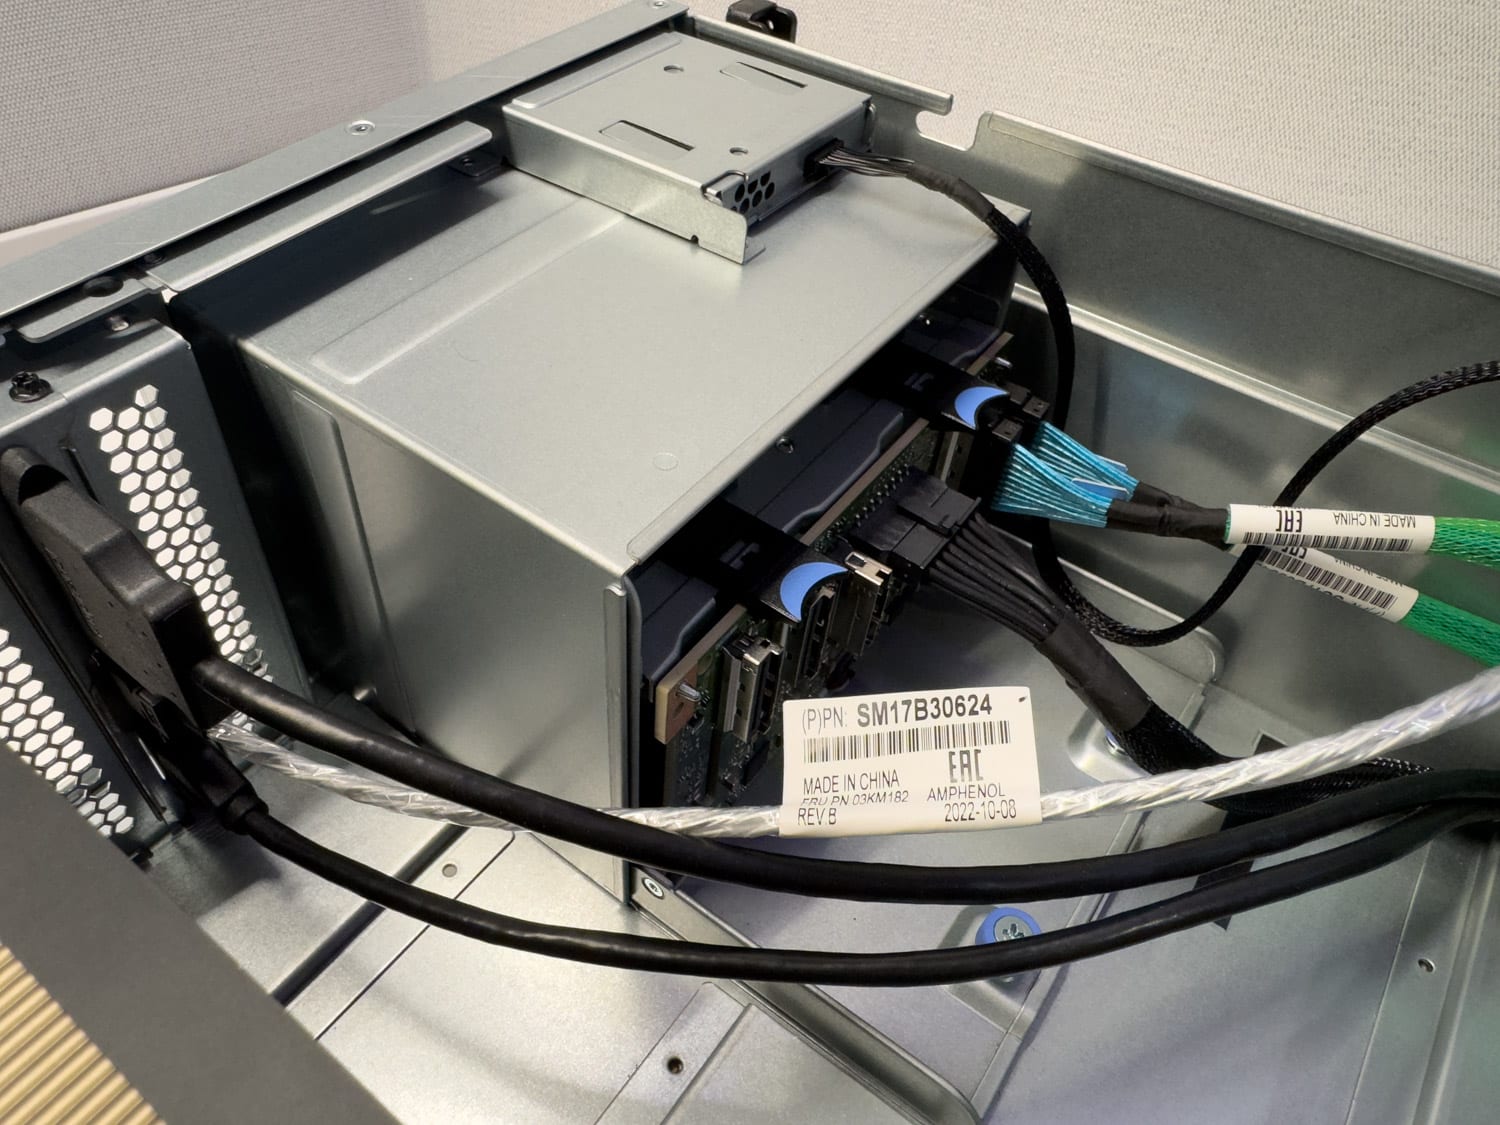
Lenovo ThinkSystem SR675 V3 드라이브 인클로저 상단 내부 모습
AI 워크로드 및 스토리지 요구 사항
AI 워크로드는 데이터 준비, 훈련 및 미세 조정, 추론의 세 단계로 크게 분류할 수 있습니다. 각 단계에는 고유한 스토리지 요구 사항이 있으며 Solidigm의 고용량 SSD는 이러한 단계에서 성능과 효율성을 크게 향상시킬 수 있습니다. Solidigm D5-P5336과 같은 대용량 QLC 드라이브를 배포하면 모든 AI 워크로드에 이점이 있습니다. 대부분의 이점은 데이터 준비에서 교육, 미세 조정, 추론에 이르기까지 다양합니다.
데이터 준비
데이터 준비는 모든 AI 프로젝트의 기초이며 데이터 수집, 정리, 변환 및 증강이 포함됩니다. 이 단계에서는 원시 데이터 세트가 엄청날 수 있으므로 광범위한 스토리지가 필요합니다. Solidigm의 61.44TB QLC SSD는 성능 저하 없이 광범위한 원시 데이터를 저장할 수 있습니다. 또한 이러한 SSD의 빠른 순차 읽기 및 쓰기 속도는 데이터에 대한 빠른 액세스를 보장하여 준비 프로세스를 가속화합니다. 데이터 준비를 위해 Soidigm 61.44TB QLC SSD는 다음과 같은 이점을 통해 위에 설명된 모든 요구 사항을 충족합니다.
- 대용량 저장 용량: 대규모 데이터 세트를 효율적으로 처리합니다.
- 높은 순차 속도: 빠른 데이터 액세스 및 처리.
- 대기 시간 감소: 데이터 검색 지연을 최소화하여 작업 흐름 효율성을 높입니다.
훈련 및 미세 조정
AI 모델 훈련은 가중치와 편향을 조정하기 위해 광범위한 데이터 세트를 신경망에 공급하는 집중적인 프로세스입니다. 이 단계는 컴퓨팅이 까다롭고 스토리지와 GPU 간의 빠른 데이터 교환을 따라잡기 위해 높은 IOPS(초당 입출력 작업)와 낮은 대기 시간의 스토리지가 필요합니다. Solidigm의 SSD는 이러한 점에서 탁월한 성능과 내구성을 제공합니다. 이러한 SSD의 극도의 밀도 덕분에 훈련에 더 광범위한 데이터 세트를 사용할 수 있어 잠재적으로 더 정확한 모델을 얻을 수 있습니다. 교육 및 미세 조정 요구 사항을 충족하기 위해 Solidigm SSD는 다음을 제공합니다.
- 높은 IOPS: 훈련에 필수적인 신속한 데이터 교환을 지원합니다.
- 내구성 : 읽기/쓰기가 많은 워크로드에 최적화된 QLC 기술로 반복적인 훈련 주기에 이상적입니다.
- 확장성: 물리적 드라이브를 추가하지 않고 스토리지를 확장하여 PCIe 레인의 효율적인 사용을 유지합니다.
추론
학습된 AI 모델은 추론이라고 알려진 새로운 데이터를 기반으로 예측이나 결정을 내리기 위해 배포됩니다. 이 단계에서는 사전 처리된 데이터에 대한 빠른 액세스와 증가하는 읽기 요청을 효율적으로 처리해야 하는 경우가 많습니다. Solidigm의 61.44TB QLC SSD는 추론 작업이 원활하고 신속하게 수행되는 데 필요한 읽기 성능과 낮은 대기 시간을 제공합니다. Solidigm SSD는 다음과 같은 이점을 제공하여 성능을 뛰어넘고 대기 시간을 단축합니다.
- 빠른 읽기 성능: 실시간 추론을 위해 데이터에 대한 신속한 액세스를 보장합니다.
- 짧은 지연 시간 : 즉각적인 응답이 필요한 애플리케이션에 매우 중요합니다.
- 높은 수용력: 광범위한 추론 데이터와 기록 결과를 효율적으로 저장합니다.
QLC 기술은 높은 스토리지 용량, 비용 효율성, 빠른 읽기 속도, 효율적인 PCIe 활용도, 내구성 및 향상된 작업 흐름 효율성을 포함하여 추론 애플리케이션에 상당한 이점을 제공합니다. 이러한 장점은 추론 작업의 성능, 확장성 및 비용 효율성을 종합적으로 향상시켜 QLC 드라이브가 최신 AI 및 기계 학습 배포를 위한 이상적인 선택이 되도록 합니다.
가능한 한 GPU에 가깝게 대용량 스토리지를 확보하는 것이 중요한 이유는 무엇입니까?
AI 및 기계 학습의 경우 스토리지와 GPU의 근접성이 성능에 큰 영향을 미칠 수 있습니다. AI 데이터 센터를 설계하려면 최적의 기능과 효율성을 보장하기 위해 여러 요소를 신중하게 고려해야 합니다. 이것이 바로 GPU에 최대한 가까운 대규모 스토리지를 보유하는 것이 중요한 이유입니다. 최근 살펴보았듯이, 대규모 네트워크 연결 스토리지 솔루션에 대한 액세스가 하나의 도구로 자리잡기 시작했지만, 그것에만 의존하는 것이 항상 최적의 선택은 아닐 수도 있습니다.
대기 시간 및 대역폭
GPU 가까이에 충분한 스토리지를 배치하는 주된 이유는 대기 시간을 최소화하고 대역폭을 최대화하기 위한 것입니다. 특히 훈련 중 AI 워크로드에는 스토리지와 GPU 간의 빈번하고 대규모 데이터 전송이 포함됩니다. 대기 시간이 길면 전체 프로세스에 병목 현상이 발생하여 훈련 시간이 느려지고 효율성이 저하될 수 있습니다.
빠른 데이터 가용성이 중요한 AI 워크로드에서는 낮은 대기 시간으로 GPU가 데이터를 즉시 수신하여 유휴 시간을 줄이고 전반적인 컴퓨팅 효율성을 향상시킵니다. 훈련 단계에서는 처리를 위해 엄청난 양의 데이터를 지속적으로 GPU에 공급해야 합니다. 대기 시간을 최소화함으로써 DAS는 AI 애플리케이션의 고속 요구 사항을 충족하여 훈련 시간을 단축하고 워크플로를 더욱 효율적으로 만듭니다.
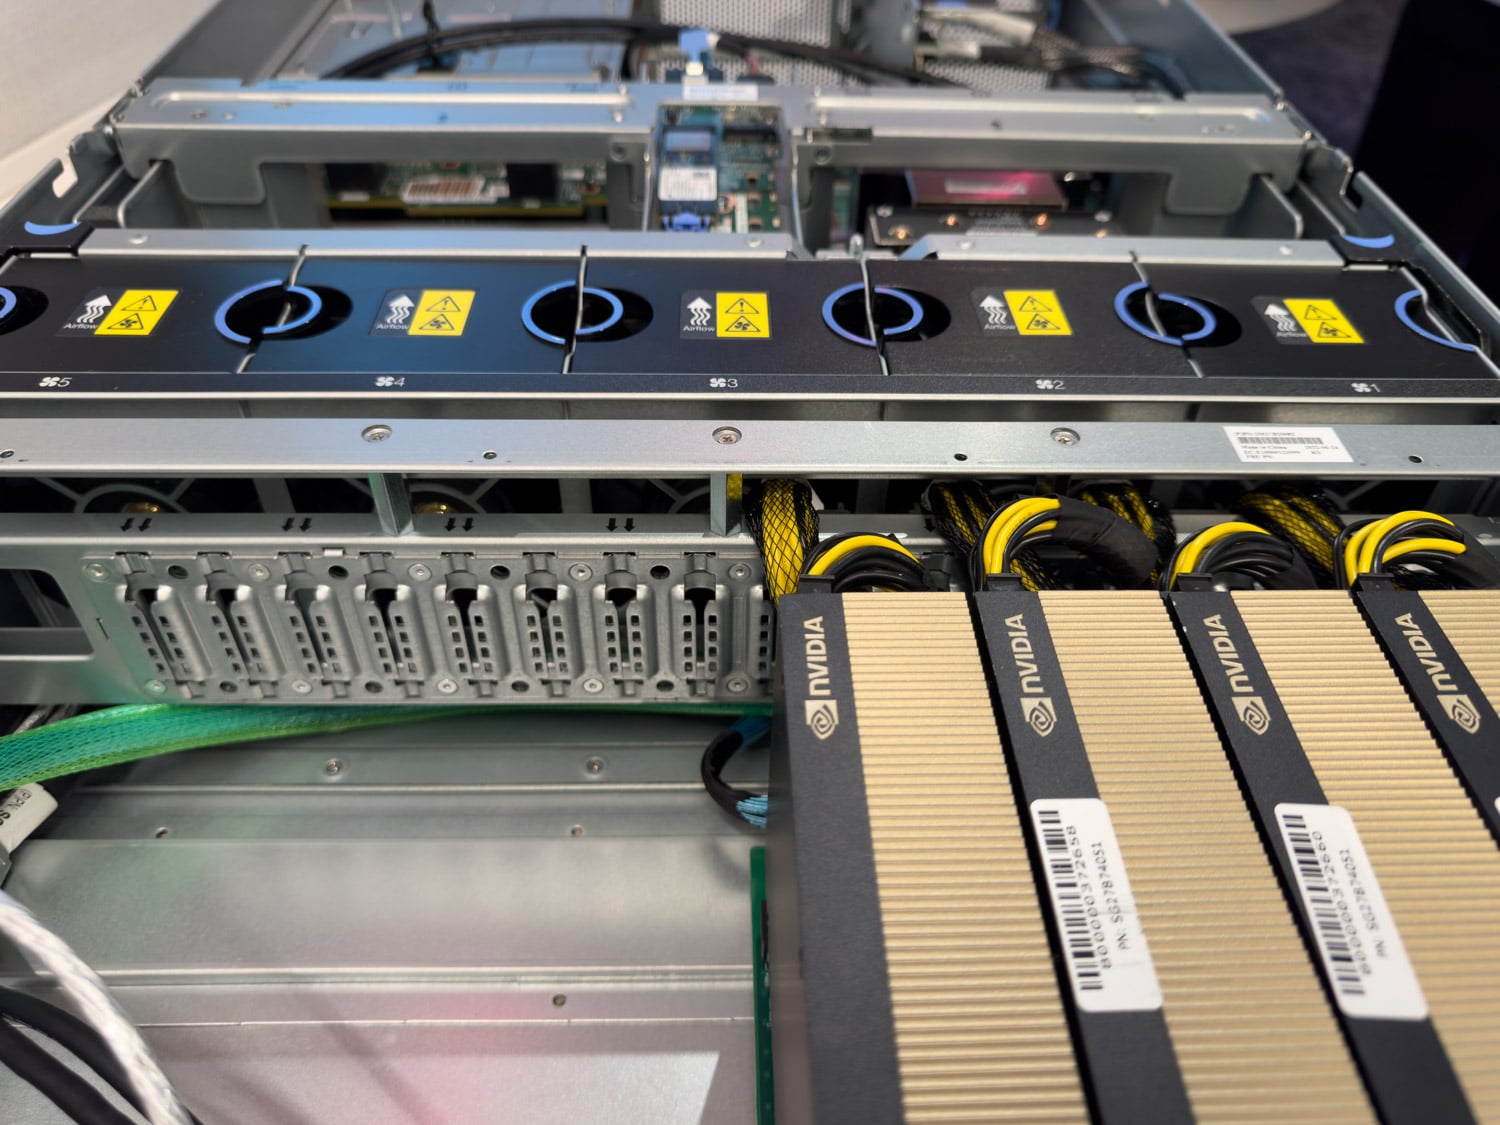
Lenovo ThinkSystem SR675 V3 보기 GPU의 내부 보기
데이터 처리량 및 I/O 성능
로컬 NVMe SSD는 읽기/쓰기 집약적인 AI 워크로드 특성에 중요한 초당 입출력 작업(IOPS)을 처리하는 데 탁월합니다. 훈련 단계에서 AI 모델은 방대한 데이터 저장소에 대한 신속한 액세스가 필요하므로 데이터 트랜잭션에 대한 높은 수요를 충족할 수 있는 스토리지 솔루션이 필요합니다.
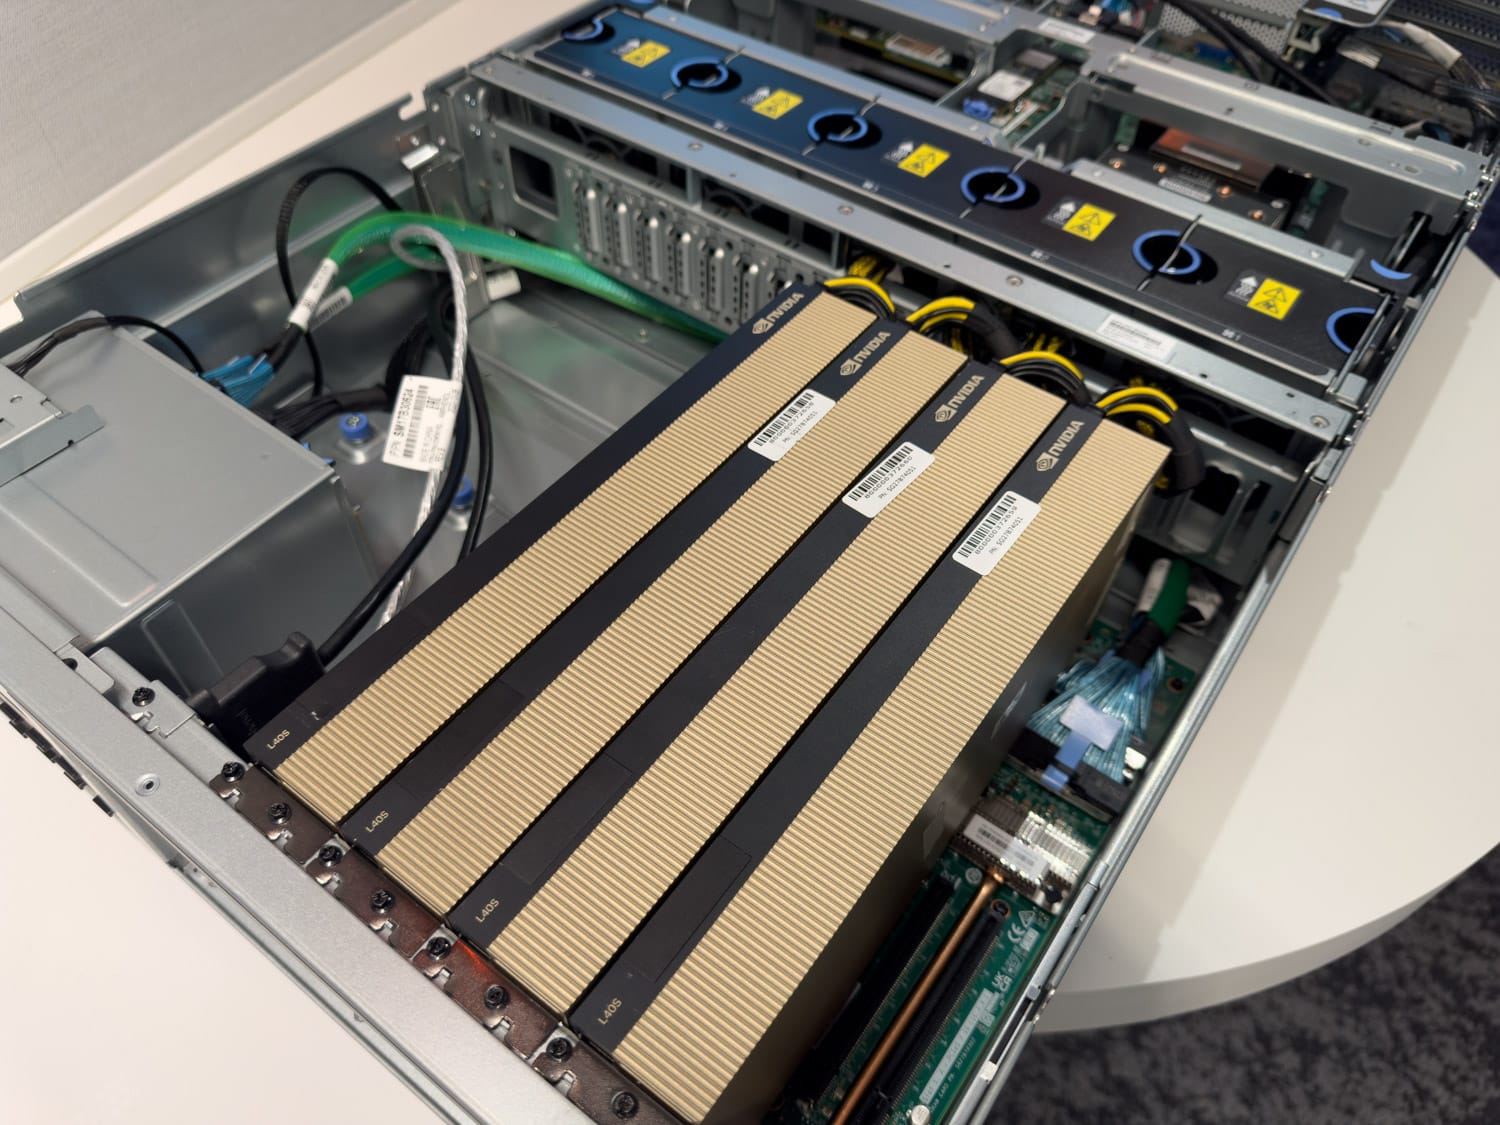
NVIDIA L40S GPU의 상단 각도 보기
대용량, 고성능 시나리오를 위해 설계된 Solidigm D5-P5336은 탁월한 IOPS를 제공하여 더 빠른 데이터 검색 및 쓰기 프로세스를 지원합니다. 이 기능을 통해 GPU는 데이터를 기다리지 않고 계산에 바쁜 상태를 유지하므로 효율성이 최대화되고 훈련 시간이 단축됩니다. 로컬 NVMe SSD의 높은 IOPS 성능은 최적의 성능을 위해 빠른 데이터 액세스 및 처리가 필수적인 AI 애플리케이션의 까다로운 환경에 이상적입니다.
데이터 관리
일부 시나리오에서는 충분한 스토리지를 GPU에 직접 연결하면 데이터 관리가 단순화되지만, 이는 GPU 서버에 데이터를 준비하는 데 필요한 데이터 관리 계층을 추가합니다. 완벽한 세상에서는 GPU가 바쁘게 처리되고 CPU는 체크포인트를 저장하거나 새 데이터를 가져오기 위해 네트워크로 나갑니다. 61.44TB Solidigm 드라이브는 필요한 데이터 트랜잭션 수를 줄이는 데 도움이 됩니다. 단순화된 네트워크 설정과 분산 파일 시스템을 사용하여 이를 설명할 수도 있습니다. 이 간단한 접근 방식은 워크플로를 간소화하고 데이터 관련 오류 또는 지연 가능성을 줄일 수 있습니다.
Lenovo ThinkSystem SR675 V3의 전면 모습
단일 서버 내에서 로컬로 연결된 소수의 GPU에 맞는 미세 조정 모델을 작업한다고 가정해 보겠습니다. 이 경우 네트워크 스토리지 솔루션보다 설정 및 관리가 더 간단한 로컬 스토리지의 이점을 누릴 수 있습니다. 네트워크 연결 스토리지를 구성, 관리 및 유지하는 작업은 복잡하고 시간이 많이 소요될 수 있으며 종종 전문 지식과 추가 인프라가 필요할 수 있습니다. 대조적으로, NVMe SSD와 같은 로컬 스토리지 솔루션은 기존 서버 설정에 통합하기가 더 간단합니다.
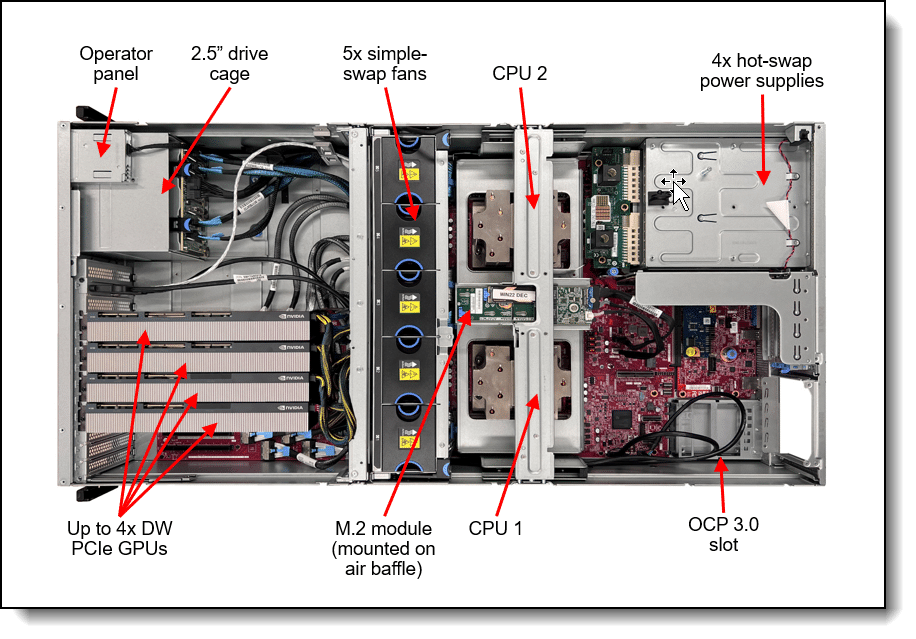
Lenovo ThinkSystem SR675 V3 회로도
이러한 구성 및 유지 관리의 단순성 덕분에 IT 팀은 복잡한 네트워크 스토리지 관리를 처리하는 대신 AI 워크로드를 최적화하는 데 더 집중할 수 있습니다. 결과적으로, 로컬 NVMe SSD를 사용하면 AI 애플리케이션용 스토리지를 더욱 간단하고 효율적으로 배포하고 관리할 수 있습니다.
비용과 확장성
NAS 솔루션은 더 많은 스토리지 장치를 추가하여 수평적으로 확장할 수 있지만 네트워크 인프라 및 잠재적인 성능 병목 현상과 관련된 비용도 발생합니다. 반대로, 대용량 로컬 스토리지에 투자하면 대규모 네트워크 업그레이드 없이 즉각적인 성능 이점을 얻을 수 있습니다.
로컬 스토리지 솔루션은 값비싼 네트워크 하드웨어와 복잡한 구성이 필요하지 않기 때문에 네트워크 연결 스토리지 시스템(NAS)보다 비용 효율성이 더 높은 경우가 많습니다. NAS를 설정하고 유지 관리하려면 고속 스위치 및 라우터와 같은 네트워킹 장비에 대한 상당한 투자와 지속적인 네트워크 관리 및 유지 관리 비용이 필요합니다.
서버에 직접 통합된 대용량 로컬 SSD를 스테이징 영역으로 사용하여 추가 인프라의 필요성을 줄입니다. 이러한 직접 통합은 하드웨어 비용을 절감하고 설정 프로세스를 단순화하여 높은 비용을 들이지 않고 AI 워크로드를 최적화하려는 조직의 예산 친화적인 환경을 제공합니다.
AI 서버 설정에서 Solidigm 61.44TB QLC SSD의 성능을 철저하게 평가하기 위해 Lenovo ThinkSystem SR5336 V61.44에 설치된 Solidigm P675 3TB SSD 40개 어레이를 벤치마킹합니다. 이 서버 구성에는 0개의 NVIDIA LXNUMXS GPU 세트도 포함되어 있습니다. 이를 위해 사용되는 벤치마킹 도구는 GPU 다이렉트 스토리지(GDS) 환경에서 스토리지 성능을 측정하도록 설계된 특수 유틸리티인 GDSIO입니다. 우리는 두 가지 구성, 즉 단일 드라이브 성능에 대한 XNUMX개의 GPU와 RAIDXNUMX용으로 구성된 XNUMX개의 드라이브에 대한 XNUMX개의 GPU를 살펴보았습니다.
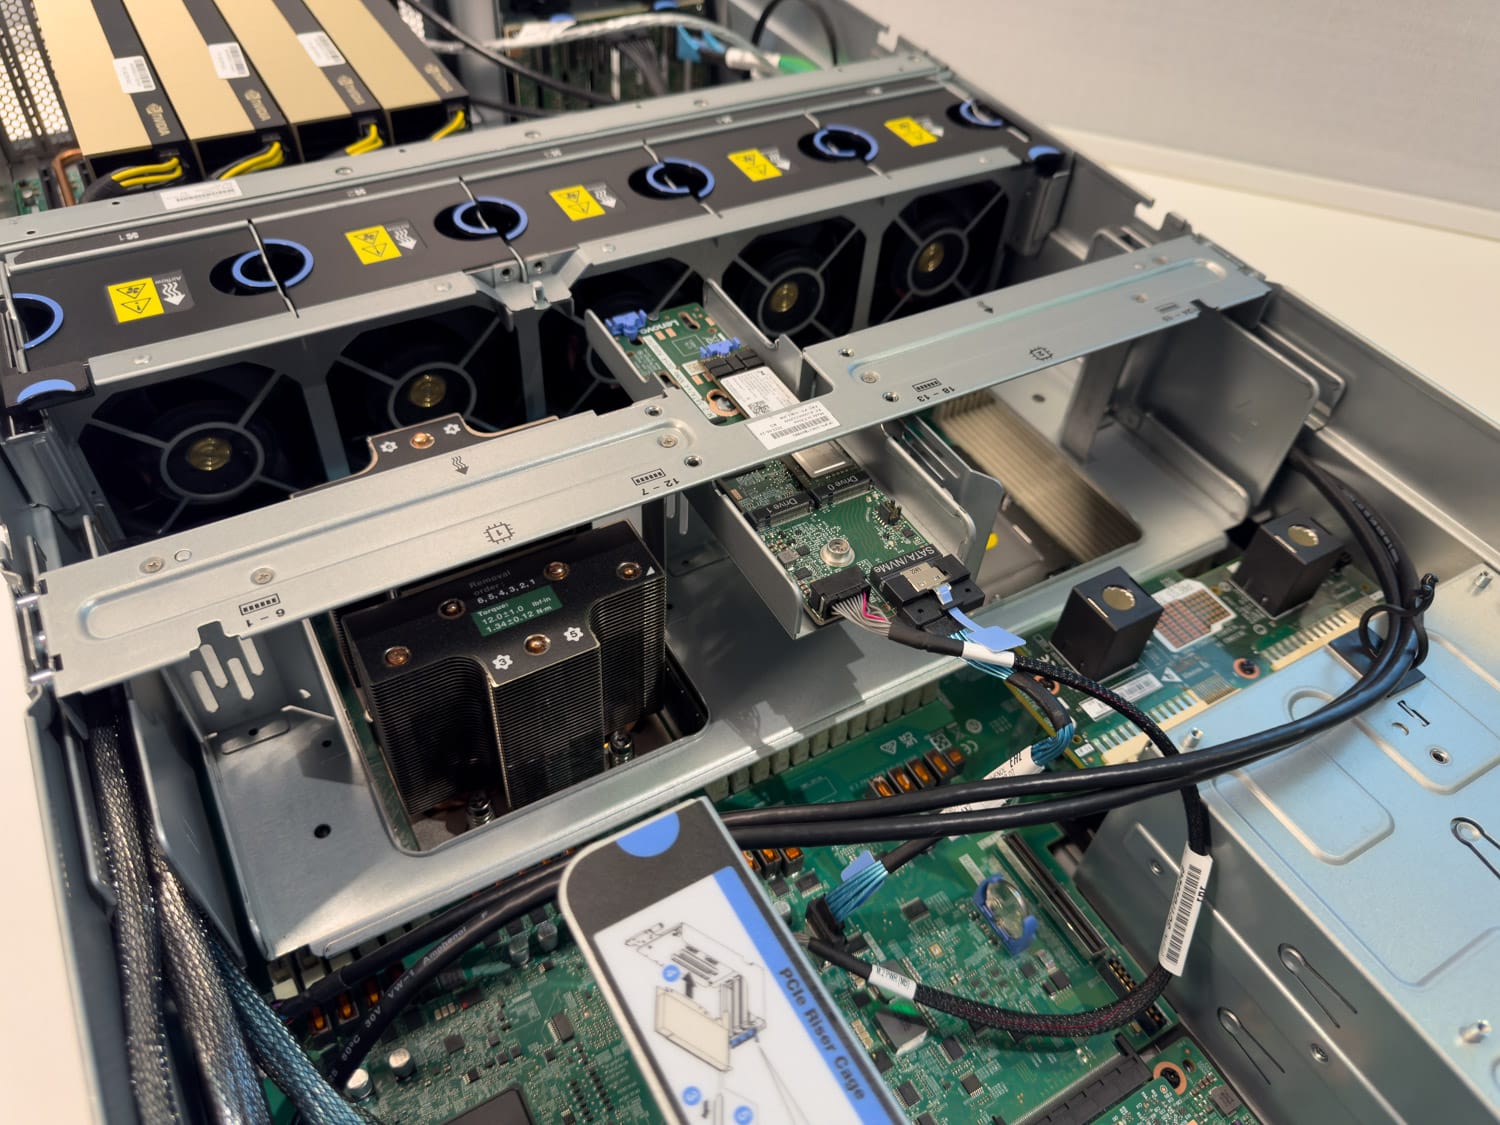
675개의 L3S GPU가 장착된 Lenovo ThinkSystem SR40 VXNUMX의 평면도
우리와 함께 있어주세요. 다음 섹션에서는 테스트의 세부 사항과 AI 파이프라인의 다양한 단계를 모방하는 방법을 다룹니다.
테스트 매개 변수
벤치마킹 프로세스에는 AI 파이프라인의 다양한 단계를 시뮬레이션하는 다양한 테스트 매개변수가 포함됩니다. 이러한 매개변수에는 io_sizes, 스레드 및 transfer_type이 포함되며, 각각은 AI 워크로드의 특정 측면을 나타내기 위해 선택됩니다.
1. IO 크기:
- 4K, 128K, 256K, 512K, 1M, 4M, 16M, 64M, 128M: 이러한 다양한 I/O 크기는 다양한 데이터 전송 패턴을 시뮬레이션하는 데 도움이 됩니다. 더 작은 I/O 크기(128K, 256K, 512K)는 일반적으로 데이터 준비 단계에서 작은 데이터 청크에 자주 액세스하는 시나리오를 모방합니다. 더 큰 I/O 크기(1M, 4M, 16M, 64M, 128M)는 전체 데이터 배치가 이동되는 훈련 및 추론 단계에서 흔히 볼 수 있는 대량 데이터 전송을 나타냅니다.
2. 스레드 :
- 1, 4, 16, 32: 스레드 수는 데이터 액세스의 동시성 수준을 나타냅니다. 단일 스레드는 기본 성능을 테스트하는 반면, 더 높은 스레드 수(4, 16, 32)는 여러 데이터 스트림이 동시에 처리되는 대규모 교육 세션 중에 발생하는 것과 유사한 더 집중적인 병렬 데이터 처리 활동을 시뮬레이션합니다.
3. 전송 유형:
- 스토리지->GPU(GDS): 이 전송 유형은 GDS(GPU Direct Storage)를 활용하여 CPU를 우회하고 SSD와 GPU 간의 직접 데이터 전송을 가능하게 합니다. 이 구성은 실시간 추론 시나리오를 반영하여 직접 데이터 경로의 효율성을 테스트하고 대기 시간을 최소화하는 데 이상적입니다.
- 스토리지->CPU->GPU: 이 전통적인 데이터 전송 경로에는 데이터를 GPU로 전송하기 전에 스토리지에서 CPU로 이동하는 작업이 포함됩니다. 이 방법은 데이터 준비 단계에서 예상되는 중간 처리 또는 캐싱이 CPU 수준에서 발생할 수 있는 시나리오를 시뮬레이션합니다. 우리는 이 데이터 경로가 GPU 공급업체에 관계없이 성능을 나타낼 것이라고 주장할 수 있습니다.
- 저장소->PAGE_CACHE->CPU->GPU: 이 경로는 데이터 전송을 위해 페이지 캐시를 사용합니다. 여기서 데이터는 CPU에서 처리되기 전에 먼저 메모리에 캐시된 다음 GPU로 전송됩니다. 이 구성은 효율성을 위해 데이터를 사전 처리하고 캐시할 수 있는 교육 중에 캐싱 메커니즘과 메모리 대역폭이 전체 성능에 미치는 영향을 테스트하는 데 유용합니다. 다시 말하지만, 이 데이터 경로는 GPU 공급업체에 관계없이 성능을 나타낼 것이라고 주장할 수 있습니다.
AI 파이프라인 단계 모방
벤치마크 테스트는 AI 파이프라인의 다양한 단계를 반영하도록 설계되어 획득된 성능 지표가 관련성이 있고 포괄적인지 확인합니다.
데이터 준비 :
- IO 크기: 더 작음(128K, 256K, 512K)
- 쓰레드 : 1, 4
- 전송 유형: “스토리지->CPU->GPU”, “스토리지->PAGE_CACHE->CPU->GPU”
- 목적 : SSD가 데이터 수집, 정리, 확장 단계에서 중요한 빈번한 소규모 데이터 전송과 CPU 개입을 어떻게 처리하는지 평가합니다.
훈련 및 미세 조정:
- IO 크기: 중대형(1M, 4M, 16M)
- 쓰레드 : 4, 16, 32
- 전송 유형: “스토리지->GPU(GDS)”, “스토리지->CPU->GPU”
- 목적 : 여러 개의 동시 데이터 스트림을 사용하여 높은 데이터 처리량 조건에서 성능을 평가합니다. 이는 모델 교육 및 미세 조정 중에 필요한 집중적인 데이터 처리를 나타냅니다.
추론:
- IO 크기: 대형~초대형(16M, 64M, 128M) 및 4K
- 쓰레드 : 1, 4, 16
- 전송 유형: 스토리지->GPU(GDS)
- 목적 : 빠른 데이터 액세스와 최소 지연 시간이 가장 중요한 실시간 추론 애플리케이션에 중요한 GPU로의 직접 대규모 데이터 전송의 효율성을 측정합니다. 4K는 발생하는 RAG 데이터베이스 검색을 보도록 설계되었습니다.
이러한 매개변수를 변경하고 다양한 구성을 테스트함으로써 고성능 AI 서버 환경에서 Solidigm 61.44TB QLC SSD의 상세한 성능 프로필을 얻을 수 있으며, 다양한 AI 워크로드에 대한 적합성과 최적화에 대한 통찰력을 제공할 수 있습니다. 우리는 몇 주에 걸쳐 1200개 이상의 테스트를 실행하여 데이터를 조사했습니다.
서버 구성
- 레노버 씽크시스템 SR675 V3
- AMD EPYC 9254 24코어 프로세서
- 6 X 64GB DDR5 384GB 총 용량
- 4X NVIDIA L40S GPU
- 4TB Solidigm P61.44 QLC NVMe SSD 5336개
- 우분투 서버 22.04
- NVIDIA 드라이버 버전: 535.171.04
- CUDA 버전: 12.2
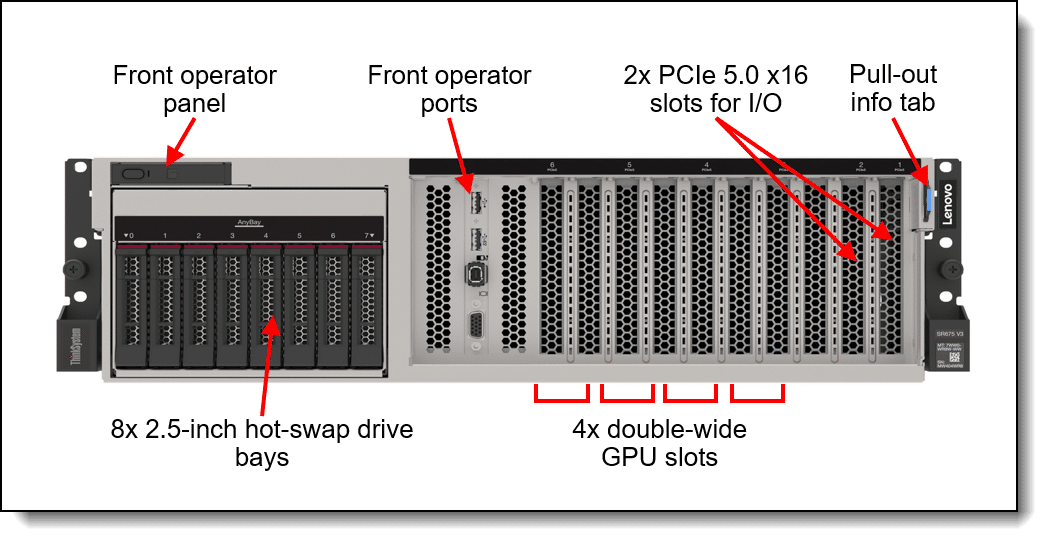
Lenovo ThinkSystem SR675 V3 전면 보기
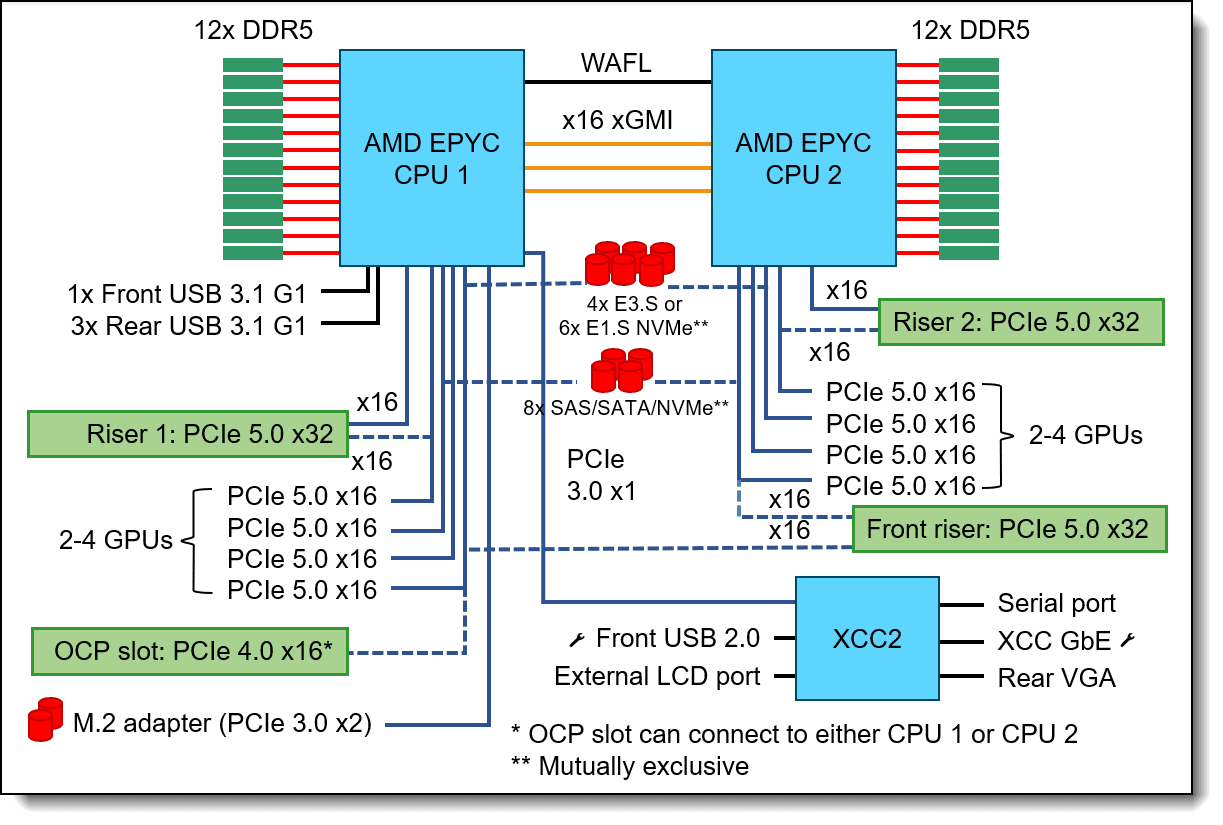
Lenovo ThinkSystem SR675 V3 아키텍처
벤치 마크 결과
먼저 훈련 및 추론 유형의 워크로드를 살펴보겠습니다. GPU Direct 1024K IO 크기는 모델 로드, GPU에 로드되는 훈련 데이터, 이미지나 비디오 작업과 같은 기타 대규모 일괄 추론 작업을 나타냅니다.
| 4드라이브 | I / O 유형 | 전송 유형 | 스레드 | 데이터 세트 크기(KiB) | IO 크기(KiB) | 처리량(GiB/초) | 평균 지연 시간(usecs) |
|---|---|---|---|---|---|---|---|
| 쓰다 | GPUD | 8 | 777,375,744 | 1024 | 12.31 | 634.55 | |
| 독서 | GPUD | 8 | 579,439,616 | 1024 | 9.30 | 840.37 | |
| 랜드라이트 | GPUD | 8 | 751,927,296 | 1024 | 12.04 | 648.67 | |
| 랜드리드 | GPUD | 8 | 653,832,192 | 1024 | 10.50 | 743.89 |
다음으로, 디스크에 저장된 RAG 데이터베이스에 대한 빠른 무작위 4k 데이터 액세스와 같은 RAG 유형 워크로드에 대해 더 작은 IO 크기를 살펴보겠습니다. 추천 시스템이나 검색 애플리케이션과 같이 추론 워크로드가 비순차적 방식으로 데이터에 액세스해야 하는 시나리오에는 효율적인 무작위 I/O가 필요합니다. RAID0 구성은 순차 및 무작위 작업에 대해 우수한 성능을 나타내며 이는 RAG와 같은 액세스 패턴이 혼합된 AI 애플리케이션에 매우 중요합니다. 특히 읽기 지연 시간 값은 눈에 띄게 낮습니다. GPUD 방법.
여기서는 SSD를 완전히 포화시키지는 않지만 RAG 유형 워크로드에서 찾을 수 있는 내용에 대한 보다 대표적인 스냅샷을 제공하는 8개의 작업자 스레드가 선택되었습니다. 이는 작업 수가 제한되고 대기열 깊이가 더 높은 GPU 관점에서 기성 애플리케이션의 컨텍스트를 제공합니다. 이는 추가 소프트웨어 최적화를 통해 달성할 수 있는 더 많은 성능이 테이블에 남아 있음을 보여주는 점에 주목할 가치가 있습니다. .
| 4드라이브 | I / O 유형 | 전송 유형 | 스레드 | 데이터 세트 크기(KiB) | IO 크기(KiB) | 처리량(GiB/초) | 평균 지연 시간(usecs) |
|---|---|---|---|---|---|---|---|
| 쓰다 | GPUD | 8 | 69,929,336 | 4 | 1.12 | 27.32 | |
| 독서 | GPUD | 8 | 37,096,856 | 4 | 0.59 | 51.52 | |
| 랜드라이트 | GPUD | 8 | 57,083,336 | 4 | 0.91 | 33.42 | |
| 랜드리드 | GPUD | 8 | 27,226,364 | 4 | 0.44 | 70.07 |
지원되지 않는 라이브러리나 GPU로 인해 GPU Direct를 사용하지 않는 경우, 데이터 전송에 CPU를 활용한다면 다음 두 가지 유형이 있습니다. 이 특정 서버인 Lenovo ThinkSystem SR675 V3에서는 모든 PCIe 장치가 CPU 루트 컴플렉스를 통과하므로 비슷한 대역폭을 볼 수 있지만 대기 시간이 단축됩니다. PCIe 스위치를 갖춘 시스템의 개선을 기대할 수 있습니다.
| 4드라이브 | I / O 유형 | 전송 유형 | 스레드 | 데이터 세트 크기(KiB) | IO 크기(KiB) | 처리량(GiB/초) | 평균 지연 시간(usecs) |
|---|---|---|---|---|---|---|---|
| 쓰다 | CPU_GPU | 8 | 767,126,528 | 1024 | 12.24 | 638.05 | |
| 독서 | CPU_GPU | 8 | 660,889,600 | 1024 | 10.58 | 738.75 | |
| 랜드라이트 | CPU_GPU | 8 | 752,763,904 | 1024 | 12.02 | 649.76 | |
| 랜드리드 | CPU_GPU | 8 | 656,329,728 | 1024 | 10.47 | 746.26 | |
| 쓰다 | CPU_GPU | 8 | 69,498,220 | 4 | 1.11 | 27.47 | |
| 독서 | CPU_GPU | 8 | 36,634,680 | 4 | 0.58 | 52.31 |
표는 특히 읽기 작업의 높은 처리량을 나타냅니다. GPUD 전송 유형. 예를 들어, 읽기 작업은 GPUD 모드는 10.5GiB/초 이상에 도달합니다. 이는 대규모 모델을 교육하기 위해 빠른 데이터 액세스가 필요한 경우가 많은 AI 워크로드에 도움이 됩니다.
무작위 작업과 순차 작업 간의 균형 잡힌 성능 덕분에 이 구성은 종종 이러한 액세스 패턴의 혼합이 필요한 추론 작업에 적합합니다. 대기 시간 값은 매우 낮지는 않지만 여전히 많은 추론 애플리케이션에서 허용되는 한도 내에 있습니다.
또한 쓰기 작업은 최대 12.31GiB/초, 읽기 작업은 최대 9.30GiB/초에 달하는 인상적인 처리 속도를 확인했습니다. 이러한 높은 처리량은 모델 교육 및 추론을 위해 빠른 데이터 액세스가 필요한 AI 워크로드에 도움이 됩니다.
순차 읽기 및 최적화
128M IO 크기로 이동하고 작업자 스레드를 반복하면 스토리지 솔루션에 대한 워크로드를 최적화한 결과를 볼 수 있습니다.
| 전송 유형 | 스레드 | 처리량(GiB/초) | 지연 시간(usec) |
|---|---|---|---|
| 스토리지->CPU->GPU | 16 | 25.134916 | 79528.88255 |
| 스토리지->CPU->GPU | 4 | 25.134903 | 19887.66948 |
| 스토리지->CPU->GPU | 32 | 25.12613 | 159296.2804 |
| 스토리지->GPU(GDS) | 4 | 25.057484 | 19946.07198 |
| 스토리지->GPU(GDS) | 16 | 25.044871 | 79770.6007 |
| 스토리지->GPU(GDS) | 32 | 25.031055 | 159478.8246 |
| 저장소->PAGE_CACHE->CPU->GPU | 16 | 24.493948 | 109958.4447 |
| 저장소->PAGE_CACHE->CPU->GPU | 32 | 24.126103 | 291792.8345 |
| 스토리지->GPU(GDS) | 1 | 23.305366 | 5362.611458 |
| 저장소->PAGE_CACHE->CPU->GPU | 4 | 21.906704 | 22815.52797 |
| 스토리지->CPU->GPU | 1 | 15.27233 | 8182.667969 |
| 저장소->PAGE_CACHE->CPU->GPU | 1 | 6.016992 | 20760.22778 |
스토리지와 상호 작용하는 애플리케이션을 올바르게 작성하는 것이 가장 중요하며 기업이 GPU 투자를 극대화하기를 원하므로 이를 고려해야 합니다.
GPU 다이렉트
모든 테스트에서 GPU Direct 전용 성능을 분리함으로써 NVIDIA 기술이 어떻게 빛을 발하는지에 대한 일반적인 아이디어를 얻을 수 있습니다.
| I / O 유형 | 전송 유형 | 스레드 | 데이터 세트 크기(KiB) | IO 크기(KiB) | 처리량(GiB/초) | 평균 지연 시간(usecs) |
|---|---|---|---|---|---|---|
| 쓰다 | GPUD | 8 | 777,375,744 | 1024 | 12.31 | 634.55 |
| 독서 | GPUD | 8 | 579,439,616 | 1024 | 9.30 | 840.37 |
| 랜드라이트 | GPUD | 8 | 751,927,296 | 1024 | 12.04 | 648.67 |
| 랜드리드 | GPUD | 8 | 653,832,192 | 1024 | 10.50 | 743.89 |
| 쓰다 | GPUD | 8 | 69,929,336 | 4 | 1.12 | 27.32 |
| 독서 | GPUD | 8 | 37,096,856 | 4 | 0.59 | 51.52 |
| 랜드라이트 | GPUD | 8 | 8,522,752 | 4 | 0.14 | 224.05 |
| 랜드리드 | GPUD | 8 | 21,161,116 | 4 | 0.34 | 89.99 |
| 랜드라이트 | GPUD | 8 | 57,083,336 | 4 | 0.91 | 33.42 |
| 랜드리드 | GPUD | 8 | 27,226,364 | 4 | 0.44 | 70.07 |
생각을 폐쇄
이 기사는 Solidigm 61.44TB P5336에 초점을 맞추고 있으므로 한 걸음 물러서서 성능과 용량을 둘러싼 TLC와 QLC 논쟁을 다루겠습니다. TLC 7D NAND를 사용한 D3 라인 등 솔리드다임 포트폴리오의 다른 제품을 보면 성능에 비해 용량이 제한되어 있다. 특히 61.44TB Solidigm 드라이브를 사용한 테스트에서 우리는 짧은 대기 시간에 GPU에 데이터를 적절하게 공급할 수 있는 총 처리량 성능을 확인했습니다. 우리는 GPU에 최대한 가까운 더 많은 스토리지에 대한 수요에 대해 ODM 및 OEM으로부터 피드백을 듣고 있으며 Solidigm D5-P5336 드라이브가 이에 적합한 것 같습니다. 일반적으로 GPU 서버에서 사용할 수 있는 NVMe 베이 수는 제한되어 있으므로 고밀도 Solidigm 드라이브는 로컬 GPU 서버 스토리지 목록의 최상위에 있습니다.
궁극적으로 이러한 드라이브가 제공하는 막대한 저장 용량과 GPU는 솔루션의 일부일 뿐이며, 뛰어난 성능 또한 필수적입니다. 여러 드라이브에 걸쳐 단일 드라이브 성능을 집계하면 가장 까다로운 작업에도 충분한 처리량을 확보할 수 있다는 것을 알 수 있습니다. GDSIO를 사용하는 4개 드라이브 RAID0 구성의 경우, 쓰기 작업의 총 처리량은 최대 12.31GiB/sec, 읽기 작업의 총 처리량은 최대 25.13GiB /sec에 달할 수 있습니다.
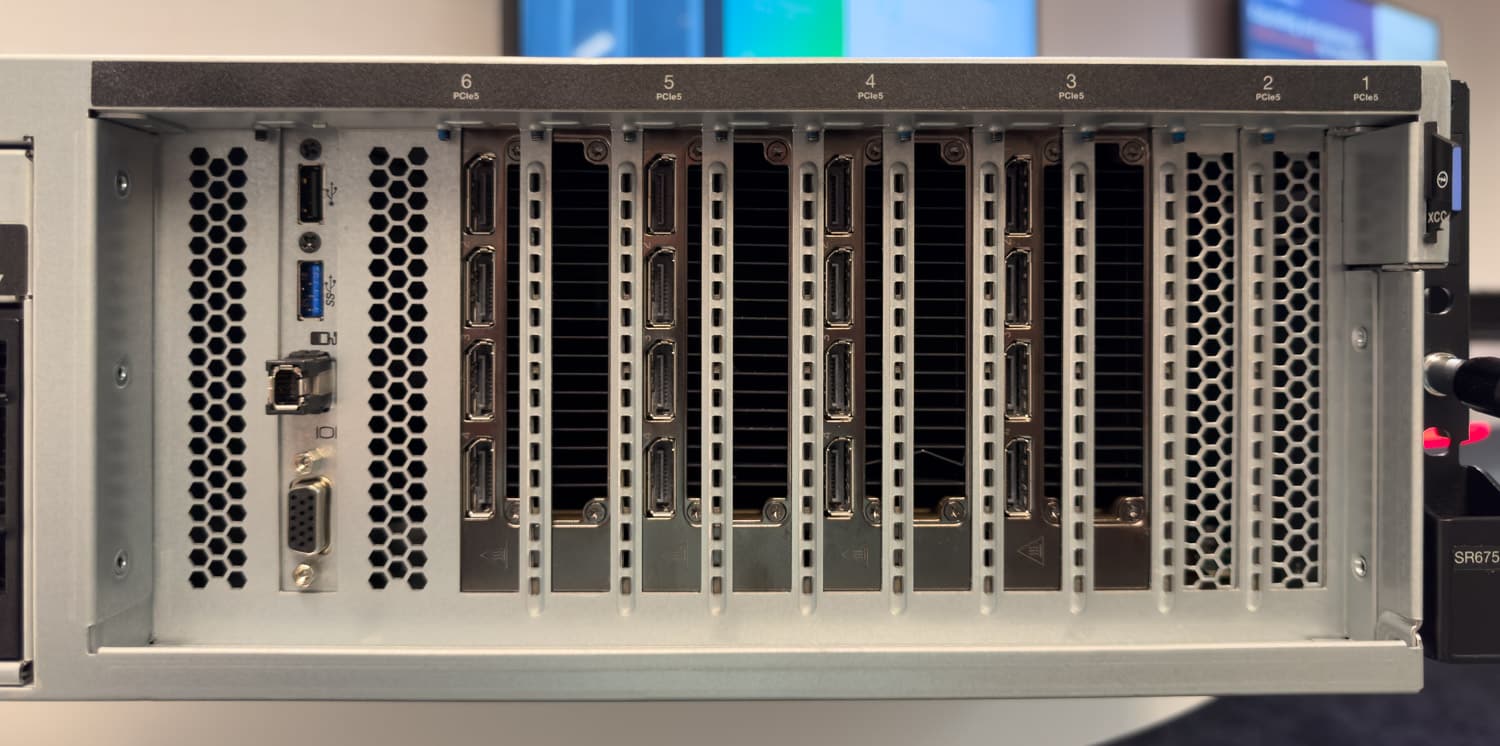
GPU용 Lenovo ThinkSystem SR675 V3 후면 보기
이 수준의 처리량은 대규모 데이터 세트에 대한 대규모 딥 러닝 모델 교육이나 고해상도 비디오 스트림에 대한 실시간 추론 실행과 같이 가장 까다로운 AI 작업에도 충분합니다. RAID0 어레이에 더 많은 드라이브를 추가하여 성능을 확장할 수 있는 기능은 빠르고 효율적인 데이터 액세스가 중요한 AI 애플리케이션에 탁월한 선택입니다.
그러나 RAID0 구성은 고성능을 제공하지만 데이터 중복성을 제공하지 않는다는 점에 유의하는 것이 중요합니다. 따라서 드라이브 오류 발생 시 데이터 손실을 방지하려면 적절한 백업 및 데이터 보호 전략을 구현하는 것이 중요합니다.
오늘날 데이터 센터에서 또 다른 고유한 고려 사항은 전력입니다. AI 서버가 그 어느 때보다 더 많은 전력을 소모하고 둔화 조짐이 보이지 않는 가운데, 사용 가능한 총 전력은 GPU를 데이터 센터로 가져오려는 사람들에게 가장 큰 병목 현상 중 하나입니다. 이는 가능한 모든 와트를 절약하는 데 더욱 중점을 두고 있음을 의미합니다. 와트당 더 많은 TB를 얻을 수 있다면 TCO 및 인프라 비용에 관한 몇 가지 흥미로운 사고 프로세스에 접근합니다. 이러한 드라이브를 GPU 서버에서 꺼내 랙 규모의 스토리지 서버에 배치하는 것만으로도 엄청난 용량으로 엄청난 처리량을 제공할 수 있습니다.
Solidigm D5-P5336 61.44TB QLC SSD를 NVMe 슬롯이 제한된 AI 서버와 통합하면 최신 AI 워크로드의 스토리지 문제를 해결하는 데 있어 상당한 발전이 이루어졌습니다. 극도의 밀도, 성능 특성 및 TB/와트 비율 덕분에 데이터 준비, 교육 및 미세 조정, 추론 단계에 이상적입니다. PCIe 레인 사용을 최적화하고 대용량 스토리지 솔루션을 제공함으로써 이러한 SSD를 통해 현대 AI Factory는 더욱 정교하고 정확한 모델을 개발 및 배포하는 데 집중하여 AI 분야 전반에 걸쳐 혁신을 주도할 수 있습니다.
Lenovo ThinkSystem SR675 V3 페이지
이 보고서는 Solidigm이 후원합니다. 이 보고서에 표현된 모든 견해와 의견은 고려 중인 제품에 대한 우리의 공정한 견해를 기반으로 합니다.


 아마존