

2026년 11월 3일 업데이트: AMD Instinct MI350P가 450W 제품군 첫 테스트에서 '테스트 대상 제품'에 추가되었으며, 두 개 카드 구성 결과는 '스케일아웃 구성'에 포함됩니다. 600W에서 Ministral 3 등급을 완료하면 순위가 결정됩니다. 2026년 10월 14일 게시. 5개의 PCIe 가속기가 하나의 vLLM 컨테이너와 하나의 모델 세트에서 순위가 매겨졌으며, H100 NVL과 MI350P가 '테스트 대상 제품'에 포함되었습니다. H200 NVL의 전력 관련 참고 사항은 아래에 설명되어 있습니다.
이 페이지에 순위가 매겨진 모든 가속기는 StorageReview 연구실에서 단일 PCIe 카드 형태로 테스트를 거쳤습니다. 엔터프라이즈 GPU 시장은 AI 팩토리에 탑재되는 HGX 및 OAM 모듈과 대부분의 데이터 센터에서 이미 사용 중인 2U 및 4U 서버에 장착되는 애드인 카드로 나뉘는데, 이 페이지는 두 번째 그룹, 즉 일반 서버 구성 도구에서 주문하여 기존 랙에 장착할 수 있는 데이터 센터용 GPU만을 다룹니다.
이것이 바로 엔터프라이즈 추론 시장이며, 여기 있는 모든 그래픽 카드의 순위는 엔터프라이즈 추론 워크로드를 기준으로 매겨집니다. 각 항목은 해당 데이터가 포함된 리뷰로 연결되며, 순위는 모든 카드에서 동일한 테스트를 거쳐 결정됩니다.
해당 테스트는 대부분의 엔터프라이즈 추론이 실행되는 스택인 vLLM 온라인 서빙을 테스트하는 것으로, 각 카드에서 1~32개의 동시 스트림, 두 개의 Hopper 카드에서는 최대 128개의 스트림을 지원하며, 동일한 NGC vLLM 26.08 컨테이너(CUDA 13.4.1 기반 vLLM 0.27.1)와 동일한 595.71.05 드라이버를 사용하는 4개의 모델에서 실행되었습니다.
6개의 그래픽 카드 중 5개는 Dell PowerEdge R770 서버에서 해당 서버가 GPU 슬롯에 공급하는 전력으로 작동했으며, RTX PRO 6000은 Dell Pro Max Tower T2에서 동일한 컨테이너와 드라이버로 작동했습니다. 아래에 표시된 순서는 모든 모델과 두 가지 요청 형태 모두에서 유지되었으므로, 이 순위는 최고 성능만을 반영한 결과가 아닙니다.
이 클래스에서는 연산 능력보다 메모리 용량이 더 중요한 역할을 합니다. 24GB 또는 32GB 카드는 채팅 시간 동안 소형 및 중형 모델을 구동할 수 있지만, 긴 프롬프트가 누적되면 KV 캐시 용량이 부족해집니다. 48GB 또는 96GB 카드는 멀티테넌트 동시 실행을 지원하는 중형 모델을 구동하며, 94GB 및 141GB HBM 카드는 70B~120B 대역의 모델에서 단일 GPU로 구동할 수 있는 수준입니다. 추천 제품은 이러한 분류를 기준으로 정리되어 있으며, 하단의 FAQ에서는 RTX PRO 6000과 H100의 비교부터 2U 시스템에서 450W와 600W의 차이점까지 구매자들이 가장 많이 묻는 비교 질문에 대한 답변을 제공합니다.
요약
초당 출력 토큰 수는 Ministral 3 14B 명령어 FP8을 사용하여 32개의 동시 스트림에서 처리한 결과이며, 이는 각 카드가 완료한 가장 부하가 큰 시점입니다. 해당 데이터는 512입력, 512출력 채팅 형식과 8,192입력, 1,024출력 문서 형식에서 얻은 것입니다. FP8은 MAMF에서 달성 가능한 최대 행렬 곱셈 결과(TFLOPS)이며, 이는 지속적인 고밀도 GEMM 측정값으로, 공급업체 최고치가 아닙니다.
| 카테고리 | 가속 자 | 메모리/대역폭 | 슬롯/전력 (테스트 결과) | 채팅 512/512 (톡/초) | 문서 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | 전체 검토 |
|---|---|---|---|---|---|---|---|
| 최고의 PCIe AI 가속기 | NVIDIA H200 NVL* | 141GB HBM3e / 4.8TB/s | 듀얼 슬롯 / 450W* | 3,435 | 1,038 | 1,262 | ET900N G3 리뷰 (H200 NVL 데이터) |
| 최고의 기업용 추론 GPU | NVIDIA RTX PRO 6000 블랙웰 서버 에디션 | 96GB GDDR7 / 1.6TB/s | 듀얼 슬롯 / 600W (450W 용량도 테스트 완료) | 2,283 | 608 | 774 | RTX PRO 6000 리뷰 |
| 최고의 싱글 슬롯 GPU | NVIDIA RTX PRO 4500 블랙웰 서버 에디션 | 32GB GDDR7 / 800GB/s | 싱글 슬롯 / 165W | 1,107 | 190 | 280 | RTX PRO 4500 SE 리뷰 |
| 최고의 주류 추론 GPU, 아직도 출시 중 | 엔비디아 L40S | 48GB GDDR6 / 864GB/s | 듀얼 슬롯 / 350W | 995 | 230 | 369 | RTX PRO 4500 SE 검토(L40S 데이터) |
| 1U 및 엣지 컴퓨팅에 최적화된 슬롯형 그래픽 카드 | 엔비디아 L4 | 24GB GDDR6 / 300GB/s | 싱글 슬롯 HHHL / 72W | 364 | 42 | 116 | L4 리뷰 |
*H200 NVL은 Dell PowerEdge R770 GPU 슬롯에서 제공하는 최대 전력인 450W에서 테스트되었습니다. 이 그래픽 카드는 600W까지 정격 전력을 지원하지만, 저희는 그 수준으로 테스트하지 않았으므로 이 페이지의 수치는 최소값입니다. RTX PRO 6000 수치는 워크스테이션 에디션을 기준으로 합니다. NVIDIA는 두 에디션 모두 600W로 정격 전력을 책정했으며, 저희 테스트에서도 동일한 전력 프로파일을 보였습니다. 서버 에디션은 동일한 GPU와 메모리를 사용하는 팬리스 방식의 보드입니다.
추천 상품
최고의 PCIe AI 가속기: NVIDIA H200 NVL
H200 NVL은 저희가 측정한 확장 카드 중 가장 빠른 성능을 보여주었으며, 이 페이지에 소개된 카드 중 유일하게 32개 이상의 스트림에서도 성능 확장이 가능한 제품입니다. Ministral 3 14B FP8에서 32개의 동시 스트림을 사용했을 때, H200 NVL은 초당 3,435개의 출력 토큰을 처리했는데, 이는 H100 NVL의 3,096개, RTX PRO 6000의 2,283개보다 훨씬 높은 수치입니다. 동시 스트림 수가 증가함에 따라 성능 격차는 더욱 벌어져 128개 스트림에서는 초당 7,336개의 토큰을 처리했는데, 이 지점에서 RTX 카드는 이미 성능 저하를 보였습니다. 8,192개의 토큰으로 구성된 문서 형태 테스트에서 141GB의 HBM3e 메모리는 용량 부족 현상을 전혀 보이지 않았으며, 동일한 동시 스트림 수에서 모든 모델에서 H100 NVL보다 21~23% 더 높은 성능을 기록했습니다.
블랙웰 카드와의 성능 격차는 스펙표에서 보이는 것보다 훨씬 큽니다. 32개 스트림에서 H200은 세 가지 FP8 및 BF16 모델 모두에서 RTX PRO 6000보다 50~81% 앞섰으며, 8K 입력에서는 14B 모델이 초당 1,038개의 토큰을 처리하는 반면 RTX 카드는 608개에 그쳤습니다. 이는 4.8TB/s의 HBM 피드가 1.6TB/s의 GDDR7로는 불가능한 방식으로 디코딩하기 때문입니다.
두 개 또는 네 개의 카드를 NVLink로 연결하여 900GB/s의 속도를 구현할 수 있는데, 이는 다른 어떤 카드에서도 찾아볼 수 없는 기능입니다. H200 NVL 성능 수치는 ET900N G3 리뷰에서 RTX PRO 6000 및 GB300 DGX Station과 비교되었는데, 해당 리뷰에서 DGX Station은 GPT-OSS-20B 코덱을 사용하여 128개 스트림에서 초당 22,041개의 출력 토큰을 처리한 반면, H200은 6,022개를 처리했습니다.
2U 랙 마운트 사용자라면 전력 소비량을 고려해야 합니다. 이 그래픽 카드는 PowerEdge R770 슬롯에서 허용하는 최대 전력인 450W를 소비하며, 600W 정격 소비량은 저희 연구실에서 테스트되지 않았습니다. 이 카드가 성능 면에서 우위를 보이지 않는 유일한 워크로드는 Qwen3.8-27B의 NVFP4 빌드입니다. 이 빌드에서는 이 카드에 FP4 하드웨어가 없고 vLLM 역양자화가 실시간으로 수행되므로, RTX PRO 6000의 616 토큰/초에 비해 467 토큰/초의 처리량을 기록했습니다. 70B~120B 규모의 배포 환경에는 메모리와 대역폭 성능이 중요하므로, 이 카드를 구매하는 것을 고려해 볼 만합니다.
ASUS ET900N G3 리뷰를 읽어보세요. 해당 리뷰에는 H200 NVL 테스트 결과가 포함되어 있습니다.
최고의 기업용 추론 GPU: NVIDIA RTX PRO 6000 Blackwell Server Edition
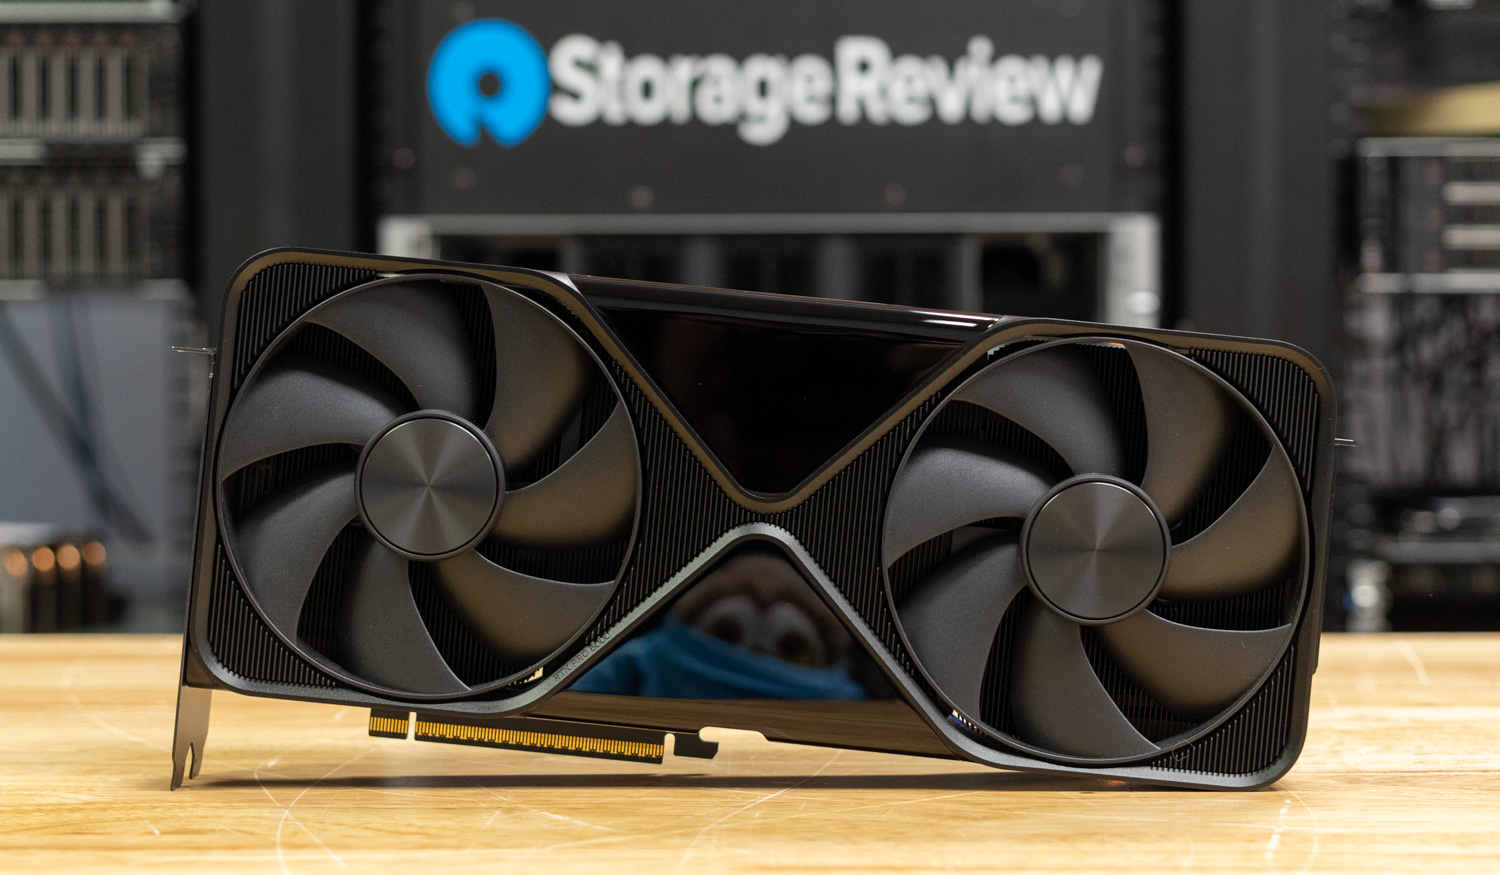
RTX PRO 6000은 이 페이지에서 소개하는 엔터프라이즈급 추론 GPU입니다. 현재 기업들이 구매하고 있는 2U 및 4U 추론 서버를 위해 설계된 Blackwell 기반 카드로, HBM 등급 아래에서 가장 큰 프레임 버퍼와 여기에 소개된 카드 중 가장 폭넓은 기능 세트를 제공합니다. 600W에서 이 제품은 Ministral 3 14B FP8에서 32 스트림으로 초당 2,283개의 출력 토큰을 처리했고, 8B 모델에서는 2,139개, 3B 모델에서는 4,155개를 처리했습니다. 이는 짧은 컨텍스트에서는 RTX PRO 4500의 약 2배, 8K 입력에서는 2.7배에서 3.5배에 해당하는 성능입니다. 특히 96GB 모델은 32 스트림까지 계속 증가하는 반면, 32GB 및 48GB 카드는 성능이 정체됩니다.
MAMF에서 FP8은 774 TFLOPS, NVFP4는 1,481 TFLOPS를 기록했는데, 이는 해당 페이지에서 가장 높은 FP4 수치입니다.
450W 전력 제한은 2U 플랫폼 구매자에게 마지막 150W의 가치를 알려줍니다. PowerEdge R770 슬롯이 제공할 수 있는 최대 전력인 450W로 제한했을 때, 이 카드는 단기 컨텍스트에서 2~5%, 장기 컨텍스트에서 4~9%의 성능 저하를 보였으며, FP8 MAMF 결과는 변화가 없었습니다. 14W에서 이 카드는 정격 와트당 초당 4.8개의 출력 토큰을 처리하는데, 이는 600W에서 3.8개보다 높은 수치입니다. 따라서 2U 플랫폼 구매자가 이 전력 제한에서 카드를 사용하더라도 성능 손실이 크지 않습니다.
이 카드는 RT 코어, 4개의 인코더 및 디코더, 디스플레이 출력을 모두 갖춘 유일한 제품입니다. 따라서 추론, 렌더링, 트랜스코딩 또는 vGPU를 사용한 가상 워크스테이션 등 다양한 작업을 혼합하여 수행하는 서버에 이 카드 하나만으로 모든 작업을 처리할 수 있습니다. 저희 측정 결과는 Dell Pro Max Tower T2에 설치된 워크스테이션 에디션을 기준으로 합니다. NVIDIA는 두 에디션 모두 600W로 표기하고 있으며, 저희 테스트에서도 동일한 성능을 보였습니다. 서버 에디션은 동일한 GB202 GPU와 96GB의 GDDR7 ECC 메모리를 탑재한 패시브 쿨링 방식의 헤드리스 버전입니다.
저희 연구실에는 HPE ProLiant DL380a Gen12 에 장착된 4개의 서버 에디션 카드 , ET900N G3 리뷰 에 사용된 Dell PowerEdge XE7740에 장착된 2개 및 4개의 카드 , 위의 수치를 산출한 Dell Pro Max Tower T2 에 장착된 단일 카드 , Dell Pro Precision 9 T2 에 장착된 300W Max-Q 카드와 600W 카드(600W 카드는 모든 코어 CPU 작업에서 Xeon 4의 성능을 최대 5%까지 저하시킴), Comino Grando에 장착된 8개의 카드와 768GB 메모리 , 그리고 Dell Precision 7875 와 HP Z8 Fury G6i 에 장착된 듀얼 Max-Q 카드가 있습니다.
NVIDIA RTX PRO 6000 전체 리뷰를 읽어보세요
최고의 싱글 슬롯 GPU: NVIDIA RTX PRO 4500 Blackwell Server Edition

RTX PRO 4500 서버 에디션은 단일 슬롯, 165W 카드에서 L40S 처리량을 제공하며, 이는 대부분의 주류 서버가 기다려온 부분입니다. 채팅창에서 32개의 스트림을 동시에 실행했을 때, 이 카드는 모든 FP8 및 BF16 모델에서 L40S와 동등하거나 약간 우수한 성능을 보였습니다. Ministral 3 14B FP8 모델에서는 초당 1,107 토큰 대 995 토큰을, 3B 모델에서는 2,006 토큰 대 1,988 토큰을 처리했는데, 이는 L40S 전력 소비량의 47%에 불과하고 슬롯 수도 절반밖에 되지 않는 카드에서 나온 결과입니다. 대체하는 L4 카드와 비교했을 때는 2.3배 더 많은 전력을 소비하면서 2.8배에서 3.6배 더 빠른 속도를 보여주었고, 2U 섀시에는 듀얼 슬롯 카드 4개를 장착할 수 있으며, 이 카드를 8개까지 장착할 수 있습니다.
최대 용량은 32GB입니다. 8,192 토큰 입력에서 이 카드는 L40S보다 17~33% 낮은 성능을 보였으며, 8개 스트림에서 성능 곡선이 평탄해진 반면 48GB 카드는 16개 스트림까지 계속 상승했습니다. 이는 연산 능력이 아닌 KV 캐시가 부족해졌기 때문입니다. 또한 이 카드는 16핀 커넥터를 사용하는 풀 사이즈, 풀 길이 보드이므로 L4의 1U 및 하프 사이즈 케이스에는 FHFL 카드용으로 제작된 케이스 없이는 장착할 수 없습니다.
NVFP4는 우리가 이 vLLM 빌드에서 테스트한 모든 카드에서 공통적으로 나타나는 또 다른 주의 사항입니다. Qwen3.8-27B에서 4500은 32개의 스트림에서 초당 320개의 토큰을 생성했지만, FP4 하드웨어는 MAMF에서 569 TFLOPS에 도달했습니다. 즉, FP4의 이점은 GEMM 레벨에서만 존재하며 아직 서버 스택에는 적용되지 않았습니다. 16GB MIG 파티션 두 개, 기밀 컴퓨팅, vGPU 20은 동일한 카드의 워크스테이션 에디션에는 없는 데이터 센터 기능 세트를 완성합니다.
저희 연구실에서는 이전에 리뷰했던 HPE ProLiant DL145 Gen11 엣지 서버 내부의 L4 레이어에도 동일한 카드를 테스트했습니다.
NVIDIA RTX PRO 4500 Blackwell Server Edition 전체 리뷰를 읽어보세요.
현재 판매 중인 최고의 메인스트림 추론 GPU: NVIDIA L40S

L40S는 2년 동안 주류 추론 카드로서 기본 자리를 차지해 왔으며, 48GB 용량 덕분에 여전히 블랙웰 시대 제품 목록에서 자리를 지키고 있습니다. 채팅 형태에서 Ministral 3 14B FP8은 32개 스트림에서 초당 995개의 출력 토큰을, 8B 모델에서는 1,005개, 3B 모델에서는 1,988개의 출력 토큰을 처리했습니다.
이는 모든 면에서 RTX PRO 4500과 12% 이내의 차이를 보이며, 8K 문서에서는 14GB 모델의 190fps보다 230fps, 8GB 모델의 185fps보다 277fps, 3GB 모델의 384fps보다 475fps로 앞섭니다. 장시간 작업 시에는 최대 16개의 스트림까지 지원하는 반면, 32GB 카드는 8개에서 멈춥니다.
해당 메모리의 가격은 350W, PCIe 4.0 기반의 듀얼 슬롯 보드이며 FP4 하드웨어는 포함되어 있지 않습니다. Qwen3.8-27B의 NVFP4 빌드에서 양자화 해제를 통해 초당 480개의 토큰을 처리했는데, 이는 해당 소프트웨어 빌드에서 RTX 4500보다 1.5배 빠른 성능입니다. MAMF 최대 성능은 BF16에서 220 TFLOPS, FP8에서 369 TFLOPS로 RTX PRO 6000의 절반에도 못 미칩니다. 이미 L40S를 사용하고 장시간 컨텍스트 처리가 필요한 환경에서는 아직 교체할 카드가 아닙니다. 새로운 2U 환경에서는 싱글 슬롯 RTX 4500이 절반의 슬롯과 전력 소비로 동일한 장시간 컨텍스트 처리 성능을 제공합니다.
저희 연구실에는 Lenovo ThinkSystem SR650 V4 에 장착된 L40S 하나 와, Omniverse용 L40S 제품 에 사용된 해당 그래픽 카드 부분이 있습니다.
RTX PRO 4500 서버 에디션 리뷰에서 L40S 테스트 결과를 확인해 보세요.
1U 및 엣지 컴퓨팅 환경에 최적화된 슬롯 기반 그래픽 카드: NVIDIA L4
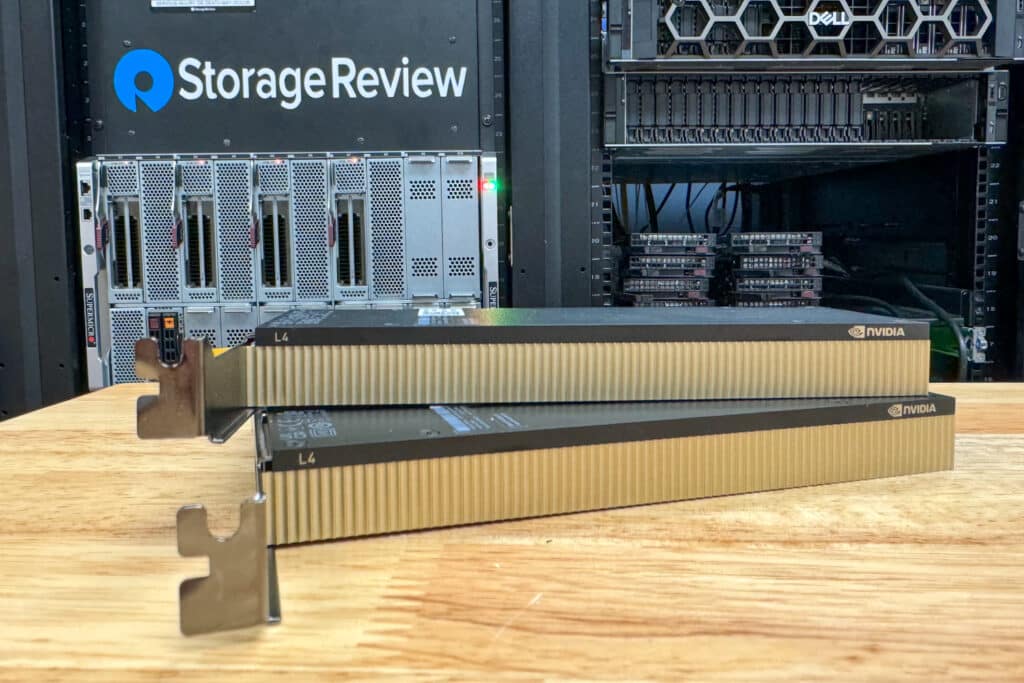
L4는 이 페이지에 있는 카드 중 유일하게 슬롯에서 전원을 공급받고 하프 높이 베이에 장착되는 카드이므로, 최신 카드가 진입할 수 없는 1U 서버 및 엣지 박스에만 사용할 수 있습니다. 72W의 전력 소모로 Ministral 3 14B FP8에서 32개 스트림으로 초당 364개의 출력 토큰을 처리했고, 8B 모델에서는 279개, 3B 모델에서는 704개를 처리했습니다. 또한 14B 모델의 정격 와트당 초당 5.1개의 출력 토큰은 L40S의 2.8개와 600W RTX PRO 6000의 3.8개를 능가합니다.
이 제품의 MAMF 상한값은 BF16에서 50 TFLOPS, FP8에서 116 TFLOPS로 여기 있는 제품 중 가장 낮으며, FP4 경로가 없기 때문에 27B NVFP4 모델은 24GB 용량에 맞지 않았습니다.
긴 컨텍스트 처리에서는 차이가 멈춥니다. 8,192개 토큰 규모의 L4 스토리지는 모든 모델에서 4개의 스트림을 사용했을 때 초당 34~130개의 토큰으로 성능이 일정하게 유지되었습니다. 이는 24GB 및 300GB/s 스토리지가 동시에 처리할 수 있는 8K 컨텍스트의 수가 매우 적기 때문입니다. RTX PRO 4500 서버 에디션은 2.8배에서 3.6배 더 빠른 성능을 제공하지만, FHFL 슬롯과 16핀 케이블이 필요하므로 1U 또는 하프 하이트 섀시에 장착된 L4 스토리지를 RTX PRO 4500으로 바로 교체할 수는 없습니다. 저희의 RTX PRO 4500 엣지 리뷰에서는 HPE ProLiant DL145 Gen11 서버에서 두 카드를 모두 측정했는데, 4500이 L4보다 2.7배 빠른 성능을 보였습니다.
저희 연구실에는 Dell PowerEdge XR7620 의 엣지형 L4 스토리지 , Dell PowerEdge T560 의 4개의 L4 스토리지 , 그리고 HPE ProLiant DL145 Gen11 에 탑재된 RTX PRO 4500 대비 그래픽 카드 도 있습니다.
또한 테스트되었습니다
엔비디아 H100 NVL
H100 NVL은 동일한 R770에서 동일한 래더를 실행했으며, 이 페이지에 해당 카테고리를 비교할 Hopper 피어가 없기 때문에 "또한 테스트됨"에 포함되어 있습니다. 한 세대 전만 해도, 우리가 실행한 FP8 및 BF16 모델에서 동일한 동시 처리량 기준으로 RTX PRO 6000보다 36~61% 더 빨랐습니다.
동일한 R770 칩셋과 컨테이너에서, 이 제품은 Ministral 3 14B FP8 프로세서를 사용하여 32개 스트림에서 초당 3,096개의 출력 토큰을 처리했고, 8B 추론 모델에서는 3,449개, 3B 추론 모델에서는 5,873개의 토큰을 처리했습니다. 또한 후속 제품과 마찬가지로 128개 스트림까지 확장하여 14B 모델에서 최대 6,038개의 토큰을 처리했습니다. FP8 기준 MAMF 성능은 1,047 TFLOPS로, RTX PRO 6000의 774 TFLOPS보다 35% 높습니다.
94GB의 HBM3 메모리(3.9TB/s)가 그 이유입니다. 문서 처리 성능 테스트에서 14B 모델은 32개의 스트림에서 초당 859개의 토큰을 처리했는데, 이는 600W RTX PRO 6000보다 41% 빠른 성능이며, H200은 H200과 동일한 곡선 형태를 유지하면서 높이는 21~23% 더 낮습니다. 두 개의 카드를 NVLink로 연결하여 600GB/s의 속도를 구현할 수 있으며(저희 Comino Grando H100 리뷰에서 다룬 구성), 카드의 소비 전력은 350~400W입니다. 또한 L40S와 동일한 라이저를 장착할 수 있는 듀얼 슬롯 패시브 패키지로 제공됩니다.
H100 NVL의 단점은 H200과 마찬가지로 NVFP4 체크포인트에 필요한 하드웨어가 없다는 점입니다. HBM 용량이 필요하고 H100 NVL 견적을 받은 구매자라면, H100 NVL은 테스트한 확장 카드 중 H200 NVL에 이어 두 번째로 빠른 제품이라는 점을 고려해야 합니다.
저희 연구실에서도 동일한 H100 NVL 두 개를 R770에 장착하여 Graid SupremeRAID AE GPU Direct Storage 테스트를 진행했습니다.
AMD 인스팅트 MI350P

MI350P는 AMD가 4년 만에 출시한 새로운 PCIe Instinct 카드이며, 아직 위의 순위표에 포함되지 않았기 때문에 '테스트 대상 제품' 목록에 있습니다. 해당 래더는 NGC 컨테이너와 Ministral 3 모델 세트를 사용합니다. 저희의 첫 번째 테스트에서는 2U PowerEdge R7725에서 ROCm용 기본 vLLM으로 450W의 전력을 소모하며 카드를 구동했는데, 이는 정격 600W에 비해 낮은 수치입니다. 이 카드는 4TB/s의 속도를 지원하는 144GB의 HBM3E 메모리를 탑재하고 있으며, 이는 저희가 테스트한 모든 PCIe 가속기 중 가장 많은 용량으로, H200 NVL보다 3GB 더 많습니다.
겹치는 테스트 항목에서는 두 NVIDIA 카드 사이의 성능을 보여줍니다. MAMF는 450W에서 FP8 연산에서 1,120 TFLOPS, 블록 스케일 FP4 연산에서 2,228 TFLOPS를 기록했는데, 이는 해당 리뷰에서 사용된 모든 정밀도에서 600W RTX PRO 6000보다 36~38% 높은 수치이며, BF16과 FP8에서는 H200 NVL에 못 미칩니다. 채팅 형식에서 128개의 스트림을 사용하는 GPT-OSS-120B 테스트에서는 초당 5,057개의 출력 토큰을 처리했는데, 이는 RTX PRO 6000의 3,064개와 H200 NVL의 3,376개보다 높은 수치입니다. 512개의 토큰 프롬프트에서는 모든 FP8, BF16, GPT-OSS 모델에서 RTX PRO 6000보다 35~65% 높은 성능을 보였습니다.
H200 NVL은 채팅 프롬프트에서 128개의 스트림을 사용하는 고밀도 FP8 및 BF16 모델에서 4~18% 앞선 성능을 보였지만, 8,192개의 토큰을 사용하는 프롬프트에서는 MI350P가 동일 모델에서 25~58% 뒤처졌고, Llama 3.1 8B 및 MiniMax M2.7에서는 16개의 스트림에서 성능 차이가 거의 없어졌습니다. 두 개의 카드를 사용한 테스트 결과(MiniMax M3 및 GLM-5.2의 MXFP4 빌드, 4개의 RTX PRO 6000 사용)는 ROCm 7.2.3에서 실행되었으며, 스케일아웃 구성 항목에 나와 있습니다.
이 제품은 Dell이 8개의 MI350P로 지원하는 PowerEdge XE7745에서 600W로 Ministral 3 등급을 충족하게 되면 상위권에 속하게 됩니다. 그 전까지는 96GB에서 144GB 사이의 모델을 사용하는 구매자에게 단일 GPU로 이 모든 용량을 지원하는 PCIe 카드 두 개 중 하나이며, 141GB를 넘는 용량을 지원하는 유일한 카드입니다.
AMD Instinct MI350P 첫인상 리뷰를 읽어보세요.
확장형 구성
이 페이지에서 카드는 단일 카드 기준으로 순위가 매겨집니다. 여러 카드를 사용한 결과는 구성 정보로 표시되며, 순위는 매겨지지 않습니다. 이는 각 구성이 서로 다른 모델 세트와 소프트웨어 스택을 사용하기 때문에 서로 또는 위의 단일 카드 순위와 비교할 수 없기 때문입니다. 각 행에는 측정 결과와 해당 결과가 나온 리뷰가 함께 표시됩니다.
| 구성 | 주인 | 측정결과 | 스택 | 출처 |
|---|---|---|---|---|
| NVIDIA RTX PRO 6000 블랙웰 서버 에디션 4개 (384GB) | 델 파워에지 XE7740 | MiniMax M3 NVFP4: 16개 스트림에서 초당 1,181개 출력 토큰, 32개 스트림에서 초당 759개 출력 토큰(512/512) | NGC vLLM 26.08, MTP 추측 디코딩 | ET900N G3 리뷰 |
| NVIDIA RTX PRO 6000 블랙웰 서버 에디션 4개 (384GB) | HPE 프로라이언트 DL380a Gen12 | GPT-OSS-120B NVFP4, TP4: 배치 64에서 총 토큰 4,016개/초, 배치 32에서 3,956개/초; Llama 3.2 90B Vision: 배치 128에서 총 토큰 1,372개/초 | vLLM 온라인 서비스 제공 | DL380a 12세대 리뷰 |
| NVIDIA RTX PRO 6000 블랙웰 서버 에디션 2개 (192GB) | 델 파워에지 XE7740 | MiniMax M2.7 NVFP4: 128개 스트림(512/512)에서 초당 1,932개 출력 토큰, 8K/1K에서 초당 511개 | NGC vLLM 26.08 | ET900N G3 리뷰 |
| 4개의 Intel Gaudi 3 PCIe (512GB HBM) | 델 파워에지 XE7740 | Llama 3.1 70B, TP4: 동시 요청 128개(1,024/1,024)에서 총 토큰 약 3,600개/초 처리; 이 빌드에서는 FP8 경로가 BF16보다 느림 | Intel vLLM 포크 2.7.1 (Gaudi Docker 1.22.2에서 실행) | XE7740 리뷰 (델 후원) |
| AMD Instinct MI350P (288GB) 2개, 카드당 450W | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 16개 스트림에서 초당 998개 출력 토큰, 32개 스트림에서 초당 1,509개 출력 토큰(512/512); DeepSeek-V4-Flash FP8: 32개 스트림에서 초당 1,081개 출력 토큰(512/512), 8K/1K에서 초당 621개 출력 토큰 | ROCm 7.2.3의 vLLM | MI350P 첫인상 |
테스트 당시 인텔 vLLM 포크는 FP8 경로를 아직 최적화하지 못했고, FP8은 BF16보다 느리게 실행되었습니다. MiniMax M3의 결과는 384GB 용량에 겨우 들어맞는 모델에서 PCIe 확장성의 한계를 보여줍니다. 16개 스트림에서는 4개의 카드가 단일 GB300 DGX 스테이션보다 앞섰지만, 32개 스트림에서는 긴 프롬프트가 캐시를 소모하면서 성능이 떨어졌습니다.
슬롯 너머
단일 카드에서 141GB를 초과하는 모델이나 400B급 체크포인트에서 수십 개의 스트림을 필요로 하는 서버 부하를 처리하는 모델은 이제 애드온 카드 시장에서 사라졌습니다. GB300 DGX 스테이션 클래스는 로컬 AI용 최고 데스크톱 순위에 올라 있으며 , 252GB의 HBM3e를 탑재한 단일 Blackwell Ultra GPU가 H200 NVL과 같은 순위에 있습니다. 또한 Supermicro JumpStart 리뷰에서 다룬 HGX B200 및 AMD Instinct MI350X 시스템은 최고 서버 순위에 속합니다 . 이러한 시스템은 카드가 아닌 시스템 자체를 기준으로 평가되므로 이 순위에는 포함되지 않습니다.
순위 산정 방식
StorageReview의 모든 순위표에는 세 가지 규칙이 적용됩니다. 첫째, 실험실에서 테스트를 거친 카드만 순위에 포함됩니다. 벤치마크 테스트를 거치지 않은 카드는 언급은 될 수 있지만, 특정 카테고리에 포함될 수는 없습니다. 둘째, 카드는 해당 카드를 지원하는 호스트에 단일 카드로 장착하여 호스트가 제공하는 전력으로 테스트하며, 각 항목에는 테스트에 사용된 전력이 명시되어 있습니다. 위의 H200 NVL 항목만 순위와 테스트 전력이 다른 유일한 경우입니다.
셋째, 워크스테이션 카드는 이 페이지에서 제외됩니다. 단, NVIDIA가 동일한 실리콘을 서버용으로 판매하고 두 제품의 프로필이 동일한 경우에는 워크스테이션 카드가 해당 항목에 포함되며, 그 내용이 명시되어 있습니다.
순위는 vLLM 온라인 서버 출력 처리량, 엔터프라이즈 추론 워크로드, 공유 모델 세트에서 동일한 동시 실행률로 계산되며, 8,192개 토큰 문서 형태와 MAMF 컴퓨팅 결과가 동점일 경우 우선순위를 결정하고, 메모리 용량이 실행 가능성 등급을 결정합니다. 벤더는 게시 전에 순위를 볼 수 없으며, 이 페이지의 게재는 유료가 아니며, 후원을 받은 내용이 인용된 경우 명시적으로 표시됩니다. 새로운 카드는 동일한 컨테이너에서 동일한 테스트를 완료할 때마다 추가되며, 상단의 변경 로그에 모든 변경 사항이 기록됩니다.
소프트웨어 스택은 몇 주마다 변경되므로 이 페이지의 각 수치는 순위를 결정한 테스트 결과를 기준으로 하며, 이후 리뷰에서는 동일한 카드에 대한 최신 테스트 결과가 나올 수 있습니다. 순위는 숫자가 바뀌는 것이 아니라 최신 테스트 결과로 순위가 변경될 때 재조정됩니다.
엔터프라이즈 GPU FAQ
기업용 추론에 가장 적합한 GPU는 무엇인가요?
대부분의 기업에서 구매하는 2U 및 4U 추론 서버에는 RTX PRO 6000 Blackwell Server Edition이 적합합니다. 이 제품은 96GB의 메모리, PCIe 카드 중 측정된 최고 수준의 FP4 컴퓨팅 성능, MIG, vGPU, 그래픽 및 비디오 엔진을 하나의 카드에 통합하면서도 메인스트림 슬롯에서 제공하는 450W의 전력 소모에도 처리량 손실이 2~9%에 불과하기 때문입니다.
H200 NVL은 메모리와 대역폭이 워크로드에 따라 결정되는 경우 더 빠른 카드이며, 저희가 테스트한 모든 모델에서 최고의 성능을 보여주었습니다. 따라서 높은 동시 접속 환경에서 70B~120B 모델을 중심으로 구축할 경우 H200 NVL부터 시작하는 것이 좋습니다. 슬롯이 단일 너비이거나 전력 예산이 165W인 경우에는 RTX PRO 4500 서버 에디션이 적합합니다.
RTX PRO 6000과 H100 NVL 중 추론 속도는 어느 쪽이 더 빠를까요?
H100 NVL은 동일한 vLLM 컨테이너에서 실행한 FP8 및 BF16 모델에서 동일한 동시 실행 수 기준으로 36~61% 더 빠르고, 8,192개 토큰으로 구성된 문서 형태에서는 41~52% 더 빠릅니다. 이는 3.9TB/s의 디코딩 속도를 제공하는 94GB HBM3가 1.6TB/s의 디코딩 속도를 제공하는 96GB GDDR7보다 빠르기 때문입니다. RTX PRO 6000은 H100에 FP4 하드웨어가 없는 NVFP4 체크포인트에서 우위를 점하며, 두 제품 중 유일하게 그래픽, 비디오 및 디스플레이 기능을 갖추고 있습니다. FP8 및 BF16 모델에서 처리량을 중시한다면 H100 NVL을, 혼합 워크로드 또는 FP4 로드맵을 고려한다면 RTX PRO 6000을 선택하십시오.
H100 NVL과 H200 NVL: 업그레이드할 가치가 있을까요?
H200 NVL은 채팅 형식에서 32개 스트림 기준으로 H100 NVL보다 10~12% 앞섰고, 128개 스트림 및 8,192개 토큰 문서 형식에서는 21~23% 앞섰습니다. 메모리 용량은 141GB 대 94GB, 처리 속도는 4.8TB/s 대 3.9TB/s였습니다. 이 수치는 2U R770 슬롯에서 최대 전력 소모량인 450W로 작동하는 H200을 기준으로 한 것이며, 600W 정격은 저희 연구실에서 테스트되지 않았으므로 이 차이는 최소값일 뿐입니다. 대부분의 구매자에게는 용량 차이가 중요한 결정 요소입니다. 141GB 용량의 FP8 120B급 모델을 구성하려면 H100 NVL 두 개가 필요합니다.
L40S와 RTX PRO 6000: 더 높은 사양의 그래픽 카드는 어떤 장점을 제공할까요?
단기적인 맥락에서 RTX PRO 6000은 Ministral 세트에서 32개 스트림을 사용할 때 L40S보다 2.1배에서 2.3배 높은 출력 처리량을 제공했습니다. 8,192개 토큰 입력에서는 그 비율이 2.2배에서 2.6배까지 증가했는데, 48GB 카드는 16개 스트림에서 KV 캐시 용량이 부족해지는 반면 96GB 카드는 계속해서 확장성을 보였습니다. 또한 RTX PRO 6000은 FP4 하드웨어, PCIe 5.0, 그리고 24GB 파티션 4개를 지원하는 MIG 기능을 갖추고 있으며, 소비 전력은 600W로 L40S의 350W보다 높습니다. 장기적인 맥락이나 멀티테넌트 작업에는 RTX PRO 6000이 더 나은 선택이지만, L40S와 비슷한 성능으로 채팅 수준의 서비스를 제공하려면 싱글 슬롯 RTX PRO 4500이 더 적합합니다.
L4 vs RTX PRO 4500: L4 함대는 업그레이드해야 할까요?
RTX PRO 4500 서버 에디션은 R770 서버에서 L4 대비 2.8배에서 3.6배 높은 출력 처리량을, HPE ProLiant DL145 Gen11 서버에서는 2.7배 높은 출력 처리량을 보였습니다. 소비 전력은 165W 대 72W, 메모리 용량은 32GB 대 24GB였습니다. 하지만 물리적인 차이점이 있습니다. 4500은 16핀 커넥터를 사용하는 풀 사이즈, 풀 길이 카드인 반면, L4는 슬롯 전원 방식의 하프 사이즈 카드입니다. 따라서 L4를 기반으로 구축된 1U 서버나 소형 엣지 박스에는 4500을 사용할 수 없습니다. 섀시에 FHFL 슬롯이 있는 경우 4500으로 업그레이드하고, 그렇지 않은 경우에는 L4를 그대로 사용하는 것이 좋습니다.
RTX PRO 6000 서버 에디션과 워크스테이션 에디션의 차이점은 무엇일까요?
동일한 GB202 GPU, 96GB GDDR7 ECC 메모리, 600W 정격 전력을 갖춘 이 제품들은 NVIDIA에서 동일하게 표기하고 있으며, 자체 테스트에서도 동일한 성능을 보였습니다. 따라서 이 페이지에서는 워크스테이션 에디션의 데이터가 서버 에디션을 대신하여 사용됩니다. 서버 에디션은 팬리스 냉각 방식을 채택하고 섀시의 공기 흐름을 고려하여 설계되었으며, MIG(Multi-Induced Gradient), 기밀 컴퓨팅, vGPU 등의 데이터 센터 기능을 제공합니다. 워크스테이션 에디션은 액티브 쿨링 방식을 채택하고 있으며, 4개의 DisplayPort 출력을 지원합니다. 서버 구매자라면 서버 에디션을 선택하는 것이 좋지만, 두 에디션의 성능 수치는 동일합니다.
PCIe GPU와 SXM 또는 HGX 모듈의 차이점은 무엇인가요?
PCIe 가속기는 표준 슬롯에 장착되는 추가 카드이며 72W에서 600W의 전력을 소모합니다. 따라서 랙에 이미 설치된 2U 및 4U 서버에 적합하며, 여러 카드 간의 통신은 PCIe 또는 NVLink 브리지를 통해 이루어집니다. SXM 및 OAM 모듈은 HGX B200 또는 MI350X 플랫폼과 같은 전용 시스템 내부의 베이스보드에 납땜되어 있으며, GPU당 700W에서 1,400W의 전력을 소모하고 NVLink 또는 Infinity Fabric 메시 네트워크를 통해 연결됩니다. 이 페이지에서는 전자의 유형을 다루고 있으며, 후자는 서버 및 로컬 AI 데스크톱 관련 페이지에서 자세히 설명합니다.
추론 서버에는 얼마나 많은 GPU 메모리가 필요합니까?
모델과 컨텍스트에 따라 다릅니다. 이 페이지에서는 24GB 및 32GB 카드가 채팅 길이에서 30억~140억 크기의 모델을 무리 없이 처리했고, 8,192 토큰 입력에서 4~8개의 스트림으로 평탄화했습니다. 48GB 카드는 최대 16개의 스트림까지 처리했고, 96GB 카드는 동일한 모델에서 용량 부족 현상이 발생하지 않았으며, 141GB H200 NVL은 ET900N G3 테스트에서 단일 카드로 GPT-OSS-120억 크기를 처리했습니다. 먼저 가중치를 고려한 다음, 예상되는 동시 접속 수에 맞춰 키-값 캐시를 할당하고, 장기 컨텍스트 또는 멀티테넌트 작업에는 48GB 이상의 카드가 필요하다고 간주하십시오.
2U 서버에서 450W와 600W의 차이가 중요한가요?
정격 출력 차이가 시사하는 것보다 실제 성능 차이는 크지 않았습니다. 두 가지 방식으로 모두 측정해 본 한 가지 카드에서 이러한 차이가 나타났습니다. PowerEdge R770 슬롯의 최대 전력 소모량인 450W로 제한했을 때, RTX PRO 6000은 단거리 컨텍스트에서 출력 처리량이 2~5% 감소했고, 장거리 컨텍스트에서는 4~9% 감소했습니다. FP8 MAMF 결과는 변화가 없었는데, 이는 전력 예산의 25%를 사용하면서 2~9%의 손실을 감수했다는 의미입니다. 이 페이지에 소개된 H200 NVL도 같은 이유로 450W에서 테스트되었으며, 600W 정격 출력에서의 결과는 아직 측정되지 않았습니다. 저희가 처음 살펴본 AMD Instinct MI350P 역시 600W 정격 출력에 비해 2U PowerEdge R7725에서 450W로 작동했으며, PowerEdge XE7745에서의 차이를 측정할 예정입니다.


 아마존