

AI 인프라 시장은 단일 방향으로 움직이는 것이 아니라, 두 개의 뚜렷한 세계로 분화되고 있습니다. 한쪽에는 대규모 기초 모델 개발을 위해 구축된 최첨단 학습 클러스터가 있으며, 이는 독점적인 패브릭 및 제한된 수의 가속기와 긴밀하게 연결되어 있습니다. 다른 한쪽은 기업 추론이라는 빠르게 확장되는 현실입니다. 기업들은 이러한 환경에서 모델을 배포하여 사용자에게 서비스를 제공하고, 실시간 데이터를 처리하며, 측정 가능한 비즈니스 가치를 창출합니다. Dell PowerEdge XE7740은 바로 이러한 두 번째 세계를 위해 특별히 설계되었습니다.
주요 요점
- PowerEdge XE7740은 기업용 추론 환경에 최적화되어 있습니다. 듀얼존 열 관리, 구조화된 PCIe Gen5 토폴로지, 그리고 실제 운영 워크로드에 맞춰 설계된 스케일아웃 네트워킹을 갖추고 있습니다.
- 시스템 균형은 의도적인 것입니다. Xeon 6 코어 밀도, 높은 메모리 대역폭 및 PCIe Gen 5 E3.S NVMe를 결합하여 KV 캐시 오프로드 및 오케스트레이션을 지원합니다.
- 실리콘의 유연성은 기본입니다. 인프라 재설계를 강요하지 않고 광범위한 PCIe Gen5 가속기를 지원합니다.
- 이 플랫폼은 시간이 지남에 따라 깔끔하게 확장됩니다. 단일 섀시에 부분적으로 GPU를 탑재하는 것부터 8개의 후면 Gen5 x16 전용 네트워킹 슬롯을 사용하여 랙 전체에 분산 추론하는 것까지 지원합니다.
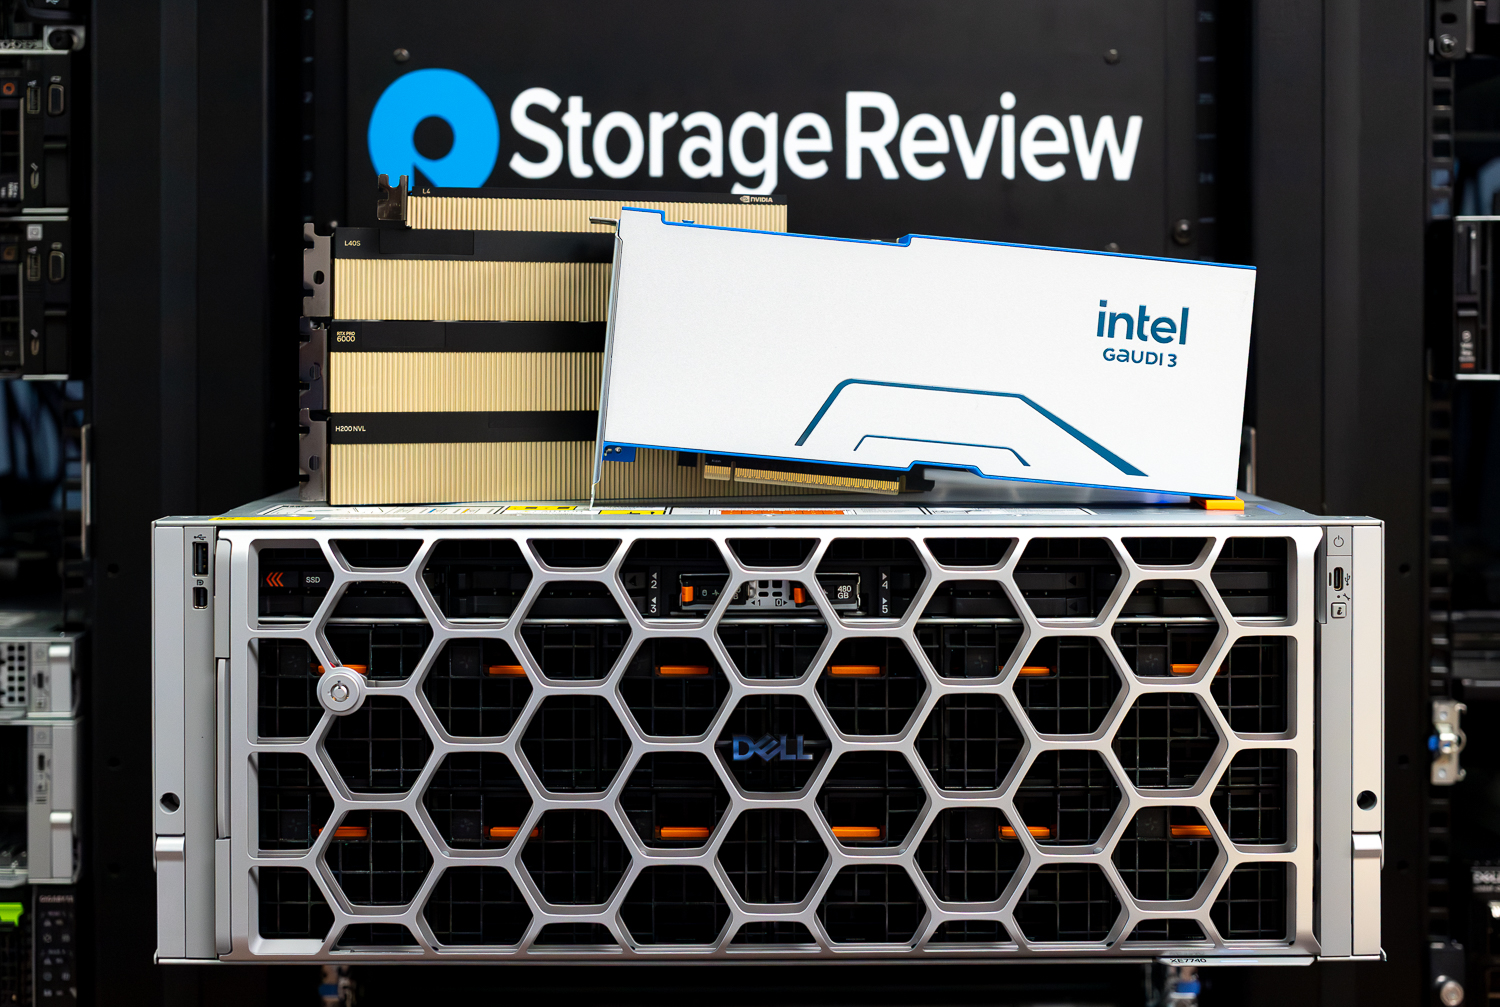
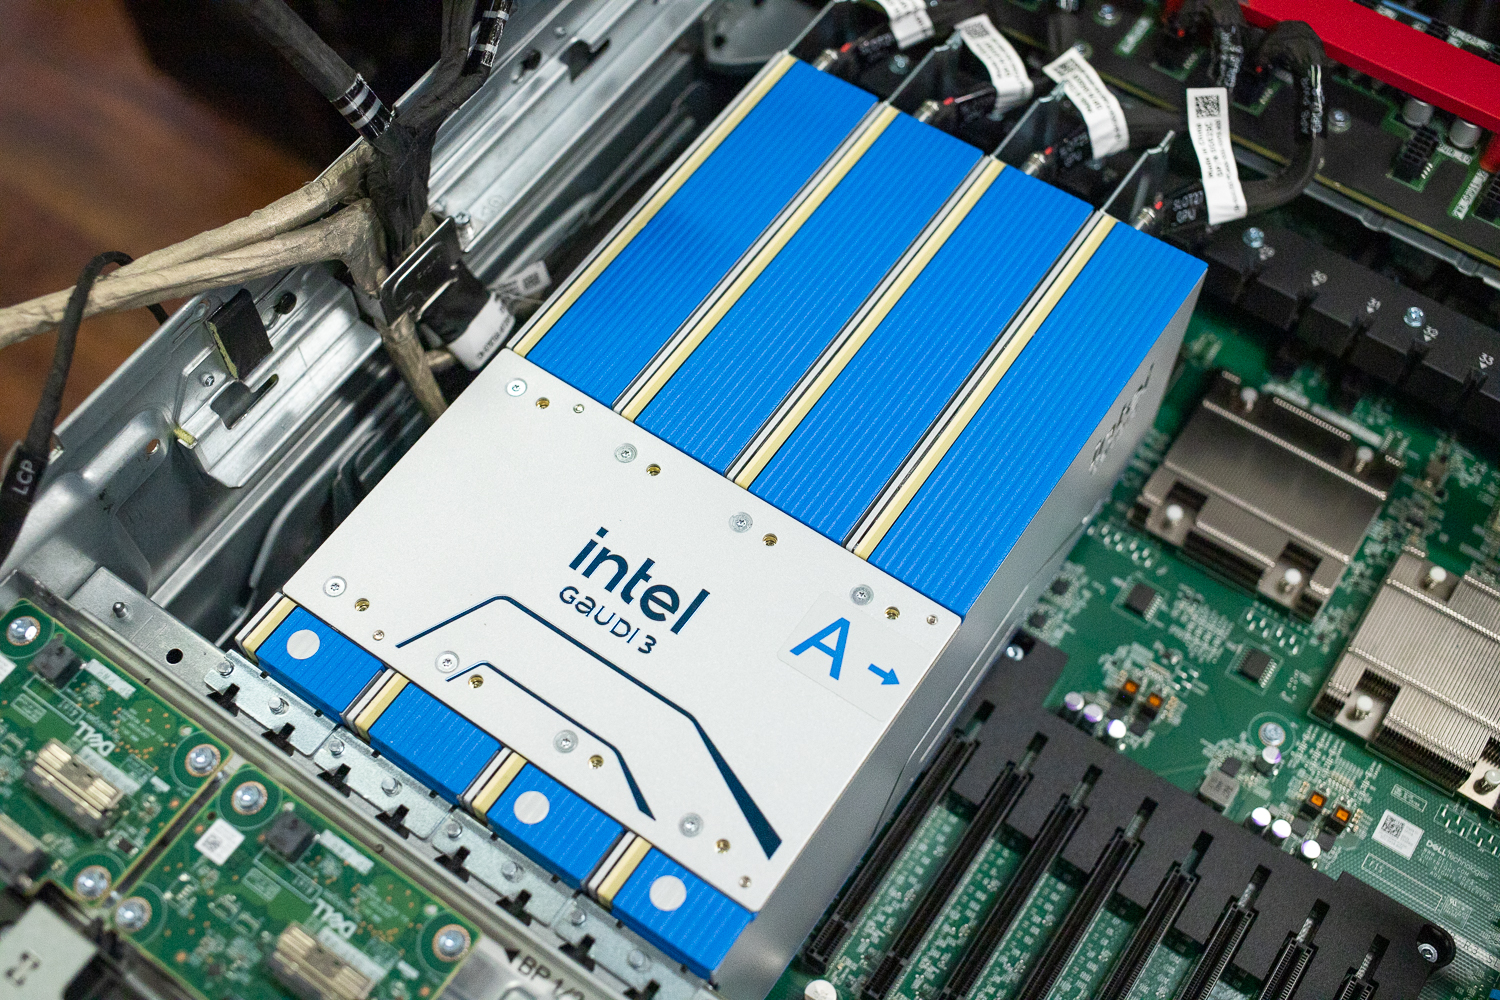
XE7740의 핵심은 실리콘 다양성에 대한 확고한 의지입니다. 델은 단일 가속기 로드맵에 플랫폼을 고정하는 대신, 가용성, 비용 및 조직의 준비 상태에 따라 유연하게 대응할 수 있는 시스템을 구축했습니다. XE7740은 NVIDIA의 RTX PRO 6000, H100/200, L40S, L4 및 A16 GPU를 포함한 다양한 PCIe Gen5 가속기를 지원하여 폭넓은 에코시스템 호환성을 중시하는 조직에 적합하며, 보다 비용 효율적이고 즉시 사용 가능한 추론 경로를 찾는 팀을 위해 Intel Gaudi 3도 지원합니다. Gaudi 3 가속기는 현재 사용 가능하므로 조직은 가속기 전략 수립에 흔히 발생하는 구매 지연 없이 계획 단계에서 배포 단계로 신속하게 전환할 수 있습니다.
추론이 AI 워크로드의 주류로 자리 잡으면서 가용성과 비용 구조가 중요해지고 있습니다. 대부분의 기업은 최첨단 규모의 모델을 학습하는 것이 아니라, 추론 파이프라인을 운영하고, 중간 규모의 언어 모델을 처리하고, 검색 증강 생성 워크플로우를 지원하며, 프로덕션 환경에 컴퓨터 비전을 배포하고 있습니다. 이러한 맥락에서 Gaudi 3는 플래그십 학습용 GPU만큼 높은 가격 부담 없이 고대역폭 메모리와 이더넷 기반 확장성을 갖춘 최신 아키텍처를 제공하는 가장 경제적인 최신 추론 가속기 중 하나로 자리매김하고 있습니다. XE7740 제품군 내에서 Gaudi 3는 기존 제품을 대체하는 것이 아니라 지속 가능한 추론 배포를 가능하게 하는 데 중점을 두고 있습니다.
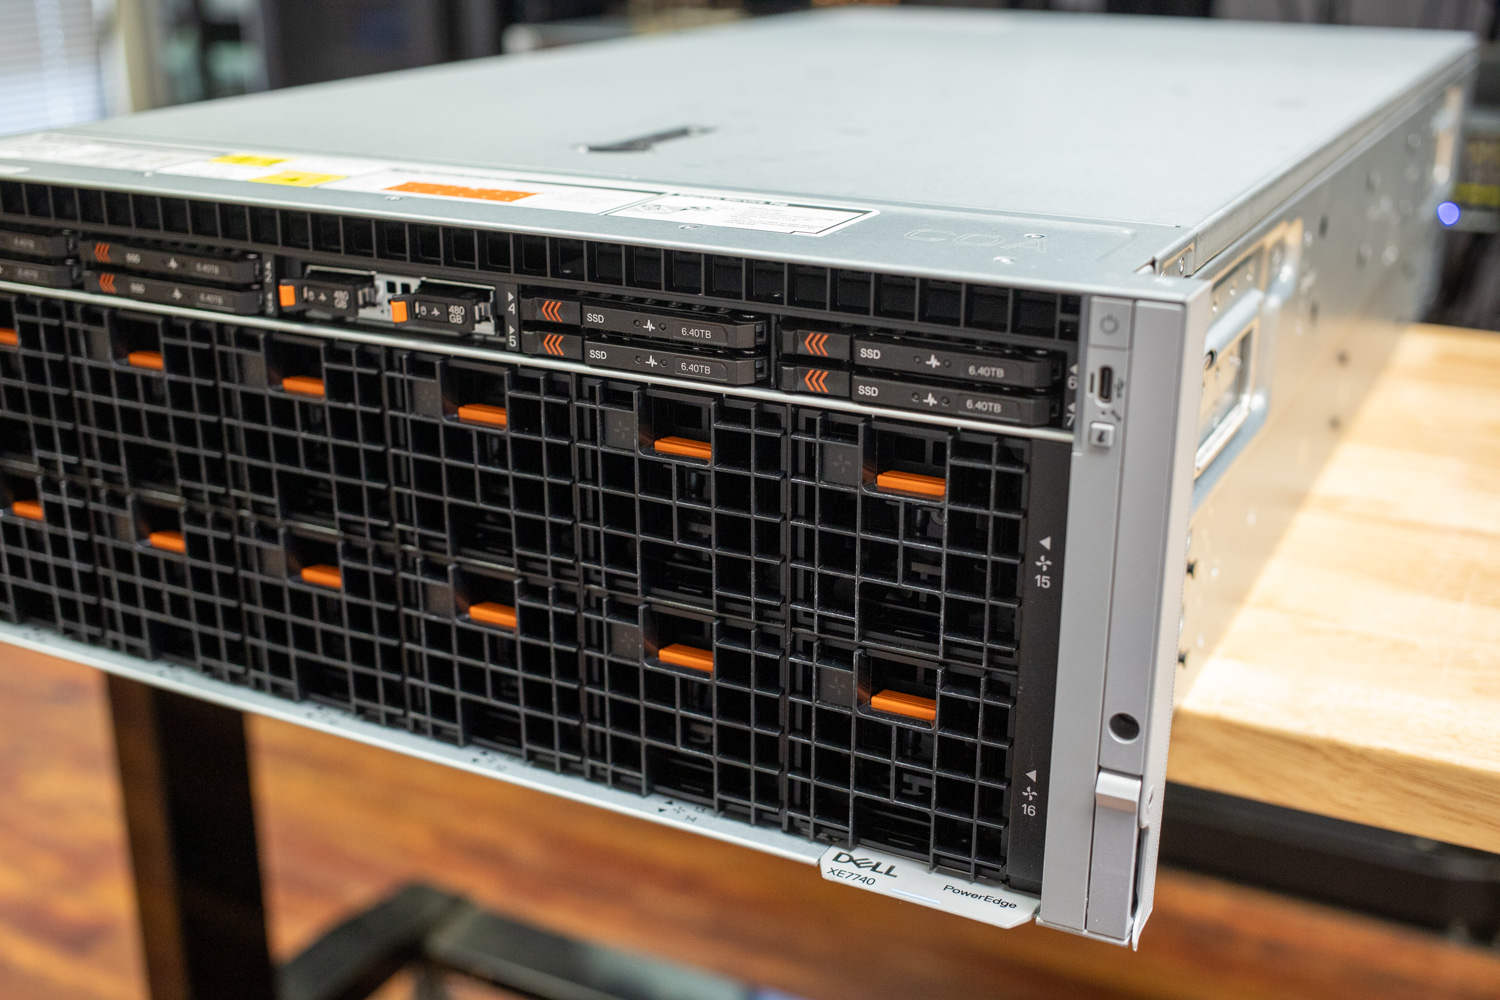
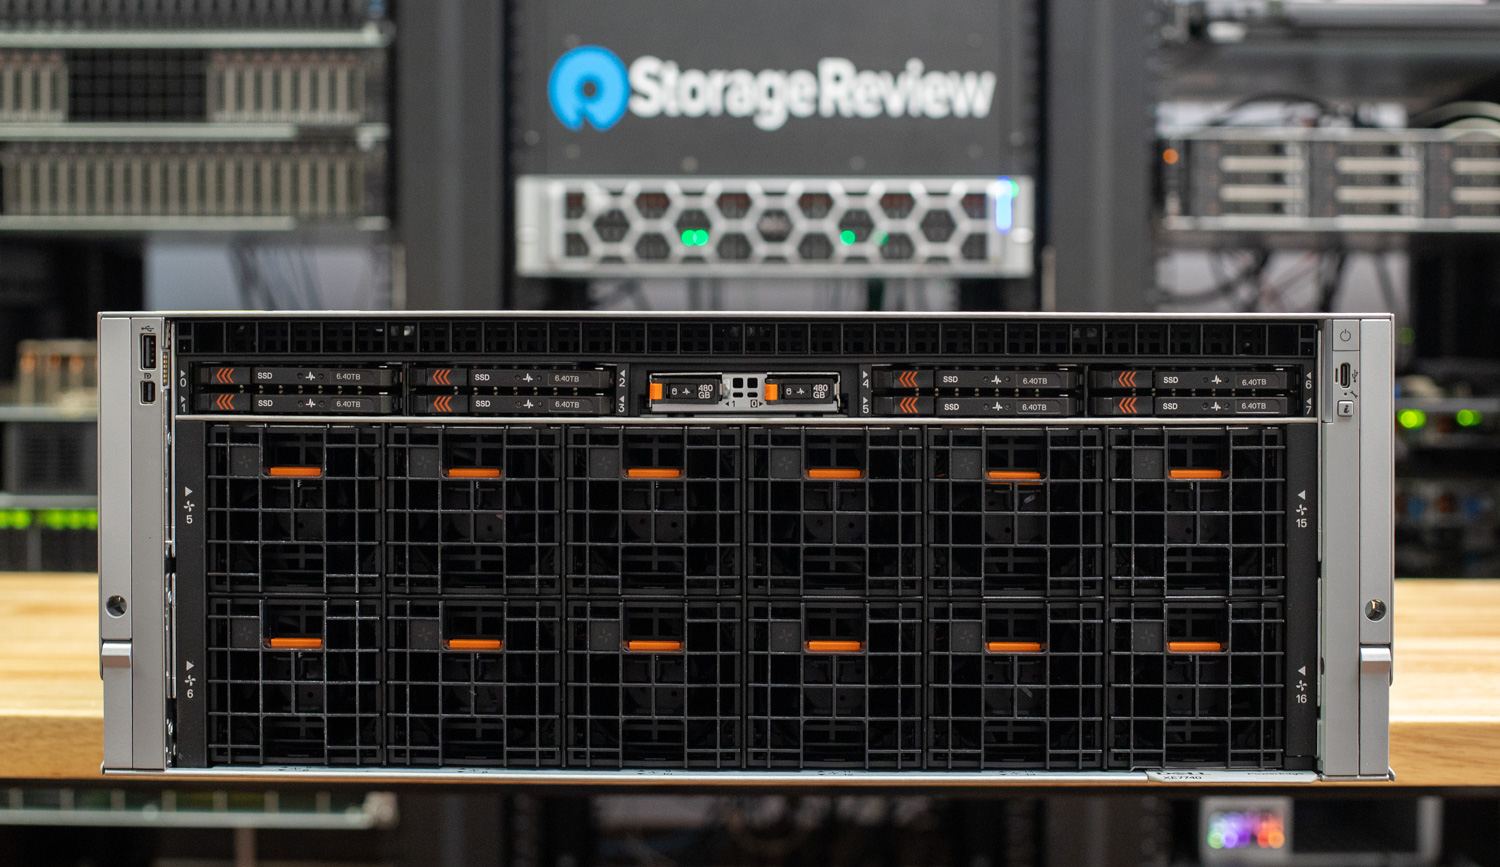
가속기를 둘러싼 플랫폼 역시 신중하게 설계되었습니다. XE7740은 인텔 제온 6 프로세서를 기반으로 하며, 추론 중심 시스템에서 CPU는 여전히 핵심 구성 요소입니다. 높은 코어 수와 향상된 메모리 대역폭은 추론의 핵심 경로에 직접 위치하는 스케줄러, 토큰화, 전처리 및 오케스트레이션 작업에 필요한 여유 공간을 제공합니다. 전면에 장착된 E3.S NVMe 스토리지는 로컬 데이터 스테이징 및 KV 캐시 오프로드를 지원하여 가속기 부하를 줄이고 시스템 효율성을 전반적으로 향상시킵니다. 이러한 균형 잡힌 설계는 추론 성능이 가속기뿐만 아니라 시스템 전체에 의해 좌우된다는 점을 고려한 것입니다.
XE7740은 시간이 지남에 따라 원활하게 확장할 수 있도록 설계되었습니다. 기업은 2개 또는 4개의 가속기와 같은 소규모 구성으로 시작하여 섀시를 완전히 채우지 않고도 즉각적인 가치를 얻을 수 있습니다. 요구 사항이 증가함에 따라 동일한 플랫폼을 수직적으로 확장하거나 분산 추론으로 전환할 수 있습니다. 후면에 있는 8개의 PCIe Gen5 x16 슬롯은 고속 네트워킹을 위한 전용 대역폭을 제공하여 XE7740이 확장형 추론 클러스터의 구성 요소 역할을 할 수 있도록 합니다. 옵션으로 제공되는 DPU 지원은 배포가 성숙해짐에 따라 네트워킹 및 통신 작업을 분담하여 이러한 유연성을 더욱 확장합니다.
델 파워엣지 XE7740 주요 사양
| 스펙 | 파워에지 XE7740 |
|---|---|
| PowerEdge XE7740의 특징 | |
| 프로세서 | 인텔® 제온® 6 시리즈 프로세서 2개, 프로세서당 최대 86개 코어 |
| 슬롯 | |
| PCIe 가속기 | 8개의 PCIe Gen 5 x16 DW-FHFL (최대 600W) 또는
16x PCIe Gen 5 x16 SW-FHFL 최대 75W |
| PCIe NIC |
|
| 폼 팩터 | |
| 폼 팩터 | 4U 랙 서버 |
| 메모리 | |
| DIMM 속도, 최대 용량 | 최대 6400 MT/s, 최대 4 TB |
| 메모리 모듈 슬롯 | 32개의 DDR5 DIMM 슬롯 등록된 ECC DDR5 RDIMM만 지원합니다. |
| 스토리지 | |
| 전면 베이 | 최대 8개의 EDSFF E3.S Gen5 NVMe(SSD) 최대 122.88TB |
| 스토리지 컨트롤러 | |
| 내부 부트 | 부팅 최적화 스토리지 서브시스템(BOSS-N1 DC-MHS): HWRAID 1, M.2 2개
NVMe SSD |
| 전원 공급 장치 | |
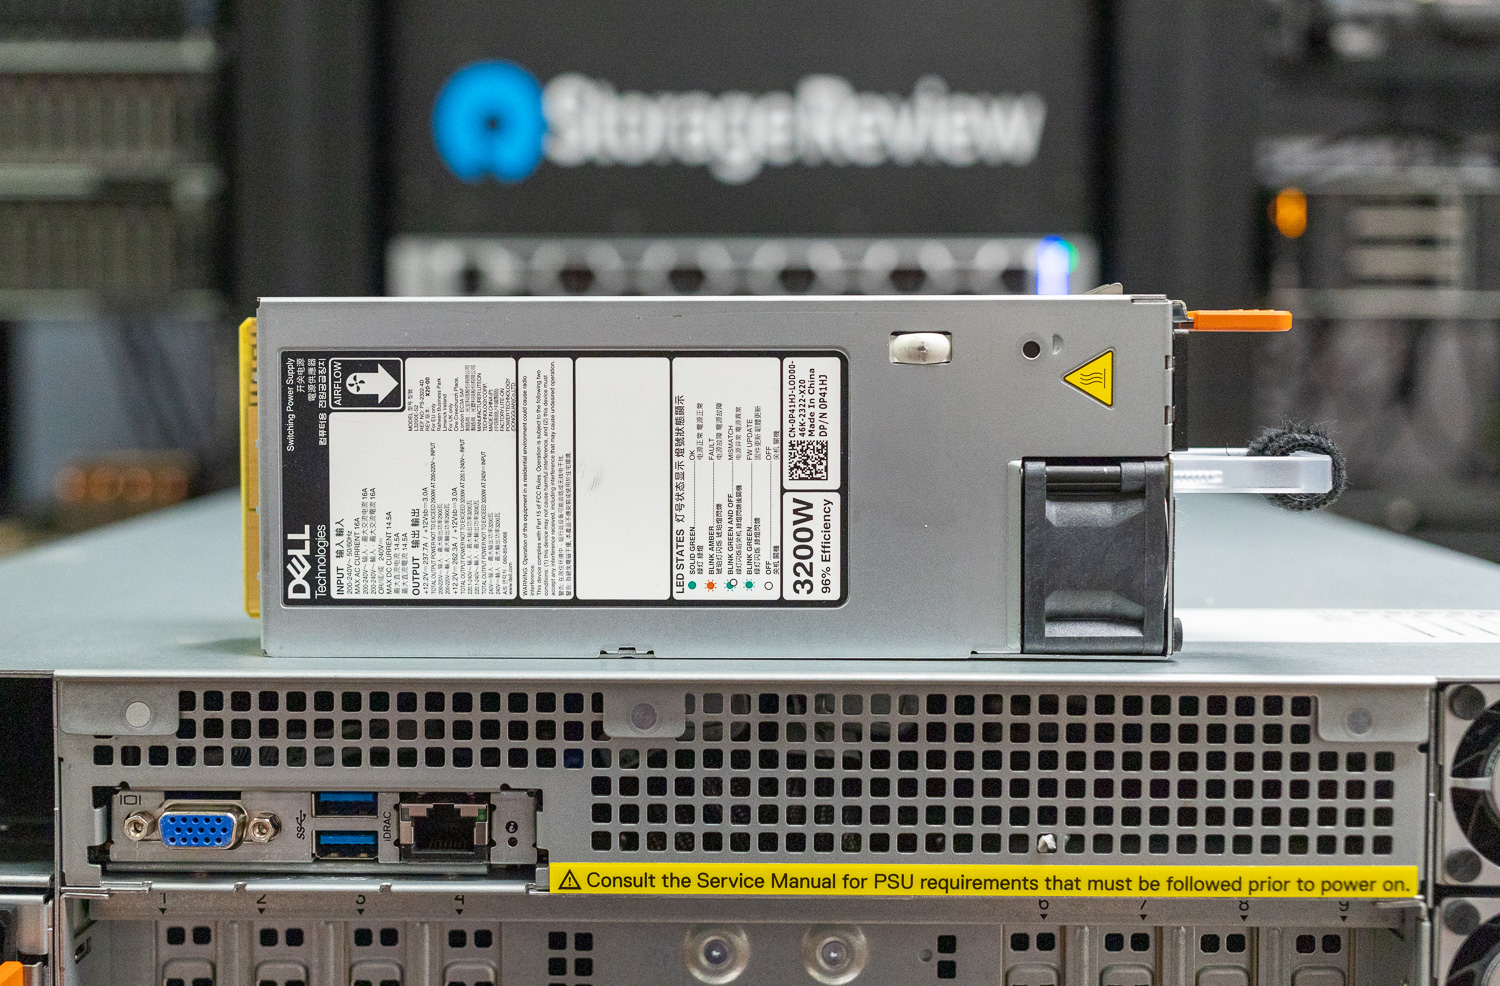
| 전원 공급 장치 | 3200W 티타늄, 200-240V AC 또는 240V DC, 핫스왑 이중화
3200W 파워서플라이용 다중 용량:
2400W 파워서플라이용 다중 용량:
주의: 시스템의 BMC 및 대기 전원 유지를 위해서는 CPU 영역과 GPU 영역에 각각 최소 1개의 전원 공급 장치(PSU)가 필요합니다. GPU 영역에 PSU가 설치되어 있지 않으면 시스템이 대기 상태로 유지됩니다. 완벽한 이중화를 위해서는 각 영역에 N+N개의 PSU를 설치하십시오. 즉, CPU 영역에는 1+1개, GPU 영역에는 3+3개를 설치하십시오. 시스템 전원이 켜진 상태에서 CPU 영역의 모든 PSU를 제거하면 시스템이 즉시 종료되고 데이터 손실이 발생할 수 있습니다. |
| 냉각 옵션 | |
| 냉각 옵션 | 공기 냉각 |
| 팬 | 중간 트레이에 최대 4세트의 고성능(HPR) 플래티넘 등급 팬(듀얼 팬 모듈)이 설치됩니다.
시스템 전면에 최대 12개의 고성능(HPR) 플래티넘 등급 팬이 설치됩니다. 모두 핫스왑 팬입니다. |
| 포트 | |
| 네트워크 옵션 | 1. PCIe Gen 5 OCP 3.0 호환 I/O (x8 PCIe 레인 지원) |
| 전면 포트 | USB 2.0 타입 A 포트 1개 (선택 사항) 미니 디스플레이 포트 1개 (선택 사항) USB 2.0 Type-C 듀얼 모드 포트 1개 (호스트/iDRAC 다이렉트 포트) |
| 후면 포트 | iDRAC/BMC 전용 다이렉트 이더넷 포트 1개 USB 3.1 타입 A 포트 2개 1의 X의 VGA |
| 내부 포트 | 1 x USB 3.1 유형 -A |
XE7740 설계 및 제작
듀얼존 아키텍처: CPU와 GPU 분리
XE7740의 가장 독특한 설계 특징 중 하나는 열 관리와 전력 관리를 위한 두 개의 독립적인 영역으로 물리적으로 분리했다는 점입니다. 상단 1U 공간에는 CPU 영역이 있으며, 여기에는 두 개의 Xeon 6 프로세서, 32개의 DIMM 슬롯, 스토리지 및 DC-SCM 관리 모듈이 포함됩니다. CPU 영역에는 고성능 듀얼 팬 모듈(40×40×56mm) 4세트가 사용되어 47.4 CFM의 풍량을 제공합니다.
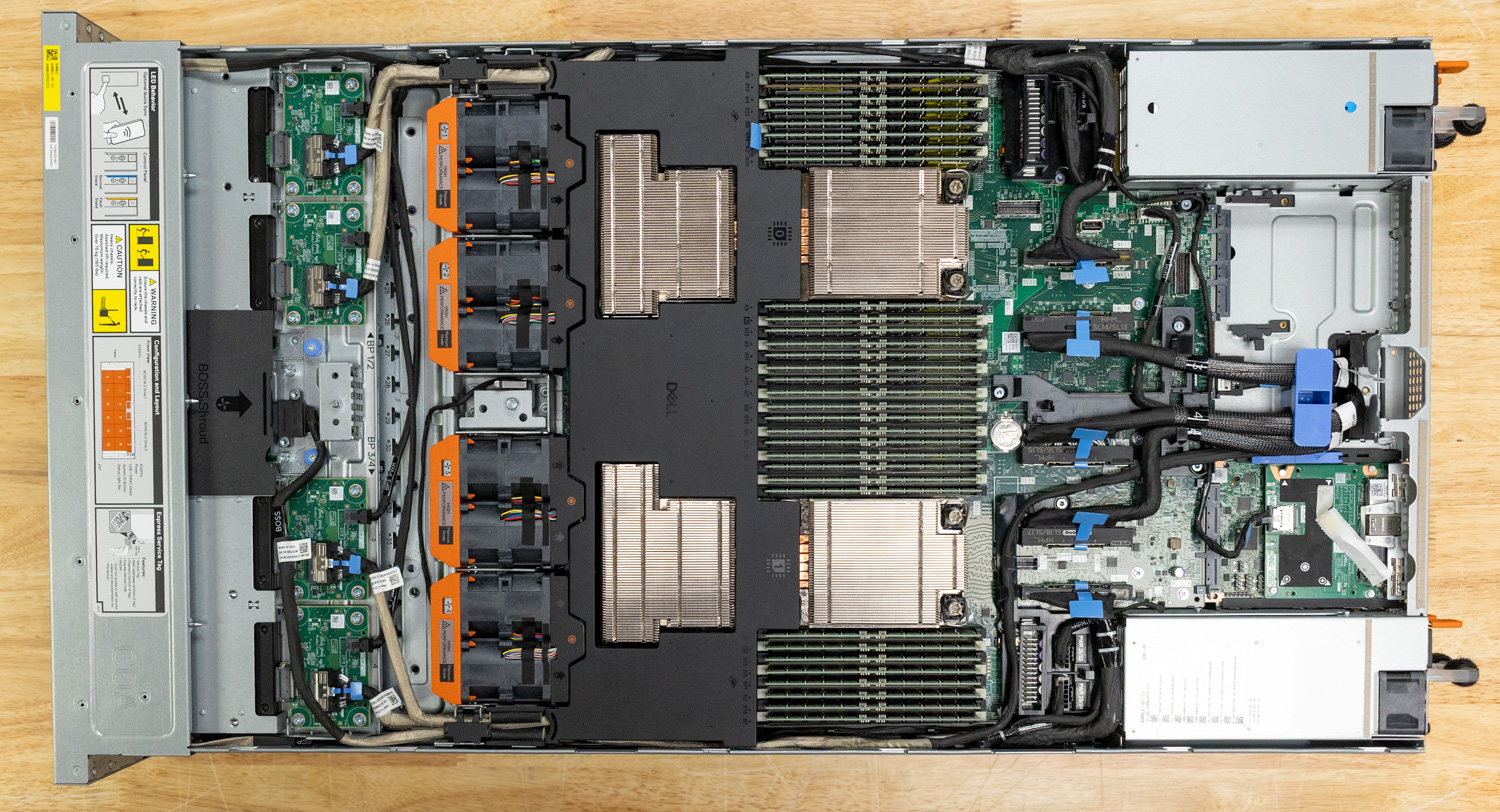
하단 3U 섹션은 GPU 영역으로, 모든 가속기 슬롯과 전용 냉각 시스템을 포함하며, PCIe 베이스 보드(PBB), 후면 PCIe 확장 슬롯 및 OCP NIC 연결 포트가 있습니다. GPU 영역에는 CPU 팬보다 훨씬 높은 풍량(팬당 최대 122.2 CFM)을 제공하는 대형 고성능 팬(60×60×56mm) 12개가 사용됩니다. 모든 팬은 핫스왑이 가능합니다. 이러한 듀얼 존 냉각 방식 덕분에 19인치 표준 랙에서 높은 TDP(카드당 최대 600W)를 가진 가속기의 발열 요구 사항이 CPU 및 메모리 냉각에 영향을 미치지 않으며, 그 반대의 경우도 마찬가지입니다.
Dell은 XE7740의 공기 흐름 최적화에 세심한 주의를 기울였습니다. 가속기 밀집 시스템은 GPU 보조 전원 케이블, HPM 보드와 PBB 사이의 PCIe 신호 케이블, 팬 보드 연결 케이블 등 상당한 양의 내부 케이블이 필요합니다. XE7740에서는 이러한 케이블들이 전용 케이블 고정 브래킷과 케이블 커버 어셈블리를 사용하여 섀시 측면 벽을 따라 깔끔하게 정리됩니다. 각 케이블은 필요한 길이로 정확하게 제작되어 시스템 내부에 불필요한 케이블 묶음이 없습니다. 케이블이 중앙 공기 흐름 통로를 막지 않도록 설계함으로써 전면에서 후면으로의 원활한 공기 흐름 경로를 확보하고 CPU 및 GPU 냉각 영역의 저항을 최소화합니다.
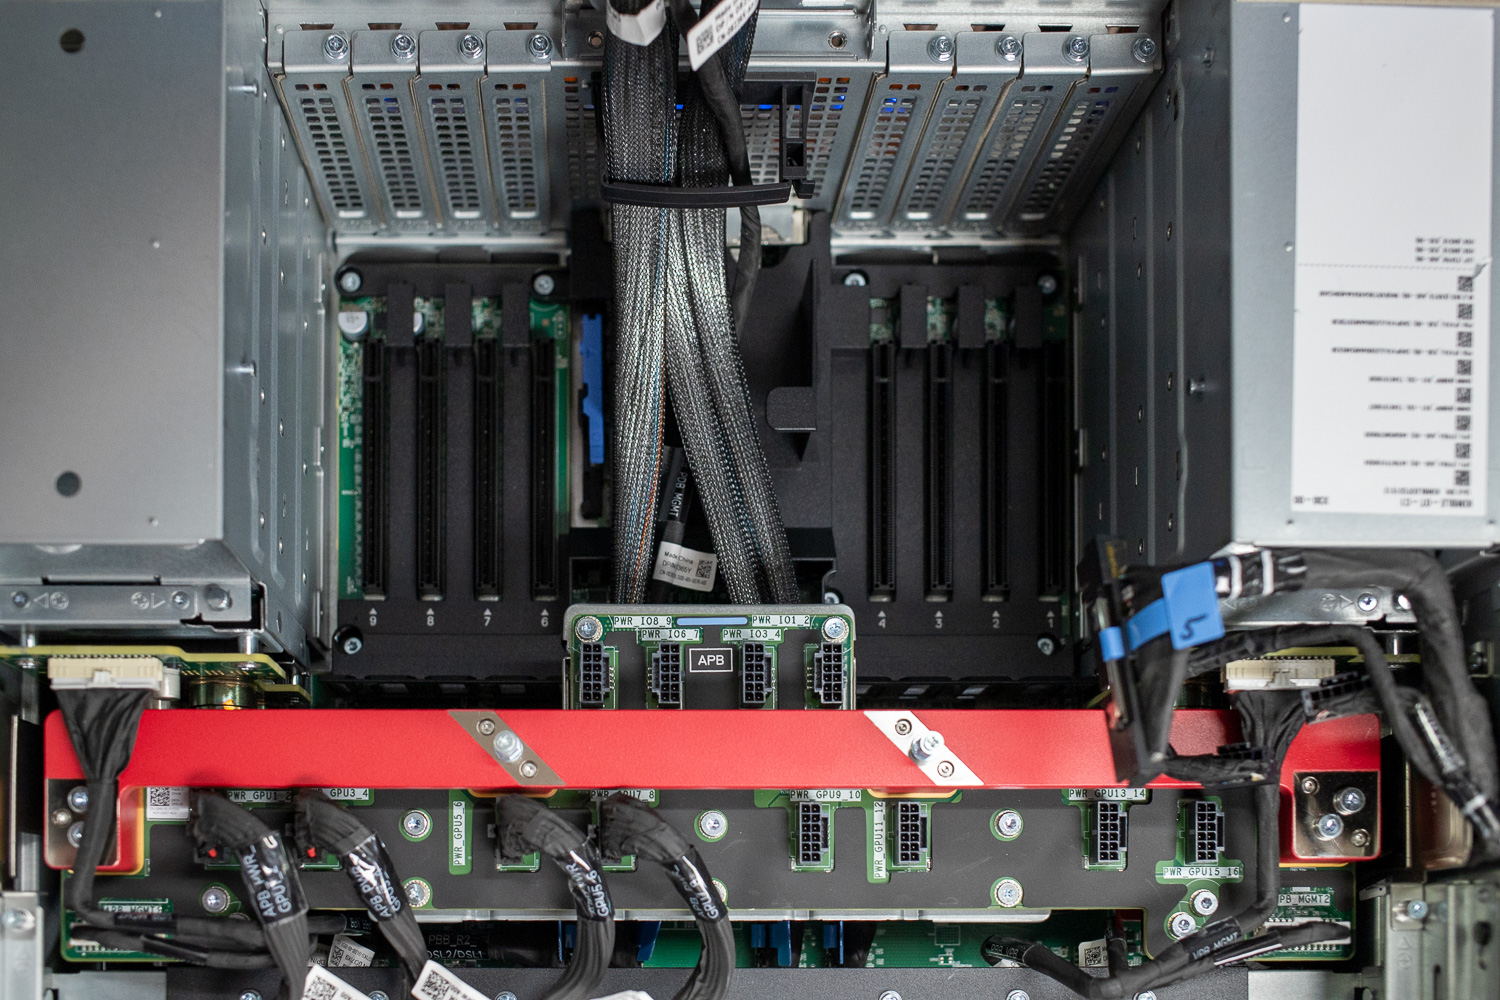
최대 8개의 600W 가속기를 탑재한 섀시에서는 공기 흐름 경로에 작은 장애물만 있어도 국부적인 과열 지점이 발생하고 팬이 더 빠른 속도로 작동하게 되어 전력 소비와 소음이 증가할 수 있습니다. Dell의 케이블 관리 방식은 섀시 중앙을 깨끗하게 유지하여 가장 필요한 구성 요소 위로 공기가 직접 흐르도록 합니다.
PCIe 스위치 토폴로지 및 데이터 흐름
XE7740의 PCIe 서브시스템은 PBB(PCIe 베이스 보드)에 있는 SW1부터 SW4까지의 4개의 PCIe Gen 5 스위치를 중심으로 구성됩니다. 이 스위치들은 시스템의 I/O 아키텍처의 핵심을 이루며, 가속기, 네트워킹 및 스토리지를 두 개의 Xeon 6 프로세서에 체계적으로 연결합니다.
16개의 내부 GPU 슬롯은 8개씩 두 개의 뱅크로 나뉘며, 각 뱅크는 한 쌍의 PCIe 스위치에 의해 제어되고, 각 스위치는 CPU에 업스트림으로 연결됩니다. 각 뱅크 내에서 인접한 두 배 너비의 GPU 슬롯 쌍은 두 스위치에 걸쳐 교차 배치됩니다. CPU0 측에서 SW1은 GPU 슬롯 21과 25, 그리고 후면 PCIe 슬롯 8과 9를 제어하고, SW2는 GPU 슬롯 23과 27, 그리고 후면 PCIe 슬롯 6과 7을 제어합니다. CPU1 측에서 SW3은 GPU 슬롯 29와 33, 그리고 후면 PCIe 슬롯 3과 4를 제어하고, SW4는 GPU 슬롯 31과 35, 그리고 후면 PCIe 슬롯 1과 2를 제어합니다.

따라서 각 CPU 도메인은 4개의 더블 폭 가속기 슬롯, 4개의 후면 NIC/I/O 슬롯, 그리고 8개의 전면 E3.S NVMe 스토리지 베이 중 4개를 소유합니다. 이러한 스위치 토폴로지는 데이터 흐름, 특히 RDMA 기반 트래픽에 중요한 영향을 미칩니다. 각 스위치에 가속기 슬롯과 후면 NIC 슬롯이 모두 있기 때문에, 동일한 스위치에 있는 가속기와 네트워크 어댑터는 스위치 패브릭 내에서 완전히 RDMA 전송을 수행할 수 있습니다. 데이터는 CPU의 루트 컴플렉스를 통과할 필요가 없으므로, 한 루트 포트의 PCIe 장치가 다른 루트 포트의 장치와 통신할 때 필요했던 CPU 바운스 버퍼가 제거됩니다. 이는 지연 시간을 줄이고, 귀중한 CPU 메모리 대역폭 소모를 방지하며, CPU 사이클을 다른 작업에 활용할 수 있도록 해줍니다.
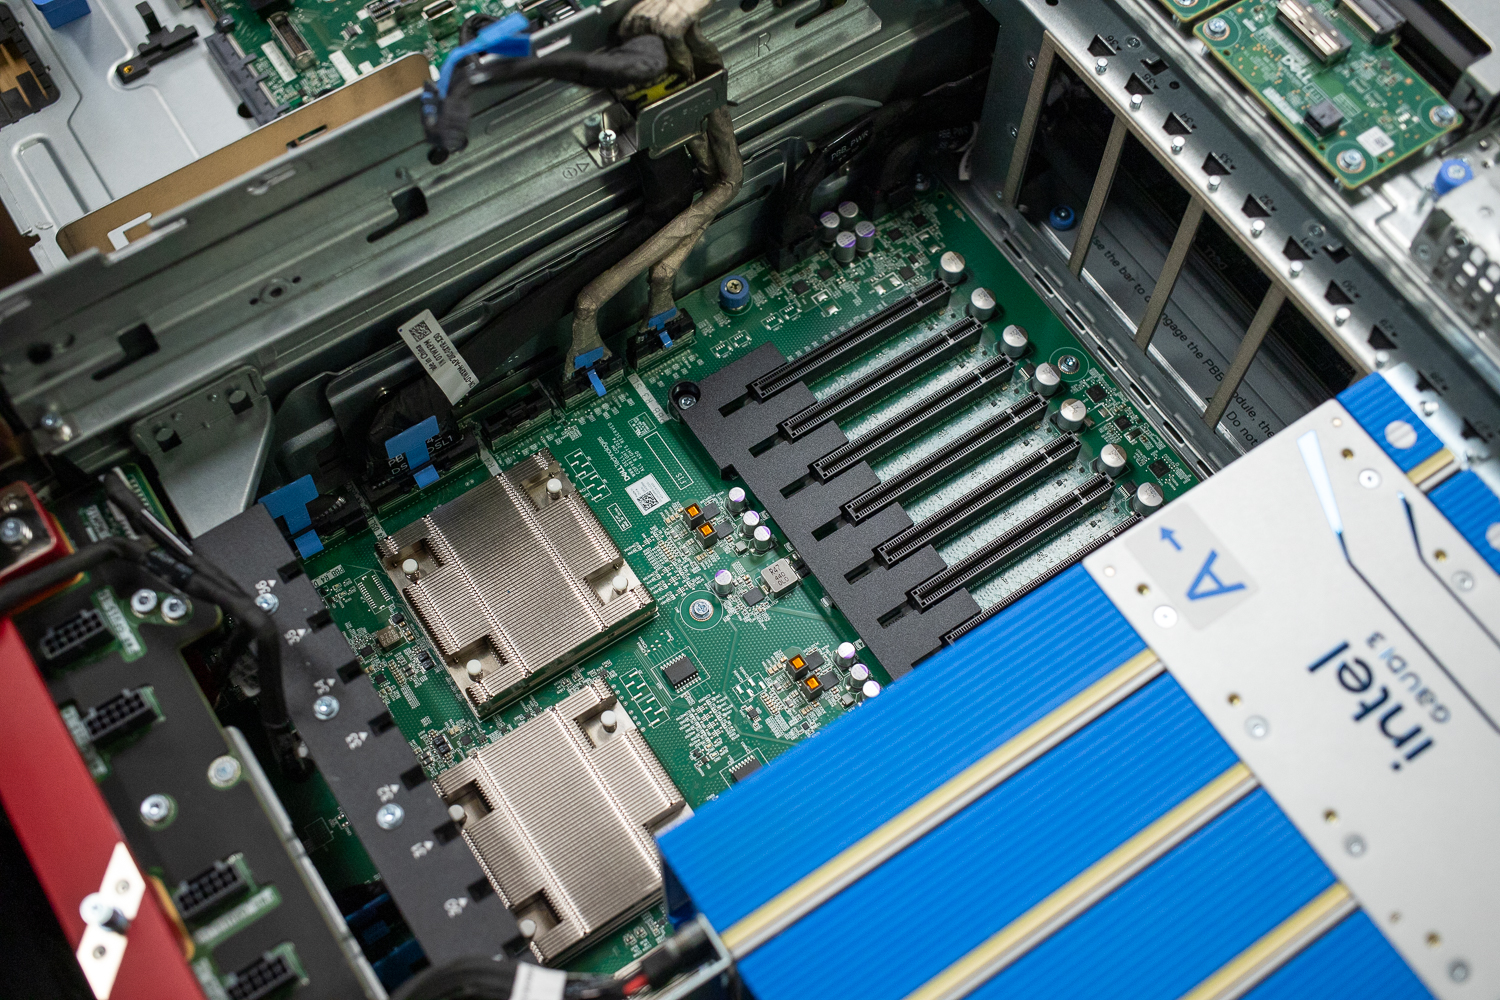
단일 CPU 도메인 내의 두 스위치 간 통신은 CPU 루트 컴플렉스를 통해 이루어지지만 해당 소켓 내에서만 처리됩니다. 그러나 CPU 간 통신은 두 Xeon 6 프로세서 간의 UPI 링크를 거쳐야 합니다. 6787P는 각각 24 GT/s의 속도를 제공하는 4개의 UPI 2.0 링크를 제공하여 상당한 소켓 간 대역폭을 제공합니다. 하지만 CPU0의 스위치 뱅크에 있는 가속기와 CPU1의 스위치 뱅크에 있는 NIC 간의 트래픽은 스위치 내 또는 동일 소켓 간 전송보다 본질적으로 더 높은 지연 시간을 갖습니다.
스위치 자체는 직접 연결되어 있지 않습니다. 모든 스위치 간 트래픽은 CPU 루트 컴플렉스를 통해 라우팅되므로 GPU 슬롯, NIC 슬롯, 스토리지 및 CPU 소켓 간의 선호도를 이해하는 것이 중요합니다. Dell은 기업에서 이러한 복잡성을 단순화할 수 있도록 널리 사용되는 가속기에 대한 검증되고 최적화된 구성을 제공합니다.
듀얼존 전원 공급 장치
XE7740의 전원 공급 방식은 다소 특이한 듀얼 존 PSU 설계를 통해 열 관리 아키텍처를 반영합니다. 이 시스템은 최대 8개의 핫스왑 가능한 전원 공급 장치를 지원하며, 두 개의 존으로 나뉩니다. 존 1(CPU 존)에는 PSU 1과 2가, 존 2(GPU 존)에는 PSU 3부터 8까지가 장착됩니다.
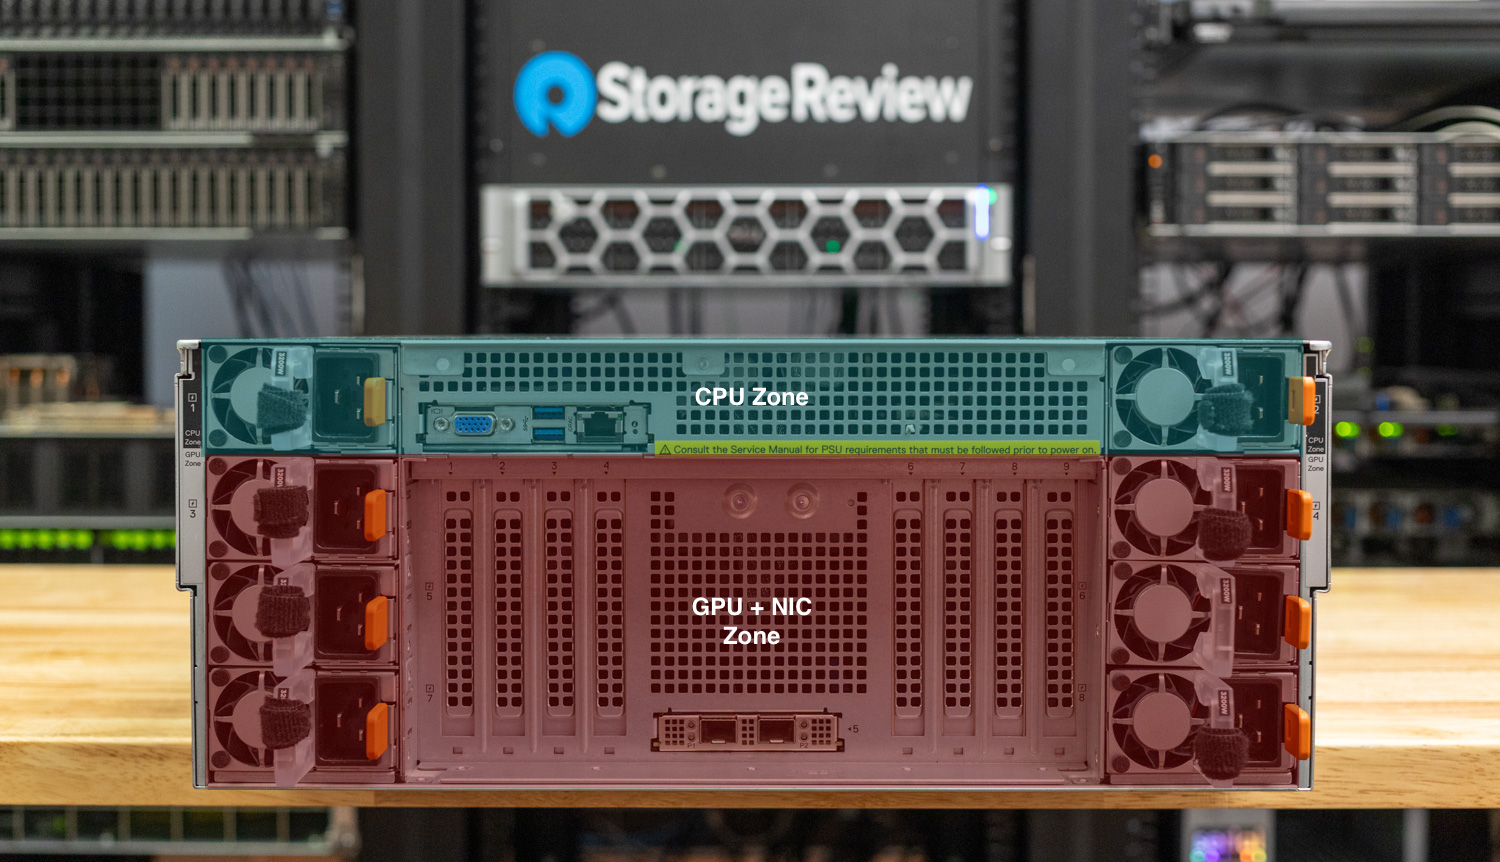
이 시스템은 BMC 및 대기 전원 유지를 위해 각 영역에 최소 하나 이상의 전원 공급 장치(PSU)가 필요합니다. 시스템 작동 중 어느 한 영역이라도 AC 전원이 차단되면 데이터 손실을 방지하기 위해 시스템이 즉시 종료됩니다. 각 영역은 물리적으로나 전기적으로 분리되어 있지만, 작동을 위해서는 서로 의존적입니다. 완전한 이중화를 위해 Dell은 CPU 영역에 1+1 구성, GPU 영역에 3+3 구성을 권장합니다. 즉, 완전한 이중화 구축을 위해서는 8개의 PSU 베이 모두에 PSU를 장착해야 합니다.
델 AIOps, 관리 및 엔터프라이즈 안정성
델의 PowerEdge 플랫폼은 업계에서 뛰어난 안정성과 서비스 용이성으로 명성을 쌓아왔습니다. 기업 고객들은 PowerEdge 시스템의 내구성, 신속한 문제 해결을 위한 델의 지원 조직, 그리고 완성도 높고 잘 통합된 관리 도구에 대해 한결같이 긍정적인 평가를 내리고 있습니다. XE7740은 이러한 전통을 계승하며, 델은 이번 세대에서 하드웨어 관리와 보안 모두에서 의미 있는 발전을 이루었습니다.
아이드락 10
XE7740에는 Dell의 차세대 iDRAC 10이 탑재되어 있습니다. 이는 Dell 고객들이 수년간 신뢰해 온 iDRAC 9를 대폭 개선한 버전입니다. OCP DC-MHS 표준에 따라 데이터 센터 보안 제어 모듈(DC-SCM)로 구현된 iDRAC 10은 단순한 펌웨어 업데이트가 아니라 완전히 새로운 하드웨어입니다. 이 컨트롤러는 64비트 아키텍처에 1GHz 코어 4개와 2GB의 DDR4 메모리(이전 세대의 두 배)를 갖추고 있어 관리 작업에서 훨씬 향상된 성능과 응답성을 제공합니다.
보안 측면에서 iDRAC 10은 여러 가지 주목할 만한 개선 사항을 제공합니다. 이 플랫폼은 SHA-384 및 SHA-512 인증과 양자 컴퓨팅 환경에서도 안전한 AES-256 암호화를 포함한 강력한 암호화 지원을 전반적으로 제공하여 양자 컴퓨팅 이후의 암호화 위협에 대비하고 있습니다. iDRAC 10 실리콘 내부에 통합된 전용 보안 영역은 장치 수준 인증 및 Dell의 맞춤형 루트 오브 트러스트를 포함한 사이버 복원력 기능을 관리합니다. 이 하드웨어 기반 루트 오브 트러스트는 모든 펌웨어(BIOS, iDRAC 및 구성 요소 펌웨어)가 실행되기 전에 암호화 방식으로 검증되도록 보장하여 공급망 공격 및 펌웨어 변조로부터 보호합니다.
보안 구성 요소 검증(Secured Component Verification)은 델 공장에서 출고되는 시스템이 고객이 지정한 정확한 구성 요소와 구성을 갖추고 있는지 확인하여 제조부터 배포까지 시스템 무결성을 유지합니다. 최신 iDRAC 10 펌웨어는 또한 일상적인 관리 환경을 개선하는 새롭고 모듈식 사용자 인터페이스를 제공합니다.
오픈매니지 엔터프라이즈
대규모 플릿 관리를 위해 Dell의 OpenManage Enterprise(OME)는 전체 PowerEdge 배포 환경에서 중앙 집중식 모니터링, 펌웨어 업데이트 및 구성 관리를 제공합니다. 특히 AI 중심 배포 환경에 유용한 최근 기능으로는, OME가 이제 별도의 벤더별 도구 없이도 GPU 및 가속기 통계(전력 소비량, 온도, 사용률, 오류 횟수 등)를 직접 확인할 수 있도록 지원한다는 점입니다. 추론 클러스터에서 수십 또는 수백 개의 XE7740 노드를 관리하는 조직의 경우, 이러한 통합 관리 플랫폼은 운영을 크게 간소화해 줍니다.
인텔 제온 6
XE7740의 핵심은 인텔 제온 6 6787P 프로세서 두 개로, 제온 6700P 시리즈의 플래그십 모델입니다. 인텔의 3nm 공정 기술을 사용한 그래닛 래피즈 아키텍처 기반의 6787P는 소켓당 86개의 P-코어(172개의 스레드)를 제공하며, TDP는 350W이고 기본 클럭은 2.0GHz, 터보 클럭은 3.8GHz입니다.
Granite Rapids가 AI 인프라에 특히 적합한 이유는 높은 코어 수와 메모리 서브시스템의 조합 때문입니다. 각 6787P 프로세서는 최대 6400 MT/s의 속도를 제공하는 8개의 DDR5 메모리 채널을 갖추고 있습니다. 32개의 DIMM이 장착된 듀얼 소켓 XE7740을 사용하면 시스템 메모리를 최대 4TB까지 구성할 수 있습니다.
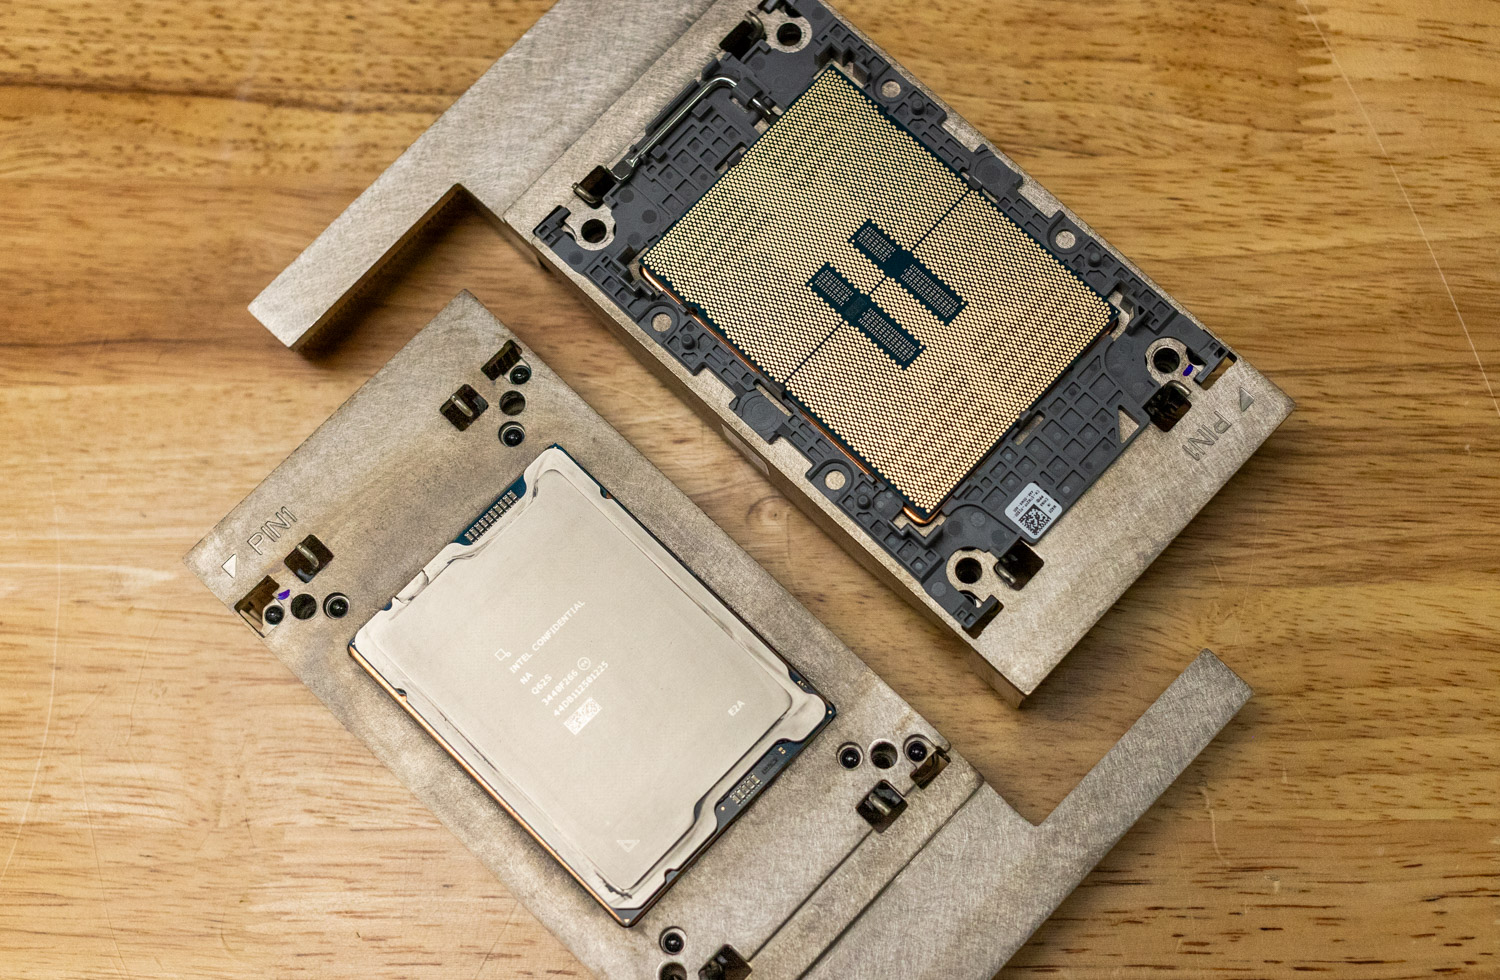
AI 워크로드, 특히 KV 캐시 오프로딩을 사용할 때 메모리 용량과 대역폭은 매우 중요합니다. 대규모 언어 모델의 컨텍스트 길이가 증가함에 따라 KV 캐시도 비례적으로 확장되어 가속기 메모리를 상당량 소모할 수 있습니다. KV 캐시의 일부를 시스템 메모리 또는 고속 스토리지로 오프로딩하면 가속기의 HBM을 능동적인 연산에 더욱 효율적으로 사용할 수 있어 다중 턴 채팅에서 첫 번째 토큰 수신 시간(TTFT)을 단축할 수 있습니다.
Xeon 6의 AMX 텐서 유닛도 주목할 만한데, 이는 CPU 측에서 상당한 작업을 처리합니다. 여기에는 전처리, 토큰화, 행렬 연산을 포함하는 하이브리드 추론 작업 등이 포함됩니다. 이는 특히 CPU를 사용하여 키-값 캐시 관리(KV Cache Management)를 위한 기수 트리(Radix Tree) 및 오버헤드 제로 스케줄링을 수행하는 SGLang과 같은 추론 프레임워크에서 매우 유용합니다.
Intel Gaudi 3 애드인 카드: 대규모 추론에서 경쟁력 있는 성능 제공
인텔의 가우디 3(Gaudi 3)는 2024년 4분기에 출시된 인텔의 플래그십 AI 가속기입니다. 인텔은 최고급 데이터 센터 학습용 가속기와 정면으로 경쟁하기보다는 이 가속기를 매우 공격적인 전략으로 포지셔닝하고 있습니다. 가우디 3는 추론(inference) 부문을 집중적으로 겨냥하고 있습니다.
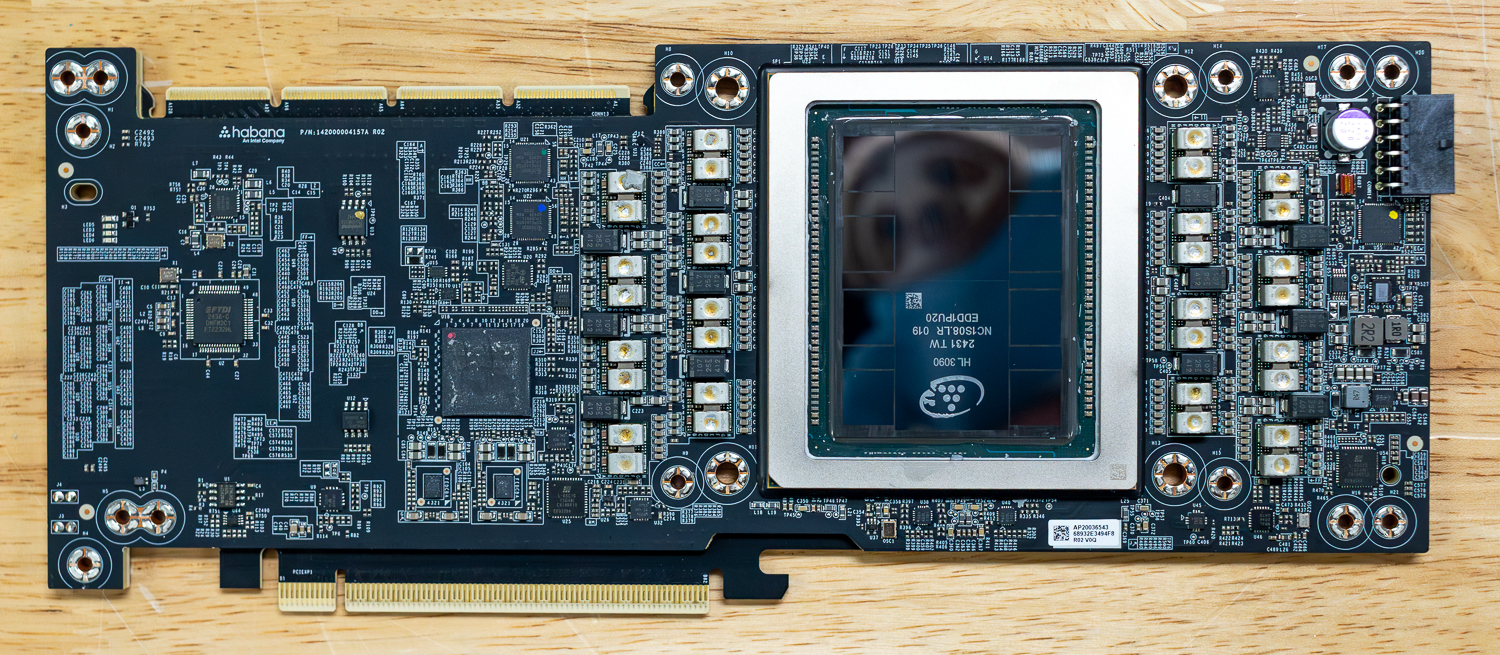
오늘날 널리 사용되는 모든 LLM(로지스틱 회귀 모델)에서 트랜스포머 기반 모델 추론은 근본적으로 메모리 제약적입니다. 자기회귀 생성의 디코딩 단계에서 모델은 토큰을 하나씩 생성하며, 생성된 각 토큰에 대한 모델 가중치와 키-값 캐시 항목을 읽습니다. 병목 현상은 컴퓨팅 성능이 아니라 메모리 대역폭, 즉 가속기가 HBM에서 컴퓨팅 엔진으로 데이터를 스트리밍하는 속도에 있습니다.
Gaudi 3는 128GB의 HBM2e 메모리와 3.7TB/s의 메모리 대역폭을 제공합니다. 아키텍처적으로 Gaudi 3는 TSMC의 5nm 공정을 기반으로 하며, 두 개의 동일한 실리콘 다이가 고대역폭 인터커넥트로 연결된 듀얼 다이 칩렛 설계를 채택하여 소프트웨어 측면에서는 단일 통합 장치처럼 작동합니다. 컴퓨팅 성능은 4개의 딥러닝 코어(DCORE)로 구성되며, 각 코어는 2개의 MME, 16개의 TPC, 그리고 24MB의 로컬 SRAM 캐시를 포함합니다. 총 96MB의 온칩 SRAM은 12.8TB/s의 내부 대역폭을 제공합니다. 또한, 이 가속기는 14개의 전용 미디어 디코더(H.265, H.264, JPEG, VP9)를 통합하여 멀티모달 워크로드에 대한 빠른 비전 전처리를 지원합니다.
오늘날 출시되는 최첨단 오픈 소스 AI 모델의 상당 부분은 FP8로 학습되었거나 FP8(E4M3)과 BF16 가중치를 혼합한 하이브리드 모델입니다. Gaudi 3는 8개의 행렬 곱셈 엔진과 64개의 텐서 프로세서 코어를 통해 이러한 모델에 대한 네이티브 FP8 가속을 제공하여 1.8 PFlops의 FP8 연산 성능을 제공합니다.
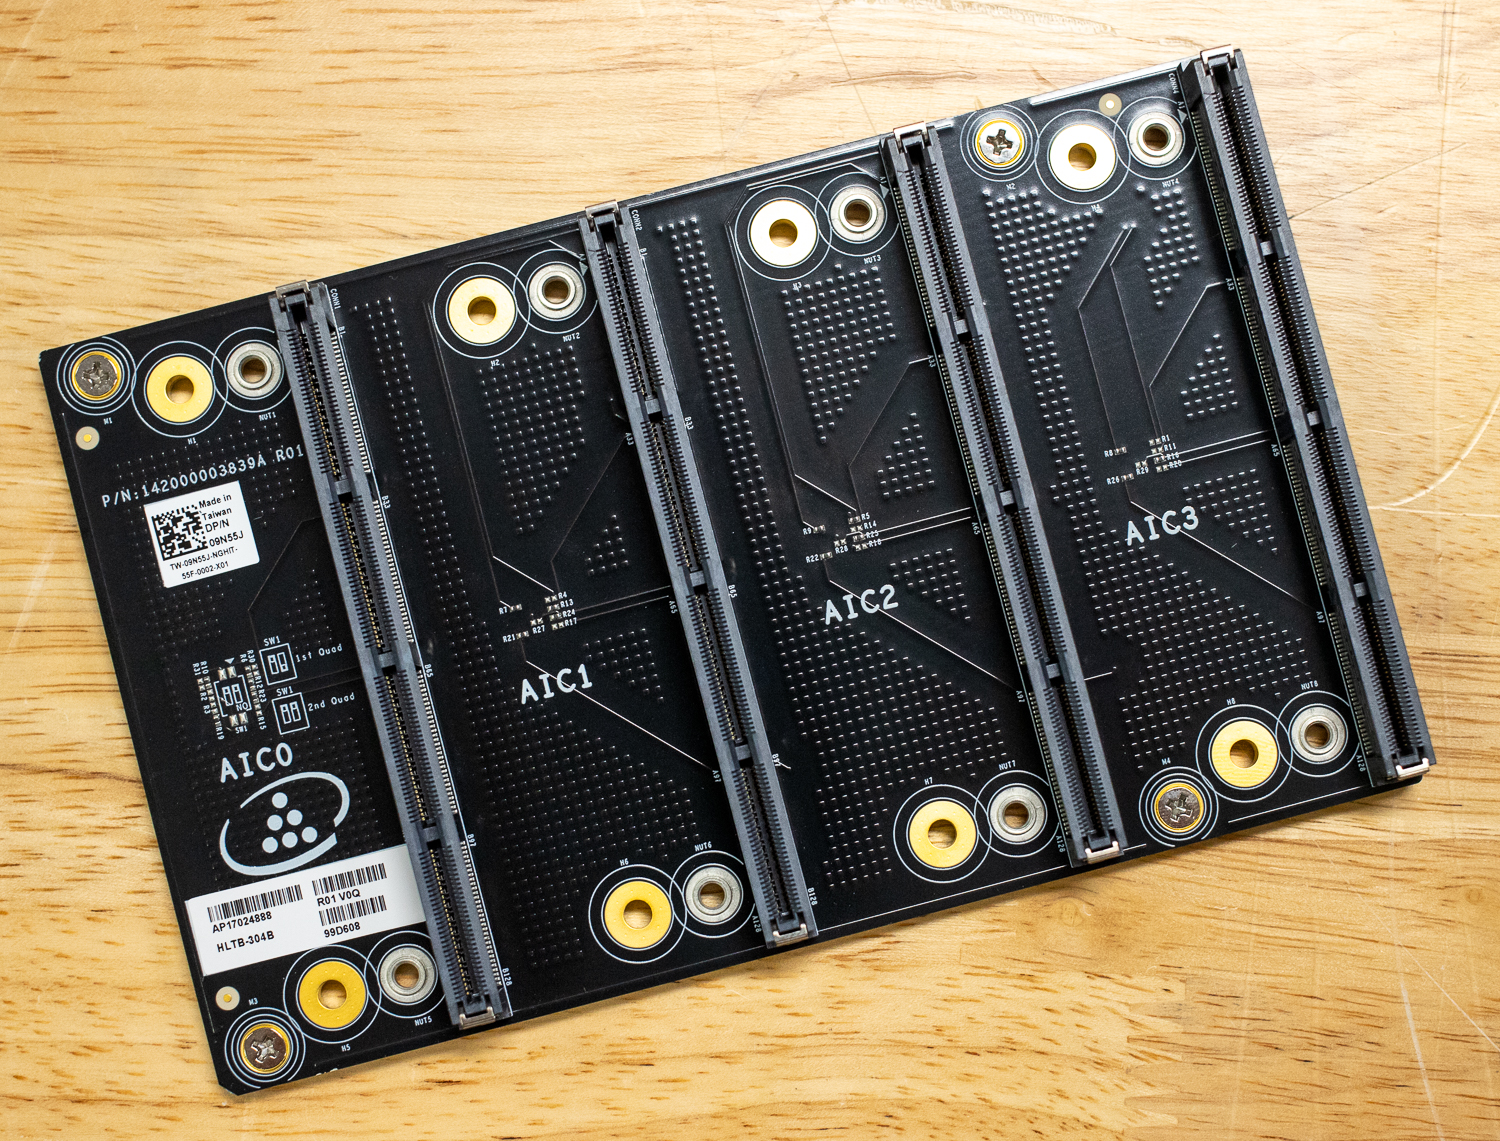
Gaudi 3는 OAM 버전에서 실리콘에 직접 내장된 24개의 200GbE 포트를 통해 RoCEv2(RDMA over Converged Ethernet) 네트워킹을 지원합니다. XE7740에 사용된 PCIe 확장 카드 변형은 이러한 포트를 모두 동일한 방식으로 노출하지는 않지만, 확장 카드 변형은 4개의 카드를 브리징하여 카드 간 통신 속도를 향상시키는 기능을 지원합니다.
성능 및 벤치마크
XE7740 구성 세부 정보:
- 인텔 제온 6787P 프로세서 2개 (86코어, 2.00GHz)
- 2TB DDR5 (32 x 64GB 5200MT/s DDR5
- 4개의 Intel Gaudi 3 PCIe AI 가속기(128GB HBM 포함)
- 우분투 24.04.5 서버
vLLM 온라인 서비스 성능
Intel Gaudi 3 가속기가 탑재된 Dell XE7740의 추론 기능을 평가하기 위해, 다양한 아키텍처, 파라미터 개수, 정밀도 형식을 아우르는 여러 인기 모델에 걸쳐 vLLM 온라인 서비스 성능을 벤치마킹했습니다. 각 모델은 동시 요청 수가 1에서 128까지 증가하는 세 가지 워크로드 프로파일에서 테스트되었습니다.
LLM 추론은 크게 두 단계로 구성됩니다. 사전 채우기 단계에서는 모든 입력 토큰을 병렬로 처리한 후에 출력 토큰을 생성합니다. 따라서 이 단계는 입력 토큰 수에 비례하여 연산량이 증가하는 연산 집약적인 작업입니다. 디코딩 단계에서는 출력 토큰을 하나씩(자기회귀 방식으로) 생성합니다. 각 토큰을 생성할 때마다 메모리에서 전체 모델 가중치를 읽어와야 하지만, 토큰당 연산량은 상대적으로 적기 때문에 메모리 대역폭에 따라 연산량이 달라집니다.
이 두 단계는 가속기의 근본적으로 다른 부분에 부하를 주므로, 우리는 이 두 단계 사이의 균형을 바꾸는 세 가지 작업 부하 프로파일을 테스트합니다.
- 동일함(입력 토큰 1024개/출력 토큰 1024개)은 균형 잡힌 채팅 상호작용을 나타냅니다.
- Prefill Heavy(8192 입력/1024 출력)는 시스템이 대규모 입력 컨텍스트를 처리해야 하는 검색 증강 생성 또는 장문 컨텍스트 요약을 시뮬레이션합니다.
- Decode Heavy(입력 1024/출력 8192)는 지속적인 메모리 대역폭이 처리량에 결정되는 장문 콘텐츠 생성을 나타냅니다.
이 섹션에서는 두 가지 주요 지표에 초점을 맞춥니다. 초당 토큰 수로 측정되는 총 토큰 처리량은 부하 상태에서 시스템의 전반적인 서비스 처리 능력을 나타냅니다. 첫 번째 토큰 수신 시간(TTFT)은 요청을 제출한 시점부터 첫 번째 생성된 토큰을 수신하는 시점까지의 지연 시간을 측정합니다. 모델은 첫 번째 토큰을 생성하기 전에 전체 사전 채우기 단계를 완료해야 하므로 TTFT는 가속기의 컴퓨팅 처리량과 직접적으로 관련됩니다. 따라서 사전 채우기 작업이 많은 시나리오(TTFT와 결합)는 시스템이 사용자가 응답을 보기 전에 8,192개의 입력 토큰을 모두 처리해야 하므로 Gaudi 3 가속기의 순수 컴퓨팅 성능을 파악하는 데 특히 유용한 지표가 됩니다.
반대로, 디코딩 작업이 많은 시나리오에서는 시스템이 수천 개의 생성된 토큰에 대해 높은 처리량을 유지해야 하므로 가속기의 메모리 대역폭을 테스트합니다. TTFT(Time To Fly-out)는 사용자가 스트리밍을 시작하기 전에 응답을 기다려야 하는 대화형 애플리케이션에 매우 중요합니다. 시스템은 배치 처리량이 많을 때는 뛰어난 처리량을 달성할 수 있지만 TTFT가 너무 높아지면 여전히 느리게 느껴질 수 있으므로 두 가지 지표 모두 실제 운영 환경에서 중요합니다.
FP8 정밀도 결과에 대한 참고 사항: Intel Gaudi 3 가속기는 네이티브 FP8 연산 가속을 지원하며, 이론적으로 FP8은 BF16보다 높은 처리량을 제공해야 하지만, 벤치마크에서 FP8 성능 수치는 BF16보다 낮게 나타났습니다. 이는 하드웨어적인 한계가 아니라 Intel의 vLLM 포크 소프트웨어의 미성숙한 부분 때문입니다. 저희가 테스트한 버전(Gaudi Docker 1.22.2에서 실행되는 vLLM 설치 프로그램 2.7.1)은 아직 FP8 코드 경로가 완전히 최적화되지 않았습니다. Intel은 현재 이러한 성능 문제를 해결할 수 있는 새로운 플러그인 기반 vLLM 베타 버전을 베타 테스트 중입니다.
라마 3.1 8B 지시
Llama 3.1 8B Instruct는 Meta에서 개발한 고밀도 트랜스포머 모델로, 생성되는 모든 토큰에 대해 모든 매개변수가 활성화됩니다. 8억 개의 매개변수를 가진 이 모델은 오픈소스 모델 중에서도 비교적 규모가 큰 편에 속합니다. 이처럼 방대한 규모의 모델은 짧은 문서 요약, 이메일 및 메시지 작성, 간단한 질문에 대한 답변, 속도와 비용 효율성이 심층적인 추론보다 중요한 간단한 챗봇 상호작용 구현 등 일상적인 작업에 널리 사용됩니다.
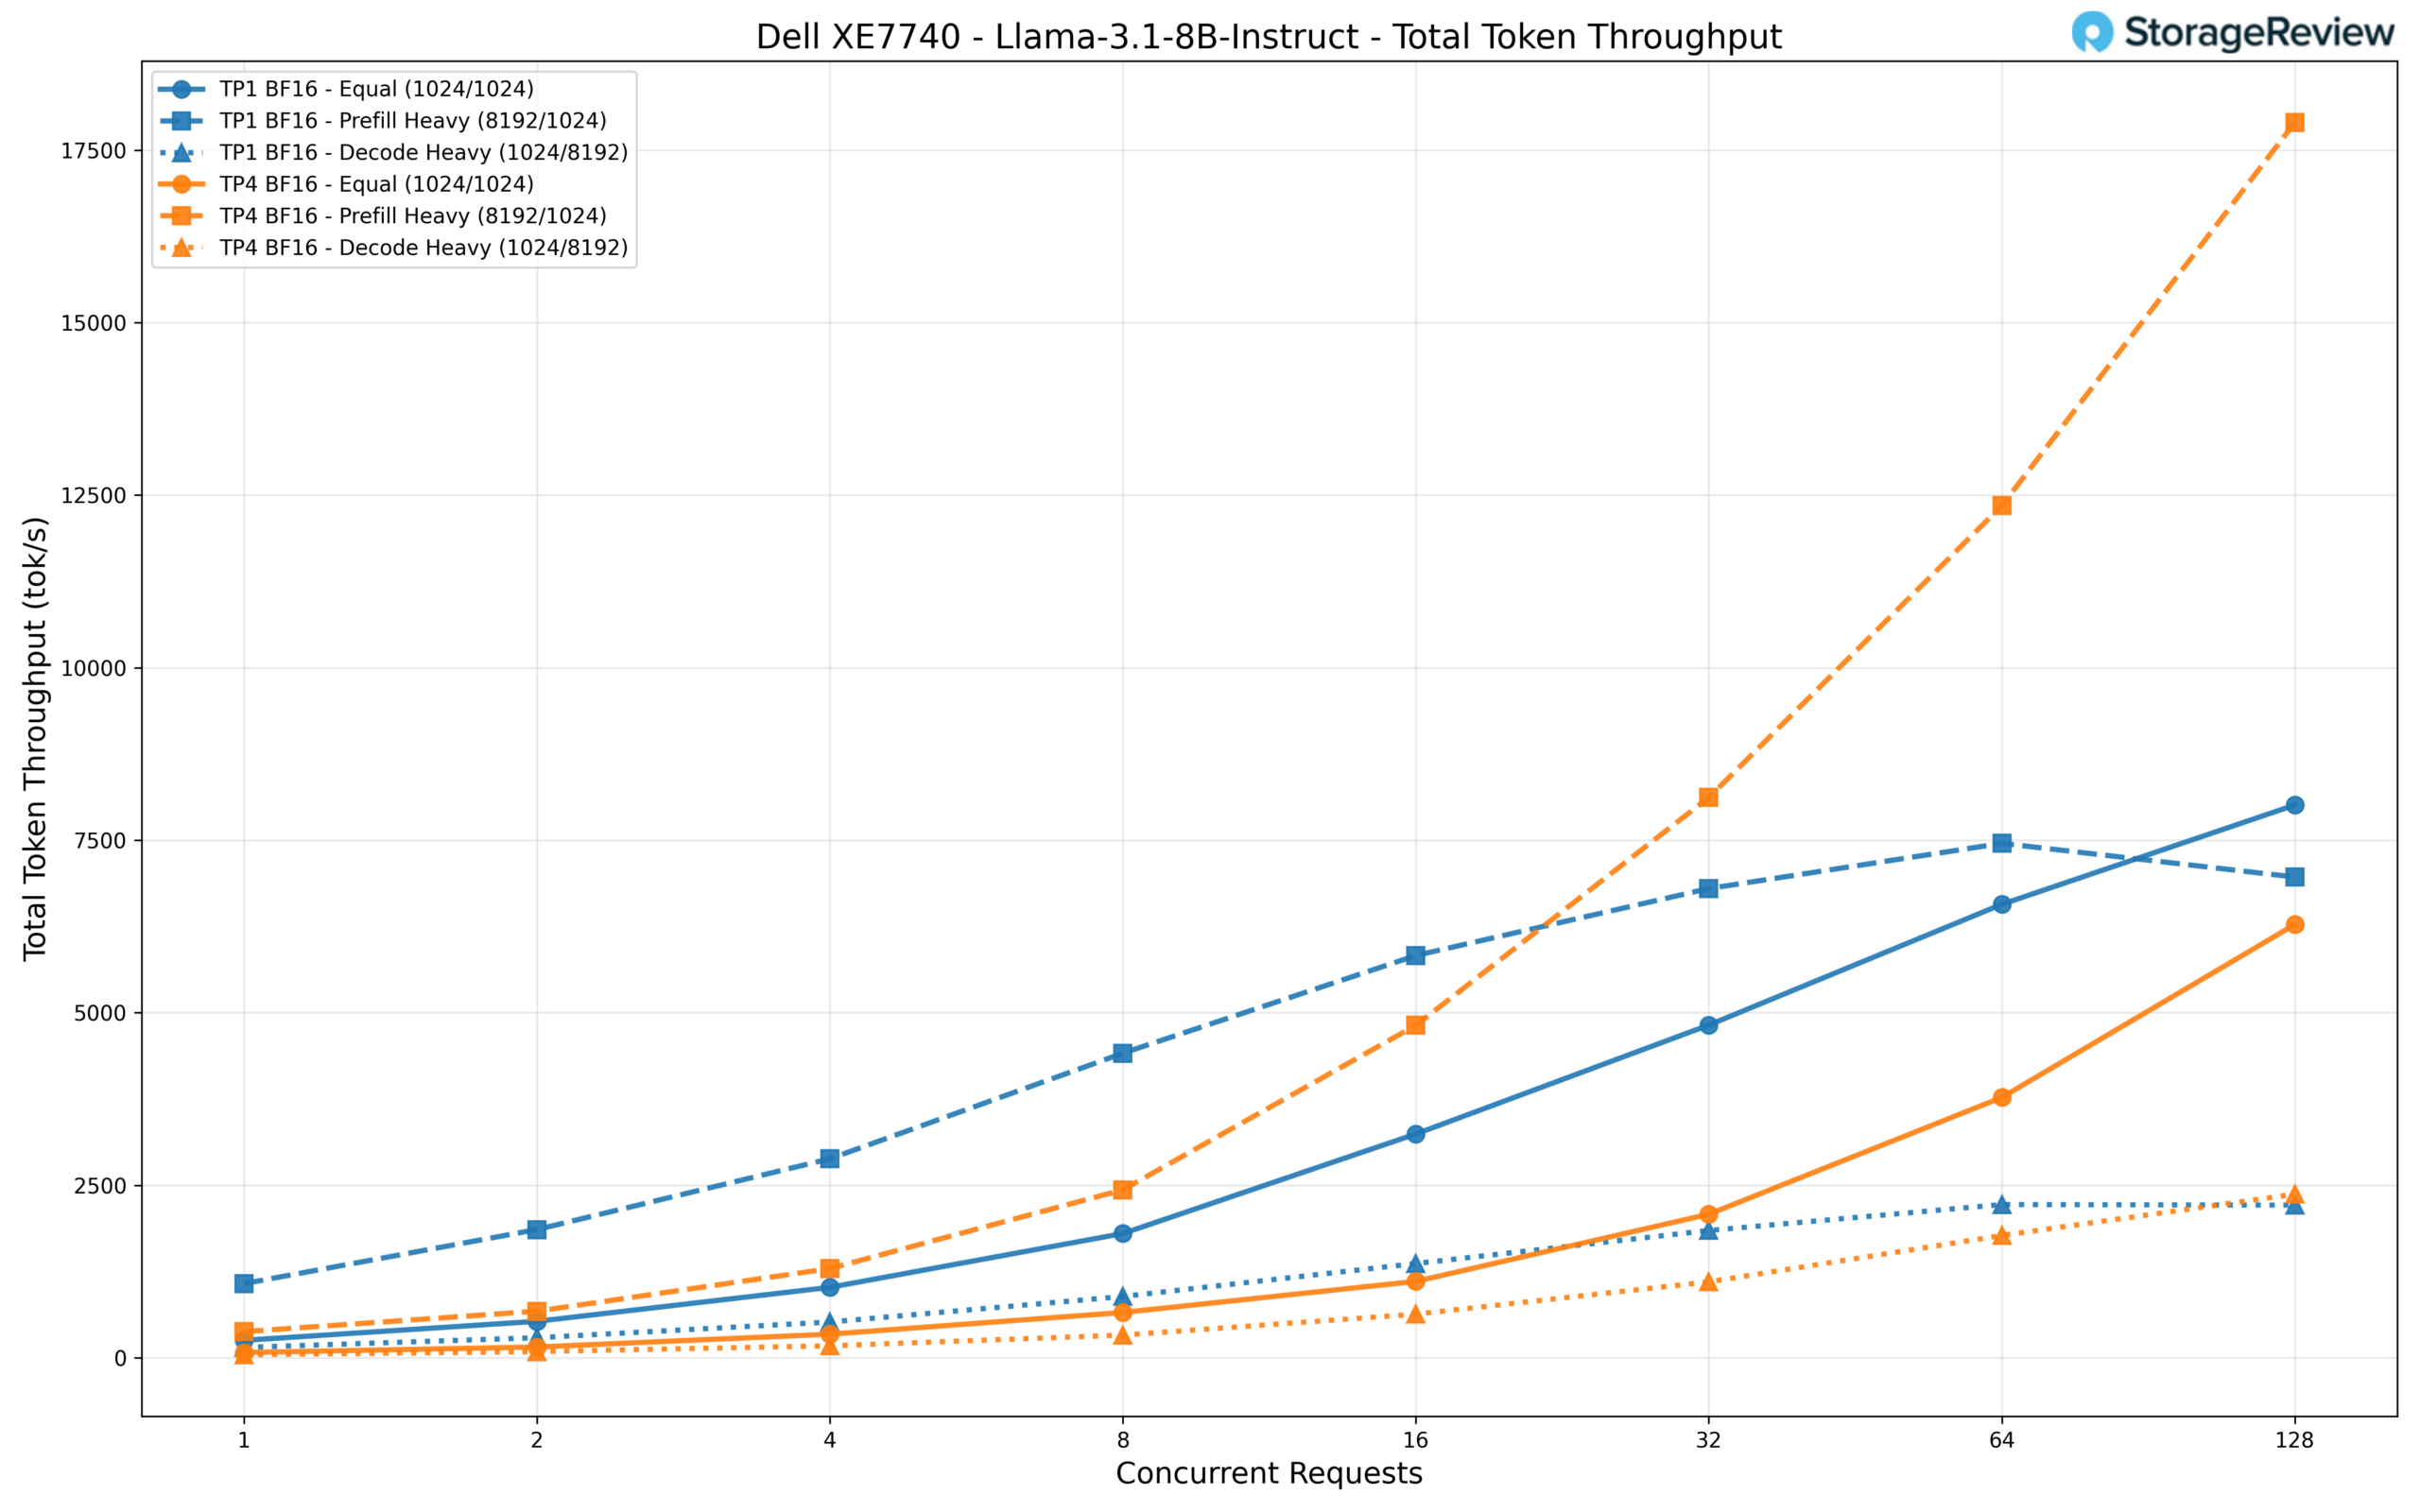
본 모델은 TP1(단일 가속기)과 TP4(Gaudi 3 가속기 4개 모두 사용) 구성에서 테스트되었습니다. TP1에서 실행했을 때, 동일한 작업 부하에서 128개의 동시 요청 시 총 처리량은 약 8,000 tok/s에 달했으며, 단일 요청 시 약 250 tok/s에서 안정적으로 확장되었습니다. 사전 입력량이 많은 시나리오에서는 흥미로운 패턴이 나타났습니다. TP1에서는 최대 약 7,000 tok/s를 기록한 반면, TP4에서는 128개의 동시 요청 시 17,900 tok/s 이상으로 급증했는데, 이는 추가 가속기를 활용하여 대규모 입력 컨텍스트를 더욱 효율적으로 처리했기 때문입니다.
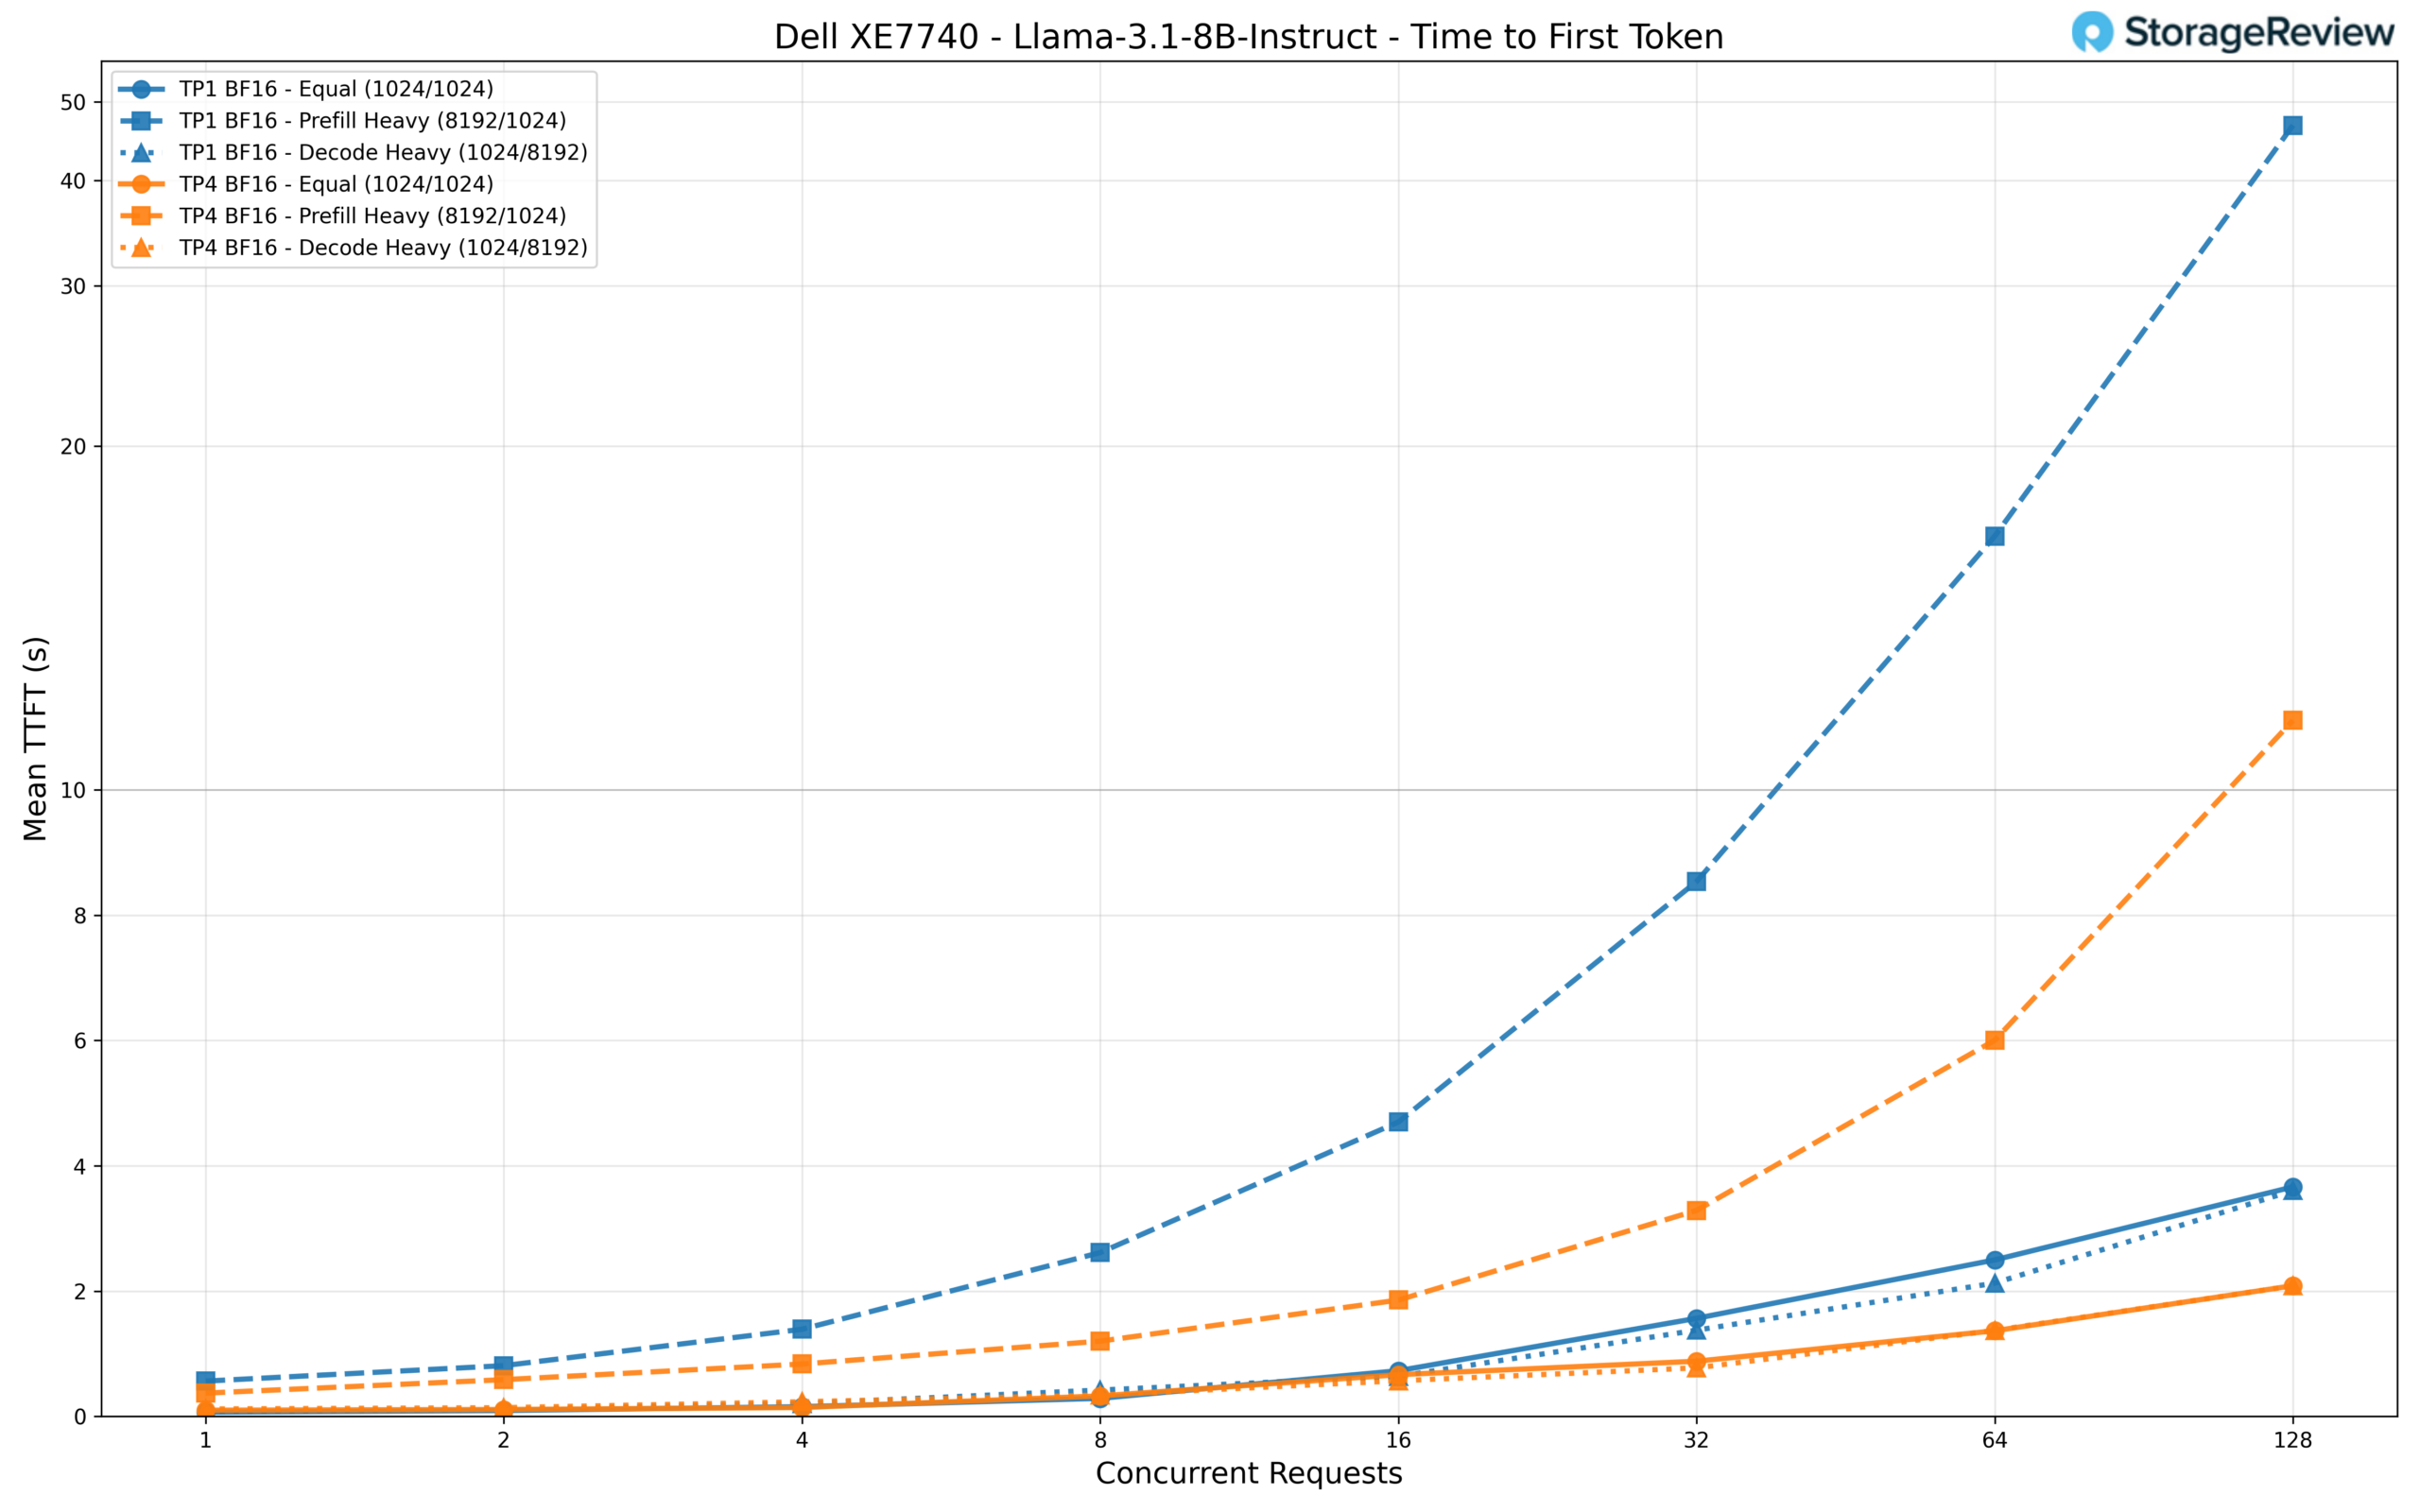
단일 사용자 지연 시간의 경우, TP1은 낮은 동시 접속 환경에서 실제로 더 낮은 TTFT(67ms 대 TP4의 98ms)를 제공합니다. 이는 하나의 가속기에서 충분히 처리할 수 있는 모델을 네 개의 가속기를 사용하여 조정하는 데 따른 오버헤드를 반영합니다. 그러나 부하가 증가함에 따라 TP4가 확실한 우위를 점합니다. 128개의 동시 요청에서 TP4는 동일 및 디코딩 워크로드 모두에서 TTFT를 약 2초로 유지하는 반면, TP1은 각각 3.7초와 6.6초까지 증가합니다. 사전 입력량이 많은 시나리오에서 격차가 가장 극명하게 드러납니다. TP1은 128개 요청에서 거의 47초의 TTFT를 기록하는 반면, TP4는 약 11초로 유지합니다.
라마 3.1 70B 지시
Llama 3.1 70B Instruct는 Meta의 Llama 3.1 제품군에서 가장 규모가 큰 밀집형 모델입니다. 70B 파라미터를 갖춘 이 모델은 8B 버전보다 훨씬 뛰어난 지시 사항 준수 및 다국어 지원 기능을 제공합니다. 이 규모의 모델은 고객 지원 상담원, 다단계 연구 보조원, 복잡한 문서 분석, 장시간 상호 작용에 걸쳐 일관된 맥락을 유지해야 하는 작업과 같이 집중적인 에이전트 워크로드에 적합합니다.
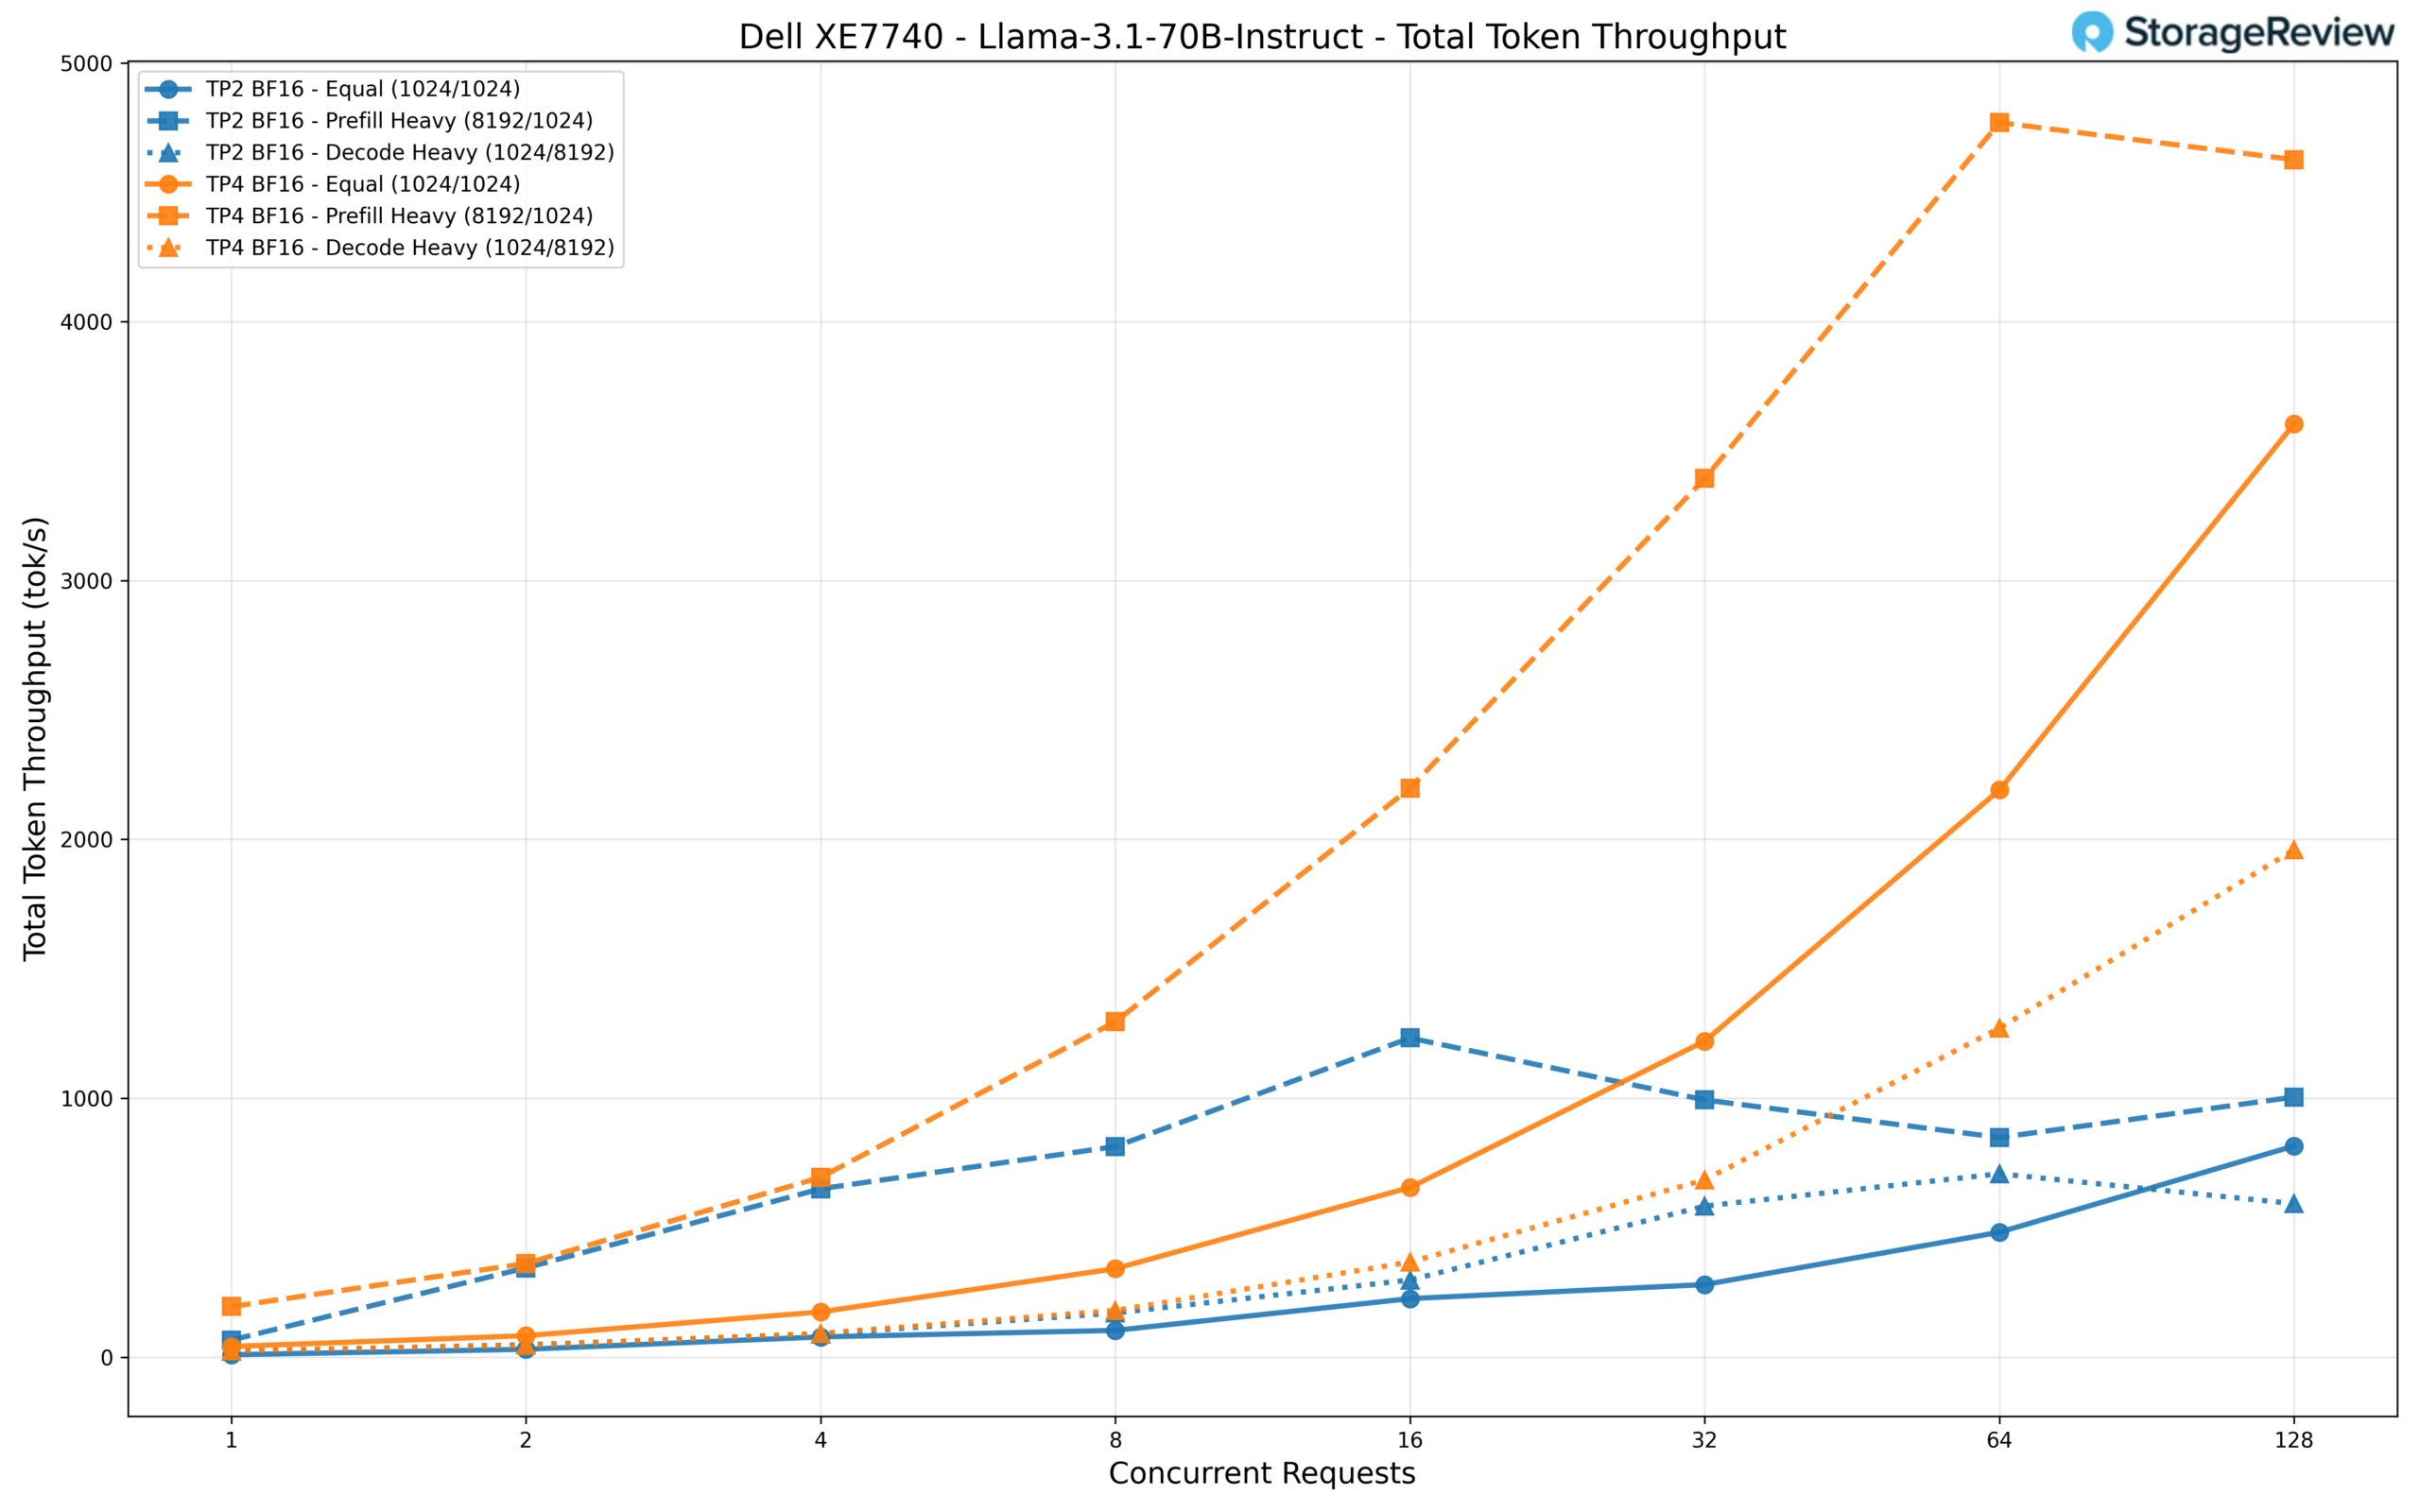
TP2 및 TP4 구성으로 이 모델을 테스트했습니다. 두 구성 간의 처리량 차이는 상당합니다. 128개의 동시 요청에서 TP4는 동일한 작업 부하에서 약 3,600 tok/s를 제공하고, 사전 채우기 작업이 많은 시나리오에서는 최대 약 4,600 tok/s에 도달합니다. 이는 최대 처리량이 각각 약 816 tok/s 및 1,005 tok/s인 TP2의 약 4.4배 및 4.6배에 해당합니다. 디코딩 작업이 많은 작업 부하에서도 TP4는 약 1,960 tok/s에 도달하는 반면, TP2는 593 tok/s에 그칩니다.
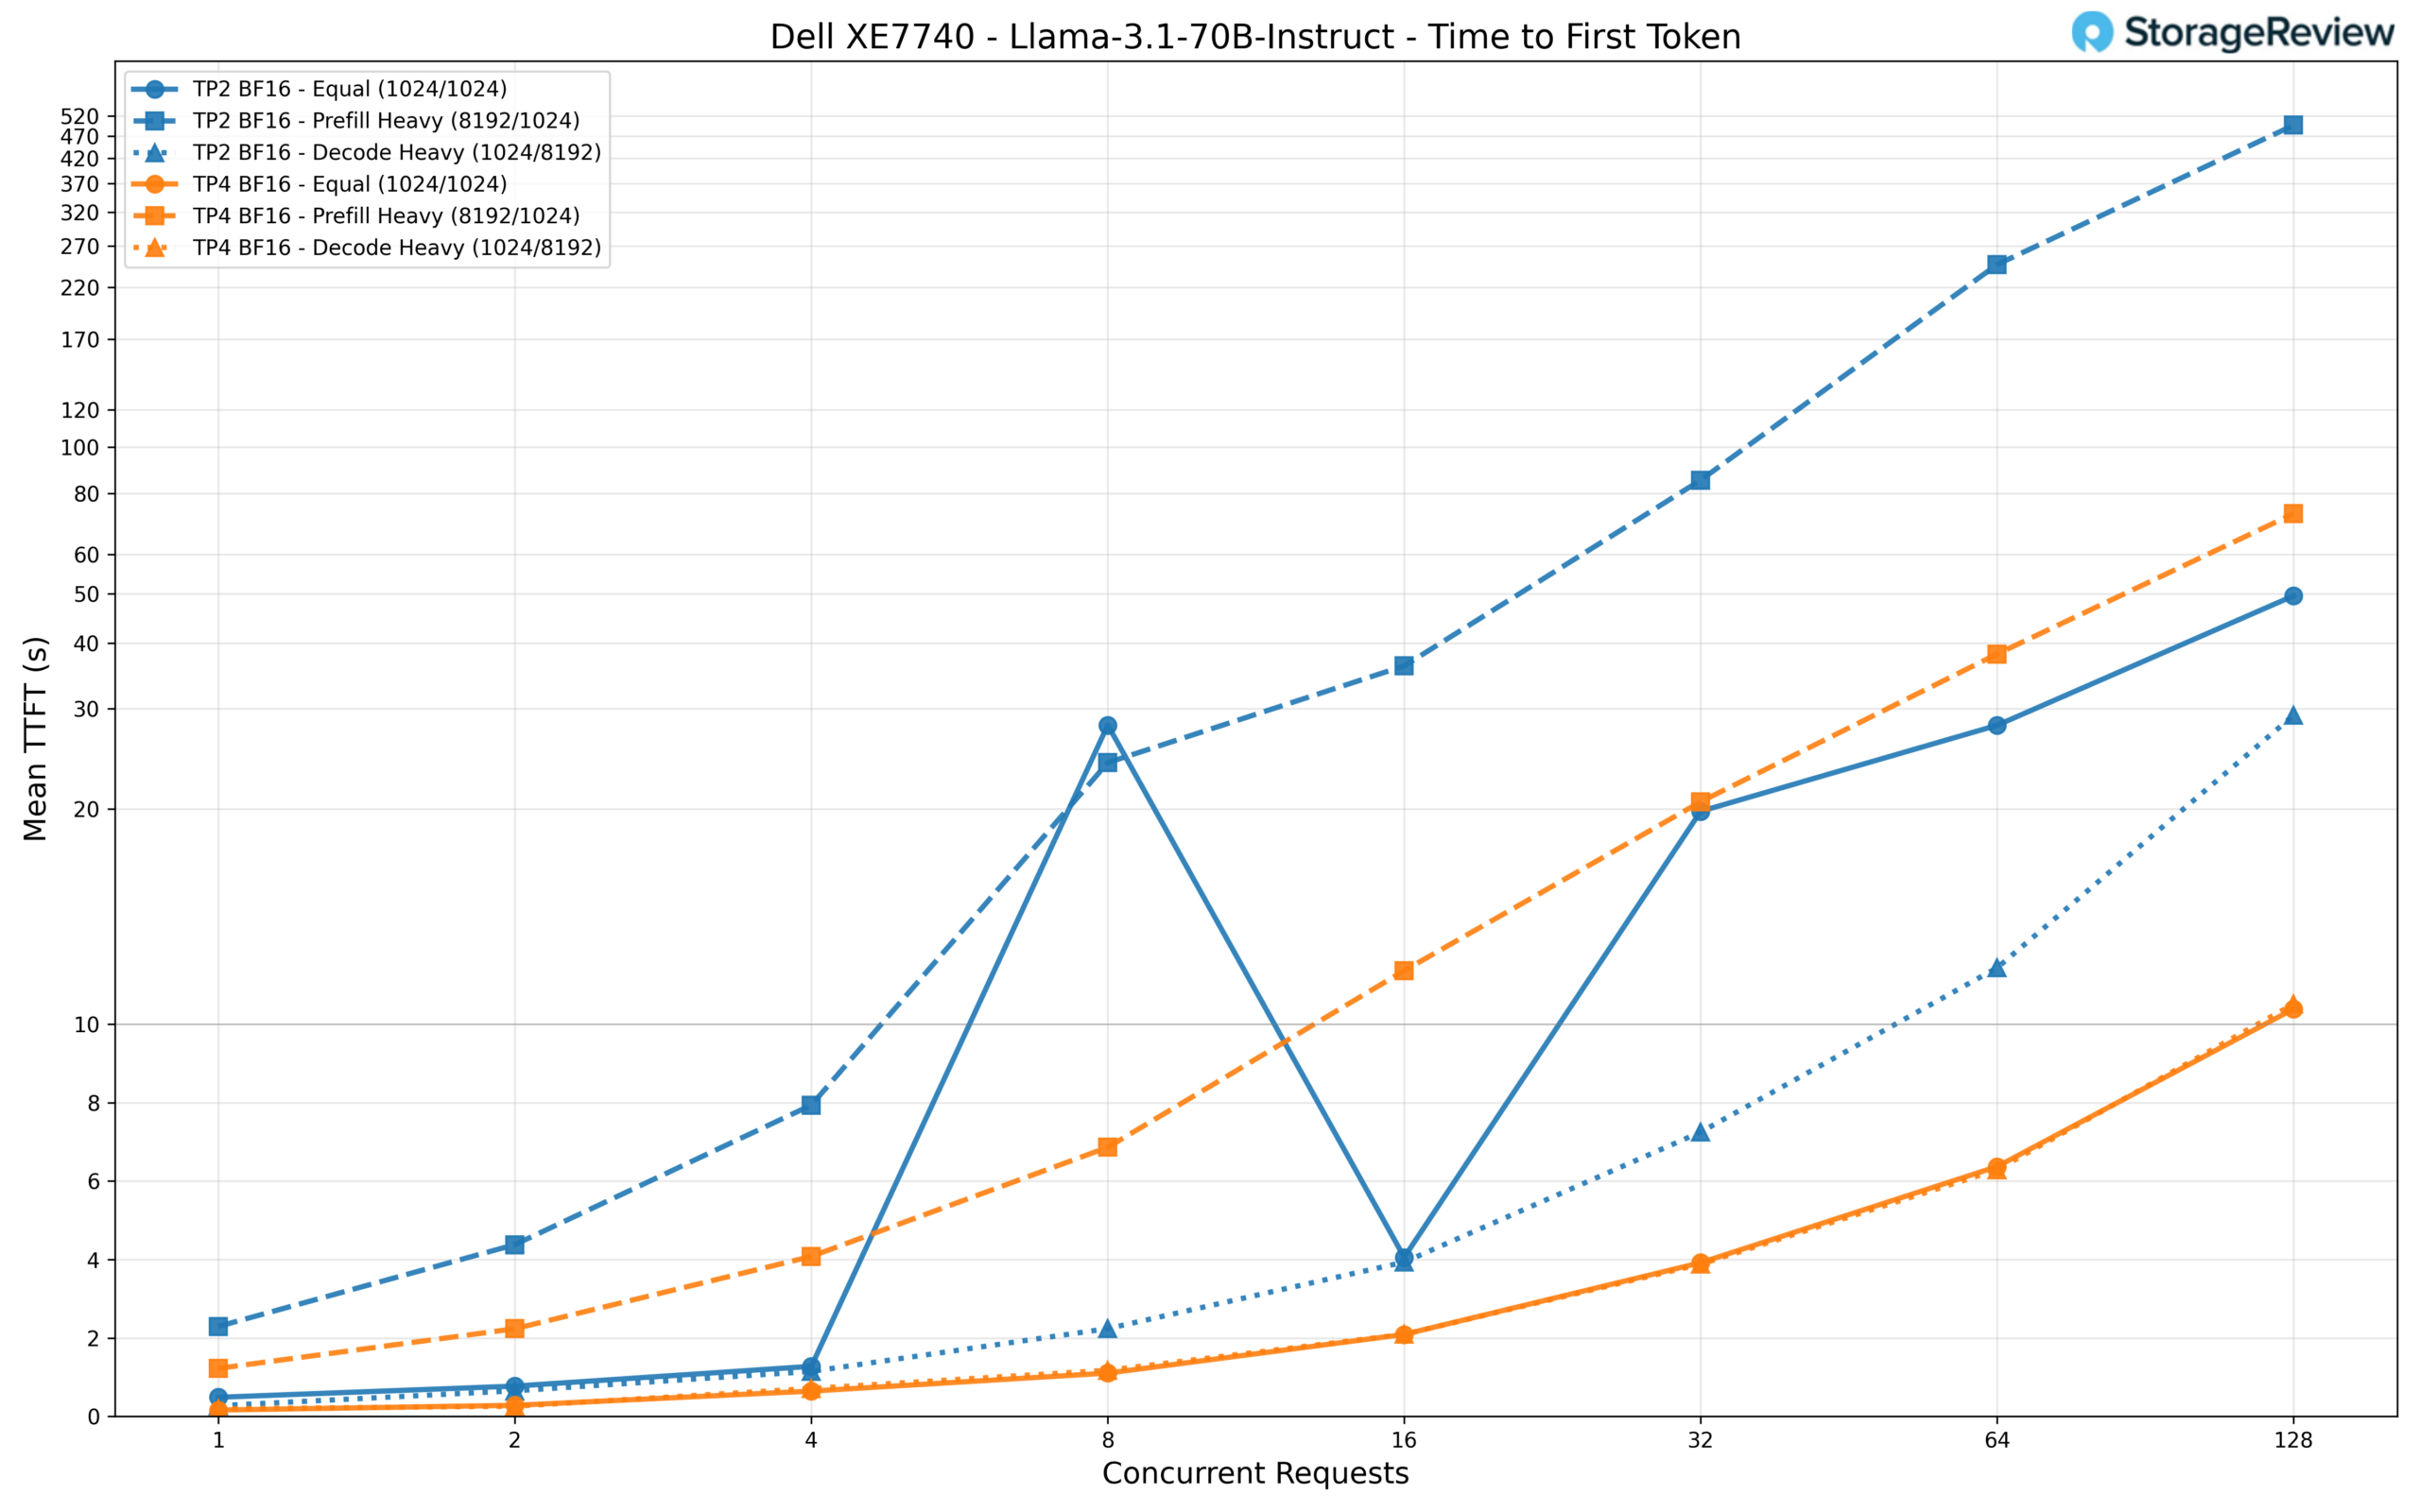
TTFT(처리 시간) 측면에서 TP2는 프리필 작업이 많은 워크로드에서 심각한 부하를 받아 128개의 동시 요청 시 무려 496초까지 소요되어 대화형 애플리케이션에 사실상 사용할 수 없는 수준입니다. TP4는 이를 약 73초로 단축했습니다. 동일 워크로드 및 디코딩 워크로드의 경우, TP4는 128개 요청에서 TTFT를 약 10초로 유지하는 반면, TP2는 각각 50초와 29초에 도달합니다. 낮은 동시 요청 수에서는 TP4가 동일 워크로드에서 첫 번째 토큰 응답을 약 160ms 만에 제공하는 반면, TP2는 486ms가 소요됩니다.
Qwen3 Coder 30B-A3B 사용 설명서
Qwen3 Coder 30B-A3B는 로컬 추론 배포에 가장 널리 사용되는 코딩 모델 중 하나로, 전문가 혼합(Mixture-of-Experts, MoE) 아키텍처를 사용합니다. 모든 파라미터가 모든 순방향 전달에 참여하는 밀집 모델과 달리, MoE 모델은 각 토큰을 소수의 특화된 전문가 네트워크를 통해 라우팅합니다. Qwen3 Coder는 BF16 정밀도로 3억 개의 파라미터를 가진 전체 모델 크기를 유지하면서 생성된 토큰당 30억 개의 파라미터만 활성화합니다. 이러한 희소 활성화 패턴 덕분에 모델은 훨씬 더 큰 네트워크와 같은 품질을 제공하면서도 토큰당 필요한 연산량은 극히 일부에 불과하여 라우팅 오버헤드를 지원하는 하드웨어에서 매우 효율적입니다. 최종 사용자에게 이 모델은 상용구 생성, 함수 완성, 코드 설명, 단위 테스트 작성, 복잡한 추론 없이 코드 특화 모델의 도움을 받아 일상적인 개발 작업을 처리하는 데 적합합니다.
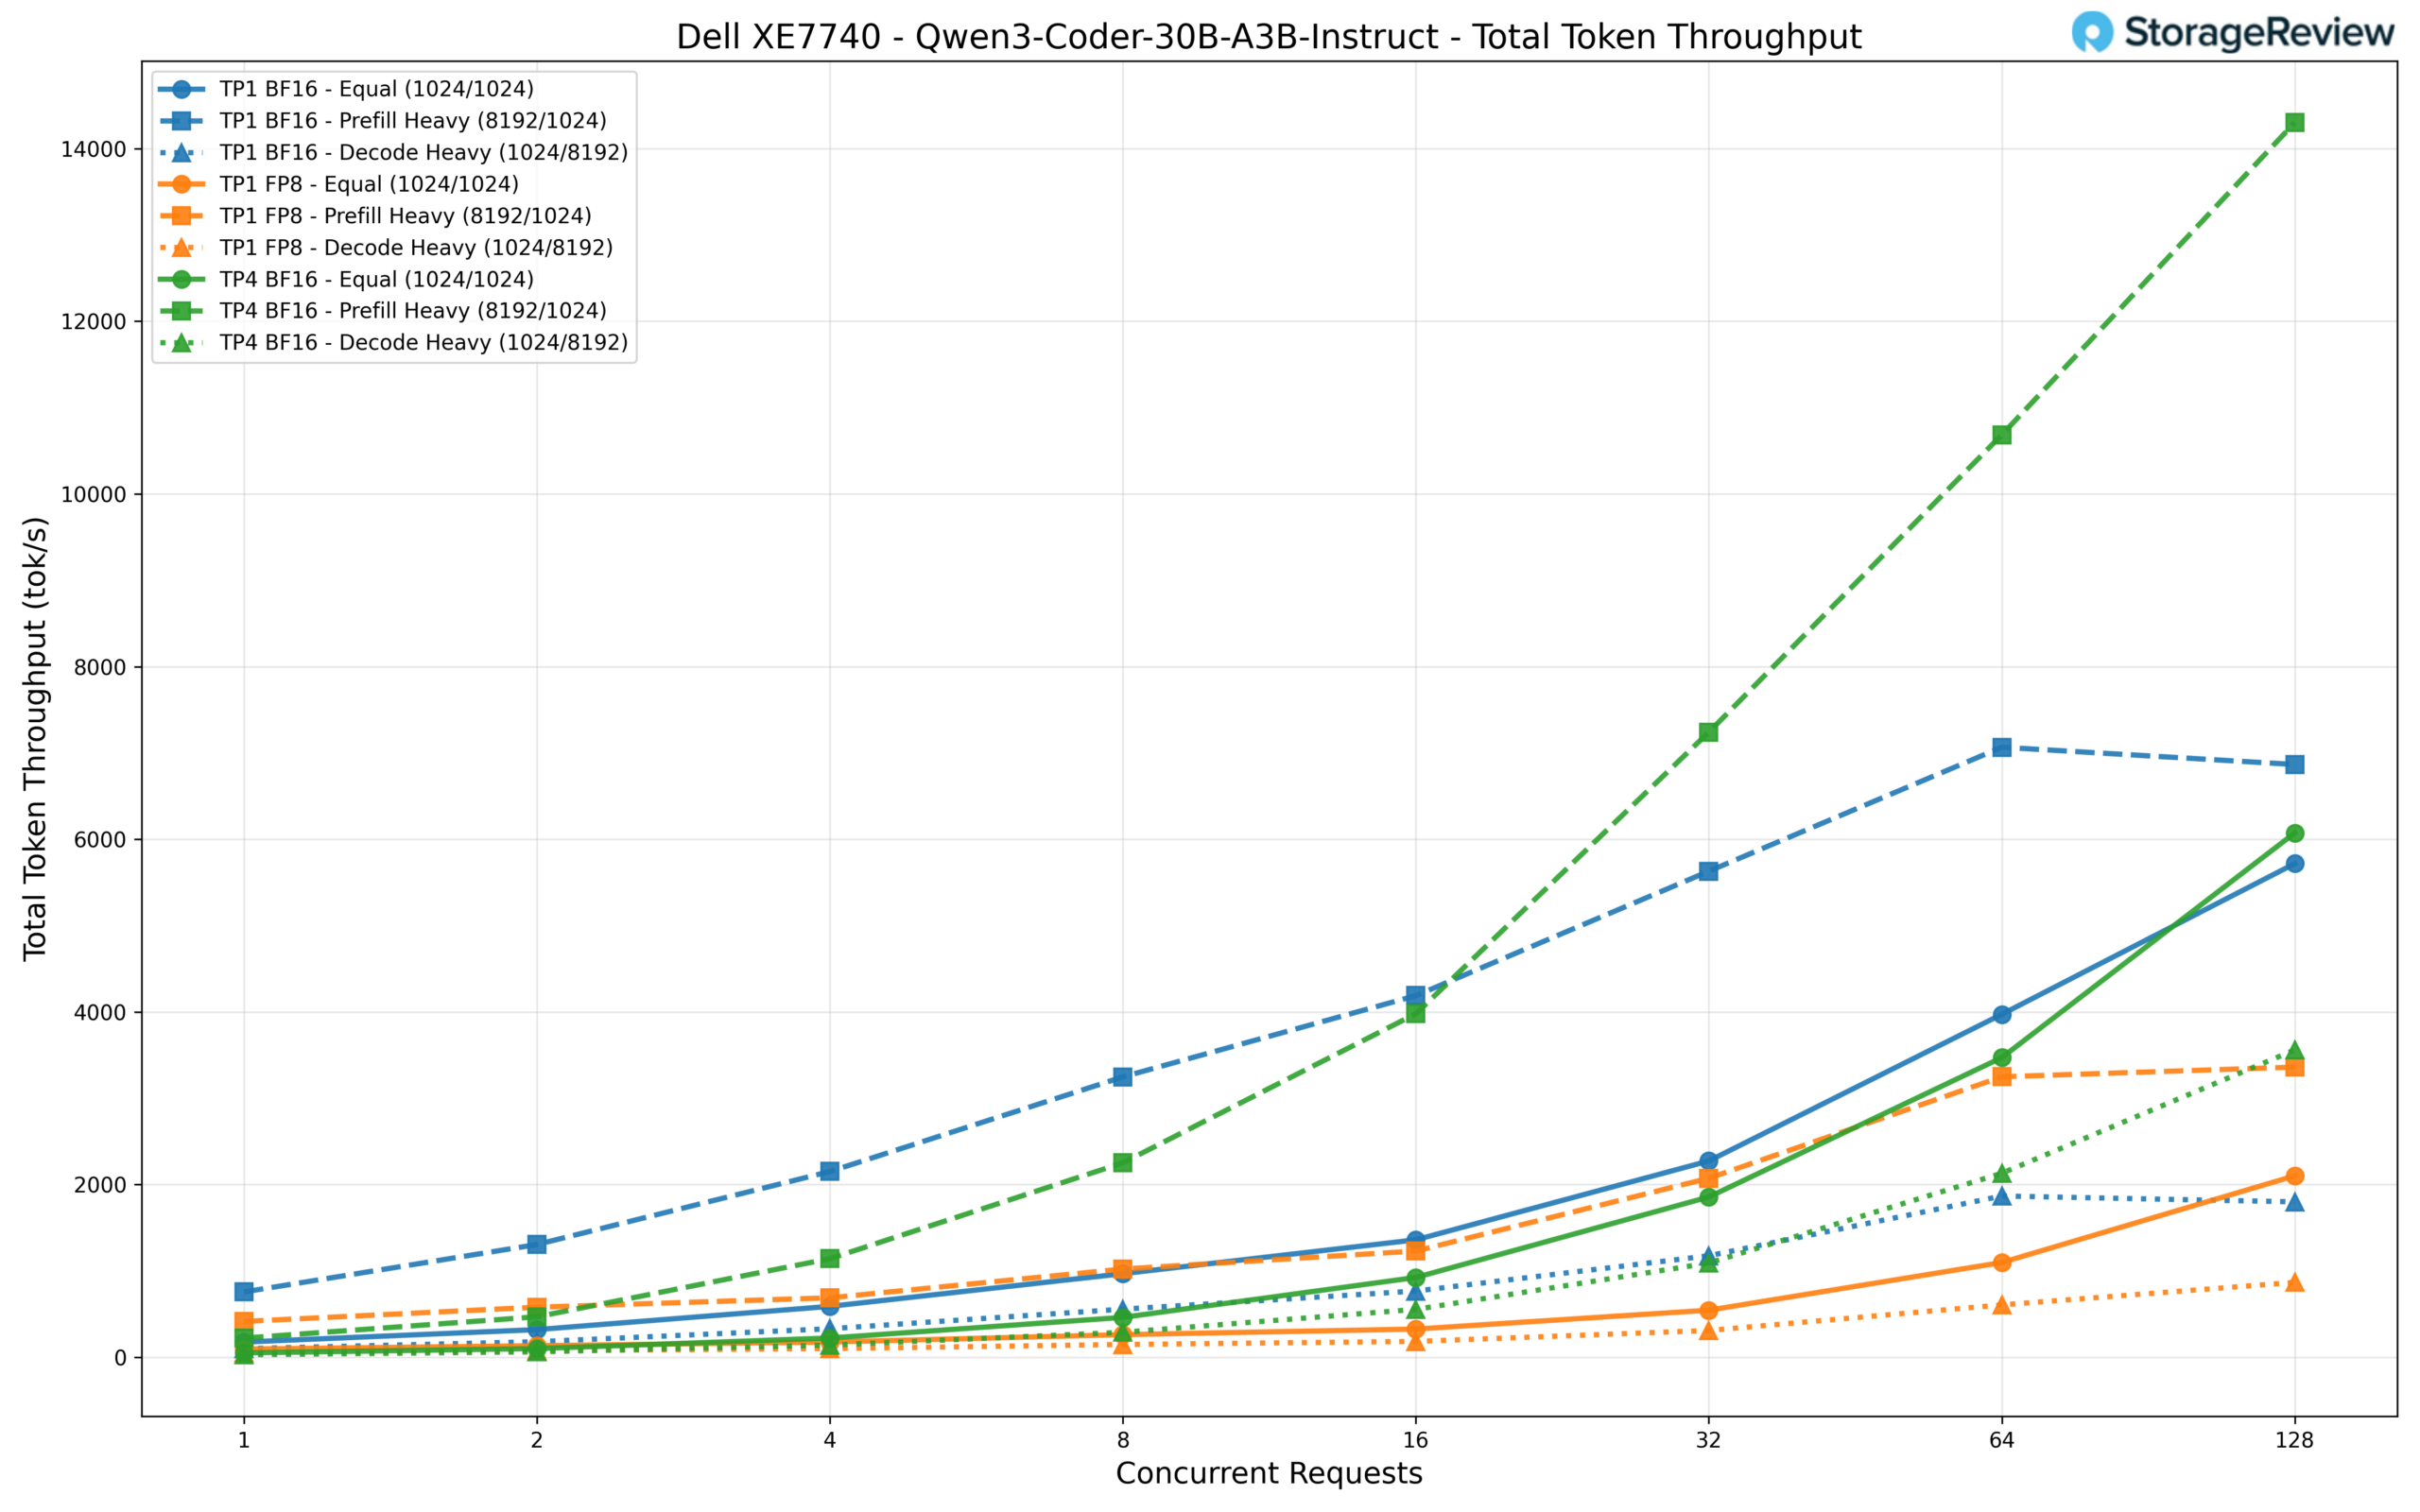
저희는 TP1 BF16, TP1 FP8, TP4 BF16의 세 가지 구성을 테스트했습니다. 128개의 동시 요청 환경에서, 사전 데이터 입력이 많은 시나리오에서 TP4 BF16이 약 14,300 tok/s의 처리량을 기록하며 가장 우수한 성능을 보였습니다. 이는 저희 테스트 제품군에 포함된 모든 모델 중 가장 높은 수치입니다. 동일한 시나리오에서 TP1 BF16은 약 6,900 tok/s, TP1 FP8은 약 3,360 tok/s의 처리량을 기록했습니다. 동일한 작업 부하에서는 TP4가 6,073 tok/s, TP1 BF16이 5,718 tok/s, TP1 FP8이 2,101 tok/s로 격차가 다소 좁아집니다. 위 FP8 관련 설명에서 언급했듯이, 여기서 FP8 수치가 낮은 것은 하드웨어 병목 현상이라기보다는 인텔의 vLLM 포크의 현재 상태를 반영한 것입니다.
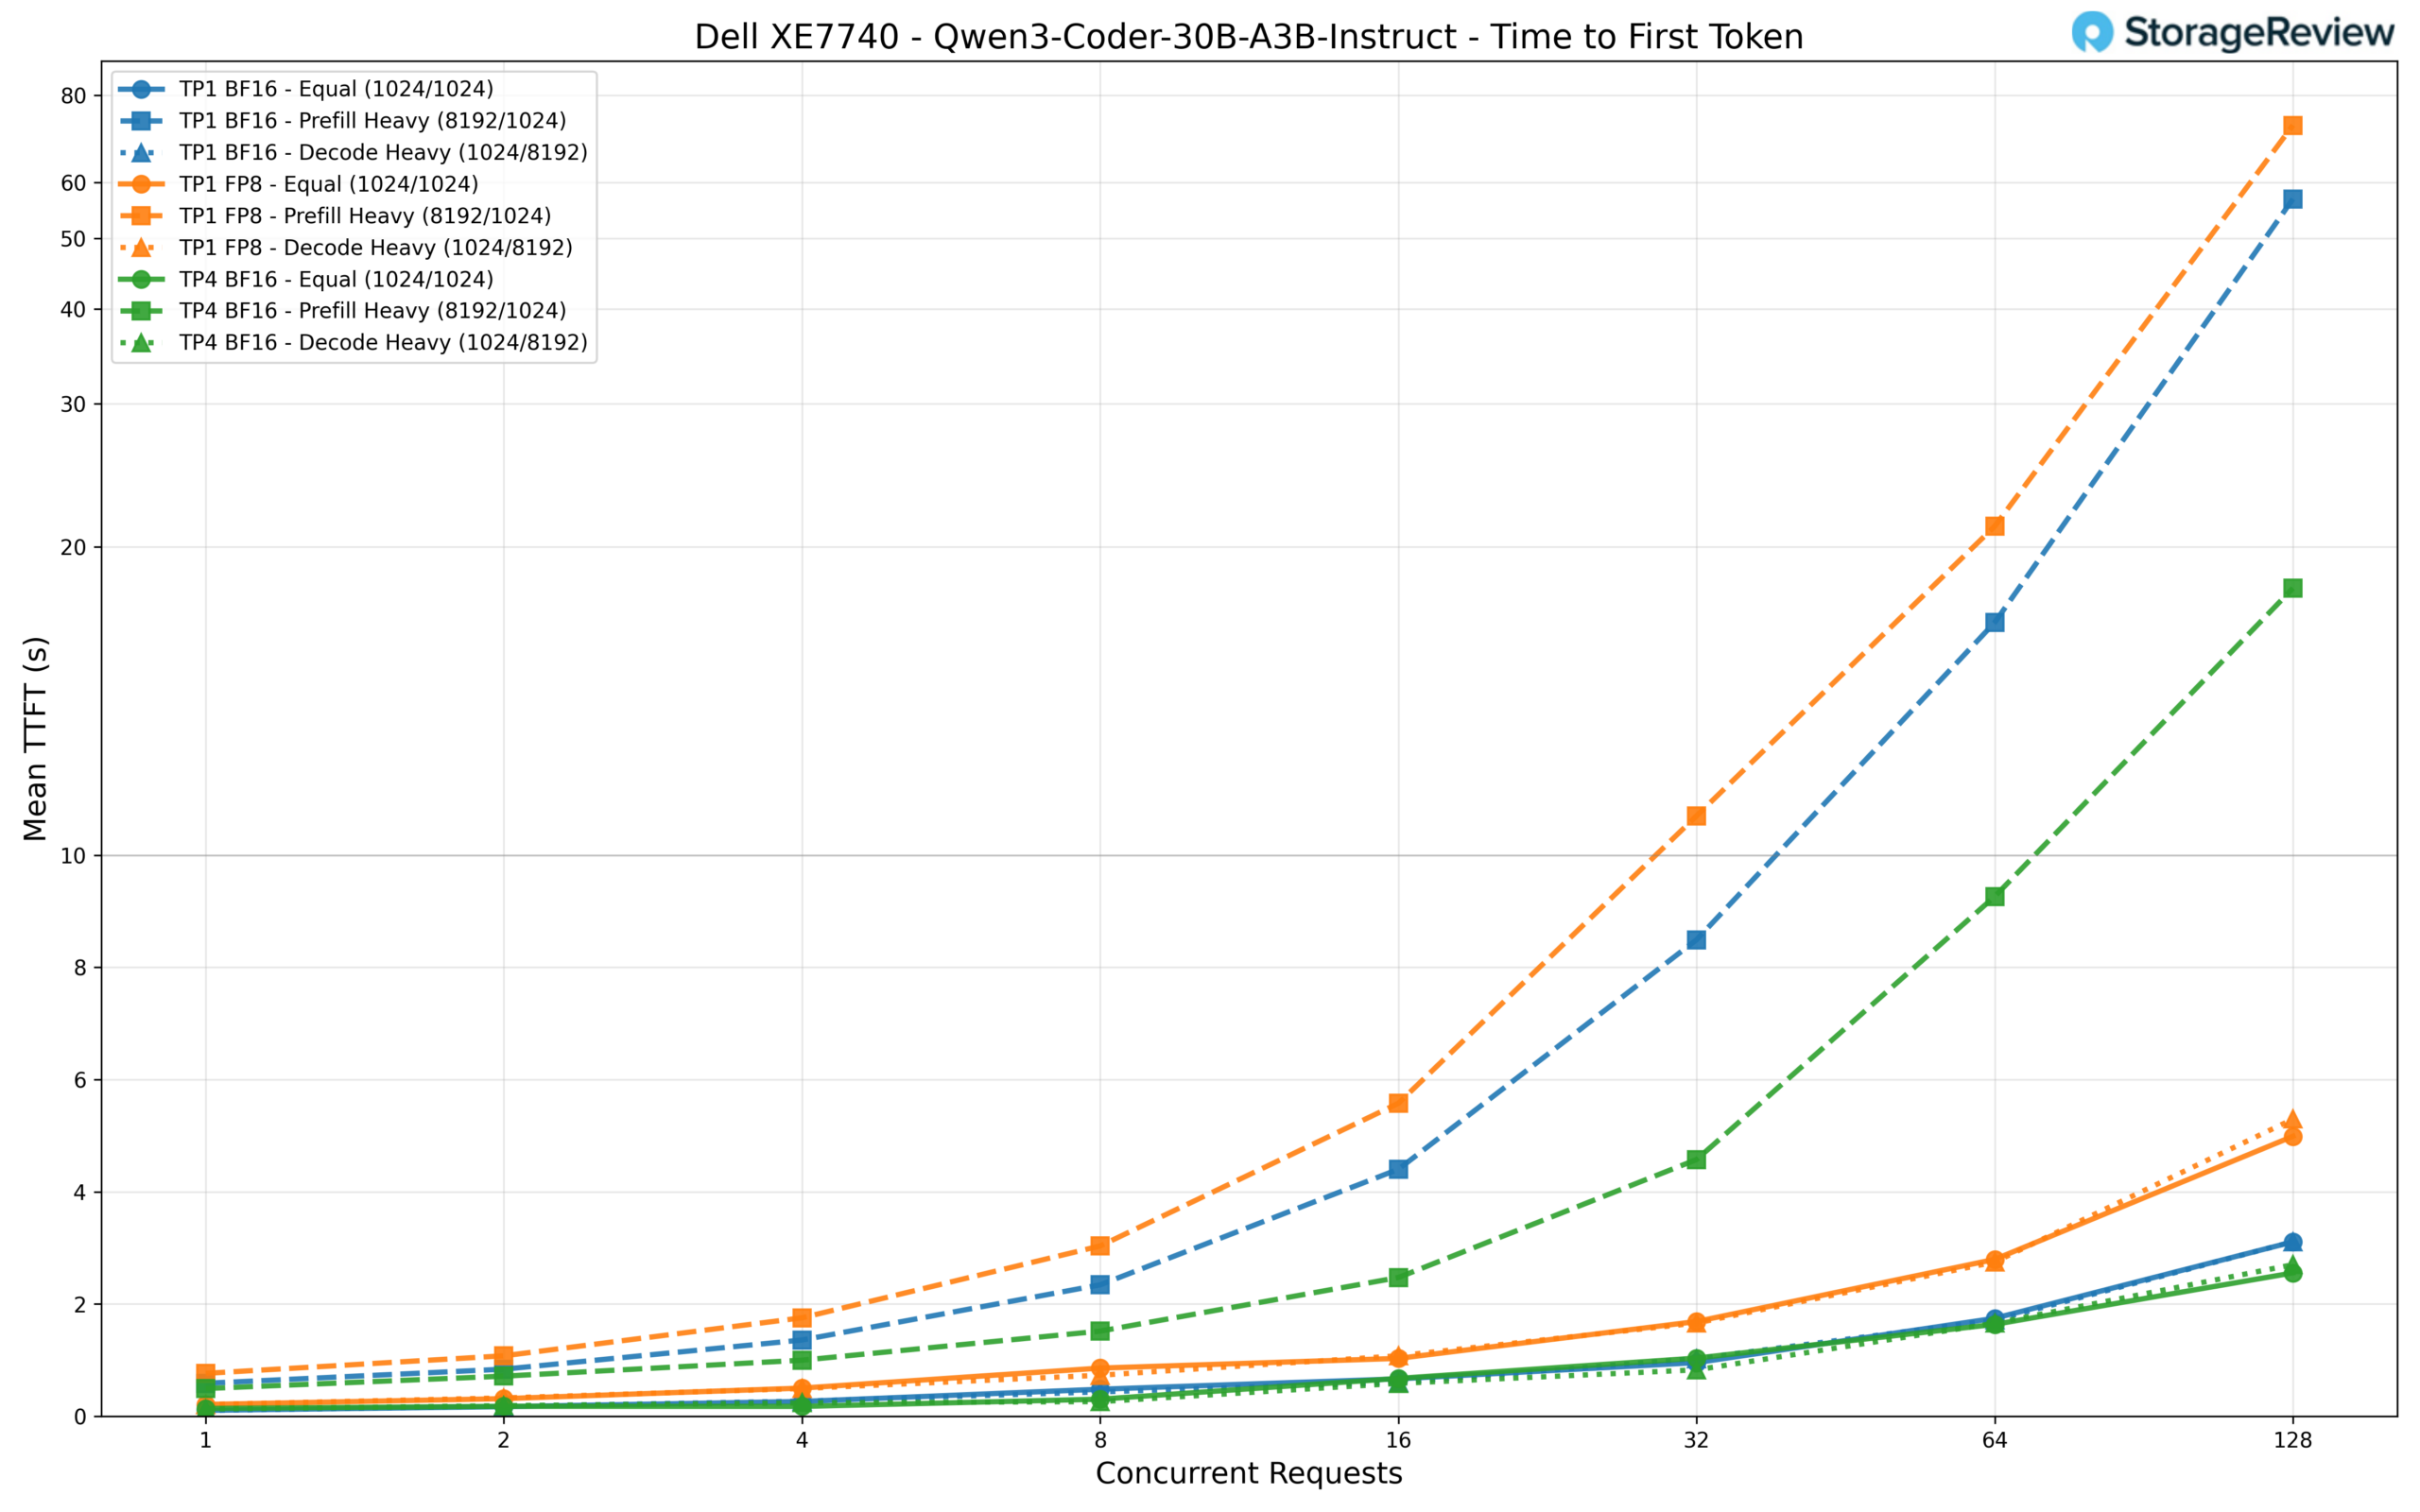
활성화 패턴이 드문드문하기 때문에 TTFT(Time To First Time)가 낮게 유지됩니다. TP4 BF16은 단일 사용자 부하에서 첫 번째 토큰 지연 시간이 약 140ms이고, 동일한 작업 부하에서 128개의 동시 요청 시에도 약 2.6초를 유지합니다. TP1 BF16은 낮은 동시 요청 수에서는 106ms로 비슷한 성능을 보이지만, 최대 부하 시에는 3.1초까지 증가합니다. 사전 채우기 작업이 많은 시나리오에서는 각 구성의 성능 차이가 확연히 드러납니다. TP4는 128개 요청 시 약 18초, TP1 BF16은 57초, TP1 FP8은 72초까지 소요됩니다.
Qwen3 235B-A22B 생각하기
벤치마크 스위트에서 가장 큰 모델인 Qwen3 235B-A22B Thinking은 총 235억 개의 파라미터와 토큰당 22억 개의 활성 파라미터를 가진 방대한 MoE 추론 모델입니다. 이 모델은 엄청난 규모 외에도, 사고 연쇄 추론 기능을 내장하고 있어 복잡한 문제를 단계별로 분석하여 해답을 도출할 수 있습니다. 다만, 이 과정에서 더 많은 디코딩 토큰이 소모됩니다. 따라서 고급 코드 생성 및 디버깅, 수학적 문제 해결, 다단계 논리적 추론, 그리고 정확도가 속도보다 중요한 복잡한 에이전트 워크플로우와 같은 까다로운 작업에 특히 적합합니다. 이 모델을 실행하려면 TP4가 필요하며, BF16 및 FP8 정밀도 모두에서 테스트를 진행했습니다.
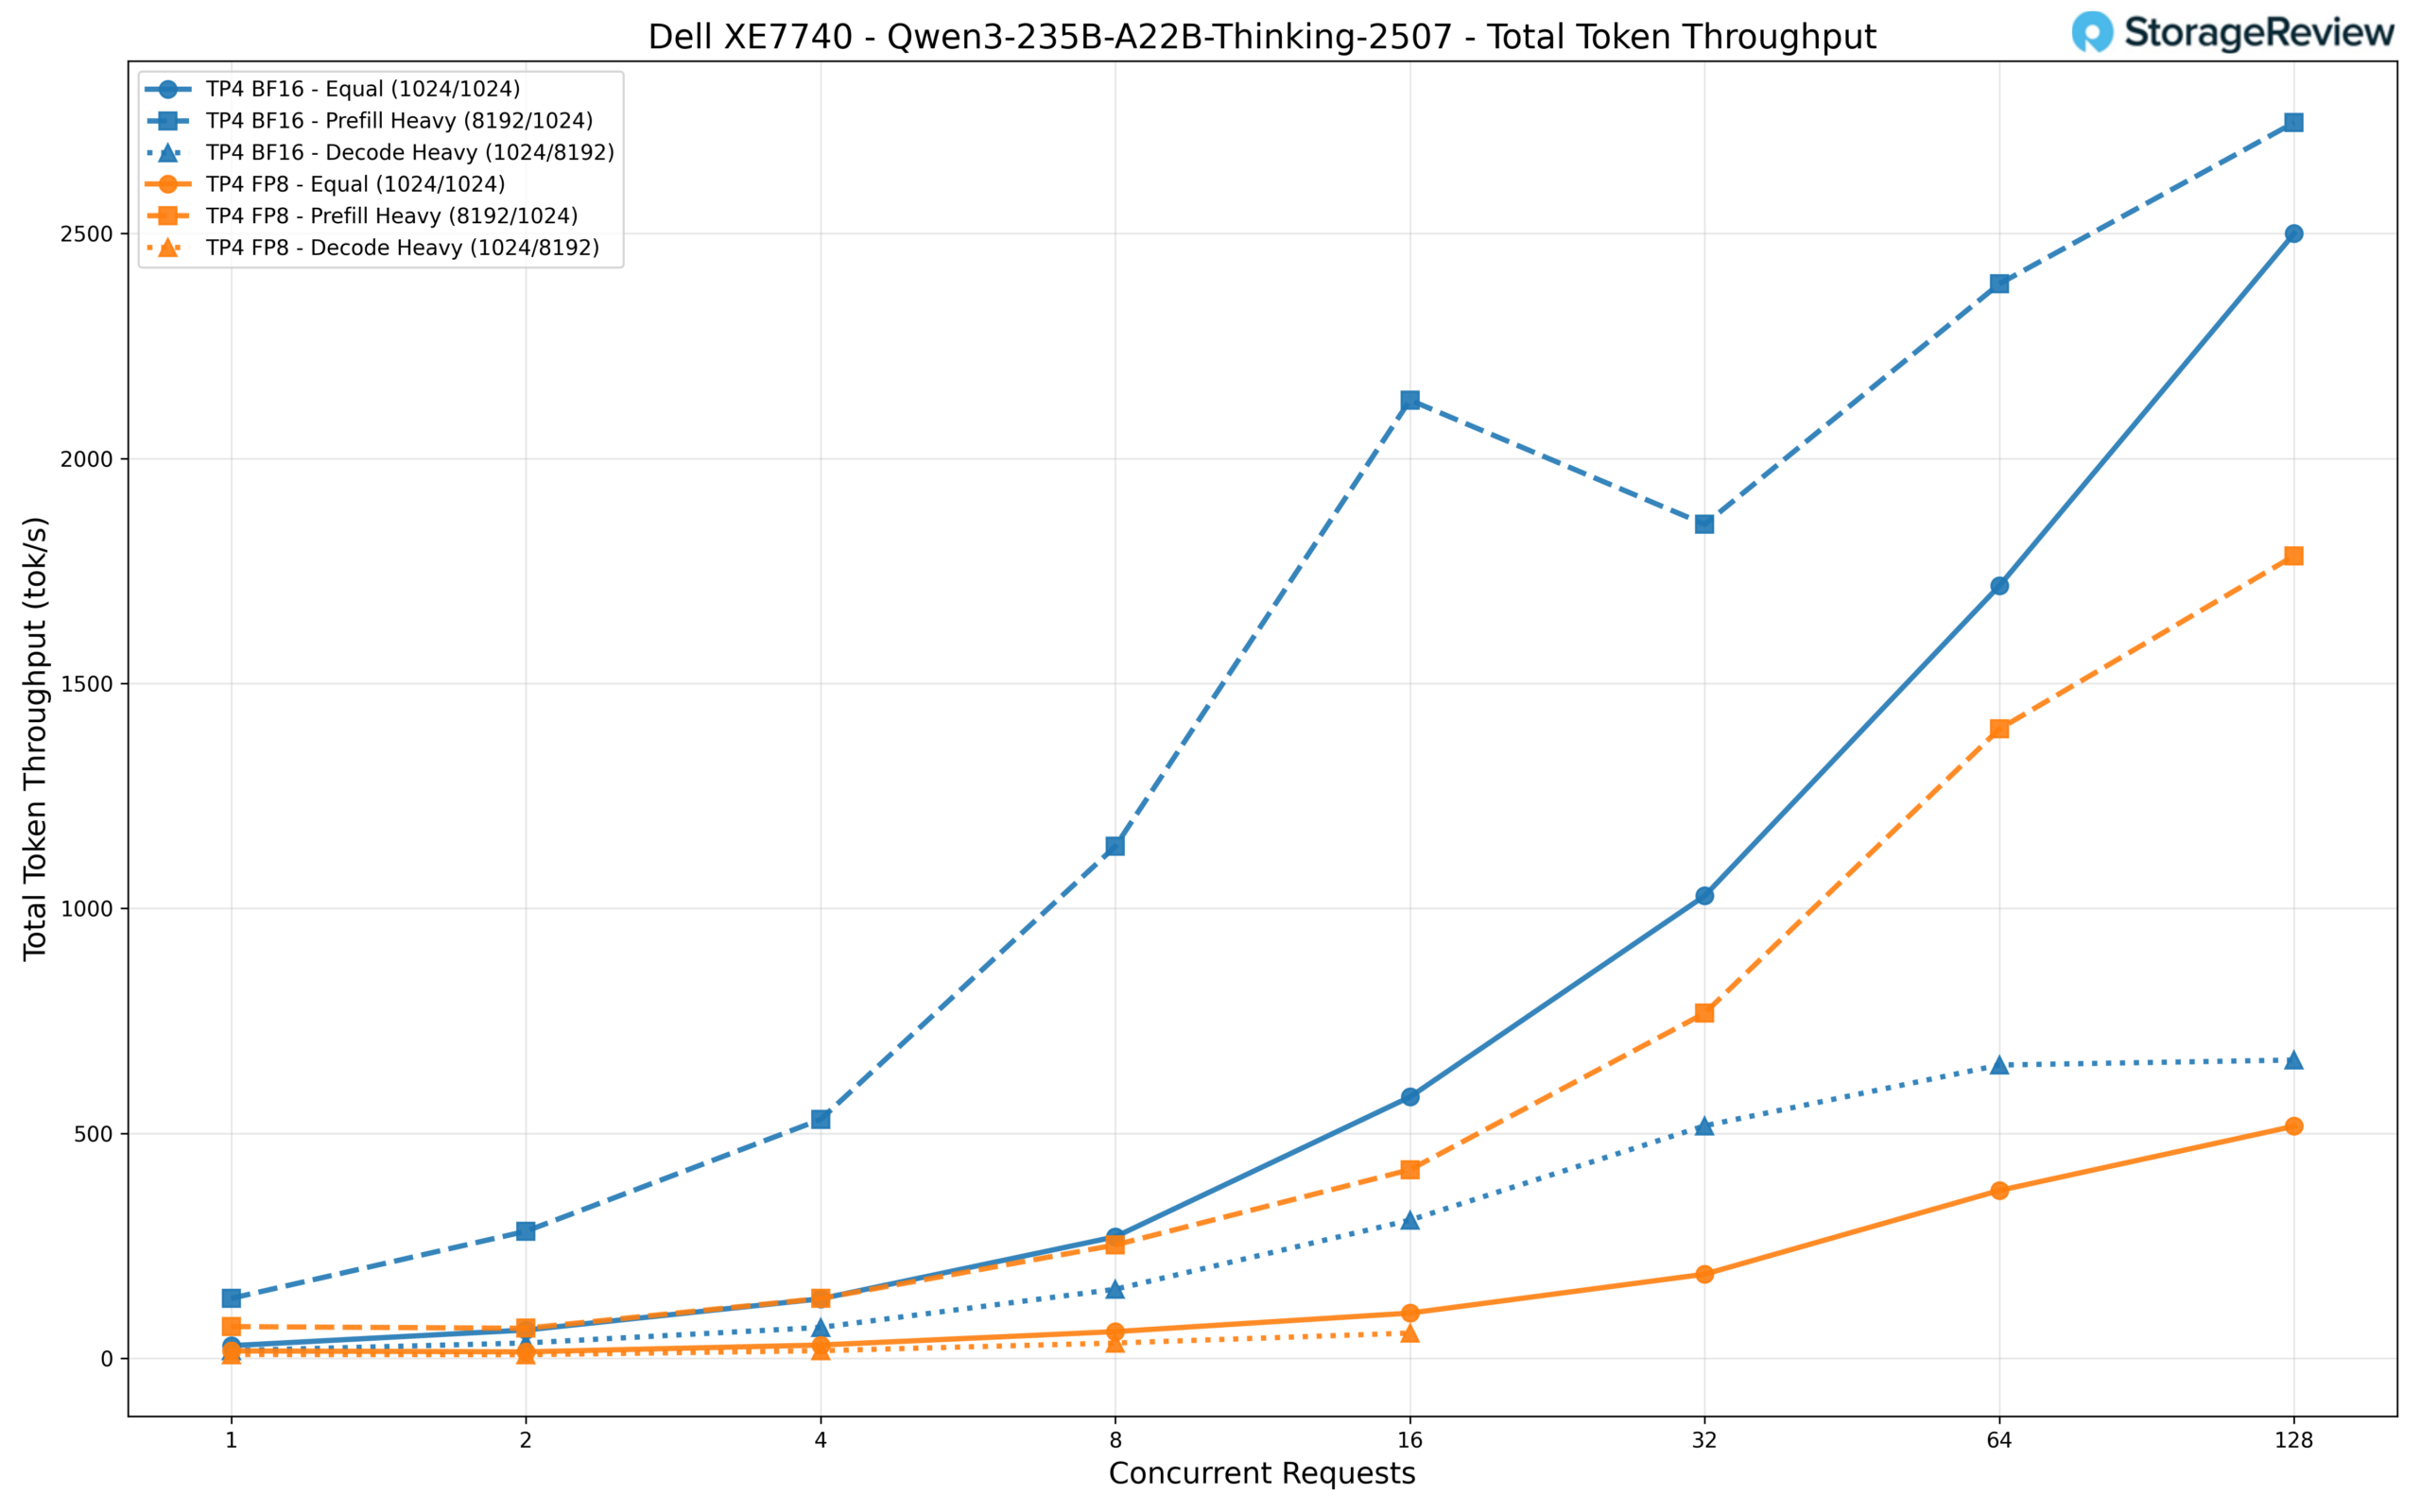
BF16은 모든 면에서 FP8보다 월등히 뛰어난 성능을 보여줍니다. 동시 요청 128개에서 BF16은 사전 채우기 작업이 많은 워크로드에서 약 2,750 tok/s, 동일한 워크로드에서 약 2,500 tok/s의 처리 속도를 달성한 반면, FP8은 각각 약 1,784 tok/s와 516 tok/s의 처리 속도를 보였습니다. 또한 FP8 변형은 동시 요청 수가 많을수록(32개 이상) 디코딩 작업이 많은 시나리오에서 타임아웃이 발생했습니다.
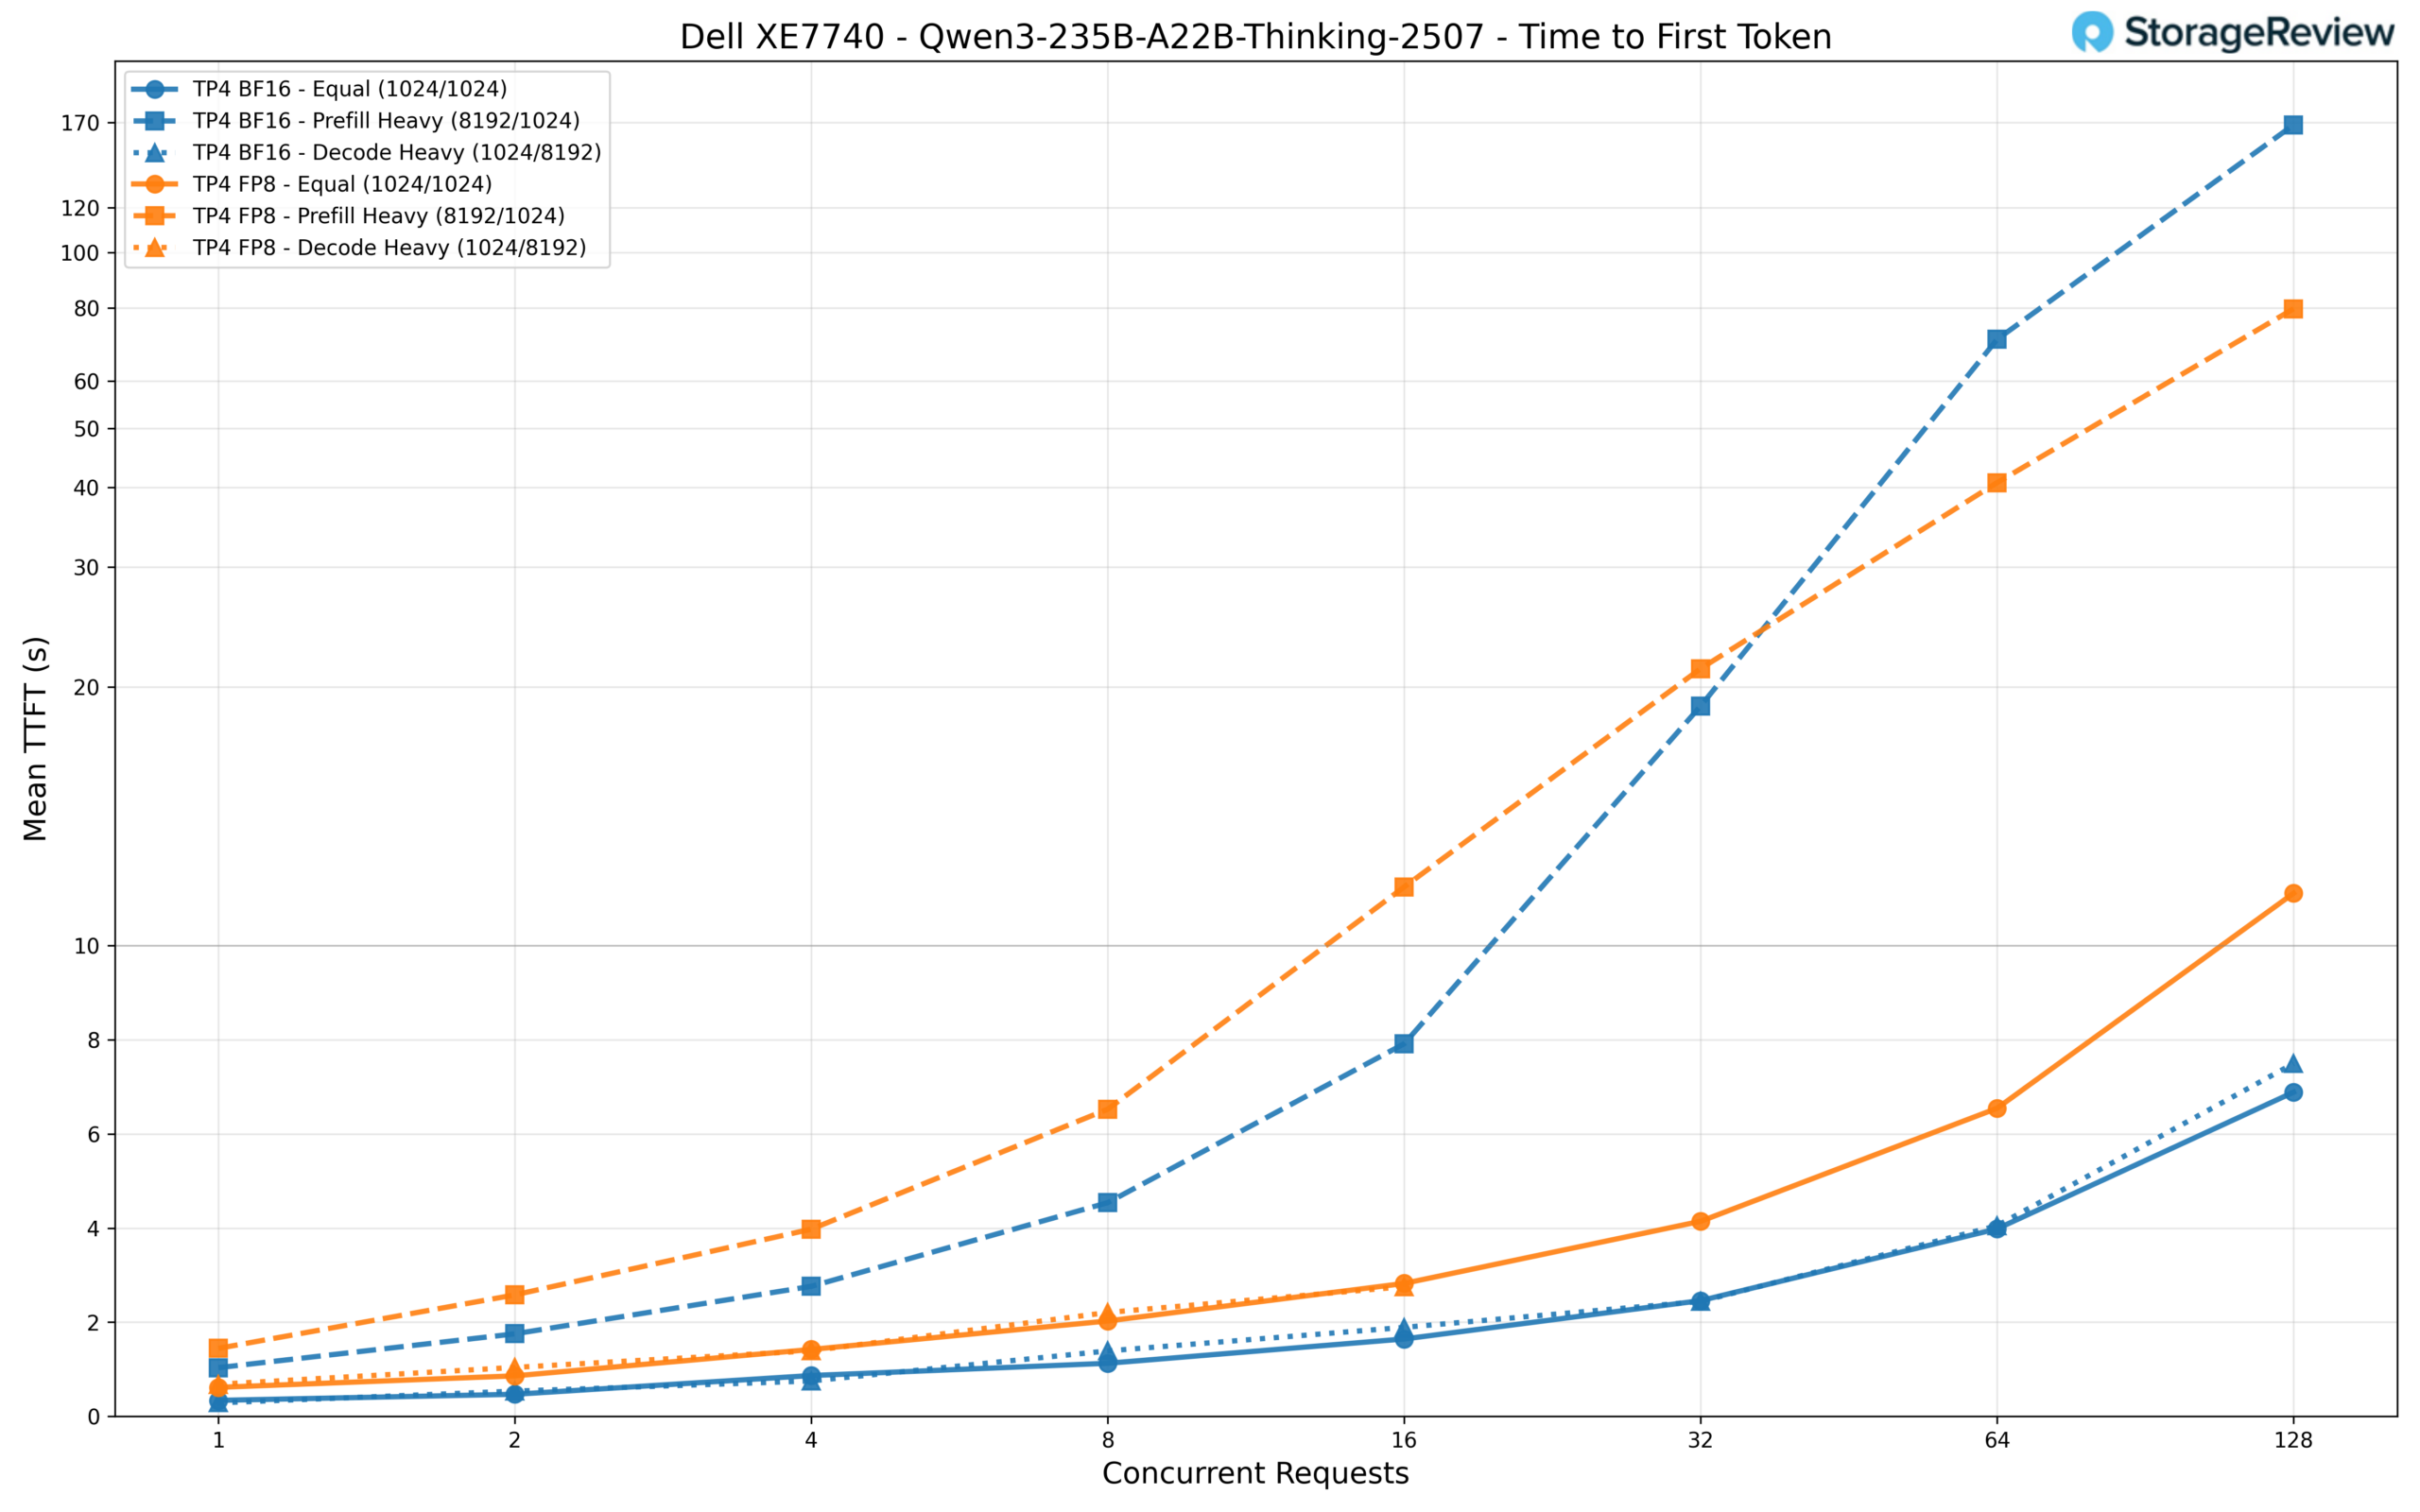
TTFT(처리 시간) 측면에서 BF16은 단일 동일 길이 요청 시 약 340ms에서 시작하여 동시 요청 128개까지 약 6.9초로 확장됩니다. 이는 이 규모의 모델로서는 상당히 빠른 응답 속도입니다. FP8은 전반적으로 BF16보다 약 2배 느리며, 615ms에서 시작하여 최대 부하 시 약 11.2초에 이릅니다. 사전 채우기 작업이 많은 워크로드가 가장 까다로운 시나리오이며, 128개 요청 시 BF16은 168초, FP8은 80초까지 증가합니다.
이게 누구야?
추론 수요는 줄어들 기미가 보이지 않습니다. 기업들이 개발팀의 속도를 높이기 위해 내부적으로 모델을 배포하든, 고객 대면 제품에 AI를 내장하든, 24시간 가동되는 자동화 파이프라인을 구축하든, 컴퓨팅 요구 사항은 계속 증가하고 있습니다. 그리고 이러한 수요 증가와 함께 익숙한 병목 현상, 즉 조달 문제가 발생합니다. 인기 있는 액셀러레이터 프로그램의 대기 기간은 몇 달씩 늘어나 이미 자금과 인력이 확보된 프로젝트가 지연되는 경우가 있습니다.
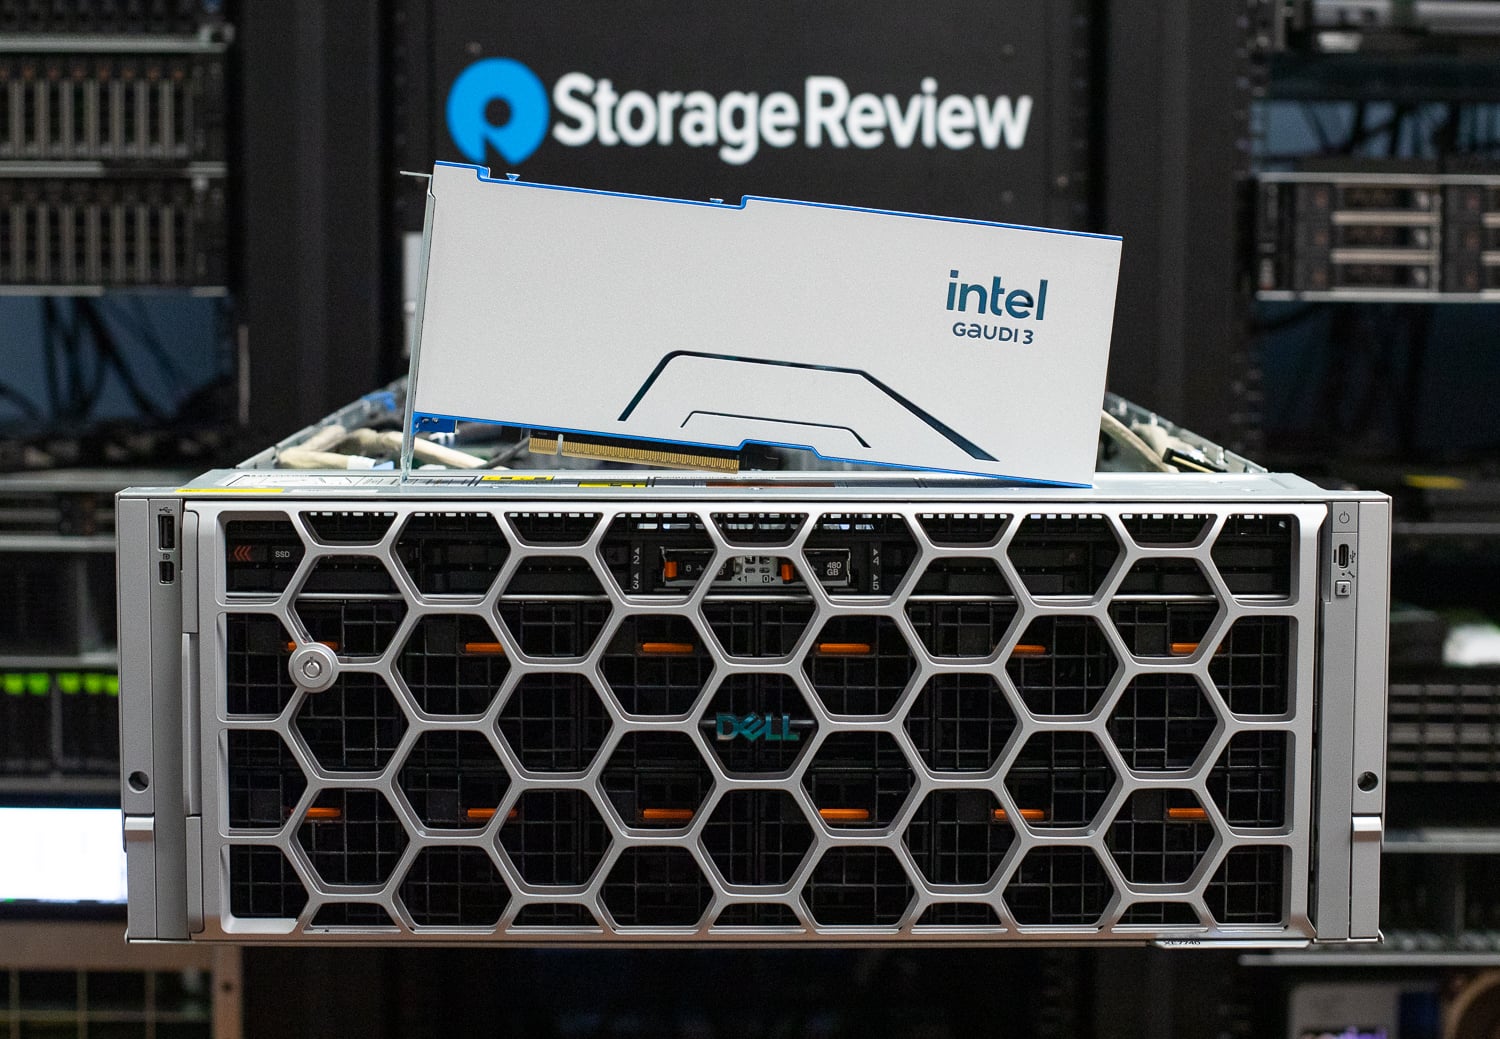
Intel Gaudi 3로 구성된 XE7740은 이러한 제약을 직접적으로 해결합니다. Gaudi 3 가속기는 현재 사용 가능하며, Intel은 검증된 배포 템플릿을 제공하여 팀이 제품 개봉부터 추론 서비스 제공까지 몇 시간 만에 완료할 수 있도록 지원합니다. Dell은 XE7740 시스템을 고객 환경에 직접 배치하는 체험 프로그램을 통해 실제 워크로드, 데이터 및 인프라에 대한 성능을 검증한 후 전체 배포를 결정할 수 있도록 함으로써 진입 장벽을 더욱 낮춥니다. 즉각적인 가용성, 빠른 가치 실현, 그리고 낮은 위험도의 평가가 결합된 Gaudi 3 구성은 추론 용량이 즉시 필요하지만 할당 대기열을 기다릴 여유가 없는 조직에 특히 매력적입니다.
하지만 XE7740은 단일 가속기 플랫폼이 아닙니다. 델은 다양한 실리콘 옵션을 제공하기 위해 노력하며, 동일한 플랫폼에서 다양한 옵션과 시중의 모든 인기 가속기를 사용할 수 있습니다. 최적의 선택은 전적으로 워크로드에 따라 달라집니다. 예를 들어 비디오 처리 파이프라인은 NVIDIA L4 GPU에 적합하며, XE7740은 16개의 L4 GPU와 8개의 PCIe Gen5 x16 NIC 슬롯을 장착하여 타협 없는 스트리밍 및 트랜스코딩 시스템을 구축할 수 있습니다. 여러 부서에서 다양한 AI 워크로드를 실행하는 조직은 XE7740 섀시를 표준으로 사용하고 각 배포 환경에 맞게 가속기 구성을 변경하여 시스템 관리를 간소화하고 작업에 맞게 컴퓨팅 성능을 최적화할 수 있습니다.
맺음말
Dell PowerEdge XE7740은 엔터프라이즈 추론 환경에 최적화되어 설계되었습니다. 듀얼 존 열 설계, 구조화된 PCIe 토폴로지, 고대역폭 메모리 아키텍처, 그리고 확장 가능한 네트워킹 기능은 지속적인 프로덕션 워크로드를 위한 시스템을 구축합니다. 이러한 설계 요소들은 우연한 선택이 아니라, 추론이 끊임없이 실행되고, 예측 가능한 확장성을 제공하며, 기존 데이터 센터 운영에 원활하게 통합되는 인프라 모델을 반영한 것입니다. 이번 평가에서 Intel Gaudi 3는 XE7740이 고밀도 및 MoE 아키텍처 전반에 걸쳐 예측 가능한 확장성과 강력한 메모리 제약 처리량을 바탕으로 추론을 원활하게 수행함을 입증했습니다. 소프트웨어 최적화는 앞으로도 계속 개선될 것이지만, 플랫폼의 아키텍처 기반은 이미 견고합니다.
더욱 중요한 것은 XE7740이 기업 AI 인프라를 위한 견고한 청사진을 제시한다는 점입니다. 기업은 일관된 섀시, 관리 스택 및 배포 모델을 표준화하고 시간이 지남에 따라 가속기 전략을 발전시킬 수 있습니다. 모델이 성장하고 워크로드가 다양해지며 추론이 비즈니스 운영에 더욱 깊이 통합됨에 따라 안정적이고 적응 가능한 인프라에 대한 필요성은 더욱 증가할 것입니다. PowerEdge XE7740은 이러한 추세에 부응하도록 설계되었습니다. 이 제품은 기업 AI가 빠른 도입에서 장기적인 통합으로 나아가는 데 필요한 아키텍처 균형, 운영 성숙도 및 확장성을 제공합니다.
이 보고서는 Dell Technologies의 후원을 받았습니다. 이 보고서에 표현된 모든 견해와 의견은 고려 중인 제품에 대한 우리의 공정한 견해를 기반으로 합니다.
순위표: 본 리뷰에서 다룬 4개 카드로 구성된 Gaudi 3 시스템은 당사의 최고 기업용 GPU 순위표 에서 확장성 부문 순위에 올라 있습니다.


 아마존