

DGX Spark 플랫폼은 이제 우리에게 익숙한 영역입니다. 우리는 NVIDIA의 GB10 Grace Blackwell 레퍼런스 디자인을 기반으로 한 Dell , ASUS , Acer , Gigabyte 제품들을 이미 리뷰했으며 , 핵심 구성 요소는 모두 동일합니다. 1,000 TOPS의 FP4 연산 능력, 128GB의 통합 LPDDR5x 메모리, 그리고 150mm 섀시에 담긴 듀얼 200GbE 네트워킹이 그것입니다. HP의 ZGX Nano G1n AI Station은 이러한 기반 위에 구축되었지만, HP가 이를 더욱 발전시킨 방식 덕분에 다른 Spark 제품들과 차별화됩니다.
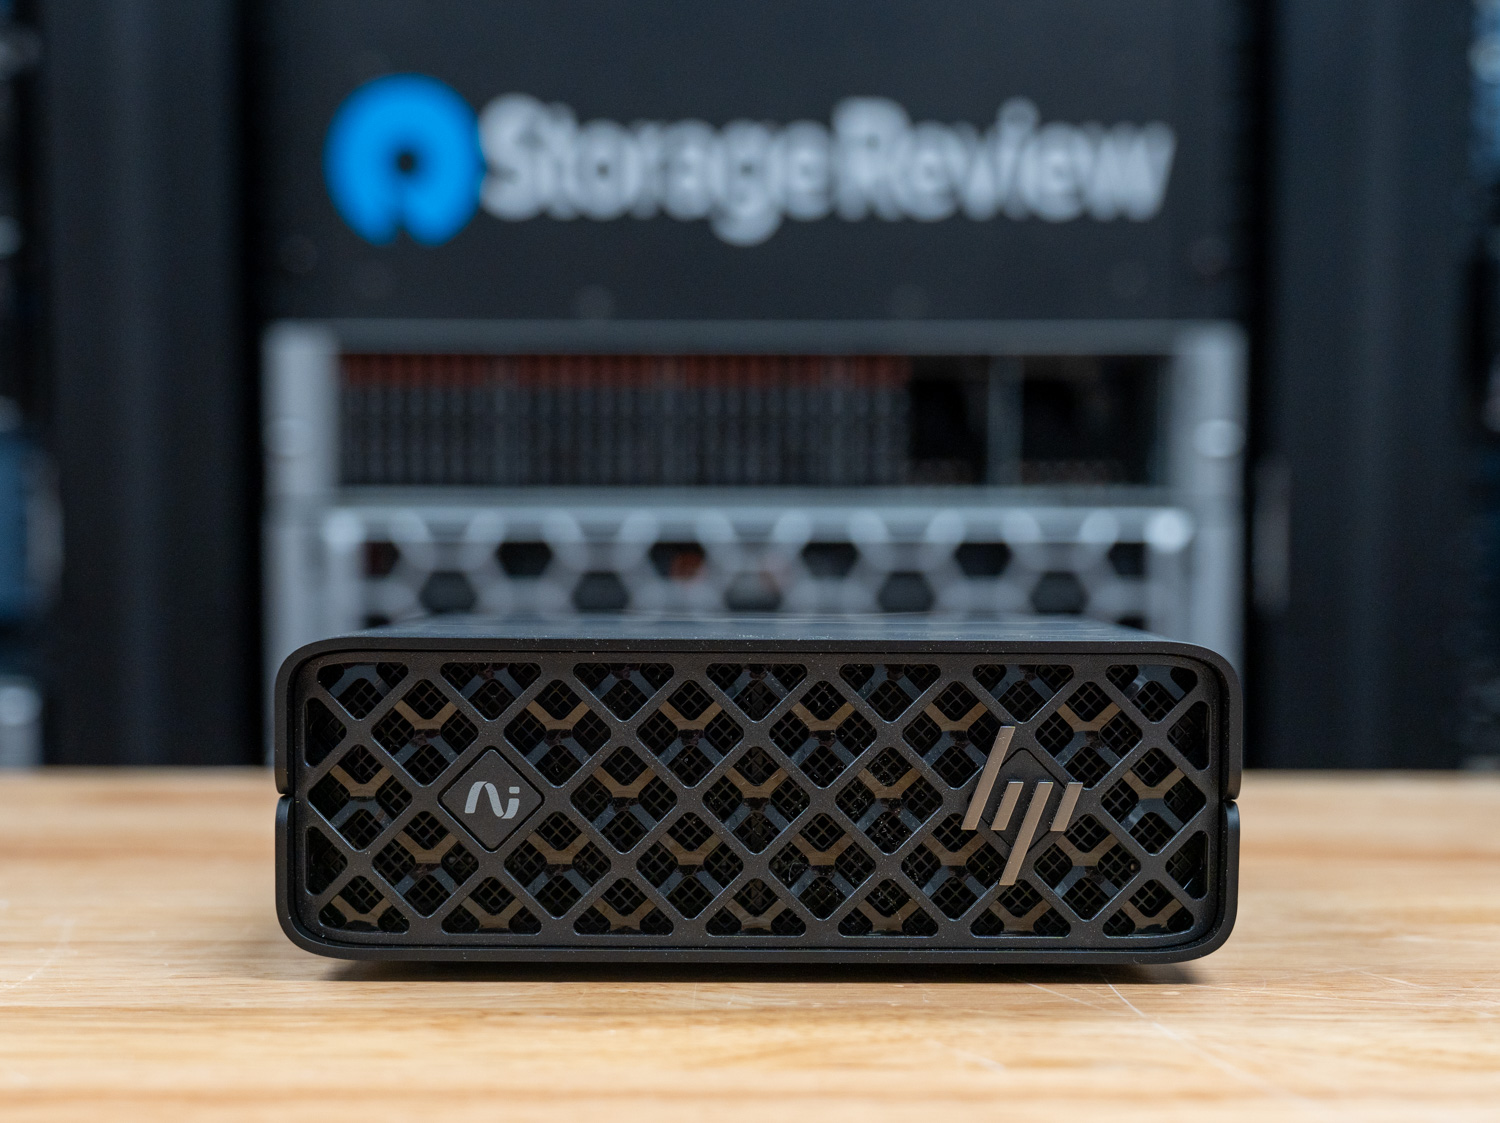
가장 눈에 띄는 차이점은 소재와 구조에 있습니다. HP는 ZGX Nano를 최대 75%의 재활용 알루미늄과 20%의 재활용 강철로 제작된 섀시에 담았으며, 포장재에는 최대 93%의 재활용 소재가 사용되었습니다. 내부 레이아웃은 섀시를 상단과 하단으로 나누어 SSD와 코인형 배터리 같은 부품에 접근하기 쉽게 설계했습니다. 이는 이전에 테스트했던 여러 Spark 모델보다 접근성이 뛰어납니다. 발열 측면에서 HP는 시스템의 소음 수준을 유휴 상태에서 22dBA, 고부하 작업 시 27.6dBA로 발표했는데, 이는 최대 약 780 BTU/hr의 열을 발산하는 시스템임을 감안하면 매우 조용한 수준입니다.
HP는 레퍼런스 플랫폼을 뛰어넘는 보안 기능을 가장 앞세워 제공합니다. ZGX Nano는 FIPS 140-2 인증 모드에서 작동하는 TPM 2.0을 탑재하고, Common Criteria EAL4+를 충족하며, BIOS 수준의 보안 부팅 및 PXE 제어 기능을 포함합니다. 스토리지는 자체 암호화 기능을 갖춘 OPAL NVMe 드라이브가 공장에서 기본으로 설치됩니다. 이러한 특징들을 통해 HP는 이 제품을 개발자 데스크톱 AI 노드일 뿐만 아니라, 공급망 인증, 저장 데이터 암호화, 변조 방지 등이 중요한 규제 환경에서도 문제없이 작동할 수 있는 시스템으로 포지셔닝하고 있습니다.
| 스펙 | HP ZGX 나노 G1n AI 스테이션 |
|---|---|
| 회사 개요 | |
| 제품명 | HP ZGX 나노 G1n AI 스테이션 |
| 폼 팩터 | 미니 |
| 운영체제 | 엔비디아 DGX OS 7 / 우분투 24.04 주의: 이 제품은 마이크로소프트 윈도우를 지원하지 않습니다. |
| 하드웨어 | |
| 프로세서 | NVIDIA GB10 그레이스 블랙웰 슈퍼칩 블랙웰 아키텍처 GPU 20코어 Arm CPU (코텍스-X925 10개 + 코텍스-A725 10개) 블랙웰 CUDA 코어 5세대 텐서 코어 4세대 RT 코어 1x NVENC 1x NVDEC |
| 메모리 | 128GB LPDDR5x, 통합형, 16채널, 납땜형 |
| 메모리 대역폭 | 273 GB / 초 |
| 저장소(내부 I/O) | 1x M.2 PCIe Gen5 x4 옵션: 2TB 또는 4TB PCIe Gen4 x4 NVMe (2242, SED OPAL TLC) |
| 네트워킹 및 I/O | |
| 후면 I/O 포트 | USB-C 전원 포트 1개 (240W) USB-C 20Gbps 포트 3개 (DisplayPort 1.4a, 총 30W) HDMI 1a 2.1 개 1x 10GbE RJ-45 2x QSFP 200GbE (ConnectX-7) |
| 네트워크 컨트롤러 | Realtek RTL8127-CG 10GbE NVIDIA ConnectX-7 200GbE |
| WiFi 및 블루투스 | AzureWave AW-EM637 Wi-Fi 7 + 블루투스 5.4 |
| 성능 | |
| AI 컴퓨팅 | 최대 1,000 TOPS (FP4) |
| 모델 용량 | 최대 200B 매개변수 |
| 신체 및 파워 | |
| 크기 (높이 x 폭 x D) | 2.01인치(받침대 없음) / 2.1인치(받침대 포함) 5.9 "X 5.9" |
| 중량(평량) | 무게는 1.25kg(2.76파운드)부터 시작합니다. |
| 전원 공급 장치 | 240W USB-C 외장 어댑터, 89% 효율, 액티브 PFC(전력 보정) 기능 탑재 |
빌드 및 디자인
HP ZGX Nano G1n은 지금까지 살펴본 다른 시스템들( Dell / ASUS / Acer / Gigabyte 리뷰 참조)과 비교했을 때 DGX Spark 디자인에 확연히 다른 접근 방식을 취했습니다. 일반적으로 내부 부품들이 상단 커버에 숨겨져 있는 듯한 구조 대신, HP는 섀시를 상단과 하단으로 분리하여 내부 구조를 쉽게 파악할 수 있도록 했습니다. 처음에는 복잡해 보일 수 있지만, 실제로 몇 개의 나사만 풀면 코인형 배터리나 SSD 같은 부품에 손쉽게 접근할 수 있어 매우 실용적입니다. 이러한 세심한 내부 구조는 외관 디자인에도 반영되어, HP는 시스템의 제작 방식과 사용된 소재에 더욱 심혈을 기울였습니다.
하지만 HP는 150mm 정사각형의 세련된 검은색 케이스에 이 제품을 담아냈으며, 재활용 소재를 적극적으로 활용했습니다. 구체적으로, 최대 75%의 재활용 알루미늄, 20%의 재활용 강철, 그리고 상당량의 사용 후 재활용 플라스틱을 사용했습니다. 포장재에서도 이러한 노력이 엿보입니다. 골판지에는 최대 93%의 재활용 소재가 사용되었고, 플라스틱 포장재에는 최소 30%의 재활용 소재가 포함되어 있습니다.
열 관리 측면에서 이 시스템은 강제 공랭식 냉각 방식을 사용합니다. NVIDIA GB10 Grace Blackwell Superchip의 높은 집적도를 고려할 때 이는 주목할 만한 엔지니어링 선택입니다. 컴팩트한 크기에도 불구하고 HP는 완벽한 열 관리 성능을 제공합니다 . 최대 부하 시 시스템은 구성에 따라 최대 약 780 BTU/hr의 열을 발산합니다. 최대 시스템 전력 소모량은 약 228W에 달합니다. 또한 HP는 유휴 상태에서 22dBA, 집중적인 작업 부하 시 27.6dBA로 비교적 낮은 소음 수준을 자랑합니다.
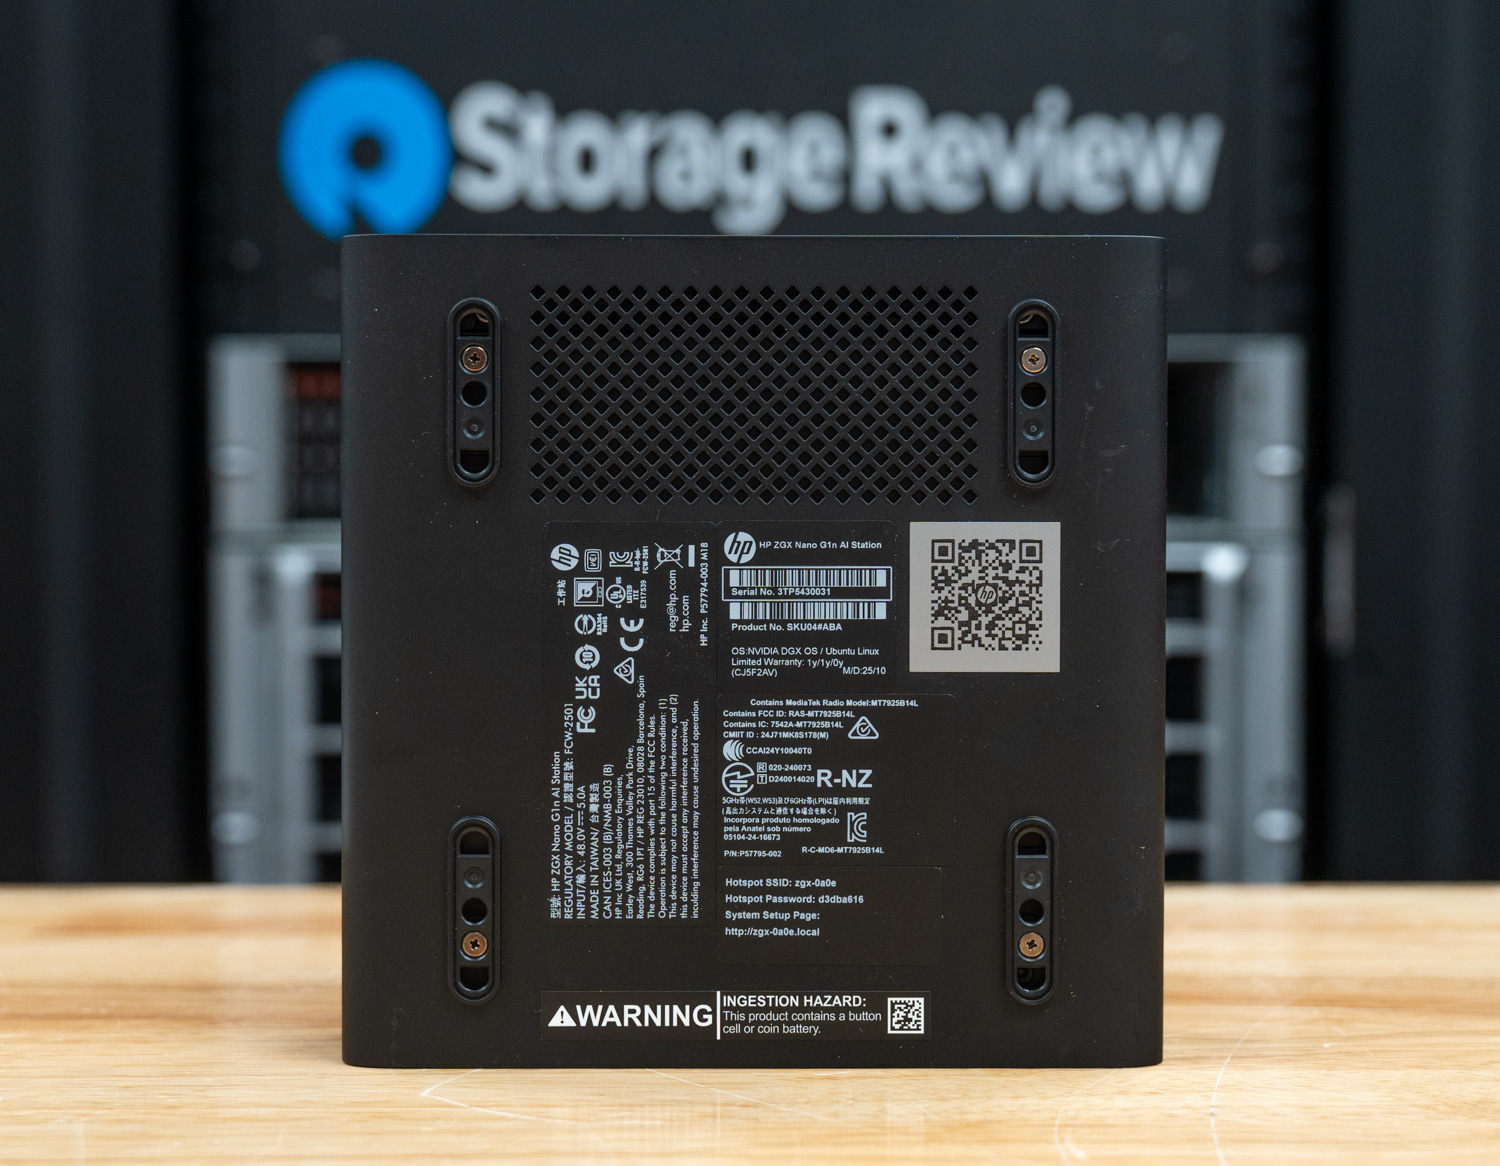
본체는 받침대를 제외하고 5.9 x 5.9 x 2.01인치의 크기로, 초소형 제품군에 속합니다. HP는 이 제품이 랙 마운트형이 아니라고 명시적으로 밝히며, 기존 데이터 센터 인프라보다는 데스크톱용 AI 노드로서의 역할을 강조합니다. 유지보수 편의성은 설계상 최소화되어 있습니다. 내부 부품에 접근하려면 십자 드라이버(#1)가 필요하며, 메모리를 포함한 대부분의 부품은 사용자가 교체할 수 없습니다.
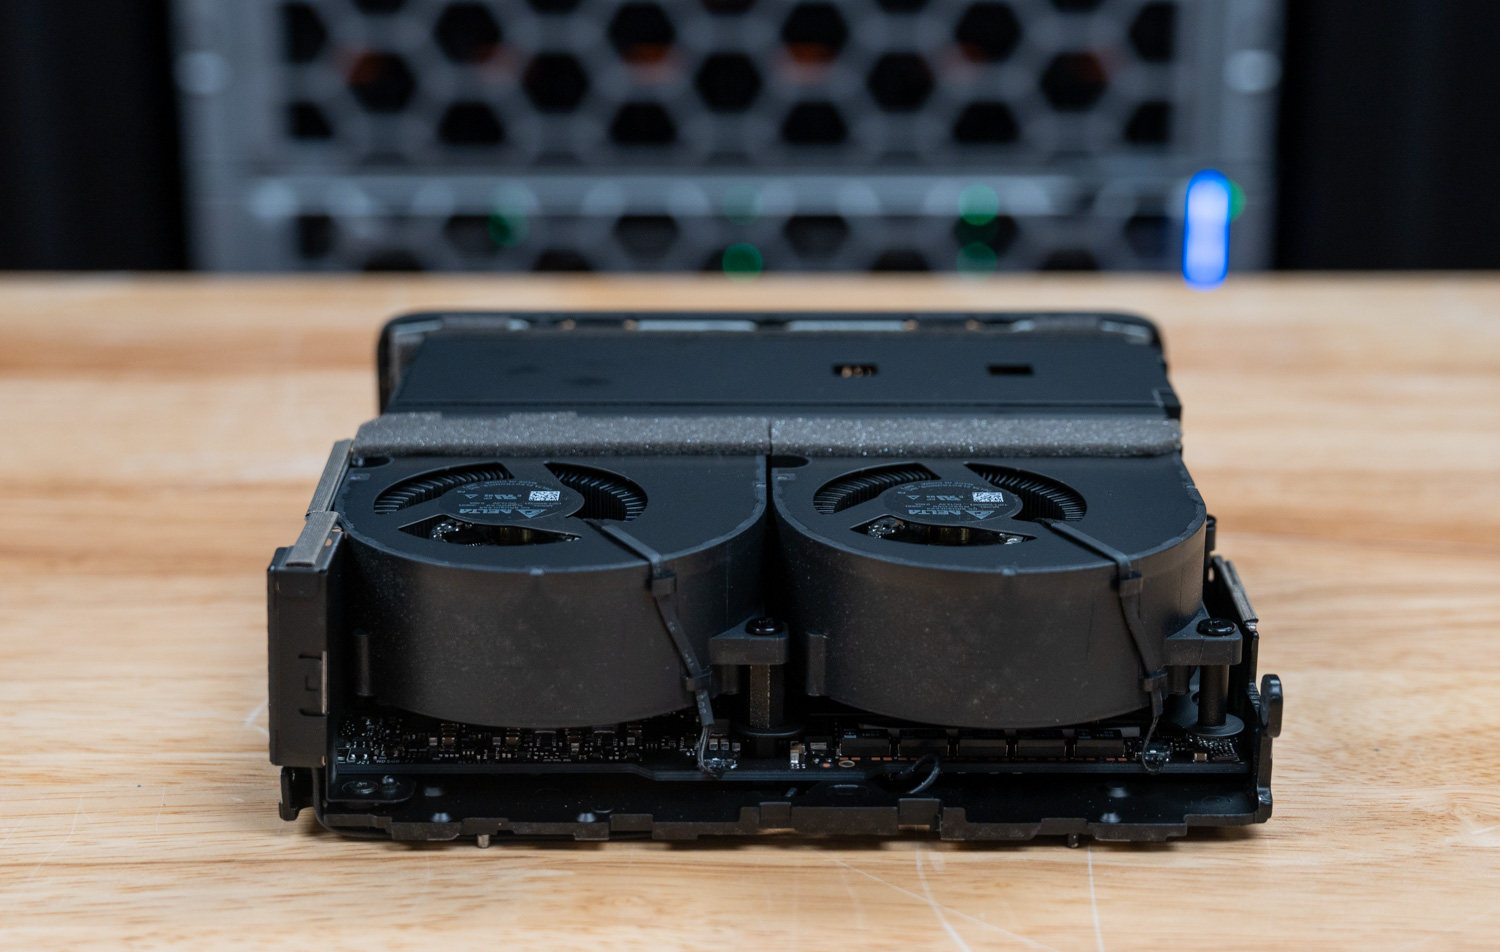
ZGX Nano는 내부적으로 NVIDIA의 레퍼런스 보드 설계를 사용하며, DGX Spark 플랫폼을 기반으로 제품을 제작하는 다른 많은 OEM 업체들도 마찬가지입니다. LPDDR5x 메모리는 보드에 직접 납땜되어 있으며 최대 8533MHz의 속도로 작동합니다. 전반적으로 이 플랫폼은 모듈성보다는 효율성과 집적도에 중점을 두고 있습니다.
보안 및 업그레이드 가능성
HP는 ZGX Nano G1n을 설계 단계부터 보안 강화했습니다. 이 제품은 FIPS 140-2 인증 모드로 작동하는 통합 TPM 2.0 모듈을 탑재하고 있으며, Trusted Computing Group(TCG) 사양과 Common Criteria EAL4+ 인증을 충족합니다. BIOS 수준의 보안 기능에는 보안 부팅 제어, PXE 기반 원격 부팅 기능, 그리고 이동식 미디어에서의 부팅을 완전히 차단하는 기능이 포함됩니다.
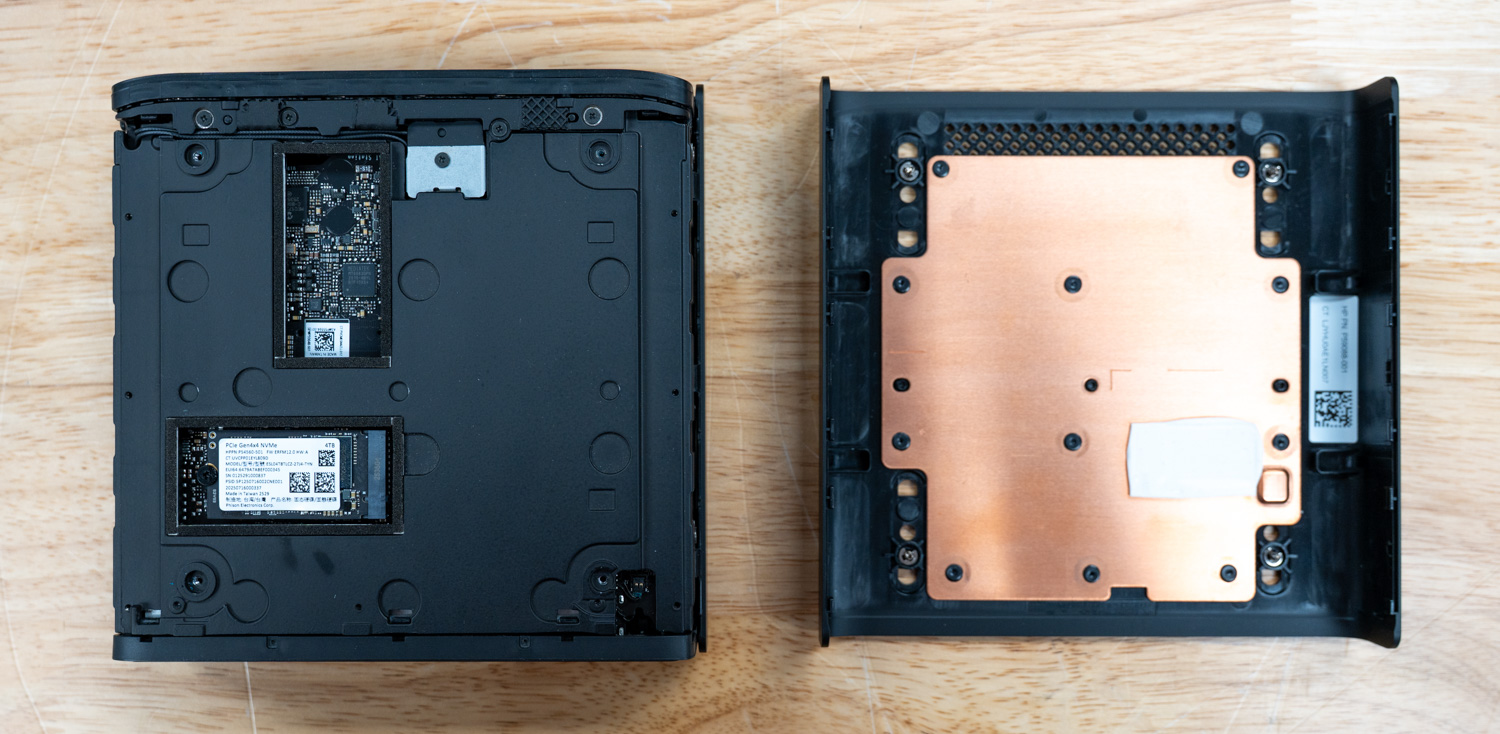
하드웨어 측면에서 HP는 이 시스템이 업그레이드 불가능하다고 명확히 밝히고 있습니다. 128GB의 LPDDR5x 통합 메모리는 메인보드에 직접 납땜되어 있습니다. 또한, 구매자는 구매 시점에 저장 장치를 선택해야 합니다. 단일 M.2 슬롯은 PCIe Gen5 x4를 지원하지만, 공장 출고 시에는 PCIe Gen4 x4 NVMe SSD가 장착됩니다. 이 SSD는 2TB 또는 4TB 용량으로 제공되며, 모두 자체 암호화 기능을 갖춘 OPAL 드라이브입니다.
HP는 생산 종료 후 최대 5년 동안 예비 부품을 계속 제공할 것이라고 밝혔습니다. 그러나 이는 모듈형 워크스테이션이라기보다는 기본적으로 어플라이언스형 시스템에 가깝습니다.
입출력 및 확장
본체 전면은 전원 버튼과 상태 LED만 있는 미니멀한 디자인입니다. 후면에는 고성능 연결 옵션이 다양하게 제공됩니다. HP는 NVIDIA에서 권장하는 표준 240W USB-C 어댑터를 통해 전원을 공급하며, 타사 어댑터를 사용할 경우 성능 저하 또는 시스템 불안정을 초래할 수 있다고 경고합니다.
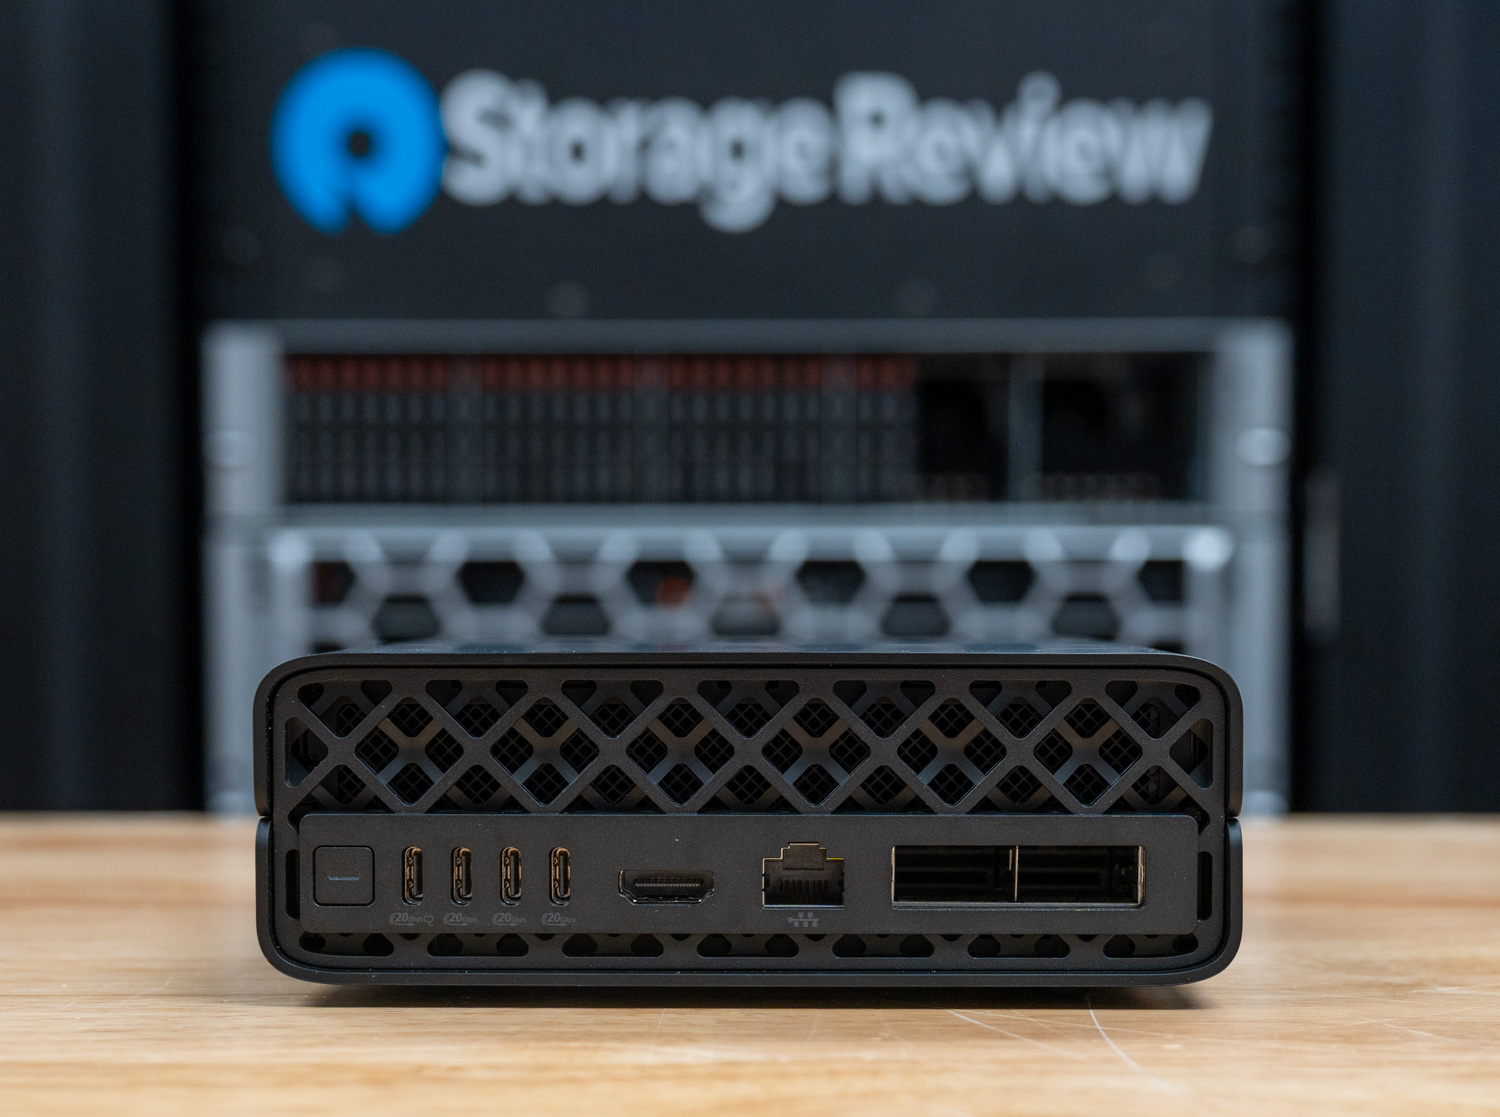
3개의 USB 3.2 Type-C 포트는 각각 20Gbps의 속도와 DisplayPort 1.4a Alt Mode를 지원하여 USB 연결을 제공합니다. 전용 HDMI 2.1a 포트는 추가적인 디스플레이 출력을 제공합니다. 네트워크 연결을 위해 Realtek RTL8127-CG 10GbE 컨트롤러와 NVIDIA ConnectX-7 컨트롤러가 탑재되어 있으며, 각각 200Gbps의 처리량을 제공하는 듀얼 200GbE QSFP112 포트를 지원합니다.
네트워킹 스택은 다양한 엔터프라이즈 기능을 지원합니다. 여기에는 PXE 부팅, Wake-on-LAN, VLAN 태깅(802.1Q), 시간 동기화(802.1as/1588) 및 지원되는 모든 속도에서 전이중 동작이 포함됩니다. 또한 Wi-Fi 7(802.11be) 2×2 모듈과 Bluetooth 5.4는 무선 연결을 제공하며 MU-MIMO, WPA3 보안을 지원하고 2.4GHz, 5GHz 및 6GHz 대역에서 작동합니다.
그래픽 및 오디오
GB10 슈퍼칩에 통합된 NVIDIA Blackwell GPU는 모든 그래픽 작업을 처리합니다. 이 시스템은 USB-C DisplayPort 1.4a를 통해 최대 8K 해상도에서 60Hz 주사율을, HDMI 2.1a를 통해 최대 8K 해상도에서 30Hz 주사율을 지원합니다. HP는 8K 출력 시 어댑터나 도크를 사용하면 시스템 불안정이나 신호 품질 저하가 발생할 수 있으므로 케이블을 직접 연결하는 것을 권장합니다.
오디오는 HDMI를 통해 전송되며, 별도의 아날로그 오디오 출력은 없습니다. 이는 시스템이 기존의 멀티미디어 워크스테이션보다는 컴퓨팅 노드로서의 역할을 수행한다는 점에 부합합니다.
열 테스트
CPU 온도
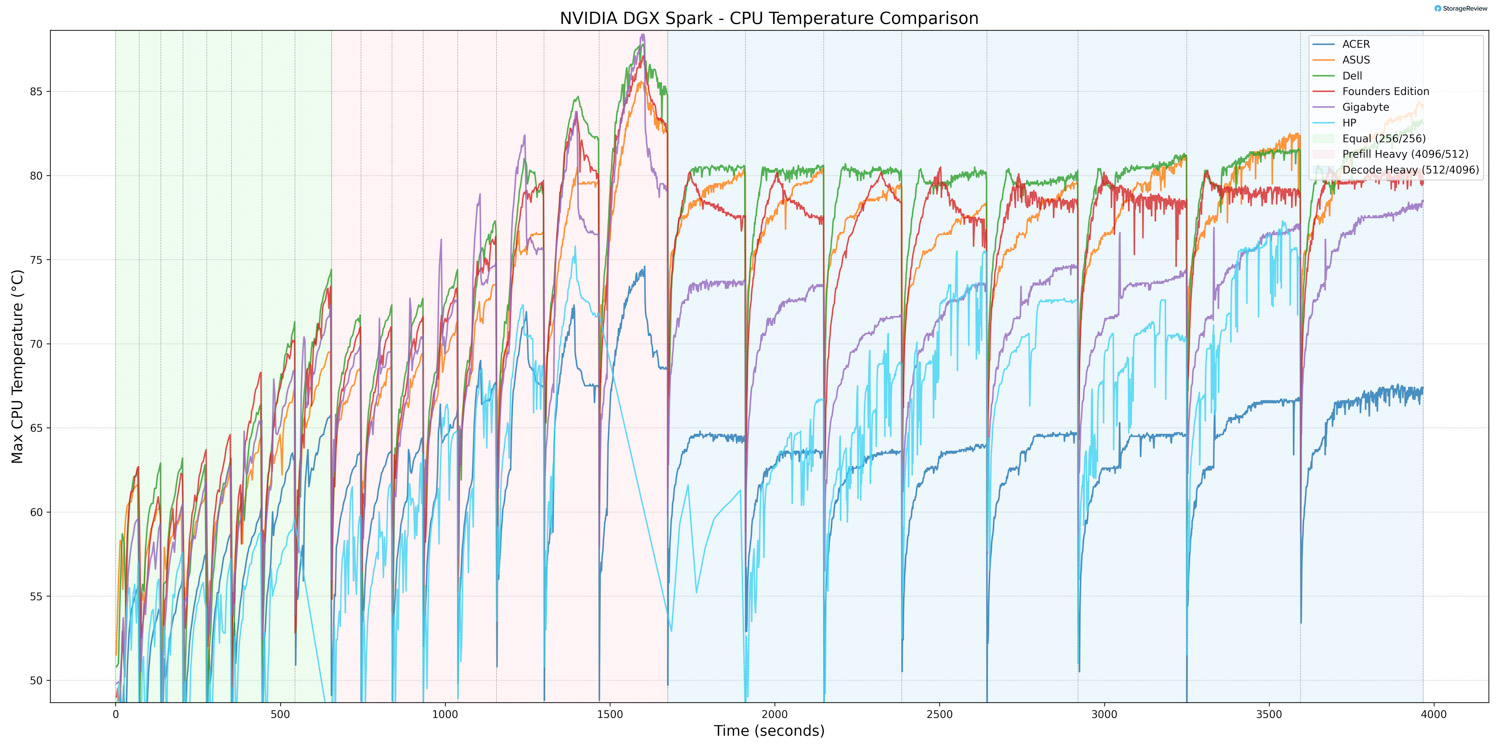
CPU 열 테스트 중 HP ZGX Nano G1n은 작업 부하가 가장 높은 구간에서 최고 온도 77.3°C를 기록했습니다. 이는 비교 대상 시스템 중 최고 온도 전환 시 90°C까지 치솟았던 다른 제품들보다 낮은 수치입니다. 작업 부하가 Equal ISL/OSL에서 Decode Heavy로 전환됨에 따라 CPU 온도는 급격히 상승하지 않고 안정화되었습니다.
저부하 조건에서 CPU는 최저 36.4°C의 온도를 기록했습니다. 이는 시스템이 과부하 상태가 아닐 때 HP ZGX가 효과적인 열 방출을 보여준다는 것을 의미합니다. 전반적으로 ZGX는 안정적인 지속 부하 성능을 유지하면서 CPU의 순간적인 발열을 효과적으로 제어했습니다.
GPU 온도
GPU 발열 또한 비슷한 양상을 보였습니다. 고강도 가속 작업 중에는 GPU 온도가 최대 69°C까지 상승했습니다. 이는 HP 제품이 피크 버스트 조건에서 비교 대상 제품들보다 낮은 온도임을 의미하며, Dell, ASUS, Founders Edition 등 다른 시스템들은 최고 부하 시 눈에 띄게 높은 온도를 기록했습니다. 작업이 Equal ISL/OSL 및 Decode Heavy 단계로 전환됨에 따라 GPU 온도는 안정화되었습니다.
GPU는 부하가 적은 단계에서 최저 34°C의 온도를 기록하여 안정적인 유휴 상태 열 관리 능력을 보여주었습니다. 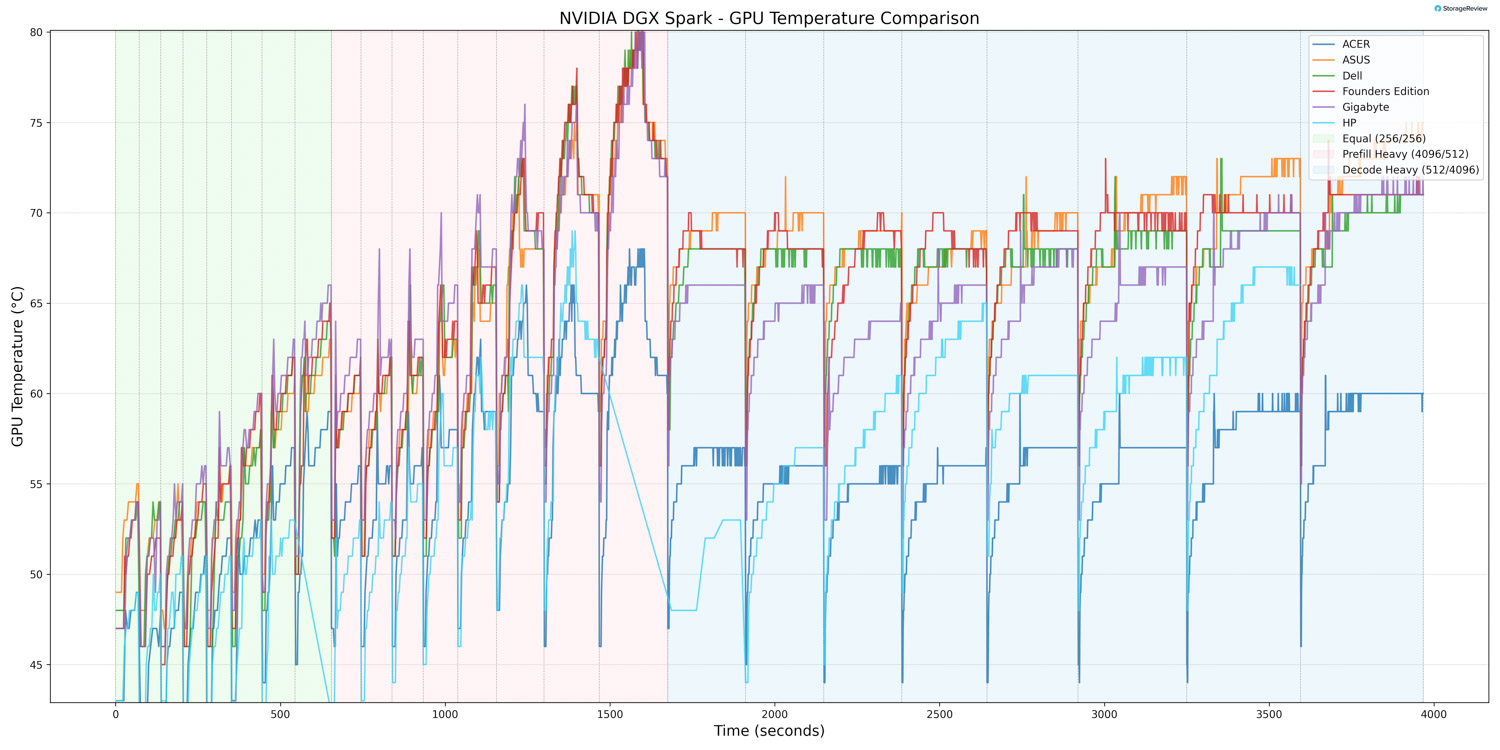
NVMe 온도
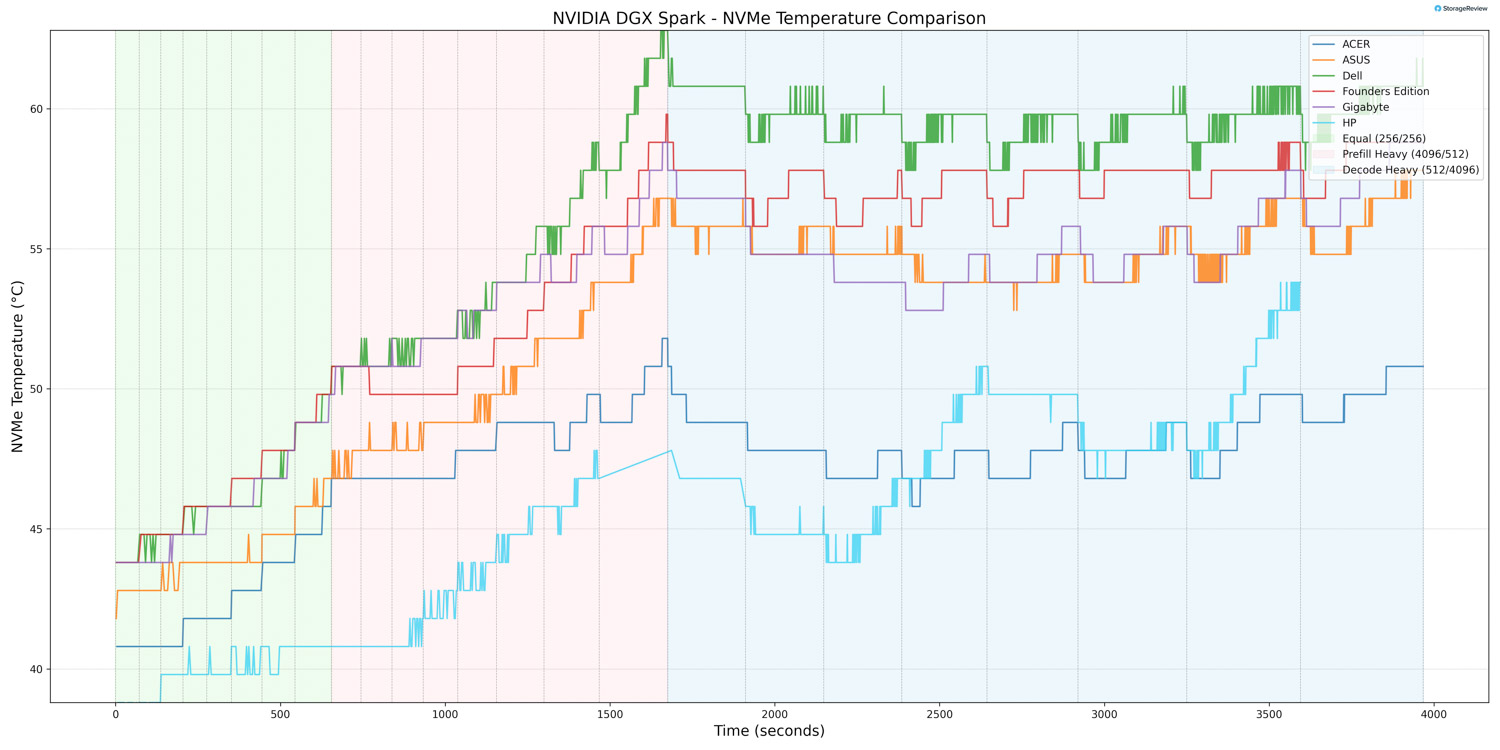
Equal 단계 동안 NVMe 드라이브는 약 42°C에 도달했으며, 휴지 상태의 기준 온도에서 서서히 상승하는 모습을 보였습니다. 작업 부하가 Prefill Heavy로 전환됨에 따라 저장 장치 온도는 42°C에서 47°C 사이로 눈에 띄게 상승했습니다. Decode Heavy 단계에서는 드라이브 온도가 47°C에서 54°C 사이로 최고치를 기록했지만, 다른 대부분의 Spark 시스템보다 훨씬 낮은 수준을 유지했습니다.
NIC 온도
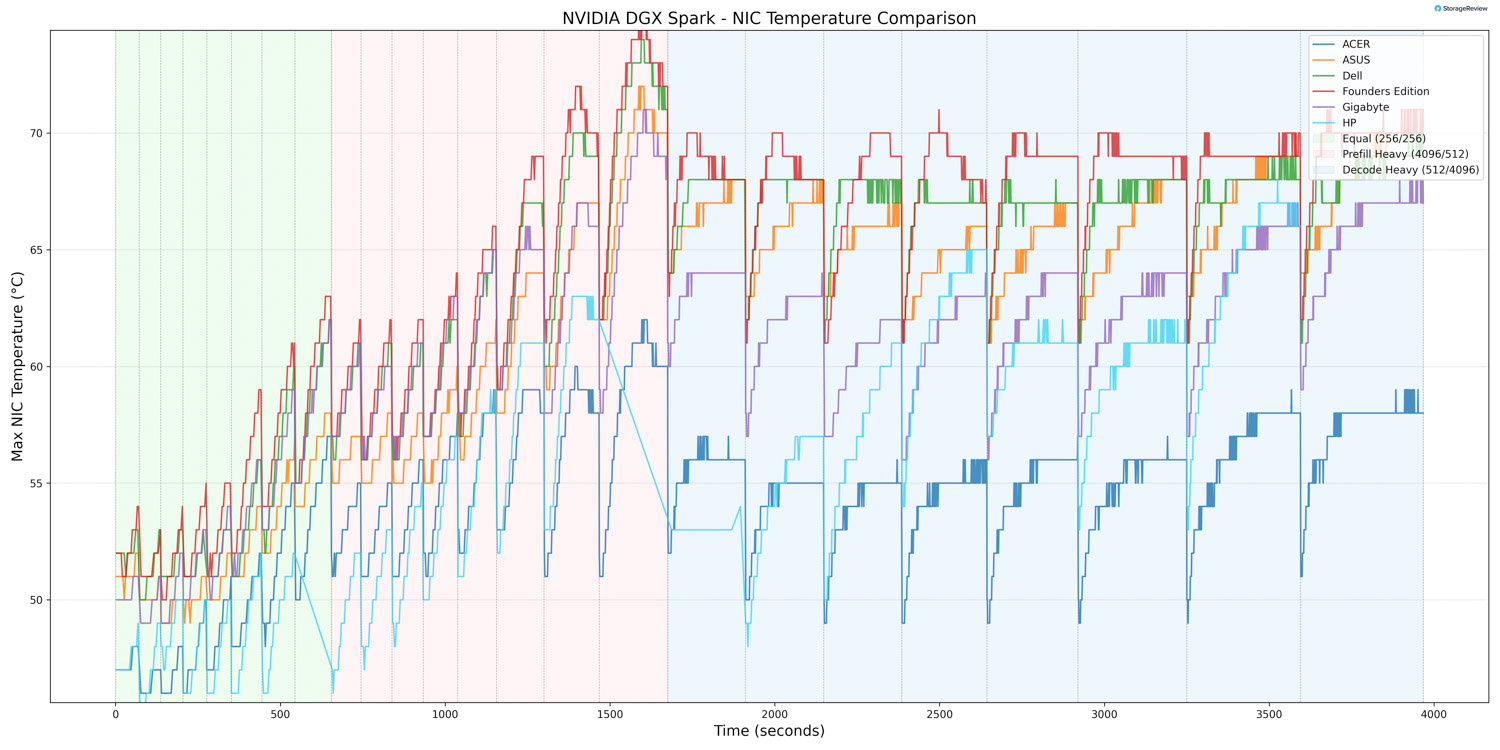
균등화 단계 동안 NIC 온도는 39°C에서 52°C 사이를 오르내리며 꾸준히 상승했는데, 이는 실행 초기에 네트워크 활동이 증가함에 따라 적당한 열 축적이 발생했음을 나타냅니다.
프리필 헤비(Prefill Heavy) 단계에서는 네트워킹 서브시스템에 지속적인 부하가 걸리기 때문에 NIC 온도가 48°C에서 64°C 사이로 상승했습니다. 디코드 헤비(Decode Heavy) 단계에서는 NIC 온도가 52°C에서 68°C 사이로 최고치를 기록하며 가장 높은 온도에 도달했습니다. 그럼에도 불구하고 테스트 전반에 걸쳐 열적 특성은 안정적으로 유지되었습니다.
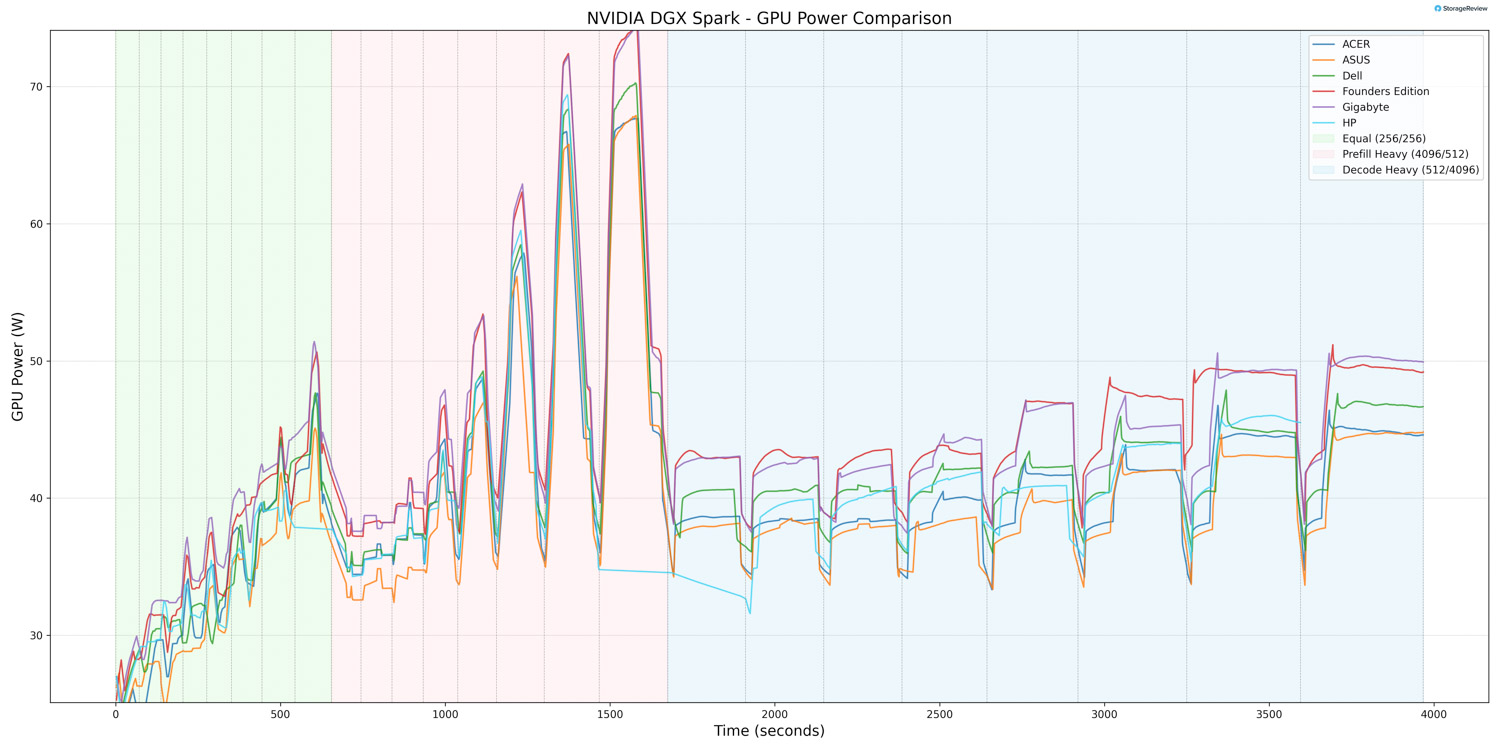
GPU 전력 소비량
동일 조건 테스트 단계에서 GPU 전력 소비량은 2.86W에서 40W를 약간 넘는 수준까지 다양했으며, HP ZGX Nano G1n은 중간 정도의 성능을 보였습니다.
프리필 헤비(Prefill Heavy) 단계에서 GPU 전력은 약 37W에서 시작하여 35W까지 떨어졌다가 69W까지 치솟아, 전체 실행 과정 중 가장 전력 소모가 많은 단계였습니다.
디코딩 작업이 집중적으로 진행되는 동안 GPU 전력 소비량은 35W~46W의 더 낮고 안정적인 범위로 수렴했는데, 이는 작업 부하가 급격한 부하 변동에서 벗어나면서 전력 요구량이 완화되었음을 나타냅니다.
열 요약
ZGX Nano G1n은 부하 상태에서도 엄격하게 제어되는 열 범위 내에서 작동합니다. 최대 시스템 전력 소비량은 약 228W이며, 발열량은 약 780 BTU/hr입니다. 반면, 유휴 상태에서의 전력 소비량은 약 36~38W로 낮아 시스템이 작동하지 않을 때 효율적인 전력 소비 제어가 이루어짐을 보여줍니다. 강제 공랭식 냉각 방식은 HP에서 지정한 5°C~30°C 범위 내에서 안정적인 작동을 유지합니다.
HP ZGX Nano AI 성능 테스트
HP ZGX Nano와 GB10의 성능을 평가하기 위해, 대규모 언어 모델을 위한 가장 널리 사용되는 고처리량 추론 및 서빙 엔진인 vLLM 온라인 서빙 벤치마크를 사용하여 Spark 유닛을 테스트했습니다. vLLM 온라인 서빙 벤치마크는 실행 중인 vLLM 서버에 동시 요청을 전송하고 다양한 부하 조건에서 총 토큰 처리량(초당 토큰 수), 첫 번째 토큰 획득 시간, 출력 토큰당 시간 등의 주요 지표를 측정하여 실제 운영 환경을 시뮬레이션합니다.
본 테스트는 밀집 아키텍처와 마이크로 스케일링 데이터 유형을 포함한 다양한 모델을 대상으로 진행되었으며, ISL/OSL 균등, 사전 입력 작업량 많음, 디코딩 작업량 많음의 세 가지 워크로드 시나리오에서 성능을 평가했습니다. 이러한 시나리오는 균형 잡힌 입력 및 출력 부하부터 연산 집약적인 프롬프트 처리 및 메모리 대역폭 제약이 있는 토큰 생성에 이르기까지 실제 서비스 환경에서 발생하는 다양한 패턴을 나타냅니다.
HP ZGX Nano(GB10 탑재) 외에도 Dell, ASUS , Acer , Gigabyte 등 다른 OEM 시스템도 벤치마킹했습니다 . 이를 통해 HP의 결과를 더 넓은 경쟁 환경 속에서 살펴보고, 다양한 모델과 워크로드에서 HP가 어떤 부분에서 선두를 달리고, 어떤 부분에서 경쟁사와 보조를 맞추며, 어떤 부분에서 뒤처지는지 파악할 수 있었습니다.
GPT-OSS-120B
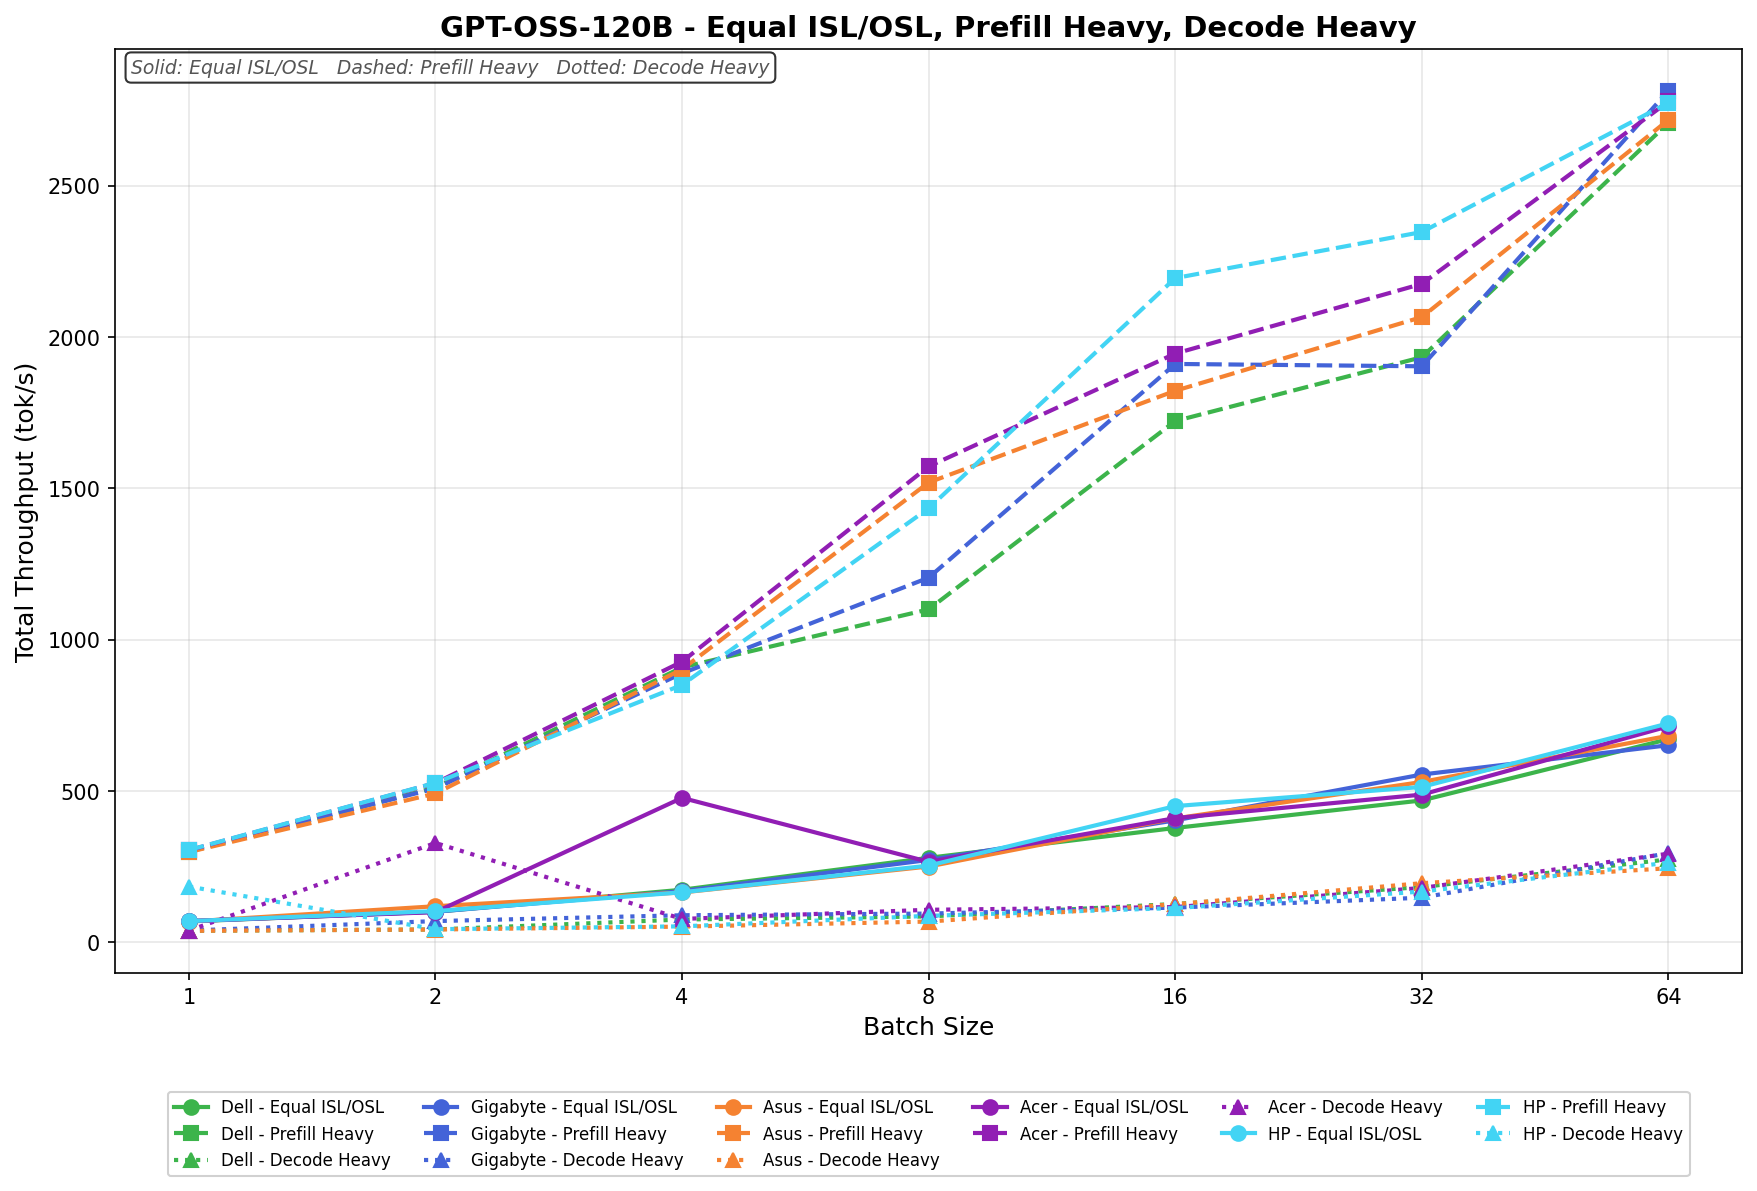
GPT-OSS-120B를 사용하는 HP ZGX Nano G1n은 Prefill Heavy 테스트에서 가장 뛰어난 성능을 보여주며, 처리량은 첫 번째 배치에서 304.5 tok/s에서 64번째 배치에서 2773.3 tok/s로 증가했습니다. Equal ISL/OSL 테스트 또한 69.6 tok/s에서 722.9 tok/s로 꾸준히 증가했습니다. Decode Heavy 테스트는 이에 비해 훨씬 가벼운 성능을 보였는데, 첫 번째 배치에서 183.7 tok/s로 시작하여 두 번째 배치에서 약간 감소한 후 64번째 배치에서 262.9 tok/s로 회복되었습니다.
GPT-OSS-20B
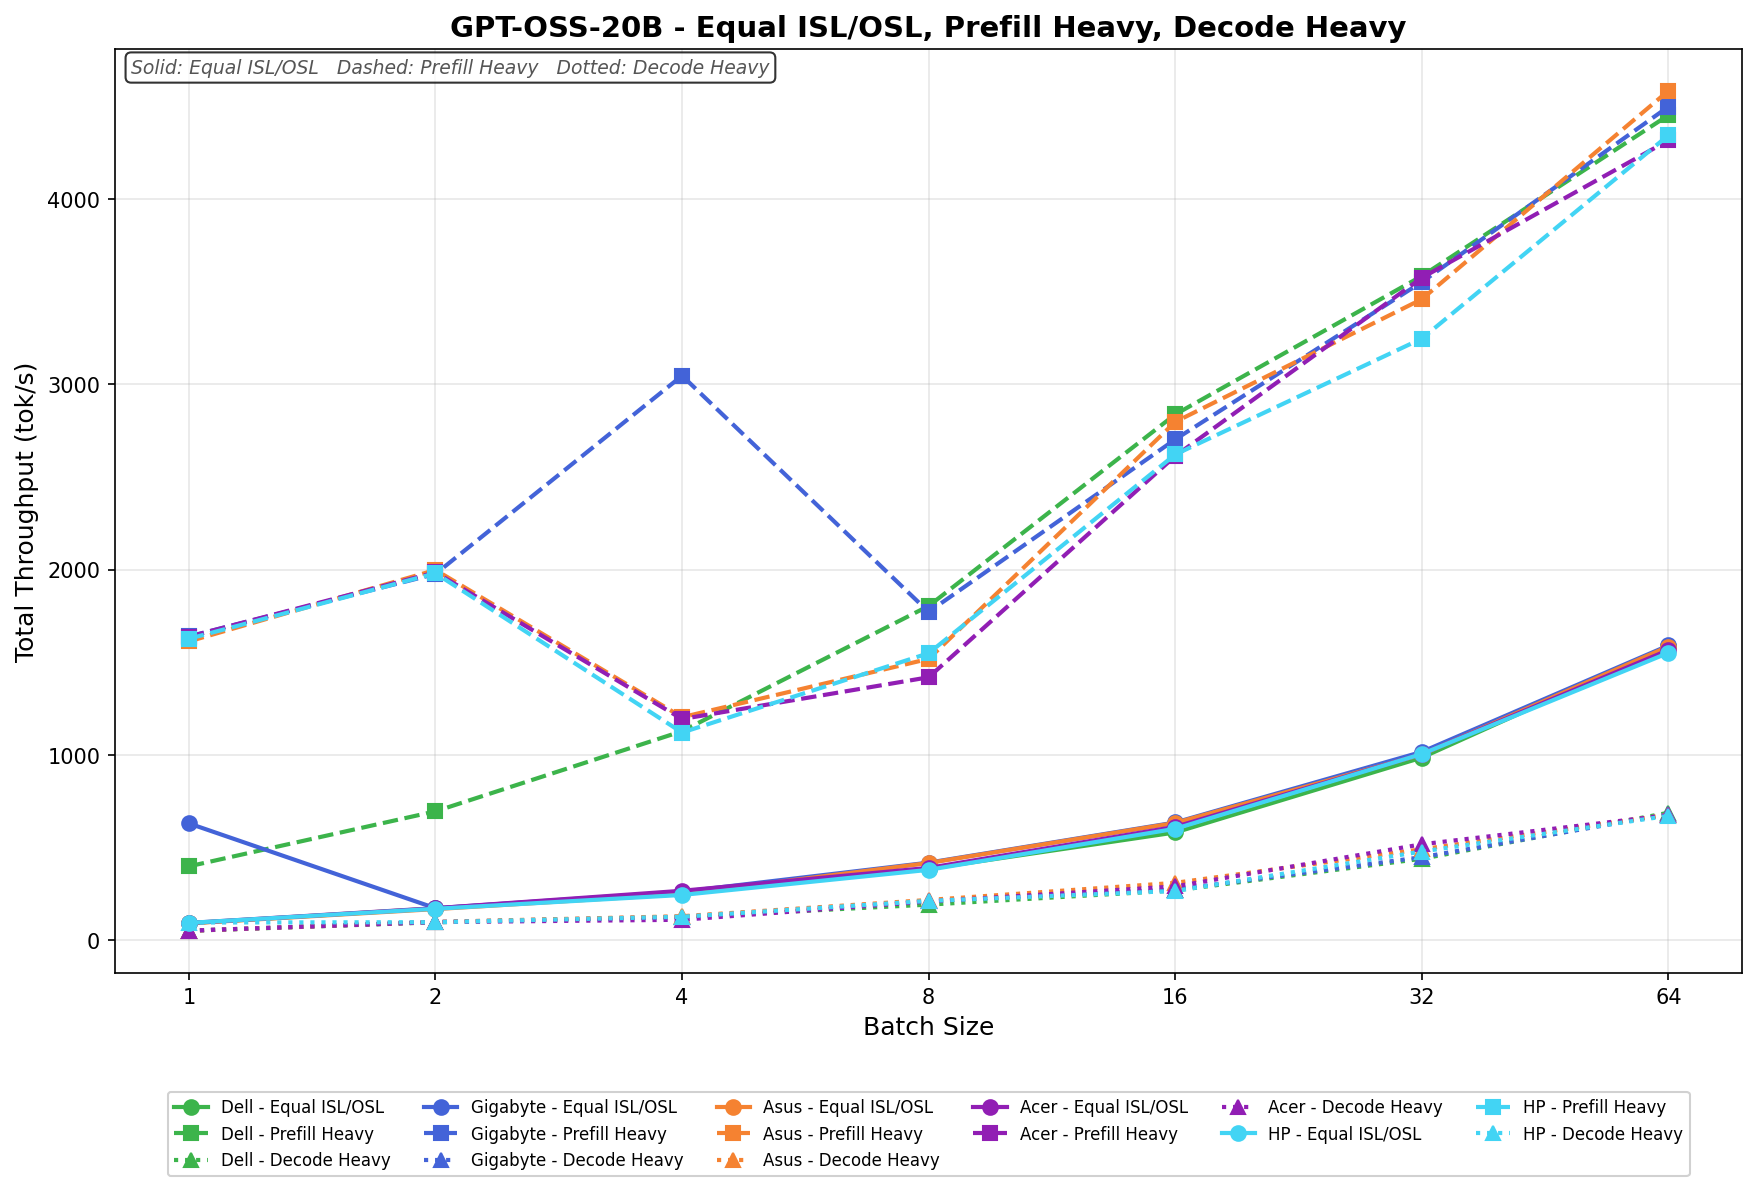
GPT-OSS-20B를 사용하는 HP의 경우, 가장 높은 처리 속도는 Prefill Heavy에서 나타나지만, 다른 모델에 비해 처리 속도 증가가 선형적이지 않습니다. Prefill은 첫 번째 배치에서 1626.6 tok/s로 시작하여 두 번째 배치에서 1980.3 tok/s까지 상승한 후 네 번째 배치에서 1120.3 tok/s로 급격히 하락하고, 여섯 번째 배치에서는 4345.1 tok/s까지 회복합니다. Equal ISL/OSL은 92.6 tok/s에서 1550.6 tok/s까지 더 부드럽게 처리 속도가 증가하며, Decode Heavy는 94.4 tok/s에서 670.4 tok/s까지 상승합니다.
Qwen3 코더 30B A3B FP8
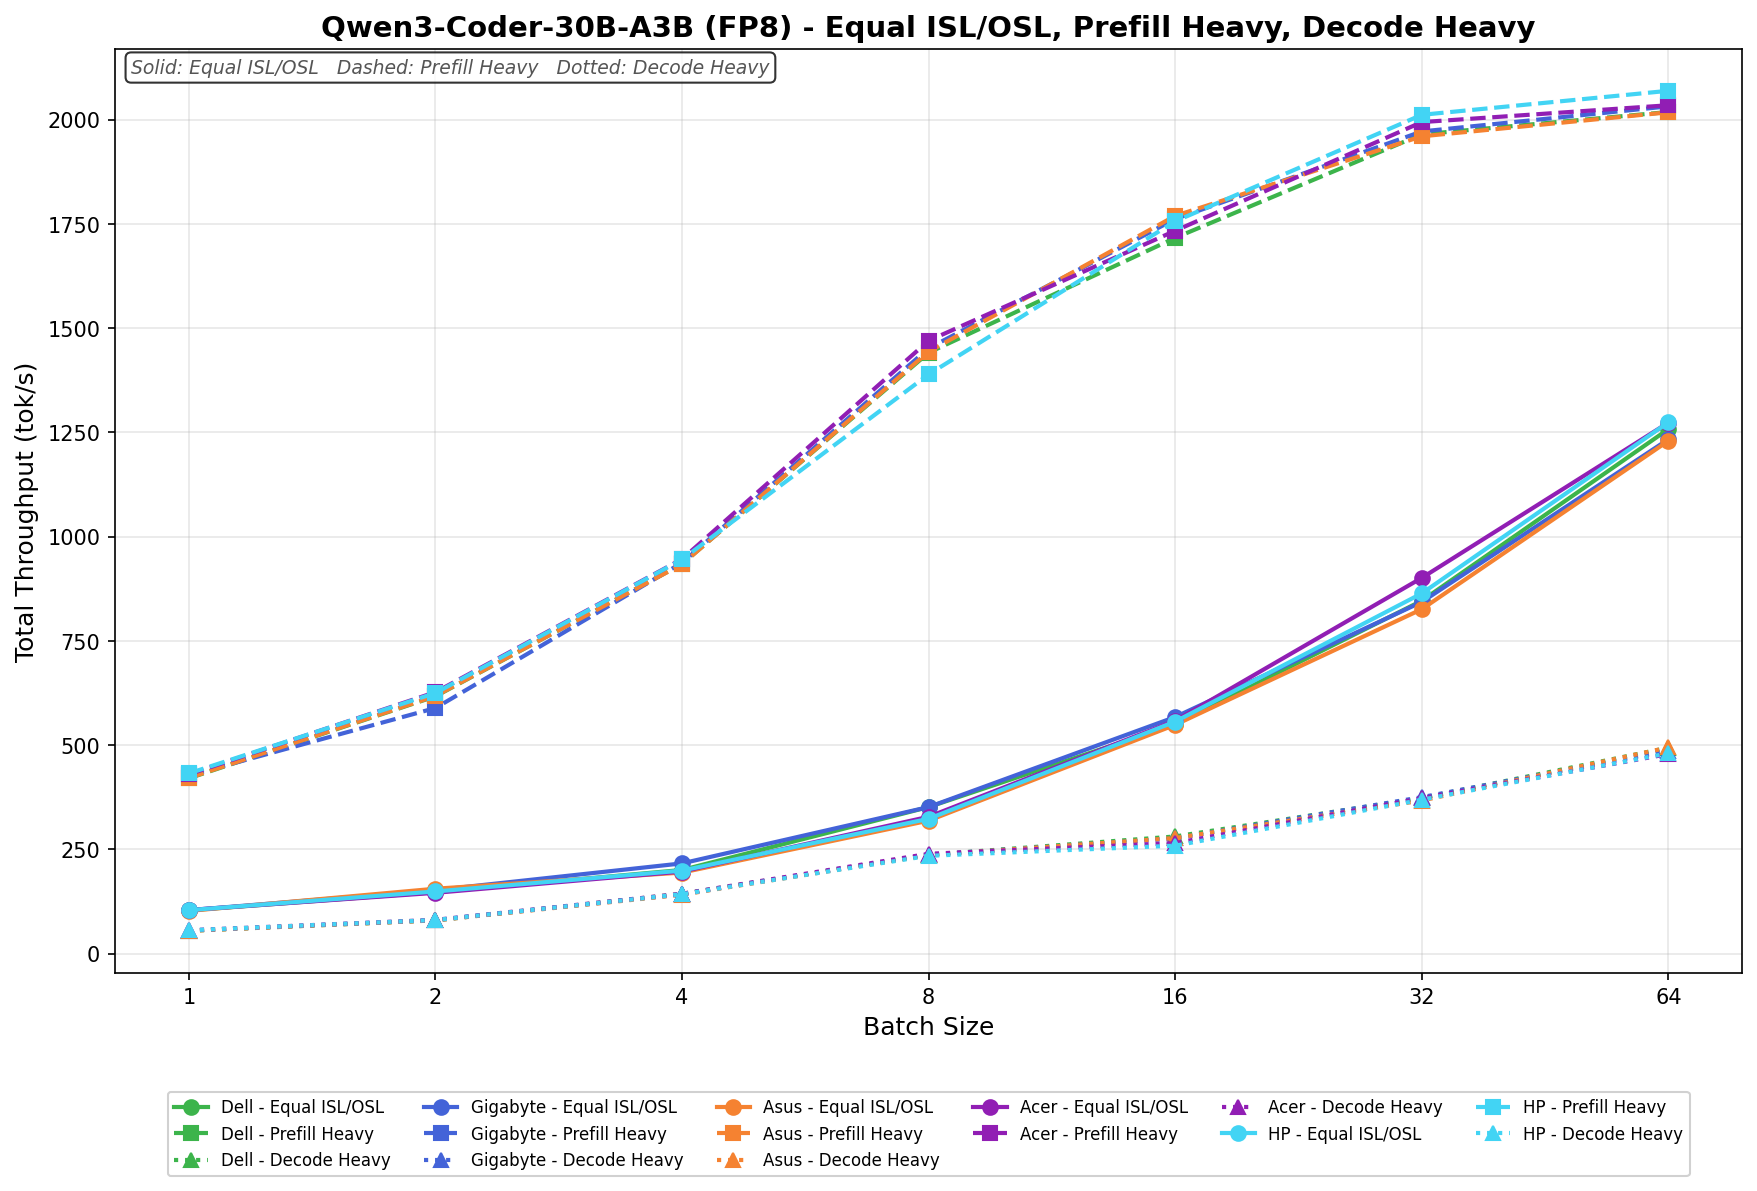
Qwen3 Coder 30B A3B(FP8)에서 HP는 프리필 헤비(Prefill Heavy) 성능에서 다시 한번 탁월한 결과를 보여주었습니다. 처리량은 배치 크기 1일 때 432.2 tok/s에서 배치 크기 64일 때 2069.4 tok/s로 증가했습니다. 동일 ISL/OSL(Isolation, Interval, and System, and System)은 104.2 tok/s에서 1274.4 tok/s로, 디코드 헤비(Decode Heavy)는 55.9 tok/s에서 480.4 tok/s로 향상되었습니다. 이는 HP의 전반적인 성능 중에서도 우수한 결과입니다.
Qwen3 코더 30B A3B 베이스
Qwen3 Coder 30B A3B(Base)에서 HP는 세 단계 모두에서 꾸준한 성장을 보였지만, 최고 성능은 프리필 헤비(Prefill Heavy) 단계에서 나타났습니다. 이 단계는 첫 번째 배치에서 258.6 tok/s에서 64번째 배치에서 1629.4 tok/s로 증가했습니다. 동일 ISL/OSL 단계는 60.3 tok/s에서 690.3 tok/s로, 디코드 헤비(Decode Heavy) 단계는 33.0 tok/s에서 331.8 tok/s로 향상되었습니다.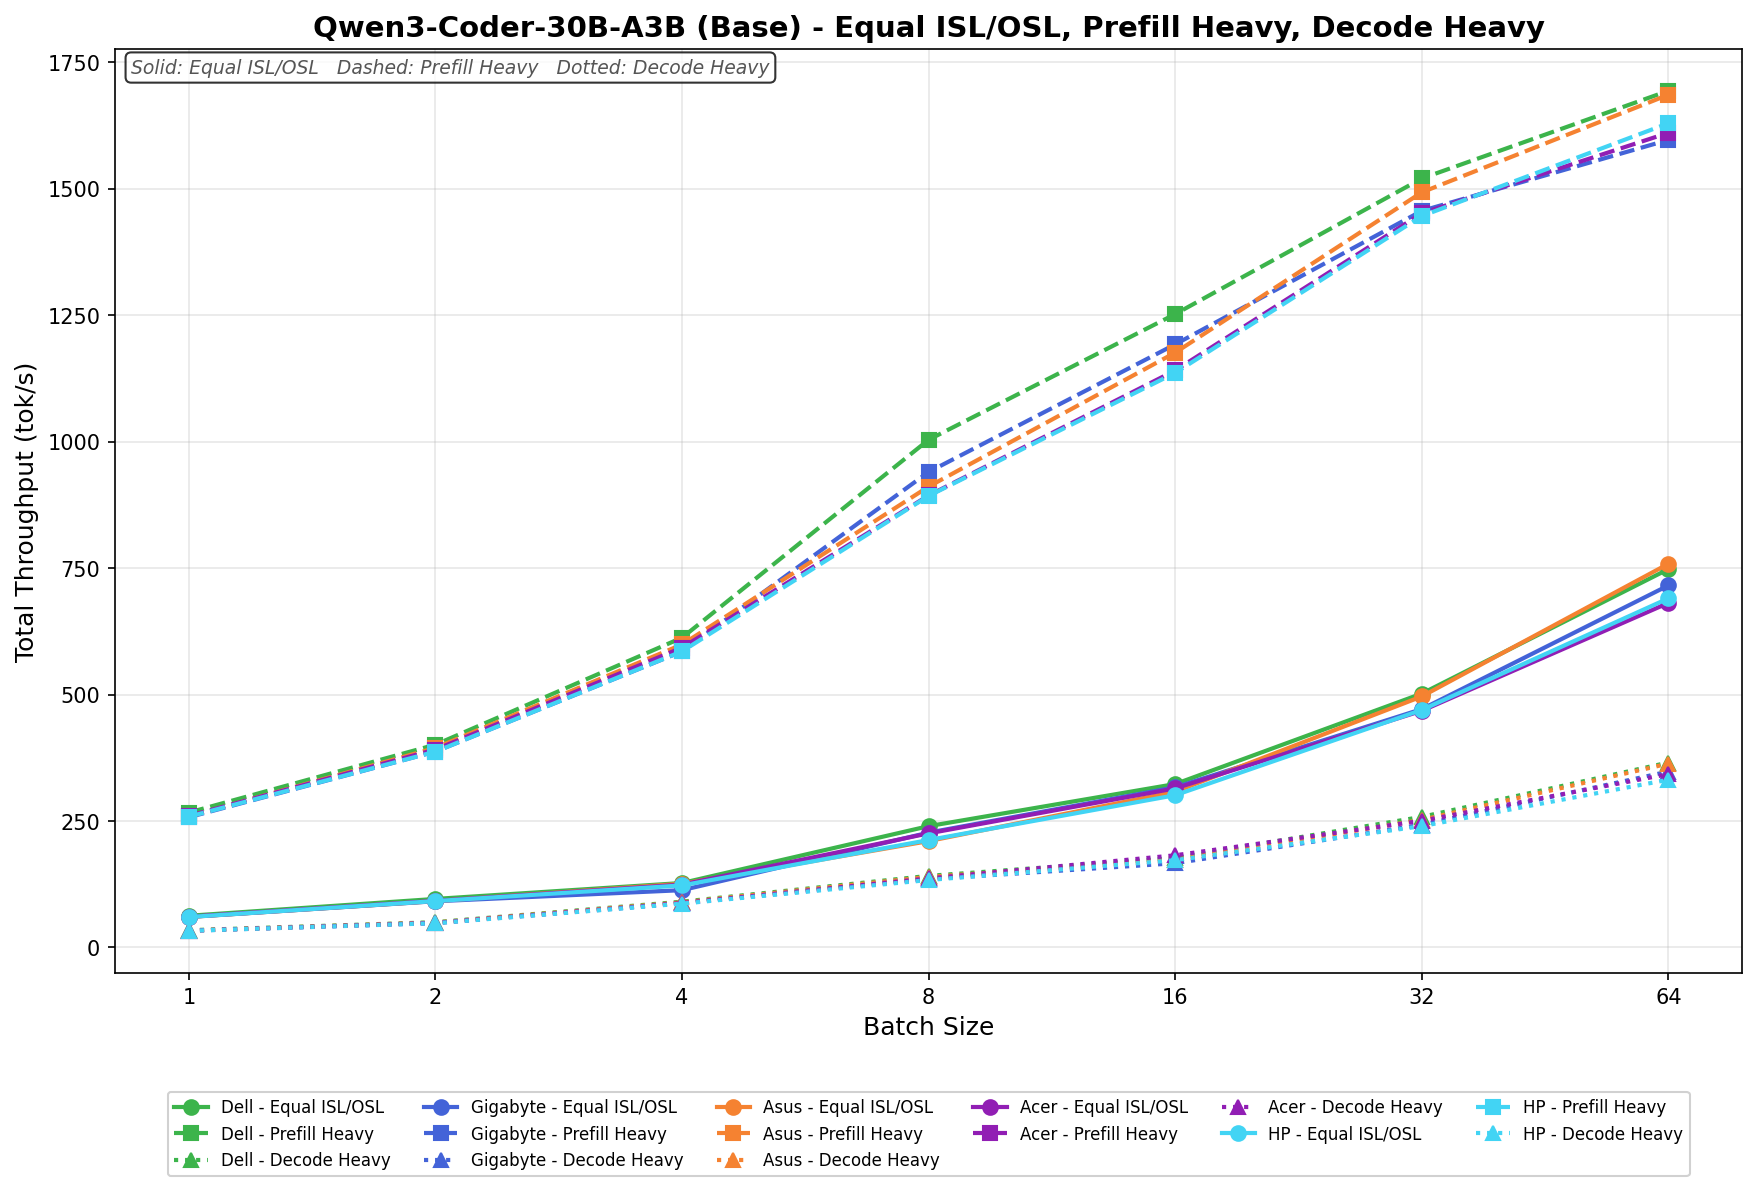
Llama 3.1 8B 명령어 FP4
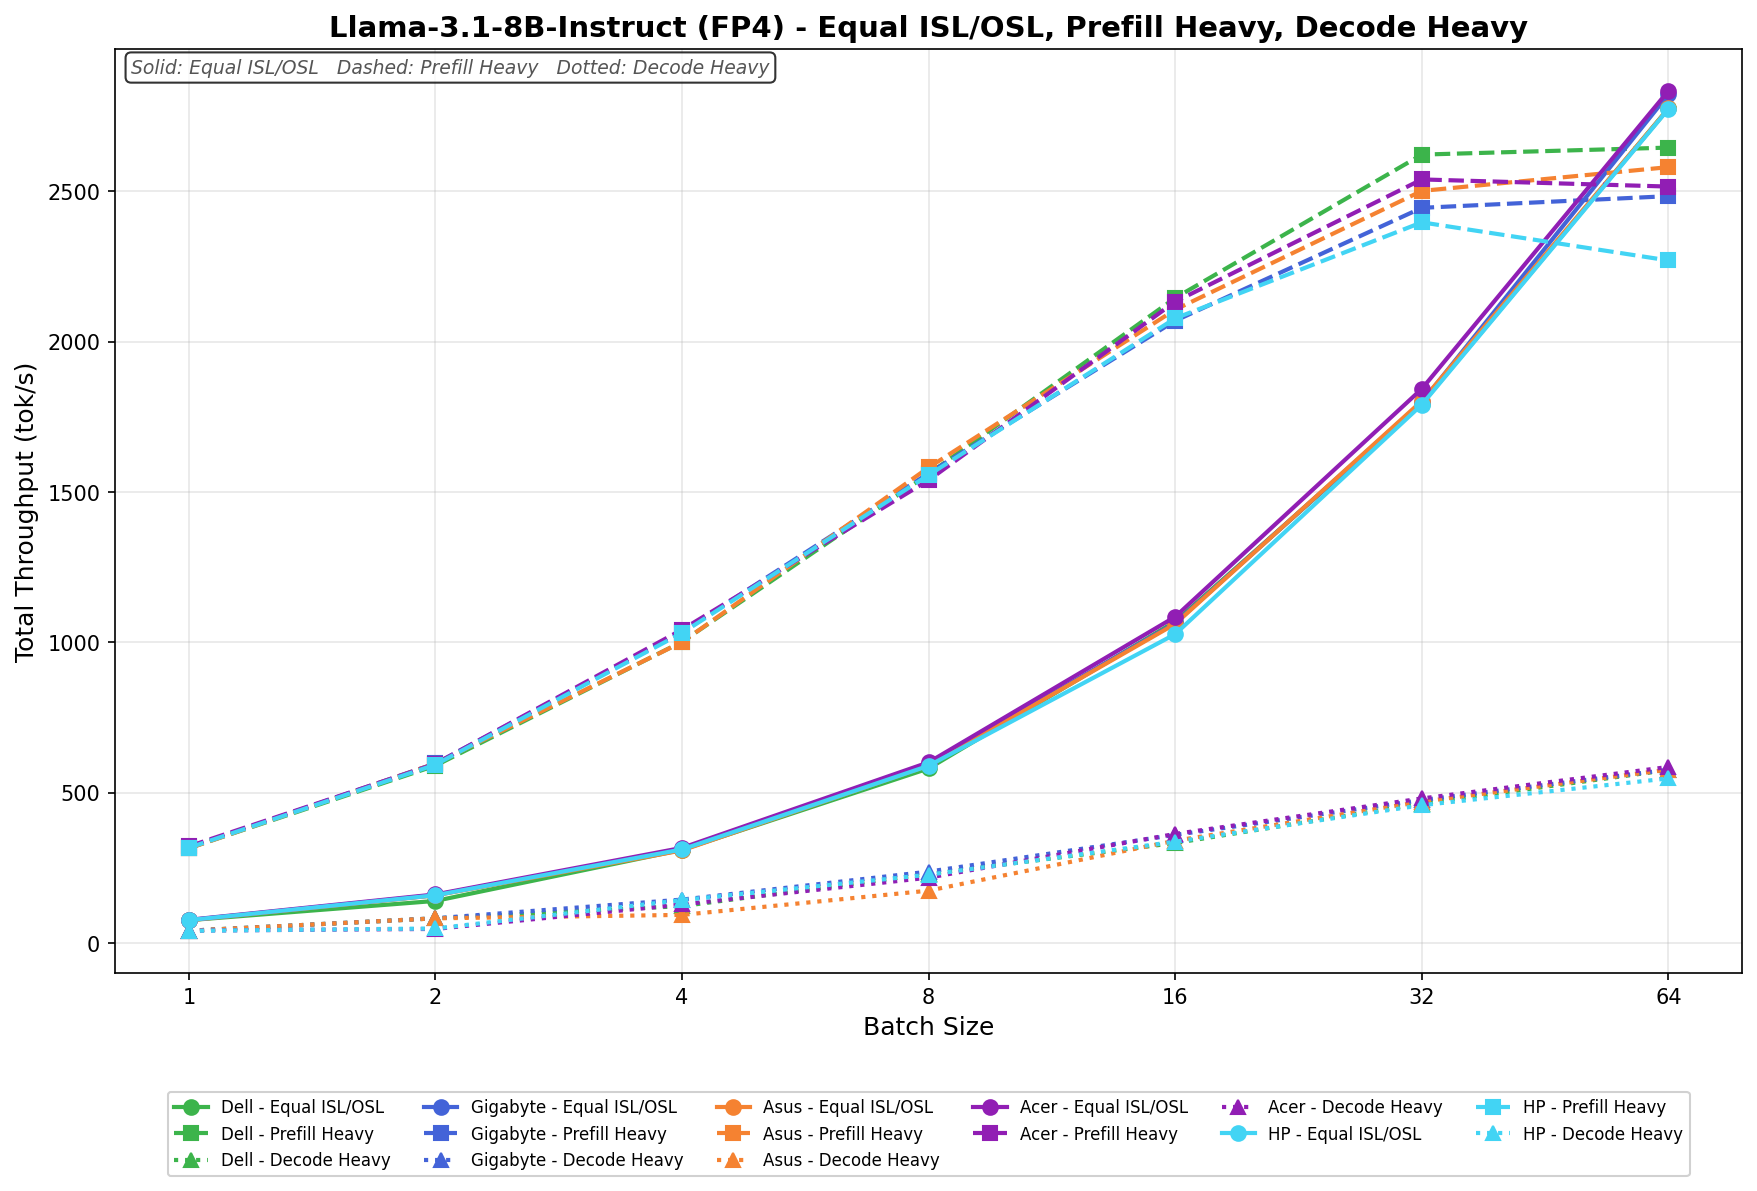
Llama-3.1-8B-Instruct(FP4)를 사용한 HP 테스트에서 처리량 향상이 뚜렷하게 나타났습니다. Equal ISL/OSL은 배치 1에서 76.4 tok/s에서 배치 64에서 2774.1 tok/s로 급증하여 이 모델에서 HP의 세 가지 단계 중 가장 강력한 성능을 보였습니다. Prefill Heavy 또한 배치 32에서 316.8 tok/s에서 2397.1 tok/s로 급격히 증가한 후 배치 64에서 2270.4 tok/s로 소폭 하락했습니다. Decode Heavy는 전체 테스트 기간 동안 40.7 tok/s에서 547.6 tok/s로 증가했습니다.
Llama 3.1 8B 지침(기본)
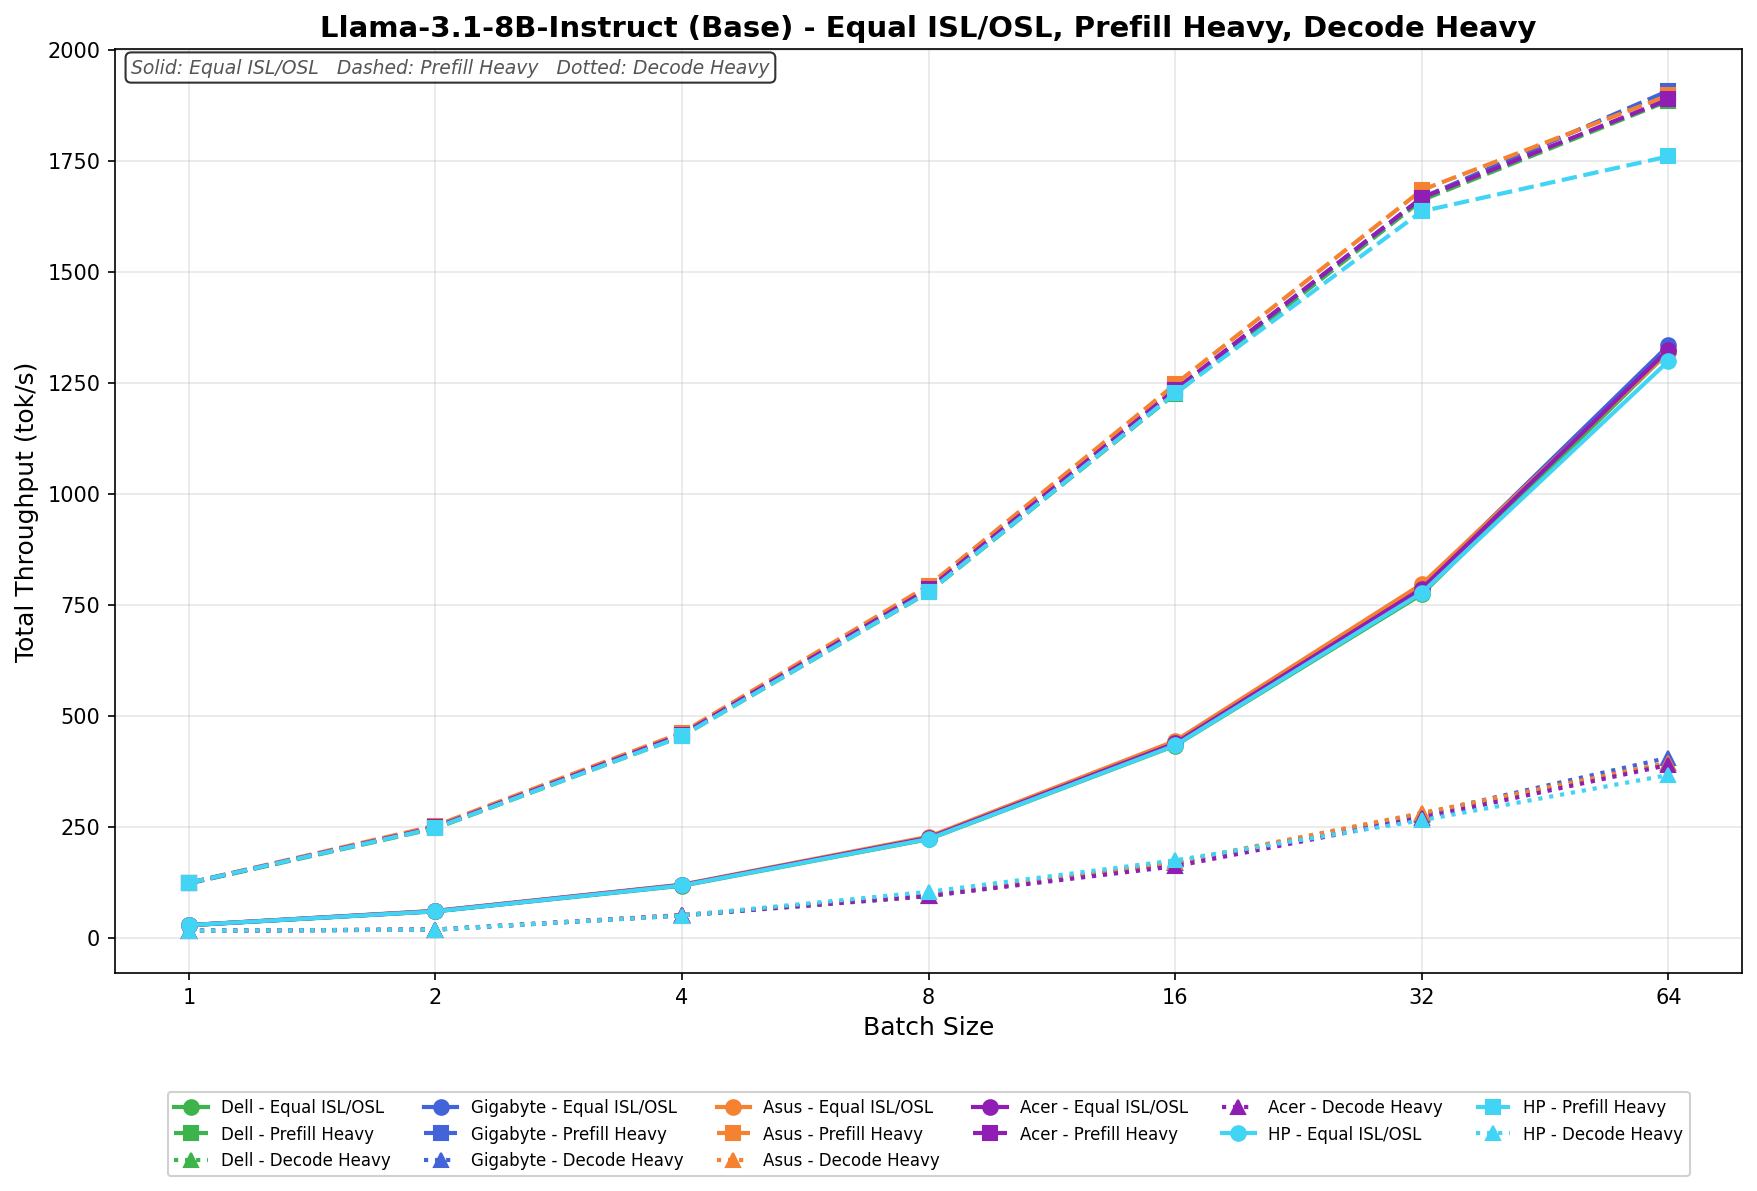
Llama-3.1-8B-Instruct(Base) 테스트에서 HP ZGX Nano G1n은 세 단계 모두에서 안정적인 성능 향상을 보여줍니다. Equal ISL/OSL 테스트에서는 처리량이 첫 번째 배치에서 28.2 tok/s에서 여섯 번째 배치에서 1298.6 tok/s로 증가했습니다. Prefill Heavy 테스트에서는 처리량이 123.2 tok/s에서 1759.5 tok/s로 증가했으며, 최고점에서 약간 감소하기 전까지 전체 테스트 범위에 걸쳐 꾸준히 향상되었습니다. Decode Heavy 테스트는 상대적으로 성능이 낮아 첫 번째 배치에서 15.5 tok/s에서 여섯 번째 배치에서 366.4 tok/s로 증가했습니다.
GPU 직접 스토리지
GPU 직접 스토리지 작동 방식
기존 방식에서는 GPU가 NVMe 드라이브의 데이터를 처리할 때, 데이터가 GPU에 도달하기 전에 먼저 CPU와 시스템 메모리를 거쳐야 했습니다. 이 과정에서 CPU가 중간 역할을 하여 지연 시간을 발생시키고 시스템 리소스를 소모하기 때문에 병목 현상이 발생합니다. GPU Direct Storage는 GPU가 PCIe 버스를 통해 스토리지 장치에서 직접 데이터에 접근할 수 있도록 함으로써 이러한 비효율성을 해결합니다. 이러한 직접 경로는 데이터 이동 오버헤드를 줄여 더 빠르고 효율적인 데이터 전송을 가능하게 합니다.
AI 워크로드, 특히 딥러닝 관련 워크로드는 데이터 집약적입니다. 대규모 신경망을 학습시키려면 테라바이트 규모의 데이터를 처리해야 하며, 데이터 전송 지연은 GPU 활용률 저하와 학습 시간 증가로 이어집니다. 따라서 GPU Direct Storage는 데이터를 최대한 빠르게 GPU로 전송하여 유휴 시간을 최소화하고 연산 효율성을 극대화함으로써 이러한 문제를 해결합니다.
또한 GDS는 비디오 처리, 자연어 처리 및 실시간 추론과 같이 대규모 데이터 세트를 스트리밍하는 워크로드에 유용합니다. CPU 의존도를 줄임으로써 데이터 이동 속도를 높이고 CPU 리소스를 다른 작업에 활용할 수 있도록 하여 전반적인 시스템 성능을 향상시킵니다.
GDSIO 읽기 처리량 16K
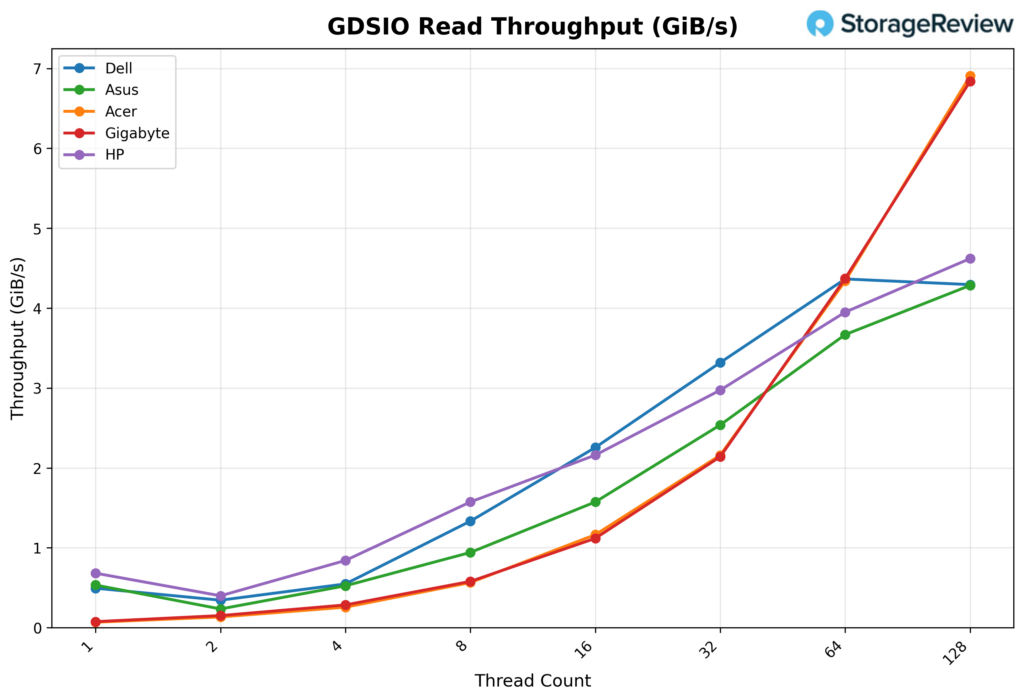
GDSIO 읽기 처리량 16K를 살펴보면, HP ZGX Nano G1n은 1개 스레드에서 0.70GiB/s로 시작하여 그룹 내에서 저스레드 성능이 우수한 편에 속합니다. 2개 스레드에서는 0.41GiB/s까지 떨어졌다가 4개 스레드에서는 0.86GiB/s까지 다시 상승하는데, 이는 다른 몇몇 시스템에서 나타나는 초기 스레드 성능의 작은 변동성과 유사합니다. 이후부터는 훨씬 더 안정적인 성능을 보여줍니다. 처리량은 8개 스레드에서 1.6GiB/s, 16개 스레드에서 2.2GiB/s까지 증가하고, 32개 스레드에서는 3.0GiB/s까지 계속 상승합니다. 큐 깊이가 높아질수록 HP는 성능 향상을 지속하여 64개 스레드에서 3.9GiB/s, 128개 스레드에서 4.6GiB/s의 최고치를 기록합니다.
GDSIO 읽기 평균 지연 시간 16K
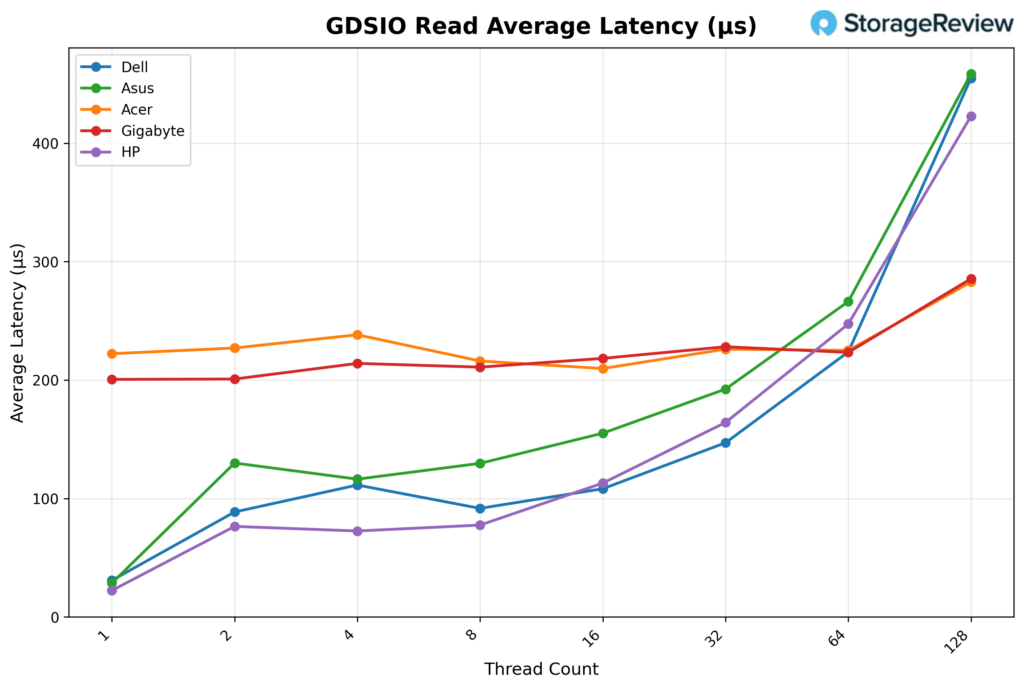
GDSIO 읽기 평균 지연 시간(16K)을 살펴보면, HP ZGX Nano G1n은 스레드 1개에서 약 0.02ms로 시작하여 스레드 2개(0.08ms)와 4개(0.07ms)까지 낮은 수준을 유지합니다. 스레드 8개(0.08ms)와 16개(0.11ms)에서는 지연 시간이 약간 증가하고, 32개(0.16ms)와 64개(0.25ms)에서는 더욱 눈에 띄게 증가합니다. 스레드 128개에서는 지연 시간이 0.42ms에 도달하지만, 이는 테스트 전반에 걸쳐 시스템의 처리량이 꾸준히 증가하는 추세를 보여주면서 그룹 내 최고 결과보다는 약간 낮은 수준입니다.
GDSIO 쓰기 처리량 16K
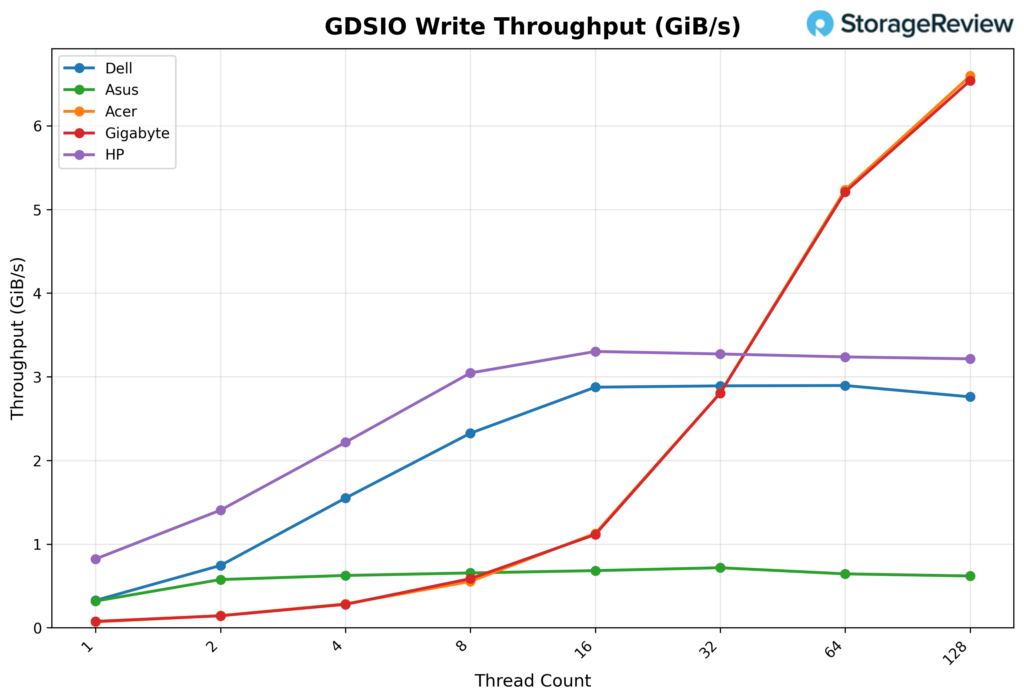
GDSIO 쓰기 처리량 16K를 살펴보면, HP ZGX Nano G1n은 1개 스레드에서 0.84GiB/s로 시작하여 2개 스레드에서 1.4GiB/s, 4개 스레드에서 2.2GiB/s에 도달합니다. 8개 스레드에서도 성능은 3.0GiB/s로 꾸준히 증가하다가 16개 스레드에서 3.3GiB/s에 이르러서는 거의 안정화됩니다. 이후 32개 및 64개 스레드에서는 처리량이 3.3GiB/s로 거의 일정하게 유지되다가 128개 스레드에서는 3.2GiB/s로 약간 감소합니다. 이는 플랫폼이 비교적 일찍 쓰기 처리량의 한계에 도달한 후 나머지 구간에서도 그 수준을 일관되게 유지함을 보여줍니다.
GDSIO 쓰기 평균 지연 시간 16K
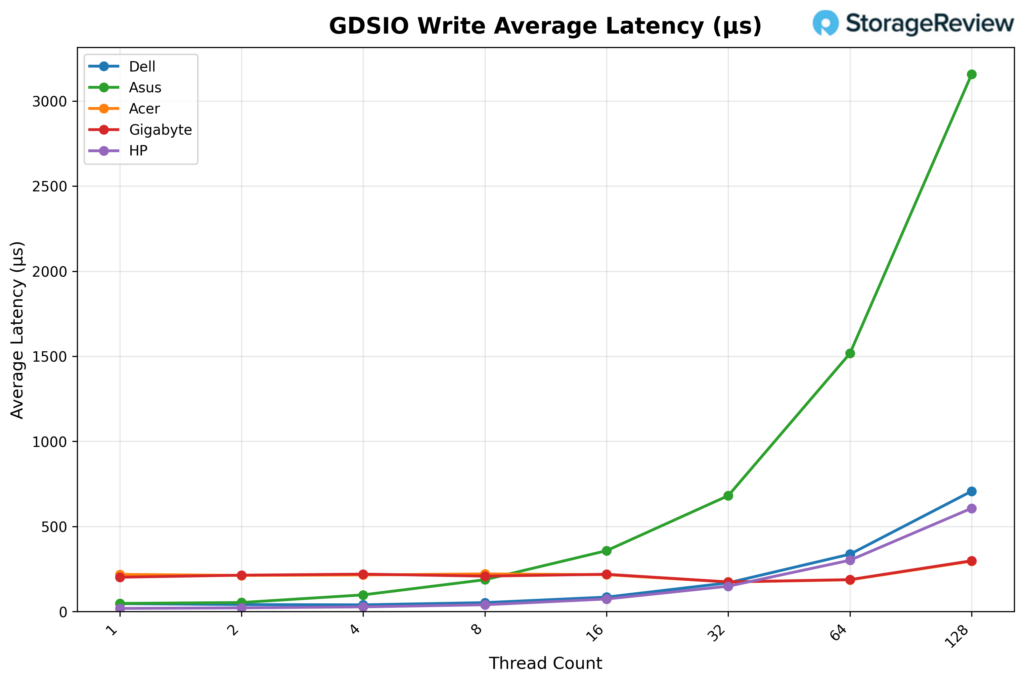
GDSIO 쓰기 평균 지연 시간(16K)을 살펴보면, HP ZGX Nano G1n은 스레드 1개에서 약 0.02ms로 시작하여 스레드 2개(0.02ms)와 4개(0.03ms)까지 매우 낮은 수준을 유지합니다. 지연 시간은 스레드 8개(0.04ms)와 16개(0.07ms)에서 약간 증가하다가, 스레드 32개(0.15ms)와 64개(0.30ms)에서는 급격히 증가합니다. 스레드 128개에서는 지연 시간이 0.61ms에 도달하지만, 전반적으로 여전히 비교적 잘 제어되는 수준입니다. 다만, 이러한 상승 추세는 스레드 수가 많아질수록 쓰기 처리량이 이미 포화 상태에 이르는 지점과 일치합니다.
GDSIO 읽기 처리량 1M
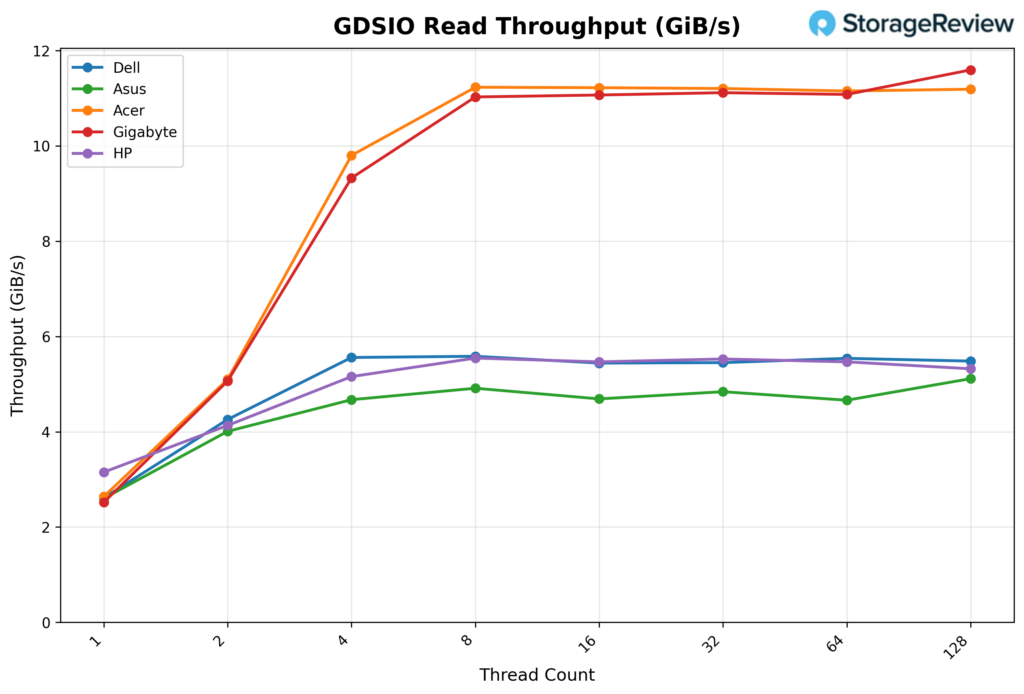
GDSIO 읽기 처리량 1M을 살펴보면, HP ZGX Nano G1n은 1개 스레드에서 3.2GiB/s로 시작하여 2개 스레드에서 4.1GiB/s까지 상승합니다. 4개 스레드(5.2GiB/s)와 8개 스레드(5.5GiB/s)에서도 성능은 계속 상승하다가 이후 플랫폼의 최대 성능에 도달합니다. 16개, 32개, 64개 스레드에서는 처리량이 5.5GiB/s로 거의 일정하게 유지되다가 128개 스레드에서 5.3GiB/s로 약간 감소하는데, 이는 초기 급격한 성능 상승 이후 고스레드 영역에서 매우 안정적인 성능을 보임을 나타냅니다.
GDSIO 읽기 평균 지연 시간 1M
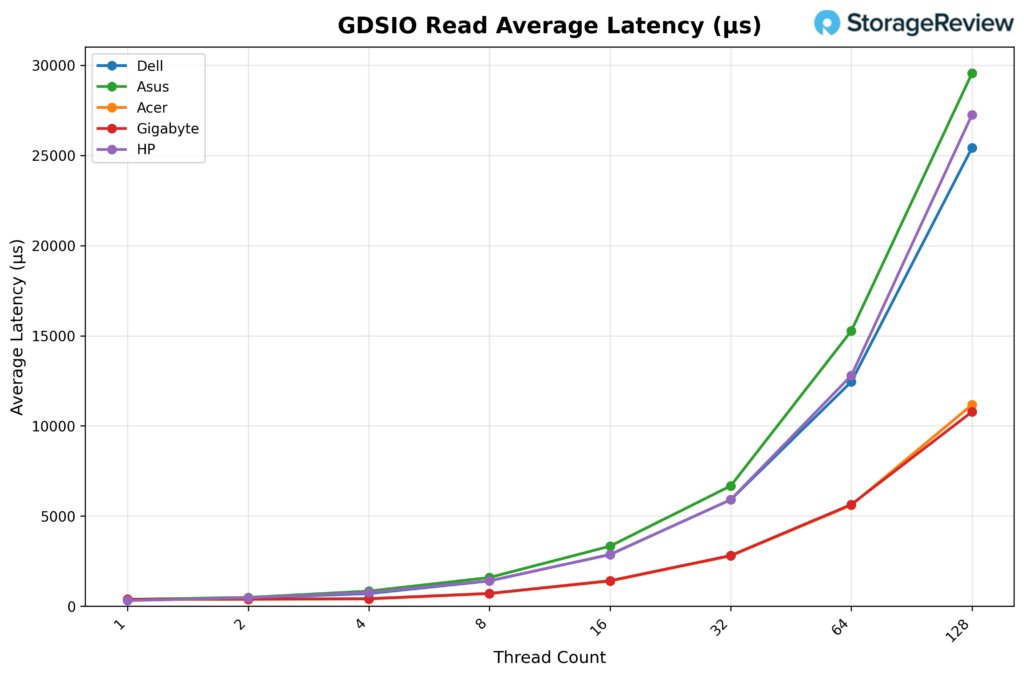
GDSIO 읽기 평균 지연 시간(1M)을 살펴보면, HP ZGX Nano G1n은 스레드 1개에서 약 0.31ms로 시작하여 스레드 2개(0.47ms)와 4개(0.76ms)에서도 비교적 낮은 수준을 유지합니다. 지연 시간은 동시 실행 스레드 수가 증가함에 따라 늘어나 8개 스레드에서 1.4ms, 16개 스레드에서 2.9ms, 32개 스레드에서 5.9ms까지 상승합니다. 이러한 추세는 스레드 64개(12.8ms)에서도 계속되어 128개 스레드에서는 27.2ms에 이르는데, 이는 처리량이 이미 스윕 초반에 안정화되었음에도 불구하고 큐 깊이가 높아질수록 지연 시간이 증가하는 경향을 보여줍니다.
GDSIO 쓰기 처리량 1M
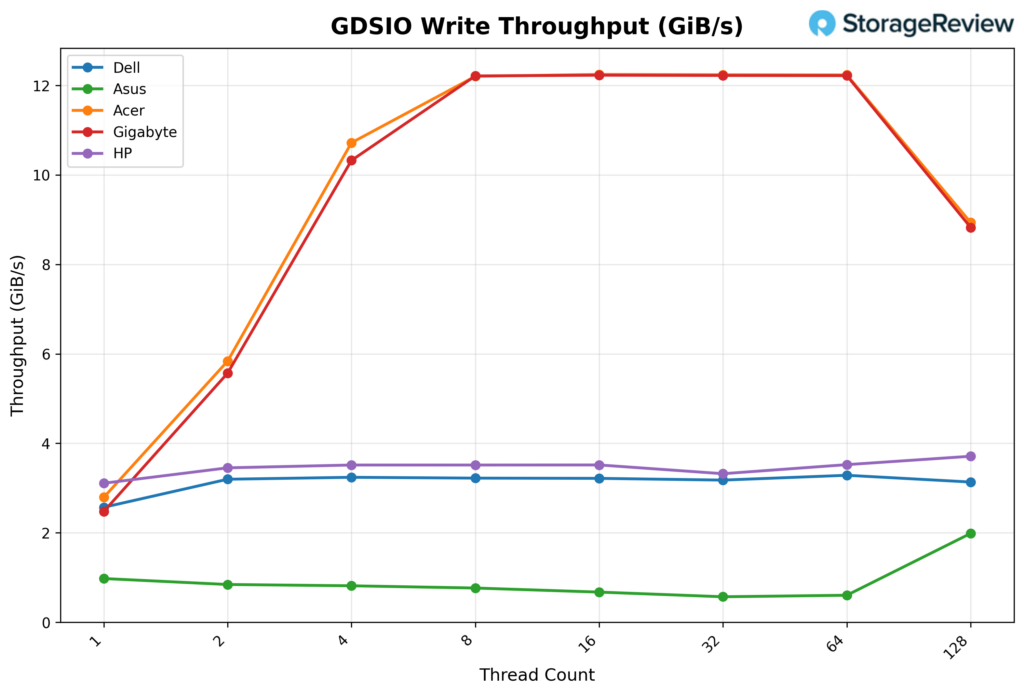
GDSIO 쓰기 처리량 1M을 살펴보면, HP ZGX Nano G1n은 스레드 1개에서 3.1GiB/s로 시작하여 스레드 2개에서 3.5GiB/s까지 상승한 후, 스레드 4개, 8개, 16개에서도 동일한 수준을 유지합니다. 스레드 32개에서는 성능이 3.3GiB/s로 약간 감소했다가 스레드 64개에서 다시 3.5GiB/s로 회복됩니다. 스레드 128개에서는 처리량이 3.7GiB/s로 증가하여, 스레드 수에 따라 전반적으로 쓰기 처리량이 거의 일정하게 유지되며, 가장 높은 스레드 수에서 약간의 변동과 함께 소폭 상승하는 것을 보여줍니다.
GDSIO 쓰기 평균 지연 시간 1M
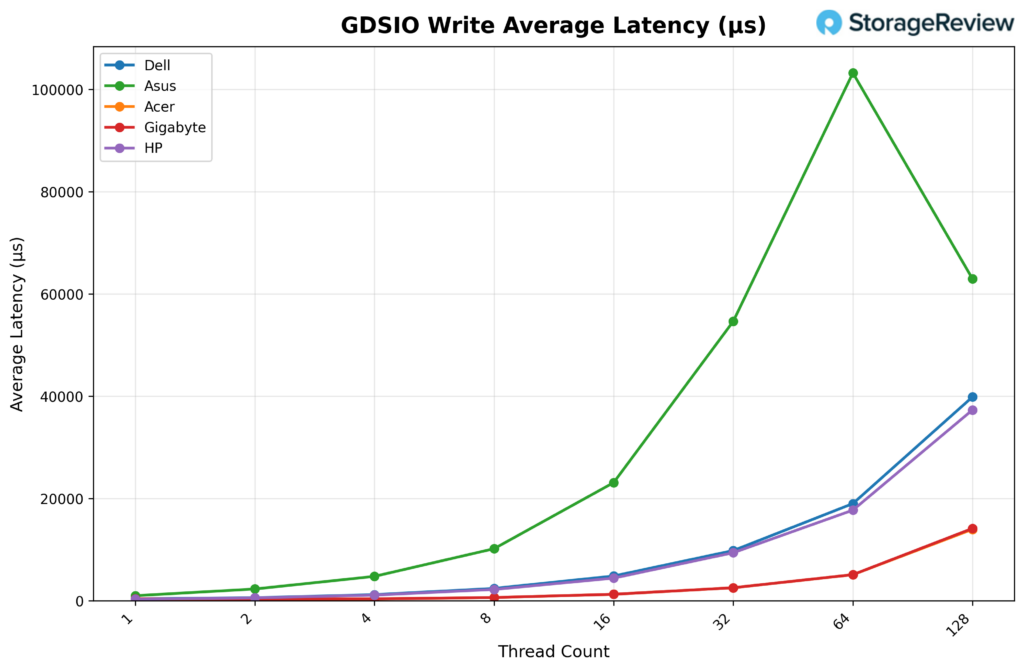
GDSIO 쓰기 평균 지연 시간(1M)을 살펴보면, HP ZGX Nano G1n은 스레드 1개일 때 약 0.31ms에서 시작하여 스레드 2개일 때 0.57ms, 스레드 4개일 때 1.1ms로 증가합니다. 동시 실행 수가 증가함에 따라 지연 시간은 계속 상승하여 스레드 8개일 때 2.2ms, 16개일 때 4.4ms, 32개일 때 9.4ms에 도달합니다. 이러한 상승 추세는 스레드 64개(17.7ms)에서도 계속되어 128개 스레드에서는 37.3ms에 이르는데, 이는 쓰기 처리량 자체는 대부분의 구간에서 비교적 일정하게 유지되었음에도 불구하고 큐 압력이 꾸준히 증가했음을 반영합니다.
맺음말
HP의 ZGX Nano G1n은 DGX Spark 플랫폼의 기대되는 성능을 제공하는 동시에 다른 Spark 시스템과 차별화되는 엔지니어링 설계를 적용했습니다. 테스트 결과, CPU 온도는 최고 77.3°C, GPU 온도는 69°C를 기록했는데, 이는 벤치마크 테스트한 Spark 시스템 중 비교적 낮은 수준입니다. vLLM 성능은 테스트한 6개 모델 모두에서 Prefill Heavy 워크로드에서 가장 우수했으며, 배치 크기가 커질수록 안정적인 확장성을 보였습니다. GPU Direct Storage 읽기 처리량은 16K 블록 크기에서 4.6GiB/s, 1M 블록 크기에서 5.5GiB/s에 도달했으며, 쓰기 처리량은 초기에 정체되었지만 이후 스레드 수에 따라 일관되게 유지되었습니다.
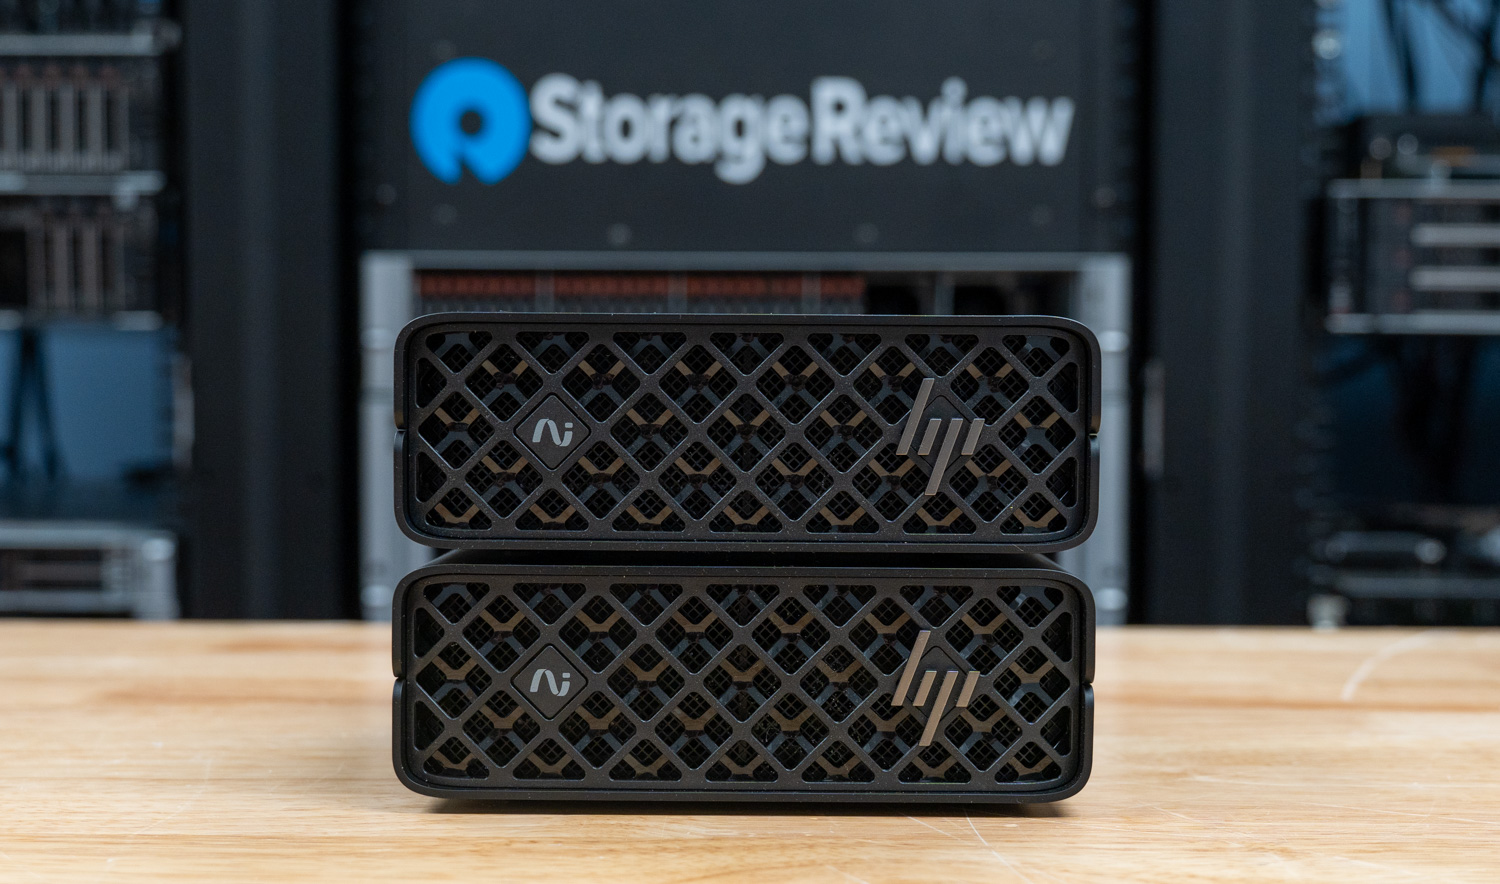
ZGX Nano G1n이 다른 Spark 제품군과 차별화되는 점은 HP가 레퍼런스 디자인을 기반으로 심혈을 기울여 설계했다는 것입니다. 재활용 소재 사용, 내부 유지보수 편의성을 향상시키는 상/하부 섀시 분리, 부하 시 27.6dBA의 저소음 유지 등은 GB10 플랫폼 자체의 요구 사항을 뛰어넘는 세심한 엔지니어링 설계의 결과입니다. 보안 스택 또한 마찬가지입니다. FIPS 140-2 모드의 TPM 2.0, Common Criteria EAL4+, SED OPAL 스토리지를 통해 이 제품은 단순한 개발자용 어플라이언스를 넘어 규제 환경에서 조달 승인을 받을 수 있는 수준에 도달했습니다.
다른 Spark 제품군과 마찬가지로 ZGX Nano G1n은 범용 워크스테이션이 아니며, HP 또한 그렇게 포지셔닝하지 않습니다. 개발자, 소규모 팀, 그리고 구매를 뒷받침할 만한 지속 가능성과 보안성을 갖춘 로컬 AI 컴퓨팅 환경이 필요한 조직에게 ZGX Nano G1n은 Spark 제품군 내에서 확실히 차별화된 선택지입니다. 이러한 기준에 부합하지 않는 기업의 경우, 기본 플랫폼은 저희가 검토한 5개 OEM 시스템 모두 동일하며, 선택은 생태계, 지원 및 가격에 달려 있습니다.
제품 페이지 – HP ZGX Nano G1n AI
순위표: HP ZGX Nano G1n AI Station은 당사의 로컬 AI용 최고 데스크톱 순위표 테스트 대상 제품 중 하나입니다.


 아마존