

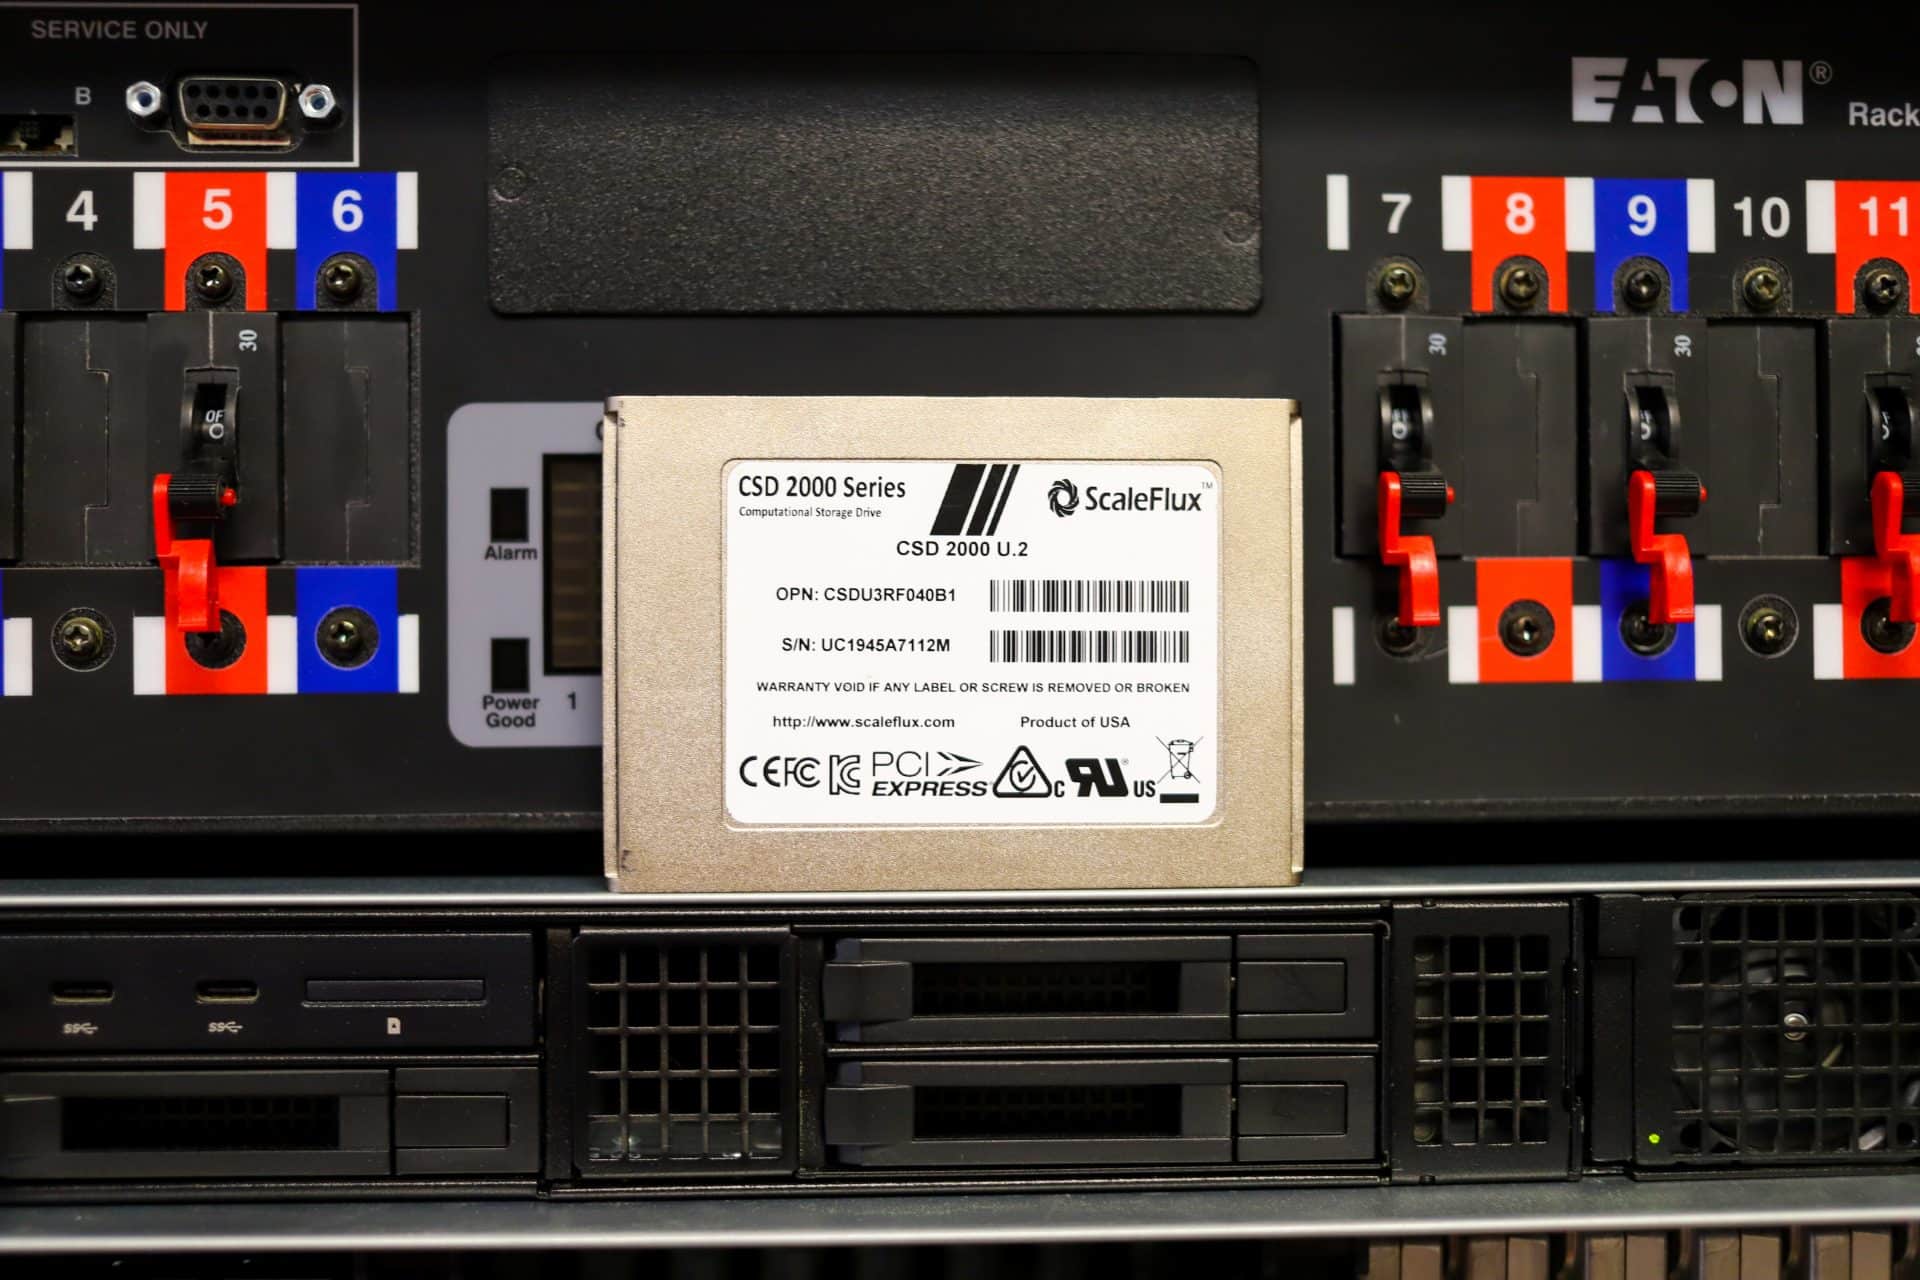
ScaleFlux는 전산 스토리지, 특히 대규모 전산 스토리지에만 집중하는 회사입니다. 이 회사는 주로 ScaleFlux 전산 스토리지 드라이브(CSD)로 이를 수행하고 있습니다. 이름에서 짐작할 수 있듯이 CSD는 드라이브 및 시스템 성능을 향상시킬 수 있는 컴퓨팅 엔진과 통합된 NVMe SSD입니다. 그러나 컴퓨팅 스토리지는 대화 상대에 따라 많은 다른 의미를 갖습니다. 이 리뷰에서는 ScaleFlux CSD 2000을 통해 ScaleFlux의 관점을 맛볼 수 있습니다.
컴퓨팅 스토리지란 무엇입니까?
우리는 실제로 여기 StorageReview에서 몇 년 동안 컴퓨팅 스토리지에 대해 글을 써왔습니다. 간단히 말해서 컴퓨팅 스토리지는 컴퓨팅 리소스(시스템의 컴퓨팅 및/또는 메모리 아키텍처가 아님)를 가져와 스토리지 자체에 배치합니다.
때때로 이러한 컴퓨팅 리소스는 호스트와 스토리지 사이에도 배치됩니다. 이렇게 하면 데이터 이동을 줄이고 시스템 컴퓨팅 리소스의 부담을 덜 수 있으며 잠재적으로 성능 또는 최소한 성능 일관성을 높일 수 있습니다. 컴퓨팅 스토리지에 참여하는 공급업체가 많기 때문에 "컴퓨팅 스토리지"라는 용어가 제품에 따라 매우 다른 의미를 가질 수 있음을 이해하는 것이 중요합니다.
ScaleFlux CSD 2000 및 컴퓨팅 스토리지
ScaleFlux CSD는 데이터 경로 압축/압축 해제 엔진을 도입하여 차별화됩니다. 회사에 따르면 이것은 효과적으로 용량을 XNUMX배, 성능을 XNUMX배로 늘릴 수 있습니다. 물론 이것은 데이터가 압축 가능하다고 가정하며, 이는 이 플랫폼이 제대로 작동하기 위한 기본 사항입니다. 조건이 맞다고 가정하면 유효 용량이 강력한 판매 포인트가 됩니다.
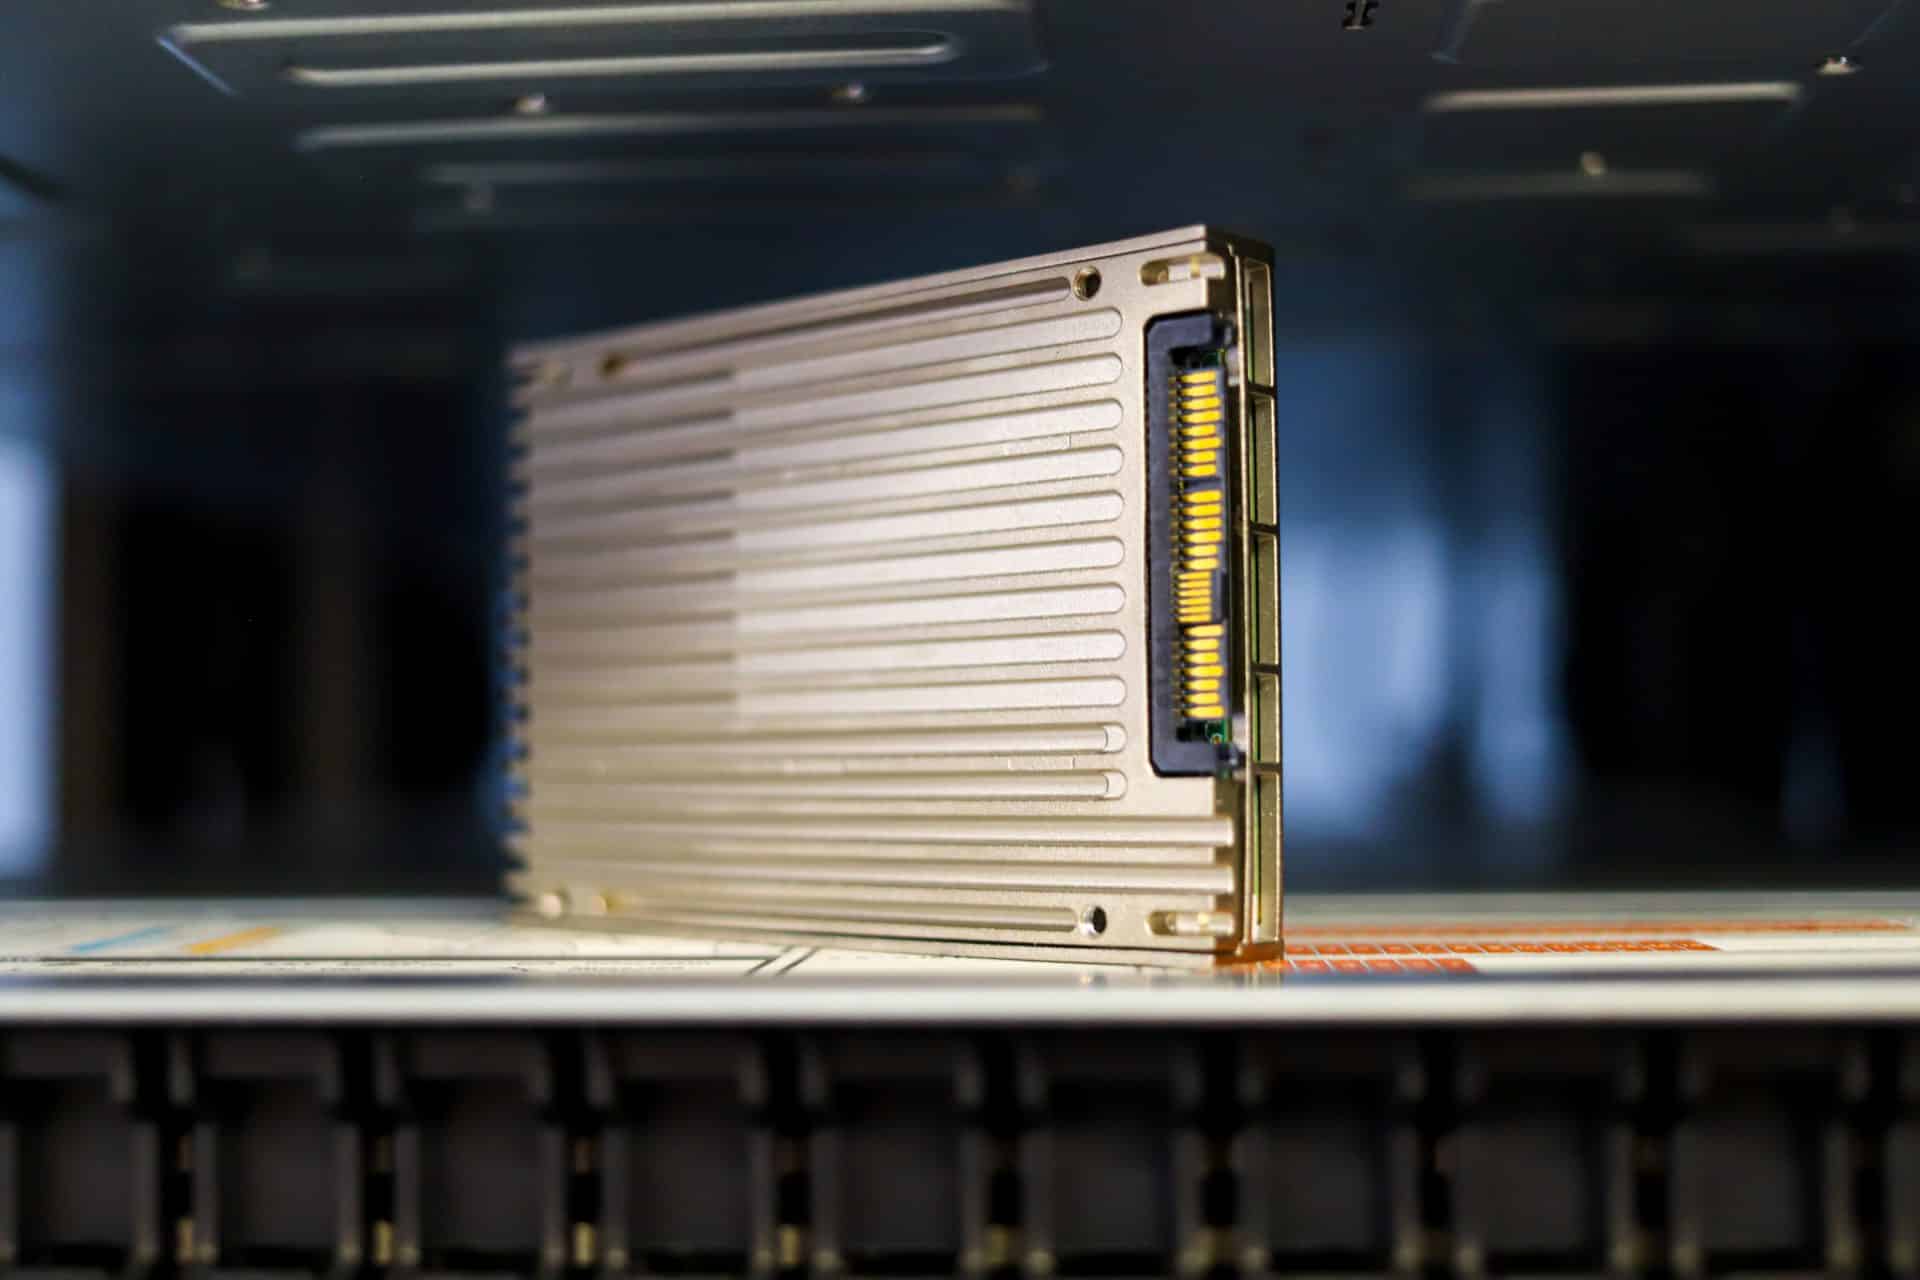
비용과 밀도에 대한 논쟁도 있습니다. 데이터를 압축하고 보다 효과적인 용량을 확보함으로써 ScaleFlux는 조직이 플래시 비용을 최대 50%까지 절감할 수 있다고 밝혔습니다. 또한 압축 덕분에 동일한 슬롯에서 "더 많은" 플래시를 제공할 수 있습니다.
비용과 효율성은 성능 없이는 거의 의미가 없습니다. 기존 SSD에 비해 ScaleFlux의 주장이 두 배가 될 수 있습니까? 드라이브는 Data Center 및 Data Scale 버전으로 제공되지만 여기에서 상위 수치를 살펴보겠습니다. 1:1 데이터 압축의 최고 수치는 750K 읽기에서 4K IOPS이고 490:4 데이터 압축에서 2K 쓰기에서 1K IOPS입니다. 순차 속도의 경우 드라이브는 압축에서 3GB/s에 도달하고 2.3:1 압축에서 최대 1GB/s 쓰기에 도달하는 것으로 인용됩니다.
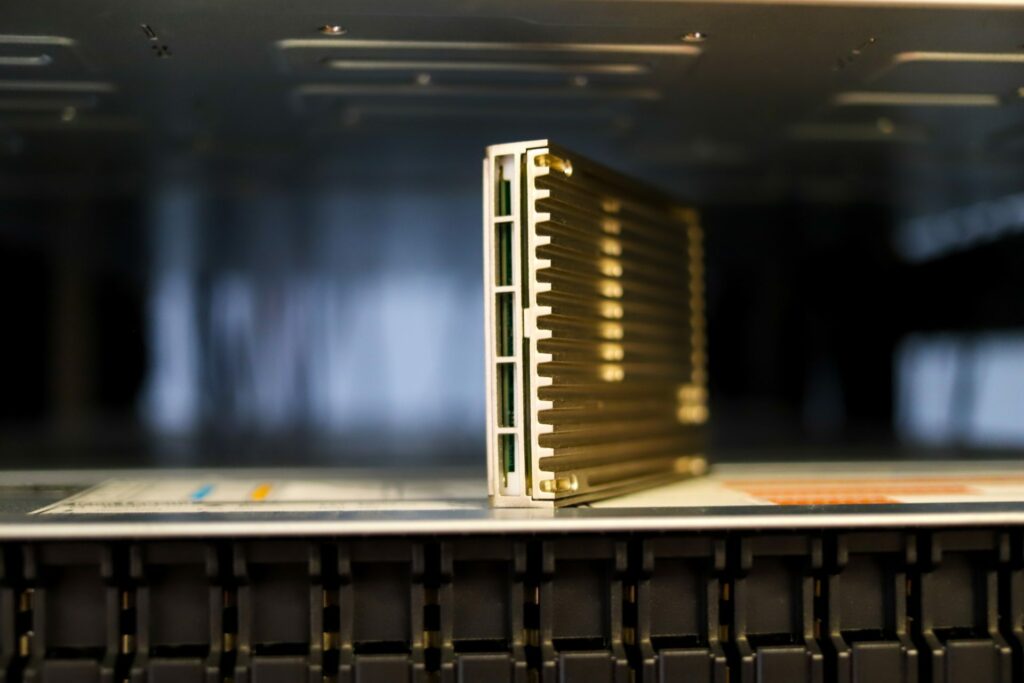
CSD의 몇 가지 다른 차이점은 조정 가능한 FTL/FM이 있어 사용자가 GB당 성능과 가격을 최적화할 수 있다는 것입니다. 고성능을 실행하면 전원 및 온도 문제가 발생할 수 있지만 과열을 방지하기 위해 조절될 수 있습니다. 데이터 보호는 더 이상 항상 뉴스에 나오는 것처럼 보입니다. 따라서 CSD는 데이터 경로의 모든 내부 메모리에 대한 엔드 투 엔드 데이터 보호 및 ECC와 정전 보호를 주장합니다.
ScaleFlux로 이 CSD 작업에 참여하려면 몇 가지 단점이 있습니다. 하나는 우리가 검토하고 있는 드라이브가 기존 SSD가 PCIe Gen 3로 마이그레이션된 시점에 Gen 4이라는 것입니다. 이것은 해결할 수 있는 문제입니다. 또 다른 히트는 현재 드라이버 지원이 Linux로 제한된다는 것입니다. Windows와 VMware는 종료되었습니다. 지역화된 가상화는 흥미로운 사용 사례가 될 것이며 데이터 감소 이점이 무르익을 것입니다. 더 폭넓은 지원이 이루어지기를 바랍니다.
ScaleFlux CSD 2000 주요 사양
| 폼 팩터 | PCIe AIC 및 2.5" U.2 |
| 인터페이스 | PCIe Gen3 x4 저지연 블록 저장 장치 |
| 낸드 미디어 | 3D TLC 및 3D QLC |
| 전력 손실 방지 | 가능 |
| 데이터 보호 |
|
| 출력 |
|
| 작동 온도 | 50°C @ 200LFM(AIC) 35°C @ 200LFM(U.2) |
| 온도 보호 | 열 스로틀링 활성화됨 |
| MTTF | 2백만 시간 |
| 컴퓨팅 기능 |
|
| 소프트웨어 호환성 | Linux OS 2.6 커널 이상만 해당
|
ScaleFlux를 사용한 압축
우리는 처음부터 압축이 구현되는 방법을 알고 싶었습니다. Linux에서 시작하려면 일반적인 nvme-cli 도구 집합의 분기인 드라이브를 보고 상호 작용할 사용자 지정 드라이버를 로드해야 합니다. 이를 통해 드라이브를 있는 그대로 보고 포맷할 수 있을 뿐만 아니라 현재 데이터 세트를 기반으로 가용 용량을 상호 작용 및/또는 수정할 수 있습니다. 다음은 워크로드 테스트 전후의 출력에 대한 간단한 예입니다. "sfx-nvme list"의 첫 번째 명령은 설치된 드라이브를 보여줍니다.
root@storagereview:~# sfx-nvme 목록
노드 SN 모델 네임스페이스 사용 형식 FW Rev BUS:slot:func
/dev/sfdv0n1 UC1945A7112M CSDU3RF040B1 1 3.20TB/3.20TB 512B + 0B 4870 0000:d8:00.0
완전히 압축할 수 없는 데이터(일반적으로 작동하는 데이터 세트)로 첫 번째 벤치마크를 수행한 후 드라이브가 1.00 압축률을 나타내는 것을 볼 수 있습니다.
root@storagereview:~# 고양이 /sys/block/sfdv*/sfx_smart_features/sfx_capacity_stat
free_space Physical_size logic_size comp_ratio Provisioned_cap space_flag
2736 6251231232 6251231312 1.00 6251233968 0
다음으로 vdbench 압축 수준을 4x로 전환하여 드라이브가 배후에서 일부 마법을 작동할 수 있도록 했습니다. 완료 후 SSD를 다시 쿼리하면 크기가 커지고 압축률이 4.10으로 증가한 것을 볼 수 있습니다. 따라서 좋은 소식은 이 기본적인 쉐이크아웃을 통해 드라이브가 압축 기능 측면에서 주장하는 대로 작동한다는 것입니다.
root@storagereview:~# 고양이 /sys/block/sfdv*/sfx_smart_features/sfx_capacity_stat
free_space Physical_size logic_size comp_ratio Provisioned_cap space_flag
4728607824 1522626144 6251231312 4.10 6251233968 0
ScaleFlux CSD 2000 성능
VDBench 워크로드 분석
스토리지 장치를 벤치마킹할 때 애플리케이션 테스트가 가장 좋고 합성 테스트가 두 번째입니다. 실제 워크로드를 완벽하게 나타내지는 못하지만 합성 테스트는 경쟁 솔루션 간의 비교를 쉽게 수행할 수 있는 반복성 요소로 스토리지 장치의 기준선을 만드는 데 도움이 됩니다.
이러한 워크로드는 "포 코너" 테스트, 일반적인 데이터베이스 전송 크기 테스트에서 다양한 VDI 환경의 추적 캡처에 이르기까지 다양한 테스트 프로필을 제공합니다. 이러한 모든 테스트는 스크립팅 엔진과 함께 공통 vdBench 워크로드 생성기를 활용하여 대규모 컴퓨팅 테스트 클러스터에서 결과를 자동화하고 캡처합니다. 이를 통해 플래시 어레이 및 개별 저장 장치를 포함한 광범위한 저장 장치에서 동일한 작업 부하를 반복할 수 있습니다.
이러한 벤치마크에 대한 테스트 프로세스는 전체 드라이브 표면을 데이터로 채운 다음 드라이브 용량의 25%에 해당하는 드라이브 섹션을 분할하여 드라이브가 애플리케이션 작업 부하에 어떻게 반응하는지 시뮬레이션합니다. 이것은 드라이브의 100%를 사용하고 정상 상태로 만드는 전체 엔트로피 테스트와 다릅니다. 결과적으로 이 수치는 더 높은 지속 쓰기 속도를 반영합니다.
프로필 :
- 4K 임의 읽기: 100% 읽기, 128 스레드, 0-120% iorate
- 4K 임의 쓰기: 100% 쓰기, 64 스레드, 0-120% iorate
- 64K 순차 읽기: 100% 읽기, 16 스레드, 0-120% iorate
- 64K 순차 쓰기: 100% 쓰기, 8개 스레드, 0-120% 속도
- 합성 데이터베이스: SQL 및 Oracle
- VDI 전체 클론 및 연결된 클론 추적
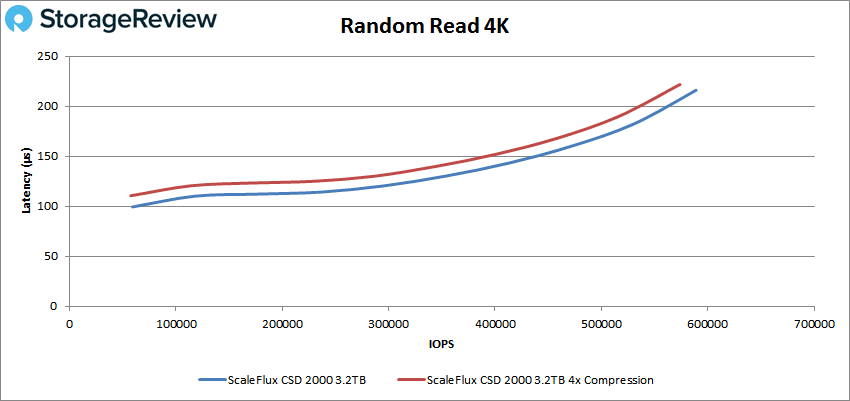
비교를 위해 VDBench가 비압축 데이터와 4배 압축 데이터를 전송하는 ScaleFlux SSD를 살펴볼 것입니다. 무작위 4K에서 비압축 CSD는 100µs 미만에서 시작하여 지연 시간이 588,893µs인 216 IOPS에서 정점에 도달했습니다. 압축을 사용하면 드라이브는 573,460µs의 대기 시간에서 최고 222 IOPS로 조금 느려졌습니다.
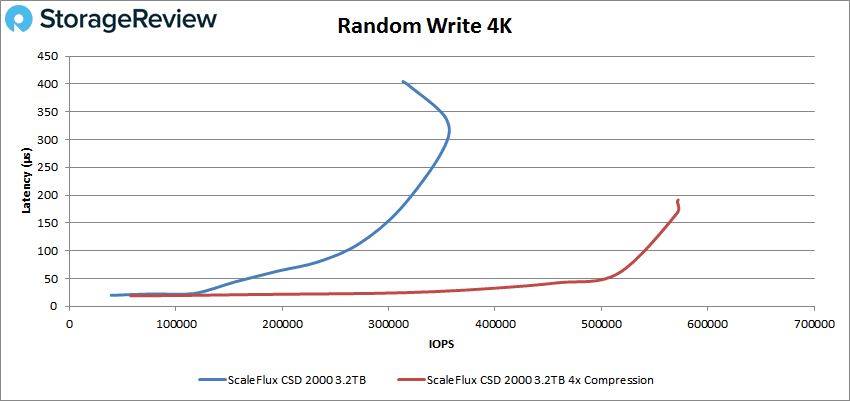
4K 랜덤 쓰기는 약 355µs에서 약 325K IOPS에서 비압축 드라이브 피크를 확인한 후 일부를 떨어뜨렸습니다. 압축을 사용하면 드라이브는 대기 시간이 100µs인 최대 약 572K IOPS로 대부분 168µs 미만으로 유지되었습니다.
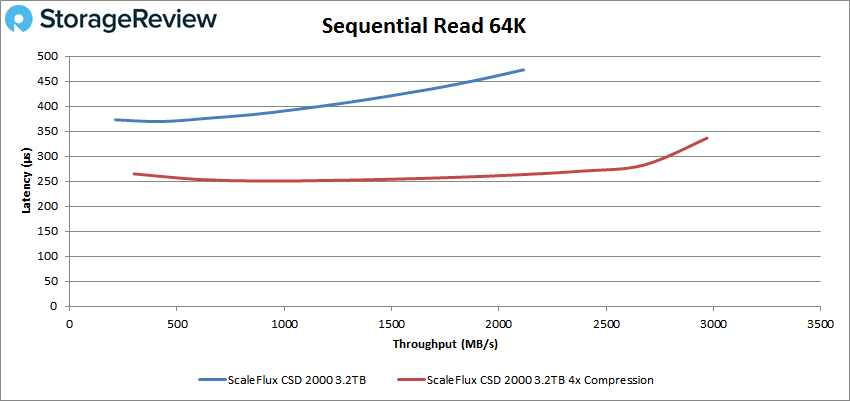
읽기를 위해 64K 순차 워크로드로 전환하면 비압축 드라이브가 33,785µs의 대기 시간에서 최고 2.11 IOPS 또는 473GB/s를 기록했습니다. 압축을 통해 우리는 드라이브가 47,489µs의 낮은 대기 시간에서 2.97 IOPS 또는 336GB/s에 도달하는 것을 확인했습니다.
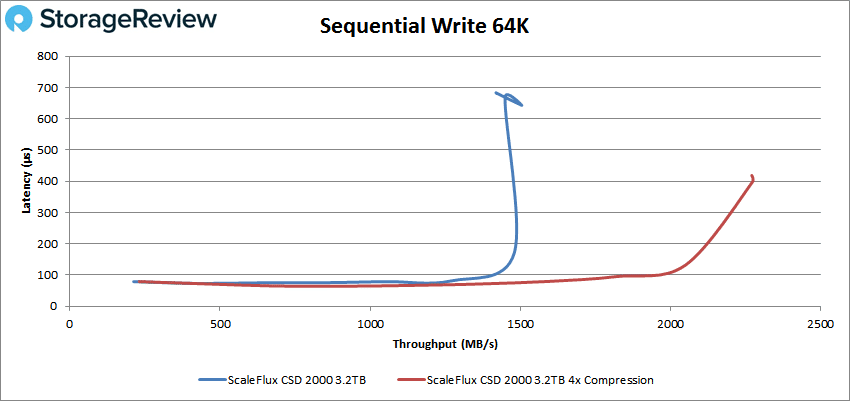
64K 쓰기에서 두 구성 모두 테스트의 큰 덩어리에 대해 100µs 미만으로 실행되었습니다. 비압축 구성은 24,074µs의 대기 시간에서 1.5 IOPS 또는 643GB/s로 정점을 찍었습니다. 4배 압축으로 36,364µs의 대기 시간에서 최고 2.27 IOPS 또는 397GB/s를 확인했습니다.
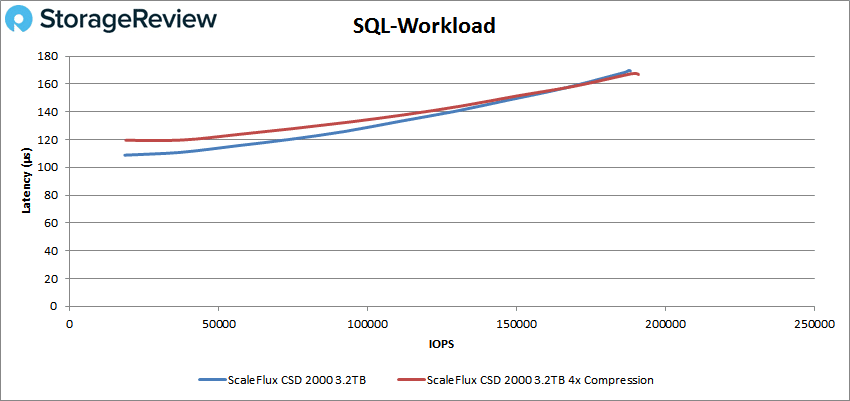
다음 테스트 세트는 SQL, SQL 90-10 및 SQL 80-20과 같은 SQL 워크로드입니다. SQL부터 시작하여 두 데이터 구성은 매우 유사했습니다. 비압축성 데이터는 대기 시간이 188,269 IOPS 및 167µs로 정점을 찍은 반면 드라이브로 가는 압축 데이터는 대기 시간이 190,370 IOPS로 정점을 찍고 대기 시간도 167µs입니다.
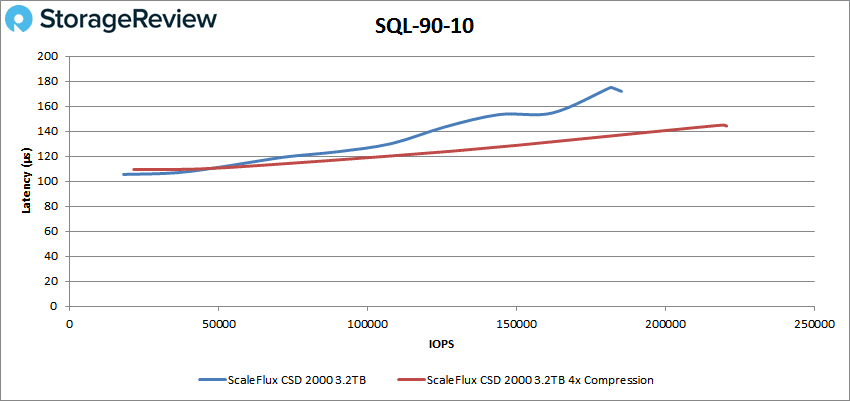
SQL 90-10에서 압축 불가능한 ScaleFlux CSD 2000은 185,310µs의 대기 시간으로 최고 172 IOPS를 기록했습니다. 드라이브에 4배 압축을 적용하면 최대 220,615 IOPS와 144µs의 대기 시간에 도달했습니다.
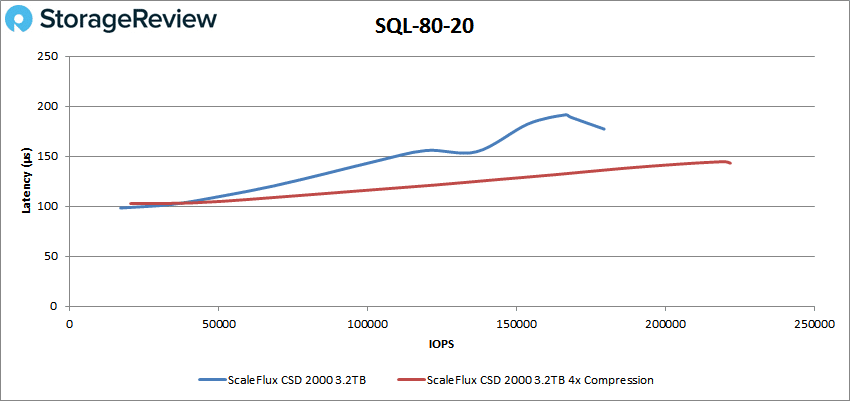
SQL 80-20은 대기 시간이 179,482µs인 177 IOPS에서 비압축 드라이브 피크를 보였습니다. CSD로 가는 압축을 보면 221,851µs의 대기 시간에서 최고 143 IOPS를 볼 수 있습니다.
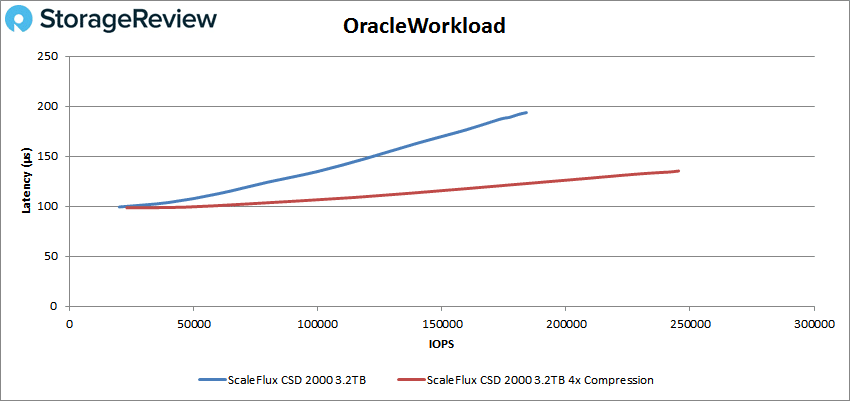
다음은 Oracle 워크로드인 Oracle, Oracle 90-10 및 Oracle 80-20입니다. Oracle부터 비압축성 최고점은 184,048 IOPS이고 대기 시간은 194µs입니다. 압축이 적용된 드라이브를 살펴보면 최대 245,385 IOPS와 135µs의 대기 시간을 확인했습니다.
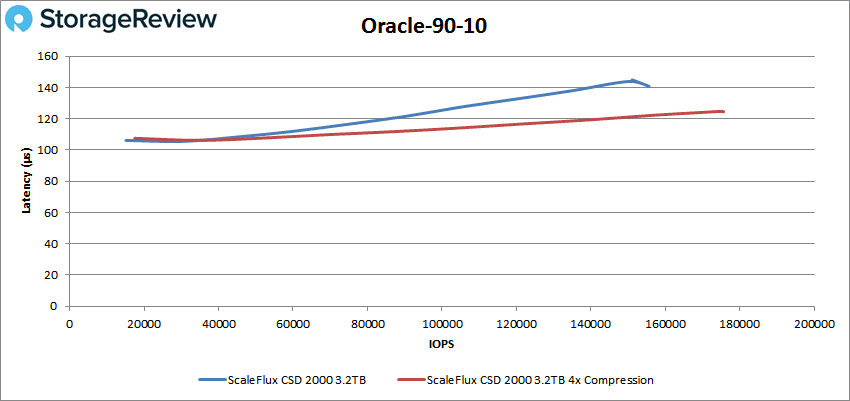
Oracle 90-10은 성능과 대기 시간이 거의 동일하게 시작되었습니다. 비압축 버전은 155,641µs의 대기 시간에서 141 IOPS로 정점을 찍었습니다. 압축 버전은 175,681µs의 대기 시간으로 최대 125 IOPS에 도달했습니다.
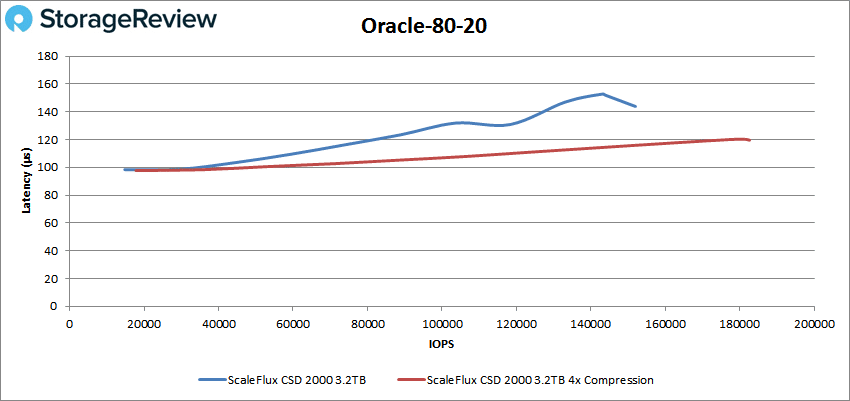
Oracle 80-20 부스 드라이브 구성은 100µs 미만에서 시작되었습니다. 비압축 데이터의 경우 최대 지연 시간은 151,983µs에서 144 IOPS였습니다. 압축 데이터를 사용하여 182,640µs의 대기 시간으로 120 IOP의 최고 성능을 확인했습니다.
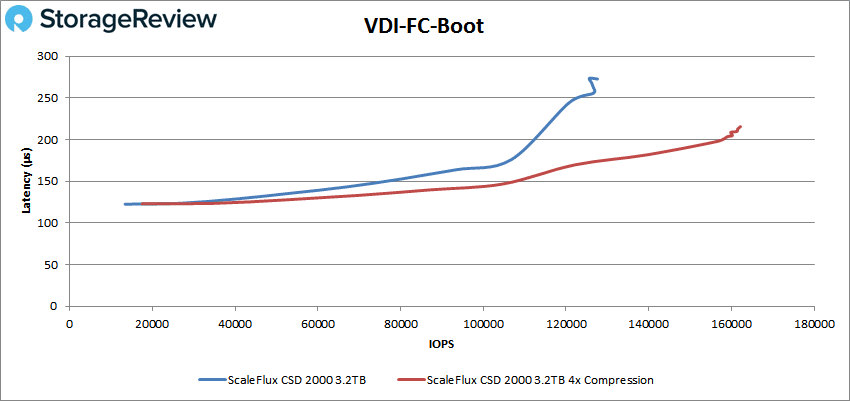
다음으로 VDI 클론 테스트인 Full and Linked로 전환했습니다. VDI 전체 클론(FC) 부팅의 경우 압축할 수 없는 데이터가 없는 ScaleFlux CSD 2000 드라이브는 127,616µs의 대기 시간에서 최대 263 IOPS에 도달했습니다. 대기 시간이 4µs인 최대 161,543 IOPS의 216배 압축 범프 성능을 전송합니다.
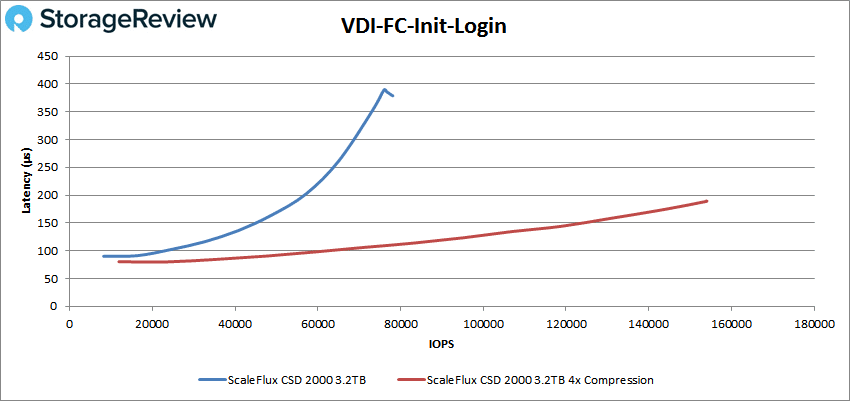
VDI FC 초기 로그인은 비압축 데이터의 경우 78,125µs에서 379 IOPS의 피크를, 압축 데이터의 경우 154,077µs에서 189 IOPS의 피크를 제공했습니다.
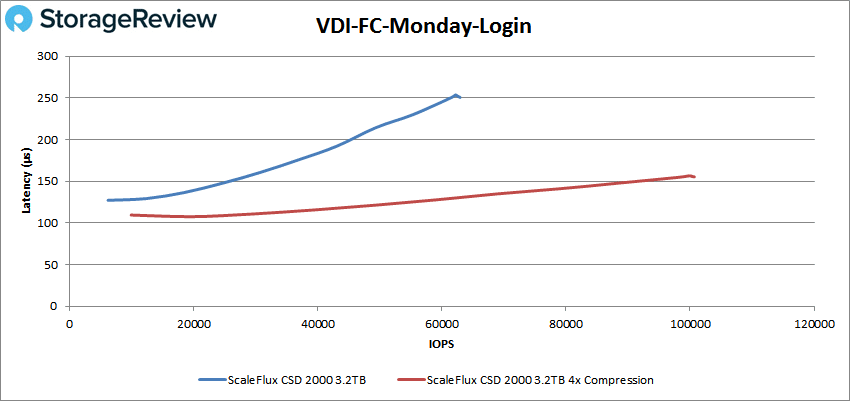
VDI FC Monday의 경우 비압축 드라이브는 62,922µs의 대기 시간과 함께 251 IOPS로 정점을 찍었습니다. 4배 압축을 사용하면 대기 시간이 100,680µs에 불과한 156 IOPS에서 훨씬 더 높은 피크가 있었습니다.
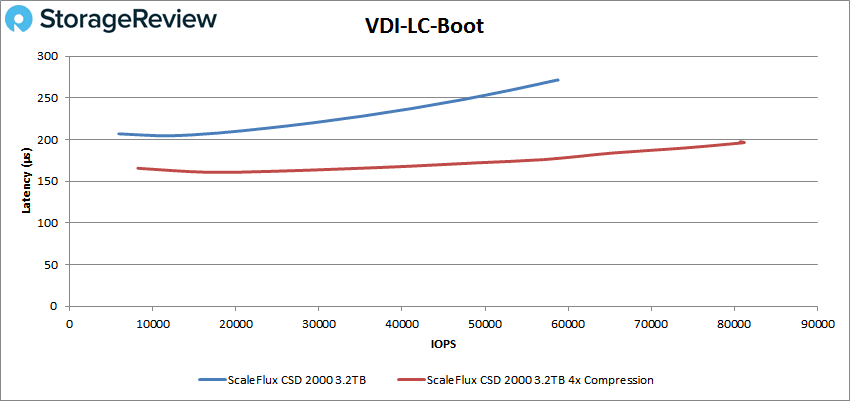
VDI LC(Linked Clone) 부팅의 경우 드라이브에 압축할 수 없는 데이터가 최대 58,705 IOPS에 도달했으며 대기 시간은 271µs입니다. 드라이브에 4배 압축을 보냈을 때 최고점은 81,137 IOPPS이고 대기 시간은 196µs였습니다.
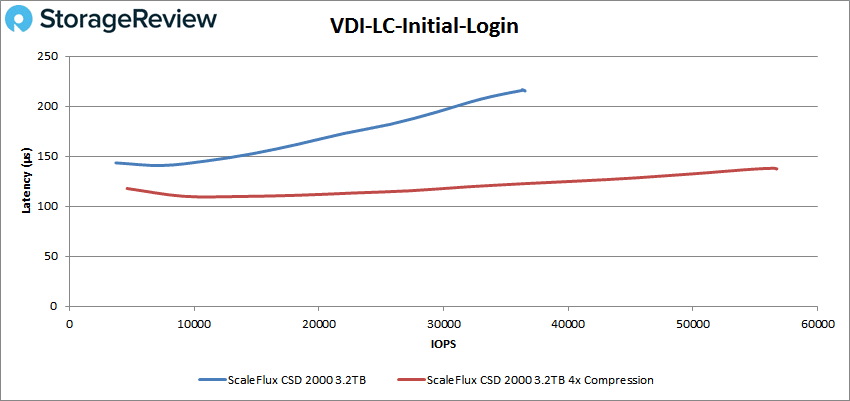
VDI LC 초기 로그인은 36,537µs의 대기 시간에서 215 IOPS의 최고 성능에 도달하는 비압축 데이터 드라이브를 가졌습니다. 4배로 압축된 데이터가 드라이브에 도달했을 때 최대 56,739 IOPS와 137µs의 대기 시간을 기록했습니다.
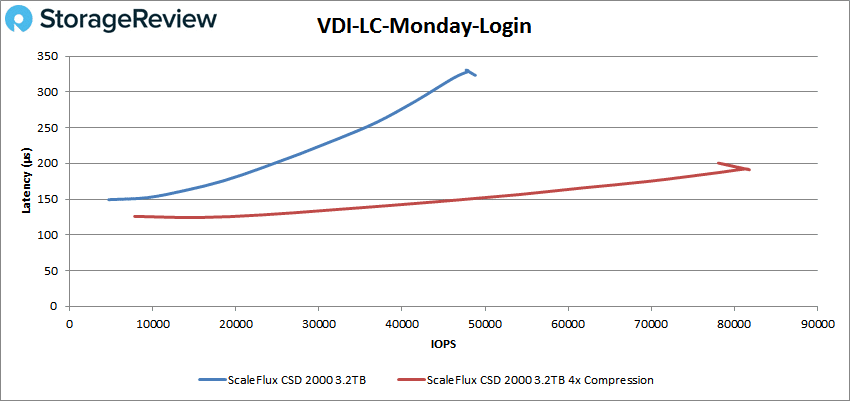
마지막으로 VDI LC Monday Login을 통해 비압축 드라이브는 48,814µs의 대기 시간에서 최고 323 IOPS에 도달했습니다. 압축을 통해 SSD는 81,799µs의 대기 시간으로 최대 192 IOPS에 도달했습니다.
맺음말
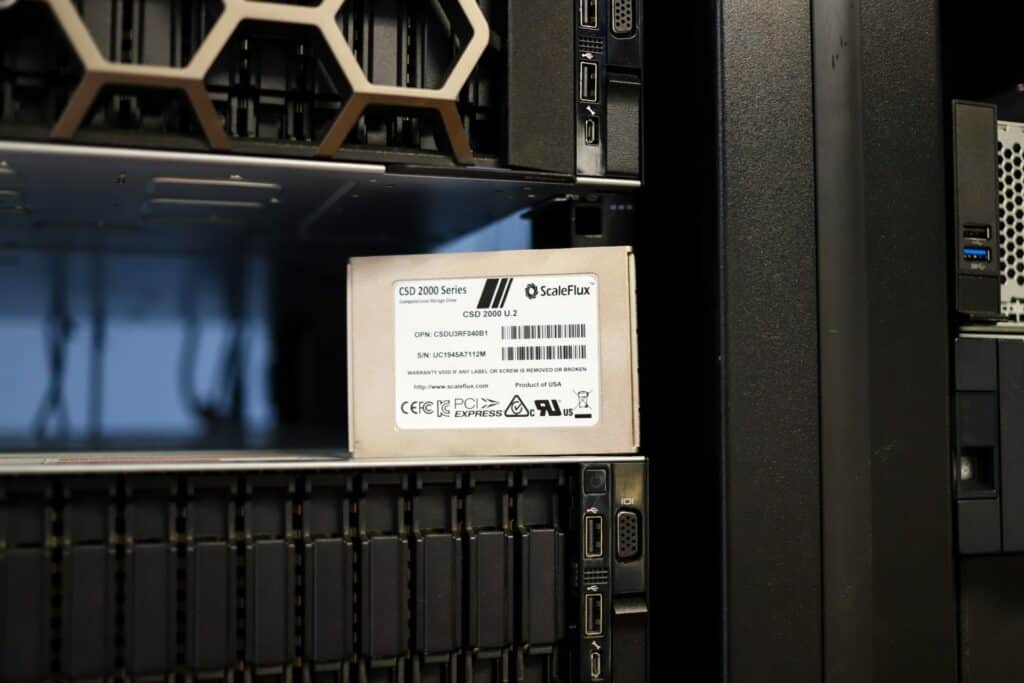
ScaleFlux는 컴퓨팅 스토리지에만 집중합니다. 이는 주로 ScaleFlux 전산 스토리지 드라이브(CSD)로 알려진 SSD를 통해 수행됩니다. 이들은 성능과 데이터 효율성을 향상시키는 컴퓨팅 엔진이 있는 PCIe Gen3 SSD입니다. 이 회사에는 몇 가지 다른 드라이브가 있지만 이 리뷰에서는 ScaleFlux CSD 2000을 살펴보았습니다.
ScaleFlux 드라이브와 다른 컴퓨팅 스토리지 간의 주요 차이점은 데이터 경로 압축/압축 해제 엔진입니다. ScaleFlux는 컴퓨팅 기술 덕분에 용량은 XNUMX배, 성능은 XNUMX배 증가했다고 주장합니다. 이것은 성능 측면에 도달할 뿐만 아니라 데이터 압축률이 높을 때 스토리지 효율성을 고려할 때 SSD 스토리지의 TB당 비용을 낮출 수도 있습니다.
주요 관심사는 압축 엔진이 작동하는가? 우리가 테스트에서 바로 게이트 밖으로 압축을 조작했기 때문에 그것은 쉬운 예였습니다. 우리는 완전히 압축할 수 없는 데이터로 시작했고 예상대로 1:1 드라이브에서 비율을 보았습니다. 4X 압축률로 전환하면 드라이브의 압축률이 4.1:1이 됩니다. 중요한 첫 번째 단계는 성능을 확인하기 전에 확인 표시를 받았습니다.
먼저 압축할 수 없는 데이터가 전송되지 않는 드라이브를 살펴보겠습니다. 하이라이트는 589K 읽기에서 4K IOPS, 355K 쓰기에서 4K IOPS, 2.11K 읽기에서 64GB/s, 1.5K 쓰기에서 64GB/s입니다. SQL에서 우리는 188K IOPS, SQL 185-90에서 10K IOPS, SQL 179-80에서 20K IOPS의 피크를 보았습니다. Oracle 워크로드의 경우 Oracle 184-156에서 90K IOPS, 10K IOPS, Oracle 152-80에서 20K IOPS의 최고치를 확인했습니다. VDI 클론 테스트에서 압축을 사용하지 않은 CSD 2000은 부팅 시 128K IOPS, 초기 로그인 시 78K IOPS, 전체 클론의 월요일 로그인 시 63K IOPS를 제공했습니다. Linked Clone의 경우 드라이브는 부팅 시 59K IOPS, 초기 로그인 시 37K IOPS, 월요일 로그인 시 49K IOPS를 제공했습니다.
4X 압축 데이터를 전송한 후 4K 읽기를 제외한 모든 테스트에서 성능이 크게 향상되는 것을 보고 놀랐습니다. 하이라이트는 573K 읽기에서 4K IOPS, 572K 쓰기에서 4K IOPS, 2.97K 읽기에서 64GB/s, 2.27K 쓰기에서 64GB/s입니다. SQL에서 우리는 190K IOPS, SQL 221-90에서 10K IOPS, SQL 222-80에서 20K IOPS의 피크를 보았습니다. Oracle의 경우 Oracle 245-176에서 90K IOPS, 10K IOPS, Oracle 183-80에서 20K IOPS의 최고치를 확인했습니다. VDI 클론 테스트에서 압축을 사용한 ScaleFlux는 부팅 시 162K IOPS, 초기 로그인 시 154K IOPS, 전체 클론의 월요일 로그인 시 101K IOPS를 제공했습니다. Linked Clone의 경우 드라이브는 부팅 시 81K IOPS, 초기 로그인 시 57K IOPS, 월요일 로그인 시 82K IOPS를 제공했습니다.
ScaleFlux CSD 2000은 정말 흥미로운 제품이며 컴퓨팅 스토리지가 다리를 벌리면서 기존 SSD 공간에서 잠재적인 변화를 지적합니다. CSD는 수년 동안 사용되어 왔으므로 개념이 새로운 것은 아닙니다. 부족한 것은 실행입니다. ScaleFlux는 우리 연구실에서 무언가를 얻은 최초의 CSD 직원입니다. 자신감은 그 자체로 오래 가지 못하지만 드라이브는 성능을 발휘해야 합니다.
이 경우 성능은 차트에서 볼 수 있는 숫자가 아닙니다. 이 SSD 푸딩의 증거는 압축 가능한 데이터에 대해 잘 작동하는 능력에 관한 것입니다. 테스트에서 예상한 대로 정확하게 수행하며 하나의 테스트 프로필을 제외한 모든 테스트 프로필에서 약간의 성능 팝을 제공합니다. 이 SSD가 이해되려면 사용 사례에 정렬만 필요합니다. 압축 가능한 데이터는 의심할 여지 없이 ScaleFlux 기술의 이점을 크게 누릴 것입니다. 현재 VMware 또는 Windows 가상화 지원이 필요하지 않은 한 CSD 2000은 작업 부하가 얼마나 많은 이점을 얻을 수 있는지 확인하기 위해 PoC에서 탐색할 가치가 있습니다.


 아마존