

Meta heeft zijn nieuwste AI-innovatie geïntroduceerd, Llama 4, een verzameling modellen die multimodale intelligentiemogelijkheden verbeteren. Llama 4 is gebaseerd op de Mixture-of-Experts (MoE)-architectuur, die uitzonderlijke efficiëntie en prestaties biedt.
Begrijpen van MoE-modellen en schaarste
Mixture-of-Experts (MoE)-modellen verschillen aanzienlijk van traditionele dichte modellen, waarbij het hele model elke invoer verwerkt. In MoE-modellen wordt slechts een subset van de totale parameters, aangeduid als "experts", geactiveerd voor elke invoer. Deze selectieve activering is afhankelijk van de kenmerken van de invoer, waardoor het model bronnen dynamisch kan toewijzen en de efficiëntie kan verbeteren.
Sparsity is een essentieel concept in MoE-modellen, dat de verhouding van inactieve parameters voor een specifieke invoer aangeeft. MoE-modellen kunnen de rekenkosten aanzienlijk verlagen door gebruik te maken van sparsity, terwijl de prestaties behouden blijven of worden verbeterd.
Maak kennis met de Llama 4-familie: Scout, Maverick en Behemoth
De Llama 4-suite bestaat uit drie modellen: Llama 4 Scout, Llama 4 Maverick en Llama 4 Behemoth. Elk model is ontworpen om te voldoen aan verschillende use cases en vereisten.
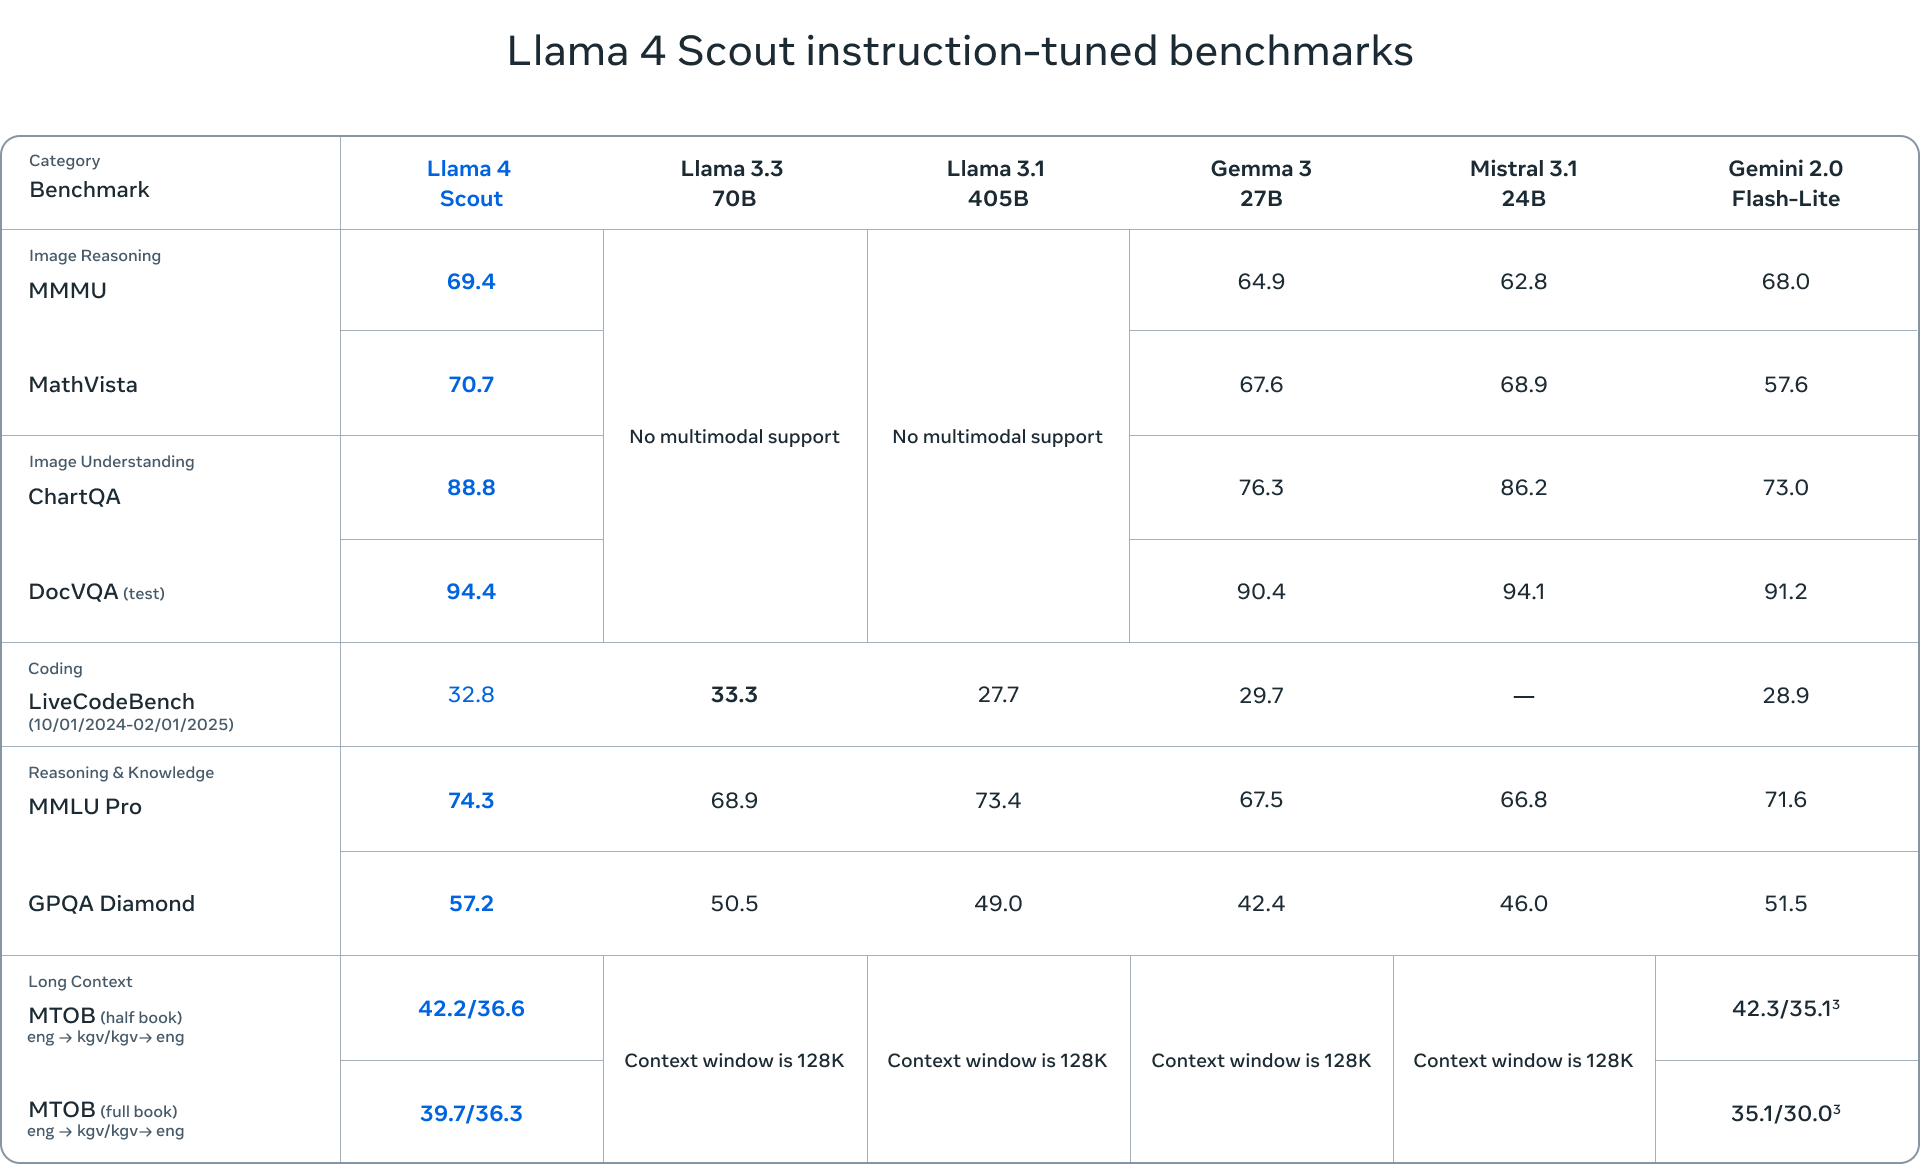
- Llama 4 Scout is een compact model met 17 miljard actieve parameters en 109 miljard totale parameters verdeeld over 16 experts. Het is geoptimaliseerd voor efficiëntie en kan draaien op een enkele NVIDIA H100 GPU (FP4 Quantized). Scout heeft een indrukwekkend contextvenster van 10 miljoen tokens, waardoor het ideaal is voor applicaties die een lange contextuele begrip vereisen.
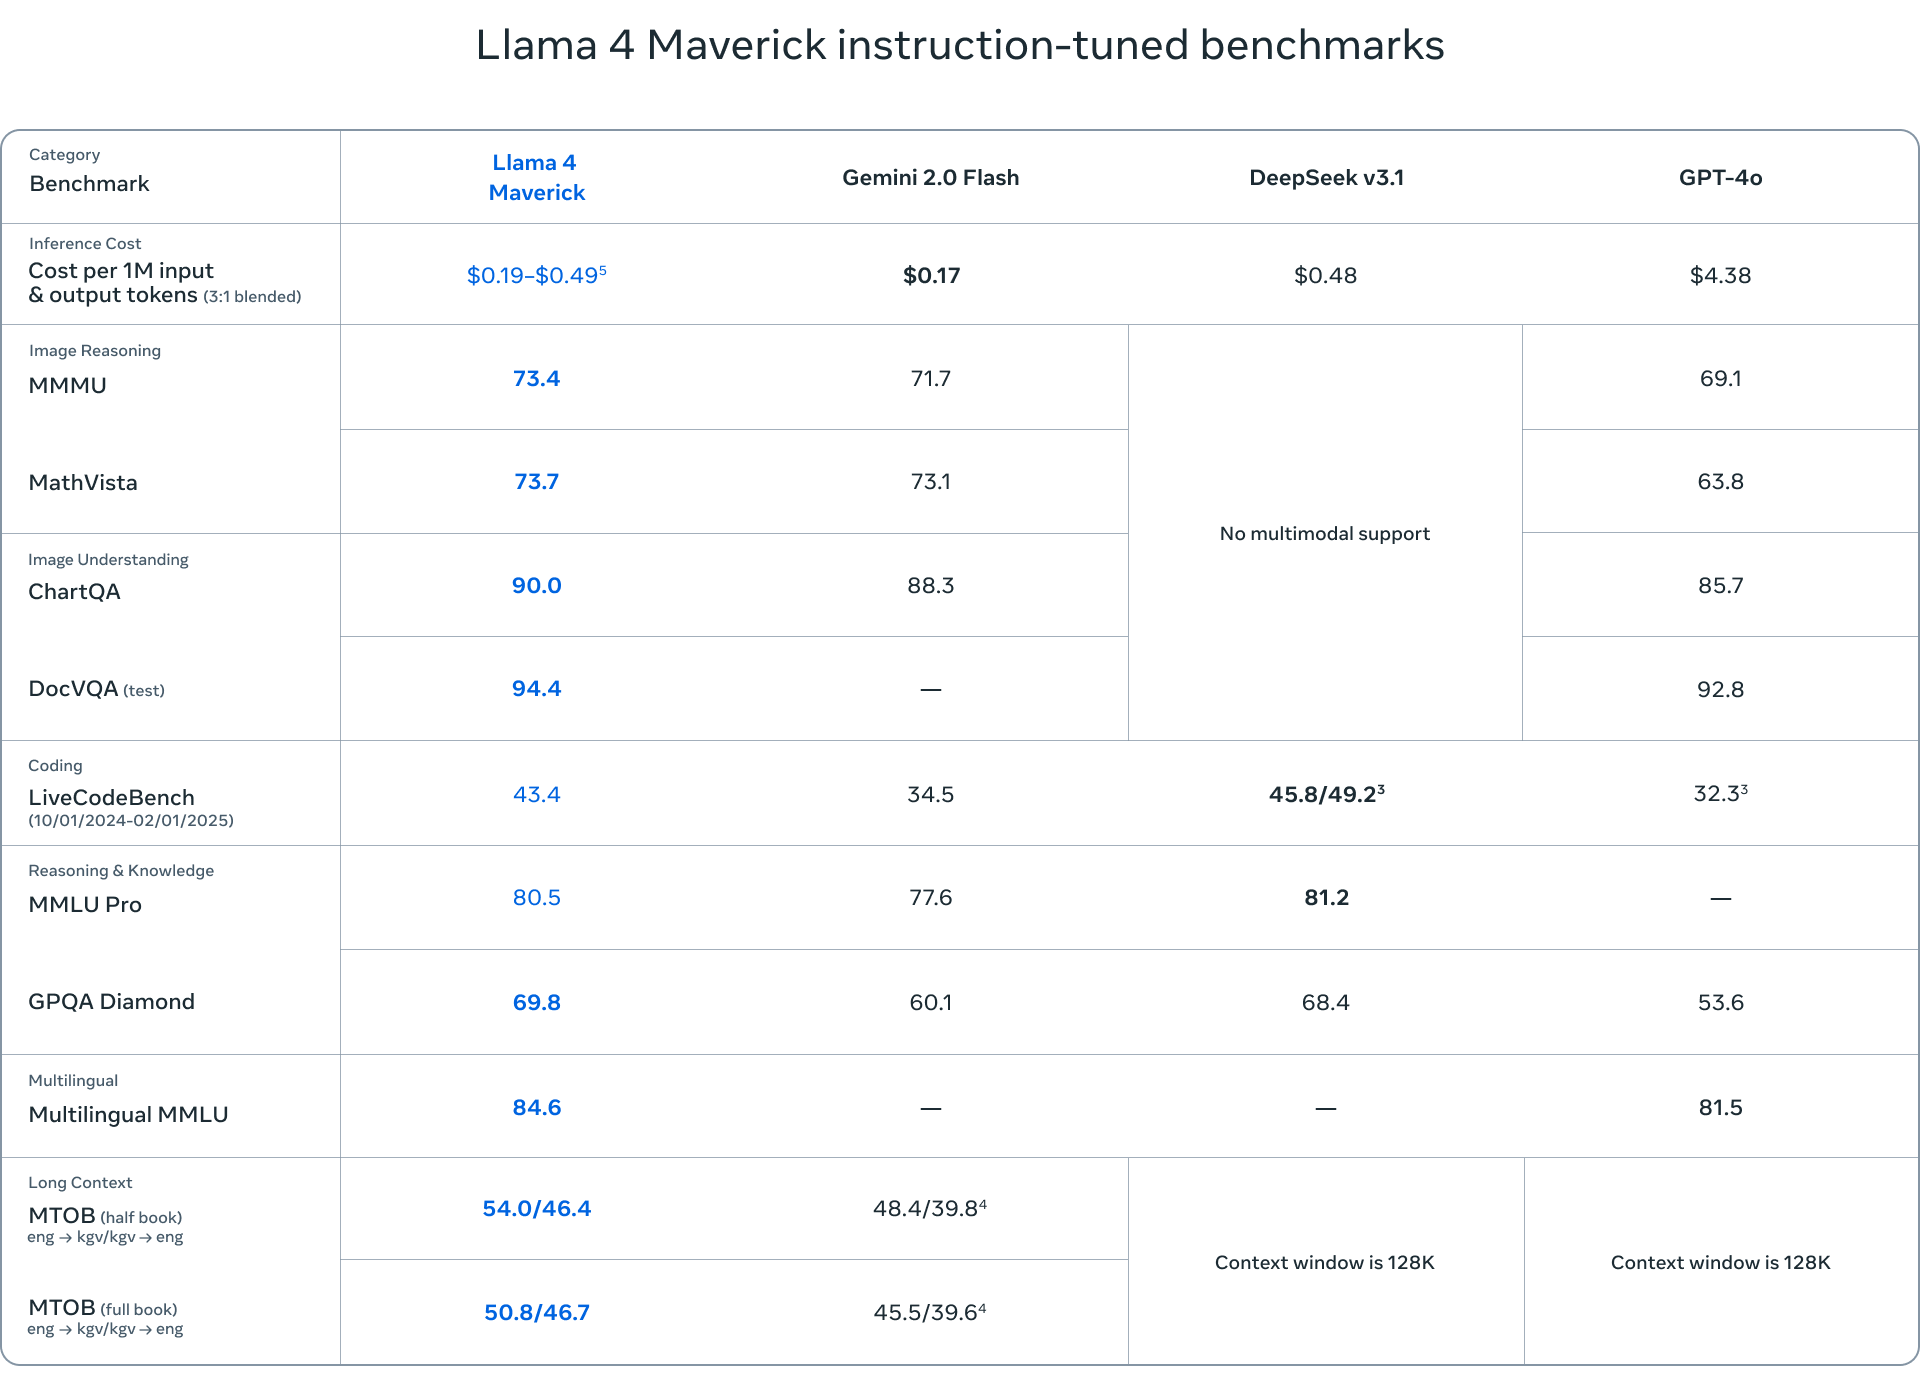
- Llama 4 Maverick is een robuuster model met dezelfde 17 miljard actieve parameters, maar met 128 experts, wat neerkomt op 400 miljard parameters. Maverick excelleert in multimodaal begrip, meertalige taken en codering, en overtreft concurrenten als GPT-4o en Gemini 2.0 Flash.
- Llama 4 Behemoth is het grootste model in de suite, met 288 miljard actieve parameters en bijna 2 biljoen totale parameters verdeeld over 16 experts. Hoewel nog in training, heeft Behemoth al state-of-the-art prestaties laten zien op verschillende benchmarks, waarmee het modellen als GPT-4.5 en Claude Sonnet 3.7 overtreft.
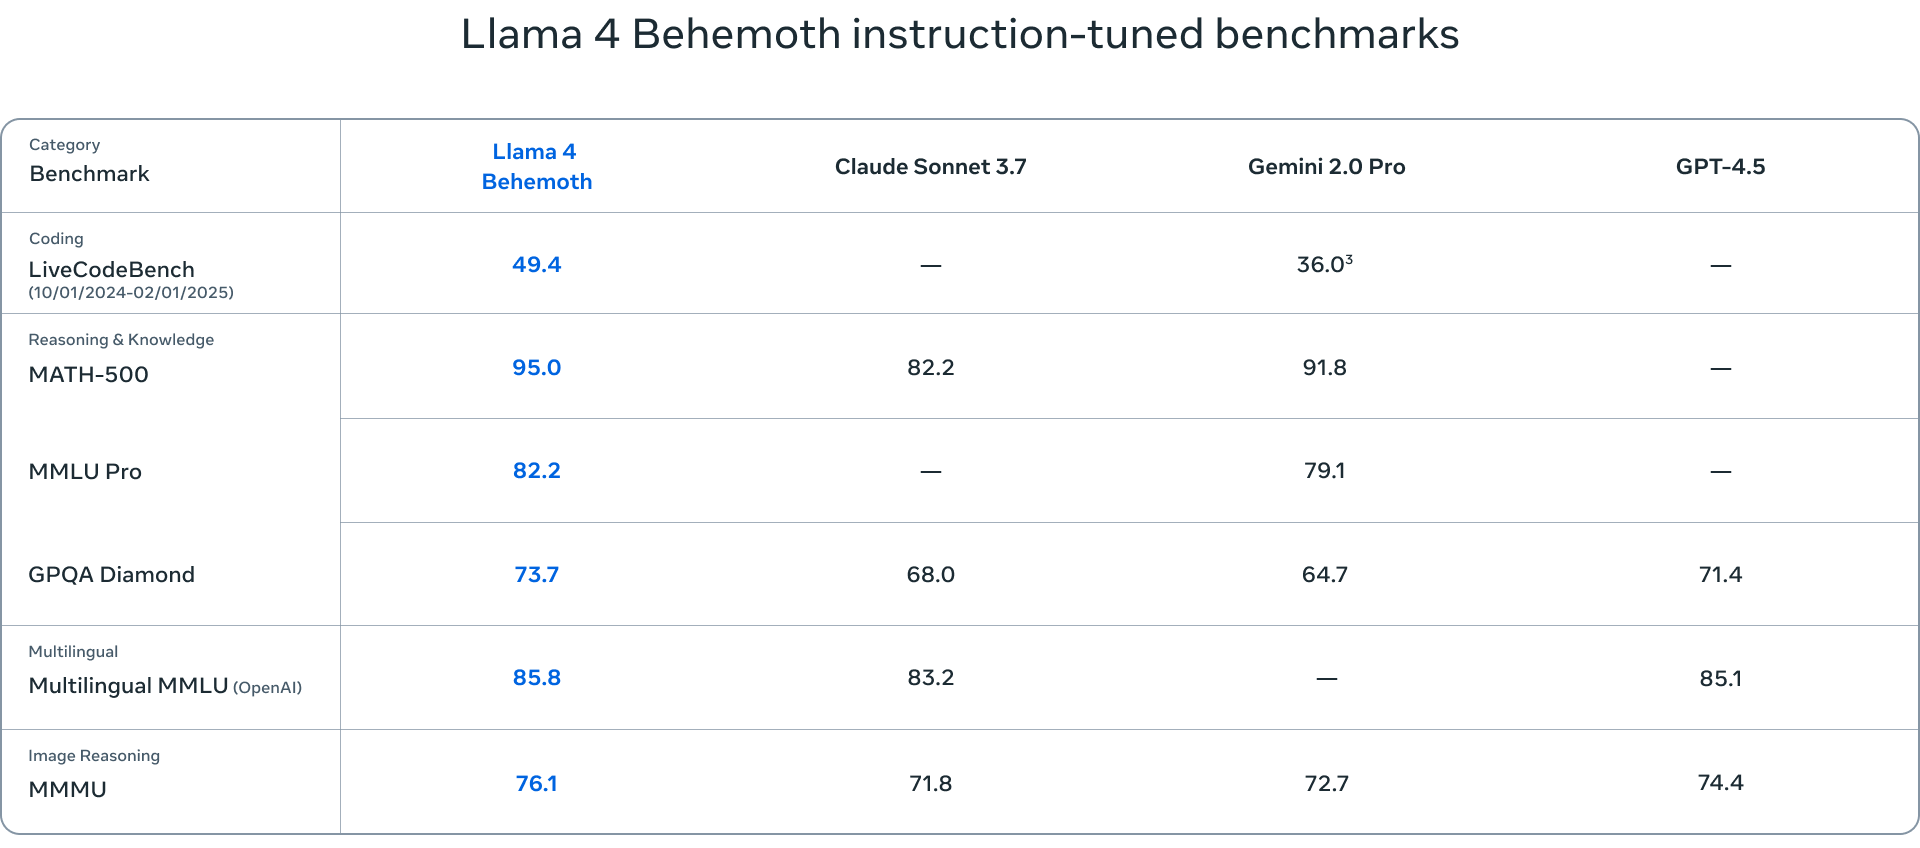
De benchmarks die worden gebruikt om de Llama 4-modellen te evalueren, bestrijken een reeks taken, waaronder taalbegrip (MMLU – Massive Multitask Language Understanding, GPQA – Google-Proof Question Answering), wiskundige probleemoplossing (MATH – Mathematical Problem-Solving, MathVista – een benchmark voor wiskundige probleemoplossing in visuele contexten) en multimodaal begrip (MMMU – Massive Multimodal Multitask Understanding). Deze standaardbenchmarks bieden een uitgebreide beoordeling van de mogelijkheden van de modellen en helpen bij het identificeren van gebieden waarin ze uitblinken of verdere verbetering behoeven.
De rol van lerarenmodellen in Llama 4
Een leraarmodel is een groot, vooraf getraind model dat kleinere modellen begeleidt en zijn kennis en vaardigheden via distillatie aan hen overdraagt. In het geval van Llama 4 fungeert Behemoth als leraarmodel en distilleert zijn kennis naar zowel Scout als Maverick. Het distillatieproces omvat het trainen van de kleinere modellen om het gedrag van het leraarmodel na te bootsen, zodat ze van de sterke en zwakke punten ervan kunnen leren. Deze aanpak stelt de kleinere modellen in staat om indrukwekkende prestaties te leveren en tegelijkertijd efficiënter en schaalbaarder te zijn.
Implicaties en toekomstige richtingen
De release van Llama 4 markeert een belangrijke mijlpaal in het AI-landschap, met verstrekkende implicaties voor onderzoek, ontwikkeling en toepassingen. Historisch gezien zijn Llama-modellen een katalysator geweest voor downstream-onderzoek, wat verschillende studies en innovaties inspireerde. De release van Llama 4 zal naar verwachting deze trend voortzetten, waardoor onderzoekers de modellen kunnen uitbouwen en verfijnen om complexe taken en uitdagingen aan te pakken.
Veel modellen zijn verfijnd en gebouwd op basis van Llama-modellen, wat de veelzijdigheid en het potentieel van de Llama-architectuur aantoont. De release van Llama 4 zal deze trend waarschijnlijk versnellen, aangezien onderzoekers en ontwikkelaars de modellen gebruiken om nieuwe en innovatieve applicaties te creëren. Dit is belangrijk omdat Llama 4 een sterke modelrelease is en een breed scala aan onderzoeks- en ontwikkelingsactiviteiten mogelijk zal maken.
Het is het vermelden waard dat de Llama 4-modellen, net als hun voorgangers, niet-denkend zijn. Daarom zouden toekomstige Llama 4-serie releases mogelijk post-getraind kunnen worden voor redeneren, wat hun prestaties verder zou verbeteren.


 Amazon