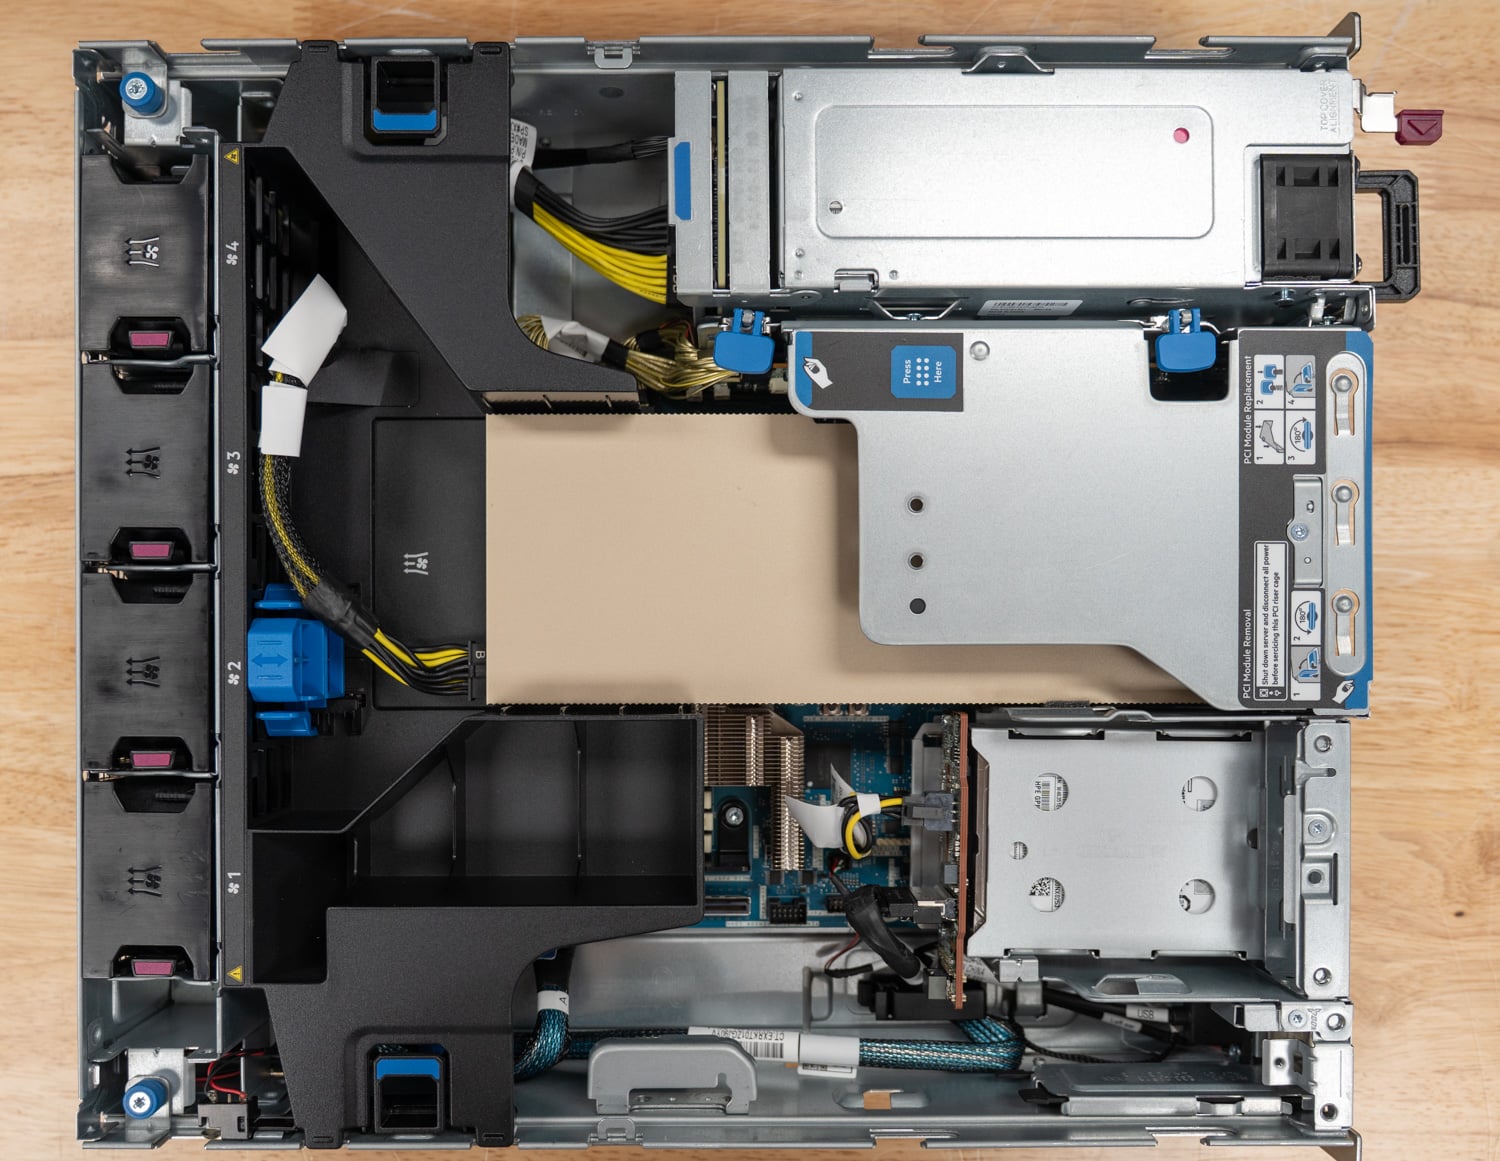
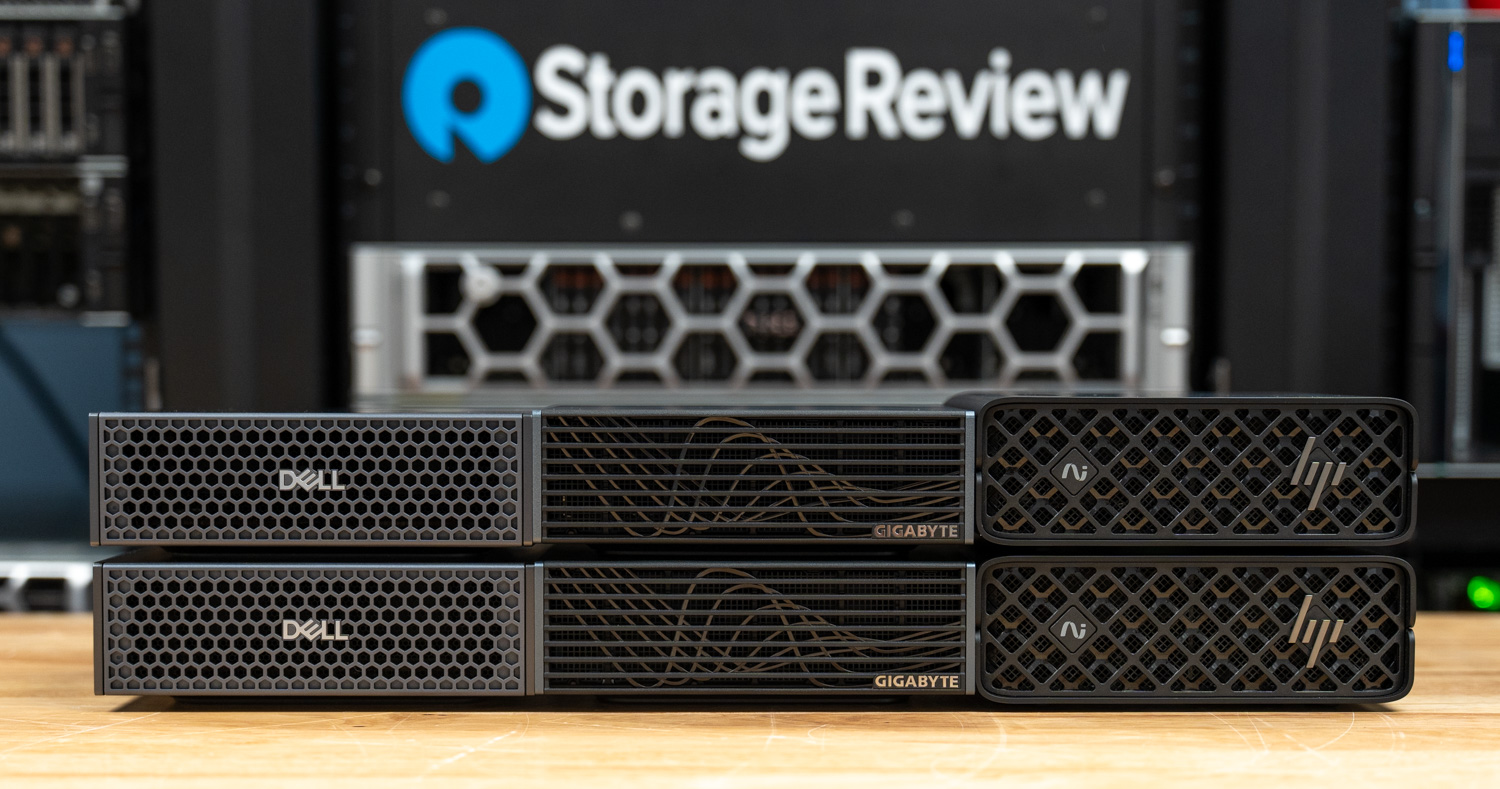
Onze huidige AI-systeemreviews richten zich op inferentie in het lab, met open-weight modellen uit de Llama-, Qwen-, DeepSeek- en gpt-oss-families die via vLLM of SGLang draaien en worden gemeten op uitvoerdoorvoer en first-token latency. De dekking loopt van edge tot volledige GPU-node: de NVIDIA RTX PRO 4500 Server Edition leverde gemiddeld 2.7 keer zoveel uitvoertokens per seconde als de L4 die hij moest vervangen in een HPE ProLiant DL145 Gen11, met ongeveer 105W meer stroomverbruik; de Dell-, GIGABYTE- en HP-versies van DGX Spark draaiden gedistribueerde inferentie als clusters van twee nodes over de 200 Gb fabric; en Supermicro JumpStart gaf ons de mogelijkheid om een NVIDIA HGX B200 en een AMD Instinct MI350X-systeem te testen. Opslag krijgt dezelfde behandeling, omdat het datapad bepaalt hoe druk die GPU's blijven. Daarom meten we de GPUDirect Storage-doorvoer met GDSIO en testen we KV-cache-offload naar flashgeheugen voor workloads met lange contexten en agentische workloads.
Als u hardware selecteert voor AI, vindt u op de pagina 'Beste servers' onze actuele aanbevelingen voor AI-inferentie en edge computing op basis van de gegevens uit deze reviews. 'Beste enterprise SSD's' behandelt de schijven die de GPU's van stroom voorzien, en 'Beste opslagarrays' behandelt de AI-opslagplatformen achter trainingsclusters en neoclouds.




 Amazon