

MinIO heeft MemKV aangekondigd, een contextgeheugen dat is ontworpen om een groeiend knelpunt in grootschalige AI-inferentieomgevingen aan te pakken. MemKV is, naast AIStor , het tweede kernonderdeel van het portfolio van het bedrijf en breidt de data-infrastructuur van MinIO uit naar de geheugenlaag. Het is gericht op persistente, gedeelde context voor agentische AI-workloads die draaien op GPU-clusters.
Naarmate AI-systemen evolueren van interacties met één enkele respons naar redeneringen en taakuitvoering in meerdere stappen, is het behoud van context gedurende inferentiecycli cruciaal geworden. In de huidige architecturen gaat context vaak verloren door de beperkte capaciteit van geheugenlagen die grenzen aan de GPU, zoals HBM en DRAM. Dit dwingt GPU's om eerder gegenereerde context opnieuw te berekenen, wat leidt tot een hogere latentie, een hoger rekengebruik en een hoger energieverbruik. MinIO omschrijft dit als een herberekeningsbelasting die op grote schaal toeneemt, met name in hyperscale- en cloudomgevingen.
MemKV is ontworpen om dit probleem te verhelpen door een gedeelde, persistente geheugenlaag te bieden die gegevens in microseconden kan ophalen op petabyteschaal. Door de context te behouden tijdens inferentiebewerkingen, vermindert het platform overbodige berekeningen en verbetert het de algehele systeemefficiëntie. In interne benchmarks rapporteert MinIO verbeteringen in de tijd tot het eerste token bij gelijktijdigheidsniveaus in productieomgevingen. In een representatieve implementatie met 128 GPU's en contextvensters van 128 tokens steeg het GPU-gebruik van ongeveer 50 procent naar meer dan 90 procent, wat resulteerde in aanzienlijke jaarlijkse besparingen op de rekenkosten.
De leiding van MinIO merkte op dat de overhead van herberekeningen in kleinere implementaties historisch gezien werd gemaskeerd, maar op grotere schaal een structurele inefficiëntie wordt. Naarmate GPU-clusters groeien, nemen de kosten van het herhaaldelijk genereren van context toe, zowel wat betreft energieverbruik als infrastructuurvereisten. Dit maakt speciaal ontworpen geheugensystemen noodzakelijk voor duurzame AI-werking.
Het aanpakken van de afweging tussen geheugen en schaalbaarheid.
Traditionele AI-infrastructuren dwingen tot een afweging tussen snelheid en schaalbaarheid. Hoogwaardige geheugenlagen zoals HBM en DRAM bieden latentie van microseconden, maar zijn beperkt in capaciteit en duur. Opslagsystemen daarentegen bieden schaalbaarheid, maar introduceren latentie van milliseconden, wat ongeschikt is voor realtime inferentie en redeneren over lange contexten.
MemKV is ontworpen om deze kloof te overbruggen door een gedeelde geheugenlaag te introduceren die toegang met lage latentie combineert met een grote capaciteit. Het platform is gebouwd om te draaien op NVIDIA BlueField-4 STX en is geïntegreerd met NVIDIA Dynamo en NIXL. Hierdoor kan een volledig GPU-cluster toegang krijgen tot een gemeenschappelijke pool van contextgegevens met snelheden die zijn afgestemd op de inferentievereisten. Deze aanpak elimineert de noodzaak om contextgegevens tussen verschillende geheugen- en opslaglagen te verplaatsen, waardoor de latentie wordt verlaagd en de doorvoer wordt verbeterd.
Architectuur geoptimaliseerd voor inferentieworkloads
MemKV is speciaal ontworpen voor het inferentiedatapad en sluit aan bij MinIO's beschrijving van de G3.5-laag in de GPU-geheugenhiërarchie. Het levert petabyte-schaalcapaciteit op NVMe-gebaseerde infrastructuur met behoud van toegangskarakteristieken op microsecondenniveau, waardoor de geheugenschaal effectief wordt losgekoppeld van de GPU-rekenkracht.
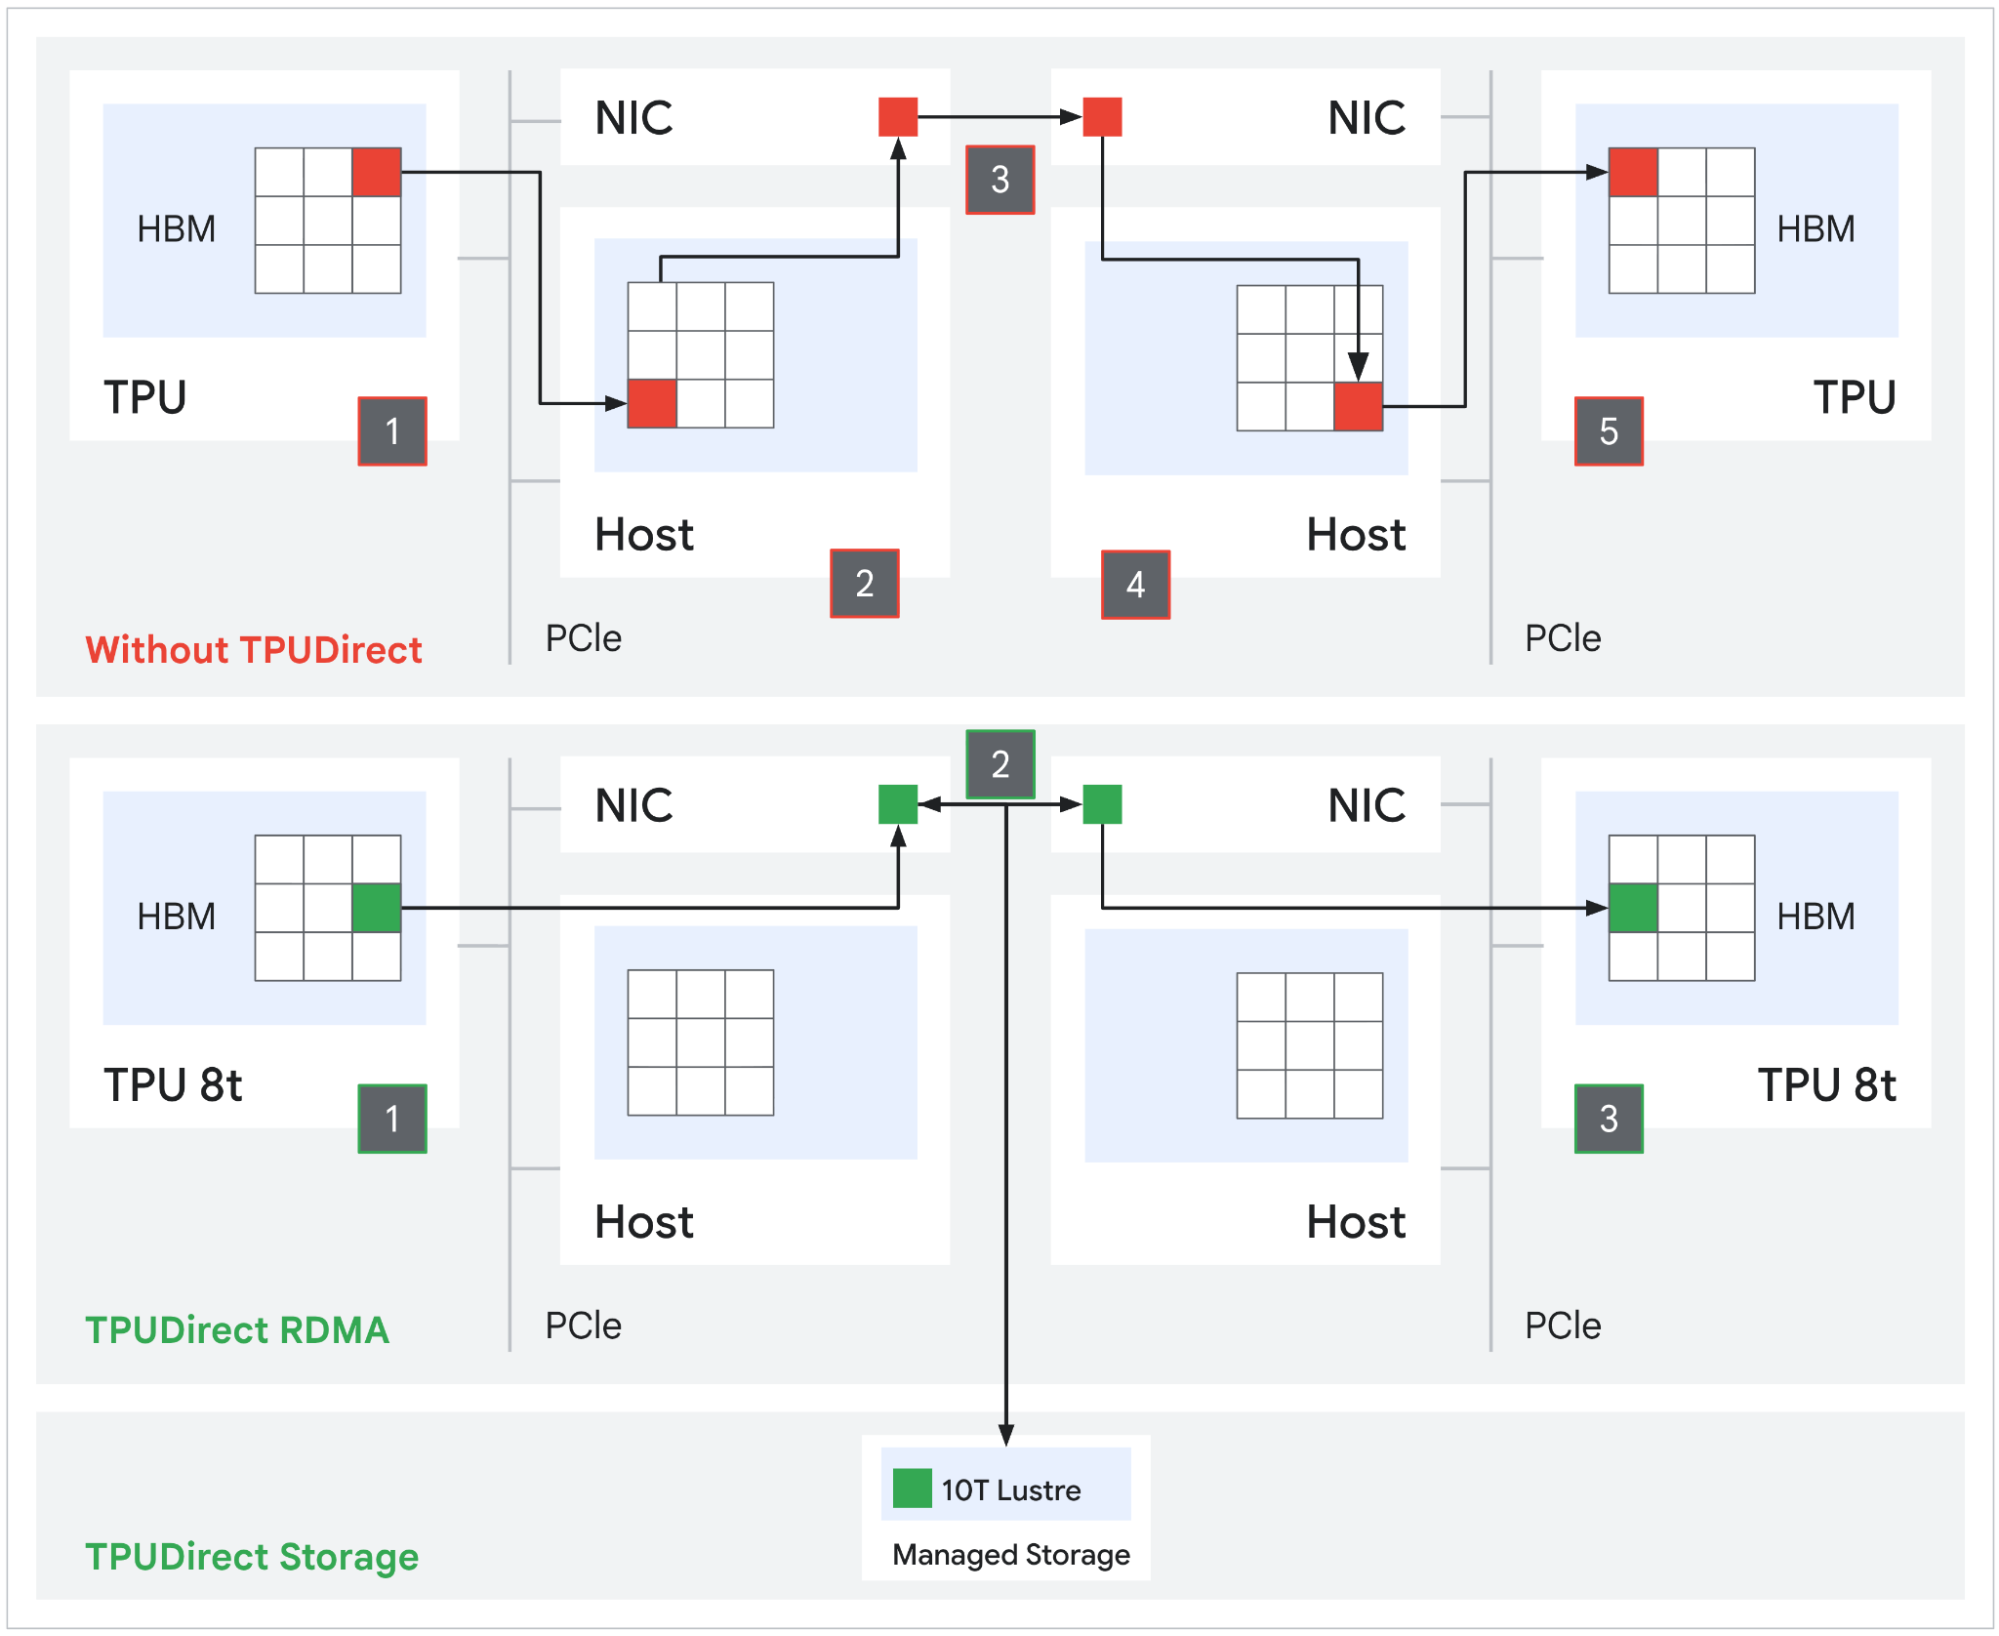
Het systeem vermijdt traditionele opslagabstracties door data rechtstreeks van NVMe naar het AI-datapad te verplaatsen via end-to-end RDMA-transport . Dit elimineert de overhead van HTTP-protocollen, bestandssysteemvertaling en tussenliggende opslagservers, die veel voorkomen in object- en bestandsgebaseerde architecturen.
Bron: Google
Belangrijke architectonische elementen zijn onder meer native uitvoering op NVIDIA BlueField-4 STX als een ARM64-binair bestand ingebed in de opslaglaag, waardoor de afhankelijkheid van externe x86-opslagknooppunten wordt verminderd. Gegevensoverdracht vindt plaats via RDMA van GPU-geheugen naar NVMe, waardoor conventionele opslagstacks worden omzeild. MemKV maakt ook gebruik van grotere blokgroottes, variërend van 2 MB tot 16 MB, geoptimaliseerd voor GPU-doorvoerpatronen in plaats van de traditionele opslagblokken van 4 KB. De netwerkprestaties zijn afgestemd op moderne, snelle netwerken, waaronder NVIDIA Spectrum-X Ethernet en PCIe Gen6, waardoor gegevensoverdracht bijna op wire-speed snelheid door het cluster mogelijk is.
Beschikbaarheid
MinIO MemKV is direct beschikbaar.


 Amazon