

MLCommons publiceerde vandaag de resultaten van MLPerf Storage v3.0, en deze ronde verandert niet alleen de aard van de benchmark, maar ook wie de leiding heeft. Voor het eerst omvat de enige gecontroleerde benchmark voor AI-opslag de volledige pipeline: trainingsdoorvoer, checkpointing en twee nieuwe inferentieworkloads, een vectordatabasetest en een KV-cachetest. Negentien organisaties dienden 143 resultaten in, waarvan elf voor het eerst, waaronder Microsoft Azure, NVIDIA, Everpure en een reeks startups op het gebied van AI-opslag die de meeste lezers niet zullen herkennen. Even opvallend is dat DDN, Huawei, Hammerspace en Lightbits, de namen die de v2.0-ranglijst domineerden, deze ronde niet hebben ingediend.
Een belangrijke kanttekening met betrekking tot de vergelijkbaarheid: versie 3.0 heeft de gesimuleerde accelerators verplaatst van H100 naar B200, waardoor de bandbreedte per accelerator hoger komt te liggen. De cijfers van versie 3.0 kunnen daarom niet worden vergeleken met de resultaten van versie 2.0. Deze gegevens zijn door MLCommons gecontroleerde inzendingen van leveranciers; StorageReview heeft deze tests niet uitgevoerd of onafhankelijk geverifieerd.
Controlepunten vormen het belangrijkste evenement.
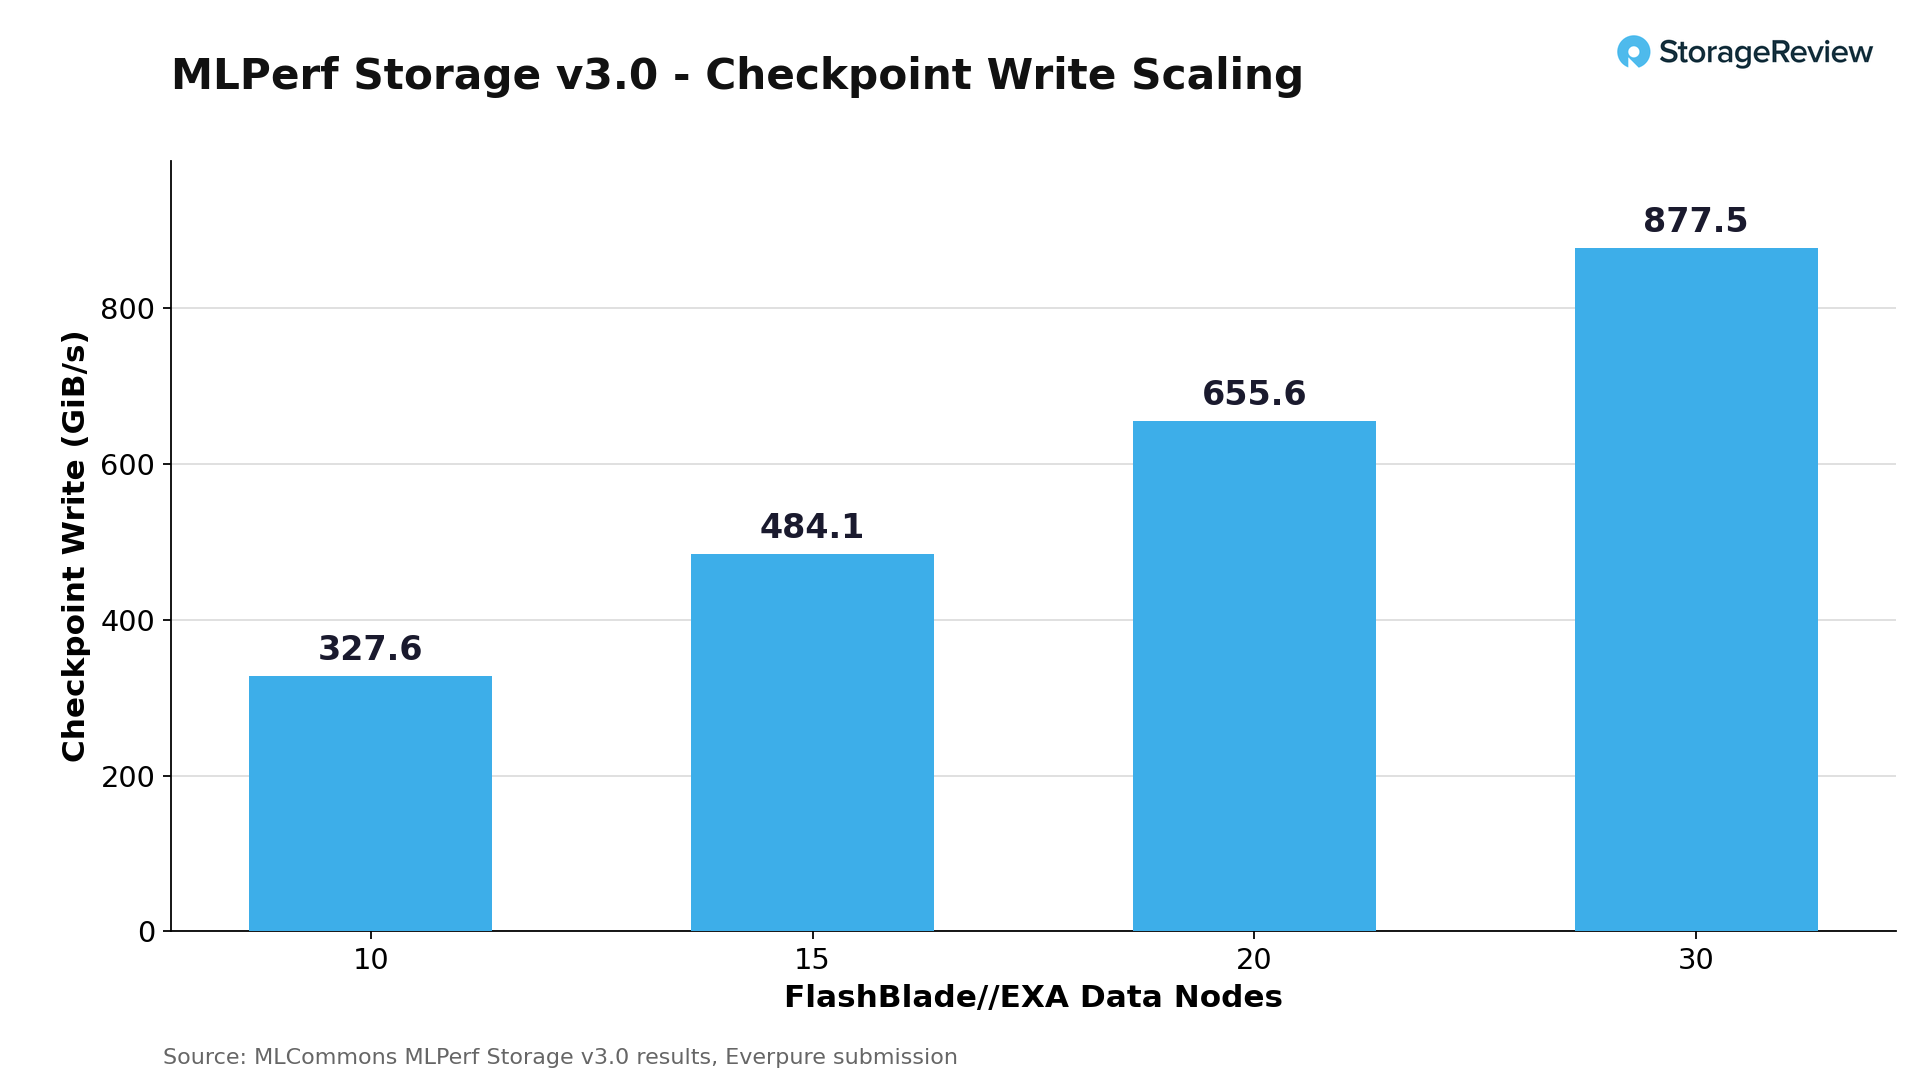
MLCommons heeft checkpointing toegevoegd als een eersteklas workload omdat het een bewezen knelpunt is geworden: grootschalige trainingstaken schrijven enorme hoeveelheden statusinformatie met regelmatige tussenpozen, en elke seconde die wordt besteed aan het doorspoelen van een checkpoint is een seconde ongebruikte acceleratortijd. Het hoogste aantal in deze ronde hoort hier thuis. Everpure (voorheen Pure Storage), dat voor het eerst deelnam aan MLPerf Storage, diende FlashBlade//EXA-resultaten in die vrijwel lineair schalen met het aantal dataknooppunten: 327.6 GiB/s aan checkpointschrijfsnelheid bij 10 dataknooppunten, 484.1 GiB/s bij 15, 655.6 GiB/s bij 20 en 877.5 GiB/s aan schrijfsnelheid met 833.0 GiB/s aan leessnelheid bij 30 dataknooppunten. Everpure heeft het afgelopen jaar grote doorvoercijfers voor //EXA geclaimd; dit is de eerste keer dat een gecontroleerd resultaat die claims ondersteunt.
Het op één na hoogste aantal checkpoints is wellicht het belangrijkste nieuws in de sector. Azure Managed Lustre, de eerste hyperscale cloudopslagservice die ooit aan de benchmark deelnam, behaalde een checkpointschrijfsnelheid van 642.2 GiB/s met een implementatie van 4,096 TiB en 128 clients. Dat een beheerde cloudbestandsservice zulke prestaties zou leveren als speciaal voor AI ontworpen opslagsystemen, was twee rondes geleden nog ondenkbaar geweest.
| Controlepunten (Beste inzendingen) | Systeem | Schrijf in zwart-wit (GiB/s) |
|---|---|---|
| Everpuur | FlashBlade//EXA, 30 dataknooppunten | 877.5 |
| Azuur | Beheerde Lustre, 4,096 TiB, 128 klanten | 642.2 |
| YanRongTech | F9000X, 8 clients | 313.7 |
| Suzhou Zishan Longlin | Meerdere configuraties | 313.7 |
| TuringData | F9200, 8 klanten | 307.1 |
| UBIX | UbiPower18000, 3 opslagknooppunten | 293.8 |
Training: Namen die je waarschijnlijk niet kent
Het klassement voor 3D U-Net-training wordt gedomineerd door nieuwkomers. De F9000X van YanRongTech behaalde een leesbandbreedte van 543.9 GiB/s met 99 gesimuleerde B200-acceleratoren, de hoogste trainingsdoorvoer van de ronde. TuringData, een Singaporees AI-infrastructuurbedrijf dat voor het eerst deelnam, bleef 4 GiB/s achter met 541.5 GiB/s, terwijl het 96 gesimuleerde B200's voedde vanaf slechts drie opslagknooppunten. Dezelfde F9200-cluster met drie knooppunten diende ook Checkpoint-70B in met een leessnelheid van 539.9 GiB/s en een schrijfsnelheid van 307.1 GiB/s. De UbiPower18000 van UBIX, met drie opslagknooppunten met 16 x 15.36 TB NVMe-schijven en vier NDR400-netwerken, behaalde een snelheid van 454.1 GiB/s. HPE was de enige gevestigde leverancier van enterprise-arrays die trainingsresultaten indiende, met de K3000 op 345.8 GiB/s.
| 3D U-Net training (beste inzendingen) | Zwart-wit lezen (GiB/s) | Gesimuleerde B200-versnellers |
|---|---|---|
| YanRongTech F9000X | 543.9 | 99 |
| TuringData F9200 | 541.5 | 96 |
| UBIX UbiPower18000 | 454.1 | 80 |
| Suzhou Zishan Longlin | 433.4 | 80 |
| FarmGPU | 406.7 | 75 |
| Door Azure beheerde glans | 379.1 | 70 |
Inferentie wordt toegevoegd aan de benchmark.
De twee nieuwe workloads erkennen waar de vraag naar opslag daadwerkelijk groeit. De KV-cachetest meet hoe snel een opslagsysteem de aandachtstatus in en uit kan laden voor LLM-servers met een lange context, een patroon dat we uitgebreid hebben onderzocht in ons onderzoek naar KV-cache-offloading bij Dell en Solidigm . Everpure behaalde opnieuw het hoogste resultaat van de testronde: 1,623.4 GiB/s aan KV-cacheleesresultaten op een FlashBlade//EXA-configuratie met 51 hosts. UBIX (443.7 GiB/s) en FarmGPU (443.6 GiB/s) waren de koplopers onder de inzendingen op standaardschaal. Aan de kant van de vectordatabases stond het Seahorse-systeem van TTA bovenaan de lijst met querydoorvoer met 57,620 queries per seconde.
De andere structurele verandering betreft het protocol. Versie 3.0 voegde ondersteuning voor S3-objectopslag toe, en ongeveer een zesde van de inzendingen maakte er gebruik van. NVIDIA was hiervoor verantwoordelijk met het grootste deel, met 20 AIStore-inzendingen die bare-metal-configuraties op OCI, AWS en GCP omvatten, met een maximale schrijfsnelheid van 133.3 GiB/s voor checkpoints. De absolute cijfers blijven achter bij die van parallelle bestandssystemen, maar objectopslag die trainings- en checkpointworkloads uitvoert binnen de benchmark, betreedt terrein dat POSIX-bestandssystemen een jaar geleden nog volledig in handen hadden.
MLCommons is deze ronde ook begonnen met het bijhouden van energieverbruik en rack-ruimte-efficiëntie als belangrijke meetinstrumenten.
Everpure FlashBlade//EXA
Het Everpure FlashBlade//EXA-systeem behaalde de hoogste score in de categorieën modelcheckpointing met 405 miljard en 1.25 biljoen parameters, evenals in de benchmarks voor het ophalen van gegevens uit de Key-Value (KV) cache. Dit onderstreept het vermogen van het platform om een hoge doorvoer te handhaven tijdens data-intensieve workloads voor het trainen en infereren van kunstmatige intelligentie.
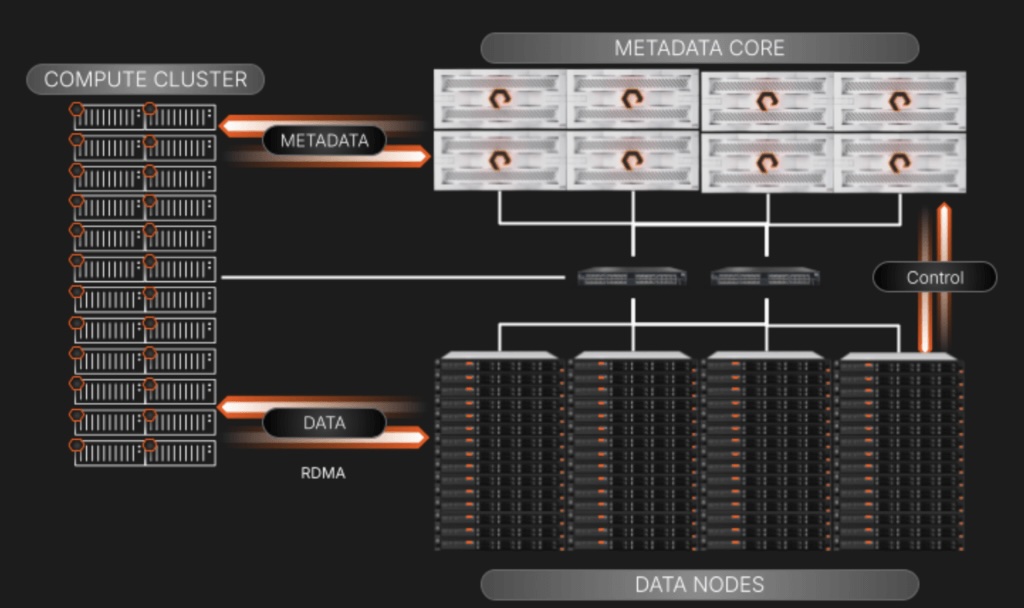
De door Everpure ingediende configuratie combineerde 30 FlashBlade//EXA-blades (120 DirectFlash-modules voor de verwerking van metadata) met 30 Linux/NVMe-dataknooppunten, wat resulteerde in een bruikbare capaciteit van ongeveer 866 TB in één bestandssysteem. De metadata werd verdeeld over pNFS/TCP en de bulkdata over NFSv3 op RDMA. In de checkpointing-simulatie met 1.25 biljoen parameters en 1,024 clientversnellers behaalde de configuratie met 30 knooppunten een schrijfsnelheid van 877.52 GiB/s gedurende een bewerking van 17.74 seconden, naast een leessnelheid van 588.28 GiB/s die in 28.99 seconden werd voltooid. Bij de KV-cache-inferentietest werden 85,736 tokens/sec gerapporteerd op een Llama 3.1 8B-run met alleen opslag, 67,642 tokens/sec op een 8B-run met een combinatie van opslag- en systeemgeheugen, en 33,403 tokens/sec op een 70B-run met alleen opslag.
Wat de afwezigheid betekent
Een benchmarkronde bewijst twee dingen: wat de deelnemers kunnen en wat de afwezigen ervoor kozen niet te laten zien. VAST Data, WEKA en DDN, de leveranciers die de grootste neocloud- en AI-factory-implementaties binnenhaalden, hebben allemaal v3.0 overgeslagen, net als de deelnemers aan v2.0: Huawei, Hammerspace en Lightbits. Leveranciers slaan rondes over om alledaagse redenen, zoals engineeringcycli, releaseplanning en de politiek achter benchmarks; het overslaan van een ronde is geen bewijs dat een systeem traag is. Het betekent echter wel dat de gecontroleerde gegevens en de implementatiegegevens nu naar verschillende leverancierslijsten verwijzen, en kopers moeten beide afwegen. Onze pagina 'Beste opslagarrays' houdt deze splitsing nauwkeurig bij, met een label voor wat gecontroleerd is en wat implementatiebewijs is, en is bijgewerkt met de volledige v3.0-resultaten.
De resultaten van versie 3.0 zijn vandaag gepubliceerd op de MLCommons-pagina voor opslagbenchmarks.



 Amazon