

De LPU, ofwel Language Processing Unit, is een op maat gemaakte AI-inferentieversneller, ontworpen en gebouwd door Groq, Inc. Groq, opgericht in 2016 door Jonathan Ross, een voormalig Google-ingenieur die wordt beschouwd als een van de oorspronkelijke uitvinders van de TPU, heeft jarenlang gewerkt aan de ontwikkeling van een deterministische, softwaregedefinieerde processorarchitectuur. In tegenstelling tot GPU's, die afhankelijk zijn van dynamische hardwareplanning en cachehiërarchieën met meerdere niveaus, hanteert de LPU een radicaal andere aanpak: alle reactieve hardwarecomponenten worden geëlimineerd en het volledige besturingsvlak wordt in de compiler geplaatst, waardoor een volledig voorspelbare uitvoering tot op de klokcyclus nauwkeurig mogelijk is.
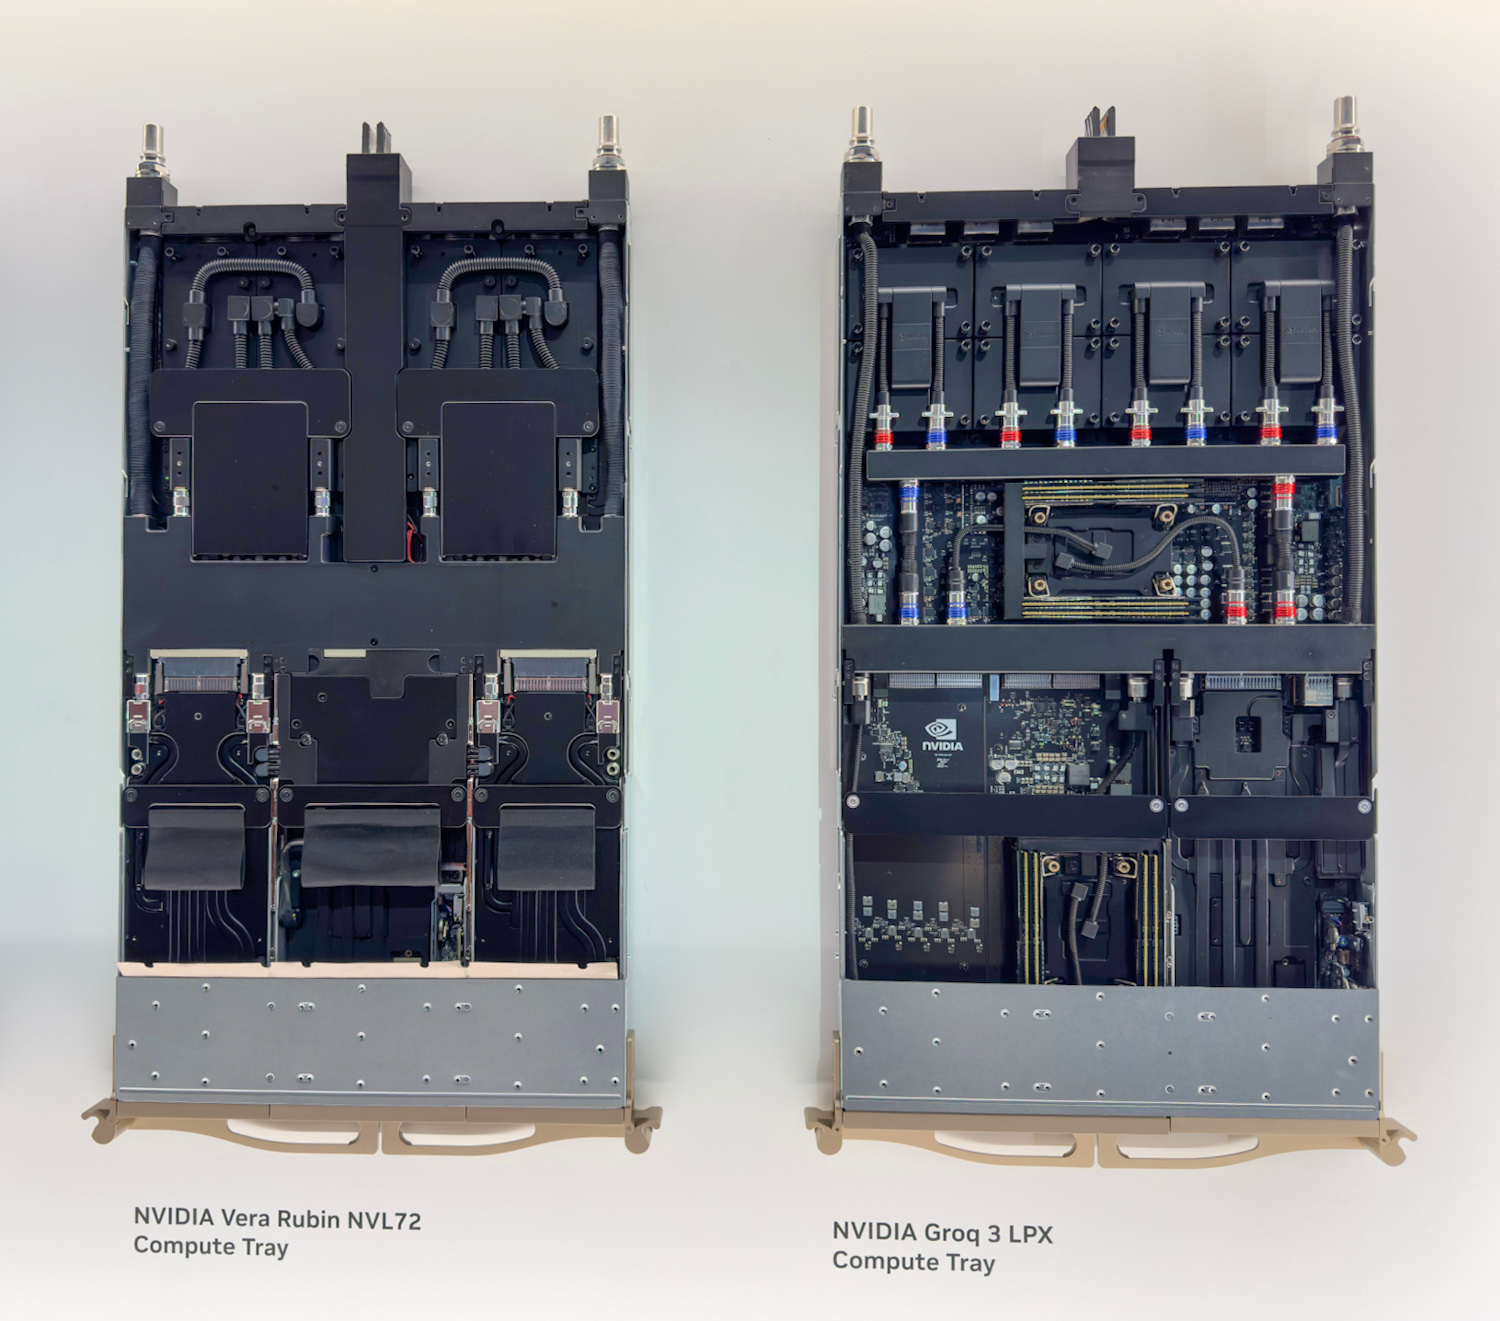
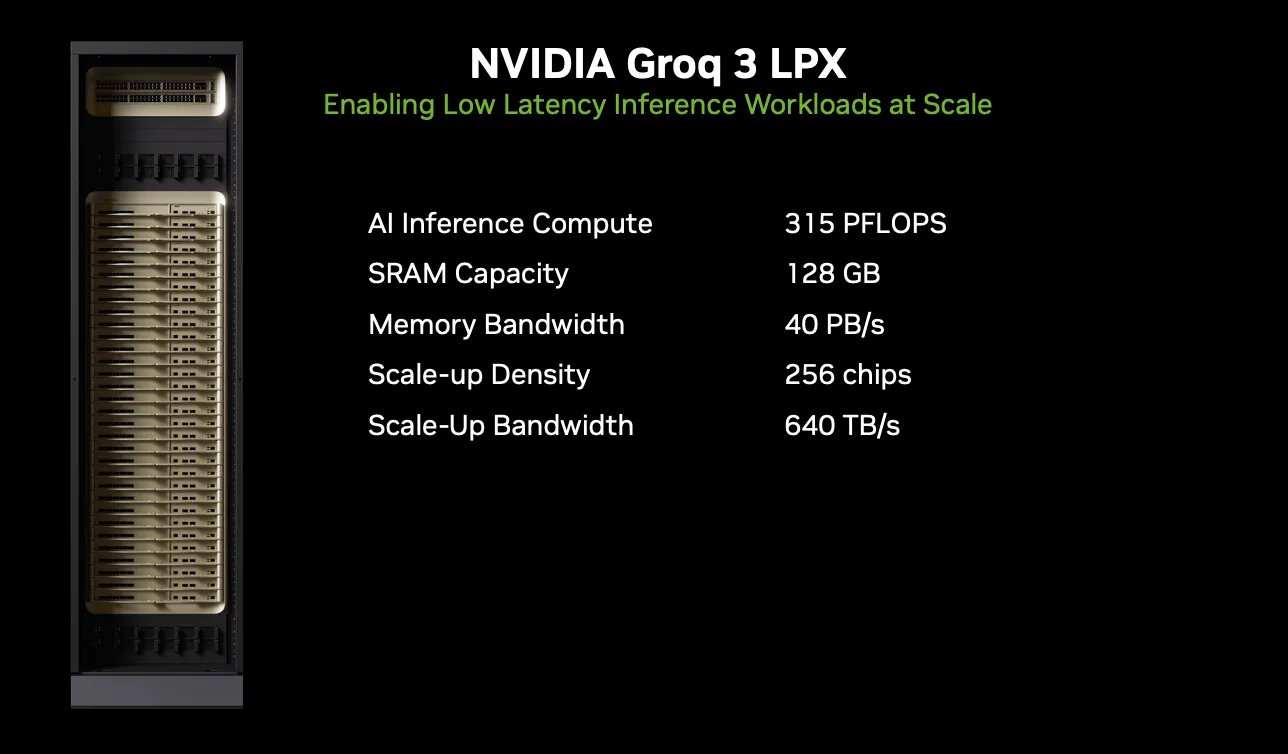
In december vorig jaar nam NVIDIA Groq over, waarmee de LPU-architectuur onder de NVIDIA-paraplu kwam. De overname werd enorm goed ontvangen in de branche en leidde direct tot speculaties over hoe NVIDIA de technologie van Groq in zijn datacenter-ecosysteem zou integreren. Die vragen werden uiteindelijk beantwoord tijdens GTC 2026, waar NVIDIA de Groq 3 LPX onthulde als de zevende chip van het Vera Rubin-platform, die 256 LPU-acceleratoren combineert in een rack-schaalsysteem naast de Vera Rubin NVL72.
Wat is er met CPX gebeurd?
Vorig jaar kondigde NVIDIA tijdens de AI Infra Summit ook de CPX-rack aan in een aantal configuraties, ontworpen om inferentiequeries met lange contexten te versnellen. Na onze eerste berichtgeving over die aankondiging rezen er bij ons een aantal vragen over de daadwerkelijke functie van de CPX. Op het eerste gezicht leek de CPX, hoewel het een interessant architectonisch concept was, niet wezenlijk meer te bieden dan de Rubin GPU zelf, afgezien van wellicht extra versnelling voor aandachtsoperaties. Toen kwam de overname van Groq, wat speculaties opriep over hoe NVIDIA de LPU-technologie van Groq zou integreren in het bredere Vera Rubin-platform.
NVIDIA heeft tijdens GTC 2026 duidelijkheid gegeven met de aankondiging van de LPX. Op basis van de gepresenteerde informatie lijkt het erop dat het CPX-rackconcept is geëvolueerd naar de Groq 3 LPX Rack. De focus van de oorspronkelijke CPX op contextverwerking heeft plaatsgemaakt voor een fundamenteel andere architectuur voor decode-acceleratie, gebouwd rondom de siliciumchips van Groq. De LPX Rack is volledig vloeistofgekoeld, gebouwd op de MGX-infrastructuur en zal beschikbaar komen in de tweede helft van 2026, gelijktijdig met de bredere introductie van Vera Rubin. NVIDIA claimt tot 35 keer hogere inferentiedoorvoer per megawatt en tot 10 keer meer omzetpotentieel voor modellen met biljoenen parameters met deze nieuwe toevoeging.
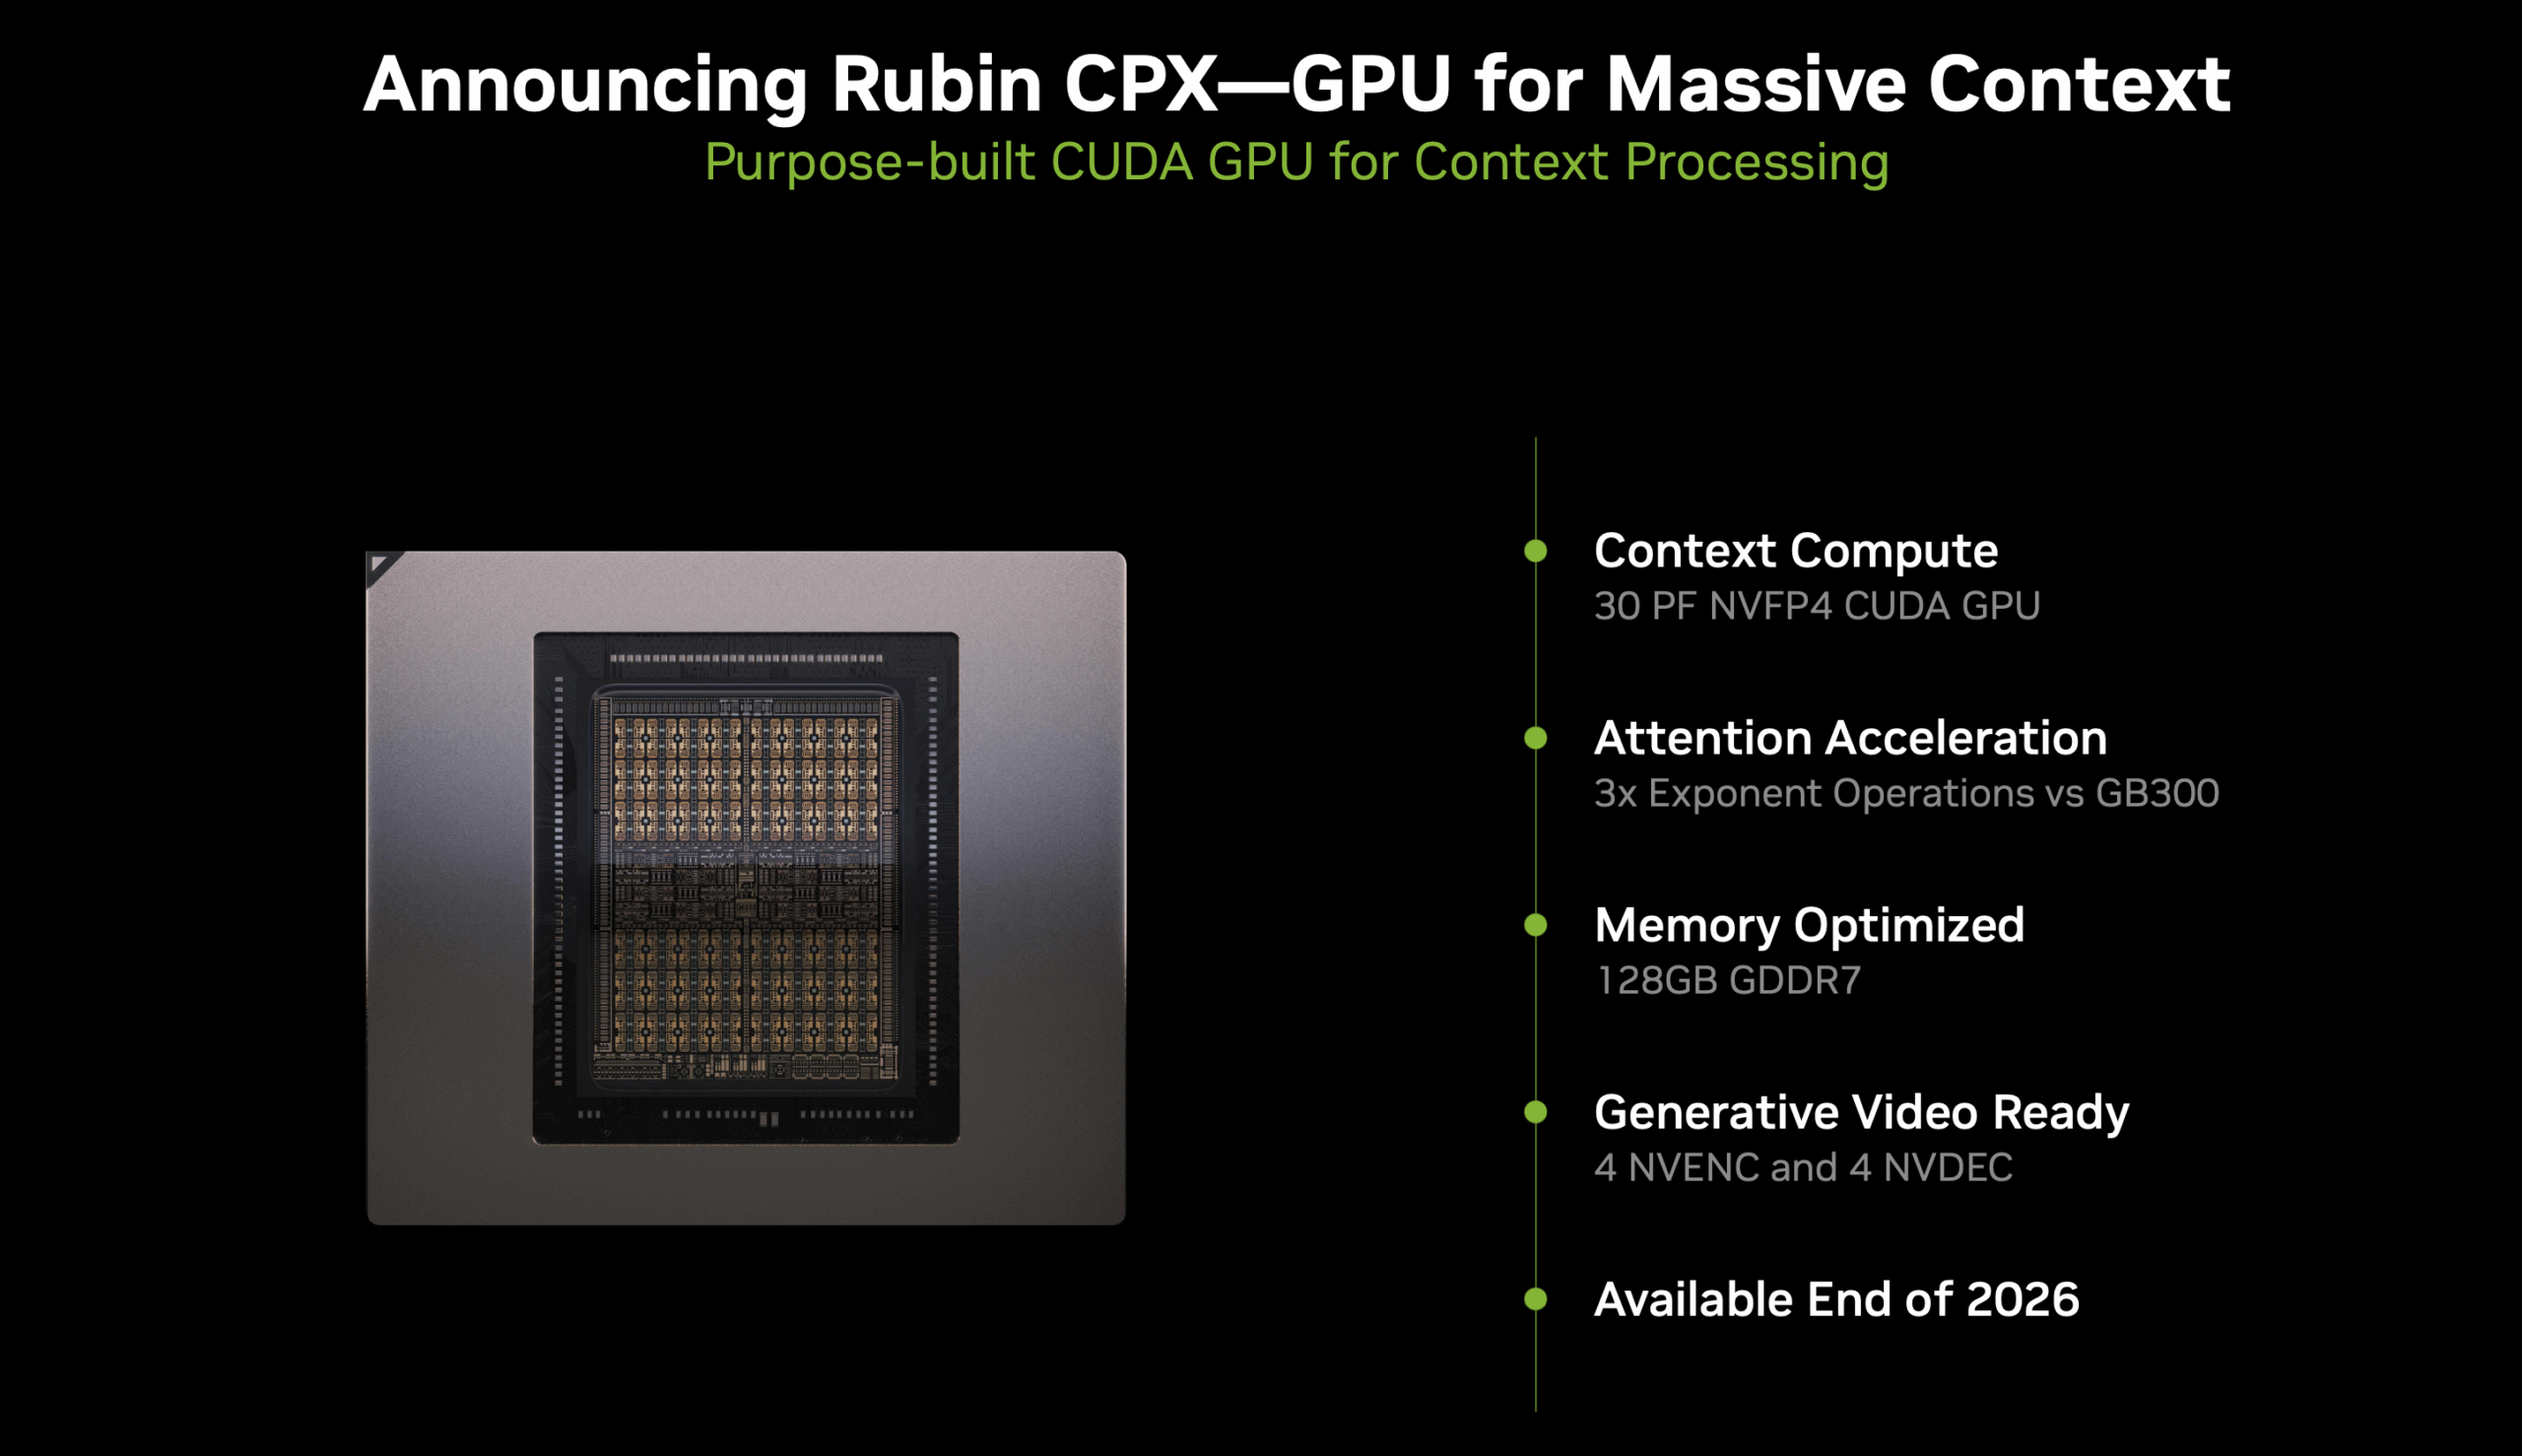
Maar belangrijker nog, NVIDIA bevestigde dat de LPU functioneert als een accelerator binnen de bestaande CUDA-stack die draait op de Vera- en NVL72-platforms, waarbij de berekeningen transparant worden uitbesteed op basis van het aantal tokens. Tijdens de GTC Q&A beschreef NVIDIA de LPU als een "decode model booster" en legde uit dat ze nauw zullen samenwerken met AI-labs en toonaangevende modelbouwers die modellen met biljoenen parameters inzetten om de volgende generatie premium modelserving mogelijk te maken.
Nu de CPX-vraag is beantwoord, is de logische vervolgvraag: wat is die LPU precies waar NVIDIA een compleet rack-scale systeem omheen bouwt?
Wat is een LPU?
De LPU is in essentie een zeer grote vectorprocessor. De fundamentele eenheid voor zowel berekening als communicatie is een vector van 320 elementen, bestaande uit 320 bytes in INT8-formaat en 640 bytes in FP16-formaat. Elke bewerking op de chip, of het nu gaat om rekenkundige bewerkingen, geheugentoegang, gegevensherschikking of gegevensoverdracht tussen chips, werkt met deze vectoren van vaste grootte.
Bron: Nvidia
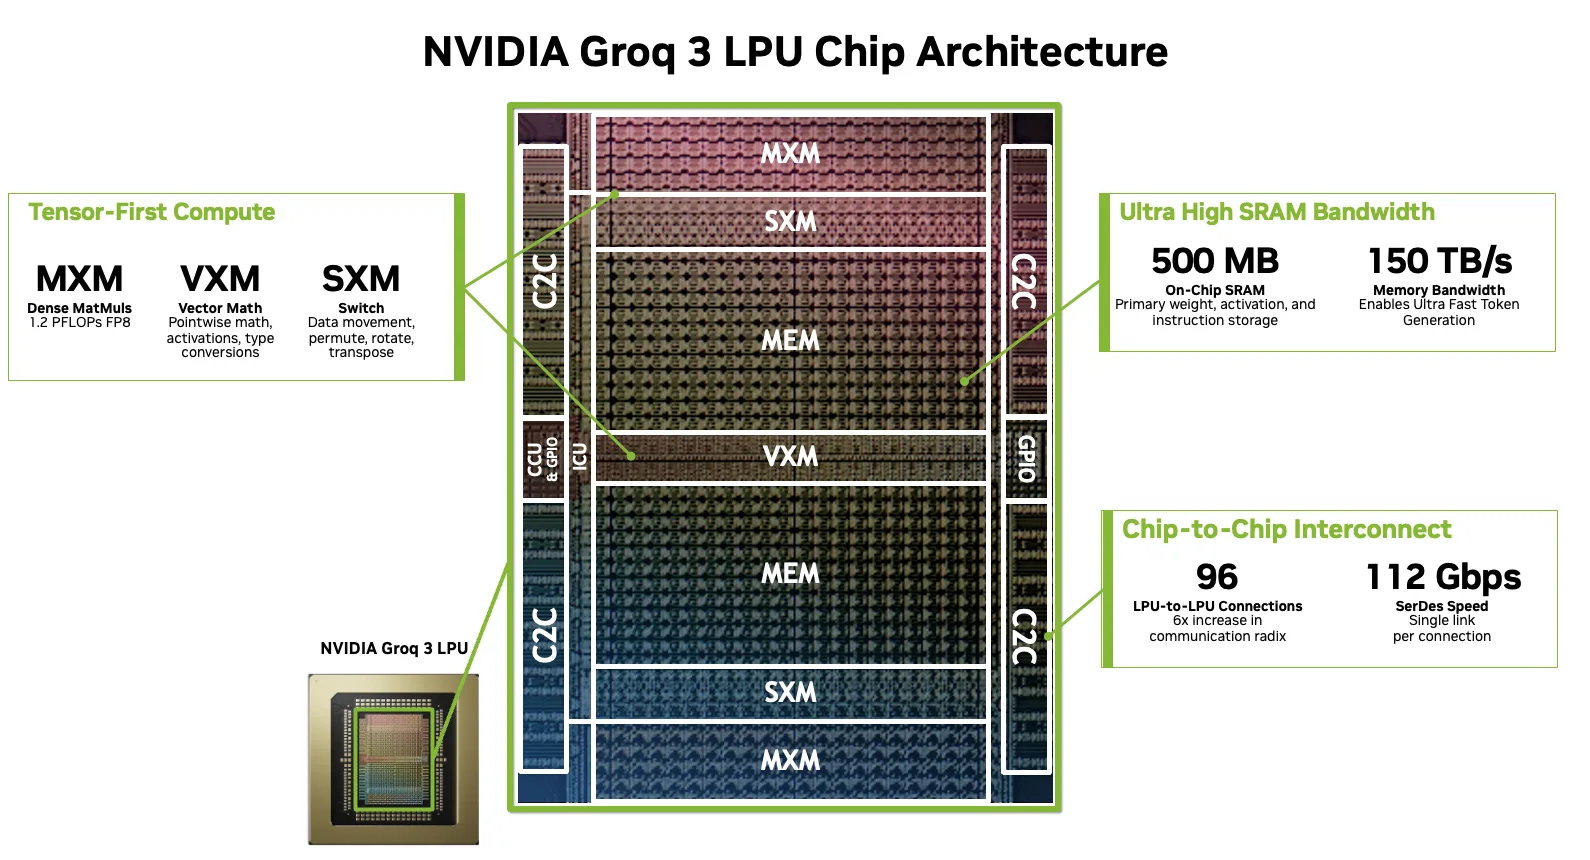
De architectuur is opgebouwd uit één fundamentele bouwsteen: een SIMD-functionele eenheid gekoppeld aan een lichtgewicht instructie-dispatch-eenheid. Groq beschouwt dit als een basisklasse die wordt gespecialiseerd in vier verschillende typen, elk geoptimaliseerd voor een specifieke categorie bewerkingen:
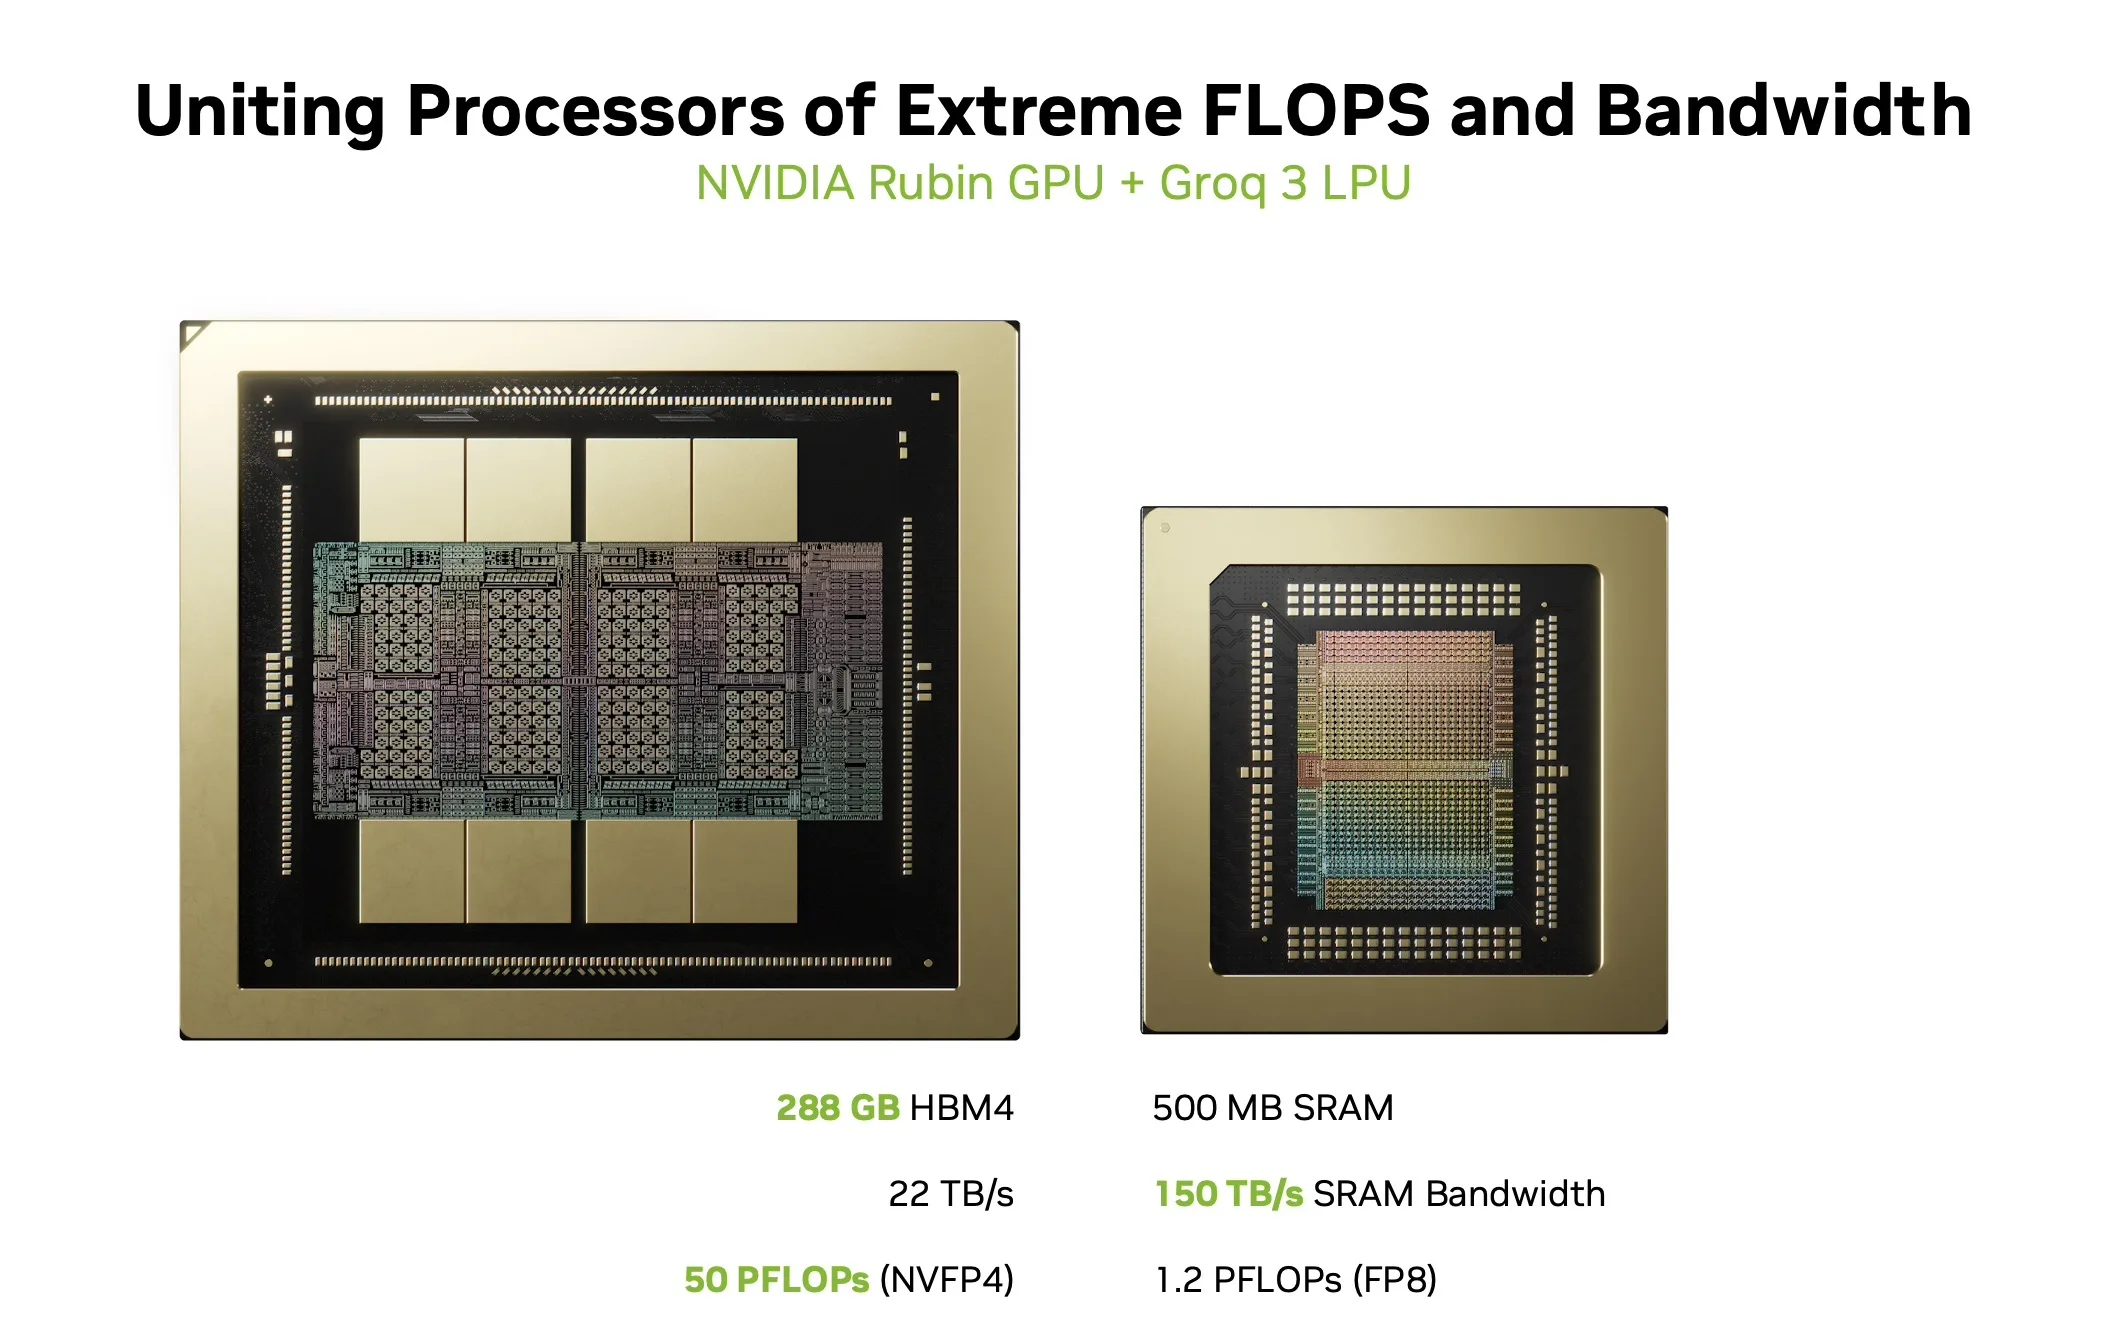
Matrix Execution Modules (MXM): De belangrijkste rekenkracht, die zorgt voor een hoge rekenkracht voor matrix-vector- en matrix-matrixbewerkingen. Elk van de 8 Groq 3 LP30-chips in NVIDIA's LPX-rack levert 1.2 PFLOPS aan FP8-rekenkracht per chip, wat neerkomt op een totaal van 9.6 PLOPS aan FP8-rekenkracht per LPX-tray.
Vector Execution Modules (VXM's): Deze verwerken puntsgewijze rekenkundige bewerkingen, logische bewerkingen, typeconversies en activeringsfuncties. De VXM bevat een reeks ALU's die de compiler automatisch aan elkaar koppelt om samengestelde bewerkingen uit te voeren (bijvoorbeeld reductie gevolgd door bias-add, gevolgd door activering, gevolgd door typeconversie) in één enkele doorgang.
Switch Execution Modules (SXM): Voeren gestructureerde gegevensverplaatsing uit, inclusief permutatie, rotatie, distributie en transpositie van vectoren.
Geheugenunits (MEM): Een platte, op SRAM gebaseerde geheugenarchitectuur zonder caches, hiërarchie of het concept van een cache-miss. De Groq 3 LP30 biedt 500 MB on-chip SRAM met een bandbreedte van 150 TB/s. De compiler adresseert rechtstreeks de fysieke geheugenlocaties en kent de exacte positie van alle gegevens gedurende de gehele programma-uitvoering.
Meerdere exemplaren van elk type functionele eenheid zijn horizontaal op de chip aangebracht. Instructies stromen van boven en onder naar het midden, terwijl datastromen van oost naar west lopen en de functionele eenheden kruisen om bewerkingen uit te voeren.
De 1D-interconnectie, streamregisters en determinisme
Streamregisters en de 1D-interconnectie
Communicatie tussen functionele eenheden op de LPU vindt plaats via streamregisters, een opzettelijk eenvoudige eendimensionale interconnectie. Er bestaan twee communicatiepaden, één oostwaarts en één westwaarts, waarbij elk streamregister een enkele hop vertegenwoordigt. Data verplaatst zich met precies één hop per klokcyclus, wat betekent dat de compiler de reistijd tussen twee willekeurige functionele eenheden kan berekenen door een eenvoudige optelling of aftrekking uit te voeren op basis van hun fysieke posities op de chiplayout.
Er zijn geen wachtrijen en geen conflicterende mechanismen binnen de interconnect. Dit vereenvoudigt het planningsprobleem van een complex 2D-probleem met bin-packing tot een veel beter hanteerbaar 1D-probleem. Igor Arsovski, Chief Architect van Groq, beschrijft het het beste: de compiler weet precies waar een stuk data zich over 10 cycli zal bevinden, omdat het zich precies 10 hops verderop bevindt. Er is geen ambiguïteit, geen speculatie en geen hardware die onafhankelijke routeringsbeslissingen neemt.
Determinisme
Het bepalende kenmerk van de LPU is determinisme. In tegenstelling tot conventionele processors, waar dynamische scheduling, cachegedrag en geheugentoegangsconflicten variatie in de uitvoeringstijd introduceren, werken LPU's met nul variatie en functioneert elke eenheid synchroon.
Deze deterministische aanpak wordt bereikt door functies zoals hardware-interlocks te verwijderen en alle besluitvorming naar de compiler te verplaatsen; de hardware voert vervolgens eenvoudigweg het resulterende schema uit. Andere voordelen van deze aanpak zijn dat alles met exact dezelfde latentie werkt en zelfs het stroomverbruik op elk moment voorspelbaar is.
Determinisme strekt zich ook uit tot het numerieke domein via wat Groq TruePoint-technologie noemt. De gegarandeerde volgorde van bewerkingen in deze architectuur maakt nauwkeurigheid op FP32-niveau mogelijk vanuit FP16-inputs via een 320-elementen fused dotproduct met slechts één afrondingsstap. De details over waarom numeriek determinisme van belang is voor LLM-inferentie, en waarom niet-deterministische hardware subtiel verschillende outputs produceert bij verschillende runs, worden uitgebreid behandeld in de whitepaper "Defeating Nondeterminism in LLM Inference" van Thinking Lab . Dat is niet het onderwerp van dit artikel, maar lezers die geïnteresseerd zijn in de implicaties voor numerieke nauwkeurigheid kunnen de relevante analyse vinden in de technische documentatie van Groq over TruePoint, waarnaar aan het einde van dit artikel wordt verwezen.
Hoe LPU's verbinding maken: RealScale, de assemblagelijn en racktopologie
De lopende band: hoe data zich verplaatst
In de meest eenvoudige vorm werkt de gegevensoverdracht tussen LPU's als een lopende band. Wanneer een model voor het systeem wordt gecompileerd, verdeelt de compiler het in fasen en wijst elke fase ruimtelijk toe aan een groep LPU-chips. Elke groep slaat de benodigde gewichtsparameters op in lokaal on-chip SRAM. Tijdens de inferentie is de enige data die tussen groepen chips wordt uitgewisseld de tussentijdse activatie-output van de vorige fase. Data stroomt van chip naar chip als een product dat over een lopende band beweegt, waarbij elk station de toegewezen berekening uitvoert en het resultaat doorgeeft aan het volgende station. Dit is fundamenteel anders dan bij GPU's, waar elke rekenfase vereist dat de volledige set gewichten uit extern HBM-geheugen wordt opgehaald en de resultaten worden teruggeschreven. Op de LPU bevinden de gewichten zich al in het SRAM van elk station; alleen de activatie-tensors worden verplaatst.
Een opmerking over C2C-links: RealScale, niet NVIDIA C2C.
Voordat we ingaan op de details van de topologie, is het belangrijk om een mogelijke bron van verwarring op te helderen. De chip-to-chip (C2C) verbindingen die in het LPX-systeem worden gebruikt, zijn Groq's RealScale C2C-interconnect. Deze zijn niet hetzelfde als NVIDIA's C2C-technologie, die elders in het NVIDIA-ecosysteem wordt gebruikt. De twee technologieën zijn architectonisch verschillend:
- NVIDIA C2C is een cache-coherente interconnect die is ontworpen voor het verbinden van twee verschillende chiptypen binnen een nauw gekoppelde module, zoals een CPU-naar-GPU-verbinding. Het maakt gebruik van een coherent protocol met snellere SerDes en is ontworpen voor heterogene chip-naar-chip-communicatie binnen één enkele behuizing of module.
- Groq RealScale C2C is een softwarematig geplande, deterministische, punt-naar-punt-interconnectie. Netwerkverbindingen worden expliciet door de compiler gecontroleerd en gepland als volwaardige functionele eenheden, net als de MXM- of VXM-rekeneenheden. Er is geen hardwarematige arbitrage of adaptieve routering en pakketten bevatten geen bron- of bestemmingsheaders. De verbindingen zijn fase-uitgelijnd en gedragen zich als snelle, stabiele verbindingen tussen chips. Een plesiochroon protocol houdt deterministisch rekening met natuurlijke klokafwijkingen tussen chips, waardoor de compiler één gemeenschappelijk tijdsdomein over het gehele netwerk kan gebruiken.
Elke C2C-verbinding in het LPX-rack, of het nu binnen een lade is, tussen lades via de spine, of tussen racks via de poorten op het voorpaneel, maakt gebruik van RealScale. Dit is dezelfde fundamentele interconnectietechnologie die Groq al sinds de originele GroqNode gebruikt, opgeschaald in verbindingssnelheid (van 30 Gbps naar 112 Gbps per lane), maar architectonisch ongewijzigd.
Opmerking: Het volgende gedeelte, waarin de connectiviteit wordt uitgelegd, is gebaseerd op ons begrip van de architectuur aan de hand van de documentatie van Groq (link onderaan), de blogpost van NVIDIA en de uitleg van het rack die we op de GTC-stand hebben gekregen.
- De C2C-verbindingen die door de LPX-rackunits worden gebruikt, zijn technologie van Groq en verschillen van de C2C-verbindingen die in andere racksystemen van NVIDIA worden gebruikt.
- De 4 C2C-links aan de voorzijde van elke LPX-rackunit worden gebruikt om verbinding te maken met aangrenzende rackunits op hetzelfde niveau.
- Binnen een rack is er sprake van all-to-all communicatie tussen alle LPU's.
- De processor in het LPX-rack is een x86-processor.
Verbindingen binnen de lade
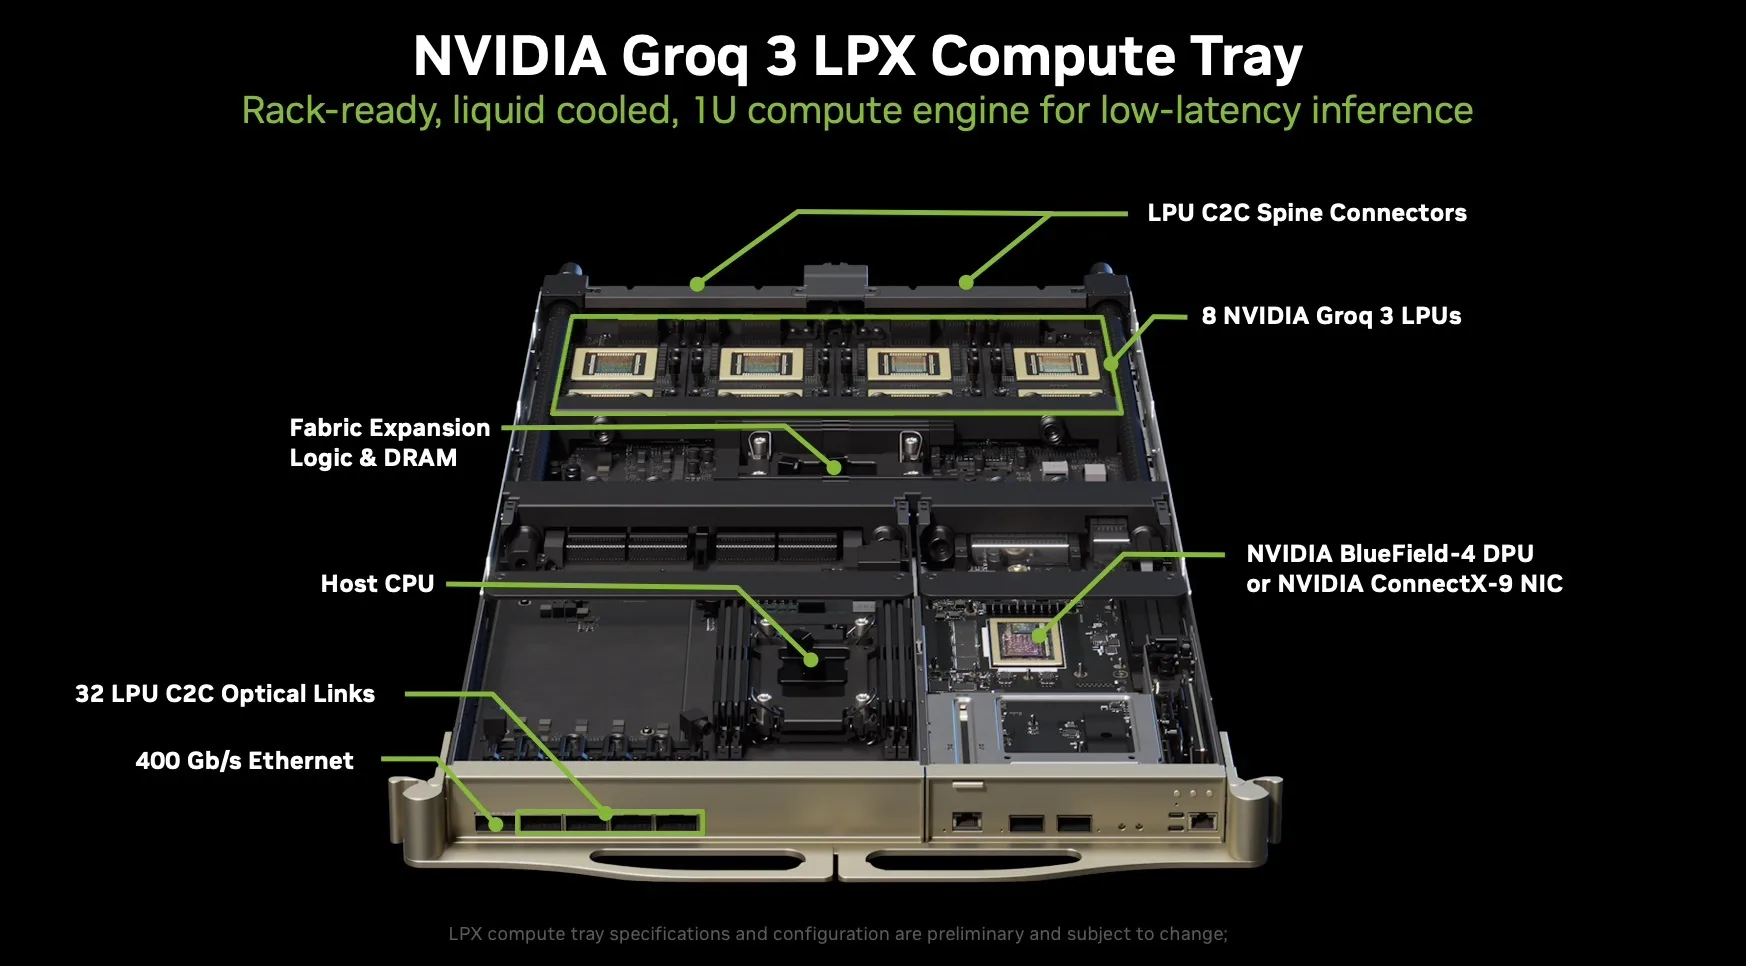
De fundamentele bouwsteen van de netwerktopologie van Groq is niet veranderd van de originele GroqNode naar de NVIDIA Groq 3 LPX. Elke 1U-rekenmodule bevat precies acht LP30-chips, die dicht met elkaar verbonden zijn in een complete grafiek (alles-naar-alles), waarbij elke chip rechtstreeks met elke andere chip kan communiceren met dezelfde snelheid.
Bron: Nvidia
Elke LP30-chip heeft 96 C2C-links, elk werkend op 112 Gbps, wat een bidirectionele bandbreedte van 2.5 TB/s per chip oplevert. In een complete grafiek van 8 chips heeft elke chip 7 buren. Het aantal unieke chip-naar-chip-verbindingen binnen een tray is C(8,2) = 28. Een deel van de 96 links van elke chip is bestemd voor deze all-to-all-verbindingen binnen de tray, terwijl de resterende links naar de backplane (voor de rack-spine) en het frontpaneel (voor inter-rack) worden geleid. De gepubliceerde specificaties van NVIDIA vermelden een totale opschalingsbandbreedte van 20 TB/s per tray, wat de gecombineerde bandbreedte binnen de tray en de spine vertegenwoordigt. We kunnen dit verifiëren: elke tray heeft 8 chips × 96 links = 768 links in totaal. Na aftrek van de 32 inter-rack-lanes op het frontpaneel blijven er 736 links over voor opschaling. Met 112 Gbps per link is dat 736 × 112 Gbps = 82,432 Gbps, oftewel ongeveer 10.3 TB/s per richting, wat neerkomt op ongeveer 20.6 TB/s in beide richtingen. Dit komt goed overeen met de door NVIDIA opgegeven 20 TB/s per kaart.
Deze groep van 8 chips met all-to-all-verbindingen vormt de "lokale groep" van een dragonfly-netwerktopologie. De originele GroqChip 1 had 11 C2C-verbindingen per kaart, elk met 30 Gbps per lane (vier lanes per verbinding), voor een totaal van 330 GB/s per kaart. De 96 verbindingen van de Groq 3 LP30 met 112 Gbps vertegenwoordigen een enorme sprong voorwaarts in de I/O-bandbreedte per chip, terwijl dezelfde topologische structuur behouden blijft.
Intra-rack connectiviteit
Binnen één LPX-rack zijn 32 compute-trays (256 chips in totaal) met elkaar verbonden via vier ETL-spines in de backplane. Deze spines transporteren RealScale C2C-verkeer tussen de trays, waardoor het rack-schaalbare opschalingsdomein ontstaat. De totale opschalingsbandbreedte over het gehele rack bedraagt 640 TB/s (32 trays × 20 TB/s per tray). Verdeeld over de vier spines transporteert elke spine ongeveer 160 TB/s aan bidirectionele bandbreedte.
Inter-rack connectiviteit
Elke 1U-computerlade biedt vier QSFP C2C-poorten op het voorpaneel, goed voor in totaal 32 lanes (8 lanes per poort) voor communicatie tussen racks. Deze poorten zijn symmetrisch verbonden met aangrenzende racks: twee poorten (16 lanes) zijn verbonden met het linker aangrenzende rack en twee poorten (16 lanes) met het rechter aangrenzende rack. Elke U-positie is verbonden met de corresponderende U-positie in het naastgelegen rack (de eerste U in rack A is verbonden met de eerste U in rack B, de tweede met de tweede, enzovoort).
Bron: Nvidia
Met 112 Gbps per lane bieden de 32 inter-rack lanes van elke tray 32 × 112 Gbps = 3,584 Gbps, oftewel ongeveer 448 GB/s per richting per tray aan inter-rack bandbreedte. Over het volledige rack bieden de 32 trays 32 × 32 = 1,024 inter-rack lanes. Dat komt neer op 1,024 × 112 Gbps = 114,688 Gbps, oftewel ongeveer 14.3 TB/s per richting naar elk aangrenzend rack (gelijk verdeeld: ~7.2 TB/s per richting naar de linkerbuur en ~7.2 TB/s per richting naar de rechterbuur).
De bandbreedte tussen racks is, zoals bedoeld, minder dicht dan de bandbreedte binnen een rack. Binnen het rack biedt het opschaaldomein van 640 TB/s een dichte, all-to-all bereikbaarheid via de spine. Tussen racks zorgen de frontpanel-links voor de minder dichte globale verbindingen van de dragonfly-topologie. Dit is hetzelfde architectuurpatroon als de originele GroqRack, waarbij vier externe C2C-links per chip lokale groepen (nodes) verbonden om multi-racksystemen te vormen met een lage netwerkdiameter (maximaal drie hops in een implementatie met 264 chips).
Alles bij elkaar: dezelfde architectuur, 4x de dichtheid
De oorspronkelijke GroqRack-implementatie met vier racks bevatte 264 GroqChip-processoren. Een enkel LPX-rack biedt plaats aan 256 LP30-chips in één MGX ETL-rack, wat neerkomt op ongeveer vier keer de chipdichtheid, samengeperst in een enkel rack met vloeistofkoeling en een draadloze backplane. De lokale all-to-all-groep van 8 chips, de dragonfly-topologie en het softwarematig geplande routeringsparadigma blijven ongewijzigd. De fundamentele Groq-netwerktechnologie is niet veranderd; ze is alleen opgeschaald.
Voor modellen die de SRAM-capaciteit van één rack overschrijden (128 GB in totaal verdeeld over 256 chips), kunnen meerdere LPX-racks of rijen racks via de C2C-poorten op het voorpaneel met elkaar worden verbonden om de productielijn verder uit te breiden. Meer hierover in de volgende sectie voor de daadwerkelijke afmetingen van modellen.
Waarom FFN-lagen? Inzicht in wat NVIDIA offloadt.
Waarom het steeds moeilijker wordt om Decode te bedienen
Voordat we ingaan op de details van wat NVIDIA precies naar LPX overdraagt en waarom, is het nuttig om de bredere trends te begrijpen, zoals NVIDIA zelf aangeeft, die deze architectonische beslissing noodzakelijk maken. AI-inferentie is geen uniforme workload. Binnen één enkele aanvraag stellen de prefill-fase (het verwerken van de prompt en het opbouwen van de KV-cache) en de decode-fase (het één voor één genereren van tokens) zeer verschillende eisen aan de hardware, en die eisen variëren met de batchgrootte, de contextlengte en de modelstructuur.
Naarmate modellen langere redeneeruitvoer en meerstaps denkprocessen genereren, verschuift een groter deel van elk verzoek naar de sequentiële decodeerfase. Tegelijkertijd verlagen technieken zoals prefix caching de kosten van prefill door gedeelde promptstatus te hergebruiken voor verschillende verzoeken, waardoor de relatieve kosten van de decodeerfase alleen maar prominenter worden. Contextvensters groeien bovendien tot honderdduizenden tokens, wat de druk op de geheugenbandbreedte tijdens aandachtsberekeningen vergroot. En in agentische workflows stapelt de latentie zich op over vele modelaanroepen, toolinteracties en verificatielussen. Het cumulatieve effect is dat de decodeerlatentie steeds vaker de bottleneck vormt die gebruikers ervaren, en hardware die puur is geoptimaliseerd voor maximale totale doorvoer is niet altijd de beste oplossing voor workloads die snelle, voorspelbare tokengeneratie voor elk individueel verzoek vereisen.
Bovendien blijkt uit de release van Anthropic's Fast Mode dat een lagere latentie en een hogere tokendoorvoer leiden tot hogere inkomsten, waarbij Anthropic's snelle inferentieaanbod zes keer zoveel kost als reguliere verzoeken.
Met deze LPX-aankondiging weten we dat NVIDIA de grootste decodeerbottleneck wil verplaatsen naar de LPU's: de feed-forward network (FFN)-lagen. Om te begrijpen waarom FFN het doelwit is en om de enorme omvang van wat dit betekent te beseffen, hebben we het aantal FFN-parameters geanalyseerd voor de populairste open-source modellen van vandaag.
Wat zijn FFN-lagen en waarom zijn ze zo dominant?
Elke Transformer-laag heeft twee hoofdblokken: een aandachtsblok en een feed-forward (FFN) blok. Het aandachtsblok zorgt ervoor dat tokens informatie van andere tokens in de sequentie kunnen bekijken en combineren. Het FFN-blok werkt onafhankelijk op elk token: het projecteert de representatie van het token naar een hogere-dimensionale ruimte, past een niet-lineariteit toe en projecteert deze vervolgens weer terug. Je kunt het zien als de kennisopslag van het model, waar feitelijke associaties en geleerde transformaties worden bewaard.
De MoE-architectuur (Mixture of Experts) is uitgegroeid tot de dominante architectuur onder de toonaangevende open-source modellen voor grote programmeertalen van vandaag: DeepSeek R1, Kimi K2, Qwen3-235B, GLM-5, MiniMax M2.5 en OpenAI's GPT-OSS 120B.
Binnen deze MoE-modellen wordt met name het FFN-blok gerepliceerd in honderden kleinere, onafhankelijke kopieën, de zogenaamde experts, terwijl de aandacht gedeeld blijft. Een lichtgewicht, geleerde routeringsfunctie selecteert dynamisch een kleine subset van experts die per token geactiveerd worden. Het resultaat is een model dat een enorm aantal parameters opslaat, maar slechts een fractie daarvan per token activeert, waardoor de kwaliteitsvoordelen van schaalvergroting worden behaald zonder de evenredige rekenkosten.
Zoals u wellicht al hebt gemerkt, brengt dit echter een andere uitdaging met zich mee: de FFN-lagen zijn verantwoordelijk voor het grootste deel van de gewichten van het model. Specifiek voor MoE-modellen kan dit oplopen tot wel 90% van de gewichten.
Een kijkje in DeepSeek R1: een uitgewerkt voorbeeld
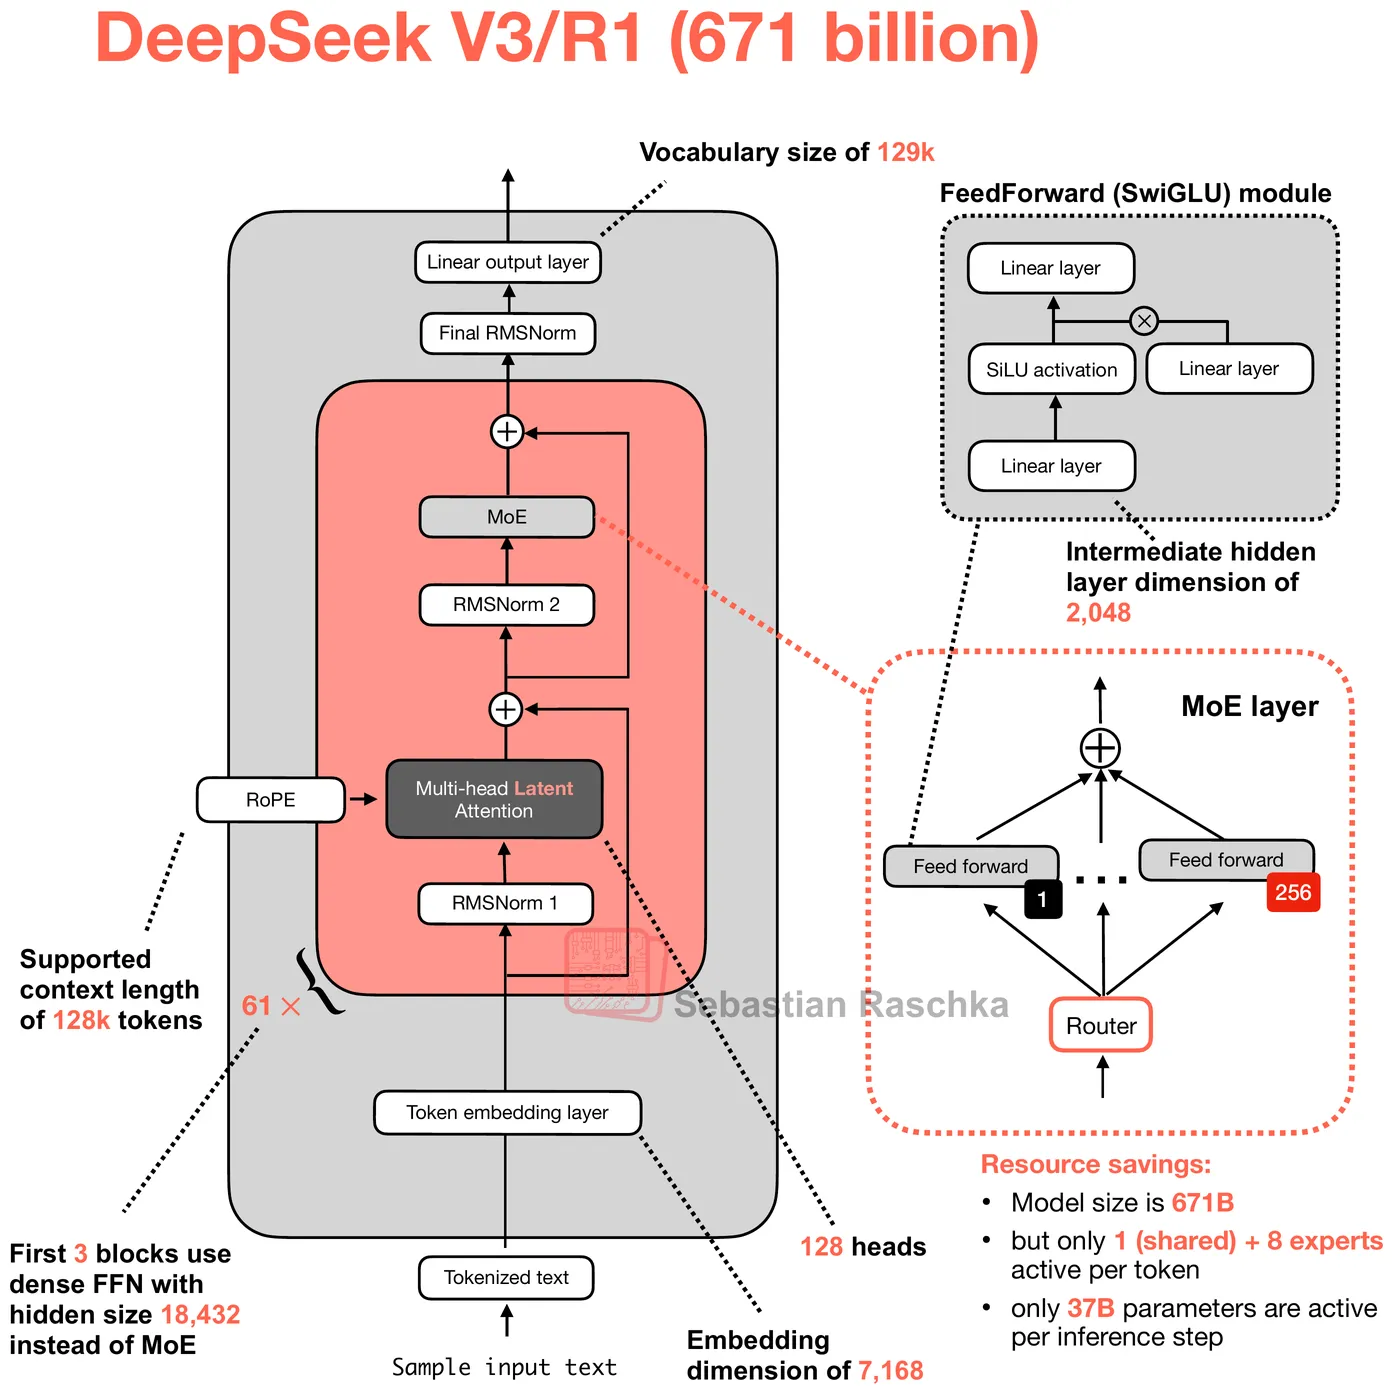
Laten we ter illustratie inzoomen op DeepSeek R1. Het model heeft 61 Transformer-lagen met een verborgen dimensie (H) van 7,168. De eerste 3 lagen gebruiken een standaard dense FFN, terwijl de resterende 58 MoE gebruiken (plus 1 extra MTP-laag met eigen experts, voor een totaal van 59 MoE-lagen). Moderne LLM's gebruiken een variant genaamd SwiGLU, die drie gewichtsmatrices heeft in plaats van twee. De forward pass berekent w2(SiLU(w1(x)) ⊙ w3(x)), waarbij w1 (de gate-projectie) en w3 (de opwaartse projectie) beide de verborgen dimensie uitbreiden van H naar een tussenliggende grootte I, en w2 (de neerwaartse projectie) deze weer comprimeert. De ⊙ staat voor elementgewijze vermenigvuldiging tussen de gated en ungated paden. Geen van deze matrices bevat bias-termen, dus elk SwiGLU FFN-blok bevat precies 3 × H × I parameters.
Bron: Sebastian Raschka
Voor de dense lagen van DeepSeek R1 (de eerste 3) is de tussenliggende dimensie 18,432, wat neerkomt op 3 × 7,168 × 18,432 = 396.4 miljoen parameters per laag. Voor de MoE-lagen is elk van de 256 gerouteerde experts een compleet SwiGLU-blok met een kleinere tussenliggende dimensie van 2,048, dus elke expert heeft 3 × 7,168 × 2,048 = 44.0 miljoen parameters. Vermenigvuldig dit met 256 experts en je krijgt 11.27 miljard parameters in de gerouteerde experts alleen al, per laag. Bovendien heeft elke MoE-laag een gedeelde expert (hetzelfde SwiGLU-blok met 44 miljoen parameters, dat altijd geactiveerd is voor elk token), een routergate (een lineaire projectie van vorm [256, 7168] = 1.8 miljoen parameters) en een kleine biasvector van 256 FP32-waarden die gebruikt wordt voor taakverdeling tijdens het routeren.
Het volledige FFN-model heeft ongeveer 669.1 miljard parameters. In FP8 E4M3-formaat (1 byte per gewicht) komt dat neer op ongeveer 623.1 GB aan FFN-data. Dat is 97.7% van de geschatte totale schijfruimte van het model. De resterende ~2.3% bestaat uit aandachtsgewichten, embeddings, de uitvoerkop, laagnormen en FP8-schaalmetadata.
Decodeer desaggregatie
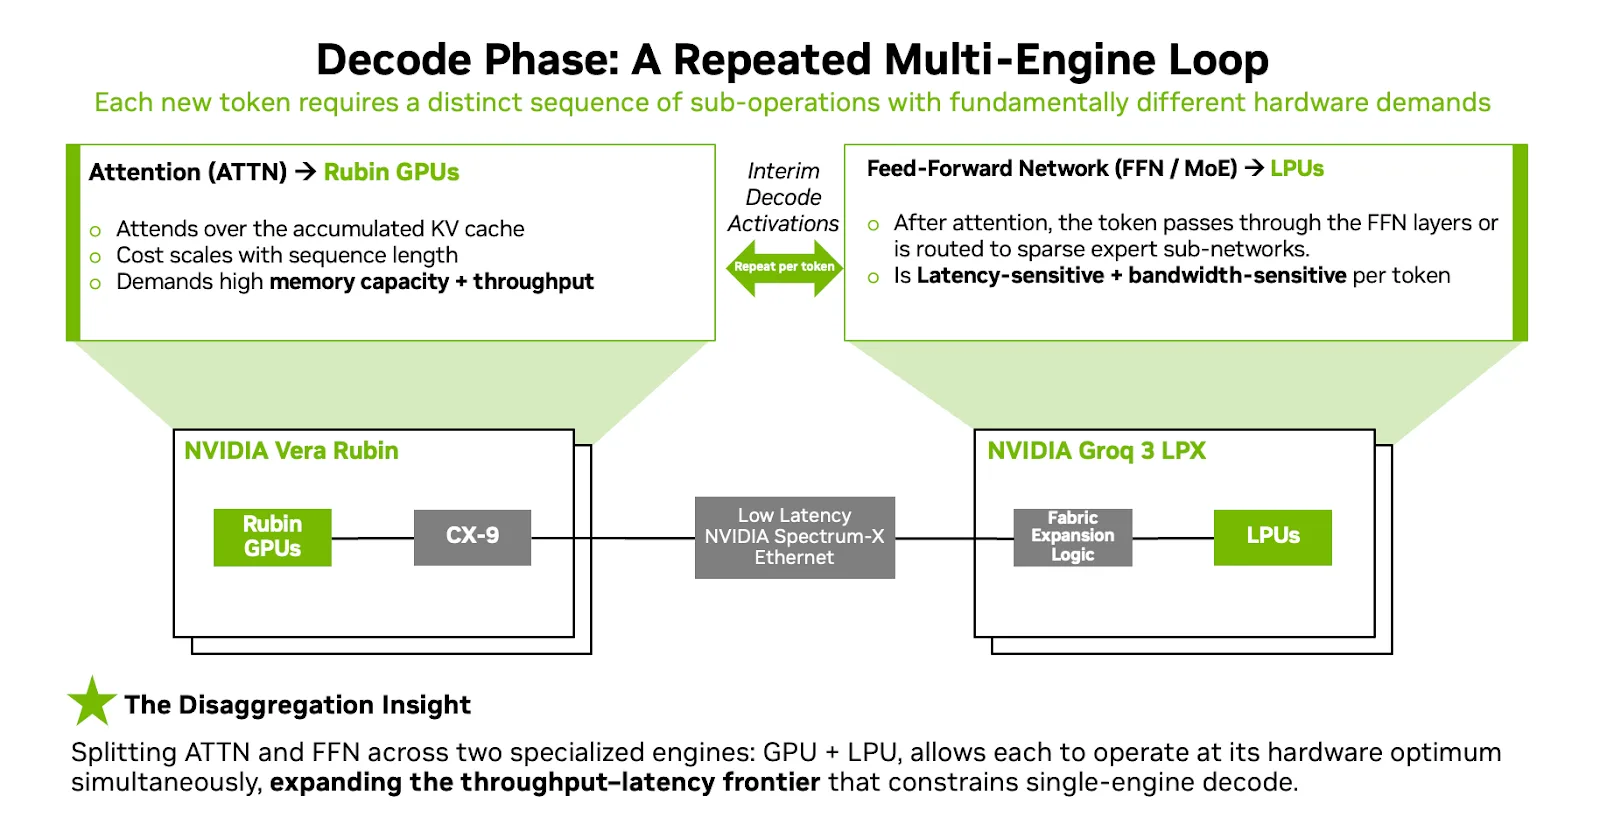
NVIDIA beschouwt de decodeerfase nu niet langer als een monolithische bewerking, maar als een herhaalde lus per token, waarbij verschillende onderdelen verschillende hardware-knelpunten belasten. De prefill-fase wordt gedomineerd door het verwerken van grote hoeveelheden data en het opbouwen van de KV-cache, een taak die baat heeft bij dichte parallelle berekeningen en een grote geheugencapaciteit. De Vera Rubin NVL72 verwerkt dit efficiënt, met name voor workloads met een lange context, waarbij de prompt enorm en zeer variabel kan zijn.
Bron: Nvidia
Decoderen is anders. Voor elk nieuw token moet het systeem aandacht genereren over de volledige geaccumuleerde KV-cache en vervolgens de FFN/MoE-berekening uitvoeren op de output van de aandachtsanalyse. In NVIDIA's Attention-FFN Disaggregation (AFD)-architectuur zijn deze twee stappen verdeeld over twee engines. Rubin GPU's verwerken de aandachtsanalyse voor de decodering: ze lezen de KV-cache uit HBM, berekenen de aandachtsscores en produceren de tussentijdse activatie. Deze activatietensor (wat NVIDIA "tussentijdse tensorstatus" noemt) wordt vervolgens doorgegeven aan de LPX, die de FFN- of MoE-expertberekening uitvoert met een extreem hoge bandbreedte en deterministische latentie, voordat het resultaat wordt teruggestuurd naar de GPU om de tokengeneratie voort te zetten.
Deze overdracht vindt plaats voor elk afzonderlijk token. De activatietensors die tussen de GPU en de LPU worden uitgewisseld, zijn klein in verhouding tot de gewichtsgegevens. Dit is precies het gebied waarin de LPU's met hun vrijwel nul overhead-netwerken uitblinken. De splitsing speelt in op de fundamentele sterke punten van elke processor: GPU's bieden de HBM-capaciteit en flexibele uitvoering die nodig zijn voor aandachtsfuncties met variabele lengte over grote KV-caches, terwijl LPU's de SRAM-bandbreedte en deterministische scheduling bieden die nodig zijn voor de bandbreedtebeperkte, statisch planbare FFN-gewichten.
Bron: Nvidia
Er is een subtiele maar belangrijke schaaleigenschap die het vermelden waard is. Naarmate de contextlengte toeneemt, schalen de reken- en geheugenvereisten van de aandachtoperatie mee: de KV-cache breidt lineair uit met elk extra token context, en elke nieuwe decodeerstap moet de volledige geaccumuleerde cache verwerken. FFN groeit echter helemaal niet mee met de context. De FFN-gewichtsmatrices (w1, w2, w3 in SwiGLU) zijn vaste constanten van de modelarchitectuur. Ze hebben dezelfde grootte, of de context nu 1,000 tokens of 1,000,000 tokens bevat, en elk token doorloopt ze onafhankelijk. Dit betekent dat in de AFD-architectuur, naarmate contextvensters blijven groeien, de GPU-kant de toenemende kosten absorbeert (meer HBM voor de KV-cache, meer rekenkracht voor de aandacht), terwijl de LPX-kant volledig statisch blijft. Het aantal LPX-racks dat nodig is om de FFN van een model te bedienen, wordt volledig bepaald door de architectuur van het model, niet door de contextlengte van de serverconfiguratie. Dit lost op elegante wijze een van de grootste uitdagingen op voor accelerators die uitsluitend op SRAM gebaseerd zijn: dat de groeiende contextvereisten uiteindelijk de vaste geheugencapaciteit op de chip overstijgen. Bij de AFD-splitsing blijft het contextafhankelijke werk op hardware met uitbreidbaar HBM, terwijl de LPU alleen het contextonafhankelijke werk afhandelt dat van nature in het vaste SRAM past.
NVIDIA Dynamo maakt heterogene decodering operationeel
Om deze twee-engine-loop in productie te laten werken, is meer nodig dan alleen hardware. De Dynamo-orkestratielaag van NVIDIA maakt heterogene decodering praktisch uitvoerbaar. Dynamo coördineert de gedisaggregeerde servering over de GPU- en LPU-backends en verzorgt de per-token classificatie, routing en activatieoverdracht die AFD vereist.
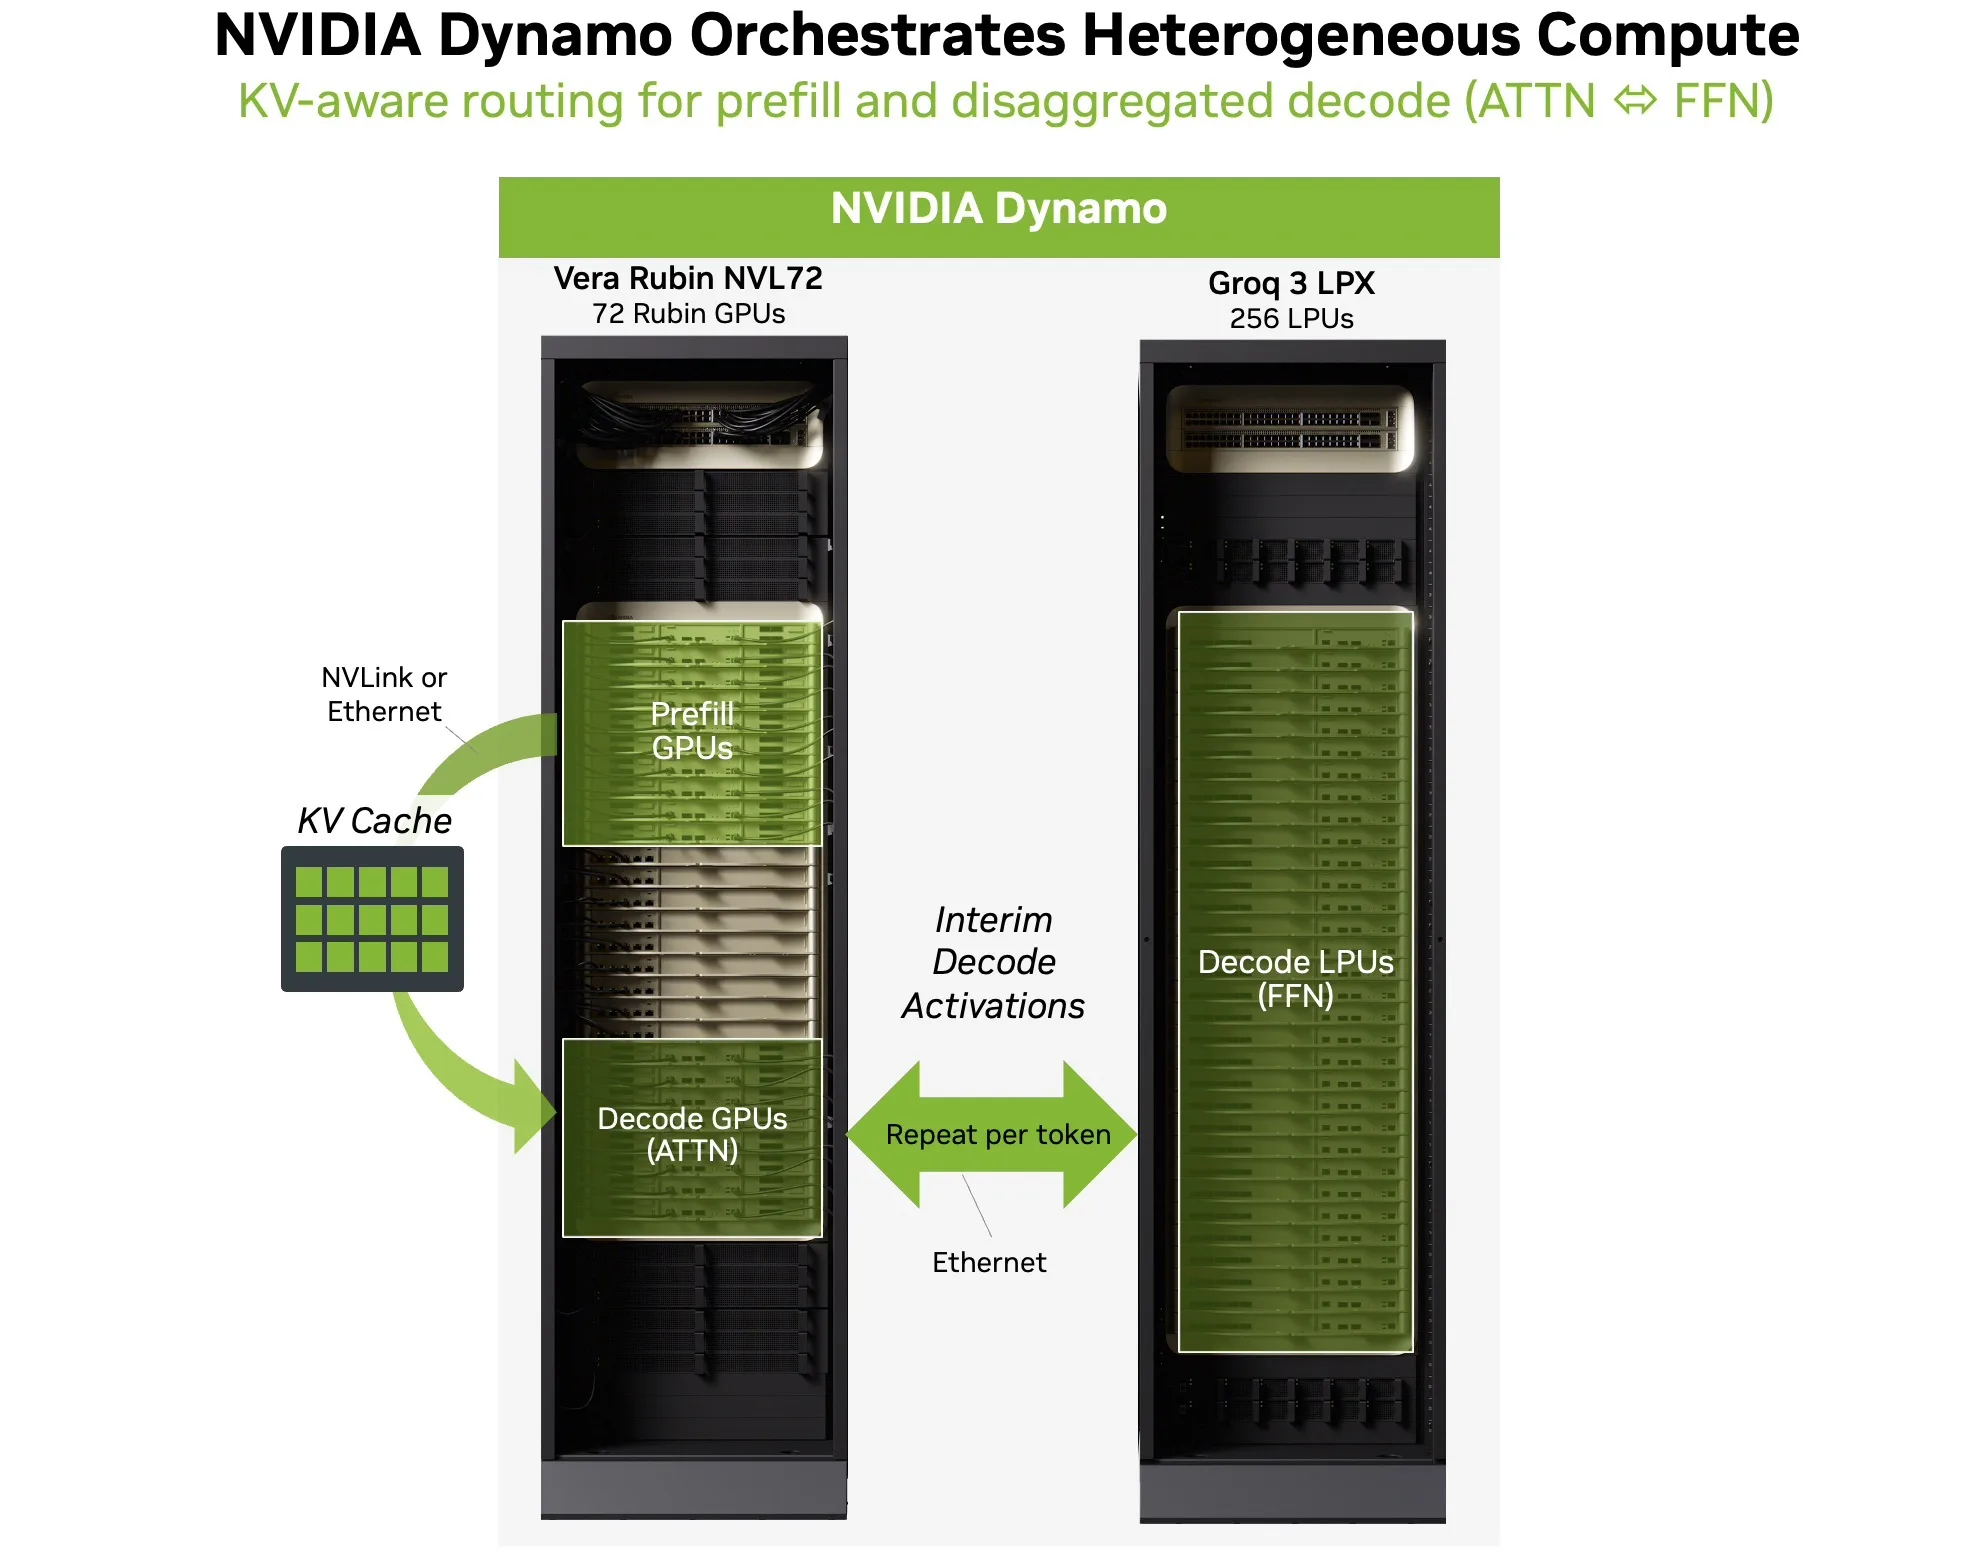
Bron: Nvidia
In de praktijk stuurt Dynamo de prefill-bewerkingen naar GPU-workers om de invoer te verwerken en de KV-cache op te bouwen. Tijdens het decoderen orkestreert Dynamo de AFD-loop: GPU's voeren aandachtstaken uit op de opgebouwde KV-cache, tussentijdse activaties worden overgedragen aan LPU's voor FFN/MoE-uitvoering, en de uitvoer keert terug naar de GPU's om de tokengeneratie voort te zetten. Het resultaat is één samenhangend verwerkingspad in plaats van twee losgekoppelde systemen.
Dynamo biedt ook KV-bewuste routing (zodat verzoeken terechtkomen bij workers die de relevante KV-cache al hebben), latency-target-driven scheduling (zodat interactieve sessies niet in lange wachtrijen terechtkomen) en transfermanagement met lage overhead. Deze mogelijkheden zijn belangrijk omdat de orchestratielaag, onder reële productieomstandigheden met variabele contextlengtes, gemengde verzoektypen en pieken in gelijktijdigheid, de staartlatentie stabiel houdt en voorkomt dat jitter tussen tenants de gebruikerservaring negatief beïnvloedt.
FFN-formaten voor alle belangrijke open-source modellen en LPX-formaten
Nu we begrijpen hoe LPX werkt en welk probleem het probeert op te lossen, gaan we kijken wat dit betekent voor de hardwarevereisten.
We hebben het aantal parameters en de FFN-grootte op schijf berekend voor populaire modellen met behulp van de bestanden config.json en model.safetensors.index.json die beschikbaar zijn op Huggingface.
| Model | FFN-parameters | FFN-grootte (op schijf) | FFN % | D-type | Experts |
|---|---|---|---|---|---|
| DeepSeek R1 en DeepSeek V3.2 | 669.1B | 623.1 GB | 97.7% | FP8 | 256 |
| Kimi K2 | 1.02T | 948.0 GB | 98.9% | FP8 | 384 |
| Kimi K2.5 | 1.02T | 474.0 GB | 98.5% | INT4 | 384 |
| MiniMax M2.5 | 224.7B | 209.3 GB | 97.7% | FP8 | 256 |
| OpenAI GPT-OSS 120B | 114.7B | 53.4 GB | 95.4% | MXFP4 | 128 |
| GLM 5 | 738.1B | 1,374.8 GB | 98.0% | BF16 | 256 |
| Qwen3 235B-A22B | 227.2B | 423.1 GB | 96.6% | BF16 | 128 |
Het patroon bevestigt wat we eerder hebben onderzocht: bij elk model in deze analyse vertegenwoordigen FFN-parameters 95% tot 99% van de totale bestandsgrootte op schijf. Kimi K2 is het meest extreme geval, met 384 gerouteerde experts per laag, waardoor het aantal FFN-parameters oploopt tot meer dan 1 biljoen en bijna 99% van het totaal uitmaakt. Zelfs het kleinste model in de set, OpenAI's GPT-OSS 120B met 128 experts opgeslagen in MXFP4, heeft nog steeds FFN-parameters die 95.4% van het totaal vertegenwoordigen. De bestandsgrootte op schijf varieert van een bescheiden 53 GB voor GPT-OSS 120B (dankzij 4-bits kwantisatie) tot bijna 1.4 TB voor GLM 5 (opgeslagen in BF16 zonder kwantisatie).
Deze cijfers helpen ons de LPX-grootte te begrijpen. Een enkel LPX-rack biedt in totaal 128 GB SRAM verdeeld over de 256 chips. Voor een model zoals de OpenAI GPT-OSS 120B met 53 GB FFN past het FFN-gewicht comfortabel in één rack, met nog ruimte over. De DeepSeek R1 met 623 GB zou ongeveer vijf LPX-racks vereisen, terwijl de GLM 5 met 1.4 TB in BF16 er meer dan tien nodig zou hebben (hoewel kwantisering naar FP8 dat ongeveer zou halveren). Dit is precies de reden waarom de C2C-poorten op het voorpaneel tussen de racks nodig zijn: ze maken het mogelijk om meerdere LPX-racks aan elkaar te koppelen, waardoor de productielijn kan worden uitgebreid om grotere modellen te produceren.
Het versnellen van speculatieve decodering met LPX
Naast de AFD-decodeerlus ziet NVIDIA een tweede belangrijk toepassingsgebied voor de LPX: het fungeren als conceptgeneratie-engine bij speculatieve decodering.
Speculatieve decodering is een steeds belangrijkere techniek voor het verminderen van latentie bij LLM-inferentie. Het idee is eenvoudig: een kleiner, sneller conceptmodel genereert vooraf meerdere kandidaat-tokens, terwijl een groter doelmodel deze parallel verifieert en accepteert. Wanneer de voorspellingen van het conceptmodel correct zijn (wat vaak het geval is bij standaardtekst), kunnen meerdere tokens in één verificatiestap worden vastgelegd. Het resultaat is een aanzienlijk hoger aantal effectieve tokens per seconde en een lagere waargenomen latentie voor de eindgebruiker.
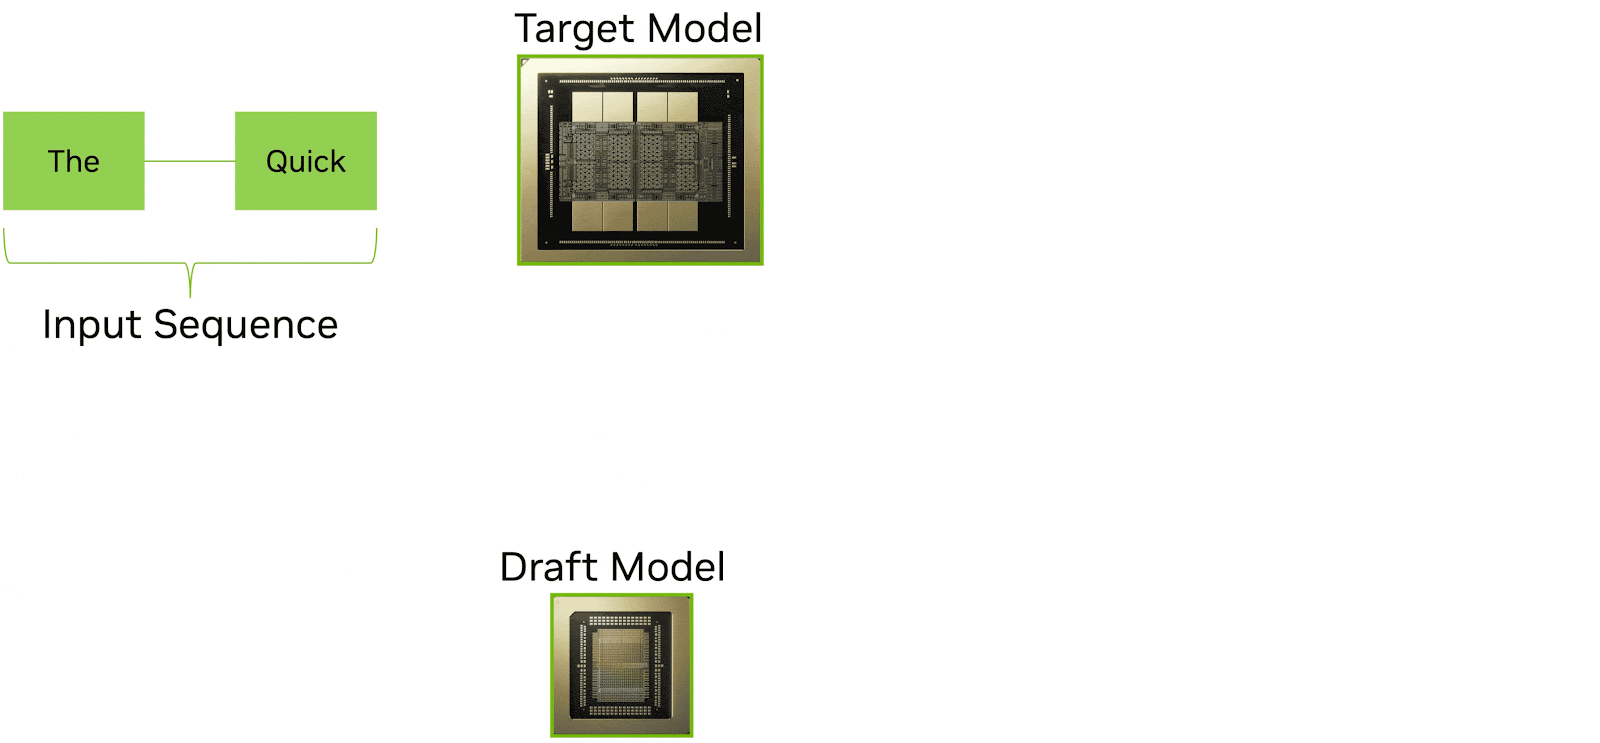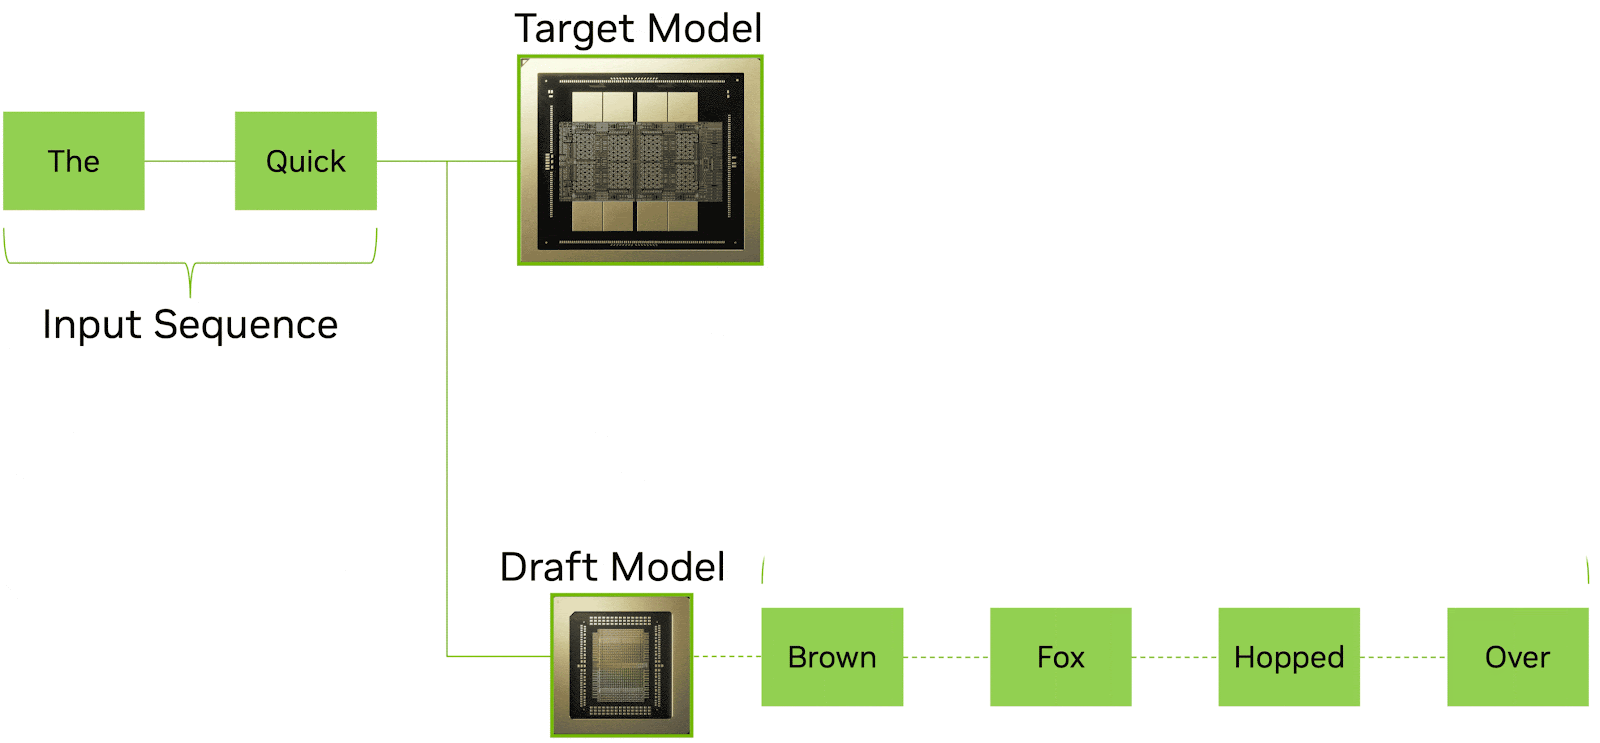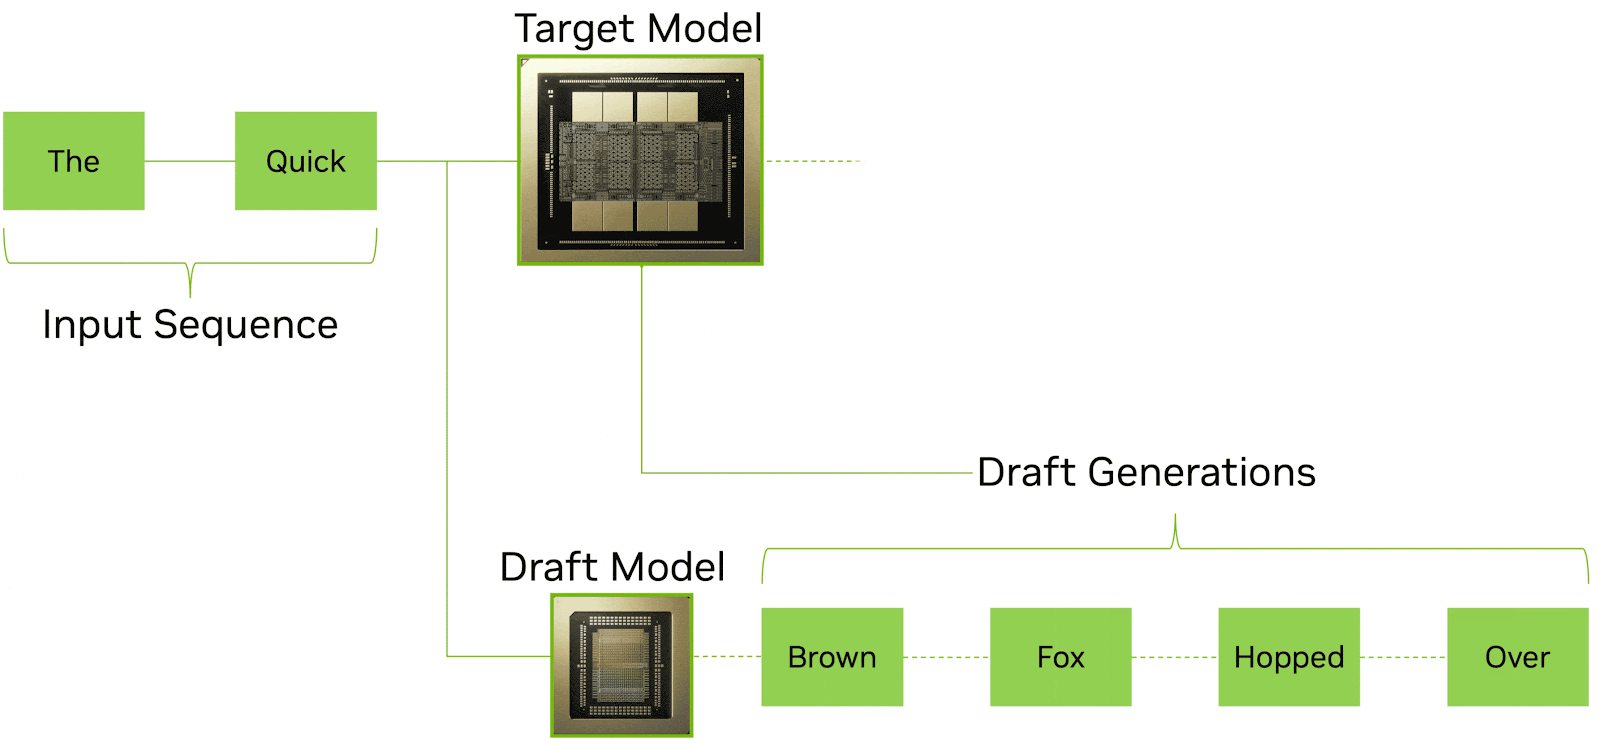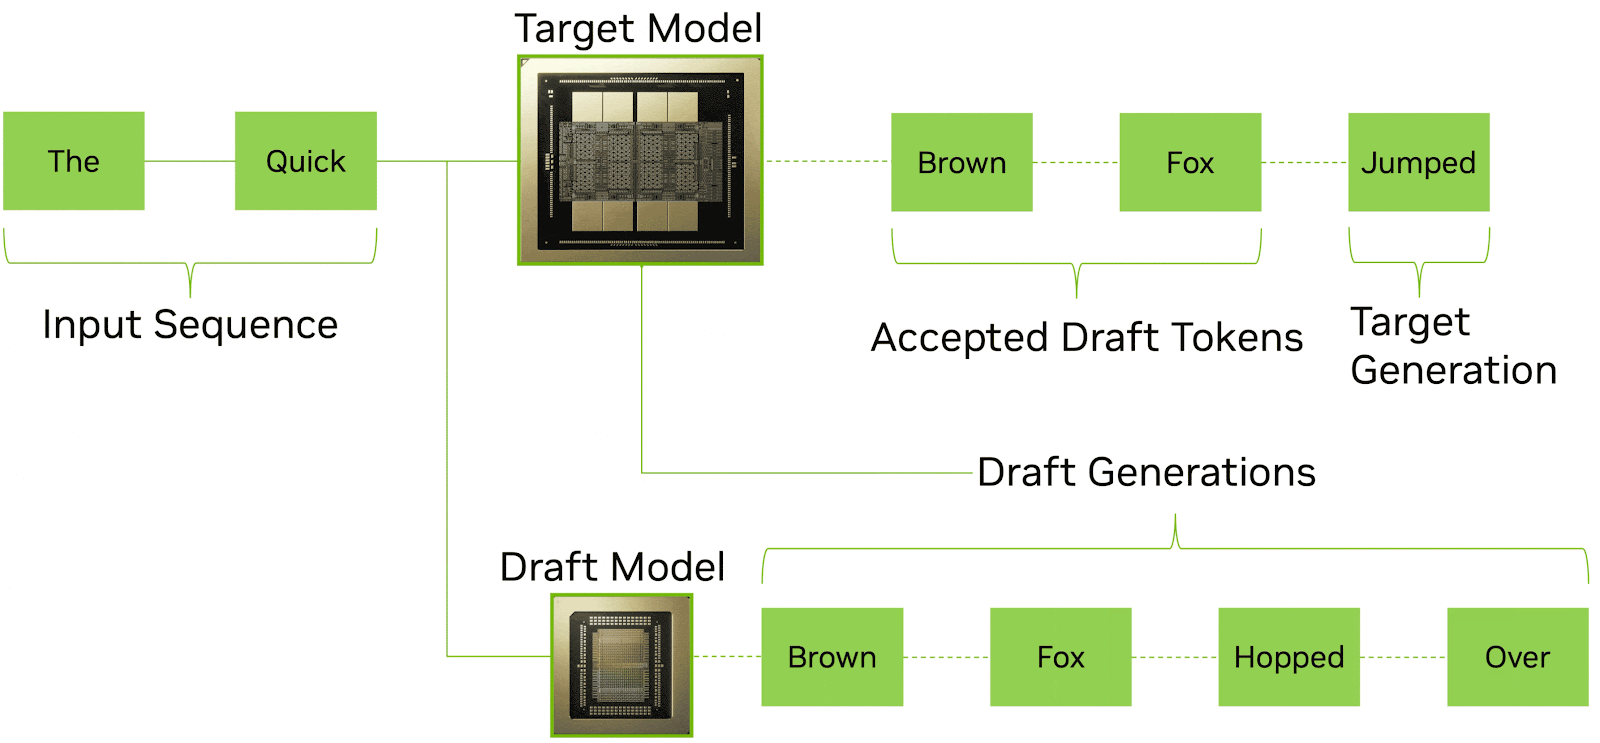
Bron: Nvidia
De uitdaging is dat speculatieve decodering vereist dat het conceptmodel extreem snel werkt. Elke milliseconde die het conceptmodel besteedt aan het genereren van kandidaten, is een milliseconde die de verificator moet wachten. In een conventionele opstelling met alleen een GPU concurreren zowel het conceptmodel als het doelmodel om dezelfde hardwarebronnen, en de snelheid van het conceptmodel wordt beperkt door dezelfde HBM-bandbreedtebeperkingen die van invloed zijn op al het andere.
LPX is uitermate geschikt voor deze rol. Het deterministische uitvoeringsmodel en de extreem hoge bandbreedte van het on-chip SRAM van de LP30 maken een zeer snelle en voorspelbare generatie van concepttokens mogelijk. Een kleiner conceptmodel past comfortabel in het SRAM van één LPX-lade of een klein aantal lades, en de deterministische planning zorgt ervoor dat de conceptgeneratie met een consistente en voorspelbare snelheid verloopt, zonder de variabiliteit die het lastig zou maken om het proces te combineren met de verificator.
In deze configuratie koppelt het systeem de twee processors voor complementaire rollen: LPX genereert snel concepttokens met behulp van zijn architectuur met lage latentie, terwijl Rubin GPU's de tokens efficiënt verifiëren en finaliseren met hun hoge rekenkracht en grote HBM-capaciteit. Deze scheiding maakt het mogelijk dat speculatieve decodering over heterogene processors verloopt in plaats van dat beide modellen één enkele GPU moeten delen, wat mogelijk de conceptsnelheid en de verificatiedoorvoer verbetert in vergelijking met een homogene opstelling.
NVIDIA heeft speculatieve decodering, naast AFD, aangemerkt als een belangrijke taak voor de LPX, wat erop wijst dat het bedrijf dit ziet als een significant onderdeel van de waardepropositie van het systeem. Naarmate grensverleggende modellen blijven groeien en redeneerketens langer worden, zou de mogelijkheid om tokens parallel te genereren en te verifiëren op gespecialiseerde hardware een belangrijke factor kunnen worden om interactieve responsiviteit te behouden.
Conclusie: Extreem HW/SW co-design
Een van de opvallende aspecten van NVIDIA's aanpak met het Vera Rubin-platform en LPX is de precieze afstemming van elk onderdeel. In de consumentenmarkt zien we regelmatig producten die problemen proberen op te lossen die niemand daadwerkelijk heeft, van bedrijven die de behoeften van hun klanten niet echt begrijpen. NVIDIA's strategie is hier een schril contrast. Het is overduidelijk dat ze de problemen van de inferentiepipeline tot in de kleinste details begrijpen en dat ze elk segment van die pipeline optimaliseren om hun klanten te helpen het maximale rendement uit hun hardware te halen.
De ontkoppeling van aandacht/FFN is geen marketingtruc. Het is een directe reactie op het gemeten knelpuntprofiel van het verwerken van MoE-modellen met biljoenen parameters. De beslissing om specifiek FFN (en niet aandacht) te ontlasten en het CPX-rack te ontwikkelen tot een LPX-rack, getuigt van een nauwkeurig begrip van welke bewerkingen bandbreedte-gebonden zijn en welke capaciteitsgebonden, welke statisch planbaar zijn en welke dynamisch variabel, en welke processorarchitectuur het meest geschikt is voor elk type bewerking. De Dynamo-orkestratielaag, de transparante CUDA-integratie en het draadloze MGX-rackontwerp wijzen allemaal op een engineeringorganisatie die de volledige implementatiecyclus zorgvuldig heeft doordacht.
Er zijn nog veel onbekende factoren rondom LPX en NVIDIA's nieuwe grensverleggende producten. Een van de belangrijkste vragen die voor ons nog openstaan, is wat het doel is van de "Fabric Expansion Logic and DRAM", welk type silicium hiervoor wordt gebruikt, en aangezien velen de x86-socket al hebben opgemerkt, en gezien de investering in Intel vorig jaar en het ontwerp van de koelplaat, is het waarschijnlijk dat het om een Intel-processor gaat, maar welk onderdeel precies, is nog grotendeels onbekend.
De LPX-implementatie zal zich in eerste instantie richten op modelbouwers en serviceproviders, in plaats van op brede beschikbaarheid. De prestaties in de praktijk onder productieomstandigheden met variabele contextlengtes, gemengde verzoektypen en pieken in gelijktijdigheid, evenals de energie-efficiëntie, moeten nog onafhankelijk worden gevalideerd. We kijken ernaar uit om toegang te krijgen tot deze systemen voor onafhankelijke tests.
Geraadpleegde bronnen:
Groq: Wat is een taalverwerkingseenheid?
Groq: De Groq LPU, AI-inferentietechnologie, zorgt voor een hogere energie-efficiëntie…
Groq: RealScale chip-naar-chip interconnectietechnologie
Groq: Lage latentie voor realtime AI en HPC
Groq: Determinisme en de Tensor Streaming Processor
Nvidia: Een kijkje in de Nvidia Groq 3 LPX…
Aleksa Gordić – De AI-openbaring: Hoe werkt Groq LPU? (met Igor Arsovski, hoofd Silicon!)


 Amazon