

Hyperscalers en infrastructuurbeheerders die zich richten op AI ontwikkelen steeds vaker eigen AI-acceleratoren en XPU's om gelijke tred te houden met grote taalmodellen en complexe redeneerworkloads. Om de fysieke, geheugen- en netwerkuitdagingen van het grootschalig inzetten van eigen chips aan te pakken, heeft NVIDIA zijn NVLink Fusion-interconnect en NVHBM-geheugenarchitectuur (custom base-die) gedetailleerd beschreven . Het uniforme portfolio is ontworpen om eigen chips te koppelen aan NVIDIA's bestaande scale-up netwerk- en MGX rack-scale platforms.
De eerste partij die NVHBM omarmt, is Annapurna Labs van Amazon. Hun NVHBM-plannen kwamen tegelijk met de uitbreiding van het AWS-partnerschap naar 2 miljoen GPU's . Deze aankondiging onthult de architectuur achter die samenwerking en noemt Trainium4 als de eerste Trainium-generatie met NVLink Fusion-ondersteuning. NVIDIA introduceert ook een standaard NVHBM-implementatie die beschikbaar is bij meerdere geheugenleveranciers. Volgens NVIDIA vermindert dit de technische inspanning die nodig is voor de integratie en kwalificatie van geheugen van verschillende leveranciers. "NVHBM vertegenwoordigt een nieuwe architectonische benadering om de prestaties en efficiëntie van high-bandwidth geheugen te verbeteren", aldus Nafea Bshara, vicepresident van Annapurna Labs bij Amazon. "We kijken ernaar uit dat deze technologische samenwerking toekomstige AWS-infrastructuurontwerpen ten goede zal komen."
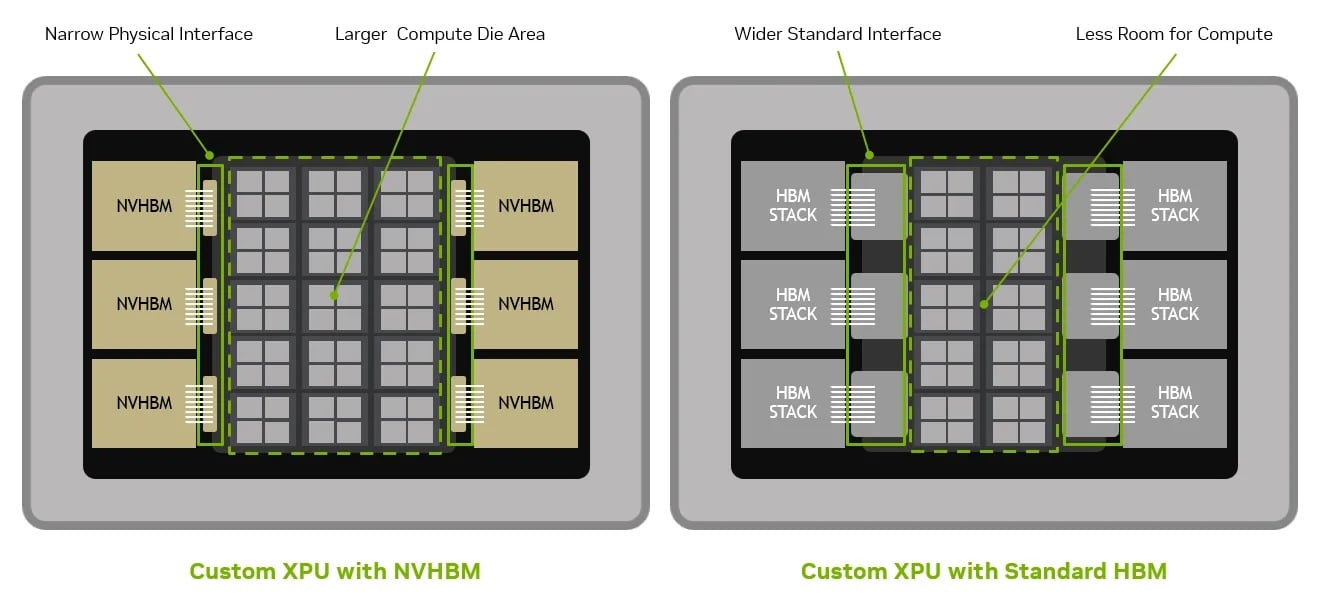
Het inzetten van aangepaste XPU's in datacenters met een hoge dichtheid vereist een evenwicht tussen rekenkracht, stroomvoorziening, warmteafvoer en geheugen met hoge bandbreedte. Het integreren en kwalificeren van geavanceerde geheugenstacks leidt vaak tot aanzienlijke knelpunten in de verpakking en ontwikkeling. Dankzij NVLink Fusion en NVHBM kunnen ontwerpers gebruikmaken van vooraf gevalideerde basischips en interface-IP, waardoor de integratiecomplexiteit wordt verminderd en de time-to-market wordt versneld.
Optimalisatie van geheugenbandbreedte en latentie
Moderne AI-workloads, met name inferentie met grote modellen en agentische pipelines, stellen hoge eisen aan de geheugendoorvoer voor het lezen van modelgewichten, activaties en sleutel-waarde-cache-items. NVHBM biedt een op maat gemaakte basischip, ontwikkeld in samenwerking met geheugenfabrikanten, die tot 30 procent hogere geheugenbandbreedte per stack levert in vergelijking met de standaard JEDEC HBM4E-specificatie.
| Kenmerk | NVHBM-voordeel |
| bandbreedte | Tot wel 30% meer geheugenbandbreedte in vergelijking met standaard HBM4e |
| De Omgeving | Dankzij efficiëntere interfaceverbindingen is tot 25% meer rekenchipoppervlak beschikbaar voor extra XPU-functionaliteit. |
| Power | Een tot wel 15% lager HBM-stroomverbruik in vergelijking met standaard HBM4e leidt tot besparingen bij duizenden XPU's. |
Tabel 1. NVHBM biedt drie belangrijke voordelen op platformniveau voor AI-acceleratorprogramma's: hogere geheugenbandbreedte, groter pakket- en siliciumoppervlak en lager HBM-stroomverbruik.
Deze verhoogde bandbreedte minimaliseert het tekort aan rekenkracht tijdens geheugenintensieve uitvoeringsfasen. Door de gegevensoverdracht tussen de HBM-stacks en de ingebouwde rekenlogica te versnellen, kunnen accelerators een hogere benutting behouden en de tokengeneratiesnelheid per gebruiker verbeteren tijdens intensieve inferentieworkloads.
Herverdeling van chipoppervlak en optimalisatie van de fysieke chip
De beschikbare siliciumruimte op moderne acceleratorpakketten is zeer beperkt, waardoor ontwerpers een evenwicht moeten vinden tussen de ruimte voor reken-ALU's, matrixengines, on-chip SRAM en perifere interfaces. Standaard HBM-architecturen vereisen brede fysieke interfaces die een aanzienlijk deel van het lay-outoppervlak in beslag nemen.
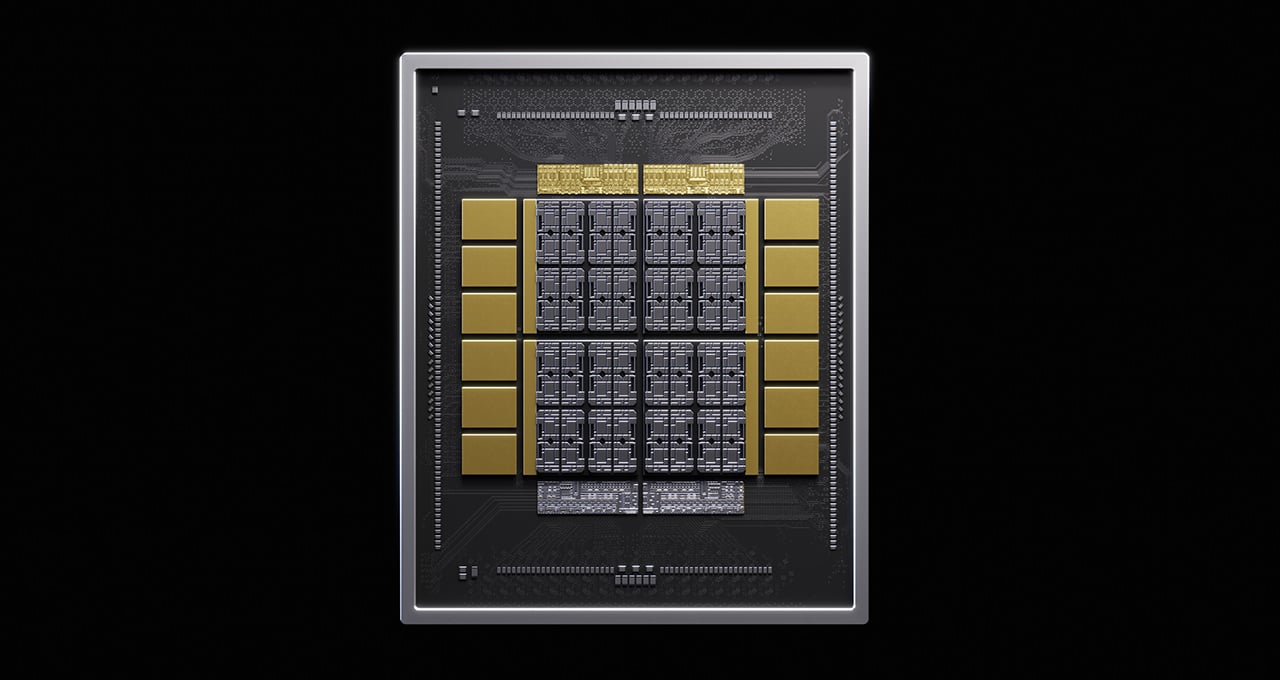
NVHBM pakt dit aan door de geheugencontroller direct in de 3D HBM-stack te plaatsen en een aangepaste fysieke laag (PHY) te gebruiken. Deze aanpak resulteert in een reductie van de PHY- en randapparatuuroppervlakte tot wel 67 procent in vergelijking met standaard HBM4E-implementaties, terwijl de routing van de interposer-traces wordt vereenvoudigd, waardoor tot 80 procent meer bruikbare siliciumruimte in de lay-out wordt teruggewonnen. De smallere geheugeninterface maakt ruimte vrij in de chip, waardoor ontwerpers de centrale AI-rekenchip met maximaal 30 procent kunnen uitbreiden om meer matrixkernen, vectoreenheden of cachehiërarchie toe te voegen binnen een vaste fysieke afmeting.
Energie-efficiëntie en operationele ruimte op facilitaire schaal
Stroomdistributie blijft een van de grootste beperkingen in hyperscale datacenters en heeft een directe invloed op het thermisch ontwerp en de koelingsvereisten van de accelerators. NVHBM verlaagt het stroomverbruik van HBM met 15 procent ten opzichte van de standaard HBM4E.
Op siliciumniveau verlaagt een lager geheugenvermogen de thermische druk, waardoor er extra elektrische ruimte ontstaat om rekenkernen op hogere, continue frequenties aan te drijven. Op locatieschaal vermenigvuldigen deze energiebesparingen zich aanzienlijk. In een theoretisch datacenter van 1 gigawatt met XPU's van 2,000 watt kan het lagere geheugenvermogen voldoende thermische en elektrische capaciteit vrijmaken om tot wel 15,000 extra XPU's te ondersteunen.
Rack-scale integratie via NVLink Fusion
Terwijl NVHBM de prestaties op individueel pakketniveau optimaliseert, fungeert NVLink Fusion als de brug op systeemniveau. Door gebruik te maken van speciale NVLink Fusion-chiplets kunnen aangepaste XPU's rechtstreeks worden aangesloten op de zesde generatie NVLink scale-up fabric , waardoor alle accelerators binnen een rack worden verenigd tot één samenhangend geheugen- en rekendomein.
Deze schaalbare architectuur is cruciaal voor geavanceerde parallelisatieschema's zoals expertparallelisme (EP) en WideEP, waarbij gedistribueerde modellen met een mix van experts een synchronisatie met lage latentie vereisen van activaties en verborgen toestanden over meerdere fysieke apparaten. Aangepaste processors kunnen ook via NVLink-C2C verbinding maken met host-CPU's.
Door semi-custom silicium te integreren in het bredere NVIDIA hardware- en software-ecosysteem, stelt NVLink Fusion operators in staat om heterogene omgevingen te implementeren die aangepaste XPU's combineren met standaard NVIDIA GPU's onder een gestandaardiseerde MGX-rackarchitectuur, waardoor de bedrijfsvoering en de toewijzing van workloads worden vereenvoudigd.


 Amazon