

Sandisk heeft de eerste High Bandwidth Flash-geheugenchip geproduceerd. Het bedrijf toonde deze op een dia tijdens de Investor Day van 2026 op 13 augustus, onder de kop 'HBF Roadmap', naast een afbeelding van de chip zelf. De tweede helft van die dia toonde de eerste HBF-inferentieproductmonsters: binnenkort beschikbaar, in 2027.

Een tapeout is een belangrijke mijlpaal bij de ontwikkeling van nieuwe siliciumchips. Het betekent dat het ontwerp is afgerond en vastgelegd op een maskerset, waarmee de architectuur ophoudt een slide te zijn en daadwerkelijk silicium wordt. Het is echter nog een aantal stappen verwijderd van een product. De wafers moeten terugkomen van de fabriek, de chip moet aan de beoogde specificaties voldoen, de opbrengst moet stijgen tot een economisch haalbaar niveau, en de chip moet vervolgens bestand zijn tegen het stapelen in 8-laags en 16-laags configuraties met een werkende logische chip en controller eronder. Daarna volgen de thermische en duurzaamheidskwalificatie, de ontwikkeling van de acceleratorsoftware om het geheugen daadwerkelijk aan te sturen, en de klantkwalificatiecycli die per kwartaal plaatsvinden. Sandisk laat investeerders weten dat de eerste van deze stappen is voltooid.
Wat Sandisk zegt, levert HBF.
HBF gebruikt NAND-geheugen in plaats van DRAM en plaatst dit in een HBM-achtige behuizing naast de accelerator. Volgens het eigen HBF-informatieblad van Sandisk is de eerste generatie gericht op 512 GB per stapel, opgebouwd uit zestien chips van 256 GB, met een leessnelheid van 1.6 TB/s. Sandisk beweert dat dit neerkomt op een capaciteit die 8 tot 16 keer zo groot is als die van HBM, tegen vergelijkbare kosten, in een behuizing die qua afmetingen, stapelhoogte en energieverbruik sterk lijkt op HBM4. Omdat het NAND-geheugen betreft, is het niet-vluchtig en verbruikt het geen energie tijdens het verversen.
De roadmap in het factsheet gaat nog verder. Een tweede generatie beoogt meer dan 2 TB/s en tot 1 TB per stack met 0.8 keer het vermogen van de eerste generatie, en een derde generatie gaat verder dan 3.2 TB/s en tot 1.5 TB per stack met 0.64 keer het vermogen. De presentatie voor investeerders schetst de beoogde workloads helder: LLM's met een mix van experts, lange contextlengtes en grote KV-caches, waarbij de architectuur is ontwikkeld met input van belangrijke cloud- en AI-klanten.
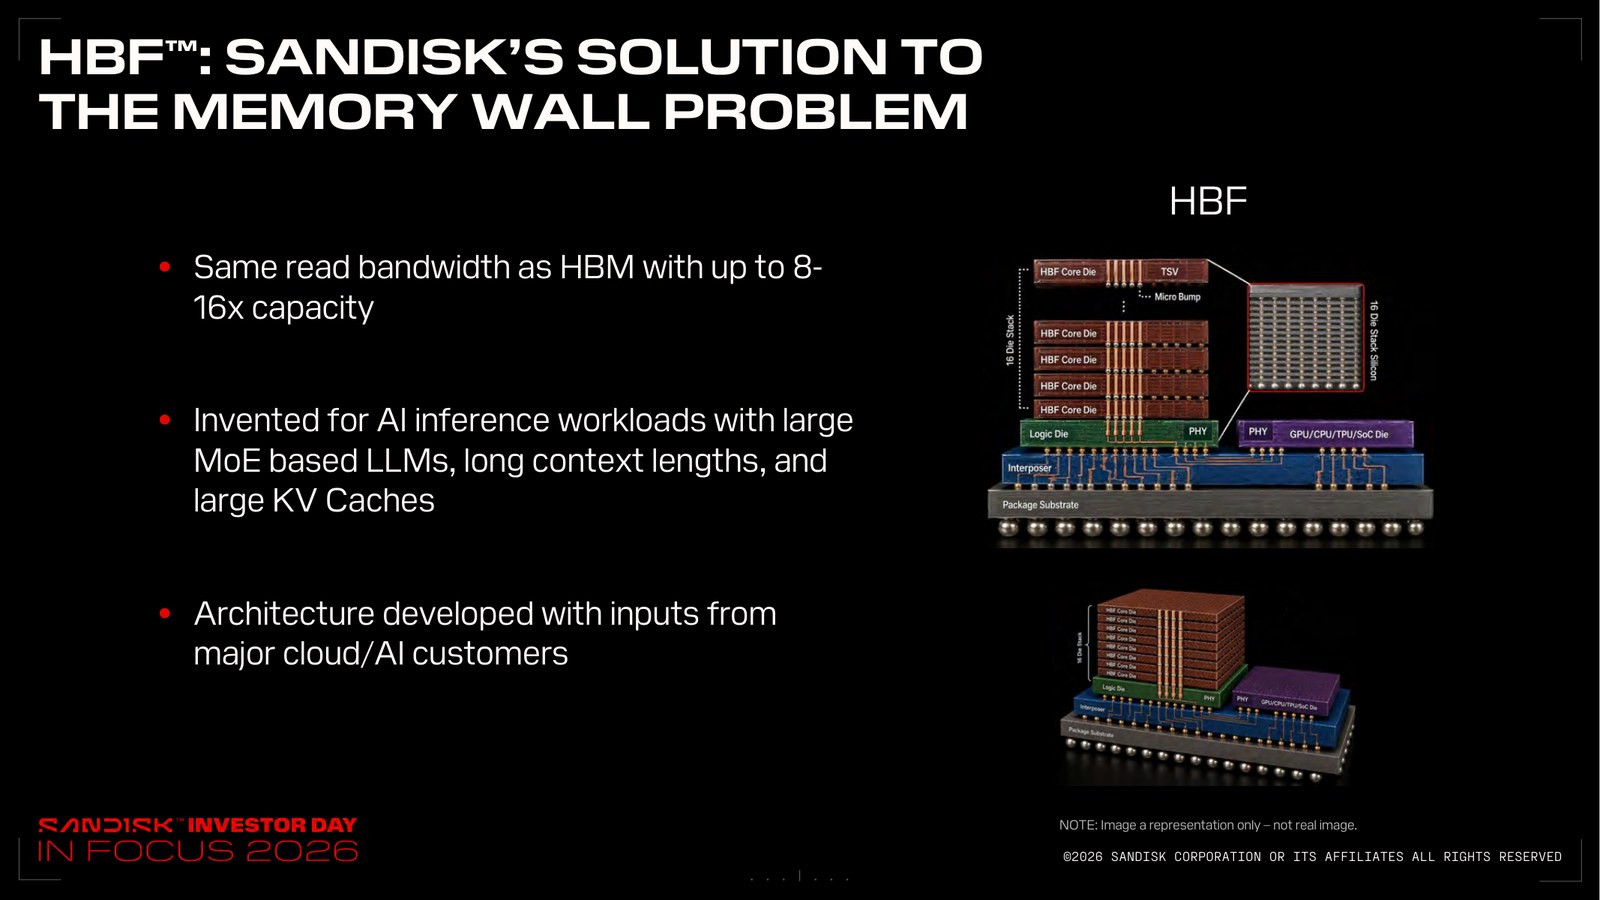
De presentatie schetst ook drie implementatiemogelijkheden. HBF kan HBM aanvullen door een deel van de stackposities rond een xPU op te vullen, terwijl HBM de rest behoudt. Het kan HBM-stacks volledig vervangen met een vergelijkbare footprint. Of het kan losstaand worden gebruikt, waarbij het decode-gewichten en de KV-cache beheert, terwijl een kleinere HBM-laag als cache fungeert. Die flexibiliteit is belangrijker dan het lijkt, omdat het HBF in een socket kan integreren zonder dat een acceleratorleverancier HBM hoeft op te geven.
De interne cijfers die Sandisk op het scherm heeft weergegeven
Sandisk presenteerde een vergelijking van de inferentie-tokenoutput met één HBF GPU, vier HBF GPU's en acht HBM GPU's. Op basis hiervan baseert het bedrijf twee beweringen, beide naar eigen zeggen gebaseerd op interne tests. De eerste is een 8x hogere capex-efficiëntie, gedefinieerd als de minimale configuratie die nodig is om het model te draaien: één HBF GPU tegenover acht HBM GPU's. De tweede is een 2x hogere GPU-efficiëntie: vier HBF GPU's leveren dezelfde tokenoutput als acht HBM GPU's. Het factsheet voegt een gerelateerd simulatieresultaat toe: HBF presteert binnen 2.2% van HBM met onbeperkte capaciteit bij het inlezen van voorgeïnstalleerde gewichten voor Llama 3.1 405B.
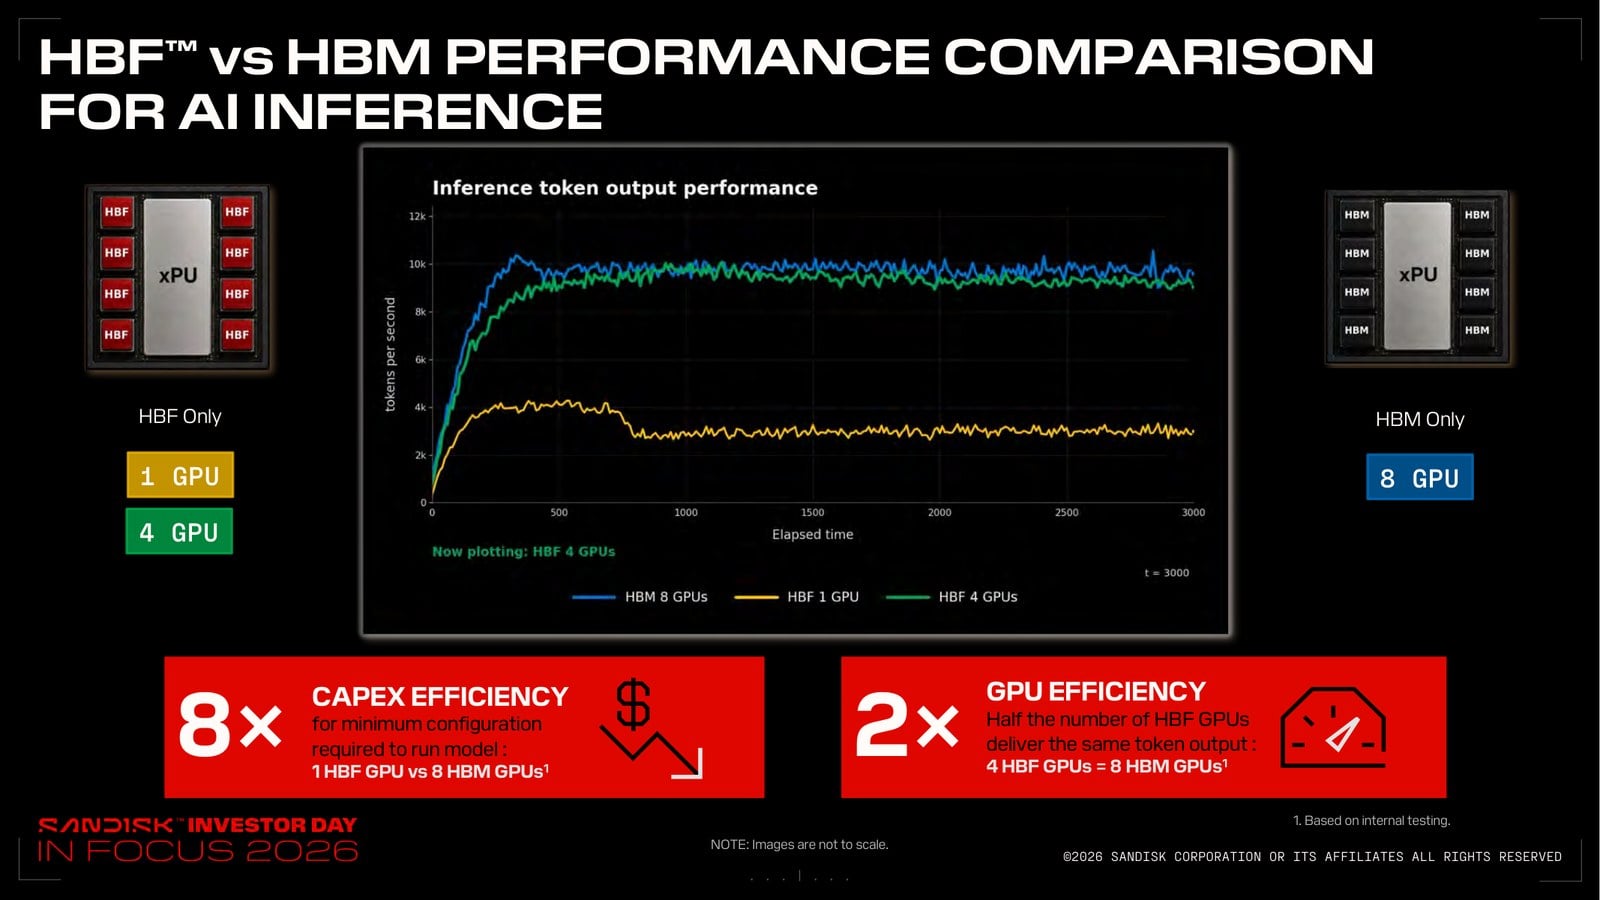
Dit zijn cijfers van leveranciers voor nog niet uitgebrachte chips, en de betreffende grafiek bevat geen aswaarden voor tokens per seconde. Ze beschrijven echter wel het concept: als een model in een geheugen past dat acht tot zestien keer groter is voor dezelfde bandbreedte en ongeveer hetzelfde stroomverbruik, heb je minder accelerators nodig om het te bevatten, en de accelerators die je hebt, hoeven minder lang te wachten.
Waar staat de tijdlijn nu?
Voor planningsdoeleinden zijn er twee verklaringen van Sandisk die het schema omkaderen. In augustus 2025 zei het bedrijf dat de eerste HBF-samples gepland stonden voor de tweede helft van 2026, en dat AI-inferentieapparaten die HBF gebruiken begin 2027 verwacht werden. Tijdens de Investor Day in augustus 2026 werden de eerste HBF-inferentieproductsamples echter aangekondigd als zijnde binnenkort beschikbaar in 2027. De planning voor nieuwe geheugenklassen wordt concreter naarmate de ontwerpen in silicium worden geproduceerd, en de eerste generatie platforms in deze cyclus is naar voren geschoven naarmate de kwalificatie-eisen duidelijker worden. De tapeout is echter het bewijs dat HBF vooruitgang boekt.
Het ecosysteem is verder ontwikkeld dan de siliciumcomponent.
De standaardisering vordert sneller dan het product zelf. Op 3 augustus publiceerden Sandisk en SK hynix de eerste technische HBF-specificatie via het Open Compute Project, zes maanden na de oprichting van het consortium, met onder andere Google en Tenstorrent als bijdragers. We berichtten over die specificatie en wat deze definieert toen deze werd uitgebracht. Jim Keller van Tenstorrent werd tijdens het evenement benoemd tot lid van de technische adviesraad.
SK Hynix, dat mede-auteur was van de specificatie en zijn eigen gelaagde geheugenpresentatie gaf op FMS 2026 , speelt een cruciale rol in de vraag of dit een standaard of een product van één leverancier wordt. Sandisk heeft momenteel een prototype, een openbare specificatie en een releasedatum voor samples in 2027. De volgende belangrijke stap is het produceren van silicium dat aan de eisen voldoet, en dat zal blijken uit een fab-rapport, waarover Sandisk hopelijk binnenkort meer informatie zal geven.



 Amazon