

Supermicro heeft aangekondigd dat de productiecapaciteit voor rack-systemen is uitgebreid en dat de directe vloeistofkoeling is verbeterd ter ondersteuning van de aankomende NVIDIA Vera Rubin NVL72- en NVIDIA HGX Rubin NVL8-platforms. Het bedrijf positioneert deze stap om de implementatietijd van AI-infrastructuur met hoge dichtheid te verkorten door in eigen huis te ontwerpen en te produceren in de VS, in combinatie met de Data Center Building Block Solutions (DCBBS)-aanpak en een complete vloeistofkoelingstechnologie.
Supermicro-CEO Charles Liang benadrukte dat de samenwerking van het bedrijf met NVIDIA en de modulaire ontwerpmethodologie bedoeld zijn om de ontwikkeling van geavanceerde AI-platformen te versnellen. Hij wees ook op de uitgebreide productiecapaciteit en de expertise van Supermicro op het gebied van vloeistofkoeling als belangrijke factoren voor efficiënte, betrouwbare en grootschalige implementaties van Vera Rubin- en Rubin-systemen in hyperscale- en bedrijfsomgevingen.
Rack-Scale vlaggenschip: NVIDIA Vera Rubin NVL72 SuperCluster
Aan de top van het spectrum zal Supermicro de NVIDIA Vera Rubin NVL72 SuperCluster ondersteunen. Dit rack-schaalbare systeem integreert 72 NVIDIA Rubin GPU's en 36 NVIDIA Vera CPU's, samen met NVIDIA ConnectX-9 SuperNIC's en NVIDIA BlueField-4 DPU's. Het platform maakt gebruik van NVIDIA NVLink 6 voor coherentie binnen het rack. Het is ontworpen om op te schalen via NVIDIA Quantum-X800 InfiniBand en NVIDIA Spectrum-X Ethernet, in lijn met de huidige trend in de industrie naar rack-as-a-system-ontwerpen voor training, inferentie en agentische AI op grote schaal.
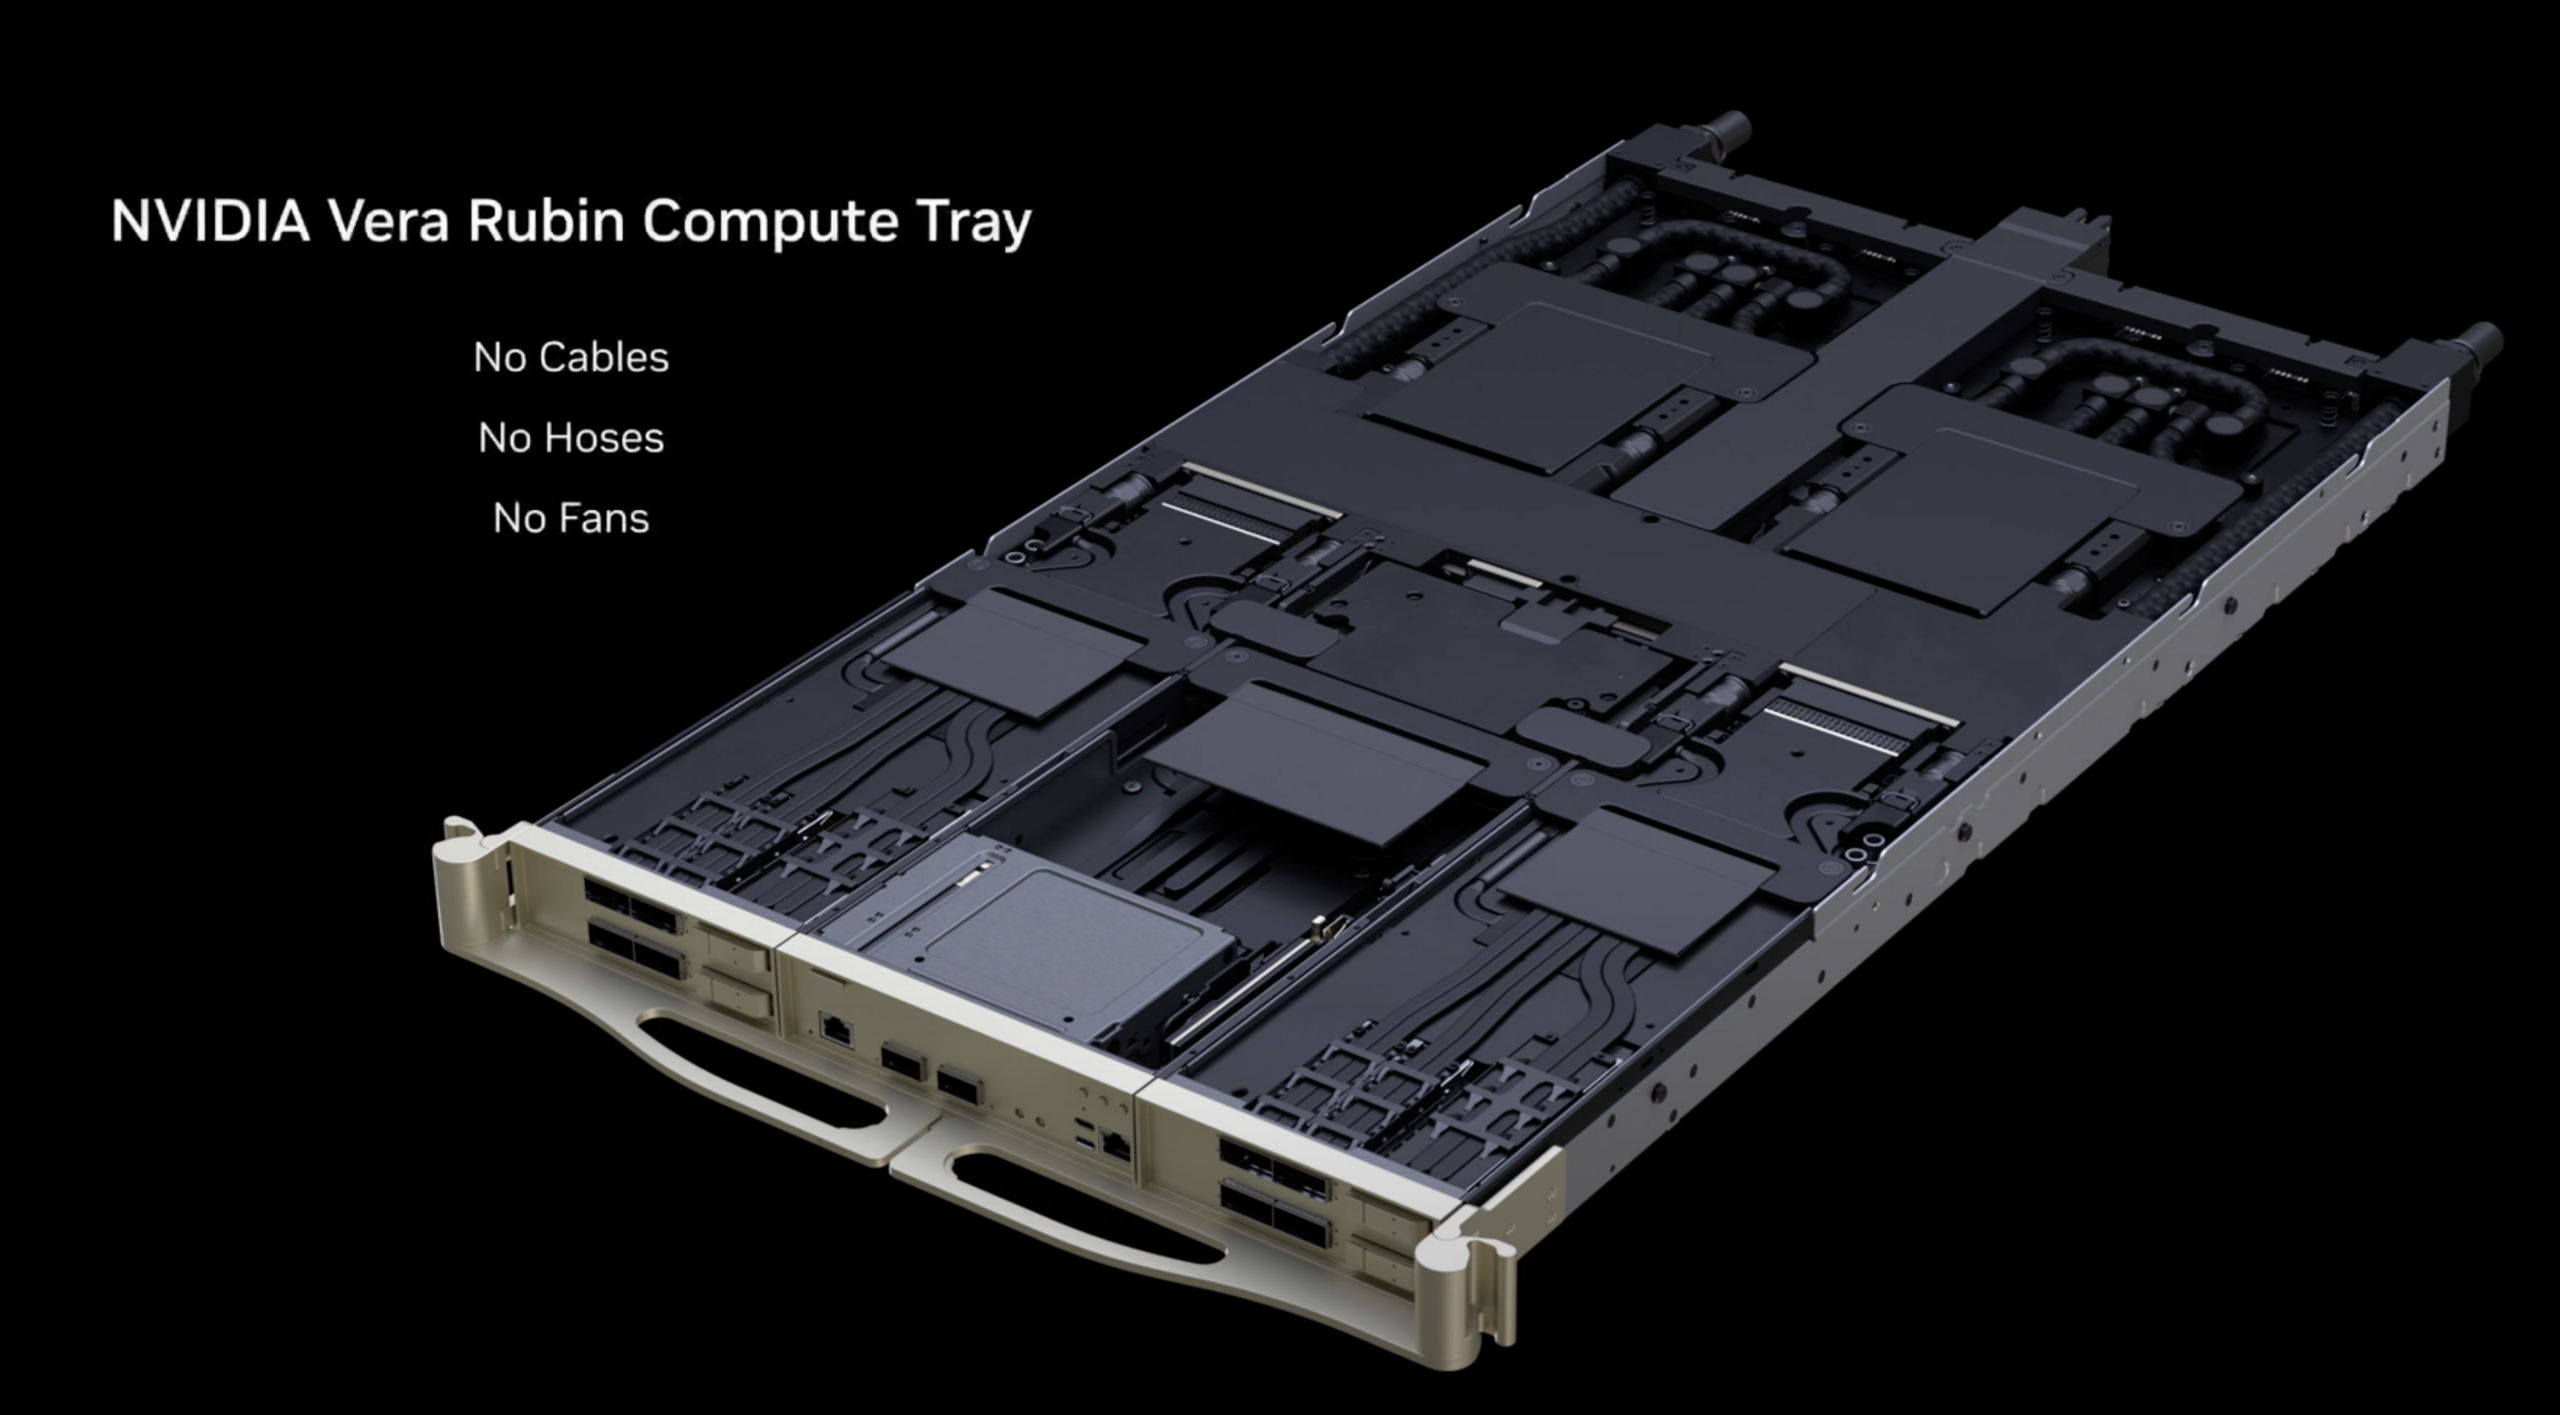
NVIDIA geeft de NVL72-configuratie een prestatie van 3.6 exaflops NVFP4, ondersteund door een HBM4-bandbreedte van 1.4 PB/s en 75 TB snel geheugen. De implementatie van Supermicro is gebouwd op de derde generatie NVIDIA MGX rackarchitectuur, met de nadruk op onderhoudbaarheid, betrouwbaarheid en beschikbaarheid ter ondersteuning van continue clusteractiviteiten.
Koeling staat centraal in het ontwerp. Supermicro integreert een verbeterde vloeistofkoelingsstack voor datacenters met in-row koelvloeistofdistributie-units (CDU's). Het doel is om schaalbare warmwaterkoeling mogelijk te maken die het energie- en waterverbruik vermindert, terwijl de dichtheid en voorspelbare prestaties onder zware AI-workloads behouden blijven.
Compacte, krachtige computer: 2U vloeistofgekoelde NVIDIA HGX Rubin NVL8
Voor bedrijven en dienstverleners die op zoek zijn naar een meer modulaire bouwsteen, benadrukte Supermicro ook de vloeistofgekoelde 2U NVIDIA HGX Rubin NVL8-systemen. Dit platform met 8 GPU's is gericht op AI- en HPC-workloads, waarbij NVIDIA een NVFP4-prestatie van 400 petaflops claimt. Het platform heeft een bandbreedte van 176 TB/s HBM4 en 28.8 TB/s NVLink, met 1600 Gb/s NVIDIA ConnectX-9-netwerken via SuperNIC's.
Supermicro biedt een rack-schaalbaar ontwerp aan dat is bedoeld om de flexibiliteit bij de implementatie te behouden, met configuratieopties met toonaangevende x86-CPU's, waaronder de volgende generatie Intel Xeon- en AMD EPYC-processors. Het bedrijf benadrukte ook een 2U-busbarontwerp met hoge dichtheid voor rackintegratie, in combinatie met Supermicro's directe vloeistofkoelingstechnologie (DLC) om hogere continue stroomverbruiken te ondersteunen zonder in te leveren op onderhoudbaarheid.
Kenmerken van het Vera Rubin-platform
De platformondersteuning van Supermicro sluit aan op diverse belangrijke mogelijkheden uit het Vera Rubin-tijdperk die direct van invloed zijn op het clusterontwerp en de operationele planning, waaronder:
- NVIDIA NVLink 6 is een snelle interconnect-architectuur die zorgt voor een hogere bandbreedte en lagere latentie voor GPU-naar-GPU- en CPU-naar-GPU-communicatie. Dit is met name relevant voor het trainen en uitvoeren van inferenties met zeer grote modellen die gebruikmaken van een mix van experts, waarbij communicatiepatronen de prestaties op grote schaal sterk kunnen beïnvloeden.
- De NVIDIA Vera CPU is voorzien van door NVIDIA ontworpen Arm-cores en levert volgens de fabrikant een verdubbeling van de prestaties ten opzichte van de vorige generatie. De CPU ondersteunt ruimtelijke multithreading met 88 cores en 176 threads, samen met een LPDDR5X-geheugenbandbreedte van 1.2 TB/s en een grotere geheugencapaciteit. Vera verbetert ook de koppeling tussen CPU en GPU met een NVLink-C2C-bandbreedte van 1.8 TB/s naar GPU's, wat volgens de fabrikant twee keer zo hoog is als de vorige generatie.
- NVIDIA's 3e generatie Transformer Engine is gericht op versnelling met lange contexten en nauwe precisie, wat cruciaal is geworden nu moderne inferentie verschuift naar persistente sessies, multi-agent pipelines en hogere gelijktijdigheid. Het platform omvat ook 3e generatie Confidential Computing, omschreven als rack-scale confidential computing met een uniforme, op GPU-niveau gebaseerde, vertrouwde uitvoeringsomgeving die modellen, data en prompts beschermt en isoleert. Voor operators die AI inzetten in gereguleerde workflows, worden confidential computing en isolatie van de GPU-uitvoeringsgrens steeds belangrijkere selectiecriteria voor het platform.
- De betrouwbaarheid is verbeterd dankzij de RAS-engine van de tweede generatie, die geavanceerde statusbewaking en realtime controles omvat om de uitvaltijd te verminderen. In omgevingen met een hoge dichtheid aan vloeistofkoeling zijn foutdetectie en onderhoudbaarheid essentieel, omdat onderhoudsvensters kostbaar zijn en de operationele tolerantie voor instabiliteit laag is.
Netwerken: Spectrum-X Ethernet Photonics en doorvoer op rackschaal
Supermicro koppelde de ondersteuning voor zijn Rubin-platform ook aan NVIDIA's Spectrum-X Ethernet Photonics, gebouwd op de Spectrum-6 Ethernet ASIC. NVIDIA specificeert een schakelsnelheid van 102.4 Tb/s op TSMC 3nm, met 200G SerDes co-packaged optische componenten en volledig gedeelde buffers.
Het gestelde doel is om de efficiëntie en operationele stabiliteit te verbeteren ten opzichte van traditionele insteekbare optische modules. NVIDIA noemt een 5x hogere energie-efficiëntie, een 10x hogere betrouwbaarheid en een 5x hogere applicatie-uptime. NVIDIA noemde meerdere switchmodellen, waaronder de vloeistofgekoelde SN6800 (409.6 Tb/s CPO met 512x 800G-poorten), de SN6810 (102.4 Tb/s CPO met 128x 800G-poorten) en de SN6600 (insteekbare optische modules, 128x 800G-poorten, beschikbaar in lucht- of vloeistofgekoelde configuraties). Voor datacenterbeheerders wijzen deze ontwerpen op 800G Ethernet-netwerken met een hogere dichtheid en verbeterde energie- en thermische eigenschappen. Dit is steeds belangrijker, aangezien het stroomverbruik van front-end netwerken een meetbaar deel van de rackbudgetten vormt.
Opslagintegratie voor AI-fabrieken
Wat opslag betreft, benadrukte Supermicro complementaire oplossingen die zijn gebouwd op hun petascale all-flash opslagservers en JBOF-systemen. Deze platforms ondersteunen NVIDIA BlueField-4 DPU's en een reeks oplossingen voor gegevensbeheer, waardoor opslag en netwerken aansluiten op dezelfde rack-scale, versnelde architectuur die ook door de rekenlaag wordt gebruikt.
Hoewel Supermicro in deze aankondiging geen prestatiecijfers voor de opslagplatformen heeft bekendgemaakt, duidt de nadruk op integratie op een voortdurende ontwikkeling richting gevalideerde full-stack ontwerpen, waarbij rekenkracht, netwerk en opslag samen gekwalificeerd zijn voor implementaties in AI-fabrieken.
Productieschaal en doorlooptijd
Het operationele thema van de aankondiging is de productiecapaciteit en de implementatiesnelheid. De uitgebreide faciliteiten en vloeistofkoelingsstack van Supermicro zijn ontworpen om de productie en levering van volledig vloeistofgekoelde Vera Rubin- en Rubin-platforms te stroomlijnen. Tegelijkertijd maakt de modulaire DCBBS-architectuur snelle configuratie, validatie en schaalbaarheid mogelijk. Voor technische inkopers in het bedrijfsleven is het onderscheidende kenmerk minder een enkele chassisspecificatie en meer een voorspelbare levering, herhaalbare rackconfiguraties en een kortere doorlooptijd van ontvangst van de apparatuur tot stabiele operationele inzetbaarheid.
Supermicro gokt erop dat naarmate vloeistofkoeling de standaard wordt voor AI-systemen met een hoge dichtheid, leveranciers die de productie en validatie op rackschaal kunnen industrialiseren het best gepositioneerd zullen zijn om grootschalige uitrol te ondersteunen zonder langdurige integratiecycli.


 Amazon