

Tijdens SC25 introduceerde WEKA de volgende generatie WEKApod-apparaten, gericht op organisaties die AI en high-performance computing willen opschalen en tegelijkertijd de kosten, het energieverbruik en de footprint onder controle willen houden. De nieuwe WEKApod Prime- en WEKApod Nitro-platformen zijn gepositioneerd om een groeiende crisis in infrastructuurefficiëntie aan te pakken, waarbij investeringen in GPU's vaak de opslag- en netwerksystemen overtreffen die nodig zijn om ze volledig te benutten.
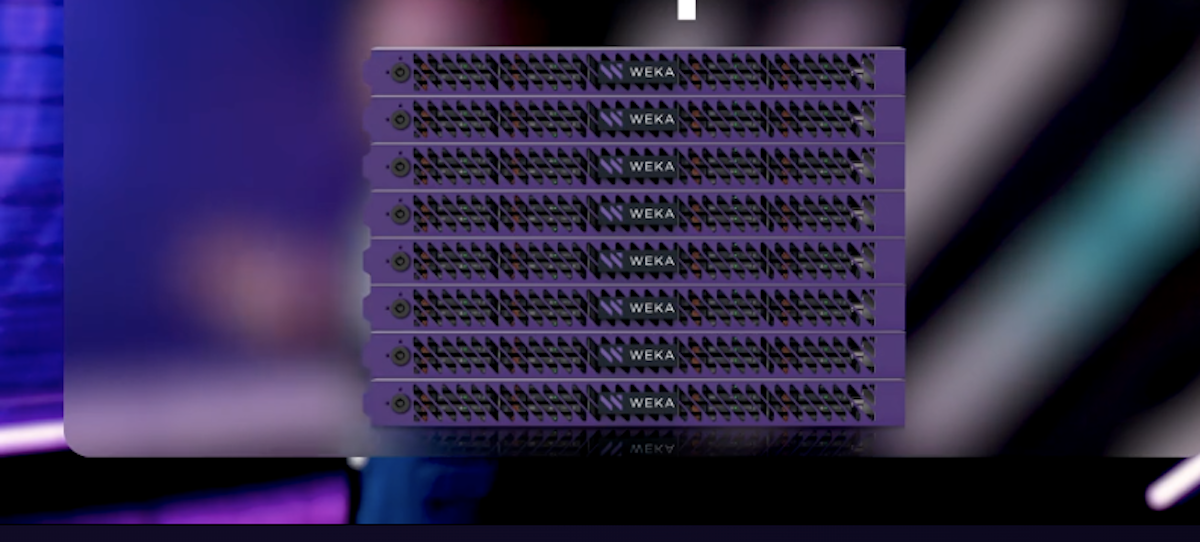
Het ontwerpdoel voor deze generatie is duidelijk: de traditionele afweging tussen prestaties en kosten elimineren en tegelijkertijd de dichtheid en efficiëntie verhogen, zodat elke rack-unit en kilowatt meer bruikbare AI-capaciteit levert.
De crisis op het gebied van infrastructuurefficiëntie
Bedrijven en AI-cloudproviders staan onder druk om rendement te behalen op snelgroeiende investeringen in AI-infrastructuur. Dure GPU's worden vaak onderbenut vanwege opslagknelpunten, lange trainingscycli verlengen de time-to-value, inferentiekosten hollen marges uit en clouduitgaven stijgen naarmate de hoeveelheid ongestructureerde data toeneemt.
Tegelijkertijd worden datacenters geconfronteerd met harde beperkingen op het gebied van rackruimte, stroomlevering en koelcapaciteit. Het simpelweg toevoegen van meer hardware is geen duurzame strategie. Opslagsystemen die een keuze vereisen tussen extreme prestaties en beheersbare kosten, sluiten niet langer aan bij de economische aspecten van grootschalige AI-implementaties. Elke node in een AI-fabriek moet bijdragen aan een hoger GPU-gebruik en lagere kosten per getraind en bediend model.
De volgende generatie WEKApod-familie is ontworpen om dit probleem direct aan te pakken, door compacte, energiezuinige hardware te combineren met WEKA's NeuralMesh-softwarestack om GPU's actief te houden en de infrastructuurkosten onder controle te houden.
WEKApod Prime: Mixed-Flash-economie zonder prestatiestraffen
WEKApod Prime is gepositioneerd als dé werkpaard voor organisaties die hun opslagefficiëntie willen verbeteren zonder in te leveren op prestaties. Het levert een gerapporteerde prijs-prestatieverbetering van 65% op door data intelligent te verdelen over een mix van flashmedia en schrijfbewerkingen te optimaliseren op basis van workloadkenmerken.
Prime maakt gebruik van WEKA's AlloyFlash-technologie om meerdere schijfklassen te combineren in één configuratie. In plaats van een traditionele cachehiërarchie met meerdere lagen, expliciete dataverplaatsing en de gebruikelijke schrijfstraffen, biedt AlloyFlash consistente prestaties over alle bewerkingen heen. Schrijfbewerkingen zijn ontworpen om de volledige prestaties te behouden in plaats van te worden afgeremd onder belasting, wat cruciaal is voor het trainen van controlepunten, logging en andere schrijfintensieve AI-workflows.
Vanuit een fysiek ontwerpperspectief ondersteunt WEKApod Prime tot 20 schijven in een 1U-server of 40 schijven in een 2U-vormfactor. Dit maakt een hoge capaciteit en prestatiedichtheid mogelijk in beperkte ruimtes. WEKA rapporteert een 4.6 keer hogere capaciteitsdichtheid dan de vorige generatie, samen met 5 keer hogere schrijf-IOPS per rackunit. Energie-efficiëntie is ook een belangrijk aandachtspunt, met een 4 keer hogere vermogensdichtheid van ongeveer 23,000 IOPS per kW en ongeveer 1.6 PB per kW, met een 68 procent lager energieverbruik per terabyte.
Voor operators die moderne AI-clusters ontwerpen, vertaalt dit zich in een opslaglaag die de GPU-doorvoer kan bijhouden en tegelijkertijd binnen de bestaande stroom- en ruimtebehoeften past. Bij schrijfintensieve taken zoals modeltraining, checkpointing en datavoorbewerking is de kans kleiner dat het opslagsysteem een beperkende factor wordt, waardoor accelerators ongebruikt blijven.
Early adopters zoals het Danish Centre for AI Innovation (DCAI) gebruiken WEKApod Prime om te bereiken wat zij omschrijven als hyperscaler-klasse doorvoer en efficiëntie binnen een compacte footprint. DCAI benadrukt dat het verhogen van de AI-capaciteit per kilowatt en per vierkante meter een directe bijdrage levert aan de economische levensvatbaarheid van hun infrastructuur en aan een snellere AI-implementatie voor klanten.
WEKApod Nitro: Prestatiedichtheid voor AI-fabrieken
Waar Prime zich richt op prijs-prestatieverhouding en capaciteitsefficiëntie, is WEKApod Nitro ontworpen voor AI-omgevingen met honderden of duizenden GPU's die maximale prestatiedichtheid vereisen. Nitro is gebouwd op bijgewerkte hardware die ongeveer twee keer zoveel prestaties en een 60% betere prijs-prestatieverhouding levert in vergelijking met de vorige generatie.
Nitro-configuraties omvatten de NVIDIA ConnectX-8 SuperNIC, die een netwerkdoorvoer van 800 Gb/s biedt in een 1U-vormfactor met 20 TLC SSD's. Dit ontwerp met hoge bandbreedte is gericht op omgevingen waar netwerk en opslag de scale-out-eigenschappen van GPU-clusters moeten evenaren om knelpunten te voorkomen tijdens grootschalige training en inferentie met hoge doorvoer.
Zowel Prime als Nitro zijn beschikbaar als kant-en-klare NVIDIA DGX SuperPOD en NVIDIA Cloud Partner (NCP) gecertificeerde apparaten. Voor technische salesteams en oplossingsarchitecten is dit belangrijk omdat het de implementatietijd verkort. In plaats van weken te besteden aan integratie-, afstemmings- en validatiewerk, kunnen klanten WEKApod gebruiken als een vooraf gevalideerde component in DGX-gebaseerde en NCP-georiënteerde architecturen, waardoor de time-to-production wordt verkort en de time-to-revenue voor nieuwe AI-services wordt versneld.
NVIDIA positioneert zijn Spectrum-X Ethernet- en ConnectX-8-netwerken als een kernfundament van de WEKApod-architectuur. Vanuit systeemontwerpperspectief benadrukt dit de nadruk op het wegnemen van dataknelpunten tussen storage, fabric en GPU-knooppunten om de algehele AI-prestaties te optimaliseren.
NeuralMesh en softwaregedefinieerde flexibiliteit
Onder de hardwareplatformen wordt WEKApod aangestuurd door NeuralMesh, wat WEKA omschrijft als het eerste opslagsysteem dat speciaal is ontwikkeld om AI op grote schaal te versnellen. NeuralMesh is verantwoordelijk voor het leveren van de softwaregedefinieerde opslaglaag, samen met de zakelijke functies die in moderne omgevingen worden verwacht.
WEKApod-apparaten bieden NeuralMesh-mogelijkheden via gebruiksklare, vooraf gevalideerde configuraties en een verbeterde installatietool, ontworpen om een plug-and-play-ervaring te bieden in plaats van een complex integratieproject. Organisaties kunnen beginnen met slechts acht servers en groeien naar honderden naarmate de vraag toeneemt, zonder de storageomgeving opnieuw te hoeven ontwerpen.
NeuralMesh bevat essentiële zakelijke functies zoals gedistribueerde gegevensbescherming, directe snapshots, multiprotocoltoegang, geautomatiseerde tiering, encryptie en hybride cloudondersteuning. Dit betekent dat AI-geoptimaliseerde prestaties en dichtheid niet ten koste gaan van dataveerkracht, governance of operationele flexibiliteit.
Door deze softwaremogelijkheden te combineren met hardware met een hoge dichtheid, wil WEKApod niet alleen dienen als een krachtige bestands- of objectopslag, maar ook als een fundamenteel gegevensplatform voor AI-fabrieken en grootschalige object-opslag en AI-datalake-implementaties.
Het aanpakken van bedrijfsresultaten voor verschillende klantsegmenten
De zakelijke impact van de volgende generatie WEKApod-familie wordt voor elke doelgroep anders gedefinieerd, maar de nadruk ligt op een beter rendement op de investering in infrastructuur en een betere benutting van bestaande investeringen.
Voor AI-cloudproviders en opkomende Neoclouds is de prijs-prestatieverbetering van 65% bedoeld om direct te resulteren in hogere marges op GPU-as-a-service-aanbiedingen. De mogelijkheid om meer klanten te ondersteunen op dezelfde infrastructuur en tegelijkertijd de prestatie-SLA's te behouden, verbetert de winstgevendheid en capaciteitsplanning. Het kant-en-klare karakter van WEKApod-implementaties verkort ook de onboardingtijd voor nieuwe klanten, wat een snellere time-to-revenue mogelijk maakt.
Voor bedrijven die interne AI-fabrieken implementeren, is WEKApod gepositioneerd als een manier om implementatiecycli van maanden naar dagen te verkorten. Kant-en-klare integratie, prevalidatie en enterprise-functionaliteit stellen IT-teams in staat om storage voor AI-workloads te implementeren zonder diepgaande, gespecialiseerde expertise in parallelle bestandssystemen of prestatie-afstemming. Tegelijkertijd kunnen verbeterde dichtheid en efficiëntie het stroomverbruik per terabyte met tot wel 68% verlagen en een-op-een-schaling van de datacentervoetafdruk voorkomen naarmate de AI-mogelijkheden toenemen.
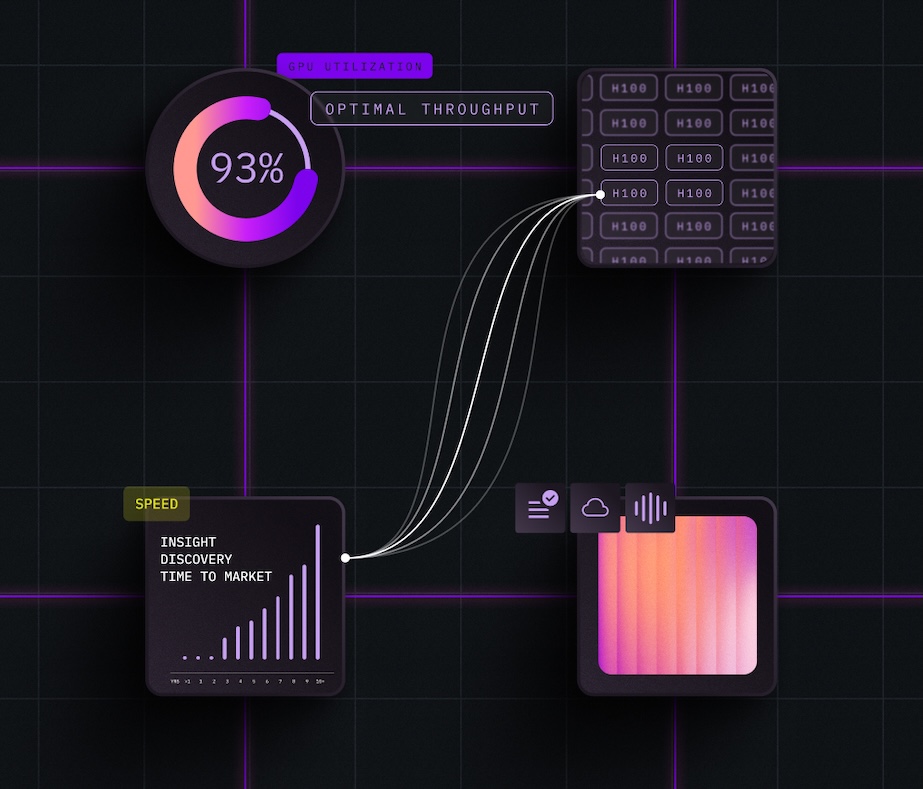
Voor AI-ontwikkelaars en -onderzoekers ligt de belangrijkste waardepropositie in een hoger GPU-gebruik en kortere trainingscycli. Het ontwerp van WEKApod is gericht op het ondersteunen van GPU-gebruikspercentages boven de 90 procent door ervoor te zorgen dat de opslaglaag en de infrastructuur geen knelpunten vormen. Snellere modeltraining en een kortere iteratietijd bieden een concurrentievoordeel in omgevingen waar de snelheid van experimenten de bedrijfsresultaten beïnvloedt. Lagere inferentiekosten, ondersteund door efficiënte opslag en netwerken, kunnen ook nieuwe AI-toepassingen economisch haalbaar maken die anders op grote schaal onbetaalbaar zouden zijn.
Ajay Singh, Chief Product Officer bij WEKA, beschouwt deze updates als cruciaal om AI-investeringen te laten renderen. Volgens hem biedt WEKApod Prime een aanzienlijk betere prijs-prestatieverhouding zonder in te leveren op throughput, terwijl WEKApod Nitro de prestatiedichtheid verhoogt om GPU's beter te benutten. Gezamenlijk ondersteunt dit snellere modelontwikkeling, hogere inferentiethroughput en een verbeterde ROI op computerinfrastructuur.
De nieuwe WEKApod Prime en Nitro-apparaten positioneren WEKA stevig in de AI- en HPC-opslagmarkt en richten zich op het snijvlak van hoge prestaties, dichtheid en efficiëntie. Prime richt zich op het doorbreken van de traditionele link tussen prestaties en kosten met behulp van intelligent mixed-flash management en AlloyFlash. Tegelijkertijd richt Nitro zich op GPU-rijke AI-fabrieken met krachtige netwerken en compacte vormfactoren.
Samen met de NeuralMesh-softwaresuite en gebruiksklare, NVIDIA-gecertificeerde configuraties, streeft WEKApod ernaar zowel technische als zakelijke uitdagingen op te lossen: GPU's actief houden, datacenterstroom en -ruimte beheren en de tijd verkorten die nodig is om AI-gestuurde diensten op de markt te brengen. Voor technische salesteams en oplossingsarchitecten richt de waardepropositie zich op een hogere benuttingsgraad, betere marges en snellere implementatie, ondersteund door meetbare verbeteringen in dichtheid, efficiëntie en prijs-prestatieverhouding.


 Amazon